
Dans le vaste champ des sciences humaines, de la médecine clinique, de l’éducation et des neurosciences comportementales, la quantification rigoureuse des phénomènes observables constitue le socle indispensable de toute démarche empirique. Contrairement aux sciences physiques, où les instruments de mesure tels que les spectromètres ou les interféromètres bénéficient d’un étalonnage mécanique direct, l’évaluation psychologique et diagnostique repose fréquemment sur un vecteur de mesure fondamentalement complexe et faillible : l’observateur humain. Qu’il s’agisse de poser un diagnostic psychiatrique lors d’un entretien sémiologique, d’évaluer la qualité des interactions précoces entre un nourrisson et sa mère, ou de coder les manifestations comportementales au sein d’une cohorte expérimentale, le clinicien ou le chercheur agit en tant qu’instrument de mesure vivant, filtrant les signaux environnementaux à travers son propre prisme cognitif, perceptif et théorique.
Cette médiation humaine pose d’emblée un défi épistémologique majeur : comment s’assurer que la cotation attribuée à un comportement reflète fidèlement la réalité de ce phénomène, plutôt que les idiosyncrasies, les biais cognitifs ou la fatigue de la personne qui l’observe ? Si deux cliniciens chevronnés observent la même séance thérapeutique et parviennent à des conclusions diagnostiques diamétralement opposées, la valeur scientifique et l’utilité clinique de leur protocole d’observation s’effondrent. C’est précisément pour répondre à cette exigence impérieuse de standardisation et d’objectivité que la métrologie psychologique a formalisé le concept de fidélité inter-juges (souvent désignée sous le terme d’accord inter-juges ou inter-rater reliability).
Comprendre la fidélité inter-juges ne se résume pas à l’apprentissage machinal de formules statistiques appliquées à des matrices de données. Il s’agit d’une réflexion approfondie sur la nature même de la mesure, sur la décomposition mathématique de l’erreur dans la théorie classique des tests, et sur les mécanismes méthodologiques permettant de minimiser l’aléa dans le jugement scientifique. Le présent article propose une exploration exhaustive de cette propriété psychométrique cardinale. Nous examinerons ses fondements théoriques, ses distinctions conceptuelles critiques, les équations mathématiques qui permettent de la quantifier — du simple pourcentage d’accord brut au Kappa de Cohen, en passant par le coefficient de corrélation intraclasse —, tout en fournissant des exemples guidés, des analyses de cas cliniques et des protocoles méthodologiques destinés à hisser vos recherches aux standards académiques les plus rigoureux.
1. Introduction et fondements conceptuels de la fidélité inter-juges
1.1 Définition préliminaire et rôle dans l’évaluation psychologique
La fidélité inter-juges désigne le degré de concordance, de consensus ou de corrélation statistique entre les évaluations indépendantes attribuées par au moins deux observateurs distincts mesurant le même phénomène, sur le même échantillon et selon une grille de cotation identique. Dans le paradigme psychométrique, elle quantifie la part de variance attribuable à l’objet ou à l’individu évalué, comparativement à la variance parasite introduite par les observateurs eux-mêmes. En d’autres termes, elle permet de déterminer si une mesure est généralisable au-delà de la personne singulière qui l’a produite.
Au sein de la théorie classique des tests, formulée initialement par Charles Spearman puis consolidée par des théoriciens comme Gulliksen et Lord, tout score observé est conceptualisé comme l’addition d’un score vrai et d’une composante d’erreur aléatoire. Lorsque l’instrument d’évaluation fait intervenir un être humain pour interpréter des signaux comportementaux, l’erreur de mesure provient non seulement de l’outil d’évaluation lui-même (par exemple, la formulation d’un questionnaire), mais également des fluctuations attentionnelles, des schèmes d’interprétation implicites et des seuils décisionnels propres à chaque examinateur. Une fidélité inter-juges élevée démontre empiriquement que cette composante d’erreur idiosyncrasique est maintenue à un niveau résiduel acceptable.
Il demeure toutefois primordial de maintenir une différenciation stricte entre la fidélité d’une mesure et sa validité psychométrique. Un instrument peut présenter une fidélité inter-juges presque parfaite tout en étant dénué de toute validité de construit. Par exemple, si deux psychiatres s’accordent systématiquement pour classer des patients comme souffrant de dépression majeure sur la seule base de la circonférence de leur crâne, leur accord mutuel sera exceptionnellement élevé, mais la validité diagnostique sera strictement nulle. La fidélité constitue ainsi une condition préalable indispensable, mais non suffisante, à la validité scientifique : sans reproductibilité du jugement entre pairs indépendants, aucune inférence valide ne peut être postulée sur les attributs psychologiques sous-jacents.
1.2 Distinction entre fidélité inter-juges et fidélité intra-juge
Dans l’arsenal psychométrique, la fidélité inter-juges ne doit en aucun cas être confondue avec la fidélité intra-juge, également désignée sous le vocable de stabilité temporelle de l’évaluateur ou fidélité test-retest de l’observateur. La fidélité intra-juge mesure la capacité d’un unique évaluateur à attribuer des scores identiques lorsqu’il est confronté au même stimulus à des moments temporels distincts, sous réserve que l’objet observé n’ait subi aucune modification intrinsèque. Elle explore la variabilité intra-individuelle de l’observateur, souvent tributaire de fluctuations circonstancielles telles que la fatigue, l’habituation, le stress ou les apprentissages implicites survenus entre les deux sessions d’observation.
À l’inverse, la fidélité inter-juges capture la variabilité inter-individuelle, c’est-à-dire les écarts structurels de jugement qui émergent entre plusieurs esprits observant une même scène simultanément ou de manière asynchrone sur enregistrement. L’évaluation conjointe de ces deux formes de fidélité devient impérative dans les dispositifs méthodologiques à haute sensibilité clinique. Par exemple, lors de l’étalonnage d’une nouvelle échelle d’évaluation de la douleur chez le jeune enfant non verbal, un protocole optimal exige d’abord de vérifier qu’un soignant évalue une vidéo de la même façon le lundi et le vendredi (fidélité intra-juge), puis que l’ensemble des infirmiers du service attribuent des notes convergentes à ce même enregistrement (fidélité inter-juges).
Une divergence marquée entre ces deux métriques apporte des informations diagnostiques cruciales sur les sources d’erreur affectant le protocole d’observation. Si un évaluateur présente une fidélité intra-juge irréprochable mais que la fidélité inter-juges globale s’avère médiocre, la conclusion méthodologique s’impose : l’évaluateur en question a développé un système d’interprétation interne cohérent et stable au fil du temps, mais totalement désaligné par rapport aux normes de ses collègues ou aux critères formels de la grille d’évaluation. Ce phénomène, baptisé dérive de cotation idiosyncrasique, exige une révision approfondie des procédures de formation et un réétalonnage collectif des cadres de référence.
1.3 Applications directes dans le domaine clinique et la recherche comportementale
L’utilité pratique de la fidélité inter-juges s’exprime avec une acuité particulière dans la pratique psychiatrique et neuropsychologique moderne. L’élaboration des nosographies contemporaines, telles que le DSM-5 ou la CIM-11, a été historiquement conditionnée par le besoin impérieux de sauver la psychiatrie de son déficit d’accord diagnostique constaté dans les années 1960 et 1970. Sans critères standardisés opérationnalisés, deux cliniciens observant la même symptomatologie psychotique pouvaient formuler des diagnostics incompatibles, compromettant irrémédiablement la trajectoire thérapeutique du patient et l’homogénéité des cohortes d’essais cliniques pharmacologiques.
Dans la recherche développementale et comportementale, la fidélité inter-juges représente le garant méthodologique fondamental de l’analyse observationnelle. Considérons l’étude des schèmes d’attachement selon le paradigme de la Situation Étrange développé par Mary Ainsworth. Les chercheurs doivent coder avec une précision chirurgicale des micro-comportements infantiles, tels que le détournement du regard, l’évitement postural ou les conduites de recherche de proximité lors du retour du parent. Puisque ces comportements durent parfois une fraction de seconde, seul un calcul scrupuleux de l’accord entre deux codeurs aveugles aux hypothèses de l’étude permet de prouver que la catégorisation de l’enfant dans le groupe « insécure-évitant » ne relève pas d’une projection projective de l’expérimentateur.
Enfin, dans le contexte de l’administration d’entretiens cliniques semi-structurés, tels que l’Échelle d’évaluation de la dépression de Hamilton (HAM-D) ou le protocole d’évaluation diagnostique de l’autisme (ADOS-2), la fidélité inter-juges permet de neutraliser les disparités d’interrogation et de cotation entre sites hospitaliers partenaires. Elle constitue la clef de voûte de la reproductibilité des protocoles expérimentaux multisites, garantissant que les données recueillies dans un laboratoire parisien possèdent la même valeur métrique que celles colligées dans un centre d’investigation clinique à Montréal ou à Genève.
2. Définition épistémologique et psychométrique de la fidélité inter-juges
2.1 Le postulat de la théorie classique des scores
Pour appréhender la mécanique mathématique sous-jacente à la fidélité inter-juges, il est nécessaire de formaliser le postulat structural de la théorie classique des scores (TCT). Dans ce modèle fondamental, la performance ou l’attribut d’un individu $i$ noté par un évaluateur $j$ est exprimé par l’équation linéaire canonique :
$$X_{ij} = T_i + E_{ij}$$
Dans cette formalisation, $X_{ij}$ représente le score brut observé, $T_i$ constitue le « score vrai » latent de l’individu (l’intensité réelle de son anxiété, de son trouble ou de son aptitude cognitive), et $E_{ij}$ symbolise l’erreur de mesure non corrélée, intrinsèque à cette passation spécifique et à cet évaluateur précis. Dans la perspective d’une évaluation impliquant des observateurs humains, la variance totale des scores observés dans une cohorte peut être décomposée de manière exhaustive selon l’analyse de variance des composantes de variance :
$$\sigma^2_{X} = \sigma^2_{T} + \sigma^2_{J} + \sigma^2_{e}$$
Où $\sigma^2_{T}$ représente la variance réelle inter-sujets que le test vise à quantifier, $\sigma^2_{J}$ incarne la variance systématique attribuable aux différences de sévérité ou d’indulgence entre les juges, et $\sigma^2_{e}$ caractérise la variance d’erreur résiduelle aléatoire. La fidélité inter-juges représente précisément la proportion de la variance totale qui est attribuable au score vrai, une fois le bruit provoqué par les juges et les erreurs résiduelles déduit. Modéliser le consensus entre évaluateurs revient mathématiquement à comprimer la variance d’erreur jusqu’à ce que la variabilité observée reflète fidèlement la dispersion des traits latents dans la population cible.
2.2 Lien structurel entre fidélité inter-juges et clarté des items
L’accord mesuré entre plusieurs juges indépendants ne reflète pas uniquement la qualification technique des examinateurs ; il agit comme un baromètre impitoyable de la qualité rédactionnelle et de l’intelligibilité des items d’évaluation. Lorsqu’un instrument psychologique souffre de définitions conceptuelles défaillantes ou d’instructions opérationnelles ambiguës, les juges sont contraints de combler les zones d’ombre sémantiques par leurs propres théories implicites de la personnalité. Cette suppléance projective entraîne immédiatement un éclatement de la variance des scores et un effondrement mécanique de l’accord inter-juges.
L’analyse qualitative et quantitative des matrices de désaccord fournit un levier diagnostique exceptionnel lors de la phase de conception d’un test. L’examen des items pour lesquels les coefficients d’accord s’écartent significativement de la moyenne générale permet d’isoler précisément les énoncés polysémiques, les descriptions comportementales redondantes ou les critères mutuellement incompatibles. Par exemple, un critère sémiologique tel que « le sujet semble distant » générera invariablement un désaccord substantiel, là où une ancre comportementale telle que « le sujet maintient le contact visuel moins de 20 % du temps total de l’interaction » rétablira un consensus statistique immédiat.
Ce processus de révision psychométrique guidée par les indices de fidélité inter-juges constitue une étape standardisée du développement d’instruments psychométriques. En élaguant méthodiquement les items générateurs d’incertitude ou en restructurant leurs ancres descriptives, le psychomètre resserre la fidélité de son instrument. Il s’assure ainsi que chaque composante de l’échelle mesure le construit cible de manière univoque, prévenant la contamination des données dès le stade de la collecte terrain.
2.3 Conditions de validité préalable pour une mesure rigoureuse
Pour qu’une étude de fidélité inter-juges puisse prétendre à une validité méthodologique irréprochable, plusieurs postulats contraignants doivent être satisfaits au plan du devis de recherche. Le premier de ces critères est l’indépendance absolue et stricte des jugements émis. Les évaluateurs doivent impérativement coter les sujets ou les protocoles de manière totalement aveugle les uns par rapport aux autres. Tout échange verbal, communication non verbale, consultation préalable des scores d’autrui ou délibération collégiale durant la phase de codage contamine irrémédiablement les observations et crée une inflation artificielle de l’accord, invalidant l’estimation statistique de la fidélité.
Le second prérequis réside dans l’équivalence stricte du niveau de qualification et de formation des évaluateurs. Comparer les notations d’un professeur d’université spécialisé depuis trente ans dans une pathologie avec celles d’un stagiaire de première année n’estime pas la fidélité de l’outil de mesure, mais mesure simplement le fossé d’expertise clinique entre les deux individus. Les juges mobilisés dans un protocole métrologique doivent être représentatifs de la population d’utilisateurs finaux auxquels l’instrument est destiné, et doivent avoir complété un entraînement formel uniforme à l’utilisation de la grille d’évaluation.
Enfin, la standardisation environnementale des sessions et la stabilité temporelle de l’attribut psychologique évalué représentent deux conditions sine qua non. Les observateurs doivent soit examiner simultanément le sujet dans un cadre d’interaction rigoureusement contrôlé, soit travailler sur des enregistrements audiovisuels haute fidélité synchronisés. Si l’évaluateur A examine un patient maniaque le matin après son traitement sédatif, et l’évaluateur B examine le même patient le soir en pleine phase d’agitation motrice, la discordance observée ne constituera pas une faille de fidélité inter-juges, mais résultera d’une instabilité réelle de l’état clinique du sujet.
3. Pourquoi la fidélité inter-juges est-elle cruciale en psychologie ?
3.1 Préservation de la robustesse des diagnostics cliniques
Dans la pratique clinique quotidienne, l’évaluation psychologique n’est pas un exercice abstrait ; elle conditionne directement l’attribution de thérapeutiques pharmacologiques lourdes, l’accès à des prestations médico-sociales, la décision d’hospitalisations sans consentement ou l’orientation vers des prises en charge psychothérapeutiques ciblées. Une mauvaise fidélité inter-juges au niveau diagnostique implique qu’un même patient pourrait recevoir l’étiquette de schizophrénie chez le praticien X, et celle de trouble bipolaire à caractéristiques psychotiques chez le praticien Y. Une telle incertitude expose les usagers de la psychiatrie à des risques iatrogènes majeurs découlant de traitements inappropriés.
L’homogénéisation de l’application des critères nosologiques modernes constitue le rempart principal contre ces dérives diagnostiques. En exigeant un seuil élevé de fidélité inter-juges pour la validation des entretiens cliniques structurés (tels que la MINI ou le SCID), la communauté scientifique impose aux praticiens de restreindre leurs interprétations subjectives au profit de critères objectifs vérifiables. Cette standardisation rigide permet de contrer efficacement deux des biais cognitifs les plus prévalents en clinique :
- Le biais d’ancrage : la propension du clinicien à surinvestir la première impression ou le premier symptôme verbalisé par le patient au détriment du tableau clinique d’ensemble.
- Le biais de confirmation : la tendance pernicieuse à ne chercher et à ne retenir que les manifestations cliniques corroborant l’hypothèse diagnostique formulée intuitivement lors des cinq premières minutes de consultation.
Au-delà de la sécurité individuelle des soins, la crédibilité institutionnelle et légale des bilans psychologiques repose directement sur cette propriété métrologique. Lors d’expertises médico-légales au tribunal, où la responsabilité pénale d’un accusé ou l’attribution de la garde d’un enfant dépend de rapports d’évaluation psychologique, un rapport fondé sur des outils à la fidélité inter-juges contestable ou non documentée peut être balayé par les magistrats, ruinant la légitimité sociétale de l’expertise psychologique.
3.2 Garantie de la réplicabilité scientifique des études empiriques
Depuis le milieu des années 2010, la psychologie traverse ce que l’épistémologie contemporaine a désigné sous le terme de crise de la réplicabilité. De nombreuses études phares publiées dans des revues prestigieuses se sont révélées incapables de produire les mêmes résultats lorsqu’elles étaient reprises par des équipes indépendantes. Si les causes de ce phénomène sont multiples (p-hacking, faible puissance statistique, biais de publication), le manque de rigueur dans le contrôle de la fidélité inter-juges lors de la mesure des variables dépendantes représente un facteur explicatif structurel sous-estimé.
Lorsque des chercheurs codent manuellement des variables qualitatives complexes — telles que les patterns de communication verbale, les réactions affectives faciales via le système FACS de Paul Ekman, ou les stratégies d’adaptation au stress —, une faible concordance entre les assistants de recherche introduit un volume colossal de variance d’erreur dans le modèle d’analyse statistique. Cette variance parasite atténue mécaniquement les tailles d’effet réelles (phénomène d’atténuation statistique) et augmente considérablement le risque d’erreurs de type II (ne pas détecter un effet pourtant réel), ou fabrique de faux positifs sous l’effet du biais d’attente de l’expérimentateur (effet Rosenthal).
Désormais, les comités de lecture des revues internationales de premier rang (comme le Journal of Abnormal Psychology ou Psychological Methods) imposent des standards de recevabilité drastiques : aucune étude empirique reposant sur une cotation manuelle ou catégorielle ne peut prétendre à la publication si elle ne documente pas de manière transparente, statistique à l’appui, la fidélité inter-juges de ses données. La fidélité n’est plus une option méthodologique de confort, mais une clause de sauvegarde de l’intégrité scientifique globale de la discipline.
3.3 Optimisation des instruments de mesure standardisés
Au niveau de la théorie psychométrique pure, la fidélité inter-juges est un déterminant direct de la validité de construit et de la puissance d’un instrument de test standardisé. Un test psychométrique n’atteint son plein pouvoir discriminant que si les items qui le composent sont immunisés contre les fluctuations d’interprétation des professionnels chargés de son administration. Dès lors qu’un item génère une discordance récurrente entre évaluateurs indépendants, il injecte de la confusion conceptuelle au sein de la matrice de corrélation de l’outil.
L’élimination des items à faible consensus inter-juges lors de la phase de pré-test produit un effet d’épuration immédiat : elle réduit l’erreur standard de mesure (SEM – Standard Error of Measurement) de l’instrument global. En comprimant la SEM, le test gagne en sensibilité et permet de distinguer avec une précision bien plus fine des individus présentant des niveaux de traits latents très proches. Ceci est particulièrement crucial lors du calibrage d’échelles composites comme les tests d’efficience intellectuelle (échelles de Wechsler : WISC, WAIS) pour lesquels certains subtests verbaux (Vocabulaire, Similitudes) requièrent un jugement humain pour l’attribution des points (0, 1 ou 2 points selon la qualité de l’abstraction formulée par le sujet).
Enfin, la justification empirique de l’étalonnage et la généralisation des normes reposent intégralement sur cette fidélité. Les tables d’étalonnage publiées dans les manuels de tests ne possèdent de validité écologique que si l’utilisateur moyen de l’instrument est capable d’attribuer exactement les mêmes scores aux réponses types que les psychologues ayant participé à l’échantillon normatif d’origine. Si la fidélité inter-juges du système de cotation est insuffisante, les tables normatives deviennent mathématiquement caduques pour la pratique clinique de terrain.
4. La méthode du pourcentage d’accord brut : Principes et formulations
4.1 Concept et formulation mathématique du pourcentage d’accord
L’approche la plus élémentaire et intuitive pour quantifier la concordance entre deux évaluateurs consiste à calculer le pourcentage d’accord brut (également désigné sous l’acronyme d’accord observé, noté conventionnellement $P_o$). Cette métrique arithmétique évalue la proportion stricte de décisions identiques prises conjointement par les observateurs par rapport à l’ensemble des unités d’observation soumises à leur regard. Son attrait réside dans son absence de complexité mathématique et sa lisibilité immédiate pour les praticiens non statisticiens.
La formulation analytique générale s’énonce comme le ratio arithmétique des cas d’accord mutuel divisé par le nombre total de jugements formulés :
$$P_o = \frac{\sum A}{N}$$
Où $\sum A$ représente la somme totale des concordances effectives constatées (les cas où les deux juges ont attribué la même catégorie ou la même valeur au sujet), et $N$ représente la somme totale des unités, items ou individus évalués. Lorsqu’il est exprimé sous forme de pourcentage standard, le coefficient est simplement multiplié par 100 :
$$% \text{ d’accord} = \left( \frac{\sum A}{N} \right) \times 100$$
Cette échelle de mesure présente des propriétés numériques strictement bornées : sa valeur théorique s’étend de 0 (ou 0 %), indiquant une divergence absolue et totale entre les juges sur chaque unité d’observation, jusqu’à 1 (ou 100 %), signifiant une congruence parfaite et sans faille des notations. Malgré sa simplicité séduisante, nous verrons ultérieurement que ce modèle arithmétique souffre de faiblesses statistiques fondamentales qui rendent son utilisation exclusive hautement problématique dans la recherche empirique moderne.
4.2 Exemple numérique guidé : Évaluation de la difficulté d’un test
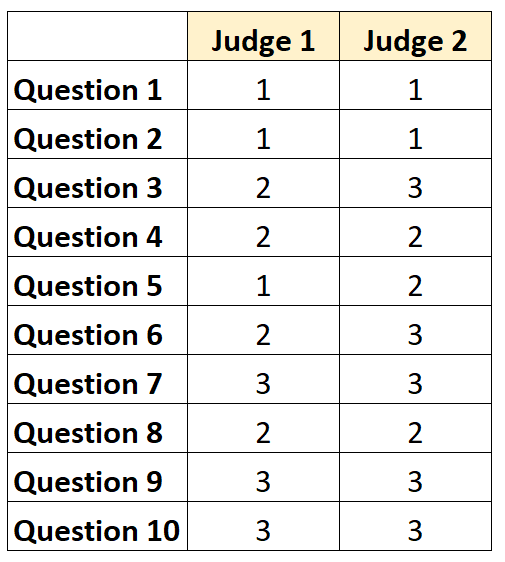
Pour matérialiser le fonctionnement du pourcentage d’accord brut, considérons une situation expérimentale concrète issue de la psychologie de l’éducation. Deux conseillers d’orientation psychologues, le Juge A et le Juge B, sont mandatés pour évaluer la difficulté intrinsèque d’une épreuve pilote de raisonnement logique composée de 10 items distincts. Pour chaque item, les évaluateurs doivent porter un jugement binaire : classer l’item comme « Difficile » (codé 1) ou comme « Accessible » (codé 0). Les deux juges travaillent de manière strictement isolée.
Le tableau ci-dessous synthétise la matrice des cotations recueillies pour les dix items examinés :
- Item 1 : Juge A = 1 | Juge B = 1 $\rightarrow$ Accord (1)
- Item 2 : Juge A = 0 | Juge B = 0 $\rightarrow$ Accord (1)
- Item 3 : Juge A = 1 | Juge B = 0 $\rightarrow$ Désaccord (0)
- Item 4 : Juge A = 0 | Juge B = 0 $\rightarrow$ Accord (1)
- Item 5 : Juge A = 1 | Juge B = 1 $\rightarrow$ Accord (1)
- Item 6 : Juge A = 0 | Juge B = 1 $\rightarrow$ Désaccord (0)
- Item 7 : Juge A = 0 | Juge B = 0 $\rightarrow$ Accord (1)
- Item 8 : Juge A = 1 | Juge B = 1 $\rightarrow$ Accord (1)
- Item 9 : Juge A = 0 | Juge B = 1 $\rightarrow$ Désaccord (0)
- Item 10 : Juge A = 0 | Juge B = 0 $\rightarrow$ Accord (1)
Pour calculer le pourcentage d’accord brut, nous dénombrons les items ayant recueilli une décision unanime : les items 1, 2, 4, 5, 7, 8 et 10 présentent un accord mutuel parfait, totalisant ainsi $\sum A = 7$ accords effectifs. En appliquant l’équation :
$$P_o = \frac{7}{10} = 0{,}70 \quad \text{soit} \quad 70,%$$
Au regard de cette métrique brute, les chercheurs pourraient être tentés de conclure à une fidélité acceptable de 70 % entre les évaluateurs. Toutefois, comme nous le démontrerons dans les sections suivantes, cette conclusion est trompeuse car elle ignore totalement la part de cet accord qui peut être le résultat direct d’une convergence aléatoire sans signification substantive.
4.3 Domaines d’application appropriés pour le pourcentage d’accord
Bien que disqualifié comme métrique de preuve définitive dans les revues psychométriques de référence, le pourcentage d’accord brut conserve une utilité opératoire réelle dans certains contextes méthodologiques précis. Son premier champ de pertinence concerne les phases pilotes hautement exploratoires du développement d’un outil de codage. Lorsque des chercheurs créent une grille d’observation comportementale à partir de zéro, le pourcentage d’accord brut permet d’obtenir un feedback pragmatique immédiat au terme des premières séances de test sans avoir à mobiliser des modèles probabilistes complexes sur de petits effectifs.
Un second domaine d’application réside dans les contextes pédagogiques et la formation initiale des cliniciens ou des étudiants de master. Lors d’ateliers d’entraînement à l’évaluation sémiologique, le pourcentage d’accord sert d’outil de sensibilisation pour illustrer graphiquement aux apprenants l’écart entre leurs notations et celles du groupe de référence. Il permet une restitution visuelle intuitive et facilite la discussion collégiale lors du débriefing item par item.
Enfin, le pourcentage d’accord brut peut être toléré dans des audits de conformité de routine portant sur des procédures très standardisées à variance équilibrée, où le nombre de catégories est élevé (rendant la probabilité d’accord par hasard marginale) et où l’enjeu décisionnel n’implique pas de conséquences cliniques ou diagnostiques majeures. Dès lors que l’on passe à une phase confirmatoire ou que la décision impacte la trajectoire d’un individu, son abandon au profit d’indices corrigés du hasard devient un impératif méthodologique incontournable.
5. Limites méthodologiques et statistiques du pourcentage d’accord
5.1 Le problème de l’accord attribuable au simple hasard
La faille épistémologique majeure du pourcentage d’accord brut réside dans son incapacité structurelle à dissocier la compétence diagnostique réelle des juges de la concordance générée par le pur hasard probabiliste. Dans tout système d’évaluation impliquant un choix discret parmi un ensemble fini de catégories, deux évaluateurs attribuant des codes de manière totalement aléatoire (par exemple en tirant à pile ou face) obtiendront mécaniquement un niveau non négligeable d’accord mutuel.
Illustrons cette réalité mathématique par une démonstration probabiliste élémentaire. Imaginons deux évaluateurs fictifs examinant un dossier clinique et devant statuer sur la présence ou l’absence d’un symptôme (système de cotation binaire). S’ils ne lisent même pas le dossier et décident de répondre au hasard avec une probabilité égale ($p = 0{,}5$) pour chaque option, la probabilité conjointe qu’ils s’accordent par inadvertance sur « Présent » est de :
$$P(\text{Présent}, \text{Présent}) = 0{,}5 \times 0{,}5 = 0{,}25$$
Simultanément, la probabilité qu’ils tombent d’accord sur « Absent » est également de :
$$P(\text{Absent}, \text{Absent}) = 0{,}5 \times 0{,}5 = 0{,}25$$
Par conséquent, la probabilité globale d’accord théorique sous l’hypothèse d’un hasard pur ($P_e$) atteint :
$$P_e = 0{,}25 + 0{,}25 = 0{,}50 \quad \text{soit} \quad 50,%$$
Cet exemple démontre qu’avec deux catégories équiprobables, un taux d’accord brut de 50 % équivaut mathématiquement à une absence absolue de fidélité informative. Le score de 70 % obtenu dans notre exemple précédent ne représente en réalité qu’un gain dérisoire de 20 points de pourcentage par rapport à ce que produiraient des machines répondant au hasard. Plus le nombre de catégories est restreint, plus l’inflation artificielle du pourcentage d’accord brut est spectaculaire, conduisant les chercheurs à une illusion de fidélité méthodologique.
5.2 L’impact des distributions marginales asymétriques
Le second écueil, encore plus pernicieux, du pourcentage d’accord brut réside dans sa vulnérabilité extrême face au phénomène des distributions marginales asymétriques, plus communément désigné dans la littérature médicale et épidémiologique sous le terme de paradoxe de la prévalence. Lorsque la prévalence réelle du phénomène mesuré dans la population est exceptionnellement basse ou exceptionnellement haute, le pourcentage d’accord brut explose artificiellement, masquant une incompétence quasi totale des juges à identifier les cas critiques.
Pour saisir ce paradoxe formalisé par Feinstein et Cicchetti en 1990, considérons l’évaluation d’une pathologie neuropsychologique très rare, dont la prévalence clinique n’est que de 5 % au sein d’une cohorte de 100 patients. Si deux cliniciens particulièrement négligents décident a priori de coter systématiquement chaque patient comme « Négatif » (absence du trouble) sans procéder à un examen attentif, ils classeront tous deux 100 patients sur 100 comme exempts de pathologie. Dans cette configuration, les deux cliniciens s’accordent sur les 95 patients réellement sains, et sont également d’accord pour classer par erreur les 5 patients malades comme sains. Le calcul arithmétique de leur pourcentage d’accord observera :
$$P_o = \frac{100}{100} = 1{,}00 \quad \text{soit} \quad 100,%$$
Le calcul brut renvoie un score de fidélité parfait de 100 %, alors même que le dispositif a échoué à détecter 100 % des individus atteints de la pathologie ! Le pourcentage d’accord brut s’avère incapable d’éclairer la performance des juges sur les cas minoritaires, qui constituent précisément l’objet d’intérêt primordial du clinicien. Cette métrique récompense l’inertie diagnostique dans les contextes de forte prévalence asymétrique, ce qui la rend dangereuse pour la recherche médicale et psychologique.
5.3 Nécessité de recourir à des métriques probabilistes avancées
Face à ces failles structurelles majeures, le statisticien et psychologue américain Jacob Cohen publia en 1960 un article séminal dans le Educational and Psychological Measurement intitulé « A Coefficient of Agreement for Nominal Scales ». Dans cette contribution devenue l’un des articles méthodologiques les plus cités de l’histoire des sciences sociales, Cohen proposa une rupture épistémologique fondamentale : un indice métrologique d’accord ne peut être jugé valide que s’il retranche formellement la part de consensus attribuable au hasard des probabilités marginales.
Cette transition conceptuelle a redéfini le standard d’excellence de la psychométrie contemporaine. Désormais, la communauté scientifique exige que toute quantification de l’accord inter-juges réponde à trois critères non négociables :
- Estimer rigoureusement la probabilité d’accord théorique espérée par hasard ($P_e$) à partir des patrons marginaux de cotation de chaque juge.
- Mettre à l’échelle la concordance observée ($P_o$) en mesurant uniquement le gain réalisé au-delà de cet accord aléatoire incompressible.
- Garantir une pénalisation statistique équitable lorsque la prévalence d’un groupe ou d’une modalité de réponse déséquilibre la distribution générale.
Pour ces motifs impérieux, les comités de lecture des revues scientifiques internationales rejettent quasi systématiquement les manuscrits qui continuent d’utiliser exclusivement le pourcentage d’accord brut dans des protocoles de recherche confirmatoire. L’abandon de l’accord brut au profit de coefficients probabilistes standardisés — au premier rang desquels figure le Kappa de Cohen — constitue le garant de la crédibilité scientifique.
6. Le Kappa de Cohen : Fondements théoriques et modèle mathématique
6.1 Genèse et formulation analytique du coefficient Kappa
Le coefficient Kappa de Cohen (noté conventionnellement $kappa$) a été expressément forgé pour neutraliser les limites intrinsèques du pourcentage d’accord brut sur des échelles de mesure nominales qualitatives. L’intuition théorique de Jacob Cohen repose sur un principe de normalisation statistique : au lieu d’évaluer le rapport de l’accord observé sur le total possible, on détermine la proportion d’accord effectif réalisée au-delà du hasard, rapportée à l’accord maximal qu’il était possible d’obtenir au-delà de ce même hasard.
L’équation maîtresse du Kappa de Cohen est formulée comme suit :
$$\kappa = \frac{P_o – P_e}{1 – P_e}$$
Dans cette expression fondamentale :
- $P_o$ (Proportion d’accord observé) : représente la somme des proportions de cas pour lesquels les deux juges ont formulé un diagnostic ou un codage strictement identique (la diagonale principale de la table de contingence).
- $P_e$ (Proportion d’accord attendu par hasard) : quantifie la probabilité théorique que les deux juges s’accordent par simple coïncidence probabiliste, compte tenu de leurs tendances marginales respectives à utiliser telle ou telle catégorie.
- $1 – P_e$ : représente l’accord potentiel résiduel qu’il était mathématiquement possible de conquérir une fois la part inhérente au hasard éliminée du système.
Le numérateur ($P_o – P_e$) mesure le gain net de fidélité réelle apporté par la grille d’évaluation et l’expertise des juges. Le dénominateur sert de facteur d’échelle pour borner la métrique. Lorsque l’accord observé est strictement identique à l’accord prédictible par le hasard, $P_o = P_e$, ce qui conduit immédiatement à $kappa = 0$. À l’inverse, si l’accord des juges est absolu et parfait sans la moindre discordance, $P_o = 1$, générant l’équation $\kappa = (1 – P_e) / (1 – P_e) = 1$.
6.2 Hypothèses sous-jacentes et conditions d’application
L’application légitime du Kappa de Cohen standard requiert le respect scrupuleux d’un ensemble d’hypothèses méthodologiques et mathématiques formelles. L’ignorer conduit à des interprétations dévoyées et à des artefacts d’évaluation. La première contrainte stipule que le dispositif doit impliquer exactement deux et seulement deux évaluateurs exclusifs, qui notent chacun l’intégralité de l’échantillon d’unités d’observation. Si le pool de juges varie d’un patient à l’autre ou s’il excède deux observateurs, le modèle de Cohen devient inapte et impose d’autres métriques (comme le Kappa de Fleiss).
La seconde condition concerne la nature des données : l’échelle de mesure doit être nominale, composée de catégories qualitatives mutuellement exclusives et exhaustives. Chaque sujet ou événement doit impérativement être assigné à une et une seule catégorie parmi l’éventail disponible (par exemple : « Trouble Dépressif », « Trouble Anxieux », « Trouble Bipolaire », ou « Absence de Trouble »). Le modèle standard suppose que toutes les erreurs de classification possèdent le même statut qualitatif, sans hiérarchisation entre elles.
Enfin, l’hypothèse fondamentale d’indépendance statistique des jugements doit être rigoureusement respectée : l’attribution d’une catégorie par le Juge 1 ne doit exercer aucune influence directe ou indirecte sur la notation formulée par le Juge 2. De surcroît, la taille de l’échantillon évalué ($N$) doit être suffisamment volumineuse pour garantir la stabilité asymptotique des totaux marginaux. Une taille d’échantillon dérisoire (inférieure à 30 unités) expose le calcul du Kappa à une forte instabilité d’échantillonnage, élargissant démesurément son intervalle de confiance.
6.3 Grilles d’interprétation conventionnelles du Kappa
Une fois le coefficient Kappa calculé, la question sémiologique de son interprétation qualitative se pose inévitablement aux chercheurs. L’échelle de classification historique la plus largement mobilisée dans la littérature internationale est celle proposée par J. Richard Landis et Gary G. Koch dans leur publication de 1977. Ces auteurs ont défini les paliers d’acceptabilité conventionnels suivants :
- $\kappa < 0{,}00$ : Accord inférieur au hasard (désaccord systématique traduisant une confusion structurelle entre juges).
- $0{,}00 le \kappa le 0{,}20$ : Accord insignifiant à très léger (Slight agreement).
- $0{,}21 le \kappa le 0{,}40$ : Accord passable ou médiocre (Fair agreement).
- $0{,}41 le \kappa le 0{,}60$ : Accord modéré (Moderate agreement).
- $0{,}61 le \kappa le 0{,}80$ : Accord substantiel ou bon (Substantial agreement).
- $0{,}81 le \kappa le 1{,}00$ : Accord quasi parfait à parfait (Almost perfect agreement).
Il importe toutefois de souligner que Joseph L. Fleiss, un autre grand nom de la biostatistique, a formulé des exigences considérablement plus sévères pour le champ spécifique de la médecine clinique et de la pharmacopsychiatrie. Selon Fleiss, un coefficient inférieur à 0,40 reflète une fidélité médiocre, un score compris entre 0,40 et 0,75 traduit une fidélité tout juste acceptable à bonne, et seule une valeur supérieure à 0,75 atteste d’une excellente fidélité justifiant des prises de décision diagnostiques individuelles.
Une mise en garde épistémologique s’avère indispensable : il convient d’éviter une adhésion dogmatique et mécanique à ces seuils conventionnels arbitraires. La valeur brute du Kappa doit toujours être contextualisée en tenant compte du nombre de catégories du système de cotation, des taux de prévalence marginale de l’échantillon et des conséquences humaines découlant d’une erreur de classification. Un $kappa$ de 0,65 peut être considéré comme acceptable pour coder des interactions verbales en laboratoire de psychologie sociale, mais s’avère insuffisant s’il s’agit de décider de l’admission d’un patient en unité psychiatrique fermée.
7. Exemple pas à pas : Calcul et interprétation du Kappa de Cohen
7.1 Mise en situation clinique et construction de la table de contingence
Afin de démythifier la mise en œuvre pratique de cette métrique, déroulons l’intégralité du calcul arithmétique à travers une étude de cas clinique réaliste. Deux psychiatres hospitaliers chevronnés, le Dr Martin (Juge 1) et le Dr Dubois (Juge 2), mènent une évaluation diagnostique indépendante auprès d’un échantillon représentatif de $N = 50$ patients admis au service des urgences psychiatriques. L’objectif est d’identifier la présence formelle d’un Épisode Dépressif Caractérisé (EDC). Les catégories décisionnelles sont strictement dichotomiques : « Présent » ou « Absent ».
À l’issue de leurs passations individuelles, les données brutes sont organisées au sein d’une matrice croisée 2×2, appelée table de contingence. Dans cette matrice, les lignes représentent les attributions formulées par le Dr Martin, et les colonnes représentent les choix posés par le Dr Dubois :
- Cellule A (Haut-Gauche) : Les deux praticiens s’accordent pour diagnostiquer la présence de la dépression $\rightarrow$ 25 patients.
- Cellule B (Haut-Droite) : Le Dr Martin diagnostique la dépression (« Présent »), mais le Dr Dubois conclut à son absence (« Absent ») $\rightarrow$ 5 patients.
- Cellule C (Bas-Gauche) : Le Dr Martin conclut à l’absence de dépression (« Absent »), tandis que le Dr Dubois diagnostique la dépression (« Présent ») $\rightarrow$ 5 patients.
- Cellule D (Bas-Droite) : Les deux psychiatres s’accordent pour exclure le diagnostic de dépression $\rightarrow$ 15 patients.
Procédons au calcul exhaustif des totaux marginaux pour chacun des deux praticiens :
- Total des patients jugés « Dépressifs » par le Dr Martin (Ligne 1) : $25 + 5 = 30$ patients.
- Total des patients jugés « Non dépressifs » par le Dr Martin (Ligne 2) : $5 + 15 = 20$ patients.
- Total des patients jugés « Dépressifs » par le Dr Dubois (Colonne 1) : $25 + 5 = 30$ patients.
- Total des patients jugés « Non dépressifs » par le Dr Dubois (Colonne 2) : $5 + 15 = 20$ patients.
- Total général des observations ($N$) : $30 + 20 = 50$ (ou $25 + 5 + 5 + 15 = 50$).
7.2 Calcul arithmétique étape par étape
Disposant de la table de contingence complète, le calcul du coefficient procède en trois séquences analytiques précises :
Étape 1 : Calcul de la proportion d’accord observé ($P_o$)
L’accord effectif correspond à la somme des effectifs situés sur la diagonale de concordance (Cellule A + Cellule D), rapportée au nombre total de patients :
$$P_o = \frac{\text{Cellule A} + \text{Cellule D}}{N} = \frac{25 + 15}{50} = \frac{40}{50} = 0{,}80$$
Le pourcentage d’accord brut s’établit donc à 80 %.
Étape 2 : Calcul de la proportion d’accord attendu par hasard ($P_e$)
Pour déterminer la part d’accord que le hasard statistique produirait mécaniquement compte tenu des tendances marginales des deux psychiatres, nous calculons la somme des probabilités conjointes indépendantes pour chaque catégorie :
- Probabilité que les deux juges disent « Présent » par hasard :
$$P(\text{Présent}) = \left( \frac{\text{Marginal Ligne 1}}{N} \right) \times \left( \frac{\text{Marginal Colonne 1}}{N} \right) = \left( \frac{30}{50} \right) \times \left( \frac{30}{50} \right) = 0{,}60 \times 0{,}60 = 0{,}36$$ - Probabilité que les deux juges disent « Absent » par hasard :
$$P(\text{Absent}) = \left( \frac{\text{Marginal Ligne 2}}{N} \right) \times \left( \frac{\text{Marginal Colonne 2}}{N} \right) = \left( \frac{20}{50} \right) \times \left( \frac{20}{50} \right) = 0{,}40 \times 0{,}40 = 0{,}16$$
L’accord attendu global sous l’hypothèse de l’indépendance aléatoire ($P_e$) est la somme de ces probabilités composantes :
$$P_e = 0{,}36 + 0{,}16 = 0{,}52$$
Ainsi, par le seul jeu du hasard, nos deux praticiens devaient converger sur 52 % des diagnostics formulés.
Étape 3 : Résolution de la formule de Cohen et calcul du Kappa
En injectant les valeurs $P_o = 0{,}80$ et $P_e = 0{,}52$ au sein de l’équation standard :
$$\kappa = \frac{P_o – P_e}{1 – P_e} = \frac{0{,}80 – 0{,}52}{1 – 0{,}52} = \frac{0{,}28}{0{,}48} \approx 0{,}5833$$
Le coefficient de fidélité inter-juges de Cohen s’élève précisément à $\kappa = 0{,}58$.
Pour déterminer l’intervalle de confiance à 95 % de ce coefficient, nous calculons l’erreur standard asymptotique du Kappa ($SE_\kappa$) selon l’approximation simplifiée :
$$SE_\kappa = \sqrt{\frac{P_o(1 – P_o)}{N(1 – P_e)^2}} = \sqrt{\frac{0{,}80 \times 0{,}20}{50 \times (1 – 0{,}52)^2}} = \sqrt{\frac{0{,}16}{50 \times 0{,}2304}} = \sqrt{\frac{0{,}16}{11{,}52}} \approx \sqrt{0{,}01389} \approx 0{,}1178$$
L’intervalle de confiance à 95 % ($IC_{95%}$) s’obtient par la formule classique $\kappa \pm (1{,}96 \times SE_\kappa)$ :
$$IC_{95%} = 0{,}583 \pm (1{,}96 \times 0{,}1178) = 0{,}583 \pm 0{,}231 = [0{,}352 ; ; ; 0{,}814]$$
7.3 Interprétation substantive des résultats obtenus
L’analyse comparée des résultats obtenus illustre avec éloquence la valeur ajoutée du modèle de Cohen sur le pourcentage d’accord brut. Alors que le pourcentage d’accord laissait miroiter un consensus confortable de 80 %, le calcul rigoureux du Kappa révèle une réalité plus nuancée, ramenant l’estimation de la fidélité réelle à un score de $\kappa = 0{,}58$. Le modèle probabiliste a extrait et retiré du score les 52 points de pourcentage attribuables à la simple prévalence marginale du diagnostic au sein de la cohorte.
En se référant à la grille de Landis et Koch, une valeur de 0,58 situe l’accord inter-juges dans la tranche supérieure de la fidélité « Modérée » (0,41 à 0,60). Selon les critères de Fleiss, ce résultat est considéré comme « passable à bon ». L’intervalle de confiance calculé, s’étendant de 0,35 (accord médiocre) à 0,81 (accord quasi parfait), démontre par ailleurs que l’échantillon de 50 patients engendre une imprécision statistique non négligeable. Pour consolider la reproductibilité de cette classification, une augmentation substantielle de la taille d’échantillon clinique ($N ge 100$) serait méthodologiquement requise.
Sur le plan de la pratique psychiatrique, un Kappa de 0,58 signifie que si la convergence des praticiens est bien supérieure à ce que produirait le hasard, dix désaccords subsistent sur 50 patients, ce qui représente un taux de divergence de 20 % sur l’accès aux soins. Ce résultat impose aux responsables du service d’organiser une session d’harmonisation sémiologique afin d’analyser en profondeur les dix dossiers litigieux (Cellules B et C) et de stabiliser les critères d’inclusion diagnostique de l’épisode dépressif au sein de l’équipe médicale.
8. Variantes avancées du Kappa pour données ordinales et juges multiples
8.1 Le Kappa pondéré de Cohen pour les échelles ordinales
Le Kappa de Cohen standard présente une limitation intrinsèque : il traite toutes les données comme purement nominales. Dans cette optique binaire, tout désaccord est sanctionné avec une sévérité uniforme, sans considération pour la distance numérique qui sépare les jugements formulés. Or, dans les sciences psychologiques, les cliniciens et chercheurs recourent massivement à des échelles de mesure ordinale, telles que les échelles de Likert graduées (par exemple : « Absence de symptôme », « Symptomatologie légère », « Symptomatologie modérée », « Symptomatologie sévère »).
Si un patient est évalué comme « Absence de symptôme » par le Juge 1 et comme « Symptomatologie légère » par le Juge 2, cette divergence d’un échelon est qualitativement bien moins grave que si le Juge 2 avait conclu à une « Symptomatologie sévère ». Le Kappa standard punit pourtant ces deux configurations d’erreur exactement de la même façon. Pour remédier à cette anomalie, Jacob Cohen a développé en 1968 le Kappa pondéré ($\kappa_w$, pour Weighted Kappa). Ce modèle introduit une matrice de poids ($w_{ij}$) permettant de pénaliser proportionnellement l’amplitude des désaccords.
Deux systèmes de pondération mathématique prévalent dans la pratique académique :
- La pondération linéaire de Cicchetti-Allison : les pénalités augmentent de manière strictement proportionnelle à la distance séparant les catégories attribuées :
$$w_{ij} = 1 – \frac{|i – j|}{k – 1}$$
où $i$ et $j$ sont les rangs des catégories et $k$ le nombre total d’échelons. - La pondération quadratique de Fleiss-Cohen : les pénalités augmentent de façon exponentielle au carré de la distance :
$$w_{ij} = 1 – \frac{(i – j)^2}{(k – 1)^2}$$
Cette formulation sanctionne lourdement les écarts d’évaluation majeurs tout en se montrant tolérante envers les légères hésitations adjacentes d’un seul échelon.
Une propriété remarquable du Kappa à pondération quadratique réside dans son équivalence mathématique absolue avec le coefficient de corrélation intraclasse (modèle à effets aléatoires à deux facteurs), établissant une passerelle entre la métrologie catégorielle et la métrologie des scores continus.
8.2 Le Kappa de Fleiss pour plus de deux évaluateurs
Le Kappa standard de Cohen et sa variante pondérée demeurent circonscrits aux dispositifs impliquant exclusivement une dyade fixe de deux évaluateurs. Dès lors qu’un protocole expérimental mobilise un panel élargi de $m$ juges (par exemple, cinq psychologues évaluant un corpus de vidéos de thérapie, ou un jury de spécialistes examinant des protocoles de Rorschach), le Kappa de Cohen s’avère mathématiquement inapplicable.
Pour surmonter cette restriction, Joseph L. Fleiss a formalisé en 1971 une extension conceptuelle majeure désignée sous le nom de Kappa de Fleiss. Ce modèle permet de quantifier le degré de concordance entre un nombre arbitraire $m$ d’évaluateurs attribuant des catégories nominales à une série de $N$ sujets. L’élégance du modèle de Fleiss repose sur sa capacité à traiter aussi bien les cas où la même équipe de juges note l’intégralité de l’échantillon, que les dispositifs beaucoup plus flexibles où chaque sujet de l’étude est noté par un groupe différent de $m$ juges tirés au sort parmi un réservoir plus large d’examinateurs.
Le calcul du Kappa de Fleiss s’appuie sur la détermination de la proportion d’accord observée pour chaque sujet individuel, en considérant toutes les paires possibles de juges qui ont convergé sur le même code, avant de calculer la moyenne globale de ces concordances sur l’ensemble du corpus. Le terme d’accord aléatoire est ensuite dérivé des fréquences marginales globales d’assignation de chaque catégorie à l’échelle de l’expérience tout entière. Cette variante est devenue la norme méthodologique incontournable pour l’analyse du consensus d’experts, l’harmonisation de comités d’éthique clinique ou la standardisation d’examens universitaires de médecine.
8.3 L’Alpha de Krippendorff : la métrique universelle
Bien que les dérivés du Kappa de Cohen et de Fleiss dominent la psychométrie traditionnelle, ils demeurent vulnérables à des contraintes structurelles : sensibilité persistante au paradoxe de la prévalence, incapacité à traiter nativement les données manquantes, et cloisonnement mathématique entre modèles nominaux et ordinaux. C’est pour unifier l’ensemble de ces méthodologies que le professeur Klaus Krippendorff a conceptualisé en 1980 l’une des métriques les plus abouties de l’analyse de contenu : l’Alpha de Krippendorff ($\alpha$).
L’Alpha de Krippendorff s’impose comme une métrique supérieure grâce à plusieurs propriétés statistiques remarquables :
- Universalité des échelles : il s’applique sans rupture mathématique à tous les niveaux de mesure de la typologie de Stevens : nominal, ordinal, d’intervalle, de rapport, et même circulaire/trigonométrique.
- Tolérance absolue aux données manquantes : contrairement aux formulations du Kappa qui exigent la suppression pure et simple des sujets incomplètement évalués (analyse par exclusion de liste), l’Alpha de Krippendorff ajuste automatiquement ses dénominateurs statistiques en fonction du nombre précis d’évaluateurs ayant effectivement noté chaque unité spécifique.
- Généralisation du nombre de juges : il s’adapte indifféremment à deux observateurs ou à des centaines d’évaluateurs sans altération de ses propriétés d’échelle.
La logique conceptuelle de Krippendorff inverse la perspective de Cohen : au lieu de raisonner en termes de proportion d’accord, l’Alpha calcule le ratio du désaccord observé sur le désaccord attendu :
$$\alpha = 1 – \frac{D_o}{D_e}$$
Dans cette formulation, $D_o$ incarne la fonction de divergence observée au sein des données, et $D_e$ modélise la divergence attendue sous l’effet du hasard probabiliste. Dans les recherches impliquant l’analyse de contenu textuel informatisée, l’extraction de thèmes en psychologie qualitative ou le codage de corpus médiatiques massifs, l’Alpha de Krippendorff représente aujourd’hui le « standard d’or » métrologique exigé par les méthodologistes les plus rigoureux.
9. Le Coefficient de Corrélation Intraclasse (CCI) pour les variables continues
9.1 Pourquoi abandonner le Kappa pour les mesures quantitatives continues
Dès lors que la variable d’intérêt clinique ou comportementale cesse d’être catégorielle pour devenir une variable quantitative continue ou pseudo-continue (par exemple : le temps de réaction en millisecondes, le score global d’efficience intellectuelle issu d’une WAIS-IV, le cortisol salivaire, ou le total dimensionnel d’une échelle de dépression allant de 0 à 63 points), la famille des coefficients Kappa devient méthodologiquement inadaptée.
Face à des scores continus, certains chercheurs commettent l’erreur d’opérer une discrétisation arbitraire de leurs données (par exemple, en segmentant les scores d’anxiété en catégories « Faible », « Moyen » et « Élevé ») pour pouvoir y appliquer artificiellement un Kappa de Cohen. Cette pratique de découpage catégoriel est vigoureusement condamnée par les méthodologistes contemporains : elle détruit une part colossale de la variance statistique naturelle, compresse la puissance de détection des tests, et génère des artefacts mathématiques à proximité immédiate des seuils de coupure choisis de manière arbitraire.
Pour évaluer la fidélité inter-juges de variables quantitatives continues, la solution psychométrique réside dans le Coefficient de Corrélation Intraclasse (CCI). Dérivé des travaux pionniers de Ronald Fisher sur l’analyse de variance (ANOVA), le CCI ne se limite pas à évaluer la corrélation bivariée linéaire entre évaluateurs (comme le ferait un coefficient de Pearson) ; il décompose la structure de variance des données pour quantifier avec exactitude la part de variance imputable aux différences réelles entre sujets par rapport à l’erreur de mesure induite par les examinateurs.
9.2 La typologie des modèles de CCI selon Shrout et Fleiss
L’utilisation correcte du CCI dans la littérature scientifique a été formalisée par l’article classique de Patrick E. Shrout et Joseph L. Fleiss publié en 1979 dans le Psychological Bulletin. Ces auteurs ont clarifié l’existence de six configurations distinctes de CCI, organisées selon deux dimensions fondamentales : le modèle de plan d’expérience d’ANOVA sous-jacent (modèle à 1 facteur, modèle à 2 facteurs aléatoires, modèle à 2 facteurs mixtes) et la nature de l’unité de mesure retenue pour l’application finale (mesure unique versus moyenne de plusieurs juges).
Le tableau conceptuel ci-dessous structure cette taxonomie fondamentale de Shrout et Fleiss :
- Modèle à 1 facteur aléatoire (One-way random – CCI(1,1) ou CCI(1,k)) : Chaque sujet est évalué par un groupe distinct d’évaluateurs sélectionnés aléatoirement au sein d’une population de juges. Les évaluateurs ne sont pas identifiés d’un sujet à l’autre. La variance des juges est confondue avec l’erreur résiduelle.
- Modèle à 2 facteurs aléatoires (Two-way random – CCI(2,1) ou CCI(2,k)) : Un ensemble identique d’évaluateurs, tirés au sort parmi un univers plus large de juges potentiels, évalue la totalité de l’échantillon. La variance liée aux juges est isolée et modélisée comme un effet aléatoire. Ce modèle permet de généraliser les conclusions de fidélité à n’importe quel autre évaluateur issu de la même population.
- Modèle à 2 facteurs mixtes (Two-way mixed – CCI(3,1) ou CCI(3,k)) : L’ensemble de l’échantillon est noté par un groupe fixe d’évaluateurs qui représentent les seuls juges d’intérêt de l’étude (effet fixe). Les résultats de fidélité ne sont pas généralisables au-delà de ces individus spécifiques.
Le second paramètre de sélection concerne la forme du score utilisé dans l’application clinique ou de recherche finale :
- Si la décision clinique future reposera sur l’évaluation formulée par un seul et unique praticien, le chercheur doit impérativement rapporter le CCI de mesure unique : $\text{CCI}(1,1)$, $\text{CCI}(2,1)$ ou $\text{CCI}(3,1)$.
- Si, dans la pratique opérationnelle, la variable sera calculée comme la moyenne arithmétique des scores attribués par $k$ évaluateurs indépendants pour accroître la stabilité de l’évaluation, le chercheur doit calculer et publier le CCI pour mesure moyenne : $\text{CCI}(1,k)$, $\text{CCI}(2,k)$ ou $\text{CCI}(3,k)$. Ce dernier sera systématiquement supérieur au premier en vertu de la loi de Spearman-Brown.
9.3 Accord absolu versus cohérence relative dans l’évaluation psychométrique
Au sein des modèles de CCI à deux facteurs (aléatoires ou mixtes), une distinction conceptuelle majeure doit impérativement guider le choix du statisticien : l’arbitrage entre l’option d’accord absolu (Absolute Agreement) et l’option de cohérence relative (Consistency). Cette distinction touche au cœur de ce que l’on attend d’un instrument d’évaluation psychologique.
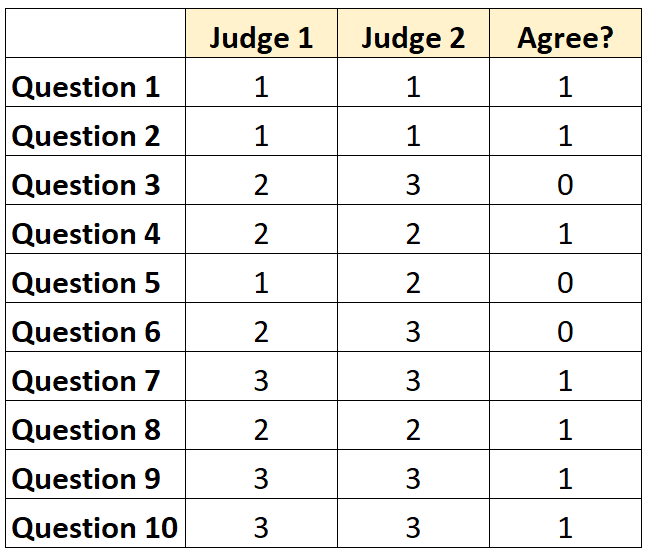
Pour saisir cette divergence, imaginons un scénario où le Juge A attribue aux sujets 1, 2 et 3 les scores respectifs de 10, 20 et 30. Simultanément, le Juge B attribue aux mêmes sujets les scores de 15, 25 et 35. Si l’on analyse ce profil sous l’angle de la cohérence relative, la fidélité est rigoureusement parfaite ($CCI = 1{,}00$) : les rangs des sujets sont parfaitement respectés, et l’écart entre les notations est d’une régularité absolue. Le Juge B est simplement systématiquement plus sévère que le Juge A d’une constante de 5 points. En mode cohérence, la variance inter-juges est extraite du dénominateur d’erreur : le modèle ignore les biais de sévérité systématique.
À l’inverse, si nous évaluons ces mêmes données sous le prisme de l’accord absolu, les scores 10 et 15 ne sont pas identiques ; la variance systématique entre les juges est réintégrée au dénominateur et pénalise directement l’indice de fidélité ($CCI < 1{,}00$). Dans la pratique de l'évaluation psychologique et médicale individuelle, l'accord absolu représente la seule option méthodologiquement défendable dès lors qu'un score seuil pathologique est en jeu. Si le diagnostic d'autisme ou de démence s'enclenche à un score strict de 20, le fait que le Juge B attribue 25 à un patient qui n'obtient que 15 avec le Juge A change radicalement le destin clinique de cet individu, rendant une simple cohérence relative dangereusement insuffisante.
10. Facteurs perturbateurs et biais d’évaluation influençant la fidélité
10.1 Biais cognitifs et styles de réponse des évaluateurs
L’observateur humain, aussi qualifié soit-il, n’est jamais un instrument de mesure parfaitement neutre. Son fonctionnement cognitif est traversé par une série de biais systématiques qui s’infiltrent dans les cotations et dégradent la fidélité inter-juges. Le plus emblématique de ces artefacts est l’effet de halo, conceptualisé par Edward Thorndike. Ce biais se manifeste lorsqu’une caractéristique saillante, séduisante ou hautement défavorable du sujet évalué (comme son attrait physique, son niveau d’élocution verbale ou son appartenance sociale perçue) irradie et contamine inconsciemment le jugement de l’évaluateur sur l’ensemble des dimensions psychologiques observées.
Parallèlement aux distorsions projectives, les styles de réponse personnels et les idiosyncrasies comportementales des évaluateurs créent une dispersion artificielle des scores observés. On recense classiquement dans la littérature méthodologique :
- Le biais de sévérité constante : tendance de certains observateurs hypercritiques à ancrer l’ensemble de leurs cotations dans le tiers supérieur de la sévérité psychopathologique.
- Le biais d’indulgence systématique : propension inverse d’autres juges à minimiser systématiquement les déviances comportementales ou les déficits cognitifs par bienveillance ou réticence à étiqueter autrui.
- Le biais de tendance centrale : attitude d’évitement cognitif conduisant l’évaluateur à concentrer l’ensemble de ses choix sur les échelons médians des échelles de Likert, refusant catégoriquement d’utiliser les ancres extrêmes par peur de commettre une erreur diagnostique flagrante.
Enfin, la vulnérabilité psychophysiologique des évaluateurs constitue une source majeure d’erreur non contrôlée. Au cours de protocoles d’évaluation longs et répétitifs, la fatigue attentionnelle, la perte de vigilance perceptive et l’ennui cognitif provoquent une dégradation sensible de la fidélité au fil des heures. Deux juges qui manifestent une concordance remarquable à 9 heures du matin sur les premiers enregistrements vidéo peuvent voir leur accord s’effondrer dramatiquement en fin d’après-midi, sous l’effet de l’épuisement mental et de la variabilité attentionnelle.
10.2 Ambiguïté et complexité intrinsèque des instruments d’évaluation
Lorsque la fidélité inter-juges d’un protocole s’effondre, la cause première réside souvent non pas dans la compétence des évaluateurs, mais dans l’architecture même de l’instrument d’évaluation qui leur est confié. Un manuel de codage lacunaire, rédigé dans un jargon théorique vague et exempt de définitions opérationnelles précises, condamne inéluctablement les observateurs au désaccord. Si un protocole demande de coter si un individu manifeste de « l’anxiété flottante » sans spécifier les critères somatiques, verbaux ou posturaux caractérisant cet état, les juges n’ont d’autre recours que de se replier sur leurs propres présupposés cliniques.
Un autre écueil psychométrique majeur réside dans le chevauchement sémantique des critères diagnostiques. Lorsque les frontières entre deux modalités de réponse sont poreuses ou mal délimitées au plan conceptuel (par exemple, distinguer « l’agressivité verbale » de « l’hostilité relationnelle » sans fournir de démarcation comportementale explicite), les évaluateurs hésitent continuellement entre les deux catégories, transformant le choix final en une loterie décisionnelle qui plombe les coefficients de Kappa.
De surcroît, la granularité excessive des échelles d’évaluation graduelle constitue une cause classique d’échec métrologique. Les concepteurs d’échelles sont parfois tentés de proposer des échelles de Likert comportant 9, 10 voire 11 échelons dans l’espoir d’obtenir une granularité descriptive maximale. Or, les recherches en psychophysique et en psychologie cognitive démontrent invariablement que l’esprit humain est structurellement incapable de discriminer de manière stable et reproductible plus de 5 à 7 niveaux d’intensité sur un construit psychologique subjectif. Dépasser ce seuil de saturation cognitive injecte immédiatement du bruit aléatoire et réduit l’accord absolu.
10.3 Effets de contexte et conditions d’observation
La fidélité inter-juges est également conditionnée par la qualité matérielle et écologique de l’environnement au sein duquel s’exécute le recueil des données. Dans les études comportementales contemporaines, une grande partie du codage repose sur l’analyse différée d’enregistrements audiovisuels. Si la qualité de capture est médiocre — angle de caméra restreint occultant une partie du corps, éclairage défectueux masquant les micro-expressions du visage, piste audio parasitée par un écho ou un bruit de fond —, les codeurs perdent l’accès aux indices perceptifs discriminants fondamentaux, ce qui maximise les interprétations divergentes.
La pression temporelle imposée aux observateurs lors de la passation de l’évaluation constitue un autre facteur de perturbation contextuelle. Si un clinicien est contraint de remplir une grille sémiologique complexe en temps réel durant l’entretien, sans possibilité de relecture ou de ralentissement du flux d’interaction, sa charge cognitive de travail atteint un point de saturation qui multiplie les erreurs de cotation par omission ou par précipitation. La standardisation de sessions d’observation asynchrones, permettant l’arrêt sur image et la réécoute segmentée, améliore mécaniquement la fidélité globale du codage.
Enfin, le phénomène de dérive de cotation longitudinale (rater drift) menace les protocoles de recherche s’étalant sur de nombreux mois. Même lorsque les évaluateurs ont été rigoureusement étalonnés et calibrés au lancement d’une étude, leurs cadres d’évaluation internes évoluent imperceptiblement au fil des semaines. Sans un processus continu de contrôle et de recalibrage statistique régulier, les juges développent progressivement de nouvelles normes idiosyncrasiques au contact des données, conduisant à une divergence silencieuse de leurs cotations au fur et à mesure que l’étude progresse dans le temps.
11. Stratégies méthodologiques pour optimiser l’accord inter-juges
11.1 Élaboration d’un guide de codage exhaustif et standardisé
La première stratégie pour maximiser la fidélité inter-juges consiste à rédiger un manuel de codage opérationnel (codebook) ne laissant aucune place à l’improvisation herméneutique. Chaque item du système d’évaluation doit faire l’objet d’une définition opérationnelle comportementale découpée selon des descripteurs concrets, observables et dénués de toute ambiguïté linguistique. Le manuel doit bannir les qualifications abstraites au profit d’actions manifestes et quantifiables.
Pour chaque niveau de l’échelle d’évaluation, le manuel doit impérativement comporter ce que la psychométrie nomme des ancres comportementales concrètes (Behaviorally Anchored Rating Scales – BARS). Ces ancres doivent être accompagnées d’exemples types prototypiques directement extraits de situations réelles, illustrant sans équivoque la morphologie exacte du comportement ciblé. Ces descriptions fournissent aux évaluateurs un gabarit perceptif direct permettant une comparaison terme à terme lors de la cotation.
Élément tout aussi déterminant : le guide de codage doit documenter de manière exhaustive les cas limites (borderline cases) ainsi qu’une collection explicite de contre-exemples exclus. Pour chaque catégorie diagnostique ou comportementale, le manuel doit stipuler ce que le comportement n’est pas, en précisant les manifestations de surface trompeuses qui ressemblent au comportement cible mais qui doivent être formellement orientées vers une autre catégorie. Ce manuel ne doit pas être figé d’emblée : il doit faire l’objet d’une actualisation itérative et d’un enrichissement collaboratif tout au long des phases pré-expérimentales de test.
11.2 Programmes de formation et sessions d’étalonnage préliminaires
L’existence d’un guide de codage irréprochable ne dispense en aucun cas d’un programme d’entraînement formel et standardisé des évaluateurs avant le lancement officiel de la collecte des données empiriques. L’apprentissage ne peut se réduire à une lecture passive du manuel : il doit s’incarner dans des ateliers pratiques d’étalonnage conduits sur des corpus tests indépendants, expressément conçus pour couvrir l’ensemble du spectre de sévérité et de variabilité des comportements à évaluer.
La méthodologie d’entraînement optimale s’articule selon un cycle d’alignement normatif en plusieurs phases successives :
- Phase de cotation aveugle : Chaque apprenti évaluateur note individuellement et de façon isolée une série d’unités ou de vidéos tests spécialement sélectionnées pour leur complexité sémiologique.
- Phase de débriefing et d’explicitation : Formateurs et apprenants comparent l’ensemble des matrices de cotation. Chaque désaccord fait l’objet d’une déconstruction maïeutique détaillée : l’évaluateur explicite les indices visuels ou verbaux qu’il a pris en compte, ce qui permet d’identifier précisément les biais de raisonnement ou les erreurs d’interprétation du manuel.
- Évaluation formelle de certification : La phase de formation ne s’interrompt que lorsque les évaluateurs atteignent formellement un seuil métrologique prédéfini sur un nouveau jeu de données test (par exemple, un $\kappa ge 0{,}80$ ou un $CCI ge 0{,}85$).
Pour prévenir le phénomène pernicieux de dérive de cotation longitudinale évoqué précédemment, cette démarche d’entraînement initial doit être prolongée par des sessions de réétalonnage périodiques tout au long du protocole expérimental. Tous les mois ou tous les trimestres selon le rythme de la recherche, une sous-fraction des données collectées (par exemple 15 à 20 % de l’échantillon global) doit être soumise à une double cotation aveugle systématique. Si le calcul continu du coefficient de fidélité met en évidence un fléchissement des scores d’accord, une session de recalibrage collectif immédiate doit être organisée pour corriger la divergence naissante.
11.3 Affinement statistique et itératif des instruments de mesure
L’optimisation de la fidélité inter-juges mobilise également des leviers d’ingénierie statistique a posteriori, visant à assainir l’instrument à la lumière des patrons d’erreur identifiés lors des phases pilotes. Lorsque l’analyse des matrices de confusion révèle que deux catégories adjacentes d’une échelle nominale ou ordinale génèrent une proportion massive et réciproque de désaccords, tout en étant individuellement sous-utilisées au sein de l’échantillon, la démarche psychométrique la plus rationnelle consiste à procéder à la fusion empirique de ces deux modalités en une catégorie conceptuelle unique plus robuste.
Parallèlement, les items individuels qui affichent de manière récurrente une variance inter-juges anormalement élevée doivent être soumis à une révision linguistique en profondeur ou tout simplement purgés du test. L’application combinée de l’analyse factorielle confirmatoire (AFC) et des modèles issus de la Théorie de la Réponse aux Items (TRI) permet de vérifier si l’élimination des items à faible fidélité inter-juges améliore l’information globale du test et renforce l’unidimensionnalité du construit théorique évalué.
Enfin, l’époque contemporaine ouvre des perspectives méthodologiques prometteuses grâce à l’intégration raisonnée d’outils d’intelligence artificielle et d’algorithmes de vision par ordinateur en prétraitement. En déléguant à des modèles algorithmiques calibrés la détection et l’extraction préliminaires de marqueurs comportementaux objectifs (temps de parole cumulé, quantification de l’agitation motrice globale par capteurs accélérométriques, extraction automatique de la prosodie acoustique), le chercheur libère l’évaluateur humain d’une part de sa charge cognitive. Ce dernier peut alors concentrer toute son attention qualitative sur l’intégration sémiologique fine des patterns complexes, réduisant la variabilité idiosyncrasique et optimisant mécaniquement la fidélité inter-juges globale du dispositif.
12. Normes de publication et restitution des résultats dans les revues académiques
12.1 Directives de publication selon les normes APA
La communication des indices de fidélité inter-juges au sein des articles scientifiques ne saurait se limiter à la mention lapidaire d’un chiffre isolé au détour d’un paragraphe méthodologique. L’American Psychological Association (APA), à travers ses directives standardisées Journal Article Reporting Standards (JARS), a établi des obligations de transparence méthodologique strictes destinées à permettre aux relecteurs et à la communauté scientifique d’évaluer la solidité réelle des mesures présentées.
Lors de la rédaction d’un manuscrit empirique, les auteurs doivent impérativement expliciter les éléments cardinaux suivants au sein de la section Méthode :
- L’identification univoque du coefficient statistique employé : Les chercheurs doivent spécifier la variante mathématique exacte utilisée (par exemple : Kappa simple de Cohen non pondéré, Kappa pondéré quadratique de Fleiss-Cohen, Alpha de Krippendorff ordinal, ou modèle précis de CCI selon Shrout et Fleiss en précisant le type — effets aléatoires ou mixtes — et la cible — mesure unique ou moyenne).
- La publication systématique de l’intervalle de confiance : Un coefficient de fidélité est une estimation ponctuelle soumise aux fluctuations d’échantillonnage ; il doit obligatoirement être flanqué de son intervalle de confiance à 95 % ($IC_{95%}$), permettant d’apprécier la précision statistique de l’estimation.
- La documentation du protocole d’observation : Le texte doit renseigner le nombre exact d’évaluateurs mobilisés, leur niveau de formation et de qualification initiale, les modalités du programme d’entraînement suivi, et attester du respect rigoureux du double aveugle et de l’indépendance stricte des codages.
- Le pourcentage de données soumis à double cotation : Dans les dispositifs où la totalité de l’échantillon n’a pas pu être notée par l’ensemble des juges pour des motifs de coût ou de temps, les auteurs doivent déclarer avec exactitude quel pourcentage aléatoire du corpus a fait l’objet d’une double évaluation indépendante pour le calcul de la fidélité.
De plus, pour les échelles catégorielles nominales, la mise à disposition de la matrice de contingence croisée complète (soit directement dans le corps de l’article, soit sous forme de matériel supplémentaire en ligne) est vivement encouragée par les comités de rédaction des revues à fort facteur d’impact, car elle permet aux pairs de recalculer les métriques et d’inspecter visuellement les asymétries marginales.
12.2 Interprétation critique et nuance des seuils d’acceptabilité
La restitution académique des données de fidélité exige des auteurs une posture épistémologique critique, rompant avec l’application naïve et mécanique de seuils statistiques universels. Revendiquer un « bon accord » au seul motif qu’un Kappa de Cohen a franchi le palier arbitraire de 0,70 relève d’une simplification méthodologique inacceptable dès lors que les enjeux de la recherche touchent à des prises de décision diagnostiques individuelles à haut risque.
Les chercheurs doivent inscrire l’interprétation de leurs coefficients au sein du contexte écologique spécifique de leur investigation clinique. Une fidélité modérée ($\kappa = 0{,}55$) peut tout à fait être jugée substantiellement satisfaisante et scientifiquement prometteuse lors d’un protocole hautement novateur visant à coder les micro-signaux émotionnels subtils de nourrissons prématurés en unité de réanimation néonatale, en raison de l’extrême complexité et de la fugacité des comportements observés. À l’inverse, cette même valeur de 0,55 doit être considérée comme un échec méthodologique critique s’il s’agit de discriminer des sous-types de démence sénile à l’aide d’un protocole neuropsychologique standardisé destiné à la routine hospitalière.
Enfin, la discussion de l’article doit aborder de front l’impact des prévalences marginales sur l’indice statistique publié. Si le phénomène mesuré présente une rareté statistique extrême, les auteurs ont le devoir méthodologique de signaler que la valeur du Kappa standard a pu être substantiellement tirée vers le bas par le paradoxe de Feinstein et Cicchetti, et doivent idéalement présenter des métriques de sensibilité alternatives (telles que le coefficient de Gwet $AC_1$ ou les pourcentages d’accord spécifiques positifs et négatifs) pour offrir une vision multidimensionnelle et non déformée de la réalité de leur consensus d’évaluation.
12.3 Check-list pour les auteurs et évaluateurs scientifiques
Afin de synthétiser les exigences méthodologiques développées tout au long de cet ouvrage de référence, le tableau synthétique ci-dessous propose une check-list opérationnelle exhaustive destinée aux chercheurs soumettant un manuscrit ainsi qu’aux relecteurs (peer-reviewers) mandatés pour évaluer la rigueur métrologique d’une étude comportementale :
- $square$ Indépendance des passations : L’indépendance stricte et le double aveugle absolu des évaluateurs sont-ils documentés de manière vérifiable sans ambiguïté procédurale ?
- $square$ Adéquation de la métrique : L’indice statistique sélectionné est-il mathématiquement adapté à la nature de l’échelle de mesure employée (Kappa simple pour données nominales bivariées, Kappa pondéré pour données ordinales, Fleiss pour panels multiples, Krippendorff pour données manquantes, CCI pour mesures continues) ?
- $square$ Modélisation du CCI : En présence d’un CCI sur données continues, le manuscrit stipule-t-il explicitement la typologie exacte retenue selon Shrout et Fleiss (modèle à 1 facteur, 2 facteurs aléatoires ou mixtes ; mesure unique ou moyenne ; cohérence relative ou accord absolu) ?
- $square$ Précision statistique : Le coefficient rapporté est-il obligatoirement accompagné de son intervalle de confiance à 95 % ($IC_{95%}$) et de la taille de l’échantillon d’unités évaluées ($N$) ?
- $square$ Formation et dérive : Le programme d’étalonnage préalable des juges est-il décrit, et les mesures prises pour contrôler ou prévenir la dérive de cotation longitudinale sont-elles consignées ?
- $square$ Transparence descriptive : Les matrices de confusion (pour les variables catégorielles) ou les graphiques de Bland-Altman (pour les variables continues) sont-ils intégrés dans l’article ou mis à disposition en annexe méthodologique ouverte ?
L’observation rigoureuse de ces standards métrologiques ne constitue pas un simple exercice d’orthodoxie académique formelle. Elle représente le garant le plus solide de la robustesse empirique des sciences psychologiques, protégeant l’édifice de la recherche et de la clinique contre les illusions subjectives, et assurant que nos mesures reflètent avec une fidélité inaltérable la complexité authentique du comportement humain.
Références
- Ainsworth, M. D. S., Blehar, M. C., Waters, E., & Wall, S. (1978). Patterns of attachment: A psychological study of the strange situation. Lawrence Erlbaum.
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cicchetti, D. V., & Allison, T. (1971). A new procedure for assessing reliability of scoring EEG sleep recordings. American Journal of EEG Technology, 11(3), 101–110. https://doi.org/10.1080/00029238.1971.11080840
- Cohen, J. (1960). A coefficient of agreement for nominal scales. Educational and Psychological Measurement, 20(1), 37–46. https://doi.org/10.1177/001316446002000104
- Cohen, J. (1968). Weighted kappa: Nominal scale agreement provision for scaled disagreement or partial credit. Psychological Bulletin, 70(4), 213–220. https://doi.org/10.1037/h0026256
- Ekman, P., & Friesen, W. V. (1978). Facial Action Coding System: A technique for the measurement of facial movement. Consulting Psychologists Press.
- Feinstein, A. R., & Cicchetti, D. V. (1990). High agreement but low kappa: I. The problems of two paradoxes. Journal of Clinical Epidemiology, 43(6), 543–549. https://doi.org/10.1016/0895-4356(90)90046-K
- Fleiss, J. L. (1971). Measuring nominal scale agreement among many raters. Psychological Bulletin, 76(5), 378–382. https://doi.org/10.1037/h0031619
- Fleiss, J. L. (1981). Statistical methods for rates and proportions (2nd ed.). John Wiley & Sons.
- Gwet, K. L. (2014). Handbook of inter-rater reliability: The definitive guide to measuring the extent of agreement among raters (4th ed.). Advanced Analytics, LLC.
- Krippendorff, K. (2004). Reliability in content analysis: Some common misconceptions and recommendations. Human Communication Research, 30(3), 411–433. https://doi.org/10.1111/j.1468-2958.2004.tb00738.x
- Landis, J. R., & Koch, G. G. (1977). The measurement of observer agreement for categorical data. Biometrics, 33(1), 159–174. https://doi.org/10.2307/2529310
- Lord, F. M., & Novick, M. R. (1968). Statistical theories of mental test scores. Addison-Wesley.
- Shrout, P. E., & Fleiss, J. L. (1979). Intraclass correlations: Uses in assessing rater reliability. Psychological Bulletin, 86(2), 420–428. https://doi.org/10.1037/0033-2909.86.2.420
- Thorndike, E. L. (1920). A constant error in psychological ratings. Journal of Applied Psychology, 4(1), 25–29. https://doi.org/10.1037/h0071663