
Dans le champ des sciences humaines, de la biométrie et de la psychométrie contemporaine, la quantification rigoureuse des relations entre des phénomènes inobservables constitue un défi méthodologique fondamental. Bien souvent, la réalité psychologique, cognitive ou clinique se déploie sous la forme d’un continuum d’intensité, de propension ou de sévérité. Pourtant, les instruments de mesure employés pour appréhender ces réalités contraignent fréquemment l’observation à des formats discrets simplifiés, tels que des réponses binaires du type « d’accord / pas d’accord », « présent / absent », ou « réussite / échec ». Cette réduction drastique de l’information brute engendre des distorsions mathématiques majeures lorsqu’on cherche à évaluer l’interdépendance réelle des construits sous-jacents au moyen des outils statistiques traditionnels.
Face à cette limitation structurelle, les pionniers de la statistique inférentielle ont développé des modélisations probabilistes sophistiquées visant à restaurer la continuité perdue à partir des fréquences catégorielles observées. Parmi ces innovations fondamentales figure la corrélation tétrachorique, un coefficient conçu spécifiquement pour estimer la corrélation linéaire qui existerait entre deux variables continues et normalement distribuées si celles-ci n’avaient pas été artificiellement scindées en deux catégories mutuellement exclusives. En postulant l’existence de traits latents gaussiens régis par des seuils d’activation critiques, cette approche transcende les contingences du recueil de données pour approcher la véritable architecture des processus psychologiques et biologiques sous-jacents.
Comprendre la nature, la dérivation mathématique et les applications empiriques de la corrélation tétrachorique est indispensable pour tout chercheur ou praticien confronté à l’analyse factorielle d’items dichotomiques, à la validation d’échelles de mesure ou à la modélisation par équations structurelles. Le présent traité se propose d’explorer de manière exhaustive l’ensemble des dimensions théoriques, historiques, algorithmiques et appliquées de ce coefficient singulier, en mettant en lumière tant sa puissance modélisatrice que ses contraintes d’utilisation dans la recherche moderne.
1. Introduction et définition fondamentale de la corrélation tétrachorique
1.1 Définition conceptuelle de la corrélation tétrachorique
La corrélation tétrachorique est une technique statistique paramétrique destinée à mesurer l’intensité et la direction de l’association linéaire présumée entre deux variables continues inobservables, dites variables latentes, lorsque celles-ci ne sont accessibles à l’expérimentateur que par l’intermédiaire de manifestations binaires manifestes. Dans le cadre de ce paradigme, chaque observation binaire observée n’est pas considérée comme une entité qualitativement autonome, mais plutôt comme le résultat de la discrétisation artificielle d’une dimension continue sous-jacente qui suit une loi de probabilité conjointe normale bivariée. Ce modèle repose sur le principe fondamental qu’une entité psychologique ou biologique invisible possède une distribution d’intensité continue au sein de la population générale, mais que l’appareil d’enregistrement impose une règle de décision catégorielle réduisant cette richesse informationnelle à deux états mutuellement exclusifs, conventionnellement codés 0 et 1.
D’un point de vue métrique, le coefficient de corrélation tétrachorique, couramment noté rtet, évolue sur une échelle de variation strictement bornée entre -1 et +1, adoptant ainsi la même métrique d’interprétation que le célèbre coefficient de corrélation produit-moment de Bravais-Pearson. Une valeur de +1 reflète une concordance absolue et déterministe entre les deux continuums latents, signifiant que tout individu se situant au-delà du seuil critique sur la première variable franchira inéluctablement le seuil critique sur la seconde variable. Réciproquement, une valeur de -1 caractérise une discordance parfaite et antagonique entre les deux dimensions sous-jacentes. La valeur 0 désigne une indépendance statistique totale entre les variables latentes : dans cette situation, la probabilité conjointe d’endosser simultanément les deux catégories cibles correspond exactement au produit des probabilités marginales de chaque variable prise isolément.
L’évaluation de la magnitude du coefficient tétrachorique ne se focalise donc pas sur la relation entre les catégories manifestes de surface, mais reconstitue l’affinité intrinsèque qui unit les deux dimensions invisibles. Cette propriété confère à la corrélation tétrachorique une supériorité conceptuelle notoire dès lors que le postulat de continuité est scientifiquement recevable. Elle permet aux statisticiens et psychométriciens de raisonner sur les véritables mécanismes générateurs de données plutôt que de subir passivement les distorsions arithmétiques induites par les protocoles de réponse forcée ou les instruments de dépistage dichotomiques.
1.2 Contexte d’émergence dans l’évaluation psychologique
L’essor fulgurant de la psychométrie au début du vingtième siècle a placé les concepteurs de tests psychologiques face à un dilemme technique récurrent : la prépondérance des protocoles de recueil de données reposant sur des items dichotomiques. Qu’il s’agisse des questionnaires de personnalité pionniers, à l’image du célèbre Woodworth Personal Data Sheet élaboré durant la Première Guerre mondiale, ou des épreuves d’aptitude intellectuelle développées par Alfred Binet et Lewis Terman, les sujets étaient systématiquement contraints de choisir entre deux modalités fermées : « vrai » ou « faux », « oui » ou « non », « réussite » ou « échec ». Si ce format présentait l’avantage indéniable d’une simplicité de passation et d’une objectivité maximale lors de la notation, il masquait inexorablement la complexité graduelle du fonctionnement cognitif et affectif des participants.
Dans la réalité psychologique, l’adhésion à une affirmation telle que « Je me sens fréquemment submergé par l’anxiété » ne procède pas d’un phénomène binaire de tout ou rien. L’expérience de l’angoisse est un trait dimensionnel s’échelonnant le long d’un continuum infini d’intensités émotionnelles, physiologiques et cognitives. De même, la résolution correcte d’un item d’aptitude arithmétique dépend d’une capacité cognitive générale sous-jacente qui varie de manière continue au sein de la population. L’émergence de la corrélation tétrachorique a ainsi répondu à une impérieuse nécessité épistémologique : fournir aux scientifiques un outil d’inférence capable de modéliser mathématiquement ces construits psychologiques continus artificiellement discrétisés par les contingences de l’évaluation standardisée.
Cette distinction conceptuelle a conduit les théoriciens de la mesure à formaliser la différenciation essentielle entre dichotomie naturelle et dichotomie artificielle. Une dichotomie naturelle ou intrinsèque qualifie un phénomène dont la réalité empirique est structurellement discontinue, comme le statut vital d’un organisme (vivant ou décédé) ou un état génétique mendélien spécifique. À l’opposé, une dichotomie artificielle résulte purement et simplement de la décision arbitraire ou pratique de l’observateur de segmenter un continuum continu au moyen d’une frontière nette. L’application de la corrélation tétrachorique est rigoureusement réservée à cette seconde catégorie d’observations, car elle suppose par essence que sous la frontière catégorielle superficielle persiste une distribution de densités de probabilité gaussienne continue.
1.3 Intérêt psychométrique par rapport aux associations classiques
L’emploi du coefficient de Pearson standard appliqué à des variables binaires codées 0 et 1 (couramment désigné sous le terme de coefficient phi) engendre des écueils analytiques considérables dans l’étude des propriétés métrologiques des instruments d’évaluation. Le biais le plus critique réside dans le phénomène de sous-estimation systématique de l’intensité de l’association. En effet, dès lors que deux items dichotomiques présentent des niveaux de difficulté ou des taux d’endossement asymétriques, le coefficient phi est mathématiquement incapable d’atteindre ses bornes théoriques de +1 ou -1. Cette limitation arithmétique contraint artificiellement la valeur de la corrélation à un intervalle restreint, pénalisant lourdement la mise en évidence des liens substantiels unissant les items d’un même domaine de compétence ou de personnalité.
La corrélation tétrachorique résout avec élégance cette distorsion structurelle en s’affranchissant de l’influence parasite exercée par les disparités des taux d’endossement marginaux. Tandis que le coefficient phi varie de manière erratique en fonction de la prévalence des réponses positives au sein de l’échantillon, la corrélation tétrachorique parvient à extraire une estimation invariante de la corrélation latente. Deux items psychométriques mesurant exactement le même construit latent avec une fidélité parfaite produiront une corrélation tétrachorique égale à +1.00, et ce même si le premier item est très facile (endossé par 90 % des participants) et le second item particulièrement ardu (endossé par seulement 10 % de la cohorte). Cette indépendance vis-à-vis des seuils d’endossement constitue l’un des piliers de l’invariance métrologique recherchée par la psychométrie moderne.
Cette propriété correctrice joue un rôle déterminant dans l’exécution des analyses factorielles exploratoires et confirmatoires appliquées aux échelles de personnalité et aux tests d’aptitude. Si l’on extrait les facteurs communs d’une matrice de corrélations de Pearson calculée sur des items binaires, les algorithmes de décomposition en valeurs propres identifient inévitablement de pseudo-facteurs méthodologiques regroupant artificiellement les items partageant des taux de prévalence similaires, indépendamment de leur contenu sémantique. L’analyse factorielle fondée sur des matrices de corrélations tétrachoriques neutralise ces artefacts de difficulté, permettant ainsi l’émergence d’une structure dimensionnelle authentique, stable et directement alignée sur les postulats théoriques des chercheurs.
2. Fondements théoriques et le concept de distribution sous-jacente
2.1 Le postulat de normalité bivariée continue
L’édifice mathématique de la corrélation tétrachorique repose fondamentalement sur l’acceptation d’un modèle probabiliste paramétrique : le postulat de normalité bivariée. Selon cette hypothèse formelle, si l’on pouvait mesurer directement les deux traits latents inobservables, conventionnellement désignés par les variables aléatoires continues X* et Y*, on observerait qu’ils suivent conjointement une loi normale à deux dimensions. Par convention et à des fins d’identifiabilité métrique, ces deux distributions latentes sont standardisées de sorte que leur espérance mathématique respective soit nulle et que leur variance unitaire soit égale à 1. La structure de leur dépendance linéaire est ainsi intégralement capturée par un unique paramètre libre : le coefficient de corrélation latent ρ.
La fonction de densité de probabilité conjointe normale standardisée pour les deux variables aléatoires continues s’exprime rigoureusement sous la forme analytique suivante :
f(x*, y*; ρ) = [1 / (2 π √(1 – ρ2))] × exp[- (x*2 – 2 ρ x* y* + y*2) / (2 (1 – ρ2))]
Dans cette formulation, le paramètre ρ correspond précisément à la corrélation tétrachorique que l’analyste cherche à estimer à partir des seules données discrètes disponibles. La matrice de variance-covariance régissant cette distribution conjointe comporte des valeurs diagonales égales à 1 et des termes extradiagonaux rigoureusement égaux à ρ. L’intégralité de la modélisation suppose donc que le couplage entre les deux traits ne comporte aucune non-linéarité fondamentale et que l’hétéroscédasticité est rigoureusement absente sur l’ensemble de l’espace latent.
Les conséquences théoriques d’une violation flagrante de cette hypothèse de normalité bivariée sont loin d’être anodines. Si les véritables distributions sous-jacentes présentent une forte asymétrie (skewness), un aplatissement excessif (kurtosis prononcé) ou, pire encore, une structure multimodale reflétant l’agrégation de sous-populations hétérogènes, l’estimateur tétrachorique perd ses propriétés de convergence asymptotique sans biais. Il en résulte des estimations qui peuvent s’avérer substantiellement surévaluées ou sous-évaluées, faussant les conclusions substantielles tirées lors de l’intégration de ce coefficient dans des modèles statistiques plus complexes.
2.2 La notion de seuil de coupure ou cut-off latent
La transformation d’un espace bidimensionnel continu en une matrice de contingence binaire s’opère par l’intermédiaire de seuils de coupure latents, fréquemment désignés par les lettres grecques τx (tau pour la variable X) et τy (tau pour la variable Y), ou alternativement par les seuils critiques h et k. Chaque individu appartenant à la population évaluée possède une valeur précise sur les continuums latents X* et Y*. Cependant, le comportement manifeste de l’individu n’adopte une forme positive (endossement de l’item, réponse « oui » ou code 1) que si et seulement si sa position sur le continuum latent dépasse le seuil critique assigné à cet item spécifique.
Formellement, les règles de passage de l’espace inobservable aux variables manifestes X et Y sont régies par des fonctions indicatrices déterministes :
X = 1 si X* > τx, et X = 0 si X* ≤ τx
Y = 1 si Y* > τy, et Y = 0 si Y* ≤ τy
Cette formulation met en lumière le fait que la prévalence observée d’un événement catégoriel est entièrement dictée par l’emplacement du seuil sur la courbe normale standardisée univariée. Si un seuil est situé très loin dans la queue droite de la distribution (par exemple τx = +1.96), une infime minorité de sujets franchira cette barrière, conduisant à une proportion marginale d’observations positives de seulement 2.5 %. Réciproquement, un seuil localisé dans les valeurs négatives profondes correspondra à un item massivement endossé.
L’estimation des coordonnées scalaires de ces seuils latents s’effectue directement à partir des probabilités marginales univariées par l’application de la fonction quantile de la loi normale centrée réduite, communément appelée fonction probit. Ainsi, si p1. représente la proportion d’individus présentant la modalité X = 0, le seuil s’obtient instantanément par l’inversion de la fonction de répartition cumulative : τx = Φ-1(p1.). Ce mécanisme assure une correspondance directe entre les fréquences marginales observées de la table de contingence et les limites d’intégration géométrique de la densité bivariée.
2.3 Interprétation géométrique dans l’espace bivarié
Sur le plan géométrique, le modèle tétrachorique offre une représentation visuelle d’une remarquable élégance au sein de l’espace euclidien bidimensionnel défini par les axes orthogonaux des traits latents X* et Y*. La fonction de densité conjointe se matérialise sous la forme d’un volume en cloche, dont la projection horizontale des lignes d’équidensité trace une famille d’ellipses concentriques centrées sur l’origine du repère cartésien. L’orientation et l’excentricité de ces ellipses sont rigoureusement conditionnées par l’amplitude du coefficient de corrélation ρ : plus la corrélation approche les bornes extrêmes, plus l’ellipse s’étire le long de la diagonale principale ou secondaire, se muant progressivement en un segment rectiligne.
L’introduction des deux seuils critiques latents, τx et τy, se traduit géométriquement par le tracé de deux droites perpendiculaires infinies, l’une verticale d’équation X* = τx et l’autre horizontale d’équation Y* = τy. Ces deux axes de démarcation partitionnent l’intégralité du plan continu en exactement quatre quadrants mutuellement disjoints. Chaque quadrant de l’espace géométrique correspond de façon univoque à l’une des quatre cellules d’une table de contingence 2×2 regroupant les fréquences observées des paires de réponses catégorielles : (0,0), (0,1), (1,0) et (1,1).
La probabilité théorique assignée à chaque cellule de la table de contingence équivaut très précisément au volume sous la surface de la cloche normale bivariée délimité par les frontières du quadrant correspondant. Dès lors, le calcul de la corrélation tétrachorique consiste géométriquement à trouver la valeur unique de l’angle d’inclinaison de l’ellipsoïde (directement déterminé par ρ) qui permet aux quatre volumes sous la surface d’épouser avec une exactitude optimale les quatre fréquences relatives empiriques issues de l’échantillon d’observation. Cette adéquation volumétrique constitue le cœur intuitif de l’inférence tétrachorique.
3. Origine historique : Les travaux fondateurs de Karl Pearson
3.1 L’article séminal de Karl Pearson en 1900
La genèse formelle de la corrélation tétrachorique remonte à l’aube du vingtième siècle, marquée par la publication en 1900 d’un article monumental rédigé par le polymathe britannique Karl Pearson au sein des prestigieuses Philosophical Transactions of the Royal Society of London. Intitulé « Mathematical Contributions to the Theory of Evolution. VII. On the Correlation of Characters not Quantitatively Measurable », ce mémoire fondateur visait à étendre la portée des méthodes biométriques à l’analyse de traits biologiques qualitatifs pour lesquels aucune graduation numérique directe n’était concevable à l’époque.
Pearson était animé par un objectif empirique précis lié aux théories de l’hérédité mendélienne et galtonienne : il cherchait à démontrer la transmission génétique quantitative de caractéristiques somatiques et comportementales telles que la couleur des yeux chez l’humain, la robe des chevaux de course ou la sévérité d’infections épidémiques face à l’efficacité vaccinale. Confronté à des tableaux croisés dénombrant des catégories discrètes comme « clair » versus « foncé », Pearson rejeta l’idée que ces traits représentaient des catégories ontologiques distinctes et soutint avec force qu’ils dérivaient d’une charge physiologique continue distribuée selon les lois normales régissant les systèmes vivants.
Pour extraire la corrélation continue sous-jacente à ces tableaux rudimentaires, Pearson élabora un appareil mathématique d’une virtuosité technique impressionnante. Ne disposant d’aucune méthode d’intégration numérique informatisée, il développa une décomposition de l’intégrale double de la loi normale bivariée sous la forme d’un développement en séries infinies faisant intervenir des fonctions polynomiales spécifiques. Ces équations sommatoires, rapidement baptisées séries tétrachoriques, permirent pour la première fois dans l’histoire de la statistique d’estimer un coefficient d’affinité continue à partir d’une simple grille de dénombrement croisant deux dichotomies.
3.2 Débats historiques et controverses méthodologiques
La proposition théorique de Pearson ne fit pas l’unanimité au sein de la communauté scientifique victorienne et déclencha l’une des querelles académiques les plus célèbres et les plus vives de l’histoire des statistiques : l’affrontement intellectuel durable opposant Karl Pearson à son ancien étudiant et collègue, George Udny Yule. Alors que Pearson soutenait une posture épistémologique résolument réaliste, postulant que la continuité normale était la règle fondamentale de la nature vivante et que les dichotomies n’étaient que des artefacts de notation humaine, Yule adopta une perspective strictement nominaliste et empiriste.
Yule critiqua vigoureusement la dépendance de la corrélation tétrachorique à l’égard de l’hypothèse invérifiable de normalité bivariée. En alternative, il développa en 1900 son propre indicateur d’association non paramétrique pour tables 2×2, le célèbre coefficient Q de Yule, dérivé directement du rapport des cotes (odds ratio). Pour Yule, les statisticiens devaient analyser les données qualitatives telles qu’elles se présentaient concrètement dans l’expérience, sans imposer arbitrairement des représentations géométriques néo-galtoniennes sur des dimensions invisibles. Pearson répliqua par des diatribes cinglantes, publiant des réquisitoires méthodologiques d’une grande sévérité dans sa revue Biometrika, allant jusqu’à qualifier les propositions de Yule de constructions mathématiquement aberrantes et dénuées de pertinence biologique.
Cette controverse fondamentale dépassait la simple querelle de préséance académique : elle inaugurait la scission conceptuelle entre l’analyse des variables catégorielles conçues comme des manifestations de traits continus latents (tradition psychométrique qui allait engendrer la corrélation tétrachorique, l’analyse factorielle et la théorie de la réponse à l’item) et l’analyse purement catégorielle des distributions de fréquences discrètes (tradition statistique biomédicale qui allait privilégier les modèles log-linéaires, le khi-carré de contingence et les risques relatifs). L’approche de Pearson s’est toutefois imposée comme le socle indispensable des modélisations dimensionnelles en psychologie différentielle.
3.3 Évolution du calcul avant l’ère informatique
En dépit de son attrait conceptuel indiscutable, la corrélation tétrachorique est demeurée pendant plus de six décennies un outil statistique notoirement redouté des praticiens en raison de sa gigantesque complexité computationnelle manuelle. Le calcul formel de l’intégrale normale bivariée nécessitait l’évaluation laborieuse des premiers termes de séries infinies incorporant les polynômes d’Hermite. La résolution de l’équation polynomiale non linéaire résultante, souvent portée jusqu’au septième ou huitième degré afin d’obtenir une précision décente à la troisième décimale, exigeait des heures d’itérations arithmétiques par approximations successives à la plume.
Conscient que ces contraintes arithmétiques paralysaient la diffusion de sa méthode auprès des biologistes, des médecins et des psychologues de terrain, Karl Pearson mobilisa les calculateurs de son laboratoire londonien pour produire de monumentales tables numériques de référence. Ces tables de fonctions tétrachoriques, publiées périodiquement dans Biometrika et regroupées dans les célèbres Tables for Statisticians and Biometricians à partir de 1914, fournissaient les racines des équations polynomiales pour une vaste gamme de fréquences marginales et conjointes prédéterminées. Les chercheurs devaient procéder par des techniques d’interpolation linéaire fastidieuses pour extraire une valeur approchée correspondant à leurs tables empiriques.
Parallèlement à l’usage de ces tables volumineuses, de nombreux méthodologistes du milieu du vingtième siècle se sont employés à concevoir des abaques graphiques, des nomogrammes manuels et des formules d’approximation algébrique rapide. Des psychométriciens de renom tels que Thurstone, Chesire et Saffir publièrent en 1933 des diagrammes d’alignement géométrique permettant de lire directement une valeur estimée de la corrélation tétrachorique sans poser une seule division complexe. Cette quête d’approximations pragmatiques n’a trouvé son terme définitif qu’avec l’avènement des premiers ordinateurs personnels et le déploiement d’algorithmes d’intégration numérique de Gauss-Legendre dans les années 1970 et 1980.
4. Différences essentielles avec les autres coefficients de corrélation
4.1 Corrélation tétrachorique versus coefficient de Pearson standard
La distinction opérée entre le coefficient de corrélation produit-moment de Pearson standard (noté r) et la corrélation tétrachorique (rtet) constitue l’un des thèmes pédagogiques les plus essentiels de la statistique multivariée. Le coefficient de Pearson classique est conçu exclusivement pour quantifier la force d’une liaison linéaire entre deux variables métriques continues dont les distributions respectives vérifient idéalement les propriétés de normalité. Lorsqu’un analyste applique par automatisme cette formule matricielle standard à des données binaires en codant arbitrairement les modalités sous forme de valeurs scalaires 0 et 1, il provoque une altération structurelle majeure de la relation mesurée.
Cette dégradation, connue sous l’appellation d’effet d’atténuation drastique, découle de la perte irréversible de variance consécutive au découpage brutal de distributions continues en deux classes numériques grossières. En comprimant l’hétérogénéité des scores individuels dans des réceptacles binaires, le chercheur supprime la sensibilité métrique fine des observations. En conséquence directe, le coefficient de Pearson standard calcule la covariance de deux variables d’échelonnage tronqué, aboutissant à une sous-estimation systématique et sévère de l’ampleur véritable du lien qui réunit les entités sous-jacentes.
À l’inverse, le modèle tétrachorique opère une véritable restauration de la métrique latente d’origine. En projetant les proportions empiriques de la table de contingence sur l’espace infini de la loi normale bivariée standardisée, il compense rigoureusement l’artefact mécanique de compression induit par la dichotomisation. Tandis que le coefficient de Pearson mesure une liaison géométrique entre deux points discrets sur un plan euclidien tronqué, la corrélation tétrachorique rétablit l’angle d’orientation véritable de l’ellipsoïde des densités latentes, conférant ainsi aux résultats une fidélité dimensionnelle hautement supérieure.
4.2 Corrélation tétrachorique versus coefficient Phi
Le coefficient Phi (φ) représente l’équivalent algébrique exact du coefficient produit-moment de Pearson lorsque ce dernier est calculé de manière brute sur deux variables dichotomiques. Il s’obtient couramment à partir de la statistique du test d’indépendance du khi-carré au moyen de la formule classique φ = √(χ2 / N), assortie d’un signe positif ou négatif reflétant l’orientation des effectifs diagonaux. Bien que très fréquemment utilisé en raison de son accessibilité calculatoire immédiate, le coefficient Phi souffre d’une vulnérabilité théorique rédhibitoire : sa dépendance absolue et pernicieuse à l’égard de la configuration des proportions marginales de la table 2×2.
Sur le plan mathématique, les limites extrêmes théoriques du coefficient Phi ne peuvent s’étendre jusqu’à -1.00 et +1.00 que dans l’unique configuration où les deux variables binaires présentent des probabilités marginales rigoureusement identiques (c’est-à-dire p1. = p.1). Dès lors que les deux items manifestent des taux de prévalence divergents — par exemple si le premier item recueille 80 % d’adhésions positives tandis que le second n’en recueille que 20 % —, la borne supérieure théorique que peut atteindre le coefficient Phi s’effondre drastiquement, plafonnant souvent à des valeurs maximales n’excédant pas 0.25 ou 0.30, et ce en dépit d’une concordance déterministe parfaite entre les sujets cibles.
Cette incapacité structurelle à saturer l’intervalle canonique [-1 ; +1] disqualifie formellement le coefficient Phi dès lors que l’on cherche à comparer la magnitude relative d’associations issues d’items aux caractéristiques marginales dissemblables. La corrélation tétrachorique neutralise intégralement ce biais : en intégrant explicitement les seuils de coupure différentiels déduits des marges, elle restitue un coefficient capable d’atteindre rigoureusement les valeurs de +1 ou -1 quelle que soit l’asymétrie marginale initiale des items, garantissant ainsi une comparabilité transversale irréprochable au sein des instruments psychométriques.
4.3 Corrélation tétrachorique versus corrélation polychorique
La relation qui unit la corrélation tétrachorique à la corrélation polychorique s’apparente rigoureusement à la relation d’inclusion unissant un cas particulier à sa généralisation formelle la plus globale. Si la corrélation tétrachorique a été historiquement conçue pour résoudre l’analyse des tables de contingence binaires d’ordre strict 2×2, la modélisation statistique moderne a rapidement ressenti le besoin d’étendre ce paradigme aux tables de dimensions supérieures r × c, représentatives de variables catégorielles ordinales comportant trois modalités ou davantage.
Cette situation se rencontre universellement dans l’évaluation contemporaine à travers l’usage quasi omniprésent des échelles de Likert ordonnées, articulées autour de gradations subjectives telles que : « Pas du tout d’accord », « Modérément d’accord », « Fortement d’accord » ou « Totalement d’accord ». Dans ce cadre élargi, chaque continuum latent univarié standardisé n’est plus découpé par un seuil de coupure unique, mais par un vecteur ordonné de seuils multiples (τ1, τ2, …, τk-1) pour une variable présentant k catégories ordonnées d’observation. La corrélation polychorique estime le paramètre de dépendance normale conjointe qui génère ces probabilités multinomiales sous-jacentes au sein du réseau de grilles délimité par ces seuils vectoriels.
D’un point de vue structural, les fondements mathématiques, les hypothèses de normalité bivariée continue, les fonctions d’estimation par le maximum de vraisemblance et le comportement asymptotique des estimateurs sont strictement identiques entre les deux coefficients. Dès lors que l’on restreint le modèle polychorique à deux items comportant chacun exactement deux catégories de réponse (un seuil unique par variable), les équations intégrales de la corrélation polychorique se simplifient instantanément pour devenir formellement indifférenciables de l’expression tétrachorique originale de Karl Pearson.
5. Formulation mathématique et méthodes d’estimation
5.1 Structure de la table de contingence 2×2
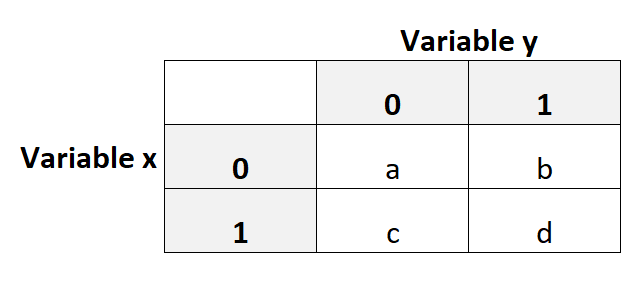
L’amorce de toute formalisation tétrachorique impose la mise en forme des observations empiriques au sein d’une table de contingence standardisée d’ordre 2×2 croisant les réalisations de deux variables dichotomiques manifestes, désignées par convention sous les étiquettes X et Y, prenant chacune exclusivement les modalités binaires 0 ou 1. La matrice résultante se structure traditionnellement autour de quatre cellules internes dénombrant les fréquences absolues observées au sein d’un échantillon représentatif de taille totale N :
- Cellule a (ou n11) : Effectif d’individus présentant conjointement X = 0 et Y = 0.
- Cellule b (ou n12) : Effectif d’individus présentant conjointement X = 0 et Y = 1.
- Cellule c (ou n21) : Effectif d’individus présentant conjointement X = 1 et Y = 0.
- Cellule d (ou n22) : Effectif d’individus présentant conjointement X = 1 et Y = 1.
La somme globale de ces fréquences cellulaires vérifie l’égalité de conservation a + b + c + d = N. En divisant chacune de ces valeurs brutes par l’effectif total N, on obtient la matrice des probabilités conjointes empiriques correspondantes, notées p00 = a/N, p01 = b/N, p10 = c/N, et p11 = d/N. Les distributions marginales univariées se déduisent trivialement par l’agrégation des lignes et des colonnes : la probabilité marginale d’obtenir la valeur 0 sur la variable X est donnée par px0 = (a + b) / N, tandis que celle d’obtenir la valeur 0 sur la variable Y s’exprime par py0 = (a + c) / N.
À partir de ces proportions marginales empiriques, l’étape analytique inaugurale consiste à déterminer les coordonnées scalaires des seuils de coupure latents h (pour l’axe X*) et k (pour l’axe Y*). En vertu du postulat de normalité standardisée univariée, ces valeurs correspondent aux scores z théoriques qui découpent la fonction de distribution cumulative de Gauss conformément aux proportions cumulées observées :
h = Φ-1(px0) = Φ-1((a + b) / N)
k = Φ-1(py0) = Φ-1((a + c) / N)
Où Φ-1 désigne formellement la fonction quantile (ou probit inverse) de la loi normale centrée réduite standard. Ces deux grandeurs numériques constituent les bornes d’intégration fixes au sein desquelles s’opère l’estimation du coefficient de corrélation inconnu.
5.2 Intégrale bivariée normale et séries tétrachoriques
La relation probabiliste unissant les fréquences empiriques observées, les seuils latents estimés h et k, et le coefficient de corrélation tétrachorique recherché ρ se cristallise sous la forme d’une équation intégrale double. En considérant par exemple la probabilité conjointe que les deux variables manifestes adoptent simultanément l’état 1 (cellule d), cette quantité correspond à l’intégrale de la densité normale bivariée standardisée étendue sur le demi-plan supérieur infini délimité par les seuils :
p11 = P(X* > h, Y* > k) = ∫h+∞ ∫k+∞ f(x*, y*; ρ) dx* dy*
Pour résoudre cette intégrale non calculable par des fonctions élémentaires, Karl Pearson a décomposé la fonction de densité conjointe au moyen d’un développement en séries de Taylor au voisinage du point d’indépendance ρ = 0. En exploitant les propriétés remarquables des dérivées successives de la fonction normale univariée, cette décomposition s’exprime au moyen des polynômes d’Hermite orthogonaux, notés Hn(x) :
p11 = Φ(-h) Φ(-k) + φ(h) φ(k) ∑n=1∞ [ ρn / n! ] Hn-1(h) Hn-1(k)
Dans cette formulation analytique, φ(z) désigne la fonction de densité de la loi normale standardisée univariée, et Φ(z) sa fonction de répartition cumulative. Les polynômes d’Hermite sont définis séquentiellement par les relations classiques : H0(z) = 1, H1(z) = z, H2(z) = z2 – 1, H3(z) = z3 – 3z, etc. En soustrayant le terme d’indépendance Φ(-h)Φ(-k) des deux côtés de l’équation, on obtient une équation polynomiale en ρ dont les coefficients scalaires dépendent exclusivement des seuils marginaux h et k.
L’estimation historique de la corrélation tétrachorique consistait dès lors à tronquer cette série infinie à un ordre suffisant (souvent entre le quatrième et le huitième degré) et à déterminer numériquement la racine réelle de ce polynôme qui s’insère strictement à l’intérieur de l’intervalle admissible [-1 ; +1]. La convergence de la série tétrachorique est mathématiquement garantie pour toutes les valeurs de |ρ| < 1, bien que sa vitesse de convergence devienne particulièrement lente lorsque la corrélation réelle approche de l’unité ou que les seuils marginaux se situent aux confins extrêmes des queues de distribution.
5.3 Estimation par le maximum de vraisemblance (MLE)
Dans l’arsenal computationnel moderne, le recours aux développements en séries d’Hermite tronquées a été avantageusement remplacé par l’estimation directe par le maximum de vraisemblance (MLE pour Maximum Likelihood Estimation). Cette approche statistique fournit des estimateurs convergents, asymptotiquement normaux et efficaces, tout en autorisant l’obtention immédiate de la matrice de variance-covariance asymptotique indispensable au calcul des erreurs-types.
Étant donné que les observations conjointes d’une table 2×2 suivent une distribution multinomiale quadri-catégorielle régie par la taille globale N et les probabilités théoriques de cellules πij(ρ, h, k), la fonction de log-vraisemblance globale s’énonce formellement ainsi :
ln L(ρ, h, k) = a ln π00(ρ, h, k) + b ln π01(ρ, h, k) + c ln π10(ρ, h, k) + d ln π11(ρ, h, k)
Pour maximiser cette fonction hautement non linéaire par rapport au paramètre de corrélation ρ, deux stratégies numériques distinctes sont couramment déployées par les logiciels psychométriques :
- La méthode conjointe directe (Full Information MLE) : Cette procédure estime simultanément les trois paramètres inconnus — les seuils h et k ainsi que la corrélation ρ — au sein d’un algorithme d’optimisation multidimensionnel, tel que l’algorithme de Newton-Raphson ou l’algorithme de quasi-Newton (BFGS). Bien qu’optimale sur le plan théorique, elle peut s’avérer instable face à des données très asymétriques.
- La méthode en deux étapes (Two-step MLE) : Largement prédominante en pratique en raison de sa robustesse calculatoire, cette méthode scinde le problème en deux phases successives. Dans la première étape, les seuils h et k sont estimés de manière univariée directement à partir des fréquences marginales empiriques via la fonction probit inverse. Dans la seconde étape, ces seuils sont fixés comme des constantes numériques dans la fonction de vraisemblance, et un algorithme d’optimisation unidimensionnel recherche la valeur de ρ qui maximise la log-vraisemblance. L’évaluation de l’intégrale bivariée s’effectue alors à chaque itération au moyen d’algorithmes de quadrature adaptative ultra-rapides, comme la célèbre méthode développée par Genz.
6. L’approximation trigonométrique simplifiée et son calcul manuel
6.1 La formule du cosinus de Pearson
Face à la complexité d’évaluation des séries polynomiales au début du vingtième siècle, Karl Pearson mit au point en 1900 une solution algébrique approchée d’une simplicité stupéfiante, conçue spécifiquement pour permettre aux chercheurs d’obtenir un ordre de grandeur fiable sans exécuter de calculs différentiels éreintants. Cette formule heuristique, passée à la postérité sous le nom de formule d’approximation trigonométrique du cosinus de Pearson, mobilise les fréquences brutes des quatre cellules de la table de contingence :
rtet ≈ cos(π / [1 + √((a × d) / (b × c))])
Le cœur opératoire de cette équation réside dans le produit croisé des cellules (a × d) / (b × c), qui n’est autre que le célèbre rapport des cotes (odds ratio, conventionnellement noté OR). La formule réécrite sous sa forme compacte devient ainsi :
rtet ≈ cos(π / [1 + √OR])
L’argument de la fonction trigonométrique cosinus est ici rigoureusement exprimé en radians. L’élégance de cette formulation repose sur des propriétés asymptotiques remarquables aux limites de l’espace statistique. Lorsque l’association empirique est parfaitement nulle, les produits croisés de la diagonale principale et de la diagonale secondaire sont égaux, conduisant à un rapport des cotes unitaire (OR = 1). L’expression sous la fonction cosinus se simplifie alors en π / (1 + 1) = π / 2 radians (soit 90 degrés sexagésimaux). Or, le cosinus de π / 2 vaut rigoureusement zéro, restituant ainsi l’absence attendue de corrélation.
À l’inverse, si l’association positive devient déterministe, les cellules b ou c tendent vers zéro, propulsant le rapport des cotes vers l’infini positif. La racine carrée de l’odds ratio tendant vers l’infini, la fraction globale π / (1 + √OR) s’évanouit vers zéro radian. Le cosinus de zéro radian étant exactement égal à +1.00, la formule reproduit fidèlement la saturation positive. Réciproquement, face à une dissociation absolue où a ou d s’annulent, le rapport des cotes tend vers zéro, réduisant l’argument à π / 1 = π radians, dont le cosinus est exactement -1.00.
6.2 Exemple de calcul pas à pas sur un cas concret
Afin d’illustrer la mise en pratique immédiate de cette approximation trigonométrique manuelle, considérons une situation empirique concrète issue de l’évaluation psychométrique. Un chercheur en psychologie cognitive administre deux items dichotomiques conçus pour évaluer le raisonnement logique abstrait auprès d’une cohorte de 200 étudiants universitaires. Les réponses obtenues sont consignées dans la matrice de contingence 2×2 suivante :
- Cellule a (Échec aux deux items : Item 1 = 0, Item 2 = 0) : 65 participants.
- Cellule b (Échec à l’Item 1, Réussite à l’Item 2 : Item 1 = 0, Item 2 = 1) : 25 participants.
- Cellule c (Réussite à l’Item 1, Échec à l’Item 2 : Item 1 = 1, Item 2 = 0) : 20 participants.
- Cellule d (Réussite aux deux items : Item 1 = 1, Item 2 = 1) : 90 participants.
La somme globale des observations confirme bien l’effectif total : N = 65 + 25 + 20 + 90 = 200 sujets. L’analyste procède en suivant méthodiquement les étapes arithmétiques séquentielles :
Étape 1 : Calcul des produits croisés et du rapport des cotes (Odds Ratio)
On effectue d’abord le produit des fréquences situées sur la diagonale concordante : a × d = 65 × 90 = 5850.
On calcule ensuite le produit des fréquences de la diagonale discordante : b × c = 25 × 20 = 500.
On en déduit l’odds ratio empirique en établissant le quotient : OR = 5850 / 500 = 11.70.
Étape 2 : Extraction de la racine carrée du rapport des cotes
On extrait la racine carrée de cette grandeur : √OR = √11.70 ≈ 3.4205.
Étape 3 : Calcul de l’argument trigonométrique en radians
On injecte cette racine dans le dénominateur de l’expression d’angle : 1 + √OR = 1 + 3.4205 = 4.4205.
En divisant la constante π (approximée à 3.14159265) par ce dénominateur, on obtient l’angle cible : θ = 3.14159265 / 4.4205 ≈ 0.71068 radians (ce qui équivaut à environ 40.72 degrés sexagésimaux).
Étape 4 : Évaluation de la fonction cosinus
En calculant le cosinus de cet angle exprimé en radians, on extrait la valeur finale du coefficient tétrachorique approché :
rtet ≈ cos(0.71068) ≈ +0.7577.
L’analyste conclut ainsi à l’existence d’une corrélation positive très substantielle (rtet ≈ 0.76) unissant les deux dimensions logiques latentes, signalant que la réussite à ces deux épreuves mobilise très largement le même noyau d’aptitude cognitive sous-jacente.
6.3 Précision, biais et limites de l’approximation
Bien que la formule du cosinus de Pearson séduise immédiatement par son ergonomie opérationnelle, il est fondamental d’en apprécier avec lucidité les limites mathématiques intrinsèques. Cette approximation a été dérivée sous l’hypothèse simplificatrice où les deux seuils de coupure marginaux se situent rigoureusement à l’origine des axes (h = 0 et k = 0), ce qui implique géométriquement que les deux items présentent une prévalence d’endossement symétrique de 50 % (px0 = 0.50 et py0 = 0.50). Dans cette situation spécifique d’équilibre marginal parfait, la formule du cosinus présente une exactitude remarquable, l’écart avec l’estimateur formel du maximum de vraisemblance ne dépassant généralement pas 0.01 à 0.02 point de corrélation.
En revanche, dès lors que les distributions marginales s’écartent notablement de la symétrie médiane, l’approximation trigonométrique commence à manifester un biais d’estimation croissant. Si l’un des items est très rare (par exemple 10 % d’adhésions) tandis que l’autre est très fréquent (par exemple 85 % d’adhésions), la déformation de l’ellipsoïde latent induit une discordance géométrique que la formule du cosinus ne parvient pas à modéliser, car elle ne prend en compte que l’odds ratio sans ajuster pour l’écart des seuils |h – k|. Dans de telles configurations marginales asymétriques, l’approximation a tendance à surestimer l’intensité réelle de l’association tétrachorique.
Par conséquent, dans la recherche contemporaine, la formule trigonométrique du cosinus de Pearson doit être cantonnée à un usage essentiellement pédagogique, didactique, ou à des calculs préliminaires d’inspection rapide lors de travaux exploratoires sur le terrain. Dès lors qu’une publication scientifique évaluée par des pairs est envisagée ou qu’une modélisation factorielle formelle doit être exécutée, il est impératif d’abandonner l’approximation algébrique au profit exclusif des algorithmes d’estimation par maximum de vraisemblance implantés dans les logiciels statistiques modernes.
7. Les postulats et conditions d’application indispensables
7.1 Le postulat de continuité et de normalité sous-jacente
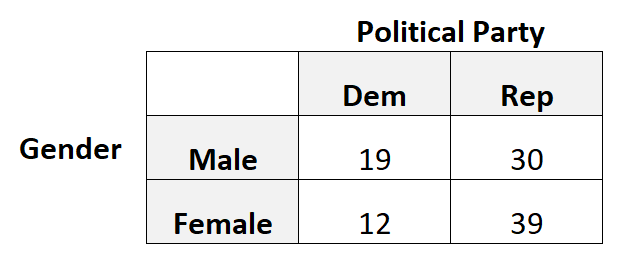
L’implémentation valide de la corrélation tétrachorique repose au premier chef sur la pertinence épistémologique et théorique du construit investigué. Le chercheur doit pouvoir justifier de manière convaincante qu’en deçà de la partition catégorielle observée réside une réalité intrinsèquement continue. Appliquer un modèle tétrachorique à des entités qui constituent des catégories nominales pures et indivisibles — telles que le pays d’origine géographique, le groupe sanguin ABO ou l’appartenance à un parti politique — constitue un contresens méthodologique flagrant, car ces variables ne procèdent d’aucun continuum sous-jacent identifiable.
Au-delà de la continuité scalaire, l’exigence d’une distribution normale bivariée constitue le talon d’Achille de la technique. Cette exigence postule non seulement que chaque trait latent pris isolément présente une densité unimodale symétrique en cloche de Gauss, mais également que leur distribution conjointe respecte rigoureusement l’homos遊びdasticité et l’absence de toute relation curviligne. Dans de nombreuses applications cliniques, ce postulat peut être sérieusement contesté. Par exemple, la symptomatologie de troubles psychiatriques majeurs très rares peut présenter des distributions latentes fortement asymétriques le long desquelles la vaste majorité de la population générale s’agglutine au point zéro absolu, violant frontalement la morphologie gaussienne.
Lorsque la loi normale bivariée sous-jacente est substantiellement déviée par une asymétrie marquée ou une kurtose excessive, les estimateurs tétrachoriques subissent un biais systématique d’estimation. Dans de telles circonstances de violation avérée du modèle générateur de données, l’analyste risque d’extraire des corrélations artificiellement gonflées ou dégradées, ce qui compromet gravement la validité des inferences structurelles qui en découlent ultérieurement.
7.2 Sensibilité aux cellules vides et aux faibles effectifs
À l’instar de la majorité des statistiques reposant sur les produits croisés de matrices d’effectifs, la corrélation tétrachorique manifeste une extrême vulnérabilité face au phénomène des cellules à effectif nul, couramment désignées sous le nom de cellules vides ou zéros d’échantillonnage. Si, au sein d’un échantillon donné, aucune observation ne vient remplir l’une des quatre cellules d’une table 2×2 (par exemple si la fréquence de la cellule b ou c est égale à 0), l’expression du rapport des cotes (a × d) / (b × c) subit une division formelle par zéro, devenant ainsi mathématiquement indéterminée ou infinie.
Dans une telle configuration, l’algorithme d’optimisation par maximum de vraisemblance diverge inévitablement et échoue à converger vers une solution intérieure stable, assignant le plus souvent une estimation dégénérée égale à la borne supérieure absolue de +1.00 ou à la borne inférieure de -1.00, assortie d’une erreur-type qui explose vers l’infini. Cette situation survient très couramment dans les recherches reposant sur de petits échantillons d’observation (typiquement N < 100) combinés à des items mesurant des comportements à très faible prévalence marginale (items dits difficiles ou rares).
Pour parer à cette défaillance algorithmique rédhibitoire, les méthodologistes ont développé des procédures correctives de régularisation bayésienne empirique. La solution la plus éprouvée consiste à appliquer la correction de continuité de Haldane-Anscombe, qui prescrit l’adjonction systématique d’une constante scalaire égale à 0.5 (ou parfois 1/2N) à chacune des quatre cellules internes de la table de contingence dès lors qu’un effectif nul est détecté. D’autres algorithmes modernes privilégient l’introduction d’une distribution a priori informative sur le paramètre de corrélation au moyen de l’inférence bayésienne afin de lisser l’estimation et d’empêcher les effondrements numériques aux frontières de l’espace des paramètres.
7.3 Tests de validité du modèle sous-jacent
L’estimation de la corrélation tétrachorique ne doit jamais constituer un processus aveugle : elle doit s’accompagner impérativement d’une vérification formelle de l’adéquation de l’hypothèse de normalité bivariée aux données recueillies. Dans le cas d’une table 2×2 unique considérée isolément, le modèle statistique sature exactement les degrés de liberté disponibles. En effet, une table 2×2 comporte trois proportions indépendantes (la somme des quatre cellules étant contrainte à l’unité), et le modèle tétrachorique estime exactement trois paramètres : le premier seuil h, le second seuil k et la corrélation ρ. Par conséquent, il subsiste exactement zéro degré de liberté statistique (ddl = 3 – 3 = 0), rendant impossible tout test d’adéquation directe sur une seule table binaire.
Toutefois, la situation devient radicalement différente dès lors que l’on manipule une batterie d’items comportant au moins trois variables binaires, ce qui correspond à la situation universelle des inventaires psychométriques. Dans ce cadre multivarié, le modèle sous-jacent postule une distribution normale multidimensionnelle conjointe régissant l’ensemble des items. Il devient alors possible de confronter les fréquences observées dans les tables croisées d’ordre supérieur (tables de contingence d’ordre 2×2×2) aux fréquences théoriques prédites par la matrice des corrélations tétrachoriques estimées par paires.
Cette confrontation s’opère par l’intermédiaire d’un test d’adéquation du khi-carré de Pearson ou d’un test du rapport de vraisemblance (G2). Si la statistique du khi-carré s’avère statistiquement significative à un seuil critique (par exemple p < 0.05), cela signifie que les écarts entre les fréquences observées et les fréquences prédites sous l’hypothèse gaussienne ne peuvent être imputés aux seules fluctuations d’échantillonnage. Un tel résultat invalide formellement le postulat de normalité bivariée continue, contraignant l’analyste à rejeter l’usage des corrélations tétrachoriques au profit d’approches non paramétriques ou de modélisations catégorielles pures exemptes d’assomptions distributionnelles gaussiennes.
8. Applications en psychométrie et évaluation psychologique
8.1 Développement et validation de questionnaires de personnalité
Le champ privilégié d’application de la corrélation tétrachorique demeure incontestablement la construction et la validation psychométrique des inventaires d’auto-évaluation de la personnalité et des échelles cliniques. De nombreux instruments mondialement établis, à l’instar des différentes versions du Minnesota Multiphasic Personality Inventory (MMPI), du California Psychological Inventory (CPI) ou encore de certaines sous-échelles du Questionnaire de Personnalité d’Eysenck (EPQ), s’appuient historiquement sur des protocoles d’administration où le répondant doit obligatoirement se positionner par « Vrai » ou « Faux » face à des centaines d’énoncés comportementaux.
Dans la phase critique de sélection et d’élagage des items destinés à composer l’instrument final, les méthodologistes évaluent systématiquement la corrélation unissant chaque item candidat au score composite global du domaine investigué, ainsi que les corrélations inter-items mutuelles. L’usage erroné du coefficient produit-moment de Pearson standard pénaliserait arbitrairement les items les plus spécifiques ou les items mesurant des caractéristiques extrêmes (qui présentent de fait des taux d’adhésion marginaux asymétriques), en affichant des coefficients d’association trompeusement affaiblis par l’artefact de discrétisation.
En substituant la corrélation tétrachorique aux métriques classiques, les concepteurs de tests restaurent la comparabilité objective de tous les énoncés. Cette démarche améliore considérablement la précision du calcul des indices de fidélité et de cohérence interne des échelles. Notamment, le calcul de l’indice de cohérence composite, tel que le coefficient oméga de McDonald appliqué aux saturations factorielles issues de matrices tétrachoriques, fournit une estimation non biaisée de la fidélité de l’instrument, préservant ainsi la validité de construit de l’échelle contre les distorsions métriques de surface.
8.2 Analyse factorielle d’items dichotomiques
L’une des contributions méthodologiques les plus cruciales de la corrélation tétrachorique réside dans son rôle de matrice d’entrée exclusive lors de la conduite d’analyses factorielles exploratoires (AFE) ou confirmatoires (AFC) sur des indicateurs discrets binaires. Lorsque des chercheurs exécutent une décomposition en composantes principales ou une analyse en facteurs communs directement sur une matrice de corrélations de Pearson calculée sur des items dichotomiques, ils s’exposent inévitablement à un artefact statistique majeur connu dans la littérature psychométrique sous le nom de pseudo-facteurs de difficulté (spurious difficulty factors).
Ce phénomène pervers a été documenté dès les travaux pionniers de Godfrey Thomson et de Louis Guttman : lorsque des items mesurant une seule et même dimension cognitive sous-jacente présentent des niveaux de difficulté très hétérogènes (certains étant résolus par 90 % des sujets, d’autres par seulement 20 %), l’analyse factorielle linéaire standard extrait artificiellement deux ou trois facteurs distincts. Les algorithmes factoriels regroupent les items faciles sur un premier facteur et les items difficiles sur un second facteur, conduisant le chercheur à l’illusion fallacieuse d’une multidimensionnalité conceptuelle là où ne règne en réalité qu’un espace univarié homogène.
L’utilisation de la matrice de corrélation tétrachorique élimine radicalement cet artefact méthodologique délétère. En neutralisant l’influence des taux d’endossement différentiels pour ne restituer que les associations fonctionnelles entre les continuums latents, l’analyse factorielle tétrachorique parvient à recouvrer fidèlement la structure unifactorielle véritable de l’instrument. La stabilité et la reproductibilité des structures factorielles exploratoires à travers des échantillons d’âges ou d’origines distincts s’en trouvent ainsi remarquablement consolidées.
8.3 Psychométrie clinique et diagnostics catégoriels
Dans la recherche épidémiologique en santé mentale et en psychiatrie quantitative, les taxonomies diagnostiques officielles, telles que le Manuel diagnostique et statistique des troubles mentaux (DSM-5) ou la Classification internationale des maladies (CIM-11), adoptent traditionnellement une présentation nosologique catégorielle : un patient est classé comme présentant ou ne présentant pas une pathologie donnée selon qu’il satisfait ou non un certain nombre de critères symptomatiques seuils.
Lorsque les épidémiologistes cherchent à étudier la comorbidité psychiatrique — par exemple la co-occurrence récurrente entre le trouble dépressif majeur et le trouble d’anxiété généralisée —, ils se heurtent aux mêmes écueils d’atténuation s’ils s’appuient sur de simples coefficients d’association binaire. L’adoption de la corrélation tétrachorique permet de modéliser ces entités diagnostiques non pas comme des états morbides discontinus étanches, mais comme les expressions phénotypiques visibles de vulnérabilités psychopathologiques continues (souvent conceptualisées sous le terme de dimensions de détresse internalisée ou externalisée).
En quantifiant la dépendance tétrachorique entre critères diagnostiques binaires, les psychiatres et épidémiologistes découvrent que des symptômes en apparence faiblement associés au niveau des dénombrements cliniques partagent en réalité une étiologie latente massivement corrélée. Cette approche a constitué le tremplin théorique ayant permis le développement récent des classifications dimensionnelles alternatives de la psychopathologie, à l’image du modèle HiTOP (Hierarchical Taxonomy of Psychopathology), qui redéfinit l’ensemble des troubles psychiatriques sur des spectres continus hiérarchisés.
9. Mise en œuvre pratique et calculs informatiques (R, Python, SPSS)
9.1 Implémentation sous le logiciel R
Dans l’environnement de programmation statistique open-source R, la corrélation tétrachorique bénéficie d’une prise en charge d’une exhaustivité exceptionnelle, principalement grâce aux travaux du professeur William Revelle au sein du package incontournable psych. Ce package propose la fonction native tetrachoric(), devenue la référence méthodologique internationale pour l’analyse des matrices binaires multivariées.
La syntaxe fondamentale s’exécute de manière particulièrement intuitive à partir d’un tableau de données binaire data ou directement d’une table de contingence 2×2 :
library(psych)
resultat <- tetrachoric(data)
L’objet résultant contient non seulement la matrice carrée des corrélations tétrachoriques estimées par maximum de vraisemblance, mais également le vecteur des seuils univariés latents (resultat$tau), ainsi que la matrice asymptotique des erreurs-types associée. La fonction tetrachoric() intègre par défaut des mécanismes de lissage automatique (smoothing) permettant de corriger les matrices de corrélation qui violeraient la propriété de semi-définition positive indispensable aux analyses factorielles ultérieures.
En outre, le package gère de façon entièrement automatisée le problème critique des cellules vides au moyen de l’argument correct, qui applique par défaut une correction de continuité adaptative (adjonction d’une valeur fractionnaire prédéterminée, couramment 0.5) pour stabiliser les estimations face à des zéros marginaux. D’autres packages spécialisés, tels que polycor développé par John Fox, offrent des fonctions d’estimation similaires (fonction polychor() configurée pour des variables à deux niveaux), garantissant une rigueur analytique maximale.
9.2 Calcul en langage Python
Au sein de l’écosystème du langage Python, prédominant dans les architectures modernes de science des données et d’apprentissage automatique, le traitement des corrélations tétrachoriques s’effectue traditionnellement par le recours aux bibliothèques scientifiques scipy et statsmodels, ou plus récemment au moyen de bibliothèques spécialisées dans les équations structurelles comme semopy.
La bibliothèque statsmodels met à disposition la classe statsmodels.stats.contingency_tables.Table2x2, qui propose une méthode intégrée permettant d’extraire la corrélation tétrachorique approximée. Pour les chercheurs désireux d’une précision maximale par maximum de vraisemblance, il est d’usage d’exploiter les fonctions de quadrature numérique de scipy.integrate couplées à la fonction de distribution cumulative multivariée scipy.stats.multivariate_normal.
L’optimisation numérique d’une fonction de log-vraisemblance multinomiale s’implémente au moyen de la méthode scipy.optimize.minimize_scalar (ou de l’algorithme BFGS multidimensionnel), recherchant le paramètre ρ dans l’intervalle contraint [-0.9999 ; +0.9999]. Cette flexibilité algorithmique facilite l’intégration harmonieuse des matrices de corrélation tétrachorique au sein de pipelines industriels de machine learning appliqués à des données tabulaires hautement éparses, garantissant une modélisation structurelle rigoureuse des caractéristiques d’entrée discrètes.
9.3 Exécution dans l’écosystème SPSS et Mplus
Dans l’environnement logiciel propriétaire commercial, l’accès à la corrélation tétrachorique s’effectue selon des modalités techniques contrastées. Au sein de la plateforme IBM SPSS Statistics, le coefficient tétrachorique ne figure historiquement pas parmi les options de corrélation de base accessibles par les menus déroulants standards. Les analystes doivent recourir à des extensions syntaxiques spécifiques, notamment l’intégration de macros Python externes ou l’exécution de scripts matriciels programmés via la commande MATRIX.
À l’opposé, le logiciel de référence mondial pour la modélisation par équations structurelles, Mplus, a été explicitement architecturé dès son origine autour de la gestion optimale des variables dépendantes catégorielles et ordinales, sous l’impulsion de Bengt Muthén. Dans la syntaxe Mplus, la simple spécification de la commande CATEGORICAL ARE variable1-variableK; informe instantanément le moteur computationnel qu’il doit traiter l’ensemble des indicateurs manifestes comme des discrétisations d’un continuum latent.
Mplus procède alors automatiquement au calcul de l’intégralité de la matrice des corrélations tétrachoriques par paires, couplée à l’estimation de sa matrice de covariance asymptotique complète. Cette approche évite aux utilisateurs les manipulations syntaxiques laborieuses et garantit une harmonisation théorique absolue entre l’estimation initiale des coefficients et les modélisations confirmatoires complexes qui exploitent cette structure de dépendance.
10. Diagnostic de validité, erreurs types et biais d’échantillonnage
10.1 Calcul de l’erreur type et intervalles de confiance
Une estimation ponctuelle du coefficient de corrélation tétrachorique ne présente aucune valeur scientifique si elle n’est pas assortie de la quantification rigoureuse de son incertitude stochastique, concrétisée par le calcul de son erreur-type asymptotique (notée SE(rtet)) et de son intervalle de confiance associé. L’erreur-type de la corrélation tétrachorique est mathématiquement dérivée de l’inversion de la matrice d’information de Fisher issue de la fonction de vraisemblance multinomiale.
L’expression analytique asymptotique de la variance d’échantillonnage, formulée initialement par Karl Pearson et affinée ultérieurement par Kendall et Stuart, s’énonce sous une forme complexe dépendant des hauteurs de la densité normale aux seuils d’intégration :
Var(rtet) ≈ [1 / (N φ(h)2 φ(k)2)] × Ψ(h, k, ρ)
Où Ψ désigne une fonction quadratique combinant les variances et covariances des proportions de cellules empiriques. Une propriété empirique fondamentale se dégage de cette formulation : l’erreur-type de la corrélation tétrachorique est systématiquement et notablement plus élevée que l’erreur-type d’un coefficient de Pearson standard calculé sur un échantillon continu de même taille. Cette inflation de la variance d’échantillonnage reflète le coût informationnel direct imputable à la dichotomisation : la perte de résolution métrique accroît l’imprécision statistique de l’estimateur.
Face à des échantillons de taille modeste ou à des distributions marginales hautement asymétriques où l’approximation gaussienne asymptotique devient précaire, les statisticiens contemporains privilégient l’usage des techniques de rééchantillonnage non paramétrique (bootstrap). En tirant avec remise des milliers de sous-échantillons empiriques de taille N et en recalculant le coefficient tétrachorique sur chaque réplication, la méthode du bootstrap percentile ou du bootstrap BCa (ajusté pour le biais et l’accélération) fournit des intervalles de confiance d’une robustesse exceptionnelle, totalement affranchis des hypothèses asymptotiques d’échantillons infinis.
10.2 Problème des matrices non définies positives
L’un des défis computationnels les plus redoutables inhérents à l’usage de la corrélation tétrachorique dans les analyses multivariées réside dans la vulnérabilité fréquente des matrices de corrélation résultantes au phénomène de non-définition positive (non-positive definite matrices). Une matrice carrée d’ordre p × p est dite définie positive si toutes ses valeurs propres (eigenvalues) sont strictement supérieures à zéro, une condition mathématique impérative pour que la matrice puisse être inversée lors des procédures factorielles ou de régression linéaire multiple.
Lorsque des chercheurs estiment une matrice de corrélations tétrachoriques pour une batterie de plusieurs variables binaires, les algorithmes procèdent presque universellement par une estimation par paires successives (pairwise estimation) : chaque corrélation bivariée est calculée indépendamment des autres à partir de sa propre table 2×2. En raison des fluctuations d’échantillonnage propres à chaque paire et des légères disparités de seuils latents, la matrice globale composite résultante ne respecte pas nécessairement les contraintes de cohérence géométrique multidimensionnelle de l’espace euclidien. Il en résulte l’apparition de valeurs propres nulles ou négatives, bloquant instantanément l’exécution des analyses factorielles exploratoires ou des modèles SEM.
Pour surmonter cette entrave algébrique sans altérer substantiellement l’information empirique, les méthodologistes recourent à des algorithmes d’ajustement géométrique matriciel désignés sous les termes de lissage de matrice (matrix smoothing) ou de courbure positive (positive definite bending). Des algorithmes renommés, comme celui développé par Higham en 2002, identifient la matrice définie positive la plus proche au sens de la norme de Frobenius, en remplaçant les valeurs propres négatives par des constantes positives infinitésimales et en renormalisant la diagonale principale à l’unité. Ces corrections permettent de poursuivre les analyses multivariées tout en préservant l’intégrité globale de la structure de dépendance observée.
10.3 Impact des erreurs de classification sur l’estimation
L’un des postulats implicites mais absolument critiques de la modélisation tétrachorique stipule que le processus de discrétisation binaire manifeste s’opère avec une fidélité déterministe parfaite, exempte de toute erreur de mesure ou de classification erronée. Dans la réalité empirique de l’auto-évaluation psychologique ou des diagnostics cliniques, cette hypothèse de perfection est constamment battue en brèche par la présence de bruit de mesure, d’inattention, de désirabilité sociale ou d’erreurs d’enregistrement.
La présence d’erreurs de classification se traduit par le fait qu’un individu dont la valeur latente X* se situe en réalité en deçà du seuil critique h peut fortuitement endosser la réponse 1 (faux positif), tandis qu’un individu franchissant le seuil peut cocher par erreur la modalité 0 (faux négatif). Des simulations statistiques poussées démontrent que l’estimateur de la corrélation tétrachorique manifeste une sensibilité et une fragilité considérables face à ce bruit de mesure catégoriel. Même de faibles taux de mauvaise classification aléatoire (de l’ordre de 2 à 5 %) suffisent à induire une dégradation dramatique de la corrélation tétrachorique estimée, qui s’effondre très rapidement vers des valeurs artificiellement biaisées vers zéro.
Dans des configurations asymétriques où les taux d’erreurs de classification sont différentiels selon les modalités de réponse, la corrélation tétrachorique peut même subir des phénomènes paradoxaux d’inflation fallacieuse ou de distorsion directionnelle. Ces constats soulignent avec gravité l’impérieuse nécessité, pour les chercheurs utilisant des indicateurs dichotomiques, d’implémenter des protocoles rigoureux de contrôle de la fidélité des informateurs, d’intégrer des échelles d’inattention et de recourir, lorsque c’est possible, à des modèles intégrant formellement des paramètres d’erreur de classification explicites.
11. Corrélation tétrachorique dans la modélisation avancée (SEM et IRT)
11.1 Intégration dans la modélisation par équations structurelles (SEM)
L’intégration de variables manifestes dichotomiques au sein de la modélisation par équations structurelles (SEM pour Structural Equation Modeling) a constitué l’une des avancées méthodologiques majeures des années 1980 et 1990. L’application directe de l’estimateur classique du maximum de vraisemblance standard fondé sur la covariance linéaire étant formellement proscrite pour des données catégorielles, les statisticiens ont conçu une méthodologie rigoureuse en trois étapes consécutives reposant fondamentalement sur les matrices de corrélation tétrachorique et polychorique.
Cette approche repose sur l’estimateur des moindres carrés pondérés (Weighted Least Squares – WLS), formulé par Browne en 1984, et perfectionné par Bengt Muthén sous la forme de l’estimateur WLSMV (Diagonally Weighted Least Squares with Mean and Variance Adjusted). La démarche analytique se déploie selon la séquence canonique suivante :
- Étape 1 : Estimation des seuils univariés latents par probit inverse sur les marges empiriques univariées.
- Étape 2 : Estimation de la matrice complète des corrélations tétrachoriques par paires conditionnellement aux seuils fixés, accompagnée du calcul de la matrice de poids asymptotique W (qui correspond à la matrice des covariances d’échantillonnage unissant l’ensemble des corrélations tétrachoriques entre elles).
- Étape 3 : Ajustement du modèle structurel ou factoriel théorique sur la matrice de corrélation tétrachorique en minimisant la fonction de divergence quadratique pondérée par la matrice W.
Cette méthodologie d’avant-garde permet l’obtention d’indices d’adéquation globale ajustés d’une grande fiabilité. Les indices classiques, tels que le CFI (Comparative Fit Index), le TLI (Tucker-Lewis Index) et le RMSEA (Root Mean Square Error of Approximation), sont recalculés par le biais d’ajustements sur la moyenne et la variance des distributions de khi-carré sous conditions catégorielles, conférant ainsi aux chercheurs une puissance de validation théorique comparable à celle prévalant dans l’analyse de données continues idéales.
11.2 Pont conceptuel avec la Théorie de la Réponse à l’Item (IRT)
L’un des accomplissements théoriques les plus saisissants de la statistique unifiée contemporaine réside dans la démonstration de l’équivalence formelle et mathématique absolue unissant l’analyse factorielle tétrachorique et les modèles fondamentaux de la théorie de la réponse à l’item (IRT pour Item Response Theory), formalisée initialement par des pionniers tels que Frederic Lord, Melvin Novick et Gerhard Fischer.
Considérons un modèle factoriel exploratoire ou confirmatoire unidimensionnel ajusté sur une matrice de corrélations tétrachoriques, au sein duquel chaque item dichotomique j est caractérisé par un seuil d’activation latent τj et par une saturation factorielle (factor loading) standardisée λj reliant le trait latent continu θ à la variable latente X*j. Parallèlement, considérons le modèle de l’ogive normale à deux paramètres (2PL Normal Ogive Model) issu de l’IRT, qui définit la probabilité de réussite d’un individu de compétence θ à l’item j au moyen de deux paramètres métriques : un paramètre de pente ou de discrimination αj, et un paramètre de difficulté βj.
Ces deux modélisations ne sont rien d’autre que deux traductions algébriques alternatives de la même réalité mathématique sous-jacente. Le passage d’une métrique à l’autre s’effectue au moyen de relations de conversion déterministes bijectives rigoureuses :
αj = λj / √(1 – λj2)
βj = τj / λj
Réciproquement, la saturation factorielle standardisée se déduit instantanément du paramètre de discrimination de l’IRT par l’équation : λj = αj / √(1 + αj2). Ce pont conceptuel fondamental prouve que l’analyse factorielle de corrélations tétrachoriques et la théorie de la réponse à l’item ne constituent pas des paradigmes rivaux, mais bien une seule et même théorie de la mesure latente exprimée dans des vocabulaires statistiques complémentaires.
11.3 Analyse de réseau psychométrique sur items binaires
Durant la dernière décennie, l’évaluation psychologique et la psychiatrie quantitative ont connu une révolution paradigmatique majeure avec l’émergence de l’analyse de réseaux psychométriques (psychometric network analysis), sous l’impulsion théorique de Denny Borsboom. Ce paradigme récuse l’existence de variables latentes causales communes pour conceptualiser les troubles mentaux comme des systèmes complexes d’éléments interconnectés, au sein desquels les symptômes individuels interagissent directement par des boucles de rétroaction mutuelles.
Lorsque les données de réseau sont constituées de symptômes dichotomiques (par exemple, présence ou absence de crises de panique, d’insomnie, de sentiments de culpabilité), l’estimation de la topologie du réseau requiert la dérivation d’une matrice de dépendances conditionnelles rigoureuse. L’utilisation brute d’associations univariées conduirait à un réseau saturé de connexions indirectes fallacieuses. Les chercheurs procèdent donc par l’inversion de la matrice de corrélation tétrachorique régularisée afin d’extraire la matrice des corrélations partielles tétrachoriques.
Pour élaguer le réseau et éliminer les connexions spurious issues du bruit d’échantillonnage, les algorithmes couplent l’inversion tétrachorique à des procédures de pénalisation statistique, telles que l’algorithme LASSO graphique (couramment désigné sous le terme d’EBICglasso, fondé sur le critère d’information bayésien étendu). Les arêtes subsistantes au sein du graphe final représentent les associations directes invariantes entre symptômes. L’analyse des indices de centralité (tels que la force nodale) calculés sur ces réseaux tétrachoriques permet aux cliniciens d’identifier avec une précision chirurgicale les symptômes pivots ou déclencheurs au sein des syndromes psychopathologiques complexes.
12. Limites méthodologiques et recommandations pratiques pour la recherche
12.1 Principales limites intrinsèques de la méthode
En dépit de sa remarquable élégance mathématique et de sa supériorité avérée sur les corrélations de surface, la corrélation tétrachorique comporte des limites méthodologiques intrinsèques qu’aucun chercheur ne saurait ignorer sous peine de compromettre la validité de ses déductions. Le risque méthodologique le plus redoutable réside dans la fragilité structurelle de l’estimateur face aux violations du postulat de normalité bivariée conjointe. Si la réalité latente est asymétrique, bimodale ou régie par des relations fonctionnelles non linéaires, le modèle tétrachorique force arbitrairement les données dans un carcan géométrique inadéquat, produisant des coefficients dont l’amplitude peut être artificiellement gonflée ou dégradée.
La seconde limite majeure tient à la forte instabilité stochastique du coefficient lorsqu’il est sollicité sur des échantillons d’observation restreints (typiquement N < 200). Dans ces contextes de faible puissance, les fréquences cellulaires deviennent extrêmement volatiles, et la présence fortuite d’une seule observation supplémentaire dans une cellule discordante peut provoquer des oscillations massives de la valeur de la corrélation estimée. Cette instabilité s’accompagne d’une variance d’échantillonnage élevée qui pénalise lourdement la réplicabilité empirique des études sous-alimentées en effectifs.
Enfin, le modèle tétrachorique manifeste un comportement mathématiquement erratique lorsque la corrélation sous-jacente approche les zones asymptotiques de saturation extrême (valeurs réelles de |ρ| > 0.90). Dans ces zones de confinement, l’ellipsoïde latent s’aplatit de manière si prononcée que la matrice hessienne de la fonction de log-vraisemblance tend vers la singularité, provoquant des échecs récurrents de convergence au sein des algorithmes itératifs de Newton-Raphson et une inflation démesurée des erreurs-types associées.
12.2 Bonnes pratiques méthodologiques pour les chercheurs
Afin de garantir une exploitation méthodologiquement irréprochable de la corrélation tétrachorique au sein des investigations empiriques, la communauté scientifique recommande le respect scrupuleux d’un ensemble de règles et de précautions opératoires :
- Vérification préalable des distributions marginales : L’analyste doit procéder à une inspection minutieuse des proportions d’endossement marginal de chaque item dichotomique. Dès lors qu’un item manifeste une prévalence marginale excessivement extrême (par exemple inférieure à 5 % ou supérieure à 95 %), son inclusion aux côtés d’autres items dissemblables engendre un risque d’instabilité calculatoire majeure. Si de tels items s’avèrent non essentiels à l’économie conceptuelle de la recherche, il est vivement préconisé de les écarter de la matrice tétrachorique.
- Déclaration systématique des erreurs-types et de l’adéquation : Les publications scientifiques doivent proscrire la divulgation isolée des coefficients de corrélation tétrachorique sans leurs erreurs-types respectives ou leurs intervalles de confiance à 95 %. De surcroît, le test global de conformité de l’hypothèse de normalité bivariée doit être systématiquement rapporté pour attester que le modèle sous-jacent n’est pas réfuté par les données empiriques.
- Privilégier le recueil de données continues ou ordinales : Bien que la corrélation tétrachorique constitue un outil de sauvetage mathématique exceptionnel face à des données binaires imposées par des contingences historiques ou matérielles, elle ne doit jamais justifier une décision méthodologique délibérée d’appauvrissement du recueil. Dès lors que le protocole d’évaluation autorise la collecte de réponses sur des échelles graduées continues ou sur des échelles ordinales de type Likert à plusieurs modalités, les chercheurs doivent résolument privilégier ces formats plus riches en information.
12.3 Directives de publication scientifique et conclusions
La restitution de modélisations reposant sur des corrélations tétrachoriques dans les revues académiques de premier plan doit impérativement se conformer aux standards de rigueur éditoriale prescrits par l’American Psychological Association (APA 7th edition) et par les déclarations méthodologiques internationales (notamment les directives JARS-Quant). Les auteurs sont tenus d’indiquer avec une transparence exhaustive l’ensemble des choix computationnels opérés.
Cette transparence impose de stipuler clairement dans la section Méthode : le logiciel statistique employé et son numéro de version exact ; le package spécifique sollicité (par exemple psych sous R ou Mplus) ; l’algorithme d’estimation numérique sélectionné (Full Information MLE ou Two-step MLE) ; la constante corrective retenue face aux éventuelles cellules vides (correction de continuité de 0.5) ; ainsi que la méthode de régularisation employée si un lissage de matrice a été requis pour restaurer la semi-définition positive.
En synthèse terminale, la corrélation tétrachorique s’affirme, plus d’un siècle après sa conceptualisation formelle par Karl Pearson, comme l’un des monuments les plus durables et les plus féconds de l’histoire de la statistique appliquée aux sciences du comportement. En comblant avec une rigueur mathématique sans compromis le gouffre séparant l’imperfection discrète des observations empiriques de la richesse continue des dimensions psychologiques réelles, elle a permis l’édification de la psychométrie moderne, de l’analyse factorielle robuste et de la modélisation structurelle contemporaine, attestant avec force que la pensée statistique constitue l’instrument suprême de dévoilement de la complexité invisible des phénomènes humains.
Références
- Bock, R. D., & Lieberman, M. (1970). Fitting a response model for n dichotomously scored items. Psychometrika, 35(2), 179–197. https://doi.org/10.1007/BF02291262
- Borsboom, D. (2005). Measuring the mind: Conceptual issues in contemporary psychometrics. Cambridge University Press. https://doi.org/10.1017/CBO9780511490026
- Browne, M. W. (1984). Asymptotically distribution-free methods for the analysis of covariance structures. British Journal of Mathematical and Statistical Psychology, 37(1), 62–83. https://doi.org/10.1111/j.2044-8317.1984.tb00788.x
- Flora, D. B., & Curran, P. J. (2004). An empirical evaluation of alternative methods of estimation for confirmatory factor analysis with ordinal data. Psychological Methods, 9(4), 466–491. https://doi.org/10.1037/1082-989X.9.4.466
- Genz, A. (1992). Numerical computation of multivariate normal probabilities. Journal of Computational and Graphical Statistics, 1(2), 141–149. https://doi.org/10.1080/10618600.1992.10477010
- Higham, N. J. (2002). Computing the nearest correlation matrix—a problem from finance. IMA Journal of Numerical Analysis, 22(3), 329–343. https://doi.org/10.1093/imanum/22.3.329
- Kline, R. B. (2023). Principles and practice of structural equation modeling (5th ed.). Guilford Press.
- Lord, F. M., & Novick, M. R. (1968). Statistical theories of mental test scores. Addison-Wesley.
- Muthén, B. (1984). A general structural equation model with dichotomous, ordered categorical, and continuous latent variable indicators. Psychometrika, 49(1), 115–132. https://doi.org/10.1007/BF02294210
- Nunnally, J. C., & Bernstein, I. H. (1994). Psychometric theory (3rd ed.). McGraw-Hill.
- Pearson, K. (1900). Mathematical contributions to the theory of evolution. VII. On the correlation of characters not quantitatively measurable. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 195, 1–47. https://doi.org/10.1098/rsta.1900.0022
- Revelle, W. (2024). psych: Procedures for Personality and Psychological Research. Northwestern University. R package version 2.4.3. https://CRAN.R-project.org/package=psych
- Yule, G. U. (1900). On the association of attributes in statistics: With illustrations from the material of the Childhood Society, &c. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 194, 257–319. https://doi.org/10.1098/rsta.1900.0019