
Dans l’architecture de la recherche scientifique contemporaine, la statistique constitue le langage universel par lequel l’empirie est traduite en modèles explicatifs et décisionnels. Pourtant, au sein de cet imposant édifice théorique peuplé d’estimateurs, de distributions asymptotiques et d’algorithmes d’apprentissage automatique complexes, repose une unité élémentaire dont l’apparente simplicité masque une profondeur épistémologique capitale : l’observation. Loin d’être un simple nombre consigné dans une cellule de tableur ou un enregistrement passif de la réalité, l’observation incarne le point de contact précis et codifié entre le phénomène naturel ou humain et l’univers du formalisme mathématique. Sans elle, nulle inférence n’est possible, nulle hypothèse ne peut être soumise à l’épreuve des faits, et aucun modèle prédictif ne saurait être calibré.
Comprendre la nature exacte de l’observation statistique requiert de dépasser le sens commun du verbe « observer ». Dans la pratique quotidienne, observer renvoie à une activité perceptive, visuelle ou cognitive, souvent continue et floue. En statistique, l’observation relève d’un acte de sélection, de discrétisation et de quantification rigoureusement défini par un protocole méthodologique. Que l’on s’intéresse aux sciences biomédicales, à l’économétrie, à l’évaluation des politiques publiques ou plus particulièrement à la psychologie et aux sciences comportementales, la définition précise de ce qui constitue une observation conditionne l’ensemble de la chaîne de traitement analytique. Une erreur de conceptualisation à ce niveau fondamental compromet irréversiblement la validité interne et externe des conclusions scientifiques.
Le présent traité propose une exploration exhaustive de la notion d’observation en statistique, depuis ses fondements théoriques jusqu’à ses implications opératoires les plus avancées. À travers l’analyse de sa structure matricielle, de ses propriétés distributionnelles, de ses impératifs d’indépendance, ainsi que des défis inhérents aux données atypiques ou incomplètes, nous mettrons en lumière la manière dont cette brique élémentaire structure le raisonnement quantitatif. Nous aborderons également les aspects éthiques et déontologiques indispensables dès lors que l’observation porte sur l’être humain, avant d’offrir un guide pratique destiné à standardiser sa manipulation dans le cadre d’une démarche de recherche transparente et reproductible.
1. Fondements conceptuels : Définition et nature d’une observation en statistique
1.1 Définition opératoire de l’observation statistique
D’un point de vue opératoire, une observation statistique se définit comme la capture et l’enregistrement formel d’une réalisation spécifique d’un ou de plusieurs caractères mesurables, associés à une entité déterminée à un moment précis du temps. Elle représente l’aboutissement d’un processus de réduction phénoménologique : la réalité empirique, brute, continue et infiniment complexe, se trouve filtrée par un appareil de mesure (qu’il s’agisse d’un capteur électronique, d’un questionnaire standardisé ou d’une grille d’évaluation comportementale) pour être convertie en une entité d’information intelligible, discrète et traitable par les méthodes de la théorie des probabilités.
Le passage de l’événement empirique brut à la donnée statistique constitue une véritable rupture épistémologique. Prenons l’exemple d’un individu manifestant un état d’agitation motrice au sein d’un laboratoire de psychologie cognitive. L’événement empirique englobe une infinité de micro-phénomènes : contractions musculaires, variations de température épidermique, verbalisations spontanées et modifications neurovégétatives. L’observation statistique, quant à elle, n’enregistrera de cette dynamique continue qu’une projection finie, par exemple un score global d’agitation de sept sur une échelle d’évaluation comportementale à dix échelons, ou une fréquence cardiaque instantanée de 94 battements par minute. Dès cet instant, l’observation devient une réalisation quantifiée, un point fixe dans un espace mathématique multidimensionnel.
Il convient dès lors de distinguer formellement la mesure continue de l’enregistrement ponctuel. Alors que le phénomène sous-jacent peut s’écouler sur un continuum spatiotemporel ininterrompu, l’observation statistique opère toujours une discrétisation. Elle capture un état, une intégration temporelle ou un cumul d’événements circonscrit à une fenêtre d’échantillonnage définie. Cette caractéristique confère à l’observation son statut constitutif fondamental : elle est l’atome insécable à partir duquel les ensembles de données, les matrices de covariance et les distributions empiriques sont agrégés pour permettre l’investigation scientifique.
1.2 Distinction entre observation, unité statistique et individu
Dans la littérature méthodologique francophone et internationale, une confusion terminologique récurrente persiste entre les notions d’unité statistique, d’individu et d’observation. L’établissement d’une frontière sémantique stricte entre ces concepts s’avère pourtant indispensable pour prévenir des erreurs analytiques majeures, notamment lors de l’application de modèles linéaires généraux ou hiérarchiques.
L’unité statistique (ou unité d’échantillonnage) représente l’entité physique, biologique ou sociale concrète qui porte les caractéristiques soumises à l’analyse. Il peut s’agir d’un patient, d’un étudiant, d’un animal de laboratoire, mais également d’une entité collective comme une entreprise, une école, une commune, ou encore d’un objet matériel comme un composant mécanique. Le terme d’individu est fréquemment employé comme un synonyme d’unité statistique, en particulier dans la tradition statistique francophone issue des travaux sur l’analyse des données, bien qu’il tende à humaniser abusivement l’objet de la mesure. L’unité statistique est le substrat sur lequel s’exerce l’investigation scientifique.
L’observation, en revanche, désigne l’instanciation empirique d’un ensemble de mesures associées à cette unité à un instant $t$ ou sous une condition expérimentale donnée. La distinction s’éclaire particulièrement lorsque l’on considère les protocoles dans lesquels une même unité statistique génère une multiplicité d’observations distinctes. Si un protocole médical mesure la pression artérielle d’un même patient chaque matin pendant trente jours consécutifs, l’échantillon ne comprend qu’une seule unité statistique humaine, mais le chercheur dispose de trente observations empiriques distinctes. Confondre le nombre d’unités statistiques avec le nombre d’observations conduit inévitablement à violer les postulats d’indépendance et à vicier les tests d’hypothèses, comme nous le verrons dans les sections subséquentes.
1.3 L’observation comme ancrage empirique en recherche psychologique
En sciences psychologiques et psychiatriques, l’observation statistique revêt une complexité particulière du fait de la nature intrinsèquement latente des objets d’étude. Contrairement aux sciences physiques qui mesurent directement des grandeurs observables comme la masse ou la longueur, la psychologie étudie des construits théoriques non directement observables tels que l’anxiété-trait, l’intelligence fluide, la mémoire épisodique ou l’affect positif. L’observation statistique y constitue le résultat d’une opérationnalisation rigoureuse, matérialisée par un instrument psychométrique ou une tâche expérimentale standardisée.
Le recueil de données chez l’être humain fait intervenir une diversité remarquable de vecteurs d’observation. Il peut s’agir de réponses auto-rapportées à des inventaires de personnalité (échelles de cotation ordinale), de performances comportementales chronométrées avec une précision à la milliseconde (temps de réaction lors d’une tâche de Stroop), ou encore de données physiologiques et biomarqueurs (taux de cortisol salivaire, connectivité fonctionnelle en imagerie par résonance magnétique, micro-variations de conductance cutanée). Chaque modalité génère une observation dont la validité repose sur des chaînes causales complexes liant l’état interne du sujet à la trace numérique finale.
Les conditions de validité d’une telle observation face à la subjectivité inhérente du participant imposent des protocoles d’administration strictement standardisés. Une observation en psychologie n’a de sens scientifique que si l’environnement expérimental, les consignes transmises, l’état de vigilance du sujet et les interactions avec l’expérimentateur sont rigoureusement contrôlés. Dès lors que l’observation est extraite de son contexte de standardisation, la variabilité enregistrée ne reflète plus le construit latent visé, mais intègre du bruit d’observation systématique, ruinant la représentativité de la mesure.
2. L’observation au sein de la matrice de données : Structure et formalisme
2.1 La représentation matricielle conventionnelle (lignes et colonnes)
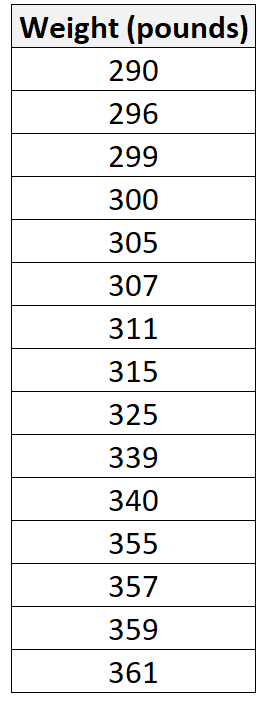
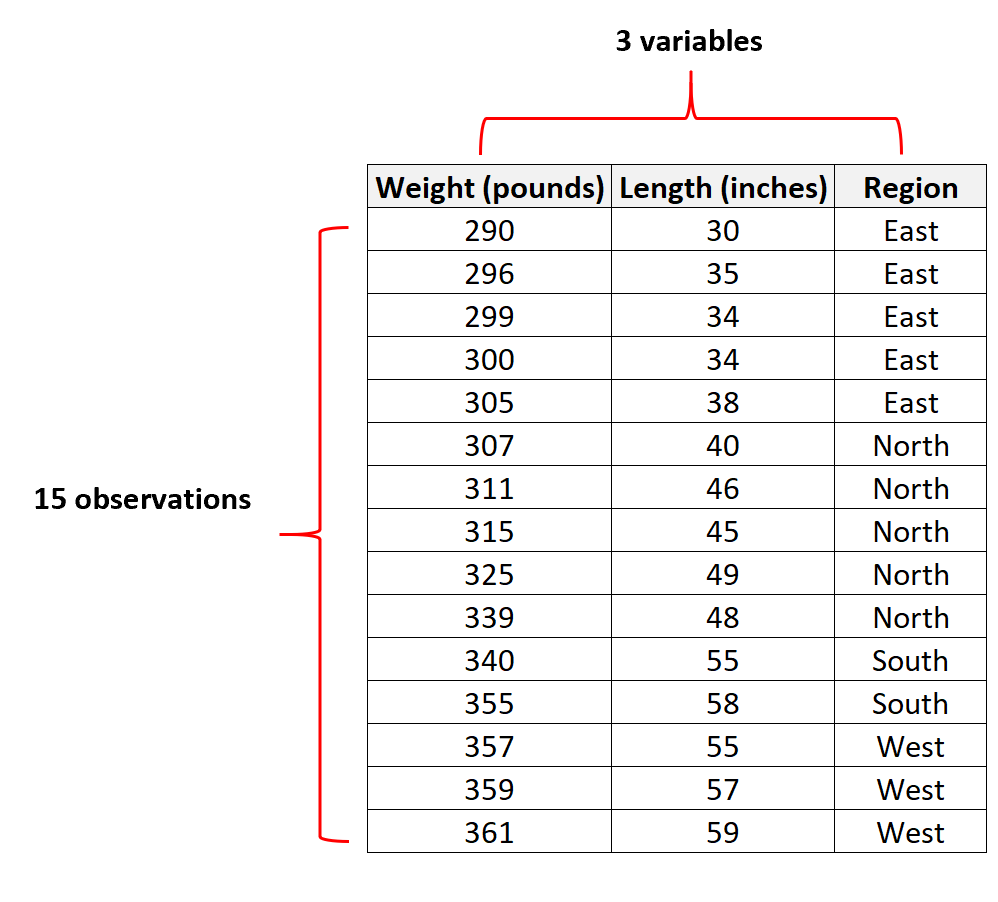
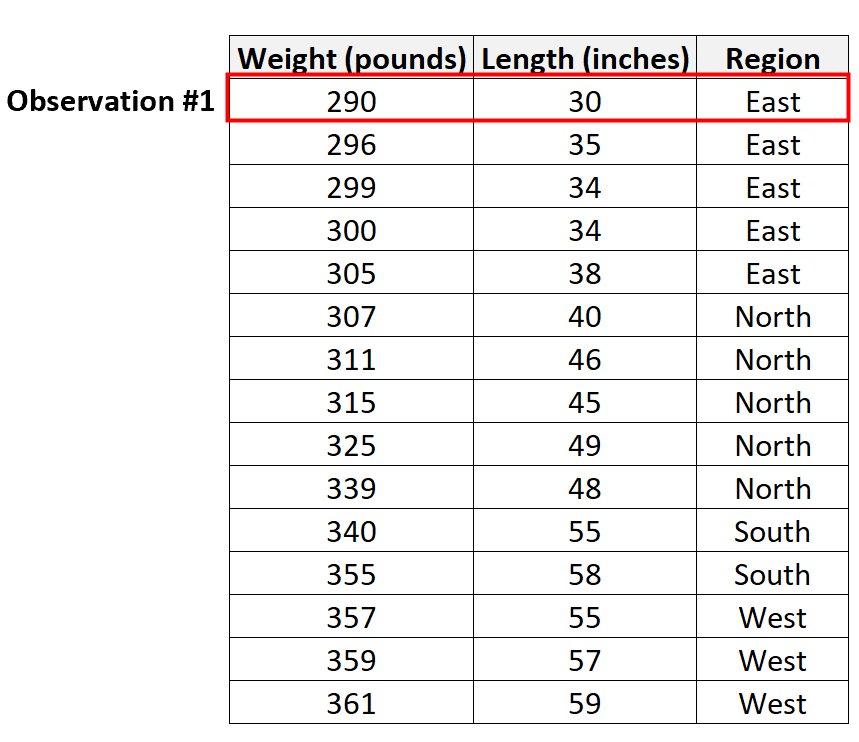
Pour être traitée par les algorithmes computationnels et les formalisations mathématiques, la collection d’observations empiriques doit impérativement être organisée sous une forme géométrique rigoureuse : la matrice de données rectangulaire. En algèbre matricielle, cette structure fondamentale est généralement désignée par la lettre $X$, d’ordre $N \times P$, où $N$ correspond au nombre total d’observations collectées et $P$ au nombre de variables distinctes mesurées au cours du protocole.
La convention internationale en statistique mathématique et en analyse de données multivariées prescrit une correspondance structurelle stricte :
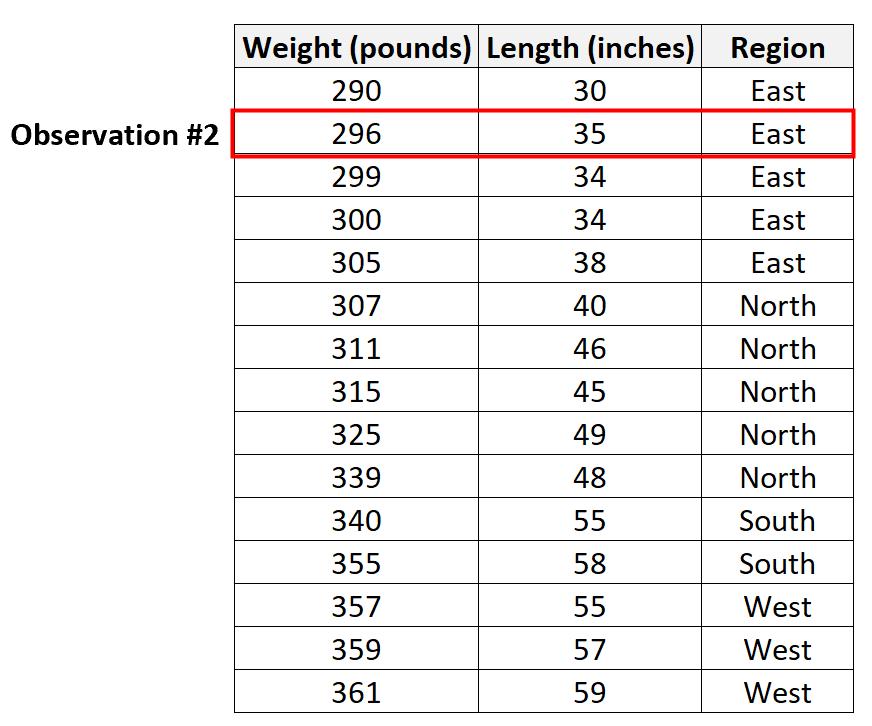
- Chaque ligne de la matrice représente une observation unique, autonome et formalisée sous la forme d’un vecteur-ligne.
- Chaque colonne représente une variable mesurée, c’est-à-dire une dimension le long de laquelle les observations sont comparées, ordonnées ou quantifiées.
Cette correspondance n’est pas arbitraire ; elle garantit l’intégrité matricielle nécessaire à l’ensemble des opérations d’algèbre linéaire sous-jacentes à l’analyse statistique : calcul des vecteurs moyennes, extraction des matrices de variance-covariance empiriques ($\Sigma$), décomposition en valeurs propres lors de l’analyse en composantes principales, ou inversion de matrices pour l’estimation des coefficients de régression par les moindres carrés ordinaires ($\beta = (X^T X)^{-1} X^T Y$). Toute inversion ou rupture dans cette disposition tabulaire invalide instantanément les postulats de traitement algorithmique.
2.2 Multidimensionnalité : Association de multiples variables à une seule observation
Dans la recherche contemporaine, une observation n’est que très rarement univariée. La réalité statistique est intrinsèquement multidimensionnelle : chaque observation correspond à un vecteur $x_i = [x_{i1}, x_{i2}, dots, x_{iP}]$, situé dans un espace géométrique à $P$ dimensions nommé l’espace des variables. Ce vecteur-ligne synthétise l’ensemble des modalités, scores et états affichés par une unité statistique donnée lors de son évaluation.
Ce formalisme permet la coexistence, au sein d’une seule et même observation, de variables de natures ontologiques profondément hétérogènes. Considérons, à titre d’illustration en neuropsychologie clinique, le bilan d’un patient suspecté de pathologie neurodégénérative. Le vecteur associé à cette observation individuelle intègre des variables numériques continues (volume hippocampique mesuré en millimètres cubes par volumétrie cérébrale, latence de rappel libre en secondes), des variables ordinales (stade de détérioration selon l’échelle clinique de démence – CDR, allant de 0 à 3), des variables nominales qualitatives (génotype de l’apolipoprotéine E : $varepsilon3/varepsilon3$, $varepsilon3/varepsilon4$, ou $varepsilon4/varepsilon4$), et des variables binaires (présence ou absence de troubles du sommeil paradoxal).
L’enjeu méthodologique majeur réside dans la prise en compte de l’interdépendance intra-observationnelle. Les différentes composantes d’une même ligne ne sont pas indépendantes les unes des autres : elles sont unies par la structure biologique, psychologique ou sociale propre à l’unité observée. La corrélation entre les colonnes de la matrice reflète précisément la structure sous-jacente qui lie ces différentes variables au sein de chaque observation individuelle.
2.3 Identifiants uniques et traçabilité des observations
Face à la massification des bases de données et aux exigences croissantes de reproductibilité méthodologique, la traçabilité de chaque observation individuelle constitue un impératif technique et éthique incontournable. À ce titre, chaque observation se voit systématiquement attribuer un identifiant unique (communément désigné sous l’acronyme ID ou UUID – Universally Unique Identifier). Cet identifiant ne porte en lui-même aucune valeur empirique substantielle, mais sert de clé primaire d’indexation dans l’architecture relationnelle des données.
L’assignation d’un identifiant exclusif prévient les risques critiques de duplication d’observations, particulièrement redoutables lors de la fusion de tables (opérations de jointure SQL ou de commandes merge / join dans les logiciels de calcul). L’absence d’une indexation univoque expose l’analyste à introduire des doublons artificiels qui gonflent fictivement les degrés de liberté et faussent les calculs d’erreurs types. De surcroît, cet identifiant garantit que les transformations subies par le jeu de données (filtrage, recodage, imputation) demeurent auditables pas à pas.
Sur le plan déontologique, l’identifiant unique assure la passerelle hermétique entre les données de recherche pseudonymisées et les registres nominatifs protégés contenant l’identité civile et le consentement éclairé des sujets. Conformément aux dispositions du Règlement Général sur la Protection des Données (RGPD), la table de correspondance reliant l’identifiant statistique aux données personnelles du participant doit être chiffrée, conservée sur un serveur sécurisé distinct et accessible exclusivement à un nombre restreint de chercheurs autorisés.
3. Taille de l’échantillon ($N$) et volume total d’observations
3.1 L’équivalence fondamentale entre taille d’échantillon et nombre d’observations
Dans la modélisation statistique classique, le paramètre $N$ symbolise la cardinalité de l’ensemble d’observations colligées lors d’une étude empirique, c’est-à-dire le nombre de lignes indépendantes composant la matrice de données. Cette grandeur arithmétique élémentaire gouverne de manière mécanique l’ensemble des estimations et des tests statistiques inférentiels via la détermination des degrés de liberté ($ddl$ ou $df$ pour degrees of freedom).
Les degrés de liberté représentent le nombre de dimensions ou de fragments d’informations indépendantes qui demeurent libres de varier après l’estimation de paramètres intermédiaires nécessaires au calcul. Par exemple, lors de l’estimation de la variance d’un échantillon à partir de sa moyenne empirique, un degré de liberté est irrémédiablement consommé pour fixer la moyenne, laissant $N – 1$ degrés de liberté pour estimer la dispersion. Si le nombre total d’observations $N$ est restreint, l’espace d’estimation est considérablement contraint, ce qui élargit mécaniquement les intervalles d’échantillonnage.
De plus, les indices descriptifs fondamentaux sont assujettis à une sensibilité directe vis-à-vis de $N$. Alors que la moyenne arithmétique empirique constitue un estimateur sans biais de l’espérance mathématique de la population quelle que soit la taille d’échantillon, sa variance d’échantillonnage est inversement proportionnelle à $N$. De même, l’estimateur de la variance corrigée utilise le dénominateur $N-1$ (correction de Bessel) précisément pour neutraliser le biais sous-estimatif inhérent aux petits échantillons d’observations.
3.2 Implications sur la puissance statistique et la représentativité
L’accroissement raisonné du volume d’observations $N$ exerce un effet direct et salutaire sur la précision métrologique par l’intermédiaire de la réduction de l’erreur type (standard error). L’erreur type de la moyenne, quantifiée par la relation mathématique fondamentale $\sigma_{\bar{x}} = \frac{\sigma}{\sqrt{N}}$, démontre que la variabilité de la moyenne d’échantillon autour du véritable paramètre populationnel diminue au rythme de la racine carrée de la taille d’échantillon. Doubler la précision d’une estimation requiert ainsi de quadrupler le nombre d’observations indépendantes.
Cette dynamique conditionne directement la puissance statistique ($1 – \beta$), c’est-à-dire la probabilité de rejeter à juste titre l’hypothèse nulle ($H_0$) lorsqu’elle est effectivement fausse dans la population générale, révélant ainsi un effet empirique authentique. Une étude caractérisée par un nombre déficitaire d’observations souffre d’une inflation dramatique du risque d’erreur de type II ($\beta$) : le chercheur conclut à l’absence d’effet faute de pouvoir distinguer le signal recherché du bruit de fond de l’échantillonnage.
La planification méthodologique rigoureuse impose la réalisation systématique de calculs de puissance a priori (au moyen d’outils tels que G*Power ou de modules spécialisés sous R). Ce dimensionnement formalisé permet d’établir le nombre d’observations strictement requis pour détecter une taille d’effet minimale jugée cliniquement ou théoriquement pertinente, évitant ainsi deux dérives contraires : l’étude sous-puissante incapable d’aboutir à des conclusions robustes, et le sur-échantillonnage coûteux, voire éthiquement contestable en milieu clinique.
3.3 Cas particuliers : Observations imbriquées et mesures répétées
L’équivalence intuitive postulant que le nombre d’observations $N$ équivaut rigoureusement au nombre de sujets recrutés s’effondre brutalement dès lors que le protocole de recherche abandonne le paradigme du plan transversal simple. Dans les architectures de données multiniveaux ou longitudinales, une dichotomie théorique impérative sépare le nombre de sujets inclus ($N_s$) du volume total d’observations accumulées ($N_o$).
Dans les protocoles à mesures répétées, chaque unité statistique $i$ fait l’objet de $T$ sessions d’évaluations successives, générant ainsi un jeu de données contenant $N_o = N_s \times T$ observations. Si un essai clinique évalue 50 patients à raison de 4 temps de mesure (ligne de base, mi-traitement, fin d’intervention et suivi à 6 mois), l’analyste manipule une matrice de 200 observations distinctes. Il serait pourtant méthodologiquement catastrophique de traiter ces 200 lignes comme si elles émanaient de 200 individus indépendants : les observations rattachées au même sujet partagent une variance intra-individuelle substantielle.
Le constat s’applique identiquement aux structures d’observations imbriquées ou hiérarchiques, omniprésentes en sociologie de l’éducation et en santé publique : des élèves imbriqués au sein de classes scolaires, elles-mêmes nichées dans des établissements distincts, ou des patients suivis par différents thérapeutes au sein de multiples centres hospitaliers. Traiter les observations du niveau micro (l’élève) sans modéliser l’appartenance au niveau macro (la classe) engendre une méconnaissance de la corrélation intra-classe et vicie gravement l’estimation des erreurs types, conduisant à des faux positifs massifs.
4. Typologie des observations selon les protocoles de recherche
4.1 Observations transversales (cross-sectional)
Les observations transversales procèdent d’une logique d’instantanéité méthodologique : elles capturent simultanément un ensemble d’unités statistiques à un point unique dans le temps ($T_0$). L’ensemble des variables descriptives, expositionnelles et d’intérêt pronostique ou diagnostique sont colligées au cours d’une même fenêtre temporelle restreinte, gelant pour ainsi dire la configuration de l’échantillon à cet instant déterminé.
Cette approche constitue le socle historique de l’épidémiologie descriptive, des sondages d’opinion et des enquêtes corrélationnelles en psychologie sociale et différentielle. Elle permet d’estimer avec une excellente efficacité logistique la prévalence ponctuelle d’un trouble psychiatrique, d’explorer la corrélation existant entre le sentiment d’efficacité personnelle et le bien-être au travail, ou de brosser un tableau comparatif inter-groupes (par exemple, en comparant les performances mnésiques d’une cohorte de jeunes adultes à celles d’un échantillon d’adultes âgés).
La limite épistémologique inhérente aux observations transversales réside toutefois dans leur incapacité fondamentale à étayer une inférence causale robuste. En l’absence de toute temporalité différentielle entre le recueil de l’exposition (la cause présumée) et celui du critère d’évaluation (l’effet constaté), le chercheur est structurellement exposé au piège de la causalité inverse et à la confusion d’effets de cohorte avec de véritables trajectoires de développement développemental.
4.2 Observations longitudinales et séries temporelles
À l’opposé méthodologique des études transversales, les observations longitudinales reposent sur le suivi diachronique d’une cohorte fixe d’unités statistiques, réévaluées à intervalles déterminés au cours du temps. L’axe temporel est ici explicitement intégré comme variable constitutive de chaque observation, permettant de suivre dynamiquement l’évolution intra-individuelle (le changement propre à chaque sujet au cours de sa vie) tout en analysant la variabilité inter-individuelle (les différences de trajectoires entre plusieurs sujets).
En psychologie du développement et en psychopathologie, ces protocoles permettent de modéliser les courbes de déclin cognitif dans le vieillissement pathologique, d’identifier les fenêtres critiques d’apprentissage du langage chez l’enfant, ou de mesurer la cinétique de rémission des symptômes dépressifs sous psychothérapie. Les observations successives associées à un même individu constituent des séries temporelles courtes, dont l’analyse révèle la stabilité ou l’instabilité temporelle des traits mesurés.
L’exploitation de ces observations séquentielles confronte néanmoins le statisticien à des artefacts méthodologiques complexes. D’une part, l’effet d’apprentissage (ou de retest) menace la validité des observations : un participant améliore fréquemment son score à un test de mémoire non pas sous l’effet d’une amélioration neurobiologique, mais par familiarisation avec la tâche. D’autre part, les effets de maturation biologique et l’attrition sélective de l’échantillon (sujets abandonnant l’étude de façon non aléatoire) altèrent profondément l’interprétation des observations recueillies lors des phases tardives.
4.3 Observations écologiques momentanées (méthode ESM / EMA)
Les innovations récentes des technologies numériques mobiles ont donné naissance à un nouveau paradigme : l’échantillonnage des expériences vécues (Experience Sampling Method – ESM) ou l’évaluation écologique momentanée (Ecological Momentary Assessment – EMA). Ce protocole consiste à collecter une multitude de micro-observations in situ, directement intégrées au quotidien écologique du participant, par le truchement de téléphones intelligents et de capteurs physiologiques portables.
Les participants sont sollicités de manière aléatoire ou semi-programmée plusieurs fois par jour (par exemple 6 à 10 fois quotidiennement sur une période de 14 jours) pour renseigner instantanément leur état affectif, leur contexte social immédiat, leur consommation de substances ou leur niveau de stress perçu. Chaque notification validée génère une micro-observation hautement granulaire, minimisant drastiquement les biais de rappel rétrospectif qui polluent habituellement les questionnaires psychométriques rétrospectifs traditionnels.
Si la méthode ESM maximise la validité écologique, elle confronte l’analyste à des défis computationnels considérables. Le volume d’observations devient massif (souvent des dizaines de milliers de lignes pour une cohorte modeste), caractérisé par une variabilité temporelle non équidistante (intervalles irréguliers entre les déclenchements) et un taux substantiel de données manquantes provoquées par les notifications non répondues. Le traitement de ces nuages d’observations dynamiques exige l’usage avancé de modèles autorégressifs d’ordre 1 (AR(1)) et de techniques d’analyse de réseaux temporels dynamiques.
5. Niveaux de mesure associés aux variables d’une observation
5.1 Observations qualitatives : Niveaux nominal et binaire
Toute variable composant une observation statistique s’inscrit au sein d’une échelle de mesure théorique, selon la célèbre taxonomie proposée par le psychophysicien Stanley Smith Stevens en 1946. Au niveau le plus fondamental se situent les observations qualitatives nominales, qui consistent en une pure classification typologique dénuée de toute hiérarchie mathématique intrinsèque.
Au niveau nominal, l’attribution d’une étiquette verbale ou d’un code numérique à l’observation obéit strictement aux axiomes d’équivalence logique : deux observations partagent la même étiquette si et seulement si elles possèdent la même qualité catégorielle. Les classes doivent impérativement respecter les conditions d’exhaustivité (chaque observation doit trouver une catégorie d’accueil) et d’exclusion mutuelle (une observation ne peut appartenir qu’à une seule catégorie). Le sexe biologique, le statut matrimonial, la nationalité ou le diagnostic psychiatrique selon les catégories du DSM-5 (ex. : Trouble bipolaire de type I, Schizophrénie, Trouble obsessionnel compulsif) constituent des variables d’observation nominales.
Le cas particulier de la variable binaire (ou dichotomique) restreint l’espace des modalités à deux états possibles : présent/absent, oui/non, succès/échec. Sur le plan opérationnel, ces observations sont formellement encodées par des variables muettes (dummy variables) adoptant les valeurs discrètes $0$ ou $1$. Bien que ces nombres n’expriment aucune grandeur métrique, leur utilisation permet d’intégrer des observations qualitatives au sein de modèles de régression multiple ou de classifications logistiques sans violer les contraintes arithmétiques sous-jacentes.
5.2 Observations semi-quantitatives : Le niveau ordinal
Le niveau de mesure ordinal introduit une relation d’ordre et de préséance entre les modalités observées, autorisant un ordonnancement qualitatif : une observation peut être classée comme supérieure, égale ou inférieure à une autre selon la propriété considérée ($A > B > C$). Toutefois, ce niveau de mesure demeure semi-quantitatif, car il ne garantit aucunement l’égalité des intervalles séparant les rangs successifs.
L’exemple archétypique en psychologie et en sciences comportementales réside dans l’utilisation omniprésente des échelles d’attitudes dites de Likert. Lorsqu’un participant quantifie son adhésion à une affirmation au moyen d’options ordonnées (« Pas du tout d’accord », « Partiellement d’accord », « D’accord », « Tout à fait d’accord »), il produit une observation ordinale. La distance psychologique séparant « Pas du tout d’accord » et « Partiellement d’accord » n’est nullement démontrable comme étant strictement équivalente à celle qui sépare « D’accord » de « Tout à fait d’accord ».
L’utilisation de statistiques descriptives et inférentielles sur des observations ordinales exige dès lors une prudence épistémologique accrue. Le calcul d’une moyenne arithmétique ou d’un écart-type sur des données purement ordinales constitue une entorse théorique aux postulats mathématiques, bien que tolérée sous certaines conditions de robustesse psychométrique. Sur le plan méthodologique rigoureux, les observations de nature ordinale doivent être synthétisées par la médiane et l’écart interquartile, et analysées par des tests non paramétriques (test des rangs de Wilcoxon, test de Kruskal-Wallis) ou des modèles de régression logistique ordinale à cotes proportionnelles.
5.3 Observations métriques : Intervalles et rapports continus
Le sommet de l’échelle de Stevens est constitué par les observations quantitatives ou métriques, subdivisées en échelles d’intervalles et échelles de rapports (ou ratios). Ces échelles confèrent aux observations une richesse informationnelle maximale, autorisant l’ensemble des opérations arithmétiques fondamentales (addition, soustraction, et pour les rapports, multiplication et division).
Une observation mesurée sur une échelle d’intervalles constants possède une unité métrique fixe et stable sur l’ensemble du continuum de mesure, mais son point zéro est conventionnel et arbitraire. Le score de quotient intellectuel standardisé (QI, d’espérance 100 et d’écart-type 15) ou la température en degrés Celsius illustrent ce niveau. Un score de QI de 140 n’indique pas une intelligence deux fois supérieure à un score de 70, précisément en raison de l’absence d’un zéro absolu signifiant le néant absolu de l’attribut psychologique considéré.
À l’inverse, l’échelle de rapport dispose d’un zéro absolu, physique et non arbitraire, qui traduit l’absence totale de la propriété mesurée. Les temps de réaction expérimentaux (mesurés en millisecondes), les concentrations sanguines d’hormones (comme le cortisol en nmol/L), le nombre d’erreurs commises lors d’un test attentionnel ou le poids corporel relèvent de ce niveau d’observation. Ici, une latence de 600 ms correspond rigoureusement au double d’une latence de 300 ms. Les observations métriques continues constituent le terrain d’application électif des modèles statistiques paramétriques classiques reposant sur la distribution normale de Gauss.
6. Organisation et manipulation des observations dans les logiciels spécialisés
6.1 Structuration sous R et Python
Dans l’écosystème contemporain de la science des données, le langage R et le langage Python dominent l’analyse statistique de pointe. Tous deux implémentent des architectures logicielles sophistiquées dédiées à l’encapsulation, à l’indexation et à la manipulation matricielle des observations.
Sous R, l’observation individuelle trouve son incarnation structurelle dans les objets de type data.frame ou, dans l’écosystème moderne du Tidyverse, dans les structures de type tibble. Un tibble impose une discipline formelle stricte : chaque ligne correspond rigoureusement à une observation unique, tandis que chaque colonne correspond à une variable typée. La manipulation d’observations s’y effectue au moyen de verbes sémantiques vectorisés issus du paquet dplyr : filtrer des observations selon des critères logiques précis (filter()), réordonner les lignes d’observations (arrange()), ou créer des regroupements statistiques d’observations (group_by()).
Sous Python, la bibliothèque centrale pour l’ingénierie des observations est incontestablement Pandas, articulée autour de la structure du DataFrame, complétée pour le calcul matriciel sous-jacent par les tableaux multidimensionnels NumPy. Pandas octroie une importance capitale à l’index explicite des observations (l’attribut .index). Cet index permet un repérage et un alignement automatique des observations lors d’opérations de fusion, garantissant qu’aucune permutation accidentelle n’altère la liaison entre les observations et leurs descripteurs vectoriels.
6.2 Traitement dans les interfaces dédiées (SPSS, Stata, Excel)
En parallèle des langages scriptés, une part considérable de la recherche académique et appliquée continue de s’appuyer sur des logiciels statistiques à interface graphique utilisateur (GUI) ou à syntaxe propriétaire, tels qu’IBM SPSS Statistics, Stata ou Microsoft Excel.
Dans SPSS, la représentation visuelle adopte immédiatement la métaphore d’une feuille de calcul matricielle divisée en deux onglets opérationnels distincts : l’affichage des données (Data View) et l’affichage des variables (Variable View). Dans la vue des données, l’observation individuelle se matérialise physiquement par une ligne numérotée dans la grille. Les colonnes définissent les variables dont les attributs métrologiques (type, largeur, décimales, étiquettes de valeurs manquantes) sont paramétrés dans la vue des variables. Stata adopte une rigueur conceptuelle analogue, imposant qu’une base chargée en mémoire active ne contienne qu’un seul jeu rectangulaire d’observations, assurant ainsi l’herméticité des calculs économétriques.
Bien que Microsoft Excel soit massivement répandu dans les milieux professionnels, son usage pour la manipulation scientifique d’observations statistiques suscite de sévères critiques méthodologiques. L’absence de distinction formelle et imperméable entre l’entête descriptif, la cellule de donnée et la cellule de formule expose l’utilisateur à des décalages involontaires de lignes d’observations, à des conversions automatiques désastreuses (notamment la corruption reconnue de noms de gènes convertis en dates de calendrier) et à une traçabilité quasi inexistante des modifications appliquées aux observations.
6.3 Format large (Wide) versus format long (Long) : Redéfinition de l’observation
L’un des défis d’ingénierie statistique les plus déterminants réside dans le choix structural entre le format de données « large » (wide format) et le format « long » (long format), un choix qui redéfinit fondamentalement l’unité sémantique incarnée par chaque ligne de la matrice.
Dans le format large, la matrice réserve strictement une seule ligne par sujet expérimental. Si une étude mesure la dépression d’un individu à quatre reprises au fil des mois, la ligne consacrée à ce sujet comportera les colonnes Score_Mois1, Score_Mois2, Score_Mois3 et Score_Mois4. L’observation statistique est ici strictement synonyme du sujet global, englobant l’intégralité de son parcours temporel au sein d’un vecteur horizontal étalé.
Dans le format long (conforme au standard tidy data de Hadley Wickham), chaque ligne ne correspond plus au sujet en soi, mais à la combinaison univoque d’un sujet et d’un instant temporel particulier ($sujet \times temps$). Pour le même individu suivi sur quatre mois, le format long utilisera quatre lignes distinctes d’observations, comprenant les colonnes ID_Sujet, Mois, et Score. Ce pivotage structurel (opéré via pivot_longer() en R ou melt() en Python) est une condition technique indispensable pour l’estimation moderne des modèles linéaires à effets mixtes (LMM) et des équations d’estimation généralisées, capables d’accommoder les observations temporelles incomplètes sans sacrifier l’intégralité du profil du participant.
7. Le postulat fondamental d’indépendance des observations
7.1 Le concept théorique de variables indépendantes et identiquement distribuées (i.i.d.)
La quasi-totalité de l’édifice inférentiel paramétrique classique — du test t de Student à l’analyse de variance (ANOVA), en passant par la régression linéaire par les moindres carrés — repose sur un postulat théorique axiomatique : les observations doivent être indépendantes et identiquement distribuées (i.i.d.). Ce postulat pose deux conditions mathématiques rigoureuses sur la nature probabiliste de chaque observation.
La condition d’identique distribution stipule que chaque observation $x_i$ est tirée au sort à partir d’une même loi de probabilité sous-jacente caractérisée par un vecteur de paramètres constants (par exemple, une distribution normale de paramètres $\mu$ et $\sigma^2$). Toutes les observations partagent ainsi le même processus générateur de données.
La condition d’indépendance implique quant à elle que la réalisation d’une observation n’exerce aucune influence probabiliste sur la valeur prise par toute autre observation de l’échantillon. Mathématiquement, la probabilité conjointe de survenue de deux observations quelconques $x_i$ et $x_j$ doit rigoureusement correspondre au produit de leurs probabilités marginales respectives : $P(x_i \cap x_j) = P(x_i) \times P(x_j)$. En termes linéaires, cela signifie que la covariance entre les termes d’erreurs stochastiques associés aux observations distinctes est strictement nulle : $\text{Cov}(\epsilon_i, \epsilon_j) = 0$ pour tout $i \neq j$. La matrice de variance-covariance des erreurs résiduelles se présente alors sous une forme strictement diagonale ($\sigma^2 I$).
7.2 Violations courantes de l’indépendance en sciences du comportement
En sciences humaines et comportementales, l’hypothèse d’indépendance des observations est fréquemment violée par la nature même des dispositifs expérimentaux et des contextes sociaux au sein desquels s’inscrivent les participants. L’ignorance de ces dépendances structurales représente l’un des vices méthodologiques les plus destructeurs pour la validité scientifique.
La première source majeure de violation réside dans l’effet de contamination sociale induit par les passations collectives de questionnaires ou de tests d’aptitude. Lorsque cinquante étudiants complètent simultanément une épreuve cognitive au sein d’un même amphithéâtre, les observations individuelles cessent d’être strictement indépendantes : elles subissent des perturbations communes liées à la température ambiante, au bruit environnant, ou à la dynamique collective d’anxiété ou de relâchement.
La seconde source découle de la dépendance temporelle (autocorrélation). Dans les études longitudinales ou les séries temporelles en neuro-imagerie, l’état d’un individu à l’instant $t$ est structurellement dépendant de son état à l’instant $t-1$. Enfin, le regroupement spatial ou institutionnel constitue une violation structurelle massive : les membres d’une même famille partagent un patrimoine génétique et un environnement socioculturel ; les patients suivis par un même psychothérapeute sont exposés aux aptitudes cliniques spécifiques de ce praticien ; les élèves d’une même classe partagent l’influence pédagogique d’un même enseignant.
7.3 Conséquences statistiques de la non-indépendance et ajustements
Ignorer la non-indépendance des observations et traiter un jeu de données corrélées au moyen de techniques paramétriques standard engendre des conséquences statistiques délétères. La répercussion principale est une sous-estimation systématique et sévère de l’erreur type des paramètres estimés. La variabilité empirique réelle étant plus faible que la variabilité théorique postulée sous l’hypothèse d’indépendance, la statistique de test ($t$ ou $F$) est artificiellement gonflée.
Ce phénomène induit une inflation spectaculaire du risque d’erreur de type I ($\alpha$) : le chercheur rejette à tort l’hypothèse nulle, concluant à la significativité statistique d’une relation empirique qui ne constitue en réalité qu’un artefact d’échantillonnage non indépendant. Une étude dont le seuil nominal est fixé à $\alpha = 0{,}05$ peut ainsi exhiber en réalité un taux de faux positifs effectif supérieur à $0{,}30$ voire $0{,}50$ si la dépendance intra-groupe n’est pas modélisée.
Pour diagnostiquer et ajuster cette dépendance, le calcul du coefficient de corrélation intraclasse (ICC pour Intraclass Correlation Coefficient) est impératif : il quantifie la proportion de variance totale attribuable au niveau de regroupement macro. Face à un ICC non négligeable (souvent dès $0{,}05$), le recours aux modèles statistiques hiérarchiques linéaires à effets mixtes (HLM) ou aux équations d’estimation généralisées (GEE) s’impose impérativement. Ces méthodes intègrent une structure de covariance personnalisée qui corrige formellement l’erreur type au niveau de l’observation.
8. Les observations atypiques et influentes : Détection et diagnostic
8.1 Définition et origines des valeurs aberrantes (outliers)
Une observation atypique (communément désignée sous l’anglicisme outlier) se définit comme une observation s’écartant si substantiellement des autres données de la distribution qu’elle suscite le soupçon légitime d’avoir été engendrée par un mécanisme probabiliste alternatif, ou de représenter une anomalie métrologique majeure au sein de l’échantillon.
Les origines d’une observation aberrante sont foncièrement hétérogènes et requièrent une analyse causale attentive de la part du statisticien. On distingue schématiquement :
- Les erreurs de saisie instrumentale ou humaines : Frappe erronée d’un chiffre (par exemple consigner un âge de 220 ans au lieu de 22 ans), défaillance temporaire d’un capteur biomécanique ou dysfonctionnement de l’horloge système lors de la journalisation d’un temps de réaction.
- Les défaillances de suivi du protocole : Un sujet expérimental qui répond au hasard sans lire les consignes, ou qui s’endort brièvement durant une tâche cognitive informatisée.
- La variabilité biologique et psychologique authentique : L’observation émane d’une unité statistique intègre et sincère, mais dont les caractéristiques réelles sont exceptionnelles au sein de la population cible (un individu surdoué affichant un score cognitif exceptionnel, ou un patient atteint d’un déficit métabolique ultra-rare).
L’impact d’une seule observation aberrante peut s’avérer catastrophique sur les estimateurs statistiques conventionnels non robustes. La moyenne arithmétique et la variance empirique présentent un point de rupture (breakdown point) théorique de $0%$ : la modification arbitraire d’une seule observation parmi des milliers peut faire tendre la moyenne ou l’écart-type vers l’infini, faussant irrémédiablement l’ensemble des conclusions mathématiques dérivées.
8.2 Méthodes de diagnostic univarié et multivarié
La détection méthodique des observations atypiques repose sur un ensemble d’outils analytiques adaptés au nombre de dimensions simultanément explorées. En analyse univariée, l’inspection visuelle par diagrammes en boîte (boxplots de Tukey) constitue une première approche heuristique : toute observation s’éloignant de plus de $1{,}5$ fois l’écart interquartile (IQR) au-delà des quartiles $Q_1$ ou $Q_3$ est qualifiée d’atypique modérée, et d’extrême au-delà de $3 \times \text{IQR}$. Sur le plan paramétrique, la conversion des valeurs en scores standardisés ($Z$-scores) permet d’identifier les observations dépassant des seuils de criticité usuels ($|Z| > 3$ ou $|Z| > 3{,}29$, correspondant à une probabilité théorique de survenue inférieure à $0{,}001$ sous l’hypothèse d’une loi normale).
Cependant, une observation peut sembler parfaitement ordinaire lorsqu’elle est examinée variable par variable, tout en étant extraordinairement anormale dans sa combinaison multidimensionnelle. Pour déceler ces anomalies multivariées, le calcul de la distance de Mahalanobis ($D_M$) est la méthode de référence. Cette distance métrique généralisée évalue l’écart quadratique entre le vecteur d’une observation $x_i$ et le vecteur moyen de l’échantillon $\bar{x}$, en le pondérant par l’inverse de la matrice de variance-covariance empirique ($\Sigma^{-1}$) :
$$D_M(x_i) = \sqrt{(x_i – \bar{x})^T \Sigma^{-1} (x_i – \bar{x})}$$
Une observation présentant une distance de Mahalanobis dont la significativité excède le seuil du $\chi^2$ à $P$ degrés de liberté est désignée comme atypique multivariée.
Dans les modèles de régression multiple, il convient de distinguer une observation atypique sur la variable dépendante d’un point de levier (leverage point, mesurant l’éloignement d’une observation par rapport au centre de gravité des variables prédictives $X$). L’indice d’influence global de prédilection demeure la distance de Cook ($D_i$), qui mesure explicitement la variation quadratique agrégée subie par l’ensemble des coefficients de régression estimés si l’observation $i$ venait à être intégralement exclue du modèle. Une distance de Cook supérieure à 1, ou dépassant le seuil empirique $\frac{4}{N – K – 1}$, désigne une observation excessivement influente dont la présence oriente à elle seule l’orientation du plan de régression.
8.3 Prise de décision méthodologique face aux observations extrêmes
La détection d’une observation atypique ne constitue que la première étape d’une démarche clinique et statistique rigoureuse ; elle impose ensuite une prise de décision méthodologique éclairée et déontologiquement irréprochable. L’élimination automatique et discrétionnaire des observations dérangeantes représente une dérive éthique majeure, apparentée à du bidouillage de données (p-hacking).
La règle d’or consiste à ne supprimer formellement une observation de la base finale que s’il existe une certitude factuelle attestant qu’elle résulte d’une erreur d’enregistrement instrumentale irrécupérable ou d’une violation documentée du protocole d’inclusion (par exemple, un participant qui a explicitement révélé avoir consommé un psychotrope avant une passation de mémoire sans en avertir l’équipe de recherche). Dès lors que l’observation reflète la variabilité biologique légitime du phénomène, elle doit impérativement être maintenue dans l’échantillon d’analyse.
Face à la persistance d’observations extrêmes authentiques, le chercheur dispose d’alternatives analytiques robustes :
- La winsorisation : Cette technique consiste à remplacer les valeurs excédant un percentile défini (par exemple le 95e ou 99e percentile) par la valeur de ce seuil spécifique, conservant l’observation au sein de l’échantillon tout en neutralisant son pouvoir de distorsion unilatérale.
- Les estimateurs statistiques robustes : L’abandon des moindres carrés ordinaires au profit de régressions robustes (comme les M-estimateurs de Huber ou la régression par quantiles) permet de minimiser le poids algorithmique attribué aux observations atypiques sans les supprimer.
- L’analyse de sensibilité : Conduire systématiquement l’analyse statistique à deux reprises — avec l’ensemble exhaustif des observations, puis en retranchant les observations hautement influentes — et présenter les deux séries de résultats de façon transparente dans les publications scientifiques, conformément aux préconisations méthodologiques de l’American Psychological Association (APA).
9. Observations incomplètes et problématique des données manquantes
9.1 Typologie des mécanismes de données manquantes
Dans la recherche quantitative appliquée, il est extrêmement fréquent que le recueil empirique soit confronté au défi des observations incomplètes : une ou plusieurs valeurs de variables font défaut au sein du vecteur-ligne associé à une observation. Pour traiter scientifiquement cette lacune sans induire de biais systématiques majeurs, il est impératif de s’appuyer sur la taxonomie probabiliste formalisée par le statisticien Donald Rubin en 1976, qui distingue trois mécanismes générateurs d’incomplétude.
Le premier mécanisme est celui des données manquantes complètement au hasard (MCAR – Missing Completely at Random). Dans ce scénario idéal mais rare, la probabilité qu’une valeur soit manquante pour une observation est strictement indépendante tant des variables observées que de la valeur manquante elle-même. La perte de données s’apparente à un tirage au sort stochastique pur (par exemple, un technicien de laboratoire échappe et brise accidentellement un tube à essai de manière totalement fortuite). Le sous-échantillon d’observations complètes constitue alors un sous-ensemble parfaitement représentatif de l’échantillon initial.
Le second mécanisme est celui des données manquantes au hasard au sens conditionnel (MAR – Missing at Random). La probabilité d’incomplétude dépend des informations observables disponibles au sein d’autres variables de la même ligne, mais ne dépend pas de la valeur non observée elle-même. Par exemple, au sein d’une enquête psychiatrique, les participants de sexe masculin peuvent être statistiquement moins enclins à répondre aux items évaluant les idéations suicidaires ; toutefois, au sein du sous-groupe des hommes, la propension à omettre cette réponse n’est pas corrélée avec la sévérité intrinsèque de leur détresse suicidaire.
Le troisième mécanisme, le plus redoutable, correspond aux données manquantes non aléatoires (MNAR – Missing Not at Random). Ici, la probabilité d’omission est directement conditionnée par la valeur même qui aurait dû être observée. Par exemple, un patient souffrant d’une dépression mélancolique d’une intensité paralysante omet de remplir son carnet de suivi symptomatique précisément en raison de la sévérité incapacitante de son épisode dépressif. Ignorer le mécanisme MNAR fausse irrémédiablement l’ensemble des estimateurs statistiques.
9.2 Conséquences des omissions au niveau de l’observation
L’occurrence de vecteurs d’observations incomplets exerce des répercussions directes et pernicieuses sur la validité de l’enquête scientifique. La première conséquence matérielle réside dans le biais d’attrition, caractéristique des protocoles longitudinaux. Les abandons successifs de participants au fil des vagues d’évaluation altèrent la composition initiale de l’échantillon : les sujets les plus fragiles, les moins éduqués ou les plus sévèrement atteints sur le plan somatique ayant tendance à quitter prématurément les cohortes, les observations colligées lors des phases avancées ne reflètent plus qu’une sous-population artificiellement résiliente ou privilégiée.
Sur le plan métrologique, l’incomplétude des observations conduit à une amputation sévère de la puissance analytique. Dès lors que l’algorithme d’analyse requiert des vecteurs complets, la réduction du nombre effectif d’observations exploitables dilate mécaniquement les erreurs types et réduit la capacité de l’étude à mettre en évidence des effets réels pourtant cliniquement fondamentaux.
Enfin, la conséquence théorique la plus insidieuse demeure la déformation systématique des paramètres de distribution. L’estimation brute d’une moyenne ou d’un coefficient de corrélation calculé sur des observations incomplètes sans correction probabiliste conduit à des distorsions massives, projetant une image falsifiée de la réalité épidémiologique ou psychologique sous-jacente.
9.3 Stratégies de traitement au niveau de l’observation
Face à des matrices contenant des observations incomplètes, plusieurs voies de résolution s’offrent au méthodologiste, de la plus rudimentaire à la plus sophistiquée sur le plan mathématique.
La pratique historique la plus expéditive consiste en la suppression par liste complète (listwise deletion ou complete case analysis), qui élimine purement et simplement de la matrice toute observation contenant ne serait-ce qu’une seule valeur manquante sur le vecteur de variables analysé. Si cette méthode conserve des propriétés non biaisées sous le postulat très restrictif de données MCAR, elle sacrifie massivement de l’information utile et engendre des biais dramatiques dès que le mécanisme d’omission est MAR ou MNAR. La suppression par paire (pairwise deletion), qui tente de conserver l’observation pour les calculs de covariances partielles tant que les deux variables analysées sont présentes, est formellement déconseillée : elle produit des matrices de corrélation non semi-définies positives, rendant impossibles les analyses multivariées ultérieures.
Les standards contemporains de la recherche internationale privilégient deux méthodologies d’excellence fondées sur la théorie des probabilités :
- L’imputation multiple par équations chaînées (MICE) : Cette approche consiste à imputer statistiquement chaque valeur manquante $M$ fois au moyen de modèles de régression conditionnelle intégrant l’ensemble des autres variables observées de la matrice, générant ainsi $M$ jeux de données complets distincts. L’analyse cible est ensuite exécutée sur chacun de ces $M$ jeux de données, puis les résultats et erreurs types sont regroupés au moyen des règles mathématiques d’agrégation de Rubin. L’incertitude inhérente à l’absence de l’observation est ainsi formellement quantifiée et intégrée au modèle final.
- L’estimation par maximum de vraisemblance à information complète (FIML – Full Information Maximum Likelihood) : Cette technique directe, très prisée dans le cadre de la modélisation par équations structurelles (SEM), n’impute aucune donnée artificielle. Elle optimise la fonction de vraisemblance globale en exploitant chaque fraction d’information présente dans chaque observation individuelle, sans jamais exclure une ligne en raison d’un vecteur partiellement incomplet.
10. L’observation au confluent de la statistique descriptive et de l’inférence
10.1 L’observation comme brique fondamentale de la synthèse descriptive
La statistique descriptive constitue le premier palier d’organisation cognitive des données : son rôle est de transformer une masse informe et brute de milliers d’observations singulières en un résumé synthétique intelligible pour l’esprit humain. Chaque observation individuelle sert de brique unitaire à l’édification de ces représentations condensées.
L’agrégation initiale des observations s’opère par le calcul des distributions de fréquences et la construction d’histogrammes ou d’estimateurs de densité par noyau (kernel density estimation). Dans ces visualisations, la position géométrique de chaque observation le long de l’axe métrique contribue à sculpter la silhouette empirique globale de l’échantillon, révélant immédiatement son uniformité, son asymétrie (skewness) ou son aplatissement (kurtosis).
À partir de cet empilement d’observations sont dérivés les paramètres de tendance centrale : le mode (valeur la plus fréquemment observée au sein de l’échantillon), la médiane (valeur séparant le volume ordonné des observations en deux moitiés équiprobables de $50%$), et la moyenne arithmétique, qui correspond au barycentre pondéré de l’ensemble des observations. Corrélativement, la variabilité inhérente à cet ensemble d’observations est quantifiée par les indices de dispersion : étendue, variance empirique et écart-type, qui mesurent la moyenne quadratique des déviations de chaque observation individuelle par rapport au barycentre collectif de la distribution.
10.2 De l’ensemble d’observations à l’inférence de la population
L’inférence statistique opère un saut conceptuel audacieux : elle vise à énoncer des vérités probabilistes universelles portant sur une population cible générale (souvent infinie ou inaccessible dans sa globalité) à partir de l’analyse restreinte d’un échantillon fini de $N$ observations concrètes.
Ce basculement repose sur le pilier théorique central des probabilités modernes : le théorème central limite (TCL). Ce théorème démontre que, sous des conditions très générales de régularité (existence d’une variance finie), la distribution d’échantillonnage de la moyenne d’un ensemble d’observations indépendantes tend asymptotiquement vers une loi normale lorsque le nombre total d’observations $N$ devient grand, et ce quelle que soit la loi de probabilité originelle régissant les observations individuelles dans la population. Ce résultat confère à l’observation statistique un pouvoir de généralisation prédictive d’une efficacité mathématique prodigieuse.
Dès lors, le statisticien est en mesure de dépasser l’estimation ponctuelle (attribuer une valeur unique calculée sur l’échantillon d’observations) pour proposer des intervalles de confiance (souvent calibrés à $95%$ ou $99%$). Un intervalle de confiance à $95%$ délimite une plage probabiliste construite à partir de l’ensemble d’observations empiriques, telle que si le protocole expérimental était répliqué un nombre infini de fois, $95%$ des intervalles calculés encadreraient rigoureusement le véritable paramètre inconnu de la population parente.
10.3 Théorie de la décision statistique appliquée aux observations
L’aboutissement de la démarche inférentielle réside dans la théorie du test d’hypothèses formalisée par Ronald Fisher, Jerzy Neyman et Egon Pearson. Au cœur de ce processus décisionnel, l’ensemble colligé d’observations empiriques est confronté formellement à une hypothèse nulle ($H_0$), postulant classiquement l’absence d’effet, l’absence de corrélation ou l’équivalence stricte entre des populations sous traitement.
Pour statuer sur cette hypothèse, le chercheur condense l’ensemble des observations matricielles en une statistique de test unique ($t$, $F$, $\chi^2$, $Z$). La confrontation de cette statistique calculée à la loi de probabilité théorique attendue sous $H_0$ permet de dériver la valeur $p$ (p-value). La $p$-value quantifie la probabilité exacte d’observer un agencement d’observations empiriques au moins aussi extrême que celui constaté dans notre échantillon, dans l’éventualité théorique où l’hypothèse nulle serait rigoureusement vraie dans la réalité.
Toutefois, la rigueur épistémologique impose de ne jamais confondre la significativité statistique (qui dépend étroitement du volume d’observations $N$) avec la taille de l’effet (qui mesure l’ampleur substantielle du phénomène indépendamment de la taille de l’échantillon). Disposer d’un échantillon gigantesque de cent mille observations peut rendre une corrélation microscopique de $r = 0{,}01$ hautement significative sur le plan de la $p$-value ($p < 0{,}0001$), alors même que cette relation empirique ne revêt qu'une pertinence clinique, pratique ou explicative rigoureusement nulle.
11. Éthique, déontologie et rigueur méthodologique autour de l’observation humaine
11.1 Anonymisation et protection des observations nominatives
Dès lors que l’observation statistique s’exerce sur l’être humain, elle s’extrait du champ purement mathématique pour s’assujettir aux cadres déontologiques et réglementaires de la bioéthique et de la protection de la vie privée. L’avènement des technologies de traitement automatisé des données a considérablement durci ces exigences, matérialisées en Europe par le Règlement Général sur la Protection des Données (RGPD) et supervisées en France par la Commission Nationale de l’Informatique et des Libertés (CNIL).
Une distinction fondamentale sépare les données pseudonymisées des données anonymisées. Une base d’observations est dite pseudonymisée lorsque les identifiants directs (nom, prénom, numéro de sécurité sociale) ont été remplacés par une clé aléatoire, mais qu’il demeure techniquement possible, par croisement d’informations, de réidentifier un participant individuel. En revanche, l’anonymisation véritable constitue une altération irréversible des observations : les données doivent être modifiées de telle sorte qu’aucun individu ne puisse être réidentifié, même par combinaison de quasi-identifiants indirects (code postal, date exacte de naissance, profession inhabituelle et diagnostic rare au sein d’une même ligne).
Le mouvement mondial en faveur de la science ouverte (Open Science), qui préconise le dépôt public et le libre partage des bases d’observations brutes sur des répertoires institutionnels (tels que le réseau Open Science Framework – OSF ou Zenodo), exige un audit drastique de dé-identification. Tout chercheur déposant un jeu d’observations publiques doit préalablement attester devant un comité d’éthique institutionnel (comité de protection des personnes ou IRB) que la structure multidimensionnelle de chaque observation ne permet aucune réidentification résiduelle malveillante par ingénierie inverse ou attaque par liaison de bases de données.
11.2 Réactivité du sujet et biais de mesure dans l’observation comportementale
L’observation statistique en sciences comportementales se heurte à une vulnérabilité ontologique ignorée par les sciences de la matière inerte : la réflexivité et la réactivité du sujet observé. L’être humain, dès lors qu’il se sait investi comme objet d’investigation scientifique, adapte son comportement, modifiant instantanément la validité écologique de l’observation recueillie.
Le premier artefact historique de cette nature est le célèbre effet Hawthorne, mis en évidence lors d’expériences de psychologie industrielle dans les années 1920 : l’amélioration des performances professionnelles des ouvrières n’était pas corrélée aux variations de l’éclairage expérimental, mais résultait directement de la conscience d’être l’objet d’une observation continue et valorisante de la part d’une équipe de recherche. De même, l’effet Pygmalion ou les biais d’attente de l’expérimentateur (experimenter-expectancy effect documenté par Robert Rosenthal) démontrent que les attentes inconscientes du chercheur peuvent influencer subtilement la performance observée chez le sujet évalué.
Dans le domaine des observations auto-rapportées (inventaires psychométriques, enquêtes d’attitudes), le biais de désirabilité sociale constitue une source massive de distorsion systématique : le répondant ajuste spontanément ses scores pour se conformer aux normes sociales dominantes ou projeter une image valorisante de soi. Pour neutraliser ces biais de mesure au niveau de l’observation brute, les protocoles scientifiques contemporains imposent :
- Des protocoles d’évaluation standardisés en double aveugle, où ni le participant ni l’expérimentateur administrant l’épreuve ne connaissent l’assignation du sujet (groupe expérimental versus placebo).
- Le recours complémentaire à des mesures implicites (telles que les tâches d’association implicite – IAT) ou à des biomarqueurs physiologiques involontaires, imperméables aux stratégies conscientes d’auto-présentation.
- L’insertion d’échelles de détection de validité interne (échelles de mensonge, de cohérence interne ou d’inattention aléatoire) directement intégrées au vecteur d’observation.
11.3 Fidélité et reproductibilité de l’observation psychométrique
Pour qu’une observation statistique quantitative ou semi-quantitative acquière une légitimité scientifique, elle doit apporter la démonstration empirique de sa qualité psychométrique, traditionnellement décomposée selon les concepts de fidélité (reliability) et de reproductibilité.
Lorsque l’observation statistique repose sur le jugement subjectif d’un évaluateur humain (par exemple, un psychiatre consignant le score de symptômes négatifs d’un patient à l’aide d’une échelle hétéro-rapportée, ou deux observateurs codant des interactions vidéo mère-enfant), la concordance métrologique entre les observateurs indépendants doit être quantifiée formellement. Pour les variables qualitatives ou ordinales, le coefficient Kappa de Cohen (pour deux juges) ou le Kappa de Fleiss (pour plus de deux juges) mesure l’accord inter-juges au-delà de l’accord purement attribuable au hasard statistique. Pour les scores continus, le coefficient de corrélation intraclasse (ICC de type accord absolu) est incontournable.
Au niveau de la cohérence interne des items articulant une observation globale complexe, l’analyste évalue le degré auquel les sous-mesures composant le vecteur-ligne convergent vers la capture du même construit latent unifié. Historiquement quantifiée par l’Alpha de Cronbach ($\alpha$), la pratique méthodologique moderne privilégie l’Oméga de McDonald ($\omega$), ce dernier n’exigeant pas le postulat hautement irréaliste de tau-équivalence (poids de saturation factorielle strictement identiques pour tous les items).
Enfin, la fidélité test-retest évalue la reproductibilité temporelle de l’observation. Administrée à un intervalle temporel raisonnable où l’attribut latent est supposé stable (par exemple à deux semaines d’intervalle pour un trait de personnalité stable), la corrélation intra-individuelle entre les deux observations successives doit demeurer supérieure aux seuils méthodologiques critiques ($r > 0{,}80$), sous peine de disqualifier l’instrument d’observation en raison d’une erreur de mesure aléatoire intolérable.
12. Protocole appliqué : Guide méthodique pour l’audit et la préparation des observations
12.1 Étape de pré-traitement et de validation systématique
Avant de soumettre un jeu matriciel d’observations à toute modélisation inférentielle ou exploratoire, une phase préliminaire d’audit systématique et de nettoyage des données (data cleaning) doit être rigoureusement orchestrée. Cette étape d’hygiène statistique conditionne l’intégrité de tous les résultats subséquents.
Le protocole d’audit commence par la vérification algorithmique des plages de valeurs théoriquement admissibles (range checks) pour chaque variable de chaque observation. Si une échelle psychométrique est étalonnée de 1 à 7, la présence d’une valeur 0 ou 8 traduit une erreur de codage manifeste devant être immédiatement signalée et résolue. De même, les variables d’âge négatives, les fractions de test dépassant $100%$ ou les latences temporelles chronométriques négatives doivent être détectées au moyen de filtres logiques conditionnels automatisés.
L’étape suivante requiert le contrôle des incohérences logiques croisées entre différentes colonnes d’une même ligne d’observation. À titre d’exemple, une observation consignant un diagnostic d’affection gynécologique associée à un statut biologique masculin, ou un score global de dépendance fonctionnelle contredisant directement les scores élémentaires d’autonomie motrice de la même ligne, signale une corruption de données qui doit être auditée à la source.
Enfin, l’analyste procède à un audit exhaustif des taux d’incomplétude au niveau de l’observation et au niveau de la variable. L’établissement d’une matrice graphique de présence des données manquantes (par exemple via le paquet R naniar) permet de visualiser les patrons géométriques d’incomplétude et d’orienter le choix vers des mécanismes MCAR ou MAR.
12.2 Création d’un dictionnaire de données et documentation (Codebook)
Une base d’observations statistiques dépourvue de documentation exhaustive est méthodologiquement stérile et condamnée à l’obsolescence rapide. La création d’un dictionnaire de données formel (communément désigné sous le terme technique de codebook) représente l’acte par lequel le chercheur formalise l’ancrage sémantique de chaque variable associée aux observations matricielles.
Un dictionnaire de données scientifique standardisé doit documenter de façon détaillée les attributs suivants pour chaque colonne de la matrice :
- Le libellé canonique : Le nom exact de la variable dans le fichier informatique (ex. :
BDI_item_04). - La signification sémantique intégrale : La description textuelle verbatim du caractère mesuré (ex. : « Score à l’item 4 de l’inventaire de dépression de Beck évaluant la perte de plaisir et l’anhédonie »).
- Le niveau métrologique de mesure : Nominal, ordinal, intervalle ou rapport.
- La grille de codage exhaustive : La correspondance entre chaque valeur numérique encodée et sa signification concrète (ex. : $0 = \text{Non}$, $1 = \text{Oui}$ ; ou $1 = \text{Jamais}$ jusqu’à $4 = \text{Presque toujours}$).
- Le traitement réservé aux valeurs manquantes : La distinction explicite des codes réservés aux non-réponses légitimes (ex. : $-999$ pour question non applicable versus $-888$ pour refus de répondre du sujet).
- Les seuils de troncature et transformations appliquées : La journalisation explicite de toute opération arithmétique (log-transformation, centrage-réduction) appliquée aux observations brutes initiales.
Ce dictionnaire de données constitue le garant contractuel de la pérennité de l’échantillon d’observations, permettant aux auditeurs externes, aux réviseurs par les pairs ou aux futurs chercheurs de répliquer fidèlement les analyses sans ambiguïté interprétative.
12.3 Standardisation du flux de travail pour une recherche reproductible
L’aboutissement de la démarche méthodologique moderne réside dans la sanctuarisation d’un flux de travail (workflow) rigoureusement standardisé, garantissant la reproductibilité computationnelle absolue de la manipulation des observations empiriques.
Le premier principe inviolable est la séparation absolue entre les données brutes initiales et les jeux de données traités. Le fichier contenant les observations brutes issues de la collecte initiale (l’export brut du logiciel de passation, le scanner du questionnaire papier ou la base de production) doit être sanctuarisé en lecture seule dans un dossier d’archive sécurisé, et ne subir aucune altération directe manuelle. Les suppressions d’observations atypiques, les imputations de données manquantes, les recodages d’échelles et les agrégations de scores doivent impérativement être orchestrés au moyen de scripts informatiques exécutables (fichiers .R, .py ou documents computationnels dynamiques de type Quarto ou R Markdown).
Ce script scripté consigne pas à pas, avec une transparence absolue, l’intégralité du parcours transformationnel subi par chaque observation de la matrice. Tout chercheur indépendant réexécutant le script à partir du fichier brut initial doit régénérer de façon déterministe et identique la base finale analysée. Enfin, la pérennisation du flux de travail passe par l’utilisation d’outils de contrôle de version distribués (comme Git) et l’archivage pérenne des codes sources et métadonnées sur des plateformes institutionnelles certifiées (Dataverse, Zenodo), consacrant ainsi le statut de l’observation statistique comme un bien scientifique vérifiable, auditable et universellement transmissible.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
Cronbach, L. J. (1951). Coefficient alpha and the internal structure of tests. Psychometrika, 16(3), 297–334. https://doi.org/10.1007/BF02310555
Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
Little, R. J. A., & Rubin, D. B. (2019). Statistical analysis with missing data (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781119482865
Mahalanobis, P. C. (1936). On the generalized distance in statistics. Proceedings of the National Institute of Sciences of India, 2(1), 49–55.
McNeish, D. (2018). Thanks coefficient alpha, we’ll take it from here. Psychological Methods, 23(3), 412–433. https://doi.org/10.1037/met0000144
Neyman, J., & Pearson, E. S. (1933). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society of London. Series A, 231(694–706), 289–337. https://doi.org/10.1098/rsta.1933.0009
Raudenbush, S. W., & Bryk, A. S. (2002). Hierarchical linear models: Applications and data analysis methods (2nd ed.). SAGE Publications.
Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581–592. https://doi.org/10.1093/biomet/63.3.581
Shrout, P. E., & Fleiss, J. L. (1979). Intraclass correlations: Uses in assessing rater reliability. Psychological Bulletin, 86(2), 420–428. https://doi.org/10.1037/0033-2909.86.2.420
Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
van Buuren, S. (2018). Flexible imputation of missing data (2nd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9780429492259
Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10