
Dans le domaine de l’évaluation biomédicale, de la métrologie clinique et de la psychométrie, la comparaison de deux instruments de mesure quantitatifs constitue une démarche scientifique cruciale. Qu’il s’agisse d’introduire un nouveau dispositif diagnostique ambulatoire, de confronter une échelle psychologique abrégée à son étalon historique ou d’évaluer la concordance entre deux observateurs indépendants, la question fondamentale demeure invariable : la nouvelle méthode est-elle suffisamment proche de la méthode établie pour pouvoir lui être substituée sans risque d’erreur diagnostique ou thérapeutique ? Pendant plusieurs décennies, la communauté scientifique a abordé cette question sous l’angle réducteur de la corrélation linéaire, commettant ainsi un contresens méthodologique majeur en confondant l’intensité d’une association statistique avec la concordance absolue entre deux mesures.
Cette lacune épistémologique a été brillamment comblée dans les années 1980 par les statisticiens britanniques John Martin Bland et Douglas G. Altman. En introduisant une approche graphique et analytique novatrice fondée sur l’étude directe des différences individuelles en regard des moyennes des mesures, ils ont profondément transformé les standards de l’évaluation méthodologique. Connu sous le nom de graphique de Bland-Altman (ou *Bland-Altman plot*), cet outil s’est imposé comme le paradigme de référence pour quantifier le biais systématique, apprécier la dispersion des écarts aléatoires et délimiter ce que l’on nomme les limites d’agrément à 95 %. Loin d’être un simple artifice visuel, ce dispositif analytique incarne une philosophie rigoureuse de la décision clinique où les critères purement statistiques s’effacent au profit de marges d’équivalence opérationnelles prédéfinies.
L’adoption du graphique de Bland-Altman s’étend aujourd’hui bien au-delà de la médecine générale et de la pharmacologie, trouvant un écho particulièrement fécond dans les sciences psychologiques, les neurosciences cognitives et l’épidémiologie comportementale. Dans ces disciplines où les construits mesurés – anxiété, fonctions exécutives, vigilance, sommeil – présentent une variabilité intrinsèque substantielle, la distinction entre la variabilité biologique, l’erreur de mesure aléatoire et le biais systématique de l’instrument s’avère déterminante. Ce traité propose une exploration exhaustive des fondements théoriques, des formulations mathématiques, des anomalies distributionnelles et des applications cliniques de cette méthode incontournable, guidant pas à pas le chercheur et le praticien vers une maîtrise irréprochable de l’analyse de concordance.
1. Introduction fondamentale au graphique de Bland-Altman
1.1 Définition théorique et genèse de la méthode
L’acte de mesurer constitue le socle de toute démarche scientifique rigoureuse. Cependant, dans les sciences de la santé et du comportement, l’évaluation de la concordance entre deux instruments a longtemps souffert de l’absence d’un cadre statistique approprié. C’est dans ce contexte de vulnérabilité méthodologique que s’inscrivent les travaux fondateurs du statisticien J. Martin Bland et du biostatisticien Douglas G. Altman. Leurs publications séminales, débutées par une communication préliminaire en 1983 dans le Journal of the Royal Statistical Society: Series D (The Statistician), ont culminé en 1986 avec leur article historique publié dans la prestigieuse revue médicale The Lancet, intitulé « Statistical methods for assessing agreement between two methods of clinical measurement ». Cet article est rapidement devenu l’un des articles scientifiques les plus cités de tous les temps, témoignant du besoin urgent d’une alternative rigoureuse à l’usage abusif du coefficient de corrélation.
La prémisse épistémologique de Bland et Altman repose sur une distinction formelle entre l’association linéaire et la concordance absolue. Si deux méthodes de mesure présentent une corrélation parfaite (caractérisée par un coefficient de corrélation de Pearson égal à 1), cela signifie uniquement que les points se situent sur une ligne droite quelconque. En aucun cas cela n’implique que les deux méthodes fournissent des résultats identiques. Par exemple, si une méthode B donne systématiquement une valeur égale au double de la méthode A, la corrélation sera de 1,00, alors même que le désaccord quantitatif entre les deux instruments sera massif et potentiellement catastrophique d’un point de vue clinique. L’analyse de concordance vise précisément à vérifier si les mesures attribuées à un même sujet par deux outils distincts sont numériquement interchangeables, c’est-à-dire si la droite d’ajustement coïncide rigoureusement avec la bissectrice parfaite (la droite d’identité y = x).
L’objectif primaire du graphique de Bland-Altman est donc de comparer deux instruments de mesure ou méthodes d’évaluation quantitatives continues appliquées à une même cohorte d’individus. Il ne s’agit pas de juger de la validité de construit dans l’abstrait, mais de quantifier le degré de divergence entre les deux instruments afin de déterminer si le nouvel outil, souvent plus rapide, plus économique ou moins invasif, peut se substituer sans péril méthodologique à l’étalon existant. Cette démarche s’inscrit au cœur de la validation instrumentale moderne.
1.2 Pertinence dans le champ des sciences psychologiques
Si la méthode de Bland-Altman a vu le jour dans les laboratoires de biologie médicale et de physiologie clinique, sa pertinence dans le champ des sciences psychologiques et psychiatriques est monumentale. Dans ces disciplines, l’évaluation repose fréquemment sur l’utilisation de tests psychométriques, d’échelles d’auto-évaluation et de grilles d’hétéro-évaluation clinique. Lorsqu’une équipe de recherche conçoit une version abrégée d’un questionnaire de personnalité ou d’un inventaire de dépression pour alléger la charge cognitive des patients, l’impératif de concordance avec l’instrument complet est direct. Le graphique de Bland-Altman offre un outil visuel et quantitatif d’une transparence inégalée pour vérifier que l’abègement de l’échelle n’induit pas une dérive systématique des scores individuels.
La psychologie clinique confronte fréquemment deux perspectives d’observation : l’auto-évaluation du patient (via des instruments de type questionnaires de Likert) et l’hétéro-évaluation par un clinicien expert (via des entretiens semi-structurés standardisés). L’utilisation de l’analyse de Bland-Altman permet de déterminer avec précision si le patient a tendance à sous-estimer ou surestimer systématiquement sa symptomatologie par rapport au clinicien, et d’évaluer l’amplitude des discordances extrêmes attendues dans la population cible. De surcroît, la méthode constitue l’approche étalon pour documenter la fidélité test-retest des instruments continus, en comparant les scores obtenus à deux moments distincts sous l’hypothèse de stabilité du trait psychologique mesuré.
Enfin, l’essor contemporain de la psychiatrie biologique et de la psychophysiologie a multiplié le recours aux dispositifs de mesure physiologique continue – tels que les biocapteurs mesurant la conductance cutanée, la variabilité de la fréquence cardiaque ou les mouvements actigraphiques. L’interchangeabilité de ces nouvelles technologies portables avec les enregistrements stationnaires de laboratoire (électroencéphalographie, polysomnographie) exige une démonstration formelle de concordance métrologique, rendant la technique de Bland-Altman absolument incontournable.
1.3 Principe conceptuel du graphique de différence
Le principe conceptuel du graphique de Bland-Altman repose sur la décomposition et la projection géométrique de la divergence individuelle entre deux mesures appariées. Dans une approche traditionnelle univariée, on se contentait souvent d’observer les moyennes marginales des deux distributions ou de superposer deux courbes de densité. Une telle démarche occulte totalement la structure des résidus appariés : deux séries de données peuvent présenter des moyennes et des variances strictement identiques tout en affichant des divergences individuelles majeures qui s’annuleraient mutuellement lors de l’agrégation.
Le passage à une représentation bivariée des discordances résout cette aporie. En plaçant sur une dimension la moyenne des deux mesures (qui constitue l’estimation non biaisée de la magnitude sous-jacente du phénomène) et sur l’autre dimension la différence arithmétique signée entre les deux mesures, la méthode isole la variance d’erreur de la variance du sujet. Ce basculement géométrique à 45 degrés neutralise la dépendance artificielle induite par l’échelle de mesure et projette le regard du chercheur au cœur même de l’erreur d’observation.
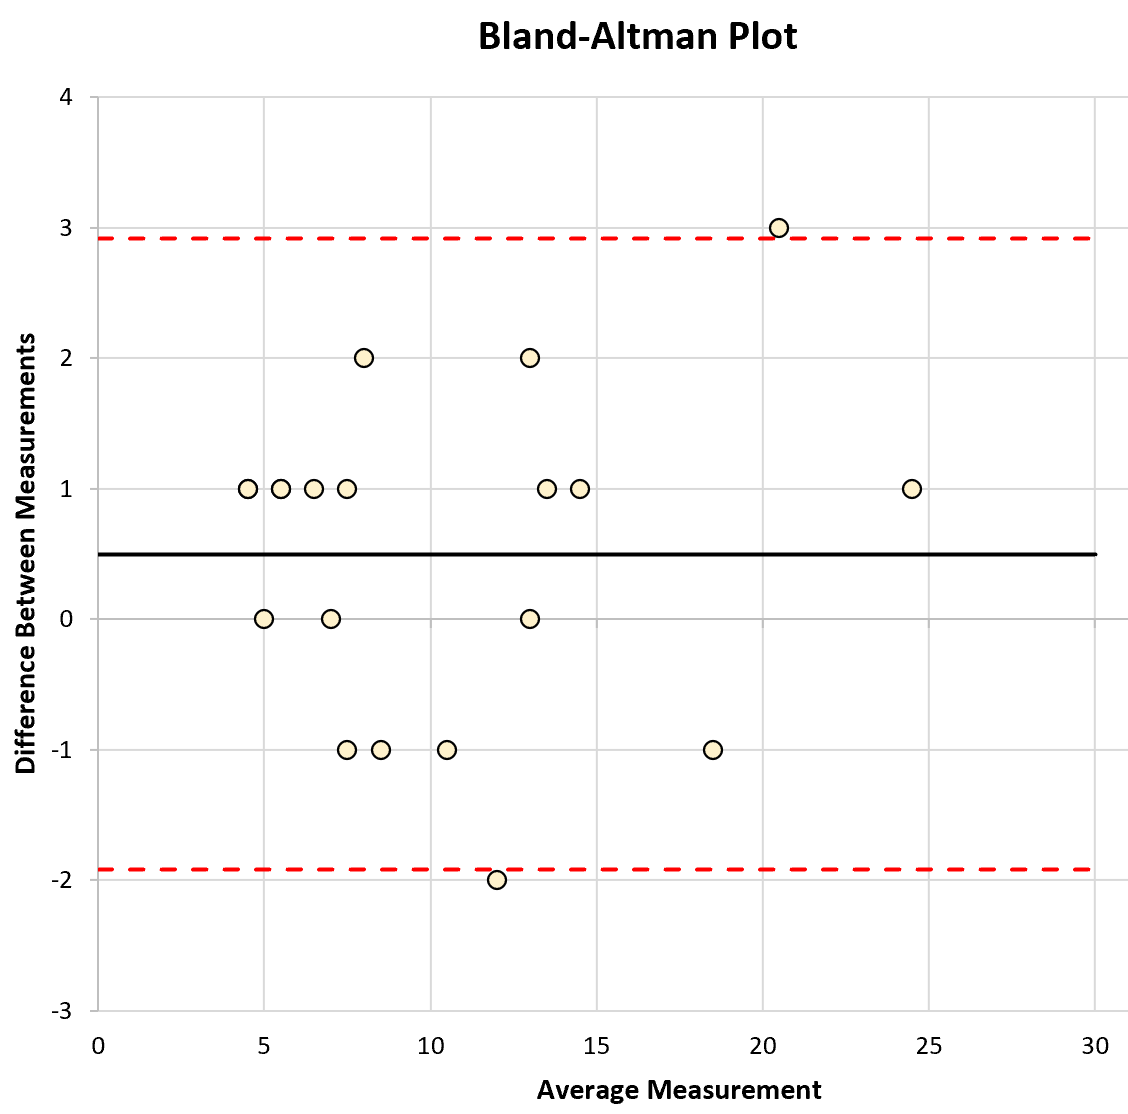
Le rôle central de cette visualisation réside dans la détection immédiate des anomalies de mesure. Contrairement à un indicateur scalaire unique (comme un coefficient de corrélation ou une valeur p), le graphique révèle la structure intime des résidus : présence de valeurs aberrantes, apparition d’une instabilité de la variance en fonction du niveau du trait, ou émergence d’un biais proportionnel où la divergence s’accroît avec la sévérité du phénomène observé. Il s’agit d’un instrument de diagnostic méthodologique autant que d’un moyen de confirmation statistique.
2. Fondements statistiques et comparaison méthodologique
2.1 L’inadéquation du coefficient de corrélation de Pearson
Durant des décennies, et encore trop souvent aujourd’hui dans certaines publications biomédicales, les chercheurs ont recouru au coefficient de corrélation linéaire de Pearson (noté r) pour attester de la validité concurrente de deux instruments. Cette pratique constitue une hérésie méthodologique dénoncée avec véhémence par Bland et Altman. La raison fondamentale en est l’insensibilité structurelle de la corrélation aux biais de mesure constants. Supposons deux instruments d’évaluation de la dépression, X et Y. Si la méthode Y ajoute systématiquement 15 points au score de la méthode X pour l’ensemble des participants (Y = X + 15), la corrélation observée sera rigoureusement égale à 1,00. Pourtant, les deux méthodes sont en désaccord clinique absolu, et une substitution directe de l’une par l’autre conduirait à classer des sujets sains parmi les dépressifs sévères.
Un danger symétrique réside dans la dépendance extrême du coefficient de corrélation à l’étendue de l’échantillon (*sampling range*). La corrélation de Pearson mesure la proportion de variance partagée par rapport à la variance totale. Par conséquent, si un échantillon présente une dispersion globale très large (incluant des participants extrêmement sains et des patients en détresse critique), le coefficient r sera artificiellement gonflé et très proche de l’unité, masquant de redoutables écarts cliniques individuels. Inversement, au sein d’un échantillon très homogène où la variance inter-sujets est ténue, la corrélation s’effondrera mathématiquement, même si les deux instruments mesurent le trait avec une précision quasi identique. La corrélation de Pearson ne renseigne donc en rien sur l’ampleur absolue de l’erreur de mesure.
Cette confusion chronique entre association linéaire et accord mutuel a généré une littérature abondante faussement rassurante. Un coefficient r = 0,92, fréquemment interprété comme la démonstration d’une concordance éclatante, est parfaitement compatible avec des erreurs de mesure individuelles pouvant atteindre 30 à 40 % de la valeur vraie du paramètre, ce qui invalide son usage en tant que garant de l’interchangeabilité.
2.2 Limites des tests de comparaison de moyennes classiques
Conscients des lacunes du coefficient de corrélation, de nombreux expérimentateurs se tournent vers les tests d’hypothèse classiques de comparaison de moyennes, au premier rang desquels figure le test t de Student pour échantillons appariés. Ce choix analytique procède d’une incompréhension tout aussi dommageable de la logique de l’inférence statistique. Le test t apparié évalue l’hypothèse nulle selon laquelle la différence moyenne au sein de la population est égale à zéro (H0 : μdiff = 0). L’échec du rejet de cette hypothèse nulle (l’obtention d’une valeur p > 0,05) est couramment et naïvement interprété comme une preuve de l’équivalence des deux instruments.
Or, en épistémologie statistique, l’absence de preuve n’est pas la preuve de l’absence. Une valeur p non significative peut découler simplement d’un manque de puissance statistique lié à un échantillon trop réduit ou à une dispersion aléatoire très large des mesures individuelles. Paradoxalement, plus les deux méthodes sont imprécises et bruitées, plus l’écart-type des différences sera important, ce qui réduira la statistique t et facilitera l’obtention d’une valeur p non significative. Féliciter deux méthodes pour leur équivalence au motif d’un test t non significatif revient à récompenser le manque de rigueur de l’échantillonnage et la médiocre fiabilité des instruments.
À l’opposé, si la taille de l’échantillon est massive (par exemple N = 2000), le test t rejettera presque inévitablement l’hypothèse nulle pour une différence moyenne infinitésimale de 0,1 point, totalement dépourvue de signification clinique. Enfin et surtout, les statistiques de groupe telles que le test t opèrent au niveau macroscopique et n’apportent strictement aucune information sur l’amplitude des déviations individuelles. Les écarts positifs chez certains participants peuvent parfaitement compenser les écarts négatifs chez d’autres, maintenant une moyenne globale nulle au prix d’une variabilité individuelle inacceptable.
2.3 Apport unique de l’approche de Bland et Altman
Face aux impasses conjuguées de la corrélation et des tests d’hypothèse traditionnels, l’approche de Bland et Altman se distingue par une focalisation exclusive sur la métrique opérationnelle du phénomène étudié. Elle abandonne les indicateurs abstraits sans dimension pour exprimer directement le désaccord dans les unités de mesure réelles de la variable d’intérêt : milligrammes par litre, points sur une échelle d’évaluation, millisecondes ou battements par minute. Cette propriété fondamentale ancre directement l’analyse dans la réalité empirique du chercheur et du praticien.
La puissance du paradigme repose sur la distinction nette et non équivoque entre deux composantes de l’erreur globale :
- L’erreur systématique (le biais moyen) : qui mesure le décalage constant moyen entre les deux instruments, indiquant si l’une des méthodes a tendance à surévaluer ou sous-évaluer la variable cible par rapport à l’autre.
- L’erreur aléatoire (la dispersion des résidus) : qui quantifie l’amplitude des fluctuations imprévisibles d’un individu à l’autre autour de cette valeur moyenne, capturant le bruit de fond inhérent aux instruments et aux fluctuations biologiques momentanées.
En isolant ces deux sources de divergence et en établissant des bornes empiriques claires – les limites d’agrément –, la méthode de Bland-Altman fournit un cadre décisionnel opérationnel. Il ne s’agit plus de savoir si deux méthodes sont « statistiquement différentes » selon un seuil d’alpha arbitraire de 5 %, mais d’établir formellement si l’écart maximal prédit entre deux mesures demeure contenu à l’intérieur des marges de tolérance acceptables définies a priori par les spécialistes du domaine.
3. Anatomie géométrique et structure des axes du graphique
3.1 Définition de l’axe des abscisses (axe X)
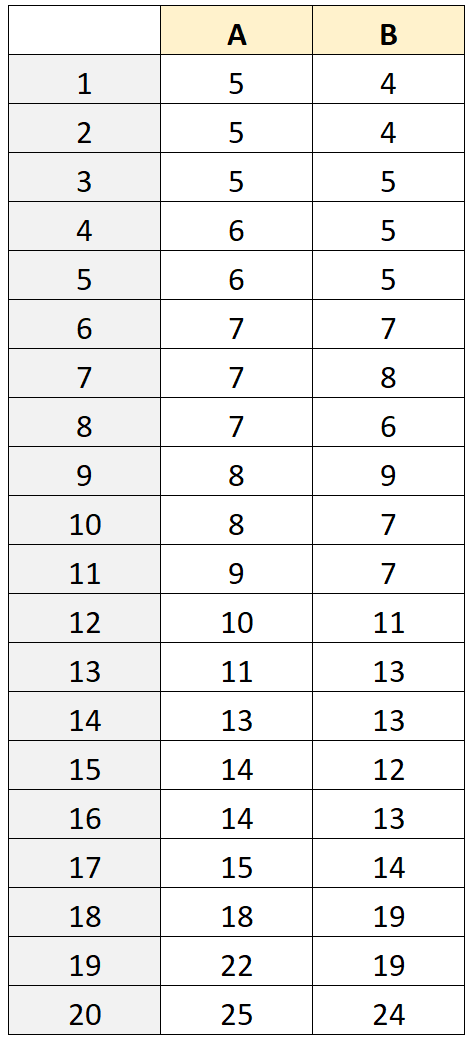
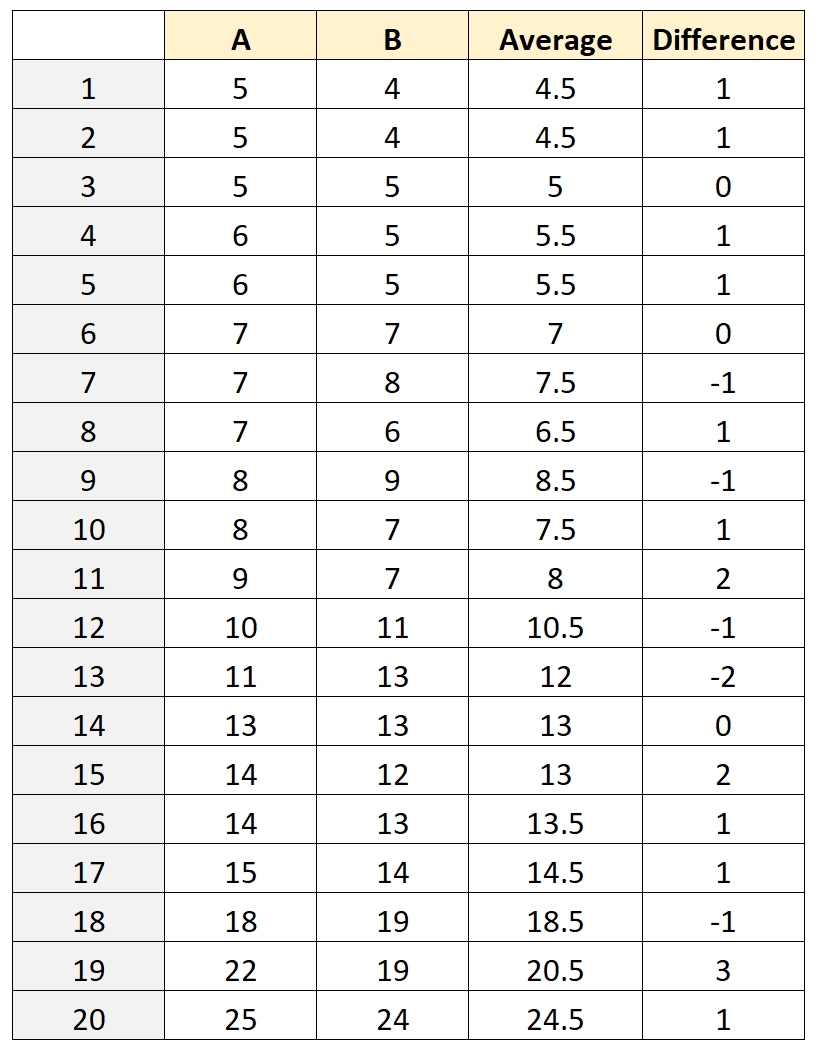
La structure géométrique du graphique de Bland-Altman est d’une apparente simplicité, mais chaque composante répond à une justification théorique méticuleuse. L’axe horizontal (axe des abscisses, ou axe X) représente la meilleure estimation disponible de la grandeur sous-jacente mesurée. Dans la quasi-totalité des contextes cliniques et expérimentaux, la valeur réelle de l’attribut demeure inaccessible en raison de l’absence d’un étalon-or absolu exempt de toute erreur. Bland et Altman ont mathématiquement démontré que la meilleure estimation de la valeur vraie correspond à la moyenne arithmétique des deux mesures obtenues pour chaque individu :
$$\text{Moyenne individu } i = \frac{S_{A,i} + S_{B,i}}{2}$$
Une erreur méthodologique récurrente observée dans la littérature consiste à positionner sur l’axe des abscisses l’une des deux méthodes de mesure de manière isolée – généralement celle considérée arbitrairement comme la méthode de référence ou l’étalon historique. Cette dérive introduit un biais statistique insidieux. Dans la mesure où la méthode étalon comporte elle-même une part d’erreur de mesure aléatoire, reporter la différence (Méthode A – Méthode B) en fonction de la seule Méthode A crée une dépendance artificielle et fallacieuse entre l’erreur et la magnitude mesurée. Ce phénomène, directement lié à la régression vers la moyenne, induit une pente oblique artificielle sur le graphique, faisant croire à l’existence d’un biais proportionnel là où il n’existe qu’une variance d’erreur d’échantillonnage. Le recours à la moyenne combinée des deux méthodes constitue le seul moyen impartial d’atténuer cet artefact mathématique.
3.2 Définition de l’axe des ordonnées (axe Y)
L’axe vertical (axe des ordonnées, ou axe Y) porte la différence arithmétique simple entre les deux mesures obtenues pour chaque sujet :
$$\text{Différence individuelle } d_i = S_{A,i} – S_{B,i}$$
Le choix de l’ordre de la soustraction doit faire l’objet d’une convention explicite dès le protocole d’analyse. Si l’on évalue un nouvel outil expérimental (A) face à un étalon de référence établi (B), la convention générale impose de soustraire la référence de la nouvelle méthode ($d_i = A_i – B_i$). Sous cette convention, une valeur résiduelle positive indique que le nouvel instrument surestime la valeur par rapport au standard, tandis qu’une valeur négative dénote une sous-estimation.
Cette disposition confère à l’axe des ordonnées une lisibilité immédiate. Tout écart par rapport à la ligne d’ordonnée zéro matérialise directement un désaccord empirique entre les deux instruments. L’inspection visuelle de la distribution des points le long de l’axe vertical permet d’apprécier instantanément la symétrie des erreurs, l’étendue de la variabilité globale et la présence éventuelle de déviations aberrantes chez certains individus particuliers.
3.3 Lignes de référence fondamentales
Un graphique de Bland-Altman conforme aux exigences académiques internationales ne se limite pas à un simple nuage de points disséminés dans un plan cartésien. Il s’articule autour de lignes horizontales de référence fondamentales qui guident l’interprétation clinique :
- La ligne de différence nulle (d = 0) : tracée généralement en trait continu fin ou en pointillés légers, elle figure la situation idéale d’égalité parfaite où les deux instruments attribuent exactement le même score ($S_{A,i} = S_{B,i}$). L’écart entre cette ligne et les données observables constitue le premier repère visuel de la performance comparée.
- La ligne centrale de biais ($\bar{d}$) : tracée en trait continu épais ou discontinu proéminent, elle correspond à la moyenne empirique de l’ensemble des différences individuelles. Sa distance absolue par rapport à la ligne de différence nulle matérialise visuellement l’ampleur du biais systématique de mesure.
- Les limites d’agrément supérieure et inférieure : tracées sous forme de lignes horizontales parallèles à la ligne centrale, elles délimitent l’intervalle dans lequel doivent se loger la vaste majorité des écarts individuels de mesure.
Cette structure géométrique transforme un nuage de points complexe en une carte de décision probabiliste, où chaque observation est évaluée en fonction de son appartenance au corridor de variabilité attendu.
4. Calcul mathématique du biais moyen et des limites d’agrément
4.1 Modélisation de l’erreur systématique (le biais moyen)
Le traitement analytique des données débute par la modélisation de l’erreur systématique, désignée techniquement sous le vocable de « biais moyen » ($\bar{d}$). Pour un échantillon représentatif de $n$ sujets appariés, chacun ayant été évalué par les méthodes A et B, le biais moyen s’obtient par la moyenne arithmétique simple des différences individuelles :
$$\bar{d} = \frac{1}{n} \sum_{i=1}^{n} d_i = \frac{1}{n} \sum_{i=1}^{n} (S_{A,i} – S_{B,i})$$
La magnitude de $\bar{d}$ quantifie l’importance du décalage systématique entre les instruments. Un biais moyen de $+4,2$ sur une échelle psychométrique signale que la méthode A fournit, en moyenne globale sur l’échantillon, un score supérieur de 4,2 points à celui de la méthode B. Sur le plan théorique, l’estimateur $\bar{d}$ bénéficie des propriétés de convergence asymptotique de la loi des grands nombres : lorsque la taille de l’échantillon $n$ tend vers l’infini, $\bar{d}$ converge en probabilité vers le biais systématique réel de la population générale ($\mu_{\text{diff}}$).
Toutefois, l’existence d’un biais systématique, même statistiquement différent de zéro, n’est pas nécessairement rédhibitoire pour la pratique clinique. Si ce biais est stable et invariant à travers toute l’étendue de l’échelle, il peut faire l’objet d’un réétalonnage ou d’une constante de recalibration ajoutée ou soustraite algorithmiquement lors de l’utilisation du nouvel outil. La véritable criticité réside dans l’amplitude de l’erreur aléatoire résiduelle qui entoure ce biais moyen.
4.2 Dérivation des limites d’agrément à 95 % (Limits of Agreement)
Pour appréhender l’amplitude de la dispersion des désaccords individuels, il est impératif de calculer l’écart-type empirique des différences, noté $s_d$. Cet écart-type est défini par la formulation quadratique usuelle appliquée aux écarts centrés sur le biais moyen :
$$s_d = \sqrt{\frac{1}{n – 1} \sum_{i=1}^{n} (d_i – \bar{d})^2}$$
Sous le postulat selon lequel les différences de mesure individuelles ($d_i$) suivent une distribution gaussienne (normale) au sein de la population parente, la théorie des probabilités stipule qu’environ 95 % des observations d’une variable aléatoire normale sont comprises dans un intervalle centré sur l’espérance et d’une largeur égale à 1,96 fois l’écart-type de part et d’autre de celle-ci. Bland et Altman ont donc canoniquement formulé les « Limites d’Agrément à 95 % » (*95% Limits of Agreement*, LoA) comme suit :
$$\text{Limite Supérieure (LoA}_{\text{\sup}}\text{)} = \bar{d} + 1{,}96 \cdot s_d$$
$$\text{Limite Inférieure (LoA}_{\text{\inf}}\text{)} = \bar{d} – 1{,}96 \cdot s_d$$
La signification probabiliste de ces limites est fondamentale : si l’on applique simultanément les deux instruments de mesure à un nouveau sujet issu de la même population, il y a 95 % de chances que l’écart entre les deux scores observés se situe entre la limite inférieure et la limite supérieure d’agrément. L’interprétation clinique ne se focalise donc plus sur la moyenne $\bar{d}$, mais sur les bornes extrêmes. Si une différence correspondant à l’une de ces bornes induit une décision thérapeutique divergente, un changement de diagnostic psychopathologique ou un pronostic erroné, alors les deux méthodes ne peuvent être déclarées cliniquement interchangeables, quand bien même leur corrélation frôlerait la perfection.
4.3 Hypothèses sous-jacentes obligatoires
La validité mathématique et l’interprétabilité des limites d’agrément reposent sur la vérification rigoureuse de trois hypothèses statistiques sous-jacentes. La méconnaissance de ces postulats constitue la cause principale des erreurs de publication dans la littérature biomédicale contemporaine :
- La normalité de la distribution des différences : Il est primordial de souligner que l’hypothèse de normalité s’applique strictement à la série des différences individuelles ($d_i$), et nullement aux mesures brutes $S_A$ ou $S_B$. Les scores initiaux peuvent être fortement asymétriques ou bimodaux sans altérer la normalité de leurs différences appariées. Cette hypothèse doit être vérifiée à l’aide d’outils formels tels que le tracé d’un diagramme quantile-quantile (Q-Q plot) normal ou le test de Shapiro-Wilk.
- L’indépendance entre les différences et la magnitude de la mesure : La différence arithmétique ne doit présenter aucune dépendance fonctionnelle à l’égard de la moyenne des mesures. En d’autres termes, les résidus ne doivent pas afficher de corrélation linéaire ascendante ou descendante à mesure que les scores globaux augmentent.
- L’homoscédasticité de la variance des résidus : La dispersion des différences autour du biais moyen doit demeurer constante sur l’intégralité du continuum de l’axe des abscisses. L’apparition d’une variabilité croissante pour les valeurs élevées traduit une violation de ce postulat, nécessitant des corrections analytiques adaptées.
5. Estimation de l’incertitude : intervalles de confiance
5.1 Erreur-type du biais moyen
Le biais moyen $\bar{d}$ et l’écart-type des différences $s_d$ calculés à partir d’un groupe d’étude ne constituent que des estimations ponctuelles d’échantillon, inéluctablement sujettes à l’erreur d’échantillonnage. Si une autre cohorte de sujets était sélectionnée selon le même protocole, les valeurs empiriques obtenues différeraient légèrement. Pour répondre aux critères de la médecine factuelle, il est donc indispensable de quantifier l’incertitude statistique entourant ces paramètres.
L’erreur-type de la moyenne des différences, classiquement désignée sous l’acronyme $SE(\bar{d})$ (*Standard Error*), reflète la fidélité de l’estimation de l’erreur systématique. Sa dérivation mathématique s’exprime par le ratio canonique :
$$SE(\bar{d}) = \sqrt{\frac{s_d^2}{n}} = \frac{s_d}{\sqrt{n}}$$
À partir de cette erreur-type, l’intervalle de confiance bilatéral à 95 % entourant le biais moyen est obtenu en multipliant cette quantité par la valeur critique de la loi de Student $t_{n-1}$ correspondant à un niveau de risque bilatéral $\alpha = 0{,}05$. Pour un échantillon de taille suffisante ($n > 60$), cette valeur critique est approximativement égale à 1,96 :
$$IC_{95%}(\bar{d}) = \left[ \bar{d} – t_{n-1;, 0{,}025} \cdot SE(\bar{d}) ; ; ; \bar{d} + t_{n-1;, 0{,}025} \cdot SE(\bar{d}) \right]$$
Lorsque la taille de l’échantillon est restreinte, l’erreur-type s’accroît considérablement, élargissant l’intervalle de confiance au point qu’un biais estimé à première vue comme négligeable peut recouvrir en réalité une divergence systématique substantielle au sein de la population générale.
5.2 Intervalles de confiance des limites d’agrément
Une des contributions les plus remarquables de Douglas Altman en 1986 a été de démontrer que l’incertitude ne pèse pas uniquement sur la ligne centrale de biais, mais s’étend avec une acuité accrue aux limites supérieure et inférieure d’agrément. L’erreur-type associée à chacune de ces limites incorpore à la fois la variance de l’estimation de la moyenne ($\bar{d}$) et la variance de l’estimation de la variance d’échantillonnage ($s_d$). Altman a dérivé une formule analytique robuste permettant d’approximer l’erreur-type des limites d’accord :
$$SE(\text{LoA}) \approx \sqrt{\frac{s_d^2}{n} + \frac{(1{,}96)^2 \cdot s_d^2}{2(n – 1)}} \approx s_d \cdot \sqrt{\frac{1}{n} + \frac{1{,}96^2}{2(n – 1)}} \approx 1{,}71 \cdot \frac{s_d}{\sqrt{n}}$$
L’intervalle de confiance à 95 % de chaque limite d’agrément est par conséquent défini par :
$$IC_{95%}(\text{LoA}_{\text{\sup}}) = \left[ \text{LoA}_{\text{\sup}} – t_{n-1;, 0{,}025} \cdot SE(\text{LoA}) ; ; ; \text{LoA}_{\text{\sup}} + t_{n-1;, 0{,}025} \cdot SE(\text{LoA}) \right]$$
$$IC_{95%}(\text{LoA}_{\text{\inf}}) = \left[ \text{LoA}_{\text{\inf}} – t_{n-1;, 0{,}025} \cdot SE(\text{LoA}) ; ; ; \text{LoA}_{\text{\inf}} + t_{n-1;, 0{,}025} \cdot SE(\text{LoA}) \right]$$
La portée méthodologique de cette formule est primordiale pour la décision clinique. Une limite d’agrément calculée ponctuellement à $+8,0$ points dans un échantillon modeste ($n = 30$) peut s’accompagner d’un intervalle de confiance s’étendant de $+5,5$ à $+10,5$ points. Si le seuil d’inacceptabilité clinique fixé par les experts est de $+9,0$ points, la limite ponctuelle semblerait indiquer que les deux outils sont interchangeables, alors que la borne haute de son intervalle de confiance excède clairement le seuil tolérable. L’omission des intervalles de confiance conduit ainsi à de graves dérives de validation instrumentale prématurée.
5.3 Représentation visuelle de l’incertitude
Afin de restituer fidèlement l’ensemble de l’information mathématique sans surcharger inutilement la lecture visuelle, les standards graphiques contemporains préconisent l’adjonction de bandes de confiance hachurées ou ombrées le long des axes de référence. Ces zones en demi-teinte encadrent la ligne centrale de biais et les deux limites d’agrément, offrant une appréciation visuelle directe de la robustesse de l’estimation statistique.
Il importe d’enseigner aux analystes la distinction herméneutique absolue entre :
- Les limites d’agrément à 95 % : qui représentent la dispersion inter-individuelle des résidus de mesure chez les sujets (intervalle de prédiction empirique pour un nouvel individu).
- Les intervalles de confiance des limites : qui représentent l’incertitude d’échantillonnage pesant sur la localisation réelle de ces bornes dans la population globale (indicateur inférentiel lié à la puissance et à la représentativité de la cohorte).
La présentation exclusive des lignes d’agrément nues est formellement proscrite par les comités de lecture des revues scientifiques de premier rang. Un graphique complet et rigoureux doit obligatoirement intégrer ces marges d’incertitude paramétriques afin de prémunir le clinicien contre les conclusions hâtives résultant d’une sur-interprétation d’estimateurs calculés sur des échantillons restreints.
6. Évaluation empirique des critères de décision clinique
6.1 Définition a priori des marges d’équivalence clinique
L’une des singularités épistémologiques du graphique de Bland-Altman réside dans son refus de fournir un verdict binaire automatisé fondé sur une p-value. Le graphique calcule des faits observationnels : un biais systématique et des bornes de divergence à 95 %. Mais aucun test mathématique ne peut, en lui-même, déclarer si un écart-type de 3 points est « cliniquement tolérable » ou « dramatiquement inacceptable ». La responsabilité du jugement est restituée aux cliniciens et aux chercheurs du domaine spécifique.
Cette responsabilité impose la fixation a priori – impérativement avant le début du recueil de données – de marges d’équivalence clinique acceptables (notées communément $[-\Delta ; +\Delta]$). La fixation arbitraire de ces marges a posteriori, après avoir pris connaissance du tracé empirique, expose le chercheur à un biais de confirmation majeur et vide la démarche de validation de toute scientificité. En diagnostic psychologique et neuropsychologique, la définition de la marge $\Delta$ repose fréquemment sur la notion de différence minimale cliniquement importante (MCID, *Minimal Clinically Important Difference*) ou sur l’erreur de mesure standardisée (SEM, *Standard Error of Measurement*) établie lors des études de standardisation psychométrique antérieures.
Il est également indispensable d’intégrer dans cette réflexion la variabilité biologique intra-individuelle naturelle. Si l’évaluation de l’anxiété d’un sujet varie spontanément de $\pm 3$ points sur une échelle donnée d’une heure à l’autre sans aucun changement contextuel, exiger de deux instruments qu’ils concordent à $\pm 1$ point près relève d’une illusion métrologique. Les marges d’équivalence doivent refléter un compromis équilibré entre la précision analytique pure et la plasticité intrinsèque du processus physiologique ou psychologique observé.
6.2 Algorithme d’interchangeabilité de deux instruments
La décision finale d’interchangeabilité entre deux outils de mesure découle de la confrontation algorithmique entre l’intervalle d’agrément empirique et l’intervalle de tolérance clinique prédéfini. Le processus de validation requiert le respect scrupuleux d’une condition d’inclusion géométrique stricte.
Pour que deux instruments soient formellement déclarés interchangeables, l’intégralité de l’intervalle d’agrément empirique – y compris les bornes les plus défavorables de ses intervalles de confiance à 95 % – doit être strictement contenue à l’intérieur du corridor prédéfini $[-\Delta ; +\Delta]$ :
$$[-\Delta] < IC_{95%}(\text{LoA}_{\text{\inf}})_{\text{bas}} \quad \text{et} \quad IC_{95%}(\text{LoA}_{\text{\sup}})_{\text{haut}} < [+\Delta]$$
Si la limite supérieure d’agrément franchit la borne $+\Delta$, ou si la limite inférieure plonge en deçà de $-\Delta$, la conclusion s’impose : bien que les instruments puissent être étroitement corrélés, le risque qu’un patient individuel reçoive une valeur divergente dépassant l’erreur cliniquement tolérable est supérieur à 5 %. Dans de telles conditions, la substitution du nouvel outil à l’ancien ne peut être validée sans compromettre la sécurité des soins ou la rigueur de l’expérimentation.
Les conséquences d’une interchangeabilité validée à tort peuvent être dramatiques : sous-estimation de scores suicidaires en psychiatrie, mauvaise classification de l’intensité de déficits cognitifs chez des patients cérébrolésés, ou ajustement inadéquat d’un traitement pharmacologique neuromodulateur. La prudence analytique s’avère ici un devoir éthique autant que scientifique.
6.3 Gestion des valeurs atypiques et points aberrants
La lecture visuelle du graphique de Bland-Altman confronte inévitablement l’expérimentateur à la présence de points se situant en dehors des limites d’agrément calculées. Il est mathématiquement impératif de rappeler que, par définition même des limites construites sur un intervalle bilatéral à 95 % sous hypothèse normale, environ 5 % des points d’un échantillon ont vocation à se situer naturellement au-delà de ces frontières (soit un point sur vingt en moyenne). La simple présence d’un point isolé à l’extérieur des limites ne traduit donc pas obligatoirement une défaillance de l’instrument ou une contamination des données.
Cependant, l’apparition de valeurs aberrantes extrêmes (*outliers*) soulève un défi analytique de premier plan. L’écart-type $s_d$ étant une fonction quadratique des écarts, un seul point massivement discordant est susceptible de gonfler artificiellement $s_d$, ce qui aura pour effet indésirable d’écarter démesurément les limites d’agrément pour l’ensemble des 99 % d’individus restants. Face à une observation atypique, la démarche méthodologique doit suivre une rigueur stricte :
- Rechercher en amont une erreur d’encodage, de transcription typographique ou une anomalie manifeste lors de la passation de l’épreuve (interruption du test, déconnexion partielle d’une électrode).
- Si l’aberration est confirmée comme une erreur technique traçable, l’observation doit être corrigée ou exclue conformément aux critères de contrôle qualité déclarés.
- Si le point correspond à une réponse authentique et non viciée du participant, son exclusion pure et simple est méthodologiquement frauduleuse. La conduite d’excellence impose alors de réaliser et de publier une analyse de sensibilité comparative, présentant les graphiques et paramètres calculés simultanément avec et sans le point litigieux, tout en documentant qualitativement les caractéristiques cliniques singulières de l’individu concerné.
7. Exemple pratique : comparaison d’échelles d’anxiété clinique
7.1 Présentation du protocole et de l’échantillon fictif
Afin d’illustrer concrètement l’application opérationnelle de la méthode, considérons une étude clinique fictive menée au sein d’une unité de neuropsychiatrie. L’objectif est de valider une nouvelle échelle abrégée d’anxiété situationnelle, administrable sur support numérique en deux minutes (dénommée Échelle Rapide d’Anxiété, ERA), destinée à remplacer l’inventaire psychométrique standard de référence (dénommé Inventaire d’Anxiété Clinique de Référence, IACR), dont la passation papier-crayon requiert vingt minutes.
Les deux échelles sont étalonnées sur un continuum quantitatif standardisé allant de 0 à 100 points, où les scores élevés correspondent à un état anxieux sévère. Le protocole implique l’administration simultanée et contrebalancée des deux instruments à un échantillon consécutif de $n = 100$ participants adultes souffrant de troubles émotionnels divers. Avant tout recueil de données, le collège d’experts cliniciens a solennellement fixé la marge d’équivalence maximale acceptable à $\pm 5{,}0$ points de score. Au-delà d’un décalage de 5 points, la discordance est jugée susceptible de modifier le niveau de prise en charge psychothérapeutique.
Le tableau suivant présente un extrait représentatif des dix premiers participants de la cohorte expérimentale, illustrant la structure des données brutes appariées et les opérations arithmétiques préliminaires :
| Participant (ID) | Score Référence (IACR) | Score Nouveau (ERA) | Moyenne appariée $(S_{A} + S_{B})/2$ | Différence individuelle $(S_{A} – S_{B})$ |
|---|---|---|---|---|
| P001 | 52,4 | 54,1 | 53,25 | +1,7 |
| P002 | 38,0 | 39,2 | 38,60 | +1,2 |
| P003 | 65,7 | 68,0 | 66,85 | +2,3 |
| P004 | 44,2 | 44,9 | 44,55 | +0,7 |
| P005 | 71,8 | 73,5 | 72,65 | +1,7 |
| P006 | 29,5 | 30,1 | 29,80 | +0,6 |
| P007 | 58,3 | 60,2 | 59,25 | +1,9 |
| P008 | 48,9 | 49,5 | 49,20 | +0,6 |
| P009 | 82,1 | 84,3 | 83,20 | +2,2 |
| P010 | 35,6 | 36,8 | 36,20 | +1,2 |
7.2 Calcul pas à pas des paramètres statistiques
L’analyse statistique computationnelle menée sur la totalité des $n = 100$ participants produit les métriques canoniques suivantes :
- Somme des différences individuelles : $\sum d_i = +142{,}00$
- Biais moyen constaté ($\bar{d}$) :
$$\bar{d} = \frac{142{,}00}{100} = +1{,}42 \text{ points}$$ - Somme des écarts centrés au carré : $\sum (d_i – \bar{d})^2 = 125{,}38$
- Variance résiduelle empirique :
$$s_d^2 = \frac{125{,}38}{99} \approx 1{,}2665$$ - Écart-type des différences ($s_d$) :
$$s_d = \sqrt{1{,}2665} \approx 1{,}1254 \text{ points}$$
À partir de ces éléments fondamentaux, la dérivation des limites d’agrément à 95 % est exécutée :
- Limite Supérieure d’Agrément ($\text{LoA}_{\text{\sup}}$) :
$$\text{LoA}_{\text{\sup}} = +1{,}42 + (1{,}96 \cdot 1{,}1254) = +1{,}42 + 2{,}2058 = +3{,}63 \text{ points}$$ - Limite Inférieure d’Agrément ($\text{LoA}_{\text{\inf}}$) :
$$\text{LoA}_{\text{\inf}} = +1{,}42 – (1{,}96 \cdot 1{,}1254) = +1{,}42 – 2{,}2058 = -0{,}79 \text{ p\oint}$$
Il convient ensuite de quantifier l’incertitude d’échantillonnage par les intervalles de confiance correspondants :
- Erreur-type du biais : $SE(\bar{d}) = 1{,}1254 / \sqrt{100} = 0{,}1125$
- Intervalle de confiance à 95 % du biais moyen (avec $t_{99} \approx 1{,}984$) :
$$IC_{95%}(\bar{d}) = [1{,}42 \pm (1{,}984 \cdot 0{,}1125)] = [1{,}20 ; ; ; 1{,}64] \text{ points}$$ - Erreur-type des limites d’agrément :
$$SE(\text{LoA}) \approx 1{,}1254 \cdot \sqrt{\frac{1}{100} + \frac{1{,}96^2}{2 \cdot 99}} \approx 1{,}1254 \cdot \sqrt{0{,}01 + 0{,}0194} \approx 1{,}1254 \cdot 0{,}1715 \approx 0{,}1930$$ - Intervalle de confiance à 95 % de la limite supérieure :
$$IC_{95%}(\text{LoA}_{\text{\sup}}) = [3{,}63 \pm (1{,}984 \cdot 0{,}1930)] = [3{,}25 ; ; ; 4{,}01] \text{ points}$$ - Intervalle de confiance à 95 % de la limite inférieure :
$$IC_{95%}(\text{LoA}_{\text{\inf}}) = [-0{,}79 \pm (1{,}984 \cdot 0{,}1930)] = [-1{,}17 ; ; ; -0{,}41] \text{ p\oint}$$
7.3 Construction graphique et interprétation clinique des résultats
Le tracé du graphique de Bland-Altman est exécuté en positionnant la moyenne des scores $[(ERA + IACR)/2]$ sur l’axe X (s’étendant de 20 à 90 points) et la différence $(ERA – IACR)$ sur l’axe Y (s’étendant de $-3$ à $+6$ points). Les observations individuelles forment un nuage de points homogène, réparti symétriquement de part et d’autre de la droite centrale horizontale positionnée à $+1,42$. Quatre-vingt-quinze des cent observations sont rigoureusement confinées à l’intérieur du corridor borné par $-0,79$ et $+3,63$, et cinq points se situent à proximité immédiate des limites, confirmant la fidélité de l’hypothèse gaussienne sous-jacente.
L’interprétation clinique découle immédiatement de l’examen analytique des résultats :
- Évaluation du biais systématique : Le biais moyen est de $+1,42$ point (différent de zéro au regard de son intervalle de confiance $[1,20 ; 1,64]$). La nouvelle échelle abrégée tend à majorer légèrement le score d’anxiété d’environ 1,4 point par rapport à l’étalon classique.
- Confrontation aux critères d’équivalence : L’intervalle de tolérance clinique prédéfini était de $[-5,0 ; +5,0]$ points. La limite supérieure d’agrément la plus défavorable, incarnée par la borne haute de son intervalle de confiance, atteint $+4,01$ points. La limite inférieure d’agrément la plus extrême plafonne à $-1,17$ point.
L’intégralité du corridor d’incertitude des limites d’agrément ($[-1,17 ; +4,01]$) se loge confortablement à l’intérieur des marges de tolérance acceptables ($[-5,0 ; +5,0]$). Sur le plan psychométrique, il est formellement établi que les divergences individuelles entre la version numérique abrégée et l’échelle longue n’excéderont jamais, avec une confiance de 95 %, le seuil critique ayant un impact sur les décisions médicales. L’interchangeabilité de l’Échelle Rapide d’Anxiété (ERA) est par conséquent scientifiquement validée.
8. Diagnostic des anomalies statistiques : hétéroscédasticité et biais proportionnel
8.1 Identification et traitement du biais proportionnel
Dans de nombreuses configurations expérimentales, l’erreur de mesure ne présente pas une magnitude invariable le long de l’échelle. On observe fréquemment ce que les métrologues nomment un « biais proportionnel », configuration pathologique où le décalage systématique entre les instruments varie de façon continue en fonction de la grandeur sous-jacente du trait mesuré. Sur le plan géométrique, le nuage de points du graphique de Bland-Altman ne s’organise plus autour d’une ligne horizontale parallèle à l’axe des abscisses, mais adopte une trajectoire oblique ascendante ou descendante, manifestant une pente non nulle hautement évocatrice.
L’identification formelle d’un biais proportionnel repose sur la modélisation statistique d’une régression linéaire ordinaire de la différence appariée ($d_i$) sur la moyenne des mesures ($M_i = (S_{A,i} + S_{B,i})/2$) :
$$d_i = \beta_0 + \beta_1 \cdot M_i + \varepsilon_i$$
L’examen du coefficient de régression $\beta_1$ et de sa p-value associée constitue le test diagnostique direct. Si le test rejette l’hypothèse nulle ($p < 0{,}05$), la présence d'un biais proportionnel est mathématiquement attestée. Dans cette circonstance, l'application de la formule canonique standard des limites d'agrément horizontales ($\bar{d} \pm 1{,}96 \cdot s_d$) est méthodologiquement erronée : les limites fixes surestimeront l'accord à l'une des extrémités de l'échelle et le sous-estimeront lourdement à l'autre extrémité.
La correction méthodologique préconisée par Bland et Altman consiste à modéliser des « limites d’agrément dépendantes de la magnitude » (*magnitude-dependent limits of agreement*). Ces limites ne sont plus matérialisées par des droites horizontales, mais par des lignes de régression obliques divergentes construites à partir de l’erreur quadratique moyenne de la régression linéaire ($s_{\text{res}}$) :
$$\text{Limites}(M) = (\hat{\beta}_0 + \hat{\beta}_1 \cdot M) \pm 1{,}96 \cdot s_{\text{res}}$$
Cette adaptation sophistiquée préserve la validité probabiliste de l’agrément en ajustant l’exigence de concordance au niveau spécifique de chaque observation.
8.2 Gestion de l’hétéroscédasticité (dispersion variable)
Une autre anomalie distributionnelle majeure est l’hétéroscédasticité, définie par une variabilité résiduelle non constante des résidus à travers l’axe des abscisses. Sa signature morphologique sur le graphique de Bland-Altman prend la forme caractéristique d’un cône, d’un éventail ou d’un entonnoir : les résidus se regroupent étroitement autour de la ligne de biais pour les faibles valeurs de mesure, puis s’écartent spectaculairement à mesure que les scores progressent le long de l’axe X (ou, plus rarement, le schéma inverse).
L’hétéroscédasticité constitue une violation directe du postulat d’homoscédasticité indispensable au calcul de l’écart-type global des différences $s_d$. Si un statisticien ignore cet état de fait et plaque un intervalle classique $\pm 1{,}96 \cdot s_d$, la largeur des limites d’agrément sera largement surévaluée pour les patients présentant des scores faibles (faisant paraître la méthode indûment imprécise à bas niveau) et considérablement sous-évaluée pour les patients sévères (créant une fausse impression de sécurité là où l’imprécision est en réalité maximale).
Le diagnostic de l’hétéroscédasticité s’effectue formellement par une régression linéaire simple reliant la valeur absolue des résidus ($|d_i – \bar{d}|$) ou le carré des résidus à la moyenne des mesures, ou via des tests statistiques robustes de type Breusch-Pagan. Lorsque ce patron en entonnoir est confirmé, l’expérimentateur doit renoncer aux formules univariées simples sous peine d’émettre des inférences cliniques invalides.
8.3 Transformation de données logarithmique
Face à une structure de données marquée par l’hétéroscédasticité ou par un biais proportionnel multiplicatif – situation extrêmement répandue lorsque l’erreur de mesure est proportionnelle à la magnitude de l’attribut biologique ou comportemental –, la stratégie analytique standardisée consiste à appliquer une transformation mathématique logarithmique aux données brutes avant toute opération de différence.
Pour chaque participant $i$, les données initiales $S_{A,i}$ et $S_{B,i}$ sont converties en leurs logarithmes népériens respectifs :
$$Y_{A,i} = \ln(S_{A,i}) \quad \text{et} \quad Y_{B,i} = \ln(S_{B,i})$$
La différence est ensuite calculée sur les valeurs transformées :
$$d_{\ln, i} = \ln(S_{A,i}) – \ln(S_{B,i}) = \ln\left(\frac{S_{A,i}}{S_{B,i}}\right)$$
Cette propriété logarithmique fondamentale convertit la différence arithmétique en un logarithme du ratio des deux mesures. L’application de la méthode classique de Bland-Altman sur cette série transformée produit un biais moyen logarithmique $\bar{d}_{\ln}$ et des limites d’agrément $[\bar{d}_{\ln} – 1{,}96 \cdot s_{d\ln} ; ; ; \bar{d}_{\ln} + 1{,}96 \cdot s_{d\ln}]$.
Pour rendre ces paramètres interprétables par le clinicien, une procédure de rétro-transformation exponentielle (*back-transformation*) est impérativement conduite :
$$\text{Ratio Moyen} = \exp(\bar{d}_{\ln})$$
$$\text{Limites d’Agrément du Ratio} = \left[ \exp(\bar{d}_{\ln} – 1{,}96 \cdot s_{d\ln}) ; ; ; \exp(\bar{d}_{\ln} + 1{,}96 \cdot s_{d\ln}) \right]$$
Les résultats ne s’énoncent plus en unités absolues, mais en variations relatives et pourcentages d’écart. Un ratio moyen de 1,03 assorti de limites à $[0{,}92 ; ; ; 1{,}15]$ signifie que la nouvelle méthode attribue en moyenne des scores supérieurs de 3 % à la méthode de référence, et que pour 95 % des sujets futurs, le score fourni par le nouvel outil oscillera entre une sous-estimation de 8 % et une surestimation de 15 % par rapport au standard. Cette formulation en ratio est particulièrement élégante et universelle en métrologie biomédicale.
9. Extensions avancées : mesures répétées et observateurs multiples
9.1 Adaptation pour mesures répétées par sujet
Le paradigme fondamental présenté jusqu’ici suppose qu’une seule et unique paire de mesures soit recueillie pour chaque participant. Or, dans les protocoles modernes d’essais cliniques, de suivi psychothérapeutique longitudinal ou de monitoring neurophysiologique continu, il est classique de disposer de plusieurs mesures répétées recueillies auprès des mêmes individus au cours du temps ou sous des conditions expérimentales multiples. Traiter ces observations successives comme des paires indépendantes et appliquer aveuglément les formules conventionnelles constitue une faute statistique majeure : cela viole le principe absolu d’indépendance des observations et conduit à une sous-estimation drastique de l’erreur d’échantillonnage, aboutissant à des limites artificiellement étroites.
Pour modéliser adéquatement les mesures répétées, Bland et Altman ont formalisé en 2007 des adaptations reposant sur la modélisation de la variance à effets mixtes ou par analyse de variance (ANOVA) à deux facteurs avec emboîtement. Le calcul requiert la décomposition rigoureuse de la variance totale des différences en deux strates distinctes :
- La variance intra-individuelle ($\sigma^2_{w}$) : qui quantifie l’instabilité de la différence observée chez un même patient d’un essai à l’autre.
- La variance inter-individuelle ($\sigma^2_{b}$) : qui capture l’hétérogénéité des biais systématiques d’un patient à l’autre au sein de la population.
La variance combinée globale des résidus ($s^2_{\text{pool}}$) est alors dérivée à partir des carrés moyens résiduels de l’ANOVA, permettant de reconstruire des limites d’agrément impartiales qui intègrent la corrélation intra-sujet sans biaiser le risque de type I.
9.2 Comparaison de multiples évaluateurs ou juges
En psychiatrie clinique et en psychologie légale, la validation d’instruments repose souvent sur l’accord inter-juges impliquant non pas deux, mais $k$ observateurs indépendants (psychiatres, experts légistes) évaluant un même panel de dossiers ou d’entretiens vidéo. La méthode conventionnelle consistant à tracer toutes les paires possibles de graphiques deux à deux ($k(k-1)/2$ graphiques) devient rapidement inextricable et augmente démesurément l’inflation du risque d’erreur globale.
L’extension avancée pour observateurs multiples consiste à estimer les limites d’agrément globales par l’intermédiaire d’un modèle linéaire mixte d’analyse de variance à effets aléatoires. Dans ce cadre computationnel, le concept de limites d’accord s’articule directement avec le Coefficient de Corrélation Intra-classe (CCI, notamment le modèle à effets aléatoires bidirectionnel à accord absolu, $\text{ICC}(2,1)$). L’écart-type de l’erreur de mesure inter-évaluateurs ($\text{SE}_{\text{inter}}$) est extrait directement de la composante de variance d’interaction sujet-évaluateur et de la variance résiduelle :
$$\text{LoA}_{\text{globales}} = \pm 1{,}96 \cdot \sqrt{2 \cdot \sigma^2_{\text{erreur}}}$$
Cette approche synthétise l’interchangeabilité de l’ensemble du collège d’évaluateurs en un estimateur opérationnel unique exprimé dans la métrique clinique originale du score diagnostique.
9.3 Mesures sans répétition versus réplicats simultanés
Une distinction conceptuelle sophistiquée doit être opérée entre les protocoles où les instruments sont appliqués en simple exemplaire et ceux intégrant des « réplicats simultanés véritables ». Lorsqu’un clinicien évalue un patient avec deux appareils distincts, la divergence totale observée agglomère indifféremment l’imprécision instrumentale propre à l’appareil A, l’imprécision instrumentale propre à l’appareil B, et le désaccord structurel entre les deux technologies.
Si le protocole expérimental recueille des mesures dupliquées simultanées pour chaque instrument (Méthode A mesurée deux fois consécutivement : $A_1, A_2$ ; et Méthode B mesurée deux fois : $B_1, B_2$), il devient possible de procéder à une décomposition formelle de la variance. L’analyse permet d’isoler :
- La répétabilité intrinsèque de la méthode A (sa propre fidélité intra-instrumentale test-retest immédiate).
- La répétabilité intrinsèque de la méthode B.
- La concordance structurelle pure entre A et B, expurgée du bruit d’imprécision aléatoire propre à chaque dispositif.
Bland et Altman ont établi des équations d’ajustement permettant de vérifier si le désaccord constaté entre les deux méthodes est simplement la conséquence arithmétique de la piètre répétabilité intrinsèque de l’un des instruments ou s’il traduit une véritable incompatibilité technologique entre les deux principes de mesure.
10. Mise en œuvre pratique sur logiciels statistiques
10.1 Implémentation sous l’environnement R
L’environnement computationnel R constitue l’écosystème de choix pour le traitement de pointe des analyses de concordance métrologique. Les utilisateurs disposent de bibliothèques spécialisées telles que blandr ou BlandAltmanLeh, mais la maîtrise de l’implémentation native via la grammaire des graphiques ggplot2 offre une flexibilité indispensable à la production de figures répondant aux standards des revues internationales.
Le traitement algorithmique suit une logique fonctionnelle rigoureuse : création d’un tableau de données apparié, calcul vectoriel des moyennes et différences, estimation analytique des paramètres gaussiens ($d$, $s_d$), dérivation des erreurs-types paramétriques pour les intervalles de confiance, et assemblage stratifié des couches géométriques. Le rendu permet de superposer des polygones translucides pour les intervalles de confiance à 95 % du biais et des limites d’agrément, garantissant une communication visuelle optimale des marges d’incertitude.
L’extraction automatisée des métriques sous forme de listes d’objets permet d’intégrer sans rupture les calculs d’interchangeabilité dans des chaînes de traitement automatisées pour les essais cliniques multicentriques, tout en facilitant les vérifications de normalité par les tests de Shapiro-Wilk et l’inspection formelle des graphiques de régression sur les résidus.
10.2 Implémentation en langage Python
Dans l’écosystème open-source de la science des données en santé, le langage Python mobilise des bibliothèques scientifiques de premier plan telles que numpy, pandas, scipy.stats et les moteurs graphiques matplotlib et seaborn. Le module spécialisé statsmodels.graphics.agreement propose une routine préconfigurée intitulée mean_diff_plot, permettant d’esquisser rapidement un tracé de Bland-Altman à des fins exploratoires.
Toutefois, pour les publications scientifiques de référence, le chercheur a intérêt à bâtir une fonction personnalisée exploitant la puissance matricielle de pandas. Les calculs vectoriels déterminent instantanément les estimateurs non biaisés des moments de la distribution des différences. L’intégration de tests statistiques conditionnels permet à la routine de tester automatiquement la pente de la régression linéaire des différences sur les moyennes, alertant immédiatement l’opérateur en cas de biais proportionnel significatif, et calculant la statistique de Levene pour statuer sur l’homoscédasticité des résidus.
L’interfaçage transparent avec des bibliothèques de machine learning permet également d’intégrer des analyses de sensibilité par rééchantillonnage non paramétrique (*bootstrapping*) lorsque la taille de l’échantillon est trop réduite pour autoriser l’hypothèse de normalité asymptotique des limites d’accord.
10.3 Procédures sous SPSS et Jamovi
Pour les praticiens hospitaliers et les chercheurs en psychologie clinique privilégiant les interfaces graphiques utilisateur, des solutions dédiées existent au sein des logiciels commerciaux et open-source :
- Procédure sous IBM SPSS Statistics : SPSS ne comporte pas historiquement d’option de menu contextuel native à un clic pour le tracé de Bland-Altman. La procédure standard requiert l’utilisation de l’option « Calculer une variable » afin de créer les variables de différence $(A – B)$ et de moyenne $((A + B)/2)$. L’analyste extrait ensuite la moyenne et l’écart-type via les statistiques descriptives, calcule manuellement les bornes, puis utilise le « Générateur de graphiques » pour créer un diagramme de dispersion en ajoutant les lignes de référence horizontales personnalisées. Des macros et extensions Python pour SPSS ont été développées pour automatiser cette séquence laborieuse.
- Ergonomie sous Jamovi et JASP : Les logiciels contemporains à code ouvert et interface intuitive Jamovi et JASP ont totalement intégré le paradigme de Bland-Altman. Par le biais du module spécialisé « Agreement » sous Jamovi, l’utilisateur sélectionne simplement les deux variables continues pour obtenir en temps réel le tracé haute résolution incluant les intervalles de confiance ombrés, les tests de normalité des résidus et le calcul du coefficient de corrélation intra-classe associé. Cette simplicité d’accès a considérablement favorisé l’abandon définitif du coefficient de Pearson dans les mémoires universitaires et thèses d’exercice clinique.
11. Applications empiriques en neuropsychologie et sciences comportementales
11.1 Validation de capteurs connectés et actigraphie
L’irruption massive des technologies numériques portables (*wearables*) dans la recherche comportementale et psychiatrique a engendré un besoin métrologique sans précédent. Les montres connectées, actimètres et anneaux intelligents promettent d’évaluer en continu l’architecture du sommeil et les paramètres végétatifs des patients ambulatoires. La validation de ces capteurs face à l’étalon-or indiscuté qu’est la polysomnographie nocturne en laboratoire de sommeil repose presque exclusivement sur le cadre méthodologique de Bland-Altman.
Lorsqu’un chercheur compare l’estimation du temps d’éveil intra-sommeil (WASO, *Wake After Sleep Onset*) fournie par un actimètre commercial à celle issue du tracé polysomnographique, l’évaluation de la concordance brute est impérative. Les études démontrent régulièrement que, malgré des corrélations modérément flatteuses ($r \approx 0{,}75$), les limites d’agrément à 95 % révèlent des discordances oscillant entre $-60$ et $+75$ minutes d’éveil par nuit. Dans une population de patients insomniaques, une telle amplitude d’incertitude invalide la substitution clinique de l’actimètre à la polysomnographie pour le diagnostic différentiel, tout en démontrant l’insuffisance du coefficient de corrélation pour statuer sur la pertinence d’un dispositif technologique.
De même, pour l’estimation de la variabilité de la fréquence cardiaque (indicateur privilégié du tonus vagal et de la régulation émotionnelle sous stress), l’agrément entre les capteurs photopléthysmographiques portables au poignet et l’électrocardiographie multi-dérivation est systématiquement disséqué par les graphiques de Bland-Altman, attestant d’une perte d’agrément majeure dès que le participant s’engage dans une activité motrice active.
11.2 Transposition informatisée des tests neuropsychologiques
La transition numérique des batteries de tests neuropsychologiques – traditionnellement administrées en format papier-crayon par un clinicien – vers des plateformes logicielles sur tablettes tactiles ou ordinateurs connectés constitue un autre champ d’application privilégié. Il est impératif d’apporter la preuve empirique que la migration de support n’altère pas les scores obtenus par le patient, ce que les psychométriciens appellent la « bio-équivalence d’interface ».
Dans l’évaluation des fonctions exécutives, du contrôle inhibiteur (test de Stroop) ou de la vitesse de traitement de l’information (test des codes ou Trail Making Test), le temps de complétion et les scores d’erreur doivent faire l’objet d’une analyse de Bland-Altman méticuleuse. Il n’est pas rare de constater qu’une interface tactile induit un biais systématique négatif (les temps de réaction mesurés informatiquement sont plus courts de plusieurs dizaines de millisecondes en raison de l’élimination des temps de manipulation manuelle des feuilles ou du déclenchement du chronomètre par le psychologue).
L’analyse de concordance permet d’estimer avec précision la magnitude de ce biais d’interface et d’ajuster les normes psychométriques par une constante de translation algorithmique, tout en s’assurant que les limites d’agrément demeurent à l’intérieur de la variabilité propre aux performances intra-individuelles normales du patient.
11.3 Harmonisation inter-centres des biomarqueurs comportementaux
La reproductibilité de la recherche translationnelle en psychiatrie et neurosciences cognitives dépend intrinsèquement de l’harmonisation des mesures recueillies par différents laboratoires au sein de consortiums multicentriques internationaux. Qu’il s’agisse de calibrer des dosages de cortisol salivaire marqueurs de l’axe corticotrope ou d’harmoniser les métriques de fixation oculaire (oculométrie ou *eye-tracking*) enregistrées chez des enfants présentant un trouble du spectre de l’autisme, le graphique de Bland-Altman constitue le pilier du contrôle qualité métrologique.
L’analyse des différences inter-laboratoires ou inter-plateformes de capture oculaire permet d’isoler les dérives systématiques imputables aux spécifications optiques des constructeurs et d’évaluer si la calibration des algorithmes parvient à resserrer les limites d’agrément sous un seuil de bruit résiduel acceptable. L’application scrupuleuse de ces démarches prévient l’introduction de faux positifs ou d’artefacts instrumentaux dans les grandes bases de données neuro-imageriques et comportementales mondiales.
12. Bonnes pratiques méthodologiques et pièges d’interprétation
12.1 Les écueils fréquents dans la littérature scientifique
En dépit de plus de quatre décennies de diffusion pédagogique, l’utilisation du graphique de Bland-Altman demeure entachée d’erreurs méthodologiques récurrentes dans un nombre non négligeable d’articles scientifiques :
- L’omission des tests de normalité des différences : De nombreux auteurs tracent le graphique sans jamais vérifier formellement la normalité de la série des écarts individuels ($d_i$). Or, si la distribution est fortement asymétrique, leptokurtique ou bimodale, la multiplication canonique par le facteur 1,96 perd toute légitimité probabiliste, et les limites calculées n’englobent plus les 95 % escomptés de la population. Dans de telles circonstances, l’analyste doit impérativement recourir à des transformations mathématiques ou à l’estimation non paramétrique des percentiles (2,5e et 97,5e percentiles empiriques).
- La confusion terminologique pernicieuse : Une méprise fréquente consiste à confondre les limites d’agrément à 95 % (qui décrivent la dispersion des individus) avec l’intervalle de confiance à 95 % du biais moyen (qui quantifie l’incertitude de la moyenne). Présenter un intervalle de confiance du biais comme s’il s’agissait des limites d’accord comprime artificiellement la vision de l’erreur par un facteur $\sqrt{n}$, créant l’illusion d’une quasi-concordance parfaite là où la variance individuelle réelle est massive.
- Le silence sur le critère d’acceptabilité clinique : Publier un graphique en concluant que « l’accord est bon » ou « tout à fait acceptable » sans avoir explicité au préalable dans la section méthodologique le seuil quantitatif d’inacceptabilité clinique relève de la rhétorique subjective et non de la démarche scientifique probante.
- L’absence d’indication des unités de mesure : Il n’est pas rare de voir des graphiques dont les axes ne comportent aucune mention claire de l’unité physique ou psychométrique des grandeurs représentées, empêchant tout clinicien de jauger la portée opérationnelle des écarts observés.
12.2 Recommandations pour la rédaction d’articles scientifiques
Afin de restaurer et de préserver l’intégrité de la communication scientifique, plusieurs comités internationaux d’experts méthodologistes ont édicté des déclarations formelles standardisées, au premier rang desquelles figurent les lignes directrices de la déclaration GRRAS (Guidelines for Reporting Reliability and Agreement Studies) ainsi que les extensions de la déclaration STARD (Standards for Reporting of Diagnostic Accuracy).
La rédaction de la section méthodologique et des résultats d’un article intégrant une analyse de Bland-Altman doit satisfaire à un cahier des charges rigoureux :
- Déclarer de manière univoque la marge d’équivalence clinique prédéfinie ($\pm \Delta$) et argumenter son choix sur des fondements biomédicaux, thérapeutiques ou psychométriques documentés.
- Préciser l’ordre de la soustraction appliquée aux variables ($A – B$ ou $B – A$) et expliciter la signification clinique de la polarité positive ou négative du biais obtenu.
- Rapporter les résultats sous forme textuelle ou tabulaire exhaustive comprenant au minimum : la taille exacte de l’échantillon $n$, la moyenne des deux méthodes, le biais moyen estimé ($\bar{d}$) assorti de son intervalle de confiance à 95 %, l’écart-type des différences ($s_d$), les bornes inférieure et supérieure des limites d’agrément (LoA), ainsi que les intervalles de confiance à 95 % encadrant chacune de ces deux limites.
- Fournir une figure haute résolution où la droite d’égalité parfaite ($d=0$), la droite de biais moyen et les deux limites d’agrément sont clairement distinctes, légendées et accompagnées de leurs zones d’incertitude hachurées ou ombrées.
12.3 Synthèse critique et arbre décisionnel d’utilisation
En synthèse ultime, le graphique de Bland-Altman ne doit pas être appréhendé comme une recette isolée en concurrence avec les autres outils statistiques, mais comme la composante visuelle et opérationnelle d’un arsenal métrologique intégré. Pour naviguer efficacement parmi ces méthodologies complémentaires, le chercheur peut s’appuyer sur un cheminement décisionnel rigoureux :
- Si l’objectif est d’évaluer la proportion de variance attribuable aux vraies différences inter-individuelles par rapport au bruit de mesure global dans un échantillon hétérogène, le Coefficient de Corrélation Intra-classe (CCI) s’impose comme l’indicateur synthétique de fiabilité relative le plus pertinent.
- Si l’on cherche à modéliser la relation fonctionnelle formelle entre deux méthodes d’analyse de laboratoire en présence d’erreurs aléatoires de part et d’autre des axes afin de recalibrer un appareil, les régressions bivariées orthogonales telles que la régression de Deming ou la régression non paramétrique de Passing-Bablok sont les méthodes d’élection pour quantifier les coefficients de pente et de constante sans assymétrie des variables.
- Si la finalité est d’évaluer l’interchangeabilité concrète, individualisée et pragmatique de deux instruments de mesure dans la pratique clinique quotidienne, le graphique et l’analyse de Bland-Altman constituent l’unique approche méthodologique fournissant une réponse probabiliste rigoureuse ancrée dans la réalité des unités cliniques.
L’adhésion rigoureuse à ces préceptes méthodologiques et psychométriques garantit que l’innovation instrumentale – qu’elle prenne la forme d’un biocapteur algorithmique miniaturisé ou d’une échelle d’auto-évaluation numérique ultracourte – soit introduite dans les soins et la recherche avec un niveau optimal de fiabilité, d’innocuité diagnostique et de solidité scientifique.
Références
- Altman, D. G., & Bland, J. M. (1983). Measurement in medicine: The analysis of method comparison studies. The Statistician, 32(3), 307–317. https://doi.org/10.2307/2987937
- Bland, J. M., & Altman, D. G. (1986). Statistical methods for assessing agreement between two methods of clinical measurement. The Lancet, 327(8476), 307–310. https://doi.org/10.1016/S0140-6736(86)90837-8
- Bland, J. M., & Altman, D. G. (1999). Measuring agreement in method comparison studies. Statistical Methods in Medical Research, 8(2), 135–160. https://doi.org/10.1177/096228029900800204
- Bland, J. M., & Altman, D. G. (2007). Agreement between methods of measurement with multiple observations per individual. Journal of Biopharmaceutical Statistics, 17(4), 571–582. https://doi.org/10.1080/10543400701329422
- Giavarina, D. (2015). Understanding Bland Altman analysis. Biochemia Medica, 25(2), 141–151. https://doi.org/10.11613/BM.2015.015
- Kottner, J., Audigé, L., Brorson, S., Donner, A., Gajewski, B. J., Hróbjartsson, A., Roberts, C., Shoukri, M., & Streiner, D. L. (2011). Guidelines for Reporting Reliability and Agreement Studies (GRRAS) were proposed. Journal of Clinical Epidemiology, 64(1), 96–106. https://doi.org/10.1016/j.jclinepi.2010.03.002
- Ludbrook, J. (2010). Confidence in Bland–Altman limits of agreement. Clinical and Experimental Pharmacology and Physiology, 37(2), 143–149. https://doi.org/10.1111/j.1440-1681.2009.05288.x
- Shrout, P. E., & Fleiss, J. L. (1979). Intraclass correlations: Uses in assessing rater reliability. Psychological Bulletin, 86(2), 420–428. https://doi.org/10.1037/0033-2909.86.2.420
- Streiner, D. L., Norman, G. R., & Cairney, J. (2015). Health measurement scales: A practical guide to their development and use (5th ed.). Oxford University Press. https://doi.org/10.1093/med/9780199685219.001.0001