
Dans le vaste champ de la statistique descriptive et de la sémiologie graphique contemporaine, la restitution synthétique des relations entre variables catégorielles constitue un défi analytique de premier ordre. Alors que les jeux de données modernes augmentent exponentiellement en volume et en complexité, les praticiens de la recherche empirique se trouvent confrontés à l’impératif de rendre intelligibles des structures d’association multivariées sans dénaturer la précision mathématique sous-jacente. C’est précisément à cette intersection entre rigueur quantitative et ergonomie cognitive que s’impose le graphique à barres segmentées, également qualifié dans la littérature anglo-saxonne de segmented bar chart ou de diagramme à barres empilées normalisé à 100 %.
Fondé sur le principe de la standardisation unitaire, cet outil de visualisation transforme chaque modalité d’une variable indépendante ou de stratification en une colonne de hauteur invariante, représentant l’intégralité d’un sous-groupe (100 %). À l’intérieur de ces enveloppes géométriques d’égale dimension, l’espace vertical est compartimenté en strates proportionnelles aux fréquences relatives d’une seconde variable catégorielle d’intérêt. Ce dispositif sémiotique permet ainsi de neutraliser instantanément les disparités d’effectifs bruts entre les groupes afin de focaliser le regard sur la structure interne des distributions conditionnelles, offrant un vecteur d’investigation visuelle particulièrement puissant pour mettre en lumière d’éventuels phénomènes de dépendance statistique.
Le présent article propose un traité méthodologique exhaustif dédié au graphique à barres segmentées. De sa formalisation théorique et ses assises épistémologiques dans les sciences du comportement jusqu’à ses prolongements inférentiels via les tests d’indépendance du Khi-deux, nous examinerons pas à pas la mécanique de conversion des tables de contingence, les exigences perceptuelles guidant sa conception visuelle, ainsi que ses arbitrages critiques face aux visualisations concurrentes. À travers l’étude empirique détaillée d’une cohorte universitaire, ce guide offre aux chercheurs, analystes et étudiants les clés d’une mise en œuvre rigoureuse, tant sur le plan conceptuel que pratique.
1. Introduction et définition théorique du graphique à barres segmentées
1.1 Définition formelle et normalisation à 100 %
D’un point de vue métrologique et géométrique, le graphique à barres segmentées se définit formellement comme une représentation graphique bidimensionnelle dans laquelle chaque barre rectangulaire s’élève jusqu’à une ordonnée fixe de 100 % (ou 1,0 en fraction unitaire), indépendamment de la taille absolue de l’échantillon ou du sous-échantillon qu’elle figure. Contrairement au graphique à barres simples dont la hauteur physique est strictement fonction de l’effectif ou de la fréquence absolue d’une catégorie, le graphique segmenté impose une contrainte de fermeture spatiale invariable. Chaque colonne unifiée fonctionne comme un contenant symbolique de la totalité, à l’intérieur duquel sont juxtaposés des rectangles contigus dont l’élévation relative correspond exactement à la proportion locale occupée par chaque sous-modalité.
Cette logique de segmentation unitaire obéit à un impératif analytique précis : l’illustration exclusive de la composition proportionnelle. En réduisant les variations d’effectifs bruts à une échelle relative universelle, ce procédé sépare méthodiquement la question du volume global de celle de la distribution interne. Il se distingue ainsi fondamentalement des histogrammes continus, conçus pour illustrer la densité de probabilité de variables quantitatives continues via la surface de rectangles contigus reposant sur des intervalles de classe. De même, il se démarque des diagrammes en barres empilées classiques non normalisés, dont les hauteurs hétérogènes obligent le récepteur à décoder simultanément les fluctuations d’effectifs totaux et les variations de proportions, une double tâche cognitive fréquemment génératrice d’erreurs d’interprétation.
En somme, le graphique à barres segmentées est l’équivalent topologique d’une série de diagrammes circulaires qui auraient été déroulés, linéarisés et dressés côte à côte le long d’un axe d’abscisse partagé. Cette transformation géométrique conserve les propriétés mathématiques des fractions du tout tout en éliminant les défauts perceptifs inhérents à l’estimation des angles et des aires sectorielles courbées.
1.2 Rôle épistémologique dans les sciences comportementales
Dans l’écosystème épistémologique des sciences humaines et comportementales, notamment la psychologie cognitive, la sociologie quantitative et la psychométrie, le graphique à barres segmentées joue un rôle heuristique fondamental. Les recherches observationnelles et corrélationnelles au sein de ces disciplines s’appuient fréquemment sur des devis d’échantillonnage où les effectifs des sous-populations analysées sont intrinsèquement déséquilibrés en raison de contraintes démographiques du terrain (par exemple, des ratios inégaux d’hommes et de femmes, des disparités de classes d’âge ou des variations régionales de recrutement). Si l’analyste se contentait de superposer des fréquences brutes, les disparités de taille de cohorte obscurciraient les véritables contrastes comportementaux ou attitudinaux.
L’utilisation de barres normalisées permet aux chercheurs d’évaluer de manière immédiate et non biaisée la distribution relative des traits psychologiques, des niveaux d’adhésion à des échelles de Likert ou des choix de vie à travers différentes strates de participants. Cette technique s’avère centrale lors de la phase exploratoire précédant la modélisation statistique avancée, car elle permet d’identifier visuellement des patrons d’interaction, des symétries ou des asymétries de répartition intra-groupe qui n’apparaîtraient que difficilement à la simple lecture d’un tableau dense de chiffres décimaux.
En outre, dans le cadre de la communication scientifique et de la restitution des résultats d’enquêtes psychométriques auprès des pairs ou du grand public, le graphique segmenté constitue une passerelle sémiotique indispensable. Il rend perceptibles les divergences d’attitudes ou de diagnostics sans contraindre le lecteur profane à recalculer mentalement les proportions de référence, démocratisant ainsi l’accès à la signification substantive des données recueillies sans sacrifier la rigueur analytique.
1.3 Propriétés géométriques et sémiotiques de la représentation
L’efficacité du graphique à barres segmentées repose sur des mécanismes sémiotiques raffinés qui encadrent la transmission de l’information quantitative par l’intermédiaire de variables visuelles primaires, théorisées initialement par Jacques Bertin dans sa Sémiologie Graphique. La propriété géométrique dominante réside dans l’utilisation conjointe de la longueur (ou hauteur relative de chaque segment) et de la position sur une échelle linéaire unifiée. Contrairement aux visualisations multidimensionnelles complexes, le lecteur opère un jugement comparatif le long d’une ordonnée standardisée graduée de 0 à 100 %, ce qui sollicite des canaux perceptifs hautement performants du système visuel humain.
Sur le plan sémiotique, le graphique réalise un codage spatial simultané bivarié : l’axe horizontal discrétise la variable de partitionnement en colonnes indépendantes et spatialement isolées, tandis que l’axe vertical accueille la variable segmentée, dont les diverses modalités sont matérialisées par des aplats chromatiques distincts ou des textures ordonnées. L’empilement vertical continu au sein d’une enveloppe rectangulaire close active spontanément chez l’observateur le schéma métaphorique de l’inclusion catégorielle et du rapport partie-tout (part-to-whole relationship).
Ce rapport géométrique partie-tout impose une lecture contextuelle immédiate : chaque segment n’est pas appréhendé de manière isolée comme une valeur scalaire autonome, mais comme une ponction relative sur un réservoir de ressources probabilistes borné à l’unité. Dès lors, toute expansion verticale d’une modalité donnée s’interprète intuitivement comme une réduction mécanique de l’espace alloué aux modalités rivales, matérialisant parfaitement la nature fermée des distributions statistiques conditionnelles.
2. Fondements statistiques et traitement des données catégorielles
2.1 Typologie des variables catégorielles applicables
La mobilisation valide d’un graphique à barres segmentées exige une compréhension précise de la nature taxinomique des données soumises à la représentation. Ces diagrammes s’appliquent exclusivement aux variables qualitatives ou catégorielles, c’est-à-dire aux attributs mesurés sur des échelles non métriques où les valeurs observées correspondent à des appartenances à des classes discrètes. On distingue traditionnellement deux sous-classes fondamentales de variables catégorielles, dont l’impact sur l’agencement graphique s’avère déterminant : les variables nominales et les variables ordinales.
Les variables nominales pures (telles que le statut marital, la nationalité ou le choix d’une discipline sportive) se caractérisent par une stricte absence d’ordre logique, mathématique ou hiérarchique intrinsèque entre leurs différentes modalités. Dans ce contexte, l’ordre d’empilement vertical des segments ou la disposition horizontale des barres relève d’une décision ergonomique libre, guidée le plus souvent par des impératifs d’intelligibilité (tri par fréquence décroissante, harmonisation alphabétique). À l’opposé, les variables ordinales (telles que les échelles de Likert mesurant l’accord, le niveau de diplôme atteint ou la sévérité d’une symptomatologie clinique) possèdent une relation d’ordre naturelle et asymétrique. Pour ces dernières, le respect strict de la hiérarchie séquentielle dans l’ordre d’empilement des segments constitue une exigence méthodologique absolue, sous peine de détruire le sens perceptif de la progression continue du phénomène sous-jacent.
Par ailleurs, la validité mathématique du graphique repose sur deux conditions logiques strictes imposées aux catégories de la variable segmentée : l’exhaustivité mutuelle et l’exclusion mutuelle. Chaque unité statistique d’un sous-groupe doit obligatoirement être classée dans une modalité (exhaustivité, au besoin via l’adjonction d’une modalité résiduelle « Autre »), et elle ne peut en aucun cas appartenir simultanément à deux modalités distinctes (exclusion mutuelle). Si ces deux conditions ne sont pas formellement réunies, la sommation des pourcentages divergera de 100 %, invalidant la fermeture géométrique de la barre.
2.2 Tableaux de contingence et distributions conjointes
L’infrastructure calculatoire qui précède immédiatement la genèse d’un graphique segmenté réside dans le tableau de contingence, encore nommé tableau croisé bidimensionnel. Soit une population ou un échantillon de taille globale $N$, sur lequel deux caractères qualitatifs $X$ et $Y$ sont observés simultanément, $X$ comportant $I$ modalités notées ${x_1, x_2, dots, x_I}$ et $Y$ comportant $J$ modalités notées ${y_1, y_2, dots, y_J}$. La matrice résultante se compose de cellules contenant les effectifs conjoints observés $n_{ij}$, représentant le nombre exact d’individus présentant concomitamment l’attribut $x_i$ et l’attribut $y_j$.
Dans cette structure matricielle fondamentale, il convient de distinguer avec la plus grande rigueur trois niveaux d’information statistique :
- Les effectifs conjoints ($n_{ij}$), qui décrivent le dénombrement brut à l’intersection des lignes et des colonnes ;
- Les totaux marginaux, obtenus par sommation le long des rangées ($n_{ibullet} = \sum_{j=1}^J n_{ij}$) ou le long des colonnes ($n_{bullet j} = \sum_{i=1}^I n_{ij}$), matérialisant les distributions univariées respectives de $X$ et de $Y$ ;
- Les distributions conditionnelles, qui expriment la répartition d’une variable lorsque l’autre variable est fixée à un niveau spécifique de modalité.
Le passage méthodologique de la distribution de fréquences conjointes vers les grandeurs visualisables sur le graphique segmenté implique une opération d’estimation de probabilités empiriques conditionnelles. Selon la théorie probabiliste classique formulée par Andreï Kolmogorov, la probabilité conditionnelle qu’un individu tiré au hasard présente la caractéristique $y_j$ sachant qu’il appartient au sous-groupe $x_i$ s’écrit formellement sous la forme :
P(Y = y_j mid X = x_i) = frac{P(X = x_i cap Y = y_j)}{P(X = x_i)} approx frac{n_{ij}}{n_{ibullet}}
C’est précisément cet estimateur du maximum de vraisemblance de la probabilité conditionnelle locale qui dictera la dimension spatiale de chaque segment vertical au sein de la barre représentative du groupe $x_i$.
2.3 Normalisation conditionnelle des données
L’acte technique de normalisation conditionnelle consiste à transformer la matrice des fréquences brutes en une matrice stochastique où la somme des éléments d’une dimension donnée est rigoureusement égale à 1 (ou 100 %). Une décision méthodologique capitale s’impose alors à l’analyste : déterminer l’axe du conditionnement, c’est-à-dire choisir entre un calcul de pourcentages par ligne (profils-lignes) ou par colonne (profils-colonnes). Cette décision n’est pas d’ordre esthétique mais conceptuel : elle dépend directement du statut causal ou temporel conféré aux variables. Si la variable $X$ est considérée comme une variable explicative, prédictive ou de stratification (par exemple, le traitement médical administré ou le groupe démographique d’appartenance) et la variable $Y$ comme le critère de réponse ou d’issue, la normalisation doit impérativement s’effectuer au sein de chaque sous-groupe de $X$.
Cette standardisation opère une neutralisation arithmétique totale de l’effet de taille d’échantillon. Qu’une modalité $x_1$ rassemble 10 000 sujets et une modalité $x_2$ seulement 50 sujets, leurs barres segmentées respectives posséderont une altitude visuelle absolument identique. Cette propriété mathématique confère au graphique un immense pouvoir de clarification en égalisant le poids visuel de chaque cohorte.
Toutefois, cette normalisation s’accompagne d’une conséquence statistique critique qu’aucun chercheur ne saurait ignorer : l’occultation complète de l’information relative au volume absolu de l’échantillon. Deux segments de hauteur identique (par exemple 40 %) figurant dans deux colonnes distinctes peuvent représenter, dans un cas, 4 000 individus au sein d’une large cohorte épidémiologique et, dans l’autre, seulement 2 individus au sein d’un groupe clinique minuscule. Cette perte de l’amplitude de l’effectif local a des répercussions directes sur l’incertitude d’échantillonnage, la variance de l’estimateur étant inversement proportionnelle à la taille du dénominateur marginal, un phénomène que le graphique segmenté conventionnel dissimule totalement à l’œil nu.
3. Perception visuelle et psychologie cognitive de l’interprétation graphique
3.1 Principes de la Gestalt appliqués à la segmentation visuelle
L’efficience avec laquelle le cerveau humain extrait du sens à partir d’un graphique à barres segmentées s’éclaire magistralement à la lumière des théories de la Gestalt, développées au début du XXe siècle par des psychologues tels que Max Wertheimer, Kurt Koffka et Wolfgang Köhler. Ces lois décrivent les mécanismes pré-attentionnels par lesquels notre système perceptif regroupe automatiquement des stimuli visuels disparates pour former des totalités cohérentes et stables.
Le principe de proximité spatiale joue ici un rôle intégrateur majeur : parce que les segments élémentaires constituant une catégorie donnée sont physiquement assemblés sans solution de continuité le long d’un axe vertical étroit, le regard les appréhende spontanément comme une entité morphologique unique (une « barre ») plutôt que comme des figures géométriques flottantes et déconnectées. De surcroît, la loi de continuité opère de manière particulièrement prégnante lorsque des teintes identiques se retrouvent sur plusieurs barres adjacentes à des hauteurs voisines ; l’appareil visuel cherche naturellement à prolonger les lignes de démarcation d’une barre à l’autre, traçant mentalement des flux horizontaux qui facilitent le repérage des tendances ou des ruptures structurelles.
Enfin, l’effet de clôture (closure) est activé par le contour rectangulaire externe des barres à 100 %. Ce cadre géométrique strict agit comme une barrière visuelle indépassable qui ancre profondément l’idée d’exhaustivité mathématique. L’esprit perçoit ce cadre comme une enceinte finie contenant l’intégralité du phénomène, ce qui prédispose cognitivement l’observateur à interpréter les sous-espaces internes comme des fractions d’un tout indivisible.
3.2 Charge cognitive et hiérarchie de décodage selon Cleveland et McGill
L’un des apports les plus déterminants de la psychophysique appliquée à la visualisation de données provient des travaux séminaux de William S. Cleveland et Robert McGill publiés en 1984 dans le Journal of the American Statistical Association. Ces chercheurs ont établi une hiérarchie empirique rigoureuse des tâches de comparaison visuelle élémentaires, classées selon leur degré de précision perceptuelle chez l’être humain, du décodage le plus fidèle vers le plus sujet aux erreurs systématiques :
- Position le long d’une échelle commune alignée ;
- Position le long d’échelles non alignées mais identiques ;
- Longueur d’un segment ;
- Direction ou pente d’une ligne ;
- Angle ;
- Superficie (aire) ;
- Volume ;
- Teinte et saturation chromatique.
L’application de cette échelle théorique au graphique à barres segmentées révèle une asymétrie cognitive intrinsèque majeure. Le segment inférieur (celui qui repose directement sur l’abscisse horizontale à $y = 0$) bénéficie du niveau de précision perceptuel le plus élevé : reposant sur une ligne de base commune et stable, sa comparaison d’une colonne à l’autre s’effectue via l’appréciation d’une position sur échelle commune, garantissant un décodage instantané et d’une exactitude mathématique maximale.
À l’inverse, l’évaluation des segments intermédiaires impose une charge cognitive nettement plus lourde. Leurs points de départ et d’arrivée verticaux dérivent de manière aléatoire en fonction des fluctuations des strates sous-jacentes. Privé de repère de base fixe, le cerveau est contraint d’évaluer une pure longueur non alignée, voire de se livrer à une estimation biaisée de la surface relative du rectangle. Des expériences de psychophysique démontrent que les observateurs tendent à sous-estimer systématiquement la longueur des segments intermédiaires situés entre deux bandes larges, en raison d’un effet d’ancrage perceptif exercé par les frontières mobiles environnantes.
3.3 Traitement perceptif des contrastes et des couleurs
La sélection chromatique dans un graphique à barres segmentées ne répond pas à des impératifs d’agrément esthétique mais à des lois strictes de traitement visuel de l’information dans la mémoire de travail. Lorsque les segments représentent une variable catégorielle nominale sans hiérarchie, l’usage d’une palette qualitative aux teintes distinctes (différenciées par leur tonalité spectrale mais égalisées en termes de luminance perçue) est requis. Toute disparité injustifiée de luminance induirait un phénomène de saillance attentionnelle involontaire : un segment sombre et très saturé paraîtra plus massif, plus important ou plus alarmant qu’un segment pastel adjacent de surface géométrique strictement identique.
Lorsque la variable segmentée est de nature ordinale, la sémiologie prescrit l’utilisation exclusive de palettes séquentielles (dégradé monochrome variant de manière ordonnée en luminosité et en saturation) ou de palettes divergentes (si la variable pivote autour d’une valeur centrale neutre, comme dans les échelles d’opinion bipartite allant du « pas du tout d’accord » au « tout à fait d’accord »). Ce codage chromatique cohérent permet au système perceptif de déduire la hiérarchie des niveaux de la variable à partir de l’intensité du signal optique reçu.
Enfin, la rigueur scientifique impose de respecter les critères universels d’accessibilité visuelle, notamment les directives du WCAG (Web Content Accessibility Guidelines). Environ 8 % de la population masculine mondiale présente des déficits de la vision des couleurs (particulièrement la deutéranopie et la protanopie, rendant indiscernables les paires de contrastes vert/rouge conventionnelles). L’emploi de combinaisons de teintes perceptuellement uniformes et testées contre le daltonisme (telles que les palettes Viridis ou ColorBrewer développées par Cynthia Brewer) évite l’altération de l’intelligibilité des segments pour ces fractions de la communauté scientifique.
4. Étape 1 : Collecte, échantillonnage et structuration des données
4.1 Protocole de collecte de données en contexte universitaire
Afin de matérialiser de manière pédagogique et empirique chaque facette du graphique à barres segmentées, nous nous appuierons sur un protocole d’enquête transversal mené auprès d’une population académique. L’investigation cible des étudiants de premier cycle inscrits dans une grande institution d’enseignement supérieur nord-américaine. L’objectif méthodologique consiste à sonder l’articulation entre l’identité de genre déclarée par les étudiants et leur discipline sportive favorite parmi un choix prédéterminé de pratiques d’équipe populaires.
L’échantillon d’étude a été circonscrit à $N = 100$ étudiants, recrutés selon un plan de sondage probabiliste stratifié aléatoire simple au sein des divers départements d’enseignement (sciences humaines, sciences exactes, ingénierie, gestion). Le questionnaire d’enquête a été conçu selon des principes rigoureux de neutralité psychométrique, en évitant toute question orientée susceptible de susciter un biais de confirmation. Les répondants ont été sollicités via une plateforme numérique d’expérimentation universitaire sécurisée.
Conformément aux normes éthiques régissant la recherche comportementale contemporaine, le protocole garantissait l’anonymisation intégrale et irréversible des données brutes dès l’étape de saisie. Les participants ont fourni un consentement éclairé libre et explicite, après avoir été informés que leurs réponses seraient exploitées dans le cadre exclusif d’une analyse agrégée de statistique descriptive portant sur les habitudes sportives étudiantes.
4.2 Opérationnalisation des variables étudiées
L’opérationnalisation empirique du problème nécessite de définir formellement les deux variables aléatoires discrètes destinées à composer les axes orthogonaux de notre future représentation :
- La variable explicative ou de stratification ($X$) : Le genre auto-déclaré du participant. Pour les nécessités de cet exemple standard et pour conserver une structure de contingence canonique facilement analysable, cette variable a été opérationnalisée sous la forme d’une variable binaire comportant deux modalités : Masculin ($x_1$) et Féminin ($x_2$).
- La variable dépendante ou d’intérêt ($Y$) : Le sport préféré du répondant. Cette variable nominale a été circonscrite à un espace de modalités comprenant trois disciplines majeures de la culture sportive étudiante : Baseball ($y_1$), Basketball ($y_2$) et Football ($y_3$).
Afin de garantir les exigences d’exclusion et d’exhaustivité mutuelle stipulées à la section 2.1, la consigne demandait aux participants de sélectionner sans ambiguïté un seul et unique sport comme étant leur discipline favorite absolue parmi les trois options proposées. Les formulaires comportant des choix multiples non autorisés ou des non-réponses ont été purgés lors du nettoyage préliminaire de la matrice de données, de manière à préserver un échantillon d’analyse parfaitement complet et intègre de 100 observations univoques.
4.3 Construction de la matrice initiale des fréquences brutes
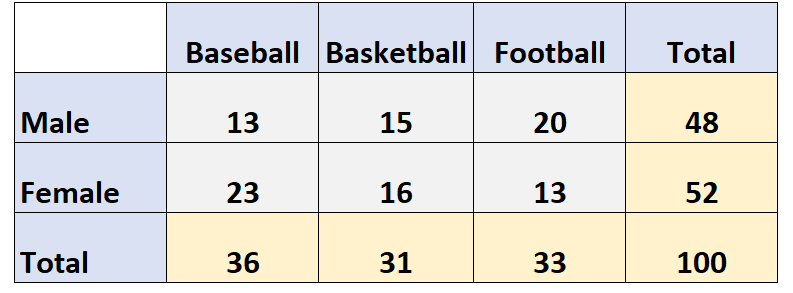
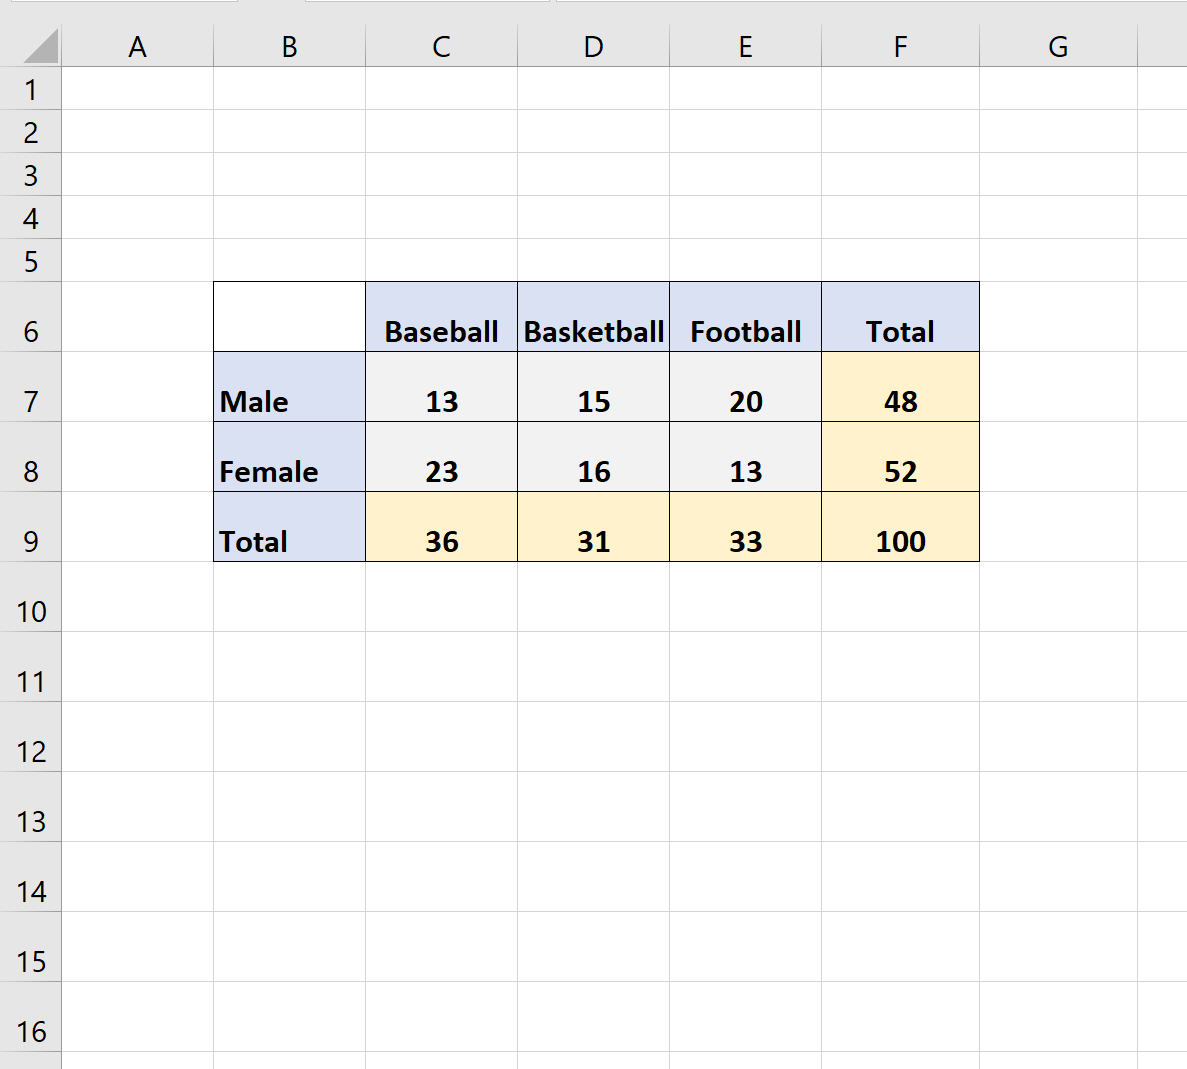
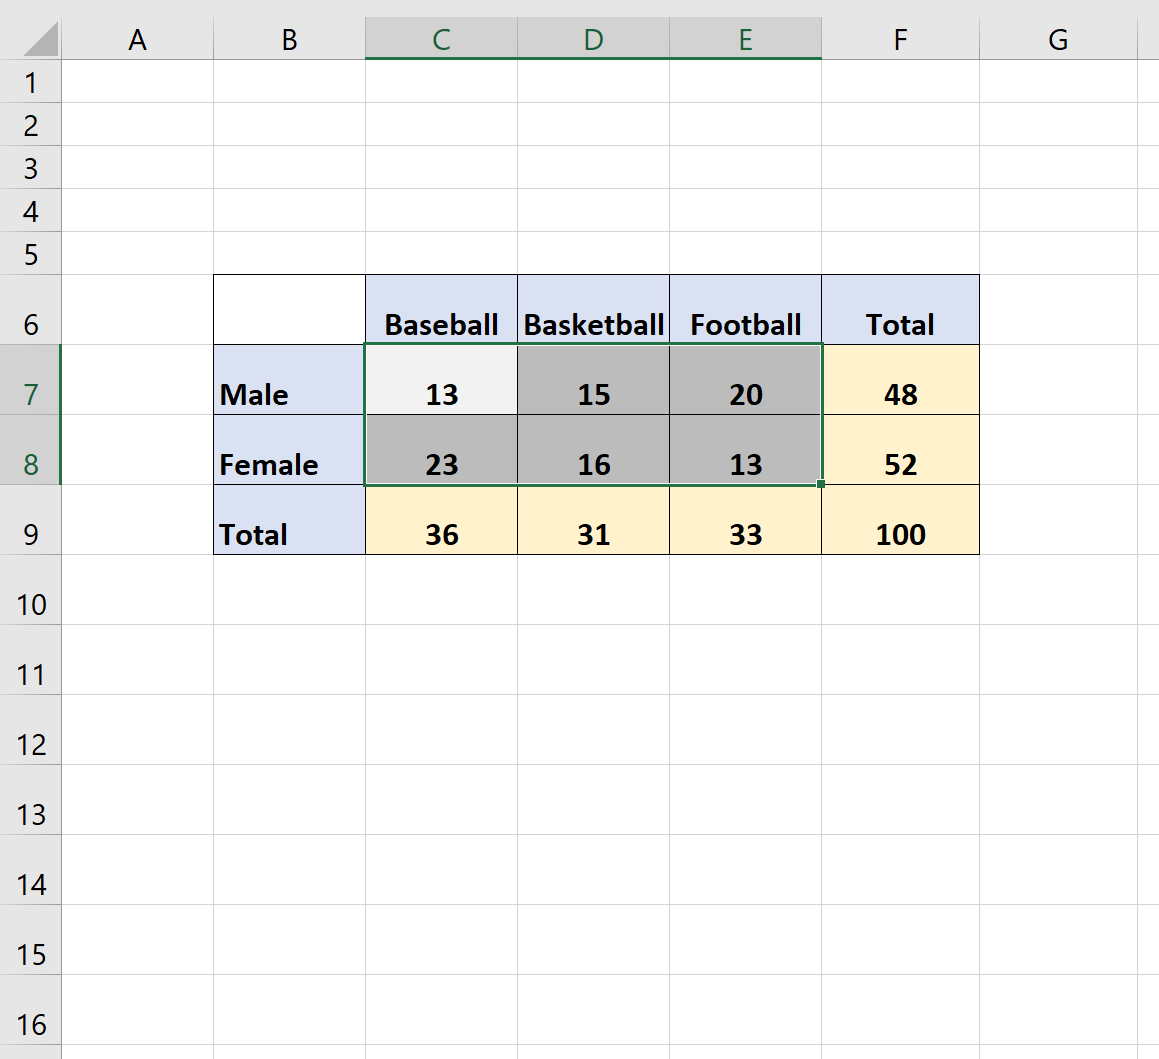
L’agrégation initiale des observations individuelles se formalise par le croisement des deux variables au sein d’une table de contingence bivariée à double entrée de dimension $2 \times 3$. Dans ce tableau élémentaire, les colonnes accueilleront les modalités de la discipline sportive ($Y$) et les lignes représenteront le genre déclaré ($X$). La saisie méticuleuse des 100 formulaires d’enquête permet de dégager les dénombrements conjoints suivants :
Pour la modalité Baseball, nous enregistrons un effectif conjoint de 13 étudiants masculins et de 23 étudiantes féminines. Pour la modalité Basketball, le croisement des données fait apparaître 15 répondants masculins et 16 répondantes féminines. Enfin, pour la discipline Football, le décompte brut dénombre 20 hommes et 13 femmes. La sommation transversale de ces effectifs permet d’établir les totaux marginaux pour chaque discipline sportive étudiée :
| Genre Sport | Baseball ($y_1$) | Basketball ($y_2$) | Football ($y_3$) | Total marginal genre |
|---|---|---|---|---|
| Masculin ($x_1$) | 13 | 15 | 20 | 48 |
| Féminin ($x_2$) | 23 | 16 | 13 | 52 |
| Total marginal sport | 36 | 31 | 33 | N = 100 |
L’intégrité numérique du jeu de données se vérifie par la double sommation marginale : $48 + 52 = 100$ sur la marge des lignes, et $36 + 31 + 33 = 100$ sur la marge des colonnes. Nous disposons désormais du substrat arithmétique indispensable pour amorcer l’étape décisive de normalisation relative.
5. Étape 2 : Conversion rigoureuse des fréquences brutes en pourcentages relatifs
5.1 Calcul de la distribution relative pour la modalité Baseball
Pour construire un graphique où chaque barre représentera une discipline sportive et illustrera sa composition selon le genre, la normalisation doit s’effectuer selon les profils-colonnes. Nous conditionnons ainsi nos calculs par rapport au total marginal de chaque sport respectif. La première colonne de notre tableau de contingence concerne l’ensemble des étudiants ayant désigné le Baseball comme leur sport favori, soit un total marginal spécifique de $n_{bullet 1} = 36$ répondants.
Le calcul de la proportion relative d’hommes au sein de ce groupe s’établit par le quotient direct de l’effectif conjoint masculin par le total du sous-groupe :
Proportion,(Masculin mid Baseball) = frac{13}{36} approx 0,36111dots rightarrow 36,11,%
De façon symétrique, la proportion d’étudiantes au sein de ce même sous-échantillon de Baseball se détermine par le ratio :
Proportion,(Féminin mid Baseball) = frac{23}{36} approx 0,63888dots rightarrow 63,89,%
Pour la transcription graphique, nous adoptons une précision d’arrondi standard au dixième de pourcentage le plus proche, ce qui donne $36,1,%$ pour la composante masculine et $63,9,%$ pour la composante féminine. La condition impérative de fermeture de la colonne unitaire est formellement vérifiée :
36,1,% + 63,9,% = 100,0,%
5.2 Calcul de la distribution relative pour la modalité Basketball
La deuxième catégorie d’intérêt correspond à la modalité Basketball, dont le sous-groupe rassemble un total marginal de $n_{bullet 2} = 31$ étudiants. L’application du même protocole de normalisation conditionnelle par colonne engendre les équations arithmétiques suivantes :
Pour la composante masculine :
Proportion,(Masculin mid Basketball) = frac{15}{31} approx 0,48387dots rightarrow 48,39,%
Pour la composante féminine :
Proportion,(Féminin mid Basketball) = frac{16}{31} approx 0,51612dots rightarrow 51,61,%
En procédant à l’arrondi décimal au dixième, nous obtenons respectivement $48,4,%$ pour les hommes et $51,6,%$ pour les femmes. La sommation de contrôle confirme la stricte préservation de la contrainte unitaire :
48,4,% + 51,6,% = 100,0,%
Dans la pratique statistique, la gestion des arrondis décimaux exige une vigilance particulière. Il arrive fréquemment que la sommation naïve de valeurs arrondies à un chiffre après la virgule engendre un résidu artificiel de $99,9,%$ ou $100,1,%$. Dans de telles configurations, il est méthodologiquement recommandé d’ajuster le segment possédant la décimale la plus proche du seuil d’arrondi supérieur ou d’opérer avec une précision flottante interne lors de la construction géométrique vectorielle pour éviter toute déformation des limites physiques des barres.
5.3 Calcul de la distribution relative pour la modalité Football
La troisième et dernière colonne d’investigation rassemble les amateurs de Football, formant un total marginal local de $n_{bullet 3} = 33$ étudiants. La transcription relative de ces dénombrements s’obtient comme suit :
Pour la composante masculine :
Proportion,(Masculin mid Football) = frac{20}{33} approx 0,60606dots rightarrow 60,61,%
Pour la composante féminine :
Proportion,(Féminin mid Football) = frac{13}{33} approx 0,39393dots rightarrow 39,39,%
Après application de l’arrondi au dixième, les valeurs fixées sont de $60,6,%$ d’hommes et $39,4,%$ de femmes. Le contrôle de fermeture valide à nouveau l’intégralité du profil-colonne : $60,6,% + 39,4,% = 100,0,%$.
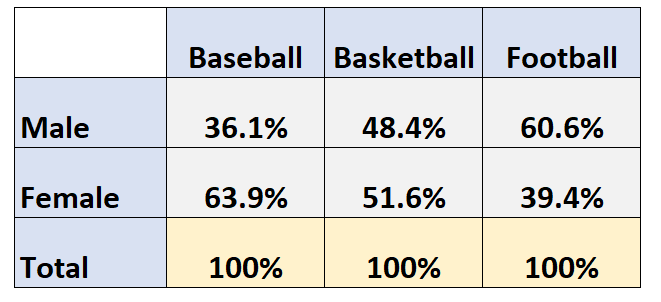
À l’issue de cette démarche calculatoire, nous pouvons dresser la matrice standardisée des fréquences relatives conditionnelles qui servira de plan architectural immédiat pour l’implantation des coordonnées cartésiennes de notre graphique :
| Genre Discipline | Baseball ($n=36$) | Basketball ($n=31$) | Football ($n=33$) |
|---|---|---|---|
| Masculin (Segment inférieur) | 36,1 % | 48,4 % | 60,6 % |
| Féminin (Segment supérieur) | 63,9 % | 51,6 % | 39,4 % |
| Total normalisé par barre | 100,0 % | 100,0 % | 100,0 % |
6. Étape 3 : Méthodologie pas à pas de construction graphique
6.1 Configuration des axes cartésiens et des échelles
La première phase géométrique de la construction du graphique réside dans la délimitation de l’espace métrique au sein d’un repère cartésien orthogonal standard. L’axe horizontal (l’abscisse) est alloué à la variable de stratification indépendante, à savoir la discipline sportive. Cet axe ne comportant aucune grandeur métrique continue, il est discrétisé en trois zones d’ancrage équidistantes, correspondant respectivement aux catégories nominales Baseball, Basketball et Football. Une règle ergonomique cardinale impose de conserver une largeur de barre strictement constante pour l’ensemble des catégories. Toute variation arbitraire de la largeur des barres déclencherait une distorsion cognitive majeure, le cerveau interprétant instinctivement l’aire totale des rectangles plutôt que leur seule hauteur, faussant ainsi l’impression de parité géométrique des sous-groupes.
L’axe vertical (l’ordonnée) héberge l’échelle de mesure des proportions standardisées. Il est impératif que cette graduation démarre rigoureusement à $0,%$ et s’achève de manière indépassable à $100,%$. Cet intervalle unitaire doit être fractionné par des pas d’incrémentation constants et lisibles, idéalement fixés à des intervalles réguliers de $10,%$ ou de $20,%$, balisés par des tirets de graduation discrets. L’insertion de lignes de quadrillage horizontal léger (d’un gris très estompé) est recommandée pour permettre à l’œil d’interpoler avec aisance l’altitude des segments intermédiaires.
6.2 Tracé et empilement des segments cumulatifs
Une fois le repère cartésien implanté, l’analyste procède au dessin vectoriel des rectangles imbriqués selon une logique d’empilement cumulatif rigoureuse. Pour chaque modalité sportive, le tracé s’effectue en deux temps moteurs :
Dans un premier temps, le segment de base (que nous choisissons arbitrairement d’affecter à la modalité Masculin) prend naissance au niveau zéro de l’abscisse ($y_0 = 0$). Le rectangle s’élève verticalement jusqu’à la coordonnée correspondant exactement à sa proportion calculée :
- Pour la barre Baseball : élévation de $y = 0$ jusqu’à la frontière $y = 36,1,%$ ;
- Pour la barre Basketball : élévation de $y = 0$ jusqu’à la frontière $y = 48,4,%$ ;
- Pour la barre Football : élévation de $y = 0$ jusqu’à la frontière $y = 60,6,%$.
Dans un deuxième temps, le second segment (affecté à la modalité Féminin) s’amorce précisément là où s’est interrompu le premier segment. Son point de départ correspond donc à l’ordonnée cumulée précédente, et son élévation verticale équivaut à la valeur de sa propre proportion relative, venant plafonner à l’ordonnée maximale absolue de $100,0,%$ :
- Pour le Baseball : débute à $y = 36,1,%$ et monte d’une amplitude de $63,9,%$, atteignant précisément $100,0,%$ ;
- Pour le Basketball : débute à $y = 48,4,%$ et s’élève de $51,6,%$, atteignant exactement $100,0,%$ ;
- Pour le Football : débute à $y = 60,6,%$ et progresse de $39,4,%$, complétant impeccablement la barre à $100,0,%$.
Ce chaînage cumulatif assure une juxtaposition parfaite des surfaces sans aucun chevauchement ni interstice vide, concrétisant visuellement l’intégrité de la sommation stochastique.
6.3 Optimisation des métadonnées visuelles et de l’habillage
L’habillage typographique et sémiotique d’un graphique segmenté conditionne son autonomie explicative et son élégance scientifique. Le premier composant textuel indispensable est la légende chromatique. Située préférentiellement en position supérieure ou latérale droite, elle doit associer sans ambiguïté la teinte ou la texture retenue à son étiquette catégorielle respective (par exemple, un aplat bleu soutenu pour la modalité Masculin et un aplat corail ou ambre pour la modalité Féminin). L’ordre d’affichage vertical des éléments dans la légende doit impérativement refléter l’ordre d’empilement physique des segments dans les barres, afin de minimiser le coût cognitif de décodage croisé pour l’observateur.
Ensuite, l’adjonction d’étiquettes numériques intra-segments (direct data labels) constitue une pratique d’excellence recommandée dans les revues académiques de premier plan. Dès lors que l’épaisseur du rectangle le permet, l’inscription de la valeur chiffrée ($36,1,%$, $63,9,%$, etc.) centrée à l’intérieur du segment libère le lecteur de l’obligation d’effectuer des interpolations approximatives vers l’axe des ordonnées. La typographie de ces chiffres doit présenter un contraste élevé avec la couleur de fond (par exemple, des caractères blancs en gras sur des segments sombres).
Enfin, le titre principal du graphique doit être formulé selon les standards de la rédaction scientifique. Au lieu d’une mention descriptive pauvre du type « Graphique des sports », l’analyste privilégiera un intitulé exhaustif intégrant les variables en présence, la population cible et le volume de l’échantillon, tel que : « Répartition proportionnelle du genre selon la discipline sportive préférée au sein d’une cohorte universitaire (N = 100) ».
7. Analyse interprétative approfondie de l’exemple empirique
7.1 Interprétation des disparités de genre dans le sport
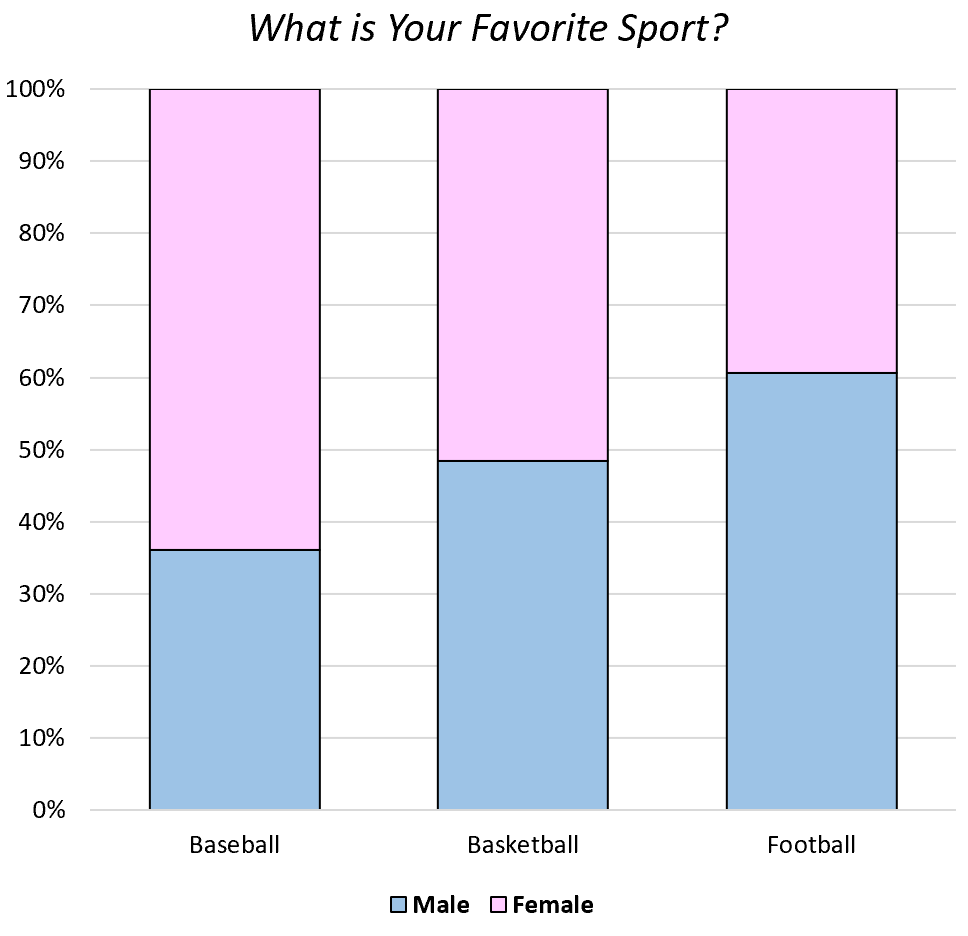
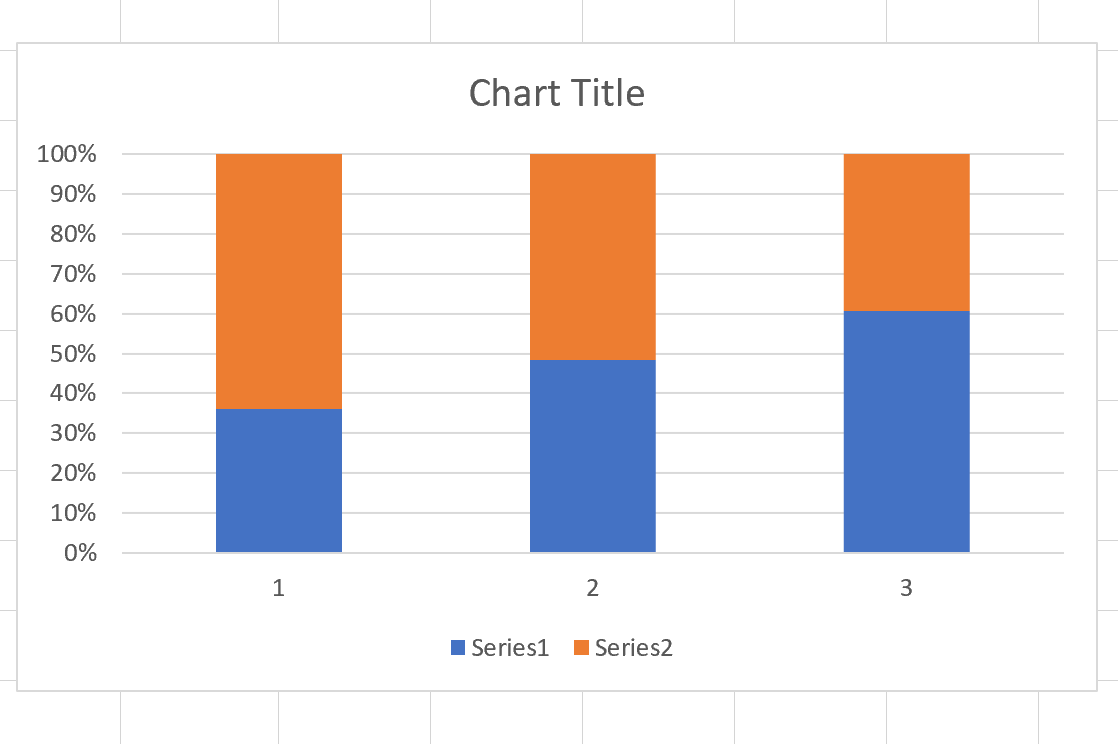
L’observation attentive du graphique à barres segmentées généré à partir de notre échantillon d’étudiants met en relief des contrastes sociologiques particulièrement nets dans les préférences d’activité physique. La première constatation analytique frappante concerne le Baseball : cette discipline se singularise par une prédominance féminine massive, près des deux tiers des étudiants plébiscitant ce sport étant des femmes ($63,9,%$) contre seulement un gros tiers d’hommes ($36,1,%$). Cette configuration visuelle se traduit par un segment supérieur dilaté qui domine nettement la colonne correspondante.
À l’autre extrémité du spectre comportemental, la modalité Football dévoile une dynamique de préférence exactement inversée. Le segment inférieur masculin s’y hisse jusqu’à $60,6,%$, reléguant la préférence féminine à un modeste $39,4,%$. Nous nous trouvons en présence d’une nette surreprésentation des hommes dans l’attrait pour cette discipline hautement physique et historiquement codifiée selon des stéréotypes de genre traditionnels.
Entre ces deux polarités divergentes, la colonne dévolue au Basketball illustre une situation d’équilibre proportionnel presque parfait. Avec une proportion d’hommes de $48,4,%$ et une proportion de femmes de $51,6,%$, la ligne de démarcation horizontale se situe quasiment au niveau médian des $50,%$. Cette parité presque intégrale suggère que le basketball exerce un attrait transcendant les clivages de socialisation genrée au sein de cette cohorte universitaire, fonctionnant comme un pôle de consensus sportif neutre.
7.2 Vérification de l’indépendance statistique apparente
Au-delà de la description morphologique des segments, le graphique à barres segmentées offre un puissant outil visuel pour appréhender le concept fondamental d’indépendance statistique au sens mathématique. En théorie des probabilités, deux variables catégorielles $X$ et $Y$ sont dites indépendantes si et seulement si la distribution conditionnelle de $Y$ demeure strictement identique quelle que soit la modalité de $X$ considérée, c’est-à-dire :
forall i, j quad P(Y = y_j mid X = x_i) = P(Y = y_j)
Sur le plan visuel, l’hypothèse nulle d’indépendance se manifesterait sur un graphique segmenté par des hauteurs de segments rigoureusement horizontales et identiques d’une barre à l’autre. La frontière séparant les segments masculin et féminin formerait une ligne rectiligne ininterrompue traversant le graphique de gauche à droite sans aucune déviation verticale.
Or, l’inspection de notre graphique révèle des fluctuations d’amplitudes manifestes : le segment masculin oscille spectaculairement de $36,1,%$ à $60,6,%$, dessinant une marche ascendante marquée entre le baseball et le football. Cette instabilité structurelle des profils-colonnes fournit un indice graphique direct de dépendance statistique apparente entre le genre de l’étudiant et son sport favori. Cependant, le chercheur rigoureux se gardera d’en déduire une conclusion définitive sans recourir aux outils formels de l’inférence statistique, la variabilité observée pouvant potentiellement résulter de simples fluctuations d’échantillonnage aléatoires propres à la taille modeste de la cohorte ($N = 100$).
7.3 Contextualisation des résultats au sein de l’échantillon collégial
L’interprétation substantive de ces écarts doit être contextualisée à l’aune des théories sociologiques contemporaines sur la socialisation corporelle en milieu universitaire. L’engouement prononcé des étudiantes pour le baseball dans cet échantillon singulier peut s’expliquer par l’existence sur ce campus d’une équipe universitaire féminine de softball ou de baseball bénéficiant d’une excellente visibilité institutionnelle et d’une dynamique de victoires mobilisatrice, influençant par osmose les réponses déclaratives des étudiantes.
Par ailleurs, la prépondérance masculine dans le football reflète la persistance de représentations virilisées de l’affrontement athlétique, fortement entretenues par les retransmissions médiatiques des championnats collégiaux masculins majeurs. Quant au basketball, sa flexibilité organisationnelle, son intégration historique dans les cours d’éducation physique mixtes et son accessibilité en milieu urbain favorisent une neutralisation salutaire des barrières symboliques de genre.
Néanmoins, l’analyste doit demeurer conscient des limites inhérentes au recueil de données par auto-déclaration. Les réponses individuelles peuvent avoir été biaisées par des phénomènes de désirabilité sociale ou par l’influence du groupe de pairs au moment de la passation de l’enquête. Ces observations descriptives ne sauraient prétendre à une généralisation universelle sans réplications systématiques sur des cohortes d’autres établissements présentant des profils sociodémographiques diversifiés.
8. Analyse comparative : le graphique segmenté face aux visualisations alternatives
8.1 Comparaison avec le graphique à barres empilées absolu
La confusion entre le graphique à barres segmentées (normalisé à 100 %) et le graphique à barres empilées classique (en effectifs bruts) est l’une des erreurs conceptuelles les plus fréquentes chez les analystes débutants. Pourtant, ces deux dispositifs répondent à des finalités épistémologiques divergentes et véhiculent des messages fondamentalement dissemblables.
Le graphique à barres empilées absolu conserve l’ordonnée en unités réelles (dénombrements absolus). Par conséquent, la hauteur totale de chaque barre fluctue librement en fonction du total marginal de sa catégorie. Si cette approche conserve l’avantage indéniable d’illustrer la masse brute respective de chaque groupe (montrant immédiatement que la cohorte de Baseball rassemble 36 personnes alors que celle de Basketball en compte 31), elle handicape lourdement la comparaison des proportions relatives. Lorsque les totaux marginaux sont très distants (par exemple une modalité regroupant 1 000 cas et une autre 100 cas), les segments de la plus petite barre deviennent minuscules et incomparables avec ceux de la grande barre.
Le graphique segmenté normalisé sacrifie délibérément l’information de volume absolu pour maximiser la sensibilité perceptuelle aux ratios. Il s’impose de façon indiscutable dès lors que la question de recherche centrale porte sur la structure interne et les équilibres proportionnels, indépendamment des variations accidentelles ou structurelles de la taille des effectifs marginaux.
8.2 Comparaison avec le graphique à barres groupées (côte à côte)
Le graphique à barres groupées (clustered bar chart) constitue l’alternative la plus robuste et la plus fréquemment recommandée par les spécialistes de la visualisation de données pour pallier les défauts de décentrement des segments empilés. Dans cette configuration, les catégories sont alignées côte à côte pour chaque discipline sportive, reposant toutes sur la même ligne de base zéro.
Cette disposition confère aux barres groupées un avantage perceptuel majeur selon les principes de Cleveland et McGill : l’ensemble des modalités peut être comparé directement via une position le long d’une échelle commune. Évaluer si la proportion d’hommes dans le baseball dépasse celle du football devient une opération visuelle immédiate, d’une précision chirurgicale, exempte des biais d’ancrage liés à la dérive des frontières d’empilement.
Toutefois, ce gain de précision analytique s’obtient au détriment d’une fonction sémiotique majeure : l’appréhension directe de la synthèse globale unitaire. Dans un diagramme à barres groupées, l’observateur perd la sensation physique du tout clos à 100 %. La perception du rapport d’arbitrage (le fait que le gain d’une modalité se fasse au détriment de l’autre au sein d’un contingent fini) disparaît de l’espace géométrique, exigeant un travail d’abstraction mentale supplémentaire pour reconstituer le portrait global de la distribution.
8.3 Comparaison avec les diagrammes circulaires (camemberts multiples)
L’une des dérives les plus sévèrement critiquées dans la littérature statistique contemporaine consiste à juxtaposer une série de diagrammes circulaires (dits camemberts ou pie charts) pour illustrer la composition de plusieurs sous-groupes (par exemple un camembert pour le baseball, un deuxième pour le basketball et un troisième pour le football). Les travaux expérimentaux accumulés depuis plusieurs décennies démontrent de manière irréfutable l’infériorité cognitive flagrante des diagrammes circulaires face au graphique à barres segmentées.
L’évaluation des portions d’un camembert sollicite deux des compétences perceptives les plus défaillantes du cortex visuel humain : le décodage de l’angle au centre et l’estimation de la superficie de secteurs courbés. Face à deux camemberts distincts, il est pratiquement impossible pour un être humain de déceler avec assurance si une part représentant $36,%$ dans le premier disque est significativement différente d’une part représentant $39,%$ dans le second, particulièrement si l’orientation spatiale de départ des parts n’est pas rigoureusement alignée.
Le graphique à barres segmentées élimine totalement ces incertitudes géométriques : en déroulant les circonférences sur un axe vertical cartésien rectiligne, il remplace la complexe lecture angulaire par une simple comparaison de longueurs et d’ordonnées linéaires. De plus, il optimise radicalement l’occupation de l’espace sur la page en évitant la redondance circulaire encombrante et non informative.
8.4 Le diagramme de mosaïque (Marimekko) comme extension bidimensionnelle
Le chercheur en quête d’un compromis méthodologique ultime entre le volume de l’échantillon et la décomposition proportionnelle se tournera vers le diagramme de mosaïque, couramment dénommé graphique Marimekko. Cette visualisation sophistiquée pousse la logique du graphique segmenté à son paroxysme théorique en introduisant une seconde dimension géométrique variable.
Tandis que la hauteur de chaque colonne demeure rigoureusement standardisée à 100 % pour accueillir les pourcentages conditionnels, la largeur physique de la barre horizontale est rendue proportionnelle à la taille marginale du sous-groupe considéré ($n_{bullet j}$). Dans notre exemple, la barre du Baseball aurait une largeur relative proportionnelle à $36,%$, celle du Basketball à $31,%$ et celle du Football à $33,%$. La surface surfacique totale de chaque rectangle élémentaire devient alors proportionnelle à l’effectif conjoint brut réel ($n_{ij}$), réconciliant dans une matrice continue l’illustration des fréquences conjointes, marginales et conditionnelles.
Cependant, ce surcroît de puissance mathématique se paie au prix d’une charge cognitive considérable. La lecture conjointe d’altitudes et de largeurs variables désarçonne les publics non formés à la statistique avancée, générant des confusions d’interprétation fréquentes. Le graphique segmenté classique à largeur de barre constante demeure ainsi le compromis de communication optimal pour la très vaste majorité des publications scientifiques destinées à un lectorat multidisciplinaire.
9. Prolongements statistiques inférentiels : du visuel au test d’hypothèse
9.1 Liaison conceptuelle avec le test d’indépendance du Khi-deux
Le graphique à barres segmentées constitue la traduction visuelle directe et fidèle de la mécanique mathématique sous-jacente au test d’indépendance du Khi-deux ($\chi^2$) de Pearson. Lorsqu’un statisticien formule l’hypothèse nulle ($H_0$) selon laquelle il n’existe aucune association entre les deux variables catégorielles étudiées, il postule que les distributions conditionnelles observées ne s’écartent des distributions théoriques marginales que sous l’effet du bruit d’échantillonnage stochastique.
La formulation analytique de la statistique du Khi-deux repose sur la confrontation directe, cellule par cellule, entre les effectifs conjoints observés ($O_{ij} = n_{ij}$) et les effectifs théoriques ou attendus ($E_{ij}$) calculés sous l’hypothèse de stricte indépendance statistique :
E_{ij} = frac{n_{ibullet} times n_{bullet j}}{N}
chi^2 = sum_{i=1}^I sum_{j=1}^J frac{(O_{ij} – E_{ij})^2}{E_{ij}}
Sur notre graphique à barres segmentées, les effectifs attendus $E_{ij}$ correspondraient à une situation où la hauteur du segment masculin serait rigoureusement identique dans les trois colonnes, fixée à la valeur du total marginal masculin global, soit $48 / 100 = 48,0,%$. Chaque écart vertical visible entre le sommet effectif d’un segment observé et cette ligne théorique marginale médiane de $48,0,%$ représente matériellement l’écart de contingence $(O_{ij} – E_{ij})$ qui alimente directement le numérateur de la statistique de test.
9.2 Mesures de taille d’effet associées
Une règle fondamentale de l’inférence statistique moderne, fortement promue par l’American Psychological Association, énonce que le rejet de l’hypothèse nulle via une valeur de $p$ significative ne renseigne aucunement sur l’ampleur substantielle du phénomène observé. Il est donc indispensable d’associer à la lecture d’un graphique segmenté des métriques de taille d’effet standardisées.
Pour des tableaux de contingence de dimension supérieure à $2 \times 2$, l’indicateur d’amplitude le plus universel est le V de Cramér ($\phi_c$). Dérivé directement de la statistique du Khi-deux calculée, il se formule selon l’équation :
V = sqrt{frac{chi^2}{N times min(I-1, J-1)}}
Le V de Cramér oscille de manière bornée entre 0 (stricte indépendance, segments graphiques parfaitement alignés) et 1 (association complète, où chaque sous-groupe est exclusivement composé d’une seule modalité). Une valeur comprise entre 0,10 et 0,30 signale une taille d’effet faible à modérée, tandis qu’une valeur excédant 0,30 indique une disparité substantielle que le graphique segmenté reflétera sous la forme de décalages de segments très marqués.
Parallèlement, lorsque l’analyste focalise son attention sur des contrastes locaux bipartites au sein de la table (par exemple la confrontation directe Baseball versus Football), l’usage des rapports de cotes (odds ratios, OR) s’avère particulièrement éclairant pour quantifier précisément le surcroît de probabilité relative qu’un profil donné appartienne à un segment plutôt qu’à un autre.
9.3 Analyse des résidus standardisés ajustés
Si la statistique globale du Khi-deux permet de trancher quant à l’existence d’une dépendance statistique, elle ne précise nullement quelles colonnes ou quels segments particuliers sont responsables de cette rupture d’indépendance. Pour enrichir l’analyse descriptive fournie par le graphique segmenté, le chercheur procède au calcul des résidus standardisés ajustés (ou résidus de Haberman) pour chaque cellule de la matrice de contingence :
z_{ij} = frac{O_{ij} – E_{ij}}{sqrt{E_{ij} (1 – frac{n_{ibullet}}{N}) (1 – frac{n_{bullet j}}{N})}}
Ces métriques résiduelles suivent asymptotiquement une loi normale centrée réduite $\mathcal{N}(0, 1)$. En conséquence, tout segment graphique dont le résidu ajusté dépasse la valeur critique de $+1,96$ ou descend sous $-1,96$ peut être désigné avec un niveau de confiance bilatéral de $95,%$ comme une cellule source de divergence statistiquement significative par rapport au modèle d’indépendance.
Cette approche confirmatoire permet de valider scientifiquement ce que le regard intuitionne sur le dessin : dans notre exemple, elle permettra d’attester si le segment supérieur étiré des femmes dans le Baseball ($63,9,%$) constitue une déviation structurelle majeure ou une fluctuation stochastique imputable à la taille restreinte de notre cohorte.
10. Règles de conception ergonomique et sémiologie graphique
10.1 Sélection et harmonisation de la palette chromatique
La crédibilité académique et l’efficience communicationnelle d’un graphique segmenté dépendent étroitement de la sobriété de sa palette chromatique. Le chercheur évitera impérativement les palettes par défaut saturées et criardes (du type rouge pur, jaune canari et vert fluo), génératrices d’une fatigue visuelle rapide et d’artéfacts perceptifs d’éblouissement. Il conviendra de sélectionner des harmonies de couleurs atténuées, issues de référentiels chromatiques éprouvés tels que l’espace chromatique perceptuel CIE L*a*b* ou la suite logicielle ColorBrewer 2.0.
Une règle déontologique et méthodologique intangible stipule qu’une modalité catégorielle donnée doit conserver une teinte rigoureusement identique à travers l’intégralité des visualisations d’un même article scientifique ou d’un même rapport de recherche. Si la couleur bleu ardoise est allouée à la modalité « Masculin » sur le graphique des sports, elle ne doit en aucun cas être réassignée à une autre catégorie dans une figure subséquente explorant une autre variable démographique.
En outre, il est impératif d’assurer un contraste de luminance suffisant (ratio minimal de contraste de 4,5:1 conformément aux directives WCAG) entre la couleur de chaque segment et la couleur des étiquettes typographiques numériques qui y sont incrustées. En cas de publication dans des revues imprimées en nuances de gris, l’analyste prendra soin de vérifier que la palette retenue demeure parfaitement discernable lorsqu’elle est convertie en monochrome, en recourant si nécessaire à des motifs de hachures discrètes pour renforcer la séparation visuelle.
10.2 Ordonnancement logique des barres et des segments
L’ordre séquentiel d’apparition des barres le long de l’abscisse horizontale constitue un levier ergonomique de premier ordre. Dans le cas de variables explicatives nominales sans ordre propre (comme nos disciplines sportives), laisser les colonnes dans un arrangement aléatoire ou strictement alphabétique appauvrit l’expérience de lecture. Il est hautement recommandé de trier les barres de manière ordonnée selon l’amplitude du segment de base inférieur (par exemple par ordre croissant de la proportion d’hommes, comme nous l’avons réalisé : Baseball à $36,1,%$, puis Basketball à $48,4,%$, puis Football à $60,6,%$).
Ce tri méthodique confère au graphique une fluidité visuelle immédiate en transformant la lecture en une progression monotone régulière, facilitant la comparaison instantanée de la variable d’intérêt transversale. Pour les variables explicatives ordinales (comme des tranches d’âge ou des niveaux de scolarité), cette recommandation de tri par amplitude s’efface devant l’obligation impérieuse de préserver la hiérarchie intrinsèque des classes temporelles ou institutionnelles le long de l’axe horizontal.
Concernant l’ordonnancement vertical intra-barre, la modalité la plus centrale pour la démonstration ou celle qui sert de groupe de contrôle doit impérativement être stabilisée en tant que segment de référence inférieur, reposant sur l’ordonnée zéro. Comme nous l’avons souligné à la section 3.2, cette position de base est la seule à bénéficier de l’alignement sur échelle commune ; elle doit donc être octroyée à la composante la plus critique pour l’argumentation scientifique de l’étude.
10.3 Typographie, étiquetage direct et réduction du bruit visuel
La mise en œuvre des principes d’économie sémiotique formalisés par Edward Tufte dans son ouvrage fondateur The Visual Display of Quantitative Information trouve son terrain d’application le plus fertile dans la rationalisation des graphiques segmentés. Le précepte fondamental réside dans la maximisation du ratio données/encre (data-ink ratio), qui préconise l’éradication sans concession de tout ornement graphique n’apportant aucune information analytique mesurable.
Cette discipline de conception implique :
- L’interdiction absolue de tout effet de perspective tridimensionnelle (barres en relief 3D, ombres portées, chanfreins biseautés), ces artifices géométriques falsifiant les surfaces relatives et introduisant des parallaxes de lecture trompeuses ;
- L’élimination des quadrillages verticaux superflus et la réduction des bordures de boîtes d’encadrement opaques ;
- Le privilège systématique accordé à l’étiquetage direct sur les segments plutôt qu’à l’usage d’une légende isolée déportée, chaque fois que la taille physique des rectangles le permet sans engorgement textuel.
L’étiquetage direct raccourcit le parcours de saccades oculaires de l’observateur en positionnant la métadonnée textuelle et chiffrée au foyer attentionnel immédiat de la surface géométrique, éliminant ainsi les allers-retours cognitifs harassants entre le corps du diagramme et un cartouche de légende périphérique.
11. Pièges méthodologiques, illusions d’optique et biais d’interprétation
11.1 Le piège de l’oblitération des effectifs totaux (biais de volume)
Le piège interprétatif le plus pernicieux inhérent au graphique à barres segmentées découle directement de son atout technique majeur : la normalisation conditionnelle unitaire. En forçant toutes les colonnes à culminer à la hauteur uniforme de 100 %, le dispositif opère une oblitération géométrique absolue des disparités de volume brut qui séparent les sous-échantillons. Ce phénomène peut induire des contresens dramatiques dans l’évaluation empirique des résultats.
Considérons un scénario hypothétique où une quatrième discipline sportive ultra-minoritaire, telle que l’escrime, aurait été introduite dans notre enquête, ne rassemblant que 2 étudiants au total sur l’ensemble du campus, dont 2 femmes. Sur le graphique segmenté à 100 %, cette discipline apparaîtrait sous la forme d’une barre imposante, entièrement remplie à $100,%$ par le segment féminin. L’observateur profane non averti y verrait spontanément le phénomène le plus colossal et le plus déterminant de toute la recherche, alors qu’il ne s’agit en réalité que d’un artéfact anecdotique portant sur un sous-échantillon dérisoire sans aucune représentativité statistique.
Pour parer à ce biais de volume potentiellement dévastateur, la déontologie scientifique impose d’adopter des contre-mesures formelles systématiques. La solution technique la plus rigoureuse consiste à faire figurer l’effectif marginal brut ($n$) de manière explicite directement sous l’intitulé textuel de chaque modalité en abscisse (par exemple en inscrivant : Baseball (n=36), Basketball (n=31), Football (n=33)). Cette mention textuelle permanente rappelle au lecteur l’amplitude du dénominateur local et prévient les extrapolations hasardeuses.
11.2 L’illusion de la ligne de base fluctuante pour les segments médians
Le talon d’Achille perceptif du graphique à barres segmentées réside incontestablement dans l’illusion de la ligne de base mobile qui affecte l’ensemble des segments intérieurs dès lors que la variable représentée comporte trois modalités ou davantage. Dans un tableau comprenant quatre catégories ordonnées (par exemple : Pas d’accord, Plutôt pas d’accord, Plutôt d’accord, Tout à fait d’accord), les segments médians flottent dans l’espace vertical sans aucun point d’ancrage fixe.
Des expériences de psychophysique visuelle ont démontré de manière répétée que les humains commettent des erreurs d’estimation allant de $15,%$ à $25,%$ lorsqu’ils tentent d’évaluer l’évolution de la taille d’un segment intermédiaire d’une colonne à l’autre. Lorsque le segment inférieur subit une forte contraction ou une forte expansion, l’œil de l’observateur est incapable de compenser spontanément le déplacement de la frontière de départ et projette une fausse perception de déformation sur le segment médian adjacent, même si la longueur réelle de ce dernier demeure rigoureusement constante.
Pour contourner ce handicap sensoriel, deux solutions palliatives s’offrent à l’analyste. La première consiste à inscrire obligatoirement les pourcentages sous forme d’étiquettes numériques lisibles à l’intérieur des segments pour suppléer la défaillance de l’estimation géométrique. La seconde, particulièrement recommandée pour les échelles d’attitudes bipolaires, consiste à abandonner le graphique empilé classique au profit d’un graphique à barres divergentes alignant la frontière de neutralité centrale sur une abscisse zéro partagée.
11.3 Mauvaises pratiques délibérées et manipulation visuelle
L’histoire de la rhétorique visuelle des données est jalonnée d’usages dévoyés du graphique à barres segmentées à des fins de désinformation ou de manipulation politique et commerciale. La distorsion la plus grossière consiste en la troncature arbitraire de l’ordonnée verticale. Si un auteur malveillant décide de ne représenter l’axe des ordonnées que dans l’intervalle restreint allant de $30,%$ à $70,%$ tout en masquant la graduation inférieure, il décuple artificiellement l’amplitude apparente des variations des segments, conférant à des écarts minimes et non significatifs une allure de séisme statistique.
Une seconde manipulation méthodologique fréquente repose sur le regroupement opportuniste de catégories (cherry-picking taxinomique). En agrégeant délibérément certaines modalités marginales sélectionnées pour former des macro-catégories ad hoc tout en maintenant d’autres catégories scindées, un communicant peut modifier substantiellement l’ordonnancement visuel des segments dominants et faire émerger artificiellement une prétendue majorité pour orienter l’opinion du décideur.
Face à ces pratiques déloyales, la communauté des statisticiens se doit de faire respecter les chartes éthiques de l’American Statistical Association et de la Société Française de Statistique. Celles-ci prescrivent l’ancrage systématique du repère à zéro, la transparence intégrale des protocoles d’agrégation catégorielle et la publication sans fard des marges d’erreur associées aux estimations proportionnelles.
12. Guide d’implémentation logicielle et syntaxe de référence
12.1 Création sous R avec l’écosystème ggplot2
Dans l’environnement de programmation statistique R, la référence incontournable pour la production de visualisations graphiques publiables est le package ggplot2, conçu par Hadley Wickham autour de la grammaire des graphiques. La genèse d’un graphique segmenté normalisé à 100 % exige que la matrice de données brutes soit préalablement convertie en un tableau de données au format long (tidy data), où chaque ligne figure une observation individuelle ou un croisement d’attributs.
La clé méthodologique sous ggplot2 réside dans le paramétrage de la fonction géométrique geom_bar(). En lui assignant l’argument technique position = "fill", le moteur graphique effectue automatiquement en arrière-plan la normalisation conditionnelle par colonne, transformant chaque barre en une structure unitaire bornée entre 0 et 1. L’habillage esthétique est ensuite parachevé via la fonction scale_y_continuous(labels = scales::percent), qui convertit automatiquement la graduation décimale flottante de l’ordonnée en pourcentages lisibles balisés de 0 % à 100 %.
L’analyste personnalise ensuite son tracé en spécifiant une palette de couleurs accessibles via scale_fill_brewer() ou scale_fill_viridis_d(), et en appliquant un thème typographique épuré comme theme_minimal() ou theme_classic(), débarrassé de toute surcharge d’encre non informative. L’intégration des étiquettes textuelles chiffrées s’opère de manière élégante au moyen de la fonction geom_text() en combinant un positionnement par position_fill(vjust = 0.5) pour garantir un centrage géométrique parfait des mentions de pourcentages au cœur de chaque strate rectangulaire.
12.2 Génération en Python via Pandas, Matplotlib et Seaborn
Dans l’écosystème open-source Python dédié à la science des données, la génération d’un graphique à barres segmentées s’articule autour des librairies pandas, matplotlib et seaborn. La première étape algorithmique s’effectue directement sur le DataFrame manipulé en générant un tableau de contingence croisé normalisé au moyen de la fonction hautement optimisée pandas.crosstab().
En renseignant l’argument normalize='columns' (ou normalize='index' selon la disposition matricielle retenue), la bibliothèque calcule instantanément les fréquences relatives conditionnelles et produit une matrice dont la sommation directionnelle équivaut à 1,0. Une fois cette matrice calculée, le tracé du graphique segmenté s’opère directement par l’appel de la méthode graphique de haut niveau de Pandas, DataFrame.plot(kind='bar', stacked=True), qui superpose verticalement les colonnes normalisées.
Pour conférer au diagramme un niveau de finition conforme aux exigences de l’édition scientifique, l’analyste fait intervenir les commandes de bas niveau de matplotlib.pyplot. Celles-ci permettent d’itérer sur les rectangles de la collection vectorielle (les patches) afin d’extraire dynamiquement leurs hauteurs relatives et leurs coordonnées centroïdes pour y apposer des annotations textuelles numériques par l’intermédiaire de la méthode ax.annotate(). La mise en forme de l’axe des ordonnées en pourcentages stricts s’effectue au moyen du formateur matplotlib.ticker.PercentFormatter(1.0), tandis que la rotation des étiquettes catégorielles de l’abscisse est verrouillée à l’horizontale pour garantir une lisibilité sans torsion cervicale.
12.3 Production assistée dans SPSS et JASP pour les chercheurs
Pour les praticiens des sciences humaines et biomédicales privilégiant les environnements logiciels assistés par interface graphique utilisateur (GUI), la conception d’un graphique à barres segmentées demeure une procédure hautement standardisée mais requiert une sélection rigoureuse des options opératoires.
Sous IBM SPSS Statistics, le chercheur navigue vers le module Générateur de graphiques (Chart Builder) accessible depuis le menu des graphiques. Dans la galerie des diagrammes en barres, il convient de sélectionner impérativement la troisième icône représentant le « Diagramme à barres empilées ». Après avoir glissé la variable sportive en abscisse et la variable de genre dans la zone de cluster de couleur, l’analyste doit impérativement ouvrir la fenêtre des Propriétés des éléments et modifier la statistique de l’axe vertical : au lieu de l’effectif brut sélectionné par défaut, il faut cocher l’option « Pourcentage » et définir la base de calcul du pourcentage sur l’option « Total pour chaque valeur de l’axe X ». Cette manipulation technique fondamentale force SPSS à convertir les barres empilées conventionnelles en barres segmentées normalisées à 100 %.
Sous JASP (environnement open-source développé par l’Université d’Amsterdam pour la statistique bayésienne et fréquentiste), la logique est encore plus fluide. Au sein du module des Tableaux de contingence (Contingency Tables), le chercheur insère ses deux variables dans les lignes et les colonnes, puis déroule l’onglet des visualisations graphiques (Plots). En cochant l’option des graphiques à barres empilées relatives, le logiciel génère instantanément une figure vectorielle d’une sobriété remarquable, respectant scrupuleusement les canons visuels de l’American Psychological Association (APA). Les options d’exportation permettent d’extraire directement la figure sous forme de fichier vectoriel évolutif (SVG ou PDF), garantissant une netteté typographique et graphique absolue lors de son incorporation définitive dans le manuscrit académique final.
Références
- Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Gauthier-Villars.
- Brewer, C. A. (2005). Designing better maps: A guide for GIS users. ESRI Press.
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Friendly, M. (2000). Visualizing categorical data. SAS Institute.
- Haberman, S. J. (1973). The analysis of residuals in cross-classified tables. Biometrics, 29(1), 205–220. https://doi.org/10.2307/2529686
- Kolmogorov, A. N. (1956). Foundations of the theory of probability (2nd ed.). Chelsea Publishing Company.
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. Philosophical Magazine Series 5, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer. https://doi.org/10.1007/0-387-28695-0