
Dans l’histoire des sciences et de l’épistémologie, la domestication de l’incertain constitue l’une des ruptures conceptuelles les plus décisives de la pensée moderne. Longtemps relégué aux marges de la philosophie naturelle ou assimilé à une simple ignorance des causes sous-jacentes dans un univers rigoureusement déterministe, le hasard a acquis le statut d’objet mathématique autonome au cours des trois derniers siècles. Au cœur de cette formalisation se trouve un concept d’une élégance et d’une puissance remarquables : la variable aléatoire. Loin d’être une simple grandeur fluctuante au gré des circonstances, la variable aléatoire représente une passerelle formelle entre la contingence des événements physiques et la rigueur de l’analyse mathématique, fournissant aux chercheurs un cadre opératoire universel pour quantifier l’imprévisible.
Dans la démarche expérimentale contemporaine, des neurosciences computationnelles à la psychométrie en passant par la physique quantique et l’économétrie, toute observation empirique est inexorablement soumise à la variabilité. Qu’il s’agisse du temps d’intégration d’un réseau neuronal, de la réponse d’un sujet à un stimulus perceptif ou de la mesure d’un trait latent chez un individu, le phénomène observé ne peut être appréhendé de manière rigoureuse sans une abstraction qui dépouille l’événement de ses scories phénoménologiques pour n’en conserver que la structure quantifiable. La variable aléatoire n’est pas le phénomène lui-même, mais la règle géométrique et algébrique qui assigne un nombre à chaque issue possible de la réalité observée.
Le présent traité propose une exploration approfondie de cette notion fondamentale, depuis ses racines théoriques ancrées dans la théorie de la mesure et l’axiomatisation moderne jusqu’à ses applications les plus pointues dans la modélisation comportementale et cognitive. En clarifiant la distinction entre incertitude ontique et épistémique, en décortiquant les mécanismes analytiques des distributions discrètes et continues, et en explorant les théorèmes limites qui sous-tendent l’inférence statistique, cette étude vise à restituer à la variable aléatoire sa double nature : un édifice mathématique d’une rigueur absolue et un instrument méthodologique indispensable à toute science empirique.
1. Introduction conceptuelle : Définition fondamentale de la variable aléatoire
1.1 Origine ontologique et formalisme de la notion de variable
L’émergence historique de la notion de variable aléatoire s’enracine dans la volonté séculaire de modéliser les jeux de hasard. Des échanges épistolaires fondateurs entre Blaise Pascal et Pierre de Fermat en 1654 jusqu’aux traités novateurs de Christiaan Huygens et de Jakob Bernoulli, l’ambition initiale était de déterminer l’espérance de gain d’un joueur face à des combinaisons combinatoires complexes. À cette époque, le hasard était principalement pensé comme une propriété intrinsèque à des dispositifs matériels symétriques : dés cubiques, roulettes équilibrées ou tirages d’urnes. Toutefois, au fil des XVIIIe et XIXe siècles, avec les travaux pionniers de Pierre-Simon de Laplace, de Carl Friedrich Gauss et d’Adolphe Quetelet, cette géométrie du jeu s’est déplacée vers l’étude des erreurs astronomiques, puis vers l’observation des populations biologiques et sociales, exigeant une refonte philosophique et conceptuelle du statut de la variabilité.
Sur le plan ontologique, une distinction fondamentale s’impose d’emblée entre l’indétermination ontique et l’incertitude épistémique. L’indétermination ontique renvoie à l’idée que le système physique réel possède un comportement intrinsèquement probabiliste, irréductible à des variables cachées, comme le suggère l’interprétation standard de la mécanique quantique. À l’opposé, l’incertitude épistémique découle d’une limitation inhérente à l’observateur : ignorance des conditions initiales microscopiques, instruments de mesure imparfaits ou complexité computationnelle insoluble d’un système par ailleurs strictement déterministe, tel un gaz régi par la dynamique newtonienne. La théorie contemporaine des probabilités s’abstrait de ce débat métaphysique : que l’aléa provienne d’une propriété irréductible de la matière ou d’une incomplétude cognitive de nos modèles, le formalisme de la variable aléatoire s’applique avec une efficacité invariante, traduisant notre état de connaissance ou d’inconnaissance en une structure analytique rigoureuse.
Cette réussite repose sur le rôle fondamental de l’abstraction numérique dans la quantification des phénomènes. Dans l’observation brute, un événement est souvent qualitatif, hétérogène et singulier : l’apparition d’un comportement d’évitement chez un rongeur, le choix d’un consommateur face à un dilemme ou l’activation d’un groupe d’astrocytes. Pour appliquer les outils puissants du calcul différentiel et intégral, il devient impératif de projeter ces entités phénoménologiques dans l’espace des nombres réels. Cette transition de l’observation brute à la modélisation statistique structurée s’opère précisément par l’intermédiaire de la variable aléatoire, qui sert d’opérateur de traduction entre le langage des faits et celui de l’analyse fonctionnelle.
1.2 Définition mathématique standard d’une variable aléatoire
En dépit d’une dénomination historique qui peut prêter à confusion, une variable aléatoire n’est ni « variable » au sens d’un symbole algébrique indéterminé, ni « aléatoire » au sens d’un objet qui changerait capricieusement de définition. En mathématiques rigoureuses, une variable aléatoire est très exactement une fonction ou une application déterministe définie sur un univers d’événements élémentaires et prenant ses valeurs dans un ensemble cible, presque toujours la droite des nombres réels. La variabilité n’intervient que par l’intermédiaire du tirage au sort d’un état fondamental de la nature, auquel la fonction associe une valeur numérique parfaitement fixe et reproductible.
Sur le plan notationnel, les conventions canoniques introduites par l’école probabiliste moderne établissent une démarcation nette : la majuscule latine, généralement notée (X), (Y) ou (Z), désigne l’application mathématique abstraite, c’est-à-dire la variable aléatoire en tant qu’opérateur mesurable. Inversement, la minuscule correspondante, (x), (y) ou (z), représente une réalisation particulière de cette variable, à savoir la valeur numérique concrète observée lorsque le système s’est stabilisé dans un état spécifique après expérimentation. Ainsi, lorsqu’un protocole indique l’écriture (X = x), il décrit l’ensemble pré-image des états de la nature qui, par l’entremise de la fonction (X), s’envoient précisément sur la valeur réelle (x).
La confusion entre l’application (X) et la valeur observée (x) est l’une des erreurs conceptuelles les plus pernicieuses dans l’apprentissage des sciences quantitatives. Confondre (X) et (x), c’est assimiler le thermomètre (l’instrument de mesure modélisé comme une fonction qui transforme l’agitation thermique en graduation) à la température affichée à midi un jour donné (le nombre particulier résultant de cette fonction). L’application (X) possède des propriétés globales, telles qu’une distribution de probabilité, une espérance théorique ou une variance, tandis que la réalisation (x) n’est qu’un point isolé sur la droite réelle, dépourvu en lui-même de toute dispersion statistique.
1.3 Utilité méthodologique dans la modélisation empirique
Dans la conduite de la science empirique, l’utilisation des variables aléatoires conditionne directement la validité métrologique des observations. Elle permet en premier lieu la transformation systématique d’observations qualitatives complexes en métriques quantitatives analysables. Par exemple, dans un paradigme psychologique portant sur l’apprentissage associatif, la réponse comportementale d’un sujet (hésitation, retrait, complétion d’une tâche) est codifiée par une variable aléatoire binaire ou ordinale, autorisant dès lors l’utilisation d’opérations algébriques d’agrégation, de moyenne et de corrélation qui seraient trivialement impossibles sur des descriptions textuelles ou narratives.
En second lieu, ce formalisme assure la standardisation des protocoles d’échantillonnage et de recueil de données. En postulant qu’une série d’expériences constitue la réalisation répétée d’une même variable aléatoire ou d’une suite de variables interchangeables, le chercheur dispose d’un cadre mathématique formel pour juger de la représentativité de son échantillon. La notion de réplication scientifique perd alors son caractère flou pour devenir l’investigation statistique de la stabilité des paramètres d’une distribution à travers différentes séries de réalisations.
Enfin, la modélisation par variable aléatoire offre un cadre opératoire indispensable pour tester la reproductibilité des résultats et quantifier rigoureusement l’erreur expérimentale. Tout dispositif de mesure dans le monde réel génère des signaux composites où la composante d’intérêt est inévitablement polluée par des perturbations thermiques, environnementales ou physiologiques. En formulant le résultat observé comme la combinaison algébrique d’une grandeur déterministe et d’une variable aléatoire d’erreur, la statistique inférentielle moderne fournit les algorithmes requis pour isoler le signal du bruit et assigner un intervalle de confiance aux conclusions tirées du protocole empirique.
2. Fondements de la théorie de la mesure et espace probabilisé
2.1 Le triplet probabiliste fondamental de Kolmogorov
L’assise formelle moderne du calcul des probabilités ne s’est consolidée qu’en 1933 avec la publication des Grundbegriffe der Wahrscheinlichkeitsrechnung par le mathématicien soviétique Andreï Kolmogorov. Ce travail monumental a résolu les paradoxes inhérents aux approches fréquentielles ou géométriques naïves en subordonnant l’étude de l’aléa à la théorie de la mesure, développée quelques décennies plus tôt par Émile Borel et Henri Lebesgue. Dans ce cadre, toute étude probabiliste commence par la définition rigoureuse d’un triplet fondamental, noté traditionnellement ((Omega, mathcal{F}, mathbb{P})).
Le premier élément de ce triplet, noté (Omega) (l’univers des possibles), représente l’ensemble exhaustif de tous les états élémentaires concevables ou résultats microscopiques mutuellement exclusifs d’une expérience aléatoire. Le deuxième élément, (mathcal{F}), désigne une tribu (ou (sigma)-algèbre) définie sur (Omega). Il s’agit d’une famille de sous-ensembles de (Omega) qui possède des propriétés de fermeture structurelles strictes : l’univers (Omega) appartient à (mathcal{F}), le complémentaire de tout ensemble appartenant à (mathcal{F}) appartient également à (mathcal{F}), et toute union dénombrable d’éléments de (mathcal{F}) est encore un élément de (mathcal{F}). Les éléments de (mathcal{F}) sont appelés les événements ; ce sont les seuls sous-ensembles auxquels il est mathématiquement licite d’attribuer une probabilité.
Le troisième élément, (mathbb{P}), est la mesure de probabilité. Il s’agit d’une fonction d’ensemble (mathbb{P} : mathcal{F} to [0, 1]) qui satisfait les axiomes de Kolmogorov : la probabilité de l’univers total est unitaire ((mathbb{P}(Omega) = 1)), la mesure d’un événement est toujours non négative, et pour toute suite dénombrable d’événements deux à deux disjoints ((A_n)_{n in mathbb{N}}), la probabilité de leur réunion est égale à la somme de leurs probabilités respectives ((sigma)-additivité) :
[ mathbb{P}left(bigcup_{n=1}^{infty} A_nright) = sum_{n=1}^{infty} mathbb{P}(A_n) ]
Ce triplet garantit une cohérence logique absolue, éliminant définitivement les contradictions logiques qui émergeaient autrefois lors de la manipulation d’ensembles infinis non dénombrables.
2.2 La condition de mesurabilité borélienne
Dès lors que l’on dispose d’un espace probabilisé ((Omega, mathcal{F}, mathbb{P})), la définition d’une variable aléatoire réelle (X) ne peut se réduire à une application arbitraire de (Omega) dans (mathbb{R}). Pour que l’on puisse calculer la probabilité que (X) prenne des valeurs dans un intervalle donné, par exemple que la variable soit inférieure ou égale à un seuil critique (c), il est impératif que le sous-ensemble des états fondamentaux conduisant à ce résultat constitue un événement légitime, c’est-à-dire appartienne à la tribu (mathcal{F}). C’est la condition de mesurabilité.
Pour formaliser cette exigence, la droite réelle (mathbb{R}) doit elle-même être dotée d’une structure de tribu. La structure standard est la tribu borélienne, notée (mathcal{B}(mathbb{R})), qui est définie comme la plus petite (sigma)-algèbre contenant tous les intervalles ouverts de la topologie usuelle de (mathbb{R}). Les éléments de (mathcal{B}(mathbb{R})) sont appelés les boréliens ; ils comprennent tous les intervalles fermés, ouverts, semi-ouverts, ainsi que toutes les réunions et intersections dénombrables de ceux-ci. Une variable aléatoire réelle est alors définie de manière universelle comme une fonction mesurable de ((Omega, mathcal{F})) dans ((mathbb{R}, mathcal{B}(mathbb{R}))).
Formellement, cette condition signifie que pour tout borélien (B in mathcal{B}(mathbb{R})), l’image réciproque (ou pré-image) de cet ensemble par l’application (X), définie par (X^{-1}(B) = {omega in Omega : X(omega) in B}), doit obligatoirement être un élément de la tribu de départ (mathcal{F}). En pratique, il suffit que cette condition soit vérifiée pour tous les intervalles de la forme (]-infty, c]), c’est-à-dire :
[ forall c in mathbb{R}, quad {omega in Omega : X(omega) le c} in mathcal{F} ]
Cette clause technique de mesurabilité borélienne est la garantie mathématique absolue qui permet d’éviter l’émergence d’ensembles « non mesurables » (tels que ceux construits à l’aide de l’axiome du choix par Vitali), sur lesquels le calcul des probabilités s’effondrerait par indétermination.
2.3 Passage de l’espace abstrait à la droite numérique réelle
L’intérêt conceptuel majeur de cette construction réside dans l’opération de projection opérée par la variable aléatoire. L’espace fondamental (Omega) est souvent une construction théorique extraordinairement complexe, multidimensionnelle, voire totalement inaccessible à la description directe. Dans l’étude d’un temps de réaction humain, (Omega) engloberait l’état biophysique complet de milliards de synapses, les fluctuations thermodynamiques de l’environnement expérimental et l’historique développemental du sujet. Manipuler directement des mesures sur un tel espace relèverait de l’impossible.
La variable aléatoire (X) agit précisément comme un opérateur de réduction dimensionnelle. En associant à chaque micro-état complexe (omega) un unique scalaire réel (X(omega) in mathbb{R}), elle transporte l’analyse de l’espace abstrait (Omega) vers la droite réelle familière. Mieux encore, elle induit sur l’espace d’arrivée ((mathbb{R}, mathcal{B}(mathbb{R}))) une nouvelle mesure de probabilité, notée (mathbb{P}_X) et appelée la loi de probabilité (ou distribution) de la variable aléatoire. Cette mesure induite (ou mesure image) est définie par :
[ mathbb{P}_X(B) = mathbb{P}(X^{-1}(B)) = mathbb{P}({omega in Omega : X(omega) in B}), quad forall B in mathcal{B}(mathbb{R}) ]
Grâce à cette projection préservant la structure probabiliste, le statisticien peut totalement s’émanciper de l’espace sous-jacent (Omega). Dès lors que la loi (mathbb{P}_X) est caractérisée, toute l’analyse mathématique se déroule sur l’axe réel à l’aide d’outils d’intégration classiques, simplifiant de manière spectaculaire les calculs sans sacrifier la rigueur épistémologique du modèle.
3. Typologie primaire : Les variables aléatoires discrètes
3.1 Caractérisation et dénombrabilité du support
La première grande catégorie issue de la classification des variables aléatoires est constituée par les variables dites discrètes. Une variable aléatoire réelle (X) est dite discrète si son ensemble de valeurs admissibles, que l’on nomme le support de la variable et que l’on note généralement (S_X = X(Omega)), est un sous-ensemble fini ou infini dénombrable de (mathbb{R}). Cela implique qu’il existe une bijection entre le support de la variable et un sous-ensemble des entiers naturels (mathbb{N}).
Sur le plan topologique, les éléments d’un support discret sont des points isolés les uns des autres. En d’autres termes, pour tout élément (x_k in S_X), il est toujours possible de trouver un voisinage ouvert suffisamment restreint autour de (x_k) qui ne contienne aucun autre point appartenant à (S_X). Cette propriété de séparation stricte interdit tout continuum de transition entre deux réalisations possibles de la variable, imposant une structure intrinsèquement granulaire à l’espace des réponses.
Dans la recherche scientifique, la dénombrabilité mathématique ne doit pas être confondue avec la finitude pratique de l’observation. Un modèle mathématique peut postuler un support infini dénombrable (comme l’ensemble des entiers ({0, 1, 2, dots})) pour représenter des processus sans borne supérieure théorique stricte, tout en sachant que les données recueillies sur le terrain seront inévitablement bornées par la durée de l’expérience ou les ressources du système. La modélisation discrète fournit alors une représentation parcimonieuse et exacte de grandeurs dont la nature même prohibe toute division arbitraire.
3.2 Exemples canoniques de variables discrètes
Les variables aléatoires discrètes abondent dans l’ensemble des sciences expérimentales, particulièrement sous la forme de données de dénombrement ou de classifications qualitatives indexées numériquement. L’exemple le plus élémentaire réside dans le comptage du nombre d’occurrences d’un événement au cours d’une séquence finie d’essais expérimentaux indépendants, telle que la réussite d’un rat à s’orienter dans un labyrinthe aquatique lors de dix sessions successives.
Dans le domaine de la psychométrie et de la neuro-ergonomie, les variables discrètes structurent l’évaluation cognitive standardisée. Le score total obtenu par un participant à une épreuve d’aptitude psychologique – calculé comme la somme des réponses correctes à un inventaire de cinquante questions à choix multiples – constitue une variable aléatoire discrète dont le support est l’ensemble fini des entiers compris entre 0 et 50. De même, la quantification de la fréquence des erreurs d’inattention dans un protocole d’attention soutenue (par exemple le Sustained Attention to Response Task) génère une distribution discrète de comptage.
Enfin, en psychopathologie clinique et en psychiatrie quantitative, la comptabilisation des symptômes comportementaux observés chez un patient lors d’un entretien semi-structuré s’inscrit dans cette typologie. Lorsqu’un praticien évalue la présence ou l’absence de neuf critères diagnostiques du trouble dépressif caractérisé selon le DSM-5, le nombre total de symptômes validés est une variable aléatoire discrète. Cette variable prend des valeurs entières isolées, chaque incrément unitaire marquant le franchissement d’un seuil clinique qualitatif.
3.3 Spécificités métrologiques des données de comptage
L’analyse des variables aléatoires discrètes impose des contraintes métrologiques rigoureuses découlant de la nature des entiers naturels. La propriété la plus limitante réside dans l’absence totale de valeurs intermédiaires : un sujet peut commettre exactement deux ou trois fautes, mais l’observation de 2,417 fautes est un non-sens physique. Lorsque les données empiriques sont restreintes aux entiers, l’application irréfléchie de modèles statistiques conçus pour des variables continues (comme le modèle linéaire généralisé standard par moindres carrés) induit de graves distorsions mathématiques, conduisant à des prédictions absurdes, telles que des nombres d’événements négatifs ou non entiers.
De plus, les variables discrètes de comptage sont structurellement vulnérables aux phénomènes de troncature, ainsi qu’aux effets de plancher et de plafond. Un effet de plancher survient lorsqu’une part massive de la distribution s’accumule sur la valeur minimale admissible (typiquement le zéro), par exemple lorsque l’on mesure des conduites agressives rares dans une cohorte scolaire générale. Inversement, un effet de plafond s’observe lorsqu’un test d’aptitude s’avère trop facile, conduisant la quasi-totalité des participants à obtenir la note maximale théorique, détruisant ainsi la variance d’échantillonnage et tronquant artificiellement l’évaluation du trait latent.
Pour traiter ces spécificités sans violer les postulats probabilistes, la recherche contemporaine recourt à des modèles de régression pour données de comptage, tels que les régressions de Poisson ou les régressions binomiales négatives. Ces architectures paramétriques intègrent explicitement la non-négativité et la nature discrète de la variable cible, évitant ainsi les biais systématiques d’arrondi ou de linéarisation forcée qui altèrent fréquemment l’interprétation des échelles discrètes dans la littérature scientifique.
4. La distribution de probabilité des variables discrètes
4.1 La fonction de masse de probabilité
La structure stochastique complète d’une variable aléatoire discrète (X) est intégralement capturée par ce que l’on nomme sa fonction de masse de probabilité (FMP), fréquemment désignée sous l’acronyme anglophone PMF (Probability Mass Function). Mathématiquement, pour toute valeur réelle (x) appartenant au support (S_X), la fonction de masse associe la probabilité ponctuelle exacte que la variable aléatoire s’égalise précisément à cette réalisation numérique particulière :
[ p_X(x) = mathbb{P}(X = x) = mathbb{P}({omega in Omega : X(omega) = x}) ]
Cette fonction de masse doit impérativement obéir à deux propriétés axiomatiques fondamentales, découlant directement des principes posés par Kolmogorov. D’une part, la condition de positivité stipule que la probabilité attribuée à chaque état ponctuel ne peut être négative, se traduisant formellement par :
[ p_X(x_k) ge 0, quad forall x_k in S_X ]
D’autre part, la condition de normalisation unitaire impose que la somme de toutes les masses de probabilité réparties sur l’intégralité du support dénombrable converge très exactement vers la certitude absolue :
[ sum_{k} p_X(x_k) = 1 ]
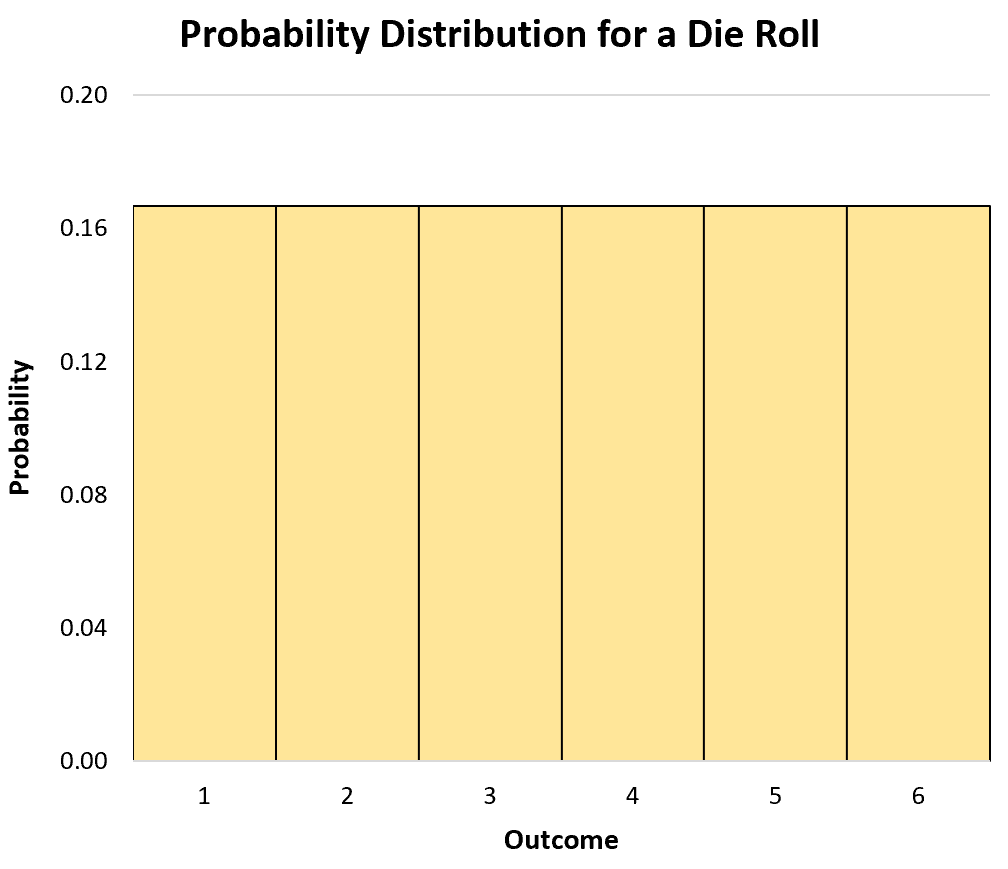
Sur le plan de la communication scientifique, la fonction de masse se représente graphiquement sous la forme d’un diagramme en bâtons (ou diagramme à pointes). La hauteur de chaque segment vertical érigé au-dessus de la valeur discrète (x_k) est rigoureusement proportionnelle à la probabilité ponctuelle (p_X(x_k)). Cette sémiologie graphique évite toute confusion visuelle avec les histogrammes continus où l’information réside dans l’aire surfacique et non dans une ligne discrète.
4.2 Lois discrètes classiques : Bernoulli et Binomiale
Parmi l’infinité des lois discrètes concevables, certaines configurations mathématiques émergent de manière quasi universelle en raison de la structure récurrente des protocoles expérimentaux. La plus élémentaire est l’épreuve de Bernoulli, modélisant une expérience aléatoire binaire qui n’admet que deux issues mutuellement exclusives, classiquement étiquetées « succès » (codé par la valeur 1) et « échec » (codé par la valeur 0). Si l’on note (p in [0, 1]) la probabilité de succès, la fonction de masse d’une variable de Bernoulli (X sim mathcal{B}(p)) s’écrit analytiquement :
[ p_X(x) = p^x (1-p)^{1-x}, quad x in {0, 1} ]
Dès lors que cette épreuve élémentaire est répétée (n) fois de manière rigoureusement indépendante et identique, la variable aléatoire (Y) dénombrant le nombre total de succès obtenus suit une loi binomiale de paramètres (n) et (p), notée (mathcal{B}(n, p)). Son support est l’ensemble fini ({0, 1, 2, dots, n}). Pour déterminer la probabilité d’observer exactement (k) succès, l’analyse combinatoire intervient pour comptabiliser le nombre de séquences distinctes présentant exactement (k) succès parmi (n) essais, conduisant à la formule classique :
[ mathbb{P}(Y = k) = binom{n}{k} p^k (1-p)^{n-k} = frac{n!}{k!(n-k)!} p^k (1-p)^{n-k} ]
En psychométrie, cette loi gouverne fondamentalement les modèles d’items dichotomiques. Lorsqu’un examen cognitif est administré sans interaction entre les questions, le nombre global de réussites individuelles est théoriquement structuré selon une loi binomiale si la difficulté des items et la compétence du candidat sont postulées invariantes.
4.3 Lois de Poisson et Géométrique
Lorsque le nombre d’essais (n) tend vers l’infini tandis que la probabilité individuelle de succès (p) devient infinitésimale, le produit (lambda = n cdot p) restant constant, la loi binomiale converge asymptotiquement vers la loi de Poisson, couramment désignée comme la loi des événements rares. Définie sur un support infini dénombrable (S_X = mathbb{N} = {0, 1, 2, dots}), une variable de Poisson de paramètre d’intensité (lambda > 0) possède la fonction de masse suivante :
[ mathbb{P}(X = k) = frac{lambda^k e^{-lambda}}{k!} ]
Cette distribution est le modèle de référence pour quantifier le nombre d’occurrences d’un événement discret dans une fenêtre temporelle ou spatiale continue, sous l’hypothèse d’indépendance mutuelle entre les intervalles disjoints. En neurobiologie, par exemple, la libération quantique de neurotransmetteurs au niveau de la fente synaptique ou la décharge des potentiels d’action spontanés d’un neurone en l’absence de stimulation obéissent avec une fidélité remarquable à une loi de Poisson.
Une autre distribution fondamentale intervenant dans les processus séquentiels est la loi géométrique. Elle modélise le nombre d’épreuves de Bernoulli indépendantes nécessaires pour observer l’émergence du tout premier succès. Si l’on s’intéresse au nombre de tentatives infructueuses (K) précédant le premier succès, son support s’étend sur (mathbb{N}) et sa loi s’écrit (mathbb{P}(K = k) = (1-p)^k p). La propriété mathématique la plus remarquable de la loi géométrique est son absence de mémoire (amnésie stochastique) :
[ mathbb{P}(K ge k + m mid K ge m) = mathbb{P}(K ge k) ]
Cette équation démontre que la probabilité de devoir patienter encore (k) étapes supplémentaires ne dépend en aucune manière du nombre d’échecs passés (m). En sciences cognitives, cette loi permet de formaliser des modèles de temps d’attente d’une découverte euristique ou de persévérance comportementale dans des environnements d’apprentissage sans rétroaction cumulative.
5. Typologie secondaire : Les variables aléatoires continues
5.1 Nature continue de l’espace d’états
À l’opposé des structures discrètes dénombrables, de nombreux phénomènes naturels se manifestent sous la forme d’un spectre ininterrompu de grandeurs physiques. Une variable aléatoire réelle (X) est qualifiée de continue (ou, au sens strict de l’analyse, absolument continue par rapport à la mesure de Lebesgue) si son support est non dénombrable et constitué d’un ou de plusieurs intervalles continus de (mathbb{R}), bornés ou non (par exemple l’ensemble des réels positifs (mathbb{R}^+) ou la droite réelle complète (mathbb{R})).
Cette topologie continue induit un bouleversement probabiliste majeur : l’impossibilité théorique d’isoler des valeurs ponctuelles consécutives. Dans un intervalle continu de nombres réels, entre deux valeurs arbitrairement proches, il existe toujours une infinité non dénombrable de valeurs intermédiaires. Par voie de conséquence directe, la théorie de la mesure impose un résultat fondamental souvent perçu comme un paradoxe par l’étudiant profane : la probabilité qu’une variable aléatoire continue prenne très exactement une valeur numérique prédéterminée (x) est rigoureusement nulle :
[ forall x in mathbb{R}, quad mathbb{P}(X = x) = 0 ]
Ce paradoxe apparent se résout dès lors que l’on comprend qu’un événement de probabilité nulle n’est pas un événement logiquement impossible (l’ensemble vide (emptyset)), mais un singleton dont la mesure de Lebesgue sur la droite réelle est nulle. Pour une variable continue, il devient mathématiquement dénué de sens de s’interroger sur la probabilité ponctuelle (mathbb{P}(X = 12{,}5473dots)). L’assignation probabiliste ne reprend sa consistance analytique que lorsque l’on mesure la chance que la variable prenne ses valeurs au sein d’un intervalle infinitésimal ou macroscopique ([a, b]), formalisant l’idée que seule l’accumulation locale de probabilité a une portée métrologique.
5.2 Exemples emblématiques en neurosciences et comportement
L’exploration contemporaine des neurosciences cognitives et des mécanismes comportementaux repose massivement sur des variables continues, reflets directs des dynamiques biophysiques sous-jacentes. L’exemple le plus représentatif est sans doute la chronométrie mentale, matérialisée par la mesure des temps de réaction. Qu’un expérimentateur mesure la latence requise par un sujet pour catégoriser un phonème ou inhiber une réponse motrice dans une tâche de type Stop-Signal, le temps écoulé constitue une grandeur physique continue s’exprimant sur l’ensemble des réels strictement positifs.
De même, l’enregistrement des signaux physiologiques continus via des capteurs biométriques haute fidélité fournit des séries temporelles de variables aléatoires continues. L’activité électrodermale (ou réponse de conductance cutanée), mesurée en micro-siemens ((mutext{S})), capture des fluctuations infinitésimales de l’activation du système nerveux autonome sympathique face à un stimulus émotionnel. Aucun seuil granulaire discret ne sépare deux états consécutifs de sudation glandulaire.
Il en va de même des potentiels évoqués continus extraits de l’électroencéphalographie (EEG) ou de la magnétoencéphalographie (MEG). Les variations d’amplitude micro-volatiles enregistrées au niveau du cuir chevelu – telle que la célèbre composante N400 liée au traitement sémantique – sont modélisées comme des variables aléatoires continues, tout comme la latence fine et l’amplitude angulaire des saccades et des fixations oculaires dans les protocoles d’eye-tracking explorant l’attention visuelle sélective.
5.3 Continuité théorique versus discrétisation instrumentale
L’affirmation empirique de la continuité d’un phénomène soulève un débat métrologique et épistémologique fondamental : la discordance inévitable entre la nature ontologique du phénomène étudié et la résolution technique de l’instrument d’enregistrement. Si le temps biologique ou la tension électrique synaptique s’écoulent selon une continuité fluide dans le monde réel, tout appareil de mesure numérique contemporain fonctionne par discrétisation temporelle et échantillonnage quantifié (par exemple via des convertisseurs analogique-numérique 16 ou 24 bits opérant à une fréquence finie de 1 000 Hz).
Cette contrainte technologique transforme de facto toute série de données brutes numériques en une variable formellement discrète, puisque le signal enregistré ne peut adopter qu’un nombre fini d’échelons de quantification prédéterminés. Dès lors, pourquoi s’obstiner à modéliser ces données au moyen de variables aléatoires continues ? La justification réside dans la formidable économie computationnelle et la puissance d’extrapolation offertes par l’analyse mathématique continue. Lorsque le nombre de paliers de quantification d’un appareil dépasse plusieurs milliers, le coût algorithmique du traitement discret devient écrasant, alors que le calcul différentiel et intégral continu fournit des approximations analytiques exactes à la limite asymptotique.
Le chercheur doit néanmoins demeurer vigilant : si la résolution de l’outil est insuffisante (par exemple, un enregistrement des temps de réponse arrondi à la seconde entière plutôt qu’à la milliseconde), traiter la variable comme continue engendre des erreurs d’inférence sévères dues au groupement artificiel des données. La modélisation continue demeure une idéalisation théorique, extraordinairement féconde, mais qui présuppose une granularité instrumentale infiniment plus fine que l’échelle de variabilité propre au processus étudié.
6. Fonction de densité de probabilité et fonction de répartition continue
6.1 La fonction de densité de probabilité (FDP)
L’impossibilité d’attribuer une masse non nulle aux points isolés d’une variable continue impose le recours à un nouvel outil mathématique : la fonction de densité de probabilité (FDP), généralement notée (f_X(x)) (ou PDF en anglais). La densité ne représente pas une probabilité brute, mais un taux local de probabilité par unité de mesure. Elle est formellement définie comme la dérivée de la fonction de répartition lorsque celle-ci est différentiable :
[ f_X(x) = lim_{Delta x to 0^+} frac{mathbb{P}(x le X le x + Delta x)}{Delta x} ]
Pour qu’une fonction réelle (f : mathbb{R} to mathbb{R}) soit admissible en tant que densité de probabilité, elle doit satisfaire deux propriétés fondamentales rigoureuses. Premièrement, la positivité universelle :
[ f_X(x) ge 0, quad forall x in mathbb{R} ]
Deuxièmement, la normalisation intégrale, stipulant que l’aire totale délimitée sous la courbe de la densité sur l’intégralité de la droite réelle doit équivaloir très exactement à l’unité :
[ int_{-infty}^{+infty} f_X(x) , dx = 1 ]
Dès lors, le calcul de la probabilité que la variable aléatoire continue (X) s’établisse à l’intérieur d’un intervalle fermé ou ouvert ([a, b]) s’obtient par l’intégration définie de sa densité sur ce segment géographique :
[ mathbb{P}(a le X le b) = int_a^b f_X(x) , dx ]
Il est crucial de souligner qu’en raison du caractère local de la densité, la valeur numérique (f_X(x)) peut parfaitement être supérieure à 1 sur un intervalle très étroit (contrairement à une probabilité qui est bornée par définition dans l’intervalle ([0, 1])), pourvu que l’intégrale globale demeure rigoureusement unitaire.
6.2 La fonction de répartition cumulative (CDF)
Tandis que la fonction de masse s’applique au monde discret et la densité au monde continu, il existe un opérateur probabiliste universel, applicable sans distinction à toute variable aléatoire : la fonction de répartition cumulative (notée (F_X(x)) ou CDF pour Cumulative Distribution Function). Cette fonction réelle est définie pour tout nombre réel (x) comme la probabilité que la variable aléatoire prenne une valeur inférieure ou égale à ce seuil :
[ F_X(x) = mathbb{P}(X le x) = mathbb{P}({omega in Omega : X(omega) le x}) ]
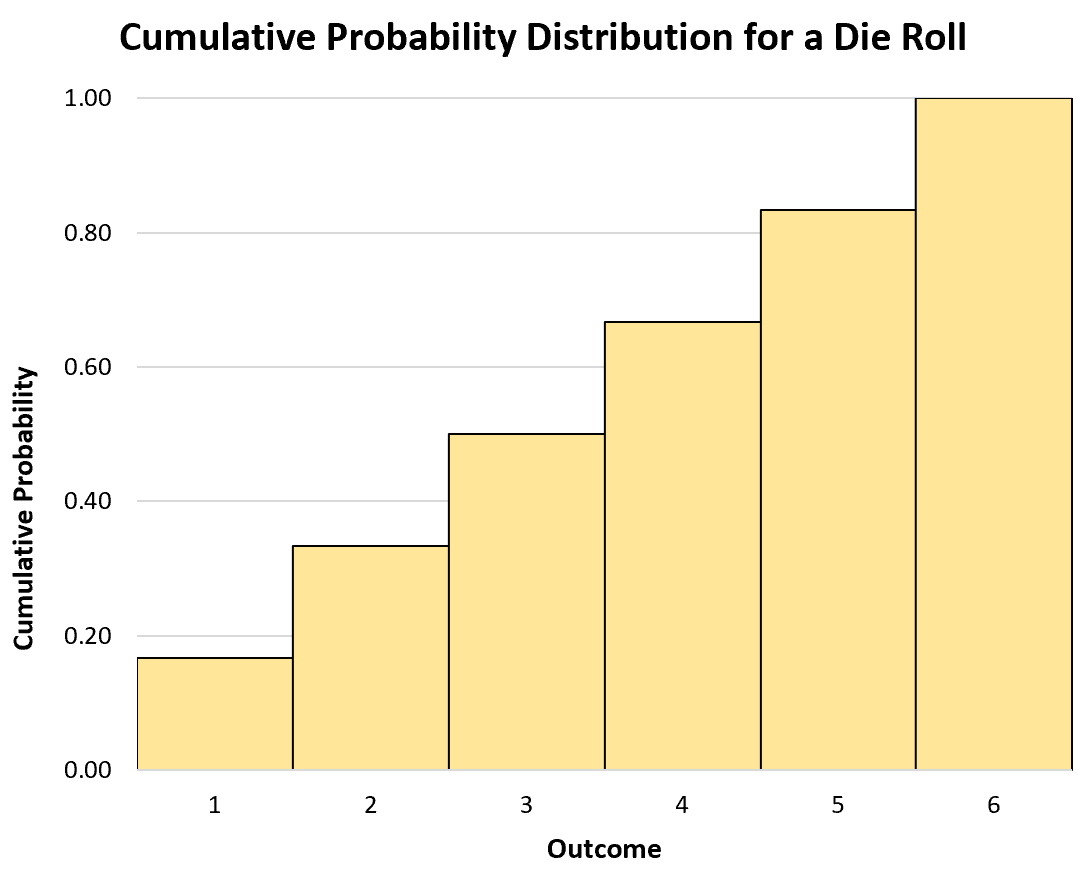
La fonction de répartition possède des propriétés structurelles universelles d’une remarquable élégance mathématique. Elle est systématiquement monotone non décroissante :
[ forall (x_1, x_2) in mathbb{R}^2, quad x_1 < x_2 implies F_X(x_1) le F_X(x_2) ]
Elle est en outre continue à droite en tout point et admet une limite à gauche en tout point (propriété dite càdlàg). De surcroît, elle obéit à des contraintes asymptotiques rigides imposées par la structure de la mesure de probabilité :
[ lim_{x to -infty} F_X(x) = 0 quad text{et} quad lim_{x to +infty} F_X(x) = 1 ]
Dans le cas d’une variable purement continue, la fonction (F_X) est absolument continue sur (mathbb{R}), éliminant tout saut vertical. Cette propriété de stricte croissance locale permet de définir la fonction quantile par l’inversion de la répartition : (Q(p) = F_X^{-1}(p)) pour (p in ]0, 1[). Cette opération est le fondement mathématique qui autorise l’extraction exacte des percentiles, quartiles et de la médiane théorique (définie par (F_X(m) = 0{,}5)), des indicateurs indispensables à l’évaluation normative standardisée.
6.3 Lois continues fondamentales : Normale, Exponentielle et Log-normale
Au panthéon des distributions continues, la loi normale (ou loi de Gauss-Laplace) occupe une place hégémonique. Notée (mathcal{N}(mu, sigma^2)), elle est caractérisée par sa courbe symétrique en cloche dépendant de son espérance (mu) et de sa variance (sigma^2). Sa fonction de densité est formalisée par :
[ f(x) = frac{1}{sigma sqrt{2pi}} expleft( -frac{(x – mu)^2}{2sigma^2} right), quad x in mathbb{R} ]
Cette omniprésence découle du Théorème Central Limite, faisant de la gaussienne l’attracteur universel des processus régis par une multiplicité de perturbations additives indépendantes.
Cependant, de nombreux phénomènes naturels sont asymétriques par essence et bornés à gauche par zéro, violant l’hypothèse de symétrie gaussienne. C’est le cas de la loi exponentielle, notée (mathcal{E}(lambda)), dont la densité est définie pour (lambda > 0) par :
[ f(x) = lambda e^{-lambda x}, quad x ge 0 ]
Cette loi continue modélise la durée de vie de composants ou le temps de survie d’un état avant une transition spontanée. À l’instar de la loi géométrique dans le domaine discret, elle est l’unique loi continue dotée de la propriété d’absence de mémoire.
Enfin, pour modéliser les temps de réaction humains ou les concentrations biochimiques, la loi log-normale s’impose comme une alternative mathématique bien plus adaptée que la loi normale. Une variable aléatoire positive (X) suit une loi log-normale si son logarithme népérien suit une loi normale : (ln(X) sim mathcal{N}(mu, sigma^2)). Sa densité présente une queue lourde étirée vers la droite :
[ f(x) = frac{1}{x sigma sqrt{2pi}} expleft( -frac{(ln x – mu)^2}{2sigma^2} right), quad x > 0 ]
Cette structure asymétrique rend compte des ralentissements occasionnels mais majeurs observés dans les réponses comportementales complexes, que la symétrie gaussienne échoue systématiquement à capturer sans biaiser l’inférence.
7. Moments d’une variable aléatoire : Espérance et tendance centrale
7.1 L’espérance mathématique comme centre de gravité
Pour résumer l’information contenue dans une distribution de probabilité sans avoir à manipuler la totalité de sa fonction de masse ou de densité, l’analyse probabiliste recourt à des grandeurs scalaires synthétiques appelées moments. Le tout premier moment non centré d’une variable aléatoire (X) est son espérance mathématique, notée (mathbb{E}[X]). Conceptuellement, l’espérance correspond au barycentre ou centre de gravité théorique de la distribution, où chaque valeur admissible est pondérée par son poids probabiliste respectif.
Pour une variable aléatoire discrète possédant un support dénombrable (S_X), l’espérance s’exprime par la série de Lebesgue pondérée :
[ mathbb{E}[X] = sum_{k} x_k , mathbb{P}(X = x_k) ]
Dans le cas d’une variable continue admettant une fonction de densité (f_X), cette sommation discrète cède la place à une intégrale généralisée de Riemann :
[ mathbb{E}[X] = int_{-infty}^{+infty} x , f_X(x) , dx ]
Sur le plan de la théorie générale de la mesure, ces deux formulations s’unifient sous l’écriture fondamentale de l’intégrale de Lebesgue par rapport à la mesure de probabilité sous-jacente :
[ mathbb{E}[X] = int_Omega X(omega) , dmathbb{P}(omega) = int_mathbb{R} x , dmathbb{P}_X(x) ]
Il est capital de noter que l’espérance n’existe pas systématiquement. Pour qu’elle soit rigoureusement définie, l’intégrale (ou la série) de la valeur absolue de la variable doit impérativement converger, c’est-à-dire que la condition d’intégrabilité (mathbb{E}[|X|] < infty) doit être satisfaite. Dans le cas contraire, comme pour la célèbre loi de Cauchy, l’espérance est indéterminée, le centre de gravité mathématique se trouvant dépourvu de sens physique en raison de queues de distribution trop lourdes.
Enfin, une rigueur épistémique exige de distinguer radicalement l’espérance mathématique (mathbb{E}[X]), constante théorique invariable caractérisant un modèle de probabilité, de la moyenne empirique (bar{X}_n = frac{1}{n}sum_{i=1}^n x_i), qui est elle-même une nouvelle variable aléatoire dépendante de l’échantillon recueilli sur le terrain.
7.2 Propriétés algébriques de la linéarité de l’espérance
L’une des propriétés les plus fondamentales et opérationnelles de l’opérateur espérance réside dans sa linéarité absolue. Contrairement à d’autres métriques statistiques plus complexes, l’espérance se comporte avec une parfaite docilité face aux combinaisons linéaires de grandeurs stochastiques. Soient (X) et (Y) deux variables aléatoires définies sur le même espace probabilisé et admettant une espérance finie, et soient (a, b in mathbb{R}) deux scalaires réels constants. L’espérance de la transformation affine s’écrit sans ambiguïté :
[ mathbb{E}[aX + b] = amathbb{E}[X] + b ]
De manière encore plus remarquable, l’additivité de l’espérance s’applique à la somme de deux variables quelconques :
[ mathbb{E}[X + Y] = mathbb{E}[X] + mathbb{E}[Y] ]
Cette propriété cardinale présente une puissance analytique inouïe, car elle est universellement vraie quelle que soit la structure de dépendance existant entre (X) et (Y). Les variables peuvent être indépendantes, fortement corrélées de manière linéaire ou liées par des dynamiques chaotiques complexes non linéaires : l’espérance de leur somme demeure invariablement égale à la somme de leurs espérances respectives.
Dans la recherche empirique, cette linéarité fonde le calcul des scores composites dans les batteries d’évaluations psychométriques ou les indices socio-économiques agrégés. Lorsque le score global d’une épreuve est défini comme la sommation linéaire de multiples sous-tests pondérés, l’espérance théorique globale peut être prédite avec une certitude absolue dès lors que les espérances élémentaires des sous-échelles sont connues, sans exiger la moindre hypothèse sur l’orthogonalité ou la covariance des épreuves composantes.
7.3 Tendance centrale et robustesse en contexte asymétrique
Bien que l’espérance mathématique constitue la référence première pour caractériser la tendance centrale d’un phénomène probabiliste, son adéquation descriptive dépend étroitement de la morphologie de la distribution étudiée. L’espérance souffre en effet d’une vulnérabilité métrologique majeure : son absence totale de robustesse statistique face aux valeurs aberrantes (ou outliers) et aux asymétries de répartition.
D’un point de vue analytique, la présence d’une seule observation extrême située à plusieurs écarts-types de la masse centrale exerce un effet de levier considérable sur le calcul de l’intégrale ou de la sommation, déplaçant artificiellement le centre de gravité loin de la majorité des observations. Dans ce contexte, la comparaison entre l’espérance, la médiane théorique (la valeur qui sépare la distribution en deux moitiés équiprobables) et le mode (la valeur correspondant au pic de densité maximale) constitue le premier diagnostic morphologique d’une distribution :
- Dans une distribution parfaitement symétrique unimodale (telle que la loi normale), l’espérance, la médiane et le mode sont rigoureusement confondus : (mathbb{E}[X] = text{Médiane} = text{Mode}).
- Dans une distribution asymétrique positive (queue étirée vers la droite, comme pour les revenus ou les temps de réponse), l’espérance est systématiquement supérieure à la médiane, elle-même supérieure au mode : (text{Mode} < text{Médiane} < mathbb{E}[X]).
- Dans une distribution asymétrique négative (queue étirée vers la gauche), la hiérarchie s’inverse : (mathbb{E}[X] < text{Médiane} < text{Mode}).
En présence d’asymétries massives ou de troncatures expérimentales, l’utilisation aveugle de l’espérance engendre des distorsions méthodologiques majeures. Par exemple, rapporter l’espérance des temps de réaction d’un groupe clinique incluant quelques épisodes de distraction sévère surestime massivement le temps de traitement cognitif réel. Dans ces circonstances, la recherche computationnelle privilégie des indicateurs de tendance centrale robustes, tels que la médiane théorique ou des espérances tronquées, qui offrent une résistance accrue aux fluctuations d’échantillonnage extrêmes.
8. Moments d’ordre supérieur : Variance, dispersion et forme de distribution
8.1 La variance et l’écart-type : Mesure du second moment centré
L’espérance mathématique ne fournit qu’une indication incomplète de la réalité stochastique : deux variables aléatoires peuvent partager rigoureusement la même espérance tout en décrivant des phénomènes radicalement dissemblables, l’une étant hyper-concentrée autour de sa moyenne et l’autre dispersée sur des amplitudes considérables. Pour mesurer cette variabilité intrinsèque, le calcul des probabilités recourt aux moments centrés, au premier rang desquels figure la variance, notée (text{Var}(X)) ou (sigma^2_X).
La variance est formellement définie comme le deuxième moment centré de la variable, c’est-à-dire l’espérance du carré des écarts de la variable à sa propre espérance mathématique, pourvu que (mathbb{E}[X^2] < infty) :
[ text{Var}(X) = mathbb{E}left[ (X – mathbb{E}[X])^2 right] ]
En exploitant la linéarité de l’espérance, ce calcul se simplifie au moyen de l’élégante identité computationnelle de Koenig-Huygens :
[ text{Var}(X) = mathbb{E}[X^2] – (mathbb{E}[X])^2 ]
La variance présente néanmoins un inconvénient métrologique : en raison de l’élévation au carré des écarts, sa dimension physique correspond au carré de l’unité de mesure initiale de la variable. Pour rétablir l’échelle d’origine et rendre la dispersion directement interprétable face aux données observées, on extrait la racine carrée positive de la variance, obtenant ainsi l’écart-type (noté (sigma_X)) :
[ sigma_X = sqrt{text{Var}(X)} ]
Dans la théorie classique de la mesure et l’évaluation psychométrique, l’écart-type constitue la métrique reine de l’incertitude et de la fidélité d’un protocole. Une variance expérimentale minimale autour d’un paramètre cible traduit une grande reproductibilité du protocole ou une homogénéité élevée des réponses d’une cohorte.
8.2 Invariance d’échelle et transformations affines de la dispersion
À la différence de l’espérance qui varie de façon strictement proportionnelle et additive sous l’effet de transformations affines, la variance obéit à des propriétés algébriques distinctes résultant de son statut quadratique. Soit une variable aléatoire (X) de variance (text{Var}(X)), et soient deux scalaires (a, b in mathbb{R}). La variance de la variable transformée (Y = aX + b) vérifie rigoureusement la relation suivante :
[ text{Var}(aX + b) = a^2 , text{Var}(X) ]
Cette formulation met en lumière deux principes structurels majeurs :
- Invariance par translation : L’ajout d’une constante déterministe (b) ne modifie en rien la variance ((text{Var}(X + b) = text{Var}(X))). La translation déplace l’ensemble du profil de distribution sur l’axe réel sans altérer d’un iota l’écartement relatif des points entre eux.
- Effet quadratique de la dilatation : La multiplication de la variable par un scalaire (a) amplifie la variance par le facteur au carré (a^2). Par conséquent, sur l’écart-type, la transformation opère selon la valeur absolue du multiplicateur : (sigma_{aX + b} = |a|sigma_X).
Ces propriétés fondent l’opération fondamentale de centrage et de réduction des variables aléatoires. En construisant la variable standardisée (Z) définie par l’équation suivante :
[ Z = frac{X – mathbb{E}[X]}{sigma_X} ]
le mathématicien obtient une nouvelle variable aléatoire adimensionnelle dont l’espérance est strictement nulle ((mathbb{E}[Z] = 0)) et la variance rigoureusement unitaire ((text{Var}(Z) = 1)). Ce procédé est le pivot de l’étalonnage psychométrique universel, permettant d’agréger ou de confronter des grandeurs initialement non commensurables (comme comparer une performance verbale brute à un score de mémoire visuo-spatiale).
8.3 Asymétrie (Skewness) et Aplatissement (Kurtosis)
Au-delà du positionnement central (ordre 1) et de la dispersion (ordre 2), la description fine d’une variable aléatoire requiert l’examen de sa géométrie intrinsèque par l’entremise des moments centrés d’ordre supérieur, normalisés par les puissances correspondantes de l’écart-type.
Le troisième moment centré normalisé donne naissance au coefficient d’asymétrie (ou skewness), couramment noté (gamma_1) :
[ gamma_1 = mathbb{E}left[ left(frac{X – mathbb{E}[X]}{sigma_X}right)^3 right] = frac{mu_3}{sigma_X^3} ]
Ce coefficient permet de quantifier sans équivoque la distorsion de la distribution par rapport à un axe de symétrie. Une distribution parfaitement symétrique (telle que la gaussienne ou la distribution uniforme) possède un (gamma_1) nul. Une valeur positive ((gamma_1 > 0)) diagnostique un étalement asymétrique vers les valeurs élevées (queue de distribution orientée à droite), alors qu’une valeur négative ((gamma_1 < 0)) indique une prépondérance de valeurs dispersées vers les valeurs faibles.
Le quatrième moment centré normalisé produit quant à lui le coefficient d’aplatissement (ou kurtosis), noté traditionnellement (beta_2) (ou (gamma_2 = beta_2 – 3) sous sa forme d’excès de kurtosis par rapport à la référence gaussienne) :
[ beta_2 = mathbb{E}left[ left(frac{X – mathbb{E}[X]}{sigma_X}right)^4 right] = frac{mu_4}{sigma_X^4} ]
Le kurtosis ne mesure pas simplement la « pointicité » du sommet de la distribution, mais renseigne surtout sur la propension de la variable aléatoire à générer des valeurs extrêmes, c’est-à-dire l’épaisseur relative de ses queues de distribution. Une distribution présentant un excès de kurtosis strictement positif ((gamma_2 > 0)) est dite leptocurtique. Dans ce cas, les queues sont plus épaisses que celles d’une loi normale, ce qui signale une probabilité accrue de chocs extrêmes ou d’événements critiques rares. En statistique inférentielle, négliger la leptocurticité d’une variable comportementale conduit à une sous-estimation systématique des intervalles de confiance et à une explosion dramatique du taux d’erreurs de type I (faux positifs statistiques).
9. Variables aléatoires multidimensionnelles et distributions conjointes
9.1 Vecteurs aléatoires et lois de probabilité conjointe
Dans la pratique expérimentale, un protocole scientifique ne s’arrête que rarement à la mesure isolée d’un trait unidimensionnel unique. L’évaluation clinique simultanée de l’anxiété et de la dépression, ou l’enregistrement conjoint de la vitesse et de la précision dans une épreuve cognitive, exige l’extension du formalisme probabiliste vers des espaces de dimension supérieure. On définit alors un vecteur aléatoire à (d) dimensions comme une application mesurable (X : Omega to mathbb{R}^d), constituée d’une collection ordonnée de variables aléatoires scalaires réelles :
[ mathbf{X}(omega) = big(X_1(omega), X_2(omega), dots, X_d(omega)big) ]
Le comportement probabiliste simultané des composantes de ce vecteur est régi par sa loi de probabilité conjointe. Si les variables sont conjointement discrètes, cette structure est modélisée par une fonction de masse conjointe assignant une probabilité à chaque combinaison de réalisations :
[ p_{mathbf{X}}(x_1, x_2, dots, x_d) = mathbb{P}(X_1 = x_1, X_2 = x_2, dots, X_d = x_d) ]
Dans le cas d’un vecteur aléatoire absolument continu, il existe une fonction de densité conjointe (f_{mathbf{X}}(x_1, x_2, dots, x_d) ge 0) telle que la probabilité que le vecteur prenne ses valeurs dans un domaine hyper-volumique (D subset mathbb{R}^d) s’obtient par l’intégration multiple définie :
[ mathbb{P}(mathbf{X} in D) = idotsint_{D} f_{mathbf{X}}(x_1, x_2, dots, x_d) , dx_1 , dx_2 dots dx_d ]
L’approche multivariée est indispensable pour appréhender les profils multidimensionnels des participants dans des tâches de discrimination perceptive, où l’interdépendance des canaux sensoriels conditionne la dynamique cognitive globale.
9.2 Lois marginales et projection unidimensionnelle
Dès lors que l’on dispose de la description probabiliste globale d’un système à plusieurs variables, il devient souvent nécessaire de s’intéresser isolément au comportement de l’une de ses composantes, indépendamment des variations des autres. Cette opération de réduction dimensionnelle est appelée la marginalisation, et les distributions qui en résultent sont les lois marginales.
Dans le cas d’un couple de variables aléatoires discrètes ((X, Y)), la loi marginale de la variable (X) s’obtient en sommant les probabilités conjointes sur l’ensemble exhaustif des valeurs admissibles de la seconde variable (Y) :
[ mathbb{P}(X = x) = sum_{y in S_Y} mathbb{P}(X = x, Y = y) ]
De manière analogue, dans le cas continu d’un couple régi par une densité conjointe (f_{X, Y}(x, y)), la densité marginale (f_X(x)) s’extrait en intégrant la fonction conjointe sur tout le domaine de variation de (y) :
[ f_X(x) = int_{-infty}^{+infty} f_{X, Y}(x, y) , dy ]
Il importe de saisir la nature fondamentale de cette opération : la marginalisation représente une projection avec perte d’information. Si la loi conjointe permet toujours de reconstituer de façon univoque les lois marginales de ses composantes individuelles, la réciproque est rigoureusement fausse. Connaître séparément le profil univarié de l’aptitude mathématique et le profil univarié de la mémoire de travail ne permet en aucun cas de deviner comment ces deux facultés interagissent au sein d’une population, à moins de disposer d’informations sur leur structure de dépendance conjointe.
9.3 Distributions conditionnelles et espérance conditionnelle
L’apport méthodologique le plus fécond des vecteurs aléatoires réside dans l’actualisation des prédictions lorsqu’une information partielle sur le système devient disponible. Ce processus est formalisé par la notion de distribution conditionnelle, fondée sur le théorème de Bayes appliqué aux mesures de probabilité.
Dans le cas continu, si la densité marginale (f_Y(y)) est strictement positive, la densité conditionnelle de la variable (X) sachant la réalisation précise (Y = y) s’établit par le quotient suivant :
[ f_{X|Y}(x mid y) = frac{f_{X, Y}(x, y)}{f_Y(y)} ]
À partir de cette distribution conditionnelle, on dérive un opérateur analytique de premier plan : l’espérance conditionnelle, notée (mathbb{E}[X mid Y = y]). Celle-ci correspond au centre de gravité théorique de la variable (X) calculé exclusivement parmi les états de la nature où la variable (Y) s’est matérialisée par la valeur (y) :
[ mathbb{E}[X mid Y = y] = int_{-infty}^{+infty} x , f_{X|Y}(x mid y) , dx ]
Considérée non pas pour une réalisation figée (y), mais à travers l’ensemble des variations possibles de la variable de conditionnement, l’espérance conditionnelle (mathbb{E}[X mid Y]) devient elle-même une nouvelle variable aléatoire mesurable par rapport à la tribu engendrée par (Y). Elle obéit à la remarquable loi de l’espérance totale (ou propriété de la tour) :
[ mathbb{E}big[mathbb{E}[X mid Y]big] = mathbb{E}[X] ]
Cette architecture probabiliste constitue le socle formel absolu de toute la théorie moderne de la régression, qu’elle soit linéaire ou non linéaire. Modéliser la performance d’un opérateur cognitif conditionnée à son niveau d’éveil ou à sa charge de fatigue accumulée consiste très exactement à spécifier une forme paramétrique ou semi-paramétrique pour la fonction de régression conditionnelle (mathbb{E}[X mid Y = y]).
10. Dépendance stochastique, covariance et corrélation
10.1 Indépendance stochastique formelle
La question centrale dans l’analyse de plusieurs variables aléatoires est celle de la nature de leur relation : les fluctuations de l’une fournissent-elles une quelconque information sur les variations de l’autre ? En théorie des probabilités, l’étalon mathématique fondamental est la notion d’indépendance stochastique.
Deux variables aléatoires réelles (X) et (Y) définies sur un même espace ((Omega, mathcal{F}, mathbb{P})) sont dites stochastiquement indépendantes si, et seulement si, pour tous boréliens (A, B in mathcal{B}(mathbb{R})), les événements correspondants sont indépendants au sens de Kolmogorov :
[ mathbb{P}(X in A text{ et } Y in B) = mathbb{P}(X in A) cdot mathbb{P}(Y in B) ]
Sur le plan distributionnel, cette clause se traduit par une factorisation parfaite des distributions conjointes en produit pur des distributions marginales associées :
- Pour des variables discrètes : (p_{X, Y}(x, y) = p_X(x) cdot p_Y(y), quad forall (x, y))
- Pour des variables continues : (f_{X, Y}(x, y) = f_X(x) cdot f_Y(y), quad forall (x, y))
- Pour les fonctions de répartition : (F_{X, Y}(x, y) = F_X(x) cdot F_Y(y), quad forall (x, y))
L’une des conséquences analytiques directes de l’indépendance réside dans la multiplicativité universelle de l’espérance. Si deux variables sont indépendantes et intégrables, l’espérance de leur produit algébrique équivaut rigoureusement au produit de leurs espérances respectives :
[ mathbb{E}[XY] = mathbb{E}[X] cdot mathbb{E}[Y] ]
En méthodologie de la recherche, l’hypothèse d’indépendance stochastique est le postulat invisible qui garantit l’absence d’effets d’interférence entre les sujets testés ou entre les essais successifs d’un protocole expérimental.
10.2 Covariance et coefficient de corrélation linéaire
Lorsque deux variables aléatoires ne sont pas indépendantes, il devient crucial de quantifier l’intensité et l’orientation de leur liaison statistique. La métrique de premier niveau mobilisée à cette fin est la covariance, notée (text{Cov}(X, Y)) ou (sigma_{XY}). Elle est définie comme l’espérance du produit croisé des déviations par rapport à leurs espérances respectives :
[ text{Cov}(X, Y) = mathbb{E}big[(X – mathbb{E}[X])(Y – mathbb{E}[Y])big] ]
En exploitant la bilinéarité de l’opérateur espérance, la formule opérationnelle de calcul s’énonce :
[ text{Cov}(X, Y) = mathbb{E}[XY] – mathbb{E}[X]mathbb{E}[Y] ]
La covariance est une forme bilinéaire symétrique sur l’espace des variables aléatoires de carré intégrable ((L^2)). Elle possède la propriété remarquable de gouverner la variance de la somme de deux variables stochastiques :
[ text{Var}(X + Y) = text{Var}(X) + text{Var}(Y) + 2,text{Cov}(X, Y) ]
Toutefois, la covariance partage avec la variance un écueil dimensionnel : sa magnitude dépend arbitrairement des unités métriques dans lesquelles sont exprimées (X) et (Y). Pour s’émanciper de cet effet d’échelle, on procède à sa standardisation adimensionnelle par le produit des écarts-types marginaux, obtenant ainsi le célèbre coefficient de corrélation linéaire de Pearson, traditionnellement noté (rho_{X, Y}) :
[ rho_{X, Y} = frac{text{Cov}(X, Y)}{sigma_X sigma_Y} ]
En vertu de l’inégalité de Cauchy-Schwarz appliquée à l’espace de Hilbert des variables aléatoires, ce coefficient est rigoureusement borné au sein du segment unitaire symétrique :
[ -1 le rho_{X, Y} le +1 ]
Les bornes extrêmes correspondent à une dépendance linéaire déterministe parfaite : (rho_{X, Y} = 1) signale une relation affine strictement croissante ((Y = aX + b) avec (a > 0)), tandis que (rho_{X, Y} = -1) indique une relation affine strictement décroissante ((a < 0)).
10.3 Distinction épistémologique entre association statistique et causalité
L’utilisation de la corrélation linéaire impose une vigilance critique de premier ordre sur le plan de la philosophie des sciences. Il convient d’énoncer sans équivoque le principe mathématique fondamental : l’indépendance stochastique implique systématiquement une covariance nulle (et donc une corrélation nulle), mais la réciproque est absolument fausse en général.
Deux variables peuvent présenter une dépendance fonctionnelle parfaite tout en affichant une covariance rigoureusement nulle si leur relation est purement symétrique ou non linéaire. Considérons par exemple une variable aléatoire (X) suivant une loi normale centrée réduite (mathcal{N}(0, 1)), et posons la variable déterministe dépendante (Y = X^2). Ici, (Y) est entièrement déterminé dès lors que (X) est connu. Pourtant, en raison de la symétrie de la distribution de (X), le moment d’ordre 3 est nul ((mathbb{E}[X^3] = 0)), ce qui conduit mécaniquement à :
[ text{Cov}(X, Y) = mathbb{E}[X cdot X^2] – mathbb{E}[X]mathbb{E}[X^2] = mathbb{E}[X^3] – 0 = 0 ]
Ainsi, le coefficient de Pearson conclurait à une absence totale de corrélation linéaire ((rho = 0)), masquant complètement une relation déterministe sous-jacente.
Sur le versant méthodologique, l’écueil le plus partagé est l’assimilation hâtive d’une association statistique positive ou négative à un lien de causalité ontologique. Deux variables peuvent être fortement corrélées en raison de la présence d’une troisième variable cachée non mesurée, appelée facteur de confusion (ou variable confondante), qui module simultanément les deux premières. La dissolution de ces corrélations fallacieuses exige soit le contrôle expérimental actif via la randomisation stricte des groupes (essais contrôlés randomisés), soit le recours à l’appareil formel des équations structurelles et des graphes causaux popularisés par Judea Pearl.
11. Théorèmes limites fondamentaux appliqués aux variables aléatoires
11.1 Convergence des suites de variables aléatoires
Lorsque l’on étudie des processus scientifiques séquentiels ou des échantillons de grande taille, on s’intéresse au comportement asymptotique d’une suite dénombrable de variables aléatoires ((X_n)_{n in mathbb{N}}) lorsque (n) tend vers l’infini. Contrairement aux suites de nombres réels où la convergence est univoque, la nature probabiliste de ces objets autorise plusieurs modes de convergence hiérarchiquement ordonnés.
Le mode le plus strict est la convergence presque sûre, notée (X_n xrightarrow{p.s.} X). Elle stipule que la trajectoire numérique des réalisations de la suite converge vers la réalisation de la variable cible pour la quasi-totalité des états fondamentaux de l’univers, c’est-à-dire en dehors d’un ensemble d’événements de mesure probabiliste strictement nulle :
[ mathbb{P}left(left{omega in Omega : lim_{n to infty} X_n(omega) = X(omega)right}right) = 1 ]
Un mode légèrement plus souple est la convergence en probabilité, notée (X_n xrightarrow{mathbb{P}} X). Elle garantit que la probabilité d’observer une déviation entre (X_n) et (X) supérieure à un seuil infinitésimal fixé (varepsilon > 0) s’évanouit lorsque le nombre d’observations tend vers l’infini :
[ forall varepsilon > 0, quad lim_{n to infty} mathbb{P}(|X_n – X| ge varepsilon) = 0 ]
Enfin, le mode le plus faible, mais d’une portée computationnelle immense, est la convergence en loi (ou en distribution), notée (X_n xrightarrow{mathcal{L}} X) (ou (X_n xrightarrow{d} X)). Elle ne requiert pas que les réalisations individuelles convergent, mais uniquement que la suite des fonctions de répartition cumulées (F_{X_n}(x)) converge simplement vers la fonction de répartition (F_X(x)) en tout point où cette dernière est continue :
[ lim_{n to infty} F_{X_n}(x) = F_X(x) ]
La hiérarchie formelle est irréversible : la convergence presque sûre implique la convergence en probabilité, qui implique elle-même la convergence en loi. Ces modes de convergence gouvernent la validité théorique des estimateurs psychométriques, garantissant que lorsque la taille d’une cohorte grandit, l’estimateur d’un trait latent converge inévitablement vers sa vraie valeur théorique.
11.2 La Loi des Grands Nombres (faible et forte)
Le théorème fondateur qui justifie mathématiquement l’induction empirique et la reproductibilité de la démarche scientifique est la Loi des Grands Nombres (LGN). Elle formalise le fait que la moyenne arithmétique calculée à partir d’une série d’observations expérimentales se stabilise inéluctablement autour de l’espérance théorique de la variable étudiée lorsque le nombre de mesures devient arbitrairement grand.
Soit une suite ((X_1, X_2, dots, X_n)) de variables aléatoires indépendantes et identiquement distribuées (i.i.d.) admettant une espérance finie (mathbb{E}[X_i] = mu). La moyenne empirique de l’échantillon est définie par la variable composée suivante :
[ bar{X}_n = frac{1}{n} sum_{i=1}^n X_i ]
La Loi Faible des Grands Nombres (formulée initialement par Khintchine) affirme que la moyenne empirique converge en probabilité vers l’espérance théorique :
[ bar{X}_n xrightarrow{mathbb{P}} mu quad Longleftrightarrow quad forall varepsilon > 0, quad lim_{n to infty} mathbb{P}(|bar{X}_n – mu| ge varepsilon) = 0 ]
La démonstration de cette loi faible découle de manière élémentaire de l’application de l’inégalité de Bienaymé-Tchebychev lorsque la variance (sigma^2) est finie, puisque la variance de la moyenne d’échantillonnage s’évanouit de façon inversement proportionnelle à la taille de l’échantillon :
[ text{Var}(bar{X}_n) = frac{sigma^2}{n} implies mathbb{P}(|bar{X}_n – mu| ge varepsilon) le frac{sigma^2}{n varepsilon^2} xrightarrow{n to infty} 0 ]
La Loi Forte des Grands Nombres (démontrée par Kolmogorov) élève cette garantie à un niveau supérieur en prouvant que la convergence est en réalité presque sûre :
[ mathbb{P}left(lim_{n to infty} bar{X}_n = muright) = 1 ]
Ce résultat monumental constitue le fondement épistémologique de toute métrologie empirique : il garantit que les fluctuations aléatoires inévitables inhérentes au tirage au sort finissent toujours par s’annihiler mutuellement sous l’effet de l’agrégation, dévoilant avec une netteté croissante l’espérance invariante sous-jacente du processus étudié.
11.3 Le Théorème Central Limite (TCL)
Si la Loi des Grands Nombres affirme que la moyenne empirique (bar{X}_n) se contracte asymptotiquement sur la constante (mu), elle ne documente en rien la morphologie des fluctuations probabilistes résiduelles autour de cette valeur d’équilibre pour des échantillons de taille finie. Cette lacune fondamentale est comblée par l’un des joyaux les plus puissants des mathématiques pures : le Théorème Central Limite (TCL), formalisé sous sa version moderne par Pierre-Simon de Laplace, puis rigoureusement généralisé par Alexandre Liapounov et Jarl Waldemar Lindeberg.
Soit ((X_n)_{n in mathbb{N}}) une suite de variables aléatoires i.i.d. possédant une espérance mathématique finie (mu) et une variance strictement positive et finie (sigma^2 in ]0, infty[). Considérons la somme brute de ces variables (S_n = sum_{i=1}^n X_i). Si l’on standardise cette somme en soustrayant son espérance globale ((nmu)) et en divisant par son écart-type d’échantillonnage total ((sigma sqrt{n})), la variable standardisée obtenue converge en loi vers la loi normale centrée réduite :
[ Z_n = frac{S_n – nmu}{sigma sqrt{n}} = frac{bar{X}_n – mu}{frac{sigma}{sqrt{n}}} xrightarrow{mathcal{L}} mathcal{N}(0, 1) quad text{lorsque } n to infty ]
Ce résultat signifie formellement que pour tous réels (a le b) :
[ lim_{n to infty} mathbb{P}(a le Z_n le b) = frac{1}{sqrt{2pi}} int_a^b e^{-frac{t^2}{2}} , dt ]
La portée scientifique de ce théorème est vertigineuse. Il stipule que quelle que soit la forme de la distribution initiale des variables individuelles (X_i) – qu’elle soit discrète, exponentielle, uniforme, asymétrique ou multimodale –, la sommation ou la moyenne d’un grand nombre de ces composantes engendre inexorablement et spontanément une variable stochastique dont la distribution épouse la cloche gaussienne.
C’est dans le Théorème Central Limite que réside l’explication théorique de l’omniprésence de la loi normale dans les sciences biologiques, comportementales et sociales. Dès lors qu’un trait psychologique latent, une caractéristique morphologique ou une erreur métrologique résulte de l’action conjointe et additive d’une multitude de micro-facteurs génétiques, environnementaux ou contextuels mutuellement indépendants et aux variances individuelles infinitésimales, le macro-phénomène résultant est mathématiquement contraint de se distribuer selon une loi normale.
12. Applications en psychométrie et sciences du comportement
12.1 Théorie classique des tests et décomposition du score
L’une des illustrations empiriques les plus marquantes de la modélisation par variable aléatoire réside dans la fondation de la Théorie Classique des Tests (TCT), initiée par Charles Spearman et formalisée de manière achevée par Melvin Novick. Ce cadre métrologique aborde la quantification d’un attribut psychologique (tel qu’un quotient d’efficience cognitive, un indice de suggestibilité ou un trait de névrosisme) en modélisant le score composite observé (X) comme une variable aléatoire composite.
L’équation fondamentale de la TCT décompose le score observé (X) sous la forme d’une sommation algébrique directe entre deux variables non observables directement :
[ X = T + E ]
Dans cette architecture, (T) représente le score vrai (ou true score) du sujet, défini formellement sur le plan mathématique comme l’espérance conditionnelle du score observé si le protocole pouvait être administré une infinité théorique de fois de façon indépendante sous un état physiologique strictement identique : (T = mathbb{E}[X]). Parallèlement, (E) matérialise la variable aléatoire d’erreur métrologique de mesure, générée par des perturbations stochastiques non contrôlées (fluctuations d’attention, bruit ambiant, variations de température).
La consistance du modèle repose sur une série de postulats probabilistes stricts concernant l’erreur (E) :
- L’erreur de mesure est non biaisée : son espérance théorique globale est nulle ((mathbb{E}[E] = 0)).
- Le score vrai et l’erreur stochastique sont stochastiquement non corrélés : (text{Cov}(T, E) = 0).
- Les erreurs métrologiques associées à des administrations indépendantes ou à des épreuves distinctes présentent une covariance systématiquement nulle : (text{Cov}(E_i, E_j) = 0) pour (i ne j).
En vertu de ces hypothèses et des propriétés bilinéaires de la covariance, la variance globale du score observé se sépare addititivement :
[ text{Var}(X) = text{Var}(T) + text{Var}(E) ]
À partir de cette partition, la théorie définit formellement le coefficient de fidélité (noté (r_{xx’})) de l’instrument d’évaluation comme la proportion de la variance totale qui est directement imputable à la variance du score vrai :
[ r_{xx’} = frac{text{Var}(T)}{text{Var}(X)} = 1 – frac{text{Var}(E)}{text{Var}(X)} ]
Ce ratio statistique montre que si la variance d’erreur aléatoire (text{Var}(E)) explose sous l’effet d’un protocole mal calibré, la fidélité s’effondre vers zéro, détruisant la précision diagnostique individuelle.
12.2 Théorie de la réponse aux items (TRI) et variables latentes
Bien que fondamentale, la TCT souffre d’une faiblesse méthodologique intrinsèque : les scores vrais dérivés dépendent entièrement de la difficulté particulière des items composant le test retenu. Pour dépasser cette limite, la psychométrie moderne a développé la Théorie de la Réponse aux Items (TRI), initiée par Georg Rasch et Frederic Lord. La TRI abandonne la simple sommation brute pour postuler l’existence d’une variable aléatoire continue inobservable, désignée comme la variable latente ou le trait latent, traditionnellement notée (theta in ]-infty, +infty[).
Dans ce cadre, la performance d’un individu à un item spécifique (i) est conceptualisée comme une variable aléatoire dichotomique de Bernoulli (U_i in {0, 1}). La TRI formalise alors une fonction caractéristique de l’item (CCI), qui modélise explicitement la probabilité conditionnelle de réussite (mathbb{P}(U_i = 1 mid theta)) comme une fonction sigmoïde continue de la compétence latente (theta). L’un des modèles les plus emblématiques est le modèle logistique à deux paramètres (2PL) :
[ mathbb{P}(U_i = 1 mid theta) = frac{expbig(a_i(theta – b_i)big)}{1 + expbig(a_i(theta – b_i)big)} ]
Dans cette formulation paramétrique, le scalaire (b_i) représente le paramètre de difficulté de l’item (le point sur l’axe du trait latent (theta) où la probabilité conditionnelle de réussite équivaut exactement à 0,5), tandis que le paramètre (a_i) matérialise le pouvoir de discrimination de l’épreuve (la pente locale de la sigmoïde au point d’inflexion).
Sous l’hypothèse centrale d’indépendance locale – stipulant qu’à niveau de trait latent (theta) rigoureusement constant, les réponses fournies par un individu aux différents items du test sont mutuellement indépendantes sur le plan stochastique –, la fonction de vraisemblance globale d’un vecteur de réponses (mathbf{u} = (u_1, u_2, dots, u_n)) se factorise par produit simple :
[ mathcal{L}(theta mid mathbf{u}) = prod_{i=1}^n Big[mathbb{P}(U_i = 1 mid theta)Big]^{u_i} Big[1 – mathbb{P}(U_i = 1 mid theta)Big]^{1 – u_i} ]
Grâce à cette paramétrisation probabiliste, la TRI permet le déploiement des tests adaptatifs informatisés (CAT). En réactualisant l’estimation de la distribution a posteriori de la variable aléatoire latente (theta) après chaque réponse fournie par le participant, l’algorithme sélectionne dynamiquement pour l’étape suivante l’item optimal qui minimise l’incertitude résiduelle (c’est-à-dire qui maximise l’information de Fisher relative à (theta)).
12.3 Modélisation stochastique de la prise de décision
L’application computationnelle la plus sophistiquée des variables aléatoires dans l’étude des processus cognitifs réside sans doute dans la modélisation de la prise de décision perceptive et des chronométries comportementales au moyen de processus stochastiques à temps continu. Le paradigme théorique dominant dans ce domaine est le modèle de diffusion pour choix binaire (ou Drift Diffusion Model, DDM), élaboré par Roger Ratcliff.
Dans une tâche de discrimination visuelle rapide (par exemple décider en quelques centaines de millisecondes si un nuage de points mobiles dérive majoritairement vers la gauche ou vers la droite), le cerveau n’atteint pas une conclusion instantanée. Le système cognitif accumule progressivement de l’information sensorielle bruitée jusqu’à ce que la preuve interne atteigne l’un des deux seuils décisionnels préétablis. Le niveau d’évidence cognitive instantanée à l’instant (t) est modélisé par une variable aléatoire continue (X(t)), dont la dynamique temporelle obéit à une équation différentielle stochastique régissant un mouvement brownien avec dérive :
[ dX(t) = v , dt + s , dW(t) ]
Dans ce modèle :
- Le terme déterministe (v , dt) traduit la vitesse de dérive (ou drift rate). Ce paramètre quantifie la vitesse moyenne d’accumulation d’information par le réseau neuronal, reflétant directement la clarté du stimulus perceptif ou l’efficience perceptive du participant.
- Le terme de diffusion stochastique (s , dW(t)) modélise le bruit neuronal intrinsèque lié aux fluctuations électrophysiologiques aléatoires, où (W(t)) désigne un processus de Wiener standard dont les incréments temporels sont des variables aléatoires gaussiennes indépendantes : (W(t + Delta t) – W(t) sim mathcal{N}(0, Delta t)).
Le processus décisionnel démarre à un point initial (z) matérialisant un éventuel a priori ou biais de départ. L’accumulation de preuve se poursuit jusqu’à ce que la trajectoire aléatoire (X(t)) franchisse pour la première fois l’une des deux frontières absorbantes : la frontière supérieure (a) (associée au choix A) ou la frontière inférieure (0) (associée au choix B). Le temps total de réponse expérimentalement observé (T) est alors modélisé comme la somme de deux variables aléatoires indépendantes : le temps de premier passage stochastique (la durée requise par la trajectoire brownienne pour heurter une frontière) et un temps résiduel non décisionnel (T_{er}) (englobant les latences de transduction rétinienne périphérique et d’exécution motrice musculaire) :
[ T = tau_{text{passage}} + T_{er} ]
L’intégration mathématique de cette équation différentielle stochastique permet d’extraire la distribution analytique fermée conjointe des choix effectués et des temps de réaction continus, formalisée sous la forme d’une loi de Wald (ou gaussienne inverse). L’ajustement empirique de ces distributions complexes offre une décomposition d’une rigueur absolue : il autorise le chercheur à isoler séparément, au sein de variables macroscopiques recueillies en laboratoire, la vitesse d’élaboration mentale du signal ((v)), le niveau de conservatisme décisionnel fixé par le sujet ((a)), l’asymétrie de ses attentes préalables ((z)) et le temps de transmission purement biomécanique ((T_{er})).
Par cette avancée computationnelle, la variable aléatoire s’affranchit définitivement de son statut initial de simple instrument de mesure passif. Elle s’érige en un modèle explicatif et mécanistique de premier ordre, démontrant avec éclat que l’analyse probabiliste fine des fluctuations microscopiques permet de dévoiler l’architecture fonctionnelle des fonctions cognitives les plus nobles de l’esprit humain.
Références
- Bernoulli, J. (1713). Ars conjectandi, opus posthumum. Impensis Thurnisiorum, Fratrum.
- Billingsley, P. (1995). Probability and measure (3rd ed.). John Wiley & Sons.
- Borel, É. (1909). Les probabilités dénombrables et leurs applications arithmétiques. Rendiconti del Circolo Matematico di Palermo, 27(1), 247–271. https://doi.org/10.1007/BF03019651
- Feller, W. (1968). An introduction to probability theory and its applications (Vol. 1, 3rd ed.). John Wiley & Sons.
- Gauss, C. F. (1809). Theoria motus corporum coelestium in sectionibus conicis solem ambientium. F. Perthes et I. H. Besser.
- Kolmogorov, A. N. (1933). Grundbegriffe der Wahrscheinlichkeitsrechnung. Julius Springer.
- Laplace, P.-S. (1812). Théorie analytique des probabilités. Courcier.
- Lebesgue, H. (1904). Leçons sur l’intégration et la recherche des fonctions analytiques. Gauthier-Villars.
- Lindeberg, J. W. (1922). Eine neue Herleitung des Exponentialgesetzes in der Wahrscheinlichkeitsrechnung. Mathematische Zeitschrift, 15(1), 211–225. https://doi.org/10.1007/BF01494395
- Lord, F. M., & Novick, M. R. (1968). Statistical theories of mental test scores. Addison-Wesley.
- Pascal, B., & Fermat, P. de. (1654). Correspondance sur le problème des partis. Recueilli dans les Œuvres complètes de Blaise Pascal. Bibliothèque de la Pléiade.
- Pearl, J. (2009). Causality: Models, reasoning, and inference (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9780511803161
- Rasch, G. (1960). Probabilistic models for some intelligence and attainment tests. Danmarks Paedagogiske Institut.
- Ratcliff, R. (1978). A theory of memory retrieval. Psychological Review, 85(2), 59–108. https://doi.org/10.1037/0033-295X.85.2.59
- Spearman, C. (1904). « General Intelligence, » objectively determined and measured. The American Journal of Psychology, 15(2), 201–292. https://doi.org/10.2307/1412107