
La recherche scientifique, et plus particulièrement la psychologie expérimentale et les sciences du comportement, repose sur une quête fondamentale : la mise au jour et la compréhension des relations de cause à effet qui régissent les phénomènes observables. Depuis l’avènement de la méthode expérimentale formalisée par des pionniers tels que Claude Bernard ou John Stuart Mill, l’expérimentateur ne se contente pas d’observer passivement la nature ; il intervient activement sur le réel. Il isole, manipule et contrôle des paramètres précis afin de déterminer dans quelle mesure ces variations induisent des modifications systématiques sur les comportements, les cognitions ou les réponses physiologiques des individus. Au cœur de cette architecture épistémologique se trouve la variable indépendante, moteur premier de l’expérimentation, dont la force explicative repose entièrement sur la façon dont elle est configurée et fractionnée.
Toutefois, définir une variable indépendante ne constitue que la première étape du travail de modélisation du chercheur. Pour qu’une telle variable puisse exercer un rôle explicatif et produire des données empiriques analysables, elle doit impérativement se décliner sous différentes formes, états ou valeurs. C’est précisément ici qu’intervient le concept fondamental de « niveaux » d’une variable indépendante, souvent désignés sous les termes de modalités, de conditions ou de traitements expérimentaux. Sans une compréhension claire et rigoureuse de ce que représentent ces niveaux, tout protocole de recherche s’expose à des ambiguïtés méthodologiques majeures, à des erreurs d’interprétation statistique et à une incapacité fondamentale à tester les hypothèses théoriques formulées initialement.
Comprendre la nature, l’agencement et la manipulation des niveaux d’une variable indépendante permet d’appréhender l’essence même du design expérimental. Qu’il s’agisse de comparer l’efficacité d’une nouvelle approche psychothérapeutique par rapport à une prise en charge standard, de mesurer l’impact de différentes doses d’une molécule psychoactive sur les capacités attentionnelles, ou de sonder les effets de la pression sociale selon la taille d’un groupe unanime, les niveaux matérialisent la variation contrôlée. Ce guide exhaustif a pour vocation d’analyser en profondeur ce concept pivot de la méthodologie scientifique, depuis ses fondements théoriques jusqu’à ses implications statistiques et pratiques les plus avancées.
1. Introduction aux variables expérimentales et définition des niveaux
1.1 Définition fondamentale de la variable indépendante (VI)
Dans le cadre de la démarche expérimentale, la variable indépendante (couramment abrégée sous l’acronyme VI) occupe le statut épistémologique d’antécédent causal présumé. Elle représente le phénomène, la caractéristique ou l’événement que l’expérimentateur choisit de manipuler de manière délibérée et systématique afin d’observer son impact éventuel sur un ou plusieurs aspects du comportement ou du fonctionnement psychologique des sujets étudiés. Contrairement à une simple approche corrélationnelle où les variables sont mesurées telles qu’elles se présentent naturellement dans l’environnement sans intervention extérieure, l’expérimentation repose sur une action proactive du chercheur, qui introduit une perturbation contrôlée dans l’environnement expérimental pour en évaluer les répercussions.
Il est essentiel d’opérer une distinction conceptuelle fondamentale entre les variables indépendantes dites « provoquées » et les variables indépendantes dites « invoquées » (ou étiquettes). Une variable provoquée fait l’objet d’une manipulation active et directe de la part du chercheur, qui assigne aléatoirement les participants aux différentes conditions expérimentales. C’est le cas, par exemple, lorsqu’un protocole fait varier la luminosité d’une pièce pour mesurer les capacités de lecture, ou lorsqu’il administre différentes consignes cognitives avant l’exécution d’une tâche de mémorisation. À l’inverse, une variable invoquée renvoie à des caractéristiques intrinsèques préexistantes chez les participants, telles que l’âge, le genre biologique, le statut socio-économique ou la présence d’un diagnostic clinique particulier. Dans cette dernière situation, l’expérimentateur ne manipule pas la variable à proprement parler ; il sélectionne les participants en fonction de leurs attributs naturels, ce qui limite la portée des inférences purement causales en raison de potentiels facteurs de confusion inhérents aux groupes naturels.
L’importance théorique et pratique de la variable indépendante réside dans sa capacité unique à établir une causalité directe et robuste selon les critères rigoureux de la causalité probabiliste et expérimentale définis notamment par l’American Psychological Association. Pour prouver qu’un facteur A cause une modification d’un comportement B, trois conditions fondamentales doivent être impérativement satisfaites : la précédence temporelle (la cause doit se manifester avant l’effet), la covariation systématique (les variations de la cause doivent s’accompagner de variations de l’effet), et l’élimination des explications alternatives plausibles (neutralisation des variables parasites). La variable indépendante, lorsqu’elle est correctement manipulée au sein d’un plan contrôlé, constitue le seul levier méthodologique capable de remplir simultanément ces trois exigences méthodologiques fondamentales.
1.2 Définition conceptuelle du terme « niveau »
D’un point de vue conceptuel et opératoire, les niveaux d’une variable indépendante correspondent aux valeurs discrètes, aux catégories spécifiques ou aux états distincts que prend cette variable dans le cadre d’un protocole expérimental donné. Si la variable indépendante définit le domaine ou la dimension générale de l’intervention (par exemple, la température ambiante ou le type de renforcement motivationnel), les niveaux en constituent les déclinaisons précises et observables. Dans la littérature méthodologique francophone et internationale, une certaine équivalence terminologique prévaut : les termes « niveaux », « modalités », « conditions expérimentales » ou « traitements » sont régulièrement employés de manière interchangeable pour désigner ces variations contrôlées.
La nature même d’une expérience scientifique implique une logique comparative. Un niveau unique ne possède aucun pouvoir explicatif ni discriminatoire : si tous les participants d’une étude sont soumis exactement à la même condition sans aucun point de référence, il devient scientifiquement impossible de déterminer si les réponses observées résultent du traitement expérimental administré, du simple écoulement du temps, de la maturation spontanée des individus ou de facteurs environnementaux non contrôlés. Par conséquent, l’exigence méthodologique minimale pour qu’une dimension puisse être qualifiée de variable indépendante est de comporter au minimum deux niveaux distincts.
Cette binarité élémentaire permet d’établir une ligne de base comparative. Que cette comparaison prenne la forme classique d’une opposition entre la présence et l’absence d’une stimulation particulière, ou qu’elle confronte deux intensités distinctes d’un même phénomène, c’est l’existence de ces deux niveaux minimaux qui génère la variance nécessaire au test de l’hypothèse nulle. Dès lors, concevoir une recherche expérimentale revient avant tout à déterminer avec précision quels seront ces niveaux, combien ils seront, et de quelle manière ils refléteront les mécanismes théoriques sous-jacents que l’on cherche à isoler et à mesurer.
1.3 L’opérationnalisation des niveaux en psychologie
L’opérationnalisation constitue le pont méthodologique indispensable qui relie une hypothèse conceptuelle abstraite à une réalité expérimentale concrète, mesurable et reproductible. Dans les disciplines psychologiques, les variables d’intérêt sont fréquemment des construits théoriques non directement observables, tels que l’anxiété, la charge mentale, l’estime de soi ou l’empathie. L’opérationnalisation des niveaux consiste donc à traduire ces concepts théoriques en modalités physiques, temporelles, spatiales ou procédurales parfaitement définies, de telle sorte qu’un autre chercheur puisse répliquer l’étude à l’identique dans n’importe quel laboratoire.
Pour garantir la rigueur de cette opérationnalisation, le protocole expérimental doit décrire avec une précision chirurgicale l’ensemble des paramètres associés à chaque niveau de la variable indépendante. Si l’on s’intéresse à l’effet du stress aigu sur la prise de décision, le niveau « stress élevé » ne peut pas se limiter à une vague incitation verbale ; il doit reposer sur un paradigme standardisé et validé, tel que le Trier Social Stress Test (TSST), comprenant un temps d’attente chronométré, une prise de parole filmée devant un jury neutre et une épreuve de calcul mental rapide. Le niveau « stress faible » ou « contrôle » doit quant à lui impliquer une tâche similaire en termes d’activité physique et de durée, mais exempte de jugement social ou de contrainte de temps, afin d’éviter tout biais de confusion.
Enfin, l’alignement entre les hypothèses de recherche et la définition des niveaux requiert une cohérence absolue. Si un chercheur émet l’hypothèse théorique que la mémorisation s’améliore de manière proportionnelle à la profondeur du traitement sémantique de l’information (en référence aux travaux de Craik et Lockhart), les niveaux opérationnalisés de sa variable indépendante devront cibler distinctement un traitement structural (ex. déterminer si un mot est écrit en majuscules), un traitement phonologique (ex. trouver une rime) et un traitement sémantique profond (ex. juger de l’utilité de l’objet sur une île déserte). Cet ajustement étroit garantit la validité de construit, assurant ainsi que les variations observées sur la variable dépendante découlent bien de la dimension psychologique visée et non d’un artefact méthodologique.
2. Distinction conceptuelle entre variable indépendante, dépendante et niveaux
2.1 La dynamique relationnelle entre VI et VD
La démarche scientifique repose sur une structure logique modélisant les liens entre causes et conséquences. Au sein de cette architecture, la variable dépendante (VD) représente l’effet présumé, la réponse comportementale, l’activité neurophysiologique ou le jugement subjectif mesuré par le chercheur pour évaluer l’impact des différentes manipulations introduites. Si la variable indépendante est la cause initiatrice sous le contrôle direct de l’expérimentateur, la variable dépendante est l’élément qui réagit, oscillant sous l’effet des différentes modalités imposées. La relation entre VI et VD s’articule donc autour d’un principe de causalité directe, formalisé sous la forme mathématique $Y = f(X)$, où la variable mesurée $Y$ est modélisée comme une fonction des niveaux de la variable indépendante $X$, à laquelle s’ajoute une composante d’erreur résiduelle non contrôlée.
L’analyse empirique de cette dynamique consiste à évaluer ce que la statistique expérimentale nomme la « variance systématique ». Lorsque les participants sont répartis entre différents niveaux d’une variable indépendante, leurs scores sur la variable dépendante ne sont jamais rigoureusement identiques. Une fraction de ces écarts individuels relève de la variance d’erreur ou variance résiduelle (différences biologiques individuelles, fluctuations attentionnelles momentanées, micro-variations de l’environnement matériel). L’objectif du chercheur est de déterminer si la variance observée entre les moyennes des différents niveaux (la variance inter-groupes ou variance systématique) s’avère significativement supérieure à la variance résiduelle observée au sein même de chaque niveau (la variance intra-groupe).
Si la manipulation des niveaux de la variable indépendante est efficace, les variations quantitatives ou qualitatives enregistrées sur la variable dépendante présenteront un patron de dispersion directement attribuable à l’alternance de ces conditions. Qu’il s’agisse de mesurer des millisecondes sur un temps de réaction moteur, un pourcentage d’items correctement rappelés dans un test cognitif, ou une intensité d’activation neuronale en imagerie fonctionnelle, la variable dépendante constitue l’instrument d’enregistrement qui atteste de la réalité psychophysique des niveaux de la variable indépendante.
2.2 Confusion fréquente : nombre de variables versus nombre de niveaux
Dans l’apprentissage de la méthodologie de la recherche en sciences sociales et cognitives, l’une des erreurs les plus fréquentes commises par les étudiants et les jeunes chercheurs réside dans la confusion systématique entre le nombre de variables indépendantes impliquées dans un protocole et le nombre de niveaux qui composent une variable unique. Cette méprise conceptuelle altère la compréhension de la structure du plan expérimental et conduit inévitablement à des erreurs majeures lors de la programmation des analyses statistiques sous des logiciels comme R, SPSS ou Jamovi.
Pour dissiper définitivement cette ambiguïté, il convient de raisonner en termes de dimensions orthogonales et de subdivisions d’une dimension. Une variable indépendante représente un facteur général, c’est-à-dire une dimension conceptuelle entière. Les niveaux représentent quant à eux les subdivisions ou les états spécifiques adoptés par cette unique dimension. Par exemple, si une étude évalue l’impact de la couleur d’arrière-plan d’une page de lecture sur la vitesse de compréhension en comparant un fond blanc, un fond bleu et un fond jaune, il n’y a pas trois variables indépendantes en jeu, mais bien une seule variable indépendante (« la couleur de fond ») qui se décline en trois niveaux distincts (blanc, bleu, jaune). L’expérimentateur n’a fait varier qu’une seule propriété de son matériel d’affichage.
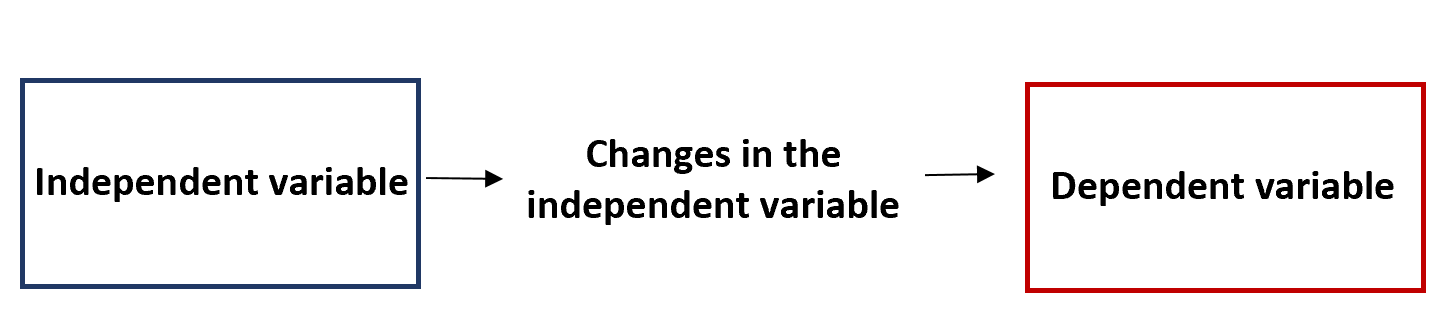
D’un point de vue mathématique et matriciel, la dimensionnalité d’un protocole expérimental s’exprime par le nombre de facteurs indépendants et non par le cumul arithmétique de leurs modalités. Confondre une variable à quatre modalités avec quatre variables indépendantes revient à confondre un meuble à quatre tiroirs avec quatre meubles distincts. La maîtrise de cette distinction est le préalable absolu à la compréhension des plans factoriels complexes, où plusieurs variables indépendantes comportant chacune plusieurs niveaux sont croisées de façon combinatoire pour examiner leurs effets conjoints.
2.3 Exemples paradigmatiques illustrant la triade conceptuelle
Afin de concrétiser parfaitement la dynamique opératoire unissant la variable indépendante, ses niveaux et la variable dépendante associée, l’examen de trois paradigmes expérimentaux issus de branches distinctes de la psychologie et des sciences cognitives s’avère particulièrement éclairant.
- Exemple en psychologie de l’éducation et des apprentissages : Un chercheur souhaite comparer l’efficacité de différentes stratégies pédagogiques pour l’acquisition du vocabulaire en langue étrangère.
- Variable indépendante : La méthode pédagogique d’apprentissage (1 seule VI).
- Niveaux de la VI : Trois niveaux distincts (Niveau 1 : répétition passive par lecture ; Niveau 2 : réécriture manuscrite active ; Niveau 3 : association visuelle par cartes interactives).
- Variable dépendante : Le score quantitatif obtenu à un test de rétention lexicale administré sept jours plus tard (noté de 0 à 100).
- Exemple en pharmacologie comportementale et neuropsychologie : Une équipe médicale évalue l’impact d’une molécule anxiolytique innovante sur des rongeurs soumis à un test de stress environnemental.
- Variable indépendante : La posologie de la substance pharmacologique administrée (1 seule VI).
- Niveaux de la VI : Trois niveaux quantitatifs précis (Niveau 1 : dose nulle ou solution saline véhicule à 0 mg ; Niveau 2 : faible dose à 10 mg/kg ; Niveau 3 : forte dose à 20 mg/kg).
- Variable dépendante : Le temps total en secondes passé par l’animal à explorer la zone ouverte et éclairée du labyrinthe en croix surélevé (indice comportemental d’anxiolyse).
- Exemple en ergonomie cognitive et interaction homme-machine : Des concepteurs de systèmes aéronautiques cherchent à optimiser le mode de saisie des commandes d’urgence dans un cockpit sous forte turbulence.
- Variable indépendante : Le type d’interface d’entrée (1 seule VI).
- Niveaux de la VI : Deux niveaux technologiques (Niveau 1 : interface tactile résistive ; Niveau 2 : interface de reconnaissance vocale mains-libres).
- Variable dépendante : Le temps de réponse mesuré en millisecondes entre l’apparition du signal d’alerte visuel critique et la validation complète de la commande d’évitement.
Dans chacun de ces trois cas, la distinction apparaît avec une clarté limpide : la variable indépendante désigne le paramètre générique dont le chercheur a le contrôle, les niveaux délimitent les options spécifiques sélectionnées pour le test, et la variable dépendante recueille la signature comportementale ou physiologique générée par ces conditions comparées.
3. Typologie des niveaux : variables qualitatives versus quantitatives
3.1 Niveaux qualitatifs ou catégoriels
Dans de nombreux champs de recherche expérimentale, notamment en psychologie sociale, en psychopathologie clinique et en psychologie de la personnalité, les variables indépendantes se déclinent sous la forme de niveaux qualitatifs ou catégoriels. Ces niveaux renvoient à des modalités nominales qui diffèrent les unes des autres par leur nature, leur essence ou leurs attributs typologiques fondamentaux, et non par une quantité ou une grandeur numérique intrinsèque. Ces modalités ne peuvent en aucun cas être ordonnées sur une échelle métrique continue ; il est impossible d’affirmer objectivement qu’un niveau est « supérieur » ou « mathématiquement plus grand » qu’un autre.
En psychologie sociale, l’étude canonique des préjugés et des dynamiques intergroupes mobilise constamment des niveaux qualitatifs. Par exemple, lorsqu’un protocole manipule l’appartenance catégorielle d’un individu fictif évalué par les participants, les niveaux peuvent être l’appartenance au groupe d’appartenance (endogroupe) versus l’appartenance à un groupe externe (exogroupe), ou la nationalité affichée d’un candidat sur un curriculum vitae. De même, en psychologie des émotions, la valence d’un stimulus visuel projeté aux participants est souvent scindée en trois niveaux qualitatifs distincts : des images à valence émotionnelle joyeuse, des images neutres et des images tristes ou anxiogènes. Ces catégories représentent des classes sémantiques hétérogènes.
L’utilisation de niveaux qualitatifs impose des exigences particulières quant à l’interprétation des résultats. Puisqu’il n’existe aucune continuité mathématique entre les modalités, les conclusions théoriques portent sur des contrastes discrets d’état à état. Le chercheur ne cherche pas à établir une fonction de pente ou une vitesse d’accroissement, mais cherche à déterminer si l’activation d’un registre conceptuel particulier modifie substantiellement le traitement cognitif ou le comportement par rapport à un autre registre conceptuel distinct.
3.2 Niveaux quantitatifs continus et discrets
À l’opposé des modalités qualitatives, les niveaux quantitatifs sont définis par une grandeur numérique objective, mesurable sur une échelle d’intervalles ou de rapports. Ces niveaux correspondent à des variations d’intensité, de durée, de fréquence, de concentration physique ou de volume d’un stimulus donné. La psychophysique, l’ergonomie physique, la chronométrie mentale et les neurosciences computationnelles recourent de manière prépondérante à des variables indépendantes aux niveaux quantitatifs.
Ces niveaux peuvent être discrets lorsqu’ils progressent par sauts de nombres entiers finis sans valeurs intermédiaires directes dans le cadre de la tâche (par exemple, mémoriser des listes composées de 3 mots, 6 mots, 9 mots ou 12 mots), ou continus lorsqu’ils sont extraits d’un continuum physique théoriquement infini (par exemple, faire varier la luminance d’un écran de détection visuelle à 50 lumens, 100 lumens, 150 lumens et 200 lumens, ou manipuler la durée d’exposition d’un stimulus subliminal à 16 ms, 33 ms, 50 ms et 100 ms). Dans tous ces cas, la distance métrique entre chaque niveau possède une signification physique constante et universellement reproductible.
L’immense avantage épistémologique des niveaux quantitatifs réside dans la capacité du chercheur à modéliser mathématiquement des « courbes de réponse selon la dose » (dose-response relationships) ou des fonctions de transfert psycho-physique. Au-delà de la simple constatation d’une différence entre conditions, l’analyse des niveaux quantitatifs permet de cartographier la nature de la relation fonctionnelle : s’agit-il d’une relation strictement linéaire, logarithmique, exponentielle, ou d’une fonction en palier présentant un seuil critique d’activation ? Cette granularité métrique confère aux modèles explicatifs une puissance prédictive hautement supérieure.
3.3 Niveaux ordinaux et hiérarchisés
Les niveaux ordinaux occupent une position intermédiaire particulièrement intéressante sur le spectre méthodologique. Ils se définissent comme des modalités qui s’agencent selon un ordre hiérarchique intrinsèque, une progression graduelle ou une échelle de rangs sans pour autant garantir que les intervalles entre les niveaux successifs soient strictement égaux d’un point de vue métrique. On retrouve fréquemment cette configuration dans l’évaluation d’états psychologiques subjectifs, de scores de sévérité clinique ou d’intensités environnementales perçues.
À titre d’illustration, considérons une recherche s’intéressant à l’impact du sentiment de stress ressenti au travail sur l’absentéisme, dans laquelle la variable indépendante est catégorisée en trois niveaux : « niveau de stress faible », « niveau de stress modéré » et « niveau de stress élevé ». Bien qu’il soit conceptuellement indiscutable qu’un niveau élevé traduit davantage de stress qu’un niveau modéré, et que ce dernier en traduit plus qu’un niveau faible, le chercheur ne peut mathématiquement pas affirmer que la distance psychologique ou physiologique séparant le niveau « faible » du niveau « modéré » est rigoureusement identique à celle qui sépare le niveau « modéré » du niveau « élevé ».
Cette particularité structurale des niveaux ordinaux conditionne de manière directe le choix des outils de modélisation statistique. L’application mécanique de tests paramétriques présupposant une métrique continue linéaire peut parfois être remise en question au profit d’approches non paramétriques (telles que le test de Kruskal-Wallis ou les contrastes polynomiaux ordinaux) ou de modèles de régression logistique ordinale. La prudence théorique s’impose ici pour ne pas traiter des rangs hiérarchisés comme des grandeurs d’intervalles parfaits.
4. Rôle et structuration des conditions de contrôle et de traitement
4.1 Le niveau de référence : la condition de contrôle
Dans la grammaire de l’expérimentation scientifique, le groupe contrôle ou la condition de contrôle constitue le niveau de référence épistémologique absolu, véritable étalon à partir duquel la portée de toute manipulation sera mesurée. Sans condition de contrôle, une expérience perd sa validité interne : il devient méthodologiquement impossible de discerner si les modifications observées chez les sujets résultent spécifiquement de la variable manipulée ou s’ils découlent de facteurs de confusion externes non contrôlés, tels que l’histoire, la maturation biologique des sujets, ou le simple effet de familiarisation avec le matériel de test (effet de pré-test).
Le niveau de référence sert à neutraliser ce que l’on qualifie de « bruit de fond » expérimental. Il incarne l’état de base du système étudié en l’absence de l’élément critique dont on veut tester l’effet causal. Il importe toutefois de distinguer deux architectures majeures de conditions de contrôle :
Le groupe de contrôle sans traitement (où les participants ne subissent absolument aucune intervention et poursuivent leur activité habituelle) et le groupe de contrôle actif ou neutre (où les participants sont placés dans un environnement expérimental rigoureusement identique, avec le même temps passé au laboratoire et le même niveau d’attention globale reçue de la part des expérimentateurs, mais en exécutant une tâche dénuée du principe actif testé). Cette seconde option est méthodologiquement supérieure car elle permet de neutraliser le célèbre effet Hawthorne, selon lequel les individus modifient spontanément leur comportement du simple fait de se savoir observés.
Le choix précis de la condition de contrôle détermine la nature même de la question à laquelle l’étude répond. Comparer une intervention psychologique active à une liste d’attente permet de démontrer si la méthode fait mieux que l’absence totale d’intervention, mais ne permet nullement d’affirmer que ses mécanismes spécifiques sont supérieurs à n’importe quelle autre activité structurée. D’où l’importance de concevoir le niveau de contrôle avec autant de rigueur conceptuelle que les niveaux de traitement expérimental eux-mêmes.
4.2 Les niveaux expérimentaux ou conditions de traitement
Les niveaux expérimentaux, fréquemment qualifiés de « conditions de traitement » ou de « conditions actives », incarnent l’introduction délibérée du facteur causal théorique à tester. Alors que la condition de contrôle maintient le système dans son état initial ou neutre, les niveaux de traitement introduisent la variation systématique censée déclencher une réorganisation des processus cognitifs, affectifs ou physiologiques chez le participant. C’est à travers l’observation et la mesure des effets produits par ces niveaux actifs que le chercheur peut tester ses hypothèses fondamentales.
La structuration des niveaux de traitement ne s’improvise pas : elle doit refléter avec rigueur les hypothèses formulées. Si l’on souhaite tester l’efficacité d’une nouvelle thérapie d’exposition pour les phobies spécifiques, le chercheur peut concevoir plusieurs niveaux expérimentaux en faisant varier, par exemple, le mode d’immersion : un niveau basé sur une exposition en réalité virtuelle immersive, un niveau reposant sur une exposition in vivo guidée, et un niveau exploitant l’imagination guidée. Chacune de ces modalités incarne une variante distincte du traitement actif, permettant de tester non seulement si la thérapie fonctionne, mais également quelle modalité spécifique de ce traitement s’avère la plus performante sur le plan clinique.
Pour démontrer avec force l’efficacité spécifique d’un traitement, le chercheur doit s’assurer que les conditions de traitement sont standardisées à l’extrême, à l’exception précise du facteur théorique manipulé. Si les niveaux actifs diffèrent entre eux par des variables parasites (telles qu’une durée d’intervention différente, un thérapeute plus enthousiaste dans une condition que dans l’autre, ou un matériel plus moderne), le principe de parité environnementale est rompu, rendant caduque toute conclusion sur la supériorité causale de l’un des niveaux expérimentaux.
4.3 La condition placebo et le contrôle en double aveugle
En psychologie clinique, en neuropsychologie et en neurosciences comportementales, l’anticipation cognitive et les attentes subjectives des participants constituent l’une des sources de variance parasite les plus puissantes. L’effet placebo désigne précisément l’amélioration clinique ou comportementale observée chez un sujet qui reçoit un traitement inerte ou factice, du simple fait de sa croyance dans le pouvoir curatif ou stimulant de cette intervention. Dès lors, pour isoler l’effet causal authentique des niveaux d’une variable indépendante, l’intégration d’un niveau spécifique « placebo » ou « condition factice » s’avère indispensable.
Dans un protocole évaluant l’effet d’une molécule cognitive sur la concentration, le niveau placebo consistera en l’administration d’une gélule visuellement et gustativement indiscernable de la gélule active, mais ne contenant qu’une substance pharmacologiquement inerte comme du glucose ou de la cellulose. En psychologie cognitive ou en ergonomie, des dispositifs équivalents existent : on parle de « placebo psychologique » ou de « neurofeedback factice », où les participants reçoivent un faux retour d’information visuel aléatoire sans lien avec leur activité cérébrale réelle, pour s’assurer que les bénéfices observés ne découlent pas simplement de l’enthousiasme généré par l’utilisation d’une technologie de pointe.
Pour garantir la validité absolue de la manipulation de ces niveaux, la procédure du double aveugle (double-blind design) représente la norme scientifique d’excellence méthodologique. Dans ce dispositif expérimental rigoureux, ni le participant ni l’expérimentateur en contact direct avec lui ne connaissent le niveau de la variable indépendante (actif, contrôle ou placebo) auquel le sujet est assigné au moment du test. Cette précaution neutralise simultanément les attentes du sujet et les biais d’attente de l’expérimentateur (effet Rosenthal ou effet Pygmalion), évitant que ce dernier n’administre inconsciemment les consignes avec plus de chaleur ou de conviction auprès des participants placés dans la condition active.
5. Plans expérimentaux unifactoriels et manipulation des niveaux
5.1 Le plan expérimental binaire à deux niveaux
Le plan expérimental le plus élémentaire dans la recherche scientifique est le plan unifactoriel à deux niveaux, couramment qualifié de plan binaire, de design bivalent ou d’« A/B testing » dans le secteur technologique et industriel. Ce plan comporte une unique variable indépendante qui ne se subdivise qu’en deux modalités spécifiques (par exemple : présence versus absence d’une musique d’ambiance durant une tâche de mémorisation, ou ancienne interface graphique versus nouvelle interface graphique). C’est la porte d’entrée classique de la vérification empirique.
Ce design minimaliste présente des atouts méthodologiques indiscutables : une simplicité remarquable de mise en œuvre, une répartition logistique aisée des effectifs de participants et une clarté analytique directe, les données se prêtant immédiatement à une comparaison de deux moyennes via un test t de Student. Il maximise souvent la puissance statistique pour un effectif global donné en concentrant la taille d’échantillon sur seulement deux cellules d’observation, réduisant ainsi les marges d’erreur autour de l’estimation de la différence inter-conditions.
Néanmoins, le plan binaire souffre d’une limite épistémologique intrinsèque majeure : son incapacité structurelle totale à détecter des relations curvilignes, non linéaires ou complexes. Lorsque le chercheur ne dispose que de deux points de mesure sur un graphique, la seule fonction mathématique qui puisse les relier est une ligne droite. Si la réalité biologique ou psychologique sous-jacente suit une courbe en cloche, une parabole ou une saturation en palier, le plan à deux niveaux masquera intégralement cette dynamique, pouvant conduire à des conclusions théoriques erronées ou excessivement simplificatrices.
5.2 Le plan unifactoriel multiniveaux (trois niveaux ou plus)
Pour pallier les insuffisances structurelles du plan bivalent, le chercheur fait appel au plan unifactoriel multiniveaux, comportant $k$ conditions expérimentales ($k ge 3$) pour une même variable indépendante. En déployant au moins trois niveaux distincts au sein de son architecture de recherche, l’expérimentateur s’ouvre la possibilité de cartographier la trajectoire complète de la réponse cognitive ou comportementale face à la variation du stimulus manipulé.
Le recours à trois niveaux ou plus est le seul moyen méthodologique permettant de révéler des phénomènes d’inversion d’effet ou de saturation fonctionnelle. L’illustration historique la plus célèbre en psychologie reste incontestablement la modélisation de la loi de Yerkes-Dodson, qui décrit la relation complexe unissant le niveau d’éveil physiologique (ou stress) à la performance cognitive. Si un expérimentateur n’avait testé que deux niveaux extrêmes (un éveil très bas et un éveil très élevé), il aurait constaté des performances médiocres dans les deux cas et aurait pu en conclure hâtivement que l’éveil n’exerce aucun impact sur la tâche. En introduisant un troisième niveau intermédiaire (éveil modéré), la fameuse courbe en « U inversé » apparaît : la performance est faible au niveau bas, optimale au niveau intermédiaire, puis s’effondre à nouveau au niveau d’éveil saturé.
Les plans multiniveaux permettent ainsi d’établir des modélisations polynomiales fines (contrastes linéaires, quadratiques ou cubiques). Ils fournissent une compréhension mécanistique infiniment plus riche et réaliste du comportement humain, qui obéit rarement à des dynamiques tout-ou-rien simplistes.
5.3 Stratégie de sélection de l’intervalle entre les niveaux
Lorsque la variable indépendante est de nature quantitative (temps, intensité, concentration, fréquence), l’une des décisions méthodologiques les plus critiques réside dans le choix de l’écartement ou de l’intervalle métrique qui séparera les différents niveaux retenus dans le protocole. Une sélection arbitraire ou mal calibrée de ces intervalles peut ruiner la validité d’une recherche, même si tous les autres aspects méthodologiques sont irréprochables.
Le premier écueil méthodologique consiste à sélectionner des niveaux d’intensités trop rapprochés les uns des autres. Si l’écart entre les modalités se situe en deçà du seuil différentiel de perception du système sensoriel ou cognitif (concept psychophysique du seuil différentiel ou loi de Weber-Fechner), les participants ne percevront aucune différence fonctionnelle entre les conditions, conduisant à une absence artificielle d’effet et à l’acceptation erronée d’une hypothèse nulle fausse (erreur de type II). Par exemple, tester l’effet du temps d’exposition à un stimulus visuel complexe en comparant 500 ms, 520 ms et 540 ms a très peu de chances de mettre en évidence des différences significatives de mémorisation.
Le second écueil, inverse mais tout aussi destructeur, consiste à adopter des niveaux d’intensités extrêmes ou caricaturaux uniquement pour s’assurer de trouver un effet statistiquement significatif. Si un chercheur évalue l’effet du bruit ambiant sur l’apprentissage en comparant un silence absolu de chambre sourde (0 dB) à un volume assourdissant de marteau-piqueur (110 dB), il obtiendra sans doute une différence massive, mais dont la pertinence théorique et la validité écologique seront quasiment nulles pour comprendre le fonctionnement cognitif des élèves dans une salle de classe ordinaire. La sélection des intervalles entre les niveaux doit systématiquement s’appuyer sur la littérature empirique préexistante, des études pilotes préalables et des considérations écologiques réelles.
6. Plans factoriels : combinaison et interaction de multiples niveaux
6.1 Comprendre la notation factorielle standard
Dans la recherche contemporaine, les comportements sont rarement la conséquence d’un facteur isolé agissant en vase clos. Pour capturer la complexité du réel, les chercheurs élaborent des plans factoriels, c’est-à-dire des dispositifs dans lesquels au moins deux variables indépendantes sont manipulées simultanément, chaque niveau de chaque facteur étant combiné avec chaque niveau des autres facteurs de manière exhaustive. Ce croisement intégral génère un système matriciel standardisé régi par une notation factorielle universelle.
La notation factorielle prend la forme conventionnelle d’une suite de multiplications de nombres entiers, tels que $2 \times 2$, $3 \times 2$ ou encore $2 \times 4 \times 3$. Cette écriture codifiée recèle deux informations fondamentales :
Le nombre de chiffres qui composent la formule indique le nombre total de variables indépendantes manipulées dans le protocole. Ainsi, un plan « $2 \times 2$ » comporte deux facteurs indépendants, tandis qu’un plan « $2 \times 4 \times 3$ » en comporte trois.
La valeur de chaque chiffre spécifie très exactement le nombre de niveaux que possède chacune de ces variables indépendantes respectives. Dans un plan factoriel $3 \times 2$, la première variable indépendante se décline en trois niveaux, et la seconde variable indépendante se décline en deux niveaux.
Le produit arithmétique de cette équation détermine instantanément le nombre total de conditions expérimentales distinctes, couramment appelées « cellules expérimentales » du plan. Un plan factoriel $2 \times 2$ engendre 4 cellules de test ; un plan $3 \times 2$ en génère 6 ; un plan $2 \times 4 \times 3$ en produit 24. Cette démultiplication met en évidence le phénomène d’accroissement exponentiel de la complexité : l’ajout d’une seule variable ou d’un niveau supplémentaire requiert immédiatement l’allocation d’un nombre beaucoup plus vaste de sujets et de ressources logistiques.
6.2 Effets principaux des niveaux d’un facteur
L’un des apports conceptuels majeurs du plan factoriel est sa capacité à isoler ce que l’on qualifie en statistique d’« effet principal ». L’effet principal d’une variable indépendante représente l’impact global et moyen de cette variable sur la variable dépendante, évalué à travers l’ensemble de ses niveaux, indépendamment des variations de tous les autres facteurs manipulés simultanément dans l’étude.
Pour calculer et conceptualiser l’effet principal d’un facteur dans une matrice factorielle, on procède au calcul des « moyennes marginales ». Imaginons un plan factoriel $2 \times 2$ évaluant l’effet du Facteur A (Type de tâche : Verbale vs Spatiale) et du Facteur B (Bruit ambiant : Calme vs Bruyant) sur la performance cognitive. Pour évaluer l’effet principal du Facteur A, on calcule la moyenne générale obtenue pour la tâche verbale (en fusionnant les conditions de calme et de bruit) et on la compare à la moyenne générale obtenue pour la tâche spatiale (en fusionnant également les deux conditions acoustiques). On « marginalise » ainsi l’effet du Facteur B pour analyser l’action isolée des niveaux du Facteur A.
L’évaluation des effets principaux permet de déterminer si, au sens large, une modalité particulière surpasse systématiquement une autre dans l’échantillon global. Néanmoins, l’interprétation isolée d’un effet principal peut s’avérer trompeuse ou incomplète s’il existe une dépendance contextuelle entre les variables, ce qui conduit à la notion centrale d’effet d’interaction.
6.3 Effets d’interaction entre les niveaux de facteurs distincts
Le concept d’effet d’interaction représente indéniablement le joyau méthodologique des plans factoriels. Il y a effet d’interaction statistique entre deux variables indépendantes lorsque l’effet produit par les niveaux de la première variable sur la variable dépendante change de direction, de magnitude ou d’intensité selon le niveau considéré de la seconde variable. Autrement dit, l’action d’un facteur ne peut plus être décrite de manière globale et absolue : elle « dépend » entièrement du contexte créé par l’autre facteur.
L’outil le plus intuitif pour détecter et interpréter une interaction reste l’analyse graphique des résultats, où les niveaux d’un facteur figurent sur l’axe horizontal et les niveaux du second facteur sont représentés par des lignes distinctes reliant les moyennes observées :
Si les lignes tracées sont rigoureusement parallèles (ou quasi-parallèles), cela signifie qu’il n’y a aucune interaction : l’effet du passage du niveau 1 au niveau 2 du premier facteur est identique quel que soit le niveau du second facteur.
À l’inverse, dès lors que les lignes ne sont plus parallèles, qu’elles convergent, divergent ou se croisent de façon flagrante (interaction croisée), une interaction statistique est présente. Une ligne horizontale face à une ligne descendante atteste que l’effet d’un niveau est conditionné par la modalité concurrente.
En psychologie, les interactions incarnent la réalité vivante des mécanismes mentaux : un médicament stimulant peut améliorer significativement l’attention chez les sujets présentant un déficit de base (niveau 1 de la population), mais altérer drastiquement cette même attention chez des sujets sur-activés (niveau 2 de la population). Si l’on ne regardait que l’effet principal de la molécule en moyennant tous les participants, l’effet global semblerait nul en raison de l’annulation mutuelle des scores, masquant une découverte clinique d’importance vitale.
7. Assignation des participants selon les niveaux : plans inter et intra-sujets
7.1 Plans inter-sujets (between-subjects) et répartition des niveaux
Le plan inter-sujets, traditionnellement appelé plan à groupes indépendants, constitue le mode d’assignation le plus classique et le plus protecteur contre les artefacts de contamination. Dans cette configuration expérimentale, chaque participant recruté est affecté à un seul et unique niveau de la variable indépendante (ou à une seule cellule spécifique dans un plan factoriel). Si une expérience comporte trois niveaux d’apprentissage (auditif, visuel, kinesthésique), un sujet donné ne testera que la condition visuelle, sans jamais voir ni expérimenter les deux autres modalités.
Le grand avantage de cette séparation étanche des niveaux réside dans l’élimination absolue de toute interférence cognitive ou temporelle entre les modalités. Il n’existe aucun risque qu’une stratégie acquise lors du premier niveau ne vienne contaminer l’exécution du second niveau (absence totale d’effets d’apprentissage ou de transfert), et les participants ne subissent pas la fatigue inhérente à la répétition de plusieurs épreuves successives.
En contrepartie, le plan inter-sujets présente deux inconvénients méthodologiques notables. D’une part, il exige un échantillon de recrutement très vaste : si l’on souhaite 30 observations robustes par cellule dans un plan à 4 niveaux, il faut recruter 120 individus distincts. D’autre part, il est particulièrement sensible à la « variance interindividuelle ». Si, par le pur jeu du hasard de l’échantillonnage, le groupe assigné au niveau 1 s’avère posséder un quotient intellectuel ou un niveau socio-culturel moyen initialement supérieur à celui du groupe assigné au niveau 2, cette disparité naturelle non contrôlée vient gonfler la variance d’erreur ou biaiser l’estimation de l’effet des niveaux, nécessitant une stricte randomisation préalable.
7.2 Plans intra-sujets (within-subjects) et mesures répétées
À l’opposé du paradigme précédent, le plan intra-sujets, universellement désigné sous le terme de plan à mesures répétées, consiste à exposer chaque participant à la totalité des niveaux de la variable indépendante. Dans un protocole testant l’effet de trois niveaux de luminosité sur l’acuité visuelle, chaque sujet passera successivement dans la condition sombre, la condition moyenne et la condition vive, fournissant ainsi une mesure de sa performance pour chacun des niveaux manipulés.
L’intérêt statistique et méthodologique majeur du plan intra-sujets réside dans la réduction drastique de la variance d’erreur. Puisque chaque participant est comparé à lui-même à travers les différents niveaux de la variable, les différences interindividuelles stables (intelligence, âge, personnalité, métabolisme de base) sont constantes à travers toutes les conditions. Elles sont donc mathématiquement neutralisées et extraites du terme d’erreur résiduelle lors du calcul statistique. Cela confère au chercheur une puissance statistique très supérieure pour détecter de faibles effets causaux, tout en exigeant une économie substantielle de participants (30 sujets suffisent amplement pour obtenir 30 observations par niveau dans notre exemple à trois conditions).
Toutefois, cette exposition séquentielle aux différents niveaux rend le protocole vulnérable aux effets de contamination temporelle : effets de fatigue si les épreuves s’accumulent, effets d’apprentissage si le sujet comprend le but de la tâche au fil des niveaux, ou effets de rémanence biochimique si une substance psychoactive administrée au niveau 1 n’a pas été totalement éliminée de l’organisme avant le passage au niveau 2.
7.3 Plans mixtes (split-plot)
Dans la recherche expérimentale avancée, il est très fréquent de combiner les deux logiques au sein d’un même dispositif factoriel hybride : c’est le plan mixte, historiquement hérité de l’agronomie sous le nom de design « split-plot ». Ce plan comporte au moins une variable indépendante manipulée en inter-sujets (groupes indépendants) et au moins une variable indépendante manipulée en intra-sujets (mesures répétées).
Le cas d’école par excellence du plan mixte est l’évaluation pré-test / post-test d’un protocole d’intervention psychologique ou pédagogique :
Le premier facteur est une variable inter-sujets à deux niveaux : le « Groupe » (Niveau 1 : Groupe recevant un entraînement à la métacognition ; Niveau 2 : Groupe témoin sans entraînement).
Le second facteur est une variable intra-sujets à deux niveaux : le « Temps de mesure » (Niveau 1 : Test cognitif administré avant l’intervention ; Niveau 2 : Test cognitif identique administré après l’intervention).
Cette architecture élégante permet d’isoler avec une rigueur statistique maximale l’interaction critique « Groupe $\times$ Temps ». L’effet thérapeutique ou formatif ne se traduit pas simplement par une différence entre les groupes au post-test, mais par une progression différentielle significative entre le pré-test et le post-test observée uniquement au sein du groupe expérimental par rapport au groupe témoin. Ce design mixte requiert une gestion rigoureuse des postulats statistiques, combinant les exigences de l’homogénéité des variances (test de Levene) et de la sphéricité des matrices de covariance (test de Mauchly).
8. Détermination optimale du nombre de niveaux dans un protocole de recherche
8.1 Équilibre entre parcimonie scientifique et finesse analytique
L’une des étapes les plus délicates de la conception d’un protocole expérimental réside dans la détermination du nombre optimal de niveaux à intégrer pour chaque variable indépendante. Ce choix doit résulter d’un arbitrage méthodologique équilibré entre la finesse analytique (le désir légitime de cartographier avec un maximum de précision les moindres nuances d’un phénomène) et le principe fondamental de parcimonie scientifique (souvent incarné par le rasoir d’Ockham), qui préconise de privilégier l’explication la plus simple ne faisant intervenir que les paramètres strictement nécessaires.
La surparamétrisation représente un danger méthodologique réel. Multiplier inutilement les niveaux d’une variable (par exemple, tester 8 dosages différents d’un complément alimentaire au lieu de 3 ou 4) alourdit considérablement l’appareil de collecte de données sans apporter systématiquement de plus-value théorique décisive. Plus un chercheur fractionne sa variable en une multitude de niveaux hyper-spécifiques, plus il s’expose à capturer du bruit aléatoire ou des micro-variations sans pertinence conceptuelle, limitant la réplicabilité et la généralisabilité de ses conclusions au-delà des conditions exactes du laboratoire.
La règle d’or méthodologique réside dans l’adéquation stricte entre les hypothèses à tester et la granularité des niveaux. Si l’hypothèse théorique est simplement directionnelle (l’accroissement d’un stimulus X augmente la réponse Y), deux à trois niveaux suffisent généralement. En revanche, si l’hypothèse prédit une cassure de pente spécifique, un effet d’asymptote ou une relation quadratique complexe, le déploiement d’un nombre plus élevé de niveaux devient justifié et indispensable pour tester empiriquement cette modélisation non linéaire.
8.2 Calcul de puissance statistique et taille de l’échantillon
La détermination du nombre de niveaux exerce un impact direct et mécanique sur la puissance statistique de l’expérience, c’est-à-dire la probabilité ($1 – \beta$) de rejeter l’hypothèse nulle lorsque celle-ci est effectivement fausse et qu’un effet réel existe dans la population. Tout ajout de niveaux au sein d’un protocole modifie en profondeur la géométrie de l’échantillonnage requis.
Dans un plan inter-sujets, la relation est immédiate : chaque niveau supplémentaire nécessite le recrutement d’un groupe d’individus additionnel pour maintenir un nombre suffisant d’observations par cellule. Mais le phénomène le plus insidieux réside dans la dilution de la puissance pour les tests omnibus. Dans une analyse de variance (ANOVA), lorsque le nombre de niveaux ($k$) augmente, les degrés de liberté du numérateur ($k – 1$) augmentent également, ce qui a pour effet direct de rehausser la valeur critique du ratio $F$ nécessaire pour atteindre le seuil de significativité $\alpha$ (généralement 0,05), à taille d’effet globale constante.
Les chercheurs doivent donc impérativement recourir à des analyses de puissance a priori à l’aide d’outils standardisés tels que le logiciel G*Power. Ces calculs prévisionnels intègrent la taille de l’effet attendue (estimée par le $d$ de Cohen pour deux niveaux, ou par le $f$ de Cohen / l’êta-carré partiel $\eta_p^2$ pour des plans multiniveaux), le risque de première espèce $\alpha$ et la puissance minimale souhaitée (conventionnellement fixée à 0,80 ou 0,95). Plus le nombre de niveaux d’une variable indépendante est élevé, plus l’effectif global de l’échantillon doit être massif pour éviter de produire une étude sous-puissante incapable de trancher entre les modalités.
8.3 Contraintes logistiques, éthiques et temporelles
Au-delà des équations mathématiques pures, la conception des niveaux d’une variable indépendante se heurte inéluctablement au principe de réalité logistique, temporelle et déontologique de la pratique de la recherche vivante. L’élégance théorique d’un plan factoriel à très nombreux niveaux s’effondre fréquemment face aux limites concrètes du terrain d’investigation.
D’un point de vue logistique et temporel, faire passer 300 participants à travers un protocole long ou mobiliser une machine d’imagerie par résonance magnétique fonctionnelle (IRMf) pour scanner des dizaines de cellules expérimentales engendre des coûts financiers et humains prohibitifs. Dans les plans à mesures répétées, l’exposition d’un même sujet à un nombre excessif de niveaux provoque une fatigue cognitive aiguë et une perte de concentration majeure, introduisant un biais systématique de mesure qui dégrade la fiabilité des données collectées lors des dernières conditions administrées.
Enfin, les considérations éthiques et déontologiques — encadrées par des comités d’éthique de la recherche institutionnels (IRB / CER) — imposent des restrictions strictes quant au choix et à la multiplication des niveaux. Exposer inutilement un plus grand nombre de participants à des conditions expérimentales stressantes, inconfortables, douloureuses (par exemple, des stimulations thermiques nociceptives) ou potentiellement anxiogènes (visionnage d’images traumatiques) enfreint le principe éthique fondamental de non-malfaisance et de minimisation des risques. Le chercheur se doit de limiter les niveaux à la stricte configuration minimale permettant de répondre à la question scientifique validée.
9. Analyse statistique des données en fonction des niveaux
9.1 Comparaison de deux niveaux : le test t de Student
Lorsque le protocole de recherche repose sur une variable indépendante ne comportant strictement que deux niveaux, la modélisation statistique s’oriente naturellement vers le test $t$ de Student pour comparaison de moyennes. Ce test inférentiel paramétrique classique permet de tester l’hypothèse nulle ($H_0 : \mu_1 = \mu_2$) selon laquelle les deux échantillons proviennent de populations présentant des moyennes théoriques identiques sur la variable dépendante mesurée.
Le choix de la variante du test $t$ dépend rigoureusement de la structure d’assignation des niveaux :
Si le plan est inter-sujets (deux groupes distincts d’individus), on applique le test $t$ pour échantillons indépendants. Ce test nécessite la vérification préalable de deux postulats cruciaux : la normalité de la distribution de la variable dépendante dans chacun des deux groupes (test de Shapiro-Wilk) et l’homogénéité des variances ou homoscédasticité (test de Levene). Si les variances sont significativement inégales, une correction robuste, telle que le test $t$ de Welch, doit être appliquée.
Si le plan est intra-sujets (les mêmes individus testent les deux niveaux), on applique le test $t$ pour échantillons appariés, qui analyse mathématiquement la distribution des scores de différence calculés pour chaque individu entre la condition 1 et la condition 2.
L’interprétation de la valeur $t$ obtenue, rapportée à ses degrés de liberté ($dl$), permet de déterminer la valeur $p$ ($p$-value). Si celle-ci est inférieure au seuil conventionnel de 0,05, le chercheur rejette l’hypothèse nulle et conclut à l’existence d’une différence statistiquement significative attribuable à la variation des deux niveaux de sa variable indépendante, tout en accompagnant systématiquement ce résultat d’une mesure de taille d’effet (le $d$ de Cohen) pour quantifier l’ampleur pragmatique de cette divergence.
9.2 Comparaison de trois niveaux ou plus : l’analyse de variance (ANOVA)
Dès lors qu’une variable indépendante comporte trois niveaux ou davantage (plan multiniveaux), l’application itérative de multiples tests $t$ de Student pour comparer les niveaux deux à deux (niveau 1 vs niveau 2, niveau 1 vs niveau 3, niveau 2 vs niveau 3) constitue une faute méthodologique majeure universellement proscrite. En procédant ainsi, le chercheur provoque une inflation exponentielle du risque d’erreur de type I (l’erreur alpha, c’est-à-dire le risque de détecter une différence faussement positive due au hasard). Le taux d’erreur global cumulé ($FWER$, pour Family-Wise Error Rate) ne respecte plus le seuil de 5 % et s’élève rapidement selon la formule $1 – (1 – \alpha)^c$, où $c$ représente le nombre total de comparaisons binaires effectuées.
Pour contourner ce biais critique, la méthode statistique canonique est l’analyse de variance unifactorielle (ANOVA à un facteur, introduite par Ronald Fisher). L’ANOVA repose sur un principe d’une grande élégance mathématique : au lieu de comparer directement les moyennes isolées, elle décompose la variance totale observée dans les données en deux composantes indépendantes :
La variance inter-niveaux (ou variance factorielle), qui quantifie l’ampleur des écarts entre les moyennes des différents niveaux et la moyenne générale de l’expérience.
La variance intra-niveaux (ou variance résiduelle / d’erreur), qui quantifie la dispersion des individus à l’intérieur de chaque condition expérimentale.
Le test statistique génère le ratio $F$ de Fisher-Snedecor, obtenu en divisant le carré moyen inter-niveaux par le carré moyen intra-niveaux :
$$F = \frac{MS_{inter}}{MS_{intra}}$$
Si la manipulation des niveaux a produit un effet réel supérieur aux simples fluctuations du hasard résiduel, le ratio $F$ sera significativement supérieur à 1. Toutefois, l’obtention d’un test $F$ statistiquement significatif ne fournit qu’une validation « omnibus » globale : elle atteste qu’au moins deux des moyennes comparées sont différentes entre elles, mais elle est intrinsèquement incapable de désigner quelles sont précisément les paires de niveaux qui diffèrent significativement.
9.3 Analyses post-hoc et contrastes planifiés
Face à un test omnibus significatif dans un plan comportant trois niveaux ou plus, le chercheur doit obligatoirement poursuivre ses investigations statistiques pour localiser avec précision où se situent les divergences entre les niveaux. Deux démarches épistémologiques fondamentales s’offrent alors à lui, dictées par la formulation initiale de ses hypothèses :
Les contrastes planifiés (ou comparaisons a priori) : Si le chercheur avait formulé des hypothèses théoriques précises et ciblées avant même de recueillir les données (par exemple : prédire que le niveau 3 surpasse la moyenne combinée des niveaux 1 et 2), il programme des contrastes linéaires orthogonaux spécifiques. Cette approche possède une grande puissance statistique et ne nécessite pas de corrections pénalisantes excessives car les comparaisons sont guidées par la théorie préalable et limitées en nombre.
Les tests post-hoc (ou comparaisons a posteriori) : Si l’investigation est exploratoire et que le chercheur souhaite comparer toutes les paires possibles de niveaux sans hypothèse directionnelle rigide préalable, il recourt à des tests post-hoc spécifiquement formulés pour ajuster la valeur $p$ et verrouiller le risque d’erreur alpha global sous le plafond de 5 %. Les procédures les plus reconnues incluent le test HSD de Tukey (idéal pour comparer toutes les paires avec des effectifs équilibrés), la méthode de Scheffé (extrêmement conservatrice mais adaptée à tous les contrastes complexes) ou l’ajustement de Bonferroni (très rigoureux, divisant le seuil alpha par le nombre de tests exécutés).
Enfin, si la variable indépendante est quantitative ordonnée, le chercheur peut réaliser des analyses de tendances (trend analysis), calculant des contrastes polynomiaux pour tester formellement si la progression à travers les niveaux épouse une dynamique significativement linéaire, quadratique ou cubique.
10. Biais méthodologiques, effets d’ordre et contrôle expérimental liés aux niveaux
10.1 Effets de report et de séquence dans les plans à mesures répétées
Lorsque les niveaux d’une variable indépendante sont administrés de manière séquentielle à un même groupe de participants au sein d’un plan à mesures répétées, l’ordre de passage devient en lui-même une variable parasite potentielle susceptible de vicier gravement la validité interne des conclusions. Ces artefacts méthodologiques se déclinent sous deux formes majeures : les effets de report et les effets d’ordre (ou de séquence).
L’effet d’ordre renvoie à la position ordinale d’une condition dans le déroulement chronologique de l’expérience, indépendamment de la nature exacte du niveau administré. Les deux manifestations les plus classiques sont l’effet d’apprentissage (la performance d’un sujet s’améliore artificiellement au fur et à mesure qu’il passe les niveaux, simplement parce qu’il comprend mieux la tâche et automatise ses réflexes) et l’effet de fatigue ou de lassitude (la performance se dégrade inexorablement lors des derniers niveaux administrés en raison de l’épuisement attentionnel ou de la baisse de motivation).
L’effet de report (couramment désigné sous le terme anglais de carryover effect) est plus pernicieux encore : il survient lorsque l’exposition préalable à un niveau spécifique contamine et modifie durablement la réponse du participant lors du niveau immédiatement consécutif. Par exemple, si le Niveau 1 d’une tâche exige un effort d’inhibition cognitive extrême (tâche de Stroop prolongée) et que le Niveau 2 évalue la régulation émotionnelle, l’état d’épuisement de l’ego ou de fatigue préfrontale induit par le premier niveau altérera directement les scores du second niveau, faussant la mesure pure de cette modalité.
10.2 Techniques de neutralisation : randomisation et contrebalancement
Pour préserver l’intégrité expérimentale des plans intra-sujets et neutraliser de façon absolue les effets d’ordre et de report entre les niveaux, les méthodologistes ont développé des techniques formelles de contrôle expérimental indispensables : la randomisation de l’ordre de passage et les procédures de contrebalancement.
La randomisation complète de l’ordre consiste à tirer au sort, pour chaque participant individuel, la séquence d’administration des niveaux. Si un plan comporte 3 niveaux (A, B, C), un participant tirera au sort la séquence B-A-C, un autre la séquence C-B-A, etc. Sur un échantillon volumineux, cette technique a pour vertu de disperser aléatoirement les effets de fatigue et d’apprentissage, évitant qu’un niveau particulier ne soit systématiquement défavorisé en clôturant toujours l’expérience.
Pour un contrôle mathématiquement parfait sur des échantillons de taille modérée, le contrebalancement complet représente l’idéal méthodologique. Il consiste à tester l’ensemble exhaustif des permutations d’ordre possibles entre les niveaux. Le nombre de séquences nécessaires est égal à la factorielle du nombre de niveaux ($k!$). Pour 3 niveaux, il existe $3! = 6$ ordres possibles (ABC, ACB, BAC, BCA, CAB, CBA), chaque séquence étant administrée à un sous-groupe équivalent de sujets. Toutefois, dès que le nombre de niveaux grandit, le contrebalancement complet devient intenable (pour 5 niveaux, $5! = 120$ ordres distincts).
Dans ce cas de figure, les chercheurs déploient un contrebalancement partiel sophistiqué : le carré latin équilibré (balanced Latin square). Cette disposition matricielle ingénieuse garantit deux propriétés fondamentales : chaque niveau de la variable indépendante apparaît une fois et une seule à chaque position ordinale chronologique (1er, 2e, 3e, etc.), et chaque niveau précède et suit immédiatement chacun des autres niveaux un nombre strictement égal de fois à travers les séquences. Ce protocole neutralise avec élégance la majorité des contaminations séquentielles tout en maintenant la charge logistique à un niveau gérable.
10.3 Biais d’attente et caractéristiques de la demande expérimentale
Un autre défi méthodologique direct lié à l’administration des niveaux réside dans les mécanismes psycho-sociaux qui émergent entre le sujet expérimenté et le chercheur. Dans les plans où les participants transitent par plusieurs niveaux successifs, ces derniers tentent fréquemment de donner un sens à la situation de laboratoire et cherchent activement à deviner l’hypothèse sous-jacente du chercheur : c’est ce que Martin Orne a conceptualisé sous l’appellation de caractéristiques de la demande expérimentale.
En observant le contraste flagrant entre les modalités qui lui sont présentées (par exemple, devoir lire un texte avec une police de caractères extrêmement fluide au niveau 1, puis un texte avec une police quasi-illisible au niveau 2), le participant déduit la nature de la comparaison effectuée. Dès lors, son comportement peut être altéré par le biais de conformisme (vouloir être un « bon sujet » et confirmer ce qu’il imagine être l’attente du chercheur en ralentissant délibérément sa lecture au niveau 2) ou, à l’inverse, par un biais de réactance psychologique d’opposition.
Parallèlement, l’expérimentateur lui-même peut introduire un biais de confirmation lors de l’administration des différentes conditions expérimentales s’il n’est pas tenu en aveugle. Il peut, par des micro-signaux non verbaux inconscients (sourires, hochements de tête, débit de parole plus encourageant), inciter le participant à performer davantage dans le niveau thérapeutique que dans le niveau de contrôle. La stricte standardisation des consignes via des interfaces informatisées et l’application aveugle des protocoles constituent les remparts indispensables contre ces dérives d’interaction.
11. Études de cas appliquées en psychologie
11.1 Cas en psychologie cognitive : charge de travail mentale et attention
Pour illustrer la manipulation rigoureuse des niveaux au sein du laboratoire de sciences cognitives, examinons une expérience dédiée à l’évaluation de la saturation de la mémoire de travail et son impact sur une tâche concurrente de détection attentionnelle. Ce cas mobilise un paradigme de double tâche classique inspiré du modèle de mémoire de travail de Baddeley.
Le chercheur opérationnalise sa recherche de la manière suivante :
Variable indépendante : La charge cognitive imposée en mémoire de travail à l’aide d’un paradigme de rétention verbale.
Niveaux de la VI : Trois niveaux distincts manipulés en intra-sujets.
– Niveau 1 (Charge faible) : Rétention active d’une séquence de 1 seul chiffre.
– Niveau 2 (Charge moyenne) : Rétention active d’une séquence de 4 chiffres aléatoires.
– Niveau 3 (Charge saturée) : Rétention active d’une séquence complexe de 7 chiffres non corrélés, flirtant avec la limite théorique de la capacité de stockage (le chiffre magique sept de Miller).
Variable dépendante : Le temps de réaction mesuré en millisecondes pour détecter l’apparition d’un stimulus visuel périphérique inattendu sur un écran de contrôle pendant la phase de maintien mémoriel.
L’analyse des résultats révèle une rupture de seuil particulièrement parlante : entre le Niveau 1 et le Niveau 2, le temps de détection ne s’accroît que modérément (passant de 320 ms à 365 ms), témoignant de la capacité du système central de gestion de l’attention à compenser l’effort mental sans dégradation sévère. En revanche, le passage au Niveau 3 provoque un effondrement de la performance attentionnelle, le temps de réaction bondissant à 580 ms avec une hausse drastique des omissions. Ce design à trois niveaux démontre ainsi de façon éclatante que l’allocation des ressources cognitives ne suit pas une détérioration linéaire douce, mais subit un effet de falaise dès que la charge mémoire atteint son plafond structurel de saturation.
11.2 Cas en psychologie clinique : évaluation de la psychothérapie
Dans le domaine de la recherche clinique et de la psychopathologie expérimentale, l’évaluation de l’efficacité relative des protocoles thérapeutiques fournit une remarquable illustration de l’usage combiné de niveaux de contrôle et de niveaux de traitements actifs concurrents.
Considérons un essai contrôlé randomisé (ECR) évaluant la prise en charge du trouble panique avec agoraphobie :
Variable indépendante : Le type de protocole d’intervention psychothérapeutique administré sur une période standardisée de 12 semaines (manipulée en plan factoriel inter-sujets).
Niveaux de la VI : Trois niveaux cliniquement distincts.
– Niveau 1 (Condition contrôle actif) : Liste d’attente avec suivi téléphonique hebdomadaire de soutien neutre (contrôle des attentes et de l’écoulement temporel).
– Niveau 2 (Traitement actif comparateur) : Thérapie interpersonnelle focalisée sur la gestion des conflits relationnels (TIP).
– Niveau 3 (Traitement actif ciblé) : Thérapie cognitivo-comportementale (TCC) intégrant restructuration cognitive et exposition intéroceptive aux sensations physiques de panique.
Variable dépendante : Le score global de sévérité mesuré à 12 semaines sur l’échelle clinique standardisée PDSS (Panic Disorder Severity Scale).
L’analyse statistique par ANOVA unifactorielle suivie de contrastes planifiés met en évidence la dynamique suivante : les deux niveaux actifs (Niveau 2 et Niveau 3) démontrent une réduction des scores de panique significativement supérieure à celle enregistrée au sein du niveau contrôle de liste d’attente ($p < 0,001$). De surcroît, le contraste direct opposant les deux niveaux de traitement actif révèle la supériorité statistique et clinique hautement significative de la TCC ($p = 0,012$, $d = 0,62$) sur la TIP dans la réduction des attaques de panique. L'intégration judicieuse de ces trois niveaux permet de prouver simultanément que les bénéfices thérapeutiques ne découlent pas du simple passage du temps et que la technique ciblée d'exposition intéroceptive surpasse une approche psychologique non spécifique.
11.3 Cas en psychologie sociale : conformité et pression du groupe
L’un des plus illustres exemples de manipulation méthodique des niveaux d’une variable indépendante dans l’histoire de la psychologie sociale demeure la célèbre étude de Solomon Asch sur la conformité sociale face à un groupe unanime, reprise et modernisée sous de multiples formes contemporaines.
Dans ce paradigme visuel devenu légendaire, les participants doivent juger de la longueur de lignes géométriques tracées sur des cartons en présence de faux participants (complices de l’expérimentateur) qui donnent tous publiquement, avant le sujet naïf, une réponse unanime manifestement fausse :
Variable indépendante : La taille numérique de la majorité unanime opposée au participant naïf.
Niveaux de la VI : Quatre niveaux quantitatifs discrets manipulés expérimentalement :
– Niveau 1 : 1 complice unanime.
– Niveau 2 : 3 complices unanimes.
– Niveau 3 : 7 complices unanimes.
– Niveau 4 : 15 complices unanimes.
Variable dépendante : Le taux d’erreur moyen du participant naïf, c’est-à-dire la proportion de fois où il capitule devant l’erreur évidente du groupe pour s’y conformer.
L’apport inestimable du déploiement de ces multiples niveaux réside dans la découverte d’un effet asymptotique saisissant. Avec un seul complice (Niveau 1), le taux de conformisme est marginal (inférieur à 4 %). Lorsque la majorité passe à trois complices unanimes (Niveau 2), le taux de conformisme subit une augmentation spectaculaire pour bondir au-delà de 30 % des réponses. Mais la révélation méthodologique la plus forte survient avec les niveaux ultérieurs : l’accroissement de la majorité à 7 complices (Niveau 3) ou à 15 complices (Niveau 4) n’augmente quasiment plus le taux de conformisme, la courbe atteignant un plateau ou plafond asymptotique. Sans la structuration rigoureuse de ces quatre niveaux, il aurait été impossible de démontrer que la pression à la conformité n’augmente pas proportionnellement au nombre d’individus, mais dépend d’une force de groupe qui acquiert la quasi-totalité de son pouvoir d’influence dès le seuil critique de trois membres unanimes.
12. Bonnes pratiques méthodologiques et rédactionnelles (normes APA)
12.1 Rapport rigoureux des niveaux dans la section Méthode
La crédibilité, l’intégrité et la reproductibilité d’un article scientifique publié dans une revue à comité de lecture dépendent au premier chef de la clarté avec laquelle les niveaux de la variable indépendante sont exposés dans la section « Méthode », sous la sous-section dédiée au plan expérimental (Research Design) et à la procédure. Les standards internationaux de publication dictés par le manuel de style de l’American Psychological Association (normes APA 7e édition) imposent des exigences rédactionnelles extrêmement explicites à cet égard.
Le chercheur doit énoncer sans la moindre ambiguïté le nombre exact de facteurs et détailler l’ensemble des niveaux correspondants dès les premières lignes du plan d’expérience. Une formulation canonique selon les normes APA s’articule comme suit : « Nous avons déployé un plan factoriel 3 (Modalité de révision : Répétition passive vs Association sémantique vs Test actif) $\times$ 2 (Délai de rappel : Immédiat vs Différé de 48 heures) entièrement inter-sujets… ». Cette désignation formelle permet au lecteur d’identifier instantanément l’architecture matricielle globale de l’étude.
Chaque niveau doit ensuite faire l’objet d’une description opérationnelle exhaustive dans le corps du texte. Les caractéristiques physiques, matérielles, chronométriques et logicielles de chaque condition doivent être documentées avec précision (durée exacte en secondes, formulation intégrale et littérale des consignes verbales fournies aux sujets, paramètres techniques des écrans ou des appareils de stimulation). De surcroît, le protocole d’assignation des participants aux différents niveaux (méthode de randomisation par blocs, tirage au sort informatisé) ainsi que les procédures de contrebalancement mises en œuvre pour les plans intra-sujets doivent être exposés avec une transparence méthodologique totale pour répondre aux critères contemporains de la science ouverte (Open Science).
12.2 Représentation graphique efficace des niveaux
Une communication scientifique performante repose sur la qualité visuelle de la restitution des données empiriques. La représentation graphique des niveaux d’une variable indépendante ne relève pas de l’esthétique pure, mais constitue un outil d’analyse cognitive puissant qui doit transmettre l’essence des relations statistiques observées de manière immédiate, fidèle et non distordue.
Le choix du format de graphique doit être rigoureusement dicté par la typologie des niveaux :
Pour des variables indépendantes aux niveaux qualitatifs ou catégoriels discrets (ex. : différentes approches thérapeutiques ou nationalités), le diagramme en bâtons (histogramme) ou les graphiques en violon (violin plots) combinés à des boîtes à moustaches (box plots) sont recommandés par les normes APA. Ils permettent de visualiser clairement la moyenne, la médiane et la dispersion des données sans suggérer une fausse impression de continuité entre les catégories.
Pour des variables indépendantes aux niveaux quantitatifs continus (ex. : doses pharmacologiques successives, durées temporelles), le graphique linéaire (courbe de points reliés) est de mise, car la pente de la droite ou de la courbe traduit fidèlement la dynamique fonctionnelle sous-jacente du continuum physique exploré.
Une exigence méthodologique absolue concerne l’incorporation systématique des mesures de dispersion et d’incertitude autour des moyennes représentatives de chaque niveau. Tout point ou barre représentant un niveau doit obligatoirement comporter des « barres d’erreur » (error bars). L’auteur a le devoir scientifique d’indiquer explicitement dans la légende du graphique si ces barres représentent l’écart-type ($ET$), l’erreur type de la moyenne ($SEM$), ou un intervalle de confiance à 95 % ($IC_{95%}$). Ce dernier indicateur est fortement recommandé par les standards contemporains car il permet d’apprécier visuellement et instantanément la significativité statistique des différences entre niveaux : deux intervalles de confiance à 95 % qui ne se chevauchent pas signalent quasi-systématiquement une divergence statistiquement significative au seuil $\alpha = 0,05$.
12.3 Discussion critique des niveaux et validité écologique
La dernière étape du processus méthodologique consiste à soumettre le choix des niveaux à une analyse critique et réflexive approfondie au sein de la section « Discussion » du manuscrit de recherche. Quel que soit le degré de sophistication mathématique des analyses menées, les inférences théoriques d’une étude demeurent conditionnées par la pertinence écologique et la justesse de calibrage des niveaux sélectionnés.
Le premier point de vigilance critique concerne l’analyse des « effets planchers » (floor effects) et des « effets plafonds » (ceiling effects). Ces artefacts destructeurs surviennent lorsque les niveaux de la variable indépendante ont été mal dosés en termes de difficulté ou d’intensité. Si une tâche d’évaluation cognitive est si effroyablement difficile que tous les participants de tous les niveaux échouent avec des scores proches de zéro (effet plancher), ou si elle est tellement simpliste que l’ensemble des sujets réussit un score parfait de 100 % (effet plafond), la variable indépendante ne peut plus exprimer sa variance fonctionnelle, masquant artificiellement des différences réelles qui auraient pu être mises en évidence avec des niveaux de calibrage intermédiaire.
Le second enjeu réside dans l’interrogation sans concession de la validité écologique des niveaux manipulés. Le chercheur doit évaluer avec honnêteté dans quelle mesure les modalités artificielles créées en laboratoire reflètent les dynamiques opérantes dans le monde réel quotidien. Un niveau de « stress » induit par un bruit blanc de 5 minutes dans un casque fermé est-il véritablement représentatif du stress chronique subi par un soignant hospitalier ou un cadre d’entreprise sur plusieurs mois ? La reconnaissance explicite de ces décalages contextuels, loin d’affaiblir l’article scientifique, enrichit la discussion critique en traçant avec précision les frontières de généralisabilité des résultats et en formulant des pistes de recherche méthodologiquement solides pour les investigations empiriques futures.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Asch, S. E. (1956). Studies of independence and conformity: I. A minority of one against a unanimous majority. Psychological Monographs: General and Applied, 70(9), 1–70. https://doi.org/10.1037/h0093718
- Baddeley, A. (2000). The episodic buffer: A new component of working memory? Trends in Cognitive Sciences, 4(11), 417–423. https://doi.org/10.1016/S1364-6613(00)01538-2
- Campbell, D. T., & Stanley, J. C. (1963). Experimental and Quasi-Experimental Designs for Research. Rand McNally.
- Cohen, J. (1988). Statistical Power Analysis for the Behavioral Sciences (2nd ed.). Lawrence Erlbaum Associates.
- Craik, F. I., & Lockhart, R. S. (1972). Levels of processing: A framework for memory research. Journal of Verbal Learning and Verbal Behavior, 11(6), 671–684. https://doi.org/10.1016/S0022-5371(72)80001-X
- Faul, F., Erdfelder, E., Lang, A. G., & Buchner, A. (2007). G*Power 3: A flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behavior Research Methods, 39(2), 175–191. https://doi.org/10.3758/BF03193146
- Fisher, R. A. (1935). The Design of Experiments. Oliver & Boyd.
- Kirk, R. E. (2013). Experimental Design: Procedures for the Behavioral Sciences (4th ed.). SAGE Publications.
- Orne, M. T. (1962). On the social psychology of the psychological experiment: With particular reference to demand characteristics and their implications. American Psychologist, 17(11), 776–783. https://doi.org/10.1037/h0043424
- Rosenthal, R. (1966). Experimenter Effects in Behavioral Research. Appleton-Century-Crofts.
- Shadish, W. R., Cook, T. D., & Campbell, D. T. (2002). Experimental and Quasi-Experimental Designs for Generalized Causal Inference. Houghton Mifflin.
- Tabachnick, B. G., & Fidell, L. S. (2019). Using Multivariate Statistics (7th ed.). Pearson.
- Yerkes, R. M., & Dodson, J. D. (1908). The relation of strength of stimulus to rapidity of habit-formation. Journal of Comparative Neurology and Psychology, 18(5), 459–482. https://doi.org/10.1002/cne.920180503