
La représentation visuelle des données constitue la clé de voûte de la communication scientifique moderne. Loin d’être un simple artifice esthétique destiné à agrémenter un rapport de recherche ou une publication dans une revue à comité de lecture, le graphique cartésien est un instrument sémiotique et analytique fondamental. Dans les disciplines quantitatives, particulièrement en psychologie expérimentale, en neurosciences cognitives et en économétrie, l’attribution des variables aux axes orthogonalisés obéit à des conventions rigoureuses dont la transgression altère immédiatement la transmission du savoir et compromet l’interprétation des modèles statistiques sous-jacents.
Le choix d’assigner une variable spécifique à l’axe horizontal, traditionnellement désigné sous le terme d’abscisse ou axe $X$, et une autre à l’axe vertical, nommé ordonnée ou axe $Y$, ne découle pas d’une préférence stylistique arbitraire. Ce protocole graphique traduit visuellement la structure formelle des hypothèses de recherche, les postulats d’antériorité temporelle, les directions de causalité présumées ou encore la relation fonctionnelle mathématique liant les entités mesurées. Mal positionner ces métriques revient à inverser la syntaxe d’une proposition logique, imposant au lecteur une gymnastique cognitive superflue qui obscurcit le message empirique fondamental.
Le présent article propose une analyse approfondie et exhaustive des principes théoriques, méthodologiques, cognitifs et statistiques guidant la sélection des axes dans la construction graphique. À travers l’examen minutieux des types de variables, des structures de modèles multivariés, de la sémiotique visuelle et des normes internationales de publication telles que celles édictées par l’American Psychological Association, ce guide entend fournir aux chercheurs, analystes de données et étudiants un cadre décisionnel systématique garantissant l’intégrité, la rigueur et la puissance persuasive de leurs visualisations de données.
1. Fondements théoriques de l’assignation des axes cartésiens en visualisation scientifique
1.1 Origine et convention du repère cartésien en analyse de données
L’introduction du plan géométrique à deux dimensions par René Descartes au XVIIe siècle a révolutionné la modélisation mathématique en instaurant un pont formel entre l’algèbre et la géométrie. Dans La Géométrie (1637), Descartes formalise la possibilité de repérer tout point de l’espace au moyen d’un couple de coordonnées scalaires mesurées le long de droites sécantes, qui devinrent rapidement orthogonales dans l’usage standard. Ce repère, qui a ensuite été popularisé et systématisé dans l’empirisme des Lumières puis dans les travaux statistiques de William Playfair à la fin du XVIIIe siècle, est devenu le support universel de l’analyse bivariée.
La distinction spatiale entre l’axe horizontal et l’axe vertical repose sur une asymétrie perceptive fondamentale. L’axe horizontal représente traditionnellement la ligne de base, la surface stable sur laquelle repose l’environnement physique, tandis que l’axe vertical incarne l’élévation, la hauteur et la dimension gravitationnelle. Dans la recherche scientifique moderne, cette distinction géométrique s’est enrichie de conventions de lecture ancrées dans l’écriture occidentale, orientée de gauche à droite, et dans la perception universelle de l’accumulation physique, orientée de bas en haut. Dès lors, le point d’origine $(0,0)$, situé à l’intersection inférieure gauche, ancre le repère comme le point de départ naturel du regard et de l’évaluation quantitative.
L’établissement d’un consensus international régissant l’orientation de ces axes s’avère indispensable pour optimiser l’économie cognitive du lecteur. Selon la théorie de la charge cognitive développée par John Sweller, la capacité de la mémoire de travail humaine est intrinsèquement limitée face à des stimuli visuels complexes. Lorsque les visualisations respectent scrupuleusement les conventions géométriques éprouvées, l’effort consacré au décodage de l’architecture graphique est minime, ce qui permet à l’esprit d’allouer l’intégralité de ses ressources attentionnelles à l’extraction de l’information sémantique, à l’évaluation des tailles d’effet et à l’examen critique des distributions empiriques.
1.2 La règle canonique : Variable indépendante versus Variable dépendante
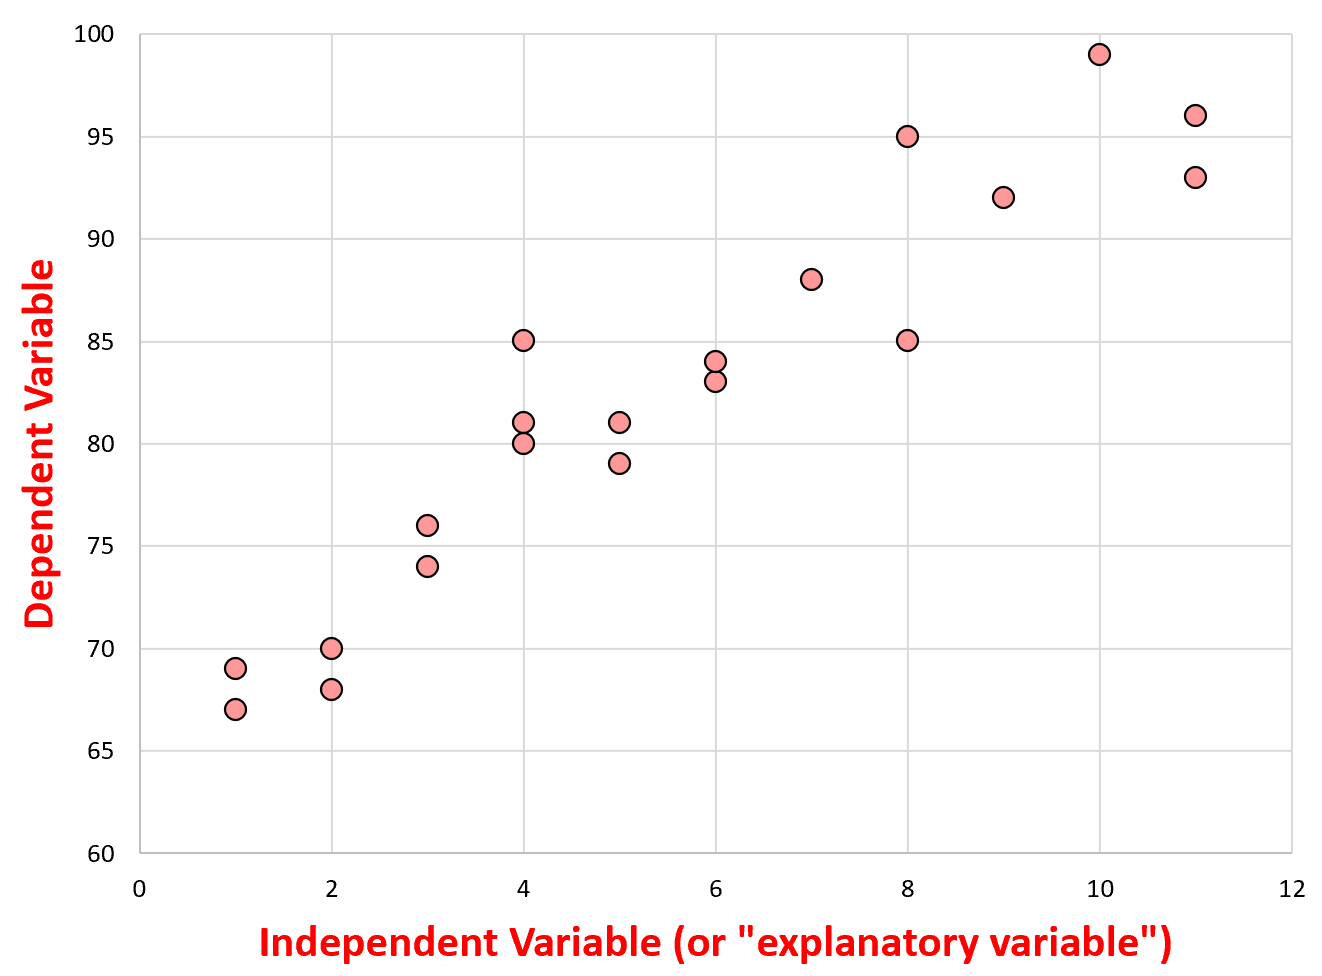
La règle fondamentale gouvernant l’assignation des grandeurs physiques ou comportementales sur un graphique cartésien s’articule autour de la distinction canonique entre la variable indépendante (VI) et la variable dépendante (VD). Dans le formalisme algébrique élémentaire, cette dynamique est immortalisée par l’expression fonctionnelle canonique :
$$y = f(x)$$
Dans cette formulation, $x$ représente la variable d’entrée, l’argument de la fonction, la composante manipulée ou préexistante dont découle la transformation mathématique. À l’inverse, $y$ figure la variable de sortie, l’image produite par l’application de la fonction $f$, dont la magnitude est tributaire des fluctuations de $x$. Transposée à la méthode scientifique, cette équation dicte formellement que la variable explicative, postulée comme l’antécédent ou le facteur prédictif, doit invariablement être projetée sur l’axe des abscisses ($X$), tandis que la variable réponse ou d’intérêt principal se loge sur l’axe des ordonnées ($Y$).
Intervertir ces axes engendre une dissonance cognitive et méthodologique considérable. Présenter visuellement la variable indépendante sur l’axe vertical et la réponse sur l’axe horizontal contraint l’évaluateur à inverser son modèle mental de lecture. Au lieu de suivre une trajectoire naturelle partant de la condition explicative au sol pour mesurer son impact en altitude, l’observateur est forcé d’analyser le système de droite à gauche ou de haut en bas le long d’un profil non naturel. Cette inversion graphique risque en outre d’induire en erreur les observateurs moins attentifs, qui pourraient présumer à tort que la pente affichée reflète la sensibilité de l’abscisse à des modifications de l’ordonnée, brouillant ainsi la compréhension du modèle statistique.
1.3 Traitement cognitif et sémiotique visuelle des graphiques
La sémiotique graphique, théorisée de manière magistrale par Jacques Bertin dans sa Sémiologie graphique (1967), enseigne que les variables visuelles ne possèdent pas toutes les mêmes propriétés perceptives ni la même efficacité évocatrice. L’altitude sur le plan vertical ($Y$) est spontanément associée par le cerveau humain à des métaphores conceptuelles de premier ordre, telles que formalisées par George Lakoff et Mark Johnson : « PLUS EST EN HAUT, MOINS EST EN BAS ». Une augmentation d’élévation spatiale déclenche une inférence immédiate d’intensification, d’accumulation, de supériorité quantitative ou d’élévation de performance.
En contrepartie, l’axe horizontal ($X$) est intuitivement mobilisé pour coder des dimensions continues stables, des étendues spatiales ou des séquences logiques et chronologiques. En raison du balayage oculaire saccadique habituel, la progression le long de l’axe $X$ évoque un déploiement, une marche en avant, la traversée d’un spectre de conditions d’exposition. Placer la variable explicative sur cette ligne horizontale permet à l’observateur d’utiliser l’axe $X$ comme une gamme de conditions fondamentales à partir desquelles il élève son regard pour sonder les variations de performance, d’état symptomatique ou de réaction physiologique projetées sur l’axe $Y$.
Pour les pairs évaluateurs au sein des revues savantes, la conformité à cette sémiotique visuelle constitue un indicateur tacite de maturité méthodologique. Un graphique dont l’organisation spatiale s’écarte sans justification théorique limpide de ces principes fondamentaux signale une méconnaissance des normes de restitution scientifique. La lisibilité immédiate conditionne la fluidité de la révision par les pairs et garantit que l’interprétation des résultats ne soit pas entachée d’ambiguïtés sémiologiques préjudiciables à la validité apparente de la publication.
2. La variable indépendante (VI) : Pourquoi et comment l’assigner à l’axe des abscisses (X)
2.1 Identification de la variable source ou manipulée par le chercheur
L’identification sans équivoque de la variable indépendante représente l’étape inaugurale de toute démarche de conception graphique. Dans un plan expérimental strict, la variable indépendante correspond au facteur directement contrôlé, administré, étalonné ou manipulé par l’expérimentateur dans le but d’observer ses répercussions sur le système d’étude. Ce facteur possède un statut logique d’antécédent : il est fixé avant que la réponse ne se manifeste, ou il constitue la condition de segmentation théorique de l’échantillon expérimental.
Parmi ces variables sources figurent les interventions pharmacologiques, telles que l’administration de posologies croissantes d’une molécule active contre un placebo, l’attribution à différents protocoles de remédiation cognitive, ou encore la manipulation systématique de stimuli environnementaux comme l’intensité lumineuse ou le niveau de bruit ambiant. En tant que générateur premier de la variabilité observée, ce facteur doit structurer la base même du graphique. L’axe des abscisses constitue le socle horizontal sur lequel le protocole expérimental s’implante, servant de repère immuable le long duquel se déploie l’investigation empirique.
Sur le plan logique, la variable explicative répond à la question : « Qu’est-ce qui varie en amont, sous l’action du chercheur ou de la nature ? » En conférant à cette dimension l’axe $X$, on matérialise visuellement son statut d’ancrage primaire. Tous les points, segments ou barres du graphique prennent naissance à partir de ces graduations horizontales, renforçant l’idée que chaque mesure dépend de sa position précise sur cette échelle de départ.
2.2 Typologies courantes de variables indépendantes en sciences comportementales
Dans l’écosystème de la recherche en psychologie, en sociologie quantitative et en neurosciences, les variables indépendantes épousent des morphologies mathématiques diversifiées qu’il convient de répertorier précisément afin d’en réussir l’assignation sur l’abscisse. On distingue principalement :
- Les variables d’exposition continue ou paramétrique : Ces métriques correspondent à des grandeurs physiques continues administrées aux sujets, telles que le nombre d’heures de privation de sommeil, la durée totale d’un module d’apprentissage assisté par ordinateur, la température ambiante dans une tâche de tolérance au stress, ou la concentration sérique d’un neurotransmetteur.
- Les facteurs différentiels inter-sujets (variables assignées ou quasi-expérimentales) : Ce sont des caractéristiques intrinsèques aux participants qui ne peuvent être manipulées pour des motifs éthiques ou biologiques, mais qui sont utilisées pour catégoriser la population étudiée (par exemple : tranches d’âge, cohortes générationnelles, niveau de scolarité atteint, appartenance diagnostique selon le DSM-5).
- Les conditions expérimentales discrètes (intra-sujets ou inter-sujets) : Ces facteurs représentent des modalités qualitatives contrôlées, comme le type de rétroaction fournie (positive, négative, absente), la modalité sensorielle de présentation du stimulus (visuelle, auditive, haptique), ou la classique confrontation entre groupe contrôle et groupe traité.
Chacune de ces typologies trouve sur l’axe horizontal un mode d’expression privilégié. Qu’il s’agisse d’un continuum linéaire représenté par une graduation métrique constante ou d’une série de catégories discrètes équidistantes, l’axe $X$ organise ces prédicteurs de façon séquentielle et intelligible, offrant une grille d’évaluation claire des différentes conditions explorées.
2.3 Conséquences visuelles d’un positionnement standard sur l’axe horizontal
L’assignation orthodoxe de la variable indépendante le long de la droite d’abscisse produit des effets structurants majeurs sur la morphologie des tracés de données. Le bénéfice le plus saillant réside dans l’alignement de l’expérimentation avec le vecteur perceptuel de progression horizontale. Lorsque les niveaux de la variable indépendante sont ordonnés selon une échelle de grandeur croissante de gauche à droite, l’esprit perçoit immédiatement l’augmentation de l’intensité de l’intrant expérimental comme un trajet continu.
Cette disposition normalisée optimise la détection des signatures fonctionnelles reliant les deux variables. Les chercheurs peuvent identifier au premier coup d’œil si la réponse observée manifeste une relation linéaire monotone, une saturation logarithmique marquant un plafonnement de la performance, une fonction en cloche traduisant la célèbre loi de Yerkes-Dodson liant l’excitation à l’efficacité cognitive, ou encore une décroissance exponentielle. Si la variable indépendante était déplacée sur l’axe $Y$, ces schémas canoniques subiraient une rotation orthogonale de quatre-vingt-dix degrés, anéantissant les réflexes visuels développés par les scientifiques à travers l’analyse de milliers de visualisations antérieures.
Enfin, l’étalonnage des intervalles de mesure le long de la base horizontale facilite la détection immédiate des espacements inégaux entre les conditions. Des dosages non linéaires (par exemple : 0, 10, 50, 200 mg) ou des paliers temporels espacés de manière exponentielle sont perçus instantanément dans leur juste proportion métrique lorsqu’ils sont projetés sur une ligne d’abscisse correctement graduée, prévenant les erreurs de surinterprétation relatives à l’ampleur des écarts entre les modalités.
3. La variable dépendante (VD) : Son ancrage systématique sur l’axe des ordonnées (Y)
3.1 Caractérisation de la variable de réponse mesurée
La variable dépendante constitue l’objet d’observation ultime du protocole scientifique. Elle capture, enregistre et quantifie les répercussions, les adaptations, les comportements ou les altérations physiologiques émergeant en réaction aux variations de la variable indépendante. Son statut d’entité dépendante découle du principe fondamental selon lequel sa valeur n’est pas prédéterminée de manière autonome par le protocole expérimental ; elle est le résultat contingent mesuré par les instruments d’investigation.
Dans la quasi-totalité des dispositifs de recherche quantitatifs, la variable dépendante adopte une nature numérique continue ou de comptage à intervalles réguliers. Elle reflète l’amplitude d’un phénomène psychologique, neurobiologique ou sociologique sous-jacent. Qu’il s’agisse de mesurer la latence d’une impulsion neuronale, l’intensité d’une détresse subjective sur une échelle d’évaluation psychométrique ou l’exactitude d’un rappel mémoriel, cette métrique fluctue en fonction de la dynamique interne de l’organisme ou du système étudié, soumis aux sollicitations de la variable explicative.
Ancrer cette grandeur sur l’axe vertical ($Y$) traduit fidèlement sa nature d’effet ou de réponse mesurée. Tout comme l’observateur scrute l’ascension ou la descente du mercure dans un baromètre pour évaluer la pression atmosphérique, le chercheur observe les élévations ou les affaissements des points de mesure le long de l’axe $Y$ pour diagnostiquer la force, la direction et la significativité statistique de l’influence exercée par la variable indépendante.
3.2 Exemples classiques de mesures psychologiques et comportementales sur l’axe Y
La recherche comportementale déploie un vaste répertoire de variables dépendantes couramment projetées sur l’axe vertical. Une classification rigoureuse de ces métriques permet d’illustrer la constance de cette convention :
- Les mesures chronométriques et de vélocité cognitive : Le temps de réaction mesuré en millisecondes lors de tâches d’inhibition cognitive (tel que l’effet Stroop), la vitesse de frappe, la durée de fixation oculaire enregistrée par un dispositif d’oculométrie ou le temps de fuite dans un labyrinthe aquatique de Morris pour les rongeurs.
- Les indicateurs d’exactitude et de performance cognitive : Le pourcentage de réponses correctes lors d’un protocole de détection de signaux, le nombre d’éléments verbaux restitués dans une épreuve d’empan mnésique, ou les scores standardisés obtenus à des batteries d’évaluation de l’efficience intellectuelle comme le WAIS (Wechsler Adult Intelligence Scale).
- Les indices psychométriques et auto-rapportés : Les scores de sommation calculés à partir d’échelles d’anxiété comme le STAI de Spielberger, les inventaires de dépression de Beck (BDI), ou les indices composites mesurant le bien-être subjectif et l’épuisement professionnel.
- Les biomarqueurs et métriques physiologiques : L’amplitude des potentiels évoqués cognitifs (comme la négativité de mésappariement ou l’onde P300 en électroencéphalographie), la conductance cutanée électrodermale, la variabilité de la fréquence cardiaque (VRC) ou la concentration de cortisol salivaire en réponse à un stresseur psychosocial standardisé.
Dans chacun de ces contextes de mesure, l’axe $Y$ reçoit la distribution continue de la variable dépendante. L’observateur évalue les modifications du comportement à travers l’amplitude de son déplacement vertical, ce qui rend la comparaison des performances immédiate et univoque.
3.3 L’ordonnée comme métaphore visuelle de l’amplitude
L’utilisation de la dimension verticale pour coder la variable dépendante s’enracine dans des mécanismes perceptifs et psycholinguistiques profonds. Dans la cognition humaine, l’axe vertical est intrinsèquement associé à la mesure de l’intensité, du succès, de l’élévation ou de l’accumulation physique. Voir une courbe s’élever le long de l’ordonnée est spontanément interprété comme le signe d’une augmentation : un score s’améliore, une charge émotionnelle s’intensifie, un temps d’attente s’allonge ou une activation neuronale gagne en puissance.
Cette métaphore de l’amplitude verticale procure une efficacité redoutable aux diagrammes scientifiques. Lorsqu’un chercheur compare l’efficacité d’un antidépresseur par rapport à un placebo, la diminution drastique de la hauteur de la barre ou du point représentant le groupe traité sur l’axe $Y$ (si la variable dépendante est l’intensité du score dépressif) signale immédiatement l’atténuation clinique de la pathologie. Inversement, si la variable dépendante code la survie cellulaire, l’élévation verticale témoigne sans ambiguïté du succès de l’intervention protectrice.
L’évaluation visuelle spontanée des écarts de hauteur entre deux points d’ordonnée distincts active le cortex visuel primaire pour comparer des longueurs alignées, ce que William S. Cleveland et Robert McGill ont démontré être la tâche perceptive élémentaire la plus précise chez l’être humain. En respectant ce positionnement, le chercheur maximise la précision avec laquelle ses pairs jaugent la taille de l’effet expérimental sans avoir besoin de consulter immédiatement le tableau numérique des moyennes.
4. Différencier causalité avérée et corrélation simple lors de la sélection des axes
4.1 Assignation des axes dans les plans expérimentaux stricts
Le choix des axes trouve sa justification la plus absolue dans les plans expérimentaux randomisés contrôlés. Dans ce paradigme épistémologique, deux conditions fondamentales sont scrupuleusement satisfaites : la précédence temporelle de l’intervention et l’isolation du système vis-à-vis des facteurs de confusion grâce à l’assignation aléatoire des unités d’observation. L’inférence causale directe de la variable indépendante vers la variable dépendante y est formellement garantie par la méthodologie même de l’essai.
Dans un tel contexte, la directionnalité causale s’établit sans ambiguïté depuis $X$ vers $Y$. La manipulation de $X$ provoque de manière démontrée la variation de $Y$. L’assignation spatiale des axes cartésiens devient alors le reflet isomorphe de la chaîne causale identifiée : la cause matérielle est ancrée sur l’abscisse, et l’effet mesurable s’élève sur l’ordonnée. Aucune hésitation n’est permise pour le statisticien, et toute déviation de cette norme est rejetée par les comités de lecture comme une faute de représentation scientifique élémentaire.
Cette configuration univoque permet de modéliser directement les relations d’intervention. Si le chercheur applique une intensité électrique $X_1$, il lit la réponse comportementale $Y_1$. Le statut causal irréversible de l’expérience scelle l’axe horizontal comme le domaine des causes opérationnelles et l’axe vertical comme l’espace des conséquences comportementales.
4.2 Gestion des études corrélationnelles et transversales non interventionnelles
Une complexité méthodologique majeure surgit lors du traitement de données issues d’études observationnelles, épidémiologiques, corrélationnelles ou transversales non interventionnelles. Dans ces protocoles d’échantillonnage, le chercheur ne manipule activement aucune composante ; il se borne à recueillir simultanément plusieurs mesures auprès d’une cohorte sans pouvoir garantir l’antécédence temporelle d’une variable sur une autre ni exclure l’action d’une tierce variable confondante non observée.
Face à l’absence de certitude causale déterministe, le choix de l’assignation des axes doit reposer sur l’ancrage théorique du modèle plutôt que sur une causalité physique établie. Le chercheur doit identifier quelle variable endosse le statut de « prédicteur présumé » ou de « variable explicative postulée » d’après la littérature scientifique et les hypothèses soumises au test. Si l’on investigue l’association entre le niveau d’anxiété trait et la qualité de la performance mnésique dans une enquête transversale, l’anxiété est théoriquement considérée comme le facteur de vulnérabilité conditionnant la performance ; elle est donc placée sur l’axe $X$, tandis que le rendement mnésique est projeté sur l’axe $Y$.
Il est impératif que le corps de l’article scientifique et la légende de la figure explicitent la nuance épistémologique : l’assignation de la variable au domaine des abscisses reflète un statut de prédicteur statistique dans un modèle de régression, sans valider à elle seule une relation causale causante univoque. La sémiotique du graphique ne doit pas induire le lecteur en erreur sur la force probante du plan d’échantillonnage mobilisé.
4.3 Cas des associations purement symétriques ou bidirectionnelles
Il existe des configurations d’analyse bivariée caractérisées par une symétrie mathématique et conceptuelle totale, où aucune variable ne peut rationnellement être qualifiée de cause ou de conséquence de l’autre. C’est typiquement le cas lors de l’estimation d’un coefficient de corrélation de Pearson entre deux traits de personnalité de même niveau hiérarchique, comme l’extraversion et l’agréabilité issues du modèle des Big Five, ou lors de l’étude de concordance entre deux épreuves de biométrie mesurant simultanément le volume de l’hippocampe gauche et de l’hippocampe droit.
Dans ce scénario d’indécidabilité causale et théorique, l’arbitrage spatial des axes obéit aux priorités spécifiques formulées dans la question de recherche :
- Le critère de référence ou méthode étalon (Gold Standard) : Lorsqu’une nouvelle échelle de mesure est comparée à un instrument de référence historiquement validé, l’instrument de référence est invariablement disposé sur l’axe $X$, et le nouvel outil évalué est projeté sur l’axe $Y$ afin d’estimer sa déviation par rapport à la norme établie.
- L’objectif pragmatique de prédiction : Si l’investigateur cherche à savoir si l’on peut estimer la variable $B$ à partir de la connaissance de la variable $A$, la grandeur source d’information ($A$) prend l’abscisse, et la grandeur prédite ($B$) prend l’ordonnée.
- La convention de lisibilité séquentielle : À défaut de tout critère logique saillant, l’assignation peut devenir conventionnelle, mais elle exige impérativement d’être documentée dans la légende par une mention précisant la nature symétrique du tracé pour prévenir toute interprétation causale hâtive par le lectorat.
L’honnêteté scientifique impose de traiter la symétrie relationnelle avec précaution pour éviter de transformer un simple alignement d’observations fortuites en un modèle mécanistique trompeur.
5. Le cas privilégié des variables temporelles et longitudinales sur l’axe X
5.1 La convention inébranlable de la flèche du temps
Parmi l’ensemble des règles régissant la sémiologie graphique en science, aucune ne possède un caractère aussi impératif et universel que celle régissant le positionnement du temps. Dans toutes les disciplines empiriques, dès lors qu’une étude intègre une métrique temporelle, chronologique ou ordinale séquentielle, celle-ci doit être assignée sans exception à l’axe horizontal ($X$). Cette norme sémiotique est le décalque spatial direct du concept philosophique et thermodynamique de la flèche du temps, formalisé notamment par Arthur Eddington, qui postule l’écoulement irréversible et continu des événements du passé vers l’avenir.
Dans la culture occidentale et dans la majorité des systèmes d’écriture globaux, ce flux irréversible s’inscrit naturellement le long d’un vecteur spatial balayant l’espace de la gauche vers la droite. Les séries chronologiques, les études de cohortes épidémiologiques suivies sur plusieurs décennies, ou les protocoles d’apprentissage moteur fondés sur l’enchaînement de blocs d’essais successifs trouvent dans l’axe des abscisses leur support de modélisation exclusif. L’origine temporelle $t_0$ prend naissance au point de convergence des axes à gauche, et le vieillissement, la maturation ou l’accumulation des essais s’étirent progressivement vers la droite.
Ce choix élimine toute ambiguïté interprétative quant à l’antériorité des états observés. Le lecteur sait d’emblée que chaque coordonnée horizontale représente un stade postérieur au point qui le précède immédiatement sur sa gauche, ce qui fluidifie l’intégration visuelle de l’ensemble du profil longitudinal.
5.2 Trajectoires de développement et courbes d’extinction
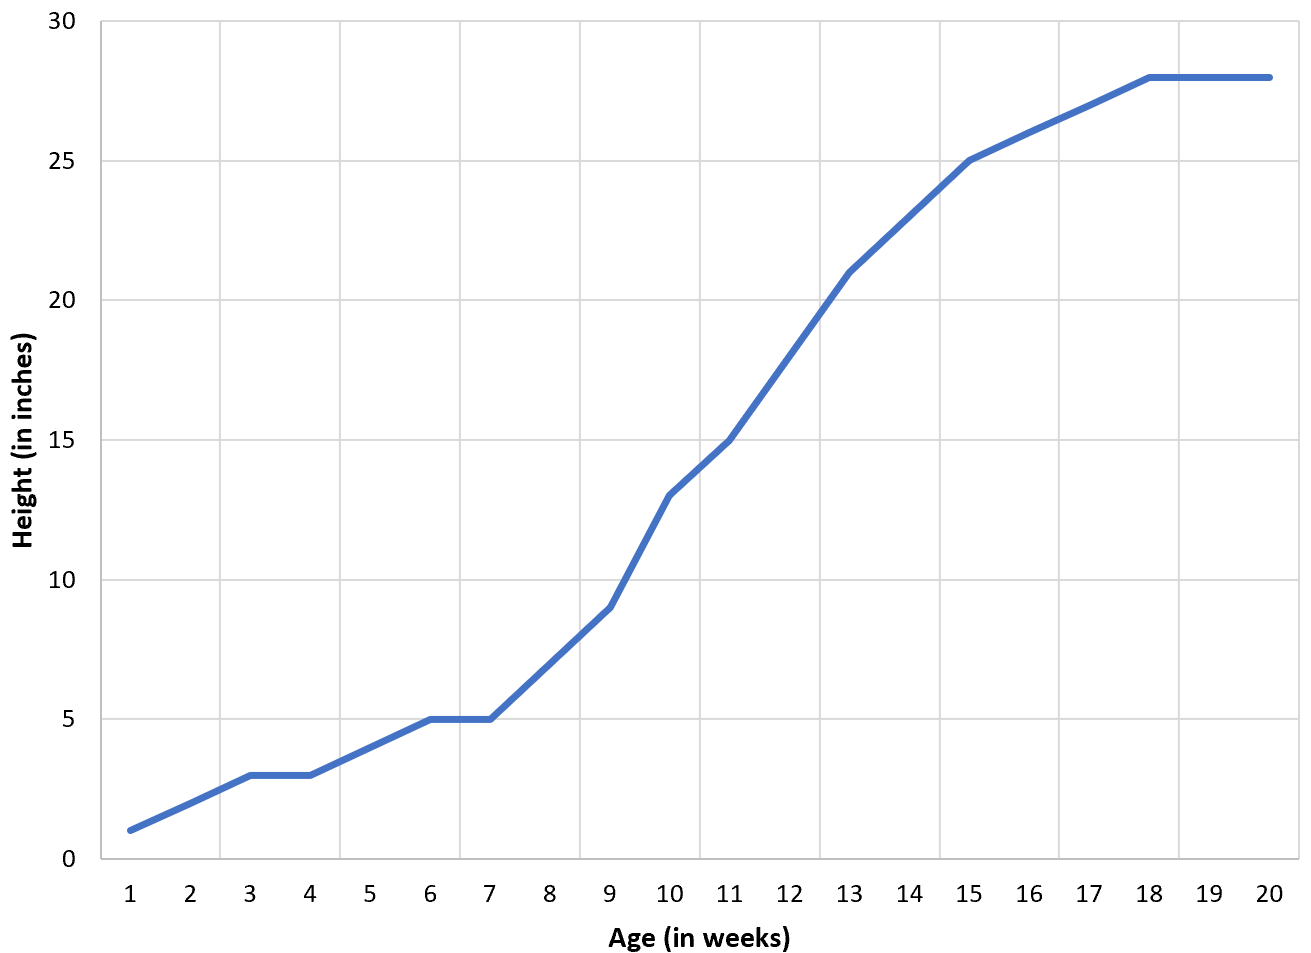
La recherche comportementale exploite massivement ce principe lors de la publication de trajectoires ontogéniques ou de dynamiques de conditionnement pavlovien et opérant. Les courbes de développement neurocognitif illustrent avec éclat cette puissance représentative : l’âge chronologique des participants (exprimé en mois chez le nourrisson ou en décennies chez l’adulte vieillissant) court sur l’axe $X$, tandis que l’efficience des fonctions exécutives, le volume de substance grise corticale ou la mémoire de travail s’ajustent en continu le long de l’axe $Y$. L’observateur identifie ainsi instantanément les fenêtres critiques de croissance, les paliers de stabilité et le déclin sénescent.
Il en va de même pour la dynamique de l’extinction comportementale dans les paradigmes de conditionnement de la peur ou de désensibilisation systématique. Les séances successives d’exposition ou les blocs d’extinction sans renforcement forment les subdivisions d’abscisse. La force de la réponse conditionnée (telle que l’amplitude du sursaut de peur ou la réponse électrodermale) s’affaisse sur l’axe $Y$ au fur et à mesure que l’on progresse vers la droite du graphique. La pente de décrémentation temporelle renseigne immédiatement le clinicien sur la vitesse d’apprentissage de l’extinction.
Un autre exemple archétypique réside dans la courbe d’oubli formalisée par Hermann Ebbinghaus dès 1885. En plaçant l’intervalle de rétention temporelle en abscisse et le pourcentage de matière conservée en mémoire sur l’ordonnée, Ebbinghaus a gravé dans le répertoire scientifique universel la signature graphique d’un déclin mnésique rapide dans les premières heures, suivi d’une stabilisation asymptotique à long terme.
5.3 Erreurs méthodologiques liées au renversement de l’axe temporel
L’inversion de l’axe temporel, consistant à positionner la temporalité sur l’axe vertical ($Y$) et la variable de réponse sur l’axe horizontal ($X$), constitue une anomalie graphique sévère qui compromet la réception critique d’un article scientifique. Une telle disposition oblige le lecteur à concevoir le temps comme une ascension gravitationnelle, une métaphore cognitive profondément contre-intuitive qui ralentit l’interprétation et induit de fréquents contresens lors du calcul mental des dérivées premières ou des pentes d’accélération d’un processus continu.
Lorsque le temps est erronément représenté sur l’axe vertical, une trajectoire qui dérive vers la droite est facilement perçue à tort comme une « augmentation temporelle », alors qu’elle ne traduit qu’une hausse de la variable de réponse. Les pentes géométriques deviennent inversées : un taux de croissance rapide, habituellement représenté par une ligne presque verticale pointant vers le haut lorsque le temps est en $X$, se transforme en une ligne presque horizontale courant vers la droite lorsque le temps est placé en $Y$.
Si certains domaines très spécialisés de la géologie ou de l’océanographie utilisent traditionnellement l’axe $Y$ descendant pour matérialiser la profondeur des carottages sédimentaires ou la colonne d’eau (agissant comme un substitut indirect du temps géologique rétrospectif), cette pratique est formellement proscrite en psychologie, en médecine et en économie quantitative, où le temps constitue une coordonnée d’évolution prospective qui ne tolère d’autre demeure que l’abscisse.
6. Application méthodologique aux diagrammes de dispersion (Scatterplots)
6.1 Construction d’un nuage de points pour évaluer une prédiction psychométrique
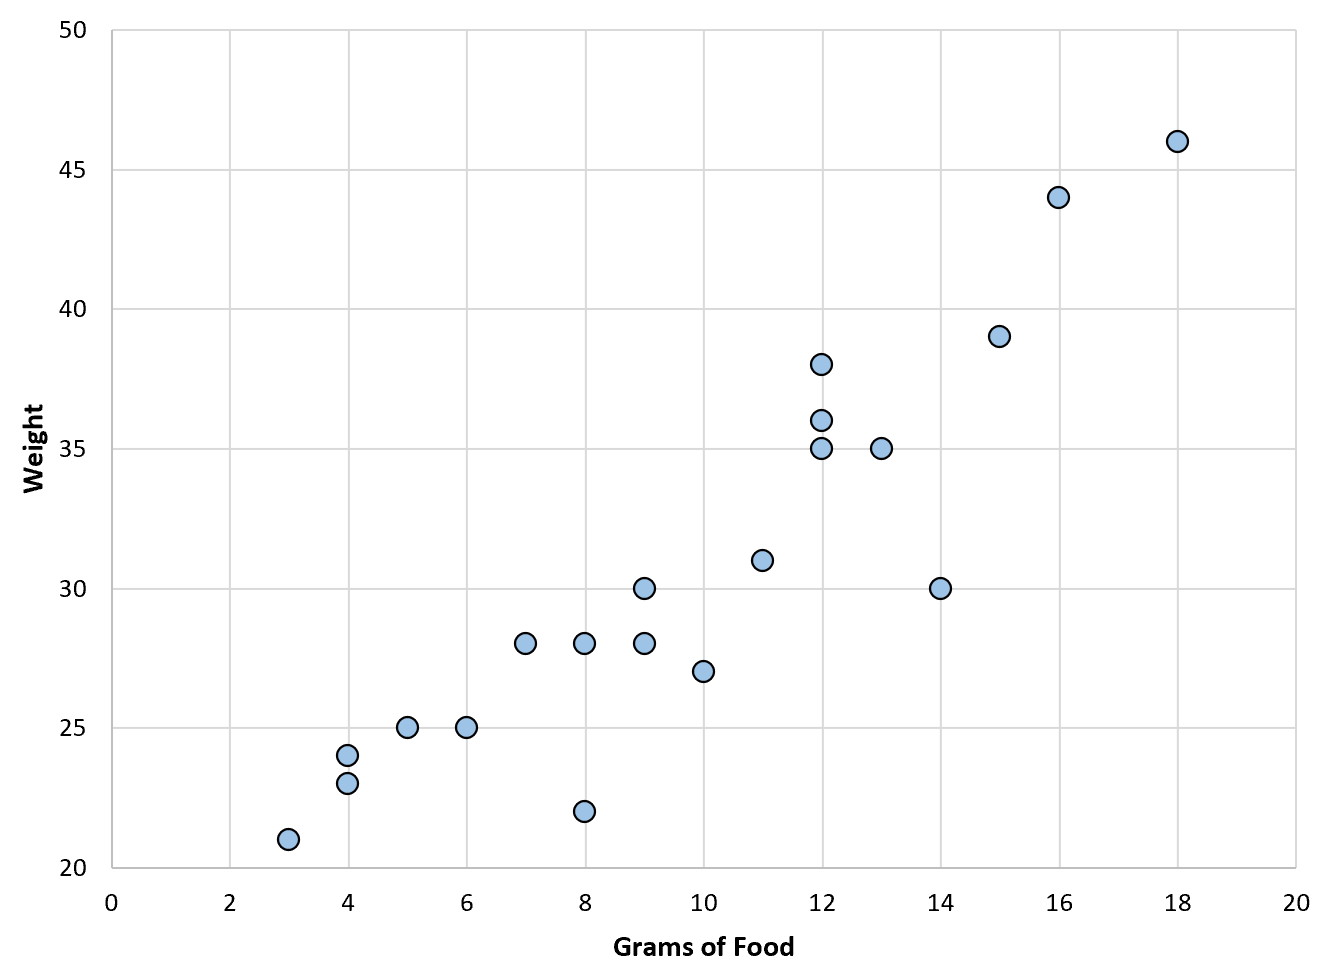
Le diagramme de dispersion bivarié, ou nuage de points, représente l’instrument graphique par excellence pour sonder la morphologie des relations entre deux variables continues. En psychométrie et en évaluation des différences individuelles, ce schéma prend une importance singulière lors de l’estimation de la validité critériée ou prédictive des instruments de mesure. La règle d’or d’assignation y est rigoureuse : la variable prédictive se positionne sur l’axe horizontal ($X$), et le critère externe évalué s’inscrit sur l’axe vertical ($Y$).
Considérons l’évaluation de la validité prédictive d’un test d’aptitude cognitive générale (tel que le quotient intellectuel mesuré à l’adolescence) sur la réussite académique ou le statut socio-économique mesuré vingt ans plus tard. L’instrument psychométrique initial constitue la variable prédictive : il s’étale donc sur l’axe des abscisses. Le critère comportemental ou sociologique ultérieur (la moyenne générale aux examens universitaires ou le salaire annuel moyen) est quantifié sur l’axe des ordonnées. Chaque sujet de la cohorte est matérialisé par un point géométrique dont les coordonnées scalaires $(x_i, y_i)$ reflètent son profil d’évaluation individuel.
Cette configuration spatiale permet à l’œil d’apprécier la forme du nuage de points : ellipticité traduisant l’intensité de la corrélation, présence d’effets de seuil plancher ou plafond, détection de sous-populations hétérogènes, et repérage immédiat des valeurs aberrantes ou d’observations influentes (au sens de la distance de Cook) susceptibles de fausser les estimateurs paramétriques.
6.2 L’orientation de la droite de régression linéaire et son interprétation
L’adjonction d’une droite de régression linéaire calculée par la méthode des moindres carrés ordinaires (MCO) sur un diagramme de dispersion illustre la nécessité mathématique absolue de respecter l’attribution normalisée des axes. La droite de régression modélise l’espérance conditionnelle de la variable dépendante sachant les valeurs prises par le prédicteur, formalisée par l’équation :
$$\hat{Y} = \beta_0 + \beta_1 X + \epsilon$$
Dans ce modèle, le coefficient de régression linéaire $\beta_1$ quantifie la variation attendue de l’ordonnée $\hat{Y}$ pour chaque incrément unitaire de l’abscisse $X$. La démarche mathématique d’estimation des paramètres des moindres carrés consiste à minimiser la somme des carrés des écarts verticaux (les résidus $e_i = y_i – \hat{y}_i$) entre les points d’observation réels et la droite modélisée. Ces distances sont mesurées parallèlement à l’axe $Y$.
Il existe une différence mathématique majeure entre la régression linéaire de $Y$ sur $X$ et la régression inverse de $X$ sur $Y$. Ces deux modèles produisent des droites géométriques aux pentes radicalement différentes dès lors que le coefficient de corrélation de Bravais-Pearson $r$ n’est pas strictement égal à $\pm 1$. Tracer les résidus le long d’un axe horizontal tout en affichant l’équation standard de prédiction de $Y$ génère un non-sens géométrique et statistique qui invalide l’interprétation visuelle du modèle des moindres carrés.
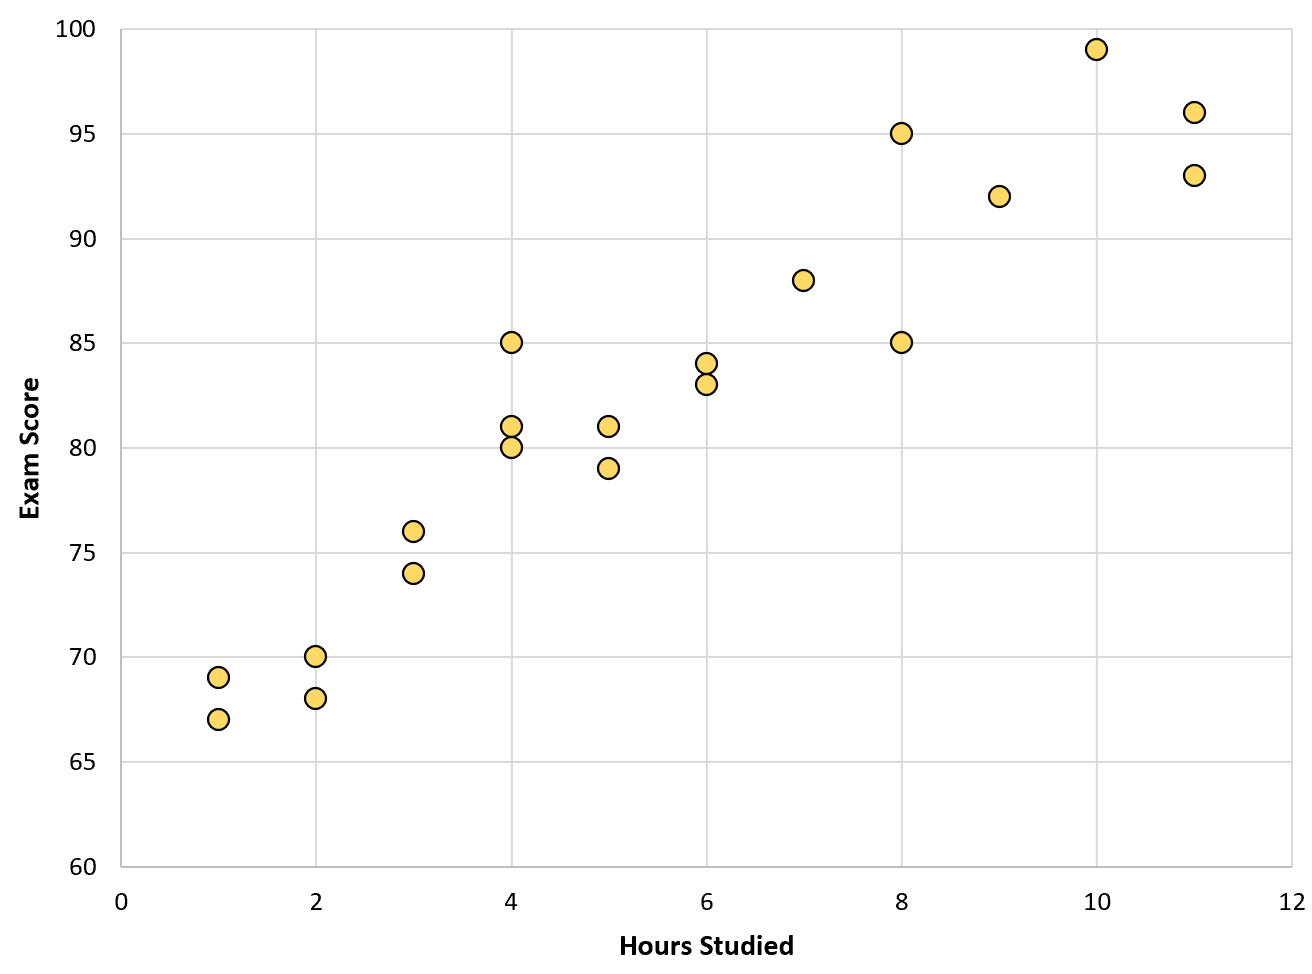
6.3 Étude détaillée : Heures de révision versus Score à l’examen
Afin d’ancrer ces considérations théoriques dans un cas empirique typique de la psychologie de l’éducation, analysons l’expérience visant à évaluer l’impact du volume de travail personnel sur l’accomplissement académique final :
- Justification théorique et antériorité logique : L’investissement temporel consenti par l’étudiant (exprimé en heures cumulées de révision au cours du semestre) se produit en amont de l’évaluation terminale. Cet investissement constitue un coût comportemental consenti dans l’anticipation d’une performance. Il possède toutes les caractéristiques d’une variable indépendante continue et prédictive, ce qui commande son ancrage exclusif sur l’axe des abscisses ($X$).
- Configuration visuelle opérationnelle : L’axe horizontal est étalonné de 0 à 50 heures de révision selon une échelle arithmétique régulière. L’axe vertical des ordonnées ($Y$) reçoit la variable de performance, soit la note standardisée obtenue à l’examen, s’échelonnant sur une échelle de 0 à 100 points.
- Lecture directe du profil fonctionnel : Cette mise en page graphique permet de lire directement le rendement marginal de l’effort consenti. Si la relation affiche une forme logarithmique avec une droite de tendance s’infléchissant à partir de 35 heures, le chercheur met en évidence visuellement un phénomène de saturation cognitive ou de rendements décroissants sans qu’aucun calcul supplémentaire ne soit requis de la part du lecteur.
Si les axes avaient été malencontreusement intervertis (note en $X$ et temps de révision en $Y$), le graphique suggérerait visuellement que c’est la note finale obtenue qui prédit rétroactivement le temps que l’étudiant a investi des semaines auparavant, violant le sens commun chronologique et le modèle d’inférence statistique sous-jacent.
7. Influence de la nature de la variable (catégorielle, ordinale, continue) sur le choix des axes
7.1 Variables indépendantes catégorielles et diagrammes en barres
Lorsque la variable indépendante est de nature nominale, qualitative ou catégorielle, le diagramme en barres (barplot) ou le diagramme en violon (violin plot) supplante le nuage de points. La convention canonique demeure inchangée : les modalités discrètes, les groupes diagnostiques ou les conditions expérimentales s’alignent le long de l’axe horizontal ($X$), tandis que la statistique récapitulative de la variable dépendante continue (la moyenne, la médiane ou la distribution de densité) s’élève le long de l’axe vertical ($Y$).
Ce format structure l’espace de comparaison en compartiments distincts. L’abscisse n’est plus une échelle métrique continue, mais un ensemble discret d’ancrages spatiaux recevant des étiquettes textuelles clairement libellées (par exemple : « Groupe Contrôle », « Thérapie Standard », « Thérapie Innovante »). La hauteur des barres ou le centre de gravité des distributions violon reflète fidèlement la magnitude du résultat observé au sein de chaque cohorte.
Une exception ergonomique notable à cette règle intervient lorsque les étiquettes textuelles des catégories sont exceptionnellement longues ou lorsque le nombre de catégories dépasse une dizaine de modalités. Dans ce cas spécifique de visualisation de données complexes, basculer le graphique à l’horizontale — en plaçant les modalités textuelles sur l’axe $Y$ et l’échelle quantitative continue sur l’axe $X$ — est toléré pour des raisons purement typographiques, évitant ainsi le chevauchement ou la rotation inconfortable des textes d’étiquettes à 45 ou 90 degrés. Toutefois, dès que le contexte le permet, le maintien de la variable de réponse sur l’axe vertical reste la norme privilégiée.
7.2 Variables ordinales et échelles psychométriques de type Likert
Les variables ordinales occupent un statut intermédiaire délicat dans la recherche comportementale. Typiquement incarnées par les échelles de Likert (par exemple, des degrés d’accord échelonnés de « Pas du tout d’accord » [1] à « Tout à fait d’accord » [5]) ou des classifications cliniques par stades de gravité (stade léger, modéré, sévère), ces métriques possèdent un ordre logique séquentiel sans que l’on puisse mathématiquement postuler l’égalité stricte des intervalles physiques entre les échelons.
Lorsqu’une variable ordinale opère comme variable indépendante ou facteur de stratification, elle doit être ordonnée de manière strictement croissante de gauche à droite le long de l’axe $X$. Le respect méticuleux de cette séquence hiérarchique permet de visualiser d’éventuels effets de palier, des transitions abruptes ou des tendances non linéaires sur la variable dépendante continue projetée sur l’axe $Y$.
Il est impératif, dans la restitution graphique de ces variables ordinales en abscisse, d’éviter de relier les points par des segments continus d’interpolation si cette liaison visuelle conduit à présumer fallacieusement l’existence de valeurs intermédiaires continues inexistantes. L’usage de diagrammes en boîtes à moustaches (boxplots) alignés côte à côte au-dessus de chaque modalité ordinale de l’axe $X$ offre la solution visuelle la plus honnête et rigoureuse, préservant la nature discrète de l’échelle tout en mettant en lumière la dispersion paramétrique de la réponse sur l’axe vertical.
7.3 Représentation bivariée de deux variables continues
La situation où deux variables continues s’affrontent sur le repère cartésien requiert un arbitrage méthodologique particulièrement rigoureux. Dès lors que l’une d’entre elles ne s’impose pas naturellement comme une variable temporelle ou une manipulation expérimentale délibérée, le chercheur doit recourir à la formalisation théorique de son protocole pour départager l’abscisse de l’ordonnée.
Dans ce cadre, la consultation des modèles structurels sous-jacents (tels que les diagrammes de pistes causales ou analyses de cheminement) s’avère déterminante. La variable positionnée le plus en amont dans le flux présumé des influences — c’est-à-dire la variable présentant le statut de variable exogène ou de régresseur primaire — est ancrée sur l’axe $X$. La variable cible, recevant les flèches d’impact ou postulée comme l’aboutissement du système comportemental étudié, est accueillie sur l’axe $Y$.
Lorsque le volume de données continues est massif (phénomène de « big data » ou d’échantillonnage dense par tensiométrie ou actigraphie), le nuage de points peut souffrir d’un phénomène de saturation perceptive totale (overplotting). Dans cette situation, les chercheurs doivent ajuster les propriétés visuelles de l’axe en introduisant des cartes de densité en deux dimensions (hexbin plots ou contours de densité par noyau), tout en maintenant intacte la hiérarchie directionnelle qui associe la condition de départ à l’axe horizontal et la variable d’intérêt à l’axe vertical.
8. Modèles multifactoriels et d’interaction : Hiérarchiser les axes et les tracés
8.1 Sélection de la variable focale à maintenir sur l’axe X
L’exploration des modèles statistiques factoriels intégrant plusieurs variables explicatives (plans factoriels ANOVA ou régressions linéaires multiples avec termes multiplicatifs) complique l’assignation graphique. Dans un dispositif examinant simultanément l’effet de deux variables indépendantes ($A$ et $B$) sur une variable dépendante ($Y$), le chercheur ne dispose que d’une seule abscisse plane pour projeter ses facteurs explicatifs. La sélection de la variable indépendante qui mérite de siéger directement sur l’axe $X$ revêt alors une importance stratégique majeure.
La règle empirique dominante consiste à attribuer l’axe des abscisses à la variable dite « focale », c’est-à-dire le facteur qui incarne le cœur théorique de la recherche ou qui présente la nature continue la plus complexe. Si une expérience examine l’influence de l’âge (variable continue s’étalant de 18 à 80 ans) et du sexe biologique (variable catégorielle binaire) sur la performance de rappel spatial, c’est l’âge qui doit impérativement occuper l’axe $X$. La richesse informationnelle d’une échelle continue exige l’amplitude spatiale de la droite d’abscisse pour déployer harmonieusement l’ensemble de ses points de mesure.
Cette approche permet de visualiser immédiatement l’effet principal du prédicteur majeur sous la forme d’un profil fonctionnel continu à travers l’ensemble du champ graphique, maximisant ainsi l’intelligibilité des tendances centrales pour l’ensemble du lectorat scientifique.
8.2 Assignation de la variable modératrice à des courbes ou facettes distinctes
La seconde variable explicative, qui endosse couramment le rôle théorique de variable modératrice (celle qui modifie la force ou la direction de la relation liant la variable indépendante focale à la variable dépendante), doit être matérialisée par d’autres canaux sémiotiques au sein du même plan graphique. La stratégie la plus répandue consiste à encoder les niveaux de ce modérateur par des tracés de lignes distincts, différenciés par des codes couleur contrastés, des styles de pointillés typographiques spécifiques ou des symboles géométriques dédiés (cercles pleins, carrés vides, triangles).
Si la variable modératrice comporte un nombre élevé de modalités ou si elle constitue elle-même un facteur continu découpé en zones de sensibilité statistique (par le biais de la technique de Johnson-Neyman ou d’une analyse des pentes simples à $\pm 1$ écart-type de la moyenne), la méthode graphique optimale repose sur le fractionnement en facettes (« small multiples » ou panneaux graphiques juxtaposés). Chaque facette hérite alors d’un couple d’axes $X-Y$ rigoureusement identique en termes d’échelles et de bornes métriques, préservant la comparabilité directe des tracés d’un panneau à l’autre.
L’identification des interactions statistiques dépend étroitement de cette disposition graphique. Lorsque le modérateur est correctement représenté sous forme de courbes superposées au-dessus du continuum horizontal de la variable focale, l’observateur évalue la présence d’une interaction en jaugeant l’écart au parallélisme des droites ou des courbes affichées. Des lignes strictement parallèles attestent de l’absence totale d’interaction (effets purement additifs), tandis que des droites sécantes ou affichant des pentes divergentes révèlent instantanément une modération significative du phénomène étudié.
8.3 Effet de l’inversion des facteurs dans les diagrammes d’interaction
Dans tout modèle d’interaction bivarié, la décision d’intervertir le facteur focal placé sur l’axe $X$ et le facteur modérateur projeté en courbes distinctes ne modifie en rien la valeur intrinsèque des coefficients statistiques de l’interaction globale ($p$, $F$ ou $\beta$). En revanche, cette permutation transforme radicalement le message perceptif délivré par le tracé, comme l’illustre la comparaison ci-dessous :
- Configuration A (Variable focale continue en X, groupe modérateur en courbes) : Met en lumière l’écart de trajectoire fonctionnelle selon l’appartenance au groupe. Le lecteur analyse comment la pente continue de réponse s’infléchit, s’accentue ou s’annule chez une sous-population spécifique par rapport au groupe de référence.
- Configuration B (Groupe modérateur en X, variable focale discrétisée en courbes) : Déplace la focale sur la comparaison statique d’amplitude brute entre les groupes à des niveaux arbitraires choisis du prédicteur. Cette disposition masque l’architecture continue du phénomène sous-jacent et rend la lecture des transitions dynamiques beaucoup plus laborieuse.
La balance décisionnelle doit toujours pencher pour la configuration graphique qui répond le plus directement et élégamment à l’hypothèse de recherche primaire formulée dans l’introduction du manuscrit. Si la question fondamentale porte sur la façon dont le stress altère l’effet de l’âge sur la mémoire, l’âge doit courir le long de l’axe $X$, et le stress doit segmenter les courbes de tendance.
9. Erreurs récurrentes, inversions d’axes et conséquences sur la rigueur scientifique
9.1 L’inversion de la causalité perçue par erreur d’affichage
L’une des défaillances méthodologiques les plus insidieuses en communication scientifique réside dans l’inversion non intentionnelle des axes, une erreur couramment qualifiée d’« inversion de causalité perçue ». Parce que l’esprit humain est entraîné par des décennies d’acculturation visuelle à déduire la causalité ou l’antécédence logique depuis le bas horizontal vers le haut vertical, inverser l’emplacement de la variable indépendante et de la variable dépendante déclenche une fausse inférence automatique chez le lecteur, y compris au sein d’une audience académique rompue aux méthodes quantitatives.
Lorsque la variable de réponse $Y$ est erronément logée en abscisse et le prédicteur $X$ en ordonnée, le cerveau appréhende la pente graphique comme la mesure de l’impact de $Y$ sur $X$. Cette distorsion cognitive a généré des controverses retentissantes dans des disciplines comme l’épidémiologie clinique ou l’économie du travail, où des visualisations erronées ont laissé croire que des indicateurs de morbidité prédisaient rétroactivement des expositions environnementales, ou que les fluctuations du taux de chômage déterminaient mécaniquement des réformes structurelles antérieures.
Le coût d’une telle méprise pour l’auteur est considérable : elle sape la crédibilité scientifique du manuscrit lors de l’évaluation par les pairs, suscite des demandes de révisions majeures et détourne l’attention des réviseurs de la pertinence des résultats vers des interrogations élémentaires relatives à la rigueur de l’équipe de recherche.
9.2 Impact mathématique de l’inversion lors des analyses de régression
Au-delà de l’illusion perceptive, l’interversion des axes soulève une incohérence mathématique fondamentale lorsque des droites de régression paramétrique sont superposées aux données. Le modèle classique des moindres carrés ordinaires repose sur l’hypothèse que la variable indépendante $X$ est mesurée sans erreur de mesure substantielle (ou qu’elle est fixée par le protocole), l’intégralité du terme d’erreur stochastique résiduelle $epsilon$ étant concentrée sur la variable dépendante $Y$.
La minimisation des résidus s’effectue donc strictement selon le vecteur vertical, en mesurant la distance au carré le long de l’axe $Y$ :
$$\min \sum_{i=1}^{n} (y_i – (\beta_0 + \beta_1 x_i))^2$$
Si l’on inverse les axes sur le graphique tout en conservant les valeurs numériques issues de l’équation standard, la ligne tracée ne minimise plus les résidus dans la dimension spatiale verticale du nouveau système d’axes, mais selon une direction horizontale. Cette discordance produit une fausse représentation de l’ajustement du modèle : les points semblent anormalement éloignés de la ligne dans les zones à forte pente, donnant l’impression trompeuse que le modèle explique mal les données alors que le coefficient de détermination $R^2$ reste mathématiquement invariant.
De surcroît, si le logiciel de traitement graphique recalcule automatiquement la droite de régression sur les axes inversés (en régressant involontairement $X$ sur $Y$), la pente obtenue $\beta^*$ ne sera pas égale à l’inverse mathématique de la pente originale $1/\beta_1$ (sauf corrélation unitaire parfaite). Cette divergence découle du fait que :
$$\beta_1 = r \frac{s_y}{s_x} \quad \text{alors que} \quad \beta^* = r \frac{s_x}{s_y}$$
Ce décalage introduit des erreurs grossières d’interprétation quantitative quant à l’intensité de la sensibilité de la réponse mesurée.
9.3 Distorsions d’échelles et pièges d’angles visuels
Le respect de l’assignation catégorielle des axes ne suffit pas à garantir la neutralité de la communication scientifique ; l’étalonnage physique et proportionnel des grandeurs projetées sur chaque axe conditionne tout autant l’interprétation. La troncature abusive de l’axe des ordonnées ($Y$), consistant à faire débuter l’échelle verticale à une valeur arbitrairement élevée plutôt qu’au zéro naturel du système de mesure, représente un artifice visuel notoire. Cette pratique a pour effet d’exagérer artificiellement des variations minimes de la variable dépendante, transformant une fluctuation insignifiante en une chute spectaculaire ou un bond prodigieux.
Un autre piège sémiotique découle du rapport d’aspect (aspect ratio) du rectangle graphique délimité par les axes $X$ et $Y$. En étirant démesurément la longueur de l’axe horizontal tout en comprimant la hauteur de l’ordonnée, un chercheur peut aplanir visuellement une pente pourtant statistiquement robuste. Inversement, l’écrasement de l’axe $X$ combiné à l’élongation de l’axe $Y$ insuffle une verticalité spectaculaire aux variations les plus ténues.
Pour prévenir ces biais d’angles visuels, William S. Cleveland a formulé le principe méthodique du « centrage à 45 degrés » (banking to 45 degrees). Cette recommandation technique préconise de calibrer le rapport d’aspect des axes de manière à ce que les segments de pente représentant les variations d’intérêt majeur oscillent autour d’une inclinaison moyenne d’environ quarante-cinq degrés par rapport à l’horizontale. Cette orientation géométrique correspond à la zone optimale de discrimination perceptive de l’œil humain pour déceler les variations locales d’accélération ou d’inflexion fonctionnelle.
10. Conformité aux normes internationales de publication (Normes APA et communauté académique)
10.1 Directives de l’APA (7e édition) sur la clarté et l’étiquetage des axes
L’American Psychological Association établit, dans la septième édition de son manuel de publication, des critères normatifs stricts régissant la typographie, la mise en page et l’identification des axes cartésiens pour les publications académiques internationales. L’orthodoxie éditoriale exige que chaque axe soit pourvu d’un libellé explicite, formulé sans abréviation opaque, précisant avec une exactitude clinique la nature de la variable observée.
La mention des unités de mesure physiques, psychométriques ou temporelles constitue une obligation absolue. Ces unités doivent être insérées entre parenthèses immédiatement après l’intitulé de la variable (par exemple : « Temps de réaction (ms) » sur l’axe $Y$, ou « Concentration plasmatique de glucose (mmol/L) » sur l’axe $X$). Les normes APA proscrivent l’usage de polices décoratives et recommandent l’emploi exclusif de typographies sans empattement nettes et neutres, telles qu’Arial, Calibri ou Helvetica, maintenues dans un corps compris entre 8 et 14 points afin de garantir une lisibilité optimale lors des étapes de réduction photolithographique opérées par les éditeurs de presse savante.
Concernant l’orientation du texte le long des axes, l’APA requiert que les libellés de l’axe horizontal soient alignés de manière strictement horizontale, centrés sous l’étendue de l’axe $X$. Pour l’axe vertical, l’intitulé doit être disposé parallèlement à l’axe des ordonnées, orienté pour une lecture de bas en haut (rotation de 90 degrés anti-horaire), avec des valeurs d’échelle numériques étalonnées horizontalement afin que le lecteur puisse apprécier les magnitudes numériques sans contorsion cervicale.
10.2 Rédaction des légendes de figures pour expliciter l’attribution des axes
Dans la grammaire de publication académique, une figure ne peut être dissociée de sa légende. La norme de reproductibilité et de clarté impose qu’une illustration scientifique soit totalement auto-suffisante : un lecteur averti doit être en mesure d’interpréter intégralement le graphique sans avoir besoin de feuilleter le corps du texte pour élucider la nature des données visualisées.
La formulation du titre et de la légende d’une figure obéit à un schéma rédactionnel canonique qui scelle verbalement l’assignation spatiale des axes. La structure syntaxique universellement préconisée s’énonce comme suit :
« Figure N. [Description de la variable Y] en fonction de [la variable X], décomposée selon [la variable modératrice Z le cas échéant]. »
L’emploi rigoureux de la locution prépositionnelle « en fonction de » (en anglais : « as a function of ») signale formellement que le premier terme cité représente la variable dépendante assignée à l’ordonnée ($Y$), tandis que le terme suivant introduit la variable indépendante logée en abscisse ($X$). Toute inversion de cette formule verbale constitue une infraction aux règles de l’art rédactionnel. De plus, la légende doit définir chaque symbole typographique, identifier précisément les métriques associées aux barres d’erreur (écart-type, erreur type de la moyenne ou intervalle de confiance à 95 %), et expliciter sans ambiguïté les seuils d’ajustement ou de significativité représentés.
10.3 Accessibilité et transmission universelle des données visualisées
L’éthique moderne de la diffusion de la science incorpore désormais les impératifs d’accessibilité universelle, garantissant que les graphiques cartésiens soient décodables par l’ensemble des chercheurs, y compris ceux présentant des déficits de la vision des couleurs (daltonisme, deutéranopie, protanopie). Selon les directives d’accessibilité aux contenus web (WCAG) et les recommandations de l’APA, la distinction entre les courbes ou les séries de données réparties au-dessus de l’axe $X$ ne doit jamais reposer uniquement sur la couleur.
Il est impératif de combiner les variations chromatiques — en privilégiant des palettes perceptuellement uniformes et éprouvées comme Viridis, Magma ou Cividis — avec des marqueurs géométriques redondants (cercles, losanges, carrés) et des motifs de traits différenciés (traits continus, tiretés, pointillés alternés). Cette redondance sémiotique assure la lisibilité intégrale de l’interaction entre l’abscisse et l’ordonnée, y compris lors d’une impression du document en noir et blanc haute résolution.
Enfin, la densité des graduations secondaires et l’adjonction de lignes de grille doivent être dosées avec parcimonie. Selon le concept de « ratio encre-données » forgé par Edward Tufte, tout élément visuel superflu n’apportant aucune information quantitative nouvelle doit être impitoyablement banni. Les grilles d’arrière-plan légères sont admises uniquement lorsqu’elles facilitent la projection oculaire précise d’un point spécifique de l’ordonnée vers son correspondant sur l’abscisse, sans surcharger la clarté d’ensemble du tracé.
11. Études de cas concrètes appliquées aux protocoles en psychologie
11.1 Cas 1 : Privation de sommeil et vitesse de traitement cognitif
Pour illustrer la mise en œuvre rigoureuse de ce protocole décisionnel, examinons un premier protocole expérimental classique mené en neurobiologie comportementale. L’étude se propose d’évaluer la détérioration de la vigilance psychomotrice induite par une privation prolongée de sommeil chez un groupe de jeunes adultes volontaires sains.
- Identification des variables : La variable manipulée par l’expérimentateur est le temps d’éveil continu, quantifié de manière longitudinale toutes les deux heures, de 0 à 48 heures sans sommeil. Il s’agit indiscutablement d’une variable indépendante continue et temporelle. La variable réponse mesurée est la latence moyenne de réponse à un test de temps de réaction sélectif à signal lumineux bref, mesurée avec une précision millimétrique en millisecondes. Il s’agit de la variable dépendante continue.
- Configuration des axes : L’axe des abscisses ($X$) reçoit la durée de veille continue, étalonnée régulièrement de 0 à 48 heures. L’axe des ordonnées ($Y$) reçoit le temps de réaction en millisecondes, avec une échelle métrique débutant à une valeur adaptée aux limites physiologiques humaines (par exemple, 150 ms) tout en signalant clairement toute rupture d’échelle si nécessaire.
- Interprétation visuelle : La trajectoire temporelle ainsi déployée de gauche à droite met en évidence la robustesse du système au cours des premières 16 heures, suivie d’une inflexion exponentielle de la pente traduisant l’effondrement des mécanismes attentionnels et l’apparition de micro-sommeils intempestifs. L’observateur suit chronologiquement le coût physiologique de l’éveil imposé sans la moindre ambiguïté cognitive.
11.2 Cas 2 : Dose de psychothérapie cognitivo-comportementale et réduction de l’anxiété
Le second cas relève de la recherche évaluative en psychologie clinique et psychothérapie. Une équipe de cliniciens cherche à quantifier l’efficacité d’un protocole de thérapie cognitivo-comportementale (TCC) ciblant le trouble panique, en fonction du volume d’heures de prise en charge clinique dispensée.
- Identification des variables : La variable explicative est le nombre cumulé de séances individuelles standardisées suivies par les patients, s’échelonnant de 0 (évaluation pré-thérapeutique initiale) à 24 séances hebdomadaires. Cette mesure d’exposition constitue la variable indépendante ordinale ou discrète. La variable réponse est l’intensité globale de la symptomatologie panique, mesurée par l’inventaire d’anxiété de Beck (BAI), produisant un score continu variant de 0 à 63 points. C’est la variable dépendante.
- Configuration des axes : Le nombre de séances thérapeutiques s’égrène de gauche à droite le long de l’axe horizontal $X$. Le score au BAI s’élève de bas en haut le long de l’axe vertical $Y$, complété par des lignes horizontales tiretées marquant les seuils diagnostiques standardisés (anxiété minime de 0 à 7, légère de 8 à 15, modérée de 16 à 25, sévère de 26 à 63).
- Interprétation clinique : Cette visualisation permet d’apprécier d’un coup d’œil la dose thérapeutique minimale efficace. Le tracé montre un affaissement rapide de la courbe le long de l’axe vertical lors des huit premières séances, franchissant le seuil clinique de l’anxiété sévère vers l’anxiété modérée, avant d’atteindre une asymptote de rémission relative vers la vingtième séance, fournissant aux cliniciens une estimation visuelle concrète du retour sur investissement psychothérapeutique.
11.3 Cas 3 : Boucle de rétroaction entre stress perçu et qualité du sommeil
Le troisième scénario confronte le chercheur à un défi méthodologique majeur : l’investigation des systèmes à causalité circulaire ou bidirectionnelle. Une étude épidémiologique prospective s’intéresse à l’interrelation complexe unissant le stress perçu auto-évalué (mesuré par l’échelle PSS de Cohen) et les perturbations de l’architecture du sommeil (quantifiées par l’index de qualité du sommeil de Pittsburgh, PSQI) au sein d’une population d’infirmiers travaillant en horaires décalés.
Dans ce modèle de santé publique, la littérature documente amplement que le stress chronique altère l’architecture du sommeil par hyperactivation de l’axe hypothalamo-hypophyso-surrénalien, mais également qu’un sommeil non réparateur fragilise la régulation émotionnelle diurne, amplifiant en retour la réactivité au stress. Les deux variables mesurées simultanément lors d’une vague d’évaluation transversale possèdent des titres théoriques équivalents pour revendiquer le statut de cause ou d’effet.
La résolution méthodologique élégante de ce dilemme graphique repose sur la construction d’un diptyque de figures croisées complémentaires :
- Figure A (Modèle du stress comme antécédent) : L’échelle de stress perçu est fixée sur l’axe $X$, et l’index de dégradation du sommeil est projeté sur l’axe $Y$. Ce premier tracé évalue l’hypothèse de l’impact du fardeau psychologique sur la somnologie.
- Figure B (Modèle du déficit de sommeil comme antécédent) : L’index de dégradation du sommeil est transféré sur l’axe $X$, tandis que le stress perçu est accueilli sur l’axe $Y$. Ce second graphique teste la vulnérabilité psychologique générée par la dette de sommeil.
En juxtaposant ces deux graphiques normalisés dotés d’échelles standardisées ($z$-scores), l’équipe de recherche peut comparer l’inclinaison des pentes de régression standardisées ($\beta$) des deux modèles. Cette comparaison visuelle et statistique conjointe permet d’identifier quelle direction d’influence prédomine au sein de la cohorte sans biaiser l’esprit du lecteur par un arbitrage spatial unilatéral réducteur.
12. Protocole décisionnel standardisé : Matrice de choix avant génération du graphique
12.1 Algorithme d’interrogation systématique en trois questions clés
Afin de prémunir les chercheurs et analystes de données contre toute erreur de conception graphique lors de la phase de programmation (sous R, Python, SPSS ou Prism), la mise en œuvre d’un protocole d’interrogation systématique s’avère hautement profitable. Cet algorithme séquentiel repose sur trois questions diagnostiques fondamentales :
Question 1 : Quelle variable constitue le prédicteur logique, la condition d’exposition ou le facteur manipulé en amont ?
Si une variable répond manifestement à ce critère d’antécédence méthodologique ou de contrôle expérimental, sa destination absolue est l’axe horizontal ($X$). Si aucune variable ne répond strictement à cette définition (comme dans une corrélation transversale pure), identifiez la variable définie comme variable explicative principale dans votre équation de modèle statistique de référence.
Question 2 : Quelle variable représente la mesure de sortie, le critère d’évaluation ou l’effet contingent mesuré ?
La métrique qui capture les conséquences, les réponses biologiques, les scores comportementaux ou les adaptations du système d’étude doit être assignée sans hésitation à l’axe vertical ($Y$). Elle incarne l’amplitude du phénomène étudié, dont les fluctuations s’interprètent en termes d’élévation ou de fléchissement vertical.
Question 3 : L’une des variables en jeu est-elle une dimension temporelle ou chronologique irréversible ?
Si la réponse est affirmative, toute autre considération théorique s’efface immédiatement : cette dimension temporelle (secondes, jours, blocs d’essais, âge chronologique) doit être ancrée sur l’axe horizontal ($X$), déroulant ainsi le flux continu des événements de gauche à droite, conformément aux lois de la sémiotique visuelle universelle.
12.2 Tableau de synthèse des combinaisons de variables et affectations recommandées
Le tableau analytique ci-dessous synthétise les recommandations formelles d’assignation des axes et les formats de visualisation géométrique préconisés en fonction de la nature mathématique des couples de variables en interaction :
- Variable 1 : Continue (Temps, Dose, Âge) | Variable 2 : Continue (Score, Biomarqueur)
- Assignation axe X : Variable 1 (Prédicteur, antécédent temporel ou manipulateur).
- Assignation axe Y : Variable 2 (Mesure de réponse, critère quantitatif dépendant).
- Format graphique recommandé : Diagramme de dispersion (Scatterplot) enrichi d’une courbe de lissage LOESS ou d’une droite de régression linéaire MCO avec enveloppe d’intervalle de confiance à 95 %.
- Variable 1 : Catégorielle / Nominale (Groupes, Traitement) | Variable 2 : Continue (Performance, Latence)
- Assignation axe X : Variable 1 (Modalités discrètes clairement espacées).
- Assignation axe Y : Variable 2 (Échelle continue de mesure).
- Format graphique recommandé : Diagrammes en violon (Violin plots) superposés de boîtes à moustaches (Boxplots) et des points de dispersion individuels (Jittered points) pour exposer l’intégralité de la distribution.
- Variable 1 : Ordinale (Stades cliniques, Échelle Likert) | Variable 2 : Continue (Activité neuronale)
- Assignation axe X : Variable 1 (Niveaux séquentiels ordonnés strictement de gauche à droite).
- Assignation axe Y : Variable 2 (Amplitude de la métrique dépendante).
- Format graphique recommandé : Diagrammes en boîtes à moustaches étagées ou diagrammes de moyennes avec barres d’erreur-type sans ligne de liaison continue abusive.
- Variable 1 : Continue (Trait A) | Variable 2 : Continue (Trait B) [Corrélation Symétrique Pure]
- Assignation axe X : Variable théoriquement postulée comme instrument de référence ou prédicteur primaire.
- Assignation axe Y : Variable cible d’évaluation ou critère dérivé.
- Format graphique recommandé : Nuage de points bivarié assorti d’une ellipse de confiance bivariée normale, complété impérativement par une note explicative documentant la symétrie relationnelle.
12.3 Grille d’auto-évaluation finale avant soumission du manuscrit
Avant d’apposer le bon à tirer final sur une figure destinée à enrichir un manuscrit de recherche ou un rapport décisionnel, il est vivement conseillé de passer chaque tracé au crible d’une liste de contrôle qualité méthodologique :
- Contrôle de conformité syntaxique : La variable indépendante est-elle incontestablement sur l’abscisse horizontale ($X$) et la réponse sur l’ordonnée verticale ($Y$) ? L’inversion éventuelle est-elle explicitement justifiée par une contrainte de mise en page textuelle incontournable ?
- Cohérence fonctionnelle mathématique : La pente géométrique visible sur le graphique traduit-elle fidèlement le signe et la magnitude du coefficient $\beta$ calculé dans le modèle statistique présenté dans le texte de la section Résultats ?
- Respect de la chronologie cognitive : Si le graphique intègre une dimension temporelle, celle-ci s’écoule-t-elle strictement de gauche à droite sans rupture de séquence ?
- Intégrité métrique de l’axe vertical : L’ordonnée est-elle convenablement étalonnée sans troncature trompeuse destinée à amplifier artificiellement une taille d’effet négligeable ? Si le zéro n’est pas inclus, une justification méthodologique est-elle fournie ?
- Auto-suffisance de la légende : Le titre de la figure respecte-t-il la formulation consacrée « [Variable Y] en fonction de [Variable X] » ? Toutes les abréviations, métriques de barres d’erreur et codes graphiques sont-ils explicités de manière exhaustive ?
- Accessibilité visuelle universelle : Les contrastes chromatiques sont-ils lisibles pour des personnes atteintes de daltonisme, et les courbes distinctes exploitent-elles des marqueurs géométriques et des styles de lignes redondants ?
La validation scrupuleuse de l’ensemble de ces points d’étape garantit que la visualisation de données ne servira pas seulement de support esthétique, mais s’imposera comme un vecteur de démonstration probant, conforme aux normes les plus rigoureuses de la méthode scientifique contemporaine.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Gauthier-Villars.
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Cleveland, W. S. (1993). Visualizing data. Hobart Press.
- Descartes, R. (1637). Discours de la méthode pour bien conduire sa raison, et chercher la vérité dans les sciences, plus la dioptrique, les météores et la géométrie qui sont des essais de cette méthode. Ian Maire.
- Ebbinghaus, H. (1885). Über das Gedächtnis: Untersuchungen zur experimentellen Psychologie. Duncker & Humblot.
- Lakoff, G., & Johnson, M. (1980). Metaphors we live by. University of Chicago Press.
- Playfair, W. (1786). The commercial and political atlas: Representing, by means of stained copper-plate charts, the progress of the commerce, revenues, expenditure and debts of England during the whole of the eighteenth century. J. Debrett.
- Sweller, J. (1988). Cognitive load during problem solving: Effects on learning. Cognitive Science, 12(2), 257–285. https://doi.org/10.1207/s15516709cog1202_4
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer Science+Business Media.