
Dans l’arsenal des méthodes quantitatives contemporaines, la visualisation et la modélisation des distributions de données constituent la pierre angulaire de l’inférence statistique. Qu’il s’agisse de sonder la variabilité biologique, de quantifier des comportements humains dans le cadre de protocoles expérimentaux ou de modéliser des fluctuations financières, les chercheurs se heurtent constamment à la nécessité de résumer l’aléa sans en dénaturer la complexité sous-jacente. Face aux limites évidentes des tableaux de fréquences brutes et à la nature fragmentaire des représentations discrètes, l’analyse exploratoire des données a progressivement forgé des instruments mathématiques capables d’appréhender le continu. Au cœur de cette transition conceptuelle se trouve un objet graphique et théorique fondamental : la courbe de densité.
Héritière directe de la théorie des probabilités et du calcul infinitésimal, la courbe de densité opère une translation décisive entre le monde empirique de l’échantillon observé et l’univers abstrait de la population parente. Alors qu’un ensemble de mesures isolées ne livre qu’une suite discontinue de points d’ancrage, la courbe de densité postule l’existence d’une régularité morphologique, d’une loi génératrice dont les données recueillies ne sont que des instanciations accidentelles. Elle unifie, sous un même tracé continu, la description topologique des observations et le calcul rigoureux des probabilités, offrant ainsi une grille de lecture visuelle et analytique d’une rare élégance.
Comprendre la nature, les mécanismes de construction et les subtilités d’interprétation des courbes de densité ne relève pas d’un simple exercice académique réservé aux statisticiens théoriciens. Il s’agit d’une compétence méthodologique essentielle pour quiconque souhaite manier avec discernement les tests paramétriques, diagnostiquer des anomalies distributionnelles, appréhender des phénomènes non linéaires ou déceler la présence de sous-groupes cliniques au sein d’une cohorte. Ce traité approfondi propose une exploration exhaustive de ces structures, depuis leurs axiomes mathématiques jusqu’à leurs implémentations empiriques et leurs dévoiements interprétatifs les plus fréquents.
1. Introduction conceptuelle aux courbes de densité
L’appréhension des distributions de variables continues exige de renoncer à l’intuition arithmétique élémentaire qui associe directement un comptage d’occurrences à une certitude probabiliste. Cette section introductive s’attache à définir les fondations épistémologiques et théoriques qui permettent de formaliser la transition d’un ensemble discret de données recueillies vers une fonction continue représentative d’une dynamique populationnelle globale.
1.1 Définition théorique et fondements statistiques
Sur le plan mathématique, une courbe de densité est la représentation géométrique d’une fonction de densité de probabilité (souvent abrégée PDF, pour Probability Density Function), associée à une variable aléatoire continue. Contrairement aux variables discrètes qui sautent d’une valeur isolée à une autre le long de l’axe réel, une variable continue peut théoriquement adopter une infinité indénombrable de valeurs au sein de n’importe quel intervalle, aussi restreint soit-il. La courbe de densité matérialise cette continuité en lissant l’espace entre les observations particulières pour dessiner le profil d’occurrence théorique de la variable étudiée.
Ce passage de l’observation brute à la modélisation mathématique marque une rupture fondamentale entre l’échantillon et la population. Lorsque nous mesurons, par exemple, la concentration plasmatique d’un biomarqueur chez deux cents patients, nous n’obtenons qu’une mosaïque discontinue de données singulières, nécessairement polluées par des erreurs de mesure et des fluctuations d’échantillonnage. La courbe de densité fait abstraction de ces aspérités stochastiques locales pour proposer une hypothèse sur la forme idéale de la distribution au sein de la population totale d’où est extrait l’échantillon. Elle substitue aux effectifs bruts observés des proportions relatives théoriques, normalisées sur l’ensemble du continuum dimensionnel.
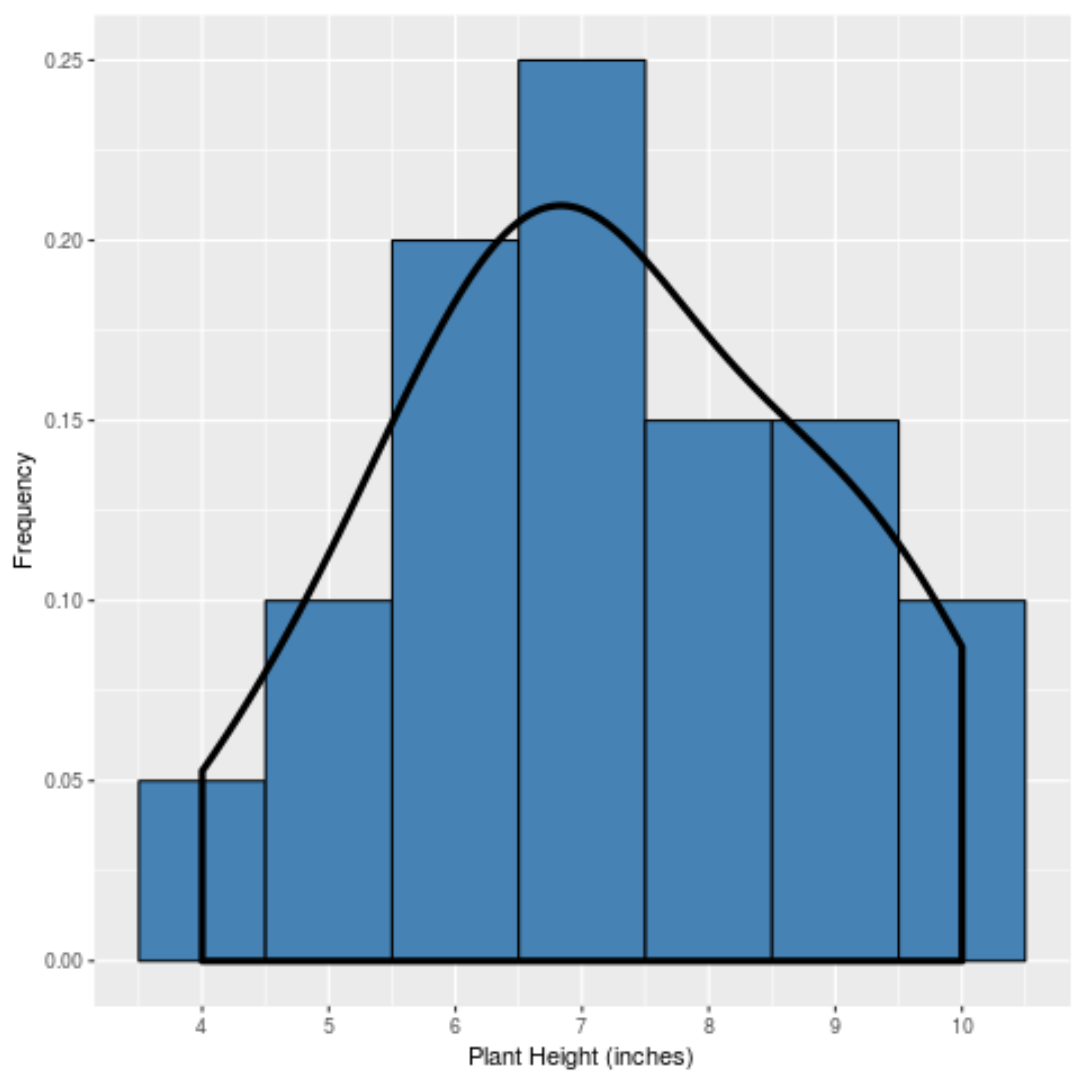
Cette conversion des effectifs en proportions s’avère indispensable pour comparer des distributions issues d’échantillons de tailles divergentes. Tandis qu’un histogramme de fréquences absolues dépend mécaniquement du nombre total d’observations collectées — une cohorte de dix mille individus produisant des hauteurs de barres cent fois supérieures à celles d’un échantillon de cent individus —, la courbe de densité présente une échelle invariable. En ramenant l’ensemble de la distribution à une loi de probabilité unifiée, elle s’affranchit du volume brut des données pour ne retenir que leur morphologie distributive intrinsèque.
1.2 Rôle des courbes de densité dans la modélisation statistique
Dans la pratique de la recherche empirique, la courbe de densité constitue en premier lieu un outil de visualisation immédiate de l’architecture globale d’une variable. L’œil humain excelle dans la reconnaissance de formes continues, mais peine à synthétiser des listes numériques ou des diagrammes encombrés d’artéfacts de discrétisation. Le tracé continu révèle instantanément l’existence de zones de concentration dense, la présence d’intervalles de raréfaction, la symétrie ou l’asymétrie générale du phénomène, ainsi que la portée des queues de distribution où nichent les valeurs extrêmes.
Au-delà de son utilité descriptive, la courbe de densité fonctionne comme un outil diagnostique incontournable préalablement à toute tentative d’inférence statistique paramétrique. La majorité des modèles inférentiels classiques — à l’instar de l’analyse de variance (ANOVA), de la régression linéaire des moindres carrés ordinaires ou des tests t de Student — reposent sur l’hypothèse explicite que les résidus du modèle ou les variables sous-jacentes suivent une loi de probabilité prédéterminée, le plus souvent la distribution normale. Superposer la courbe de densité estimée sur les données empiriques permet d’évaluer au premier coup d’œil la conformité de l’échantillon à ces prérequis théoriques, orientant ainsi le chercheur vers des tests paramétriques standards ou vers des alternatives non paramétriques plus robustes.
Enfin, la courbe de densité joue un rôle prédictif et régulateur. En formalisant la loi de distribution sous forme d’une fonction mathématique continue, elle permet d’extrapoler le comportement de la variable au-delà du strict périmètre des valeurs déjà observées. Elle offre la possibilité de formuler des estimations probabilistes rigoureuses sur des plages de valeurs encore vierges de toute collecte empirique, fondant ainsi les bases de la prise de décision en univers incertain, de l’actuariat financier à l’évaluation des risques épidémiologiques majeurs.
1.3 Distinction entre variables aléatoires discrètes et continues
Pour saisir pleinement la substance des courbes de densité, il convient d’approfondir la frontière conceptuelle séparant les lois de probabilité discrètes des lois continues. Dans le cadre discret, chaque état possible de la variable se voit attribuer une masse de probabilité positive non nulle. Si l’on considère le lancer d’un dé cubique équilibré, la fonction de masse de probabilité assigne exactement 1/6 à chacune des six faces identifiables. La somme arithmétique de ces probabilités ponctuelles équivaut à 1. Dans ce paradigme, la question « quelle est la probabilité d’obtenir exactement le chiffre 4 ? » possède une réponse arithmétique immédiate, finie et mesurable.
La situation bascule radicalement lorsqu’on bascule dans l’univers d’une variable continue, telle que la taille d’un adulte, la durée d’une réaction biochimique ou la température ambiante. La droite réelle possède une cardinalité non dénombrable. Entre 170 centimètres et 171 centimètres de taille, il existe une infinité infiniment dense de mesures envisageables si la précision de l’instrument devenait absolue (170,45279… cm). Par conséquent, si l’on attribuait une probabilité non nulle, si infinitésimale soit-elle, à chaque point individuel du continuum, la somme globale des probabilités sur n’importe quel intervalle divergerait instantanément vers l’infini, violant les axiomes fondamentaux d’Andrei Kolmogorov.
La conséquence mathématique incontournable de cette propriété est que pour une variable aléatoire continue strictement modélisée par une courbe de densité, la probabilité ponctuelle d’observer une valeur parfaitement précise est rigoureusement nulle :
P(X = c) = 0 pour toute constante réelle c.
Dès lors, la courbe de densité ne mesure pas une probabilité directe sur son axe vertical. La hauteur de la courbe en un point donné représente un taux de probabilité par unité de mesure, autrement dit une densité locale. C’est uniquement par l’accumulation de cette densité sur un intervalle d’une certaine largeur que la probabilité prend corps. La densité constitue l’analogue direct de la masse volumique en physique élémentaire : un point géométrique infiniment petit ne possède aucune masse propre, mais une portion d’espace dotée d’un volume fini acquiert une masse mesurable grâce à l’intégration de sa masse volumique.
2. Propriétés mathématiques fondamentales d’une courbe de densité
Pour qu’une fonction mathématique réelle continue puisse prétendre au statut officiel de fonction de densité de probabilité et être graphiquement matérialisée sous forme d’une courbe de densité légitime, elle doit impérativement satisfaire deux contraintes structurelles indérogeables, desquelles découle un ensemble de propriétés géométriques et analytiques fondamentales.
2.1 Principe de non-négativité de la fonction
La première contrainte formelle impose que la fonction de densité, traditionnellement notée f(x), soit supérieure ou égale à zéro pour tout point x situé sur son domaine de définition :
f(x) ≥ 0 pour tout x ∈ ℜ.
Sur le plan géométrique, cette exigence axiomatique dicte que la courbe de densité doit reposer entièrement sur l’axe horizontal des abscisses ou s’élever au-dessus de celui-ci, sans jamais plonger dans la région des ordonnées négatives. Une courbe traversant l’axe des abscisses pour pénétrer le demi-plan inférieur perdrait instantanément toute consistance probabiliste.
L’impossibilité théorique et physique d’une densité négative s’enracine dans la nature même du concept de probabilité. Les axiomes de probabilité fondateurs stipulent qu’une probabilité est une mesure bornée inférieurement par zéro, seuil correspondant à l’événement impossible, et supérieurement par un, seuil de l’événement certain. Si f(x) venait à adopter une valeur négative sur un intervalle donné, le calcul de l’aire sous la courbe sur cette plage produirait une intégrale négative. Cela signifierait qu’un sous-ensemble d’événements posséderait une probabilité inférieure à zéro, ce qui constitue un non-sens ontologique absolu. La non-négativité garantit que l’accumulation probabiliste s’effectue toujours de façon monotone croissante au fur et à mesure que l’on élargit les bornes d’analyse.
Il importe de souligner que le principe de non-négativité n’interdit aucunement à la courbe de densité de toucher l’axe des abscisses. Dans de nombreuses distributions à support borné — telles que la loi uniforme continue sur un intervalle défini ou la loi Bêta —, la fonction de densité s’annule complètement à l’extérieur des limites théoriques du phénomène étudié. La valeur zéro indique simplement l’absence totale de probabilité que la variable se manifeste dans ces régions désertes de l’axe réel.
2.2 L’aire totale sous la courbe égale à 1
La seconde contrainte structurelle, tout aussi primordiale, stipule que l’intégrale de la fonction de densité sur l’ensemble de son domaine — s’étendant théoriquement de l’infini négatif à l’infini positif — doit converger exactement vers l’unité :
∫-∞+∞ f(x) dx = 1.
Cette égalité n’est pas une simple convention d’écriture mathématique, mais la transcription analytique du principe de certitude. L’univers des possibles d’une expérience aléatoire — noté conventionnellement Ω — englobe l’exhaustivité des réalisations envisageables pour la variable X. Par définition, la probabilité que la variable prenne une valeur quelconque située quelque part sur l’axe des réels s’établit à 100 %, soit la valeur numérique 1. L’aire géométrique délimitée par la courbe de densité au sommet, l’axe des abscisses à la base, et s’étendant latéralement jusqu’aux confins des queues de distribution, matérialise l’intégralité de cet espace probabiliste.
Cette condition d’unitarité impose une corrélation morphologique stricte entre la hauteur de la courbe et son étalement horizontal. Puisque l’aire globale demeure invariablement égale à 1, toute modification de la dispersion de la variable entraîne des répercussions géométriques automatiques :
- Si les observations se concentrent massivement autour d’une valeur centrale étroite (faible variance), la courbe de densité doit s’étirer verticalement pour compenser son rétrécissement latéral, propulsant son sommet vers des valeurs de densité élevées.
- Inversement, si les données présentent une dispersion très étendue le long de l’axe des abscisses (forte variance), la courbe doit nécessairement s’affaisser et s’aplatir pour éviter que l’aire cumulée ne dépasse le plafond obligatoire de 1.
C’est précisément cette relation d’invariance d’échelle surfacique qui confère aux courbes de densité leur extraordinaire pouvoir de comparaison : peu importe l’unité de mesure — des millisecondes, des années-lumière, des kilogrammes ou des points à un test standardisé —, l’espace de référence total demeure universellement égal à l’unité.
2.3 Probabilité ponctuelle versus probabilité sur un intervalle
La confrontation entre la mesure ponctuelle et la mesure par intervalle constitue l’un des écueils conceptuels les plus déroutants pour les observateurs néophytes des courbes de densité. Dans un diagramme en bâtons représentant une variable discrète, la hauteur de chaque segment vertical renseigne immédiatement la probabilité exacte associée à la valeur correspondante. Sur une courbe de densité, la tentation est grande de repérer une valeur c sur l’axe horizontal, de remonter verticalement jusqu’à la courbe et de lire sur l’axe des ordonnées la probabilité de cette valeur. Cette démarche procède d’une incompréhension fondamentale du calcul infinitésimal appliqué aux probabilités.
Sur le plan géométrique élémentaire, l’aire d’une figure correspond au produit de ses dimensions. Un point isolé sur l’axe horizontal possède une largeur strictement nulle (dx = 0). Dès lors, la surface géométrique d’un segment vertical érigé au-dessus d’un point unique est égale à sa hauteur multipliée par sa largeur nulle :
Aire = f(c) × 0 = 0.
Il en résulte le théorème fondamental selon lequel, pour toute variable aléatoire continue régie par une densité f, la probabilité d’occurrence d’une valeur exacte prédéterminée est invariablement nulle :
P(X = c) = ∫cc f(x) dx = 0.
Pour qu’une probabilité prenne une valeur numérique non nulle, il faut nécessairement introduire une marge de tolérance, c’est-à-dire définir un intervalle de valeurs compris entre deux bornes réelles distinctes, a et b (avec a < b). La probabilité que la variable se matérialise à l’intérieur de cet intervalle est alors définie par l’intégrale définie de la fonction de densité entre ces bornes :
P(a ≤ X ≤ b) = ∫ab f(x) dx.
Une conséquence remarquable de cette réalité mathématique réside dans l’indifférenciation totale entre les inégalités strictes et les inégalités larges lors du maniement des variables aléatoires continues. Puisque la probabilité attribuée aux points frontières isolés a et b est nulle, leur inclusion ou leur exclusion ne modifie en rien l’aire surfacique calculée sous la courbe :
P(a ≤ X ≤ b) = P(a < X ≤ b) = P(a ≤ X < b) = P(a < X < b).
Cette propriété fluide distingue irrévocablement le calcul des probabilités continues du calcul discret, où l’inclusion d’une modalité limite modifie immédiatement les sommes probabilistes cumulées.
3. De l’histogramme empirique à la courbe de densité continue
Pour véritablement appréhender l’utilité pratique de la courbe de densité, il convient de retracer son cheminement généalogique depuis l’histogramme de données empiriques. L’histogramme représente le point de passage classique de la statistique descriptive, mais ses rigidités intrinsèques justifient le basculement méthodologique vers le lissage continu.
3.1 Limites inhérentes aux représentations par histogrammes
L’histogramme constitue traditionnellement le premier réflexe d’exploration graphique face à une série de données continues. Son principe d’élaboration paraît d’une simplicité désarmante : l’intervalle de variation de la variable est découpé en une succession de classes adjacentes (appelées couramment bins en anglais), puis des rectangles sont dressés au-dessus de chaque classe avec une hauteur proportionnelle au nombre d’observations tombant dans cette tranche. Malgré sa popularité indéniable, cette technique présente des vulnérabilités structurelles majeures qui compromettent régulièrement la robustesse de l’analyse visuelle.
La première faille fondamentale réside dans l’extrême sensibilité de l’histogramme au choix arbitraire du nombre et de la largeur des classes. Si l’on choisit un nombre de classes excessivement restreint (classes trop larges), on assiste à un phénomène de sous-segmentation brutale qui efface impitoyablement les structures réelles de la distribution : deux modes distincts situés à proximité peuvent être fusionnés en une unique masse informe. À l’inverse, si l’on opte pour une largeur de classe excessivement étroite, la structure générale se dilue dans un émiettement chaotique : l’histogramme devient une succession de pics vertigineux et de vallées vides, reflétant le bruit aléatoire d’échantillonnage plutôt que la forme sous-jacente du phénomène.
La seconde limite, tout aussi insidieuse, concerne l’impact du point d’origine ou du décalage des frontières des classes. Pour une même largeur de classe parfaitement identique, le simple fait de translater le seuil initial de quelques fractions d’unités peut redistribuer les observations frontalières d’un casier à l’autre. Cette fluctuation artificielle est susceptible de transformer visuellement une distribution apparaissant unimodale en une forme apparemment bimodalement asymétrique, introduisant des biais subjectifs majeurs dans l’interprétation du chercheur. Enfin, l’histogramme impose une discontinuité géométrique artificielle (des marches d’escalier en falaise) à des processus physiques ou psychologiques qui se déroulent dans une parfaite continuité substantielle.
3.2 Processus de normalisation des fréquences relatives
Pour établir une passerelle rigoureuse entre l’histogramme brut et la courbe de densité mathématique, il est impératif de soumettre la représentation par barres à un processus de normalisation surfacique standardisé. Dans un histogramme de comptage conventionnel, l’axe vertical affiche des effectifs absolus (counts). Si l’on calcule la surface totale de l’ensemble des rectangles composant le graphique en multipliant la largeur de chaque classe par son effectif, la somme globale obtenue équivaut à la taille de l’échantillon multipliée par la largeur de classe, une valeur dépourvue d’interprétation probabiliste immédiate.
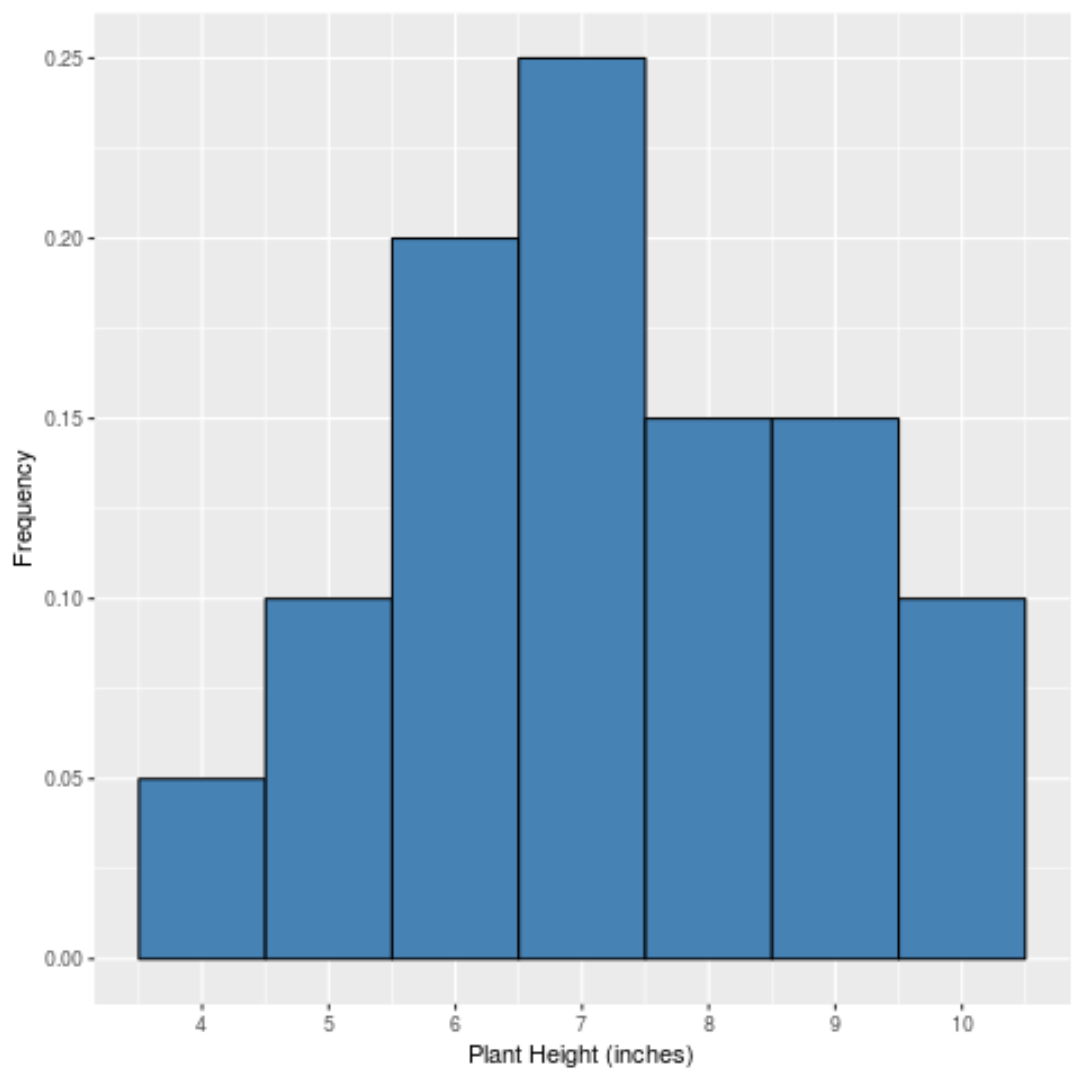
L’étape de normalisation préliminaire consiste à substituer aux effectifs absolus des fréquences relatives, obtenues en divisant le nombre d’observations de chaque classe par la taille totale de l’échantillon n. Cette modification permet de s’affranchir de la taille d’échantillon, mais la somme des aires des rectangles demeure dépendante de la largeur arbitraire choisie pour les intervalles. L’étape décisive de normalisation complète nécessite donc de recalculer la hauteur de chaque rectangle en définissant une nouvelle grandeur : la densité empirique.
Cette densité empirique s’obtient en divisant la fréquence relative de chaque classe par la largeur de celle-ci :
Hauteur du rectangle = (Fréquence relative de la classe) / (Largeur de la classe).
Grâce à cette opération de redimensionnement arithmétique, l’aire géométrique de chaque rectangle individuel devient rigoureusement identique à la proportion d’observations logées dans la classe correspondante :
Aire du rectangle = (Hauteur) × (Largeur) = [(Fréquence relative) / (Largeur)] × Largeur = Fréquence relative.
Puisque la somme de toutes les fréquences relatives d’une distribution statistique équivaut obligatoirement à 1 (soit 100 % de l’échantillon), la somme des surfaces de tous les rectangles de l’histogramme normalisé converge parfaitement vers l’unité. Dès cet instant, l’histogramme normalisé satisfait la seconde propriété fondamentale d’une courbe de densité : son aire globale est unitaire. Il offre un socle géométrique direct sur lequel la courbe continue peut désormais venir s’ajuster avec une cohérence mathématique parfaite.
3.3 Lissage continu et fonction de densité de probabilité (PDF)
Une fois l’histogramme normalisé érigé, la transition vers la courbe de densité s’opère par le biais d’une démarche d’abstraction et de lissage mathématique. L’objectif fondamental consiste à interpoler la surface discrète et crénelée de l’histogramme par une fonction continue différentiable, éliminant les décrochements arbitraires propres au découpage en classes pour révéler l’épure de la distribution.
D’un point de vue asymptotique, imaginons une expérience de pensée dans laquelle la taille de l’échantillon collecté s’accroît indéfiniment vers l’infini (n → ∞). À mesure que les observations affluent, il devient possible de réduire progressivement la largeur de chaque classe sans que les rectangles ne se vident de leurs données. Lorsque la largeur de classe tend vers une quantité infinitésimale (dx → 0) tandis que le nombre d’observations tend vers l’infini, les marches d’escalier de l’histogramme normalisé s’estompent, s’amenuisent et fusionnent dans un mouvement de convergence continue vers une trajectoire lisse : la véritable fonction de densité de probabilité de la population.
Dans la pratique scientifique courante, où la taille de l’échantillon demeure inévitablement finie et restreinte, la courbe de densité ne peut être observée dans sa perfection asymptotique. Elle doit être estimée. Elle intervient alors comme un modèle idéalisé de la réalité observée. En traçant cette courbe, le statisticien postule que les irrégularités locales observées sur l’histogramme ne constituent que des bruits de mesure contingents et sans signification théorique profonde. La courbe continue filtre ce bruit d’échantillonnage pour ne conserver que le signal distributionnel robuste, offrant une abstraction mathématique maniable, élégante et propice au développement de calculs déductifs rigoureux.
4. Interprétation visuelle de la forme et de la symétrie
L’immense valeur heuristique d’une courbe de densité réside dans sa lisibilité morphologique. Une analyse attentive de la géométrie de son tracé permet de poser un diagnostic immédiat sur les processus sous-jacents gouvernant la genèse des données. Quatre dimensions formelles méritent un examen approfondi : la modalité, l’asymétrie positive, l’asymétrie négative et le comportement d’aplatissement des queues de distribution.
4.1 Unimodalité, bimodalité et multimodalité
La première caractéristique topologique observée sur une courbe de densité concerne le dénombrement de ses sommets ou points culminants locaux, désignés sous le terme de modes. Le profil le plus couramment rencontré dans les processus homogènes est celui de l’unimodalité. Une distribution unimodale présente une bosse prédominante unique, indiquant que les données convergent massivement vers un point central privilégié avant de décroître de façon monotone au fur et à mesure que l’on s’écarte de cette zone de haute densité. De nombreux phénomènes physiques, biologiques et biométriques — tels que la pression artérielle au repos dans une cohorte homogène de jeunes adultes sains — adoptent spontanément une forme unimodale.
À l’opposé, l’apparition de deux sommets distincts séquestrés par une dépression intermédiaire caractérise une distribution bimodale. Sur le plan théorique, la bimodalité signale quasi systématiquement que l’échantillon analysé n’est pas homogène, mais qu’il résulte de l’agrégation non discriminée de deux sous-populations aux caractéristiques divergentes. Si l’on trace la courbe de densité de la masse corporelle au sein d’une population mixte d’adultes sans stratifier par sexe biologique, la superposition des distributions masculine et féminine génère fréquemment une morphologie à deux bosses distinctes.
Lorsque la courbe déploie trois pics ou davantage, elle est qualifiée de multimodale. Ce type de profil traduit un mélange complexe de processus générateurs ou l’influence de facteurs de stratification catégoriels non contrôlés au moment du recueil des données. Ignorer une structure multimodale sur une courbe de densité constitue une faute méthodologique majeure : appliquer des indicateurs globaux comme la moyenne arithmétique ou ajuster une régression linéaire simple sur de telles données revient à masquer la réalité de sous-groupes structurellement distincts, conduisant à des inférences statistiques fallacieuses.
4.2 Asymétrie positive ou étalement vers la droite
Une courbe de densité est dite présenter une asymétrie positive (ou étalement vers la droite, right-skewed en anglais) lorsque sa morphologie générale déploie une queue allongée s’étirant vers les valeurs supérieures de l’axe des abscisses, tandis que la masse dominante des observations se trouve concentrée dans la portion inférieure à moyenne de l’échelle de mesure. Graphiquement, la pente s’élève abruptement depuis l’origine pour former un sommet resserré à gauche, puis redescend beaucoup plus progressivement vers la droite dans une longue déclivité étirée.
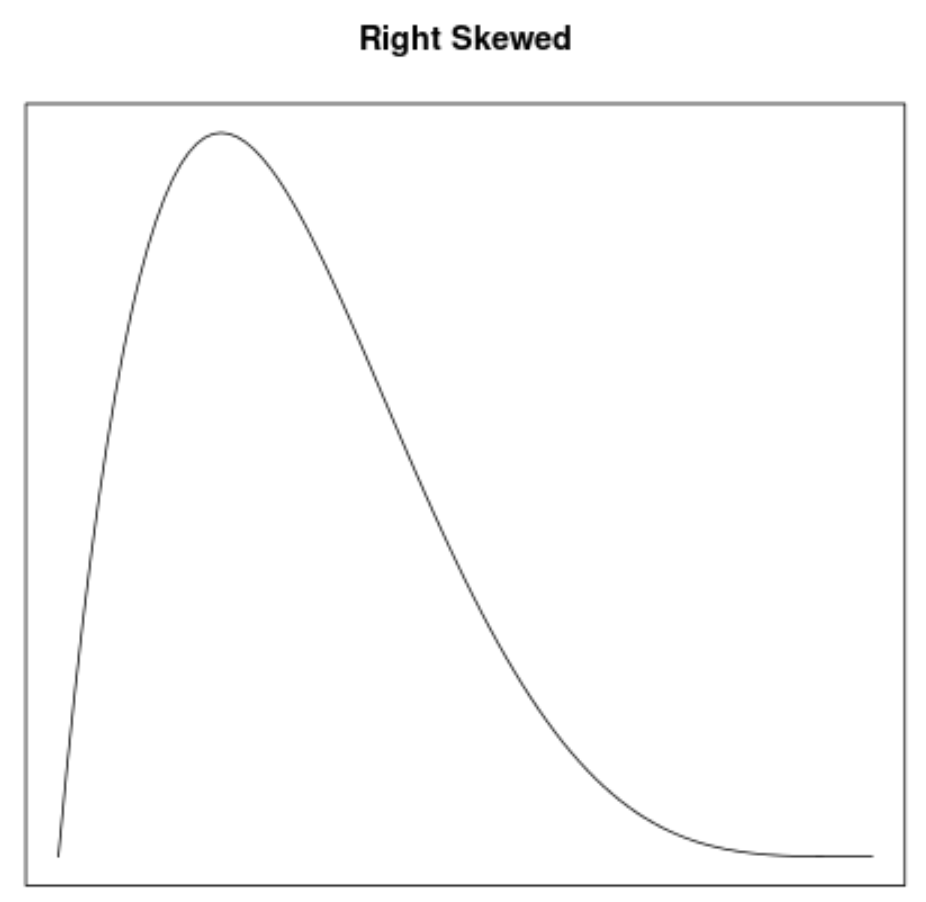
Ce patron distributionnel est omniprésent dans les sciences sociales, l’économie et la psychométrie chronométrique. L’exemple archétypal est fourni par la distribution des revenus financiers : l’immense majorité des salariés perçoit des rémunérations regroupées dans une fourchette modeste à médiane, alors qu’une infime proportion d’individus accumule des revenus monumentaux. Ces valeurs extravagantes ne forment pas un groupe séparé, mais étirent le tracé de la courbe de densité vers l’extrême droite le long d’une traînée asymptotique.
L’asymétrie positive exerce un effet mécanique puissant sur les propriétés statistiques globales de la distribution. Les observations atypiquement élevées logées dans la queue droite agissent comme un levier gravitationnel sur les paramètres statistiques sensibles aux extrêmes. En analysant visuellement une courbe étalée vers la droite, l’analyste sait immédiatement que les hypothèses classiques de normalité symétrique sont violées, imposant soit l’utilisation d’outils statistiques résistants, soit l’application de transformations mathématiques non linéaires — telles que la transformation logarithmique — pour compresser la queue droite et restaurer une allure symétrique exploitable.
4.3 Asymétrie négative ou étalement vers la gauche
La situation symétrique inverse est désignée sous le terme d’asymétrie négative (ou étalement vers la gauche, left-skewed). Dans cette configuration, la courbe de densité présente une morphologie caractérisée par une longue queue s’étirant vers les valeurs minimales de l’échelle, alors que la grande majorité des observations s’agglomère densément à l’extrémité supérieure du spectre de mesure. Le pic principal trône à droite du graphique, précédé par une longue pente ascendante douce venue des profondeurs de la gauche.
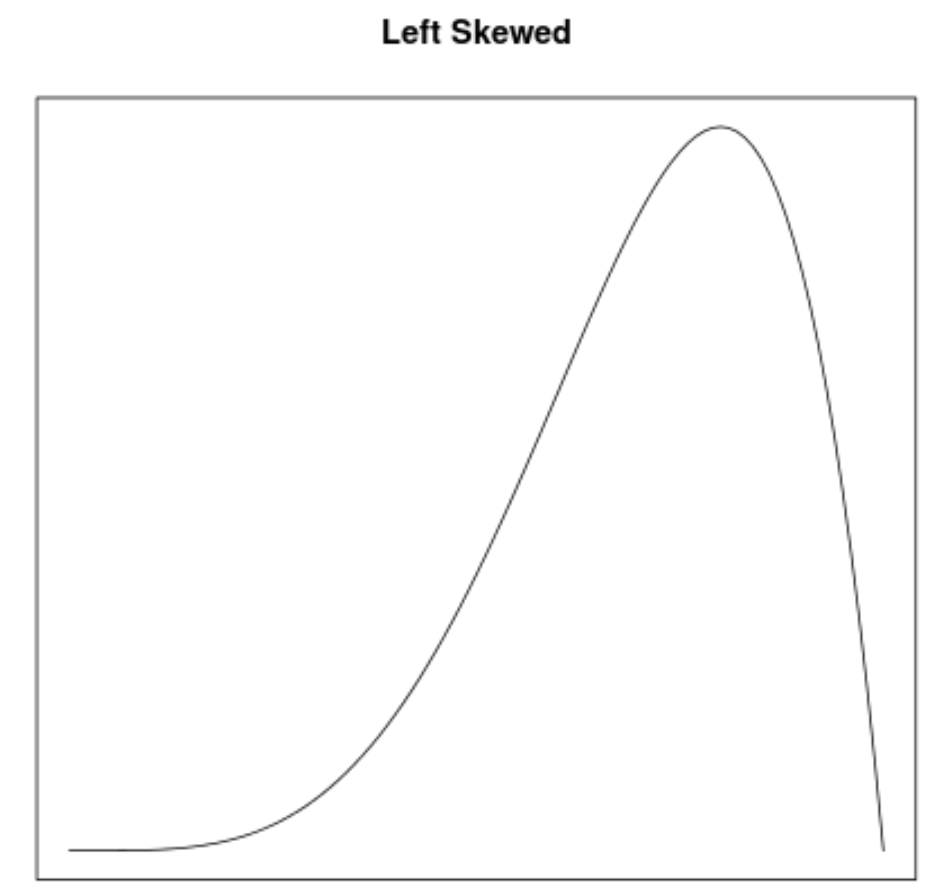
Cette configuration émerge typiquement en présence de phénomènes régis par un seuil d’achèvement ou un effet plafond structurel. En psychologie du développement ou en docimologie académique, les scores obtenus à un examen standardisé conçu avec des questions excessivement faciles génèrent une courbe de densité étalée vers la gauche : la masse écrasante des étudiants atteint des notes proches du score maximal théorique (effet plafond), tandis que seule une poignée d’étudiants en grande difficulté forme une queue résiduelle s’étirant vers le zéro.
L’asymétrie négative s’observe également de façon emblématique dans la modélisation de la durée de vie humaine au sein des pays développés disposant d’infrastructures sanitaires avancées. La mortalité frappe préférentiellement les individus aux âges très avancés, concentrant la densité des décès entre soixante-dix et quatre-vingt-dix ans. Les décès survenus prématurément au cours de l’enfance ou de la jeunesse, devenus rarissimes, forment une queue résiduelle longue et effilée vers les faibles âges le long du tracé de densité.
4.4 Aplatissement et comportement des queues (Kurtosis)
Au-delà du degré de symétrie, l’allure d’une courbe de densité se distingue par son degré d’aplatissement et le comportement relatif de ses queues, une propriété formellement quantifiée par le concept d’aplatissement statistique (Kurtosis). Cette dimension descriptive permet d’évaluer la propension d’une distribution à concentrer sa probabilité soit dans son centre, soit dans ses flancs intermédiaires, soit au fin fond de ses queues extrêmes.
La taxonomie statistique classique distingue trois grands régimes d’aplatissement :
- Les distributions mésocurtiques : Elles adoptent pour référence la courbe normale standard. Leurs queues décroissent à un rythme exponentiel quadratique tempéré, offrant un équilibre canonique entre la hauteur du pic central et l’épaisseur des queues.
- Les distributions leptocurtiques : Elles se caractérisent visuellement par un pic central très aigu et effilé, flanqué d’épaulements amincis mais — point capital — de queues de distribution remarquablement épaisses et lourdes (fat tails). Ces queues chargées indiquent une probabilité anormalement élevée d’observer des valeurs extrêmes ou aberrantes par rapport à ce que prédirait une loi normale. Les rendements boursiers constituent un exemple universellement documenté de courbes leptocurtiques.
- Les distributions platicurtiques : À l’inverse, ces courbes affichent un profil tronqué, émoussé, parfois aplati en plateau, assorti de queues de distribution particulièrement fines et fuyantes qui se tarissent rapidement. Les événements extrêmes y sont considérablement plus rares que dans un cadre gaussien. La distribution uniforme représente l’incarnation extrême de ce profil.
L’épaisseur visuelle des queues sur une courbe de densité revêt une importance vitale pour l’évaluation des risques opérationnels. Dans les systèmes complexes, ignorer le caractère leptocurtique d’une courbe de densité en lui substituant indûment un modèle normal conduit à sous-estimer dramatiquement la fréquence de survenue de chocs systémiques cataclysmiques (le fameux phénomène des « cygnes noirs » formalisé par Nassim Nicholas Taleb).
5. Localisation des mesures de tendance centrale
L’un des apports pédagogiques et méthodologiques majeurs de la courbe de densité réside dans sa capacité à rendre palpable l’ordonnancement spatial des paramètres fondamentaux de tendance centrale. Selon que la courbe est parfaitement symétrique ou déformée par une asymétrie latérale, le mode, la médiane et la moyenne arithmétique adoptent des positions géométriques rigoureusement hiérarchisées.
5.1 Le mode comme point culminant de la densité
Dans l’univers géométrique de la courbe de densité, la détermination du mode s’opère par une lecture purement visuelle et directe. Le mode correspond à la valeur sur l’axe horizontal des abscisses qui soutient le sommet le plus élevé du graphique. Sur le plan de l’analyse fonctionnelle, il s’agit de la valeur xmode pour laquelle la dérivée première de la fonction de densité s’annule en changeant de signe du positif vers le négatif :
f'(xmode) = 0 et f »(xmode) < 0.
Le mode représente ainsi la valeur localement la plus probable, celle qui affiche la plus haute concentration probabiliste unitaire immédiate. Son caractère est strictement local : il est défini par le comportement de la fonction dans le voisinage infinitésimal de son pic, restant remarquablement insensible aux dynamiques distantes se produisant à l’autre extrémité de la distribution. Même si une queue s’étire sur des milliers d’unités de distance, l’abscisse du sommet demeure impassiblement immobile.
Dans les distributions multimodales, chaque sommet distinct est considéré comme un mode local. Toutefois, le mode absolu (ou majeur) correspond au pic qui s’élève au niveau le plus haut de l’axe des ordonnées. La détection du mode constitue la première étape de repérage topographique pour caractériser le pôle d’attraction primordial des données.
5.2 La médiane comme ligne de partage équiprobable
La médiane (notée xmed ou M) répond à une définition géométrique d’une remarquable simplicité volumétrique : elle correspond à la droite verticale qui scinde l’aire totale située sous la courbe de densité en deux parties rigoureusement égales. Puisque l’aire globale totale sous une courbe normalisée équivaut précisément à 1, la médiane représente la ligne de démarcation délimitant exactement une surface de 0,5 à sa gauche et une surface de 0,5 à sa droite :
∫-∞xmed f(x) dx = 0,5 et ∫xmed+∞ f(x) dx = 0,5.
Cette définition surfacique confère à la médiane une puissante propriété de robustesse. Parce qu’elle ne dépend que du décompte cumulé de l’aire et non de la distance métrique séparant les valeurs extrêmes du centre, la médiane demeure pratiquement insensible à l’étirement infini d’une queue de distribution. Si l’on déplace la valeur maximale observée d’un échantillon à des millions de kilomètres vers la droite, l’aire cumulée sous la courbe ne change pas de morphologie centrale : la médiane ne bouge pas d’un iota.
Cette imperméabilité aux variations extrêmes fait de la médiane l’indicateur d’élection de la tendance centrale dès lors que la courbe de densité révèle une asymétrie marquée ou la présence de valeurs aberrantes susceptibles de fausser les synthèses descriptives.
5.3 La moyenne comme centre de gravité physique
La moyenne théorique (notée μ ou E[X]) possède une interprétation mécanique concrète qui illumine sa fonction dans l’espace statistique. Si l’on découpait dans une plaque de métal ou de carton d’épaisseur parfaitement uniforme la silhouette dessinée par la courbe de densité, la moyenne correspondrait très exactement au point d’appui unique sur lequel cette silhouette tiendrait en équilibre physique parfait sans basculer d’un côté ni de l’autre. Elle est le centre de gravité géométrique de la distribution :
μ = E[X] = ∫-∞+∞ x × f(x) dx.
Dans cette formulation intégrale, chaque valeur possible de l’abscisse x est pondérée par sa densité respective f(x). Cela signifie que la moyenne se comporte comme un levier mécanique : une masse de densité située très loin du centre exerce un bras de levier proportionnel à sa distance métrique par rapport à l’origine. En conséquence, la moyenne fait preuve d’une extrême vulnérabilité face aux étirements morphologiques.
Dès lors qu’une courbe de densité commence à déployer une longue queue latérale, la moyenne se détache mécaniquement du groupe dominant pour migrer dans le sens de l’étirement afin de contrebalancer le couple généré par ces valeurs périphériques éloignées. Cette sensibilité mécanique explique pourquoi la moyenne peut parfois s’établir dans une région où la densité de la courbe est devenue très faible, cessant de représenter fidèlement le cas typique de la population étudiée.
5.4 Relations spatiales relatives selon le degré d’asymétrie
La confrontation géométrique de ces trois mesures permet de dresser une cartographie spatiale immuable qui renseigne instantanément sur le degré et la direction de l’asymétrie distributionnelle sans qu’il soit nécessaire d’effectuer le moindre calcul algébrique complexe.
Dans le cas théorique idéal d’une courbe parfaitement symétrique et unimodale (telle que la distribution normale standard), le centre de symétrie concentre simultanément tous les équilibres. Le sommet maximal coïncide avec la droite de partage équiprobable et le centre de gravité physique :
Mode = Médiane = Moyenne.
Dans le cas d’une distribution présentant une asymétrie positive prononcée (étalée vers la droite), la queue étirée vers les hautes valeurs tire le centre de gravité gravitationnel loin vers la droite. La médiane, quant à elle, résiste mieux et ne glisse que modérément vers la droite pour préserver l’équipartition des aires de 0,5, tandis que le mode demeure ancré sur le pic culminant initial à gauche. L’ordre hiérarchique spatial s’établit donc invariablement de la gauche vers la droite comme suit :
Mode < Médiane < Moyenne.
À l’inverse, dans le cadre d’une distribution affectée par une asymétrie négative (étalée vers la gauche), c’est la queue gauche qui attire mécaniquement la moyenne vers les faibles valeurs, suivie par la médiane qui s’incline légèrement, laissant le mode isolé au faîte de sa colline à droite. L’ordre spatial s’inverse rigoureusement :
Moyenne < Médiane < Mode.
Cette hiérarchie spatiale fournit aux chercheurs une heuristique visuelle d’une efficacité redoutable : il suffit d’observer l’écartement relatif de ces trois balises centrales pour poser un diagnostic instantané sur la distorsion morphologique de la population sous-jacente.
6. Calcul des probabilités et aire sous la courbe
La raison d’être fondamentale de la courbe de densité ne se cantonne pas à l’ornementation visuelle des rapports statistiques ; elle réside dans sa capacité opératoire à convertir une géométrie continue en probabilités exploitables. Cette section détaille les articulations analytiques reliant la courbe à son intégrale cumulative.
6.1 Intégration mathématique et calcul géométrique
Comme nous l’avons théoriquement établi, le calcul de la probabilité qu’une variable continue X prenne une valeur comprise entre deux limites données a et b s’incarne géométriquement par la mesure de la surface délimitée par la courbe de densité supérieurement, l’axe horizontal inférieurement, et les segments verticaux x = a et x = b latéralement. Sur le plan formel, cette surface se quantifie au moyen de l’intégrale de Riemann de la fonction de densité :
P(a ≤ X ≤ b) = ∫ab f(x) dx.
Il existe une correspondance rigoureuse entre la fraction d’aire obtenue par cette intégrale et la fréquence relative attendue du phénomène : si la surface hachurée sous la courbe entre 10 et 15 unités représente 25 % de l’aire totale unitaire sous la courbe, la probabilité théorique qu’une observation future sélectionnée au hasard tombe dans cette plage s’élève rigoureusement à 0,25.
Dans la pratique analytique, le calcul de cette intégrale se heurte fréquemment à un obstacle mathématique majeur. Pour de nombreuses distributions continues fondamentales — à commencer par la distribution normale gaussienne —, la fonction de densité f(x) ne possède pas de primitive analytique pouvant s’exprimer sous forme d’une combinaison close de fonctions élémentaires. Il s’avère rigoureusement impossible d’intégrer symboliquement la fonction en employant de simples formules algébriques. Pour contourner cette impasse, les statisticiens ont historiquement eu recours à des tables numériques précalculées d’intégration par séries entières, relayées aujourd’hui par des algorithmes d’approximation numérique haute précision (quadrature de Gauss-Legendre, méthodes de Simpson ou intégration de Monte-Carlo).
6.2 Intervalles spécifiques et quantiles remarquables
L’utilisation de la courbe de densité permet d’isoler des portions d’espace probabiliste calibrées pour répondre à des interrogations pratiques précises, notamment au moyen des quantiles. Un quantile d’ordre p (où 0 ≤ p ≤ 1) représente l’abscisse xp pour laquelle la surface accumulée sous la courbe depuis l’extrême gauche jusqu’à ce seuil équivaut exactement à la proportion p de l’aire totale :
∫-∞xp f(x) dx = p.
Certains quantiles jouent un rôle cardinal dans l’organisation de l’analyse exploratoire :
- Les quartiles : Le premier quartile (Q1 ou 25e percentile) délimite la tranche inférieure d’un quart de l’aire totale. Le troisième quartile (Q3 ou 75e percentile) marque le seuil en dessous duquel se logent trois quarts de la distribution probabiliste. L’intervalle séparant ces deux bornes, désigné sous le nom d’écart interquartile (IQR = Q3 – Q1), matérialise directement sur l’axe horizontal la largeur du couloir concentrant les 50 % centraux de la population étudiée.
- Les seuils critiques d’inférence : Dans le cadre des tests d’hypothèses statistiques, les analystes découpent souvent des zones d’exclusion situées dans les queues marginales de la courbe. Par exemple, pour un risque d’erreur consenti α de 5 % dans un test bilatéral, on découpe géométriquement deux aires de 2,5 % (soit 0,025 chacune) à chaque extrémité de la courbe de densité. Les valeurs de l’abscisse isolant ces surfaces circonscrivent les régions de rejet de l’hypothèse nulle.
La manipulation géométrique des quantiles transforme ainsi la courbe de densité en une règle graduée probabiliste, capable d’indiquer avec une précision absolue la rareté ou la banalité d’une mesure observée.
6.3 Lien structurel avec la fonction de répartition cumulative (CDF)
La courbe de densité ne saurait être pleinement comprise sans expliciter son articulation intime avec une autre fonction maîtresse du calcul probabiliste : la fonction de répartition cumulative (notée conventionnellement F(x) ou CDF, pour Cumulative Distribution Function). La fonction de répartition exprime la probabilité cumulée que la variable aléatoire prenne une valeur inférieure ou égale à un point x déterminé :
F(x) = P(X ≤ x) = ∫-∞x f(t) dt.
Sur le plan géométrique, tandis que la courbe de densité f(t) trace une trajectoire de hauteur qui monte et redescend au gré de la concentration locale des données, la fonction de répartition F(x) affiche une morphologie invariablement monotone croissante en forme de « S » (sigmoïde). Elle part asymptotiquement de la valeur 0 à l’extrême gauche (−∞) pour s’élever progressivement et plafonner asymptotiquement à la valeur 1 à l’extrême droite (+∞).
En vertu du théorème fondamental de l’analyse, si la fonction de densité f(x) est continue, elle s’avère être la dérivée formelle directe de la fonction de répartition :
f(x) = dF(x) / dx = F'(x).
Cette correspondance déploie une double lecture géométrique spectaculaire :
- La hauteur de la courbe de densité en n’importe quel point de l’abscisse correspond très exactement à la pente locale (le taux de croissance instantané) de la fonction de répartition cumulative au même point.
- Dans les régions centrales où la courbe de densité forme son pic le plus volumineux, la pente de la courbe de répartition cumulative s’avère la plus abrupte et vertigineuse, traduisant une accumulation probabiliste fulgurante.
- Dans les queues effilées de la courbe de densité où le tracé s’écrase contre l’axe des abscisses, la fonction cumulative s’aplatit horizontalement, son élévation devenant quasi imperceptible.
La courbe de densité se révèle donc être l’expression différentielle instantanée de la trajectoire cumulative globale d’une variable.
7. La courbe normale : archétype de la courbe de densité
Bien qu’il existe une infinité de configurations morphologiques pour les courbes de densité, une forme particulière s’est hissée au panthéon de la statistique jusqu’à dominer l’imaginaire scientifique universel : la courbe normale, ou courbe de Gauss-Laplace. Elle représente l’archétype par excellence de la densité continue symétrique unimodale.
7.1 Architecture mathématique de la courbe de Gauss
L’expression analytique de la fonction de densité de la loi normale, formalisée indépendamment par Abraham de Moivre, Carl Friedrich Gauss et Pierre-Simon de Laplace, s’énonce selon une élégance mathématique redoutable :
f(x) = (1 / [σ √(2π)]) × exp(- ½ [(x – μ) / σ]2).
Cette fonction ne dépend que de deux constantes transcendantes fondamentales (le nombre d’Archimède π et la base népérienne e) et de deux paramètres statistiques définis sur la population :
- Le paramètre de localisation μ (moyenne de la population), qui ancre le centre de la courbe sur l’axe horizontal et gouverne la position de son sommet symétrique absolu.
- Le paramètre de dispersion σ (écart-type de la population), qui régit l’étalement horizontal et commande mécaniquement la hauteur du pic pour garantir le maintien de l’aire unitaire.
La morphologie de la courbe normale dessine sa célèbre silhouette « en cloche » parfaitement symétrique autour de son axe vertical central situé en x = μ. Une caractéristique géométrique d’une importance capitale réside dans la localisation précise de ses deux points d’inflexion — c’est-à-dire les deux points précis où la concavité de la courbe bascule d’une courbure orientée vers le bas (forme concave de dôme) à une courbure orientée vers le haut (forme convexe s’évasant vers l’asymptote). Ces deux points d’inflexion se situent rigoureusement à une distance d’un écart-type de part et d’autre de la moyenne :
Points d’inflexion : x = μ – σ et x = μ + σ.
Cette propriété géométrique confère à l’écart-type une matérialité visuelle directe sur le tracé de densité gaussien : il s’agit littéralement de la demi-largeur de la cloche mesurée au niveau de son changement de courbure.
7.2 La règle empirique 68-95-99,7
En raison de l’invariance mathématique de la formule gaussienne par changement d’échelle, l’intégration de la courbe de densité normale déploie une répartition surfacique constante bien connue sous l’appellation de règle empirique des trois sigmas (ou règle 68-95-99,7). Cette partition géométrique dicte les proportions probabilistes logées dans des couloirs symétriques multiples de l’écart-type :
- L’intervalle [μ – σ, μ + σ] : La surface sous la courbe délimitée entre un écart-type en dessous de la moyenne et un écart-type au-dessus concentre exactement 68,27 % de l’aire totale unitaire. Plus des deux tiers de la population se nichent donc dans cet espace circonscrit par les points d’inflexion.
- L’intervalle [μ – 2σ, μ + 2σ] : Dès que l’on élargit le couloir d’intégration à une distance de deux écarts-types de part et d’autre du centre, la surface cumulée englobe 95,45 % de la probabilité globale. Les observations situées en dehors de cette bande ne représentent qu’environ une occurrence sur vingt.
- L’intervalle [μ – 3σ, μ + 3σ] : En poussant les frontières à trois écarts-types autour de la moyenne, la courbe normale capte une proportion titanesque de 99,73 % de l’espace probabiliste total. Moins de 0,3 % de la population théorique réside au-delà de ces frontières (soit environ une observation sur 370).
Cette régularité surfacique transforme la courbe de densité normale en un détecteur d’anomalies opérationnel extrêmement performant. Dès lors qu’une observation empirique se détache à plus de trois écarts-types du centre sur une variable réputée gaussienne, le chercheur sait avec une certitude quasi absolue qu’il se trouve en présence d’une valeur atypique majeure (outlier), traduisant soit une erreur de mesure instrumentale, soit l’expression d’un phénomène biologique ou comportemental exceptionnel.
7.3 Standardisation et courbe normale centrée réduite
Afin de manipuler les probabilités associées à des variables normales sans avoir à réinventer le calibrage pour chaque couple singulier (μ, σ), la statistique théorique recourt au processus d’isomorphisme de standardisation. Cette manipulation repose sur la transformation affine dite « transformation Z » :
Z = (X – μ) / σ.
Cette opération arithmétique déploie une double action géométrique sur la courbe de densité d’origine :
- La soustraction de la moyenne (− μ) effectue une translation rigide de l’ensemble de la courbe le long de l’axe horizontal, recalant son sommet central exactement sur l’origine zéro de l’axe des abscisses (la courbe est désormais centrée).
- La division subséquente par l’écart-type (/ σ) applique une compression ou une dilatation d’échelle horizontale qui normalise la dispersion de la cloche, imposant un écart-type universellement égal à 1 (la courbe est désormais réduite).
La fonction de densité résultante — notée conventionnellement φ(z) — définit la courbe normale centrée réduite N(0, 1) :
φ(z) = (1 / √(2π)) × exp(- ½ z2).
L’immense mérite pratique de cette transformation réside dans son universalité. Une seule et unique table mathématique (ou un sous-programme algorithmique élémentaire) suffit pour calculer n’importe quelle aire sous n’importe quelle courbe normale imaginable. Qu’il s’agisse d’évaluer le diamètre d’arbres séculaires mesuré en dizaines de mètres ou le diamètre de nanostructures mesuré en nanomètres, la conversion préalable des unités brutes en scores Z permet d’utiliser le même tracé de densité archétypal, autorisant des comparaisons directes d’échelles de mesures intrinsèquement hétérogènes.
8. Courbes de densité non normales courantes
L’omniprésence pédagogique de la courbe normale ne doit pas occulter une réalité fondamentale : le monde réel déploie fréquemment des processus physiques, économiques ou cognitifs qui violent structurellement les prémisses de la symétrie gaussienne. Le tableau des sciences statistiques s’enrichit dès lors d’une constellation de courbes de densité non normales aux morphologies hautement spécialisées.
8.1 La distribution log-normale et les dynamiques multiplicatives
Alors que la courbe normale émerge naturellement de processus régis par l’addition de perturbations stochastiques indépendantes et modérées (en vertu de la dynamique du Théorème Central Limite), la courbe de densité log-normale surgit spontanément dans les systèmes gouvernés par des forces multiplicatives indépendantes. Une variable aléatoire X est dite log-normale si son logarithme népérien suit une loi normale classique :
ln(X) ~ N(μ, σ2).
La morphologie de la courbe de densité log-normale présente une identité visuelle immédiatement reconnaissable. Puisque la fonction exponentielle ne peut produire de résultat négatif, la courbe log-normale possède une borne inférieure stricte à zéro :
f(x) = 0 pour tout x ≤ 0.
Le tracé s’élève brutalement au-dessus de zéro, franchit rapidement un pic modal étroit situé dans la partie basse du spectre, puis développe une longue queue d’asymétrie positive qui s’étire vers les valeurs infiniment grandes.
Cette courbe constitue le modèle universel de description des phénomènes qui ne peuvent adopter de valeurs négatives mais qui sont susceptibles d’exploser ponctuellement par rétroaction multiplicative : la taille des dépôts minéraux souterrains, le volume des flux financiers circulant sur les marchés boursiers, la durée de survie d’équipements sous contrainte mécanique, ou encore les temps de latence verbale en neurosciences. L’avantage analytique de ce modèle réside dans sa réversibilité : il suffit d’appliquer une transformation logarithmique aux données empiriques brutes pour métamorphoser instantanément la courbe log-normale asymétrique en une cloche gaussienne symétrique parfaitement maniable.
8.2 La distribution de Student et la distribution Gamma
Parmi les courbes de densité qui partagent avec la loi normale une morphologie symétrique et unimodale, la courbe de distribution t de Student occupe une place méthodologique prépondérante. Élaborée par William Sealy Gosset (sous le pseudonyme de « Student »), cette courbe présente visuellement l’aspect d’une cloche centrée sur zéro, mais elle s’en distingue par un aplatissement plus marqué de son pic central et — surtout — par des queues de distribution substantiellement plus épaisses.
L’architecture de la courbe de Student est gouvernée par un paramètre unique : les degrés de liberté (notés k ou df). Ce paramètre reflète directement la taille de l’échantillon utilisé pour estimer l’écart-type inconnu d’une population normale :
- Lorsque le nombre de degrés de liberté est très faible (par exemple df = 3 ou df = 4), les queues de la courbe de densité de Student demeurent volumineuses, traduisant graphiquement la grande incertitude introduite par l’échantillonnage de petite taille et la probabilité accrue d’observer des écarts extrêmes.
- Au fur et à mesure que les degrés de liberté s’accroissent (df → ∞), les queues s’amincissent, le sommet se redresse et la courbe de densité de Student converge asymptotiquement jusqu’à se superposer de façon indiscernable sur la courbe normale unitaire standard.
Dans un registre totalement asymétrique, la distribution Gamma fournit une famille de courbes de densité continues d’une flexibilité morphologique remarquable, définies sur l’espace des réels positifs. Dotée d’un paramètre de forme (k ou α) et d’un paramètre d’échelle (θ ou β), la courbe Gamma est capable de se métamorphoser : elle peut dessiner une pente décroissante purement exponentielle, s’arquer en une courbe asymétrique positive semblable à la log-normale, ou s’arrondir progressivement jusqu’à mimer une cloche quasi gaussienne lorsque son paramètre de forme devient très grand. Elle s’impose comme le modèle d’élection pour l’analyse des durées de survie, des temps de traitement cognitif et des intervalles temporels entre flux d’événements complexes.
8.3 Distributions uniformes et exponentielles
Pour parachever ce tour d’horizon des morphologies distributionnelles, il convient d’aborder deux formes élémentaires qui rompent délibérément avec le schéma classique de la silhouette en cloche : la courbe uniforme et la courbe exponentielle.
La distribution uniforme continue (ou loi rectangulaire) matérialise l’impartialité probabiliste absolue sur un intervalle borné [a, b]. Sa fonction de densité est rigoureusement constante sur tout l’intervalle :
f(x) = 1 / (b – a) pour a ≤ x ≤ b, et f(x) = 0 ailleurs.
Sur le plan géométrique, sa courbe de densité ne dessine ni dôme ni cloche : elle forme un rectangle horizontal parfait soutenu par deux tombées verticales abruptes en a et b. L’aire surfacique sous ce rectangle — donnée par sa hauteur 1 / (b – a) multipliée par sa largeur (b – a) — égale exactement 1. Chaque sous-intervalle d’une largeur donnée possède une probabilité strictement identique d’advenir, modélisant l’état d’entropie maximale et d’incertitude totale dans les bornes autorisées.
La distribution exponentielle, quant à elle, incarne la modélisation mathématique du temps séparant des occurrences successives au sein d’un processus de Poisson sans mémoire. Sa courbe de densité prend son départ maximal au niveau de l’origine (ou d’un seuil minimum) pour s’effondrer ensuite selon une décroissance continue exponentiellement abrupte :
f(x) = λ exp(-λ x) pour x ≥ 0.
Sa morphologie ne comporte aucun sommet isolé : son point culminant est irrémédiablement rivé à l’abscisse zéro (x = 0). Cette courbe se caractérise par une asymétrie positive radicale et une décroissance continue, illustrant des dynamiques de décroissance radioactive, de durée d’attente à un guichet de service ou de délai d’apparition de pannes mécaniques dans des composants industriels dépourvus de vieillissement structurel.
9. Méthodes d’estimation de la densité par noyau (KDE)
Lorsque les données empiriques recueillies sur le terrain ne s’accommodent manifestement d’aucune loi paramétrique classique théorisée (normale, log-normale, gamma, etc.), comment construire une courbe de densité continue rigoureuse qui épouse la vérité du terrain sans imposer de présupposé arbitraire ? C’est précisément pour relever ce défi épistémologique qu’a été développée l’estimation de la densité par noyau (désignée par l’acronyme KDE, pour Kernel Density Estimation).
9.1 Fondements de l’approche non-paramétrique
L’estimation par noyau s’inscrit au cœur de la statistique non-paramétrique. Contrairement à l’approche paramétrique classique — qui consiste à postuler d’emblée une formule mathématique globale (par exemple, « mes données suivent une loi normale ») puis à calculer simplement μ et σ pour caler la cloche correspondante —, l’approche non-paramétrique refuse toute modélisation préconçue. Elle postule que la forme distributionnelle doit être dictée de manière organique par les données elles-mêmes.
Le principe fondamental de la méthode KDE, initialement formulé par Emanuel Parzen et Murray Rosenblatt à la fin des années 1950, repose sur une idée géométrique d’une rare ingéniosité. Plutôt que de partitionner l’espace en tranches rigides comme le fait l’histogramme, la méthode place une petite colline mathématique continue — appelée le noyau (kernel) — directement au-dessus de chaque point de donnée individuel présent dans l’échantillon. Chaque observation empirique xi devient le centre d’une micro-courbe de densité localisée, dont l’aire individuelle équivaut à 1 / n.
La courbe de densité globale f̂(x) est ensuite construite en sommant continûment l’ensemble de ces micro-noyaux le long de l’axe horizontal pour obtenir une fonction lissée unique :
f̂(x) = (1 / [n × h]) × ∑i=1n K((x – xi) / h),
où K désigne la fonction noyau unitaire, n la taille de l’échantillon, et h un paramètre dimensionnel crucial dénommé la largeur de bande (ou bandwidth). Aux endroits où les observations s’accumulent densément, les noyaux individuels se superposent et leurs hauteurs s’additionnent, créant un pic d’amplitude élevé sur la courbe finale. Là où les points se raréfient, les noyaux s’isolent et s’aplatissent, dessinant les vallées et les queues de la distribution.
9.2 Types de fonctions noyau et propriétés
La fonction noyau K(u) qui sert de brique élémentaire à l’édification de la courbe de densité doit elle-même satisfaire les propriétés d’une fonction de densité unitaire : elle doit être non négative pour tout u, symétrique autour de zéro, et son intégrale sur son support doit égaler 1. La littérature statistique propose un catalogue varié de fonctions noyaux, chacune dotée de propriétés analytiques spécifiques :
- Le noyau gaussien : Sans doute le plus universellement implémenté dans les progiciels de statistique (R, Python, SPSS). Il applique à chaque point individuel la silhouette d’une courbe normale centrée en ce point : K(u) = (1 / √(2π)) exp(- ½ u2). Puisque la fonction gaussienne est indéfiniment différentiable (de classe C∞), la courbe de densité globale résultante hérite d’une douceur mathématique parfaite, dépourvue de tout point anguleux.
- Le noyau d’Epanechnikov : Formalisé par Vasily Epanechnikov en 1969, il s’exprime selon une formulation parabolique bornée : K(u) = ¾ (1 – u2) pour |u| ≤ 1, et 0 ailleurs. Ce noyau possède un titre de noblesse théorique : il est mathématiquement prouvé qu’il minimise l’erreur quadratique moyenne intégrée (MISE, Mean Integrated Squared Error), s’imposant comme le noyau le plus efficient au sens de l’optimisation de la variance et du biais d’estimation.
- Les noyaux triangulaire et rectangulaire : Le noyau rectangulaire — équivalant à un filtre de moyenne mobile classique — et le noyau triangulaire appliquent des pondérations linéaires. Ils présentent l’avantage d’une grande frugalité de calcul, mais produisent des courbes de densité heurtées, affectées de discontinuités de pente (dérivée première non continue) à la frontière de leur support compact.
En pratique statistique réelle, le choix spécifique de la fonction noyau exerce un impact remarquablement mineur sur la morphologie générale de la courbe finale. Du moment que le noyau utilisé est symétrique et continu, les courbes résultantes s’avèrent quasiment superposables. En revanche, le véritable maître du jeu de l’estimation de densité réside dans le calibrage de son paramètre d’échelle : la largeur de bande.
9.3 Le rôle déterminant de la largeur de bande (Bandwidth)
La largeur de bande (généralement symbolisée par h) contrôle la largeur horizontale de chaque micro-noyau individuel et, par conséquent, régule le degré d’étalement et d’adoucissement appliqué à la courbe de densité finale. Elle incarne de manière magistrale le dilemme universel en modélisation statistique entre le biais et la variance :
- Le phénomène de sous-lissage (bandwidth trop faible) : Si le paramètre h est calibré à une valeur excessivement étroite, les noyaux individuels se dressent comme des aiguilles pointues centrées sur chaque point observé sans se recouvrir harmonieusement. La courbe de densité globale devient une silhouette convulsée, striée d’une multitude d’artefacts verticaux sans substance théorique. L’estimation possède une très faible erreur de biais (elle colle méticuleusement aux données observées), mais une variance démesurée : le moindre nouvel échantillon produirait une courbe radicalement différente.
- Le phénomène de sur-lissage (bandwidth trop large) : À l’opposé, si h est démesurément étiré, chaque noyau individuel s’étale horizontalement sur une distance immense en s’affaissant verticalement. L’accumulation de ces dômes aplatis produit une courbe de densité artificiellement lissée, informe et émoussée. La variance est minimale, mais le biais devient catastrophique : les sommets modaux réels sont gommés, les vallées intermédiaires sont comblées et une distribution réellement bimodale apparaît fallacieusement unimodale.
Pour dépasser l’arbitraire du choix manuel de h, des mathématiciens ont forgé des algorithmes de sélection automatique optimisée. L’approche la plus célèbre est la règle empirique de Silverman (Silverman’s rule of thumb), qui calibre le paramètre h idéal selon la formule :
hopt = 0,9 × min(σ̂, IQR / 1,34) × n-1/5,
où σ̂ représente l’écart-type de l’échantillon, IQR l’écart interquartile et n la taille de l’échantillon. D’autres techniques plus intensives en calcul, à l’image des méthodes de validation croisée (unbiased cross-validation ou plug-in methods de Sheather et Jones), optimisent le paramètre en évaluant numériquement la prédiction de chaque point exclu sur le lissage des points restants, garantissant ainsi une fidélité morphologique optimale de la courbe de densité estimée.
10. Exemple pratique pas-à-pas : Construction et interprétation d’une courbe
Afin de transposer ces architectures théoriques dans la réalité tangible de la pratique de recherche, déroulons l’intégralité d’un protocole expérimental appliqué à un jeu de données quantitatives continues restreint.
10.1 Présentation du jeu de données empiriques
Considérons une étude clinique menée dans une unité de neuropsychologie cognitive. L’investigateur évalue le temps d’assimilation et de résolution (exprimé en secondes) d’un test visuo-spatial complexe administré à un groupe de vingt patients adultes (n = 20) souffrant de troubles attentionnels modérés. Les données brutes recueillies se présentent dans la série continue ordonnée suivante :
12,4 ; 13,1 ; 13,8 ; 14,2 ; 14,9 ; 15,3 ; 15,7 ; 16,1 ; 16,5 ; 17,0 ; 17,4 ; 17,9 ; 18,6 ; 19,2 ; 20,1 ; 21,5 ; 22,8 ; 24,3 ; 26,7 ; 29,5.
Un survol préliminaire de cet échantillon permet de dégager quelques repères métriques initiaux : le minimum observé s’établit à 12,4 secondes, le maximum culmine à 29,5 secondes, définissant une amplitude totale (étendue) de 17,1 secondes. La médiane de l’échantillon (moyenne des 10e et 11e valeurs) se loge à (17,0 + 17,4) / 2 = 17,2 secondes, tandis que le calcul de la moyenne arithmétique donne une valeur sensiblement plus élevée : μ̂ = 18,35 secondes. L’écart entre médiane et moyenne laisse d’ores et déjà deviner une dynamique d’étalement vers la droite que la spatialisation graphique va mettre en lumière.
10.2 Élaboration de l’histogramme de fréquences relatives
Pour amorcer la transformation géométrique de cette collection numérique brute, procédons au découpage de l’axe horizontal en classes régulières. Retenons un intervalle de classe d’une largeur de 3 secondes, débutant à 12 secondes et s’achevant à 30 secondes, délimitant ainsi six tranches successives :
- Classe [12 – 15[ : 5 observations (12,4 ; 13,1 ; 13,8 ; 14,2 ; 14,9). Fréquence relative = 5 / 20 = 0,25.
- Classe [15 – 18[ : 7 observations (15,3 ; 15,7 ; 16,1 ; 16,5 ; 17,0 ; 17,4 ; 17,9). Fréquence relative = 7 / 20 = 0,35.
- Classe [18 – 21[ : 3 observations (18,6 ; 19,2 ; 20,1). Fréquence relative = 3 / 20 = 0,15.
- Classe [21 – 24[ : 2 observations (21,5 ; 22,8). Fréquence relative = 2 / 20 = 0,10.
- Classe [24 – 27[ : 2 observations (24,3 ; 26,7). Fréquence relative = 2 / 20 = 0,10.
- Classe [27 – 30[ : 1 observation (29,5). Fréquence relative = 1 / 20 = 0,05.
Si nous dressions un histogramme brut, les hauteurs seraient respectivement 5, 7, 3, 2, 2, 1. Pour convertir cet étagement en densités de fréquence normalisées, nous divisons chaque fréquence relative par la largeur de classe fixe (Δx = 3) :
- Densité classe 1 : 0,25 / 3 ≈ 0,0833
- Densité classe 2 : 0,35 / 3 ≈ 0,1167
- Densité classe 3 : 0,15 / 3 ≈ 0,0500
- Densité classe 4 : 0,10 / 3 ≈ 0,0333
- Densité classe 5 : 0,10 / 3 ≈ 0,0333
- Densité classe 6 : 0,05 / 3 ≈ 0,0167
Vérifions rigoureusement la surface totale de cette construction géométrique :
Aire = (0,0833 × 3) + (0,1167 × 3) + (0,0500 × 3) + (0,0333 × 3) + (0,0333 × 3) + (0,0167 × 3) = 0,25 + 0,35 + 0,15 + 0,10 + 0,10 + 0,05 = 1,00.
L’histogramme normalisé remplit parfaitement sa mission : ses barres crénelées totalisent une aire égale à l’unité probabiliste, mais leur profil demeure brut, heurté et discontinu.
10.3 Superposition et ajustement de la courbe de densité
L’étape subséquente consiste à ajuster sur cet histogramme une courbe de densité continue par l’application d’un lissage par noyau gaussien (KDE). En déployant un algorithme calibré avec une largeur de bande optimale (par exemple h ≈ 2,1 selon la formule de Silverman adaptée à notre écart-type empirique s ≈ 4,77), chaque point de la série projette sa petite cloche locale.
La sommation continue de ces vingt contributions génère un tracé curviligne d’une parfaite fluidité :
- La courbe prend naissance en glissant doucement au-dessus de l’axe horizontal dès 8 secondes, s’élève rapidement au fur et à mesure qu’elle pénètre dans la zone des 13-14 secondes.
- Elle atteint son sommet modal unique (mode visuel) aux alentours de 16,2 secondes, où l’ordonnée de densité culmine à environ f̂(x) ≈ 0,105.
- Passé ce pic culminant, la pente s’adoucit et redescend en formant un long flanc incliné qui s’étire vers la droite de manière asymétrique, prolongeant sa décroissance bien au-delà de 25 secondes avant de venir tangenter asymptotiquement le zéro aux abords de 33 secondes.
L’observateur constate d’emblée la disparition salutaire des marches d’escalier arbitraires imposées par le découpage en blocs de 3 secondes. La courbe de densité met en relief une distribution unimodale marquée par une nette asymétrie positive. L’aire totale sous cette courbe lissée unifie les observations et se stabilise rigoureusement à la valeur unitaire 1.
10.4 Extraction de probabilités et d’inférences à partir de la courbe
Disposant désormais d’un modèle continu, le chercheur peut formuler des requêtes d’inférence probabiliste fine que l’histogramme discret était incapable de fournir avec nuance. Supposons que l’équipe clinique souhaite estimer la proportion de patients susceptibles d’afficher une vitesse de traitement ralentie comprise précisément dans un intervalle critique délimité entre 20 et 25 secondes.
Si l’on se fiait au décompte empirique simpliste sur les données brutes, l’intervalle [20 ; 25] contient exactement 4 observations (20,1 ; 21,5 ; 22,8 ; 24,3), soit une fréquence d’échantillon ponctuelle de :
4 / 20 = 0,20 (soit 20 %).
Cependant, ce comptage brut ignore la variabilité d’échantillonnage et les zones lacunaires inhérentes à un collectif de seulement vingt individus. En opérant une intégration numérique sous la courbe de densité ajustée entre les bornes x = 20 et x = 25 :
Surface = ∫2025 f̂(x) dx ≈ 0,186.
La courbe de densité nous indique que, sous l’hypothèse de lissage de population, la probabilité réelle qu’un patient présente un temps de résolution situé dans cet intervalle est d’environ 18,6 %. La courbe a tempéré le saut discret des données observées en réinjectant une partie de la densité dans les flancs adjacents. Si l’on élargit la question à la probabilité qu’un sujet mette plus de 24 secondes pour terminer la tâche (queue supérieure droite) :
Surface = ∫24+∞ f̂(x) dx ≈ 0,123 (soit environ 12,3 % de la population théorique).
Cette approche permet de fonder des normes cliniques continues, s’affranchissant du caractère fortuit de l’échantillon particulier ayant servi au calibrage initial.
11. Applications des courbes de densité en psychologie et sciences du comportement
Les sciences du comportement et la psychologie quantitative offrent un terrain d’application privilégié pour les courbes de densité. L’impossibilité d’observer directement les processus mentaux sous forme matérielle oblige les chercheurs à déduire l’architecture des fonctions psychologiques à partir de la morphologie distributive de variables de performance observables.
11.1 Modélisation des aptitudes cognitives et scores psychométriques
L’évaluation psychométrique de l’intelligence générale et des aptitudes cognitives repose historiquement sur l’alignement délibéré des scores sur des courbes de densité théoriques universelles. Les échelles de quotient intellectuel contemporaines (telles que le WAIS ou le WISC, élaborés sous l’égide de David Wechsler) ne mesurent pas une quantité physique absolue d’intelligence, mais opèrent une standardisation morphologique de la performance relative.
Les scores bruts obtenus par des échantillons de standardisation représentatifs sont intentionnellement translatés pour se conformer de façon quasi parfaite à une courbe de densité normale canonique calibrée avec une moyenne fixée à μ = 100 et un écart-type de σ = 15 :
fQI(x) = (1 / [15 √(2π)]) × exp(- ½ [(x – 100) / 15]2).
Grâce aux propriétés surfaciques immuables de cette courbe de densité, les frontières diagnostiques de la psychopathologie ou de l’exceptionnalité cognitive ne sont pas fixées par des critères qualitatifs vagues, mais par des aires d’intégration précises sous la courbe :
- Le seuil du retard mental ou de la déficience intellectuelle est historiquement fixé à deux écarts-types en dessous de la moyenne (x ≤ 70). Sur la courbe de densité gaussienne, l’aire cumulée sous l’abscisse 70 correspond rigoureusement à 2,27 % de la population.
- Symétriquement, le seuil identifiant le haut potentiel intellectuel (HPI) s’établit à deux écarts-types au-dessus de la moyenne (x ≥ 130), isolant également une aire surfacique unitaire de 2,27 % dans la queue extrême droite de la cloche.
Il en va de même pour les modèles contemporains de la personnalité, à l’instar du modèle des Big Five (Extraversion, Agréabilité, Conscience, Neuroticisme, Ouverture). La courbe de densité permet de rompre avec la tentation typologique réductionniste qui enferme arbitrairement les individus dans des catégories binaires étanches (« extraverti » versus « introverti »). La représentation continue démontre avec force que l’immense majorité des êtres humains se concentre dans la portion centrale de la cloche de densité (les « ambivertis »), les manifestations caricaturales d’un trait ne constituant que les terminaisons effilées des queues distributionnelles.
11.2 Analyse des temps de réaction et dynamique cognitive
S’il est un domaine où la symétrie de la courbe normale est universellement et systématiquement réfutée par les données empiriques, c’est celui de la chronométrie cognitive. Lorsqu’un sujet humain effectue une tâche expérimentale consistant à détecter un stimulus sensoriel ou à faire un choix discriminatif élémentaire, la courbe de densité de ses temps de réaction (TR) affiche systématiquement une asymétrie positive massive : un décollage abrupte à gauche plafonnant rapidement en un mode aigu, suivi d’une queue droite démesurément étirée vers les latences temporelles élevées.
Tenter de résumer de telles données par la moyenne arithmétique constitue une aberration scientifique, car cette dernière est irrémédiablement faussée par les ralentissements attentionnels épisodiques logés dans la queue droite. Les modélisateurs ont donc développé des courbes de densité hybrides sophistiquées, parmi lesquelles la courbe de densité ex-gaussienne s’impose comme une référence incontournable. La loi ex-gaussienne résulte de la convolution mathématique d’une distribution normale (capturant les processus d’exécution motrice et de transmission sensorielle élémentaires) et d’une distribution exponentielle (modélisant les processus décisionnels centraux et les défaillances attentionnelles transitoires).
L’ajustement d’une courbe de densité ex-gaussienne permet de décomposer l’architecture cognitive sous-jacente en extrayant trois paramètres directeurs :
- Le paramètre μ, qui contrôle la position horizontale du corps de la cloche (vitesse de transmission sensorimotrice brute).
- Le paramètre σ, qui reflète la variabilité gaussienne locale.
- Le paramètre τ (tau), qui quantifie l’épaisseur volumétrique de la queue droite exponentielle.
Dans des pathologies neuropsychologiques telles que le Trouble du Déficit de l’Attention avec ou sans Hyperactivité (TDAH), la superposition des courbes de densité révèle que les patients ne diffèrent souvent des sujets témoins ni par leur mode ni par leur paramètre μ (leurs temps de réaction les plus rapides sont parfaitement normaux), mais par un gonflement spectaculaire du paramètre τ. C’est la queue de la courbe de densité — et elle seule — qui trahit la signature clinique de l’instabilité cognitive.
11.3 Détection de sous-populations cliniques par la bimodalité
L’inspection des courbes de densité joue également un rôle diagnostique de premier plan dans l’identification de mélanges de populations au sein de cohortes cliniques apparemment indifférenciées. Lorsqu’un questionnaire psychologique standardisé évaluant la sévérité d’un trouble — par exemple l’échelle de dépression de Beck (BDI, pour Beck Depression Inventory) ou l’échelle d’anxiété généralisée GAD-7 — est administré à un vaste échantillon issu de la population générale, la courbe de densité globale ne suit que rarement un profil unimodal homogène.
Le tracé continu fait souvent émerger une bimodalité frappante :
- Un premier sommet imposant s’érige tout près du zéro de l’échelle, représentant la sous-population majoritaire asymptomatique exempte d’altération psychopathologique notable.
- Une dépression intermédiaire se creuse, marquant un intervalle de densité raréfiée.
- Un second sommet plus modeste, mais structurellement distinct, émerge à un niveau de score substantiellement plus élevé, signalant l’agrégation d’une sous-population clinique activement symptomatique.
Visualiser cette bimodalité sur une courbe de densité alerte immédiatement le chercheur sur le fait qu’il ne peut traiter la cohorte comme un continuum homogène. Les modèles statistiques de mélanges gaussiens (Gaussian Mixture Models ou régression à classes latentes) s’appuient directement sur la modélisation de cette courbe continue pour décomposer le tracé global en deux sous-courbes de densité sous-jacentes. Cette décomposition offre un protocole mathématiquement rigoureux pour déterminer le seuil clinique discriminant optimal : ce dernier est précisément localisé au point le plus bas de la vallée séparant les deux modes culminants de la densité. La courbe fournit ainsi la justification géométrique du seuil diagnostique séparant le normal du pathologique.
12. Limites, pièges d’interprétation et recommandations méthodologiques
Si la courbe de densité constitue un instrument heuristique et analytique d’une puissance indéniable, son maniement exige une rigueur épistémologique constante. Une lecture naïve ou une mauvaise maîtrise des paramètres de lissage peut induire l’analyste en erreur et déboucher sur des conclusions méthodologiques totalement biaisées.
12.1 La confusion entre hauteur de densité et probabilité
L’erreur la plus universellement commise par les étudiants et les chercheurs non spécialistes de la théorie probabiliste consiste à confondre la hauteur de la courbe de densité f(x) avec une probabilité ponctuelle directe. Cette méprise procède d’un transfert erroné des réflexes acquis lors de la lecture des diagrammes en bâtons ou des histogrammes de fréquences relatives. Sur un graphique discret, l’axe vertical affiche des probabilités strictes comprises entre 0 et 1. Sur une courbe de densité continue, l’axe des ordonnées affiche une densité de probabilité, dont l’unité de mesure est l’inverse de l’unité de la variable mesurée (1 / Unité de x).
La conséquence mathématique la plus spectaculaire — et souvent source de sidération pour les praticiens non avertis — est que la valeur de f(x) peut parfaitement être supérieure à 1 sans qu’aucun axiome de la théorie probabiliste ne soit violé. Considérons par exemple une variable aléatoire continue distribuée uniformément sur le micro-intervalle [0 ; 0,2]. Pour que l’aire du rectangle sous la courbe unitaire demeure égale à 1 :
Aire = Hauteur × Largeur = f(x) × 0,2 = 1 ⇒ f(x) = 1 / 0,2 = 5.
La densité s’élève à 5 sur toute la largeur de l’intervalle, une valeur bien supérieure à l’unité. Il ne s’agit aucunement d’une probabilité de 500 %, mais d’un taux volumétrique : si la variable était mesurée en mètres, la densité s’exprimerait en 5 « unités de probabilité par mètre ».
Il convient de marteler cette règle pédagogique fondamentale : sur une courbe de densité, la probabilité est une aire, jamais une altitude. La hauteur f(x) ne prend de sens probabiliste qu’une fois multipliée par une largeur infinitésimale dx ou intégrée le long d’un intervalle tangible. Lire directement le sommet d’une courbe sur l’axe vertical pour affirmer « la probabilité d’avoir cette valeur est de 80 % » constitue une faute théorique rédhibitoire.
12.2 Les distorsions introduites par les artefacts de lissage
Le second piège méthodologique majeur concerne la confiance aveugle accordée aux algorithmes d’estimation de densité par noyau (KDE), sans examen critique des conditions aux limites. Les progiciels contemporains appliquent par défaut des noyaux symétriques continus — le plus souvent le noyau gaussien — qui possèdent un support s’étendant théoriquement de l’infini négatif à l’infini positif.
Cette particularité algorithmique génère un problème récurrent bien documenté dans la littérature statistique sous le vocable de phénomène de débordement de support (boundary bias ou spillover effect). Lorsqu’une variable empirique est intrinsèquement bornée par la nature — par exemple des temps de réaction qui ne peuvent physiologiquement jamais être inférieurs à zéro, ou des scores de tests bornés par construction entre 0 et 100 —, l’application d’un noyau standard au-dessus des observations situées près de la limite projette une moitié de son dôme en dehors de l’espace des valeurs possibles. La courbe de densité estimée se met alors à déborder artificiellement dans des régions négatives absurdes, violant les lois physiques du phénomène étudié et affaissant parallèlement la hauteur de la densité au niveau de la frontière réelle.
De surcroît, un lissage excessif est capable de masquer délibérément des discontinuités de pente bien réelles ou des structures complexes, tandis qu’un sous-lissage dans des échantillons de modeste envergure (n < 30) transforme des fluctuations fortuites d’échantillonnage en fausses bosses multimodales. L’analyste risque alors d’interpréter comme des découvertes théoriques majeures ce qui ne relève en vérité que d’artefacts algorithmiques induits par un mauvais paramétrage de la largeur de bande.
12.3 Bonnes pratiques pour la recherche empirique et la publication
Pour prémunir les chercheurs contre ces écueils et garantir une reproductibilité optimale des analyses exploratoires publiées dans les revues à comité de lecture, la communauté statistique internationale a codifié un ensemble de recommandations méthodologiques rigoureuses :
- Systématiser la double visualisation avec diagramme de dispersion (rug plot) : Ne jamais publier une courbe de densité par noyau isolée. Il est fortement préconisé d’adosser systématiquement à la courbe de densité un rug plot (un tapis de petits traits verticaux placé sous l’axe des abscisses, matérialisant l’emplacement exact de chaque donnée empirique observée) ou de superposer la courbe sur un histogramme normalisé semi-transparent. Cette précaution permet au lecteur d’évaluer immédiatement si un pic de la courbe repose sur un agrégat dense de points réels ou s’il n’est que l’illusion d’une observation isolée sur-lissée.
- Faire preuve d’une transparence absolue sur les hyperparamètres : Dans la section méthodologique des articles scientifiques, il est impératif de stipuler explicitement non seulement la fonction noyau sélectionnée (ex. : gaussienne, Epanechnikov), mais surtout le paramètre précis de largeur de bande (bandwidth h) retenu, ainsi que l’algorithme ayant servi à son optimisation (ex. : règle de Silverman, validation croisée SJ).
- Traiter rigoureusement les frontières de support : Face à des données strictement bornées, abandonner les noyaux gaussiens naïfs au profit de techniques corrigées, telles que l’estimation par noyaux tronqués aux limites, la méthode de réflexion de Silverman, ou le recours à des distributions à support strictement positif (noyaux Gamma ou transformation logarithmique préalable).
- Articuler l’inspection visuelle et les tests formels d’adéquation : La courbe de densité ne doit pas se substituer aux tests d’hypothèses statistiques d’adéquation distributionnelle. L’observation visuelle d’une forme en cloche doit obligatoirement être corroborée par des tests d’ajustement formels — tels que le test de normalité de Shapiro-Wilk, le test d’Anderson-Darling ou le test de Kolmogorov-Smirnov —, ainsi que par l’examen de diagrammes quantile-quantile (Q-Q plots).
En respectant scrupuleusement ces garde-fous méthodologiques, le chercheur s’assure d’exploiter la courbe de densité pour ce qu’elle est véritablement : un pont analytique d’une remarquable puissance, capable d’éclairer la structure stochastique profonde des phénomènes naturels et humains tout en préservant l’intégrité de la vérité empirique.
Références
DeGroot, M. H., & Schervish, M. J. (2012). Probability and Statistics (4th ed.). Addison-Wesley. https://www.pearson.com
Epanechnikov, V. A. (1969). Non-parametric estimation of a multivariate probability density. Theory of Probability & Its Applications, 14(1), 153–158. https://doi.org/10.1137/1114019
Parzen, E. (1962). On estimation of a probability density function and mode. The Annals of Mathematical Statistics, 33(3), 1065–1076. https://doi.org/10.1214/aoms/1177704472
Rosenblatt, M. (1956). Remarks on some non-parametric estimates of a density function. The Annals of Mathematical Statistics, 27(3), 832–837. https://doi.org/10.1214/aoms/1177728190
Scott, D. W. (2015). Multivariate Density Estimation: Theory, Practice, and Visualization (2nd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118575499
Silverman, B. W. (1986). Density Estimation for Statistics and Data Analysis. Chapman and Hall/CRC. https://doi.org/10.1201/9781315140919
Tukey, J. W. (1977). Exploratory Data Analysis. Addison-Wesley. https://www.pearson.com
Wand, M. P., & Jones, M. C. (1995). Kernel Smoothing. Chapman and Hall/CRC. https://doi.org/10.1201/9780203748725
Weisstein, E. W. (2023). Probability Density Function. From MathWorld–A Wolfram Web Resource. https://mathworld.wolfram.com/ProbabilityDensityFunction.html