
Dans le champ foisonnant des sciences quantitatives, et plus particulièrement au sein de la psychologie empirique et des neurosciences comportementales, l’inférence statistique constitue la clé de voûte de la validation des hypothèses. Parmi l’arsenal méthodologique à la disposition du chercheur, le test t de Student occupe sans conteste une position prééminente, consacrée par plus d’un siècle d’usages empiriques, de publications académiques et d’enseignements universitaires. Conçu initialement pour extraire des conclusions valides à partir d’échantillons de taille modeste, ce test paramétrique permet d’évaluer si les moyennes de deux groupes diffèrent de manière statistiquement significative ou si une moyenne observée s’écarte substantiellement d’une valeur théorique de référence. Son omniprésence dans la littérature scientifique témoigne de son élégance mathématique et de son apparente simplicité de mise en œuvre au moyen des progiciels statistiques contemporains.
Cependant, cette apparente simplicité opérationnelle dissimule une armature théorique rigide dont l’ignorance s’avère méthodologiquement désastreuse. À l’instar de tout modèle mathématique appliqué au monde réel, le test t repose sur un ensemble de conditions structurales strictes, communément qualifiées d’hypothèses sous-jacentes ou de postulats de validité. Ces postulats — à savoir l’indépendance probabiliste des observations, la normalité distributionnelle de la variable d’intérêt au sein des populations d’origine, l’homogénéité des variances (homoscédasticité) et l’échantillonnage aléatoire représentatif — ne constituent pas de simples idéaux académiques négligeables. Ils définissent précisément le cadre axiomatique sous lequel les distributions d’échantillonnage théoriques dérivées par la théorie des probabilités demeurent exactes et interprétables.
Le manquement à ces exigences fondamentales expose le chercheur à des distorsions analytiques sévères : inflation exponentielle de l’erreur de première espèce (α), dégradation de la puissance statistique propice aux erreurs de seconde espèce (β), et production d’estimations biaisées des tailles d’effet ainsi que de leurs intervalles de confiance. Dans le contexte actuel de la « crise de la réplicabilité » qui traverse les sciences du comportement, une réévaluation épistémologique et pratique de ces quatre postulats s’impose avec une acuité renouvelée. Ce guide exhaustif a pour vocation d’analyser en profondeur les fondements théoriques, les méthodes diagnostiques, les répercussions quantitatives des violations et les alternatives computationnelles robustes associées aux quatre piliers du test t.
1. Introduction aux fondements théoriques du test t de Student en psychologie
L’édifice de l’inférence statistique moderne repose sur la capacité à généraliser les observations issues d’une fraction restreinte de la réalité — l’échantillon — à l’ensemble d’une population parente inobservable dans son exhaustivité. En psychologie expérimentale, où les ressources humaines, temporelles et financières interdisent le recours à des recensements complets, le test d’hypothèse paramétrique offre une méthode formelle pour trancher entre deux interprétations concurrentes : la variabilité observée est-elle le simple reflet de fluctuations aléatoires d’échantillonnage, ou traduit-elle un véritable effet expérimental sous-jacent ? Comprendre les origines et la formalisation du test t permet d’appréhender la genèse de ses postulats d’application.
1.1 Origine historique et rôle en inférence statistique
L’histoire de la statistique inférentielle a été marquée par une rupture fondamentale en 1908, lors de la publication de l’article fondateur intitulé « The Probable Error of a Mean » dans la revue Biometrika. Cet article était signé du pseudonyme mystérieux de « Student », masque éditorial adopté par William Sealy Gosset. Chimiste et mathématicien d’exception, Gosset œuvrait au sein de la célèbre brasserie Guinness à Dublin, où il était confronté à des problématiques industrielles précises : évaluer la qualité des matières premières, telles que les souches d’orge ou les rendements de fermentation du houblon, sur la base d’échantillons extrêmement restreints, souvent limités à trois ou quatre mesures seulement.
À cette époque, la tradition statistique dominée par Karl Pearson reposait quasi exclusivement sur l’hypothèse des grands échantillons, autorisant le recours à la distribution normale standard z. Dans ce cadre classique, l’écart-type de la population (σ) était présumé connu ou parfaitement approximé par l’écart-type de l’échantillon (s). Gosset démontra mathématiquement que lorsque l’on travaille sur des échantillons de petite taille, le fait de remplacer le paramètre inconnu σ par son estimateur empirique s introduit une source additionnelle d’incertitude aléatoire fondamentale. Par conséquent, le ratio résultant ne suit plus une loi normale standard, mais une distribution plus étalée, caractérisée par des queues de distribution plus épaisses et plus lourdes : la distribution t de Student.
Cette transition de la statistique z vers la statistique t a révolutionné la recherche empirique. La forme précise de la distribution t dépend d’un paramètre fondamental, les degrés de liberté (ν ou df), qui reflètent la quantité d’informations indépendantes disponibles pour estimer la variance d’échantillonnage. Lorsque les degrés de liberté tendent vers l’infini, la distribution t converge asymptotiquement vers la loi normale standard. Néanmoins, pour des effectifs typiques des protocoles de psychologie cognitive ou clinique — souvent compris entre 15 et 30 participants par condition —, l’utilisation de la loi de Student demeure indispensable pour ne pas sous-estimer la marge d’erreur et préserver l’intégrité de l’inférence.
1.2 Typologie des tests t et spécificités du modèle à deux échantillons indépendants
Dans l’arsenal méthodologique du chercheur, le test t se décline en trois variantes fondamentales selon le devis d’échantillonnage :
- Le test t pour échantillon unique : il confronte la moyenne observée d’un seul groupe à une constante théorique prédéterminée.
- Le test t pour échantillons appariés (mesures répétées) : il évalue si la moyenne intra-individuelle des différences entre deux conditions est significativement différente de zéro.
- Le test t pour deux échantillons indépendants : il compare les moyennes de deux groupes distincts d’individus sans appariement.
Sur le plan formel, la comparaison de deux moyennes indépendantes s’articule autour d’une hypothèse nulle ($H_0$) postulant l’absence de différence entre les deux paramètres populationnels ($\mu_1 = \mu_2$, soit $\mu_1 – \mu_2 = 0$), opposée à une hypothèse alternative bilatérale ($H_1 : \mu_1 \neq \mu_2$) ou unilatérale ($H_1 : \mu_1 > \mu_2$ ou $\mu_1 < \mu_2$). Le calcul de la statistique empirique t obéit au principe d’un ratio signal/bruit :
$$t = \frac{\bar{X}_1 – \bar{X}_2}{SE_{(\bar{X}_1 – \bar{X}_2)}}$$
Dans cette formalisation, le numérateur incarne le « signal », c’est-à-dire l’écart empirique observé entre les moyennes des deux groupes. Le dénominateur représente l’erreur standard de la différence ($SE$), métrique du « bruit » de fond attribuable aux seules fluctuations aléatoires d’échantillonnage. Pour calculer cette erreur standard dans le modèle classique de Student, on suppose que les deux populations partagent une variance commune ($\sigma_1^2 = \sigma_2^2 = \sigma^2$), ce qui conduit à calculer une variance combinée pondérée (pooled variance, notée $s_p^2$).
Cette architecture factorielle inter-sujets impose des exigences inférentielles strictes. La validité probabiliste de l’inférence exige que l’erreur standard reflète fidèlement la variabilité non contrôlée, ce qui lie intrinsèquement la mécanique du test au respect scrupuleux de ses hypothèses fondamentales.
1.3 La portée épistémologique des postulats statistiques
L’édifice des tests d’hypothèses nulles (NHST pour Null Hypothesis Significance Testing) repose sur un contrat mathématique précis. Les formules de dérivation de la distribution de la statistique t sous l’hypothèse nulle sont analytiquement exactes uniquement si les axiomes du modèle sont satisfaits. Ces postulats ne sont pas des recommandations facultatives : ils constituent les fondations déductives à partir desquelles la probabilité critique (la p-valeur) est calculée.
Lorsque ces conditions sont violées, la distribution réelle de la statistique d’échantillonnage dévie de la loi théorique de Student tabulée dans les logiciels statistiques. Deux conséquences épistémologiques majeures en découlent :
- L’inflation du taux d’erreur de type I ($\alpha$) : le risque de rejeter l’hypothèse nulle alors qu’elle est en réalité vraie excède le seuil nominal de 5 %. Une étude configurée pour tolérer 5 % de faux positifs peut ainsi voir son risque réel grimper à 15 %, 30 % voire plus de 50 % selon la nature des violations.
- L’inflation de l’erreur de type II ($\beta$) : le chercheur échoue à détecter un effet expérimental authentique par suite d’une dégradation substantielle de la puissance statistique ($1 – \beta$).
La pratique contemporaine en psychologie a souvent souffert d’un automatisme algorithmique critiquable. L’utilisation aveugle de progiciels tels que SPSS, Jamovi ou R peut inciter les analystes à exécuter des tests t sans vérifier si les données respectent les postulats du modèle. Cette complaisance méthodologique a directement alimenté la crise de la reproductibilité documentée par l’Open Science Framework, où de nombreuses découvertes empiriques initiales se sont révélées être des artefacts statistiques issus d’analyses paramétriques inappropriées.
2. Postulat 1 : L’indépendance des observations et son rôle fondamental
Parmi les quatre conditions sous-jacentes au test t de Student, l’indépendance des observations représente le postulat le plus critique et le moins négociable. Tandis que certaines violations de la normalité ou de l’homoscédasticité peuvent être atténuées par de grands effectifs ou des corrections mathématiques, la violation de l’indépendance corrompt irréversiblement la structure probabiliste des données.
2.1 Définition conceptuelle de l’indépendance statistique
Sur le plan mathématique, deux variables aléatoires $X$ et $Y$ sont dites indépendantes si et seulement si leur distribution conjointe est égale au produit de leurs distributions marginales, c’est-à-dire $P(X \cap Y) = P(X) \cdot P(Y)$. Appliqué au devis d’échantillonnage d’un test t à deux échantillons indépendants, ce principe exige que la probabilité d’occurrence d’une valeur particulière pour un participant donné soit totalement indépendante de la valeur observée chez n’importe quel autre participant de l’échantillon.
Dans la formulation du modèle linéaire général, cela se traduit par l’absence stricte de covariance entre les termes d’erreur résiduelle :
$$operatorname{Cov}(\varepsilon_i, \varepsilon_j) = 0 \quad \text{pour tout } i \neq j$$
Ce postulat implique deux dimensions impératives :
- L’indépendance intra-échantillon : au sein d’un même groupe expérimental, la réponse d’un participant ne doit en aucun cas prédire ou influencer la réponse d’un autre participant.
- L’indépendance inter-échantillons : les unités expérimentales assignées au groupe contrôle et celles assignées au groupe expérimental doivent être mutuellement exclusives et n’entretenir aucune relation structurelle ou transactionnelle.
Cette exigence découle directement du principe d’échangeabilité probabiliste : chaque observation doit apporter une quantité d’information totalement neuve et non redondante au calcul de la statistique globale.
2.2 Facteurs de vulnérabilité et violations courantes en recherche psychologique
Malgré sa limpidité théorique, l’indépendance des observations est fréquemment compromise par des configurations méthodologiques insidieuses propres aux sciences humaines. L’une des violations les plus courantes réside dans la présence de données hiérarchiques, emboîtées ou en grappes (clustered data). Considérons une recherche en psychologie de l’éducation comparant deux méthodes pédagogiques de lecture sur deux groupes de 30 élèves :
Si les 30 élèves du groupe expérimental appartiennent à la même classe avec le même enseignant, et que les 30 élèves du groupe contrôle proviennent d’une autre classe unique, les scores individuels ne sont pas indépendants. Les élèves d’une même classe partagent l’influence d’un enseignant commun, une dynamique de groupe spécifique, un climat socio-émotionnel et des perturbations environnementales identiques. Ignorer cette structure emboîtée revient à traiter des observations corrélées comme des entités purement indépendantes.
D’autres violations fréquentes méritent d’être soulignées :
- L’administration collective d’expérimentations : tester des participants regroupés dans une même salle d’ordinateurs induit une dépendance spatio-temporelle (bruits ambiants, température, réactions expressives d’un voisin).
- Les mesures répétées non modélisées : inclure plusieurs essais d’une même tâche cognitive par individu en les traitant comme autant de sujets distincts dans un test t indépendant.
- Les effets de contamination inter-sujets : lorsque des participants ayant déjà terminé l’expérience divulguent la supercherie expérimentale ou les hypothèses de recherche à des pairs en attente de passation.
- La dépendance sérielle temporelle : l’évolution de la compétence de l’expérimentateur, la fatigue progressive au fil de la journée ou la dérive d’étalonnage des appareils de mesure (ex. EEG, eye-tracking) introduisent une corrélation chronologique systématique entre les scores successifs.
2.3 Impact de la pseudoréplication sur les inférences statistiques
Le terme de pseudoréplication, conceptualisé par le biologiste et statisticien Stuart Hurlbert en 1984, désigne l’erreur méthodologique consistant à traiter des données corrélées ou dépendantes comme si elles constituaient des réplicats statistiquement indépendants. Dans le cadre du test t, les répercussions quantitatives de la pseudoréplication sont dévastatrices.
Lorsque des observations au sein d’un groupe sont positivement corrélées, la variance réelle des données se trouve concentrée entre les grappes plutôt qu’au sein des grappes. Le calcul standard de l’erreur standard de la différence :
$$SE = \sqrt{\frac{s_1^2}{n_1} + \frac{s_2^2}{n_2}}$$
repose sur la prémisse que chaque nouvelle observation apporte un degré complet de liberté statistique ($n_1 + n_2 – 2$). Cependant, en présence de corrélation intraclasse, chaque sujet supplémentaire n’apporte qu’une fraction d’information nouvelle. En conséquence, l’erreur standard conventionnelle sous-estime massivement l’incertitude réelle d’échantillonnage.
Cette sous-estimation du dénominateur entraîne une inflation mécanique artificielle de la statistique t calculée. Les degrés de liberté théoriques sont indûment gonflés, ce qui resserre arbitrairement les valeurs critiques de rejet. Le taux réel d’erreur de première espèce (α) explose littéralement : pour une corrélation intra-classe modeste de $\rho = 0{,}10$ au sein de grappes de 10 individus, le risque de faux positifs peut passer du seuil théorique de 5 % à plus de 30 % ou 40 %. L’analyste conclut ainsi avec une apparente certitude à l’existence d’un effet expérimental qui n’est en réalité qu’un artefact d’échantillonnage.
3. Méthodes diagnostiques pour évaluer l’indépendance des données
Contrairement aux postulats de normalité ou d’homoscédasticité, pour lesquels abondent des tests de conformité automatisés, l’évaluation de l’indépendance des observations relève avant tout d’une démarche d’audit méthodologique et de modélisation préventive. Une violation majeure de l’indépendance ne peut être réparée simplement en transformant mathématiquement la variable dépendante.
3.1 Analyse rigoureuse du devis expérimental
Le diagnostic de l’indépendance exige en premier lieu un examen critique de l’architecture du protocole de collecte de données. L’expérimentateur doit tracer avec précision le parcours de chaque unité statistique afin de déceler les points de contact ou de dépendance partagée :
- Exclusivité mutuelle des groupes : vérifier qu’aucun sujet n’a participé simultanément ou séquentiellement aux deux conditions expérimentales du test t indépendant.
- Isolation environnementale des passations : examiner si les sujets ont été testés individuellement en cabines insonorisées ou collectivement en grands groupes. En cas de passation collective, la session de test doit être consignée comme une variable de groupement potentielle.
- Temporalité du recueil : consigner l’horodatage exact de chaque observation. Une dispersion asymétrique des passations (ex. : condition témoin testée le matin et condition expérimentale testée en fin de journée) introduit une confusion irrémédiable entre le traitement expérimental et le rythme circadien d’éveil cognitif.
- Facteurs d’encadrement : documenter l’identité des évaluateurs ou expérimentateurs ayant administré le protocole afin de prévenir les biais de l’opérateur (effets Rosenthal).
3.2 Outils quantitatifs de détection d’autocorrélation
Lorsque les données comportent un ordonnancement chronologique ou une structuration spatiale, des instruments mathématiques permettent d’objectiver l’existence d’une dépendance résiduelle.
Pour des séries temporelles ou des passations séquentielles, le test de Durbin-Watson permet d’évaluer l’autocorrélation des résidus de premier ordre :
$$d = \frac{\sum_{i=2}^{n} (e_i – e_{i-1})^2}{\sum_{i=1}^{n} e_i^2}$$
La statistique $d$ oscille entre 0 et 4. Une valeur proche de 2 atteste de l’absence d’autocorrélation sérielle. Une valeur s’approchant de 0 signale une autocorrélation positive prononcée (les résidus successifs se ressemblent), tandis qu’une valeur tendant vers 4 caractérise une autocorrélation négative.
En présence de structures hiérarchiques potentielles (sujets imbriqués dans des hôpitaux, écoles, équipes de travail), le calcul du coefficient de corrélation intraclasse (CCI) constitue le standard diagnostique absolu :
$$\text{CCI} = \frac{\sigma_{\text{inter}}^2}{\sigma_{\text{inter}}^2 + \sigma_{\text{intra}}^2}$$
Un CCI non nul (par exemple supérieur à 0,05) indique qu’une part non négligeable de la variance totale de la variable dépendante est directement attribuable à l’appartenance aux grappes, confirmant l’invalidation formelle du postulat d’indépendance élémentaire du test t.
4. Remédier aux violations du postulat d’indépendance
Dès lors que le diagnostic révèle une dépendance structurelle au sein des données empiriques, l’usage du test t classique pour échantillons indépendants doit être proscrit. Plusieurs voies de réorientation méthodologique permettent de préserver la validité des conclusions scientifiques.
4.1 Réorientation vers des modèles statistiques adaptés
L’approche la plus rigoureuse face à une rupture d’indépendance consiste à abandonner le test t au profit d’un cadre d’analyse capable d’incorporer explicitement la corrélation des observations dans sa structure probabiliste :
- Le test t pour échantillons appariés : si la dépendance découle d’un devis intra-sujet ou d’un appariement cas-témoin délibéré (par exemple des jumeaux monozygotes ou des couples), l’analyse doit se focaliser sur la moyenne des différences individuelles ($D_i = X_{1i} – X_{2i}$), neutralisant la corrélation intra-sujet.
- Les modèles linéaires mixtes (LMM — Linear Mixed Models) : ils constituent l’alternative moderne par excellence aux données hiérarchiques ou longitudinales. En intégrant des effets fixes (les conditions expérimentales) et des effets aléatoires (intercepts et pentes variant selon les participants ou les grappes), les modèles mixtes décomposent la variance sans sous-estimer l’erreur standard des effets fixes.
- Les équations d’estimation généralisées (GEE) : méthode semi-paramétrique très prisée en épidémiologie et psychiatrie, qui modélise la moyenne marginale de la population tout en spécifiant une matrice de corrélation de travail pour traiter la dépendance des résidus.
- L’agrégation analytique des unités : si l’emboîtement est inévitable mais que les effectifs ne permettent pas d’ajuster un modèle mixte complexe, le chercheur peut agréger les données au niveau de la grappe (calculer la moyenne par classe ou par thérapeute) et exécuter le test t sur ces moyennes de grappes. Cette approche est conservatrice mais restaure l’indépendance stricte entre les unités statistiques analysées.
4.2 Ajustements de la variance d’échantillonnage
Une alternative économétrique robuste aux modèles mixtes réside dans l’emploi d’estimateurs de variance-covariance robustes aux grappes (cluster-robust standard errors ou corrections de type Huber-White / sandwich). Ces algorithmes permettent de conserver l’estimation des coefficients par les moindres carrés ordinaires tout en recalculant la matrice de variance pour intégrer la corrélation intra-grappe :
$$V_{\text{cluster}} = (X’X)^{-1} \left( \sum_{j=1}^{G} X_j’ e_j e_j’ X_j \right) (X’X)^{-1}$$
Cette correction élargit les intervalles de confiance et réduit la statistique de test à proportion de la corrélation résiduelle, restaurant ainsi le taux nominal d’erreur $\alpha$.
Cependant, cette approche nécessite un nombre suffisant de grappes (généralement $G \geq 30$ à 50) pour garantir la précision asymptotique des erreurs standard robustes. La réduction du nombre d’unités indépendantes diminue mécaniquement la puissance statistique effective de l’étude, soulignant la nécessité d’anticiper ces contraintes dès la planification expérimentale par des calculs d’effectifs adaptés aux plans en grappes (en appliquant le facteur d’inflation de la variance : $\text{VIF} = 1 + (m – 1)\rho$, où $m$ est la taille moyenne d’une grappe).
5. Postulat 2 : La normalité de la distribution des populations
Le deuxième pilier théorique du test t de Student repose sur l’hypothèse de normalité. Souvent mal comprise ou appliquée de façon dogmatique, cette condition stipule que la variable dépendante quantitative continue doit suivre une distribution normale gaussienne au sein de chacune des populations faisant l’objet de la comparaison.
5.1 Fondements de l’hypothèse de normalité
Le test t s’inscrit structurellement dans la famille du modèle linéaire général univarié :
$$Y_{ij} = \mu_j + \varepsilon_{ij}$$
où $Y_{ij}$ représente l’observation du sujet $i$ dans le groupe $j$, $\mu_j$ est la moyenne populationnelle du groupe, et $\varepsilon_{ij}$ est l’erreur résiduelle aléatoire. La dérivation mathématique exacte de la distribution de probabilité de Student repose sur le postulat que ces termes d’erreur résiduelle sont indépendants et identiquement distribués selon une loi normale d’espérance nulle et de variance $\sigma^2$ :
$$\varepsilon_{ij} \overset{iid}{\sim} \mathcal{N}(0, \sigma^2)$$
Une distinction fondamentale doit être établie ici : la condition de normalité ne concerne pas l’échantillon groupé combiné (qui présente fréquemment une distribution bimodale si les deux moyennes diffèrent sensiblement), mais bien la distribution de la variable au sein de chaque groupe pris isolément, ce qui équivaut rigoureusement à la normalité des résidus du modèle complet.
La distribution normale théorique se caractérise par deux propriétés géométriques et mathématiques strictes :
- Une symétrie parfaite autour de son espérance, impliquant un coefficient d’asymétrie (skewness) théoriquement nul ($\gamma_1 = 0$).
- Un aplatissement mésocurtique, caractérisé par un coefficient de voussure (kurtosis) théorique égal à 3 (ou un excès de kurtosis nul, $\gamma_2 = 0$).
Dans cette configuration idéale, la moyenne, la médiane et le mode de la distribution coïncident rigoureusement.
5.2 Le théorème central limite et la robustesse asymptotique
Une incompréhension fréquente de ce postulat découle de l’interprétation abusive du Théorème Central Limite (TCL). Le TCL établit que, sous des conditions très générales de variance finie, la distribution d’échantillonnage de la moyenne d’un échantillon aléatoire tend vers une loi normale lorsque la taille de l’échantillon ($n$) s’approche de l’infini, quelle que soit la forme de la distribution sous-jacente de la variable dans la population parente :
$$\bar{X} x\rightarrow{d} \mathcal{N}\left(\mu, \frac{\sigma^2}{n}\right) \quad \text{lorsque } n to \infty$$
De nombreux manuels universitaires ont tiré de ce théorème une règle empirique arbitraire, affirmant que dès lors que l’effectif dépasse $n = 30$ par groupe, le postulat de normalité devient obsolète et le test t devient parfaitement « robuste ». Cette assertion relève d’une simplification méthodologique excessive :
La vitesse de convergence asymptotique garantie par le théorème central limite dépend intimement de la forme de la distribution d’origine. Si la population parente présente une asymétrie modérée, un effectif de $n = 30$ à 40 est en effet souvent suffisant pour que la distribution des moyennes soit approximativement normale. En revanche, si la distribution est hautement asymétrique (ex. : temps de réaction cognitifs ou concentrations de biomarqueurs) ou présente des queues extrêmement lourdes (distributions de type Cauchy, Pareto ou log-normale sévère), des effectifs de $n = 100$, 200, voire 500 participants par groupe peuvent s’avérer nécessaires pour compenser les distorsions distributionnelles.
De surcroît, le problème se complexifie dramatiquement lorsque des distributions non normales s’associent à des tailles d’échantillon inégales ($n_1 \neq n_2$), configuration fréquente qui altère la robustesse du test de Student.
5.3 Conséquences psychométriques de l’asymétrie et des valeurs extrêmes
Dans la recherche psychologique et comportementale, les violations de la normalité s’expriment principalement par l’asymétrie distributionnelle et la présence de valeurs aberrantes (outliers). Ces distorsions ont des répercussions directes sur l’ensemble de la mécanique inférentielle :
La moyenne arithmétique ($\bar{X}$) constitue l’estimateur de tendance centrale le plus efficace sous condition de stricte normalité gaussienne. Toutefois, elle possède un « point de rupture » (breakdown point) nul : il suffit d’une seule valeur extrême aberrante pour déplacer la moyenne de façon disproportionnée. L’écart-type d’échantillonnage ($s$) souffre d’une vulnérabilité quadratique accrue face aux valeurs extrêmes, puisqu’il somme les écarts élevés au carré.
Cette hypersensibilité génère deux effets pervers majeurs :
- L’écart-type est artificiellement dilaté, ce qui gonfle l’erreur standard au dénominateur du test t. Le ratio empirique chute, provoquant un effondrement drastique de la puissance statistique ($1 – \beta$). L’expérimentateur passe alors à côté d’effets réels faute de puissance.
- L’estimation de la taille d’effet standardisée — le d de Cohen — est biaisée vers le bas en raison de l’inflation de l’écart-type combiné, masquant l’amplitude psychologique concrète du phénomène étudié.
6. Outils et tests statistiques pour évaluer la normalité
L’évaluation rigoureuse de la normalité requiert une stratégie diagnostique multimodale combinant des outils graphiques d’inspection visuelle et des indicateurs numériques quantitatifs, tout en évitant les écueils liés aux tests d’hypothèses formels automatisés.
6.1 Méthodes graphiques d’inspection visuelle
L’examen graphique constitue systématiquement la première étape analytique incontournable. L’œil humain exercé est capable d’identifier instantanément des structures distributionnelles aberrantes que des indices scalaires agrégés ne parviennent pas à isoler.
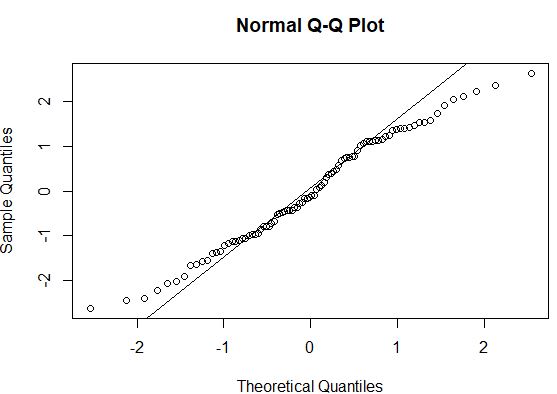
Le diagramme quantile-quantile (Q-Q plot normal) constitue l’outil visuel le plus puissant. Il met en relation les quantiles empiriques de la distribution observée (ordonnées) avec les quantiles théoriques d’une distribution normale parfaite de même moyenne et de même variance (abscisses). Si la normalité est respectée, les points s’alignent étroitement le long de la bissectrice droite diagonale :
- Une courbure systématique en forme de « J » ou de banane indique une asymétrie prononcée (positive ou négative).
- Une courbure sigmoïde en forme de « S » révèle un problème d’aplatissement, signalant des queues plus lourdes (leptocurticité) ou plus légères (platycurticité) que la gaussienne.
- Des points isolés s’écartant nettement de la trajectoire linéaire aux extrémités visualisent immédiatement les valeurs aberrantes.
D’autres représentations complètent utilement le Q-Q plot : l’histogramme avec superposition de la courbe de densité normale théorique permet d’apprécier la morphologie globale (présence éventuelle de bimodalité ou de multimodalité), tandis que le diagramme en boîte à moustaches (boxplot) identifie les scores atypiques au-delà de 1,5 fois l’écart interquartile.
6.2 Tests d’adéquation et métriques quantitatives
Pour étayer l’inspection visuelle, l’analyste dispose de métriques distributionnelles objectives et d’épreuves d’hypothèses formelles de conformité :
Les coefficients standardisés de forme fournissent une estimation directe de l’écart à la gaussienne :
- Le coefficient d’asymétrie (skewness de Fisher) : des valeurs comprises entre $-1$ et $+1$ sont généralement considérées comme tolérables pour un test paramétrique.
- Le coefficient d’aplatissement (kurtosis excessif) : une valeur nulle caractérise la loi normale. Des écarts substantiels (au-delà de l’intervalle $[-2, +2]$) signalent des risques de queues épaisses invalidant l’erreur standard.
Une règle empirique classique consiste à diviser le coefficient par son erreur standard d’estimation ($z_{\text{skew}} = \frac{\text{Skewness}}{SE_{\text{skew}}}$). Si cette valeur absolue dépasse 1,96 (au seuil critique $\alpha = 0{,}05$), l’hypothèse de symétrie est statistiquement rejetée.
Parmi les tests d’hypothèses de normalité formels :
- Le test de Shapiro-Wilk ($W$) : fondé sur la corrélation entre les quantiles ordonnés des données et les coefficients de covariance théoriques normaux. Il est universellement reconnu comme le test d’adéquation le plus puissant pour des effectifs petits à modérés ($n < 50$). Une statistique $W$ proche de 1 valide l'adéquation ; une valeur de $p < 0{,}05$ commande le rejet de la normalité.
- Le test de Kolmogorov-Smirnov avec correction de Lilliefors : basé sur la divergence maximale entre la fonction de répartition empirique et la fonction théorique. Nettement moins puissant que Shapiro-Wilk, il est aujourd’hui déconseillé pour les petits et moyens échantillons.
6.3 Le piège de la sur-sensibilité des tests formels
Une dépendance exclusive envers la valeur p issue de tests formels tels que Shapiro-Wilk ou Kolmogorov-Smirnov expose l’analyste à un double paradoxe méthodologique tributaire de la taille d’échantillon :
Dans les échantillons de grande taille ($N > 300$ ou 500 par condition), ces tests statistiques deviennent hypersensibles en vertu de l’accroissement de la puissance statistique. Ils rejetteront systématiquement l’hypothèse nulle de normalité ($p < 0{,}001$) pour des déviations minuscules et totalement bénignes qui n'altèrent en rien la validité du test t (le théorème central limite opérant alors pleinement). Le chercheur risque ainsi d’abandonner à tort un test paramétrique puissant au profit de tests de rangs moins informatifs.
À l’inverse, dans les échantillons restreints ($n < 20$ par condition) — précisément la situation où le test t est le plus vulnérable à la non-normalité —, les tests formels souffrent d’un manque criant de puissance statistique. Une distribution substantiellement asymétrique peut produire un test de Shapiro-Wilk non significatif ($p > 0{,}05$) par simple incapacité de détection due à l’effectif limité.
La communauté méthodologique préconise donc une stratégie de triangulation : ne jamais subordonner la décision à la seule p-valeur d’un test d’adéquation, mais conjuguer l’examen approfondi des Q-Q plots, l’amplitude des coefficients de skewness et de kurtosis, et la taille absolue de l’échantillon.
7. Stratégies de correction et alternatives face à la non-normalité
Face à une déviation attestée de la normalité sur des échantillons de taille modeste, le chercheur dispose d’un continuum d’options analytiques, allant de la transformation mathématique des échelles jusqu’aux approches computationnelles non paramétriques et robustes.
7.1 Transformations mathématiques des données brutes
La transformation de données consiste à appliquer une fonction mathématique monotone et continue à l’ensemble des scores bruts afin de remodeler la distribution empirique vers la symétrie gaussienne :
- La transformation logarithmique ($log(X)$ ou $ln(X + 1)$) : particulièrement efficace pour corriger une asymétrie positive marquée (étalement vers la droite) et stabiliser les variances proportionnelles à la moyenne. Elle est très employée sur les temps de réaction, les temps de fixation oculaire ou les indices salivaires de cortisol.
- La transformation racine carrée ($\sqrt{X}$) : idéale pour des données de comptage (ex. : nombre d’erreurs commises, nombre de rechutes) suivant une distribution de Poisson sous-jacente.
- La transformation inverse ou réciproque ($1/X$) : correction drastique pour des données d’asymétrie sévère. En chronométrie cognitive, elle convertit naturellement un temps de réponse en vitesse de traitement ($1/\text{temps}$).
- La famille de transformations de Box-Cox : algorithme d’optimisation paramétrique qui identifie la valeur optimale de puissance $lambda$ permettant de maximiser la normalité des résidus.
Cependant, les transformations mathématiques soulèvent des défis herméneutiques majeurs. Les résultats du test t s’expriment sur une échelle transformée (logarithmes, racines carrées), ce qui complique considérablement l’interprétation clinique et théorique directe des différences observées. De plus, une transformation logarithmique modifie l’hypothèse testée : le test compare désormais des moyennes géométriques et non plus des moyennes arithmétiques.
7.2 Méthodes non paramétriques
L’alternative classique la plus fréquemment mobilisée face à l’échec de la normalité est le basculement vers des méthodes d’inférence non paramétriques, au premier rang desquelles figure le test U de Mann-Whitney (strictement équivalent au test de la somme des rangs de Wilcoxon) :
Ce test abandonne les valeurs métriques brutes au profit de leurs rangs relatifs au sein de l’échantillon groupé combiné. Les scores sont classés par ordre croissant de 1 à $N$, et la somme des rangs attribuée à chaque condition expérimentale est comparée à son espérance théorique sous l’hypothèse nulle.
Une confusion épistémologique fréquente mérite toutefois d’être dissipée : le test U de Mann-Whitney n’est un test de comparaison de médianes que si et seulement si les deux populations partagent exactement la même forme distributionnelle (seul un décalage de position les distinguant). Si les distributions diffèrent par leur forme ou leur dispersion, Mann-Whitney teste formellement une hypothèse de dominance stochastique :
$$P(X > Y) = P(Y > X) = 0{,}50$$
soit la probabilité qu’un individu tiré au hasard dans le groupe 1 présente un score supérieur à un individu du groupe 2.
Sur le plan des performances, le test de Mann-Whitney présente une excellente efficacité relative asymptotique (environ 95,5 % de la puissance du test t lorsque les données sont en réalité normales). De plus, il traite adéquatement les ex-aequo (ties) par attribution de rangs moyens et conserve une résistance absolue aux valeurs aberrantes extrêmes.
7.3 Approches computationnelles modernes : Rééchantillonnage et statistiques robustes
Grâce à la puissance de calcul informatique contemporaine, la dichotomie rigide entre test t de Student et test de Mann-Whitney est aujourd’hui dépassée au profit de méthodes statistiques computationnelles supérieures :
Le bootstrapping (auto-amorçage non paramétrique), conceptualisé par Bradley Efron, s’affranchit de tout postulat de normalité théorique. L’algorithme génère des milliers de ré-échantillons virtuels (typiquement 2 000 à 10 000 itérations) tirés avec remise à partir de l’échantillon empirique initial :
À chaque itération, la différence entre les deux moyennes ré-échantillonnées ($\bar{X}_1^* – \bar{X}_2^*$) est calculée, ce qui permet de construire empiriquement la distribution d’échantillonnage exacte du paramètre. Le chercheur en dérive des intervalles de confiance bootstrappés corrigés pour le biais et accélérés ($BC_a$), offrant une inférence d’une fiabilité remarquable même sous forte asymétrie.
Les statistiques robustes de Rand Wilcox constituent une seconde voie d’excellence. Elles reposent sur l’utilisation des moyennes tronquées (trimmed means, élaguant typiquement 20 % des observations extrêmes à chaque queue) combinées aux variances de Winsor. Le test de Yuen pour moyennes tronquées offre une alternative robuste directe au test t, maintenant un taux $\alpha$ nominal et une puissance statistique optimale sans requérir l’abandon de l’échelle métrique originale des données.
8. Postulat 3 : L’homogénéité des variances (homoscédasticité)
Le troisième postulat fondamental conditionnant la validité du test t de Student traditionnel pour échantillons indépendants est l’égalité stricte des variances dans les populations parentes, propriété technique désignée sous le terme d’homoscédasticité.
8.1 Concept et formulation mathématique de l’homoscédasticité
L’hypothèse d’homogénéité des variances postule que les deux populations dont sont extraits les échantillons comparés présentent une dispersion interne strictement identique :
$$\sigma_1^2 = \sigma_2^2 = \sigma^2$$
Cette prémisse est cruciale pour le calcul du dénominateur du test t de Student. Sous cette condition d’égalité, le chercheur n’a pas à estimer deux variances distinctes, mais une unique variance commune inconnue ($\sigma^2$). Pour maximiser la précision de cette estimation, le modèle classique calcule une variance combinée (pooled variance, $s_p^2$) qui pondère la variance de chaque groupe par ses degrés de liberté respectifs :
$$s_p^2 = \frac{(n_1 – 1)s_1^2 + (n_2 – 1)s_2^2}{n_1 + n_2 – 2}$$
L’erreur standard de la différence de moyennes se simplifie alors :
$$SE = \sqrt{s_p^2 \left( \frac{1}{n_1} + \frac{1}{n_2} \right)}$$
Sur le plan conceptuel et psychométrique, l’homoscédasticité est intimement liée au principe d’additivité pure du traitement. Elle suppose que l’effet expérimental — s’il existe — s’exprime par une translation uniforme et constante de l’ensemble des scores du groupe expérimental le long de l’axe de mesure, sans modifier la variabilité interindividuelle relative. Si le traitement augmente ou réduit la dispersion des participants (par exemple en bénéficiant fortement à certains individus tout en restant inefficace chez d’autres), l’hypothèse d’additivité est violée et l’hétéroscédasticité émerge.
8.2 Conséquences de l’hétéroscédasticité selon la parité des effectifs
L’impact de la violation de l’homoscédasticité sur la validité du test t de Student dépend de manière critique du ratio entre les effectifs des deux échantillons ($n_1 / n_2$) :
Lorsque les effectifs sont rigoureusement égaux ($n_1 = n_2$), le test t de Student fait preuve d’une remarquable robustesse face à des hétérogénéités modérées de variance (ratios de variance de 2:1 ou 3:1). Dans cette situation symétrique, l’impact d’une sous-estimation de la variance d’un groupe est mathématiquement compensé par la surestimation de l’autre au sein de la variance combinée. Le taux réel d’erreur de type I reste proche du seuil nominal de 5 %.
En revanche, lorsque l’hétérogénéité des variances se conjugue avec des effectifs inégaux ($n_1 \neq n_2$), deux scénarios asymétriques aux conséquences délétères se produisent :
- Le cas libéral (le scénario du piège méthodologique) : le groupe dont l’effectif est le plus restreint présente la variance la plus élevée ($n_1 s_2^2$). Dans ce cas de figure, la variance combinée est indûment dominée par le grand échantillon à faible variance. L’erreur standard est lourdement sous-estimée, ce qui gonfle artificiellement la valeur de la statistique t. Le taux d’erreur de type I (α) subit une inflation dramatique, pouvant atteindre 15 %, 25 % voire plus de 40 % au lieu des 5 % théoriques prévus. Le chercheur produit des déclarations de significativité statistique factices.
- Le cas conservateur (le scénario d’atrophie de puissance) : le groupe ayant le plus grand effectif présente la variance la plus forte ($n_1 > n_2$ et $s_1^2 > s_2^2$). La variance combinée est alors artificiellement gonflée par le poids dominant du grand groupe, surestimant l’erreur standard globale. Le taux réel d’erreur de type I s’effondre en deçà de 5 % (souvent autour de 1 % ou 2 %), provoquant un déficit d’erreur $\alpha$ mais au prix d’une chute drastique de la puissance statistique ($1 – \beta$). L’étude s’avère incapable d’identifier un effet expérimental tangible.
9. Protocoles d’évaluation de l’homoscédasticité
Face à la menace posée par les variances inégales, le statisticien dispose d’un éventail d’instruments diagnostiques formels et informels pour quantifier l’écart à l’homogénéité.
9.1 Tests statistiques formels de comparaison de variances
Le test de comparaison de variances le plus ancien est le test F de Fisher-Snedecor ($F = s_1^2 / s_2^2$). Cependant, ce test souffre d’une hypersensibilité notoire : il est extrêmement vulnérable aux moindres écarts de normalité. Une distribution légèrement leptocurtique provoquera le rejet systématique de l’égalité des variances sans qu’il n’y ait d’hétéroscédasticité substantielle. Pour cette raison, le test F est aujourd’hui déconseillé comme test préliminaire.
Le standard analytique actuel repose sur le test d’homogénéité des variances de Levene (1960). Sa logique consiste à exécuter une analyse de variance univariée (ANOVA) sur les écarts absolus entre les scores individuels et la moyenne de leur groupe respectif :
$$z_{ij} = |Y_{ij} – \bar{Y}_j|$$
Le test évalue si la dispersion moyenne de ces déviations diffère significativement entre les conditions. Si le test de Levene affiche une valeur de $p < 0{,}05$, l'homoscédasticité est statistiquement rejetée.
Pour parer à la sensibilité résiduelle du test de Levene envers les données asymétriques, Brown et Forsythe (1974) ont introduit une variante robuste supérieure : le test de Brown-Forsythe. Cette variante substitue la médiane du groupe ($\tilde{Y}_j$) à la moyenne arithmétique pour le calcul des écarts absolus :
$$z_{ij} = |Y_{ij} – \tilde{Y}_j|$$
Cette formulation offre une stabilité exemplaire même sous de sévères déviations de la normalité gaussienne.
Enfin, le test de Fligner-Killeen constitue une alternative non paramétrique basée sur les rangs des déviations médianes, idéale lorsque les distributions des deux groupes violent simultanément la normalité et l’homoscédasticité.
9.2 Règles empiriques et inspection graphique
Comme pour la normalité, les tests formels d’homoscédasticité souffrent de dépendance vis-à-vis de la taille de l’échantillon : trop puissants sur grands échantillons (rejet pour des écarts dérisoires) et sous-puissants sur petits effectifs. D’où l’importance de critères heuristiques complémentaires :
- La règle du ratio de variance maximale sur minimale : l’analyste calcule le ratio $s_{\max}^2 / s_{\min}^2$. En présence d’effectifs égaux ($n_1 = n_2$), une valeur inférieure à 3 ou 4 est généralement tolérée par le test t classique. En revanche, si les effectifs sont inégaux (avec un ratio $n_{\max}/n_{\min} > 1{,}5$), un ratio de variance excédant 1,5 ou 2 doit impérativement inciter à la prudence et à l’abandon du modèle de Student classique.
- L’inspection graphique : l’utilisation conjointe de stripcharts (nuages de points individuels superposés), de graphiques d’intervalles d’écarts-types ou de diagrammes en boîte permet de comparer visuellement l’amplitude de dispersion des données entre les deux modalités.
10. Solutions méthodologiques à l’hétéroscédasticité : Le test t de Welch
Lorsqu’une situation d’hétéroscédasticité est avérée ou suspectée, l’inférence ne doit pas s’interrompre. Les mathématiciens ont développé une adaptation algorithmique élégante et universelle : le test t de Welch.
10.1 Mécanique du test t de Welch-Satterthwaite
Publié en 1938 par le statisticien britannique Bernard Lewis Welch et complété par F. E. Satterthwaite, le test t de Welch (ou test t pour variances inégales) modifie radicalement le calcul de l’erreur standard et des degrés de liberté associés.
Le test de Welch renonce définitivement au calcul d’une variance combinée ($s_p^2$). Il utilise directement les variances estimées propres à chaque échantillon pour déterminer l’erreur standard de la différence :
$$t_{\text{Welch}} = \frac{\bar{X}_1 – \bar{X}_2}{\sqrt{\frac{s_1^2}{n_1} + \frac{s_2^2}{n_2}}}$$
La statistique $t_{\text{Welch}}$ qui en résulte ne suit plus exactement une distribution de Student classique basée sur les degrés de liberté additifs ($n_1 + n_2 – 2$). L’innovation fondamentale de Welch et Satterthwaite consiste à calculer des degrés de liberté effectifs corrigés ($\nu^*$), calculés selon l’équation suivante :
$$\nu^* = \frac{\left(\frac{s_1^2}{n_1} + \frac{s_2^2}{n_2}\right)^2}{\frac{\left(\frac{s_1^2}{n_1}\right)^2}{n_1 – 1} + \frac{\left(\frac{s_2^2}{n_2}\right)^2}{n_2 – 1}}$$
Ces degrés de liberté corrigés présentent la particularité de ne plus être nécessairement entiers : ils prennent des valeurs décimales (ex. : $\nu^* = 34{,}72$). Cette valeur décimale traduit l’ajustement continu de la loi de distribution en fonction de l’asymétrie conjointe des variances et des effectifs.
Le résultat de cet ajustement est remarquable : le test de Welch maintient le taux d’erreur de première espèce (α) rigoureusement calé sur sa valeur nominale (5 %), que les variances soient identiques ou radicalement hétérogènes, et ce quels que soient les effectifs respectifs des groupes.
10.2 Le débat méthodologique : Test de Welch par défaut ou procédure séquentielle ?
Durant plusieurs décennies, les manuels d’enseignement ont préconisé une démarche conditionnelle en deux étapes dite « séquentielle » :
- L’analyste applique un test de Levene pour tester l’égalité des variances.
- Si le test de Levene n’est pas significatif ($p \geq 0{,}05$), l’analyste recourt au test t classique de Student avec variance combinée.
- Si le test de Levene est significatif ($p < 0{,}05$), l'analyste bascule vers le test de Welch.
Ce protocole en deux étapes a fait l’objet de critiques dévastatrices dans la littérature méthodologique contemporaine (notamment par Hayes & Cai en 2007, et Delacre, Lakens & Leys en 2017). Les simulations de Monte-Carlo démontrent que cette procédure préliminaire conditionnelle perturbe la maîtrise du risque d’erreur de type I global. En effet, en raison du manque de puissance du test de Levene sur petits échantillons, l’analyste est fréquemment renvoyé vers le test t classique alors même qu’une hétérogénéité nuisible est présente, provoquant des faux positifs non détectés.
De plus, lorsque les variances sont en réalité parfaitement égales, le test de Welch affiche des performances asymptotiques et une puissance statistique rigoureusement équivalentes à celles du test de Student (la perte d’efficacité est infinitésimale, inférieure à 1 %). En conséquence, le consensus méthodologique moderne recommande d’adopter le test t de Welch par défaut comme standard systématique d’analyse pour la comparaison de deux échantillons indépendants, rendant caduque l’exécution préliminaire du test de Levene.
11. Postulat 4 : L’échantillonnage aléatoire et la représentativité
Le quatrième postulat — l’échantillonnage probabiliste et la représentativité des données — se situe à la croisée de la formalisation mathématique et de l’épistémologie méthodologique. C’est lui qui confère au test t sa légitimité à titre d’instrument d’inférence vers le monde réel.
11.1 Définition théorique et portée épistémique du tirage aléatoire
L’inférence statistique classique s’enracine dans la théorie des probabilités appliquées à des populations définies. Le modèle standard suppose que chaque échantillon étudié est le produit d’un échantillonnage aléatoire simple, processus par lequel chaque unité élémentaire de la population parente cible dispose d’une probabilité strictement égale et non nulle d’être sélectionnée :
$$P(S_k) = \frac{1}{\binom{N}{n}}$$
Ce tirage aléatoire garantit que l’erreur d’échantillonnage s’organise de manière non systématique, autorisant la modélisation formelle de sa distribution théorique. Il assure ainsi la validité externe et la généralisabilité des inférences tirées de l’échantillon empirique.
Il est impératif d’opérer une distinction nette entre deux concepts fréquemment confondus par les étudiants et les jeunes chercheurs :
- La sélection aléatoire (random selection) : modalité d’échantillonnage qui détermine si les conclusions statistiques peuvent être valablement généralisées de l’échantillon vers la population parente globale (validité externe).
- L’assignation aléatoire (random assignment ou randomisation) : processus expérimental consistant à répartir par tirage au sort les participants déjà recrutés entre les différentes conditions expérimentales (groupe témoin versus groupe expérimental). L’assignation aléatoire contrôle les variables de confusion potentielles et fonde l’inférence causale interne, indépendamment de la représentativité de l’échantillon initial.
11.2 Les biais d’échantillonnage endémiques en psychologie
Si la théorie de l’échantillonnage aléatoire simple constitue la pierre angulaire des mathématiques inférentielles, la pratique concrète des sciences comportementales en offre un contraste frappant. Les échantillons aléatoires authentiques sont quasi inexistants dans la littérature expérimentale en psychologie.
Une fragilité endémique réside dans la dépendance historique envers des échantillons de convenance universitaires. Dans un article devenu célèbre, Henrich, Heine et Norenzayan (2010) ont démontré que l’immense majorité des publications de psychologie reposait sur des populations qualifiées d’échantillons WEIRD (Western, Educated, Industrialized, Rich, Democratic) :
Ces populations ne représentent qu’environ 12 % de la démographie mondiale, mais fournissent plus de 80 % des données empiriques des revues de référence. Les étudiants de premier cycle en psychologie participant à des études contre des crédits de cours constituent un sous-groupe hyper-spécifique, présentant des singularités en termes d’âge, de développement cognitif, d’intégration socioculturelle et de fonctionnement métacognitif.
À ces spécificités s’ajoutent d’autres biais méthodologiques persistants :
- Les biais d’auto-sélection : le recours massif aux plateformes participatives de recrutement en ligne (Amazon Mechanical Turk, Prolific, crowdsourcing) attire des volontaires partageant des motivations financières précises et une familiarité excessive avec les paradigmes expérimentaux traditionnels (« participants professionnels »).
- L’attrition différentielle : dans les études longitudinales ou les protocoles d’intervention exigeants, la perte sélective de participants entre le pré-test et le post-test (par exemple, abandon préférentiel des sujets les plus déprimés dans une intervention clinique) détruit l’homogénéité initiale et biaise gravement la représentativité résiduelle.
- La restriction d’étendue (range restriction) : la sélection involontaire d’une sous-population restreinte comprime artificiellement la variance observée par rapport à la variance de la population générale, distordant les tests de différence de moyennes.
11.3 Atténuation et déclaration des faiblesses d’échantillonnage
Puisqu’il est souvent impossible d’opérer un tirage aléatoire pur à l’échelle d’une population nationale ou continentale, le chercheur doit déployer des stratégies d’atténuation et de transparence méthodologique rigoureuses :
Sur le plan computationnel, des techniques de redressement statistique a posteriori peuvent corriger partiellement les déséquilibres d’échantillonnage :
- La stratification a posteriori (post-stratification weighting) : elle consiste à attribuer des coefficients de pondération analytiques aux observations afin de réaligner la structure démographique de l’échantillon (en termes de genre, d’âge, de catégorie socio-professionnelle) sur la structure connue de la population cible issue de recensements nationaux.
- Le calcul des scores de propension : employé pour rééquilibrer les covariables pré-existantes dans des plans quasi-expérimentaux non randomisés.
Sur le plan épistémologique, l’honnêteté scientifique impose d’abandonner les prétentions à l’universalité abstraite lorsque les données sont issues d’échantillons de convenance. Les chercheurs sont invités à formaliser explicitement les déclarations de contraintes de généralisabilité (Constraints on Generality – COG statements), identifiant formellement les caractéristiques des populations pour lesquelles les effets observés sont présumés s’appliquer, et celles pour lesquelles une extrapolation demeure spéculative.
Enfin, le mouvement récent vers les réplications directes multi-sites (consortiums Psychological Science Accelerator, projets Many Labs) permet de collecter des données à travers des dizaines de laboratoires internationaux simultanés, neutralisant les idiosyncrasies locales et rétablissant la validité écologique et transculturelle de l’inférence.
12. Synthèse décisionnelle et bonnes pratiques d’application en recherche quantitative
Pour l’analyste confronté à des données concrètes, l’articulation méthodique de ces quatre postulats requiert une stratégie opérationnelle claire, standardisée et conforme aux meilleures exigences académiques.
12.1 Arbre de décision intégré pour l’analyste de données
L’arbre de décision suivant synthétise le cheminement diagnostique et le choix du modèle optimal :
-
Étape 1 : Diagnostic de la structure d’indépendance
- Les données comportent-elles des mesures répétées ou des paires appariées ?
→ Oui : Abandonner le test t indépendant. Utiliser le test t pour échantillons appariés ou un modèle mixte. - Les participants sont-ils regroupés dans des grappes (classes, centres, sessions collectives) ?
→ Oui : Évaluer le CCI. Si $\text{CCI} > 0{,}02$, adopter des modèles linéaires mixtes avec intercepts aléatoires ou des équations GEE. - Les observations sont-elles strictement indépendantes ?
→ Poursuivre vers l’Étape 2.
- Les données comportent-elles des mesures répétées ou des paires appariées ?
-
Étape 2 : Évaluation conjointe de la distribution et de la taille d’échantillon
- Inspecter les Q-Q plots et vérifier l’asymétrie/kurtosis au sein de chaque groupe.
- Les effectifs sont-ils élevés ($n_1, n_2 \geq 40$) sans présence de valeurs aberrantes extrêmes ?
→ Oui : Le Théorème Central Limite assure la robustesse distributionnelle. Poursuivre vers l’Étape 3. - Les effectifs sont-ils réduits ($n < 30$) et la distribution viole-t-elle substantiellement la normalité (asymétrie sévère, bimodalité) ?
→ Oui : Deux orientations s’imposent :- Si les hypothèses portent sur des rangs/stochastique : Test U de Mann-Whitney.
- Si les hypothèses portent sur la tendance centrale métrique : Test de Yuen sur moyennes tronquées ou Bootstrapping $BC_a$ de la différence de moyennes.
-
Étape 3 : Évaluation de la dispersion et choix de la variante du test
- Les effectifs sont-ils égaux ou inégaux ? Les variances sont-elles équivalentes ou hétérogènes ?
→ Recommandation universelle : Retenir systématiquement le test t de Welch (avec degrés de liberté corrigés de Welch-Satterthwaite) par défaut, éliminant tout risque lié à l’hétéroscédasticité potentielle sans perte substantielle de puissance.
- Les effectifs sont-ils égaux ou inégaux ? Les variances sont-elles équivalentes ou hétérogènes ?
12.2 Normes de rapportage selon les standards académiques (APA 7e édition)
Les normes de l’American Psychological Association (APA 7e édition) exigent une transparence exemplaire dans la communication des résultats inférentiels. Un rapportage rigoureux ne doit plus se résumer à l’assertion simpliste d’une valeur de p :
L’auteur doit explicitement stipuler que la conformité aux postulats du modèle a été vérifiée en amont : mention des protocoles d’isolation garantissant l’indépendance, description des inspections visuelles des distributions (Q-Q plots), et justification argumentée du choix de la statistique de test. Lorsque le test de Welch est employé — ce qui devrait constituer la norme académique standard —, les degrés de liberté effectifs corrigés doivent être rapportés avec leurs valeurs décimales exactes.
Le rapportage d’une taille d’effet standardisée et de son incertitude estimationnelle est impératif. Pour le test de Welch, il est vivement recommandé de rapporter le g de Hedges corrigé (plutôt que le d de Cohen traditionnel, souvent biaisé sous hétéroscédasticité), accompagné systématiquement de son intervalle de confiance à 95 %.
Voici un gabarit de formulation empirique conforme aux exigences de publication contemporaines :
« Afin d’évaluer l’impact du programme d’entraînement à la pleine conscience sur le niveau d’anxiété pré-compétitive, un test t de Welch pour échantillons indépendants a été conduit en raison de la divergence des variances observées entre les cohortes. L’indépendance des observations a été garantie par des passations en cabines isolées sans interaction entre participants. L’inspection des diagrammes quantile-quantile (Q-Q plots) et les indices de dissymétrie ($\text{skewness} < |0{,}65|$) ont attesté d'une distribution compatible avec la normalité dans chaque condition. Les participants du groupe expérimental ($M = 18{,}42$, $SD = 3{,}15$, $n_1 = 28$) ont affiché des scores d'anxiété significativement inférieurs à ceux des participants du groupe contrôle ($M = 23{,}78$, $SD = 5{,}82$, $n_2 = 24$), $t(34{,}87) = 3{,}98$, $p < 0{,}001$, $g_{\text{Hedges}} = 1{,}13$, $IC_{95%} [0{,}53, 1{,}72]$. Ces résultats attestent d'une réduction cliniquement et statistiquement robuste de l'anxiété pré-compétitive sous l'effet de l'intervention. »
12.3 Matrice récapitulative des postulats et conséquences de leurs violations
Le tableau analytique ci-dessous synthétise la hiérarchie de gravité relative, les répercussions empiriques et les solutions logicielles contemporaines associées à chaque postulat du modèle :
| Postulat | Gravité de la violation | Impact direct sur l’inférence | Méthode diagnostique recommandée | Alternatives et corrections |
|---|---|---|---|---|
| 1. Indépendance des observations | Critique / Fatale | Sous-estimation massive du SE ; explosion drastique du taux d’erreur $\alpha$ (faux positifs incontrôlés). | Audit du devis expérimental ; calcul du CCI ; test de Durbin-Watson sur les résidus. | Modèles linéaires mixtes (LMM) ; modèles GEE ; test t apparié ; agrégation au niveau supérieur. |
| 2. Normalité distributionnelle | Modérée à Faible (selon $N$) | Perte de puissance statistique ($1 – \beta$) ; distorsion de la moyenne et du d de Cohen sous forte asymétrie. | Inspection visuelle (Q-Q plots, histogrammes) ; skewness / kurtosis ; test de Shapiro-Wilk (pour $n < 50$). | Test t asymptotique (si $N > 40$) ; test de Yuen (moyennes tronquées) ; bootstrapping $BC_a$ ; test de Mann-Whitney. |
| 3. Homoscédasticité (égalité des variances) | Majeure (si effectifs inégaux) | Scénario libéral : inflation de $\alpha$ (jusqu’à 40 %). Scénario conservateur : effondrement de la puissance. | Ratio $s_{\max}^2 / s_{\min}^2$ ; test de Brown-Forsythe ; test de Levene basé sur la médiane. | Test t de Welch systématique par défaut (avec correction de Welch-Satterthwaite). |
| 4. Échantillonnage représentatif | Épistémique / Contextuelle | Biais de sélection ; altération de la validité externe et restriction arbitraire de la transférabilité des conclusions. | Audit des biais de recrutement (échantillons WEIRD) ; analyse de l’attrition différentielle. | Pondération par post-stratification ; déclarations des contraintes de généralisabilité (COG) ; réplications multi-sites. |
En conclusion de ce panorama méthodologique, il apparaît clairement que le test t n’est ni un simple presse-bouton logiciel, ni une formule figée universelle. Il représente un modèle mathématique dont l’élégance n’a d’égale que la précision de ses axiomes. À l’ère contemporaine de la science ouverte et de la reproductibilité, l’analyste quantitatif averti se distingue par sa capacité à auditer scrupuleusement la structure probabiliste de ses données, à rejeter les procédures automatiques obsolètes et à mobiliser avec discernement les alternatives modernes les plus robustes — au premier rang desquelles l’emploi systématique du test de Welch et des méthodes de rééchantillonnage computationales.
Références
- Brown, M. B., & Forsythe, A. B. (1974). Robust tests for the equality of variances. Journal of the American Statistical Association, 69(346), 364-367. https://doi.org/10.1080/01621459.1974.10482955
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch’s t-test instead of Student’s t-test. International Review of Social Psychology, 30(1), 92-101. https://doi.org/10.5334/irsp.82
- Efron, B., & Tibshirani, R. J. (1994). An introduction to the bootstrap. CRC Press. https://doi.org/10.1201/9780429246593
- Hayes, A. F., & Cai, L. (2007). Further evaluating the conditional inference model for comparing two independent groups: The Welch test and the test of Levene. Psychological Methods, 12(4), 488-504. https://doi.org/10.1037/1082-989X.12.4.488
- Henrich, J., Heine, S. J., & Norenzayan, A. (2010). The weirdest people in the world? Behavioral and Brain Sciences, 33(2-3), 61-83. https://doi.org/10.1017/S0140525X0999152X
- Hurlbert, S. H. (1984). Pseudoreplication and the design of ecological field experiments. Ecological Monographs, 54(2), 187-211. https://doi.org/10.2307/1942661
- Levene, H. (1960). Robust tests for equality of variances. In I. Olkin, S. G. Ghurye, W. Hoeffding, W. G. Madow, & H. B. Mann (Eds.), Contributions to Probability and Statistics: Essays in Honor of Harold Hotelling (pp. 278-292). Stanford University Press.
- Satterthwaite, F. E. (1946). An approximate distribution of estimates of variance components. Biometrics Bulletin, 2(6), 110-114. https://doi.org/10.2307/3002019
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591-611. https://doi.org/10.2307/2333709
- Simons, D. J., Shoda, Y., & Lindsay, D. S. (2017). Constraints on generality (COG): A proposed addition to all empirical papers. Perspectives on Psychological Science, 12(6), 1123-1128. https://doi.org/10.1177/1745691617708630
- Student [Gosset, W. S.]. (1908). The probable error of a mean. Biometrika, 6(1), 1-25. https://doi.org/10.1093/biomet/6.1.1
- Welch, B. L. (1938). The significance of the difference between two means when the population variances are unequal. Biometrika, 29(3/4), 350-362. https://doi.org/10.1093/biomet/29.3-4.350
- Wilcox, R. R. (2012). Introduction to robust estimation and hypothesis testing (3rd ed.). Academic Press. https://doi.org/10.1016/C2010-0-67044-5