
Dans le vaste champ de l’analyse quantitative appliquée aux sciences humaines, sociales et comportementales, la modélisation statistique repose traditionnellement sur le postulat d’une relation rectiligne entre les variables explicatives et les critères mesurés. La régression linéaire simple et multiple, par son élégance algorithmique et sa relative simplicité d’interprétation, constitue la pierre angulaire de la formation méthodologique universitaire. Néanmoins, l’observation empirique de la réalité psychologique, physiologique et sociale démontre sans équivoque que la majorité des processus dynamiques, adaptatifs ou homéostatiques ne se conforment pas à une dynamique strictement linéaire. Les phénomènes de seuil, les rendements décroissants, les points de bascule émotionnels et les ajustements homéostatiques imposent aux chercheurs de dépasser le carcan de la proportionnalité constante afin d’éviter des erreurs de spécification majeures.
Face à des structures de données présentant des courbures manifestes, la régression polynomiale émerge comme l’extension paramétrique la plus immédiate, la plus rigoureuse et la plus féconde du modèle linéaire général. En intégrant des puissances successives d’un ou plusieurs prédicteurs continus au sein de l’équation prédictive, ce paradigme analytique permet de capturer avec une grande précision mathématique des trajectoires non linéaires complexes, telles que des dynamiques en cloche, des fonctions de saturation ou des oscillations polyphasiques, tout en conservant l’infrastructure inférentielle robuste des moindres carrés ordinaires. Pourtant, son adoption ne saurait être le fruit d’un automatisme calculatoire ou d’un opportunisme statistique visant à gonfler artificiellement le coefficient de détermination.
Le recours à la modélisation polynomiale soulève des défis épistémologiques, algébriques et méthodologiques considérables : risque accru de multicolinéarité structurelle, instabilité prédictive aux extrémités du domaine expérimental (phénomène de Runge), surajustement aux fluctuations aléatoires de l’échantillon et complexification de l’interprétation théorique des coefficients. Dès lors, une question fondamentale s’impose à tout méthodologue et chercheur rigoureux : quand et comment devriez-vous utiliser la régression polynomiale ? Cet article propose une exploration exhaustive, théorique et appliquée de cette approche, détaillant ses fondements mathématiques, ses protocoles de diagnostic visuel et résiduel, ses applications canoniques en psychologie, ses critères stricts de sélection de modèles et ses alternatives contemporaines.
1. Fondements théoriques et formulation mathématique de la régression polynomiale
1.1 Définition structurelle du modèle polynomial
La modélisation polynomiale d’un phénomène quantitatif repose sur l’extension algébrique du modèle linéaire standard par l’adjonction de termes exponentiels successifs assignés à une variable indépendante continue. Dans sa formulation univariée générale d’ordre $k$, l’équation mathématique liant la variable dépendante $Y$ au prédicteur continu $X$ pour la $i$-ème observation s’exprime sous la forme rigoureuse suivante :
$$Y_i = \beta_0 + \beta_1 X_i + \beta_2 X_i^2 + \beta_3 X_i^3 + dots + \beta_k X_i^k + \varepsilon_i$$
Dans cette formalisation canonique, le paramètre $\beta_0$ représente l’ordonnée à l’origine (ou constante du modèle), désignant la valeur attendue de $Y$ lorsque le prédicteur $X$ s’annule strictement. Les paramètres $\beta_1, \beta_2, dots, \beta_k$ correspondent aux coefficients de régression partiels associés aux puissances progressives de la variable indépendante, tandis que le terme $\varepsilon_i$ capture l’erreur résiduelle stochastique, supposée classiquement de moyenne nulle et de variance constante dans le cadre des moindres carrés ordinaires.
Il importe d’opérer une distinction épistémologique et méthodologique fondamentale, fréquemment source de confusions conceptuelles chez les praticiens : la régression polynomiale demeure, sur le plan strictement statistique, un modèle linéaire. Cette affirmation s’appuie sur la distinction théorique entre la linéarité par rapport aux variables explicatives et la linéarité par rapport aux paramètres estimés. Bien que la fonction liant $Y$ à $X$ soit intrinsèquement non linéaire au sens géométrique en raison des termes $X^2, X^3, dots, X^k$, l’équation prédictive demeure rigoureusement linéaire par rapport à ses paramètres $\beta$. Les dérivées partielles de la fonction d’espérance conditionnelle par rapport à chaque coefficient $\beta_j$ ne dépendent en aucun cas des autres paramètres inconnus, ce qui garantit la convexité de la fonction de perte quadratique et autorise l’obtention d’une solution analytique exacte sous forme close via les équations normales matricielles :
$$\mathbf{\hat{\beta}} = (\mathbf{X}^T \mathbf{X})^{-1} \mathbf{X}^T \mathbf{Y}$$
Par conséquent, les hypothèses classiques du modèle linéaire général continuent de gouverner l’ensemble du processus d’estimation et d’inférence. L’espérance conditionnelle des erreurs doit satisfaire l’hypothèse de nullité, soit $E(\varepsilon_i | X_i) = 0$, ce qui implique que la composante polynomiale doit capturer fidèlement l’intégralité de la structure fonctionnelle déterministe. Les termes d’erreur doivent en outre manifester une variance homoscédastique conditionnelle, vérifiant l’égalité $Var(\varepsilon_i | X_i) = \sigma^2$, et demeurer mutuellement non corrélés, c’est-à-dire $Cov(\varepsilon_i, \varepsilon_j) = 0$ pour tout $i \neq j$. L’hypothèse de normalité multidimensionnelle des résidus résiste également en tant que prérequis conditionnant la validité des distributions théoriques de Student et de Fisher mobilisées lors des tests d’hypothèses univariés et omnibulaires.
1.2 Différenciation conceptuelle avec la régression linéaire simple
L’inadéquation structurelle des modèles à pente constante apparaît de manière flagrante dès lors que le processus empirique sous-jacent implique des dynamiques d’accélération, de décélération, d’inversion directionnelle ou de saturation asymptotique. Dans une régression linéaire simple classique, la dérivée première de la fonction conditionnelle par rapport au prédicteur est strictement invariante :
$$\frac{dY}{dX} = \beta_1$$
Cette propriété mathématique impose l’axiome réducteur selon lequel une variation d’une unité de $X$ induit invariablement le même effet différentiel moyen sur $Y$, indépendamment du point de départ sur l’échelle de mesure. Or, dans les systèmes biologiques, cognitifs ou sociaux, l’impact marginal d’une ressource ou d’un stimulus s’altère inévitablement à mesure que son intensité s’accroît. Ignorer cette réalité fonctionnelle engendre une erreur systématique de spécification, conduisant à des prédictions biaisées et à une sous-estimation systématique de la variance expliquée par le construit investigué.
La justification formelle du recours aux formulations polynomiales s’enracine profondément dans l’analyse mathématique, et plus spécifiquement dans le théorème de Taylor et le théorème d’approximation de Stone-Weierstrass. En vertu du développement de Taylor avec reste, toute fonction arbitraire $f(x)$ continûment différentiable jusqu’à l’ordre $k+1$ sur un intervalle compact $[a, b]$ peut être décomposée au voisinage d’un point central $x_0$ selon l’expression formelle :
$$f(x) = \sum_{m=0}^{k} \frac{f^{(m)}(x_0)}{m!} (x – x_0)^m + R_k(x)$$
où $R_k(x)$ désigne le reste de Lagrange, caractérisant l’erreur d’approximation locale. Sur le plan épistémologique, la régression polynomiale n’exige pas que la véritable loi de la nature régissant les variables soit fondamentalement un polynôme algébrique parfait ; elle exploite plutôt cette propriété fondamentale pour approximer localement n’importe quelle fonction continue et lisse inconnue. Cette flexibilité mathématique considérable s’obtient sans abandonner le cadre opératoire et inférentiel immensément maîtrisé de l’estimation par les moindres carrés ordinaires, offrant ainsi un compromis puissant entre souplesse de modélisation et tractabilité analytique.
1.3 Pertinence méthodologique en psychologie et sciences du comportement
L’étude scientifique de l’esprit, des affects et des conduites humaines confronte inéluctablement le chercheur à une complexité systémique où la non-linéarité constitue la règle fondamentale plutôt que l’exception anecdotique. Les construits psychologiques latents, tels que la mémoire de travail, l’anxiété situationnelle, l’auto-efficacité, la motivation intrinsèque ou l’engagement professionnel, interagissent selon des mécanismes régulés par des boucles de rétroaction bio-psycho-sociales. Ces boucles génèrent des dynamiques d’épuisement, de compensation adaptative et d’inhibition réciproque.
Pendant des décennies, une tendance dominante en psychométrie appliquée a consisté à imposer une linéarisation forcée aux observations empiriques, sous prétexte d’appliquer le principe de parcimonie scientifique (le rasoir d’Ockham). Cette pratique méthodologique s’est souvent avérée délétère pour l’avancement théorique. Considérer qu’une augmentation de la charge mentale produit une détérioration continue et uniforme des fonctions exécutives constitue une simplification fallacieuse. De même, postuler que l’anxiété dégrade de façon purement monotone les performances mnésiques masque la réalité clinique des stratégies d’adaptation temporaires déployées par le sujet.
La transition d’une approche strictement descriptive vers une modélisation théorique fine exige l’adoption d’équations capables de matérialiser ces points de rupture fonctionnels. L’utilisation raisonnée de la régression polynomiale en psychologie permet d’opérationnaliser formellement des concepts théoriques de premier plan, tels que le niveau de tolérance psychologique optimale, le point critique de bascule affective vers l’épuisement professionnel (burnout), ou encore le phénomène d’adaptation hédonique. En accordant aux données empiriques la liberté géométrique de révéler leurs courbures intrinsèques, le chercheur s’affranchit des artéfacts de linéarisation pour accéder à une cartographie fidèle des processus psychologiques sous-jacents.
2. Diagnostic visuel initial : L’analyse exploratoire du nuage de points
2.1 Examen de la configuration bivariée brute
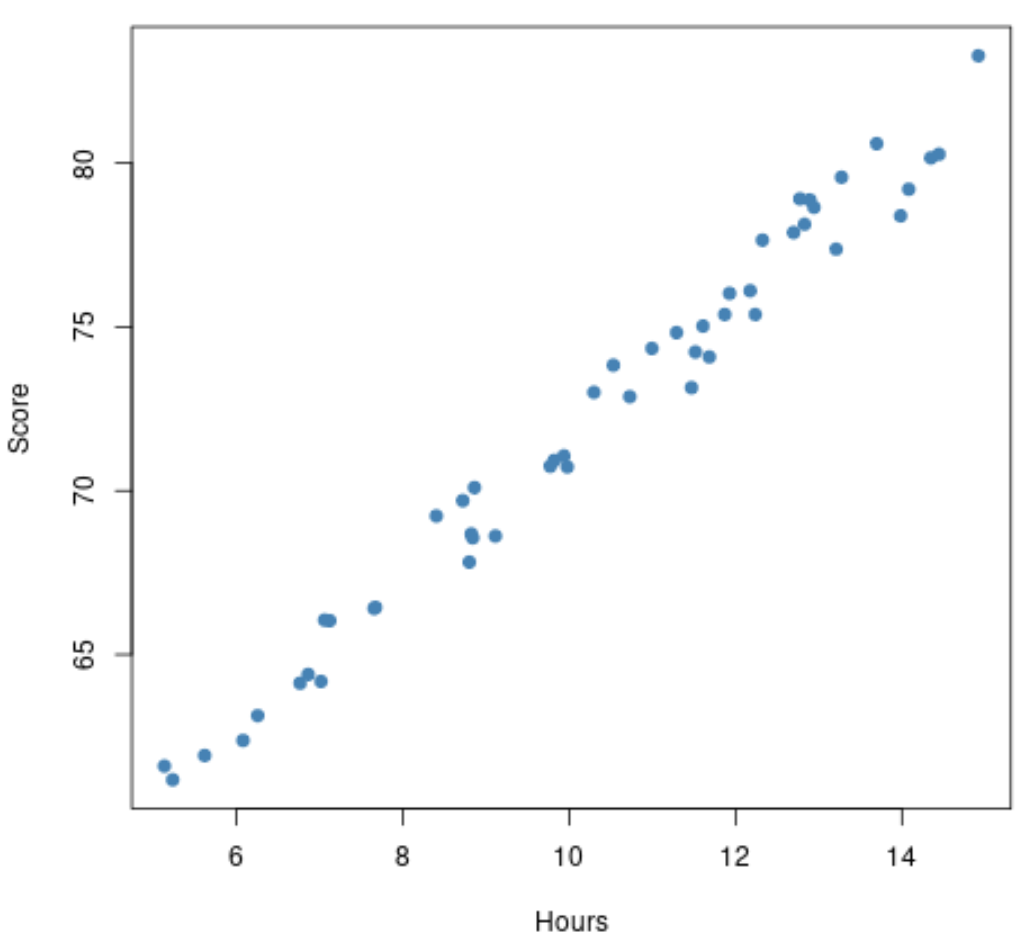
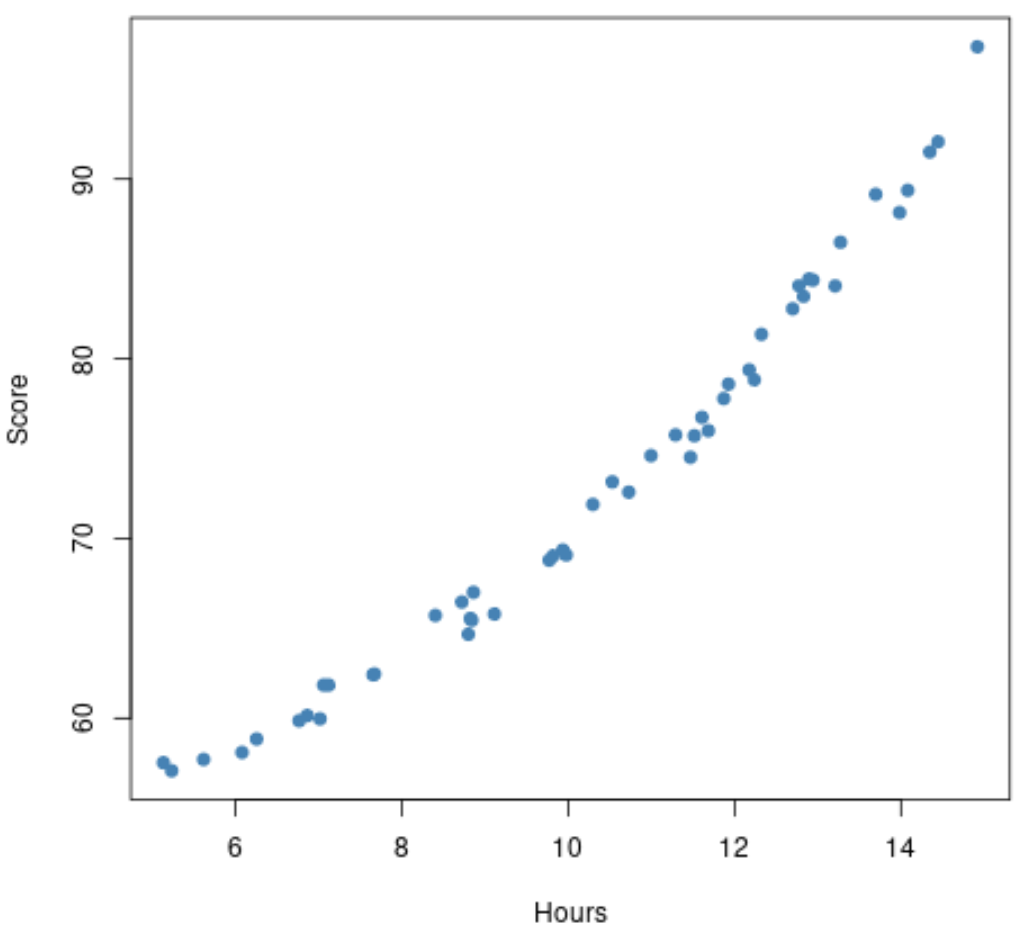
Tout protocole d’analyse quantitative rigoureux doit débuter par une analyse exploratoire approfondie des données, dont l’étape inaugurale est l’inspection scrupuleuse de la configuration géométrique du nuage de points au sein du diagramme de dispersion bivarié. L’œil humain constitue un instrument heuristique d’une remarquable puissance pour identifier des structures émergentes, des discontinuités topologiques et des trajectoires non linéaires globales. Cette analyse visuelle vise à repérer la présence éventuelle d’inflexions concaves ou convexes, de courbures symétriques en cloche, ou d’asymptotes empiriques suggérant que la trajectoire conditionnelle de $Y$ s’écarte substantiellement d’une trajectoire rectiligne.
Une démarche préliminaire hautement informative consiste à superposer sur ce même diagramme de dispersion deux trajectoires d’ajustement géométrique distinctes : d’une part, la droite classique issue de la régression linéaire simple univariée, et d’autre part, la courbe parabolique issue d’un ajustement quadratique de second ordre. Si la droite linéaire traverse le nuage de points en sous-estimant systématiquement les valeurs de $Y$ au centre de la distribution de $X$ tout en surestimant ces mêmes valeurs aux deux extrémités distales (ou inversement), cette divergence systématique constitue un indice visuel flagrant d’une mauvaise spécification fonctionnelle linéaire. Les seuils de rupture visuelle et les changements de direction de la densité de points trahissent la présence d’une dynamique non monotone que seule une formulation mathématique d’ordre supérieur est susceptible de modéliser avec fidélité.
2.2 Superposition de lisseurs non paramétriques (LOESS)
Afin de guider l’intuition du chercheur sans lui imposer a priori une contrainte paramétrique rigide sur la forme globale de la relation, l’adjonction d’un lisseur non paramétrique local représente une pratique d’excellence méthodologique. Parmi les algorithmes disponibles, la régression pondérée localement par dispersion de nuages de points, universellement désignée sous l’acronyme LOESS (ou LOWESS), s’avère particulièrement appropriée pour diagnostiquer la nature de la courbure fonctionnelle.
Le principe fondamental du lisseur LOESS consiste à estimer la valeur prédite en chaque point $x$ du support continu par le biais d’un ajustement de régression linéaire ou quadratique pondéré, calculé exclusivement sur une fraction locale de données définies à l’intérieur d’une fenêtre glissante (paramètre de lissage ou span). Les observations situées à proximité immédiate du point cible reçoivent des pondérations maximales (souvent déterminées par une fonction de noyau tricubique), tandis que les observations plus distantes voient leur influence s’annuler graduellement. Cette procédure non paramétrique produit une courbe empirique d’une grande fluidité géométrique, affranchie des hypothèses de modélisation globales et résistante aux perturbations locales du bruit stochastique.
L’observation attentive de la trajectoire LOESS permet d’identifier sans ambiguïté les régimes de concavité et de convexité locaux du phénomène étudié. Si la courbe non paramétrique révèle une seule inversion de courbure majeure (une allure générale de parabole orientée vers le haut ou vers le bas), un polynôme de degré 2 (quadratique) apparaîtra conceptuellement et empiriquement justifié. En revanche, si le lisseur dévoile deux inversions successives dessinant une silhouette sigmoïdale ou en « S », l’hypothèse d’une composante d’ordre 3 (cubique) sera immédiatement convoquée. Le LOESS agit ainsi comme un étalon neutre, permettant d’aligner l’ordre du polynôme candidat sur la structure géométrique intrinsèque des données sans biaiser prématurément le processus d’ajustement.
2.3 Limites de l’inspection visuelle et risques d’artéfacts
Bien que l’analyse graphique bivariée et le lissage non paramétrique constituent des préalables exploratoires incontournables, s’en remettre exclusivement au jugement visuel expose le chercheur à des écueils interprétatifs majeurs. La psychologie cognitive de la perception a largement démontré la tendance systématique de l’esprit humain à rechercher et à imposer des motifs réguliers (paréidolie de régularité) au sein de distributions purement aléatoires. Des agrégats stochastiques d’observations distantes, combinés à une forte dispersion hétérogène de points marginaux aux confins de la distribution expérimentale, peuvent artificiellement conférer une apparence de courbure globale à un nuage de points dont le véritable mécanisme générateur sous-jacent est purement rectiligne.
Ce phénomène d’illusion visuelle s’exacerbe dramatiquement lorsque la taille de l’échantillon est réduite ou que la variance résiduelle du phénomène est substantielle. Quelques points aberrants à fort levier (high-leverage outliers), asymétriquement positionnés dans les quadrants distaux du graphique, suffisent à infléchir de manière spectaculaire l’allure d’une courbe de tendance quadratique ou la trajectoire locale d’un lisseur LOESS à petit paramètre de lissage. Par conséquent, l’observation d’une courbure visuelle ne peut en aucun cas constituer une justification statistique suffisante en elle-même. Elle doit impérativement être considérée comme une hypothèse de travail provisoire, qu’il convient de soumettre au crible d’analyses résiduelles rigoureuses et de tests d’inférence formels.
3. Analyse rigoureuse des résidus : Détecter la mauvaise spécification linéaire
3.1 Graphique des résidus en fonction des valeurs ajustées
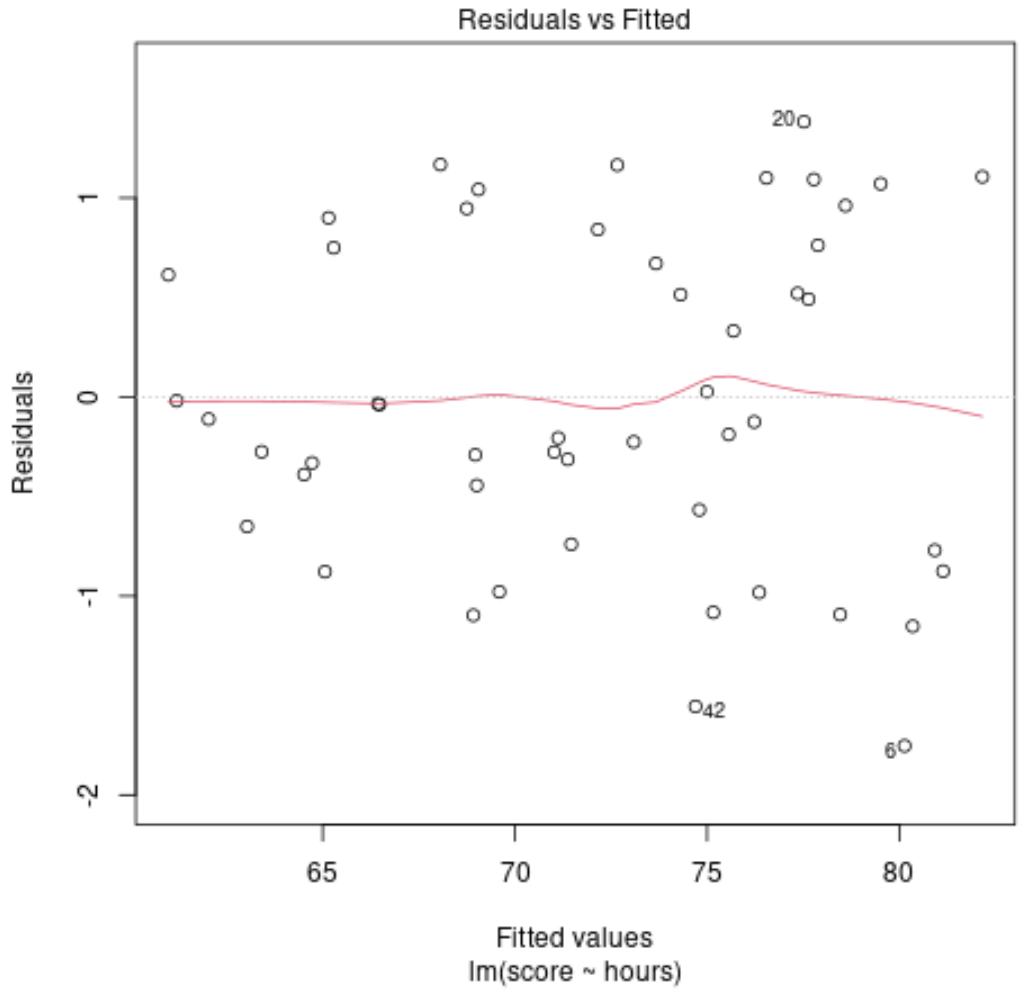
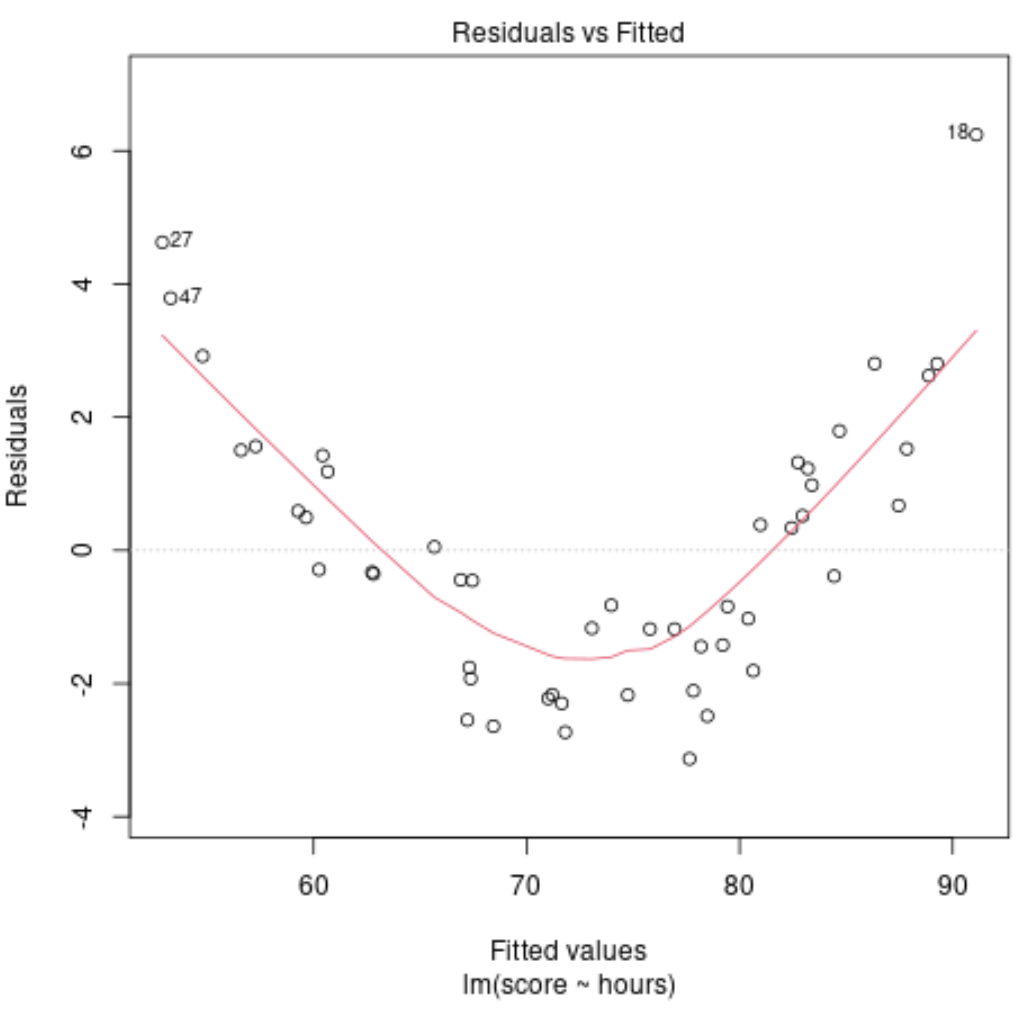
Le véritable révélateur de l’adéquation ou de la défaillance d’un modèle de régression ne réside pas dans l’espace des données observées brutes, mais dans l’espace multidimensionnel des résidus. Lorsque l’on ajuste une régression linéaire simple classique sur des données dont la cinétique fondamentale est curvilinéaire, l’incapacité de la droite à épouser la trajectoire réelle reporte mathématiquement l’intégralité du patron déterministe omis au sein des erreurs d’estimation. L’outil diagnostique par excellence pour objectiver cette anomalie est le graphique bivarié confrontant les résidus ordinaires standardisés $e_i = Y_i – \hat{Y}_i$ aux valeurs prédictives ajustées $\hat{Y}_i$ (ou aux valeurs du prédicteur $X_i$).
Dans l’hypothèse où le modèle linéaire simple serait parfaitement spécifié, ce diagramme résiduel devrait idéalement matérialiser un nuage de points amorphe, homogène, dépourvu de structure apparente, formant une bande horizontale uniforme gravitant symétriquement autour de la ligne de référence zéro. Si, à l’inverse, l’examen visuel de ce tracé révèle une forme curviligne proéminente — classiquement une parabole en « U » ou en « U inversé », voire une oscillation périodique —, le diagnostic de mauvaise spécification de la forme fonctionnelle est sans appel. Cette géométrie ordonnée des résidus prouve de manière irréfutable que la composante déterministe du modèle a échoué à extraire toute l’information systématique contenue dans le prédicteur.
La conséquence théorique de cette distorsion est particulièrement grave : elle enfreint directement l’hypothèse fondamentale d’espérance nulle conditionnelle des perturbations stochastiques :
$$E(\varepsilon_i | X_i) \neq 0$$
En d’autres termes, les erreurs d’estimation deviennent mathématiquement dépendantes du niveau du prédicteur, ce qui invalide l’optimalité asymptotique conférée par le théorème de Gauss-Markov. Il importe en outre de distinguer rigoureusement une véritable anomalie de linéarité d’un phénomène d’hétéroscédasticité pure. Alors que l’hétéroscédasticité se caractérise par un élargissement ou un rétrécissement de la dispersion verticale des résidus (forme d’entonnoir ou de cône) le long de l’axe des abscisses sans déviation de leur valeur centrale, la non-linéarité non modélisée produit un déplacement systématique de la moyenne conditionnelle locale des résidus au-dessus et en dessous de l’ordonnée zéro.
3.2 Tests formels de spécification et de linéarité
Pour dépasser l’évaluation visuelle subjective des graphiques résiduels, l’arsenal économétrique et biométrique met à la disposition des chercheurs des tests statistiques inférentiels rigoureux dédiés à la vérification formelle de la linéarité. Le plus puissant et universellement reconnu d’entre eux est le test de mauvaise spécification de l’erreur de régression de Ramsey, universellement désigné par son acronyme anglophone Ramsey RESET (Regression Equation Specification Error Test).
Le protocole opératoire du test RESET repose sur une démarche ingénieuse : il consiste à régresser, dans un second temps, la variable dépendante $Y$ non seulement sur les prédicteurs originaux de l’équation de base, mais également sur les puissances successives des valeurs ajustées calculées lors de la première étape, soit typiquement $\hat{Y}^2, \hat{Y}^3$ et éventuellement $\hat{Y}^4$ :
$$Y_i = \mathbf{X}_i boldsymbol{\beta} + \gamma_1 \hat{Y}_i^2 + \gamma_2 \hat{Y}_i^3 + dots + \gamma_p \hat{Y}_i^{p+1} + u_i$$
Puisque les valeurs ajustées $\hat{Y}_i$ constituent des combinaisons linéaires des régresseurs initiaux, leurs puissances exponentielles représentent une synthèse directe et parcimonieuse des termes d’ordre supérieur (polynômes) et des termes d’interaction croisée potentiellement omis par le modèle initial. L’hypothèse nulle ($H_0$) stipule la nullité conjointe stricte de l’ensemble de ces coefficients additionnels :
$$H_0 : \gamma_1 = \gamma_2 = dots = \gamma_p = 0$$
Cette hypothèse se teste par le biais d’une statistique de Fisher classique comparant les sommes des carrés des résidus des deux équations emboîtées. Un rejet statistiquement significatif de l’hypothèse nulle ($p < \alpha$) confirme de manière incontestable que le modèle linéaire initial souffre d'une omission de variables d'ordre supérieur et que la relation fonctionnelle réelle présente une composante curvilinéaire substantielle qui commande l'introduction explicite de termes polynomiaux.
En complément du test de Ramsey, les analystes peuvent mobiliser le test des suites (runs test) ou le test de Wald-Wolfowitz appliqué aux signes des résidus ordonnés chronologiquement selon les valeurs croissantes du prédicteur continu. Si la spécification linéaire est erronée, on observera une succession prolongée et anormale de résidus de même signe (par exemple, une série continue de résidus négatifs au centre de la distribution précédée et suivie de longues séquences de résidus strictement positifs), révélant une rupture radicale d’indépendance séquentielle locale. L’omission d’une structure polynomiale induit en effet un biais systématique d’estimation sur l’ensemble des coefficients vectoriels, faussant l’évaluation de l’ampleur des effets et augmentant exponentiellement le risque d’erreur d’inférence de type II sur d’autres covariables d’intérêt.
3.3 Résidus partiels et graphiques de régression partielle
Dans le contexte hautement fréquent des devis de recherche multivariés en psychologie clinique, différentielle ou sociale, le chercheur manipule rarement un prédicteur unique et isolé. Lorsque de multiples variables explicatives continues et catégorielles sont intégrées au sein d’une équation linéaire générale pour neutraliser les facteurs de confusion, l’examen de simples graphiques bivariés bruts devient incapable de refléter fidèlement la nature spécifique de l’association reliant une variable indépendante particulière au critère d’intérêt. Pour contourner cet obstacle analytique et évaluer l’opportunité d’introduire un terme polynomial sur un prédicteur donné au sein d’une matrice complexe de régresseurs, il devient impératif de recourir aux graphiques de résidus partiels (communément désignés sous le vocable de graphiques « composante plus résidu » ou component-plus-residual plots).
Le principe mathématique du résidu partiel consiste à isoler la relation brute entre le prédicteur d’intérêt spécifique $X_j$ et le critère $Y$ après avoir purgé l’ensemble des données de l’influence linéaire exercée par l’intégralité des autres variables de contrôle incluses dans le modèle. Formellement, le vecteur des résidus partiels $\mathbf{r}_j$ associé au $j$-ème prédicteur est calculé en réintégrant le produit de son propre coefficient estimé $\hat{\beta}_j$ et de ses valeurs observées au vecteur des résidus ordinaires $\mathbf{e}$ du modèle multivarié global :
$$\mathbf{r}_j = \mathbf{e} + \hat{\beta}_j \mathbf{X}_j$$
En traçant graphiquement ces résidus partiels $\mathbf{r}_j$ en fonction de la variable originale $\mathbf{X}_j$, le chercheur visualise avec une pureté méthodologique totale la courbure nette de la relation liant cette variable cible au critère, une fois contrôlée l’influence confondante de toutes les autres covariables. Si ce graphique de résidus partiels révèle une morphologie parabolique ou sigmoïdale distincte, la nécessité d’intégrer une composante polynomiale quadratique ou cubique pour ce prédicteur spécifique est formellement démontrée, prévenant ainsi toute confusion entre une non-linéarité authentique et des artéfacts d’agrégation statistique.
4. Modélisation des théories psychologiques curvilinéaires : La loi de Yerkes-Dodson
4.1 Opérationnalisation statistique de la fonction en U inversé
Au-delà des purs impératifs de conformité statistique et de distribution des erreurs, la régression polynomiale s’impose comme une nécessité absolue lorsque les postulats théoriques régissant le domaine d’étude anticipent formellement un comportement non monotone. L’une des illustrations paradigmatiques les plus célèbres en psychologie expérimentale et cognitive demeure sans conteste la loi de Yerkes-Dodson, formulée originellement en 1908 et raffinée au fil des décennies dans les domaines de l’ergonomie cognitive, des neurosciences comportementales et de la psychologie de la performance.
Cette théorie fondamentale postule l’existence d’une relation curvilinéaire en forme de « U inversé » entre le niveau d’activation physiologique ou psychologique (l’état d’éveil ou d’anxiété situationnelle) et l’efficacité de la performance cognitive ou motrice. À de faibles niveaux d’activation, l’organisme souffre d’un déficit d’attention, de léthargie et d’un engagement motivationnel insuffisant, conduisant à une performance sous-optimale. À mesure que l’éveil augmente, le recrutement des ressources attentionnelles s’accroît, optimisant le traitement de l’information jusqu’à atteindre un sommet fonctionnel d’efficience maximale. Au-delà de ce point d’acmé, un éveil excessif surcharge le système nerveux central, induit une désorganisation cognitive et provoque un rétrécissement attentionnel délétère, précipitant l’effondrement graduel de la performance.
Pour formaliser mathématiquement et tester empiriquement cette dynamique comportementale, le chercheur spécifie un modèle de régression polynomiale de second ordre :
$$\text{Performance}_i = \beta_0 + \beta_1 \text{Éveil}_i + \beta_2 \text{Éveil}_i^2 + \varepsilon_i$$
Dans ce modèle quadratique, la signature mathématique indispensable attestant d’une fonction en U inversé repose sur l’examen rigoureux de la significativité et du signe du coefficient associé au terme de puissance deux : le paramètre $\beta_2$ doit être strictement négatif et statistiquement différent de zéro au seuil de signification choisi ($\beta_2 < 0, p < \alpha$). Un coefficient $\beta_2$ négatif garantit en effet que la concavité de la parabole est orientée vers le bas, traduisant le ralentissement initial de la progression puis l'inversion finale de la trajectoire d'efficience.
4.2 Calcul et interprétation du point d’inflexion critique
L’estimation des coefficients d’un modèle polynomial ne constitue pas l’aboutissement de la démarche analytique ; elle ouvre la voie à l’extraction de métriques quantitatives d’une importance stratégique pour la compréhension psychologique et l’intervention pratique. Le sommet de la parabole modélisée par l’équation quadratique représente précisément l’extremum local de la fonction, c’est-à-dire le niveau théorique optimal d’activation produisant l’efficacité cognitive maximale.
Pour déterminer analytiquement la coordonnée de cet optimum de performance, il convient d’appliquer les règles de base du calcul différentiel en calculant la dérivée première de la fonction d’espérance conditionnelle par rapport à la variable d’éveil, puis en annulant cette dérivée :
$$\frac{d(\text{Performance})}{d(\text{Éveil})} = \beta_1 + 2\beta_2 \text{Éveil} = 0$$
En résolvant cette équation du premier degré, on obtient la formule close universelle du point critique d’inflexion directionnelle, fréquemment noté $X^*$ ou $\text{Éveil}^*$ :
$$X^* = -\frac{\beta_1}{2\beta_2}$$
Toutefois, dans le cadre d’une recherche académique de haute rigueur, identifier la valeur ponctuelle de ce seuil empirique ne saurait suffire. Puisque les coefficients $\hat{\beta}_1$ et $\hat{\beta}_2$ sont des estimateurs statistiques sujets à la variabilité d’échantillonnage, le ratio non linéaire qui définit $X^*$ constitue lui-même une variable aléatoire dotée d’une distribution d’échantillonnage. Il est donc méthodologiquement impératif de calculer les intervalles de confiance encadrant ce point critique, typiquement au seuil bilatéral de 95%.
Cette estimation s’opère usuellement par le recours à la méthode delta, une technique d’approximation analytique fondée sur un développement de Taylor de premier ordre autour des espérances des paramètres estimés, qui dérive la variance asymptotique d’un ratio de paramètres à partir de la matrice de covariance estimée :
$$\widehat{Var}(X^*) \approx \left( \frac{\partial X^*}{\partial \beta_1} \right)^2 \widehat{Var}(\hat{\beta}_1) + \left( \frac{\partial X^*}{\partial \beta_2} \right)^2 \widehat{Var}(\hat{\beta}_2) + 2 \left( \frac{\partial X^*}{\partial \beta_1} \right) \left( \frac{\partial X^*}{\partial \beta_2} \right) \widehat{Cov}(\hat{\beta}_1, \hat{\beta}_2)$$
Alternativement, le rééchantillonnage non paramétrique par bootstrap percentile permet de générer des intervalles empiriques sans postulat distributionnel contraignant. En psychologie ergonomique et dans les sciences du travail, la localisation précise de cet intervalle de confiance permet aux gestionnaires et cliniciens de calibrer scientifiquement les marges d’intensité de la charge mentale, en déterminant la zone d’efficience avant que les symptômes de détresse psychologique ne déclenchent la chute des facultés cognitives.
4.3 Validation formelle de l’existence d’une véritable relation en U
L’un des pièges méthodologiques les plus insidieux et les plus répandus dans la littérature académique concerne l’acceptation prématurée d’une fonction en « U » ou en « U inversé » sur la foi exclusive d’un coefficient quadratique $\beta_2$ statistiquement significatif. Une proportion considérable d’articles publiés commet l’erreur de conclure à l’existence d’une inversion de tendance alors que les données empiriques ne capturent en réalité qu’un phénomène de rendement décroissant, de saturation ou de décélération monotone (un segment de parabole ne franchissant jamais son extremum).
Pour immuniser la communauté scientifique contre ces faux positifs méthodologiques dévastateurs, Lind et Mehlum (2010) ont formalisé un cadre d’évaluation strict, aujourd’hui incontournable, connu sous le nom de test de Lind-Mehlum ou test des deux pentes. Selon ce protocole rigoureux, pour qu’un chercheur soit fondé à conclure à une authentique relation curvilinéaire en cloche, trois conditions conjointes non négociables doivent être impérativement satisfaites :
- Significativité du terme quadratique : Le paramètre de courbure $\hat{\beta}_2$ doit être statistiquement significatif dans le sens attendu par le modèle théorique ($\hat{\beta}_2 < 0$ pour un U inversé).
- Pente initiale statistiquement significative : La pente locale de la fonction calculée à la limite inférieure observée du prédicteur ($X_{\min}$) doit être substantiellement positive et statistiquement différente de zéro :
$$\beta_1 + 2\beta_2 X_{\min} > 0$$ - Pente terminale statistiquement significative : La pente locale calculée à la limite supérieure observée du prédicteur ($X_{\max}$) doit être substantiellement négative et statistiquement différente de zéro :
$$\beta_1 + 2\beta_2 X_{\max} < 0$$ - Positionnement interne du point critique : Le point d’inflexion calculé $X^* = -\frac{\hat{\beta}_1}{2\hat{\beta}_2}$ doit impérativement se situer à l’intérieur du spectre des valeurs réelles de l’échantillon ($X_{\min} < X^* < X_{\max}$), et son intervalle de confiance à 95% ne doit pas englober les bornes extrêmes de distribution.
Si la dérivée ne change pas formellement de signe à l’intérieur du domaine de définition observé de l’échantillon, le modèle ne décrit pas une dynamique en U, mais une fonction monotone concave ou convexe. Dans une telle configuration, interpréter le phénomène sous le prisme d’une inversion fonctionnelle relève d’une spéculation erronée, masquant une dynamique qui relève probablement d’un modèle logarithmique ou d’une saturation asymptotique.
5. Phénomènes de saturation, plafonnement et rendements décroissants
5.1 Courbes d’apprentissage et acquisition d’habiletés motrices
L’étude de l’acquisition des compétences procédurales, de la dextérité motrice et de la mémorisation verbale à travers la pratique répétée constitue un domaine de prédilection historique pour l’analyse des fonctions curvilinéaires. Les processus d’apprentissage humain sont intrinsèquement gouvernés par la dynamique universelle des rendements décroissants : les premiers essais ou séances d’entraînement permettent des gains de performance massifs et rapides en raison de l’appropriation des structures cognitives fondamentales de la tâche. À mesure que le niveau d’expertise se consolide, le réservoir de progression immédiate s’amenuise, et les gains d’efficience marginaux par unité de temps deviennent de plus en plus modestes, tendant vers un seuil de stabilisation asymptotique imposé par les limites neurobiologiques de l’organisme.
Dans de nombreuses situations expérimentales de courte ou moyenne durée, la modélisation polynomiale d’ordre deux offre une approximation locale hautement performante pour capturer cette décélération de l’apprentissage. En assignant un coefficient linéaire positif ($\beta_1 > 0$) couplé à un terme quadratique négatif ($\beta_2 < 0$), l'équation modélise élégamment cette phase d'accroissement initial rapide suivie d'un aplanissement progressif de la trajectoire. Cependant, le méthodologue avisé doit exercer une vigilance épistémologique critique quant aux bornes d'applicabilité de ce modèle. Contrairement aux formulations exponentielles négatives de type loi de puissance (power law of practice) ou aux modèles logarithmiques qui intègrent naturellement une asymptote horizontale indépassable, la parabole mathématique est vouée, par construction algébrique, à s’inverser et à décroître vers l’infini négatif au-delà de son sommet. Elle ne doit dès lors être employée pour modéliser l’apprentissage que sur la fenêtre temporelle empirique stricte précédant son extremum fonctionnel.
5.2 Effets de seuil dans l’exposition au stress et la charge mentale
Les modèles d’ajustement cognitif et psychologique face aux stresseurs environnementaux et organisationnels illustrent avec une grande acuité l’incapacité rédhibitoire des modèles de régression linéaire à retranscrire la réalité humaine. Lorsqu’un individu est exposé à des niveaux croissants de charge de travail ou de pression psychologique, ses ressources d’autorégulation et ses mécanismes de compensation adaptative ne fléchissent pas de façon proportionnelle et continue dès la première sollicitation.
Au cours d’une première phase d’exposition modérée, l’architecture psychologique manifeste une remarquable résilience homéostatique : le niveau de bien-être subjectif et l’intégrité cognitive demeurent stables, le sujet absorbant l’impact du stresseur par une mobilisation accrue de son énergie volitionnelle. Cependant, si l’intensité ou la chronicité du stress dépasse un seuil de tolérance psychologique critique, ces réserves adaptatives s’effondrent brutalement. L’analyse polynomiale cubique (de degré 3) ou quadratique permet d’opérationnaliser quantitativement cette inertie initiale suivie de cette décompensation précipitée.
En capturant cette cinétique non linéaire, le modèle polynomial permet d’évaluer la marge de sécurité psychologique dont dispose un groupe d’individus dans un environnement professionnel ou thérapeutique donné. L’incapacité d’un modèle linéaire simple à identifier ces points de bascule systémiques conduirait à une sous-estimation systématique du danger potentiel encouru par les sujets proches de la frontière de décompensation, en masquant la non-linéarité de l’impact pathologique cumulatif.
5.3 Relations curvilinéaires en psychologie organisationnelle
Au cours des deux dernières décennies, la recherche en comportement organisationnel et en psychologie du management a été profondément renouvelée par l’émergence théorique du méta-principe désigné sous l’expression « Trop d’une bonne chose » (Too-Much-of-a-Good-Thing effect ou TMGT), rigoureusement théorisé par Pierce et Aguinis (2013). Ce cadre conceptuel postule que des traits de personnalité, des comportements de leadership ou des ressources professionnelles universellement célébrés comme des vertus cardinales engendrent des conséquences destructrices et toxiques lorsqu’ils sont manifestés à des intensités extrêmes.
Considérons par exemple l’autonomie accordée aux collaborateurs au sein de structures managériales complexes. Alors qu’un degré modéré à élevé d’autonomie stimule l’engagement professionnel, l’innovation et la satisfaction au travail, une autonomie absolue et sans encadrement bascule fréquemment dans le vide structurel, l’ambiguïté de rôle délétère et le sentiment d’abandon organisationnel, détériorant in fine la santé psychologique des employés. Un schéma similaire s’observe pour le trait de personnalité de conscience professionnelle (conscientiousness) : bénéfique pour la rigueur d’exécution jusqu’à un seuil optimal, son exacerbation extrême se mue en perfectionnisme pathologique rigide, en microgestion obsessionnelle et en paralysie décisionnelle paralysante.
La régression polynomiale de second ordre constitue l’outil analytique standard pour tester empiriquement l’hypothèse TMGT au sein des entreprises et des institutions. En quantifiant précisément la courbure descendante des indicateurs de performance globale ou d’équilibre psychologique au-delà d’un zénith déterminé, elle permet d’identifier empiriquement la frontière invisible séparant la vertu comportementale de la toxicité organisationnelle.
6. Critères statistiques comparatifs d’ajustement et sélection de modèles
6.1 Gain incrémental de variance expliquée et test F hiérarchique
L’introduction d’un terme polynomial au sein d’une équation de régression ne doit en aucun cas reposer sur une pétition de principe, mais faire l’objet d’une validation statistique rigoureuse attestant de son utilité incrémentale. Le protocole méthodologique le plus éprouvé pour évaluer cette contribution repose sur la procédure de régression hiérarchique par étapes (hierarchical polynomial regression), consistant à comparer formellement deux modèles statistiques emboîtés (nested models).
Dans cette démarche séquentielle, le chercheur estime en premier lieu le modèle restreint (linéaire standard) intégrant le prédicteur au premier degré. Dans un second temps, il estime le modèle complet enrichi du terme polynomial de degré supérieur ($X^2$ pour un modèle quadratique). La métrique pivot de cette comparaison réside dans le calcul du gain incrémental de variance expliquée, noté $\Delta R^2$ :
$$\Delta R^2 = R^2_{\text{complet}} – R^2_{\text{restre\int}}$$
Pour vérifier si cet accroissement du coefficient de détermination est statistiquement supérieur à ce que le simple hasard de l’échantillonnage pourrait produire par l’adjonction mathématique d’un paramètre supplémentaire, on applique le test F incrémental de changement de $R^2$ (F-change test) :
$$F_{\text{changement}} = \frac{(R^2_{\text{complet}} – R^2_{\text{restre\int}}) / (k_{\text{complet}} – k_{\text{restre\int}})}{(1 – R^2_{\text{complet}}) / (N – k_{\text{complet}} – 1)}$$
où $N$ représente la taille totale de l’échantillon, $k_{\text{restre\int}}$ le nombre de prédicteurs du modèle initial, et $k_{\text{complet}}$ le nombre de prédicteurs du modèle enrichi. Sous l’hypothèse nulle d’absence de contribution curvilinéaire réelle ($\beta_k = 0$), cette statistique suit fidèlement une loi de distribution de Fisher avec $\Delta k$ et $(N – k_{\text{complet}} – 1)$ degrés de liberté. Seul l’obtention d’un seuil $p$ inférieur au critère de significativité nominal ($\alpha = 0,05$) autorise à rejeter l’hypothèse nulle et à affirmer que le terme polynomial capture une fraction substantielle et unique de variance au sein du phénomène exploré.
6.2 Critères d’information pénalisés : AIC et BIC
Bien que le test F hiérarchique offre un arbitrage rigoureux pour des modèles strictement emboîtés sous des hypothèses d’erreurs gaussiennes, l’évaluation moderne de la qualité d’ajustement s’enrichit considérablement par l’adjonction de critères d’information fondés sur la théorie statistique de l’information. Les deux métriques les plus renommées et robustes sont le critère d’information d’Akaike (AIC) et le critère d’information bayésien (BIC).
Ces indices partagent un principe philosophique et mathématique unificateur : ils évaluent simultanément la qualité d’adéquation du modèle aux données empiriques (quantifiée par la log-vraisemblance maximale de l’échantillon, $\ln(\hat{L})$) tout en infligeant une pénalité mathématique explicite directement proportionnelle à la complexité structurelle du modèle, c’est-à-dire au nombre de paramètres libres estimés ($p$) :
$$\text{AIC} = 2p – 2\ln(\hat{L})$$
$$\text{BIC} = p \ln(N) – 2\ln(\hat{L})$$
L’arbitrage épistémologique entre ces deux métriques réside dans la sévérité différentielle de leur pénalisation paramétrique. L’AIC, fondé sur la minimisation de la divergence de Kullback-Leibler, possède une vocation prioritairement prédictive : il cherche à identifier le modèle qui minimisera l’erreur quadratique moyenne lors de prédictions sur de nouvelles données indépendantes. En revanche, le BIC pénalise le nombre de coefficients par le logarithme de la taille de l’échantillon ($ln(N)$). Lorsque $N > e^2 \approx 7,4$, la pénalité imposée par le BIC est systématiquement plus draconienne que celle de l’AIC. Sur le plan asymptotique, le BIC est consistant : sous l’hypothèse théorique où le véritable modèle générateur de données appartiendrait à l’ensemble des architectures candidates, la probabilité que le BIC sélectionne exactement ce vrai modèle tend vers 1 lorsque la taille de l’échantillon tend vers l’infini.
Dans la pratique de sélection de modèles, un modèle polynomial n’est considéré comme véritablement supérieur à son homologue linéaire que s’il affiche une baisse substantielle de ses scores d’information. Selon les lignes directrices conventionnelles de Burnham et Anderson (2004), une différence d’AIC ($\Delta \text{AIC} = \text{AIC}_{\text{modèle}} – \text{AIC}_{\text{\min}}$) comprise entre 0 et 2 confère un soutien substantiel équivalent aux deux modèles ; un $\Delta \text{AIC}$ compris entre 4 et 7 signale un soutien considérablement amoindri pour le modèle affichant la valeur la plus haute ; tandis qu’un $\Delta \text{AIC} > 10$ démontre que le modèle au score le plus élevé n’a pratiquement aucune plausibilité empirique comparé au meilleur modèle. Des règles équivalentes s’appliquent au BIC (différence de BIC supérieure à 6 pour une preuve forte, supérieure à 10 pour une preuve décisive en faveur du modèle polynomial).
6.3 Évaluation du R² ajusté face à l’inflation mécanique
L’utilisation brute du coefficient de détermination standard $R^2$ constitue une erreur méthodologique classique dénoncée de longue date par les spécialistes de l’économétrie. En vertu des propriétés fondamentales de l’optimisation par les moindres carrés ordinaires, l’adjonction systématique de nouveaux termes régresseurs — qu’il s’agisse de puissances polynomiales ($X^2, X^3, dots, X^k$) ou de variables purement aléatoires indépendantes du phénomène étudié — augmente mathématiquement de manière strictement monotone la valeur du $R^2$, ou au pire la maintient invariante :
$$R^2_{k+1} \geq R^2_k$$
Ce comportement mathématique mécanique induit le risque majeur de confondre une amélioration réelle de l’ajustement du modèle avec un simple artefact lié à l’absorption stochastique du bruit de l’échantillon. Pour remédier à ce biais inflationniste, le chercheur doit obligatoirement évaluer le coefficient de détermination ajusté ($R^2_{\text{adj}}$), dont la formule introduit une correction statistique prenant en compte les degrés de liberté résiduels :
$$R^2_{\text{adj}} = 1 – \left[ \frac{(1 – R^2)(N – 1)}{N – k – 1} \right]$$
Contrairement au coefficient brut, le $R^2_{\text{adj}}$ n’augmente que si la réduction de la somme des carrés des erreurs résiduelles excède le coût imposé par la perte d’un degré de liberté lors de l’estimation du coefficient polynomial additionnel. L’apparition d’un plateau ou, a fortiori, d’une régression de la valeur du $R^2_{\text{adj}}$ lors du passage d’un degré polynomial $k$ à un degré $k+1$ constitue un diagnostic sans appel : l’inclusion de la puissance supérieure est superflue, surcharge inutilement l’architecture du modèle et signale un risque imminent de surapprentissage statistique (overfitting), particulièrement périlleux au sein d’échantillons de taille modeste.
7. Inférence statistique et hiérarchie structurelle des termes polynomiaux
7.1 Significativité individuelle des coefficients d’ordre supérieur
L’examen de la validité d’une modélisation polynomiale s’articule autour de l’évaluation inférentielle de la significativité statistique de chaque paramètre pris individuellement, en se focalisant en priorité sur le terme de plus haut degré spécifié dans l’équation. Pour tester l’hypothèse nulle selon laquelle le coefficient polynomial d’ordre supérieur est strictement nul dans la population parente ($H_0 : \beta_k = 0$), on applique le test $t$ de Student univarié classique :
$$t = \frac{\hat{\beta}_k}{\widehat{SE}(\hat{\beta}_k)}$$
où $\widehat{SE}(\hat{\beta}_k)$ désigne l’erreur-type de l’estimateur des moindres carrés, calculée à partir de la diagonale de la matrice de covariance estimée des estimateurs $\widehat{\sigma}^2 (\mathbf{X}^T \mathbf{X})^{-1}$.
L’acceptation empirique de la courbure fonctionnelle postulée exige impérativement le rejet de cette hypothèse nulle au seuil critique $\alpha$ préétabli. Toutefois, le chercheur doit faire preuve d’une rigueur accrue quant au contrôle du risque d’erreur de type I (faux positifs) lors de démarches exploratoires successives. La tentation d’estimer en cascade des modèles de degrés polynomiaux croissants jusqu’à identifier par hasard un terme de puissance $k$ significatif sans justification théorique préalable gonfle dramatiquement le taux d’erreur global de la famille de tests (family-wise error rate). Si une approche séquentielle d’exploration de polynômes de degrés successifs est adoptée, l’utilisation de procédures de correction pour tests multiples, telles que la méthode séquentielle de Holm-Bonferroni ou le contrôle du taux de fausses découvertes (FDR de Benjamini-Hochberg), s’avère méthodologiquement indispensable pour préserver la robustesse de l’inférence.
7.2 Le principe de hiérarchie bien formée (well-formed polynomials)
L’une des règles les plus impératives et pourtant trop fréquemment transgressées dans la pratique de la modélisation polynomiale est le principe fondamental de hiérarchie des termes, communément désigné dans la littérature méthodologique sous le concept de modèle polynomial bien formé (well-formed polynomial) ou principe d’inclusion marginale de Nelder (1977).
Ce principe méthodologique stipule de manière absolue que si un modèle intègre un terme polynomial de degré $k$ (par exemple un terme quadratique $X^2$ ou un terme cubique $X^3$), il est formellement interdit de supprimer de l’équation les termes de puissances inférieures associées ($X$ pour un modèle quadratique ; $X$ et $X^2$ pour un modèle cubique), même si les coefficients de ces termes d’ordre inférieur n’atteignent pas le seuil conventionnel de significativité statistique ($p > 0,05$). Supprimer un terme d’ordre un au motif spécieux que son $p$-value est non significative pour ne conserver que la constante et le terme au carré aboutit à une catastrophe mathématique : la perte immédiate de la propriété d’invariance par translation du système de coordonnées.
Pour comprendre la gravité de cette distorsion, considérons l’opération algébrique élémentaire consistant à appliquer une translation constante $c$ à la variable explicative, en posant $X’ = X + c$ (ce qui correspond simplement à un changement d’unité ou à un recentrage des données). Dans un modèle polynomial complet d’ordre 2 :
$$Y = \beta_0 + \beta_1 X + \beta_2 X^2$$
l’injection de la variable translatée génère après développement :
$$Y = \beta_0 + \beta_1(X’ – c) + \beta_2(X’ – c)^2 = (\beta_0 – \beta_1 c + \beta_2 c^2) + (\beta_1 – 2\beta_2 c)X’ + \beta_2 (X’)^2$$
On constate avec évidence que la forme de la parabole, sa concavité dictée par $\beta_2$, la qualité globale d’ajustement ($R^2$) et l’emplacement physique réel du sommet demeurent parfaitement invariants ; seuls les paramètres d’ordonnée et de pente linéaire locale se sont réajustés pour absorber la translation. En revanche, si l’on force prématurément le modèle non hiérarchique :
$$Y = \alpha_0 + \alpha_2 X^2$$
l’application de la même translation $X’ = X + c$ impose mathématiquement l’émergence d’un terme linéaire parasite :
$$Y = \alpha_0 + \alpha_2 (X’ – c)^2 = (\alpha_0 + \alpha_2 c^2) – 2\alpha_2 c X’ + \alpha_2 (X’)^2$$
Le modèle restreint ne possède pas la flexibilité paramétrique pour neutraliser ce terme. En supprimant le terme linéaire, le chercheur impose artificiellement l’axiome géométrique rigide selon lequel le point d’inflexion (l’extremum) de la parabole est obligatoirement ancré à la valeur arbitraire $X = 0$. Si l’échelle de mesure n’a pas un zéro absolu physiquement immuable (ce qui est le cas de la quasi-totalité des échelles psychométriques de Likert ou d’intervalles), cette contrainte non hiérarchique produit des estimations complètement fallacieuses et détruit la cohérence scientifique du travail empirique.
7.3 Problématique de la puissance statistique bivariée
L’estimation rigoureuse de relations curvilinéaires via la régression polynomiale exige une vigilance accrue quant à la puissance statistique des devis de recherche. Une intuition erronée mais largement partagée postule qu’une taille d’échantillon suffisante pour détecter une association linéaire simple garantit automatiquement la détection d’une courbure fonctionnelle d’intensité comparable. Rien n’est plus faux sur le plan analytique.
La puissance statistique requise pour détecter un effet polynomial d’ordre supérieur ($X^2$ ou $X^3$) est systématiquement inférieure à celle requise pour un effet linéaire de taille standard. Cela s’explique par le fait que le terme polynomial capture une composante de variance conditionnelle résiduelle après que la composante linéaire a déjà extrait la part dominante de la covariance bivariée. En outre, la distribution des puissances d’une variable continue tend fréquemment à manifester une asymétrie positive marquée (skewness) et un aplatissement prononcé (kurtosis), ce qui accroît la variabilité d’échantillonnage de l’estimateur $\hat{\beta}_2$ et gonfle son erreur-type.
Ce phénomène se trouve lourdement aggravé dans les sciences psychologiques et comportementales par l’inévitable présence d’erreur de mesure au sein des instruments psychométriques (questionnaires d’évaluation, échelles d’attitudes, tests de performance cognitive). Alors que l’atténuation classique induite par l’imperfection de la fidélité de mesure affaiblit les corrélations linéaires simples d’un facteur proportionnel au produit des racines des coefficients de fidélité ($\sqrt{r_{xx} r_{yy}}$), son impact sur les termes de puissances exponentielles et les interactions non linéaires est exponentiellement plus dévastateur. Comme l’ont formellement démontré Busemeyer et Jones (1983), une baisse modérée de la fidélité de l’instrument d’évaluation réduit la puissance statistique de détection d’un terme quadratique de manière disproportionnée comparée au terme linéaire, multipliant considérablement le risque d’erreur de type II (conclusion erronée à l’absence de non-linéarité). Tout devis polynomial en psychométrie requiert donc une analyse de puissance a priori spécifiquement dimensionnée, imposant couramment des effectifs d’échantillon doublés ou triplés comparativement à des designs purement linéaires.
8. Le problème crucial de la multicolinéarité structurelle et son traitement
8.1 Nature de la multicolinéarité induite par les puissances
L’obstacle technique et algorithmique le plus immédiat rencontré lors de la mise en œuvre de la régression polynomiale réside dans l’apparition spontanée et inévitable d’une forme sévère de dépendance linéaire entre les régresseurs, universellement qualifiée de multicolinéarité structurelle. Contrairement à la multicolinéarité de données (qui découle d’un échantillonnage défaillant ou d’une corrélation substantielle fortuite entre deux variables distinctes dans la réalité), la multicolinéarité structurelle est un sous-produit direct et mathématiquement programmé de la construction de l’équation régressionnelle.
Dès lors qu’une variable continue $X$ présente une moyenne arithmétique différente de zéro ($\bar{X} \neq 0$), la variable transformée issue de son élévation au carré $X^2$ exhibe intrinsèquement et mécaniquement une corrélation bivariée élevée avec sa propre variable d’origine $X$. Si les valeurs du prédicteur sont toutes strictement positives (par exemple, des scores d’âge chronologique s’étendant de 20 à 70 ans, ou des échelles de Likert graduées de 1 à 7), la corrélation de Pearson entre $X$ et $X^2$ atteint fréquemment des valeurs extrêmes avoisinant $r = 0,95$ à $0,99$.
Cette corrélation quasi parfaite entre les colonnes de la matrice de conception $\mathbf{X}$ engendre un quasi-effondrement du déterminant de la matrice d’information $\mathbf{X}^T \mathbf{X}$, qui tend vers zéro. Les conséquences numériques et inférentielles de cette pathologie matricielle sont redoutables :
- Gonflement spectaculaire des erreurs-types : Les variances d’échantillonnage des coefficients $\hat{\beta}_1$ et $\hat{\beta}_2$ explosent, ce qui se traduit par des facteurs d’inflation de la variance (VIF) atteignant couramment des valeurs stratosphériques (dépassant fréquemment 20, 50, voire 100).
- Instabilité numérique des estimations : La sensibilité computationnelle des estimateurs devient extrême ; une modification minime d’une seule observation de l’échantillon peut induire des inversions brutales de signes ou des oscillations incontrôlées de l’amplitude des coefficients estimés.
- Masquage d’effets réels : Bien que le modèle global affiche un $R^2$ significatif lors du test F omnibulaire, les tests $t$ individuels des coefficients $\beta_1$ et $\beta_2$ peuvent paradoxalement s’avérer tous deux non significatifs ($p > 0,05$), la multicolinéarité empêchant l’algorithme d’attribuer de manière univoque la variance expliquée à la composante linéaire ou à la composante quadratique.
8.2 La technique du centrage sur la moyenne
Fort heureusement, la méthodologie statistique moderne offre une solution algébrique d’une simplicité désarmante et d’une efficacité remarquable pour juguler l’intégralité des désagréments causés par la multicolinéarité structurelle : la technique du centrage sur la moyenne de l’échantillon (mean-centering), formalisée et popularisée dans les sciences comportementales par Aiken et West (1991).
Le protocole opératoire du centrage consiste à soustraire systématiquement la moyenne arithmétique de la variable $\bar{X}$ à chaque observation individuelle avant d’opérer la moindre élévation de puissance mathématique. En définissant la variable centrée $X_c = X – \bar{X}$, l’équation de régression polynomiale de second ordre se reformule alors strictement comme suit :
$$Y_i = \beta_0^* + \beta_1^* (X_i – \bar{X}) + \beta_2^* (X_i – \bar{X})^2 + \varepsilon_i$$
L’effet géométrique et algébrique de cette transformation est immédiat : la distribution de la nouvelle variable $X_c$ présente désormais une moyenne strictement nulle ($\sum X_c = 0$). Dès lors, si la distribution de la variable originale $X$ est approximativement symétrique autour de son centre, la covariance théorique et empirique liant la variable centrée à son propre carré devient exactement égale à zéro :
$$Cov(X_c, X_c^2) = E(X_c^3) – E(X_c)E(X_c^2) = E(X_c^3) = 0$$
La multicolinéarité structurelle est ainsi totalement annihilée. Les facteurs d’inflation de la variance (VIF) chutent drastiquement pour s’établir à des niveaux proches de l’unité fondamentale ($VIF \approx 1$), restaurant l’efficience statistique des estimateurs et la stabilité numérique de l’inversion matricielle.
Au-delà de l’assainissement computationnel, le centrage sur la moyenne restaure de manière spectaculaire l’interprétabilité psychologique et théorique des paramètres du modèle. Dans un modèle non centré où $X=0$ se situe en dehors de l’échelle des observations plausibles, la constante $\beta_0$ ne possède aucune signification concrète, et le coefficient linéaire $\beta_1$ représente la pente locale de la parabole au point théorique $X=0$, ce qui n’offre aucune pertinence pratique. En revanche, au sein du modèle centré :
- Le coefficient $\beta_0^*$ représente désormais la valeur prédite attendue de $Y$ pour un individu moyen sur le prédicteur ($X = \bar{X}$).
- Le coefficient linéaire $\beta_1^*$ représente la dérivée première locale de la fonction calculée exactement à la moyenne de l’échantillon, c’est-à-dire la pente linéaire instantanée moyenne du phénomène étudié.
- Le coefficient quadratique $\beta_2^*$ demeure strictement invariant comparé au modèle non centré ($\beta_2^* = \beta_2$), garantissant la préservation intégrale de la quantification de la courbure intrinsèque.
8.3 Utilisation des polynômes orthogonaux
Lorsque le devis de recherche relève de l’expérimentation hautement contrôlée en laboratoire — où les niveaux de la variable indépendante continue sont délibérément fixés par l’expérimentateur à des intervalles rigoureusement équidistants et associés à des effectifs d’échantillons égaux par condition —, l’ingénierie statistique permet de franchir un palier méthodologique supérieur par le recours aux polynômes orthogonaux.
La méthode des polynômes orthogonaux repose sur l’application de transformations matricielles dérivées du procédé d’orthogonalisation de Gram-Schmidt ou des fonctions de Tchebychev discrètes. Au lieu d’injecter directement des puissances corrélées $X, X^2, X^3$, les données subissent une projection algébrique vers une nouvelle base de vecteurs transformés $P_1(X), P_2(X), P_3(X)$ possédant la propriété mathématique fondamentale d’orthogonalité stricte deux à deux :
$$\sum_{i=1}^N P_j(X_i) P_m(X_i) = 0 \quad \forall j \neq m$$
Cette indépendance matricielle absolue confère des avantages analytiques majeurs qui surpassent les méthodes de régression ordinaires. D’une part, la multicolinéarité est rigoureusement et mathématiquement éliminée ($VIF = 1,000$ pour l’intégralité des termes), autorisant une stabilité computationnelle totale même pour des polynômes d’ordres très élevés. D’autre part, cette orthogonalité induit une décomposition additive parfaite de la somme des carrés du modèle : l’estimation et la significativité du coefficient linéaire ne sont nullement modifiées par l’adjonction ou la suppression ultérieure des termes quadratiques, cubiques ou quartiques. Chaque degré de liberté séquentiel extrait une fraction de variance totalement exclusive et étanche, rendant l’analyse de variance des tendances (trend analysis) au sein des plans expérimentaux univariés et à mesures répétées d’une limpidité interprétative absolue.
9. Le dilemme biais-variance et les dangers critiques du surapprentissage
9.1 Comportement oscillatoire et phénomène de Runge
L’extraordinaire flexibilité géométrique conférée par l’algèbre des polynômes dissimule un piège épistémologique et algorithmique dévastateur qui guette tout chercheur séduit par la perspective d’accroître indéfiniment la puissance de son modèle : le phénomène de surapprentissage (overfitting) et les instabilités oscillatoires intrinsèques aux approximations d’ordre élevé. Dans l’histoire des mathématiques appliquées, cette anomalie fondamentale est formellement identifiée sous le concept de phénomène de Runge, découvert en 1901 par le mathématicien Carl Runge.
Le théorème de Runge stipule que lors de l’interpolation d’une fonction continue sur un ensemble de points équidistants au moyen d’un polynôme de degré croissant, l’erreur d’approximation ne décroît pas uniformément vers zéro. Si le polynôme parvient à réduire l’écart au centre du domaine de définition, il génère en contrepartie des oscillations sinusoïdales d’une amplitude exponentiellement divergente à proximité immédiate des extrémités de l’intervalle expérimental. Appliqué à l’économétrie et à la psychométrie, ce mécanisme produit des conséquences délétères : dès lors que l’on dépasse le degré 3 (cubique) pour explorer des polynômes d’ordre 4, 5 ou 6, l’algorithme des moindres carrés cesse de modéliser la fonction directrice sous-jacente du phénomène pour s’évertuer à relier servilement chaque fluctuation stochastique locale propre au bruit d’échantillonnage.
La trajectoire polynomiale résultante prend alors l’allure d’une sinusoïde frénétique, affichant des montées fulgurantes et des plongeons abyssaux parfaitement artificiels qui n’ont aucune correspondance dans la réalité empirique. En sciences humaines, sociales et comportementales, où les mécanismes physiologiques et cognitifs sont caractérisés par une relative continuité et une inertie fondamentale, l’émergence d’oscillations multiples d’ordre supérieur constitue presque invariablement un artéfact méthodologique disqualifiant. Il est par conséquent universellement admis en méthodologie quantitative contemporaine que le franchissement du seuil du degré 3 (modèle cubique à deux points d’inflexion) ne possède pratiquement jamais de justification théorique ou écologique recevable.
9.2 Dégradation dramatique de la validité écologique et prédictive
La manifestation directe du compromis fondamental biais-variance (bias-variance tradeoff) s’illustre de manière caricaturale lors de l’utilisation non régulée de degrés polynomiaux excessifs. Si un polynôme de haut degré minimise artificiellement le biais empirique sur l’échantillon d’entraînement en gonflant le $R^2$ vers des sommets trompeurs, il fait exploser de manière catastrophique la variance d’échantillonnage des prédictions.
Cette fragilité structurelle se traduit par un effondrement radical de la validité écologique et des performances du modèle dès lors qu’il est confronté à des données non observées, par exemple lors d’une tentative de réplication indépendante au sein d’une seconde cohorte. Le modèle ultra-ajusté, ayant capturé les caprices aléatoires et le bruit stochastique du jeu de données initial, échoue lamentablement à généraliser ses prédictions, affichant des erreurs quadratiques moyennes de prédiction (MSE) considérablement plus dégradées que celles issues d’un modèle linéaire standard ou quadratique parcimonieux.
Ce péril atteint son paroxysme absolu dans le domaine de l’extrapolation, c’est-à-dire la formulation de prédictions au-delà du domaine strict des valeurs observées ($X X_{\max}$). Par construction mathématique, les fonctions polynomiales sont gouvernées à leurs limites asymptotiques par le comportement de leur terme de plus haut degré :
$$\lim_{X to \pm\infty} (\beta_k X^k) = \pm\infty$$
Une simple fraction d’unité au-delà de la borne maximale de mesure de l’échantillon suffit à précipiter l’équation polynomiale vers des valeurs prédictives délirantes (par exemple des temps de réaction négatifs ou des scores de bien-être tendant vers des milliards). La régression polynomiale est un outil d’interpolation locale rigoureux, mais constitue l’un des pires instruments statistiques imaginables pour toute forme d’extrapolation prospective.
9.3 Techniques de régularisation comme alternative de contention
Lorsqu’un cadre théorique complexe ou des signaux d’analyse exploratoire imposent le maintien d’une formulation polynomiale flexible mais que l’analyste redoute à juste titre la survenue du surapprentissage et de la dégradation prédictive, la solution méthodologique contemporaine réside dans l’abandon de l’estimation par les moindres carrés ordinaires au profit des algorithmes d’apprentissage statistique pénalisés (techniques de régularisation).
La régression Ridge (pénalisation L2 de Tikhonov) constitue la première arme de contention contre l’instabilité induite par les puissances polynomiales. En imposant une contrainte quadratique sur la somme des carrés des coefficients, le critère d’optimisation Ridge minimise la fonction de coût modifiée suivante :
$$\mathcal{L}_{\text{Ridge}} = \sum_{i=1}^N (Y_i – \hat{Y}_i)^2 + \lambda \sum_{j=1}^k \beta_j^2$$
où $\lambda \geq 0$ représente l’hyperparamètre de pénalisation (usuellement syntonisé par validation croisée). L’adjonction de ce terme de pénalité L2 stabilise de manière spectaculaire l’inversion matricielle en compressant harmonieusement l’amplitude des coefficients $\hat{\beta}_j$ vers zéro sans les annuler formellement, ce qui amortit les oscillations sauvages de Runge et restaure la robustesse des prédictions aux limites du support.
Conjointement, l’algorithme Lasso (Least Absolute Shrinkage and Selection Operator), articulé autour d’une pénalisation de norme L1 :
$$\mathcal{L}_{\text{Lasso}} = \sum_{i=1}^N (Y_i – \hat{Y}_i)^2 + \lambda \sum_{j=1}^k |\beta_j|$$
possède la propriété mathématique remarquable d’induire une parcimonie structurelle (sparsity). Le Lasso agit comme un mécanisme automatisé et rigoureux de sélection de variables : en écrasant certains coefficients polynomialement non essentiels pour les contraindre strictement à zéro, il élimine de l’équation les puissances parasites ne contribuant pas à la généralisation réelle du modèle, réconciliant ainsi flexibilité non linéaire et sobriété paramétrique.
10. Protocoles de validation croisée pour déterminer le degré optimal
10.1 Validation croisée k-fold et Leave-One-Out (LOOCV)
Pour arbitrer de manière scientifique et incontestable le choix du degré polynomial optimal à retenir sans succomber aux mirages de l’ajustement intra-échantillon, le recours aux protocoles d’échantillonnage par rééchantillonnage et validation croisée représente le standard d’excellence méthodologique contemporain.
Le paradigme de la validation croisée à $k$ blocs ($k$-fold cross-validation) consiste à partitionner pseudo-aléatoirement l’échantillon empirique initial de taille $N$ en $k$ sous-ensembles (blocs) mutuellement exclusifs et de volumes équivalents (communément $k = 5$ ou $k = 10$). La procédure opère ensuite de manière itérative : à chaque étape $m in {1, dots, k}$, le $m$-ème bloc est temporairement mis en réserve pour servir de base de validation (test), tandis que le modèle polynomial d’ordre spécifique est calibré exclusivement sur les $k-1$ blocs restants (base d’entraînement). Une fois les paramètres estimés, le modèle génère les prédictions sur les données du bloc test, permettant le calcul d’une mesure non biaisée de l’erreur quadratique moyenne de test :
$$\text{MSE}_m = \frac{1}{N_m} \sum_{i in \text{Bloc}_m} (Y_i – \hat{Y}_{i}^{(-m)})^2$$
Cette opération est répétée pour l’ensemble des $k$ blocs, et l’indicateur global de performance prédictive résulte de la moyenne arithmétique des $k$ erreurs de test obtenues :
$$\text{CV}_{(k)} = \frac{1}{k} \sum_{m=1}^k \text{MSE}_m$$
Dans le cas limite où $k = N$, le protocole prend le nom de validation croisée avec exclusion d’une observation ou Leave-One-Out Cross-Validation (LOOCV). Dans le cadre spécifique de la régression linéaire et polynomiale estimée par les moindres carrés ordinaires, la LOOCV bénéficie d’une propriété algébrique majeure : elle peut être calculée instantanément à partir du modèle unique ajusté sur l’échantillon complet, sans nécessiter $N$ ré-estimations matricielles, grâce à la formule analytique exacte fondée sur les valeurs de levier diagonalisées $h_{ii}$ (la matrice chapeau) :
$$\text{CV}_{\text{LOOCV}} = \frac{1}{N} \sum_{i=1}^N \left( \frac{e_i}{1 – h_{ii}} \right)^2$$
L’observation scrupuleuse de l’évolution de la courbe de cette erreur de validation croisée en fonction de l’élévation graduelle du degré polynomial constitue le diagnostic le plus robuste pour identifier le point de rupture exact où l’ajout d’une puissance mathématique cesse de capturer un signal utile pour commencer à modéliser le bruit stochastique.
10.2 Optimisation empirique du degré polynomial
L’algorithme séquentiel d’optimisation empirique consiste à juxtaposer sur un même graphique les trajectoires de l’erreur d’ajustement intra-échantillon (training MSE) et de l’erreur de généralisation calculée par validation croisée (cross-validation test MSE) pour les degrés successifs $k in {1, 2, 3, 4, 5}$. Alors que la courbe de l’erreur d’entraînement décline invariablement de façon monotone vers zéro à mesure que le degré s’élève, la courbe de l’erreur de validation croisée dessine universellement une morphologie en cuvette (« U-shape »).
Le creux de cette trajectoire marque la capacité prédictive maximale du modèle. Toutefois, le praticien rigoureux ne doit pas automatiquement sélectionner le degré affichant la valeur minimale absolue de $\text{CV}_{(k)}$. Il convient d’appliquer la règle heuristique hautement éprouvée de l’écart-type unique, désignée sous l’appellation anglophone de one standard error rule (règle du 1-SE). En vertu de ce principe de parcimonie scientifique, on calcule l’erreur-type de la métrique de validation croisée associée au degré offrant la performance optimale absolue, notée $SE(\text{CV}_{\text{\min}})$. L’analyste choisit alors le modèle le plus simple et le plus sobre (c’est-à-dire affichant le degré polynomial $k$ le plus bas possible) dont l’erreur prédictive demeure comprise dans l’intervalle d’un écart-type autour du minimum :
$$\text{CV}_{(k)} \leq \text{CV}_{\text{\min}} + SE(\text{CV}_{\text{\min}})$$
Cette approche méthodologique immunise la démarche de recherche contre la complexité computationnelle superflue, garantissant la rétention du modèle polynomial qui concilie l’ajustement aux données, la puissance explicative et la capacité de réplication au sein de designs expérimentaux longitudinaux ultérieurs.
10.3 Stratification et contrôle des sous-populations
L’implémentation de la validation croisée pour arbitrer le degré d’un polynôme exige une considération méticuleuse quant à l’homogénéité démographique et clinique de la cohorte d’étude. Dans de nombreux domaines de la psychologie et des sciences sociales, un échantillon global agrège des sous-populations distinctes (structures par genre, tranches d’âge, cohortes pathologiques vs groupes témoins sains) qui peuvent différer substantiellement dans la cinétique de leurs réponses fonctionnelles.
Si la partition des blocs de validation croisée est effectuée de manière totalement aléatoire sans précaution, le risque est grand de masquer des dynamiques disparates. Par exemple, une relation quadratique en cloche hautement prononcée au sein d’une sous-population spécifique peut être écrasée par la trajectoire linéaire dominante d’un sous-groupe majoritaire. Pour prévenir ces artéfacts d’agrégation statistique fallacieux, l’adoption d’un protocole de validation croisée stratifiée s’impose, garantissant que chaque bloc de test reflète rigoureusement les proportions démographiques de la population cible.
En outre, l’analyste doit vérifier l’invariance structurelle de la courbure estimée à travers ces différents segments de population en testant formellement l’interaction modératrice entre le terme polynomial et les facteurs catégoriels de stratification (par exemple, un terme $X^2 \times \text{Groupe}$). Si une telle interaction s’avère statistiquement significative, le postulat d’un degré polynomial global et universel doit être abandonné au profit de modélisations segmentées ou de régressions à coefficients aléatoires multigroupes, préservant la validité écologique de l’inférence à chaque strate du tissu social.
11. Modélisation des surfaces de réponse et interactions polynomiales
11.1 Extension multivariée : Régression polynomiale conjointe
L’exploration de processus psychologiques complexes exige fréquemment de transcender le cadre univarié pour considérer l’impact conjoint et combinatoire de multiples prédicteurs continus non linéaires. Dans les domaines de la psychologie différentielle, du comportement organisationnel et de la psychométrie du travail, les chercheurs sont confrontés à des dynamiques où deux variables indépendantes continues (notées $X$ et $Z$) exercent des influences interactives curvilignes majeures sur un critère comportemental ou clinique $Y$.
Cette configuration analytique donne lieu à la formulation de l’équation complète de régression polynomiale de second ordre à deux variables, intégrant simultanément les composantes linéaires directes, les composantes quadratiques individuelles et le terme d’interaction multiplicatif :
$$Y_i = \beta_0 + \beta_1 X_i + \beta_2 Z_i + \beta_3 X_i^2 + \beta_4 (X_i Z_i) + \beta_5 Z_i^2 + \varepsilon_i$$
Dans cette architecture multivariée hautement sophistiquée, chaque coefficient capture une composante géométrique précise de la dynamique bivariée :
- $\beta_1$ et $\beta_2$ mesurent les composantes de pente linéaire locale le long des axes respectifs à l’origine du repère (après centrage des variables).
- $\beta_3$ et $\beta_5$ quantifient l’intensité et l’orientation de la courbure intrinsèque (accélération ou concavité) de chaque variable le long de son propre plan vectoriel.
- Le coefficient croisé $\beta_4$ formalise la non-linéarité multiplicative, déterminant à quel point la courbure et la trajectoire de $X$ sont modulées et déformées par le niveau atteint par le prédicteur $Z$.
Cette formulation intégrée requiert impérativement un centrage scrupuleux des deux variables continues sur leurs moyennes arithmétiques respectives afin de maîtriser la prolifération de la multicolinéarité structurelle qui menacerait autrement la fiabilité des tests d’hypothèses sur les coefficients d’ordre supérieur.
11.2 Méthodologie de la surface de réponse (Response Surface Methodology)
L’interprétation conjointe de cinq coefficients de régression non linéaires interdépendants au sein d’une équation de second ordre s’avère cognitivement ardue et propice à des erreurs de déduction. C’est pour surmonter cette opacité analytique que la méthodologie de la surface de réponse (Response Surface Methodology ou RSM), originellement conceptualisée par Box et Wilson en génie chimique et brillamment introduite en psychologie organisationnelle par Jeffrey Edwards (2002), s’impose comme le cadre opératoire de référence.
La RSM transcende la simple analyse tabulaire des coefficients pour transposer l’intégralité de l’équation quadratique dans un espace géométrique tridimensionnel, générant une topographie surfacique continue (paraboloïde elliptique, paraboloïde hyperbolique ou col de selle). Cette cartographie visuelle et analytique est particulièrement mobilisée pour tester empiriquement les théories fondamentales de l’adéquation individu-environnement (person-environment fit), de la congruence des attentes ou de l’alignement conceptuel de dyades (telles que les relations superviseur-subordonné ou les interactions conjugales).
L’appareil mathématique de la RSM permet de sonder la topographie surfacique le long de deux trajectoires critiques transversales d’une importance théorique cardinale :
- La ligne de parfaite congruence ($X = Z$) : Cette ligne examine l’impact du niveau absolu des variables lorsque celles-ci sont en accord parfait. Sa pente au point central est mesurée par la quantité $a_1 = \beta_1 + \beta_2$, tandis que sa courbure le long de cet axe est quantifiée par la quantité $a_2 = \beta_3 + \beta_4 + \beta_5$.
- La ligne d’incongruence ($X = -Z$ pour des variables centrées) : Cette trajectoire transversale sonde les conséquences de la divergence directionnelle entre les construits. Sa pente à l’origine s’exprime par $a_3 = \beta_1 – \beta_2$, et sa courbure critique est gouvernée par la combinaison $a_4 = \beta_3 – \beta_4 + \beta_5$.
Grâce à ces équations différentielles spécifiques, les chercheurs peuvent tester avec une élégance mathématique parfaite des hypothèses théoriques d’une grande subtilité. Par exemple, ils peuvent déterminer si le bien-être psychologique est maximal lorsque les compétences professionnelles correspondent strictement aux exigences de l’emploi ($a_4 0$).
11.3 Avantages sur les méthodes traditionnelles de score de différence
L’essor fulgurant de la modélisation polynomiale conjointe et de la méthodologie de surface de réponse dans la recherche de haut niveau découle principalement de la crise méthodologique majeure qui a frappé les approches analytiques antérieures, fondées sur l’usage naïf des scores de différence algébrique ($(X – Z)$) ou des scores de divergence absolue ($|X – Z|$).
Pendant des décennies, les chercheurs ont quantifié l’inadéquation entre deux construits en soustrayant simplement le score de la variable $Z$ du score de la variable $X$, puis en intégrant ce terme unique de divergence dans une régression linéaire standard. Or, les travaux fondateurs de Cronbach (1958) puis d’Edwards (1994) ont démontré de manière irréfutable les tares psychométriques destructrices inhérentes à ces indices différentiels synthétiques :
- Chute catastrophique de la fidélité de mesure : La fidélité psychométrique d’un score de différence est mathématiquement inférieure à la moyenne des fidélités des deux composantes individuelles, atteignant fréquemment des valeurs inacceptables ($r_{dd} < 0,50$) dès lors que les construits $X$ et $Z$ sont modérément corrélés entre eux.
- Imposition arbitraire de contraintes paramétriques simplistes : L’emploi d’un terme $(X – Z)$ force artificiellement l’égalité absolue et de signe opposé des coefficients directeurs des deux prédicteurs ($\beta_X = -\beta_Z$), une hypothèse restrictive qui est presque systématiquement violée par les données empiriques réelles.
- Masquage total des asymétries directionnelles : Le recours aux valeurs absolues $|X – Z|$ postule péremptoirement qu’une surqualification de l’employé ($X > Z$) engendre des conséquences psychologiques rigoureusement identiques à celles d’une sous-qualification ($X < Z$), occultant les asymétries fonctionnelles substantielles.
La régression polynomiale conjointe s’affranchit totalement de ces handicaps méthodologiques en traitant simultanément $X$ et $Z$ comme des entités continues distinctes, sans agréger prématurément leur variance. Elle ne présuppose aucune contrainte d’égalité a priori et autorise la cartographie libre d’asymétries topologiques complexes, établissant un niveau de rigueur analytique désormais exigé par les revues scientifiques de premier rang.
12. Guide décisionnel : Protocole séquentiel d’arbitrage méthodologique
12.1 Arbre décisionnel pour l’adoption d’un modèle polynomial
Pour prémunir les chercheurs et analystes de données contre l’improvisation analytique et garantir une standardisation des protocoles d’investigation non linéaire, il est hautement profitable d’articuler la stratégie analytique autour d’un arbre décisionnel séquentiel en trois étapes méthodologiques interconnectées :
- Étape 1 : Justification théorique substantielle et plausibilité conceptuelle : Avant toute manipulation des données informatiques, le chercheur doit fonder son hypothèse sur un corpus théorique validé ou sur des arguments mécanistiques plausibles postulant formellement l’existence d’une dynamique non monotone (loi de Yerkes-Dodson, saturation des ressources, effets de seuil psychologique). La régression polynomiale ne saurait être employée comme un outil purement athéorique de pêche aux résultats (p-hacking).
- Étape 2 : Confirmation empirique exploratoire et analyse diagnostique des résidus : L’inspection visuelle du lisseur LOESS et l’examen du graphique des résidus en fonction des valeurs ajustées du modèle linéaire simple doivent corroborer la trajectoire postulée. Cette convergence visuelle doit être formellement confirmée par la significativité statistique d’un test de mauvaise spécification (test Ramsey RESET à $p < 0,05$).
- Étape 3 : Validation inférentielle comparative et contrôle de parcimonie : Le chercheur estime le modèle polynomial hiérarchique bien formé en intégrant les puissances centrées sur la moyenne. Le terme de plus haut degré doit afficher un coefficient significatif au test $t$, l’incrément de variance expliquée $\Delta R^2$ doit être confirmé par un test F de changement significatif, les critères pénalisés d’Akaike et de Bayes doivent afficher une baisse nette ($\Delta \text{AIC} > 4$ et $\Delta \text{BIC} > 6$), et l’erreur d’ajustement par validation croisée doit atteindre son minimum structurel sans franchissement de la règle du 1-SE.
Si et seulement si l’intégralité de ces trois jalons séquentiels est franchie avec succès, l’analyste est scientifiquement autorisé à retenir le modèle polynomial comme l’architecture inférentielle finale de son étude.
12.2 Quand préférer des alternatives non linéaires alternatives ?
Bien que la régression polynomiale constitue un instrument mathématique puissant, elle ne représente nullement la panacée universelle pour toutes les structures curvilinéaires observées dans la nature. Le méthodologue avisé doit savoir discerner les scénarios empiriques où des alternatives analytiques concurrentes s’avèrent infiniment plus appropriées et théoriquement défendables :
Dans les configurations où la relation monotone entre les variables ne comporte strictement aucun changement de direction mais se caractérise par une dynamique de compression d’échelle ou de décélération continue, le recours à une transformation monotone des variables (telle que la transformation logarithmique népérienne, la racine carrée ou la transformation de puissance de Box-Cox appliquée au prédicteur ou au critère) s’avère considérablement supérieure à l’introduction d’un terme quadratique. Une modélisation semi-logarithmique ($Y = \beta_0 + \beta_1 \ln(X)$) capture les rendements décroissants de manière stable sans risquer l’inversion de courbure parabolique non désirée inhérente aux polynômes.
Lorsque le phénomène investigué comporte des bornes physiques, biologiques ou psychométriques infranchissables — générant des plateaux asymptotiques horizontaux absolus aux deux extrémités de l’échelle —, la régression polynomiale échoue structurellement en raison de son comportement divergent vers l’infini. Dans un tel contexte, le chercheur doit impérativement s’orienter vers des modèles de croissance non linéaires intrinsèques, tels que les fonctions logistiques à 3 ou 4 paramètres (logistic growth curves), les modèles de Gompertz, ou les équations de Michaelis-Menten issues de la cinétique biochimique.
Enfin, face à des séries temporelles longues, des dynamiques développementales d’une extrême complexité ou des configurations topologiques manifestant des ondulations locales multiples et imprévisibles, vouloir forcer un ajustement polynomial global de degré élevé conduit directement à la faillite algorithmique de Runge. Dans ces situations, le standard moderne réside dans le déploiement des splines de régression (B-splines, splines de lissage cubiques naturalisées) ou dans le cadre infiniment flexible des Modèles Additifs Généralisés (GAM). En découpant le support continu en sous-intervalles reliés par des nœuds optimisés tout en contrôlant la rugosité locale par une pénalité sur la dérivée seconde, les modèles GAM capturent avec une grâce mathématique totale les non-linéarités les plus intriquées sans jamais succomber à l’instabilité oscillatoire des polynômes d’ordre supérieur.
12.3 Recommandations de bonnes pratiques de restitution académique
La communication scientifique d’une modélisation polynomiale dans les revues internationales à comité de lecture ne saurait se limiter à la mention lapidaire d’un coefficient quadratique significatif dans le corps du texte. La transparence méthodologique et l’impératif de reproductibilité commandent le respect scrupuleux de directives de restitution normalisées :
L’article doit obligatoirement présenter un tableau synoptique de comparaison hiérarchique de modèles, affichant côte à côte les paramètres estimés du modèle linéaire de base (Modèle 1) et ceux du modèle polynomial complet (Modèle 2). Pour chaque configuration, les métriques indispensables doivent être rigoureusement reportées : coefficients non standardisés ($B$) avec leurs erreurs-types associées ($SE$), coefficients standardisés ($\beta$), valeurs exactes des statistiques $t$ ou $F$, coefficient de détermination brut ($R^2$), $R^2$ ajusté, incrément de variance ($\Delta R^2$), ainsi que les valeurs des critères pénalisés d’AIC et de BIC.
Toute modélisation polynomiale doit être obligatoirement accompagnée de sa représentation graphique soignée. L’illustration visuelle doit projeter la courbe prédite par l’équation mathématique sur l’ensemble du domaine empirique observé de la variable indépendante, en superposant impérativement les intervalles de confiance à 95% dérivés de l’erreur-type de prédiction. Les points d’observations empiriques bruts ou la densité des données doivent apparaître en arrière-plan transparent pour attester de la distribution réelle de l’échantillon. Enfin, la section discussion doit se garder de toute réification algébrique stérile pour ancrer l’interprétation des courbures et des points d’inflexion dans leur signification psychologique, clinique et comportementale concrète, conférant ainsi à l’élégance des mathématiques toute sa portée humaine et scientifique.
Références
- Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. Sage Publications.
- Box, G. E., & Wilson, K. B. (1951). On the experimental attainment of optimum conditions. Journal of the Royal Statistical Society: Series B (Methodological), 13(1), 1-38. https://doi.org/10.1111/j.2517-6161.1951.tb00067.x
- Burnham, K. P., & Anderson, D. R. (2004). Multimodel inference: Understanding AIC and BIC in model selection. Sociological Methods & Research, 33(2), 261-304. https://doi.org/10.1177/0049124104268644
- Busemeyer, J. R., & Jones, L. E. (1983). Analysis of multiplicative combination rules when the causal variables are measured with error. Psychological Bulletin, 93(3), 549-562. https://doi.org/10.1037/0033-2909.93.3.549
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Cronbach, L. J. (1958). Proposals leading to analytic treatment of social perception scores. In R. Tagiuri & L. Petrullo (Eds.), Person perception and interpersonal behavior (pp. 353-379). Stanford University Press.
- Edwards, J. R. (1994). The study of congruence in organizational behavior research: Critique and a proposed alternative. Organizational Behavior and Human Decision Processes, 58(1), 51-100. https://doi.org/10.1006/obhd.1994.1029
- Edwards, J. R. (2002). Alternatives to difference scores: Polynomial regression analysis and response surface methodology. In F. Drasgow & N. W. Schmitt (Eds.), Measuring and analyzing behavior in organizations: Advances in measurement and data analysis (pp. 350-400). Jossey-Bass.
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Lind, J. T., & Mehlum, H. (2010). With or without U? The appropriate test for a U-shaped relationship. Oxford Bulletin of Economics and Statistics, 72(1), 109-118. https://doi.org/10.1111/j.1468-0084.2009.00569.x
- Nelder, J. A. (1977). A reformulation of linear models. Journal of the Royal Statistical Society: Series A (General), 140(1), 48-63. https://doi.org/10.2307/2344517
- Pierce, J. R., & Aguinis, H. (2013). The too-much-of-a-good-thing effect in management. Journal of Management, 39(2), 313-338. https://doi.org/10.1177/0149206311410060
- Ramsey, J. B. (1969). Tests for specification errors in classical linear least-squares regression analysis. Journal of the Royal Statistical Society: Series B (Methodological), 31(2), 350-371. https://doi.org/10.1111/j.2517-6161.1969.tb00796.x
- Runge, C. (1901). Über empirische Funktionen und die Interpolation zwischen äquidistanten Ordinaten. Zeitschrift für Mathematik und Physik, 46, 224-243.
- Yerkes, R. M., & Dodson, J. D. (1908). The relation of strength of stimulus to rapidity of habit-formation. Journal of Comparative Neurology and Psychology, 18(5), 459-482. https://doi.org/10.1002/cne.920180503