
Dans le domaine de l’analyse quantitative et de l’expérimentation scientifique, l’évaluation des changements survenus au sein d’une même cohorte d’individus constitue l’une des démarches méthodologiques les plus courantes. Qu’il s’agisse de mesurer l’efficacité d’une thérapie cognitivo-comportementale par un protocole pré-test et post-test, d’évaluer l’impact d’un programme d’entraînement ergonomique sur la réduction des erreurs opératoires, ou d’analyser l’évolution des scores de douleur après administration d’une molécule pharmacologique, le chercheur se trouve confronté à des données appariées ou dépendantes. Lorsque ces mesures satisfont aux postulats restrictifs de la statistique classique, le test t de Student pour échantillons appariés s’impose historiquement comme l’outil privilégié pour comparer deux moyennes arithmétiques.
Toutefois, la réalité empirique du laboratoire ou du terrain clinique contredit fréquemment ces exigences mathématiques idéales. Les distributions de scores psychométriques, les échelles ordinales d’appréciation subjective ou les temps de réaction présentent très régulièrement des asymétries prononcées, une bimodalité ou des queues de distribution épaisses, quand ils ne sont pas tout simplement pollués par des observations aberrantes incompressibles. Face à ces violations systématiques de l’hypothèse de normalité gaussienne, l’application aveugle des méthodes paramétriques expose l’analyste à des distorsions majeures du taux d’erreur de première espèce ainsi qu’à un effondrement dramatique de la puissance statistique de ses inférences. C’est précisément pour surmonter ces écueils théoriques et pratiques que les tests non paramétriques ont été développés au cours du vingtième siècle.
Parmi cet arsenal méthodologique moderne, le test des rangs signés de Wilcoxon occupe une place prépondérante en tant qu’équivalent direct, robuste et élégant du test t dépendant. Bien que des environnements logiciels spécialisés comme R, Python, SPSS ou SAS intègrent des routines automatisées pour son exécution, la maîtrise de son implémentation pas à pas dans Microsoft Excel représente une compétence analytique inestimable. Décomposer chaque phase du calcul au sein d’un tableur permet non seulement de démystifier l’algorithme sous-jacent, mais assure également un contrôle absolu sur la gestion des cas particuliers, tels que les différences nulles et les ex aequo. Ce guide exhaustif a pour vocation d’exposer avec une rigueur académique sans compromis l’ensemble des fondements théoriques, des prérequis méthodologiques et des manipulations pratiques nécessaires pour mener à bien un test des rangs signés de Wilcoxon dans Excel.
1. Introduction et fondements théoriques du test des rangs signés de Wilcoxon
1.1 Définition et rôle de l’alternative non paramétrique
Proposé initialement par le chimiste et statisticien américain Frank Wilcoxon dans son article fondateur de 1945 intitulé Individual Comparisons by Ranking Methods, le test des rangs signés constitue une rupture paradigmatique majeure dans l’histoire de la statistique inférentielle. Conçu expressément pour traiter les devis expérimentaux impliquant des mesures répétées ou des paires de sujets étroitement appariés, ce test s’affranchit du postulat selon lequel la population parente dont sont issus les échantillons suit une distribution normale ou gaussienne. Dans l’épistémologie des sciences empiriques, l’obligation d’abandonner les méthodes paramétriques émerge dès lors que la forme analytique sous-jacente de la distribution des données ne peut être modélisée de manière fiable par une loi de probabilité spécifiée a priori avec un nombre fini de paramètres mathématiques.
Le principe mécanique fondamental qui confère au test de Wilcoxon toute son originalité réside dans la transformation des valeurs quantitatives continues ou ordinales brutes en une structure d’ordonnancement par les rangs, tout en préservant l’information critique portée par la magnitude et le signe des différences observées. Contrairement au test des signes élémentaire, qui ignore délibérément l’amplitude des écarts pour ne retenir que leur direction qualitative (positive ou négative), le test des rangs signés quantifie la distance relative séparant chaque paire de mesures. Il classe ensuite ces écarts de manière ascendante selon leur valeur absolue. Cette opération confère un poids statistique proportionnellement plus élevé aux variations substantielles survenues entre deux conditions expérimentales, tout en atténuant le pouvoir de distorsion des valeurs extrêmes.
Cette élégante dualité méthodologique prend toute sa pertinence dans les protocoles de recherche contemporains en psychologie clinique, en neuropsychologie et dans les sciences comportementales. Dans ces disciplines, les instruments de mesure reposent massivement sur des batteries d’évaluations psychométriques, des échelles de dépression ou d’anxiété, et des grilles d’observation dont les propriétés métriques ne garantissent nullement l’intervalle constant requis par les modèles linéaires classiques. Face à des échantillons de taille modeste, où l’évaluation formelle de la normalité par des tests tels que celui de Shapiro-Wilk manque cruellement de puissance, le recours systématique au test des rangs signés de Wilcoxon s’impose comme une garantie de validité interne et de reproductibilité empirique.
1.2 Différences fondamentales avec le test t pour échantillons appariés
L’arbitrage entre le test t de Student pour échantillons dépendants et le test des rangs signés de Wilcoxon soulève des questions centrales de puissance statistique, de robustesse et de signification théorique des inférences produites. Sur le plan de l’efficacité asymptotique relative, la littérature statistique classique démontre que lorsque la distribution sous-jacente des différences respecte scrupuleusement l’hypothèse de normalité, le test de Wilcoxon conserve une efficacité relative d’environ 95,5 % par rapport au test t. Cela signifie que la perte de puissance induite par la conversion des grandeurs continues en rangs est minime. En revanche, dès que la distribution réelle s’écarte de la normalité, notamment en présence de queues lourdes ou de contamination par des données asymétriques, l’efficacité relative du test de Wilcoxon dépasse largement 100 %, pouvant atteindre des valeurs théoriques infinies face à des lois particulièrement dispersées ou discontinues.
Cette supériorité opérationnelle face aux distributions non gaussiennes s’explique par l’insensibilité intrinsèque des statistiques d’ordre aux observations aberrantes extrêmes, communément désignées sous le terme d’outliers. Dans un test t paramétrique, une unique valeur déviante issue d’un artéfact de mesure ou d’une réaction atypique d’un participant peut gonfler démesurément la variance de l’échantillon ou déplacer artificiellement la moyenne arithmétique, conduisant soit à une erreur de type I (faux positif), soit à une erreur de type II (faux négatif). À l’inverse, dans le test de Wilcoxon, l’écart le plus colossal ne recevra jamais qu’un rang ordinal maximal (par exemple, le rang 15 dans un échantillon de quinze paires), neutralisant de facto son potentiel destructeur sur la stabilité de la statistique inférentielle.
Par ailleurs, la nature même de l’hypothèse testée diverge profondément entre les deux approches. Alors que le test t évalue formellement l’égalité des espérances mathématiques, vérifiant si la moyenne des différences de population est égale à zéro, le test de Wilcoxon évalue la distribution stochastique des écarts, ce qui se traduit opérationnellement par une comparaison de médianes ou, plus rigoureusement, par l’estimation de la pseudo-médiane de Hodges-Lehmann des différences appariées. Cette distinction prend une résonance épistémologique cruciale lors de l’exploitation d’échelles psychométriques de type Likert à 5 ou 7 points. Attribuer une signification arithmétique à la moyenne d’un score de Likert constitue une transgression méthodologique fréquente, car la distance séparant un état « tout à fait d’accord » d’un état « d’accord » n’est pas quantitativement démontrée comme équivalente à celle séparant l’état « neutre » de l’état « en désaccord ». Le test de Wilcoxon, en opérant exclusivement sur l’ordonnancement des amplitudes, respecte scrupuleusement la nature ordinale de ces mesures psychologiques sans introduire de postulats métriques abusifs.
2. Conditions d’application et postulats méthodologiques préalables
2.1 Structure et appariement des données expérimentales
La validité des conclusions issues d’un test des rangs signés de Wilcoxon dépend impérativement du respect de plusieurs exigences structurales relatives au plan d’échantillonnage. La condition primordiale concerne la nature appariée ou dépendante des données recueillies. L’analyste doit se trouver en présence de deux séries d’observations appariées terme à terme, ce qui se concrétise généralement à travers deux paradigmes expérimentaux distincts. Le premier est le plan à mesures répétées, dans lequel une cohorte unique de participants subit une double évaluation temporelle ou conditionnelle, classiquement illustrée par un schéma pré-test / post-test évaluant l’état des sujets avant et après l’administration d’un traitement expérimental.
Le second paradigme repose sur l’appariement direct de sujets distincts selon des critères d’homogénéisation extrêmement stricts. Dans ce cadre, chaque participant du groupe expérimental est jumelé de façon univoque avec un individu du groupe témoin partageant des caractéristiques démographiques ou biologiques fondamentales, telles que l’âge chronologique, le sexe biologique, le niveau socio-économique ou le niveau de base d’une pathologie donnée. Qu’il s’agisse de mesures répétées sur les mêmes individus ou de paires artificiellement constituées, la structure des données impose que la valeur issue de la condition B soit conceptuellement et fonctionnellement liée à la valeur correspondante issue de la condition A.
Enfin, une condition méthodologique absolue, souvent négligée dans la pratique, réside dans l’indépendance mutuelle entre les différentes paires d’observations au sein de l’échantillon global. Si l’interdépendance intra-paire est le moteur même du test, toute forme de dépendance inter-paires est strictement prohibée. Cela implique que la réponse, l’évolution ou la performance d’un sujet (ou d’une paire appariée) ne doit en aucun cas être influencée par celle d’un autre sujet de la cohorte. Les protocoles impliquant des dynamiques de groupe, des mesures collectées en grappes ou des apprentissages interactifs non contrôlés violent cette règle d’indépendance stochastique, ce qui entraîne une distorsion majeure de la distribution d’échantillonnage théorique de la statistique de test.
2.2 Niveau de mesure et postulats de distribution
Sur le plan métrologique, le test des rangs signés de Wilcoxon requiert que les variables dépendantes soient mesurées au minimum sur une échelle de mesure ordinale possédant des propriétés de continuité relative, ou idéalement sur une échelle d’intervalles ou de rapports. La nécessité sous-jacente est que l’opération de soustraction arithmétique entre la mesure post-intervention et la mesure pré-intervention ait un sens conceptuel et mathématique clair. Il ne suffit pas que les variables initiales puissent être ordonnées ; il est impératif que les différences individuelles calculées puissent elles-mêmes être ordonnées les unes par rapport aux autres en termes de magnitude absolue, ce qui exclut de fait les simples données nominales catégorielles non hiérarchisées.
Au-delà de la nature de l’échelle métrique, le postulat de distribution le plus critique, et paradoxalement le plus méconnu des praticiens utilisant les alternatives non paramétriques, concerne la symétrie de la distribution des différences dans la population parente. Si le test de Wilcoxon ne requiert absolument pas la normalité des scores, il postule formellement que la distribution de la variable de différence (Condition 2 moins Condition 1) est symétrique autour de sa médiane théorique. La distribution peut être aplatie (platykurtique), pointue (leptokurtique) ou multimodale, mais la probabilité d’observer un écart positif d’une magnitude donnée doit être égale à la probabilité d’observer un écart négatif de même magnitude sous l’hypothèse nulle.
La violation substantielle de ce postulat de symétrie altère profondément la nature de l’inférence statistique produite. Si la distribution des différences présente une asymétrie marquée (skewness prononcée), un résultat statistiquement significatif ne peut plus être interprété de façon univoque comme un déplacement de la médiane entre les deux conditions expérimentales. Dans un tel cas, le rejet de l’hypothèse nulle indique simplement qu’une distribution domine stochastiquement l’autre, sans que l’on puisse affirmer avec certitude que le centre de gravité ou la valeur centrale de la population a changé de position. L’analyste rigoureux se doit donc d’examiner visuellement la forme de la distribution des écarts, via un histogramme ou un diagramme de dispersion des résidus, avant de finaliser ses interprétations cliniques ou expérimentales.
3. Formulation formelle des hypothèses statistiques nulle et alternative
3.1 Énonciation des hypothèses bilatérales
L’armature logique de l’inférence statistique repose sur la confrontation systématique de deux énoncés mutuellement exclusifs et exhaustifs : l’hypothèse nulle, notée conventionnellement H0, et l’hypothèse alternative, désignée par H1. Dans le cadre d’un plan d’analyse bilatéral (ou non directionnel), le chercheur postule a priori qu’une intervention, une manipulation expérimentale ou l’écoulement du temps peut engendrer une modification des performances ou des scores, sans toutefois s’engager théoriquement sur le sens d’apparition de cette variation.
Formellement, si l’on définit la variable aléatoire $D = X_2 – X_1$ comme représentant la différence individuelle entre la condition post-intervention ($X_2$) et la condition pré-intervention ($X_1$), et que l’on note $\theta$ (thêta) la médiane de la population de ces différences appariées, l’hypothèse nulle s’énonce de la manière suivante :
$$H_0 : \theta = 0$$
Cette formulation mathématique postule que la médiane des différences au sein de la population générale est rigoureusement égale à zéro. Sous l’hypothèse nulle, il n’existe aucun effet systématique attribuable au traitement expérimental : les écarts positifs et négatifs observés au niveau de l’échantillon ne résultent que des fluctuations d’échantillonnage aléatoires et des bruits de mesure inhérents au protocole expérimental.
À l’opposé, l’hypothèse alternative bilatérale stipule l’existence d’une altération statistiquement démontrable de l’état des sujets, quelle que soit la polarité de ce changement. Elle s’exprime symboliquement ainsi :
$$H_1 : \theta \neq 0$$
Dans la recherche appliquée, la validation de cette hypothèse alternative implique que la distribution des scores sous la seconde condition a subi une translation stochastique significative par rapport à la première condition, signifiant un impact réel du facteur étudié, qu’il s’agisse d’un progrès mesurable ou d’une détérioration clinique.
3.2 Énonciation des hypothèses unilatérales et seuil de décision
Lorsque le corpus théorique sous-jacent ou des résultats préliminaires robustes permettent d’anticiper avec certitude la direction précise de l’effet attendu, l’investigateur peut légitimement formuler une hypothèse alternative unilatérale (ou directionnelle). Ce choix augmente mécaniquement la puissance statistique du test pour détecter un effet orienté dans la direction prédéfinie, tout en renonçant complètement à identifier un effet significatif qui se manifesterait dans la direction opposée.
Dans l’éventualité où le protocole vise à démontrer une amélioration clinique se traduisant par une augmentation des scores (par exemple, une hausse de l’estime de soi ou des capacités mnésiques), l’hypothèse unilatérale droite s’articule comme suit :
$$H_0 : \theta \leq 0 \quad \text{versus} \quad H_1 : \theta > 0$$
Inversement, si l’objectif clinique consiste à réduire une symptomatologie invalidante (telle qu’une échelle de phobie sociale ou un marqueur biochimique de stress), l’hypothèse unilatérale gauche postule une décroissance des scores, s’énonçant par :
$$H_0 : \theta \geq 0 \quad \text{versus} \quad H_1 : \theta < 0$$
L’arbitrage formel entre le maintien et le rejet de l’hypothèse nulle exige la fixation rigoureuse, préalable à toute manipulation des données empiriques, du risque d’erreur de première espèce, universellement désigné par la lettre grecque $\alpha$ (alpha). Dans l’immense majorité des publications scientifiques en sciences humaines, biomédicales et comportementales, ce seuil est fixé conventionnellement à $\alpha = 0,05$, ce qui signifie que l’analyste consent à accepter une probabilité maximale de 5 % de déclarer à tort l’existence d’un effet thérapeutique alors que l’hypothèse nulle est mathématiquement vérifiée dans la population. Dans des contextes de recherche clinique à haute criticité médicale ou pharmacologique, un seuil plus conservateur, tel que $\alpha = 0,01$ voire $\alpha = 0,001$, peut être institutionnellement requis afin de limiter drastiquement l’occurrence de faux positifs.
4. Étape 1 : Structuration et saisie des données expérimentales dans Excel
4.1 Organisation tabulaire des paires d’observations
L’exécution sans faille d’une analyse non paramétrique dans Microsoft Excel repose sur une structuration architecturale rigoureuse de la feuille de calcul. L’organisation matricielle standardisée adoptée par les biométriciens consiste à dédier chaque ligne de la grille à une unité statistique unique (un participant, un patient ou un couple apparié) et à assigner les colonnes aux variables expérimentales successives.
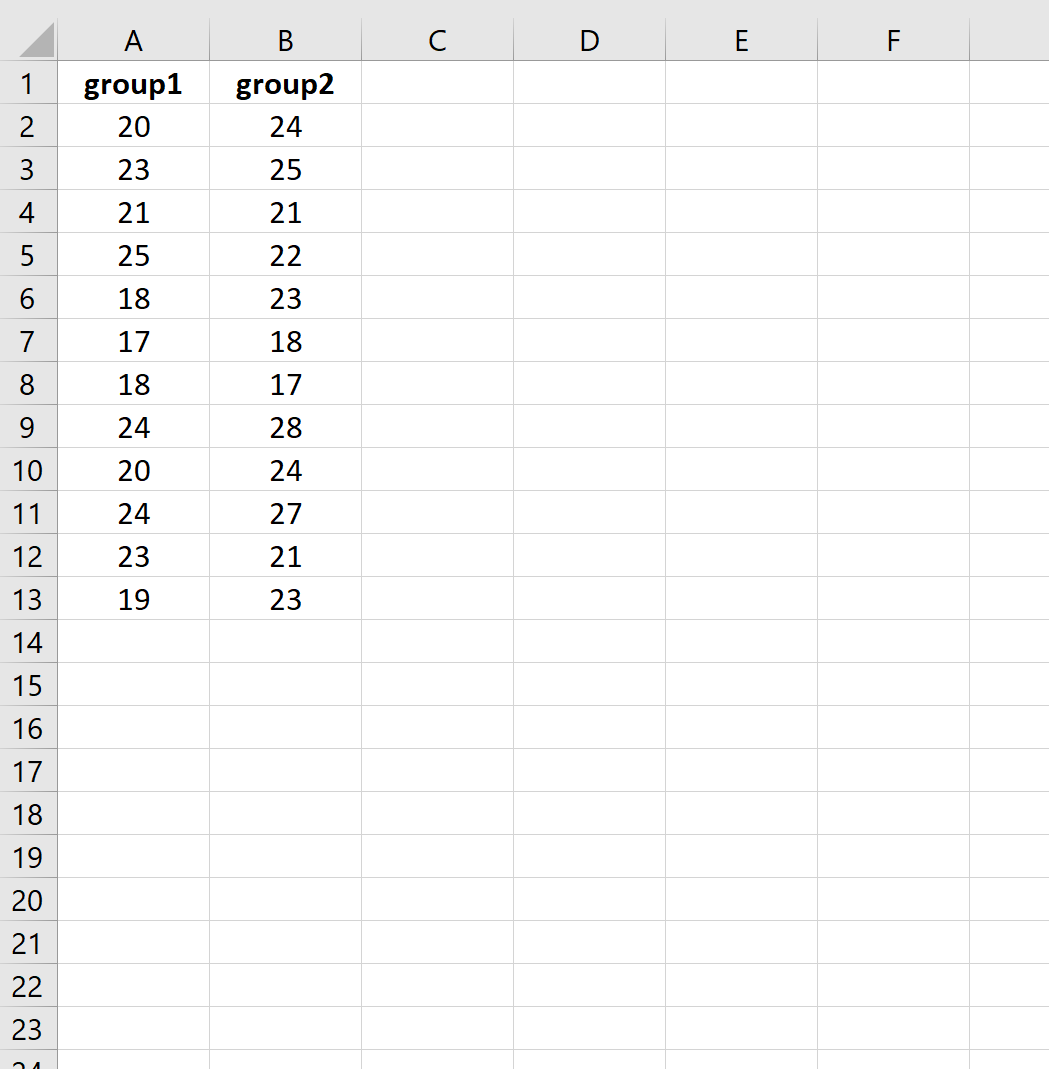
Pour illustrer concrètement notre démarche tout au long de ce guide, considérons un protocole expérimental mené sur un échantillon clinique de douze patients ($N = 12$) souffrant d’anxiété généralisée, chez lesquels un score composite de détresse psychologique a été recueilli avant et après la mise en œuvre d’une thérapie comportementale brève. La disposition tabulaire s’articule selon le modèle normatif suivant :
- Colonne A (Ligne 1 : « Identifiant Sujet ») : Cette colonne accueille le code alphanumérique unique attribué à chaque participant (ex. : Patient_01, Patient_02, …, Patient_12), consigné dans les cellules s’étendant de
A2àA13. Cet étiquetage strict empêche toute ambiguïté lors des manipulations de tri ultérieures. - Colonne B (Ligne 1 : « Pré-intervention ») : Elle héberge la mesure de référence (baseline) issue de la première condition expérimentale, saisie rigoureusement dans les cellules de
B2àB13. - Colonne C (Ligne 1 : « Post-intervention ») : Elle contient la mesure subséquente obtenue auprès du même individu à l’issue du protocole thérapeutique, consignée dans la plage s’étendant de
C2àC13.
La règle d’or méthodologique à cette étape réside dans la préservation scrupuleuse de l’intégrité de chaque couple de données. Une cellule vide au sein d’une paire détruit l’appariement expérimental et invalide l’application directe du test pour cette ligne spécifique, imposant soit l’exclusion préalable du sujet de l’analyse, soit l’application d’un protocole standardisé de traitement des données manquantes.
4.2 Nettoyage préliminaire et formatage des cellules
Avant d’engager la moindre opération mathématique, une phase de nettoyage préliminaire des données s’avère indispensable pour neutraliser les erreurs d’encodage susceptibles de fausser les calculs vectoriels dans Excel. La défaillance la plus pernicieuse survient lorsqu’une valeur numérique est interprétée par le logiciel comme une chaîne textuelle, souvent en raison de l’utilisation erronée d’un point au lieu d’une virgule décimale (selon les paramètres régionaux du système d’exploitation) ou de la présence d’espaces insécables résiduels.
Pour garantir une interopérabilité numérique absolue, l’analyste doit sélectionner l’intégralité des plages quantitatives (ici B2:C13), effectuer un clic droit pour ouvrir la boîte de dialogue Format de cellule, et attribuer explicitement la catégorie Nombre avec un nombre fixe de décimales (par exemple, 1 ou 2 décimales). Un contrôle visuel élémentaire permet de s’assurer de la bonne exécution de ce formatage : par défaut dans l’environnement Excel, les valeurs numériques correctement encodées s’alignent automatiquement sur le bord droit de la cellule, tandis que les entrées textuelles résiduelles demeurent alignées sur le bord gauche.
Enfin, la documentation des métadonnées dans les en-têtes de colonnes doit être irréprochable. Évitez les caractères accentués complexes ou les symboles exotiques dans les intitulés des cellules de la ligne 1 si vous envisagez une portabilité vers des scripts Visual Basic (VBA) ou des ponts d’interopérabilité avec le langage R. Les étiquettes courtes, explicites et normalisées facilitent l’audit analytique ultérieur et garantissent la traçabilité des procédures de calcul conformément aux critères de qualité scientifique des données (bonnes pratiques de laboratoire).
5. Étape 2 : Calcul des différences algébriques individuelles
5.1 Implémentation de la soustraction vectorielle
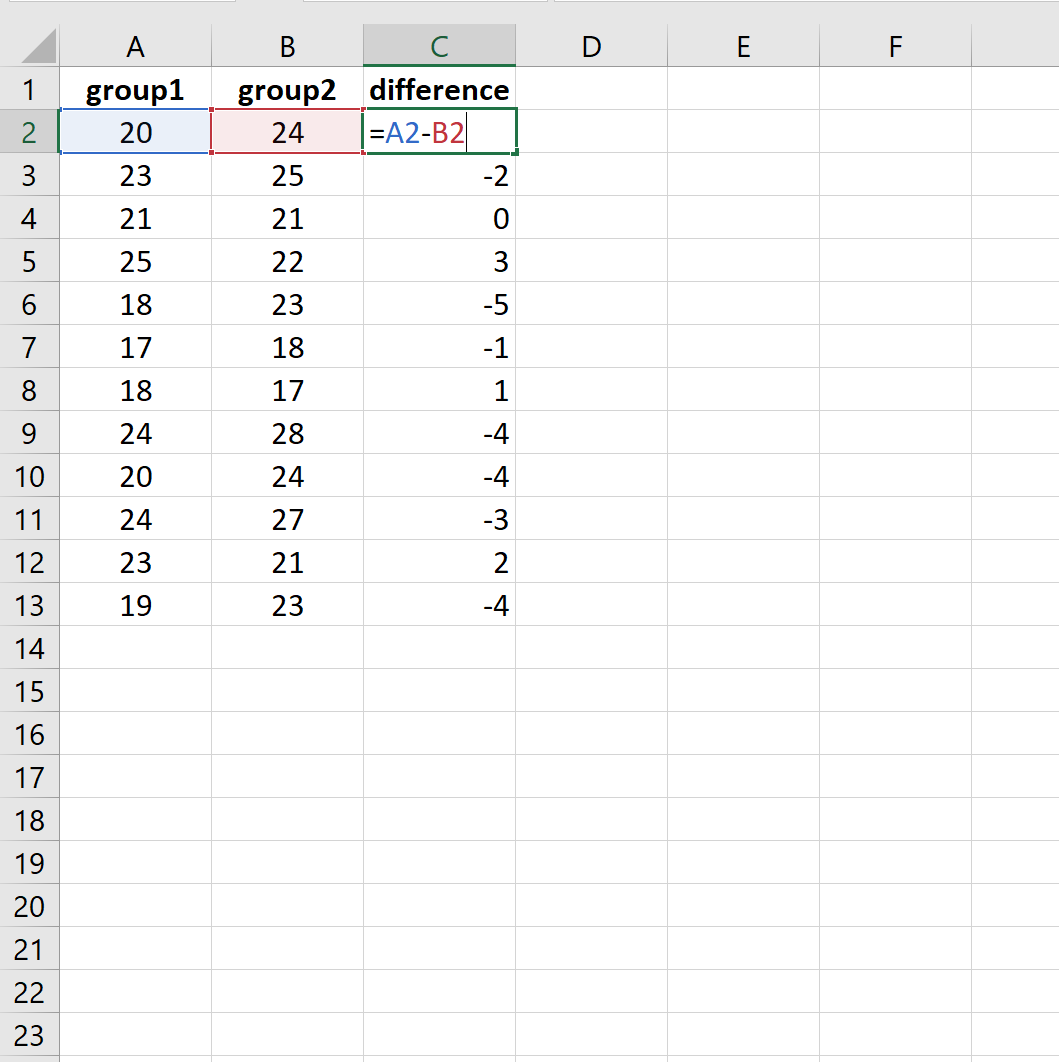
Le traitement algorithmique du test de Wilcoxon débute par la modélisation mathématique du changement individuel observé chez chaque participant entre les deux temps de mesure. Cette variation s’exprime à travers le calcul d’une différence algébrique vectorielle. Pour implémenter ce calcul, l’analyste crée une nouvelle colonne au sein de la feuille de calcul :
- Colonne D (Ligne 1 : « Différence (D) ») : Cette colonne a pour fonction d’enregistrer l’écart arithmétique signé pour chaque ligne de données de l’échantillon.
La syntaxe de calcul est saisie au niveau de la première cellule de données, à savoir D2. La formule doit être libellée comme suit :
=C2-B2
Une fois cette équation validée par la touche Entrée, la propagation de l’instruction sur l’ensemble de la cohorte s’effectue au moyen de la poignée de recopie incrémentale. L’analyste positionne le curseur sur le coin inférieur droit de la cellule D2 jusqu’à ce que le pointeur se transforme en une croix noire fine, puis effectue un double-clic gauche (ou fait glisser la formule manuellement jusqu’à la cellule D13). Grâce au système d’adressage relatif intrinsèque à Microsoft Excel, la formule s’ajuste dynamiquement sur chaque rangée : la cellule D3 calculera automatiquement =C3-B3, la cellule D4 exécutera =C4-B4, et ainsi de suite jusqu’à la terminaison de la série d’observations.
Le résultat de cette étape constitue une série de valeurs signées. Il est impératif de souligner que la conservation scrupuleuse du signe mathématique (positif ou négatif) associé à chaque valeur calculée dans cette colonne D représente un prérequis absolu pour la suite des opérations algorithmiques. Une altération prématurée de ce signe détruirait irréversiblement l’information directionnelle indispensable à la ségrégation des rangs.
5.2 Sens méthodologique de l’ordre de soustraction
D’un point de vue strictement formel et mathématique, que l’on effectue l’opération sous la forme (Post moins Pré) ou sous la forme inverse (Pré moins Post), la valeur absolue de la statistique de Wilcoxon demeurera rigoureusement identique. Néanmoins, sur le plan méthodologique et sémiotique, le choix de l’ordre de soustraction détermine directement la polarité conceptuelle du score et conditionne l’interprétation intuitive des résultats intermédiaires.
En adoptant la convention standardisée internationale Condition 2 - Condition 1 (Post-intervention moins Pré-intervention), les signes algébriques obtenus s’alignent naturellement avec le sens de l’évolution temporelle du participant :
- Un signe positif ($D > 0$) reflète sans ambiguïté une augmentation arithmétique du score entre la mesure initiale et la mesure terminale.
- Un signe négatif ($D < 0$) signale une décroissance effective de la valeur mesurée au terme du traitement expérimental.
- Une valeur nulle ($D = 0$) témoigne d’une parfaite constance temporelle, traduisant une stricte absence d’évolution mesurable chez l’individu.
L’analyste doit maintenir de façon rigoureusement constante cette convention tout au long de son tableur. L’inversion inopinée de l’ordre de soustraction entre deux lignes ou lors de la comparaison de plusieurs sous-groupes engendrerait une confusion interprétative dévastatrice, pouvant conduire le chercheur à affirmer l’efficacité d’un protocole clinique qui aurait en réalité provoqué une détérioration de l’état des patients.
6. Étape 3 : Calcul des valeurs absolues et traitement des différences nulles
6.1 Extraction de la magnitude absolue des écarts
L’architecture interne du test des rangs signés repose sur le principe de dissocier la magnitude du changement de son orientation directionnelle. Pour isoler la force brute ou l’amplitude de l’écart mesuré sans tenir compte de son signe algébrique, le recours à la fonction de valeur absolue s’avère mathématiquement indispensable. Cette transformation projette l’ensemble des écarts sur la demi-droite des réels positifs.
À cet effet, l’analyste dédie une nouvelle colonne dans la feuille de travail :
- Colonne E (Ligne 1 : « Valeur Absolue |D| ») : Destinée à héberger les grandeurs d’écart désignées par la notation formelle $|D|$.
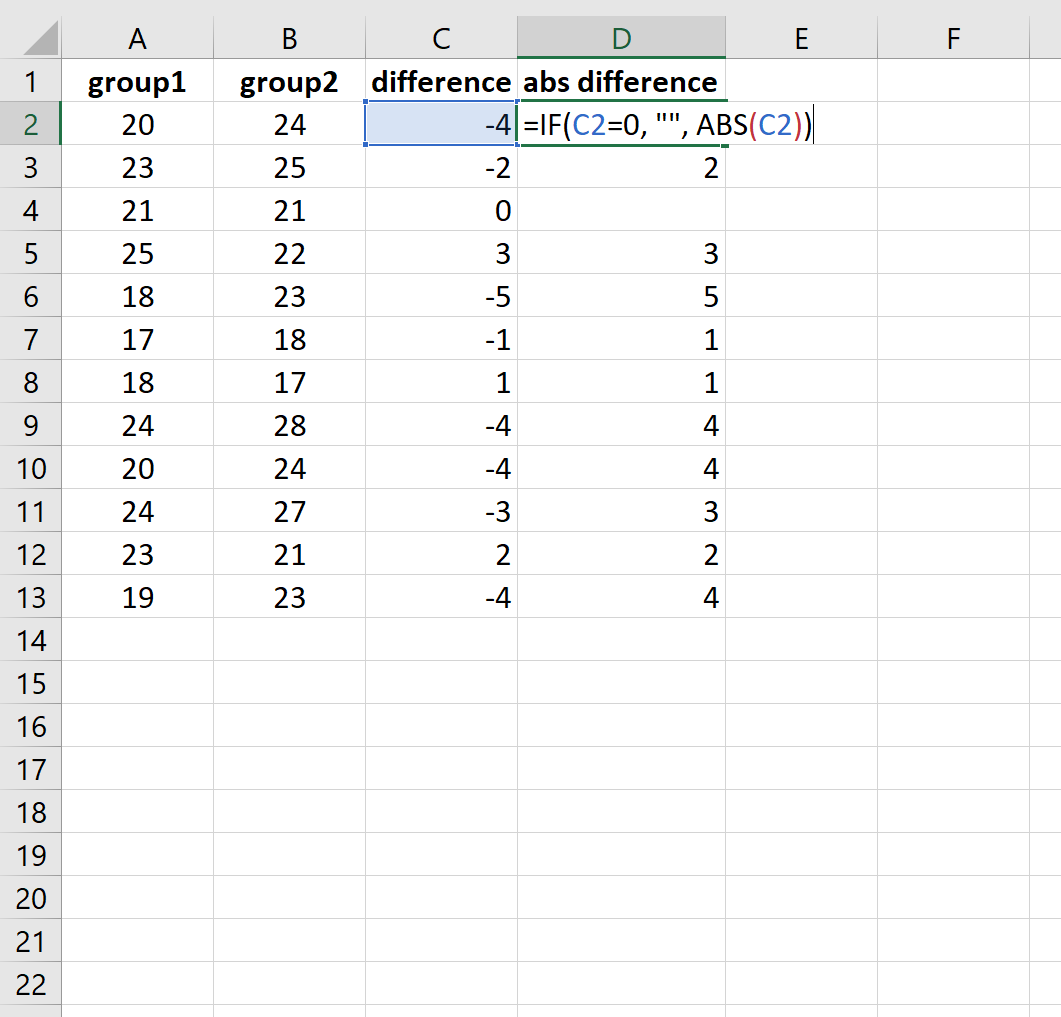
Dans sa forme élémentaire, l’extraction de la valeur absolue s’exécute dans la cellule E2 par l’appel de la fonction mathématique native d’Excel :
=ABS(D2)
Cette commande convertit instantanément tout écart négatif (par exemple, une différence de $-4,5$) en sa valeur positive correspondante ($4,5$), tout en laissant inchangés les écarts positifs préalables. Toutefois, l’intégration immédiate d’une logique de traitement spécifique aux différences nulles transforme avantageusement cette syntaxe de base, comme nous allons le détailler dans la section suivante.
6.2 Gestion procédurale des différences égales à zéro
La gestion des paires pour lesquelles la mesure post-intervention est rigoureusement identique à la mesure pré-intervention ($D = 0$) constitue l’un des débats méthodologiques les plus techniques de l’analyse non paramétrique. La convention standard universellement adoptée par Frank Wilcoxon dans ses travaux initiaux prescrit l’élimination pure et simple de l’échantillon d’analyse de toutes les observations présentant une différence algébrique nulle.
D’un point de vue théorique, cette règle d’exclusion repose sur l’impossibilité d’attribuer un signe positif ou négatif à une différence d’amplitude zéro. Maintenir un zéro dans le classement obligerait à lui conférer le rang le plus faible (le rang 1), mais l’absence de signe empêcherait son affectation ultérieure à la composante positive ($W^+$) ou à la composante négative ($W^-$), biaisant ainsi artificiellement la somme des rangs signés. Par conséquent, l’élimination de ces paires entraîne une réduction subséquente de la taille d’échantillon nominale : si une cohorte initiale comprend $N$ paires, et que $n_0$ paires affichent une différence nulle, la taille effective de l’échantillon d’analyse devient :
$$N_{\text{effectif}} = N – n_0$$
Afin d’automatiser cette exclusion au sein de notre architecture Excel sans nécessiter de suppression manuelle de lignes, l’analyste imbrique une condition logique dans la colonne E. Au lieu d’un simple calcul de valeur absolue, saisissez dans la cellule E2 la formule conditionnelle avancée suivante :
=SI(D2=0; ""; ABS(D2))
Cette instruction évalue la cellule D2. Si la différence calculée est égale à zéro, la fonction renvoie une chaîne vide (représentée par les guillemets doubles ""), masquant la valeur et préparant son ignorance procédurale par les fonctions statistiques en aval. Si la différence est non nulle, la fonction calcule et affiche la valeur absolue standard. Il convient de souligner que certains théoriciens, à l’instar de Pratt (1959), ont suggéré des méthodes alternatives conservant les différences nulles jusqu’à l’étape d’attribution des rangs avant de les écarter de la somme finale. Néanmoins, l’approche originale de Wilcoxon demeure la norme institutionnelle dominante implémentée par défaut dans la plupart des logiciels académiques internationaux.
7. Étape 4 : Classement et attribution des rangs aux différences absolues
7.1 Utilisation de la fonction RANG.MOYENNE pour la gestion des ex aequo
L’étape charnière du test de Wilcoxon réside dans la conversion des magnitudes absolues en un ordonnancement par rangs statistiques continus. Le principe fondamental exige que l’écart absolu le plus faible se voie assigner le rang 1, le second plus faible le rang 2, et ainsi de suite jusqu’à l’écart maximal qui reçoit le rang le plus élevé ($N_{\text{effectif}}$).
Cependant, dans tout jeu de données empiriques réel, il est extrêmement fréquent que plusieurs participants présentent des amplitudes d’écart rigoureusement identiques (par exemple, deux patients distincts affichant tous deux une amélioration ou une baisse de 3 points). Ces situations d’égalité statistique, désignées sous le vocable d’ex aequo (ties), exigent une méthode d’arbitrage mathématique rigoureuse : la méthode des rangs fractionnaires moyens.
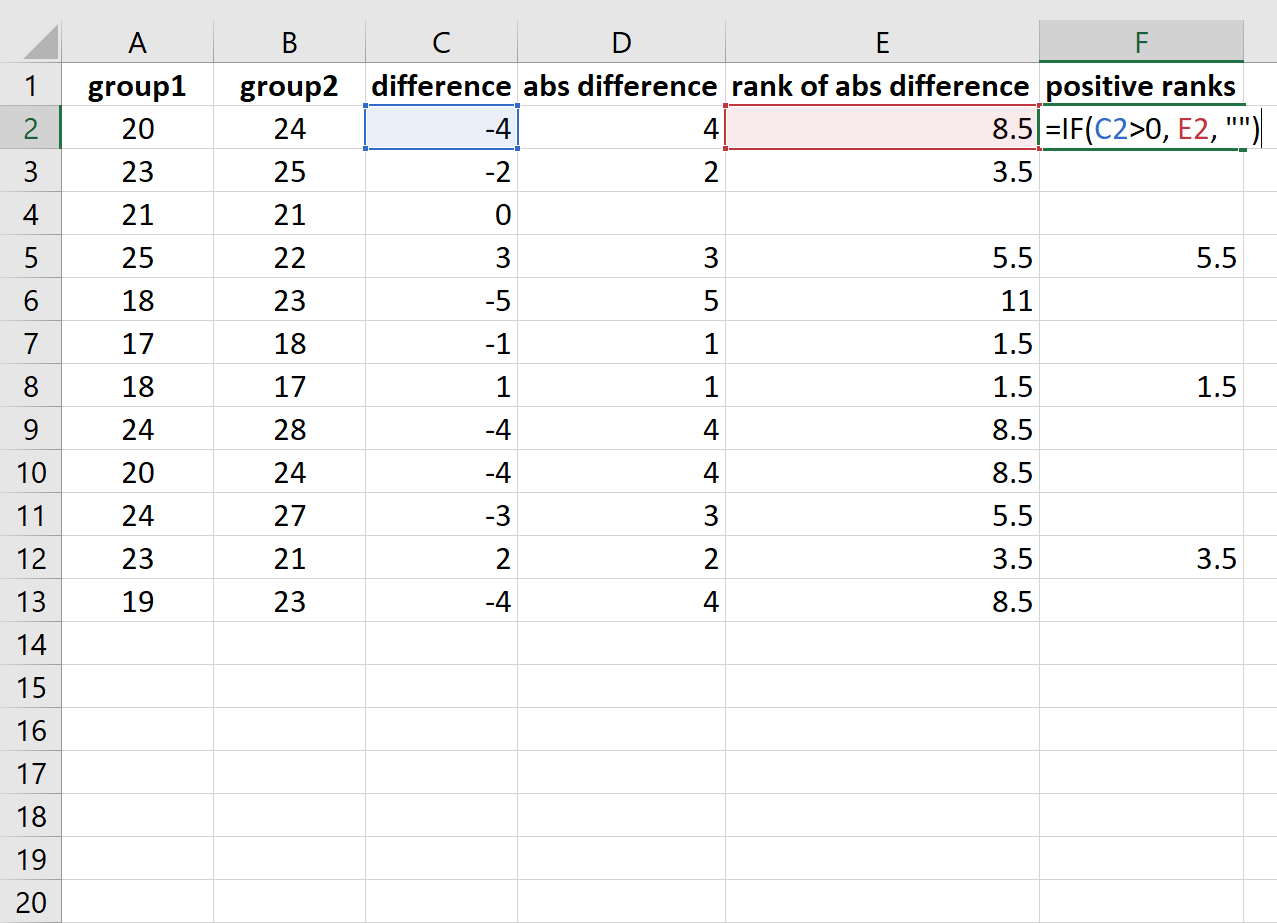
Si deux observations sont à égalité pour les rangs théoriques 3 et 4, il serait arbitraire et erroné d’attribuer le rang 3 à l’une et le rang 4 à l’autre. La statistique non paramétrique impose de leur assigner conjointement la moyenne arithmétique des rangs qu’elles auraient occupés en l’absence de ligature, soit :
$$\text{Rang moyen} = \frac{3 + 4}{2} = 3,5$$
Pour implémenter automatiquement cette règle au sein de notre tableau de données, l’analyste crée la colonne suivante :
- Colonne F (Ligne 1 : « Rang Absolu ») : Réservée aux rangs statistiques attribués aux valeurs absolues.
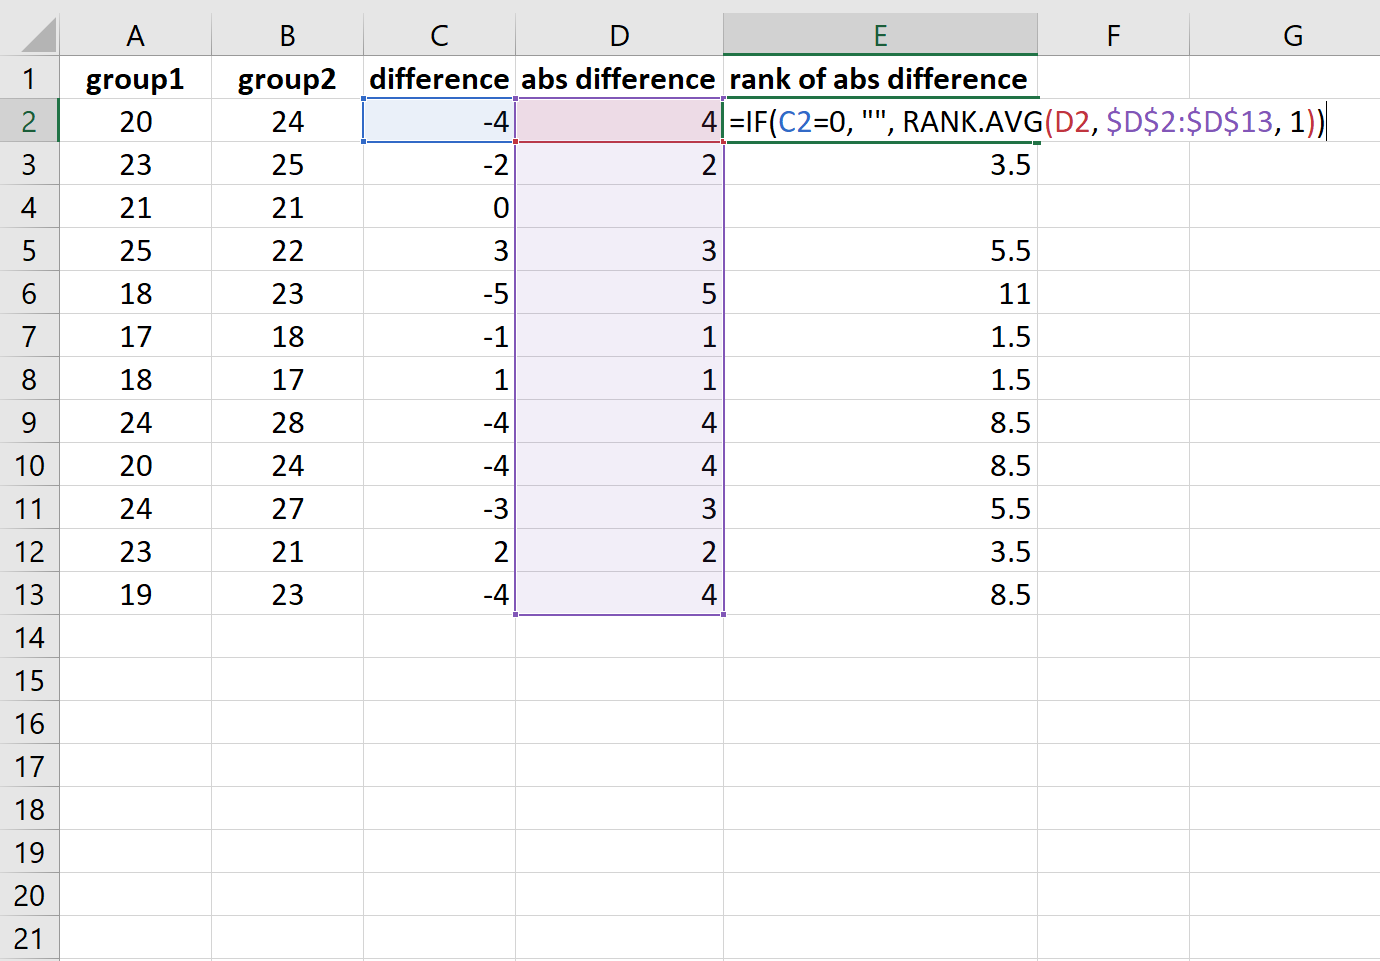
Excel propose une fonction native spécifiquement programmée pour exécuter cette opération : la fonction RANG.MOYENNE. Sa syntaxe générale est la suivante :
=RANG.MOYENNE(nombre; référence; [ordre])
Le troisième argument, ordre, s’avère ici décisif. Par défaut, si cet argument est omis ou fixé à 0, Excel classe les valeurs par ordre décroissant (la plus grande valeur reçoit le rang 1). Or, le postulat de Wilcoxon exige impérativement un ordre croissant (la plus petite valeur absolue doit recevoir le rang 1). L’argument doit donc impérativement être configuré avec la valeur 1. De plus, la plage de référence contenant les valeurs absolues doit être ancrée de manière absolue au moyen des symboles dollar ($) pour éviter tout décalage lors de l’incrémentation verticale.
7.2 Gestion conditionnelle des cellules vides dans l’attribution des rangs
Une difficulté algorithmique survient dans Excel lorsque la colonne E contient des chaînes vides ("") générées par notre formule d’exclusion des différences nulles ($D = 0$). Si l’on applique directement la fonction RANG.MOYENNE sur une cellule vide, le tableur génère instantanément une erreur d’exécution bloquante de type #VALEUR! ou #N/A, ce qui corrompt irrémédiablement l’ensemble des formules dépendantes dans la suite de la feuille de calcul.
Pour contourner de manière élégante cette limitation technique, l’analyste doit encapsuler l’algorithme d’attribution des rangs au sein d’une structure logique conditionnelle. La formule finale à implémenter dans la cellule F2 s’énonce comme suit :
=SI(E2=""; ""; RANG.MOYENNE(E2; $E$2:$E$13; 1))
Cette instruction vérifie préalablement si la cellule E2 a été neutralisée en raison d’une différence initiale nulle. Dans l’affirmative, elle transmet immédiatement une cellule vide dans la colonne F, neutralisant tout calcul inutile. Si, au contraire, la cellule E2 renferme une valeur absolue valide, Excel calcule son rang moyen croissant au sein de la matrice active $E$2:$E$13.
Après validation, l’analyste étire cette formule complexe jusqu’à la cellule F13. Il convient d’effectuer une vérification visuelle immédiate de la continuité mathématique de la suite des rangs attribués : la somme cumulée des rangs générés doit refléter parfaitement le nombre d’observations non nulles, et les observations possédant la même amplitude dans la colonne E doivent obligatoirement arborer des rangs identiques et fractionnaires dans la colonne F.
8. Étape 5 : Ségrégation des rangs selon la polarité de la différence initiale
8.1 Isolement algorithmique des rangs positifs (W+)
Une fois les rangs attribués à la magnitude brute des variations, le test de Wilcoxon exige la réintroduction du signe algébrique original préalablement mis en réserve. L’objectif mathématique consiste à partitionner la série des rangs de la colonne F en deux sous-ensembles mutuellement exclusifs : le sous-ensemble des rangs associés à des différences strictement positives, et le sous-ensemble des rangs associés à des différences strictement négatives.
Cette procédure de ségrégation vectorielle requiert l’adjonction de deux nouvelles colonnes d’analyse :
- Colonne G (Ligne 1 : « Rang Positif (W+) ») : Dédiée à l’accueil exclusif des rangs dont l’écart initial était supérieur à zéro.
- Colonne H (Ligne 1 : « Rang Négatif (W-) ») : Dédiée à l’accueil exclusif des rangs dont l’écart initial était inférieur à zéro.
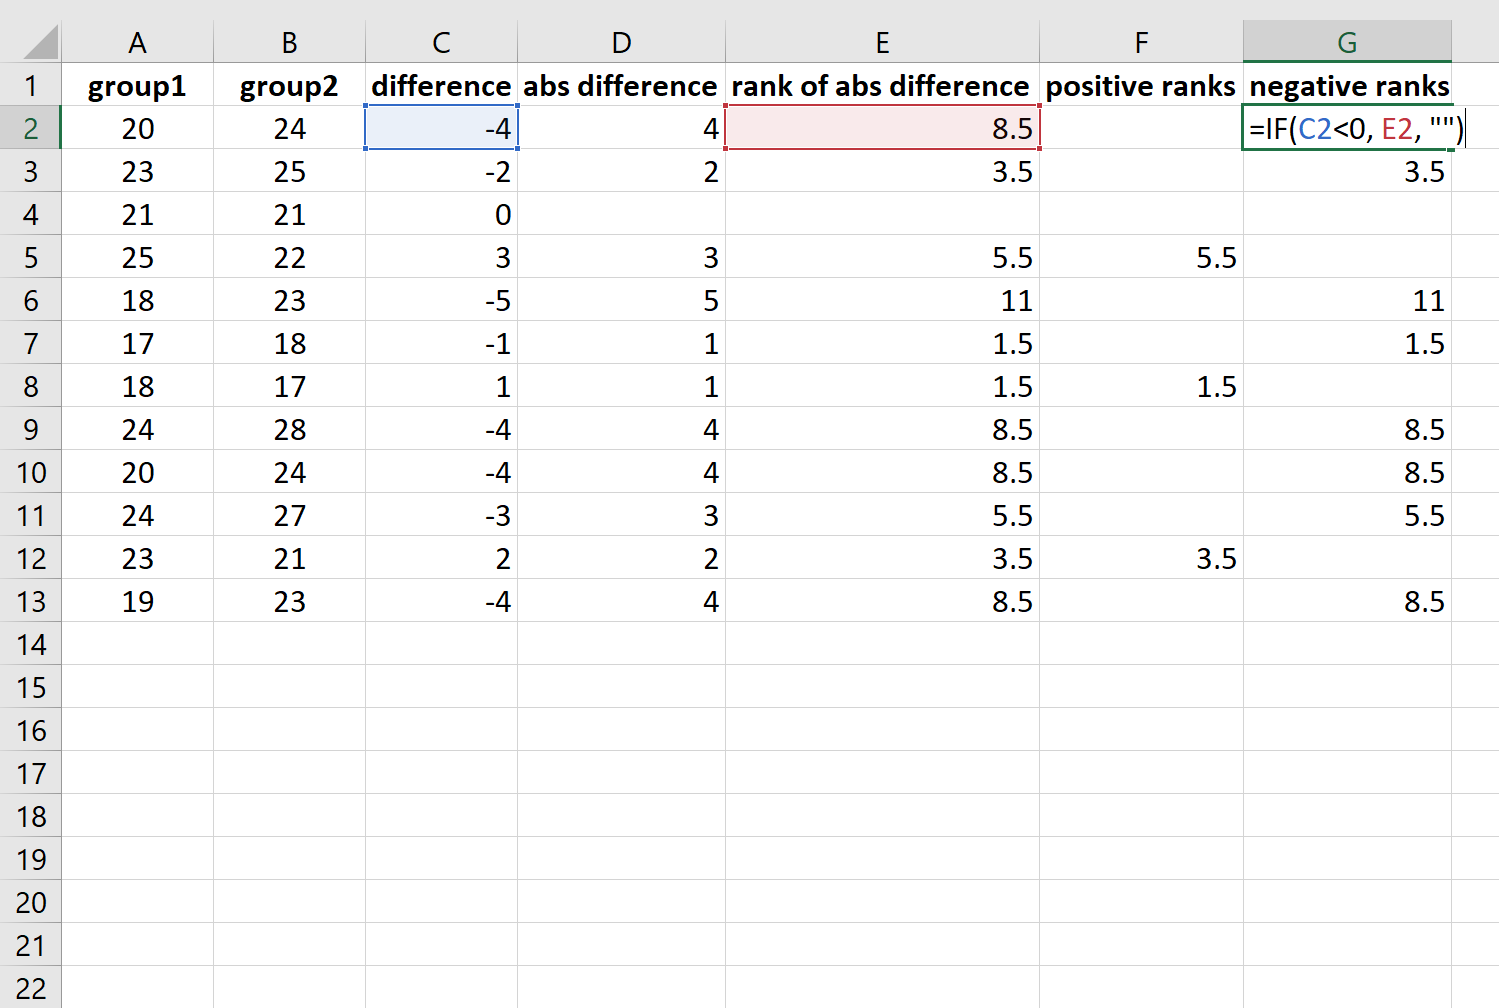
L’isolement des composantes positives dans la colonne G s’opère par l’implémentation d’une fonction logique conditionnelle dans la cellule G2, dont la syntaxe s’articule comme suit :
=SI(D2>0; F2; 0)
Cette formule examine la polarité de la différence algébrique brute présente dans la cellule D2. Si cette valeur est strictement supérieure à zéro (ce qui traduit, selon notre convention, une progression du score entre le pré-test et le post-test), la cellule de la colonne G s’approprie la valeur numérique exacte du rang statistique calculé dans la cellule F2. Dans le cas contraire (c’est-à-dire si la différence est strictement négative ou si elle a été identifiée comme nulle), la cellule se voit attribuer la valeur numérique zéro (0). L’analyste propage cette formule par double-clic sur l’ensemble de la plage G2:G13.
8.2 Isolement algorithmique des rangs négatifs (W-)
De façon rigoureusement symétrique, la séparation des rangs associés à des régressions ou des réductions de score s’exécute au sein de la colonne H. L’analyste se positionne sur la première cellule de données, H2, et encode la structure logique discriminante suivante :
=SI(D2<0; F2; 0)
Le fonctionnement algorithmique est analogue au précédent : la condition teste si le contenu de la cellule D2 est strictement inférieur à zéro. Si cette proposition logique est vraie, la cellule H2 extrait la valeur du rang assigné dans la cellule F2. Si la proposition est fausse (ce qui correspond à un écart initial positif ou nul), l’algorithme renvoie la valeur numérique zéro (0). La formule est ensuite répliquée sur toute la hauteur de la cohorte jusqu’à la cellule H13.
L’attribution délibérée de la valeur numérique zéro (au lieu d’une cellule vide ou d’un texte) lors de la non-vérification de la condition logique représente une précaution structurelle majeure. Elle permet d’assurer une parfaite compatibilité avec les fonctions d’agrégation arithmétique ultérieures, tout en garantissant que chaque ligne statistique ne contribue que dans une et une seule des deux colonnes de ségrégation.
9. Étape 6 : Calcul de la statistique de test W et validation de cohérence
9.1 Sommation des composantes positives et négatives
L’aboutissement des étapes de classement et de ségrégation réside dans l’agrégation arithmétique des rangs pour condenser l’information expérimentale sous la forme de statistiques d’échantillonnage globales. L’analyste procède à la sommation indépendante de chacune des deux colonnes de rangs signés :
- La somme des rangs positifs, notée formellement $W^+$ (ou parfois $T^+$ selon les conventions de notation anglo-saxonnes).
- La somme des rangs négatifs, notée formellement $W^-$ (ou $T^-$).
Au sein de la feuille de calcul Excel, positionnez-vous en dessous des colonnes de données pour consigner ces grandeurs fondamentales. Par exemple :
- Dans la cellule
G15(avec le libellé « Somme W+ » enF15), saisissez la fonction de sommation :=SOMME(G2:G13) - Dans la cellule
H15(avec le libellé « Somme W- » enF16), saisissez la formule équivalente :=SOMME(H2:H13)
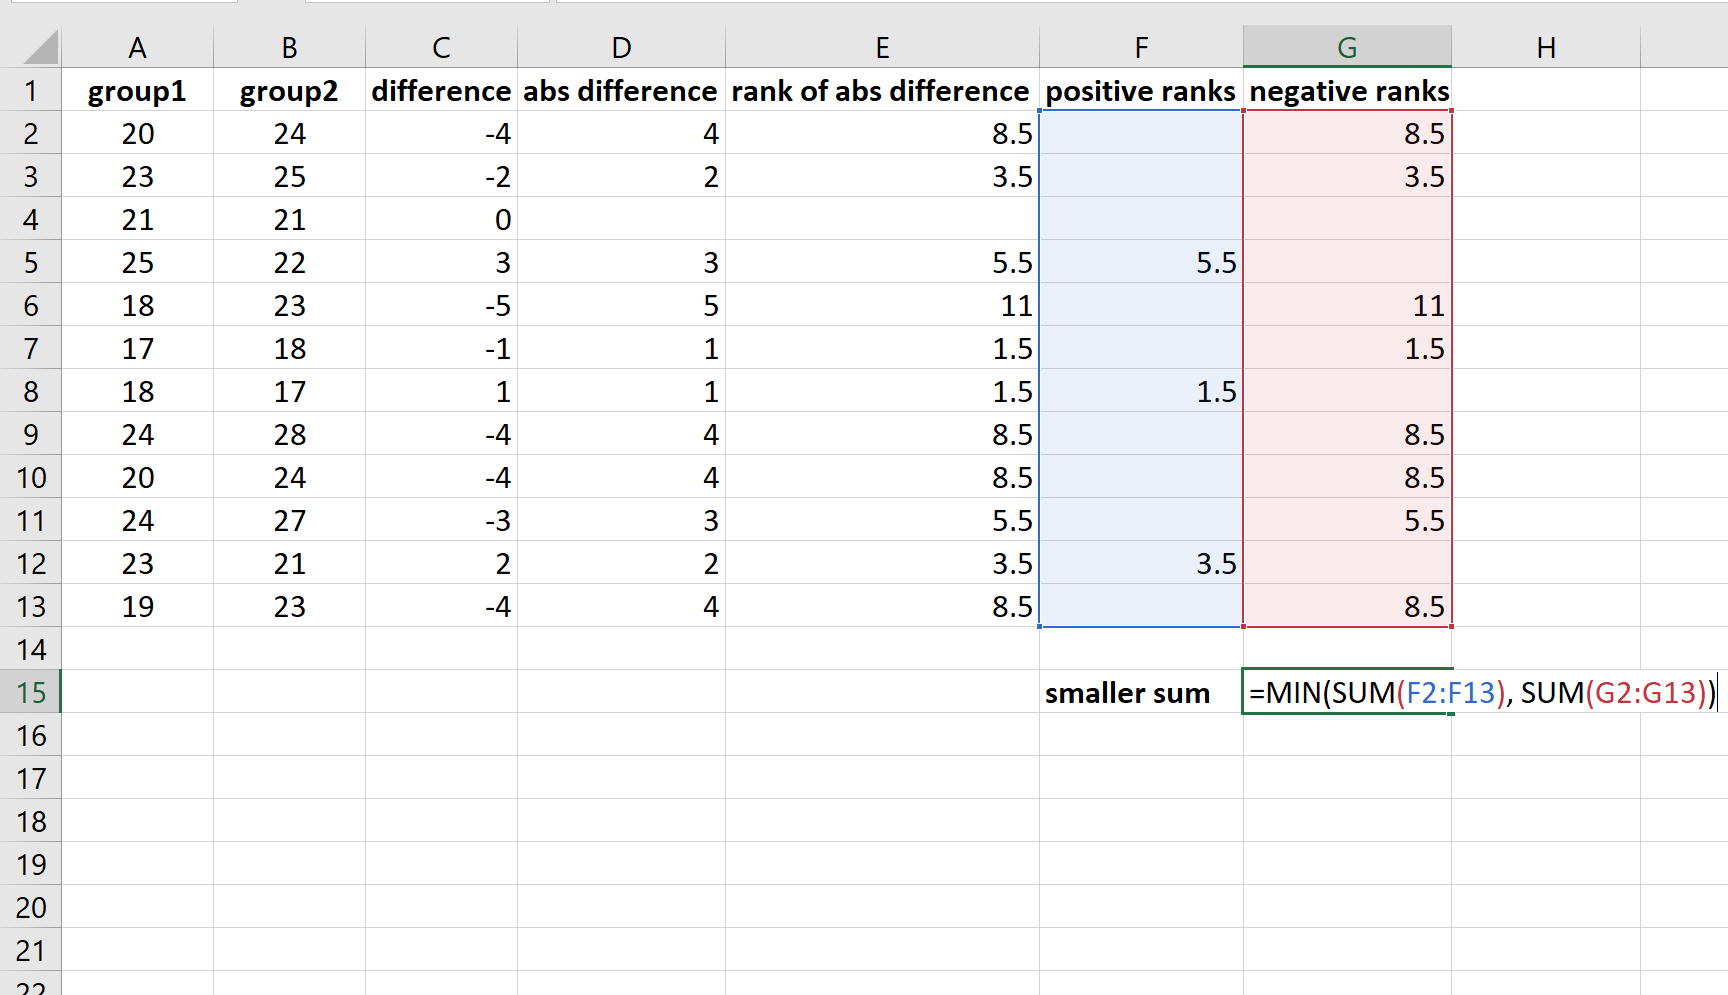
La statistique de test définitive de Wilcoxon, généralement symbolisée par la lettre $W$ (ou $T$), fait l’objet d’une légère variation définitoire dans la littérature scientifique internationale selon que l’on se réfère à la tradition des tables critiques historiques ou aux implémentations algorithmiques informatisées :
- Dans l’approche canonique classique de Wilcoxon, utilisée pour l’interrogation directe des tables de distribution exacte, la statistique de test $W$ correspond à la plus petite des deux valeurs obtenues :
$$W = \min(W^+, W^-)$$
Pour l’implémenter dans la celluleG17, encodez la formule :=MIN(G15; H15) - Dans de nombreuses publications contemporaines et certains progiciels tels que R (via la fonction
wilcox.test), la statistique rapportée correspond directement à la somme des rangs positifs ($W^+$), la somme complémentaire pouvant être déduite sans ambiguïté.
La maîtrise des deux modes de désignation est indispensable pour interpréter correctement la littérature spécialisée. Tout au long de ce guide, nous conserverons la définition conventionnelle fondamentale $W = \min(W^+, W^-)$ pour l’analyse des petits échantillons.
9.2 Formule de contrôle et vérification de la somme théorique
Une analyse statistique quantitative ne saurait être validée sans la mise en œuvre d’une procédure d’audit interne visant à exclure toute anomalie algorithmique ou omission accidentelle de calcul. En statistique d’ordre, la théorie combinatoire établit un théorème arithmétique fondamental : la somme de tous les entiers successifs de $1$ à $N$ est rigoureusement invariable et répond à la formule universelle établie par Carl Friedrich Gauss :
$$\sum_{i=1}^{N_{\text{effectif}}} i = \frac{N_{\text{effectif}} \times (N_{\text{effectif}} + 1)}{2}$$
Dans le cadre du test de Wilcoxon, étant donné que chaque rang théorique (ou chaque fraction moyenne en cas d’ex aequo) a été affecté sans perte ni duplication à l’une ou l’autre des composantes $W^+$ ou $W^-$, la somme globale des rangs observés doit égaler au centime près cette espérance théorique. Toute disparité entre ces deux grandeurs indique une erreur de programmation dans le tableur (par exemple, un mauvais ancrage des plages ou une exclusion fautive).
Pour implémenter ce diagnostic de conformité dans Excel :
- Déterminez d’abord le nombre d’observations effectives non nulles dans une cellule dédiée, par exemple en
B15, à l’aide de la formule :=NB.SI(D2:D13; "0") - Calculez la somme théorique gaussienne dans la cellule
B16par l’expression :=(B15*(B15+1))/2 - Calculez la somme empirique cumulée des rangs dans la cellule
B17:=G15+H15 - Implémentez un test logique de validation en
B18:=SI(B16=B17; "CONTRÔLE VALIDÉ : Intégrité arithmétique parfaite"; "ERREUR DÉTECTÉE : Divergence de sommation")
Cette vérification systématique protège le chercheur contre toute distorsion silencieuse de son analyse.
10. Étape 7 : Détermination de la significativité pour petits échantillons
10.1 Utilisation des tables de valeurs critiques de Wilcoxon
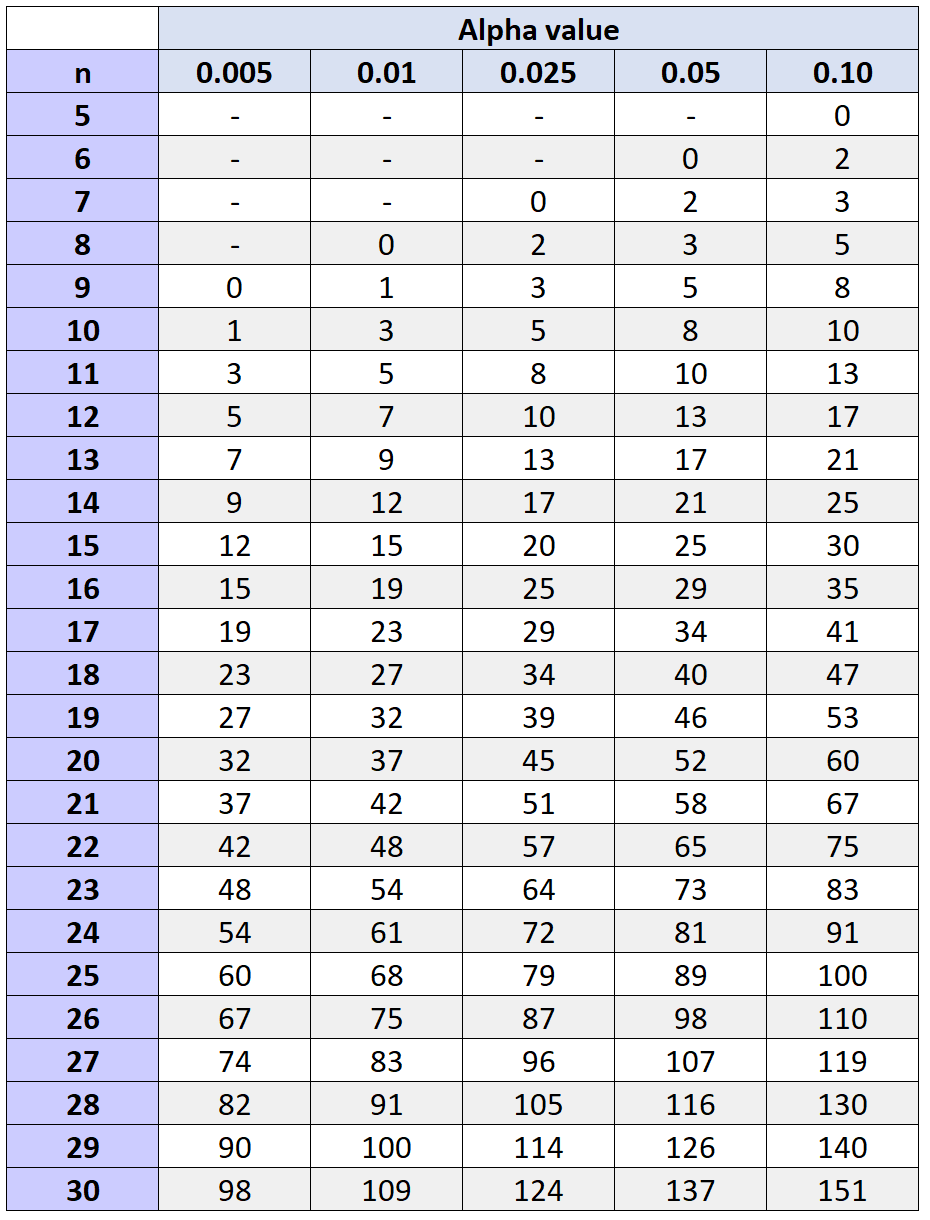
Lorsque la taille effective de l’échantillon d’analyse est restreinte (conventionnellement établie à $N_{\text{effectif}} \leq 20$), la distribution d’échantillonnage de la statistique de Wilcoxon ne suit pas une loi de probabilité continue standard mais une distribution discrète exacte, répertoriée dans des tables de référence statistiques spécialisées. L’inférence ne s’appuie donc pas sur un calcul asymptotique continu, mais sur la confrontation directe de la statistique observée $W_{\text{obs}}$ à un seuil numérique tabulé nommé valeur critique, noté $W_{\text{critique}}$.
Pour exécuter cette confrontation, l’analyste consulte une table de Wilcoxon standardisée en croisant deux paramètres méthodologiques :
- La taille effective de l’échantillon d’analyse ($N_{\text{effectif}}$), expurgée de toute différence nulle.
- Le niveau de risque consenti $\alpha$ (classiquement 0,05), en spécifiant scrupuleusement la nature du test (bilatéral ou unilatéral).
La règle de décision du test de Wilcoxon présente une particularité contre-intuitive essentielle qu’il convient de souligner avec force : la zone de rejet de l’hypothèse nulle se situe dans les valeurs inférieures ou égales à la valeur critique :
$$\text{Rejet de } H_0 iff W_{\text{obs}} \leq W_{\text{critique}}$$
Si la statistique observée calculée dans le tableur est inférieure ou strictement égale au seuil critique extrait de la table statistique, l’analyste conclut au rejet formel de l’hypothèse nulle au seuil $\alpha$ spécifié, attestant de l’existence d’une différence statistiquement significative entre les deux conditions expérimentales.
Pour intégrer ce mécanisme directement dans Excel pour les petites cohortes, il est possible de bâtir une table de consultation simplifiée dans un onglet distinct ou dans un coin libre de la feuille (par exemple, les plages J2:K20 hébergeant les valeurs de $N$ de 5 à 20 et les valeurs critiques associées pour un $\alpha$ bilatéral de 0,05) et de mobiliser la fonction RECHERCHEV pour extraire dynamiquement le seuil :
=RECHERCHEV(B15; $J$2:$K$20; 2; FAUX)
10.2 Erreurs courantes d’interprétation de la valeur critique
L’expérience pédagogique et l’audit méthodologique démontrent la récurrence systématique de trois méprises critiques lors de l’étape décisionnelle menée sur de petits échantillons.
La première erreur, particulièrement délétère, résulte de l’assimilation réflexe de la logique décisionnelle du test de Wilcoxon à celle du test t de Student. Dans un test paramétrique classique, le chercheur s’attend à observer une valeur de test élevée pour franchir un seuil et déclarer la significativité ($t_{\text{obs}} \geq t_{\text{critique}}$). Dans le test des rangs signés de Wilcoxon, la mécanique logique est diamétralement inversée : un effet expérimental d’une puissance maximale se traduit par le fait que l’intégralité des variations s’opère dans une seule direction (par exemple, uniquement des hausses). Dans ce scénario extrême, la somme des rangs opposés ($W^-$) devient égale à zéro, ce qui donne $W = \min(W^+, 0) = 0$. Ainsi, plus l’effet est colossal, plus la statistique $W$ est proche de zéro. Prétendre que $W$ doit excéder le seuil tabulé constitue donc un contresens statistique majeur qui inverserait la décision inférentielle.
La seconde méprise concerne l’absence d’ajustement de la valeur $N$ suite à l’exclusion des différences nulles. Consulter la table critique à la ligne $N = 15$ alors que trois participants ont affiché une différence de zéro (ramenant l’effectif réel à $N_{\text{effectif}} = 12$) conduit à utiliser un seuil critique erroné, faussant dramatiquement le contrôle du risque d’erreur $\alpha$.
Enfin, la confusion entre les colonnes bilatérales et unilatérales des tables constitue un piège classique. Une valeur critique correspondant à un test bilatéral avec $\alpha = 0,05$ équivaut à un test unilatéral avec $\alpha = 0,025$. Une lecture désinvolte des en-têtes de colonnes de la table imprimée entraîne inévitablement un dédoublement ou une division non maîtrisée du risque de première espèce réellement appliqué à l’expérimentation.
11. Étape 8 : Approximation par la loi normale pour grands échantillons
11.1 Calcul des paramètres de la distribution d’échantillonnage
Lorsque la taille effective de l’échantillon s’accroît et franchit le seuil de $N_{\text{effectif}} > 20$, le calcul combinatoire exact des probabilités discrètes devient superflu en raison des propriétés asymptotiques démontrées par le théorème central limite. La distribution d’échantillonnage de la statistique de Wilcoxon $W$ converge rapidement et harmonieusement vers une loi normale continue.
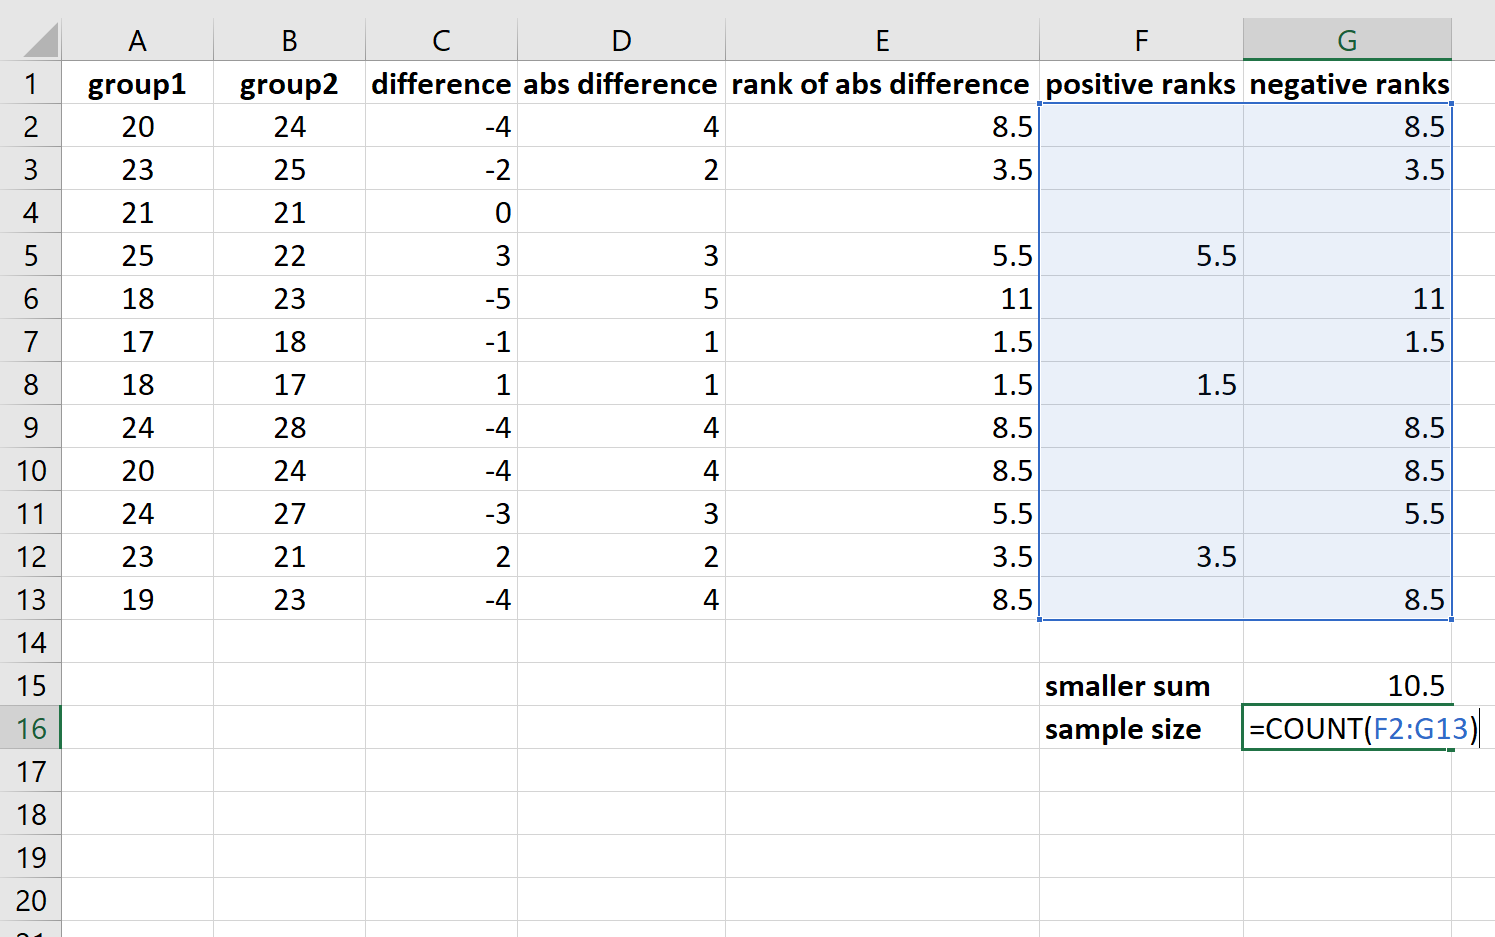
Pour exploiter cette convergence asymptotique au sein d’Excel, l’analyste doit calculer l’espérance mathématique théorique (la moyenne de la distribution d’échantillonnage sous l’hypothèse nulle), notée $\mu_W$, ainsi que son écart-type théorique, noté $\sigma_W$. Ces deux paramètres dépendent exclusivement du nombre d’observations non nulles $N_{\text{effectif}}$ :
$$\mu_W = \frac{N_{\text{effectif}} \times (N_{\text{effectif}} + 1)}{4}$$
$$\sigma_W = \sqrt{\frac{N_{\text{effectif}} \times (N_{\text{effectif}} + 1) \times (2N_{\text{effectif}} + 1)}{24}}$$
Dans l’environnement Excel, ces expressions mathématiques s’implémentent au moyen des commandes natives suivantes (en supposant toujours la présence de $N_{\text{effectif}}$ dans la cellule B15) :
- Espérance théorique ($\mu_W$), calculée dans la cellule
B20:=(B15*(B15+1))/4 - Écart-type théorique sans ex aequo ($\sigma_W$), calculé dans la cellule
B21:=RACINE((B15*(B15+1)*(2*B15+1))/24)
Il est à noter que lorsqu’un nombre substantiel d’ex aequo affecte le jeu de données, la variance théorique subit une légère réduction. La formule complète intégrant le terme de correction pour ex aequo s’énonce comme suit :
$$\sigma_{W, \text{corrigé}} = \sqrt{\frac{N(N + 1)(2N + 1) – \frac{1}{2}\sum_{j=1}^{g} (t_j^3 – t_j)}{24}}$$
où $g$ désigne le nombre de groupes d’égalités distincts et $t_j$ le nombre d’observations ex aequo au sein du $j$-ème groupe. Toutefois, dans la majorité des applications empiriques où les égalités demeurent peu nombreuses, l’écart entre la formule simple et la formule corrigée s’avère infinitésimal et n’altère nullement les décisions inférentielles finales.
11.2 Calcul de la cote standardisée Z et de la p-value associée
Une fois les paramètres de la distribution asymptotique modélisés, l’analyste convertit la statistique empirique observée (ici la somme $W^+$ présente en G15) en un score standardisé ou cote réduite, universellement désignée par la lettre $Z$.
Dans la mesure où l’on modélise une distribution discrète (la distribution des rangs entiers) à l’aide d’une distribution continue (la loi normale), la rigueur statistique impose l’application d’une correction de continuité de 0,5 unité. Cette correction resserre la statistique vers son espérance théorique, évitant ainsi une surestimation artificielle de la significativité. La formule de calcul du score $Z$ s’énonce formellement comme suit :
$$Z = \frac{W^+ – \mu_W – 0,5 \times \text{signe}(W^+ – \mu_W)}{\sigma_W}$$
Dans Microsoft Excel, l’analyste implémente cette standardisation dans la cellule B22 par la formule suivante :
=SI(G15>B20; (G15-B20-0,5)/B21; (G15-B20+0,5)/B21)
L’étape finale consiste à dériver la valeur de probabilité critique, la célèbre p-value, qui quantifie la probabilité exacte d’obtenir, sous l’hypothèse nulle, une valeur de déviation au moins aussi extrême que celle observée expérimentalement. Pour un test bilatéral non directionnel, la probabilité correspond aux deux queues de la distribution normale standardisée. Excel dispose d’une fonction de haute précision pour convertir une cote $Z$ en probabilité cumulée : LOI.NORMALE.STANDARD.N.
La formule finale de la p-value bilatérale s’encode dans la cellule B23 :
=2*(1 - LOI.NORMALE.STANDARD.N(ABS(B22); VRAI))
L’utilisation de la valeur absolue ABS(B22) garantit que la fonction analyse systématiquement la queue supérieure de la distribution, tandis que la multiplication par le facteur 2 intègre les deux polarités du rejet bilatéral. L’analyste compare ensuite directement ce résultat numérique au seuil décisionnel prédéfini : si la cellule B23 affiche une valeur strictement inférieure à $0,05$, l’hypothèse nulle est définitivement rejetée, confirmant l’existence d’une différence d’intervention statistiquement démontrable.
12. Interprétation avancée, reporting académique et pièges méthodologiques
12.1 Estimation de la taille d’effet non paramétrique
Dans l’épistémologie contemporaine des sciences quantitatives, la publication exclusive d’une p-value, aussi impressionnante soit-elle, est désormais jugée scientifiquement insuffisante par l’ensemble des comités éditoriaux internationaux. Une valeur de $p$ dépendante de la taille de l’échantillon ne renseigne en rien sur l’amplitude clinique ou pratique du phénomène observé. Il est donc impératif de quantifier cette amplitude à l’aide d’une mesure standardisée de la taille d’effet (effect size).
Dans le domaine de l’analyse non paramétrique, l’estimateur canonique recommandé par Jacob Cohen et formalisé par Robert Rosenthal est le coefficient de corrélation de rang $r$, calculé à partir du score standardisé $Z$ et du volume global des observations :
$$r = \frac{|Z|}{\sqrt{N_{\text{total_observations}}}}$$
Une précaution méthodologique capitale doit être soulignée quant à la définition du dénominateur $N_{\text{total_observations}}$. Dans le cadre d’un test apparié, ce terme représente le nombre total d’observations individuelles combinées sur les deux temps de mesure (soit $2 \times N_{\text{effectif}}$), et non le nombre de paires simples. L’analyste calcule cet indice dans la cellule B24 d’Excel au moyen de la commande :
=ABS(B22)/RACINE(2*B15)
L’interprétation qualitative de ce coefficient $r$ s’effectue selon les balises empiriques établies par Cohen :
- $r \approx 0,10$ : Taille d’effet modeste ou faible, signalant une influence subtile de l’intervention.
- $r \approx 0,30$ : Taille d’effet moyenne, révélant une variation clinique ou comportementale nettement perceptible.
- $r \geq 0,50$ : Taille d’effet forte ou majeure, attestant d’une transformation substantielle de l’état des sujets.
En complément de ce coefficient de corrélation, l’analyste rigoureux calcule et rapporte systématiquement la médiane et l’écart interquartile (EIQ) des différences individuelles brutes, qui constituent les estimateurs de position non paramétriques les plus fidèles pour résumer l’amplitude brute du changement.
12.2 Rédaction standardisée des résultats selon les normes APA
La transcription des analyses inférentielles au sein d’un manuscrit scientifique doit obéir aux directives stylistiques et typographiques prescrites par l’American Psychological Association (APA 7th edition). Cette normalisation internationale garantit la clarté, la concision et la transparence des résultats statistiques rapportés.
Une formulation textuelle canonique conforme aux normes APA doit obligatoirement intégrer :
- L’énoncé précis du test employé.
- Les descripteurs de tendance centrale et de dispersion pour chaque condition (idéalement la médiane et l’écart interquartile).
- La statistique de test observée ($W$ ou $Z$).
- La taille de l’échantillon effectif.
- La valeur exacte de la p-value (rapportée sans zéro initial, par exemple $p = ,023$ et non $p = 0,023$).
- Le coefficient de taille d’effet ($r$).
Voici un modèle rédactionnel exemplaire directement transposable à un rapport de recherche :
« Un test des rangs signés de Wilcoxon pour échantillons appariés a été conduit afin d’évaluer l’efficacité d’un programme d’intervention thérapeutique brève sur le niveau d’anxiété des participants. Les analyses révèlent une réduction statistiquement significative des scores de détresse psychologique entre la phase pré-intervention (Mdn = 48,5, EIQ = 12,0) et la phase post-intervention (Mdn = 31,0, EIQ = 9,5), W = 8,0, Z = -2,58, p = ,010, avec une taille d’effet substantielle, r = ,53. Ces données confirment la pertinence clinique de l’approche thérapeutique testée chez les patients de cette cohorte. »
12.3 Synthèse des biais et erreurs fréquentes dans Excel
Pour conclure cette étude méthodologique, il est capital de dresser une synthèse préventive des écueils opérationnels qui menacent fréquemment la validité des analyses conduites sous tableur par des praticiens non avertis.
Le premier biais technique majeur réside dans la négligence de l’ancrage absolu des plages de cellules à l’aide du symbole dollar ($) lors de la mise en œuvre de la fonction RANG.MOYENNE. Si l’opérateur saisit E2:E13 sans ancrage absolu et étire sa formule vers le bas, la matrice de référence glisse mécaniquement d’une ligne à chaque itération (devenant E3:E14, puis E4:E15), excluant progressivement les premières observations du jeu de comparaison et générant des rangs statistiques totalement invalides.
Le second piège consiste en une confusion conceptuelle dévastatrice entre le test des rangs signés de Wilcoxon (destiné exclusivement aux données appariées ou répétées) et le test de la somme des rangs de Wilcoxon, plus couramment désigné sous le nom de test U de Mann-Whitney. Ce dernier s’applique exclusivement à des échantillons indépendants issus de deux groupes distincts (par exemple, un groupe recevant un traitement versus un groupe contrôle placebo). Appliquer l’algorithme du test des rangs signés sur des mesures issues de populations non appariées constitue un contresens méthodologique disqualifiant l’ensemble de l’étude.
Enfin, l’écueil théorique le plus subtil réside dans l’omission du postulat fondamental de symétrie de la distribution des différences. Nombre d’analystes se tournent aveuglément vers le test de Wilcoxon en croyant s’affranchir de toute contrainte statistique, sans vérifier que les écarts individuels se distribuent de manière symétrique autour de leur médiane. Si la distribution des différences présente une asymétrie violente et documentée, le chercheur rigoureux se doit de modérer ses conclusions ou d’envisager des méthodologies computationnelles alternatives fondées sur des techniques de rééchantillonnage de type bootstrap ou des tests de permutation exacte.
Références
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://www.worldcat.org/title/statistical-power-analysis-for-the-behavioral-sciences/oclc/17877467
- Conover, W. J. (1999). Practical nonparametric statistics (3rd ed.). John Wiley & Sons. https://www.wiley.com/en-us/Practical+Nonparametric+Statistics%2C+3rd+Edition-p-9780471160687
- Hodges, J. L., & Lehmann, E. L. (1963). Estimates of location based on rank tests. The Annals of Mathematical Statistics, 34(2), 598-611. https://doi.org/10.1214/aoms/1177704172
- Holland-Cunz, S., & Lehmacher, W. (2010). A note on rank-based effect size measures for two independent samples. Biometrical Journal, 52(4), 505-517. https://doi.org/10.1002/bimj.200900277
- Pratt, J. W. (1959). Remarks on zeros and ties in the Wilcoxon signed rank procedures. Journal of the American Statistical Association, 54(287), 655-667. https://doi.org/10.1080/01621459.1959.10501526
- Rosenthal, R. (1991). Meta-analytic procedures for social research (Rev. ed.). SAGE Publications. https://doi.org/10.4135/9781412984997
- Siegel, S., & Castellan, N. J. (1988). Nonparametric statistics for the behavioral sciences (2nd ed.). McGraw-Hill. https://www.worldcat.org/title/nonparametric-statistics-for-the-behavioral-sciences/oclc/17202381
- Wilcoxon, F. (1945). Individual comparisons by ranking methods. Biometrics Bulletin, 1(6), 80-83. https://doi.org/10.2307/3001968