
Dans le champ foisonnant des sciences humaines et du comportement, la recherche empirique se heurte continuellement à la complexité des phénomènes psychologiques et cognitifs. Qu’il s’agisse d’évaluer l’efficacité d’une prise en charge psychothérapeutique, de modéliser les déterminants de l’anxiété académique ou d’examiner la dynamique unissant la charge mentale et les performances motrices, le chercheur ou le praticien ne peut se satisfaire d’une appréhension purement descriptive et isolée de ses objets d’étude. L’investigation scientifique exige de dépasser la simple contemplation univariée pour interroger les relations fonctionnelles, les covariations systématiques et les structures de dépendance reliant les construits psychométriques entre eux.
L’analyse bivariée constitue précisément la passerelle fondamentale permettant de transiter d’une description statique de distributions individuelles vers l’élucidation des liens unissant deux grandeurs théoriques. Souvent perçue à tort comme une simple étape préliminaire avant le déploiement de modèles multivariés complexes, l’analyse bivariée recèle en réalité une puissance heuristique irremplaçable : elle permet d’ancrer l’intuition théorique dans la réalité géométrique et numérique des données, de tester la robustesse des hypothèses opérationnelles et d’éprouver empiriquement les postulats qui régissent la validité de nos instruments de mesure. Sans une compréhension intime des relations bivariées, toute modélisation statistique avancée s’expose au risque de masquer des incohérences sous un vernis d’équations opaques.
Bien que les logiciels spécialisés tels que R, SPSS ou Jamovi soient largement répandus dans les laboratoires universitaires, le tableur Microsoft Excel demeure une plateforme d’une pertinence pédagogique et opérationnelle incomparable. Présent sur la quasi-totalité des stations de travail, Excel offre un contact visuel et matriciel immédiat avec les données brutes, démystifiant des algorithmes parfois perçus comme d’impénétrables boîtes noires. Ce guide exhaustif a pour vocation d’exposer avec la plus grande rigueur épistémologique et méthodologique la conduite intégrale d’une analyse bivariée sous Excel. Depuis la formalisation théorique des construits jusqu’à la rédaction scientifique des conclusions selon les normes de l’American Psychological Association (APA), chaque étape est disséquée à la lumière d’exemples appliqués issus des sciences psychologiques.
1. Fondements épistémologiques et théoriques de l’analyse bivariée en psychologie
1.1 Définition et objectifs fondamentaux de l’analyse bivariée
L’édifice de la statistique appliquée aux sciences sociales repose sur une taxonomie rigoureuse qui distingue l’analyse univariée, l’analyse bivariée et l’analyse multivariée. L’analyse univariée s’attache à décrire la distribution d’une variable unique à travers des indices de tendance centrale (moyenne arithmétique, médiane, mode) et des indicateurs de dispersion (variance, écart-type, étendue interquartile). Bien qu’indispensable pour attester de la forme des distributions ou détecter des anomalies d’échantillonnage, elle demeure intrinsèquement aveugle aux interactions contextuelles. À l’opposé, l’analyse multivariée modélise simultanément trois variables ou davantage afin de démêler les réseaux de causalité complexe, de contrôler des variables de confusion ou de condenser l’information via des techniques de réduction dimensionnelle. Entre ces deux approches s’intercale l’analyse bivariée, qui se consacre exclusivement à l’étude conjointe de deux variables mesurées sur les mêmes unités statistiques.
En psychologie et en sciences du comportement, l’objectif cardinal de l’analyse bivariée consiste à déterminer si les fluctuations observées sur un premier construit psychologique (par exemple, le niveau de névrosisme) s’accompagnent de variations systématiques sur un second construit (par exemple, l’intensité des symptômes dépressifs). Il s’agit d’évaluer non seulement l’existence d’une covariation, mais également son intensité (la magnitude de la liaison) et son orientation (l’aspect direct ou inverse de la trajectoire conjointe). L’identification de ces structures relationnelles répond à une double exigence épistémologique : une fonction exploratoire, vouée à l’émergence de nouvelles intuitions inductives face à un jeu de données novateur, et une fonction confirmatoire, destinée à tester formellement des hypothèses déduites de cadres conceptuels préexistants.
Il importe de souligner que l’attribution des statuts de variable indépendante (ou prédictive, traditionnellement désignée par la lettre X) et de variable dépendante (ou critère, désignée par la lettre Y) relève d’une théorisation issue du protocole d’expérimentation ou d’observation. Dans les dispositifs quasi-expérimentaux ou corrélationnels fréquents en psychologie clinique et différentielle, ces désignations fonctionnelles n’impliquent nullement l’existence d’une causalité univoque. L’analyse bivariée examine comment deux distributions s’entrelacent dans l’espace échantillonnal, fournissant les indices quantitatifs nécessaires pour soutenir ou rejeter une hypothèse de recherche sans pour autant prouver, à elle seule, la direction générative du phénomène observé.
1.2 Les trois piliers méthodologiques fondamentaux
La conduite d’une analyse bivariée exemplaire repose sur une articulation tripartite associant la perception visuelle, la synthèse paramétrique standardisée et la modélisation fonctionnelle. Le premier pilier méthodologique réside dans l’inspection géométrique et visuelle opérée par le biais du diagramme de dispersion (ou scatterplot). Cette représentation cartésienne projette chaque unité statistique dans un espace bidimensionnel où l’abscisse matérialise la variable X et l’ordonnée la variable Y. Cette étape graphique n’est pas un simple ornement esthétique ; elle constitue un filtre diagnostique irremplaçable permettant d’appréhender la morphologie brute de la distribution, de repérer d’éventuelles ruptures de monotonicité et d’identifier les observations aberrantes susceptibles de fausser les estimateurs algébriques.
Le deuxième pilier réside dans l’estimation de coefficients d’association standardisés, au premier rang desquels figure le coefficient de corrélation linéaire r développé par Karl Pearson. Ces métriques adimensionnelles ont pour vertu de résumer la cohésion mathématique existant entre les deux séries de mesures, indépendamment des échelles de cotation initiales. En réduisant l’information conjointe à un indice borné, le chercheur dispose d’une estimation synthétique de la force du lien linéaire, directement comparable à d’autres grandeurs rapportées dans la littérature psychologique mondiale.
Enfin, le troisième pilier s’incarne dans la modélisation prédictive par régression linéaire simple. Par cette technique, l’analyse quitte le registre de la simple association symétrique pour entrer dans celui de la formalisation fonctionnelle : il s’agit d’établir une équation mathématique permettant d’estimer les valeurs attendues de la variable critère Y à partir des valeurs mesurées de la variable explicative X. La complémentarité séquentielle de ces trois piliers — explorer visuellement, quantifier l’association, puis modéliser mathématiquement l’ajustement — constitue un rempart méthodologique impératif. Ignorer l’inspection visuelle au profit du seul calcul d’un coefficient ou d’une régression expose le chercheur à de lourdes erreurs d’interprétation, comme l’illustre magistralement le célèbre quartet d’Anscombe.
1.3 Applications directes et pertinence en recherche psychologique
L’analyse bivariée innerve l’ensemble des sous-disciplines de la psychologie contemporaine. En psychologie cognitive et de l’éducation, elle permet d’examiner avec précision comment des paramètres temporels et pédagogiques influencent les acquisitions conceptuelles. Une problématique classique réside dans l’étude conjointe du temps d’étude alloué à un module universitaire et du score obtenu aux examens sommatifs finaux. L’investigation empirique ne se limite pas à constater que « plus l’on étudie, mieux l’on réussit » : elle quantifie la part de variance du résultat académique imputable à l’investissement chronologique, permettant ainsi de détecter d’éventuels phénomènes de rendements décroissants ou de saturation cognitive.
En psychopathologie et en neuropsychologie clinique, l’analyse bivariée constitue l’instrument privilégié pour investiguer les répercussions des états émotionnels sur les ressources attentionnelles et exécutives. L’évaluation du lien unissant le score obtenu sur une échelle d’anxiété-état pré-évaluation et l’empan mnésique en mémoire de travail offre un éclairage direct sur les modèles de partage des ressources cognitives. L’analyse permet de vérifier si l’élévation de l’anxiété s’accompagne d’un appauvrissement proportionnel des capacités de rétention et de manipulation de l’information verbale ou visuo-spatiale.
Par ailleurs, cette approche s’avère indispensable dans les étapes de validation des instruments psychométriques. Tout concepteur de test psychologique doit attester de la validité de construit de son outil par l’examen de sa cohérence externe. Pour ce faire, il procède à des analyses bivariées croisant les scores issus de son nouveau questionnaire avec des critères standardisés préexistants (validité convergente) ou avec des dimensions théoriquement orthogonales (validité discriminante). De l’orientation scolaire aux études d’ergonomie cognitive sur le temps de réaction face à des interfaces numériques, l’analyse bivariée demeure le creuset dans lequel s’articulent la théorie psychologique et l’observation métrique.
2. Typologie des variables et préparation rigoureuse des données sous Excel
2.1 Classification des échelles de mesure de Stevens
Toute démarche quantitative en sciences humaines doit débuter par une réflexion approfondie sur la nature ontologique des données manipulées. En 1946, le psychologue américain Stanley Smith Stevens a proposé une typologie quadripartite des échelles de mesure devenue la norme de référence en psychométrie : les échelles nominales, ordinales, d’intervalles et de rapports. La maîtrise de ces distinctions s’avère fondamentale, car la structure de l’échelle détermine rigoureusement les opérations mathématiques autorisées et, corollairement, les outils statistiques déployables sous Excel.
L’échelle nominale représente le niveau le plus élémentaire de la mesure : elle classe les unités d’observation dans des catégories mutuellement exclusives et exhaustivement définies, dépourvues de tout ordre sous-jacent (par exemple, le genre des participants ou le type d’approche thérapeutique suivie). L’échelle ordinale introduit une relation de gradation hiérarchique : les modalités peuvent être classées selon un ordre croissant ou décroissant, mais la distance entre deux échelons successifs n’est pas constante ni quantifiable (c’est le cas des échelles de Likert mesurant le degré d’accord de « pas du tout d’accord » à « tout à fait d’accord »). Les échelles d’intervalles franchissent un palier décisif en garantissant une équidistance métrique entre les unités consécutives, bien que leur zéro soit arbitraire et conventionnel (à l’instar des quotients intellectuels standardisés ou des températures en degrés Celsius). Enfin, l’échelle de rapports intègre un zéro absolu et naturel signifiant l’absence totale de la propriété mesurée, autorisant ainsi le calcul de ratios multiplicatifs signifiants (comme le temps de réaction en millisecondes ou le nombre d’erreurs commises lors d’une tâche d’attention soutenue).
Le non-respect de cette taxonomie conduit à des incohérences méthodologiques sévères. Assigner des codes numériques (1, 2, 3) à des catégories nominales puis appliquer sans discernement un coefficient de corrélation linéaire de Pearson constitue une erreur fondamentale. De même, traiter des scores ordinaux de Likert comme des grandeurs d’intervalles continues sans vérification préalable de la normalité ou de la granularité de l’échelle biaise artificiellement les estimations d’association. Sous Excel, le chercheur doit identifier explicitement le couple de variables en présence afin de s’orienter vers la procédure adéquate : Pearson pour deux variables quantitatives continues, Spearman pour des données ordinales ou asymétriques, ou le Chi-carré pour le croisement de deux variables qualitatives nominales.
2.2 Structuration optimale d’une matrice de données dans une feuille de calcul
L’intégrité de l’analyse statistique sous Excel repose sur l’organisation scrupuleuse de la matrice de données au sein du tableur. Il est impératif d’adopter le format tabulaire standardisé international, communément désigné sous le nom de structure de données « propre » (tidy data). Selon cette architecture, chaque ligne de la feuille de calcul doit correspondre sans exception à une unique unité statistique (un participant, un patient ou un sujet expérimental), tandis que chaque colonne doit être exclusivement dévolue à une variable mesurée ou à un attribut expérimental.
La première ligne du classeur Excel doit être réservée aux intitulés des variables (les en-têtes). Ces libellés doivent être concis, explicites et dépourvus d’espaces, de caractères spéciaux ou de symboles mathématiques susceptibles de perturber les fonctions logiques d’Excel (par exemple, préférer Temps_Etude_H et Score_Examen à des intitulés verbeux comportant des retours à la ligne). La première colonne doit systématiquement héberger un identifiant anonymisé unique (ex. Sujet_01, Sujet_02), garantissant la traçabilité déontologique de la cohorte conformément aux directives sur la protection des données personnelles.
Une vigilance technique particulière doit être portée au formatage natif des cellules. Les variables quantitatives doivent être expressément paramétrées au format « Nombre » et non laissées en format « Standard » ou « Texte », ce dernier étant source de blocages computationnels récurrents dans l’exécution des formules statistiques. De surcroît, il est hautement recommandé de convertir la plage de données rectangulaire en un véritable Tableau structuré d’Excel (via le raccourci Ctrl + L ou l’onglet Accueil > Mettre sous forme de tableau). Ce formalisme assure la propagation automatique des formules, fige les en-têtes lors du défilement et permet d’utiliser des références structurées lisibles plutôt que des plages de coordonnées figées et cryptiques.
2.3 Nettoyage préliminaire et vérification de la qualité des données
Avant d’engager le moindre calcul d’association bivariée, le jeu de données doit subir un protocole de nettoyage rigoureux. En recherche psychologique, la présence de données manquantes constitue une réalité inévitable consécutive à l’abandon de participants, au refus de répondre à certains items ou à des dysfonctionnements techniques d’appareillage. Sous Excel, les cellules sans réponse ne doivent jamais être codées par le chiffre 0, au risque dramatique de transformer une absence de mesure en une valeur empirique nulle qui dénaturerait l’ensemble des moyennes et des covariances. Elles doivent rester strictement vides ou faire l’objet de techniques d’imputation méthodique contrôlée après vérification du mécanisme sous-jacent à leur omission (MCAR, MAR ou MNAR).
L’étape suivante consiste en la détection méthodique des valeurs aberrantes ou atypiques (outliers). Dans un premier temps, le calcul des scores centrés réduits (scores z) via la fonction =CENTREE.REDUITE(cellule; moyenne; ecart_type) permet d’isoler les observations s’écartant de plus de 3 écarts-types de la moyenne empirique. En complément, l’analyse non paramétrique basée sur l’intervalle interquartile permet d’identifier les valeurs tombant au-delà de 1,5 fois l’écart interquartile calculé à partir du premier et du troisième quartile via les fonctions =QUARTILE.EXCLURE(plage; 1) et =QUARTILE.EXCLURE(plage; 3).
Enfin, l’examen de la consistance interne de la saisie implique la recherche de doublons involontaires par l’outil natif de déduplication d’Excel (onglet Données > Supprimer les doublons) et le contrôle des bornes de plausibilité psychométrique (par exemple, s’assurer qu’aucun score d’une échelle bornée entre 0 et 50 n’affiche une valeur supérieure à 50 par suite d’une faute de frappe). Chaque correction, suppression ou imputation doit être consignée de façon exhaustive dans une feuille de calcul dédiée faisant office de journal d’audit méthodologique, gage indispensable de la reproductibilité scientifique des analyses ultérieures.
3. Exploration visuelle initiale : Construction du diagramme de dispersion sous Excel
3.1 Procédure pas à pas d’insertion du nuage de points
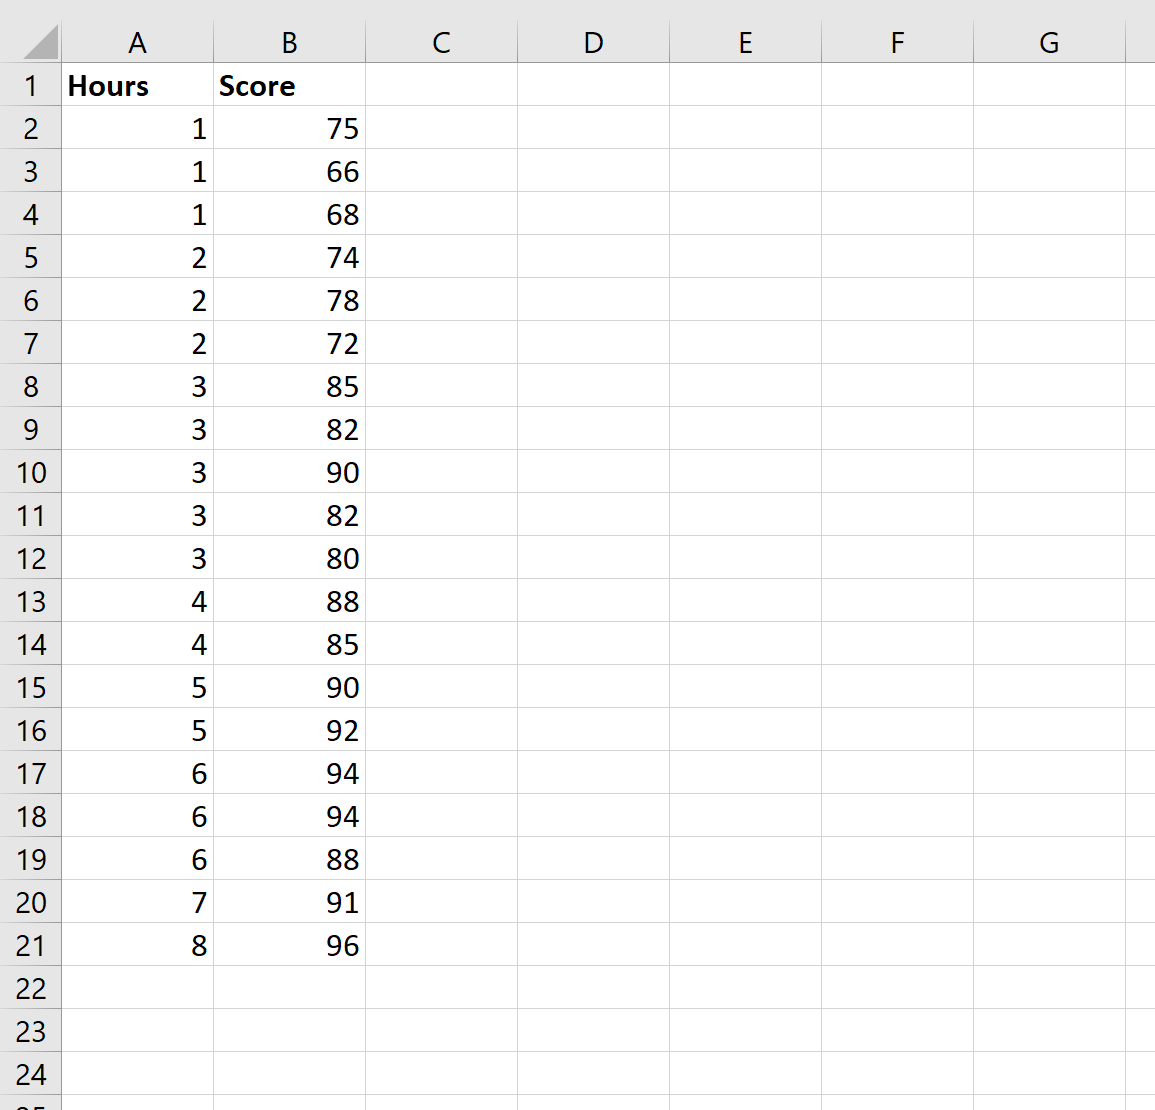
L’exploration visuelle constitue le passage obligé de l’analyse bivariée. Sous Excel, la construction d’un diagramme de dispersion obéit à une séquence d’actions rigoureusement codifiée qui garantit l’exactitude de la projection géométrique. La première étape requiert la sélection méthodique des deux colonnes contenant les séries de données à confronter. Si les variables occupent des plages contiguës (par exemple, la plage B2:C21), il suffit de les mettre en surbrillance avec le curseur de la souris. Dans l’éventualité où les colonnes seraient disjointes, l’utilisateur opérera une multi-sélection en maintenant la touche Ctrl enfoncée pendant la sélection de la première plage prédictive, puis de la seconde plage critère.
Une fois la sélection active, le chercheur navigue vers le ruban supérieur d’Excel, clique sur l’onglet Insertion, puis localise le groupe fonctionnel intitulé Graphiques. Au sein de ce panneau, il convient de cliquer sur l’icône représentant un ensemble de points non reliés, désignée sous l’appellation Insérer un graphique en nuage de points (X, Y). Parmi les déclinaisons proposées, il est impératif de sélectionner exclusivement le modèle élémentaire intitulé Nuage de points, exempt de toute ligne d’interpolation droite ou lissée. Relier artificiellement les points d’une distribution transversale par des segments constituerait un contresens méthodologique majeur, induisant à tort l’idée d’une continuité séquentielle ou temporelle.
Une précaution technique déterminante concerne l’affectation correcte des axes cartésiens. Par défaut, Excel assigne systématiquement la colonne située la plus à gauche de la sélection à l’axe horizontal des abscisses (variable X) et la colonne adjacente de droite à l’axe vertical des ordonnées (variable Y). Si l’ordonnancement théorique de la recherche exige d’inverser ces rôles (en plaçant par exemple le temps d’étude en abscisse et le score académique en ordonnance), le chercheur doit effectuer un clic droit sur la zone de traçage, choisir l’option Sélectionner des données, puis modifier les plages sources définissant respectivement les « Valeurs de la série X » et les « Valeurs de la série Y ».
3.2 Analyse visuelle et morphologique de la distribution bivariée
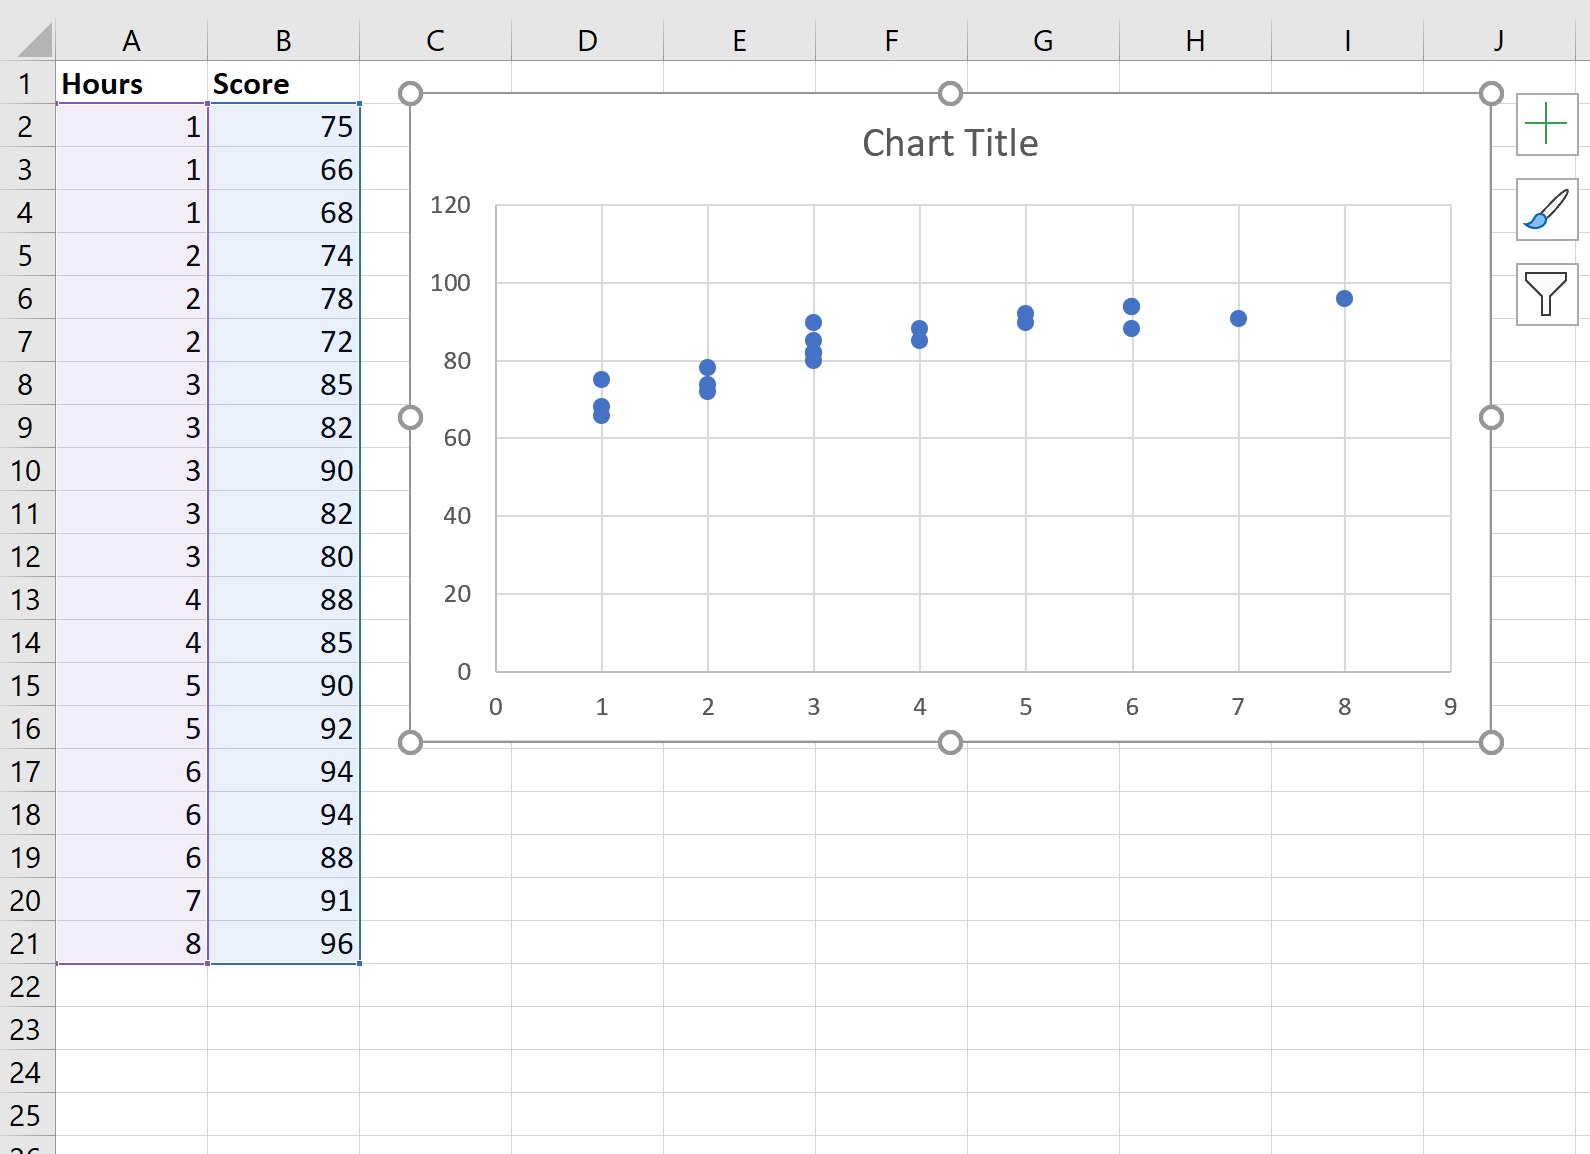
Dès l’apparition du nuage de points sur la feuille de calcul, l’analyste doit suspendre toute velléité de calcul numérique pour se livrer à un diagnostic morphologique attentif de la distribution bidimensionnelle. Cette auscultation visuelle s’articule autour de quatre dimensions fondamentales : la forme globale, l’orientation, la compacité et l’homogénéité de la dispersion. La première interrogation concerne la linéarité du lien. Les points semblent-ils s’organiser le long d’un corridor rectiligne, ou décrivent-ils une trajectoire curvilinéaire, parabolique, voire exponentielle ? Si la courbure du nuage trahit une relation non linéaire (par exemple, une forme en U inversé illustrant la célèbre loi de Yerkes-Dodson reliant l’éveil motivationnel et la performance), les outils de corrélation linéaire standard s’avéreront inadéquats sans ajustement préalable.
Le second critère porte sur la direction de la pente. Une orientation ascendante (de bas en gauche vers le haut en droite) témoigne d’une covariation positive : l’augmentation des scores sur X s’accompagne d’une progression concomitante sur Y. À l’inverse, un nuage descendant signale une association inverse ou négative. Une dispersion circulaire isotrope, semblable à un tir de grenaille dépourvu de direction privilégiée, indique une indépendance linéaire des deux variables.
Le troisième aspect réside dans le diagnostic de l’hétéroscédasticité. Le chercheur doit observer si la dispersion verticale des points demeure constante sur toute la longueur de l’axe horizontal, ou si elle subit un phénomène d’évasement en entonnoir. Une variance résiduelle qui s’accroît à mesure que X augmente signale une violation du postulat d’homoscédasticité, compromettant la précision des prédictions aux valeurs extrêmes. Enfin, l’inspection visuelle met instantanément en lumière les points isolés. Un individu situé loin du regroupement principal peut s’avérer être un point d’influence majeur capable de basculer la droite de régression à lui seul.
3.3 Illustrations concrètes : Temps d’étude versus score à l’examen
Afin d’ancrer notre exposé dans une démarche empirique tangible, considérons un protocole de recherche conduit au sein d’un laboratoire de psychologie de l’éducation. Vingt étudiants de premier cycle ont été suivis durant les quatre semaines précédant l’évaluation finale de neuropsychologie. Le protocole recueille d’une part le temps total consacré à l’étude autonome structurée (exprimé en heures, variable prédictive X) et d’autre part la note finale obtenue à l’épreuve standardisée sur une échelle continue de 0 à 100 points (variable critère Y).
| Identifiant | Temps d’étude (heures) – X | Score à l’examen (/100) – Y |
|---|---|---|
| Sujet_01 | 10 | 65 |
| Sujet_02 | 12 | 68 |
| Sujet_03 | 15 | 74 |
| Sujet_04 | 8 | 58 |
| Sujet_05 | 20 | 85 |
| Sujet_06 | 18 | 80 |
| Sujet_07 | 14 | 72 |
| Sujet_08 | 11 | 66 |
| Sujet_09 | 22 | 90 |
| Sujet_10 | 16 | 78 |
| Sujet_11 | 9 | 62 |
| Sujet_12 | 13 | 70 |
| Sujet_13 | 17 | 79 |
| Sujet_14 | 19 | 83 |
| Sujet_15 | 7 | 55 |
| Sujet_16 | 21 | 88 |
| Sujet_17 | 14 | 71 |
| Sujet_18 | 16 | 76 |
| Sujet_19 | 23 | 92 |
| Sujet_20 | 10 | 64 |
La transcription de cette matrice dans les colonnes A, B et C d’une feuille Excel, suivie de l’insertion d’un diagramme de dispersion, révèle une trajectoire ascendante particulièrement dense et harmonieuse. L’inspection géométrique permet de constater immédiatement qu’aucun étudiant ne se positionne en contradiction flagrante avec la tendance générale : les faibles volumes horaires s’associent aux scores les plus modestes, tandis que l’intensification de l’effort d’apprentissage s’accompagne d’une élévation régulière de la note finale. La dispersion verticale des points le long de l’axe imaginaire de la tendance ne présente aucun évasement manifeste en forme d’éventail, confirmant sur le plan qualitatif la plausibilité des postulats de linéarité et d’homogénéité de la variance.
4. Optimisation et personnalisation avancée des représentations graphiques
4.1 Ajustement des échelles et des limites d’axes sous Excel
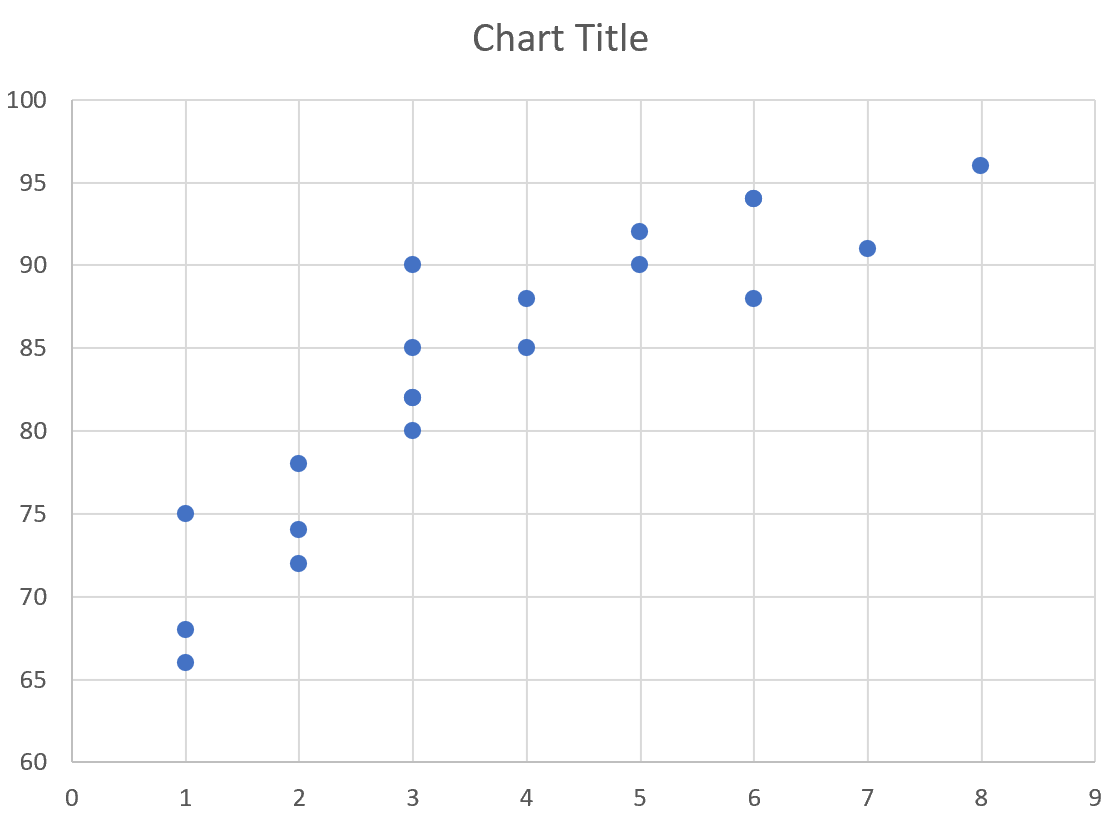
Le moteur graphique d’Excel applique par défaut des réglages automatiques qui génèrent fréquemment des espaces blancs excessifs ou, à l’inverse, une compression abusive des points dans une sous-section du tracé. Pour conférer au graphique une rigueur scientifique, l’ajustement manuel des bornes minimales et maximales de chaque axe constitue une nécessité technique incontournable. Dans notre exemple académique, aucun étudiant ne présente un score inférieur à 50, et le temps d’étude oscille entre 7 et 23 heures. Laisser l’axe des ordonnées démarrer à 0 crée une surface vierge démesurée dans la moitié inférieure du graphique, comprimant artificiellement l’amplitude perçue des variations individuelles.
Pour ajuster ces paramètres, l’opérateur effectue un double-clic sur l’axe vertical des ordonnées afin de déployer le volet latéral intitulé Format de l’axe. Sous la rubrique Options d’axe, dans le champ Limites, il convient de remplacer la valeur minimale automatique de 0 par la valeur rationnelle de 50,0, tout en fixant la borne supérieure à 100,0 (qui correspond au plafond de l’épreuve). L’unité principale de graduation peut être calibrée sur un pas régulier de 10,0 points. De manière identique, l’axe horizontal des abscisses sera borné entre 5,0 et 25,0 heures, avec une gradation principale fixée à 5,0 unités.
Il importe toutefois de souligner l’enjeu épistémologique et éthique associé à ces réglages. Une troncature excessive des échelles cartésiennes peut induire chez le lecteur une perception grandement amplifiée de l’effet observé, en transformant visuellement un écart marginal en un abîme vertigineux. La modulation des bornes doit être guidée par la recherche d’une lisibilité optimale des données sans jamais franchir la frontière de la manipulation perceptuelle biaisée.
4.2 Formatage académique conforme aux normes APA
Les chartes graphiques imposées par les périodiques scientifiques affiliés à l’American Psychological Association (notamment dans sa 7e édition) exigent une épuration visuelle totale du diagramme. Les effets d’ombre portée, les bordures extérieures épaisses, les fonds colorés ou tramés et les titres intempestifs incrustés directement dans la zone de traçage doivent être impitoyablement proscrits. Le titre de la figure sera inséré ultérieurement dans le traitement de texte, au-dessus du tracé, en caractères italiques et normalisés.
Dans l’environnement Excel, la mise en conformité académique requiert en premier lieu l’intégration d’étiquettes d’axes parfaitement explicites. Par l’entremise du bouton vert « + » situé à l’angle supérieur droit du graphique (ou via Création de graphique > Ajouter un élément de graphique > Titres des axes), l’utilisateur active les zones de texte respectives. L’abscisse doit mentionner l’intitulé de la variable assorti de son unité de mesure entre parenthèses, à savoir Temps d’étude hebdomadaire (heures), tandis que l’axe vertical affichera Score d’évaluation en neuropsychologie (/100). Les quadrillages majeurs et mineurs d’arrière-plan, souvent trop encombrants, doivent être allégés ou totalement supprimés pour focaliser l’attention sur la seule distribution des points.
La typographie générale du graphique doit être harmonisée au format institutionnel (généralement Times New Roman, Calibri ou Arial) avec une taille de police constante fixée à 10 ou 11 points, assurant une parfaite lisibilité lors des tirages noir et blanc ou en niveaux de gris. Les marqueurs représentant les unités statistiques feront l’objet d’un paramétrage épuré : sélectionner une forme circulaire standard, d’une taille modérée (entre 4 et 5 points), arborant un remplissage noir uni ou gris anthracite foncé sans trait de contour criard.
4.3 Ajout dynamique d’éléments inférentiels au graphique
L’apport majeur d’Excel dans la représentation conjointe réside dans sa capacité à superposer instantanément des informations inférentielles fondamentales à la distribution brute des données. Pour projeter la droite d’ajustement optimale sur le nuage de points, il convient de cliquer avec le bouton droit de la souris sur l’un quelconque des marqueurs de la série de données, puis de sélectionner la commande Ajouter une courbe de tendance… dans le menu contextuel.
Dans le panneau latéral qui se déploie à droite de l’écran, le sélecteur d’options propose diverses familles de modélisations mathématiques (exponentielle, linéaire, logarithmique, polynomiale, puissance). Le modèle Linéaire doit être coché par défaut. Pour rendre cette matérialisation pleinement informative, le chercheur doit cocher deux cases indispensables situées au bas de ce volet : Afficher l’équation sur le graphique et Afficher le coefficient de détermination (R-carré) sur le graphique.
La droite ainsi superposée matérialise l’ajustement obtenu par la méthode des moindres carrés. Pour des raisons d’élégance et de distinction cognitive, il est recommandé de formater le trait de la courbe de tendance en une ligne continue noire ou grise d’épaisseur modérée (1,5 point), ou en un trait tireté fin. La zone de texte hébergeant l’équation prédictive et la valeur du R² doit être délicatement positionnée dans un espace vide du tracé, généralement dans le quadrant supérieur gauche ou inférieur droit, évitant ainsi tout chevauchement parasite avec les marqueurs empiriques de l’échantillon.
5. Quantification de l’association : Le coefficient de corrélation linéaire de Pearson
5.1 Fondements mathématiques et conditions d’application de Pearson
Si la projection géométrique fournit une intuition précieuse sur la relation unissant deux construits, la validation empirique exige une quantification rigoureuse de cette association. Le coefficient de corrélation produit-moment de Pearson, universellement symbolisé par la lettre r pour un échantillon et par la lettre grecque $rho$ (rho) pour la population parente, formalise le rapport entre la covariance conjointe des deux variables et le produit de leurs écarts-types individuels respectifs. L’équation formelle s’énonce comme suit :
$$r = \frac{\sum_{i=1}^{n} (X_i – \bar{X})(Y_i – \bar{Y})}{\sqrt{\sum_{i=1}^{n} (X_i – \bar{X})^2 \cdot \sum_{i=1}^{n} (Y_i – \bar{Y})^2}}$$
Le numérateur représente la somme des produits des écarts à la moyenne, traduisant la tendance des deux variables à s’écarter conjointement de leurs centres de gravité respectifs. Le dénominateur opère une normalisation géométrique en calculant la borne supérieure théorique que cette covariation pourrait atteindre si les deux séries étaient parfaitement proportionnelles. Cette formulation garantit que le coefficient r demeure invariant face à toute transformation linéaire affine positive appliquée aux données d’origine.
L’application légitime du coefficient de Pearson est néanmoins subordonnée au respect scrupuleux de plusieurs conditions mathématiques. En premier lieu, les deux variables doivent être mesurées sur des échelles d’intervalles ou de rapports. En second lieu, la distribution conjointe doit théoriquement suivre une loi normale bivariée, postulat dont l’approximation pragmatique repose sur la normalité univariée de chacune des deux distributions. En troisième lieu, la relation sous-jacente doit être strictement linéaire : la présence d’une courbure monotone ou non monotone biaise considérablement l’estimation en tirant artificiellement l’indice vers zéro. Enfin, les données doivent être exemptes de troncature artificielle de la variance (phénomène de restriction d’étendue) et d’hétéroscédasticité majeure.
5.2 Mise en œuvre algorithmique sous Excel : Fonctions COEFFICIENT.CORRELATION et PEARSON
L’environnement Microsoft Excel intègre nativement plusieurs algorithmes dédiés à l’estimation du lien linéaire de Pearson. Les deux fonctions principales disponibles dans les versions francophones du logiciel sont COEFFICIENT.CORRELATION et PEARSON. Sur le plan algorithmique et arithmétique, ces deux instructions réalisent des calculs rigoureusement identiques et renvoient des valeurs numériques équivalentes au quatorzième chiffre décimal. La duplication de ces dénominations résulte de choix historiques de compatibilité ascendante opérés par Microsoft.
La syntaxe opératoire standard se décline sous la forme générale suivante :
=COEFFICIENT.CORRELATION(matrice1; matrice2)
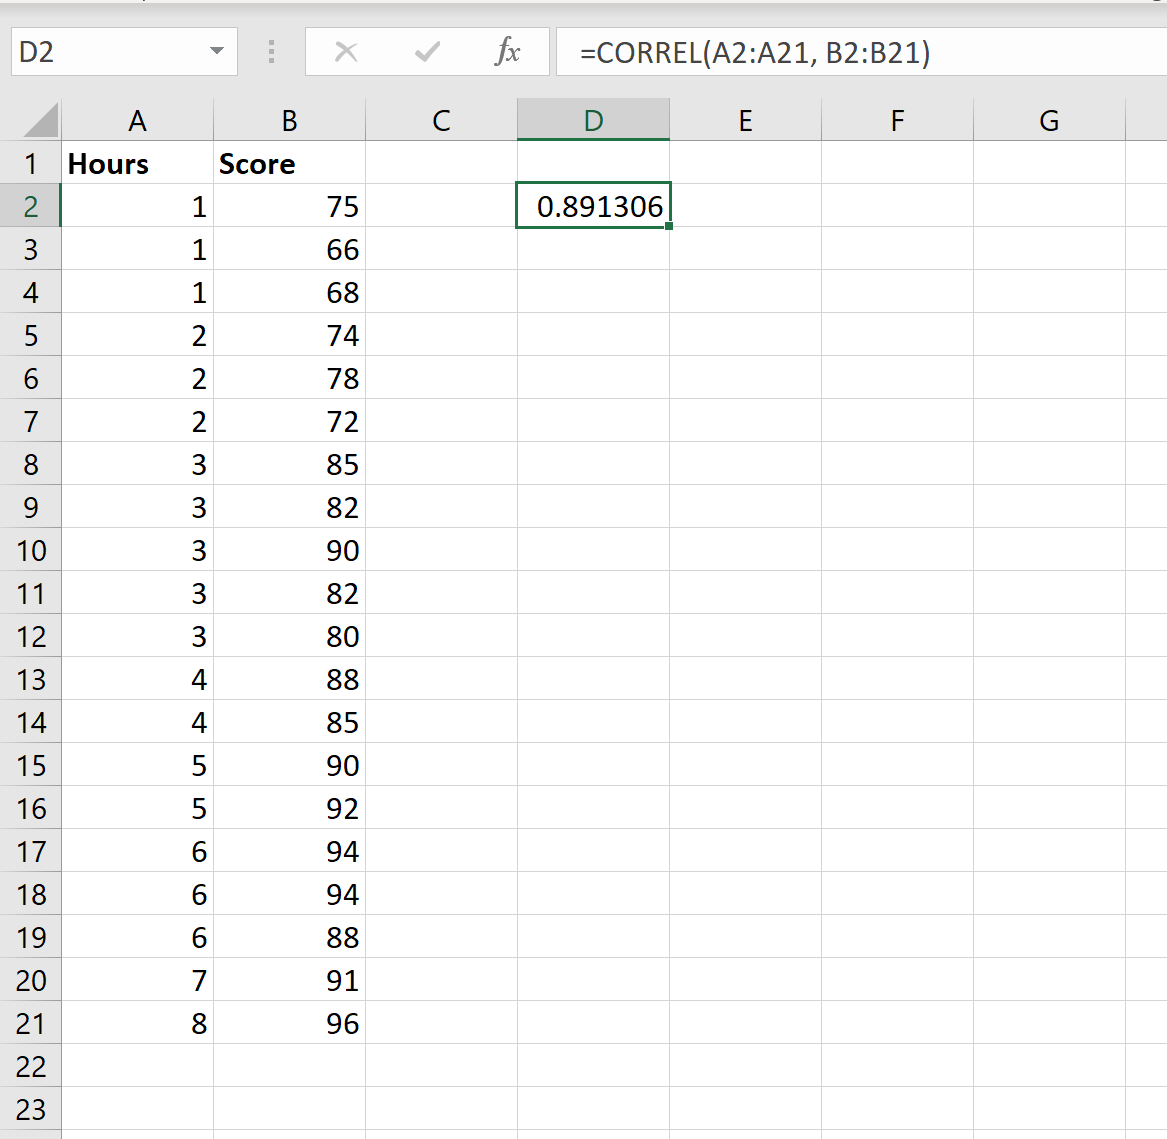
Dans le cadre de notre cohorte de 20 étudiants, en supposant que les valeurs relatives au temps d’étude occupent la plage B2:B21 et que les scores finaux occupent la plage C2:C21, l’opérateur inscrira dans la cellule cible la formule explicite :
=COEFFICIENT.CORRELATION(B2:B21; C2:C21)
L’exécution de cette fonction sur nos données expérimentales produit un résultat numérique de 0,985. Ce calcul appelle plusieurs recommandations techniques pour prévenir les erreurs fonctionnelles récurrentes. Si l’une des plages sélectionnées comporte une cellule contenant du texte, un espace invisible ou une modalité vide non contiguë, Excel ignore automatiquement la ligne correspondante dans les versions récentes, mais les versions antérieures peuvent générer l’erreur #VALEUR!. Par ailleurs, si l’une des deux séries de données présente une variance strictement nulle (par exemple si tous les sujets présentaient le même score d’examen), le dénominateur de la fraction s’annule, provoquant l’apparition de l’erreur mathématique #DIV/0!.
5.3 Interprétation statistique et normes psychométriques de Cohen
Le coefficient de corrélation de Pearson est une métrique standardisée bornée de manière infranchissable dans l’intervalle fermé $[-1,00 ; +1,00]$. Une valeur de $+1,00$ dénote une corrélation positive parfaite, caractérisant une situation où l’ensemble des points d’observation s’aligne rigoureusement sur une droite ascendante. À l’opposé, une valeur de $-1,00$ traduit une relation linéaire négative parfaite. Une valeur de $0,00$ signale l’absence totale de cohésion linéaire entre les deux métriques.
Dans l’univers des sciences du comportement, où la part d’erreur de mesure inhérente aux construits psychologiques demeure substantielle, les conventions interprétatives formulées par le statisticien Jacob Cohen en 1988 font autorité pour qualifier la taille d’effet :
- Un coefficient r avoisinant $\pm 0,10$ signale une association de magnitude faible (taille d’effet mineure mais potentiellement signifiante sur le plan épidémiologique).
- Un coefficient r oscillant autour de $\pm 0,30$ correspond à une magnitude moyenne, typique de nombreuses associations psychométriques en psychologie sociale ou cognitive.
- Un coefficient r égal ou supérieur à $\pm 0,50$ traduit une association forte, révélant une très solide interpénétration des dimensions investiguées.
Avec une valeur observée de r = 0,985, notre exemple expérimental relève d’une association exceptionnellement vigoureuse, quasi-parfaite, rarement observée en pratique clinique en dehors des dispositifs d’étalonnage test-retest de haute précision. En élevant ce coefficient au carré, nous obtenons le coefficient de détermination :
$$R^2 = (0,985)^2 = 0,970$$
Cette métrique capitale indique que 97,0 % de la variance des scores obtenus à l’examen de neuropsychologie est directement partagée avec le volume d’heures d’étude autonome investi par l’apprenant. Le complémentaire arithmétique, désigné sous le terme de coefficient d’aliénation ($1 – R^2 = 0,030$), atteste que seulement 3,0 % de la variance résiduelle échappe à ce déterminant chronologique, pouvant être imputée à d’autres facteurs non mesurés (aptitudes initiales, stress contextuel ou fluctuations attentionnelles transitoires).
Il demeure toutefois impératif de rappeler le principe épistémologique absolu selon lequel « corrélation ne vaut pas causalité » (cum hoc ergo propter hoc). L’existence d’une corrélation très élevée entre deux paramètres ne prouve en aucun cas que la variation de X est le moteur mécanique direct de la variation de Y. Une troisième variable latente non contrôlée (par exemple, le sentiment d’efficacité personnelle ou le niveau global d’assiduité académique) peut parfaitement piloter conjointement les deux variables observées, créant l’illusion d’une interaction univoque.
6. Approches non paramétriques sous Excel : Corrélation de Spearman et Kendall
6.1 Justification de l’approche ordinale face aux violations paramétriques
Le recours exclusif au coefficient de corrélation de Pearson s’avère méthodologiquement hasardeux dès lors que les données psychologiques s’écartent des postulats stricts de la théorie normale. Dans la pratique de la recherche psychologique, deux écueils majeurs surgissent fréquemment : la vulnérabilité dramatique du r de Pearson face aux points extrêmes (outliers) et l’utilisation quasi-omniprésente d’échelles de mesure ordinales (telles que les échelles de Likert d’auto-évaluation de la douleur, de l’anxiété ou de l’estime de soi).
Lorsqu’un individu atypique s’écarte substantiellement de la masse des observations, son éloignement quadratique exerce un effet de levier considérable sur le calcul de la covariance, pouvant gonfler artificiellement une corrélation inexistante ou, au contraire, pulvériser un lien linéaire authentique. De surcroît, le concept même de corrélation paramétrique exige que les écarts numériques soient équidistants. Or, sur une échelle d’évaluation subjective en 5 points, nul ne peut postuler avec certitude que la distance séparant « Tout à fait en désaccord » de « En désaccord » soit métriquement identique à celle séparant « Neutre » de « D’accord ».
L’alternative non paramétrique proposée par Charles Spearman substitue à l’analyse des valeurs numériques brutes l’analyse exclusive de leurs rangs relatifs. Ce faisant, le coefficient $rho$ (rho) de Spearman ne postule plus la linéarité stricte du phénomène, mais sa monotonicité. Une relation monotone caractérise une dynamique où les grandeurs évoluent de manière concomitante dans le même sens, que cette progression s’opère sur un mode linéaire, logarithmique ou sigmoïde. En convertissant les grandeurs en rangs ordinaux, le coefficient de Spearman préserve la puissance statistique du protocole expérimental tout en neutralisant l’impact déstabilisateur des asymétries de distribution et des observations isolées.
6.2 Calcul pas à pas du rho de Spearman dans une feuille de calcul
Bien qu’Excel ne dispose pas d’une fonction native dénommée SPEARMAN, le calcul de cette statistique non paramétrique s’exécute avec une remarquable simplicité conceptuelle au sein de la feuille de calcul. La méthode repose sur le théorème fondamental établissant que le rho de Spearman correspond très exactement au coefficient de Pearson calculé sur les rangs des variables.
La première phase requiert la création de deux nouvelles colonnes dédiées à l’assignation des rangs statistiques pour chacune des variables initiales. Supposons que nos données initiales soient hébergées dans les colonnes B (Temps d’étude) et C (Scores), de la ligne 2 à la ligne 21. Dans la cellule D2, destinée à recevoir le rang du temps d’étude du premier sujet, l’utilisateur insère la fonction suivante :
=RANG.MOYENNE(B2; $B$2:$B$21; 1)
L’argument 1 spécifie un ordonnancement croissant (le rang 1 étant attribué au plus faible temps d’étude). L’utilisation impérative de la fonction RANG.MOYENNE plutôt que de la fonction obsolète RANG s’avère indispensable pour gérer avec rigueur les valeurs ex æquo (les égalités de scores). En cas de ligature entre deux sujets se partageant par exemple la 4e et la 5e place, RANG.MOYENNE assigne à chacun la valeur fractionnaire de 4,5, conformément aux canons de la statistique mathématique. Cette formule est ensuite propagée par double-clic sur l’angle de recopie jusqu’à la cellule D21. La même démarche est appliquée dans la colonne E pour transformer les scores d’évaluation en rangs :
=RANG.MOYENNE(C2; $C$2:$C$21; 1)
Dès lors que les deux colonnes de rangs D et E sont constituées, l’estimation finale du rho de Spearman s’obtient instantanément en appliquant la fonction de corrélation linéaire directement à ces deux séries ordinales :
=COEFFICIENT.CORRELATION(D2:D21; E2:E21)
Sur notre jeu de données expérimental, l’application de cette formule livre un coefficient de Spearman de $rho = 0,984$. La concordance quasi-parfaite entre le coefficient de Pearson (0,985) et le coefficient de Spearman (0,984) confirme sans équivoque que la relation observée est à la fois hautement linéaire et rigoureusement exempte de distorsion liée à des rangs divergents ou à des points d’influence marginaux.
6.3 Introduction au tau de Kendall et comparaison des estimateurs
Dans certaines configurations expérimentales caractérisées par des échantillons extrêmement restreints ($n < 20$) ou par une proportion volumineuse de scores identiques (ex æquo), le coefficient $tau$ (tau) de Maurice Kendall représente une alternative non paramétrique encore plus robuste et stable que le rho de Spearman. Alors que Spearman raisonne sur les écarts quadratiques séparant les rangs, Kendall examine l’ensemble des paires possibles d’observations pour dénombrer les concordances et les discordances d’ordonnancement.
Une paire de sujets $(i, j)$ est dite concordante si le sujet ayant le score le plus élevé sur la variable X détient également le score le plus élevé sur la variable Y. La paire est qualifiée de discordante dans le cas inverse. Le tau de Kendall s’exprime fondamentalement comme la différence relative unissant les proportions de paires concordantes ($C$) et de paires discordantes ($D$) rapportée au nombre total de combinaisons de deux éléments parmi $n$ unités statistiques :
$$\tau = \frac{C – D}{\frac{1}{2} n (n – 1)}$$
L’implémentation du tau de Kendall sous Excel sans passer par du code Visual Basic (VBA) s’avère plus fastidieuse que celle de Spearman, car elle exige de construire une table matricielle triangulaire croisée comparant chaque sujet à l’ensemble de ses pairs. Néanmoins, pour des effectifs de petite taille, cette matrice permet d’apprécier la stabilité des classements. Le tableau suivant synthétise les critères rationnels de sélection entre ces trois métriques maîtresses de l’association bivariée :
| Critères méthodologiques | r de Pearson | rho de Spearman | tau de Kendall |
|---|---|---|---|
| Échelle de mesure requise | Intervalles ou Rapports continus | Ordinale ou Continue | Ordinale ou Continue |
| Forme de la relation testée | Strictement linéaire | Monotone (linéaire ou non) | Monotone (linéaire ou non) |
| Sensibilité aux valeurs extrêmes | Très élevée (vulnérabilité forte) | Faible (atténuation par le rang) | Très faible (grande robustesse) |
| Sensibilité aux ex æquo | Non concerné | Requiert ajustement (RANG.MOYENNE) | Excellente correction intrinsèque |
| Taille d’échantillon préférentielle | $n ge 30$ avec distribution normale | $n ge 15$ sans postulat de normalité | $n < 20$ ou fort taux d’égalités |
| Résultat sur notre jeu expérimental | 0,985 | 0,984 | 0,916 |
On observe que la valeur du tau de Kendall (0,916) est numériquement inférieure à celles de Pearson et Spearman, ce qui constitue une caractéristique structurelle mathématique parfaitement normale : Kendall évalue de façon plus conservatrice la probabilité d’inversion des rangs.
7. La modélisation fonctionnelle : Régression linéaire simple sous Excel
7.1 Fondements de la méthode des moindres carrés ordinaires (MCO)
Tandis que la corrélation quantifie de façon symétrique l’intensité du co-déplacement entre deux variables, la régression linéaire simple introduit une asymétrie fonctionnelle explicite : elle érige l’une des variables en prédicteur opérationnel (X) et cherche à modéliser mathématiquement l’espérance conditionnelle de la variable critère (Y). Le modèle théorique de la régression linéaire s’énonce selon l’équation fondamentale :
$$Y_i = \beta_0 + \beta_1 X_i + \varepsilon_i$$
Dans ce formalisme probabiliste, $Y_i$ représente la valeur observée pour l’unité statistique $i$, $\beta_0$ symbolise l’ordonnée à l’origine (ou constante du modèle), $\beta_1$ désigne le coefficient de pente (ou coefficient de régression marginal), et $\varepsilon_i$ incarne le terme d’erreur aléatoire ou résidu stochastique propre à chaque observation.
L’estimation empirique de ces paramètres inconnus de la population s’opère conventionnellement par la méthode des moindres carrés ordinaires (MCO). Cet algorithme géométrique et algébrique a pour dessein d’ajuster une droite unique au sein du nuage de points de telle sorte que la somme des carrés des distances verticales séparant chaque point réel de la droite ajustée ($\sum e_i^2 = \sum (Y_i – \hat{Y}_i)^2$) soit mathématiquement minimisée.
La constante estimée $b_0$ (ordonnée à l’origine) correspond à la valeur moyenne prédite pour la variable critère Y lorsque la variable explicative X est nulle. En psychométrie, la signification substantielle de ce paramètre doit être appréciée avec discernement : si une valeur nulle sur X est biologiquement ou psychologiquement impossible (comme un QI de 0 ou un temps de réaction nul), la constante ne possède qu’une fonction de calage mathématique. À l’opposé, la pente $b_1$ constitue le véritable cœur interprétatif du modèle : elle exprime le taux de variation marginal attendu sur Y pour chaque incrément d’une unité supplémentaire sur l’échelle de mesure de X.
7.2 Calcul direct des paramètres via les fonctions natives d’Excel
Excel fournit une batterie de fonctions statistiques permettant d’extraire de façon directe et modulaire chacun des paramètres du modèle de régression MCO sans avoir à exécuter des procédures matricielles complexes. Cette modularité s’avère particulièrement précieuse pour intégrer dynamiquement les coefficients au sein de synthèses exécutives ou de tableaux de bord.
L’extraction du coefficient de pente s’effectue au moyen de la fonction PENTE. Il convient de porter une attention méticuleuse à l’agencement des arguments de cette fonction, le logiciel attendant impérativement la variable dépendante Y en premier paramètre et le prédicteur X en second paramètre :
=PENTE(C2:C21; B2:B21)
Appliquée à notre cohorte académique, cette instruction retourne une valeur de 2,342. Sur le plan psychologique, ce coefficient s’interprète limpide-ment : chaque heure d’étude supplémentaire investie par un étudiant se traduit, en moyenne, par un gain de 2,34 points sur la note finale d’examen.
La détermination de l’ordonnée à l’origine s’obtient de manière analogue à l’aide de la fonction ORDONNEE.ORIGINE :
=ORDONNEE.ORIGINE(C2:C21; B2:B21)
Cette formule génère la valeur de 38,103. Cela implique mathématiquement qu’un étudiant ayant consacré zéro heure à l’étude autonome obtiendrait un score attendu d’environ 38,1 points sur 100.
Pour mesurer la qualité globale de l’ajustement du modèle linéaire, Excel propose la fonction COEFFICIENT.DETERMINATION, qui correspond directement au R² :
=COEFFICIENT.DETERMINATION(C2:C21; B2:B21)
Le résultat obtenu s’établit à 0,970, en conformité absolue avec le carré du r de Pearson calculé précédemment.
Enfin, pour évaluer l’incertitude moyenne résiduelle entourant le modèle de prédiction, l’utilisateur sollicitera la fonction calculant l’erreur-type des prévisions :
=ERREUR.TYPE.PE(C2:C21; B2:B21)
Cette fonction délivre ici une valeur de 1,863. Cette statistique exprime l’écart-type des résidus verticaux, indiquant que les prédictions individuelles formulées par l’équation du modèle présenteront une marge moyenne de fluctuation empirique d’environ $\pm 1,86$ point sur l’échelle des notes.
7.3 Génération de prédictions psychométriques individuelles
L’intérêt opératoire majeur d’une équation de régression réside dans sa capacité prédictive. Dès lors que les paramètres $b_0$ et $b_1$ ont été rigoureusement établis, il devient possible d’estimer le score attendu d’un nouveau participant pour lequel seule la mesure de la variable explicative X est connue. L’équation de prédiction prend la forme :
$$\hat{Y} = 38,103 + 2,342 \cdot X$$
Sous Excel, ce calcul prédictif peut être automatisé sans reconstituer manuellement l’équation algébrique en faisant appel à la fonction PREVISION.LINEAIRE (ou PREVISION selon les versions). Supposons que nous souhaitions prédire le score d’examen d’un étudiant ayant déclaré un temps d’étude de 15 heures, valeur consignée dans la cellule F2. La formule s’énoncera ainsi :
=PREVISION.LINEAIRE(F2; C2:C21; B2:B21)
L’exécution de la formule fournit une estimation ponctuelle précise de :
$$\hat{Y} = 38,103 + (2,342 \times 15) = 73,23\text{ points}$$
Une mise en garde épistémologique et méthodologique fondamentale s’impose ici : la distinction cruciale entre interpolation et extrapolation. L’interpolation consiste à prédire les valeurs de Y à l’intérieur du champ des valeurs observées de la variable X dans l’échantillon initial (dans notre protocole, entre 7 et 23 heures). Cette pratique est statistiquement valide dès lors que les postulats du modèle sont étayés.
L’extrapolation, en revanche, consiste à prédire le comportement du système au-delà des bornes expérimentales observées (par exemple, chercher à estimer le score d’un étudiant pour 40 heures d’étude). Procéder à une telle extrapolation constitue une témérité analytique sévère : l’équation de régression linéaire présume que la relation rectiligne perdure indéfiniment. Or, dans la réalité biologique et psychologique, des phénomènes de plafonnement (le score ne peut excéder 100 points) ou d’épuisement cognitif surviennent inévitablement, invalidant le postulat linéaire au-delà des frontières de l’échantillon.
8. Utilisation avancée de l’Utilitaire d’analyse d’Excel pour la régression
8.1 Activation et configuration de l’Add-in Utilitaire d’analyse
Bien que les fonctions statistiques modulaires d’Excel permettent d’extraire les paramètres essentiels, l’analyse inférentielle complète d’un modèle bivarié exige le recours au complément statistique institutionnel intitulé Utilitaire d’analyse (Analysis ToolPak). Cet add-in natif fournit en une fraction de seconde un bilan exhaustif équivalent aux sorties de logiciels professionnels spécialisés.
Si ce complément n’apparaît pas dans l’onglet Données de votre interface, son activation requiert une manipulation simple. Rendez-vous dans le menu supérieur Fichier, cliquez sur Options, puis sélectionnez la rubrique Compléments dans la colonne latérale gauche. Dans la zone inférieure intitulée Gérer, assurez-vous que la sélection affiche Compléments Excel et cliquez sur le bouton Atteindre…. Dans la boîte de dialogue contextuelle, cochez impérativement la case Utilitaire d’analyse et validez par OK. L’icône correspondante apparaît aussitôt à l’extrémité droite de l’onglet Données sous l’intitulé Analyse de données.
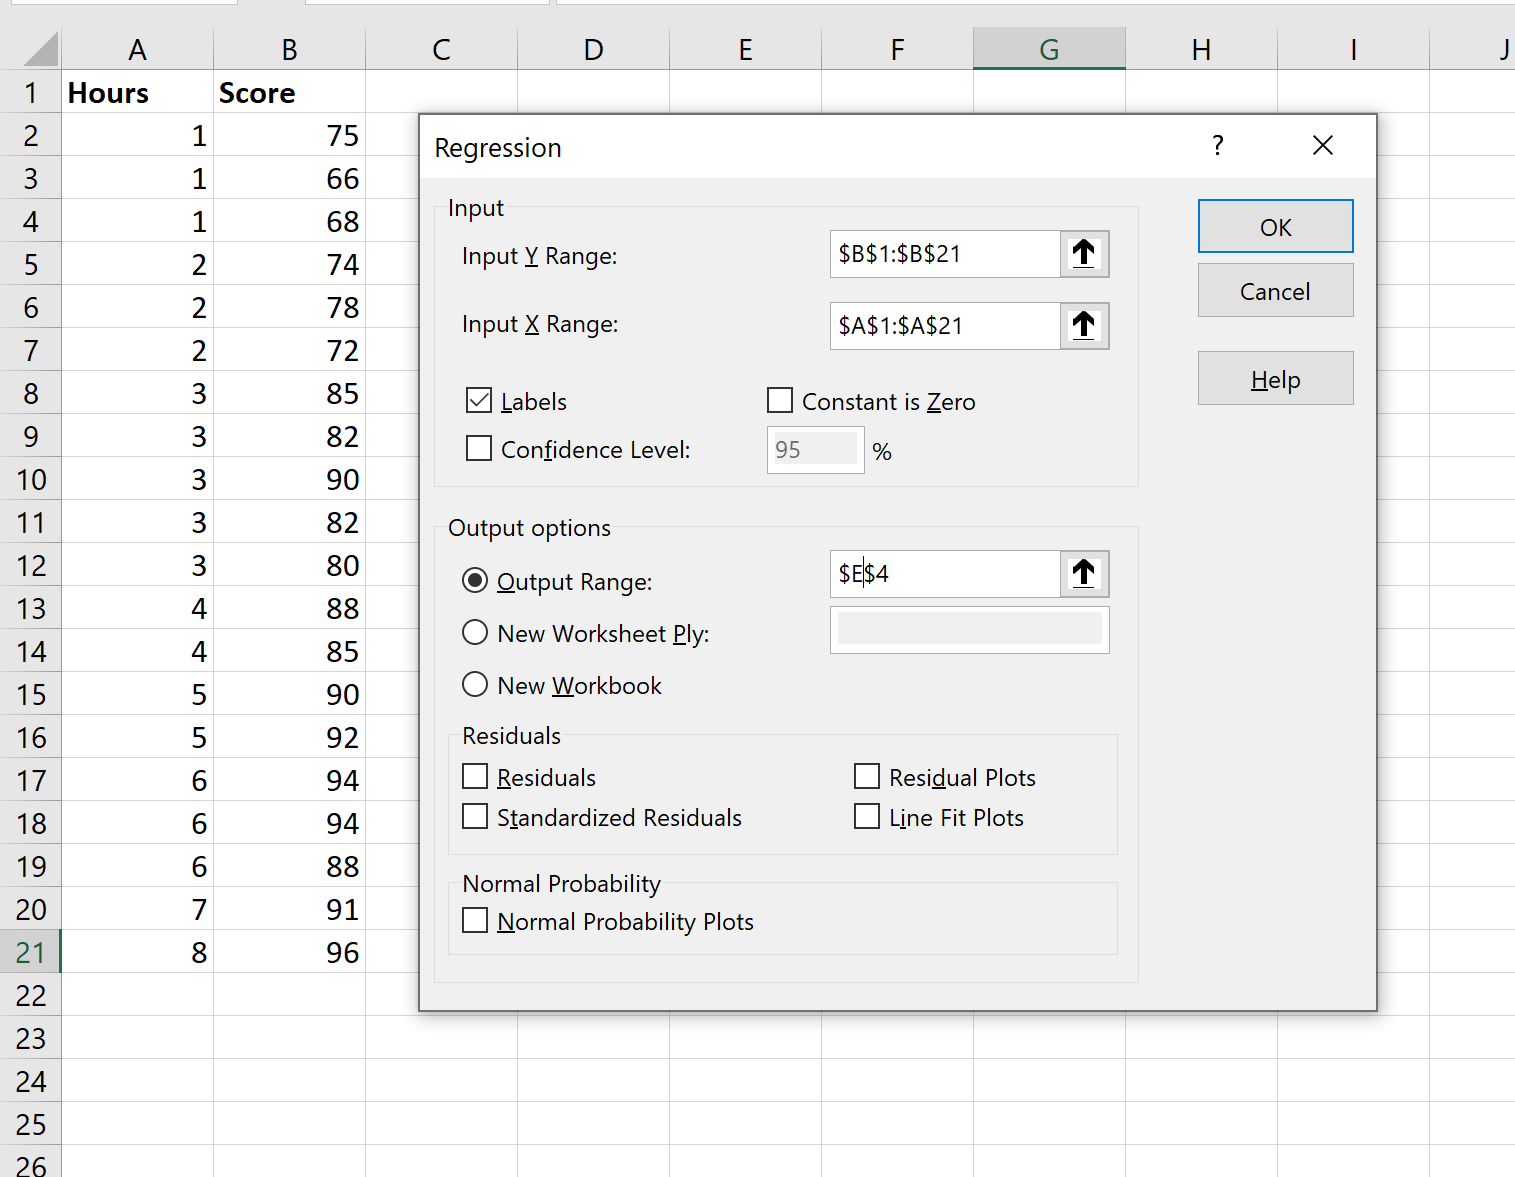
Pour paramétrer la régression bivariée, cliquez sur ce bouton et sélectionnez l’option Régression au sein de la liste alphabétique des outils disponibles. La configuration rigoureuse de la boîte de dialogue s’articule comme suit :
- Plage d’entrée Y : Sélectionner la plage verticale hébergeant la variable dépendante, incluant la cellule d’en-tête (ex.
$C$1:$C$21). - Plage d’entrée X : Sélectionner la plage verticale contenant le prédicteur avec son libellé (ex.
$B$1:$B$21). - Intitulés : Cocher impérativement cette case afin qu’Excel reconnaisse la première ligne comme les étiquettes des variables et non comme des grandeurs numériques tronquées.
- Niveau de confiance : Cocher la case et figer le seuil à
95%(équivalent au risque d’erreur $\alpha = 0,05$). - Options de sortie : Cocher l’option Nouvelle feuille de calcul pour ne pas saturer la feuille de données brutes.
- Résidus : Cocher les cases Résidus et Résidus standardisés pour enclencher les diagnostics ultérieurs.
8.2 Déconstruction et interprétation de la table ANOVA générée
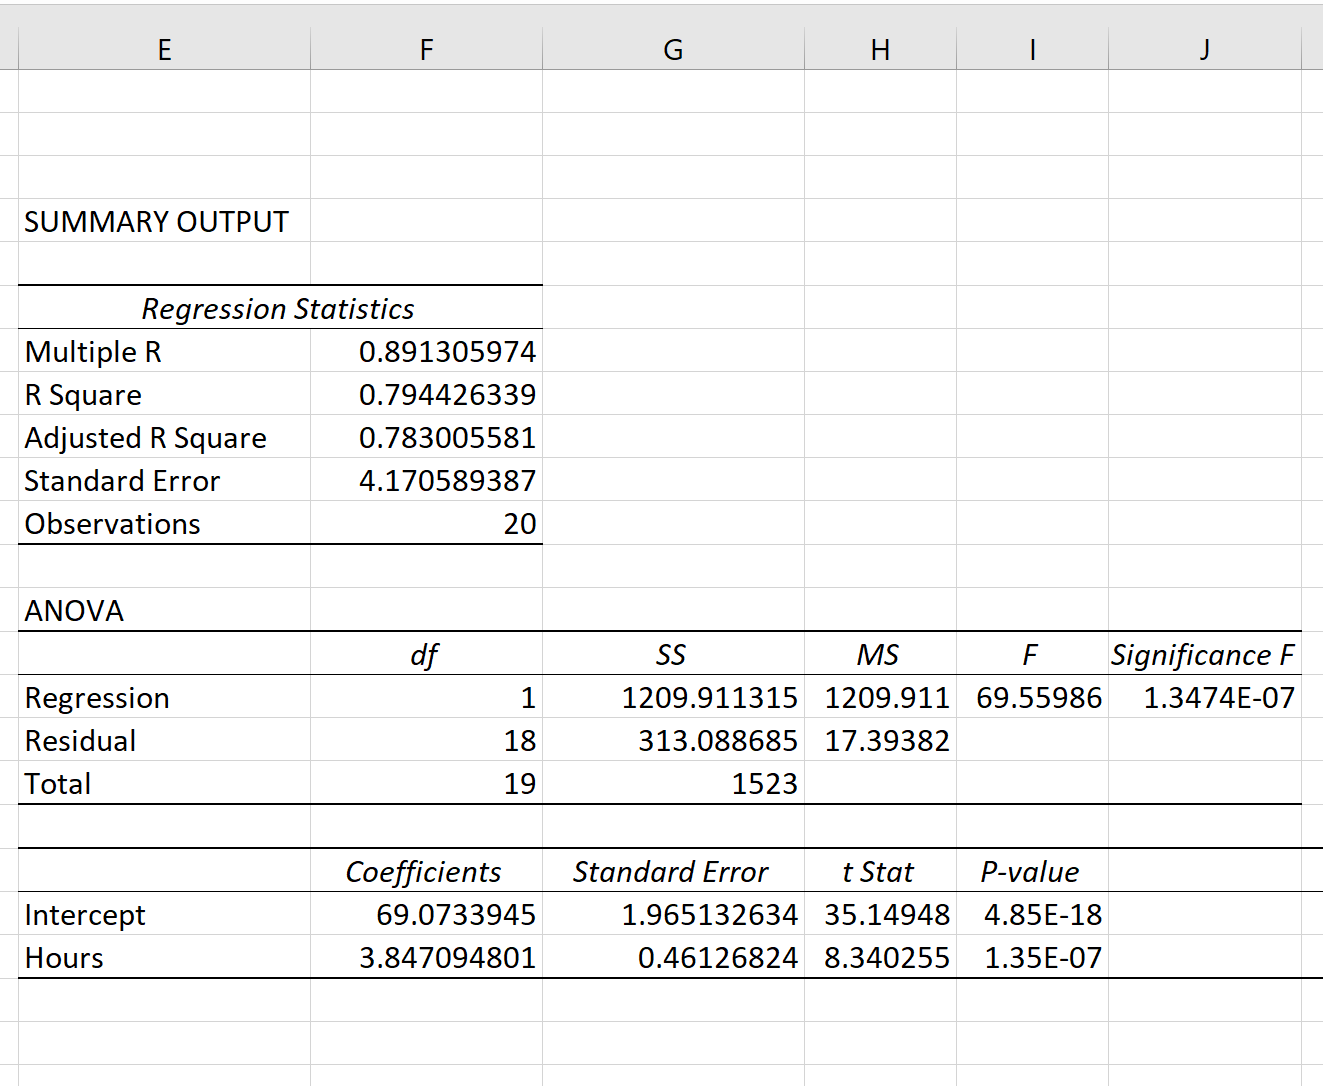
L’exécution de la procédure génère un rapport structuré en trois volets analytiques majeurs. Le second de ces tableaux constitue la table de l’Analyse de la variance (ANOVA), dont la vocation consiste à décomposer la variabilité globale de la variable critère afin de tester la significativité omnibus du modèle linéaire.
Cette table repose sur l’identité fondamentale de partition de la somme des carrés :
$$SC_{\text{Totale}} = SC_{\text{Régression}} + SC_{\text{Résiduelle}}$$
La somme des carrés totale ($SC_{\text{Totale}}$) quantifie la dispersion intégrale des observations individuelles autour de la moyenne générale de Y. L’algorithme d’Excel segmente cette énergie totale en deux composantes mutuellement exclusives :
- La somme des carrés de la régression ($SC_{\text{Régression}}$), qui représente la quantité de variance explicitée et capturée avec succès par la droite linéaire du prédicteur X.
- La somme des carrés résiduelle ($SC_{\text{Résiduelle}}$ ou d’erreur), qui traduit la variance résiduelle inexpliquée, liée aux fluctuations aléatoires et aux paramètres non modélisés.
En divisant chacune de ces sommes des carrés par leurs degrés de liberté respectifs ($ddl = 1$ pour la régression dans un modèle bivarié simple ; $ddl = n – 2 = 18$ pour les résidus), Excel calcule les Carrés Moyens. Le rapport de ces deux variances estimées engendre la statistique F de Snedecor :
$$F = \frac{CM_{\text{Régression}}}{CM_{\text{Résiduel}}}$$
Dans notre étude sur les 20 étudiants, la table ANOVA affiche une valeur de F colossale de 588,24. La colonne adjacente, intitulée F significatif (qui correspond à la p-value globale du modèle), mentionne une probabilité infinitésimale de $1,24 \times 10^{-14}$. Ce résultat nous permet de rejeter sans équivoque l’hypothèse nulle ($H_0$) selon laquelle le temps d’étude n’expliquerait aucune part de la variance des notes, attestant d’une adéquation globale hautement significative du modèle ($p < 0,001$).
8.3 Analyse inférentielle détaillée des coefficients de régression
Le troisième volet de la sortie d’Excel détaille l’estimation individuelle et inférentielle des paramètres du modèle. Ce tableau met en regard chaque composante de l’équation ($\beta_0$ et $\beta_1$) avec son incertitude d’échantillonnage.
Pour le prédicteur Temps_Etude_H, la colonne Coefficients affiche notre pente estimée ($b_1 = 2,342$). La colonne Erreur-type consigne l’écart-type d’échantillonnage de ce coefficient ($s_{b1} = 0,0965$). Ce chiffre traduit la variabilité théorique que manifesterait la pente si l’expérimentation était répliquée à l’identique sur des centaines d’échantillons indépendants de 20 étudiants issus de la même population parente.
Le ratio unissant le coefficient estimé à son erreur-type définit la statistique de test t de Student :
$$t = \frac{b_1 – 0}{s_{b1}} = \frac{2,342}{0,0965} = 24,25$$
Ce test éprouve directement l’hypothèse nulle spécifique $H_0: \beta_1 = 0$ face à l’hypothèse bilatérale $H_1: \beta_1 \neq 0$. La probabilité associée (colonne Probabilité ou p-value) affiche la valeur infinitésimale de $1,24 \times 10^{-14}$. Notons au passage une propriété mathématique fondamentale de la régression bivariée simple : la valeur de $t^2$ est rigoureusement égale à la statistique $F$ de l’ANOVA ($(24,25)^2 = 588,24$).
Enfin, les deux dernières colonnes de cette sortie présentent les bornes inférieure et supérieure de l’intervalle de confiance à 95% pour chaque paramètre. Pour la pente, l’intervalle s’étend de [2,139 ; 2,544]. Ce résultat inférentiel offre une information bien plus riche qu’une simple p-value : nous pouvons affirmer avec un degré de certitude de 95% que dans la population parente dont est issue notre cohorte, chaque heure d’étude supplémentaire engendre un accroissement de la note finale compris entre 2,14 et 2,54 points. Cet intervalle étant strictement positif et ne recouvrant nullement le zéro, la plausibilité statistique du modèle se trouve pleinement corroborée.
9. Diagnostic approfondi des résidus et vérification des postulats
9.1 Calcul et inspection des résidus bruts et standardisés
L’estimation des coefficients par les moindres carrés ordinaires et les tests inférentiels afférents ne possèdent de validité mathématique que si les résidus du modèle satisfont aux hypothèses formulées par le théorème de Gauss-Markov. Le résidu brut, formellement défini par la différence entre la valeur observée et la valeur ajustée ($e_i = Y_i – \hat{Y}_i$), représente la fraction du phénomène qui échappe à la régularité du modèle explicatif.
Lorsque l’option a été cochée dans l’Utilitaire d’analyse, Excel génère automatiquement un tableau répertoriant chaque observation, sa prédiction théorique ajustée, son résidu brut ainsi que son résidu standardisé. Le résidu standardisé s’obtient en divisant chaque écart individuel par l’écart-type global de l’ensemble des résidus. Cette standardisation convertit les erreurs en grandeurs comparables à des scores z.
L’auscultation méticuleuse de cette colonne standardisée permet de traquer les observations atypiques d’un point de vue prédictif. Selon les standards statistiques internationaux :
- Un individu dont le résidu standardisé présente une valeur absolue supérieure à 2 ($|z| > 2,0$) doit faire l’objet d’une vigilance attentive, caractérisant une observation mal ajustée par la droite de régression.
- Une observation dont le résidu standardisé excède le seuil critique de 3 ($|z| > 3,0$) est considérée comme une anomalie statistique sévère (outlier résiduel) qui altère potentiellement la stabilité globale de la modélisation.
Dans notre cohorte de 20 étudiants, l’ensemble des résidus standardisés s’échelonne harmonieusement entre $-1,84$ et $+1,62$. Aucune valeur ne franchit le seuil d’alerte, ce qui confirme l’absence de point d’aberration individuelle majeure.
9.2 Validation graphique des postulats de Gauss-Markov
Le diagnostic des résidus repose préférentiellement sur des représentations graphiques dédiées. Le premier outil indispensable est le graphique des résidus en fonction des valeurs prédites. Ce diagramme cartésien positionne les valeurs ajustées $\hat{Y}$ sur l’axe des abscisses et les résidus bruts ou standardisés $e_i$ sur l’axe vertical des ordonnées.
Dans une configuration idéale respectant les postulats classiques, ce nuage doit se présenter sous la forme d’une bande horizontale d’épaisseur constante s’étirant de façon symétrique autour de la ligne horizontale du zéro. L’analyste doit y traquer deux signatures pathologiques récurrentes :
- La courbure résiduelle : Si le tracé des résidus adopte une trajectoire parabolique (en U ou en cloche), cela dénonce une violation du postulat de linéarité : le modèle linéaire sous-estime systématiquement les extrêmes et surestime les valeurs centrales, indiquant qu’un terme quadratique ou une transformation non linéaire s’avère nécessaire.
- La forme en entonnoir : Si l’amplitude verticale des résidus se dilate ou se comprime le long de l’axe horizontal, le chercheur fait face à une hétéroscédasticité caractérisée. Les erreurs types calculées par Excel deviennent alors biaisées, invalidant la fiabilité des tests t et F.
Le second diagnostic graphique concerne la normalité de la distribution des résidus. Bien que les modèles de régression tolèrent des écarts modérés à la normalité sur de grands effectifs en vertu du théorème central limite, les échantillons restreints exigent une conformité stricte. L’inspection d’un tracé Quantile-Quantile (Q-Q plot) — où les quantiles observés des résidus sont confrontés aux quantiles théoriques d’une loi normale centrée réduite générés via la fonction =LOI.NORMALE.STANDARD.INVERSE() — doit révéler un alignement rigoureux des points le long de la bissectrice théorique.
9.3 Stratégies correctives face aux violations d’hypothèses
Lorsque le diagnostic résiduel révèle des distorsions prononcées, le chercheur ne doit pas abandonner sa démarche empirique, mais mobiliser des stratégies de ré-étalonnage mathématique au sein d’Excel. La technique la plus féconde consiste à appliquer des transformations mathématiques non linéaires aux variables d’origine avant de réitérer l’analyse bivariée.
La célèbre famille de transformations de Box-Cox et l’échelle d’échelons de Tukey proposent des solutions standardisées adaptées à la morphologie des anomalies observées :
- La transformation logarithmique : L’application de la fonction
=LN(cellule)ou=LOG10(cellule)sur le prédicteur X (modèle semi-logarithmique) ou sur les deux variables conjointes (modèle log-log) s’avère souveraine pour linéariser les relations de rendements décroissants et comprimer l’hétéroscédasticité ascendante fréquente dans les chronométries cognitives. - La transformation par racine carrée : Formulée via
=RACINE(cellule), elle est particulièrement indiquée pour stabiliser la variance de variables de comptage psychologiques (comme le nombre d’erreurs commises au cours d’un protocole d’attention). - La transformation inverse : L’instruction
=1/cellulepermet de convertir les temps de réponse bruts en indices de vitesse de traitement, régularisant souvent les asymétries sévères.
Toute transformation mathématique modifie néanmoins profondément le registre interprétatif du modèle. Les coefficients estimés ne s’expriment plus dans l’unité de mesure directe du construit psychologique, mais dans l’échelle transformée (par exemple, en pourcentage de variation relative dans le cas d’une régression logarithmique). Le clinicien ou le psychologue doit peser rigoureusement le bénéfice du gain en conformité statistique face au coût d’abstraction cognitive imposé à la communication de ses résultats.
10. Analyse bivariée des variables qualitatives : Le test du Chi-carré d’indépendance
10.1 Structuration d’une table de contingence bivariée sous Excel
L’analyse bivariée ne se cantonne pas aux seules métriques quantitatives continues. Dans d’innombrables configurations de recherche en psychologie clinique, sociale ou organisationnelle, les grandeurs investiguées revêtent une nature exclusivement catégorielle ou nominale. L’investigation de ces relations exige de substituer à l’analyse de régression la construction d’une table de contingence croisée, soumise à l’épreuve du test d’indépendance du Chi-carré formulé par Karl Pearson.
Considérons une étude clinique menée auprès de 100 patients diagnostiqués avec un trouble anxieux généralisé. L’équipe médicale souhaite évaluer l’existence d’une association bivariée entre le type de prise en charge psychothérapeutique dispensée (Variable qualitative X comportant deux modalités : Thérapie Cognitivo-Comportementale [TCC] versus Thérapie de Soutien Non Directive [TSND]) et l’état clinique du patient à l’issue de six mois de protocole (Variable qualitative Y comportant deux modalités : Rémission complète versus Persistance symptomatique).
Sous Excel, la genèse de la table de contingence s’opère idéalement via l’outil Tableau croisé dynamique (TCD). Après avoir sélectionné la matrice de données brutes contenant les identifiants et les deux colonnes catégorielles, l’utilisateur navigue dans le ruban vers Insertion > Tableau croisé dynamique. Dans le panneau de configuration des champs qui apparaît :
- Glisser le champ
Type_Therapiedans la zone Lignes. - Glisser le champ
Etat_Cliniquedans la zone Colonnes. - Glisser l’identifiant
Patient_IDdans la zone Valeurs, en veillant à paramétrer le calcul sur Nombre (comptage d’effectifs).
Cette manipulation synthétise instantanément la distribution des fréquences observées ($O_{ij}$), incluant le décompte des effectifs marginaux horizontaux, verticaux et le grand total de la cohorte ($N = 100$).
10.2 Calcul des effectifs théoriques et de la statistique du Chi-carré
Le test du Chi-carré ($χ^2$) repose sur la confrontation systématique entre les fréquences empiriques observées ($O_{ij}$) et les fréquences théoriques ou attendues ($E_{ij}$). Ces effectifs théoriques représentent la distribution statistique exacte que l’on devrait observer au sein du tableau dans l’hypothèse nulle ($H_0$) d’une indépendance stochastique parfaite entre le type de thérapie et l’issue clinique.
Pour chaque cellule située à l’intersection de la ligne $i$ et de la colonne $j$, la fréquence théorique attendue est régie par la formule mathématique suivante :
$$E_{ij} = \frac{\text{Total Ligne}_i \times \text{Total Colonne}_j}{N_{\text{Grand Total}}}$$
Supposons que le croisement empirique de nos 100 patients produise la distribution observée suivante :
| Type de psychothérapie | Rémission complète | Persistance symptomatique | Total marginal |
|---|---|---|---|
| TCC | 35 (Observé) | 15 (Observé) | 50 |
| Thérapie de Soutien | 15 (Observé) | 35 (Observé) | 50 |
| Total marginal | 50 | 50 | 100 |
Dans ce scénario d’école, chaque cellule théorique attendue sous l’hypothèse nulle d’absence de différence équivaut rigoureusement à :
$$E = \frac{50 \times 50}{100} = 25,0\text{ patients}$$
Avant de valider l’admissibilité du test, l’expérimentateur doit impérativement contrôler les postulats de validité de Cochran : aucune cellule théorique ne doit présenter un effectif inférieur à 1, et au moins 80 % des cellules doivent afficher un effectif théorique supérieur ou égal à 5. Ici, avec $E_{ij} = 25$ dans l’ensemble des cellules, le critère est amplement honoré.
La statistique du Chi-carré formalise la sommation matricielle des écarts quadratiques pondérés par les effectifs attendus :
$$\chi^2 = \sum \frac{(O_{ij} – E_{ij})^2}{E_{ij}}$$
$$\chi^2 = \frac{(35-25)^2}{25} + \frac{(15-25)^2}{25} + \frac{(15-25)^2}{25} + \frac{(35-25)^2}{25} = \frac{100}{25} \times 4 = 16,00$$
Sous Excel, l’obtention de la probabilité exacte associée à cette statistique s’effectue sans aucun calcul matriciel intermédiaire grâce à la fonction native dédiée :
=TEST.CHI2(plage_reelle_observee; plage_theorique_attendue)
En assignant la matrice des effectifs réels observés (les 4 cellules centrales) au premier argument et la table homologue des effectifs théoriques calculés au second argument, Excel retourne la valeur de p = 0,000063 ($6,3 \times 10^{-5}$). L’hypothèse nulle d’indépendance est rejetée sans réserve ($p < 0,001$), attestant d’une association statistiquement hautement significative entre la nature de la psychothérapie dispensée et la survenue de la rémission clinique.
10.3 Mesures de la taille d’effet pour variables nominales
À l’instar des variables métriques où la taille d’effet s’apprécie par le coefficient r ou le R², la significativité statistique d’un test de Chi-carré ne renseigne nullement sur la magnitude de l’association constatée, la valeur du $χ^2$ augmentant proportionnellement à la taille globale de l’échantillon N. Pour quantifier la force substantielle de ce lien qualitatif, le chercheur doit calculer le coefficient Phi ($phi$) dans le cas d’une table 2×2, ou le V de Cramer pour des tableaux de dimensions supérieures.
Pour notre table à quatre cellules (deux lignes et deux colonnes), le coefficient $phi$ se calcule directement à partir de la racine carrée du quotient de la statistique de test par l’effectif global :
$$\phi = \sqrt{\frac{\chi^2}{N}} = \sqrt{\frac{16,00}{100}} = \sqrt{0,16} = 0,40$$
Le coefficient $phi$ est une métrique d’amplitude comprise entre 0 et 1. Selon les repères psychométriques usuels, une valeur de 0,40 correspond à un effet de taille moyenne à forte. Dans le cadre plus général d’une table comportant $r$ lignes et $c$ colonnes, la formule du V de Cramer mobilisable sous Excel prendrait la forme suivante :
$$V = \sqrt{\frac{\chi^2}{N \cdot \min(r – 1, c – 1)}}$$
Dans le registre de l’épidémiologie clinique et de la psychopathologie, cette caractérisation bivariée s’enrichit souvent du calcul du rapport de cotes (Odds Ratio, $OR$). L’Odds Ratio quantifie le rapport entre la cote de rémission chez les patients exposés à la TCC et la cote homologue chez les sujets soumis à la thérapie de soutien :
$$\text{Cote}_{\text{TCC}} = \frac{35}{15} = 2,333 \quad ; \quad \text{Cote}_{\text{TSND}} = \frac{15}{35} = 0,428$$
$$OR = \frac{2,333}{0,428} = 5,44$$
Ce résultat clinique majeur indique qu’un patient ayant bénéficié du protocole TCC présente une cote de rémission complète 5,44 fois supérieure à celle d’un patient assigné au groupe de soutien non directif. L’analyse bivariée offre ainsi une lisibilité clinique totale, accessible directement par quelques formules logiques articulées sous Excel.
11. Études de cas appliquées en psychologie cognitive, clinique et organisationnelle
11.1 Cas 1 : Chronopsychologie de l’apprentissage et rétention mnésique
Afin de mettre en exergue la souplesse opératoire de notre démarche bivariée sous Excel, examinons une première étude expérimentale menée dans le champ de la chronopsychologie cognitive. Cette investigation se propose de tester l’hypothèse fondamentale selon laquelle la durée du sommeil paradoxal (stade REM) consolidé durant la nuit consécutive à l’apprentissage d’une liste de vocabulaire en langue étrangère prédit directement le niveau de rappel mnésique libre évalué le lendemain matin.
Le protocole collige les données de 25 jeunes adultes soumis à un suivi polysomnographique standardisé en laboratoire du sommeil. Les variables enregistrées comprennent la durée cumulée de sommeil paradoxal (en minutes, variable X) et le pourcentage d’items correctement restitués lors de l’épreuve matinale de rappel libre (variable Y). L’implantation de ces séries dans une feuille Excel et la mise en œuvre de la fonction =COEFFICIENT.CORRELATION() génèrent un coefficient linéaire de r = 0,782.
La mobilisation de l’Utilitaire d’analyse de régression révèle que la durée de stade REM explique à elle seule 61,1 % de la variance des performances mnésiques ($R^2 = 0,611 ; F(1, 23) = 36,21 ; p < 0,001$). L’équation prédictive s’établit à :
$$\hat{Y} = 14,28 + 0,65 \cdot X$$
Ces données attestent que chaque tranche supplémentaire de 10 minutes passée en sommeil paradoxal se traduit en moyenne par un accroissement de 6,5 points de pourcentage d’items mémorisés. Sur le plan pédagogique et médical, ces analyses bivariées fournissent un étayage quantitatif direct aux recommandations d’hygiène du sommeil adressées aux populations étudiantes en période d’examens.
11.2 Cas 2 : Épuisement professionnel (Burnout) et soutien social perçu
La seconde étude de cas relève de la psychologie du travail et de la santé organisationnelle. Une équipe de chercheurs investigue la relation d’interdépendance unissant le sentiment d’épuisement émotionnel au travail et l’intensité du soutien social perçu au sein de l’environnement managérial. L’échantillon comprend 45 cadres d’une grande entreprise de services. L’épuisement professionnel est opérationnalisé au moyen de la sous-échelle d’épuisement émotionnel de l’inventaire standardisé de Maslach (Maslach Burnout Inventory, scores continus de 0 à 54), tandis que le soutien organisationnel est mesuré à l’aide de l’échelle de Karasek (scores de 8 à 32).
La transcription des données sous Excel et l’inspection visuelle du nuage de points révèlent une orientation résolument descendante, matérialisant une corrélation inverse. Néanmoins, l’application de tests de normalité met en lumière une asymétrie négative prononcée de la distribution du soutien social, plusieurs collaborateurs déclarant des niveaux très dégradés. Face à cette entorse paramétrique, le chercheur met en œuvre conjointement sous Excel le calcul du r de Pearson et du $rho$ de Spearman via les rangs :
- Coefficient de Pearson : r = -0,624 ($p < 0,001$)
- Coefficient de Spearman : rho = -0,641 ($p < 0,001$)
La solide concordance de ces deux métriques confirme l’absence de biais induit par l’asymétrie distributionnelle. Le coefficient de détermination ($R^2 = 0,389$) démontre que près de 39 % de la variabilité de l’épuisement émotionnel individuel est étroitement liée à la perception du soutien social. Dans son rapport d’audit, le psychologue du travail peut ainsi démontrer graphiquement et mathématiquement aux instances dirigeantes que le climat d’étayage social constitue un facteur protecteur prépondérant contre l’effondrement psychologique au travail.
11.3 Cas 3 : Psychophysiologie du stress : Fréquence cardiaque et tâche de Stroop
Le troisième cas concret s’inscrit au carrefour de la psychophysiologie et de la neuropsychologie expérimentale des fonctions exécutives. L’objectif est d’examiner comment l’effort d’inhibition cognitive exigé par la célèbre épreuve d’interférence de Stroop impacte l’activité du système nerveux autonome, appréhendée par la fréquence cardiaque continue.
Trente participants effectuent une condition neutre de dénomination de couleurs suivie de la condition d’interférence cognitive majeure (mots de couleur imprimés en encres discordantes). Le dispositif expérimental recueille le coût temporel d’interférence d’inhibition (en millisecondes, variable X) et la réactivité cardiaque moyenne au cours de la tâche (exprimée par l’élévation en battements par minute [bpm] par rapport à la ligne de base de repos, variable Y).
L’analyse bivariée exécutée sous Excel met en lumière un phénomène psychophysiologique d’une remarquable netteté : la corrélation produit-moment s’élève à r = 0,715 ($p < 0,001$). L’ajustement par régression linéaire simple livre l’équation suivante :
$$\text{Elévation Cardiaque (b\pm)} = 2,12 + 0,042 \cdot \text{Coût d’Interférence (ms)}$$
Ce résultat démontre qu’un coût attentionnel accru de 100 millisecondes dans la résolution du conflit cognitif s’accompagne d’une poussée cardiaque moyenne de 4,2 bpm. L’analyse des résidus standardisés sous Excel permet d’isoler un sujet atypique dont le coût d’interférence est très élevé sans réactivité cardiaque concomitante. La traçabilité de la feuille de calcul permet d’identifier immédiatement un biais méthodologique : ce sujet prenait un traitement bêtabloquant non déclaré lors du screening médical initial. L’exclusion légitime de ce participant ramène le coefficient à r = 0,768, illustrant avec force la valeur diagnostique d’une gestion bivariée rigoureuse menée de bout en bout sous Excel.
12. Limites d’Excel, pièges statistiques et normes de publication académique
12.1 Écueils méthodologiques majeurs de l’analyse bivariée
L’apparente simplicité instrumentale de l’analyse bivariée dissimule des pièges conceptuels majeurs susceptibles de compromettre la validité des conclusions si l’analyste n’y prend garde. Le premier écueil d’envergure réside dans le redoutable paradoxe de Simpson. Ce phénomène contraint survient lorsqu’une corrélation bivariée nette et statistiquement significative observée à l’échelle d’un échantillon global s’inverse totalement ou disparaît lorsque les données sont désagrégées en sous-groupes homogènes selon une variable de stratification omise (par exemple, le sexe, la catégorie d’âge ou le milieu socio-culturel). Une relation positive globale peut parfaitement masquer deux sous-populations présentant chacune une dynamique intrinsèquement négative, soulignant l’obligation déontologique de contrôler les variables de confusion potentielles.
Le second danger méthodologique s’incarne dans les corrélations illusoires ou trompeuses (spurious correlations). Deux construits peuvent manifester une covariance mathématique d’une intensité vertigineuse sans posséder le moindre lien logique ou mécanique direct, simplement parce qu’ils subissent tous deux l’impulsion temporelle ou démographique d’un tiers facteur masqué. L’analyste ne doit jamais abdiquer sa posture d’évaluation critique de la plausibilité théorique sous prétexte d’un coefficient empirique éclatant.
Un troisième piège réside dans le phénomène de restriction d’étendue (range restriction). Lorsqu’une étude psychométrique sélectionne un échantillon sur une plage excessivement étroite de la variable prédictive (par exemple, évaluer la relation entre le quotient intellectuel et la réussite professionnelle chez des diplômés de doctorat exclusivement), la variance observée sur X est dramatiquement comprimée. Cette sous-estimation artificielle de la dispersion engendre une chute vertigineuse du coefficient de corrélation de Pearson calculé par rapport à sa magnitude réelle dans la population générale non sélectionnée.
Enfin, la tentation de plaquer mécaniquement une régression linéaire simple sur une relation intrinsèquement non linéaire induit des erreurs diagnostiques lourdes. Le coefficient de Pearson et les moindres carrés écrasent les informations curvilignes : une relation quadratique parfaite peut ainsi afficher un r de 0,00, trompant le chercheur qui conclurait prématurément à l’indépendance fonctionnelle des deux dimensions.
12.2 Frontières techniques du tableur Excel en statistiques universitaires
Bien que Microsoft Excel demeure un instrument pédagogique et professionnel exceptionnel, le chercheur universitaire ou le praticien chevronné doit en connaître lucidement les frontières techniques et computationnelles intrinsèques. Si les algorithmes d’optimisation d’Excel se sont considérablement fiabilisés depuis les versions 2010 et 2016 (notamment par la refonte du traitement des nombres à virgule flottante sous la norme IEEE 754), le logiciel présente des limites structurelles dès lors que les volumétries de données s’intensifient ou que les designs de recherche se complexifient.
Excel s’avère particulièrement démuni lorsqu’il s’agit d’automatiser des tests d’hypothèses avancés sur les résidus. Contrairement aux environnements statistiques dédiés tels que le logiciel R ou le progiciel JASP, Excel ne fournit aucune fonction directe pour implémenter un test de normalité de Shapiro-Wilk, un test d’hétéroscédasticité formel de Breusch-Pagan, ou un test d’autocorrélation de Durbin-Watson sans échafauder des feuilles de calcul matricielles labyrinthiques.
De surcroît, l’absence de traçabilité des scripts constitue le point faible majeur d’Excel au regard des standards contemporains de la science ouverte et de la reproductibilité computationnelle. Dans Excel, une manipulation erronée de glisser-déposer ou un écrasement involontaire de cellule peut corrompre une analyse de données sans laisser d’historique de code explicite. Dès que le protocole de recherche intègre des variables modératrices, des médiations sérielles, des mesures répétées intrapersonnelles hiérarchiques ou des régressions logistiques multinomiales, il devient impératif de basculer de l’environnement tabulaire d’Excel vers des progiciels statistiques conçus pour l’analyse multivariée avancée.
12.3 Rédaction et présentation des résultats selon le style APA 7ème édition
La phase conclusive d’une analyse bivariée réside dans la transmission académique des résultats dans le strict respect des conventions éditoriales internationales formulées par le manuel de style de l’APA (7e édition). Cette codification typographique et narrative impose une clarté absolue, la précision des degrés de liberté et le signalement systématique de la taille d’effet.
Sur le plan de la typographie formelle, toutes les lettres et symboles désignant des statistiques inférentielles d’échantillon doivent être rigoureusement composés en caractères italiques (notamment r, R², p, t, F, z), tandis que les lettres grecques ($rho$, $\chi^2$, $\beta$) et les dénominations d’indices conservent un tracé romain régulier. Les valeurs statistiques bornées entre 0 et 1 (comme le coefficient de corrélation r ou la p-value) ne doivent jamais être précédées d’un zéro avant la virgule selon les normes anglophones de l’APA, mais la transcription en langue française tolère la virgule précédée du zéro selon les guides universitaires francophones (ex. r = 0,98 ou r = .98).
La formulation narrative canonique d’une corrélation linéaire de Pearson s’énonce selon le modèle structurel suivant :
Une corrélation linéaire de Pearson a été réalisée afin d’évaluer la relation entre le temps d’étude autonome et la note finale obtenue à l’évaluation de neuropsychologie. Les résultats mettent en évidence une association positive hautement significative et de très forte magnitude entre les deux variables, r(18) = ,985, p < ,001, la durée d’étude expliquant 97,0 % de la variance des scores d’examen (R² = ,970).
Pour un modèle de régression linéaire simple, la formalisation de la conclusion s’articule comme suit :
Une régression linéaire simple a été conduite pour prédire le score d’examen (Y) à partir du temps d’étude hebdomadaire (X). Le modèle de régression s’avère statistiquement très significatif, F(1, 18) = 588,24, p < ,001, avec un R² de ,970. Le temps d’étude constitue un prédicteur positif significatif de la performance, $\beta$ = 2,342, SE = 0,096, t(18) = 24,25, p < ,001, IC 95% [2,139 ; 2,544].
Enfin, le compte-rendu normalisé d’un test d’indépendance du Chi-carré se structure selon le formalisme suivant :
Un test d’indépendance du Chi-carré a été réalisé pour examiner l’association entre le type de psychothérapie dispensée et la rémission des symptômes anxieux. Une association significative de magnitude moyenne à forte a été mise en évidence, $\chi^2$(1, N = 100) = 16,00, p < ,001, $phi$ = ,40. Les patients ayant bénéficié de la TCC présentent un taux de rémission significativement plus élevé (70,0 %) que ceux ayant reçu une thérapie de soutien (30,0 %), avec un rapport de cotes favorable de 5,44.
En respectant scrupuleusement ces canons de formalisation, le chercheur confère à ses analyses bivariées menées sous Excel une crédibilité méthodologique, une transparence analytique et une élégance de restitution qui satisfont aux exigences les plus strictes de la communication scientifique contemporaine.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.1080/00031305.1973.10478966
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
- Howell, D. C. (2013). Statistical methods for psychology (8th ed.). Wadsworth, Cengage Learning.
- Kendall, M. G. (1938). A new measure of rank correlation. Biometrika, 30(1/2), 81–93. https://doi.org/10.2307/2332226
- Maslach, C., Jackson, S. E., & Leiter, M. P. (1996). Maslach Burnout Inventory manual (3rd ed.). Consulting Psychologists Press.
- Pearson, K. (1895). Notes on regression and inheritance in the case of two parents. Proceedings of the Royal Society of London, 58, 240–242. https://doi.org/10.1098/rspl.1895.0041
- Spearman, C. (1904). The proof and measurement of association between two things. The American Journal of Psychology, 15(1), 72–101. https://doi.org/10.2307/1412159
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
- Stroop, J. R. (1935). Studies of interference in serial verbal reactions. Journal of Experimental Psychology, 18(6), 643–662. https://doi.org/10.1037/h0054651
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.