
L’analyse des données quantitatives repose fondamentalement sur l’adéquation entre les propriétés empiriques des observations recueillies et les postulats théoriques qui sous-tendent les modèles statistiques inférentiels. Dans l’ensemble des sciences du comportement, de la psychologie cognitive, de la biométrie et de l’économétrie, la distribution gaussienne occupe une position prépondérante, servant de pierre angulaire à l’évaluation des hypothèses via les modélisations linéaires classiques. Néanmoins, l’application aveugle de tests paramétriques sans vérification préalable de leurs conditions de validité expose les chercheurs à des distorsions méthodologiques majeures, pouvant altérer la reproductibilité des résultats scientifiques et induire des conclusions erronées sur les phénomènes étudiés.
La vérification de l’hypothèse de normalité constitue ainsi un prérequis analytique incontournable, incitant les statisticiens à concevoir des procédures d’évaluation diagnostique à la fois sensibles, spécifiques et adaptées aux particularités des échantillons finis. Parmi la panoplie des tests d’adéquation distributionnelle développés au fil des décennies, le test de Shapiro-Wilk s’est progressivement imposé au sein de la communauté académique comme le standard d’excellence méthodologique. Sa capacité remarquable à détecter des déviations subtiles de symétrie ou d’aplatissement confère à cet outil une supériorité opérationnelle manifeste sur les approches concurrentes basées exclusivement sur la fonction de répartition empirique.
Ce guide exhaustif propose une exploration approfondie de la théorie, de la mise en œuvre computationnelle et de l’interprétation diagnostique du test de Shapiro-Wilk dans l’environnement statistique R. En conjuguant rigueur mathématique, considérations psychométriques appliquées et scripts programmatiques détaillés, cet article offre aux chercheurs et analystes de données une feuille de route complète pour naviguer avec assurance à travers les complexités de l’évaluation de la normalité univariée.
1. Introduction au test de Shapiro-Wilk et au postulat de normalité en psychologie
1.1 Importance de la distribution normale dans la recherche quantitative
Dans l’édifice de la statistique inférentielle moderne, la distribution normale univariée, également désignée sous le nom de loi de Gauss-Laplace, constitue le modèle théorique central sur lequel repose la majeure partie des techniques paramétriques. Le fondement mathématique de cette omniprésence découle du théorème central limite, qui stipule que la somme ou la moyenne d’un grand nombre de variables aléatoires indépendantes et identiquement distribuées converge asymptotiquement vers une loi normale, indépendamment de la forme de la distribution sous-jacente des variables primitives. En psychologie expérimentale et dans les sciences du comportement, les processus cognitifs, les traits de personnalité et les réponses psychophysiologiques résultent fréquemment de l’interaction complexe d’une multitude de facteurs génétiques, environnementaux et neuronaux de faible amplitude individuelle. Cette nature additive des déterminants biologiques et psychosociaux justifie conceptuellement l’émergence empirique de profils distributionnels symétriques en forme de cloche au sein des populations saines.
L’obligation méthodologique de tester la normalité procède directement des hypothèses fondamentales requises pour l’estimation par les moindres carrés ordinaires et le calcul des rapports de variance dans le cadre du modèle linéaire généralisé. Les procédures inférentielles canoniques, telles que le test t de Student pour échantillons indépendants ou appariés, l’analyse de variance univariée et multivariée (ANOVA/MANOVA), ainsi que la régression linéaire standard, supposent formellement que les résidus d’échantillonnage proviennent d’une population normalement distribuée de moyenne nulle et de variance constante. Lorsque cette condition d’adéquation distributionnelle est respectée, les estimateurs linéaires sans biais à variance minimale (BLUE) atteignent une efficacité statistique optimale, garantissant l’exactitude des calculs de probabilité critique associés aux distributions F de Fisher-Snedecor et t de Student.
À l’inverse, l’inobservation délibérée ou accidentelle du postulat de normalité peut avoir des répercussions désastreuses sur la validité des conclusions inférentielles tirées par le chercheur. Dans des conditions de non-normalité sévère, en particulier en présence de distributions asymétriques ou de queues lourdes (leptokurticité prononcée), les estimateurs de variance deviennent instables et biaisés. Cette perturbation altère dramatiquement le contrôle de l’erreur de première espèce (taux d’erreur de type I, conventionnellement fixé par le seuil alpha), conduisant le statisticien à rejeter l’hypothèse nulle à tort avec une fréquence bien supérieure au niveau nominal toléré. Parallèlement, la puissance statistique des tests paramétriques conventionnels s’effondre face à des alternatives non gaussiennes, augmentant corrélativement le risque d’erreur de seconde espèce (erreur de type II, bêta) et dissimulant des effets réels de taille modeste pourtant cruciaux pour la progression des connaissances empiriques.
1.2 Rôle et portée spécifique du test de Shapiro-Wilk
Face à la nécessité méthodologique d’évaluer la conformité empirique d’un jeu de données fini avec une distribution normale théorique, Samuel Sanford Shapiro et Martin Wilk ont formulé en 1965 une procédure inférentielle novatrice spécifiquement dédiée au diagnostic de la normalité. Contrairement aux approches fondées sur des critères subjectifs ou des visualisations informelles, le test de Shapiro-Wilk quantifie formellement l’écart structurel entre la structure observée des données et le comportement attendu sous le modèle gaussien. Ce test évalue la cohérence interne des observations sans imposer la spécification préalable de la moyenne théorique ou de la variance de la population, ces deux paramètres de position et d’échelle étant directement dérivés et standardisés au sein de la mécanique algorithmique de la statistique de test.
La littérature biostatistique et méthodologique contemporaine a largement établi la supériorité statistique intrinsèque du coefficient W de Shapiro-Wilk par rapport à ses compétiteurs historiques omnibus. Les études comparatives de simulation de Monte-Carlo, notamment celles menées par Razali et Wahab ou encore Ralph D’Agostino, démontrent sans ambiguïté que le test de Shapiro-Wilk présente la puissance statistique la plus élevée parmi une large classe de tests d’adéquation, incluant le test classique de Kolmogorov-Smirnov, la correction de Lilliefors, le test de Cramer-von Mises ou encore la procédure d’Anderson-Darling. Cette supériorité opérationnelle se manifeste de manière flagrante dans les contextes où l’échantillon présente une asymétrie modérée ou des variations de kurtosis qui échappent fréquemment à la sensibilité des statistiques fondées sur l’écart supremum de la fonction de répartition cumulative.
Dans le domaine particulier de la psychométrie et de l’évaluation quantitative des fonctions cognitives, la portée du test de Shapiro-Wilk s’avère particulièrement déterminante. Les chercheurs manipulent couramment des variables composites dérivées d’instruments standardisés, tels que l’Inventaire de Dépression de Beck, l’Échelle d’Anxiété État-Trait de Spielberger, ou les épreuves d’intelligence de Wechsler. Ces mesures psychométriques, souvent issues d’agrégations d’items ordinaux ou de temps de réaction contraints, présentent fréquemment des distorsions distributionnelles structurelles induites par des biais de mesure ou des caractéristiques intrinsèques aux populations cliniques. L’application du test de Shapiro-Wilk permet d’établir avec un degré de certitude mathématique élevé si les scores observés autorisent l’utilisation de méthodologies de profilage standardisées (notes Z, scores T) ou s’ils exigent des modélisations non linéaires adaptées aux singularités des distributions psychopathologiques.
1.3 Hypothèses statistiques formelles du test
Sur le plan de la logique inférentielle formelle, le test de Shapiro-Wilk s’articule autour d’un système binaire d’hypothèses statistiques mutuellement exclusives. L’hypothèse nulle, invariablement notée H0, formalise la proposition selon laquelle l’échantillon aléatoire analysé est issu d’une population distribuée de manière rigoureusement normale, avec des paramètres de moyenne mu et de variance sigma carrée inconnus mais constants. Dans ce cadre épistémologique, l’hypothèse nulle postule que l’ensemble des déviations observées entre les valeurs quantiles de l’échantillon et les valeurs théoriques d’une gaussienne découle exclusivement des fluctuations d’échantillonnage stochastiques aléatoires inhérentes à la mesure d’un sous-ensemble fini d’individus.
À l’opposé, l’hypothèse alternative, traditionnellement désignée par la notation H1, formule l’assertion que la fonction génératrice des données d’où proviennent les observations diverge systématiquement et substantiellement d’une loi normale. Il est fondamental de souligner que le test de Shapiro-Wilk est un test omnibus non directionnel : l’hypothèse H1 n’explicite pas la forme fonctionnelle alternative de la population source. Cette non-normalité peut résulter indifféremment d’une asymétrie distributionnelle prononcée (vers la droite ou la gauche), d’une multimodalité sous-jacente reflétant des sous-populations non identifiées, d’un aplatissement excessif (distribution platykurtique) ou d’une présence inhabituelle d’observations marginales localisées dans les extrémités (distribution leptokurtique à queues lourdes).
La règle de décision inférentielle s’établit par la confrontation de la probabilité critique calculée (la p-valeur) avec un seuil de significativité nominal arbitré a priori, usuellement désigné par la lettre grecque alpha. Dans la pratique scientifique standard, le seuil alpha est traditionnellement fixé à 0,05, ou plus restrictivement à 0,01 dans les protocoles d’évaluation clinique haute précision. Si la p-valeur générée par le calcul est strictement supérieure au seuil alpha retenu (p > 0,05), le chercheur conclut à l’absence de preuves statistiques suffisantes pour réfuter la normalité, acceptant de fait le non-rejet de l’hypothèse nulle H0. Dans ce cas, les postulats des tests paramétriques subséquents sont présumés satisfaits. En revanche, lorsque la p-valeur tombe en deçà du seuil critique (p ≤ 0,05), l’hypothèse nulle est formellement rejetée au profit de l’hypothèse H1, certifiant que l’échantillon dévie de façon statistiquement significative de la structure gaussienne, ce qui impose d’aménager l’arsenal analytique employé.
2. Fondements théoriques et mathématiques de la statistique W
2.1 Structure analytique du calcul du coefficient W
La mécanique algorithmique élaborée par Shapiro et Wilk repose sur une formulation mathématique élégante consistant à comparer deux estimateurs distincts de la variance de la population, dont le rapport asymptotique converge vers l’unité sous réserve de l’exactitude de l’hypothèse nulle de normalité. Considérons un échantillon aléatoire simple ordonné de taille n, désigné par le vecteur croissant x(1) ≤ x(2) ≤ … ≤ x(n). Le dénominateur de la statistique W représente la somme conventionnelle des carrés des écarts à la moyenne empirique, qui équivaut, à un facteur de normalisation près (n – 1), à l’estimateur sans biais standard de la variance empirique échantillonnale. Ce terme capte la dispersion globale de l’échantillon sans présumer de l’ordonnancement structurel des quantiles.
Le numérateur de la statistique W intègre quant à lui une combinaison linéaire hautement structurée des statistiques d’ordre de l’échantillon. Cette composante s’exprime sous la forme du carré d’un produit scalaire entre un vecteur de pondérations mathématiquement optimales a et le vecteur ordonné des observations x. Le calcul s’exprime analytiquement selon la formule suivante :
W = ( ∑ [i = 1 à n] a_i * x(i) )^2 / ( ∑ [i = 1 à n] (x_i – x_barre)^2 )
Les coefficients de pondération a_i sont dérivés formellement à partir des espérances mathématiques, des variances et des covariances des statistiques d’ordre issues d’une distribution normale standardisée de taille n. Sur le plan matriciel, ces coefficients sont proportionnels au produit de l’inverse de la matrice de covariance des statistiques d’ordre normales par le vecteur des espérances théoriques de ces mêmes statistiques d’ordre. Ce formalisme garantit que les poids a_i confèrent une importance maximale aux observations situées aux extrémités distributionnelles, tout en préservant des propriétés d’invariance d’échelle et de position géographique. Par construction, la somme des carrés de ces poids a_i est contrainte d’être rigoureusement égale à 1.
Sur le continuum mathématique, la statistique de test W est bornée au sein d’un intervalle théorique fermé compris strictement entre 0 et 1. Une conformité parfaite des observations empiriques avec les espérances idéalisées d’une distribution gaussienne génère un rapport W extrêmement proche de la valeur unitaire (W ≈ 1,00). Toute déformation morphologique de la courbe d’échantillonnage, qu’elle émane d’une asymétrie de distribution ou d’un écrasement de la voûte centrale, engendre une discordance arithmétique entre l’estimateur par statistiques d’ordre et l’estimateur de variance usuel. Cette discordance abaisse mécaniquement la valeur numérique de W vers des grandeurs significativement inférieures à l’unité, fournissant le signal statistique nécessaire à l’invalidation de l’hypothèse gaussienne.
2.2 Sensibilité aux écarts d’asymétrie et d’aplatissement
L’extrême puissance inférentielle du test de Shapiro-Wilk découle directement de sa capacité à réagir simultanément et harmonieusement aux altérations des moments d’ordre supérieur de la distribution observée, à savoir le moment d’ordre 3 (l’asymétrie ou skewness) et le moment d’ordre 4 (l’aplatissement ou kurtosis). Dans le cadre de l’asymétrie distributionnelle, les écarts entre les statistiques d’ordre symétriques s’éloignent de la linéarité attendue dans une distribution gaussienne standard. Puisque les pondérations mathématiques a_i de Shapiro-Wilk vérifient une relation d’antisymétrie stricte (a_i = -a_{n-i+1}), toute dissymétrie prononcée des ailes de la distribution rompt la compensation bilatérale au sein du numérateur, entraînant une chute substantielle et immédiate de la valeur calculée de W.
Parallèlement, le comportement de la statistique W face aux anomalies d’aplatissement témoigne d’un calibrage d’une remarquable finesse théorique. Les distributions de nature leptokurtique, caractérisées par un pic central hypertrophié et des queues de distribution épaissies peuplées d’observations marginales étendues, provoquent une déformation disproportionnée du calcul d’écart quadratique par rapport aux projections linéaires théoriques. Inversement, les architectures platykurtiques, illustrées de manière paroxystique par la distribution uniforme où la cloche s’affaisse totalement en faveur d’un plateau étendu sans queues réelles, déstabilisent l’agencement théorique des statistiques d’ordre. Le test de Shapiro-Wilk identifie ces deux pathologies distributionnelles avec une sensibilité bien plus aiguë que les tests basés exclusivement sur les moments échantillonaux simples, lesquels sont notoires pour leur instabilité sur les effectifs réduits.
Cette sensibilité structurelle aux queues de distribution s’avère particulièrement pertinente au sein des investigations psychométriques contemporaines. Dans les protocoles cliniques ou les évaluations neurocognitives chronométrées, les distributions empiriques se heurtent fréquemment à des limitations physiques incompressibles (telles que le temps incompressible d’intégration perceptivo-motrice) qui tronquent la distribution à gauche, ou au contraire à des accès d’extrême distractibilité qui allongent indéfiniment la queue droite des latences de réponse. Les échelles psychopathologiques standardisées génèrent quant à elles de fréquentes accumulations au point d’origine d’absence de symptôme (effet plancher), produisant une troncature abrupte à l’une des bornes de mesure. Le coefficient W de Shapiro-Wilk réagit avec une sévérité appropriée à ces altérations de frontières, alertant immédiatement le chercheur de la présence d’hétérogénéités distributionnelles incompatibles avec les suppositions de symétrie gaussienne illimitée.
3. Environnement R et syntaxe fondamentale de shapiro.test()
3.1 Paramétrage de la fonction native du package stats
Le langage de programmation statistique R intègre nativement l’exécution du test de Shapiro-Wilk au sein de son environnement de base par l’intermédiaire du package standard stats, présent par défaut dans chaque distribution logicielle officielle mise à disposition par le Comprehensive R Archive Network. La commande dédiée prend la forme fonctionnelle canonique shapiro.test(x). Cette simplicité syntaxique apparente dissimule en réalité des exigences typologiques rigoureuses quant à la nature et à la structure de l’objet argumentaire transmis au paramètre d’entrée x, nécessitant une préparation méthodique en amont de toute invocation inférentielle.
L’argument x transmis à la fonction shapiro.test() doit obligatoirement et strictement être un vecteur atomique numérique unidimensionnel composé d’observations quantitatives continues. Si un chercheur transmet par inadvertance un tableau rectangulaire de type data.frame, un objet matriciel multidimensionnel ou une variable codée sous forme de facteurs qualitatifs ou de chaînes de caractères textuelles, l’interpréteur R interrompt brutalement l’exécution et renvoie un message d’erreur explicite signalant l’incompatibilité de type. Par conséquent, lors de l’extraction de variables logées à l’intérieur d’un jeu de données complexe, il est indispensable de cibler précisément la colonne d’intérêt par l’usage explicite de l’opérateur dollar (par exemple : base_donnees$score_anxiete) ou de chaîner les requêtes d’extraction à l’aide des primitives de sélection appropriées.
Un autre écueil courant en analyse appliquée concerne la gestion opérationnelle des valeurs manquantes, codées sous le symbole réservé NA dans l’écosystème R. Par conception stricte, si le vecteur x injecté dans shapiro.test() comporte ne serait-ce qu’une seule occurrence non assignée, la fonction échoue et émet un avertissement formel l’empêchant de procéder au calcul. Contrairement à d’autres procédures qui possèdent un argument logique interne du type na.rm = TRUE, la commande shapiro.test() n’intègre pas de paramètre de purge automatique. Le statisticien doit donc impérativement procéder à l’assainissement préalable du vecteur de travail en encapsulant l’argument dans la fonction d’omission native na.omit() ou en filtrant les données via la fonction is.na(), garantissant ainsi que la procédure inférentielle n’opère exclusivement que sur des enregistrements valides et exploitables.
3.2 Contraintes structurelles relatives à la taille d’échantillon
L’algorithme de calcul du test de Shapiro-Wilk programmé dans le noyau de R impose des restrictions mathématiques et computationnelles strictes quant à l’effectif numérique n de l’échantillon soumis à évaluation. La borne inférieure indépassable est formellement fixée à n = 3 observations. D’un point de vue statistique, il est rigoureusement impossible d’extraire une estimation différenciée de l’asymétrie et de la courbure à partir d’un ensemble restreint à deux points, puisque deux observations quelconques définissent mécaniquement une ligne droite parfaite au sein de l’espace des statistiques d’ordre, interdisant toute confrontation empirique avec la distribution théorique. Si un utilisateur tente d’exécuter shapiro.test() sur un vecteur de longueur 1 ou 2, la console R renvoie immédiatement l’erreur bloquante spécifiant que la taille de l’échantillon doit être comprise entre 3 et 5000.
La borne supérieure de l’effectif représente une singularité algorithmique historique notable au sein de l’environnement R, le plafond d’observations étant rigoureusement verrouillé à n = 5000. Cette barrière logicielle tire son origine de l’implémentation sous-jacente du test, codée dans les routines compilées en langage C et Fortran d’après l’algorithme AS R94 de Royston formulé en 1995. Dans cette formulation computationnelle optimisée pour les machines de la fin du vingtième siècle, le calcul matriciel des poids optimaux a_i et l’approximation polynomiale par fonctions splines des moments de distribution perdaient en précision numérique et engendraient un coût de calcul prohibitif au-delà de 5000 enregistrements.
Lorsque le volume d’un vecteur dépasse ce seuil arbitraire de cinq mille entités, R refuse d’exécuter l’analyse et déclenche sans équivoque une erreur système bloquante indiquant que la taille d’échantillon excède les capacités de l’algorithme implémenté. Face à un grand volume de données en santé publique, en génomique ou en analyse de flux web, les chercheurs doivent adapter leur méthodologie. Ils peuvent alors recourir à des sous-échantillonnages aléatoires répétés ou employer d’autres tests omnibus non plafonnés structurellement, tels que les tests d’Anderson-Darling ou de Lilliefors, dont les routines algorithmiques s’affranchissent de ce plafond technique.
3.3 Anatomie de l’objet htest retourné
L’exécution de la fonction shapiro.test() génère un objet structuré encapsulé sous la classe standardisée htest (acronyme de hypothesis test), commune à l’ensemble des procédures d’évaluation statistique natives sous R. Cet objet n’est pas une simple chaîne de texte imprimable dans le terminal, mais bien une liste ordonnée contenant une suite d’attributs nommés hautement structurés. L’affichage textuel obtenu spontanément à l’écran lors d’une saisie directe en console représente la restitution mise en forme par la méthode spécifique d’impression print.htest(), mais chaque composant interne demeure accessible individuellement pour des traitements automatisés ultérieurs.
Pour exploiter programmatiquement la substance du test au sein de chaînes d’analyse complexes ou de protocoles reproductibles, l’analyste peut assigner le retour de la fonction à un identifiant d’objet (par exemple : resultat <- shapiro.test(donnees)). À partir de cette assignation, l'accès direct à la valeur de la statistique W s'opère par l'interrogation de l'attribut statistique via la syntaxe resultat$statistic. Ce scalaire numérique extrait offre la possibilité de comparer précisément le degré d'alignement distributionnel entre plusieurs cohortes ou de consigner la mesure dans une matrice de résultats quantitatifs destinée à la diffusion éditoriale.
De manière parfaitement analogue, la valeur exacte de la probabilité critique calculée se récupère instantanément par l’extraction de l’attribut nommé p.value (via l’instruction resultat$p.value). La récupération programmatique directe de cette p-valeur sous forme d’une valeur numérique continue à virgule flottante permet aux analystes d’intégrer des règles conditionnelles automatisées dans leurs scripts R. Ainsi, un pipeline d’analyse bio-informatique ou psychométrique peut conditionner dynamiquement le choix du test d’hypothèse ultérieur : orienter le calcul vers une comparaison paramétrique si resultat$p.value > 0.05, ou commuter automatiquement vers une procédure non paramétrique par les rangs si le critère de normalité est infirmé.
4. Exemple 1 : Test de Shapiro-Wilk sur des données simulées normales
4.1 Génération contrôlée d’une distribution normale
Afin de saisir concrètement la mécanique opérationnelle et les manifestations inférentielles du test de Shapiro-Wilk dans un cadre contrôlé, il s’avère particulièrement formateur de déployer la procédure sur un ensemble de données artificielles dont les caractéristiques distributionnelles sont paramétrées avec exactitude a priori. Dans l’écosystème R, la simulation d’observations suivant rigoureusement une loi de Gauss s’effectue au moyen de la primitive native rnorm(), qui génère des nombres pseudo-aléatoires selon des paramètres de moyenne empirique et d’écart-type fixés par l’utilisateur.
La reproductibilité stricte des calculs scientifiques constitue un impératif épistémologique absolu. Toute génération stochastique sous R s’appuyant sur un algorithme générateur de congruence linéaire ou de Mersenne-Twister, il est indispensable de fixer préalablement l’état initial de la graine aléatoire à l’aide de la commande set.seed(), en lui adjoignant un entier quelconque comme paramètre numérique (par exemple : set.seed(12345)). Cette précaution programmatique élémentaire garantit que toute réplication ultérieure du script sur une autre machine produira rigoureusement la même séquence d’observations stochastiques, sécurisant l’intégrité de la démonstration analytique.
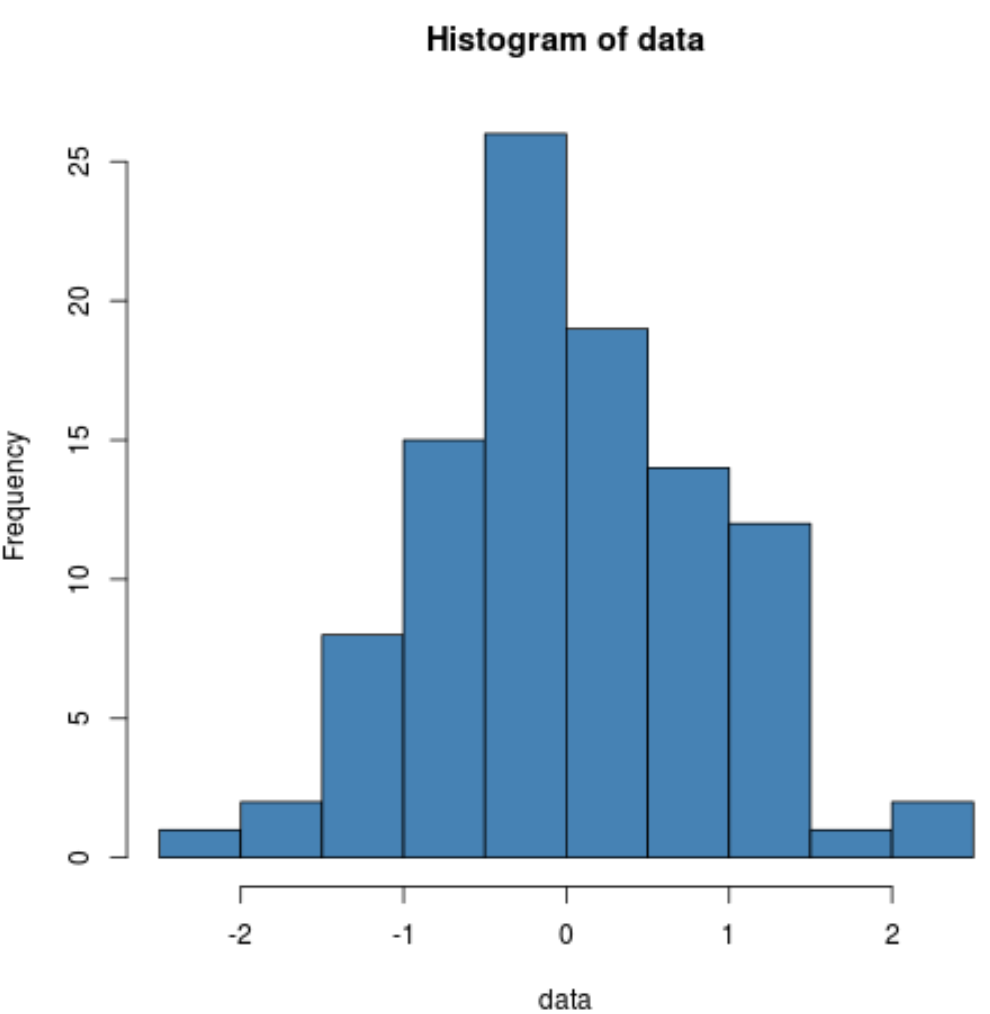
Pour illustrer ce premier scénario idéal, simulons un échantillon représentatif de n = 100 observations reproduisant une variable psychométrique classique, telle qu’une mesure standardisée de quotient intellectuel ou un score factoriel centré-réduit. L’exécution de l’instruction echantillon_normal <- rnorm(n = 100, mean = 100, sd = 15) génère ainsi un vecteur de cent réalisations continues centrées autour d'une moyenne théorique de 100 unités avec une dispersion standard théorique de 15 points. Une vérification descriptive élémentaire conduite via les fonctions mean() et sd() confirme immédiatement la cohérence empirique des paramètres d'échantillonnage, qui oscillent autour des valeurs théoriques assignées en vertu des fluctuations d'échantillonnage prévisibles.
4.2 Exécution du test et lecture des résultats
L’application directe du test de Shapiro-Wilk sur le vecteur de simulation ainsi constitué s’opère par l’invocation unitaire de l’instruction shapiro.test(echantillon_normal). Dès la validation de la commande, le terminal de l’environnement R restitue le bloc textuel formel récapitulant les paramètres de l’analyse, explicitant le nom du test sous le libellé « Shapiro-Wilk normality test », l’identification du jeu de données évalué, suivi de la ligne critique affichant conjointement la valeur numérique de la statistique W et la probabilité critique p-value associée.
Dans le cadre de cette expérience simulée sur des données issues d’une population intrinsèquement normale, l’analyse des résultats révèle typiquement une statistique W extrêmement élevée, fluctuant dans l’intervalle immédiat de 0,985 à 0,995. Cette proximité quasi-parfaite avec la borne supérieure théorique de 1 atteste formellement d’une remarquable linéarité entre les quantiles empiriques de l’échantillon d’entraînement et les espérances quantiles théoriques issues de la matrice d’ordonnancement de Shapiro et Wilk. Aucune déformation asymétrique ou anomalie de densité ne vient perturber l’harmonie structurelle de l’échantillon de cent individus.
Conjointement, l’examen de la p-valeur indique une magnitude nettement supérieure au seuil de significativité conventionnel de 0,05, se positionnant couramment aux alentours d’indices oscillant entre 0,35 et 0,85 selon les graines de simulation employées. Sur le plan de la logique inférentielle, ce résultat se traduit formellement par le non-rejet de l’hypothèse nulle H0. Le chercheur conclut en toute rigueur scientifique à l’absence d’indication statistique permettant de suspecter une violation de la normalité au sein de l’échantillon analysé. Les données empiriques franchissent avec succès l’étape de diagnostic distributionnel, validant l’emploi ultérieur des techniques paramétriques gaussiennes sans nécessiter de transformations d’échelle ou de substitutions non paramétriques de repli.
5. Exemple 2 : Détection de la non-normalité sur des données asymétriques
5.1 Simulation d’une asymétrie positive marquée
Pour mettre à l’épreuve la réactivité et la sensibilité du test de Shapiro-Wilk face à une déviation manifeste du postulat de normalité, il convient d’étudier le comportement de la statistique W sur un échantillon caractérisé par une asymétrie structurelle majeure. Dans les champs expérimentaux de la neuropsychologie, de la psychologie cognitive et de l’ergonomie, les chronométries comportementales (telles que les temps de réaction perceptifs simples ou les temps d’inspection visuelle) constituent l’archétype même de distributions asymétriques positives étalées vers les valeurs élevées, dénommées distributions à étalement droit.
Ce profil distributionnel singulier s’explique par des contraintes physiologiques incontournables : le temps de réaction humain présente une frontière physiologique inférieure infranchissable (environ 150 millisecondes pour l’intégration visuo-motrice élémentaire), générant une barrière abrupte sur la gauche de la distribution, tandis que des accès d’inattention sporadique ou des hésitations décisionnelles génèrent une longue traînée de valeurs très élevées vers la droite. Pour reproduire fidèlement cette cinématique cognitive, la distribution log-normale représente une modélisation théorique particulièrement pertinente. Dans l’environnement de programmation R, cette génération s’effectue via la primitive rlnorm().
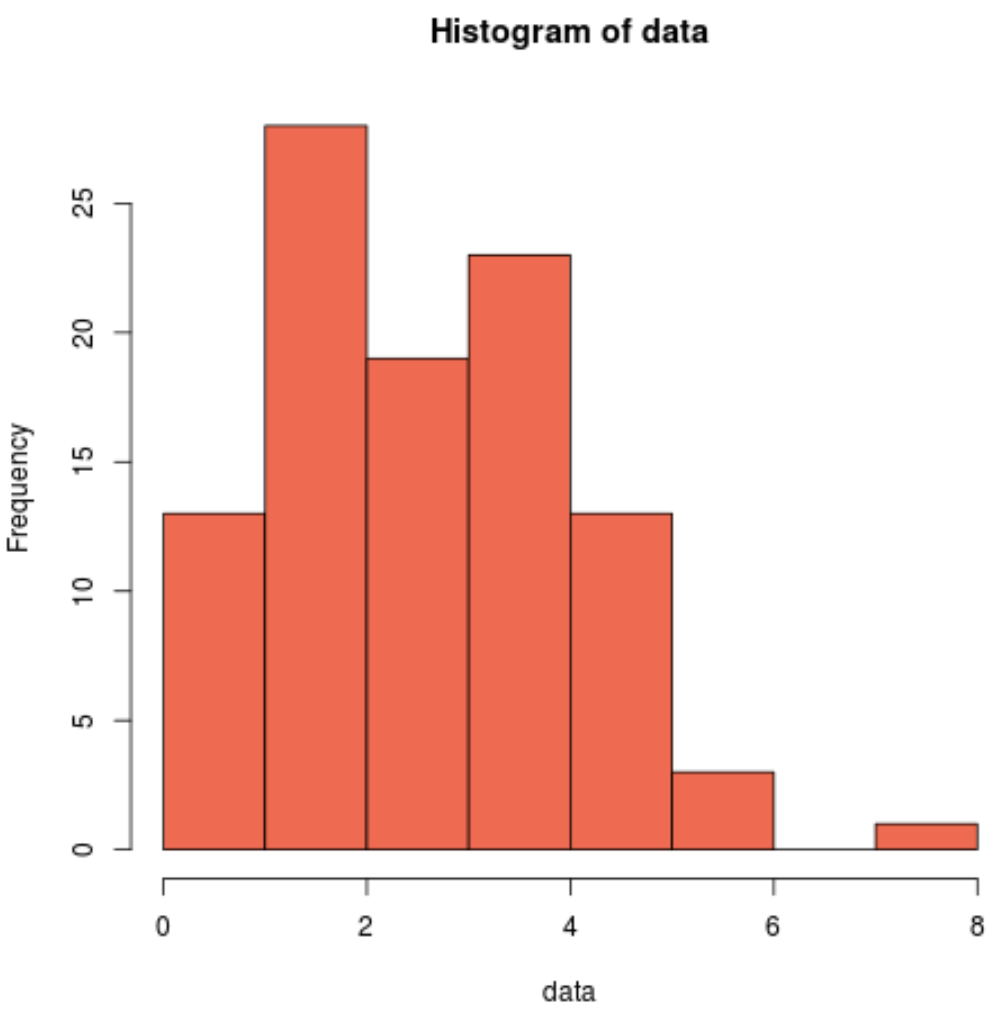
Définissons un échantillon de simulation de n = 100 observations chronométriques en appliquant l’instruction rlnorm(n = 100, meanlog = 5.5, sdlog = 0.45). Les valeurs brutes obtenues décrivent des latences temporelles exprimées en millisecondes. L’inspection des paramètres de centralité et de dispersion empirique révèle instantanément la dissociation classique des distributions asymétriques : la moyenne empirique de l’échantillon se trouve artificiellement tirée vers le haut par les quelques scores exceptionnellement lents, se positionnant nettement au-dessus de la valeur médiane des observations. Cette distorsion des indices descriptifs de tendance centrale illustre l’étirement unilatéral caractéristique de la densité empirique.
5.2 Diagnostic statistique du rejet de normalité
L’application de la commande shapiro.test() sur cet échantillon simulé de latences cognitives déclenche un verdict inférentiel sans équivoque. Contrairement à la configuration précédente où la statistique W gravitait aux abords de l’unité, le calcul mathématique sur données log-normales aboutit à un affaissement marqué de la statistique W, qui régresse typiquement dans des zones de valeurs comprises entre 0,78 et 0,89 selon la variance logarithmique paramétrée lors de la phase de génération.
Cette dégradation substantielle du coefficient de Shapiro-Wilk traduit mathématiquement l’incompatibilité radicale entre la structure des écarts observée au numérateur et la dispersion globale mesurée au dénominateur. L’allongement unilatéral de la traînée des temps de réaction rompt la relation d’invariance des statistiques d’ordre théoriques, signalant la présence d’une masse disproportionnée de résidus localisés dans le quadrant supérieur droit de la distribution des observations.
Corrélativement, la p-valeur générée par le moteur statistique de R plonge vertigineusement sous les seuils d’invalidation usuels, affichant des ordres de grandeur infinitésimaux fréquemment inférieurs à 10^-6 (retranscrits dans la console sous la nomenclature de notation scientifique condensée, par exemple 2.45e-08). Cette probabilité infime indique qu’il est hautement improbable d’extraire un tel arrangement de statistiques d’ordre par simple accident d’échantillonnage à partir d’une population parente gaussienne. L’hypothèse nulle H0 est par conséquent rejetée de manière péremptoire au profit de l’hypothèse H1. Le praticien conclut formellement à la non-normalité flagrante de la distribution sous-jacente, interdisant toute utilisation immédiate de modélisations paramétriques linéaires sous peine d’altérer lourdement le contrôle des erreurs statistiques.
6. Exemple 3 : Application à des scores psychométriques réels
6.1 Préparation d’un jeu de données d’inventaire de personnalité
L’exploration empirique de la normalité prend tout son sens pratique lorsqu’elle s’applique à des données psychométriques authentiques recueillies dans le cadre d’enquêtes ou de protocoles de recherche en psychologie différentielle. Dans de nombreuses banques de données ouvertes, telles que celles diffusées par la plateforme Open Source Psychometrics Project, les chercheurs ont accès à de vastes cohortes de participants ayant répondu à des inventaires évaluant des dimensions psychologiques majeures, à l’instar du modèle des cinq facteurs de personnalité (Big Five) ou de questionnaires évaluant la dépression et l’anxiété clinique.
Considérons l’importation sous R d’un jeu de données quantitatives évaluant le névrosisme ou l’anxiété générale, au sein duquel chaque sujet évalue son accord avec une suite d’énoncés à l’aide d’échelles de réponse de type Likert graduées en 5 ou 7 points d’ancrage sémantique. L’opération inaugurale consiste à calculer un score psychométrique composite global pour chaque individu, opération classiquement effectuée en sommant ou en moyennant les réponses fournies sur les différents items constitutifs de la sous-échelle considérée, après avoir rigoureusement procédé à l’inversion arithmétique préalable des items formulés sous une tournure négative.
Dans ce contexte de terrain, une attention analytique maximale doit être accordée au traitement exhaustif des omissions de saisie et des valeurs marginales discordantes. L’absence d’une seule valeur d’item peut compromettre la justesse du score global cumulé. Le protocole de nettoyage doit ainsi mobiliser des instructions précises de vérification d’exhaustivité, en excluant explicitement les participants présentant des protocoles incomplets par l’usage judicieux de la fonction na.omit() ou par des techniques d’imputation multiple lorsque le cadre théorique l’autorise. De surcroît, la détection des points aberrants extrêmes résultant d’erreurs de saisie cléricale constitue un préalable obligatoire pour éviter d’invalider superficiellement la normalité d’un ensemble de données par la simple présence d’artefacts d’enregistrement.
6.2 Évaluation inférentielle de la normalité du score global
Dès lors que le vecteur numérique du score composite d’anxiété est extrait et assaini au sein de l’environnement de travail, l’analyste procède à son diagnostic distributionnel en exécutant l’instruction formelle shapiro.test(donnees$score_anxiete). L’interprétation de la sortie logicielle exige ici une finesse herméneutique bien supérieure à celle requise par les simples modèles de simulation théorique, car les variables issues d’évaluations en santé mentale et en psychométrie clinique présentent des particularités distributionnelles intrinsèques directement corrélées à la nature des phénomènes psychopathologiques mesurés.
Très fréquemment, les scores composites issus d’échelles de détresse psychologique appliquées à des échantillons issus de la population générale manifestent des effets d’asymétrie structurelle induits par ce que les méthodologistes qualifient d’effet plancher (floor effect). La vaste majorité des individus sains ne ressentant qu’un niveau d’anxiété minime ou modéré, les scores s’agrègent massivement vers la borne inférieure de l’échelle, générant une concentration artificielle de données sur les faibles magnitudes et une traînée de dispersion décroissante vers les scores de sévérité clinique. Lors de l’exécution du test, cette concentration asymétrique se traduit de manière quasi-systématique par une statistique W significativement dégradée (par exemple W = 0,92) et une probabilité critique p largement inférieure au seuil critique standard (p < 0,001).
Ce rejet franc de l’hypothèse de normalité invite le chercheur à une réflexion critique fondamentale sur la modélisation sous-jacente du construit évalué. En psychométrie de la santé mentale, la normalité distributionnelle d’un score n’est nullement une loi universelle ni un objectif biologique intrinsèque, mais plutôt une hypothèse commode d’ingénierie mathématique. La distribution réelle de la détresse psychologique au sein de la communauté obéit davantage à des topologies exponentielles ou gamma. Reconnaître cette non-normalité par l’intermédiaire du diagnostic formel de Shapiro-Wilk évite au statisticien d’appliquer à tort des segmentations normatives basées sur des déviations-standards symétriques, qui surestimeraient grossièrement la prévalence des troubles aux extrémités cliniques.
7. Diagnostic graphique complémentaire : QQ-plots et histogrammes de densité
7.1 Construction de diagrammes quantile-quantile avec ggplot2
Bien que le test de Shapiro-Wilk fournisse un arbitrage inférentiel probabiliste rigoureux et formalisé, la communauté statistique internationale s’accorde unanimement sur le fait qu’aucun test d’adéquation numérique ne devrait être interprété dans l’isolement analytique le plus complet. La confrontation du résultat numérique avec des représentations graphiques dédiées s’impose comme une règle de bonne pratique méthodologique incontournable. Parmi les outils visuels diagnostiques les plus performants figure le diagramme quantile-quantile normal, universellement désigné sous l’acronyme de diagramme QQ-plot.
L’écosystème graphique offert par la bibliothèque moderne ggplot2 permet d’édifier des visualisations QQ-plot d’une haute précision sémiologique. Le diagramme quantile-quantile procède en ordonnant les valeurs réelles de l’échantillon empirique sur l’axe des ordonnées en regard des quantiles théoriques attendus d’une loi normale standardisée calculés sur l’axe des abscisses. La fonction stat_qq() de ggplot2 génère la projection géométrique de chaque observation empirique sous la forme d’un point cartésien. Conjointement, l’adjonction de la couche géométrique stat_qq_line() trace la ligne droite directrice idéale traversant les premier et troisième quartiles distributionnels théoriques.
L’inspection analytique de l’alignement des données empiriques sur la droite de référence offre une lisibilité instantanée de la topologie distributionnelle du phénomène mesuré. Si les points observés se juxtaposent avec fidélité sur le vecteur diagonal tout au long du continuum, le postulat de normalité se trouve visuellement corroboré, fournissant une cohérence graphique parfaite avec une statistique de Shapiro-Wilk non significative. En revanche, toute torsion structurelle du tracé renseigne avec précision sur l’origine arithmétique de la non-normalité : une courbure en forme de « U » signale une asymétrie positive, une morphologie en « S » inversé dénote des queues de distribution épaissies typiques de la leptokurticité, tandis que le détachement d’observations isolées aux extrémités graphiques met en exergue l’existence de valeurs aberrantes singulières influençant indûment le calcul inférentiel global.
7.2 Superposition de densités empiriques et théoriques
En complément structurel du diagramme quantile-quantile, l’exploration graphique de la forme d’une distribution gagne à être complétée par la construction d’un histogramme de fréquences pondéré par une estimation par noyau de densité, auquel vient se superposer la trajectoire de la courbe normale théorique de Gauss ajustée aux caractéristiques de l’échantillon. Cette représentation conjointe permet d’appréhender directement la morphologie empirique de la variable dans l’espace naturel de ses unités d’échelle d’origine, rendant les écarts d’adéquation immédiatement intelligibles pour le lecteur non spécialiste.
Dans l’environnement de syntaxe ggplot2, cette visualisation sophistiquée s’élabore en configurant l’axe des ordonnées de l’histogramme pour qu’il n’affiche pas le décompte brut des fréquences absolues, mais bien la densité relative probabiliste via l’argument esthétique y = after_stat(density) au sein de la fonction geom_histogram(). Cette normalisation d’échelle permet de superposer harmonieusement sur le même plan deux fonctions continues : d’une part, la densité empirique réelle lissée générée par geom_density(), et d’autre part, la cloche théorique gaussienne paramétrée grâce à la commande stat_function() recevant les paramètres mean() et sd() dérivés de l’échantillon observé.
Ce procédé de superposition révèle instantanément les discordances fines entre le modèle théorique et l’enregistrement expérimental. Les divergences d’amplitude au sommet de la courbe illustrent les anomalies de voussure centrale (aplatissement ou pointe hyper-gaussienne), tandis que les débordements des surfaces colorées sur les flancs latéraux mettent en évidence les zones d’accumulation asymptotique d’observations atypiques. L’association méthodique entre le test de Shapiro-Wilk, le diagramme QQ-plot et l’histogramme de densité enrichi matérialise une approche diagnostique robuste, immunisant le chercheur contre les erreurs d’interprétation hâtives dictées exclusivement par des seuils décisionnels probabilistes rigides.
8. Automatisation du test par groupes expérimentaux avec le Tidyverse
8.1 Application conditionnelle selon les facteurs de stratification
Dans la conduite des protocoles de recherche contemporains en sciences empiriques, l’évaluation de l’hypothèse de normalité ne s’applique que très rarement à une cohorte globale indiscriminée. Dans les plans d’expérimentation factoriels, qu’il s’agisse de comparer les effets d’un principe thérapeutique actif contre un placebo ou d’analyser les variations de performances mnésiques à travers plusieurs classes d’âge, le postulat de normalité du modèle linéaire classique n’exige nullement que l’échantillon total soit normalement distribué. Il postule avec précision que les résidus d’échantillonnage, ou de manière rigoureusement équivalente, les observations au sein de chaque niveau ou condition expérimentale de stratification, proviennent de populations normalement distribuées.
L’utilisation de la suite logicielle intégrée Tidyverse, et plus particulièrement des capacités de manipulation offertes par la bibliothèque dplyr, révolutionne l’automatisation de cette vérification par sous-groupes d’analyse. Plutôt que de contraindre le statisticien à segmenter manuellement son tableau de données en sous-fichiers temporaires ou d’écrire des boucles itératives fastidieuses et sujettes à erreurs programmatiques, l’utilisation de l’opérateur de chaînage (le traditionnel pipe %>% ou le natif |>) combiné à la primitive group_by() permet de partitionner logiquement l’ensemble des données selon un ou plusieurs facteurs expérimentaux de stratification.
En associant la fonction de partitionnement group_by() à des instructions de synthèse avancées comme group_modify() ou reframe(), le chercheur peut formuler une routine condensée appliquant le test de Shapiro-Wilk de façon itérative et étanche sur chaque strate expérimentale. Cette approche modulaire permet de générer en une seule passe computationnelle un tableau analytique complet regroupant les niveaux de facteurs, la taille effective de chaque sous-groupe n, la statistique W correspondante et la p-valeur respective, autorisant un diagnostic immédiat et exhaustif de l’homogénéité distributionnelle à travers l’ensemble des conditions expérimentales du protocole de recherche.
8.2 Mise en œuvre simplifiée avec la librairie rstatix
Pour accroître encore l’efficacité computationnelle et faciliter l’intégration des protocoles d’analyse dans des rapports automatisés, l’écosystème R s’est enrichi d’outils haut niveau conçus spécifiquement pour la recherche expérimentale, au premier rang desquels figure le package rstatix. Cette bibliothèque novatrice opère une synthèse ergonomique remarquable entre la rigueur mathématique des tests inférentiels de base et la philosophie syntaxique fluide et élégante de l’architecture Tidyverse.
Le package rstatix introduit la fonction dédiée shapiro_test(), qui transcende les limitations d’utilisation de la primitive de base en acceptant directement des tableaux de données (data.frames) et en adoptant le formalisme standardisé des formules statistiques. Dès lors, l’évaluation de la normalité au travers d’un plan factoriel s’exécute à travers une formulation d’une simplicité exemplaire : donnees %>% group_by(condition) %>% shapiro_test(score_mesure). Le moteur d’analyse prend automatiquement en charge l’itération conditionnelle, la purge contextuelle des valeurs manquantes et le calcul de la statistique de test sur chaque sous-ensemble d’observations.
L’avantage opérationnel déterminant de cette formulation réside dans la structure même du résultat restitué par la machine. En lieu et place de l’objet textuel de classe htest standard, la fonction shapiro_test() extrait immédiatement les grandeurs calculées sous la forme d’un tableau rectangulaire harmonisé (un tibble). Ce format de données tabulaire présente l’immense intérêt méthodologique d’être immédiatement intégrable dans des chaînes de traitement subséquentes. Il peut ainsi être exporté sans aucune restructuration complexe vers des outils de mise en page académique automatisée (comme knitr::kable ou gt) ou servir de base conditionnelle à la sélection automatisée d’analyses statistiques différentielles paramétriques ou non paramétriques selon les issues diagnostiques observées.
9. Limites méthodologiques : taille d’échantillon et sur-puissance statistique
9.1 Comportement du test sur les très petits échantillons (N < 30)
L’un des défis méthodologiques les plus délicats et les plus fréquemment sous-estimés dans l’interprétation du test de Shapiro-Wilk réside dans sa dépendance fonctionnelle intrinsèque à la taille de l’échantillon observé n. Dans les contextes de recherche où les effectifs expérimentaux sont très réduits, configuration omniprésente dans les études cliniques pilotes, les investigations neuropsychologiques de cas rares ou les protocoles précliniques en pharmacologie utilisant des cohortes animales limitées (fréquemment inférieures à 20 ou 30 individus), le test de Shapiro-Wilk souffre d’un manque criant et inhérent de puissance statistique.
Sur le plan probabiliste formel, la puissance statistique représente la probabilité de rejeter à bon escient l’hypothèse nulle H0 lorsque celle-ci est effectivement erronée dans la réalité de la population mère. Face à un échantillon composé de dix ou quinze mesures seulement, le test de Shapiro-Wilk ne dispose pas d’un nombre d’observations suffisant pour discerner avec une certitude mathématique satisfaisante si les irrégularités de distribution procèdent d’une distorsion pathologique réelle de la fonction génératrice des données ou de simples aléas d’échantillonnage inoffensifs. Par voie de conséquence, le risque d’erreur de seconde espèce (erreur de type II) explose dramatiquement, amenant le chercheur à obtenir une probabilité critique supérieure au seuil nominal (p > 0,05) et à conclure faussement à la normalité d’une distribution qui dévie pourtant lourdement du modèle gaussien.
Dans ce régime de faible représentativité numérique, une p-valeur de Shapiro-Wilk non significative ne peut en aucun cas être interprétée comme une preuve irréfutable de normalité. Les chercheurs travaillant sur des cohortes réduites doivent faire preuve d’une extrême prudence épistémologique et s’interdire de considérer le test de Shapiro-Wilk comme une certification absolue autorisant les modélisations linéaires classiques. Dans ces configurations délicates, l’évaluation visuelle attentive des diagrammes de dispersion, l’analyse scrupuleuse de la bibliographie empirique préexistante quant à la nature théorique du construit évalué, et le recours prudentiel à des méthodologies de rééchantillonnage ou à des procédures non paramétriques s’avèrent infiniment plus sûrs et scientifiquement défendables.
9.2 Le paradoxe des grands échantillons (N > 500)
À l’exact opposé du spectre d’échantillonnage surgit une aporie méthodologique symétrique, couramment désignée par les biostatisticiens sous le concept de sur-puissance statistique ou de paradoxe des grands effectifs. Dès lors que la taille d’un échantillon s’accroît pour atteindre des cohortes substantielles (dépassant couramment plusieurs centaines, voire plusieurs milliers de participants, comme c’est le cas dans les vastes enquêtes épidémiologiques ou les études d’évaluation sociologique à grande échelle), le test de Shapiro-Wilk acquiert une sensibilité mathématique hyper-aiguë, devenant capable de détecter des micro-déviations infinitésimales de distribution.
Dans la réalité empirique du monde naturel et social, aucune variable biologique ou comportementale réelle ne se conforme à cent pour cent et avec une exactitude mathématique infinie aux équations de la distribution de Gauss-Laplace, cette dernière ne constituant qu’un modèle d’approximation théorique idéalisé de l’esprit humain. Lorsque n dépasse 500 ou 1000 observations, la puissance du test de Shapiro-Wilk devient tellement monumentale que la plus infime variation d’asymétrie locale ou une oscillation triviale de kurtosis sans la moindre portée pratique engendre systématiquement une p-valeur inférieure à 0,001, ordonnant péremptoirement le rejet formel de l’hypothèse de normalité.
L’application dogmatique de cette sentence inférentielle conduirait le chercheur à abandonner à tort l’arsenal des statistiques paramétriques au profit de méthodes de substitution, alors même que le théorème central limite garantit qu’avec des cohortes d’une telle ampleur, les distributions d’échantillonnage des moyennes et des coefficients de régression s’alignent rigoureusement sur la normalité asymptotique la plus parfaite. Dans le cadre de grands échantillons, l’arbitrage méthodologique ne doit plus reposer aveuglément sur la p-valeur du test de Shapiro-Wilk, mais impérativement sur des critères quantitatifs d’amplitude d’effet, tels que la valeur absolue des coefficients d’asymétrie et d’aplatissement (communément tolérés au sein d’intervalles standards, par exemple |skewness| < 2 et |kurtosis| < 7), garantissant la robustesse opératoire des modèles d'analyse de variance et de régression linéaire sous-jacents.
9.3 Contournement de la limite technique de R (N > 5000)
Comme explicité préalablement lors de l’étude de l’environnement fonctionnel R, la primitive native shapiro.test() oppose un refus d’exécution péremptoire dès lors que l’effectif de la variable analysée franchit la barre des 5000 unités numériques. Cette limitation architecturale, dérivée de contraintes historiques d’optimisation mémoire et de convergence polynomiale des coefficients splines de l’algorithme sous-jacent de Patrick Royston, place l’analyste contemporain du Big Data ou de l’épidémiologie computationnelle face à un blocage technique direct lors du traitement de registres massifs de données.
Pour surmonter cette restriction logicielle tout en préservant le bénéfice analytique de l’architecture d’évaluation de Shapiro et Wilk, une première solution computationnelle élégante consiste à déployer une stratégie de sous-échantillonnage aléatoire répété (stratégie de subsampling Monte-Carlo). Cette méthode programmatique implique l’exécution d’une boucle automatisée ou d’une routine fonctionnelle (via la commande replicate()) qui extrait itérativement des sous-échantillons aléatoires sans remise d’un effectif calibré (par exemple n = 1000 ou n = 2000 observations) au sein de la base de données principale. En appliquant shapiro.test() sur chaque réplique et en agrégeant la distribution des statistiques W et des p-valeurs ainsi collectées, l’analyste obtient un diagnostic distributionnel d’une grande stabilité stochastique, libre de toute barrière algorithmique formelle.
Une démarche alternative, souvent préférable d’un point de vue conceptuel sur les grands volumes d’observations, consiste à s’émanciper définitivement du test de Shapiro-Wilk au profit d’outils statistiques spécifiquement armés pour traiter des volumétries massives sans plafonnement arbitraire de taille. L’emploi d’autres tests omnibus d’adéquation tels que le test d’Anderson-Darling (via ad.test()), ou mieux encore, l’estimation conjointe des indices de standardisation des moments de Pearson à l’aide d’intervalles de confiance construits par rééchantillonnage (bootstrap), fournit une caractérisation diagnostique infiniment plus pertinente, évitant de mobiliser des calculs d’ordonnancement de statistiques d’ordre inadaptés aux masses volumineuses d’information numérique.
10. Comparaison avec d’autres tests de normalité disponibles dans R
10.1 Le test de Kolmogorov-Smirnov avec correction de Lilliefors
Dans l’arsenal classique des tests d’adéquation distributionnelle non paramétriques, la procédure historique de Kolmogorov-Smirnov occupe une place prépondérante dans les manuels de méthodologie introductive. Sur le plan théorique, le test de Kolmogorov-Smirnov calcule la distance maximale de séparation verticale absolue (désignée par l’indice de supremum D) séparant la fonction de répartition cumulative empirique de l’échantillon observé F_n(x) et la fonction de répartition théorique cumulative continue F_0(x) de la loi sous-jacente spécifiée a priori.
Cependant, une méprise méthodologique dramatique et hautement répandue consiste à mobiliser la fonction standard ks.test() pour évaluer la normalité d’une série de données empiriques dont la moyenne et la variance sont estimées directement à partir de l’échantillon lui-même. Dans sa formulation mathématique originale élaborée par Kolmogorov et Smirnov, le test exige formellement que la loi théorique de référence soit spécifiée de manière totalement indépendante et fixée a priori (loi exogène). Dès lors que les paramètres mu et sigma sont calculés à partir des données de l’échantillon pour ajuster la loi de référence, la distance maximale D se trouve artificiellement réduite, invalidant complètement les tables de probabilité standard et conduisant à une sous-estimation massive du risque de première espèce.
Pour remédier à cette tare opératoire, Hubert Lilliefors a conçu une adaptation probabiliste rigoureuse, recalculant la distribution d’échantillonnage de la statistique D via des simulations dédiées lorsque les paramètres de centrage et d’échelle sont estimés empiriquement. Dans l’écosystème logiciel R, cette procédure corrigée est accessible par la commande lillie.test(), incluse au sein de la bibliothèque spécialisée nortest. Néanmoins, en dépit de cette correction de Lilliefors indispensable, de multiples études de puissance empirique démontrent sans équivoque que le test de Lilliefors demeure notablement moins puissant que le test de Shapiro-Wilk face à une vaste variété d’alternatives non gaussiennes, en particulier sur des échantillons de taille modeste ou intermédiaire, justifiant le statut préférentiel conservé par l’approche de Shapiro et Wilk au sein des protocoles de recherche rigoureux.
10.2 Le test d’Anderson-Darling
Développé par Theodore Wilbur Anderson et Donald A. Darling en 1952 pour pallier le déficit structurel de sensibilité du test de Kolmogorov-Smirnov sur les frontières de distribution, le test d’Anderson-Darling représente une des alternatives omnibus les plus solides et les plus respectées face au test de Shapiro-Wilk. Contrairement à la métrique de Kolmogorov qui ne focalise son évaluation que sur le point unique d’écart maximal absolu, la statistique d’Anderson-Darling intègre l’ensemble quadratique des divergences sur l’intégralité du domaine continu en appliquant une fonction de pondération mathématique spécifique.
Cette fonction de pondération mathématique confère une importance prépondérante et ciblée aux observations localisées au niveau des queues de distribution (extrémités gauche et droite), précisément là où la fonction de répartition cumulative standard tend vers zéro ou vers l’unité, zones où le test classique de Kolmogorov-Smirnov manifeste une inertie diagnostique préjudiciable. Dans le langage de programmation R, le test d’Anderson-Darling est implémenté au sein du package nortest à travers l’instruction standardisée ad.test(x).
Sur le terrain de l’analyse empirique appliquée, le test d’Anderson-Darling se révèle être un compétiteur redoutable pour le test de Shapiro-Wilk. S’il s’avère légèrement inférieur à ce dernier dans la détection des asymétries pures sur des cohortes réduites, il démontre en revanche une puissance diagnostique parfois supérieure face à des distributions leptokurtiques complexes ou lors de l’identification de mélanges de distributions normales partageant une moyenne commune mais dotées d’hétérogénéités de variance. Dans les contextes de modélisation du risque financier extrême, d’analyse de survie ou d’évaluation de la fiabilité industrielle où la précision d’ajustement des événements rares situés aux ailes extrêmes est primordiale, le recours conjoint ou préférentiel à ad.test() constitue une décision analytique d’une haute pertinence méthodologique.
10.3 Le test de Jarque-Bera fondé sur les moments
Élaboré originellement pour le traitement des séries temporelles en économétrie et en macroéconomie financière, le test de Carlos Jarque et Anil Bera adopte un paradigme d’évaluation fondamentalement différent de ceux de Shapiro-Wilk ou d’Anderson-Darling. Plutôt que de confronter des fonctions de répartition ordonnées ou des statistiques de rang, le test de Jarque-Bera opère une vérification structurelle directe sur les moments empiriques centrés et réduits de la distribution de l’échantillon, ciblant simultanément l’asymétrie de Fisher (S) et le kurtosis excessif (K).
Sous l’hypothèse nulle d’une loi normale authentique, les coefficients théoriques d’asymétrie et de kurtosis excessif s’établissent tous deux rigoureusement à zéro. La statistique de test de Jarque-Bera calcule une somme pondérée des carrés de ces deux estimateurs empiriques :
JB = (n / 6) * [ S^2 + ( (K – 3)^2 / 4 ) ]
Sur le plan mathématique, cette grandeur combinée converge asymptotiquement vers une loi de distribution du Chi-deux (χ²) structurée à deux degrés de liberté sous condition de validité de H0. Dans l’écosystème R, cette méthode est opérationnalisée par la bibliothèque tseries par l’intermédiaire de la fonction jarque.bera.test().
Toutefois, la pertinence pratique du test de Jarque-Bera en psychologie quantitative et en sciences du comportement s’avère nettement plus circonscrite que celle du test de Shapiro-Wilk. La propriété d’équivalence asymptotique au Chi-deux ne tient formellement que sur de grands volumes d’échantillonnage, le test manifestant une instabilité substantielle et un calibrage de taille nominale déficient sur les petites cohortes inférieures à cent observations. De surcroît, sa focalisation exclusive sur les moments d’ordre 3 et 4 le rend aveugle à certaines configurations bimodales symétriques singulières. Il conserve néanmoins une valeur diagnostique majeure dans l’exploration de séries chronologiques longitudinales continues ou lors de la manipulation de vastes agrégats de cotations financières où la rapidité de calcul matriciel surpasse les algorithmes d’ordonnancement de rangs.
11. Conduite méthodologique en cas de rejet de l’hypothèse de normalité
11.1 Application de transformations mathématiques aux variables
Lorsque le test de Shapiro-Wilk délivre une p-valeur significativement inférieure au seuil critique de décision (α = 0,05) et que l’examen complémentaire des graphiques diagnostiques confirme une violation substantielle du postulat de normalité, le chercheur ne doit pas considérer cette issue inférentielle comme une impasse méthodologique insurmontable. La première voie de remédiation classique consiste à appliquer une transformation mathématique continue non linéaire à l’échelle de mesure originale de la variable dépendante, dans le but d’en corriger la morphologie géométrique et de la rapprocher d’un profil gaussien symétrique autorisant l’usage ultérieur des modélisations paramétriques standard.
Face à une variable présentant une asymétrie positive marquée (étalement vers la droite), comme c’est le cas récurrent des temps de réaction cognitive ou des concentrations plasmatiques d’hormones de stress, l’application de la transformation logarithmique népérienne native log(x) ou décimale log10(x) constitue la procédure standard. Le logarithme comprime drastiquement les valeurs élevées de l’échelle tout en dilatant les écarts entre les scores faibles, opérant un redressement efficace de la symétrie distributionnelle. Si l’asymétrie positive s’avère d’une intensité modérée ou si les données intègrent des décomptes discrets nuls (valeurs à zéro), l’emploi de la fonction racine carrée sqrt(x) ou de la transformation inverse 1 / x offre des alternatives de calibrage géométrique appropriées.
Au-delà de ces transformations ponctuelles empiriques guidées par tâtonnement, la méthodologie moderne favorise l’optimisation paramétrique continue via la famille de transformations de Box-Cox, développée par George Box et David Cox. Cette technique statistique permet d’estimer computationnellement le paramètre optimal lambda (λ) qui maximise formellement la log-vraisemblance de normalité de la variable transformée. Dans l’environnement de programmation R, cette procédure d’estimation continue s’exécute à l’aide de la fonction boxcox() disponible dans la bibliothèque spécialisée MASS. Dès lors que le paramètre lambda optimal est dérivé mathématiquement, la variable ajustée peut être soumise à nouveau au test de Shapiro-Wilk pour vérifier formellement la restauration de la conformité distributionnelle gaussienne.
11.2 Bascule vers l’inférence non paramétrique
Dans de multiples situations d’investigation psychologique ou clinique, l’application de transformations mathématiques sur les données brutes s’avère soit inefficace face à des anomalies morphologiques complexes (telles que des distributions multimodales ou des distributions tronquées), soit conceptuellement contestable. Transformer l’échelle d’une mesure altère la métrique d’interprétation originale du phénomène : modéliser le logarithme du temps de réaction ou l’inverse d’un score d’anxiété rend les résultats expérimentaux parfois difficiles à communiquer aux praticiens de terrain ou lors de synthèses méta-analytiques formalisées.
Lorsque la normalité est réfutée sans remédiation fonctionnelle possible, la bascule raisonnée vers les méthodologies d’inférence non paramétrique, dites statistiques libres d’échelle ou basées sur les rangs d’ordonnancement, constitue la réponse méthodologique canonique. Ces procédures s’affranchissent totalement de l’hypothèse de distribution normale de la population parente. Ainsi, pour comparer deux conditions expérimentales indépendantes, le classique test t de Student cède la place au test de Wilcoxon-Mann-Whitney (exécutable via wilcox.test() sous R). De même, pour des comparaisons impliquant trois groupes ou davantage, l’analyse de variance univariée (ANOVA) est méthodologiquement substituée par le test de Kruskal-Wallis (kruskal.test()), tandis que les protocoles à mesures répétées intra-sujets basculent vers l’analyse de rangs de Friedman (friedman.test()).
Néanmoins, le recours aux procédures non paramétriques impose des ajustements épistémologiques majeurs quant à la nature même des conclusions inférentielles formulées par le statisticien. Les tests basés sur les rangs ne testent plus formellement l’égalité des moyennes arithmétiques des groupes comparés, mais évaluent des hypothèses relatives à la dominance stochastique, à la concordance des fonctions de répartition ou à l’équivalence des médianes sous des postulats stricts d’homogénéité de forme. Le chercheur doit impérativement adapter la formulation textuelle de ses conclusions scientifiques, en renonçant à exprimer les effets sous forme d’écarts de moyennes et en privilégiant la restitution rigoureuse de médianes, d’intervalles interquartiles (IQR) et de tailles d’effet non paramétriques standardisées telles que le r de Rosenthal ou la probabilité de supériorité stochastique.
11.3 Méthodes robustes modernes et rééchantillonnage
L’évolution computationnelle contemporaine offre aujourd’hui aux statisticiens une troisième voie d’une puissance méthodologique bien supérieure au dilemme historique opposant transformations aveugles et bascule vers les rangs : le déploiement des méthodes statistiques robustes modernes et des algorithmes inférentiels fondés sur le rééchantillonnage itératif (technique du bootstrap). Ces approches computationnelles permettent de conserver la métrique d’interprétation originale des paramètres d’intérêt tout en s’immunisant intégralement contre les biais délétères induits par les violations du postulat de normalité.
La méthodologie du bootstrap non paramétrique, démocratisée par Bradley Efron et pleinement opérationnelle sous R via le package boot, repose sur le rééchantillonnage stochastique intensif avec remise au sein même des données observées. En calculant le paramètre cible (moyenne, différence de moyennes, coefficient de régression linéaire) sur plusieurs milliers de répliques d’échantillonnage artificielles, l’algorithme construit empiriquement la distribution d’échantillonnage réelle de l’estimateur sans faire appel à l’hypothèse gaussienne théorique. L’extraction d’intervalles de confiance par la méthode du bootstrap corrigé des biais et accéléré (BCa) garantit un contrôle optimal de l’erreur inférentielle, même en présence d’asymétries distributionnelles majeures réfutées par le test de Shapiro-Wilk.
Conjointement, l’environnement logiciel R donne accès aux techniques de modélisation statistique robuste les plus avancées grâce à des bibliothèques hautement spécialisées comme le package WRS2, développé d’après les travaux fondateurs de Rand Wilcox. Ces outils fournissent des substituts directs et puissants aux tests paramétriques traditionnels (tests t robustes, ANOVA sur moyennes tronquées à 20 %, modélisations basées sur des M-estimateurs de Huber et de Hampel). De surcroît, l’adoption des modèles linéaires généralisés (GLM via la fonction native glm()), permettant d’ajuster formellement des distributions d’erreurs non gaussiennes issues de la famille exponentielle (loi Gamma, loi binomiale négative, distribution de Poisson), constitue le standard méthodologique contemporain d’excellence pour modéliser des scores asymétriques sans subir les limitations inhérentes aux tests d’hypothèse classiques.
12. Rédaction académique et communication des résultats selon les normes APA
12.1 Formulation formelle des résultats statistiques dans le texte
La restitution éditoriale des vérifications diagnostiques préalables à l’inférence statistique constitue une exigence fondamentale de transparence et de reproductibilité dans l’écriture scientifique internationale, rigoureusement encadrée par les directives du Manuel de Publication de l’American Psychological Association (normes APA, 7e édition). La simple mention vague selon laquelle « la normalité a été testée et validée » est jugée formellement insuffisante par les pairs évaluateurs et les comités éditoriaux des revues scientifiques de premier rang.
Pour chaque variable dépendante ou résidu de modélisation soumis à l’évaluation, le texte académique doit rapporter explicitement et conjointement l’identification formelle du test mobilisé, la valeur numérique arrondie de la statistique calculée W, la taille effective de l’échantillon ou les degrés de liberté pertinents, ainsi que la valeur exacte de la probabilité critique p. Conformément aux conventions typographiques de l’APA, les lettres d’abréviation statistique symbolisant des fonctions mathématiques ou des paramètres d’échantillonnage (telles que W, p, M, SD) doivent être systématiquement composées en caractères italiques.
Dans le cas d’une distribution validant le postulat de normalité, la rédaction académique formelle adoptera une formulation d’une grande sobriété technique, comparable à l’énoncé suivant : « L’examen de la distribution des scores de bien-être subjectif au sein de l’échantillon (N = 85) atteste d’une adéquation satisfaisante avec la loi normale théorique selon le test de Shapiro-Wilk (W = 0,987, p = 0,542). » Inversement, lors de l’invalidation formelle de l’hypothèse gaussienne, le rapport scientifique consignera rigoureusement la sentence statistique et justifiera la décision méthodologique de bifurcation : « Le score composite d’évitement comportemental mesuré lors de la phase post-interventionnelle dévie significativement d’une distribution gaussienne, W(120) = 0,864, p < 0,001. En conséquence, les comparaisons intergroupes ultérieures ont été conduites à l'aide de procédures inférentielles non paramétriques robustes. »
12.2 Présentation tabulaire et graphique des hypothèses sous-jacentes
Lorsque le plan de recherche empirique implique l’évaluation d’un grand nombre de variables psychométriques ou déploie des modèles factoriels multivariés intégrant de multiples sous-échelles, la juxtaposition textuelle linéaire de l’ensemble des tests de Shapiro-Wilk surcharge la prose et nuit à l’intelligibilité globale de la section méthodologique. Dans cette configuration d’analyse complexe, la synthèse des diagnostics distributionnels au sein d’un tableau synthétique harmonisé, élaboré selon les standards typographiques rigoureux du manuel de l’APA, constitue la modalité éditoriale optimale.
Un tableau d’évaluation des postulats d’analyse statistique structuré selon les normes APA se distingue par une sobriété formelle totale, proscrivant formellement l’utilisation de grilles ou de quadrillages verticaux et ne retenant exclusivement que trois lignes de démarcation horizontales majeures. Pour chaque variable explorée, le tableau présente de manière ordonnée l’effectif d’échantillon valide (n), la moyenne arithmétique (M), l’écart-type empirique (SD), les coefficients standardisés d’asymétrie (skewness) et d’aplatissement (kurtosis) assortis de leurs erreurs-types respectives, complétés par la statistique du test de Shapiro-Wilk (W) et la probabilité critique p associée, permettant au lecteur d’appréhender d’un coup d’œil l’ensemble du profil morphologique des données.
Sur le plan des restitutions iconographiques destinées à l’édition scientifique, l’inclusion de planches graphiques multipanneaux associant diagrammes quantile-quantile (QQ-plots) et histogrammes de densité enrichis garantit une transparence méthodologique absolue vis-à-vis de la communauté scientifique. Les figures transmises doivent comporter des axes rigoureusement libellés dans la langue de rédaction, afficher des échelles cohérentes sans discontinuités trompeuses, et inclure des légendes descriptives autonomes détaillant précisément la taille des échantillons, les méthodes d’ajustement géométrique employées et les interprétations diagnostiques qui en découlent, scellant ainsi l’alliance entre rigueur mathématique computationnelle et communication académique d’excellence.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Anderson, T. W., & Darling, D. A. (1952). Asymptotic theory of certain goodness of fit criteria based on stochastic processes. The Annals of Mathematical Statistics, 23(2), 193–212. https://doi.org/10.1214/aoms/1177729437
- Box, G. E. P., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211–243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
- D’Agostino, R. B. (1986). Tests for the normal distribution. In R. B. D’Agostino & M. A. Stephens (Eds.), Goodness-of-fit techniques (pp. 367–419). Marcel Dekker.
- Efron, B., & Tibshirani, R. J. (1993). An introduction to the bootstrap. Chapman and Hall/CRC. https://doi.org/10.1007/978-1-4899-4541-9
- Jarque, C. M., & Bera, A. K. (1987). A test for normality of observations and regression residuals. International Statistical Review, 55(2), 163–172. https://doi.org/10.2307/1403192
- Lilliefors, H. W. (1967). On the Kolmogorov-Smirnov test for normality with mean and variance unknown. Journal of the American Statistical Association, 62(318), 399–402. https://doi.org/10.1080/01621459.1967.10482916
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Razali, N. M., & Wah, Y. B. (2011). Power comparisons of Shapiro-Wilk, Kolmogorov-Smirnov, Lilliefors and Anderson-Darling tests. Journal of Statistical Modeling and Analytics, 2(1), 21–33.
- Royston, P. (1995). Remark AS R94: A remark on algorithm AS 181: The W-test for normality. Applied Statistics, 44(4), 547–551. https://doi.org/10.2307/2986146
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
- Wickham, H., Averick, M., Bryan, J., Chang, W., McGowan, L. D., François, R., Grolemund, G., Hayes, A., Henry, L., Hester, J., Kuhn, M., Pedersen, T. L., Miller, E., Bache, S. M., Müller, K., Ooms, J., Robinson, D., Seidel, D. P., Spinu, V., … Yutani, H. (2019). Welcome to the Tidyverse. Journal of Open Source Software, 4(43), Article 1686. https://doi.org/10.21105/joss.01686
- Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press. https://doi.org/10.1016/C2015-0-02293-8