
Dans le paysage foisonnant de la recherche quantitative en psychologie, en sciences cognitives et en neurosciences comportementales, peu d’outils statistiques ont exercé une influence aussi structurante que le coefficient de corrélation produit-moment développé par Karl Pearson. Omniprésent dans les publications académiques, cet indice scalaire sert de fondement à une multitude de méthodologies avancées, allant de la simple régression linéaire à la modélisation en équations structurelles, en passant par l’analyse factorielle exploratoire et confirmatoire. Cependant, cette hégémonie instrumentale dissimule une fragilité épistémologique majeure : le coefficient de Pearson est une statistique strictement paramétrique dont la légitimité repose sur un ensemble d’hypothèses mathématiques formelles qui, lorsqu’elles sont éludées, transforment une inférence scientifique rigoureuse en un artefact méthodologique trompeur.
L’application routinière de formules logicielles standardisées au sein d’environnements d’analyse tels que R, SPSS, SAS ou JASP a paradoxalement favorisé un découplage progressif entre l’exécution computationnelle et l’évaluation critique des postulats distributionnels. Trop souvent, la métrique r est rapportée de manière aveugle, réduite à une valeur statistique accompagnée d’un seuil de significativité arbitraire, sans que ne soit documentée la conformité de la structure empirique sous-jacente aux exigences axiomatiques du modèle. Une telle complaisance opératoire expose les chercheurs à des distorsions considérables : sous-estimation drastique de la force d’associations réelles mais non linéaires, émergence de corrélations fallacieuses sous l’effet de valeurs aberrantes isolées, ou inflation incontrôlée des erreurs de type I et II compromettant directement la réplicabilité des résultats.
Cet article propose une dissection théorique, mathématique et méthodologique exhaustive des cinq postulats fondamentaux régissant l’application légitime du coefficient de corrélation de Pearson dans la recherche quantitative. En analysant la nature des échelles de mesure, la dynamique géométrique de la linéarité, la complexité de la normalité bivariée, les impératifs d’indépendance de l’échantillonnage et la vulnérabilité intrinsèque aux observations extrêmes, nous fournirons aux chercheurs, cliniciens et analystes de données un cadre systématique de diagnostic, d’assainissement et de modélisation alternative. L’objectif est de restaurer la rigueur inférentielle indispensable à toute science comportementale empirique digne de ce nom.
1. Fondements théoriques du coefficient de corrélation de Pearson en psychologie
1.1 Origine historique et définition mathématique du coefficient r
L’émergence du coefficient de corrélation linéaire s’inscrit au carrefour de la biométrie évolutionniste et de l’anthropométrie victorienne de la fin du XIXe siècle. La filiation conceptuelle remonte initialement aux investigations de Sir Francis Galton sur les lois de l’hérédité biologique. En examinant la transmission de la taille des parents à leurs descendants, Galton observe le phénomène désormais célèbre de la « réversion vers la moyenne » (qui deviendra plus tard la régression statistique) et conçoit dès 1888 la notion d’un indice quantitatif permettant de résumer la force de codépendance entre deux attributs phénotypiques continus, qu’il nomme le « coefficient de co-relation ».
C’est toutefois le mathématicien et polymathe britannique Karl Pearson qui, s’appuyant sur les travaux d’Auguste Bravais relatifs à la théorie des erreurs géodésiques, formalise rigoureusement le cadre mathématique de l’indice en 1895. Pearson démontre que la meilleure mesure de la relation linéaire entre deux variables statistiques continues est constituée par la moyenne des produits des écarts standardisés par rapport à leurs moyennes respectives. Algébriquement, pour un échantillon de n observations bivariées notées (Xi, Yi), le coefficient de corrélation produit-moment empirique r se formule comme le rapport entre la covariance observée des variables X et Y et le produit géométrique de leurs écarts-types individuels :
r = cov(X, Y) / (sX · sY) = [ ∑ (Xi – X̄)(Yi – Ȳ) ] / [ √{ ∑ (Xi – X̄)2 } · √{ ∑ (Yi – Ȳ)2 } ]
Cette expression analytique garantit des propriétés métriques remarquables au coefficient. D’un point de vue topologique et en vertu de l’inégalité de Cauchy-Schwarz, la valeur de r est bornée de façon absolue et invariante dans l’intervalle fermé [-1, +1]. Un score égal à +1 traduit une relation linéaire positive parfaite, où toute variation unitaire de X engendre une variation proportionnelle exacte et directe de Y selon une pente strictement ascendante. Inversement, un coefficient de -1 reflète une association inverse parfaite. Une valeur nulle de r atteste de l’absence totale de covariance linéaire entre les deux métriques, signifiant que la droite des moindres carrés ajustée au nuage de points est horizontale.
Sur le plan conceptuel, le coefficient r constitue une mesure standardisée de la magnitude de l’effet, affranchie des unités d’échelle spécifiques des variables analysées. Son carré, le coefficient de détermination R2, formalise la fraction de la variance totale de Y directement imputable ou prédictible à partir de la variation linéaire de X au sein de la droite de régression. Ainsi, si un chercheur met en évidence un r = 0,50 entre la mémoire de travail et les capacités de raisonnement fluide, cela démontre précisément que 25 % (0,502) de la variance observée dans les scores de raisonnement sont linéairement partagés avec l’efficience de la mémoire de travail du participant.
1.2 Importance méthodologique de la vérification des postulats préalables
L’estimation ponctuelle d’un coefficient r à partir d’un échantillon ne constitue que le préambule de la démarche inférentielle. Dès lors que le chercheur aspire à extrapoler cette mesure descriptive à l’échelle de la population parente — par le biais d’un intervalle de confiance ou d’un test de significativité statistique sous l’hypothèse nulle H0 : ρ = 0 —, le modèle mathématique requiert des hypothèses strictes pour que ses distributions d’échantillonnage théoriques soient valides. Ignorer ces conditions préalables revient à violer la logique même du théorème de la limite centrale et de la dérivation des moindres carrés ordinaires.
La première exigence méthodologique réside dans la préservation intransigeante de la validité interne des conclusions de recherche. Dans les disciplines quantitatives du comportement, la tendance au calcul aveugle d’indicateurs paramétriques expose les praticiens à deux catastrophes inférentielles majeures. D’une part, l’inflation non contrôlée du taux d’erreur de Type I (rejet erroné d’une hypothèse nulle d’absence de lien, aboutissant à l’affirmation indue de la découverte d’un effet psychologique inexistant), fréquemment observée en présence de dépendance des observations ou de valeurs aberrantes de levier. D’autre part, l’augmentation dramatique du taux d’erreur de Type II (non-rejet d’une hypothèse nulle fausse), se matérialisant lorsqu’une relation fonctionnelle forte mais curviligne produit un r proche de zéro, conduisant le chercheur à abandonner à tort une piste théorique substantielle.
De surcroît, la communauté psychologique demeure historiquement vulnérable au glissement cognitif pernicieux qui tend à assimiler corrélation observée et causalité mécanistique. La validation rigoureuse des postulats permet d’éviter l’interprétation abusive d’associations artificielles produites par des biais d’échantillonnage, des effets de structure ou des aberrations de distribution, rappelant constamment que la relation linéaire paramétrique n’est qu’un modèle statistique abstrait décrivant la co-variation conjointe, et non le reflet ontologique d’une dynamique causale directe entre les entités mesurées.
1.3 Vue d’ensemble synoptique des cinq conditions d’application
L’architecture axiomatique qui sous-tend la corrélation de Pearson peut être scindée de manière formelle en cinq conditions directrices et interdépendantes. Ces postulats ne doivent en aucun cas être appréhendés comme des barrières isolées ou hiérarchisées de manière étanche, mais bien comme un système cohérent d’hypothèses statistiques formant l’échafaudage de la théorie de la distribution normale bivariée et des propriétés d’optimalité de l’estimateur des moindres carrés.
Ces cinq conditions indispensables se déclinent comme suit :
- Le niveau de mesure métrique : Les deux variables considérées doivent être continues et posséder un statut métrique authentique, relevant au minimum de l’échelle d’intervalle ou de l’échelle de rapport selon la typologie de Stevens, afin de légitimer le calcul des moments statistiques d’ordre un et deux (moyenne et variance).
- La linéarité de l’association bivariée : La relation sous-jacente unissant les variables au sein de l’espace vectoriel bidimensionnel doit suivre une trajectoire de ligne droite. Toute inflexion, inflexibilité sigmoïde ou courbure polynomiale invalide l’interprétation du coefficient standard.
- La normalité des distributions (univariée et bivariée) : Bien que la simple description descriptive d’un échantillon s’en accommode, l’inférence statistique (tests de Student, intervalles de confiance basés sur l’asymptotique normale) postule que la distribution conjointe des deux variables adopte la géométrie d’une cloche bivariée ellipsoïdale.
- L’appariement des unités et l’indépendance statistique : Les données doivent obligatoirement se composer de paires couplées de mesures collectées sur les mêmes entités, tandis que chaque paire d’observations (Xi, Yi) doit être totalement indépendante de toutes les autres paires du protocole expérimental.
- L’absence absolue d’observations aberrantes (Outliers) : Le jeu de données ne doit comporter aucune valeur discordante, univariée ou bivariée, susceptible d’exercer un effet de levier asymétrique démesuré sur le positionnement de la droite des moindres carrés et de dénaturer la covariance.
L’exploration de ces conditions requiert l’établissement d’une véritable arborescence décisionnelle avant toute analyse inférentielle de données comportementales. La négligence d’un seul de ces axes met en péril l’intégralité de l’édifice mathématique, rendant caduques les conclusions publiées et altérant la confiance méthodologique au sein de la communauté scientifique.
2. Postulat 1 : Le niveau de mesure des variables (Échelles d’intervalle ou de rapport)
2.1 Typologie des échelles selon Stevens et exigences paramétriques
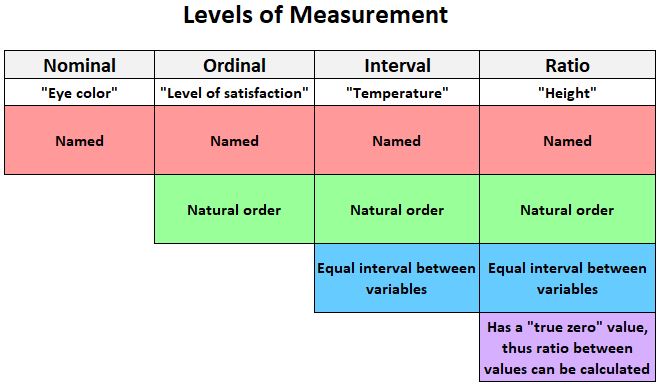
La question du statut quantitatif des grandeurs observées en psychologie trouve son cadre épistémologique fondamental dans la taxonomie quadripartite formalisée par Stanley Smith Stevens en 1946. Selon cette classification, les données collectées se distribuent le long d’un continuum d’informativité croissante : nominale, ordinale, d’intervalle et de rapport (ou ratio). Chacun de ces paliers métriques impose des restrictions structurales strictes quant aux transformations mathématiques admissibles et aux opérations statistiques mathématiquement légitimes.
Les échelles nominales (classification qualitative par catégories discrètes dénuées de hiérarchie) et les échelles ordinales (qui introduisent une simple relation d’ordre ou de classement sans calibrage métrique de la distance entre deux échelons successifs) sont structurellement inaptes aux calculs paramétriques. Le coefficient de Pearson postule impérativement que les grandeurs manipulées appartiennent au statut d’échelle d’intervalle ou d’échelle de rapport. L’exigence fondamentale réside dans l’existence d’une unité de mesure constante et stable sur l’ensemble du spectre de la variable : l’écart spatial ou conceptuel séparant une valeur de 10 d’une valeur de 12 doit être strictement équivalent à celui séparant 80 de 82.
Sur une échelle d’intervalle — dont le score au test d’intelligence classique du quotient intellectuel (QI) constitue l’illustration paradigmatique —, le point zéro est purement conventionnel, arbitraire et ne reflète en rien une absence totale de la dimension mesurée (un score de zéro au QI n’indique pas une absence absolue de cognition). Sur une échelle de rapport, en revanche, un zéro absolu, universel et non arbitraire existe naturellement dans l’espace physique, comme pour les mesures de temps de réaction chronométrique (en millisecondes), les taux d’erreurs absolus, les taux hormonaux sériques (cortisol salivaire) ou les potentiels évoqués électrophysiologiques.
L’application illégitime des formules de Pearson sur des structures purement ordinales (telles que des classements de rangs scolaires ou des échelons de sévérité clinique) engendre une violation directe de l’axiome d’additivité. L’instabilité des distances inter-modalités fausse le calcul de la moyenne arithmétique et de l’écart-type, injectant un biais systématique imprévisible dans l’estimation de la covariance standardisée.
2.2 La controverse de l’utilisation des échelles de Likert en sciences du comportement
L’un des débats les plus vifs et les plus durables de la méthodologie quantitative en psychologie sociale et clinique concerne le statut métrique des données générées par les échelles de type Likert. Développé initialement par Rensis Likert en 1932, ce format recueille les réponses des sujets sous la forme d’items à choix ordonnés gradués (allant généralement de « Pas du tout d’accord » à « Tout à fait d’accord »). D’un point de vue axiomatique strict, les puristes méthodologiques rappellent à juste titre qu’un item isolé de Likert ne constitue rien de plus qu’une mesure strictement ordinale : rien ne permet d’affirmer mathématiquement que la distance psychologique subjective entre « Neutre » et « D’accord » soit rigoureusement identique à celle qui sépare « D’accord » de « Tout à fait d’accord ».
Face à ce purisme, un pragmatisme psychométrique s’est imposé au fil des décennies, soutenu par d’abondantes études empiriques de simulation statistique. Les modélisations démontrent que lorsque plusieurs items de Likert mesurant une dimension latente commune sont sommés ou moyennés pour forger un score composite agrégé, l’indice obtenu se comporte asymptotiquement comme une variable continue d’intervalle. Pour autoriser légitimement le traitement de ces scores par le coefficient de corrélation de Pearson, la littérature contemporaine identifie plusieurs conditions impératives :
- Chaque item constitutif doit proposer un nombre suffisant de modalités de réponse, le consensus établissant un plancher minimal de 5 à 7 points d’ancrage afin de limiter le biais délétère d’atténuation lié à la discrétisation excessive.
- Le score global doit résulter de l’agrégation pondérée ou non pondérée d’un nombre substantiel d’items cohérents (idéalement supérieur ou égal à 8-10 items), assurant ainsi une granularité fine et un étalement suffisant des scores totaux dans la population d’étude.
- La fidélité de consistance interne de l’échelle globale doit être rigoureusement établie au préalable, se traduisant par un coefficient alpha de Cronbach ou un coefficient oméga de McDonald excédant les standards académiques usuels (typiquement > 0,80).
En revanche, tenter d’estimer un coefficient r de Pearson bivarié directement entre deux items de Likert individuels comportant trois ou quatre modalités constitue une hérésie méthodologique caractérisée. Une telle démarche aboutit à une restriction sévère de la variance, à l’apparition massive d’ex æquo discrets et à une déformation non linéaire artificielle de la distribution conjointe.
2.3 Protocoles de vérification du niveau métrique des données psychologiques
Avant d’engager le traitement algorithmique d’un jeu de données, le chercheur doit soumettre chaque instrument de collecte à un audit métrique préalable documenté. Ce protocole qualitatif et quantitatif démarre par l’analyse conceptuelle du format de réponse de l’outil standardisé utilisé : les données proviennent-elles d’une échelle validée par la théorie des réponses aux items (TRI), d’un enregistrement chronométrique de laboratoire, ou d’une batterie d’items composites ?
L’évaluation de la granularité et de la sensibilité de la distribution observée constitue le second verrou méthodologique. L’analyste examine attentivement le nombre de valeurs distinctes uniques générées par la variable : si une variable continue présumée ne présente dans les faits qu’une poignée de valeurs distinctes en raison d’un mauvais étalonnage ou d’un effet d’arrondi excessif, la métrique se rapproche artificiellement d’une structure ordinale discrète, invalidant l’application sereine du modèle linéaire standard.
Si cet audit révèle que l’une au moins des variables ne satisfait pas à la condition d’intervalle, l’arbitrage méthodologique impose sans compromis d’abandonner l’estimateur de Pearson. Le chercheur doit alors réorienter sa stratégie analytique vers des coefficients non paramétriques explicitement construits sur les permutations de rangs ou sur les concordances par paires, tels que le rho de Spearman ou le tau de Kendall, prévenant ainsi toute dénaturation des inférences statistiques ultérieures.
3. Postulat 2 : La linéarité de la relation bivariée
3.1 Définition conceptuelle et implications de l’hypothèse de linéarité
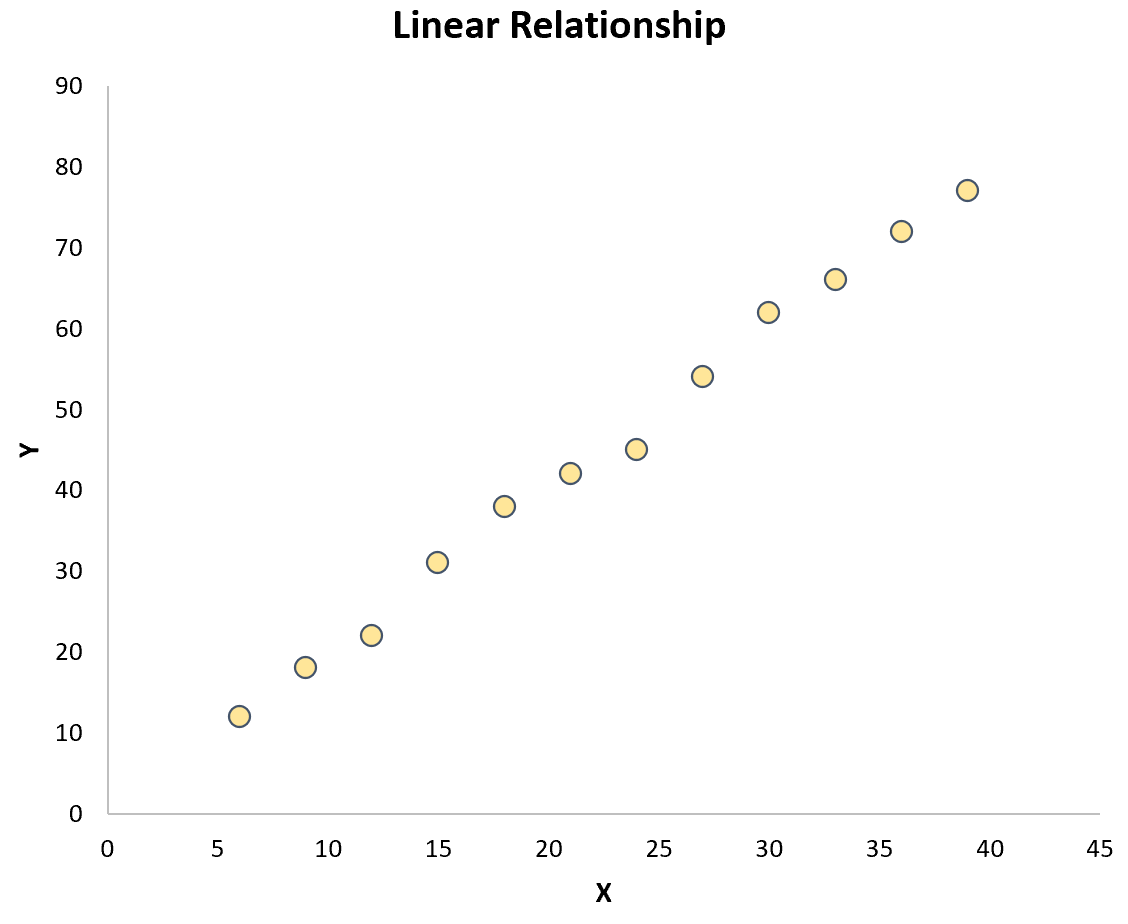
Le postulat de linéarité est consubstantiel à la géométrie même de la statistique paramétrique de Pearson. Par définition, le coefficient r est mathématiquement optimisé pour quantifier la proximité des points observés par rapport à une trajectoire en ligne droite univoque dans le repère cartésien bidimensionnel. L’équation de la droite d’estimation Ŷ = β0 + β1X assume fondamentalement que le taux de variation marginal de Y consécutif à une augmentation constante de X demeure invariant sur l’ensemble du domaine de définition des variables observées.
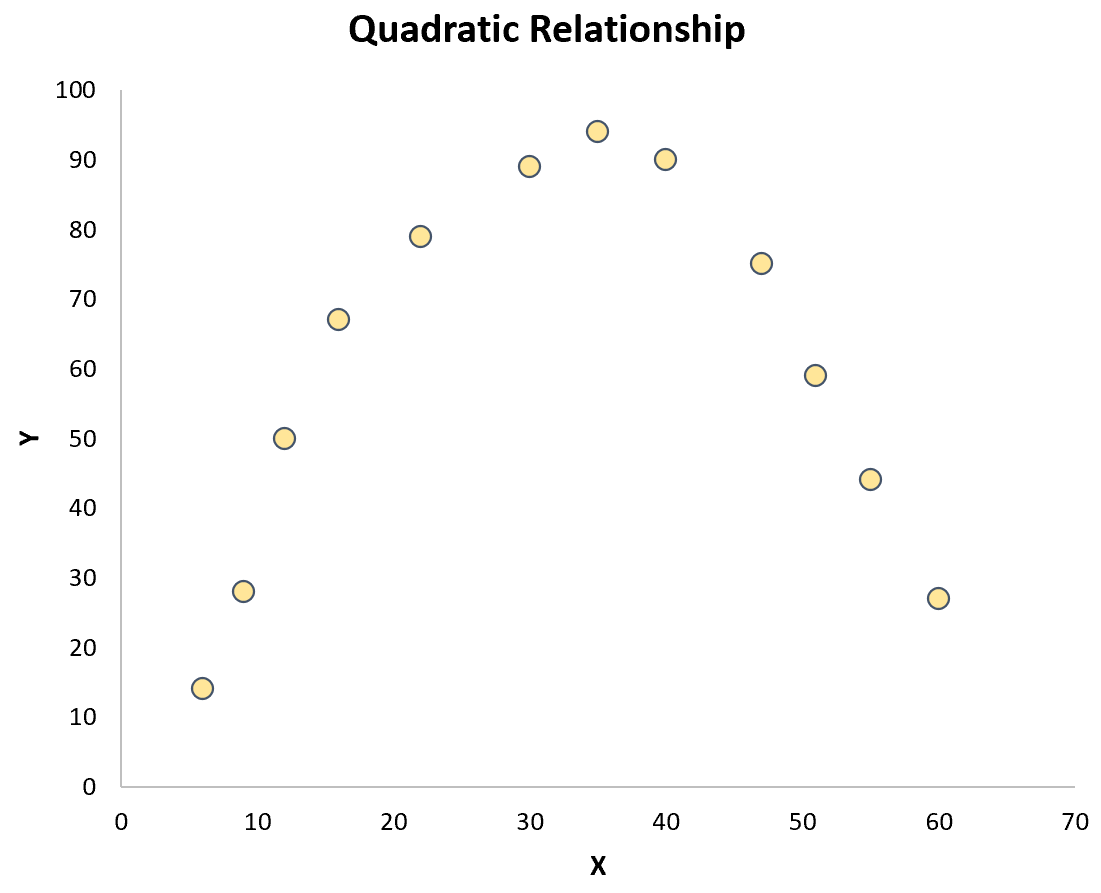
Cette particularité structurelle implique une limitation drastique : le r de Pearson est totalement aveugle aux associations non linéaires, curvilignes, exponentielles, sinusoïdales ou polynomiales. Lorsqu’une relation non linéaire relie deux construits psychologiques, le calcul standard de Pearson produit une sous-estimation systématique et potentiellement colossale de l’intensité de la dépendance réelle existant entre ces variables. Dans les cas extrêmes de courbure symétrique, la valeur de r peut chuter à un niveau rigoureusement égal à 0,00, alors même qu’une fonction déterministe parfaite lie les deux métriques sans la moindre erreur résiduelle.
Le domaine de la psychologie cognitive et expérimentale regorge d’illustrations concrètes de relations hautement curvilignes. L’exemple historique le plus éloquent demeure la loi de Yerkes-Dodson (1908), qui modélise l’efficience de la performance cognitive en fonction du niveau d’éveil ou de stress physiologique par une courbe en U inversé. À un niveau de stress bas, la performance est médiocre (manque d’attention) ; elle atteint son zénith à un niveau d’activation physiologique modéré et optimal ; enfin, elle s’effondre à nouveau sous l’effet d’une anxiété aiguë destructrice. Calculer un r de Pearson sur un tel jeu de données empiriques aboutira irrémédiablement à une conclusion absurde proclamant une absence complète d’association (r ≈ 0,00, p > 0,05), masquant une interdépendance fonctionnelle pourtant cruciale pour la théorie psychologique.
D’autres phénomènes empiriques majeurs obéissent à des cinétiques non linéaires : le plateau de saturation cognitive dans l’apprentissage selon la loi de puissance de Snoddy, l’effet de seuil d’épuisement dans le syndrome du burnout, ou la relation asymptotique unissant le bien-être subjectif et le revenu économique selon le paradoxe d’Easterlin. Dans toutes ces configurations, le postulat de linéarité est structurellement battu en brèche.
3.2 Techniques d’évaluation graphique de la linéarité
La règle d’or pour diagnostiquer la linéarité d’un lien bivarié ne repose pas sur un algorithme aveugle, mais sur l’inspection graphique préliminaire systématique. Aucun indicateur numérique ne saurait supplanter la visualisation directe du nuage de points (scatterplot) matérialisant chaque observation empirique dans le plan (X, Y). Les fameux quatre jeux de données d’Anscombe (1973) ont magistralement démontré que des ensembles de points aux géométries radicalement différentes — incluant une parabole parfaite et un nuage vertical associé à un point d’influence distant — peuvent partager au millième près exactement les mêmes moyennes, les mêmes variances et le même coefficient de corrélation r = 0,816.
Pour dépasser l’écueil d’une inspection visuelle purement subjective, la méthodologie contemporaine préconise la superposition systématique, sur le nuage de points, d’un ajustement non paramétrique local de type LOESS (Locally Estimated Scatterplot Smoothing) ou LOWESS. Cette technique d’estimation par régression polynomiale pondérée locale calcule une ligne de tendance empirique fluide sans imposer a priori aucune forme fonctionnelle rigide. Si la courbe lissée produite par le LOESS dévie de manière flagrante d’une trajectoire rectiligne pour adopter une courbure marquée en U, en S ou en cloche, la violation de l’hypothèse de linéarité est instantanément établie.
Une démarche complémentaire hautement discriminante réside dans l’analyse graphique des résidus ordinaires ou standardisés issus du modèle de régression linéaire simple reliant X et Y. Lorsque le postulat de linéarité est satisfait, le graphique projetant les résidus (en ordonnée) contre les valeurs prédites Ŷ (en abscisse) doit révéler un alignement purement stochastique, une dispersion homogène et aléatoire semblable à un bandeau nébuleux horizontal sans organisation spatiale décelable. L’émergence d’un pattern structuré dans les résidus — notamment une arche parabolique caractéristique ou une alternance de segments positifs et négatifs — apporte la preuve incontestable que la droite des moindres carrés a échoué à capter la composante non linéaire fondamentale des données.
3.3 Procédures analytiques et tests formels de non-linéarité
Bien que l’examen graphique demeure irremplaçable, la pratique académique rigoureuse exige fréquemment la corroboration des constats visuels par des procédures inférentielles formalisées. L’approche paramétrique standard de confirmation de la non-linéarité s’appuie sur la régression hiérarchique polynomiale bivariée. Le chercheur compare deux modèles statistiques imbriqués :
- Modèle 1 (Linéaire standard) : Y = β0 + β1X + ε
- Modèle 2 (Polynomial quadratique) : Y = β0 + β1X + β2X2 + ε
L’évaluation repose alors sur le test de l’incrément de variance expliquée (test ΔR2 via le test F de Fisher). Si le coefficient de régression associé au terme quadratique β2 s’avère statistiquement significatif (p < 0,05) et apporte un accroissement substantiel de la variance expliquée par rapport au modèle purement rectiligne, le modèle linéaire sous-jacent à la corrélation de Pearson doit être rejeté comme sous-spécifié.
Parallèlement, l’économétrie appliquée et la biostatistique ont conçu des tests formels d’adéquation globale de la spécification fonctionnelle, particulièrement le test RESET de Ramsey (Regression Equation Specification Error Test) et le test de linéarité de Harvey-Collier basé sur les résidus récursifs. Le test RESET teste formellement l’hypothèse selon laquelle des puissances supérieures non linéaires des valeurs prédites (Ŷ2, Ŷ3) n’améliorent pas significativement le modèle de base. Si le test s’avère significatif, le chercheur doit obligatoirement opérer un choix méthodologique : linéariser les données au moyen d’une transformation mathématique appropriée (comme une échelle logarithmique) ou abandonner Pearson au bénéfice d’approches de corrélation non paramétrique ou de modélisation non linéaire semi-paramétrique (GAM).
4. Postulat 3 : La normalité univariée et bivariée des distributions
4.1 Distinguer la normalité univariée de la normalité bivariée
La question de la normalité des distributions au sein du paradigme de la corrélation de Pearson recèle l’un des malentendus conceptuels les plus pernicieux de la psychométrie appliquée. Trop fréquemment, les praticiens se contentent de valider la forme en cloche gaussienne univariée de chacune des deux variables isolément, en postulant naïvement que la conjonction de deux variables individuellement normales garantit ipso facto la normalité conjointe de leur association. Il s’agit là d’une illusion mathématique complète.
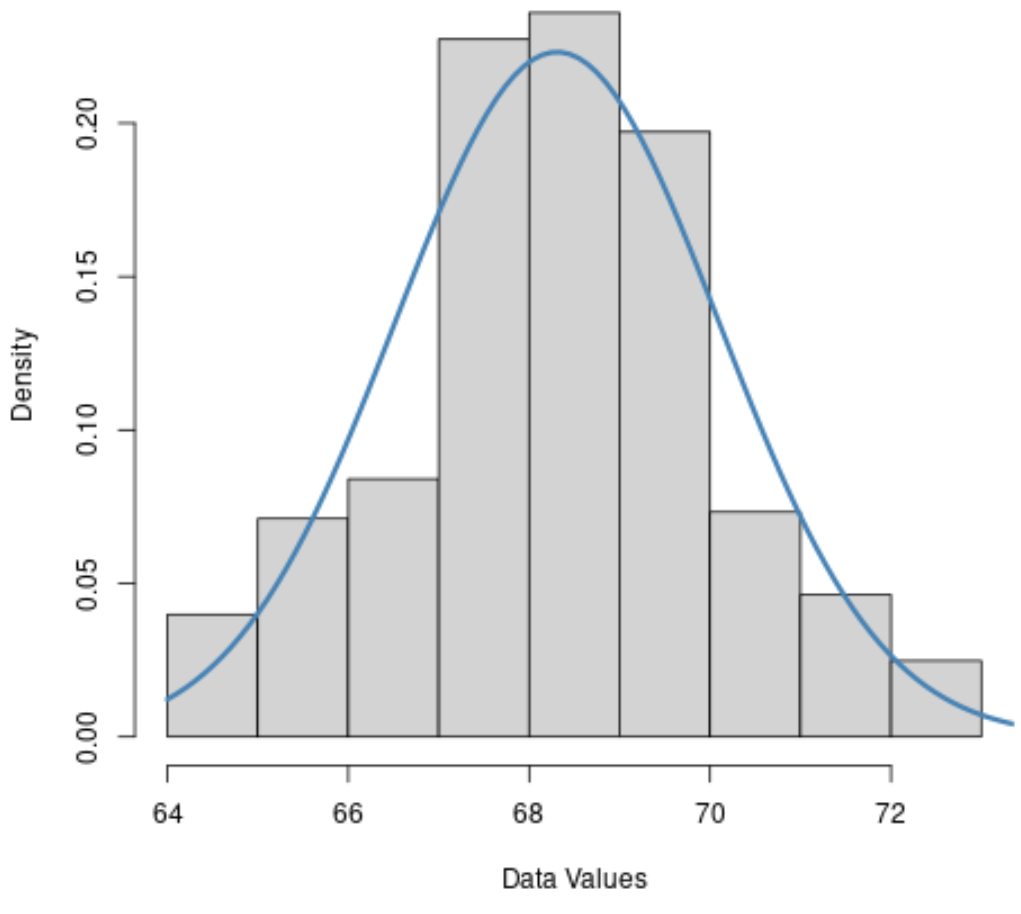
La normalité univariée postule simplement que la distribution marginale d’une variable X suit une densité de probabilité gaussienne classique régie par son espérance mathématique μ et son écart-type σ. La distribution normale bivariée, en revanche, est une entité géométrique tridimensionnelle beaucoup plus restrictive. Pour qu’une distribution bivariée soit véritablement normale, trois conditions géométriques et probabilistes strictes doivent être simultanément satisfaites :
- Chacune des deux distributions marginales individuelles de X et de Y doit être rigoureusement normale univariée.
- Pour n’importe quelle valeur fixée de X (tranche transversale du plan), la distribution conditionnelle de Y doit suivre une loi normale, avec une variance conditionnelle rigoureusement constante. Réciproquement, la distribution de X conditionnellement à Y doit être gaussienne.
- Dans le plan cartésien horizontal, les courbes d’isodensité de probabilité conjointe doivent adopter une configuration rigoureusement ellipsoïdale, dont l’axe principal coïncide avec la droite de régression linéaire théorique.
Il est aisé de construire mathématiquement deux variables parfaitement normales au niveau marginal mais dont la distribution conjointe s’avère non gaussienne, par exemple si les données se concentrent de façon discontinue le long d’axes spécifiques ou présentent des zones d’exclusion sectorielles créant une distribution en sablier ou en croix. Or, les tables de Student classiquement employées pour tester la significativité du coefficient r (via la statistique t = r √[(n-2) / (1 – r2)]) et les transformations en Z de Fisher indispensables au calcul des intervalles de confiance reposent formellement sur l’hypothèse fondamentale d’échantillonnage extrait d’une population parente normale bivariée. En l’absence de normalité conjointe, les seuils de significativité p calculés par les logiciels sont mathématiquement biaisés et ne correspondent plus à la probabilité réelle de commettre une erreur de Type I.
4.2 Indicateurs descriptifs et méthodes visuelles de diagnostic
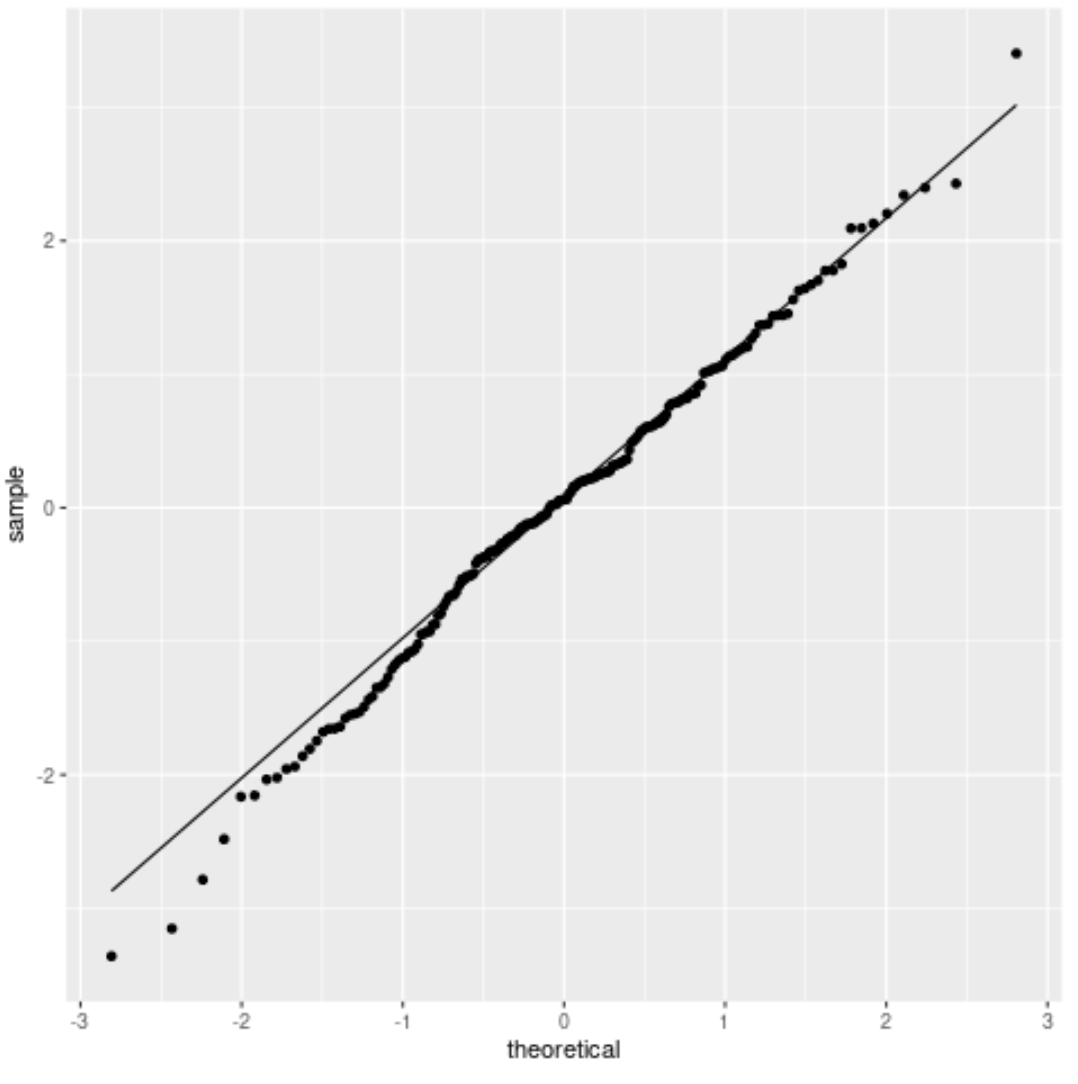
L’exploration de la normalité requiert une approche séquentielle, débutant au niveau univarié pour converger vers la dimension bivariée. Sur le plan descriptif univarié, le dépistage s’appuie historiquement sur l’analyse des moments centrés d’ordre trois et quatre : le coefficient d’asymétrie (skewness) et le coefficient d’aplatissement (kurtosis). Pour une distribution normale théorique, ces coefficients valent rigoureusement zéro (lorsque le kurtosis est exprimé en excès de kurtosis relatif à la gaussienne). Dans la recherche empirique en psychologie, des valeurs de skewness comprises entre -1 et +1 et d’excès de kurtosis entre -2 et +2 sont couramment considérées comme tolérables pour limiter l’impact sur l’erreur standard ; toutefois, dès que ces indicateurs excèdent ces plages, les inférences paramétriques deviennent hautement suspectes.
Les visualisations graphiques univariées incontournables incluent les diagrammes quantile-quantile (Q-Q plots). Le Q-Q plot projette les quantiles observés de la distribution de l’échantillon contre les quantiles théoriques attendus d’une loi normale parfaite. Si les données proviennent d’une distribution gaussienne, les points doivent s’agencer de manière rectiligne le long de la bissectrice à 45 degrés. Tout décrochage aux extrémités — qu’il s’agisse de courbes en forme de « S » ou de déviations unilatérales vers le haut — traduit une queue de distribution lourde (leptokurtique) ou une asymétrie marquée.
Pour transposer cette évaluation au niveau bivarié, plusieurs méthodologies visuelles avancées sont requises. La première consiste à projeter sur le nuage de points l’ellipse de confiance bivariée à 95 %. Si l’hypothèse de normalité conjointe tient, le nuage empirique doit s’inscrire harmonieusement dans cette ellipse, présentant une concentration maximale au centre centroïde (coordonnées des moyennes des deux variables) et s’effilant de manière symétrique et graduelle vers la périphérie sans déformation dissymétrique en poire, en banane ou en croissant.
La seconde méthodologie visuelle bivariée consiste à calculer, pour chaque paire de données (Xi, Yi), sa distance de Mahalanobis au carré (D2) par rapport au centroïde bivarié, en tenant compte de la matrice de covariance. En théorie de la distribution normale multivariée, si les données sont conjointement normales, ces distances au carré doivent obligatoirement suivre une loi du Chi-deux dont les degrés de liberté égalent le nombre de variables considérées (ici, df = 2). La construction d’un Chi-square Q-Q plot confrontant les distances de Mahalanobis empiriques ordonnées aux quantiles théoriques du Chi-deux fournit un diagnostic visuel sans équivoque de la normalité bivariée globale.
4.3 Tests d’hypothèse formels pour la normalité
L’évaluation univariée formelle de la normalité est traditionnellement dévolue à une palette de tests statistiques bien identifiés. Le test de Shapiro-Wilk est quasi-unanimement reconnu comme le test le plus puissant et le plus robuste pour les tailles d’échantillons courantes en psychologie (généralement n < 2000). Il évalue la corrélation interne entre les données ordonnées et les scores normaux attendus. Le test de Kolmogorov-Smirnov, quant à lui, ne doit être employé qu’avec la correction de Lilliefors lorsque les paramètres de moyenne et de variance de la population ne sont pas connus a priori mais estimés à partir de l’échantillon, bien que sa puissance demeure structurellement inférieure à celle de Shapiro-Wilk.
Au niveau bivarié et multivarié, les tests d’asymétrie et de kurtosis de Mardia constituent la référence méthodologique majeure. Les coefficients de Mardia calculent les extensions multivariées des moments d’ordre 3 et 4 sur la base des distances de Mahalanobis entre toutes les paires possibles d’observations. Si la valeur de p résultant du test de Mardia s’avère inférieure au seuil de signification de 0,05, l’hypothèse nulle de normalité bivariée conjointe est formellement réfutée. D’autres approches algorithmiques confirment ce statut, à l’image du test de Royston (qui agrège les statistiques transformées de Shapiro-Wilk univariées en tenant compte de la corrélation mutuelle des variables) ou du test d’énergie multivarié fondé sur la distance euclidienne.
Une mise en garde épistémologique cruciale s’impose néanmoins quant à l’interprétation aveugle de ces tests d’hypothèse formels. Dans les très grands échantillons (typiquement n > 500 à 1 000 participants), les tests de normalité deviennent hypersensibles à des micro-déviations triviales n’ayant aucun impact tangible sur le comportement du coefficient r, conduisant à un rejet systématique et fallacieux de l’hypothèse de normalité. À l’inverse, dans les échantillons restreints (typiquement n < 30), ces mêmes tests souffrent d’un manque de puissance statistique critique, échouant fréquemment à détecter des asymétries pourtant massives. Ainsi, la communauté statistique recommande fermement d’articuler en permanence les constats visuels graphiques (Q-Q plots, ellipses) avec les métriques numériques descriptives et les tests formels pour forger un jugement clinique équilibré.
5. Postulat 4 : L’appariement des observations et l’indépendance statistique
5.1 Structure des données appariées en psychologie
L’architecture opératoire du calcul de la corrélation de Pearson impose une contrainte algorithmique irréductible : les données empiriques doivent obligatoirement se présenter sous la forme d’un ensemble de paires vectorielles ordonnées (Xi, Yi), dans lesquelles chaque composante de la paire est prélevée sur la même unité d’observation. Cette exigence structurelle découle de la définition même de la covariance bivariée : pour calculer la contribution du produit croisé (Xi – X̄)(Yi – Ȳ), le logiciel doit posséder une correspondance univoque et bilatérale entre la mesure de l’individu sur la dimension X et sa propre mesure sur la dimension Y.
Dans la matrice de données rectangulaire standard (sujets en lignes, variables en colonnes), chaque ligne doit correspondre à une entité d’échantillonnage singulière clairement identifiée par un matricule unique non ambigu. Les configurations de recherche comportementale illustrant cet appariement intrinsèque sont variées :
- Les designs corrélationnels transversaux simples : Un participant donné complète simultanément une épreuve de régulation émotionnelle (X) et un inventaire de symptômes dépressifs (Y).
- Les protocoles de fidélité test-retest : Le même instrument de mesure psychométrique est administré à un groupe de sujets à un temps 1 (X), puis réadministré aux mêmes individus à un temps 2 distant (Y) pour vérifier la stabilité temporelle du construit.
- Les études dyadiques couplées : Les unités d’observation sont des couples, des paires jumeaux-jumelles ou des tandems soignant-patient, où la variable X est mesurée chez le premier membre de la dyade et la variable Y chez le second.
Toute rupture accidentelle dans l’ordonnancement de ces paires — qu’elle découle d’un décalage de tri d’une colonne dans un tableur ou d’une erreur d’alignement d’identifiants informatiques — détruit irrémédiablement la covariance réelle de l’échantillon. En redistribuant aléatoirement les valeurs de Y par rapport à celles de X, le coefficient r calculé tend asymptotiquement vers une valeur nulle, créant une catastrophe méthodologique par falsification involontaire des données réelles.
5.2 Le postulat d’indépendance des observations et pièges d’échantillonnage
Alors que l’appariement interne des mesures au sein d’une même paire (Xi, Yi) est une condition technique absolue, les différentes paires d’observations composant l’échantillon global doivent, quant à elles, être rigoureusement indépendantes les unes des autres sur le plan statistique. En termes probabilistes, la réalisation de la paire d’observations (Xk, Yk) ne doit contenir aucune information prédictive, directe ou indirecte, quant à la probabilité de survenue de la paire (Xm, Ym) pour toute observation m distincte de k. Ce postulat garantit que chaque unité expérimentale apporte un degré de liberté informatif réel et autonome à l’estimation statistique.
Dans la pratique de la recherche psychologique, la violation de l’indépendance est fréquente et découle souvent de protocoles d’échantillonnage défaillants ou mal modélisés. La première source de violation réside dans la dépendance temporelle ou sérielle, typique des mesures répétées ou des séries chronologiques d’expérience vécue (Experience Sampling Method, ESM) : si un chercheur enregistre l’humeur et la concentration d’un même individu dix fois par jour pendant un mois, les 300 observations collectées ne constituent pas 300 unités indépendantes, mais une trajectoire dynamique autocorrélée d’un seul et unique sujet.
La seconde violation, omniprésente en psychologie scolaire, organisationnelle et clinique, découle de la structure emboîtée ou hiérarchique des données sociales. Si l’on recrute 300 élèves répartis dans seulement six classes d’école différentes, les élèves partageant la même classe subissent l’influence commune des mêmes enseignants, des mêmes interactions de groupe et du même climat scolaire. De manière analogue, des patients traités par un même psychothérapeute développent une dépendance statistique par rapport à ceux traités par un autre praticien.
Les conséquences quantitatives de cette violation sont majeures : l’estimation naïve des degrés de liberté de la corrélation de Pearson (fixés par défaut à n – 2 par les logiciels) devient massivement surévaluée. Cette inflation artificielle des degrés de liberté produit un rétrécissement illégitime des erreurs-types, provoquant un effondrement artificiel des valeurs de p et une envolée incontrôlée du risque d’erreur de Type I. Le chercheur conclut ainsi à la découverte d’effets psychologiques « hautement significatifs » qui ne sont, en réalité, que des artéfacts produits par la dépendance des grappes contextuelles.
5.3 Diagnostic et détection de la dépendance des données
L’anticipation de la dépendance statistique constitue avant tout une responsabilité méthodologique au stade du plan expérimental. La stratégie d’échantillonnage aléatoire simple ou stratifié, garantissant l’inclusion d’un seul sujet par unité sociale indépendante (ex. un seul membre par foyer, un seul individu par groupe de travail), constitue la meilleure parade préventive.
Lorsque la structure du protocole induit des regroupements inhérents aux données, le recours au diagnostic par le calcul du coefficient de corrélation intraclasse (ICC pour Intraclass Correlation Coefficient) est impératif. L’ICC quantifie formellement la proportion de la variance totale de la variable d’intérêt imputable à l’appartenance aux différentes grappes ou groupes d’origine :
ICC = σentre-groupes2 / (σentre-groupes2 + σintra-groupes2)
Un seuil d’ICC excédant 0,05 dans les données comportementales indique une dépendance contextuelle non négligeable qui disqualifie l’application d’un coefficient de Pearson brut fondé sur la somme totale des sujets. L’analyste doit alors soit agréger les données au niveau du groupe, soit délaisser la corrélation bivariée standard au bénéfice de la modélisation multiniveau (Linear Mixed Models) ou des équations d’estimation généralisées (GEE).
Enfin, pour les protocoles comportant une dimension temporelle ou des séquences ordonnées continues, la vérification de l’absence d’autocorrélation s’appuie classiquement sur le calcul de la statistique de Durbin-Watson ou le tracé de la fonction d’autocorrélation (ACF) des résidus. Une valeur de Durbin-Watson s’écartant sensiblement de la valeur centrale de 2,00 (en dessous de 1,50 ou au-dessus de 2,50) apporte la preuve irréfutable d’une dépendance sérielle qui fausse toute l’inférence de Pearson.
6. Postulat 5 : L’absence de valeurs aberrantes extrêmes (Outliers)
6.1 Vulnérabilité géométrique de la droite des moindres carrés face aux outliers
La méthode des moindres carrés ordinaires, qui constitue l’armature algorithmique du calcul de la covariance et de la régression linéaire associées au r de Pearson, présente une sensibilité extrême face aux observations marginales atypiques. Cette fragilité provient directement de sa formule mathématique, qui repose sur l’élévation au carré des écarts par rapport à la moyenne : plus une donnée s’éloigne du centre centroïde de gravité de l’échantillon, plus son poids dans la fonction de coût quadratique augmente de façon exponentielle.
En matière d’analyse bivariée, il est indispensable de discriminer formellement trois catégories d’observations problématiques dont la terminologie obéit à des concepts géométriques précis :
- Les outliers univariés : Observations présentant une valeur extrême et isolée sur l’une des dimensions isolées (X ou Y), s’écartant drastiquement de la moyenne de cette variable unique.
- Les outliers bivariés : Observations dont la valeur individuelle sur X et la valeur individuelle sur Y sont tout à fait ordinaires au regard de leurs distributions marginales respectives, mais dont l’association conditionnelle (la combinaison conjointe) constitue une anomalie flagrante au vu de la structure générale du nuage de points.
- Les points de fort levier et points d’influence : Observations situées à des coordonnées extrêmes sur l’axe X (fort levier géométrique) qui, lorsqu’elles s’écartent également de l’alignement de la tendance générale, exercent un couple de torsion mécanique majeur sur la droite d’estimation, la contraignant à pivoter vers elles.
Les ravages de ces observations aberrantes sur la statistique r s’incarnent dans deux écueils opposés mais également destructeurs :
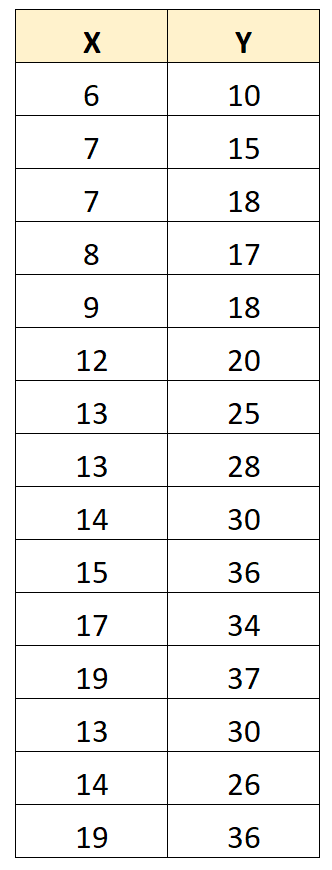
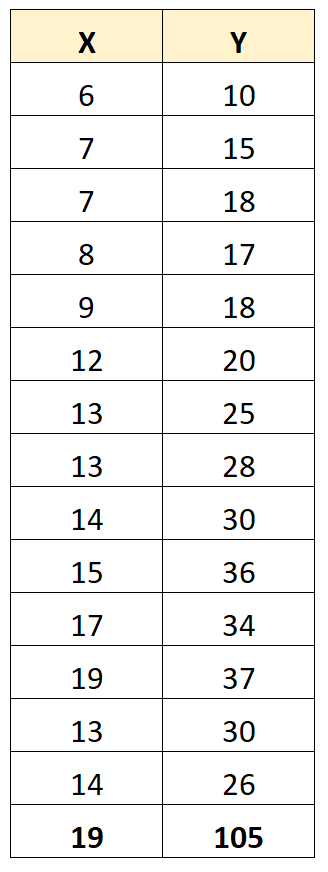
D’une part, l’inflation fallacieuse d’une corrélation inexistante (effet d’aubaine statistique). Considérons un nuage de 100 observations adoptant la forme d’un disque circulaire sans aucune corrélation réelle (r = 0,02). L’introduction d’un unique point excentré situé conjointement à +5 écarts-types sur X et +5 écarts-types sur Y suffit mathématiquement à faire bondir le coefficient à r = 0,45 (p < 0,001), incitant le chercheur à proclamer la confirmation d’une théorie psychologique majeure sur la seule foi d’une anomalie isolée.
D’autre part, l’atténuation dévastatrice d’une association réelle puissante. Si 99 points s’alignent le long d’une droite de corrélation forte de r = 0,85, l’intrusion d’une seule valeur aberrante discordante située à +6 écarts-types sur X mais à -4 écarts-types sur Y va exercer un effet d’ancrage négatif violent sur la covariance globale, faisant chuter le coefficient global sous le seuil de significativité. Une véritable relation comportementale est ainsi masquée et rejetée à tort par le chercheur.
6.2 Outils méthodologiques de détection univariée et multivariée
Le dépistage scientifique rigoureux des valeurs aberrantes transcende la simple détection visuelle opportuniste. L’investigation démarre au niveau univarié par le calcul de scores standardisés scores Z pour chaque observation (Zi = [Xi – X̄] / s). La règle heuristique universellement acceptée en psychométrie stipule que toute observation affichant une valeur absolue de |Z| excédant 3,29 (seuil correspondant à une probabilité d’occurrence théorique p < 0,001 sous la loi normale) doit être formellement isolée comme valeur aberrante potentielle.
Sur le plan non paramétrique univarié, les diagrammes en boîte à moustaches de Tukey (boxplots) fournissent un diagnostic direct fondé sur l’écart interquartile (IQR = Q3 – Q1). Sont définies comme :
- Outliers modérés : Les observations situées entre 1,5 × IQR et 3,0 × IQR au-delà des charnières de la boîte.
- Outliers extrêmes : Les observations franchissant le seuil critique de 3,0 × IQR au-delà des quartiles, identifiées systématiquement par des symboles spécifiques dans les logiciels modernes.
Pour démasquer les outliers bivariés dissimulés, l’outil matriciel par excellence demeure la distance de Mahalanobis (D2). À la différence de la distance euclidienne simple, Mahalanobis quantifie la distance spatiale séparant chaque point individuel du centroïde multidimensionnel en pondérant le vecteur d’écart par l’inverse de la matrice de covariance empirique. Cela permet de tenir compte de la pente naturelle et de la corrélation existant entre les dimensions. Les valeurs de D2 obtenues sont ensuite testées formellement contre la distribution théorique du Chi-deux à 2 degrés de liberté pour un seuil conservateur de p < 0,001.
Enfin, pour évaluer l’impact direct de chaque point sur la robustesse du modèle de régression sous-jacent, le chercheur doit calculer des indices de diagnostic d’influence spécifiques :
- Le D de Cook : Mesure globale du déplacement agrégé de l’ensemble des valeurs prédites consécutif à la suppression ponctuelle du i-ème individu du jeu de données. Un D de Cook supérieur à 1,00 (ou dépassant le seuil empirique plus strict de 4 / n) signale un point exerçant un pouvoir démesuré sur l’estimation de Pearson.
- Les statistiques DFBETAS et DFFITS : Qui chiffrent respectivement la variation standardisée induite sur la pente du coefficient et sur la prédiction individuelle par l’exclusion de l’observation suspecte.
- Les résidus studentisés supprimés : Permettant d’isoler les points dont l’écart à la droite excède l’erreur résiduelle standardisée attendue après neutralisation de leur propre effet d’influence.
6.3 Processus d’investigation de l’origine des anomalies de données
La découverte d’une valeur aberrante dans un jeu de données ne constitue pas un passe-droit pour son effacement arbitraire et discret de la feuille de calcul. L’éthique de la recherche et les standards de la science ouverte exigent une investigation rigoureuse de la traçabilité de chaque anomalie répertoriée. Trois origines fondamentales doivent être discriminées avec clarté :
Premièrement, les erreurs techniques d’encodage ou de mesure. Il s’agit des fautes matérielles de frappe lors de la saisie (ex. taper un âge de « 220 ans » au lieu de « 20 ans »), des bogues de scripts d’extraction informatique d’interfaces de passation en ligne, ou du dérèglement d’un équipement de laboratoire biométrique (ex. électrode d’EEG décrochée produisant un signal aberrant). Lorsque de telles erreurs matérielles sont documentées avec certitude, la correction s’impose immédiatement si la source originale est accessible ; à défaut, la suppression de l’observation erronée est absolument légitime et obligatoire.
Deuxièmement, les violations des critères d’inclusion du protocole d’échantillonnage. Il peut s’agir d’un participant ayant complété l’épreuve expérimentale sans maîtriser la langue de passation, d’un individu ayant validé un questionnaire sous l’emprise avérée de substances psychoactives non autorisées, ou d’un sujet dont le temps de réponse global à un protocole de 40 minutes n’excède pas 90 secondes (attestant d’un comportement d’inattention ou de clics aléatoires). Dans ces conditions, l’observation n’appartient pas à la population cible définie et son exclusion est méthodologiquement impérative.
Troisièmement, la variabilité clinique authentique. Il s’agit d’un participant conforme en tous points aux critères d’inclusion, ayant scrupuleusement suivi les consignes, mais dont les facultés cognitives, la structure de personnalité ou l’expression symptomatique s’avèrent exceptionnelles (ex. un individu doué d’une mémoire eidétique hors norme ou un patient souffrant d’une détresse post-traumatique rarissime). Éliminer ces observations au seul motif qu’elles perturbent l’ajustement linéaire d’un modèle statistique constitue une faute méthodologique et déontologique grave. Cela équivaut à falsifier artificiellement la variabilité naturelle du construit psychologique.
Conformément aux normes rédactionnelles de l’American Psychological Association (APA 7th edition), toute observation marginale écartée de l’analyse finale doit faire l’objet d’une mention exhaustive et transparente dans la section Méthode : justification théorique de l’exclusion, statut exact de l’anomalie, et nombre d’unités concernées. Idéalement, la démarche de bonne pratique impose la réalisation d’une analyse de sensibilité systématique en publiant les coefficients de corrélation obtenus à la fois avec et sans l’inclusion des points atypiques.
7. Homoscédasticité et propriétés résiduelles : la condition implicite d’homoscédasticité
7.1 Définition de l’homoscédasticité et sa pertinence pour le r de Pearson
Si la littérature méthodologique simplifiée limite souvent l’exposé des postulats de Pearson aux cinq conditions matricielles, une évaluation statistique rigoureuse ne saurait faire l’économie de la condition sous-jacente d’homoscédasticité (ou d’homogénéité de la variance conditionnelle des erreurs). Bien qu’elle soit historiquement formulée dans le contexte du modèle de régression linéaire bivariée par les moindres carrés, l’homoscédasticité est intimement liée au coefficient de Pearson : elle constitue une condition intrinsèque et indissociable de la validité de la théorie de la distribution normale bivariée.
Par définition, l’homoscédasticité postule que la variance des résidus (les écarts entre les valeurs observées et les valeurs modélisées par la droite) demeure parfaitement stationnaire et constante sur l’intégralité du continuum des valeurs prises par la variable prédictive :
Var(εi | Xi) = σε2 = Constante, pour tout i
À l’inverse, l’hétéroscédasticité désigne une configuration dans laquelle la dispersion des observations fluctue de manière systématique en fonction des niveaux de la variable X. Visuellement, l’hétéroscédasticité se traduit sur le nuage de points par une forme caractéristique d’entonnoir (funnel shape) ou d’éventail ouvert : les points sont extrêmement resserrés et proches de la droite à l’une des extrémités de la distribution, mais s’éparpillent de manière anarchique à l’autre extrémité.
Bien que la présence d’hétéroscédasticité ne rende pas le coefficient r ponctuel biaisé au sens strict de l’espérance asymptotique (l’indicateur continue de refléter la covariance moyenne standardisée de l’échantillon), elle détruit totalement l’efficience de l’estimateur et invalide complètement le calcul de son erreur-type. En présence de variances conditionnelles inégales, l’erreur-type standard computed par défaut par les formules classiques de Pearson est gravement faussée. Cette distorsion compromet la totalité des tests inférentiels de significativité (statistique t de Student erronée) et altère la largeur des intervalles de confiance basés sur la transformation de Fisher, conduisant généralement à une surévaluation optimiste de la précision empirique du lien.
7.2 Évaluation graphique et tests formels d’hétéroscédasticité
La détection de l’hétéroscédasticité repose prioritairement sur l’analyse graphique du comportement des résidus de la régression linéaire sous-jacente au coefficient de Pearson. Le graphique roi est le diagramme de dispersion confrontant les résidus standardisés ou studentisés (sur l’axe Y) aux valeurs théoriques prédites Ŷ (sur l’axe X). Dans un modèle homoscédastique irréprochable, les résidus doivent se distribuer de façon symétrique à l’intérieur d’une bande horizontale d’épaisseur rigoureusement constante tout au long de l’axe des abscisses. L’émergence d’une expansion progressive de l’épaisseur du nuage résiduel (forme en trompette ou en mégaphone) atteste visuellement d’une violation substantielle.
Pour confirmer formellement cette anomalie par des indices quantitatifs, l’analyste dispose de deux tests d’hypothèse prédominants :
- Le test de Breusch-Pagan : Ce test régresse les résidus au carré obtenus à partir du modèle de base sur la variable prédictive X. Si le coefficient de détermination de cette régression auxiliaire est statistiquement significatif (test du multiplicateur de Lagrange via la distribution du Chi-deux), l’hypothèse nulle d’homoscédasticité résiduelle est formellement rejetée, confirmant une variance d’erreur fonctionnellement liée au niveau de X.
- Le test de White : Test plus général et conservateur qui teste la dépendance de la variance des erreurs non seulement vis-à-vis des termes linéaires de X, mais également vis-à-vis de ses termes quadratiques (X2), ce qui le rend performant pour détecter des dynamiques d’hétéroscédasticité non linéaires complexes.
En psychologie différentielle et clinique, l’hétéroscédasticité possède fréquemment une signification psychométrique fondamentale qu’il convient d’interpréter conceptuellement plutôt que de la traiter comme un simple bruit statistique. Par exemple, la célèbre « hypothèse de différenciation cognitive » suggère que la structure des aptitudes intellectuelles est plus unitaire chez les individus présentant un niveau général faible (faible dispersion résiduelle), mais se diversifie et s’autonomise considérablement chez les individus doués d’un potentiel intellectuel élevé, produisant naturellement un schéma hétéroscédastique franc entre QI global et performances cognitives spécialisées.
8. Impact psychométrique de la restriction de variance et de la discrétisation
8.1 Le phénomène de restriction d’étendue (Range Restriction)
L’estimation valide du coefficient de Pearson postule que la variabilité intégrale des construits sous-jacents présents dans la population cible se retrouve reflétée sans distorsion au sein de l’échantillon analysé. Dès lors que cette représentativité distributionnelle est entravée, le phénomène psychométrique dévastateur de restriction d’étendue (ou Range Restriction) se manifeste, altérant la magnitude de la corrélation empirique.
La restriction d’étendue peut être directe (troncation délibérée ou mécanique d’une variable par un seuil d’admissibilité) ou indirecte (sélection opérée sur une tierce variable corrélée). Sur le plan mathématique, l’affaissement de la variance de la variable tronquée (sX2) comprime artificiellement la covariance mesurée avec la seconde variable. Il en résulte un effondrement drastique de la magnitude observée du coefficient r de Pearson par rapport à la corrélation réelle ρ existant dans la population globale non sélectionnée.
Ce biais est structurel dans les domaines de la psychologie du travail, des ressources humaines et des admissions universitaires compétitives. Considérons l’évaluation de la validité prédictive d’un test d’aptitudes cognitives générales (X) sur la performance professionnelle ultérieure (Y) au sein d’une organisation d’élite. Si l’entreprise ne recrute que les candidats ayant obtenu un score situé dans le décile supérieur (les 10 % les meilleurs au test), la corrélation calculée a posteriori sur les collaborateurs en poste semblera dérisoire (par exemple, r = 0,15, p > 0,05). Conclure naïvement à l’inefficacité du test constitue une bévue méthodologique colossale : la troncation drastique de la variance sur X a tout simplement anéanti la capacité du coefficient de Pearson à capturer la relation causale pourtant puissante qui régit la population tout entière.
Pour remédier à cette distorsion systématique, la psychométrie a développé des algorithmes de correction statistique, au premier rang desquels figurent les formules de correction de Thorndike (1949). Lorsque le chercheur dispose de l’estimation de l’écart-type de la variable dans la population parente non sélectionnée (SX) et dans l’échantillon restreint (sX), la formule classique du cas 2 de Thorndike permet d’estimer la corrélation réelle dé-biaisée :
rcorrigé = [ robservé · (SX / sX) ] / √[ 1 + robservé2 · ((SX2 / sX2) – 1) ]
8.2 Biais induits par la dichotomisation et la perte d’information métrique
L’une des pratiques les plus décriées mais historiquement tenaces dans la recherche comportementale consiste en la transformation artificielle de variables quantitatives continues en variables catégorielles qualitatives. La méthode la plus pernicieuse demeure la dichotomisation par coupure à la médiane (median split), par laquelle un chercheur partitionne un score continu (ex. le score d’anxiété) en deux groupes artificiels dénommés « Anxiété basse » versus « Anxiété haute » afin d’appliquer des analyses de variance bivariées simples.
Sur le plan méthodologique et statistique, la dichotomisation arbitraire d’une variable métrique continue constitue une véritable hérésie qui entraîne des conséquences analytiques dramatiques :
- Une perte instantanée colossale d’information quantitative fine, équivalant au gaspillage pur et simple d’environ un tiers à la moitié de la taille effective de l’échantillon en termes d’efficience statistique.
- Un affaissement massif de la puissance statistique du test, augmentant dramatiquement le taux d’erreur de Type II et rendant indétectables des effets d’association psychologique réels mais d’intensité modérée.
- Une distorsion sévère de la taille d’effet : la conversion mathématique d’un continuum vers un format binaire discrétisé force l’estimation de Pearson à se transformer structurellement en un coefficient de corrélation point-bisériel (rpb), dont le plafond mathématique théorique est borné bien en deçà de 1,00 (le maximum absolu n’excédant pas 0,798 même pour une liaison univoque absolue).
- Le risque d’engendrer de faux effets d’interaction fallacieux (erreurs de Type I) lors de l’intégration ultérieure dans des plans factoriels complexes.
La littérature contemporaine unanime, appuyée par les directives formelles des comités éditoriaux internationaux, prescrit de proscrire sans réserve la dichotomisation artificielle de variables continues. Lorsque des structures binaires naturelles existent (ex. vivant/décédé), le chercheur doit calculer en toute conscience le coefficient adéquat (bispécifique, bisériel de Jaspen ou tétrachorique) plutôt que d’appliquer aveuglément la formule standard de Pearson sans correction de la discrétisation sous-jacente.
9. Conséquences quantitatives de la violation conjointe des postulats
9.1 Dégradation de la puissance statistique et inflation des erreurs inférentielles
L’évaluation académique de la robustesse d’un test paramétrique ne peut se limiter à l’examen théorique de la violation d’un postulat unique de manière isolée. Dans les contextes réels de recherche empirique, les entorses aux postulats surviennent rarement de façon compartimentée ; elles s’entremêlent et se renforcent mutuellement dans ce que l’on peut qualifier de « tempête méthodologique parfaite ». Un échantillon psychométrique réel comportera fréquemment une asymétrie de distribution marginale combinée à une discrétisation partielle d’échelle, le tout contaminé par quelques données de levier et une structure faiblement hétéroscédastique.
La première séquelle quantitative de cette conjonction de violations réside dans l’effondrement imprévisible de la puissance statistique (1 – β). Si la droite des moindres carrés tente de s’ajuster à un nuage de points dont la trajectoire fondamentale dévie de la rectitude et dont les résidus présentent des queues épaisses leptokurtiques, l’erreur quadratique moyenne explose. Il en résulte un élargissement démesuré de l’écart-type de la distribution d’échantillonnage de r. Par voie de conséquence, la capacité statistique à détecter des tailles d’effet réelles moyennes (typiquement les corrélations de l’ordre de 0,20 à 0,30 omniprésentes en sciences comportementales) s’effondre de façon critique, conduisant au rejet injustifié d’hypothèses de recherche fondées.
Parallèlement, la dégradation s’exprime par le comportement anarchique de la statistique pivotale sous l’hypothèse nulle. La transformation hyperbolique en Z de Fisher, formulée par l’équation :
Zr = 0,5 · ln[ (1 + r) / (1 – r) ]
possède asymptotiquement une erreur standard théorique définie par σZ = 1 / √(n – 3). Or, cette élégante formule repose entièrement sur l’hypothèse stricte de normalité conjointe bivariée. Lorsque celle-ci est violée par la présence d’asymétrie conjointe ou d’hétéroscédasticité, la variance réelle de Zr dans les échantillons répétés dévie considérablement de sa borne théorique. Dès lors, les intervalles de confiance à 95 % rapportés par les chercheurs dans leurs publications deviennent fallacieux : leur taux de couverture effectif réel peut chuter sous la barre des 85 % ou des 80 %, instillant une confiance illusoire dans l’exactitude des estimations et détériorant directement l’édifice de réplicabilité des études psychologiques.
9.2 Sous-estimation versus surestimation fallacieuse des liens d’association
L’impact cumulé de ces distorsions pousse l’estimation paramétrique vers l’un des deux versants de l’erreur inférentielle :
Le versant de l’atténuation artificielle sévère est généralement orchestré par l’action combinée de l’erreur de mesure aléatoire non corrélée, de la non-linéarité et de la restriction d’étendue. Conformément aux principes de la théorie classique des tests de Spearman, le coefficient de corrélation empiriquement observé rXY entre deux scores mesurés imparfaitement est structurellement bridé par la fidélité de consistance de chacun des deux instruments :
rXY = ρTXTY · √(rxx · ryy)
où ρTXTY symbolise la corrélation théorique réelle existant entre les scores vrais, tandis que rxx et ryy désignent les indices de fidélité respectifs des échelles. Si deux construits partagent en réalité une corrélation ontologique puissante de 0,70, mais que les instruments employés ne présentent qu’une fidélité marginale de 0,60 (courante dans des échelles courtes ou des protocoles exploratoires), la corrélation de Pearson observable s’effondrera mécaniquement à r = 0,70 · √(0,60 · 0,60) = 0,42. L’analyste se trouve alors trompé par une minoration factice de 40 % de l’intensité de la relation réelle.
À l’opposé, le versant de la surestimation fallacieuse découle de la collusion pernicieuse entre les valeurs d’influence aberrantes et les biais de méthode commune (Common Method Variance). De multiples simulations numériques fondées sur des protocoles de Monte Carlo ont mis en exergue la vulnérabilité extrême de Pearson dans des configurations pathologiques récurrentes : il a été prouvé que dans des échantillons tirés de distributions asymétriques à queues lourdes dépourvues d’association réelle (ρ = 0,00), le taux d’erreur de Type I empirique au seuil théorique de 5 % peut grimper jusqu’à plus de 25 % dès lors que deux points extrêmes concordants coexistent dans l’échantillon. Le calcul aveugle de Pearson transforme alors un pur artefact d’échantillonnage en une découverte scientifique prétendument robuste.
10. Stratégies d’assainissement et de transformation des données
10.1 Transformations mathématiques pour restaurer normalité et linéarité
Face à la détection avérée de non-normalité univariée ou de déviations curvilignes modérées, le chercheur n’est pas immédiatement contraint de renoncer au modèle paramétrique : il peut mobiliser un ensemble éprouvé de transformations mathématiques monotones. Ces opérations algorithmiques ont pour propriété fondamentale de modifier l’espacement relatif des scores sur l’axe continu sans en altérer l’ordre sous-jacent, recalibrant ainsi la morphologie de la distribution vers la symétrie gaussienne et réalignant les trajectoires vers la rectitude.
Le choix de la fonction mathématique d’assainissement s’articule directement sur la typologie de la déformation morphologique initiale :
- Pour une asymétrie positive modérée (distribution étirée vers la droite, skewness > 0) : L’application de la fonction racine carrée (Y’ = √Y) compresse proportionnellement les valeurs élevées tout en préservant les scores faibles.
- Pour une asymétrie positive sévère (fréquente pour les données de temps de réaction, de revenus ou de concentrations biologiques) : La transformation logarithmique népérienne ou décimale (Y’ = ln[Y] ou Y’ = log10[Y]) constitue la solution souveraine de rééquilibrage. Si la variable contient des valeurs nulles, la variante Y’ = ln(Y + 1) est appliquée.
- Pour une asymétrie positive extrême : La transformation inverse (Y’ = 1 / Y) permet un tassement radical des valeurs périphériques distantes.
- Pour les distributions présentant une asymétrie négative (étirées vers la gauche) : Les données doivent préalablement subir une opération de réflexion (inversion du sens de la distribution par soustraction à une constante maximale K : Yréfléchi = K – Y) avant l’application de la fonction logarithmique ou racine carrée adéquate.
- Pour les variables exprimées sous forme de proportions ou pourcentages bornés dans l’intervalle [0, 1] : La transformation arcsinus de la racine carrée (Y’ = 2 · arcsin[√Y]) stabilise la variance conditionnelle et étire les extrémités comprimées.
Au-delà de ces approches pragmatiques segmentées, la méthodologie moderne recourt fréquemment à la procédure d’optimisation paramétrique de Box-Cox (1964). La transformation de Box-Cox formalise une famille continue de fonctions de puissance dépendant d’un paramètre unique λ :
Y(λ) = (Yλ – 1) / λ, si λ ≠ 0 ; et Y(λ) = ln(Y), si λ = 0
Par la méthode d’estimation du maximum de vraisemblance, le logiciel calcule la valeur numérique optimale de λ qui minimise la variance résiduelle et maximise formellement la proximité de la distribution résultante avec une loi normale théorique parfaite.
Une précaution épistémologique fondamentale doit néanmoins être formulée : le recours aux transformations mathématiques modifie structurellement l’unité de mesure native des construits psychologiques. Si calculer un coefficient r entre le logarithme du temps de latence cognitive et la racine carrée des scores d’anxiété restaure l’orthodoxie mathématique du test, cela complique considérablement l’interprétation théorique directe des grandeurs psychologiques pour le clinicien et le chercheur appliqué.
10.2 Traitements robustes des valeurs aberrantes univariées et multivariées
Lorsque la présence de valeurs atypiques irréductibles menace la stabilité du modèle de Pearson sans qu’il soit méthodologiquement justifiable de les expurger purement et simplement du fichier source, l’analyste peut mobiliser des stratégies statistiques robustes de neutralisation de l’effet de levier.
La première technique d’excellence est la winsorisation (ou winsorizing), développée d’après les intuitions du biostatisticien Charles P. Winsor. Contrairement à l’élagage destructeur, la winsorisation préserve l’intégralité de l’effectif total n de l’échantillon. Le protocole consiste à ramener systématiquement toutes les valeurs extrêmes qui excèdent des percentiles de démarcation prédéterminés au niveau de valeur exacte de ces seuils. Dans une winsorisation symétrique à 90 %, toutes les observations inférieures au 5e percentile sont remplacées par la valeur numérique exacte du 5e percentile, tandis que toutes les observations supérieures au 95e percentile sont ramenées à la valeur du 95e percentile. Le calcul ultérieur de la corrélation de Pearson sur ces séries assainies est dénommé corrélation de Pearson winsorisée, une métrique hautement résistante aux déviations périphériques.
La seconde approche repose sur le trimming symétrique (ou élagage ordonné). Cette méthode consiste à tronquer un pourcentage prédéterminé fixe d’observations (généralement 10 % ou 20 %) à chacune des deux extrémités de la distribution bivariée ordonnée, pour calculer la covariance sur les données centrales restantes. L’estimation des degrés de liberté et de l’erreur standard doit alors subir une correction mathématique appropriée tenant compte de l’effet de compression distributionnelle induit.
Enfin, lorsqu’une anomalie s’avère indiscutablement causée par un bogue d’enregistrement localisé sur une seule variable, plutôt que de procéder à une suppression systématique de l’individu complet par listwise deletion (ce qui engendre une perte sèche regrettable d’informations valides collectées sur les autres mesures), la méthodologie moderne préconise de convertir la cellule aberrante en donnée manquante (NA), puis d’implémenter un algorithme d’imputation multiple par équations chaînées (MICE) ou par modélisation FIML (Full Information Maximum Likelihood). Cette démarche garantit une préservation optimale de la représentativité et de la puissance de l’échantillon global.
11. Alternatives non paramétriques et approches robustes au r de Pearson
11.1 Le coefficient rho de Spearman : logique ordinale et monotonie
Lorsque la structure empirique des données réfute irrévocablement la condition de linéarité ou la normalité conjointe, mais que le chercheur postule néanmoins l’existence d’une relation continue ordonnée, le coefficient rho de Spearman (rs ou ρ) s’impose comme l’alternative non paramétrique de premier recours. Formulé par le psychologue et statisticien Charles Spearman en 1904, cet indice repose sur une logique algorithmique à la fois élégante et accessible : il consiste à convertir l’intégralité des scores bruts observés de X et de Y en leurs rangs séquentiels respectifs (de 1 à n), puis à appliquer la formule computationnelle exacte du coefficient de corrélation produit-moment de Pearson directement sur ces structures de rangs.
Lorsque le jeu de données ne comporte aucun ex æquo dans les classements, le coefficient de Spearman peut être calculé par son expression simplifiée historique :
rs = 1 – [ (6 · ∑ di2) / (n · (n2 – 1)) ]
où di = R(Xi) – R(Yi) représente l’écart entre le rang assigné à l’individu sur la dimension X et son rang sur la dimension Y.
Le saut épistémologique accompli par Spearman réside dans la transition de l’hypothèse de linéarité vers l’hypothèse beaucoup plus souple et tolérante de monotonie. Une relation est dite rigoureusement monotone si une augmentation de la variable X s’accompagne systématiquement d’une augmentation de la variable Y (monotonie croissante) ou d’une diminution systématique de Y (monotonie décroissante), quelle que soit l’allure fonctionnelle de la trajectoire (exponentielle, logarithmique ou sigmoïdale). Pour une relation exponentielle parfaite, le r de Pearson est pris en défaut et produit une sous-estimation substantielle (r < 1,00), tandis que le rho de Spearman atteint rigoureusement la valeur maximale de 1,00, capturant fidèlement l’intégrité de l’interdépendance fonctionnelle.
De surcroît, le plafonnement intrinsèque induit par la transformation en rangs confère à Spearman une insensibilité naturelle aux valeurs aberrantes univariées distantes : qu’un score individuel maximal dépasse la moyenne de 3 ou de 300 écarts-types, son rang demeure invariant au sommet de la série (rang n), neutralisant net tout effet de levier mécanique démesuré. Sa seule vulnérabilité méthodologique réside dans le traitement des ex æquo (ties) massifs, qui requiert l’application de rangs moyens et une correction spécifique de la variance de la formule paramétrique matricielle.
11.2 Le coefficient tau de Kendall : robustesse et interprétation probabiliste
Bien que le rho de Spearman bénéficie d’une popularité historique ancrée dans la tradition psychologique, la majorité des statisticiens et biostatisticiens contemporains lui préfèrent formellement le coefficient tau de Kendall (τ), théorisé par Maurice Kendall en 1938. Le tau de Kendall abandonne la métrique des écarts de rangs pour embrasser un paradigme d’analyse combinatoire fondé sur le dénombrement des paires concordantes et discordantes.
Pour un échantillon bivarié de taille n, il existe au total N = [ n(n – 1) ] / 2 paires distinctes composées de deux observations (Xi, Yi) et (Xj, Yj) avec i < j. Une paire est définie comme :
- Concordante : Si la hiérarchie relative des deux sujets est identique sur les deux dimensions (soit Xi > Xj et Yi > Yj, soit Xi < Xj et Yi < Yj).
- Discordante : Si la hiérarchie relative est inversée d’une dimension à l’autre (soit Xi > Xj et Yi < Yj, soit Xi < Xj et Yi > Yj).
La formulation théorique fondamentale du Tau-a de Kendall (en l’absence d’ex æquo) s’écrit :
τ = (C – D) / [ n(n – 1) / 2 ]
où C symbolise le nombre total de paires concordantes et D le total des paires discordantes recensées dans l’échantillon.
Les vertus statistiques du tau de Kendall face au rho de Spearman sont considérables. En premier lieu, sa distribution d’échantillonnage théorique converge vers la loi normale de façon infiniment plus rapide et symétrique, conférant aux tests d’hypothèse et aux intervalles de confiance une validité remarquable y compris au sein de très petits échantillons (dès n = 10 à 20 observations). En second lieu, son interprétation conceptuelle offre une lisibilité probabiliste intuitive directe : un tau de 0,40 signifie précisément que la probabilité d’observer un classement concordant entre deux sujets choisis au hasard sur les deux attributs excède la probabilité d’un classement discordant de 40 points de pourcentage. Enfin, la variante Tau-b intègre une régulation matricielle pour neutraliser les ex æquo sur X et sur Y, faisant de lui l’outil par excellence de corrélation pour les échelles ordinales courtes et les grilles de Likert limitées.
11.3 Méthodes de rééchantillonnage et corrélation robuste
L’essor de la puissance computationnelle a libéré l’analyse contemporaine des contraintes imposées par les modèles de distribution analytique rigides. L’une des armes les plus efficaces pour estimer l’association bivariée en présence de postulats vacillants réside dans le recours au bootstrapping non paramétrique (rééchantillonnage itératif avec remise développé par Bradley Efron). Dans ce cadre, le chercheur génère un nombre massif d’échantillons virtuels (typiquement 2 000 à 10 000 réplications de même taille n) tirés aléatoirement parmi les paires empiriques originales.
L’estimation de l’intervalle de confiance du r de Pearson s’opère alors directement à partir de la distribution empirique des coefficients recalculés, de préférence par la méthode BCa (Bias-Corrected and Accelerated). Cette approche algorithmique ajuste automatiquement les bornes pour corriger à la fois le biais d’estimation ponctuelle et l’asymétrie de la distribution d’échantillonnage, permettant la délivrance d’un intervalle de confiance à 95 % fiable, indépendant de toute hypothèse gaussienne conjointe.
Pour les contextes où l’on souhaite délibérément conserver une métrique linéaire continue tout en se prémunissant activement contre les effets de contamination par des données marginales, la biostatistique moderne propose des estimateurs bivariés paramétriquement robustes :
- La corrélation par pourcentage de courbure (percentage bend correlation) : Développée par Rand Wilcox, elle protège l’estimation de Pearson en modulant le poids des observations périphériques par un seuil de flexion géométrique (bending constant fixé classiquement à 20 %), abaissant la sensibilité aux queues de distribution épaisses.
- Les corrélations basées sur les matrices de covariance robuste : Notamment l’estimateur du déterminant minimal de covariance (MCD, Minimum Covariance Determinant) ou l’algorithme OGK (Orthogonalized Gnanadesikan-Kettenring). Ces méthodologies isolent un sous-ensemble fondamental d’observations pures hautement cohérentes (h > n/2) pour calculer une matrice de variance-covariance intrinsèque totalement immunisée contre l’impact de points d’influence massifs.
12. Guide pratique de décision méthodologique et rédaction académique
12.1 Algorithme séquentiel de diagnostic pas-à-pas pour les chercheurs
Afin de conjurer définitivement la pratique délétère du calcul aveugle, tout projet d’analyse quantitative impliquant des corrélations bivariées doit être conduit selon un protocole séquentiel standardisé et auditable. Nous proposons ci-après l’algorithme décisionnel structuré en quatre phases chronologiques incontournables :
Étape 1 : Cartographie métrique et intégrité de l’échantillonnage
Avant même d’ouvrir l’environnement d’analyse, l’analyste valide la conformité conceptuelle des instruments : les variables relèvent-elles d’échelles d’intervalle ou de rapport authentiques (ou de composites psychométriques Likert continus fidèles) ? L’appariement univoque des identifiants sujets est-il vérifié ligne par ligne sans décalage ? L’indépendance inter-individuelle des observations est-elle scellée par le devis expérimental, ou les calculs d’ICC révèlent-ils une structure de grappes nécessitant un modèle hiérarchique ?
Étape 2 : Exploration graphique multivariée et dépistage des outliers
Construction systématique et obligatoire du scatterplot bivarié avec superposition conjointe de la droite des moindres carrés, d’un lisseur LOESS et de l’ellipse de confiance à 95 %. Visualisation conjointe des boxplots univariés sur les marges. Dépistage algorithmique des valeurs de levier : calcul des scores Z (|Z| > 3,29), calcul des distances de Mahalanobis bivariées au seuil du Chi-deux à df = 2 (p < 0,001), et estimation des distances D de Cook (seuil critique 4 / n). Si des anomalies techniques sont détectées, documenter leur correction ou exclusion légitime.
Étape 3 : Quantification analytique des distributions et des résidus
Calcul des indices descriptifs de skewness et de kurtosis. Conduite des tests de Shapiro-Wilk univariés et du test multivarié de Mardia. Inspection du Q-Q plot de régression résiduelle et du Chi-square plot de Mahalanobis. Extraction des résidus standardisés et confrontation aux valeurs prédites : absence de courbure structurelle (test RESET ou polynomial) et réalisation du test de Breusch-Pagan pour valider l’homoscédasticité.
Étape 4 : Sélection motivée de l’estimateur final
Si l’ensemble des 5 postulats (métrique d’intervalle, linéarité graphique, normalité bivariée, indépendance, absence d’outliers) ainsi que l’homoscédasticité sont scrupuleusement honorés : exécution du coefficient r de Pearson standard.
Si une asymétrie univariée nette est isolée sans autre violation majeure : application et justification d’une transformation mathématique (logarithme, Box-Cox) ou calcul d’intervalles de confiance par bootstrap BCa.
Si une relation monotone nettement non linéaire est établie, ou en présence de données purement ordinales/scores Likert isolés : réorientation formelle vers le tau de Kendall (prioritaire) ou le rho de Spearman.
En présence d’outliers cliniques authentiques irréductibles qui perturbent le lien sans violer la théorie générale : recours documenté à une corrélation winsorisée ou à un estimateur fondé sur la covariance robuste (MCD).
12.2 Standard de présentation des résultats selon les normes de l’APA (7e édition)
L’exigence de rigueur scientifique s’étend directement à la formalisation rédactionnelle des résultats dans le corps du texte académique. L’American Psychological Association, dans sa 7e édition du Publication Manual (2020), prescrit un ensemble de règles typographiques et statistiques rigides pour la communication des indices de corrélation.
Sur le plan typographique et formel :
- Le symbole de la statistique empirique r doit être rédigé en lettre minuscule et obligatoirement stylisé en italique.
- Les degrés de liberté exacts du test (calculés selon la formule df = n – 2) doivent obligatoirement être spécifiés entre parenthèses immédiatement après la lettre statistique : r(df).
- La valeur numérique du coefficient ne doit comporter aucun zéro introductif avant le séparateur décimal (point typographique en anglais académique, virgule en français conventionnel selon les contextes éditoriaux), dans la mesure où le coefficient r est borné mathématiquement et ne peut excéder 1,00 (écrire r(148) = ,45 et non 0,45).
- La valeur exacte de la significativité statistique p doit être formulée avec deux ou trois décimales (ex. p = ,024), en proscrivant les notations vagues de type « p < ,05 », à l’exception impérative des valeurs inférieures à un millième, notées rigoureusement p < ,001.
- L’inclusion systématique et obligatoire de l’intervalle de confiance à 95 % de la statistique (95% IC [,xx, ,xx]), paramètre décisif permettant de juger de la précision de l’estimation de l’effet.
De surcroît, le texte méthodologique doit déclarer explicitement les démarches d’audit préalables entreprises, les exclusions d’outliers opérées et les motivations des arbitrages statistiques adoptés.
Modèle d’énoncé académique exemplaire :
« Préalablement à l’évaluation de l’association, la vérification des postulats statistiques de l’estimateur de Pearson a été menée. L’inspection des diagrammes de dispersion bivariés et des résidus de régression a confirmé la linéarité satisfaisante de la relation. Le test multivarié de Mardia a attesté de la normalité bivariée conjointe des distributions (b2,d = 8,12, p = ,18), tandis que le test de Breusch-Pagan n’a révélé aucune hétéroscédasticité significative, χ2(1) = 1,42, p = ,23. Aucun outlier bivarié n’a franchi le seuil critique de la distance de Mahalanobis au seuil p < ,001. Conformément à notre hypothèse de travail, une corrélation linéaire positive statistiquement significative et de magnitude modérée a été mise en évidence entre la capacité de mémoire de travail et les scores de contrôle inhibiteur exécutif, r(184) = ,38, p < ,001, 95% IC [,25, ,50], la mémoire de travail expliquant 14,4 % de la variance observée de l’inhibition. »
Modèle en cas de recours alternatif à une méthode robuste :
« En raison d’une asymétrie univariée positive marquée sur les temps de réponse persistant après transformation et de la détection de trois observations de fort levier géométrique confirmées par le D de Cook (Di > ,06), le postulat de normalité bivariée a été jugé violé. Conformément à notre protocole décisionnel, l’association a été évaluée au moyen du coefficient Tau-b de Kendall. L’analyse révèle une corrélation monotone positive robuste entre les deux dimensions, τb = ,29, p = ,002, 95% IC BCa [,11, ,44], confirmant la pérennité du lien indépendamment des données de queues distributionnelles. »
12.3 Synthèse critique des erreurs récurrentes dans la littérature psychologique
Un examen lucide des pratiques de publication contemporaines en psychologie quantitative met en relief la persistance coupable de trois dérives méthodologiques systémiques qu’il convient de combattre résolument :
La première erreur cardinale réside dans la confusion pernicieuse entre significativité statistique et adéquation du modèle. D’innombrables chercheurs se satisfont de l’obtention d’une valeur p < ,05 sur un coefficient r pour proclamer sans réserve la découverte d’une « relation linéaire forte ». Il s’agit là d’une illusion méthodologique : dans un échantillon de 1 000 participants, un coefficient marginal de r = 0,07 (qui n’explique même pas 0,5 % de la variance mutuelle) s’avère statistiquement très hautement significatif (p < ,02). La significativité atteste uniquement du rejet de l’hypothèse nulle d’orthogonalité stricte à zéro dans la population parente, mais ne garantit en rien que la droite linéaire soit un modèle pertinent, exhaustif ou fidèle pour décrire la cinétique psychologique observée.
La seconde dérive correspond à l’amnésie générale de la normalité conjointe au profit de l’univariée. Des générations d’étudiants et de chercheurs ont été formées à tester consciencieusement Shapiro-Wilk sur la variable X, puis sur la variable Y, pour ensuite foncer tête baissée dans l’exécution de Pearson dès lors que les deux indicateurs sont conformes. Comme nous l’avons théoriquement démontré, la normalité bivariée impose des exigences structurelles sur les tranches conditionnelles et l’orientation géométrique des contours d’isodensité qu’aucune combinaison de tests univariés n’est capable d’attester. L’omission de cette étape bivariée invalide la précision des tests inférentiels de Pearson.
La troisième faute concerne l’automatisation aveugle de l’analyse statistique pilotée par logiciel. Trop souvent, l’analyste clique mécaniquement sur le bouton d’exécution de sa matrice de corrélation, examine une table de chiffres abstraits criblée d’astérisques de significativité (*p < ,05, **p < ,01), sans jamais avoir pris la peine élémentaire de générer et de contempler visuellement les scatterplots des variables associées. Les nuages d’Anscombe ont prouvé depuis un demi-siècle qu’un calcul aveugle déconnecté de l’observation visuelle est le vecteur par excellence des plus grandes bévues de la science empirique. Aucun progrès statistique, aucun algorithme d’intelligence artificielle ne saurait exonérer le chercheur en sciences du comportement de l’examen critique, lucide et rigoureux de la géométrie de ses données.
Références
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.1080/00031305.1973.10478966
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Box, G. E., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211–243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
- Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica: Journal of the Econometric Society, 47(5), 1287–1294. https://doi.org/10.2307/1911963
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
- Efron, B., & Tibshirani, R. J. (1994). An introduction to the bootstrap. CRC press. https://doi.org/10.1201/9780429246593
- Galton, F. (1888). Co-relations and their measurement, chiefly from anthropometric data. Proceedings of the Royal Society of London, 45(273-279), 135–145. https://doi.org/10.1098/rspl.1888.0082
- Kendall, M. G. (1938). A new measure of rank correlation. Biometrika, 30(1/2), 81–93. https://doi.org/10.2307/2332226
- Likert, R. (1932). A technique for the measurement of attitudes. Archives of Psychology, 22(140), 1–55.
- Mardia, K. V. (1970). Measures of multivariate skewness and kurtosis with applications. Biometrika, 57(3), 519–530. https://doi.org/10.1093/biomet/57.3.519
- Pearson, K. (1895). Note on regression and inheritance in the case of two parents. Proceedings of the Royal Society of London, 58, 240–242. https://doi.org/10.1098/rspl.1895.0041
- Ramsey, J. B. (1969). Tests for specification errors in classical linear least-squares regression analysis. Journal of the Royal Statistical Society: Series B (Methodological), 31(2), 350–371. https://doi.org/10.1111/j.2517-6161.1969.tb00796.x
- Rousseeuw, P. J., & Driessen, K. V. (1999). A fast algorithm for the minimum covariance determinant estimator. Technometrics, 41(3), 212–223. https://doi.org/10.1080/00401706.1999.10485670
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
- Spearman, C. (1904). The proof and measurement of association between two things. The American Journal of Psychology, 15(1), 72–101. https://doi.org/10.2307/1412159
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
- Thorndike, R. L. (1949). Personnel selection: Test and measurement techniques. John Wiley & Sons.
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- White, H. (1980). A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity. Econometrica: Journal of the Econometric Society, 48(4), 817–838. https://doi.org/10.2307/1912934
- Wilcox, R. R. (2012). Introduction to robust estimation and hypothesis testing (3rd ed.). Academic Press. https://doi.org/10.1016/B978-0-12-386983-8.00001-9
- Yerkes, R. M., & Dodson, J. D. (1908). The relation of strength of stimulus to rapidity of habit-formation. Journal of Comparative Neurology and Psychology, 18(5), 459–482. https://doi.org/10.1002/cne.920180503