
Dans le champ des sciences du comportement, de la biomédecine et des sciences sociales, l’inférence statistique constitue le pivot sur lequel repose la validation des hypothèses scientifiques. Parmi l’arsenal des tests paramétriques à la disposition des chercheurs, le test t de Student pour échantillons appariés — fréquemment désigné sous les appellations de test t pour mesures répétées ou test t intra-sujets — occupe une place prépondérante. Utilisé pour évaluer si la moyenne des différences entre deux observations corrélées diffère significativement de zéro, cet outil permet de neutraliser la variabilité interindividuelle en utilisant chaque participant comme son propre témoin. Qu’il s’agisse d’évaluer l’efficacité d’une psychothérapie avant et après traitement, de quantifier l’impact d’un entraînement cognitif sur les temps de réaction, ou de mesurer des variations neurobiologiques sous deux conditions expérimentales distinctes, sa puissance analytique en fait un standard incontournable de la modélisation statistique univariée.
Cependant, la validité des conclusions issues d’un test t apparié n’est pas absolue ; elle est strictement conditionnée par le respect d’exigences probabilistes fondamentales. Trop souvent réduit à une simple commande logicielle exécutée de manière routinière dans des progiciels tels que R, SPSS ou JASP, ce test repose sur des fondations mathématiques précises que l’on nomme ses « postulats » ou « conditions d’application ». L’application aveugle de l’algorithme sans vérification préalable de ces hypothèses théoriques expose le praticien à des biais inférentiels majeurs. L’inflation non contrôlée de l’erreur de première espèce (le risque d’affirmer l’existence d’un effet inexistant) ou l’effondrement de la puissance statistique (conduisant à ignorer un effet réel) représentent les conséquences directes d’une modélisation effectuée en violation des axiomes de la statistique paramétrique.
Pour garantir une rigueur scientifique optimale et satisfaire aux exigences contemporaines de reproductibilité de la recherche, il est impératif de disséquer avec précision les trois postulats fondamentaux qui gouvernent le test t apparié : l’indépendance des paires d’observations, la normalité de la distribution des scores de différence, et l’absence de valeurs aberrantes extrêmes. Ce guide exhaustif propose une analyse approfondie de chacun de ces postulats, explorant leurs fondements mathématiques, leurs implications méthodologiques concrètes, les outils diagnostiques visuels et formels permettant d’en attester la viabilité, ainsi que l’ensemble des solutions palliatives — paramétriques, non paramétriques et robustes — à adopter lorsque les données empiriques s’écartent des exigences théoriques du modèle.
1. Introduction au test t pour échantillons appariés et à ses fondements statistiques
1.1 Définition et structure des plans de recherche intra-sujets en psychologie
La recherche expérimentale en psychologie et en neurosciences cognitives fait un usage intensif des devis de recherche dits intra-sujets (ou within-subjects designs). Dans une telle configuration méthodologique, chaque participant est exposé successivement à l’ensemble des modalités de la variable indépendante manipulée par l’expérimentateur, ou évalué de manière longitudinale à travers plusieurs moments temporels. Par opposition aux plans inter-sujets (où chaque participant n’est assigné qu’à une seule condition expérimentale), le plan de mesures répétées permet d’éliminer la majeure partie de la variance d’erreur imputable aux caractéristiques intrinsèques des individus, telles que l’intelligence cristallisée, la personnalité, le patrimoine génétique ou le statut socio-économique.
Une variante méthodologique rigoureuse réside dans l’appariement précis de participants distincts selon des variables de contrôle jugées critiques (par exemple, apparier des sujets d’un groupe clinique et d’un groupe contrôle sur la base exacte de l’âge, du sexe et du niveau d’éducation formelle), ou encore dans l’utilisation de jumeaux homozygotes. Dans toutes ces situations, l’architecture du protocole génère une dépendance statistique structurelle entre les couples de données recueillies. L’évaluation de l’effet ne se fait plus par la confrontation globale des moyennes des deux groupes isolés, mais par le calcul direct, pour chaque unité expérimentale i, d’un score de différence individuel défini par l’équation fondamentale :
Di = X1i – X2i
Ce score différentiel condense l’ampleur et la direction du changement survenu entre les conditions 1 et 2 pour chaque entité observée. L’avantage heuristique de cette opérationnalisation est considérable : en soustrayant le score de la condition de base à celui de la condition expérimentale, on extrait mathématiquement le « bruit » lié à la variabilité interindividuelle stable. Ainsi, la puissance statistique d’une telle approche est nettement supérieure à celle d’un plan à groupes indépendants pour une taille d’échantillon équivalente, autorisant la détection de tailles d’effet plus subtiles tout en requérant une mobilisation moindre de sujets humains ou animaux.
1.2 Le modèle mathématique sous-jacent et calcul de la statistique t
Sur le plan mathématique, le test t pour échantillons appariés ne constitue pas une entité distincte du test t pour échantillon unique : il s’agit précisément de l’application directe de la statistique de Student à la variable aléatoire univariée constituée par les scores de différence D. Le cadre inférentiel débute par la spécification formelle de l’hypothèse nulle (H0) et de l’hypothèse alternative (H1). Dans le cadre d’un test bilatéral standard, ces hypothèses s’énoncent comme suit :
H0 : μD = 0
H1 : μD ≠ 0
Où μD symbolise l’espérance mathématique (la moyenne théorique de la population) de la variable des différences. L’hypothèse nulle postule ainsi que le changement moyen observé au sein de la population parente est rigoureusement nul. La statistique empirique t est calculée en divisant la moyenne observée des différences par l’erreur type de cette même moyenne, selon la formule classique :
t = (D̄ – μ0) / (sD / √n)
Dans cette formalisation, D̄ représente la moyenne empirique calculée sur les n paires d’observations, μ0 est la valeur postulée sous l’hypothèse nulle (presque universellement fixée à 0), et sD est l’écart-type d’échantillon des scores de différence, défini par :
sD = √[ (1 / (n – 1)) × ∑ (Di – D̄)2 ]
Le dénominateur complet, sD / √n, représente l’erreur type de la moyenne des différences (notée SED̄). Cette quantité reflète l’amplitude théorique de la fluctuation d’échantillonnage de la moyenne des différences autour de sa valeur populationnelle. La statistique t résultante suit, sous réserve de la validité stricte des postulats mathématiques, une distribution de Student théorique paramétrée par df = n – 1 degrés de liberté. La comparaison de la statistique calculée aux valeurs critiques de la table de Student, pour un niveau de signification donné (généralement α = 0,05), détermine le rejet ou le non-rejet de l’hypothèse d’absence d’effet.
1.3 Importance de la validation préalable des postulats pour l’inférence
L’inférence statistique paramétrique repose sur un contrat épistémologique : les probabilités associées aux décisions d’acceptation ou de rejet des hypothèses ne sont mathématiquement exactes que si les prémisses du modèle sont respectées. Les distributions de probabilité théoriques — en l’occurrence la loi de Student — sont déduites analytiquement sous l’hypothèse indépassable que les données observées ont été générées par un processus stochastique répondant à des propriétés formelles précises.
Lorsqu’un chercheur applique un test t apparié sur des données empiriques qui enfreignent substantiellement ces hypothèses sous-jacentes, les valeurs de p calculées par les logiciels d’analyse cessent d’être exactes. Deux conséquences délétères majeures peuvent alors survenir :
- L’inflation du taux d’erreur de type I (alpha) : Le seuil nominal de 5 % peut en réalité masquer un taux effectif de faux positifs grimpant à 10 %, 20 % voire davantage. Dans cette configuration, le chercheur conclut à l’efficacité probante d’une intervention psychologique ou d’une molécule pharmacologique alors que l’effet n’est qu’un artefact d’échantillonnage amplifié par la distorsion du modèle.
- L’effondrement de la puissance statistique (hausse de l’erreur de type II ou bêta) : À l’inverse, certaines violations altèrent l’estimation de la variance d’échantillonnage en la surestimant artificiellement, ce qui gonfle le dénominateur de la fraction du test t. Le test perd alors toute sensibilité, échouant à détecter des effets comportementaux authentiques, ce qui engendre un gaspillage de ressources scientifiques et l’abandon potentiel de pistes théoriques prometteuses.
Dans le contexte actuel de la crise de la reproductibilité en psychologie et en médecine, la validation méthodologique et statistique des conditions d’application est devenue un standard incontournable de rigueur. Les comités de rédaction des revues internationales de premier rang exigent désormais que les chercheurs documentent de manière transparente les diagnostics réalisés en amont de toute inférence paramétrique.
2. Vue d’ensemble des trois postulats fondamentaux du test t apparié
2.1 Cartographie conceptuelle des trois conditions d’application
L’application légitime d’un test t de Student pour échantillons appariés repose formellement sur une triade de conditions méthodologiques et probabilistes. Il importe de souligner d’emblée que ces conditions ne s’appliquent pas de manière disjointe aux deux séries de mesures brutes initiales (avant et après intervention), mais bien à la variable univariée résultante : la série des scores de différence individuels. Ces trois postulats cardinaux sont les suivants :
- Postulat 1 : L’indépendance mutuelle des paires d’observations. Chaque unité d’observation (chaque dyade, chaque sujet mesuré deux fois) doit être totalement indépendante de toutes les autres unités composant l’échantillon global. Si les deux mesures d’une même paire sont intrinsèquement corrélées (ce qui fonde la logique même du plan intra-sujet), aucune corrélation, influence ou contagion ne doit exister entre les différentes paires.
- Postulat 2 : La distribution normale de la population des scores de différence. La variable aléatoire D représentant l’écart entre les deux conditions doit suivre une loi normale dans la population d’où provient l’échantillon. Cette normalité conditionne directement l’exactitude de la dérivation théorique du ratio de Student et la conformité de la distribution d’échantillonnage de la moyenne des écarts.
- Postulat 3 : L’absence de valeurs aberrantes extrêmes (outliers) dans la distribution des différences. Les écarts observés ne doivent pas comporter de scores excessivement distants du centre de la distribution, car la moyenne arithmétique et l’écart-type — composants fondamentaux de la statistique t — possèdent un degré de résistance mathématique nul face aux observations discordantes.
Ces trois exigences opèrent de manière concertée au sein de la machine inférentielle. L’indépendance garantit que l’information contenue dans chaque degré de liberté est unique et non redondante. La normalité assure que les fluctuations d’échantillonnage épousent fidèlement la distribution analytique de référence. L’absence de valeurs extrêmes protège l’estimation de l’amplitude de l’effet et de l’erreur type contre des distorsions disproportionnées.
2.2 Idées reçues fréquentes sur les conditions du test apparié
La littérature méthodologique relève un ensemble récurrent de méconceptions relatives aux prérequis du test t apparié, souvent colportées par des manuels introductifs simplificateurs. La première confusion conceptuelle — et sans doute la plus répandue — consiste à exiger que la variable dépendante suive une loi normale au sein de la condition pré-test et au sein de la condition post-test prises isolément. Cette exigence est rigoureusement non fondée. Il est tout à fait possible que les distributions des mesures X1 et X2 soient asymétriques, bimodales ou uniformes, tandis que la distribution de leur soustraction arithmétique D = X1 – X2 adopte une morphologie gaussienne parfaitement symétrique en vertu de la compensation des structures de covariation.
La deuxième idée reçue concerne l’homogénéité des variances (l’homoscédasticité). De nombreux praticiens tentent d’exécuter un test de Levene préalablement à un test t apparié, croyant devoir vérifier l’égalité des variances entre les temps 1 et 2. Or, le test t apparié ne postule en aucune manière l’égalité des variances entre les deux conditions de mesure. Le calcul mathématique s’opère exclusivement sur la variance de la différence (sD2), rendant l’hypothèse d’homogénéité des variances entre les conditions totalement sans objet pour ce modèle mathématique univarié.
Enfin, une troisième erreur réside dans l’invocation aveugle du Théorème Central Limite (TCL). S’il est exact que le TCL assure la convergence asymptotique de la distribution d’échantillonnage de la moyenne vers une loi normale dès lors que la taille d’échantillon devient substantielle (souvent approximée par convention à n ≥ 30), cela ne confère pas une immunité absolue au test t. En présence de distributions fortement asymétriques ou à queues particulièrement épaisses, et tout particulièrement en présence de valeurs aberrantes, la convergence est nettement plus lente, nécessitant parfois des centaines d’observations pour stabiliser le taux nominal d’erreur alpha.
3. Postulat 1 : Le principe d’indépendance des paires d’observations
3.1 Clarification conceptuelle : indépendance inter-paires contre dépendance intra-paire
Pour appréhender rigoureusement le premier postulat du test t apparié, il convient de distinguer avec une précision absolue deux niveaux de dépendance statistique opérant simultanément au sein des données : la dépendance intra-paire et l’indépendance inter-paires.
La dépendance intra-paire représente la raison d’être méthodologique du test apparié. Lorsque l’on mesure la performance d’un même individu à l’instant t1 puis à l’instant t2, il existe une corrélation théorique et empirique non nulle entre ces deux scores. Mathématiquement, la covariance Cov(X1, X2) est positive et substantielle, car un sujet hautement performant au départ a tendance à le demeurer lors de la seconde session. Cette covariance est directement exploitée par la formule de la variance de la différence :
Var(D) = Var(X1) + Var(X2) – 2 × Cov(X1, X2)
Lorsque la covariance est positive, le terme soustractif réduit drastiquement la variance globale de la différence Var(D), ce qui diminue d’autant l’erreur type et confère au test sa puissance statistique remarquable.
À l’opposé, l’indépendance inter-paires exige que chaque paire d’observations soit strictement non corrélée à toute autre paire présente dans l’échantillon expérimental. En termes probabilistes, la probabilité conjointe d’observer une différence donnée pour la paire j sachant la différence observée pour la paire k doit être égale au produit de leurs probabilités marginales :
P(Dj ∩ Dk) = P(Dj) × P(Dk) pour tout j ≠ k
Cela signifie qu’aucune information ne peut être déduite sur le score de différence d’un participant à partir des scores différentiels des autres participants. Si ce principe de cloisonnement stochastique est rompu, la base même du calcul du nombre de degrés de liberté (n – 1) s’effondre, car les données apportent une quantité d’information empirique inférieure à ce que prétend le nombre d’observations comptabilisées.
3.2 Menaces méthodologiques courantes sur l’indépendance en recherche psychologique
L’indépendance des observations est sans doute le postulat le plus critique, mais paradoxalement le plus vulnérable aux imperfections de la collecte des données. Dans les protocoles en sciences humaines et comportementales, plusieurs sources d’interférence écologique peuvent corrompre cette indépendance sans que l’analyste n’en prenne immédiatement conscience.
Une première menace classique concerne les effets de contamination ou de communication inter-sujets. Considérons une étude évaluant l’efficacité d’une technique d’apprentissage mnémotechnique selon un schéma pré-test / post-test. Si des participants appartenant à une même cohorte universitaire interagissent entre les sessions et partagent des astuces ou discutent des épreuves administrées, les performances de certains sujets ne sont plus autonomes mais deviennent fonction des interactions sociales au sein du réseau d’étudiants. Les paires d’observations deviennent ainsi dépendantes les unes des autres.
Une seconde menace découle des effets de grappe (ou effets de groupe/classe) lors de l’administration collective des protocoles. Lorsque des participants sont évalués simultanément au sein d’une même salle ou par un même expérimentateur doté d’une posture spécifique, des variables environnementales parasites non contrôlées (telles que le niveau sonore ambiant, la luminosité, la température ou de subtiles variations dans l’énoncé des consignes) influencent l’ensemble des individus de cette session de manière uniforme. Les scores des sujets testés dans la session A partageront une covariance résiduelle systématique qui les distinguera des sujets de la session B, brisant irrémédiablement l’indépendance inter-paires.
Enfin, les dépendances sérielles ou temporelles surviennent fréquemment dans les contextes où les participants sont testés séquentiellement sur un même appareil expérimental tout au long d’une journée ou sur plusieurs semaines. Si l’instrumentation subit une dérive technique graduelle (échauffement d’un capteur biomédical, recalibrage d’un oculomètre), ou si l’expérimentateur accumule de la fatigue au fil des passations, les scores de différence des paires testées consécutivement dans le temps manifesteront une autocorrélation temporelle résiduelle proscrite par le modèle linéaire univarié.
4. Méthodes d’évaluation du postulat d’indépendance
4.1 Contrôle à la source par le plan expérimental et l’échantillonnage aléatoire
Il est fondamental de reconnaître une réalité mathématique incontournable : l’indépendance des observations ne peut pas être démontrée empiriquement ou formellement validée de manière rétrospective par un simple test statistique. Elle doit avant tout être garantie en amont par la rigueur du devis expérimental et le processus d’échantillonnage. Contrairement à la normalité qui se vérifie sur les chiffres obtenus, l’indépendance est une propriété inhérente au protocole de collecte.
Pour immuniser une étude contre les ruptures d’indépendance, le chercheur doit appliquer des règles méthodologiques préventives strictes :
- Échantillonnage probabiliste : Tirer les unités expérimentales de façon véritablement aléatoire au sein de la population cible, en évitant les filières de recrutement pyramidales ou les réseaux de connaissances où les individus sont corrélés entre eux.
- Passation individuelle et isolation : Réaliser les passations expérimentales de manière individuelle dans un environnement standardisé, insonorisé et contrôlé, afin d’éradiquer toute interaction entre participants ou toute influence environnementale partagée.
- Contrebalancement et randomisation de l’ordre : Si les mesures répétées portent sur deux conditions expérimentales (par exemple, Tâche sous musique versus Tâche en silence), l’ordre d’administration doit être strictement contrebalancé (la moitié des participants commence par la musique, l’autre moitié par le silence) afin d’éviter que les effets d’apprentissage ou d’épuisement n’induisent une dépendance systématique liée à la séquence.
- Procédures de double aveugle : Neutraliser les attentes de l’expérimentateur qui pourraient le conduire à interagir différemment avec des sous-groupes de participants, uniformisant ainsi l’erreur de mesure sur l’ensemble de la cohorte.
4.2 Analyses statistiques diagnostiques de l’autocorrélation
Bien que l’indépendance absolue ne se prouve pas, il demeure possible et fortement recommandé de procéder à des audits diagnostiques quantitatifs visant à détecter des signaux avérés de dépendance sérielle ou hiérarchique au sein des résidus de la différence. Lorsque les données ont été recueillies de manière ordonnée au fil du temps, l’analyse d’autocorrélation temporelle s’avère indispensable.
Le test de Durbin-Watson, traditionnellement appliqué aux résidus des modèles de régression linéaire, peut être directement mobilisé sur la variable des différences ordonnée selon l’ordre chronologique de collecte :
d = ∑i=2n (ei – ei-1)2 / ∑i=1n ei2
Où ei = Di – D̄ représente l’écart entre la différence individuelle et la différence moyenne. Une valeur de d proche de 2 indique l’absence totale d’autocorrélation du premier ordre. Des valeurs tendant vers 0 trahissent une corrélation positive substantielle entre paires consécutives, tandis que des valeurs proches de 4 signalent une alternance négative systématique. La visualisation du corrélogramme (fonction d’autocorrélation ou ACF) permet de sonder des décalages temporels (lags) d’ordre supérieur.
Dans les contextes où les données comportent une structure de regroupement potentiel (comme des élèves nichés dans différentes écoles, ou des patients suivis par différents thérapeutes), le diagnostic repose sur le calcul du Coefficient de Corrélation Intraclasse (ICC) au moyen d’une analyse de variance à effets aléatoires. Un ICC non nul appliqué aux scores de différence :
ICC = σentre2 / (σentre2 + σintra2)
révèle qu’une proportion substantielle de la variance des différences est explicable par l’appartenance au groupe, disqualifiant immédiatement l’hypothèse d’indépendance inter-paires si ce coefficient excède les seuils tolérés (généralement ICC > 0,05).
5. Conséquences de la violation de l’indépendance et solutions méthodologiques
5.1 Impact probabiliste d’une dépendance résiduelle entre les paires
Parmi l’ensemble des postulats des tests paramétriques, la violation de l’indépendance est unanimement reconnue par les statisticiens mathématiciens comme étant la plus dévastatrice pour la validité inférentielle. Contrairement aux écarts à la normalité face auxquels le test t fait preuve d’une robustesse appréciable lorsque les effectifs augmentent, aucune propriété de convergence ne vient corriger une rupture d’indépendance.
L’effet probabiliste direct d’une corrélation positive non prise en compte entre les paires d’observations est la sous-estimation massive de l’erreur type de la moyenne des différences. En présence d’une covariance positive inter-paires, les observations se répètent partiellement les unes les autres : l’échantillon ne contient pas autant d’informations indépendantes que le nombre nominal d’unités n le suggère. La taille effective d’échantillon (neff) est en réalité inférieure à la taille observée. L’erreur type calculée par le progiciel statistique est donc artificiellement comprimée :
SEbiaisée << SEréelle
Puisque la statistique t est le résultat de la division de la différence observée par cette erreur type, la valeur de t se trouve artificiellement gonflée. Le chercheur observe alors des valeurs t démesurément élevées associées à des valeurs de p extrêmement faibles, le conduisant à rejeter l’hypothèse nulle à tort dans des proportions alarmantes. Des études de simulation de Monte Carlo ont démontré qu’une corrélation inter-paires résiduelle aussi ténue que ρ = 0,10 peut faire bondir le taux d’erreur de première espèce réel au-dessus de 15 % ou 20 % pour un seuil théorique fixé à α = 0,05. Les intervalles de confiance calculés autour de la taille d’effet s’avèrent de facto beaucoup trop étroits, conférant un sentiment fallacieux de précision métrique.
5.2 Modélisations alternatives adaptées aux données dépendantes
Lorsque la structure de collecte des données comporte inévitablement des dépendances hiérarchiques, géographiques, temporelles ou groupées, l’abandon du test t pour échantillons appariés s’impose impérativement. Le chercheur doit alors basculer vers des architectures analytiques conçues spécifiquement pour intégrer et modéliser la dépendance résiduelle.
La solution reine réside dans l’emploi des Modèles Linéaires Mixtes (LMM – Linear Mixed-Effects Models), également désignés sous le vocable de modélisation multiniveau ou hiérarchique. Dans ce cadre, la variable dépendante reste la mesure brute répétée, mais l’architecture permet d’estimer simultanément des effets fixes (l’effet moyen de la condition ou du temps) et des effets aléatoires (les trajectoires individuelles de chaque sujet, mais également l’effet de grappe lié au groupe, à la classe ou au thérapeute) :
Yijk = β0 + β1 × Conditionijk + u0j + v0k + εijk
Dans ce modèle formel, u0j capture la variabilité interindividuelle aléatoire des sujets et v0k modélise la variance résiduelle imputable aux groupes ou grappes. L’erreur type de l’effet de la condition (β1) est alors ajustée de manière non biaisée, restituant à l’inférence sa validité probabiliste exacte.
Une seconde alternative éprouvée, issue de l’épidémiologie et de la biomédecine, réside dans les Équations d’Estimation Généralisées (GEE – Generalized Estimating Equations). Plutôt que de modéliser explicitement les variations individuelles, l’approche GEE spécifie une « matrice de corrélation de travail » (autorégressive, échangeable ou non structurée) pour tenir compte de la covariance entre les mesures au sein d’un même groupe ou d’une même unité, tout en utilisant des estimateurs de variance dits « sandwich » ou robustes de Huber-White, insensibles à la mauvaise spécification mineure de la structure de dépendance.
6. Postulat 2 : La normalité de la distribution des scores de différence
6.1 Fondement mathématique du critère de normalité univariée des écarts
Le deuxième pilier formel du test t apparié est le postulat selon lequel la population d’où est extrait l’échantillon des scores de différence suit une loi normale de paramètres moyenne μD et variance σD2, ce qui s’écrit formellement :
D ~ N(μD, σD2)
La nécessité de cette condition découle directement de la construction théorique originelle de William Sealy Gosset (sous le pseudonyme de « Student ») en 1908. Pour que le ratio empirique :
(D̄ – μD) / (sD / √n)
suive rigoureusement une loi de Student à n – 1 degrés de liberté, deux conditions mathématiques conjointes doivent être remplies : le numérateur (la moyenne d’échantillon D̄) doit être distribué normalement, et le terme (n – 1)sD2 / σD2 au dénominateur doit suivre indépendamment une distribution du Khi-deux (χ2) à n – 1 degrés de liberté. Cette dernière exigence n’est vérifiée que si la variable d’origine D est elle-même rigoureusement normale.
Il est crucial de réitérer avec force la distinction conceptuelle entre la normalité des distributions initiales et la normalité de la différence. Soient deux variables aléatoires X1 et X2. Même si ni X1 ni X2 ne sont individuellement distribuées selon la loi normale, leur différence linéaire D = X1 – X2 peut parfaitement épouser une courbe en cloche symétrique. Inversement, deux distributions univariées marginalement normales peuvent engendrer des différences non normales si leur structure de dépendance conjointe est non linéaire. Le didacticien et le statisticien appliqués ne doivent donc porter leur regard que sur l’objet mathématique effectivement soumis au test : le vecteur différentiel univarié D.
6.2 Influence de l’asymétrie et de l’aplatissement sur la distribution d’échantillonnage
Lorsque la population des scores différentiels dévie de la forme théorique gaussienne, cette distorsion s’exprime principalement à travers deux moments d’ordre supérieur de la distribution : le coefficient d’asymétrie (skewness) et le coefficient d’aplatissement ou de voussure (kurtosis).
L’asymétrie (skewness) exerce l’effet le plus délétère sur la statistique de Student. Dans une distribution asymétrique (positivement ou négativement), la moyenne arithmétique D̄ et la variance d’échantillon sD2 cessent d’être statistiquement indépendantes : elles deviennent corrélées. Par conséquent, la distribution d’échantillonnage de la statistique t n’est plus symétrique autour de zéro sous l’hypothèse nulle ; elle devient elle-même asymétrique. Les valeurs critiques théoriques issues des tables de Student ne correspondent plus aux véritables quantiles empiriques. Si l’on applique un test unilatéral (par exemple en formulant l’hypothèse que D̄ > 0), une asymétrie de la population induit un déséquilibre majeur :
- Une asymétrie positive engendre une sous-estimation du risque d’erreur de première espèce dans une queue de la distribution et une sur-estimation critique dans l’autre queue.
- Le taux nominal α = 0,05 peut ainsi correspondre à un taux réel de 0,01 pour un côté du test et de 0,09 pour le côté opposé. Pour les tests bilatéraux, une compensation partielle intervient entre les deux queues, mais la validité de l’intervalle de confiance demeure profondément compromise.
L’aplatissement (kurtosis), et particulièrement la leptocurticité (caractérisée par un excès de kurtosis positif, c’est-à-dire des queues de distribution épaisses et un pic central aiguisé), altère la variabilité de la variance d’échantillon sD2. La présence de queues épaisses signifie que l’échantillon a une probabilité non négligeable de produire des estimations extrêmes de la variance, déstabilisant le dénominateur de la statistique t. Le résultat direct en est une perte notable de puissance statistique du test : le dénominateur ayant tendance à être surévalué en présence d’écarts occasionnels importants, la valeur t s’effondre vers zéro, masquant des effets réels pourtant cliniquement ou scientifiquement substantiels.
7. Diagnostics graphiques et tests formels d’évaluation de la normalité
7.1 Outils de diagnostic visuel des scores de différence
L’évaluation rigoureuse de la normalité requiert une démarche en deux volets, accordant une priorité heuristique fondamentale aux méthodes d’inspection graphique. Les représentations visuelles permettent en effet d’appréhender la morphologie globale des données, de situer les déviations (centre ou queues) et d’éviter les pièges inhérents aux tests formels d’hypothèse.
Le diagramme quantile-quantile normal (Normal Q-Q Plot) constitue sans conteste l’outil de référence absolu. Il met en relation graphique les quantiles observés au sein de la série des scores de différence empiriques avec les quantiles théoriques attendus sous une loi normale standardisée parfaite :
(zthéorique (i) , Dobservé (i))
Si la variable D est rigoureusement normale, les points s’alignent étroitement le long d’une droite de référence diagonale à 45 degrés. Tout écart systématique par rapport à cette droite révèle une pathologie distributionnelle spécifique :
- Une courbure convexe ou concave continue traduit une asymétrie marquée (la queue s’éloigne prématurément de la trajectoire linéaire).
- Une morphologie sigmoïde en « S » ou « S inversé » trahit une anomalie d’aplatissement : des extrémités qui se relèvent brusquement traduisent des queues particulièrement lourdes (distribution leptocurtique), tandis que des extrémités qui s’aplatissent prématurément indiquent des queues courtes ou tronquées (distribution platycurtique).
L’histogramme de densité, enrichi de la superposition d’un estimateur de densité par noyau (Kernel Density Estimation) et de la courbe de Gauss théorique ajustée sur les mêmes paramètres de moyenne et d’écart-type, permet d’apprécier la symétrie centrale et l’unimodalité des données. Les représentations en boîtes à moustaches (boxplots) offrent quant à elles une lecture immédiate du positionnement de la médiane par rapport aux quartiles supérieur et inférieur (révélant l’asymétrie) et de la longueur relative des moustaches.
7.2 Batterie de tests statistiques d’ajustement à la loi normale
Pour étayer l’inspection visuelle par des métriques probabilistes objectivables, la communauté méthodologique s’appuie sur une batterie de tests d’adéquation (tests de normalité). Chacun de ces outils mathématiques possède des sensibilités algorithmiques distinctes :
- Le test de Shapiro-Wilk (W) : Considéré par un consensus quasi universel comme le test formel le plus puissant pour des échantillons de taille petite à modérée (n < 50). Il calcule le ratio entre l’estimateur au sens des moindres carrés de la pente du diagramme Q-Q et la variance d’échantillon classique. Une valeur de W proche de 1 atteste de la normalité ; une valeur significativement inférieure (associée à p < 0,05) conduit au rejet de l’hypothèse de normalité.
- Le test d’Anderson-Darling (A2) : Cette procédure apporte un raffinement notable au test classique de Kolmogorov-Smirnov en intégrant un système de pondération spécifique qui attribue un poids supérieur aux écarts survenant dans les queues de la distribution. Il est particulièrement recommandé lorsque le statisticien redoute la présence de queues lourdes susceptibles de compromettre la variance d’échantillonnage.
- Le test de Kolmogorov-Smirnov avec correction de Lilliefors : Historiquement très répandu, ce test compare la fonction de répartition empirique à la fonction théorique normale cumulée. Cependant, ses performances statistiques sont notoirement limitées. Sa puissance est médiocre face aux échantillons restreints, et son usage exclusif est aujourd’hui déconseillé au profit de Shapiro-Wilk.
Une mise en garde épistémologique majeure s’impose quant à l’interprétation des tests formels d’adéquation. Sous l’influence directe de la taille d’échantillon, ces tests souffrent de deux limitations symétriques :
- Sur des petits échantillons (ex. n = 12) : Les tests de normalité manquent cruellement de puissance. Ils échouent régulièrement à détecter des déviations majeures par rapport à la loi normale (débouchant sur des valeurs p > 0,05 faussement rassurantes).
- Sur des grands échantillons (ex. n = 500) : La puissance statistique devient excessivement élevée. Le test rejettera l’hypothèse de normalité (p < 0,001) pour des micro-déviations triviales et asymptotiquement inoffensives qui ne menaceraient en rien l’inférence du test t. Le chercheur chevronné confrontera systématiquement le p-value de Shapiro-Wilk aux ratios standardisés d’asymétrie et de voussure (calculés comme Skewness / SEskew et Kurtosis / SEkurt), considérés comme problématiques uniquement s’ils s’écartent drastiquement de l’intervalle [-2 ; +2].
8. Stratégies palliatives face à la non-normalité des différences
8.1 Transformations mathématiques de la variable de différence
Lorsqu’un faisceau de preuves convergentes (confrontant diagnostics graphiques et tests formels) atteste d’une non-normalité substantielle des scores de différence, le recours direct au test t classique doit être proscrit. Une première voie de remédiation paramétrique réside dans l’application de transformations mathématiques non linéaires.
L’objectif d’une transformation est de comprimer l’espace métrique dans les zones de dispersion excessive afin de restaurer la symétrie et la morphologie gaussienne. Les fonctions les plus couramment sollicitées incluent :
- La transformation logarithmique (naturelle ou base 10) : Particulièrement efficace pour corriger une asymétrie positive prononcée. Cependant, dans le cadre d’un test apparié, les scores de différence D comportent fréquemment des valeurs nulles ou négatives. L’application du logarithme exige alors l’ajout préalable d’une constante scalaire d’ajustement c telle que Dtransf = ln(D + c) avec c > |min(D)|. Alternativement, le statisticien peut appliquer la transformation directement sur les scores bruts avant soustraction : ln(X1) et ln(X2), la différence logarithmique équivalant au logarithme du ratio des performances.
- La transformation racine carrée : Adaptée aux asymétries positives modérées, fréquemment rencontrée dans l’analyse de données de comptage.
- La famille de transformations de Box-Cox : Cette approche paramétrique identifie de façon algorithmique le paramètre optimal λ qui maximise la vraisemblance de normalité de la variable transformée par :
y(λ) = (yλ – 1) / λ si λ ≠ 0, et ln(y) si λ = 0
Bien que mathématiquement élégantes, les transformations posent un défi herméneutique majeur : elles altèrent l’échelle de mesure originelle. Interpréter la moyenne d’une différence de logarithmes ou de racines carrées se révèle conceptuellement abstrait pour les cliniciens et praticiens, rendant la communication des résultats et le calcul de tailles d’effet brutes particulièrement ardus.
8.2 Alternatives non paramétriques et approches par rééchantillonnage
Face aux écueils interprétatifs des transformations, l’orientation moderne de l’analyse des données privilégie le recours à des approches non paramétriques ou computationnelles exemptes d’exigences distributionnelles strictes.
L’alternative non paramétrique classique par excellence est le test des rangs signés de Wilcoxon (Wilcoxon signed-rank test). Ce test s’affranchit du postulat de normalité en substituant aux grandeurs métriques réelles leurs rangs relatifs ordonnés :
- On calcule les différences absolues |Di| pour chaque paire en excluant provisoirement les paires nulles.
- On attribue un rang croissant allant de 1 à n’ à ces valeurs absolues.
- On réassigne à chaque rang le signe arithmétique initial de la différence (positif ou négatif).
- On effectue la somme des rangs positifs (W+) et la somme des rangs négatifs (W–).
Sous l’hypothèse nulle d’un positionnement médian centré à zéro et d’une distribution symétrique de la différence, la distribution théorique de la statistique W est tabulée de manière exacte ou approximée par la loi normale pour des effectifs plus larges. Il convient néanmoins de souligner que le test de Wilcoxon requiert que la distribution des différences soit au moins approximativement symétrique pour tester formellement une hypothèse sur la médiane ; si l’asymétrie est totale, il se transforme en un simple test de dominance stochastique.
Une approche encore plus fondamentale et minimaliste est le test des signes, qui ne comptabilise que la direction du changement (le signe + ou -), convertissant le problème en une loi binomiale exacte de paramètre p = 0,5. Bien que robuste à toute forme distributionnelle, ce test souffre d’un manque criant de puissance statistique.
Enfin, les méthodes computationnelles de bootstrap non paramétrique représentent le standard contemporain le plus robuste. En rééchantillonnant avec remise des milliers de fois (par exemple B = 10 000 réplications) la série empirique des scores de différence, on reconstruit numériquement la distribution d’échantillonnage de la moyenne sans formuler la moindre supposition théorique quant à la normalité populationnelle. Le calcul d’un intervalle de confiance bootstrap corrigé des biais et accéléré (BCa – bias-corrected and accelerated) permet de déterminer avec une fiabilité optimale si l’effet moyen inclut ou exclut la valeur zéro, fournissant une inférence robuste d’une précision remarquable.
9. Postulat 3 : L’absence de valeurs aberrantes extrêmes dans les différences
9.1 Nature et typologie des valeurs aberrantes dans les scores de différence
Le troisième postulat indispensable à la bonne marche inférentielle du test t apparié réside dans l’absence de valeurs aberrantes (outliers) au sein de la série des scores de différence D. Une valeur aberrante est formellement définie comme une observation qui dévie de manière si substantielle des autres éléments de l’échantillon qu’elle suscite le soupçon légitime d’avoir été générée par un mécanisme sous-jacent fondamentalement différent.
Une confusion récurrente doit être impérativement dissipée : une valeur aberrante sur les mesures brutes ne produit pas nécessairement une différence aberrante, et inversement. Considérons un sujet présentant un score extrêmement élevé au temps 1 et un score tout aussi exceptionnellement élevé au temps 2 (par exemple un sujet très âgé ou doté d’une expertise exceptionnelle). Sa différence arithmétique Di = X1i – X2i peut s’avérer parfaitement conforme au comportement moyen du groupe. À l’opposé, un participant affichant des scores bruts parfaitement banals aux deux sessions peut manifester une inversion radicale et inexpliquée de performance, engendrant un score différentiel colossal qui se détachera de manière disruptive du reste de la cohorte.
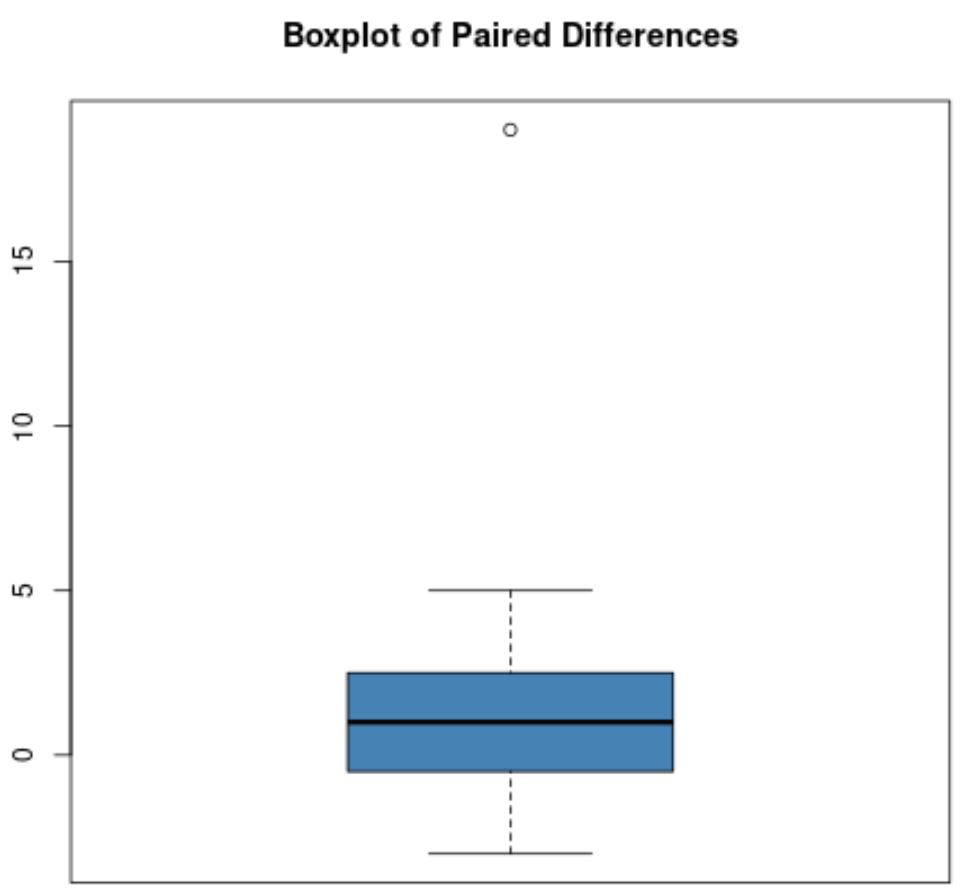
Sur le plan ontologique, les valeurs aberrantes observées dans les cohortes psychologiques ou biomédicales se divisent en deux catégories étiologiques bien distinctes :
- Les aberrations mécaniques ou artéfactuelles : Elles découlent d’une anomalie technique dans le processus de mesure ou de manipulation des données. Cela inclut l’erreur de saisie manuelle (fautes de frappe), une défaillance ponctuelle du matériel de mesure numérique (comme un capteur EEG qui décroche), la non-compréhension manifeste des consignes par un sujet expérimental, ou une tricherie délibérée. Ces points constituent des données factuellement invalides qui corrompent l’échantillon.
- Les aberrations substantielles ou écologiques : Elles reflètent une réelle variabilité biologique ou psychologique individuelle. Il s’agit d’un individu réagissant de manière hautement idiosyncrasique à une intervention (un « super-répondeur » ou un patient subissant un effet secondaire clinique violent). Ces données sont empiriquement authentiques, mais leur dynamique singulière entre en contradiction directe avec le modèle statistique de la tendance centrale gaussienne.
9.2 Conséquences statistiques de la contamination par valeurs aberrantes
L’extrême sensibilité du test t apparié à l’action d’une seule valeur aberrante découle de l’absence totale de robustesse statistique de ses estimateurs fondamentaux : la moyenne arithmétique et l’écart-type. Le point de rupture (breakdown point) de ces deux métriques est de 1/n, signifiant qu’une unique valeur arbitrairement déviante suffit à déplacer la moyenne ou à faire exploser la variance vers l’infini.
L’impact statistique d’une valeur aberrante sur le test t peut s’exercer de deux manières antagonistes, mais identiquement néfastes pour la véracité de la conclusion :
- La destruction de puissance statistique (faux négatif) : Lorsqu’une valeur aberrante survient dans la distribution des différences, son impact est décuplé dans le calcul de la somme des écarts quadratiques :
∑ (Di – D̄)2
L’écart-type sD s’accroît alors de façon exponentielle. Puisque l’erreur type sD / √n constitue le dénominateur du ratio de Student, ce gonflement artificiel de la variance dilue littéralement la statistique t, dont la valeur s’effondre. Un effet expérimental globalement partagé par l’immense majorité des sujets peut ainsi devenir totalement indétectable sur le plan statistique en raison de la présence d’une seule dyade discordante qui sature l’erreur de mesure.
- L’amplification fallacieuse de l’effet (faux positif) : Si l’observation aberrante est excessivement distante dans la direction théorique attendue par le chercheur, son levier arithmétique peut déplacer la moyenne D̄ de l’ensemble de l’échantillon, générant une différence significative globale alors que l’ensemble des autres participants ne présente aucun changement mesurable. La conclusion scientifique finale attribuera indûment une efficacité générale à un processus clinique ou cognitif qui n’a en fait été exprimé que par une anomalie isolée.
10. Détection statistique et diagnostic des valeurs aberrantes
10.1 Méthodes basées sur la dispersion et la médiane
Pour dépister avec certitude les observations discordantes au sein de la série D, le chercheur doit mobiliser des outils statistiques résistants, c’est-à-dire non influencés par les valeurs aberrantes qu’ils sont précisément chargés de localiser. Les métriques basées sur l’écart-type classique sont inopérantes à cette fin, car l’aberration gonfle la jauge même qui cherche à la mesurer (phénomène de masquage statistique ou masking effect).
La première ligne diagnostique repose sur la règle empirique de John Tukey, structurée autour des quartiles et de l’Écart Interquartile (IQR), défini par :
IQR = Q3 – Q1
Tukey définit deux barrières méthodologiques rigoureuses pour classifier les observations suspectes :
- Clôtures intérieures (valeurs aberrantes modérées) : Tout score de différence situé en dehors de l’intervalle :
[ Q1 – 1,5 × IQR ; Q3 + 1,5 × IQR ]
Ces points sont généralement représentés sous la forme de points isolés au-delà des moustaches sur un diagramme en boîte.
- Clôtures extérieures (valeurs aberrantes extrêmes) : Tout score de différence franchissant le seuil critique :
[ Q1 – 3,0 × IQR ; Q3 + 3,0 × IQR ]
La présence de tels points signale une violation critique absolue qui invalide toute application brute du test t standard.
Une alternative encore plus sophistiquée et résistante consiste à recourir à l’Écart Absolu Médian (MAD – Median Absolute Deviation), popularisé par Peter Rousseeuw. Le MAD est formellement défini comme la médiane des écarts absolus par rapport à la médiane de l’échantillon :
MAD = médiane( |Di – médiane(D)| )
En multipliant le MAD par un facteur de consistance normalisée (1,4826 pour une distribution normale), on obtient un estimateur d’échelle robuste MADσ. Le calcul d’un score Z robuste pour chaque score de différence individuel s’obtient alors par :
Zrobuste (i) = (Di – médiane(D)) / (1,4826 × MAD)
Tout individu présentant une valeur absolue |Zrobuste| > 2,5 ou > 3 est formellement étiqueté comme une valeur discordante majeure à investiguer méthodologiquement.
10.2 Diagnostics numériques standardisés
Aux côtés des approches basées sur les rangs et la médiane, des indices de diagnostic numérique standardisés peuvent être extraits en modélisant le test t apparié sous sa forme équivalente de régression linéaire univariée ou de modèle linéaire général. Dans ce cadre formel, l’interception du modèle représente la moyenne des différences, et chaque observation individuelle se voit assigner des indices d’influence géométrique.
Le calcul des scores Z classiques standardisés est couramment mentionné dans la littérature :
zi = (Di – D̄) / sD
Dans les échantillons d’effectifs modérés à élevés, le seuil conventionnel classique d’admission stipule que toute observation telle que |zi| > 3,29 (correspondant à une probabilité théorique inférieure à p = 0,001 dans une loi normale) doit être considérée comme potentiellement aberrante. Toutefois, en raison du phénomène d’entraînement de la moyenne et de l’écart-type par la valeur extrême, cet indice standardisé tend à sous-détecter les anomalies dans les très petits échantillons.
L’adaptation de la Distance de Cook (DCook) au cadre des scores appariés offre une quantification directe de l’effet de levier exercé par chaque dyade. La distance de Cook évalue de combien l’estimation globale de l’effet moyen se déplacerait si l’observation i était purement et simplement retirée du modèle :
DCook (i) = ∑ (D̂j – D̂j(i))2 / (p × MSE)
Toute valeur de distance de Cook franchissant le seuil heuristique DCook > 4/n ou s’approchant de 1 signale une observation excessivement influente qui dicte de manière disproportionnée l’issue du calcul inférentiel.
Enfin, l’examen bidimensionnel conjoint au moyen de la distance de Mahalanobis appliquée aux variables brutes appariées (X1, X2) permet de détecter si une observation ne brise pas la structure de corrélation conjointe bivariée, consolidant ainsi la granularité du diagnostic avant même la phase de soustraction arithmétique.
11. Gestion méthodologique et statistique des valeurs aberrantes
11.1 Protocoles de traitement des données discordantes
Dès lors que des valeurs discordantes extrêmes ont été formellement identifiées au sein de la série des scores de différence, une posture scientifique rigoureuse exclut toute suppression mécanique ou aveugle. L’éradication injustifiée de données constitue une pratique de recherche discutable (Questionable Research Practice) assimilable à une manipulation sélective (p-hacking).
Le processus décisionnel de traitement doit être rigoureusement hiérarchisé :
- Vérification d’erreur matérielle : Si l’investigation méthodologique révèle de manière incontestable une erreur de frappe (par exemple un temps de réaction encodé à 15000 ms au lieu de 1500 ms) ou une avarie technique documentée du capteur de mesure, l’observation est immédiatement corrigée à partir de la trace source ou formellement supprimée.
- Règles d’exclusion a priori : Si l’aberration provient d’une non-conformité aux critères d’inclusion (par exemple, un participant a pris un médicament proscrit juste avant la passation), l’exclusion est légitime, à la condition expresse que ces critères aient fait l’objet d’un pré-enregistrement formel ou d’une description méthodologique préalable.
- Procédures d’élagage (Trimming) symétrique : Lorsque les valeurs aberrantes sont authentiques mais menacent la représentativité de la moyenne, le chercheur peut appliquer un élagage symétrique (par exemple à 10 % ou 20 %). Dans un élagage à 20 %, les 20 % des scores les plus faibles et les 20 % des scores les plus élevés sont éliminés, et l’inférence est conduite sur la moyenne élaguée au moyen du test t de Yuen pour échantillons dépendants. Le test de Yuen ajuste les degrés de liberté effectifs et redéfinit l’erreur type sur la base de la variance winsorisée, restaurant une précision statistique irréprochable.
- Winsorisation des différences : Plutôt que de supprimer les observations extrêmes (ce qui réduit la taille d’échantillon n), la technique de winsorisation consiste à remplacer les valeurs situées au-delà d’un percentile défini (par exemple le 5e et le 95e percentile) par la valeur exacte de ce percentile. Cette manipulation préserve la structure de taille de l’échantillon tout en neutralisant l’effet d’entraînement des queues de distribution sur l’estimation centrale.
11.2 Analyses de sensibilité et robustesse de la décision inférentielle
L’exigence éthique de transparence scientifique impose aujourd’hui l’exécution systématique d’analyses de sensibilité face à la présence de valeurs discordantes. L’analyse de sensibilité consiste à conduire parallèlement le pipeline analytique complet sous deux conditions expérimentales computationnelles distinctes :
- Une analyse primaire incluant l’intégralité des observations recueillies, y compris les valeurs extrêmes identifiées.
- Une analyse secondaire conduite après exclusion ou traitement robuste des cas extrêmes.
Le tableau comparatif de ces deux modélisations doit être intégralement explicité dans le manuscrit scientifique. Le chercheur examine minutieusement la stabilité des conclusions inférentielles : la valeur de p franchit-elle ou non le seuil de signification de 0,05 selon le traitement appliqué ? L’estimation de la taille d’effet (d de Cohen apparié) subit-elle une variation marginale ou une déviation dramatique ?
Si les deux analyses mènent à des décisions statistiques convergentes (par exemple rejet de l’hypothèse nulle avec p < 0,01 dans les deux cas, et une fluctuation minime de la taille d’effet), la robustesse de la conclusion scientifique est établie de manière inattaquable. En revanche, si la signification statistique n’apparaît que lors de l’inclusion d’une valeur extrême et s’évapore instantanément dès qu’elle est écartée, le chercheur a le devoir déontologique de suspendre toute affirmation péremptoire quant à l’efficacité générale de l’intervention et de discuter la spécificité clinique de ce cas isolé.
Dans ce contexte, les méthodes de régression et d’estimation robuste au sens de Huber (M-estimateurs) apportent une solution mathématique élégante. L’estimateur de Huber attribue un poids continu unitaire aux observations centrales et applique une pondération graduellement décroissante aux observations distantes au prorata de leur éloignement, évitant ainsi la dichotomie arbitraire entre inclusion et exclusion.
12. Guide d’application pratique, reporting APA et liste de contrôle
12.1 Protocole séquentiel d’évaluation des postulats avant analyse
Afin de prémunir les praticiens contre les écueils analytiques, nous formalisons ci-dessous un protocole algorithmique rigoureux, structuré en quatre phases séquentielles indépendantes, à dérouler chronologiquement avant toute exploitation inférentielle de données appariées :
- Phase 1 : Audit méthodologique de l’indépendance inter-paires.
- Vérifier que les conditions de passation garantissent l’absence de contamination sociale ou de communication entre les sujets.
- Contrôler la randomisation ou le contrebalancement parfait de l’ordre des conditions expérimentales.
- S’assurer de l’absence d’effets de groupe cachés (calcul du coefficient de corrélation intraclasse ICC si les passations ont été réalisées par session ou par site). Si ICC > 0,05, basculer immédiatement vers un modèle linéaire mixte (LMM).
- Phase 2 : Construction de la variable différentielle et audit des valeurs aberrantes.
- Calculer rigoureusement la variable différentielle pour chaque participant : Di = XCondition2 (i) – XCondition1 (i).
- Générer un diagramme en boîte de Tukey et calculer le MAD ainsi que les scores Z robustes modifiés sur D.
- En présence de valeurs aberrantes extrêmes (|Zrobuste| > 3), procéder à l’audit étiologique (erreur matérielle versus variabilité réelle). Programmer l’exécution conjointe d’une analyse de sensibilité et envisager l’emploi du test de Yuen sur moyennes élaguées.
- Phase 3 : Évaluation de la normalité de la distribution des différences.
- Construire et inspecter attentivement le diagramme Q-Q plot de la variable D pour diagnostiquer l’asymétrie et la lourdeur des queues.
- Calculer les ratios standardisés d’asymétrie et de voussure, ainsi que la statistique du test de Shapiro-Wilk (pour n < 50).
- Si les données manifestent une déviation gaussienne sévère et non remédiable sans distorsion sur un petit échantillon (n < 30), rejeter le test t au profit du test des rangs signés de Wilcoxon ou de l’estimation par bootstrap non paramétrique (BCa).
- Phase 4 : Décision inférentielle et sélection du modèle final.
- Si l’ensemble des trois postulats est validé : exécution du test t apparié classique de Student.
- En cas de défaillance ciblée : application de la procédure alternative idoine dictée par l’architecture des violations constatées.
12.2 Normes de rédaction et de communication selon les standards APA 7
L’American Psychological Association, dans sa 7e édition des normes de publication (APA 7), prescrit une transparence totale dans la restitution des modélisations statistiques. L’époque où les auteurs se contentaient d’une ligne évasive mentionnant « t(24) = 2.45, p = .022 » est révolue. Le reporting des résultats doit documenter l’évaluation scrupuleuse de chaque postulat.
Le protocole de communication écrit en section Résultats doit intégrer harmonieusement les dimensions suivantes :
- Statistiques descriptives complètes : Mentionner la moyenne des différences, l’écart-type de la différence, ainsi que les moyennes et écarts-types des conditions brutes d’origine.
- Compte-rendu de la vérification des postulats : Mentionner explicitement les résultats des tests d’adéquation (valeur du test de Shapiro-Wilk et de son p-value), la conformité du Q-Q plot, et l’absence de valeurs aberrantes influentes (ou la teneur de l’analyse de sensibilité conduite).
- Résultat inférentiel paramétrique exact : Préciser la statistique t avec ses degrés de liberté entre parenthèses, la valeur exacte de la probabilité critique (p-value sans zéro initial, arrondie à trois décimales, ou p < .001), et le caractère bilatéral ou unilatéral du test.
- Taille d’effet et intervalle de confiance : Rapporter systématiquement une métrique standardisée de la taille d’effet, généralement le d de Cohen pour échantillons appariés (noté dz ou drm) ou le g de Hedges corrigé pour les petits échantillons, accompagné de son intervalle de confiance à 95 % (IC 95 %).
Voici un modèle rédactionnel académique exemplaire selon les critères APA 7 :
« Un test t de Student pour échantillons appariés a été conduit afin de déterminer l’effet d’un programme d’entraînement cognitif de six semaines sur les scores de mémoire de travail. L’évaluation préalable des postulats statistiques a confirmé l’adéquation des données au modèle paramétrique. L’inspection visuelle du diagramme quantile-quantile (Q-Q plot) a attesté de la normalité de la distribution des scores de différence, observation corroborée par le test de Shapiro-Wilk qui ne met pas en évidence d’écart statistiquement significatif à la normalité (W = 0,978, p = 0,682). L’analyse basée sur l’écart absolu médian (MAD) n’a révélé aucune valeur aberrante extrême au sein de la variable différentielle. L’analyse révèle une amélioration statistiquement significative des performances mnésiques consécutivement à l’entraînement (D̄ = 4,85, sD = 2,14) par rapport à la ligne de base (Mpré = 18,20, SDpré = 3,45 ; Mpost = 23,05, SDpost = 3,12), t(27) = 11,98, p < 0,001, test bilatéral. L’amplitude de cet effet est particulièrement robuste, comme en témoigne la taille d’effet calculée, dz = 2,26, IC 95 % [1,58 ; 2,93]. »
Dans l’éventualité où le chercheur a été contraint de basculer vers un test non paramétrique à la suite de la violation du postulat de normalité, la rédaction doit refléter cette adaptation avec une précision équivalente :
« En raison d’une asymétrie positive prononcée de la distribution des scores de différence et du rejet formel de la normalité par le test de Shapiro-Wilk (W = 0,812, p = 0,002), un test des rangs signés de Wilcoxon a été privilégié au test t apparié. L’analyse indique que la médiane des différences diffère significativement de zéro (Z = 3,41, p < 0,001), la performance médiane augmentant de manière substantielle post-intervention (Médiane = 12,00, IQR = 6,50) par rapport au pré-test (Médiane = 8,00, IQR = 4,00), r de Rosenthal = 0,62. »
12.3 Liste de contrôle méthodologique finale pour les chercheurs
Avant de sceller définitivement les analyses quantitatives d’une étude utilisant des mesures répétées et d’en soumettre le manuscrit à l’expertise par les pairs, chaque chercheur est invité à auditer son travail au moyen de la grille de contrôle méthodologique récapitulative suivante :
- [ ] Structure de la paire : La variable de soustraction a-t-elle été calculée dans une direction conceptuellement cohérente (ex. Post – Pré) et appliquée de façon rigoureusement homogène à l’ensemble des dyades ?
- [ ] Vérification de l’indépendance inter-paires : Le protocole expérimental garantit-il l’isolement complet de chaque paire d’observations vis-à-vis des autres (absence d’effets de contamination ou d’influences environnementales partagées) ?
- [ ] Contrôle des effets sériels et d’ordre : L’ordre d’attribution des conditions expérimentales a-t-il été rigoureusement contrebalancé, ou les dépendances temporelles résiduelles ont-elles été testées via Durbin-Watson ?
- [ ] Diagnostic univarié des différences : Les vérifications de normalité et de détection des valeurs discordantes ont-elles bien porté sur la différence D, et non sur les groupes de mesures brutes pris séparément ?
- [ ] Inspection visuelle de la forme : Un diagramme quantile-quantile (Q-Q plot) ainsi qu’un histogramme de densité ont-ils été tracés et interprétés au-delà de la seule lecture des tests d’adéquation statistiques ?
- [ ] Gestion des cas extrêmes : Des seuils résistants (IQR de Tukey ou MAD) ont-ils été mobilisés pour classifier d’éventuelles valeurs aberrantes ? En présence de cas discordants, une analyse de sensibilité documentant l’impact de leur inclusion/exclusion a-t-elle été exécutée ?
- [ ] Adéquation de la puissance et taille d’échantillon : Si l’effectif est faible (n < 20), la vigilance a-t-elle été redoublée quant à l’impact des micro-déviations de normalité ?
- [ ] Reporting APA exhaustif : Le compte-rendu textuel intègre-t-il les statistiques descriptives complètes, les degrés de liberté, la valeur exacte de p, ainsi que la métrique de taille d’effet accompagnée de son intervalle de confiance à 95 % ?
- [ ] Reproductibilité computationnelle : Les scripts d’analyse (fichiers de syntaxe R, SPSS, syntaxe Python ou scripts JASP) documentant le calcul des diagnostics et des modèles alternatifs sont-ils intégralement sauvegardés et disponibles pour un archivage ouvert (Open Science) ?
Le respect méticuleux de cette feuille de route statistique prémunit l’analyste contre les périls des conclusions hâtives et garantit que le test t pour échantillons appariés accomplisse fidèlement sa fonction fondamentale : fournir une assise probabiliste inattaquable à la découverte scientifique.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Box, G. E. P., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211-252. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7-29. https://doi.org/10.1177/0956797613504966
- Durbin, J., & Watson, G. S. (1951). Testing for serial correlation in least squares regression. II. Biometrika, 38(1/2), 159-177. https://doi.org/10.2307/2332325
- Efron, B., & Tibshirani, R. J. (1994). An introduction to the bootstrap. CRC Press. https://doi.org/10.1201/9780429246593
- Huber, P. J. (1981). Robust statistics. John Wiley & Sons. https://doi.org/10.1002/0471725250
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863
- Rousseeuw, P. J., & Croux, C. (1993). Alternatives to the median absolute deviation. Journal of the American Statistical Association, 88(424), 1273-1283. https://doi.org/10.1080/01621459.1993.10476408
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591-611. https://doi.org/10.1093/biomet/52.3-4.591
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1-25. https://doi.org/10.1093/biomet/6.1.1
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wilcox, R. R. (2012). Introduction to robust estimation and hypothesis testing (3rd ed.). Academic Press. https://doi.org/10.1016/C2010-0-67044-1
- Wilcoxon, F. (1945). Individual comparisons by ranking methods. Biometrics Bulletin, 1(6), 80-83. https://doi.org/10.2307/3001968
- Yuen, K. K. (1974). The two-sample trimmed t for unequal population variances. Biometrika, 61(1), 165-170. https://doi.org/10.1093/biomet/61.1.165