
L’évaluation rigoureuse des propriétés distributionnelles d’un ensemble de données constitue l’un des piliers méthodologiques les plus fondamentaux de la recherche quantitative contemporaine, tout particulièrement dans le champ de la psychométrie et des sciences du comportement. Lorsque les chercheurs s’attachent à mesurer des construits latents complexes tels que l’anxiété, l’intelligence cognitive, les traits de personnalité ou les attitudes sociales, ils s’appuient presque invariablement sur des échelles de mesure composites dont les propriétés numériques conditionnent la légitimité des inférences statistiques ultérieures. Le recours quasi automatique aux modèles linéaires généraux — qu’il s’agisse de l’analyse de variance univariée ou multivariée, des régressions linéaires multiples ou de la modélisation par équations structurelles — repose sur le postulat que les résidus ou les variables continues sous-jacentes suivent une distribution normale théorique au sein de la population parente.
Toutefois, la vérification empirique de cette hypothèse de normalité univariée est trop souvent reléguée au rang de formalité superficielle ou exécutée au moyen de procédures mal adaptées à la taille de l’échantillon ou à la nature métrologique des variables. Dans cet écosystème d’analyse quantitative, le test d’adéquation de Kolmogorov-Smirnov s’impose comme l’un des outils non paramétriques les plus emblématiques et historiques pour quantifier la divergence entre une fonction de répartition observée et une fonction de répartition théorique cumulative. Développé initialement dans le cadre de la théorie des probabilités pures, ce test a connu des adaptations majeures, notamment sous l’impulsion de Hubert Lilliefors, pour permettre l’évaluation conjointe de paramètres distributionnels estimés directement à partir des données de l’échantillon.
Le système logiciel SAS (Statistical Analysis System) offre un environnement d’une puissance computationnelle et d’une précision analytique inégalées pour exécuter ces diagnostics distributionnels via des procédures spécialisées telles que PROC UNIVARIATE et PROC NPAR1WAY. Ce guide exhaustif a pour vocation d’accompagner pas à pas les chercheurs, biostatisticiens et psychométriciens dans la maîtrise théorique, l’implémentation algorithmique, l’interprétation critique et la restitution académique du test de Kolmogorov-Smirnov sous SAS. À travers une exploration approfondie des fondements mathématiques, des pièges métrologiques, des scripts d’automatisation et des standards de publication internationaux, cet ouvrage de référence fournit toutes les clés pour garantir la robustesse et la reproductibilité des analyses de normalité dans les protocoles de recherche les plus exigeants.
1. Fondements théoriques du test de Kolmogorov-Smirnov en psychométrie
1.1 Origine mathématique et principe de la fonction de distribution empirique
Le test d’adéquation proposé par les mathématiciens russes Andreï Kolmogorov en 1933 et Vladimir Smirnov en 1939 s’enracine dans la théorie asymptotique des probabilités et l’analyse fonctionnelle des processus stochastiques. Le principe cardinal de cette approche repose sur la comparaison globale et non locale entre deux fonctions de répartition cumulée : d’une part, la fonction de distribution théorique postulée, notée usuellement F0(x), qui représente la probabilité cumulative qu’une variable aléatoire continue prenne une valeur inférieure ou égale à x selon une loi définie a priori ; d’autre part, la fonction de répartition empirique, conventionnellement désignée par l’acronyme anglophone EDF pour Empirical Distribution Function et notée Fn(x).
Pour un échantillon indépendant et identiquement distribué de taille n dont les observations ordonnées de manière croissante sont notées x(1) ≤ x(2) ≤ … ≤ x(n), la fonction de répartition empirique est définie formellement comme une fonction en escalier, discontinue à droite, attribuant un saut d’amplitude 1/n à chaque point d’observation. L’expression mathématique s’établit comme la somme pondérée de fonctions indicatrices :
Fn(x) = (1 / n) × ∑ I(xi ≤ x), où I désigne la fonction indicatrice valant 1 si l’inégalité est satisfaite et 0 dans le cas contraire.
Le génie méthodologique de Kolmogorov a consisté à démontrer que la variable aléatoire représentant l’écart suprémum entre cette fonction empirique discontinue et la fonction continue théorique converge vers une loi de probabilité invariante, indépendante de la loi continue postulée sous l’hypothèse nulle. Cette statistique de test, traditionnellement désignée par la lettre D, capture la plus grande divergence absolue verticale enregistrée sur l’ensemble du domaine de définition de la variable. En psychométrie, cette propriété permet d’évaluer sans a priori sur la forme locale des données si le patron cumulé des réponses d’une population d’individus s’écarte substantiellement de la courbe normale de Gauss-Laplace ou de tout autre modèle distributionnel probabiliste de référence.
1.2 Rôle de l’hypothèse de normalité dans les protocoles de recherche en psychologie
Dans l’architecture de la recherche en psychologie clinique, différentielle, cognitive et organisationnelle, l’hypothèse de normalité univariée constitue le pivot justificatif sur lequel repose la validité des modèles linéaires généraux. Qu’il s’agisse d’évaluer l’efficacité différentielle de protocoles thérapeutiques via une analyse de variance factorielle (ANOVA), de mesurer les interactions entre variables dispositionnelles par l’analyse de covariance (ANCOVA), ou d’estimer des coefficients de régression multiple pour prédire un comportement, ces techniques paramétriques dérivent leurs distributions d’échantillonnage théoriques (notamment les lois de Student t et de Fisher-Snedecor F) du postulat fondamental selon lequel les perturbations aléatoires ou les résidus d’estimation sont distribués de manière normale, indépendante et homoscédastique.
La sensibilité des tests statistiques paramétriques face aux violations de la normalité dépend étroitement de la nature spécifique de la non-normalité rencontrée. Lorsque la distribution des scores psychométriques présente une forte asymétrie positive ou négative (asymétrie ou skewness) ou des queues anormalement épaisses traduisant une forte propension aux événements extrêmes (aplatissement ou kurtosis leptokurtique), les estimateurs classiques par les moindres carrés ordinaires perdent leur propriété d’efficacité asymptotique minimale. Dans ces conditions, les erreurs types des paramètres estimés se trouvent biaisées de manière non prévisible.
Sur le plan décisionnel, ces distorsions distributionnelles altèrent gravement les taux d’erreur de première espèce (α), conduisant le chercheur à rejeter à tort des hypothèses nulles légitimes (faux positifs), ou dégradent drastiquement la puissance statistique (1 – β), provoquant l’incapacité récurrente de détecter des effets cliniques ou cognitifs pourtant réels (erreur de type II). Dès lors, le diagnostic rigoureux de la normalité ne relève pas d’une simple convenance technique, mais constitue un impératif épistémologique absolu pour prémunir la discipline contre les crises de reproductibilité empirique.
1.3 Distinction entre le test standard et la correction de Lilliefors
Une confusion méthodologique persistante dans la littérature empirique concerne l’assimilation hâtive entre le test originel de Kolmogorov-Smirnov et son adaptation indispensable aux contextes réels de recherche : le test de Lilliefors. Le théorème limite classique de Kolmogorov stipule expressément que la loi théorique F0(x) doit être complètement spécifiée à l’avance, ce qui signifie que tous ses paramètres de position et d’échelle — à savoir la moyenne de population μ et la variance σ² dans le cas de la loi normale — doivent être connus a priori et indépendamment des données récoltées. Or, dans l’écrasante majorité des protocoles expérimentaux ou quasi-expérimentaux en sciences humaines, les véritables valeurs de μ et σ de la population parente demeurent strictement inconnues du statisticien.
Dans la pratique, le chercheur est contraint d’estimer ces paramètres à partir de son échantillon d’étude via la moyenne arithmétique empirique (notée x̄) et l’écart-type non biaisé (noté s). L’utilisation de ces paramètres estimés pour construire la fonction théorique cumulative de référence engendre un phénomène statistique critique : la fonction théorique estimée s’ajuste mécaniquement de manière beaucoup plus étroite aux données observées que ne le ferait la véritable fonction inconnue de la population. En conséquence, la statistique D tend à être artificiellement plus petite, et l’application des tables critiques originelles de Kolmogorov-Smirnov produit des valeurs de p excessivement conservatrices, augmentant de façon inacceptable le risque d’erreur de type II.
En 1967, le statisticien américain Hubert Lilliefors publia une solution d’ajustement majeure en recalculant par simulations stochastiques de Monte-Carlo la distribution exacte de la statistique D lorsque la moyenne et la variance sont estimées conjointement à partir de l’échantillon. Le logiciel SAS intègre nativement cette distinction méthodologique cruciale : lorsque la procédure PROC UNIVARIATE est invoquée sans paramètres théoriques fixés numériquement à l’avance, elle applique de manière totalement automatisée la correction de Lilliefors pour le test de Kolmogorov-Smirnov, garantissant ainsi le calcul de probabilités critiques exactes et scientifiquement irréprochables.
2. Formulation formelle des hypothèses statistiques
2.1 Définition rigoureuse des hypothèses nulle et alternative
L’inférence statistique structurant le test de normalité de Kolmogorov-Smirnov repose sur un cadre décisionnel binaire rigoureux, qu’il convient de formaliser sans ambiguïté conceptuelle. L’hypothèse nulle, traditionnellement désignée par la notation H0, postule que la variable psychométrique continue étudiée X est issue d’une population parente dont la distribution sous-jacente est parfaitement congruente avec une fonction de loi normale N(μ, σ²) :
H0 : F(x) = F0(x) pour l’ensemble des valeurs x appartenant à l’ensemble des réels, où F0(x) correspond à la fonction de répartition cumulative d’une loi normale de paramètres μ et σ².
À l’opposé, l’hypothèse alternative, notée H1 ou Ha, stipule une rupture d’adéquation entre le comportement empirique de la variable et la distribution théorique normale :
H1 : Il existe au moins une valeur x ∈ ℜ telle que F(x) ≠ F0(x).
Il est fondamental de souligner la nature strictement non directionnelle ou bilatérale de ce test d’hypothèse. Contrairement aux tests de Student orientés qui investiguent la supériorité ou l’infériorité d’une moyenne par rapport à un standard, le test de Kolmogorov-Smirnov réagit indifféremment à toute forme de discordance structurelle entre la courbe empirique et le modèle théorique. Qu’il s’agisse d’une asymétrie marquée vers les scores élevés, d’une concentration anormale d’observations autour du centre modal (leptokurtose), d’un écrasement excessif de la cloche (platikurtose) ou de la présence de queues de distribution asymétriques, l’hypothèse alternative englobe toutes ces déviations sans discrimination fonctionnelle préalable.
2.2 Calcul et dérivation de la statistique de test D
L’exécution calculatoire du test repose sur l’isolement de l’écart vertical le plus prononcé observable entre la courbe discontinue par paliers de la fonction empirique Fn(x) et la courbe continue et monotone croissante de la fonction normale théorique F0(x). Pour chaque observation ordonnée xi de l’échantillon, la divergence doit être évaluée en considérant à la fois le palier inférieur et le palier supérieur résultant de la discontinuité de la fonction d’escalier empirique. Mathématiquement, la dérivation s’articule autour de deux écarts unilatéraux complémentaires :
L’écart positif maximal : D+ = max [ (i / n) – F0(x(i)) ], pour 1 ≤ i ≤ n.
L’écart négatif maximal : D- = max [ F0(x(i)) – ((i – 1) / n) ], pour 1 ≤ i ≤ n.
La statistique globale de Kolmogorov-Smirnov, désignée par la lettre majuscule D, correspond alors à la valeur maximale absolue entre ces deux composantes :
D = max(D+, D-).
La convergence asymptotique de cette statistique vers la loi de Kolmogorov est assurée par le théorème de Glivenko-Cantelli, qui garantit que la fonction de répartition empirique converge uniformément et presque sûrement vers la véritable fonction de répartition de la population lorsque n tend vers l’infini. Néanmoins, une propriété analytique fondamentale de la statistique D mérite une attention psychométrique particulière : en raison de sa formulation suprémum, le test de Kolmogorov-Smirnov présente une sensibilité différentielle maximale aux écarts situés vers le centre de la distribution, là où la pente de la densité normale cumulative est la plus abrupte, tandis que sa sensibilité décroît notablement au niveau des queues extrêmes de la distribution, là où les fonctions de répartition se rapprochent asymptotiquement de 0 ou de 1.
2.3 Seuils critiques et comportement de la p-valeur
La transformation de la statistique calculée D en une probabilité critique opérationnelle (valeur de p ou p-value) constitue l’étape décisionnelle finale de la procédure. Sous l’hypothèse nulle H0 et dans le cadre du test standard avec paramètres connus, la quantité √n × D converge vers la distribution de Kolmogorov, dont la fonction de survie asymptotique s’exprime par une série alternée infinie :
P(K ≥ z) = 2 × ∑ (-1)^(k-1) × exp(-2 × k² × z²), pour k variant de 1 à l’infini.
Cependant, dans l’environnement SAS où l’ajustement de Lilliefors est mobilisé pour pallier l’inconnaissance des paramètres μ et σ, le calcul de la probabilité exacte ne repose plus sur cette série analytique classique, mais sur des approximations polynomiales empiriques de haute précision calibrées sur de vastes simulations de Monte-Carlo. Dans les tables de résultats générées par le logiciel SAS, les utilisateurs sont fréquemment confrontés à des sorties textuelles spécifiques indiquant par exemple Pr > D > 0.150 ou inversement Pr > D < 0.010.
Ce comportement algorithmique s’explique par le fait que les bornes de tables de Lilliefors implémentées dans les versions canoniques du moteur analytique de SAS possèdent des plages tabulées restreintes. Lorsque la distance empirique D observée est exceptionnellement faible, traduisant un ajustement empirique remarquable à la courbe normale, la valeur de p dépasse la limite supérieure précalculée du tableau, et SAS affiche prudemment la mention conservative > 0.150. Le chercheur peut alors conclure sans aucune ambiguïté que l’écart n’atteint aucunement le seuil de significativité nominal de 5 % (α = 0.05), validant le non-rejet de l’hypothèse de normalité.
3. Préparation et structuration des données psychologiques sous SAS
3.1 Importation et création manuelle de la table de données
L’exploitation optimale des capacités analytiques de SAS pour le contrôle distributionnel exige une rigueur méthodologique absolue dès l’étape fondamentale de création et d’alimentation des tables de données (Data Sets). Le langage SAS repose sur une architecture dialectique scindée en deux phases interdépendantes : l’étape DATA, responsable de l’acquisition, du nettoyage et de la transformation fonctionnelle des matrices de données, et l’étape PROC, dédiée à l’exécution des calculs statistiques et des restitutions graphiques.
Pour des échantillons expérimentaux ou cliniques collectés sur papier ou via des interfaces web de passation de tests psychologiques, le chercheur peut déclarer ses variables directement dans le script d’analyse en faisant appel aux instructions combinées INPUT et DATALINES (ou son synonyme CARDS). La déclaration explicite des variables s’effectue en assignant un libellé numérique ou alphanumérique à chaque colonne. Dans le cadre de scores psychométriques continus, la variable d’intérêt sera déclarée de manière numérique pure sans suffixe textuel.
Pour les bases volumineuses issues de cohortes épidémiologiques ou de systèmes d’évaluation institutionnels stockées sous format texte délimité (CSV), l’instruction INFILE couplée aux options de délimitation (notamment DLM=’,’ ou DLM=’09’x pour les tabulations) permet une lecture séquentielle robuste. Dès la finalisation de l’étape DATA, il est formellement recommandé d’exécuter la procédure PROC CONTENTS. Cette bonne pratique élémentaire permet de valider le format d’encodage, le nombre exact d’observations chargées, l’absence de troncature non intentionnelle et la conformité typologique des variables avant toute manipulation inférentielle.
3.2 Nettoyage préliminaire et détection des valeurs aberrantes
Avant d’engager le test de Kolmogorov-Smirnov, un audit exhaustif de la propreté métrologique du fichier de données s’impose avec la plus grande acuité. Les scores psychologiques sont fréquemment pollués par des erreurs matérielles de saisie (par exemple, un score de 77 encodé par inadvertance au lieu de 7 sur une échelle théoriquement bornée de 1 à 10) ou par des profils de réponse aberrants résultant d’un désengagement total du participant, de conduites de simulation ou d’une incompréhension manifeste des consignes expérimentales.
La présence de telles valeurs aberrantes (outliers) exerce un impact particulièrement destructeur sur le test de Lilliefors. En effet, un score extrême isolé déplace substantiellement la moyenne empirique x̄ tout en augmentant de manière artificielle l’écart-type d’échantillon s. Cette dispersion artificiellement gonflée a pour conséquence immédiate d’aplatir la courbe normale théorique de référence F0(x) estimée par maximum de vraisemblance, créant ainsi des distorsions d’ajustement artificielles sur l’ensemble des scores réguliers situés au cœur de la distribution.
Le traitement des valeurs manquantes (valeurs désignées par un point conventionnel ‘.’ sous SAS pour les types numériques) constitue un autre impératif de préparation. Par défaut, la procédure PROC UNIVARIATE exclut automatiquement les observations contenant des valeurs manquantes pour la variable soumise au test (suppression univariée par observation ou listwise deletion). Le chercheur doit impérativement documenter le mécanisme générateur de ces données manquantes afin de s’assurer qu’elles respectent l’hypothèse de manque complètement aléatoire (MCAR pour Missing Completely at Random) et ne reflètent pas un biais d’attrition systématique lié aux caractéristiques cliniques des sujets.
3.3 Gestion des formats et typologie des variables psychométriques
La métrologie psychologique opère à l’intersection de niveaux de mesure épistémologiquement hétérogènes, théorisés par Stanley Smith Stevens : nominal, ordinal, d’intervalle et de rapport. L’application du test de Kolmogorov-Smirnov postule formellement que la variable soumise à l’analyse relève d’un continuum mathématique strictly continu avec une infinité potentielle de valeurs intermédiaires. Or, dans les investigations en psychologie, le recours aux échelles de cotation discrètes de type Likert (par exemple, des échelons d’accord variant de 1 à 5 ou de 1 à 7) est omniprésent.
L’utilisation brute d’un item individuel de Likert viole de manière frontale le postulat de continuité sous-jacent à la statistique D de Kolmogorov-Smirnov. Les données résultantes présentent une multitude de valeurs ex æquo (liens ou ties) et une structure en paliers discrets très espacés. Lorsque l’on confronte une telle variable discontinue à une fonction normale théorique strictement continue, la fonction empirique Fn(x) affiche obligatoirement de vastes paliers horizontaux artificiels, générant des écarts suprêmes D gonflés qui ne reflètent en rien la structure latente du construit psychologique mais uniquement l’imperfection discrète de l’instrument de mesure.
En revanche, lorsque plusieurs items de Likert mesurant une dimension théorique commune sont sommés ou moyennés pour former un score composite global (par exemple, un indice global de détresse psychologique dérivé d’un questionnaire à 20 items), le nombre de valeurs distinctes possibles s’accroît considérablement, et la variable composite peut alors être assimilée à une variable quasi-continue répondant de manière admissible aux exigences métrologiques du test. L’attribution d’étiquettes de variables rigoureuses via l’instruction LABEL et la déclaration de formats numériques explicites permettent de documenter de façon transparente la nature métrologique exacte des indices soumis au diagnostic.
4. Implémentation pas à pas via la procédure PROC UNIVARIATE
4.1 Syntaxe fondamentale et options requises de la procédure
L’environnement SAS intègre de nombreuses procédures descriptives, telles que PROC MEANS ou PROC SUMMARY, mais seule la procédure PROC UNIVARIATE dispose de la granularité algorithmique nécessaire pour exécuter des tests formels d’adéquation distributionnelle accompagnés de diagnostics graphiques avancés. L’architecture de commande de cette procédure est d’une remarquable élégance conceptuelle tout en autorisant une grande flexibilité de paramétrage.
La syntaxe fondamentale débute par l’appel formel de l’instruction d’ouverture :
PROC UNIVARIATE DATA = nom_de_la_table;
Cette instruction doit être immédiatement articulée avec l’instruction VAR, qui spécifie la ou les variables quantitatives continues sur lesquelles l’évaluation distributionnelle doit être réalisée. Si l’instruction VAR venait à être omise par le programmateur, SAS tenterait par défaut d’exécuter l’ensemble des analyses univariées sur toutes les variables numériques présentes dans la table active, ce qui engendrerait des temps de calcul superflus et un déversement massif de tableaux non pertinents.
Pour ordonner à SAS de calculer formellement la statistique de Kolmogorov-Smirnov et les autres tests d’adéquation, il convient de déclarer l’instruction HISTOGRAM. Bien que son libellé évoque une finalité purement graphique, c’est précisément au sein des options de cette instruction que réside le déclenchement des algorithmes inférentiels de normalité les plus sophistiqués du logiciel.
4.2 Paramétrage de l’option NORMAL avec estimation des paramètres
L’instruction HISTOGRAM doit être complétée par une barre oblique séparatrice (/) suivie de l’option analytique maîtresse NORMAL. C’est à cet emplacement syntaxique précis que s’articule la distinction entre le test théorique classique et le test ajusté de Lilliefors. Afin d’indiquer sans équivoque au compilateur SAS que les paramètres de position et d’échelle de la loi normale de référence doivent être dérivés directement des données de l’échantillon, le chercheur doit utiliser la syntaxe formelle suivante :
HISTOGRAM nom_de_variable / NORMAL(MU=EST SIGMA=EST);
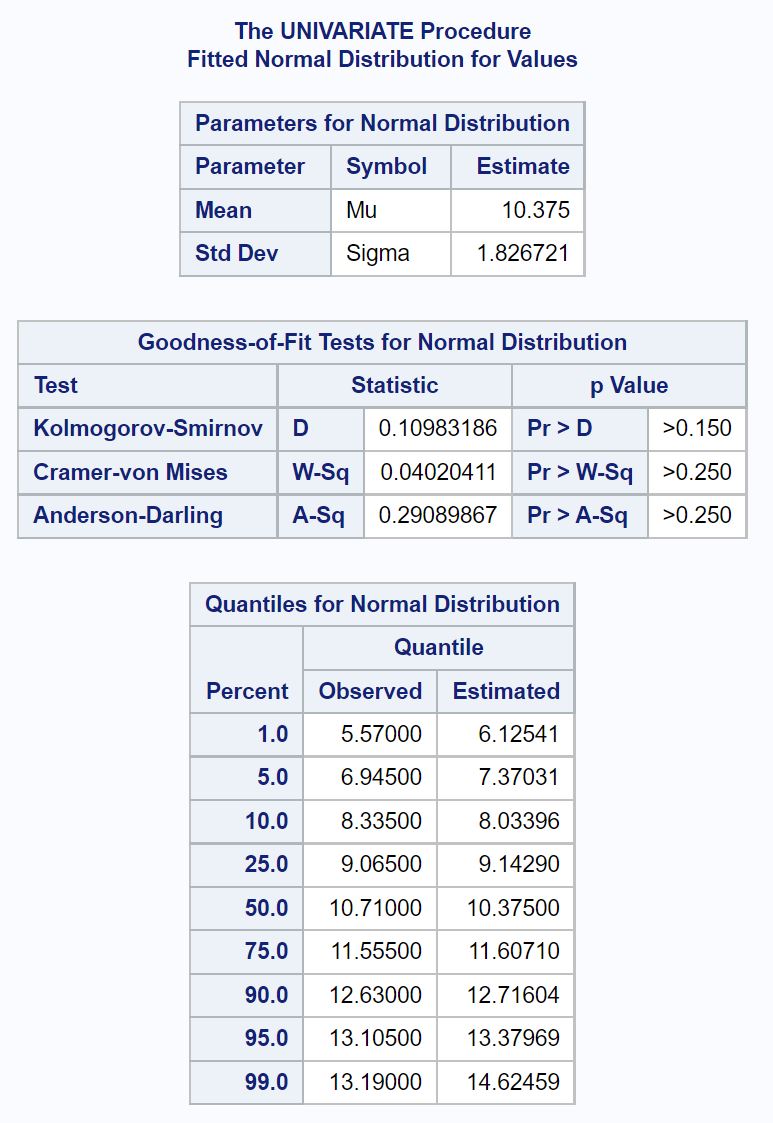
L’utilisation explicite des paramètres MU=EST et SIGMA=EST informe l’algorithme d’optimisation numérique qu’il doit mobiliser les estimateurs par maximum de vraisemblance (identiques à la moyenne arithmétique et à l’écart-type d’échantillon divisé par n – 1) pour caler la courbe cumulative théorique F0(x). SAS applique alors rigoureusement l’approximation de Lilliefors pour dériver la probabilité critique associée à la statistique D.
Dans la configuration inverse où le chercheur souhaiterait tester la stricte adéquation de son échantillon à un standard normatif préétabli issu d’un manuel d’étalonnage psychométrique national — par exemple, un test de quotient intellectuel standardisé avec une moyenne théorique postulée μ = 100 et un écart-type σ = 15 —, la syntaxe s’adapterait en renseignant directement les constantes déterministes :
HISTOGRAM score_qi / NORMAL(MU=100 SIGMA=15);
Dans ce second scénario, SAS calcule le test de Kolmogorov-Smirnov standard originel sans faire intervenir la correction de Lilliefors, démontrant ainsi la remarquable polyvalence adaptative de sa structure de commande.
4.3 Optimisation de l’environnement de sortie ODS
Par défaut, l’exécution non bridée de PROC UNIVARIATE engendre une prolifération considérable de sorties tabulaires dans la fenêtre de résultats : moments élémentaires, paramètres de position et de dispersion, quantiles extrêmes, tests d’hypothèse de localisation univariée (Student, signe, rangs signés) et tableaux d’observations extrêmes. Pour les projets de recherche institutionnels ou les méta-analyses exigeant une focalisation ciblée, ce flux d’informations peut rapidement saturer l’espace de travail et nuire à la clarté opérationnelle.
Le puissant système de distribution des sorties de SAS, désigné sous le sigle ODS (Output Delivery System), permet de filtrer avec une précision chirurgicale les composants analytiques pertinents. En insérant l’instruction de sélection ciblée :
ODS SELECT TestsForNormality;
juste avant le bloc d’exécution de PROC UNIVARIATE, le chercheur ordonne au moteur SAS d’occulter l’ensemble des tableaux descriptifs secondaires pour ne restituer que le tableau synthétique formel regroupant les tests d’ajustement distributionnel.
De surcroît, ODS offre la faculté d’exporter directement ces indicateurs statistiques sous la forme d’une nouvelle table de données SAS exploitable pour des consolidations automatisées ou des chaînes de traitement par lots via l’instruction :
ODS OUTPUT TestsForNormality = ma_table_de_resultats;
Cette approche d’ingénierie statistique garantit une traçabilité totale des analyses, élimine le risque d’erreur humaine inhérent à la transcription manuelle des valeurs numériques et optimise significativement les flux de travail pour les rapports scientifiques académiques.
5. Analyse détaillée et décryptage des sorties statistiques de SAS
5.1 Lecture du tableau synthétique des tests de normalité
Lorsque l’option d’ajustement normal est invoquée, SAS génère un tableau standardisé intitulé dans la version anglophone du logiciel Tests for Normality. Ce tableau matriciel synthétique regroupe systématiquement quatre métriques inférentielles d’adéquation distinctes : le test de Shapiro-Wilk (W), le test de Kolmogorov-Smirnov (D), le test de Cramér-von Mises (W-Sq) et le test d’Anderson-Darling (A-Sq). Pour l’utilisateur francophone ou international, le décodage de ce tableau nécessite une attention méthodique portée aux intitulés de colonnes et aux symboles de renvoi.
La ligne dédiée au test de Kolmogorov-Smirnov présente trois informations primordiales : l’intitulé formel du test suivi de la mention explicite du qualificatif de Lilliefors entre parenthèses lorsque les paramètres ont été estimés, la valeur de la statistique de divergence sous la colonne libellée Stat (ou Statistique), et le seuil de signification asymptotique sous la colonne libellée p Value (ou Valeur p). La valeur de la statistique D représente l’amplitude numérique de la distance suprémum verticale observée, oscillant obligatoirement entre 0 (congruence absolue parfaite) et 1 (discordance distributionnelle totale).
Il convient d’examiner minutieusement les notes de bas de page automatiquement générées par le compilateur SAS sous le tableau. Lorsque la p-valeur s’affiche sous la forme Pr > D > 0.150, SAS insère un astérisque ou une référence textuelle indiquant clairement : p-value is greater than the tabulated upper limit. Cette annotation confirme que la distance d’échantillon D est si ténue qu’elle s’insère profondément dans la zone de non-rejet de la loi normale, au-delà de la frontière de 0.150 généralement couverte par les tables algorithmiques classiques de Lilliefors.
5.2 Prise de décision statistique : rejet ou non-rejet de H0
L’arbitrage décisionnel inférentiel procède de la confrontation directe entre la p-valeur empirique calculée par SAS et le seuil de signification nominal α préalablement fixé par le protocole expérimental, conventionnellement établi à 0.05 (ou 5 %) dans les sciences comportementales. La règle de décision s’énonce selon un formalisme d’une clarté absolue :
Si la probabilité critique vérifie la condition p ≤ α (par exemple, p = 0.024), le chercheur est contraint de rejeter l’hypothèse nulle H0. La conclusion méthodologique s’impose sans équivoque : les données empiriques s’écartent significativement d’un modèle distributionnel normal gaussien, et l’emploi sans précaution de statistiques paramétriques s’avère compromis.
Inversement, si la probabilité critique satisfait la condition p > α (notamment dans la situation fréquente où SAS rapporte Pr > D > 0.150), le chercheur se trouve dans l’incapacité méthodologique de rejeter l’hypothèse nulle H0. Une faute épistémologique majeure, fréquemment relevée dans les publications débutantes, consiste à déclarer que ce résultat « prouve » que l’échantillon suit une loi normale. En logique statistique de type poppérienne ou neyman-pearsonienne, un test d’hypothèse ne prouve jamais la véracité de l’hypothèse nulle ; il conclut exclusivement à l’absence de preuve suffisante de non-normalité au vu de la taille de l’échantillon étudié. L’hypothèse de normalité est ainsi retenue à titre de modèle de travail plausible et opératoire pour les étapes d’analyse subséquentes.
5.3 Indicateurs d’asymétrie et d’aplatissement associés
Une interprétation scientifique rigoureuse de la statistique de Kolmogorov-Smirnov ne saurait s’effectuer de manière isolée sans une mise en relation étroite avec les moments d’ordre supérieur fournis simultanément dans le tableau des moments descriptifs de PROC UNIVARIATE. Ces indicateurs morphologiques fondamentaux sont le coefficient d’asymétrie (Skewness) et le coefficient d’aplatissement (Kurtosis).
Sous une loi normale théorique parfaite, la valeur attendue du coefficient d’asymétrie de Fisher est exactement égale à zéro. Une valeur positive indique un étirement prononcé de la queue de distribution vers la droite (scores élevés dispersés), tandis qu’une valeur négative dénote une prédominance de la queue gauche (scores faibles dispersés). De même, SAS rapporte par défaut le coefficient d’excès d’aplatissement (Excess Kurtosis), dont la référence théorique pour la courbe gaussienne est également calibrée à zéro. Un coefficient d’excès positif traduit une morphologie leptokurtique caractérisée par un pic central acéré et des queues lourdes propices aux extrêmes, alors qu’un excès négatif désigne une structure platikurtique écrasée avec des épaules larges.
En examinant conjointement les erreurs types associées à ces moments (fournies sous SAS via les options descriptives avancées), le chercheur peut décomposer la raison géométrique exacte pour laquelle le test de Kolmogorov-Smirnov a rejeté ou validé l’adéquation distributionnelle. Une valeur élevée de D associée à un Skewness significativement différent de zéro oriente immédiatement le diagnostic vers une distorsion orientée de l’instrument de mesure, tandis qu’un D élevé combiné à un Kurtosis positif excessif alerte sur l’impact de réponses polaires ou de variances hétérogènes au sein de la cohorte évaluée.
6. Diagnostic graphique complémentaire de la distribution
6.1 Génération et interprétation du diagramme quantile-quantile (Q-Q Plot)
L’évaluation de la normalité à l’aide de seules valeurs numériques de probabilité présente des limites intrinsèques que la communauté internationale des biostatisticiens et des méthodologues en psychologie a depuis longtemps documentées. Les tests formels fournissent un verdict binaire mais ne livrent aucune information qualitative sur la localisation anatomique exacte des déviations dans la distribution. C’est pourquoi la génération conjointe d’un diagramme quantile-quantile (Q-Q Plot) est unanimement préconisée dans tout protocole de recherche de premier rang.
Sous la procédure PROC UNIVARIATE, ce tracé de précision s’obtient au moyen de l’instruction dédiée QQPLOT (ou de son équivalent structural PROBPLOT) :
QQPLOT nom_de_variable / NORMAL(MU=EST SIGMA=EST);
Le diagramme Q-Q confronte visuellement les quantiles observés dans la série empirique (portés sur l’axe des ordonnées) aux quantiles théoriques qui seraient attendus si la variable suivait rigoureusement une loi normale d’égaux paramètres (portés sur l’axe des abscisses). Si la conformité à la loi normale est totale, l’ensemble des points d’observation vient s’agréger de façon continue et linéaire le long d’une ligne droite diagonale de référence (droite de Henri).
L’analyse visuelle des ondulations morphologiques par rapport à cette droite idéale permet un diagnostic pathognomonique immédiat. Si les points situés aux extrémités s’écartent en dessinant une morphologie caractéristique en « S » traversant la diagonale, le statisticien identifie sans équivoque la présence de queues lourdes ou leptokurtiques. Si les observations s’incurvent de manière concave ou convexe par rapport à la droite de guidage, le diagramme met en évidence une asymétrie univariée sévère. Enfin, la présence de points isolés décrochés de manière abrupte à l’extrême périphérie de la trajectoire linéaire signale la survenue de valeurs aberrantes nécessitant un examen clinique individualisé.
6.2 Superposition de courbes de densité sur l’histogramme empirique
L’enrichissement graphique de l’histogramme des fréquences constitue un autre levier d’investigation visuelle majeur proposé nativement par SAS. Pour transcender l’arbitraire potentiel lié au découpage en classes de l’histogramme de fréquences, il est d’un intérêt diagnostique majeur de superposer à la fois une courbe paramétrique normale d’ajustement et une courbe non paramétrique d’estimation de densité par noyau (courbe Kernel).
Cette double superposition graphique s’exécute avec une remarquable concision syntaxique au sein de la commande HISTOGRAM en adjoignant les options simultanées NORMAL et KERNEL :
HISTOGRAM nom_de_variable / NORMAL(MU=EST SIGMA=EST) KERNEL;
La courbe normale paramétrique trace la densité de probabilité gaussienne continue théorique ajustée sur la moyenne et la variance de l’échantillon. En parallèle, la fonction d’estimation par noyau calcule une courbe lissée empirique entièrement libérée de tout postulat de forme distributionnelle a priori, révélant la véritable morphologie intrinsèque des données de mesure.
La comparaison dynamique entre ces deux tracés superposés s’avère particulièrement discriminante pour débusquer des phénomènes distributionnels complexes qu’une simple statistique univariée D pourrait occulter. En particulier, si la courbe Kernel présente deux sommets d’amplitude comparable (structure bimodale) ou plusieurs ondulations successives (multimodalité), cette divergence frappante par rapport à la courbe normale en cloche univoque signale immédiatement au psychométricien l’hétérogénéité sous-jacente de sa population d’étude, suggérant l’existence de sous-groupes cliniques ou typologiques distincts dissimulés au sein de la cohorte analysée.
6.3 Rapprochement entre représentations visuelles et tests d’hypothèses
La pratique contemporaine de l’analyse des données exige d’opérer un rapprochement dialectique permanent entre l’inférence formelle dérivée du test de Kolmogorov-Smirnov et les représentations visuelles obtenues par les diagrammes Q-Q et les densités lissées. La dépendance exclusive envers le seuil arbitraire de la p-valeur (p < 0.05) expose le chercheur à de graves erreurs de jugement méthodologique.
Dans certaines configurations expérimentales impliquant des effectifs intermédiaires, le test de Kolmogorov-Smirnov peut échouer à rejeter l’hypothèse de normalité en raison de sa sensibilité conservative au niveau des queues, affichant une p-valeur non significative (par exemple, p = 0.082), alors même que le diagramme Q-Q met en relief un décollement franc et régulier des quantiles extrêmes traduisant une asymétrie clinique cliniquement préoccupante. Réciproquement, un test formel peut s’avérer hautement significatif en raison de légers effets d’arrondi induits par la discrétisation des scores psychométriques, alors que le tracé Q-Q démontre une linéarité globale impressionnante le long de la droite normale de référence.
Le chercheur doit par conséquent cultiver une approche diagnostique par faisceau convergent d’indices. L’hypothèse de normalité ne doit être entérinée que lorsque la statistique inférentielle de Lilliefors, l’alignement visuel des quantiles sur la droite théorique, la cohérence géométrique des courbes de densité et la modération des indices d’asymétrie et d’aplatissement concourent de manière harmonieuse à étayer la plausibilité du modèle gaussien.
7. Comparaison critique entre Kolmogorov-Smirnov et autres tests de normalité
7.1 Kolmogorov-Smirnov versus Shapiro-Wilk (W)
Parmi l’arsenal des tests d’adéquation distributionnelle mis à disposition dans le tableau des sorties de PROC UNIVARIATE, le test développé par Samuel Sanford Shapiro et Martin Wilk en 1965 constitue sans conteste le rival le plus emblématique du test de Kolmogorov-Smirnov. Reposant sur la régression linéaire généralisée des statistiques d’ordre de l’échantillon sur les espérances des statistiques d’ordre d’une loi normale univariée standardisée, la statistique W de Shapiro-Wilk mesure le rapport entre le carré d’un estimateur linéaire de l’écart-type et la somme classique des carrés des écarts à la moyenne.
D’innombrables études de simulation de Monte-Carlo, menées notamment sur des configurations distributionnelles asymétriques ou tronquées représentatives des mesures psychologiques, ont formellement démontré la supériorité statistique écrasante du test de Shapiro-Wilk en termes de puissance sur les petits et moyens échantillons, typiquement pour des effectifs n compris entre 10 et 2 000 participants. La statistique W capte avec une sensibilité mathématique nettement plus fine les asymétries locales et les perturbations de courbure.
En conséquence directe de cette sensibilité différentielle, il est extrêmement fréquent sous SAS d’observer une discordance apparente dans les sorties analytiques : la statistique de Kolmogorov-Smirnov affiche une p-valeur supérieure à 0.150 (concluant à l’adéquation normale), tandis que le test de Shapiro-Wilk génère une p-valeur de 0.021 (ordonnant le rejet de la normalité). Dans ce cas de figure précis, il est universellement recommandé de privilégier le verdict formulé par le test de Shapiro-Wilk, le test de Kolmogorov-Smirnov manquant de puissance pour détecter la distorsion structurelle sous-jacente.
7.2 Apport des tests d’Anderson-Darling (A-Sq) et de Cramér-von Mises (W-Sq)
Face aux faiblesses structurelles du test classique de Kolmogorov-Smirnov, la classe des tests fondés sur la fonction de distribution empirique (EDF) s’est enrichie de formulations quadratiques hautement sophistiquées, représentées dans SAS par la statistique W-Sq de Cramér-von Mises et la statistique A-Sq d’Anderson-Darling. Contrairement à la statistique D qui ne retient que la déviation suprémum ponctuelle la plus extrême le long de l’axe réel, les tests de Cramér-von Mises et d’Anderson-Darling intègrent l’intégrale de l’écart quadratique pondéré sur l’ensemble du domaine de répartition :
Q = n × ∫ [ Fn(x) – F0(x) ]² × ψ(x) dF0(x).
Lorsque la fonction de pondération ψ(x) est définie comme une constante égale à 1, l’équation correspond au test de Cramér-von Mises. Ce test offre une excellente robustesse pour appréhender l’inadéquation distributionnelle moyenne globale. En revanche, lorsque la fonction de pondération est spécifiée de manière à accentuer le poids relatif des extrémités selon l’expression ψ(x) = 1 / [ F0(x) × (1 – F0(x)) ], l’intégrale se convertit en la statistique d’Anderson-Darling (A-Sq).
Cette pondération réciproque confère au test d’Anderson-Darling une acuité de détection phénoménale pour repérer les anomalies distributionnelles logées au sein des queues de distribution extrêmes. Dans le cadre de recherches cliniques ou psychiatriques où la pathologie mentale sévère s’exprime précisément par une concentration anormale de scores aux bornes supérieures ou inférieures des échelles psychométriques, le test d’Anderson-Darling surclasse systématiquement la métrique de Kolmogorov-Smirnov en garantissant une sensibilité clinique optimale aux variations des profils atypiques.
7.3 Synthèse comparative pour orienter le choix du chercheur
Face à la pluralité des indicateurs déployés dans la procédure univariée de SAS, le chercheur doit se doter d’une grille de décision méthodologique rationnelle pour fonder ses conclusions sans céder à la tentation opportuniste de sélectionner le test qui confirme arbitrairement ses préconceptions de recherche (pratique prohibée assimilable au p-hacking).
- Pour des échantillons d’effectif restreint à modéré (N ≤ 2 000) : Le test de Shapiro-Wilk doit être systématiquement érigé en critère inférentiel prépondérant, complété par l’analyse visuelle du diagramme Q-Q. Le test de Kolmogorov-Smirnov ne sera consulté qu’à titre indicatif et secondaire en raison de son déficit récurrent de puissance.
- Pour l’analyse spécifique des queues et des valeurs extrêmes : Le test d’Anderson-Darling doit être privilégié en priorité absolue, particulièrement lorsque la fidélité de mesure aux bornes de l’échelle conditionne la sécurité diagnostique d’un instrument de dépistage clinique.
- Pour des échantillons de très grande dimension (N > 2 000) : Le test de Kolmogorov-Smirnov avec correction de Lilliefors conserve toute sa pertinence opératoire. Sa nature suprémum globale permet d’évaluer la convergence de la fonction empirique tout en étant relativement moins vulnérable à l’hyper-sensibilité locale que n’en présente le test de Shapiro-Wilk sur les mégadonnées.
- En cas de divergence entre les indicateurs : La présence d’un désaccord entre les tests formels (ex. D non significatif mais W et A-Sq significatifs) doit impérativement inciter le chercheur à examiner attentivement les diagrammes de dispersion et les indices de Skewness et Kurtosis. La rédaction méthodologique du rapport d’analyse devra expliciter cette discordance en justifiant le choix de l’inférence retenue sur la base de la morphologie observée des scores.
8. Impact de la taille de l’échantillon sur la validité du test
8.1 Vulnérabilité du test aux grands échantillons : le paradoxe de la sur-significativité
L’un des défis les plus redoutables de l’analyse inférentielle moderne réside dans la relation mathématique directe qui lie la puissance statistique d’un test d’adéquation à la taille totale de l’échantillon n. En vertu du comportement asymptotique de la statistique D, le seuil critique requis pour franchir la barrière de la significativité statistique décroît de manière approximativement proportionnelle à 1 / √n. Il en résulte que pour des cohortes épidémiologiques massives ou des enquêtes en ligne portant sur des milliers de participants (par exemple, n = 10 000), le test de Kolmogorov-Smirnov rejette systématiquement l’hypothèse nulle de normalité (p < 0.0001).
Cette situation engendre ce que les méthodologues qualifient de paradoxe de la sur-significativité statistique : le test identifie comme statistiquement significative une divergence maximale D infinitésimale (par exemple, D = 0.015), purement fortuite ou imputable à d’infimes imperfections d’échantillonnage, alors même que cette déviation est totalement dépourvue de la moindre pertinence pratique ou clinique. Or, sur le plan de la théorie des modèles linéaires, une divergence aussi infime n’exerce absolument aucun effet négatif tangible sur la robustesse du calcul des seuils F ou des estimations de pente d’une régression.
Le chercheur confronté à de vastes bases de données sous SAS doit par conséquent s’émanciper d’une adhésion servile à la seule p-valeur de Kolmogorov-Smirnov. Dans ce contexte d’effectifs massifs, l’ampleur brute de la statistique D doit être convertie en une mesure d’effet d’ajustement global, et l’évaluation finale doit s’appuyer de manière prépondérante sur l’examen qualitatif des tracés Q-Q et la vérification que les coefficients de Skewness et de Kurtosis demeurent contenus dans des intervalles acceptables (typiquement compris entre -1.0 et +1.0).
8.2 Perte drastique de puissance statistique sur petits échantillons
Le phénomène symétrique inverse se manifeste avec une gravité méthodologique encore supérieure lorsque les protocoles de recherche en psychologie clinique ou en neurosciences cognitives doivent se satisfaire de cohortes réduites (notamment pour des effectifs n < 30, fréquents lors de l’étude de pathologies cérébrales rares ou de protocoles d’imagerie fonctionnelle coûteux). Sur de tels échantillons, la statistique de Kolmogorov-Smirnov souffre d’un déficit catastrophique de puissance statistique.
En raison de la dispersion stochastique considérable inhérente aux petits effectifs, les seuils critiques tabulés par Lilliefors deviennent particulièrement élevés. Dès lors, une distribution empirique manifestant une asymétrie flagrante ou une bimodalité prononcée produira fréquemment une statistique de test dont la probabilité critique dépassera allègrement le seuil de significativité nominal de 0.05, conduisant le chercheur au non-rejet de l’hypothèse nulle. Ce résultat ne traduit aucunement l’adéquation réelle des données au modèle gaussien mais reflète simplement l’impuissance structurelle du test à discriminer le signal du bruit d’échantillonnage.
Cette erreur de type II s’avère particulièrement préjudiciable : conforté par une p-valeur faussement rassurante générée par SAS, le praticien s’engage dans l’exécution de tests paramétriques classiques dont les hypothèses de base sont en réalité sévèrement violées, invalidant la crédibilité scientifique des conclusions rapportées. Il est formellement recommandé de ne jamais accorder de crédit au test de Kolmogorov-Smirnov pour des effectifs inférieurs à 50 observations, et de recourir exclusivement à des méthodes non paramétriques exactes ou à des procédures de rééchantillonnage bootstrap lorsque n est restreint.
8.3 Stratégies d’ajustement face aux variations d’effectifs
Pour neutraliser les distorsions inhérentes aux fluctuations de la taille d’échantillon, les méthodologues ont développé des stratégies d’investigation distributionnelle adaptatives que l’on peut programmer aisément sous SAS. Une approche empirique particulièrement féconde face à des bases de très grande taille réside dans la technique du sous-échantillonnage répété (subsampling). En exploitant la procédure PROC SURVEYSELECT, le statisticien peut extraire aléatoirement et sans remise des sous-échantillons d’effectif standardisé (par exemple, des réplicats de n = 300) pour y réitérer l’exécution de la procédure univariée.
La distribution empirique des statistiques D et de leurs p-valeurs associées calculées sur ces multiples tirages offre une vision éminemment plus stable et représentative de la véritable adéquation de la population parente, affranchie du biais d’hypertrophie d’effectif. Parallèlement, l’évaluation de la normalité peut être corrélée au calcul d’intervalles de tolérance statistique paramétriques et non paramétriques fournis dans les sorties spécialisées de PROC UNIVARIATE.
Enfin, le recours aux indices d’adéquation relative, empruntés à la logique des équations structurelles, permet d’apprécier la conformité de la distribution empirique en quantifiant la proportion de variance distributionnelle expliquée par le modèle gaussien. Quelle que soit la taille de la cohorte analysée, l’indépendance de jugement du chercheur doit s’appuyer sur la contextualisation systématique de la p-valeur à l’aune de la taille d’échantillon effectivement engagée dans l’algorithme computationnel.
9. Procédure SAS pour le test de Kolmogorov-Smirnov à deux échantillons
9.1 Différenciation conceptuelle : test univarié vs test d’homogénéité à deux échantillons
Une confusion sémantique et théorique fréquente dans la pratique de la recherche consiste à amalgamer le test de normalité univarié (test d’adéquation à une loi théorique prédéfinie) et le test de Kolmogorov-Smirnov à deux échantillons indépendants (test d’homogénéité ou de comparaison de deux lois empiriques). Bien que ces deux procédures dérivent de la même armature axiomatique originelle formulée par Andreï Kolmogorov et Vladimir Smirnov, leurs finalités inférentielles et leurs spécifications algorithmiques sous SAS sont radicalement distinctes.
Dans le test d’homogénéité à deux échantillons, l’objectif n’est nullement de comparer une distribution d’échantillon à un modèle mathématique abstrait, mais de déterminer si deux groupes d’individus empiriquement observés (par exemple, un groupe de patients souffrant de trouble dépressif majeur comparé à un groupe témoin d’individus sains) sont issus d’une même population parente et partagent rigoureusement la même fonction de répartition continue inconnue. L’hypothèse nulle s’énonce formellement :
H0 : F1(x) = F2(x) pour l’ensemble des valeurs x réelles,
où F1(x) et F2(x) désignent respectivement les fonctions de répartition cumulatives des populations d’origine dont sont extraits les deux sous-groupes d’étude. Ce test présente un intérêt méthodologique colossal en psychométrie : il est totalement non paramétrique et ne formule aucun postulat d’égalité préalable des variances (homoscédasticité) ou de forme distributionnelle commune.
9.2 Mise en œuvre avec la procédure PROC NPAR1WAY
Alors que le diagnostic univarié de conformité à la loi normale s’opère sous la commande PROC UNIVARIATE, le test d’homogénéité de Kolmogorov-Smirnov pour deux échantillons indépendants requiert la mobilisation d’une procédure SAS entièrement dédiée aux tests non paramétriques à une dimension : PROC NPAR1WAY.
Pour déployer ce test, la table de données SAS doit impérativement être configurée selon une structure univariée longue, comprenant au minimum deux variables : la variable dépendante continue d’intérêt (par exemple, un score clinique de labilité émotionnelle) et une variable de classification discrète à deux modalités identifiant l’appartenance groupale des sujets. L’appel canonique s’exécute selon l’enchaînement syntaxique suivant :
PROC NPAR1WAY DATA = ma_table_clinique EDF;
CLASS groupe_traitement;
VAR score_stabilite;
RUN;
L’argument EDF (abréviation d’Empirical Distribution Function) positionné dans l’instruction d’ouverture de PROC NPAR1WAY constitue la clé de voûte indispensable de la commande. C’est cette option spécifique qui ordonne au compilateur SAS de calculer la classe intégrale des statistiques fondées sur la fonction de distribution empirique, incluant le test de Kolmogorov-Smirnov bilatéral et unilatéral, ainsi que les statistiques d’homogénéité de Kuiper et de Cramér-von Mises à deux échantillons. Pour les très petits échantillons, l’adjonction de l’instruction subsidiaire EXACT EDF; permet d’ordonner le calcul combinatoire exact des probabilités par permutation sans s’en remettre aux approximations asymptotiques.
9.3 Interprétation des statistiques bilatérales et unilatérales
La restitution tabulaire générée par PROC NPAR1WAY sous la rubrique Kolmogorov-Smirnov Test offre une décomposition analytique remarquable de la divergence observée entre les deux distributions empiriques. SAS calcule trois statistiques spécifiques qui éclairent la structure de la comparaison :
- L’écart positif maximal (noté D+) : Mesure la plus grande distance verticale où la courbe de distribution empirique du premier groupe se positionne au-dessus de celle du second groupe.
- L’écart négatif maximal (noté D-) : Mesure la plus grande déviation verticale où la fonction empirique du premier groupe s’enfonce sous celle du second groupe.
- La statistique bilatérale globale (notée D) : Représente le suprémum absolu entre ces deux composantes : D = max(D+, D-).
L’évaluation conjointe de D+ et D- permet de diagnostiquer des phénomènes majeurs de dominance stochastique en psychologie. Si la statistique globale D s’avère hautement significative et que cette divergence est presque intégralement portée par l’écart unilatéral D+, cela démontre mathématiquement que la distribution du groupe 1 domine stochastiquement celle du groupe 2, ce qui signifie que les probabilités cumulées d’obtenir des scores inférieurs sont systématiquement plus élevées dans le groupe 1 pour l’ensemble du spectre de mesure. SAS délivre à la fois la statistique brute D, la statistique normalisée asymptotique KSa (correspondant à √[(n1 × n2) / (n1 + n2)] × D), et la probabilité critique exacte ou asymptotique associée Pr > KSa, autorisant une conclusion scientifique d’une précision inattaquable.
10. Conduite à tenir en cas de rejet de la normalité
10.1 Transformations mathématiques des variables sous SAS
Lorsque le couperet du test de normalité tombe et que l’hypothèse nulle H0 est rejetée sans équivoque par SAS (p ≤ 0.05), le chercheur ne doit pas considérer son protocole d’analyse comme invalidé. La première stratégie d’ajustement méthodologique consiste à appliquer une fonction de transformation mathématique continue non linéaire sur la variable dépendante afin de reconfigurer sa géométrie distributionnelle et la rapprocher de la morphologie gaussienne.
Sous l’étape DATA de SAS, ces transformations s’opèrent avec une concision algorithmique immédiate :
- Transformation logarithmique népérienne : score_log = log(score_brut); (ou log(score_brut + 1) si l’échelle psychométrique comporte des valeurs strictement nulles). Cette fonction mathématique constitue le remède par excellence pour corriger les distributions manifestant une asymétrie positive sévère étirée vers la droite avec queues leptokurtiques.
- Transformation par racine carrée : score_sqrt = sqrt(score_brut);, particulièrement performante pour stabiliser la variance de variables de comptage psychologiques (comme le nombre d’erreurs commises à une tâche d’attention soutenue) dont la distribution s’apparente à une loi de Poisson.
- Transformation inverse ou réciproque : score_inv = 1 / score_brut;, réservée aux asymétries positives extrêmes, couramment mobilisée dans le traitement des temps de réaction latents.
Pour une approche d’optimisation automatisée, le système SAS intègre la procédure PROC TRANSREG (abréviation de Transformation Regression). Cette procédure sophistiquée permet d’estimer par maximum de vraisemblance le paramètre d’ajustement optimal λ (lambda) au sein de la célèbre famille des transformations de Box-Cox via la syntaxe analytique :
PROC TRANSREG DATA = ma_table;
MODEL BOXCOX(score_brut / CONVENIENT) = IDENTITY(score_predicteur);
RUN;
Dès lors que la transformation mathématique a été opérée, il est impératif d’exécuter à nouveau la procédure PROC UNIVARIATE sur la nouvelle variable transformée pour vérifier formellement que la statistique de Kolmogorov-Smirnov valide cette fois l’adéquation distributionnelle avant d’engager toute modélisation paramétrique ultérieure.
10.2 Recours aux méthodes statistiques non paramétriques
Si aucune transformation mathématique monotone ne parvient à normaliser de manière satisfaisante la variable ou si la communauté de pairs dans la discipline concernée s’oppose à la transformation non linéaire des scores au motif qu’elle complexifie l’interprétation directe des unités de mesure cliniques brutes, le recours aux alternatives non paramétriques s’impose comme la démarche la plus rigoureuse.
Les méthodes non paramétriques ont pour dénominateur commun d’affranchir l’inférence de tout postulat de normalité en substituant aux valeurs numériques continues brutes leur rang ordinal séquentiel au sein de l’échantillon global. Le chercheur exploitera alors les procédures natives de SAS dédiées :
- En remplacement du test t de Student pour échantillons indépendants : La mise en œuvre du test de la somme des rangs de Wilcoxon ou test de Mann-Whitney sous la procédure PROC NPAR1WAY avec l’option WILCOXON.
- En remplacement de l’analyse de variance factorielle univariée (ANOVA) : L’exécution du test non paramétrique de Kruskal-Wallis pour les comparaisons impliquant plus de deux groupes indépendants, disponible également sous PROC NPAR1WAY.
- En remplacement du test t pour mesures répétées : Le recours au test des rangs signés de Wilcoxon pour les comparaisons appariées ou au test de Friedman via la commande PROC FREQ assortie de l’option CMH (Cochran-Mantel-Haenszel).
Bien que ces procédures garantissent un contrôle parfait du taux d’erreur de première espèce (α) même sous des distributions sévèrement pathologiques, le statisticien doit rester conscient du coût méthodologique inhérent à cette transition : la perte d’information consécutive à la conversion des scores continus en rangs ordinaires engendre une baisse modérée de puissance statistique par rapport à un test paramétrique appliqué sur des données intrinsèquement normales.
10.3 Approches par rééchantillonnage et modélisation robuste
Les avancées considérables des capacités computationnelles de SAS ont favorisé l’essor de méthodologies modernes qui contournent élégamment l’inadéquation distributionnelle sans exiger la dégradation des scores en rangs : les approches par rééchantillonnage bootstrap et les modélisations linéaires généralisées.
La méthodologie du rééchantillonnage empirique ou bootstrapping consiste à générer des milliers de sous-échantillons pseudo-aléatoires par tirage avec remise à partir de l’échantillon initial à l’aide de la procédure PROC SURVEYSELECT. En calculant le paramètre cible (par exemple, la différence entre deux moyennes ou un coefficient de régression) sur chacun de ces réplicats, le chercheur reconstruit empiriquement la véritable distribution d’échantillonnage de la statistique sans formuler la moindre hypothèse sur la normalité de la population parente. L’estimation d’intervalles de confiance bootstrap corrigés des biais et accélérés (intervalles BCa) constitue aujourd’hui le standard d’excellence pour rapporter des effets en psychologie quantitative lorsque les postulats classiques sont violés.
Parallèlement, la procédure PROC GENMOD permet de déployer des modèles linéaires généralisés (GLM) en spécifiant des lois d’émission distributionnelles parfaitement calibrées sur la nature asymétrique des données (notamment les lois Gamma, Poisson ou Binomiale négative pour les variables de comptage ou les échelles fortement tronquées). Enfin, il convient de rappeler la robustesse asymptotique offerte par le Théorème Central Limite : dans les plans d’expérience factoriels parfaitement équilibrés présentant des effectifs par cellule substantiels (typiquement n ≥ 50 par modalité), les estimateurs de la variance des moyennes d’échantillons convergent vers la normalité, conférant aux tests F de l’ANOVA une remarquable résilience face aux déviations modérées de la normalité univariée.
11. Erreurs fréquentes et bonnes pratiques méthodologiques dans SAS
11.1 Pièges syntaxiques et erreurs de paramétrage courantes
L’exploitation pratique de SAS pour l’évaluation de la normalité recèle plusieurs pièges syntaxiques susceptibles d’induire le chercheur en erreur ou de fausser substantiellement les résultats inférentiels. Le piège le plus universellement constaté réside dans l’omission des paramètres d’estimation au sein de l’option NORMAL. Lorsque l’instruction est déclarée de manière abrupte sans argument complémentaire :
HISTOGRAM score / NORMAL; /* AVERTISSEMENT MÉTHODOLOGIQUE */
le moteur d’analyse de SAS évalue par défaut l’adéquation de la variable à une loi normale standardisée centrée et réduite de moyenne μ = 0 et d’écart-type σ = 1. Si la variable psychométrique analysée est une échelle de bien-être dont la moyenne empirique se situe à 45.3 avec une dispersion de 8.2, le test calculera la divergence suprémum par rapport à une courbe centrée sur zéro ! La statistique D atteindra alors des valeurs astronomiques proches de 1.0, conduisant à un rejet erroné et catastrophique de la normalité. La mention explicite de NORMAL(MU=EST SIGMA=EST) est donc strictement obligatoire pour calibrer l’ajustement sur la réalité empirique des données.
Un autre écueil récurrent concerne la gestion des analyses stratifiées par sous-groupes. Lorsqu’un chercheur souhaite vérifier la normalité des résidus au sein de différents groupes expérimentaux, l’utilisation de l’instruction WHERE doit être manipulée avec précaution pour éviter d’analyser la population agglomérée globale. De même, la confusion syntaxique entre l’instruction BY (qui exige un tri séquentiel préalable impératif de la table via PROC SORT) et l’instruction CLASS sous PROC UNIVARIATE engendre fréquemment des interruptions d’exécution du script ou des générations de résultats segmentés erronés.
11.2 Mauvaises interprétations scientifiques des résultats
Au-delà de la syntaxe informatique pure, les confusions épistémologiques relatives à l’interprétation des résultats de normalité polluent abondamment la littérature empirique. La première dérive interprétative réside dans la réification dogmatique du seuil p > 0.05. Assimiler une probabilité critique élevée à la démonstration irréfutable que la variable suit une distribution gaussienne relève d’une méconnaissance de la logique du test d’hypothèse. Le statisticien doit impérativement rédiger ses conclusions en explicitant que les observations disponibles ne présentent pas une divergence statistiquement significative par rapport au modèle gaussien, tout en conservant une lucidité critique sur les limites de puissance de son protocole.
La seconde erreur d’interprétation fréquente consiste à négliger l’impact des plans d’échantillonnage complexes. Dans les grandes enquêtes scolaires ou sociologiques où les participants sont recrutés par grappes (classes, établissements) ou par stratification territoriale, les observations ne satisfont pas au postulat fondamental d’indépendance statistique des erreurs. L’application standard de la procédure univariée sans ajustement des effets de grappe gonfle artificiellement le taux de faux positifs, conduisant à rejeter la normalité pour des motifs liés à la corrélation intra-classe et non à la forme intrinsèque de la variable psychologique.
11.3 Check-list méthodologique pour fiabiliser les analyses SAS
Pour prémunir les équipes de recherche contre ces écueils et institutionnaliser des standards de travail reproductibles et rigoureux, il est recommandé de suivre systématiquement une check-list méthodologique normalisée avant toute validation finale des analyses :
- 1. Audit des effectifs : Évaluer la taille effective de l’échantillon N. Si N < 50, renoncer au test de Kolmogorov-Smirnov au profit de Shapiro-Wilk ou d’approches non paramétriques. Si N > 2 000, anticiper le paradoxe de sur-significativité et privilégier la taille d’effet D sur la seule p-valeur.
- 2. Contrôle syntaxique : Vérifier la présence impérative de l’option NORMAL(MU=EST SIGMA=EST) dans la commande HISTOGRAM de PROC UNIVARIATE pour activer la correction de Lilliefors.
- 3. Triangulation inférentielle : Examiner la cohérence mutuelle des quatre tests de normalité (Shapiro-Wilk, Kolmogorov-Smirnov, Cramér-von Mises, Anderson-Darling). Documenter tout désaccord entre les indicateurs.
- 4. Validation visuelle systématique : Générer et inspecter obligatoirement le tracé Q-Q (QQPLOT) et l’histogramme lissé avec courbe de densité par noyau (KERNEL) pour localiser la nature anatomique des anomalies éventuelles (queues lourdes, asymétrie, bimodalité).
- 5. Examen des moments : Calculer et analyser conjointement les coefficients de Skewness et de Kurtosis ainsi que leurs erreurs types associées.
- 6. Traçabilité et reproductibilité : Conserver l’intégralité du code SAS dans le journal d’analyse (Log sans aucune erreur ni avertissement critique), isoler les résultats via les instructions ODS, et documenter explicitement les éventuelles exclusions d’observations atypiques.
12. Étude de cas intégrée et rédaction des résultats selon les normes académiques
12.1 Scénario empirique : Analyse d’un score d’anxiété sur un échantillon clinique
Afin de concrétiser l’ensemble de ces préceptes théoriques et opératoires au sein d’une démonstration empirique réaliste, considérons une investigation menée en psychologie clinique auprès d’une cohorte de N = 50 patients adultes admis au sein d’une unité spécialisée dans la prise en charge des troubles anxio-dépressifs. Chaque participant a complété à son admission l’inventaire d’anxiété de Hamilton (HAM-A), dont le score total composite, sommé sur une série d’items gradués, est traité comme une variable quantitative continue. Le protocole méthodologique impose de statuer sur la normalité univariée de ce score avant d’envisager une comparaison de moyennes avec un groupe témoin.
Le programme SAS complet assurant l’acquisition des données, la sélection modulaire des sorties via ODS, l’ajustement distributionnel et la génération des diagnostics graphiques est structuré selon la séquence suivante :
DATA Evaluation_Clinique;
INPUT Identifiant Score_Anxiete @@;
LABEL Score_Anxiete = ‘Score Total Inventaire Anxiété Hamilton’;
DATALINES;
1 18.2 2 22.4 3 15.6 4 24.1 5 19.8 6 21.0 7 26.3 8 17.5
9 20.2 10 23.9 11 16.4 12 28.1 13 19.5 14 22.0 15 25.4 16 18.9
17 21.3 18 20.7 19 24.8 20 17.1 21 23.2 22 19.1 23 26.9 24 15.9
25 22.8 26 20.4 27 27.5 28 18.4 29 21.9 30 25.1 31 16.8 32 23.5
33 19.6 34 22.1 35 24.4 36 17.9 37 20.9 38 26.0 39 18.7 40 21.5
41 23.0 42 19.4 43 27.2 44 16.1 45 22.6 46 20.1 47 25.8 48 18.0
49 21.7 50 24.0
;
RUN;
ODS GRAPHICS ON;
ODS SELECT Moments TestsForNormality ParameterEstimates QQPlot Histogram;
PROC UNIVARIATE DATA = Evaluation_Clinique NORMAL;
VAR Score_Anxiete;
HISTOGRAM Score_Anxiete / NORMAL(MU=EST SIGMA=EST COLOR=RED) KERNEL(COLOR=BLUE);
QQPLOT Score_Anxiete / NORMAL(MU=EST SIGMA=EST SQUARE);
RUN;
ODS GRAPHICS OFF;
L’exécution de cette syntaxe génère les sorties numériques suivantes : pour un effectif N = 50, la moyenne d’échantillon s’établit à x̄ = 21.46 avec un écart-type s = 3.34. Le coefficient d’asymétrie calculé est de Skewness = 0.142 (erreur-type = 0.337) et le coefficient d’aplatissement s’établit à Excess Kurtosis = -0.612 (erreur-type = 0.662). Au niveau du tableau synthétique des tests d’adéquation, SAS rapporte pour la ligne de Kolmogorov-Smirnov (correction de Lilliefors) une statistique D = 0.068 assortie d’une probabilité critique affichée sous la forme Pr > D > 0.150. Parallèlement, le test de Shapiro-Wilk indique une statistique W = 0.984 avec une valeur de p = 0.724. Le tracé Q-Q démontre une adhérence remarquable des points d’observation le long du vecteur linéaire théorique.
12.2 Rédaction formelle des résultats selon les normes APA
La publication scientifique de ces résultats au sein d’une revue internationale à comité de lecture affiliée à l’American Psychological Association (APA 7e édition) requiert le respect scrupuleux d’un formalisme de notation codifié. La restitution textuelle doit obligatoirement expliciter la nature exacte du test mobilisé (en spécifiant expressément l’ajustement de Lilliefors), la valeur de la statistique de test D rapportée avec deux ou trois décimales, la taille d’échantillon engagée, la probabilité critique exacte ou bornée, ainsi que les indicateurs descriptifs complémentaires.
Modèle de rédaction académique standard en cas de conformité distributionnelle (validation de la normalité) :
« L’évaluation de l’adéquation distributionnelle des scores totaux d’anxiété mesurés à l’aide de l’inventaire de Hamilton a été réalisée en préambule aux modélisations comparatives. L’analyse des moments descriptifs indique une asymétrie négligeable (Skewness = 0.14, SE = 0.34) ainsi qu’un aplatissement modéré (Kurtosis = -0.61, SE = 0.66). L’application formelle du test de Kolmogorov-Smirnov assorti de la correction de Lilliefors démontre l’absence de divergence statistiquement significative par rapport à une loi normale théorique, D(50) = 0.07, p > .150. Ce diagnostic de normalité est pleinement corroboré par le test de Shapiro-Wilk, W = 0.98, p = .724, ainsi que par l’inspection visuelle du diagramme quantile-quantile (Q-Q plot) qui atteste d’un alignement continu des quantiles empiriques sur la diagonale normale. L’hypothèse de normalité univariée est par conséquent retenue, légitimant l’application ultérieure de tests statistiques paramétriques. »
Modèle de rédaction académique standard en cas d’infirmation distributionnelle (rejet de la normalité) :
« L’examen de la distribution des temps de réaction latents mesurés en millisecondes a mis en évidence une importante déviation morphologique par rapport aux exigences du modèle linéaire général. La distribution empirique se caractérise par une forte asymétrie positive (Skewness = 1.84, SE = 0.28) associée à une structure leptokurtique marquée (Kurtosis = 4.12, SE = 0.55). Le test d’adéquation de Kolmogorov-Smirnov avec correction de Lilliefors conduit au rejet formel de l’hypothèse nulle de normalité, D(75) = 0.18, p < .001, observation confirmée par le test d'Anderson-Darling attestant d'une surcharge majeure au niveau des queues de distribution, A² = 3.42, p < .001. Face à cette violation substantielle du postulat de normalité univariée, l'ensemble des comparaisons groupales subséquentes a été exécuté à l'aide de procédures non paramétriques de Wilcoxon-Mann-Whitney accompagnées de rééchantillonnages bootstrap (10 000 réplications). »
12.3 Synthèse et recommandations pour les publications en psychologie quantitative
L’élévation des exigences méthodologiques imposée par les comités éditoriaux des grandes revues scientifiques en psychologie et neurosciences cognitives (telles que Psychological Methods, Journal of Applied Psychology ou Neuropsychologia) transforme en profondeur les habitudes de publication. Il n’est désormais plus jugé acceptable de se contenter d’une mention évasive telle que « la normalité a été vérifiée », formulation opaque qui dissimule trop souvent une absence totale de vérification computationnelle.
Les chercheurs sont instamment invités à faire preuve d’une transparence absolue en adoptant les directives de la science ouverte (Open Science Framework). Cette rigueur implique :
- De déposer le script SAS complet (fichiers .sas commentés) au sein des annexes méthodologiques en ligne ou sur des dépôts institutionnels publics pérennes, garantissant la reproductibilité exacte des analyses de normalité par les réviseurs indépendants.
- D’intégrer systématiquement dans les manuscrits soumis une figure composite associant l’histogramme des densités et le tracé quantile-quantile (Q-Q plot), permettant aux pairs d’apprécier la morphologie des données au-delà des seules métriques tabulaires.
- D’expliciter sans détour la conduite tenue face aux éventuelles discordances entre indicateurs (notamment entre le test de Lilliefors et le test de Shapiro-Wilk) en justifiant les arbitrages méthodologiques retenus sur des bases statistiques objectives.
- De documenter systématiquement la puissance statistique contextuelle du test d’adéquation au regard de l’effectif réel de l’échantillon, évitant ainsi les écueils jumeaux de la sur-interprétation sur grands effectifs et de l’illusion de normalité sur cohortes réduites.
En articulant une maîtrise théorique approfondie des fonctions de distribution empiriques, une exploitation experte des procédures PROC UNIVARIATE et PROC NPAR1WAY du logiciel SAS, et une fidélité intransigeante aux standards de rédaction académiques internationaux, les chercheurs s’assurent d’ériger leurs édifices inférentiels sur des bases distributionnelles d’une solidité méthodologique irréprochable.
Références
- Anderson, T. W., & Darling, D. A. (1954). A test of goodness of fit. Journal of the American Statistical Association, 49(268), 765–769. https://doi.org/10.1080/01621459.1954.10501232
- Cramér, H. (1946). Mathematical Methods of Statistics. Princeton University Press. https://press.princeton.edu/books/paperback/9780691005478/mathematical-methods-of-statistics
- Kolmogorov, A. N. (1933). Sulla determinazione empirica di una legge di distribuzione. Giornale dell’Istituto Italiano degli Attuari, 4, 83–91.
- Lilliefors, H. W. (1967). On the Kolmogorov-Smirnov test for normality with mean and variance unknown. Journal of the American Statistical Association, 62(318), 399–402. https://doi.org/10.1080/01621459.1967.10482916
- National Institute of Standards and Technology. (2012). NIST/SEMATECH e-Handbook of Statistical Methods: Kolmogorov-Smirnov Goodness-of-Fit Test. U.S. Department of Commerce. https://www.itl.nist.gov/div898/handbook/eda/section3/eda35g.htm
- Razali, N. M., & Wah, Y. B. (2011). Power comparisons of Shapiro-Wilk, Kolmogorov-Smirnov, Lilliefors and Anderson-Darling tests. Journal of Statistical Modeling and Analytics, 2(1), 21–33.
- SAS Institute Inc. (2023). SAS/STAT 15.3 User’s Guide: The UNIVARIATE Procedure. SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/procstat/procstat_univariate_toc.htm
- SAS Institute Inc. (2023). SAS/STAT 15.3 User’s Guide: The NPAR1WAY Procedure. SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/procstat/procstat_npar1way_toc.htm
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
- Smirnov, N. V. (1939). Sur les écarts de la courbe de distribution empirique. Recueil Mathématique (Matematicheskii Sbornik), 6(48), 3–26.
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677