
Dans le champ des sciences humaines et du comportement, l’évaluation empirique des modèles théoriques repose très fréquemment sur l’estimation de relations linéaires entre variables latentes et observables. Qu’il s’agisse de mesurer l’impact de l’anxiété sur les performances académiques, de modéliser le déclin cognitif en fonction de biomarqueurs neurophysiologiques ou d’évaluer l’efficacité différentielle d’interventions psychothérapeutiques, la modélisation statistique constitue la passerelle entre l’abstraction conceptuelle et la réalité expérimentale. Cependant, la validité interne et la robustesse des conclusions tirées de ces modèles dépendent fondamentalement de la conformité des données aux postulats sous-jacents de l’estimation paramétrique. L’un des écueils méthodologiques les plus insidieux réside dans la présence de cas singuliers, capables de distordre de manière disproportionnée les paramètres estimés et d’engendrer des inférences erronées.
L’avènement de l’analyse exploratoire et des méthodes de diagnostic résiduel a mis en lumière la vulnérabilité intrinsèque des estimateurs conventionnels, tels que les moindres carrés ordinaires, face aux observations atypiques. Dans de nombreux protocoles de recherche en psychologie, des profils atypiques de participants — qu’ils résultent d’erreurs de mesure, de biais de réponse, d’inattention ou de réelles divergences cliniques idiosyncrasiques — peuvent exercer une attraction gravitationnelle sur la droite ou l’hyperplan de régression. Face à ce défi, la simple inspection descriptive univariée se révèle largement impuissante à déceler des configurations multivariées anormales, rendant indispensable l’usage d’outils géométriques et statistiques bidimensionnels capables d’articuler simultanément l’écart prédictif et la singularité positionnelle des individus.
Le graphique des résidus par rapport au levier, couramment désigné sous sa terminologie anglo-saxonne de Residuals vs. Leverage Plot, représente l’un des instruments diagnostiques les plus sophistiqués et indispensables de la boîte à outils du psychomètre et du biostatisticien contemporain. En projetant chaque observation dans un repère orthogonal où l’axe des abscisses quantifie l’excentricité structurelle du profil de prédicteurs et l’axe des ordonnées mesure l’amplitude de l’erreur d’ajustement standardisée, cette visualisation permet d’identifier avec une précision chirurgicale les observations qui ne se contentent pas d’être déviantes, mais qui dictent activement la géométrie du modèle statistique. Le présent article propose une déconstruction exhaustive de cet outil, depuis ses fondements matriciels jusqu’à ses implications éthiques et pratiques dans la recherche quantitative moderne.
1. Introduction aux diagnostics de régression en psychologie quantitative
1.1 La place centrale des modèles linéaires dans l’étude des comportements
La psychologie quantitative contemporaine accorde une place prépondérante à la régression linéaire multiple et à ses extensions généralisées pour formaliser et tester des hypothèses relatives aux processus cognitifs, émotionnels et relationnels. Ce cadre analytique permet aux chercheurs de décomposer la variance d’un phénomène psychologique complexe en composantes attribuables à divers facteurs prédictifs, qu’ils soient dispositionnels, situationnels ou démographiques. Qu’il s’agisse de tester l’effet modérateur de la résilience psychologique face au stress perçu ou de quantifier la part de variance expliquée par les traits de personnalité dans la prise de décision à risque, le modèle linéaire sert de standard de preuve empirique.
Cependant, l’utilisation de ces modèles mathématiques repose sur un ensemble strict d’hypothèses théoriques : la linéarité de la relation, la normalité des erreurs, l’homoscédasticité de la variance résiduelle, l’indépendance conditionnelle des observations et, implicitement, l’homogénéité de l’influence exercée par chaque unité d’échantillonnage. Dans les cohortes de recherche comportementale, cette dernière hypothèse est fréquemment violée. La variabilité inhérente aux dynamiques humaines conduit inévitablement à l’émergence de participants dont les caractéristiques psychométriques s’écartent drastiquement de la norme collective.
Une interprétation aveugle des coefficients de régression, fondée exclusivement sur les indices de signification statistique traditionnels (valeurs p) et sur le coefficient de détermination globale, expose la recherche à des périls majeurs. Sans une vérification rigoureuse des diagnostics résiduels, un chercheur s’expose à publier des conclusions dont la signification empirique est entièrement dictée par un ou deux individus atypiques, créant ainsi des artéfacts théoriques voués à l’échec lors des tentatives de réplication.
1.2 La vulnérabilité de la méthode des moindres carrés ordinaires face aux données atypiques
L’algorithme fondamental d’estimation par les moindres carrés ordinaires procède par minimisation mathématique de la somme des carrés des erreurs résiduelles. Cette formulation confère au critère d’optimisation une sensibilité quadratique aux écarts : plus un point de données s’éloigne de la surface de prédiction, plus le coût pénalisant imposé par la fonction objectif croît de manière exponentielle. En conséquence, un point géométriquement excentré dispose d’une force mécanique considérable, capable de faire pivoter la droite de régression vers lui afin d’atténuer la pénalité quadratique qu’il engendre.
Cette instabilité structurelle est particulièrement préoccupante dans l’analyse de profils psychologiques atypiques. Considérons, par exemple, une recherche examinant la relation entre le temps d’écran quotidien et le sentiment de solitude chez des adolescents. La présence d’un seul répondant déclarant vingt heures de temps d’écran journalier et un score de solitude minimal ou maximal peut suffire à inverser la trajectoire de la pente de régression de l’échantillon entier, masquant ainsi une relation curvilinéaire ou linéaire sous-jacente propre à la quasi-totalité de la population étudiée.
Pour prévenir cette dégradation pernicieuse du modèle statistique, les statisticiens ont développé une riche panoplie d’indicateurs analytiques et de diagnostics visuels. L’inspection des distributions univariées par des diagrammes en boîte ou des histogrammes s’avère manifestement insuffisante, car elle échoue à appréhender les anomalies positionnelles multivariées. C’est précisément dans cette brèche méthodologique que s’insèrent les diagnostics visuels bidimensionnels, conçus pour désenchevêtrer l’écart résiduel pur de la position spatiale occupée par les prédicteurs.
1.3 Définition conceptuelle du graphique des résidus par rapport au levier
Le graphique des résidus par rapport au levier est un espace de coordonnées cartésiennes bidimensionnel élaboré pour évaluer simultanément la justesse prédictive d’un modèle et la stabilité structurelle de ses paramètres face aux singularités de l’échantillon. Contrairement aux graphiques résiduels classiques qui se bornent à projeter les résidus bruts ou standardisés contre les valeurs prédites, ce graphique confronte de manière directe deux métriques orthogonales complémentaires : la magnitude de l’erreur commise par le modèle pour une observation donnée et la propension géométrique de cette observation à peser sur l’orientation de l’ajustement.
En mettant en relation l’écart à la prédiction (axe des ordonnées) et l’excentricité de la variable prédictive (axe des abscisses), l’outil transcende la dichotomie simpliste entre « valeur normale » et « valeur aberrante ». Il permet de distinguer les sujets qui échouent simplement à être bien décrits par le modèle théorique de ceux dont la divergence structurelle déplace activement les frontières de ce modèle. L’objectif premier de cette représentation n’est pas d’inciter à une purge aveugle des données déviantes, mais bien d’isoler les observations susceptibles d’altérer unilatéralement les conclusions empiriques.
Dans le contexte de la psychologie quantitative, cet instrument devient une lentille d’examen incontournable. Il offre aux chercheurs la possibilité de disséquer l’hétérogénéité de leurs échantillons, de détecter d’éventuelles sous-populations cliniques non modélisées, d’identifier des erreurs de protocole expérimental et de garantir que les régularités comportementales rapportées reflètent véritablement une dynamique partagée par le groupe étudié plutôt que l’empreinte mathématique d’une poignée d’individus marginaux.
2. Les fondements mathématiques du levier statistique
2.1 La matrice de projection et le calcul du levier
Pour appréhender rigoureusement la nature du levier statistique, il est nécessaire d’examiner la formulation matricielle du modèle de régression linéaire multiple. Soit le modèle exprimé sous la forme matricielle vectorielle suivante :
Y = Xβ + ε
où Y représente le vecteur des observations de la variable dépendante de dimension n × 1, X est la matrice de conception de dimension n × p contenant les vecteurs de prédicteurs augmentés d’une colonne unitaire pour l’intercepte, β est le vecteur des paramètres de dimension p × 1, et ε désigne le vecteur des erreurs stochastiques non corrélées. L’estimation des coefficients par la méthode des moindres carrés ordinaires s’obtient par la résolution de l’équation normale bien connue :
β̂ = (XᵀX)⁻¹XᵀY
En réinjectant cette estimation dans l’équation de prédiction des valeurs ajustées Ŷ, nous obtenons la relation :
Ŷ = Xβ̂ = X(XᵀX)⁻¹XᵀY
L’opérateur matriciel linéaire H = X(XᵀX)⁻¹Xᵀ est désigné dans la littérature sous le vocable de matrice chapeau (Hat Matrix), car il assure la transformation directe du vecteur des valeurs observées Y en vecteur des valeurs estimées Ŷ (« coiffant » ainsi la variable dépendante). Cette matrice est symétrique (H = Hᵀ) et idempotente (H² = H), ce qui traduit géométriquement une projection orthogonale du vecteur Y sur le sous-espace vectoriel engendré par les colonnes de X.
Le levier statistique attribué à un individu spécifique i, noté formellement hᵢᵢ, correspond précisément au i-ème élément situé sur la diagonale principale de cette matrice chapeau H. Mathématiquement, cet élément s’exprime sous la forme :
hᵢᵢ = xᵢᵀ(XᵀX)⁻¹xᵢ
où xᵢᵀ désigne le vecteur ligne correspondant aux valeurs des prédicteurs observées pour le i-ème sujet. Une propriété fondamentale de cette métrique réside dans le fait que la trace de la matrice chapeau est invariablement égale au nombre de paramètres estimés dans le modèle régressif, soit :
∑ hᵢᵢ = tr(H) = p
Par conséquent, la valeur moyenne du levier pour l’ensemble d’un échantillon comprenant n sujets est strictement définie par la quantité p / n. De surcroît, chaque valeur de levier individuelle est bornée dans l’intervalle théorique compris entre 1/n (dans un modèle pourvu d’une constante) et 1. Cette formulation montre que le levier quantifie le poids proportionnel conféré à la réponse observée yᵢ dans la détermination de sa propre valeur ajustée ŷᵢ, puisque la dérivée partielle de ŷᵢ par rapport à yᵢ n’est autre que hᵢᵢ.
2.2 Interprétation géométrique du levier dans l’espace multidimensionnel
Au-delà de son formalisme matriciel, le levier admet une interprétation géométrique limpide dans l’espace vectoriel des prédicteurs. Il mesure de manière synthétique l’éloignement spatial d’un participant par rapport au point moyen de distribution de l’échantillon, couramment désigné sous le terme de centroïde multivarié des variables indépendantes.
Il existe une correspondance mathématique directe entre la valeur de levier hᵢᵢ et la prestigieuse distance de Mahalanobis (notée Dᵢ²), qui pondère les distances euclidiennes par la matrice de variance-covariance des prédicteurs. Dans le cadre d’un modèle incluant une ordonnée à l’origine, cette relation s’exprime rigoureusement par l’équation :
hᵢᵢ = (1 / n) + (Dᵢ² / (n – 1))
Cette égalité éclaire la nature du levier : un individu présentant un hᵢᵢ élevé est un sujet dont le profil psychologique sur les variables indépendantes s’avère hautement singulier, atypique ou isolé dans l’espace multidimensionnel défini par les prédicteurs. S’il s’agit d’une étude portant sur la mémoire de travail combinant des épreuves d’empan spatial, d’empan verbal et de vitesse de traitement, un participant qui se démarquerait par une vitesse de traitement exceptionnellement véloce couplée à un empan spatial extrêmement dégradé présentera une distance de Mahalanobis considérable, et se verra conséquemment attribuer un levier élevé.
Il est impératif de souligner un principe épistémologique capital : le calcul du levier est rigoureusement aveugle à la variable dépendante Y. Le levier ne renseigne en rien sur la réussite, l’échec ou la conformité de la prédiction relative au comportement d’intérêt ; il traduit exclusivement la rareté topologique du profil de conditions expérimentales ou de traits psychométriques propre à cet individu au sein de la cohorte analysée.
2.3 Seuils critiques d’identification du levier élevé
L’évaluation pratique d’un modèle statistique requiert l’établissement de bornes critiques permettant de distinguer les fluctuations ordinaires de l’échantillonnage d’une excentricité structurellement problématique. Étant donné que le levier moyen d’un échantillon s’élève à p / n, les statisticiens ont formalisé plusieurs règles de décision empiriques.
La règle heuristique la plus répandue, initialement formulée par Hoaglin et Welsch, préconise de considérer comme suspecte et potentiellement préoccupante toute observation dont le levier excède le double du levier moyen, soit :
hᵢᵢ > 2(p / n)
Cette frontière s’avère particulièrement adaptée aux échantillons de taille modeste ou intermédiaire, tels que ceux que l’on observe usuellement dans les expérimentations en neurosciences cognitives ou en psychologie clinique (par exemple, n compris entre 30 et 100). Pour les protocoles épidémiologiques ou les enquêtes psychométriques à large échelle impliquant des milliers de participants, ce seuil de 2p/n a tendance à identifier un nombre excessivement élevé de sujets comme étant à fort levier, en raison du resserrement asymptotique de la moyenne.
Dans les contextes d’échantillons volumineux, une posture décisionnelle plus conservatrice est privilégiée, plaçant le critère d’investigation au triple du levier moyen :
hᵢᵢ > 3(p / n)
L’application de ces seuils ne doit toutefois jamais se transformer en un automatisme algorithmique dénué de réflexion psychométrique. L’analyste doit impérativement mettre ces seuils en balance avec le ratio participants-variables et la dispersion inhérente aux instruments de mesure comportementaux. Un levier franchissant ces bornes signale une observation possédant un potentiel mécanique élevé d’influence, mais ne présume pas de la réalité effective de cette distorsion sur les paramètres régressifs.
3. Les résidus standardisés et studentisés : mesure de l’écart prédictif
3.1 Des résidus bruts aux résidus standardisés
Tandis que le levier statistique quantifie la singularité sur l’axe des X, l’évaluation de la justesse prédictive s’ancre dans l’analyse des écarts observés sur l’axe de la réponse comportementale Y. Le résidu brut associé à la i-ème observation se définit simplement comme la différence arithmétique entre la valeur empiriquement recueillie et la valeur estimée par la fonction de régression :
eᵢ = yᵢ – ŷᵢ
L’utilité diagnostique directe de ce résidu brut est sévèrement limitée par son asservissement aux unités de mesure des échelles psychologiques employées (par exemple, des points sur une échelle d’estime de soi de Rosenberg ou des millisecondes mesurées dans une tâche de temps de réaction). De surcroît, une propriété mathématique souvent méconnue de la régression linéaire stipule que les résidus bruts ne possèdent pas une variance uniforme à travers l’échantillon. En effet, la variance théorique du i-ème résidu dépend intrinsèquement de son levier selon la relation :
Var(eᵢ) = σ²(1 – hᵢᵢ)
Cette équation démontre que plus le levier d’un point est élevé (c’est-à-dire plus hᵢᵢ s’approche de 1), plus la variance de son résidu brut s’amenuise, le modèle étant contraint de passer à proximité de ce point. Pour affranchir l’analyse des biais d’échelle et corriger cette hétérogénéité de variance artificielle, on recourt aux résidus standardisés (parfois appelés résidus normalisés), calculés en divisant le résidu brut par son écart-type estimé :
rᵢ = eᵢ / (s √(1 – hᵢᵢ))
où s représente l’écart-type résiduel global de la régression (l’estimateur non biaisé de la variance d’erreur σ). Grâce à cette normalisation, les résidus standardisés possèdent une variance unitaire approximative, ce qui permet d’interpréter un écart prédictif à l’aune d’une métrique universelle comparable à celle des scores z.
3.2 La pertinence des résidus studentisés en psychométrie
Bien que les résidus standardisés représentent un progrès méthodologique substantiel par rapport aux écarts bruts, ils souffrent d’une limite statistique : l’estimateur de l’erreur résiduelle s inclut dans son calcul l’observation i elle-même. Si le point sous investigation présente un écart monumental par rapport à la tendance, sa propre erreur gonfle artificiellement la valeur de s, ce qui a pour effet pervers de comprimer son propre résidu standardisé et de masquer l’ampleur réelle de sa singularité. Ce phénomène d’autoconsommation de l’erreur est désigné sous le terme de masquage (masking effect).
Pour contourner ce biais dans les évaluations psychométriques rigoureuses, on utilise le résidu studentisé supprimé (souvent appelé jackknife residual ou résidu studentisé externe). Le calcul de cet estimateur repose sur l’exclusion délibérée du i-ème participant lors de l’estimation de la variance d’erreur, notée alors s₍ᵢ₎ :
tᵢ = eᵢ / (s₍ᵢ₎ √(1 – hᵢᵢ))
Sous l’hypothèse nulle d’adéquation du modèle et de normalité des erreurs, ces résidus studentisés externes suivent exactement une loi de Student à n – p – 1 degrés de liberté. Cette propriété mathématique permet aux chercheurs d’assigner des valeurs p formelles à la déviance prédictive de chaque participant. Dans le dépouillement d’épreuves cognitives complexes, des valeurs absolues de |tᵢ| excédant 2 ou 3 constituent des indicateurs probants d’irrégularités comportementales majeures, telles que des réponses générées au hasard par désengagement motivationnel ou des perturbations neuropsychologiques singulières non prises en compte par la batterie de tests.
3.3 Distinction formelle entre une valeur aberrante et un point à fort levier
Dans le discours méthodologique profane, la confusion règne souvent entre les notions d’observation aberrante (outlier) et de point de levier (high leverage point). Il importe d’établir une démarcation conceptuelle irréductible entre ces deux réalités statistiques, résumée dans le tableau de comparaison suivant :
- L’observation aberrante (sur Y) : Elle correspond à un participant dont la valeur sur la variable dépendante est hautement discordante par rapport à la prédiction générée par le modèle régressif, compte tenu de son profil sur les variables prédictives. Elle se matérialise visuellement par un résidu standardisé ou studentisé d’amplitude exceptionnelle (généralement |tᵢ| > 2,5 ou 3), mais ne s’accompagne pas obligatoirement d’une configuration atypique sur les prédicteurs X.
- L’observation à fort levier (sur X) : Elle caractérise un participant occupant une position isolée, périphérique ou extrême dans l’espace multidimensionnel des variables indépendantes (hᵢᵢ > 2p/n). Ce statut dépend exclusivement des caractéristiques d’entrée du sujet, et demeure parfaitement agnostique quant à la précision avec laquelle le modèle rend compte de son comportement observé.
Il découle de cette distinction que ces deux caractéristiques sont conceptuellement orthogonales. Un individu peut présenter un levier titanesque tout en se situant exactement sur la trajectoire théorique de la droite régressive (produisant ainsi un résidu quasi nul). Réciproquement, un individu situé au barycentre parfait des variables prédictives peut manifester un résidu considérable en cas de réponse atypique imprévisible. La convergence simultanée de ces deux propriétés chez un même participant constitue la genèse du phénomène d’influence statistique, dont l’évaluation méthodique constitue le rôle précis du graphique résidus vs levier.
4. Anatomie visuelle et lecture du graphique résidus vs levier
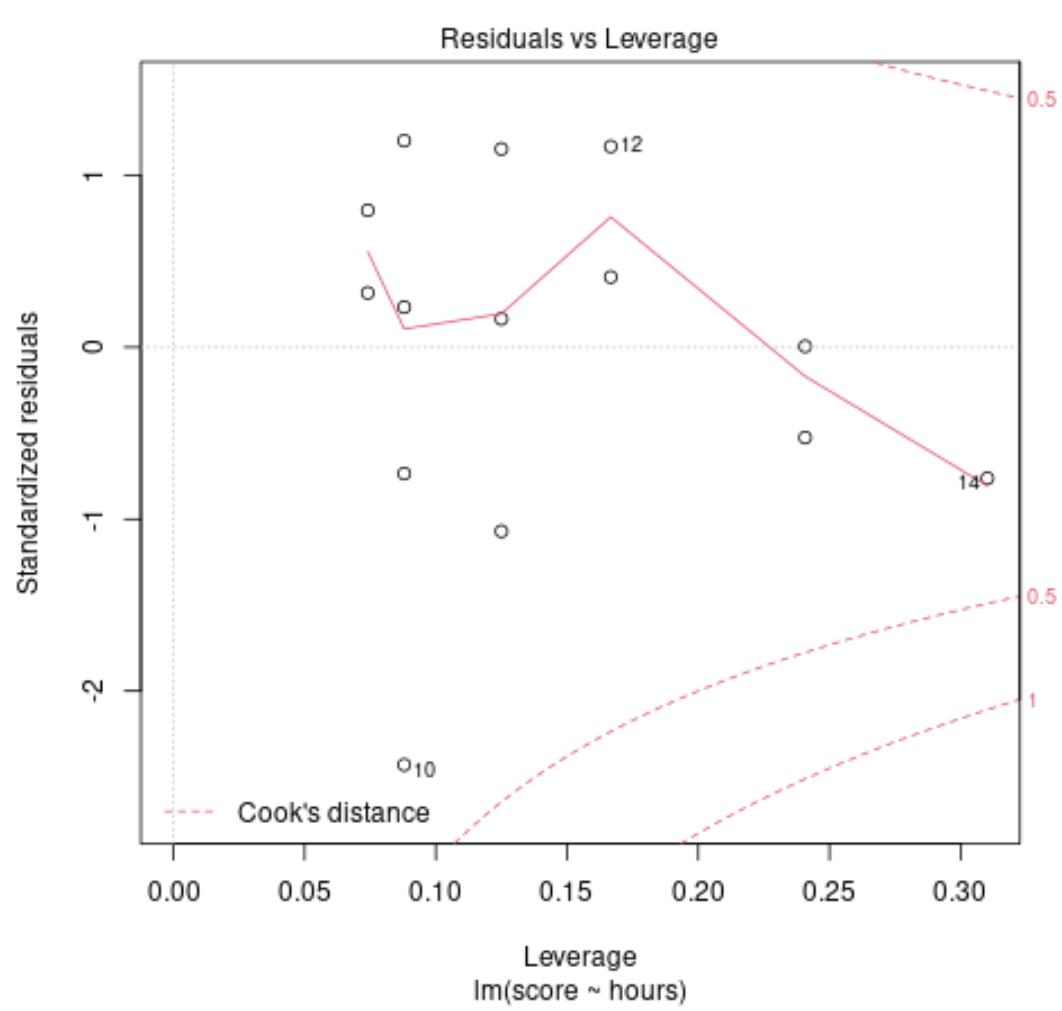
4.1 L’axe des abscisses : la dispersion du levier individuel
L’axe horizontal du graphique des résidus par rapport au levier est dévolu à la métrique de levier hᵢᵢ. Cet axe débute conventionnellement à zéro (ou à la valeur minimale théorique 1/n) et s’étend vers la droite en direction de la borne supérieure unitaire, bien que dans la pratique psychologique courante, les valeurs maximales observées dépassent rarement 0,5 à moins que l’échantillon ne soit particulièrement exigu ou la matrice des covariables excessivement dispersée.
L’examen visuel de cet axe permet d’appréhender instantanément l’architecture structurelle de l’échantillon de recherche. Dans un protocole expérimental équilibré et représentatif, la vaste majorité des observations se concentre sous la forme d’un nuage dense et compact sur le tiers ou le quart gauche de l’affichage, gravitant sagement autour de la valeur moyenne de levier p/n. Cette concentration témoigne d’un recouvrement satisfaisant des profils psychométriques parmi les répondants.
À l’inverse, l’apparition de points isolés dérivant vers la marge droite du graphique trahit l’existence de participants au profil prédicteur idiosyncrasique. Plus un point s’éloigne horizontalement de la masse centrale de l’échantillon, plus son potentiel de torsion sur l’espace d’estimation régressif s’accroît. Le repérage de cette ségrégation spatiale constitue la première phase indispensable d’une analyse rigoureuse de la validité de l’ajustement.
4.2 L’axe des ordonnées : la répartition des erreurs standardisées
L’axe vertical accueille la mesure des écarts prédictifs, généralement exprimée sous la forme de résidus standardisés ou de résidus studentisés externes. Cet axe est obligatoirement centré sur l’ordonnée zéro, matérialisée par une ligne de référence horizontale continue ou pointillée. Tout point de données s’inscrivant précisément sur cette ligne médiane correspond à un participant dont la performance comportementale réelle coïncide à la perfection avec l’estimation dérivée de l’équation linéaire.
La graduation de l’axe vertical s’étend de manière symétrique dans les registres positif et négatif, s’étalant le plus souvent entre -3 et +3 unités d’écart-type résiduel. Les points situés au-dessus de la ligne zéro traduisent une sous-estimation du modèle (le comportement observé du sujet est supérieur à ce qui était théoriquement prédit), tandis que les points projetés en deçà dénotent une surestimation systématique.
Dans un contexte psychologique standard répondant aux postulats de linéarité et de normalité, les observations doivent se répartir selon une dispersion approximativement symétrique et homogène, avec environ 95 % des points logés à l’intérieur de l’enveloppe délimitée par les ordonnées [-2, +2]. Toute émergence d’individus culminant au-delà de ces frontières atteste d’un mauvais ajustement local du modèle, signalant une variance comportementale inexpliquée substantielle.
4.3 La ligne de lissage non paramétrique et sa signification
Pour assister le regard analytique du chercheur, les environnements de calcul statistique modernes superposent systématiquement au nuage de points une courbe de lissage non paramétrique locale, généralement obtenue par régression polynomiale pondérée localement (algorithme LOESS ou LOWESS). Cette ligne, traditionnellement colorée en rouge dans les sorties logicielles par défaut de R, synthétise la tendance moyenne des résidus à chaque échelon de levier.
Dans une configuration idéale attestant de la validité structurelle globale du modèle linéaire, cette ligne LOESS adopte la forme d’un segment horizontal parfaitement rectiligne, confondu avec la ligne d’ordonnée zéro sur l’ensemble du spectre de levier. Cette rectitude indique l’absence de biais systématique : l’espérance conditionnelle des erreurs d’ajustement demeure strictement nulle, que l’on évalue des participants au profil prédicteur conventionnel ou des individus manifestant un fort levier.
En revanche, toute inflexion, courbure ou ondulation marquée de cette ligne de lissage constitue un avertissement méthodologique sévère. Une courbure parabolique révèle fréquemment la méconnaissance d’une relation non linéaire (par exemple, un effet de fatigue curvilinéaire en fonction de la durée d’une tâche). De même, un relèvement ou un abaissement prononcé de la courbe aux extrémités de fort levier indique que les participants atypiques tirent l’erreur moyenne dans une direction privilégiée, révélant la présence d’interactions non modélisées ou d’hétérogénéités structurelles au sein du groupe étudié.
5. La distance de Cook : quantification de l’influence globale
5.1 Formulation algébrique de la distance de Cook
Si la distinction entre écart résiduel et levier est fondamentale, le praticien de la recherche a besoin d’une métrique intégrative capable de quantifier l’effet conjoint de ces deux paramètres sur la stabilité globale des estimations. Introduite par le statisticien américain R. Dennis Cook en 1977, la distance de Cook (notée Dᵢ) répond avec élégance à cet impératif d’évaluation synthétique.
La distance de Cook pour la i-ème observation évalue formellement la somme des carrés des déplacements subis par l’ensemble des n valeurs prédites lorsque cette observation spécifique est intégralement retranchée de l’ensemble d’entraînement. Sa formulation matricielle s’établit comme suit :
Dᵢ = ( (Ŷ – Ŷ₍ᵢ₎)ᵀ (Ŷ – Ŷ₍ᵢ₎) ) / (p · s²)
où Ŷ₍ᵢ₎ représente le vecteur des valeurs ajustées obtenues après avoir réestimé le modèle de régression sans la i-ème observation, p désigne le nombre total de paramètres du modèle (incluant la constante), et s² est la variance d’erreur estimée sur l’échantillon complet. Il est remarquable que cette grandeur, d’apparence computationnellement exigeante, puisse se factoriser de façon exacte à partir des diagnostics individuels élémentaires :
Dᵢ = ( rᵢ² / p ) · ( hᵢᵢ / (1 – hᵢᵢ) )
Cette décomposition algébrique illustre de façon limpide la nature composite de la distance de Cook. Elle s’articule comme le produit de deux composantes dynamiques distinctes :
- Le terme rᵢ² / p, qui mesure la sévérité de l’échec d’ajustement du modèle pour l’observation considérée à travers son résidu standardisé au carré.
- Le ratio hᵢᵢ / (1 – hᵢᵢ), qui quantifie la puissance mécanique de bascule de l’observation découlant de son positionnement spatial dans l’espace des prédicteurs.
Cette formulation met en lumière une propriété mathématique cruciale : un résidu gigantesque associé à un levier infinitésimal engendre une distance de Cook modeste. Réciproquement, un levier titanesque assorti d’un résidu nul n’engendre aucune influence. L’influence statistique au sens de Cook émerge exclusivement de la concordance multiplicative entre une position déviante sur X et un écart de prédiction substantiel sur Y.
5.2 Les courbes de niveau en pointillés rouges sur le graphique
L’un des raffinements visuels majeurs du graphique résidus vs levier réside dans l’incrustation directe de lignes isométriques figurant la distance de Cook. Dans la restitution standard sous le logiciel R, ces isolignes se matérialisent sous la forme de courbes en pointillés rouges situées dans les quadrants périphériques de l’espace d’affichage.
Ces courbes matérialisent les lieux géométriques où le produit combiné de l’ordonnée (résidu) et de l’abscisse (levier) aboutit à une distance de Cook constante. Les logiciels projettent le plus souvent deux seuils de référence traditionnels : l’isoligne D = 0,5 et l’isoligne critique D = 1,0. De par leur formulation mathématique asymptotique, ces courbes s’infléchissent de manière hyperbolique vers les coins supérieur droit et inférieur droit du graphique.
L’utilité diagnostique immédiate de ce procédé visuel saute aux yeux : le chercheur n’a nul besoin d’inspecter de fastidieux tableaux de chiffres pour juger de la gravité d’une anomalie. Si l’ensemble des points d’un échantillon demeure confiné à l’intérieur des lignes de démarcation de D = 0,5, le modèle peut être considéré comme globalement imperméable à l’influence unilatérale d’un individu. En revanche, dès qu’une observation franchit ces frontières et pénètre au-delà de la ligne D = 1,0, une alerte méthodologique majeure est immédiatement déclenchée.
5.3 Seuils décisionnels appliqués aux sciences du comportement
Si la littérature statistique historique adossée aux travaux initiaux de Cook préconisait le seuil absolu de Dᵢ > 1 comme marqueur indiscutable d’une influence délétère — seuil justifié par le fait que cette valeur correspond approximativement au 50e percentile d’une distribution de Fisher F(p, n – p), signifiant que l’omission du cas déplacerait l’estimation conjointe des coefficients hors de leur région de confiance à 50 % —, ce standard s’avère souvent trop permissif dans les disciplines comportementales contemporaines.
Dans un échantillon psychométrique classique composé de 100 à 300 répondants, une observation peut exercer une altération destructrice sur la significativité statistique d’une corrélation partielle sans nécessairement atteindre l’unité sur la métrique de Cook. C’est la raison pour laquelle la communauté des sciences quantitatives applique aujourd’hui préférentiellement des seuils décisionnels indexés sur la taille de l’échantillon. Le seuil adaptatif le plus préconisé est défini par l’expression :
Dᵢ > 4 / n
ou, dans des configurations où le nombre de paramètres estimés est substantiel, par la formule de Bollen et Jackman :
Dᵢ > 4 / (n – p – 1)
L’utilisation de ces critères ajustés garantit que la sensibilité du diagnostic s’affine à mesure que l’échantillon croît. Néanmoins, l’analyste rigoureux se gardera d’ériger ces seuils mathématiques en dogmes aveugles. En psychologie, une observation ne doit jamais être écartée sur le simple constat arithmétique qu’elle présente un Dᵢ = 4/n + 0,001 ; ce franchissement doit plutôt agir comme un signal déclenchant une investigation qualitative approfondie sur la nature psychologique du profil concerné.
6. Typologie en quatre quadrants des observations comportementales
6.1 Faible levier et faible résidu : le noyau de conformité empirique
La cartographie résultant du graphique résidus vs levier permet de catégoriser la totalité des observations d’un échantillon selon une typologie fonctionnelle à quatre quadrants distincts, dont l’interprétation renseigne sur la structure interne des données psychologiques.
Le premier quadrant, localisé sur la partie centre-gauche et basse du repère vertical (faible levier, faible résidu standardisé), constitue le réceptacle naturel de la majorité des répondants. Dans une cohorte comportementale robuste, 80 à 90 % des participants se concentrent dans cette zone. Ces sujets possèdent des caractéristiques prédictives courantes et leurs réponses sur la variable dépendante s’alignent fidèlement sur les lois probabilistes dictées par l’équation régressive.
Ce noyau de conformité empirique assure l’ancrage stable du modèle théorique. Les observations qui y résident contribuent de manière homogène et synergique à la précision de l’estimation des erreurs standards et à la solidité des inférences statistiques. Leur présence conjointe certifie que le modèle capture une tendance psychologique véritablement partagée par la collectivité étudiée.
6.2 Faible levier et fort résidu : l’anomalie sans pouvoir de bascule
Le deuxième quadrant regroupe les observations caractérisées par un faible levier spatial couplé à une amplitude d’erreur résiduelle très élevée (|rᵢ| > 2 ou 3), se déployant verticalement aux marges supérieure ou inférieure du côté gauche de l’affichage. Ces individus représentent des anomalies comportementales franches, mais dénuées de pouvoir de bascule mécanique sur le modèle.
En psychométrie, cette configuration correspond classiquement à des répondants dont les scores sur les variables indépendantes sont parfaitement typiques et représentatifs de la population moyenne, mais dont la réaction observée sur la variable dépendante est totalement inattendue. Citons l’exemple d’un participant présentant un niveau d’anxiété et des aptitudes cognitives rigoureusement dans la moyenne, mais enregistrant un score d’échec cuisant lors d’un examen universitaire standardisé.
Bien que ces cas singuliers dégradent la variance expliquée globale (en abaissant le coefficient R²) et gonflent l’erreur standard résiduelle globale, leur faible levier les prive du bras de levier géométrique nécessaire pour faire basculer l’orientation des pentes de régression. Ils témoignent d’une variabilité comportementale idiosyncrasique, d’un événement perturbateur transitoire lors du test ou de l’omission d’une variable explicative orthogonale, mais ne constituent pas une menace pour la direction générale des effets découverts.
6.3 Fort levier et faible résidu : le levier renforçateur
Positionnées sur l’extrême droite du graphique mais à proximité étroite de la ligne d’ordonnée zéro, les observations du troisième quadrant allient un levier statistique substantiel à un résidu négligeable. Ces participants se caractérisent par des profils d’entrée hautement insolites dans l’espace des prédicteurs, mais leur comportement observé sur la variable dépendante épouse avec une exactitude troublante la trajectoire linéaire extrapolationnelle du reste de la cohorte.
En recherche quantitative, ces points sont qualifiés de « bons points de levier » ou de leviers renforçateurs. Loin de déstabiliser l’orientation de la surface de régression, ils viennent la corroborer à ses frontières spatiales les plus reculées. Ce phénomène produit un effet statistique spectaculaire : en augmentant considérablement la variance des prédicteurs ∑ (xᵢ – x̄)² sans introduire de discordance résiduelle, ces observations réduisent mécaniquement les erreurs-types associées aux coefficients de régression et augmentent artificiellement la puissance apparente du test statistique ainsi que le R².
Néanmoins, la prudence méthodologique s’impose face à ces cas renforçateurs. Bien qu’ils ne faussent pas l’estimation centrale de la pente, ils peuvent donner une fausse impression de robustesse à une loi théorique sur des portions d’espace empirique où les données sont en réalité quasi inexistantes. De plus, ils masquent parfois l’émergence d’effets de seuil ou de saturations non linéaires aux extrêmes de la distribution psychologique.
6.4 Fort levier et fort résidu : l’observation influente critique
Le quatrième quadrant, situé aux confins supérieurs droits et inférieurs droits de l’espace graphique — franchissant fréquemment les isolignes de Cook à 0,5 ou 1,0 —, abrite les entités méthodologiquement les plus explosives : les observations à la fois excentrées dans l’espace prédictif et violemment discordantes avec la fonction d’ajustement. Ces points incarnent la définition opérationnelle exacte de l’observation influente critique.
Ces cas disposent simultanément d’un puissant bras de levier géométrique et d’une force d’attraction résiduelle maximale. Le modèle des moindres carrés, contraint par sa nature quadratique, est obligé de fléchir significativement sous l’action d’un tel point. À elle seule, une observation influente critique est capable de faire basculer une pente négative vers une orientation positive, de transformer un résultat statistiquement non significatif en une découverte apparente hautement robuste, ou inversement de neutraliser un effet empirique légitime partagé par 99 % des autres sujets.
En psychologie expérimentale et clinique, ces points traduisent souvent des anomalies de recueil de données dramatiques : un participant ayant inversé l’échelle de réponse lors du test, un profil clinique pathologique sévère introduit par erreur dans un groupe témoin sain, ou une saisie informatique corrompue. Leur maintien acritique dans une analyse constitue une négligence méthodologique coupable, susceptible de polluer durablement la littérature scientifique d’artéfacts non réplicables.
7. Exemple pratique : étude de l’impact du stress chronique sur l’épuisement professionnel
7.1 Contexte de la recherche et modélisation psychométrique
Afin de concrétiser les principes théoriques exposés, examinons une étude empirique fictive mais représentative, menée auprès d’une cohorte clinique de n = 150 professionnels de santé exerçant dans des services d’urgences hospitalières. L’objectif de la modélisation consiste à prédire le niveau d’épuisement professionnel (score d’épuisement émotionnel évalué par le Maslach Burnout Inventory, échelle continue de 0 à 50) à partir de deux prédicteurs psychométriques standardisés :
- Le score de stress chronique perçu (mesuré via la Perceived Stress Scale de Cohen, échelle de 0 à 40).
- Le score de soutien managérial perçu (évalué via une échelle de climat organisationnel, échelle de 10 à 50).
Le cadre théorique postule une dynamique d’ajustement double : le stress chronique perçu est présumé accélérer de manière linéaire le développement de l’épuisement émotionnel (effet principal positif), tandis que le soutien managérial est conceptualisé comme une ressource protectrice modératrice, censée atténuer la vulnérabilité des soignants face aux stresseurs professionnels. L’équation de régression linéaire multiple estimée sur l’échantillon brut prend la forme conventionnelle suivante :
Burnout = β₀ + β₁ · Stress + β₂ · Soutien + β₃ · (Stress × Soutien) + ε
Lors de l’ajustement initial sur les 150 observations, les calculs conventionnels fournissent un coefficient de détermination modeste (R² = 0,22, p < 0,001). Plus surprenant encore au regard de la littérature établie, le terme d’interaction entre le stress et le soutien managérial ressort comme non statistiquement significatif (β₃ = -0,08, p = 0,214), suggérant un échec apparent de la théorie du tampon protecteur du soutien organisationnel. Avant de rejeter cette hypothèse fondamentale, une analyse diagnostique de régression est impérativement déployée.
7.2 Génération et inspection du graphique résidus vs levier sous R
Pour scruter l’intégrité du modèle ajusté sous l’environnement R, le chercheur génère la suite des graphiques diagnostiques via l’instruction canonique :
plot(modele_burnout, which = 5)
L’exécution de cette commande produit le graphique des résidus standardisés en fonction du levier. À l’affichage, l’observateur constate d’emblée une topologie générale satisfaisante pour l’immense majorité des 150 participants : 149 observations forment un nuage harmonieux confiné sous un levier statistique hᵢᵢ < 0,06 (largement inférieur au seuil théorique de 2p / n = 2 × 4 / 150 = 0,053 pour les cas bénins), avec des résidus standardisés sagement inscrits entre -2 et +2.
Toutefois, une anomalie graphique spectaculaire attire immédiatement l’attention dans le cadran inférieur droit. Un point unique, automatiquement annoté du libellé de son identifiant d’observation « 42 », s’extrait de façon spectaculaire du regroupement collectif. Ce sujet se localise à un niveau d’abscisse de h₄₂ = 0,185 — soit plus de 3,5 fois le levier moyen — et affiche sur l’axe vertical un résidu standardisé négatif massif de r₄₂ = -3,45. De surcroît, le point franchit ostensiblement l’isoligne rouge pointillée délimitant la distance de Cook D = 0,5 et tangente la frontière critique de D = 1,0.
7.3 Déconstruction analytique du cas critique identifié
Une extraction ciblée des données brutes afférentes à l’observation numéro 42 permet de décrypter la genèse mathématique de cette position graphique extrême. Les indicateurs individuels de ce soignant révèlent une configuration empirique hautement paradoxale :
- Score de stress chronique perçu : 39/40 (soit la valeur maximale observée sur l’ensemble de la cohorte, située à plus de 3,5 écarts-types de la moyenne).
- Score de soutien managérial perçu : 11/50 (niveau de détresse relationnelle managériale extrême, le score plancher de l’échantillon).
- Score d’épuisement émotionnel (variable dépendante) : 2/50 (absence absolue et quasi impossible de burnout).
Cette combinaison explique précisément la projection du sujet sur le graphique. Sur les variables indépendantes (X), le sujet combine les deux scores les plus déviants et marginaux de toute l’étude, ce qui propulse sa distance de Mahalanobis à un sommet et confère à son point une valeur de levier statistique disproportionnée (h₄₂ = 0,185). Sur la variable dépendante (Y), l’équation de régression ajustée sur le groupe prédisait pour un tel niveau de stress et un tel déficit de soutien un score d’épuisement proche du plafond théorique (valeur ajustée Ŷ₄₂ ≈ 48). L’écart entre la réalité observée (2) et la prédiction théorique (48) génère un résidu négatif colossal, matérialisant un échec prédictif total.
En croisant ce levier titanesque et cette erreur résiduelle exceptionnelle, la distance de Cook de l’observation 42 culmine à D₄₂ = 0,91, écrasant sans commune mesure le seuil d’alerte adaptatif 4/n = 4/150 = 0,027. L’observation 42 agit comme un point gravitationnel colossal, exerçant une traction unilatérale sur la géométrie de l’hyperplan de régression.
7.4 Comparaison du modèle avant et après neutralisation du point influent
Pour mesurer concrètement la toxicité inférentielle de cette observation singulière sur la théorie psychologique évaluée, le modèle de régression est réestimé en neutralisant l’observation 42 (après avoir vérifié, lors d’un audit de terrain, qu’il s’agissait d’une erreur d’encodage informatique où un score de burnout de « 20 » avait été imputé « 2 »). Les répercussions sur les coefficients estimés et sur les métriques globales du modèle sont saisissantes, comme l’illustre la confrontation chiffrée suivante :
| Paramètre / Métrique | Modèle initial (N = 150) | Modèle révisé sans cas 42 (N = 149) | Impact inférentiel |
|---|---|---|---|
| Coefficient Stress (β₁) | 0,38 (p < 0,001) | 0,51 (p < 0,001) | Sous-estimation initiale de 34 % de l’effet toxique du stress |
| Coefficient Soutien (β₂) | -0,19 (p = 0,042) | -0,31 (p < 0,001) | Sous-estimation massive du bénéfice direct du soutien |
| Interaction Stress × Soutien (β₃) | -0,08 (p = 0,214) | -0,24 (p = 0,003) | Effet tampon masqué ; restauration de la significativité statistique |
| Variance expliquée (R²) | 0,22 | 0,38 | Gain net de 16 % de variance empirique expliquée |
| Distance de Cook maximale | 0,91 (Cas 42) | 0,04 (Cas 112) | Stabilisation structurelle intégrale du système |
Ce comparatif démontre avec une acuité saisissante la vulnérabilité des conclusions scientifiques face aux observations influentes non diagnostiquées. À elle seule, l’observation 42 avait anéanti la significativité statistique de l’effet modérateur de protection organisationnelle, conduisant potentiellement les chercheurs à publier une remise en cause fallacieuse de la littérature existante. Le recours méthodique au graphique résidus vs levier a permis de sauvegarder la véracité empirique de l’étude.
8. Implémentation computationnelle et personnalisation graphique
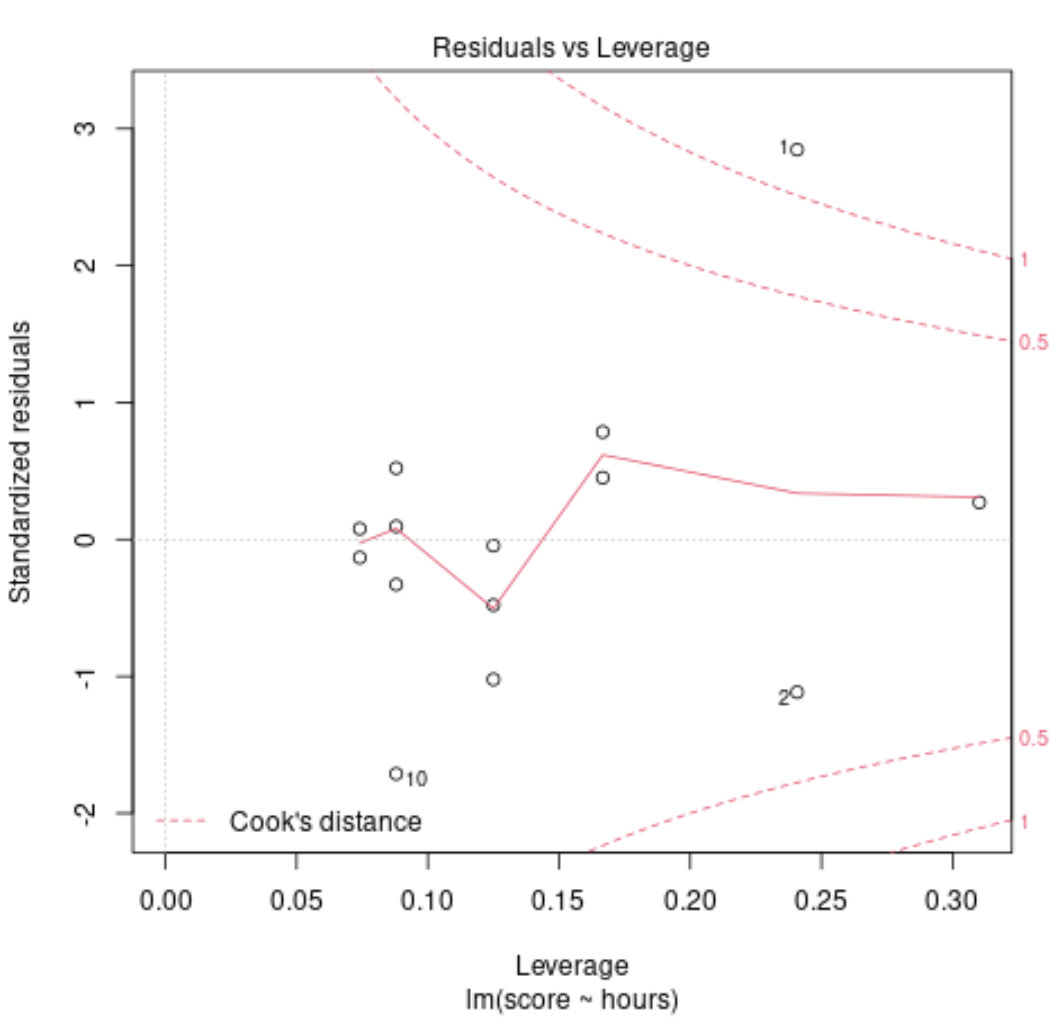
8.1 Production du graphique dans l’écosystème R
L’écosystème de programmation statistique R propose un ensemble remarquablement étendu de solutions pour générer et personnaliser le graphique des résidus par rapport au levier, allant de la syntaxe de base aux architectures graphiques vectorielles les plus sophistiquées.
Au niveau le plus élémentaire, l’instruction intégrée au moteur de base de R demeure la méthode la plus rapide d’accès lors de la phase exploratoire initiale :
modele <- lm(burnout ~ stress + soutien, data = donnees)
plot(modele, which = 5)
Pour les psychomètres et biostatisticiens désireux d’obtenir des analyses d’influence plus riches et interactives, le package car (Companion to Applied Regression), développé par John Fox et Sanford Weisberg, propose la fonction incontournable influencePlot(). Cette fonction matérialise une version enrichie du graphique résidus vs levier, dans laquelle l’axe vertical arbore les résidus studentisés externes et le diamètre circulaire de chaque point est proportionnel à la magnitude de sa distance de Cook, facilitant un diagnostic multidimensionnel instantané :
library(car)
influencePlot(modele, id = list(method = « identify »), main = « Graphique d’Influence Diagnostique »)
Enfin, pour répondre aux standards esthétiques et typographiques rigoureux des publications académiques à fort impact, le couplage de ggplot2 avec le package d’extension ggfortify permet de concevoir des représentations vectorielles d’une élégance irréprochable. L’instruction autoplot(modele, which = 5, colour = "steelblue") + theme_minimal() produit un rendu graphique personnalisable à l’infini, respectant fidèlement les directives de mise en page des comités éditoriaux les plus stricts.
8.2 Génération via l’environnement Python scientifique
Dans le paradigme des sciences de données comportementales adossées à l’environnement Python, la modélisation économétrique et psychométrique s’effectue principalement au travers des bibliothèques statsmodels et scikit-learn.
La bibliothèque statsmodels propose une implémentation analytique directe du diagnostic de levier via son module graphique. Après avoir ajusté un modèle par moindres carrés ordinaires (OLS), l’utilisateur dispose de fonctions graphiques hautement spécialisées telles que plot_leverage_resid2() :
import statsmodels.api as sm
import statsmodels.formula.api as smf
import matplotlib.pyplot as plt
modele = smf.ols(‘burnout ~ stress + soutien’, data=df).fit()
fig, ax = plt.subplots(figsize=(10, 6))
sm.graphics.plot_leverage_resid2(modele, ax=ax)
plt.show()
Parallèlement, l’écosystème Python propose la bibliothèque Yellowbrick, spécialisée dans la visualisation d’apprentissage automatique. Le visualiseur CooksDistance ou les modules de diagnostic résiduel de Yellowbrick permettent d’examiner interactivement le profil d’influence des observations en s’interfaçant nativement avec les pipelines de transformation de scikit-learn.
Il demeure également aisé d’extraire matriciellement l’ensemble des grandeurs scalaires fondamentales (éléments diagonaux de la matrice chapeau, résidus studentisés, distances de Cook) sous la forme d’un DataFrame Pandas structuré en exploitant la méthode modele.get_influence().summary_frame(), conférant à l’analyste une liberté totale pour élaborer ses propres visualisations algorithmiques sous seaborn ou matplotlib.
8.3 Traitement au sein des logiciels d’interface graphique (SPSS, JASP)
La recherche clinique et psychologique fondamentale s’appuie encore très largement sur des environnements logiciels à interface graphique utilisateur (GUI), au premier rang desquels figurent IBM SPSS Statistics et le logiciel libre JASP.
Dans l’environnement IBM SPSS, la procédure de régression linéaire standard n’offre pas par défaut un graphique résidus vs levier préprogrammé sous forme d’une option directe en un clic. L’analyste doit orchestrer une démarche en deux temps :
- Dans la boîte de dialogue de la régression linéaire, activer le sous-menu Enregistrer… (Save…) et cocher explicitement les métriques diagnostiques appropriées : les Résidus studentisés exclus (Studentized Deleted Residuals), les Valeurs de levier (Leverage values, qui stocke les hᵢᵢ) et les Distances de Cook.
- Une fois les variables calculées et annexées au fichier de données actif, solliciter le Générateur de graphiques (Chart Builder) pour concevoir un nuage de points paramétré en affectant la variable de levier sur l’axe des X et la variable de résidu studentisé sur l’axe des Y, en appliquant une taille de marqueur modulée par la distance de Cook.
À l’inverse de cette démarche laborieuse, le logiciel moderne à vocation ouverte JASP (développé sous l’égide de l’Université d’Amsterdam) intègre de façon native les diagnostics résiduels contemporains. Dans son module de régression linéaire fréquentiste ou bayésienne, le simple dépliement de l’onglet Diagnostics assorti du cochage de la case relative aux tracés diagnostiques résiduels génère instantanément, au sein d’une interface dynamique et intuitive, un graphique résidus vs levier aux normes vectorielles prêtes pour la publication, complété par l’affichage contextuel des bornes d’influence de Cook.
9. Conséquences psychométriques et méthodologiques des points influents
9.1 Distorsion des paramètres régressifs et inflation des erreurs statistiques
Les répercussions de la présence non contrôlée d’observations influentes sur l’architecture mathématique d’un modèle de régression linéaire dépassent le simple désagrément d’ajustement local. Elles altèrent la validité même du processus d’inférence statistique en induisant deux écueils symétriques : les erreurs décisionnelles de Type I et de Type II.
Le risque d’induire une erreur de type I (faux positif) survient lorsqu’un point doté d’un fort levier et d’une coordonnée excentrée sur Y crée de toutes pièces une corrélation artificielle là où les observations du reste du groupe se répartissent de manière totalement aléatoire. Dans ce scénario pernicieux, le chercheur conclut à l’existence d’une loi psychologique inédite ou d’un lien prédictif prometteur, alors que l’ensemble de l’effet repose sur l’ancrage unilatéral d’un unique participant singulier.
Réciproquement, le risque d’erreur de type II (faux négatif) s’avère tout aussi destructeur pour l’avancement des connaissances. Une observation influente orientée à contre-courant de la tendance empirique dominante peut exercer un effet de contrepoids suffisant pour aplatir artificiellement une pente régressive véritable, conduisant les chercheurs à rejeter une hypothèse théorique parfaitement valide au niveau populationnel. De surcroît, le gonflement corrélatif de la somme des carrés résiduels induit une inflation spectaculaire des erreurs standards associées aux coefficients, diminuant considérablement la puissance statistique globale du protocole d’investigation.
Enfin, l’indicateur d’ajustement global qu’est le coefficient de détermination R² se trouve profondément corrompu. Qu’il soit artificiellement gonflé par un levier renforçateur situé sur la ligne ou indûment effondré par un cas dissident critique, le R² perd sa valeur de mesure non biaisée de la validité écologique et de la taille d’effet théorique du modèle.
9.2 Menaces sur la réplicabilité des résultats en sciences psychologiques
Depuis le début des années 2010, les sciences psychologiques traversent une épreuve épistémologique salutaire connue sous le nom de « crise de la réplicabilité ». De nombreuses découvertes considérées comme des classiques de la littérature académique ont échoué à être répliquées de manière fiable par des laboratoires indépendants au sein de consortiums de réplication internationale.
Si la pratique des degrés de liberté du chercheur (p-hacking), le faible dimensionnement des échantillons et le biais de publication sont régulièrement pointés du doigt, la tolérance aveugle à l’égard des observations influentes dans les analyses statistiques primaires constitue un facteur contributif méconnu mais dévastateur. Lorsqu’une publication scientifique rapporte un effet empirique dont la significativité dépend de la présence d’une ou deux observations à fort levier logées dans un échantillon de 60 sujets, il est statistiquement garanti que toute tentative de réplication menée sur une nouvelle cohorte indépendante — dans laquelle ce profil singulier ne réapparaîtra pas par simple fluctuation d’échantillonnage — se soldera par un échec cuisant.
Ce constat a conduit les comités de prospective méthodologique à exiger que le diagnostic de levier et de résidu devienne une obligation procédurale incontournable. Dans le cadre du paradigme de la Science Ouverte (Open Science), la mise à disposition publique des données brutes assortie de scripts documentant rigoureusement la détection et le comportement des points de levier s’impose désormais comme un garant éthique fondamental pour restaurer la confiance dans la solidité cumulative de la psychologie quantitative.
9.3 Biais d’échantillonnage et validité écologique de la mesure
L’émergence d’observations à fort levier sur le graphique diagnostique pose une question fondamentale touchant à la représentativité de l’échantillon et à la validité écologique des instruments d’évaluation psychométrique. Pourquoi un participant donné occupe-t-il une place si marginale dans l’espace multidimensionnel des prédicteurs ?
Dans nombre d’investigations en psychologie comportementale ou clinique, un profil multivarié hautement excentré ne relève pas nécessairement d’une erreur fortuite, mais peut être le révélateur d’un biais d’échantillonnage systématique. Une observation isolée peut témoigner de l’inclusion involontaire d’un individu appartenant en réalité à une population clinique distincte de celle visée par l’étude (par exemple, un participant manifestant un trouble du spectre de l’autisme non déclaré dans une étude sur la reconnaissance des micro-expressions faciales, ou un sujet présentant une douance intellectuelle extrême dans un protocole sur le raisonnement déductif standard).
Cette confrontation entre la validité interne du modèle statistique — qui réclame l’homogénéité et la stabilité des paramètres — et la validité externe (ou écologique) de la recherche — qui exige de rendre compte de la diversité intrinsèque des êtres humains — soulève un dilemme épistémologique crucial. L’élimination hâtive des cas à fort levier sous prétexte de « nettoyer » le modèle risque de confiner la recherche à une vision idéalisée, aseptisée et trompeuse de la réalité psychologique.
10. Protocole de traitement des observations influentes identifiées
10.1 Audit systématique de la source de l’anomalie
La découverte sur le graphique des résidus par rapport au levier d’un point franchissant les seuils critiques de Cook ou de levier ne doit en aucun cas déclencher une suppression mécanique et immédiate de l’observation. La première étape, impérative et déontologique, consiste à mener un audit d’investigation médico-légal sur la trajectoire de la donnée incriminée.
Cet audit systématique se déploie selon trois axes séquentiels d’investigation :
- Vérification de l’intégrité matérielle et numérique : L’analyste doit contrôler scrupuleusement la chaîne d’acquisition de la mesure pour écarter toute erreur typographique, d’encodage ou de conversion informatique. Des erreurs classiques — telles que la saisie d’un code de valeur manquante « 99 » interprété comme une valeur numérique continue, l’omission d’une virgule décimale transformant un temps de réponse de « 1,23 » seconde en « 123 » secondes, ou la permutation accidentelle de deux colonnes de variables — représentent une part majeure des cas influents observés en pratique. Si une telle erreur matérielle est confirmée par retour au cahier d’observation primaire, la donnée doit être corrigée sans altérer l’intégrité de l’échantillon.
- Contrôle des critères d’admissibilité et d’engagement attentionnel : Il convient d’examiner si le participant répondait strictement aux critères d’inclusion formalisés par le protocole de recherche. Dans les enquêtes administrées en ligne, l’analyse des temps de complétion (survey duration) et des items de contrôle d’attention (attention checks) permet souvent d’établir que l’observation influente découle d’un comportement d’inattention délibérée ou de réponses aléatoires automatisées (robots). La violation manifeste des critères d’admissibilité justifie formellement le rejet du cas.
- Examen qualitatif de l’anamnèse clinique : Lorsque la donnée est avérée authentique et exempte de corruption technique, le chercheur doit se pencher sur les notes qualitatives ou le dossier du participant. Un profil singulier peut découler d’un événement idiosyncrasique majeur vécu durant la passation (crise de panique transitoire, prise médicamenteuse non déclarée, interruption physique de l’épreuve), justifiant une requalification conceptuelle du cas.
10.2 La décision d’exclusion face aux impératifs déontologiques de recherche
Si l’audit exhaustif confirme que la donnée observée est rigoureusement exacte, que le sujet répondait à l’ensemble des critères d’éligibilité et qu’il a participé avec sérieux au protocole, la décision méthodologique devient hautement délicate. La déontologie de la recherche scientifique prohibe de manière absolue l’amputation sélective et opportuniste de données atypiques dans l’unique dessein de faire basculer artificiellement un seuil de signification sous la barre de p < 0,05.
L’exclusion arbitraire d’un individu légitime introduit une censure statistique qui fausse l’estimation des distributions réelles de la population, surestime artificiellement la précision de la mesure et compromet irrémédiablement l’honnêteté intellectuelle des conclusions. Pour qu’une suppression d’observation soit recevable devant la communauté scientifique, elle doit satisfaire à des conditions formelles très strictes :
- L’exclusion ne peut être motivée que par la mise en évidence d’un dysfonctionnement avéré du processus de mesure rendant le score obtenu non interprétable psychométriquement.
- Le chercheur a l’obligation éthique d’expliciter, au sein de la section « Méthode » ou « Résultats préliminaires » de son manuscrit académique, le nombre exact d’observations retranchées, les critères statistiques objectifs ayant motivé cette décision (valeurs explicites de hᵢᵢ, de résidus studentisés et de distance de Cook), ainsi que la justification théorique sous-jacente.
Dans tous les autres cas où l’observation singulière reflète une authentique variation de l’expérience humaine, le rejet pur et simple doit être catégoriquement proscrit au profit d’approches statistiques plus évoluées et transparentes.
10.3 La conduite d’analyses de sensibilité systématiques
Lorsque le chercheur se trouve confronté à des observations authentiques manifestant une forte influence sur le graphique résidus vs levier, la conduite d’une analyse de sensibilité s’impose comme l’étalon-or méthodologique. Cette démarche repose sur le principe de la double estimation et de la transparence intégrale.
L’analyste réalise et présente conjointement deux estimations complètes du modèle statistique :
- Une estimation paramétrique conduite sur l’échantillon total incluant les points influents critiques (modèle complet).
- Une réestimation miroir conduite sur l’échantillon restreint duquel ont été soustraits temporairement les cas influents litigieux (modèle réduit).
Les résultats comparés de ces deux modélisations doivent être systématiquement rapportés au sein d’un tableau synthétique dans le corps de l’article ou dans des annexes méthodologiques en ligne. L’objectif est de permettre aux évaluateurs pairs et aux lecteurs de jauger par eux-mêmes de la résilience des inférences scientifiques formulées. Si les conclusions substantielles et le sens des coefficients demeurent stables malgré l’exclusion des cas influents, le chercheur peut revendiquer une robustesse empirique indiscutable de son modèle. Si, à l’inverse, l’exclusion d’un point influent unique effondre l’effet observé, l’honnêteté scientifique impose de reconnaître explicitement la fragilité conditionnelle de la découverte et de suspendre toute affirmation théorique catégorique dans l’attente d’études complémentaires disposant d’un échantillon plus étendu.
11. Approches alternatives et modélisation robuste
11.1 La régression linéaire robuste pour contourner le problème du levier
Face à la vulnérabilité intrinsèque de la méthode des moindres carrés ordinaires et aux dilemmes éthiques posés par l’exclusion de données légitimes, la statistique mathématique a développé une panoplie d’estimateurs alternatifs conçus pour neutraliser l’influence disproportionnée des anomalies sans supprimer le moindre participant de la base de données : la régression robuste.
Si les estimateurs classiques de Huber (estimateurs M) parviennent à juguler l’impact des grands résidus en substituant à la fonction de coût quadratique une fonction de pénalisation linéaire au-delà d’un seuil critique d’erreur, ils demeurent tragiquement vulnérables face aux points cumulant fort levier et résidu déviant, leur point de rupture (breakdown point) théorique étant de 1/n (ce qui signifie qu’un seul point de levier extrême peut corrompre l’ensemble de l’estimation).
Pour immuniser véritablement le modèle contre les dérives visualisées dans le quadrant critique du graphique résidus vs levier, les psychomètres doivent privilégier les estimateurs à haut point de rupture, au premier rang desquels figurent les estimateurs MM (introduits par Yohai en 1987) ou les moindres carrés réajustés (LTS – Least Trimmed Squares). Ces algorithmes itératifs sophistiqués calculent d’abord une estimation initiale de l’échelle des résidus hautement résistante aux points de levier, puis appliquent une pondération adaptative (telle que la fonction biséquarrée de Tukey) qui attribue un poids quasi nul ou infinitésimal aux observations qui combinent fort levier et grand résidu.
En mobilisant par exemple le package robustbase sous R via la fonction lmrob(), l’analyste obtient des coefficients de régression parfaitement stables et fiables, préservant l’intégralité des n sujets dans le protocole, contournant ainsi avec brio les écueils mécaniques identifiés sur le tracé résidus vs levier.
11.2 Méthodes non paramétriques et rééchantillonnage par bootstrap
Une seconde alternative méthodologique d’une puissance remarquable réside dans l’utilisation du rééchantillonnage statistique par bootstrap. Contrairement à l’inférence asymptotique paramétrique qui postule l’existence d’une distribution normale des erreurs et une homogénéité stricte de la variance, le bootstrap évalue empiriquement la variabilité d’échantillonnage des coefficients de régression en générant des milliers de sous-échantillons par tirage avec remise à partir de la matrice d’observations originale.
Pour juguler l’influence délétère des observations singulières identifiées sur le graphique diagnostique, l’analyste peut générer des intervalles de confiance bootstrappés robustes, en privilégiant l’intervalle de confiance ajusté pour le biais et accéléré (BCa bootstrap, bias-corrected and accelerated). Le paramètre d’accélération intégré dans l’algorithme BCa est précisément dérivé de l’influence locale des observations et du levier de chaque individu sur le calcul de l’estimateur.
Lorsqu’un modèle linéaire est menacé par des points de levier substantiels, la comparaison entre les intervalles de confiance paramétriques standard de Student et les intervalles empiriques issus du bootstrap BCa met immédiatement en lumière l’instabilité des estimations. Si les intervalles bootstrappés s’élargissent considérablement ou enjambent la valeur zéro, le chercheur dispose d’un signal clair indiquant que la significativité statistique apparente n’était qu’un mirage computationnel tributaire de la composition contingente de l’échantillon analysé.
11.3 Transformations de variables et modélisation non linéaire
Dans de nombreuses configurations psychométriques, la présence récurrente de participants présentant un levier prohibitif sur l’axe des X découle non pas d’une singularité existentielle des sujets, mais de la forme asymétrique marquée de la distribution des variables indépendantes brutes (asymétrie positive prononcée sur des échelles de cortisol salivaire, des temps de réaction ou des indices d’agressivité verbale).
L’application judicieuse d’une transformation mathématique stabilisatrice de variance — telle qu’une transformation logarithmique, racine carrée ou la recherche de la puissance optimale via l’algorithme de transformation de Box-Cox — permet fréquemment de réintégrer harmonieusement les valeurs extrêmes de prédicteurs au sein de la densité centrale de la distribution. En réduisant drastiquement l’excentricité spatiale sur l’axe des X, la transformation abaisse mécaniquement la distance de Mahalanobis et neutralise le levier excessif des observations périphériques.
Par ailleurs, si le graphique résidus vs levier exhibe une courbure flagrante de la ligne LOESS indiquant un échec de la linéarité, le chercheur doit abandonner la rigidité du modèle paramétrique linéaire au profit de Modèles Additifs Généralisés (GAM). En substituant aux pentes linéaires strictes des fonctions de lissage spline non paramétriques (smooth functions), les modèles GAM épousent fidèlement les inflexions et asymptotes réelles du comportement humain, transformant ce qui apparaissait sur le graphique comme un résidu discordant en une composante fonctionnelle parfaitement modélisée du processus psychologique.
Enfin, lorsque l’émergence d’observations à fort levier et fort résidu reflète l’existence d’une sous-population structurellement hétérogène au sein de la cohorte, la modélisation en classes latentes (Latent Class Growth Analysis ou régressions à mélange de finis) s’avère indispensable pour découpler les régimes comportementaux différentiels qui cohabitent au sein des données.
12. Recommandations méthodologiques et standards de publication académique
12.1 Directives de rédaction selon les normes de l’American Psychological Association (APA)
L’American Psychological Association (APA), à travers ses manuels de publication successifs et les recommandations du Statistical Inference and Reporting Group, exige désormais une transparence méthodologique accrue concernant la vérification des postulats statistiques et la gestion des données influentes dans les manuscrits scientifiques.
Pour satisfaire pleinement aux exigences éditoriales contemporaines lors de la rédaction d’un article empirique, les auteurs doivent respecter plusieurs directives formelles :
- Déclaration systématique des diagnostics d’influence : L’analyse des diagnostics résiduels et d’influence ne doit plus être cantonnée à un sous-entendu implicite. Le chercheur doit déclarer explicitement dans le paragraphe d’introduction de la section « Résultats » avoir examiné l’adéquation du modèle au moyen des graphiques diagnostiques appropriés, en mentionnant formellement le recours au graphique des résidus par rapport au levier et à la distance de Cook.
- Spécification précise des métriques et seuils décisionnels : Il est impératif d’énoncer clairement les seuils mathématiques adoptés a priori pour qualifier une observation d’atypique ou d’influente (par exemple, un levier supérieur à 2p/n ou 3p/n, des résidus studentisés externes excédant |tᵢ| > 3, et une distance de Cook excédant 4/n). Les valeurs maximales observées pour ces indicateurs dans l’échantillon doivent être rapportées textuellement (par exemple : « La distance de Cook maximale s’est élevée à D = 0,12, confirmant l’absence d’observation unilatéralement déstabilisatrice »).
- Documentation intégrale des décisions relatives aux cas déviants : Si des points influents critiques sont mis en évidence, le manuscrit doit consigner avec une précision absolue le nombre d’observations concernées, leur nature diagnostique précise, la justification théorique ou méthodologique de leur traitement, ainsi que les résultats comparatifs de l’analyse de sensibilité menée.
12.2 Arbre décisionnel pour l’évaluation diagnostique de routine
Afin de systématiser la pratique méthodologique des chercheurs, nous proposons un arbre décisionnel rationnel articulé en trois étapes séquentielles, formalisant la conduite à tenir face à l’examen d’un modèle de régression linéaire multiple :
Étape 1 : Inspection visuelle et repérage spatial
Procéder à la génération systématique du graphique des résidus par rapport au levier. Sonder visuellement la forme de la courbe de lissage non paramétrique LOESS. Si la ligne est rigoureusement horizontale et confondue avec zéro, le postulat de linéarité globale est préservé. Sonder ensuite la présence d’observations franchissant les seuils critiques de levier (hᵢᵢ > 2p/n) et les isolignes de Cook à 0,5 ou 1,0.
Étape 2 : Typification catégorielle de l’observation
Pour tout point suspect repéré à l’étape 1, déterminer son positionnement au sein de la typologie en quatre quadrants :
- Faible levier et résidu modéré : Aucune action corrective requise ; adéquation validée.
- Faible levier et fort résidu (Outlier) : L’observation dégrade la variance expliquée mais ne biaise pas les coefficients de régression. Vérifier l’absence d’erreur de mesure. Maintenir l’observation dans le modèle ou recourir à des estimateurs M de Huber.
- Fort levier et faible résidu (Point d’appui) : L’observation stabilise le modèle mais peut masquer un déficit d’échantillonnage spatial. Vérifier que la validité de la mesure reste assurée à ces niveaux extrêmes.
- Fort levier et fort résidu (Cas influent critique) : Alerte méthodologique maximale. L’observation altère activement l’estimation des paramètres. Déclencher impérativement l’étape 3.
Étape 3 : Déploiement analytique et arbitrage inférentiel
Face à un cas influent critique :
- Conduire immédiatement l’audit de la source de l’anomalie (vérification des encodages, conformité d’admissibilité du sujet, vigilance attentionnelle).
- Si une corruption matérielle ou une violation formelle de protocole est établie : corriger l’erreur ou exclure l’observation en explicitant la démarche dans la section Méthode.
- Si la donnée est avérée authentique et valide : proscrire l’exclusion opportuniste. Mener et publier systématiquement une analyse de sensibilité tabulée (modèle complet versus modèle restreint) et confronter les résultats à une estimation de régression linéaire robuste (estimateurs MM) ou à des intervalles de confiance bootstrappés BCa.
12.3 L’évolution des diagnostics graphiques à l’ère des données comportementales massives
À l’ère contemporaine de la psychologie computationnelle, de l’évaluation écologique momentanée (Ecological Momentary Assessment – EMA) et de l’avènement des mégadonnées (Big Data) issues des réseaux sociaux et des capteurs physiologiques connectés, la nature des diagnostics de régression subit une mutation structurelle profonde.
Dans des jeux de données intégrant des dizaines de milliers ou des millions de points comportementaux (n → ∞), le comportement asymptotique des métriques du graphique résidus vs levier se modifie radicalement. Le levier moyen p/n converge inexorablement vers zéro, rendant les seuils heuristiques classiques hypersensibles, tandis que les distances de Cook individuelles chutent drastiquement, chaque point ne représentant plus qu’une fraction infinitésimale de l’information totale. Pour autant, le risque d’influence ne s’éteint pas : il migre de l’échelle individuelle vers l’échelle collective sous la forme d’effets de grappes ou de masquage conjoint (joint leverage and masking effects), où des sous-groupes entiers d’utilisateurs atypiques partagent le même profil singulier et déstabilisent de concert le modèle sans qu’aucun point isolé ne franchisse individuellement les seuils d’alerte.
Pour répondre à ces volumétries massives et à la complexité des modèles multiniveaux ou hiérarchiques propres aux données longitudinales en vie réelle, les graphiques diagnostiques s’adaptent. Ils intègrent désormais des tracés de densité résiduelle par hexagones (hexbin plots), des métriques d’influence dérivées de la matrice chapeau par blocs (cluster leverage) et des distances d’influence de Cook au niveau des grappes (Cluster Cook’s Distance). Quels que soient l’avancement algorithmique et la taille des corpus d’apprentissage, le principe directeur incarné par le graphique des résidus par rapport au levier demeure intemporel : il constitue le rempart méthodologique le plus élégant, transparent et indispensable pour préserver la vérité scientifique face aux mirages de l’artefact statistique.
Références
Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. John Wiley & Sons. https://doi.org/10.1002/0471725153
Bollen, K. A., & Jackman, R. W. (1985). Regression diagnostics: An expository treatment of outliers and influential cases. Sociological Methods & Research, 13(4), 510-542. https://doi.org/10.1177/0049124185013004004
Chatterjee, S., & Hadi, A. S. (1986). Influential observations, high leverage points, and outliers in linear regression. Statistical Science, 1(3), 379-393. https://doi.org/10.1214/ss/1177013622
Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15-18. https://doi.org/10.1080/00401706.1977.10489493
Cook, R. D., & Weisberg, S. (1982). Residuals and influence in regression. Chapman & Hall.
Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3e éd.). SAGE Publications.
Hoaglin, D. C., & Welsch, R. E. (1978). The hat matrix in regression and ANOVA. The American Statistician, 32(1), 17-22. https://doi.org/10.1080/00031305.1978.10479237
Huber, P. J. (1981). Robust statistics. John Wiley & Sons. https://doi.org/10.1002/0471725250
Maronna, R. A., Martin, R. D., Yohai, V. J., & Salibián-Barrera, M. (2019). Robust statistics: Theory and methods (with R) (2e éd.). John Wiley & Sons. https://doi.org/10.1002/9781119214656
Open Science Collaboration. (2015). Estimating the reproducibility of psychological science. Science, 349(6251), aac4716. https://doi.org/10.1126/science.aac4716
Rousseeuw, P. J., & Leroy, A. M. (1987). Robust regression and outlier detection. John Wiley & Sons. https://doi.org/10.1002/0471725382
Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4e éd.). Academic Press. https://doi.org/10.1016/C2015-0-02220-4
Yohai, V. J. (1987). High breakdown-point and high efficiency robust estimates for regression. The Annals of Statistics, 15(2), 642-656. https://doi.org/10.1214/aos/1176350366