
L’analyse prédictive et la modélisation statistique occupent une place prépondérante dans l’investigation scientifique contemporaine, singulièrement au sein des sciences du comportement, de la psychométrie et de la neurobiologie computationnelle. Depuis la formalisation historique de la méthode des moindres carrés par Adrien-Marie Legendre et Carl Friedrich Gauss au début du XIXe siècle, le modèle linéaire standard s’est imposé comme l’instrument privilégié pour caractériser les relations fonctionnelles liant un ensemble de prédicteurs empiriques à une variable réponse quantitative. Cette longévité méthodologique s’explique principalement par une interprétabilité directe des coefficients de régression, interprétés sous réserve d’orthogonalité comme des effets partiels, et par l’existence d’une solution analytique explicite régie par des postulats distributionnels précis.
Cependant, l’avènement de protocoles empiriques sophistiqués générant des données massives, multidimensionnelles et structurellement interdépendantes met en lumière les limites inhérentes à l’approche classique par les moindres carrés ordinaires. En psychométrie moderne comme en neuro-imagerie fonctionnelle, les chercheurs sont confrontés à des matrices de conception où le nombre d’indicateurs observés rivalise avec la taille des échantillons cliniques disponibles, voire la dépasse largement. Dans ce régime analytique, le postulat de rang plein s’effondre, provoquant une instabilité numérique critique des estimateurs, une inflation exponentielle de l’erreur d’échantillonnage et une dégradation substantielle du pouvoir de généralisation des modèles. Les observations récoltées sur des échelles d’évaluation comportementale, des batteries de tests neuropsychologiques ou des profils d’expression génétique présentent des corrélations mutuelles denses qui violent le postulat d’indépendance conditionnelle.
Face à ces défis épistémologiques et mathématiques, les méthodes de régularisation statistique, au premier rang desquelles figurent la régression Ridge formulée par Hoerl et Kennard (1970) et la régression Lasso théorisée par Robert Tibshirani (1996), constituent une révision méthodologique majeure. En modifiant délibérément la fonction de coût par l’adjonction d’une contrainte pénalisant l’amplitude des paramètres, ces architectures introduisent un arbitrage contrôlé entre le biais d’estimation et la variance d’échantillonnage. Ce traité approfondi se propose d’analyser de manière exhaustive les fondements mathématiques, les propriétés spectrales, les dynamiques prédictives et les implications clinico-théoriques des pénalisations L1 et L2, offrant aux chercheurs et aux analystes avancés une grille décisionnelle rigoureuse guidant le choix entre Ridge, Lasso et leurs extensions hybrides.
1. Fondements théoriques de la régression linéaire multiple et ses limites
1.1 Le modèle des moindres carrés ordinaires en psychométrie
La régression linéaire multiple par les moindres carrés ordinaires (MCO) repose sur la formalisation d’une relation structurelle où une variable dépendante scalaire $y in \mathbb{R}^n$ est modélisée comme une combinaison linéaire de $p$ prédicteurs regroupés dans une matrice de conception $X in \mathbb{R}^{n \times p}$, perturbée par un vecteur résiduel stochastique $\varepsilon in \mathbb{R}^n$. Le formalisme matriciel s’exprime sous la forme canonique $y = X\beta + \varepsilon$, dans laquelle $\beta in \mathbb{R}^p$ représente le vecteur des paramètres inconnus régissant les contributions marginales de chaque variable explicative. L’estimation paramétrique procède traditionnellement par la minimisation de la somme des carrés des résidus, formalisée par la fonction objectif $\mathcal{S}(\beta) = |y – Xbeta|_2^2 = (y – X\beta)^T(y – X\beta)$. En dérivant cette expression par rapport au vecteur $\beta$ et en annulant le gradient résultant, on obtient le système d’équations normales $X^TX\hat{\beta} = X^Ty$, dont la résolution analytique produit l’estimateur classique $\hat{\beta}_{\text{MCO}} = (X^TX)^{-1}X^Ty$, sous réserve impérieuse que la matrice de Gram $X^TX$ soit non singulière et donc inversible.
Sous les hypothèses du théorème de Gauss-Markov, stipulant la stricte exogénéité des prédicteurs ($\mathbb{E}[varepsilon|X] = 0$), l’homoscédasticité des résidus ($\text{Var}(varepsilon|X) = \sigma^2 I_n$) et l’absence d’autocorrélation ($\text{Cov}(\varepsilon_i, \varepsilon_j) = 0$ pour tout $i \neq j$), l’estimateur $\hat{\beta}_{\text{MCO}}$ jouit du statut théorique d’estimateur non biaisé de variance minimale (BLUE, pour Best Linear Unbiased Estimator). En vertu de ces conditions idéales, la matrice de variance-covariance des coefficients estimés est rigoureusement définie par $\text{Var}(\hat{\beta}_{\text{MCO}}) = \sigma^2 (X^TX)^{-1}$. Cette formulation mathématique séduisante a historiquement garanti la suprématie des MCO dans la modélisation psychométrique, notamment pour établir les pondérations optimales des échelles de personnalité, estimer la validité concourante des sous-scores d’intelligence ou décomposer les composantes environnementales et héréditaires des conduites humaines.
Toutefois, la validité pratique de ce paradigme analytique s’effondre dès lors que la réalité des protocoles psychométriques s’écarte de ces idéalisations mathématiques. Les inventaires de personnalité, à l’instar du NEO-PI-3 ou du modèle HEXACO, ainsi que les composites d’évaluation neuropsychologique (tels que la WAIS-IV), intègrent des sous-échelles qui mesurent des facettes adjacentes de construits sous-jacents fortement intriqués. Cette réalité phénoménologique engendre une quasi-dépendance linéaire entre les colonnes de la matrice $X$. Lorsque la matrice $X^TX$ tend vers la singularité, ses valeurs propres s’effondrent vers zéro, provoquant une expansion incontrôlée des éléments diagonaux de son inverse $(X^TX)^{-1}$. L’estimateur conserve théoriquement son absence de biais, mais sa variance d’échantillonnage s’accroît d’une magnitude telle que l’erreur quadratique moyenne de prédiction diverge, rendant les coefficients empiriquement inutilisables et instables d’un échantillon d’étalonnage à un autre.
1.2 La décomposition du compromis biais-variance
L’évaluation rigoureuse de la fidélité prédictive d’un modèle d’apprentissage supervisé nécessite la décomposition analytique de l’erreur quadratique moyenne de généralisation (MSE, Mean Squared Error). Soit un point de test arbitraire $x_0 in \mathbb{R}^p$ et la variable cible associée $y_0 = f(x_0) + \varepsilon$, où $f(x_0) = x_0^T\beta$ représente la véritable fonction génératrice sous-jacente et $varepsilon$ un bruit gaussien irréductible de variance $\sigma^2$. L’erreur quadratique d’un estimateur $\hat{f}(x_0) = x_0^T\hat{\beta}$ conditionnée par les données d’entraînement se décompose rigoureusement selon l’égalité canonique suivante :
$$\mathbb{E}_{\mathcal{D}, \varepsilon}\left[\left(y_0 – \hat{f}(x_0)\right)^2\right] = \sigma^2 + \left(\text{Biais}[\hat{f}(x_0)]\right)^2 + \text{Var}[\hat{f}(x_0)]$$
Dans cette formalisation mathématique, le terme $\sigma^2$ représente le bruit incompressible de la dynamique comportementale, tenant aux erreurs instrumentales aléatoires et à la stochasticité neurobiologique. Le biais quadratique, formulé par $\left(\mathbb{E}_{\mathcal{D}}[\hat{f}(x_0)] – f(x_0)\right)^2$, quantifie l’erreur systématique issue de l’inadéquation structurelle du modèle mathématique à restituer la véritable régularité des données. La variance d’échantillonnage, définie par $\mathbb{E}_{\mathcal{D}}\left[\left(\hat{f}(x_0) – \mathbb{E}_{\mathcal{D}}[\hat{f}(x_0)]\right)^2\right]$, traduit la sensibilité paramétrique des estimations aux fluctuations contingentes de l’échantillon d’apprentissage $\mathcal{D}$.
L’estimation par les moindres carrés ordinaires s’ancre dans une contrainte axiomatique stricte : l’annulation absolue du biais théorique ($\text{Biais}[\hat{\beta}_{\text{MCO}}] = 0$). Si cette exigence d’impartialité statistique constitue une propriété désirable d’un point de vue asymptotique dans de très grands échantillons parfaitement découplés, elle s’avère opérationnellement néfaste en présence d’échantillons cliniques restreints ou modérés, situation omniprésente en psychopathologie expérimentale. Lorsque le nombre de prédicteurs $p$ augmente relativement au volume d’observations $n$, la variance totale de l’estimateur, donnée par $\text{Tr}(\text{Var}(\hat{\beta}_{\text{MCO}})) = \sigma^2 \sum_{j=1}^p \lambda_j^{-1}$ (où les $\lambda_j$ désignent les valeurs propres de $X^TX$), subit une inflation asymptotique dès lors que la plus petite valeur propre $\lambda_{\min}$ approche de zéro.
Le sacrifice consenti par les MCO pour maintenir un biais strictement nul génère ainsi une instabilité paramétrique délétère. La théorie moderne de l’apprentissage statistique démontre qu’il est mathématiquement opportun d’abandonner l’exigence d’un estimateur sans biais. En tolérant l’introduction délibérée d’un biais d’estimation de magnitude contrôlée, il devient possible de comprimer drastiquement la variance d’échantillonnage de l’estimateur. Dès lors que la réduction marginale de variance compense l’accroissement quadratique du biais, l’erreur globale de prédiction s’en trouve significativement amoindrie. Cette dynamique constitue la justification épistémologique fondamentale des approches pénalisées.
1.3 Vulnérabilités structurelles face aux données comportementales complexes
Les investigations psychologiques et cognitives contemporaines se heurtent de plein fouet au fléau de la haute dimensionnalité relative. Cette situation se manifeste dès lors que le ratio $p/n$ n’est plus infinitésimal, mais s’approche de l’unité ou la dépasse ($p ge n$). Dans les protocoles cliniques évaluant des pathologies psychiatriques sévères ou des dysfonctionnements neuropsychologiques rares, le recrutement de cohortes homogènes dépasse rarement quelques dizaines ou centaines d’individus ($n \approx 50-200$). Parallèlement, l’administration d’inventaires multidimensionnels, l’extraction de métriques oculométriques, l’enregistrement de séries physiologiques temporelles et la caractérisation génétique fournissent des centaines, voire des milliers de covariables candidates.
Dans un tel régime structurel, l’espace des prédicteurs devient creux en vertu de la géométrie de la dimensionnalité supérieure. Les données sont éparpillées à la périphérie de l’espace d’échantillonnage, et la matrice de Gram $X^TX$ est systématiquement mal conditionnée, voire strictement non inversible si $p > n$. Dans ce dernier cas de figure pathologique, le système d’équations normales admet une infinité non dénombrable de solutions exactes interpolant parfaitement les données d’apprentissage. L’erreur d’ajustement intra-échantillon devient rigoureusement nulle, induisant un surapprentissage (overfitting) massif : le modèle incorpore l’aléa d’échantillonnage, le bruit de mesure instrumental et les idiosyncrasies des sujets de l’échantillon d’étalonnage au détriment des lois sous-jacentes stables.
Ce surajustement structurel détruit systématiquement la capacité de transportabilité ou de validité croisée des modèles développés. Lors du transfert prédictif des équations estimées sur une cohorte clinique externe ou sur de nouvelles sessions expérimentales, le coefficient de détermination prédictif ($R_{\text{test}}^2$) s’effondre fréquemment dans des plages négatives. Cette catastrophe analytique traduit le fait que la moyenne empirique de la variable réponse de la nouvelle cohorte constitue un prédicteur substantiellement plus précis que l’ajustement complexe généré par les MCO. Les sciences du comportement ont payé un lourd tribut à cette vulnérabilité méthodologique, qui a alimenté la crise de reproductibilité des biomarqueurs psychiatriques et des indices psychométriques prédictifs au cours des deux dernières décennies.
2. La problématique critique de la multicollinéarité dans la recherche psychologique
2.1 Origines de l’interdépendance des prédicteurs psychologiques
La multicollinéarité désigne la situation mathématique dans laquelle deux ou plusieurs variables explicatives d’un modèle de régression manifestent une corrélation linéaire approximative ou rigoureuse. Au sein des sciences empiriques dures, la collinéarité résulte principalement de limites expérimentales fortuites ou d’une sélection défaillante des plages d’intervention. Dans la recherche psychologique, cognitive et psychiatrique, la collinéarité n’est pas un artefact accidentel : elle est inhérente à l’architecture conceptuelle des processus mentaux sous investigation.
La première source d’interdépendance réside dans le chevauchement sémantique et conceptuel des sous-échelles psychométriques. Par exemple, les construits d’anxiété généralisée, d’affect négatif, de neuroticisme et d’idéation dépressive partagent une variance latente considérable issue d’un facteur de vulnérabilité émotionnelle commun. Lorsqu’un investigateur tente d’isoler la contribution spécifique de chacune de ces dimensions sur l’observance thérapeutique en intégrant simultanément les scores composites d’échelles validées, les matrices de corrélation inter-items exhibent des coefficients bivariés $r$ excédant fréquemment $0,70$ ou $0,80$. Cette proximité structurelle reflète la nature continue et intriquée des manifestations émotionnelles, lesquelles défient les frontières catégorielles nettes établies par les taxonomies diagnostiques traditionnelles.
La seconde source découle de la structure des batteries d’évaluation standardisées en neuropsychologie cognitive. L’investigation des fonctions exécutives mobilise des épreuves composites telles que le test de Stroop, le Trail Making Test (TMT-A et B), ou les tâches de Wisconsin Card Sorting (WCST). Toutes ces mesures sollicitent simultanément des composantes fondamentales sous-jacentes : la vitesse de traitement de l’information, le contrôle attentionnel, l’inhibition et la mémoire de travail. Par voie de conséquence, ces métriques partagent une fraction substantielle de leur dynamique fonctionnelle, invalidant l’hypothèse d’orthogonalité stricte nécessaire à une estimation stable des effets additifs.
2.2 Conséquences mathématiques et analytiques de la collinéarité
D’un point de vue analytique, la présence d’une multicollinéarité sévère affecte dramatiquement le conditionnement de la matrice d’information empirique. Soit la décomposition spectrale de la matrice de corrélation des prédicteurs $C = X^TX / (n-1)$, normalisée sur la diagonale par des unités : $C = V \Lambda V^T$, où $V$ est la matrice orthogonale des vecteurs propres et $\Lambda = \text{diag}(\lambda_1, \lambda_2, dots, \lambda_p)$ la matrice diagonale des valeurs propres ordonnées telles que $\lambda_1 ge \lambda_2 ge dots ge \lambda_p ge 0$. L’indice de conditionnement de la matrice est formellement défini par $\kappa = \sqrt{\lambda_{\max} / \lambda_{\min}}$. En présence de fortes interdépendances linéaires, la plus petite valeur propre $\lambda_p$ s’approche asymptotiquement de zéro, propulsant le nombre de conditionnement vers des valeurs critiques ($kappa > 30$).
Cette quasi-singularité entraîne une explosion directe de la trace de la matrice de variance-covariance des coefficients :
$$\sum_{j=1}^p \text{Var}(\hat{\beta}_j) = \sigma^2 \sum_{j=1}^p \frac{1}{\lambda_j}$$
Dès lors que $\lambda_p to 0$, le terme correspondant $1/\lambda_p$ domine la somme, provoquant une dilatation démesurée de l’hypersphéroïde de confiance conjointe des paramètres. L’incertitude entourant la localisation du vecteur $\beta$ dans l’espace $\mathbb{R}^p$ devient critique. En conséquence, les erreurs types des coefficients estimés s’envolent, réduisant mécaniquement les statistiques de test de Student associées ($t_j = \hat{\beta}_j / \text{SE}(\hat{\beta}_j)$) à des grandeurs sous-critiques. Des prédicteurs dont l’effet bivarié sur la variable réponse est massif et hautement significatif sur le plan probabiliste ($p < 0,001$) se voient assigner des valeurs $p$ multivariées supérieures au seuil conventionnel de $0,05$. Le chercheur commet alors une erreur de type II en concluant à l'absence de rôle explicatif de variables cruciales.
Plus pernicieux encore est le phénomène d’instabilité d’orientation des coefficients, parfois désigné sous le terme de paradoxe de fractionnement ou inversion de signe. L’espace d’optimisation de la fonction de coût résiduelle acquiert une topologie en forme de vallée étroite et étirée. De minimes perturbations aléatoires dans l’échantillonnage, le bruit de mesure ou l’exclusion arbitraire de deux ou trois sujets d’un protocole clinique peuvent faire basculer le point d’inflexion optimal d’une extrémité à l’autre de cette vallée. Sur le plan empirique, cela se traduit par des inversions brutales de polarité des coefficients : une variable mesurant le soutien social, positivement corrélée au bien-être psychologique dans une analyse univariée, peut hériter d’un coefficient $\hat{\beta}$ négatif absurde au sein du modèle multivarié saturé, simplement pour compenser numériquement le poids alloué à une échelle conjointe d’intégration communautaire.
2.3 Insuffisance des solutions traditionnelles de diagnostic et d’éviction
Pour faire face à ces distorsions, la pratique quantitative conventionnelle s’appuie fréquemment sur des heuristiques diagnostiques telles que le Facteur d’Inflation de la Variance (VIF, Variance Inflation Factor), défini pour le $j$-ème prédicteur par $\text{VIF}_j = 1 / (1 – R_j^2)$, où $R_j^2$ est le coefficient de détermination issu de la régression de $X_j$ sur l’ensemble des $p-1$ autres prédicteurs. Bien que des seuils conventionnels arbitraires aient été formulés ($\text{VIF} > 5$ ou $10$), ces métriques n’offrent aucune solution opérationnelle satisfaisante et se cantonnent à un constat descriptif. Pire, elles échouent à capturer des collinéarités complexes réparties sur des constellations d’items plutôt que sur des paires isolées de variables.
La réaction usuelle des praticiens consiste à éliminer manuellement du modèle de régression les variables présentant les VIF les plus élevés, ou à confier cette sélection à des algorithmes automatisés pas-à-pas (sélection ascendante stepwise, élimination descendante ou bidirectionnelle). Cette méthodologie de contournement soulève d’immenses écueils épistémologiques et statistiques :
- Biais de spécification théorique : L’exclusion arbitraire d’un construit psychométrique corrélé viole la validité de contenu du protocole. Si l’on retire la sous-échelle d’anhédonie d’un modèle d’évaluation de la dépression majeure au motif qu’elle corréle excessivement avec la tristesse ressentie, le modèle final ne mesure plus la dépression dans sa plénitude nosologique, mais une forme tronquée du phénomène clinique.
- Instabilité structurelle des algorithmes pas-à-pas : Les procédures stepwise reposent sur des décisions discrètes guidées par des seuils de significativité arbitraires. Une modification microscopique des données entraîne des bifurcations catégoriques totalement divergentes dans les prédicteurs conservés, donnant une illusion de parcimonie tout en générant des modèles irréproductibles.
- Distorsion des distributions d’échantillonnage : L’utilisation des mêmes données pour sélectionner les variables puis pour estimer leurs coefficients conditionnels invalide les postulats distributionnels des tests $F$ et de Student, produisant des intervalles de confiance artificiellement resserrés et des taux de faux positifs dramatiquement gonflés.
3. Mécanismes fondamentaux de la régularisation statistique
3.1 Le principe de pénalisation de la fonction de perte empirique
L’échec des méthodes de sélection discrètes et l’instabilité des estimateurs non régularisés ont imposé l’émergence d’un cadre mathématique unifié : la régularisation par pénalisation de la fonction de perte empirique. Fondamentalement, cette démarche s’inspire des travaux du mathématicien soviétique Andrey Tikhonov sur la résolution des problèmes inverses mal posés, où la sensibilité aux perturbations rend les solutions exactes dénuées de pertinence physique.
Au lieu de minimiser exclusivement l’écart quadratique aux observations d’entraînement, le problème d’optimisation est redéfini comme une minimisation bi-objective. Le statisticien cherche à identifier un vecteur de paramètres $\hat{\beta}$ qui minimise simultanément l’erreur de prédiction intra-échantillon et une fonctionnelle mesurant la complexité paramétrique globale du modèle. L’expression générale de ce programme s’écrit formellement :
$$\hat{\beta}(\lambda) = arg\min_{\beta in \mathbb{R}^p} \left{ \frac{1}{2n} |y – Xbeta|_2^2 + \lambda \mathcal{P}(\beta) \right}$$
Dans cette formulation canonique, le terme $|y – Xbeta|_2^2$ représente la fonction de perte quadratique conventionnelle mesurant la fidélité de l’ajustement empirique, normalisée par la taille d’échantillon $n$ ou $2n$. La fonction $\mathcal{P}(\beta)$ constitue la pénalité de régularisation, qui opère comme un coût géométrique dissuadant le vecteur des paramètres d’atteindre des amplitudes arbitrairement grandes ou redondantes. Le scalaire non négatif $lambda ge 0$ agit comme un hyperparamètre de régularisation, gouvernant l’intensité du compromis entre adéquation descriptive et parcimonie paramétrique.
Lorsque $lambda = 0$, la fonctionnelle pénalisée se réduit strictement au critère des moindres carrés ordinaires, produisant l’estimateur classique sans biais mais à forte variance. Inversement, lorsque $\lambda to \infty$, l’importance accordée à la réduction de l’erreur empirique s’annule devant l’impératif de minimisation de la pénalité, contraignant le vecteur $\hat{\beta}$ à converger asymptotiquement vers le vecteur nul $\mathbf{0}$ (ou vers le vecteur de l’intercepte moyen si celui-ci est exclu du terme régularisé). Pour toute valeur intermédiaire finie de $lambda$, la solution se situe dans un continuum optimal, introduisant une contraction (shrinkage) paramétrique continue qui compresse sélectivement les composantes instables du modèle.
3.2 Interprétation géométrique des espaces de contrainte
Une compréhension approfondie des mécanismes différentiels qui séparent les familles de régularisation repose sur l’analyse de leur formulation duale sous forme de contrainte lagrangienne. En vertu des conditions d’optimalité de Karush-Kuhn-Tucker (KKT), le problème de pénalisation sans contrainte ci-dessus est strictement équivalent au problème d’optimisation sous contrainte d’inégalité suivant :
$$\min_{\beta in \mathbb{R}^p} \frac{1}{2n} |y – Xbeta|_2^2 \quad \text{sujet à} \quad \mathcal{P}(\beta) le t$$
où il existe une correspondance univoque et décroissante entre la borne de contrainte $t > 0$ et le paramètre de pénalisation $lambda ge 0$.
L’espace d’optimisation est géométriquement subdivisé en deux entités mathématiques en interaction : d’une part, les lignes de niveau de la fonction de perte des moindres carrés forment des hyperellipsoïdes concentriques centrés sur l’estimateur sans contrainte $\hat{\beta}_{\text{MCO}}$. L’excentricité et l’orientation des axes de ces ellipsoïdes sont dictées par les vecteurs propres et les valeurs propres de la matrice de Gram $X^TX$. D’autre part, la région admissible délimitée par la contrainte $\mathcal{P}(\beta) le t$ forme une boule géométrique unitaire fermée et convexe centrée à l’origine de l’espace $\mathbb{R}^p$.
La morphologie de cette sphère unitaire varie radicalement selon la norme choisie pour définir la contrainte :
- Contrainte quadratique L2 (Ridge) : L’équation correspond à $\sum_{j=1}^p \beta_j^2 le t$. Dans un espace bidimensionnel ($p=2$), la frontière de cette contrainte dessine un disque circulaire continu et lisse. Dans des dimensions supérieures, elle forme une hypersphère parfaitement isotrope dénuée d’aspérités géométriques.
- Contrainte absolue L1 (Lasso) : L’équation correspond à $\sum_{j=1}^p |\beta_j| le t$. Dans un plan bidimensionnel, cette contrainte génère un losange régulier dont les sommets reposent précisément sur les axes de coordonnées cartésiennes. En dimension $p$, elle prend la forme d’un hyperoctaèdre ou d’un polytope régulier doté de facettes planes, d’arêtes saillantes et de sommets pointus positionnés à l’intersection des hyperplans où un ou plusieurs coefficients sont rigoureusement nuls.
Le point optimal régularisé correspond au point de contact tangentiel entre l’hyperellipsoïde de perte le plus proche de $\hat{\beta}_{\text{MCO}}$ et la région de contrainte convexe. Compte tenu de la convexité différentiable et de la courbure uniforme de l’hypersphère L2, la probabilité que le point de tangence survienne exactement sur un axe de coordonnées est de mesure nulle dans l’espace continu : la régression Ridge contracte continûment les paramètres sans jamais annuler strictement aucun d’entre eux. À l’opposé, les sommets aigus et les arêtes de l’hyperoctaèdre L1 font saillie le long des axes de coordonnées. Les ellipsoïdes de perte ont ainsi une probabilité d’intersection prépondérante avec ces points singuliers non différentiables, ce qui a pour conséquence immédiate de contraindre formellement un sous-ensemble de coefficients $\hat{\beta}_j$ à prendre la valeur rigoureuse de zéro. Le Lasso opère donc intrinsèquement une sélection parcimonieuse de variables, tandis que Ridge réalise une atténuation globale et conjointe de la variance.
3.3 Perspective bayésienne de la régularisation
L’ancrage théorique des estimateurs pénalisés s’enrichit considérablement lorsqu’on examine leur correspondance structurelle au sein du paradigme de l’inférence bayésienne. Dans cette perspective épistémologique, le vecteur des paramètres inconnus $\beta$ n’est pas appréhendé comme une constante déterministe fixe, mais comme une variable aléatoire dotée d’une distribution de probabilité a priori $p(\beta)$ reflétant l’état de connaissance ou les contraintes théoriques préalables à la collecte des données.
Sous l’hypothèse canonique d’erreurs d’observation distribuées selon une loi normale multivariée $\varepsilon \sim \mathcal{N}(0, \sigma^2 I_n)$, la fonction de vraisemblance de l’échantillon conditionnellement aux paramètres s’exprime par la densité gaussienne standard :
$$p(y|X, \beta, \sigma^2) = \left(2\pi\sigma^2\right)^{-n/2} \exp\left(-\frac{1}{2\sigma^2} |y – Xbeta|_2^2\right)$$
En mobilisant la règle d’inversion de Bayes, la distribution a posteriori des coefficients, proportionnelle au produit de la vraisemblance et du modèle a priori, s’établit comme suit : $p(beta|X, y) propto p(y|X, \beta) p(\beta)$. L’estimateur du maximum a posteriori (MAP) correspond à la valeur paramétrique qui maximise la densité de probabilité postérieure, ce qui équivaut rigoureusement à minimiser la log-vraisemblance négative conjointe :
$$\hat{\beta}_{\text{MAP}} = arg\max_{\beta} \ln p(beta|X, y) = arg\min_{\beta} \left{ \frac{1}{2\sigma^2} |y – Xbeta|_2^2 – \ln p(\beta) \right}$$
L’équivalence formelle avec les modèles régularisés découle directement du choix de la distribution a priori allouée au vecteur $\beta$ :
- Régularisation Ridge et a priori Gaussien : Si l’on assigne aux coefficients $\beta_j$ une distribution a priori indépendante et identiquement distribuée selon une loi normale centrée sur zéro et de variance $\tau^2$, soit $\beta \sim \mathcal{N}(0, \tau^2 I_p)$, le terme pénalisant de la log-densité devient $-\ln p(\beta) = \frac{1}{2\tau^2} \sum_{j=1}^p \beta_j^2 + \text{constante}$. En posant $\lambda = \sigma^2 / \tau^2$, l’estimateur MAP coïncide rigoureusement avec la solution de la régression Ridge. Cette formulation postule a priori que tous les effets psychologiques sont potentiellement actifs mais que les effets d’amplitudes extrêmes sont hautement improbables, traduisant un phénomène d’amortissement homéostatique des traits cognitifs.
- Régularisation Lasso et a priori de Laplace : Si l’on attribue aux coefficients une loi a priori de Laplace (ou double exponentielle) centrée sur l’origine avec un paramètre d’échelle $b$, soit $p(\beta_j) = \frac{1}{2b} \exp(-|\beta_j|/b)$, la log-densité négative se réduit directement à $-\ln p(\beta) = \frac{1}{b} \sum_{j=1}^p |\beta_j| + \text{constante}$. En identifiant $\lambda = \sigma^2 / b$, la maximisation a posteriori devient strictement identique à l’algorithme du Lasso. La loi de Laplace se distingue par une concentration de masse infinitésimale aiguë au point zéro et des queues de distribution épaisses, postulant formellement une structure de rareté (sparsity). Sur le plan épistémologique, cela revient à poser l’hypothèse cognitive forte qu’une écrasante majorité des variables mesurées sont rigoureusement dépourvues d’impact fonctionnel, seuls de très rares prédicteurs majeurs exerçant une influence déterministe significative.
4. La régression Ridge : Caractéristiques, formulation et propriétés
4.1 Formulation mathématique de la pénalité L2
Introduite formellement dans le domaine de la chimiométrie et de l’ingénierie statistique par Arthur E. Hoerl et Robert W. Kennard en 1970 sous le terme originel de ridge trace analysis, la régression Ridge (ou régression par crête) s’établit sur une modification ciblée de la fonction de coût résiduelle par l’adjonction de la norme euclidienne quadratique du vecteur paramétrique. La fonctionnelle à minimiser s’écrit de façon canonique :
$$\mathcal{L}_{\text{Ridge}}(\beta) = |y – Xbeta|_2^2 + \lambda |beta|_2^2 = (y – X\beta)^T(y – X\beta) + \lambda \beta^T\beta$$
où $|beta|_2^2 = \sum_{j=1}^p \beta_j^2$ représente la norme euclidienne au carré. Contrairement aux problèmes posés par la régularisation L1, la fonction objective $\mathcal{L}_{\text{Ridge}}$ est continue, infiniment différentiable par rapport à $\beta$ et strictement convexe pour toute valeur de $lambda > 0$. Le calcul différentiel classique s’applique donc directement pour déterminer le minimum global en calculant le gradient vectoriel :
$$\nabla_{\beta}\mathcal{L}_{\text{Ridge}}(\beta) = -2X^T(y – X\beta) + 2\lambda\beta = 0$$
En développant cette égalité fondamentale, on obtient le système d’équations normales régularisées :
$$(X^TX + \lambda I_p)\hat{\beta}_{\text{Ridge}} = X^Ty$$
Cette dérivation produit une solution analytique en forme fermée d’une élégance algorithmique remarquable :
$$\hat{\beta}_{\text{Ridge}}(\lambda) = (X^TX + \lambda I_p)^{-1}X^Ty$$
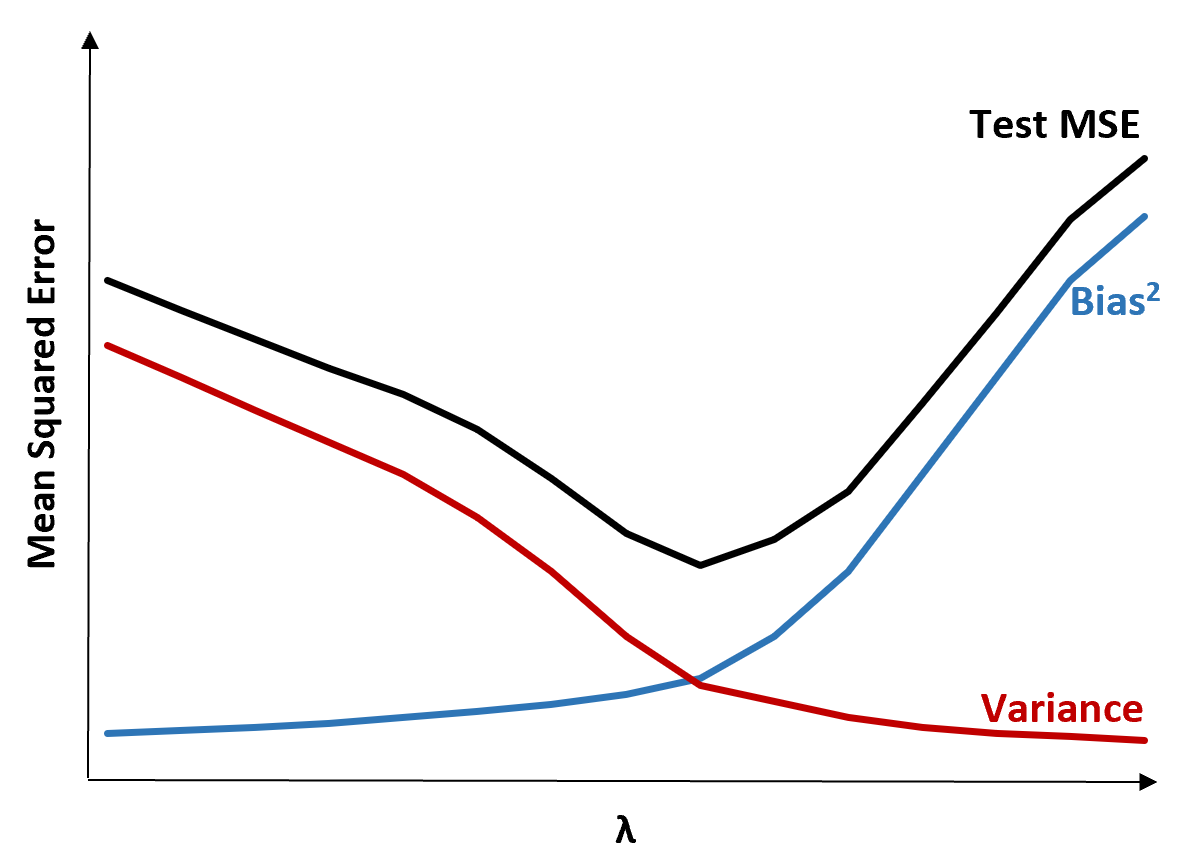
L’apport mathématique décisif de cette expression réside dans la perturbation scalaire positive introduite sur la diagonale principale de la matrice d’information empirique. Même dans les configurations expérimentales les plus défavorables où la matrice $X^TX$ est singulière, non inversible et de rang déficient ($p > n$ ou présence d’identités collinéaires parfaites), la matrice modifiée $(X^TX + \lambda I_p)$ devient systématiquement symétrique, définie positive et strictement inversible pour tout $lambda > 0$. Le spectre des valeurs propres de la matrice régularisée est rigoureusement translaté d’une quantité égale à $lambda$, les nouvelles valeurs propres étant données par $\mu_j = \lambda_j + \lambda > 0$. Par cette opération d’addition scalaire, le nombre de conditionnement effectif de la matrice s’effondre, jugulant l’instabilité numérique des estimateurs.
4.2 Le processus d’atténuation proportionnelle des coefficients
Pour appréhender le mécanisme intime de l’atténuation opérée par la régression Ridge, il convient de décomposer la matrice de conception par la décomposition en valeurs singulières (SVD, Singular Value Decomposition). Soit $X = U D V^T$, où $U in \mathbb{R}^{n \times p}$ et $V in \mathbb{R}^{p \times p}$ sont des matrices à colonnes orthogonales représentant respectivement les espaces propres gauche et droit, et $D = \text{diag}(d_1, d_2, dots, d_p)$ regroupe les valeurs singulières ordonnées telles que $d_1 ge d_2 ge dots ge d_p ge 0$. Les valeurs propres de la matrice de Gram s’expriment comme $\lambda_j = d_j^2$.
En substituant cette factorisation spectrale dans l’expression des estimateurs des moindres carrés ordinaires et de la régression Ridge, les prédictions correspondantes sur le jeu d’apprentissage révèlent une différence opérationnelle fondamentale :
$$\hat{y}_{\text{MCO}} = X\hat{\beta}_{\text{MCO}} = \sum_{j=1}^p u_j u_j^T y$$
$$\hat{y}_{\text{Ridge}} = X\hat{\beta}_{\text{Ridge}} = \sum_{j=1}^p u_j \left(\frac{d_j^2}{d_j^2 + \lambda}\right) u_j^T y$$
Le terme de contraction scalaire, défini par le ratio $f_j = \frac{d_j^2}{d_j^2 + \lambda} le 1$, agit comme un filtre spectral continu. Pour les composantes principales associées à une forte variance empirique ($d_j^2 gg \lambda$), le ratio tend vers l’unité ($f_j \approx 1$), préservant quasi intégralement le signal psychologique dominant. En revanche, pour les directions de l’espace des prédicteurs caractérisées par des valeurs singulières minuscules ($d_j^2 ll \lambda$), reflétant typiquement la quasi-collinéarité ou le bruit de mesure aléatoire, le ratio s’effondre vers zéro ($f_j \approx 0$).
Ce processus réalise une atténuation différentielle très fine : Ridge n’annule jamais brutalement un coefficient, mais comprime préférentiellement les directions statistiques instables. Contrairement aux méthodes de filtrage binaire, tous les prédicteurs demeurent inscrits dans l’équation finale avec des poids continus modulés. De surcroît, face à une configuration où deux prédicteurs $X_1$ et $X_2$ présentent une corrélation bivariée proche de l’unité ($r \approx 1$), l’algorithme Ridge réagit en leur assignant des coefficients rigoureusement identiques : $\hat{\beta}_1 \approx \hat{\beta}_2 \approx \frac{1}{2}\hat{\beta}_{\text{total}}$. La pénalité quadratique résout ainsi l’ambiguïté de l’attribution des poids en forçant un partage coopératif et équitable de la variance explicative.
4.3 Avantages computationnels et stabilité prédictive
D’un point de vue informatique et pratique, la régression Ridge possède des atouts majeurs qui soutiennent sa résilience en analyse de données. L’existence d’une formulation matricielle directe évite le recours obligatoire à des procédures d’optimisation itérative stochastique ou à des algorithmes de descente par coordonnées complexes. L’évaluation du profil complet des solutions pour une grille étendue de valeurs de $lambda$ peut être accomplie de manière instantanée après une unique décomposition spectrale de la matrice de Gram, réduisant le coût computationnel à $O(np^2 + p^3)$ opérations de virgule flottante.
Cette supériorité algorithmique s’accompagne d’une stabilité prédictive éprouvée dans les protocoles confrontés à un ratio signal-sur-bruit intrinsèquement faible. En psychométrie clinique, les scores bruts sont inévitablement entachés d’une incertitude instrumentale, modélisée dans la théorie classique des tests par l’équation $X_{\text{obs}} = X_{\text{vrai}} + E$. Ce bruit résiduel agit comme une perturbation aléatoire délétère lors de l’inversion matricielle standard. Par sa structure d’amortissement quadratique, la régularisation L2 immunise l’estimation contre les fluctuations des résidus non corrélés. Les modèles de prédiction du déclin cognitif ou de la réponse à un protocole pharmacothérapeutique calibrés par Ridge affichent ainsi une reproductibilité substantiellement accrue par rapport aux modèles MCO classiques lors de réplications croisées inter-centres.
5. La régression Lasso : Caractéristiques, parcimonie et sélection
5.1 Formulation mathématique de la pénalité L1
Formulée en 1996 par Robert Tibshirani sous l’acronyme Lasso (Least Absolute Shrinkage and Selection Operator), cette méthodologie de régularisation s’est érigée en standard analytique pour le traitement des données hautement dimensionalisées. Le Lasso modifie l’objectif des moindres carrés ordinaires en lui intégrant la norme géométrique L1 du vecteur des paramètres, mesurant la somme absolue de ses composantes. L’équation d’optimisation prend la forme suivante :
$$\mathcal{L}_{\text{Lasso}}(\beta) = \frac{1}{2n} |y – Xbeta|_2^2 + \lambda |beta|_1 = \frac{1}{2n} \sum_{i=1}^n \left(y_i – \sum_{j=1}^p X_{ij}\beta_j\right)^2 + \lambda \sum_{j=1}^p |\beta_j|$$
où $|beta|_1 = \sum_{j=1}^p |\beta_j|$ désigne la norme L1. Une rupture fondamentale sépare cette formalisation de celle de Ridge : la fonction valeur absolue n’est pas différentiable à l’origine ($x = 0$). Par conséquent, la fonctionnelle globale $\mathcal{L}_{\text{Lasso}}$ ne possède pas de gradient conventionnel en tout point et ne peut être résolue par un système d’équations algébriques linéaires fermées.
Pour surmonter cette singularité non différentiable, l’analyse convexe recourt au concept de sous-gradient. Le sous-différentiel de la norme L1 pour une composante scalaire $\beta_j$ est formellement défini par l’intervalle multi-valué suivant :
$$\partial |\beta_j| = \begin{\cases} {1} &a\mp; \text{si } \beta_j > 0 {-1} &a\mp; \text{si } \beta_j < 0 [-1, 1] &a\mp; \text{si } \beta_j = 0 \end{\cases}$$
Les conditions d’optimalité de Karush-Kuhn-Tucker (KKT) imposent que le vecteur nul appartienne au sous-différentiel de la fonction objective à l’optimum. La résolution numérique de ce problème à grande échelle est aujourd’hui universellement assurée par l’algorithme de descente de gradient par coordonnées cyclique (coordinate descent), popularisé par Friedman, Hastie et Tibshirani. Dans le cas particulier où la matrice de conception est strictement orthogonale ($X^TX = I_p$), la solution du Lasso s’obtient analytiquement de manière explicite par l’opérateur d’écrêtage doux (soft-thresholding operator), noté $\mathcal{S}_{\lambda}$ :
$$\hat{\beta}_j^{\text{Lasso}}(\lambda) = \mathcal{S}_{\lambda}(\hat{\beta}_j^{\text{MCO}}) = \text{signe}(\hat{\beta}_j^{\text{MCO}}) \cdot \max\left(0, |\hat{\beta}_j^{\text{MCO}}| – \lambda\right)$$
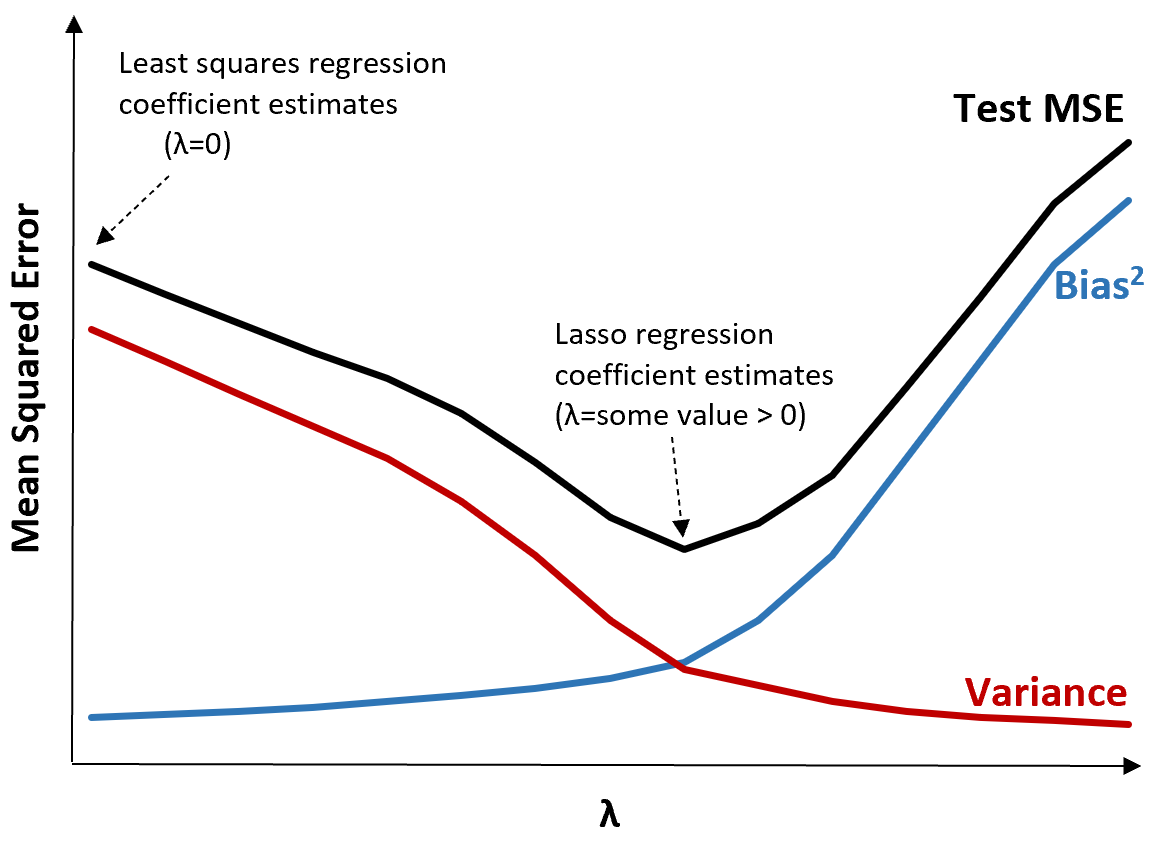
Cette formulation analytique épurée éclaire le fonctionnement intrinsèque du Lasso : chaque estimateur sans contrainte se voit retranché d’une constante scalaire égale à $lambda$. Si sa magnitude d’origine est inférieure ou égale au seuil de pénalisation ($|\hat{\beta}_j^{\text{MCO}}| le \lambda$), le coefficient est impitoyablement projeté et fixé à la valeur absolue de zéro.
5.2 Le mécanisme intrinsèque de sélection de variables
La mise à zéro rigoureuse des coefficients constitue la propriété distinctive majeure du Lasso par rapport à Ridge. En contraignant les coordonnées non significatives à s’annuler, le Lasso transcende la simple fonction d’estimation continue pour agir simultanément comme un algorithme automatique de sélection de variables intégrée. Il génère ce que la littérature nomme un modèle parcimonieux (sparse model).
Dans la recherche neuropsychologique ou psychiatrique contemporaine, cette propriété apporte une avancée phénoménologique considérable. Face à un protocole clinique évaluant des trajectoires symptomatiques complexes à partir d’un ensemble de 500 variables composites (incluant des métriques comportementales, cognitives, métaboliques et environnementales), un modèle Ridge délivrera invariablement une équation de 500 termes. L’investigateur demeure alors incapable d’isoler les marqueurs étiologiques prépondérants pour guider le raisonnement diagnostique. À l’inverse, en calibrant adéquatement le paramètre $lambda$, le Lasso élimine les 480 composantes redondantes ou purement aléatoires pour restituer une équation ne conservant que les 20 prédicteurs les plus informatifs.
Cette capacité d’élagage automatique transforme le problème d’optimisation en un filtre continu et convexe. Contrairement aux approches par saut discret (comme le best-subset selection, qui relève d’une complexité combinatoire NP-difficile incalculable dès que $p > 30$), le Lasso optimise le profil de sélection de manière continue et computationnellement efficiente. Il isole le signal structurel latent tout en compressant les dimensions parasites, produisant des modèles d’une grande limpidité sémiologique.
5.3 Limites opérationnelles du Lasso classique
En dépit de son efficacité dans la réduction dimensionnelle, le Lasso classique présente des vulnérabilités structurelles bien documentées par la théorie mathématique :
- Instabilité face aux blocs de corrélation : Dès lors qu’un groupe de variables présente de fortes corrélations mutuelles ($|r| > 0,85$), le comportement du Lasso devient hautement imprévisible. Au lieu de modéliser conjointement ce cluster de prédicteurs, l’algorithme sélectionne de façon quasiment arbitraire un unique représentant au sein du groupe et force tous les autres à une valeur strictement nulle. De surcroît, une modification infinitésimale de l’échantillon d’apprentissage peut conduire le Lasso à permuter sa sélection en faveur d’un autre prédicteur du même groupe, introduisant une instabilité de sélection qui compromet l’interprétation théorique.
- Le plafond structurel en haute dimensionnalité ($p > n$) : Dans les configurations critiques où le nombre de variables candidates excède le nombre de sujets disponibles, la géométrie du polytope de contrainte L1 limite mathématiquement le nombre maximal de coefficients non nuls pouvant être retenus à au plus $n$. Cette barrière peut se révéler invalidante en génomique psychiatrique ou en connectomique cérébrale, où l’architecture biologique d’un trait implique potentiellement plusieurs milliers d’effets simultanés au sein d’une cohorte de quelques centaines d’individus.
- Biais systématique de sous-estimation pour les coefficients forts : L’opérateur de seuillage doux applique une soustraction uniforme d’amplitude $lambda$ sur tous les coefficients retenus. Les prédicteurs exerçant des effets réels massifs subissent ainsi une atténuation identique à celle appliquée aux composantes mineures, introduisant un biais asymptotique qui détériore l’erreur prédictive globale du modèle.
6. Quand privilégier la régression Ridge : Critères décisionnels et contextes d’application
6.1 Présence de variables fortement corrélées toutes conceptuellement essentielles
L’arbitrage méthodologique entre Ridge et Lasso repose sur des critères statistiques formels et des exigences épistémologiques propres au modèle théorique testé. La régression Ridge s’impose prioritairement dès lors que l’investigateur opère dans un paradigme où la présence de prédicteurs fortement corrélés coexiste avec l’obligation théorique de conserver l’ensemble de ces dimensions au sein du modèle final.
En psychométrie, les construits psychologiques sont traditionnellement conceptualisés comme des entités multidimensionnelles ordonnées. Considérons l’évaluation du trouble de déficit de l’attention avec hyperactivité (TDAH) à l’aide d’échelles standardisées mesurant séparément l’inattention, l’impulsivité motrice, l’impulsivité cognitive et la labilité émotionnelle. Ces quatre sous-échelles partagent une corrélation empirique élevée ($r ge 0,75$). Si le praticien appliquait aveuglément la régression Lasso pour modéliser le retentissement fonctionnel sur la réussite académique, l’algorithme retiendrait potentiellement l’inattention tout en contraignant l’impulsivité et la labilité émotionnelle à une valeur rigoureusement nulle.
Une telle décision mathématique ruinerait la validité de contenu de l’investigation : le modèle délivrerait la conclusion fallacieuse selon laquelle l’impulsivité n’exerce aucun impact sur la trajectoire fonctionnelle du patient. Dans cette situation, la régression Ridge constitue la méthodologie d’élection. En répartissant continûment les coefficients au sein du faisceau de variables collinéaires sans en exclure aucune, elle préserve l’intégrité conceptuelle de l’outil d’évaluation tout en neutralisant l’inflation de variance qui aurait résulté d’une estimation par les moindres carrés ordinaires.
6.2 Objectif de prédiction pure sans impératif de simplification
Le second contexte d’élection de la régression Ridge réside dans les protocoles d’analyse où la finalité scientifique exclusive réside dans l’exactitude de la prédiction hors-échantillon, la parcimonie formelle du vecteur de paramètres étant d’un intérêt secondaire. Dans ces cadres d’ingénierie prédictive, le statisticien privilégie la minimisation absolue de l’erreur quadratique moyenne de validation par rapport à la simplicité d’interprétation du modèle.
Dans de nombreuses configurations empiriques complexes, le comportement d’atténuation progressive et fluide de la pénalité L2 produit une erreur quadratique moyenne de test substantiellement inférieure à celle générée par le découpage abrupte du Lasso. Ce phénomène découle directement de l’absence de biais systématique sur les variables secondaires : alors que le Lasso supprime complètement les descripteurs sous-critiques au risque d’amputer de précieux fragments de signal statistique diffus, Ridge condense harmonieusement l’ensemble de la structure de variance. Dans l’apprentissage de scores pronostiques combinant une vaste batterie de sous-tests cognitifs chez des patients au stade prodromique de la démence d’Alzheimer, l’utilisation de Ridge surpasse de manière documentée le Lasso lorsque la détérioration cérébrale est globalement distribuée à travers de multiples réseaux corticaux.
6.3 Configuration où de nombreux prédicteurs exercent des effets de faible magnitude
Le troisième scénario décisif en faveur de la régression Ridge correspond à la modélisation de phénomènes régis par une architecture causale polyphénique ou distribuée. En génétique comportementale comme en psychologie différentielle moderne, l’hypothèse historique selon laquelle un trait mental complexe résulterait de l’influence déterministe d’un nombre infime de gènes majeurs ou de traits prépondérants a été largement invalidée.
Les scores de risque polygénique (PRS, Polygenic Risk Scores) appliqués à l’autisme, à la schizophrénie ou à l’intelligence cognitive générale démontrent que ces attributs émergent de l’accumulation de centaines ou de milliers d’allèles ou d’indicateurs de variance minime, exerçant chacun une influence ténue mais agrégativement décisive. Face à une telle topologie sous-jacente, l’hypothèse de rareté inhérente au Lasso s’effondre : en contraignant les effets mineurs à zéro, le Lasso supprime l’essentiel de la variance explicative réelle et sous-estime tragiquement le potentiel prédictif des données. Ridge s’avère parfaitement accordé à cette réalité théorique, stabilisant la modélisation conjointe d’un très large spectre de micro-effets additifs.
7. Quand privilégier la régression Lasso : Critères décisionnels et contextes d’application
7.1 Nécessité d’une parcimonie stricte et interprétabilité clinique
La régression Lasso devient le choix méthodologique optimal lorsque la finalité de la modélisation exige une réduction d’échelle drastique, la production d’un modèle parcimonieux et une interprétabilité immédiate au lit du malade ou dans des contextes d’intervention d’urgence. Dans de multiples environnements de santé mentale, l’administration d’une batterie neuropsychologique de 80 épreuves requérant quatre heures d’évaluation n’est pas viable en routine clinique.
L’utilisation du Lasso permet de concevoir des versions abrégées scientifiquement validées d’outils diagnostiques denses. En contraignant l’espace paramétrique par une pénalisation L1 rigoureuse, l’algorithme sélectionne l’ensemble minimal d’items (par exemple, 6 questions précises au sein d’un questionnaire d’évaluation de la détresse suicidaire en 40 items) qui préserve l’essentiel du pouvoir prédictif de l’instrument global. Les coefficients nuls éliminent les items superflus, réduisant la charge cognitive imposée aux patients vulnérables tout en fournissant aux praticiens non statisticiens une règle de décision linéaire claire et facilement auditable.
7.2 Situations de très haute dimensionnalité
Le second cadre opérationnel incontournable du Lasso se déploie dans les environnements expérimentaux caractérisés par une volumétrie de données massive où le nombre de descripteurs dépasse de plusieurs ordres de grandeur la taille de la cohorte observée ($p gg n$).
Ce paradigme est omniprésent en neuro-imagerie fonctionnelle par résonance magnétique (IRMf), où l’investigation des corrélats neuronaux de la prise de décision ou de la réponse émotionnelle implique la quantification du signal BOLD à travers 150 000 voxels tridimensionnels pour une cohorte de 40 participants. Une telle volumétrie se retrouve dans les analyses de séquençage épigénétique ou transcriptomique examinant la méthylation de l’ADN à travers des millions de sites CpG. Dans ces contextes, la parcimonie mathématique n’est pas une option esthétique : elle est le seul rempart computationnel et théorique contre l’écroulement des algorithmes d’estimation. Le Lasso opère un tamisage puissant, éliminant l’immense majorité des voxels ou des marqueurs non informatifs pour localiser précisément les agrégats anatomiques où réside le signal expérimental robuste.
7.3 Présomption théorique d’un faible nombre de variables explicatives actives
Le troisième scénario d’application découle directement de l’adéquation entre l’hypothèse de rareté (sparsity) du Lasso et la structure biologique ou cognitive réelle du phénomène modélisé. Lorsque le modèle théorique formulé par l’investigateur postule que l’émergence d’un état comportemental dépend de l’activation sélective d’un nombre restreint de modules fonctionnels distincts au sein d’un bruit de fond environnemental vaste, la pénalité L1 devient structurellement supérieure.
En pharmacovigilance psychiatrique, par exemple, lorsqu’il s’agit de détecter les prédicteurs environnementaux et métaboliques singuliers régissant l’apparition d’un effet secondaire délétère rare (tel que le syndrome métabolique sous neuroleptiques atypiques) parmi des centaines de covariables d’anamnèse, l’hypothèse étiologique privilégiée postule un petit nombre d’interactions causales directes. Le Lasso concentre alors son optimisation sur l’identification de ces leviers discriminants, prévenant l’incorporation de covariables fortuites qui viendraient contaminer le jugement médical.
8. Le compromis Elastic Net : Quand combiner les pénalités Ridge et Lasso
8.1 Fondements de l’hybridation des normes L1 et L2
Les limites structurelles inhérentes au Lasso d’une part (instabilité de sélection en présence de collinéarité, plafonnement à $n$ variables) et à Ridge d’autre part (absence totale de sélection de variables) ont conduit Hui Zou et Trevor Hastie à formuler en 2005 une synthèse de ces deux paradigmes : le modèle Elastic Net. Cette architecture combine de manière convexe et symétrique les pénalités quadratique L2 et absolue L1 dans une même fonction de perte empirique :
$$\mathcal{L}_{\text{ElasticNet}}(\beta) = \frac{1}{2n} |y – Xbeta|_2^2 + \lambda \left( \alpha |beta|_1 + \frac{1 – \alpha}{2} |beta|_2^2 \right)$$
Dans ce formalisme bicéphale, l’optimisation dépend de deux hyperparamètres régulateurs distincts mais interconnectés :
- $lambda ge 0$ contrôle l’intensité globale de la pénalité de contraction imposée au modèle.
- $\alpha in [0, 1]$ représente le paramètre de mélange (mixing parameter), gouvernant le compromis structural entre la parcimonie et la stabilisation spectrale. Lorsque $\alpha = 1$, la formulation se réduit strictement à la régression Lasso classique ; à l’opposé, lorsque $\alpha = 0$, l’équation devient formellement équivalente à la régression Ridge. Pour toute valeur comprise dans l’intervalle ouvert $]0, 1[$, l’Elastic Net mobilise simultanément les forces régulatrices des deux normes.
La surface de contrainte lagrangienne associée à l’Elastic Net adopte une morphologie géométrique hybride remarquable. Les frontières du polytope de contrainte ne sont ni strictement sphériques comme chez Ridge, ni totalement planes et polyédriques comme chez Lasso : elles exhibent une courbure continue combinée à des sommets anguleux acérés au niveau des axes de coordonnées cartésiennes. Cette singularité morphologique permet à l’algorithme de fixer rigoureusement des coefficients à zéro (sélection de variables via la composante L1) tout en maintenant une courbure différentiable assurant la robustesse du conditionnement matriciel (stabilisation via la composante L2).
8.2 Gestion des structures de corrélation par blocs
L’avantage opératoire déterminant de l’Elastic Net réside dans ce que les théoriciens désignent sous le nom d’effet de regroupement (grouping effect). Soit deux prédicteurs standardisés fortement corrélés $X_i$ et $X_j$ tels que leur corrélation empirique approche de l’unité ($r to 1$). Zou et Hastie ont formellement démontré que la distance euclidienne séparant leurs coefficients estimés satisfait la majoration théorique suivante :
$$|\hat{\beta}_i(\lambda, \alpha) – \hat{\beta}_j(\lambda, \alpha)|_1 le \frac{1}{\lambda(1 – \alpha)} \sqrt{2(1 – r)}$$
Dès lors que la corrélation $r$ tend vers $1$, la borne supérieure s’annule, contraignant mécaniquement la différence entre les deux coefficients à converger vers zéro. Cette propriété résout l’arbitraire du Lasso classique : au lieu de sélectionner au hasard un unique prédicteur parmi un bloc d’items hautement corrélés, l’Elastic Net sélectionne ou élimine conjointement le cluster tout entier. Les variables formant un bloc cohérent voient leurs poids converger vers des magnitudes équilibrées, préservant la représentativité des composantes fonctionnelles.
Par ailleurs, l’adjonction de la composante L2 libère l’algorithme du plafond contraignant du nombre d’observations : même en configuration de haute dimensionnalité où $p gg n$, l’Elastic Net est capable de sélectionner simultanément un ensemble de prédicteurs dépassant la taille d’échantillon $n$ si la structure des corrélations empiriques le justifie.
8.3 Applications types en neurobiologie comportementale
Cette plasticité analytique confère à l’Elastic Net une pertinence reconnue dans les investigations neurobiologiques et neuropsychiatriques contemporaines. Dans l’exploration des réseaux neuronaux fonctionnels par connectomique cérébrale, les voxels corticaux ne fonctionnent pas de manière isolée : ils s’organisent en réseaux d’activation cohérents interconnectés (tels que le réseau du mode par défaut ou le réseau exécutif central). L’application de l’Elastic Net permet de sélectionner de manière parcimonieuse des circuits neuronaux entiers corrélés, tout en rejetant le bruit anatomique périphérique.
De même, dans les protocoles d’intégration multi-omique associant la transcription d’ARN, la méthylation épigénétique et des inventaires de fonctionnement exécutif chez des populations gériatriques suivies pour un déclin cognitif, les prédicteurs s’agencent naturellement en blocs fonctionnels hautement corrélés. L’Elastic Net constitue l’instrument d’arbitrage méthodologique par excellence, offrant la sélectivité nécessaire à la communication médicale tout en neutralisant les distorsions d’estimation générées par les interdépendances biologiques.
9. Optimisation des hyperparamètres et validation croisée
9.1 Sélection rigoureuse du coefficient de régularisation
L’efficacité prédictive et la validité inférentielle des estimateurs pénalisés dépendent de la calibration de leurs hyperparamètres de contrôle ($lambda$ pour Ridge et Lasso ; le couple $(\lambda, \alpha)$ pour l’Elastic Net). Le paramètre $lambda$ ne peut être déduit analytiquement à partir des données par les équations normales, puisqu’il gouverne précisément la complexité structurelle de ces équations.
La procédure standard d’exploration procède par la construction d’une grille logarithmique discrète de valeurs candidates. L’éventail de test est traditionnellement amorcé à une valeur $\lambda_{\max}$, définie comme la borne minimale de pénalité suffisante pour forcer la totalité des coefficients à zéro (pour le Lasso, cette valeur correspond analytiquement à $\lambda_{\max} = \frac{1}{n} \max_j |X_j^T y|$), puis s’étend de manière décroissante sur une échelle géométrique jusqu’à une valeur $\lambda_{\min} = \epsilon \lambda_{\max}$ (avec $epsilon$ couramment fixé à $10^{-3}$ ou $10^{-4}$). Cette exploration permet de tracer les trajectoires régularisées des paramètres (regularization paths), visualisant l’évolution continue de chaque coefficient en fonction du niveau de contrainte.
9.2 Méthodes de validation croisée k-fold
L’estimation non biaisée du risque prédictif associé à chaque valeur de l’hyperparamètre requiert l’application d’un protocole de validation croisée à $k$ blocs (k-fold cross-validation, classiquement $k=5$ ou $k=10$). Ce processus impose de scinder aléatoirement l’échantillon empirique initial $\mathcal{D}$ en $k$ sous-ensembles mutuellement exclusifs et de volumes équivalents :
- Pour chaque itération $v in {1, dots, k}$, le $v$-ème sous-ensemble sert d’échantillon de validation (test fold), tandis que les $k-1$ blocs restants sont fusionnés pour former l’échantillon d’entraînement effectif.
- Le modèle régularisé est calibré sur l’échantillon d’entraînement pour chaque nœud de la grille de pénalité, puis son erreur quadratique moyenne de prédiction est évaluée exclusivement sur l’échantillon de validation tenu en réserve.
- Les performances d’évaluation sont ensuite moyennées sur les $k$ itérations pour chaque valeur candidate de $lambda$, produisant la courbe empirique de l’erreur quadratique de validation croisée $\text{CV}_{(\lambda)}$ et son erreur type associée $\text{SE}(\text{CV}_{(\lambda)})$.
Dans les contextes cliniques où les données présentent des déséquilibres de classes ou des structures de clusters (familles, centres hospitaliers de collecte), l’implémentation impose une stratification rigoureuse pour garantir la préservation des ratios de sous-groupes à travers l’ensemble des blocs. En outre, pour prévenir tout risque d’optimisme statistique lié au surapprentissage des hyperparamètres, les protocoles méthodologiques rigoureux adoptent une validation croisée imbriquée (nested cross-validation) : une boucle externe évalue la performance de généralisation non biaisée du pipeline global, tandis qu’une boucle interne calibre les valeurs optimales de $lambda$ et d’atténuation.
9.3 Critères de décision entre erreur minimale et règle d’un écart-type
L’examen de la fonction d’erreur issue de la validation croisée révèle typiquement un profil en forme de « U », traduisant le compromis biais-variance. Pour orienter la décision statistique, deux métriques opérationnelles ont été standardisées dans la littérature spécialisée :
- Le critère d’erreur minimale ($\lambda_{\min}$) : Cette valeur correspond rigoureusement à l’hyperparamètre qui minimise la moyenne empirique de l’erreur quadratique de prédiction : $\lambda_{\min} = arg\min_{\lambda} \text{CV}_{(\lambda)}$. Ce critère maximise mécaniquement l’ajustement prédictif sur l’espace d’échantillonnage, mais il tend fréquemment à sélectionner un modèle conservant un nombre substantiel de variables marginales contaminées par le bruit d’échantillonnage.
- La règle d’un écart-type ($\lambda_{\text{1-SE}}$) : Formulée par Hastie, Tibshirani et Friedman, cette heuristique de parcimonie identifie la valeur de pénalisation la plus sévère dont l’erreur quadratique moyenne de validation ne dépasse pas d’un écart-type l’erreur minimale enregistrée : $\lambda_{\text{1-SE}} = \max { \lambda : \text{CV}_{(\lambda)} le \text{CV}_{(\lambda_{\min})} + \text{SE}(\text{CV}_{(\lambda_{\min})}) }$.
Le choix entre ces deux repères analytiques doit être guidé par la posture épistémologique de l’investigateur. Si l’impératif réside dans la précision pure du pronostic clinique, $\lambda_{\min}$ constitue la référence mathématique. Si, en revanche, l’investigation vise l’identification reproductible d’un noyau fonctionnel robuste de biomarqueurs ou la dérivation d’un instrument psychométrique ultra-court, l’adoption de $\lambda_{\text{1-SE}}$ est recommandée. En acceptant une dégradation statistiquement indistincte de la performance prédictive, elle favorise l’élimination des covariables instables et garantit une parcimonie accrue.
10. Prétraitement des données et exigences méthodologiques préalables
10.1 Standardisation impérative des variables d’entrée
Une exigence méthodologique absolue, fréquemment méconnue dans les applications empiriques naïves des pénalisations statistiques, réside dans la standardisation préalable systématique de l’ensemble des prédicteurs quantitatifs. La fonction de perte classique des moindres carrés ordinaires jouit d’une invariance d’échelle naturelle : la multiplication d’une variable par une constante scalaire $c$ induit une division proportionnelle exacte de son coefficient par $c$, sans altérer ni l’ajustement global, ni la trajectoire résiduelle.
Cette invariance géométrique s’effondre en présence d’un terme de pénalité de régularisation :
$$\mathcal{P}_{\text{Ridge}}(\beta) = \lambda \sum_{j=1}^p \beta_j^2 \quad \text{ou} \quad \mathcal{P}_{\text{Lasso}}(\beta) = \lambda \sum_{j=1}^p |\beta_j|$$
La pénalité traite chaque coefficient $\beta_j$ de manière isotrope, appliquant une sanction identique quelle que soit l’unité de mesure sous-jacente. Si un modèle de psychologie de la santé intègre simultanément le temps de réaction mesuré en millisecondes (avec une variance d’ordre $10^5$) et le taux sérique d’un neuromédiateur quantifié en nanomoles par litre (avec une variance d’ordre $10^{-3}$), la magnitude brute du coefficient associé au neuromédiateur devra être disproportionnellement élevée pour exercer une influence équivalente sur la réponse. En conséquence, la pénalité L1 ou L2 appliquera une répression démesurée sur le biomarqueur tout en épargnant artificiellement le temps de réaction, en raison d’un simple artefact de calibration métrique.
Pour neutraliser ce biais, chaque colonne de la matrice de conception doit subir une transformation de centrage et de réduction avant toute optimisation :
$$\tilde{X}_{ij} = \frac{X_{ij} – \bar{X}_j}{\hat{\sigma}_j}$$
Cette normalisation contraint toutes les variables à exhiber une moyenne nulle et une variance empirique unitaire ($\hat{\sigma}_j = 1$). De façon symétrique, l’intercepte $\beta_0$ est universellement exclu du terme de contrainte pénalisante, afin d’éviter que le niveau de base moyen de la variable dépendante ne soit arbitrairement biaisé par l’intensité de $lambda$. Une fois les coefficients optimisés sur l’espace transformé, ils doivent être reconvertis vers leur métrique d’origine par calcul inverse pour restituer leur interprétabilité substantielle.
10.2 Gestion rigoureuse des données manquantes et imputation
Les protocoles d’investigation longitudinale en psychologie et les recueils de données cliniques sont structurellement vulnérables au problème des données manquantes (attrition des cohortes, omission de réponses, artéfacts d’imagerie). La tentation fréquente d’appliquer une suppression de listes complètes (complete-case analysis) présente des dangers majeurs : elle contracte dramatiquement la puissance statistique d’échantillonnage et introduit un biais d’attrition systématique si le mécanisme de perte n’est pas strictement aléatoire (MCAR, Missing Completely At Random).
L’intégration de procédures d’imputation multiple par équations chaînées (MICE, Multivariate Imputation by Chained Equations) s’impose comme la solution méthodologique d’excellence. Toutefois, l’articulation entre imputation multiple et régularisation statistique soulève une complexité computationnelle non triviale. L’application de la régression Lasso sur chaque jeu de données imputé conduit inévitablement à des configurations où un prédicteur donné est sélectionné dans certains jeux de données mais exclu dans d’autres. L’agrégation de ces résultats disjoints requiert des méthodologies spécifiques, telles que le calcul de la proportion d’inclusion sur l’ensemble des imputations ou l’application du Lasso groupé appliqué conjointement à la matrice empilée des données complétées.
10.3 Traitement des variables catégorielles et non linéaires
L’incorporation de prédicteurs nominaux qualitatifs (tels que les catégories nosologiques diagnostiques ou les conditions d’assignation expérimentale) impose leur décomposition préalable sous forme de variables indicatrices binaires (encodage disjonctif complet ou one-hot encoding). Cette transformation soulève un écueil direct lors de l’application de la pénalité Lasso standard : l’algorithme évalue chaque variable indicatrice de manière atomisée et indépendante.
Face à un facteur qualitatif découpé en quatre modalités binaires, le Lasso peut contraindre à zéro deux de ces modalités tout en conservant les deux autres. Cette fragmentation détruit l’invariance géométrique du modèle par rapport au choix arbitraire de la catégorie de référence, rendant l’interprétation clinique incohérente. Pour préserver l’intégrité fonctionnelle des attributs nominaux, il convient de recourir au Group Lasso, formalisé par Ming Yuan et Yi Lin. Cette extension regroupe l’ensemble des modalités indicatrices d’un même facteur au sein d’un vecteur sous-matriciel $X_{(g)}$ pénalisé collectivement par sa norme euclidienne non quadratique $\sum_{g=1}^G \sqrt{p_g} |\beta_{(g)}|_2$, assurant que le facteur qualitatif soit retenu ou rejeté en bloc de façon harmonieuse.
11. Inférence statistique et communication des résultats selon les normes académiques
11.1 Les écueils de l’inférence post-sélection
L’un des angles morts méthodologiques les plus critiques dans la littérature quantitative contemporaine concerne l’inférence post-sélection. Il est fréquent d’observer des protocoles de recherche où les auteurs appliquent un algorithme Lasso pour sélectionner un sous-ensemble restreint de prédicteurs jugés pertinents, puis réinjectent ces variables au sein d’un modèle linéaire des moindres carrés ordinaires classique pour publier des valeurs $p$ et des intervalles de confiance standards.
Cette séquence analytique est formellement erronée d’un point de vue probabiliste. La théorie statistique de l’inférence (les tests de Student, de Fisher ou les intervalles de confiance à 95 %) repose sur le postulat fondamental que la structure du modèle et l’espace des paramètres ont été postulés a priori, de manière totalement indépendante de la réalisation empirique des données. Dès lors que les données d’échantillonnage ont été préalablement mobilisées pour guider le choix du modèle via l’élagage L1, la distribution sous-jacente des statistiques de test conventionnelles s’effondre. Les tests conditionnels standards ne suivent plus des lois de Student, mais des lois tronquées et asymétriques.
Ce phénomène, théorisé sous le concept de biais de sélection ou d’optimisme statistique, aboutit à une sous-estimation systématique des erreurs types et à une inflation majeure du taux de faux positifs (taux d’erreur de type I). Des valeurs $p$ affichées comme hautement significatives ($p < 0,0001$) après une régularisation Lasso naïve se révèlent fréquemment non discernables de l'aléa lorsque l'incertitude inhérente au processus de sélection lui-même est formellement intégrée par les outils de l'inférence sélective.
11.2 Techniques de rééchantillonnage non paramétrique
Pour contourner l’échec des hypothèses distributionnelles classiques sans s’enfermer dans une approche heuristique, les chercheurs doivent mobiliser des méthodologies fondées sur le rééchantillonnage non paramétrique. La quantification robuste de l’incertitude des coefficients régularisés s’opère préférentiellement par l’implémentation du bootstrap par paires (pairs bootstrap) :
- L’échantillon d’origine $\mathcal{D}$ fait l’objet d’un tirage avec remise répété $B$ fois (typiquement $B ge 1000$ ou $2000$) pour générer des pseudo-échantillons de taille $n$.
- L’intégralité du pipeline méthodologique — incluant le centrage-réduction, l’optimisation croisée de l’hyperparamètre $lambda$ et l’ajustement du modèle pénalisé — est exécutée de façon autonome sur chaque réplicat bootstrap.
- La variabilité empirique des estimations obtenues permet de dériver des intervalles de confiance non paramétriques (notamment par la méthode des centiles ajustés ou BCa, bias-corrected and accelerated) pour les coefficients contractés.
Parallèlement, la robustesse de la sélection opérée par le Lasso peut être rigoureusement mesurée par des procédures de sélection par stabilité (stability selection), théorisées par Nicolai Meinshausen et Peter Bühlmann. Cette technique consiste à soumettre des centaines de sous-échantillons aléatoires de taille $n/2$ à une pénalisation L1, afin de quantifier la probabilité marginale d’inclusion empirique de chaque prédicteur. Seules les variables dont la fréquence de sélection dépasse un seuil probabiliste strict (souvent fixé entre $0,60$ et $0,80$) sont conservées dans le modèle final. Cette approche garantit un contrôle mathématiquement rigoureux sur le taux d’erreur par famille (Family-Wise Error Rate, FWER), immunisant l’analyse contre les fluctuations aléatoires de l’échantillonnage.
11.3 Standardisation des rapports d’analyse selon les directives de l’APA
La publication de modèles pénalisés au sein des revues affiliées à l’American Psychological Association (APA) impose le respect strict des critères de reproductibilité et de transparence méthodologique, formalisés dans les standards JARS-REC (Journal Article Reporting Standards for Quantitative Research). Tout rapport quantitatif mobilisant des approches de régularisation doit consigner explicitement les éléments suivants :
- Le protocole exhaustif de prétraitement : La spécification univoque des méthodes de normalisation ou de centrage-réduction appliquées, la gestion formelle de l’intercepte, ainsi que les algorithmes d’imputation des données manquantes doivent être documentés en détail.
- La justification théorique de la fonction de coût : L’explicitation formelle des arguments épistémologiques ayant guidé le choix exclusif de Ridge, de Lasso ou de l’Elastic Net (incluant, pour ce dernier, la valeur du paramètre de mélange $\alpha$).
- Le cadre de validation croisée : La déclaration de la structure de partitionnement adoptée (k-fold, stratifiée, groupée ou imbriquée), le nombre de blocs mobilisés, ainsi que le critère exact de décision retenu pour fixer la pénalité finale ($\lambda_{\min}$ ou $\lambda_{\text{1-SE}}$).
- La communication visuelle des trajectoires : L’inclusion systématique dans le corps de l’article ou dans les annexes scientifiques de la courbe d’évolution de l’erreur de validation croisée en fonction de $log(lambda)$ assortie des barres d’erreur standard, ainsi que du tracé des chemins de régularisation montrant la dynamique d’extinction des coefficients.
- L’ouverture des protocoles computationnels : En conformité avec les impératifs de la science ouverte, le dépôt systématique des scripts de calcul traçables (en langages R ou Python) au sein de plateformes d’archivage pérennes (telles que le Open Science Framework ou Zenodo), garantissant la réplication exacte des estimations publiées.
12. Synthèse comparative et arbre de décision pour le chercheur
12.1 Matrice comparative des propriétés opératoires
Pour clarifier les compromis mathématiques régissant les approches étudiées, la matrice comparative ci-dessous résume leurs propriétés structurelles sous-jacentes :
- Moindres Carrés Ordinaires (MCO) :
- Pénalisation : Aucune ($lambda = 0$).
- Sélection automatique de variables : Nulle (conserve l’intégralité des $p$ prédicteurs).
- Comportement face à la multicollinéarité : Divergence de la variance d’échantillonnage, inversion des signes et instabilité numérique extrême.
- Performance en régime $p > n$ : Échec absolu (infinité de solutions, non inversibilité de la matrice de Gram).
- Biais théorique d’estimation : Nul ($\text{Biais} = 0$).
- Variance des estimateurs : Maximale.
- Régression Ridge :
- Pénalisation : Norme euclidienne quadratique L2 ($\lambda |beta|_2^2$).
- Sélection automatique de variables : Nulle (atténuation continue, rétention systématique de tous les prédicteurs).
- Comportement face à la multicollinéarité : Excellente stabilisation matricielle, partage équitable des coefficients entre variables collinéaires.
- Performance en régime $p > n$ : Opérationnelle (solution analytique unique définie positive).
- Biais théorique d’estimation : Biais contrôlé introduit délibérément.
- Variance des estimateurs : Forte compression de la variance.
- Régression Lasso :
- Pénalisation : Norme absolue géométrique L1 ($\lambda |beta|_1$).
- Sélection automatique de variables : Intrinsèque et parcimonieuse (annulation formelle d’un sous-ensemble de coefficients).
- Comportement face à la multicollinéarité : Sélection arbitraire d’un prédicteur unique au sein d’un cluster corrélé, mise à zéro des autres.
- Performance en régime $p > n$ : Opérationnelle, mais plafonnée à un maximum structurel de $n$ variables actives retenues.
- Biais théorique d’estimation : Biais introduit sur l’ensemble des coefficients, y compris sur les composantes majeures.
- Variance des estimateurs : Forte réduction de la variance via la projection parcimonieuse.
- Régression Elastic Net :
- Pénalisation : Combinaison convexe hybride des normes L1 et L2 ($\lambda [\alpha |beta|_1 + \frac{1-\alpha}{2}|beta|_2^2]$).
- Sélection automatique de variables : Modulable et flexible (sélection parcimonieuse régie par le ratio $\alpha$).
- Comportement face à la multicollinéarité : Effet de regroupement (grouping effect), conservation ou élimination conjointe des clusters collinéaires.
- Performance en régime $p > n$ : Opérationnelle sans plafond formel sur le volume de variables corrélées sélectionnées.
- Biais théorique d’estimation : Biais double (souvent atténué par un recalibrage proportionnel).
- Variance des estimateurs : Minimisation conjointe optimale de la variance de prédiction.
12.2 Arbre décisionnel séquentiel fondé sur les objectifs de l’étude
Afin de guider méthodiquement le praticien dans le choix de la procédure de régularisation la plus conforme à son protocole expérimental, la démarche séquentielle suivante offre un cadre opérationnel unifié :
- Étape 1 : Diagnostic structurel de l’échantillon et de la matrice de conception
L’investigateur doit évaluer le ratio $p/n$ et la matrice de corrélation empirique des prédicteurs. Si le nombre d’observations $n$ surpasse massivement le nombre de prédicteurs $p$ ($n gg p$, par exemple $n > 100 \times p$) et que le conditionnement de la matrice est excellent ($kappa < 10$, VIF systématiquement $ n$, ou que des corrélations substantielles sont détectées entre prédicteurs ($r > 0,60$), la transition vers une architecture régularisée s’impose comme une nécessité formelle.
- Étape 2 : Clarification de la visée théorique et clinique prioritaire
La question pivot concerne la finalité explicative versus prédictive : Le protocole vise-t-il l’extraction d’un sous-ensemble parcimonieux d’indicateurs facilement administrables et directement interprétables en clinique au prix d’un élagage substantiel ? Ou requiert-il la maximisation de l’exactitude pronostique en préservant l’intégralité des sous-dimensions psychométriques évaluées ?
- Si la parcimonie et la sélection de variables sont impératives : Écarter Ridge et progresser vers les méthodes intégrant la norme L1 (Lasso ou Elastic Net).
- Si la rétention exhaustive et la représentativité de contenu sont obligatoires : Sélectionner sans ambiguïté la régression Ridge.
- Étape 3 : Arbitrage fin entre Lasso et Elastic Net
Dans l’éventualité où la sélection de variables est exigée, l’investigateur doit examiner l’architecture des interdépendances au sein de ses prédicteurs :
- Les prédicteurs présentent-ils des blocs denses de corrélations mutuelles, ou le volume $p$ excède-t-il largement $n$ ? Si la réponse est affirmative, la régression Lasso classique produira une instabilité de sélection critique ou un plafonnement paramétrique. L’adoption de l’Elastic Net est alors la voie méthodologique préconisée, en calibrant simultanément les paramètres $lambda$ et $\alpha$ par validation croisée bidimensionnelle.
- Les prédicteurs manifestent-ils des corrélations faibles à modérées, avec la présomption théorique documentée qu’un nombre restreint d’entre eux concentre l’effet causal ? Dans cette configuration spécifique, la régression Lasso classique constitue l’instrument optimal, minimisant la complexité computationnelle et délivrant une parcimonie directe.
12.3 Recommandations pragmatiques pour la recherche reproductible
Pour conclure cette synthèse, la transposition opérationnelle de la régularisation statistique au sein des sciences du comportement requiert une vigilance méthodologique rigoureuse. L’utilisation d’algorithmes avancés ne compense jamais les failles d’un devis expérimental mal contrôlé, les biais d’échantillonnage de convenance ou l’absence de fondation théorique dans le choix des instruments de mesure.
Premièrement, les chercheurs sont vivement encouragés à recourir au pré-enregistrement systématique de leurs pipelines analytiques sur des registres scientifiques ouverts. La formalisation préalable de la stratégie de régularisation retenue (incluant le modèle pénalisé, l’espace d’exploration des hyperparamètres et la règle de validation croisée) constitue le rempart le plus efficace contre le dragage de données (data dredging ou p-hacking), prévenant les dérives exploratoires a posteriori où le paramètre de pénalité est manipulé jusqu’à l’obtention de résultats arbitrairement conformes aux attentes de l’investigateur.
Deuxièmement, la validité prédictive finale d’un modèle régularisé ne devrait jamais être déclarée exclusivement sur la base de son erreur de validation croisée intra-cohorte. L’évaluation ultime de la robustesse d’une équation pénalisée exige son administration directe sur une cohorte clinique externe totalement indépendante, collectée sur un site expérimental distinct. C’est à l’aune exclusive de cette confrontation hors-site que la régularisation statistique démontre sa réelle capacité à extraire des lois comportementales stables et pérennes.
Enfin, l’interprétation substantielle des coefficients contractés doit être maniée avec une prudence académique rigoureuse. Un coefficient conservé dans une équation Lasso ou stabilisé par une contrainte Ridge reflète une capacité de prédiction conjointe sous contrainte géométrique d’optimisation ; il ne constitue en aucun cas la démonstration d’un lien de causalité directe au sens expérimental. La régularisation statistique offre un puissant cadre géométrique pour naviguer dans l’espace complexe des covariances comportementales, mais c’est à la théorie scientifique et à la rigueur de l’expérimentation qu’incombe la charge finale de conférer à ces estimations une portée explicative authentique.
Références
- Friedman, J., Hastie, T., & Tibshirani, R. (2010). Regularization paths for generalized linear models via coordinate descent. Journal of Statistical Software, 33(1), 1–22. https://doi.org/10.18637/jss.v033.i01
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2e éd.). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Hastie, T., Tibshirani, R., & Wainwright, M. (2015). Statistical learning with sparsity: The Lasso and generalizations. CRC Press. https://doi.org/10.1201/b18401
- Hoerl, A. E., & Kennard, R. W. (1970). Ridge regression: Biased estimation for nonorthogonal problems. Technometrics, 12(1), 55–67. https://doi.org/10.1080/00401706.1970.10488634
- Lockhart, R., Taylor, J., Tibshirani, R. J., & Tibshirani, R. (2014). A significance test for the lasso. The Annals of Statistics, 42(2), 413–468. https://doi.org/10.1214/13-AOS1175
- Meinshausen, N., & Bühlmann, P. (2010). Stability selection. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 72(4), 417–473. https://doi.org/10.1111/j.1467-9868.2010.00740.x
- Tibshirani, R. (1996). Regression shrinkage and selection via the lasso. Journal of the Royal Statistical Society: Series B (Methodological), 58(1), 267–288. https://doi.org/10.1111/j.2517-6161.1996.tb02080.x
- Yuan, M., & Lin, Y. (2006). Model selection and estimation in regression with grouped variables. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 68(1), 49–67. https://doi.org/10.1111/j.1467-9868.2005.00532.x
- Zou, H., & Hastie, T. (2005). Regularization and variable selection via the elastic net. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 67(2), 301–320. https://doi.org/10.1111/j.1467-9868.2005.00503.x