
Dans le paysage foisonnant de l’analyse quantitative et de la modélisation statistique appliquée aux sciences humaines, la corrélation occupe une place à la fois fondamentale et singulière. Omniprésente dans la littérature empirique contemporaine, elle constitue souvent la première incursion analytique du chercheur confronté à un ensemble de données multidimensionnelles. Pourtant, cette popularité indéniable s’accompagne d’un paradoxe méthodologique persistant : sa simplicité apparente de calcul et d’interprétation dissimule une armature théorique rigoureuse, soumise à des conditions d’application strictes trop souvent méconnues ou transgressées dans la pratique de recherche quotidienne.
Le recours aveugle ou machinal aux indices de corrélation engendre d’innombrables écueils interprétatifs, allant de la réification fallacieuse de relations purement accidentelles à l’occultation désastreuse de dynamiques non linéaires pourtant déterminantes pour la compréhension des conduites humaines. L’analyse statistique ne saurait être réduite à un simple protocole algorithmique automatisé ; elle engage une responsabilité épistémologique quant à la manière dont les phénomènes observés sont découpés, quantifiés, puis articulés au sein d’un modèle théorique cohérent. Comprendre avec exactitude quand, pourquoi et selon quelles modalités mobiliser l’analyse de corrélation s’avère donc impératif pour tout investigateur soucieux de rigueur scientifique.
Le présent article propose une exploration systématique, exhaustive et approfondie de l’outil corrélatif, en articulant ses fondements mathématiques fondamentaux, ses postulats métrologiques incontournables et ses applications concrètes au sein de protocoles empiriques diversifiés. À travers une typologie détaillée de cas d’usage légitimes, une analyse méticuleuse des situations de contre-indication méthodologique et une mise en lumière des alternatives paramétriques et non paramétriques, nous définirons les critères directeurs permettant d’exploiter la corrélation avec une pertinence scientifique inattaquable.
1. Introduction conceptuelle : Fondements de la corrélation en sciences psychologiques
1.1 Définition théorique de l’association statistique linéaire
Sur le plan mathématique formel, la corrélation linéaire désigne l’estimation quantitative standardisée de la covariance existant entre deux variables aléatoires continues. Lorsque nous considérons deux distributions métriques, notées $X$ et $Y$, la covariance brute reflète l’espérance mathématique du produit des écarts à leurs moyennes respectives, formalisée par l’expression $Cov(X, Y) = E[(X – \mu_X)(Y – \mu_Y)]$. Si cette grandeur capture la direction générale de la co-variation conjointe, son amplitude absolue demeure intimement assujettie aux unités de mesure arbitraires régissant les échelles d’observation. La normalisation de cette covariance par le produit des écarts-types marginaux ($\sigma_X \sigma_Y$) permet d’abstraire la métrique originale pour générer un coefficient adimensionnel pur, universellement désigné sous le symbole $r$ de Pearson.
D’un point de vue purement épistémologique, l’association statistique linéaire formalise l’ampleur avec laquelle deux dimensions phénoménologiques varient de concert dans une population donnée, sans pour autant postuler le moindre ordonnancement chronologique ou la moindre primauté ontologique de l’une sur l’autre. Il convient d’opérer une ligne de démarcation conceptuelle nette entre une association purement stochastique — qui décrit une régularité distributionnelle au sein d’un espace probabiliste — et une interdépendance fonctionnelle ou causale stricte, laquelle exigerait l’élucidation des mécanismes générateurs sous-jacents.
L’émergence historique de ce concept illustre magistralement cette nuance. Initiée par les travaux pionniers de Sir Francis Galton à la fin du XIXe siècle dans le cadre de ses études sur l’hérédité biologique et la régression vers la moyenne, l’idée d’une co-relation fut ensuite mathématisée et formalisée avec une rigueur biométrique par Karl Pearson. Cette avancée théorique majeure a fourni aux sciences du comportement naissantes l’armature quantitative indispensable pour étudier empiriquement les variations psychologiques interindividuelles en s’affranchissant du carcan rigide du déterminisme physicaliste unilatéral.
1.2 Le spectre du coefficient de corrélation : De l’opposition parfaite à l’accord parfait
La métrique issue du produit-moment de Pearson se déploie sur un continuum fermé et invariant, borné par les limites théoriques absolues de -1 et +1. L’investigation sémantique et mathématique de ce spectre révèle des dynamiques structurelles fondamentalement distinctes. Une valeur empirique égale à -1 sanctionne une corrélation négative linéaire parfaite : chaque incrément standardisé sur la variable $X$ induit une diminution strictement proportionnelle et invariante sur la variable $Y$. Dans l’espace cartésien, l’ensemble des points d’observation vient s’aligner rigoureusement sur une droite de pente négative, dénotant une opposition dimensionnelle absolue sans le moindre bruit résiduel.
À l’exact barycentre de cet intervalle, la valeur $r = 0$ indique une indépendance linéaire totale entre les deux séries numériques considérées. Cette valeur nulle traduit l’absence absolue de tendance vectorielle commune : la connaissance précise du score obtenu par un sujet sur l’axe des abscisses n’apporte aucune réduction d’incertitude quant à son positionnement sur l’axe des ordonnées au sein d’un modèle d’ajustement rectiligne. Il est capital de préciser qu’un coefficient nul n’équivaut nullement à une indépendance stochastique universelle, mais atteste uniquement de l’inexistence d’une trajectoire linéaire entre les distributions.
À l’opposé polaire, l’obtention d’un indice s’élevant à +1 traduit une concordance positive absolue sur le plan vectoriel. Les vecteurs centrés des variables pointent dans une direction strictement identique, caractérisant une covariation conjointe univoque exempte de toute distorsion résiduelle. Entre ces points nodaux s’étend une gradation d’amplitudes dont l’interprétation a fait l’objet de systématisations psychométriques rigoureuses. En psychologie et en sciences sociales, les repères conventionnels établis par Jacob Cohen découpent pragmatiquement le spectre d’association en trois paliers : un effet faible ($|r| \approx 0,10$), un effet modéré ($|r| \approx 0,30$) et un effet fort ($|r| ge 0,50$). Ces balises, bien que purement indicatives, fournissent un cadre normatif indispensable pour appréhender la magnitude relative des régularités comportementales.
1.3 Pertinence épistémologique de la corrélation dans l’étude du comportement
La mobilisation de l’outil corrélatif répond à des impératifs épistémologiques et éthiques inhérents à l’investigation des conduites humaines. L’expérimentation standard en laboratoire, fondée sur l’assignation aléatoire des participants et l’isolation artificielle d’une variable indépendante manipulée activement, s’avère fréquemment inapplicable, voire conceptuellement inadéquate en psychologie. De nombreuses caractéristiques humaines fondamentales — qu’il s’agisse des traits structurels de personnalité, des traumatismes infantiles, du quotient intellectuel ou des appartenances sociodémographiques — constituent des attributs organiquement intriqués à l’écologie du sujet, rétifs à toute instanciation expérimentale directe.
La corrélation s’érige ainsi en vecteur privilégié de la démarche observationnelle naturaliste et des devis de recherche transversaux. Elle permet de cartographier méticuleusement l’architecture des interrelations interindividuelles sans dénaturer le tissu écologique au sein duquel les comportements se déploient spontanément. L’investigateur renonce délibérément au contrôle manipulatoire au profit d’une modélisation descriptive passive, captant les régularités phénotypiques telles qu’elles se manifestent au grand jour.
En outre, cette approche démontre une compatibilité remarquable avec les protocoles psychométriques contemporains, largement tributaires de mesures autodéclarées et d’échelles de Likert à intervalles supposés réguliers. Dans l’exploration préliminaire de nouveaux construits hypothétiques, l’analyse corrélative constitue le socle indispensable sur lequel s’édifient la validation d’outils d’évaluation, le repérage de patterns comportementaux convergents et la clarification conceptuelle des frontières séparant les composantes de la psyché humaine.
2. La règle d’or méthodologique : Le critère d’application de la corrélation
2.1 L’absence de hiérarchie entre variable prédictive et variable réponse
Le critère cardinal régissant l’emploi légitime de l’analyse corrélative réside dans la symétrie conceptuelle et computationnelle parfaite unissant les grandeurs soumises à l’examen. Sur le plan purement algébrique, cette symétrie s’incarne dans l’invariance absolue de l’indice de Pearson : $r(X, Y) = r(Y, X)$. Contrairement aux architectures analytiques asymétriques telles que la régression univariée ou l’analyse de variance, la corrélation n’impose ni n’admet aucun statut subordonné entre les variables. Aucune des deux entités métriques ne peut prétendre au rôle de variable indépendante (VI) causalement directrice ou de variable dépendante (VD) mécanistiquement façonnée.
Cette stricte équivalence vectorielle implique que la question de recherche fondamentale doit impérativement porter sur la concomitance, le chevauchement ou la co-présence de deux attributs mesurables, et non sur un processus de génération ou d’impact unilatéral. Recourir à la corrélation lorsqu’un chercheur postule explicitement qu’une dynamique $X$ est le moteur agissant d’une modification survenue en $Y$ constitue un contresens méthodologique flagrant.
L’analyse corrélative projette les deux distributions au sein d’un même espace métrique partagé où elles bénéficient d’un traitement strictement équitable. Il ne s’agit pas de quantifier la manière dont une échelle $Y$ varie sous l’influence unitaire d’un incrément artificiel de $X$, mais d’évaluer dans quelle mesure les positions relatives des individus sur deux dimensions continues s’ordonnent mutuellement de manière consistante.
2.2 L’évaluation stricte de la linéarité
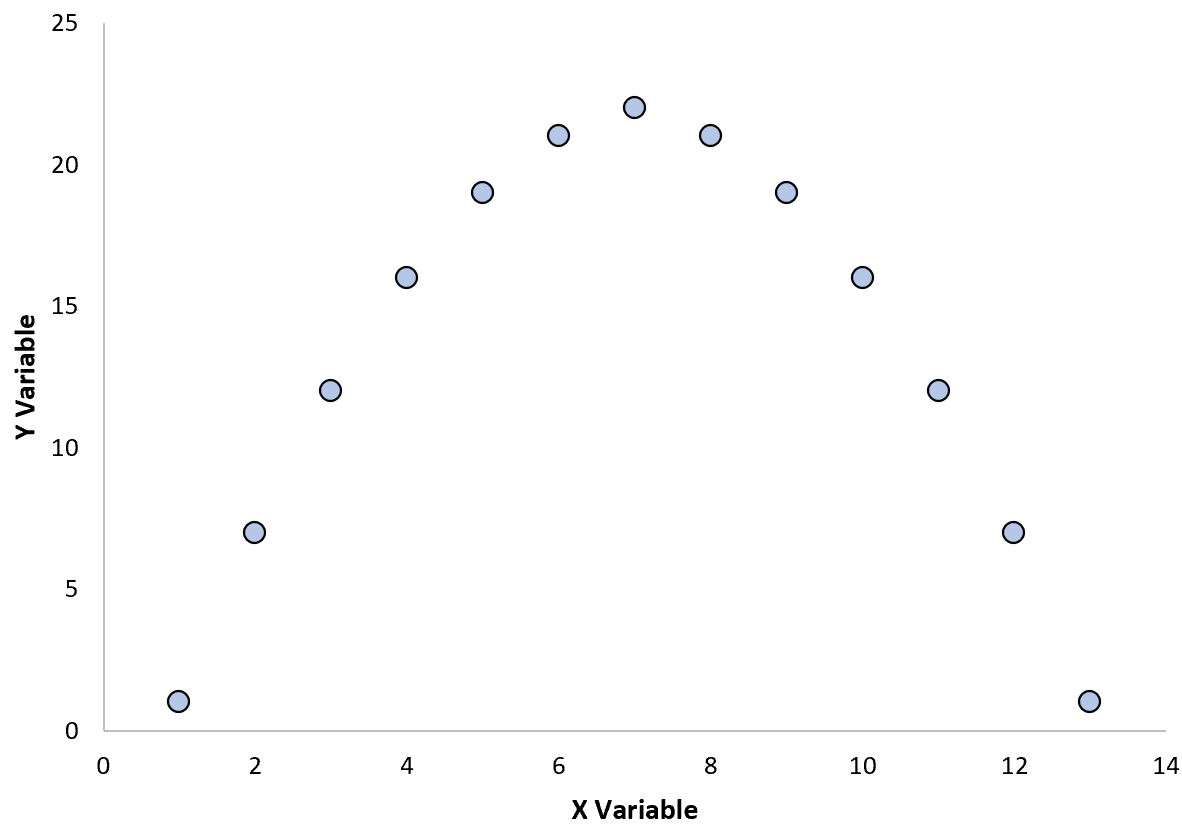
L’utilisation orthodoxe du coefficient $r$ de Pearson repose sur l’hypothèse incontournable de linéarité : la relation entre les deux distributions doit pouvoir être représentée adéquatement par une droite de tendance au sein d’un repère bi-dimensionnel. Ce postulat implique qu’à une variation donnée sur l’échelle $X$ corresponde un changement proportionnellement invariant sur l’échelle $Y$, et ce, quel que soit le segment du continuum considéré (début, milieu ou extrémités de la distribution).
Avant d’engager tout calcul numérique ou d’accorder le moindre crédit à un coefficient automatisé par un progiciel d’analyse, l’inspection visuelle minutieuse d’un graphique de dispersion cartésien (scatterplot) s’impose comme un impératif méthodologique non négociable. Cette inspection graphique préliminaire a pour vocation de démasquer la présence d’éventuels motifs géométriques non linéaires : courbures asymptotiques, dynamiques exponentielles, infléchissements sinusoïdaux ou structures cycliques.
Appliquer aveuglément l’algorithme de Pearson à des phénomènes régis par des lois non linéaires produit des distorsions méthodologiques sévères. Lorsqu’une relation est curviligne, le coefficient de corrélation linéaire sous-estime tragiquement la force réelle de la dépendance entre les variables, s’effondrant fréquemment vers des valeurs statistiquement insignifiantes alors même que les deux variables sont unies par un déterminisme fonctionnel rigoureux mais non rectiligne.
2.3 Nature métrique des variables requises
Sur le versant de la métrologie quantitative, l’éligibilité des données au calcul du coefficient $r$ de Pearson est conditionnée par l’utilisation de véritables échelles d’intervalles constants ou de rapports. Les variables analysées doivent posséder des unités quantitatives stables et homogènes, garantissant qu’une distance numérique donnée possède une signification phénoménologique strictement identique sur l’ensemble de l’étendue de l’échelle d’évaluation psychologique.
Au-delà de la nature des échelles individuelles, le modèle mathématique de l’inférence corrélative requiert le respect de l’hypothèse de normalité bivariée. Cette distribution conjointe suppose non seulement que chaque variable présente isolément une distribution normale univariée, mais que pour toute valeur donnée de la première variable, la distribution conditionnelle de la seconde suive une loi normale, avec une variance d’erreur parfaitement homogène sur l’ensemble du continuum (homoscédasticité).
Un danger métrologique additionnel réside dans le phénomène pernicieux de troncature de variance. Si le protocole d’échantillonnage sélectionne un sous-groupe homogène au sein de la population parente — limitant artificiellement l’étendue observable des scores —, la variance conjointe s’effondre drastiquement. Cette restriction d’amplitude entraîne une déflation mécanique et artificielle du coefficient de corrélation observé, masquant l’intensité réelle de l’association telle qu’elle se manifeste dans l’ensemble de la population de référence.
3. Exemple d’application 1 : L’exploration des aptitudes cognitives croisées
3.1 Contexte de recherche : Notes aux épreuves de mathématiques et de sciences
Afin d’illustrer la pertinence de l’analyse corrélative, examinons le cas concret d’un enseignant-chercheur en sciences de l’éducation évaluant les performances académiques d’une cohorte de première année universitaire en filière scientifique ($N = 250$). Les données collectées comprennent les scores standardisés obtenus à l’examen final de mathématiques appliquées et ceux recueillis à l’épreuve terminale de physique fondamentale. L’objectif épistémique de cette investigation n’est aucunement de postuler qu’une maîtrise aiguisée du calcul différentiel cause unilatéralement la compréhension des lois de la thermodynamique, ni d’affirmer inversement que l’assimilation des principes physiques engendre la virtuosité formelle en algèbre.
La question scientifique s’énonce en termes de concomitance cognitive et de chevauchement structural des compétences : dans quelle mesure les capacités de raisonnement quantitatif et de modélisation abstraite mobilisées dans un champ disciplinaire s’articulent-elles de concert avec les schémas cognitifs réclamés par l’autre ? Aucune hiérarchie temporelle ou causale ne vient structurer le protocole. Les examens se déroulent de manière quasi synchrone lors d’une même session d’évaluation, excluant d’emblée la possibilité d’ériger méthodologiquement l’une des disciplines au statut de variable indépendante antécédente.
Ce contexte académique illustre parfaitement l’adéquation conceptuelle de la corrélation bivariée. En l’absence d’intervention expérimentale manipulatoire et face au refus de plaquer artificiellement un modèle causal déterministe unilatéral sur des compétences intellectuelles en constante transaction mutuelle, la mesure de leur co-variation linéaire constitue l’approche analytique la plus objective et élégante.
3.2 Protocole de calcul et interprétation psychométrique
Pour neutraliser les écarts d’étalonnage et les biais de sévérité inhérents aux barèmes spécifiques de chaque discipline, les distributions de notes brutes sont préalablement standardisées sous la forme de scores Z ($M = 0, Ecart-type = 1$). L’inspection visuelle préalable du nuage de points confirme l’alignement elliptique des données, l’absence de cassures fonctionnelles ou de non-linéarités patentes, et valide le postulat d’homoscédasticité des résidus.
Le calcul du coefficient de corrélation produit-moment de Pearson débouche sur une estimation empirique substantielle : $r = +0,68$, assorti d’un intervalle de confiance à 95 % compris entre $[0,61 ; 0,74]$ ($p < 0,001$). Ce résultat quantitativement robuste indique l’existence d’une association linéaire positive forte reliant les performances académiques dans les deux matières. Sur le plan psychométrique fondamental, une telle concordance empirique apporte un soutien solide à l’hypothèse de l’intervention prépondérante du facteur général d’intelligence ($g$), formalisé initialement par Charles Spearman, qui sous-tend et traverse de multiples expressions cognitives spécialisées.
L’utilisation de la corrélation s’avère ici pleinement légitime : elle quantifie sans biais de surinterprétation causaliste la force de la liaison observable entre deux indicateurs continus, fournissant une synthèse descriptive unifiée de la structure des compétences partagées au sein de l’échantillon d’apprenants.
3.3 Implications pédagogiques et limites de l’observation
L’exploitation fine du graphique de dispersion permet d’aller au-delà de la seule synthèse numérique globale apportée par l’indice de Pearson. En examinant attentivement l’écartement des observations individuelles par rapport à l’axe diagonal d’alignement idéal, le chercheur repère immédiatement des profils cognitifs atypiques : des étudiants présentant une performance mathématique exceptionnelle juxtaposée à des résultats médiocres en physique, ou la configuration réciproque inverse.
Cependant, le chercheur doit se prémunir contre toute dérive prescriptive unilatérale qui découlerait d’une lecture hâtive du coefficient de corrélation. En vertu de la nature strictement non causale de l’indice, il serait scientifiquement absurde de décréter un plan de soutien pédagogique consistant à imposer un entraînement mathématique mécanique intensif dans le but illusoire d’augmenter automatiquement et proportionnellement les compétences de raisonnement physique. La corrélation atteste de la co-présence de dispositions intellectuelles partagées au sein de la population ; elle ne garantit en rien qu’une intervention ciblée sur l’une des dimensions produira mécaniquement un transfert positif sur la seconde.
Pour affiner la compréhension de ces interactions et dépasser le cadre purement descriptif de l’association globale, le protocole gagnerait à adjoindre des mesures cognitives spécifiques additionnelles (mémoire de travail spatiale, vitesse de traitement, niveau d’anxiété mathématique) afin de décomposer analytiquement les composantes psychologiques qui sous-tendent cette covariation empirique.
4. Exemple d’application 2 : Étude des traits de personnalité et du bien-être
4.1 Cadre théorique du Big Five et du bien-être subjectif
Le champ de la psychologie différentielle et de la personnalité offre un second terrain d’élection pour le déploiement méthodique de l’analyse corrélative. Considérons un protocole évaluant les interrelations unissant les traits structuraux du modèle du Big Five — plus particulièrement la dimension d’extraversion — et les mesures quantitatives du bien-être subjectif ou de la satisfaction de vie globale au sein d’un échantillon représentatif de la population générale adulte ($N = 600$).
D’un point de vue structural, les traits de personnalité et les affects subjectifs constituent des construits hypothétiques mesurés sur un pied d’égalité épistémique. Il s’agit de dispositions phénotypiques stables et d’évaluations cognitives autodéclarées qui coexistent au sein du système psychique individuel. L’extraversion ne saurait être assimilée à une variable indépendante que l’investigateur pourrait manipuler expérimentalement par assignation en double aveugle. On n’injecte pas de l’extraversion à un sujet expérimental pour en quantifier les répercussions immédiates sur une jauge de satisfaction existentielle.
Dans ce cadre non interventionnel, le calcul d’une matrice d’inter-corrélations préliminaire constitue le protocole méthodologique étalon. Il permet d’appréhender de manière exploratoire la façon dont ces entités psychologiques s’organisent spontanément, sans violer les contraintes écologiques de la vie psychique par des hypothèses causales prématurées.
4.2 Interprétation d’un coefficient modéré à élevé
Supposons que le traitement quantitatif des données révèle un coefficient de Pearson s’élevant à $r = +0,45$ ($p < 0,001$) entre le score d’extraversion et l’indice global de satisfaction de vie. Dans le contexte empirique des recherches psychosociales, où la variabilité des conduites est façonnée par une multitude d’influences environnementales et biographiques, une telle magnitude est considérée comme modérée à élevée selon la nomenclature standard.
L’opérationnalisation mathématique rigoureuse de cette corrélation impose de calculer le coefficient de détermination, noté $R^2$, obtenu en élevant simplement le coefficient à la puissance deux : $R^2 = (0,45)^2 \approx 0,20$. Cette métrique capitale signifie que 20 % de la variance observée dans les scores de satisfaction de vie sont directement partagés avec la variabilité documentée de l’extraversion au sein de la cohorte évaluée. Corrélativement, 80 % de la dispersion des scores relèvent de facteurs externes non mesurés ou d’erreurs d’échantillonnage.
L’analyste méticuleux doit également intégrer dans son interprétation la part résiduelle d’erreur de mesure inhérente à l’administration de questionnaires psychométriques fondés sur l’auto-évaluation. Des biais systématiques, à l’instar de la désirabilité sociale ou de l’acquiescement passif, sont susceptibles d’induire une covariation conjointe fallacieuse, surévaluant artificiellement la proximité réelle unissant les deux dimensions psychologiques examinées.
4.3 Validation divergente et convergente des échelles
Dans l’ingénierie psychométrique contemporaine, la corrélation s’affirme comme l’instrument fondamental dédié à l’évaluation de la validité de construit d’un nouvel instrument d’évaluation. Pour asseoir la légitimité théorique d’une échelle mesurant le bien-être subjectif, le psychologue quantitativiste doit démontrer à la fois sa validité convergente et sa validité divergente au moyen d’un patron d’associations différenciées et contrastées.
La validité convergente se trouve empiriquement confortée lorsque la nouvelle échelle de bien-être manifeste des corrélations positives statistiquement robustes avec des construits psychologiques théoriquement proches, tels que l’optimisme dispositionnel ($r \approx +0,55$) ou l’estime de soi globale ($r \approx +0,50$). À l’inverse, la validité divergente ou discriminante exige que l’échelle atteste de son indépendance ou de son opposition théorique attendue vis-à-vis d’autres dimensions psychopathologiques.
Ainsi, l’observation méthodique d’une corrélation négative substantielle entre l’échelle de bien-être et la dimension de névrosisme ($r = -0,48$, $p < 0,001$) corrobore formellement les prédictions du modèle théorique. La conjonction simultanée d’associations positives cohérentes et de corrélations négatives attendues apporte la preuve empirique irréfutable que l’outil métrologique capture avec précision le réseau nomologique ciblé, tout en restant distinct des artefacts de mesure transversaux.
5. Exemple d’application 3 : Biomarqueurs et états émotionnels en psychopathologie
5.1 Variabilité de la fréquence cardiaque et anxiété état
L’interface complexe unissant la neurophysiologie et les sciences affectives constitue un champ d’investigation où la corrélation bivariée se révèle indispensable. Considérons un protocole de recherche clinique explorant la dynamique somato-psychique chez des patients souffrant de troubles paniques, chez qui l’on enregistre simultanément un biomarqueur autonome — la variabilité de la fréquence cardiaque (VFC, calculée par l’indice RMSSD en millisecondes) — et le score d’anxiété état auto-évalué via l’inventaire STAI ($N = 120$).
L’expérience affective aiguë et l’activation du système nerveux autonome s’inscrivent dans une ontologie corporelle incarnée (embodied cognition) caractérisée par une synchronie biologique et expérientielle absolue. La chute du tonus vagal cardiaque ne peut être artificiellement décrétée comme la cause première et exclusive de la terreur panique subjective, pas plus que l’angoisse mentale consciente ne peut être isolée comme le moteur antécédent unilatéral de la modification végétative. Les deux manifestations émergent conjointement au sein d’un même embrasement neuro-émotionnel synchrone.
Le recours à l’indice de corrélation répond ici à un impératif d’étalonnage mutuel et d’appariement phénoménologique. L’objectif clinique est d’évaluer dans quelle mesure la modulation continue d’un indicateur somatosensoriel périphérique reflète fidèlement la fluctuation de l’état émotionnel interne rapporté par le patient, évitant l’écueil de raisonnements mécanistes linéaires réductionnistes.
5.2 Traitement quantitatif de données synchrones
L’estimation rigoureuse d’une corrélation reliant des flux biométriques et des auto-évaluations psychologiques exige un protocole de synchronisation chronologique d’une précision millimétrique. Les scores d’anxiété doivent être collectés à des intervalles strictement calqués sur les fenêtres temporelles d’analyse spectrale des signaux électrocardiographiques, neutralisant ainsi tout biais d’asynchronie de mesure susceptible de distordre l’indice de Pearson.
Par ailleurs, le traitement de données chronologiques continues requiert l’élimination systématique des tendances temporelles parasites (drift). Si la fréquence cardiaque de base présente une dérive graduelle au cours du protocole en raison de la fatigue posturale ou de l’accoutumance thermique du laboratoire, cette inertie temporelle peut engendrer une association fallacieuse avec les scores d’anxiété. L’application préalable de techniques de différentiation temporelle ou de dé-tendance s’avère indispensable pour que le calcul de covariance opère sur des résidus dynamiques purs.
De surcroît, le clinicien doit soigneusement discriminer la corrélation intra-sujet (analysée longitudinalement chez un même individu au fil de multiples épreuves inductrices de stress) de la corrélation inter-sujets (calculée transversalement entre des patients distincts). Confondre ces deux niveaux d’agrégation quantitative constitue une faute méthodologique majeure, les variations physiologiques intra-individuelles répondant à des dynamiques de régulation homéostatique non superposables à la dispersion structurelle interindividuelle.
5.3 Retombées diagnostiques de l’association observée
Sur le versant de l’application clinique, la documentation empirique d’une corrélation négative forte et robuste ($r = -0,58$, $p < 0,001$) entre la VFC vagale et l’intensité de l’anxiété état offre des perspectives translationnelles de premier plan. Ce constat consolide la théorie polyvagale en attestant que le déficit d’inhibition parasympathique coïncide étroitement avec l’effondrement du sentiment de sécurité subjective.
Cette covariation sert de socle à la modélisation de phénotypes physiologiques à risque en psychiatrie. Un biomarqueur autonome hautement corrélé aux manifestations subjectives d’un trouble autorise la conception d’outils de biofeedback en temps réel, où le monitoring continu d’un signal biologique direct sert de miroir thérapeutique pour la régulation des états affectifs débordants.
Cependant, le praticien-chercheur doit préserver une stricte prudence épistémique. Une forte corrélation moyenne au sein d’une cohorte clinique n’implique aucunement une sensibilité et une spécificité diagnostiques parfaites au niveau individuel. La réactivité végétative singulière face à l’évaluation en laboratoire et les facteurs confondants physiologiques (consommation de caféine, niveau de condition physique aérobie, médication parasympatholytique) imposent de contextualiser cliniquement chaque observation sans jamais réifier le coefficient d’association comme une sentence médicale infaillible.
6. Quand NE PAS utiliser la corrélation : Présence d’une relation asymétrique ou causale
6.1 La transition impérative vers la régression linéaire simple ou multiple
L’utilisation de la corrélation bivariée devient méthodologiquement invalide dès l’instant où la problématique scientifique postule une hiérarchie structurelle, fonctionnelle ou directionnelle entre les variables. Lorsqu’un cadre théorique assigne sans ambiguïté à une entité le statut de déterminant prédictif ($X$) et à une autre celui d’état conséquent ou de réponse ($Y$), l’invariance mathématique de la corrélation ($r_{XY} = r_{YX}$) se transforme en un obstacle épistémologique handicapant.
La corrélation brute s’avère structurellement incapable de quantifier l’amplitude de l’effet unitaire provoqué par une variation incrémentale de la variable explicative. Elle résume l’intensité d’une association sans renseigner sur la pente de l’ajustement métrique sous-jacent. Dès lors qu’il s’avère indispensable d’estimer une fonction de transfert opérationnelle — formalisée par l’équation de droite $\hat{Y} = \beta_0 + \beta_1 X$ —, la substitution impérative de la corrélation par la régression linéaire devient obligatoire.
Considérons l’évaluation clinique de l’impact direct de doses croissantes d’une molécule antidépressive sur la réduction d’une symptomatologie mélancolique quantifiée sur l’échelle de Hamilton. Se borner à calculer un coefficient $r$ entre le dosage administré et la baisse symptomatique constitue une régression analytique. Le médecin-chercheur n’a que faire d’un indice symétrique abstrait ; il exige l’estimation de la pente de régression non standardisée $B_1$, laquelle quantifie précisément le nombre de points de réduction symptomatique obtenus pour chaque milligramme additionnel de composé pharmacologique administré.
6.2 Designs expérimentaux avec manipulation de variables
L’inadéquation de la corrélation s’affirme de manière radicale au sein des devis de recherche expérimentaux purs, caractérisés par l’assignation aléatoire des participants au sein d’un groupe contrôle et d’un ou plusieurs groupes d’intervention. Dans ce type de dispositif, la manipulation délibérée et active de la variable indépendante brise unilatéralement la logique de libre covariation conjointe propre aux distributions stochastiques naturelles.
Évaluer l’efficacité thérapeutique comparative d’une prise en charge cognitivo-comportementale face à une condition contrôle sur liste d’attente au moyen d’un coefficient de corrélation bivarié constitue une erreur de méthode impardonnable. L’analyse requise par ce paradigme causal relève formellement du modèle linéaire généralisé, instancié à travers l’analyse de variance (ANOVA) ou les modélisations mixtes pour données répétées.
Ces architectures statistiques asymétriques permettent de comparer de manière rigoureuse les espérances mathématiques moyennes inter-groupes, d’isoler méticuleusement la variance imputable à l’intervention thérapeutique de la variance d’erreur aléatoire, et de valider les inférences causales directes en s’appuyant sur la neutralisation préalable des variables parasites rendue possible par la randomisation initiale.
6.3 Erreur courante de substitution épistémologique
La littérature académique témoigne d’une confusion intellectuelle fréquente et insidieuse consistant à substituer subrepticement un discours causal unilatéral à un constat de simple covariation empirique. Observer qu’un coefficient de corrélation s’élève à une valeur impressionnante de $r = +0,82$ n’autorise en rien le chercheur à proclamer l’efficacité causale indiscutable d’une variable sur l’autre dans le corps de son argumentation théorique.
Cette faute épistémologique découle d’une confusion fondamentale entre la covariance descriptive mesurée au sein d’un échantillon fini et la capacité prédictive généralisable hors échantillon. Une liaison statistique, aussi intense soit-elle mathématiquement, ne contient intrinsèquement aucune information relative à l’orientation du flux causal sous-jacent. Elle atteste d’un fait mathématique d’alignement empirique, non d’un principe explicatif de production dynamique.
En oblitérant l’exigence d’ordonnancement temporel strict et en faisant fi des critères incontournables d’imputation causale (tels que ceux formulés par Sir Austin Bradford Hill en épidémiologie), l’investigateur qui surinterprète un indice de corrélation s’expose à prescrire des conclusions sociétales, cliniques ou éducatives fallacieuses, reposant sur une mécompréhension de l’armature logico-mathématique de l’indice mis en œuvre.
7. Quand NE PAS utiliser la corrélation : Relations non linéaires et distributions atypiques
7.1 Le piège des lois curvilinéaires : La loi de Yerkes-Dodson
L’un des angles morts les plus redoutables de l’analyse corrélative de Pearson réside dans son incapacité structurelle à détecter ou à résumer fidèlement les relations régies par des dynamiques non linéaires et curvilinéaires. L’illustration la plus célèbre en psychologie générale demeure sans conteste la loi de Yerkes-Dodson, postulant une relation en forme de cloche ou de $U$ inversé entre le niveau d’éveil physiologique (arousal) ou d’anxiété et l’efficacité d’une performance motrice ou cognitive complexe.
Dans ce modèle fonctionnel, un niveau d’éveil excessivement bas plonge le sujet dans la léthargie et pénalise sa performance ; un niveau modéré optimise ses facultés attentionnelles et culmine en une efficience maximale ; tandis qu’une activation neurovégétative excessive désorganise le comportement et provoque un effondrement spectaculaire de la performance. Si un chercheur applique machinalement la formule du coefficient $r$ de Pearson à de telles données sans inspection graphique préalable, la moitié ascendante de la courbe compense et neutralise arithmétiquement la moitié descendante. Le résultat numérique produit par le progiciel s’effondre lamentablement vers une valeur dérisoire de $r \approx 0$.
L’investigateur peu rigoureux conclura à l’indépendance statistique absolue des deux phénomènes, commettant un contresens tragique : les deux dimensions sont unies par une dépendance mathématique déterministe totale, mais celle-ci est purement non linéaire. L’examen graphique rigoureux du diagramme de dispersion et l’analyse minutieuse de la structure des résidus constituent les seuls remparts méthodologiques capables d’endiguer ce type d’illusion statistique destructrice.
7.2 Impact destructeur des valeurs aberrantes (outliers)
Le calcul du coefficient $r$ de Pearson implique le produit des écarts à la moyenne arithmétique. Cette spécificité algébrique confère à la métrique une sensibilité extrême et une vulnérabilité dramatique face à la présence de valeurs extrêmes ou aberrantes (outliers) tapies au sein de l’espace bivarié. Un point d’observation isolé, situé à plusieurs écarts-types des barycentres marginaux, exerce un bras de levier disproportionné sur l’inclinaison de l’axe de régression implicite.
Cette vulnérabilité mathématique s’exprime à travers deux pathologies d’échantillonnage symétriques :
- L’inflation artificielle de l’association : Au sein d’un nuage de points formant un ensemble sphérique parfaitement aléatoire ($r = 0$), l’adjonction fortuite d’un unique participant situé simultanément aux limites supérieures extrêmes des variables $X$ et $Y$ suffit à faire basculer le coefficient global vers une valeur positive statistiquement significative ($r = 0,40$). La relation ainsi générée est un artefact mathématique pur causé par une observation déviante.
- La déflation artificielle de l’association : Inversement, au sein d’une distribution caractérisée par un alignement rectiligne robuste ($r = 0,75$), la présence d’une poignée d’individus atypiques situés à la périphérie contradictoire de l’ellipse de covariance suffit à réduire à néant l’association globale, masquant ainsi une régularité psychologique authentique partagée par 95 % de la cohorte.
Face à ces périls, l’investigateur quantitativiste doit impérativement déployer des algorithmes de détection géométrique multivariée, à l’instar de la distance de Mahalanobis ou de la distance de Cook, afin de traquer et neutraliser ces observations aberrantes avant de procéder au calcul de Pearson.
7.3 Hétérogénéité des sous-groupes et paradoxe de Simpson
L’agrégation indistincte de sous-populations structurellement hétérogènes au sein d’un même échantillon de calcul expose le chercheur à l’un des phénomènes les plus troublants de la statistique appliquée : le paradoxe de Simpson. Ce phénomène se caractérise par une configuration aberrante où un coefficient de corrélation documenté au sein de chaque sous-groupe pris isolément voit sa direction s’inverser totalement dès lors que les données sont fusionnées et analysées globalement.
Considérons, à titre d’illustration psychosociale, l’analyse de l’association entre le niveau d’anxiété évaluative et l’efficience à une tâche de raisonnement mathématique complexe chez des apprenants novices et des experts chevronnés. Au sein du sous-groupe des novices, l’anxiété s’avère négativement corrélée à la performance ($r = -0,40$), l’angoisse saturant la mémoire de travail disponible. Au sein du groupe des experts, l’anxiété demeure également négativement associée à la performance ($r = -0,35$). Toutefois, les experts présentent structurellement un niveau moyen d’anxiété plus élevé (en raison de l’enjeu perçu de leur statut) conjugué à une performance globale infiniment supérieure à celle des novices.
Si l’analyste ignore l’appartenance catégorielle sous-jacente et compile l’ensemble des scores dans un unique calcul de Pearson, le nuage de points se disloque en deux îlots distants, générant une pente d’ajustement global positive artificielle ($r = +0,45$). Cette conclusion macroscopique est méthodologiquement fausse et pédagogiquement désastreuse. La décomposition préalable des strates de l’échantillon et la vérification systématique de l’invariance factorielle de mesure s’affirment donc comme des conditions d’application impératives avant toute généralisation corrélative.
8. L’illusion de la causalité : Biais d’interprétation et facteurs de confusion
8.1 Le problème fondamental de la troisième variable (variable confondante)
L’adage épistémologique « corrélation n’implique pas causalité » puise sa justification la plus éclatante dans l’existence pernicieuse de la variable confondante non observée (troisième variable). Dans toute étude transversale non contrôlée, l’observation d’une covariance linéaire étroite entre deux variables $X$ et $Y$ peut être entièrement imputable à l’action souterraine d’une variable latente $Z$ qui influence simultanément et indépendamment les deux entités mesurées.
L’illustration métaphorique canonique réside dans la corrélation positive indéniable identifiée entre les variations des ventes de glaces sur le littoral et l’augmentation statistique des noyades estivales. Nul esprit éclairé n’en déduira que l’ingestion de crème glacée induit une syncope aquatique. L’évidence d’une troisième variable macroscopique — la température météorologique estivale — explique la totalité de cette association : la chaleur incite à la consommation de rafraîchissements tout en maximisant massivement l’affluence des baigneurs dans l’océan.
Ce mécanisme trompeur prend un tour dramatique lorsqu’il contamine les sciences psychopathologiques. Ainsi, observer une corrélation élevée entre l’exposition chronique au stress perçu et la prévalence de l’insomnie chronique peut conduire à des interventions psychothérapeutiques ciblées inefficaces si l’on omet de constater que le niveau de précarité socio-économique globale opère en amont comme la cause réelle façonnant à la fois le dérèglement de l’horloge biologique et l’insécurité psychique. Pour assainir l’association d’intérêt, le recours aux techniques de corrélation partielle et semi-partielle devient alors indispensable afin de contrôler statistiquement l’impact distordant de ces tierces influences.
8.2 La causalité inverse et la bidirectionnalité
L’indétermination inhérente à la symétrie de l’indice corrélatif prive l’investigateur de tout repère temporel permettant d’arbitrer l’ordre séquentiel des phénomènes observés. Confronté à une corrélation empirique positive robuste ($r = +0,52$) reliant la sévérité des symptômes dépressifs au repli et à l’isolement social chez de jeunes adultes, le chercheur se heurte à une aporie herméneutique insoluble sur la seule base d’un devis transversal.
S’agit-il d’un mécanisme psychologique où l’effondrement thymique et l’anhédonie inhérents à l’épisode dépressif incitent le sujet à s’extraire de son tissu relationnel (causalité directe $X to Y$) ? Ou est-ce au contraire l’exposition antérieure à une solitude objective et à un dénuement relationnel persistant qui engendre de manière réactionnelle la symptomatologie dépressive (causalité inverse $Y to X$) ? L’analyse de Pearson demeure fondamentalement agnostique face à cette question existentielle.
Dans la réalité clinique, de telles dynamiques s’inscrivent presque toujours au sein de boucles rétroactives bidirectionnelles continues où chaque variable nourrit dynamiquement l’autre dans une spirale délétère. Trancher cette directionnalité requiert l’abandon méthodologique des corrélations transversales instantanées au profit de protocoles longitudinaux armés de modèles à panel croisé (cross-lagged panel models), capables d’évaluer les effets d’une dimension sur l’autre décalés dans le temps ($T_1 to T_2$).
8.3 Biais d’échantillonnage et conditionnement sur un collisionneur (Berkson’s bias)
L’altération de la valeur d’une corrélation peut découler d’un artefact méthodologique sournois généré par la procédure de recrutement des sujets : le conditionnement sur un collisionneur, historiquement théorisé sous le nom de paradoxe de Berkson. Ce biais survient dès lors que l’inclusion dans l’échantillon d’analyse dépend fonctionnellement de la conjonction préalable des deux variables étudiées.
Ce piège contamine massivement les études épidémiologiques menées en milieu hospitalier ou institutionnel psychiatrique. Imaginons que l’on évalue l’association existant entre les troubles de l’usage de substances et le diagnostic de trouble dépressif majeur au sein d’une unité de soins tertiaires hautement spécialisée. L’admission dans cette structure spécifique est hautement favorisée par la gravité cumulée des deux pathologies. Chez ces patients hospitalisés, le chercheur observera fréquemment une corrélation empirique négative artificielle entre l’addiction et la dépression.
Cette association paradoxale s’explique par un mécanisme d’exclusion statistique : pour figurer dans cette unité sélective, un patient présentant un niveau modéré de dépression doit impérativement compenser par une addiction sévère pour franchir le seuil d’admission, et vice-versa. Extrapoler ce constat fallacieux à la population générale adulte — au sein de laquelle ces deux pathologies présentent en vérité une comorbilité fortement positive — engendre des conclusions cliniques dévastatrices et obère la reproductibilité des protocoles en neurosciences translationnelles.
9. Alternatives non paramétriques : Quand les postulats de Pearson sont violés
9.1 Le coefficient rho de Spearman : La corrélation sur rangs
Lorsque les données empiriques recueillies transgressent ouvertement les postulats rigides imposés par le modèle de Karl Pearson — en particulier face à la violation de la normalité bivariée ou face à l’utilisation d’échelles de mesure à nature purement ordinale —, le recours au coefficient rho ($rho$) de Spearman constitue l’alternative non paramétrique de première intention.
Le fondement algorithmique de l’indice de Spearman repose sur une transformation élégante : substituer aux valeurs numériques brutes des variables leurs rangs ordinaux respectifs ($1, 2, dots, N$) au sein de la distribution ordonnée. Le coefficient $rho$ n’est rien d’autre que l’application de la formule standard de Pearson à ces séries de rangs converties. Cette conversion procure un avantage méthodologique capital : le test n’évalue plus la stricte linéarité géométrique, mais la monotonicité parfaite de la relation.
Dès lors qu’une variable augmente continuellement lorsque la seconde croît — que cette progression suive une droite, une courbe logarithmique ou une dynamique sigmoïdale —, le rho de Spearman attribuera une valeur idéale de $+1$. De plus, cette métrique présente une imperméabilité remarquable face aux valeurs aberrantes univariées : une observation isolée déviante se voyant assigner le rang le plus élevé, son amplitude numérique absolue n’exerce plus aucun levier disproportionné sur la synthèse d’association. Sa seule limite réside dans la perte d’information quantitative relative aux écarts métriques réels séparant les individus.
9.2 Le tau de Kendall : Robustesse et petits échantillons
Une alternative non paramétrique souvent supérieure à l’indice de Spearman, particulièrement dans les protocoles de recherche clinique restreints ($N < 30$), s’incarne dans le tau ($tau$) de Kendall. Contrairement à l’approche de Spearman, qui procède par calcul d’écarts de rangs quadratiques, le tau de Kendall repose sur une approche probabiliste directe fondée sur le dénombrement rigoureux des paires concordantes et discordantes formées par l’ensemble des observations.
Considérant l’ensemble combinatoire des paires de sujets $(i, j)$ au sein de la cohorte, le calcul évalue si le sujet présentant le score le plus élevé sur la variable $X$ surpasse également son pair sur la variable $Y$ (paire concordante) ou si l’ordre s’inverse (paire discordante). Le coefficient synthétise la différence relative normalisée entre la probabilité de concordance et celle de discordance. Cette formulation confère au tau de Kendall une robustesse mathématique inégalée et une interprétabilité sémantique limpide.
Dans les échantillons cliniques de taille modeste comportant de nombreux scores ex æquo (fréquents lors de l’usage de grilles d’évaluation diagnostiques courtes), le tau de Kendall fournit une estimation asymptotique de la population cible infiniment moins biaisée et d’une variance d’échantillonnage plus resserrée que le rho de Spearman, constituant ainsi la métrique d’élection pour les investigations neuropsychologiques de précision.
9.3 Autres métriques d’association adaptées aux typologies de données
La taxonomie des indices d’association statistique s’étend bien au-delà de la confrontation de variables d’intervalles ou purement ordinales. Le chercheur quantitativiste est quotidiennement confronté à des configurations distributionnelles mixtes exigeant le déploiement d’algorithmes métrologiques spécifiques :
- La corrélation bisérielle ponctuelle ($r_{pb}$) : Mobilisée lorsqu’il s’agit d’estimer l’association unissant une variable métrique continue (ex: temps de réaction à une tâche informatisée) et une variable nominale binaire réelle ou naturelle (ex: appartenance biologique de sexe ou statut génétique porteur/non porteur d’un allèle).
- La corrélation bisérielle ($r_b$) : Adaptée à la situation où une variable continue est mise en relation avec une variable dichotomisée de manière artificielle par un seuillage arbitraire (ex: classifier les participants en « admis » ou « recalés » d’après une note de test continu sous-jacent).
- La corrélation tétrachorique ($r_{tet}$) : Déployée lorsque l’analyste croise deux variables catégorielles binaires artificielles, mais dont la théorie postule qu’elles reposent chacune sur une dimension continue latente sous-jacente normalement distribuée au sein de la population.
Le choix scrupuleux de l’indice mathématique idoine en fonction de la nature ontologique des échelles d’observation constitue la condition sine qua non de la validité interne des conclusions métrologiques dérivées de l’étude.
10. Considérations psychométriques : Fiabilité de la mesure et atténuation
10.1 La formule de correction pour atténuation de Spearman
L’une des méconnaissances les plus dommageables en psychologie empirique concerne la dépendance absolue liant le coefficient de corrélation de Pearson à la fiabilité métrologique des instruments de mesure mobilisés. En vertu des axiomes de la théorie classique des tests, tout score brut observé ($X$) se décompose en un score vrai latent ($V$) contaminé par une erreur de mesure aléatoire ($E$), tel que $X = V + E$.
Si deux construits psychologiques vrais sont associés de manière robuste, mais que les instruments conçus pour les enregistrer sont altérés par une fiabilité médiocre — caractérisée par des coefficients de cohérence interne (alpha de Cronbach ou oméga de McDonald) faiblards —, l’erreur de mesure aléatoire dilue la covariance conjointe. Ce phénomène universel, formalisé sous le nom d’atténuation statistique, provoque une sous-estimation systématique et massive de la corrélation réelle unissant les construits.
Dès le début du XXe siècle, Charles Spearman formula l’équation correctrice permettant de remédier à cette dégradation :
$$r_{V_X V_Y} = \frac{r_{XY}}{\sqrt{r_{XX’} \cdot r_{YY’}}}$$
où $r_{XY}$ désigne la corrélation brute observée, et $r_{XX’}$, $r_{YY’}$ représentent les indices de fiabilité respectifs des deux échelles. Cette correction pour atténuation reconstitue la corrélation mathématique théorique qui émergerait si les construits étaient mesurés de manière absolue, exempte de tout bruit d’évaluation. Cependant, l’analyste doit se méfier de la sur-correction : l’application de cette formule à des outils présentant des fiabilités empiriques dramatiquement basses engendre des artefacts numériques aberrants débouchant sur des corrélations estimées dépassant l’unité ($> 1,00$).
10.2 La restriction de variance et son impact réducteur
L’altération de la magnitude du coefficient de corrélation survient également dès lors que le processus d’échantillonnage induit une restriction ou une troncature artificielle de la variance au sein de l’une ou l’autre des distributions analysées. Ce phénomène affecte structurellement les recherches conduites dans des contextes de sélection institutionnelle ou académique.
Considérons l’évaluation empirique du pouvoir prédictif d’un test d’aptitudes cognitives générales administré à des candidats postulant à une école doctorale d’élite sur la réussite académique ultérieure mesurée à l’issue du cursus. Par construction, seuls les candidats ayant obtenu des scores d’aptitude exceptionnellement élevés situés au sommet de la distribution ($5 %$ supérieurs) sont admis et fournissent des données académiques terminales. L’échantillon final se caractérise par une variance d’aptitude extraordinairement comprimée et homogène.
Cette restriction d’amplitude entraîne un effondrement mécanique du coefficient de corrélation calculé sur cette sous-population ($r \approx 0,15$). Conclure que l’aptitude cognitive n’est que marginalement liée à la performance doctorale constitue une erreur méthodologique gravissime. Au sein de la population générale non sélectionnée, la corrélation réelle atteindrait vraisemblablement $r = 0,60$. Pour pallier cette anomalie majeure, l’application des formules de correction de la restriction d’étendue développées par Robert Thorndike est impérative afin d’estimer la covariance telle qu’elle opère dans l’univers de référence non restreint.
10.3 Taille de l’échantillon et puissance statistique
L’interprétation orthodoxe du coefficient $r$ exige d’accorder une vigilance critique constante à l’influence déterminante de la taille d’échantillon ($N$) sur l’inférence statistique et les tests de significativité. Dans les protocoles fondés sur de très petits échantillons ($N < 20$), la métrique de Pearson présente une volatilité et une fluctuation d’échantillonnage majeures : la marge d’erreur d’un coefficient observé de $r = 0,40$ peut englober un intervalle de confiance à 95 % oscillant dramatiquement entre $-0,05$ et $+0,70$, interdisant toute conclusion psychométrique ferme.
À l’inverse, l’analyse d’échantillons massifs issus de bases de données contemporaines ($N > 10,000$) engendre un piège interprétatif symétrique. Dans de telles cohortes, la puissance statistique du test de l’hypothèse nulle ($H_0: r = 0$) devient astronomique : une corrélation triviale de $r = 0,03$ franchit triomphalement le seuil canonique de significativité statistique ($p < 0,001$). Déclarer que cette relation est « hautement significative » constitue une confusion sémantique entre significativité statistique (rejet de l’hypothèse nulle) et significativité clinique ou théorique (taille d’effet phénoménologique réelle).
La planification méthodologique rigoureuse d’une étude d’association impose donc de procéder à un calcul de puissance statistique a priori (via des outils tels que G*Power). Pour détecter un effet modéré attendu ($r = 0,30$) avec une puissance conventionnelle standard de $1 – \beta = 0,80$ au seuil de risque $\alpha = 0,05$ bilatéral, le recrutement strict d’un minimum de 84 participants s’avère indispensable pour prémunir l’investigateur contre les risques jumeaux de faux positifs (erreur de type I) et d’omission aveugle d’effets réels (erreur de type II).
11. Applications avancées : De la matrice de corrélation aux modèles multivariés
11.1 La matrice de corrélation comme socle de l’analyse factorielle exploratoire (AFE)
Loin d’être cantonnée à l’analyse bivariée élémentaire, la corrélation constitue la pierre angulaire et la matière première computationnelle sur laquelle s’édifient les méthodologies de réduction dimensionnelle multivariée, au premier rang desquelles figure l’analyse factorielle exploratoire (AFE). L’extraction d’architectures psychométriques latentes — qu’il s’agisse de mesurer les facettes de la personnalité ou les composantes de l’intelligence — opère fondamentalement sur la matrice d’inter-corrélations ($R$) croisant l’ensemble des items mesurés.
Avant d’engager toute extraction factorielle, la qualité et la pertinence mathématique de cette matrice de corrélation de départ doivent faire l’objet d’audits méthodologiques stricts. Deux indicateurs statistiques directeurs sont universellement mobilisés :
- Le test de sphéricité de Bartlett : Il éprouve l’hypothèse nulle postulant que la matrice de corrélation de l’échantillon est une matrice identité (où toutes les corrélations hors-diagonale valent zéro). Un rejet franc de cette hypothèse ($p < 0,001$) atteste de l’existence d’une structure de covariance collective exploitable.
- L’indice de Kaiser-Meyer-Olkin (KMO) : Cette métrique évalue l’adéquation d’échantillonnage en comparant l’amplitude des corrélations bivariées directes à celle des corrélations partielles entre chaque paire d’items. Une valeur globale supérieure à 0,80 certifie une factorisabilité optimale des données.
Toutefois, l’analyste doit surveiller la présence pernicieuse d’une colinéarité excessive ou d’une singularité matricielle ($|R| to 0$), qui survient dès lors que des items présentent des inter-corrélations frôlant l’unité ($r > 0,90$). Cette redondance informationnelle déstabilise dramatiquement les algorithmes d’inversion matricielle nécessaires à l’estimation des poids factoriels.
11.2 La corrélation canonique pour les ensembles de variables
Lorsque la question de recherche s’émancipe de la confrontation de paires de variables pour embrasser la mise en relation synthétique de deux faisceaux multidimensionnels distincts, l’analyse des corrélations canoniques s’affirme comme l’extension multivariée naturelle du modèle de Pearson. Développée par Harold Hotelling, cette modélisation vise à quantifier l’association globale existant entre un ensemble multidimensionnel de prédicteurs ($X_1, X_2, dots, X_p$) et un ensemble multidimensionnel de réponses ($Y_1, Y_2, dots, Y_q$).
Considérons, dans le champ de la psychopathologie développementale, un protocole visant à confronter un vecteur composé d’indicateurs de traumatismes infantiles (abus physiques, négligences émotionnelles, insécurité d’attachement) à un vecteur composé de manifestations psychopathologiques à l’âge adulte (anxiété, dépression, impulsivité, dissociation). Recourir à une kyrielle d’analyses bivariées individuelles gonflerait dramatiquement le taux global d’erreur de type I tout en disloquant la cohérence systémique des deux domaines cliniques.
L’analyse canonique résout cette impasse en extrayant des combinaisons linéaires optimales (variates canoniques) au sein de chaque ensemble de variables, de manière à maximiser spécifiquement le coefficient de corrélation reliant ces synthèses dimensionnelles. Elle offre ainsi une compréhension holistique du couplage structural unissant deux constellations phénoménologiques entières sans rompre leur articulation synergique.
11.3 Préparation aux modèles d’équations structurelles (SEM)
Au sommet de la hiérarchie méthodologique quantitative contemporaine se déploient les modèles d’équations structurelles (SEM), lesquels conjuguent la rigueur métrologique de l’analyse factorielle confirmatoire à la puissance explicative de la modélisation causale en réseau. Même au sein de ces modélisations sophistiquées, la matrice de covariance et de corrélation empirique demeure la source unique et absolue d’estimation des paramètres de l’algorithme.
Dans un modèle SEM, la transition méthodologique décisive s’opère entre la covariance non dirigée (représentée graphiquement par des flèches bidirectionnelles courbes entre variables latentes) et les coefficients de régression structurels standardisés ($\beta$, symbolisés par des flèches unidirectionnelles droites traçant l’inférence causale théorique). Si l’investigateur intègre une corrélation empirique brute non validée dans son modèle d’ajustement sans justifier son ancrage conceptuel, la solution globale risque de diverger ou d’engendrer des indices d’ajustement dégradés ($\chi^2$, RMSEA, CFI).
L’interprétation avisée et prudente de la matrice de corrélation de départ constitue le garde-fou fondamental évitant l’instanciation de modèles structurels complexes empiriquement insolvables ou déconnectés de la réalité écologique des données.
12. Guide pratique décisionnel : Arbre de choix méthodologique
12.1 Algorithme séquentiel pour le choix de l’analyse d’association
Afin de guider l’investigateur au sein du labyrinthe des alternatives quantitatives et de sanctuariser l’intégrité de ses choix méthodologiques, nous proposons un algorithme décisionnel séquentiel articulé en quatre étapes analytiques successives et obligatoires :
Étape 1 : Clarification de la finalité épistémique et du statut théorique des variables
- Si la problématique vise une description symétrique de la co-présence ou du chevauchement de dimensions continues sans primauté causale $to$ La démarche corrélative est conceptuellement légitime.
- Si la problématique implique une assignation expérimentale unilatérale, une chronologie séquentielle stricte ou une volonté de prédiction fonctionnelle asymétrique ($X to Y$) $to$ Exclusion formelle de la corrélation ; transition impérative vers la régression linéaire, l’ANOVA ou les modèles mixtes.
Étape 2 : Inspection visuelle approfondie des distributions conjointes (Scatterplot)
- Si le nuage de points dessine une tendance rectiligne homogène, elliptique et homoscédastique $to$ Validation de la condition de linéarité.
- Si le nuage manifeste une courbure patente (en U, sigmoïdale, exponentielle) $to$ Exclusion absolue du r de Pearson ; exploration de modèles de régression polynomiale, non linéaire ou transformation d’échelles.
Étape 3 : Qualification métrologique et examen des postulats distributionnels
- Variables d’intervalles ou de rapports respectant la normalité bivariée $to$ Application orthodoxe du coefficient r de Pearson.
- Variables ordinales, distributions asymétriques ou violations caractérisées de la normalité $to$ Orientation impérative vers le rho de Spearman ou le tau de Kendall.
- Combinaisons mixtes continues/dichotomiques $to$ Application de la corrélation bisérielle ponctuelle ou de la corrélation tétrachorique selon la nature du découpage sous-jacent.
Étape 4 : Traitement rigoureux des observations extrêmes et des sous-groupes
- Examen des distances multivariées (Mahalanobis) et suppression ou winsorisation documentée des valeurs aberrantes génératrices d’effets de levier fallacieux.
- Test d’invariance sur les strates sociodémographiques ou cliniques pour éradiquer tout risque de paradoxe de Simpson avant agrégation terminale.
12.2 Bonnes pratiques de restitution selon les normes APA (7e édition)
La transmission académique irréprochable des résultats d’une analyse corrélative est encadrée par des exigences typographiques et statistiques rigoureusement formalisées par l’American Psychological Association (APA, 7e édition). La simple mention laconique d’un indice numérique isolé au détour d’un paragraphe constitue un manquement déontologique aux principes de reproductibilité scientifique.
Le formalisme textuel standard exige l’inscription en italique du symbole $r$, la spécification explicite des degrés de liberté associés ($df = N – 2$), la valeur empirique arrondie à deux décimales, et la communication de la valeur de $p$ exacte (sans jamais recourir à la mention archaïque $p = 0,000$, laquelle doit être restituée sous la forme stricte $p < 0,001$). De manière tout à fait déterminante, les normes contemporaines imposent l’intégration systématique de l’intervalle de confiance à 95 % entourant le coefficient estimé :
Exemple de formulation conforme : « Une corrélation linéaire statistiquement significative a été observée entre l’extraversion et la satisfaction de vie globale, $r(248) = 0,45$, $p < 0,001$, IC 95 % $[0,34 ; 0,55]$. »
Dans la section Discussion du manuscrit, l’auteur a l’obligation éthique d’épurer méticuleusement son lexique de toute contamination verbale suggestive de causalité : les termes « impact », « influence », « déterminant » ou « effet de » doivent être formellement proscrits au bénéfice exclusif de désignations rigoureusement associatives telles que « concomitance », « chevauchement », « co-variation » ou « magnitude d’association ». Les matrices de corrélations présentées sous forme tabulaire doivent systématiquement intégrer les moyennes, les écarts-types marginaux et les indices de fidélité de mesure (alpha ou oméga) situés sur la diagonale principale.
12.3 Répertoire synthétique des erreurs fatales à proscrire
Pour parachever ce vade-mecum méthodologique, nous récapitulons de manière solennelle les trois transgressions épistémiques les plus dévastatrices répertoriées dans la littérature, dont l’évitement scrupuleux conditionne la valeur de toute recherche quantitative :
- L’assimilation abusive de l’absence de corrélation linéaire à une absence absolue de relation : Clamer péremptoirement qu’il n’existe aucun lien entre deux construits psychologiques au seul motif que l’indice de Pearson affiche $r = 0,02$, sans avoir préalablement réfuté l’existence d’une relation curvilinéaire puissante (loi de Yerkes-Dodson), constitue une faute scientifique lourde de conséquences.
- La dichotomisation artificielle et dévastatrice de variables continues : Procéder au découpage arbitraire d’une distribution métrique continue en deux catégories factices au niveau de la médiane (« sujets à haute anxiété » vs « sujets à basse anxiété ») pour calculer ensuite des comparaisons catégorielles ou des corrélations dégradées est une pratique désastreuse. Ce procédé détruit massivement l’information variance, divise la puissance statistique et génère d’innombrables faux positifs méthodologiques.
- L’inférence abusive d’efficacité thérapeutique sur la foi d’une simple corrélation pré-post : Établir qu’il existe une corrélation positive élevée entre les scores symptomatiques pré-intervention et post-intervention ne renseigne en rien sur l’efficacité clinique du protocole de soin. Seul un devis randomisé et contrôlé, analysé au moyen de modèles linéaires mesurant le changement moyen réel net des effets de maturation spontanée et de régression vers la moyenne, autorise la validation d’une intervention thérapeutique.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Galton, F. (1886). Regression towards mediocrity in hereditary stature. The Journal of the Anthropological Institute of Great Britain and Ireland, 15, 246–263. https://doi.org/10.2307/2841583
Hotelling, H. (1936). Relations between two sets of variates. Biometrika, 28(3/4), 321–377. https://doi.org/10.2307/2333955
Kendall, M. G. (1938). A new measure of rank correlation. Biometrika, 30(1/2), 81–93. https://doi.org/10.2307/2332226
Pearson, K. (1895). Note on regression and inheritance in the case of two parents. Proceedings of the Royal Society of London, 58, 240–242. https://doi.org/10.1098/rspl.1895.0041
Simpson, E. H. (1951). The interpretation of interaction in contingency tables. Journal of the Royal Statistical Society: Series B (Methodological), 13(2), 238–241. https://doi.org/10.1111/j.2517-6161.1951.tb00088.x
Spearman, C. (1904). The proof and measurement of association between two things. The American Journal of Psychology, 15(1), 72–101. https://doi.org/10.2307/1412159
Thorndike, R. L. (1949). Personnel selection: Test and measurement techniques. John Wiley & Sons.
Yerkes, R. M., & Dodson, J. D. (1908). The relation of strength of stimulus to rapidity of habit-formation. Journal of Comparative Neurology and Psychology, 18(5), 459–482. https://doi.org/10.1002/cne.920180503