
Dans le paysage contemporain des sciences quantitatives, de la psychologie différentielle à l’épidémiologie comportementale, la quantification de l’intensité des liens unissant deux phénomènes constitue l’un des piliers fondamentaux de l’inférence empirique. Depuis l’avènement des méthodes biométriques à la fin du dix-neuvième siècle, le calcul du coefficient d’association s’est imposé comme un outil privilégié pour transcender la simple observation intuitive et fournir un indicateur standardisé des relations observées au sein du monde naturel et social. Pourtant, malgré l’apparente clarté arithmétique d’une échelle bornée entre les valeurs extrêmes de la parfaite dépendance linéaire, l’interprétation concrète d’une magnitude empirique demeure l’un des territoires les plus controversés et les plus mal compris de la pratique scientifique moderne.
Au cœur de cette ambiguïté herméneutique réside la qualification d’une corrélation comme étant « faible ». L’adjectif lui-même, emprunté au langage vernaculaire, véhicule une connotation péjorative immédiate, suggérant l’insignifiance, l’échec de la mesure, ou l’absence d’intérêt pratique et théorique. Dans les laboratoires comme dans les médias généralistes, le réflexe dominant consiste fréquemment à reléguer au rang d’artefact négligeable toute relation statistique n’atteignant pas des seuils impressionnants de co-variation. Cette tendance découle en grande partie d’une assimilation hâtive entre la force brute d’un signal numérique et son importance ontologique, omettant les dynamiques stochastiques propres aux systèmes complexes, où de multiples facteurs causaux agissent de concert pour façonner les manifestations observables du comportement humain ou des processus biologiques.
Le présent traité se propose de déconstruire en profondeur le concept de corrélation faible, en examinant ses fondements mathématiques, son ancrage historique au sein des conventions méthodologiques, ainsi que ses implications épistémologiques dans l’étude des phénomènes multivariés. En réévaluant les bornes classiques proposées à l’origine par Jacob Cohen à l’aune des découvertes méta-analytiques contemporaines et des impératifs de la santé publique ou de la psychologie scientifique, nous mettrons en lumière la manière dont des associations numériques d’amplitude modeste peuvent receler une valeur heuristique capitale, gouverner des transformations populationnelles d’envergure et constituer le véritable reflet de la texture causale de notre univers.
1. Fondements statistiques du coefficient de corrélation linéaire
1.1 Définition mathématique du r de Pearson
Le coefficient de corrélation produit-moment de Pearson, universellement désigné par le symbole r, représente la mesure paramétrique standard de l’association linéaire unissant deux variables continues mesurées à l’échelle d’intervalle ou de rapport. Formellement conceptualisé par Karl Pearson à partir des intuitions géométriques initiales de Francis Galton, cet indice s’obtient par la normalisation rigoureuse de la covariance empirique des deux distributions par le produit scalaire de leurs écarts-types respectifs. L’équation fondamentale s’écrit comme le rapport entre la somme des produits des écarts à la moyenne pour chaque paire d’observations et la racine carrée du produit des sommes des carrés de ces mêmes écarts. Cette opération algébrique a pour conséquence directe de purger la relation de toute dépendance vis-à-vis des unités de mesure originelles, conférant au résultat une nature strictement adimensionnelle.
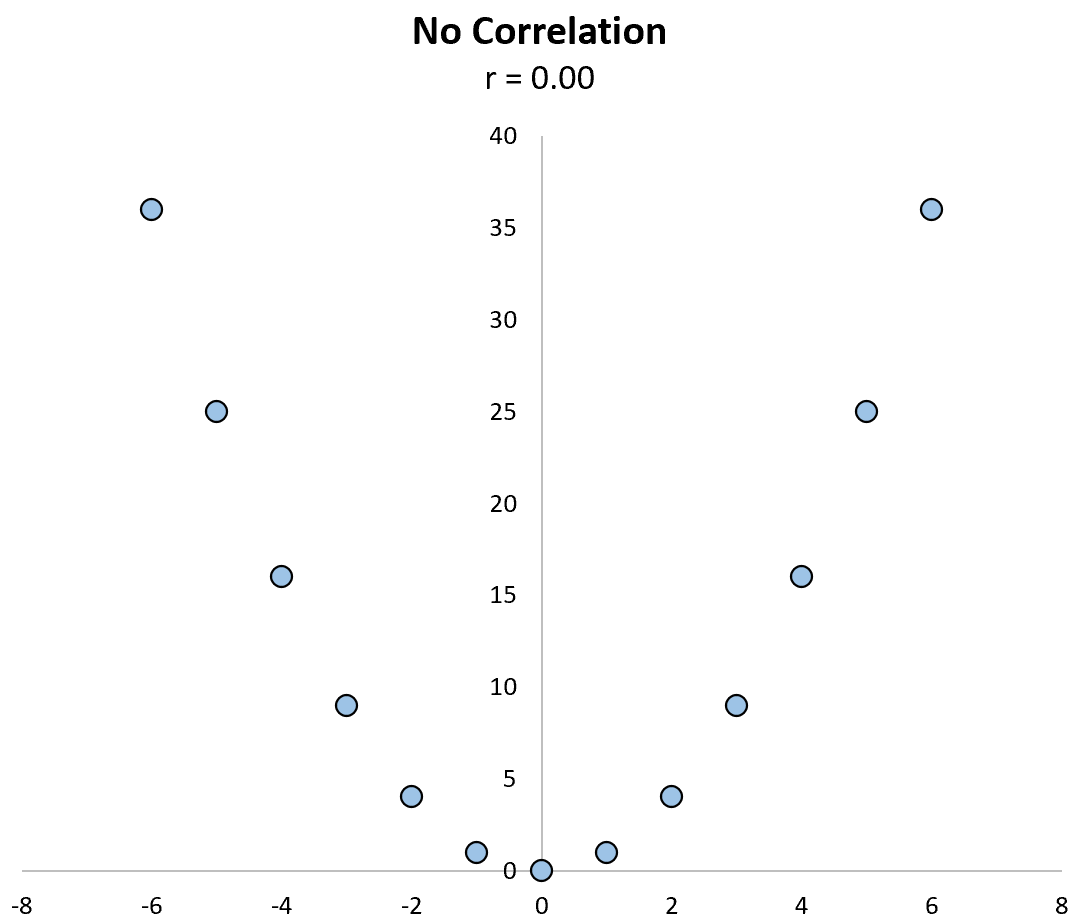
Cette adimensionnalité confère au coefficient une propriété d’invariance remarquable par rapport aux transformations linéaires positives : qu’une variable soit exprimée en millisecondes, en scores bruts d’anxiété ou en fractions monétaires, l’amplitude du coefficient de Pearson demeure rigoureusement identique. Toutefois, cette universalité repose sur un postulat mécanique inflexible : le coefficient ne mesure avec exactitude que la force et la direction d’une relation strictement linéaire. Si la dynamique reliant les deux construits adopte une courbure logarithmique, quadratique ou sinusoïdale, le r de Pearson sous-estimera structurellement l’interdépendance réelle des variables, réduisant parfois une relation déterministe non linéaire à une valeur numérique proche de zéro.
En outre, le comportement mathématique de cet indice s’avère particulièrement tributaire des propriétés distributionnelles univariées et bivariées des données sous-jacentes. L’estimation non biaisée du paramètre populationnel présuppose une distribution normale bivariée, au sein de laquelle la dispersion conditionnelle d’une variable pour toute valeur fixée de l’autre présente une homoscédasticité constante. Toute violation majeure de ces prérequis, telle qu’une asymétrie marquée (skewness) ou un aplatissement inhabituel (kurtosis), exerce une distorsion mécanique sur le calcul de la covariance, comprimant ou amplifiant artificiellement la valeur estimée et faussant l’évaluation subséquente de la force d’association.
1.2 L’échelle théorique de distribution de -1 à +1
L’espace métrique au sein duquel se déploie le coefficient de Pearson constitue un continuum mathématique parfaitement délimité, s’étendant sans discontinuité de la valeur négative extrême -1,00 jusqu’à la valeur positive maximale +1,00. Ces deux bornes terminales incarnent le déterminisme linéaire absolu : une valeur de +1 indique qu’une fonction affine ascendante exacte relie l’ensemble des points d’observation, de sorte que toute variation standardisée sur la variable prédictive se traduit instantanément par une variation identique et de même sens sur la variable critère. Réciproquement, la valeur de -1 décrit une relation fonctionnelle descendante parfaite, où chaque incrément standardisé de l’une entraîne une réduction proportionnelle rigoureuse de l’autre, annulant toute variance résiduelle au sein du plan cartésien.
Au barycentre exact de cette échelle se situe la valeur zéro (0,00), dont la signification statistique correspond à l’absence totale de co-variation linéaire détectable entre les séries de données. Dans un tel scénario, la connaissance préalable de la position d’un individu sur l’axe des abscisses ne fournit aucune information mathématique exploitable pour ajuster la probabilité de sa localisation sur l’axe des ordonnées par une droite de régression. Le nuage de points adopte alors une morphologie circulaire ou rectangulaire informe, dont la pente de la droite des moindres carrés ordinaires est rigoureusement nulle.
Il importe de souligner la parfaite symétrie mathématique qui gouverne cet édifice : un coefficient d’une magnitude de -0,20 reflète rigoureusement le même degré d’interdépendance quantitative qu’un coefficient de +0,20. Le signe algébrique n’informe aucunement sur la compacité du regroupement des données ni sur la précision prédictive du modèle, mais renseigne exclusivement sur le sens vectoriel de la covariance. Le continuum entre le pôle négatif et le pôle positif forme ainsi un gradient d’intensité ordonné en miroir autour de l’indépendance linéaire centrale.
1.3 La nature de la décroissance vers l’indépendance
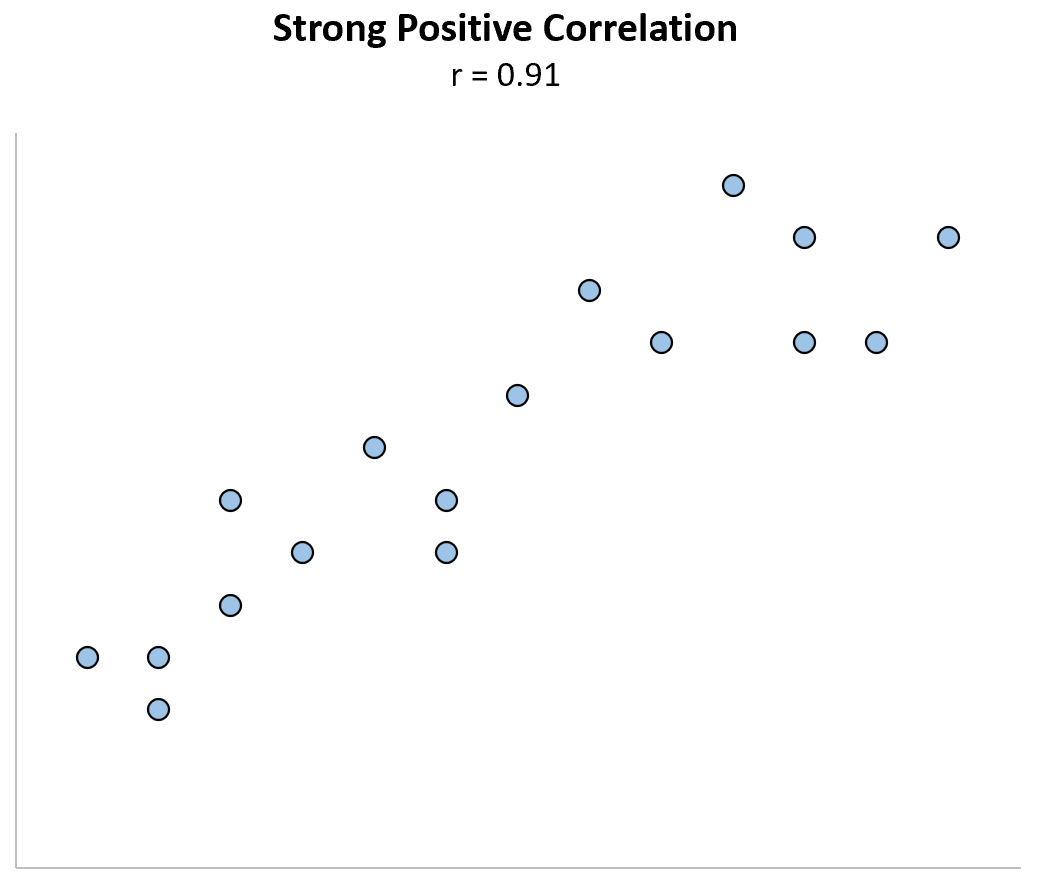
Lorsque le coefficient de corrélation décroît progressivement depuis les magnitudes élevées pour se rapprocher de la valeur zéro, la structure géométrique du nuage de points subit une métamorphose continue. Dans les régimes de forte corrélation (par exemple supérieure à 0,70), l’ellipse de dispersion bivariée apparaît extrêmement étirée et étroite, matérialisant un ratio signal-sur-bruit particulièrement favorable où la trajectoire commune des variables domine outrageusement les fluctuations particulières. À mesure que l’amplitude numérique régresse vers des valeurs comprises entre 0,30 et 0,10, l’ellipse s’épaissit considérablement, ses contours se dilatent et sa circularité globale augmente de manière frappante.
Cette transition visuelle reflète une réalité stochastique sous-jacente : l’atténuation graduelle du signal statistique partagé au profit de l’inflation concomitante de la variance résiduelle, couramment assimilée au bruit aléatoire. Dans une configuration où r flirte avec les paliers inférieurs, la variance spécifique non partagée, alimentée par des erreurs de mesure instrumentales, des fluctuations d’échantillonnage et l’omission d’une multitude de facteurs causaux non observés, vient masquer la trame déterministe ténue qui continue pourtant d’unir les deux construits.
Il en résulte une zone épistémologique particulièrement délicate, située aux confins immédiats de l’indépendance statistique. La frontière départageant un véritable signal ténu d’une simple fluctuation stochastique dépourvue de sens causal devient extraordinairement floue. À ce niveau de la décroissance linéaire, l’observateur non averti est aisément trompé par la morphologie du diagramme de dispersion, qui ressemble désormais à s’y méprendre à un bombardement aléatoire de particules, dissimulant l’existence d’une régularité probabiliste sous-jacente qui ne peut être révélée que par une agrégation statistique de grande puissance.
2. Les seuils conventionnels de Jacob Cohen et leur genèse
2.1 La typologie historique de Cohen (1988)
L’évaluation contemporaine de la magnitude des corrélations demeure tributaire des repères quantitatifs formulés par le statisticien et psychologue américain Jacob Cohen dans son ouvrage séminal consacré à l’analyse de puissance statistique en sciences du comportement (éditions de 1977 et 1988). Confronté à l’absence de standards partagés pour déterminer a priori les effectifs d’échantillonnage requis lors de la planification expérimentale, Cohen entreprit de formaliser une nomenclature opérationnelle universelle. C’est dans ce cadre purement pragmatique qu’il introduisit la fameuse tripartition catégorielle des tailles d’effet pour le coefficient de corrélation linéaire : la valeur r = 0,10 fut désignée pour qualifier un effet faible (small effect size), r = 0,30 pour un effet moyen (medium effect size), et r = 0,50 pour un effet fort (large effect size).
Il est impératif de resituer la genèse de cette typologie dans son contexte méthodologique d’origine. Cohen cherchait avant tout à fournir aux chercheurs un outil de calcul prospectif de la puissance statistique (notée 1 – beta) afin d’éviter la prolifération d’études sous-puissantes incapables de détecter des phénomènes réels. Le choix de r = 0,10 comme archétype de la faible magnitude n’était pas le produit d’une dérivation mathématique déterministe, mais d’une tentative d’isoler une amplitude minimale en dessous de laquelle la plupart des dispositifs d’investigation en sciences sociales se révéleraient aveugles, à moins d’engager des moyens logistiques considérables pour recruter de très vastes échantillons.
Dans ses écrits originaux, Cohen multiplia d’ailleurs les avertissements épistémologiques formels, exhortant la communauté scientifique à ne jamais concevoir ces repères numériques comme des vérités immuables ou des décrets dogmatiques. Il souligna avec insistance que ces seuils n’avaient de sens que par défaut, en l’absence totale de connaissances empiriques préalables dans un champ disciplinaire balbutiant. Paradoxalement, la postérité méthodologique a ignoré ces réserves prudentes, transformant des conventions d’étape en véritables couperets interprétatifs appliqués de façon machinale par des générations d’étudiants et de chercheurs.
2.2 L’intervalle numérique caractérisant une corrélation faible
Dans la pratique académique standardisée qui s’est cristallisée au fil des décennies, le consensus dominant tend à définir l’intervalle absolu s’étendant de |0,10| à |0,29| comme la zone délimitant par excellence la corrélation faible. En deçà de la borne inférieure de 0,10, les coefficients compris entre 0,00 et |0,09| reçoivent habituellement l’étiquette d’effets « négligeables », « triviaux » ou « nuls », suggérant que l’intensité de la co-variation s’avère trop indétectable pour mériter une théorisation quelconque dans les paradigmes usuels de laboratoire.
Cette sectorisation suscite cependant d’âpres controverses quant à la légitimité de découper arbitrairement un continuum d’intensités mathématiques en compartiments discrets étanches. La transition entre un coefficient de 0,09 et un coefficient de 0,11 relève d’une nuance numérique infinitésimale de deux centièmes d’unité, pourtant le premier se voit fréquemment rejeté comme négligeable tandis que le second accède au statut d’effet faible scientifiquement attestable. De telles ruptures ontologiques artificielles illustrent les dangers d’une approche nominaliste des grandeurs statistiques continues.
Par ailleurs, d’autres taxonomies concurrentes ont été proposées dans la littérature méthodologique pour affiner ou concurrencer les critères de Cohen. À titre d’illustration, des auteurs comme Evans (1996) ont proposé une gradation plus sévère qualifiant toute corrélation inférieure à 0,20 de « très faible », cantonnant l’effet faible à l’intervalle 0,20 – 0,39. À l’opposé, des méthodologistes comme Hemphill (2003), réexaminant des centaines de méta-analyses en psychologie clinique, ont souligné qu’une corrélation de 0,15 se situe déjà au tiers inférieur de la distribution des tailles d’effet réelles observées sur le terrain empirique. Ces discordances taxonomiques démontrent qu’il n’existe aucun socle axiomatique absolu définissant la faiblesse d’une corrélation, celle-ci n’étant qu’une convention contingente aux grilles d’analyse des disciplines qui l’emploient.
2.3 La contextualisation des règles empiriques
L’application décontextualisée et aveugle des règles empiriques de Cohen constitue l’une des dérives les plus pernicieuses de l’analyse quantitative. Qualifier un coefficient d’association de « faible » sans ancrer cette évaluation dans le cadre de référence opérationnel, instrumental et théorique propre au domaine d’investigation conduit immanquablement à des jugements scientifiques dévoyés. En premier lieu, la force brute d’un r empirique est indissociable de la précision des outils de mesure utilisés : un instrument psychométrique entaché d’une erreur de mesure substantielle générera inévitablement un coefficient modeste, quand bien même la dynamique structurelle sous-jacente entre les dimensions psychologiques théoriques serait puissante.
En second lieu, il est impératif d’opérer une disjonction conceptuelle absolue entre la magnitude numérique d’un coefficient et son importance substantielle. Un effet statistiquement mesuré à r = 0,12 peut se révéler monumental lorsqu’il concerne la réduction d’une pathologie létale ou la prédiction d’un risque systémique à l’échelle d’une population continentale, tandis qu’un coefficient de r = 0,60 peut n’avoir qu’une utilité théorique dérisoire s’il ne fait que mesurer la redondance sémantique tautologique entre deux items d’un même questionnaire d’auto-évaluation psychologique.
La contextualisation exige par conséquent que chaque chercheur évalue son estimation quantitative à l’aune d’une matrice tridimensionnelle intégrant l’état de l’art du domaine considéré, la nature plus ou moins proximale ou distale de la chaîne causale reliant les variables, et le coût ou l’utilité pratique des décisions consécutives à la détection de cette co-variation. Ignorer cette triangulation au profit d’une lecture rigide des seuils revient à confondre la lecture d’un instrument d’arpentage avec la topographie réelle du paysage qu’il tente de cartographier.
3. Le statut épistémologique des corrélations faibles en psychologie
3.1 La complexité multicausale des conduites humaines
S’il est un domaine scientifique où la présence endémique de corrélations de faible amplitude constitue la norme plutôt que l’exception, c’est indubitablement la psychologie, dans l’ensemble de ses sous-disciplines cognitives, développementales, cliniques et différentielles. Cette situation ne témoigne nullement d’une infériorité méthodologique ou d’une immaturité scientifique de la psychologie vis-à-vis des sciences physiques dites dures, mais reflète fidèlement la complexité ontologique inouïe de son objet d’étude. Les comportements humains, les états émotionnels et les trajectoires cognitives sont le produit émergent de systèmes ouverts et hautement multidéterminés, au sein desquels s’entremêlent des facteurs biologiques, génétiques, épigénétiques, biographiques, socioculturels et écologiques immédiats.
Dans un tel réseau causal ultra-complexe, aucun déterminant individuel ne peut prétendre saturer à lui seul la variance d’un critère comportemental complexe. Attendre d’un trait de personnalité spécifique, d’une prédisposition génétique ou d’une pratique éducative parentale qu’il affiche une corrélation supérieure à 0,40 ou 0,50 avec une conduite telle que la performance académique, le risque de divorce ou l’apparition d’un épisode dépressif majeur relève d’une illusion mécaniste simpliste. Le fonctionnalisme probabiliste nous enseigne qu’une variable distale ne peut exercer qu’une impulsion infinitésimale sur la trajectoire finale d’un système vivant.
En outre, l’écologie de la mesure psychologique impose ce que l’on nomme un « plafond de validité écologique ». Les conditions de passation d’un test, la subjectivité inhérente aux auto-évaluations et l’instabilité transitoire des états affectifs introduisent un niveau incompressible d’entropie qui bride mécaniquement l’amplitude maximale théoriquement observable sur le plan empirique. Reconnaître cette multicausalité intrinsèque implique d’accepter qu’en psychologie, une corrélation d’ordre modeste constitue l’empreinte normale et attendue d’un déterminisme dispersé et dynamique.
3.2 La réévaluation empirique par Funder et Ozer (2019)
Face à la persistance d’un sentiment diffus de culpabilité méthodologique au sein de la communauté psychologique, les chercheurs David C. Funder et Daniel J. Ozer ont publié en 2019 un article fondateur plaidant pour une réévaluation empirique complète de la taille des effets en psychologie. S’appuyant sur des méta-analyses extensives recensant des dizaines de milliers d’associations documentées à travers l’ensemble de la littérature internationale, les auteurs ont démontré sans équivoque que la distribution réelle des coefficients de corrélation se concentre massivement sur des valeurs qui, selon l’orthodoxie désuète de Cohen, auraient été dédaignées comme faibles ou marginales.
Les conclusions métascientifiques de Funder et Ozer révèlent que le coefficient de corrélation médian véritablement documenté en psychologie de la personnalité et en psychologie sociale culmine à environ r = 0,19 à 0,21. Dès lors, ériger r = 0,30 comme seuil d’un effet « moyen » et r = 0,50 comme étalon d’un effet « fort » apparaît comme une distorsion manifeste de la réalité de la discipline. Pour combler ce gouffre normatif, ils ont proposé une grille révisée, calibrée non plus sur des spéculations a priori, mais sur la distribution empirique authentique des données scientifiques publiées :
- r = 0,05 : Un effet très modeste, potentiellement fonctionnel et porteur de conséquences mesurables s’il est cumulé à grande échelle ou répété de manière itérative dans le temps.
- r = 0,10 : Un effet d’ampleur typique, ayant une portée théorique notable et des implications directes pour l’explication probabiliste des comportements individuels normaux.
- r = 0,20 : Un effet de magnitude moyenne à substantielle, doté d’une valeur prédictive de premier ordre dans les interventions psychosociales et cliniques courantes.
- r = 0,30 : Un effet très puissant et particulièrement rare dans l’étude des processus psychologiques profonds et non redondants, méritant une attention théorique majeure.
Cette refondation audacieuse a permis d’affranchir la psychologie moderne d’une grille de lecture inadaptée, repositionnant les corrélations jadis qualifiées de faibles comme le véritable cœur battant de la réalité empirique des sciences humaines contemporaines.
3.3 La validité théorique d’une relation d’amplitude modeste
Loin de constituer une tare métrologique, l’obtention délibérée d’une corrélation d’amplitude modeste représente fréquemment une condition sine qua non pour valider expérimentalement des modèles théoriques sophistiqués. Dans le cadre de l’architecture nomologique conceptualisée par Cronbach et Meehl, la démonstration de la validité d’un construit n’exige pas seulement de mettre en évidence des corrélations massives avec des critères convergents (validité convergente), mais requiert avec la même rigueur de prouver la faiblesse des corrélations unissant ce construit à des dimensions dont il est supposé diverger théoriquement (validité discriminante).
À titre d’exemple paradigmatique, si un nouvel outil psychométrique conçu pour mesurer l’anxiété sociale présentait une corrélation de r = 0,75 avec l’introversion générale, le chercheur se trouverait face à une crise de validité conceptuelle majeure, le chevauchement excessif des variances indiquant que l’outil échoue à capturer une psychopathologie spécifique pour ne mesurer qu’un trait tempéramental normatif. C’est précisément l’observation d’une corrélation faible, disons de l’ordre de r = 0,18 à 0,22, qui permet d’attester que l’anxiété sociale partage bien un lien modeste d’affinité avec l’introversion tout en conservant une irréductible spécificité nosologique.
De surcroît, la solidité d’une chaîne causale s’évalue souvent à la cohérence du réseau de multiples prédicteurs affichant tous des corrélations faibles mais stables avec l’entité étudiée. Une théorie comportementale élégante et mature s’illustre par sa capacité à articuler dix ou quinze facteurs de vulnérabilité corrélés chacun entre 0,10 et 0,20 avec le résultat clinique, composant une mosaïque probabiliste hautement prédictive lorsqu’elle est intégrée au sein d’un modèle structurel unifié.
4. Corrélation faible positive versus corrélation faible négative
4.1 Dynamique d’une corrélation faible positive (+0,10 à +0,29)
L’examen d’une corrélation faible s’inscrivant dans le registre des valeurs positives comprises entre +0,10 et +0,29 permet d’appréhender la mécanique d’une propension probabiliste discrète à l’élévation conjointe de deux grandeurs. Dans cette configuration géométrique et statistique, la pente de la droite de régression linéaire standardisée (coefficient bêta bivarié) affiche une trajectoire légèrement ascendante. Les unités d’observation situées aux échelons supérieurs de la variable indépendante tendent, en moyenne distributionnelle, à occuper des positions quelque peu plus élevées sur la variable dépendante que celles situées aux échelons inférieurs.
Toutefois, la caractéristique prédominante d’une telle distribution réside dans la dispersion considérable des points individuels autour de la trajectoire théorique moyenne. Contrairement à une situation de liaison robuste où les points se lovent étroitement le long du vecteur central, le nuage associé à une corrélation faible positive s’apparente à une ellipse obèse et diffuse. Cette disposition spatiale trahit l’omniprésence d’un grand nombre de cas discordants contredisant frontalement la tendance centrale globale : on y observera ainsi une pléthore d’individus cumulant des scores maximaux sur la première variable tout en affichant des niveaux minimaux sur la seconde, et réciproquement.
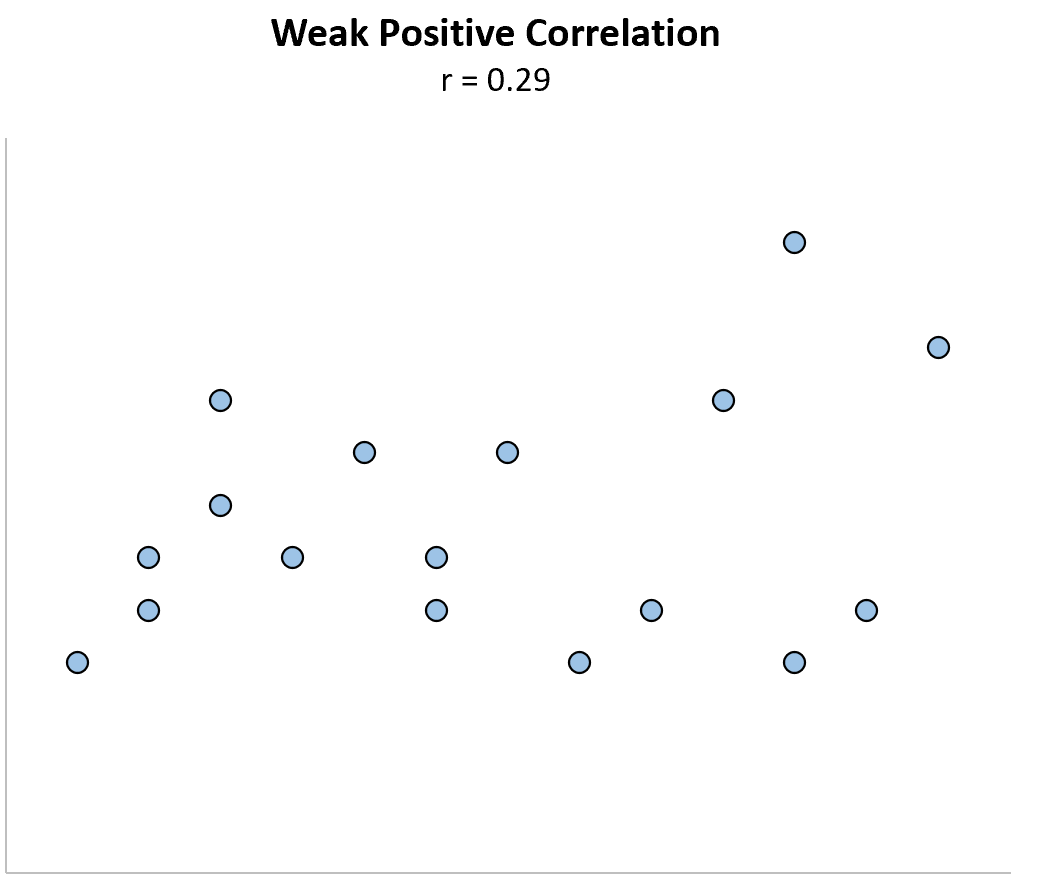
Un exemple empirique classique de cette dynamique réside dans la relation unissant l’estime de soi globale auto-rapportée et la performance académique objectivement mesurée à l’université, où les méta-analyses relèvent continuellement un r gravitant autour de +0,15 à +0,20. Si la co-variation générale confirme qu’une image de soi favorable s’accompagne en moyenne statistique de résultats académiques marginalement plus élevés, la masse des observations discordantes — étudiants très doués rongés par le doute ou étudiants excessivement confiants en situation de faillite académique — illustre la fragilité du pouvoir prédictif bivarié immédiat au niveau singulier.
4.2 Dynamique d’une corrélation faible négative (-0,10 à -0,29)
À l’inverse symétrique du quadrant positif, une corrélation faible négative, cantonnée entre -0,10 et -0,29, matérialise une dynamique où la tendance centrale indique qu’un accroissement sur un construit coïncide avec une légère régression sur l’autre. Le vecteur linéaire présente alors une pente descendante modeste, sans que la nature stochastique sous-jacente du phénomène ne diffère en aucune manière de son homologue positif. La dispersion bivariée conserve l’exacte même compacité volumétrique et la même proportion de variance non expliquée que celles caractérisant une intensité positive équivalente.
Dans ce scénario, les cas déviants pullulent avec la même intensité probabiliste : l’existence de sujets affichant simultanément des valeurs extrêmes sur les deux pôles ou des scores conjoints excessivement bas demeure une régularité permanente du diagramme de dispersion. Le bruit aléatoire résiduel s’oppose avec force à toute inférence univoque ou déterministe lors de la transition du plan populationnel à l’observation d’un profil individuel unique.
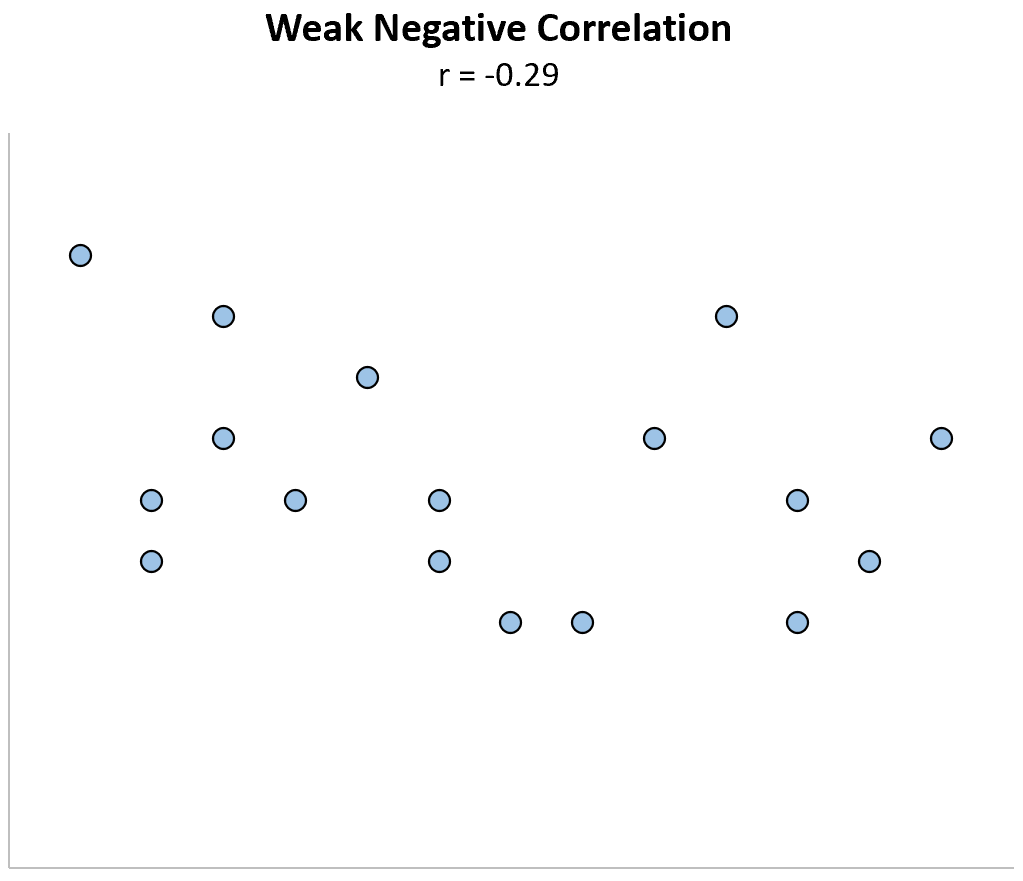
Cette dynamique s’observe de manière récurrente dans l’investigation des traits de personnalité et de leurs corrélats psychophysiologiques. Considérons la relation fréquemment documentée entre le trait de névrosisme (ou instabilité émotionnelle) et la propension à utiliser des stratégies de réévaluation cognitive face au stress aigu, dont le coefficient s’établit généralement aux alentours de r = -0,16. Cette métrique atteste qu’une propension supérieure à la réactivité émotionnelle négative entrave tendanciellement la mise en œuvre de recadrages cognitifs adaptatifs. Pour autant, la modestie du coefficient garantit que d’innombrables individus hautement névrotiques parviennent à mobiliser d’excellentes compétences de régulation rationnelle grâce à des ressources intellectuelles ou thérapeutiques compensatoires.
4.3 L’erreur d’interprétation liée au signe
L’analyse des corrélations faibles négatives se heurte fréquemment à un biais cognitif tenace chez les étudiants et les praticiens débutants, consistant à amalgamer la polarité négative du signe algébrique avec une faiblesse intrinsèque du degré de dépendance statistique. Par une confusion psychologique élémentaire, le signe moins (-) est intuitivement appréhendé comme une soustraction de substance, induisant l’illusion qu’un coefficient de -0,25 traduirait une association substantiellement plus fragile, moins crédible ou moins consistante qu’un coefficient de +0,15.
Il est donc capital de réaffirmer avec force que la métrique de la magnitude s’évalue toujours en valeur absolue (|r|). Le signe n’est qu’un opérateur d’orientation vectorielle dénué de tout impact sur la géométrie de l’ellipse de co-variation ou sur l’aptitude mathématique du modèle à réduire l’incertitude prédictive. Un lien caractérisé par r = -0,28 surpasse indéniablement en force explicative et en compacité relationnelle une association quantifiée à r = +0,18.
Cette distorsion interprétative prend une dimension critique lorsqu’interviennent des inversions méthodologiques dans le codage des échelles de mesure psychométriques. Il suffit qu’un investigateur code l’anxiété en « stabilité émotionnelle » ou le bien-être subjectif en « détresse psychologique » pour que le signe algébrique d’une corrélation bascule instantanément du positif au négatif, sans que la nature de l’association ontologique entre les deux phénomènes n’ait subi la moindre altération d’un millième de pourcent. Confondre l’orientation et l’intensité d’une corrélation faible constitue une faute de raisonnement statistique majeure qui altère profondément la synthèse des résultats de recherche.
5. La variance expliquée et le coefficient de détermination (r²)
5.1 Le calcul et la signification du r²
L’une des méthodes traditionnelles les plus répandues pour donner un sens concret à la magnitude d’un coefficient de Pearson consiste à procéder à son élévation au carré, générant ainsi le coefficient de détermination, universellement désigné par le symbole r². Mathématiquement, cette statistique exprime le ratio entre la somme des carrés due à la régression et la somme des carrés totale des observations. Elle quantifie donc très exactement la fraction ou le pourcentage de la variance totale du critère qui peut être attribuée, de manière déterministe linéaire, à la variance du prédicteur au sein de l’échantillon analysé.
Cette opération d’exponentiation quadratique opère une transformation non linéaire brutale sur l’échelle des intensités. En comprimant de façon drastique les valeurs initialement inférieures à l’unité, elle génère une distorsion optique qui tend à anéantir visuellement les associations de magnitude modeste. Tandis qu’une fonction linéaire conserve les proportions d’échelle, l’élévation au carré creuse un abîme artificiel entre les grands coefficients et les petits coefficients, instillant chez l’analyste un sentiment persistant d’inutilité opérationnelle dès lors que l’indice de départ ne présente pas un profil élevé.
Du point de vue du formalisme des moindres carrés, le r² répond à la question suivante : de quelle proportion l’erreur quadratique de prédiction est-elle réduite lorsque l’on substitue à la moyenne marginale du critère la droite de régression calculée sur le prédicteur ? Pour les corrélations qualifiées de faibles, cette réduction de l’erreur quadratique apparaît dérisoire au profane, alimentant une rhétorique sceptique qui prédomine dans les débats méthodologiques depuis plus d’un demi-siècle.
5.2 L’interprétation des pourcentages de 1 % à 9 %
L’application concrète de la règle du coefficient de détermination à l’intervalle conventionnel des corrélations faibles produit des chiffres qui frappent l’esprit par leur extrême exigüité arithmétique. Lorsque l’on traduit les magnitudes de Pearson comprises entre |0,10| et |0,29| en termes de variance partagée, on découvre les équivalences suivantes :
- Un coefficient de corrélation r = 0,10 n’explique qu’exactement 1 % de la variance totale de la variable étudiée, abandonnant 99 % de la dispersion à l’inconnu ou au bruit stochastique.
- Un coefficient de corrélation r = 0,20 ne parvient à rendre compte que de 4 % de la variance partagée, laissant 96 % des fluctuations individuelles inexpliquées.
- Un coefficient de corrélation r = 0,30, considéré comme le point de bascule vers l’effet moyen, n’atteint péniblement que 9 % de variance expliquée, soit une part résiduelle colossale de 91 %.
Face à de tels pourcentages, la tentation réductionniste est presque irrésistible : comment un théoricien ou un praticien pourrait-il accorder le moindre crédit scientifique à une variable incapable d’expliquer plus de 2 à 4 % d’un comportement, d’une maladie ou d’un choix existentiel ? Dans les jurys de thèse comme dans les comités de lecture des revues scientifiques, il n’est pas rare de voir des évaluateurs balayer d’un revers de main méprisant des résultats empiriques sous le prétexte fallacieux que « 96 % de la variance demeure mystérieuse, rendant le résultat cliniquement futile ».
Ce réflexe nihiliste procède pourtant d’une profonde incompréhension des propriétés intrinsèques de l’opérateur quadratique. En se focalisant exclusivement sur le déficit d’explication univarié, l’observateur perd de vue que dans les systèmes naturels ouverts, aucun phénomène complexe n’est réductible à un dénominateur unique, et que l’accumulation de fragments de 2 % constitue la structure ordinaire de la réalité empirique.
5.3 Les limites de la variance expliquée comme métrique d’impact
De nombreux statisticiens méthodologistes de premier plan, au rang desquels figurent Robert Rosenthal et Donald Rubin dès le début des années 1980, ont vigoureusement dénoncé le « pessimisme excessif » et les distorsions trompeuses générées par l’usage systématique du r² comme métrique de l’impact théorique et pratique d’une association. La métrique quadratique souffre d’un défaut rédhibitoire : elle est décalibrée par rapport aux décisions concrètes, binaires ou incrémentielles, qui régissent la vie humaine et les interventions scientifiques.
Il a été mathématiquement et expérimentalement démontré que des pourcentages de variance expliquée oscillant entre 1 % et 4 % peuvent gouverner des processus sociétaux et biomédicaux d’une ampleur monumentale. Par exemple, comme nous le détaillerons ultérieurement, des essais cliniques randomisés majeurs ont été interrompus prématurément pour des raisons impératives d’éthique médicale afin de fournir immédiatement un traitement protecteur au groupe contrôle, alors même que l’efficacité du médicament ne rendait compte que de moins de 1 % de la variance du taux de survie des patients.
En conséquence, le consensus méthodologique contemporain en épidémiologie, en psychométrie et en sciences de la décision tend à abandonner la tyrannie du r² pour revenir à l’examen direct du coefficient de corrélation non transformé r. Celui-ci s’avère infiniment plus linéaire, intuitif et proportionnel aux effets réels mesurables sur le terrain, délivrant les corrélations faibles de la relégation infondée à laquelle le formalisme des pourcentages quadratiques les avait injustement condamnées.
6. Distinction cruciale entre force d’association et significativité statistique
6.1 L’influence déterminante de la taille de l’échantillon (N)
L’un des écueils pédagogiques et scientifiques les plus dévastateurs dans l’enseignement de l’inférence quantitative concerne la confusion fréquente entre la magnitude substantielle d’une corrélation et son niveau de significativité statistique, généralement consigné sous la forme de la fameuse p-valeur. Pour dissiper cette méprise, il est fondamental d’examiner la formule standard de calcul de l’erreur-type du coefficient de corrélation linéaire sous l’hypothèse nulle d’indépendance, laquelle s’écrit approximativement comme l’inverse de la racine carrée de la taille de l’échantillon : SE = 1 / √(N – 1).
Cette relation mathématique implique une conséquence fondamentale : la dispersion de l’échantillonnage se contracte inexorablement à mesure que l’effectif N croît vers l’infini. Dès lors, le test de Student calculé pour éprouver l’hypothèse d’une corrélation nulle dépend directement de la taille de l’échantillon : t = r × √(N – 2) / √(1 – r²). Il devient ainsi parfaitement mécanique d’obtenir une p-valeur infinitésimale (par exemple p < 0,0001) pour une corrélation objectivement minuscule de r = 0,05, pour peu que le protocole de recherche soit administré à une cohorte épidémiologique comprenant 20 000 participants.
À l’inverse symétrique, si un psychologue clinicien explore une hypothèse novatrice auprès d’un échantillon clinique hautement spécialisé composé de seulement 25 individus, une corrélation empirique substantielle de r = 0,35 — franchissant allègrement le seuil théorique de l’effet moyen selon Cohen — échouera à franchir le cap conventionnel de la significativité statistique bilatérale à alpha = 0,05, car son test produira un t insuffisant au regard de la dispersion d’échantillonnage inhérente à un effectif aussi modeste. La force du lien existe bel et bien au sein de l’échantillon, mais l’incertitude quant à son extrapolation populationnelle demeure prépondérante.
6.2 La confusion entre rejet de l’hypothèse nulle et importance empirique
La persistance du rituel de vérification de l’hypothèse nulle (Null Hypothesis Significance Testing ou NHST) a forgé une génération de chercheurs obnubilés par la dichotomie simpliste « significatif versus non-significatif ». Dans ce paradigme réducteur, l’obtention d’un astérisque attestant que p < 0,05 est fréquemment célébrée comme le couronnement de la quête scientifique, conduisant à surinterpréter des corrélations faibles au seul motif qu’elles ont franchi le filtre du hasard statistique.
Il est impératif de rappeler sans relâche qu’une p-valeur ne renseigne strictement sur rien d’autre que sur la probabilité d’observer un coefficient au moins aussi extrême que celui mesuré dans l’échantillon si l’on postule que la véritable relation dans la population est rigoureusement égale à zéro. La significativité statistique est un certificat de non-nullité probabiliste, en aucun cas un baromètre de la force, de la beauté, de la pertinence clinique ou de l’utilité théorique du phénomène investigué. Déclarer qu’une corrélation est « hautement significative » parce que p < 0,001 ne confère pas un iota de puissance supplémentaire à un r plafonnant à 0,08.
Cette confusion méthodologique engendre en outre une vulnérabilité toxique face aux pratiques de recherche contestables (QRPs) et au fléau du « p-hacking ». Disposant de bases de données massives (Big Data) agrégées sans plan d’expérience préalable rigoureux, certains analystes explorent des matrices croisant des centaines de variables hétéroclites, déterrant inévitablement des dizaines de corrélations de r = 0,07 hautement significatives du fait de la démesure de l’échantillon, pour ensuite bâtir a posteriori des théories spéculatives justifiant ces prétendues découvertes majeures.
6.3 L’usage obligatoire des intervalles de confiance
Afin de juguler ces distorsions d’interprétation et de focaliser l’attention sur l’estimation de la magnitude réelle plutôt que sur l’illusion d’un verdict binaire, les associations scientifiques internationales recommandent sans ambiguïté l’abandon de la dépendance exclusive aux p-valeurs au profit de la publication systématique des intervalles de confiance entourant le coefficient de Pearson, généralement établis au seuil de certitude de 95 %.
En raison du fait que la distribution d’échantillonnage de r devient de plus en plus asymétrique au fur et à mesure qu’elle s’éloigne de zéro, le calcul correct de son intervalle de confiance exige impérativement le recours à la transformation z de Fisher : z’ = 0,5 × ln((1 + r) / (1 – r)). Cette manipulation mathématique stabilise la variance de l’échantillon, permettant d’ériger les bornes critiques standardisées avant d’opérer la rétro-conversion vers l’échelle d’origine de Pearson. L’amplitude de cet intervalle constitue une révélation sans fard de l’incertitude paramétrique du modèle :
- Un coefficient de r = 0,15 dérivé d’un échantillon de 60 personnes produira un intervalle de confiance à 95 % s’étirant approximativement de -0,11 à +0,39, démontrant que la réalité sous-jacente est compatible aussi bien avec une relation négative qu’avec une relation positive modérément forte.
- Le même coefficient de r = 0,15 établi sur une cohorte de 1 500 sujets offrira un intervalle resserré oscillant entre +0,10 et +0,20, certifiant avec une précision chirurgicale l’ancrage définitif du phénomène au sein de la frange des corrélations faibles.
L’intervalle de confiance remet ainsi la précision au centre de la démarche épistémologique, interdisant aux chercheurs de dissimuler la fragilité métrique de leurs estimations ponctuelles derrière le simple apparat d’un seuil de significativité nominal.
7. Artefacts méthodologiques provoquant une sous-estimation de la corrélation
7.1 L’atténuation due au manque de fidélité des mesures
L’une des causes les plus pernicieuses et les plus universelles de l’observation d’une corrélation d’apparence faible réside dans l’imperfection psychométrique des instruments mis en œuvre pour capturer les construits cibles. Dans le cadre de la théorie classique des tests (Classical Test Theory), tout score observé est conceptualisé comme la résultante de la somme d’un score vrai latent et d’une composante d’erreur aléatoire de mesure. Dans la mesure où les erreurs de mesure associées à deux outils indépendants sont postulées comme n’étant pas corrélées entre elles, leur présence massive au sein des variances univariées opère comme un amortisseur mécanique sur la covariance bivariée.
Ce phénomène d’affaissement porte le nom canonique d’atténuation statistique. Charles Spearman fut le premier, dès 1904, à modéliser mathématiquement ce mécanisme et à concevoir la formule fondamentale permettant de rectifier cette distorsion : la corrélation vraie désatténuée entre deux construits latents correspond au ratio entre la corrélation brute observée et la racine carrée du produit des indices de fidélité (tels que l’alpha de Cronbach ou l’oméga de McDonald) des deux échelles d’évaluation employées : r_vrai = r_obs / √(r_xx * r_yy).
L’impact pratique de cette équation s’avère vertigineux. Si une étude explore le lien unissant la flexibilité cognitive et l’empathie à l’aide de tests affichant chacun une fidélité interne médiocre de 0,60, et qu’elle mesure un coefficient de Pearson brut apparemment anecdotique de r = 0,18, l’application de la correction pour atténuation révèle que la véritable association latente culmine en réalité à r = 0,30 (soit un effet moyen substantiel). La faiblesse de la corrélation mesurée n’était donc nullement le reflet d’une indifférence ontologique entre les processus mentaux, mais le strict symptôme de la médiocrité de la tuyauterie instrumentale mobilisée. D’où la supériorité contemporaine des modèles d’équations structurelles (SEM), qui séparent l’erreur de mesure des trajectoires latentes.
7.2 La restriction d’étendue (restriction of range)
Un autre artefact méthodologique redoutable, capable d’écraser artificiellement une relation puissante au point de lui conférer l’apparence d’une corrélation microscopique, est désigné sous le terme de restriction d’étendue ou de sélection de variance. Le coefficient produit-moment de Pearson dépend viscéralement de l’amplitude de la dispersion des observations au sein de l’espace étudié : si la variance univariée de l’un ou des deux prédicteurs est drastiquement amputée par un processus de sélection directe ou indirecte, la covariance bivariée s’effondre de concert par une contrainte purement géométrique.
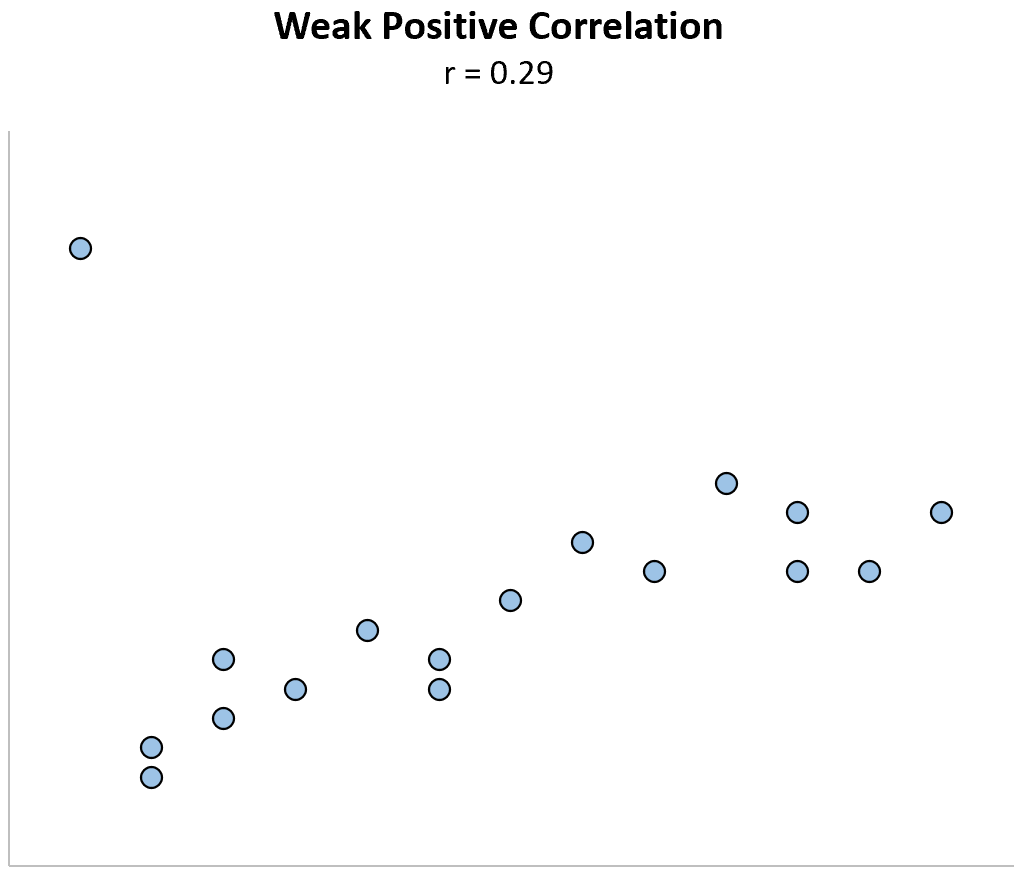
L’illustration historique la plus magistrale de ce paradoxe réside dans l’investigation empirique du lien unissant les scores obtenus aux tests d’aptitude intellectuelle générale (quotient intellectuel ou tests standardisés d’admission de type SAT/GRE) et la réussite ultérieure au cours d’un cursus doctoral d’élite ou dans les grandes écoles de commerce. En explorant cette relation au sein d’une promotion de doctorants hautement sélectionnés, les psychologues documentent couramment des corrélations faibles, oscillant entre r = 0,08 et r = 0,18. Les détracteurs de la psychométrie s’empressent régulièrement d’en déduire que l’intelligence n’exerce aucune influence sur la performance intellectuelle de haut vol.
Cette conclusion relève pourtant d’un sophisme statistique complet. Les étudiants admis dans de tels programmes ont tous été préalablement sélectionnés sur la base de scores d’aptitude phénoménaux, éliminant de facto 95 % de la distribution normale de la population générale. Si l’on applique les formules de correction pour restriction d’étendue développées par Thorndike, on rétablit la variance réelle de la population globale, révélant que la véritable corrélation populationnelle avoisine r = 0,55. La prétendue corrélation faible n’était qu’un trompe-l’œil produit par l’homogénéité artificielle du sous-groupe sélectionné.
7.3 Non-linéarité et influence des valeurs extrêmes
Le calcul du r de Pearson postule inconditionnellement que la trajectoire unissant les centroïdes bivariés épouse la forme rectiligne d’une fonction affine. Or, un nombre considérable de dynamiques psychophysiologiques et comportementales obéissent à des fonctions curvilignes ou sinusoïdales. Le cas paradigmatique le plus célèbre est incontestablement incarné par la loi neurobiologique de Yerkes-Dodson, qui théorise que l’efficacité de la performance motrice ou cognitive croît de manière continue avec l’activation de l’éveil attentionnel (arousal) jusqu’à un plateau optimal, avant de se dégrader brutalement sous l’effet d’une anxiété tétanisante, dessinant une parfaite parabole en U inversé.
Si un analyste applique aveuglément le coefficient linéaire de Pearson sur une distribution bivariée régie par un tel patron en U inversé parfaitement déterministe, les moitiés ascendante et descendante de la courbe neutraliseront mutuellement leurs covariances respectives, aboutissant à un r empirique de 0,04. Conclure à l’existence d’une corrélation faible ou d’une absence d’effet constituerait une aberration scientifique dévastatrice, le lien latent étant en vérité d’une puissance absolue mais d’une nature géométrique non linéaire invisible au regard myope du test de Pearson.
Parallèlement, la vulnérabilité extrême de ce coefficient à l’influence de points atypiques aberrants (outliers) peut défigurer radicalement la métrique. La simple présence d’un ou deux individus extravagants situés à plusieurs écarts-types de la moyenne bivariée peut suffire, en agissant comme des leviers mathématiques disproportionnés, soit à fabriquer artificiellement une corrélation artificielle là où règne le vide absolu, soit à aplatir totalement une association substantielle existante, la ramenant frauduleusement dans la catégorie des corrélations faibles. L’inspection visuelle minutieuse et systématique des diagrammes de dispersion demeure le rempart méthodologique indispensable avant toute assignation d’un qualificatif de magnitude.
8. Applications et exemples de corrélations faibles en recherche psychologique
8.1 Psychologie de la personnalité et consistance comportementale
L’histoire de la psychologie différentielle moderne a été profondément ébranlée en 1968 par la publication de l’ouvrage iconoclaste de Walter Mischel intitulé Personality and Assessment. Réalisant une synthèse critique impitoyable de décennies d’investigations psychométriques, Mischel formula un constat qui fit l’effet d’une déflagration institutionnelle : la corrélation unissant les scores obtenus sur un trait de personnalité global auto-évalué (par exemple l’amabilité, l’honnêteté ou l’extraversion) et la manifestation d’un comportement objectif concret mesuré en laboratoire ou sur le terrain ne dépasse pratiquement jamais un plafond structurel oscillant entre r = 0,20 et r = 0,30. Il baptisa cette barrière métrique le « coefficient de personnalité ».
Ce constat déclencha ce que la discipline appela la « controverse personne-situation », au cours de laquelle le courant béhavioriste et les partisans du situationnisme radical proclamèrent la mort théorique du concept de personnalité stable, arguant que des traits n’expliquant que 4 à 9 % du comportement immédiat ne constituaient que des fictions sémantiques dénuées de pouvoir explicatif réel face à la puissance du contexte situationnel immédiat. L’observation d’une corrélation faible à modeste servait ainsi d’argument pour invalider un pan entier de la recherche scientifique.
Il fallut les travaux de riposte d’auteurs comme Seymour Epstein pour démontrer que si la corrélation trait-comportement est effectivement faible (r ≈ 0,20) lorsqu’on prétend prédire un acte spécifique isolé à un moment T (par exemple, le fait qu’un sujet extraverti prenne la parole à une réunion donnée), cette même association s’élève à des niveaux impressionnants (r > 0,70) dès lors que l’on agrège les comportements sur des périodes temporelles étendues. Le comportement spécifique individuel est volatile et contextuel, mais la sédimentation probabiliste sur le long cours valide la réalité fonctionnelle de ces impulsions faibles du tempérament.
8.2 Psychologie clinique et efficacité des interventions
Dans le domaine de la psychologie clinique et de la psychothérapie fondée sur les preuves (Evidence-Based Practice), l’illusion de la toute-puissance d’un facteur déterminant unique a depuis longtemps cédé la place à la reconnaissance de dynamiques multifactorielles régies par des associations modestes. L’une des découvertes les plus constantes de la recherche contemporaine sur les facteurs communs concerne l’impact de l’alliance thérapeutique perçue par le patient sur la rémission symptomatique globale. Malgré le statut prépondérant accordé à ce concept par les écoles cliniques humanistes, psychodynamiques et cognitives, les méta-analyses les plus exhaustives (telles que celles de Horvath et Symonds) chiffrent inlassablement la corrélation globale à r ≈ 0,22.
Un tableau similaire s’impose dès que l’on explore l’interaction entre les biomarqueurs neurologiques ou génétiques et l’expression clinique des pathologies psychiatriques. L’association reliant, par exemple, le polymorphisme génétique du transporteur de la sérotonine (5-HTTLPR) à la vulnérabilité dépressive face aux traumatismes infantiles s’inscrit au mieux dans une fourchette de corrélation comprise entre r = 0,10 et r = 0,15. De même, les corrélations reliant les anomalies volumétriques de l’hippocampe aux scores sur les échelles de stress post-traumatique dépassent très exceptionnellement 0,20.
Ces magnitudes discrètes ne discréditent en rien l’importance théorique de l’alliance relationnelle ou de la neurobiologie clinique. Elles rappellent simplement avec humilité que l’étiologie des troubles mentaux comme les leviers de leur guérison s’articulent autour d’un concert polyphonique de variables, où la résilience de l’individu émerge de l’interaction symphonique de dizaines de micro-déterminants interconnectés.
8.3 Psychologie sociale et bien-être subjectif
La psychologie sociale et l’économie comportementale fournissent sans conteste les exemples les plus contre-intuitifs et médiatisés de corrélations dont la faiblesse numérique contredit les représentations naïves du sens commun. L’une des illustrations les plus éclatantes concerne l’association entre le niveau de revenu financier annuel d’un individu et son niveau de bonheur subjectif ou de satisfaction vitale auto-rapportée. Malgré la conviction populaire tenace affirmant que la richesse constitue le moteur absolu de l’épanouissement humain, les enquêtes sociologiques massives menées sur des centaines de milliers de citoyens à travers le globe (dans le sillage des travaux de Kahneman et Deaton) révèlent une corrélation linéaire faible, oscillant invariablement entre r = 0,12 et r = 0,17 dès lors que le seuil de pauvreté absolue est franchi.
Un autre cas empirique d’actualité brûlante concerne l’impact présumé de l’exposition aux écrans et aux réseaux sociaux sur la santé psychologique et le déclin du bien-être des adolescents contemporains. Alors que le discours médiatique et politique s’alarme d’un prétendu cataclysme psychosocial, les méta-analyses rigoureuses menées par Amy Orben et Andrew Przybylski mobilisant des jeux de données regroupant plus de 300 000 participants ont révélé que la corrélation réelle entre l’usage des technologies numériques et le mal-être psychologique culmine à r = -0,04 (ou au mieux r = -0,11 pour des sous-populations spécifiques), une magnitude comparable à l’impact négatif sur la santé de la consommation d’aliments riches en matières grasses ou du fait de ne pas porter régulièrement de lunettes correctrices.
Ces données démontrent avec force que la surmédiatisation de relations causales directes relève souvent de la panique morale, tandis que l’investigation statistique révèle des liens d’une subtilité ténue qui interdisent les explications péremptoires et appellent à des politiques publiques nuancées.
9. L’impact cumulatif à grande échelle d’une corrélation qualifiée de faible
9.1 Le Binomial Effect Size Display (BESD) de Rosenthal et Rubin
Afin de dissiper l’injustice herméneutique causée par la métrique réductrice du pourcentage de variance expliquée et d’illustrer la puissance pratique insoupçonnée des corrélations faibles, Robert Rosenthal et Donald Rubin ont forgé en 1982 un puissant paradigme de conversion cognitive : l’affichage binomial de la taille de l’effet, ou Binomial Effect Size Display (BESD). Le principe mathématique fondamental du BESD consiste à traduire instantanément un coefficient de Pearson r calculé sur des variables continues en un tableau de contingence bivarié classique 2×2 représentant les taux de succès et d’échec différentiels entre deux groupes contrastés d’effectifs égaux.
La formule matricielle de conversion s’avère d’une élégance algorithmique absolue : le taux de succès au sein du groupe bénéficiant d’une intervention ou d’une condition favorable s’exprime par l’équation 0,50 + r / 2, tandis que le taux de succès dans le groupe témoin ou défavorable devient symétriquement 0,50 – r / 2. Dès lors, examinons la transmutation opérée pour une corrélation statistiquement étiquetée comme « très faible », par exemple un modeste r = 0,10, dont nous avons vu qu’il n’expliquait qu’un minuscule 1 % de variance partagée :
L’application du BESD transforme ce r = 0,10 en un différentiel éclatant : le taux de succès au sein du groupe recevant l’intervention s’élève à 0,50 + (0,10 / 2) = 0,55 (soit 55 %), tandis que le taux de succès du groupe contrôle tombe à 0,50 – (0,10 / 2) = 0,45 (soit 45 %). En termes d’efficacité réelle, une corrélation d’apparence négligeable de 0,10 induit un écart net de 10 points de pourcentage de performance d’une condition à l’autre. Dans un processus industriel de sélection professionnelle ou dans un protocole clinique, déplacer le taux de réussite de 45 % à 55 % représente un levier opérationnel colossal, aux retombées économiques et humaines monumentales.
9.2 Conséquences démographiques et de santé publique
L’incompréhension des décideurs politiques face aux grandeurs statistiques abstraites a fréquemment été désamorcée par les épidémiologistes grâce à des transpositions démographiques issues du monde médical. L’analogie la plus célèbre et la plus spectaculaire demeure sans conteste l’essai clinique randomisé historique du Physicians’ Health Study conduit en 1988, évaluant l’efficacité de la prise quotidienne d’aspirine à faible dose sur la prévention primaire de l’infarctus du myocarde chez plus de 22 000 praticiens de santé.
À l’issue de l’analyse intermédiaire, le comité de surveillance indépendant a exigé l’interruption prématurée immédiate de l’essai clinique afin de ne pas priver les participants du groupe placebo d’un bienfait vital évident. Or, quelle était la corrélation mathématique linéaire mesurée entre la prise d’aspirine et la survenue de l’attaque cardiaque ? Le coefficient s’élevait précisément à r = 0,034 (soit un r² ridicule d’environ 0,0011, expliquant à peine un dixième de 1 % de la variance totale). Dans la grille aveugle de Jacob Cohen, un tel résultat aurait été purement et simplement balayé comme un bruit de fond inexistant. Pourtant, à l’échelle démographique, ce micro-effet de 0,034 représentait la prévention avérée de centaines de décès prématurés et la survie confirmée d’un contingent massif d’êtres humains.
Dans le secteur de la prévention psychologique et de la santé mentale communautaire, ce raisonnement s’applique avec une vigueur redoublée. Une campagne numérique de prévention du suicide ou une intervention minimale de pleine conscience qui n’affiche qu’une corrélation d’ordre r = 0,06 avec la réduction de l’idéation dépressive se traduira, si elle est diffusée à l’échelle d’une métropole de dix millions d’âmes, par le sauvetage effectif de plusieurs centaines de vies humaines chaque année. Juger la pertinence d’une action publique à l’aune de la seule magnitude brute de son association statistique constitue une faute éthique et managériale inacceptable.
9.3 Accumulation temporelle des petits effets
La puissance latente d’une corrélation faible se dévoile également lorsqu’on introduit la coordonnée du temps et le principe de l’itération développementale. Dans le tissu de l’existence quotidienne, les décisions comportementales, les affects et les micro-choix cognitifs ne se déploient pas dans le vide d’une administration de questionnaire unique, mais se répètent des centaines de milliers de fois au fil des semaines, des années et des décennies d’une biographie humaine.
Ce phénomène d’accumulation dynamique a été théorisé avec brio par David Funder et Daniel Ozer sous le modèle de « l’effet d’entraînement cumulé » (cumulative compounding effect). Si un individu possède un trait de caractère qui n’exerce qu’une influence probabiliste infinitésimale de r = 0,08 sur sa probabilité quotidienne d’adopter une conduite proactive (par exemple, relire ses notes de cours, manger un fruit plutôt qu’une sucrerie, ou écouter patiemment son conjoint), cet effet sera totalement invisible et insaisissable sur l’observation d’une seule journée d’enregistrement. La prédiction instantanée de l’acte ponctuel échouera lamentablement.
Néanmoins, comme pour les intérêts composés dans le calcul financier exponentiel, la réitération continue de cette infime déviation probabiliste sur 365 jours par an pendant une trentaine d’années creuse un fossé gigantesque entre deux trajectoires biographiques. Au terme de plusieurs décennies, ce qui n’était initialement qu’une corrélation microscopique d’ordre zéro aura forgé de toutes pièces la différence entre le succès académique et l’échec scolaire, la longévité biologique et la morbidité cardio-vasculaire précoce, la stabilité conjugale et la rupture affective. L’effet faible instantané est la brique élémentaire invisible dont sont bâties les grandes destins longitudinaux.
10. Comparaison du r de Pearson avec d’autres indices d’association
10.1 Le coefficient rho de Spearman et le tau de Kendall
L’évaluation rigoureuse d’une corrélation faible implique de situer le classique r de Pearson au sein du panthéon plus large des métriques d’association non paramétriques, dominé par le coefficient rho (ρ) de Spearman et le tau (τ) de Kendall. Alors que Pearson impose l’homoscédasticité et l’alignement strictement rectiligne sur des échelles métriques, Spearman opère une transformation préliminaire des données brutes en rangs ordinaux, calculant le produit-moment sur ces classements hiérarchiques.
Cette approche par les rangs confère au rho de Spearman une insensibilité structurelle aux valeurs aberrantes extrêmes et lui permet d’évaluer la monotonie globale d’une fonction plutôt que sa seule linéarité affine. Dès lors, ce qui apparaît comme une corrélation faible à travers les lunettes de Pearson (par exemple un r = 0,18) en raison de l’écrasement produit par des asymptotes ou des étirements aux extrémités peut fort bien se métamorphoser en une association ordinale d’intensité modérée à forte (rho = 0,38) une fois l’influence parasitaire des intervalles réels neutralisée.
Le tau de Kendall, pour sa part, repose sur une modélisation purement probabiliste et combinatoire fondée sur le dénombrement des paires concordantes et discordantes au sein de la matrice bivariée. Il en résulte que les valeurs numériques générées par le tau de Kendall sont intrinsèquement plus resserrées vers zéro que celles du r de Pearson. Un tau de Kendall de magnitude τ = 0,15 équivaut conceptuellement et mathématiquement à un coefficient de Pearson d’environ r = 0,23. L’analyste doit donc faire preuve d’une prudence sémantique extrême : un même adjectif qualificatif de « faiblesse » ne saurait recouvrir la même réalité numérique selon qu’il s’applique aux rangs inversés de Kendall ou au formalisme direct de Pearson.
10.2 Le coefficient point-bisériale et phi
La taxonomie des corrélations s’enrichit dès lors que l’architecture des données s’écarte de la bi-continuité pour faire intervenir des variables catégorielles ou binaires. Lorsque l’investigateur explore l’association unissant une variable métrique continue à une entité dichotomique naturelle (par exemple le genre biologique ou la survie versus le décès), le coefficient produit-moment de Pearson prend formellement l’appellation de corrélation point-bisériale (r_pb). Lorsque les deux dimensions sont strictement dichotomiques (présence/absence d’un gène croisée avec présence/absence d’un trouble), la métrique prend le nom de coefficient phi (φ).
Or, les coefficients r_pb et φ sont frappés d’une sévère contrainte mathématique intrinsèque souvent occultée : la magnitude maximale théoriquement atteignable par la formule n’atteint pratiquement jamais +1,00 ou -1,00, à moins que la proportion de distribution des modalités sur les deux variables soit rigoureusement symétrique et équilibrée à 50/50. Dès que la prévalence du phénomène devient asymétrique ou rare (par exemple, une pathologie clinique n’affectant que 2 % de la population), la valeur plafond du coefficient s’effondre drastiquement par construction algébrique, plafonnant parfois mécaniquement à 0,25 ou 0,30.
Qualifier à tort de « corrélation faible » un coefficient point-bisériale de r_pb = 0,18 obtenu sur une cohorte médicale asymétrique procède d’une grave méconnaissance méthodologique. Si la borne supérieure mathématiquement accessible pour cette distribution est de 0,22, un coefficient mesuré à 0,18 représente en réalité 81 % de l’intensité maximale concevable dans l’univers réel. L’interprétation de la magnitude ne doit jamais s’affranchir de la topographie des plafonds mathématiques propres à chaque type de codage variable.
10.3 Équivalence avec le d de Cohen et les rapports de cotes (Odds Ratios)
Pour parfaire la maîtrise herméneutique des corrélations de faible magnitude, il est essentiel de connaître les algorithmes de transposition permettant de naviguer sans heurts entre la famille des métriques de corrélation (famille r) et la famille des métriques de différence standardisée de moyennes (famille d), dont le d de Cohen représente l’étalon d’or en recherche expérimentale. Grâce aux dérivations établies de longue date par les méthodologistes, la conversion standardisée approximative s’opère par la formule : d ≈ 2r / √(1 – r²).
L’exploitation de cette équivalence mathématique réserve des enseignements saisissants quant à la portée réelle d’une corrélation qualifiée de faible :
- Une corrélation de r = 0,10 correspond très exactement à un d de Cohen de 0,20.
- Une corrélation de r = 0,20 équivaut à un d de Cohen de 0,41 (ce qui frôle le seuil d’un effet modéré).
- Une corrélation de r = 0,30 se traduit par un d de Cohen de 0,63 (soit un effet d’une ampleur considérable dépassant largement le stade moyen).
Dans la littérature biomédicale et épidémiologique, cette même corrélation de r = 0,10 se traduira couramment, par les équations logistiques de conversion, en un rapport de cotes (Odds Ratio ou OR) gravitant autour de 1,45 à 1,50. Or, tout épidémiologiste sait pertinemment qu’une exposition environnementale augmentant les cotes d’apparition d’une pathologie de 45 % constitue une alerte sanitaire majeure justifiant des politiques régaliennes immédiates. Dès lors, convertir stratégiquement une corrélation modeste de 0,10 en d de Cohen ou en Odds Ratio constitue souvent le meilleur moyen pédagogique de briser l’aveuglement des comités de décision et des cliniciens face aux associations statistiques méconnues.
11. Les pièges d’interprétation et biais fréquents face aux corrélations faibles
11.1 Le saut injustifié vers la causalité
Le piège épistémologique le plus ancien et le plus universellement combattu dans les cours d’introduction à la méthode scientifique réside dans le saut inférentiel injustifié de la co-variation vers la causalité déterministe, matérialisé par le célèbre adage latin cum hoc ergo propter hoc. Si ce risque de confusion est universel, il prend une acuité particulièrement trompeuse et pernicieuse lorsqu’il s’applique à des corrélations faibles oscillant entre 0,10 et 0,25.
Dans la littérature de vulgarisation comme dans certaines publications scientifiques précipitées, il est fréquent de voir des auteurs s’emparer d’un lien faible mais significatif (par exemple entre la pratique de jeux vidéo et des manifestations discrètes d’agressivité verbale) pour échafauder instantanément un récit mécaniste direct affirmant que « les jeux vidéo causent la délinquance ». L’omission des facteurs de confusion (confounding variables) et l’incapacité à tester l’hypothèse de la causalité inverse constituent ici des négligences méthodologiques flagrantes. Il est infiniment plus plausible qu’un ensemble complexe de tiers facteurs non contrôlés (dysfonctionnements familiaux, impulsivité innée, isolement social) gouverne à la fois l’attrait pour l’écran et l’irritabilité affective.
L’utilisation d’un vocabulaire causal insidieux — tel que « l’influence », « l’impact », « la modulation » ou « l’empreinte » — doit être impitoyablement bannie dès lors que l’on se trouve en présence d’associations corrélationnelles transversales faibles. Une corrélation d’amplitude modeste est la porte d’entrée d’une énigme empirique complexe, en aucun cas son dénouement causal univoque.
11.2 L’omission de variables modératrices et médiatrices
Un autre biais majeur guettant l’investigateur confronté à une corrélation globale d’ordre zéro proche de zéro consiste à conclure hâtivement à l’absence de lien substantiel, en négligeant la présence potentielle de variables modératrices qui fragmentent la structure du phénomène. L’occultation d’un effet d’interaction majeur peut conduire à une situation d’annulation symétrique où deux dynamiques opposées s’annihilent mutuellement au sein de l’échantillon agrégé :
- Une variable indépendante peut exercer un effet fortement positif (+0,40) chez les hommes.
- Cette même variable peut manifester un effet fortement négatif (-0,40) chez les femmes.
- Le calcul global indifférencié du coefficient de Pearson sur la population totale produira un r de 0,00 parfaitement nul.
De surcroît, le phénomène méthodologique redoutable de la « variable de suppression » (suppressor variable) peut masquer totalement une relation causale robuste. Une variable intermédiaire non prise en compte dans le modèle bivarié peut absorber l’erreur résiduelle ou bloquer la transmission du signal. Ce n’est qu’en intégrant des équations de médiation et de modération au sein de régressions multivariées hiérarchiques que la corrélation d’ordre zéro, initialement faible ou insignifiante, dévoile toute sa puissance et sa profondeur architecturale.
11.3 Le piège de la minimisation nihiliste
À l’exact opposé de la surinterprétation causale se trouve un travers tout aussi délétère pour le progrès de la connaissance : le piège de la minimisation nihiliste. Nourri par une lecture rigide et dévitalisée des critères de Jacob Cohen, ce biais pousse des évaluateurs de revues à fort impact et des directeurs de recherche à rejeter systématiquement des manuscrits solides au seul motif que les corrélations rapportées n’atteignent pas un plancher arbitraire de r = 0,30 ou 0,40.
Cette forme de censure méthodologique alimente directement le « biais de publication » (publication bias) et le fléau du tiroir de classement (file-drawer effect). Les jeunes chercheurs, terrorisés à l’idée de publier des tailles d’effet réalistes mais qualifiées de faibles, sont incités à torturer leurs données par des purges arbitraires d’échantillons ou à manipuler leurs critères d’inclusion jusqu’à gonfler artificiellement la magnitude de leurs indices au-delà des standards exigés. Ce faisant, on expulse de l’espace académique les mesures authentiques de la subtilité humaine au profit d’artefacts sensationnalistes irréplicables.
Le mépris envers les corrélations faibles constitue ainsi un obstacle majeur à la découverte de mécanismes fins, discrets et cumulatifs qui tissent la trame fondamentale de l’esprit humain et des écosystèmes sociétaux. L’orthodoxie méthodologique doit apprendre à accueillir les signaux ténus avec la même révérence épistémologique que les séismes théoriques majeurs.
12. Bonnes pratiques méthodologiques pour documenter une corrélation faible
12.1 La contextualisation systématique dans la littérature du domaine
Face à l’émergence d’une corrélation d’amplitude modeste au sein d’une investigation empirique, la première règle de bonne conduite scientifique consiste à proscrire impérativement l’usage des adjectifs génériques vagues et paresseux, tels que « le lien est faible » ou « l’association est médiocre ». Le chercheur se doit d’ancrer immédiatement sa trouvaille numérique dans le tissu comparatif des méta-analyses contemporaines publiées dans son champ disciplinaire spécifique.
Une magnitude de r = 0,16 doit être explicitement comparée à la médiane empirique documentée par Funder et Ozer pour des paradigmes équivalents, ou confrontée aux distributions d’effets recensées dans des synthèses systématiques rigoureuses. En démontrant qu’un coefficient de 0,16 se situe au cinquantième percentile des découvertes de la psychologie différentielle, le chercheur désamorce par avance les critiques décontextualisées et valide l’inscription normale de son travail dans l’état de l’art du domaine.
En outre, l’évaluation doit porter sur la rentabilité prédictive incrémentielle de la variable. Même si elle n’affiche qu’une corrélation isolée modeste, apporte-t-elle une amélioration statistiquement robuste de l’ajustement du modèle lorsqu’elle est ajoutée à un ensemble de prédicteurs classiques préexistants ? C’est à cette utilité marginale que se jauge véritablement la noblesse théorique d’un résultat scientifique.
12.2 Rigueur du rapport statistique et transparence open science
La communication scientifique moderne, portée par les exigences du mouvement de la science ouverte (Open Science Framework), impose des standards de transparence intransigeants pour la documentation des coefficients de faible magnitude. Il est désormais formellement proscrit de se borner à mentionner une corrélation par un simple r flanqué d’une mention nébuleuse de p < 0,05. Le protocole de rédaction rigoureux exige impérativement la mention simultanée :
- De la valeur métrique exacte du coefficient non arrondi (par exemple r = 0,142).
- De la p-valeur exacte sans troncature arbitraire (par exemple p = 0,023 au lieu de p < 0,05).
- De l’intervalle de confiance bilatéral à 95 % calculé via la métrique de Fisher (par exemple IC95% [0,02 ; 0,26]).
- De la taille finale effective de l’échantillon d’analyse après purge transparente des données manquantes.
Parallèlement, la mise à disposition publique des données brutes au sein de dépôts institutionnels certifiés, ainsi que la publication des matrices de corrélation intégrales et non tronquées, permettent à la communauté des pairs de soumettre ces résultats à des méta-analyses futures et de vérifier la robustesse des modèles face à des spécifications alternatives, prémunissant la discipline contre les illusions de tiroir.
12.3 Adoption d’une approche multivariée intégrative
Enfin, la maturité méthodologique contemporaine invite à transcender la vision atomistique et isolée des corrélations bivariées simples au profit d’une approche multivariée et systémique unifiée. Dans le paysage de la modélisation moderne, une corrélation faible d’ordre zéro n’est jamais considérée comme une finalité statique, mais comme une ligne de force élémentaire au sein d’un treillis dynamique de covariations interactives.
Le recours à des techniques d’analyse avancées, telles que les modèles en réseaux psychologiques (network analysis) développés par Denny Borsboom et ses collaborateurs, permet de cartographier la manière dont une multitude de relations d’intensités modestes (r ≈ 0,10 à 0,20) s’agrègent pour former des nœuds centraux et des grappes d’attraction gouvernant la transition d’un état psychique sain vers une boucle psychopathologique fermée. Dans ce cadre, ce ne sont plus les liens isolés qui prédisent le comportement, mais la connectivité globale et la densité du réseau dans son ensemble.
L’avenir de la recherche quantitative n’appartient plus à la quête chimérique de variables magiques affichant des corrélations spectaculaires et simplistes, mais à l’orchestration savante de dizaines de micro-connexions discrètes intégrées au sein d’architectures causales sophistiquées. C’est en embrassant la réalité incontournable des corrélations faibles que la science contemporaine honore enfin l’infinie et fascinante complexité de l’esprit humain et des systèmes vivants.
Références
Borsboom, D., Cramer, A. O., Schmittmann, V. D., Epskamp, S., & Waldorp, L. J. (2011). The small world of psychopathology. PloS ONE, 6(11), Article e27407. https://doi.org/10.1371/journal.pone.0027407
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2e éd.). Lawrence Erlbaum Associates.
Cronbach, L. J., & Meehl, P. E. (1955). Construct validity in psychological tests. Psychological Bulletin, 52(4), 281-302. https://doi.org/10.1037/h0040957
Evans, J. D. (1996). Straightforward statistics for the behavioral sciences. Brooks/Cole Publishing Company.
Funder, D. C., & Ozer, D. J. (2019). Evaluating effect size in psychological research: Sense and nonsense. Advances in Methods and Practices in Psychological Science, 2(2), 156-168. https://doi.org/10.1177/2515245919877207
Gignac, G. E., & Szodorai, E. T. (2016). Effect size guidelines for individual differences researchers. Personality and Individual Differences, 102, 74-78. https://doi.org/10.1016/j.paid.2016.06.069
Hemphill, J. F. (2003). Interpreting the magnitudes of correlation coefficients. American Psychologist, 58(1), 78-79. https://doi.org/10.1037/0003-066X.58.1.78
Horvath, A. O., & Symonds, B. D. (1991). Relation between working alliance and outcome in psychotherapy: A meta-analysis. Journal of Counseling Psychology, 38(2), 139-149. https://doi.org/10.1037/0022-0167.38.2.139
Kahneman, D., & Deaton, A. (2010). High income improves evaluation of life but not emotional well-being. Proceedings of the National Academy of Sciences, 107(38), 16489-16493. https://doi.org/10.1073/pnas.1011492107
Meyer, G. J., Finn, S. E., Eyde, L. D., Kay, G. G., Moreland, K. L., Dies, R. R., Eisman, E. J., Kubiszyn, T. W., & Reed, G. M. (2001). Psychological testing and psychological assessment: A review of evidence and issues. American Psychologist, 56(2), 128-165. https://doi.org/10.1037/0003-066X.56.2.128
Mischel, W. (1968). Personality and assessment. John Wiley & Sons.
Orben, A., & Przybylski, A. K. (2019). The association between adolescent well-being and digital technology use. Nature Human Behaviour, 3(2), 173-182. https://doi.org/10.1038/s41562-018-0506-1
Pearson, K. (1895). Note on regression and inheritance in the case of two parents. Proceedings of the Royal Society of London, 58, 240-242. https://doi.org/10.1098/rspl.1895.0041
Rosenthal, R., & Rubin, D. B. (1982). A simple, general purpose display of magnitude of experimental effect. Journal of Educational Psychology, 74(2), 166-169. https://doi.org/10.1037/0022-0663.74.2.166
Spearman, C. (1904). The proof and measurement of association between two things. The American Journal of Psychology, 15(1), 72-101. https://doi.org/10.2307/1412159
Steiger, J. H. (1980). Tests for comparing elements of a correlation matrix. Psychological Bulletin, 87(2), 245-251. https://doi.org/10.1037/0033-2909.87.2.245
Thorndike, R. L. (1949). Personnel selection: Test and measurement techniques. John Wiley & Sons.