
Dans le champ de la recherche scientifique, de la psychologie quantitative et de l’analyse biostatistique, la structure intrinsèque d’un jeu de données détermine la validité des conclusions théoriques et cliniques que l’on peut en tirer. L’architecture d’un protocole d’évaluation ne se résume pas à l’accumulation de valeurs numériques ; elle repose sur la nature fondamentale du lien logique et probabiliste qui relie ces observations. Parmi les configurations expérimentales les plus robustes figurent les données dites appariées, ou échantillons dépendants, dont l’exploitation judicieuse constitue l’un des piliers méthodologiques de l’inférence moderne.
Trop souvent confondues avec des observations indépendantes par les praticiens novices, les données appariées répondent à une logique de couplage strict. Elles surviennent dès lors que deux mesures partagent une source commune de variance systématique, qu’il s’agisse d’un même individu évalué à des moments distincts ou de deux participants minutieusement associés sur la base de covariables critiques. Cette dépendance, loin de constituer une entrave analytique, représente un levier d’une efficacité mathématique remarquable : elle permet d’isoler l’effet expérimental direct en neutralisant le bruit de fond induit par l’hétérogénéité interindividuelle.
Comprendre la nature, les prérequis mathématiques, les méthodes d’analyse paramétriques et non paramétriques, ainsi que les pièges méthodologiques inhérents aux données appariées est une condition sine qua non pour tout chercheur en sciences du comportement et de la santé. Cet article explore de manière exhaustive les fondements conceptuels, les typologies protocolaires, les modélisations inférentielles de pointe et les pratiques computationnelles indispensables à la maîtrise de ces architectures de données.
1. Introduction fondamentale aux données appariées en psychologie
1.1 Définition statistique et conceptuelle des données appariées
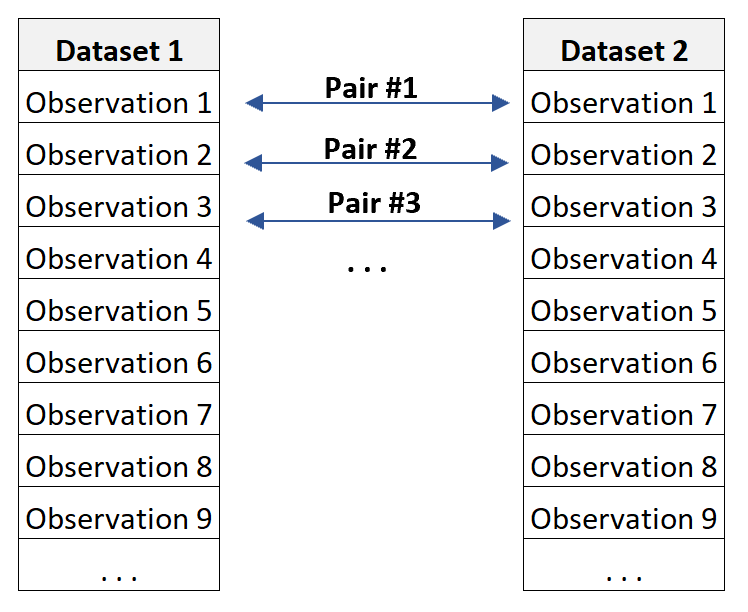
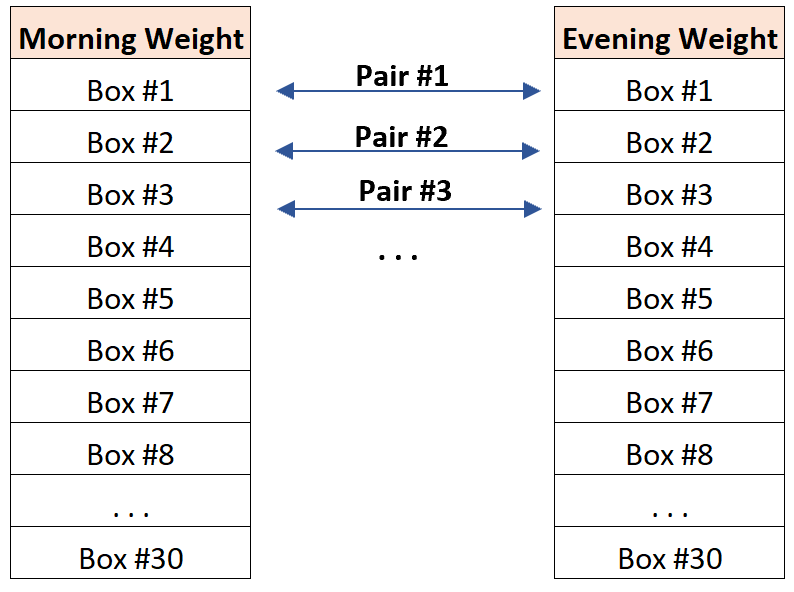
D’un point de vue formel, un ensemble de données est qualifié d’apparié lorsque deux vecteurs d’observations présentent une dimension rigoureusement identique et que chaque élément du premier vecteur est intrinsèquement et exclusivement relié à un élément spécifique du second vecteur. Contrairement aux plans à groupes indépendants où les participants sont distribués de manière aléatoire sans relation mutuelle, les données appariées reposent sur une covariance positive sous-jacente entre les paires d’observations. Dans la recherche en psychologie, cette interdépendance émane du fait que les deux scores d’une même paire partagent une multitude de déterminants biologiques, cognitifs, environnementaux et mnésiques inhérents à l’unité statistique observée.
Cette dépendance statistique intrinsèque modifie en profondeur la dynamique de la variance. Lorsqu’un même individu est mesuré à deux reprises, sa vitesse de traitement de base, ses traits de personnalité stables, son niveau socio-économique et ses prédispositions génétiques demeurent constants d’une passation à l’autre. En termes probabilistes, la covariance entre la mesure initiale et la mesure consécutive n’est pas nulle. Cette structure de corrélation intra-sujet est la clé de voûte de la modélisation appariée : elle permet de partitionner la variance totale observée en séparant la variance d’intérêt — celle provoquée par la manipulation expérimentale ou le facteur temporel — de la variance d’erreur attribuée aux différences stables entre les sujets.
L’importance de cette approche dans les plans expérimentaux réside dans sa capacité à réduire drastiquement la variance d’erreur non contrôlée. En éliminant l’hétérogénéité interindividuelle de l’équation différentielle, le chercheur améliore considérablement le rapport signal sur bruit. Une modification subtile d’un état psychologique, qui aurait été totalement masquée par les écarts massifs existant naturellement d’un participant à l’autre dans un plan factoriel inter-sujets, peut alors être détectée avec une sensibilité et une précision analytique optimales.
1.2 Le principe fondamental de la correspondance univoque
L’intégrité formelle des données appariées repose sur l’exigence absolue d’une bijection mathématique stricte entre les éléments des deux ensembles de données. En d’autres termes, chaque observation collectée dans la condition A doit correspondre à une, et une seule, observation dans la condition B. Cette réciprocité parfaite implique que l’ordre des éléments n’est pas interchangeable de manière aléatoire : désolidariser une valeur de son homologue détruit instantanément la structure d’appariement et vicie l’ensemble des estimateurs de variance calculés ultérieurement.
Les conséquences d’une rupture d’appariement sont particulièrement délétères pour l’intégrité de la structure matricielle des données. Si, en raison d’une perte de vue au suivi clinique ou d’un échec technique lors de l’enregistrement de la réponse cognitive, un score de la condition B vient à manquer, l’observation correspondante de la condition A perd son ancre relationnelle. Dans le cadre des analyses paramétriques classiques telles que le test t pour échantillons appariés, cela se traduit traditionnellement par l’élimination pure et simple de l’ensemble de la paire, ce qui altère la complétude de l’échantillon et peut introduire des biais d’attrition systématiques.
Il convient par ailleurs d’établir une distinction épistémologique et méthodologique entre l’appariement naturel et l’appariement artificiel :
- L’appariement naturel : Il s’impose de lui-même par l’ontologie de l’objet d’étude. Il s’agit typiquement du même sujet biologique suivi au fil du temps (mesures répétées longitudinales) ou de dyades écologiquement interdépendantes, telles que des paires de jumeaux monozygotes, des couples mariés ou des fratries.
- L’appariement artificiel : Il résulte d’un choix délibéré du chercheur lors de la phase de conception du protocole. Face à l’impossibilité d’utiliser un plan intra-sujet, l’expérimentateur associe artificiellement deux participants distincts mais rendus équivalents sur des dimensions critiques identifiées a priori, telles que le quotient intellectuel, l’âge chronologique ou la sévérité basale d’un trouble psychiatrique.
1.3 Distinction critique entre échantillons indépendants et échantillons dépendants
La distinction entre échantillons indépendants et dépendants réside dans la matrice de variance-covariance des observations. Dans un devis à échantillons indépendants, la covariance théorique entre le score d’un individu du groupe expérimental et celui d’un individu du groupe témoin est strictement égale à zéro. La variance de la différence entre les moyennes des deux groupes est alors égale à la somme arithmétique de leurs variances échantillonnales respectives divisées par leurs effectifs. En revanche, dans un schéma apparié, la variance de la différence moyenne intègre un terme de covariance négatif soustractif : plus la corrélation intra-paire est élevée, plus la variance de l’estimateur de contraste s’effondre.
L’application erronée d’un modèle pour échantillons indépendants sur des données structurellement appariées constitue une faute méthodologique lourde d’implications inférentielles. En négligeant la covariance positive entre les mesures, le chercheur gonfle artificiellement le dénominateur du ratio de test (l’erreur type de la différence). Cela conduit inévitablement à une sous-estimation dramatique de la statistique de test observée et à une explosion du risque d’erreur de type II (non-rejet d’une hypothèse nulle pourtant fausse dans la population, ou faux négatif).
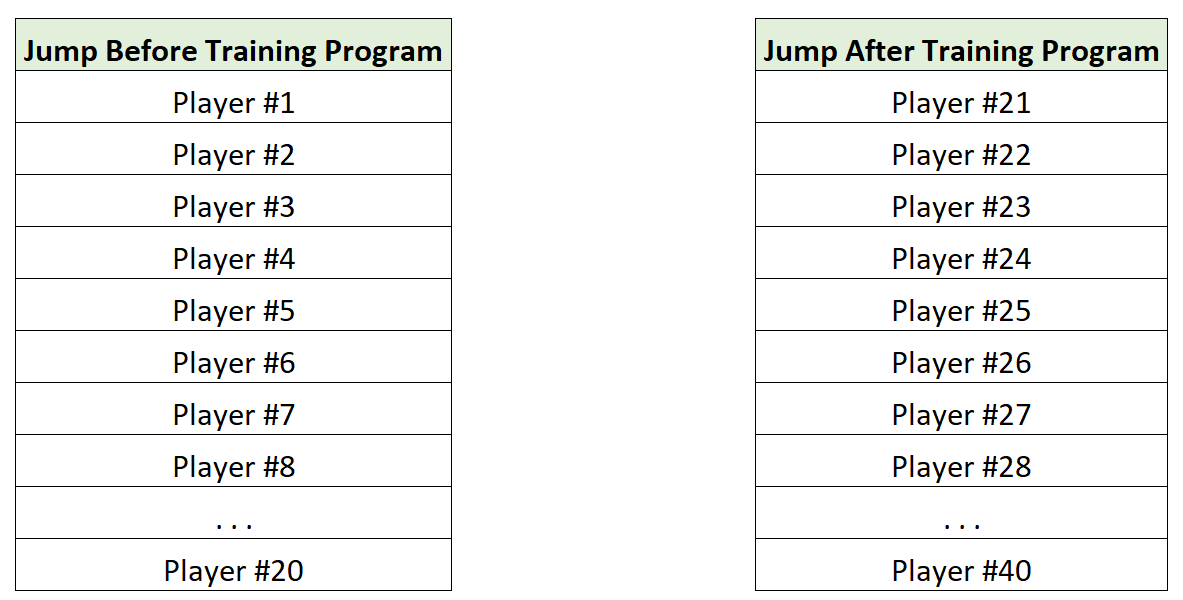
Inversement, traiter des échantillons indépendants avec un algorithme conçu pour les données appariées constitue une violation mathématique majeure de l’indépendance conditionnelle. Une telle manœuvre altère le calcul des degrés de liberté, qui passent de (N_1 + N_2 – 2) pour un test de Student indépendant à (N – 1) (où (N) est le nombre de paires) pour un test apparié. L’analyste s’expose alors à des conclusions fallacieuses, à un rétrécissement artificiel des intervalles de confiance et à une perte de calibration de l’erreur de type I (taux de faux positifs), rendant la réplication empirique de l’étude presque impossible.
2. Typologie des protocoles expérimentaux générant des données appariées
2.1 Les protocoles pré-test et post-test à mesures répétées
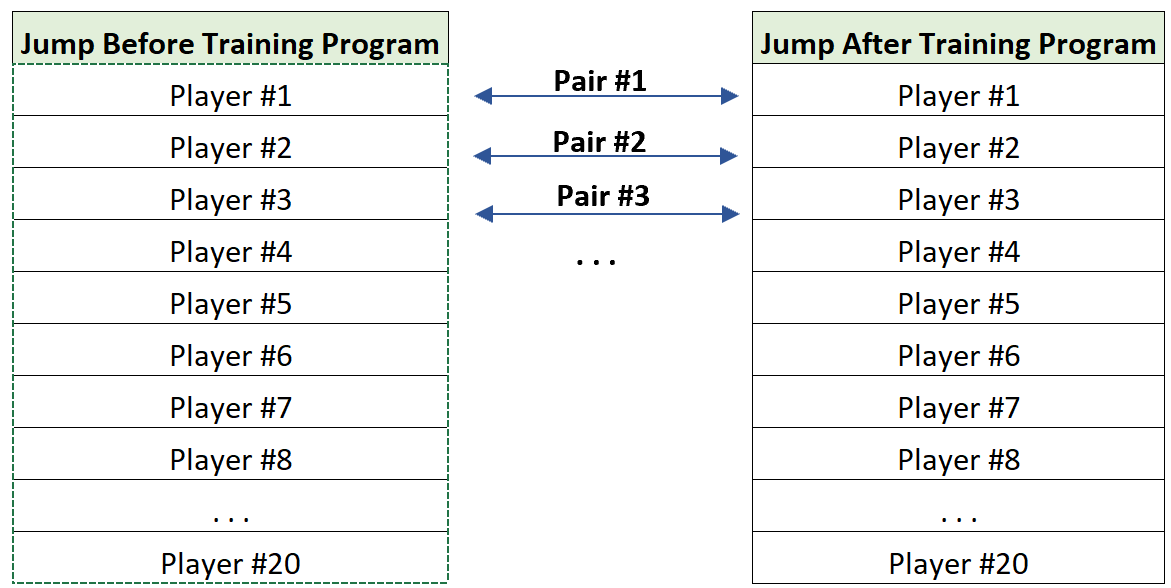
Le devis pré-test/post-test constitue l’archétype par excellence du protocole à mesures répétées en psychologie clinique, en psychopédagogie et en neuropsychologie. Dans cette configuration, une variable dépendante continue est quantifiée chez un sujet à un instant (T_1), avant toute manipulation ou intervention thérapeutique. Cette première mesure sert de ligne de base ou d’étalonnage idiosyncrasique. Le chercheur administre ensuite une variable indépendante — par exemple, un protocole de remédiation cognitive, un médicament psychoactif ou un module d’apprentissage — puis procède à une seconde évaluation identique au temps (T_2).
L’avantage cardinal de ce dispositif réside dans le fait que chaque participant opère comme son propre témoin. En comparant le score au post-test avec celui du pré-test pour une même personne, le modèle annule conceptuellement l’impact des caractéristiques individuelles persistantes. Si un participant présente un niveau élevé d’anxiété de base, cette disposition constante teintera à la fois sa performance initiale et sa performance finale ; la différence brute entre les deux scores reflétera alors plus fidèlement l’effet spécifique du traitement administré.
Ce protocole permet ainsi d’évaluer de manière très précise l’évolution temporelle des variables psychologiques mesurées. Il autorise l’estimation de trajectoires individuelles de changement et la distinction entre les variations structurelles durables et les fluctuations aléatoires du comportement. Néanmoins, l’analyste doit demeurer vigilant quant au fait que le simple passage du temps, la maturation biologique des participants ou des événements extérieurs non contrôlés peuvent corrompre la causalité attribuée au traitement si aucun groupe témoin n’est inclus en parallèle.
2.2 Les plans expérimentaux intra-sujets à conditions multiples
Les plans intra-sujets (souvent dénommés within-subjects designs dans la littérature anglophone) étendent la logique des données appariées au-delà de la simple comparaison chronologique pré/post. Dans ce cadre, chaque participant est exposé séquentiellement à l’ensemble des modalités d’une ou plusieurs variables indépendantes manipulant les contextes cognitifs, perceptifs ou émotionnels. Par exemple, un chercheur étudiant la reconnaissance faciale des émotions confrontera le même participant à des stimuli visuels neutres, menaçants, joyeux et tristes au cours d’une unique session de laboratoire.
Ce type de plan permet de minimiser les variables de confusion associées aux traits cognitifs profonds des sujets. Dans un plan inter-sujets classique, une différence observée entre la condition neutre et la condition menaçante pourrait simplement provenir du fait que le hasard a alloué davantage d’individus très empathiques au groupe exposé aux visages menaçants. Dans le devis intra-sujet, cette hypothèse rivale est immédiatement invalidée, puisque les mêmes individus traitent l’intégralité des stimuli, garantissant une équivalence absolue des aptitudes cognitives basales à travers toutes les conditions expérimentales.
Toutefois, l’exposition séquentielle d’un même sujet à des conditions expérimentales multiples introduit des menaces spécifiques à la validité interne, notamment les effets d’ordre et de report. Pour prémunir le modèle expérimental contre ces biais de contamination, le chercheur doit obligatoirement intégrer des techniques rigoureuses de contrebalancement. La méthode du contrebalancement complet ou l’utilisation d’un carré latin permettent de distribuer de manière homogène les séquences de passage à travers l’échantillon, s’assurant ainsi que les effets d’apprentissage ou d’épuisement cognitif n’agissent pas comme des facteurs systématiques de distorsion.
2.3 L’appariement de sujets distincts par paires jumelées
Il existe de nombreuses situations expérimentales ou éthiques où un protocole intra-sujet s’avère irréalisable. C’est notamment le cas lorsque le traitement entraîne un effet irréversible (comme une intervention chirurgicale, un programme psychoéducatif terminal ou une lésion cérébrale acquise). Dans de telles circonstances, le chercheur peut recourir à la technique de l’appariement de sujets distincts par paires jumelées (matched-pairs design). Ce devis consiste à recruter deux participants distincts qui partagent des profils identiques sur un ensemble de covariables jugées déterminantes pour la variable dépendante analysée.
Sur le plan computationnel, l’appariement moderne s’appuie largement sur l’appariement sur score de propension (propensity score matching) ou sur des algorithmes d’optimisation combinatoire (comme le jumelage exact ou le jumelage par plus proche voisin avec distance de Mahalanobis). Dans la recherche en neuropsychologie cognitive, cette méthode est vitale : lorsqu’on étudie un patient ayant subi un accident vasculaire cérébral dans une région temporale précise, on l’associe à un participant sain témoin strictement équivalent sur le plan de l’âge chronologique, du sexe biologique, des années de scolarité et du niveau d’intelligence prémorbide estimé par des épreuves de vocabulaire.
Une fois les paires constituées, le traitement statistique ne s’effectue plus comme si les deux cohortes étaient mutuellement indépendantes. Bien que physiquement incarnées par des corps distincts, les deux séries de mesures sont mathématiquement liées par leur similarité de profil : elles doivent impérativement être traitées par des tests statistiques pour données appariées afin de préserver les gains de précision induits par le contrôle des covariables d’appariement.
2.4 Les études gémellaires et familiales
Les sciences du comportement font appel aux modèles gémellaires et familiaux pour dénouer les écheveaux complexes de la génétique comportementale et de l’environnement. Dans les protocoles comparant des paires de jumeaux monozygotes (partageant 100 % de leur patrimoine génétique) et dizygotes (partageant en moyenne 50 % de leurs allèles ségréguants), la structure de données appariées est naturellement imposée par les liens de parenté biologique. Chaque jumeau constitue l’ancre d’appariement de son co-jumeau, ce qui permet d’évaluer la variance intra-paire par rapport à la variance inter-paires.
Au-delà de la génétique formelle, les études de psychologie du développement et de thérapie systémique recourent fréquemment aux analyses de dyades naturelles :
- Paires parent-enfant dans l’évaluation des styles d’attachement ;
- Couples conjugaux dans l’étude des processus de communication émotionnelle ;
- Paires soignant-soigné dans l’analyse du fardeau psychologique et de l’épuisement émotionnel.
Dans ces contextes écologiques, les données de la dyade présentent une interdépendance mutuelle substantielle. Le bien-être subjectif d’un conjoint influence directement et réciproquement celui de l’autre. Le traitement statistique de ces scores couplés en tant que données appariées est indispensable pour modéliser adéquatement les effets d’acteur et les effets de partenaire, souvent opérationnalisés au sein du cadre conceptuel de l’Actor-Partner Interdependence Model (APIM).
3. Exemples concrets d’application en psychologie clinique et cognitive
3.1 Évaluation de l’efficacité d’une thérapie cognitivo-comportementale
Considérons une étude clinique évaluant l’efficacité d’une psychothérapie cognitivo-comportementale (TCC) de 12 semaines sur des patients souffrant de trouble dépressif caractérisé. L’intensité de la symptomatologie est mesurée au moyen de l’Inventaire de Dépression de Beck (BDI-II) avant le début de la prise en charge (pré-test, (T_1)) et lors de la séance conclusive (post-test, (T_2)). Chaque patient dispose ainsi de deux scores ordonnés qui forment un vecteur bidimensionnel individuel.
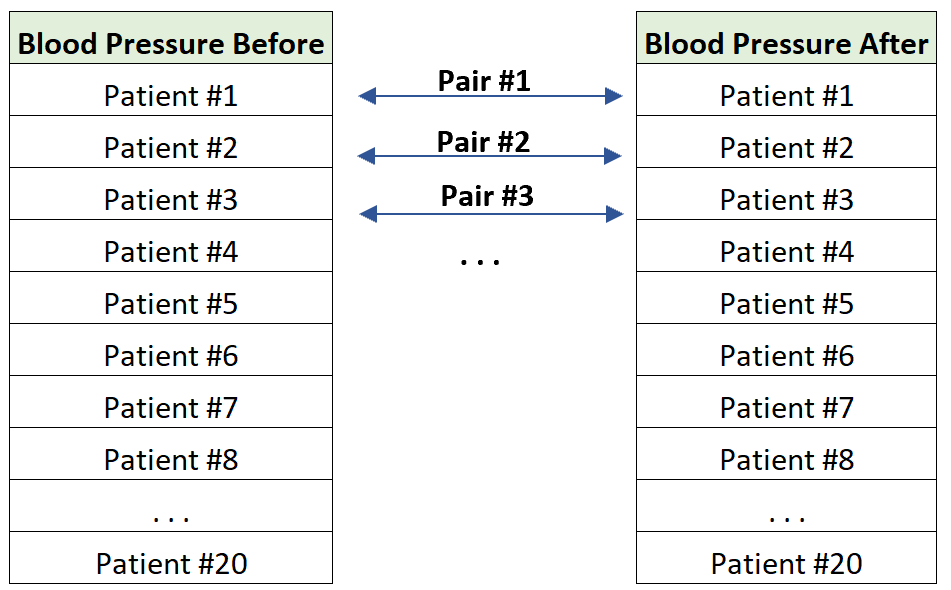
L’objectif analytique consiste à isoler le changement thérapeutique intra-individuel au-delà du bruit de mesure intrinsèque à l’évaluation psychométrique. Si l’on se contentait de comparer la moyenne globale du groupe au pré-test à celle du groupe au post-test via un test non apparié, la dispersion initiale des scores (certains patients débutant avec une dépression légère à 18, d’autres avec une sévérité critique à 45) masquerait la cohérence de l’amélioration clinique. En modélisant la différence individuelle brute (D_i = T_{1i} – T_{2i}) comme unité d’analyse fondamentale, le chercheur neutralise la sévérité initiale globale et concentre son inférence statistique sur l’amplitude nette de la régression symptomatique propre à chaque sujet.
Cette approche permet non seulement de calculer un indice de changement fiable (Reliable Change Index, RCI) pour déterminer si l’évolution individuelle dépasse l’erreur standard de mesure, mais elle offre également une base rigoureuse pour affirmer que la réduction observée des scores du BDI-II est attribuable aux composantes actives du protocole psychothérapeutique plutôt qu’à l’hétérogénéité des états dépressifs recrutés.
3.2 Impact du stress aigu sur le temps de réaction cognitive
Dans le domaine de la neuropsychologie expérimentale, l’étude de l’impact de l’activation neuroendocrinienne sur les fonctions exécutives repose classiquement sur des paradigmes de stress aigu induit en laboratoire, tels que le Trier Social Stress Test (TSST). Un protocole typique consiste à mesurer les temps de réaction de participants soumis à une tâche de flexibilité cognitive informatisée (comme le paradigme de Stroop) sous deux conditions distinctes : une session neutre sans enjeu psychosocial et une session sous stress social induit (évaluation par un comité d’experts et enregistrement vidéo).
Les temps de réaction se caractérisent par une variabilité interindividuelle considérable. Certains participants possèdent une vitesse de conduction nerveuse et des temps de traitement basaux très véloces (de l’ordre de 400 millisecondes), tandis que d’autres affichent des profils cognitifs plus prudents ou plus lents (dépassant 750 millisecondes). Une comparaison inter-groupes indépendante requerrait des tailles d’échantillon monumentales pour compenser cette immense dispersion naturelle.
En recourant à un appariement intra-sujet où chaque individu est son propre contrôle, le chercheur opère une comparaison directe des temps de latence au niveau individuel. La métrique clé devient la différence de vitesse de traitement observée chez la personne (X) entre son état relaxé et son état d’activation physiologique. La variabilité basale de la vitesse cognitive étant mathématiquement soustraite de l’équation, le test statistique peut isoler avec une finesse extrême l’effet délétère ou facilitateur de la libération de cortisol sur les réseaux attentionnels préfrontaux.
3.3 Entraînement de la mémoire de travail chez les personnes âgées
Le vieillissement cognitif s’accompagne d’un déclin progressif de l’empan mnésique et des capacités de rétention à court terme. Pour évaluer la plasticité cérébrale chez les personnes âgées, un protocole d’entraînement cognitif informatisé ciblant la mémoire de travail peut être administré sur une durée de deux mois. La performance des participants est jaugée avant et après le protocole à l’aide d’une tâche d’empan envers (digit span backward).
L’appariement rigoureux des scores initiaux et finaux pour chaque participant permet de quantifier le gain mnésique net imputable au programme de stimulation cérébrale. L’enjeu méthodologique majeur consiste à différencier l’effet d’apprentissage procédural de la tâche elle-même (l’adaptation mécanique à l’interface logicielle et au type de consignes) du bénéfice neurobiologique et cognitif réel. La configuration appariée permet d’aligner avec précision les points de départ individuels.
En intégrant des groupes témoins appariés sur le niveau cognitif de base via des tests de dépistage global (comme le MoCA) et soumis à une tâche informatisée passive (contrôle actif), les chercheurs peuvent procéder à des analyses différentielles rigoureuses. La modélisation conjointe des paires d’observations pré-post au sein du groupe actif et du groupe témoin assure que l’augmentation du nombre de blocs mémorisés découle bien d’une expansion fonctionnelle de la mémoire de travail plutôt que d’une simple familiarisation avec l’environnement de test.
4. Applications psychométriques : Mesures répétées et fidélité d’évaluation
4.1 Fidélité test-retest des instruments de mesure psychologiques
L’une des conditions préliminaires à l’utilisation clinique d’un instrument d’évaluation psychologique est la démonstration de ses qualités métrologiques, au premier rang desquelles figure la fidélité test-retest. Ce protocole consiste à administrer un questionnaire psychométrique ou une batterie de tests à un échantillon stable de participants à un temps (T_1), puis à répéter exactement la même procédure d’évaluation à un temps ultérieur (T_2), en veillant à ce que l’intervalle temporel choisi soit suffisamment court pour exclure une maturation développementale, mais suffisamment long pour estomper les traces mnésiques directes des réponses fournies.
Les matrices de données générées par ce paradigme sont purement appariées. L’analyse statistique ne recherche pas ici la démonstration d’une différence significative, mais au contraire la preuve empirique d’une concordance et d’une invariance maximale des rangs ou des valeurs absolues entre les deux passations. Le coefficient de corrélation intra-classe (ICC) et les équations de Pearson appliquées à ces vecteurs appariés permettent de formaliser la stabilité temporelle du construit.
Cette approche permet aux psychométriciens d’opérer une décomposition fondamentale : distinguer l’instabilité véritable du trait psychologique latent (qui fluctue sous l’effet de contingences environnementales) de l’erreur aléatoire d’échantillonnage inhérente aux imperfections de l’outil de mesure. Sans cette structure de données appariées, l’estimation des erreurs types de mesure et l’établissement des seuils de confiance clinique seraient impossibles.
4.2 Évaluation de la concordance inter-juges et inter-instruments
Dans l’évaluation diagnostique psychiatrique et neuropsychologique, la concordance entre cliniciens indépendants représente un impératif de premier ordre. Lorsqu’un protocole méthodologique prévoit que deux praticiens expérimentés évaluent simultanément les mêmes entretiens diagnostiques cliniques enregistrés sur vidéo pour coter une échelle de psychopathologie (telle que l’échelle PANSS pour la schizophrénie), la structure de données obtenue est intrinsèquement couplée par patient examiné.
Chaque sujet clinique dispose de deux scores attribués pour chaque symptôme : le score du juge A et le score du juge B. L’analyse de données appariées s’avère alors cruciale pour quantifier l’éventuelle présence d’un biais systématique entre évaluateurs. Un test t apparié explorant la différence moyenne entre les juges peut révéler si un praticien a tendance à sous-estimer ou surestimer systématiquement la sévérité clinique par rapport à son confrère, un phénomène qu’un simple coefficient de corrélation bivariée ne permettrait pas d’isoler (une corrélation pouvant être parfaite alors même qu’un biais constant de plusieurs points sépare les deux observateurs).
Ce même paradigme s’applique avec une pertinence égale à la comparaison de versions parallèles ou alternatives d’une même batterie neuropsychologique. Afin d’éviter les biais de mémorisation lors d’évaluations successives, les cliniciens utilisent des versions alternatives de tests de mémoire verbale (par exemple des listes de mots différentes). L’administration de ces deux versions à un échantillon de sujets appariés permet de garantir l’équivalence métrique stricte des deux formes de l’instrument.
4.3 Contrôle de la réactivité de la mesure et de l’effet d’habituation
L’acte même de mesurer un phénomène psychologique ou psychophysiologique modifie fréquemment l’état interne du participant, un phénomène désigné sous le terme de réactivité de la mesure. Dans les laboratoires de psychophysiologie cognitive, le placement d’électrodes cutanées pour quantifier la conductance électrodermale ou l’enregistrement de l’activité cardiovasculaire induit souvent une réaction initiale de surprise ou d’anxiété diffuse chez le sujet naïf.
L’utilisation de données appariées sur des phases de repos successives permet de documenter et de contrôler formellement l’effet d’habituation. En comparant les paramètres physiologiques de la première minute de calibration à ceux de la dixième minute chez les mêmes individus, les chercheurs peuvent quantifier mathématiquement la cinétique de décroissance de l’hyperréactivité autonome consécutive à la familiarisation avec l’environnement expérimental et l’appareillage technique.
Dans le champ de l’évaluation par auto-questionnaires, la sensibilisation des répondants lors de passations répétées constitue un défi similaire. La confrontation répétée à des items interrogeant des schémas de pensée dysfonctionnels peut amener le sujet à développer une métacognition accrue sur ses propres processus psychiques, altérant ainsi la manière dont il interprète les énoncés lors des sessions ultérieures. Les paires de mesures permettent de suivre longitudinalement cette dérive sémantique et d’introduire des ajustements statistiques contrôlant la familiarité progressive avec les épreuves.
5. Avantages méthodologiques et statistiques de l’appariement
5.1 Réduction drastique de la variance résiduelle interindividuelle
Le bénéfice mathématique majeur des protocoles fondés sur des données appariées réside dans leur capacité à purger l’analyse de l’influence de la variance interindividuelle. Dans la population humaine, les caractéristiques physiologiques et psychologiques se distribuent selon des spectres extrêmement étendus. Dans un plan expérimental conventionnel à groupes indépendants, toute cette hétérogénéité naturelle est versée directement dans le réservoir de la variance résiduelle, communément appelée la variance d’erreur non expliquée.
Le ratio statistique fondamental gouvernant les tests d’hypothèse paramétriques (qu’il s’agisse du ratio (t) de Student ou du ratio (F) de Fisher-Snedecor) obéit à la logique suivante :
$$\text{Statistique de test} = \frac{\text{Variance expliquée par l’effet expérimental}}{\text{Variance d’erreur résiduelle}}$$
Lorsque des données appariées sont mobilisées, la variabilité stable propre au participant est soustraite du dénominateur. En éliminant les différences statiques inter-sujets, la variance d’erreur se contracte massivement, ne conservant que les fluctuations véritablement aléatoires de la mesure. Il en découle une élévation mécanique du rapport signal sur bruit, conférant aux estimations une précision numérique inaccessible aux schémas indépendants.
5.2 Accroissement substantiel de la puissance statistique
La conséquence directe de cette contraction de l’erreur type est une augmentation phénoménale de la puissance statistique ((1 – beta)). La puissance statistique représente la probabilité mathématique de rejeter avec succès l’hypothèse nulle ((H_0)) lorsqu’un effet réel existe bel et bien dans la population parente. Dans les sciences humaines, où les grandeurs d’effet clinique sont souvent subtiles (tailles d’effet moyennes oscillant fréquemment entre des valeurs de (d) de Cohen de 0,20 et 0,50), de nombreuses études indépendantes échouent par manque cruel de puissance.
Le gain de puissance associé aux données appariées est directement indexé sur la magnitude de la corrélation positive ((rho)) reliant les scores au sein de chaque paire. L’erreur type de la différence de moyennes entre deux conditions appariées s’exprime formellement par l’équation :
$$\sigma_D = \sqrt{\frac{\sigma_1^2 + \sigma_2^2 – 2\rho\sigma_1\sigma_2}{N}}$$
Il apparaît avec évidence que plus la corrélation intra-paire (rho) se rapproche de la valeur théorique maximale de (1,00), plus le terme soustractif (2rhosigma_1sigma_2) neutralise la somme des variances individuelles, conduisant à une erreur standard (sigma_D) tendant vers zéro. Cette propriété mathématique réduit drastiquement le risque d’erreur de type II et assure au chercheur la détection fiable d’effets réels, même modestes, sans avoir à gonfler artificiellement ses cohortes expérimentales.
5.3 Optimisation de la taille d’échantillon et économie de recherche
Cette puissance accrue se traduit immédiatement par une optimisation logistique et financière substantielle : la réduction de la taille d’échantillon nécessaire pour valider les hypothèses expérimentales. Pour un niveau de puissance fixé conventionnellement à (1 – beta = 0,80) avec un seuil de significativité (alpha = 0,05), la démonstration d’une taille d’effet moyenne requiert un nombre considérablement moindre de participants dans un plan apparié que dans un plan indépendant, où deux cohortes distinctes et volumineuses doivent être enrôlées.
Cette économie de moyens prend une résonance critique lorsqu’on opère auprès de populations cliniques rares, difficiles d’accès ou lourdement fragilisées, telles que des patients atteints de pathologies neurodégénératives orphelines, de traumatismes crâniens pédiatriques ou d’affections psychiatriques réfractaires. Le recrutement de dizaines d’individus présentant des critères d’inclusion rigides représente parfois des années de travail prospectif au sein d’unités hospitalières spécialisées.
Enfin, cet avantage mathématique s’accompagne d’un impératif éthique majeur. Conformément aux principes de la Déclaration d’Helsinki et aux directives des comités d’éthique de la recherche biomédicale, les scientifiques ont le devoir moral de n’exposer que le nombre strictement minimal d’êtres humains aux contraintes, à la fatigue et aux risques inhérents aux protocoles expérimentaux. Par sa frugalité en matière de taille d’échantillon, le recours aux données appariées répond parfaitement à cette exigence éthique fondamentale.
6. Conditions de validité et postulats statistiques des données appariées
6.1 L’indépendance des paires d’observations
S’il est vrai que les deux données composant une paire donnée doivent être dépendantes l’une de l’autre, il est impératif que chaque paire prise dans son ensemble soit rigoureusement indépendante de toutes les autres paires constituant l’échantillon d’analyse. Ce postulat d’indépendance inter-paires signifie que la réponse ou la performance manifestée par la dyade numéro (k) ne doit en aucun cas exercer une influence probabiliste sur les réponses de la dyade numéro (j).
Dans la pratique de recherche, la violation de ce postulat survient fréquemment lors d’échantillonnages en grappes (cluster sampling) non contrôlés. Supposons qu’un protocole d’apprentissage apparié soit testé sur des élèves au sein de plusieurs classes scolaires distinctes. Si des élèves interagissent entre eux, partagent leurs stratégies cognitives ou subissent l’influence commune d’un enseignant particulièrement stimulant, les paires d’observations pré-post au sein d’une même classe seront corrélées entre elles. Cette contamination inter-paires viole le postulat fondamental d’indépendance.
L’ignorance de cette structure hiérarchique entraîne une inflation artificielle des taux de faux positifs, les tests statistiques classiques supposant que chaque paire apporte une quantité d’information totalement neuve et décorrélée. Le chercheur doit donc opérer une distinction stricte entre la dépendance intra-paire, qui constitue le cœur vertueux du modèle, et la dépendance inter-paires, qui constitue une anomalie méthodologique majeure nécessitant des modélisations multi-niveaux spécifiques.
6.2 Normalité de la distribution des différences
L’une des méconnaissances les plus répandues concernant les postulats du test paramétrique pour données appariées concerne la condition de distribution normale. De nombreux analystes évaluent la normalité des données brutes au pré-test d’une part, et au post-test d’autre part. Or, le postulat de normalité ne porte aucunement sur les variables mères considérées individuellement, mais exclusivement sur le vecteur des différences individuelles calculées :
$$D_i = X_{1i} – X_{2i}$$
Il est tout à fait possible que la distribution des scores pré-test soit asymétrique et que celle du post-test le soit également, tout en générant un vecteur de différences (D) dont la distribution suit une courbe de Gauss d’une régularité remarquable. À l’inverse, deux distributions apparemment normales peuvent engendrer une distribution des différences bimodalement asymétrique si des sous-groupes de répondeurs divergent fortement. L’investigation de ce postulat requiert le déploiement d’outils formels :
- Des tests statistiques d’adéquation, tels que le test de Shapiro-Wilk (hautement recommandé pour les échantillons restreints à modérés) ou le test de Kolmogorov-Smirnov avec correction de Lilliefors ;
- Des indices quantitatifs d’asymétrie (skewness) et d’aplatissement (kurtosis), qui ne doivent pas dévier excessivement des standards tolérés ;
- Des visualisations graphiques de type diagramme quantile-quantile (Q-Q plot), sur lequel les écarts des quantiles empiriques par rapport à la droite de normalité théorique peuvent être détectés visuellement.
Il convient de rappeler que, par le truchement du théorème central limite (TCL), les tests paramétriques font preuve d’une robustesse relative face aux déviations modérées de normalité dès lors que la taille de l’échantillon devient substantielle (typiquement (N ge 30) paires). En deçà de ce seuil, toute violation notable impose d’abandonner l’inférence paramétrique au profit de méthodes non paramétriques robustes.
6.3 Nature de l’échelle de mesure et contraintes métriques
L’exécution d’analyses paramétriques sur des données appariées exige que la métrique sous-jacente respecte le statut d’échelle d’intervalle ou d’échelle de rapport, selon la célèbre classification psychométrique de Stevens. Les opérations arithmétiques requises par le calcul de la moyenne et de l’écart-type des différences supposent que la distance séparant une valeur de 10 à une valeur de 12 soit rigoureusement équivalente à celle séparant une valeur de 48 à une valeur de 50. Sans cette propriété métrique, la soustraction directe (D_i = X_{1i} – X_{2i}) perd sa légitimité mathématique.
Cette condition soulève un débat récurrent dans les sciences comportementales lors de l’utilisation d’échelles de type Likert (par exemple des échelles de réponse graduées de 1 pour « pas du tout d’accord » à 5 pour « totalement d’accord »). Considérer la soustraction entre deux catégories ordinales subjectives comme une unité métrique continue constitue une approximation empirique qui, bien que tolérée lorsque les échelles sont composées d’un nombre élevé d’items sommés formant un score total continu, s’avère hautement contestable sur des items uniques ou courts.
Lorsque les données recueillies relèvent indiscutablement d’un niveau d’échelle purement ordinal, ou lorsque les intervalles entre les modalités de réponse ne peuvent être tenus pour équidistants, l’application du test t de Student apparié doit être écartée au profit d’alternatives non paramétriques basées exclusivement sur l’analyse des rangs ou des directions ordinales des écarts observés.
7. Analyse paramétrique : Le test t de Student pour échantillons appariés
7.1 Formulation théorique et calcul de la statistique de test
L’élégance théorique du test t de Student pour échantillons appariés réside dans sa simplification dimensionnelle : il transforme un problème statistique bivarié composé de deux mesures interdépendantes en un problème univarié à échantillon unique appliqué sur une variable de différence composite. Soit un échantillon de (N) paires de mesures représentées par ((X_{1i}, X_{2i})) pour (i in {1, 2, dots, N}). La première étape analytique consiste à calculer pour chaque participant sa différence individuelle :
$$D_i = X_{1i} – X_{2i}$$
À partir de cette nouvelle variable aléatoire unidimensionnelle (D), l’analyste détermine la moyenne de ces différences ((bar{D})) ainsi que l’écart-type échantillonnal des différences ((S_D)) :
$$\bar{D} = \frac{1}{N} \sum_{i=1}^{N} D_i$$
$$S_D = \sqrt{\frac{1}{N-1} \sum_{i=1}^{N} (D_i – \bar{D})^2}$$
L’erreur type de la distribution d’échantillonnage de la différence moyenne, notée (SE_{bar{D}}), est alors définie par le ratio de l’écart-type échantillonnal par la racine carrée de l’effectif des paires :
$$SE_{\bar{D}} = \frac{S_D}{\sqrt{N}}$$
La statistique de test observée (t_{obs}) s’obtient alors en divisant la différence moyenne observée soustraite de la différence théorique attendue sous l’hypothèse nulle (qui est conventionnellement (mu_0 = 0)) par cette erreur type :
$$t_{obs} = \frac{\bar{D} – 0}{SE_{\bar{D}}} = \frac{\bar{D}}{\frac{S_D}{\sqrt{N}}}$$
Sur le plan conceptuel, le test t pour échantillons appariés est rigoureusement identique à un test t pour échantillon unique testant l’hypothèse que la moyenne d’une population est égale à zéro. La covariance sous-jacente est implicitement absorbée dans la réduction de l’ampleur numérique de (S_D).
7.2 Interprétation des degrés de liberté et des intervalles de confiance
Dans un test t pour données appariées, la statistique de test suit une distribution théorique de Student régie par un nombre de degrés de liberté strictement fixé à :
$$dl = N – 1$$
où (N) correspond au nombre total de paires complètes de mesures, et non au nombre total de points de données enregistrés ((2N)). Ce calcul reflète la contrainte mathématique imposée par l’estimation préalable d’un seul paramètre : la moyenne empirique de la différence (bar{D}).
La probabilité critique associée (la p-valeur) quantifie la vraisemblance d’obtenir, par le seul jeu des fluctuations aléatoires d’échantillonnage, une valeur de (t) au moins aussi extrême que celle observée, sous l’hypothèse stricte que la véritable différence moyenne dans la population soit nulle ((H_0: mu_D = 0)). Selon la nature des hypothèses opérationnelles déduites du cadre théorique, l’investigateur optera pour :
- Un test bilatéral (two-tailed), n’émettant aucune présomption directionnelle a priori quant au sens de l’évolution des scores ;
- Un test unilatéral (one-tailed), formulant une direction univoque (par exemple, prédiction formelle d’une baisse des symptômes après thérapie), ce qui concentre la région critique de rejet à une seule extrémité de la distribution théorique.
Au-delà de la seule dichotomie décisionnelle de la significativité statistique, l’estimation par intervalle constitue l’outil le plus informatif pour apprécier la précision de l’effet. L’intervalle de confiance à 95 % de la différence moyenne s’établit selon la formule :
$$IC_{95%} = \left[ \bar{D} – t_{crit(0.05, N-1)} \times SE_{\bar{D}} ; ; ; \bar{D} + t_{crit(0.05, N-1)} \times SE_{\bar{D}} \right]$$
Si cet intervalle exclut la valeur zéro, le chercheur conclut au rejet de l’hypothèse nulle avec un taux d’erreur de première espèce contrôlé à 5 %. La largeur de cet intervalle renseigne directement sur la précision clinique de l’estimation : un intervalle étroit reflète une grande stabilité de l’effet à travers les sujets appariés.
7.3 Évaluation de la taille de l’effet pour mesures répétées
La seule obtention d’une p-valeur statistiquement significative ne renseigne en rien sur l’amplitude pratique ou la portée clinique d’un résultat expérimental. Pour satisfaire aux exigences actuelles de la publication scientifique, le calcul d’un indice standardisé de taille de l’effet est indispensable. Dans le cadre des données appariées, le calcul du d de Cohen présente des subtilités méthodologiques fondamentales trop souvent ignorées.
Deux formulations distinctes du d de Cohen coexistent dans la littérature pour les mesures répétées :
- Le (d_z) de Cohen : Il standardise la différence moyenne directement par l’écart-type des différences individuelles :
$$d_z = \frac{\bar{D}}{S_D} = \frac{t_{obs}}{\sqrt{N}}$$
Cet indice est particulièrement utile pour réaliser des calculs de puissance statistique a priori. Néanmoins, il possède le désavantage majeur de gonfler mécaniquement la taille de l’effet lorsque la corrélation intra-paire (rho) est élevée, car (S_D) devient alors artificiellement très faible. - Le (d_{rm}) (pour repeated measures) ou (d_{av}) (pour average) : Il standardise la différence moyenne par la moyenne des écarts-types des deux temps de mesure, en réintégrant la corrélation de Pearson entre les scores :
$$d_{rm} = \frac{\bar{X}_1 – \bar{X}_2}{\sqrt{S_1^2 + S_2^2 – 2\rho S_1 S_2}} \times \sqrt{2(1 – \rho)}$$
ou plus couramment, en utilisant l’écart-type combiné moyen :
$$d_{av} = \frac{\bar{X}_1 – \bar{X}_2}{\frac{S_1 + S_2}{2}}$$
Ce second type d’indice préserve la comparabilité métrique directe avec les études indépendantes lors de la réalisation future de méta-analyses. Les seuils conventionnels introduits initialement par Jacob Cohen pour caractériser l’amplitude de l’effet continuent de servir de repères généraux :
- (d approx 0,20) : effet de petite taille (subtil, difficilement discernable à l’œil nu) ;
- (d approx 0,50) : effet de taille moyenne (perceptible dans la pratique clinique quotidienne) ;
- (d ge 0,80) : effet de grande taille (changement massif et robuste du comportement mesuré).
8. Alternatives non paramétriques pour les données appariées
8.1 Le test des rangs signés de Wilcoxon
Lorsque la taille de l’échantillon est modeste et que la distribution empirique des différences individuelles (D_i) contrevient sévèrement au postulat de normalité gaussienne (présence d’une forte asymétrie unilatérale, d’un aplatissement excessif ou de valeurs aberrantes extrêmes), le recours au test des rangs signés de Wilcoxon s’impose comme l’alternative non paramétrique par excellence. Conçu par Frank Wilcoxon en 1945, ce test ne postule aucune loi de distribution paramétrique spécifique pour la population parente, tout en exploitant à la fois la direction et la magnitude relative des écarts observés.
Le déroulement algorithmique du calcul s’opère selon les étapes séquentielles suivantes :
- Calcul des différences individuelles (D_i = X_{1i} – X_{2i}) pour l’ensemble des (N) paires ;
- Élimination des paires où la différence est strictement nulle ((D_i = 0)), l’effectif utile étant alors réduit à (N_r) (bien que la méthode alternative de Pratt permette d’intégrer les différences nulles pour limiter les biais) ;
- Conversion de toutes les différences résiduelles non nulles en valeurs absolues : (|D_i|) ;
- Attribution d’un rang hiérarchique croissant à ces valeurs absolues, de 1 pour la différence la plus ténue à (N_r) pour la différence la plus volumineuse. En cas d’égalités numériques (scores ex æquo), on alloue à chaque valeur concernée le rang moyen équivalent ;
- Réassignation à chaque rang attribué du signe arithmétique d’origine de la différence ((+) ou (-)) ;
- Calcul séparé de la somme des rangs de polarité positive ((W^+)) et de la somme des rangs de polarité négative ((W^-)).
La statistique de test formelle, souvent désignée par (W) ou (T), correspond à la plus petite de ces deux sommes sous l’approche bilatérale classique : (W = min(W^+, W^-)). Pour les petits effectifs ((N_r < 20)), la significativité est déterminée en comparant la valeur observée aux tables critiques exactes construites par dénombrement combinatoire. Lorsque l'effectif s'accroît ((N_r ge 20)), la distribution d'échantillonnage de (W) converge très rapidement vers une loi normale sous-jacente, autorisant le recours à l'approximation asymptotique par le calcul d'un score standardisé normalisé (Z) intégrant une correction de continuité.
8.2 Le test des signes comme alternative ultra-robuste
Si la distribution des différences est à ce point dégradée qu’elle empêche même une assignation ordinale équitable des magnitudes relatives (par exemple lors de l’existence de valeurs hautement divergentes polluant le calcul des rangs), ou si les scores collectés relèvent d’une nature purement qualitative ordinale grossière, le test des signes représente l’outil d’inférence le plus épuré et le plus robuste conceptuellement.
Le principe du test des signes évacue complètement la grandeur quantitative de la différence pour ne conserver que son orientation binaire fondamentale. Chaque paire de données est exclusivement codée sous l’un des trois états logiques possibles :
- Un signe positif ((+)) si la condition 2 est supérieure à la condition 1 ((X_{2i} > X_{1i})) ;
- Un signe négatif ((-)) si la condition 2 est inférieure à la condition 1 ((X_{2i} < X_{1i})) ;
- Une égalité stricte (tie) si les deux mesures sont indifférenciables, conduisant généralement à l’exclusion conventionnelle de la paire de l’espace de calcul.
Sous l’hypothèse nulle d’absence de divergence systématique entre les conditions, la probabilité d’observer un signe positif ou un signe négatif est strictement équiprobable ((p = q = 0,50)). Le nombre de succès observés (par exemple le compte des signes positifs (k)) suit alors rigoureusement une distribution binomiale exacte de paramètres (N) et (p = 0,5) :
$$P(K = k) = \binom{N}{k} (0.5)^k (0.5)^{N-k} = \binom{N}{k} (0.5)^N$$
La p-valeur exacte est calculée directement en sommant les probabilités d’obtenir une configuration binomiale au moins aussi extrême que celle relevée empiriquement. D’une insensibilité absolue aux données aberrantes, le test des signes paye toutefois cette ultra-robustesse par une perte d’efficacité statistique marquée (puissance plus faible que celle du test de Wilcoxon ou de Student), exigeant un déséquilibre éclatant des polarités de réponse pour rejeter formellement l’hypothèse nulle.
8.3 Calcul de la taille de l’effet non paramétrique
L’abandon des hypothèses de normalité paramétrique n’exonère nullement le chercheur de quantifier et de déclarer formellement l’amplitude de l’effet. Pour le test des rangs signés de Wilcoxon, l’indice de taille de l’effet le plus largement adopté est le coefficient de corrélation de rang (r), dérivé directement de la valeur de l’approximation normale standardisée (Z) :
$$r = \frac{|Z|}{\sqrt{N_{total}}}$$
où (Z) correspond au score de déviation normale issu du test de Wilcoxon et (N_{total}) au nombre total d’observations individuelles engagées dans la comparaison (soit deux fois le nombre de paires actives, ou parfois le nombre de paires selon certaines conventions logicielles qu’il convient de spécifier rigoureusement lors de la rédaction méthodologique). L’interprétation de cet indice (r) se conforme aux métriques corrélationnelles classiques : 0,10 correspond à un petit effet, 0,30 à un effet modéré, et 0,50 ou plus à un effet substantiel.
Une alternative élégante et de plus en plus valorisée dans la littérature moderne est l’indice de supériorité probabiliste ou probabilité de supériorité pour scores appariés (souvent formalisé sous l’appellation d’effet de taille de non-recouvrement ou common language effect size pour données dépendantes). Cet indicateur exprime directement le pourcentage ou la probabilité qu’un individu pris aléatoirement dans l’échantillon voie son score progresser d’une condition à l’autre. Une valeur de 0,50 reflète l’absence totale de gain directionnel systématique, tandis qu’une valeur s’élevant à 0,85 traduit le fait que 85 % des paires démontrent une trajectoire de progression conforme à l’hypothèse du chercheur.
Le choix d’arbitrage méthodologique entre test paramétrique et non paramétrique repose sur un compromis fondamental entre sensibilité et robustesse. Si les postulats métriques et distributionnels sont tenus, le test t de Student demeure le choix le plus sensible. Si ces postulats s’effondrent, l’obstination paramétrique conduit à des estimateurs biaisés, justifiant pleinement la transition ordinale vers le test de Wilcoxon ou le test des signes.
9. Modélisation avancée : ANOVA à mesures répétées et modèles mixtes
9.1 L’analyse de variance (ANOVA) à mesures répétées
Lorsque le dispositif d’appariement s’étend à plus de deux conditions expérimentales ou à plus de deux fenêtres temporelles d’observation (par exemple, des évaluations systématiques conduites au pré-test, à mi-parcours, au post-test immédiat et lors d’un suivi à 6 mois), le test t de Student apparié ne peut plus être employé sans encourir un risque majeur d’inflation cumulée de l’erreur de type I induit par la multiplication des contrastes bivariés. Le cadre analytique approprié devient alors l’ANOVA à mesures répétées univariée.
Ce modèle généralise le partitionnement de la variance intra-sujet en décomposant la somme des carrés totale en trois entités mathématiques bien distinctes :
- La somme des carrés inter-sujets (reflétant les variations intrinsèques immuables entre les participants) ;
- La somme des carrés intra-sujets associée à l’effet de la condition expérimentale ou du temps ;
- La somme des carrés résiduelle ou d’interaction sujet-condition, qui sert d’erreur type d’estimation au dénominateur du ratio (F).
Cependant, l’extension à plus de deux conditions introduit un postulat mathématique contraignant qui n’existait pas pour le test t apparié : le postulat de sphéricité (ou condition d’homogénéité des variances des différences). La sphéricité exige que les variances des différences calculées pour toutes les combinaisons possibles de paires de conditions soient rigoureusement homogènes dans la population. Ce postulat est traditionnellement éprouvé par le test de sphéricité de Mauchly.
En présence d’une violation significative de la sphéricité (fréquente dans les données longitudinales en raison de l’effet d’atténuation temporelle où deux temps rapprochés corrèlent plus fortement que deux temps distants), le chercheur doit obligatoirement corriger les degrés de liberté du test (F) sous peine d’émettre des conclusions faussement positives. Les facteurs correctifs d’épsilon ((varepsilon)) développés par Greenhouse-Geisser (approche conservatrice recommandée lorsque (varepsilon < 0,75)) ou par Huynh-Feldt (recommandée lorsque (varepsilon ge 0,75)) permettent de réajuster les distributions théoriques de référence.
9.2 Les modèles linéaires à effets mixtes (LMM)
En dépit de sa popularité historique, l’ANOVA à mesures répétées est aujourd’hui de plus en plus supplantée dans la recherche internationale par les modèles linéaires à effets mixtes (Linear Mixed Models ou LMM), également qualifiés de modèles hiérarchiques linéaires (HLM). Les modèles mixtes représentent le cadre le plus complet et le plus souple pour analyser des données structurellement appariées et longitudinales.
La supériorité architecturale des LMM repose sur leur capacité à distinguer explicitement deux types de composantes au sein d’une équation unique :
- Les effets fixes : Ils correspondent aux paramètres constants dans la population que le chercheur manipule ou étudie directement (l’effet moyen de l’intervention clinique, la modalité expérimentale cognitive, l’âge comme covariable fixe).
- Les effets aléatoires : Ils capturent la structure de variabilité non observée propre aux unités d’appariement. Le modèle peut intégrer des ordonnées à l’origine aléatoires (random intercepts), permettant à chaque individu de démarrer à un niveau initial personnalisé, ainsi que des pentes aléatoires (random slopes), permettant à chaque individu de progresser à un rythme différent au fil des passations.
En outre, les modèles mixtes s’affranchissent des contraintes rigides de la sphéricité en permettant à l’analyste de spécifier explicitement la matrice de variance-covariance résiduelle la plus ajustée empiriquement aux données (matrice autorégressive d’ordre 1 [AR(1)], matrice non structurée, ou matrice symétrique composée). Ils autorisent également l’analyse de données collectées selon des intervalles d’observation temporels irréguliers, ce que les devis classiques d’ANOVA sont incapables de gérer.
9.3 Gestion statistique des données manquantes dans les paires
L’un des talons d’Achille des protocoles à données appariées réside dans la vulnérabilité aux données manquantes. Dans une étude longitudinale à mesures répétées, l’abandon d’un participant au cours du suivi (drop-out) ou une défaillance instrumentale ponctuelle est monnaie courante. Dans l’approche classique de l’analyse matricielle par les méthodes de Student ou d’ANOVA, le traitement standard par défaut des logiciels est l’exclusion de l’analyse de cas complets (listwise deletion). La perte d’une seule observation entraîne ainsi le rejet aveugle de l’ensemble des données historiques collectées chez ce participant.
Cette suppression systématique engendre deux périls majeurs : un effondrement dramatique de la puissance statistique par atrophie de l’échantillon utile, et l’apparition de biais de sélection massifs dès lors que les données manquantes ne sont pas distribuées de manière strictement aléatoire (mécanisme Missing Completely at Random, MCAR). Si les patients qui abandonnent le protocole sont précisément ceux dont l’état psychologique s’aggrave le plus sévèrement, les données résiduelles créent l’illusion fallacieuse d’une efficacité thérapeutique éclatante du traitement testé (mécanisme Missing Not at Random, MNAR).
Les modèles avancés offrent des solutions de pointe pour surmonter cette aporie :
- L’estimation par maximum de vraisemblance à information complète (FIML) : Mobilisée nativement dans les modèles linéaires mixtes, la FIML permet d’intégrer dans le calcul probabiliste global tous les participants disposant d’au moins un point d’observation valide, exploitant l’information partielle sans nécessiter d’imputation artificielle.
- L’imputation multiple (MI) : Cette approche computationnelle comble les valeurs manquantes au sein des paires par des tirages stochastiques successifs basés sur l’ensemble des covariables disponibles, générant plusieurs jeux de données complets analysés en parallèle avant la mise en commun formelle des paramètres statistiques finaux selon les règles d’agrégation de Rubin.
10. Biais méthodologiques et menaces à la validité interne
10.1 Effets d’ordre, de pratique et de fatigue
L’exposition répétée d’une même entité biologique ou cognitive à des mesures successives modifie l’appareil psychique et comportemental du sujet. Ces altérations constituent ce que la méthodologie expérimentale désigne sous le terme générique d’effets de séquence ou de report, qui menacent directement la validité interne des conclusions inférentielles.
L’effet de pratique ou d’apprentissage représente la première dérive : lors de la deuxième administration d’un test neuropsychologique de fluidité verbale ou de mémoire de travail, le participant bénéficie mécaniquement de sa première expérience. Il a décodé les intentions de la tâche, développé des heuristiques de résolution plus agiles, neutralisé son appréhension initiale et automatisé ses schémas de réponse. L’amélioration consécutive de ses scores au post-test peut ainsi n’avoir strictement aucun rapport avec l’intervention théorique étudiée, résultant simplement d’un polissage procédural de la performance.
À l’inverse symétrique, les effets de fatigue et de désengagement motivationnel exercent une influence destructrice sur les performances mesurées en fin de batterie d’évaluation. Confronté à des tests cognitifs astreignants et répétés au cours d’une même session de laboratoire, le sujet subit un épuisement attentionnel progressif qui fait chuter ses temps de réaction et altère sa vigilance exécutive. L’application systématique de protocoles d’équilibrage et de contrebalancement en carré latin demeure la seule parade expérimentale crédible pour neutraliser ces artefacts séquentiels.
10.2 Le phénomène de régression statistique vers la moyenne
Identifié historiquement par Sir Francis Galton, le phénomène de régression statistique vers la moyenne (RTM) constitue l’un des pièges épistémologiques les plus redoutables guettant les utilisateurs de données appariées pré-post, en particulier dans la recherche clinique et interventionnelle.
Ce mécanisme probabiliste inéluctable s’énonce ainsi : si une variable est imparfaitement corrélée avec elle-même à travers le temps (en raison d’une fidélité de mesure imparfaite et de fluctuations physiologiques aléatoires), les individus sélectionnés lors du pré-test parce qu’ils présentaient des valeurs exceptionnellement extrêmes (très pathologiques ou remarquablement élevées) afficheront, lors de la seconde mesure post-test, une tendance mécanique spontanée à converger vers la moyenne générale de la population, même en l’absence totale de la moindre intervention active.
Dans une étude évaluant un programme antidépressif où seuls les sujets présentant un score BDI supérieur à 35 sont inclus, une fraction substantielle de leur détresse mesurée au jour d’inclusion était tributaire de contingences éphémères du moment (une mauvaise nuit de sommeil, un conflit interpersonnel récent). Deux mois plus tard, la dispersion naturelle ramène ces scores vers un niveau moins dramatique. Attribuer fallacieusement cette rémission à la seule puissance curative de la thérapie administrée constitue une erreur d’attribution causale majeure. L’adjonction systématique d’un groupe témoin apparié non traité ou traité par placebo constitue l’unique moyen formel de soustraire la part imputable à la régression vers la moyenne.
10.3 Effets de report et rémanence du traitement (Carryover Effects)
Dans les plans croisés (crossover designs) où chaque participant expérimente alternativement la condition contrôle puis la condition expérimentale, l’effet de rémanence ou de report (carryover effect) constitue un risque méthodologique paralysant. Ce phénomène désigne la persistance des altérations physiologiques, biochimiques, comportementales ou cognitives induites par la première condition au moment précis où le sujet entame l’évaluation de la seconde modalité.
En psychopharmacologie, la demi-vie d’élimination sanguine d’une molécule psychoactive administre la preuve éclatante de ce principe : si une substance neuroactive n’est pas intégralement métabolisée et évacuée de l’organisme avant le démarrage de la condition suivante, les récepteurs neuronaux demeurent partiellement occupés ou désensibilisés, altérant la validité de la ligne de base ultérieure. En psychologie cognitive, un principe similaire s’observe lorsqu’une condition d’induction de stress ou d’activation de stéréotypes modifie durablement le schéma mental du sujet bien au-delà de la phase expérimentale dédiée.
Pour prévenir cette contamination croisée des paires d’observations, les chercheurs doivent intercaler une période de neutralisation méthodologique suffisante, désignée sous le terme de période de sevrage ou de latence (washout period). Cette fenêtre temporelle sans contrainte expérimentale doit être rigoureusement calibrée en amont afin d’assurer un retour intégral de l’organisme et de l’appareil psychique à leur niveau d’homéostasie initiale avant toute nouvelle manipulation.
11. Protocoles d’analyse pratique avec les logiciels statistiques (R, SPSS, Python)
11.1 Structuration des matrices de données : Format large versus format long
L’exploitation computationnelle des données appariées exige une compréhension limpide des deux modes fondamentaux de représentation tabulaire des matrices numériques : le format large (wide format) et le format long (long format). Le choix de l’un ou de l’autre format dépend directement de la famille d’algorithmes et du package statistique mobilisés.
La structuration canonique s’articule comme suit :
- Le format large (wide) : Dans cette disposition matricielle, chaque participant n’occupe qu’une seule et unique ligne de données. Les différentes mesures appariées sont réparties horizontalement sur plusieurs colonnes distinctes (par exemple une colonne nommée
Score_Preet une colonne adjacenteScore_Post). Ce format est traditionnellement exigé pour le calcul des tests t de Student appariés classiques dans SPSS ou pour la fonction de soustraction différentielle brute. - Le format long (long) : À l’inverse, cette architecture réorganise les données de manière verticale : chaque mesure individuelle occupe une ligne dédiée. Un même participant dispose dès lors d’autant de lignes distinctes qu’il y a eu de moments d’évaluation ou de conditions d’exposition. Une colonne spécifique sert d’identifiant individuel invariable (
ID_Sujet), une autre colonne indique le facteur de condition ou le temps (Condition), et une colonne unique rassemble l’ensemble des réponses numériques (Performance).
Le format long constitue le standard absolu et obligatoire pour la modélisation statistique avancée, en particulier lors de la spécification des modèles linéaires à effets mixtes (LMM) ou de l’exécution de graphiques de trajectoires sous des environnements de programmation modernes. Les routines automatisées de restructuration (comme les fonctions pivot_longer() et pivot_wider() du package tidyr en R, ou les méthodes melt() et pivot() de la bibliothèque Pandas en Python) constituent les outils clés de cette gymnastique préalable des données.
11.2 Exécution pas à pas dans le logiciel R
L’environnement statistique de programmation R offre une suite complète d’outils analytiques pour conduire l’ensemble de la séquence inférentielle sur données appariées. Supposons une étude comparant les scores de mémoire de participants avant (pre) et après (post) entraînement. La démarche standardisée débute par l’évaluation du postulat de normalité des différences individuelles :
Le calcul de la variable de différence s’opère directement par assignation vectorielle : diff <- post - pre. L’analyste soumet ensuite ce vecteur au test formel de normalité via la commande shapiro.test(diff), complétée par l’inspection visuelle du tracé quantile-quantile par l’exécution combinée de qqnorm(diff) et qqline(diff, col = "red").
Si la normalité des écarts est étayée empiriquement, le test paramétrique est mobilisé par l’instruction de base :
t.test(post, pre, paired = TRUE, alternative = "two.sided", conf.level = 0.95)
Le paramètre explicite paired = TRUE est capital : son omission instruirait R de traiter par défaut les deux vecteurs comme des groupes indépendants, détruisant instantanément l’appariement statistique.
Pour le calcul normé de la taille de l’effet, l’écosystème enrichi rstatix met à disposition la syntaxe unifiée cohens_d(data, formula = Score ~ Condition, paired = TRUE). Enfin, si une déviation sévère de distribution impose le renoncement à l’approche de Student, l’alternative ordinale robuste de Wilcoxon est appelée sans délai par la routine parallèle wilcox.test(post, pre, paired = TRUE).
11.3 Mise en œuvre sous SPSS et Python
Dans l’interface graphique du progiciel IBM SPSS Statistics, le traitement des données appariées s’articule à travers une navigation structurée à partir du format large. L’analyste sélectionne la trajectoire de menus :
Analyser > Comparer les moyennes > Test T pour échantillons appariés…
Dans la boîte de dialogue contextuelle, les deux variables d’intérêt sont transférées conjointement au sein de la fenêtre active « Paires de variables » (la variable pré-test occupant la colonne Variable 1 et la variable post-test la colonne Variable 2). La matrice de sortie délivrée par SPSS présente successivement un tableau de statistiques descriptives univariées, un tableau de corrélation bivariée pré-post (quantifiant la magnitude de l’interdépendance (rho)), et le tableau du test inférentiel fournissant la moyenne de la différence, son écart-type, l’erreur type, l’intervalle de confiance à 95 %, la valeur empirique de (t), les degrés de liberté ((N-1)) et la p-valeur bilatérale exacte.
En environnement Python, le traitement s’appuie classiquement sur l’écosystème scientifique articulé autour des bibliothèques scipy.stats et pingouin. Sous SciPy, après importation du module adéquat, la commande analytique directe s’écrit :
from scipy.stats import ttest_rel, wilcoxon
stat, p_val = ttest_rel(post_scores, pre_scores)
La fonction ttest_rel (nommée ainsi pour related samples) prend en charge le calcul différentiel et l’intégration de la covariance. Le package spécialisé pingouin offre une syntaxe plus descriptive, orientée vers les sciences comportementales, en fournissant d’emblée une table complète intégrant les intervalles de confiance et la taille d’effet du d de Cohen apparié via l’exécution de l’unique commande pingouin.ttest(post, pre, paired=True).
12. Visualisation des données appariées et rédaction des résultats selon les normes académiques
12.1 Techniques graphiques optimales pour illustrer le changement intra-individuel
La visualisation des données appariées ne saurait se satisfaire des traditionnels diagrammes en barres flanqués de moustaches d’erreur standard (communément qualifiés de dynamite plots), dont l’opacité graphique masque l’essentiel de l’information statistique. Les diagrammes en barres masquent totalement la distribution interne, ignorent la corrélation intra-sujet et peuvent faire paraître identiques deux contextes empiriques aux dynamiques individuelles radicalement opposées.
Trois représentations graphiques vectorielles s’imposent pour valoriser la richesse des données appariées :
- Le graphique de trajectoires individuelles (spaghetti plot ou diagramme de pentes avant-après) : Il relie par un segment de droite le score initial et le score final de chaque participant individuel, souvent superposé à une ligne médiane épaisse et colorée représentant la tendance moyenne du groupe. Cette approche permet de détecter instantanément l’hétérogénéité des réponses : les trajectoires descendantes, stagnantes ou atypiquement ascendantes deviennent immédiatement visibles.
- Le diagramme de Bland-Altman : Principalement utilisé lors des études de fidélité et de concordance instrumentale, il représente en ordonnée la différence entre les deux mesures appariées ((X_{1i} – X_{2i})) et en abscisse leur moyenne individuelle (((X_{1i} + X_{2i})/2)). Des limites de concordance à (pm 1,96) écart-type sont tracées, permettant d’identifier d’éventuels biais systématiques ou une hétéroscédasticité proportionnelle (dispersion accrue des écarts pour les valeurs élevées).
- Le graphique de dispersion bivarié avec droite d’égalité ((y = x)) : En projetant le pré-test sur l’axe horizontal et le post-test sur l’axe vertical, la diagonale théorique d’invariance sépare l’espace en deux : tous les points situés au-dessus de la droite traduisent une progression individuelle, tandis que les points situés en deçà matérialisent une régression.
12.2 Directives de rédaction des résultats selon les standards APA (7e édition)
La transcription des résultats statistiques d’un protocole apparié au sein d’un article académique doit se conformer rigoureusement aux normes édictées par l’American Psychological Association (APA, 7e édition). Ces directives exigent que la communication ne se cantonne pas à la simple litanie d’une valeur (t) et de sa p-valeur, mais décrive exhaustivement les estimateurs ponctuels et d’intervalle associés à la différence elle-même.
Il est notamment impératif de déclarer explicitement la moyenne et l’écart-type de la différence individuelle ((bar{D}) et (S_D)), et non pas uniquement les descriptifs marginaux des deux groupes pris séparément, car ces derniers ne permettent pas au lecteur d’apprécier la magnitude de l’erreur standard couplée. Le modèle de formalisation textuelle rigoureux s’articule comme suit :
« Une analyse par test t de Student pour échantillons appariés a été conduite afin de déterminer l’impact d’une remédiation cognitive informatisée de huit semaines sur le rappel libre différé. Les résultats indiquent une amélioration statistiquement significative des performances mnésiques entre le pré-test ((M = 14,32), (ET = 3,12)) et le post-test ((M = 18,75), (ET = 2,85)), avec une progression moyenne de (4,43) points, (IC_{95%} [3,21, 5,65]), (t(47) = 7,28), (p < 0,001), (d_{rm} = 0,94). »
Dans l’éventualité où l’analyste a privilégié l’alternative non paramétrique des rangs signés de Wilcoxon, la formulation doit préciser la valeur de la statistique de somme de rangs ((W) ou (V)), le score standardisé d’approximation asymptotique (Z), la significativité exacte, la médiane des différences et la taille d’effet (r) :
« Le test des rangs signés de Wilcoxon révèle une atténuation statistiquement significative des scores d’anxiété situationnelle post-intervention ((Mdn = 22,00)) par rapport à la ligne de base ((Mdn = 34,50)), (W = 45,50), (Z = -3,84), (p < 0,001), avec une taille d'effet substantielle (r = 0,55). »
12.3 Grille d’aide à la décision pour le chercheur en sciences du comportement
Face à la pluralité des options méthodologiques envisageables lors du traitement de mesures couplées, l’intégration d’un arbre décisionnel formel permet de fiabiliser le parcours de traitement analytique. Le chercheur peut structurer son arbitrage selon une séquence rigoureuse d’étapes décisionnelles successives :
- Étape 1 : Examen du niveau métrique de la variable dépendante : Si la variable est nominale dichotomique (ex. échec/réussite pré-post), le test de McNemar constitue l’outil dédié. Si la variable est strictement ordinale sur item isolé, s’orienter vers le test des signes ou le test de Wilcoxon. Si la variable est continue (intervalle ou rapport), poursuivre vers l’étape 2.
- Étape 2 : Diagnostic de distribution du vecteur des différences : Calculer la différence (D = X_1 – X_2) et tester son adéquation à la normalité par le test de Shapiro-Wilk et l’analyse visuelle du Q-Q plot. Si la distribution est normale (ou si (N ge 30) en l’absence de valeurs aberrantes extrêmes), privilégier le test t de Student pour échantillons appariés. Si la normalité est rejetée, basculer vers le test des rangs signés de Wilcoxon.
- Étape 3 : Dimension du plan expérimental : Si le nombre de conditions appariées est strictement égal à deux, le test t ou le test de Wilcoxon est suffisant. Si le nombre de temps ou de conditions est supérieur à deux, vérifier le postulat de sphéricité de Mauchly. Si la sphéricité est respectée, appliquer l’ANOVA à mesures répétées standard ; si la sphéricité est violée, appliquer les corrections d’épsilon de Greenhouse-Geisser ou Huynh-Feldt.
- Étape 4 : Complétude des données et complexité hiérarchique : En présence d’un taux notable de données manquantes au suivi (perte de vue non aléatoire), d’intervalles de temps hétérogènes entre sujets ou de covariables dynamiques dépendantes du temps, abandonner les approches matricielles classiques au profit exclusif des modèles linéaires à effets mixtes (LMM) avec estimation par maximum de vraisemblance.
Cette rigueur de décision garantit l’alignement le plus harmonieux entre l’architecture conceptuelle de l’expérience, la morphologie réelle des distributions mathématiques collectées et la robustesse des inférences cliniques et théoriques portées au sein de la communauté scientifique internationale.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Bland, J. M., & Altman, D. G. (1986). Statistical methods for assessing agreement between two methods of clinical measurement. The Lancet, 327(8476), 307-310. https://doi.org/10.1016/S0140-6736(86)90837-8
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7-29. https://doi.org/10.1177/0956797613504966
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
- Greenhouse, S. W., & Geisser, S. (1959). On methods in the analysis of profile data. Psychometrika, 24(2), 95-112. https://doi.org/10.1007/BF02289823
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863
- Magezi, D. A. (2015). Linear mixed-effects models for within-participant psychology experiments: An introductory tutorial. Frontiers in Psychology, 6, Article 2. https://doi.org/10.3389/fpsyg.2015.00002
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- Wilcoxon, F. (1945). Individual comparisons by ranking methods. Biometrics Bulletin, 1(6), 80-83. https://doi.org/10.2307/3001968