
L’analyse inférentielle de données quantitatives recueillies dans le cadre de protocoles expérimentaux ou observationnels exige une adéquation parfaite entre la nature distributionnelle des variables et le modèle statistique sélectionné. Dans les sciences biomédicales, la psychologie clinique, l’épidémiologie et les sciences du comportement, les plans de recherche longitudinaux à mesures répétées constituent la norme méthodologique pour évaluer l’efficacité d’un traitement thérapeutique, l’impact d’une intervention comportementale ou la dynamique temporelle d’un biomarqueur. Lorsque le paradigme d’évaluation confronte deux conditions dépendantes sur une même unité statistique, le réflexe classique de la communauté scientifique consiste à mobiliser le test t de Student pour échantillons appariés. Toutefois, cette approche paramétrique repose sur le postulat indépassable de normalité de la distribution des différences intrapaires, une condition fréquemment violée dans les contextes empiriques réels où dominent les asymétries prononcées, les distributions à queue lourde, les données ordinales issues d’échelles psychométriques et les échantillons d’effectif restreint.
Face à ces contraintes distributionnelles qui fragilisent la validité interne des conclusions et majorent substantiellement le risque d’erreur de première espèce ou d’erreur de type II, l’inférence non paramétrique propose des solutions d’une grande rigueur mathématique. Parmi ces approches, le test des rangs signés de Wilcoxon s’impose comme la référence méthodologique cardinale. En substituant aux valeurs brutes des différences le classement de leurs grandeurs absolues tout en préservant le sens de leur variation, ce test offre une robustesse remarquable sans sacrifier la puissance statistique. Il permet ainsi de tester l’hypothèse d’une distribution des différences symétriquement distribuée autour d’une valeur de référence, généralement fixée à zéro pour refléter l’absence d’effet d’une condition par rapport à l’autre.
La mise en œuvre computationnelle de cette méthode au sein de l’environnement SAS (Statistical Analysis System) requiert néanmoins une maîtrise technique et conceptuelle approfondie. Contrairement à d’autres logiciels qui encapsulent ce test dans des menus automatisés parfois opaques, SAS offre plusieurs voies procédurales, dominées par la procédure univariée PROC UNIVARIATE. L’exécution rigoureuse de cette analyse exige de comprendre la structuration optimale des tables de données, la vérification formelle des postulats sous-jacents, l’arbitrage entre approximation asymptotique et dénombrement combinatoire exact, le traitement mathématique des ex æquo et des différences nulles, ainsi que le calcul systématique des estimateurs de taille d’effet. Ce guide académique a pour ambition de détailler exhaustivement les fondements théoriques, les mécanismes algorithmiques et les protocoles de programmation nécessaires à la conduite experte du test des rangs signés de Wilcoxon sous SAS.
1. Introduction théorique au test des rangs signés de Wilcoxon
1.1 Définition et fondements mathématiques du test
Le test des rangs signés de Wilcoxon a été initialement conceptualisé et formalisé par le chimiste et statisticien américain Frank Wilcoxon dans sa publication séminale de 1945, intitulée Individual Comparisons by Ranking Methods. Conçu pour pallier l’inapplicabilité du test de Student lorsque les distributions sous-jacentes s’écartent drastiquement de la courbe de Gauss, ce test non paramétrique repose sur un mécanisme fondamental : la transformation des scores continus ou ordinaux en rangs ordonnés. Plus précisément, pour un échantillon de n paires d’observations appariées (X1, Y1), (X2, Y2), …, (Xn, Yn), le statisticien calcule d’abord les différences individuelles notées Di = Xi – Yi. Les observations présentant une différence nulle (Di = 0) sont traditionnellement soustraites de l’analyse dans la formulation canonique du test, réduisant ainsi la taille de l’échantillon effectif à n’ paires informatives.
La procédure algorithmique procède ensuite au tri croissant des valeurs absolues de ces différences résiduelles, |Di|, sans considération immédiate de leur signe algébrique initial. À chaque valeur absolue est alors attribué un rang entier allant de 1, assigné à la plus petite amplitude de variation, jusqu’à n’, attribué à la divergence intrapaire la plus marquée. Une fois cette hiérarchisation établie, le signe mathématique originel de chaque différence (positif ou négatif) est réaffecté au rang correspondant. Mathématiquement, la statistique de test fondamentale, désignée sous le symbole W+ (ou T+), correspond à la somme arithmétique de l’ensemble des rangs associés aux différences strictement positives :
W+ = Σi: Di > 0 Ri
Symétriquement, la somme des rangs négatifs est définie par W– = Σi: Di < 0 Ri. La somme totale des rangs alloués vérifiant invariablement l’identité combinatoire W+ + W– = n'(n’ + 1) / 2, la connaissance de W+ détermine de manière bijective W–. Sous l’hypothèse nulle (H0) selon laquelle il n’existe aucune divergence d’emplacement entre les deux conditions appariées et que la distribution des différences est symétrique autour de zéro, l’espérance mathématique de la statistique W+ équivaut rigoureusement à E(W+) = n'(n’ + 1) / 4. La divergence observée entre la valeur empirique de W+ et cette espérance théorique conditionne le rejet ou le maintien de l’hypothèse nulle. Cette construction confère au test sa nature non paramétrique, en substituant à l’échelle métrique d’origine une métrique de position relative invariante aux transformations monotones croissantes.
1.2 Positionnement comme alternative au test t pour échantillons appariés
Dans l’arsenal des méthodes d’inférence statistique, le test des rangs signés de Wilcoxon occupe une position intermédiaire particulièrement féconde entre le test t de Student pour échantillons dépendants et le test des signes élémentaire. Contrairement au test t pour séries appariées, dont l’efficience repose sur la normalité de la variable de différence et l’absence de points aberrants susceptibles de biaiser l’estimation de la moyenne et de la variance empirique, le test de Wilcoxon démontre une insensibilité structurelle aux valeurs extrêmes. Dans un test t, une seule observation aberrante peut gonfler artificiellement la variance au point de masquer un effet expérimental réel, ou inversement distordre la moyenne pour générer un faux positif. Le test de Wilcoxon amortit cet impact, car la valeur aberrante, quelle que soit sa démesure métrique, ne reçoit que le rang maximal n’.
D’un point de vue de l’efficacité asymptotique relative (ARE, pour Asymptotic Relative Efficiency), le test des rangs signés de Wilcoxon présente des propriétés mathématiques exceptionnelles face au test t de Student. Dans la situation la plus défavorable pour lui, c’est-à-dire lorsque la distribution des différences suit parfaitement une loi normale gaussienne, l’ARE du test de Wilcoxon par rapport au test t s’établit à 3 / π ≈ 0,955. Cela signifie que le test non paramétrique ne subit qu’une déperdition de puissance marginale de l’ordre de 4,5 % par rapport à l’optimal théorique paramétrique. En revanche, dès que la distribution empirique s’écarte de la normalité, notamment en présence de distributions à queues lourdes telles que les lois logistiques, de Laplace ou de Cauchy, ou lorsqu’il existe une asymétrie modérée mais symétrisable, l’ARE du test de Wilcoxon surpasse systématiquement l’unité, atteignant des valeurs arbitrairement élevées face aux distributions hautement contaminées.
Par ailleurs, en le comparant au test des signes, qui n’exploite que le vecteur binaire des directions de changement (+ ou -), le test des rangs signés mobilise une fraction beaucoup plus substantielle de l’information contenue dans les données. Le test des signes ignore totalement la magnitude relative des variations : une amélioration d’un dixième de point pèse exactement le même poids qu’une dégradation de cent unités. En intégrant le classement ordonné des amplitudes, Wilcoxon restitue la hiérarchie des grandeurs d’effet intrapaires sans pour autant subir la vulnérabilité de la moyenne arithmétique. Il en résulte un gain de puissance statistique substantiel qui fait de cette procédure l’alternative privilégiée lorsque le test t de Student échoue structurellement à satisfaire ses postulats de validité.
1.3 Pertinence dans la recherche comportementale et psychologique
Les sciences psychologiques, cognitives et comportementales constituent des domaines d’application privilégiés pour le test des rangs signés de Wilcoxon. Les protocoles expérimentaux de type « pré-test / post-test » sont omniprésents dans la littérature clinique, qu’il s’agisse de mesurer la réduction d’une symptomatologie anxieuse consécutive à une psychothérapie brève, l’amélioration des capacités de mémoire de travail après un entraînement cognitif informatisé, ou l’altération de la vigilance sous l’effet d’une substance psychotrope. Dans ce cadre, les données collectées dérivent très fréquemment d’inventaires d’auto-évaluation, de questionnaires psychométriques standardisés ou d’échelles de Likert à 5 ou 7 points.
Bien que la pratique courante consiste souvent à sommer les items d’une échelle psychométrique pour produire un score global traité de manière quasi continue, la nature intrinsèque de ces grandeurs demeure purement ordinale. L’intervalle séparant un score d’anxiété de 10 à 15 sur l’inventaire de Beck n’est pas rigoureusement équivalent à l’intervalle séparant 35 de 40 en termes d’intensité subjective de détresse psychologique. Appliquer un modèle linéaire gaussien ou un test t de Student sur des différences calculées à partir de telles échelles viole le postulat d’intervalle métrique constant. Le test des rangs signés de Wilcoxon s’affranchit de ce problème en ne requérant qu’une capacité à classer les amplitudes relatives d’évolution clinique d’un patient par rapport à un autre, conférant ainsi une légitimité méthodologique inattaquable aux conclusions tirées.
De surcroît, la recherche psychologique et comportementale se heurte continuellement à la contrainte de la petite taille des échantillons, notamment dans le champ de la neuropsychologie clinique où l’accès à des cohortes de patients présentant des lésions cérébrales spécifiques est par définition limité. Dans des cohortes comprenant entre 8 et 20 sujets, vérifier formellement la normalité d’une distribution via des tests de puissance tels que le test de Shapiro-Wilk devient notoirement peu fiable en raison du manque de puissance statistique pour rejeter l’hypothèse de normalité, combiné à une sensibilité extrême à la moindre fluctuation échantillonnale. Le recours systématique au test de Wilcoxon dans ce périmètre disciplinaire garantit une inférence valide et reproductible, indemne des dérives paramétriques sur petits groupes.
2. Conditions d’application et postulats statistiques fondamentaux
2.1 Structure et appariement des observations
L’assise méthodologique du test des rangs signés de Wilcoxon impose une architecture expérimentale spécifique reposant sur l’appariement strict des unités d’observation. L’échantillon d’analyse doit impérativement être composé de paires conceptuellement inséparables, générées soit par une modalité d’auto-appariement (mesures répétées sur le même sujet à deux temps de mesure distincts ou sous deux conditions de traitement croisées), soit par un appariement fondé sur des covariables critiques (sujets jumelés un à un sur la base de l’âge, du sexe, du quotient intellectuel ou d’un indice de gravité clinique initial). La dépendance intra-paire est le moteur même du modèle : elle permet de neutraliser la variance interindividuelle résiduelle afin d’isoler l’effet factoriel étudié.
Simultanément, le second principe fondamental postule l’indépendance mutuelle stricte entre les différentes paires statistiques constituant l’échantillon global. L’observation (Xi, Yi) propre au sujet ou à la paire i ne doit en aucun cas être corrélée, conditionnée ou influencée par l’observation (Xj, Yj) propre au sujet ou à la paire j. Cette hypothèse d’indépendance interindividuelle exclut formellement les structures de données hiérarchiques ou emboîtées (par exemple, des élèves observés au sein d’une même classe, ou des patients recrutés par grappes familiales) sans ajustement computationnel préalable. Tout manquement à cette indépendance globale entraîne une surdispersion statistique et une sous-estimation substantielle de la variance de la statistique de test, culminant dans une inflation incontrôlée du taux d’erreur de type I.
Enfin, le schéma expérimental impose une symétrie opérationnelle totale dans la collecte des données : le volume des observations doit être strictement identique entre la condition A et la condition B pour chaque unité. L’absence d’une mesure pour l’un des deux temps temporels au sein d’un couple d’observations dénature l’appariement et requiert un arbitrage méthodologique, consistant soit en l’éviction ciblée de la paire incomplète (stratégie par cas complets), soit en la mise en œuvre de techniques d’imputation multiple adaptées aux données non gaussiennes, avant toute tentative de calcul de la métrique de rang.
2.2 Échelle de mesure et nature des variables
L’utilisation légitime du test de Wilcoxon requiert un niveau de mesure sous-jacent rigoureusement qualifié. Bien qu’il appartienne à la famille non paramétrique, ce test est beaucoup plus exigeant sur le plan de la métrologie que le test des signes ou le test du chi-carré. La variable dépendante mesurée sous les conditions X et Y doit être quantifiée selon une échelle continue ou, au minimum, selon une échelle ordinale à intervalles conceptuellement comparables. L’élément central réside dans l’opération de soustraction : la différence arithmétique Di = Xi – Yi doit elle-même pouvoir être positionnée sur une échelle de mesure permettant un ordonnancement complet et sans équivoque.
Cette condition implique que le chercheur ne doit pas seulement être capable de statuer sur le fait qu’une condition surpasse l’autre (exigence minimale d’un ordre strict), mais doit pouvoir affirmer avec certitude que la divergence constatée chez le sujet 1, |D1|, est supérieure, égale ou inférieure à la divergence constatée chez le sujet 2, |D2|. Par conséquent, les données qualitatives purement nominales ou polytomiques sans ordre sous-jacent sont formellement exclues de ce champ d’application. Dans le cas de données ordinales issues d’échelles de Likert, l’application de Wilcoxon repose sur le postulat que les échelons de réponse reflètent une variable latente sous-jacente continue dont les incréments conservent un sens d’ordonnancement univoque lorsqu’on en extrait la différence algébrique.
Lorsque cette exigence d’ordonnancement des différences n’est pas remplie, le chercheur bascule dans une zone de flou méthodologique susceptible d’invalider le processus d’attribution des rangs. Par exemple, si l’on mesure une attitude au moyen de catégories floues où la transition entre deux niveaux n’a pas la même substance selon l’extrémité de l’échelle, classer la différence brute devient une opération discutable. Le respect de ce postulat garantit que la statistique des rangs signés conserve sa signification mathématique première : une mesure ordinale de la grandeur d’effet relative entre les deux états expérimentaux.
2.3 Le postulat de symétrie de la distribution des différences
Parmi l’ensemble des conditions théoriques régissant le test des rangs signés de Wilcoxon, le postulat de symétrie de la distribution des différences est à la fois le plus déterminant et le plus fréquemment ignoré par les praticiens de l’analyse de données. L’hypothèse nulle véritablement évaluée par le test est que la variable aléatoire représentant les différences, D = X – Y, est distribuée de manière continue et symétrique autour d’une médiane centrale θD, fixée à zéro dans le cadre du test de conformité. Lorsque la distribution empirique des différences est effectivement symétrique, la moyenne, la médiane et la pseudo-médiane de cette distribution coïncident parfaitement ; dans ce cas exclusif, le rejet de l’hypothèse nulle autorise formellement à conclure à une différence statistiquement significative entre les médianes des deux conditions appariées.
À l’inverse, lorsque la distribution des différences intrapaires présente une asymétrie substantielle (présence d’une queue de distribution étirée unilatéralement, concentration asymétrique des variations positives vis-à-vis des variations négatives), le test des rangs signés de Wilcoxon ne teste plus une simple égalité de médianes. Il se transforme en un test de symétrie globale autour de la valeur centrale spécifiée. Dans cette conjoncture, une valeur p statistiquement significative peut émerger non pas parce que la médiane des différences est dissemblable de zéro, mais uniquement parce que la forme géométrique de la distribution viole l’hypothèse de symétrie postulée sous H0. L’analyste risque alors d’affirmer à tort l’existence d’un décalage d’emplacement là où ne réside qu’une distorsion de la variance ou de la skewness.
Il est donc impératif de procéder à un examen exploratoire de la distribution des différences préalablement à toute conclusion inférentielle. Cet examen mobilise des outils graphiques et descriptifs pour évaluer si la dispersion des observations positives autour de leur médiane reflète fidèlement celle des observations négatives. Si une violation majeure de la symétrie est avérée et que l’objectif scientifique strict demeure la comparaison des médianes pures, l’analyste devra envisager des alternatives plus conservatrices mais affranchies de toute contrainte de forme, telles que le test des signes binaire ou des modélisations semi-paramétriques basées sur la régression quantile pour mesures répétées.
3. Préparation et structuration des données sous SAS
3.1 Organisation des données : format large versus format long
L’environnement SAS manipule les données tabulaires selon deux architectures structurelles distinctes : le format large (wide format) et le format long (long format). Dans un format large, chaque ligne de la table représente une unité statistique individuelle unique (le participant, le sujet expérimental ou l’animal de laboratoire), et les mesures répétées acquises au fil des conditions sont stockées dans des colonnes séparées (par exemple, les variables Score_Pre et Score_Post). Inversement, dans le format long, chaque ligne de la table correspond à une seule occurrence de mesure, de sorte qu’un participant suivi sur deux temps d’évaluation occupe deux lignes distinctes, associées à une variable indicatrice de temps (Temps = 1, Temps = 2) et une colonne unique recueillant la réponse métrique.
Pour la mise en œuvre canonique du test des rangs signés de Wilcoxon au moyen de la procédure PROC UNIVARIATE, les données doivent impérativement être configurées selon le format large. Cette structure est indispensable pour permettre le calcul vectoriel direct de la variable de différence au sein d’une seule et même ligne du jeu de données. Lorsque les bases de données institutionnelles ou les entrepôts de données cliniques livrent des tables initialement configurées en format long, l’analyste SAS doit orchestrer une restructuration tabulaire en mobilisant la procédure PROC TRANSPOSE. La syntaxe requiert de déclarer l’identifiant individuel dans l’instruction BY, la variable indicatrice temporelle dans l’instruction ID, et la variable mesurée dans l’instruction VAR.
Une vigilance méthodologique absolue doit être accordée à l’intégrité de la variable d’identification lors de cette transposition. Tout doublon non contrôlé ou identifiant manquant engendre des collisions d’enregistrements et des transpositions défectueuses qui faussent l’appariement intrapaire. La validation de la cohérence de l’identifiant individuel constitue le prérequis absolu pour garantir que la différence calculée ultérieurement traduira rigoureusement l’évolution intrapersonnelle et non une hybridation erratique entre deux unités distinctes.
3.2 Écriture de l’étape DATA pour la saisie des mesures
L’étape DATA représente le fondement de la programmation SAS pour la création, le nettoyage et la manipulation des structures tabulaires. Pour illustrer concrètement la conduite du test de Wilcoxon, considérons un essai clinique fictif mené auprès de 15 patients souffrant de stress post-traumatique, chez lesquels un score d’anxiété clinique (quantifié sur une échelle de 0 à 100) est colligé avant l’administration d’une intervention thérapeutique innovante (variable Pre_Traitement) puis immédiatement après la fin du protocole (variable Post_Traitement).
La saisie manuelle et structurée de ces observations fait intervenir l’instruction INPUT couplée au marqueur de fin de code de données DATALINES (ou CARDS). Lors de cette phase d’ingestion programmatique, chaque variable fait l’objet d’un typage strict au sein du compilateur SAS. L’instruction INPUT définit le pointeur de lecture pour le numéro d’identification (variable numérique ou alphanumérique précédée d’un dollar) ainsi que pour les scores métriques continus. L’intégrité du typage numérique garantit que SAS n’appliquera pas de conversion implicite de type caractère à numérique susceptible d’engendrer des valeurs manquantes non désirées ou des messages d’alerte dans le journal d’exécution (SAS Log).
Voici l’illustration programmatique de cette étape fondamentale au sein de l’environnement SAS :
DATA Cohorte_Therapie;
INPUT Sujet_ID $ Pre_Traitement Post_Traitement;
DATALINES;
P001 78 62
P002 85 80
P003 64 65
P004 92 71
P005 70 70
P006 88 74
P007 76 68
P008 81 59
P009 69 63
P010 95 82
P011 73 75
P012 84 69
P013 79 71
P014 90 85
P015 67 60
;
RUN;
Dans cet extrait de script, le compilateur procède séquentiellement à la lecture des 15 lignes de données, assignant chaque colonne à son conteneur respectif au sein de la table temporaire WORK.Cohorte_Therapie. Cette base nettoyée et typée fournit la matière première indispensable aux transformations différentielles subséquentes.
3.3 Calcul programmatique de la variable de différence
Une fois les mesures appariées formalisées au sein du jeu de données, l’étape programmatique suivante réside dans la dérivation explicite de la colonne représentant les variations intrapaires. Bien que certaines procédures statistiques spécialisées puissent en apparence calculer en interne des contrastes, l’utilisation optimale et transparente de la procédure univariée dans SAS requiert l’existence d’une variable arithmétique dédiée, calculée de manière déclarative au sein d’une nouvelle étape DATA ou par dérivation dans l’étape existante.
La directionnalité de la soustraction doit être explicitement réfléchie et documentée par l’analyste, car elle gouverne le signe mathématique de l’ensemble des métriques de rangs signés qui seront affichées en sortie. Dans le cadre d’un essai thérapeutique où l’on postule une régression d’un score symptomatique, poser Difference = Post_Traitement – Pre_Traitement induira des différences majoritairement négatives en présence d’un traitement efficace. Inversement, configurer la variable selon la formule Difference = Pre_Traitement – Post_Traitement permettra de manipuler des valeurs positives pour refléter le gain thérapeutique obtenu. Cette convention directionnelle conditionne directement l’orientation des tests unilatéraux et l’interprétation des rangs signés cumulés.
Par ailleurs, l’étape de calcul programmatique doit incorporer un contrôle d’intégrité sur les valeurs manquantes. Sous SAS, si l’une des deux variables initiales contient une donnée manquante (représentée par un point pour les données numériques), l’opération arithmétique de soustraction propage automatiquement la valeur manquante dans la variable différentielle calculée. Il convient donc d’intégrer une clause conditionnelle de validation pour s’assurer de la complétude du jeu de données final destiné à l’analyse :
DATA Analyse_Wilcoxon;
SET Cohorte_Therapie;
IF NOT MISSING(Pre_Traitement) AND NOT MISSING(Post_Traitement) THEN DO;
Difference = Post_Traitement – Pre_Traitement;
END;
ELSE DELETE;
RUN;
Ce fragment d’instruction garantit la production d’une table d’analyse rigoureusement épurée, écartant automatiquement toute observation fragmentaire susceptible de compromettre la cohérence de la taille effective de l’échantillon apparié.
4. Évaluation préliminaire des hypothèses avec SAS
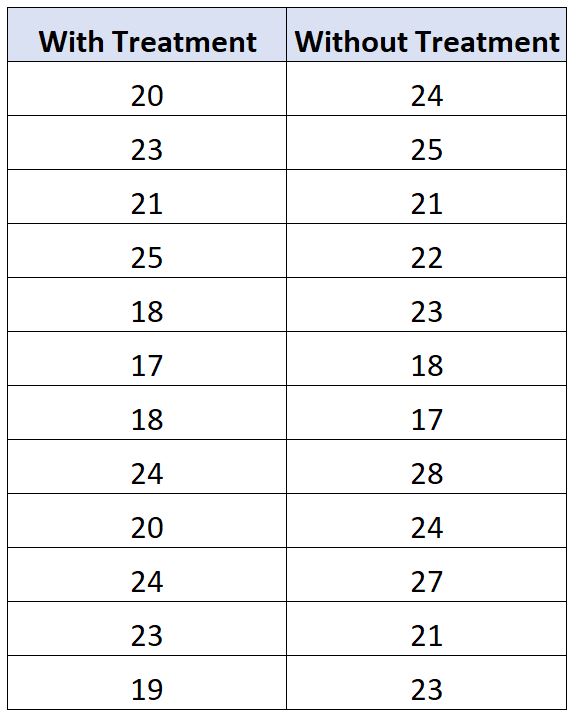
4.1 Vérification de la non-normalité avec PROC UNIVARIATE
L’arbitrage formel justifiant l’abandon du modèle paramétrique classique du test t au bénéfice du test des rangs signés de Wilcoxon repose sur l’évaluation diagnostique de la normalité de la variable de différence. Le statisticien doit se prémunir d’une erreur méthodologique courante consistant à tester la normalité séparée des variables initiales Pre_Traitement et Post_Traitement. En effet, dans un plan d’échantillons appariés, la condition de distribution gaussienne concerne exclusivement la série différentielle Di = Post – Pre. Des distributions marginales hautement asymétriques peuvent tout à fait engendrer des différences rigoureusement normales par compensation mathématique, tout comme des variables individuelles apparemment gaussiennes peuvent produire des différences non normales sous l’action d’une hétérogénéité des variations individuelles.
Au sein du logiciel SAS, la procédure d’investigation univariée la plus complète pour tester formellement cette propriété est PROC UNIVARIATE couplée à l’option de modélisation NORMAL. Cette instruction déclenche automatiquement l’exécution de quatre batteries de tests d’adéquation distributionnelle : le test de Shapiro-Wilk (W), le test de Kolmogorov-Smirnov (D), le test de Cramér-von Mises (W-Sq) et le test d’Anderson-Darling (A-Sq). Pour des échantillons de petite taille (n < 50), le test de Shapiro-Wilk constitue la référence académique absolue en raison de sa puissance de discrimination supérieure face aux alternatives asymétriques ou à queues courtes.
L’analyste examine attentivement la valeur p associée à la statistique de Shapiro-Wilk : si celle-ci s’avère inférieure au seuil de significativité nominal (α = 0,05), l’hypothèse de normalité de la distribution des différences est formellement rejetée. Cet élément inférentiel, conjointement à l’examen des coefficients de dissymétrie (skewness) et d’aplatissement (kurtosis) documentés dans la sortie standard de SAS, apporte la justification incontestable requise par les comités de lecture des revues scientifiques pour asseoir la légitimité du recours au test non paramétrique de Wilcoxon.
4.2 Analyse visuelle et graphique de la distribution
Les tests d’hypothèse d’adéquation distributionnelle ne doivent jamais être exploités de façon aveugle, car ils souffrent d’une double vulnérabilité méthodologique : une puissance statistique défaillante sur des cohortes réduites (incapacité à rejeter l’hypothèse nulle malgré des écarts sévères) et une hypersensibilité sur des cohortes volumineuses (rejet systématique de la normalité pour des déviations infimes et dénuées de conséquences pratiques). Une inspection visuelle et graphique poussée de la variable de différence, activée par le système graphique intégré ODS Graphics (Output Delivery System) de SAS, est par conséquent indispensable.
L’association des instructions graphiques HISTOGRAM et QQPLOT (quantile-quantile plot) au sein de la procédure univariée offre une visualisation diagnostique de premier ordre. L’instruction HISTOGRAM permet de superposer à la distribution empirique une courbe de densité théorique normale paramétrée par la moyenne et l’écart-type de l’échantillon, mais également une courbe d’estimation à noyau non paramétrique (KERNEL) mettant en relief les bimodalités locales et l’asymétrie réelle de la dispersion. L’instruction QQPLOT projette quant à elle les quantiles empiriques de la série différentielle contre les quantiles théoriques d’une loi normale univariée.
La mise en œuvre de cette exploration graphique s’articule comme suit :
ODS GRAPHICS ON;
PROC UNIVARIATE DATA=Analyse_Wilcoxon NORMAL;
VAR Difference;
HISTOGRAM Difference / NORMAL(COLOR=RED) KERNEL(COLOR=BLUE);
QQPLOT Difference / NORMAL(MU=EST SIGMA=EST COLOR=RED);
RUN;
ODS GRAPHICS OFF;
Sur le diagramme quantile-quantile, l’alignement linéaire des points le long de la diagonale de référence valide l’adéquation gaussienne. L’observation de points s’incurvant de manière concave ou convexe aux extrémités signale une asymétrie marquée, tandis qu’une configuration en « S » révèle un épaississement critique des queues de distribution. Cette démarche visuelle permet de statuer formellement sur le respect ou la violation de la symétrie, postulat fondateur du test des rangs signés.
4.3 Détection des données aberrantes et influentes
La présence de valeurs extrêmes ou aberrantes (outliers) au sein des séries différentielles exerce une influence pernicieuse sur les outils statistiques paramétriques standard, en déformant de manière disproportionnée la variance empirique. Bien que le test des rangs signés de Wilcoxon soit intrinsèquement plus robuste que le test t face à de telles anomalies métriques, la présence d’aberrances distributionnelles sévères nécessite une détection minutieuse pour appréhender leur genèse clinique ou expérimentale.
Dans l’environnement SAS, la procédure PROC UNIVARIATE génère par défaut, dès lors que l’environnement ODS Graphics est activé, une boîte à moustaches (boxplot) enrichie. Cette représentation graphique sépare les observations standard des valeurs dites éloignées (situées à plus de 1,5 fois l’écart interquartile au-delà des premier et troisième quartiles) et des valeurs hautement aberrantes (situées à plus de 3 fois cet écart). Parallèlement, la table descriptive ExtremeObs (Extreme Observations) éditée dans le rapport SAS répertorie systématiquement les cinq valeurs les plus basses et les cinq valeurs les plus élevées de la distribution différentielle, en affichant le numéro d’observation correspondant dans la table source.
L’identification d’une observation aberrante pose un problème de décision scientifique : reflète-t-elle une erreur de saisie typographique, un artefact instrumental, ou témoigne-t-elle de l’hétérogénéité biologique réelle de la population (par exemple, un patient super-répondeur ou réfractaire) ? Contrairement à un réflexe hâtif d’exclusion des données qui biaise la représentativité scientifique, le test des rangs signés de Wilcoxon permet de conserver l’observation dans le modèle sans en corrompre la validité inférentielle, son rang demeurant borné par l’effectif total n’, garantissant une estimation robuste et conservatrice de l’effet d’intervention.
5. Mise en œuvre du test de Wilcoxon avec PROC UNIVARIATE
5.1 Syntaxe fondamentale et structure de la commande
Dans l’architecture logicielle de SAS, le test des rangs signés de Wilcoxon pour données appariées n’est pas invoqué par une procédure dédiée aux échantillons indépendants, mais s’exécute nativement au travers de la puissante procédure univariée PROC UNIVARIATE. Dès lors qu’une variable de différence D = X – Y a été préalablement calculée pour chaque paire statistique, évaluer si les conditions expérimentales diffèrent revient mathématiquement à tester si cette variable univariée est centrée sur zéro. C’est pourquoi le test des rangs signés apparié est traité par SAS comme un test de localisation univarié portant sur la série des différences.
La structure syntaxique de base pour initier l’analyse requiert l’appel de la procédure, le ciblage de la table de données d’intérêt, et la désignation de la variable de différence au sein de l’instruction obligatoire VAR. L’algorithme interne de PROC UNIVARIATE calcule alors automatiquement une gamme exhaustive de métriques de tendance centrale, de dispersion, d’extrêmes, ainsi qu’une table spécifique intitulée Tests for Location regroupant le test t de Student univarié, le test des signes élémentaire, et le test des rangs signés de Wilcoxon.
La commande canonique minimale s’énonce selon le bloc programmatique suivant :
PROC UNIVARIATE DATA=Analyse_Wilcoxon;
VAR Difference;
RUN;
À la compilation de cette directive, SAS balaye séquentiellement les enregistrements de la variable Difference, procède à l’exclusion interne des observations manquantes et des différences nulles, trie les résidus absolus, leur attribue les rangs conventionnels et évalue la somme des rangs signés. La sortie produit l’ensemble des descripteurs nécessaires pour poser le diagnostic inférentiel sans paramétrage complexe préalable.
5.2 Paramétrage de l’hypothèse nulle avec l’option MU0
Par défaut, l’instruction PROC UNIVARIATE positionne le point de référence de l’hypothèse nulle à la valeur zéro (μ0 = 0), postulant que l’emplacement de la distribution est centré sur l’absence totale de décalage métrique. Cependant, dans les protocoles d’investigation clinique ou de recherche industrielle avancée, le chercheur peut souhaiter évaluer des hypothèses de non-infériorité ou tester si le gain thérapeutique induit dépasse un seuil d’efficacité clinique minimale prédéfini (Minimal Clinically Important Difference – MCID). Par exemple, on peut chercher à valider si la réduction moyenne des scores dépasse substantiellement une valeur seuil de 5 points.
Pour implémenter cette contrainte théorique sans recourir à un recalcul artificiel de la variable différentielle au sein de l’étape DATA, SAS propose l’option formelle MU0= (ou LOCCOUNT) directement déclarée dans l’en-tête de la procédure PROC UNIVARIATE. L’algorithme soustrait alors dynamiquement la constante spécifiée par MU0 à l’ensemble des observations avant de procéder au tri et à la sommation des rangs signés :
PROC UNIVARIATE DATA=Analyse_Wilcoxon MU0=5;
VAR Difference;
RUN;
De plus, les versions modernes de SAS enrichissent cette analyse au moyen de l’option ROBUSTSCALE, qui génère des estimateurs d’échelle alternatifs robustes face aux écarts de distribution, tels que l’écart absolu médian (MAD) ou les estimateurs Qn et Sn de Rousseeuw et Croux. Cette combinaison offre un panorama analytique d’une grande sophistication, permettant à l’analyste de confronter les résultats du test de Wilcoxon à des ancrages théoriques personnalisés tout en validant la stabilité de la variabilité mesurée.
5.3 Optimisation de l’affichage avec ODS SELECT
L’exécution par défaut de PROC UNIVARIATE génère un volume substantiel d’informations statistiques, occupant fréquemment plusieurs pages de rapport : moments statistiques, mesures basiques de dispersion, quantiles empiriques, tableaux d’observations extrêmes et tests de normalité. Dans un contexte de production de rapports d’analyse clinique standardisés ou d’automatisation de chaînes de traitement de données volumineuses, cette profusion de tableaux encombre le journal et disperse l’attention de l’analyste.
Pour rationaliser l’affichage et cibler rigoureusement l’information décisionnelle pertinente, le gestionnaire de sortie SAS Output Delivery System (ODS) met à disposition l’instruction de filtrage dynamique ODS SELECT. En consultant la table des noms d’objets graphiques et textuels associés à la procédure, on constate que la table regroupant les statistiques inférentielles de localisation porte l’identifiant immuable TestsForLocation. Pour obtenir simultanément les descripteurs élémentaires de tendance centrale et de dispersion sans le bruit des autres tables, on adjoindra l’objet BasicMeasures.
La structuration optimale et épurée du script s’orchestre dès lors ainsi :
ODS SELECT TestsForLocation BasicMeasures;
PROC UNIVARIATE DATA=Analyse_Wilcoxon;
VAR Difference;
RUN;
Cette directive ordonne au moteur SAS de bloquer le rendu de toutes les sorties accessoires et de ne projeter dans la fenêtre de résultats que les tables strictement nécessaires. Cette optimisation technique accélère le traitement, préserve la lisibilité académique des sorties et facilite l’exportation sélective des estimations tabulaires vers des formats bureautiques ou des fichiers de données SAS pérennes via l’instruction ODS OUTPUT.
6. Méthodes alternatives d’exécution dans le logiciel SAS
6.1 Utilisation de PROC TTEST avec l’instruction PAIRED
Une démarche fréquemment entreprise par les utilisateurs de SAS formés à l’approche paramétrique consiste à solliciter la procédure PROC TTEST pour traiter des mesures dépendantes, en mobilisant l’instruction dédiée PAIRED. Cette dernière adopte une syntaxe explicite sous la forme PAIRED Var1 * Var2;, laquelle indique sans ambiguïté au processeur statistique que l’analyse doit porter sur la structure de corrélation intrapaire entre les deux colonnes spécifiées du format large.
L’intérêt de PROC TTEST réside dans sa capacité à produire une analyse paramétrique complète, fournissant l’intervalle de confiance de la moyenne des différences ainsi que des représentations graphiques intégrées automatisées de haute qualité, telles que le graphique de corrélation des profils d’appariement ou le graphique de distribution des différences individuelles. Néanmoins, sur le plan strict du test non paramétrique de Wilcoxon, PROC TTEST présente une limite opérationnelle majeure : elle ne calcule pas la statistique des rangs signés. Son algorithme se cantonne rigoureusement à l’inférence fondée sur la loi t de Student et l’estimation de l’écart-type résiduel.
L’utilisation de PROC TTEST dans ce contexte méthodologique ne peut donc être envisagée que comme une étape diagnostique préliminaire ou comparative. L’observation des graphiques édités par cette procédure s’avère précieuse pour apprécier visuellement l’ampleur du couplage entre les deux conditions de mesure, mais dès lors que la violation des conditions de normalité impose le basculement vers les rangs signés de Wilcoxon, l’abandon de PROC TTEST au profit de PROC UNIVARIATE devient une obligation méthodologique incontournable.
6.2 Utilisation de PROC NPAR1WAY après restructuration
Une confusion méthodologique et technique récurrente au sein de la communauté des praticiens de SAS concerne l’utilisation de la procédure PROC NPAR1WAY. Cette procédure est universellement reconnue comme le module de référence pour l’analyse non paramétrique à un facteur (englobant le test de la somme des rangs de Wilcoxon, rigoureusement équivalent au test de Mann-Whitney, ainsi que le test de Kruskal-Wallis pour les designs multigroupes). Face à des données appariées, certains analystes tentent de restructurer la table en format long (deux lignes par sujet) et d’appliquer PROC NPAR1WAY avec une variable de groupe binaire distinguant la condition pré-test de la condition post-test.
Une telle démarche constitue une faute statistique sévère aux conséquences dramatiques sur la validité inférentielle. PROC NPAR1WAY postule par essence l’indépendance mutuelle stricte entre l’ensemble des lignes soumises à la comparaison. En lui injectant des données issues d’un plan à mesures répétées, l’algorithme ignore totalement le lien d’appariement intrapersonnel. L’importante variance interindividuelle, qui aurait dû être mathématiquement soustraite par le calcul des différences individuelles, vient polluer le dénominateur de variance de la statistique de test.
L’utilisation de PROC NPAR1WAY sur des échantillons dépendants débouche inexorablement sur une perte drastique de puissance statistique (incapacité à déceler un effet réel masqué par la variabilité interindividuelle) ou, dans certaines configurations de dispersion asymétrique, sur une distorsion imprévisible de la valeur p. L’instruction PROC NPAR1WAY ne doit en aucun cas être sollicitée pour conduire le test des rangs signés de Wilcoxon, son champ d’application étant restreint aux comparaisons de groupes strictement indépendants.
6.3 Comparaison algorithmique des différentes procédures SAS
L’architecture modulaire de SAS invite à synthétiser les caractéristiques algorithmiques des différents outils mobilisables pour l’analyse de deux mesures couplées. Le tableau conceptuel ci-après met en perspective les propriétés computationnelles des procédures majeures :
- PROC UNIVARIATE (sur la variable D = X – Y) : Méthode de référence absolue. Exécute le test des rangs signés de Wilcoxon exact ou asymptotique, élimine les différences nulles, gère les ex æquo, évalue les postulats de symétrie et de normalité, calcule les descripteurs robustes.
- PROC TTEST (avec instruction PAIRED) : Méthode strictement paramétrique. Fournit l’inférence basée sur la moyenne de la différence et la distribution t de Student. Inadaptée aux violations de normalité, elle n’intègre aucun algorithme de rangs signés.
- PROC NPAR1WAY (sur format long restructuré) : Inadéquate et non valide pour les données appariées. Conçue exclusivement pour des unités statistiques indépendantes (Mann-Whitney / Kruskal-Wallis), son application sur mesures répétées viole l’hypothèse d’indépendance intergroupes.
D’un point de vue computationnel, l’algorithme sous-jacent à PROC UNIVARIATE traite les opérations de tri et d’assignation de rangs selon une complexité temporelle asymptotique de l’ordre de O(n log n), ce qui garantit des temps d’exécution quasi instantanés, même sur des cohortes englobant plusieurs dizaines de milliers de paires d’observations. La fidélité numérique du noyau de calcul SAS garantit une cohérence absolue entre les estimations descriptives et les tables inférentielles, positionnant définitivement PROC UNIVARIATE comme le standard institutionnel pour le traitement non paramétrique des séries appariées.
7. Traitement des ex æquo et des différences nulles dans SAS
7.1 Gestion des différences nulles selon l’algorithme de Pratt versus Wilcoxon
Dans la pratique expérimentale, il est fréquent que certaines paires d’observations n’enregistrent aucune variation entre la phase initiale et la phase finale, aboutissant à une différence rigoureusement nulle (Di = Xi – Yi = 0). La gestion computationnelle de ces données nulles constitue un sujet de controverse statistique de longue date, opposant la stratégie canonique originale de Frank Wilcoxon à la méthodologie proposée ultérieurement par John W. Pratt en 1959.
Dans son approche originelle de 1945, Wilcoxon préconisait l’exclusion pure et simple de toutes les paires présentant une différence nulle préalablement à toute attribution de rangs. La taille d’échantillon opérationnelle est alors réduite à n’ = n – n0, où n0 représente le volume de différences nulles écartées. Cette convention mathématique constitue le comportement algorithmique par défaut adopté par SAS dans PROC UNIVARIATE. L’inconvénient méthodologique de cette éviction réside dans la perte d’information clinique : observer qu’un traitement n’induit aucun changement chez un sous-groupe de patients est une donnée scientifique fondamentale qui devrait théoriquement renforcer l’hypothèse nulle d’absence d’effet global.
À l’inverse, l’algorithme développé par Pratt consiste à inclure l’ensemble des observations initiales dans la phase de tri et d’attribution des rangs, les différences nulles recevant les rangs les plus bas (partageant le rang moyen lié aux ex æquo initiaux). Ce n’est qu’après cette hiérarchisation globale que les rangs attribués aux différences nulles sont exclus de la sommation de la statistique des rangs positifs W+. La méthode de Pratt préserve ainsi l’échantillon nominal n pour le calcul de la variance théorique. Bien que SAS applique prioritairement la méthode classique de Wilcoxon, l’analyste doit impérativement documenter le volume n0 d’observations évincées dans ses rapports de recherche afin de prévenir tout biais de sélection induit par cette réduction artificielle de la cohorte effective.
7.2 Calcul et attribution des rangs moyens en présence d’ex æquo
Lorsque plusieurs sujets présentent des amplitudes de variations intrapaires absolues strictement identiques (|Di| = |Dj| pour i ≠ j), la hiérarchisation ordinale se heurte à l’impossibilité d’attribuer des rangs entiers distincts sans introduire d’arbitraire aléatoire. Pour résoudre cette indétermination, l’algorithme standard implémenté dans le noyau SAS mobilise la technique universelle du rang moyen (mid-rank). Les observations ex æquo occupant consécutivement les positions d’ordre k à k + m – 1 se voient attribuer la moyenne arithmétique exacte des rangs théoriques qu’elles auraient occupés si leurs valeurs avaient été distinctes.
La présence d’ex æquo exerce une influence mathématique directe sur la dispersion de la statistique de test. Sous l’hypothèse nulle, la variance théorique de la statistique des rangs signés, formulée initialement sans ex æquo par :
Var(W+) = [n'(n’ + 1)(2n’ + 1)] / 24
se trouve systématiquement réduite en présence de rangs moyens partagés. Si cette réduction de variance n’est pas corrigée, l’approximation normale de la statistique produit des scores Z sous-estimés et, subséquemment, des p-values erronées. Pour rétablir l’exactitude de l’inférence, le moteur computationnel de SAS intègre automatiquement une correction de variance calculée sur la base de la multiplicité des groupes d’égalités. La formule de correction retranche au numérateur un facteur d’ajustement défini par :
Correction = Σ (tj3 – tj) / 48
où tj représente le nombre d’observations liées composant le j-ième groupe d’ex æquo. Grâce à cette correction automatisée, SAS garantit que l’erreur de type I demeure rigoureusement contrôlée au seuil nominal, y compris sur des données issues d’échelles de Likert caractérisées par une discrétisation prononcée générant une proportion massive d’ex æquo.
7.3 Correction de continuité et robustesse des p-values
La statistique des rangs signés de Wilcoxon relève d’un univers combinatoire discret, les valeurs possibles prises par la somme des rangs W+ n’évoluant que par sauts entiers ou demi-entiers en cas d’ex æquo. À l’opposé, l’approximation normale utilisée pour dériver la probabilité asymptotique de dépassement repose sur la loi de Gauss, par définition continue sur l’axe des réels. L’évaluation de l’aire sous la courbe d’une distribution continue pour approximer la probabilité d’une masse discrète requiert l’application d’une correction de continuité.
La correction de continuité de Yates consiste à ajuster la statistique observée d’une demi-unité (0,5) en direction de son espérance mathématique nulle avant d’opérer la division par l’écart-type de la distribution d’échantillonnage. Ce décalage permet d’englober la totalité de l’intervalle unitaire centré sur le point discret évalué. Dans les architectures SAS, l’implémentation de la correction de continuité varie selon la procédure sollicitée. Au sein de PROC UNIVARIATE, la dérivation asymptotique du test de Wilcoxon applique une formulation standardisée qui garantit une robustesse optimale face aux petits échantillons approchant les seuils critiques.
Il demeure essentiel de noter que lorsque la proportion d’égalités au sein de l’échantillon devient prépondérante (par exemple dans le cas où plus de 40 % des paires partagent des amplitudes identiques), l’approximation normale même corrigée pour la continuité commence à perdre en fiabilité mathématique. Dans ces contextes extrêmes de forte granularité discrète, l’analyste SAS averti doit basculer vers les méthodes de permutation exacte, qui dénombrent sans approximation l’ensemble des arrangements combinatoires des rangs liés.
8. Lecture et interprétation approfondie de la sortie SAS
8.1 Interprétation de la statistique S de Wilcoxon
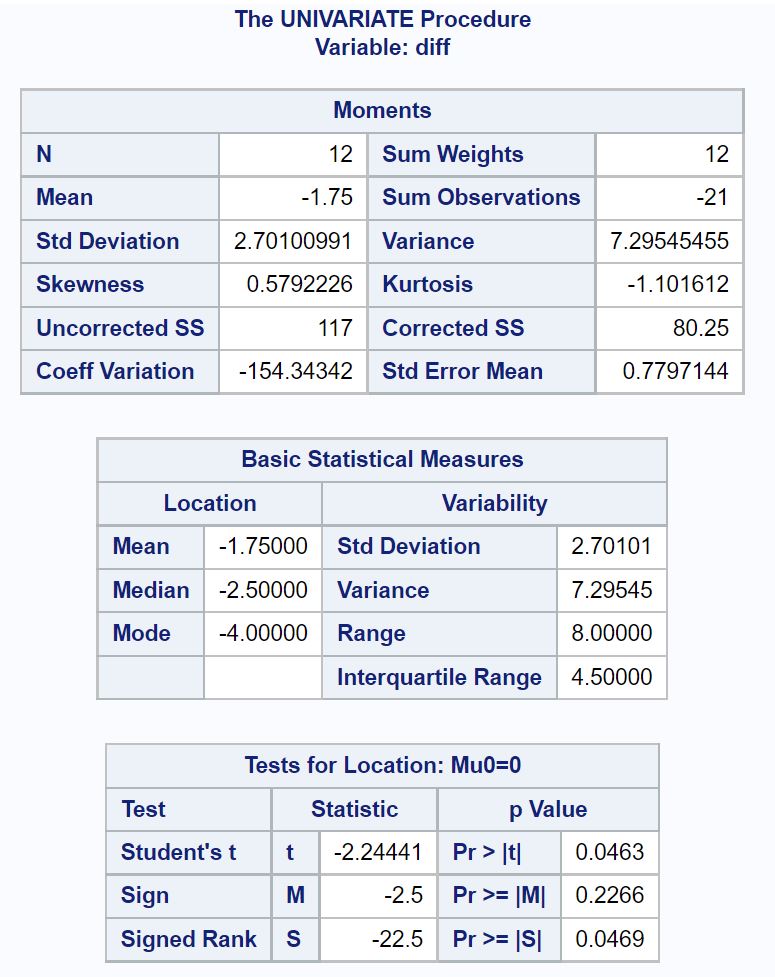
L’un des écueils d’interprétation les plus répandus chez les utilisateurs de SAS découle de la présentation tabulaire propre à la table TestsForLocation générée par PROC UNIVARIATE. Alors que la quasi-totalité des manuels académiques et des logiciels statistiques concurrents expriment le résultat du test des rangs signés au travers de la somme brute des rangs positifs, W+ (dont la valeur est obligatoirement positive et comprise entre 0 et n'(n’+1)/2), SAS édite une métrique centrée intitulée Statistique S (Signed Rank).
Cette statistique S de SAS est mathématiquement définie comme la déviation directe de la somme des rangs positifs par rapport à son espérance théorique sous H0. La formule liant la statistique affichée dans SAS à la statistique canonique W+ s’exprime selon la relation linéaire bijective suivante :
S = W+ – [n'(n’ + 1) / 4]
Cette formulation centrée induit des conséquences immédiates sur la lecture des résultats. Premièrement, contrairement à W+, la statistique S peut prendre des valeurs positives ou négatives. Une valeur S positive indique sans équivoque que la somme des rangs associés aux différences positives surpasse l’attente probabiliste sous l’hypothèse nulle, témoignant d’une tendance globale à l’accroissement des scores entre les deux conditions. Réciproquement, une valeur S négative démontre la prédominance des rangs négatifs, signifiant une diminution médiane globale des mesures observées. Une valeur S égale à zéro traduirait un équilibre combinatoire parfait entre les variations positives et négatives.
Deuxièmement, la magnitude absolue de S reflète directement la force du décalage de distribution : plus |S| s’approche de sa borne théorique maximale n'(n’+1)/4, plus l’effet intrapaire est massif. Il est fondamental que l’analyste comprenne cette spécificité de SAS pour éviter d’imputer l’émergence d’une valeur négative à une défaillance computationnelle ou de confondre cette métrique centrée avec un score standardisé en loi normale.
8.2 Analyse de la p-value bilatérale et unilatérale
Dans la table TestsForLocation, la ligne consacrée au test des rangs signés (intitulée Signed Rank) affiche la statistique S ainsi qu’une probabilité d’erreur associée, documentée sous l’étiquette normalisée Pr >= |S|. Cette valeur probabiliste correspond strictement au test bilatéral (two-sided p-value). Elle quantifie la probabilité exacte ou asymptotique d’observer, sous l’hypothèse nulle d’une distribution symétrique centrée en zéro, une statistique S au moins aussi extrême en valeur absolue que celle dérivée de l’échantillon empirique.
Le seuil de décision académique standard est universellement calé sur le risque d’erreur alpha de première espèce (α = 0,05). Si la valeur affichée pour Pr >= |S| est strictement inférieure à 0,05, l’hypothèse nulle est rejetée au profit de l’hypothèse alternative postulant l’existence d’une divergence systématique de localisation intrapaire entre les deux conditions expérimentales. Dans le cas contraire, les données ne permettent pas d’écarter l’hypothèse de l’équivalence stochastique.
Lorsque le cadre théorique impose une hypothèse unilatérale directionnelle formulée a priori (par exemple, la prédiction clinique stricte que le traitement réduira les symptômes), l’analyste doit convertir manuellement la valeur p bilatérale fournie par PROC UNIVARIATE. Si le signe de la statistique S concorde avec le sens prédit par l’hypothèse de recherche, la p-value unilatérale s’obtient rigoureusement en divisant par deux la valeur affichée :
punilatérale = (Pr >= |S|) / 2
Si en revanche le signe de S contredit la direction postulée par le chercheur, la p-value unilatérale s’établit à 1 – [(Pr >= |S|) / 2], interdisant formellement tout rejet d’hypothèse nulle. Cette rigueur arithmétique prévient toute pratique déviante consistant à ajuster la directionnalité du test a posteriori en fonction des résultats observés.
8.3 Statistiques descriptives associées : médiane et dispersion
L’inférence statistique n’a de sens scientifique que si elle s’articule intimement avec des descripteurs de position et de dispersion en parfaite adéquation avec la philosophie du test mobilisé. Une faute courante dans la littérature biomédicale consiste à présenter un test de Wilcoxon pour justifier l’abandon du modèle gaussien, tout en décrivant l’ampleur des données au moyen de la moyenne arithmétique et de l’écart-type. Ce hiatus méthodologique vicie l’interprétation : la moyenne demeure sensible aux aberrations que Wilcoxon a précisément neutralisées par l’assignation de rangs.
L’accompagnement descriptif obligatoire du test des rangs signés repose sur la médiane de la variable de différence, accompagnée d’un indicateur de dispersion robuste, au premier rang desquelles figure l’écart interquartile (IQR, défini par la différence entre le 75e percentile et le 25e percentile). Ces métriques sont instantanément consultables au sein de la table BasicMeasures produite par PROC UNIVARIATE. L’analyste synthétise ainsi le comportement central sous la forme : Médiane (Q1 – Q3).
Il est impératif de souligner que la médiane de la différence médiane(X – Y) ne correspond pas, sur le plan mathématique, à la soustraction arithmétique des médianes marginales médiane(X) – médiane(Y), en raison de la non-linéarité de l’opérateur quantile. L’analyste doit impérativement rapporter la médiane calculée sur le vecteur différentiel lui-même pour garantir la cohérence mathématique la plus absolue avec la conclusion inférentielle tirée de la statistique S.
9. Calcul et rapport de la taille d’effet
9.1 Calcul du coefficient de corrélation de rang r de Rosenthal
La seule publication d’une valeur p, même hautement significative, s’avère aujourd’hui formellement proscrite par les normes méthodologiques contemporaines et les recommandations éditoriales internationales. Une valeur p est conditionnée par la taille de l’échantillon : un échantillon colossal permettra d’atteindre un seuil de significativité extrême pour un effet d’une insignifiance clinique totale, tandis qu’une cohorte restreinte masquera un effet thérapeutique massif derrière une absence de significativité apparente. La quantification standardisée de la magnitude de l’effet s’avère donc indispensable.
Dans le périmètre non paramétrique des rangs signés, la taille d’effet la plus universellement reconnue et recommandée par le statisticien Robert Rosenthal est le coefficient de corrélation de rang, désigné sous le symbole r. Cet indice standardisé dérive de la conversion de la statistique de test en une valeur de score Z standardisé de la loi normale centrée réduite. L’équation canonique liant le score Z à la taille d’effet r s’exprime selon la relation :
r = |Z| / √N
où N représente le nombre total d’observations individuelles impliquées dans le test. Dans un schéma apparié de n’ paires d’observations, N correspond conventionnellement au double du nombre de paires (N = 2 × n’), chaque paire engageant deux mesures distinctes. Certains auteurs emploient alternativement la racine de la taille des paires (√n’) ; il est donc crucial que le chercheur mentionne explicitement la convention adoptée dans son manuscrit.
L’interprétation de la valeur absolue de ce coefficient r s’aligne rigoureusement sur les balises heuristiques définies par Jacob Cohen pour les sciences comportementales :
- Effet de faible amplitude : 0,10 ≤ r < 0,30
- Effet d’amplitude modérée : 0,30 ≤ r < 0,50
- Effet de forte amplitude : r ≥ 0,50
L’intégration systématique du coefficient r de Rosenthal confère une profondeur analytique essentielle, permettant de comparer directement les résultats obtenus avec d’autres études exploitant des designs ou des métriques hétérogènes.
9.2 Estimation de l’emplacement robuste : pseudo-médiane de Hodges-Lehmann
Au-delà de la corrélation de rang r, l’inférence non paramétrique moderne valorise l’estimation de l’amplitude du décalage d’emplacement exprimée dans l’unité de mesure originelle. Pour le test des rangs signés de Wilcoxon, l’estimateur ponctuel robuste associé par excellence est la pseudo-médiane de Hodges-Lehmann (souvent désignée sous le symbole Δ̂HL).
Cet estimateur ne correspond pas à la médiane empirique brute des différences individuelles, mais se définit mathématiquement comme la médiane exacte de toutes les moyennes par paires possibles, appelées moyennes de Walsh. Pour une série de n’ différences Di, l’algorithme génère les n'(n’ + 1) / 2 moyennes calculées pour toutes les combinaisons (Di + Dj) / 2 pour 1 ≤ i ≤ j ≤ n’. La pseudo-médiane de Hodges-Lehmann représente la médiane ordonnée de cet ensemble combinatoire élargi. Elle jouit de propriétés mathématiques remarquables : elle est invariante par translation, strictement symétrique, et possède un point de rupture élevé garantissant son immunité face aux distorsions locales de distribution.
SAS permet d’obtenir cet estimateur robuste ainsi que son intervalle de confiance asymptotique ou exact par l’intermédiaire de l’instruction ROBUSTSCALE ou en mobilisant des étapes analytiques avancées. Rapporter la pseudo-médiane de Hodges-Lehmann adossée à son intervalle de confiance à 95 % offre une description clinique d’une richesse exceptionnelle, traduisant le bénéfice médian attendu dans la population cible sans céder aux faiblesses inhérentes à la moyenne arithmétique gaussienne.
9.3 Automatisation du calcul de la taille d’effet via une étape DATA
Bien que SAS ne délivre pas directement le coefficient r de Rosenthal dans la table TestsForLocation de PROC UNIVARIATE, la puissance de l’environnement ODS permet d’extraire la statistique inférentielle calculée pour programmer automatiquement la dérivation de cet indice au sein d’une étape DATA subséquente, garantissant ainsi un pipeline d’analyse entièrement automatisé et reproductible.
Le protocole de programmation requiert en premier lieu d’intercepter la table inférentielle au moyen de l’instruction ODS OUTPUT. SAS isole alors la ligne correspondant au test des rangs signés, extrait la statistique S et la taille effective de la cohorte, calcule la variance théorique ajustée, dérive le score Z normalisé et applique la formule de Rosenthal. L’ensemble s’exécute de façon transparente au travers du script suivant :
ODS OUTPUT TestsForLocation=Table_Test LocCount=Table_Effectif;
PROC UNIVARIATE DATA=Analyse_Wilcoxon LOCCOUNT;
VAR Difference;
RUN;
ODS OUTPUT CLOSE;
DATA Taille_Effet;
MERGE Table_Test(WHERE=(Test= »Signed Rank »)) Table_Effectif(WHERE=(Parameter= »Num Obs > 0″ OR Parameter= »Num Obs < 0″));
RETAIN N_Pairs S_Stat;
IF Test = « Signed Rank » THEN S_Stat = StatVal;
IF Parameter in (« Num Obs > 0 », « Num Obs < 0 ») THEN N_Pairs = SUM(N_Pairs, Count);
IF LAST.Parameter THEN DO;
/* Variance théorique sans ex æquo */
Var_S = (N_Pairs * (N_Pairs + 1) * (2 * N_Pairs + 1)) / 24;
/* Calcul du score Z avec correction de continuité */
IF S_Stat > 0 THEN Z_Score = (S_Stat – 0.5) / SQRT(Var_S);
ELSE IF S_Stat < 0 THEN Z_Score = (S_Stat + 0.5) / SQRT(Var_S);
ELSE Z_Score = 0;
/* Calcul du r de Rosenthal basé sur le nombre total d’observations (2 * N_Pairs) */
r_Rosenthal = ABS(Z_Score) / SQRT(2 * N_Pairs);
OUTPUT;
END;
KEEP N_Pairs S_Stat Z_Score r_Rosenthal;
RUN;
PROC PRINT DATA=Taille_Effet NOOBS;
RUN;
Cette approche programmatique confère une traçabilité intégrale à l’inférence statistique. Les métriques résultantes peuvent être instantanément fusionnées dans les tableaux récapitulatifs finaux destinés aux publications médicales ou psychométriques.
10. Exactitude et méthodes de rééchantillonnage pour petits échantillons
10.1 Limites de l’approximation normale asymptotique
L’inférence statistique standard documentée par la plupart des logiciels repose sur le théorème central limite, stipulant que la distribution d’échantillonnage de la statistique de test converge vers une loi normale lorsque la taille d’échantillon tend vers l’infini. Dans le cadre du test des rangs signés de Wilcoxon, cette approximation asymptotique produit d’excellents résultats dès lors que le nombre de paires informatives n’ dépasse 30, et s’avère acceptable dès n’ ≥ 20 sous réserve d’une dispersion régulière exempte de regroupements massifs d’ex æquo.
En deçà de ce seuil méthodologique de 20 paires — une situation omniprésente dans les essais de phase précoce, les protocoles de neuro-imagerie fonctionnelle ou la recherche sur les maladies rares —, l’approximation normale commence à dériver de façon substantielle. Dans la région des queues de distribution, où se joue précisément la prise de décision statistique par rapport au seuil critique de 5 %, la loi discrète de la somme des rangs signés diverge géométriquement de la courbe continue de Gauss. Les queues de la distribution discrète exacte sont en effet plus épaisses ou irrégulières, oscillant au gré des combinaisons entières possibles.
Recourir aveuglément à la p-value asymptotique dans un échantillon de 10 ou 12 patients expose le chercheur à un risque majeur d’erreur d’inférence. Le taux d’erreur de première espèce réel peut s’écarter considérablement du taux nominal α = 0,05, entraînant soit des rejets indus de l’hypothèse nulle (faux positifs), soit au contraire une pénalisation de puissance masquant une découverte scientifique légitime. Dans ces configurations restreintes, l’abandon de l’approximation au profit d’un calcul combinatoire exact constitue une exigence de rigueur scientifique incontournable.
10.2 Obtention de la p-value exacte avec l’instruction EXACT
Le système SAS intègre des algorithmes combinatoires de pointe permettant d’élaborer la distribution exacte des rangs sans recourir à aucune approximation distributionnelle. Pour les plans d’échantillons indépendants, la procédure PROC NPAR1WAY mobilise l’instruction formelle EXACT. Dans le cadre de l’évaluation univariée des différences sous PROC UNIVARIATE, l’algorithme sous-jacent passe automatiquement en mode de calcul combinatoire exact pour les petits échantillons lorsque la commande le permet, ou l’analyste peut solliciter des procédures transversales adaptées.
Le calcul exact repose sur l’énumération complète de l’ensemble des 2n’ assignations possibles de signes positifs ou négatifs aux n’ rangs alloués. Pour n’ = 15, l’algorithme dénombre 215 = 32 768 permutations équiprobables sous H0 ; il calcule pour chacune d’elles la statistique W+ correspondante, et quantifie la proportion exacte d’arrangements dont la valeur absolue est supérieure ou égale à la statistique observée. Pour les structures de données complexes ou lorsque PROC UNIVARIATE ne déploie pas le calcul exact direct, l’analyste peut reformuler l’analyse via la procédure PROC FREQ sur un tableau de contingence de signes appariés ou recourir à des macros certifiées SAS dédiées au calcul combinatoire direct.
La p-value exacte ainsi obtenue ne souffre d’aucune distorsion liée à la continuité ou à l’asymétrie résiduelle des rangs. Elle représente la probabilité mathématiquement indiscutable de l’événement statistique observé sous l’hypothèse nulle. Sa mention explicite dans le corps d’un article scientifique garantit une conformité totale avec les standards de publication les plus intransigeants du secteur biomédical.
10.3 Approches par bootstrap non paramétrique dans SAS
Lorsque la taille de l’échantillon se situe dans une zone grise (par exemple entre 15 et 30 paires) et que la structure des données est polluée par une proportion non négligeable d’ex æquo compromettant le calcul exact combinatoire conventionnel, les méthodes de rééchantillonnage par bootstrap non paramétrique offrent une alternative inférentielle d’une robustesse exceptionnelle. Le bootstrap permet de reconstruire empiriquement la distribution d’échantillonnage de la statistique de test en tirant avec remise des milliers d’échantillons de taille n’ au sein de la cohorte observée.
Sous SAS, la mise en œuvre de cette stratégie fait intervenir la procédure de sondage PROC SURVEYSELECT. L’algorithme tire avec remise, typiquement 10 000 réplicats de l’échantillon de paires, puis la procédure PROC UNIVARIATE est exécutée de façon groupée au moyen de l’instruction BY Replicate pour calculer la statistique S sur chaque pseudo-échantillon. L’intervalle de confiance empirique de la statistique ou de la pseudo-médiane de Hodges-Lehmann est ensuite dérivé par la méthode des percentiles au travers de PROC UNIVARIATE.
L’orchestration d’un schéma bootstrap sous SAS se synthétise selon le flux computationnel suivant :
/* Génération de 10 000 rééchantillons bootstrap avec graine fixée */
PROC SURVEYSELECT DATA=Analyse_Wilcoxon OUT=Bootstrap_Data
METHOD=URS SAMPRATE=1 OUTHITS REP=10000 SEED=45678;
RUN;
/* Calcul de la variable de test sur l’ensemble des réplicats */
ODS SELECT NONE;
PROC UNIVARIATE DATA=Bootstrap_Data;
BY Replicate;
VAR Difference;
OUTPUT OUT=Bootstrap_Out MEDIAN=Med_Diff;
RUN;
ODS SELECT ALL;
/* Extraction de l’intervalle de confiance bootstrap à 95 % */
PROC UNIVARIATE DATA=Bootstrap_Out;
VAR Med_Diff;
OUTPUT OUT=IC_Bootstrap PCTLPTS=2.5 97.5 PCTLPRE=IC_;
RUN;
Cette méthodologie affranchit l’inférence de toute hypothèse distributionnelle théorique, tout en offrant une estimation d’une précision remarquable de la variabilité réelle de l’effet mesuré.
11. Rédaction des résultats selon les normes académiques et APA
11.1 Normes de présentation des tests non paramétriques (APA 7e édition)
La communication scientifique des résultats d’un test des rangs signés de Wilcoxon doit impérativement respecter les canons de standardisation édictés par l’American Psychological Association (APA, 7e édition) ou par les directives de l’International Committee of Medical Journal Editors (ICMJE). L’objectif est d’assurer une transparence méthodologique absolue permettant aux lecteurs d’évaluer la force de l’évidence empirique et d’intégrer les paramètres dans de futures méta-analyses.
Selon les exigences de l’APA (7e édition), un compte rendu rigoureux ne peut se limiter à la mention de la significativité statistique. Il doit obligatoirement juxtaposer les éléments formels suivants :
- Les descripteurs de tendance centrale et de dispersion pour chaque condition temporelle ou pour la série différentielle, exprimés sous forme de médiane et d’écart interquartile (IQR) ;
- La taille de l’échantillon effectif n’, en documentant explicitement le volume des éventuelles différences nulles évincées ;
- Le symbole de la statistique de test, formaté en italique. Pour Wilcoxon, on utilise conventionnellement W ou Z si l’approximation normale est rapportée, ou S en précisant sa nature centrée issue de SAS ;
- La valeur exacte de la probabilité d’erreur (p-value), rapportée avec trois décimales (par exemple p = .014), en évitant les expressions vagues telles que « p < 0.05 » à moins que le niveau n’atteigne le plancher algorithmique (p < .001) ;
- La magnitude standardisée de la taille d’effet (généralement le coefficient r de Rosenthal ou la pseudo-médiane de Hodges-Lehmann accompagnée de son intervalle de confiance à 95 %).
Le respect de ce standard rédactionnel garantit l’intelligibilité universelle du protocole expérimental et son intégration sans friction dans le corpus de la science ouverte.
11.2 Modèles de phrases types pour articles de recherche
Afin de guider la transposition rédactionnelle des sorties produites par SAS vers le corps d’un manuscrit soumis pour publication, les modèles de verbalisation académique suivants illustrent les deux cas de figure canoniques rencontrés dans la pratique.
Cas 1 : Résultat statistiquement significatif (rejet de l’hypothèse nulle)
« Une analyse non paramétrique par test des rangs signés de Wilcoxon a été conduite sous SAS afin d’évaluer l’efficacité d’une intervention thérapeutique sur les scores de détresse psychologique auprès de 15 patients appariés. L’examen distributionnel ayant mis en évidence une violation de la normalité des différences intrapaires (Shapiro-Wilk W = 0,862, p = .028), les descripteurs sont présentés sous forme de médianes et d’écarts interquartiles. Les résultats démontrent une réduction statistiquement significative des scores d’anxiété clinique entre la phase initiale pré-traitement (Mdn = 78,0, IQR = 15,0) et l’évaluation post-interventionnelle (Mdn = 70,0, IQR = 12,0), S = -48,50, Z = -2,78, p = .005 (bilatéral). La magnitude de cette diminution témoigne d’une taille d’effet de forte amplitude selon les critères de Cohen, r = .51. Ces données confirment l’hypothèse clinique d’une atténuation substantielle de la symptomatologie sous l’effet du protocole thérapeutique. »
Cas 2 : Absence de différence statistiquement significative (maintien de l’hypothèse nulle)
« Le test des rangs signés de Wilcoxon pour séries appariées appliqué à la variation des performances cognitives ne met en évidence aucune évolution statistiquement significative consécutivement à la tâche d’entraînement (médiane de la différence = 1,50, IQR = 4,00, S = 7,00, Z = 0,59, p = .558). La taille d’effet observée s’avère négligeable (r = .11). Ces observations empiriques ne permettent pas d’écarter l’hypothèse nulle d’équivalence stochastique des performances au seuil nominal de 5 %. »
Il est crucial de relever la nuance rédactionnelle adoptée dans le second cas : l’analyste ne conclut jamais que « les deux conditions sont strictement identiques », ce qui constituerait une affirmation d’équivalence indue, mais précise rigoureusement que les données ne fournissent pas d’évidence suffisante pour rejeter l’absence d’effet.
11.3 Conception de figures d’accompagnement scientifiques avec SAS ODS
Une communication scientifique d’impact ne saurait reposer exclusivement sur des formulations textuelles ou des tables d’agrégation numérique. La valorisation visuelle des profils individuels appariés constitue l’un des leviers les plus puissants pour illustrer la dynamique réelle des modifications intra-sujets. Dans l’écosystème SAS, la procédure de graphisme statistique vectoriel PROC SGPLOT permet de concevoir des représentations visuelles de qualité éditoriale supérieure.
Parmi les figures les plus adaptées aux mesures appariées figure le graphique de profils individuels avant-après (communément désigné sous l’anglicisme spaghetti plot), éventuellement combiné à des boîtes à moustaches adjacentes ou des diagrammes en violon visualisant la densité non paramétrique. Cette figure projette chaque sujet sous la forme d’un segment reliant son score initial à son score final, mettant instantanément en exergue les trajectoires convergentes d’amélioration clinique ainsi que les cas atypiques d’aggravation symptomatique.
Voici la programmation SAS permettant de générer une telle figure vectorielle haute définition :
/* Restructuration temporaire en format long pour l’instruction SGPLOT */
DATA Graph_Long;
SET Analyse_Wilcoxon;
Temps = « Pré-Intervention « ; Score = Pre_Traitement; OUTPUT;
Temps = « Post-Intervention »; Score = Post_Traitement; OUTPUT;
RUN;
ODS GRAPHICS ON / RESET IMAGENAME= »Figure_Profils_Wilcoxon » IMAGEFMT=TIFF WIDTH=6IN HEIGHT=4.5IN DPI=300;
PROC SGPLOT DATA=Graph_Long;
VBOX Score / CATEGORY=Temps FILLATTRS=(COLOR=LIGHTGREY) TRANSPARENCY=0.5 NOOUTLIERS;
SERIES X=Temps Y=Score / GROUP=Sujet_ID LINEATTRS=(PATTERN=SOLID THICKNESS=1 COLOR=STEELBLUE);
SCATTER X=Temps Y=Score / GROUP=Sujet_ID MARKERATTRS=(SYMBOL=CIRCLEFILLED SIZE=7 COLOR=STEELBLUE);
XAXIS LABEL= »Phase Expérimentale » VALUEATTRS=(SIZE=10 WEIGHT=BOLD);
YAXIS LABEL= »Score d’Anxiété Clinique (0 – 100) » GRID VALUEATTRS=(SIZE=10);
KEYLEGEND / EXCLUDE=(« ») NOBORDER;
RUN;
ODS GRAPHICS OFF;
Cette configuration logicielle exporte un fichier graphique au format TIFF natif à une résolution de 300 points par pouce (DPI), satisfaisant rigoureusement aux critères techniques de soumission des plus grandes maisons d’édition scientifique internationales.
12. Diagnostic des erreurs courantes et bonnes pratiques
12.1 Erreurs fréquentes de codage et d’interprétation dans SAS
L’exploitation de SAS pour conduire un test des rangs signés de Wilcoxon s’accompagne d’une série de pièges méthodologiques et de programmation qu’un statisticien professionnel doit savoir identifier et corriger sans délai. La première erreur fondamentale réside dans l’inversion de l’orientation directionnelle de la différence. Configurer l’opération différentielle selon Post – Pre versus Pre – Post inverse le signe mathématique de la statistique S. Un analyste distrait examinant une statistique S = -48,50 pourrait conclure hâtivement à un effet délétère ou régressif de l’intervention, alors que cette valeur reflète précisément la diminution recherchée d’une symptomatologie clinique. L’alignement permanent entre l’orientation arithmétique de la soustraction et l’hypothèse substantielle de recherche constitue la première règle de sécurité analytique.
Le second écueil critique touche à la gestion passive des données manquantes. Si un fichier contient des sujets n’ayant complété que la phase préliminaire sans mesure post-test, et que l’analyste exécute une soustraction sans filtrage formel, SAS propage la valeur manquante. Mais si des procédures composites sont appliquées en amont sans vérification d’alignement, des désynchronisations d’enregistrements peuvent émerger. Il convient de vérifier systématiquement le journal d’exécution (SAS Log) pour confirmer le nombre exact d’observations lues et effectivement mobilisées dans l’analyse inférentielle.
Enfin, une troisième erreur d’interprétation récurrente consiste à assimiler la statistique S de SAS à un score de Student ou à une valeur Z. Certains chercheurs novices rapportent dans leurs articles des mentions aberrantes telles que « t = 48.50, p = .005 » en recopiant textuellement la valeur brute de S. Une telle confusion décrédibilise instantanément le manuscrit auprès des réviseurs experts. Il est impératif de comprendre que S est une somme de rangs déviée et qu’elle ne doit jamais être assimilée à une statistique de rapport de variance ou à une ordonnée de Student.
12.2 Distinction cruciale entre rangs signés et test de Mann-Whitney
L’une des fautes théoriques les plus préjudiciables constatées dans la littérature scientifique empirique réside dans la confusion intellectuelle entre le test des rangs signés de Wilcoxon (destiné aux échantillons appariés) et le test de la somme des rangs de Wilcoxon (rigoureusement équivalent au test U de Mann-Whitney, destiné aux groupes totalement indépendants). Bien que portant tous deux le patronyme de Frank Wilcoxon, ces deux outils reposent sur des fondements combinatoires et des postulats de dépendance diamétralement opposés.
Employer le modèle des groupes indépendants (via PROC NPAR1WAY) sur un protocole pré-test / post-test détruit la validité interne de la recherche. En traitant les deux séries temporelles comme si elles émanaient d’individus totalement distincts, l’analyste sacrifie l’avantage méthodologique majeur du design en mesures répétées : le contrôle de la variance interindividuelle. Dans un modèle apparié, chaque individu agit comme son propre témoin, ce qui permet de soustraire la variabilité propre aux caractéristiques basales du sujet. Ignorer cette covariance intrapaire gonfle artificiellement le terme d’erreur statistique et se solde par un effondrement dramatique de la puissance de détection du test.
Pour prévenir cette dérive, la check-list décisionnelle suivante doit être scrupuleusement appliquée préalablement à toute analyse SAS :
- S’agit-il des mêmes sujets évalués à deux moments distincts, ou de paires jumelées un à un ? Si OUI → Schéma apparié obligatoire. Utiliser exclusivement PROC UNIVARIATE sur la variable D = X – Y. Proscrire formellement PROC NPAR1WAY.
- S’agit-il de deux cohortes d’individus distincts n’entretenant aucun lien de parenté statistique ? Si OUI → Schéma indépendant. Utiliser PROC NPAR1WAY avec l’instruction WILCOXON. Proscrire formellement la soustraction intrapaire univariée.
Cette stricte séparation épistémologique garantit que l’outil statistique employé demeure le reflet fidèle de la mécanique causale du protocole expérimental.
12.3 Bonnes pratiques pour un script SAS reproductible et documenté
La pérennité, l’auditabilité et la reproductibilité des analyses computationnelles constituent le socle de l’intégrité scientifique contemporaine. Un script SAS ne doit pas être rédigé comme une séquence éphémère d’instructions interactives, mais pensé comme un programme modulaire, auto-documenté et prêt à être ré-exécuté à l’identique dans le cadre d’un audit de recherche clinique ou d’une réplication méthodologique.
La première bonne pratique réside dans l’encapsulation macro-paramétrique du code de test des rangs signés. En intégrant les étapes d’évaluation préliminaire, d’extraction des rangs signés et de dérivation automatisée de la taille d’effet r au sein d’une macro SAS documentée (par exemple %Macro Test_Wilcoxon_Apparie(Data=, VarPre=, VarPost=);), l’analyste homogénéise ses pratiques sur l’ensemble de ses projets de recherche et élimine tout risque d’erreur manuelle de copier-coller.
La deuxième exigence méthodologique porte sur la traçabilité intégrale du journal SAS (SAS Log). L’analyste doit archiver systématiquement le journal d’exécution aux côtés des tables de résultats. Le journal doit être scanné pour confirmer l’absence formelle de messages d’erreur de compilation (ERROR), d’alertes d’incompatibilité de type (WARNING) ou de notes signalant des conversions implicites de variables ou des suppressions inattendues d’observations manquantes (NOTE: Missing values were generated).
Enfin, lorsque des procédures de rééchantillonnage bootstrap ou de permutations exactes stochastiques sont mobilisées, la fixation explicite d’une graine aléatoire déterministe (paramètre SEED= dans PROC SURVEYSELECT) est strictement obligatoire. Elle seule garantit qu’un auditeur externe ré-exécutant le script sur la même station de calcul obtiendra rigoureusement, au chiffre décimal près, la même séquence d’échantillonnage et des intervalles de confiance strictement superposables. Cette rigueur programmatique hisse la pratique de l’analyse statistique sous SAS aux plus hauts standards de l’éthique scientifique moderne.
Références
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Conover, W. J. (1999). Practical nonparametric statistics (3rd ed.). John Wiley & Sons.
- Hodges, J. L., & Lehmann, E. L. (1963). Estimates of location based on rank tests. The Annals of Mathematical Statistics, 34(2), 598-611. https://doi.org/10.1214/aoms/1177704172
- Hollander, M., Wolfe, D. A., & Chicken, E. (2013). Nonparametric statistical methods (3rd ed.). John Wiley & Sons.
- Pratt, J. W. (1959). Remarks on zeros and ties in the Wilcoxon signed rank procedures. Journal of the American Statistical Association, 54(287), 655-667. https://doi.org/10.1080/01621459.1959.10501526
- Rosenthal, R. (1991). Meta-analytic procedures for social research (Revised ed.). SAGE Publications. https://doi.org/10.4135/9781412985017
- SAS Institute Inc. (2023). SAS/STAT 15.3 user’s guide: The UNIVARIATE procedure. SAS Institute Inc. https://documentation.sas.com
- Wilcoxon, F. (1945). Individual comparisons by ranking methods. Biometrics Bulletin, 1(6), 80-83. https://doi.org/10.2307/3001968