
Dans l’architecture complexe des sciences humaines, de la psychologie, de l’éducation et de la recherche biomédicale, la mesure des attributs intangibles constitue un défi épistémologique permanent. Contrairement aux grandeurs physiques telles que la masse, la longueur ou la température, les phénomènes psychologiques et éducatifs — qu’il s’agisse de l’intelligence, de l’anxiété, de la compétence clinique ou de la maîtrise statistique — ne peuvent être observés directement. Ils constituent des construits hypothétiques, des entités conceptuelles déduites à partir de manifestations comportementales observables. Pour que les inférences tirées des scores attribués à ces construits possèdent une valeur scientifique et pratique, les instruments de mesure doivent faire la démonstration irréfutable de leurs propriétés psychométriques, au premier rang desquelles figure la validité.
Parmi les multiples facettes de la validité de mesure, la validité de contenu occupe une place matricielle et séminale. Elle s’intéresse à l’adéquation intrinsèque entre les éléments constitutifs d’un instrument d’évaluation (items, questions, tâches, observations) et le domaine théorique ou pratique qu’il est censé circonscrire. Sans une validité de contenu solidement établie dès la genèse d’un test, toute tentative subséquente d’évaluation de la fidélité, de modélisation factorielle ou de corrélation prédictive repose sur des fondations fragiles. Un questionnaire d’évaluation diagnostique qui omet des symptômes cardinaux d’une pathologie, ou un examen universitaire qui évalue des connaissances périphériques au détriment des compétences fondamentales du cursus, fausse inévitablement les conclusions et peut induire des décisions délétères tant sur le plan individuel qu’institutionnel.
Le présent article propose une analyse exhaustive, méthodique et approfondie de la validité de contenu, embrassant son évolution historique, ses fondements théoriques, ses démarches quantitatives contemporaines et ses applications pratiques dans divers secteurs d’activité. En décortiquant les concepts d’univers de contenu, de sous-représentation du construit et de variance non pertinente, tout en exposant les protocoles d’expertise qualitative et les indices statistiques formalisés par des théoriciens tels que Lawshe, Lynn ou Aiken, cette étude a pour dessein d’offrir un guide de référence tant aux chercheurs, psychomètres et concepteurs d’épreuves qu’aux praticiens soucieux de la rigueur de leurs outils d’évaluation.
1. Introduction et fondements théoriques de la validité de contenu
1.1 Origine et place dans la psychométrie moderne
L’émergence formelle du concept de validité de contenu s’inscrit au cœur des grands débats épistémologiques qui ont façonné la psychométrie au cours du XXe siècle. Historiquement, l’évaluation psychologique s’est d’abord focalisée sur des approches purement empiristes et pragmatiques, où la valeur d’un test était quasi exclusivement jugée à l’aune de sa corrélation avec un critère externe immédiat. Toutefois, l’article fondateur de Lee Cronbach et Paul Meehl (1955) consacré à la validité de construit a opéré une rupture paradigmatique majeure en soulignant que les instruments d’évaluation ne pouvaient se contenter d’associations statistiques brutes : ils devaient être ancrés dans un réseau nomologique explicitant la nature théorique de ce qui est mesuré. Parallèlement, les travaux séminaux d’auteurs comme Anne Anastasi et Jum Nunnally ont progressivement mis en exergue le fait que la représentativité du contenu constituait la condition première de toute interprétation légitime des scores.
Cette prise de conscience a trouvé son expression la plus aboutie dans l’évolution des Standards for Educational and Psychological Testing, élaborés conjointement par l’American Psychological Association (APA), l’American Educational Research Association (AERA) et le National Council on Measurement in Education (NCME). Dès leurs premières éditions dans les années 1950 et 1960, ces normes ont officialisé la distinction classique entre trois grands types de validité, souvent désignés sous le terme de « trinité de la validité » : la validité de contenu, la validité de critère (englobant la validité prédictive et la validité concourante) et la validité de construit. Dans les éditions contemporaines de ces standards, la validité est désormais appréhendée comme un concept unitaire — le degré auquel les preuves empiriques et la théorie soutiennent l’adéquation des interprétations des scores pour les usages prévus —, mais les preuves fondées sur le contenu du test (evidence based on test content) demeurent la première ligne de défense de tout processus de validation.
Il importe d’établir d’emblée une distinction conceptuelle nette entre la fidélité, la consistance interne et la validité d’un instrument. La fidélité (ou fiabilité) renvoie à la précision, à la stabilité et à la reproductibilité des scores en l’absence d’erreurs aléatoires de mesure. La consistance interne, souvent mesurée par le coefficient alpha de Cronbach ou le coefficient oméga de McDonald, évalue le degré d’inter-corrélation entre les items d’une même échelle. Or, un instrument peut afficher une consistance interne exceptionnellement élevée tout en étant totalement dépourvu de validité de contenu. Si un test conçu pour évaluer la compétence globale en programmation informatique ne comporte que des questions portant sur la syntaxe élémentaire d’un seul langage, les items pourront présenter une corrélation mutuelle très forte, mais le test échouera dramatiquement à couvrir l’univers des compétences requises (algorithmique, débogage, optimisation architecturale). La validité de contenu s’attache ainsi non pas à la reproductibilité mathématique des scores, mais à la légitimité théorique et à l’exhaustivité de la matière soumise à l’évaluation.
1.2 La notion de domaine ou d’univers de contenu
Au cœur de la validité de contenu réside la notion d’univers ou de domaine de contenu (content domain). Un domaine de contenu représente l’ensemble total, théoriquement délimité, des connaissances, habiletés, attitudes, comportements ou processus cognitifs qui définissent le construit psychologique ou pédagogique d’intérêt. Délimiter avec précision les frontières conceptuelles d’un construit s’avère une entreprise intellectuelle exigeante : il s’agit d’expliciter non seulement ce qui appartient de droit au domaine, mais également d’établir des frontières étanches excluant ce qui relève de construits connexes ou distincts. Dans la théorie de la généralisabilité développée par Cronbach, Gleser, Nanda et Rajaratnam, un score à un test n’est rien d’autre qu’un échantillon fini prélevé au sein d’un univers infini de conditions de mesure et de questions possibles.
L’enjeu central de la conception d’un instrument réside par conséquent dans l’échantillonnage représentatif de cet univers. Tout comme un sondeur politique cherche à constituer un échantillon démographique reflétant fidèlement la structure sociologique d’une nation, le psychomètre doit générer un échantillon d’items qui reproduit fidèlement la composition, la structure et la hiérarchie du domaine cible. Cet échantillonnage doit naviguer constamment entre deux impératifs contradictoires : l’idéal théorique d’exhaustivité et les contraintes pragmatiques incontournables de l’administration des tests. Dans les contextes réels, qu’il s’agisse d’examens scolaires, d’évaluations en milieu hospitalier ou de tests de sélection professionnelle, le temps de passation est sévèrement contraint pour limiter la fatigue des sujets et les coûts logistiques. Un instrument ne peut jamais contenir des milliers d’items pour sonder chaque micro-facette d’un domaine.
Pour résoudre cette tension, les cadres de référence théoriques jouent un rôle prépondérant dans la cartographie systématique du domaine. Ces cadres formalisent la nomenclature des compétences ou des manifestations symptomatiques à travers des matrices multidimensionnelles. Ils permettent de segmenter le domaine en composantes majeures et mineures, d’assigner des pondérations théoriques explicites à chacune d’elles et de s’assurer qu’aucune dimension constitutive fondamentale n’est marginalisée lors de la sélection finale des stimuli d’évaluation. La cartographie rigoureuse du domaine constitue ainsi le socle indispensable sans lequel l’échantillonnage d’items dégénère en un agrégat arbitraire d’énoncés.
1.3 Objectifs académiques et scientifiques de la validation de contenu
L’exigence de rigueur dans l’établissement de la validité de contenu répond à des objectifs scientifiques, éthiques et méthodologiques fondamentaux. Le premier objectif est de garantir la validité de l’inférence logique allant du score brut obtenu par un sujet vers le niveau estimé de son construit sous-jacent. Lorsqu’un étudiant obtient la note de 85/100 à une épreuve de neuroanatomie, ou lorsqu’un patient présente un score indiquant une symptomatologie anxieuse sévère, l’utilisateur du test postule implicitement que ce score est directement généralisable à l’ensemble du domaine de la neuroanatomie ou de l’anxiété pathologique. Si le test souffre d’un défaut de validité de contenu, cette extrapolation devient scientifiquement caduque : le score ne reflète alors qu’une performance idiosyncrasique restreinte aux quelques questions spécifiques administrées, interdisant toute généralisation légitime.
Le deuxième objectif fondamental réside dans la prévention et l’éradication des biais systématiques lors de la collecte de données empiriques. En recherche fondamentale ou appliquée, l’utilisation d’instruments mal calibrés sur le plan du contenu introduit des erreurs systématiques de mesure qui faussent les relations observées entre variables. Dans le cadre d’études épidémiologiques ou expérimentales, un outil qui capture une facette non pertinente d’un phénomène tout en omettant ses traits saillants mènera inévitablement à des erreurs de type I (détection fallacieuse d’effets inexistants) ou de type II (incapacité à déceler des relations réelles), ruinant la reproductibilité des résultats scientifiques.
Enfin, sur le plan éthique et sociétal, la validation rigoureuse du contenu garantit l’équité des évaluations auprès de populations diversifiées et hétérogènes. Dans les contextes à fort enjeu (high-stakes testing), tels que les concours d’entrée aux grandes écoles, l’octroi de licences professionnelles d’exercice médical ou les décisions de recrutement en entreprise, l’instrument de mesure possède un pouvoir d’arbitrage déterminant sur les trajectoires individuelles. Démontrer la validité de contenu d’une épreuve est la seule garantie objective que les candidats sont évalués exclusivement sur les compétences intrinsèquement nécessaires au rôle visé, protégeant ainsi les institutions contre les discriminations directes ou indirectes et établissant l’impartialité et la crédibilité scientifique des processus de décision.
2. Définition conceptuelle et opératoire de la validité de contenu
2.1 Définition formelle de la validité de contenu
Sur le plan formel, la validité de contenu se définit comme le degré d’adéquation et de représentativité avec lequel les composantes individuelles d’un instrument d’évaluation échantillonnent l’ensemble du domaine de contenu que cet instrument est censé mesurer. Dans leur traité classique de psychométrie, des auteurs de référence comme Nunnally et Bernstein (1994) soulignent qu’un test possède une haute validité de contenu dans la mesure exacte où ses items constituent un échantillon sans biais de l’univers de comportements théoriques d’intérêt. Cette exigence implique un alignement direct et documenté entre chaque élément de l’épreuve (l’item, sa formulation, ses options de réponse ou sa grille de notation) et les facettes opérationnelles circonscrites dans la définition du construit.
Il est fondamental de reconnaître que la validité de contenu ne relève pas primitivement d’un calcul statistique a posteriori, mais procède fondamentalement d’un jugement qualitatif structuré, appuyé par des évidences logiques et des preuves empiriques rigoureuses. Contrairement à la validité de critère, qui se quantifie commodément à travers des coefficients de corrélation linéaire de Pearson, ou à la validité structurelle, qui se vérifie par des analyses factorielles confirmatoires, la validité de contenu se construit dès la phase de conception du test. Elle mobilise des processus déductifs où des panels d’experts examinent minutieusement les correspondances conceptuelles entre les stimuli et les cadres de référence.
Les conséquences d’un déficit de validité de contenu sur l’interprétation des scores sont particulièrement insidieuses. Lorsqu’un test présente des failles de contenu, le sens théorique assigné au score devient profondément ambigu, voire erroné. On assiste alors à un phénomène de tromperie métrologique : l’utilisateur croit mesurer l’anxiété de performance mais évalue en réalité l’introversion sociale ; une commission d’examen croit mesurer la maîtrise du raisonnement clinique chez de jeunes internes mais évalue leur vitesse de lecture ou leur capacité de mémorisation passive. Dès lors que l’isomorphisme entre le domaine cible et l’instrument est brisé, l’ensemble de l’édifice interprétatif s’effondre.
2.2 Sous-représentation du construit : mécanismes et risques
Dans sa théorisation monumentale de la validité, Samuel Messick (1989, 1995) a identifié les deux menaces épistémologiques majeures qui guettent tout instrument de mesure. La première de ces menaces est la sous-représentation du construit (construct underrepresentation). Ce phénomène se produit lorsque le test s’avère trop étroit par rapport au domaine théorique, omettant des dimensions, des facettes ou des niveaux de complexité cognitivo-comportementale pourtant cruciaux pour définir l’attribut dans sa plénitude.
Les mécanismes conduisant à la sous-représentation du construit sont souvent d’ordre pragmatique ou méthodologique. Les concepteurs d’épreuves ont une tendance naturelle à sursélectionner les facettes d’un construit qui se prêtent le plus aisément à une standardisation rapide, au détriment des aspects plus nuancés, complexes ou difficiles à formaliser. Par exemple, dans un test de compétence linguistique, il est considérablement plus aisé de concevoir des questions à choix multiples évaluant la reconnaissance de règles grammaticales isolées ou l’orthographe lexicale que d’évaluer la compétence discursive pragmatique, la négociation du sens en interaction orale ou la fluidité rhétorique. En éludant ces dimensions complexes, l’instrument mutile le construit de ses composantes les plus significatives.
Le risque inhérent à la sous-représentation du construit est une dégradation dramatique de la validité externe et de la transférabilité des conclusions tirées du test. Si un examen certifiant pour des médecins urgentistes ignore délibérément l’évaluation de la gestion du stress sous pression temporelle et de la communication interdisciplinaire pour ne sonder que la mémorisation de posologies pharmacologiques, les candidats brillamment reçus sur la base de leur score théorique pourront s’avérer dangereux en pratique réelle au chevet des patients. La sous-représentation crée un faux sentiment de sécurité en tronquant la réalité de la compétence observée. Pour prévenir ce péril, la mise en place d’un audit systématique de la table de spécifications de l’épreuve est impérative, imposant une vérification croisée pointilleuse entre chaque dimension théorique et les items alloués.
2.3 Variance non pertinente au construit : identification et exclusion
La seconde menace canonique identifiée par Messick est la variance non pertinente au construit (construct-irrelevant variance). Elle représente le phénomène inverse et symétrique de la sous-représentation : le test est pollué par des exigences étrangères au construit cible, introduisant dans la mesure des sources systématiques de variance qui n’ont aucun rapport avec l’attribut d’intérêt. Les variations de scores observées entre les individus ne reflètent plus seulement leurs différences sur le trait ciblé, mais traduisent également leur hétérogénéité vis-à-vis de ces facteurs parasites contaminants.
La variance non pertinente se manifeste généralement sous deux formes : la difficulté non pertinente (construct-irrelevant difficulty) et la facilité non pertinente (construct-irrelevant easiness). La difficulté non pertinente survient lorsque des obstacles annexes entravent la performance des répondants. Un exemple paradigmatique réside dans l’usage d’un vocabulaire inutilement abscons, de structures syntaxiques alambiquées ou de métaphores culturellement spécifiques dans des items destinés à évaluer le raisonnement mathématique chez de jeunes écoliers ou des allophones. L’élève échoue non pas par incompétence numérique, mais en raison d’une barrière d’accès linguistique. À l’inverse, la facilité non pertinente intervient lorsque des indices fortuits, des redondances syntaxiques ou des défauts d’ingénierie des distracteurs permettent à des sujets sagaces de deviner la réponse correcte sans posséder la compétence intellectuelle requise.
L’effet de contamination méthodologique induit par la variance non pertinente est dévastateur pour la pureté psychométrique du test. Il altère profondément la validité des comparaisons interindividuelles et nuit particulièrement aux minorités socioculturelles ou aux individus présentant des profils cognitifs neurodivergents non visés par l’évaluation. La purification systématique des items requiert une analyse critique impitoyable de chaque stimulus afin d’éliminer toute charge cognitive accessoire, tout jargon stylistique superflu et tout indice involontaire, garantissant que seule l’expression authentique du trait ciblé pilote la variabilité des performances.
3. Les composantes fondamentales de la validité de contenu
3.1 Pertinence des items (Item Relevance)
Pour qu’un instrument d’évaluation démontre une haute validité de contenu globale, il doit impérativement satisfaire à des exigences strictes réparties en trois composantes fondamentales : la pertinence des items, la représentativité du domaine et la clarté technique. La pertinence des items (item relevance) renvoie à l’adéquation logique, conceptuelle et comportementale directe de chaque énoncé pris individuellement au regard du construit ciblé. Chaque item soumis à l’évaluation doit prouver son utilité et sa nécessité intrinsèque au sein du dispositif.
L’examen de la pertinence impose une analyse rigoureuse visant l’élimination sans concession des items ambigus, superflus, périphériques ou tangentiels. Un écueil fréquent dans la conception de questionnaires psychologiques ou d’enquêtes de climat organisationnel réside dans l’accumulation d’items « intéressants » sur le plan sociologique ou anecdotique, mais qui dévient subrepticement du noyau définitionnel du construit. Si l’on conçoit une échelle évaluant l’épuisement professionnel (burnout), un item interrogeant l’insatisfaction relative à la rémunération salariale, bien qu’étroitement lié à l’environnement de travail, ne mesure pas l’état d’épuisement émotionnel ou de dépersonnalisation en tant que tel ; il s’agit d’un facteur contributif ou contextuel, et non d’une manifestation directe de l’état psychologique. Son inclusion affaiblirait la pertinence de l’instrument.
La pertinence implique également d’ajuster avec finesse la gradation de la difficulté des items et leur registre lexical aux caractéristiques sociodémographiques et développementales de la population cible. Un item d’évaluation clinique pertinent pour un adulte cultivé peut s’avérer totalement inadapté pour un adolescent ou un patient présentant un déficit cognitif léger, brisant ainsi son alignement conceptuel. La clarté linguistique, l’absence absolue de double sens et l’évitement de formulations alambiquées constituent des prérequis indispensables pour s’assurer que le stimulus est perçu et interprété de manière univoque par tous les répondants conformément à l’intention originelle des concepteurs.
3.2 Représentativité du domaine (Domain Coverage)
Tandis que la pertinence opère à l’échelle microscopique de l’item individuel, la représentativité du domaine (domain coverage ou domain representativeness) s’exerce à l’échelle macroscopique de l’instrument dans son ensemble. Elle garantit l’équilibre proportionnel des items entre les différents sous-domaines, facettes et composantes théoriques préalablement identifiés lors de la cartographie conceptuelle. Un test peut être composé exclusivement d’items hautement pertinents, mais souffrir d’une distorsion majeure de représentativité si l’ensemble de ces items se concentre sur une fraction minuscule du domaine en délaissant tout le reste.
La clé méthodologique pour sécuriser cette représentativité réside dans l’utilisation méthodique d’une matrice croisée, universellement désignée sous le terme de table de spécifications. Cette matrice met en regard les différentes dimensions thématiques ou de contenu avec les niveaux cognitifs attendus. Une pondération explicite, généralement exprimée en pourcentages du total des points ou du nombre d’items, est assignée à chaque cellule de la matrice en fonction de l’importance relative que la théorie ou les profils de compétences professionnelles accordent à chaque dimension. Par exemple, si la théorie stipule que la dépression majeure se manifeste à 40 % par des altérations cognitives, 30 % par des perturbations affectives et 30 % par des dysfonctionnements somatiques, l’instrument final doit impérativement reproduire cette clé de répartition dans son échantillonnage de questions.
Cette approche permet d’endiguer le risque insidieux de surreprésentation d’aspects facilement mesurables. Dans le champ de l’évaluation pédagogique, il est notoirement documenté que les concepteurs d’examens tendent spontanément à surcharger leurs épreuves d’items faisant appel au simple rappel de faits ou à la mémorisation littérale de définitions, au détriment des opérations cognitives de niveau supérieur comme l’analyse critique, la synthèse ou la résolution de problèmes inédits. La vérification méthodique de la couverture cognitive globale à travers des référentiels reconnus s’avère indispensable pour conférer à l’instrument une authentique validité de contenu holistique.
3.3 Clarté technique et qualité de formulation
La troisième composante fondamentale de la validité de contenu concerne la clarté technique et la qualité formelle de conception des stimuli d’évaluation. Même un ensemble d’items impeccablement sélectionnés quant à leur pertinence et parfaitement répartis sur la table de spécifications peut voir sa validité méthodologique annihilée si sa mise en forme technique souffre de négligences structurelles. La clarté technique touche aux consignes de passation, à la lisibilité visuelle, à l’accessibilité ergonomique et à la rédaction irréprochable des options de réponse.
Dans le domaine spécifique des questions à choix multiples (QCM), la validité de contenu dépend étroitement de la neutralité et de la plausibilité des distracteurs (les options de réponse erronées). Des distracteurs mal conçus, invraisemblables ou caricaturaux réduisent artificiellement la complexité de la tâche en permettant aux candidats d’éliminer des options par simple bon sens plutôt que par une maîtrise effective du sujet. À l’inverse, des distracteurs piégeurs reposant sur des subtilités sémantiques gratuites introduisent de la variance non pertinente au détriment de l’équité de la mesure. Les consignes d’administration doivent être rigoureusement standardisées, explicitant sans ambiguïté la nature de la tâche demandée, le barème d’évaluation, le traitement des réponses omises et la gestion du temps imparti.
Enfin, l’adhésion aux principes de la conception universelle de l’évaluation (Universal Design for Assessment) représente aujourd’hui un impératif éthique et psychométrique. Il s’agit de s’assurer que les stimuli sont accessibles à l’ensemble de la population cible, y compris les personnes en situation de handicap visuel, moteur ou cognitif, sans altérer la difficulté inhérente au construit évalué. En éliminant les obstacles physiques, sensoriels ou ergonomiques qui n’ont aucun rapport avec l’attribut psychologique mesuré, les concepteurs préservent l’intégrité de la validité de contenu et l’inviolabilité de la comparabilité des scores.
4. Exemples pratiques d’application de la validité de contenu
4.1 Exemple 1 : L’examen universitaire de statistiques élémentaires
Pour illustrer de manière concrète et didactique les principes abstraits exposés précédemment, examinons le cas de l’élaboration de l’examen terminal sanctionnant un cours universitaire de « Statistiques appliquées aux sciences sociales » de première année de licence. Le programme officiel, dispensé sur douze semaines d’enseignement, a été rigoureusement structuré autour de quatre piliers thématiques majeurs : les statistiques descriptives univariées et bivariées (pondération théorique : 25 %), la théorie élémentaire des probabilités et lois de distribution (pondération théorique : 20 %), l’échantillonnage et les intervalles de confiance (pondération théorique : 25 %), et l’introduction aux tests d’hypothèses paramétriques et non paramétriques (pondération théorique : 30 %).
Un examen affichant une haute validité de contenu sera matérialisé par une épreuve écrite respectant scrupuleusement cette clé de répartition. L’épreuve comprendra une proportion équilibrée d’items : calculs de paramètres de dispersion (variance, écart-type), lecture critique d’histogrammes et de diagrammes en boîte, calculs de probabilités conditionnelles simples, formulation rigoureuse d’hypothèses nulle ($H_0$) et alternative ($H_1$), détermination du seuil de significativité $\alpha$, lecture d’une table de Student ou de Chi-deux, et interprétation sociologique contextualisée d’une p-valeur. Aucune déviation par rapport aux modules effectivement enseignés n’est tolérée, et l’épreuve mobilise des niveaux cognitifs variés allant de l’application procédurale directe à l’interprétation critique de résultats empiriques issus de jeux de données réels.
Considérons à présent un cas flagrant de rupture de validité de contenu pour ce même cours. Supposons que l’enseignant, par paresse académique ou goût personnel pour les mathématiques pures, consacre 70 % de son épreuve à des démonstrations théoriques complexes de théorèmes asymptotiques (tels que la démonstration intégrale du théorème central limite) ou à des calculs d’algèbre linéaire matricielle jamais abordés en cours magistral ni nécessaires aux objectifs du syllabus. Simultanément, les tests d’hypothèses et les statistiques descriptives de base sont purement et simplement omis de l’évaluation. Un tel examen subit une double défaillance dévastatrice : une sous-représentation critique du construit (les étudiants peuvent valider l’UE sans savoir formuler un test statistique ni lire une moyenne) et une variance non pertinente massive (l’épreuve mesure l’habileté en mathématiques formelles pures et non la compétence d’analyse statistique appliquée attendue d’un étudiant en sciences sociales).
4.2 Exemple 2 : L’épreuve théorique d’obtention de la licence de pilote
Le second exemple concret s’ancre dans un domaine où la défaillance d’évaluation engage directement la vie humaine : l’examen théorique d’obtention de la licence de pilote privé (PPL – Private Pilot License) régulé par les autorités de l’aviation civile (telles que l’EASA en Europe ou la FAA aux États-Unis). Le domaine d’exigence professionnelle d’un commandant de bord en aviation générale est formalisé avec une minutie extrême. Il englobe la réglementation aérienne, la météorologie aéronautique, les principes de la navigation à l’estime et par balises, la mécanique du vol et la performance de l’aéronef, les procédures opérationnelles, les facteurs humains et la gestion des ressources de l’équipage, ainsi que la radiotéléphonie.
Les conditions d’une haute validité de contenu imposent que la batterie d’évaluation théorique reflète fidèlement la réalité opérationnelle et décisionnelle à laquelle sera confronté le navigant dans son cockpit. L’épreuve doit impérativement comporter une proportion significative de scénarios appliqués portant sur la prise de décision aéronautique en situation d’urgence : reconnaissance immédiate des symptômes d’un givrage carburateur, calcul du devis de masse et de centrage avant décollage sur piste courte en herbe par forte chaleur, déroutement météo face à une ligne d’orages imprévue, et gestion des pannes électriques en vol de nuit. Chaque item doit avoir une portée pragmatique directement corrélée à la sécurité des vols.
Une défaillance majeure de validité de contenu se matérialiserait ici si l’organisme certificateur construisait une épreuve théorique saturée de questions portant sur les équations différentielles de l’aérodynamique avancée (par exemple, la résolution des équations de Navier-Stokes pour l’écoulement laminaire autour d’un profil NACA) au détriment des procédures réglementaires de gestion du carburant de réserve ou de la lecture des cartes d’aérodromes (VAC). Le risque pour la sécurité publique découlant d’une telle sous-représentation des compétences critiques d’exploitation aérienne serait intolérable : un candidat pourvu d’un bagage théorique mathématique remarquable pourrait réussir l’épreuve haut la main tout en étant incapable de décoder correctement un bulletin météorologique METAR/TAF, augmentant exponentiellement le risque d’accidents mortels en vol réel.
4.3 Exemple 3 : Évaluation clinique de la dépression majeure
Dans le champ de la santé mentale et de la psychiatrie, l’évaluation psychométrique de la dépression majeure offre une illustration clinique saisissante des enjeux de contenu. Le cadre diagnostique universellement accepté est consigné dans les classifications nosographiques internationales, principalement le Manuel diagnostique et statistique des troubles mentaux (DSM-5-TR de l’APA) et la Classification internationale des maladies (CIM-11 de l’OMS). Pour porter un diagnostic de trouble dépressif caractérisé, la nosologie impose la présence documentée d’au moins cinq symptômes parmi neuf critères spécifiques pendant une durée minimale de deux semaines consécutives, avec la présence obligatoire d’au moins l’un des deux symptômes cardinaux : l’humeur dépressive et l’anhédonie (perte d’intérêt ou de plaisir).
Une échelle d’auto-évaluation ou un hétéro-questionnaire conçu pour mesurer la sévérité de l’épisode dépressif majeur — à l’instar de versions rigoureusement validées de l’Inventaire de Dépression de Beck (BDI-II) ou de la Patient Health Questionnaire-9 (PHQ-9) — doit manifester une validité de contenu absolue en offrant une couverture symétrique de l’intégralité du spectre symptomatique : altération thymique, ralentissement psychomoteur ou agitation, fatigue chronique, sentiment d’indignité ou de culpabilité inappropriée, troubles de la concentration, fluctuations pondérales ou modifications de l’appétit, perturbations du sommeil (insomnie ou hypersomnie), et idéations suicidaires récurrentes.
La menace d’invalidité de contenu se produit fréquemment lorsqu’une échelle présente un déséquilibre structurel, par exemple en se focalisant de manière disproportionnée sur les manifestations somatiques de l’affection (céphalées, dyspepsie, tensions musculaires) tout en occultant les perturbations cognitives profondes et le désespoir existentiel. Dans un tel cas de figure, l’instrument surévaluerait artificiellement la dépression chez des patients atteints de pathologies organiques chroniques (comme les maladies auto-immunes ou le cancer) qui présentent naturellement une asthénie et des douleurs physiques. De plus, une défaillance de validité de contenu réside dans l’incapacité de l’outil à discriminer formellement les symptômes spécifiques de la dépression de ceux relevant de l’anxiété généralisée comorbide (tels que l’irritabilité diffuse ou la tension motrice), conduisant à des faux positifs diagnostiques et à des prescriptions médicamenteuses inadaptées.
5. Validité de contenu vs autres formes de validité psychométrique
5.1 Validité de contenu et validité apparente (Face Validity)
L’une des confusions les plus récurrentes au sein de la littérature non spécialisée concerne la distinction entre la validité de contenu et la validité apparente (ou validité de façade, face validity). Bien que ces deux concepts s’intéressent aux items qui composent un test, leur statut épistémologique et méthodologique diverge radicalement. La validité apparente ne constitue pas, sur le plan technique, une preuve scientifique de validité : elle renvoie simplement au jugement superficiel et subjectif porté par le candidat, le profane ou l’observateur non expert quant au fait de savoir si le test « a l’air », au premier coup d’œil, de mesurer ce qu’il prétend mesurer.
À l’inverse, la validité de contenu repose sur un processus systématique, structuré et documenté, conduit par des experts du domaine à l’aide de grilles d’évaluation rigoureuses, de cadres théoriques explicites et d’indices de quantification mathématique. Un test peut posséder une validité de contenu exceptionnelle tout en ayant une validité apparente délibérément basse. Ce cas de figure est particulièrement fréquent dans les inventaires de personnalité utilisés en milieu professionnel ou dans les expertises médico-légales (par exemple, le MMPI-3). Afin de neutraliser les biais de désirabilité sociale et la dissimulation volontaire, les psychomètres rédigent des items subtils dont le lien avec le trait sous-jacent (par exemple, la paranoïa ou la tendance à la délinquance) échappe totalement au répondant profane.
Cependant, la validité apparente ne doit pas être dédaignée sur le plan pragmatique. Bien qu’insuffisante sur le plan psychométrique, elle joue un rôle psychologique déterminant dans l’acceptabilité sociale d’un instrument d’évaluation. Si des cadres d’entreprise chevronnés sont soumis, lors d’un assessment center de recrutement de dirigeants, à des tests de logique abstraite perçus comme puérils ou infantilisants, leur motivation à s’investir sérieusement dans l’épreuve risque de s’effondrer, suscitant de la méfiance, de la réactance psychologique et d’éventuels recours contentieux. Une validité apparente harmonieusement alignée sur une solide validité de contenu optimise ainsi l’alliance d’évaluation tout en garantissant la probité métrologique.
5.2 Validité de contenu et validité de construit (Construct Validity)
La relation unissant la validité de contenu et la validité de construit est à la fois hiérarchique et dialectique. Historiquement dissociées, ces deux facettes ont été unifiées sous la bannière conceptuelle moderne développée par Samuel Messick. Selon cette perspective holistique contemporaine, la validité de construit représente la finalité intégrative suprême de toute démarche métrologique, englobant toutes les formes d’évidence, tandis que la validité de contenu constitue le socle opérationnel sine qua non sur lequel repose l’ensemble de l’édifice.
Le tableau suivant met en lumière les spécificités fondamentales qui distinguent la validité de contenu des autres grandes manifestations de la validité psychométrique :
| Dimension d’analyse | Validité de contenu | Validité de construit | Validité de critère | Validité apparente |
|---|---|---|---|---|
| Nature fondamentale | Preuve logique, théorique et rationnelle | Théorie unifiée étayée par des évidences empiriques plurielles | Relation statistique empirique avec une mesure externe | Perception intuitive et superficielle de pertinence |
| Moment d’intervention | Amont : Conception et développement de l’outil | Aval et itératif : Analyses factorielles, réseau nomologique | Aval : Administration simultanée ou différée du critère | Post-conception : Administration aux répondants |
| Évaluateurs clés | Comité d’experts indépendants du domaine | Chercheurs, psychomètres et modélisateurs statistiques | Praticiens, analystes de données empiriques | Candidats, profanes, utilisateurs finaux |
| Outils de confirmation | Tables de spécifications, indices CVR, CVI, Aiken | Analyse factorielle confirmatoire (AFC), MTMM, corrélations | Coefficients de régression, validité prédictive et concourante | Sondages d’opinion, entretiens d’acceptabilité |
La différence méthodologique de nature entre contenu et construit s’exprime dans leurs protocoles de vérification. Alors que la validité de contenu s’attache à la substance même des items, à leur provenance et à leur conformité au domaine théorique, la validité de construit mobilise des analyses statistiques sophistiquées, notamment l’analyse factorielle confirmatoire (AFC), l’invariance de mesure à travers des groupes hétérogènes, et la matrice multitraite-multiméthode (MTMM) de Campbell et Fiske visant à démontrer la validité convergente et discriminante. Toutefois, une structure factorielle élégante est dénuée de sens si le contenu initial était biaisé : une analyse factorielle appliquée à un ensemble d’items présentant un défaut massif de validité de contenu ne fera que structurer mathématiquement de la variance hors-sujet.
5.3 Validité de contenu et validité de critère (Criterion Validity)
La validité de critère se distingue fonctionnellement de la validité de contenu en déplaçant son foyer d’intérêt depuis l’architecture interne du test vers sa capacité opérationnelle à prédire ou à concourir avec une mesure externe de référence (le critère). Dans l’univers de la sélection du personnel, par exemple, un test psychotechnique peut être validé sur la base de sa corrélation empirique étroite avec les chiffres de vente annuels réalisés ultérieurement par les commerciaux recrutés (validité prédictive).
Cette distinction génère parfois des scénarios psychométriques fascinants et paradoxaux où la validité empirique est statistiquement élevée malgré une validité de contenu notoirement défaillante. Imaginons un test de sélection pour des candidats pompiers qui comporterait une épreuve de culture générale académique très pointue. De manière purement contingente et empirique, les candidats excellant à cette épreuve pourraient afficher d’excellentes aptitudes d’apprentissage en école préparatoire, générant une corrélation critériée positive statistiquement significative. Cependant, la validité de contenu d’une telle épreuve au regard des compétences fondamentales requises sur le terrain (endurance cardiorespiratoire, sang-froid, dextérité de sauvetage en espace confiné) est quasi nulle. Sur le plan juridique et éthique, fonder une sélection sur cette base s’avère hautement contestable et juridiquement sanctionnable.
Inversement, un instrument conçu pour des fins de diagnostic pédagogique ou de bilan de compétences professionnelles peut afficher une validité de contenu irréprochable sans pour autant prédire fidèlement des performances professionnelles globales ultérieures, car ces dernières sont tributaires d’une infinité de contingences contextuelles (climat managérial, logistique, vie personnelle). L’arbitrage psychométrique entre l’accent mis sur le contenu ou sur le critère dépend ainsi étroitement de la finalité d’utilisation assignée à l’évaluation.
6. Méthodologie et protocoles d’évaluation de la validité de contenu
6.1 Définition rigoureuse du domaine et cartographie conceptuelle
L’établissement d’une validité de contenu inattaquable obéit à une séquence méthodologique rigoureuse et standardisée qui s’enclenche bien avant la formulation du premier énoncé d’item. La phase inaugurale et décisive réside dans la délimitation formelle de l’univers de contenu à travers une cartographie conceptuelle exhaustive. Cette étape requiert une analyse documentaire approfondie de la littérature scientifique existante, embrassant les méta-analyses contemporaines, les revues systématiques, les manuels théoriques de référence et les nomenclatures officielles régissant le domaine d’étude.
Dans le contexte spécifique des examens professionnels, des certifications d’État et des évaluations de compétences en entreprise, la cartographie conceptuelle s’appuie obligatoirement sur une analyse de tâches (Task Analysis) ou une analyse de poste (Job Analysis). Cette démarche ergonomique et psychologique de terrain mobilise des entretiens d’explicitation semi-directifs auprès de professionnels expérimentés (les « titulaires du poste »), des observations directes en conditions réelles de travail et la méthode des incidents critiques théorisée par John Flanagan. Cette investigation empirique permet d’extraire le répertoire complet des Connaissances, Habiletés, Aptitudes et Autres caractéristiques personnelles (les KSAOs – Knowledge, Skills, Abilities, and Other characteristics) indispensables à l’exercice sans faille de l’activité ciblée.
Une fois les données collectées, le concepteur formalise la table de spécifications détaillée. Cette matrice opérationnelle associe chaque sous-domaine de compétences ou de connaissances aux niveaux de traitement cognitif attendus, en s’appuyant très fréquemment sur la taxonomie révisée de Bloom (connaissance, compréhension, application, analyse, évaluation, création). Chaque croisement de la grille se voit attribuer une pondération numérique explicite, traduisant son importance relative et sa fréquence d’apparition dans l’activité réelle. Ce cadre conceptuel formalisé fait ensuite l’objet d’une première revue critique et d’une validation collégiale par un cercle restreint de chercheurs et théoriciens avant d’engager la production des items.
6.2 Rédaction systématique et standardisée des items
La deuxième phase du protocole concerne l’opérationnalisation du cadre théorique sous la forme de stimuli d’évaluation. Une règle méthodologique d’or en psychométrie impose de concevoir initialement un ensemble (ou pool) d’items largement surdimensionné, comprenant généralement deux à trois fois le nombre final d’items requis dans l’instrument définitif. Ce surdimensionnement stratégique anticipe l’attrition inévitable d’items lors des phases ultérieures d’expertise qualitative, de filtrage statistique et de pré-test empirique.
La rédaction de chaque item doit se conformer aux directives psychométriques de rédaction les plus strictes. Les rédacteurs doivent proscrire formellement l’usage des doubles négations, des tournures passives inutilement complexes, des propositions subordonnées imbriquées et des termes vagues ou subjectifs (tels que « souvent », « parfois » ou « exceptionnellement » sans ancrage comportemental). Chaque énoncé doit être formulé de manière directe, concise et univoque. De plus, chaque item rédigé est formellement rattaché par son auteur à une cellule unique et spécifique de la table de spécifications préalablement arrêtée, documentant de façon transparente la dimension visée.
Cette étape s’achève par une révision linguistique minutieuse et un contrôle standardisé de lisibilité textuelle. À travers des formules algorithmiques telles que l’indice de Flesch-Kincaid ou le score de lisibilité de Gunning Fog, les concepteurs vérifient que le niveau de complexité de lecture requis par les énoncés se situe résolument en deçà du niveau scolaire de la population ciblée, immunisant ainsi l’instrument contre l’introduction subreptice de variance non pertinente liée à la compétence de lecture.
6.3 Processus d’expertise et de consultation de panels indépendants
L’apogée méthodologique de la validation de contenu réside dans la consultation formelle d’un panel d’experts indépendants du sujet évalué. Ces juges externes (Subject Matter Experts ou SMEs) sont sélectionnés sur la base de critères d’excellence académique, clinique ou professionnelle préalablement documentés. Leur mission est de porter un regard critique externe et impartial sur la conformité théorique et technique de la batterie d’items soumise à leur arbitrage.
Pour encadrer ce processus, les concepteurs transmettent à chaque expert un guide d’évaluation standardisé, stipulant sans ambiguïté les définitions opérationnelles du domaine, les objectifs de mesure et les grilles de cotation psychométrique. Deux modalités d’administration sont envisageables : l’expertise en aveugle (où les experts doivent eux-mêmes associer chaque item à l’une des dimensions du cadre théorique sans connaître l’assignation originale des rédacteurs) ou l’expertise guidée (où l’association théorique est affichée et où le juge cote la pertinence et la qualité de l’alignement). Le mode en aveugle offre une rigueur supérieure en permettant de mesurer objectivement l’erreur de classification thématique.
Enfin, le protocole d’expertise ne se borne pas à un relevé chiffré : il organise systématiquement un débriefing qualitatif. Chaque expert est expressément invité à formuler des commentaires textuels sur la syntaxe, à proposer des reformulations d’énoncés litigieux et, surtout, à signaler d’éventuelles lacunes de contenu, suggérant la création de nouveaux items pour pallier une sous-représentation thématique décelée. Cette boucle de rétroaction qualitative enrichit substantiellement la qualité intrinsèque du matériel métrologique.
7. Quantifier la validité de contenu : indices et formules statistiques
7.1 Le ratio de validité de contenu de Lawshe (CVR)
Bien que la validité de contenu procède primitivement d’un jugement humain qualitatif, la psychométrie moderne a développé des outils statistiques remarquables pour quantifier ces jugements et leur appliquer des tests d’hypothèses rigoureux. La contribution pionnière la plus célèbre est incontestablement celle de C. H. Lawshe (1975), qui a introduit le Ratio de Validité de Contenu (Content Validity Ratio ou CVR).
La méthode de Lawshe repose sur la soumission de chaque item à un panel d’experts, avec une échelle d’évaluation trichotomique demandant au juge d’indiquer si la compétence ou la connaissance sondée par l’item est :
- Essentielle pour l’exercice du métier ou la mesure du domaine ;
- Utile mais non essentielle ;
- Inutile / Non pertinente.
La formule mathématique du CVR pour un item donné s’exprime comme suit :
$$CVR = \frac{n_e – \frac{N}{2}}{\frac{N}{2}}$$
Où :
- $n_e$ représente le nombre d’experts du panel ayant qualifié l’item d’« essentiel » ;
- $N$ représente le nombre total d’experts composant le panel de juges.
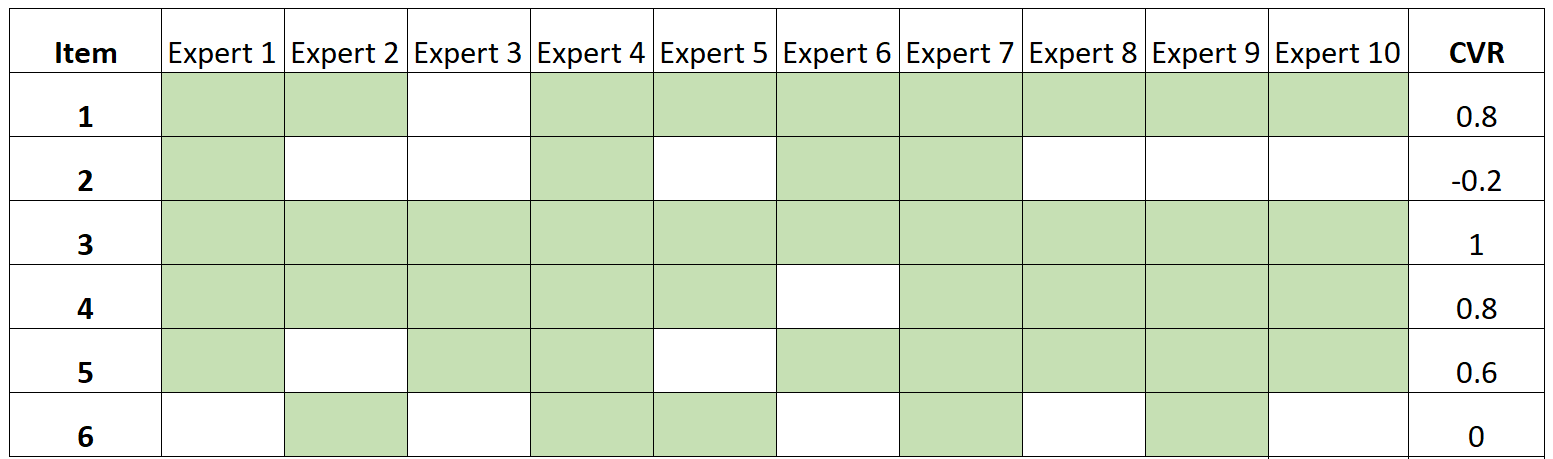
Le CVR oscille sur un continuum allant de -1,00 (lorsqu’aucun expert ne juge l’item essentiel, soit $n_e = 0$) à +1,00 (lorsque l’unanimité absolue du panel qualifie l’item d’essentiel, soit $n_e = N$). Une valeur de 0,00 indique qu’exactement la moitié des membres du panel considèrent l’item comme essentiel. Afin d’éliminer les items dont la note résulterait d’un simple accord dû au hasard, Lawshe a établi une table des valeurs critiques minimales statistiquement significatives au seuil de risque $\alpha = 0{,}05$ (test unilatéral), en fonction de la taille du panel $N$.
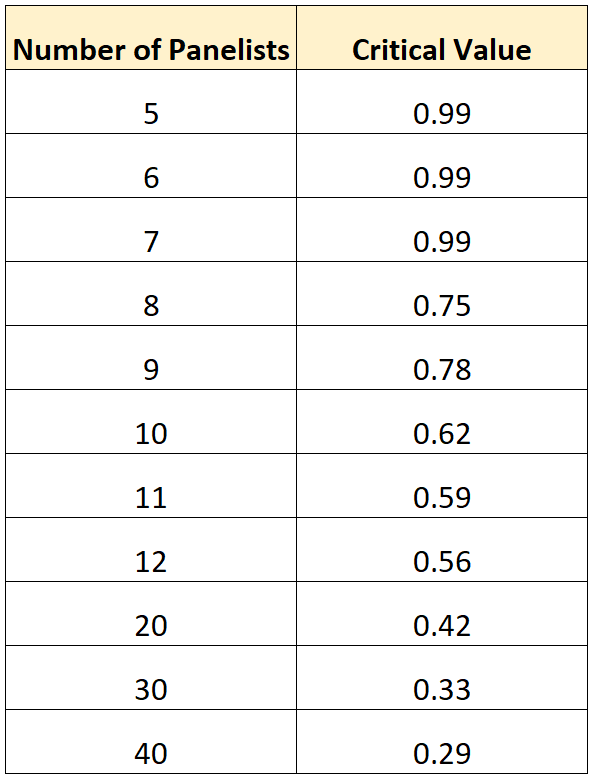
Lorsque la taille du panel grandit, le seuil d’accord minimal requis diminue mathématiquement. Par exemple, pour un panel restreint de 5 experts, l’accord unanime ($CVR = 1{,}00$) est requis ; pour un panel de 10 experts, le CVR critique est de 0,62 ; pour 20 experts, il s’établit à 0,42 ; et pour un grand panel de 40 experts, un CVR de 0,29 suffit pour rejeter l’hypothèse nulle d’un consensus fortuit. Tout item n’atteignant pas le seuil critique est immédiatement éliminé ou soumis à une refonte complète. Par ailleurs, Lawshe a introduit l’Indice de Validité de Contenu global (Content Validity Index ou CVI), défini comme la moyenne arithmétique des valeurs de CVR de l’ensemble des items retenus dans l’instrument final, fournissant une estimation synthétique de l’adéquation du test global.
7.2 L’indice de validité de contenu (I-CVI et S-CVI) de Lynn
Malgré sa popularité historique, l’approche de Lawshe a fait l’objet de critiques méthodologiques, notamment en raison du caractère trichotomique de son échelle qui mélange la pertinence et le degré d’utilité pratique. Pour pallier ces faiblesses, Marion Lynn (1986) a développé un cadre métrologique devenu aujourd’hui le standard international de référence dans les sciences biomédicales, les sciences infirmières et la psychologie clinique : le modèle I-CVI et S-CVI, largement popularisé et enrichi par Polit et Beck (2006).
Lynn préconise l’utilisation d’une échelle ordinale de pertinence à 4 points, exempte de point médian neutre afin de contraindre l’expert à une prise de position non équivoque :
- 1 = Non pertinent ;
- 2 = Quelque peu pertinent (nécessite des révisions substantielles) ;
- 3 = Assez pertinent (pertinent mais perfectible à la marge) ;
- 4 = Hautement pertinent.
Pour chaque item, on calcule l’Indice de Validité de Contenu au niveau de l’Item (Item-level Content Validity Index ou I-CVI). L’I-CVI se calcule en divisant le nombre d’experts ayant attribué la note 3 ou 4 par le nombre total d’experts :
$$I\text{-}CVI = \frac{\text{Nombre d’experts attribuant un score de 3 ou 4}}{N}$$
Lynn et Polit ont établi des normes d’acceptation extrêmement strictes :
- Pour un panel de 3 à 5 experts, l’I-CVI doit atteindre 1,00 (accord unanime).
- Pour un panel de 6 à 10 experts, l’I-CVI ne doit jamais être inférieur à 0,78 (par exemple, au moins 8 juges sur 9 ou 8 juges sur 10 doivent coter 3 ou 4).
- Tout item dont l’I-CVI est inférieur à ces seuils doit être purement et simplement exclu de l’instrument.
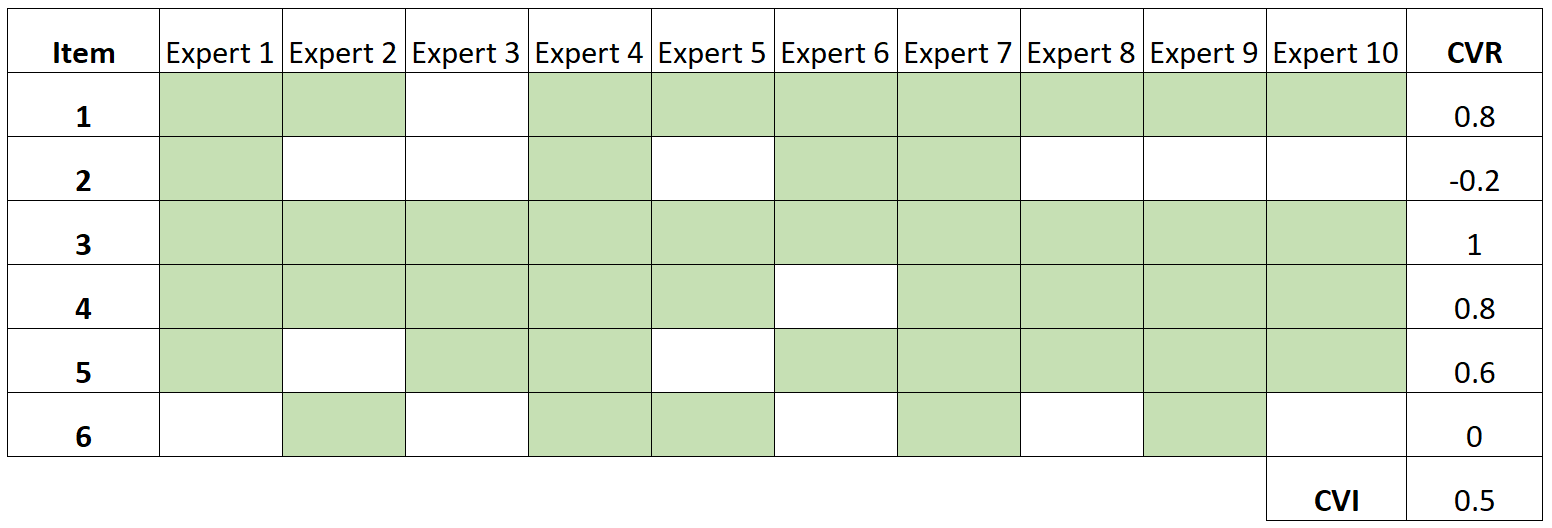
Au niveau de l’échelle globale, Lynn et Polit distinguent deux méthodes pour calculer le Scale-level Content Validity Index (S-CVI) :
- Le S-CVI/UA (Universal Agreement) : Proportion d’items de l’instrument pour lesquels l’ensemble absolu des experts a attribué une note de 3 ou 4. C’est un indice extrêmement conservateur et pénalisant. Le seuil conventionnel acceptable pour le S-CVI/UA est fixé à 0,80.
- Le S-CVI/Ave (Average) : Moyenne arithmétique de l’ensemble des I-CVI de tous les items de l’échelle. Considéré comme l’indice de référence par l’ensemble de la littérature contemporaine, le standard psychométrique exige un S-CVI/Ave minimal de 0,90 pour attester d’une excellente validité de contenu à l’échelle de l’instrument complet.
7.3 Le coefficient V d’Aiken et approches de concordance
Une alternative mathématique sophistiquée aux approches de Lawshe et Lynn a été formulée par Lewis Aiken (1980, 1985) avec le coefficient $V$ d’Aiken. L’immense supériorité algorithmique de la méthode d’Aiken réside dans sa capacité à traiter des échelles de cotation ordinale comportant un nombre quelconque de degrés (de 3 à 7 points, ou plus), tout en offrant un test statistique formel d’hypothèse nulle sous distribution binomiale.
La formule du coefficient $V$ d’Aiken est la suivante :
$$V = \frac{S}{N \cdot (c – 1)}$$
Où :
- $S = \sum (r – lo)$, avec $r$ représentant la note attribuée par chaque expert individuel et $lo$ la note la plus basse possible sur l’échelle choisie (par exemple, $lo = 1$) ;
- $N$ représente le nombre total d’experts du panel ;
- $c$ représente le nombre total de catégories de réponse ordonnées sur l’échelle (par exemple, $c = 5$ pour une échelle de Likert à 5 points allant de 1 à 5).
Le coefficient $V$ d’Aiken produit un indice normalisé borné entre 0,00 et 1,00. Aiken a modélisé des tables de distribution de probabilités exactes permettant de déterminer si la valeur de $V$ calculée est significativement supérieure au hasard pour un niveau d’erreur de première espèce donné ($\alpha = 0{,}05$ ou $\alpha = 0{,}01$).
Enfin, les psychomètres contemporains s’appuient fréquemment sur des mesures de concordance inter-juges ajustées pour la chance, en adaptant le coefficient Kappa de Cohen ou de Fleiss. Polit, Beck et Owen (2007) ont notamment préconisé le calcul du Kappa modifié ($k^*$). Ce coefficient intègre l’I-CVI tout en ajustant mathématiquement la probabilité d’accord fortuit par la formule binomiale :
$$k^* = \frac{I\text{-}CVI – P_c}{1 – P_c}$$
Où $P_c$ représente la probabilité binomiale d’accord dû au hasard :
$$P_c = \frac{N!}{A! , (N – A)!} \cdot 0{,}5^N$$
Dans cette formulation, $N$ est la taille du panel et $A$ le nombre d’accords favorables. Selon les critères de Fleiss, une valeur de $k^* ge 0{,}75$ dénote un accord inter-juges excellent, confirmant sans ambiguïté la robustesse métrologique du contenu évalué.
8. Le rôle du comité d’experts dans le processus de validation de contenu
8.1 Sélection et représentativité du panel de juges
L’intégrité de l’ensemble du dispositif quantitatif exposé précédemment repose inconditionnellement sur la compétence, la légitimité intellectuelle et la probité des membres qui composent le panel d’évaluation. La sélection de ce panel d’experts (Subject Matter Experts) ne saurait résulter d’un choix de complaisance ou de commodité académique ; elle exige une stratégie d’échantillonnage rigoureuse répondant à des critères d’inclusion et d’exclusion préétablis.
Un panel équilibré et méthodologiquement solide doit idéalement trianguler trois profils complémentaires d’expertise :
- Les théoriciens et chercheurs académiques : Ils possèdent une maîtrise intime des publications scientifiques récentes, des controverses théoriques, de la modélisation des construits et des cadres conceptuels formels.
- Les praticiens et professionnels de terrain : Ils sont confrontés quotidiennement à l’expression concrète des phénomènes mesurés (par exemple, des cliniciens recevant des patients au cabinet, ou des gestionnaires gérant des équipes opérationnelles). Ils garantissent l’ancrage écologique et le réalisme pragmatique du matériel d’évaluation.
- Les méthodologistes et psychomètres : Ils apportent leur expertise technique sur l’art de concevoir des items, la neutralisation des biais de réponse et les contraintes formelles de la mesure.
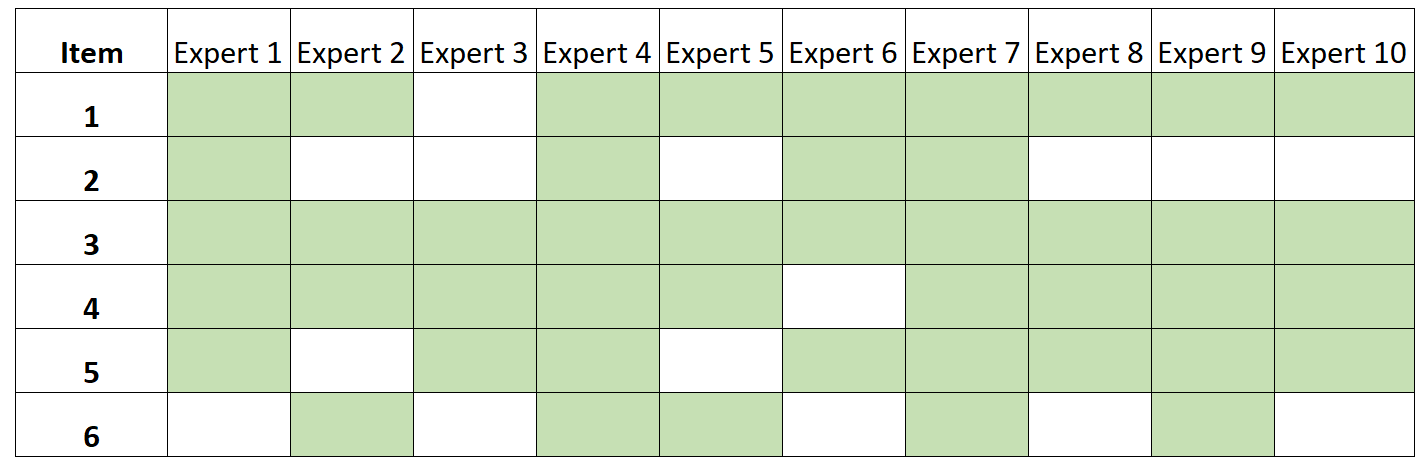
La question de la taille optimale du panel a suscité de multiples débats au sein de la communauté psychométrique. Alors que certains auteurs anciens toléraient des panels réduits à trois experts, la littérature contemporaine (notamment Lynn, Polit, Grant et Davis) préconise formellement un seuil minimal de 5 à 10 experts pour stabiliser les estimations et neutraliser les idiosyncrasies individuelles. Dépasser un effectif de 15 à 20 experts produit rarement des gains méthodologiques substantiels et alourdit exponentiellement la complexité logistique de la démarche. Enfin, la prévention active de la pensée de groupe (Groupthink), la déclaration préalable de tout conflit d’intérêts financier ou institutionnel, et le respect d’une authentique diversité géographique, culturelle et démographique sont cruciaux pour immuniser le panel contre des angles morts préjudiciables.
8.2 Protocoles de recueil des jugements d’experts
La manière dont les jugements d’experts sont sollicités et recueillis détermine directement la validité écologique des résultats obtenus. Pour prémunir les experts contre les influences interpersonnelles directes, les effets de halo, les phénomènes de domination statutaire ou les pressions à la conformité sociale, le recours à la technique Delphi s’avère l’approche méthodologique la plus noble et la plus rigoureuse.
La technique Delphi organise une série de consultations itératives menées de manière totalement anonyme et individualisée. Au cours du premier tour (Round 1), chaque expert renseigne de façon indépendante une grille structurée informatisée, évaluant quantitativement chaque item sur des échelles normées de pertinence, de clarté et de représentativité, tout en consignant obligatoirement des observations qualitatives détaillées pour chaque note défavorable. Le coordonnateur de l’étude psychométrique compile et analyse ensuite l’ensemble de ces données, calcule les indices de tendance centrale, de dispersion et les coefficients de concordance, et rédige un rapport de synthèse entièrement anonymisé.
Au cours du second tour (Round 2), la grille d’évaluation est soumise une nouvelle fois aux experts, accompagnée de la synthèse statistique et du recueil complet des arguments qualitatifs de leurs pairs. Chaque juge est ainsi invité à reconsidérer son évaluation initiale à la lumière des perspectives développées par le collectif. Ce protocole itératif permet d’atteindre un consensus rationnel et éclairé, affranchi de toute dynamique d’intimidation intellectuelle.
8.3 Résolution des désaccords et arbitrage éditorial
Même au sein des comités d’experts les plus prestigieux et les plus expérimentés, des divergences d’appréciation irréconciliables peuvent émerger quant à la pertinence ou à la formulation d’un item. L’analyse des écarts-types et des distributions de fréquences permet d’isoler immédiatement les énoncés faisant l’objet d’une forte polarisation des jugements. La gestion de ces désaccords exige une gouvernance éditoriale transparente et impartiale, documentée pas à pas dans le rapport technique final de validation.
Face à un item litigieux n’atteignant pas le seuil statistique prédéterminé de CVR ou d’I-CVI, trois décisions éditoriales sont envisageables :
- La suppression pure et simple : L’item est éliminé si la majorité des experts démontre qu’il introduit de la variance non pertinente ou qu’il est hors-sujet au regard de la définition opérationnelle du construit.
- La réécriture et le réajustement formel : Lorsque le contenu fondamental de l’item est jugé capital mais que sa formulation technique est jugée déficiente (ambiguïté lexicale, complexité syntaxique), l’énoncé est réécrit en intégrant les suggestions qualitatives des juges, puis réinjecté dans une nouvelle boucle d’expertise.
- La conservation motivée : Dans des cas très exceptionnels, un item dont l’indice statistique est légèrement marginal peut être conservé si les concepteurs peuvent prouver théoriquement que son retrait créerait un trou béant dans la représentativité du domaine (sous-représentation du construit). Cet arbitrage exceptionnel doit être intégralement explicité et justifié dans la documentation publique de l’instrument.
Toute tentative d’élimination ou d’altération arbitraire d’items sans justification méthodologique documentée constitue une faute déontologique majeure en psychométrie, susceptible de disqualifier la valeur légale et scientifique de l’outil.
9. La validité de contenu dans l’évaluation psychologique et clinique
9.1 Conception d’échelles de personnalité et inventaires cliniques
L’opérationnalisation des concepts psychologiques au sein d’échelles de personnalité et d’inventaires d’évaluation clinique illustre avec une acuité particulière les exigences de la validité de contenu. Considérons le modèle structural dominant de la personnalité contemporaine : le modèle des Big Five ou modèle à cinq facteurs (OCEAN : Ouverture, Conscienciosité, Extraversion, Agréabilité, Névrosisme), théorisé par Costa et McCrae. Chacun de ces super-traits n’est pas une entité monolithique : il se subdivise en une constellation de six sous-traits hiérarchisés, désignés sous le vocable de facettes.
Pour revendiquer une haute validité de contenu, un inventaire de personnalité explorant le trait « Conscienciosité » ne peut se contenter d’évaluer la ponctualité ou le sens de l’ordre. Il doit obligatoirement déployer un échantillonnage d’items comportementaux balayant symétriquement l’intégralité des six facettes constitutives du modèle : la compétence perçue, l’ordre, le sens du devoir, la recherche d’accomplissement, l’auto-discipline et la délibération réfléchie. Si un inventaire omettait la facette d’auto-discipline au profit exclusif de la recherche d’ordre matériel, il subordonnerait le construit à une vision tronquée, diminuant sa valeur heuristique pour prédire des comportements complexes dans les sphères personnelle et professionnelle.
De plus, l’ingénierie des items de personnalité doit soigneusement ancrer les stimuli dans la réalité écologique des répondants, en tenant compte des variations contextuelles. Les énoncés doivent être purgés de tout jugement de valeur moral implicite afin de minimiser le fardeau de la désirabilité sociale, garantissant que l’adhésion à un énoncé découle authentiquement de la position du sujet sur le continuum du trait, et non de sa volonté délibérée de projeter une image socialement irréprochable.
9.2 Évaluation neuropsychologique et tests de performance cognitive
Dans les neurosciences cognitives et la neuropsychologie clinique, la validité de contenu s’affronte à des contraintes biomédicales et physiologiques encore plus sophistiquées. Les batteries d’évaluation neuropsychologique sont conçues pour cartographier et quantifier l’intégrité de processus neurocognitifs spécialisés : les fonctions exécutives (inhibition, flexibilité mentale, mémoire de travail), l’attention sélective, la mémoire épisodique ou le traitement visuospatial.
La menace omniprésente pesant sur la validité de contenu en neuropsychologie est la contamination systématique de la mesure cognitive par des déficits sensoriels, moteurs ou phastiques périphériques. Si une tâche d’inhibition exécutive (de type tâche de Stroop ou tâche d’appariement de cartes du Wisconsin) requiert de manière accessoire une excellente acuité visuelle chromatique ou une coordination motrice ultra-rapide des membres supérieurs, un sujet souffrant de daltonisme, d’arthrose sévère ou d’un tremblement parkinsonien obtiendra un score d’échec cuisant. Or, cet échec ne traduit en rien une atrophie des lobes frontaux ou une défaillance de l’inhibition exécutive, mais résulte exclusivement d’un obstacle moteur étranger à l’attribut mesuré (difficulté non pertinente au construit).
La préservation de la validité de contenu impose donc aux neuropsychologues de calibrer les stimuli d’évaluation en neutralisant scrupuleusement l’impact des handicaps physiques périphériques. De surcroît, lors de la transition contemporaine massive depuis les formats traditionnels « papier-crayon » vers les plateformes d’évaluation numérique et informatisée sur tablette tactile, une réévaluation formelle de la validité de contenu s’avère impérative : la familiarité technologique avec les écrans tactiles, particulièrement hétérogène chez les populations gériatriques, ne doit en aucun cas devenir la variable explicative des scores cognitifs observés.
9.3 Adaptation transculturelle et validité de contenu transculturelle
À l’ère de la mondialisation de la recherche biomédicale et des essais cliniques multicentriques internationaux, le transfert d’un instrument psychologique ou médical d’une aire linguistique et culturelle vers une autre représente un chantier métrologique périlleux. Une erreur épistémologique colossale consisterait à penser qu’une simple traduction linguistique littérale suffit à préserver les propriétés d’un test. Les directives internationales édictées par l’International Test Commission (ITC) imposent une méthodologie d’adaptation transculturelle hautement sophistiquée pour garantir la validité de contenu transculturelle.
Certains concepts ou comportements ont une signification profondément ancrée dans des contextes socio-écologiques locaux. Un item conçu aux États-Unis pour évaluer la vitalité physique chez des personnes âgées demandant : « Êtes-vous capable de conduire un tracteur de tondeuse à gazon pendant une heure ? » perd toute pertinence et toute représentativité lorsqu’il est administré à des populations vivant dans des favelas ou des zones rurales d’Afrique subsaharienne. De même, les métaphores idiomatiques utilisées pour décrire la détresse psychologique varient drastiquement selon les aires culturelles, où la somatisation corporelle prévaut parfois largement sur l’expression verbale des émotions internes.
Le protocole canonique d’adaptation exige un processus rigoureux de double traduction inversée (back-translation), orchestré par des traducteurs indépendants biculturels et natifs de la langue cible, suivi d’une réévaluation minutieuse par un comité multidisciplinaire d’experts transculturels. Ce comité vérifie formellement quatre dimensions fondamentales d’équivalence :
- L’équivalence sémantique (les mots conservent-ils la même signification ?) ;
- L’équivalence idiomatique (les figures de style sont-elles adéquatement adaptées sans dénaturer le sens ?) ;
- L’équivalence expérientielle (les activités mentionnées existent-elles et font-elles partie du quotidien de la culture cible ?) ;
- L’équivalence conceptuelle (le construit psychologique sous-jacent est-il compris et perçu de manière isomorphe dans les deux cultures ?).
Ce n’est qu’au terme de ce méticuleux filtrage que la validité de contenu transculturelle peut être légitimement proclamée.
10. La validité de contenu dans le milieu éducatif et les examens professionnels
10.1 Alignement curriculaire dans les examens scolaires et universitaires
Dans l’univers éducatif, de l’enseignement primaire aux facultés de médecine, la validité de contenu s’incarne sous le concept d’alignement curriculaire. Il s’agit de la congruence absolue qui doit unir les objectifs pédagogiques prescrits (les standards d’apprentissage), les activités d’enseignement dispensées en classe et les modalités d’évaluation terminale. Dans le modèle de l’alignement constructif théorisé par John Biggs, un enseignement ne possède une cohérence fonctionnelle que si les évaluations mesurent exactement les performances intellectuelles que les étudiants étaient censés développer.
Pour assurer cet alignement de façon systématique, les autorités académiques s’appuient sur des référentiels taxonomiques d’objectifs éducatifs, parmi lesquels la taxonomie de Bloom demeure la plus influente. Cette taxonomie hiérarchise les compétences cognitives en six paliers d’exigence croissante :
- Niveau 1 : La Connaissance (mémorisation et rappel d’informations factuelles) ;
- Niveau 2 : La Compréhension (explication d’idées ou de concepts avec ses propres mots) ;
- Niveau 3 : L’Application (utilisation d’informations dans des situations concrètes nouvelles) ;
- Niveau 4 : L’Analyse (décomposition des parties constitutives et exploration des relations structurelles) ;
- Niveau 5 : L’Évaluation (jugement critique fondé sur des critères explicites) ;
- Niveau 6 : La Création (conception d’un produit original ou intégration d’éléments disparates).
Une rupture dramatique d’alignement survient lorsque les enseignants axent l’intégralité de leur cursus sur l’enseignement exclusif des réponses au test (le travers pernicieux du Teaching to the test). Dans cette dérive, l’épreuve cesse d’échantillonner représentativement le domaine du savoir pour devenir elle-même le domaine restreint enseigné aux élèves. Ce rétrécissement curriculaire produit une illusion trompeuse de réussite scolaire : les scores s’envolent artificiellement tandis que la compétence réelle des élèves sur l’ensemble de la discipline s’effondre dramatiquement. L’instauration d’audits curriculaires externes indépendants s’avère indispensable pour certifier la validité de contenu des examens d’État et des baccalauréats nationaux.
10.2 Examens de certification et d’accréditation professionnelle
Dans le monde du travail et de la régulation économique, les épreuves de certification, d’octroi de brevets d’exercice et de validation des acquis sont soumises à un encadrement juridique et psychométrique d’une intransigeance absolue. Aux États-Unis, les lignes directrices fédérales de l’Equal Employment Opportunity Commission (EEOC), formalisées dans les célèbres Uniform Guidelines on Employee Selection Procedures, confèrent à la validité de contenu une valeur probante devant les tribunaux pour contrer toute accusation de discrimination injustifiée à l’embauche.
Lorsqu’un test de sélection ou de certification est contesté en justice par des candidats évincés plaidant un impact disparate (disparate impact), l’employeur ou l’organisme de réglementation n’a d’autre choix que de démontrer la nécessité professionnelle (business necessity) et la validité de l’outil. Cette démonstration repose exclusivement sur la documentation irréfutable de la validité de contenu, prouvant par une analyse de poste méticuleuse que chaque item de l’examen évalue une compétence minimale indispensable à la sécurité du public ou à la viabilité de l’entreprise. Si l’évaluation comporte des épreuves déconnectées du quotidien du métier — par exemple, un test d’aptitude physique éliminatoire exigeant de soulever des charges de 40 kg alors que le poste réel ne requiert jamais de manutention supérieure à 15 kg —, l’épreuve est jugée discriminatoire et frappée d’illégalité.
La règle fondamentale dans les examens de certification professionnelle consiste à évaluer rigoureusement le standard de compétence minimale requise (le minimally competent candidate) pour pratiquer sans danger pour autrui, et non pas l’excellence d’un expert chevronné cumulant vingt ans de carrière. Omettre une compétence de sécurité fondamentale dans une certification chirurgicale, ou y inclure des questions de gestion d’entreprise hors-sujet, constitue une infraction majeure aux règles déontologiques et juridiques de l’accréditation.
10.3 Évaluation des apprentissages en milieu professionnel continu
Au sein des organisations modernes, les départements de ressources humaines et de formation professionnelle consacrent des budgets substantiels au développement des compétences de leurs salariés. Pour évaluer le retour sur investissement et l’efficacité intrinsèque de ces programmes, les entreprises se réfèrent massivement au modèle quadri-niveaux d’évaluation des formations formulé par Donald Kirkpatrick :
- Niveau 1 : Réaction (satisfaction immédiate des participants) ;
- Niveau 2 : Apprentissage (acquisition mesurable des savoirs et compétences) ;
- Niveau 3 : Comportement (transfert opérationnel dans l’environnement de travail) ;
- Niveau 4 : Résultats (impact économique global sur l’organisation).
La validité de contenu constitue le pivot névralgique de l’évaluation au Niveau 2. Trop souvent, les questionnaires administrés à l’issue d’une formation d’entreprise se réduisent à des quiz anecdotiques, testant la mémorisation superficielle de diapositives de présentation plutôt que la maîtrise des gestes métiers réels. Pour préserver la validité de contenu, les évaluations doivent reposer sur des simulations fidèles, des analyses d’incidents critiques vécus et des études de cas complexes reproduisant avec exactitude l’écosystème de travail des salariés.
Par ailleurs, les concepteurs pédagogiques doivent opérer une distinction épistémologique intransigeante entre les connaissances déclaratives (savoir que : énoncer des règles de conformité ou des principes juridiques) et les connaissances procédurales (savoir comment : exécuter un plan de sauvetage ou paramétrer un serveur sécurisé). Une évaluation professionnelle qui ne mobilise que des connaissances déclaratives sous forme de QCM pour sanctionner une formation essentiellement procédurale souffre d’un défaut rédhibitoire de validité de contenu, rendant impossible toute inférence quant à l’efficacité future du travailleur sur le terrain.
11. Erreurs courantes, menaces et limites de la validité de contenu
11.1 Biais méthodologiques fréquents lors de la conception
Malgré l’existence d’une abondante littérature théorique, l’histoire de la psychométrie est jalonnée de tests défaillants en raison de biais méthodologiques récurrents survenus lors de leur phase d’ingénierie. Le premier et le plus pernicieux de ces travers est le biais de facilité (ou opportunisme de mesure). Rédiger des items évaluant le raisonnement critique, le jugement éthique en situation d’incertitude ou l’empathie clinique est une tâche intellectuellement ardue et chronophage ; à l’inverse, rédiger des questions fermées sur la date d’adoption d’un décret ou la nomenclature d’un os est élémentaire. Les concepteurs cèdent fréquemment à la tentation de surreprésenter ces questions simples, dénaturant ainsi la substance du construit au nom de la commodité rédactionnelle.
Un deuxième écueil méthodologique classique réside dans la dépendance étroite et exclusive envers une unique source théorique, un auteur singulier ou un manuel spécifique. Un instrument d’évaluation ne saurait prétendre à une validité de contenu générale s’il n’est en réalité que le miroir servile de la doctrine d’une seule école de pensée. La conception métrologique doit impérativement embrasser les points de vue concurrents et intégrer l’état de l’art scientifique dans sa pluralité.
Enfin, l’absence de documentation formalisée consignant les motifs de rejet ou de conservation des items constitue une grave négligence procédurale. Dans de trop nombreux projets de recherche, les suppressions d’items au sein du pool originel s’opèrent de manière opaque, lors de réunions informelles non archivées. Ce déficit de traçabilité interdit tout audit externe indépendant ultérieur et fragilise irrémédiablement la crédibilité scientifique de l’instrument lors des processus d’évaluation par les pairs (peer-review) ou d’homologation légale.
11.2 Limites inhérentes à la validité de contenu seule
Il est impératif pour tout chercheur d’adopter une posture de lucidité épistémologique : la validité de contenu, aussi méticuleusement établie soit-elle, n’est jamais suffisante à elle seule pour affirmer la qualité psychométrique globale d’un instrument. Elle présente des limites intrinsèques indépassables qui imposent son articulation étroite avec les autres piliers de la validation métrologique.
Premièrement, la validation de contenu est structurellement incapable d’apporter la preuve empirique de la structure factorielle sous-jacente du test. Une table de spécifications peut postuler avec une élégance théorique absolue que l’intelligence émotionnelle se décompose en quatre dimensions étanches ; cependant, seule l’administration du test à un échantillon substantiel de sujets et la modélisation statistique confirmatoire (AFC) pourront prouver si ces quatre facteurs émergent réellement des données empiriques ou si l’outil se comporte comme une échelle unidimensionnelle indifférenciée.
Deuxièmement, la validité de contenu ne fournit aucune indication chiffrée sur la fidélité temporelle (stabilité test-retest), sur l’erreur standard de mesure (SEM), ni sur la précision des scores aux différents points du continuum latent (information que seule la Théorie de la Réponse à l’Item — TRI — est à même de fournir). Enfin, elle demeure tributaire de la subjectivité collective des experts sollicités : un consensus d’experts biaisés ou formés au sein du même paradigme périmé ne garantit aucunement la vérité scientifique. La validation de contenu constitue la condition première, essentielle et indispensable de la métrologie, mais elle demeure stérile sans confirmation corrélationnelle et empirique subséquente.
11.3 Dégradation temporelle de la validité de contenu
La validité de contenu n’est jamais une propriété statique ou immuable, acquise une fois pour toutes lors du baptême méthodologique d’un test. Elle possède une demi-vie intrinsèque et se dégrade inévitablement sous l’action de l’obsolescence temporelle. Les sciences, les technologies, les cadres légaux et les conventions linguistiques évoluent à une vitesse sans précédent, frappant d’obsolescence les batteries d’évaluation les plus réputées.
Dans le domaine technologique et médical, cette dégradation est foudroyante. Un examen d’accréditation en informatique conçu au début des années 2010 omettant les architectures cloud, la cybersécurité moderne ou l’intelligence artificielle générative a perdu la quasi-totalité de sa validité de contenu pour juger de la compétence contemporaine d’un ingénieur logiciel. De même, en psychiatrie, la parution de nouvelles éditions des nomenclatures diagnostiques (comme le passage du DSM-IV au DSM-5) modifie les seuils, reclasse les affections et introduit de nouveaux critères symptomatiques, rendant caduques les échelles diagnostiques calquées sur les versions antérieures.
De surcroît, les glissements sémantiques sociétaux altèrent la résonance des items. Des termes autrefois neutres peuvent acquérir des connotations péjoratives ou archaïques avec le temps, induisant des biais imprévus chez les jeunes générations de répondants. Pour contrer cette dégradation naturelle, les institutions sérieuses imposent des protocoles cycliques de révision métrologique (typiquement tous les cinq à dix ans), engageant un réétalonnage de l’épreuve et une réévaluation complète de la validité de contenu auprès d’un nouveau panel d’experts du domaine.
12. Guide étape par étape pour concevoir un instrument doté d’une forte validité de contenu
12.1 Phases préparatoires : du concept à la grille de spécifications
Afin de traduire l’ensemble des concepts théoriques développés tout au long de cet article en un canevas immédiatement opérationnel pour les chercheurs et praticiens, ce dernier chapitre articule le protocole de validation de contenu en une séquence méthodologique standardisée en douze étapes successives, réparties en trois grandes phases de développement.
Étape 1 : Définir formellement le construit théorique. Rédiger une définition conceptuelle exhaustive de l’attribut psychologique ou éducatif ciblé. Énoncer explicitement ce qui est inclus dans le périmètre du construit et ce qui en est strictement exclu (délimitation des frontières nomologiques externes).
Étape 2 : Mener une revue systématique de la littérature et consulter le terrain. Explorer les bases de données scientifiques internationales (PsycINFO, PubMed, ERIC) pour extraire l’ensemble des modèles théoriques validés. Compléter cette synthèse académique par des observations sur site ou des analyses de poste approfondies si l’instrument cible des compétences professionnelles.
Étape 3 : Établir la table de spécifications multidimensionnelle. Croiser les dimensions et facettes théoriques du construit avec les niveaux taxonomiques cognitifs ou comportementaux requis. Assigner des pourcentages de pondération explicites à chaque cellule de la matrice pour figer la représentativité architecturale de l’instrument.
Étape 4 : Déterminer les modalités et formats de réponse optimaux. Choisir les formats de stimuli les plus pertinents au regard des objectifs de mesure : échelles de Likert graduées, questions à choix multiples à distracteurs calibrés, vignettes cliniques scénarisées ou épreuves de performance situationnelle directe.
12.2 Phases de développement et d’évaluation par panel
Étape 5 : Rédiger un pool surdimensionné d’items. Rédiger une banque de questions initiale contenant au moins le double du volume d’items visé pour l’instrument définitif. Respecter les canons de l’ingénierie psychométrique : clarté lexicale, phrases courtes, proscription des formulations ambiguës, rattachement formel et univoque de chaque item à sa cellule matricielle.
Étape 6 : Recruter et instruire le panel d’experts indépendants. Sélectionner méthodiquement entre 6 et 12 experts du domaine, équilibrant théoriciens de renom, praticiens chevronnés et méthodologistes. Préparer un dossier de cadrage d’expertise explicitant sans ambiguïté les définitions opérationnelles et le protocole d’évaluation.
Étape 7 : Administrer les grilles d’évaluation standardisées. Soumettre aux experts l’ensemble du pool d’items selon un protocole rigoureux (idéalement Delphi anonymisé). Faire coter chaque item sur une échelle ordinale à 4 points pour la pertinence (modèle de Lynn) et recueillir obligatoirement des observations qualitatives et des propositions d’amendements pour toute note inférieure à 3.
Étape 8 : Calculer les indices statistiques de validité de contenu. Compiler rigoureusement les matrices de données issues du panel. Calculer l’I-CVI de chaque item individuel, le coefficient de concordance Kappa modifié ($k^*$), le coefficient $V$ d’Aiken, ainsi que les indices d’échelle globale (S-CVI/UA et S-CVI/Ave) ou le CVR de Lawshe si une échelle trichotomique a été employée.
12.3 Phases d’ajustement, de pré-test et de finalisation
Étape 9 : Filtrer, épurer et réviser la banque d’items. Exclure sans concession tout item affichant un I-CVI strictement inférieur au seuil normatif critique (par exemple < 0,78 pour un panel de 9 experts). Réviser les items signalés comme linguistiquement ambigus et vérifier que l’ensemble des items retenus respecte scrupuleusement la balance des pondérations de la table de spécifications initiale.
Étape 10 : Conduire un pré-test cognitif sur la population cible. Administrer la version provisoire de l’instrument à un échantillon restreint mais représentatif d’individus issus de la population cible (15 à 30 répondants). Mener des entretiens d’explicitation cognitive (think-aloud protocols) pour observer la manière dont les répondants décodent, comprennent et traitent intellectuellement chaque énoncé, éliminant ainsi les dernières sources résiduelles de variance non pertinente.
Étape 11 : Standardiser les consignes, le format et le chronométrage final. Figer la maquette définitive de l’instrument, rédiger des instructions d’administration standardisées limpides, établir les conditions de passation ergonomiques et vérifier le respect absolu des principes de conception universelle de l’évaluation pour garantir une équité sans faille.
Étape 12 : Rédiger et publier le rapport technique de validité de contenu. Consigner l’intégralité de la chaîne méthodologique dans un document technique officiel : définitions conceptuelles, composition détaillée du panel d’experts, valeurs brutes et standardisées de l’ensemble des indices calculés (I-CVI, S-CVI, V), justifications éditoriales des suppressions ou réécritures d’items, et table de spécifications finale. Ce rapport exhaustif servira de passeport scientifique et d’attestation juridique lors de l’intégration de l’instrument au sein de la communauté scientifique ou de son déploiement à grande échelle.
Références
- Aiken, L. R. (1980). Content validity and reliability of single items or questionnaires. Educational and Psychological Measurement, 40(4), 955-959. https://doi.org/10.1177/001316448004000419
- Aiken, L. R. (1985). Three coefficients for analyzing the reliability and validity of ratings. Educational and Psychological Measurement, 45(1), 131-142. https://doi.org/10.1177/0013164485451012
- American Educational Research Association, American Psychological Association, & National Council on Measurement in Education. (2014). Standards for Educational and Psychological Testing. American Educational Research Association.
- Anastasi, A., & Urbina, S. (1997). Psychological Testing (7th ed.). Prentice Hall.
- Biggs, J. (1996). Enhancing teaching through constructive alignment. Higher Education, 32(3), 347-364. https://doi.org/10.1007/BF00138871
- Bloom, B. S., Engelhart, M. D., Furst, E. J., Hill, W. H., & Krathwohl, D. R. (1956). Taxonomy of Educational Objectives: The Classification of Educational Goals. Handbook I: Cognitive Domain. David McKay Company.
- Campbell, D. T., & Fiske, D. W. (1959). Convergent and discriminant validation by the multitrait-multimethod matrix. Psychological Bulletin, 56(2), 81-105. https://doi.org/10.1037/h0046016
- Cronbach, L. J., & Meehl, P. E. (1955). Construct validity in psychological tests. Psychological Bulletin, 52(4), 281-302. https://doi.org/10.1037/h0040957
- Cronbach, L. J., Gleser, G. C., Nanda, H., & Rajaratnam, N. (1972). The Dependability of Behavioral Measurements: Theory of Generalizability for Scores and Profiles. John Wiley & Sons.
- Flanagan, J. C. (1954). The critical incident technique. Psychological Bulletin, 51(4), 327-358. https://doi.org/10.1037/h0061470
- Grant, J. S., & Davis, L. L. (1997). Selection and use of content experts for instrument development. Research in Nursing & Health, 20(3), 269-274. <a href="https://doi.org/10.1002/(SICI)1098-240X(199706)20:33.0.CO;2-G »>https://doi.org/10.1002/(SICI)1098-240X(199706)20:3<269::AID-NUR9>3.0.CO;2-G
- International Test Commission. (2017). The ITC Guidelines for Translating and Adapting Tests (2nd ed.). International Test Commission. https://www.intestcom.org
- Kirkpatrick, D. L. (1996). Revisiting Kirkpatrick’s four-level model. Training & Development, 50(1), 54-57.
- Lawshe, C. H. (1975). A quantitative approach to content validity. Personnel Psychology, 28(4), 563-575. https://doi.org/10.1111/j.1744-6570.1975.tb01393.x
- Lynn, M. R. (1986). Determination and quantification of content validity. Nursing Research, 35(6), 382-385. https://doi.org/10.1097/00006199-198611000-00017
- Messick, S. (1989). Validity. In R. L. Linn (Ed.), Educational Measurement (3rd ed., pp. 13-103). Macmillan.
- Messick, S. (1995). Validity of psychological assessment: Validation of inferences from persons’ responses and performances as scientific inquiry into score meaning. American Psychologist, 50(9), 741-749. https://doi.org/10.1037/0003-066X.50.9.741
- Nunnally, J. C., & Bernstein, I. H. (1994). Psychometric Theory (3rd ed.). McGraw-Hill.
- Polit, D. F., & Beck, C. T. (2006). The content validity index: Are you sure you know what’s being reported? Critique and recommendations. Research in Nursing & Health, 29(5), 489-497. https://doi.org/10.1002/nur.20147
- Polit, D. F., Beck, C. T., & Owen, S. V. (2007). Is the CVI an acceptable indicator of content validity? Appraisal and recommendations. Research in Nursing & Health, 30(4), 459-467. https://doi.org/10.1002/nur.20199
- Sireci, S. G. (1998). The construct of content validity. Social Indicators Research, 45(1-3), 83-117. https://doi.org/10.1023/A:1006985528729
- U.S. Equal Employment Opportunity Commission. (1978). Uniform Guidelines on Employee Selection Procedures. Federal Register, 43(166), 38290-38315.