
Dans le domaine de la psychométrie, de l’économétrie et de l’analyse statistique appliquée aux sciences humaines et du comportement, l’estimation rigoureuse des relations entre différentes variables constitue le fondement même de la construction théorique et de la validation empirique. Qu’il s’agisse d’évaluer la validité prédictive d’un test d’aptitude cognitive sur la performance au travail, de modéliser le lien entre un biomarqueur et la sévérité d’un trouble psychologique, ou encore d’estimer l’impact d’un programme pédagogique innovant sur les résultats universitaires, les chercheurs s’appuient massivement sur des indices de corrélation linéaire et des modèles de régression bivariés ou multivariés. Toutefois, ces estimations reposent sur une prémisse méthodologique implicite souvent mise à mal sur le terrain : l’échantillon observé reflète adéquatement la dispersion réelle et la variabilité totale de la population cible sous-jacente.
Lorsque cette prémisse s’avère violée en raison d’un mécanisme de filtrage, de sélection préalable, d’attrition ou de contraintes inhérentes à l’instrumentation de mesure, les données collectées ne représentent plus qu’une fraction tronquée ou compressée de l’espace des variations possibles. Cette limitation artificielle ou systématique de la variabilité porte le nom de restriction d’étendue (ou restriction of range en anglais). Loin de constituer une simple anomalie descriptive mineure sans incidence théorique, la restriction d’étendue altère profondément les coefficients statistiques usuels, au premier rang desquels figure le coefficient de corrélation linéaire de Pearson. Ce phénomène tend le plus souvent à comprimer substantiellement la valeur apparente des associations statistiques, conduisant praticiens et scientifiques à sous-évaluer drastiquement l’efficacité de leurs instruments de mesure, la portée de leurs interventions ou l’universalité de leurs modèles.
Comprendre la nature, les manifestations mathématiques et les répercussions empiriques de la restriction d’étendue est donc un prérequis indispensable pour quiconque souhaite analyser des données issues de populations sélectionnées. De la sélection professionnelle à la recherche clinique, en passant par les méta-analyses contemporaines et l’élaboration de politiques publiques fondées sur des preuves, la prise en compte de cet artéfact statistique sépare l’inférence causale erronée de l’évaluation méthodologique rigoureuse. Cet article propose une analyse exhaustive et approfondie de la restriction d’étendue, explorant ses bases théoriques, son formalisme mathématique, ses manifestations pratiques dans divers secteurs des sciences comportementales, ainsi que les solutions quantitatives modernes développées pour en corriger les effets délétères.
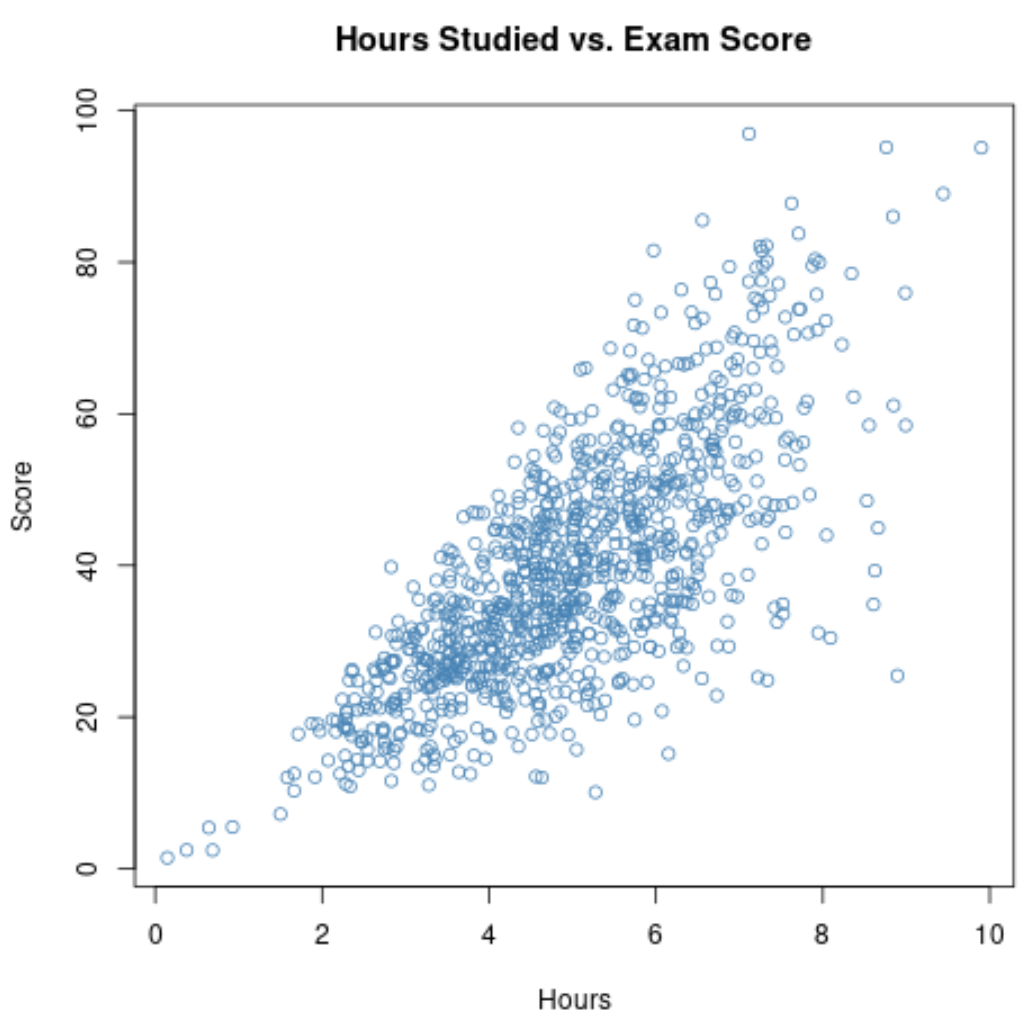
1. Définition fondamentale et principes conceptuels de la restriction d’étendue
1.1 Origine statistique et concept de base
La restriction d’étendue désigne, dans son acception statistique la plus pure, le phénomène par lequel la variabilité observée d’au moins une variable au sein d’un échantillon d’analyse est significativement inférieure à la variabilité présente au sein de la population parente à laquelle cet échantillon appartient conceptuellement. Ce rétrécissement de la dispersion ne résulte pas d’une caractéristique intrinsèque des individus mesurés, mais découle d’un mécanisme de filtrage systématique, volontaire ou fortuit, qui élimine ou n’enregistre pas les observations situées au-delà de certaines limites ou seuils critiques. Lorsque l’amplitude des scores possibles est ainsi amputée, la variance échantillonnale s’effondre comparativement à la variance de la population totale.
Il importe d’établir d’emblée une distinction théorique fondamentale entre la variance tronquée et la variance censurée, deux concepts fréquemment amalgamés bien qu’obéissant à des réalités méthodologiques différentes. Une distribution est dite tronquée lorsque les individus se situant en dehors d’un intervalle défini sont totalement absents de l’échantillon : ni leurs scores sur la variable de sélection ni leurs scores sur les autres variables d’intérêt ne sont enregistrés ou accessibles au chercheur. En revanche, une distribution est qualifiée de censurée lorsque les individus existent bel et bien dans le jeu de données et que leurs informations collatérales sont connues, mais que leur score précis sur la variable d’intérêt est borné à une valeur maximale ou minimale prédéfinie en raison des limites d’enregistrement de l’outil de mesure.
L’origine historique de ce concept remonte aux travaux fondateurs de la biométrie et de la psychométrie au tournant du XXe siècle. Dès 1903, le mathématicien et biostatisticien britannique Karl Pearson publia un article séminal consacré à l’influence de la sélection naturelle et artificielle sur la corrélation et la variation au sein des populations biologiques. Pearson comprit immédiatement qu’observer une corrélation sur un sous-groupe sélectionné d’une espèce fournissait une estimation biaisée de la covariation originelle. Quelques décennies plus tard, durant la Seconde Guerre mondiale, des psychologues militaires tels que Robert L. Thorndike formalisèrent l’application de ces notions à la sélection des pilotes de l’armée de l’air américaine, documentant comment le rejet des candidats aux scores initiaux faibles masquait l’efficacité réelle des tests d’aptitude psychomotrice.
1.2 Différenciation entre variance observée et variance réelle de la population
L’écart systématique qui s’installe entre la variance observée au sein de l’échantillon d’étude (souvent notée s²) et la variance réelle de la population cible (notée σ²) découle d’un processus d’échantillonnage non aléatoire. Dans une démarche d’inférence statistique classique, le chercheur postule que son échantillon constitue un miroir probabiliste non biaisé de la population générale, autorisant ainsi l’usage des statistiques descriptives échantillonnales pour estimer les paramètres populationnels par des estimateurs sans biais. Lorsque la restriction d’étendue intervient, cette hypothèse d’échantillonnage aléatoire simple s’effondre totalement : la probabilité pour un individu d’être inclus dans l’étude devient fonction de son score sur une ou plusieurs variables.
Ce mécanisme de sélection non équiprobable modifie profondément non seulement la variance, mais également la moyenne de l’échantillon. Dans un schéma de sélection unilatérale supérieure (par exemple, retenir uniquement les 20 % des individus les plus performants à un test), la moyenne observée au sein de l’échantillon sera mécaniquement supérieure à la moyenne populationnelle, tandis que l’écart-type sera substantiellement contracté. Cette compression de l’écart-type n’est pas une simple perte de précision d’échantillonnage réductible par l’augmentation de la taille N du groupe étudié : il s’agit d’un biais paramétrique structurel. Augmenter le nombre de sujets retenus au sein du groupe restreint ne rétablira en rien la variance de la population générale, car tous les nouveaux participants ajoutés demeureront cantonnés à l’intérieur de la tranche de scores pré-sélectionnée.
Cet écart systématique entre les paramètres inférés et les paramètres réels de la population cible génère un problème d’invariance des propriétés statistiques. L’estimation de l’erreur-type de la moyenne, la puissance statistique des tests d’hypothèse et la capacité à détecter des différences interindividuelles fines se trouvent faussées. En ignorant la différence entre l’étendue empirique du groupe restreint et l’étendue théorique du domaine de généralisation, le statisticien attribue à la nature même du phénomène étudié une homogénéité artificielle qui n’est en réalité que le produit dérivé du protocole de recrutement ou des critères d’admissibilité.
1.3 Importance du phénomène en sciences psychologiques et comportementales
Les sciences psychologiques, comportementales et sociales présentent une vulnérabilité singulière face au phénomène de restriction d’étendue en raison de la prédominance des mesures standardisées et des contextes écologiques au sein desquels s’exécutent les protocoles de recherche. Contrairement aux sciences physiques où les variables d’intérêt peuvent souvent être isolées expérimentalement en laboratoire sans introduire de biais de sélection démographique, la psychologie étudie des êtres humains engagés dans des parcours sociaux, éducatifs et professionnels hautement régulés par des barrières sélectives formelles ou informelles.
Cette vulnérabilité pèse lourdement sur la reproductibilité scientifique et la validité externe des conclusions publiées. Lorsqu’un protocole expérimental ou corrélationnel est déployé dans une université d’élite sur une cohorte d’étudiants en psychologie de premier cycle, l’étendue des aptitudes intellectuelles, du statut socio-économique et parfois des traits de personnalité se trouve considérablement plus étroite que celle observée dans la population générale adulte. Si les chercheurs tentent de répliquer une étude d’association entre la mémoire de travail et la flexibilité cognitive sur des échantillons aux niveaux de restriction divergents, les tailles d’effet obtenues oscilleront considérablement, non pas en raison d’une instabilité théorique du construit psychologique, mais simplement à cause de la variation du ratio de restriction d’un échantillon à l’autre.
Sur le plan éthique et sociétal, les conséquences des erreurs d’interprétation induites par la restriction d’étendue peuvent s’avérer dommageables. Dans le domaine du diagnostic clinique, une sous-estimation des corrélations entre des mesures autorapportées et des critères comportementaux peut conduire à disqualifier à tort des outils de dépistage précoce très efficaces dans l’ensemble de la population, mais dont la validité apparente semble faible au sein d’une clinique spécialisée n’accueillant que des patients souffrant de pathologies sévères. De même, en orientation scolaire ou professionnelle, déclarer un test inefficace sur la base de données restreintes peut priver des institutions d’instruments équitables et objectifs, favorisant ainsi le retour à des méthodes de sélection intuitives et perméables aux préjugés discriminatoires.
2. Mécanismes mathématiques sous-jacents de la corrélation et impact de la restriction
2.1 Le coefficient de corrélation de Pearson et ses hypothèses
Pour appréhender avec rigueur les déformations induites par la restriction d’étendue, il est indispensable de revenir à la structure algébrique du coefficient de corrélation produit-moment de Bravais-Pearson, conventionnellement désigné par la lettre r. Développé pour quantifier l’intensité et le sens de la relation linéaire unissant deux variables continues X et Y, le coefficient r est défini comme le rapport entre la covariance des deux variables et le produit de leurs écarts-types respectifs :
rXY = Cov(X, Y) / (σX · σY) = E[(X – μX)(Y – μY)] / (σX · σY)
L’estimation rigoureuse de ce coefficient repose sur plusieurs hypothèses distributionnelles fondamentales, parmi lesquelles l’hypothèse de normalité bivariée occupe une place centrale. Cette condition implique que pour chaque valeur conditionnelle de X, la distribution des scores de Y suit une loi normale, et vice-versa, avec une variance résiduelle constante (hypothèse d’homoscédasticité). De surcroît, le modèle suppose implicitement que la dispersion des points le long des axes X et Y couvre l’intégralité du continuum pertinent sur lequel le phénomène a vocation à être théorisé.
La structure même du coefficient de corrélation le rend intrinsèquement dépendant des écarts-types marginaux. La covariance mesure la tendance conjointe des variables à s’écarter simultanément de leurs moyennes respectives. Si l’on applique un filtre qui comprime artificiellement les écarts à la moyenne sur l’axe X, la covariance diminue d’une façon qui n’est pas proportionnelle à la simple diminution de l’écart-type σX au dénominateur, altérant ainsi la valeur finale du ratio r. La dispersion n’agit pas comme un simple facteur d’échelle neutre : elle détermine directement la sensibilité du coefficient de corrélation à capter l’alignement linéaire des observations.
2.2 L’effet de la réduction de la variance sur le numérateur et le dénominateur
L’atténuation mathématique du coefficient de corrélation sous l’effet de la restriction d’étendue s’explique par l’asymétrie de contraction qui s’opère entre le numérateur (la covariance) et le dénominateur (le produit des écarts-types). Considérons un modèle de régression linéaire classique où la relation entre X et Y dans la population générale non restreinte s’exprime par l’équation standard : Y = β0 + β1X + ε, où ε représente un terme d’erreur indépendant de X avec une variance résiduelle constante notée σ²e.
Dans ce cadre linéaire homoscédastique, la pente de régression non standardisée β1 possède la propriété remarquable de demeurer invariante face à une sélection directe sur X. Mathématiquement, β1 = Cov(X, Y) / σ²X. Lorsque la variance de X est restreinte à une valeur s²x < σ²X, la nouvelle covariance observée Covres(X, Y) se trouve contractée dans une proportion exactement identique, de sorte que le rapport Covres(X, Y) / s²x reste théoriquement égal à la pente originale β1. En revanche, le coefficient de corrélation de Pearson dans l’échantillon restreint, noté rres, s’exprime en fonction de cette pente invariante par la relation :
rres = β1 · (sx / sy)
Or, tandis que la variance de X passe de σ²X à s²x, la variance conditionnelle de Y ne se contracte pas au même rythme, car elle est lestée par la variance d’erreur σ²e qui reste inchangée : s²y = β1² · s²x + σ²e. En insérant cette égalité dans l’expression du coefficient de corrélation restreint, on obtient :
rres = β1 · sx / √(β1² · s²x + σ²e) = 1 / √(1 + [σ²e / (β1² · s²x)])
Cette décomposition algébrique met en lumière le comportement asymptotique du coefficient : à mesure que la dispersion restreinte sx tend vers zéro, le ratio σ²e / (β1² · s²x) diverge vers l’infini, entraînant inéluctablement rres vers zéro, et ce, quelle que soit la force de la corrélation originale dans la population sans restriction. Dans certains cas limites hautement spécifiques marqués par une forte hétéroscédasticité ou des relations non linéaires, la troncature peut même provoquer une inversion paradoxale du signe de la corrélation ou une surévaluation artificielle, bien que l’atténuation vers zéro demeure la manifestation standard écrasante observée en pratique.
2.3 Conséquences géométriques sur le nuage de points et la régression
Pour conceptualiser intuitivement l’impact de la restriction d’étendue, il est particulièrement instructif d’adopter une perspective géométrique. Dans un repère cartésien bidimensionnel représentant les variables standardisées X et Y au sein d’une population normale bivariée, le nuage de points adopte la forme d’une ellipse de dispersion dont l’excentricité reflète la magnitude de la corrélation. Plus l’ellipse est étirée et étroite le long de son grand axe, plus le coefficient de corrélation s’approche des valeurs extrêmes +1 ou -1. À l’inverse, une corrélation nulle se matérialise par une ellipse circulaire symétrique.
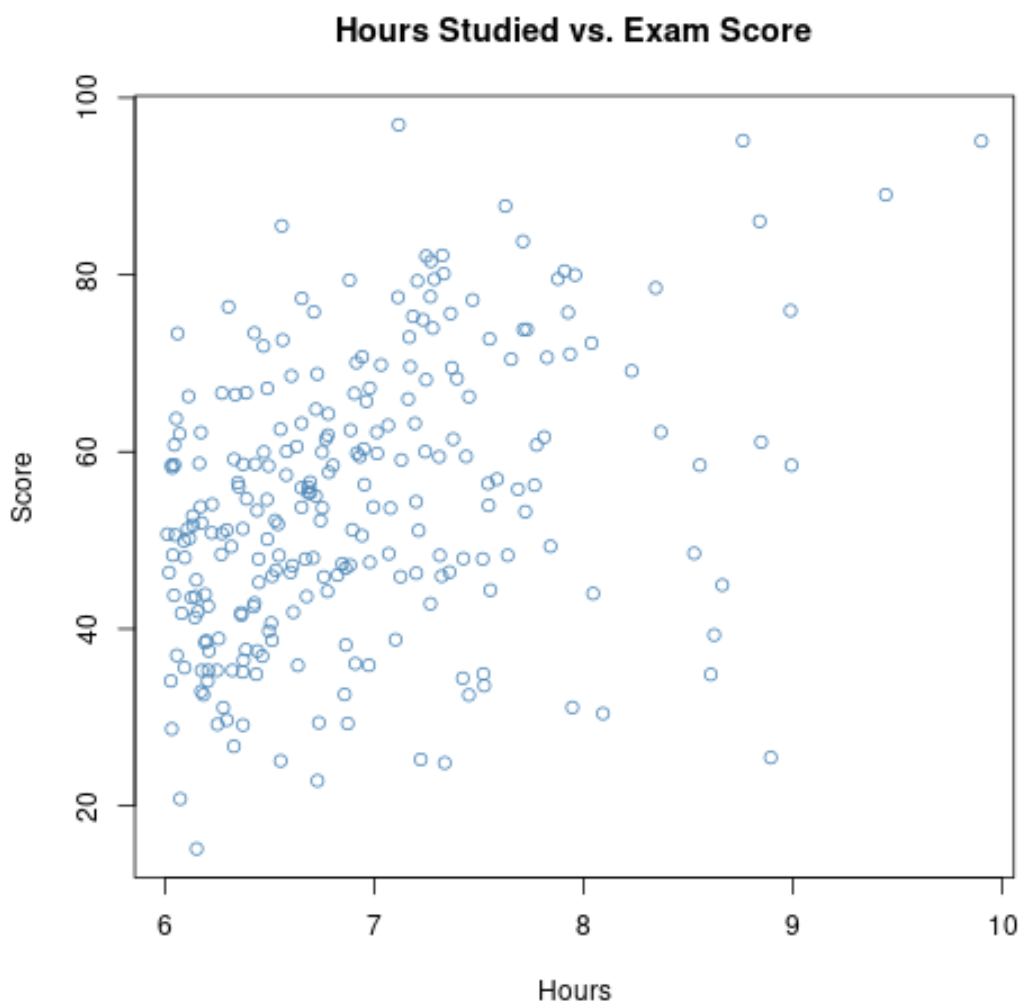
Lorsqu’une restriction directe d’étendue survient sur l’axe horizontal des abscisses (la variable X), deux lignes verticales délimitent le sous-ensemble conservé, sectionnant sans ménagement les extrémités gauche et droite de l’ellipse originelle. Ce qui subsiste entre ces bornes n’est plus une ellipse complète étirée le long de sa diagonale, mais un segment tronqué dont la configuration géométrique se rapproche davantage d’un cercle ou d’une bande verticale compacte. Les distances entre les observations selon l’axe horizontal étant considérablement réduites alors que l’étalement vertical résiduel σe demeure intact, l’orientation directionnelle du nuage devient beaucoup moins nette à l’œil comme aux algorithmes d’estimation.
Cette altération géométrique modifie substantiellement l’erreur standard d’estimation et déforme la structure apparente des résidus. Bien que la droite des moindres carrés conserve théoriquement la même orientation angulaire (invariance de la pente non standardisée), la certitude entourant son ajustement s’effondre. Les résidus orthogonaux semblent occuper une place prépondérante face à la variance expliquée par le modèle, induisant un coefficient de détermination R² effondré. Le chercheur non averti, contemplant ce nuage de points rabougri, conclura souvent hâtivement à une absence de relation linéaire ou à une dispersion aléatoire incontrôlée, alors qu’il n’observe qu’une fenêtre observationnelle arbitrairement rétrécie d’un système bivarié ordonné.
3. Typologie formelle : Restriction directe versus restriction indirecte
3.1 La restriction directe sur la variable prédictive
La taxonomie de la restriction d’étendue repose sur les mécanismes structurels ayant conduit au rétrécissement de l’échantillon. La configuration méthodologique la plus classique, étudiée historiquement par Karl Pearson sous l’appellation de Cas II, est la restriction directe sur la variable prédictive (souvent notée X). Dans ce scénario, l’inclusion d’un individu au sein du jeu de données final découle explicitement et exclusivement d’une règle de coupure appliquée directement sur ses scores obtenus à la variable prédictive.
Ce cas de figure est omniprésent dans les processus sélectifs institutionnalisés. Considérons une université prestigieuse qui soumet tous ses postulants à un examen standardisé d’admission et qui refuse systématiquement tout candidat obtenant une note inférieure à un seuil d’admissibilité fixé par le jury. Si un chercheur évalue ultérieurement la relation entre la note à cet examen et les résultats obtenus à la fin du cursus universitaire, il travaille sur un échantillon directement restreint sur X. Aucune donnée n’existe, par définition, sur la variable critère Y pour l’ensemble des candidats dont le score X était inférieur au point de coupure, créant une troncature unilatérale abrupte et totale du domaine expérimental.
La modélisation mathématique du cas direct bénéficie d’une clarté théorique remarquable. Dans la mesure où la règle de sélection dépend de manière déterministe d’une variable observée pour tous les postulants initiaux, la distribution de X avant sélection est généralement accessible au chercheur sous forme de données d’archives institutionnelles. La connaissance de la variance originelle de la population parente rend possible une restauration analytique exacte des paramètres d’association bivariés grâce aux équations classiques de Pearson, sous réserve de la véracité des hypothèses de linéarité et d’homoscédasticité sur l’ensemble de l’étendue théorique.
3.2 La restriction directe sur la variable critère
Le second scénario répertorié dans la taxonomie fondamentale concerne la restriction directe opérée sur la variable critère (conventionnellement notée Y). Moins fréquente dans les processus de sélection institutionnels formels, cette forme de restriction émerge avec une acuité particulière dans la recherche clinique, médicale, épidémiologique et dans les études d’évaluation de programmes d’intervention.
La restriction directe sur Y survient lorsque les individus sont admis ou maintenus dans l’échantillon d’analyse uniquement s’ils satisfont à une condition stricte portant sur la variable d’aboutissement elle-même. Par exemple, une étude clinique investiguant les déterminants cognitifs ou génétiques de la dépression majeure peut choisir d’inclure uniquement des patients hospitalisés présentant un score à l’échelle d’évaluation de la dépression de Hamilton supérieur à 24 points. Dans cette configuration, c’est la variable dépendante qui subit une troncature nette. De même, les phénomènes d’attrition différentielle — où les participants abandonnent prématurément une étude longitudinale précisément parce qu’ils connaissent une dégradation de leur état de santé ou de leur performance — engendrent une sélection directe sur le critère.
D’un point de vue analytique, la restriction directe sur Y soulève des difficultés méthodologiques considérablement plus épineuses que la restriction sur X. Dans ce contexte, la pente de régression de Y sur X n’est plus invariante : elle est elle-même sévèrement atténuée, faussant radicalement l’estimation de l’impact direct du prédicteur. De surcroît, la distribution complète de la variable critère au sein de la population générale est très fréquemment inconnue ou impossible à échantillonner avec précision pour des raisons logistiques ou éthiques. Corriger l’impact d’une restriction directe sur le critère requiert l’inversion de l’équation de régression (régression de X sur Y) ou le recours à des estimateurs économétriques complexes tels que les modèles de sélection de Heckman.
3.3 La restriction indirecte ou fortuite via une tierce variable
Si les cas directs offrent un cadre didactique élégant, la réalité écologique des données en sciences humaines est dominée par une troisième configuration, beaucoup plus insidieuse et complexe : la restriction indirecte (ou incidental range restriction). Dans ce schéma, ni le prédicteur d’intérêt opérationnel X ni le critère final Y ne font l’objet d’un seuillage explicite direct. La sélection des individus dans l’échantillon s’opère plutôt sur la base d’une tierce variable intermédiaire (ou d’un composite de variables) notée Z, laquelle présente une corrélation substantielle simultanée avec X et avec Y.
Ce phénomène s’illustre de manière paradigmatique dans les contextes de recrutement organisationnel où une entreprise recrute ses employés en se basant sur un entretien de motivation semi-structuré (variable Z). Si un chercheur tente d’étudier rétrospectivement la validité prédictive d’un test d’intelligence fluide (variable X) passé lors de l’embauche mais non utilisé pour la décision finale d’engagement, vis-à-vis du rendement professionnel annuel (variable Y), l’échantillon des collaborateurs en poste souffre d’une restriction indirecte. Parce que les individus retenus possédaient d’excellents scores à l’entretien Z, et que cet entretien partageait une variance commune avec l’intelligence fluide X, la variabilité de X chez les employés embauchés se trouve indirectement contractée.
La modélisation de la restriction indirecte exige d’abandonner les équations univariées traditionnelles au profit de formulations matricielles multivariées. L’atténuation de la corrélation rXY ne dépend pas uniquement du ratio de contraction de la variance de X, mais est médiée par les coefficients de cheminement reliant X à Z et Z à Y. La sous-estimation de la validité qui en découle est souvent plus sévère encore que dans le cas d’une restriction directe, car l’analyste n’a généralement pas conscience de l’ensemble des filtres implicites (variables Z1, Z2, … Zk) qui ont modulé l’accès des individus à l’échantillon analysé.
4. Manifestations et enjeux en psychologie du travail et sélection du personnel
4.1 Le paradoxe de la sélection des candidats hautement qualifiés
Le champ de la psychologie industrielle et organisationnelle, et plus particulièrement celui de la sélection du personnel, constitue le théâtre historique privilégié où la restriction d’étendue déploie ses paradoxes les plus déroutants. Lorsqu’une organisation déploie un système de recrutement particulièrement compétitif pour pourvoir des postes à haute responsabilité, elle élimine impitoyablement la vaste majorité des postulants pour ne conserver qu’une frange infime de candidats affichant les scores les plus élevés aux batteries de tests initiaux.
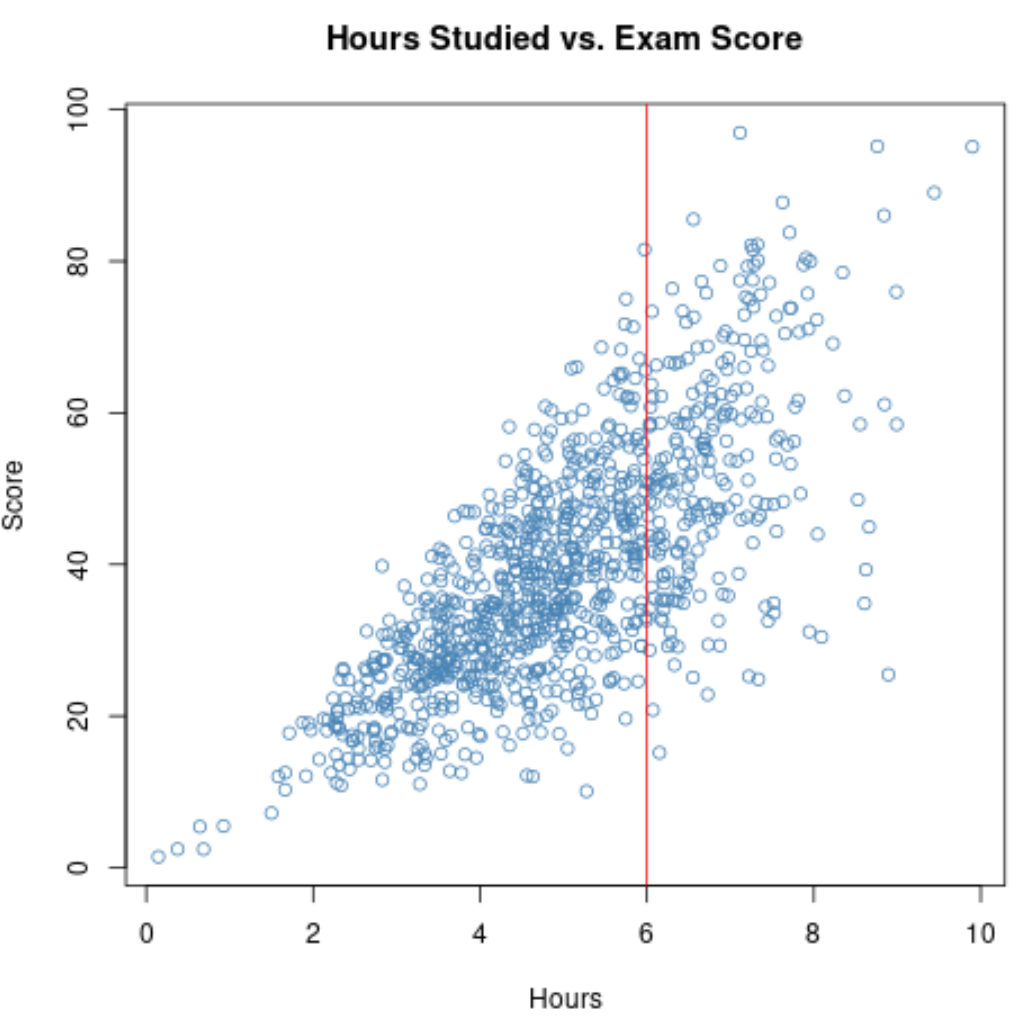
Une fois ces individus intégrés au sein de l’entreprise, les départements des ressources humaines mesurent périodiquement leur performance opérationnelle réelle via des indicateurs quantitatifs ou des évaluations hiérarchiques. En calculant le coefficient de corrélation de Pearson entre les scores obtenus lors du processus d’embauche et les notes de performance professionnelles au bout d’un an, les praticiens sont fréquemment stupéfaits de constater une valeur dérisoire, oscillant souvent entre 0,05 et 0,15, quand elle n’est pas tout simplement non significative sur le plan statistique. Ce résultat contre-intuitif donne naissance à ce que l’on nomme couramment le paradoxe de la sélection : les tests qui ont servi à choisir les candidats semblent rétrospectivement incapables de différencier les meilleurs professionnels au sein du groupe embauché.
Le piège interprétatif réside dans l’oubli que ce groupe sélectionné est devenu extraordinairement homogène sur le plan des aptitudes mesurées. Les postulants faibles, chez qui l’absence de compétences aurait provoqué des échecs professionnels patents, n’ont jamais franchi les portes de l’organisation. Au sein de la cohorte d’élite retenue, la variance résiduelle des aptitudes cognitives est si étroite que la variabilité de la performance au travail n’est plus expliquée par ces aptitudes, mais par d’autres facteurs non contrôlés (la motivation contextuelle, les relations interpersonnelles, la santé physique ou des contingences organisationnelles fortuites). Sans une compréhension lucide de la restriction d’étendue, les directions d’entreprises courent le risque mortifère d’abandonner prématurément des outils de sélection pourtant scientifiquement irréprochables et dotés d’un pouvoir prédictif immense sur la population générale.
4.2 Sous-estimation de la validité prédictive des instruments d’évaluation
L’impact direct de la restriction d’étendue sur l’estimation de la validité de critère fausse systématiquement la hiérarchie comparée des prédicteurs de réussite professionnelle. Dans les manuels classiques de psychologie appliquée, les méta-analyses contemporaines non corrigées dressent un portrait erroné de l’utilité relative des instruments. Un test d’aptitude cognitive générale qui présente une validité théorique réelle de ρ = 0,55 dans la population générale des candidats postulant à un emploi technique verra sa validité observée chuter à r = 0,20 voire 0,15 si seulement les 10 % supérieurs sont embauchés.
Ce phénomène introduit une distorsion comparative majeure lorsque différents instruments de sélection sont confrontés au sein d’une même étude empirique. Si une variable prédictive A (comme un test cognitif hautement sélectif) a servi de base exclusive à l’embauche tandis qu’une variable prédictive B (comme un questionnaire de personnalité ou un test d’intérêts professionnels) a été administrée à titre purement indicatif sans influer sur la décision finale, la variable A subit une restriction directe sévère alors que la variable B ne subit qu’une restriction indirecte modérée. Les coefficients de corrélation observés suggéreront fallacieusement que la personnalité est un prédicteur supérieur ou équivalent aux capacités cognitives pour le poste en question, induisant en erreur les comités de recrutement lors de la conception de leurs futures batteries d’évaluation.
Les jurys et les praticiens fondent alors leurs choix stratégiques sur des données quantitatives amputées de leur contexte méthodologique. Cette distorsion systématique favorise le déploiement d’instruments d’évaluation à faible validité intrinsèque au détriment de méthodes éprouvées, affaiblissant la qualité globale du capital humain recruté et exposant paradoxalement les processus de sélection à des contestations juridiques quant à leur pertinence empirique et leur validité de contenu.
4.3 Répercussions sur l’analyse d’utilité organisationnelle
L’utilité économique des systèmes de sélection du personnel s’évalue traditionnellement au moyen de modèles d’équations financières formalisés, au premier rang desquels figure le célèbre modèle de Brogden-Cronbach-Gleser (BCG). Cette formulation mathématique estime le gain financier net (ΔU) généré par l’introduction d’un nouveau système de sélection par rapport à un recrutement aléatoire ou rudimentaire, en fonction de la taille de la cohorte recrutée (N), de la durée moyenne de rétention en poste (T), du coût d’administration par candidat (C), du ratio de sélection, de l’écart-type de la valeur de la performance au travail exprimée en unités monétaires (SDy), et surtout de la validité opérationnelle du test (rxy) :
ΔU = N · T · rxy · SDy · λ – (C · N / SR)
Dans cette formule canonique, la validité opérationnelle rxy agit comme un coefficient multiplicateur direct et linéaire de la valeur financière créée par le processus de sélection. Si un cabinet d’audit ou un département des ressources humaines intègre dans cette équation le coefficient de corrélation brut et non corrigé observé chez les employés en poste (par exemple r = 0,20) au lieu de la validité réelle non restreinte de la population des candidats (qui s’élève par exemple à ρ = 0,50), l’utilité financière calculée du dispositif d’évaluation sera divisée par 2,5. Le retour sur investissement projeté apparaît alors artificiellement anémique.
Cette sous-évaluation financière substantielle décourage les directions financières d’investir les capitaux nécessaires dans des technologies de tests psychométriques robustes, des centres d’évaluation structurés ou des entretiens comportementaux standardisés. Les organisations se replient alors par calcul erroné vers des processus de filtrage rudimentaires et peu coûteux à court terme (tri informel de curriculums vitae, entretiens non directifs), sans réaliser que le manque à gagner annuel en matière de productivité et de performance organisationnelle se chiffre en millions d’euros, uniquement en raison d’un biais d’estimation statistique non corrigé dans leurs feuilles de calcul prévisionnelles.
5. La restriction d’étendue dans la recherche en psychologie clinique et cognitive
5.1 Échantillons cliniques homogènes et atténuation des corrélations
Si la psychologie du travail illustre la sélection intentionnelle de l’excellence, la recherche en psychologie clinique et en psychopathologie affronte un défi symétrique : la restriction d’étendue causée par la sélection intentionnelle de la pathologie. Les protocoles de recherche médicale et clinique recrutent prioritairement leurs participants au sein d’institutions spécialisées, de services psychiatriques d’urgence ou de cohortes hospitalières composées exclusivement d’individus ayant franchi des critères d’inclusion diagnostiques draconiens basés sur le DSM-5 ou la CIM-11.
Cette homogénéité clinique sévère a pour conséquence directe d’écraser la variance des scores psychopathologiques au sein du groupe étudié. Par exemple, si l’on cherche à analyser la relation fondamentale unissant le trait de personnalité Névrosisme (instabilité émotionnelle) à la fréquence des crises d’angoisse au sein d’un échantillon d’individus hospitalisés pour un trouble panique sévère, la corrélation calculée sera quasi systématiquement décevante. Tous les patients inclus dans l’étude affichent des scores de névrosisme exceptionnellement élevés et des fréquences de crises quotidiennes massives. La quasi-absence de sujets calmes, stables et asymptomatiques au sein de l’échantillon détruit le continuum de dispersion bivarié naturel.
Ce rétrécissement conduit fréquemment à des impasses théoriques dommageables. Les chercheurs peuvent être tentés d’inférer à tort que le névrosisme n’est pas un facteur pronostique de la sévérité du trouble panique, sous prétexte que le p-value n’atteint pas le seuil de significativité au sein de leur cohorte hospitalière restreinte. L’impossibilité de généraliser les relations observées d’un sous-groupe clinique à la population générale saine — où le continuum complet de variance permettrait d’observer une corrélation robuste — est l’un des facteurs majeurs de divergence entre les études cliniques institutionnelles et les grandes enquêtes épidémiologiques communautaires.
5.2 Effets de plancher et de plafond dans les instruments psychométriques
Dans la recherche cognitive et psychologique fondamentale, la restriction d’étendue ne procède pas toujours d’un filtre d’échantillonnage démographique externe ; elle est fréquemment engendrée de manière endogène par les propriétés psychométriques défectueuses des instruments de mesure eux-mêmes. On parle alors d’effet de plancher (floor effect) ou d’effet de plafond (ceiling effect).
Un effet de plafond se manifeste lorsqu’un test d’aptitude cognitive, un questionnaire d’évaluation scolaire ou une tâche de mémoire de travail s’avère d’une difficulté si faible que la majorité des participants obtiennent le score maximal théorique possible permis par l’échelle. Réciproquement, un effet de plancher survient lorsque l’épreuve est tellement ardue ou inadaptée à la population évaluée qu’une fraction massive des sujets s’agglutine au score minimal théorique (souvent le score zéro). Dans les deux cas, l’instrument de mesure agit comme une barrière mécanique rigide qui censure brutalement la distribution continue sous-jacente des aptitudes réelles des participants.
Cette saturation psychométrique détruit l’information discriminante aux extrémités de la distribution. Deux individus obtenant un score maximal parfait à une tâche cognitive peuvent en réalité posséder des capacités latentes considérablement divergentes que le test s’est avéré incapable de capturer. Lors de l’analyse statistique, la variance observée est artificiellement rabotée, comprimant drastiquement les corrélations reliant cette variable saturée à d’autres construits cognitifs. Une confusion méthodologique persistante consiste à interpréter cette faiblesse de corrélation comme une absence substantielle de lien psychologique entre les fonctions cognitives évaluées, alors qu’elle ne fait que trahir le calibrage inadéquat et le manque de pouvoir discriminant de l’outil de mesure.
5.3 Études sur les aptitudes cognitives et le quotient intellectuel chez les élites
L’un des débats les plus virulents de la psychologie différentielle contemporaine concerne la relation entre le quotient intellectuel (QI) et la créativité ou l’accomplissement professionnel exceptionnel chez les individus hautement doués. Depuis plusieurs décennies, de nombreuses publications avancent ce qui est communément dénommé l’hypothèse du seuil d’intelligence (proposée initialement par Ellis Paul Torrance), stipulant qu’au-delà d’un QI d’environ 120, la corrélation entre capacités intellectuelles générales et créativité s’éteindrait pour devenir statistiquement négligeable.
De même, il est fréquemment observé que la corrélation entre les scores de QI et la réussite académique au sein des promotions d’étudiants admis dans les grandes écoles scientifiques (comme Polytechnique ou les filières médicales sélectives) s’effondre comparativement aux corrélations observées dans les cohortes du secondaire. Des essayistes non statisticiens en concluent régulièrement que l’intelligence générale cesserait de prédire l’excellence dès lors que l’on atteint les strates supérieures du fonctionnement cognitif humain.
Pourtant, une analyse psychométrique rigoureuse démontre que cette « disparition » de la corrélation chez les élites intellectuelles constitue une illustration emblématique de restriction unilatérale sévère de la variance. Dans un échantillon d’élèves ingénieurs admis sur concours avec des seuils de QI mesurés systématiquement au-delà du 98e centile (QI moyen supérieur à 130 avec un écart-type résiduel très faible de 4 ou 5 points au lieu des 15 points habituels de la population générale), la variance de X est compressée de plus de 80 %. Lorsque l’on réapplique les équations de correction psychométriques rétablissant la distribution normale sans troncature, la relation entre facteur g et créativité ou accomplissement complexe réapparaît avec vigueur et constance le long de l’intégralité du spectre cognitif, infirmant l’hypothèse d’une rupture qualitative du fonctionnement intellectuel au sommet de la distribution.
6. Conséquences méthodologiques sur les méta-analyses contemporaines
6.1 L’artéfact statistique selon l’approche de Hunter et Schmidt
L’avènement des méthodes quantitatives d’agrégation de données au cours du dernier quart du XXe siècle a profondément révolutionné l’épistémologie des sciences comportementales. Sous l’impulsion pionnière de psychologues et méthodologistes tels que Frank L. Schmidt et John E. Hunter, la méta-analyse psychométrique s’est constituée en réponse à l’hétérogénéité conflictuelle inexplicable qui caractérisait alors les revues de littérature narrative.
Hunter et Schmidt ont démontré qu’une grande part de la variabilité observée entre les tailles d’effet rapportées par différentes études portant sur une question identique ne relevait nullement de modérateurs substantiels (tels que des différences culturelles, des nuances contextuelles d’entreprises ou des variations démographiques subtiles), mais résultait de l’action pernicieuse d’une série d’artéfacts statistiques méthodologiques. Parmi ces artéfacts délétères, l’erreur d’échantillonnage (liée à la taille modeste des échantillons individuels), l’infidélité de mesure des instruments et, précisément, la restriction d’étendue différentielle jouent les rôles de perturbateurs prédominants.
La théorie de la généralisation de la validité de Hunter et Schmidt postule qu’en l’absence de correction rigoureuse pour ces artéfacts statistiques, les méta-analyses conventionnelles se contentent de moyenner des indices fondamentalement incomparables et faussés dès leur origine. En développant des algorithmes formels permettant de purifier les estimations méta-analytiques de l’effet d’atténuation causé par la restriction de variance, ils ont pu établir que les vérités scientifiques en psychologie étaient beaucoup plus robustes, généralisables et invariantes qu’on ne le soupçonnait alors au milieu des années 1970.
6.2 Risques d’accumulation d’erreurs dans l’estimation de la taille d’effet
L’ignorance ou le traitement superficiel de la restriction d’étendue dans une synthèse quantitative expose la méta-analyse à un risque systémique d’accumulation et de propagation d’erreurs d’inférence. Si dix études primaires incluses dans une méta-analyse ont opéré des sélections d’échantillons avec des taux de coupure radicaux (par exemple, des ratios d’écart-type de u = 0,40), calculer une moyenne pondérée par la taille d’échantillon des corrélations de Pearson brutes produira une taille d’effet agrégée massivement sous-estimée. Cette sous-estimation collective ne fait que donner une illusion de robustesse et de précision mathématique accrue à une mesure fondamentalement déviée de la réalité ontologique.
De surcroît, le degré de restriction d’étendue fluctue de manière anarchique d’une étude primaire à l’autre au sein d’une même littérature empirique. Une équipe de chercheurs travaillant sur des ouvriers non qualifiés aura pu obtenir un échantillon à variance quasi normale, tandis qu’une autre équipe évaluant des gestionnaires de portefeuille aura interrogé une cohorte ultra-sélectionnée. Comparer directement les corrélations brutes de ces deux études sans standardiser préalablement leur étendue de variance respective génère une variance inter-études totalement artificielle, faussement interprétée par les analystes comme l’indice d’une hétérogénéité substantielle nécessitant l’introduction de modèles à effets aléatoires ou la quête de variables modératrices fantômes.
Ces controverses théoriques stériles encombrent durablement la littérature scientifique. Des décennies de débats passionnés sur la question de savoir si tel trait de personnalité n’opère que dans certains secteurs d’activité ou si l’intelligence générale perd son pouvoir prédictif dans certains métiers complexes trouvent souvent leur dénouement mathématique le plus limpide dès lors que les variances sous-jacentes des prédicteurs sont rigoureusement harmonisées d’une publication à l’autre.
6.3 Procédures d’ajustement global dans les synthèses quantitatives
Pour neutraliser ces distorsions systématiques dans les synthèses contemporaines de grande ampleur, les méta-analystes déploient des procédures d’ajustement statistique global standardisées. La méthode repose sur l’exploitation du paramètre u, défini comme le ratio de l’écart-type restreint de l’échantillon sur l’écart-type de la population sans sélection (u = s / σ). Lorsque les valeurs du ratio u sont rapportées dans les études primaires ou peuvent être inférées à partir de données normatives publiées, chaque corrélation individuelle ri fait l’objet d’une correction unitaire avant intégration au corpus global.
Lorsque les études primaires omettent de mentionner l’écart-type observé de leur échantillon restreint — omission hélas fréquente dans la littérature psychologique —, Hunter et Schmidt ont introduit la technique des distributions d’artéfacts. Cette procédure probabiliste compile les informations partielles disponibles sur les distributions du ratio u et de la fidélité de mesure observées dans un sous-ensemble d’études de référence représentatives. Les méta-analystes peuvent alors calculer la moyenne et la variance asymptotique des facteurs de correction d’artéfacts pour ajuster collectivement la distribution globale des corrélations observées.
Cette méthodologie sophistiquée permet non seulement d’estimer la corrélation opérationnelle moyenne corrigée (notée ρ̂), mais également de calculer des intervalles de crédibilité à 80 % ou 90 % (à ne pas confondre avec les simples intervalles de confiance autour de la moyenne). Les intervalles de crédibilité ajustés pour la restriction d’étendue fournissent aux chercheurs et décideurs publics une mesure empirique réaliste de l’étendue des tailles d’effet réelles dans la population générale, garantissant que les prises de décision managériales ou cliniques reposent sur des preuves quantitatives débarrassées des distorsions d’échantillonnage.
7. Formules classiques de correction : L’héritage de Karl Pearson
7.1 La formule univariée historique de Pearson (Cas II)
L’édifice mathématique de la correction pour restriction d’étendue repose sur l’article fondamental publié en 1903 par Karl Pearson dans les Philosophical Transactions of the Royal Society of London. Dans ce texte matriciel, Pearson résolut le problème de l’estimation de la corrélation non restreinte dans la population (notée RXY ou ρXY) à partir de la corrélation observée dans l’échantillon tronqué (notée rxy), dans le cas où la sélection s’est opérée de manière directe et univariée sur la variable prédictive X (le modèle historique dénommé Cas II de Pearson).
La formule analytique fermée déduite par Pearson s’articule autour du ratio d’écart-type, universellement désigné sous le symbole uX, défini par le rapport de la dispersion de l’échantillon restreint sur la dispersion de la population de référence non restreinte :
uX = sX / σX
À partir de cette métrique de compression de la variance, la relation mathématique exacte permettant de rétablir le coefficient de corrélation non restreint RXY s’exprime comme suit :
RXY = (rxy / uX) / √[1 + rxy² · ((1 / uX²) – 1)]
Une formulation algébrique alternative strictement équivalente, souvent privilégiée dans les manuels de psychométrie pour sa simplicité de calcul, s’écrit :
RXY = rxy · (σX / sX) / √[1 – rxy² + rxy² · (σX² / sX²)]
Pour illustrer la mécanique de cette équation : supposons qu’un test de sélection présente une corrélation observée modeste de rxy = 0,30 au sein d’une cohorte de candidats admis, mais que la sélectivité drastique du concours ait réduit l’écart-type de moitié par rapport à la population générale des postulants, ce qui donne uX = 0,50 (soit σX / sX = 2,0). En appliquant la formule de Pearson, le terme sous la racine carrée devient 1 – 0,09 + 0,09 · (4,0) = 0,91 + 0,36 = 1,27, dont la racine carrée est approximativement 1,127. Le numérateur étant égal à 0,30 · 2,0 = 0,60, le coefficient corrigé s’établit à RXY = 0,60 / 1,127 ≈ 0,532. La force réelle de la relation est donc de 0,53 et non de 0,30, soit une sous-estimation initiale de plus de 43 % de la magnitude de l’association.
7.2 Paramètres et conditions d’application de la correction
L’application rigoureuse de la formule univariée du Cas II de Pearson ne saurait être effectuée sans vérifier scrupuleusement le respect d’un ensemble d’hypothèses statistiques contraignantes. La validité de l’estimation ajustée dépend entièrement de la conformité des données empiriques à ces postulats théoriques fondamentaux.
En premier lieu, la méthode exige la disponibilité d’un paramètre de dispersion de référence fiable pour la population non restreinte (σX). Cette information doit obligatoirement provenir soit de la cohorte complète des candidats avant l’application du filtre sélectif, soit de manuels de standardisation psychométrique rigoureusement étalonnés sur la population cible générale. Toute approximation arbitraire ou erronée de la variance non restreinte biaise proportionnellement l’ajustement final du coefficient.
En second lieu, l’hypothèse de linéarité stricte de la régression de Y sur X sur l’ensemble de l’étendue des valeurs doit impérativement prévaloir. Si la relation sous-jacente est asymptotique, sigmoïde ou curviligne dans les zones non observées, la formule de Pearson extrapolera une relation linéaire fallacieuse, surestimant dramatiquement le coefficient populationnel.
En troisième lieu, la condition critique d’homoscédasticité postule que la variance conditionnelle des résidus d’erreur (σ²e) demeure parfaitement uniforme et constante sur l’intégralité du continuum théorique de X. Si l’erreur de mesure ou la dispersion de Y explose chez les sujets aux scores X très élevés ou très bas (hétéroscédasticité), l’invariance théorique de la pente de régression conditionnelle est violée, rendant l’équation mathématique du Cas II structurellement invalide.
7.3 Limites inhérentes aux formules univariées traditionnelles
Bien que mathématiquement élégante et d’une utilité historique indiscutable, la formule univariée originelle de Karl Pearson montre rapidement ses limites dans les contextes empiriques complexes contemporains. Sa première vulnérabilité réside dans son extrême sensibilité aux violations de l’hypothèse de normalité bivariée. Lorsque les distributions marginales s’écartent sensiblement de la loi de Gauss (présence d’asymétrie forte, de bimodalité ou de queues de distribution épaisses), la correction a tendance à dériver et peut fournir des valeurs ajustées incohérentes.
Par ailleurs, la formule univariée est structurellement incapable de traiter les mécanismes de sélection portant sur plusieurs variables simultanément ou les sélections séquentielles par étapes (hurdles). Dans un recrutement moderne, un candidat n’est presque jamais retenu sur la seule base d’un examen unique : il franchit une succession de filtres incluant des tests cognitifs, des entretiens de recrutement, des mises en situation et des contrôles de références. L’application mécanique de la formule univariée du Cas II de Pearson à un test isolé au sein d’un processus multi-filtres viole les prémisses du modèle et engendre des corrections erratiques.
Enfin, il existe un risque majeur d’instabilité numérique lorsque la taille de l’échantillon restreint observé est réduite et que l’erreur d’échantillonnage interagit avec le ratio de correction. Si le coefficient de corrélation observé rxy a été surestimé par un simple coup de chance probabiliste dans un échantillon de petite taille, l’application de la formule de Pearson va amplifier exponentiellement cet aléa d’échantillonnage, projetant parfois le coefficient ajusté à des niveaux stratosphériques, voire mathématiquement impossibles (coefficients excédant théoriquement 1,00), discréditant ainsi l’analyse aux yeux des praticiens.
8. Modèles avancés d’ajustement pour la restriction multivariée et non linéaire
8.1 La correction multivariée de Birnbaum et ses extensions
Face aux limites évidentes du modèle univarié classique pour modéliser des systèmes de sélection complexes, les statisticiens ont développé des extensions matricielles multivariées. Les travaux pionniers du statisticien Allan Birnbaum (1968), s’appuyant sur les théories d’invariance développées par D. N. Lawley dans les années 1940, ont donné naissance à ce que la littérature nomme couramment la correction de sélection multivariée de Lawley-Birnbaum.
Cette approche considère un vecteur complet de p variables prédictives et critères interdépendants noté Z = (X₁, X₂, …, Xk, Y₁, Y₂, …, Ym)T. Les variables soumises directement ou indirectement au mécanisme de filtrage sélectif sont regroupées au sein d’une sous-matrice explicite. Sous l’hypothèse générale de linéarité multivariée et d’homoscédasticité multivariée (invariance de la matrice de covariance résiduelle conditionnelle), l’algorithme de Lawley-Birnbaum permet de reconstruire l’intégralité de la matrice de covariance de la population non restreinte (notée Σ) à partir de la matrice de covariance observée dans l’échantillon restreint (notée S) et de la matrice de covariance connue des prédicteurs avant sélection (notée ΣXX).
L’équation matricielle fondamentale s’énonce selon le formalisme suivant :
Σ̂ = S + (S SXX⁻¹ – I) · (ΣXX – SXX) · (SXX⁻¹ S)
Grâce aux progrès de la puissance computationnelle et à l’intégration de ces algorithmes matriciels dans des packages spécialisés sous des environnements de programmation tels que R (par exemple le package psychmeta développé par Dahlke et Sackett), la correction multivariée est devenue accessible. Elle offre une robustesse sans précédent en intégrant simultanément les corrélations croisées entre de multiples prédicteurs et permet de résoudre avec élégance les cas épineux de restriction indirecte complexe.
8.2 Approches par modèles d’équations structurelles (SEM)
L’une des avancées méthodologiques contemporaines les plus remarquables pour neutraliser la restriction d’étendue réside dans la reconceptualisation de ce phénomène sous l’angle de la théorie des données manquantes. Dans le cadre de la modélisation par équations structurelles (SEM), la restriction d’étendue n’est plus envisagée comme une déformation déterministe irrémédiable de l’échantillon, mais comme un mécanisme de génération de données manquantes obéissant aux axiomes probabilistes de Donald Rubin.
Lorsque la sélection est opérée directement sur la variable prédictive X (Cas II de Pearson), les scores sur le critère Y sont absents pour les personnes non retenues. Toutefois, puisque la probabilité de non-observation de Y dépend exclusivement des valeurs d’une variable parfaitement observée pour tous (les scores X de l’ensemble des candidats initiaux), le mécanisme de données manquantes est rigoureusement qualifié de manquant au hasard (Missing At Random, ou MAR). Dès lors, l’utilisation de l’estimation par maximum de vraisemblance à information complète (Full Information Maximum Likelihood, FIML) au sein d’un modèle SEM permet d’estimer les paramètres structurels de population (moyennes, variances, covariances et régressions) sans aucun biais d’atténuation, sans avoir recours aux formules manuelles de correction de Pearson.
Cette approche par équations structurelles présente des avantages considérables sur les formules algébriques classiques. Elle permet de modéliser conjointement des construits latents débarrassés de l’erreur de mesure, de tester des hypothèses de médiation complexe sous sélection, et de contraindre l’estimation pour préserver l’invariance factorielle à travers différents sous-groupes démographiques. De surcroît, le FIML fournit automatiquement des erreurs-types asymptotiques correctes, éliminant les incertitudes chroniques qui entourent la précision des calculs d’erreurs standards dans les formules de correction manuelles traditionnelles.
8.3 Méthodes de rééchantillonnage et imputation multiple
Parallèlement aux modèles d’équations structurelles, les méthodes computationnelles modernes de rééchantillonnage non paramétrique et d’imputation stochastique offrent des alternatives précieuses pour gérer les restrictions d’étendue complexes, notamment en présence de violations caractérisées des hypothèses de normalité bivariée.
L’application des techniques de bootstrap (avec rééchantillonnage stratifié ou non) est devenue un standard indispensable pour construire des intervalles de confiance non paramétriques robustes autour des coefficients de corrélation corrigés pour la restriction d’étendue. Les formules analytiques traditionnelles d’erreur-type pour les corrélations corrigées sont notoirement réputées pour leur complexité et leur instabilité asymptotique. En appliquant la procédure de correction de Pearson ou de Lawley-Birnbaum à plusieurs milliers d’échantillons générés par rééchantillonnage avec remise (bootstrap percentiles ou BCa), les chercheurs peuvent dériver des intervalles de confiance asymétriques reflétant fidèlement l’incertitude statistique sans dépendre d’hypothèses gaussiennes rigides.
D’autre part, les techniques d’imputation multiple par équations chaînées (Multiple Imputation by Chained Equations, MICE) permettent de combler stochastiquement les valeurs tronquées ou censurées de la variable critère chez les individus non sélectionnés. En exploitant l’ensemble de l’information auxiliaire disponible dans les dossiers administratifs initiaux (données socio-démographiques, notes d’examens antérieurs, réponses à d’autres épreuves), l’imputation multiple génère une série de jeux de données complets synthétiques reproduisant l’hétérogénéité naturelle de la population. L’analyse corrélationnelle est ensuite déployée de manière classique sur chaque jeu de données imputé, avant que les résultats ne soient combinés selon les règles d’agrégation formelles de Rubin, préservant la validité externe des conclusions scientifiques.
9. Facteurs confondants : Interaction entre fidélité du test et restriction d’étendue
9.1 La double atténuation : combinaison d’erreur de mesure et de restriction
Dans l’univers concret de l’évaluation psychologique et de la recherche empirique, la restriction d’étendue n’opère jamais de manière isolée. Elle interagit de manière synergique et cumulative avec un autre artéfact statistique omniprésent dans les sciences comportementales : l’erreur de mesure aléatoire, dont la magnitude est quantifiée à travers le concept psychométrique de fidélité (reliability).
La théorie classique des tests (TCT) postule que tout score observé X est la sommation linéaire d’un score vrai T et d’un score d’erreur aléatoire indépendant E (X = T + E). La présence de cette erreur de mesure aléatoire atténue systématiquement la corrélation observable entre deux variables par rapport à la corrélation théorique unissant leurs scores vrais respectifs, un phénomène formalisé dès 1904 par Charles Spearman sous le nom de formule d’atténuation : rXY = rTXTY · √(rxx · ryy), où rxx et ryy représentent les coefficients de fidélité des deux instruments.
Lorsque l’infidélité des instruments s’entremêle à une restriction sévère de la variance échantillonnale, les chercheurs se trouvent confrontés au phénomène de la double atténuation. L’erreur de mesure compresse initialement l’association au dénominateur par le bruit aléatoire, tandis que le processus sélectif d’échantillonnage compresse ensuite la dispersion observable sur le terrain. Le résultat de cette cascade de biais est souvent catastrophique pour la visibilité empirique des construits théoriques : une relation ontologique majeure de magnitude ρvrai = 0,70 unissant deux aptitudes psychologiques fondamentales dans la population générale peut aisément se dégrader, sous l’effet conjugué d’une fidélité imparfaite (par exemple rxx = 0,70, ryy = 0,60) et d’une sélection modérée (u = 0,60), pour n’apparaître sous forme de corrélation observée brute qu’à une valeur dérisoire de robs = 0,22.
Il est donc impératif de distinguer rigoureusement trois niveaux hiérarchiques de validité dans tout rapport scientifique : la validité observée brute (faussée à la fois par la restriction et la double infidélité), la validité opérationnelle (corrigée pour la restriction d’étendue et l’infidélité de la variable critère, utile pour comparer concrètement des tests imparfaits dans des contextes de sélection réels), et la validité théorique pure des scores vrais (corrigée pour la restriction d’étendue et la double infidélité des deux variables, indispensable pour la modélisation conceptuelle en psychologie fondamentale).
9.2 Ordre logique et hiérarchique des corrections statistiques
L’existence conjointe de l’infidélité de mesure et de la restriction d’étendue soulève un dilemme méthodologique qui a divisé la communauté psychométrique durant des décennies : dans quel ordre séquentiel précis convient-il d’appliquer les corrections statistiques ? Faut-il corriger d’abord le coefficient de corrélation observé pour l’infidélité de mesure (formule de Spearman) puis ajuster pour la restriction d’étendue (formule de Pearson), ou l’ordre inverse doit-il être impérativement prescrit ?
Les démonstrations mathématiques formelles apportées notamment par Frank Schmidt, John Hunter et leurs collègues ont établi de manière catégorique que le résultat numérique final dépend directement de la séquence retenue, et qu’une séquence inappropriée induit des erreurs systématiques de surévaluation ou de sous-estimation. L’ordre mathématiquement et logiquement correct dépend de la façon dont les coefficients de fidélité disponibles ont été évalués.
Le consensus méthodologique contemporain, entériné par les standards de l’American Psychological Association (APA), stipule la démarche séquentielle suivante dans le cas standard de sélection du personnel :
- Si le coefficient de fidélité du prédicteur rxx a été mesuré avant sélection au sein de la population générale candidate non restreinte, il convient d’appliquer en premier lieu la correction de Pearson pour la restriction d’étendue sur le coefficient de corrélation brut observé, en utilisant l’écart-type de cette population de référence.
- Puis, dans un second temps, le coefficient de corrélation ajusté pour l’étendue est corrigé pour l’infidélité du critère (et de manière optionnelle pour l’infidélité du prédicteur selon l’objectif théorique ou opérationnel poursuivi).
- À l’inverse, si l’indice de fidélité a été mesuré directement au sein de l’échantillon restreint sélectionné, la consistance interne observée s’avère elle-même biaisée par la troncature de variance, imposant un ajustement préalable de la fidélité elle-même avant toute tentative de désatténuation. L’inversion aveugle de ces étapes fondamentales sans traçabilité de l’origine distributionnelle des indices de fidélité aboutit régulièrement à des anomalies numériques aberrantes.
9.3 Impact direct de la restriction sur l’estimation de la fidélité elle-même
L’un des aspects les plus pernicieux de l’interaction entre fidélité et variabilité réside dans le fait que les coefficients de fidélité psychométriques — au premier rang desquels figure le célébrissime coefficient alpha de Cronbach ou les coefficients de fidélité par test-retest — ne constituent pas des propriétés intrinsèques, absolues et immuables d’un instrument d’évaluation. La fidélité est, par construction mathématique, une propriété conjointe d’un instrument et d’une population spécifique caractérisée par une variance donnée.
La formule fondamentale de l’alpha de Cronbach repose sur le rapport entre la somme des variances des items individuels et la variance totale du test composé :
α = (k / [k – 1]) · [1 – (∑ σ²item_i / σ²total)]
Lorsque la population étudiée est soumise à une restriction d’étendue sévère, la variance totale du test σ²total au dénominateur s’effondre dramatiquement, alors que les variances résiduelles d’erreurs individuelles des items demeurent comparativement stables. En conséquence immédiate, la valeur du coefficient alpha de Cronbach diminue mécaniquement au sein d’un groupe homogène restreint. Un test psychométrique d’une remarquable consistance interne affichant un α = 0,90 au sein de la population générale verra son coefficient chuter à α = 0,65 si on l’administre exclusivement à un sous-groupe ultra-spécialisé dont la variance est divisée par trois.
Pour prévenir des conclusions calomnieuses concluant à tort à la « dégradation métrologique » ou à « l’inconsistance » d’un test chez les groupes restreints, la psychométrie classique met à disposition une formule de correction d’ajustement de la fidélité en fonction de l’écart-type de référence :
rXX_corrigé = 1 – [(σ²non_restreinte / s²restreinte) · (1 – rxx_observé)]
Ignorer cette dynamique conduit nombre de chercheurs à rejeter des instruments standardisés pourtant parfaitement fidèles pour la population générale, au motif erroné que leur consistance interne empirique semble défaillante dans leurs échantillons cliniques ou académiques spécifiques.
10. Détection et diagnostic de la restriction d’étendue dans un jeu de données
10.1 Évaluation comparative des indices de dispersion
Face à un jeu de données empirique dont les mécanismes d’échantillonnage sont potentiellement compromis par des filtres explicites ou insidieux, l’analyste méthodologiste doit déployer un véritable protocole de diagnostic statistique avant toute interprétation corrélationnelle. Le premier jalon de cet audit consiste en l’évaluation comparative systématique des indices de dispersion.
La métrique diagnostique fondamentale à documenter de manière prioritaire est le ratio d’écart-type, conventionnellement désigné par u :
u = séchantillon / σnormatif
Dans les guides pratiques de psychométrie, des seuils empiriques indicatifs sont couramment adoptés pour qualifier la sévérité du phénomène :
- Restriction légère (u ∈ [0,80 ; 0,99]) : La variabilité échantillonnale conserve l’essentiel de sa dynamique originale ; les corrélations observées sont marginalement atténuées, mais les conclusions qualitatives d’une étude demeurent généralement fiables.
- Restriction modérée (u ∈ [0,50 ; 0,79]) : Phénomène courant dans les recrutements universitaires ou professionnels sélectifs standards ; l’atténuation est sensible et requiert impérativement un rapportage méthodologique explicite doublé d’une estimation corrigée.
- Restriction sévère (u < 0,50) : Contexte d’hyper-sélection (admission dans les filières d’excellence, recrutement des cadres dirigeants, unités militaires spéciales) ; les corrélations observées sont presque réduites à néant et toute inférence brute devient purement trompeuse.
Au-delà du simple ratio d’écart-type, le diagnostic exige l’examen approfondi des moments d’ordre supérieur de la distribution empirique, notamment les coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis). Une distribution théoriquement normale qui présente dans l’échantillon un aplatissement anomalement tronqué du côté gauche avec une coupure nette (asymétrie positive brutale) trahit indubitablement un mécanisme de censure ou de sélection unilatérale artificielle.
10.2 Techniques graphiques et visuelles de diagnostic
L’exploration visuelle constitue un complément indispensable à la simple inspection des indicateurs numériques synthétiques. Les outils graphiques modernes permettent de démasquer instantanément la présence de seuils de coupure stricts dissimulés ou de discontinuités distributionnelles majeures.
En premier lieu, l’inspection visuelle du diagramme de dispersion (scatterplot) bivarié offre des indices topologiques flagrants. Lorsqu’une restriction directe s’applique sur l’axe des X, le nuage de points s’arrête brusquement le long d’une ligne verticale perpendiculaire infranchissable, sans aucune transition progressive vers les scores plus faibles. En cas de restriction indirecte médiée par une variable tierce Z, le nuage de points adopte souvent une géométrie caractéristique en cône ou en fer de lance dissymétrique, révélant une sélection conjointe non linéaire masquée.
En second lieu, l’analyse comparative des graphiques quantile-quantile (Q-Q plots) permet de confronter la distribution empirique des résidus standardisés à la droite théorique de normalité gaussienne. La présence d’une déviation horizontale brutale à l’une des extrémités du diagramme Q-Q signale immédiatement une troncature sévère des quantiles extrêmes.
Enfin, la superposition graphique des courbes de densité de probabilité (via l’estimation par noyau de densité, Kernel Density Estimation) de l’échantillon étudié face à la courbe de Gauss de la population normative mère met en scène de manière lumineuse la perte substantielle de variance. Elle permet de visualiser l’amplitude géométrique du volume d’individus disparus sous l’action du filtre sélectif.
10.3 Audit des mécanismes d’attrition et de sélection d’échantillon
La détection de la restriction d’étendue ne saurait se cantonner à des examens statistiques purement a posteriori. Elle doit s’enraciner dans un audit méthodologique qualitatif exhaustif de l’ensemble du cycle de vie des données, depuis la conception du protocole jusqu’à l’enregistrement final des observations.
Cet audit impose de cartographier rigoureusement chaque étape de filtrage successif, en construisant ce que les standards épidémiologiques CONSORT nomment un diagramme de flux d’inclusion des participants. Combien d’individus ont manifesté leur intérêt initial ? Combien ont été éliminés pour non-respect des critères administratifs ? Combien ont échoué aux pré-tests d’admissibilité ? Combien de sujets inclus ont prématurément abandonné le protocole lors du suivi longitudinal (attrition) ?
Il est fondamental de soumettre à une comparaison systématique les caractéristiques démographiques et psychométriques initiales des participants retenus et de ceux ayant été écartés. Si les individus qui abandonnent une étude ou qui sont éliminés par un filtre d’admission affichent des différences statistiquement significatives sur des variables collatérales (âge, niveau d’éducation, stabilité émotionnelle, capacités cognitives de base), le chercheur a la certitude méthodologique formelle qu’une restriction indirecte multivariée est activement à l’œuvre. Cette cartographie d’audit permet d’identifier formellement les variables masquées Z indispensables à la construction ultérieure d’un modèle d’ajustement multivarié ou d’un modèle d’équations structurelles corrigé.
11. Études de cas empiriques appliquées en psychologie
11.1 Cas 1 : Prédiction des performances universitaires par les tests standardisés
L’une des illustrations les plus emblématiques et documentées de la restriction d’étendue dans la littérature académique concerne l’utilisation des tests standardisés d’admission aux États-Unis — tels que le SAT (Scholastic Assessment Test) ou le GRE (Graduate Record Examinations) — pour prédire la réussite universitaire matérialisée par la moyenne cumulative des notes (Grade Point Average, ou GPA).
Dans de nombreuses universités d’élite particulièrement sélectives (appartenant par exemple à l’Ivy League), les comités pédagogiques et les chercheurs en sciences de l’éducation ont périodiquement fait état de corrélations observées étonnamment faibles, fluctuant souvent entre r = 0,15 et 0,25, entre les scores SAT obtenus par les étudiants au lycée et leur GPA final à l’université. Ces résultats ont alimenté de vives polémiques publiques, certains acteurs affirmant que le SAT ne possédait aucune valeur prédictive substantielle et devait être banni des procédures d’admission.
Une étude psychométrique historique menée par l’Educational Testing Service (ETS) a permis de déconstruire cette illusion statistique en documentant rigoureusement la restriction de variance. Alors que l’écart-type du SAT dans la population générale nationale des lycéens candidats est d’environ σ = 200 points par section, l’écart-type observé chez les étudiants effectivement admis dans ces universités d’élite est souvent compressé à s = 60 voire 50 points, ce qui correspond à un ratio de restriction drastique de u ≈ 0,25 à 0,30. En intégrant ces paramètres dans la formule de correction du Cas II de Pearson et en ajustant pour la fidélité imparfaite des notations professorales du GPA, la corrélation réelle réévaluée dans la population complète des postulants remonte à un niveau compris entre R = 0,55 et 0,62, confirmant que le SAT est un prédicteur robuste et puissant de la réussite académique globale.
11.2 Cas 2 : Évaluation des traits de personnalité (Big Five) chez les cadres supérieurs
Dans le domaine de l’évaluation des compétences managériales, l’analyse de la relation entre les traits de personnalité du modèle des Big Five — et singulièrement la Conscience (caractérisée par l’organisation, la persévérance et le sens du devoir) — et l’efficacité des cadres supérieurs de direction (C-level executives) se heurte à des distorsions empiriques remarquables.
Lorsqu’un cabinet de conseil administre des inventaires de personnalité validés (tels que le NEO-PI-R) à un groupe de directeurs généraux en poste dans de grandes multinationales et corrèle ces profils avec les performances financières ou organisationnelles de leurs divisions, le coefficient de corrélation linéaire observé pour le trait de Conscience s’avère fréquemment proche de zéro (par exemple r = 0,08, non significatif). La conclusion hâtive consisterait à professer que la conscience professionnelle n’a aucune importance pour diriger une organisation complexe.
La réalité sous-jacente est que nul ne parvient au sommet de la pyramide d’une multinationale sans avoir fait la démonstration, durant vingt ou trente ans d’une trajectoire professionnelle hyper-compétitive, d’une conscience professionnelle, d’une capacité de travail et d’une rigueur exceptionnelles. Il existe donc une sélection implicite cumulative sur ce trait tout au long de la carrière, opérant une restriction indirecte massive. La quasi-totalité des dirigeants interrogés affichent des scores situés au-delà du 90e centile de la population générale, avec une variance échantillonnale infinitésimale. Lorsque l’on applique les corrections matricielles de Birnbaum en réintégrant la variance normative de la population adulte salariée, la validité prédictive du trait de Conscience se réaffirme autour d’une valeur substantielle (R ≈ 0,32), démontrant qu’il s’agit bel et bien d’une condition préalable indispensable à l’accession et au maintien dans les fonctions d’encadrement supérieur.
11.3 Cas 3 : Efficacité d’interventions thérapeutiques dans des cohortes ciblées
Le troisième cas d’application clinique illustre comment la restriction d’étendue peut compromettre l’évaluation de protocoles de psychothérapie dans le traitement des troubles de l’humeur. Considérons un essai contrôlé randomisé conçu pour étudier la relation dose-réponse unissant le nombre de séances de thérapie cognitive et comportementale (TCC) et le pourcentage de réduction des symptômes dépressifs chez des patients souffrant d’un trouble dépressif caractérisé.
Pour des impératifs éthiques de sécurité et d’homogénéité du protocole, l’équipe hospitalière décide d’exclure les patients présentant des formes dépressives légères ou subcliniques (jugées non prioritaires), ainsi que les dépressions ultra-sévères avec risque suicidaire imminent nécessitant une prise en charge médicamenteuse lourde en milieu fermé. L’échantillon final de l’étude ne conserve que les patients situés dans un créneau clinique intermédiaire très étroit (scores compris entre 18 et 25 sur l’échelle de dépression de Beck).
L’analyse des données de l’essai révèle une corrélation remarquablement faible (r = 0,12) entre la dose de séances délivrées et la magnitude de l’amélioration clinique au sein de ce groupe sélectionné. Cette observation erronée conduit initialement les chercheurs à douter de la rentabilité de prolonger les prises en charge au-delà d’un forfait thérapeutique minimal. Cependant, la modélisation ultérieure incorporant l’ensemble du continuum psychopathologique — incluant les cohortes de dépressions légères et sévères suivies en médecine de ville — révèle que la restriction d’étendue avait effondré le coefficient d’efficacité thérapeutique. En restaurant l’amplitude naturelle du critère, la relation dose-réponse réelle démontre une forte progressivité (R = 0,46), validant pleinement la pertinence clinique de moduler l’intensité des protocoles thérapeutiques en fonction de l’évolution longitudinale des patients.
12. Recommandations pratiques pour les chercheurs et praticiens en psychologie
12.1 Bonnes pratiques lors de la phase de conception de la recherche
La méthode la plus élégante et la plus efficiente pour traiter la restriction d’étendue consiste à prévenir son émergence dès la conception architecturale du protocole d’investigation. Si des contraintes matérielles ou institutionnelles imposent inévitablement des filtres de sélection, une démarche méthodologique rigoureuse et proactive permet d’en minimiser radicalement les impacts délétères sur la qualité des inférences statistiques futures.
En tout premier lieu, les chercheurs doivent diversifier délibérément leurs canaux d’échantillonnage. Plutôt que de recruter exclusivement au sein d’une institution d’élite ou d’un centre hospitalier hautement spécialisé, il convient de concevoir des protocoles d’échantillonnage multicentriques englobant des populations diversifiées (entreprises de secteurs variés, universités aux critères d’admission hétérogènes, patientèles de médecine générale ou échantillons communautaires sains). L’objectif explicite doit être de préserver la représentativité maximale de la variabilité naturelle des construits étudiés.
En second lieu, lorsqu’un protocole de sélection formel est inévitable (par exemple dans le cadre d’un audit de recrutement organisationnel), les praticiens doivent instaurer pour règle méthodologique absolue de collecter, archiver et coder rigoureusement l’ensemble des données de pré-sélection de tous les postulants initiaux, y compris — et surtout — des candidats qui sont finalement refusés. Conserver ces matrices de données complètes avant troncature est la condition sine qua non permettant ultérieurement aux biostatisticiens et psychométriciens de calculer des ratios de restriction exacts et d’appliquer avec certitude les modèles d’ajustement multivariés ou les estimateurs FIML.
En troisième lieu, le choix des instruments de mesure doit être guidé par une exigence métrologique de couverture spectrale adaptée. Les chercheurs doivent sélectionner des tests psychométriques dotés d’une profondeur d’échelle suffisante pour éradiquer les effets de plancher ou de plafond. L’utilisation de tests adaptatifs informatisés (CAT) basés sur les modèles de la théorie de réponse aux items (TRI) permet précisément d’ajuster dynamiquement la difficulté des items au niveau de chaque participant, assurant ainsi une précision de mesure et une conservation de la variance sur l’ensemble du continuum latent.
12.2 Transparence méthodologique et exigences de publication
L’assainissement de la littérature scientifique en sciences humaines et comportementales face aux ravages de la restriction d’étendue passe inéluctablement par un durcissement des exigences de transparence lors de la rédaction et de l’évaluation par les pairs des articles soumis aux revues académiques. L’omission des indices de dispersion descriptive constitue une faute méthodologique majeure qui empêche tout lecteur averti ou méta-analyste d’évaluer la portée réelle d’une découverte.
Les recommandations contemporaines imposent le respect d’une grille de divulgation systématique des paramètres suivants :
- Rapportage exhaustif des moyennes et écarts-types : Publier obligatoirement les moyennes arithmétiques et les écarts-types observés pour toutes les variables étudiées au sein de l’échantillon d’analyse final, ainsi que ceux de la population de référence si ces données sont accessibles dans des manuels normatifs étalonnés.
- Divulgation systématique du ratio u : Documenter explicitement le ratio de dispersion calculé ou estimé (u = s / σ) pour chaque variable sous-jacente au modèle corrélationnel ou de régression, en justifiant méthodologiquement le choix du groupe de référence ayant servi d’ancrage normatif.
- Double présentation des résultats statistiques : Présenter systématiquement dans les tableaux de synthèse à la fois les coefficients de corrélation empiriques bruts non corrigés et les coefficients de validité corrigés selon les équations formelles de Pearson, Hunter-Schmidt ou Lawley-Birnbaum, assortis de leurs intervalles de confiance ou de crédibilité respectifs.
Cette transparence dans le rapportage scientifique permet de démystifier les variations de magnitude des tailles d’effet entre publications et d’alimenter avec des données saines et exploitables les futures synthèses quantitatives internationales.
12.3 Prudence interprétative et garde-fous statistiques
Si la correction mathématique de la restriction d’étendue est un devoir déontologique pour qui manipule des échantillons sélectionnés, elle ne doit en aucun cas se muer en un réflexe mécanique dogmatique affranchi de tout esprit critique. L’application indiscriminée d’équations statistiques d’ajustement sans vérification des fondements théoriques et des conditions de régularité peut générer des artéfacts inverses tout aussi trompeurs que le biais qu’elle ambitionne de combattre.
Le praticien et le chercheur doivent se doter d’une série de garde-fous méthodologiques rigides :
- Éviter les surcorrections mathématiques aberrantes : Lorsque l’échantillon restreint est de petite taille (N < 50) et que le ratio de restriction est extrême (u < 0,35), les formules d’ajustement amplifient considérablement l’erreur d’échantillonnage initiale. Si le coefficient de corrélation observé brut a été gonflé par un aléa d’échantillonnage fortuit, l’ajustement peut conduire à des corrélations aberrantes supérieures à 1,00. Une correction mathématique qui aboutit à une valeur hors de l’intervalle canonique [-1,00 ; +1,00] est l’indice indiscutable que les hypothèses distributionnelles du modèle (normalité bivariée, homoscédasticité ou linéarité) ont été profondément violées.
- Évaluer la plausibilité écologique substantielle : Tout coefficient corrigé doit être jaugé à l’aune du bon sens théorique et des connaissances accumulées dans la littérature du domaine. Une méthode de sélection qui semble miraculeusement acquérir une validité corrigée de R = 0,90 en psychologie sociale doit éveiller la suspicion la plus vive quant à la pertinence des variances normatives choisies pour opérer le calcul.
- Reconnaître les situations d’inapplicabilité : Il existe des configurations méthodologiques où les données manquantes dues à la restriction sont dites « manquantes de manière non ignorables » (Missing Not At Random, MNAR), par exemple lorsque l’attrition d’un échantillon dépend directement d’une variable inobservée que le protocole n’a jamais mesurée sous aucune forme. Dans ces contextes opaques, aucune formule classique de Pearson ou algorithme FIML ne peut restaurer miraculeusement la variance originale. La prudence épistémologique la plus élémentaire commande alors d’admettre humblement les limites de généralisation de l’échantillon plutôt que d’ériger des échafaudages mathématiques illusoires sur des sables mouvants méthodologiques.
Références
- Birnbaum, A. (1968). Some latent trait models and their use in inferring an examinee’s ability. In F. M. Lord & M. R. Novick (Eds.), Statistical theories of mental test scores (pp. 397-479). Addison-Wesley.
- Brogden, H. E. (1949). When testing pays off. Personnel Psychology, 2(2), 171-183. https://doi.org/10.1111/j.1744-6570.1949.tb01397.x
- Cronbach, L. J., & Gleser, G. C. (1965). Psychological tests and personnel decisions (2nd ed.). University of Illinois Press.
- Dahlke, J. A., & Wiernik, B. M. (2020). psychmeta: An R package for psychometric meta-analysis. Applied Psychological Measurement, 44(8), 615-616. https://doi.org/10.1177/0146621619885652
- Hunter, J. E., Schmidt, F. L., & Le, H. (2006). Implications of direct and indirect range restriction for meta-analysis methods and findings. Journal of Applied Psychology, 91(3), 594-606. https://doi.org/10.1037/0021-9010.91.3.594
- Lawley, D. N. (1943). A method of estimating the variance of a test when the test is truncated. Psychometrika, 8(4), 221-224. https://doi.org/10.1007/BF02288701
- Pearson, K. (1903). Mathematical contributions to the theory of evolution.—XI. On the influence of natural selection on the variability and correlation of organs. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 200, 1-66. https://doi.org/10.1098/rsta.1903.0001
- Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581-592. https://doi.org/10.1093/biomet/63.3.581
- Sackett, P. R., & Yang, H. (2000). Correction for range restriction: An expanded typology. Journal of Applied Psychology, 85(1), 112-118. https://doi.org/10.1037/0021-9010.85.1.112
- Schmidt, F. L., & Hunter, J. E. (2015). Methods of meta-analysis: Correcting error and bias in research findings (3rd ed.). SAGE Publications.
- Thorndike, R. L. (1949). Personnel selection: Test and measurement techniques. John Wiley & Sons.