
Dans le domaine de l’analyse numérique, de la modélisation stochastique et de la conception de plans d’expériences informatiques, la représentativité spatiale des échantillons constitue un défi fondamental. Lorsque des chercheurs et des ingénieurs cherchent à sonder les comportements de systèmes dynamiques hautement non linéaires ou à calibrer des architectures computationnelles complexes, la simple force brute du calcul se heurte inévitablement à des contraintes budgétaires rigoureuses. Évaluer une fonction de réponse peut nécessiter plusieurs heures, voire plusieurs jours de calcul sur des grappes de processeurs à haute performance. Dès lors, le choix de la méthode d’échantillonnage ne relève pas d’une simple décision technique périphérique, mais d’une stratégie méthodologique déterminante conditionnant la validité des inférences statistiques ultérieures.
L’échantillonnage par hypercube latin (connu sous l’acronyme anglophone Latin Hypercube Sampling ou LHS) s’est imposé depuis sa formalisation à la fin des années 1970 comme l’une des approches les plus élégantes et efficientes pour résoudre ce dilemme. En combinant la rigueur structurelle de la stratification multidimensionnelle à la flexibilité exploratoire du tirage pseudo-aléatoire, cette méthodologie permet de maximiser l’information extraite d’un nombre restreint d’itérations. Contrairement aux approches traditionnelles qui laissent le hasard pur créer des zones d’agglomération redondantes et des déserts informationnels au sein de l’espace des paramètres, l’hypercube latin applique une contrainte combinatoire stricte garantissant qu’aucune dimension marginale n’est sous-représentée ou négligée.
Le présent article propose une exploration encyclopédique et approfondie de l’échantillonnage par hypercube latin. En partant de sa genèse historique et de ses fondements mathématiques rigoureux, nous détaillerons son mécanisme algorithmique, ses variantes optimisées, ses propriétés fondamentales de réduction de la variance, ainsi que ses multiples implémentations logicielles. Une attention toute particulière sera portée à ses applications contemporaines dans des domaines à haute complexité paramétrique, notamment la psychométrie computationnelle, les neurosciences cognitives et l’analyse de sensibilité globale.
1. Introduction et fondements conceptuels de l’échantillonnage par hypercube latin
1.1 Genèse historique et définition formelle
L’échantillonnage par hypercube latin a été formellement introduit dans la littérature scientifique en 1979 par trois statisticiens américains : Michael D. McKay, Richard J. Beckman et William J. Conover, dans leur publication séminale parue au sein de la revue Technometrics. Travaillant en collaboration étroite avec le Laboratoire national de Los Alamos, ces chercheurs étaient confrontés à la nécessité d’estimer les distributions de sortie de modèles thermo-hydrauliques et nucléaires particulièrement lourds, pour lesquels chaque évaluation numérique exigeait un temps de calcul considérable. La méthode standard de Monte Carlo se révélait dramatiquement inefficace en raison de son taux de convergence lent et de sa tendance structurelle à agréger involontairement des points dans certaines sous-régions tout en laissant de vastes zones inexplorées.
Sur le plan formel, l’échantillonnage par hypercube latin se définit comme une généralisation multidimensionnelle de l’échantillonnage stratifié. Son principe fondamental consiste à garantir que l’ensemble du domaine de variation de chaque variable d’entrée est partitionné en intervalles d’égale probabilité, et que chaque intervalle marginal ne reçoit exactement qu’une seule observation. Cette contrainte transforme radicalement la nature probabiliste de l’échantillon : il ne s’agit plus d’un tirage purement indépendant et identiquement distribué, mais d’un processus stochastique contraint où la sélection de chaque point dépend de la grille de discrétisation préalablement définie sur les marges.
D’un point de vue épistémologique, le LHS opère une distinction cruciale entre l’aléatoire pur, souvent synonyme d’inhomogénéité spatiale à faible effectif, et un échantillonnage pseudo-aléatoire contrôlé. Dans le cadre de l’optimisation des plans d’expériences numériques, également désignés sous le terme de Design of Computer Experiments (DoCE), le LHS s’est établi comme le socle incontournable permettant d’alimenter les surfaces de réponse, les émulateurs gaussiens et les analyses de sensibilité globale, transformant l’exploration computationnelle en une démarche économe et statistiquement robuste.
1.2 L’analogie bidimensionnelle du carré latin
Pour appréhender l’intuition géométrique qui sous-tend l’hypercube latin, il convient de se référer au concept mathématique plus ancien de carré latin, théorisé au XVIIIe siècle par le mathématicien suisse Leonhard Euler. En combinatoire, un carré latin d’ordre $N$ est une grille matricielle carrée de dimensions $N \times N$ remplie de $N$ symboles distincts de telle sorte que chaque symbole apparaisse exactement une fois sur chaque ligne et exactement une fois sur chaque colonne. Cette propriété d’orthogonalité marginale garantit un équilibre parfait de la distribution des symboles dans les deux dimensions de l’espace matriciel.
Transposée au domaine spatial et probabiliste de l’échantillonnage, cette configuration trouve une illustration classique dans le problème combinatoire du placement de tours sur un échiquier : comment positionner $N$ tours sur un échiquier de taille $N \times N$ sans qu’aucune tour ne puisse en capturer une autre ? La réponse impose que chaque rangée horizontale et chaque colonne verticale ne contienne qu’une et une seule tour. Dans le cadre d’un échantillon par carré latin à deux variables continues, l’espace bidimensionnel $[0,1]^2$ est découpé en une grille de $N \times N$ cellules de probabilités marginales uniformes, et $N$ points d’échantillonnage sont positionnés de sorte qu’il n’y ait qu’un seul point par tranche horizontale et un seul point par tranche verticale.
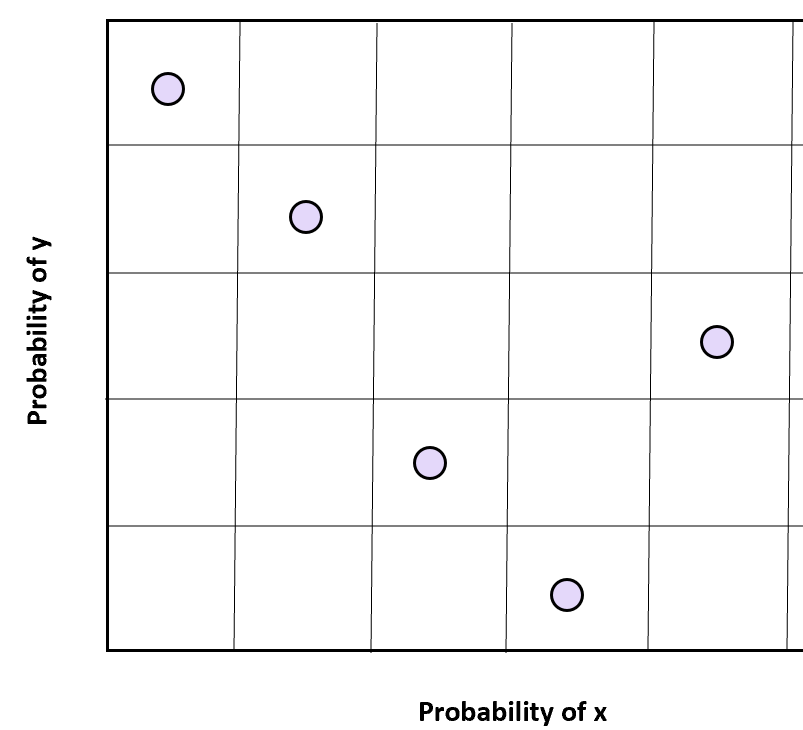
Cette condition assure une double propriété : une équiprobabilité spatiale sur le plan continu et une indépendance marginale stricte de la couverture. Lorsque le nombre de variables dépasse deux, l’échiquier se métamorphose géométriquement en un espace vectoriel à $d$ dimensions. Le carré latin devient alors un hypercube latin au sein de l’espace $[0,1]^d$. La condition fondamentale demeure inchangée : si l’on projette l’ensemble des $N$ points multidimensionnels sur n’importe lequel des $d$ axes de coordonnées, la projection révèle exactement un point dans chacun des $N$ intervalles définis sur cet axe particulier.
1.3 Objectifs primordiaux dans la recherche quantitative
L’objectif cardinal de l’échantillonnage par hypercube latin dans la recherche scientifique quantitative réside dans la maximisation de la couverture de l’espace d’état sous contrainte d’un budget computationnel restreint. Dans de nombreux champs disciplinaires, de la dynamique des fluides computationnelle aux modèles économétriques d’équilibre général, la fonction de transfert reliant les paramètres d’entrée aux variables d’intérêt ne dispose d’aucune expression analytique close. Elle prend la forme d’une boîte noire algorithmique coûteuse. Le chercheur doit donc sonder cet espace avec un nombre d’évaluations aussi réduit que possible tout en s’assurant qu’aucun pan du comportement du système ne demeure dissimulé.
Un autre avantage majeur réside dans l’élimination systématique du phénomène d’agglomération spatiale, fréquemment désigné par le terme de clustering, inhérent au tirage aléatoire simple. Par la simple loi des séries, un tirage de type Monte Carlo classique tend à grouper arbitrairement certains points dans des voisinages étroits, induisant une redondance analytique inutile, tout en laissant subsister d’immenses lacunes informatives. L’hypercube latin prévient structurellement cette redondance en forçant la dispersion des observations le long de chaque dimension du problème.
Enfin, cette garantie de non-redondance sur les axes marginaux s’avère particulièrement précieuse lorsque le modèle analysé possède une dimensionnalité effective faible. Si, parmi les vingt variables d’entrée intégrées dans une simulation, seules deux ou trois gouvernent l’essentiel de la variance de la réponse, le plan d’échantillonnage LHS projeté sur ce sous-espace critique préserve une représentativité quasi optimale. À l’inverse, un plan factoriel complet aurait gaspillé des milliers d’évaluations à tester des combinaisons stériles de facteurs inertes, tandis qu’un tirage aléatoire pur aurait produit une dispersion chaotique.
2. Principes mathématiques et formulation probabiliste
2.1 Partitionnement de l’espace probabiliste
La formulation mathématique rigoureuse de l’échantillonnage par hypercube latin repose sur la décomposition spectrale des fonctions de répartition univariées associées à chaque variable aléatoire. Soit un vecteur aléatoire $\mathbf{X} = (X_1, X_2, dots, X_d) in \mathbb{R}^d$ dont chaque composante $X_j$ est caractérisée par une fonction de répartition continue notée $F_j(x) = \mathbb{P}(X_j \leq x)$. L’objectif est de générer un ensemble de $N$ points d’échantillonnage $\mathbf{x}^{(i)} = (x_{1}^{(i)}, x_{2}^{(i)}, dots, x_{d}^{(i)})$ pour $i in {1, 2, dots, N}$.
La première étape consiste à partitionner l’espace des probabilités marginales unitaire $[0, 1]$ de chaque dimension $j$ en $N$ sous-intervalles contigus d’égale probabilité mesurée par la loi uniforme. Chaque sous-intervalle $I_k$ pour $k in {1, dots, N}$ est formellement défini par l’ensemble :
$$I_k = \left[ \frac{k-1}{N}, \frac{k}{N} \right]$$
Par construction, la mesure de probabilité assignée à chaque strate marginale est strictement équivalente à $1/N$, garantissant une représentativité probabiliste uniforme.
Pour transposer cette partition probabiliste unitaire dans l’espace physique ou réel des variables du modèle, la méthode applique la transformation intégrale de probabilité inverse, couramment appelée méthode d’inversion quantile. Si la fonction de répartition marginale $F_j$ est strictement croissante et continue, elle admet une fonction inverse $F_j^{-1} : ]0, 1[ to \mathbb{R}$. Ainsi, à chaque intervalle de probabilité unitaire $I_k$ correspond un intervalle dans l’espace de la variable $X_j$ délimité par $[F_j^{-1}((k-1)/N), F_j^{-1}(k/N)]$. Il s’établit un isomorphisme fonctionnel direct entre l’hypercube unité $[0,1]^d$ et l’espace de support des variables cibles, assurant la préservation intégrale des lois marginales ciblées par le chercheur.
2.2 Tirage au sort intra-strate et matrices de permutation
Une fois la partition unitaire établie pour l’ensemble des dimensions, il convient de déterminer la localisation précise des coordonnées à l’intérieur de chaque strate et de coupler ces coordonnées à travers les différentes dimensions. Au sein de chaque strate $k$ de la dimension $j$, un point univarié $U_{j,k}$ est prélevé selon une loi uniforme continue locale :
$$U_{j,k} = \frac{k – 1 + \xi_{j,k}}{N}$$
où $\xi_{j,k} \sim \mathcal{U}(0, 1)$ représente une variable aléatoire indépendante et uniformément distribuée sur l’intervalle $[0, 1]$. Dans certaines variantes déterministes dites « point-milieu » (midpoint LHS), le terme stochastique $\xi_{j,k}$ est fixé conventionnellement à la constante $0.5$ afin d’éliminer toute variance intra-strate résiduelle.
L’assemblage multidimensionnel des points repose sur l’introduction de matrices de permutation aléatoires. Pour chaque dimension $j in {1, dots, d}$, on génère une permutation indépendante $\pi_j$ de l’ensemble des entiers ${1, 2, dots, N}$, choisie de manière équiprobable parmi les $N!$ permutations possibles. La $i$-ème observation du plan d’échantillonnage pour la variable $j$ est alors définie par l’évaluation quantile :
$$X_j^{(i)} = F_j^{-1}\left( \frac{\pi_j(i) – 1 + \xi_{j,\pi_j(i)}}{N} \right)$$
L’association des indices de rangs via ces permutations forme une matrice de conception $\mathbf{D} in \mathbb{R}^{N \times d}$. Cette stochasticité résiduelle issue des permutations combinatoires confère au plan sa représentativité globale tout en maintenant la contrainte de stratification marginale stricte.
2.3 Propriétés statistiques fondamentales de l’échantillon généré
L’une des propriétés les plus remarquables de l’échantillonnage par hypercube latin réside dans sa capacité à préserver exactement les distributions marginales théoriques imposées par l’expérimentateur, et ce, quelle que soit la taille de l’échantillon $N$. Contrairement à l’échantillonnage de Monte Carlo conventionnel où la fonction de répartition empirique converge vers la fonction théorique selon un processus stochastique soumis aux fluctuations d’échantillonnage, la fonction empirique marginale d’un échantillon LHS épouse avec une fidélité mathématique rigoureuse la fonction cible sur chacun des $N$ quantiles de référence.
Concernant le comportement asymptotique des moments statistiques d’ordre un et deux, l’estimateur de la moyenne obtenu via le LHS est rigoureusement non biaisé. De surcroît, la moyenne échantillonnale présente une variance inférieure ou égale à celle produite par un tirage aléatoire simple de même taille. Cette propriété découle de l’élimination de la composante de variance liée aux fluctuations d’effectifs entre strates marginales. De même, l’échantillonnage conserve l’invariance d’échelle face à toute transformation monotone croissante appliquée aux variables d’entrée.
Cependant, l’introduction de permutations purement aléatoires et indépendantes pour chaque colonne dimensionnelle engendre une vulnérabilité statistique : l’apparition potentielle de corrélations linéaires fallacieuses ou non intentionnelles entre variables initialement supposées indépendantes. Par le simple jeu des permutations aléatoires à effectif $N$ modéré, deux vecteurs de rangs peuvent présenter un coefficient de corrélation de Spearman substantiellement différent de zéro. Cette limite intrinsèque du LHS standard a stimulé le développement de méthodes de contrôle des dépendances matricielles, que nous aborderons ultérieurement.
3. Mécanisme algorithmique de l’échantillonnage pas à pas
3.1 L’échantillonnage unidimensionnel : analyse détaillée
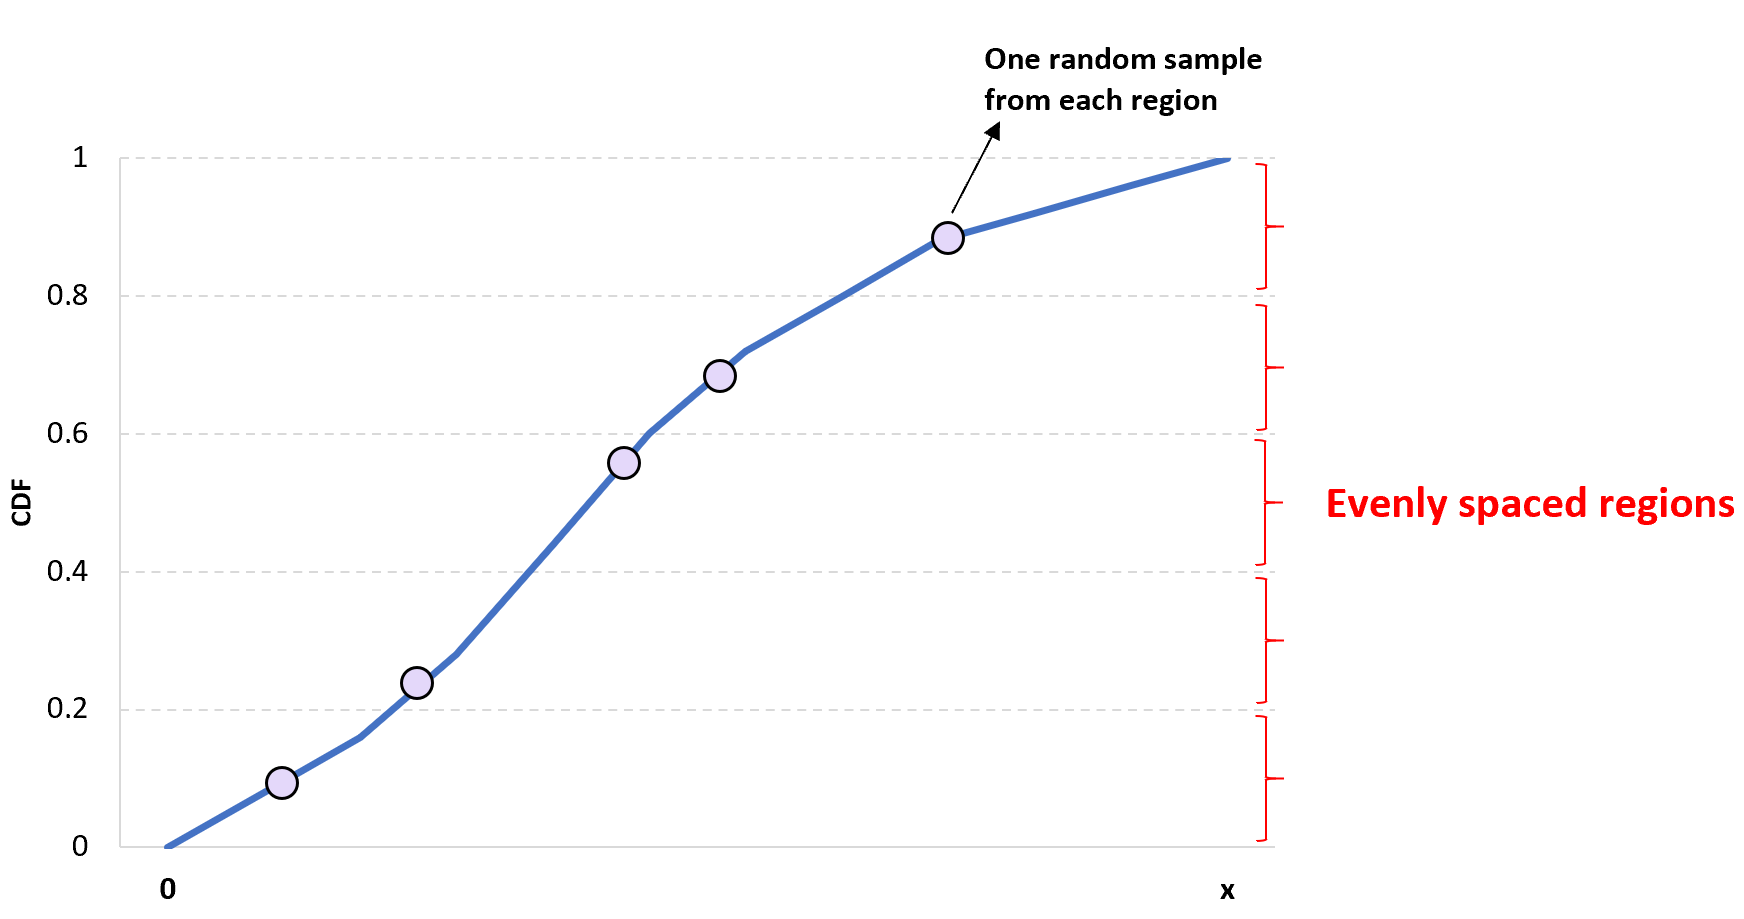
Pour illustrer la mécanique fine du LHS, analysons son fonctionnement sur une unique variable aléatoire continue $X in \mathbb{R}$. Considérons le cas classique où $X$ suit une distribution normale standard, telle que $X \sim \mathcal{N}(0, 1)$, et fixons un effectif expérimental modeste de $N = 5$ points. L’intervalle de probabilité cumulée $[0, 1]$ est immédiatement segmenté en cinq tranches d’égale amplitude probabiliste : $[0.0, 0.2]$, $[0.2, 0.4]$, $[0.4, 0.6]$, $[0.6, 0.8]$ et $[0.8, 1.0]$.
Au sein de chacune de ces tranches, un nombre uniformément distribué est généré. Supposons que les réalisations stochastiques intra-strates soient respectivement $u_1 = 0.12$, $u_2 = 0.35$, $u_3 = 0.51$, $u_4 = 0.78$ et $u_5 = 0.94$. L’application de la fonction de répartition inverse de la loi normale, traditionnellement désignée par la fonction quantile $\Phi^{-1}(u)$, permet d’obtenir les valeurs physiques des points d’échantillonnage :
- $x_1 = \Phi^{-1}(0.12) \approx -1.175$
- $x_2 = \Phi^{-1}(0.35) \approx -0.385$
- $x_3 = \Phi^{-1}(0.51) \approx +0.025$
- $x_4 = \Phi^{-1}(0.78) \approx +0.772$
- $x_5 = \Phi^{-1}(0.94) \approx +1.555$
Cette décomposition illustre la garantie structurelle offerte par l’hypercube latin : le plan échantillonne obligatoirement les queues de distribution tout en explorant la zone centrale à forte densité de probabilité. Dans un échantillonnage Monte Carlo standard, il existerait une probabilité non négligeable de $(1 – 0.2)^5 \approx 0.328$ (soit près d’une chance sur trois) de ne prélever absolument aucun point dans la queue inférieure $[-\infty, \Phi^{-1}(0.2)]$, ce qui fausserait gravement l’analyse de sensibilité locale. La dispersion des résidus par rapport à la distribution cible se trouve ainsi drastiquement comprimée dès la première dimension.
3.2 Extension multidimensionnelle et couplage des variables
Lorsque le modèle requiert l’évaluation conjointe de $d$ dimensions, l’algorithme passe d’un vecteur de quantiles à une matrice d’échantillonnage de dimensions $N \times d$. Le cœur de la procédure réside dans l’association des strates unidimensionnelles entre les différents axes. Cette association s’opère par la concaténation de $d$ vecteurs colonnes, chacun contenant une permutation pseudo-aléatoire indépendante de l’ensemble d’entiers ${1, 2, dots, N}$.
Considérons une situation bidimensionnelle ($d = 2$) avec un budget de $N = 4$ simulations. L’algorithme génère deux permutations aléatoires distinctes, par exemple $\pi_1 = (3, 1, 4, 2)$ pour la première variable et $\pi_2 = (2, 4, 1, 3)$ pour la seconde. En appariant les composantes de même rang, les quatre couples d’intervalles probabilistes obtenus sont : $(I_3, I_2)$, $(I_1, I_4)$, $(I_4, I_1)$ et $(I_2, I_3)$. Cette combinaison assure qu’aucune tranche marginale n’est dupliquée ni omise dans aucune direction du plan spatial.
La méthode gère avec une flexibilité remarquable l’hétérogénéité des types de variables. Si certaines composantes sont discrètes ou catégorielles, la fonction de répartition cumulative sous forme d’escalier est discrétisée de sorte que la largeur de chaque marche reflète la masse de probabilité de chaque catégorie. L’algorithme d’inversion associe alors naturellement les strates uniformes aux états discrets correspondants. De plus, la complexité calculatoire de génération d’un plan LHS standard croît de manière strictement linéaire en fonction de la dimensionnalité $O(d \cdot N)$, évitant l’explosion combinatoire exponentielle propre aux plans factoriels complets qui exigent $N^d$ évaluations.
3.3 Gestion des fonctions de densité non standard et corrélées
Dans la modélisation de systèmes réels, les variables d’entrée ne sont que rarement mutuellement indépendantes et distribuées selon des lois analytiques simples. Pour traiter le cas de variables interdépendantes, l’échantillonnage par hypercube latin doit être couplé à des techniques d’isoprobabilité plus avancées, au premier rang desquelles figure la transformation de Rosenblatt. Cette transformation conditionnelle séquentielle permet de mapper un vecteur de variables dépendantes $(X_1, dots, X_d)$ vers un vecteur de variables uniformes indépendantes $(U_1, dots, U_d) in [0, 1]^d$, sur lequel le maillage de l’hypercube latin peut être appliqué sans distorsion de mesure.
Une alternative moderne et particulièrement puissante repose sur la théorie des copules, encadrée par le théorème de Sklar. En dissociant la modélisation des marges individuelles de la structure de dépendance conjointe, les copules permettent d’appliquer l’échantillonnage LHS sur l’espace des variables latentes uniformes régies par une copule donnée (telle qu’une copule gaussienne, de Clayton, ou de Gumbel), avant d’inverser chaque composante vers sa distribution marginale finale. Cette approche garantit la capture fidèle des corrélations de queue et des asymétries de dépendance non linéaires.
Par ailleurs, pour imposer une structure de covariance linéaire ou de rang spécifique sans altérer la rigueur des lois marginales, la méthode d’Iman et Conover (1982) s’avère être la référence algorithmique absolue. Cette technique utilise une matrice de corrélation cible pour réordonner les permutations de l’hypercube latin par orthogonalisation de Cholesky sur des variables de score normal, préservant ainsi scrupuleusement les valeurs numériques échantillonnées tout en induisant la dépendance souhaitée. La robustesse du LHS s’étend ainsi sans altération méthodologique aux lois à queues lourdes (comme les distributions de Pareto ou de Cauchy) fréquemment rencontrées dans les systèmes financiers ou climatiques complexes.
4. Comparaison méthodologique : Hypercube latin vs Monte Carlo traditionnel
4.1 Limitations intrinsèques du tirage Monte Carlo brut
L’échantillonnage de Monte Carlo traditionnel (souvent qualifié de Simple Random Sampling ou SRS) puise ses racines théoriques dans la loi des grands nombres et le théorème central limite. Bien que conceptuellement direct et d’une mise en œuvre triviale, le tirage aléatoire pur présente des faiblesses structurelles majeures lorsqu’il est appliqué à des espaces multidimensionnels sous des contraintes de calcul strictes. Le défaut le plus pénalisant réside dans la formation spontanée de grappes de points (clustering) juxtaposées à d’immenses vides exploratoires (voids).
En vertu des propriétés stochastiques d’un processus de Poisson spatial homogène gouvernant le tirage indépendant de points uniformes, la probabilité qu’une sous-région donnée de volume relatif $epsilon$ ne contienne aucun point après $N$ tirages est strictement égale à :
$$\mathbb{P}(\text{vide}) = (1 – \epsilon)^N \approx e^{-N\epsilon}$$
Dans un espace paramétrique de dimension modérée à élevée, la majorité de l’espace reste tragiquement vierge de toute observation si $N$ n’est pas colossal, tandis que de multiples points redondants sont évalués à proximité immédiate les uns des autres, apportant une quantité négligeable d’information nouvelle.
De surcroît, la vitesse de convergence théorique de l’estimateur de Monte Carlo standard est notoirement lente, son erreur type diminuant à un taux proportionnel à $\mathcal{O}(N^{-1/2})$. Pour diviser l’incertitude de l’estimation par un facteur dix, l’expérimentateur doit multiplier le budget de calcul par cent. Lorsque chaque évaluation numérique prend plusieurs dizaines de minutes au sein d’un simulateur thermo-mécanique ou d’un solveur d’équations aux dérivées partielles, cette lenteur prohibitive rend le Monte Carlo brut totalement inexploitable pour l’ingénierie et la recherche quantitative de pointe.
4.2 Gain d’efficacité de l’échantillonnage par hypercube latin
L’échantillonnage par hypercube latin transcende ces contraintes en imposant une stratification rigide sur toutes les projections univariées du domaine expérimental. Ce contrôle combinatoire assure une baisse spectaculaire de l’erreur quadratique moyenne (EQM) pour une vaste classe d’intégrales numériques. La variance de l’estimateur LHS est mathématiquement démontrée comme étant systématiquement inférieure ou égale à celle de l’échantillonnage aléatoire simple, ne pouvant en aucun cas se dégrader au-delà des performances du Monte Carlo pur, sous réserve de la monotonie ou de la séparabilité des fonctions modélisées.
Ce gain de précision se manifeste avec une acuité particulière lors de l’estimation des moments statistiques d’une réponse de modèle. Par exemple, si la réponse $Y = f(\mathbf{X})$ est dominée par des effets principaux additifs, c’est-à-dire que le modèle peut s’approximer par une somme de fonctions univariées $f(\mathbf{X}) \approx \mu + \sum_{j=1}^d f_j(X_j)$, l’hypercube latin élimine presque intégralement la variance liée à ces composantes principales. La vitesse de convergence de l’estimateur de la moyenne peut alors asymptotiquement tendre vers $\mathcal{O}(N^{-1})$, offrant un gain d’efficacité numérique d’un ordre de grandeur remarquable.
En pratique, cette propriété implique qu’un plan LHS de seulement quelques dizaines ou centaines d’évaluations peut atteindre un niveau de représentativité et de précision statistique qu’un tirage Monte Carlo brut ne parviendrait à égaler qu’au prix de plusieurs milliers d’itérations. Cette rationalisation computationnelle permet d’explorer des fonctions hautement non linéaires sans sacrifier l’exploration des frontières du domaine expérimental.
4.3 Positionnement face aux séquences à faible discrépance (Quasi-Monte Carlo)
Pour parfaire l’analyse comparative, il est impératif de situer le LHS vis-à-vis des méthodes Quasi-Monte Carlo (QMC), fondées sur l’emploi de séquences déterministes à faible discrépance telles que les suites de Sobol, de Halton ou de Faure. Contrairement au LHS qui intègre une composante stochastique résiduelle au sein des strates et des permutations, les générateurs QMC reposent sur des constructions purement arithmétiques basées sur la théorie des corps finis et la numération en base première, visant à minimiser de façon déterministe la discrépance spatiale en étoile $D_N^*$.
Les séquences QMC bénéficient d’un taux de convergence théorique optimal asymptotique en $\mathcal{O}((\log N)^d / N)$, ce qui les rend mathématiquement supérieures au LHS lorsque la dimension de l’espace $d$ est très faible et que le nombre d’échantillons $N$ est suffisamment vaste pour dépasser le goulet d’étranglement dimensionnel $(\log N)^d$. Toutefois, dès que la dimensionnalité du système dépasse une quinzaine ou une vingtaine de paramètres, le facteur polynomial logarithmique dégrade drastiquement la performance pratique des suites de Sobol ou de Halton, à moins de recourir à des pondérations sophistiquées.
C’est dans ce contexte que l’hypercube latin conserve un avantage épistémologique et opérationnel majeur :
- Estimation non biaisée de l’erreur : La stochasticité inhérente au LHS permet de préserver des estimateurs non biaisés de l’erreur d’échantillonnage via la réplication indépendante de plans, ce qui est impossible avec des suites QMC purement déterministes sans recourir au scrambling (randomisation des suites).
- Robustesse à la dimension nominale : Le LHS est intrinsèquement insensible à l’élévation du nombre brut de dimensions, sa performance dépendant principalement de la dimension effective au sens de superposition (effective dimension in the superposition sense).
- Complémentarité hybride : L’échantillonnage par hypercube latin randomisé et orthogonal unifie les vertus des deux paradigmes en associant la régularité d’espacement géométrique du QMC aux propriétés inférentielles de l’échantillonnage probabiliste.
5. Propriétés statistiques et réduction de la variance
5.1 Démonstration théorique de la réduction de variance
L’assise théorique démontrant la supériorité de l’échantillonnage par hypercube latin en matière de dispersion stochastique repose sur le théorème séminal établi par McKay, Beckman et Conover en 1979. Soit l’estimation de la moyenne mathématique $\mu = \mathbb{E}[f(\mathbf{X})]$ d’une variable de sortie scalaire issue de l’évaluation d’une fonction de transfert multivariée arbitraire $f : \mathbb{R}^d to \mathbb{R}$. L’estimateur standard construit sur un échantillon LHS de taille $N$ est défini par :
$$\hat{\mu}_{LHS} = \frac{1}{N} \sum_{i=1}^N f\left(\mathbf{X}^{(i)}\right)$$
Pour expliciter la structure de la variance de cet estimateur, les auteurs décomposent la fonction cible $f$ par une analyse de variance fonctionnelle, connue sous le formalisme de l’expansion ANOVA (ou décomposition de Hoeffding-Sobol). La fonction $f$ s’exprime comme une somme orthogonale de termes d’ordres croissants :
$$f(\mathbf{X}) = \mu + \sum_{j=1}^d f_j(X_j) + \sum_{1 \leq j < k \leq d} f_{jk}(X_j, X_k) + dots + f_{1,dots,d}(\mathbf{X})$$
où chaque fonction composante possède une espérance conditionnelle nulle par rapport à chacune de ses variables d’intégration.
Le théorème fondamental de décomposition montre que la variance de l’estimateur de l’hypercube latin satisfait l’équation analytique suivante :
$$\mathbb{V}\text{ar}(\hat{\mu}_{LHS}) = \mathbb{V}\text{ar}(\hat{\mu}_{SRS}) – \frac{N-1}{N} \sum_{j=1}^d \mathbb{V}\text{ar}\left( \mathbb{E}[f(\mathbf{X}) mid X_j] \right) + R_N$$
où $\hat{\mu}_{SRS}$ désigne l’estimateur de Monte Carlo brut et $R_N$ représente un terme résiduel associé aux interactions d’ordre supérieur. Lorsque la fonction $f$ est monotone par rapport à chacune de ses coordonnées ou purement additive, le terme résiduel est strictement négatif ou asymptotiquement négligeable, garantissant que $\mathbb{V}\text{ar}(\hat{\mu}_{LHS}) \leq \mathbb{V}\text{ar}(\hat{\mu}_{SRS})$. L’amplitude du gain de précision est directement proportionnelle à la fraction de variance totale expliquée par les effets principaux univariés $f_j(X_j)$.
5.2 Comportement asymptotique et convergence
L’analyse asymptotique de l’échantillonnage par hypercube latin a franchi une étape décisive grâce aux contributions formelles du statisticien Art B. Owen au début des années 1990. Owen a démontré que pour toute fonction $f$ différentiable à support compact dont les dérivées partielles sont bornées, l’estimateur de la moyenne par hypercube latin converge en loi vers une distribution normale selon un théorème central limite fonctionnel :
$$\sqrt{N} \left( \hat{\mu}_{LHS} – \mu \right) x\rightarrow{\mathcal{D}} \mathcal{N}\left(0, \sigma_{LHS}^2\right) \quad \text{lorsque } N to \infty$$
La variance asymptotique $\sigma_{LHS}^2$ correspond précisément à la variance totale du modèle de laquelle a été retranchée l’intégralité de la variance attribuable à l’ensemble des effets principaux univariés.
Si le système sous-jacent est entièrement additif, c’est-à-dire exempt de toute interaction non linéaire entre ses variables ($f_{jk} \equiv 0$), la variance asymptotique converge vers zéro à un taux accéléré, et la vitesse de convergence de l’erreur type s’élève vers $\mathcal{O}(N^{-1})$ au lieu du classique $\mathcal{O}(N^{-1/2})$. Cette propriété confère au LHS une régularité asymptotique remarquable pour les modèles d’ingénierie et de physique computationnelle où les comportements globaux sont fréquemment guidés par des effets de premier ordre prédominants.
En ce qui concerne les moments statistiques d’ordre supérieur (tels que la variance de sortie $\sigma^2$, le coefficient d’asymétrie skewness et le coefficient d’aplatissement kurtosis), l’estimateur LHS conserve sa consistance et présente une stabilité supérieure à celle du Monte Carlo simple. Toutefois, la régularité et la continuité des fonctions étudiées demeurent des conditions préalables rigoureuses : l’existence de discontinuités abruptes ou de singularités spatiales au sein de $f$ tend à diffuser la variance vers les termes d’interaction de haute dimension, modérant l’avantage de la stratification univariée.
5.3 Précision de l’estimation des quantiles et probabilités de défaillance
Au-delà de l’estimation de l’espérance mathématique, l’ingénierie de la fiabilité et l’analyse des risques s’intéressent prioritairement à l’évaluation des quantiles extrêmes $x_q$ et des probabilités de défaillance associées à des événements rares :
$$P_f = \mathbb{P}(g(\mathbf{X}) \leq 0) = \int_{{\mathbf{x} : g(\mathbf{x}) \leq 0}} f_{\mathbf{X}}(\mathbf{x}) , d\mathbf{x}$$
où $g(\mathbf{x})$ représente la fonction d’état limite du système considéré. Dans ce contexte, l’échantillonnage par hypercube latin offre une robustesse structurelle accrue pour l’identification des seuils critiques par rapport au tirage stochastique standard, car il interdit catégoriquement la sous-représentation des queues de distribution univariées.
Cependant, l’estimation des événements rares pose des limites structurelles bien identifiées à la stratification marginale standard. Lorsque la zone de défaillance ${\mathbf{x} : g(\mathbf{x}) \leq 0}$ est hautement localisée dans une région étroite de l’espace conjoint des paramètres (par exemple, dans un coin extrême de l’hypercube où plusieurs variables doivent simultanément adopter des valeurs exceptionnelles), la simple stratification des marges univariées ne garantit en rien la génération de points au sein de ce volume critique conjoint minuscule. Si la probabilité $P_f$ est de l’ordre de $10^{-5}$, un LHS de taille $N = 1000$ ne rencontrera aucun point défaillant dans la vaste majorité de ses réalisations.
Pour surmonter cette contrainte intrinsèque, la littérature méthodologique préconise le couplage de l’hypercube latin à des techniques d’échantillonnage d’importance adaptatif (Adaptive Importance Sampling) ou à des approches de simulations de sous-ensembles (Subset Simulation). Dans ces hybridations sophistiquées, le LHS est employé pour échantillonner des densités instrumentales décentrées ou conditionnelles, démultipliant ainsi la puissance de détection des défaillances rares tout en conservant le bénéfice de la non-redondance spatiale des strates.
6. Variantes avancées et stratégies d’optimisation de l’hypercube latin
6.1 Échantillonnage par hypercube latin orthogonal (OLHS)
Bien que l’échantillonnage par hypercube latin garantisse une stratification parfaite sur chacune des $d$ dimensions marginales univariées prises isolément, il n’offre aucune garantie théorique quant à la répartition spatiale conjointe des points dans les sous-espaces de dimensions intermédiaires ($2, 3, dots, d-1$). Deux variables projetées sur un plan bidimensionnel peuvent présenter des alignements le long d’une diagonale, laissant des quadrants entiers désespérément inexplorés. Pour remédier à cette déficience structurelle, Art Owen (1992) et Boxin Tang (1993) ont développé l’échantillonnage par hypercube latin orthogonal (Orthogonal Latin Hypercube Sampling ou OLHS).
Le fondement de l’OLHS repose sur l’intégration des tableaux orthogonaux issus de l’algèbre combinatoire. Un tableau orthogonal $OA(N, d, q, t)$ est une matrice de dimensions $N \times d$ à coefficients pris dans un ensemble de $q$ symboles, telle que pour toute sous-matrice formée de $t$ colonnes arbitraires, chacune des $q^t$ combinaisons possibles de symboles apparaît exactement un même nombre de fois $lambda$. Le paramètre $t$ est désigné comme la force (strength) du tableau. Tang a démontré qu’en substituant chaque symbole du tableau orthogonal par une permutation locale d’hypercube latin de taille proportionnée, on obtient un plan d’échantillonnage qui hérite d’une stratification conjointe rigoureuse sur tous les sous-espaces de dimension $t$.
Un plan OLHS de force $t=2$ assure ainsi que non seulement chaque axe univarié est uniformément échantillonné en $N$ strates, mais que toute projection bidimensionnelle est simultanément stratifiée selon une grille régulière de $q \times q$ cellules équiprobables recevant chacune un nombre strictement identique d’observations. Ce contrôle combinatoire d’ordre supérieur entraîne une réduction spectaculaire de la variance associée aux termes d’interaction bivariés $f_{jk}(X_j, X_k)$. Cette sophistication impose néanmoins une contrainte arithmétique rigide : la taille globale d’échantillon $N$ ne peut plus être choisie arbitrairement, mais doit impérativement respecter les contraintes algébriques d’existence des tableaux orthogonaux sous-jacents, telles que $N = \lambda q^2$ ou des puissances de nombres premiers.
6.2 Critères géométriques d’optimisation : Maximin et Minimax
Face à la liberté combinatoire laissée par le choix des matrices de permutation dans le LHS conventionnel, une branche prolifique de la recherche s’est tournée vers l’optimisation géométrique de la distribution spatiale des points au sein de l’hypercube unitaire $[0, 1]^d$. Ces plans d’expériences optimisés, dits de remplissage d’espace (space-filling designs), exploitent des critères métriques formels pour évaluer et maximiser l’homogénéité globale du nuage de points.
Le critère le plus célèbre est sans conteste le critère Maximin, conceptualisé par Mark E. Johnson, Leslie M. Moore et Donald Ypsilantis en 1990. L’objectif d’un hypercube latin Maximin est de maximiser la distance euclidienne minimale séparant deux points quelconques du plan d’échantillonnage :
$$\max_{\mathbf{D}} \min_{1 \leq i < j \leq N} |\mathbf{x}^{(i)} – \mathbf{x}^{(j)}|$$
Ce critère force les points à se repousser mutuellement au sein de l’hypercube, empêchant catégoriquement l’apparition de proximités indues et garantissant une dispersion spatiale optimale. À l’inverse, le critère Minimax cherche à minimiser la distance maximale qui sépare un point quelconque du domaine $[0, 1]^d$ du point d’échantillonnage le plus proche, assurant ainsi qu’aucun recoin de l’espace des paramètres ne se trouve isolé d’une observation.
La résolution de ces problèmes d’optimisation combinatoire complexe implique le recours à des métaheuristiques stochastiques sophistiquées, au premier rang desquelles l’algorithme du recuit simulé (Simulated Annealing) développé dans ce cadre par Morris et Mitchell (1995), ou encore les algorithmes génétiques et l’optimisation par essaims particulaires. La génération de ces plans exige une puissance de calcul préliminaire non négligeable, mais cet investissement algorithmique en amont est immédiatement rentabilisé par la qualité de prédiction supérieure qu’offrent ces matrices de conception lors du calage de métamodèles gaussiens.
6.3 Hypercube latin optimal pour la corrélation (Iman-Conover)
Dans sa forme purement stochastique, l’association aléatoire des strates dimensionnelles peut fortuitement engendrer des coefficients de corrélation linéaire parasite très élevés entre deux variables théoriquement indépendantes, en particulier lorsque le ratio entre la dimension $d$ et l’effectif $N$ est substantiel. La présence de ces corrélations fallacieuses peut fausser dramatiquement l’identification des relations fonctionnelles et gonfler artificiellement la variance d’estimation des coefficients de régression.
Pour neutraliser ce risque méthodologique, Ronald L. Iman et William J. Conover ont conçu en 1982 un algorithme d’appariement de rangs fondé sur l’orthogonalisation matricielle. L’algorithme cible soit une matrice de corrélation strictement identité (pour éliminer toute dépendance spurieuse), soit une matrice de corrélation cible $\mathbf{C}^*$ choisie délibérément pour refléter des dépendances empiriques connues entre les paramètres d’entrée. La procédure opère selon la séquence calculatoire suivante :
- Génération d’une matrice de scores normaux standard $\mathbf{S} in \mathbb{R}^{N \times d}$ issue d’un échantillon par hypercube latin indépendant ;
- Calcul de la matrice de covariance empirique $\mathbf{\Sigma}_S$ des scores normaux et extraction de sa factorisation de Cholesky $\mathbf{\Sigma}_S = \mathbf{P}\mathbf{P}^T$ ;
- Décomposition de Cholesky de la matrice de corrélation désirée $\mathbf{C}^* = \mathbf{Q}\mathbf{Q}^T$ et transformation linéaire des scores : $\mathbf{S}^* = \mathbf{S} \mathbf{P}^{-1} \mathbf{Q}$ ;
- Réorganisation ordinale : pour chaque dimension $j$, les observations initiales de l’hypercube latin sont permutées de sorte que leurs rangs coïncident strictement avec l’ordre de tri des colonnes correspondantes de la matrice de scores modifiée $\mathbf{S}^*$.
L’élégance suprême de l’approche d’Iman-Conover réside dans le fait qu’elle n’altère en rien les valeurs numériques prélevées dans chaque intervalle marginal, préservant ainsi intégralement l’exactitude des fonctions de distribution univariées, tout en contraignant la corrélation de rang de Spearman empirique du plan à converger de manière quasi parfaite vers la cible matricielle prescrite.
7. Implémentation computationnelle et protocoles algorithmiques
7.1 Architecture algorithmique standard
L’implémentation informatique d’un générateur d’hypercube latin standard repose sur une architecture algorithmique claire, concise et hautement optimisable. Le protocole prend en entrée le nombre d’observations souhaité $N$, le nombre de dimensions $d$, ainsi que les fonctions quantiles inverses $F_j^{-1}$ associées à chaque composante paramétrique. Sa structure séquentielle se déploie selon le pseudo-code conceptuel suivant :
Pour chaque dimension $j$ allant de 1 à $d$, l’algorithme génère un vecteur de probabilités de taille $N$. Pour chaque indice de strate $k in {1, dots, N}$, la coordonnée probabiliste est calculée selon l’expression univariée $U_{j,k} = (k – 1 + \xi)/N$, où $xi$ est extrait d’un générateur pseudo-aléatoire uniforme sur $[0, 1]$. Une fois ce vecteur ordonné produit, une procédure de mélange aléatoire est appliquée pour redistribuer de manière équiprobable l’ordonnancement des cellules.
Le mélange de ces vecteurs s’appuie classiquement sur l’algorithme de Fisher-Yates (ou mélange de Knuth), qui garantit une permutation non biaisée en temps linéaire $\mathcal{O}(N)$. La complexité temporelle globale du tirage s’établit ainsi à $\mathcal{O}(d \cdot N)$, tandis que l’empreinte spatiale en mémoire vive demeure strictement bornée à la matrice de conception $\mathcal{O}(d \cdot N)$. Pour des applications critiques ou des simulations à grande échelle, la qualité statistique du générateur de nombres pseudo-aléatoires (PRNG) est déterminante : l’utilisation d’algorithmes modernes tels que le Mersenne Twister (MT19937) ou les générateurs de la famille PCG (Permuted Congruential Generator) évite l’apparition de périodicités structurales ou d’artéfacts de treillis qui viendraient dégrader les propriétés stochastiques du plan.
7.2 Écosystème logiciel et bibliothèques scientifiques
L’échantillonnage par hypercube latin bénéficie d’une maturité exceptionnelle au sein de l’écosystème open source et des environnements de calcul scientifique propriétaires contemporains. Dans l’écosystème Python, la bibliothèque standard SciPy intègre nativement depuis ses versions récentes le module scipy.stats.qmc (Quasi-Monte Carlo), proposant la classe LatinHypercube. Cette implémentation offre des fonctionnalités avancées permettant de spécifier des critères d’optimisation géométrique (tels que le critère de centrage ou le critère maximin) et d’appliquer des réordonnancements matriciels automatisés. En parallèle, la boîte à outils spécialisée SMT (Surrogate Modeling Toolbox) fournit des fonctionnalités d’échantillonnage LHS orientées vers la construction de métamodèles d’ingénierie aérospatiale.
Dans l’univers statistique R, le package de référence demeure lhs, conçu par Rob Carnell, qui propose des routines spécialisées pour l’hypercube latin standard, optimisé (maximinLHS, geneticLHS) ou orthogonal. Les chercheurs exploitent également la suite DiceDesign, développée dans le cadre du consortium DICE pour l’analyse des plans d’expériences numériques complexes, ainsi que le package sensitivity, incontournable pour l’exploration de la variabilité globale. Dans l’environnement MATLAB, la fonction native lhsdesign offre une interface directe paramétrable avec des options de lissage, de minimisation de la corrélation et de réitérations itératives d’optimisation spatiale.
Au-delà de la syntaxe logicielle, la rigueur méthodologique impose des protocoles stricts de gestion de la reproductibilité scientifique. Tout protocole computationnel exploitant le LHS doit impérativement enregistrer et documenter l’état initial des graines de génération stochastique (seed management), la version exacte de l’interpréteur algorithmique utilisé et les métriques de convergence appliquées, garantissant ainsi qu’une matrice d’expérimentation numérique puisse être répliquée bit à bit par des équipes de recherche indépendantes.
7.3 Diagnostics de qualité du plan d’échantillonnage
Préalablement à l’injection des points d’un plan LHS au sein d’un simulateur numérique coûteux, il est indispensable de procéder à un audit diagnostique rigoureux de la qualité structurelle de la matrice d’échantillonnage. Ce contrôle qualité repose sur l’évaluation conjointe de métriques géométriques, de critères combinatoires et de visualisations projectives.
La première métrique analytique est la discrépance spatiale, qui mesure l’écart maximal entre le volume théorique d’un sous-ensemble spatial quelconque et la proportion empirique de points d’échantillonnage qu’il englobe. On évalue couramment la discrépance centrée $L_2$ (notée $CD_2$) ou la discrépance en étoile (star discrepancy) : plus cette valeur est faible, plus le plan s’approche d’une couverture parfaitement homogène du domaine d’intégration. La seconde évaluation concerne le conditionnement de la matrice de corrélation empirique : le statisticien calcule le nombre de conditionnement $kappa$ et vérifie que la valeur maximale absolue des corrélations hors diagonale demeure en deçà d’un seuil critique tolérable (typiquement $|rho| < 2/\sqrt{N}$).
Sur le plan diagnostique graphique, l’utilisation de matrices de nuages de points croisés, couramment désignées sous l’anglicisme de scatter plot matrices (SPLOM), constitue la référence visuelle fondamentale. Elles permettent de scruter instantanément chaque projection bivariée afin de détecter d’éventuels alignements parasites, des zones creuses anormales ou des concentrations périphériques asymétriques. Des tests formels d’uniformité multidimensionnelle peuvent également être déployés pour valider statistiquement l’absence d’artefacts structurels induits par les générateurs pseudo-aléatoires.
8. Applications en modélisation psychologique et sciences cognitives
8.1 Calibration des modèles de processus cognitifs
L’essor des sciences cognitives computationnelles a vu émerger des formalismes mathématiques sophistiqués visant à capturer la dynamique interne du traitement de l’information dans le système nerveux central. Parmi ces formalismes, le modèle de diffusion de la décision (Drift Diffusion Model ou DDM), popularisé par Roger Ratcliff, décrit le processus de prise de décision binaire comme une marche aléatoire stochastique continue à travers une accumulation d’évidences sensorielles jusqu’à l’atteinte d’un seuil critique de déclenchement comportemental.
Le modèle DDM dépend d’un faisceau de paramètres latents sensibles, incluant le taux de dérive (vitesse d’accumulation informationnelle), l’écartement des seuils de réponse (conservatisme décisionnel), le temps moteur non décisionnel et le point de départ de l’accumulation (biais a priori). Lorsque les chercheurs cherchent à explorer l’espace de ces paramètres pour estimer les temps de réaction et les taux d’erreur, ou pour analyser la sensibilité de macro-architectures cognitives unifiées telles que ACT-R (Adaptive Control of Thought-Rational) ou SOAR, l’échantillonnage par hypercube latin se révèle indispensable.
Le LHS permet de sonder avec une efficience maximale l’espace multidimensionnel des paramètres cognitifs, surmontant les problèmes récurrents d’identifiabilité croisée. Dans de nombreuses configurations expérimentales, différentes combinaisons de dérive et de seuil peuvent produire des moyennes de temps de réaction identiques mais des profils d’asymétrie de distribution distincts. Grâce à la non-redondance marginale du LHS, l’intégralité du continuum des seuils et des dérives est balayée, ce qui permet aux algorithmes d’ajustement structurel d’isoler les signatures comportementales distinctives sans risquer d’ignorer des sous-régions d’équilibre paramétrique non triviales.
8.2 Psychométrie computationnelle et validation de théories latentes
Dans le domaine de la psychométrie avancée, l’évaluation des compétences psychologiques et des construits cliniques s’opère fréquemment via les modèles de la théorie de la réponse à l’item multidimensionnelle (Multidimensional Item Response Theory ou MIRT). Ces architectures probabilistes relient la probabilité de réussite d’un individu à un ensemble d’items d’évaluation en fonction d’un vecteur latent de traits intellectuels ou de dispositions comportementales $boldsymbol{\theta} = (\theta_1, dots, \theta_d) in \mathbb{R}^d$.
L’utilisation de l’échantillonnage par hypercube latin est devenue une pratique d’excellence pour la génération de populations virtuelles de répondants synthétiques lors d’études de simulation de Monte Carlo à des fins méthodologiques. Pour évaluer la résilience des algorithmes d’estimation de paramètres latents (tels que les méthodes du maximum de vraisemblance marginale via espérance-maximisation ou les approches bayésiennes MCMC) face à des variations de taille de cohorte ou de violations des postulats de normalité, le LHS assure que les profils virtuels couvrent rigoureusement l’ensemble de l’espace latent $boldsymbol{\theta}$, y compris les profils atypiques situés aux frontières des capacités cognitives.
Cette approche est également exploitée pour vérifier l’invariance de mesure au sein de modélisations par équations structurelles bayésiennes (BSEM). En générant des configurations factorielles par hypercube latin, les chercheurs quantifient la stabilité des indices d’ajustement (tels que le RMSEA, le CFI ou le TLI) face à des perturbations paramétriques locales, assurant ainsi que les instruments de mesure psychométrique et neuropsychologique conservent une validité transculturelle et clinique robuste.
8.3 Simulations à base d’agents en psychologie sociale et comportementale
La psychologie sociale moderne recourt de manière croissante aux modèles computationnels multi-agents (Agent-Based Models ou ABM) pour étudier la manière dont des interactions microscopiques locales entre individus engendrent des dynamiques macroscopiques émergentes, telles que la polarisation idéologique au sein des réseaux de communication ou la propagation de cascades de panique collective. Chaque agent synthétique est caractérisé par un ensemble d’attributs idiosyncratiques, souvent articulés autour du modèle des cinq grands facteurs de personnalité (Big Five) : ouverture, conscience, extraversion, agréabilité et névrosisme.
L’attribution des valeurs initiales de ces traits comportementaux, conjuguée à la calibration des seuils de conformisme normatif et des réceptivités à la contagion émotionnelle, exige un protocole d’initialisation rigoureux. Un échantillonnage stochastique mal calibré des conditions initiales peut introduire un biais de sélection masqué, où une dynamique sociologique observée à l’échelle du groupe ne découle pas des règles intrinsèques de communication du modèle, mais d’une anomalie statistique dans la répartition de départ des agents influents.
Le recours à l’hypercube latin maximin pour initialiser les attributs de la population d’agents garantit que l’hétérogénéité psychologique du réseau d’expérimentation synthétique reflète fidèlement la variance de la population cible sans biais de regroupement accidentel. Les chercheurs peuvent ainsi exécuter des plans de balayage systématique pour déterminer avec exactitude les seuils de rupture (tipping points) à partir desquels une croyance minoritaire bascule vers un consensus hégémonique ou, inversement, fragmente le corps social en enclaves étanches.
9. Analyse de sensibilité globale et métamodélisation
9.1 Couplage avec les méthodes d’indices de Sobol
L’analyse de sensibilité globale (ASG) vise à quantifier rigoureusement la manière dont l’incertitude pesant sur les sorties d’un modèle mathématique peut être attribuée, de manière quantitative et non ambiguë, aux différentes sources d’incertitude de ses paramètres d’entrée. Dans ce corpus méthodologique, l’approche par décomposition de la variance d’Ilya M. Sobol représente l’étalon-or international, formulant les indices de sensibilité de premier ordre $S_i$ (impact principal direct du paramètre) et les indices d’interaction totale $S_{Ti}$ (impact du paramètre incluant toutes ses interactions avec les autres variables).
Le calcul empirique direct de ces indices requiert l’évaluation d’intégrales multidimensionnelles complexes par l’intermédiaire de matrices de conception spécifiques réordonnées selon le schéma d’échantillonnage de Saltelli. Lorsque ces matrices de base $\mathbf{A}$ et $\mathbf{B}$ de dimensions $N \times d$ sont construites à l’aide de tirages indépendants par hypercube latin plutôt que par Monte Carlo conventionnel, le gain en vitesse de convergence est substantiel. L’estimateur de Monte Carlo des indices de Sobol exige fréquemment $N \sim 10^4$ à $10^5$ évaluations pour stabiliser les estimations des effets d’interaction fine, alors qu’un couplage LHS performant permet de converger vers des marges d’erreur acceptables avec des effectifs de l’ordre de $N \sim 10^2$ à $10^3$.
Dans l’étude des modèles psychologiques et cognitifs à grand nombre de variables latentes, cette réduction de variance computationnelle s’avère providentielle. Elle permet d’identifier sans ambiguïté les paramètres critiques gouvernant les réponses décisionnelles ou d’isoler les facteurs inertes susceptibles d’être figés à des valeurs constantes sans altérer le comportement prédictif global du modèle.
9.2 Construction de modèles de substitution (Surrogate Models / Krigeage)
Lorsque la complexité algorithmique d’un simulateur comportemental ou biomécanique interdit formellement son exécution des milliers de fois pour mener des optimisations ou des calages bayésiens, la solution d’ingénierie canonique consiste à lui substituer un émulateur analytique rapide, également dénommé modèle de substitution (surrogate model) ou métamodèle. Parmi les paradigmes dominants, la régression par processus gaussien, universellement désignée sous le terme de krigeage, s’est imposée grâce à sa capacité intrinsèque à fournir non seulement une prédiction de la réponse, mais également une estimation rigoureuse de l’incertitude épistémique entourant cette prédiction.
La performance d’un métamodèle de krigeage dépend de manière critique de la matrice de conception initiale qui a servi à son entraînement numérique. Si des zones spatiales volumineuses demeurent vierges de points expérimentaux, la variance du processus gaussien y explose, rendant toute interpolation hautement instable. L’utilisation d’un échantillon par hypercube latin Maximin représente la méthodologie par excellence pour l’entraînement de tels processus. En maximisant la distance minimale entre les points de calage, le plan Maximin-LHS minimise la variance de prédiction intégrée (critère IMSE) sur l’ensemble de l’espace de définition.
Cette approche est au cœur des méthodes modernes d’estimation bayésienne sans vraisemblance (Approximate Bayesian Computation ou ABC) et des algorithmes d’inversion paramétrique en neuro-imagerie computationnelle. L’émulateur gaussien entraîné sur un plan LHS permet d’approximer le paysage complexe de log-vraisemblance en quelques secondes de calcul, rendant possibles des explorations bayésiennes de modèles cognitifs qui auraient autrement exigé des semaines de calcul sur des clusters dédiés.
9.3 Dépistage des facteurs influents via la méthode de Morris
Lorsque l’espace paramétrique d’un modèle neuropsychologique ou physiologique s’étend à plusieurs dizaines ou centaines de variables d’entrée, le calcul exhaustif des indices de Sobol, même accéléré par LHS, peut demeurer hors de portée computationnelle. Dans cette situation, la démarche méthodologique rationnelle préconise une phase préliminaire de criblage (screening) qualitatif à l’aide de la méthode des effets élémentaires de Max D. Morris (1991).
Le plan de Morris classique repose sur la génération d’un ensemble de trajectoires discrétisées au sein d’une grille spatiale, où chaque trajectoire avance pas à pas le long d’une dimension unique pour mesurer la dérivée discrète locale de la fonction de réponse. L’hybridation moderne de cette méthode consiste à optimiser le positionnement des points de départ de ces trajectoires en contraignant leur sélection par un plan d’hypercube latin maximin dans l’espace des coordonnées discrètes. Cette optimisation structurelle élimine les redondances entre trajectoires concurrentes et assure une couverture optimale des régions d’interaction potentielles.
Le traitement analytique des effets élémentaires permet de classer les paramètres cognitifs en trois groupes distincts : les paramètres dont les effets sont statistiquement négligeables, ceux exerçant des effets linéaires directs sans interaction majeure, et ceux gouvernant de fortes non-linéarités ou des interactions en cascade. L’élagage méthodique permis par ce protocole basé sur l’hypercube latin permet de concentrer les ressources de calcul intensives sur les seuls paramètres véritablement déterminants du système neuromimétique.
10. Diagnostic de convergence, dimensionnement et validation des modèles
10.1 Critères de détermination de la taille d’échantillon optimale
La question du dimensionnement optimal d’un échantillon par hypercube latin conditionne directement le compromis entre coût computationnel et précision statistique. Bien qu’il n’existe pas de formule analytique universelle capable de prescrire une taille magique $N$ indépendamment de la régularité mathématique de la boîte noire simulée, la communauté des plans d’expériences numériques s’accorde largement autour de la règle empirique de Loeppky, Sacks et Welch (2009), couramment désignée sous l’appellation de règle des $10d$ :
$$N \approx 10 \times d$$
Cette heuristique stipule que pour calibrer convenablement un modèle de substitution initial ou estimer les tendances globales d’un système à $d$ dimensions, un budget minimal de dix observations par variable d’entrée représente un point d’inflexion coût-bénéfice particulièrement efficient.
Toutefois, la rigidité de cette règle doit être modulée en présence de fortes non-linéarités ou d’interactions croisées d’ordre élevé. Dans de tels contextes, le dimensionnement requis peut s’élever à $20d$ voire $50d$. Pour s’affranchir de conjectures statiques a priori, les méthodologies contemporaines préconisent l’adoption de protocoles séquentiels ou adaptatifs. Dans un hypercube latin séquentiel, le chercheur commence avec un plan initial modeste, analyse la variance résiduelle des sorties ou la précision prédictive du métamodèle via validation croisée, puis enrichit itérativement le plan par de nouveaux points stratifiés sans détruire l’équilibre d’équiprobabilité marginale de la conception globale.
Le critère d’arrêt s’articule alors autour de la stabilisation asymptotique des moments calculés : lorsque l’ajout de nouvelles strates ne modifie plus l’espérance ou la variance de la réponse au-delà d’un epsilon fixé par le cahier des charges de la recherche, la taille de l’échantillon est réputée suffisante, évitant ainsi tout gaspillage computationnel superflu.
10.2 Évaluation de la convergence stochastique
Contrairement aux suites déterministes de Quasi-Monte Carlo pour lesquelles le calcul a posteriori de l’erreur d’intégration s’avère particulièrement ardu en pratique, l’hypercube latin conserve une nature stochastique sous-jacente qui autorise une quantification statistique directe et rigoureuse de son incertitude résiduelle. Pour auditer la convergence d’un estimateur LHS sans réexécuter l’intégralité du modèle informatique, les chercheurs exploitent intensivement le rééchantillonnage par bootstrap non paramétrique.
Le protocole consiste à rééchantillonner avec remise parmi les $N$ évaluations disponibles afin d’approximer la distribution d’échantillonnage de l’estimateur $\hat{\mu}_{LHS}$ ou des indices de sensibilité associés. Cette procédure permet de construire des intervalles de confiance empiriques fiables autour des métriques d’intérêt. De façon complémentaire, la méthodologie préconise, lorsque les ressources de calcul le permettent, la génération de $M$ réplications indépendantes du plan LHS complet (chacune mobilisant des graines aléatoires distinctes pour le tirage des permutations et des bruits intra-strates) :
$$\hat{\sigma}^2_{\bar{Y}} = \frac{1}{M(M-1)} \sum_{m=1}^M \left( \hat{\mu}_{LHS}^{(m)} – \frac{1}{M} \sum_{k=1}^M \hat{\mu}_{LHS}^{(k)} \right)^2$$
Cette variance entre réplications fournit un estimateur parfaitement non biaisé de l’erreur quadratique moyenne globale. La surveillance de l’écrasement de cet intervalle de confiance en fonction de l’accroissement graduel de la taille $N$ offre un indicateur empirique direct de la stabilité prédictive des simulations comportementales, assurant que les conclusions tirées sur les dynamiques psychologiques simulées ne sont pas des artéfacts d’un tirage combinatoire chanceux ou défaillant.
10.3 Détection et correction des biais d’échantillonnage résiduels
Bien que le protocole de l’hypercube latin garantisse structurellement l’uniformité des projections marginales, la présence de corrélations parasites résiduelles entre colonnes dimensionnelles peut dégrader la fiabilité des régressions statistiques construites sur l’échantillon. Ce phénomène est particulièrement insidieux dans les études où le nombre de paramètres est important par rapport au nombre d’évaluations disponibles. L’apparition d’une colinéarité accidentelle entre deux facteurs d’entrée peut conduire à une inflation artificielle de la variance des estimateurs de coefficients de régression linéaire ou logistique, un écueil quantifié par le facteur d’inflation de la variance (Variance Inflation Factor ou VIF).
Pour auditer et assainir la matrice de conception avant son exploitation opérationnelle, plusieurs procédures correctives de post-traitement matriciel sont couramment déployées :
- Algorithme de Gram-Schmidt adapté aux rangs : Cette procédure réorthogonalise les vecteurs de permutations par projection vectorielle séquentielle, ramenant la corrélation empirique bivariée à des valeurs arbitrairement proches de zéro sans dénaturer la représentativité univariée des strates.
- Optimisation par échange de cellules : Des routines itératives comparent la matrice de corrélation courante à la matrice cible et permutent localement les éléments d’une colonne jusqu’à ce que la norme de Frobenius de l’erreur matricielle $|\mathbf{C}_{e\mp} – \mathbf{I}|_F$ franchisse un minimum strict.
- Contrôle des effets de bordure spatiale : L’analyse méticuleuse des frontières de l’hypercube permet de vérifier que des singularités fonctionnelles situées sur les parois du domaine d’intégration ne captent pas indûment un poids disproportionné dans les régressions comportementales globales.
La mise en œuvre de ces audits qualité systématiques est aujourd’hui reconnue comme une condition sine qua non de la science ouverte et reproductible, garantissant la traçabilité intégrale de la chaîne d’inférence computationnelle.
11. Limites épistémologiques, contraintes dimensionnelles et défis méthodologiques
11.1 Le fléau de la dimensionnalité (Curse of Dimensionality)
En dépit de son efficience remarquable face au tirage aléatoire brut, l’échantillonnage par hypercube latin n’échappe pas totalement aux manifestations perverses du fléau de la dimensionnalité, théorisé à l’origine par Richard Bellman. Lorsque la dimensionnalité $d$ du modèle mathématique croît de manière importante pour atteindre des valeurs de plusieurs dizaines ou centaines de variables, la géométrie de l’hypercube unitaire $[0, 1]^d$ subit des déformations contraintuitives majeures qui altèrent la portée des garanties marginales offertes par le LHS.
L’un des aspects les plus frappants de cette pathologie géométrique est le phénomène de concentration de la mesure. Dans un espace à haute dimension, le volume d’un hypercube se concentre de manière quasi exclusive dans ses coins périphériques, tandis que le volume de sa sphère inscrite tend asymptotiquement vers zéro :
$$\lim_{d to \infty} \frac{\text{Vol}(\mathcal{S}^d)}{\text{Vol}(\mathcal{H}^d)} = \lim_{d to \infty} \frac{\pi^{d/2}}{\Gamma(d/2 + 1) \cdot 2^d} = 0$$
Par conséquent, bien qu’un échantillon LHS stratifie impeccablement chaque composante prise individuellement, l’ensemble des points d’échantillonnage se retrouve relégué sur les bordures extrêmes du domaine multidimensionnel, laissant l’intérieur du volume global désespérément vide. La projection conjointe sur des sous-espaces de dimension intermédiaire cesse d’être uniforme et souffre d’un appauvrissement dramatique de densité spatiale.
Dans les applications computationnelles de psychologie ou de neurosciences complexes impliquant des centaines de connexions synaptiques ou de traits comportementaux, l’application aveugle de l’hypercube latin sur l’espace brut s’avère inopérante. Il devient impératif d’opérer une réduction dimensionnelle préalable rigoureuse, par le biais d’analyses en composantes principales (ACP), d’analyses factorielles confirmatoires ou de techniques d’apprentissage de variétés (manifold learning), afin de projeter le modèle sur un espace latent d’ordre inférieur avant d’entreprendre l’échantillonnage expérimental.
11.2 Dépendances complexes et géométries non convexes
Le postulat architectural fondamental de l’hypercube latin repose sur l’hypothèse que le domaine de définition des paramètres peut être représenté sous la forme d’un produit cartésien régulier d’intervalles univariés : $\Omega = \prod_{j=1}^d [a_j, b_j]$. Dès que les contraintes physiques, biologiques ou psychologiques du système imposent des restrictions conjointes non linéaires, cette régularité géométrique s’effondre.
Considérons, par exemple, un modèle cognitif imposant la contrainte logique que la somme de trois paramètres d’attention sélective ne puisse jamais excéder l’unité : $\theta_1 + \theta_2 + \theta_3 \leq 1$. Le domaine de faisabilité comportementale n’est plus un hypercube, mais un simplexe géométrique non rectangulaire. Si l’on génère un hypercube latin sur l’enveloppe rectangulaire englobante, une proportion considérable de points d’échantillonnage violera la contrainte logique et devra être impérativement rejetée. Cette élimination par filtrage détruit instantanément l’équiprobabilité des strates marginales et corrompt les propriétés d’optimalité statistique et de réduction de variance du plan initial.
Des difficultés similaires et plus aiguës encore surgissent lorsque le domaine des paramètres forme une variété riemannienne non euclidienne ou une topologie non convexe truffée de zones interdites. La préservation conjointe de la stratification marginale et du respect strict de frontières non linéaires complexes demeure un problème ouvert en recherche mathématique, nécessitant le déploiement de transformations conformes ou d’approches de transport optimal complexes pour courber l’hypercube sans dilater arbitrairement ses densités locales.
11.3 Compromis computationnel entre optimisation géométrique et coût de tirage
Si la génération d’un hypercube latin stochastique standard est d’une fluidité calculatoire presque instantanée grâce à sa complexité temporelle en $\mathcal{O}(d \cdot N)$, il n’en va pas de même pour les variantes géométriquement optimisées. La recherche d’un plan d’échantillonnage Maximin ou Minimax rigoureux relève de la classe des problèmes d’optimisation combinatoire NP-difficiles. Lorsque l’expérimentateur cherche à positionner $N = 500$ points dans un espace de dimension $d = 30$, l’espace combinatoire des permutations matricielles possibles atteint des échelles astronomiques incommensurables : $(N!)^{d-1} = (500!)^{29}$.
Dans ces conditions, l’exécution d’algorithmes métaheuristiques tels que le recuit simulé ou les algorithmes génétiques exige un investissement en temps de calcul machine qui peut se chiffrer en plusieurs heures ou journées. Un arbitrage pragmatique s’impose donc au chercheur : le gain marginal de régularité géométrique justifie-t-il l’allocation d’une telle enveloppe de ressources informatiques à la seule étape de conception du plan d’échantillonnage ? Si le simulateur aval est modérément coûteux, consacrer davantage de calcul à optimiser le plan qu’à évaluer le modèle lui-même constitue une dérive méthodologique manifeste.
De surcroît, une sur-optimisation déterministe peut introduire des régularités spatiales rigides indésirables, réduisant la variabilité statistique indispensable aux diagnostics d’incertitude non biaisés. Enfin, la sensibilité de ces plans aux erreurs d’appréciation a priori sur les bornes paramétriques est critique : si le domaine expérimental initial a été mal calibré par l’expérimentateur, l’hypercube latin optimisé aura exploré avec une perfection mathématique stérile des régions totalement dénuées d’intérêt comportemental tout en ignorant le cœur fonctionnel du phénomène étudié.
12. Perspectives futures et intégration dans les approches computationnelles modernes
12.1 Hybridation avec l’intelligence artificielle et l’apprentissage automatique
L’intersection contemporaine entre le calcul scientifique traditionnel et l’intelligence artificielle ouvre des perspectives méthodologiques stimulantes pour l’échantillonnage par hypercube latin. L’un des domaines les plus féconds réside dans l’émergence des réseaux de neurones informés par la physique (Physics-Informed Neural Networks ou PINN). Ces architectures profondes intègrent directement des équations aux dérivées partielles au sein de leur fonction de perte empirique pour apprendre la dynamique de systèmes physiques ou neuronaux continus.
Pour évaluer les résidus différentiels lors de la rétropropagation du gradient, l’algorithme doit échantillonner un nuage massif de points de collocation spatio-temporels. La substitution du tirage aléatoire brut par un échantillonnage par hypercube latin maximin pour générer ces points de collocation accélère significativement la vitesse de convergence de l’apprentissage profond tout en prévenant l’apparition de poches d’instabilité numérique là où le gradient n’aurait pas été contraint. De même, dans le cadre de l’apprentissage actif (active learning), le LHS s’impose de plus en plus comme la technique canonique d’initialisation (cold start) des méta-modèles bayésiens, avant que des politiques d’acquisition dynamique ne prennent le relais pour sonder les régions d’ambiguïté informationnelle maximale.
Enfin, l’optimisation des hyperparamètres régissant l’architecture des modèles d’apprentissage automatique profonds (taux d’apprentissage, taux d’abandon, nombre de couches masquées) exploite massivement l’hypercube latin comme alternative supérieure à la recherche sur grille (grid search, paralysée par l’explosion combinatoire) et à la recherche aléatoire simple (random search, sujette au clustering). L’échantillonnage LHS garantit un balayage non redondant des hyperparamètres avec un budget d’entraînement strictement maîtrisé.
12.2 Intégration en neurosciences computationnelles et connectomique
À l’échelle neurobiologique, la modélisation de la dynamique cérébrale globale (Whole-Brain Modeling) et les recherches en connectomique fonctionnelle représentent un défi computationnel de premier ordre. Les plateformes de simulation cérébrale contemporaines, telles que The Virtual Brain (TVB), modélisent les interactions entre dizaines d’aires corticales interconnectées par des faisceaux de substance blanche issus de l’imagerie par résonance magnétique de diffusion (IRM-d). Chaque nœud cortical est piloté par des équations différentielles non linéaires complexes simulant des populations de réseaux de neurones à impulsions (Spiking Neural Networks).
Explorer la sensibilité de ces réseaux cérébraux globaux aux fluctuations des conductances synaptiques locales, aux vitesses de transmission axonale et aux hétérogénéités d’excitabilité régionale exige de sonder des espaces de paramètres de haute dimensionnalité sous une incertitude de mesure instrumentale substantielle. L’échantillonnage par hypercube latin permet de cartographier méthodiquement ces paysages dynamiques complexes, facilitant l’identification des régimes de bifurcation critiques marquant la transition entre un fonctionnement cérébral sain et l’émergence de crises épileptiformes synchronisées.
De surcroît, le LHS permet de conduire des campagnes massives de simulation de lésions virtuelles (virtual brain lesion profiling). En faisant varier de façon ordonnée et non redondante les coefficients d’atténuation structurelle des faisceaux connectomiques majeurs, les chercheurs quantifient la robustesse fonctionnelle globale du connectome face à des atteintes neurodégénératives progressives (telles que la maladie d’Alzheimer), éclairant les mécanismes de résilience cognitive et d’adaptation plastique à l’échelle du réseau cérébral complet.
12.3 Vers des standards méthodologiques rigoureux en science ouverte
La crise de la reproductibilité qui traverse les sciences empiriques et comportementales contemporaines a mis en exergue l’impérieuse nécessité de renforcer la rigueur et la transparence des protocoles de simulation informatique. Trop souvent, les publications scientifiques omettent de documenter avec une précision adéquate les conditions exactes de génération des plans d’échantillonnage ayant servi à calibrer leurs modèles synthétiques ou à valider leurs hypothèses psychométriques, rendant la réplication indépendante de leurs résultats hautement problématique.
Dans ce contexte épistémologique, l’adoption de l’échantillonnage par hypercube latin, encadrée par des standards de science ouverte, s’affirme comme une condition essentielle de fiabilité :
- Publication systématique des matrices de conception : Les plans d’expériences LHS complets, incluant les identifiants univoques de graines pseudo-aléatoires et les métriques de discrépance associées, doivent être systématiquement déposés au sein de répertoires ouverts pérennes (tels que Zenodo ou l’Open Science Framework).
- Standardisation des protocoles d’analyse de sensibilité : L’intégration standardisée de l’hypercube latin dans les pipelines d’analyse computationnelle en psychologie et en sociologie computationnelle garantit que l’influence relative des paramètres postulés d’un modèle découle d’une exploration impartiale de l’espace mathématique, et non d’un échantillonnage biaisé favorable aux hypothèses des auteurs.
- Intégration curriculaire universitaire : Il devient crucial d’enseigner formellement les principes des plans d’expériences numériques, de la discrépance spatiale et du LHS dans les programmes universitaires quantitatifs de sciences humaines et sociales, émancipant ainsi la future génération de chercheurs de la dépendance exclusive et naïve au tirage de Monte Carlo brut.
En comblant le fossé entre la rigueur combinatoire abstraite et les exigences concrètes des simulations empiriques modernes, l’échantillonnage par hypercube latin s’affirme bien plus que comme un simple artifice calculatoire : il s’érige en un véritable principe directeur de l’exploration rationnelle des modèles de la complexité.
Références
Bellman, R. (1957). Dynamic Programming. Princeton University Press.
Carnell, R. (2022). lhs: Latin Hypercube Samples (R package version 1.1.5). https://cran.r-project.org/package=lhs
Dupuy, D., Helbert, C., & Franco, J. (2015). DiceDesign and DiceEval: Two R packages for design and analysis of computer experiments. Journal of Statistical Software, 65(11), 1–38. https://doi.org/10.18637/jss.v065.i11
Euler, L. (1782). Recherches sur une nouvelle espèce de quarrés magiques. Verhandelingen uitgegeven door het zeeuwsch genootschap der wetenschappen te Vlissingen, 9, 85–239.
Iman, R. L., & Conover, W. J. (1982). A distribution-free approach to inducing rank correlation among input variables. Communications in Statistics – Simulation and Computation, 11(3), 311–334. https://doi.org/10.1080/03610918208812265
Johnson, M. E., Moore, L. M., & Ylvisaker, D. (1990). Minimax and maximin designs. Journal of Statistical Planning and Inference, 26(2), 131–148. https://doi.org/10.1016/0378-3758(90)90122-B
Loeppky, J. L., Sacks, J., & Welch, W. J. (2009). Choosing the sample size of a computer experiment: A practical guide. Technometrics, 51(4), 366–376. https://doi.org/10.1198/TECH.2009.08040
McKay, M. D., Beckman, R. J., & Conover, W. J. (1979). A comparison of three methods for selecting values of input variables in the analysis of output from a computer code. Technometrics, 21(2), 239–245. https://doi.org/10.1080/00401706.1979.10489755
Morris, M. D. (1991). Factorial sampling plans for preliminary computational experiments. Technometrics, 33(2), 161–174. https://doi.org/10.1080/00401706.1991.10484804
Morris, M. D., & Mitchell, T. J. (1995). Exploratory designs for computational experiments. Journal of Statistical Planning and Inference, 43(3), 381–402. https://doi.org/10.1016/0378-3758(94)00035-T
Owen, A. B. (1992). Orthogonal arrays for computer experiments, integration and visualization. Statistica Sinica, 2(2), 439–452. https://www.jstor.org/stable/24304899
Owen, A. B. (1994). Controlling correlations in Latin hypercube samples. Journal of the American Statistical Association, 89(428), 1517–1522. https://doi.org/10.1080/01621459.1994.10476891
Ratcliff, R., & McKoon, G. (2008). The diffusion decision model: Theory and data for two-choice decision tasks. Neural Computation, 20(4), 873–922. https://doi.org/10.1162/neco.2008.12-06-420
Sacks, J., Welch, W. J., Mitchell, T. J., & Wynn, H. P. (1989). Design and analysis of computer experiments. Statistical Science, 4(4), 409–423. https://doi.org/10.1214/ss/1177012413
Saltelli, A., Ratto, M., Andres, T., Campolongo, F., Cariboni, J., Gatelli, D., Saisana, M., & Tarantola, S. (2008). Global Sensitivity Analysis: The Primer. John Wiley & Sons.
Sklar, A. (1959). Fonctions de répartition à n dimensions et leurs marges. Publications de l’Institut de Statistique de l’Université de Paris, 8, 229–231.
Sobol, I. M. (2001). Global sensitivity indices for nonlinear mathematical models and their Monte Carlo estimates. Mathematics and Computers in Simulation, 55(1–3), 271–280. https://doi.org/10.1016/S0378-4754(00)00270-6
Tang, B. (1993). Orthogonal array-based Latin hypercubes. Journal of the American Statistical Association, 88(424), 1392–1397. https://doi.org/10.1080/01621459.1993.10476423
Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., Burovski, E., Peterson, P., Weckesser, W., Bright, J., van der Walt, S. J., Brett, M., Wilson, J., Millman, K. J., Mayorov, N., Nelson, A. R. J., Jones, E., Kern, R., Larson, E., Carey, C. J., Polat, İ., Feng, Y., Moore, E. W., VanderPlas, J., Laxalde, D., Perktold, J., Cimrman, R., Henriksen, I., Quintero, E. A., Harris, C. R., Archibald, A. M., Ribeiro, A. H., Pedregosa, F., van Mulbregt, P., & SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2