
Dans le champ des sciences humaines, sociales et comportementales, l’accès empirique à des populations cibles d’envergure se heurte inéluctablement à des contraintes matérielles, financières et temporelles majeures. Lorsqu’un chercheur ou une institution envisage de mesurer avec rigueur des phénomènes psychologiques complexes, tels que la détresse psychologique, l’anxiété généralisée ou la dynamique du bien-être au travail, l’idéal théorique consisterait à recourir à un échantillonnage aléatoire simple. Toutefois, cette approche présuppose l’existence d’une base de sondage unifiée, exhaustive et actualisée répertoriant chaque individu de la population cible, une condition qui s’avère quasi impossible à satisfaire dès lors que le champ d’investigation s’étend à l’échelle d’une région, d’une nation ou d’un réseau organisationnel transcontinental.
Face à cette aporie méthodologique, la théorie des sondages a développé des architectures probabilistes sophistiquées capables de concilier les exigences mathématiques de l’inférence statistique et les impératifs pratiques du déploiement sur le terrain. L’échantillonnage à plusieurs degrés, souvent qualifié d’échantillonnage multi-étapique ou hiérarchique, s’impose comme la solution par excellence pour surmonter l’absence de base de sondage globale tout en maîtrisant les coûts logistiques liés à la dispersion géographique des sujets. En décomposant le processus d’inclusion en une cascade de sélections aléatoires emboîtées, cette méthode permet de concentrer les efforts de collecte au sein de sous-ensembles circonscrits sans renoncer aux fondements de l’échantillonnage probabiliste.
Cet article propose une analyse exhaustive et rigoureuse de l’échantillonnage à plusieurs degrés, depuis ses fondements conceptuels et mathématiques jusqu’à ses applications concrètes en psychologie et en épidémiologie comportementale. À travers l’examen de ses mécanismes probabilistes, de ses différences fondamentales avec les plans par grappes ou stratifiés, et de ses répercussions sur l’estimation de la variance par le biais de l’effet de plan, ce guide détaille l’ensemble des protocoles requis pour concevoir, exécuter et analyser des enquêtes quantitatives complexes selon les normes méthodologiques les plus strictes de la recherche scientifique contemporaine.
1. Introduction et fondements conceptuels de l’échantillonnage à plusieurs degrés
L’histoire de l’inférence statistique moderne repose sur la quête permanente d’une représentativité optimale à partir d’observations partielles du réel. Dans les disciplines étudiant les comportements humains, la tension entre la pureté des modèles mathématiques et la réalité logistique du terrain d’enquête constitue un moteur épistémologique constant, contraignant les méthodologistes à inventer des structures de tirage capables de naviguer au sein de populations vastes, fragmentées et hétérogènes.
1.1 Le défi de l’accès aux grandes populations en recherche psychologique
En psychologie clinique, sociale et cognitive, la validité externe des conclusions scientifiques dépend directement de la capacité des protocoles à généraliser des observations recueillies auprès d’un sous-ensemble d’individus à l’ensemble d’une population parente. Cependant, lorsqu’il s’agit d’étudier la distribution des traits de personnalité, la prévalence des troubles anxio-dépressifs ou l’impact des stresseurs environnementaux sur de larges segments démographiques, les chercheurs se heurtent immédiatement à l’inaccessibilité de bases de sondage exhaustives. Contrairement aux essais cliniques de laboratoire où les cohortes sont restreintes et recrutées sur des critères délibérément étroits, les recherches populationnelles nécessitent de contacter des individus vivant dans des contextes écologiques diversifiés. L’absence d’un registre centralisé répertoriant, par exemple, tous les adolescents scolarisés d’un pays ou l’intégralité des travailleurs du secteur tertiaire exclut d’emblée la possibilité de procéder à un tirage au sort direct et individuel.
À cette carence documentaire s’ajoutent des contraintes budgétaires, temporelles et logistiques considérables. Même si un registre national exhaustif était disponible, un échantillonnage aléatoire simple aboutirait à une dispersion spatiale extrême des sujets sélectionnés. Les coûts de déplacement des enquêteurs ou des psychologues évaluateurs, les dépenses d’acheminement du matériel de passation psychométrique standardisé et la dispersion des efforts de suivi rendraient le protocole financièrement prohibitif et matériellement ingérable. De plus, la durée requise pour collecter des données auprès d’individus isolés géographiquement introduirait des biais d’histoire ou de maturation au sein des séries temporelles de la recherche.
Dès lors, les chercheurs sont contraints d’opérer des arbitrages méthodologiques éclairés. Il ne s’agit pas de sacrifier la rigueur statistique au profit de la facilité pratique en recourant à des échantillons de convenance non probabilistes, mais plutôt de concevoir des plans de sondage probabilistes alternatifs capables de préserver les propriétés formelles de l’inférence tout en concentrant les opérations sur des unités spatiales ou institutionnelles gérables. C’est précisément au confluent de cette double exigence qu’intervient l’échantillonnage à plusieurs degrés, offrant une modélisation structurelle qui rationalise les ressources sans abdiquer l’exigence de randomisation.
1.2 Genèse et évolution de l’échantillonnage aréolaire et hiérarchique
L’échantillonnage à plusieurs degrés trouve ses racines historiques dans les travaux pionniers de la statistique publique et de la démographie au cours de la première moitié du XXe siècle. Confrontés à la nécessité de réaliser des recensements agricoles et des enquêtes sur la main-d’œuvre à grande échelle, des statisticiens fondamentaux tels que Jerzy Neyman, Morris Hansen, William Hurwitz et Leslie Kish ont formalisé les principes de l’échantillonnage aréolaire (area sampling). Cette technique consistait à substituer à la liste inaccessible des individus une liste accessible de circonscriptions géographiques, au sein desquelles des subdivisions successives étaient opérées jusqu’à atteindre l’unité finale de collecte.
Au fil des décennies, cette méthodologie purement territoriale a muté vers des approches structurelles plus complexes, intégrant les hiérarchies institutionnelles propres à la sociologie et à l’épidémiologie. Les chercheurs ont rapidement compris que la réalité humaine s’organise spontanément selon des structures emboîtées : les individus résident au sein de ménages, qui s’intègrent dans des quartiers, eux-mêmes regroupés dans des municipalités ; de même, les élèves sont regroupés dans des classes, qui appartiennent à des écoles, gérées par des académies ou des districts scolaires. La statistique computationnelle et l’émergence des théories des probabilités appliquées aux plans de sondage ont permis de formaliser les mécanismes de décomposition de la variance associée à ces structures arborescentes.
Dans le domaine des sciences du comportement et de la santé mentale, l’adoption de ces plans hiérarchiques a été catalysée par les grandes enquêtes épidémiologiques internationales, telles que les enquêtes de l’Organisation mondiale de la santé sur la santé mentale mondiale (World Mental Health Surveys). Ces initiatives d’envergure ont démontré que la mesure rigoureuse des troubles psychiatriques et des construits psychologiques à l’échelle d’une population entière ne pouvait s’effectuer sans recourir à des plans multi-étapiques rigoureusement documentés, capables de s’adapter aux disparités des systèmes de recensement locaux tout en garantissant des estimateurs robustes et non biaisés.
1.3 Place de la méthode parmi les protocoles probabilistes
Au sein de la taxonomie des méthodes d’échantillonnage quantitatives, les protocoles se divisent fondamentalement en deux grandes familles épistémologiques : les approches non probabilistes (ou empiriques) et les approches probabilistes (ou aléatoires). Les méthodes non probabilistes, parmi lesquelles figurent l’échantillonnage par quotas, l’échantillonnage de convenance ou les techniques boule de neige, sélectionnent les répondants sur la base de critères subjectifs, de disponibilité immédiate ou d’auto-sélection. Bien que rapides et économiques, ces approches souffrent d’une incapacité théorique fondamentale : il est strictement impossible de déterminer la probabilité d’inclusion d’un individu donné, ce qui invalide le calcul mathématique de l’erreur d’échantillonnage et interdit toute inférence statistique formelle au sens de la théorie classique des probabilités.
L’échantillonnage à plusieurs degrés s’inscrit sans équivoque dans la famille des méthodes probabilistes. Sa légitimité découle du respect impératif d’une condition cardinale : à chaque stade du processus de sélection en cascade, le choix des unités doit obligatoirement reposer sur un mécanisme de randomisation objectif et probabilisé. Qu’il s’agisse de tirer au sort des régions administratives au premier degré, des établissements scolaires au deuxième degré, des classes d’élèves au troisième degré ou enfin des individus au sein des classes, chaque opération de prélèvement est gouvernée par des lois de probabilité connues à l’avance.
Il importe de lever toute ambiguïté théorique : la complexité structurelle d’une sélection séquentielle ne dilue en rien son statut probabiliste, pourvu que la chaîne de sélection ne soit interrompue par aucune dérive de convenance. Même si le protocole aboutit à une concentration spatiale ou institutionnelle des sujets, la calculabilité exacte de la probabilité conjointe d’inclusion confère aux estimateurs dérivés de ces données les mêmes garanties asymptotiques de consistance et d’absence de biais que celles offertes par un échantillon aléatoire simple, sous réserve d’ajustements statistiques rigoureux liés à la structure de dépendance des données.
2. Définition formelle et principes probabilistes sous-jacents
La compréhension rigoureuse de l’échantillonnage à plusieurs degrés exige d’abandonner l’intuition naïve d’un prélèvement direct dans une population homogène pour adopter une vision ensembliste et hiérarchique. Cette section formalise les mécanismes mathématiques régissant la transition entre les différents niveaux d’agrégation d’un plan de sondage multi-étapique.
2.1 Définition théorique et opérationnelle
Sur le plan théorique, l’échantillonnage à plusieurs degrés se définit comme un processus stochastique de division récursive d’une population globale en une suite d’unités emboîtées de granularité décroissante, suivi d’une série ordonnée d’opérations d’échantillonnage probabiliste appliquées successivement à chaque niveau hiérarchique. Formellement, si l’on désigne la population cible totale par l’ensemble $\Omega$, cette population est préalablement partitionnée en un ensemble exhaustif et mutuellement exclusif d’unités de premier niveau, appelées Unités Primaires d’Échantillonnage (UPE). Chacune de ces UPE est elle-même constituée d’une collection d’unités de second niveau, désignées sous le terme d’Unités Secondaires d’Échantillonnage (USE), et ainsi de suite jusqu’à atteindre les unités finales contenant les éléments d’observation.
Sur le plan opérationnel, la méthode procède du général vers le particulier. Au lieu de tenter de répertorier immédiatement l’ensemble des éléments ultimes de $\Omega$, le chercheur se contente de dresser la liste des UPE. Un premier échantillon d’UPE est tiré selon une règle probabiliste explicite. Dans un deuxième temps, et uniquement au sein des UPE sélectionnées lors du premier stade, le chercheur dresse l’inventaire des unités secondaires, parmi lesquelles un nouvel échantillon aléatoire est extrait. Ce processus de sous-échantillonnage se poursuit de manière séquentielle sur autant de niveaux que l’exige l’architecture du projet de recherche.
La taxonomie distingue les plans bi-étapiques (à deux degrés), fréquents dans les enquêtes institutionnelles simples (par exemple, sélection d’hôpitaux puis sélection de patients au sein des hôpitaux retenus), des plans multi-étapiques (à trois degrés ou plus), caractéristiques des enquêtes nationales de grande ampleur (par exemple : régions, départements, communes, ménages, puis un individu tiré au sort au sein de chaque ménage). Le choix du nombre de degrés dépend directement du degré de dispersion spatiale de la population, de la structure des bases de données administratives intermédiaires et de l’optimisation des coûts de collecte.
2.2 Le principe fondamental de sélection probabiliste à chaque étape
Le fondement inaliénable de l’échantillonnage à plusieurs degrés réside dans l’attribution déterministe d’une probabilité d’inclusion non nulle et parfaitement calculable à chaque unité, quel que soit l’échelon considéré. Pour qu’un plan d’échantillonnage multi-étapique conserve sa validité inférentielle, chaque étape de sélection doit se conformer aux axiomes de la théorie de l’échantillonnage de survey design, théorisée notamment par Särndal, Swensson et Wretman (1992). Toute défaillance dans la chaîne probabiliste—telle que la sélection non aléatoire d’une sous-unité pour des raisons de commodité matérielle—rompt instantanément le contrat probabiliste et invalide l’estimation des erreurs-types.
Ce principe assure le maintien de la validité externe des conclusions. Lorsque la probabilité d’inclusion conjointe est connue, il devient possible d’utiliser l’estimateur d’Horvitz-Thompson pour calculer des moyennes, des proportions, des indices de corrélation ou des coefficients de régression rigoureusement représentatifs de la population globale. Si un chercheur venait à introduire un choix subjectif au dernier degré—par exemple, en laissant les enquêteurs interroger le membre du ménage qui se présente en premier à la porte au lieu de procéder à un tirage au sort probabiliste par méthode de Kish ou date d’anniversaire—les propriétés de variance deviendraient indéterminables mathématiquement, et l’échantillon perdrait sa valeur probante.
La distinction entre sélection probabiliste stricte et approche par convenance au niveau final est précisément ce qui sépare l’ingénierie statistique rigoureuse du sondage d’opinion commercial rudimentaire. La préservation de la chaîne stochastique garantit que l’espérance mathématique des estimateurs converge vers le paramètre réel de la population cible à mesure que la taille d’échantillon croît, respectant ainsi les lois fondamentales des grands nombres et du théorème central limite appliqué aux populations finies.
2.3 Les concepts clés : grappes, sous-grappes et unités finales
Pour naviguer dans l’architecture d’un plan multi-étapique, il est nécessaire de maîtriser avec précision le vocabulaire normalisé de la théorie des sondages. Les unités agrégées sélectionnées lors de la première phase sont universellement dénommées Unités Primaires d’Échantillonnage (UPE). Une UPE constitue une grappe macroscopique, c’est-à-dire un regroupement naturel ou artificiel d’éléments de la population. Une caractéristique majeure des UPE est leur hétérogénéité intrinsèque : elles englobent généralement une diversité interne substantielle tout en présentant, dans certains cas, une relative variabilité entre elles. En pratique, une UPE peut être une zone géographique (un canton, un code postal), un organisme fonctionnel (une université, un centre hospitalier) ou une structure organisationnelle (une succursale d’entreprise).
Au sein des UPE sélectionnées, les sous-ensembles soumis au deuxième tirage constituent les Unités Secondaires d’Échantillonnage (USE). Celles-ci agissent comme des sous-grappes. Dans le contexte d’une étude en milieu scolaire, si l’UPE est l’établissement d’enseignement secondaire, l’USE correspondra typiquement à la classe pédagogique ou au niveau de scolarité. Si le protocole comporte des étapes supplémentaires, on parlera d’Unités Tertiaires d’Échantillonnage (UTE), telles que des groupes de travaux pratiques ou des dortoirs au sein des internats.
Enfin, au terme de la cascade de sélections, se trouve l’Unité Finale d’Échantillonnage (ou Unité Statistique Ultime). C’est à ce niveau précis que se produit l’observation empirique et que la mesure psychométrique est effectuée. L’unité ultime peut être un individu singulier (un patient, un étudiant, un employé), une dyade (un couple parent-enfant), ou une entité collective indivisible (un ménage, une cellule familiale). La clarification taxonomique préalable de chaque strate hiérarchique est une condition sine qua non de la modélisation mathématique du plan de sondage, car chaque échelon possède ses propres probabilités conditionnelles de sélection.
3. Anatomie d’un plan d’échantillonnage à plusieurs degrés : Étapes et unités
La construction opérationnelle d’un dispositif multi-étapique s’articule comme une progression rigoureuse, guidée par une diminution méthodique de l’échelle d’observation. Chaque niveau répond à des impératifs administratifs distincts et mobilise des outils probabilistes adaptés à la nature des cadres de sondage disponibles.
3.1 Premier degré : Sélection des Unités Primaires d’Échantillonnage (UPE)
Le premier degré constitue l’infrastructure fondamentale sur laquelle repose la totalité de l’édifice empirique. À cette étape, la tâche principale du chercheur consiste à établir une base de sondage primaire exhaustive. Contrairement à une base d’individus, la liste des UPE est généralement accessible par le biais d’annuaires officiels, de registres ministériels ou de bases cartographiques de l’institut national de statistique (tel que l’INSEE en France ou Statistique Canada). Ces unités doivent partitionner intégralement la population cible, sans chevauchement ni omission.
L’un des défis majeurs du premier degré réside dans la variabilité démographique des UPE. Dans un cadre géographique, les départements, communes ou districts n’ont que très rarement des tailles identiques. Si l’on applique un tirage aléatoire simple à ce niveau, une petite commune de 200 habitants aurait la même probabilité d’être choisie qu’une métropole de plusieurs centaines de milliers d’âmes. Cela introduirait des distorsions sévères dans la probabilité finale des individus. Pour remédier à cette asymétrie, les chercheurs mobilisent quasi systématiquement au premier degré l’échantillonnage avec probabilité proportionnelle à la taille (PPT), développé en détail ultérieurement dans cet article.
La délimitation des UPE doit également intégrer des critères de faisabilité terrain. Il convient de veiller à ce que les UPE soient suffisamment vastes pour englober la diversité du phénomène psychologique étudié, tout en demeurant suffisamment compactes sur le plan spatial pour que les équipes d’évaluation puissent s’y déplacer aisément lors des phases ultérieures sans engager de dépenses de transport disproportionnées.
3.2 Degrés intermédiaires : Réduction progressive de la granularité
Une fois les UPE retenues dans l’échantillon de premier rang, le chercheur opère une transition vers les degrés intermédiaires, qui ont pour fonction de réduire la granularité d’observation jusqu’à des périmètres d’intervention restreints. À ce stade, il n’est plus nécessaire de disposer de listes exhaustives pour la totalité du pays ou de l’organisation : seules les UPE sélectionnées font l’objet d’un recensement minutieux de leurs sous-unités (les USE).
Cette phase intermédiaire permet de capitaliser sur les cadres administratifs locaux. Par exemple, au sein des municipalités sélectionnées lors du premier stade, il devient envisageable de solliciter des registres de quartiers, des listes électorales par bureau de vote, ou les inventaires des structures scolaires locales. L’analyste doit ici résoudre un arbitrage statistique fondamental : faut-il échantillonner un grand nombre de sous-unités de petite taille ou un petit nombre de sous-unités de grande taille ?
Les théories de l’optimisation des sondages démontrent que pour un budget fixe, l’efficacité statistique est généralement maximisée en sélectionnant un nombre relativement élevé d’unités aux stades initiaux, tout en restreignant le nombre d’éléments prélevés aux stades finaux. Ce sous-échantillonnage progressif permet de briser la redondance informationnelle issue de la proximité physique ou sociale des individus au sein d’une même sous-grappe, limitant ainsi la dégradation de la précision des estimateurs.
3.3 Dernier degré : Sélection des unités statistiques individuelles
Le dernier degré correspond au prélèvement de l’unité ultime d’observation, là où s’appliquent concrètement les échelles psychologiques, les entretiens cliniques standardisés ou les tests neuropsychologiques. C’est à ce niveau que l’inventaire complet des éléments individuels doit être dressé pour la première fois. Parce que l’espace d’investigation a été drastiquement circonscrit par les degrés précédents, la création de cette base de sondage finale locale devient logistiquement abordable : il peut s’agir du registre des résidents d’un immeuble tiré au sort, de la liste nominative des élèves d’une classe spécifique, ou de la base de paie d’un service d’entreprise.
Le protocole de sélection finale doit bannir toute subjectivité des enquêteurs de terrain. L’échantillonnage aléatoire simple ou systématique est alors exécuté à partir de la liste locale. En outre, une méthodologie d’échantillonnage rigoureuse à ce dernier degré doit intégrer des règles univoques pour la gestion des non-réponses et des refus de participation. Dans les études psychologiques portant sur des sujets sensibles (tels que les traumatismes psychiques ou les addictions), les taux d’attrition au niveau individuel peuvent être substantiels.
Pour préserver l’intégrité probabiliste, les protocoles modernes interdisent le remplacement spontané d’un non-répondant par son voisin direct—procédure courante mais statistiquement déviante—sans passer par des procédures de substitution probabilistes prédéfinies ou par une sur-inclusion initiale calculée lors de la phase de dimensionnement de l’échantillon. La documentation rigoureuse des issues de contact à ce dernier degré conditionne l’attribution ultérieure des coefficients de redressement statistique.
4. Exemple canonique et modélisation détaillée étape par étape
Afin d’ancrer les concepts mathématiques abstraits dans la réalité de la démarche scientifique, cette section développe une simulation empirique complète illustrant l’implémentation pratique d’un plan d’échantillonnage probabiliste à trois degrés appliqué à la recherche en psychopathologie quantitative.
4.1 Mise en situation : Estimation des traits anxieux dans une population nationale
Considérons un projet de recherche d’épidémiologie psychiatrique dont l’objectif central est d’estimer la prévalence et l’intensité des symptômes d’anxiété généralisée au sein de la population adulte active d’un pays fictif de 10 millions d’individus. Le protocole implique l’administration en face-à-face d’une batterie d’instruments psychométriques standardisés, incluant l’échelle GAD-7 (Spitzer et al., 2006) et un entretien diagnostique semi-structuré d’une durée d’une heure mené par des psychologues qualifiés.
Deux contraintes rendent l’échantillonnage aléatoire simple irréalisable : d’une part, les lois de protection de la vie privée interdisent l’accès direct au registre fiscal ou électoral centralisé des 10 millions de citoyens à des fins de tirage nominatif direct ; d’autre part, même si un tel fichier existait, les 15 000 participants nécessaires à la puissance statistique de l’étude se trouveraient dispersés sur des milliers de kilomètres carrés, rendant le coût des vacations et des déplacements des cliniciens incompatible avec l’enveloppe budgétaire allouée par l’organisme de financement de la recherche.
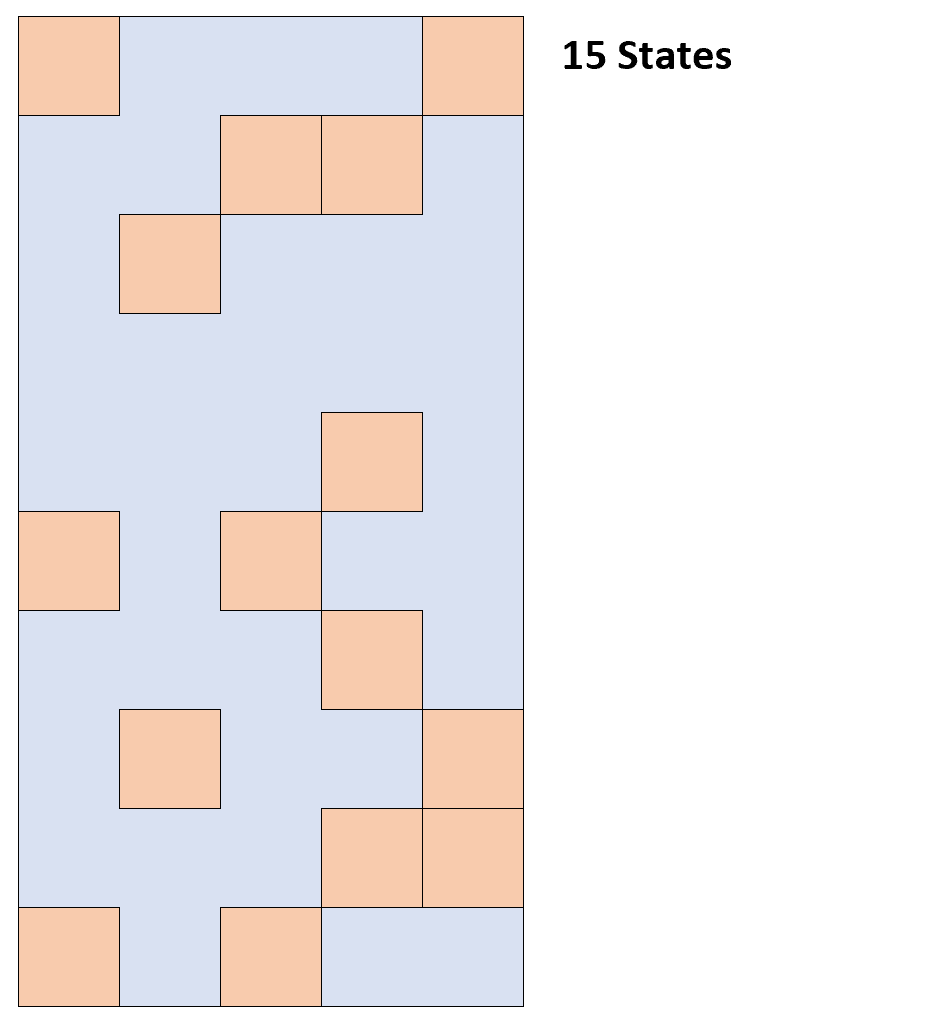
L’équipe méthodologique opte donc pour la modélisation d’un plan d’échantillonnage aréolaire tri-étapique. L’espace national est découpé selon les divisions administratives existantes : le pays compte 100 départements (contenant chacun plusieurs municipalités), chaque département regroupe une centaine de communes, et chaque commune abrite ses ménages de citoyens adultes. Le plan tri-étapique consistera à sélectionner un échantillon de départements, puis au sein de ceux-ci un échantillon de communes, et enfin un groupe de ménages dans chaque commune retenue.
4.2 Déroulement quantitatif des trois degrés d’échantillonnage
La cascade de sélection est paramétrée selon des cibles de dimensionnement calculées pour garantir une dispersion territoriale contrôlée et un volume d’observations suffisant :
- Premier degré (Sélection des UPE) : La base de sondage primaire comprend l’intégralité des $N_{UPE} = 100$ départements nationaux. L’équipe procède à un tirage au sort probabiliste de $n_1 = 15$ départements. Pour les besoins de la modélisation simple dans ce scénario, supposons un échantillonnage aléatoire sans remise à probabilités égales.
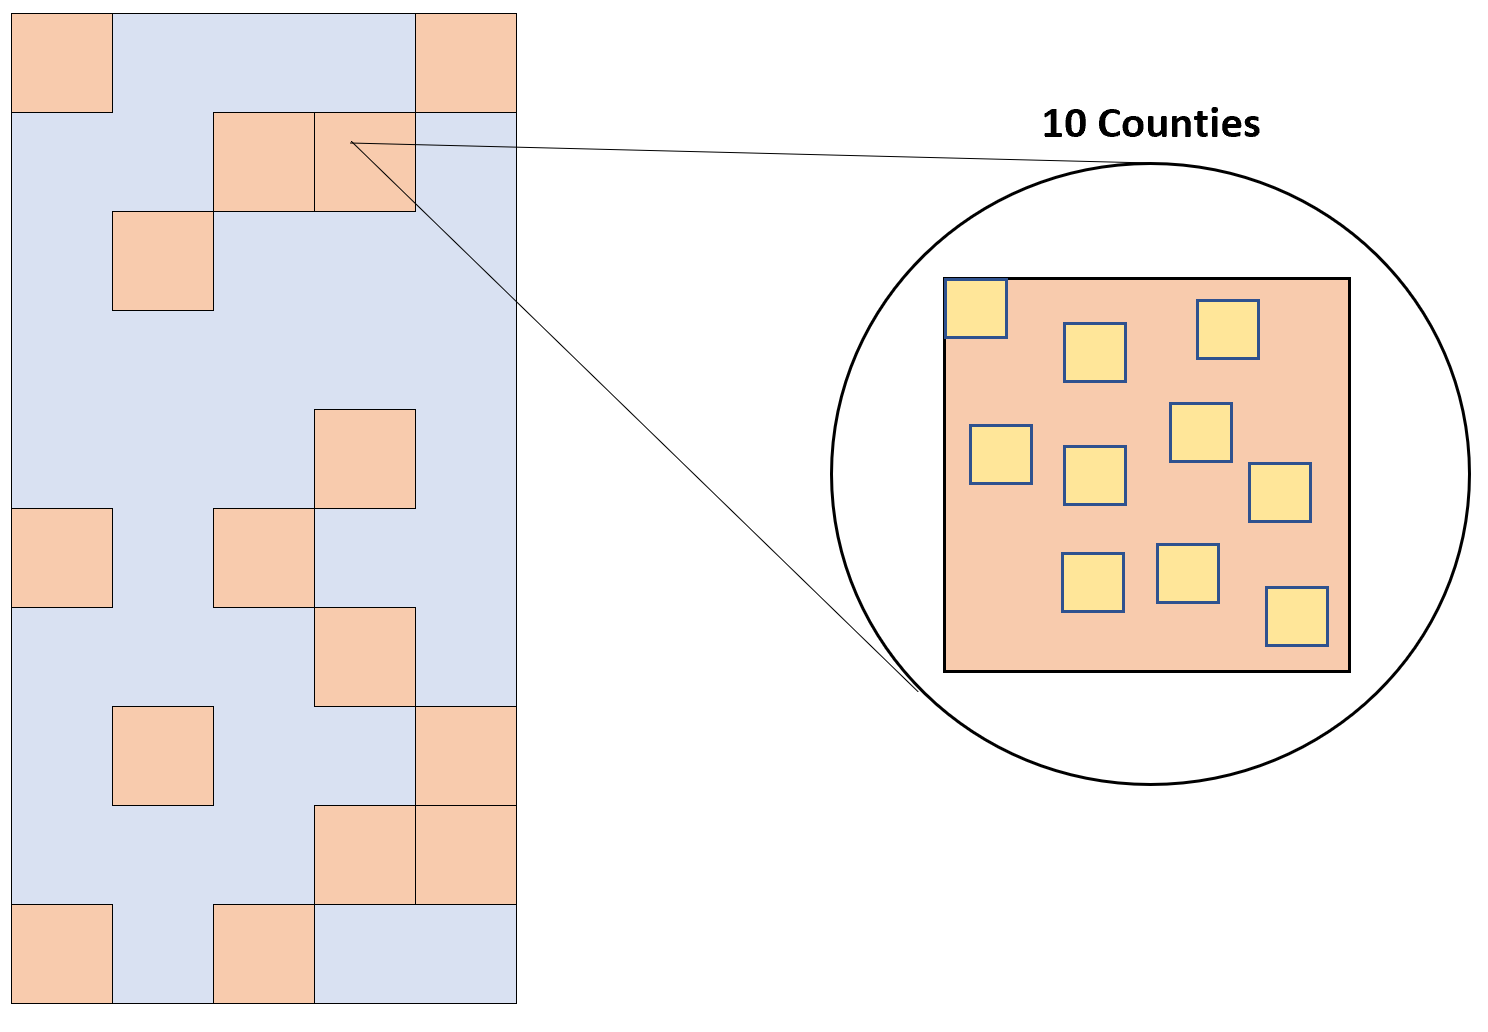
- Deuxième degré (Sélection des USE) : Au sein de chacun des 15 départements retenus lors de la première étape, les chercheurs établissent la liste exhaustive des communes. Supposons que chaque département sélectionné comprenne $N_{USE} = 80$ communes. Un tirage aléatoire simple sans remise est alors effectué pour prélever $n_2 = 10$ communes par département. Le nombre total de communes incluses dans l’étude s’élève donc à $15 \times 10 = 150$ communes.
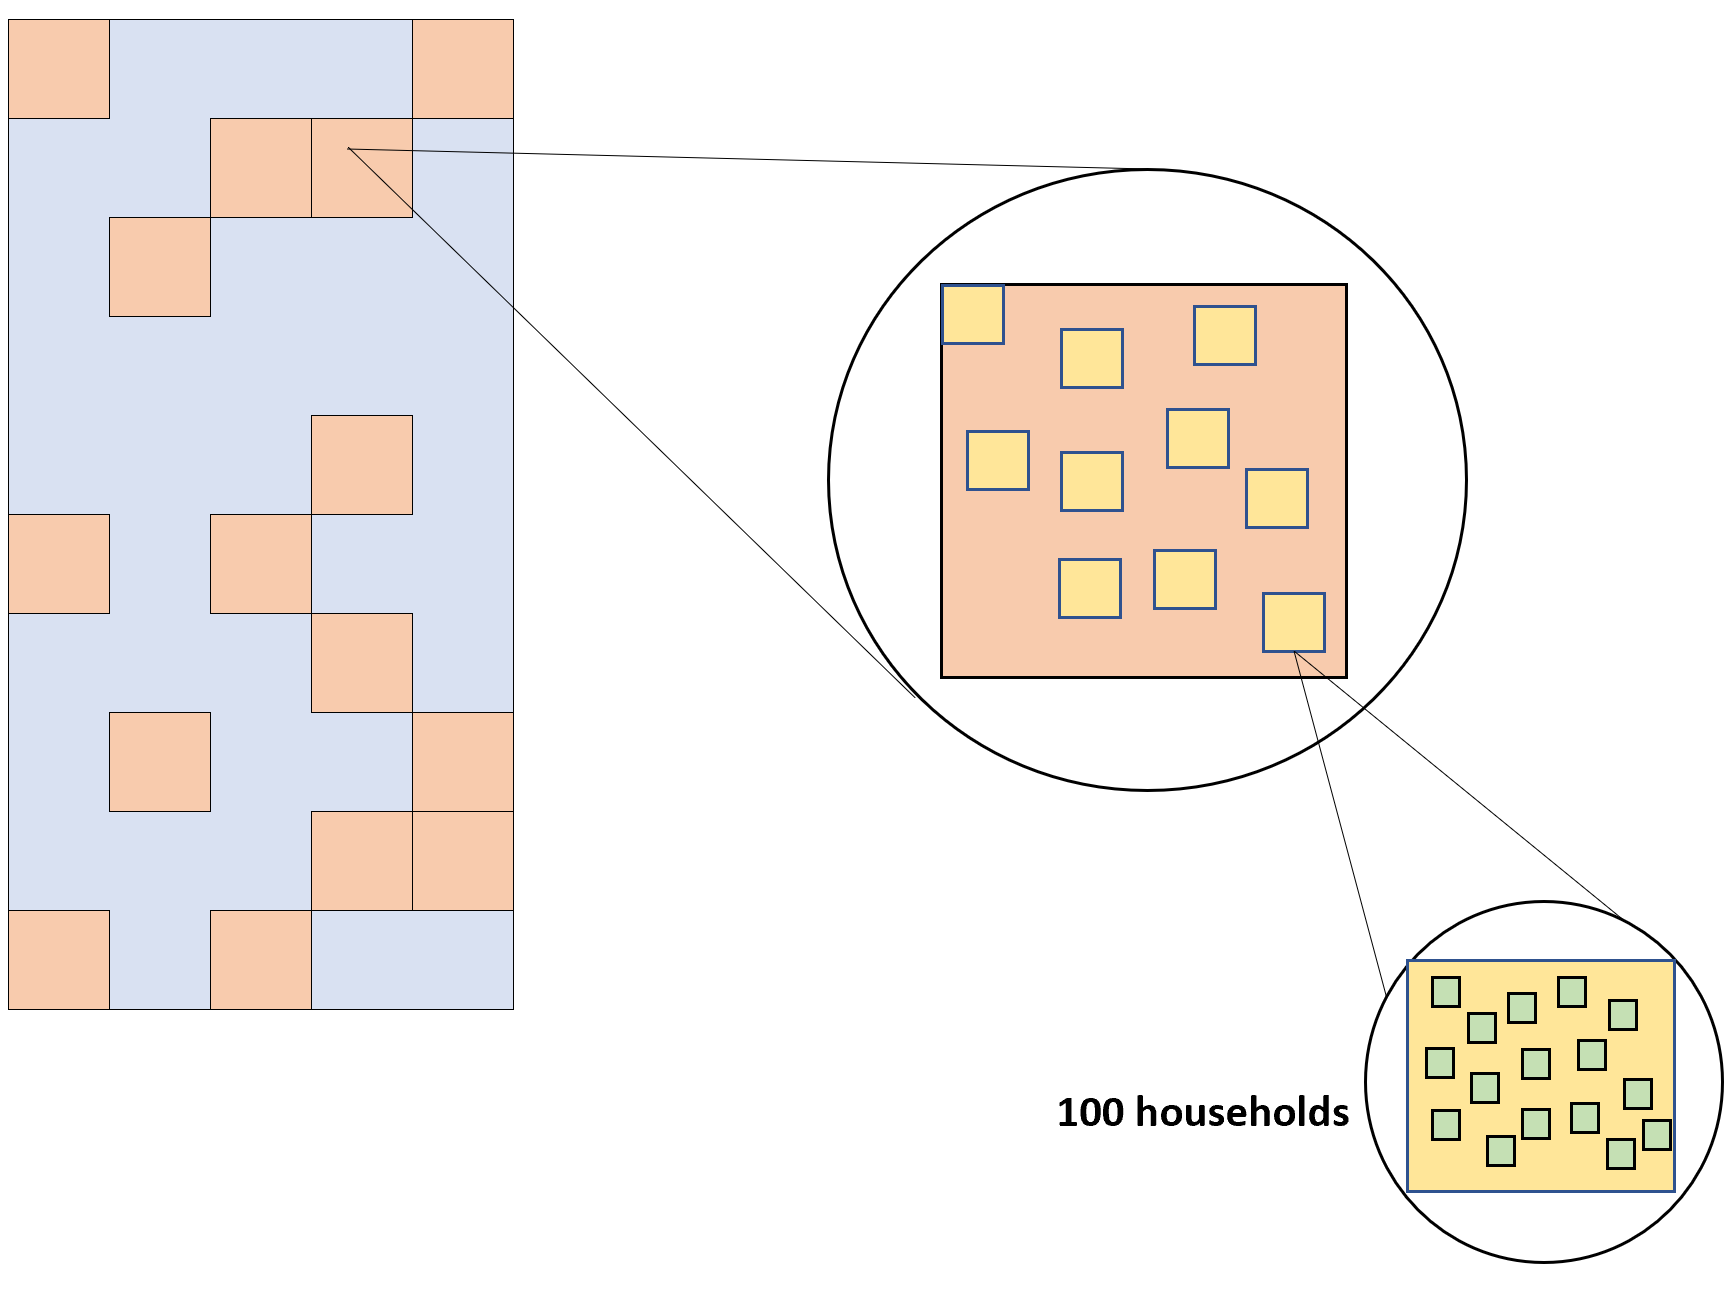
- Troisième degré (Sélection des unités finales) : Dans chacune des 150 communes sélectionnées, les enquêteurs accèdent aux registres d’habitation locaux pour dresser la liste des foyers. Supposons que chaque commune contienne en moyenne $N_{UF} = 2 000$ foyers éligibles. Un tirage aléatoire simple est opéré au sein de chaque registre municipal pour sélectionner $n_3 = 100$ foyers. Au sein de chaque foyer sélectionné, un unique adulte est désigné au hasard via une table de tirage aléatoire pour répondre aux instruments psychométriques.
La taille globale finale de l’échantillon d’observation ($n_{total}$) s’établit par le produit arithmétique simple des unités échantillonnées à chaque étape du processus en cascade :
$$n_{total} = n_1 \times n_2 \times n_3 = 15 \times 10 \times 100 = 15,000\text{ participants}$$
Grâce à ce dispositif, les cliniciens et évaluateurs n’ont à se déplacer que sur 150 sites géographiques bien délimités à travers le pays (les 150 communes sélectionnées), au lieu de parcourir le territoire entier de manière erratique pour joindre 15 000 points spatiaux déconnectés.
4.3 Calcul de la probabilité globale d’inclusion d’un individu
En vertu des axiomes fondamentaux du calcul des probabilités, la probabilité globale qu’un individu spécifique de la population générale fasse partie de l’échantillon final dépend directement de l’intersection stochastique des événements de sélection survenus à chaque degré. Conformément à la formule des probabilités conditionnelles composées, la probabilité d’inclusion du premier ordre pour un individu $k$, notée $\pi_k$, est le produit multiplicatif des probabilités conditionnelles d’inclusion à chaque échelon hiérarchique :
$$\pi_k = P(UPE_i) \times P(USE_{ij} mid UPE_i) \times P(Individu_{ijk} mid USE_{ij})$$
En appliquant les paramètres numériques de notre protocole canonique où les probabilités sont supposées égales au sein de chaque strate d’échelon :
- Probabilité que le département $i$ soit tiré au sort au 1er degré :
$$P(UPE_i) = \frac{n_1}{N_{UPE}} = \frac{15}{100} = 0{,}15$$ - Probabilité conditionnelle que la commune $j$ soit sélectionnée au 2ème degré sachant que son département a été tiré :
$$P(USE_{ij} mid UPE_i) = \frac{n_2}{N_{USE}} = \frac{10}{80} = 0{,}125$$ - Probabilité conditionnelle que le résident $k$ soit sélectionné au 3ème degré sachant que sa commune a été tirée :
$$P(Individu_{ijk} mid USE_{ij}) = \frac{n_3}{N_{UF}} = \frac{100}{2,000} = 0{,}05$$
En agrégeant ces probabilités conditionnelles au sein de l’équation multiplicative :
$$\pi_k = 0{,}15 \times 0{,}125 \times 0{,}05 = 0{,}0009375$$
Chaque citoyen de cette population présente une probabilité d’inclusion théorique strictement non nulle et parfaitement quantifiée de $\pi_k = 9{,}375 \times 10^{-4}$, soit un peu moins d’une chance sur mille d’être interrogé. Le facteur d’extrapolation ou poids de sondage de base ($w_k$), représentant le nombre d’individus de la population générale symbolisés par ce répondant unique, est défini par l’inverse formel de sa probabilité d’inclusion :
$$w_k = \frac{1}{\pi_k} = \frac{1}{0{,}0009375} \approx 1,066{,}67$$
Dans l’hypothèse simplifiée où toutes les unités à chaque niveau ont rigoureusement la même taille démographique, ce plan présente la propriété remarquable d’être auto-pondéré (epsem : equal probability selection method), car tous les individus partagent une valeur de probabilité identique. Cependant, dans les contextes réels où les unités territoriales fluctuent en population, l’auto-pondération requiert le recours à des tirages PPT, comme analysé plus loin.
5. Distinctions critiques : Échantillonnage à plusieurs degrés vs par grappes vs stratifié
Une confusion méthodologique persistante dans la littérature empirique consiste à amalgamer les notions d’échantillonnage stratifié, d’échantillonnage en grappes et d’échantillonnage à plusieurs degrés. Bien que ces plans partagent la caractéristique commune de segmenter la population en sous-ensembles, leurs fondements mathématiques, leurs objectifs structurels et leurs dynamiques de variance divergent radicalement.
5.1 Différenciation avec l’échantillonnage en grappes simple
L’échantillonnage en grappes simple (mono-étapique) présente une analogie évidente avec l’approche à plusieurs degrés au stade initial, car la population y est également partitionnée en groupes d’éléments appelés grappes (écoles, cliniques, pâtés de maisons). La divergence fondamentale réside dans l’exhaustivité de l’observation au sein des grappes sélectionnées. Dans un échantillonnage par grappes conventionnel à un seul degré, une fois qu’un échantillon de grappes a été tiré au sort, le chercheur procède au recensement complet de tous les éléments sans exception contenus dans ces grappes.
Par contraste, l’échantillonnage à plusieurs degrés se caractérise précisément par la rupture systématique de cette exhaustivité au profit d’un sous-échantillonnage probabiliste. Au lieu d’administrer les questionnaires psychologiques à la totalité des 2 000 ménages d’une commune retenue, l’approche multi-étapique prélève une fraction aléatoire de ces ménages. Cette distinction technique modifie profondément le profil économique et statistique du projet :
- Charge de collecte et saturation de terrain : Interroger tous les individus d’une grappe crée souvent une redondance massive en raison de la ressemblance psychologique ou comportementale des sujets proches (homophilie). Le sous-échantillonnage propre au multi-étapique évite cette sur-représentation locale inutile et libère des moyens pour échantillonner un plus grand nombre d’UPE diversifiées.
- Acceptabilité psychologique et éthique : Dans les contextes institutionnels sensibles (écoles, hôpitaux psychiatriques), recenser exhaustivement tous les membres d’une structure peut engendrer des pressions de groupe, des phénomènes de contagion de réponses ou perturber gravement le fonctionnement organisationnel. Le tirage d’une fraction aléatoire atténue ces nuisances.
5.2 Différenciation avec l’échantillonnage stratifié
La confusion entre échantillonnage stratifié et multi-étapique découle du fait que les deux méthodes identifient des groupes avant la sélection. Néanmoins, leurs logiques probabilistes sont diamétralement opposées quant à la couverture des ensembles et à l’architecture de la variance :
- Critère d’inclusion des groupes : Dans un plan stratifié, la totalité sans exception des strates constituées (par exemple, chaque tranche d’âge, ou chaque catégorie socio-professionnelle) est présente dans l’échantillon. Un échantillon est prélevé au sein de chaque strate. Dans un plan à plusieurs degrés, seule une fraction probabiliste des UPE est retenue ; les UPE non tirées au sort lors du premier tour sont totalement exclues de la collecte de données.
- Optimisation de la variance : La stratification vise à créer des groupes qui soient le plus homogènes possible en interne (faible variance intra-strate) et le plus hétérogènes possible entre eux (forte variance inter-strates), ce qui permet de réduire mathématiquement l’erreur d’échantillonnage globale. À l’inverse, dans les plans multi-étapiques par grappes, l’idéal théorique—rarement atteint dans la réalité—exigerait que les grappes soient aussi diversifiées en interne que la population générale (forte variance intra-grappe) et se ressemblent le plus possible entre elles (faible variance inter-grappes).
L’échantillonnage stratifié est un outil de maximisation de la précision de l’estimateur par réduction de la variance. L’échantillonnage à plusieurs degrés, quant à lui, est initialement un outil d’optimisation de la faisabilité logistique, qui accepte généralement une dégradation modérée de la précision statistique (inflation de la variance) en échange d’une réduction substantielle des coûts de déplacement et de constitution des cadres d’enquête.
5.3 Tableau comparatif des propriétés statistiques et logistiques
Le tableau suivant synthétise les propriétés structurelles, probabilistes et opérationnelles qui distinguent les trois grands plans d’échantillonnage complexes utilisés dans les protocoles de recherche en sciences humaines et comportementales :
| Caractéristique | Échantillonnage Stratifié | Échantillonnage en Grappes (1 degré) | Échantillonnage à Plusieurs Degrés |
|---|---|---|---|
| Sélection des groupes | Toutes les strates sont obligatoirement incluses (100%). | Seul un sous-ensemble aléatoire de grappes est inclus. | Seul un sous-ensemble aléatoire d’UPE (et sous-unités) est inclus. |
| Sélection au sein des groupes | Échantillon probabiliste d’individus prélevé dans chaque strate. | Recensement exhaustif de tous les individus au sein des grappes retenues. | Sous-échantillonnage probabiliste à chaque degré successif. |
| Bases de sondage requises | Base exhaustive de tous les individus de la population globale classés par strate. | Base exhaustive des grappes, puis listes complètes des individus des seules grappes retenues. | Base des UPE, puis bases successives créées uniquement pour les unités retenues. |
| Coûts de déplacement | Élevés (dispersion géographique nationale des individus tirés). | Très faibles (concentration totale sur quelques grappes circonscrites). | Modérés à faibles (compromis optimal de dispersion sur sites sélectionnés). |
| Impact sur la variance | Réduction de la variance (gain de précision par rapport à l’aléatoire simple). | Forte augmentation de la variance (effet de plan souvent très élevé). | Augmentation modérée de la variance (effet de plan contrôlé par sous-échantillonnage). |
| Complexité analytique | Modérée (pondérations de strate, standardisation classique). | Élevée (prise en compte impérative de la corrélation intra-classe). | Très élevée (modélisations hiérarchiques, linéarisation de Taylor, poids emboîtés). |
6. Méthodes probabilistes employées à chaque degré d’échantillonnage
Un plan d’échantillonnage à plusieurs degrés ne se résume pas à l’application uniforme d’un tirage au sort classique. L’ingénierie statistique moderne consiste à mobiliser des algorithmes de tirage probabilistes différenciés et complémentaires à chaque strate hiérarchique, afin d’atténuer les biais liés aux inégalités démographiques des unités structurelles.
6.1 L’échantillonnage aléatoire simple (EAS) à chaque niveau
L’implémentation la plus élémentaire d’un plan multi-étapique consiste à exécuter un échantillonnage aléatoire simple (EAS) sans remise à chaque niveau de la hiérarchie. Dans cette configuration, chaque UPE dispose rigoureusement de la même chance d’être tirée lors du premier stade, et chaque sous-unité jouit d’une équiprobabilité au sein de son unité d’appartenance. Ce schéma est mathématiquement séduisant par sa limpidité algorithmique, mais ses conditions strictes de validité opérationnelle sont rarement satisfaites dans le monde réel.
L’EAS n’est efficient et équitable que dans l’éventualité où toutes les unités d’un degré donné possèdent approximativement la même taille démographique. Or, dans les contextes écologiques ou organisationnels, cette égalité est une illusion : les établissements hospitaliers psychiatriques varient de quelques dizaines de lits à plusieurs milliers ; de même, les universités peuvent compter de 500 à 40 000 étudiants. Si un chercheur applique un tirage aléatoire simple sur des UPE de tailles fortement asymétriques tout en prélevant ensuite un nombre fixe d’individus au dernier degré, il introduit un biais d’échantillonnage sévère :
- Les individus résidant au sein de petites UPE bénéficient d’une probabilité conjointe finale de sélection disproportionnellement plus élevée que ceux appartenant à de vastes UPE.
- L’échantillon final cesse d’être auto-pondéré, contraignant l’analyste à appliquer des poids de redressement massifs qui déstabilisent l’efficacité des estimateurs et gonflent artificiellement la variance d’échantillonnage.
6.2 L’échantillonnage avec Probabilité Proportionnelle à la Taille (PPT)
Pour résoudre définitivement l’asymétrie démographique des grappes, la méthodologie des enquêtes a instauré l’échantillonnage avec Probabilité Proportionnelle à la Taille (PPT ou Probability Proportional to Size – PPS). Le principe théorique fondamental de cette approche consiste à calibrer la probabilité d’inclusion d’une UPE lors du premier stade sur le volume effectif de sa population constitutive ($M_i$). Ainsi, une grande ville regroupant 10% de la population nationale aura exactement 10 fois plus de probabilités d’être tirée au premier tour qu’une bourgade abritant 1% des résidents.
La puissance méthodologique du tirage PPT éclate lorsqu’on l’associe à un tirage à taille fixe d’unités ($m$) au degré ultérieur au moyen d’un échantillonnage aléatoire simple. Cette combinaison ingénieuse restaure la condition d’auto-pondération de l’échantillon global. Démontrons ce résultat fondamental sur le plan mathématique :
Soit $M_0 = \sum_{i=1}^{N} M_i$ la population globale totale, $a$ le nombre d’UPE tirées au premier degré, $M_i$ la taille spécifique de la $i$-ème UPE, et $m$ le nombre constant d’individus sélectionnés au sein de chaque UPE retenue :
- La probabilité de tirage de la $i$-ème UPE au premier degré sous sélection PPT est :
$$P(UPE_i) = a \times \frac{M_i}{M_0}$$ - La probabilité conditionnelle de tirer un individu particulier $k$ au sein de cette UPE lors du second degré au moyen d’un tirage équiprobable est :
$$P(Individu_k mid UPE_i) = \frac{m}{M_i}$$
En formulant la probabilité finale conjointe d’inclusion $\pi_k$ de cet individu :
$$\pi_k = P(UPE_i) \times P(Individu_k mid UPE_i) = \left(a \times \frac{M_i}{M_0}\right) \times \left(\frac{m}{M_i}\right) = \frac{a \times m}{M_0}$$
Le terme spécifique de taille $M_i$ s’annule algébriquement dans l’équation. La probabilité d’inclusion finale $\pi_k$ devient indépendante de l’UPE à laquelle appartient l’individu : elle est strictement constante pour tous les membres de la population. L’échantillon final est auto-pondéré ($w_k = M_0 / (a \times m)$ pour tous), ce qui élimine le fardeau analytique des poids variables et optimise radicalement la précision des estimateurs statistiques, tout en maintenant les charges de collecte rigoureusement identiques pour les équipes d’enquêteurs sur chaque site sélectionné ($m$ questionnaires administrés par site).
6.3 Combinaison avec la stratification préalable des UPE
L’architecture d’un plan d’échantillonnage gagne considérablement en robustesse lorsqu’elle hybride plusieurs stratégies fondamentales. L’un des agencements les plus puissants en épidémiologie et en sociologie comportementale est l’échantillonnage stratifié à plusieurs degrés (stratified multistage sampling). Dans ce modèle, la population totale des UPE n’est pas soumise directement à un tirage probabiliste brut : elle est préalablement scindée en strates mutuellement exclusives selon des variables auxiliaires majeures d’intérêt psychologique ou démographique.
Par exemple, dans le cadre d’une enquête nationale sur les comportements addictifs chez les jeunes adultes, les UPE (départements ou municipalités) peuvent être stratifiées selon leur typologie géographique (milieu hyper-urbain, tissu périurbain, couronne industrielle, zone rurale dispersée) ou leur statut socio-économique moyen (revenu médian local). Une fois ces macro-strates délimitées de manière exhaustive :
- Un échantillon d’UPE est prélevé de façon indépendante au sein de chaque strate, fréquemment en appliquant un algorithme de tirage PPT.
- Le processus de sélection aux degrés intermédiaires et finaux se déploie ensuite selon les mécanismes probabilistes décrits précédemment.
Cette approche combinée sécurise la représentativité des sous-groupes démographiques minoritaires ou atypiques. Elle garantit qu’aucun pan crucial de la diversité sociétale n’est fortuitement omis par le tirage au sort aléatoire du premier degré. De surcroît, elle tire simultanément parti des bénéfices de la stratification (réduction de la variance inter-strates) et de l’échantillonnage multi-étapique (rationalisation des coûts logistiques et opérationnels de l’investigation clinique de terrain).
7. Applications empiriques en psychologie et sciences du comportement
La psychologie et les sciences du comportement ont longtemps pâti du syndrome WEIRD (Western, Educated, Industrialized, Rich, and Democratic), fondé sur des études de laboratoire menées auprès d’étudiants de premier cycle universitaire. L’adoption des protocoles d’échantillonnage à plusieurs degrés a permis de rompre avec ce confinement académique en déployant la recherche psychométrique et clinique à l’échelle écologique de populations entières.
7.1 Évaluation du bien-être et de la santé mentale en milieu scolaire
Le milieu scolaire constitue un champ d’application paradigmatique des modèles d’échantillonnage hiérarchique. L’évaluation de construits psychologiques chez l’enfant et l’adolescent—tels que les phénomènes de harcèlement scolaire, les symptômes dépressifs précoces ou les compétences socio-émotionnelles—requiert une insertion harmonieuse dans des structures éducatives fortement hiérarchisées. Tenter d’extraire des élèves individuels au hasard dans tout un pays pour leur faire passer des tests psychométriques créerait une désorganisation institutionnelle inacceptable.
Un plan d’échantillonnage à trois degrés s’organise alors classiquement comme suit :
- Degré 1 : Sélection aléatoire stratifiée d’académies ou d’autorités scolaires régionales à l’échelle de l’État.
- Degré 2 : Tirage probabiliste par PPT d’établissements scolaires (collèges, lycées) au sein des académies sélectionnées, la taille étant le nombre d’élèves inscrits.
- Degré 3 : Tirage au sort aléatoire simple d’une ou deux classes d’élèves au sein de chaque niveau d’enseignement de l’établissement retenu.
Tous les élèves de la classe sélectionnée sont ensuite invités à remplir les auto-questionnaires sous la supervision d’un psychologue ou d’un évaluateur formé. Cette méthodologie préserve l’intégrité de la dynamique de classe, simplifie l’obtention des consentements éclairés auprès des directions scolaires et des associations parentales, et optimise l’affectation temporelle des professionnels de l’évaluation psychologique sans dénaturer la représentativité populationnelle finale des données épidémiologiques scolaires.
7.2 Études épidémiologiques psychiatriques à l’échelle territoriale
À l’échelle d’une région sanitaire ou d’un État, l’analyse de la prévalence des troubles bipolaires, de l’état de stress post-traumatique ou de la dépendance aux substances psychoactives fait appel à des dispositifs multi-étapiques aréolaires standardisés, à l’instar des protocoles mis en œuvre dans l’enquête ESEMeD (European Study of the Epidemiology of Mental Disorders, 2004). La complexité de ces études découle de la lourdeur des protocoles cliniques (entretiens diagnostiques approfondis Composite International Diagnostic Interview – CIDI de l’OMS nécessitant jusqu’à deux heures de passation individuelle).
Le protocole structure l’investigation spatiale selon un découpage emboîté : les UPE sont représentées par les secteurs sanitaires ou les circonscriptions de santé mentale ; les USE correspondent aux zones de collecte élémentaires (pâtés de maisons ou îlots statistiques de recensement) ; enfin, les unités ultimes sont les résidents désignés au sein des foyers tirés au sort. Cette densification géographique ciblée permet de standardiser strictement les conditions d’administration des entretiens cliniques.
Elle permet également de mettre en place des équipes mobiles de cliniciens supervisés localement par des coordinateurs de zone. La proximité géographique des sujets interrogés facilite le ré-envoi immédiat d’enquêteurs pour contrôler la fidélité inter-juges, vérifier l’absence d’erreurs d’encodage et réaliser des contre-visites de contrôle auprès d’un sous-échantillon d’audits diagnostiques, garantissant une métrologie psychométrique rigoureuse à l’échelle de territoires géographiques vastes.
7.3 Psychologie du travail et climat organisationnel dans les multinationales
Le diagnostic des risques psychosociaux (RPS), de l’épuisement professionnel (burnout via le Maslach Burnout Inventory) et de la culture d’entreprise au sein des grandes entreprises privées ou des conglomérats industriels internationaux présente des défis d’échantillonnage spécifiques. Déployer une enquête globale auprès de 200 000 salariés dispersés dans 40 pays via un envoi numérique simple engendre des biais massifs d’auto-sélection : seuls les salariés fortement mécontents ou sur-engagés répondent généralement, faussant radicalement le diagnostic organisationnel.
Pour obtenir des estimations robustes et exploitables sur le plan managérial, la direction des ressources humaines et les psychologues du travail adoptent un plan d’échantillonnage multi-étapique :
- Premier degré : Sélection probabiliste d’un nombre ciblé de filiales industrielles ou de sites géographiques, après stratification par pays et type d’activité (production industrielle, centres de recherche et développement, services tertiaires).
- Deuxième degré : Tirage aléatoire d’équipes fonctionnelles ou de départements de projet au sein de chaque site retenu.
- Troisième degré : Sous-échantillonnage probabiliste de collaborateurs au sein de chaque équipe pour des sessions de passation supervisées ou des focus groups psychologiques structurés.
Ce protocole garantit une couverture rigoureuse de toutes les conditions de travail effectives, évite la perturbation simultanée de l’ensemble de la chaîne productive de la firme et autorise l’analyse des interactions entre les variables organisationnelles de niveau macro (la culture de la filiale) et les indicateurs psychologiques de niveau micro (la détresse perçue individuelle).
8. Avantages méthodologiques, logistiques et financiers
Le succès prépondérant de l’échantillonnage à plusieurs degrés dans les grands programmes de recherche internationaux ne relève pas d’un fétichisme mathématique, mais de son efficience pratique exceptionnelle face aux contraintes du monde réel.
8.1 Réduction drastique des coûts logistiques et de déplacement
Dans toute recherche empirique impliquant des mesures en présentiel (tests neuropsychologiques, prises de paramètres physiologiques, biomarqueurs salivaires de cortisol associés au stress), le poste budgétaire afférent aux transports des évaluateurs, à leur hébergement et au fret du matériel clinique représente la part la plus lourde des dépenses directes. L’échantillonnage à plusieurs degrés concentre structurellement les observations au sein de noyaux géographiques restreints.
Au lieu de disperser 1 000 observations sur 1 000 municipalités distinctes réparties sur l’ensemble d’un sous-continent, le modèle multi-étapique sélectionnera par exemple 20 municipalités et y interrogera 50 sujets dans chacune. Les gains d’échelle sont immédiats :
- Les trajets interurbains sont réduits d’un facteur d’au moins dix, amortissant substantiellement le coût carbone et financier du projet de recherche.
- L’affectation des psychologues évaluateurs et du matériel de diagnostic standardisé s’effectue sur des bases locales pérennes pour plusieurs semaines consécutives, éliminant les temps morts et la fatigue des professionnels.
- Le rendement budgétaire global devient supérieur : à budget égal alloué par un organisme public de recherche, un plan multi-étapique permet d’observer un volume d’individus nettement plus important que ne le permettrait un échantillonnage aléatoire dispersé, compensant largement les contraintes d’effet de plan.
8.2 Absence de nécessité d’une base de sondage globale préalable
L’avantage épistémologique et opérationnel le plus déterminant réside dans la libération absolue de l’obligation de détenir une base de sondage exhaustive nominative de la population globale dès l’entame de la recherche. Obtenir la liste nominative, actualisée et sans doublons de tous les résidents d’un pays ou de l’ensemble des patients souffrant d’une pathologie chronique donnée est un objectif chimérique dans la quasi-totalité des juridictions mondiales en raison des régulations strictes sur les données personnelles (comme le RGPD en Europe).
L’architecture multi-étapique contourne cette impasse structurelle par une construction documentaire séquentielle et différée :
- Au lancement de l’étude, seule la liste macroscopique des UPE est requise (nombre de cantons, liste des écoles, inventaire des entreprises). Cette information est presque toujours disponible dans le domaine public ou auprès des institutions de tutelle.
- Les listes nominatives détaillées des unités ultimes ne sont confectionnées que postérieurement et uniquement pour les quelques unités retenues lors des tirages préliminaires.
Cette particularité opérationnelle réduit de façon exponentielle les délais de préparation des protocoles scientifiques. Elle rend possibles des recherches empiriques probabilistes de haute volée dans les pays en développement ou au sein de populations vulnérables et marginalisées, pour lesquelles aucun registre d’état civil centralisé n’a jamais été constitué.
8.3 Flexibilité opérationnelle et adaptation contextuelle
L’échantillonnage à plusieurs degrés confère aux méthodologistes une modularité analytique qu’aucun autre plan ne peut égaler. Il est tout à fait envisageable d’adapter les modalités de contact ou d’administration psychométrique en fonction des spécificités structurelles de chaque niveau hiérarchique. Par exemple, une étude nationale sur la santé psychologique des soignants peut opérer par tirage aléatoire d’hôpitaux au degré 1, tirage de services cliniques au degré 2, et au degré 3, administrer des questionnaires numériques en ligne pour les services administratifs tout en procédant à des passations papier en face-à-face pour les unités de soins intensifs sous contraintes sanitaires sévères.
Cette modularité s’étend également à l’adaptation linguistique et culturelle. Dans les études internationales ou transfrontalières, les questionnaires psychométriques peuvent être adaptés ou traduits en dialectes régionaux uniquement au sein des UPE géographiques ciblées, évitant ainsi des dépenses de traduction et de contre-traduction pour des langues parlées dans des zones géographiques qui n’auraient finalement pas été retenues lors du tirage de premier rang.
Enfin, le regroupement des observations sur des sites concentrés simplifie considérablement le monitoring et l’audit de qualité des protocoles de recherche. Les coordinateurs scientifiques peuvent se rendre sur place de manière inopinée pour contrôler le respect scrupuleux des consignes de passation standardisées par les assistants de recherche, limitant les dérives expérimentales et maximisant la fidélité de l’évaluation psychologique collective.
9. Limites statistiques, biais potentiels et effet de plan
En dépit de ses atouts pratiques indiscutables, l’échantillonnage à plusieurs degrés n’est pas un substitut neutre à l’échantillonnage aléatoire simple. Sur le plan purement mathématique, il paie sa commodité logistique par une dégradation de l’efficacité statistique théorique. Ignorer les implications stochastiques d’un tel plan expose les chercheurs à des biais d’inférence sévères et à des conclusions fallacieuses.
9.1 L’effet de plan (Design Effect – Deff) et la corrélation intraclasse
L’inconvénient statistique structurel de l’échantillonnage à plusieurs degrés réside dans la violation de l’hypothèse d’indépendance des observations, postulat sous-jacent à la quasi-totalité des équations classiques de la statistique inférentielle paramétrique (tests $t$ de Student, analyses de variance, régressions des moindres carrés ordinaires). En pratique, des individus appartenant à une même grappe physique ou institutionnelle (la même classe, le même hôpital, le même quartier) se ressemblent davantage entre eux qu’avec des individus prélevés au hasard dans la population générale. Ce phénomène de ressemblance interne est formellement quantifié par le coefficient de corrélation intraclasse, noté $rho$ (rho).
Pour modéliser l’impact de ce regroupement sur la variance des estimateurs, Leslie Kish (Kish, 1965) a forgé le concept fondamental d’effet de conception ou effet de plan (Design Effect, noté $Deff$). Le $Deff$ mesure le ratio entre la variance réelle de l’estimateur sous le plan complexe considéré et la variance théorique qu’aurait produit un échantillon aléatoire simple de taille numérique rigoureusement identique :
$$Deff = \frac{operatorname{Var}_{\text{complexe}}(\hat{\theta})}{operatorname{Var}_{\text{EAS}}(\hat{\theta})}$$
Dans un plan d’échantillonnage hiérarchique où les grappes sélectionnées au dernier niveau ont une taille moyenne de sous-échantillon égale à $m$, le $Deff$ s’exprime par l’approximation linéaire classique :
$$Deff = 1 + (m – 1)\rho$$
L’analyse de cette formule met en lumière les leviers mathématiques de l’inflation de la variance :
- Si $rho = 0$ (absence absolue de ressemblance au sein des grappes), $Deff = 1$ : le plan complexe possède la même efficacité qu’un échantillonnage aléatoire simple. Cette situation ne se produit pratiquement jamais en sciences humaines.
- Dès lors que $rho > 0$, l’effet de plan devient strictement supérieur à 1. Plus le nombre de participants interrogés par grappe ($m$) est élevé, plus le $Deff$ s’amplifie dramatiquement, même face à une corrélation intraclasse modeste. Par exemple, si l’on évalue l’anxiété dans des classes avec $\rho = 0{,}08$ et que l’on teste $m = 31$ élèves par classe, $Deff = 1 + (31 – 1) \times 0{,}08 = 1 + 2{,}4 = 3{,}4$. La variance réelle de l’estimateur est donc 3,4 fois plus élevée que celle calculée par les formules logicielles conventionnelles !
9.2 Inflation de l’erreur type et réduction de la taille effective
La conséquence directe et immédiate d’un effet de plan supérieur à 1 est l’inflation systématique des erreurs-types des estimateurs statistiques. L’erreur-type réelle d’un estimateur sous échantillonnage complexe équivaut à son erreur-type sous tirage aléatoire simple multipliée par la racine carrée de l’effet de plan, un coefficient d’ajustement désigné sous l’acronyme de $Deft$ :
$$SE_{\text{complexe}}(\hat{\theta}) = SE_{\text{EAS}}(\hat{\theta}) \times \sqrt{Deff} = SE_{\text{EAS}}(\hat{\theta}) \times Deft$$
Si un analyste des données psychologiques applique des logiciels standards sans spécifier la structure complexe du sondage, le logiciel utilisera naïvement la formule de variance de l’aléatoire simple. Il en résultera une sous-estimation substantielle des erreurs-types. Les intervalles de confiance à 95% affichés seront beaucoup trop étroits, et les $p$-valeurs associées aux tests d’hypothèses se trouveront artificiellement réduites, générant un risque critique d’erreurs de type I : le chercheur rejettera à tort l’hypothèse nulle en croyant identifier des différences psychologiques ou des corrélations cliniques statistiquement significatives qui ne sont en réalité que le produit des fluctuations d’échantillonnage induites par la structure des grappes.
Pour appréhender la portée concrète de cette perte de précision, la méthodologie des enquêtes recourt à la notion de taille d’échantillon effective ($n_{\text{eff}}$). Celle-ci formalise la taille théorique qu’aurait dû avoir un échantillon aléatoire simple pur pour égaler la précision statistique effectivement atteinte par notre échantillon complexe réel de taille $n$ :
$$n_{\text{eff}} = \frac{n}{Deff}$$
Dans l’illustration précédente où $n = 15,000$ sujets avec un $Deff = 3{,}4$, la taille effective réelle de l’étude ne s’élève qu’à :
$$n_{\text{eff}} = \frac{15,000}{3{,}4} \approx 4,412\text{ participants}$$
L’équipe de recherche dispose donc en réalité de la puissance statistique d’une étude de seulement 4 412 individus indépendants, ce qui exige impérativement une anticipation mathématique rigoureuse lors de la phase de calcul initial de puissance.
9.3 Biais de non-réponse et attrition différentielle selon les unités
Un autre défi méthodologique propre aux structures multi-étapiques concerne l’architecture de la non-réponse. Dans un échantillon aléatoire simple, le refus d’un individu sélectionné représente une perte d’observation ponctuelle et statistiquement isolée. Dans un plan à plusieurs degrés, les phénomènes de non-réponse peuvent intervenir à n’importe quel échelon hiérarchique, avec des répercussions exponentiellement plus dévastatrices à mesure que l’on remonte vers les unités primaires.
Si une UPE sélectionnée (par exemple, un établissement scolaire sensible ou un bassin de population marginalisé) refuse massivement de collaborer au protocole de recherche, ce n’est pas un individu qui s’échappe de l’étude, mais un pan entier de la variabilité sociale du phénomène étudié qui se trouve amputé. L’impact de l’attrition au niveau d’une grappe entière est infiniment plus délétère pour la validité externe du modèle que des non-réponses individuelles disséminées :
- Biais de sélection structurel : Les UPE qui refusent de participer partagent souvent des traits contextuels corrélés aux construits psychologiques investigués (par exemple, surcharge de travail des équipes hospitalières, tensions institutionnelles, sentiment de stigmatisation communautaire). Leur exclusion passive sélectionne implicitement les grappes les plus stables et collaboratives.
- Impossibilité de substitution mécanique : Remplacer au pied levé une UPE défaillante par une autre unité institutionnelle disponible détruit le principe probabiliste originel et amplifie les biais d’auto-sélection bienveillante du nouvel entrant, invalidant le calcul initial des probabilités conjointes.
10. Considérations statistiques avancées : Pondération et modélisation multiniveau
L’analyse des jeux de données psychométriques issus d’un échantillonnage à plusieurs degrés interdit le recours aux routines analytiques traditionnelles. Le traitement rigoureux de ces données complexes requiert une double expertise méthodologique : la calibration par pondération d’enquête et l’intégration des structures de dépendance par les modèles de régression multiniveaux.
10.1 Calcul et application des poids de sondage
Puisque la perfection d’un plan auto-pondéré parfait est exceptionnellement rare sur le terrain en raison des fluctuations imprévisibles de la composition des ménages et des profils de non-réponse différentiels, chaque individu observé au terme d’un protocole multi-étapique doit impérativement se voir affecter un poids statistique final ($W_k$). Ce poids exprime la contribution relative de cette observation à l’estimation des paramètres de la population macroscopique.
Le calcul du poids final résulte d’une décomposition algorithmique séquentielle en trois temps :
- Le poids de sondage de base ($w_k$) : C’est l’inverse formel de la probabilité globale d’inclusion d’un individu $k$, déterminée par le produit multiplicatif des probabilités conditionnelles de chaque degré de tirage :
$$w_k = \frac{1}{\pi_k}$$ - L’ajustement pour non-réponse : Ce facteur d’équilibrage réattribue le poids des sujets ayant décliné l’invitation aux participants répondants au sein de cellules d’homogénéité de réponse (définies sur des variables sociodémographiques connues pour toute la base d’origine).
- Le calage sur marges (post-stratification) : À l’aide d’algorithmes mathématiques de calage (méthode de Deville et Särndal, 1992, mise en œuvre par des fonctions comme raking ratio), les poids sont ajustés de manière itérative pour que les totaux estimés de l’échantillon sur des distributions clés (sexe, tranches d’âge, niveau d’études) coïncident rigoureusement avec les distributions réelles issues des recensements officiels les plus récents de l’institut national de statistique.
L’omission délibérée de ces poids de pondération dans l’estimation de paramètres descriptifs simples (comme la moyenne d’un score de bien-être ou la prévalence du syndrome dépressif) biaise mécaniquement les résultats vers les caractéristiques moyennes des sous-groupes ayant bénéficié d’une sur-représentation fortuite ou délibérée dans le protocole de sondage.
10.2 Estimation de la variance pour données d’enquête complexes
Dès lors que des données ont été prélevées selon un plan multi-étapique non-indépendant et dotées de poids variables, le calcul de la variance d’un estimateur quelconque ($\hat{\theta}$) ne peut plus s’appuyer sur la somme des carrés des écarts divisée par les degrés de liberté usuels. L’analyste doit impérativement recourir à des méthodes de traitement spécifiques pour plans de sondage complexes :
- La linéarisation par série de Taylor : Cette approche analytique dominante repose sur le développement d’une approximation par série de Taylor du premier ordre pour transformer un estimateur non linéaire complexe (tels que des ratios, des coefficients de corrélation de Pearson ou des odds ratios logistiques) en une forme linéaire approchée. La variance de cette forme approchée est ensuite calculée en intégrant formellement les strates et les identifiants d’UPE du plan de sondage.
- Les méthodes de rééchantillonnage pour plans complexes : Lorsque les approximations analytiques deviennent insolubles, des algorithmes itératifs calibrés spécifiquement pour les hiérarchies d’enquêtes sont appliqués :
- Le Jackknife répété pour sondages en grappes (JRR).
- Le Bootstrap pour plans complexes (tirage avec remise répété d’UPE entières au sein des strates, et non d’individus isolés).
- La technique des répliques répétées équilibrées (Balanced Repeated Replications – BRR).
Le chercheur doit impérativement utiliser des environnements logiciels dotés de moteurs computationnels dédiés à l’ingénierie des sondages. Sous l’environnement statistique R, le package centralisé survey (Lumley, 2010) permet de déclarer l’objet de plan de sondage via la fonction svydesign() en spécifiant explicitement les arguments ids = ~UPE + USE, strata = ~Strate et weights = ~Poids, garantissant que toutes les erreurs-types ultérieurement calculées (fonctions svymean, svyglm) intègrent rigoureusement l’effet de plan. Des modules équivalents existent dans d’autres plateformes de référence, comme le module Complex Samples d’IBM SPSS ou les préfixes de commande svy: sous Stata.
10.3 Articulation avec les Modèles Mixtes et Linéaires Hiérarchiques (HLM)
L’existence d’une structure de données emboîtée issue d’un échantillonnage à plusieurs degrés, traditionnellement perçue comme une nuisance statistique par l’analyste univarié en raison de l’inflation de la variance, se métamorphose en une formidable opportunité conceptuelle dès lors qu’elle est appréhendée par le prisme des Modèles Linéaires Hiérarchiques (HLM ou modèles multiniveaux), théorisés notamment par Snijders et Bosker (2012).
L’adéquation entre l’échantillonnage à plusieurs degrés et les modèles multiniveaux est absolue et consubstantielle :
- Décomposition orthogonale de la variance : Au lieu d’ignorer la variabilité issue des groupements écologiques, le modèle multiniveau scinde formellement la variance totale du construit psychologique ($Y_{ij}$) en deux composantes indépendantes : la variance résiduelle intra-groupe ($\sigma^2_{\text{intra}}$, variance individuelle) et la variance inter-groupes ($\tau^2_{\text{inter}}$, variance entre UPE).
- Modélisation des effets de contexte vs individuels : Cette structure mathématique permet de tester des hypothèses psychosociales fascinantes qu’aucun échantillonnage aléatoire simple ne saurait étayer : par exemple, évaluer dans quelle mesure l’anxiété d’un élève individuel ($Y_{ij}$) est directement modulée par ses compétences métacognitives personnelles (variable de niveau 1), par le climat relationnel global de l’établissement scolaire ($X_j$, variable contextuelle de niveau 2), et par des interactions trans-niveaux (cross-level interactions) testant si l’efficacité d’un trait individuel est conditionnée par l’atmosphère de l’institution.
Toutefois, les méthodologistes doivent veiller à l’intégration conjointe des poids de sondage au sein des équations d’estimation du maximum de vraisemblance restreint (REML) des modèles multiniveaux, un protocole technique connu sous le nom de modélisation multiniveau pondérée (weighted multilevel analysis), disponible dans des packages comme WeMix ou lavaan sous R.
11. Guide pratique pour concevoir un protocole d’échantillonnage à plusieurs degrés
Concevoir et mener à terme une enquête par échantillonnage à plusieurs degrés nécessite une gouvernance méthodique rigoureuse. Cette section fournit un canevas opérationnel pas-à-pas destiné aux directeurs de recherche et aux méthodologistes de laboratoire.
11.1 Phase de cadrage : Définition de la population et des unités hiérarchiques
La première démarche consiste à formaliser avec une précision chirurgicale la population cible de l’étude à l’aide de critères d’inclusion et d’exclusion théoriques et opérationnels. S’agit-il des résidents majeurs des logements ordinaires, excluant les personnes institutionnalisées en centres de convalescence ou en milieu carcéral ? Ces exclusions structurelles doivent être actées dès la rédaction du protocole initial.
L’étape suivante requiert la cartographie du squelette hiérarchique naturel ou organisationnel au sein duquel s’insère la population cible. Les chercheurs doivent évaluer la disponibilité matérielle et la fraîcheur documentaire des cadres de sondage intermédiaires :
- Vérifier l’accessibilité légale aux listes exhaustives des UPE postulées (annuaires des hôpitaux, cartographies d’îlots cadastraux, répertoires d’entreprises).
- S’assurer que ces unités intermédiaires s’emboîtent de façon strictement exclusive sans recoupement stochastique (une USE ne peut appartenir à deux UPE simultanément).
- Déterminer le nombre optimal d’échelons de décomposition : l’ajout d’un degré supplémentaire simplifie la confection des listes locales mais ajoute un terme de variance conditionnelle supplémentaire dans la cascade probabiliste globale. Le modèle bi-étapique ou tri-étapique constitue la norme dominante d’efficacité opérationnelle.
11.2 Phase de dimensionnement : Calcul de la puissance statistique et des UPE
Le dimensionnement d’un plan d’échantillonnage à plusieurs degrés exige une rupture formelle avec les calculatrices de taille d’échantillon rudimentaires trouvées en ligne. Le calcul de la taille cible doit impérativement intégrer la majoration liée au coefficient d’effet de plan prévisionnel ($Deff$).
L’équipe méthodologique applique le protocole quantitatif de dimensionnement suivant :
- Calculer la taille de l’échantillon nominal de référence sous hypothèse d’indépendance pure ($n_{\text{EAS}}$), requise pour atteindre la puissance statistique désirée ($1 – \beta = 0{,}80$ ou $0{,}90$) pour tester l’effet clinique ou la corrélation psychométrique escomptée à un seuil $\alpha = 0{,}05$.
- Estimer la corrélation intraclasse $rho$ attendue pour la variable d’intérêt clinique principale à partir de méta-analyses antérieures ou de la littérature épidémiologique publiée sur des terrains similaires.
- Déterminer le compromis optimal entre le nombre d’UPE ($k$) et le nombre de sujets par UPE ($m$) sous contrainte budgétaire : la théorie montre qu’il est mathématiquement plus avantageux d’augmenter le nombre d’UPE ($k$) tout en limitant $m$, afin de comprimer l’effet de plan ($Deff = 1 + (m-1)rho$).
- Calculer la taille finale théorique corrigée : $n_{\text{corrigé}} = n_{\text{EAS}} \times [1 + (m – 1)\rho]$.
- Appliquer une sur-allocation d’anticipation pour compenser le taux d’attrition et de non-réponse projeté ($R$) au niveau individuel et au niveau des grappes :
$$n_{\text{final}} = \frac{n_{\text{corrigé}}}{1 – R}$$
11.3 Phase d’exécution et de contrôle qualité sur le terrain
La crédibilité scientifique d’un protocole complexe se joue sur le terrain lors de l’application rigoureuse des algorithmes de randomisation. L’équipe centrale doit élaborer des manuels de procédures de standardisation stricts et organiser des sessions de formation obligatoires pour l’ensemble du personnel d’enquête.
Les leviers de contrôle qualité doivent inclure :
- Algorithmes de sélection automatisés : Proscrire l’usage par les enquêteurs de tirages au sort artisanaux sur le terrain. Les tirages des unités finales au sein des listes locales doivent être exécutés numériquement par des scripts centralisés chiffrés ou des applications mobiles de collecte dédiées (type CSPro, Qualtrics ou ODK) intégrant des tables de nombres pseudo-aléatoires traçables.
- Supervision des quotas d’efforts de contact : Définir une règle impérative d’au moins 3 à 5 passages à des horaires différenciés (matin, soir, week-end) avant de classer un foyer comme « injoignable », pour ne pas biaiser l’échantillon en faveur des personnes inactives ou sédentaires.
- Audit continu des taux de participation par UPE : Détecter immédiatement les grappes présentant des chutes anormales de réponse pour dépêcher des superviseurs seniors de soutien, et consigner exhaustivement chaque événement de collecte afin de recalculer les poids de sondage effectifs lors de la phase de clôture de la base de données.
12. Synthèse méthodologique et recommandations pour les chercheurs
L’intégration de l’échantillonnage à plusieurs degrés au sein de la boîte à outils des sciences du comportement marque une étape décisive vers une recherche quantitative plus inclusive, écologiquement valide et méthodologiquement robuste.
12.1 Arbre décisionnel : Quand privilégier l’échantillonnage à plusieurs degrés ?
Pour accompagner les chercheurs dans leurs arbitrages méthodologiques, l’arbre de décision suivant résume les critères discriminants guidant le choix vers ou contre l’échantillonnage à plusieurs degrés :
- Critère 1 : Disponibilité d’une base de sondage nominative complète de la population ?
- Oui : La population est-elle concentrée sur une zone géographique restreinte ou le protocole se déroule-t-il intégralement en ligne ?
- Oui : Privilégier un Échantillonnage Aléatoire Simple ou un Échantillonnage Stratifié pur (variance minimale, simplicité analytique).
- Non : Les coûts de déplacement physique pour des passations présentielles individuelles dispersées sont-ils acceptables ?
- Oui : Échantillonnage Stratifié.
- Non : Privilégier l’Échantillonnage à Plusieurs Degrés (par regroupement géographique).
- Non : L’Échantillonnage à Plusieurs Degrés est impératif pour reconstituer des listes locales séquentielles.
- Oui : La population est-elle concentrée sur une zone géographique restreinte ou le protocole se déroule-t-il intégralement en ligne ?
- Critère 2 : La question de recherche implique-t-elle des effets de contexte ou des structures hiérarchiques naturelles ?
- Oui (ex. dynamique de classe, culture d’entreprise) : L’Échantillonnage à Plusieurs Degrés est optimal, car sa structure alimente nativement les analyses multiniveaux (HLM).
- Non (ex. essais cliniques pharmacologiques ou psychothérapeutiques d’efficacité pure en phase 2) : Éviter l’échantillonnage multi-étapique pour ne pas subir l’inflation inutile de la variance liée à l’effet de plan.
12.2 Bonnes pratiques de reporting selon les normes scientifiques (APA, STROBE)
La publication des résultats issus d’un échantillon complexe doit répondre aux standards les plus exigeants de transparence et de reproductibilité, définis par le style officiel de l’American Psychological Association (APA JARS – Journal Article Reporting Standards) et les directives épidémiologiques STROBE (Strengthening the Reporting of Observational Studies in Epidemiology).
La section Méthode d’un manuscrit scientifique de haut niveau doit impérativement documenter :
- La description détaillée de chaque niveau d’échantillonnage, la définition formelle des UPE et USE, et la méthode de tirage appliquée à chaque stade (aléatoire simple, PPT, systématique).
- L’explicitation des bases de données administratives ayant servi de cadres de sondage primaires et secondaires, incluant leurs dates d’actualisation et limitations éventuelles.
- Le rapportage rigoureux des taux de participation, d’attrition et de refus à chaque niveau de la cascade (taux d’acceptation des écoles, taux de participation des classes, taux de réponse finale des élèves).
- Les valeurs estimées de la corrélation intraclasse ($rho$) et des coefficients d’effet de plan ($Deff$ ou $Deft$) pour les principaux construits psychométriques analysés.
- La formulation mathématique des procédures de calcul des poids de sondage, des ajustements pour non-réponse et des calages démographiques sur marges mis en œuvre.
- L’identification formelle des bibliothèques logicielles et algorithmes computationnels mobilisés pour estimer la variance sous plan de sondage complexe (fonctions Taylor, modèles mixtes pondérés).
12.3 Perspectives contemporaines : Échantillonnage à plusieurs degrés à l’ère numérique
L’irruption des méthodologies numériques et des flux massifs de données (Big Data) ne rend nullement caduc l’échantillonnage à plusieurs degrés : elle en élargit au contraire les horizons opératoires. À l’ère de la psychologie numérique et de l’évaluation écologique momentanée (Ecological Momentary Assessment – EMA), la collecte de données s’est largement dématérialisée via les smartphones et les réseaux sociaux.
Cependant, les échantillons massifs issus du crowdsourcing ou des plateformes en ligne (comme Amazon Mechanical Turk ou Prolific) souffrent de biais d’auto-sélection colossaux. Les chercheurs en sciences comportementales conçoivent désormais des architectures multi-étapiques virtuelles :
- Échantillonnage en cascade sur les réseaux sociaux : Le premier degré consiste à échantillonner de manière probabiliste des grappes de communautés virtuelles ou des nœuds d’intérêt spécifiques, au sein desquels des sous-échantillons d’utilisateurs actifs sont ensuite tirés au sort pour recevoir des propositions de protocoles psychométriques sécurisés.
- Échantillonnage temporel multi-étapique en EMA : La recherche comportementale moderne articule le multi-étapique non plus seulement dans l’espace physique, mais dans le temps : Degré 1 : Sélection aléatoire de participants humains selon les méthodes probabilistes classiques ; Degré 2 : Tirage probabiliste de semaines d’évaluation au cours de l’année ; Degré 3 : Échantillonnage aléatoire de fenêtres temporelles au cours de la journée (signaux aléatoires invitant le sujet à noter son anxiété immédiate sur application mobile).
- Hybridation avec l’intelligence artificielle : L’apprentissage automatique est dorénavant mobilisé pour optimiser le calage sur marges multi-variables et prédire avec une finesse sans précédent les probabilités de non-réponse différentielle au sein des UPE, affinant les facteurs de pondération d’une manière que les théories classiques de l’échantillonnage ne permettaient pas d’envisager.
L’échantillonnage à plusieurs degrés demeure ainsi une technologie statistique centrale, dynamique et irremplaçable : le trait d’union indispensable entre l’idéalité abstraite des modèles stochastiques et l’infinie complexité logistique de la recherche empirique sur la condition humaine.
Références
- Cochran, W. G. (1977). Sampling techniques (3rd ed.). John Wiley & Sons.
- Deville, J.-C., & Särndal, C.-E. (1992). Calibration estimators in survey sampling. Journal of the American Statistical Association, 87(418), 376–382. https://doi.org/10.1080/01621459.1992.10475217
- European Study of the Epidemiology of Mental Disorders (ESEMeD) / Mental Health Disability European Consortium. (2004). Prevalence, impairment and treatment in mental disorders: The European Study of the Epidemiology of Mental Disorders (ESEMeD) survey. Acta Psychiatrica Scandinavica, 109(Suppl. 420), 5–9. https://doi.org/10.1111/j.1600-0447.2004.00333.x
- Groves, R. M., Fowler, F. J., Couper, M. P., Lepkowski, J. M., Singer, E., & Tourangeau, R. (2009). Survey methodology (2nd ed.). John Wiley & Sons.
- Hansen, M. H., Hurwitz, W. N., & Madow, W. G. (1953). Sample survey methods and theory (Vols. 1–2). John Wiley & Sons.
- Kish, L. (1965). Survey sampling. John Wiley & Sons. https://www.wiley.com/en-us/Survey+Sampling-p-9780471488492
- Lumley, T. (2010). Complex surveys: A guide to analysis using R. John Wiley & Sons. https://doi.org/10.1002/9780470580066
- Särndal, C.-E., Swensson, B., & Wretman, J. (1992). Model assisted survey sampling. Springer-Verlag. https://doi.org/10.1007/978-1-4612-0919-5
- Snijders, T. A. B., & Bosker, R. J. (2012). Multilevel analysis: An introduction to basic and advanced multilevel modeling (2nd ed.). SAGE Publications.
- Spitzer, R. L., Kroenke, K., Williams, J. B., & Löwe, B. (2006). A brief measure for assessing generalized anxiety disorder: The GAD-7. Archives of Internal Medicine, 166(10), 1092–1097. https://doi.org/10.1001/archinte.166.10.1092
- von Elm, E., Altman, D. G., Egger, M., Pocock, S. J., Gøtzsche, P. C., & Vandenbroucke, J. P. (2007). The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies. The Lancet, 370(9596), 1453–1457. https://doi.org/10.1016/S0140-6736(07)61602-X