
Dans le domaine de l’analyse quantitative et de la modélisation statistique, la robustesse des conclusions repose fondamentalement sur la stabilité des estimateurs face aux fluctuations de l’échantillonnage. Pourtant, au sein de presque tout ensemble de données empiriques, certaines données singulières exercent une force disproportionnée sur les paramètres du modèle, au point d’orienter à elles seules les inférences scientifiques. Une observation influente se caractérise précisément par cette capacité à altérer substantiellement la topographie d’un ajustement statistique lorsqu’elle est extraite du jeu de données. Loin de constituer une simple curiosité calculatoire, ce phénomène touche au cœur même de la validité de la recherche scientifique, exposant la fragilité inhérente des méthodes d’estimation classiques face aux structures de données atypiques.
L’estimation par la méthode des moindres carrés ordinaires (MCO), omniprésente dans la régression linéaire, les analyses de variance et les modélisations prédictives, repose sur la minimisation de la somme des carrés des écarts. Si cette propriété confère aux estimateurs une élégance analytique et une efficacité optimale sous les postulats de Gauss-Markov, elle constitue également leur plus grande vulnérabilité. En élevant les erreurs au carré, les moindres carrés confèrent aux points géométriquement excentrés un moment d’inertie démesuré, comparable à un levier mécanique déplaçant le point d’équilibre de l’ensemble du système. Ainsi, un unique participant au sein d’une cohorte clinique ou comportementale peut transformer une corrélation nulle en une relation statistiquement significative, ou inversement, masquer un effet expérimental authentique.
Comprendre, diagnostiquer et traiter les observations influentes constitue une compétence méthodologique indispensable pour tout chercheur ou praticien de la donnée. Ce traité exhaustif explore les fondements mathématiques, les représentations géométriques, les implications psychométriques et les stratégies computationnelles liées à l’identification de ces points critiques. À travers une décomposition rigoureuse des concepts de valeur aberrante, d’effet de levier et d’influence globale, nous examinerons comment les métriques modernes — telles que la distance de Cook, les DFBETAS ou le DFFITS — permettent de préserver l’intégrité inférentielle des modèles face aux distorsions empiriques.
1. Introduction fondamentale aux observations influentes en statistique
1.1 Définition conceptuelle et intuition théorique
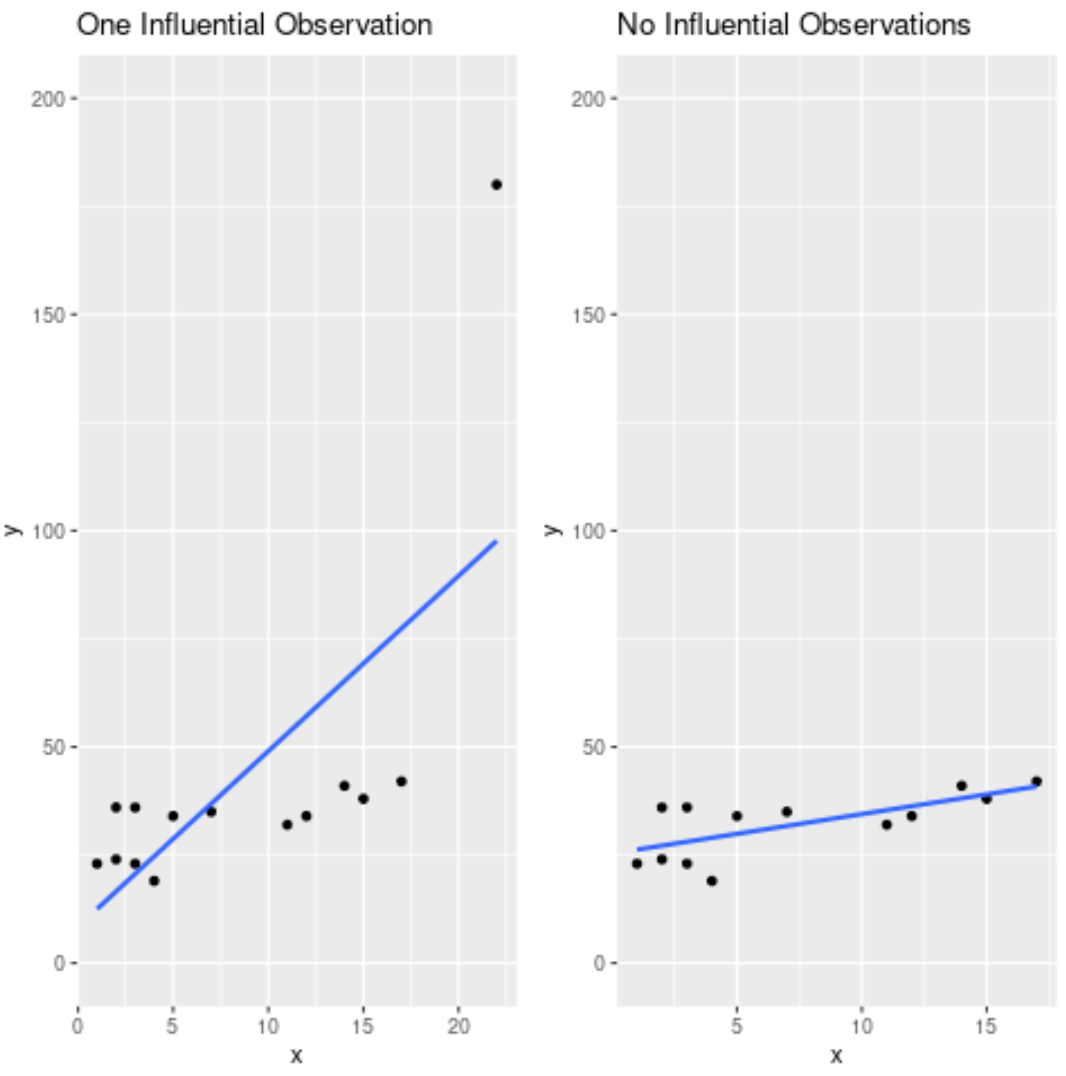
D’un point de vue formel, une observation influente est définie comme une unité statistique dont la suppression du jeu de données produit une modification substantielle des estimations des paramètres du modèle. Contrairement aux observations conformes qui renforcent l’ajustement général sans en altérer la structure, le point influent agit comme un pôle d’attraction sur l’hyperplan de régression. Si l’on note $\hat{\beta}$ le vecteur des coefficients estimés sur l’échantillon complet de taille $n$, et $\hat{\beta}_{(i)}$ le vecteur des coefficients recalculé sur l’échantillon de taille $n-1$ après l’exclusion de la $i$-ème observation, celle-ci sera qualifiée d’influente si la distance vectorielle entre $\hat{\beta}$ et $\hat{\beta}_{(i)}$ excède un seuil critique déterminé par la théorie de l’échantillonnage.
L’impact direct de ce phénomène se manifeste tant sur la pente que sur l’ordonnée à l’origine du modèle de régression. Dans un espace bidimensionnel, une observation influente peut faire pivoter la droite de régression autour du barycentre des données, inversant parfois le signe du coefficient de corrélation de Pearson. Dans un espace multidimensionnel, elle déforme la surface de réponse, altérant les coefficients partiels et faussant l’évaluation des contributions relatives de chaque prédicteur. Cette instabilité compromet gravement l’inférence statistique, dans la mesure où les tests d’hypothèses classiques (tests $t$ de Student et tests $F$ de Fisher), les erreurs-types et les intervalles de confiance sont calculés sous l’hypothèse que les résidus sont indépendants, homoscédastiques et normalement distribués.
La vulnérabilité fondamentale de la méthode des moindres carrés ordinaires face à ces observations provient de sa fonction de perte quadratique. En minimisant $\sum_{i=1}^n e_i^2$, l’algorithme accorde une importance proportionnelle au carré de la distance résiduelle. Un point situé à cinq unités d’écart du modèle exerce une pénalité vingt-cinq fois supérieure à un point situé à une unité. Par conséquent, pour minimiser cette perte globale, la ligne de régression s’écarte inévitablement de la masse principale des observations pour se rapprocher de l’observation excentrée, réduisant artificiellement le résidu de cette dernière au détriment de l’ajustement global.
1.2 Pertinence et enjeux en psychologie quantitative
Dans les sciences du comportement et la psychologie quantitative, la problématique des observations influentes prend une résonance critique en raison de la nature des instruments de mesure. Les données comportementales reposent fréquemment sur des échelles psychométriques ordinales, des inventaires auto-rapportés de type Likert ou des temps de réaction chronométriques. Ces métriques présentent une sensibilité intrinsèque aux biais de réponse, à la fatigue cognitive, à la distraction soudaine ou aux stratégies d’acquiescement systématique. Une seule réponse erronée sur une échelle de dépression ou un temps de réponse de dix secondes lors d’une tâche d’attention sélective peut engendrer une valeur extrême déstabilisant la modélisation statistique.
Le risque majeur réside dans l’invalidation ou la validation artificielle de théories cognitives majeures en raison de simples artefacts d’échantillonnage. En psychologie cognitive, par exemple, la démonstration d’un effet d’interaction entre deux variables expérimentales constitue souvent le socle d’une publication scientifique. Or, un unique participant combinant un score extrême sur le prédicteur et une valeur atypique sur la variable dépendante peut générer une interaction statistiquement significative là où il n’existe qu’une superposition de bruits aléatoires. Réciproquement, un individu atypique peut masquer une relation fonctionnelle réelle au sein d’une population clinique.
Il est par conséquent crucial d’établir une distinction épistémologique stricte entre les profils cliniques atypiques et les erreurs de mesure instrumentales. Dans le premier cas, l’observation singulière reflète une manifestation authentique mais rare de la psychopathologie humaine, porteuse d’une valeur écologique inestimable. Dans le second cas, il s’agit d’une pollution du signal empirique causée par un défaut matériel ou une incompréhension des consignes. L’incapacité à discriminer ces deux réalités a largement alimenté la crise de la réplicabilité qui frappe les sciences sociales et biomédicales, nombre de découvertes publiées reposant sur des effets fragiles conditionnés par une poignée d’individus atypiques au sein d’échantillons de taille modeste.
1.3 Évolution historique de l’analyse diagnostique de régression
Pendant la première moitié du XXe siècle, la pratique de la régression linéaire était largement dominée par une confiance aveugle dans les calculs matriciels purs, sans vérification systématique des postulats distributionnels sous-jacents. Les chercheurs évaluaient la validité de leurs modèles presque exclusivement à travers le coefficient de détermination ($R^2$) et les valeurs de $p$, ignorant l’état des résidus sous-jacents. Cette approche computationnelle aveugle masquait le fait que des jeux de données structurellement différents pouvaient générer des métriques de sortie identiques, comme l’illustrera plus tard de manière magistrale le célèbre quartet d’Anscombe en 1973.
Les prémices d’un changement de paradigme apparaissent avec les travaux pionniers de statisticiens comme Frank Wilcoxon et plus tard John Tukey, qui ont jeté les fondations de l’analyse exploratoire des données et stimulé l’essor de la statistique robuste. Tukey a mis en lumière la nécessité d’examiner visuellement les résidus et de développer des estimateurs capables de résister à la contamination par des valeurs extrêmes, introduisant des concepts fondamentaux tels que les moyennes tronquées et les diagrammes en boîte. Ces développements ont ouvert la voie à une formalisation mathématique rigoureuse des perturbations locales.
Le véritable tournant méthodologique survient à la fin des années 1970 avec les travaux révolutionnaires de R. Dennis Cook. Dans son article fondateur publié en 1977 dans la revue Technometrics, Cook formalise le premier indice synthétique d’influence globale, désormais universellement connu sous le nom de distance de Cook. Peu après, en 1980, David Belsley, Edwin Kuh et Roy Welsch publient leur ouvrage séminal Regression Diagnostics, qui introduit un ensemble cohérent d’outils analytiques fondés sur la théorie de la suppression unitaire (jackknife), notamment le DFFITS, les DFBETAS et le ratio de covariance. Aujourd’hui, ces procédures diagnostiques sont intégrées en standard dans l’ensemble des progiciels statistiques contemporains, marquant le passage d’une modélisation mécanique à une analyse critique et réflexive de l’influence locale.
2. Distinction conceptuelle : Valeurs aberrantes, points de levier et observations influentes
2.1 Les valeurs aberrantes : Aberrations sur la variable dépendante
Dans la littérature statistique moderne, les termes d’aberrance, de levier et d’influence sont fréquemment employés de manière interchangeable dans le langage courant, créant une confusion méthodologique préjudiciable. Une valeur aberrante (ou outlier) se définit formellement et exclusivement par rapport à l’espace de la variable dépendante (notée $Y$). Il s’agit d’une observation dont la valeur observée $y_i$ s’écarte considérablement de la valeur prédite par le modèle $\hat{y}_i$. Autrement dit, une valeur aberrante se caractérise par un résidu brut $e_i = y_i – \hat{y}_i$ d’une magnitude anormalement élevée au regard de la distribution générale des erreurs.
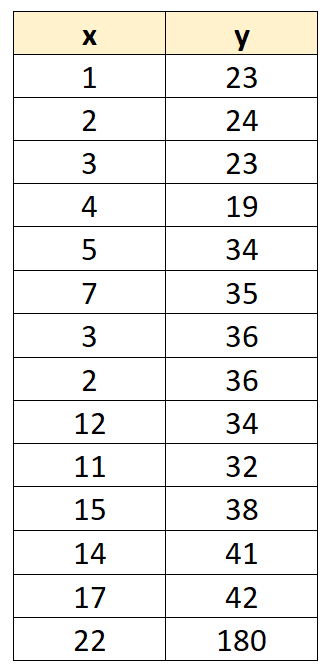
Pour évaluer rigoureusement le caractère aberrant d’un point, les résidus bruts sont insuffisants car leur variance dépend de la position des variables prédictives. On recourt donc aux résidus standardisés et, de manière encore plus robuste, aux résidus studentisés externes (ou résidus jackknife). Ces derniers sont obtenus en divisant chaque résidu par une estimation de l’écart-type résiduel calculée en excluant l’observation concernée :
$$t_i = \frac{e_i}{s_{(i)} \sqrt{1 – h_{ii}}}$$
où $s_{(i)}$ représente l’écart-type des résidus estimé sans la $i$-ème observation et $h_{ii}$ désigne l’élément diagonal de la matrice chapeau. Un résidu studentisé dont la valeur absolue excède 2 ou 3 est généralement qualifié d’aberrant au sens distributionnel.
Il est capital de noter qu’une valeur aberrante n’est pas nécessairement influente. Si une observation présente un résidu majeur mais que sa position sur les prédicteurs $X$ se situe précisément au barycentre de la distribution échantillonnale ($\bar{x}$), elle n’exercera aucun effet de couple mécanique sur l’estimation de la pente. Elle décalera légèrement l’ordonnée à l’origine et augmentera la variance résiduelle globale (diminuant ainsi le $R^2$), mais elle ne modifiera pas l’inclinaison de la trajectoire linéaire modélisée. Les causes de ces aberrations sont multiples : erreurs de codage transcriptionnel, pannes temporaires de capteurs expérimentaux ou fluctuations aléatoires extrêmes propres aux systèmes dynamiques non linéaires.
2.2 Les points de levier : Positions extrêmes dans l’espace des prédicteurs
À l’opposé des valeurs aberrantes, un point de levier (ou leverage point) se définit strictement dans le sous-espace des variables explicatives ($X$). Une observation possède un fort potentiel de levier lorsque la configuration de ses valeurs sur les prédicteurs se situe à une distance substantielle du centre gravitationnel constitué par les moyennes vectorielles de ces mêmes variables. Le levier quantifie l’isolation spatiale d’un individu dans l’espace géométrique multidimensionnel des prédicteurs, sans porter le moindre regard sur la valeur prise par la variable réponse $Y$.
La mesure fondamentale du levier statistique repose sur les éléments diagonaux $h_{ii}$ de la matrice de projection orthogonale, conventionnellement dénommée matrice chapeau ($H$) :
$$H = X(X^T X)^{-1} X^T$$
Chaque valeur $h_{ii}$ mesure la dérivée partielle de la prédiction $\hat{y}_i$ par rapport à l’observation $y_i$ ($\partial \hat{y}_i / \partial y_i$). La valeur de $h_{ii}$ est intrinsèquement bornée par l’intervalle $[1/n, 1]$ dans un modèle comportant une ordonnée à l’origine, et la somme de tous les leviers diagonaux est égale au nombre total de paramètres estimés dans le modèle, noté $p$ :
$$\sum_{i=1}^n h_{ii} = p$$
Des seuils heuristiques rigoureux sont établis dans la littérature statistique pour repérer les points de levier excessifs. Belsley, Kuh et Welsch recommandent d’examiner avec une vigilance critique toute observation pour laquelle $h_{ii} > 2p/n$ lorsque l’échantillon est de grande taille, ou $h_{ii} > 3p/n$ pour des échantillons plus restreints.
Il existe une disjonction fondamentale entre le levier potentiel et l’influence réelle. Un point de fort levier possède le potentiel théorique d’altérer considérablement les coefficients de régression, à l’image d’une longue barre de fer actionnée par un opérateur. Cependant, si ce point se situe en parfait alignement avec la trajectoire linéaire naturelle définie par le reste du nuage de points, il n’exercera aucun couple de torsion sur le modèle. Au contraire, il stabilisera l’estimation de la pente en diminuant son erreur-type. Le levier est une condition nécessaire mais nullement suffisante à l’influence statistique.
2.3 La convergence de l’erreur et du levier : L’observation influente
L’observation influente authentique naît de la conjonction destructrice de ces deux propriétés géométriques : une position extrême dans l’espace des prédicteurs couplée à un écart significatif par rapport à la tendance moyenne du reste des observations. L’influence statistique est régie par un mécanisme multiplicatif plutôt qu’additif :
$$\text{Influence} \approx \text{Levier (Position dans } X\text{)} \times \text{Aberrance (Erreur dans } Y\text{)}$$
Si l’une de ces deux composantes est nulle ou négligeable, l’influence globale demeure minimale. Un individu présentant un résidu colossal mais un levier égal à sa moyenne $p/n$ n’aura qu’une influence très circonscrite sur les pentes. Inversement, un individu possédant un levier colossal mais un résidu quasiment nul épousera la ligne de régression et ne modifiera pas les paramètres estimés.
Cette dynamique permet d’établir une typologie géométrique rigoureuse en quatre quadrants dans le plan cartésien :
- Quadrant I : Faible levier et faible résidu. L’observation typique, parfaitement intégrée au nuage de points, contribuant harmonieusement à l’ajustement sans créer de tension structurelle.
- Quadrant II : Faible levier et fort résidu. Une valeur aberrante verticale classique. Elle augmente la variance résiduelle globale et dégrade les métriques d’ajustement ($R^2$), mais laisse les pentes stables.
- Quadrant III : Fort levier et faible résidu (Point de levier conforme). L’observation isolée sur l’axe des $X$ qui se positionne exactement dans le prolongement de la régression. Elle accroît artificiellement le coefficient de détermination et comprime les erreurs-types sans biaiser les coefficients.
- Quadrant IV : Fort levier et fort résidu (Point de levier non conforme ou observation influente pure). L’observation tire la droite d’ajustement vers elle, modifiant de fond en comble les estimations des pentes et de l’intercept. En l’éliminant, la droite subit une rotation spectaculaire.
C’est ce dernier scénario qui hante l’analyste de données : un point qui, par sa simple présence, impose au modèle une trajectoire contredisant la réalité empirique du reste de l’échantillon.
3. Fondements mathématiques et structure de projection de la régression
3.1 Formulation matricielle des moindres carrés ordinaires
Pour disséquer les mécanismes intimes par lesquels une observation s’érige en pivot d’un modèle, il est impératif de formaliser la régression linéaire sous sa structure matricielle générale. Soit un modèle de régression linéaire multiple spécifié par l’équation :
$$Y = X\beta + \varepsilon$$
où $Y$ est le vecteur colonne de dimension $(n \times 1)$ contenant les valeurs de la variable dépendante, $X$ est la matrice du plan d’expérience (matrice de régression) de dimension $(n \times p)$, supposée de plein rang de colonnes $\text{rg}(X) = p$, $\beta$ est le vecteur de dimension $(p \times 1)$ des coefficients de régression inconnus, et $varepsilon$ est le vecteur des erreurs stochastiques non observables répondant aux hypothèses standards d’espérance nulle $\mathbb{E}(\varepsilon) = 0$ et de matrice de variance-covariance $\mathbb{V}\text{ar}(\varepsilon) = \sigma^2 I_n$.
L’estimateur des moindres carrés ordinaires, dérivé par l’annulation du gradient de la somme des carrés résiduels $S(\beta) = (Y – X\beta)^T(Y – X\beta)$, est la solution unique du système des équations normales :
$$(X^T X)\hat{\beta} = X^T Y implies \hat{\beta} = (X^T X)^{-1} X^T Y$$
Dans l’espace euclidien à $n$ dimensions $\mathbb{R}^n$, l’espérance mathématique de la réponse conditionnelle est modélisée par le vecteur des valeurs ajustées $\hat{Y} = X\hat{\beta}$. Ce vecteur géométrique représente la projection orthogonale du vecteur observé $Y$ sur le sous-espace vectoriel de dimension $p$ engendré par les colonnes de $X$, noté $\text{Im}(X)$. L’orthogonalité des résidus $e = Y – \hat{Y}$ avec l’espace des prédicteurs constitue le fondement géométrique garantissant que $X^T e = 0$.
La sensibilité analytique du modèle aux observations extrêmes réside dans la vulnérabilité de l’opérateur d’inversion matricielle $(X^T X)^{-1}$. En développant le produit matriciel, on constate que chaque terme de la matrice de dispersion $X^T X$ est une somme de produits croisés de type $\sum_{i=1}^n x_{ij}x_{ik}$. Un individu dont les coordonnées $(x_{i1}, dots, x_{ip})$ s’éloignent de plusieurs écarts-types de la moyenne produit des valeurs quadratiques disproportionnées qui dominent les coefficients de la matrice, distordant son conditionnement spectral et rendant l’inversion excessivement sensible aux coordonnées de ce point spécifique.
3.2 La matrice chapeau et l’effet de levier
La transformation opérant le passage du vecteur des valeurs observées $Y$ au vecteur des valeurs prédites $\hat{Y}$ s’exprime de façon compacte grâce à un opérateur linéaire central :
$$\hat{Y} = X\hat{\beta} = X(X^T X)^{-1} X^T Y = H Y$$
La matrice $H = X(X^T X)^{-1} X^T$, appelée matrice chapeau (hat matrix) car elle « met un chapeau » sur le vecteur $Y$, est une matrice carrée de dimension $(n \times n)$. Elle possède deux propriétés algébriques cardinales qui définissent les projecteurs orthogonaux : elle est symétrique ($H^T = H$) et idempotente ($H^2 = H$). De surcroît, la matrice résiduelle $M = I_n – H$, qui permet d’extraire les résidus selon $e = (I_n – H)Y = MY$, partage rigoureusement ces mêmes propriétés fondamentales.
L’attention diagnostique se focalise sur les éléments situés sur la diagonale principale de $H$, désignés individuellement par $h_{ii}$. L’écriture explicite de la $i$-ème valeur ajustée révèle la nature exacte de cette métrique :
$$\hat{y}_i = h_{ii} y_i + \sum_{j \neq i}^n h_{ij} y_j$$
Il apparaît ainsi sans équivoque que $h_{ii}$ quantifie la part directe que prend la propre observation $y_i$ dans la construction de sa prédiction $\hat{y}_i$. Si $h_{ii}$ tend vers sa limite théorique supérieure 1, la formule indique immédiatement que $\hat{y}_i to y_i$, ce qui implique que le modèle linéaire est contraint de passer exactement par ce point, réduisant son résidu $e_i$ à zéro, quelle que soit la réalité théorique sous-jacente.
Sur le plan géométrique, dans le cas d’une régression linéaire simple avec une seule variable explicative $X$, la valeur du levier prend la forme particulièrement transparente suivante :
$$h_{ii} = \frac{1}{n} + \frac{(x_i – \bar{x})^2}{\sum_{k=1}^n (x_k – \bar{x})^2}$$
Cette expression démontre avec éclat que le levier n’est rien d’autre que la distance au carré normalisée séparant le point $x_i$ de la moyenne d’échantillon $\bar{x}$. Dans un cadre multidimensionnel, cette relation se généralise sous la forme de la distance de Mahalanobis ($D_M^2$) calculée dans l’espace des covariables :
$$h_{ii} = \frac{1}{n} + \frac{1}{n-1} D_M^2(x_i)$$
Le levier statistique traduit donc avec une précision absolue le poids gravitationnel qu’un individu exerce sur l’hyperplan de régression en vertu de son positionnement spatial relatif.
3.3 Décomposition de la variance et perturbation des résidus
La présence d’un levier non nul sur chaque observation altère profondément les propriétés distributionnelles des résidus observés. Sous les postulats classiques du modèle linéaire, les perturbations théoriques $\varepsilon_i$ possèdent une variance constante $\sigma^2$. En revanche, le vecteur des résidus empiriques $e = (I_n – H)\varepsilon$ présente une matrice de variance-covariance hétérogène :
$$\mathbb{V}\text{ar}(e) = \mathbb{V}\text{ar}((I_n – H)\varepsilon) = (I_n – H)\mathbb{V}\text{ar}(\varepsilon)(I_n – H)^T = \sigma^2 (I_n – H)$$
Pour une observation individuelle $i$, la variance de son résidu brut s’écrit de manière remarquable :
$$\mathbb{V}\text{ar}(e_i) = \sigma^2 (1 – h_{ii})$$
Cette équation fondamentale dévoile un paradoxe contre-intuitif mais capital pour le diagnostic statistique : plus le potentiel de levier d’un point ($h_{ii}$) est élevé, plus la variance de son résidu brut est faible. Lorsque $h_{ii}$ approche l’unité, la variance de son résidu s’effondre vers zéro. Ce phénomène est connu sous le terme de masquage géométrique de l’erreur : parce qu’un point de fort levier contraint la surface de régression à se rapprocher impérativement de lui, son résidu ordinaire $e_i$ apparaît artificiellement minuscule, dissimulant l’anomalie fondamentale qu’il incarne.
Ce constat mathématique a dicté le développement indispensable des résidus studentisés. Pour neutraliser l’effet anesthésiant du levier sur l’écart observé, le résidu studentisé interne incorpore une standardisation ajustée par la variance locale :
$$r_i = \frac{e_i}{s \sqrt{1 – h_{ii}}}$$
où $s = \sqrt{\frac{e^T e}{n-p}}$ est la racine de l’erreur quadratique moyenne globale. Cependant, si l’observation $i$ est exceptionnellement influente ou aberrante, sa présence biaise à la hausse l’estimateur $s$ lui-même. C’est pourquoi la formulation du résidu studentisé externe (ou résidu supprimé) constitue la métrique suprême d’aberrance, en remplaçant $s$ par $s_{(i)}$, la variance calculée sur les $n-1$ observations sans le point en question :
$$t_i = \frac{e_i}{s_{(i)} \sqrt{1 – h_{ii}}} = e_i \left( \frac{n – p – 1}{(n – p) s^2 (1 – h_{ii}) – e_i^2} \right)^{1/2}$$
Sous l’hypothèse nulle d’absence d’aberrance, cette quantité suit rigoureusement une loi de Student à $n – p – 1$ degrés de liberté, rendant possible la réalisation d’un test d’hypothèse formel muni d’une correction pour comparaisons multiples (correction de Bonferroni).
4. La distance de Cook : Métrique fondamentale de l’influence globale
4.1 Origine et formule mathématique de la distance de Cook
Devant la multiplicité des vecteurs et matrices nécessaires à l’analyse diagnostique, le statisticien américain R. Dennis Cook a introduit en 1977 une mesure synthétique d’une redoutable efficacité, baptisée par la postérité distance de Cook ($D_i$). La formulation originale conçoit la métrique comme une mesure standardisée du déplacement global du vecteur des prédictions lorsque la $i$-ème observation est omise du processus d’ajustement :
$$D_i = \frac{(\hat{Y} – \hat{Y}_{(i)})^T (\hat{Y} – \hat{Y}_{(i)})}{p , s^2}$$
où $\hat{Y}_{(i)} = X\hat{\beta}_{(i)}$ représente le vecteur prédictif issu du modèle réajusté sans le $i$-ème individu, $p$ est le nombre total de paramètres (pentes plus ordonnée à l’origine) et $s^2$ est la variance résiduelle du modèle complet.
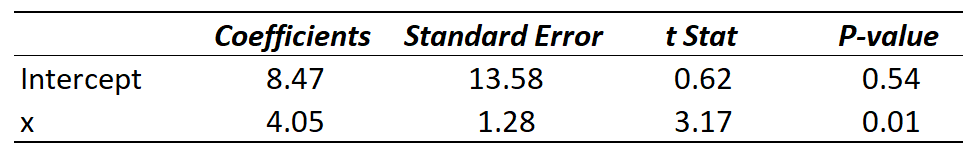
Le génie algorithmique de la distance de Cook réside dans sa réécriture algébrique. Grâce aux théorèmes d’inversion des matrices perturbées par une dyade (notamment le lemme de Sherman-Morrison-Woodbury), il est formellement démontré que le calcul de $D_i$ ne nécessite nullement d’ajuster $n$ régressions distinctes en omettant chaque observation tour à tour. La distance de Cook se calcule directement et instantanément à partir des sorties du modèle original global :
$$D_i = \frac{e_i^2}{p , s^2 (1 – h_{ii})^2} \cdot h_{ii} = \frac{r_i^2}{p} \cdot \frac{h_{ii}}{1 – h_{ii}}$$
Cette factorisation remarquable dévoile la mécanique sous-jacente évoquée précédemment : la distance de Cook est le produit exact de deux composantes structurelles distinctes. La première composante, $\frac{r_i^2}{p}$, est une fonction directe du résidu standardisé interne, mesurant la faillite locale du modèle à prédire la variable $Y$ pour ce point. La seconde composante, $\frac{h_{ii}}{1 – h_{ii}}$, est une fonction monotone croissante du levier statistique, reflétant l’excentricité topologique du point dans l’espace $X$. Si un individu n’est pas aberrant ($r_i \approx 0$), sa distance de Cook s’annule quel que soit son levier. S’il n’a aucun levier ($h_{ii} to 0$), sa distance de Cook est étouffée même en présence d’un écart vertical substantiel.
Sur le plan de la théorie géométrique de l’inférence, la distance de Cook s’interprète rigoureusement comme la position du vecteur perturbé $\hat{\beta}_{(i)}$ par rapport à l’ellipsoïde de confiance standard à $(1 – \alpha)$ centré sur $\hat{\beta}$. Elle permet de répondre sans ambiguïté à la question : « Dans quelle mesure l’élimination de cette observation déplace-t-elle le centre de gravité de nos estimations paramétriques à travers l’espace des covariances de Fisher ? »
4.2 Critères de décision et seuils d’alerte
L’utilisation de la distance de Cook dans la pratique de la modélisation statistique impose l’usage de critères de décision clairs et fondés afin d’identifier les unités justifiant une inspection approfondie. Dans la littérature appliquée, plusieurs seuils d’alerte coexistent, relevant d’approches absolues ou adaptatives :
- Le seuil absolu classique : $D_i ge 1$. Historiquement proposé par Cook, ce seuil s’appuie sur le fait que la distance $D_i$ possède une distribution mathématique proche d’une statistique de Fisher-Snedecor $F(p, n – p)$. Une valeur $D_i > 1$ correspond approximativement au 50e percentile de la loi de Fisher. Cela signifie que le retrait de cette observation déplacerait l’estimation $\hat{\beta}$ jusqu’au bord de sa région de confiance à 50 %, ce qui représente une distorsion considérable.
- Le seuil conservateur : $D_i ge 0.5$. De nombreux auteurs, particulièrement en épidémiologie et en économétrie, suggèrent qu’un déplacement atteignant le quartile supérieur d’incertitude suffit à compromettre l’interprétation des modèles explicatifs complexes.
- Le seuil relatif dépendant de l’échantillon : $D_i > \frac{4}{n}$ ou $D_i > \frac{4}{n – p – 1}$. Il s’agit du seuil contemporain le plus largement plébiscité dans les sciences du comportement. À mesure que la taille de l’échantillon $n$ croît, l’inertie globale du système augmente, rendant presque impossible pour une observation unique d’atteindre un $D_i$ de 1, même en altérant significativement la stabilité locale du modèle. Ce seuil dynamique ajuste la sensibilité du filtre diagnostique proportionnellement à la volumétrie des données.
- Le seuil comparatif de distribution continue : $D_i > 3 \times \bar{D}$. Cette heuristique locale isole les observations dont la distance dépasse de trois fois la moyenne arithmétique de toutes les distances de Cook du modèle analysé.
Il est capital de souligner les risques inhérents à une lecture dogmatique de ces règles de décision. L’application mécanique du critère $4/n$ au sein de très grands échantillons ($n > 50 000$) conduira inévitablement à une sur-détection pathologique de dizaines de points qualifiés d’influents alors qu’ils n’induisent aucun impact théorique notable sur l’interprétation substantielle des paramètres. À l’inverse, l’usage du seuil absolu de 1 sur de très petits échantillons expérimentaux ($n < 20$) génère un taux dramatique de sous-détection, masquant des instabilités profondes.
4.3 Limites inhérentes à la distance de Cook
Malgré sa prééminence méritée dans l’analyse de régression, la distance de Cook présente des faiblesses structurelles que l’analyste rigoureux ne saurait ignorer. La première d’entre elles réside dans sa vulnérabilité majeure au phénomène de masquage (masking effect). La distance de Cook est calculée selon une procédure de suppression unitaire. Si un ensemble de données contient non pas une, mais deux ou trois observations fortement atypiques regroupées dans la même région excentrée de l’espace multivarié, l’omission d’une seule d’entre elles ne modifiera que marginalement la régression, car les observations sœurs continuent de maintenir l’hyperplan dans leur direction. Ainsi, le $D_i$ de chaque point individuel apparaîtra modeste, dissimulant l’influence titanesque exercée par la coalition de cette grappe d’observations.
Le problème inverse, désigné sous le nom de phénomène d’inondation (swamping effect), se produit lorsqu’une ou plusieurs observations hautement aberrantes déforment tellement l’estimation de la variance résiduelle $s^2$ et la position de l’hyperplan qu’elles conduisent à attribuer à des observations saines et parfaitement conformes des résidus artificiellement démesurés, les faisant apparaître faussement comme influentes au regard des seuils diagnostics.
Enfin, la distance de Cook est une métrique d’agrégation scalaire : elle quantifie la norme globale du déplacement du vecteur vectoriel $\hat{\beta}$, mais ne fournit aucune information directionnelle. Elle est incapable d’indiquer quel coefficient de régression spécifique subit la déformation, ni si cette altération concerne une variable de contrôle triviale ou le prédicteur expérimental d’intérêt central. Pour obtenir cette granularité analytique, il est impératif d’adjoindre à l’analyse de Cook l’arsenal des métriques différentielles.
5. Métriques diagnostiques complémentaires de détection
5.1 Le DFFITS : Évaluation du changement prédictif individuel
Le diagnostic DFFITS (acronyme de Difference in Fits), conceptualisé par Belsley, Kuh et Welsch, se concentre exclusivement sur l’évaluation de l’impact exercé par l’exclusion d’une observation sur sa propre prédiction. Alors que la distance de Cook synthétise le déplacement de l’ensemble des $n$ valeurs ajustées dans le modèle, le DFFITS isole le comportement ponctuel du point supprimé :
$$\text{DFFITS}_i = \frac{\hat{y}_i – \hat{y}_{(i)}}{s_{(i)} \sqrt{h_{ii}}}$$
où $\hat{y}_i$ est la prédiction calculée avec l’échantillon complet, $\hat{y}_{(i)}$ est la prédiction pour ce même $i$-ème point obtenue à partir de l’équation réajustée sans lui, et $s_{(i)}$ est la racine de la variance d’erreur estimée sans l’individu $i$.
Tout comme la distance de Cook, le DFFITS bénéficie d’une relation algébrique directe permettant son extraction sans itération computationnelle, reliant explicitement l’erreur externe et la structure de projection :
$$\text{DFFITS}_i = t_i \left( \frac{h_{ii}}{1 – h_{ii}} \right)^{1/2}$$
où $t_i$ représente le résidu studentisé externe précédemment défini. Cette formulation met en lumière la parenté mathématique intime liant le DFFITS à la distance de Cook. Une simple manipulation algébrique montre que le carré du DFFITS est proportionnel à la distance de Cook calculée avec la variance d’omission : $\text{DFFITS}_i^2 \approx p \cdot D_i$.
Pour l’interprétation empirique, la littérature académique préconise deux seuils d’identification :
- Dans les phases exploratoires ou sur des échantillons restreints : $|\text{DFFITS}_i| > 1$.
- Dans les contextes d’inférence confirmatoire et pour des échantillons modérés à larges : $|\text{DFFITS}_i| > 2 \sqrt{\frac{p}{n}}$.
Le principal atout distinctif du DFFITS par rapport à la distance de Cook réside dans l’utilisation du résidu studentisé externe $t_i$. En employant $s_{(i)}$ au dénominateur plutôt que l’estimateur global $s$, le DFFITS s’avère nettement plus réactif et sensible à la présence d’aberrations sévères qui écrasent la variance générale de l’erreur.
5.2 Les DFBETAS : Diagnostic de l’instabilité coefficient par coefficient
Lorsque la finalité de la recherche n’est pas uniquement la prédiction globale, mais l’évaluation théorique fine de l’impact marginal de covariables spécifiques, l’indice DFBETAS (Difference in Betas Standardized) s’impose comme la métrique diagnostique par excellence. Pour chaque observation $i$ et pour chaque coefficient individuel $j$ ($j = 0, 1, dots, p-1$), le DFBETAS mesure la variation standardisée induite sur ce coefficient spécifique par la suppression du cas :
$$\text{DFBETAS}_{j(i)} = \frac{\hat{\beta}_j – \hat{\beta}_{j(i)}}{s_{(i)} \sqrt{(X^T X)^{-1}_{jj}}}$$
où $\hat{\beta}_j$ est le coefficient original, $\hat{\beta}_{j(i)}$ est le coefficient recalculé en omettant l’individu $i$, et $(X^T X)^{-1}_{jj}$ représente le $j$-ème élément diagonal de la matrice inverse de dispersion, proportionnel à la variance asymptotique de l’estimateur.
Grâce à cette décomposition unitaire, le chercheur dispose d’une matrice complète de dimensions $(n \times p)$ fournissant un scanner intégral des vulnérabilités locales de son modèle. Les seuils de criticité classiquement reconnus sont :
- Seuil absolu heuristique : $|\text{DFBETAS}_{j(i)}| > 1$. Une telle valeur signale qu’une unique donnée déplace à elle seule l’estimation du paramètre de plus d’un écart-type complet, inversant fréquemment sa significativité statistique.
- Seuil ajusté à l’échantillon : $|\text{DFBETAS}_{j(i)}| > \frac{2}{\sqrt{n}}$. Recommandé dès que l’échantillon excède une trentaine de sujets.
Cette approche est particulièrement précieuse dans l’analyse des régressions hiérarchiques, des modèles de médiation ou des modèles testant des interactions modératrices (termes produits $X \times Z$). En pratique, il est très fréquent qu’une observation ne présente aucune influence sur l’effet principal d’une variable de contrôle tout en exerçant une influence catastrophique sur le coefficient d’interaction conditionnelle, transformant une régression linéaire standard en un artéfact complet de modélisation.
5.3 Le ratio de covariance et le volume de confiance
Les métriques telles que la distance de Cook, le DFFITS et les DFBETAS s’intéressent prioritairement au déplacement ponctuel des estimations (la justesse ou le biais de localisation). Cependant, une observation peut exercer une influence fondamentale sur un autre aspect capital de l’inférence statistique : la précision (ou l’incertitude d’échantillonnage) de la matrice de covariance estimée des coefficients. L’instrument diagnostique dédié à cette inspection est le ratio de covariance (noté COVRATIO).
Le COVRATIO compare formellement le déterminant de la matrice de variance-covariance des coefficients estimés sans la $i$-ème observation au déterminant de la matrice issue du modèle complet :
$$\text{COVRATIO}_i = \frac{det \left( s_{(i)}^2 (X_{(i)}^T X_{(i)})^{-1} \right)}{det \left( s^2 (X^T X)^{-1} \right)}$$
Sur le plan de l’algèbre linéaire, le déterminant de la matrice de variance-covariance des coefficients est proportionnel au volume de l’ellipsoïde de confiance paramétrique conjointe dans l’espace $\mathbb{R}^p$. Le COVRATIO quantifie donc le facteur par lequel l’exclusion d’un sujet compresse ou dilate ce volume d’incertitude :
$$\text{COVRATIO}_i = \frac{1}{(1 – h_{ii})} \left( \frac{n – p – e_i^{*2}}{n – p – 1} \right)^p$$
où $e_i^*$ est le résidu standardisé. L’interprétation du ratio de covariance s’articule autour de l’unité :
- Si $\text{COVRATIO}_i > 1$, la suppression de l’observation conduit à une augmentation du volume de l’ellipsoïde de confiance, ce qui signifie que sa présence dans le modèle améliore la précision globale des estimations (effet typique d’un point de bon levier).
- Si $\text{COVRATIO}_i < 1$, la suppression de l'observation réduit l'ellipsoïde, signalant que l'observation dégrade la précision générale des paramètres en gonflant artificiellement la variance résiduelle.
Belsley et ses collaborateurs ont établi que les observations justifiant une alerte critique sont celles dont le ratio s’écarte significativement de l’unité au-delà du seuil asymptotique :
$$|\text{COVRATIO}_i – 1| ge \frac{3p}{n}$$
L’intégration du COVRATIO aux côtés des mesures de déplacement de pente permet de prévenir l’élimination hâtive de données hautement informatives qui renforcent la puissance statistique globale du modèle.
6. Analyses visuelles et représentations graphiques diagnostiques
6.1 Graphiques des résidus studentisés en fonction du levier
Aucune démarche diagnostique sérieuse ne saurait se cantonner à la lecture passive de métriques numériques tabulées au sein d’écrans de sortie logicielle. L’œil humain excelle dans la reconnaissance de motifs morphologiques complexes et d’architectures spatiales non linéaires que des scalaires isolés échouent à synthétiser. Le dispositif graphique cardinal de l’évaluation de l’influence est le diagramme de dispersion confrontant les résidus studentisés externes au levier statistique ($t_i$ en fonction de $h_{ii}$).
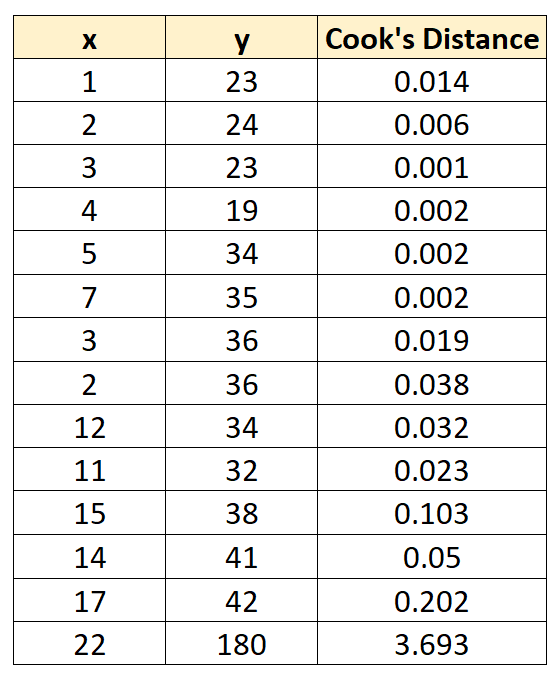
Dans cette représentation bidimensionnelle, l’axe horizontal porte les valeurs de levier $h_{ii}$, bornées à gauche par leur valeur minimale théorique et bornées à droite par 1. L’axe vertical accueille les résidus studentisés $t_i$, centrés sur zéro. Pour transformer cette simple projection en un instrument d’évaluation instantanée, on y superpose :
- Des lignes horizontales de référence matérialisant les seuils distributionnels classiques d’aberrance (typiquement les lignes $t = -2$, $t = 0$ et $t = +2$, voire $+3$).
- Une ligne verticale marquant le seuil critique de levier heuristique ($2p/n$).
- Les courbes de niveau iso-influentes de la distance de Cook, matérialisées par des hyperboles d’égale valeur ($D = 0.5$ et $D = 1.0$), calculées d’après la relation liant $t_i$, $h_{ii}$ et $D_i$.
Cette topographie isole visuellement les points critiques dans le quadrant supérieur droit et le quadrant inférieur droit du graphique. Tout point projeté au-delà des courbes hyperboliques extérieures constitue immédiatement une observation influente majeure. Par ailleurs, la dispersion globale des points sur ce plan permet d’identifier des structures résiduelles perverses telles que l’hétéroscédasticité (forme en entonnoir se déployant avec le levier) ou des ruptures de linéarité sous-jacentes.
6.2 Graphiques d’indices et d’influence séquentielle
Le graphique séquentiel des indices (index plot) constitue la cartographie séquentielle standard de l’intégrité d’un jeu de données. Il consiste à projeter en ordonnée la grandeur diagnostique étudiée (par exemple la distance de Cook $D_i$, les valeurs de levier $h_{ii}$ ou les résidus studentisés $|t_i|$) directement en fonction du numéro d’ordre séquentiel de l’observation ($i = 1, 2, dots, n$) disposé sur l’axe des abscisses.
L’utilité méthodologique de cette visualisation dépasse largement la simple identification visuelle des émergences individuelles dépassant les lignes horizontales de coupure statistique ($4/n$). Elle permet d’appréhender la structure temporelle et méthodologique de la collecte empirique :
- Repérage des grappes séquentielles : L’apparition d’un amas contigu de points influents regroupés sur une série d’indices consécutifs (par exemple du sujet 45 au sujet 52) met fréquemment en lumière un biais de passation expérimental, tel qu’un changement d’expérimentateur, une mise à jour logicielle impromptue ou une détérioration matérielle des instruments de mesure intervenue en cours de protocole.
- Effets d’apprentissage ou de fatigue : Dans les collectes longitudinales, une dérive progressive des indices diagnostiques signale des dérives instrumentales ou des effets systématiques liés à la durée de l’étude.
- Détection des blocs d’échantillonnage : Si les données sont issues de centres hospitaliers ou d’établissements scolaires distincts codés par blocs séquentiels, le graphique d’indices révèle immédiatement si un centre particulier génère systématiquement la totalité des déviations influentes du modèle global.
6.3 Diagrammes de régression partielle et résidus ajoutés
Dans les modèles comportant de multiples covariables corrélées entre elles (phénomène de multicolinéarité partielle), les diagrammes de dispersion bivariés ordinaires ($Y$ en fonction de $X_j$) deviennent totalement trompeurs pour évaluer l’influence réelle d’un point sur le coefficient de régression spécifique $\beta_j$. Pour résoudre cette limite, on emploie les diagrammes de résidus ajoutés (added-variable plots ou partial regression plots).
La construction mathématique de ce graphique pour un prédicteur particulier $X_j$ repose sur le théorème de Frisch-Waugh-Lovell :
- On régresse d’abord la variable réponse $Y$ sur l’ensemble des prédicteurs du modèle en excluant formellement $X_j$, et l’on extrait le vecteur des résidus obtenus, noté $e_{Y | X_{(-j)}}$. Ce vecteur isole la variance de $Y$ inexpliquée par les autres variables.
- On régresse ensuite la variable $X_j$ elle-même sur l’ensemble des autres prédicteurs $X_{(-j)}$, et l’on extrait le vecteur résiduel résultant, noté $e_{X_j | X_{(-j)}}$. Ce vecteur représente la fraction de variation unique et spécifique de $X_j$ orthogonale aux autres régresseurs.
- On trace enfin le nuage de points projetant $e_{Y | X_{(-j)}}$ en ordonnée contre $e_{X_j | X_{(-j)}}$ en abscisse.
Les propriétés de ce graphique sont exceptionnelles : la pente de la droite des moindres carrés ajustée sur ce diagramme partiel est strictement identique au coefficient partiel $\hat{\beta}_j$ issu de la régression multiple complète, et les résidus de cette droite coïncident rigoureusement avec les résidus du modèle final. Ce graphique offre ainsi une vision épurée de la relation marginale : il permet d’isoler avec une clarté totale les observations qui se comportent comme des ancres géométriques à l’extrémité du nuage partiel, imposant artificiellement la significativité ou la non-significativité d’un coefficient au mépris du consensus incarné par le reste de l’échantillon.
7. Étude de cas empirique : Analyse pas à pas d’un jeu de données
7.1 Présentation du jeu de données initial et modélisation brute
Afin de concrétiser l’ensemble de ces propositions théoriques, analysons pas à pas une situation expérimentale réaliste issue des sciences comportementales. Considérons une étude de psychologie cognitive examinant le lien fonctionnel entre le niveau d’anxiété cognitive d’évaluation (mesuré sur une échelle psychométrique standardisée variant de 10 à 50 points, noté variable prédictive $X$) et le score de performance d’un individu lors d’une tâche complexe de mémoire de travail sous contrainte temporelle (noté variable réponse $Y$). L’échantillon d’étalonnage comprend $n = 14$ participants soumis à des conditions standardisées en laboratoire.
Le tableau suivant synthétise les données brutes recueillies auprès de ces 14 sujets expérimentaux :
| Sujet ($i$) | Anxiété ($X_i$) | Performance ($Y_i$) | Valeur ajustée ($\hat{Y}_i$) | Résidu brut ($e_i$) | Levier ($h_{ii}$) | Résidu studentisé externe ($t_i$) | Distance de Cook ($D_i$) |
|---|---|---|---|---|---|---|---|
| 1 | 12 | 78 | 73.21 | 4.79 | 0.182 | 0.74 | 0.061 |
| 2 | 14 | 75 | 72.13 | 2.87 | 0.155 | 0.43 | 0.017 |
| 3 | 15 | 69 | 71.59 | -2.59 | 0.143 | -0.38 | 0.012 |
| 4 | 18 | 71 | 69.96 | 1.04 | 0.113 | 0.15 | 0.001 |
| 5 | 19 | 68 | 69.42 | -1.42 | 0.105 | -0.20 | 0.002 |
| 6 | 22 | 65 | 67.80 | -2.80 | 0.087 | -0.40 | 0.008 |
| 7 | 24 | 64 | 66.72 | -2.72 | 0.080 | -0.38 | 0.006 |
| 8 | 25 | 67 | 66.18 | 0.82 | 0.078 | 0.11 | 0.001 |
| 9 | 27 | 61 | 65.09 | -4.09 | 0.076 | -0.58 | 0.014 |
| 10 | 29 | 66 | 64.01 | 1.99 | 0.079 | 0.28 | 0.003 |
| 11 | 31 | 63 | 62.93 | 0.07 | 0.085 | 0.01 | 0.000 |
| 12 | 33 | 59 | 61.85 | -2.85 | 0.095 | -0.41 | 0.009 |
| 13 | 35 | 58 | 60.77 | -2.77 | 0.110 | -0.40 | 0.010 |
| 14 | 48 | 82 | 53.73 | 28.27 | 0.485 | 4.82 | 3.120 |
L’estimation par les moindres carrés ordinaires réalisée sur l’ensemble des 14 observations produit l’équation de régression suivante :
$$\hat{Y}_i = 79.71 – 0.541 \cdot X_i$$
Les indicateurs d’inférence globale semblent, en première lecture, cohérents sur le plan conventionnel : le coefficient de détermination s’élève à $R^2 = 0.284$, le test omnibus d’ajustement est significatif ($F(1, 12) = 4.76, p = 0.049$) et l’erreur-type associée au coefficient de régression $\hat{\beta}_1$ est de $0.248$, délivrant une statistique de Student $t = -2.18$ ($p = 0.0498$). Sur la base de ces résultats conventionnels, un chercheur pressé conclurait immédiatement à l’existence d’une relation négative statistiquement significative entre anxiété et performance cognitive, validant la théorie du déficit d’attention induit par le stress.
7.2 Calcul et détection de l’observation influente
Une analyse diagnostique approfondie révèle immédiatement l’extrême fragilité du modèle. L’inspection des coordonnées du sujet numéro 14 signale une double singularité morphologique :
- Sur l’axe des prédicteurs ($X$), ce sujet présente un score d’anxiété de 48 points, alors que la moyenne de l’échantillon est $\bar{x} = 25.0$. Son levier statistique culmine à $h_{14,14} = 0.485$. Ce chiffre écrase le seuil critique $2p/n = 2(2)/14 = 0.286$. Ce participant détient à lui seul près de 25 % du poids gravitationnel total du modèle ($p = 2$).
- Sur l’axe de la variable dépendante ($Y$), ce sujet affiche une performance de 82 points, en totale contradiction avec la baisse supposée induite par un haut niveau de stress. Il en résulte un résidu brut spectaculaire de $e_{14} = +28.27$.
Le calcul du résidu studentisé externe pour ce point atteint la valeur colossale de $t_{14} = +4.82$. Au regard d’une loi de Student à $n – p – 1 = 11$ degrés de liberté, la probabilité d’observer un tel écart par pur hasard stochastique est de $p = 0.0005$, confirmant le statut d’aberrance absolue de cette donnée.
La convergence de ce levier démesuré et de ce résidu aberrant propulse la distance de Cook à :
$$D_{14} = \frac{(4.82)^2}{2} \cdot \frac{0.485}{1 – 0.485} \approx 3.12$$
Cette valeur de $D_{14} = 3.12$ dépasse très largement le seuil absolu critique de 1.0 et pulvérise le seuil relatif $4/n = 4/14 \approx 0.286$. En inspectant les autres sujets dans le tableau diagnostique, on constate qu’aucun d’entre eux ne dépasse un $D_i$ de 0.061. Le sujet 14 est donc une observation isolée exerçant une emprise totale sur la modélisation statistique.
7.3 Réestimation post-exclusion et comparaison des modèles
Pour mesurer la portée de cette perturbation, procédons à la réestimation stricte du modèle linéaire ordinaire après avoir retiré le sujet 14 de l’échantillon ($n = 13$). Les calculs fournissent les résultats comparatifs suivants :
| Indicateur statistique | Modèle complet ($n = 14$) | Modèle épuré ($n = 13$) | Variation structurelle |
|---|---|---|---|
| Ordonnée à l’origine ($\hat{\beta}_0$) | 79.71 | 86.32 | +6.61 points |
| Pente de régression ($\hat{\beta}_1$) | -0.541 | -0.814 | -50.5 % d’accentuation |
| Erreur-type de la pente ($SE_{\beta_1}$) | 0.248 | 0.098 | Division par 2.53 |
| Statistique $t$ de la pente | -2.18 ($p = 0.0498$) | -8.31 ($p < 0.00001$) | Explosion de la significativité |
| Coefficient de détermination ($R^2$) | 0.284 | 0.863 | Multiplication par 3.04 |
| Variance résiduelle estimée ($s^2$) | 52.4 | 5.12 | Réduction de 90.2 % de l’erreur |
L’analyse comparative de ces deux colonnes illustre magistralement le phénomène d’occultation statistique produit par une observation influente :
- Sous-estimation massive de l’effet théorique : Dans le modèle complet, le sujet 14 tirait la queue de la droite vers le haut, atténuant artificiellement la pente réelle qui passe de $-0.54$ à $-0.81$. L’effet inhibiteur réel du stress était donc fortement sous-évalué.
- Explosion de la variance d’erreur : La présence du point 14 gonflait la variance résiduelle de plus de 900 % ($s^2$ passant de 5.12 à 52.4). Ce gonflement avait pour effet d’élargir démesurément l’erreur-type du coefficient, fragilisant le test $t$ qui flirtait dangereusement avec le seuil arbitraire de 0.05.
- Dissimulation de la qualité d’ajustement : Le $R^2$ passe de 28.4 % à un spectaculaire 86.3 %. Loin d’être un phénomène marginal, le retrait d’un seul individu démontre que la relation entre les deux concepts psychologiques est en réalité extrêmement forte et prédictive au sein du reste de la cohorte.
Cette démonstration prouve sans appel la précarité d’un modèle non diagnostiqué. Fonder des conclusions scientifiques sur l’équation initiale revenait à publier un artéfact statistique entièrement dicté par la singularité idiosyncrasique d’un seul participant.
8. Impacts méthodologiques et théoriques en psychologie expérimentale
8.1 Distorsion de la taille d’effet et inflation de l’erreur de type I et II
L’existence d’observations influentes non contrôlées perturbe profondément le cadre inférentiel neyman-pearsonien sur lequel s’appuie la recherche expérimentale. Cette altération se manifeste sous la forme d’une double pathologie statistique : l’inflation débridée de l’erreur de type I (faux positifs) et de l’erreur de type II (faux négatifs).
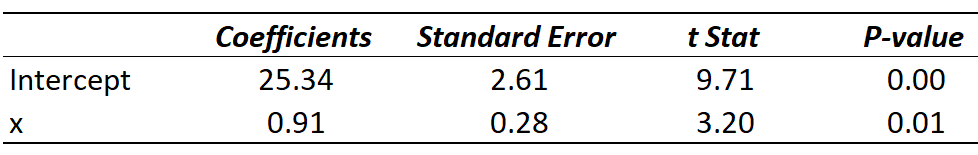
L’inflation de l’erreur de type I se produit lorsqu’une observation atypique crée une association artificielle entre deux construits psychologiques totalement indépendants dans la population cible. Il suffit qu’un individu cumule par hasard un score excentré sur le prédicteur et la réponse pour que la statistique $F$ franchisse le seuil de significativité. Ce mécanisme génère une profusion d’affirmations scientifiques illusoires, proclamant la découverte de dissociations cognitives ou d’effets thérapeutiques qui ne correspondent à aucune réalité biologique ou psychologique reproductible.
À l’opposé, l’inflation de l’erreur de type II découle du gonflement spectaculaire de l’erreur quadratique moyenne ($s^2$) provoqué par une observation aberrante. Les dénominateurs des statistiques de Student et de Fisher étant proportionnels à cette variance résiduelle, la présence de ces perturbations a pour conséquence mécanique de réduire la puissance statistique du dispositif. Des effets expérimentaux parfaitement authentiques se trouvent ainsi relégués dans l’obscurité de la non-significativité ($p > 0.05$), conduisant les laboratoires à abandonner des pistes de recherche fécondes sur la base de faux négatifs instrumentaux.
Par ailleurs, cette instabilité détruit la validité des métriques de taille d’effet (d de Cohen, $\eta^2$ partiel, $r$ de Pearson). Dans la mesure où les futures méta-analyses synthétisent quantitativement ces tailles d’effet pour établir les consensus scientifiques et guider les politiques de santé publique, la contamination de ces indices par des observations influentes propage des distorsions cumulatives au sein de l’ensemble du corpus scientifique disciplinaire.
8.2 Implications pour les échelles psychométriques et questionnaires
Dans le domaine de la psychométrie et du développement d’instruments de mesure, les observations influentes compromettent gravement l’étalonnage des échelles. Les inventaires de personnalité, les échelles de dépression ou les batteries d’intelligence reposent sur des modèles de mesure supposant une fidélité et une cohérence interne rigoureuses. Or, l’analyse des matrices de corrélations inter-items est d’une vulnérabilité extrême aux profils de réponse aberrants.
Un cas d’école concerne les profils de réponse uniformes dictés par la distraction ou l’acquiescement passif (par exemple, cocher invariablement « Tout à fait d’accord » sur l’intégralité des 60 items d’un inventaire, y compris sur les items inversés conçus pour vérifier l’attention). Un tel profil se positionne immédiatement comme une observation hyper-influente dans l’espace multidimensionnel des réponses. Sa présence dans l’échantillon d’étalonnage provoque :
- La distorsion de l’analyse factorielle exploratoire et confirmatoire : L’apparition de facteurs latents fallacieux (souvent appelés « facteurs d’inattention ») n’ayant aucune substance théorique, mais émergeant de l’alignement artificiel induit par les réponses du sujet atypique.
- L’altération de l’alpha de Cronbach et de l’oméga de McDonald : Une baisse ou une hausse spectaculaire de la cohérence interne estimée, résultant de la modification artificielle de la covariance moyenne inter-items.
- La dénaturation des seuils d’étalonnage : Le calcul des percentiles cliniques (notes T, étalonnages stanines) se trouve biaisé, conduisant à des faux diagnostics ou à l’absence de repérage d’individus en détresse psychologique réelle.
La distinction rigoureuse entre une inattention méthodologique et une structure clinique exceptionnellement atypique mais valide requiert impérativement le croisement des métriques statistiques d’influence avec des indices d’inattention intégrés au protocole (temps de réponse moyen par page, indices de consistance de réponse intra-individuelle).
8.3 Crise de la reproductibilité et vulnérabilité des inférences
La psychologie quantitative traverse depuis plus d’une décennie une crise majeure de la reproductibilité, mise en lumière par les projets de réplications massives menés au niveau international (comme l’Open Science Collaboration en 2015). L’une des causes méthodologiques les plus insidieuses de ces échecs systématiques de réplication réside précisément dans la non-généralisabilité de modèles fondés sur des observations influentes isolées.
Lorsqu’une étude initiale rapporte un effet concluant obtenu sur un échantillon modeste de 30 ou 40 participants, il n’est pas rare que cet effet repose sur la présence d’un ou deux individus hyper-influents qui ont incliné la régression dans le sens de l’hypothèse des auteurs. Lorsqu’un laboratoire indépendant tente de répliquer le protocole de manière rigoureuse sur une nouvelle cohorte de même taille tirée de la même population, la probabilité que cette nouvelle cohorte contienne une configuration identique de points de levier non conformes est quasiment nulle. En conséquence logique, le nouvel échantillon présente un résultat rigoureusement nul, plongeant la communauté dans l’incompréhension et la controverse théorique stérile.
Cette fragilité démontre que les méthodes statistiques traditionnelles d’inférence, pensées pour un monde idéal de données pures et gaussiennes, exigent un changement de posture épistémologique. La robustesse d’une découverte ne peut plus être attestée par la seule valeur de $p$ : elle doit être conditionnée par la démonstration formelle de son invariance par suppression locale. Un effet scientifique qui s’effondre lors de l’omission de 1 % de l’échantillon n’est pas un effet régulier de la population : c’est un artefact échantillonnal dénué de portée nomothétique.
9. Étiologie des observations influentes dans la recherche comportementale
9.1 Erreurs techniques, méthodologiques et de saisie
Avant d’invoquer la complexité de l’esprit humain pour expliquer la survenue d’un point influent, l’analyste rigoureux doit systématiquement traquer l’étiologie instrumentale et humaine de la distorsion. Dans la chaîne de traitement de l’information empirique, de multiples failles techniques constituent la source primaire des observations atypiques :
- Erreurs de saisie manuelle et typographiques : L’inversion de chiffres lors de la numérisation manuelle d’un protocole papier (par exemple saisir 84 au lieu de 48 pour l’âge d’un sujet, ou omettre un point décimal et transformer un temps de réaction de 1.25 seconde en 125 secondes). Ces erreurs créent instantanément des points de levier monstrueux.
- Défaillances matérielles des capteurs physiologiques : Dans les recherches en neurosciences comportementales et psychophysiologie (électroencéphalographie, réponse électrodermale, suivi oculaire ou pupillométrie), un décrochage temporaire d’électrode, un clignement d’yeux ou un artefact de mouvement corporel engendre des pics de voltage irréalistes qui s’érigent en points influents lors du lissage des signaux.
- Non-respect des protocoles de passation standardisés : Les biais introduits par des expérimentateurs distraits, des bruits parasites imprévus dans la salle d’expérimentation ou des consignes mal énoncées provoquent des décrochages cognitifs majeurs chez certains participants.
- Incompréhension des échelles de mesure : Il arrive fréquemment qu’un sujet inverse involontairement la logique d’une échelle (pensant que 1 signifie « Excellent » et 5 « Très mauvais »), fournissant un profil diamétralement opposé à la cohérence de l’ensemble de la cohorte.
Ces anomalies techniques n’ont aucune légitimité théorique et doivent impérativement être identifiées et purgées lors des phases d’audit préliminaire de la qualité des données.
9.2 Biais d’échantillonnage et hétérogénéité de la population
Une seconde catégorie d’observations influentes découle non pas d’une erreur d’enregistrement, mais d’une discordance fondamentale entre le participant recruté et la population théorique postulée par le cadre de recherche. Il s’agit des cas de contamination de population ou d’hétérogénéité structurelle non modélisée.
Dans les études de psychologie expérimentale recrutant traditionnellement des cohortes d’étudiants universitaires, l’échantillon n’est que superficiellement homogène. L’inclusion involontaire d’un individu souffrant d’un trouble neurologique non diagnostiqué, d’un participant sous l’emprise récente de substances psychotropes, ou d’une personne dont la langue maternelle n’est pas celle utilisée dans les tâches verbales complexes génère un profil de performance radicalement discordant. Cet individu n’appartient pas à la même densité de probabilité multivariée que le reste du groupe.
Ce problème s’accentue dans les protocoles multicentriques ou stratifiés. Si un échantillon réunit des données issues de sous-populations distinctes sans intégrer les covariables sociodémographiques ou culturelles appropriées, les individus situés à l’intersection de ces groupes se comporteront comme des points de levier massifs, contraignant le modèle linéaire à forger un compromis géométrique qui ne correspond à la réalité d’aucun des sous-groupes sous-jacents.
9.3 Validité écologique des participants exceptionnels
Il existe enfin une troisième origine, théoriquement passionnante : l’observation influente authentique issue d’un individu exceptionnel dont la déviance n’est ni une erreur instrumentale, ni un biais d’échantillonnage, mais l’expression la plus pure d’un phénomène cognitif rare. En sciences du comportement, les trajectoires d’apprentissage atypiques, les génies cognitifs, les synesthètes ou les profils neurodivergents constituent des fenêtres inestimables sur le fonctionnement psychologique.
Le traitement dogmatique et expéditif consistant à éliminer aveuglément tout point dont la distance de Cook dépasse un seuil arbitraire représente un péril épistémologique majeur : le risque d’éliminer la découverte scientifique pour préserver la beauté cosmétique d’un modèle statistique. L’histoire de la neuropsychologie moderne s’est construite sur l’analyse approfondie de cas uniques exceptionnels (du célèbre patient H.M. amnésique au patient Phineas Gage). Éliminer ces observations au motif qu’elles perturbent la linéarité d’un ajustement aux moindres carrés reviendrait à détruire l’essence même de l’avancée théorique.
Par conséquent, avant d’appliquer le moindre algorithme de suppression mathématique, l’analyste se doit d’entreprendre une enquête qualitative rétrospective approfondie sur l’anamnèse de l’observation suspecte : Qui est ce participant ? Comment s’est déroulée la passation ? Cette valeur extrême est-elle théoriquement intelligible ? Ce n’est qu’à l’issue de cet arbitrage qualitatif que les choix quantitatifs de modélisation peuvent être arrêtés.
10. Stratégies de traitement et processus décisionnel rigoureux
10.1 L’alternative de la suppression : Justifications et dérives
Face à une observation influente dûment identifiée, l’arbitrage le plus drastique consiste en son exclusion pure et simple du jeu de données final. Si cette décision s’impose comme une évidence mathématique lorsqu’une preuve irréfutable d’erreur technique ou d’invalidation protocolaire est documentée (coquille de saisie, capteur déconnecté), elle s’avère particulièrement périlleuse dans toutes les autres circonstances.
L’élimination ad hoc de points de données pour la seule raison qu’ils « abîment le modèle » ou « font chuter la significativité sous 0.05 » constitue une dérive déontologique sévère assimilée au p-hacking et aux pratiques de recherche douteuses (questionable research practices). La suppression sélective non déclarée biaise artificiellement la taille des effets, induit des inférences trop optimistes et invalide la probabilité nominale d’erreur de première espèce.
Lorsque l’élagage d’une donnée influente est scientifiquement jugé nécessaire mais que sa cause exacte demeure incertaine, la méthodologie moderne impose la réalisation rigoureuse d’une analyse de sensibilité. Cette pratique consiste à présenter systématiquement, dans le corps du texte ou en matériel supplémentaire, les deux versions du modèle : le modèle complet incluant l’ensemble des données, et le modèle épuré excluant l’observation contestée. Ce n’est que si les conclusions substantielles et les orientations théoriques demeurent invariantes entre les deux estimations que le chercheur peut légitimement affirmer la robustesse de sa modélisation.
10.2 Techniques de transformation et d’accommodation des données
Plutôt que d’amputer le jeu de données de ses éléments singuliers, une stratégie élégante consiste à transformer l’espace métrique afin d’accommoder les valeurs extrêmes et de rétablir la linéarité et l’homoscédasticité sans perte d’information statistique.
La première solution réside dans l’application de transformations mathématiques non linéaires sur la variable dépendante ou les prédicteurs excentrés :
- La transformation logarithmique ($log(Y)$ ou $log(X)$) : Idéale pour comprimer les distributions fortement étirées vers la droite, telles que les temps de réaction chronométriques ou les revenus économiques, réduisant drastiquement l’effet de levier des valeurs supérieures.
- La transformation racine carrée ($\sqrt{Y}$) : Particulièrement appropriée pour les données de comptage (fréquence d’erreurs, nombre d’hésitations).
- La famille de transformations paramétriques de Box-Cox : Cette approche cherche algorithmiquement le paramètre optimal $lambda$ qui maximise la normalité et stabilise la variance des résidus selon la fonction :
$$y^{(\lambda)} = \begin{\cases} \frac{y^\lambda – 1}{\lambda} &a\mp; \text{si } \lambda \neq 0 \ln(y) &a\mp; \text{si } \lambda = 0 \end{\cases}$$
Une seconde approche d’accommodation réside dans la winsorisation (du nom du statisticien Charles Winsor). Contrairement au tronquage qui élimine définitivement les données, la winsorisation borne les valeurs extrêmes au-delà d’un percentile spécifique (par exemple le 95e ou 99e percentile) en leur attribuant la valeur exacte de cette limite. Cette procédure préserve le rang et le poids de l’observation au sein de l’effectif total tout en bridant son potentiel géométrique de levier.
Toutefois, ces transformations doivent être appliquées avec prudence : elles modifient l’échelle de mesure et peuvent rendre l’interprétation théorique directe des coefficients plus complexe, substituant à des effets additifs linéaires des relations multiplicatives ou exponentielles.
10.3 Approches statistiques robustes alternatives aux moindres carrés
Lorsque la structure des données contient des observations influentes légitimes que l’on refuse d’exclure ou de transformer arbitrairement, la démarche statistique la plus rigoureuse consiste à renoncer à la méthode des moindres carrés ordinaires au profit d’estimateurs robustes dotés d’un haut point de rupture.
Le point de rupture ($\epsilon^*$) d’un estimateur désigne la proportion minimale d’observations contaminées ou aberrantes qu’un échantillon peut contenir avant que l’estimateur ne puisse être conduit à des valeurs infinies ou arbitraires. Le point de rupture des moindres carrés ordinaires est de $\epsilon^* = 1/n to 0$ : une seule observation suffit à détruire l’estimation. À l’opposé, les méthodes robustes modernes garantissent des points de rupture pouvant atteindre jusqu’à 50 % de contamination :
- La régression quantile et la régression médiane (norme $L_1$) : En minimisant la somme des valeurs absolues des résidus ($\sum |e_i|$) plutôt que leurs carrés, l’ajustement médian est totalement insensible aux variations des valeurs extrêmes sur la variable réponse $Y$.
- Les estimateurs M de Huber : Cette approche hybride combine la fonction de perte quadratique pour les petits résidus (préservant l’efficacité gaussienne des MCO) et une fonction de perte linéaire absolue au-delà d’un seuil de distance ($k = 1.345\sigma$). Elle est résolue par la méthode des moindres carrés pondérés itératifs (IRLS), où chaque observation reçoit un poids décroissant inversement proportionnel à son aberrance.
- Les estimateurs MM et les S-estimateurs : Ces estimateurs de haute performance combinent un point de rupture élevé (50 %) face aux points de fort levier dans l’espace $X$ et une haute efficacité statistique asymptotique (souvent calibrée à 95 % de l’efficacité MCO sous l’hypothèse de normalité).
- Le rééchantillonnage par bootstrap robuste : L’inférence par bootstrap non paramétrique (avec centrage ou pondération robuste) permet de dériver des intervalles de confiance empiriques pour les coefficients de régression qui ne reposent pas sur la normalité des résidus et demeurent résilients face aux asymétries locales.
Ces estimateurs robustes transforment le problème de l’observation influente : au lieu de manipuler manuellement les données pour les faire entrer dans le moule contraignant des MCO, on adapte l’outil d’optimisation mathématique à la réalité complexe du jeu de données.
11. Implémentation computationnelle dans les logiciels statistiques
11.1 Diagnostics d’influence sous le langage R
Le langage statistique open-source R offre sans conteste l’environnement le plus riche, modulaire et transparent pour l’exploration diagnostique approfondie des modèles linéaires. Dès son installation de base (package stats), R dispose d’un ensemble de primitives optimisées conçues pour extraire les métriques d’influence sans nécessiter de boucles itératives coûteuses en calcul.
L’extraction des grandeurs scalaires individuelles repose sur des fonctions vectorielles dédiées s’appliquant directement à l’objet retourné par la fonction d’ajustement linéaire standard :
cooks.distance(modele): extrait le vecteur des distances de Cook ($D_i$).hatvalues(modele): calcule les éléments diagonaux du levier statistique ($h_{ii}$).rstudent(modele): extrait les résidus studentisés externes (jackknife, $t_i$).dffits(modele)etdfbetas(modele): génèrent respectivement les vecteurs de changement prédictif et la matrice $(n \times p)$ des variations de pentes.influence.measures(modele): produit une synthèse tabulaire exhaustive accompagnée d’un marquage textuel automatique des observations critiques par des astérisques basés sur les seuils théoriques de Belsley et al.
Pour l’analyse visuelle, la fonction générique plot(modele) génère séquentiellement quatre graphiques diagnostiques fondamentaux, dont le célèbre panneau Residuals vs Leverage incorporant le tracé des courbes de niveau de la distance de Cook via des lignes pointillées rouges aux seuils 0.5 et 1.0. Pour aller plus loin, le package spécialisé car (Companion to Applied Regression), maintenu par John Fox, propose la fonction incontournable influencePlot(modele). Cette fonction cartographie simultanément les résidus studentisés en ordonnée contre le levier en abscisse, tout en modulant dynamiquement la surface de chaque point de dispersion proportionnellement à sa distance de Cook, facilitant le repérage instantané des unités déstabilisatrices.
11.2 Mise en œuvre dans l’écosystème Python
Dans l’écosystème Python dédié à la science des données, l’exploration des observations influentes s’articule autour de la bibliothèque statistique statsmodels, qui reproduit fidèlement la rigueur méthodologique des logiciels d’économétrie, complétée par les capacités graphiques de matplotlib et seaborn.
Lors de l’ajustement d’un modèle de régression par les moindres carrés via statsmodels.formula.api.ols, l’extraction de la classe dédiée aux diagnostics s’opère par l’invocation de la méthode get_influence(). Cet objet compilé donne immédiatement accès à l’ensemble des métriques d’influence sous forme de tableaux NumPy :
influence.cooks_distance: renvoie un tuple contenant la distance de Cook vectorielle et les p-valeurs associées calculées sur la distribution $F$.influence.hat_matrix_diag: fournit les valeurs de levier $h_{ii}$.influence.resid_studentized_external: extrait les résidus studentisés externes.influence.dfbetas: génère la matrice des instabilités de coefficients.
Sur le versant graphique, le module statsmodels.graphics.regressionplots propose des fonctions intégrées hautement spécialisées telles que plot_leverage_resid2() et la fonction influence_plot(), qui calque son rendu sur celui de R en dessinant des cercles dont le diamètre reflète la magnitude de la distance de Cook. Pour les flux d’apprentissage automatique de production déployés sous scikit-learn, la détection des points de levier non conformes s’intègre généralement en amont dans des pipelines de préparation de données (via l’algorithme d’estimation robuste RANSACRegressor ou HuberRegressor), garantissant que les hyperplans prédictifs ne soient pas assujettis aux artéfacts d’échantillonnage.
11.3 Procédures dans les logiciels à interface graphique : SPSS et JASP
Pour les chercheurs et cliniciens utilisant préférentiellement des environnements logiciels pilotés par des interfaces graphiques sans ligne de commande, le repérage des observations influentes est entièrement accessible et automatisé au sein de plates-formes établies telles qu’IBM SPSS Statistics ou le logiciel open-source contemporain JASP.
Sous SPSS, la procédure s’active lors de la configuration de la boîte de dialogue de régression linéaire :
- Dans le sous-menu Enregistrer (Save), le chercheur coche les cases dédiées aux diagnostics : Distances de Cook, Valeurs de levier (qui enregistre les $h_{ii}$ sous la variable
LEV_1), Résidus studentisés supprimés (SRE_1), ainsi que les DFBETAS standardisés. SPSS crée alors directement de nouvelles colonnes dans la matrice de données active. - Dans le sous-menu Statistiques, l’activation de l’option Diagnostics des observations permet de générer automatiquement un tableau listant uniquement les sujets dont les résidus standardisés dépassent un seuil prédéfini (par exemple $\pm 2$ ou $\pm 3$ écarts-types).
Le logiciel libre JASP (développé par l’Université d’Amsterdam) démocratise ces analyses avec une interface épurée et moderne. Dans le module de régression linéaire, l’onglet Diagnostics permet de cocher en un clic les options de Cas influents (Cook’s distance, DFFITS, covariance ratio). JASP génère instantanément des tableaux clairs et interactifs, affichant en temps réel les graphiques séquentiels d’indices et les diagrammes résidus-levier, offrant ainsi aux non-programmeurs une rigueur diagnostique égale à celle des langages de script les plus avancés.
12. Recommandations déontologiques et bonnes pratiques de recherche
12.1 Pré-enregistrement des critères de traitement des données
La crédibilité de l’édifice scientifique moderne repose sur l’adoption d’une transparence méthodologique absolue visant à neutraliser les degrés de liberté non documentés du chercheur (researcher degrees of freedom). Dans le cadre de la gestion des données aberrantes et influentes, cette exigence s’incarne dans le pré-enregistrement systématique des protocoles d’analyse sur des registres publics indépendants (tels que l’Open Science Framework ou AsPredicted).
Le pré-enregistrement déontologique impose de définir formellement, avant le démarrage effectif de la collecte des données ou avant l’accès aux bases d’observation, les règles de décision algorithmiques intangibles qui seront appliquées :
- Quelles métriques quantitatives spécifiques seront utilisées pour qualifier une observation d’influente (par exemple, la distance de Cook avec le seuil explicite $4/n$) ?
- Quelle procédure séquentielle sera suivie en présence d’une donnée critique : vérification technique immédiate du protocole, test d’inattention comportementale, ou maintien d’office ?
- Quelle technique statistique alternative sera mobilisée en cas d’instabilité structurelle du modèle (passage formel à une régression robuste MM ou à une régression quantile pré-spécifiée) ?
Cette rigueur a priori empêche tout glissement opportuniste post hoc où le chercheur serait tenté de tester successivement plusieurs critères d’exclusion dans le but conscient ou inconscient d’amener la p-valeur de son effet expérimental d’intérêt sous le seuil arbitraire de 0.05.
12.2 Standardisation du reporting scientifique selon les normes APA
La communication des résultats statistiques au sein des publications à comité de lecture doit se conformer aux standards de transparence méthodologique, notamment formalisés par les directives de l’American Psychological Association (normes APA 7e édition, directives JARS pour le reporting quantitatif). Les omissions et silences méthodologiques quant au devenir des cas atypiques ne sont plus tolérés par les revues de rang international.
Le compte rendu textuel et tabulaire d’une recherche doit comporter un ensemble d’informations incontournables :
- Divulgation quantitative intégrale : Le nombre exact de participants exclus de l’échantillon final doit être explicitement mentionné dès la section « Participants », en détaillant précisément la justification théorique, méthodologique ou statistique de chaque retrait.
- Description des indicateurs diagnostiques employés : La section « Analyses de données » doit stipuler expressément que les postulats de la régression linéaire ont fait l’objet d’une vérification formelle, en précisant les indices calculés (résidus studentisés, leviers, distances de Cook).
- Rapport de l’analyse de sensibilité : Si des observations influentes ambiguës ont été écartées, l’auteur doit obligatoirement inclure un paragraphe ou un tableau comparatif documentant les coefficients, les erreurs-types et les conclusions inférentielles du modèle avant et après exclusion.
- Mise à disposition des graphiques diagnostiques : L’inclusion du diagramme des résidus studentisés contre levier ou du tracé des DFBETAS en matériel supplémentaire en ligne garantit la reproductibilité et permet aux relecteurs d’apprécier la qualité de la distribution empirique.
12.3 Check-list méthodologique pour le praticien et le chercheur
Pour clore ce traité et accompagner le statisticien, le data scientist et le chercheur en sciences du comportement dans sa pratique quotidienne de la modélisation, nous proposons une check-list décisionnelle standardisée en cinq étapes incontournables à dérouler avant toute validation définitive d’un modèle linéaire :
- Étape 1 : Exploration descriptive et assainissement initial des données. Inspecter systématiquement les minima, maxima, diagrammes en boîte et distributions univariées. Traquer impitoyablement les erreurs de saisie, les valeurs impossibles hors échelle et les défaillances de codage instrumental avant toute régression.
- Étape 2 : Ajustement initial et calcul exhaustif du spectre diagnostique. Estimer le modèle de référence et extraire conjointement les trois composantes structurelles de l’instabilité : les résidus studentisés externes ($t_i$) pour l’aberrance, les valeurs de levier ($h_{ii}$) pour l’isolation spatiale des covariables, et la distance de Cook ($D_i$) pour l’influence globale.
- Étape 3 : Cartographie visuelle et examen des seuils d’alerte. Construire systématiquement le graphique cartésien confrontant $t_i$ à $h_{ii}$ avec les courbes d’isodistance de Cook. Vérifier si des points franchissent le seuil critique adapté à la taille d’échantillon ($D_i > 4/n$ ou $|\text{DFBETAS}| > 2/\sqrt{n}$).
- Étape 4 : Investigation qualitative et étiologique approfondie. Pour chaque observation signalée par les indicateurs, enquêter sur la réalité empirique du sujet correspondant : Est-ce un artefact ? Un profil inattentif ? Un individu clinique exceptionnel ? Déterminer si l’observation appartient ou non à la population cible légitime.
- Étape 5 : Arbitrage modélisateur et documentation transparente. Choisir la stratégie d’accommodation la plus rigoureuse : rapport systématique d’une analyse de sensibilité si une suppression est envisagée, ou migration vers des estimateurs statistiques robustes (estimateurs M, régression quantile) si les cas singuliers sont authentiques. Documenter l’intégralité du processus dans le rapport final selon les standards de la science ouverte.
Références
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17-21. https://doi.org/10.1080/00031305.1973.10478966
- Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. John Wiley & Sons. https://doi.org/10.1002/0471725153
- Box, G. E., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211-243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15-18. https://doi.org/10.1080/00401706.1977.10489493
- Cook, R. D., & Weisberg, S. (1982). Residuals and influence in regression. Chapman and Hall.
- Fox, J. (2016). Applied regression analysis and generalized linear models (3rd ed.). Sage Publications.
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage Publications.
- Huber, P. J. (1981). Robust statistics. John Wiley & Sons. https://doi.org/10.1002/0471725280
- Open Science Collaboration. (2015). Estimating the reproducibility of psychological science. Science, 349(6251), aac4716. https://doi.org/10.1126/science.aac4716
- Rousseeuw, P. J., & Leroy, A. M. (1987). Robust regression and outlier detection. John Wiley & Sons. https://doi.org/10.1002/0471725382
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press.