
Dans le paysage contemporain de la recherche quantitative en sciences humaines, sociales et biomédicales, la modélisation statistique ne se résume plus à une simple description d’échantillons homogènes. Dès lors que les protocoles expérimentaux intègrent des structures factorielles croisées, la compréhension précise des métriques d’évaluation devient une exigence méthodologique primordiale. Parmi ces métriques, la moyenne marginale occupe une position centrale, servant de passerelle analytique entre les observations brutes recueillies en laboratoire et les inférences théoriques généralisables à l’ensemble d’une population cible. Pourtant, son calcul, sa signification exacte et sa portée déductive sont fréquemment obscurcis par des confusions récurrentes avec les moyennes conditionnelles d’échantillon ou les grandes moyennes d’agrégation globale.
L’analyse des phénomènes comportementaux complexes exige des chercheurs qu’ils isolent l’influence de variables indépendantes spécifiques sans pour autant ignorer la structure multidimensionnelle au sein de laquelle ces variables opèrent. Qu’il s’agisse d’évaluer l’efficacité différentielle d’interventions psychothérapeutiques à travers différentes strates cliniques ou de mesurer l’impact de techniques pédagogiques selon les profils sociodémographiques, la moyenne marginale permet de résumer l’effet principal d’un facteur en neutralisant ou en standardisant l’impact des autres facteurs concomitants. Cette démarche de synthèse mathématique répond à une nécessité épistémologique : comment dégager une loi psychologique générale tout en tenant compte de la variabilité intrinsèque des sous-groupes d’individus observés ?
Le présent article propose une analyse approfondie et systématique de la moyenne marginale, depuis ses fondements mathématiques et historiques jusqu’à ses applications avancées dans les protocoles de neurosciences, de psychométrie et de psychologie cognitive. En articulant formalisation théorique rigoureuse, démonstrations numériques pas à pas, comparaisons critiques et recommandations computationnelles sous les environnements logiciels de référence (R, SPSS, Python), ce guide vise à doter les chercheurs, étudiants et praticiens des outils conceptuels indispensables pour interpréter, communiquer et publier des résultats statistiques irréprochables, conformes aux standards académiques contemporains les plus exigeants.
1. 1. Introduction fondamentale à la moyenne marginale en statistiques psychologiques
1.1 1.1 Définition générale et importance dans la recherche comportementale
D’un point de vue conceptuel élémentaire, la moyenne marginale désigne la moyenne des valeurs d’une variable dépendante calculée pour une modalité spécifique d’une variable indépendante donnée, après avoir agrégé et combiné l’ensemble des modalités des autres variables indépendantes incluses dans le plan d’expérience. Historiquement, l’expression tire son ancrage lexical de la disposition spatiale concrète des premiers registres d’inventaire et des tables de contingence manuelles : les chercheurs et actuaires inscrivaient les sommes et moyennes des sous-groupes dans les marges physiques — horizontales et verticales — de la feuille de calcul sur laquelle étaient dressées les colonnes et lignes du protocole. Ce qui n’était au départ qu’une convention de mise en page calligraphique s’est progressivement mué en un concept statistique formel doté de propriétés inférentielles majeures.
Dans le domaine de la recherche comportementale et de la psychologie expérimentale, l’importance de ce concept s’avère considérable. Les comportements humains ne sont que très rarement régis par des facteurs d’influence uniques et isolés. Un protocole clinique étudiant la dépression majeure testera couramment l’effet d’une molécule pharmacologique en association avec un type de psychothérapie, tout en stratifiant par tranche d’âge ou niveau de sévérité symptomatique. Face à une telle multiplicité factorielle, le chercheur a besoin d’isoler l’effet moyen d’un traitement thérapeutique précis indépendamment de la distribution des variables modératrices présentes dans son schéma expérimental. La moyenne marginale constitue précisément l’outil mathématique idoine pour quantifier cet effet global sans être biaisé par la granularité excessive des sous-échantillons locaux.
De surcroît, la moyenne marginale répond à une exigence de parcimonie scientifique. Elle permet de synthétiser des ensembles de données multidimensionnelles extrêmement denses en un ensemble restreint d’indicateurs intuitifs et directement interprétables. Lorsqu’une étude évalue les capacités d’apprentissage moteur à travers trois méthodes d’entraînement chez des sujets novices et experts, la moyenne marginale de chaque méthode d’entraînement offre une évaluation globale et unifiée de son efficacité pédagogique fondamentale, servant ainsi de guide décisionnel tant pour la recherche fondamentale que pour l’application pratique sur le terrain éducatif ou clinique.
1.2 1.2 Le cadre des modèles linéaires et de l’analyse factorielle
L’intégration de la moyenne marginale dans la panoplie des outils quantitatifs modernes s’est consolidée avec le développement et la formalisation du modèle linéaire généralisé par John Nelder et Robert Wedderburn au début des années 1970. Au sein de cette architecture théorique, la moyenne marginale n’est plus simplement une moyenne arithmétique descriptive calculée sur un coin de table, mais l’estimation ponctuelle d’un paramètre populationnel sous-jacent issu de la combinaison linéaire de variables explicatives catégorielles et continues. Elle structure la lecture des matrices de conception expérimentale en assignant une espérance mathématique nette à chaque modalité factorielle.
C’est tout particulièrement dans le cadre de l’analyse de variance (ANOVA) factorielle que la moyenne marginale démontre sa puissance opératoire. Lorsqu’un plan factoriel croisé de type 2×2, 2×3 ou 3×4 est mis en œuvre, l’évaluation des effets principaux d’un facteur dépend exclusivement de la variance observée entre ses moyennes marginales respectives. Si les moyennes marginales associées aux différentes modalités d’un facteur A ne présentent pas de différences statistiquement significatives au regard de l’erreur résiduelle, le chercheur conclut à l’absence d’effet principal dudit facteur, indépendamment de ce qui peut être observé à l’échelle micro-analytique des cellules individuelles.
Cette approche impose d’établir dès l’abord une distinction fondamentale entre les observations brutes individuelles, les moyennes de cellules (qui correspondent aux intersections factorielles strictes, c’est-à-dire aux conditions expérimentales conjointes) et les moyennes marginales proprement dites. Tandis que la moyenne de cellule capture la réponse comportementale spécifique à un contexte expérimental hautement contraint et situé, la moyenne marginale abstrait le contexte transversal pour dégager la contribution moyenne inhérente à un niveau factoriel unitaire, constituant ainsi le socle des tests omnibus basés sur la distribution F de Fisher-Snedecor.
1.3 1.3 Utilité méthodologique pour la psychométrie et les neurosciences
Dans les champs spécialisés de la psychométrie contemporaine, la moyenne marginale s’avère indispensable pour l’étalonnage et la validation d’instruments de mesure psychologiques standardisés. Lors de l’administration d’échelles d’anxiété, d’extraversion ou d’efficience intellectuelle à des cohortes hétérogènes, les psychométriciens doivent s’assurer que les scores attribués à des groupes sociodémographiques distincts (par exemple, selon l’âge, le statut socio-économique ou le niveau d’instruction) reflètent des construits latents comparables. L’agrégation des scores sous forme de moyennes marginales permet d’examiner le comportement global des échelles à travers diverses cohortes tout en contrôlant l’impact des variables de confusion démographiques qui fausseraient une comparaison brute directe.
Dans les neurosciences cognitives et computationnelles, où les protocoles utilisent couramment l’imagerie par résonance magnétique fonctionnelle (IRMf) ou l’électroencéphalographie (EEG) à haute densité, les jeux de données se caractérisent par une dimensionalité massive et des plans d’expérience à mesures répétées complexes. Les chercheurs y analysent des potentiels évoqués ou des variations du signal BOLD face à des stimuli visuels variant selon de multiples attributs (par exemple, la valence émotionnelle, la fréquence spatiale et la vitesse de présentation). Le calcul des moyennes marginales temporelles ou spatiales permet de modéliser les réponses cérébrales moyennes associées à une modalité sensorielle unique sans que ces mesures ne soient artéfactées par l’hétérogénéité des variations individuelles ou des blocs de passation séquentiels.
Enfin, la standardisation du reporting des résultats scientifiques selon les directives formelles édictées par l’American Psychological Association (APA 7e édition) place la moyenne marginale au cœur de la communication académique. Les comités de lecture et les revues à fort facteur d’impact exigent systématiquement la présentation des moyennes marginales accompagnées de leurs erreurs types ou intervalles de confiance associés pour chaque effet principal rapporté. Cette transparence méthodologique facilite la comparabilité inter-groupes, autorise l’intégration précise des résultats dans des méta-analyses ultérieures et garantit la réplicabilité des déductions empiriques au sein de la communauté scientifique internationale.
2. 2. Définition mathématique et formalisation conceptuelle
2.1 2.1 Formulation mathématique de base
Pour fonder rigoureusement le concept de moyenne marginale, il convient de poser un cadre mathématique explicite. Considérons un plan factoriel croisé à deux facteurs, désignés respectivement par les symboles factoriels A et B. Supposons que le facteur A comporte un nombre de modalités noté I (indexé par la lettre minuscule i variant de 1 à I), et que le facteur B comporte un nombre de modalités noté J (indexé par la lettre minuscule j variant de 1 à J). Chaque intersection entre la modalité i du facteur A et la modalité j du facteur B constitue une cellule expérimentale élémentaire, au sein de laquelle la variable dépendante continue Y est observée sur un nombre d’individus ou d’unités d’observation noté n_ij.
La moyenne observée au sein d’une cellule expérimentale unique, qualifiée de moyenne conditionnelle locale ou moyenne de cellule, est formellement exprimée par la sommation arithmétique classique des observations individuelles divisée par le nombre de sujets présents dans cette cellule :
Ȳ_ij = (1 / n_ij) * ∑_{k=1}^{n_ij} Y_ijk
À partir de cette définition cellulaire, la moyenne marginale non pondérée de la modalité i du facteur A, conventionnellement notée Ȳ_i., représente la simple moyenne arithmétique des moyennes de cellules calculées sur l’ensemble des J modalités du facteur B. L’opérateur de sommation porte alors sur l’indice j :
Ȳ_i. = (1 / J) * ∑_{j=1}^{J} Ȳ_ij
De manière rigoureusement symétrique, la moyenne marginale non pondérée de la modalité j du facteur B, notée Ȳ_.j, correspond à la moyenne arithmétique des moyennes de cellules calculées sur l’ensemble des I modalités du facteur A, l’opérateur de sommation s’appliquant cette fois sur l’indice i :
Ȳ_.j = (1 / I) * ∑_{i=1}^{I} Ȳ_ij
Ces formulations arithmétiques illustrent deux propriétés mathématiques fondamentales : la linéarité et l’invariance par translation. Si l’on applique une transformation linéaire affine de type f(Y) = a * Y + b à l’ensemble des scores individuels bruts, la nouvelle moyenne marginale correspondra exactement à la transformation affine de la moyenne marginale d’origine. Cette cohérence formelle assure que les métriques marginales conservent l’intégralité des relations d’ordre et des écarts relatifs existant au sein des échelles de mesure d’intervalle couramment manipulées en psychométrie.
2.2 2.2 Propriétés distributionnelles et hypothèses sous-jacentes
L’inférence statistique menée à partir des moyennes marginales repose sur un socle de postulats distributionnels précis, inhérents à la théorie des estimateurs linéaires sans biais à variance minimale. En premier lieu, le modèle linéaire sous-jacent assume que la variable aléatoire Y_ijk suit, au sein de chaque sous-cellule (i, j), une distribution normale de moyenne théorique μ_ij et de variance résiduelle σ²_ij. Cette normalité conditionnelle garantit, par les propriétés d’addition des variables aléatoires indépendantes normalement distribuées, que les moyennes de cellules Ȳ_ij suivent elles-mêmes des distributions normales de paramètres respectifs μ_ij et de variance σ²_ij / n_ij.
En second lieu, l’hypothèse d’homoscédasticité, ou d’égalité des variances intra-cellulaires, stipule que pour l’ensemble des combinaisons factorielles (i, j), la variance résiduelle est uniforme : σ²_ij = σ² pour tout i et tout j. Lorsque cette condition d’homogénéité est rigoureusement satisfaite, la variance de l’estimateur de la moyenne marginale non pondérée Ȳ_i. peut être dérivée analytiquement de façon exacte. En admettant l’indépendance statistique entre les sujets échantillonnés dans les différentes cellules, la variance de la moyenne marginale non pondérée prend la forme suivante :
Var(Ȳ_i.) = (1 / J²) * ∑_{j=1}^{J} (σ² / n_ij) = (σ² / J²) * ∑_{j=1}^{J} (1 / n_ij)
Dans la situation théorique idéale où le plan d’expérience est strictement équilibré, c’est-à-dire lorsque chaque cellule comporte exactement le même nombre d’observations n (n_ij = n pour tout i et j), cette formulation se simplifie de manière remarquable en Var(Ȳ_i.) = σ² / (J * n). Du point de vue asymptotique, en vertu du théorème central limite, dès lors que les effectifs n_ij augmentent, la distribution d’échantillonnage de la moyenne marginale converge avec une grande régularité vers une loi normale, conférant aux estimateurs marginaux une robustesse remarquable, même lorsque de légères déviations de la normalité univariée sont observées au sein des données brutes de départ.
2.3 2.3 Espérance conditionnelle et décomposition de la variance
Au niveau de la théorie probabiliste fondamentale, la moyenne marginale s’articule de manière directe avec le concept d’espérance conditionnelle et le théorème de l’espérance totale, souvent désigné sous le vocable de loi des espérances itérées. Dans un espace de probabilité modélisant deux variables aléatoires discrètes A et B conjointement distribuées avec une variable dépendante continue Y, l’espérance marginale de Y sachant que le facteur A prend la modalité i s’exprime par l’intégration de l’espérance conditionnelle de Y sur l’ensemble de la distribution de probabilité du facteur B :
E[Y | A = i] = E_B [ E_Y [ Y | A = i, B ] ]
Cette perspective probabiliste éclaire la décomposition fondamentale de la variance totale dans l’analyse factorielle. La somme totale des carrés des écarts (SST) se partitionne de manière orthogonale en plusieurs composantes additives distinctes : la somme des carrés associée à l’effet principal du facteur A (SSA), la somme des carrés associée à l’effet principal du facteur B (SSB), la somme des carrés imputable à l’interaction conjointe entre A et B (SSAB), et enfin la somme des carrés des erreurs résiduelles (SSE) :
SST = SSA + SSB + SSAB + SSE
Dans cette partition géométrique de l’espace vectoriel des observations, la somme des carrés de l’effet principal SSA quantifie précisément l’écart quadratique pondéré existant entre chaque moyenne marginale Ȳ_i. et la grande moyenne globale de l’expérience. Si l’ensemble des moyennes marginales relatives au facteur A sont rigoureusement identiques entre elles, la somme des carrés SSA s’annule identiquement, indiquant que la variable A, prise dans son acception globale marginalisée, n’explique aucune fraction de la dispersion totale de la variable de réponse. L’espérance marginale traduit ainsi l’effet moyen exercé par une modalité factorielle lorsque toutes les autres sources de variation expérimentales sont systématiquement intégrées et neutralisées.
3. 3. Structure des tableaux de contingence et organisation des données
3.1 3.1 Conception d’un tableau croisé factoriel à deux facteurs
La structuration matricielle d’un plan expérimental factoriel repose traditionnellement sur la disposition des données au sein d’un tableau croisé à double entrée. Cette géométrie tabulaire n’est pas un simple artifice de présentation : elle détermine l’architecture computationnelle à partir de laquelle s’extraient les métriques descriptives et inférentielles. Dans une telle organisation, les lignes du tableau sont assignées aux modalités distinctes du premier facteur étudié (Facteur A), tandis que les colonnes reçoivent les modalités correspondantes du second facteur (Facteur B).
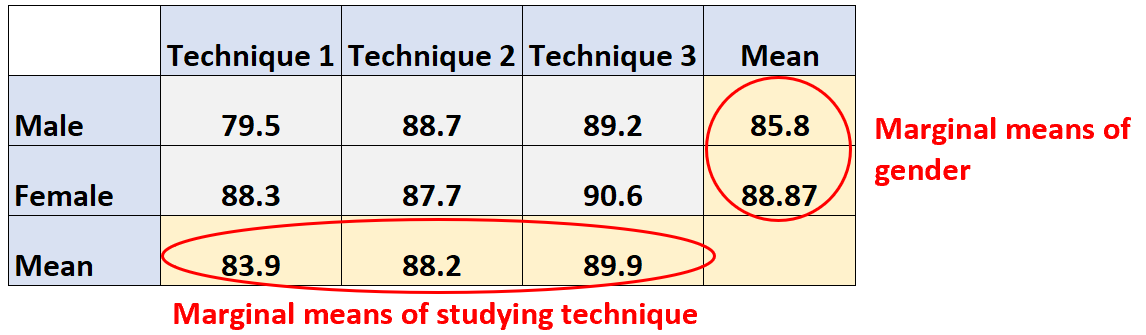
L’intersection précise entre une ligne donnée i et une colonne j forme une cellule factorielle unique. Cette cellule représente la condition expérimentale conjointe spécifique où les sujets ont été exposés de manière combinée au traitement i du facteur A et au traitement j du facteur B. À la périphérie immédiate de ce maillage cellulaire se déploient les espaces marginaux. L’extrémité droite de chaque ligne constitue la marge de ligne, lieu désigné pour consigner la moyenne marginale associée à la modalité correspondante du facteur A. Réciproquement, la base inférieure de chaque colonne constitue la marge de colonne, où s’inscrit la moyenne marginale relative à la modalité sous-jacente du facteur B.
Pour qu’un tel tableau croisé factoriel soit valide et exploitable sur le plan méthodologique, il est impératif de s’assurer de l’exhaustivité des combinaisons expérimentales. Dans un plan factoriel dit « complet », chaque cellule du tableau doit être non vide et comporter un ensemble d’observations représentatives. L’absence fortuite ou systématique de sujets dans l’une des cellules crée une discontinuité structurelle (plan factoriel incomplet ou cellules vides) qui complexifie drastiquement le calcul et l’interprétation théorique des moyennes marginales, exigeant alors le recours à des paramétrisations de régression singulières.
3.2 3.2 Représentation des données brutes versus moyennes agrégées de cellules
Dans la pratique de la recherche, il est primordial d’opérer une distinction rigoureuse entre deux formes de tableaux croisés : les tableaux de contingence d’effectifs purs et les tableaux factoriels de métriques continues. Un tableau de contingence classique, fréquemment mobilisé lors de l’application de tests d’indépendance du Chi-deux (χ²), ne contient dans ses cellules que des décomptes discrets d’individus ou de fréquences d’occurrence. Les marges de ce type de tableau ne représentent alors que des sommes d’effectifs, donnant lieu à des distributions marginales de fréquences relatives.
À l’inverse, dans le cadre de l’évaluation de variables quantitatives continues (par exemple, des scores d’anxiété, des temps de réaction en millisecondes ou des pourcentages de mémorisation), chaque cellule factorielle contient une synthèse métrique de l’échantillon qui lui est propre : sa moyenne observée Ȳ_ij, son écart-type intra-groupe s_ij, ainsi que l’effectif d’échantillonnage associé n_ij. Le remplissage initial du tableau consiste donc à convertir l’ensemble des scores bruts individuels en métriques agrégées de cellules, réduisant la dispersion individuelle à des estimateurs locaux de tendance centrale et de variabilité.
Cette étape de structuration tabulaire permet d’identifier visuellement et immédiatement d’éventuelles dissymétries d’échantillonnage. Si les effectifs n_ij oscillent substantiellement d’une cellule à l’autre en raison de perdus de vue ou de contraintes de recrutement clinique, la simple sommation arithmétique des scores bruts à l’échelle de la ligne ne coïncidera plus avec la moyenne des moyennes de cellules. Cette divergence fondamentale impose au statisticien de choisir lucidement entre une moyenne marginale brute dépendant du poids numérique des sous-groupes et une moyenne marginale non pondérée accordant un statut égal à chaque condition expérimentale.
3.3 3.3 Visualisation spatiale des effets marginaux
La représentation graphique constitue un levier heuristique indispensable pour interpréter la dynamique des moyennes marginales et des moyennes de cellules au sein d’un plan factoriel. Le support visuel de prédilection en psychologie expérimentale est le graphique de profils ou graphique d’interaction. Sur ce type de graphique, l’axe horizontal (abscisse) est généralement dévolu aux modalités d’un facteur d’intérêt (par exemple le facteur A), tandis que l’axe vertical (ordonnée) mesure l’échelle continue de la variable dépendante observée.
Les moyennes conditionnelles de cellules y sont représentées par des points distincts, reliés entre eux par des segments de droite pour chaque modalité du second facteur (facteur B). Dans ce système de coordonnées, les moyennes marginales du facteur A se visualisent géométriquement comme les points d’ancrage situés au centre de gravité vertical des points de cellules pour chaque niveau i de l’abscisse. Lorsque l’expérimentateur trace la ligne joignant ces moyennes marginales globales, il visualise directement la trajectoire de l’effet principal du facteur A, affranchie de la modulation locale exercée par le facteur B.
Ces représentations spatiales obéissent à des normes strictes de clarté scientifique définies par les conventions internationales. Tout graphique de profils doit systématiquement faire figurer les barres d’erreur associées à chaque point, représentant soit l’erreur type de la moyenne, soit l’intervalle de confiance à 95 %. L’observation d’un décalage vertical net et régulier entre les tracés de profils, sans altération substantielle de leur pente, fournit une indication visuelle limpide de la présence d’effets marginaux significatifs en l’absence d’interaction statistique entre les variables.
4. 4. Exemple numérique pas à pas : performance aux examens et techniques d’étude
4.1 4.1 Description du protocole expérimental et des données recueillies
Pour illustrer de manière concrète et opérationnelle le processus de calcul des moyennes marginales, considérons un protocole expérimental conduit au sein d’un département de sciences de l’éducation et de psychologie cognitive. Cette étude porte sur l’efficacité relative de différentes stratégies d’apprentissage sur la réussite académique finale. Un échantillon de 100 étudiants de premier cycle universitaire a été recruté et stratifié selon deux facteurs expérimentaux indépendants : le Genre des apprenants (avec deux modalités : Hommes et Femmes) et la Technique d’étude assignée de manière aléatoire (comportant trois modalités : Répétition espacée, Auto-évaluation active, et Lecture passive du manuel).
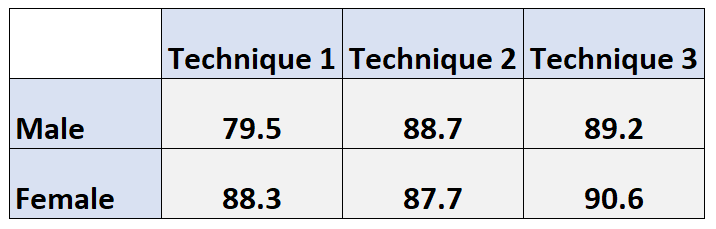
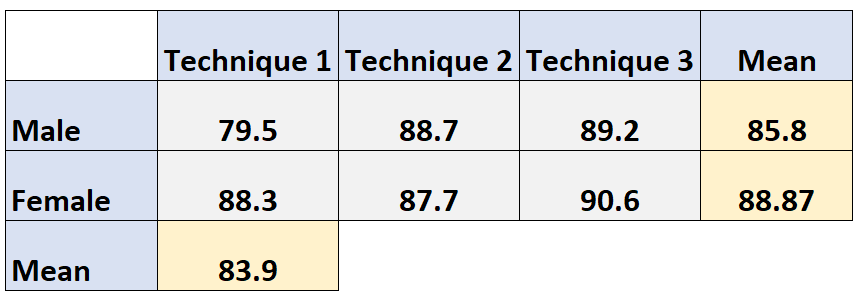
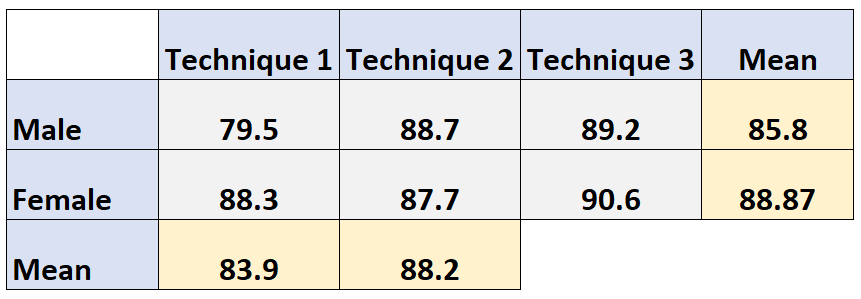
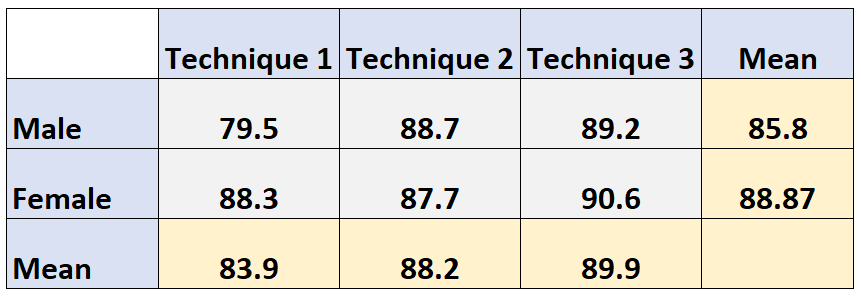
À l’issue d’un cycle d’apprentissage d’une durée de quatre semaines portant sur un module d’apprentissage complexe en neurophysiologie, l’ensemble des 100 participants a été soumis à une évaluation finale standardisée notée sur une échelle continue de 0 à 100 points. Les performances moyennes obtenues au sein de chacune des six cellules expérimentales issues du croisement 2×3 ont été minutieusement compilées. Le tableau suivant consigne les moyennes de cellules observées pour chaque combinaison factorielle :
- Groupe Hommes :
- Technique 1 (Répétition espacée) : Moyenne de cellule = 79,5 points
- Technique 2 (Auto-évaluation active) : Moyenne de cellule = 88,7 points
- Technique 3 (Lecture passive) : Moyenne de cellule = 89,2 points
- Groupe Femmes :
- Technique 1 (Répétition espacée) : Moyenne de cellule = 88,3 points
- Technique 2 (Auto-évaluation active) : Moyenne de cellule = 87,7 points
- Technique 3 (Lecture passive) : Moyenne de cellule = 90,6 points
Ce protocole factoriel croisé 2×3 offre un cas d’étude parfaitement adapté pour décomposer manuellement la mécanique d’agrégation arithmétique et appréhender la manière dont les marges factorielles permettent d’isoler l’effet principal de chacune des deux variables explicatives.
4.2 4.2 Calcul arithmétique rigoureux des moyennes marginales du facteur Genre
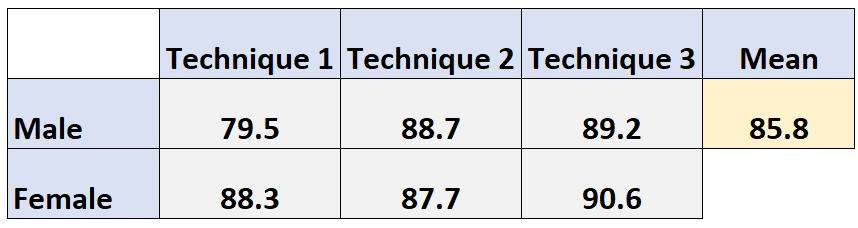
Le premier calcul marginal porte sur le facteur Genre, positionné ici en ligne dans notre tableau croisé. L’objectif méthodologique est d’obtenir une évaluation de la performance moyenne des étudiants selon leur identité de genre, tout en neutralisant l’influence des trois techniques d’étude réparties de manière égale dans le dispositif expérimental. Pour ce faire, nous calculons la moyenne arithmétique non pondérée des scores observés à travers les trois modalités d’apprentissage pour chaque ligne factorielle.
Pour la modalité « Hommes », l’opération consiste à additionner les moyennes des trois cellules correspondantes et à diviser ce résultat par le nombre total de colonnes (J = 3) :
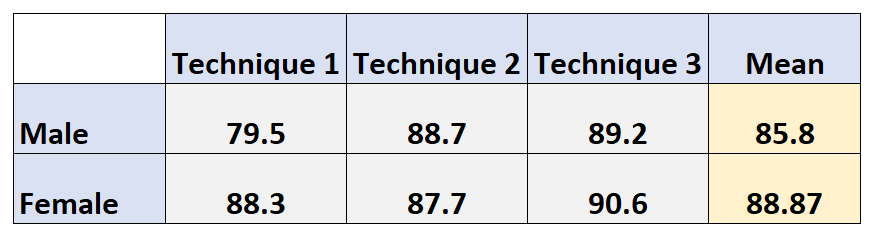
Moyenne marginale (Hommes) = (79,5 + 88,7 + 89,2) / 3 = 257,4 / 3 = 85,80 points
Pour la modalité « Femmes », la même procédure d’agrégation arithmétique est appliquée sur la seconde ligne du tableau :
Moyenne marginale (Femmes) = (88,3 + 87,7 + 90,6) / 3 = 266,6 / 3 = 88,87 points (arrondi au centième le plus proche)
La comparaison directe de ces deux moyennes marginales met en évidence un écart brut de 3,07 points en faveur de la cohorte féminine (88,87 contre 85,80). Cette métrique marginale résume l’effet principal du genre sur la performance à l’examen. D’un point de vue psychologique et pédagogique, cet écart indique que, prise sur l’ensemble des conditions d’études expérimentées, la population des étudiantes démontre une performance globale légèrement supérieure à celle des étudiants masculins, sans que ce constat ne préjuge encore de la disparité spécifique qui a pu s’exprimer au sein d’une méthode d’apprentissage singulière comme la répétition espacée.
4.3 4.3 Calcul arithmétique rigoureux des moyennes marginales des Techniques d’étude
Dans un second temps, nous procédons à l’évaluation marginale des trois Techniques d’étude, disposées verticalement en colonnes au sein du tableau expérimental. Il s’agit ici d’extraire la performance intrinsèque de chaque approche pédagogique en marginalisant, c’est-à-dire en intégrant et en moyennant, les variations associées au genre des apprenants. Chaque moyenne marginale de colonne résultera donc de la sommation des deux cellules constitutives de la colonne divisée par le nombre total de lignes (I = 2).
Pour la Technique 1 (Répétition espacée), le calcul marginal se formule ainsi :
Moyenne marginale (Technique 1) = (79,5 + 88,3) / 2 = 167,8 / 2 = 83,90 points
Pour la Technique 2 (Auto-évaluation active), la sommation sur la seconde colonne donne le résultat suivant :
Moyenne marginale (Technique 2) = (88,7 + 87,7) / 2 = 176,4 / 2 = 88,20 points
Pour la Technique 3 (Lecture passive du manuel), l’agrégation de la troisième colonne s’établit comme suit :
Moyenne marginale (Technique 3) = (89,2 + 90,6) / 2 = 179,8 / 2 = 89,90 points
L’analyse comparée de ces trois grandeurs marginales révèle une hiérarchie pédagogique explicite sur l’ensemble de l’échantillon : la Technique 3 affiche la moyenne marginale la plus élevée (89,90 points), immédiatement suivie par la Technique 2 (88,20 points), tandis que la Technique 1 se positionne en retrait avec une moyenne marginale de 83,90 points. Ce calcul marginal permet aux chercheurs d’identifier l’effet principal du facteur d’intervention : la lecture passive et l’auto-évaluation semblent procurer un avantage académique global supérieur à la répétition espacée au sein de ce protocole précis, indépendamment de toute considération liée au genre des étudiants.
4.4 4.4 Déduction de la moyenne globale et vérification de consistance
L’étape finale de ce traitement numérique consiste à déduire la grande moyenne globale de l’expérimentation (notée Ȳ_..) et à exécuter un test de consistance arithmétique croisée. La grande moyenne peut être théoriquement appréhendée de deux manières alternatives : soit comme la moyenne arithmétique des moyennes marginales de lignes, soit comme la moyenne arithmétique des moyennes marginales de colonnes. La concordance parfaite entre ces deux voies de calcul constitue la preuve formelle de la rectitude des opérations arithmétiques préalablement menées.
Calculons d’abord la moyenne globale à partir des moyennes marginales du facteur Genre (moyenne des marges de lignes) :
Ȳ_.. = (Moyenne Hommes + Moyenne Femmes) / 2 = (85,80 + 88,8667) / 2 = 174,6667 / 2 = 87,3333 points
Calculons ensuite la moyenne globale à partir des moyennes marginales des Techniques d’étude (moyenne des marges de colonnes) :
Ȳ_.. = (Technique 1 + Technique 2 + Technique 3) / 3 = (83,90 + 88,20 + 89,90) / 3 = 262,00 / 3 = 87,3333 points
L’égalité arithmétique absolue (87,33 points dans les deux configurations) valide formellement la cohérence de notre matrice factorielle. Au-delà de cette vérification algébrique, ce résultat offre un point de référence central crucial pour le retour d’information aux apprenants et aux équipes enseignantes : la valeur 87,33 points représente le barycentre académique de l’étude. Tout écart d’une moyenne marginale individuelle par rapport à cette valeur charnière mesure précisément l’ampleur de l’effet principal associé à cette modalité (par exemple, un effet principal de +1,53 point pour le groupe Femmes et de -3,43 points pour la Technique 1 de répétition espacée).
5. 5. Moyennes marginales observées versus moyennes marginales estimées (EMMs)
5.1 5.1 Définition et émergence historique des Estimated Marginal Means
Si le calcul manuel arithmétique exposé à la section précédente convient parfaitement aux dispositifs expérimentaux parfaits, la réalité de la recherche appliquée en psychologie se heurte quasi systématiquement à des distributions d’échantillons imparfaites et à des déséquilibres structurels d’effectifs. Pour pallier les limites des moyennes d’échantillons brutes, Walter R. Harvey a développé dans les années 1960 et 1970, initialement pour l’amélioration génétique animale, le concept novateur de « Least-Squares Means » (moyennes des moindres carrés). Cette méthodologie a été ultérieurement généralisée et rebaptisée Estimated Marginal Means (EMMs, ou moyennes marginales estimées) par les concepteurs de progiciels statistiques tels que SAS et SPSS.
Contrairement à la moyenne marginale observée, qui se contente de résumer les observations empiriques présentes dans le fichier de données brut, la moyenne marginale estimée est une grandeur dérivée d’un modèle paramétrique explicite (tel qu’un modèle linéaire général ou un modèle mixte). L’EMM correspond à la prédiction que le modèle ajusté formulerait pour une modalité factorielle donnée, si l’ensemble des autres facteurs catégoriels du modèle étaient parfaitement équilibrés et si les covariables continues étaient fixées à des valeurs de référence standardisées, usuellement leur moyenne globale.
Dans l’écosystème contemporain du calcul scientifique, notamment au sein du langage statistique R, cette standardisation a été magistralement formalisée par Russell V. Lenth à travers le développement du package de référence emmeans. Ce cadre méthodologique a profondément transformé la recherche translationnelle : la moyenne marginale n’est plus envisagée comme une entité descriptive statique issue de données brutes, mais comme une estimation inférentielle ajustée issue d’une fonction de lien statistique, autorisant des déductions d’une robustesse inégalée face aux aléas de terrain.
5.2 5.2 Ajustement pour covariables continues dans l’ANCOVA
L’apport le plus éclatant des moyennes marginales estimées réside dans leur capacité à intégrer et neutraliser l’impact de covariables continues parasites via l’analyse de covariance (ANCOVA). Dans de nombreuses investigations psychologiques, les participants entrent dans le protocole avec des caractéristiques individuelles préexistantes qui exercent une influence déterminante sur la variable dépendante d’intérêt. Il peut s’agir du quotient intellectuel de base, du niveau d’anxiété-trait pré-expérimental, de l’âge chronologique ou du niveau de fatigue initiale.
Dans une telle configuration, une moyenne marginale brute s’avère méthodologiquement trompeuse : un groupe expérimental pourrait afficher une moyenne de score final supérieure non pas en raison de l’intervention testée, mais simplement parce que ses membres possédaient par hasard un niveau intellectuel initial plus élevé. L’analyse de covariance résout cette menace de validité interne en ajustant le modèle de régression linéaire conjointement sur les facteurs catégoriels et sur la covariable continue X :
Y_ijk = μ + α_i + β_j + (αβ)_ij + γ * (X_ijk – X̄_…) + ε_ijk
Les moyennes marginales estimées (EMMs) pour les modalités du facteur A sont alors calculées en contraignant théoriquement la covariable continue X à être égale à sa grande moyenne générale observée X̄_… Ce processus mathématique revient à recalculer ce que seraient les scores moyens de chaque groupe si tous les participants avaient possédé rigoureusement le même score initial sur la covariable. Cette standardisation statistique élimine le biais de confusion pré-expérimental et accroît considérablement la précision et la puissance statistique des tests de comparaison d’hypothèses en soustrayant de l’erreur résiduelle la variance attribuable à la covariable.
5.3 5.3 Comparaison critique : moyennes brutes versus prédictions du modèle
Il est impératif pour tout chercheur d’identifier les circonstances dans lesquelles les moyennes marginales observées coïncident avec les moyennes marginales estimées, et celles où elles divergent de façon drastique. La convergence mathématique parfaite entre moyennes brutes et EMMs ne se produit que sous deux conditions strictes et cumulatives : premièrement, le plan expérimental factoriel doit être rigoureusement orthogonal et parfaitement équilibré (effectifs identiques dans chaque cellule factorielle), et deuxièmement, le modèle statistique ne doit incorporer aucune covariable continue continue d’ajustement.
Dès lors que l’une de ces conditions fait défaut, les divergences apparaissent, et leur magnitude peut s’avérer substantielle. En présence de cellules aux effectifs inégaux, la moyenne observée d’un groupe reflète disproportionnellement la cellule la plus peuplée, introduisant une corrélation fallacieuse entre les prédicteurs. De même, en présence d’une covariable distribuée de manière asymétrique entre les conditions cliniques, les moyennes brutes masquent ou amplifient artificiellement les contrastes. Dans les situations extrêmes de multicolinéarité ou de modélisation non linéaire, les moyennes brutes peuvent même suggérer une conclusion scientifique diamétralement opposée à celle fournie par les EMMs.
Les recommandations méthodologiques internationales de publication imposent désormais sans ambiguïté de privilégier systématiquement les EMMs par rapport aux moyennes descriptives brutes dès lors que des inférences sont formulées au sein de modèles factoriels complexes ou ajustés. La moyenne marginale estimée reflète la réalité structurelle isolée par la modélisation mathématique, offrant une traduction fidèle du monde contre-factuel visé par la démarche expérimentale : quelle serait la réponse du comportement si toutes les autres influences exogènes étaient rigoureusement neutralisées ?
6. 6. Moyennes marginales dans l’Analyse de Variance factorielle (ANOVA)
6.1 6.1 Décomposition du modèle factoriel linéaire
L’analyse de variance factorielle à effets fixes constitue le cadre canonique au sein duquel s’enracine la théorie inférentielle de la moyenne marginale. Dans un protocole expérimental croisé impliquant les facteurs A et B, l’équation fondamentale de décomposition linéaire de chaque score individuel Y_ijk s’exprime selon la formule standard suivante :
Y_ijk = μ + α_i + β_j + (αβ)_ij + ε_ijk
Dans cette formalisation mathématique rigoureuse, le symbole μ représente la grande moyenne théorique de la population d’intérêt. Le terme α_i figure l’effet principal spécifique de la modalité i du facteur A, le terme β_j quantifie l’effet principal de la modalité j du facteur B, tandis que (αβ)_ij formalise l’effet non additif d’interaction conjointe entre la modalité i et la modalité j. Enfin, le terme résiduel ε_ijk représente l’erreur aléatoire individuelle, postulée identiquement et indépendamment distribuée selon une loi normale centrée d’écart-type σ.
Au cœur de cette architecture d’inférence, la moyenne marginale théorique relative à la modalité i du facteur A se définit très exactement par l’expression μ + α_i. Dès lors, le test de l’hypothèse nulle (H0) relatif à l’effet principal du facteur A dans une ANOVA factorielle équivaut formellement à tester l’égalité simultanée de l’ensemble des moyennes marginales théoriques de ce facteur :
H0 : μ_1. = μ_2. = … = μ_I. équivalent à H0 : α_1 = α_2 = … = α_I = 0
Le test statistique associé à cette hypothèse nulle s’incarne dans le ratio de variance F de Snedecor. Ce ratio confronte le carré moyen inter-marginal du facteur A (obtenu en divisant la somme des carrés marginaux SSA par ses degrés de liberté I – 1) au carré moyen de l’erreur résiduelle intra-cellulaire MSE. Le rejet de l’hypothèse nulle confirme que les variations observées entre les moyennes marginales de ligne ne peuvent être raisonnablement attribuées aux simples fluctuations d’échantillonnage aléatoire.
6.2 6.2 Rapprochement entre contrastes orthogonaux et différences marginales
L’obtention d’un test omnibus F statistiquement significatif au niveau d’un facteur principal indique globalement que les moyennes marginales ne sont pas toutes identiques, mais n’identifie nullement quelles sont les modalités spécifiques qui se différencient mutuellement. Pour explorer la structure fine de ces disparités, les chercheurs ont recours à la théorie des contrastes linéaires appliqués directement sur les marges factorielles.
Un contraste marginal se définit mathématiquement comme une combinaison linéaire des moyennes marginales pondérée par un vecteur de coefficients constants c_i (où i varie de 1 à I), astreints à la condition d’équilibrage fondamental suivante : la sommation de ces coefficients c_i sur l’ensemble des modalités doit être rigoureusement égale à zéro (∑_{i=1}^{I} c_i = 0). L’estimation ponctuelle L de ce contraste s’exprime ainsi :
L = ∑_{i=1}^{I} c_i * Ȳ_i.
L’orthogonalité entre deux contrastes distincts L1 (de coefficients c_i) et L2 (de coefficients d_i) est vérifiée si la sommation du produit croisé de leurs coefficients respectifs est nulle (∑_{i=1}^{I} c_i * d_i = 0). Dans les plans factoriels équilibrés, cette orthogonalité garantit que les comparaisons a priori partitionnent la somme des carrés du facteur principal en fractions d’information totalement indépendantes, qu’il s’agisse de contrastes polynomiaux (testant des composantes de tendance linéaire, quadratique ou cubique au sein des marges) ou de comparaisons par paires ciblées.
Toutefois, la multiplication des contrastes post-hoc sur les moyennes marginales expose inévitablement la recherche au risque d’inflation de l’erreur de première espèce (l’erreur de type I globale). Pour préserver l’intégrité de l’inférence, des procédures d’ajustement de multiplicité s’imposent : les corrections classiques de Bonferroni ou de Holm pour les comparaisons pré-planifiées restreintes, ou l’incontournable méthode de Tukey (Tukey’s Honestly Significant Difference – HSD), spécifiquement paramétrée pour contrôler le taux d’erreur de famille lors de la comparaison exhaustive de toutes les paires de moyennes marginales possibles.
6.3 6.3 Les plans factoriels mixtes et à mesures répétées
Dans les investigations longitudinales ou de chronométrie mentale, les plans d’expérience intègrent fréquemment des mesures répétées où les mêmes sujets sont évalués à travers le temps ou sous différentes conditions cognitives. Ces dispositifs génèrent des plans factoriels mixtes (dits « split-plot »), associant des facteurs inter-sujets (ex. un groupe clinique versus un groupe contrôle) et des facteurs intra-sujets (ex. pré-test, post-test immédiat et suivi à 6 mois).
Le calcul et l’interprétation des moyennes marginales dans ces architectures mixtes requièrent une modélisation sophistiquée de la matrice de variance-covariance des résidus. Alors que pour les facteurs inter-sujets, l’erreur de mesure provient de la variabilité entre individus distincts, pour les facteurs intra-sujets, les observations répétées sur une même personne sont intrinsèquement corrélées. La moyenne marginale temporelle agrège ainsi des trajectoires intra-individuelles, exigeant la satisfaction de l’hypothèse de sphéricité (ou circularité de Mauchly), stipulant que les variances de toutes les différences possibles entre paires de mesures répétées doivent être équivalentes.
Lorsque cette condition de sphéricité est transgressée — une situation presque universelle dans les études cliniques portant sur des processus de récupération ou d’apprentissage —, les tests inférentiels sur les moyennes marginales temporelles voient leur taux d’erreur de type I sévèrement gonflé. L’application de corrections de degrés de liberté, telles que les ajustements de Greenhouse-Geisser ou de Huynh-Feldt, devient impérative pour garantir que les inférences portées sur les profils temporels marginaux reflètent des variations développementales ou cliniques authentiques et non des artéfacts d’autocorrélation résiduelle.
7. 7. Distinction conceptuelle : moyennes marginales, conditionnelles et globales
7.1 7.1 La moyenne globale (Grand Mean)
Pour appréhender avec clarté la taxonomie des tendances centrales au sein des plans factoriels, il est essentiel d’isoler en premier lieu la grande moyenne globale (notée conventionnellement Ȳ_.. ou GM). La moyenne globale constitue le barycentre ou l’ancrage central géométrique de l’intégralité du jeu de données expérimentales. Elle est calculée en sommant l’ensemble absolu des scores individuels bruts recueillis à travers toutes les conditions du protocole et en divisant cette somme totale par l’effectif cumulé d’échantillonnage N :
Ȳ_.. = (1 / N) * ∑_{i=1}^{I} ∑_{j=1}^{J} ∑_{k=1}^{n_ij} Y_ijk
Dans la topologie des modèles linéaires, la moyenne globale joue le rôle fondamental d’origine de référence pour le calcul de la somme totale des carrés des écarts (SST). Elle fixe le niveau de base comportemental en l’absence de toute différentiation catégorielle. Toutefois, dans les plans déséquilibrés où certaines conditions comportent un nombre disproportionné de participants, la moyenne brute globale de l’échantillon N s’écarte de la moyenne arithmétique simple des marges factorielles, créant un décalage structurel qui nécessite une vigilance analytique aiguë.
D’un point de vue heuristique, la moyenne globale ne fournit qu’une vision indifférenciée de la cohorte étudiée. Elle indique le niveau moyen de performance sans opérer la moindre décomposition factorielle. Bien qu’indispensable comme constante d’ajustement au sein des équations de régression, elle ne renseigne en rien sur l’impact spécifique des manipulations expérimentales entreprises par le chercheur.
7.2 7.2 Les moyennes conditionnelles (ou moyennes de cellules)
À l’extrême opposé du niveau d’abstraction de la moyenne globale se situent les moyennes conditionnelles, rigoureusement désignées sous l’appellation de moyennes de cellules. Une moyenne conditionnelle est l’estimation de tendance centrale calculée sous une combinaison stricte, unique et conjointe de modalités factorielles spécifiques. Sur le plan formel de la théorie des probabilités conditionnelles, elle représente l’espérance de la variable dépendante Y sachant la réalisation simultanée des événements factoriels A = i et B = j :
Ȳ_ij = E[ Y | A = i, B = j ]
L’immense valeur scientifique des moyennes conditionnelles réside dans leur sensibilité micro-analytique absolue. Elles capturent avec une précision granulaire la réponse comportementale à l’intersection exacte des stimuli expérimentaux. Par voie de conséquence, elles constituent le matériau exclusif à partir duquel se manifestent et se décomposent les effets d’interaction statistique. Si l’effet d’une psychothérapie dépend de façon critique du profil génétique d’un patient, seule l’observation détaillée des moyennes de chaque sous-cellule permettra de révéler cette contingence locale.
Néanmoins, cette granularité descriptive comporte une limite intrinsèque majeure : l’hyperspécialisation contextuelle. Une moyenne de cellule n’a pas vocation à établir une loi psychologique générale. Elle informe sur ce qui se produit sous des contraintes environnementales et dispositionnelles hautement verrouillées, empêchant toute extrapolation directe à des contextes où les autres facteurs varieraient librement au sein de la population générale.
7.3 7.3 Tableau synoptique de comparaison et critères de choix
Afin de synthétiser de manière opérationnelle la distinction conceptuelle entre ces trois métriques et de guider le chercheur dans ses arbitrages analytiques, le tableau comparatif ci-dessous détaille les propriétés distinctives de chaque grandeur :
| Métrique Statistique | Formule Arithmétique Idéale | Rôle Analytique Majeur | Question de Recherche Cible |
|---|---|---|---|
| Moyenne Globale (Grand Mean) | (1 / N) * ∑ Y_ijk | Point d’ancrage central et référence d’écart pour la partition de la variance totale. | « Quel est le niveau de performance moyen général de l’ensemble de la cohorte étudiée ? » |
| Moyenne Marginale (Marginal Mean) | (1 / J) * ∑_j Ȳ_ij | Évaluation de l’effet principal d’une variable indépendante en intégrant les autres facteurs. | « Quel est l’impact global de ce traitement ou facteur, indépendamment des autres modérateurs ? » |
| Moyenne Conditionnelle (Cell Mean) | (1 / n_ij) * ∑_k Y_ijk | Détection des contingences locales et analyse des effets simples en cas d’interaction. | « Quel résultat précis obtient-on sous la combinaison spécifique du Traitement A1 et du Profil B2 ? » |
Le choix entre ces métriques est conditionné par la question de recherche posée et la structure des données. Une erreur fréquente recensée dans les mémoires de recherche et thèses universitaires réside dans la tentative de tirer des conclusions globales sur un traitement en s’appuyant de façon myope sur une moyenne conditionnelle locale, ou inversement, de postuler une efficacité universelle à partir d’une moyenne marginale alors même qu’une interaction croisée substantielle annule la validité de cette généralisation.
8. 8. Interprétation des effets principaux en présence et absence d’interaction
8.1 8.1 Scénario d’absence d’interaction statistique
La validité théorique et la pertinence pratique de l’interprétation des moyennes marginales dépendent de manière fondamentale du statut statistique de l’interaction factorielle au sein du modèle linéaire. Le scénario le plus limpide et méthodologiquement le plus confortable est celui où le test de l’interaction conjointe (effet A x B) s’avère non significatif, et où la visualisation graphique atteste d’un parallélisme manifeste des profils de réponse à travers les différentes conditions expérimentales.
Dans un tel cadre d’additivité stricte des effets, l’interprétation directe et inconditionnelle des moyennes marginales est pleinement légitime. L’effet principal mesuré par l’écart entre les moyennes marginales du facteur A s’applique de manière uniforme et invariable à chacun des niveaux individuels du facteur B. Si l’on évalue l’impact d’une psychothérapie comportementale versus un groupe témoin sur la réduction des scores d’anxiété au sein de trois tranches d’âge distinctes (jeunes adultes, adultes d’âge moyen, personnes âgées) et que l’interaction s’avère rigoureusement nulle, le chercheur peut formuler une conclusion générale irréfutable : la thérapie réduit l’anxiété d’une magnitude moyenne identique, quel que soit l’âge des participants.
La moyenne marginale acquiert alors son statut le plus noble : celui d’une constante d’action comportementale généralisable. Elle permet aux cliniciens, aux administrateurs de la santé publique et aux éducateurs de préconiser des protocoles d’intervention avec une confiance inductive élevée, sachant que le bénéfice moyen quantifié à l’échelle des marges se déclinera de manière stable et prédictible dans chaque strate de la population cible.
8.2 8.2 Scénario d’interaction ordinale
La seconde configuration analytique correspond à l’émergence d’une interaction ordinale (parfois désignée sous le terme d’interaction quantitative ou de magnitude). Dans ce scénario, les tracés de profils ne sont plus strictement parallèles, révélant une modulation de l’effet d’un facteur selon les niveaux du second. Toutefois, les lignes ne se croisent à aucun point du continuum de mesure : la hiérarchie relative des modalités demeure rigoureusement identique d’un niveau à l’autre.
À titre d’illustration, imaginons qu’un programme de remédiation cognitive améliore la mémoire de travail de 15 points chez des adultes jeunes, mais de seulement 6 points chez des adultes d’âge très avancé, comparativement à leurs contrôles respectifs. La méthode active surpasse le contrôle dans les deux cohortes d’âge, mais l’ampleur de ce bénéfice est conditionnée par le substrat développemental des individus. Dans cette situation, la moyenne marginale globale de l’intervention cognitive reste mathématiquement supérieure à celle du groupe contrôle, résumant fidèlement la tendance dominante globale du protocole.
Néanmoins, le chercheur doit faire preuve d’une prudence sémantique rigoureuse lors de la restitution de ses déductions. S’il demeure statistiquement acceptable de mentionner l’existence d’un effet principal significatif à l’échelle marginale, il est scientifiquement fallacieux de laisser entendre que cet effet s’exprime avec une magnitude constante. La moyenne marginale doit impérativement être accompagnée d’une mise en garde explicite précisant la fluctuation de son amplitude pratique selon les sous-groupes examinés.
8.3 8.3 Scénario d’interaction désordonnée (croisée)
Le troisième scénario — le plus périlleux sur le plan méthodologique — est celui d’une interaction désordonnée (ou interaction qualitative croisée). Ce phénomène se produit lorsque les lignes de réponse se croisent nettement sur le graphique factoriel, signifiant que la direction même de l’effet d’une variable s’inverse totalement selon les modalités de la seconde variable. Dans cette situation, l’interprétation naïve et décontextualisée des moyennes marginales constitue une faute méthodologique majeure.
Considérons l’exemple paradigmatique d’une étude en psychopharmacologie évaluant les effets d’un agent sédatif comparativement à un placebo sur les performances motrices, chez des sujets en état d’excitation maniaque versus des sujets en état de dépression léthargique profonde. L’agent sédatif réduit l’agitation et améliore substantiellement la régulation motrice chez les patients maniaques, alors qu’il aggrave considérablement l’inhibition motrice chez les patients déprimés. Si l’on calcule aveuglément la moyenne marginale de la molécule sédative sur l’ensemble de l’échantillon combiné, les deux effets opposés de grande amplitude vont s’annihiler arithmétiquement, aboutissant à une moyenne marginale strictement identique à celle du placebo.
Le test de l’effet principal marginal conclura alors faussement à une absence totale d’impact de la molécule (F ≈ 0 ; p non significatif). Présenter ce résultat marginal brut reviendrait à affirmer que le traitement n’exerce aucune influence motrice, une déduction scientifiquement désastreuse masquant deux effets d’une puissance clinique considérable mais de polarités inverses. Dès lors qu’une interaction croisée substantielle est détectée, le chercheur a le devoir déontologique de neutraliser l’interprétation des moyennes marginales d’effets principaux pour concentrer l’intégralité de sa restitution statistique sur l’analyse approfondie des effets simples conditionnels.
9. 9. Plans factoriels déséquilibrés, types de sommes des carrés et paradoxe de Simpson
9.1 9.1 Le problème des effectifs inégaux par cellule
L’orthogonalité mathématique d’un plan factoriel repose entièrement sur l’égalité stricte des effectifs au sein de chaque cellule (n_ij = n pour tout i et j), ou sur la stricte proportionnalité des fréquences cellulaires aux distributions marginales. Dès lors que ces conditions géométriques idéales sont compromises — un écueil récurrent dans la recherche empirique lié à l’attrition de participants, aux taux d’abandon différentiels dans les essais cliniques ou aux difficultés d’inclusion de patients rares —, le plan d’expérience devient non orthogonal ou « déséquilibré ».
Cette perte d’orthogonalité génère une conséquence statistique immédiate : les facteurs explicatifs cessent d’être mutuellement indépendants dans le jeu de données empirique. En d’autres termes, les variables catégorielles partagent de la variance commune et deviennent corrélées. Dès lors, le calcul d’une moyenne marginale brute pondérée (qui attribue à chaque cellule un poids proportionnel à son effectif réel d’observation n_ij) ne mesure plus seulement l’effet du facteur considéré, mais incorpore une part de variance propre à l’autre facteur.
Il devient dès lors indispensable de formaliser la dissociation mathématique entre la moyenne marginale brute pondérée par l’échantillonnage et la moyenne marginale non pondérée théorique. La première reflète la réalité contingente d’un échantillon spécifique, tandis que la seconde accorde un poids conceptuel équivalent (1/J) à chaque condition expérimentale, simulant ainsi la moyenne qui aurait été observée si le plan avait conservé un équilibre d’allocation rigoureux.
9.2 9.2 Les types I, II et III de sommes des carrés
Face à la non-orthogonalité induite par le déséquilibre des cellules, la communauté statistique a développé différentes stratégies de partitionnement de la somme des carrés au sein du modèle linéaire généralisé, désignées conventionnellement sous les vocables de Types I, II et III de sommes des carrés. Chacune de ces approches modélise l’estimation des effets marginaux selon une logique inférentielle distincte :
- Sommes des carrés de Type I (Approche séquentielle ou hiérarchique directe) : Les variables explicatives sont introduites pas à pas dans l’équation. Le premier facteur incorporé reçoit l’intégralité de la variance partagée, ce qui rend le résultat entièrement dépendant de l’ordre d’entrée des facteurs dans le logiciel. Cette méthode est rigoureusement inadaptée pour tester des moyennes marginales dans un plan factoriel général standard.
- Sommes des carrés de Type II (Approche hiérarchique conditionnelle) : Chaque effet principal est évalué en contrôlant les autres effets principaux, mais sans ajustement pour l’interaction factorielle. Cette approche possède une puissance statistique optimale lorsque l’expérimentateur a la certitude formelle préalable que l’interaction d’ordre supérieur est rigoureusement nulle dans la population.
- Sommes des carrés de Type III (Méthode de Yates ou des moyennes non pondérées) : Chaque effet principal est ajusté de manière marginale simultanée par rapport à l’ensemble des autres effets principaux ET par rapport à tous les termes d’interaction d’ordre supérieur. Elle teste précisément l’égalité des moyennes marginales estimées non pondérées.
Dans la littérature méthodologique en psychologie et selon les standards institutionnels de l’APA, l’utilisation de l’approche de Type III est quasi-universellement préconisée pour les plans factoriels factoriels avec déséquilibre modéré. Cette paramétrisation garantit que l’effet principal d’une variable reflète fidèlement la variabilité des moyennes marginales non pondérées, immunisant le chercheur contre les distorsions d’échantillonnage induites par la taille asymétrique des cellules.
9.3 9.3 Le paradoxe de Simpson appliqué aux moyennes de groupes
Le déséquilibre sévère des effectifs au sein de tables factorielles croisées peut engendrer une pathologie statistique fascinante et contre-intuitive : le paradoxe de Simpson (ou paradoxe de Yule-Simpson). Cette anomalie se manifeste lorsqu’une tendance statistique clairement identifiée au niveau de chaque sous-groupe ou condition conditionnelle s’inverse totalement lorsque les données sont agrégées sous la forme de moyennes marginales globales d’échantillon.
Pour en saisir la mécanique délétère, considérons un essai clinique psychiatrique évaluant l’efficacité d’une nouvelle thérapie cognitive (T) comparativement à un protocole standard (S) pour traiter l’anxiété sévère, chez des cohortes de patients ambulatoires (forme légère) et hospitalisés (forme clinique lourde). Au sein du groupe ambulatoire, la thérapie T surpasse la thérapie S de 4 points. Au sein du groupe hospitalisé, la thérapie T surpasse également la thérapie S de 4 points. Cependant, en raison d’un biais de sélection majeur, la grande majorité des patients hospitalisés (qui présentent naturellement des scores d’anxiété beaucoup plus hauts) ont été orientés vers la thérapie T, tandis que les patients ambulatoires ont principalement reçu la thérapie S.
Lors de l’agrégation brute des scores pour calculer la moyenne marginale observée de chaque thérapie sur l’ensemble de la clinique, le poids disproportionné des patients hospitalisés tire la moyenne marginale globale de la thérapie T vers des niveaux d’anxiété très élevés. Le résultat marginal brut conclut alors fallacieusement à la supériorité de la thérapie standard S sur l’ensemble de l’étude, inversant la vérité biologique observée dans chaque strate ! Seule l’utilisation rigoureuse des moyennes marginales estimées (EMMs) — qui neutralisent la structure de pondération de la variable de confusion — permet de rétablir la réalité empirique : la thérapie T est supérieure dans chaque cellule, et conserve donc sa supériorité à l’échelle de la moyenne marginale correctement ajustée.
10. 10. Applications avancées en psychologie, psychométrie et neurosciences
10.1 10.1 Évaluation psychométrique et théorie de la réponse aux items (TRI)
Dans le domaine de la psychométrie avancée, le recours aux moyennes marginales est consubstantiel aux architectures d’étalonnage des instruments psychologiques sous la Théorie de la Réponse aux Items (TRI). Lors du développement d’une échelle multidimensionnelle évaluant des construits de personnalité ou des compétences cognitives, les modélisateurs utilisent l’estimation du maximum de vraisemblance marginale (Marginal Maximum Likelihood – MML) pour calibrer les paramètres de difficulté (b) et de discrimination (a) des items d’un test.
Dans ce cadre méthodologique probabiliste, la distribution des capacités latentes individuelles (notée θ) est marginalisée — c’est-à-dire intégrée sur l’ensemble du continuum de la population cible selon une loi de probabilité a priori (typiquement normale standard) — afin d’estimer les caractéristiques intrinsèques de chaque item de façon indépendante de l’échantillon particulier de sujets ayant passé le test. La moyenne marginale de difficulté d’un sous-test constitue alors un indice d’ancrage fondamental pour harmoniser les versions alternatives d’examens psychométriques standardisés à travers le temps.
Parallèlement, l’analyse du Fonctionnement Différentiel d’Item (Differential Item Functioning – DIF) s’appuie sur la comparaison des profils marginaux de réponse entre sous-groupes démographiques (ex. selon le genre, la culture d’origine ou la langue maternelle). Si un item présente une moyenne marginale de réussite divergente entre deux groupes à niveau de compétence latente rigoureusement équivalent, cet item est suspecté de biais psychométrique structurel et doit faire l’objet d’une révision clinique ou d’une exclusion afin de préserver l’équité psychologique de l’évaluation.
10.2 10.2 Psychologie cognitive et chronométrie mentale
La psychologie cognitive expérimentale, particulièrement dans ses investigations chronométriques de l’attention et du contrôle inhibiteur, recourt systématiquement aux moyennes marginales pour extraire des invariants de traitement mental. Dans des protocoles informatisés emblématiques tels que les tâches de Stroop, de Simon ou de Flanker d’Eriksen, les participants exécutent des centaines d’essais où des stimuli congruents et incongruents sont présentés à des rythmes variables.
Les temps de réaction en millisecondes et les taux d’erreurs font l’objet d’une double marginalisation analytique. D’une part, les chercheurs calculent des moyennes marginales temporelles à travers les blocs de passation successifs afin de neutraliser l’impact parasite des processus d’habituation, d’apprentissage procédural ou au contraire de fatigue mentale cumulative. D’autre part, la moyenne marginale calculée pour une condition d’incongruence fournit l’estimation de référence du coût cognitif de l’inhibition (le fameux « effet d’interférence »), mesuré de manière robuste au niveau individuel et populationnel.
De surcroît, les distributions de temps de réaction étant notoirement asymétriques à droite, les modélisations cognitives récentes délaissent la simple moyenne arithmétique pour combiner les moyennes marginales estimées aux décompositions distributionnelles ex-gaussiennes ou aux modèles de diffusion de drift (Drift-Diffusion Models – DDM). Les moyennes marginales des paramètres de dérive permettent d’isoler la vitesse d’accumulation de l’information sensorielle indépendamment de la variabilité marginale du temps non décisionnel lié à la préparation motrice.
10.3 10.3 Essais cliniques randomisés en santé mentale
L’évaluation rigoureuse de l’efficacité thérapeutique au sein d’essais contrôlés randomisés (ECR) multicentriques en santé mentale représente l’un des théâtres d’application les plus cruciaux pour les moyennes marginales estimées. Lorsque l’efficacité d’un nouvel antidépresseur ou d’un protocole de thérapie d’acceptation et d’engagement (ACT) est testée à travers une douzaine de centres hospitaliers répartis sur un territoire national, la variabilité inter-sites (différences dans les pratiques soignantes locales, caractéristiques sociodémographiques des bassins de population) constitue un facteur modérateur de confusion majeur.
L’utilisation de modèles linéaires mixtes généralisés permet de considérer les centres de soins comme des effets aléatoires ou des facteurs de stratification fixes, tout en estimant la moyenne marginale d’amélioration clinique associée à chaque modalité thérapeutique. Cette moyenne marginale standardisée mesure le bénéfice clinique réel net que l’on peut raisonnablement anticiper lors du déploiement généralisé du traitement dans le système de santé, affranchi de l’idiosyncrasie d’un centre hospitalier particulier.
Enfin, face au phénomène critique de l’attrition des patients (abandons de traitement fréquents lors de prises en charge de troubles sévères comme l’addiction ou les troubles du comportement alimentaire), le calcul des moyennes marginales estimées par l’approche du Maximum de Vraisemblance sous l’hypothèse de données manquantes au hasard (Missing at Random – MAR) évite les biais dramatiques de l’analyse exclusive des cas complets. Ces moyennes marginales ajustées offrent ainsi aux autorités sanitaires et aux praticiens des métriques décisionnelles d’une fiabilité éthique et scientifique exemplaire.
11. 11. Implémentation computationnelle : calcul des moyennes marginales sous R, SPSS et Python
11.1 11.1 Implémentation complète sous le logiciel R
L’environnement open-source de calcul statistique R s’impose comme la référence méthodologique internationale pour l’extraction, la modélisation et la visualisation des moyennes marginales estimées. La démarche computationnelle canonique s’articule autour de l’ajustement préalable d’un modèle linéaire univarié via la commande intégrée lm() ou aov(), suivi de l’exploitation de la bibliothèque d’excellence emmeans.
Dans un script d’analyse reproductible, l’ajustement du modèle factoriel s’effectue en déclarant explicitement les effets principaux et les termes d’interaction croisée. Une fois l’objet de modélisation instancié en mémoire, la fonction emmeans() est invoquée en spécifiant la formule de partitionnement marginal souhaitée :
Par exemple, pour extraire les moyennes marginales estimées associées au facteur « Traitement », l’analyste écrit la syntaxe suivante :
modele <- lm(Score ~ Traitement * Groupe, data = donnees_recherche)
marges_traitement <- emmeans(modele, ~ Traitement)
Pour procéder à la comparaison différentielle exhaustive par paires de ces moyennes marginales avec un ajustement rigoureux du taux d’erreur de famille via la procédure de Tukey, il suffit d’appliquer la commande complémentaire :
pairs(marges_traitement, adjust = « tukey »)
Enfin, pour la restitution visuelle de haute résolution vectorielle destinée à l’édition scientifique, l’écosystème propose la fonction dédiée emmip() qui génère automatiquement des graphiques d’interaction de qualité publication en se couplant parfaitement aux fonctionnalités graphiques avancées du package standard ggplot2.
11.2 11.2 Procédure sous IBM SPSS Statistics
Le logiciel propriétaire IBM SPSS Statistics, largement déployé au sein des départements universitaires de psychologie et des laboratoires hospitaliers, intègre nativement une panoplie d’outils sophistiqués pour l’analyse des moyennes marginales estimées via son module d’Analyse du Modèle Linéaire Général (GLM).
Par l’interface graphique utilisateur (GUI), le chercheur accède à cette procédure en suivant le chemin de menu classique : Analyse > Modèle linéaire général > Univarié…. Après avoir transféré la variable de score dans le champ « Variable dépendante » et assigné les variables catégorielles dans le champ « Facteurs fixes », l’utilisateur clique sur la sous-boîte de dialogue intitulée spécifiquement « Moyennes marginales estimées » (EM Means). Il sélectionne alors les facteurs d’intérêt dans la liste disponible et les fait glisser dans la fenêtre active « Afficher les moyennes pour ».
Cependant, pour garantir l’automatisation et l’exhaustivité des sorties statistiques lors de rapports méthodologiques exigeants, le recours à la syntaxe programmée SPSS demeure la voie de référence. La commande de syntaxe suivante illustre l’extraction des moyennes marginales et l’exécution conjointe des contrastes par paires ajustés :
UNIANOVA Score BY Traitement Groupe
/METHOD=SSTYPE(3)
/EMMEANS=TABLES(Traitement) COMPARE(Traitement) ADJ(BONFERRONI)
/EMMEANS=TABLES(Traitement*Groupe)
/DESIGN=Traitement Groupe Traitement*Groupe.
Le tableau de sortie généré par SPSS restitue avec une clarté remarquable la moyenne marginale estimée de chaque condition, son erreur type asymptotique, ainsi que les bornes inférieure et supérieure de son intervalle de confiance à 95 %, accompagnées des matrices de comparaisons univariées correspondantes.
11.3 11.3 Modélisation en Python avec Statsmodels
L’essor considérable du langage Python dans le champ de la science des données et des neurosciences computationnelles a conduit au développement d’architectures statistiques permettant de manipuler les moyennes marginales avec la même rigueur formelle que sous R ou SPSS. La bibliothèque de modélisation économétrique et statistique de référence est statsmodels, articulée autour de son interface par formule inspirée de l’environnement R.
L’implémentation débute par l’importation de la structure tabulaire sous forme de DataFrame pandas, suivie de l’ajustement du modèle linéaire par moindres carrés ordinaires (OLS) :
import statsmodels.api as sm
import statsmodels.formula.api as smf
modele = smf.ols(‘Score ~ C(Traitement) * C(Groupe)’, data=df).fit()
Pour le calcul précis des effets marginaux et des moyennes estimées, les scientifiques des données s’appuient aujourd’hui de manière croissante sur la bibliothèque spécialisée marginaleffects, désormais totalement portée et interfaçable en environnement Python, ou utilisent les fonctionnalités d’analyse multivariée de statsmodels.stats.multicomp.
La fonction predictions() de la bibliothèque permet d’extraire la grille complète des moyennes marginales prédictives en fixant systématiquement les autres covariables à leurs moyennes marginales respectives. Les résultats structurés sont instantanément exportables sous la forme d’un tableau synthétique Pandas, autorisant une intégration transparente dans des pipelines d’apprentissage automatique ou des routines graphiques automatisées sous seaborn ou matplotlib.
12. 12. Synthèse méthodologique, erreurs fréquentes et recommandations de publication
12.1 12.1 Pièges et erreurs courantes d’interprétation
En dépit de sa relative simplicité de calcul arithmétique élémentaire, la moyenne marginale est la cible d’erreurs méthodologiques et conceptuelles fréquentes dans la littérature empirique évaluée par les pairs. Le piège le plus universel et sans doute le plus préjudiciable consiste en l’omission délibérée ou ignorante de l’interaction factorielle. Se focaliser de manière exclusive sur un effet principal marginal statistiquement significatif en négligeant de tester préalablement l’existence d’une interaction désordonnée peut conduire à formuler des prescriptions cliniques ou pédagogiques totalement infondées, voire délétères pour certains sous-groupes de sujets.
Une seconde erreur récurrente procède de la confusion intellectuelle entre les moyennes marginales pondérées et les moyennes marginales non pondérées au sein des plans d’expérience déséquilibrés. Présenter comme représentative d’un effet principal la simple moyenne d’agrégation d’une colonne sans avoir corrigé l’asymétrie numérique des cellules équivaut à réintroduire insidieusement des facteurs de confusion sociodémographiques ou contextuels dans une métrique supposée isoler une causalité expérimentale pure.
Enfin, les comités de lecture dénoncent régulièrement la surinterprétation des différences marginales infinitésimales. L’obtention d’une valeur p hautement significative (p < 0,001) sur un test marginal F dans un échantillon de très grande taille (plusieurs milliers de sujets) ne garantit nullement que l’écart entre les moyennes marginales présente la moindre pertinence pratique ou clinique sur le terrain. La taille de l’échantillon grossit artificiellement la significativité statistique, rendant indispensable l’adossement de toute moyenne marginale à des indicateurs standardisés de magnitude réelle.
12.2 12.2 Liste de contrôle pour le chercheur avant soumission
Afin de prémunir les auteurs contre les écueils méthodologiques avant la soumission d’un manuscrit scientifique dans une revue à comité de lecture, il est vivement recommandé de valider rigoureusement la liste de contrôle (checklist) suivante :
- Vérification de l’orthogonalité du plan : Les effectifs cellulaires sont-ils strictement identiques ? En cas de déséquilibre avéré, la méthode des sommes des carrés de Type III (ou une approche par modélisation mixte) a-t-elle été expressément sélectionnée dans le progiciel statistique ?
- Examen préalable de l’interaction : L’interaction factorielle d’ordre supérieur a-t-elle été formellement testée et visualisée sur un graphique de profils avant d’interpréter les effets marginaux principaux ?
- Choix motivé des métriques : Les moyennes rapportées sont-elles des moyennes marginales estimées (EMMs) ajustées pour les covariables pertinentes, et non de simples moyennes d’échantillons brutes ?
- Présentation conjointe de l’incertitude : Chaque moyenne marginale consignée dans le texte ou les tableaux est-elle systématiquement flanquée de son erreur type (SE) ou de son intervalle de confiance à 95 % (IC 95%) ?
- Correction de multiplicité explicitée : Si des comparaisons par paires entre moyennes marginales ont été exécutées, la procédure d’ajustement du risque global (Tukey, Bonferroni, Holm) est-elle clairement stipulée dans la section Méthode ?
- Reproductibilité computationnelle : Le script d’analyse complet (sous R, Python ou syntaxe SPSS) documentant fidèlement le paramétrage du modèle est-il archivé et accessible en annexe ou sur un répertoire ouvert (OSF) ?
L’adhésion scrupuleuse à ces critères méthodologiques garantit non seulement la solidité épistémologique des conclusions formulées, mais fluidifie substantiellement le processus d’évaluation par les pairs en levant d’emblée toute ambiguïté sur la rectitude de l’architecture d’analyse quantitative déployée.
12.3 12.3 Normes de rédaction et de restitution selon les directives APA
La communication académique des résultats statistiques obéit à des conventions typographiques et structurelles codifiées avec une grande minutie par le manuel de style de l’American Psychological Association (APA 7e édition). Lors de la rédaction de la section « Résultats » d’un article scientifique, la restitution des moyennes marginales doit s’intégrer de manière fluide et harmonieuse au sein de la narration textuelle ou faire l’objet d’un tableau factoriel formalisé selon les canons en vigueur.
Sur le plan typographique et formel, les symboles statistiques doivent être systématiquement composés en italique (par exemple : F, p, M, SE, η²). De surcroît, chaque test d’effet principal sur une moyenne marginale doit impérativement associer les degrés de liberté du numérateur et du dénominateur, la statistique F exacte, la valeur p précise (rapportée au millième près), ainsi qu’une mesure reconnue de la taille d’effet, typiquement l’êta-carré partiel (η_p²) ou le d de Cohen pour les contrastes marginalisés deux à deux.
À titre de modèle pratique directement transposable, voici un exemple canonique de formulation narrative conforme aux exigences de l’APA 7e édition pour la restitution d’un effet principal marginal en présence de deux facteurs :
« Une analyse de variance (ANOVA) factorielle 2 x 3 à effets fixes a été menée pour évaluer l’impact du Genre et de la Technique d’étude sur la performance à l’évaluation finale. L’analyse a mis en évidence un effet principal statistiquement significatif de la Technique d’étude, F(2, 94) = 4,82, p = 0,010, η_p² = 0,093. Les moyennes marginales estimées indiquent une performance globale supérieure pour les étudiants assignés à la lecture passive (M = 89,90, SE = 0,95, IC 95% [88,01, 91,79]) et à l’auto-évaluation active (M = 88,20, SE = 0,95, IC 95% [86,31, 90,09]), comparativement aux participants soumis à la répétition espacée (M = 83,90, SE = 0,95, IC 95% [82,01, 85,79]). Les comparaisons post-hoc menées à l’aide de la procédure de Tukey ont confirmé que la moyenne marginale de la répétition espacée différait significativement de celle de la lecture passive (p = 0,008), tandis qu’aucune différence significative n’a été détectée entre l’auto-évaluation active et la lecture passive (p = 0,412). L’interaction entre le Genre et la Technique d’étude n’ayant pas atteint le seuil de significativité statistique, F(2, 94) = 1,15, p = 0,321, η_p² = 0,024, ces écarts marginaux reflètent fidèlement l’efficacité globale des approches pédagogiques indépendamment de la variable sociodémographique. »
Ce paragraphe modèle illustre l’intégration méthodique de l’ensemble des garde-fous théoriques examinés au fil de ce guide : contextualisation globale, formulation des métriques marginales assorties de leur marge d’erreur, justification par l’absence d’interaction croisée et interprétation des contrastes ciblés. Maîtriser l’usage et la restitution des moyennes marginales permet ainsi au chercheur de transcender l’empirisme des observations brutes pour hisser ses déductions au rang d’inférences scientifiques robustes, transparentes et pérennes.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9780203771587
- Harvey, W. R. (1960). Least-squares analysis of data with unequal subclass numbers. United States Department of Agriculture, Agricultural Research Service, ARS 20-8, 1-157. https://naldc.nal.usda.gov/download/CAT87209355/PDF
- Lenth, R. V. (2016). Least-squares means: The R package lsmeans. Journal of Statistical Software, 69(1), 1-33. https://doi.org/10.18637/jss.v069.i01
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- Nelder, J. A., & Wedderburn, R. W. M. (1972). Generalized linear models. Journal of the Royal Statistical Society: Series A (General), 135(3), 370-384. https://doi.org/10.2307/2344614
- Searle, S. R., Speed, F. M., & Milliken, G. A. (1980). Population marginal means in the linear model: An alternative to least squares means. The American Statistician, 34(4), 216-221. https://doi.org/10.1080/00031305.1980.10483031
- Simpson, E. H. (1951). The interpretation of interaction in contingency tables. Journal of the Royal Statistical Society: Series B (Methodological), 13(2), 238-241. https://doi.org/10.1111/j.2517-6161.1951.tb00088.x
- Yates, F. (1934). The analysis of multiple classifications with unequal numbers in the different classes. Journal of the American Statistical Association, 29(185), 51-66. https://doi.org/10.1080/01621459.1934.10502686