
Dans l’édifice de la statistique inférentielle moderne, l’estimation ponctuelle constitue l’opération fondamentale par laquelle le chercheur tente de combler le gouffre épistémologique séparant les observations empiriques limitées de la réalité universelle inobservable. Lorsque des scientifiques s’interrogent sur l’efficacité réelle d’un nouveau protocole psychothérapeutique, sur la proportion exacte d’individus atteints d’un trouble neurologique dans une nation, ou sur le temps de réaction cognitif moyen de l’espèce humaine soumise à un stress aigu, il leur est matériellement impossible de mesurer l’intégralité de la population d’intérêt. L’inférence statistique propose alors un mécanisme rigoureux : extraire d’un échantillon fini une valeur numérique unique, calculée à partir des données observées, afin de postuler la meilleure approximation possible du paramètre latent inconnu.
Cette démarche, faussement simple en apparence, repose sur des théorèmes mathématiques profonds développés au fil des siècles par des pionniers tels que Pierre-Simon de Laplace, Carl Friedrich Gauss, Karl Pearson et Ronald Fisher. Une estimation ponctuelle ne se résume pas à un simple calcul arithmétique ; elle incarne une décision probabiliste opérée sous condition d’incertitude radicale. Elle condense une masse potentiellement colossale d’observations individuelles en un point d’ancrage synthétique, projetant un ensemble de mesures multidimensionnelles sur une droite unidimensionnelle de paramètres plausibles. Cependant, cette condensation s’accompagne d’une tension inévitable entre la simplicité opérationnelle du résultat obtenu et la perte d’information quant à la variabilité inhérente au processus d’échantillonnage.
Comprendre la nature, la dérivation, les vertus et les périls des estimations ponctuelles s’avère indispensable pour quiconque souhaite analyser des données quantitatives avec lucidité, particulièrement dans les sciences humaines, biomédicales et comportementales où la variabilité interindividuelle est omniprésente. Du calcul de la moyenne empirique à la modélisation complexe par maximum de vraisemblance, des propriétés de non-biais et de convergence jusqu’à la transition inévitable vers les intervalles de confiance, ce traité exhaustif explore les fondements mathématiques, les déclinaisons méthodologiques et les implications cliniques de l’estimation ponctuelle en statistique.
1. Fondements théoriques de l’estimation ponctuelle en statistique
1.1 Définition formelle et nature mathématique de l’estimateur
Sur le plan mathématique formel, l’estimation ponctuelle se définit comme l’attribution d’une valeur numérique déterminée à un paramètre inconnu de la loi de probabilité gouvernant une population, à partir de la réalisation empirique d’un vecteur d’échantillonnage. Il est impératif d’établir une distinction conceptuelle et notationnelle d’une rigueur absolue entre l’estimateur et l’estimation. L’estimateur, conventionnellement coiffé d’un accent circonflexe ou désigné par une lettre majuscule, est une fonction mesurable, c’est-à-dire une statistique définie sur l’espace probabilisé des observations. En tant que fonction de variables aléatoires avant toute collecte de données, l’estimateur constitue lui-même une variable aléatoire dotée de sa propre distribution de probabilité théorique, de sa propre espérance et de sa propre dispersion.
À l’inverse, l’estimation représente la réalisation numérique concrète de cette variable aléatoire, obtenue lorsque les données empiriques ont été effectivement recueillies et injectées dans la fonction mathématique. Si l’on désigne par X = (X1, X2, …, Xn) le n-uplet de variables aléatoires composant un échantillon aléatoire et par x = (x1, x2, …, xn) les valeurs numériques réelles mesurées chez les participants, l’estimateur s’écrit formellement comme une application T reliant l’espace des observations à l’espace des paramètres réels. L’estimation ponctuelle n’est autre que le point scalaire unique résultant de cette projection : θ̂ = T(x). Cette distinction est capitale : on étudie les propriétés théoriques (comme le biais ou la variance) de l’estimateur en tant qu’opérateur mathématique, mais on utilise l’estimation en tant que valeur décisionnelle pragmatique.
La formulation d’une fonction de décision statistique permet d’opérationnaliser ce pont entre le monde probabiliste abstrait et l’action concrète. En réduisant un volume complexe de données brutes à une statistique synthétique décisionnelle, le statisticien réalise une compression drastique de l’information empirique. L’objectif fondamental de la théorie de l’estimation ponctuelle consiste dès lors à identifier et à prouver quelles fonctions de projection garantissent que cette valeur unique soit la plus fidèle, la plus stable et la moins trompeuse possible vis-à-vis de l’état réel de la nature.
1.2 Distinction épistémologique entre paramètre de population et statistique d’échantillon
L’édifice de la statistique inférentielle repose entièrement sur la rupture ontologique entre le paramètre de population et la statistique d’échantillon. Un paramètre de population est une quantité constante, fixe, mais irrémédiablement inconnue dans la quasi-totalité des contextes scientifiques réels. Qu’il s’agisse de la moyenne populationnelle (μ), de la variance populationnelle (σ2) ou de la corrélation réelle entre deux construits psychologiques (ρ), le paramètre caractérise la distribution d’une variable au sein de l’univers théorique exhaustif de tous les individus existants, ayant existé ou susceptibles d’exister sous des conditions définies. Ce paramètre ne varie pas : il est l’invariant ontologique que la science cherche à cerner.
À l’opposé diamétral, la statistique d’échantillon est une entité éminemment variable, directement calculable et observable. Parce qu’elle est dérivée d’un sous-ensemble fini d’individus extraits de cette population, sa valeur numérique fluctue d’un échantillon à l’autre selon les aléas de l’échantillonnage probabiliste. Il est matériellement impossible pour un chercheur d’accéder au paramètre réel sans réaliser un recensement exhaustif de la population, une démarche qui s’avère dans l’immense majorité des cas techniquement irréalisable, logistiquement prohibitive ou conceptuellement contradictoire (par exemple dans le cas de populations infinies de mesures de laboratoire répétables à volonté).
Le principe de représentativité probabiliste s’érige alors en fondement épistémologique exclusif rendant cette démarche légitime. Si l’échantillon n’est pas le reflet probabiliste exact de la population mère, la statistique calculée ne possède aucune valeur d’ancrage pour approcher le paramètre. C’est l’aléa contrôlé lors du protocole d’inclusion qui permet à la statistique d’échantillon de devenir une fenêtre rigoureuse ouverte sur l’invisible paramètre populationnel, transformant une simple curiosité empirique locale en une affirmation scientifique de portée générale.
1.3 Nécessité de l’échantillonnage dans la recherche quantitative
La recherche empirique contemporaine, qu’elle s’exerce en psychologie cognitive, en pharmacologie ou en sociologie quantitative, se heurte inéluctablement à des contraintes physiques, économiques et temporelles strictes. Réaliser un recensement exhaustif nécessiterait de mobiliser des budgets colossaux et des décennies d’investigation, rendant caduque toute tentative d’obtenir des résultats applicables en temps opportun. Par ailleurs, dans nombre de protocoles expérimentaux ou cliniques, les mesures imposent des coûts cognitifs ou psychologiques majeurs aux participants — fatigue attentionnelle, passation de tests neuropsychologiques denses, ingestion de molécules expérimentales — voire la destruction du matériel dans certains tests de contrôle de conformité industrielle.
L’échantillonnage constitue donc une nécessité absolue dictée par l’optimisation des ressources scientifiques. Il permet de concentrer des protocoles méthodologiques sophistiqués sur un sous-groupe restreint d’individus avec un degré de précision et de supervision clinique impossible à maintenir à l’échelle d’une population entière. Toutefois, cette réduction impose une vigilance méthodologique sans faille lors de la sélection des participants. L’utilisation de méthodes d’échantillonnage aléatoire simple, d’échantillonnage stratifié ou de plans de sondage en grappes vise précisément à préserver l’équiprobabilité de sélection ou la structure sociodémographique de la population cible.
Sans un échantillonnage rigoureusement calibré, l’estimation ponctuelle perd instantanément sa validité inférentielle. Calculer une estimation à partir d’un échantillon de convenance non représentatif revient à déterminer avec une fausse rigueur mathématique la valeur d’un paramètre d’un artefact d’observation, totalement déconnecté de la réalité de la population cible que l’on prétendait documenter.
2. Paramètres de population fondamentaux versus statistiques d’échantillon
2.1 Les paramètres de population fondamentaux
Dans la théorie des probabilités et la modélisation statistique, la structure d’une distribution théorique est gouvernée par une poignée de paramètres fondamentaux qui synthétisent l’intégralité de sa forme fonctionnelle. Le premier et le plus intuitif de ces paramètres est la moyenne de population, notée traditionnellement par la lettre grecque μ (mu). Sur le plan mécanique et géométrique, μ représente le centre de gravité de la distribution probabiliste, le point d’équilibre parfait où la somme des déviations pondérées par les probabilités d’occurrence s’annule rigoureusement.
Pour les attributs qualitatifs dichotomiques ou binaires — tels que la présence ou l’absence d’un biomarqueur, le succès ou l’échec à une tâche d’inhibition cognitive — le paramètre clé est la proportion de population, notée π (pi) ou parfois p. Ce paramètre exprime la probabilité théorique intrinsèque qu’un individu extrait au hasard de la population globale possède la modalité d’intérêt, matérialisant ainsi la fréquence relative théorique sous-jacente.
La dispersion des trajectoires individuelles autour de ce centre est quantifiée par la variance de population, désignée par σ2 (sigma carré). Ce paramètre mesure l’étalement intrinsèque des scores, calculé comme l’espérance mathématique des carrés des écarts à la moyenne théorique. Enfin, pour explorer la structure relationnelle entre plusieurs construits au niveau populationnel, les paramètres d’association linéaire, au premier rang desquels figure le coefficient de corrélation de population ρ (rho) de Bravais-Pearson, capturent la covariance normalisée entre deux variables aléatoires. Ces paramètres sont immuables sous les mêmes conditions environnementales ou biologiques : ils constituent l’architecture mathématique cachée du phénomène sous examen.
2.2 Les statistiques d’échantillon correspondantes
Puisque les paramètres de population demeurent hors de portée directe, les statisticiens emploient des analogues empiriques calculés directement sur les éléments de l’échantillon. Pour chaque paramètre de population théorique, il existe une statistique d’échantillon naturelle conçue pour servir d’estimateur ponctuel. Pour approcher la moyenne théorique μ, la recherche s’appuie sur la moyenne d’échantillon, universellement notée X̄ (X barre), qui effectue la sommation arithmétique des observations divisée par la taille n du sous-ensemble analysé.
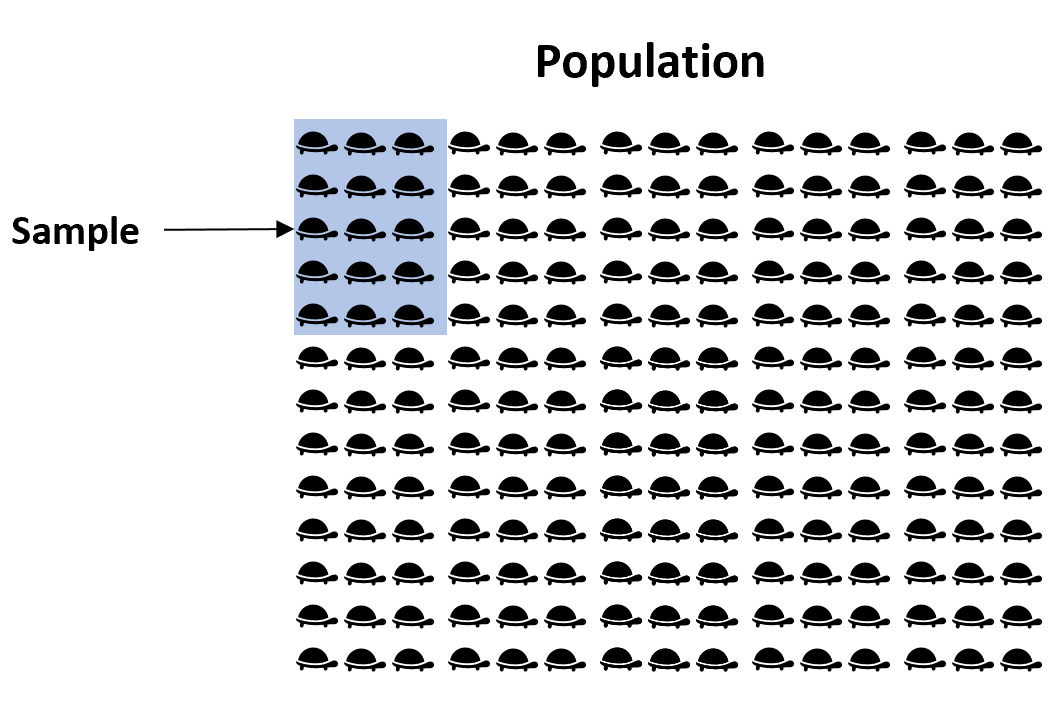
De manière analogue, la proportion de population π est estimée par la proportion d’échantillon, notée p̂ (p chapeau), obtenue en divisant le nombre de succès effectifs par la taille globale de l’échantillon. En ce qui concerne la modélisation de la variabilité, la variance de population σ2 trouve son pendant dans la variance d’échantillon corrigée, notée s2, dont la formule mathématique incorpore une modification structurelle majeure en divisant par (n − 1) au lieu de n pour compenser le biais inhérent à l’estimation simultanée du centre distributionnel.
Enfin, le coefficient de corrélation linéaire de Pearson d’échantillon, symbolisé par la lettre minuscule r, sert d’estimateur ponctuel du coefficient ρ de la population. Ce parallélisme méthodologique et symbolique structure toute la littérature scientifique internationale : les lettres grecques décrivent la vérité ontologique inaccessible de la population, tandis que les lettres latines (ou les lettres grecques surmontées d’un accent circonflexe) désignent les valeurs contingentes issues des échantillons examinés.
2.3 Le pont inférentiel : relier le connu à l’inconnu
L’articulation entre les paramètres théoriques et les statistiques empiriques constitue l’essence même du raisonnement inductif en science. Dans les laboratoires de psychologie expérimentale ou de médecine translationnelle, le chercheur recueille des observations locales dans des conditions hautement contrôlées ; il formule ensuite l’hypothèse fondamentale que ces données observées permettent de généraliser des énoncés nomothétiques à l’ensemble de l’espèce ou de la classe de phénomènes étudiée. Ce saut inductif, de l’échantillon mesuré vers la population globale, n’a de validité que si le pont inférentiel est adossé à un modèle formel de calcul des probabilités.
Ce pont inférentiel reconnaît explicitement et mathématiquement l’inévitable décalage entre la valeur calculée et le paramètre latent. Jamais un statisticien avisé ne prétendra qu’une moyenne d’échantillon X̄ coïncide de façon chirurgicale avec la moyenne de population μ. Il existe de manière irréductible une erreur d’échantillonnage, définie formellement par la différence arithmétique e = θ̂ − θ.
La modélisation de cet écart ne relève pas de la conjecture subjective, mais de l’analyse du risque statistique. En postulant un cadre d’échantillonnage probabiliste, il devient possible de formaliser la distribution exacte de cette fluctuation d’échantillonnage. Le pont inférentiel ne garantit donc pas que l’estimation ponctuelle soit rigoureusement exacte, mais il permet d’établir rigoureusement avec quelle fréquence et avec quelle amplitude maximale prévisible cette estimation oscillera autour de la cible idéale lors d’expérimentations répétées.
3. L’estimation de la moyenne : du concept théorique à la pratique clinique
3.1 La moyenne d’échantillon comme estimateur canonique
L’estimation de la tendance centrale d’une variable quantitative continue représente l’opération la plus commune en statistique appliquée. Au sein de cet arsenal, la moyenne arithmétique d’échantillon X̄ s’impose historiquement et pratiquement comme l’estimateur canonique de la moyenne de population μ. Sa formulation algébrique standard s’exprime comme :
X̄ = (1 / n) ∑i=1n Xi
Cette popularité universelle ne relève pas d’un simple réflexe intuitif, mais de propriétés géométriques et analytiques uniques. La moyenne arithmétique possède la propriété géométrique intrinsèque de minimiser la somme des carrés des écarts : pour tout jeu de données, la fonction f(c) = ∑ (xi − c)2 atteint son minimum absolu unique précisément en c = X̄. Cette caractéristique fait de la moyenne d’échantillon le candidat optimal naturel pour tout modèle minimisant la perte quadratique.
Dans le domaine clinique, cet estimateur est massivement employé pour quantifier les niveaux d’humeur, les intensités de douleur perçue sur des échelles visuelles analogiques ou les chronométries cognitives. Par exemple, lorsqu’une équipe de neuropsychiatrie évalue le temps d’inhibition motrice d’un groupe de patients lors d’une tâche de type Stroop, ou lorsqu’un clinicien étudie le score d’anxiété préopératoire à l’aide de l’inventaire STAI (State-Trait Anxiety Inventory), la moyenne arithmétique des scores observés dans l’échantillon sert immédiatement d’estimation ponctuelle du niveau moyen d’anxiété de la population clinique cible, à condition que la distribution des scores ne présente pas d’asymétrie pathologique trop prononcée.
3.2 Propriétés mathématiques sous-jacentes de la moyenne empirique
Sur le plan de la théorie statistique, la prééminence de la moyenne empirique repose sur plusieurs théorèmes majeurs. Le premier découle directement de la linéarité de l’opérateur d’espérance mathématique :
E[X̄] = E[(1 / n) ∑ Xi] = (1 / n) ∑ E[Xi] = (1 / n) · (n · μ) = μ
Cette démonstration élégante garantit de manière inconditionnelle l’absence de biais de la moyenne d’échantillon, et ce quelle que soit la loi de distribution sous-jacente des observations individuelles, pourvu que l’espérance μ existe. En outre, la variance de cet estimateur décroît proportionnellement à la taille d’échantillon : Var(X̄) = σ2 / n. Cela implique une stabilité croissante de la moyenne empirique sous échantillonnage répété de taille constante.
Sur le plan asymptotique, la loi des grands nombres (dans ses formulations faible de Khinchine et forte de Kolmogorov) établit formellement que lorsque la taille n de l’échantillon tend vers l’infini, la moyenne empirique converge de manière déterministe vers la moyenne théorique de la population. Néanmoins, cette perfection analytique cache une vulnérabilité redoutable : la moyenne arithmétique possède un point de rupture (breakdown point) égal à 0. L’adjonction d’une unique valeur aberrante d’amplitude infinie dans un échantillon suffit à déplacer arbitrairement la moyenne vers l’infini, rendant cet estimateur particulièrement instable face aux données contaminées ou aux distributions présentant une asymétrie marquée.
3.3 Exemples d’application en psychologie expérimentale
Considérons l’application de l’estimation ponctuelle dans un protocole de psychologie clinique explorant l’efficacité d’une thérapie cognitivo-comportementale sur des cohortes d’individus souffrant de dépression caractérisée. Les cliniciens administrent le célèbre inventaire de dépression de Beck (BDI-II), dont les scores s’échelonnent de 0 à 63, à un échantillon de 85 participants après l’intervention. L’application de l’estimateur canonique fournit une estimation ponctuelle du score moyen de x̄ = 14,2 points. Ce chiffre unique devient l’estimation opérationnelle de la sévérité dépressive moyenne au sein de la population théorique de tous les patients susceptibles de suivre ce protocole précis.
Dans un registre purement expérimental, prenons l’exemple de l’évaluation de l’empan mnésique de travail mesuré à travers la tâche informatisée du Digit Span inversé chez 120 jeunes adultes sains. Si la somme des scores d’empan observés est de 744 éléments, l’estimation ponctuelle de la capacité moyenne de mémorisation de travail dans cette population est de x̄ = 744 / 120 = 6,20 unités d’information. C’est sur ce point estimé unique que les modèles computationnels d’architecture cognitive calibreront ultérieurement leurs paramètres de mémoire tampon.
Enfin, dans les protocoles pré-post évaluant la réduction du stress perçu au travail, l’estimation ponctuelle du différentiel moyen — calculée comme la moyenne des différences individuelles d̄ = (1 / n) ∑ (xpost − xpré) — offre une mesure immédiate de l’amplitude moyenne de l’effet thérapeutique, guidant les décisions préliminaires de validation du programme avant toute phase de déploiement à large échelle.
4. L’estimation des proportions et fréquences dans les populations
4.1 Définition formelle de la proportion d’échantillon
Lorsque la variable aléatoire sous étude est qualitative et ne prend que deux modalités exclusives (codées conventionnellement par 1 pour la présence de l’attribut ou « succès », et par 0 pour son absence ou « échec »), le cadre probabiliste est celui d’une suite de variables de Bernoulli indépendantes et identiquement distribuées de paramètre π. L’estimateur ponctuel naturel de cette proportion inconnue est la proportion d’échantillon, notée p̂, définie comme le ratio arithmétique de la variable de comptage Y (somme des réalisations de Bernoulli) sur l’effectif total n :
p̂ = Y / n = (1 / n) ∑i=1n Xi
Puisque la variable Y suit rigoureusement une loi binomiale de paramètres n et π, il s’ensuit par les propriétés de l’espérance binomiale que E[Y] = nπ, ce qui entraîne directement E[p̂] = E[Y / n] = π. La proportion empirique d’échantillon est donc un estimateur strictement sans biais de la proportion théorique de population.
La variance de cet estimateur ponctuel s’écrit Var(p̂) = π(1 − π) / n. En vertu du théorème central limite sous sa forme de Moivre-Laplace, la distribution d’échantillonnage de cet estimateur converge rapidement vers une distribution gaussienne dès lors que la taille d’échantillon n est suffisamment importante et que la probabilité π ne se situe pas aux franges extrêmes de l’intervalle [0, 1]. Cette approximation normale standardisée facilite l’utilisation de cet estimateur ponctuel pour alimenter les algorithmes de décision clinique et sanitaire.
4.2 Applications en épidémiologie psychiatrique et santé mentale
L’estimation des proportions constitue la colonne vertébrale des investigations épidémiologiques en santé mentale et en psychopathologie quantitative. Lorsqu’une agence de santé publique cherche à quantifier le fardeau sociétal du trouble anxieux généralisé (TAG) au sein d’une métropole, elle soumet un échantillon représentatif de 2 500 résidents à des entretiens cliniques structurés basés sur les critères nosographiques du DSM-5. Si 175 participants remplissent l’intégralité des critères diagnostiques, la proportion d’échantillon calculée p̂ = 175 / 2 500 = 0,07 (soit 7,0 %) constitue l’estimation ponctuelle officielle du taux de prévalence ponctuelle du TAG dans cette population.
Dans le domaine des essais cliniques randomisés appliqués à la psychothérapie brève, l’estimation de la proportion d’échec ou de résistance thérapeutique revêt une importance stratégique majeure. L’identification de la proportion d’individus qualifiés de « non-répondeurs » (définis par exemple par une réduction inférieure à 50 % sur l’échelle de dépression de Hamilton) permet aux chercheurs de dériver une estimation ponctuelle du taux d’attrition de l’intervention testée.
De même, dans les études de suivi ambulatoire de patients souffrant de schizophrénie, la mesure de l’adhésion thérapeutique — quantifiée par la proportion de patients respectant strictement leur schéma posologique antipsychotique au cours des six mois post-hospitalisation — fournit aux équipes soignantes un indicateur ponctuel synthétique indispensable pour évaluer le risque épidémiologique de rechute et de réhospitalisation précoce.
4.3 Contraintes distributionnelles et stabilité selon la rareté du phénomène
Bien que l’estimateur de proportion soit d’une simplicité d’emploi exemplaire, son comportement mathématique se dégrade profondément dès lors que le phénomène observé devient exceptionnel ou ultra-rare dans la population générale. Si la prévalence réelle π est très proche de 0 (par exemple la survenue d’un effet indésirable neurologique sévère touchant une personne sur dix mille) ou symétriquement très proche de 1, la distribution d’échantillonnage de la statistique p̂ souffre d’une asymétrie positive ou négative extrême qui contredit violemment l’approximation gaussienne habituelle.
Pour garantir la validité pratique et la stabilité relative de l’estimateur de proportion standard, la règle empirique classique exige le respect des conditions de validité de Cochran ou de Wald : n · p̂ ≥ 10 et n(1 − p̂) ≥ 10 (certains auteurs plus permissifs tolérant un seuil minimal de 5). Lorsque la taille de l’échantillon est trop réduite pour satisfaire cette condition, l’estimation ponctuelle standard devient chaotique. Par exemple, si dans un échantillon pilote de n = 12 sujets aucun cas de suicide n’est répertorié, l’estimation brute p̂ = 0 / 12 = 0 donne l’illusion absurde d’une impossibilité totale du phénomène au niveau populationnel.
Dans de tels contextes de rareté ou de faible volume observationnel, le recours à des estimateurs corrigés s’impose impérativement. L’estimateur d’Agresti-Coull (souvent désigné sous le terme imagé de « règle de l’addition de quatre pseudo-observations »), qui ajoute deux succès et deux échecs fictifs aux données empiriques avant de recalculer la proportion ponctuelle p̃ = (Y + 2) / (n + 4), offre une stabilité distributionnelle et une réduction spectaculaire de l’erreur quadratique moyenne par rapport à l’estimateur naïf traditionnel.
5. Propriétés fondamentales d’un estimateur ponctuel optimal
5.1 L’absence de biais (Unbiasedness)
L’absence de biais, ou justesse, constitue la première propriété théorique classiquement recherchée lors de la construction d’un estimateur ponctuel. Formellement, un estimateur θ̂ est qualifié de sans biais pour le paramètre inconnu θ si son espérance mathématique sur l’ensemble infini des répétitions théoriques de l’échantillonnage coïncide rigoureusement avec la véritable valeur de ce paramètre :
Bias(θ̂) = E[θ̂] − θ = 0, ce qui équivaut à E[θ̂] = θ
Cette définition implique qu’un estimateur sans biais ne commet pas d’erreur directionnelle systématique : il peut dévier ponctuellement de la cible vers la droite ou vers la gauche pour un échantillon spécifique, mais son centre de gravité moyen à long terme frappe exactement au centre de la cible paramétrique.
L’exemple paradigmatique du biais d’estimation est incarné par la variance empirique naïve non corrigée. Si l’on calcule la variance d’un échantillon par la formule intuitive Snaïve2 = (1 / n) ∑ (Xi − X̄)2, le calcul de son espérance mathématique révèle que E[Snaïve2] = ((n − 1) / n) · σ2. L’estimateur naïf sous-estime systématiquement la variance réelle de la population d’un facteur égal à (n − 1) / n. Cette sous-estimation découle du fait que les observations de l’échantillon sont nécessairement plus proches de leur propre moyenne empirique X̄ qu’elles ne le sont de la moyenne théorique absolue μ.
Pour corriger cette distorsion structurelle, la statistique recourt à la célèbre correction de Bessel, qui consiste à substituer le diviseur (n − 1) au diviseur n dans la somme quadratique, donnant naissance à la variance d’échantillon corrigée :
s2 = (1 / (n − 1)) ∑i=1n (Xi − X̄)2
Cette correction garantit de façon impeccable que E[s2] = σ2. Dans le domaine psychométrique, ignorer ce biais de variance conduirait à sous-estimer systématiquement l’hétérogénéité des aptitudes cognitives au sein de la population clinique, faussant ainsi le calcul ultérieur des scores standardisés et la détection d’individus atypiques situés aux extrémités de la distribution.
5.2 L’efficacité statistique et la borne de Cramér-Rao
L’absence de biais n’est toutefois pas une condition suffisante pour désigner un estimateur comme optimal. Il est aisé de concevoir une multitude d’estimateurs rigoureusement sans biais pour un même paramètre : par exemple, la première observation unique X1 extraite au hasard d’un échantillon vérifie rigoureusement E[X1] = μ, tout comme la moyenne empirique X̄. Cependant, la dispersion de X1 autour de la cible est immensément supérieure à celle de X̄. C’est ici qu’intervient la notion d’efficacité statistique, qui renvoie à la précision ou à la concentration de la distribution d’échantillonnage de l’estimateur autour de son espérance.
Entre deux estimateurs sans biais θ̂1 et θ̂2, l’estimateur θ̂1 est dit statistiquement plus efficace que θ̂2 si sa variance distributionnelle est strictement inférieure pour toute valeur possible du paramètre : Var(θ̂1) < Var(θ̂2). La recherche du meilleur estimateur possible a culminé dans le développement du concept d’estimateur sans biais à variance minimale (MVUE, pour Minimum Variance Unbiased Estimator).
L’inégalité fondamentale établie indépendamment par Harald Cramér et C. R. Rao formalise cette quête d’absolu. La borne de Cramér-Rao stipule que, sous certaines conditions de régularité mathématique de la fonction de vraisemblance, la variance de tout estimateur sans biais ne peut jamais être inférieure à l’inverse de l’information de Fisher I(θ) contenue dans l’échantillon :
Var(θ̂) ≥ 1 / I(θ)
Un estimateur sans biais qui atteint exactement cette borne limite inférieure est qualifié d’estimateur efficace. Il exploite 100 % de l’information statistique théoriquement disponible dans les données observées. Il existe toutefois des contextes où les statisticiens acceptent délibérément d’introduire un léger biais systématique si cela permet de réduire considérablement la variance globale de l’estimateur. Ce compromis stratégique s’incarne dans le concept d’erreur quadratique moyenne (EQM ou MSE en anglais) :
EQM(θ̂) = E[(θ̂ − θ)2] = Var(θ̂) + [Bias(θ̂)]2
L’arbitrage biais-variance constitue le cœur théorique de nombreuses techniques contemporaines comme la régression régularisée (Ridge, Lasso) en biostatistique computationnelle.
5.3 La convergence et la consistance asymptotique
Alors que l’absence de biais et l’efficacité sont des propriétés dites à échantillon fini (valables pour une taille n fixée), la consistance ou convergence asymptotique évalue le comportement de l’estimateur lorsque la quantité de données observées croît au-delà de toute limite, c’est-à-dire quand n tend vers l’infini (n → ∞). Un estimateur est dit convergent ou consistant (au sens faible) si la suite de variables aléatoires θ̂n converge en probabilité vers la constante paramétrique inconnue θ. Formellement, pour tout seuil de tolérance ε > 0 arbitrairement petit :
limn→∞ P(|θ̂n − θ| > ε) = 0
Cette définition mathématique garantit que, pour un volume d’observations gigantesque, la probabilité que l’estimation s’écarte de la réalité du paramètre d’une quantité perceptible s’évapore totalement. Si la convergence est vérifiée non seulement en probabilité mais avec une probabilité égale à 1 (convergence presque sûre), l’estimateur est dit fortement consistant.
La consistance est le réquisit minimal absolu de la démarche scientifique moderne : un estimateur qui ne serait pas consistant fournirait des résultats erratiques ou déviants même si le chercheur parvenait à collecter un nombre quasi infini de sujets d’expérience. La reproductibilité des découvertes scientifiques dépend fondamentalement de la consistance asymptotique des algorithmes de calcul statistique mobilisés.
5.4 La suffisance et la robustesse statistique
L’inventeur de la statistique mathématique moderne, Ronald Fisher, a enrichi cette taxonomie des propriétés d’optimalité par le concept d’exhaustivité ou de suffisance (sufficiency). Une statistique T(X) est dite exhaustive ou suffisante pour un paramètre θ si la distribution de probabilité conditionnelle des données brutes de l’échantillon X, sachant la valeur calculée T(X), est totalement indépendante du paramètre θ. Sur le plan pratique, cela signifie qu’une statistique exhaustive capture, extrait et résume à elle seule absolument toute l’information utile contenue dans l’ensemble des données individuelles concernant le paramètre sous étude.
L’identification formelle d’une statistique suffisante est régie par le prestigieux critère de factorisation de Fisher-Neyman. Si la fonction de densité conjointe peut être décomposée en un produit de deux fonctions séparées — l’une dépendant uniquement de T(x) et de θ, et l’autre dépendant exclusivement des données x sans comporter le paramètre θ — alors T(X) est une statistique exhaustive. Ainsi, pour une distribution gaussienne de variance connue, la moyenne arithmétique d’échantillon X̄ est une statistique suffisante : aucune information supplémentaire sur μ ne peut être glanée en examinant la séquence ordonnée ou la dispersion des points de données résiduels.
Parallèlement à la suffisance émerge l’impératif contemporain de robustesse statistique. Alors que les estimateurs canoniques sont souvent dérivés sous l’hypothèse idyllique de lois normales pures, les données réelles en sciences comportementales exhibent quasi systématiquement des contaminations, des asymétries ou des queues de distribution épaisses. Un estimateur robuste est conçu pour maintenir une stabilité inférentielle acceptable même lorsque les conditions de régularité théoriques ou les postulats de normalité sont violés. Dans cette optique, la médiane d’échantillon ou la moyenne tronquée (trimmed mean) se posent comme des estimateurs ponctuels de remplacement infiniment plus robustes face aux anomalies d’enregistrement empirique que la moyenne arithmétique vulnérable.
6. Méthodes de dérivation mathématique des estimateurs ponctuels
6.1 La méthode des moments
Introduite à la fin du XIXe siècle par Pafnouti Tchebychev et formalisée par Karl Pearson, la méthode des moments représente l’une des démarches les plus intuitives pour dériver analytiquement un estimateur ponctuel. Son principe directeur repose sur une équivalence analogique : il consiste à égaliser les moments théoriques d’une distribution de probabilité avec les moments empiriques directement observables calculés sur l’échantillon.
Soit une variable aléatoire dotée de k paramètres inconnus (θ1, θ2, …, θk). Le j-ième moment théorique d’ordre j centré à l’origine est défini par l’espérance αj = E[Xj] = gj(θ1, …, θk). Le j-ième moment empirique correspondant calculé à partir de l’échantillon s’exprime sous la forme mj = (1 / n) ∑i=1n Xij. La méthode consiste à poser un système de k équations reliant ces entités :
m1 = E[X] = g1(θ1, …, θk)
m2 = E[X2] = g2(θ1, …, θk)
…
mk = E[Xk] = gk(θ1, …, θk)
La résolution algébrique de ce système permet d’exprimer chaque paramètre inconnu en fonction exclusive des moments empiriques, fournissant ainsi les estimateurs ponctuels recherchés. L’attrait majeur de la méthode des moments réside dans sa formidable simplicité calculatoire, qui débouche souvent sur des solutions explicites rapides sans nécessiter de procédures d’optimisation numérique lourdes. Toutefois, sur le plan de la performance statistique moderne, les estimateurs issus des moments souffrent fréquemment d’un déficit d’efficacité marqué : pour des échantillons de taille finie, ils présentent presque toujours une variance d’échantillonnage supérieure à celle des estimateurs obtenus par des méthodes plus complexes.
6.2 La méthode du maximum de vraisemblance (MLE)
Développée de manière systématique par Ronald Fisher au cours des années 1920, la méthode du maximum de vraisemblance (Maximum Likelihood Estimation ou MLE) trône incontestablement au sommet de l’inférence paramétrique contemporaine. Le principe philosophique sous-jacent est d’une grande élégance : considérant les données empiriques observées comme fixées et immuables, quelle est la valeur spécifique du paramètre inconnu θ qui confère à cet échantillon précis la probabilité d’apparition la plus élevée possible ?
Pour un échantillon de variables aléatoires indépendantes et identiquement distribuées ayant pour densité marginale f(xi; θ), la fonction de vraisemblance conjointe L(θ; x) s’exprime comme le produit continu des densités individuelles :
L(θ; x) = ∏i=1n f(xi; θ)
Par commodité analytique et computationnelle, les statisticiens recourent universellement au logarithme népérien de cette fonction, nommé la log-vraisemblance ℓ(θ; x) = ln L(θ; x), ce qui transforme le produit multiplicatif en une somme additive :
ℓ(θ; x) = ∑i=1n ln f(xi; θ)
L’estimateur ponctuel du maximum de vraisemblance, θ̂MLE, est la valeur argument qui maximise cette fonction. Mathématiquement, on résout le système d’équations de score en annulant le gradient (dérivée première) par rapport au vecteur de paramètres : ∂ℓ(θ; x) / ∂θ = 0, en s’assurant que la matrice hessienne des dérivées secondes est strictement définie négative pour certifier la concavité locale.
Les propriétés asymptotiques du MLE sont exceptionnelles : il est asymptotiquement sans biais, asymptotiquement efficace (il sature la borne de Cramér-Rao lorsque n → ∞), asymptotiquement distribué selon une loi normale, et vérifie la propriété d’invariance fonctionnelle (si θ̂ est le MLE de θ, alors g(θ̂) est le MLE rigoureux de g(θ)). C’est cette méthode qui propulse la modélisation en équations structurelles, la régression logistique et l’analyse factorielle confirmatoire en sciences humaines.
6.3 La méthode des moindres carrés ordinaires (MCO)
Historiquement développée par Carl Friedrich Gauss et Adrien-Marie Legendre au tournant du XIXe siècle pour déterminer la trajectoire des corps célestes en astronomie, la méthode des moindres carrés ordinaires (MCO, ou Ordinary Least Squares en anglais) structure l’ensemble de la modélisation linéaire et de la régression statistique. Contrairement au maximum de vraisemblance qui exige la spécification intégrale d’une loi de probabilité explicite pour la population, les moindres carrés reposent sur une démarche d’optimisation purement géométrique et déterministe.
L’objectif des moindres carrés consiste à déterminer les paramètres d’une fonction mathématique (par exemple les coefficients de pente et d’ordonnée à l’origine dans un modèle linéaire Y = β0 + β1X + ε) qui minimisent la somme quadratique des résidus d’ajustement entre les valeurs effectivement mesurées yi et les projections théoriques prédites ŷi :
S(β) = ∑i=1n (yi − ŷi)2 = ∑i=1n (yi − (β0 + β1xi))2
L’annulation des dérivées partielles par rapport à chacun des coefficients produit les célèbres équations normales dont la résolution matricielle fournit directement l’estimateur ponctuel des moindres carrés : β̂ = (XTX)−1XTy.
L’autorité conceptuelle des estimateurs des moindres carrés repose sur le théorème de Gauss-Markov. Ce résultat mathématique fondamental établit que, sous les seules hypothèses de linéarité, d’homoscédasticité (variance résiduelle constante) et d’absence d’autocorrélation des résidus — sans exiger que ces résidus suivent une loi normale —, l’estimateur des moindres carrés ordinaires est le meilleur estimateur linéaire sans biais (connu sous l’acronyme anglo-saxon BLUE pour Best Linear Unbiased Estimator). Sa variance est mathématiquement la plus faible parmi toute la classe concurrente des estimateurs linéaires sans biais.
6.4 L’estimation bayésienne : modes et moyennes a posteriori
L’école de pensée bayésienne introduit une rupture philosophique et mathématique radicale avec le paradigme fréquentiste traditionnel. Dans l’approche bayésienne, le paramètre de population inconnu θ n’est plus envisagé comme une constante déterministe figée, mais comme une variable aléatoire dotée de sa propre loi de distribution de probabilité épistémique, traduisant l’état de croyance ou de connaissance préalable du chercheur avant l’acquisition des nouvelles données empiriques.
Le protocole bayésien débute par la formulation d’une distribution a priori (prior) notée p(θ). Lorsque les données empiriques x sont collectées, la confrontation entre ces données et la structure préalable s’opère par le biais de la fonction de vraisemblance p(x | θ) via l’application stricte du théorème de Bayes :
p(θ | x) = (p(x | θ) · p(θ)) / p(x) ∝ p(x | θ) · p(θ)
Le résultat de cette équation n’est pas un nombre unique, mais une distribution de probabilité complète : la distribution a posteriori p(θ | x). Pour extraire une estimation ponctuelle unique à des fins pratiques ou communicationnelles, le paradigme bayésien propose plusieurs options issues de la théorie de la décision statistique, déterminées par la nature de la fonction de perte retenue :
- La moyenne a posteriori (Posterior Mean) : E[θ | x] = ∫ θ · p(θ | x) dθ. Cet estimateur ponctuel minimise mathématiquement l’erreur quadratique moyenne attendue sous la distribution a posteriori (perte quadratique L2).
- Le mode a posteriori (Maximum A Posteriori ou MAP) : argmaxθ p(θ | x). Il représente la valeur ponctuelle la plus dense et la plus probable a posteriori, équivalent bayésien direct du maximum de vraisemblance modulé par l’information préalable (perte tout-ou-rien).
- La médiane a posteriori (Posterior Median) : valeur partageant la densité a posteriori en deux aires égales de 50 %. Cet estimateur minimise formellement l’écart absolu attendu (perte L1), offrant une immunité accrue face aux distributions asymétriques.
7. Variabilité d’échantillonnage et erreur standard de l’estimateur
7.1 La distribution théorique d’échantillonnage
Pour appréhender l’estimation ponctuelle dans toute sa profondeur méthodologique, il est impératif de s’abstraire de l’échantillon singulier que l’on tient sous les yeux pour embrasser l’expérience de pensée de l’échantillonnage répété à l’infini. Si un protocole d’observation était répliqué dans des conditions d’indépendance identiques un milliard de fois, chaque échantillon de taille fixe n donnerait lieu au calcul d’une estimation ponctuelle distincte. L’ensemble de ces milliards d’estimations ponctuelles constitue une population numérique en soi, dont la loi de distribution porte le nom de distribution théorique d’échantillonnage.
Cette distribution est au cœur de l’inférence. Elle décrit la manière dont la statistique fluctue sous l’effet du pur hasard de sélection. Même si les individus composant la population d’origine suivent une loi asymétrique, bimodale ou uniforme, le théorème central limite (TCL) garantit que la distribution d’échantillonnage de la moyenne empirique converge rapidement vers une distribution normale dès que la taille n franchit le seuil conventionnel de 30 observations, à condition que la variance de départ soit finie.
L’étalement de cette distribution d’échantillonnage est directement proportionnel à la variance intrinsèque de la population mère, mais inversement proportionnel à la taille de l’échantillon extrait. Plus la population d’origine est homogène, plus la distribution d’échantillonnage est resserrée ; à l’inverse, une dispersion colossale dans la population génère une variabilité d’échantillonnage importante, rendant l’estimation ponctuelle issue d’un échantillon singulier hautement fluctuante.
7.2 Calcul et interprétation de l’erreur type (Standard Error)
L’écart-type de cette distribution théorique d’échantillonnage porte un nom fondamental en statistique : l’erreur type (ou Standard Error en anglais, abrégée SE). L’erreur type quantifie la marge de fluctuation attendue d’un estimateur ponctuel sous l’effet de l’aléa de sélection. Pour l’estimateur de la moyenne X̄, l’erreur type théorique s’exprime par la formule mathématique :
σX̄ = σ / √n
Dans la pratique expérimentale réelle, l’écart-type réel de la population σ est inconnu. Les chercheurs utilisent alors son estimateur d’échantillon corrigé s pour dériver l’erreur type estimée de la moyenne :
SE(X̄) = s / √n
Pour l’estimateur ponctuel d’une proportion p̂ sous distribution binomiale, l’erreur type théorique se formalise par :
σp̂ = √[π(1 − π) / n]
dont l’analogue empirique estimé s’écrit SE(p̂) = √[p̂(1 − p̂) / n].
Il est impératif d’insister sur la distinction capitale, omniprésente source de confusion chez les jeunes chercheurs, entre l’écart-type (Standard Deviation, SD) et l’erreur type (Standard Error, SE). L’écart-type s décrit la variabilité descriptive empirique des observations individuelles au sein de l’échantillon : il demeure approximativement constant quelle que soit l’augmentation de la taille de l’échantillon. En revanche, l’erreur type SE décrit l’incertitude pesant sur l’estimateur ponctuel lui-même : elle diminue inexorablement au fur et à mesure que la taille d’échantillon croît. L’écart-type documente la nature biologique ou comportementale du trait mesuré ; l’erreur type caractérise la fidélité de l’outil statistique de mesure.
7.3 Conséquences de la taille de l’échantillon sur la précision de l’estimation
La présence mathématique du radical √n au dénominateur de l’erreur standard entraîne des conséquences pratiques de premier ordre sur la planification expérimentale. En vertu de cette fonction racine carrée, la précision d’une estimation ponctuelle ne s’améliore pas de manière linéaire avec le volume de données collectées, mais obéit à une stricte loi des rendements décroissants.
Pour réduire de moitié l’erreur standard associée à une estimation ponctuelle (c’est-à-dire pour doubler la précision métrique de l’estimation), il ne suffit pas de doubler la taille de l’échantillon : il faut obligatoirement la quadrupler (n × 4). De même, pour diviser l’erreur standard par un facteur 10, le laboratoire doit décupler au carré son effort d’inclusion, ce qui exige de recruter cent fois plus de participants (n × 100).
Cette réalité mathématique impose un arbitrage méthodologique permanent entre le gain marginal de précision statistique et les coûts logistiques, temporels et éthiques inhérents au recrutement expérimental. Au-delà d’un certain seuil d’effectif, l’accroissement de la taille de l’échantillon ne produit qu’une réduction infinitésimale de l’incertitude ponctuelle, incitant les méthodologistes à concevoir des analyses de puissance rigoureuses pour identifier la taille d’échantillon optimale avant d’engager les ressources de recherche.
8. Limites inhérentes à l’estimation ponctuelle unique
8.1 L’illusion d’exactitude et la probabilité ponctuelle nulle
Le principal danger inhérent à l’estimation ponctuelle réside dans le sentiment trompeur de certitude et d’exactitude qu’elle communique. Délivrer un nombre unique — par exemple affirmer que « l’espérance de survie moyenne sous traitement est de 14,35 mois » ou que « le score moyen d’intelligence émotionnelle s’établit à 104,2 » — crée une réification psychologique de la métrique. Or, sur le plan strict du calcul des probabilités, pour toute variable aléatoire continue, la probabilité théorique que l’estimation ponctuelle coïncide à l’atome près avec le paramètre ontologique réel est rigoureusement égale à zéro :
P(X̄ = μ) = 0
Cette proposition mathématique ne relève pas de la rhétorique : sur le continuum infini des nombres réels, la mesure d’un point géométrique singulier est d’une probabilité nulle (mesure de Lebesgue nulle). L’estimation ponctuelle est donc certaine d’être fausse au sens de la coïncidence mathématique absolue. Ce que le statisticien sait être une simple statistique d’ancrage probabiliste est fréquemment interprété à tort par les praticiens, les cliniciens ou les décideurs publics comme une vérité déterministe achevée.
Ce biais est dramatiquement amplifié par l’affichage informatique d’un nombre excessif de décimales. Présenter un score d’efficacité clinique sous la forme « d = 0,421896 » confère à l’estimation une illusion de précision instrumentale qui masque totalement le fait que l’erreur type de cette même estimation peut être de l’ordre de 0,15. Il convient de dissocier formellement la précision apparente de l’affichage décimal de la précision statistique réelle régie par la distribution d’échantillonnage.
8.2 Absence d’information contextuelle sur la dispersion des données
Une statistique ponctuelle de tendance centrale est, par essence, réductrice. En écrasant une distribution pluridimensionnelle complexe sur un point scalaire unique, l’estimation ponctuelle détruit toute l’information relative à l’hétérogénéité des trajectoires individuelles. Deux distributions statistiques aux topologies radicalement distinctes peuvent produire rigoureusement la même moyenne d’échantillon :
- Une première population où tous les scores sont étroitement agglomérés autour de la valeur centrale (variance minime, distribution unimodale très homogène).
- Une seconde population présentant une distribution bimodale polarisée, composée d’un groupe d’individus aux scores très faibles et d’un second groupe aux scores massifs, sans qu’aucun individu ne présente en réalité un score proche de la moyenne arithmétique globale calculée.
En psychologie clinique et en psychiatrie de précision, se fier exclusivement à l’estimation ponctuelle de la moyenne d’un groupe traité revient à s’aveugler sur la présence fondamentale de sous-types pathologiques distincts ou de profils de répondeurs versus réfractaires. L’estimation ponctuelle occulte le fait qu’un traitement dont l’estimation d’amélioration moyenne est positive peut en réalité provoquer une amélioration spectaculaire chez 60 % des patients, mais une dégradation iatrogène marquée chez les 40 % restants.
8.3 Conséquences décisionnelles des erreurs d’estimation ponctuelle
Les répercussions pratiques d’une confiance aveugle accordée à une estimation ponctuelle peuvent s’avérer dramatiques en matière de diagnostic clinique et d’évaluation des politiques de santé. Dans de nombreuses classifications nosologiques ou médico-légales, des seuils d’intervention stricts sont définis de manière déterministe (par exemple, un quotient intellectuel inférieur ou égal à 70 pour ouvrir droit à des compensations de handicap cognitif, ou une concentration d’hémoglobine glyquée supérieure à 6,5 % pour caractériser un diabète).
Si un individu obtient un score ponctuel de 71 à l’évaluation, fonder une décision administrative binaire sur cette unique valeur sans intégrer l’erreur type de mesure expose le clinicien à commettre une erreur de décision diagnostique majeure. Une seconde évaluation réalisée le lendemain avec une version parallèle du test pourrait aisément attribuer un score de 69 en vertu de la simple fluctuation d’échantillonnage des items ou de l’état attentionnel du sujet.
De même, dans la conduite des essais cliniques randomisés, la comparaison naïve de deux estimations ponctuelles d’efficacité thérapeutique entre un nouveau médicament (x̄1 = 45 % d’amélioration) et un comparateur standard (x̄2 = 40 %) conduit régulièrement les promoteurs à revendiquer abusivement une supériorité médicale. Cette divergence numérique de 5 points peut être le pur reflet d’une fluctuation aléatoire de l’échantillonnage, dépourvue de toute signification thérapeutique réelle. L’estimation ponctuelle isolée ne fournit aucun levier probabiliste autonome permettant d’écarter l’hypothèse nulle d’égalité des effets réels.
9. De l’estimation ponctuelle à l’estimation par intervalle
9.1 La transition conceptuelle vers l’intervalle de confiance
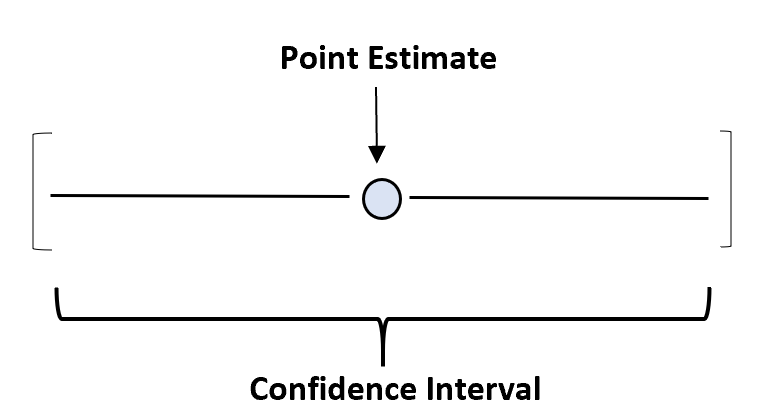
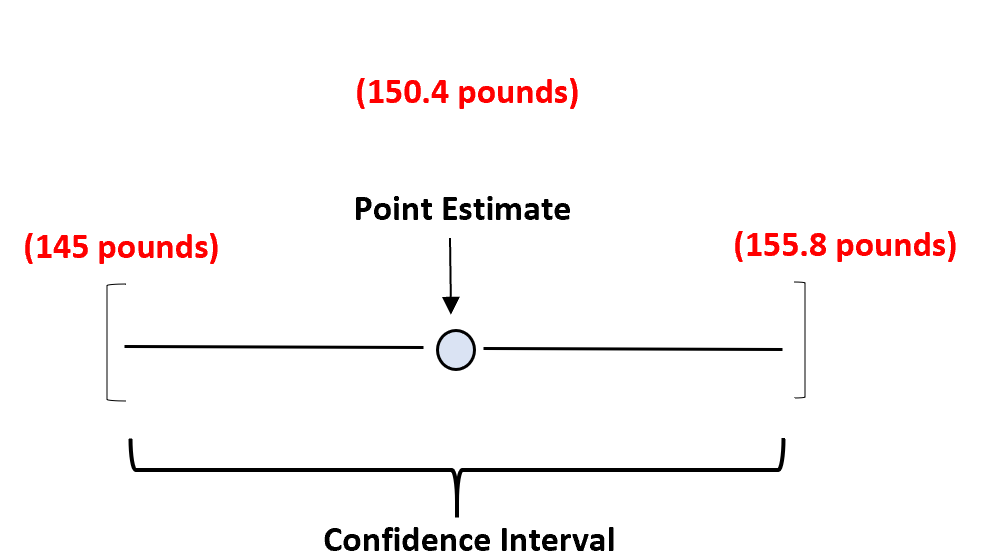
Face aux limites inhérentes à l’estimation ponctuelle unique, l’édifice statistique s’est enrichi sous l’impulsion de Jerzy Neyman d’une méthodologie complémentaire incontournable : l’estimation par intervalle de confiance. La démarche consiste à ne plus fournir un chiffre unique dénué de contexte d’erreur, mais une plage de valeurs plausibles construite autour de l’estimation ponctuelle, assortie d’un indice de certitude probabiliste contrôlé.
Dans la construction classique fréquentiste, l’estimation ponctuelle ne perd pas son utilité ; elle se trouve magnifiée en devenant le centre géométrique de l’intervalle. L’intervalle de confiance bilatéral symétrique s’établit en soustrayant et en additionnant une marge d’erreur (ME) à l’estimation ponctuelle :
IC1−α = [θ̂ − ME ; θ̂ + ME]
Cette marge d’erreur résulte du produit d’un coefficient critique distributionnel (issu de la loi normale centrée réduite z1−α/2 ou de la loi de Student tn−1, 1−α/2) et de l’erreur type de l’estimateur :
ME = zcritique · SE(θ̂)
Pour un niveau de confiance classique calibré à 95 % (soit un niveau de risque α = 0,05 et un score z = 1,96), l’interprétation fréquentiste rigoureuse se formule ainsi : si l’on répétait indéfiniment la procédure d’échantillonnage selon le même protocole rigide et que l’on recalculait à chaque fois un intervalle à partir des données de l’échantillon recueilli, 95 % de ces intervalles construits recouvriraient effectivement le paramètre théorique invariant μ, tandis que 5 % d’entre eux échoueraient à l’englober.
9.2 Intervalles asymétriques et transformations de variables
L’hypothèse d’une marge d’erreur symétrique autour de l’estimation ponctuelle s’effondre dès lors que la variable sous étude est bornée ou présente une distribution fortement asymétrique, ce qui est le cas des proportions proches de 0 ou de 1 et des coefficients de corrélation linéaire bornés dans l’intervalle [−1, +1]. Dans de telles circonstances, centrer un intervalle linéaire classique sur l’estimation ponctuelle peut aboutir à des aberrations mathématiques flagrantes, telles que des limites inférieures négatives pour des probabilités d’occurrence ou des corrélations estimées dépassant l’unité absolue.
Pour l’estimation du coefficient de corrélation de population ρ à partir de la statistique empirique r, Ronald Fisher a élaboré la célèbre transformation z de Fisher :
zr = arctanh(r) = (1 / 2) ln((1 + r) / (1 − r))
Cette transformation non linéaire métamorphose la statistique asymétrique bornée en une variable asymptotiquement gaussienne avec une erreur standard stabilisée ne dépendant que de la taille d’échantillon : SE(zr) = 1 / √(n − 3). Après calcul des bornes symétriques dans cet espace transformé, l’application de la fonction tangente hyperbolique inverse permet de rétro-projeter les bornes dans l’espace originel de corrélation, générant un intervalle de confiance asymétrique par rapport à l’estimation ponctuelle r, respectant rigoureusement les frontières physiques de l’indice.
Dans les contextes où la forme analytique de la distribution sous-jacente est totalement inconnue, les méthodologistes recourent aux méthodes de rééchantillonnage non paramétriques par bootstrap (introduites par Bradley Efron). En simulant des milliers de ré-échantillons avec remise à partir des données initiales et en recalculant l’estimation ponctuelle pour chacun d’eux, on génère une distribution empirique de l’estimateur. La méthode des percentiles de bootstrap permet alors de dériver des intervalles asymétriques empiriques sans imposer le moindre postulat paramétrique sur la loi mère.
9.3 Comparaison entre paradigme fréquentiste et crédibilité bayésienne
La transition de l’estimation ponctuelle vers l’intervalle met en lumière la divergence conceptuelle profonde entre statisticiens fréquentistes et bayésiens quant à l’interprétation de l’incertitude. Pour un fréquentiste strict, il est formellement interdit d’affirmer, une fois l’intervalle de confiance calculé sur un échantillon précis, qu’« il y a 95 % de chances que le vrai paramètre appartienne à l’intervalle [12,4 ; 18,6] ». En effet, le paramètre μ étant une constante fixe inconnue et l’intervalle calculé étant un objet numérique figé, le paramètre est soit à l’intérieur de l’intervalle, soit à l’extérieur : la probabilité est donc de 0 ou de 1, mais le chercheur ignore laquelle.
À l’inverse, l’approche bayésienne construit ce que l’on nomme un intervalle de crédibilité (ou intervalle de plus haute densité a posteriori, HPDI). Puisque le paramètre est traité comme une variable aléatoire dotée d’une distribution de probabilité a posteriori p(θ | x), le bayésien est pleinement autorisé à affirmer : « Il y a une probabilité subjective de 95 % que le vrai paramètre soit compris entre 13,1 et 17,9 à la lumière des données observées et de l’information préalable ».
Néanmoins, dans ces deux cadres épistémologiques pourtant antinomiques, l’estimation ponctuelle conserve son statut irremplaçable : elle constitue le point d’ancrage central indispensable — soit comme moyenne ou mode de la distribution a posteriori chez le bayésien, soit comme point focal minimisant la variance d’échantillonnage chez le fréquentiste.
10. Applications empiriques en psychométrie et sciences comportementales
10.1 L’estimation du score vrai en théorie classique des tests (TCT)
La psychométrie constitue l’un des domaines les plus féconds pour illustrer la nécessité d’une estimation ponctuelle théoriquement guidée. Dans le cadre de la Théorie Classique des Tests (TCT), initiée par Charles Spearman, tout score empiriquement observé X obtenu par un participant à une épreuve cognitive ou psychologique est postulé comme la sommation linéaire d’un score vrai inobservable V (l’espérance mathématique de la performance de ce sujet sous des répétitions infinies) et d’une erreur de mesure aléatoire E :
X = V + E
L’estimation ponctuelle naïve du score vrai d’un individu consiste à considérer que V̂ = X. Cependant, cette pratique ignore le phénomène statistique inévitable de régression vers la moyenne. Un individu qui réalise un score extrêmement élevé à une passation d’un test a statistiquement bénéficié d’une composante d’erreur aléatoire positive qui a gonflé sa performance ponctuelle ; lors d’une réévaluation, son score aura tendance à décroître pour se rapprocher de la moyenne de sa population de référence.
Pour dériver une estimation ponctuelle rigoureuse et non biaisée du score vrai, la TCT applique l’estimateur de Kelly. Cet estimateur ajuste le score observé en le pondérant par le coefficient de fidélité rxx du test et par la moyenne de la population X̄ :
V̂ = rxx(X − X̄) + X̄
Si un test psychométrique d’intelligence présente une fidélité médiocre de 0,70 et que le sujet testé obtient un score empirique de 130 au sein d’une population dont la moyenne est de 100, l’estimation ponctuelle corrigée du score vrai ne sera pas de 130, mais de V̂ = 0,70 · (130 − 100) + 100 = 121. Cette estimation ponctuelle rétractée protège le psychologue clinicien contre des interprétations diagnostiques outrancières fondées sur des scores aberrants induits par le pur bruit instrumental.
10.2 Estimation des paramètres d’items dans la théorie de réponse à l’item (TRI)
Au cours des dernières décennies, la Théorie de Réponse à l’Item (TRI ou Item Response Theory) s’est imposée pour surmonter les limitations de la TCT. Dans ce cadre, la probabilité qu’un sujet réussisse un item psychologique spécifique n’est plus traitée de façon linéaire, mais modélisée via une fonction logistique non linéaire (la courbe caractéristique de l’item). Par exemple, le modèle logistique à deux paramètres (2PL) formalise cette probabilité selon l’équation :
P(Yij = 1 | θi) = 1 / [1 + exp(−aj(θi − bj))]
Ce paradigme exige l’estimation ponctuelle conjointe de multiples paramètres :
- Le paramètre bj : estimation ponctuelle de la difficulté intrinsèque de l’item (le point sur l’échelle du trait latent où la probabilité de réussite s’établit exactement à 50 %).
- Le paramètre aj : estimation ponctuelle du pouvoir discriminant de l’item (la pente de la courbe logistique au point d’inflexion).
- Le paramètre θi : estimation ponctuelle du niveau d’aptitude ou de trait latent de l’individu évalué.
Pour dériver les estimations ponctuelles des paramètres des items (a et b), les psychométriciens emploient des algorithmes d’estimation par maximum de vraisemblance marginale (MMLE) couplés à l’algorithme Espérance-Maximisation (EM). Une fois les items calibrés et leurs paramètres fixés, l’estimation ponctuelle du trait θ du sujet est calculée en temps réel au moyen d’estimateurs bayésiens comme l’EAP (Expected A Posteriori) ou le MAP. C’est précisément cette chaîne d’estimations ponctuelles séquentielles qui permet le fonctionnement des tests adaptatifs informatisés contemporains (CAT) : l’ordinateur actualise l’estimation ponctuelle de l’aptitude du candidat après chaque réponse et sélectionne dynamiquement l’item suivant dont la difficulté correspond le plus fidèlement à cette estimation.
10.3 L’estimation ponctuelle de la taille d’effet dans les méta-analyses
Dans la recherche médicale et comportementale contemporaine, une découverte scientifique ne tire pas sa légitimité d’une expérience isolée, mais de la synthèse méta-analytique de l’ensemble des études disponibles. Au sein d’une méta-analyse, chaque étude individuelle fournit une estimation ponctuelle standardisée de l’ampleur de l’effet thérapeutique observé.
L’estimateur ponctuel le plus utilisé pour comparer deux moyennes indépendantes est le d de Cohen, calculé comme la différence entre les deux moyennes d’échantillon divisée par l’écart-type combiné : d = (X̄1 − X̄2) / spooled. Cependant, le d de Cohen souffre d’un léger biais de surestimation dans les petits échantillons. Les méta-analystes lui substituent quasi systématiquement le g de Hedges, qui applique un facteur de correction exact J(df) garantissant l’absence totale de biais :
g ≈ d · [1 − (3 / (4(n1 + n2) − 9))]
L’objectif de la méta-analyse consiste ensuite à synthétiser ces multiples estimations ponctuelles individuelles gk en une estimation ponctuelle globale de l’effet moyen combiné (θ̂méta). Dans un modèle à effets fixes ou à effets aléatoires, cette opération s’effectue via une moyenne pondérée :
θ̂méta = (∑ wk · gk) / (∑ wk)
Le poids wk attribué à chaque estimation ponctuelle est mathématiquement égal à l’inverse de sa variance d’échantillonnage : wk = 1 / Var(gk). Ce schéma confère mécaniquement une influence accrue aux estimations ponctuelles issues des vastes échantillons rigoureux (caractérisés par une faible variance d’échantillonnage), assurant ainsi une estimation globale du paramètre d’une précision et d’une efficacité statistique maximales pour guider les recommandations de santé publique.
11. Pièges méthodologiques et erreurs courantes d’interprétation
11.1 Confusion fréquente entre statistique d’échantillon et paramètre absolu
L’un des écueils cognitifs les plus fréquents chez les analystes novices et les consommateurs non avertis de littérature scientifique réside dans la réification immédiate de la statistique d’échantillon en propriété intrinsèque immuable de la population. Lorsqu’un article scientifique stipule qu’« un groupe de 40 participants atteints d’hyperactivité a obtenu un score attentionnel moyen de 58 », il se produit régulièrement un glissement sémantique fallacieux conduisant à affirmer que « les enfants hyperactifs ont un score attentionnel moyen de 58 ».
Cette confusion gomme intégralement le statut de variable aléatoire de la statistique. L’estimation ponctuelle est contingente à l’échantillon particulier sélectionné à un instant t dans un laboratoire x. Répéter l’expérience avec un second échantillon d’individus diagnostiqués selon les mêmes critères produira immanquablement une valeur numérique différente (par exemple 62 ou 55). Omettre de rappeler systématiquement la taille d’échantillon n et la nature fluctuante de la mesure conduit à propager une illusion d’invariance et favorise des attributions causales totalement infondées.
11.2 Biais d’échantillonnage compromettant la validité de l’estimation
Une règle d’or fondamentale de la méthodologie quantitative énonce qu’un estimateur, aussi mathématiquement optimal soit-il, ne peut jamais compenser une distorsion systémique introduite lors de la phase de recrutement des données. Si le plan d’échantillonnage souffre d’un biais de sélection, l’estimation ponctuelle convergera avec une précision aveugle et implacable vers la valeur fausse du paramètre de la sous-population biaisée, et non vers le paramètre de la population cible.
En sciences du comportement et en psychologie expérimentale, ce péril s’est incarné de manière spectaculaire dans le phénomène dit de l’échantillon WEIRD (acronyme pour Western, Educated, Industrialized, Rich, and Democratic). Une proportion écrasante des estimations ponctuelles des lois fondamentales de la perception, de la motivation ou de la cognition sociale ont été calculées à partir d’échantillons d’étudiants de premier cycle en psychologie d’universités nord-américaines et européennes. Considérer que ces estimations ponctuelles reflètent les paramètres réels de l’humanité dans sa globalité constitue une erreur de généralisation massive :
Il est crucial de comprendre la dissymétrie structurelle entre l’erreur aléatoire et l’erreur systématique (biais). L’erreur aléatoire diminue mécaniquement avec l’augmentation de la taille d’échantillon ; en revanche, l’erreur systématique ne diminue en aucune façon avec l’accroissement de n. Recueillir les données de dix millions de personnes via un sondage en ligne auto-sélectionné sur les réseaux sociaux ne fait qu’augmenter le degré de confiance statistique accordé à une estimation ponctuelle intrinsèquement biaisée et dépourvue de toute représentativité réelle.
11.3 Rapport inapproprié des estimations dans la littérature scientifique
La transmission éditoriale des résultats statistiques souffre régulièrement de pratiques défectueuses qui appauvrissent la portée des études scientifiques. La première mauvaise pratique réside dans l’omission récurrente du signalement de l’incertitude entourant l’estimation ponctuelle. Publier une moyenne ou une proportion sans consigner conjointement son erreur standard (SE) ou son intervalle de confiance (IC) prive la communauté des pairs des informations minimales requises pour juger de la précision du travail et pour intégrer ultérieurement ces données dans des méta-analyses cumulatives.
La seconde dérive concerne l’affichage trompeur de la précision numérique. Consigner dans un tableau que la proportion d’individus guéris dans un échantillon de 23 participants est de « 43,47826 % » démontre une incompréhension radicale de la physique de la mesure. Chaque participant représentant à lui seul 1 / 23 ≈ 4,35 % de l’échantillon global, l’étalage de cinq décimales relève d’une pseudo-précision algorithmique absurde. Les normes méthodologiques exigent que le nombre de décimales reflète fidèlement la précision métrologique réelle des instruments d’enregistrement.
Enfin, un piège fréquent réside dans la surinterprétation narrative de micro-fluctuations arithmétiques observées entre des cohortes distinctes. Observer que la moyenne d’un groupe passe de 24,2 à 25,1 après une courte intervention ne constitue en aucun cas une preuve substantielle de changement si cette variation d’un dixième d’écart-type est totalement absorbée par l’amplitude de l’erreur standard d’échantillonnage.
12. Directives de reporting et intégration dans les publications académiques
12.1 Conformité avec les normes éditoriales de l’APA (7e édition)
L’American Psychological Association (APA), dont les normes éditoriales régissent la majorité des revues internationales en sciences humaines, comportementales et biomédicales, a défini des exigences de reporting particulièrement strictes dans sa 7e édition concernant la communication des données quantitatives. La directive cardinale stipule que toute estimation ponctuelle d’un effet principal ou d’une statistique descriptive fondamentale doit être obligatoirement accompagnée de son intervalle de confiance ou de son erreur type associée.
Sur le plan typographique et formel, les normes APA imposent une distinction graphique stricte pour séparer les paramètres théoriques des statistiques empiriques :
- Les statistiques calculées sur un échantillon sont composées en lettres latines et en italique : M pour la moyenne d’échantillon (ou X̄ selon le contexte didactique), SD pour l’écart-type empirique corrigé, SE pour l’erreur type, r pour le coefficient de Pearson, et N (taille globale) ou n (taille de sous-groupe).
- Les paramètres de population, lorsqu’ils sont mentionnés dans le texte théorique, sont libellés à l’aide de lettres grecques non italiques ou conventionnellement formatées : μ, σ, ρ.
Dans le corps du texte ou dans les tableaux récapitulatifs, la présentation doit respecter une standardisation rigoureuse. L’APA recommande d’arrondir les valeurs numériques à deux décimales (trois pour les valeurs de probabilité p). Une formulation canonique s’exprime typiquement sous la forme : « Le score moyen de dépression post-traitement était de M = 14,35 (SD = 3,21, 95% IC [13,15 ; 15,55]) ». Cette structuration garantit que le lecteur dispose instantanément de l’estimation ponctuelle centrale, de la dispersion interindividuelle dans l’échantillon et de l’incertitude inférentielle projetée sur la population générale.
12.2 Visualisation graphique efficace de l’estimation ponctuelle
La communication visuelle des estimations statistiques a connu une révolution méthodologique majeure au cours des deux dernières décennies. Longtemps, les revues scientifiques ont été saturées de diagrammes dits « en bâtons » ou diagrammes en colonnes (bar plots ou dynamite plots), où une simple barre pleine représentait la moyenne empirique, surmontée d’une minuscule antenne verticale indiquant l’écart-type ou l’erreur standard. Cette pratique a été formellement bannie par les comités éditoriaux des plus prestigieuses revues méthodologiques en raison de sa toxicité informative.
Un diagramme en colonnes occulte totalement la forme de la distribution réelle des données : une distribution normale, une distribution exponentielle fortement asymétrique ou une distribution parfaitement bimodale peuvent générer une barre verticale rigoureusement identique. De nos jours, la visualisation scientifique exige des représentations transparentes qui intègrent simultanément les données brutes et les estimations statistiques :
- Les graphiques en violon (violin plots) combinés : ils dessinent la fonction de densité de probabilité lissée des données brutes, laissant apparaître clairement les asymétries et les multimodalités.
- Les nuages de points avec dispersion aléatoire (jittered stripcharts) : ils superposent chaque point de donnée individuel en arrière-plan, attestant de l’intégrité de la collecte sans masquer les valeurs atypiques.
- L’estimation ponctuelle enrichie : la moyenne ou la médiane empirique est représentée au premier plan par un point contrasté massif ou un losange horizontal, encadré par des barres d’erreur explicites définissant rigoureusement l’intervalle de confiance à 95 % ou l’erreur type (la nature exacte de la barre d’erreur devant obligatoirement être explicitée dans la légende graphique).
12.3 Reproductibilité computationnelle et partage des scripts d’estimation
L’estimation ponctuelle contemporaine ne s’effectue plus à la main ou sur une simple calculatrice de bureau ; elle est le produit d’algorithmes implémentés dans des environnements logiciels hautement sophistiqués tels que le langage de programmation R, Python (avec les bibliothèques NumPy, SciPy et Statsmodels) ou SPSS. Or, un même jeu de données soumis à des progiciels distincts peut parfois générer des estimations ponctuelles marginalement différentes en raison de variantes computationnelles sous-jacentes (par exemple, la façon dont les algorithmes gèrent les valeurs manquantes, choisissent les méthodes de tie-breaking pour la médiane, ou paramètrent la fonction d’optimisation numérique pour le maximum de vraisemblance).
Dans le cadre des principes de la science ouverte (Open Science), la reproductibilité computationnelle stricte est devenue un impératif éthique. Tout rapport d’estimation ponctuelle dans une publication scientifique doit pouvoir être tracé et reproduit de façon algorithmique indépendante. Les chercheurs sont tenus de documenter rigoureusement :
- La version exacte du logiciel et des packages d’analyse statistique mobilisés (par exemple le package
lavaansous R pour les modèles structurels oulme4pour les modèles linéaires mixtes). - La spécification détaillée des critères de convergence algorithmique et des méthodes d’ajustement numérique (telles que le traitement des degrés de liberté selon Satterthwaite ou Kenward-Roger).
- Le dépôt public, sur des registres pérennes certifiés (comme l’Open Science Framework, OSF), des scripts de code annotés ayant permis de transformer la matrice des données brutes en estimations ponctuelles finales.
Cette transparence algorithmique totale assure la pérennité des résultats, prémunit la science contre les erreurs accidentelles de codage et garantit que l’estimation ponctuelle ne soit jamais un artéfact informatique opaque, mais l’expression la plus pure, contrôlée et vérifiable du processus d’induction statistique.
Références
Agresti, A., & Coull, B. A. (1998). Approximate is better than « exact » for interval estimation of binomial proportions. The American Statistician, 52(2), 119–126. https://doi.org/10.1080/00031305.1998.10480550
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Casella, G., & Berger, R. L. (2002). Statistical inference (2nd ed.). Duxbury Press.
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Cramér, H. (1946). Mathematical methods of statistics. Princeton University Press.
Efron, B., & Tibshirani, R. J. (1993). An introduction to the bootstrap. Chapman & Hall/CRC. https://doi.org/10.1007/978-1-4899-4541-9
Fisher, R. A. (1922). On the mathematical foundations of theoretical statistics. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 222(594–604), 309–368. https://doi.org/10.1098/rsta.1922.0009
Gelman, A., Carlin, J. B., Stern, H. S., Dunson, D. B., Vehtari, A., & Rubin, D. B. (2013). Bayesian data analysis (3rd ed.). Chapman & Hall/CRC. https://doi.org/10.1201/b16018
Hedges, L. V., & Olkin, I. (1985). Statistical methods for meta-analysis. Academic Press.
Lord, F. M., & Novick, M. R. (1968). Statistical theories of mental test scores. Addison-Wesley.
Neyman, J. (1937). Outline of a theory of statistical estimation based on the classical theory of probability. Philosophical Transactions of the Royal Society of London. Series A, Mathematical and Physical Sciences, 236(767), 333–380. https://doi.org/10.1098/rsta.1937.0005
Rao, C. R. (1945). Information and the accuracy attainable in the estimation of statistical parameters. Bulletin of the Calcutta Mathematical Society, 37, 81–91.
Wilcox, R. R. (2012). Introduction to robust estimation and hypothesis testing (3rd ed.). Academic Press.