
Dans l’architecture de la statistique moderne et de l’épistémologie quantitative, la distribution d’échantillonnage constitue le pivot conceptuel sans lequel le passage de l’observation contingente à l’inférence universelle s’avérerait impossible. Toute démarche empirique, qu’elle s’ancre dans les sciences du comportement, la biomédecine ou l’économétrie, se heurte inéluctablement à une finitude matérielle : le chercheur ne peut appréhender l’intégralité d’un univers théorique et doit se résoudre à observer une fraction circonscrite de la réalité, désignée sous le terme d’échantillon. Dès lors, une question lancinante émerge : avec quel degré de certitude une mesure calculée sur ce fragment particulier permet-elle de déduire les lois régissant la population globale ? La réponse réside précisément dans la conceptualisation de la distribution d’échantillonnage, cette construction probabiliste qui modélise l’ensemble des valeurs qu’une statistique donnée adopterait si le protocole d’observation était réitéré une infinité de fois dans des conditions strictement identiques.
Trop souvent occultée ou confondue avec la simple distribution des données recueillies, la distribution d’échantillonnage ne décrit pas le comportement d’individus concrets, mais le comportement probabiliste d’une métrique calculée à partir d’eux. Elle s’érige ainsi en un méta-niveau théorique d’une puissance formelle remarquable. Sans elle, le calcul des p-valeurs, l’érection des intervalles de confiance, les tests d’hypothèses néo-fisheriens ou neyman-pearsoniens et la quantification de l’erreur d’estimation s’effondreraient, réduits à des heuristiques fragiles dépourvues de fondement mathématique. C’est elle qui fournit le pont déductif permettant d’assigner une probabilité d’occurrence à un résultat empirique donné en le confrontant au spectre théorique de tous les résultats possibles générés par le simple hasard du tirage.
Comprendre la nature, la genèse et les propriétés dynamiques de la distribution d’échantillonnage implique d’explorer une mécanique mathématique raffinée, portée par des théorèmes fondamentaux tels que le Théorème Central Limite, et de maîtriser des notions clés telles que l’erreur type, les degrés de liberté ou les lois asymptotiques. Le présent traité propose une déconstruction exhaustive de cette clé de voûte de l’inférence statistique. En naviguant des origines historiques de la théorie des erreurs jusqu’aux protocoles contemporains de rééchantillonnage par bootstrap, ce document décortique les mécanismes par lesquels la variabilité locale se transmute en certitude probabiliste, offrant ainsi aux chercheurs et aux praticiens les outils d’une rigueur méthodologique sans faille.
1. Introduction fondamentale à la notion de distribution d’échantillonnage
1.1 Définition conceptuelle et portée méthodologique
Sur le plan formel, la distribution d’échantillonnage est définie comme la loi de probabilité théorique d’une statistique donnée, calculée à partir d’un ensemble infini d’échantillons aléatoires indépendants, tous de même taille, extraits d’une même population parente. Il s’agit par conséquent d’une abstraction fondamentale qui ne réside pas dans les données directement observées sur le terrain, mais dans l’espace de probabilité associé à un estimateur. Une statistique — qu’il s’agisse d’une moyenne arithmétique, d’une variance corrigée, d’une médiane, d’une proportion ou d’un coefficient de régression linéaire — est elle-même une variable aléatoire. En tant que telle, elle varie inévitablement d’une réplication empirique à une autre, en raison de ce que l’on qualifie d’aléa ou d’erreur d’échantillonnage. La distribution d’échantillonnage capture et modélise cette variabilité inter-échantillons dans une fonction de densité ou de masse continue et prévisible.
D’un point de vue épistémologique, il est crucial d’opérer une distinction nette et irrévocable entre la distribution des variables observées au niveau individuel et la distribution des statistiques d’échantillon. Lorsque l’on mesure par exemple l’activité électrodermale ou le temps de traitement cognitif chez cent participants, les scores individuels forment une distribution empirique de données élémentaires. En revanche, la moyenne globale obtenue sur ces cent sujets ne représente qu’un seul et unique point d’une distribution beaucoup plus large et abstraite : celle de toutes les moyennes d’échantillons de taille cent qu’il serait possible de concevoir au sein de la même population cible. Cette métaphore de la répétition infinie d’expériences indépendantes constitue le moteur heuristique de l’approche fréquentiste classique.
Sur le plan méthodologique, la distribution d’échantillonnage réalise l’articulation nécessaire entre la statistique descriptive et la statistique inférentielle. La statistique descriptive s’enferme volontairement dans les limites de l’échantillon recueilli pour en synthétiser les caractéristiques numériques au moyen d’indices de tendance centrale et de dispersion. La statistique inférentielle, à l’inverse, nourrit l’ambition d’extrapoler ces observations circonscrites à une réalité plus vaste et non observable directement. Pour franchir cette frontière épistémique sans verser dans l’arbitraire, la science quantitative utilise la distribution d’échantillonnage comme étalon universel, permettant de déterminer si un résultat constaté reflète un phénomène substantiel ou s’il s’inscrit simplement dans la dispersion prévisible des fluctuations d’échantillonnage.
1.2 Origines historiques et développement dans la théorie statistique
L’émergence formelle de la notion de distribution d’échantillonnage s’ancre dans la théorie des erreurs développée à la fin du XVIIIe et au début du XIXe siècle par Pierre-Simon de Laplace et Carl Friedrich Gauss. Confrontés aux imprécisions récurrentes des mesures astronomiques et géodésiques, ces mathématiciens ont cherché à modéliser la manière dont les erreurs de mesure accidentelles s’agrégeaient autour de la valeur véritable d’une grandeur céleste. Gauss, en formalisant la loi normale (souvent dénommée courbe en cloche ou loi de Laplace-Gauss), posa les premières bases mathématiques montrant que la moyenne d’une série d’observations répétées possède une dispersion nettement plus restreinte que celle des observations isolées, anticipant ainsi la formulation de l’erreur type.
Toutefois, le véritable basculement conceptuel vers une théorie autonome des distributions d’échantillonnage s’est opéré au début du XXe siècle, sous l’impulsion décisive de William Sealy Gosset (qui publia sous le pseudonyme de « Student ») et de Sir Ronald Aylmer Fisher. Gosset, alors chimiste pour les brasseries Guinness, constata que lorsque la taille de l’échantillon est restreinte et que la variance de la population demeure inconnue, l’approximation normale de la distribution de la moyenne devient erronée en sous-estimant la probabilité des valeurs extrêmes. Sa dérivation de la distribution t en 1908 marqua la naissance de la modélisation exacte des distributions d’échantillonnage pour de petits effectifs. Par la suite, Ronald Fisher, suivi par Jerzy Neyman et Egon Pearson, systématisa cette démarche en introduisant des distributions de référence adaptées à l’analyse de variance et aux rapports de dispersion, telles que la distribution F de Fisher-Snedecor et la loi de Pearson pour le Khi-deux.
Dans la seconde moitié du XXe siècle, ces fondations analytiques ont été adoptées et adaptées au sein des sciences humaines, notamment par la formalisation rigoureuse des plans d’expérience en psychologie expérimentale et en psychométrie. Alors que les statisticiens de l’ère classique devaient s’en remettre à des tables mathématiques précalculées et à des dérivations formelles parfois inextricables pour des paramètres non gaussiens, l’avènement de l’informatique et des puissances de calcul algorithmiques a bouleversé le domaine. Des mathématiciens comme Bradley Efron ont étendu la théorie de la distribution d’échantillonnage en substituant à l’analyse pure des méthodes de simulation numérique intensives, permettant d’approcher empiriquement la forme de la distribution d’une statistique complexe sans formuler d’hypothèses de départ restrictives sur la population parente.
1.3 L’expérience de pensée de l’échantillonnage répété
Pour appréhender l’essence d’une distribution d’échantillonnage sans s’égarer dans l’abstraction mathématique brute, il convient de recourir à l’expérience de pensée canonique du tirage répété au sein d’une population dont la configuration est entièrement connue. Imaginons un univers expérimental constitué d’une population de dix millions d’individus dont nous mesurons une variable quantitative donnée, par exemple un score d’anxiété cognitive calibré sur une échelle continue. Supposons que cette population possède une moyenne fixe rigoureusement égale à 100 et un écart-type égal à 15. Si un premier chercheur prélève de manière aléatoire et sans biais un échantillon de 50 sujets, il calculera une première moyenne, disons 101,4. Si un second chercheur réitère rigoureusement le même protocole sur un autre échantillon distinct de 50 sujets, il obtiendra potentiellement une moyenne de 98,7. Un troisième obtiendra 100,2, et ainsi de suite.
Cette variabilité inhérente aux statistiques générées d’un échantillon à un autre reflète ce que l’on nomme l’erreur d’échantillonnage. Si nous poussons cette expérience de pensée jusqu’à ses limites logiques et demandons à un ordinateur d’extraire successivement un million d’échantillons distincts, chacun contenant très exactement 50 observations, nous collecterons un ensemble massif d’un million de valeurs de moyennes empiriques. En reportant ces moyennes dans un histogramme de fréquences, une métamorphose spectaculaire s’opère : la dispersion brute et le désordre apparent des tirages individuels s’effacent au profit d’une structure géométrique remarquable, régulière, symétrique et prédictible, centrée avec une précision chirurgicale sur la moyenne théorique originelle de la population.
Cette expérience de pensée démontre empiriquement l’utilité pédagogique de la distribution des moyennes d’échantillons. Elle révèle que bien qu’un échantillon individuel soit intrinsèquement marqué par l’aléa et l’imperfection, le système composé par l’ensemble des échantillons possibles obéit à des lois d’une rigueur absolue. La distribution d’échantillonnage n’est donc pas une simple vue de l’esprit sans ancrage pratique ; elle constitue la réalité probabiliste sous-jacente qui borne notre incertitude et conditionne notre capacité à extraire des énoncés scientifiques fiables à partir de mesures limitées.
2. Distinction primordiale : Population, échantillon et méta-distribution
2.1 La distribution de la population (univers théorique)
Dans l’échafaudage épistémologique de la démarche inférentielle, la distribution de la population renvoie à l’univers théorique exhaustif de tous les éléments, individus, scores ou événements répondant à un ensemble de critères bien définis. Cet ensemble est désigné en statistique par la taille N, laquelle peut être finie mais d’une dimension prohibitivement vaste (comme l’ensemble des citoyens d’un continent), ou virtuellement infinie (comme la somme de toutes les réalisations passées, présentes et futures d’une tâche de laboratoire informatisée). Les attributs numériques décrivant cette population cible sont nommés des paramètres. Par convention typographique immuable dans la littérature académique, ces paramètres sont notés à l’aide de lettres grecques : la moyenne populationnelle est désignée par $\mu$ (mu) et l’écart-type de la population par $\sigma$ (sigma).
Il est fondamental de noter que les paramètres $\mu$ et $\sigma$ d’une population donnée sont des grandeurs fixes, des constantes ontologiques de l’univers considéré au moment de l’observation. Toutefois, dans la quasi-totalité des investigations empiriques, ces valeurs réelles demeurent éternellement inconnues du chercheur, dissimulées derrière l’impossibilité logistique, financière, éthique ou temporelle de mener un recensement exhaustif. De surcroît, la morphologie même de la distribution parente ne répond à aucune obligation de régularité : une population réelle peut afficher une morphologie unimodale gaussienne, mais elle peut tout aussi bien être fortement asymétrique, uniformément répartie, tronquée, exponentielle ou présenter une bimodalité prononcée traduisant l’existence de sous-classes latentes au sein du corpus d’étude.
En psychologie et dans les sciences du comportement, cette inaccessibilité est particulièrement exacerbée. Lorsqu’un protocole s’intéresse aux mécanismes neuronaux de la consolidation mnésique chez l’être humain, la population cible n’est pas uniquement restreinte aux individus vivants à un instant t, mais englobe le potentiel universel de l’architecture cognitive humaine. Tenter de mesurer exhaustivement cette entité relève de l’illusion métaphysique ; le chercheur est contraint d’accepter l’incomplétude fondamentale de son matériau d’observation et de travailler exclusivement sur des représentations projetées.
2.2 La distribution de l’échantillon empirique
L’échantillon empirique constitue la structure de données concrète, tangible et finie collectée par le scientifique au cours de son investigation de terrain ou de laboratoire. Désigné par la lettre n, l’effectif de cet échantillon ne regroupe qu’un sous-ensemble délimité d’individus extraits de la population parente. Contrairement à la population dont les paramètres sont fixes et abstraits, l’échantillon livre des données concrètes à partir desquelles sont calculées des métriques descriptives appelées statistiques ou estimateurs ponctuels. La tradition statistique anglo-saxonne et internationale utilise ici l’alphabet latin pour formaliser ces entités : la moyenne calculée au sein de l’échantillon est notée $\bar{x}$ (prononcée « x-barre ») et l’écart-type calculé sur ce groupe d’individus est dénoté par la lettre $s$.
La caractéristique fondamentale de la distribution de l’échantillon réside dans sa nature fugace, contingente et instable. Alors que les paramètres $\mu$ et $\sigma$ sont des repères fixes, les statistiques $\bar{x}$ et $s$ sont intrinsèquement sensibles à la composition particulière du groupe extrait. Elles subissent les fluctuations incompressibles de l’échantillonnage et font preuve d’une haute sensibilité à l’intrusion d’observations singulières ou de valeurs extrêmes. Si une personne possédant des capacités attentionnelles prodigieuses ou, à l’inverse, un état de fatigue extrême se trouve intégrée fortuitement au sein d’un échantillon restreint, la moyenne $\bar{x}$ subira une distorsion immédiate par rapport au centre de gravité réel de la population générale.
L’échantillon empirique se présente donc comme une maquette imparfaite et transitoire de la population parente. L’erreur commune du statisticien novice consiste à assimiler béatement cette maquette locale à la réalité globale. Or, un échantillon isolé ne détient aucune autorité normative : sans une théorie mathématique permettant d’interpréter ses déviations et d’en circonscrire les anomalies, la statistique $\bar{x}$ demeure un simple indicateur descriptif, muet quant à la vérité ontologique de la population $\mu$.
2.3 La distribution d’échantillonnage en tant que méta-niveau théorique
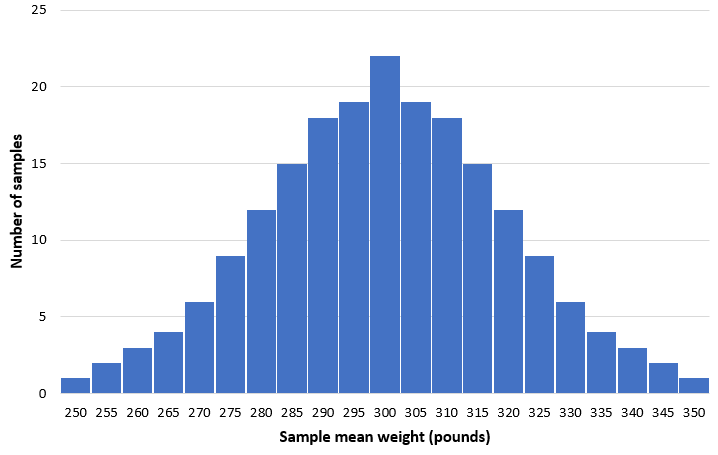
C’est ici qu’intervient la bascule vers le méta-niveau conceptuel. Tandis que la distribution de la population modélise la fréquence des individus au sein de l’univers complet, et que la distribution de l’échantillon formalise la dispersion de ces mêmes individus au sein du groupe réuni sous l’œil de l’observateur, la distribution d’échantillonnage opère un saut de niveau logique : elle n’est pas composée d’individus concrets, mais de statistiques agrégées. Chaque unité fondamentale composant cette distribution n’est pas un être humain, un temps de réponse ou une tension artérielle, mais une moyenne $\bar{x}$, une médiane, une variance $s^2$ ou un coefficient de corrélation r issu d’un échantillon hypothétique distinct.
Pour saisir cette tripartition essentielle, une analyse comparative synoptique s’avère indispensable :
- Distribution de la population : univers de référence ; unités fondamentales = observations individuelles ($X_i$) ; paramètres = fixes et généralement inaccessibles ($\mu, \sigma$) ; dispersion = écart-type de la population ($\sigma$).
- Distribution de l’échantillon : fragment empirique observé ; unités fondamentales = observations empiriques réelles ($x_i$) ; statistiques = variables ponctuelles (${\bar{x}}, s$) ; dispersion = écart-type de l’échantillon ($s$).
- Distribution d’échantillonnage : espace méta-théorique ; unités fondamentales = statistiques issues d’échantillons de taille n répétés (${\bar{x}}_1, {\bar{x}}_2, dots, {\bar{x}}_k$) ; paramètres = espérance de la statistique ($E({\bar{x}})$) et dispersion méta ; dispersion formelle = erreur type ($\sigma_{\bar{x}}$).
Ce statut abstrait engendre des conséquences ontologiques capitales pour l’administration de la preuve scientifique. En dotant la statistique d’une loi de probabilité propre, le chercheur s’affranchit de l’étroitesse de son observation singulière. L’écart-type de cette méta-distribution, formellement baptisé erreur type, mesure la marge d’erreur inhérente à la procédure d’échantillonnage elle-même. Dès lors, le chercheur est armé pour quantifier formellement l’incertitude scientifique : il ne prétend plus détenir la vérité absolue de la population générale, mais il peut énoncer avec une exactitude mathématique la probabilité que son observation s’éloigne de cette vérité d’une amplitude déterminée.
3. Le mécanisme générateur : De l’échantillonnage répété à la distribution empirique
3.1 Le processus d’échantillonnage aléatoire simple
L’édification rigoureuse d’une distribution d’échantillonnage, qu’elle soit simulée sur ordinateur ou conceptualisée par voie analytique, repose sur un prérequis fondamental : le respect des postulats de l’échantillonnage aléatoire probabiliste. L’échantillonnage aléatoire simple exige que chaque individu de la population parente bénéficie d’une probabilité d’inclusion strictement équivalente et positive dans l’échantillon sélectionné, et que l’inclusion de toute unité d’observation n’exerce aucune influence sur la probabilité de sélection d’une quelconque autre unité. Ce double principe d’équiprobabilité et d’indépendance statistique garantit la représentativité espérée du mécanisme générateur.
Dans ce contexte théorique, la modalité du tirage — avec ou sans remise — soulève des considérations formelles précises. Dans un tirage avec remise, la population demeure rigoureusement invariante après chaque sélection, ce qui assure une stricte indépendance des épreuves au sens mathématique. Dans un tirage sans remise au sein d’une population finie, la probabilité d’extraction des individus restants est mathématiquement altérée à chaque pas séquentiel, ce qui induit une interdépendance marginale. Néanmoins, lorsque la population parente N est gigantesque par rapport à la taille n de l’échantillon (typiquement lorsque la fraction d’échantillonnage $n/N$ est inférieure à 0,05), l’impact de l’absence de remise devient négligeable, et les propriétés de la distribution d’échantillonnage se superposent fidèlement à celles observées sous tirage avec remise.
En pratique expérimentale, notamment lors du recrutement de cohortes de sujets dans les études biomédicales ou psychologiques, la violation de ces conditions probabilistes est courante. Le recours systématique à des échantillons de convenance (étudiants d’université, volontaires rémunérés sur Internet) introduit des distorsions systématiques. Ces biais d’échantillonnage brisent l’équiprobabilité fondamentale et détruisent l’alignement théorique entre la population cible réelle et la population effectivement échantillonnée, altérant irréversiblement les garanties de validité apportées par la distribution d’échantillonnage calculée.
3.2 Construction séquentielle d’une distribution d’échantillonnage empirique
Pour matérialiser ce mécanisme sans passer par des théorèmes purement abstraits, il est possible d’exécuter un protocole itératif de simulation informatique. Soit un algorithme paramétré pour agir sur une population connue de dimension N. Le processus se déploie selon une séquence systématique rigoureuse en quatre temps distincts, répétée à très grande échelle :
- Étape 1 : Extraction. Un échantillon aléatoire de taille déterminée n est extrait de manière indépendante au sein de la population parente.
- Étape 2 : Calcul. La statistique cible dont on cherche à modéliser le comportement (par exemple, la moyenne $\bar{x}$) est calculée sur ce groupe d’observations et stockée dans un vecteur numérique de stockage.
- Étape 3 : Réitération massive. Le protocole des étapes 1 et 2 est réitéré de manière autonome k fois (où k représente le nombre de répétitions, typiquement $k = 10,000$, $k = 100,000$ ou davantage).
- Étape 4 : Agrégation géométrique. Les k valeurs de la statistique ainsi générées sont projetées sous la forme d’un histogramme de fréquences ou d’une courbe d’estimation de densité par noyau (KDE).
La dynamique de cette simulation révèle une propriété asymptotique cardinale : lorsque le nombre de réplications k progresse vers l’infini, l’histogramme empirique se lisse, les fluctuations aléatoires d’observation s’estompent et la forme géométrique résultante converge avec une stabilité inaltérable vers la distribution d’échantillonnage théorique exacte. Cette régularité illustre de manière spectaculaire le fait que si l’issue d’un tirage isolé demeure imprévisible, le comportement agrégé de dix mille tirages successifs est soumis à un déterminisme statistique d’une précision mathématique absolue.
3.3 L’analogie des dauphins et son équivalent en sciences cognitives
Une analogie biologique canonique permet d’illustrer ce phénomène avec netteté. Considérons l’ensemble des dauphins à nez de bouteille évoluant dans une vaste région océanique. Admettons que le poids réel moyen de cette population de cétacés soit de $\mu = 200\text{ kg}$, avec un étalement naturel modélisé par un écart-type de $\sigma = 30\text{ kg}$. Si une équipe océanographique capture temporairement dix dauphins ($n = 10$) pour les peser, il est concevable, par pure coïncidence géographique, qu’elle tombe sur un groupe comportant une majorité de jeunes individus sous-pondérés, produisant une moyenne échantillonnale de 175 kg. Une autre expédition, opérant à quelques milles nautiques, capturera une majorité de mâles adultes robustes et obtiendra une moyenne de 222 kg.
Cependant, si ce protocole de capture-pesée-relâchement était reconduit par des milliers d’équipes indépendantes, la moyenne de l’ensemble de ces moyennes se calerait exactement sur les 200 kg de la population originelle. Plus encore, l’observation d’un échantillon moyen pesant moins de 150 kg ou plus de 250 kg apparaîtrait comme une anomalie statistique d’une rareté extrême. La distribution d’échantillonnage démontre ici son pouvoir régulateur : les fluctuations individuelles s’annulent mutuellement dès lors que l’on manipule des moyennes de sous-groupes.
Cette logique trouve une transposition immédiate au sein des laboratoires de sciences cognitives. Lors d’une tâche informatisée de décision lexicale (où le sujet doit déterminer le plus rapidement possible si une suite de lettres projetée sur un écran forme un mot de la langue française ou un pseudo-mot), la latence de traitement est mesurée en millisecondes. Les temps de réaction individuels fluctuent d’un essai à l’autre en fonction de micro-variations de l’attention, de clignements d’yeux ou de bruits parasites. Pourtant, lorsque l’on calcule le temps moyen de décision sur des séries d’essais répétés, ces moyennes d’échantillons se resserrent autour du temps de traitement latent réel du système visuo-sémantique. Les déviations massives s’évaporent au profit d’une courbe prédictible, fournissant à la psychologie expérimentale la stabilité métrologique sans laquelle aucune inférence chronométrique ne serait possible.
4. Le Théorème Central Limite (TCL) : Pilier mathématique de la distribution d’échantillonnage
4.1 Énoncé formel et conditions d’application
Le socle théorique conférant à la distribution d’échantillonnage sa puissance opérationnelle réside dans l’un des sommets de l’analyse mathématique : le Théorème Central Limite (TCL). Formalisé dans sa version moderne par des mathématiciens tels qu’Alexandre Liapounov et Jarl Waldemar Lindeberg, ce théorème s’intéresse au comportement asymptotique de la somme et de la moyenne d’un ensemble de variables aléatoires. Sous sa formulation classique (théorème de Lindeberg-Lévy), il stipule que si l’on extrait une suite de variables aléatoires $X_1, X_2, dots, X_n$ indépendantes et identiquement distribuées (i.i.d.), issues d’une population caractérisée par une espérance mathématique finie $\mu$ et une variance finie $\sigma^2$ (avec $\sigma^2 > 0$), alors la distribution d’échantillonnage de la moyenne normalisée converge en loi vers la distribution normale standard $\mathcal{N}(0, 1)$ lorsque $n$ tend vers l’infini.
Sur le plan analytique, la formulation mathématique s’énonce comme suit :
$$\lim_{n to \infty} P\left( \frac{\bar{X}_n – \mu}{\sigma / \sqrt{n}} le z \right) = \Phi(z) = \frac{1}{\sqrt{2\pi}} \int_{-\infty}^{z} e^{-\frac{t^2}{2}} , dt$$
où $Phi(z)$ représente la fonction de répartition cumulative de la loi gaussienne standard. L’aspect le plus fascinant et le plus universel de ce résultat réside dans son indépendance morphologique : la population d’origine dont sont tirées les observations individuelles n’a nullement besoin d’être symétrique ou de suivre une loi normale. Qu’elle soit uniformément distribuée, exponentielle, triangulaire, log-normale ou discrète et discontinue, la distribution d’échantillonnage de sa moyenne convergera irrémédiablement vers la morphologie d’une courbe en cloche symétrique au fur et à mesure que la taille $n$ de l’échantillon croît.
La seule contrainte formelle absolue imposée par le théorème classique réside dans l’existence d’une variance finie ($\sigma^2 < \infty$). Dans les rares cas où cette condition est transgressée — par exemple pour des variables régies par des distributions à queues infiniment lourdes telles que la loi de Cauchy ou certaines lois de Pareto extrêmes sans moment du second ordre —, le théorème ne s’applique pas et la distribution d’échantillonnage de la moyenne ne se stabilise pas autour d’une gaussienne, conservant l’instabilité de sa loi d’origine. En dehors de ces singularités théoriques, le TCL s’applique à la quasi-totalité des mesures empiriques manipulées dans les sciences de la vie et du comportement.
4.2 Le rôle du seuil de taille d’échantillon (la règle n >= 30)
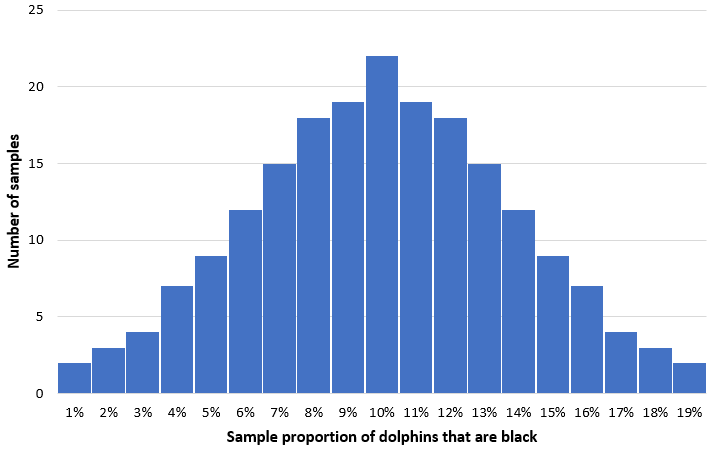
Dans la pratique statistique appliquée et les manuels de formation quantitative, une règle empirique tenace établit qu’un effectif d’échantillon de $n ge 30$ est suffisant pour invoquer le Théorème Central Limite et supposer la normalité opérationnelle de la distribution d’échantillonnage des moyennes. D’un point de vue historique et méthodologique, ce seuil de 30 constitue une convention heuristique d’ingénierie statistique plutôt qu’une frontière mathématique absolue. Son origine remonte aux travaux computationnels préalables à la démocratisation des ordinateurs, où l’on considérait que pour $n = 30$, les écarts critiques entre la table de Student et la loi normale standard commençaient à devenir acceptables pour les décisions industrielles ou agronomiques standards.
En réalité scientifique rigoureuse, la vitesse de convergence de la distribution d’échantillonnage vers la normalité parfaite dépend dramatiquement de la forme de la population parente de départ. Deux paramètres géométriques régissent ce rythme : le coefficient d’asymétrie (ou skewness) et le coefficient d’aplatissement (ou kurtosis). Si la population d’origine présente déjà une forme symétrique et unimodale approchant une cloche, la distribution d’échantillonnage de sa moyenne sera remarquablement proche d’une loi normale pour des effectifs aussi modestes que $n = 5$ ou $n = 10$. À l’inverse, face à des distributions mères hautement asymétriques — comme les revenus financiers, les temps de survie cellulaire ou les délais de réaction cognitive — la distribution d’échantillonnage conserve une asymétrie résiduelle notable à $n = 30$.
Dans de telles conditions d’extrême distorsion, des échantillons de taille $n = 100$, voire $n = 500$, s’avèrent strictement indispensables pour que les queues de distribution d’échantillonnage s’alignent fidèlement avec les probabilités théoriques de la loi normale. Sous des régimes de petits effectifs ($n < 30$) tirés de populations non normales, s’appuyer aveuglément sur la loi normale pour modéliser la distribution d’échantillonnage expose le statisticien à un risque majeur de sous-estimation systématique des probabilités critiques dans les zones extrêmes, conduisant à des inférences substantiellement faussées.
4.3 Conséquences fonctionnelles pour l’inférence statistique
Les implications fonctionnelles du Théorème Central Limite pour l’épistémologie de la recherche expérimentale sont d’une portée vertigineuse. Il offre ni plus ni moins qu’un principe d’universalité méthodologique : il garantit que, peu importe la complexité ou le manque de régularité mathématique du phénomène psychologique, social ou biologique étudié au niveau des comportements individuels, les moyennes agrégées de ces comportements obéissent à un modèle mathématique standardisé et universellement documenté.
C’est ce théorème fondamental qui légitime l’usage quasi universel des tests paramétriques (tels que le test t de Student, l’analyse de variance ANOVA ou la régression des moindres carrés ordinaires) au sein des sciences quantitatives. Ces tests reposent tous, de façon directe ou indirecte, sur le postulat que la statistique d’intérêt — ou son erreur résiduelle — se déploie selon une distribution normale connue. Grâce au TCL, les chercheurs n’ont pas l’obligation contraignante d’attester que la cognition humaine ou l’affectivité émotionnelle sont en elles-mêmes « normales » au sens géométrique du terme ; il leur suffit de travailler sur des échantillons d’une taille suffisante pour que la distribution d’échantillonnage des métriques calculées acquière cette morphologie gaussienne régulatrice.
Cette convergence autorise l’opération de standardisation sous la forme du score Z classique :
$$Z = \frac{\bar{x} – \mu}{\sigma_{\bar{x}}} = \frac{\bar{x} – \mu}{\sigma / \sqrt{n}}$$
Cette équation transforme n’importe quelle moyenne brute $\bar{x}$ issue d’un échantillon empirique en un écart standardisé universel, dont la probabilité exacte d’occurrence peut être instantanément dérivée de la fonction de Gauss. Il s’opère ainsi un découplage conceptuel salvateur entre la nature brute, souvent chaotique et non-gaussienne, des comportements humains empiriques et la régularité normale des agrégats d’échantillonnage qui les mesurent.
5. Paramètres clés : Moyenne, variance et erreur type de la distribution d’échantillonnage
5.1 L’espérance de la moyenne échantillonnale (propriété de non-biais)
La caractérisation formelle de toute distribution de probabilité requiert la spécification de son centre de gravité et de son degré d’étalement. Dans le cas de la distribution d’échantillonnage de la moyenne, le premier paramètre déterminant est son espérance mathématique, notée $E(\bar{X})$ ou $\mu_{\bar{x}}$. En vertu de la propriété de linéarité de l’opérateur d’espérance, nous pouvons démontrer avec une rigueur absolue que la moyenne de la distribution de toutes les moyennes d’échantillons possibles est rigoureusement identique à la moyenne véritable de la population parente $\mu$.
Considérons en effet un échantillon aléatoire simple composé de $n$ variables aléatoires $X_1, X_2, dots, X_n$ issues de la même population, de sorte que pour chaque variable individuelle, $E(X_i) = \mu$. La moyenne échantillonnale s’exprime sous la forme :
$$\bar{X} = \frac{1}{n} \sum_{i=1}^{n} X_i$$
En appliquant l’opérateur d’espérance à cette équation, nous obtenons :
$$E(\bar{X}) = E\left( \frac{1}{n} \sum_{i=1}^{n} X_i \right) = \frac{1}{n} \sum_{i=1}^{n} E(X_i) = \frac{1}{n} (n \mu) = \mu$$
Cette équation fondamentale formalise le fait que la moyenne échantillonnale $\bar{X}$ est un estimateur sans biais (ou non biaisé) de la moyenne populationnelle $\mu$. L’absence de biais signifie qu’aucune distorsion systématique n’affecte la mesure : la distribution d’échantillonnage ne penche ni vers une surestimation, ni vers une sous-estimation du paramètre théorique. Son centre de gravité coïncide exactement avec la cible ontologique, et ce, de manière totalement indépendante de la taille $n$ de l’échantillon retenu (qu’il soit composé de deux ou de dix mille individus).
Il est toutefois impératif de dissiper une confusion sémantique fréquente entre l’exactitude d’un estimateur et sa précision. L’espérance $E(\bar{X}) = \mu$ garantit l’exactitude de l’estimateur dans l’espace abstrait de la répétition infinie : l’ensemble des estimations est impeccablement calibré sur la cible. Cela ne signifie nullement qu’un échantillon unique de petite taille fournira une valeur précise ; la précision dépend entièrement du second paramètre structurel de la distribution : sa dispersion.
5.2 L’erreur type de la moyenne (SEM) : Quantification de la dispersion
Le second paramètre cardinal de la distribution d’échantillonnage est sa variance, notée $\sigma^2_{\bar{x}}$, dont la racine carrée positive porte le nom fondamental d’erreur type de la moyenne (fréquemment désignée par le sigle anglais SEM pour Standard Error of the Mean). Là où la variance d’un échantillon ($s^2$) ou d’une population ($\sigma^2$) quantifie l’amplitude des différences séparant les individus singuliers les uns des autres, l’erreur type quantifie la dispersion des statistiques calculées à travers l’infinité des réplications possibles.
En exploitant l’indépendance statistique des observations élémentaires tirées par échantillonnage aléatoire simple, la variance de la somme de variables aléatoires équivaut à la somme de leurs variances respectives. La dérivation algébrique de l’erreur type s’opère ainsi sans ambiguïté :
$$\text{Var}(\bar{X}) = \text{Var}\left( \frac{1}{n} \sum_{i=1}^{n} X_i \right) = \frac{1}{n^2} \sum_{i=1}^{n} \text{Var}(X_i) = \frac{1}{n^2} (n \sigma^2) = \frac{\sigma^2}{n}$$
En extrayant la racine carrée de cette variance d’échantillonnage, nous aboutissons à la formulation universelle de l’erreur type de la moyenne :
$$\sigma_{\bar{x}} = \frac{\sigma}{\sqrt{n}}$$
Lorsque la variance $\sigma$ de la population est inconnue — ce qui constitue la norme dans les contextes de recherche empirique —, le paramètre est estimé au moyen de l’écart-type non biaisé de l’échantillon $s$, donnant lieu à l’estimateur empirique de l’erreur type :
$$SE_{\bar{x}} = \frac{s}{\sqrt{n}}$$
Cette relation mathématique dévoile la fameuse « loi en racine carrée » de la statistique d’échantillonnage. Elle stipule que l’incertitude entourant une estimation ne décroît pas de façon linéaire avec le nombre d’observations recueillies, mais de façon proportionnelle à $\sqrt{n}$. Par conséquent, pour diviser l’erreur d’estimation par deux, le chercheur doit obligatoirement quadrupler la taille de sa cohorte expérimentale. Pour diviser l’erreur type par un facteur dix, il est contraint de multiplier l’effort d’échantillonnage par un facteur cent. Cette asymétrie induit un coût marginal croissant de la précision statistique qui gouverne toute la planification financière et logistique des protocoles de recherche contemporains.
5.3 Le facteur de correction pour population finie (FPCF)
Les équations standard présentées précédemment présupposent que la population parente est infinie ou que les tirages sont effectués avec remise. Or, dans de nombreuses applications concrètes relevant de l’épidémiologie, de l’audit organisationnel ou de la sociologie d’entreprise, les populations cibles possèdent un effectif fini et borné $N$. Dès lors que la fraction d’échantillonnage devient substantielle — conventionnellement fixée au seuil où le ratio $n/N > 0{,}05$ (soit plus de 5 % de la population globale extraite au sein de l’échantillon) —, le prélèvement successif d’individus sans remise épuise progressivement le réservoir des données restantes, réduisant mathématiquement la variabilité possible des échantillons subséquents.
Pour intégrer cette compression de l’incertitude dans la modélisation de la distribution d’échantillonnage, la formule de la variance doit être ajustée par l’application d’un coefficient multiplicateur correctif nommé le facteur de correction pour population finie (noté FPCF, pour Finite Population Correction Factor). La formulation algébrique de la variance d’échantillonnage ajustée devient :
$$\text{Var}(\bar{X})_{\text{ajustée}} = \frac{\sigma^2}{n} \left( \frac{N – n}{N – 1} \right)$$
Par extraction de la racine carrée, l’erreur type de la distribution d’échantillonnage sous régime de population finie prend la forme :
$$\sigma_{\bar{x}} = \frac{\sigma}{\sqrt{n}} \sqrt{\frac{N – n}{N – 1}}$$
L’examen de cette structure algébrique met en lumière un comportement asymptotique limpide : lorsque la taille de la population $N$ est gigantesque par rapport à $n$, le ratio $(N – n)/(N – 1)$ converge vers 1, rendant le radical inopérant et restituant la formule classique de l’erreur type. En revanche, si la taille de l’échantillon $n$ s’approche de l’effectif global $N$ (dans le cas limite d’un recensement quasi exhaustif où $n to N$), le numérateur $N – n$ tend vers zéro. L’erreur type s’effondre alors vers zéro, traduisant le fait incontestable que si la quasi-totalité d’une population est observée, l’incertitude relative à la valeur de sa moyenne s’éteint complètement.
Ce facteur revêt une importance méthodologique de premier ordre en psychologie du travail et des organisations, lorsqu’une enquête étudie l’épuisement professionnel ou le climat organisationnel au sein d’une firme regroupant un nombre déterminé de salariés (par exemple $N = 300$). Omettre d’appliquer le FPCF lors d’une extraction de $n = 100$ employés conduirait à surestimer artificiellement l’erreur type de la distribution d’échantillonnage, pénalisant lourdement la puissance statistique des tests d’inférence et élargissant indûment les intervalles de confiance associés aux indicateurs analysés.
6. Les différents types de distributions d’échantillonnage selon les statistiques estimées
6.1 Distribution d’échantillonnage de la moyenne (Z et Student t)
La statistique la plus fréquemment examinée est la moyenne arithmétique. La morphologie exacte de sa distribution d’échantillonnage est subordonnée à deux facteurs contextuels stricts : la normalité de la population parente et la disponibilité opérationnelle de la variance théorique $\sigma^2$. Lorsque la variance de la population $\sigma^2$ est formellement connue — un cas d’école précieux sur le plan théorique mais rarissime sur le plan empirique —, et que la population sous-jacente est normale ou que l’échantillon satisfait aux conditions du Théorème Central Limite, la distribution d’échantillonnage standardisée obéit à la loi normale centrée réduite $\mathcal{N}(0, 1)$, régie par la statistique de Wald ou score $Z$.
En revanche, dans la quasi-totalité des configurations cliniques ou de laboratoire, la variance théorique $\sigma^2$ est inconnue du chercheur. Celui-ci se trouve dans l’obligation de lui substituer la variance calculée au sein de son propre échantillon empirique $s^2$. Cette substitution introduit une seconde source d’incertitude aléatoire dans le dénominateur de la formule de standardisation : la statistique résultante ne confronte plus une moyenne fluctuante à un écart-type fixe, mais combine deux variables aléatoires distinctes ($\bar{x}$ au numérateur et $s$ au dénominateur). Cette dynamique statistique donne naissance à la variable régie par la distribution t de Student :
$$t = \frac{\bar{x} – \mu}{s / \sqrt{n}} \sim t(\nu)$$
où $\nu = n – 1$ désigne les degrés de liberté attachés à l’estimateur de la dispersion.
La distribution de Student présente une silhouette symétrique semblable à la courbe en cloche, mais possède des queues de distribution nettement plus épaisses et un aplatissement plus prononcé (kurtosis supérieur) que la loi normale standard. Cette épaisseur accrue des extrémités exprime mathématiquement le surcroît d’incertitude causé par l’estimation de la variance : les écarts statistiques majeurs y sont plus fréquents que sous une stricte loi de Gauss. Au fur et à mesure que les degrés de liberté $\nu$ s’élèvent sous l’effet de l’accroissement de la taille de l’échantillon $n$, l’estimateur $s$ gagne en précision et converge asymptotiquement vers $\sigma$. Par conséquent, pour des effectifs importants, la distribution d’échantillonnage de Student se superpose de manière quasi indiscernable à la loi normale unitaire.
6.2 Distribution d’échantillonnage des proportions
Lorsque la variable d’intérêt n’est pas continue mais qualitative binaire (succès/échec, présence/absence d’un trouble psychiatrique, adhésion ou rejet d’une proposition), la statistique manipulée prend la forme d’une proportion échantillonnale notée $p$ (ou $\hat{p}$). L’univers sous-jacent repose ici sur le formalisme du modèle de Bernoulli, caractérisé par une probabilité théorique de succès désignée par $\pi$ (ou parfois notée $P$). Si l’on extrait un échantillon aléatoire de taille $n$, le nombre total de succès observés $X$ suit rigoureusement une loi binomiale de paramètres $n$ et $\pi$, soit $X \sim \mathcal{B}(n, \pi)$.
La statistique proportion s’écrit formellement comme la moyenne des tirages bernoulliens :
$$\hat{p} = \frac{X}{n}$$
L’espérance de la distribution d’échantillonnage de cette proportion correspond à la probabilité véritable de la population parente, garantissant sa nature d’estimateur sans biais :
$$E(\hat{p}) = \pi$$
La variance de cette distribution s’obtient directement par division de la variance binomiale par $n^2$ :
$$\text{Var}(\hat{p}) = \frac{\text{Var}(X)}{n^2} = \frac{n \pi (1 – \pi)}{n^2} = \frac{\pi (1 – \pi)}{n}$$
D’où l’expression de l’erreur type canonique de la proportion :
$$\sigma_{\hat{p}} = \sqrt{\frac{\pi (1 – \pi)}{n}}$$
En vertu des théorèmes d’approximation asymptotique (notamment le théorème de De Moivre-Laplace), la distribution d’échantillonnage discrète d’une proportion peut être fidèlement approximée par une loi normale continue dès lors que l’effectif d’observations est suffisamment large et que la proportion ne se situe pas à des valeurs extrêmes. Les critères méthodologiques de validité classiquement requis pour opérer cette approximation imposent que les produits $n \pi ge 5$ (ou 10 selon les auteurs) et $n(1 – \pi) ge 5$ soient simultanément satisfaits. Si ces conditions sont rompues, la distribution d’échantillonnage conserve une asymétrie discrète marquée, obligeant les épidémiologistes et les sondeurs d’opinion à abandonner les formules analytiques normales au profit du calcul exact binomial de Clopper-Pearson.
6.3 Distribution d’échantillonnage de la variance (Khi-deux) et des rapports de variance (Fisher F)
L’inférence statistique ne se cantonne pas à l’estimation des tendances centrales : la quantification de la variabilité est souvent l’objet direct du questionnement scientifique. Lorsque l’on s’intéresse à la variance calculée au sein d’un échantillon empirique extrait d’une population normale, cette statistique $s^2$ ne se distribue absolument pas selon une loi normale. En effet, une variance étant par définition la somme de déviations quadratiques strictement positives, sa distribution d’échantillonnage est nécessairement tronquée à zéro et s’avère hautement asymétrique, déployant une longue traîne étirée vers les valeurs positives.
Sur le plan mathématique, la transformation normalisée de la variance d’échantillon obéit à la distribution du Khi-deux ($\chi^2$) de Pearson à $n – 1$ degrés de liberté :
$$\frac{(n – 1)s^2}{\sigma^2} \sim \chi^2(n – 1)$$
Cette asymétrie structurale fondamentale démontre qu’une variance échantillonnale sous-estime plus souvent la variance véritable qu’elle ne la surestime dans des échantillons réduits, bien que son espérance algébrique formelle demeure non biaisée grâce à l’application du dénominateur correctif de Bessel ($n – 1$).
Lorsque le protocole de recherche vise à confronter empiriquement deux variances indépendantes — comme dans le cadre de l’évaluation de l’homoscédasticité préalable à un test comparatif, ou lors du découpage des sources de variance dans l’analyse de variance (ANOVA) —, la statistique d’intérêt devient le ratio pondéré de deux variances d’échantillon. La distribution d’échantillonnage modélisant ce ratio d’estimateurs sous l’hypothèse nulle d’égalité des variances fondamentales est la distribution de Fisher-Snedecor (loi F) :
$$F = \frac{s_1^2 / \sigma_1^2}{s_2^2 / \sigma_2^2} \sim F(df_1, df_2)$$
Cette distribution d’échantillonnage est asymétrique, bornée à gauche par zéro et gouvernée par une double graduation de degrés de liberté ($df_1 = n_1 – 1$ au numérateur, $df_2 = n_2 – 1$ au dénominateur). Elle possède la particularité d’être extraordinairement sensible aux violations de la normalité de la population parente : si les populations de départ s’écartent même modérément de la gaussianité, la distribution réelle du ratio de variance s’éloigne drastiquement du modèle formel de Fisher, exposant le chercheur à de sévères distorsions de son taux d’erreur de type I.
6.4 Distribution d’échantillonnage des coefficients d’association
L’estimation des corrélations linéaires constitue un autre pan massif de l’activité scientifique. Le coefficient de corrélation de Pearson calculé sur un échantillon, noté r, est utilisé pour estimer la corrélation réelle régnant dans la population bivariée, notée $rho$ (rho). Lorsque la corrélation véritable au sein de la population est rigoureusement nulle ($rho = 0$), la distribution d’échantillonnage de r est remarquablement symétrique et centrée sur l’origine zéro. Sous cette hypothèse nulle, la statistique normalisée dérive directement vers une distribution de Student classique à $n – 2$ degrés de liberté :
$$t = \frac{r \sqrt{n – 2}}{\sqrt{1 – r^2}} \sim t(n – 2)$$
Cependant, une rupture majeure de symétrie intervient dès lors que la corrélation populationnelle $rho$ s’écarte substantiellement de zéro. En effet, le coefficient de Pearson étant mathématiquement borné par l’intervalle strict $[-1, +1]$, la distribution d’échantillonnage subit un phénomène mécanique de compression et de contrainte géométrique à l’approche de ces limites physiques. Si $\rho = +0{,}80$, la distribution d’échantillonnage de r présentera une asymétrie négative prononcée : elle possédera une queue étirée vers la gauche et un resserrement abrupt vers la valeur +1, car aucun échantillon ne peut générer une valeur supérieure à l’unité.
Pour résoudre cette distorsion morphologique qui empêche le calcul direct d’intervalles de confiance symétriques ou de tests bilatéraux simples, Ronald Fisher a introduit une procédure analytique élégante : la transformation z de Fisher (ou transformation tangente hyperbolique inverse, $\text{ar\tanh}$) :
$$z_r = \frac{1}{2} \ln\left( \frac{1 + r}{1 – r} \right) = \text{ar\tanh}(r)$$
Cette transformation non linéaire a pour vertu d’étirer les bornes de $[-1, +1]$ vers l’infini ($[-\infty, +\infty]$), convertissant ainsi la distribution d’échantillonnage asymétrique d’origine en une distribution remarquablement normale, d’espérance $\mu_z = \text{ar\tanh}(\rho)$ et d’erreur type constante remarquablement stable, dépendante uniquement de la taille de l’échantillon :
$$\sigma_{z} \approx \frac{1}{\sqrt{n – 3}}$$
Grâce à ce redressement, le calcul d’intervalles de confiance fiables pour un coefficient de corrélation s’effectue aisément dans l’espace métrique z avant d’être re-projeté, par fonction inverse, dans l’espace initial des corrélations de Pearson. Des logiques similaires s’appliquent aux distributions d’échantillonnage des coefficients de régression multiple et logistique, dont les erreurs types découlent des propriétés de la matrice de variance-covariance des résidus.
7. Facteurs influençant la forme et la dispersion de la distribution d’échantillonnage
7.1 L’impact critique de la taille de l’échantillon (n)
De tous les paramètres régissant le comportement de la distribution d’échantillonnage, la taille d’échantillon n est incontestablement le levier méthodologique le plus puissant aux mains de l’expérimentateur. L’influence de l’effectif s’exerce simultanément sur deux dimensions structurelles complémentaires : le degré d’étalement (la dispersion) et la configuration morphologique (la symétrie).
Sur le plan de la dispersion, l’équation universelle de l’erreur type $\sigma_{\bar{x}} = \sigma / \sqrt{n}$ explicite la dynamique du resserrement. Au fur et à mesure que $n$ grandit, le dénominateur de l’expression s’accroît, forçant la variance d’échantillonnage à décroître proportionnellement. Sur le plan géométrique, cela se traduit par une métamorphose visuelle flagrante : la distribution d’échantillonnage s’étire verticalement au centre tout en contractant drastiquement ses ailes latérales. Les estimations obtenues à partir d’échantillons massifs viennent ainsi s’agglutiner dans un voisinage infinitésimal autour du paramètre populationnel réel $\mu$. L’amplitude des erreurs d’échantillonnage majeures s’effondre.
Sur le plan morphologique, l’élévation de $n$ active l’effet régularisateur du Théorème Central Limite. Quelle que soit l’irrégularité initiale de la population (asymétrie prononcée, présence d’un aplatissement anomal), l’accroissement continu de l’effectif rabote méthodiquement les aspérités distributionnelles. Les coefficients d’asymétrie et de kurtosis de la distribution d’échantillonnage convergent vers 0, instaurant une symétrie parfaite. Cependant, cette quête de la précision statistique pure doit être arbitrée au regard des contraintes éthiques et économiques de la recherche. Sur-échantillonner pour traquer un gain résiduel minime d’erreur type au-delà d’un certain seuil représente souvent une allocation inefficace des ressources scientifiques, voire une exposition inutile de participants à des procédures expérimentales contraignantes.
7.2 La dispersion inhérente à la population (sigma)
Le second déterminant intrinsèque gouvernant la dispersion de la distribution d’échantillonnage est la variabilité naturelle régnant au sein de la population d’origine, modélisée par l’écart-type théorique $\sigma$. L’examen direct du numérateur de la formule $\sigma / \sqrt{n}$ souligne une relation de stricte proportionnalité linéaire : si l’hétérogénéité naturelle du phénomène double au sein de la population cible, l’incertitude entourant l’estimation de sa moyenne doublera à son tour pour tout niveau d’effectif donné.
Cette propriété met en relief l’importance capitale du contrôle de la variance expérimentale dans les protocoles de recherche. Alors que l’augmentation de la taille d’échantillon n relève d’une approche de « force brute », la maîtrise de $\sigma$ procède d’une démarche d’ingénierie méthodologique fine. En améliorant la fidélité des instruments de mesure, en standardisant scrupuleusement les consignes de passation et en régulant les variables parasites environnementales (température de laboratoire, éclairage, bruits de fond lors d’une tâche d’attention auditive), le chercheur réduit artificiellement la composante d’erreur aléatoire intégrée dans $\sigma$.
C’est également ce mécanisme mathématique qui fonde la supériorité métrologique des plans de recherche à mesures répétées (intra-sujets) par rapport aux plans inter-sujets dans les disciplines comportementales. En demandant à chaque participant d’être son propre témoin à travers les différentes conditions expérimentales, la variance systématique attribuable aux différences inter-individuelles stables (telles que le quotient intellectuel général, la vitesse motrice basale ou la personnalité) est mathématiquement retranchée de la variance d’erreur. Cette manœuvre abaisse drastiquement la valeur effective du numérateur $\sigma$ dans la modélisation de la distribution d’échantillonnage de la différence, conférant au protocole une précision et une puissance statistique inaccessibles par un plan inter-sujets équivalent.
7.3 La forme de la distribution d’origine sous petits échantillons
Lorsque la taille de l’échantillon s’avère restreinte ($n < 20$ ou $30$), l’effet d’atténuation du Théorème Central Limite n’a pas encore atteint sa pleine puissance opératoire. Dans ce régime transitoire, la morphologie de la distribution d’échantillonnage se trouve fortement dépendante de l’architecture distributionnelle de la population d’origine. Les caractéristiques de la population parente s’impriment directement sur la distribution de la statistique.
Si la population d’origine est régie par une distribution log-normale ou exponentielle hautement asymétrique à droite — ce qui est typique du coût des soins médicaux, du temps mis pour résoudre un problème logique complexe ou du nombre d’erreurs commises dans une tâche visuo-spatiale —, la distribution d’échantillonnage de la moyenne pour un petit effectif présentera elle aussi une asymétrie résiduelle substantielle vers les valeurs positives. L’application des règles de décision gaussesques conduira alors à une sous-estimation systématique des probabilités dans la queue droite et à une surestimation dans la queue gauche.
De même, si la population sous-jacente est bimodale (révélant deux sous-populations distinctes non ségrégées), la distribution d’échantillonnage sous de très faibles effectifs peut conserver une morphologie aplatie ou platykurtique, voire une bimodalité fantôme. Ce constat rend impérative la mise en œuvre systématique de diagnostics graphiques préalables (diagrammes quantile-quantile ou Q-Q plots, histogrammes de densité, tests formels de Shapiro-Wilk) afin d’apprécier la morphologie des données brutes. Dès lors que l’effectif est faible et que l’écart à la normalité apparaît indiscutable, s’obstiner à utiliser des distributions d’échantillonnage théoriques conventionnelles relève d’une faute méthodologique, imposant le basculement vers des méthodes exactes ou des algorithmes de rééchantillonnage non paramétriques.
8. La distribution d’échantillonnage en psychologie et en sciences comportementales
8.1 Défis spécifiques liés aux échantillons en psychologie
La psychologie scientifique et les sciences cognitives entretiennent une relation complexe avec la théorie de l’échantillonnage en raison des contraintes empiriques encadrant le recrutement de leurs participants. Historiquement, une proportion écrasante des découvertes comportementales a été établie à partir d’échantillons désignés sous l’acronyme WEIRD (Western, Educated, Industrialized, Rich, Democratic), souvent constitués d’étudiants de premier cycle en psychologie participant à des expériences en échange de crédits universitaires. Sur le plan de la théorie distributionnelle, ces cohortes constituent une population parente hyper-spécifique, hautement homogène sur le plan de l’âge, de l’efficience intellectuelle et de l’habitus socioculturel.
Cette restriction de variance altère profondément l’universalité des distributions d’échantillonnage dérivées de ces protocoles. D’une part, l’homogénéité artificielle du groupe abaisse le paramètre $\sigma$, ce qui procure une fausse impression de précision dans l’estimation de l’erreur type. D’autre part, la moyenne $\mu$ de cette niche ne correspond nullement à la moyenne globale de la population humaine générale pour des processus psychologiques complexes tels que le raisonnement moral, la perception spatiale ou la prise de décision économique. Les chercheurs commettent ainsi l’erreur de modéliser avec précision une distribution d’échantillonnage qui ne pointe tout simplement pas vers le bon univers théorique.
À cet écueil de représentativité s’ajoute la question de la sous-puissance statistique chronique qui a traversé l’histoire de la discipline. Pendant des décennies, des effectifs moyens oscillant autour de $n = 15$ à $n = 25$ participants par condition expérimentale ont constitué la norme empirique. Ces effectifs étriqués génèrent des distributions d’échantillonnage extraordinairement étalées, caractérisées par de larges erreurs types. Dans de telles conditions de dispersion, le « bruit » de l’échantillonnage rivalise souvent en intensité avec le « signal » de l’effet expérimental testé, favorisant l’éclosion d’artefacts statistiques et compromettant la reproductibilité des résultats lors de tentatives de réplication ultérieures.
8.2 Application à la mesure psychométrique
Dans le champ de la psychométrie contemporaine — dédiée à la modélisation et à l’étalonnage des aptitudes cognitives et des traits de personnalité au moyen de tests standardisés —, la distribution d’échantillonnage intervient au cœur des théories de la fidélité et de l’invariance de mesure. Tout score composite obtenu par un individu à un inventaire d’auto-évaluation ou à un test neuropsychologique (comme les échelles d’intelligence de Wechsler) intègre une part de fluctuation d’échantillonnage, cette fois-ci non pas liée à l’échantillonnage des personnes, mais à l’échantillonnage des items au sein de l’univers théorique de toutes les questions possibles mesurant le trait latent.
De surcroît, les métriques fondamentales certifiant la qualité psychométrique d’un instrument — à l’instar du coefficient de cohérence interne $\alpha$ (alpha de Cronbach) ou du coefficient $\omega$ (oméga de McDonald) — sont elles-mêmes des statistiques calculées sur un échantillon empirique fini de sujets. Elles possèdent donc leur propre distribution d’échantillonnage théorique. Les chercheurs ont longtemps commis l’erreur de considérer l’indice $\alpha = 0{,}82$ calculé sur 80 individus comme un absolu non négociable, omettant d’évaluer son erreur type associée. Or, la distribution d’échantillonnage de l’alpha de Cronbach sous de faibles effectifs affiche une variabilité prononcée, signifiant que la fiabilité réelle du test au sein de la population générale pourrait en réalité osciller entre 0,65 et 0,90.
Cette dispersion impose des contraintes rigoureuses lors du calibrage des normes cliniques. L’étalonnage d’un test diagnostique (par exemple, identifier un déficit mnésique fixé au seuil de deux écarts-types sous la moyenne normative) suppose que les normes de référence reposent sur des échantillons massifs. Si l’échantillon normatif est de taille réduite, les moyennes et écarts-types de standardisation subissent les fluctuations de leur distribution d’échantillonnage, déplaçant insidieusement les seuils cliniques et augmentant la prévalence des faux positifs ou des faux négatifs lors de diagnostics médicaux ou scolaires.
8.3 Variabilité d’échantillonnage dans les protocoles expérimentaux complexes
La recherche cognitive contemporaine déploie fréquemment des plans factoriels sophistiqués associant des facteurs inter-sujets (manipulation de groupes cliniques vs témoins) et des facteurs intra-sujets (manipulation de niveaux de charge attentionnelle), couplés à des recueil de données continues à haute densité temporelle (chronométrie oculaire, trajectoires motrices sur tablette graphique, magnétoencéphalographie). Dans ces contextes écologiques, la modélisation de la distribution d’échantillonnage des différences de moyennes devient hautement complexe.
L’observation brute agrège en effet deux sources de variabilité d’échantillonnage distinctes et emboîtées : la variabilité liée à l’échantillonnage aléatoire des participants au sein de la population humaine, et la variabilité liée à l’échantillonnage des stimuli ou des essais au sein du corpus matériel expérimental. Longtemps, les analyses statistiques classiques (ANOVA par les sujets, $F_1$, ou par les items, $F_2$) ont ignoré cette structure emboîtée, commettant le biais d’« assomption de langage fixe » dénoncé par Herbert Clark, ce qui conduisait à une sous-estimation systématique de l’erreur type de la distribution d’échantillonnage.
Pour capturer fidèlement la véritable distribution d’échantillonnage de ces protocoles multivariés, la science translationnelle recourt désormais massivement aux modèles mixtes linéaires à effets aléatoires (Linear Mixed Models, LMM). Ces architectures d’analyse décomposent explicitement la variance d’échantillonnage en séparant les composantes aléatoires liées aux sujets de celles imputables aux items. Elles permettent d’ériger des distributions d’échantillonnage conditionnelles d’une fidélité inégalée, évitant aux neuroscientifiques de conclure à l’existence d’un effet cérébral là où ne s’exprime qu’un artefact généré par l’échantillonnage d’un stimulus visuel atypique.
9. Rôle central dans l’inférence statistique et les tests d’hypothèses
9.1 Modélisation de l’hypothèse nulle (H0)
L’inférence statistique fréquentiste conventionnelle — issue de la synthèse des travaux de Fisher, Neyman et Pearson — opère par le biais d’un raisonnement par l’absurde probabilisé, articulé autour de la construction rigoureuse d’une distribution d’échantillonnage spécifique : celle générée sous l’hypothèse nulle ($H_0$). Cette hypothèse pose par convention l’absence de tout effet, de toute différence entre les groupes expérimentaux ou de toute corrélation entre les variables à l’échelle de la population générale (par exemple : $H_0 : \mu_1 – \mu_2 = 0$).
La distribution d’échantillonnage sous $H_0$ constitue l’espace de référence qui matérialise l’ensemble exhaustif de tous les résultats empiriques qu’il serait possible d’observer par la seule action du hasard et des fluctuations d’échantillonnage si l’intervention expérimentale était totalement inerte. À partir de cette fonction de densité mathématiquement délimitée, le chercheur fixe un seuil d’exception probabiliste conventionnel — le niveau de signification $\alpha$ (généralement calibré à 0,05 ou 0,01). Ce seuil permet de partitionner l’espace de la distribution d’échantillonnage en deux entités géométriques distinctes : une zone centrale de non-rejet (englobant 95 % de la masse de probabilité sous $H_0$) et une ou deux régions critiques marginales de rejet situées aux extrémités (couvrant les 5 % de probabilité restants).
C’est au regard strict de cette distribution théorique que s’articule le calcul et la définition même de la p-valeur. La p-valeur représente la probabilité exacte d’observer, dans un échantillon de même taille issu de la même population, une statistique au moins aussi extrême que celle effectivement recueillie, sachant que l’hypothèse nulle est vraie :
$$p = P(\text{données} mid H_0)$$
Il est épistémologiquement primordial de rappeler que la p-valeur ne quantifie jamais la probabilité que l’hypothèse nulle soit vraie ou fausse en soi ($P(H_0 mid \text{données})$) — une inversion probabiliste fallacieuse courante —, mais mesure exclusivement le degré de compatibilité géométrique entre le résultat observé et la distribution d’échantillonnage théorique construite sous le postulat du hasard strict.
9.2 Modélisation sous l’hypothèse alternative (H1) et puissance statistique
Tandis que l’école fisherienne focalise son attention sur la distribution d’échantillonnage sous $H_0$, la formalisation neyman-pearsonienne enrichit le paradigme décisionnel en introduisant simultanément une seconde méta-distribution : la distribution d’échantillonnage modélisée sous l’hypothèse alternative ($H_1$). L’hypothèse $H_1$ postule l’existence d’un effet expérimental d’une magnitude non nulle spécifique dans la population générale (par exemple : $H_1 : \mu_1 – \mu_2 = \delta$).
L’introduction de cette seconde distribution d’échantillonnage décale spatialement le centre de gravité probabiliste le long de l’axe des abscisses, créant une zone de chevauchement géométrique avec la distribution sous $H_0$. Ce face-à-face structurel permet de définir formellement les deux grands risques d’erreur de la décision statistique binaire :
- Erreur de type I ($\alpha$) : probabilité de rejeter indûment $H_0$ alors qu’elle est vraie, mesurée par l’aire sous la courbe de la distribution d’échantillonnage sous $H_0$ qui empiète dans la région critique de rejet.
- Erreur de type II ($\beta$) : probabilité de ne pas rejeter $H_0$ alors qu’elle est fausse au profit de $H_1$, mesurée par l’aire sous la courbe de la distribution d’échantillonnage sous $H_1$ qui retombe à l’intérieur de la zone de rétention de l’hypothèse nulle.
La puissance statistique de l’expérience est définie géométriquement comme le complémentaire de l’erreur de type II :
$$\text{Puissance} = 1 – \beta$$
Elle représente la proportion de la masse de la distribution d’échantillonnage sous $H_1$ qui dépasse le seuil critique d’exclusion fixé par $\alpha$. Pour optimiser cette puissance — que les standards méthodologiques fixent minimalement à $1 – \beta ge 0{,}80$ (soit 80 % de chances de détecter l’effet réel s’il existe) —, le chercheur doit agir sur la forme des deux distributions : soit en accentuant la distance séparant leurs moyennes respectives (amplification du signal expérimental), soit en rétrécissant leur dispersion interne via une réduction de l’erreur type $\sigma / \sqrt{n}$ (gonflement massif de la taille d’échantillon).
9.3 La crise de la réplicabilité vue sous l’angle de l’échantillonnage
La « crise de la réplicabilité » qui a ébranlé les fondements méthodologiques de la psychologie, de la psychiatrie et des neurosciences au cours des quinze dernières années trouve son explication centrale dans une mauvaise appréhension des lois de la distribution d’échantillonnage. Lorsque des études sont conduites sous un régime de faible puissance statistique (faibles effectifs $n$ induisant des erreurs types gigantesques), la distribution d’échantillonnage de la statistique testée sous $H_1$ s’étale de façon démesurée, chevauchant très largement la distribution sous $H_0$.
Dans ce contexte de flou distributionnel, les seules estimations qui parviennent à franchir le filtre artificiel du seuil de significativité conventionnel ($p < 0{,}05$) sont celles qui, par pure fluctuation fortuite d’échantillonnage, tombent à l’extrémité la plus déviante de leur distribution réelle. Ce phénomène engendre la pathologie de la « malédiction du vainqueur » (winner’s curse) : les tailles d’effet publiées dans les études pionnières sous-puissantes sont systématiquement et massivement surestimées par rapport à leur paramètre populationnel réel. Dès lors qu’une tentative de réplication ultérieure utilise un protocole rigoureux, la nouvelle moyenne retombe vers le véritable centre de la distribution, faisant s’évaporer l’effet initialement proclamé par simple régression vers la moyenne.
Cette fragilité structurelle a été amplifiée par des pratiques de recherche douteuses désignées sous le concept de p-hacking. En interrompant prématurément le recueil de données dès l’obtention d’un seuil $p < 0{,}05$ (échantillonnage séquentiel opportuniste), ou en testant de multiples variables dépendantes pour ne rapporter que la seule s’avérant significative, les chercheurs manipulent artificiellement l’espace de la distribution d’échantillonnage. Ils violent les règles fondamentales du calcul probabiliste en gonflant clandestinement le taux d’erreur de type I global. C’est pour cadenasser définitivement ces dérives et restaurer l’intégrité de la distribution d’échantillonnage théorique que la science ouverte promeut désormais le pré-enregistrement obligatoire des hypothèses et des protocoles d’échantillonnage.
10. Intervalles de confiance et estimation paramétrique via la distribution d’échantillonnage
10.1 Définition rigoureuse de l’intervalle de confiance
Face aux limites inhérentes à la dichotomie réductrice des tests d’hypothèses nulles (rejet vs non-rejet), l’estimation par intervalle s’impose comme une modalité d’inférence supérieure et infiniment plus informative. L’intervalle de confiance (IC) est directement dérivé d’une inversion mathématique de la distribution d’échantillonnage de l’estimateur considéré.
Dans le paradigme fréquentiste strict formalisé par Jerzy Neyman, l’intervalle de confiance n’attribue pas une probabilité subjective à des paramètres inconnus qui demeurent des constantes fixes de la nature. Il caractérise la performance probabiliste à long terme de la procédure de calcul elle-même. Énoncer qu’un intervalle de confiance pour une moyenne est calculé au niveau de confiance bilatéral de 95 % signifie que si nous devions répéter le processus d’échantillonnage une infinité de fois sous des conditions strictement identiques, et calculer un intervalle pour chaque échantillon extrait, très exactement 95 % de ces intervalles construits emprisonneraient en leur sein la véritable moyenne de la population $\mu$, tandis que 5 % échoueraient à la capturer.
L’erreur d’interprétation la plus répandue dans le champ biomédical et psychologique consiste à affirmer qu’après extraction d’un échantillon singulier et calcul de ses bornes numériques — disons [48,2 ; 54,6] —, il y a « 95 % de chances que la vraie moyenne se trouve entre 48,2 et 54,6 ». Cette assertion est rigoureusement fausse au regard de la théorie fréquentiste : la vraie moyenne $\mu$ étant une constante fixe, elle se trouve soit à 100 % à l’intérieur de ces bornes fixes, soit à 0 %. Ce n’est pas le paramètre qui fluctue à l’intérieur d’un piège fixe, c’est l’intervalle de confiance qui est lui-même une variable aléatoire, dont la translation spatiale est gouvernée d’un tirage à l’autre par la dynamique de la distribution d’échantillonnage.
10.2 Construction mathématique pour la moyenne
L’opérationnalisation mathématique de l’intervalle de confiance découle immédiatement de l’encadrement probabiliste de la distribution d’échantillonnage standardisée de la statistique. Partant de la distribution de Student $t = (\bar{x} – \mu) / SE_{\bar{x}}$ qui gouverne la moyenne échantillonnale sous variance populationnelle inconnue, nous fixons une probabilité bilatérale $1 – \alpha$ telle que :
$$P\left( -t_{alpha/2, , n-1} le \frac{\bar{X} – \mu}{s / \sqrt{n}} le +t_{alpha/2, , n-1} \right) = 1 – \alpha$$
où $t_{alpha/2, , n-1}$ représente la valeur critique issue de la table de Student laissant une aire unilatérale de $alpha/2$ dans chaque queue, pour $n – 1$ degrés de liberté. En réorganisant algébriquement cette double inégalité afin d’isoler le paramètre théorique inconnu $\mu$ au centre du prédicat, nous obtenons :
$$P\left( \bar{X} – t_{alpha/2, , n-1} \left( \frac{s}{\sqrt{n}} \right) le \mu le \bar{X} + t_{alpha/2, , n-1} \left( \frac{s}{\sqrt{n}} \right) \right) = 1 – \alpha$$
La structure formelle de l’intervalle de confiance s’exprime ainsi sous la forme synoptique canonique :
$$\text{IC}_{1-\alpha} = \text{Estimateur Ponctuel} \pm (\text{Valeur Critique} \times \text{Erreur Type})$$
Le produit du point critique par l’erreur type constitue ce que l’on nomme la marge d’erreur ($ME$) de l’estimation. L’amplitude totale de l’intervalle est donc une fonction directe de la dispersion de la distribution d’échantillonnage. Si le chercheur exige une certitude quasi absolue en élevant le niveau de confiance à 99 % ($\alpha = 0{,}01$), la valeur critique $t$ s’éloignera mécaniquement vers les confins de la distribution, élargissant l’intervalle au détriment de la finesse de l’estimation métrique. À l’inverse, l’adjonction massive de nouveaux participants compresse l’erreur type $s / \sqrt{n}$, resserrant les bornes sans dégrader le niveau de garantie formelle du protocole.
10.3 Intervalles de confiance pour la taille d’effet
Dans le sillage des réformes méthodologiques impulsées par l’American Psychological Association (APA), les chercheurs sont instamment invités à ne plus limiter leur reporting à la seule significativité dichotomique, mais à documenter la magnitude concrète des phénomènes au moyen d’indices standardisés de taille d’effet (à l’image du d de Cohen pour les comparaisons de moyennes ou du $\eta^2$ pour l’analyse de variance), systématiquement assortis de leurs intervalles de confiance respectifs.
Cependant, l’érection d’un intervalle de confiance autour d’une taille d’effet standardisée comme le d de Cohen se heurte à une complexité computationnelle majeure. Contrairement à la moyenne brute $\bar{x}$ dont la distribution d’échantillonnage est parfaitement symétrique et centrée sur $\mu$, la statistique standardisée sous une hypothèse d’effet non nul n’obéit pas à une distribution de Student classique. Sa modélisation mathématique exige le recours aux distributions d’échantillonnage non-centrales, en l’occurrence la distribution $t$ non-centrale, gouvernée par un paramètre de non-centralité noté $\delta$ (delta) :
$$\delta = \frac{\mu_1 – \mu_2}{\sigma} \sqrt{\frac{n_1 n_2}{n_1 + n_2}} = d_{\text{pop}} \sqrt{\frac{n_1 n_2}{n_1 + n_2}}$$
Les distributions non-centrales présentent la particularité géométrique d’être asymétriques. L’asymétrie s’accentue à mesure que le paramètre de non-centralité s’éloigne de zéro. Par conséquent, il est analytiquement impossible de calculer l’intervalle de confiance d’un d de Cohen en appliquant une simple formule d’addition-soustraction symétrique de type $d \pm (1{,}96 \times SE)$. Les limites inférieure et supérieure de l’intervalle doivent impérativement être extraites par des algorithmes numériques d’inversion itérative de la fonction de répartition non-centrale. Cette rupture de symétrie rappelle avec force que chaque statistique d’intérêt génère son propre espace distributionnel, obéissant à des géométries mathématiques singulières que l’expérimentateur ne saurait uniformiser sans péril métrologique.
11. Méthodes modernes et alternatives non-paramétriques : Le rééchantillonnage (Bootstrap)
11.1 Les limites des distributions d’échantillonnage théoriques
L’édifice classique de l’inférence paramétrique présenté jusqu’ici repose sur une élégance mathématique certaine : grâce à des théorèmes asymptotiques rigoureux, la distribution d’échantillonnage d’une statistique peut être dérivée sous une forme close et analytique (gaussienne, Student, Khi-deux, Fisher). Néanmoins, cette puissance d’abstraction se heurte régulièrement aux réalités rugueuses des données de terrain, pour lesquelles les hypothèses mathématiques sous-jacentes s’avèrent insoutenables.
D’une part, les postulats de normalité ou d’homoscédasticité sont fréquemment violés de manière sévère par des distributions empiriques hautement tronquées, polytomiques ou caractérisées par des queues lourdes contaminées par des valeurs extrêmes irréductibles. D’autre part, la statistique dont le chercheur a besoin pour répondre à sa problématique théorique peut s’avérer rétive à tout traitement analytique conventionnel. S’il est aisé d’exprimer par dérivation mathématique l’erreur type théorique d’une moyenne arithmétique ($\sigma / \sqrt{n}$), il est infiniment plus ardu, voire strictement impossible, d’établir la formule analytique fermée de la distribution d’échantillonnage exacte d’une médiane émondée, d’un coefficient d’inégalité de Gini, d’un rapport de cotes ajusté complexe, ou du point d’inflexion d’une courbe de croissance non linéaire sous de petits effectifs.
Face à de telles impasses, le statisticien historique n’avait d’autre choix que de recourir à des tests non paramétriques basés sur les rangs (Wilcoxon, Mann-Whitney, Kruskal-Wallis). Si ces méthodes s’affranchissent effectivement du postulat de normalité, elles altèrent substantiellement la nature de la question de recherche en substituant la comparaison de rangs relatifs à l’estimation métrique des grandeurs réelles, tout en accusant une perte d’efficacité asymptotique regrettable. C’est pour surmonter cette aporie que l’ingénierie statistique contemporaine a forgé des approches computationnelles de rééchantillonnage.
11.2 Le paradigme du Bootstrap non-paramétrique
Introduit en 1979 par le mathématicien Bradley Efron dans un article séminal, le bootstrap constitue une révolution conceptuelle majeure dans la modélisation des distributions d’échantillonnage. Le nom même de la méthode dérive de la légende des aventures du baron de Münchhausen, qui prétendait s’être extrait d’un marécage en tirant sur les lanières de ses propres bottes (bootstraps). Le postulat philosophique de cette méthode s’énonce avec une audace déconcertante : en l’absence de toute information préalable sur la population parente, l’échantillon empirique observé constitue la meilleure et la plus fidèle approximation de cette population théorique.
Le protocole opératoire du bootstrap non paramétrique substitue la puissance algorithmique de l’ordinateur à la résolution des intégrales analytiques. Le mécanisme se déroule de la façon suivante :
- Soit un échantillon empirique original constitué de $n$ observations réelles : $\mathbf{x} = (x_1, x_2, dots, x_n)$.
- L’ordinateur génère un « pseudo-échantillon bootstrap » de taille rigoureusement identique $n$ en procédant par tirage aléatoire avec remise (resampling with replacement) au sein de l’échantillon original. En raison de la remise, certaines observations initiales se trouveront dupliquées plusieurs fois dans ce nouveau jeu de données, tandis que d’autres seront purement et simplement omises.
- La statistique cible (notée $\theta^*$, qu’il s’agisse d’une médiane, d’un écart-type ou d’un rapport non linéaire) est calculée sur ce pseudo-échantillon et consignée dans une base de stockage vectorielle.
- Cette séquence de rééchantillonnage-calcul est itérée de façon massive, typiquement $B = 1,000$, $B = 5,000$ ou $B = 10,000$ fois.
L’agrégation des $B$ estimations obtenues ($\hat{\theta}^*_1, \hat{\theta}^*_2, dots, \hat{\theta}^*_B$) matérialise directement la distribution d’échantillonnage bootstrap empirique de la statistique. L’écart-type de cette série numérique fournit une estimation directe, sans hypothèse de normalité, de l’erreur type réelle de l’estimateur. Pour extraire un intervalle de confiance, la méthode la plus intuitive — la méthode des percentiles — consiste simplement à trier les $B$ valeurs calculées par ordre croissant et à retenir les valeurs séparant les percentiles 2,5 % et 97,5 % pour fixer les bornes d’un intervalle de confiance à 95 %. Des variantes mathématiquement perfectionnées, à l’instar du bootstrap BCa (bias-corrected and accelerated), ajustent ces percentiles pour corriger l’asymétrie latente et le biais distributionnel, offrant une fidélité d’inférence exceptionnelle même sur des échantillons restreints et irréguliers.
11.3 Applications empiriques dans les modèles de médiation et de modération
L’avènement du bootstrap a transformé la modélisation statistique avancée, particulièrement dans l’analyse des médiations en psychologie sociale et cognitive. Dans un modèle de médiation simple, un chercheur postule qu’une variable indépendante $X$ exerce une influence sur une variable dépendante $Y$ non pas directement, mais par l’entremise d’une variable intermédiaire médiatrice $M$. L’ampleur de cet effet indirect est mathématiquement modélisée par le produit de deux coefficients de régression linéaire distincts : le coefficient a (reliant $X$ à $M$) et le coefficient b (reliant $M$ à $Y$ après contrôle de $X$), soit l’indice composite :
$$\text{Effet Indirect} = a \times b$$
Pendant des décennies, la significativité de cet effet indirect a été testée au moyen du fameux test de Sobel. Or, le test de Sobel présuppose que la distribution d’échantillonnage de la statistique $a \times b$ suit une loi normale unitaire $Z$. Cette assomption est mathématiquement erronée : même si les estimateurs individuels a et b sont tous deux rigoureusement distribués selon une loi normale, le produit mathématique de deux variables aléatoires normales n’est en aucun cas une normale. Sa distribution d’échantillonnage véritable se caractérise par une asymétrie aiguë et un kurtosis positif marqué, formant une distribution pointue à queue lourde étirée dans le sens du signe dominant des coefficients.
L’application d’un test basé sur la distribution normale classique conduisait à une perte massive de puissance statistique et à une déformation de l’erreur type, empêchant l’identification de nombreuses médiations psychologiques authentiques. Aujourd’hui, l’implémentation standardisée des algorithmes de bootstrap dans des outils comme la macro PROCESS d’Andrew Hayes a résolu ce problème. En générant la distribution d’échantillonnage empirique directe du produit $a \times b$ sans formuler d’injonction théorique de symétrie, le bootstrap offre une assise méthodologique robuste aux inférences causales indirectes, s’imposant comme la norme incontournable des publications scientifiques modernes.
12. Erreurs courantes, écueils d’interprétation et bonnes pratiques méthodologiques
12.1 Confusions conceptuelles fréquentes chez les chercheurs et praticiens
En dépit de son omniprésence dans les cursus universitaires et les revues scientifiques à comité de lecture, la distribution d’échantillonnage demeure l’un des objets méthodologiques les plus mal compris de la communauté des chercheurs, générant des confusions récurrentes aux conséquences délétères.
La première faille conceptuelle, spectaculairement répandue dans les publications biomédicales et comportementales, réside dans la confusion pernicieuse entre l’écart-type de l’échantillon (SD) et l’erreur type de la moyenne (SEM). Bien qu’ils partagent une dimension métrique similaire, ils répondent à des finalités diamétralement opposées. L’écart-type est un indice de statistique descriptive qui quantifie la dispersion des individus singuliers autour de la moyenne de l’échantillon : il mesure la diversité biologique ou comportementale réelle des sujets. L’erreur type, quant à elle, est un indice de statistique inférentielle qui quantifie la précision théorique avec laquelle la moyenne d’un échantillon estime la moyenne de la population globale : elle mesure notre incertitude méthodologique.
Présenter systématiquement des résultats sous la forme $\bar{x} \pm \text{SEM}$ plutôt que $\bar{x} \pm \text{SD}$ est souvent une manœuvre cosmétique inconsciente ou délibérée visant à donner l’illusion d’une dispersion restreinte, le dénominateur $\sqrt{n}$ comprimant artificiellement l’indice graphique. De surcroît, le statisticien est souvent confronté à la « croyance en la loi des petits nombres », identifiée par Amos Tversky et Daniel Kahneman. Ce biais cognitif conduit les expérimentateurs à présumer qu’un échantillon restreint de dix individus se doit d’être une réplique miniature parfaite de la population parente, projetant à tort la stabilité asymptotique du Théorème Central Limite sur des régimes d’échantillonnage minuscules où l’aléa règne en maître.
Enfin, une dernière dérive réside dans l’omission totale des effets de grappe ou de dépendance des observations. Si les données collectées intègrent une corrélation intra-classe latente — par exemple, des élèves recrutés au sein d’un nombre restreint d’écoles, ou des patients suivis par un même praticien —, le postulat d’indépendance statistique des tirages est rompu. L’erreur type réelle de la distribution d’échantillonnage s’en trouve dramatiquement sous-estimée par les formules classiques, exposant l’expérimentateur à décréter des découvertes statistiquement significatives qui ne sont que le reflet d’une dépendance non modélisée.
12.2 Représentation graphique et communication visuelle des résultats
L’adhésion aux bonnes pratiques de la distribution d’échantillonnage impose une révision profonde des modes de visualisation graphique des données dans la littérature académique. Pendant plusieurs décennies, le paysage des publications a été dominé par les diagrammes en barres simples flanqués d’une barre d’erreur unidirectionnelle, péjorativement désignés dans le vocabulaire méthodologique contemporain sous le terme de dynamite plots.
Ces figures sont coupables d’une triple régression épistémologique :
- Elles masquent totalement la distribution empirique sous-jacente des observations individuelles, dissimulant l’asymétrie éventuelle, la bimodalité ou la présence de points aberrants qui invalideraient le modèle d’échantillonnage théorique.
- Elles entretiennent une ambiguïté coupable quant à la nature exacte de la barre d’erreur représentée (s’agit-il d’un écart-type, d’une erreur type ou d’un intervalle de confiance à 95 % ?), l’omission de cette mention dans la légende de la figure étant fréquente.
- Elles créent une illusion d’ancrage visuel trompeuse en projetant l’attention sur la surface pleine de la colonne plutôt que sur la zone critique où se joue l’incertitude inférentielle.
Pour assainir la communication scientifique, la communauté méthodologique préconise l’abandon systématique des dynamite plots au profit de visualisations composites et enrichies. Les raincloud plots (qui combinent un nuage de points bruts individuels légèrement dispersés par jittering, un diagramme en boîte de Tukey synthétisant les quartiles, et une projection de densité par noyau lissée) constituent l’étalon contemporain de la transparence. Parallèlement, lorsque l’objectif est d’illustrer une inférence statistique sur une moyenne, les représentations graphiques doivent projeter explicitement l’estimation ponctuelle entourée de son intervalle de confiance découpé selon les percentiles exacts de sa distribution d’échantillonnage, garantissant ainsi une distinction visuelle sans faille entre variabilité individuelle empirique et incertitude d’échantillonnage théorique.
12.3 Guide de bonnes pratiques pour la planification et l’analyse
Au terme de cette analyse approfondie, il est possible de synthétiser une charte systématique de bonnes pratiques méthodologiques guidant le chercheur depuis la conception de son étude jusqu’à la publication finale de ses inférences :
1. Conduite impérative d’analyses de puissance statistique a priori : La taille d’échantillon n ne doit jamais être arrêtée de façon opportuniste ou arbitraire. Le chercheur se doit d’utiliser des logiciels dédiés (tels que G*Power) ou des simulations de Monte Carlo pour dimensionner son échantillon de manière à restreindre la variance de sa distribution d’échantillonnage au niveau exact requis pour isoler la taille d’effet minimale théoriquement pertinente.
2. Vérification rigoureuse des conditions de dérivation analytique : Avant de mobiliser des distributions d’échantillonnage théoriques conventionnelles (loi de Gauss, Student t, Fisher F), il convient d’attester empiriquement du respect de leurs conditions de validité formelle (indépendance des erreurs, diagnostic de l’asymétrie parente face à l’effectif n disponible, homoscédasticité).
3. Basculement stratégique vers le rééchantillonnage dès l’apparition d’un doute morphologique : Dès lors que les données brutes exhibent des distorsions sévères non résolubles par transformation mathématique, ou lorsque la statistique testée s’avère non linéaire ou complexe, le recours systématique au bootstrap non paramétrique (avec corrections de type BCa) doit être privilégié pour construire la distribution d’échantillonnage empirique directe.
4. Transparence absolue dans la documentation du recueil : Toute inférence scientifique reposant sur la représentativité du mécanisme générateur, les manuscrits de recherche doivent documenter scrupuleusement la stratégie de tirage mise en œuvre, la définition de la population cible, le taux d’attrition, la règle d’arrêt de l’échantillonnage (qui doit être figée avant le début du recueil) et la justification exhaustive des exclusions d’observations.
En respectant scrupuleusement ces impératifs, la démarche scientifique s’ancre dans la pleine maîtrise de son outillage statistique. La distribution d’échantillonnage cesse d’être une formule abstraite subie par l’expérimentateur pour redevenir ce qu’elle n’a jamais cessé d’être : la boussole mathématique universelle permettant à la science expérimentale de naviguer avec rigueur et humilité dans l’océan de l’incertain.
Références
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Cumming, G. (2012). Understanding the new statistics: Effect sizes, confidence intervals, and meta-analysis. Routledge. https://doi.org/10.4324/9780203807002
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Hayes, A. F. (2022). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.). The Guilford Press.
- Neyman, J., & Pearson, E. S. (1933). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 231(694-706), 289–337. https://doi.org/10.1098/rsta.1933.0009
- Student [Gosset, W. S.]. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.2307/2331554
- Tversky, A., & Kahneman, D. (1971). Belief in the law of small numbers. Psychological Bulletin, 76(2), 105–110. https://doi.org/10.1037/h0031322
- Wilcox, R. R. (2022). Introduction to robust estimation and hypothesis testing (5th ed.). Academic Press. https://doi.org/10.1016/C2019-0-03823-3