
Dans le paysage contemporain de la recherche quantitative, la modélisation statistique ne se résume plus à l’examen isolé de relations bivariées simplistes. Face à la complexité intrinsèque des phénomènes naturels, sociaux et comportementaux, les chercheurs sont confrontés à une multitude de facteurs fluctuants susceptibles d’obscurcir, d’amplifier ou de distordre les liens de causalité présumés entre une intervention et une mesure d’intérêt. C’est précisément au cœur de cette dynamique d’ajustement et de contrôle méthodologique qu’intervient la notion fondamentale de covariable.
Une covariable représente, dans son acception la plus pure au sein du modèle linéaire général, une variable auxiliaire continue ou catégorielle introduite dans un dispositif analytique pour rendre compte de la variance concomitante de la variable dépendante. Loin de constituer un simple artifice calculatoire, la prise en compte rigoureuse des covariables permet d’accroître substantiellement la puissance statistique des tests d’hypothèse, de réduire l’erreur résiduelle non expliquée et de corriger les déséquilibres inhérents aux protocoles non parfaitement randomisés. Qu’elle soit mobilisée au sein d’une analyse de covariance, intégrée dans une régression logistique ou articulée dans un modèle d’équations structurelles, la covariable se situe au carrefour de la validité interne et de la précision inférentielle.
Pourtant, malgré son omniprésence dans la littérature empirique, l’usage des covariables demeure semé d’embûches conceptuelles et de dérives méthodologiques. La confusion récurrente entre covariable, variable confondante, médiateur et modérateur, couplée aux pratiques délétères de sélection après coup des variables, expose la recherche scientifique à des risques sévères de biais de confirmation et d’erreurs inférentielles majeures. Le présent traité se propose d’explorer de manière exhaustive l’architecture théorique, mathématique et pratique de la covariable en statistique, offrant aux chercheurs et analystes un cadre rigoureux pour optimiser leurs protocoles et garantir l’intégrité de leurs conclusions scientifiques.
1. Introduction et définition fondamentale d’une covariable
1.1 Définition conceptuelle et étymologie
D’un point de vue étymologique, le terme « covariable » trouve sa genèse dans le préfixe latin cum (« avec ») et le verbe variare (« changer, diverger »), traduisant littéralement une grandeur dont les fluctuations s’opèrent de concert avec celles d’autres entités au sein d’un même système empirique. En inférence statistique, le concept tire ses origines historiques des travaux fondateurs de Ronald Aylmer Fisher sur le partitionnement de la variance dans les années 1930. Fisher cherchait alors à épurer l’effet des traitements agricoles des variations pédologiques non maîtrisées au sein des parcelles expérimentales de Rothamsted. La covariable émerge ainsi initialement comme une variable métrique concomitante, mesurée simultanément ou préalablement à l’expérience, dont l’influence parasite doit être neutralisée afin d’isoler la variance véritablement imputable au facteur sous investigation.
La distinction épistémologique entre la variable d’intérêt primaire et la variable auxiliaire constitue la pierre angulaire de cette démarche. Alors que la variable indépendante principale incarne l’objet théorique central manipulé par l’expérimentateur ou observé dans le cadre d’une hypothèse substantive, la covariable occupe un statut purement instrumental. Elle n’est pas étudiée pour elle-même, mais pour sa capacité avérée à expliquer une portion substantielle de la variabilité observée sur la variable critère. Dans les protocoles expérimentaux randomisés de type essai contrôlé, son intégration permet de soustraire du bruit statistique, tandis que dans les dispositifs quasi-expérimentaux ou observationnels, elle sert de vecteur d’ajustement pour pallier l’absence d’assignation aléatoire des participants.
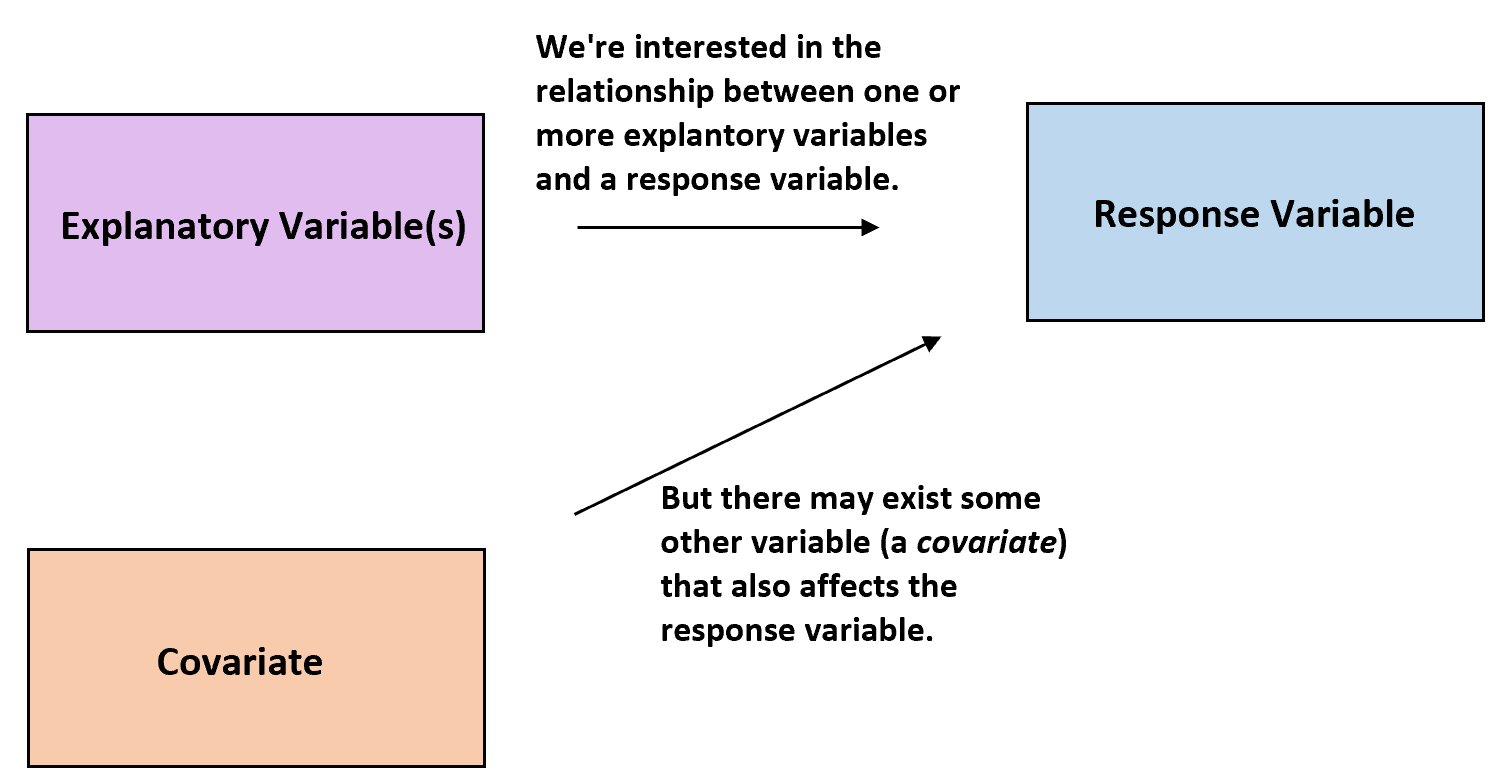
Ainsi, la covariable opère comme une source de variation concomitante que le modélisateur cherche délibérément à isoler. En quantifiant mathématiquement la part d’hétérogénéité du système attribuable à cette variable auxiliaire, l’analyste affine la lentille par laquelle l’effet du traitement est scruté, empêchant que des disparités préexistantes ne viennent masquer une causalité sous-jacente ou, à l’inverse, générer des associations totalement fallacieuses.
1.2 Objectifs scientifiques de l’inclusion d’une covariable
L’introduction méthodique d’une covariable dans un modèle d’inférence répond à des impératifs scientifiques hautement précis, au premier rang desquels figure la réduction systématique de la variance résiduelle non expliquée. Dans tout modèle linéaire, la variabilité totale de la variable dépendante est segmentée entre la variance expliquée par les facteurs d’intérêt et une somme des carrés résiduelle reflétant l’ignorance du chercheur ou les fluctuations aléatoires d’échantillonnage. En capturant une fraction déterminée de cette variance résiduelle, la covariable diminue directement le terme d’erreur quadratique moyenne, ce qui a pour conséquence immédiate d’accroître la précision des estimateurs et de rétrécir leurs intervalles de confiance.
Cette mécanique de réduction de l’erreur résiduelle induit un bénéfice direct : l’augmentation sensible de la puissance statistique des tests d’hypothèse. Pour une taille d’échantillon donnée et une amplitude d’effet constante, la capacité d’un test paramétrique tel que le test F de Fisher ou le test t de Student à rejeter l’hypothèse nulle lorsque celle-ci est fausse se trouve démultipliée. L’inclusion judicieuse d’une covariable fortement corrélée à la variable dépendante confère ainsi à l’étude un gain d’efficacité équivalant souvent à une augmentation substantielle du nombre de sujets recrutés, sans les coûts logistiques et financiers afférents.
Dans les contextes quasi-expérimentaux où l’assignation aléatoire s’avère éthiquement ou matériellement irréalisable, la covariable poursuit un objectif de correction des biais de sélection initiale. Lorsque les groupes de comparaison présentent des asymétries systématiques avant l’exposition à la variable indépendante, l’ajustement linéaire sur les covariables pertinentes réaligne artificiellement les unités statistiques sur une ligne de base commune. Enfin, cette procédure participe à la clarification mathématique de la relation causale présumée, en garantissant que l’association observée résiste au contrôle rigoureux des facteurs de confusion majeurs identifiés par la théorie scientifique.
1.3 Illustration empirique dans les sciences du comportement
Pour matérialiser ces concepts théoriques, considérons une illustration classique issue des sciences de l’éducation et de la psychologie cognitive : l’évaluation de l’efficacité d’un nouveau protocole d’entraînement de la mémoire de travail sur les performances en raisonnement fluide auprès d’élèves du cycle secondaire. Dans un tel protocole, un groupe d’élèves suit le programme expérimental informatisé tandis qu’un groupe contrôle bénéficie d’activités pédagogiques standards. La variable dépendante réside dans le score obtenu à une épreuve standardisée de matrices progressives administrée à l’issue de huit semaines d’intervention.
Si l’analyste se contente d’une simple comparaison bivariée des moyennes post-intervention, les résultats risquent d’être profondément pollués par les aptitudes cognitives préexistantes des apprenants. En mesurant le niveau de raisonnement fluide initial de chaque élève préalablement au démarrage de l’entraînement (mesure pré-test) et en intégrant cette mesure continue comme covariable dans le modèle, le statisticien réalise une double opération. D’une part, il élimine de la variance d’erreur l’hétérogénéité massive liée aux compétences intrinsèques et à l’historique intellectuel des participants. D’autre part, il neutralise d’éventuels déséquilibres fortuits survenus lors de la constitution des classes expérimentales.
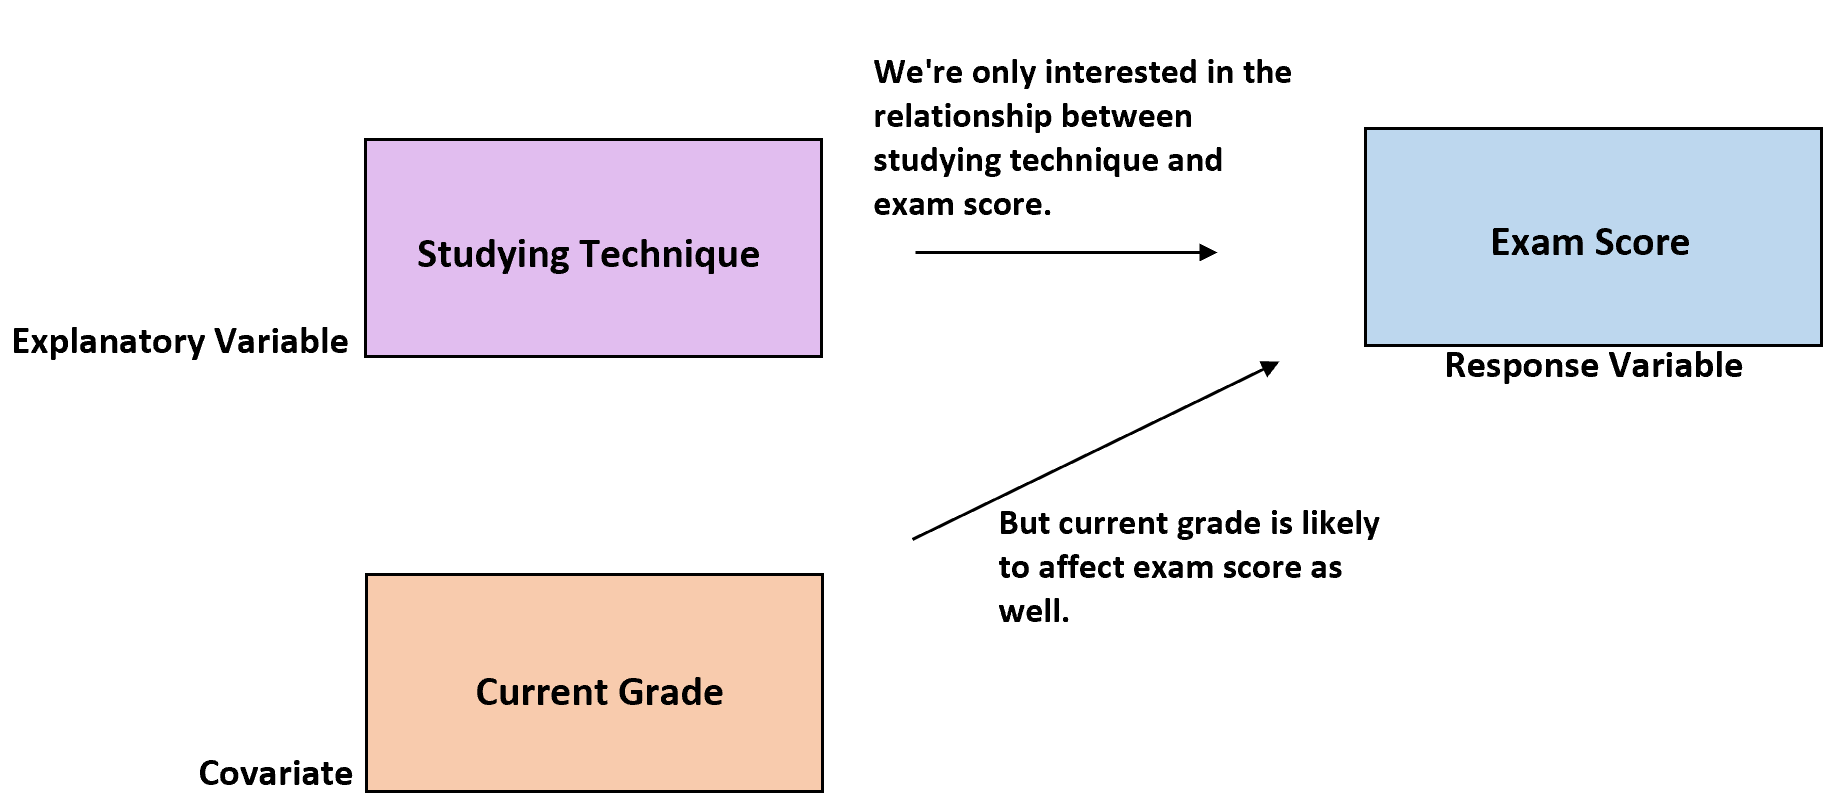
Grâce à cet ajustement, l’effet spécifique du traitement expérimental se trouve isolé avec une acuité accrue. La comparaison ne porte plus sur les scores bruts post-intervention, mais sur des scores résiduels ou des moyennes marginales estimées, conditionnées à un niveau de compétence initial équivalent. Les gains attribuables spécifiquement à la méthode pédagogique émergent alors avec clarté, immunisés contre les biais d’aptitude initiale qui auraient pu gonfler ou oblitérer l’impact effectif du dispositif d’apprentissage.
2. Distinction conceptuelle entre covariable, prédicteur et variable confondante
2.1 Covariable versus variable indépendante principale
La distinction entre une covariable et une variable indépendante principale ne repose pas sur une quelconque divergence de nature mathématique, puisque le modèle linéaire les traite toutes deux comme des régresseurs au sein d’une matrice de conception. Elle réside intégralement dans le statut théorique conféré à la variable et dans l’architecture de la question de recherche fondamentale formulée par l’investigateur. La variable indépendante principale incarne le facteur central dont on cherche à tester l’impact causal ou l’association prédictive primaire, guidée par une hypothèse substantive formalisée a priori.
À l’inverse, la covariable se voit attribuer un rôle subordonné de variable de contrôle ou de facteur de nuisance dont l’influence doit être statistique neutralisée pour observer sans distorsion l’effet de la variable indépendante focale. Dans l’interprétation des sorties de modélisation, cette hiérarchie se manifeste par une asymétrie délibérée : le chercheur concentre son attention théorique sur le coefficient de régression ou le test de significativité de la variable d’intérêt, tandis que le coefficient associé à la covariable n’est généralement interprété que pour vérifier l’efficacité de l’ajustement et s’assurer de sa cohérence avec la littérature préexistante.
De surcroît, le statut de ces entités est fluide et éminemment contextuel : une variable qui sert de covariable dans une étude donnée (par exemple, le statut socio-économique dans une étude sur les styles parentaux) peut parfaitement devenir la variable indépendante principale dans un autre protocole ciblant spécifiquement les inégalités structurelles de santé mentale. C’est l’ancrage paradigmatique du chercheur qui délimite la frontière entre le signal étudié et le bruit de fond à contrôler.
2.2 Covariable versus variable confondante (confounder)
Dans la taxonomie épidémiologique et l’analyse causale moderne développée par des statisticiens comme Judea Pearl, une variable confondante obéit à une définition structurelle extrêmement stricte. Pour qu’une variable auxiliaire soit formellement qualifiée de facteur de confusion, elle doit satisfaire simultanément à trois conditions causales impératives : elle doit être une cause directe ou indirecte de la variable dépendante, elle doit être statistiquement associée à l’exposition ou variable indépendante principale, et elle ne doit pas se situer sur le chemin causal reliant le traitement à la réponse (elle ne doit pas être un médiateur intermédiaire).
Toute variable confondante identifiée constitue une covariable candidate indispensable qu’il convient absolument d’inclure dans l’analyse pour éliminer le biais de confusion. Néanmoins, la réciproque est formellement inexacte : toute covariable n’est pas nécessairement une variable confondante. Dans le cadre d’un essai randomisé contrôlé parfait, où l’assignation au traitement est totalement orthogonale aux caractéristiques des participants par la vertu de la randomisation, aucune variable de base n’est corrélée au traitement. Par conséquent, aucune variable pré-interventionnelle ne constitue un facteur de confusion au sens épidémiologique.
Pourtant, intégrer une covariable de base fortement prédictive du résultat dans cet essai randomisé demeure une pratique méthodologique optimale. Bien qu’elle ne serve pas à corriger un biais de confusion inexistant grâce au tirage au sort, elle opère une réduction drastique de la variance résiduelle et accroît la puissance du test. Ainsi, le concept de covariable englobe un spectre fonctionnel plus vaste que celui de variable confondante, incluant tant les régulateurs de biais causaux que les optimiseurs de précision pure.
2.3 Différenciation avec les variables médiatrices et modératrices
L’une des fautes méthodologiques les plus destructrices en modélisation statistique consiste à confondre une covariable avec un médiateur ou un modérateur, erreurs conceptuelles qui altèrent irrémédiablement la validité des conclusions. Selon le cadre conceptuel classique formalisé par Baron et Kenny, une variable médiatrice représente le mécanisme ou le vecteur intermédiaire par lequel la variable indépendante transmet son influence sur la variable dépendante. Le médiateur se situe en aval causal du traitement : la variable indépendante altère le médiateur, qui à son tour engendre une variation sur la variable dépendante.
Si un analyste traite par mégarde un médiateur avéré comme une simple covariable et l’insère à ce titre dans un modèle d’ajustement conventionnel, il opère ce que la littérature causale nomme un phénomène de sur-contrôle (overcontrolling). Cette opération a pour effet mathématique d’annihiler précisément la fraction de l’effet causal que l’on cherchait à documenter, conduisant à sous-estimer drastiquement, voire à effacer complètement l’effet total du traitement sous analyse.
La variable modératrice, quant à elle, spécifie les conditions d’apparition, d’intensité ou de direction de l’effet : elle interagit multiplicativement avec la variable indépendante, signifiant que la relation entre X et Y change d’amplitude selon le niveau de la variable modératrice Z. Alors qu’une covariable standard est supposée opérer de façon additive et parallèle (sans interaction avec le traitement), le modérateur réclame explicitement l’estimation d’un terme d’interaction dans le modèle. Traiter un modérateur comme une simple covariable additive masque l’hétérogénéité cruciale de l’effet du traitement et conduit à une interprétation moyenne trompeuse pour les sous-populations d’intérêt.
3. Le mécanisme mathématique et statistique des covariables
3.1 Décomposition de la somme des carrés
Pour appréhender la mécanique intime par laquelle opère une covariable, il est indispensable de disséquer le partitionnement classique de la variabilité au sein du modèle linéaire général. Dans une analyse de variance univariée standard comparant plusieurs groupes, la somme des carrés totale (notée $SS_{totale}$) est décomposée de manière additive et exclusive en deux entités disjointes : la somme des carrés inter-groupes ($SS_{traitement}$), reflétant l’influence de la variable catégorielle indépendante, et la somme des carrés intra-groupes ou résiduelle ($SS_{erreur}$), encapsulant l’hétérogénéité non maîtrisée entre les sujets au sein d’un même groupe :
$$SS_{totale} = SS_{traitement} + SS_{erreur}$$
Lorsqu’une covariable métrique continue $X$, corrélée linéairement à la variable dépendante $Y$, est adjointe au modèle statistique, la structure même de cette décomposition se trouve profondément reconfigurée. La somme des carrés de l’erreur initiale est désormais elle-même fractionnée en deux sous-composantes : une portion prédictible attribuable directement à la régression linéaire de $Y$ sur $X$ (notée $SS_{covariable}$), et une nouvelle somme des carrés résiduelle ajustée ($SS^*_{erreur}$) substantiellement amenuisée :
$$SS^*_{erreur} = SS_{erreur} – SS_{covariable}$$
Cette extraction ciblée de la variance expliquée par la covariable hors du réservoir d’erreur se répercute de façon critique sur le calcul de la statistique de test. Dans le cadre du test $F$ de Fisher, le numérateur évalue le carré moyen du traitement ($MS_{traitement}$), tandis que le dénominateur est constitué par le carré moyen de l’erreur ($MS^*_{erreur} = SS^*_{erreur} / df^*$). En dépit du fait que l’introduction de la covariable consomme exactement un degré de liberté au dénominateur ($df^* = df – 1$), la réduction quadratique opérée sur $SS^*_{erreur}$ compense très largement cette perte lorsque la corrélation entre la covariable et la variable dépendante est modérée à forte. Il en résulte un dénominateur plus faible, propulsant mécaniquement la valeur du ratio $F$ vers des amplitudes plus élevées et abaissant corrélativement la $p$-valeur associée.
3.2 Ajustement mathématique des moyennes de groupes
Au-delà de la compression de l’erreur résiduelle, l’inclusion d’une covariable engendre une translation mathématique des centres de gravité empiriques observés : il s’agit du calcul des moyennes marginales estimées, historiquement désignées sous le vocable de moyennes ajustées. Dans toute situation expérimentale où les moyennes de la covariable diffèrent ne serait-ce que marginalement d’un groupe à l’autre (qu’il s’agisse d’un déséquilibre fortuit issu d’une randomisation imparfaite ou d’un biais d’assignation structurel en quasi-expérimentation), la comparaison brute des moyennes de $Y$ s’avère fondamentalement biaisée.
L’algorithme d’ajustement géométrique repose sur l’estimation d’une pente de régression commune, notée $B$, modélisant la relation linéaire moyenne existant entre la covariable $X$ et la variable dépendante $Y$ à travers l’ensemble des conditions expérimentales. La moyenne ajustée du groupe $j$, notée $\bar{Y}_{j(adj)}$, est alors formellement obtenue en projetant la moyenne observée $\bar{Y}_j$ le long de cette droite de régression jusqu’au point où la covariable atteint sa moyenne générale pan-échantillale $\bar{X}_{bulletbullet}$ :
$$\bar{Y}_{j(adj)} = \bar{Y}_j – B (\bar{X}_j – \bar{X}_{bulletbullet})$$
Cette formulation élégante met en lumière la nature correctrice de l’opération : si un groupe expérimental présentait un avantage initial sur la covariable ($\bar{X}_j > \bar{X}_{bulletbullet}$), sa moyenne post-test observée se voit amputée d’un montant proportionnel à cet avantage immérité ($B(\bar{X}_j – \bar{X}_{bulletbullet})$). Inversement, un groupe pénalisé par des scores de base défavorables voit sa moyenne dépendante réhaussée de manière équitable. Les comparaisons subséquentes ne comparent plus des entités hétérogènes, mais évaluent les performances théoriques qui auraient été observées si tous les groupes avaient partagé exactement le même niveau moyen sur la covariable.
3.3 Impact direct sur la taille d’effet et la précision
L’assainissement de l’erreur résiduelle et l’ajustement vectoriel des moyennes ont des répercussions directes sur l’estimation de la magnitude des effets observés. Dans le cadre de l’analyse de variance, la taille d’effet est couramment quantifiée par le coefficient êta-carré partiel ($\eta^2_p$), dont l’expression formelle s’écrit :
$$\eta^2_p = \frac{SS_{traitement}}{SS_{traitement} + SS_{erreur}}$$
Dès lors que la somme des carrés de l’erreur brute est remplacée par la somme des carrés résiduelle ajustée $SS^*_{erreur}$, le dénominateur de cette fraction se trouve contracté, ce qui induit mécaniquement une élévation de l’êta-carré partiel associé au facteur étudié. L’effet du traitement apparaît ainsi sous un jour plus net, débarrassé de la poussière statistique générée par les variations individuelles exogènes.
Concomitamment, la précision métrologique des contrastes s’en trouve décuplée. L’erreur standard des différences de moyennes ajustées est directement indexée sur la racine carrée du carré moyen de l’erreur résiduelle ajustée. Par conséquent, les intervalles de confiance encadrant les différences inter-groupes subissent un rétrécissement substantiel. Cette acuité accrue confère au dispositif expérimental une sensibilité statistique décuplée, offrant aux chercheurs la capacité de détecter des signaux de faible magnitude sans devoir recourir à des cohortes démesurées.
4. L’analyse de covariance (ANCOVA) : fondements et postulats
4.1 Principes directeurs de l’ANCOVA
L’analyse de covariance (ANCOVA) représente l’archétype méthodologique de l’intégration des covariables au sein du modèle linéaire général. Elle réalise une synthèse mathématique formelle entre l’analyse de variance factorielle, qui décompose la variance selon des facteurs catégoriels discrets, et la régression linéaire multiple, qui modélise des relations fonctionnelles continues. Dans son architecture univariée la plus élémentaire impliquant un facteur de traitement à $k$ modalités et une covariable continue unique, l’équation fondamentale du modèle pour le $i$-ème individu au sein du $j$-ème groupe s’énonce comme suit :
$$Y_{ij} = \mu + \alpha_j + \beta (X_{ij} – \bar{X}_{bulletbullet}) + \varepsilon_{ij}$$
Dans ce formalisme rigoureux, $\mu$ représente la grande moyenne ajustée de la population, $\alpha_j$ symbolise l’effet différentiel fixe associé à l’appartenance au groupe $j$ (sous la contrainte classique d’identifiabilité $\sum \alpha_j = 0$), $\beta$ désigne le coefficient de régression linéaire unifié (la pente commune) reliant la covariable $X$ à la variable dépendante $Y$, et $\varepsilon_{ij}$ capture l’erreur résiduelle aléatoire propre à chaque observation, postulée distribuée de manière indépendante et identique selon une loi normale $\mathcal{N}(0, \sigma^2)$.
L’ANCOVA ne se limite donc pas à juxtaposer une régression et une ANOVA : elle réalise une modélisation conjointe et simultanée où l’estimation des paramètres de groupe ($\alpha_j$) s’effectue conditionnellement à l’estimation de la pente de la covariable ($\beta$). Ce modèle permet d’interroger formellement la significativité du traitement expérimental une fois que la dépendance linéaire vis-à-vis de $X$ a été totalement purgée.
4.2 Le postulat critique d’homogénéité des pentes de régression
Parmi les conditions de validité requises pour déployer licitement une ANCOVA, le postulat d’homogénéité des pentes de régression figure au sommet des priorités méthodologiques. Cette exigence mathématique stipule que la relation fonctionnelle unissant la covariable à la variable dépendante doit demeurer invariante à travers tous les niveaux du facteur catégoriel. En termes algébriques, cela impose que la pente de régression $\beta_j$ calculée isolément au sein de chaque groupe expérimental $j$ ne dévie pas de la pente moyenne commune $\beta$ au-delà de ce que les fluctuations d’échantillonnage permettent de tolérer :
$$\beta_1 = \beta_2 = dots = \beta_k = \beta$$
D’un point de vue conceptuel, violer ce postulat revient à admettre qu’il existe une interaction statistique significative entre la covariable continue et la variable indépendante catégorielle (modèle avec terme $X \times \text{Traitement}$). Si une telle interaction se manifeste empiriquement, l’hypothèse d’un ajustement vectoriel uniforme devient mathématiquement caduque : l’effet du traitement n’est plus constant le long de l’axe de la covariable, mais varie en magnitude, voire inverse son signe selon la valeur prise par $X$. Ajuster sur une pente commune moyenne masquerait cette dynamique hétérogène et induirait des inférences erronées.
Lorsque le test préliminaire d’interaction révèle une hétérogénéité avérée des pentes, le recours à l’ANCOVA conventionnelle doit être impérativement abandonné au profit d’approches de modélisation plus flexibles. La procédure de Johnson-Neyman s’impose alors comme la solution méthodologique d’excellence : elle ne cherche pas à forcer un parallélisme artificiel, mais cartographie de manière continue les régions exactes de la covariable où la différence entre les groupes expérimentaux s’avère statistiquement significative, transformant une entrave technique en une découverte théorique majeure sur la modération de l’effet.
4.3 Autres postulats indispensables pour l’ANCOVA
L’édifice inférentiel de l’ANCOVA repose en outre sur une série de postulats additionnels tout aussi contraignants, dont la méconnaissance compromet l’exactitude des probabilités critiques calculées. En premier lieu, la relation unissant la covariable à la variable dépendante doit impérativement respecter une stricte linéarité. Si le pattern de liaison empirique adopte une cinétique quadratique, exponentielle ou logarithmique, un ajustement linéaire classique échouera à purger la totalité de la variance systématique, laissant subsister une fraction de résidus corrélés qui biaiseront les estimateurs.
En second lieu, les résidus conditionnels du modèle $\varepsilon_{ij}$ doivent satisfaire aux exigences standards de normalité et d’homoscédasticité (homogénéité des variances résiduelles entre les différents groupes expérimentaux). Les tests d’adéquation tels que le test de Shapiro-Wilk et le test de Levene constituent des préalables diagnostiques indispensables pour attester de la robustesse des données face aux exigences du modèle linéaire.
Enfin, deux postulats méthodologiques de portée supérieure méritent une attention sans faille :
l’absence totale d’erreur de mesure sur la covariable et son indépendance stricte vis-à-vis du traitement administré.
- Fiabilité psychométrique de la covariable : Le modèle théorique de l’ANCOVA postule que $X$ est une variable fixée et mesurée sans imprécision. Si l’instrument psychométrique présente une fidélité médiocre, l’erreur de mesure induit un phénomène pernicieux d’atténuation de la pente de régression ($B$), conduisant à un sous-ajustement systématique des moyennes et à une réintroduction occulte de variance d’erreur résiduelle.
- Indépendance de la covariable par rapport au traitement : La covariable doit être mesurée impérativement en amont de l’exposition au traitement ou être totalement réfractaire à son influence (comme l’âge ou le sexe biologique). Si le traitement altère la valeur de la covariable, l’ajustement statistique revient à neutraliser une portion de l’effet du traitement lui-même, plongeant l’analyse dans le sophisme du sur-contrôle causal.
5. Covariables dans la recherche en psychologie et sciences comportementales
5.1 Les scores de base et mesures pré-intervention
Dans l’écosystème de la recherche en psychologie clinique, en neuropsychologie et en sciences comportementales, l’utilisation des scores de base (baseline measures) ou évaluations pré-interventionnelles représente incontestablement l’application la plus rigoureuse et la plus féconde des covariables. Qu’il s’agisse d’évaluer la réduction de la symptomatologie dépressive via l’Inventaire de Dépression de Beck (BDI-II) à la suite d’une thérapie cognitivo-comportementale ou d’analyser la diminution de l’anxiété sociale consécutive à un protocole d’exposition en réalité virtuelle, le score initial mesuré avant toute administration thérapeutique constitue le meilleur prédicteur empirique du score terminal.
L’intégration formelle du score pré-test à titre de covariable permet d’éradiquer l’un des artefacts méthodologiques les plus universels et trompeurs de la recherche longitudinale : le phénomène de régression vers la moyenne, initialement formalisé par Sir Francis Galton. En vertu de ce principe statistique fondamental, les individus présentant des scores initiaux extrêmement déviants (par exemple, des scores d’anxiété exceptionnellement élevés à l’inclusion) afficheront quasi systématiquement des scores plus modérés lors de la seconde passation, par la simple dissipation de la composante aléatoire de l’erreur de mesure, indépendamment de toute efficacité clinique réelle de l’intervention.
En recourant à un modèle d’ANCOVA intégrant le score de base en covariable plutôt qu’en procédant à une analyse naïve des scores de différence bruts (post-test moins pré-test), le chercheur neutralise mathématiquement cet effet régressif. De surcroît, cette approche permet de juguler l’hétérogénéité clinique initiale intrinsèque aux cohortes de patients, garantissant que les différences résiduelles observées entre le groupe recevant la thérapie et le groupe sous condition contrôle reflètent des modifications psychologiques authentiques et non des disparités de trajectoires d’admission.
5.2 Variables socio-démographiques et traits individuels stables
Les investigations psychologiques se déploient au sein d’échantillons humains caractérisés par une vaste palette de traits différentiels stables, susceptibles de moduler intensément la réactivité aux stimuli expérimentaux. L’âge chronologique et le quotient intellectuel (évalué via les échelles de Wechsler ou des épreuves factorielles comme les matrices de Raven) figurent parmi les covariables démographiques et psychométriques les plus indispensables. Dans les recherches explorant le déclin cognitif ou l’apprentissage tout au long de la vie, omettre de contrôler l’âge reviendrait à introduire un facteur de confusion d’une magnitude telle qu’il écraserait les nuances fines des manipulations expérimentales.
De même, le statut socio-économique (incluant le revenu du ménage et le niveau d’éducation formelle des parents) et le nombre total d’années de scolarisation constituent des covariables régulatrices incontournables dans les travaux portant sur le développement du langage, les fonctions exécutives ou la réussite académique chez l’enfant. Ces variables macro-structurelles capturent des disparités profondes d’enrichissement environnemental et de stimulation cognitive précoce qu’il est méthodologiquement impératif de neutraliser pour évaluer objectivement l’efficacité d’un protocole éducatif spécifique.
Enfin, la prise en compte des traits de personnalité fondamentaux, singulièrement au travers de l’architecture en cinq facteurs du modèle du Big Five (Ouverture, Conscienciosité, Extraversion, Agréabilité, Névrosisme), enrichit considérablement la modélisation statistique en sciences sociales. Par exemple, contrôler le niveau initial de Conscienciosité dans une étude mesurant l’adhésion thérapeutique à une application mobile de santé permet d’isoler l’ergonomie intrinsèque du dispositif technologique des dispositions comportementales générales à l’autodiscipline et à la rigueur d’exécution des participants.
5.3 Variables situationnelles et environnementales
À côté des caractéristiques intrapersonnelles durables, l’acte de recueil de données en laboratoire psychologique ou en conditions écologiques est tributaire d’une multitude de perturbations situationnelles et contextuelles labiles. L’heure précise de passation de l’expérience constitue une covariable temporelle de premier plan : les variations circadiennes régissant les niveaux d’éveil physiologique, la concentration et la disponibilité des ressources attentionnelles sont susceptibles d’introduire une dérive systématique des scores, en particulier lors d’épreuves mesurant la vigilance soutenue ou le contrôle inhibiteur.
De manière analogue, l’effet d’expérimentateur représente une source de variabilité parasitaire notoire. Même en présence de protocoles strictement standardisés, le sexe, l’attitude non verbale, l’intonation vocale ou le niveau d’expérience de l’examinateur qui conduit la session expérimentale induisent des fluctuations mesurables dans les temps de réaction ou les réponses psychophysiologiques des sujets. Coder l’identité de l’expérimentateur ou le laboratoire d’acquisition sous forme de covariable catégorielle (ou l’intégrer comme effet aléatoire) permet d’épurer l’effet principal des distorsions relationnelles d’administration.
Enfin, la durée de latence temporelle exacte séparant différentes sessions d’évaluation psychologique longitudinales doit fréquemment faire l’objet d’un ajustement quantitatif. Dans les protocoles prévoyant un suivi à trois ou six mois, il est fréquent que les contraintes d’agenda des participants introduisent une variance non négligeable dans les délais effectifs de réévaluation (certains sujets revenant après 75 jours, d’autres après 110 jours). Modéliser cet intervalle chronologique réel en tant que covariable dynamique prévient les distorsions attribuables au temps objectif écoulé plutôt qu’au traitement analysé.
6. Méthodes de sélection et d’identification des covariables pertinentes
6.1 Sélection guidée par la théorie versus sélection automatisée
L’identification des covariables à inclure dans un protocole d’analyse constitue un arbitrage épistémologique crucial. Deux paradigmes diamétralement opposés s’affrontent traditionnellement : l’approche guidée par l’expertise théorique et les processus algorithmiques de sélection automatisée de variables. Les algorithmes automatisés pas à pas (sélection ascendante dite forward, sélection descendante dite backward, ou régression pas à pas stepwise) ont longtemps joui d’une grande popularité en raison de leur facilité mécanique apparente.
Toutefois, la communauté statistique contemporaine condamne unanimement le recours à la sélection automatisée pour l’identification des covariables dans une démarche inférentielle ou causale. Ces procédures purement inductives reposent sur des critères d’optimisation mathématique opportunistes (maximisation du $R^2$ ou minimisation mécanique des $p$-valeurs d’échantillon). Elles souffrent d’une instabilité chronique : une modification marginale de l’échantillon bouleverse radicalement la liste des covariables conservées. De surcroît, ces méthodes génèrent une inflation colossale du risque d’erreur de type I par dragage de données (data-dredging), biaisent sévèrement les coefficients de régression vers le haut et conduisent à des intervalles de confiance artificiellement étroits en ignorant l’incertitude liée à l’étape même de sélection.
La primauté absolue doit donc être accordée à la sélection fondée sur la théorie substantielle et la littérature empirique cumulative. Une covariable ne doit jamais être intégrée au motif fortuit qu’elle présente un seuil de significativité arbitraire ($p < 0,05$) dans une matrice de corrélation bivariée, mais parce que des fondements mécanistiques éprouvés désignent cette variable comme une source plausible de variation concomitante ou un facteur de confusion avéré dans la genèse du phénomène étudié.
6.2 Modélisation causale et graphes acycliques dirigés (DAGs)
Pour dépasser l’empirisme aveugle et formaliser rigoureusement le choix des covariables, l’épidémiologie moderne et la statistique computationnelle s’appuient désormais sur la méthodologie des graphes acycliques dirigés (DAGs), formalisée par Judea Pearl. Un DAG est une représentation graphique qualitative dans laquelle les nœuds matérialisent les variables (observées ou latentes) et les flèches unidirectionnelles encodent les relations de causalité directe postulées par l’état des connaissances scientifiques.
L’utilisation formelle des DAGs permet d’appliquer le critère mathématique de la porte dérobée (backdoor criterion). Ce critère spécifie de manière univoque l’ensemble suffisant et minimal de covariables qu’il est impératif de contrôler statistiquement pour bloquer tous les chemins non causaux (dits chemins de porte dérobée) reliant l’exposition $X$ à la réponse $Y$, isolant ainsi l’effet causal authentique sans introduire de distorsion.
Plus fondamentalement encore, l’analyse par DAG prémunit l’analyste contre le péril mortel de l’ajustement sur une variable collisionneur (collider). Un collisionneur est une variable $C$ qui reçoit l’influence causale directe de deux autres variables distinctes (structure $A \rightarrow C \leftarrow B$). Si un statisticien commet l’erreur d’inclure ce collisionneur $C$ comme covariable dans son modèle, cette opération mathématique déconditionne le chemin et crée de toutes pièces une corrélation fallacieuse artificielle entre $A$ et $B$. Ce phénomène, connu sous le nom de biais de Berkson ou paradoxe du conditionnement sur un collisionneur, démontre avec force que « contrôler pour le plus de variables possible » n’est pas une garantie de rigueur, mais une source potentielle de biais épistémologiques majeurs.
6.3 Évaluation quantitative des corrélations préalables
Bien que la sélection conceptuelle prime, l’évaluation quantitative des patterns de corrélation empirique demeure indispensable pour s’assurer de l’efficience pratique des covariables retenues au sein du modèle d’analyse. Pour qu’une covariable apporte un gain mesurable de puissance statistique dans une ANCOVA, sa corrélation bivariée avec la variable dépendante doit afficher une magnitude substantielle, traditionnellement estimée comme devant idéalement franchir le seuil empirique de $r ge 0,30$. En deçà de ce seuil, la réduction de variance opérée est si minime qu’elle compense à peine la perte du degré de liberté résiduel consommé par son inclusion.
Concomitamment, il est impératif d’évaluer scrupuleusement l’absence de colinéarité excessive entre les covariables et les prédicteurs principaux d’une part, et entre les covariables elles-mêmes d’autre part. L’introduction de covariables quasi redondantes ne confère aucun apport informationnel additionnel et déstabilise dramatiquement l’estimation matricielle du modèle linéaire général. Cette multicolinéarité fait exploser les erreurs standard des coefficients et rend les inférences statistiques chaotiques.
Le diagnostic méthodique de cette pathologie métrologique repose sur l’examen rigoureux de l’indice d’inflation de la variance (VIF – Variance Inflation Factor) et de son corollaire direct, la tolérance statistique ($1 / \text{VIF}$). Une tolérance s’effondrant en dessous de 0,20 ou un VIF excédant une valeur seuil conservatrice de 5 (voire 10 selon les manuels) signale une redondance périlleuse qui impose l’élimination ou la synthèse factorielle des covariables en cause avant de poursuivre l’ajustement.
7. Typologie et échelles de mesure des covariables
7.1 Covariables continues
Les covariables continues constituent la configuration classique de l’ANCOVA historique. Elles se déploient sur des échelles d’intervalles ou de proportions, capturant des grandeurs physiologiques, psychophysiques ou psychométriques caractérisées par un spectre granulaire de réalisations numériques (temps de réaction en millisecondes, potentiels évoqués, pression artérielle, scores à des échelles de Likert cumulées). Sur le plan computationnel, l’intégration brute de covariables continues soulève fréquemment des difficultés d’interprétation cognitive des paramètres.
Pour conférer une intelligibilité théorique immédiate aux coefficients du modèle, la pratique du centrage sur la moyenne (mean centering) est particulièrement recommandée. Cette transformation arithmétique simple consiste à soustraire la moyenne générale de l’échantillon ($\bar{X}_{bulletbullet}$) à chaque observation individuelle ($X_i – \bar{X}_{bulletbullet}$). Grâce au centrage, l’ordonnée à l’origine (l’intercepte du modèle) ne reflète plus la valeur théorique souvent absurde ou impossible de la variable dépendante lorsque la covariable est égale à zéro (comme un score de quotient intellectuel ou un âge chronologique nul), mais désigne exactement la moyenne de la variable dépendante lorsque la covariable se situe à son niveau moyen d’échantillon.
De surcroît, lorsque plusieurs covariables continues mesurées sur des métriques incommensurables sont intégrées simultanément (par exemple, des revenus financiers en milliers d’euros et des concentrations hormonales en picogrammes par millilitre), la standardisation par score centré-réduit ($z$-scores) s’avère un outil puissant. Elle permet aux chercheurs de comparer directement la magnitude relative des coefficients de régression partiels pour évaluer le poids prédictif respectif de chaque covariable dans la dynamique du modèle.
7.2 Covariables catégorielles ou qualitatives
Il est fréquent que les facteurs de nuisance à contrôler ne présentent pas une métrique quantitative continue, mais s’incarnent sous la forme de variables qualitatives nominales ou ordinales (sexe biologique, affiliation ethnique auto-déclarée, géographie hospitalière de recrutement, niveau de formation échelonné). L’introduction de telles entités dans le formalisme du modèle linéaire général requiert leur conversion préalable par des techniques d’encodage matriciel adaptées.
Le codage binaire standard (dit dummy coding ou codage par variables indicatrices) constitue la méthode canonique pour les variables nominales non ordonnées. Pour une variable qualitative comportant $k$ catégories distinctes, l’analyste génère $k – 1$ variables binaires mutuellement exclusives prenant la valeur 1 en présence de la catégorie cible et 0 sinon. L’une des modalités est arbitrairement érigée en modalité de référence, et chaque coefficient estimé capture le contraste différentiel direct existant entre la catégorie cible et cette modalité de base après ajustement.
Alternativement, le codage par contraste (contrast coding, tel que le codage d’Helmert ou le codage orthogonal centré) permet de tester des hypothèses scientifiques hautement structurées, en alignant les poids matriciels sur des comparaisons de sous-ensembles théoriquement pertinentes. En ce qui concerne les variables ordinales (comme les stades d’une pathologie clinique ou les tranches d’un indice socio-économique ordonné), le statisticien doit trancher entre les traiter comme des variables discrétisées via un codage indicatrice polytomique ou, sous des conditions psychométriques strictes de monotonicité et de distances perçues égales, les traiter comme des métriques quasi-continues.
7.3 Covariables dynamiques et longitudinales
L’essor des devis de recherche à mesures répétées et des protocoles longitudinaux intensifs (tels que la méthode d’échantillonnage de l’expérience – ESM ou l’évaluation écologique momentanée – EMA) a conduit à l’émergence d’une classe complexe de variables : les covariables dynamiques, couramment désignées sous le vocable de variables variant dans le temps (time-varying covariates). Contrairement aux covariables invariantes dans le temps qui caractérisent l’individu une fois pour toutes (comme la date de naissance), les covariables dynamiques fluctuent de façon concomitante avec la variable dépendante à chaque vague d’évaluation temporelle (le niveau de stress subjectif du moment, la consommation d’alcool la veille, ou la qualité du sommeil de la nuit précédente).
La modélisation de ces covariables dynamiques exige une décomposition analytique fine de leur variance en deux composantes mathématiques orthogonales : la composante inter-individuelle (between-person, mesurant le niveau moyen habituel du sujet au fil du temps) et la composante intra-individuelle (within-person, mesurant la déviation ponctuelle du sujet à un instant $t$ par rapport à sa propre moyenne). Ignorer cette partition et modéliser la covariable brute expose le chercheur à un biais d’agrégation redoutable connu sous le nom d’erreur écologique, où les dynamiques longitudinales internes d’un individu sont fallacieusement confondues avec les disparités structurelles séparant les individus.
Enfin, dans l’analyse des processus temporels fins, les covariables à effet différé (lagged covariates) s’avèrent indispensables. Elles stipulent formellement que l’impact d’un facteur contextuel n’est pas nécessairement synchronique mais peut présenter une période de latence biologique ou psychologique : la mesure de la covariable à l’instant $t-1$ est alors utilisée pour prédire l’état de la variable d’intérêt à l’instant $t$, conférant à la modélisation une dimension chronologique robuste pour l’inférence causale.
8. Modèles statistiques avancés intégrant des covariables
8.1 Régression multiple et modèles linéaires généralisés (GLM)
Bien que l’ANCOVA fournisse un cadre pédagogique intuitif, la majorité des applications analytiques contemporaines mobilisant des covariables s’inscrit dans la vaste matrice des modèles linéaires généralisés. Cette architecture mathématique unificatrice transcende le carcan strict des distributions gaussiennes pour modéliser des variables dépendantes binaires, catégorielles multinomiales ou discrètes de comptage. Dans la régression logistique binaire, par exemple, où l’on cherche à prédire l’occurrence d’un événement clinique (succès thérapeutique versus rechute), l’ajustement par covariables s’opère sur l’échelle des logarithmes des cotes (log-odds) :
$$operatorname{logit}(P(Y=1)) = \ln\left(\frac{P(Y=1)}{1 – P(Y=1)}\right) = \beta_0 + \beta_1 \cdot \text{Traitement} + \sum_{k=1}^p \gamma_k \cdot \text{Covariable}_k$$
Dans ce contexte non linéaire, le coefficient exponentié associé au traitement ($\exp(\beta_1)$) s’interprète rigoureusement comme un rapport de cotes ajusté (adjusted odds ratio), reflétant le surcroît de probabilité conditionnelle imputable à l’intervention, toutes choses égales par ailleurs sur les covariables maintenues constantes. De façon analogue, pour des variables de comptage psychologiques (nombre de crises de panique hebdomadaires, nombre d’erreurs commises lors d’une tâche d’attention), les régressions de Poisson ou les modèles binomiaux négatifs intègrent des covariables sous une fonction de lien logarithmique, ajustant ainsi les rapports de taux d’incidence.
L’estimation de ces architectures complexes repose sur le principe du maximum de vraisemblance, où les algorithmes itératifs (tels que Newton-Raphson) convergent vers des estimateurs asymptotiquement efficaces, permettant de réaliser des ajustements probabilistes puissants même face à des distributions sévèrement asymétriques ou tronquées.
8.2 Modèles mixtes et hiérarchiques (HLM / LMM)
Les données collectées en sciences comportementales et de l’éducation violent quasi systématiquement le postulat d’indépendance des observations en raison de leur organisation intrinsèquement imbriquée : les élèves sont nichés au sein de classes scolaires, elles-mêmes regroupées au sein d’établissements territoriaux, ou encore les mesures répétées sont nichées au sein des individus. Pour traiter cette dépendance sans commettre d’erreur d’estimation sur la variance, les modèles linéaires à effets mixtes (LMM) et les modélisations hiérarchiques (HLM) s’avèrent irremplaçables.
Dans ces dispositifs hiérarchiques, les covariables peuvent être introduites à différents niveaux d’agrégation structurelle, exigeant une conceptualisation méthodique :
- Covariables de niveau 1 (niveau individuel) : Elles mesurent les attributs fluctuants propres à chaque observation ou sujet (l’âge de l’élève, son score d’anxiété de base).
- Covariables de niveau 2 (niveau contextuel ou groupal) : Elles capturent les caractéristiques environnementales macroscopiques partagées par l’ensemble des membres d’une même grappe (le climat de classe, le statut socio-économique moyen de l’école, la taille du groupe thérapeutique).
Cette distinction permet de partitionner rigoureusement la variance résiduelle en composantes intra-grappe et inter-grappes via le calcul du coefficient de corrélation intraclasse (ICC). De surcroît, les modèles mixtes autorisent non seulement l’ajustement sur des covariables pour décaler les ordonnées à l’origine de manière aléatoire (random intercepts), mais ils permettent également de modéliser des pentes aléatoires (random slopes). Il devient dès lors possible de vérifier formellement si l’impact d’une covariable individuelle sur le résultat varie significativement selon les contextes éducatifs ou cliniques de niveau supérieur, enrichissant considérablement la compréhension écologique des phénomènes.
8.3 Modélisation par équations structurelles (SEM)
La quintessence de la sophistication statistique en matière de traitement des covariables est sans conteste atteinte dans le cadre de la modélisation par équations structurelles (SEM). Dans les modèles linéaires traditionnels décrits précédemment, un postulat méthodologique lourd et souvent irréaliste pèse sur les estimations : la covariable est implicitement supposée mesurée avec une fiabilité parfaite, sans aucune trace d’erreur d’échantillonnage ou d’aléa psychométrique ($r_{xx} = 1,0$). Or, dans les sciences humaines, la quasi-totalité des covariables (estime de soi, motivation intrinsèque, résilience psychologique) souffre d’imprécision métrologique.
Le cadre structural résout cette faille béante en permettant d’incorporer les covariables non pas comme des scores composites bruts observés, mais comme de véritables variables latentes non observées, estimées à partir de multiples indicateurs empiriques au sein d’un modèle de mesure factoriel confirmatoire. Ce faisant, la SEM procède à une disjonction mathématique explicite entre la variance vraie de la covariable latente et la variance de l’erreur de mesure propre à chaque item ou sous-échelle.
En conséquence, l’ajustement statistique s’effectue sur le construit purifié, éradiquant l’atténuation classique des pentes de régression et restaurant la pleine puissance de la correction. Enfin, la modélisation structurale offre une flexibilité incomparable pour comparer rigoureusement des architectures concurrentes : l’analyste peut contraindre l’effet d’une covariable à l’invariance stricte à travers des sous-groupes démographiques distincts via des analyses multi-groupes, testant formellement des hypothèses d’universalité transculturelle ou développementale.
9. Biais méthodologiques et pièges liés à l’usage des covariables
9.1 Le paradoxe de Lord et les ajustements fallacieux
L’introduction aveugle de covariables au sein de données observationnelles expose le chercheur à l’un des casse-têtes épistémologiques les plus stimulants et déroutants de l’inférence statistique : le paradoxe de Lord, initialement formulé par le statisticien et psychométricien Frederic M. Lord en 1967. Ce paradoxe met en lumière une contradiction mathématique apparente totale entre deux stratégies d’analyse d’une même question longitudinale en présence de groupes initiaux non équivalents : l’analyse par scores de différence (post-test moins pré-test via un test t ou une ANOVA) et l’analyse de covariance (ajustement du post-test sur le pré-test via l’ANCOVA).
Dans l’illustration canonique proposée par Lord, une université mesure le poids corporel des étudiants masculins et féminins en début d’année universitaire (septembre) et à la fin de celle-ci (juin), dans le but d’évaluer si le régime alimentaire du réfectoire a produit un impact différentiel sur la prise de poids selon le sexe. Au plan empirique, le poids moyen des hommes reste strictement identique entre septembre et juin, tout comme le poids moyen des femmes. L’analyse par score de différence conclut logiquement et sans ambiguïté à une absence totale d’effet différentiel du régime sur la prise de poids ($\Delta \text{Poids}_{Hommes} = \Delta \text{Poids}_{Femmes} = 0$).
Toutefois, si un analyste applique une ANCOVA en traitant le poids de septembre comme une covariable pour prédire le poids de juin conditionnellement au sexe, le modèle fait émerger un effet du traitement extraordinairement significatif en faveur d’une prise de poids masculine substantiellement supérieure. Cette contradiction brutale découle du fait que l’ANCOVA et l’analyse de différence posent des questions causales fondamentalement divergentes. L’ANCOVA conditionne sur une variable préexistante qui est intrinsèquement et génétiquement indissociable du groupe (le dimorphisme sexuel de masse corporelle), effectuant un ajustement contrefactuel impossible : comparer un homme et une femme qui auraient eu le même poids initial. Dès lors que l’assignation aux groupes est liée à la distribution de la covariable, l’ANCOVA produit un résultat mathématiquement exact mais potentiellement fallacieux sur le plan théorique.
9.2 Sur-contrôle (overcontrolling) et blocage de voies causales
L’illusion selon laquelle l’ajout sans retenue de multiples covariables constitue un gage de rigueur scientifique et immunise mécaniquement l’analyse contre les critiques de validité relève d’une profonde incompréhension des processus générateurs de données. La première conséquence désastreuse d’une prolifération irréfléchie de covariables réside dans le phénomène de sur-contrôle, qui survient lorsqu’un chercheur intègre dans son modèle d’ajustement une variable qui se situe en réalité sur la chaîne causale intermédiaire reliant la variable indépendante à l’issue finale.
Imaginons une recherche explorant l’efficacité d’une nouvelle thérapie comportementale pour réduire l’hypertension artérielle. Si l’analyste inclut l’adhésion au régime alimentaire comme covariable d’ajustement, alors même que la thérapie déploie précisément son action en incitant et en éduquant les patients à modifier leurs comportements nutritionnels, le modèle linéaire va mathématiquement épurer l’effet du traitement de la variance partagée avec l’alimentation. L’effet causal global du protocole thérapeutique se trouve ainsi artificiellement castré, conduisant à la conclusion dramatiquement erronée que la thérapie est inopérante, alors qu’elle constituait le moteur premier de l’amélioration clinique.
Ce péril se manifeste avec une acuité décuplée lors de l’ajustement accidentel sur des variables post-traitement, mesurées après le déclenchement de l’intervention. Enfin, d’un point de vue purement statistique, chaque covariable superflue ajoutée consomme inutilement un précieux degré de liberté d’échantillon, érode la parcimonie globale du modèle et augmente exponentiellement le risque de générer une instabilité computationnelle due à des structures sous-jacentes de colinéarité fortuite.
9.3 Effets de suppression et corrélations fallacieuses
L’introduction d’une covariable peut transformer la magnitude, mais également inverser de façon spectaculaire la direction vectorielle d’une relation empirique par le biais de ce que la théorie statistique désigne sous le terme d’effets de suppression (suppressor effects). Un phénomène de suppression survient lorsqu’une covariable, qui ne présente qu’une faible corrélation bivariée apparente avec la variable dépendante, partage une variance substantielle avec les composantes parasites ou non pertinentes de la variable indépendante principale.
En intégrant cette covariable répressive dans le modèle de régression, celle-ci opère un nettoyage mathématique ciblé : elle soustrait de la variable indépendante son bruit résiduel parasite, ce qui a pour conséquence paradoxale d’augmenter spectaculairement la corrélation partielle et le coefficient bêta standardisé du traitement d’intérêt, faisant surgir une significativité statistique là où l’examen bivarié ne révélait qu’un néant apparent. Les psychométriciens distinguent traditionnellement plusieurs variantes raffinées de ce mécanisme :
- La suppression classique : La covariable est totalement non corrélée à la variable dépendante ($r_{y,cov} \approx 0$), mais fortement corrélée au prédicteur ($r_{x,cov} > 0$), épurant ce dernier de sa variance résiduelle non explicative.
- La suppression coopérative (réciproque) : Deux prédicteurs positivement corrélés entre eux et positivement corrélés à l’issue voient leurs coefficients de régression s’amplifier mutuellement bien au-delà de leurs corrélations univariées brutes une fois inclus conjointement.
Bien que mathématiquement valides au sein de l’échantillon analysé, les effets de suppression réclament une vigilance extrême. Ils constituent très fréquemment des artefacts fragiles résultant du surajustement (overfitting) sur du bruit d’échantillonnage spécifique, incapables d’être répliqués au sein d’une cohorte indépendante. L’apparition d’un renversement de signe ou d’une amplification soudaine d’un coefficient après ajustement doit alerter l’analyste et commander une inspection minutieuse des matrices de variance-covariance.
10. Techniques non paramétriques et approches causales alternatives
10.1 Le score de propension (Propensity Score Matching)
Lorsque les chercheurs sont confrontés à des protocoles observationnels ou quasi-expérimentaux lourds impliquant des dizaines de covariables de confusion potentielles, le recours aux modèles linéaires conventionnels de type ANCOVA devient périlleux en raison de la malédiction de la dimensionnalité et de l’incapacité à vérifier visuellement les postulats de linéarité multidimensionnelle. Dans ce paysage méthodologique, la méthodologie du score de propension, introduite par Paul Rosenbaum et Donald Rubin en 1983, a opéré une véritable révolution paradigmatique.
Le score de propension résout le problème de la haute dimensionnalité en condensant un vecteur multidimensionnel complexe de covariables pré-interventionnelles ($X_1, X_2, dots, X_p$) en un scalaire unidimensionnel unique : la probabilité conditionnelle pour un individu donné de recevoir le traitement expérimental ($Z = 1$) sachant son profil de caractéristiques initiales :
$$e(X) = P(Z = 1 mid X)$$
Cette probabilité est généralement estimée au moyen d’un modèle de régression logistique initial. Une fois le score de propension généré pour chaque unité statistique, diverses stratégies analytiques peuvent être déployées pour équilibrer les groupes de comparaison :
- L’appariement par score de propension (Matching) : Les sujets du groupe traité sont appariés un à un (ou selon un ratio $1:k$) avec des sujets du groupe contrôle présentant un score de propension identique ou très voisin au moyen d’algorithmes sophistiqués (voisin le plus proche avec calibre, appariement génétique ou par noyau).
- La pondération par l’inverse de la probabilité de traitement (IPTW) : Chaque individu est pondéré au sein d’une pseudo-population synthétique par l’inverse de la probabilité d’avoir reçu le traitement qu’il a effectivement suivi, recréant artificiellement les conditions d’un essai randomisé où les covariables sont parfaitement orthogonales à l’assignation.
10.2 Approches basées sur le rééchantillonnage et modèles robustes
Face à la violation récurrente des postulats distributionnels austères du modèle linéaire classique (non-normalité sévère des résidus, hétéroscédasticité persistante, présence de valeurs extrêmes ou aberrantes sur les covariables), la statistique contemporaine privilégie de plus en plus les approches algorithmiques non paramétriques et les techniques d’inférence par rééchantillonnage de type bootstrapping.
Le bootstrap non paramétrique permet d’estimer la distribution d’échantillonnage des coefficients de régression partiels et des moyennes marginales ajustées sans devoir postuler une distribution gaussienne théorique sous-jacente. En tirant avec remise des milliers de sous-échantillons aléatoires au sein du jeu de données originel, l’analyste dérive empiriquement des intervalles de confiance corrigés des biais et accélérés ($BC_a$) d’une fidélité éprouvée, immunisés contre les asymétries de distribution.
Parallèlement, les méthodes de régression robuste (estimateurs de Huber, régression des moindres déviations absolues, estimateurs $M$ et $MM$) offrent des parades directes contre l’influence disproportionnée des observations aberrantes (points à fort levier) qui polluent fréquemment les échelles de covariables continues. Enfin, lorsque la relation entre la covariable et la variable dépendante s’avère résolument non linéaire, les modèles additifs généralisés (GAM – Generalized Additive Models) permettent de modéliser cette liaison sous la forme de fonctions splines lissées et flexibles, capturant la véritable complexité des dynamiques biologiques ou comportementales sans forcer arbitrairement un ajustement linéaire rectiligne tronqué.
10.3 Applications en quasi-expérimentation psychologique
Les sciences psychologiques et psychiatriques se heurtent quotidiennement à des impératifs déontologiques et pratiques interdisant le recours à la randomisation contrôlée. C’est le cas emblématique de l’évaluation de l’efficacité des psychothérapies au sein des structures hospitalières publiques : refuser arbitrairement par tirage au sort une intervention thérapeutique vitale à des patients suicidaires ou profondément traumatisés pour constituer un groupe placebo pur soulève des dilemmes éthiques insurmontables. Les cohortes observationnelles constituent dès lors le seul matériau empirique exploitable.
Dans ces dispositifs quasi-expérimentaux, les patients s’orientent vers tel ou tel programme de soins selon la gravité perçue de leurs symptômes, leurs ressources économiques ou les orientations cliniques du médecin traitant, créant une disparité initiale massive entre les groupes de traitement. Le déploiement couplé de scores de propension et d’analyses de covariance avancées permet d’égaliser a posteriori les profils cliniques à l’admission (équilibration de la sévérité des antécédents, des comorbidités somatiques et de la durée d’évolution du trouble), rendant les comparaisons d’efficacité cliniquement recevables.
Néanmoins, l’analyste doit impérativement conserver une lucidité épistémologique absolue : ces techniques statistiques sophistiquées n’ajustent les modèles qu’au regard des covariables formellement mesurées et intégrées dans le modèle mathématique. Elles demeurent structurellement aveugles aux covariables non observées ou mesurées avec imprécision. Si un facteur pronostique occulte majeur n’a pas été colligé lors de la collecte initiale, le spectre du biais de confusion résiduel continue de hanter l’analyse, interdisant toute assimilation naïve des résultats ajustés à des vérités causales définitives.
11. Directives de publication et normes éthiques (normes APA)
11.1 Transparence et pré-enregistrement des covariables
Dans le sillage de la crise de la réplicabilité qui a profondément ébranlé la psychologie et les sciences de la santé au cours de la dernière décennie, l’usage des covariables s’est retrouvé au centre des critiques méthodologiques les plus acerbes. Il a été abondamment démontré que l’introduction opportuniste, le retrait sélectif ou la substitution post-hoc de covariables au cours de la phase d’exploration des données constituent l’un des leviers les plus puissants du p-hacking, permettant aux chercheurs d’abaisser artificiellement une $p$-valeur sous le seuil symbolique de 0,05 pour décrocher une publication.
Face à ces dérives épistémologiques délétères, les normes déontologiques internationales et les recommandations édictées par l’American Psychological Association (APA, 7e édition) imposent désormais une transparence méthodologique totale. Les chercheurs sont instamment encouragés à consigner l’intégralité de leur stratégie de modélisation dans des plans d’analyse pré-enregistrés (pre-registration protocols) sur des registres publics indépendants tels que l’Open Science Framework (OSF) ou ClinicalTrials.gov préalablement à l’accès aux données.
Ce protocole rigoureux exige de formaliser en amont la liste exhaustive des covariables retenues, la justification théorique de leur inclusion, leur échelle de mesure opérationnelle, le mode précis de codage des modalités catégorielles, et les règles d’exclusion des valeurs aberrantes. Lorsqu’un article est soumis pour publication, une distinction nette, étanche et transparente doit être opérée dans le corps du texte entre les analyses confirmatoires prévues au pré-enregistrement et les analyses exploratoires ajustées menées après coup au gré de découvertes empiriques fortuites.
11.2 Rédaction et présentation tabulaire selon les normes APA
La communication scientifique des résultats issus de modèles incorporant des covariables obéit à des standards de rédaction et de mise en forme tabulaire hautement codifiés. Les directives de l’APA stipulent que l’auteur doit systématiquement rapporter de façon conjointe les statistiques descriptives non ajustées (moyennes et écarts-types bruts observés) et les statistiques déduites du modèle (moyennes marginales estimées ajustées et leurs erreurs standard associées). Cette double présentation permet aux relecteurs et à la communauté scientifique d’évaluer directement l’ampleur et la direction de la correction spatiale opérée par l’ajustement.
Dans le corps du texte, la formulation statistique relative à une ANCOVA doit consigner sans omission la statistique de test, les degrés de liberté exacts, la probabilité critique et la taille d’effet standardisée. Par exemple : « L’effet principal du traitement demeure statistiquement significatif après ajustement sur le niveau cognitif de base, F(1, 87) = 8,45, p = ,005, η²p = ,089. » Il est en outre impératif de stipuler explicitement que le postulat d’homogénéité des pentes a été vérifié et satisfait préalablement au lancement du modèle d’ANCOVA principal (en mentionnant par exemple la non-significativité statistique du terme d’interaction : F(1, 86) = 1,12, p = ,293).
Lorsque les données s’inscrivent dans une régression linéaire multiple hiérarchique, la présentation sous forme d’un tableau synthétique structuré en blocs séquentiels successifs représente le standard d’excellence. Le tableau doit typiquement agencer :
- Le Modèle 1 (Bloc des covariables seules) : Mentionnant les coefficients de régression non standardisés ($B$), leurs erreurs standard ($SE$), les coefficients standardisés ($\beta$), ainsi que la proportion totale de variance expliquée ($R^2$).
- Le Modèle 2 (Bloc incluant la variable indépendante d’intérêt) : Documentant les mêmes paramètres actualisés, accompagnés de la statistique de variation de variance ($\Delta R^2$), du test $F$ de changement ($F_{\text{change}}$) et de sa $p$-valeur associée.
11.3 Interprétation prudente des résultats ajustés
La rédaction de la section Discussion d’un manuscrit scientifique requiert une retenue philosophique et herméneutique majeure dès lors que des covariables ont été mobilisées. Le premier écueil à contourner réside dans la réification des scores ajustés : une moyenne marginale estimée est une entité statistique abstraite, déduite mathématiquement d’une trajectoire linéaire hypothétique, et ne saurait être assimilée à une réalité biologique ou psychologique tangible observée sur le terrain.
Les chercheurs doivent formellement reconnaître et expliciter dans leurs limites l’incertitude liée à l’erreur de mesure intrinsèque aux covariables collectées. Si la fidélité de l’instrument mesurant la covariable n’est pas absolue, l’ajustement opéré demeure partiel, laissant subsister un biais sous-jacent que l’analyste se doit de concéder avec humilité. De surcroît, la tentation de conférer une interprétation causale péremptoire à un coefficient de régression issu de données non expérimentales, sous le prétexte fallacieux que « les principaux facteurs ont été contrôlés », relève d’une faute méthodologique impardonnable.
Une discussion scientifique honnête doit systématiquement ouvrir le débat sur l’existence probable de variables omises (omitted variable bias). Le champ des conduites humaines étant infini, aucun modèle empirique, aussi exhaustif soit-il, ne saurait encapsuler la totalité des antécédents causaux d’un comportement. Reconnaître les angles morts de l’arsenal de covariables mobilisé constitue la marque de fabrique d’une démarche scientifique intègre et pérenne.
12. Guide pratique étape par étape pour le traitement des covariables
12.1 Phase de conception : sélection a priori
La gestion méthodologique rigoureuse des covariables ne débute pas devant un logiciel d’analyse statistique à l’issue de l’acquisition des données, mais prend racine dès la conceptualisation théorique du protocole expérimental. La première démarche opérationnelle consiste à réaliser une recension exhaustive et critique de la littérature scientifique consacrée au phénomène sous examen, en vue d’identifier formellement les facteurs de confusion et les sources de variabilité récurrentes déjà documentés de façon robuste au sein des méta-analyses antérieures.
À partir de cet ancrage conceptuel, l’équipe de recherche doit s’attacher à modéliser un graphe causal préliminaire (DAG). Cet outil schématique permettra de positionner sans équivoque chaque variable candidate : s’agit-il d’un véritable facteur de confusion pré-interventionnel justifiant un ajustement pour bloquer une porte dérobée ? D’un médiateur potentiel dont l’introduction provoquerait un sur-contrôle désastreux ? D’une variable collisionneur qu’il convient absolument de tenir à l’écart de l’analyse ? Cette clarification graphique prémunit le chercheur contre les choix arbitraires.
Enfin, cette étape décisionnelle gouverne le choix métrologique des instruments de mesure empiriques. Afin de préserver la validité du modèle d’ajustement, les chercheurs doivent sélectionner des échelles psychométriques ou des outils d’acquisition affichant des coefficients de fidélité élevés (par exemple un coefficient alpha de Cronbach ou un oméga de McDonald excédant 0,80, ou une excellente fidélité test-retest). C’est à ce stade précoce que s’élabore le plan d’analyse pré-enregistré, gravant dans le marbre les intentions analytiques avant tout contact avec le terrain.
12.2 Phase d’exploration : diagnostic des données
Une fois les données collectées et préalablement à toute exécution du modèle d’inférence final, une phase exploratoire méticuleuse s’impose pour diagnostiquer la conformité du jeu de données avec les postulats mathématiques sous-jacents aux modèles à covariables. Ce protocole diagnostique se structure selon une séquence logique immuable :
- Inspection graphique de la linéarité : Génération de diagrammes de dispersion bivariés (scatterplots) croisant la covariable avec la variable dépendante au sein de chaque groupe expérimental séparément, enrichis de courbes de lissage local (courbes LOESS). Cette visualisation directe permet d’attester de la rectitude de la trajectoire linéaire et de repérer d’éventuelles inflexions polynomiales.
- Détection des valeurs aberrantes multivariées : Si le dépistage univarié classique via les scores $z$ et les diagrammes en boîte est requis, l’évaluation des déviances conjointes à l’aide de la distance de Mahalanobis ou de la distance de Cook s’avère indispensable. Un point isolé sur la covariable peut exercer un effet de levier destructeur et tordre la pente de régression estimée.
- Test formel du postulat d’homogénéité des pentes : Ajustement d’un modèle préliminaire incorporant explicitement le terme d’interaction multiplicative entre le traitement catégoriel et la covariable continue ($Y = \mu + \text{Groupe} + \text{Covariable} + \text{Groupe} \times \text{Covariable}$). L’analyste examine attentivement la statistique de test associée à ce produit croisé. Si la $p$-valeur s’avère nettement supérieure au seuil d’alpha conventionnel ($p > 0,05$), le postulat d’homogénéité des pentes est considéré comme empiriquement soutenu, autorisant le retrait du terme d’interaction et la poursuite vers l’ANCOVA standard.
12.3 Phase de modélisation et communication des inférences
L’ultime étape méthodologique concerne la phase de calcul, d’évaluation comparative et de dissémination scientifique des résultats modélisés. L’analyste procède à l’exécution séquentielle de deux architectures analytiques : le modèle primaire non ajusté (ANOVA simple ou régression univariée ignorant la covariable) et le modèle complet ajusté intégrant les covariables éligibles. La comparaison rigoureuse de ces deux modélisations documente avec une clarté exemplaire l’impact précis exercé par l’ajustement statistique sur les paramètres estimés.
Le statisticien inspecte la stabilité vectorielle des coefficients : le terme d’erreur quadratique moyenne a-t-il été réduit comme escompté ? L’amplitude de l’effet principal a-t-elle été substantiellement altérée, signalant la correction d’un biais de confusion préexistant ? Les résidus du modèle final satisfont-ils désormais aux critères de normalité et d’homogénéité par l’analyse des graphiques de résidus studentisés contre valeurs prédites ? Tout signe d’instabilité soudaine des coefficients (comme un gonflement anomal des erreurs standard) doit faire suspecter une multicolinéarité dissimulée.
Enfin, la communication écrite des inférences doit être rédigée avec une rectitude académique irréprochable. L’analyste rapporte fidèlement l’intégralité des indices numériques exigés par les guides de publication internationaux (valeurs d’ordonnées, coefficients de pente, statistiques de Fisher ou Wald, degrés de liberté, probabilités critiques exactes, amplitudes d’effet partiel et intervalles de confiance à 95 %). En ancrant résolument ses conclusions dans les frontières délimitées par la validité interne de son dispositif expérimental, le chercheur offre à la communauté scientifique une contribution méthodologiquement inattaquable, transparente et authentiquement réplicable.
Références
- Baron, R. M., & Kenny, D. A. (1986). The moderator-mediator variable distinction in social psychological research: Conceptual, strategic, and statistical considerations. Journal of Personality and Social Psychology, 51(6), 1173–1182. https://doi.org/10.1037/0022-3514.51.6.1173
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Fisher, R. A. (1932). Statistical methods for research workers (4th ed.). Oliver and Boyd.
- Johnson, P. O., & Neyman, J. (1936). Tests of certain linear hypotheses and their application to some educational problems. Statistical Research Memoirs, 1, 57–93.
- Lord, F. M. (1967). A paradox in the interpretation of group comparisons. Psychological Bulletin, 68(5), 304–305. https://doi.org/10.1037/h0025105
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- Pearl, J. (2009). Causality: Models, reasoning, and inference (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9780511803161
- Raudenbush, S. W., & Bryk, A. S. (2002). Hierarchical linear models: Applications and data analysis methods (2nd ed.). Sage Publications.
- Rosenbaum, P. R., & Rubin, D. B. (1983). The central role of the propensity score in observational studies for causal effects. Biometrika, 70(1), 41–55. https://doi.org/10.1093/biomet/70.1.41
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.