
La recherche scientifique en sciences sociales, en psychologie et en épidémiologie repose fondamentalement sur la capacité du chercheur à tirer des inférences valides à partir de données empiriques recueillies auprès d’un sous-ensemble d’individus. Au cœur de cette démarche d’inférence statistique se trouve la transition délicate entre le monde théorique, où sont formulées les hypothèses concernant une population d’intérêt globale, et le monde opérationnel, où les participants doivent être concrètement identifiés, contactés et mesurés. Cette passerelle méthodologique indispensable porte un nom précis : la base de sondage (ou sampling frame en littérature anglophone). Sans une compréhension intime et rigoureuse de la structure, des limites et des propriétés mathématiques de cet instrument, toute tentative de généralisation s’expose à des biais structurels dévastateurs qui compromettent la validité externe et interne des résultats scientifiques.
Trop souvent négligée au profit des seuls algorithmes de tirage aléatoire ou des modèles d’analyse multivariée sophistiqués, la base de sondage constitue pourtant le socle matériel et conceptuel sur lequel repose l’ensemble de l’édifice probabiliste. Qu’il s’agisse d’un registre national exhaustif, d’une liste hospitalière de patients souffrant de troubles psychiatriques, d’un annuaire professionnel ou d’une base numérique de panélistes, chaque support présente des caractéristiques intrinsèques qui déterminent qui a une probabilité d’être inclus dans l’étude et qui en est irrémédiablement exclu. L’erreur de couverture, composante majeure du cadre de l’erreur totale d’enquête (Total Survey Error), naît précisément dans les failles de cette interface.
Dans cet article de référence exhaustif, nous explorerons en profondeur l’ensemble des dimensions théoriques, mathématiques, empiriques et éthiques de la base de sondage, avec un accent particulier sur la psychologie quantitative, la psychométrie et les sciences du comportement. De sa caractérisation formelle aux stratégies novatrices d’échantillonnage en réseau ou à base multiple, ce guide offre aux chercheurs, cliniciens, statisticiens et doctorants les repères indispensables pour concevoir, auditer et exploiter des dispositifs d’échantillonnage à la pointe des exigences méthodologiques contemporaines.
1. Définition fondamentale et concepts clés de la base de sondage
1.1 Qu’est-ce qu’une base de sondage (sampling frame) ?
Sur le plan opérationnel, une base de sondage se définit comme le dispositif matériel, documentaire ou algorithmique qui recense, identifie et permet d’accéder physiquement à chaque unité élémentaire appartenant à une population déterminée. Loin d’être une simple liste passive d’adresses ou de numéros, la base de sondage incarne le protocole explicite d’accès aux unités statistiques. Selon les formulations classiques de la statistique d’enquête, telles que formalisées par Leslie Kish et développées ultérieurement par William G. Cochran, elle constitue le cadre opérationnel effectif sans lequel le principe même de l’échantillonnage probabiliste s’avère inapplicable. En l’absence de base formelle, il devient impossible d’attribuer une probabilité d’inclusion non nulle et connue à chaque individu de la population cible.
Le rôle premier de la base de sondage est de fonctionner comme l’interface directe reliant le concept abstrait d’une population cible définie par le chercheur et l’échantillon empirique final extrait par les procédures d’échantillonnage. Il convient d’établir une distinction fondamentale entre la base matérielle (telle qu’un fichier de données, un répertoire téléphonique, un registre d’état civil municipal ou une base de données hospitalière) et la règle d’accès abstraite qui la sous-tend. Par exemple, un protocole d’échantillonnage par numérotation aléatoire (Random Digit Dialing – RDD) ne s’appuie pas sur une liste préexistante de personnes vivantes, mais sur un ensemble algorithmique de numéros téléphoniques possibles générés selon un cadre probabiliste strict. Même dans cette configuration dématérialisée, la combinaison des plages de préfixes valides constitue la base de sondage formelle du protocole.
Un attribut indispensable de toute base de sondage rigoureuse réside dans l’identifiant unique assigné à chaque unité statistique. Qu’il s’agisse d’un numéro d’ordre séquentiel, d’un identifiant national de santé, d’une adresse IP couplée à un code alphanumérique crypté ou d’une clé de registre d’immatriculation universitaire, cet identifiant doit garantir l’absence d’ambiguïté lors des tirages aléatoires. Il prévient les confusions homonymiques et autorise la reproductibilité exacte des algorithmes de sélection probabiliste pseudo-aléatoire au sein des environnements de calcul scientifique.
1.2 Distinction cruciale : Population cible, base de sondage et échantillon
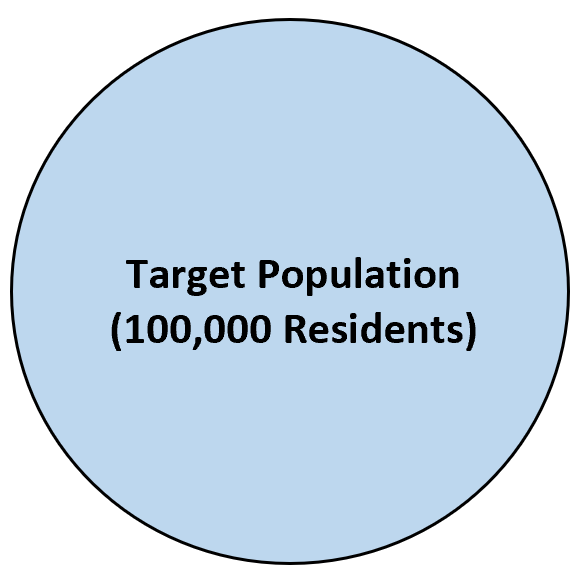
La confusion conceptuelle entre la population cible, la base de sondage et l’échantillon constitue l’une des erreurs méthodologiques les plus pernicieuses dans la recherche empirique. La population cible (ou univers théorique) représente l’ensemble complet des unités d’observation auxquelles le chercheur souhaite étendre ses conclusions théoriques. Par exemple, dans une étude portant sur les manifestations cognitives de l’anxiété généralisée, la population cible pourrait être l’ensemble des adultes âgés de 18 à 65 ans résidant en France métropolitaine et répondant aux critères diagnostiques du DSM-5. Cet univers est une construction conceptuelle, souvent infinie ou inaccessible dans sa totalité immédiate.
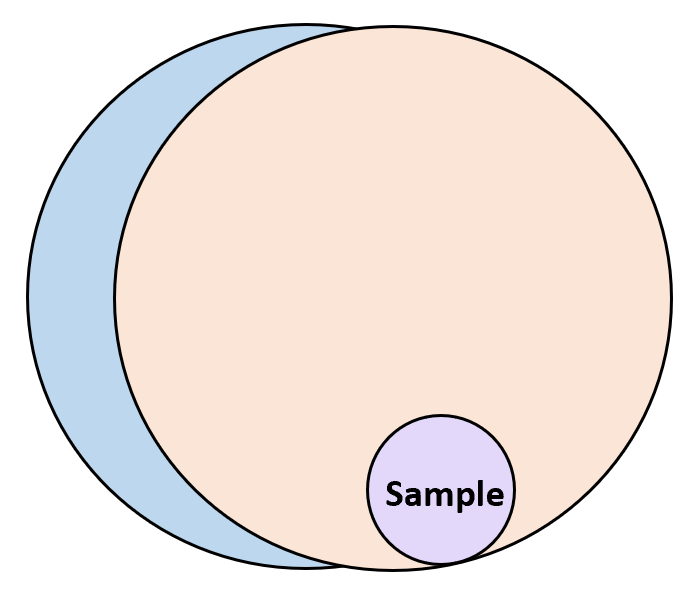
La base de sondage, quant à elle, représente l’opérationnalisation concrète, tangible et nécessairement finie de cet univers. Pour la même recherche sur l’anxiété, la base de sondage pourrait être le registre des patients admis dans les centres médico-psychologiques (CMP) d’une région administrative donnée sur une période de douze mois consécutifs. Dès cet instant, une divergence structurelle apparaît : les individus souffrant d’anxiété mais ne consultant jamais en institution psychiatrique, ou consultant exclusivement en cabinet libéral, appartiennent indubitablement à la population cible théorique, mais sont totalement exclus de la base de sondage disponible. L’échantillon désigne enfin le sous-ensemble d’unités effectivement sélectionnées à partir de cette base de sondage via une procédure d’échantillonnage probabiliste ou non probabiliste pour faire l’objet de l’investigation empirique.
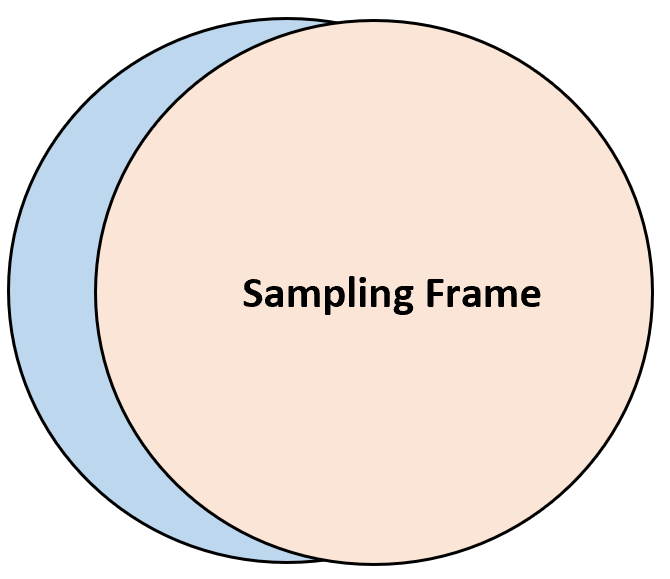
La problématique centrale qui découle de ce triptyque réside dans l’écart systématique entre l’univers théorique et la base disponible. Tout décalage entre la composition de la population cible et les entrées présentes dans la base de sondage génère un biais de couverture. Lorsque les inférences sont projetées directement de l’échantillon vers la population cible sans tenir compte de la distorsion inhérente à la base de sondage intermédiaire, les estimations de paramètres (moyennes, proportions, coefficients de corrélation, tailles d’effet) sont structurellement entachées d’erreur, quelle que soit la taille de l’échantillon ou la puissance du test statistique retenu.
1.3 L’importance méthodologique en psychologie et sciences du comportement
En psychologie expérimentale, en psychométrie et dans les sciences du comportement, la rigueur de la base de sondage est le garant ultime de la validité des inférences statistiques et psychométriques. Dans le champ de la modélisation psychométrique, notamment dans le cadre de la théorie de réponse aux items (IRT) ou de l’analyse factorielle confirmatoire (CFA), l’invariance de mesure suppose que les relations structurales entre les variables latentes et les indicateurs manifestes soient stables à travers les sous-populations. Or, si la base de sondage surreprésente ou omet sélectivement des strates psychologiques spécifiques (par exemple, les personnes présentant des traits dépressifs sous-cliniques ou des profils cognitifs neurodivergents), les paramètres d’étalonnage des échelles d’évaluation s’en trouvent irrémédiablement faussés.
Par ailleurs, la crise de la reproductibilité qui a secoué les sciences du comportement au cours de la dernière décennie tire une large part de ses racines de l’instabilité des cadres d’échantillonnage. Historiquement, la recherche académique en psychologie a eu recours de manière quasi systématique à des bases de convenance hautement homogènes et sélectives : les cohortes d’étudiants de premier cycle en psychologie participant aux expériences en échange de crédits académiques obligatoires. Cette pratique a institutionnalisé ce que Henrich, Heine et Norenzayan (2010) ont qualifié d’échantillons WEIRD (Western, Educated, Industrialized, Rich, Democratic).
Le recours à de telles bases de sondage restreintes fausse la distribution empirique des fonctions cognitives fondamentales, des biais attentionnels et des processus socio-affectifs. En croyant mesurer des invariants universels de l’esprit humain, les chercheurs ont souvent documenté les spécificités neurocognitives d’un sous-ensemble minuscule de la population mondiale. Seule la constitution de bases de sondage représentatives, documentées et diversifiées permet d’atténuer ce biais ethnocentrique et socio-économique, et de conférer aux théories psychologiques une authentique portée nomothétique.
2. Caractéristiques d’une base de sondage idéale
2.1 L’exhaustivité et la complétude des éléments
D’un point de vue axiomatique, la perfection d’une base de sondage repose en premier lieu sur son exhaustivité absolue : chaque élément constitutif de la population cible définie au préalable doit y figurer, sans exception. Cette exigence de complétude implique une couverture intégrale sans omission arbitraire de sous-groupes démographiques, culturels, socio-économiques ou géographiques. Dans une enquête épidémiologique en santé mentale visant la population générale adulte, l’exhaustivité requiert que les résidents d’habitats non conventionnels, les personnes sans domicile fixe, les populations carcérales ou les personnes hospitalisées en établissements de soins de longue durée soient intégrés dans le dispositif ou pris en compte dans des segments spécifiques de la base.
L’omission de franges marginalisées ou atypiques altère non seulement les estimations de prévalence ponctuelle, mais détruit également l’exactitude des calculs de variance. En théorie des sondages probabilistes, l’estimation sans biais de la variance d’un estimateur dépend de l’existence de probabilités d’inclusion positives pour toutes les paires possibles d’unités dans la population (conditions de Horvitz-Thompson). Si une fraction de la population est totalement absente de la base (probabilité d’inclusion nulle, $\pi_i = 0$), il devient mathématiquement impossible d’estimer sans biais les caractéristiques de cette fraction et leur variabilité conjointe avec le reste du corps social.
Dans les sciences cognitives et le diagnostic neuropsychologique, l’absence de complétude de la base servant à l’étalonnage d’un test conduit à des erreurs de diagnostic dramatiques. Par exemple, si la base d’étalonnage d’un test mnésique omet systématiquement les personnes âgées faiblement scolarisées ou issues de minorités linguistiques, les scores seuils pathologiques établis induiront des taux alarmants de faux positifs parmi ces sous-groupes, assimilant à tort une différence socioculturelle à un déclin cognitif organique.
2.2 L’actualité et la précision des informations d’identification
Une base de sondage ne constitue pas une entité statique figée pour l’éternité ; elle est une photographie dynamique d’un univers en perpétuelle mutation. La qualité d’une base dépend directement de l’actualité de ses données et de la précision méticuleuse de ses informations de contact et de ses variables de stratification auxiliaires. Les déménagements, les changements d’opérateur de téléphonie, les fermetures de comptes de messagerie électronique, les mariages entraînant des changements d’état civil et les décès créent une attrition naturelle et continue au sein de tout registre.
L’impact de la dégradation temporelle des coordonnées se traduit immédiatement sur le terrain par l’apparition d’une non-réponse technique. Lorsqu’un chercheur tente de joindre un participant sélectionné selon un protocole aléatoire strict mais que l’adresse physique est obsolète ou que le numéro de téléphone est réattribué, cette défaillance technique ne doit pas être assimilée à un refus de participer. Elle représente une rupture d’accès imputable à la dégradation de la base. Pour maintenir la fidélité de l’outil, la fréquence optimale de rafraîchissement des registres administratifs ou des panels de recherche psychologique doit être calibrée sur le taux de rotation naturel de la population étudiée, souvent établi entre six et douze mois dans les cohortes longitudinales exigeantes.
En outre, la précision des variables sociodémographiques enregistrées dans la base (comme le niveau d’éducation formelle, la tranche de revenu ou le statut matrimonial) est cruciale si le chercheur envisage un échantillonnage probabiliste stratifié. Des variables auxiliaires erronées dans la base conduiront à des attributions erronées de strates, réduisant à néant les gains d’efficacité statistique attendus de la stratification et complexifiant le calcul ultérieur des facteurs de redressement statistique.
2.3 L’absence d’entrées dupliquées ou erronées
Le principe de base de l’échantillonnage aléatoire repose sur la règle de l’unicité stricte : chaque individu de la population cible ne doit être représenté qu’une seule et unique fois dans la base de sondage. L’existence d’entrées dupliquées détruit l’égalité ou la maîtrise théorique des probabilités d’inclusion. Un individu figurant deux fois dans une liste électorale ou dans un annuaire a mathématiquement deux fois plus de chances d’être sélectionné par un tirage aléatoire simple qu’un individu n’y figurant qu’une seule fois, ce qui viole l’hypothèse d’équirépartition des chances et introduit un biais d’échantillonnage non contrôlé.
De même, la présence d’enregistrements erronés — c’est-à-dire d’unités qui n’appartiennent pas ou plus à la population cible, telles que des personnes décédées, des individus ayant émigré définitivement à l’étranger ou des entités commerciales inscrites par mégarde dans un registre d’individus — pollue la sélection. Ces unités fantômes augmentent les coûts logistiques de l’enquête et réduisent la taille effective de l’échantillon utile préétabli par l’analyse de puissance statistique a priori.
Pour parer à ces dérives structurelles, la mise en œuvre de protocoles de déduplication algorithmique constitue un préalable incontournable avant tout tirage. Ces procédures font appel à des techniques d’appariement déterministe et probabiliste, croisant les noms de famille, prénoms, dates de naissance, codes postaux et identifiants électroniques afin d’agréger les entrées redondantes et d’éliminer les enregistrements corrompus avant le déclenchement de la phase de recrutement.
3. Les anomalies et disparités structurelles de la base de sondage
3.1 Le sous-dénombrement (sous-couverture) et ses conséquences
Le sous-dénombrement, ou sous-couverture (undercoverage), constitue l’anomalie la plus pernicieuse et la plus fréquente rencontrée dans la pratique méthodologique. Il se produit dès lors que des segments entiers de la population cible sont totalement omis de la base de sondage disponible. Cette déficience structurelle ne relève pas du hasard : les populations omises partagent souvent des caractéristiques systématiques qui les distinguent radicalement du reste des individus indexés dans la liste.
Dans le domaine de la recherche psychologique et épidémiologique, l’exclusion systématique des populations vulnérables représente un enjeu critique. Par exemple, les études consacrées aux déterminants socio-environnementaux de la détresse psychologique majeure sous-estiment systématiquement l’ampleur du phénomène si la base de sondage repose sur un registre des contribuables ou sur des annuaires de téléphonie fixe. Les individus en précarité économique extrême, les travailleurs saisonniers non déclarés, les demandeurs d’asile ou les personnes souffrant de dépendances sévères aux substances psychoactives sont massivement absents de ces bases conventionnelles.
Sur le plan mathématique, le biais d’estimation découlant du sous-dénombrement s’exprime avec une limpidité redoutable. Si l’on note $\bar{Y}$ la moyenne réelle de la variable psychologique dans l’ensemble de la population cible, $\bar{Y}_c$ la moyenne au sein de la fraction couverte par la base, $\bar{Y}_u$ la moyenne au sein de la fraction non couverte (omise), et $W_u$ la proportion de la population cible qui n’est pas couverte par la base, le biais théorique de la base s’écrit :
$$\text{Biais}(\bar{y}_c) = \bar{Y}_c – \bar{Y} = W_u (\bar{Y}_c – \bar{Y}_u)$$
Cette relation démontre formellement que le biais ne dépend pas seulement de l’ampleur quantitative de l’omission ($W_u$), mais surtout du contraste substantiel $(\bar{Y}_c – \bar{Y}_u)$ entre les individus répertoriés et les exclus. Même si le taux de sous-couverture est relativement faible (par exemple 5 %), le biais sera massif si la détresse psychologique est considérablement plus élevée chez les non-inscrits que chez les inscrits. Les méthodes d’imputation et les techniques d’ajustement statistique a posteriori (telles que le calage sur marges ou la post-stratification) peuvent atténuer ces distorsions, mais elles demeurent impuissantes lorsque les mécanismes d’omission dépendent directement de la variable d’intérêt elle-même (données manquantes non aléatoires, Missing Not At Random – MNAR).
3.2 Le sur-dénombrement (sur-couverture) et la présence d’unités étrangères
À l’opposé du spectre des distorsions se trouve le sur-dénombrement, ou sur-couverture (overcoverage). Cette anomalie se manifeste par l’inclusion dans la base de sondage d’unités qui ne satisfont pas aux critères d’admissibilité théoriques fixés par les objectifs de la recherche. Ce phénomène survient fréquemment lorsque les frontières de la base sont plus larges que celles de la population cible. Par exemple, si l’objectif d’une investigation neurocognitive est d’étudier les fonctions exécutives chez les adolescents âgés de 12 à 15 ans, mais que la base de sondage mobilisée est un registre général de tous les élèves inscrits dans le secondaire (incluant des enfants de 10 ans et des jeunes adultes de 18 ans), la base est affectée de sur-couverture.
Bien que moins dommageable sur le plan de l’invariance mathématique que le sous-dénombrement — pourvu que les unités étrangères puissent être formellement identifiées et éliminées —, la sur-couverture engendre des coûts opérationnels et temporels considérables. Les équipes de recherche doivent déployer d’importantes ressources financières et humaines pour administrer des questionnaires de sélection préliminaire (screening) visant à écarter les unités inéligibles contactées par inadvertance.
Le danger méthodologique devient critique lorsque le filtrage sur le terrain est imparfait. Dans les cohortes de psychologie clinique, si des critères diagnostiques stricts (par exemple, absence de comorbidité neurologique ou de dépendance active aux psychotropes) ne sont pas rigoureusement vérifiés lors du premier contact avec les individus tirés d’une base générale, des cas non conformes s’infiltrent dans la cohorte expérimentale. Cette contamination affaiblit considérablement la puissance statistique des tests d’hypothèses et brouille la clarté des liens causaux modélisés.
3.3 La duplication et les regroupements d’unités
La présence de duplications et de grappes structurelles non résolues constitue le troisième grand piège anatomique des bases de sondage. La duplication correspond à la situation où une même unité cible est associée à plusieurs lignes ou enregistrements au sein du fichier. En conséquence directe, sa probabilité d’inclusion dans l’échantillon final est mécaniquement multipliée par le nombre de fois où elle est représentée. Dans une enquête menée auprès de professionnels de santé mentale enregistrés à la fois à leur cabinet privé et à leur adresse hospitalière au sein d’un registre professionnel, les praticiens cumulant les deux statuts voient leur poids probabiliste doubler par rapport à leurs confrères n’exerçant que dans un seul cadre.
Le regroupement d’unités (ou problème des unités en grappes apparaissant comme des entités simples) survient lorsque l’identifiant présent dans la base ne désigne pas un individu unique, mais un groupe, une structure collective ou un ménage. Dans les enquêtes téléphoniques ou résidentielles traditionnelles, l’identifiant géographique (l’adresse postale ou le numéro d’appartement) renvoie fréquemment à une famille composée de plusieurs personnes. Si le chercheur applique un protocole d’échantillonnage simple en sélectionnant une adresse puis en choisissant un seul individu au hasard au sein du foyer (par exemple via la méthode de la prochaine date d’anniversaire ou la grille de Kish), les individus vivant dans des foyers nombreux ont une probabilité d’inclusion bien plus faible que ceux vivant seuls :
$$\pi_{i|j} = \pi_j \times \frac{1}{M_j}$$
où $\pi_j$ est la probabilité de sélection du ménage $j$, et $M_j$ est le nombre d’individus éligibles résidant dans ce ménage. Si le statisticien omet d’incorporer ces facteurs d’ajustement dans les poids de sondage finaux ($w_i = 1 / \pi_{i|j}$), les individus issus de ménages à faible effectif seront indûment surreprésentés dans toutes les analyses subséquentes, distordant irrémédiablement les estimations de la recherche.
4. Typologie des bases de sondage en recherche psychologique
4.1 Les registres institutionnels et administratifs
Les registres institutionnels, administratifs et gouvernementaux représentent la référence méthodologique la plus solide en matière d’échantillonnage de population générale. Il s’agit des fichiers électoraux nationaux, des registres municipaux d’état civil, des bases de la sécurité sociale ou des répertoires exhaustifs tenus par les ministères de l’Éducation nationale pour les populations scolarisées. Ces cadres institutionnels possèdent l’immense avantage d’une couverture quasi universelle et d’un contrôle rigoureux de la précision des identifiants civils.
Dans l’étude du développement cognitif, linguistique et émotionnel de l’enfant et de l’adolescent, les registres d’inscriptions scolaires offrent un cadre d’une robustesse exceptionnelle. Ils permettent de cerner avec précision des cohortes complètes d’âges spécifiques et de déployer des tirages stratifiés croisant les zones géographiques, les indices de défavorisation sociale de l’établissement scolaire et les programmes pédagogiques suivis. Les inférences tirées de telles bases bénéficient d’une légitimité statistique et d’une représentativité externe incomparables.
Toutefois, l’accès à ces registres administratifs est strictement encadré par des barrières réglementaires et juridiques draconiennes, dictées par la protection de la vie privée. En France et dans l’Union européenne, l’obtention de tels fichiers requiert des autorisations complexes auprès d’autorités de régulation telles que la CNIL et l’approbation de comités d’éthique de la recherche. De surcroît, un obstacle conceptuel récurrent réside dans l’hétérogénéité des taxonomies : les classifications administratives (catégories socioprofessionnelles, découpages administratifs) ne coïncident pas toujours avec les construits théoriques affinés exigés par les modèles psychologiques contemporains.
4.2 Les bases de données cliniques et dossiers médicaux
En psychopathologie expérimentale, en neuropsychologie et en psychiatrie biologique, les chercheurs mobilisent massivement les bases de données issues des dossiers médicaux électroniques (DME), les registres de cohortes hospitalières spécialisées ou les bases médico-administratives d’assurance maladie (comme le Système National des Données de Santé – SNDS en France). Ces bases fournissent une infrastructure précieuse : elles contiennent des données diagnostiques standardisées préalables, établies selon les classifications nosographiques internationales (CIM-11, DSM-5), associées à des historiques thérapeutiques détaillés et des bilans paracliniques (neuro-imagerie, biomarqueurs génétiques).
Néanmoins, le recours aux bases hospitalières et cliniques introduit un biais structurel majeur bien documenté dans la littérature épidémiologique : le biais de Berkson ou biais institutionnel. Les patients figurant dans les registres des centres hospitaliers universitaires de pointe ne sont pas représentatifs de l’ensemble des personnes atteintes du trouble mental considéré dans la communauté. Ils présentent systématiquement une gravité clinique accrue, une résistance plus marquée aux traitements conventionnels, un niveau de comorbidités psychiatriques et somatiques plus élevé et une dégradation psychosociale plus profonde que les patients pris en charge en médecine ambulatoire libérale ou ceux ne recevant aucun soin.
De plus, l’utilisation de ces répertoires médicaux exige des protocoles de consentement éclairé stricts et une traçabilité sans faille des extractions de données. Les identifiants directs des patients doivent être neutralisés via des méthodes de pseudonymisation irréversible avant toute exploitation par les équipes d’analyse statistique, sous peine d’enfreindre les chartes internationales de bioéthique et les régulations sanitaires nationales.
4.3 Les bases numériques, panels en ligne et plateformes participatives
L’essor des technologies numériques et de l’Internet a révolutionné la collecte de données en sciences du comportement via l’apparition de plateformes de recrutement participatif en ligne, telles que Prolific, Amazon Mechanical Turk (MTurk), CloudResearch ou les panels commerciaux propriétaires gérés par des instituts de sondage (Qualtrics Panels, YouGov). Ces systèmes mettent à la disposition des laboratoires des bases de plusieurs centaines de milliers de panélistes prêts à participer quasi instantanément à des protocoles expérimentaux moyennant une compensation financière.
Si ces bases numériques garantissent une rapidité de collecte exceptionnelle et permettent de réaliser des études expérimentales complexes à moindre coût, leur nature soulève de vives inquiétudes méthodologiques. La base sous-jacente est intégralement auto-sélectionnée. Les panélistes ne sont pas recrutés selon des mécanismes probabilistes à partir d’une population définie, mais s’inscrivent volontairement sur les plateformes. Cela favorise l’émergence d’une population de répondants « professionnels », hyper-entraînés à déjouer les épreuves d’attention, maîtrisant d’avance les paradigmes classiques de la psychologie cognitive (dilemme du tramway, tâche de Stroop, jeu de l’ultimatum) et développant des attitudes artificielles de conformisme social ou d’optimisation financière.
Les évaluations psychométriques approfondies révèlent que les panélistes en ligne présentent, par rapport à la population générale équivalente sur le plan sociodémographique, des taux significativement plus élevés d’anxiété sociale, d’introversion, de symptômes dépressifs légers et d’isolement relationnel, tout en étant plus jeunes et plus scolarisés. Par conséquent, loin de constituer un miroir de la population globale, ces bases numériques incarnent une niche comportementale spécifique façonnée par les algorithmes de recrutement des plateformes et les incitations monétaires.
4.4 Les bases de sondage aréolaires et géographiques
Lorsque la recherche vise des populations pour lesquelles aucun registre nominatif centralisé n’existe — ce qui est fréquent dans les pays à faible revenu, dans les zones urbaines hautement informelles ou dans les contextes post-catastrophes naturelles —, les chercheurs recourent aux bases de sondage aréolaires (area sampling frames). Dans cette approche cartographique, l’unité de base n’est pas un individu nommé, mais une portion précisément délimitée du territoire physique : un secteur de recensement, un îlot urbain, un district cadastral ou une coordonnée géographique parcellisée par imagerie satellitaire.
La psychologie environnementale, la psychologie sociale communautaire et l’épidémiologie des traumatismes collectifs mobilisent largement ce dispositif. Le protocole s’articule selon une sélection hiérarchique par étapes successives :
- Premier degré : Sélection probabiliste d’unités primaires d’échantillonnage (UPE), telles que des communes ou des îlots urbains délimités par des frontières physiques non ambiguës.
- Deuxième degré : Énumération et sélection systématique de segments plus restreints (rues, blocs d’immeubles).
- Troisième degré : Dénombrement exhaustif in situ de tous les logements physiques présents dans les segments retenus.
- Quatrième degré : Tirage au sort probabiliste d’un individu résident éligible au sein de chaque foyer sélectionné.
L’avantage cardinal de la base aréolaire est de garantir une couverture physique exhaustive sans dépendre de fichiers nominatifs préexistants, neutralisant ainsi les biais de sous-couverture liés aux omissions administratives. Cependant, son talon d’Achille réside dans les coûts opérationnels massifs qu’elle engendre. Le dénombrement physique préalable sur le terrain, l’envoi d’enquêteurs qualifiés et la gestion des disparités géographiques nécessitent des budgets logistiques sans commune mesure avec les enquêtes administrées par voie postale ou numérique.
5. Rôle de la base de sondage dans l’échantillonnage probabiliste
5.1 L’échantillonnage aléatoire simple et sa stricte dépendance à la base
L’échantillonnage aléatoire simple (EAS) constitue la pierre angulaire axiomatique de la théorie statistique de l’échantillonnage. Dans sa modalité sans remise, il accorde à chaque sous-ensemble de taille $n$ extrait d’une population de taille $N$ exactement la même probabilité d’être sélectionné, assurant à chaque unité une probabilité marginale d’inclusion égale à :
$$\pi_i = \frac{n}{N}$$
Cette élégance mathématique s’effondre instantanément si la base de sondage présente des défauts matériels. Pour qu’un algorithme de tirage pseudo-aléatoire moderne (tel que le générateur de Mersenne Twister implémenté dans les environnements statistiques comme R ou Python) fonctionne correctement, la base de sondage doit être structurée sous la forme d’un vecteur ordonné et continu d’unités numérotées de $1$ à $N$, sans discontinuité numérique, sans cases vides et sans duplication d’indices.
Si la base contient des « trous » (indices correspondant à des unités fictives ou supprimées) ou des doublons non documentés, la distribution d’échantillonnage réelle de la moyenne empirique $\bar{y}$ dévie de sa distribution d’échantillonnage théorique. Les propriétés d’absence de biais des estimateurs élémentaires cessent d’être garanties :
$$\mathbb{E}[\bar{y}] \neq \mu$$
La sensibilité de l’échantillonnage aléatoire simple à la pureté de la base est telle que toute négligence dans le contrôle qualité du registre initial se répercute de manière linéaire sur l’exactitude des inférences ultérieures.
5.2 L’échantillonnage stratifié assisté par variables auxiliaires
L’échantillonnage stratifié consiste à scinder la base de sondage en sous-groupes mutuellement exclusifs et collectivement exhaustifs appelés strates, au sein desquels des tirages indépendants sont réalisés. L’objectif méthodologique est d’exploiter les variables auxiliaires (telles que le genre, la tranche d’âge, le niveau socio-éducatif, ou la sévérité d’un tableau clinique) déjà disponibles dans la base de sondage pour accroître considérablement la précision statistique des estimations globales et garantir la représentation adéquate de sous-groupes minoritaires.
La puissance de la stratification dépend entièrement de la fiabilité et de la granularité des attributs descriptifs codés au sein de la base de sondage. Si l’on souhaite réaliser une stratification proportionnelle ou une allocation optimale de Neyman — où la taille d’échantillon allouée à chaque strate $h$ dépend de la variance intra-strate $\sigma_h$ et du coût d’échantillonnage $c_h$ :
$$n_h = n \frac{N_h \sigma_h / \sqrt{c_h}}{\sum_{k=1}^L N_k \sigma_k / \sqrt{c_k}}$$
toute erreur de classification initiale des individus au sein de la base (par exemple un adulte dépressif classé à tort dans la strate asymptomatique) vicie l’allocation mathématique des effectifs. Une classification auxiliaire imprécise entraîne une contamination croisée des strates, diluant les gains d’efficacité statistique attendus et augmentant la variance d’échantillonnage de l’estimateur combiné.
5.3 L’échantillonnage en grappes et hiérarchique
Dans de nombreuses configurations de recherche en psychologie, le coût ou l’impossibilité matérielle de dresser une liste exhaustive d’individus impose le recours à l’échantillonnage en grappes. Dans ce modèle, la base de sondage primaire ne recense pas des personnes individuelles, mais des agrégats institutionnels ou naturels d’individus, appelés grappes (écoles, services hospitaliers, casernes militaires, entreprises).
Ce protocole allège considérablement l’investissement initial : au lieu d’obtenir la liste de tous les écoliers d’un pays, le chercheur n’a besoin que de la liste officielle de tous les établissements scolaires (base primaire). Une fois un échantillon aléatoire d’écoles sélectionné, une base de sondage secondaire est alors dressée localement, répertoriant uniquement les classes ou les élèves appartenant aux établissements retenus. Cette procédure hiérarchique à plusieurs degrés résout des impasses logistiques majeures.
Toutefois, cette économie méthodologique a un coût statistique bien documenté : l’effet de grappe. Les individus regroupés au sein d’une même grappe ont tendance à se ressembler davantage entre eux qu’avec des individus tirés au hasard dans la population globale (homophilie sociale, influences environnementales communes, méthodes pédagogiques identiques). Cette corrélation intra-grappe est quantifiée par le coefficient de corrélation intraclasse ($rho$ ou ICC) :
$$\text{ICC} = \frac{\sigma_b^2}{\sigma_b^2 + \sigma_w^2}$$
où $\sigma_b^2$ représente la variance entre grappes et $\sigma_w^2$ la variance intra-grappe. L’effet de plan qui en résulte ($Deff = 1 + (m – 1)\text{ICC}$, où $m$ est la taille moyenne des grappes) dégrade la précision des estimateurs. Les calculs statistiques doivent impérativement intégrer cette structure hiérarchique via des modèles multiniveaux ou des corrections d’erreurs types de type sandwich (estimateurs robustes de Huber-White), sous peine de sous-estimer drastiquement les erreurs types et de gonfler le taux d’erreurs de type I.
6. Conséquences des erreurs de base de sondage sur la validité de la recherche
6.1 Menaces pour la validité externe et la généralisabilité
L’impact fondamental d’une base de sondage viciée réside dans la destruction de la validité externe des résultats scientifiques. La validité externe désigne la légitimité théorique et empirique permettant d’extrapoler les constats établis sur l’échantillon observé à la population cible au sens large, ainsi qu’à d’autres contextes spatio-temporels. Une confusion tenace persiste dans la littérature entre la représentativité interne de l’échantillon (sa conformité formelle avec la base dont il est extrait) et la représentativité substantielle de la base de sondage elle-même vis-à-vis de l’univers théorique.
Un échantillon peut être parfaitement fidèle à sa base de sondage par le biais d’un tirage probabiliste irréprochable et d’un taux de réponse exceptionnel de 100 %, tout en étant profondément non représentatif de la population cible si la base de sondage a exclu de sa structure 40 % des profils sociodémographiques ou cliniques les plus atypiques. Dès lors, les théories psychologiques échafaudées sur ces données manquent de robustesse face aux réalités écologiques du monde réel.
Ce phénomène explique les échecs cuisants constatés lors de la réplication indépendante de programmes d’intervention psychologique ou pédagogique à grande échelle. Une thérapie comportementale validée initialement auprès d’une cohorte issue d’une base de sondage hyper-sélectionnée (patients hautement motivés, sans comorbidités, issus de milieux socio-économiques favorisés) s’avère souvent inopérante lorsqu’elle est déployée sur le terrain clinique ordinaire, où la population réelle cumule des facteurs de stress et des vulnérabilités structurellement absents de la base d’origine.
6.2 Biais de sélection et distorsion des scores psychométriques
Les imperfections d’une base de sondage exercent des ravages profonds sur les métriques et les propriétés psychométriques des outils d’évaluation. Lorsqu’une base souffre d’un biais de sous-couverture sélectif, les estimations des paramètres distributionnels des traits latents — notamment la moyenne, l’écart-type, l’asymétrie (skewness) et l’aplatissement (kurtosis) — subissent une déformation systématique.
Considérons l’évaluation psychométrique d’un instrument mesurant la résilience psychologique face au stress chronique. Si la base de sondage exclut de facto les individus confrontés à une précarité extrême ou à des traumatismes sévères, la distribution empirique observée des scores sera artificiellement tronquée vers les valeurs supérieures. Plus grave encore, cette restriction de variance distord les coefficients de corrélation de Pearson entre les variables psychologiques via le phénomène bien connu de restriction d’étendue (range restriction). La corrélation observée $r_{xy}$ sous-estimera dramatiquement la véritable corrélation populationnelle $R_{xy}$ :
$$r_{xy} = \frac{R_{xy} \frac{s_x}{S_x}}{\sqrt{1 + R_{xy}^2 \left(\frac{s_x^2}{S_x^2} – 1\right)}}$$
où $s_x$ et $S_x$ désignent respectivement l’écart-type restreint et l’écart-type total non restreint de la variable prédictive.
Cette altération sape directement l’analyse de l’invariance factorielle à travers les groupes (invariance configurationnelle, métrique, scalaire et stricte). Si la structure d’une base de sondage induit une sélection conditionnelle dépendante de variables latentes sous-jacentes, des items d’une échelle psychométrique apparaîtront faussement comme présentant un fonctionnement différentiel d’item (Differential Item Functioning – DIF). Les chercheurs risquent alors d’imputer à des biais d’items ou à des différences psychologiques réelles ce qui ne relève en réalité que d’un artéfact structurel produit par la composition de la base de sondage.
6.3 Impact sur l’inférence causale et la puissance statistique
L’inférence causale, traditionnellement considérée comme l’apanage méthodologique exclusif de l’expérimentation randomisée en laboratoire, est elle-même tributaire de la composition de la base de sondage. Dans les plans quasi-expérimentaux, observationnels ou les grands essais contrôlés randomisés pragmatiques en santé publique, la validité interne des inférences causales dépend de l’absence de facteurs de confusion non mesurés associés au statut de participation.
Si la base de sondage intègre de manière asymétrique certains types d’unités en interaction avec le traitement expérimental — un phénomène formalisé sous le concept d’effet de traitement hétérogène —, l’effet moyen du traitement (Average Treatment Effect – ATE) estimé sur la base divergera substantiellement de l’effet moyen du traitement dans la population globale. Cette divergence introduit un biais d’extrapolation causale irréductible.
Sur le plan de l’inférence inférentielle fréquentiste, les distorsions de la base perturbent gravement le calcul de l’erreur type et de la puissance statistique des tests d’hypothèses :
- Risque d’erreur de type I ($\alpha$) : Le gonflement artificiel de l’homogénéité d’un échantillon extrait d’une base restreinte conduit à une sous-estimation systématique de la variance réelle des estimateurs. Les intervalles de confiance calculés sont trop étroits, et des tests statistiques rejettent indûment l’hypothèse nulle ($H_0$), détectant de faux effets psychologiques ou d’illusoires différences intergroupes.
- Risque d’erreur de type II ($\beta$) : Si le sur-dénombrement ou l’incorporation d’unités étrangères non pertinentes introduit un bruit de mesure aléatoire massif, ou si la sous-couverture réduit drastiquement le volume effectif de participants qualifiés au sein d’un sous-groupe clé, la puissance statistique s’effondre. Le chercheur devient incapable de détecter des effets réels et cliniquement significatifs.
7. Procédures d’audit, de diagnostic et de nettoyage de la base de sondage
7.1 Détection algorithmique des doublons et des incohérences
Avant d’engager tout processus d’extraction ou de tirage probabiliste, la base de sondage brute doit impérativement faire l’objet d’un audit de nettoyage rigoureux et documenté. La première étape méthodologique consiste à identifier et neutraliser les doublons réels et cachés. Si la détection d’identifiants strictement identiques relève d’une simple requête informatique élémentaire, la traque des doublons fragmentaires exige des techniques d’appariement probabiliste sophistiquées (probabilistic record linkage), telles que le modèle de Fellegi et Sunter.
Ces protocoles appliquent des algorithmes de calcul de distance textuelle et de logique floue (fuzzy matching), notamment la distance de Levenshtein ou la distance de Jaro-Winkler, pour déceler les variations orthographiques de noms de famille, les inversions de prénoms, les fautes de frappe dans les adresses postales ou les discordances mineures de dates de naissance :
$$d_J(s_1, s_2) = \frac{1}{3}\left(\frac{m}{|s_1|} + \frac{m}{|s_2|} + \frac{m – t}{m}\right)$$
où $m$ représente le nombre de caractères correspondants et $t$ le nombre de transpositions. Une fois les correspondances potentielles signalées au-dessus d’un seuil statistique de similarité prédéfini, un arbitrage décisionnel déterministe est opéré pour fusionner les entrées ou éliminer l’enregistrement redondant.
Parallèlement, la cohérence interne des attributs doit être scrupuleusement vérifiée à travers des filtres logiques conditionnels : incohérences chronologiques (date de délivrance d’un diplôme antérieure à la date de naissance), valeurs aberrantes de variables démographiques ou codes postaux incompatibles avec les identifiants territoriaux. Chaque modification, fusion ou suppression opérée dans la base doit être consignée dans un journal d’audit crypté et horodaté garantissant la traçabilité intégrale de la préparation des données.
7.2 Benchmarking et confrontation avec des sources externes indépendantes
L’audit de la qualité d’une base de sondage ne peut se limiter à une vérification intrinsèque ; il requiert une confrontation externe systématique, appelée benchmarking démographique. Cette procédure consiste à comparer les distributions marginales des variables sociodémographiques fondamentales contenues dans la base de sondage avec les données de référence publiées par des organismes de statistique publique faisant autorité (tels que l’INSEE en France, Eurostat ou le Bureau du recensement des États-Unis).
Le chercheur compare les proportions observées dans sa base avec les distributions populationnelles connues concernant :
- La pyramide des âges par tranches décennales fines.
- La répartition des sexes selon les classes d’âge.
- La distribution des niveaux d’instruction formelle (absence de diplôme, enseignement secondaire, enseignement supérieur).
- La structure socioprofessionnelle et les indices de statut socio-économique territorialisés.
Des écarts statistiques majeurs — mis en évidence par des tests de conformité du chi-deux ($\chi^2$) ou par le calcul d’indices de dissimilarité de Duncan — signalent immédiatement des déficits structurels de couverture. Dans le champ de la santé mentale et de l’épidémiologie clinique, le benchmarking confronte également la prévalence observée des pathologies répertoriées dans la base avec les estimations issues de grandes enquêtes épidémiologiques en population générale.
Lorsque la taille exacte de la population cible est inconnue, les chercheurs utilisent les techniques de capture-recapture à double source. En croisant deux listes indépendantes $A$ et $B$ d’une même population marginalisée, le nombre total d’individus dans l’univers ($N$) peut être estimé via l’estimateur classique de Lincoln-Petersen :
$$\hat{N} = \frac{n_A \times n_B}{m_{AB}}$$
où $n_A$ et $n_B$ sont les effectifs respectifs des deux listes, et $m_{AB}$ le nombre d’individus figurant simultanément dans les deux sources, permettant ainsi de quantifier précisément l’ampleur de la fraction non répertoriée ($N – (n_A + n_B – m_{AB})$).
7.3 Calcul quantitatif des taux de couverture
Une formalisation quantitative méticuleuse de la couverture constitue un impératif déontologique dans toute publication scientifique empirique. Les statisticiens distinguent traditionnellement plusieurs ratios pour évaluer la qualité du cadre d’échantillonnage :
Le taux de couverture brut ($CR_{\text{brut}}$) se définit comme le rapport arithmétique simple entre le nombre total d’unités inscrites dans la base de sondage ($N_{\text{base}}$) et l’effectif réel estimé de la population cible ($N_{\text{cible}}$) :
$$CR_{\text{brut}} = \frac{N_{\text{base}}}{N_{\text{cible}}} \times 100$$
Ce taux brut peut s’avérer trompeur s’il masque des effets compensatoires : un sur-dénombrement massif peut mathématiquement masquer un sous-dénombrement tout aussi dramatique, donnant l’illusion d’un ratio proche de 100 %.
Il est donc impératif de calculer le taux de couverture net ($CR_{\text{net}}$), qui ne prend en compte que les unités de la base appartenant véritablement et légitimement à la population cible ($N_{\text{base} \cap \text{cible}}$) :
$$CR_{\text{net}} = \frac{N_{\text{base} \cap \text{cible}}}{N_{\text{cible}}} \times 100$$
Le taux de sous-couverture net ($UCR$) s’en déduit directement : $UCR = 100 – CR_{\text{net}}$. Dans la recherche en sciences comportementales, un taux de couverture net supérieur à 90 % est généralement jugé satisfaisant pour des inférences standard de population générale. Entre 80 % et 90 %, des procédures correctives de redressement statistique (post-stratification par calage sur marges via l’algorithme raking ratio) sont rigoureusement requises. En deçà de 75-80 %, la base présente des failles structurelles majeures qui doivent être documentées de manière transparente dans la section « Méthode » et discutées parmi les limites incontournables de l’étude.
8. Stratégies méthodologiques face à l’absence de base de sondage accessible
8.1 L’échantillonnage en boule de neige (Snowball Sampling)
Dans de nombreuses situations d’investigation psychologique ou sociologique, il n’existe absolument aucune base de sondage disponible. Cette impasse survient systématiquement lors de l’étude de ce que la sociologie quantitative qualifie de « populations cachées » ou difficiles à atteindre (hard-to-reach populations) : consommateurs de substances illicites, travailleurs du sexe, individus souffrant de paraphilies stigmatisées, ou personnes vivant avec des troubles psychiques rares non diagnostiqués officiellement.
La stratégie historique la plus immédiate pour pallier cette absence de cadre institutionnel est l’échantillonnage en boule de neige (snowball sampling). Le protocole débute par l’identification d’un petit noyau initial de participants éligibles (« graines » ou seeds) issus des réseaux directs du chercheur ou d’organisations de terrain. Après avoir complété le protocole de recherche, il est demandé à chaque participant d’identifier et de recruter activement un ou plusieurs membres de son réseau personnel partageant les critères d’admissibilité de l’étude, déclenchant ainsi un processus de chaînage itératif.
Si cette méthode permet d’accéder à des sous-populations hautement imperméables aux registres classiques, elle souffre de tares statistiques rédhibitoires pour l’inférence probabiliste :
- Les probabilités d’inclusion individuelles demeurent rigoureusement inconnues et incalculables.
- L’échantillon final est lourdement tributaire des caractéristiques psychosociales des « graines » initiales.
- Le processus est dominé par le biais d’homophilie : les individus tendent à entretenir des liens sociaux avec des personnes qui leur ressemblent étroitement sur le plan de la classe sociale, de l’appartenance ethnique ou de la sévérité clinique, induisant une autocorrélation massive des données et isolant les individus socialement marginalisés au sein même de la population cachée.
8.2 L’échantillonnage guidé par les répondants (Respondent-Driven Sampling – RDS)
Pour dépasser les limites intrinsèques de l’échantillonnage en boule de neige tout en opérant en l’absence de base de sondage préalable, Douglas Heckathorn a formalisé à la fin des années 1990 une méthodologie probabiliste innovante : l’échantillonnage guidé par les répondants (Respondent-Driven Sampling – RDS). Cette approche combine un protocole d’incitations financières croisées (double système de rémunération : pour sa propre participation et pour chaque pair recruté avec succès) avec un cadre mathématique rigoureux fondé sur la théorie des chaînes de Markov et les processus de réseaux réguliers.
Le RDS impose des règles de recrutement très strictes :
- Le chercheur sélectionne un petit nombre de graines hétérogènes.
- Chaque répondant reçoit un nombre strictement limité de coupons de recrutement numérotés (généralement 2 ou 3) pour solliciter des pairs.
- Le chaînage de recrutement se poursuit à travers de nombreuses vagues successives (idéalement plus de 5 ou 6 vagues) jusqu’à atteindre un état d’équilibre statistique stable, indépendant des graines de départ.
- Chaque participant déclare avec précision la taille de son réseau personnel pertinent (le nombre d’individus éligibles qu’il connaît personnellement).
En modélisant la dynamique de propagation sur le réseau sous-jacent, le RDS génère une approximation probabiliste où la probabilité d’inclusion d’un individu est inversement proportionnelle à son degré social (la taille de son réseau personnel, notée $d_i$). Les estimateurs de type Volz-Heckathorn pondèrent ensuite chaque observation par cette métrique :
$$\hat{\mu}_{\text{RDS}} = \frac{\sum_{i=1}^n \frac{y_i}{d_i}}{\sum_{i=1}^n \frac{1}{d_i}}$$
Le RDS permet ainsi de reconstituer formellement les propriétés d’une base de sondage théorique virtuelle en s’affranchissant du biais d’homophilie des réseaux, ce qui en fait aujourd’hui l’instrument privilégié en psychologie de la santé publique et en épidémiologie comportementale des populations hautement marginalisées.
8.3 L’échantillonnage spatio-temporel (Time-Space Sampling)
L’échantillonnage spatio-temporel (Time-Space Sampling – TSS, ou venue-based sampling) constitue une alternative probabiliste robuste pour atteindre des populations qui ne disposent d’aucun registre individuel centralisé, mais qui se rassemblent physiquement de manière régulière dans des espaces publics ou semi-privés identifiables. Cette technique est largement déployée dans les recherches auprès des personnes sans domicile fixe (structures d’hébergement d’urgence, soupes populaires), des minorités sexuelles et de genre (bars associatifs, centres communautaires), ou des usagers de drogues injectables (salles de consommation à moindre risque).
La singularité méthodologique du TSS réside dans la construction délibérée d’une base de sondage dont les unités primaires ne sont pas des individus, mais des intersections d’unités de temps et d’espace. Le processus s’organise selon un protocole précis :
- Phase ethnographique préparatoire : Cartographie exhaustive des sites géographiques fréquentés par la population cible et de leurs plages horaires d’affluence.
- Création du cadre spatio-temporel : Formalisation d’une grille répertoriant l’ensemble des blocs de 4 heures croisés avec chaque lieu identifié (par exemple : « Lieu A, mardi 14h-18h », « Lieu B, vendredi 20h-00h »).
- Tirage aléatoire primaire : Sélection probabiliste d’un échantillon de créneaux spatio-temporels au sein de cette base.
- Échantillonnage in situ : Une équipe de chercheurs se déploie sur le site sélectionné durant l’intervalle temporel fixé, trace une ligne de démarcation visuelle et intercepte de manière systématique (par exemple un individu sur trois franchissant la ligne) les personnes présentes pour leur administrer le protocole.
Cette démarche confère à chaque individu une probabilité d’inclusion calculable, corrélée au nombre de fois où il fréquente les sites identifiés durant les plages horaires considérées, restituant ainsi les exigences formelles du paradigme probabiliste au sein d’environnements dépourvus de répertoires nominatifs.
9. Utilisation de bases de sondage multiples (Dual and Multiple Frame Sampling)
9.1 Principes théoriques de la méthode à base double
Face à l’impossibilité pratique de trouver une base de sondage unique à la fois exhaustive, économique et actualisée, les méthodologistes contemporains privilégient de plus en plus l’approche par bases multiples (multiple frame sampling), dont la déclinaison la plus courante est l’échantillonnage à base double (dual frame sampling). Cette stratégie théorique, introduite par H. O. Hartley en 1962, repose sur la combinaison intentionnelle et synergique de deux listes distinctes ou de deux protocoles d’accès différents dont l’union permet de recouvrir l’intégralité de la population cible à un coût maîtrisé.
Le paradigme d’application classique en recherche comportementale est l’articulation des annuaires de téléphonie fixe (Base A) et des plages de numéros de téléphonie mobile (Base B). La base fixe garantit une couverture solide et peu coûteuse des populations plus âgées et sédentaires, mais omet dramatiquement les jeunes générations et les ménages mobiles (sous-couverture). Inversement, la base mobile touche de manière exhaustive les tranches d’âge jeunes et actives, mais présente des coûts opérationnels accrus de filtrage et des taux d’attrition plus marqués. La conjonction mathématique des deux bases permet d’englober la totalité du corps social.
La structure formelle découpe la population cible en trois domaines mutuellement exclusifs :
- Le domaine $a$ : individus présents exclusivement dans la base A.
- Le domaine $b$ : individus présents exclusivement dans la base B.
- Le domaine $ab$ : zone de chevauchement (individus présents simultanément dans la base A et la base B).
L’enjeu méthodologique majeur réside alors dans la gestion mathématique de ce chevauchement central : les unités appartenant au domaine $ab$ ont une probabilité accrue d’être sélectionnées puisqu’elles peuvent être tirées soit par la base A, soit par la base B, ce qui nécessite des ajustements statistiques stricts.
9.2 Modèles d’estimation et pondération pour bases chevauchantes
Pour neutraliser le risque de double comptabilisation et dériver des estimateurs sans biais à partir de bases de sondage chevauchantes, les statisticiens ont développé des formulations mathématiques rigoureuses. L’estimateur pionnier de Hartley propose une combinaison linéaire convexe des estimateurs calculés sur les différents domaines :
$$\hat{Y}_{\text{Hartley}} = \hat{Y}_a + \theta \hat{Y}_{ab}^{(A)} + (1 – \theta) \hat{Y}_{ab}^{(B)} + \hat{Y}_b$$
où $\hat{Y}_a$ et $\hat{Y}_b$ sont les totaux estimés pour les domaines exclusifs, $\hat{Y}_{ab}^{(A)}$ est l’estimation du domaine de chevauchement issue de l’échantillon extrait de la base A, $\hat{Y}_{ab}^{(B)}$ est l’estimation du même domaine issue de l’échantillon de la base B, et $\theta$ est un paramètre de pondération arbitraire compris entre 0 et 1 ($0 le \theta le 1$). La théorie statistique montre que la variance de l’estimateur combiné est minimisée lorsque $\theta$ est choisi proportionnellement à la variance relative et aux coûts d’échantillonnage associés à chaque base.
Des approches plus récentes, telles que celles de Fuller-Burmeister ou les pseudo-estimateurs du maximum de vraisemblance de Skinner et Rao, intègrent des mécanismes d’étalonnage plus puissants permettant d’estimer conjointement les paramètres démographiques et psychopathologiques en présence de données catégorielles et continues. Dans les environnements logiciels spécialisés comme le package survey sous R ou les modules de complexes samples sous SPSS, le calcul de ces poids composites est automatisé dès lors que le statut d’appartenance au domaine de chevauchement ($ab$) est explicitement codé pour chaque répondant via une question de cadrage standardisée (« Disposez-vous d’une ligne téléphonique fixe à votre domicile en plus de votre téléphone mobile personnel ? »).
9.3 Applications empiriques en épidémiologie psychiatrique
L’échantillonnage à base double a démontré une efficacité spectaculaire dans le champ de l’épidémiologie psychiatrique et de la santé mentale communautaire. Dans de nombreuses enquêtes nationales visant à quantifier la prévalence des troubles psychotiques, des états dépressifs majeurs ou des conduites suicidaires, l’utilisation d’une base de sondage unique en population générale (par exemple par numérotation téléphonique aléatoire ou registre d’adresses postales) sous-estime massivement la prévalence des pathologies les plus sévères.
En réponse à ce défi, des programmes d’envergure combinent :
- Une base de population générale (assurant la capture des formes légères, modérées et des individus non suivis par le système de santé).
- Une base clinique spécialisée, constituée des registres d’admissions des services d’urgence psychiatrique, des centres médico-psychologiques et des cliniques privées de santé mentale de la même aire géographique (assurant la capture rigoureuse des formes aiguës et sévères).
Cette synergie méthodologique permet d’obtenir un continuum clinique complet. Elle résout le problème de l’exclusion des patients institutionnalisés ou temporairement désocialisés tout en évitant le biais institutionnel pur d’une cohorte strictement hospitalière. La détermination de la probabilité conjointe d’appartenance à l’intersection des deux listes s’effectue au moyen d’un questionnaire d’anamnèse court vérifiant si le patient tiré de la base générale a consulté un service spécialisé au cours de la période d’observation, autorisant l’application sans biais des estimateurs composites.
10. Considérations éthiques, déontologiques et réglementaires
10.1 Protection des données personnelles et conformité au RGPD
La constitution, l’acquisition et la manipulation d’une base de sondage nominative s’inscrivent dans un cadre légal particulièrement rigide, dicté en Europe par le Règlement Général sur la Protection des Données (Règlement UE 2016/679 – RGPD) et les législations équivalentes à l’échelle internationale. L’élaboration d’un cadre d’échantillonnage requiert impérativement une base légale formelle au sens de l’article 6 du RGPD, qu’il s’agisse de l’exécution d’une mission d’intérêt public, de la recherche scientifique autorisée ou du consentement explicite des personnes fichées.
Le principe fondamental de minimisation des données (Article 5 du RGPD) interdit formellement de collecter et d’agréger dans la base de sondage des variables descriptives accessoires ou disproportionnées au regard des nécessités strictes de l’échantillonnage. Par exemple, si la stratification statistique requiert uniquement l’âge et la région administrative, le stockage du numéro de sécurité sociale complet ou des détails des revenus au sein du fichier de contact de travail constitue une violation légale manifeste.
Lorsque la base de sondage implique des données de santé mentale ou des profils psychopathologiques — considérées comme des données de catégorie particulière (sensibles) au sens de l’Article 9 —, les exigences de sécurité s’élèvent drastiquement. Les chercheurs sont tenus de mettre en œuvre des protocoles de pseudonymisation immédiats : le fichier de contact contenant les identités civiles doit être dissocié physiquement et informatiquement de la base des données de recherche, les deux étant reliés uniquement par une clé cryptographique stockée sur un serveur sécurisé distinct, accessible uniquement à un délégué à la protection des données ou à un gestionnaire d’échantillon indépendant de l’équipe de modélisation.
10.2 Consentement éclairé et collecte passive d’identifiants
L’une des tensions déontologiques les plus délicates dans l’utilisation des bases de sondage institutionnelles réside dans la collecte passive d’identifiants. Dans de nombreux protocoles nationaux, les individus sont inclus dans une base de sondage issue d’un registre d’état civil, d’un registre scolaire ou d’une liste administrative sans en avoir été préalablement avertis individuellement au moment de leur inscription institutionnelle. Cette configuration soulève l’opposition structurelle entre le modèle de consentement explicite préalable (opt-in) et le modèle de droit d’opposition a posteriori (opt-out).
Le cadre éthique international de la recherche sur l’être humain tolère l’utilisation de registres sans consentement préalable pour l’étape exclusive de la constitution de la base de tirage, à la condition stricte que le premier contact opérationnel avec le participant sélectionné soit consacré à une information complète, loyale et transparente sur l’origine exacte de ses coordonnées. Le chercheur doit expliciter avec précision :
- L’organisme officiel ayant communiqué le fichier source.
- La base légale et les finalités scientifiques exclusives du projet.
- Le droit absolu et inconditionnel du participant de refuser de poursuivre, sans justification requise.
- L’exercice immédiat du droit d’accès, de rectification et d’effacement définitif de ses coordonnées de la base de l’enquête (Article 17 du RGPD).
L’obtention du consentement éclairé formel doit précéder le recueil de la moindre variable psychologique ou cognitive substantielle, marquant la frontière étanche entre le statut de cible potentielle dans la base et celui de participant volontaire à l’étude.
10.3 Responsabilité éthique envers les populations vulnérables
La gestion d’une base de sondage répertoriant des populations vulnérables — enfants, personnes sous tutelle ou curatelle, réfugiés en situation d’insécurité juridique, individus souffrant de troubles psychiatriques débilitants ou de tendances suicidaires — engage une responsabilité morale accrue de la part des chercheurs. Le danger premier est le risque de stigmatisation institutionnelle : l’inscription d’un individu dans un registre identifié comme « cohorte de schizophrénie » ou « base d’étude des comportements délinquants » fait peser une menace grave sur sa réputation et sa dignité si l’intégrité du fichier venait à être compromise par une fuite de données.
Les Comités de Protection des Personnes (CPP) et les comités d’éthique de la recherche institutionnels (IRB) procèdent à une balance bénéfice/risque minutieuse avant d’autoriser l’extraction d’identifiants. Ils évaluent si la nécessité méthodologique d’une base de sondage probabiliste l’emporte sur les risques d’intrusion dans la vie privée, et exigent des mesures de cyber-sécurité maximales : chiffrement AES-256 bits des répertoires d’échantillonnage, politiques strictes de contrôle d’accès fondées sur les rôles, et engagement formel de destruction irréversible des fichiers nominatifs dès l’achèvement de la phase d’administration de terrain.
11. Études de cas appliquées en psychologie et sciences cognitives
11.1 Enquête sur la santé mentale des étudiants universitaires
Pour illustrer concrètement la gestion des compromis liés à la base de sondage, analysons le cas d’une vaste enquête épidémiologique consacrée à la dépression et aux idéations suicidaires chez les étudiants d’un pôle métropolitain regroupant 80 000 inscrits. La population cible est définie comme l’ensemble des étudiants légalement inscrits pour l’année universitaire en cours au sein des établissements publics d’enseignement supérieur de l’académie.
La base de sondage mobilisée est issue des registres d’immatriculation administrative des bureaux de la scolarité centrale. L’audit préalable de la liste révèle immédiatement plusieurs anomalies de couverture critiques :
- Sous-couverture : Omission systématique des étudiants inscrits en programmes d’échanges internationaux (Erasmus) gérés sur des fichiers parallèles, et des étudiants en situation de suspension temporaire d’études (césure pour motif de santé). Or, ces deux groupes présentent potentiellement des niveaux accrus d’isolement social ou de vulnérabilité psychologique.
- Sur-couverture : Présence de 4 % d’étudiants ayant abandonné leurs études au cours du premier trimestre ou inscrits formellement sans fréquenter l’université.
Pour y remédier, l’équipe a déployé un protocole d’harmonisation en intégrant manuellement les fichiers du bureau des relations internationales et en insérant une question de filtrage lors du contact numérique pour écarter les unités inéligibles. Après administration du questionnaire sur un échantillon probabiliste stratifié par filière d’études et cycle académique (Licence, Master, Doctorat), un biais de non-réponse lié au genre est apparu (taux de réponse de 42 % chez les étudiantes contre seulement 21 % chez les étudiants masculins). L’équipe a corrigé ce décalage au moyen d’une post-stratification par calage sur marges sur la base des effectifs réels connus du registre académique d’origine, restaurant ainsi la validité distributionnelle des scores de l’échelle PHQ-9.
11.2 Évaluation de l’épuisement professionnel (burnout) en milieu hospitalier
La direction d’un centre hospitalier universitaire (CHU) de 6 000 salariés commande une évaluation psychométrique indépendante de l’épuisement professionnel (burnout via l’inventaire MBI de Maslach) auprès de l’ensemble du personnel soignant (médecins, infirmiers, aides-soignants). La base de sondage opérationnelle est extraite du progiciel de gestion intégrée de la Direction des Ressources Humaines (DRH).
L’obstacle méthodologique majeur réside dans la formidable instabilité temporelle du cadre d’échantillonnage : le secteur de la santé est caractérisé par un turnover élevé, le recours massif à des vacataires temporaires, des congés parentaux prolongés, des arrêts maladie longue durée et des mobilités internes inter-services quotidiennes. Si la base est extraite le 1er janvier et que le recueil se déploie en avril, 15 % des affectations de services sont devenues obsolètes.
La solution méthodologique a consisté en la mise en place d’une base de sondage dynamique actualisée hebdomadairement par liaison API directe avec le registre RH jusqu’au jour exact du tirage au sort probabiliste. Une stratification non proportionnelle par catégorie de métier a été appliquée pour suréchantillonner les aides-soignants de nuit — profession historiquement sous-représentée dans les enquêtes institutionnelles bien qu’exposée à une pénibilité accrue. Les poids de sondage ont été calibrés pour refléter les probabilités inégales d’inclusion, garantissant une estimation sans biais du score d’épuisement émotionnel à l’échelle de l’établissement tout entier.
11.3 Étude longitudinale sur le déclin cognitif chez les personnes âgées
Considérons une recherche longitudinale prospective sur dix ans s’intéressant à l’évolution des marqueurs précoces de la maladie d’Alzheimer chez les personnes âgées de 75 ans et plus résidant à domicile. L’absence de registre unique répertoriant exhaustivement le lieu de résidence des personnes âgées non institutionnalisées impose une stratégie à base double croisant les listes électorales municipales et les fichiers d’une caisse d’assurance retraite régionale.
Le diagnostic de couverture met en lumière un phénomène de sous-dénombrement sélectif particulièrement critique : les personnes âgées entrant dans les premières phases du déclin cognitif ou de la perte d’autonomie ont une probabilité significativement plus élevée que les autres de ne plus être inscrites sur les listes électorales (démarche de désinscription passive ou absence de mise à jour lors de l’emménagement chez un proche aidant). De plus, l’isolement social sévère corrèle négativement avec la présence sur les registres associatifs locaux.
Pour contrer ce biais d’exclusion, l’équipe a couplé le tirage initial avec un protocole de repérage spatio-temporel auprès des pharmacies d’officine et des services de soins infirmiers à domicile (SSIAD). Au cours des vagues d’observation successives (Vague 1 à l’inclusion, Vague 2 à 3 ans, Vague 3 à 6 ans), la gestion de l’attrition sélective (due aux décès, aux entrées en EHPAD et aux refus consécutifs à l’aggravation de la maladie) a nécessité la réinjection de cohortes de rafraîchissement (refreshment samples) issues de versions actualisées de la base de sondage, traitées par des modèles d’équations structurelles à variables latentes pondérées.
12. Guide pratique pour concevoir, auditer et maintenir une base de sondage rigoureuse
12.1 Démarche séquentielle : De la question de recherche à la base finalisée
L’élaboration d’une base de sondage scientifique ne s’improvise pas au coup par coup sur le terrain ; elle exige une planification méthodique séquentielle en quatre phases fondamentales :
- Phase 1 : Formalisation théorique des critères d’admissibilité
Définition opérationnelle sans ambiguïté des bornes de la population cible. Les critères d’inclusion (tranches d’âge, critères diagnostiques, localisation géographique, statuts institutionnels) et d’exclusion doivent être formalisés par écrit dans le protocole de recherche avant toute quête de données matérielles.
- Phase 2 : Cartographie et inventaire critique des sources disponibles
Recension exhaustive des registres, listes administratives, annuaires ou plateformes capables de fournir une prise matérielle sur la population. Évaluation critique de chaque source : degré de complétude estimé, réputation de l’organisme émetteur, fraîcheur des données et légalité de l’accès au regard du RGPD.
- Phase 3 : Évaluation comparative des coûts et faisabilité
Arbitrage économique et logistique entre l’achat de bases commerciales, la négociation d’accords d’accès avec des institutions publiques, le coût de mise en conformité de bases imparfaites et l’alternative de protocoles spatio-temporels ou RDS en cas d’impossibilité d’obtenir une liste propre.
- Phase 4 : Standardisation, nettoyage et codage
Harmonisation typographique des variables (noms, adresses, dates), suppression des espaces parasites, uniformisation des codages manquants, normalisation des identifiants uniques et vérification algorithmique de l’absence de doublons.
12.2 Protocoles de maintenance et d’actualisation pour études longitudinales
Dans les devis de recherche longitudinale et les études de cohortes en psychologie du développement ou de la santé, le maintien de la base d’échantillonnage constitue une activité continue vitale. Dès lors qu’une cohorte est suivie sur plusieurs mois ou années, la base de sondage d’origine perd progressivement de sa validité empirique sous l’effet conjugué des déménagements, des changements de coordonnées électroniques et des modifications de structure familiale.
Les protocoles de maintenance exemplaires intègrent des cycles réguliers de confirmation de coordonnées :
- Envoi trimestriel de lettres de liaison, d’infolettres numériques ou de messages SMS contenant un lien sécurisé permettant aux participants de mettre à jour leurs coordonnées en cas de changement d’adresse (maintien du lien relationnel).
- Utilisation des fichiers officiels de suivi des changements d’adresses (par exemple les services de réexpédition postale ou les bases de données d’abonnés postaux).
- Mise en place d’un protocole de gestion standardisée des défections : tout retour de pli avec la mention « N’habite plus à l’adresse indiquée » ou toute notification d’adresse de messagerie invalide doit être immédiatement documenté dans le fichier maître avec la date d’apparition du dysfonctionnement.
- Pour les études à cohortes ouvertes, prévision de règles formelles d’intégration de nouveaux entrants (flux de renouvellement lié au vieillissement naturel de la population) afin de prévenir le vieillissement artificiel de la cohorte initiale.
12.3 Grille d’évaluation critique de la base pour chercheurs et évaluateurs
Pour assurer la transparence méthodologique et satisfaire aux exigences des comités de lecture des revues internationales de premier rang (APAs, Elsevier, Frontiers), tout chercheur soumettant un manuscrit empirique devrait vérifier la conformité de sa base de sondage à l’aide de la grille synthétique suivante :
- Transparence de la source : L’origine exacte, la nature institutionnelle et la date de génération de la base de sondage sont-elles explicitement décrites dans la section « Participants » ou « Méthode » ?
- Adéquation populationnelle : La divergence structurelle entre la population cible théorique et les unités indexées dans la base de sondage a-t-elle été formellement discutée ?
- Quantification de la couverture : Les taux de couverture bruts ou nets sont-ils calculés, ou à défaut, les omissions systématiques sont-elles identifiées et argumentées sur le plan théorique ?
- Déduplication et assainissement : Les procédures algorithmiques mobilisées pour purger les doublons, les valeurs aberrantes et les enregistrements non admissibles sont-elles détaillées ?
- Correction des probabilités inégales : Si la base présente une structure en grappes, des duplications inévitables ou des inclusions inégales, des facteurs de pondération statistique inverses ont-ils été appliqués lors de l’estimation des paramètres ?
- Conformité éthique : Le fondement juridique de l’utilisation de la base nominative (consentement, autorisation réglementaire type CNIL/IRB, pseudonymisation) est-il formellement consigné ?
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Cochran, W. G. (1977). Sampling techniques (3rd ed.). John Wiley & Sons. https://www.wiley.com/en-us/Sampling+Techniques%2C+3rd+Edition-p-9780471162407
Fellegi, I. P., & Sunter, A. B. (1969). A theory for record linkage. Journal of the American Statistical Association, 64(328), 1183–1210. https://doi.org/10.1080/01621459.1969.10501049
Groves, R. M., Fowler, F. J., Couper, M. P., Lepkowski, J. M., Singer, E., & Tourangeau, R. (2009). Survey methodology (2nd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118778357
Hartley, H. O. (1962). Multiple frame surveys. Proceedings of the Social Statistics Section, American Statistical Association, 203–206.
Heckathorn, D. D. (1997). Respondent-driven sampling: A new approach to the study of hidden populations. Social Problems, 44(2), 174–199. https://doi.org/10.2307/3096941
Henrich, J., Heine, S. J., & Norenzayan, A. (2010). The weirdest people in the world? Behavioral and Brain Sciences, 33(2-3), 61–83. https://doi.org/10.1017/S0140525X0999152X
Horvitz, D. G., & Thompson, D. J. (1952). A generalization of sampling without replacement from a finite universe. Journal of the American Statistical Association, 47(260), 663–685. https://doi.org/10.1080/01621459.1952.10483446
Kish, L. (1965). Survey sampling. John Wiley & Sons.
Lohr, S. L. (2021). Sampling: Design and analysis (3rd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9780429298899
Skinner, C. J., & Rao, J. N. K. (1996). Estimation in dual frame surveys with complex designs. Journal of the American Statistical Association, 91(433), 349–356. https://doi.org/10.1080/01621459.1996.10476694
Volz, E., & Heckathorn, D. D. (2008). Probability based estimation with respondent-driven sampling. Journal of Official Statistics, 24(1), 79–97.