
Dans le vaste champ de la modélisation statistique, de l’économétrie contemporaine et de la psychométrie quantitative, l’élucidation des mécanismes générateurs de données constitue l’ambition fondamentale de la démarche scientifique. Qu’il s’agisse d’estimer la trajectoire de rémission d’une cohorte clinique en fonction de biomarqueurs spécifiques, de prédire le rendement d’un actif financier sous des chocs macroéconomiques, ou de disséquer les déterminants cognitifs de l’apprentissage chez l’enfant, l’analyste se heurte invariablement à la nécessité de formaliser des relations fonctionnelles entre des entités théoriques observables. Au cœur de cette architecture se déploie une dichotomie fondamentale : celle qui sépare l’événement ou l’état que l’on cherche à comprendre de la multitude de facteurs mobilisés pour rendre compte de ses fluctuations. C’est précisément au sein de cet espace opératoire que s’enracine la notion de régresseur.
Le terme de régresseur désigne rigoureusement toute entité analytique insérée dans un modèle probabiliste ou déterministe dans le dessein d’exercer une fonction de levier explicatif ou prédictif à l’égard d’une variable cible. Loin d’être une simple commodité technique réservée aux logiciels de calcul matriciel, le régresseur incarne le support opératoire par lequel la théorie substantielle s’incarne dans les équations. Il traduit mathématiquement une hypothèse formulée sur le monde réel, transformant une intuition qualitative — l’influence du temps de sommeil sur l’attention soutenue, ou l’incidence de l’inflation sur les arbitrages de consommation — en une quantité mesurable, paramétrable et réfutable au sens de la logique poppérienne. Comprendre la nature intrinsèque d’un régresseur implique dès lors d’explorer sa genèse épistémologique, ses propriétés géométriques dans l’espace euclidien des observations, ainsi que les contraintes strictes qui conditionnent la validité de son interprétation.
Pourtant, la manipulation des régresseurs s’accompagne d’une complexité méthodologique souvent sous-estimée dans les applications empiriques superficielles. Selon les cadres disciplinaires et les traditions épistémiques, ce concept s’hybride sous les appellations de variable explicative, de covariable, de prédicteur ou d’attribut algorithmique, chacune de ces déclinaisons véhiculant des exigences formelles et des prétentions causales singulières. De la régression bivariée minimale héritée du dix-neuvième siècle aux raffinements des pénalisations régularisées de haute dimension et aux formalismes causaux modernes régis par les graphes acycliques dirigés, la stature du régresseur a subi d’incessantes métamorphoses. Ce traité exhaustif propose une exploration systématique et approfondie du concept de régresseur, en articulant rigueur mathématique, clarté conceptuelle et illustrations concrètes au sein des sciences humaines et de la modélisation quantitative.
1. Définition fondamentale du concept de régresseur en statistique
1.1 Origine épistémologique et conceptualisation formelle
D’un point de vue formel et canonique, le régresseur est défini comme une variable mathématique ou empirique servant de support d’estimation à l’intérieur d’un modèle statistique conditionnel. Dans le paradigme des espaces de probabilité, si l’on considère une variable aléatoire réelle $Y$ mesurable sur un espace donné, l’objectif fondamental de la régression consiste à caractériser la loi conditionnelle de $Y$ sachant un ensemble d’informations structurées. Le régresseur constitue précisément l’élément constitutif de cet ensemble conditionnant. Il s’agit de la coordonnée selon laquelle l’analyste segmente la population ou l’échantillon pour examiner les variations systématiques du phénomène sous étude. Cette posture sépare immédiatement la variable d’entrée de la variable de sortie au sein des modèles déterministes et stochastiques : le régresseur se situe en amont du processus de projection fonctionnelle, endossant le statut de variable exogène ou supposée connue dans le calcul de la distribution d’arrivée.
L’ascendance historique de cette construction remonte aux travaux pionniers de Sir Francis Galton à la fin du dix-neuvième siècle. En étudiant la transmission héréditaire de la taille humaine entre les générations parentales et filiales, Galton mit en évidence une tendance géométrique remarquable : les enfants de parents exceptionnellement grands ou exceptionnellement petits présentaient une stature moyenne qui se rapprochait systématiquement de la moyenne générale de la population. Il baptisa ce phénomène « régression vers la médiocrité » (regression towards mediocrity), expression qui fut ultérieurement simplifiée sous le vocable de « régression vers la moyenne ». Dans ce modèle originel, la stature parentale constituait le premier régresseur formalisé de l’histoire statistique, c’est-à-dire l’axe de référence par rapport auquel s’évaluait le repli proportionnel de la descendance vers l’espérance globale du groupe biologique.
Au-delà de cette genèse anthropométrique, la portée heuristique du concept s’est émancipée de l’acception galtonienne de repli pour embrasser l’ensemble des techniques de paramétrisation des phénomènes observables. Modéliser le réel par l’intermédiaire de régresseurs revient à postuler que la variance brute observée dans un système n’est pas le produit exclusif d’un chaos indéchiffrable ou d’un bruit blanc invariant, mais qu’elle se compose d’une composante déterministe décomposable et d’une perturbation résiduelle aléatoire. Le régresseur agit alors comme un projecteur théorique : en introduisant des variations mesurées d’un stimulus, d’une caractéristique environnementale ou d’un trait individuel, le chercheur réduit l’entropie du système modélisé et confère une structure analytique à l’expérience empirique.
1.2 Le rôle du régresseur vis-à-vis du régressant
L’appréhension rigoureuse du régresseur exige sa mise en tension dialectique permanente avec son pendant structurel : le régressant. Également désigné sous les appellations de variable dépendante, de variable critère, de variable réponse ou d’endogène selon les chapelles méthodologiques, le régressant matérialise l’entité quantitative dont la dispersion phénoménologique fait l’objet de l’investigation. Le rôle premier du régresseur consiste à décomposer la variance totale manifestée par ce régressant, en isolant les portions de variabilité qui peuvent être systématiquement associées aux oscillations du régresseur lui-même. Dans un cadre linéaire classique, cette dynamique se résume à une opération géométrique de projection orthogonale : le régresseur forme une base dans l’espace vectoriel des observations, sur laquelle le vecteur représentatif du régressant est projeté afin de maximiser la part de variance géométriquement alignée.
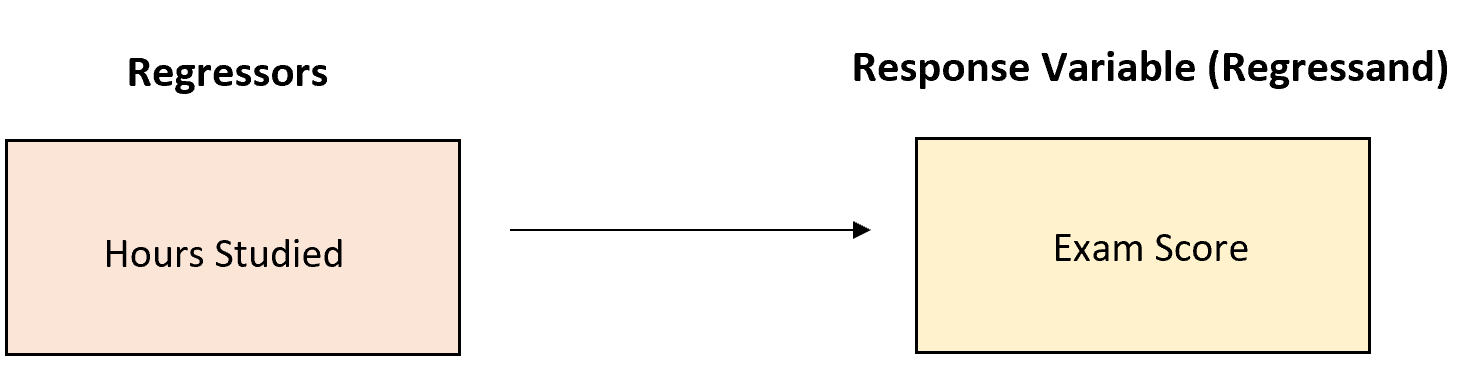
Cette articulation instancie le mécanisme de prédiction statistique et d’ajustement empirique. Lorsque le régresseur varie d’une magnitude donnée, le modèle stipule une réévaluation conditionnelle de l’espérance mathématique du régressant, notée $\mathbb{E}[Y|X]$. Le régresseur n’a pas pour vocation d’annihiler la stochasticité du vivant, mais de fournir la meilleure trajectoire d’approximation conditionnelle possible, en minimisant une fonction de coût prédéterminée, le plus souvent la somme quadratique des déviations observées. Le modèle statistique convertit ainsi les fluctuations brutes du régresseur en une trajectoire d’estimation structurée pour le régressant.
Il importe toutefois de tracer une frontière épistémologique intransigeante entre une simple structure d’association descriptive et une structure de prédiction fonctionnelle incarnée par le régresseur. Une association symétrique, telle que mesurée par le coefficient de corrélation de Bravais-Pearson, traite les deux variables sans distinction hiérarchique : la corrélation de $X$ avec $Y$ est strictement identique à celle de $Y$ avec $X$. À l’inverse, l’introduction d’un régresseur brise cette symétrie. Choisir $X$ comme régresseur et $Y$ comme régressant postule un ordre opérationnel dans lequel $X$ informe sur $Y$ de manière unidirectionnelle au sein de l’équation spécifiée. Cette asymétrie fonctionnelle demeure présente même lorsque le chercheur s’abstient prudemment d’attribuer une causalité substantielle directe à l’équation, car le modèle conditionne formellement la réponse de $Y$ aux états réalisés de $X$, et non l’inverse.
1.3 Cadre d’application dans la recherche quantitative
Dans l’arsenal de la recherche quantitative contemporaine, le régresseur constitue le véhicule privilégié par lequel les hypothèses théoriques abstraites effectuent leur transition vers l’arène empirique. Une proposition théorique issue des sciences sociales ou biomédicales — telle que l’hypothèse selon laquelle l’insécurité socio-économique détériore les capacités de régulation émotionnelle — ne peut être soumise à l’épreuve de la réfutation sans une paramétrisation analytique précise. Dans cette perspective, l’analyste sélectionne des indicateurs quantifiables (par exemple, le ratio d’endettement ou la précarité de l’emploi) pour les ériger en régresseurs, tandis que l’instabilité affective mesurée sur une échelle psychométrique standardisée opérera comme régressant. Le régresseur traduit ainsi une intuition théorique en une variable opératoire dotée d’une métrique explicite.
La nature et la pertinence du régresseur sont étroitement conditionnées par la structure spatio-temporelle des données collectées. Dans le cadre de données en coupe transversale (cross-sectional data), où les observations sont saisies à un instant $t$ unique au sein d’une population hétérogène, les régresseurs capturent des écarts interindividuels statiques, exposant l’analyste à des risques majeurs de facteurs de confusion inobservés. Dans les protocoles longitudinaux ou les données de panel, les régresseurs acquièrent une dimension temporelle dynamique, se déclinant en variations intra-individuelles (comment les changements temporels chez un individu affectent son issue) et en variations interindividuelles (comment les profils moyens diffèrent entre sujets). Enfin, dans le contexte d’essais contrôlés randomisés, le régresseur prend la forme pure d’une assignation expérimentale manipulée par le chercheur, maximisant ainsi la validité interne du dispositif d’évaluation.
À travers ces configurations diverses, l’intégration des régresseurs poursuit une finalité duelle qui oscille en permanence entre explication théorique et prédiction pragmatique. D’une part, la visée explicative ambitionne de sonder la plausibilité des architectures nomologiques : il s’agit d’isoler l’impact net, partiel et non biaisé d’un régresseur précis afin de valider ou d’infirmer un pan d’une théorie scientifique. D’autre part, la visée prédictive, prédominante en épidémiologie pronostique ou en sciences actuarielles, accorde une importance secondaire à la pureté causale des régresseurs individuels, privilégiant leur capacité conjointe à réduire l’incertitude sur les valeurs futures du régressant avec une erreur quadratique moyenne minimale.
2. Terminologies interchangeables et nuances disciplinaires
2.1 Variable indépendante versus régresseur en milieu expérimental
L’une des ambiguïtés sémantiques les plus persistantes de la littérature méthodologique réside dans la substitution fréquente du concept de régresseur par celui de « variable indépendante ». Bien que ces deux termes soient régulièrement traités comme de parfaits synonymes dans les manuels élémentaires, leur équivalence formelle ne tient qu’au prix d’un compromis épistémologique contestable. En psychologie expérimentale stricte, telle qu’héritée des protocoles de Claude Bernard et de l’American Psychological Association, une variable indépendante correspond exclusivement à une condition manipulée de façon délibérée et directe par l’expérimentateur, à l’instar de l’administration d’un dosage pharmacologique ou de l’exposition à un paradigme d’amorçage cognitif au sein d’un laboratoire hermétique.
Dans ce dispositif idéal de randomisation parfaite, l’indépendance de la variable n’est pas seulement statistique mais ontologique : la probabilité d’assignation d’un participant à une condition expérimentale est rigoureusement indépendante de ses caractéristiques intrinsèques, génétiques, psychologiques ou sociales préalables. Le terme de variable indépendante porte donc en lui un certificat de validité causale robuste : la variation observée sur la réponse ne peut être imputée qu’à l’intervention, éliminant par dessein expérimental le biais d’auto-sélection. Le passage au laboratoire statistique et à l’analyse de données observationnelles brouille profondément cette pureté méthodologique.
Lorsque des données sont recueillies dans des environnements non contrôlés — comme dans les enquêtes épidémiologiques ou les suivis sociologiques — les variables mobilisées pour prédire le phénomène cible ne sont jamais « indépendantes » au sens expérimental. Elles sont corrélées à une myriade d’autres facteurs systémiques, culturels et physiologiques. Employer l’étiquette de variable indépendante pour qualifier un score d’estime de soi ou un niveau de revenu dans une enquête transversale constitue un glissement lexical impropre qui sous-entend faussement l’existence d’une manipulation isolée. Le terme de régresseur s’impose dès lors comme une désignation d’une rigueur scientifique supérieure : il atteste d’un rôle fonctionnel au sein d’une équation d’estimation sans préjuger fallacieusement de l’indépendance ontologique ou méthodologique du facteur considéré.
2.2 Variable explicative, covariable et prédicteur en statistique
La sémantique des sciences statistiques déploie également d’autres termes apparentés qui, loin de constituer des redondances gratuites, soulignent des nuances fonctionnelles spécifiques relatives aux objectifs de la modélisation. Dans la tradition économétrique et psychométrique, le terme de variable explicative est employé dès lors que la théorie scientifique sous-jacente revendique un lien de causalité substantiel, direct ou indirect, entre le facteur modélisé et la variable endogène. La variable explicative est investie d’une charge d’intelligibilité : elle ne vise pas simplement à anticiper une tendance, mais à fournir les raisons mécanistiques pour lesquelles le phénomène se manifeste avec une magnitude particulière.
À l’opposé, le vocable de prédicteur relève d’une logique opérationnelle dominée par le rendement prédictif et l’efficacité algorithmique. Un prédicteur peut être dépourvu de toute plausibilité causale mécanique intrinsèque tout en conservant une utilité statistique remarquable. Par exemple, l’observation d’une baisse subite de la pression barométrique constitue un prédicteur d’une précision chirurgicale pour l’apparition d’un orage imminent, sans qu’aucun physicien ne considère cette baisse barométrique comme la cause physique ultime de la formation thermodynamique de la cellule orageuse, les deux phénomènes procédant d’une cause commune sous-jacente. Dans l’évaluation psychométrique ou l’actuariat, un prédicteur pronostique est conservé tant qu’il minimise l’erreur de classification ou d’estimation, indépendamment de son statut théorique.
La notion de covariable intervient quant à elle principalement dans le cadre des analyses de variance et de covariance (ANOVA, ANCOVA) ainsi que dans les modèles mixtes et de survie. Dans cette configuration méthodologique, la covariable représente un régresseur secondaire que le chercheur introduit dans le modèle non pas en raison de son intérêt théorique central, mais pour neutraliser statistiquement son impact perturbateur sur la variable dépendante. La covariable est un facteur d’ajustement : en purgeant la variance du régressant de la part attribuable à cette covariable (telle que l’âge, le genre ou le quotient intellectuel de base), elle accroît la précision d’estimation de l’effet du régresseur principal et prémunit l’analyste contre certains biais d’assignation dans les comparaisons de groupes.
2.3 Attributs (« features ») dans l’apprentissage automatique
L’essor vertigineux de la science des données, de l’apprentissage automatique (machine learning) et de l’intelligence artificielle au cours des dernières décennies a imposé une refonte terminologique et conceptuelle majeure dans le traitement des variables d’entrée. Dans ce paradigme computationnel moderne, le régresseur statistique conventionnel est universellement désigné sous le terme d’attribut ou de feature. Cette transition lexicale ne constitue pas une simple coquetterie de langage propre aux informaticiens : elle marque un glissement épistémologique profond dans la façon dont les données empiriques sont appréhendées et traitées.
Alors que la régression paramétrique classique développée par Gauss, Markov ou Fisher privilégie l’inférence parcimonieuse — où un nombre restreint de régresseurs rigoureusement sélectionnés sur des bases théoriques a priori font l’objet de tests de significativité hypothético-déductifs —, l’apprentissage automatique superviseur envisage les régresseurs comme les coordonnées scalaires d’un vecteur d’entrée dimensionnel au sein d’un espace vectoriel de cardinalité souvent gigantesque ($\mathbb{R}^p$ où $p gg n$). L’attribut perd sa dimension de vecteur de sens phénoménologique pour devenir un signal informationnel brut, destiné à alimenter des algorithmes d’optimisation non linéaires, tels que les forêts aléatoires, les réseaux neuronaux profonds ou les machines à vecteurs de support.
Ce changement de paradigme modifie substantiellement les impératifs de la recherche quantitative appliquée. Dans le paradigme des features, la question de l’interprétabilité marginale ou de la significativité asymptotique (valeurs $p$) est fréquemment reléguée au second plan au bénéfice exclusif de la capacité de généralisation hors-échantillon, évaluée par validation croisée. Le travail méthodologique ne se concentre plus sur la justification substantielle de chaque variable, mais sur « l’ingénierie des attributs » (feature engineering), consistant à multiplier artificiellement les régresseurs par des projections polynomiales, des encodages dimensionnels complexes ou des décompositions spectrales pour capturer la moindre non-linéarité susceptible d’améliorer le pouvoir prédictif de l’algorithme.
3. Formalisation mathématique : la place du régresseur dans les équations
3.1 Décomposition structurelle de l’équation linéaire générale
Pour appréhender le régresseur dans toute sa rigueur analytique, il convient d’examiner son inscription au sein du Modèle Linéaire Généralisé (MLG). Dans sa formulation unifiée la plus classique, l’équation régissant l’observation individuelle $i$ (pour $i = 1, dots, n$) au sein d’un échantillon s’énonce selon l’expression scalaire :
$$Y_i = \beta_0 + \beta_1 X_{i1} + \beta_2 X_{i2} + dots + \beta_k X_{ik} + \varepsilon_i$$
Dans cet agencement structurel, l’entité $Y_i$ symbolise la réalisation concrète du régressant pour l’observation $i$, tandis que la séquence ordonnée ${X_{i1}, X_{i2}, dots, X_{ik}}$ constitue le vecteur des $k$ régresseurs distincts intégrés au modèle. Chaque $X_{ij}$ matérialise la mesure empirique du $j$-ème régresseur pour le sujet $i$. La constante scalaire $\beta_0$, universellement qualifiée d’ordonnée à l’origine ou d’intercept, correspond à la valeur attendue de $Y_i$ lorsque l’ensemble des régresseurs du système s’annule simultanément ($X_{i1} = X_{i2} = dots = X_{ik} = 0$). L’omission ou la présence de cet intercept détermine l’ancrage spatial du plan d’ajustement dans le référentiel des données.
Lorsque le volume des observations et la dimension des régresseurs s’accroissent, l’algèbre linéaire offre une représentation matricielle compacte et élégante qui constitue le socle computationnel de l’économétrie moderne. Le système s’écrit alors sous la forme :
$$\mathbf{Y} = \mathbf{X}boldsymbol{\beta} + boldsymbol{\varepsilon}$$
où $\mathbf{Y}$ est un vecteur colonne de dimension $(n \times 1)$ contenant les réalisations du régressant, et $boldsymbol{\beta}$ est le vecteur colonne de dimension $((k+1) \times 1)$ contenant les paramètres théoriques inconnus à estimer. L’entité centrale de cette équation réside dans la matrice $\mathbf{X}$, rigoureusement désignée sous le terme de matrice d’expérience ou design matrix, de dimension $(n \times (k+1))$. Chaque colonne de cette matrice représente un régresseur spécifique étendu sur l’ensemble des $n$ observations empiriques, la première colonne étant traditionnellement saturée par un vecteur unitaire $\mathbf{1}_n$ servant de support à l’estimation de l’intercept $\beta_0$.
3.2 Les coefficients de régression (β) et leur signification
Chaque régresseur inséré dans l’architecture matricielle est intimement associé à un coefficient de régression théorique désigné par la lettre grecque $\beta_j$. Ce paramètre quantifie l’intensité de la liaison conditionnelle liant le régresseur au régressant. En termes de calcul différentiel, le coefficient $\beta_j$ s’interprète rigoureusement comme la dérivée partielle de l’espérance conditionnelle du régressant par rapport au régresseur ciblé :
$$\beta_j = \frac{\partial \mathbb{E}[Y | \mathbf{X}]}{\partial X_j}$$
Cette formulation mathématique éclaire le sens marginal du paramètre : $\beta_j$ indique l’amplitude de l’incrément attendu sur la variable dépendante $Y$ lorsqu’on fait croître la valeur du régresseur $X_j$ d’une unité métrique standard, sous la condition expresse et fondamentale que tous les autres régresseurs présents dans le système demeurent rigoureusement immobiles et constants. Le signe algébrique associé au paramètre oriente la polarité du phénomène : un coefficient strictement positif indique une synergie covariationnelle directe (croissance conjointe), tandis qu’un coefficient négatif dénote une dynamique d’inversion proportionnelle (le régresseur inhibe ou comprime la réponse moyenne du régressant).
Il est capital de distinguer conceptuellement les coefficients bruts ou non standardisés (notés généralement $b_j$ ou $B_j$ au niveau de l’échantillon) des coefficients standardisés (souvent libellés $\beta^*$ ou coefficients bêta). Les coefficients bruts préservent l’échelle métrique d’origine des instruments de mesure employés (par exemple, des milligrammes par litre, des années d’ancienneté ou des euros de revenu). Si cette préservation métrique est indispensable pour des prédictions concrètes dans le monde matériel, elle empêche la comparaison frontale de la puissance relative des régresseurs : un coefficient associé au revenu annuel exprimé en centimes sera mathématiquement minuscule par rapport au coefficient associé à l’âge exprimé en décennies, sans que cela n’implique une quelconque supériorité explicative du second. Les coefficients standardisés, obtenus en recentrant et en divisant chaque régresseur et le régressant par leur écart-type respectif, convertissent les effets en unités d’écart-type, autorisant ainsi un classement normé de l’amplitude relative des prédicteurs au sein de l’échantillon analysé.
3.3 Le terme d’erreur stochastique (ε) et le résidu
L’équation de régression ne saurait prétendre à l’exhaustivité déterministe en dehors des lois parfaites de la mécanique classique newtonienne. La réalité empirique étant dominée par l’incomplétude informationnelle et la complexité des facteurs sous-jacents, l’introduction d’un terme d’erreur stochastique $\varepsilon_i$ est une obligation mathématique absolue. Ce terme représente précisément la fraction de la variance totale du régressant $Y_i$ qui échappe systématiquement à la capacité de capture de l’ensemble des régresseurs incorporés dans la matrice d’expérience $\mathbf{X}$. Il absorbe pêle-mêle les micro-influences non mesurées, les fluctuations accidentelles d’échantillonnage, la variabilité idiosyncrasique inhérente aux sujets et l’imprécision instrumentale inévitable des capteurs ou questionnaires.
Il existe une frontière étanche entre le terme d’erreur théorique $\varepsilon_i$, qui est une variable aléatoire inobservable par nature car attachée à la population d’origine, et le résidu empirique $e_i$ (ou $\hat{\varepsilon}_i$), qui est calculé concrètement sur l’échantillon comme la simple soustraction arithmétique entre la valeur empirique constatée $Y_i$ et la prédiction projetée par le modèle $\hat{Y}_i$ :
$$e_i = Y_i – \hat{Y}_i = Y_i – (\hat{\beta}_0 + \sum_{j=1}^k \hat{\beta}_j X_{ij})$$
L’intégrité inférentielle du modèle repose sur une hypothèse nodale : celle de l’indépendance statistique (ou a minima de l’absence de corrélation) entre les régresseurs et le terme d’erreur inobservable, formellement énoncée par la condition d’espérance conditionnelle nulle :
$$\mathbb{E}[boldsymbol{\varepsilon} | \mathbf{X}] = \mathbf{0}$$
Si un régresseur pertinent sur le plan théorique et corrélé aux régresseurs déjà présents est arbitrairement exclu du modèle, son influence causale se trouve mécaniquement compressée au sein du terme d’erreur $varepsilon$. Il en résulte une violation désastreuse de l’hypothèse de non-corrélation ($\text{Cov}(X_j, \varepsilon) \neq 0$), générant ce que les économètres nomment le « biais de variable omise ». Les propriétés distributionnelles asymptotiques exigées des résidus — notamment leur normalité distributionnelle et leur homoscédasticité (variance d’erreur constante sur toute l’étendue des valeurs des régresseurs) — constituent les garants mathématiques indispensables qui autorisent la formulation de tests de significativité non biaisés sur les coefficients associés aux régresseurs.
4. Typologie des régresseurs selon les échelles de mesure
4.1 Régresseurs continus et échelles psychométriques d’intervalles
L’opérationnalisation empirique des régresseurs dépend de la structure de l’espace métrique dans lequel s’inscrivent les données collectées. La typologie la plus intuitive et mathématiquement fluide concerne les régresseurs quantitatifs continus. Par définition, un régresseur continu est une variable susceptible de prendre une infinité non dénombrable de valeurs sur un intervalle donné de la droite réelle $\mathbb{R}$. En physiologie ou en psychophysique, des grandeurs telles que le temps de réaction mesuré en millisecondes, la conductance cutanée, la pression artérielle systolique ou l’âge chronologique constituent des archétypes de régresseurs continus. Dans ce contexte, l’interprétation de la pente de régression se fait de manière infinitésimale : elle cartographie de manière univoque la déformation de l’espérance du régressant sous l’effet d’une translation unitaire continue le long de l’axe réel.
Toutefois, dans le domaine des sciences du comportement, de la psychologie et de l’éducation, les analystes manipulent fréquemment des régresseurs issus de scores composites générés par des batteries de tests standardisés, tels que les quotients intellectuels mesurés par les matrices de Raven ou l’échelle de Wechsler, ou encore les scores factoriels extraits d’un modèle d’équations structurelles. Bien que ces métriques soient constituées de scores discrets (des décomptes d’items validés), la communauté méthodologique s’accorde généralement à les traiter comme des échelles d’intervalles théoriques, postulant que la distance séparant un score de 100 à 110 est substantiellement identique à celle séparant un score de 110 à 120. Cette hypothèse de continuité requiert des vérifications empiriques scrupuleuses.
L’utilisation de régresseurs continus confronte l’analyste à des pathologies distributionnelles récurrentes, au premier rang desquelles figurent les effets de plancher et de plafond. Lorsqu’un instrument d’évaluation psychologique s’avère trop aisé ou excessivement complexe, les observations s’agglutinent massivement aux bornes extrêmes de l’échelle, introduisant une distorsion majeure dans la distribution du régresseur. De telles anomalies compromettent la linéarité présumée de la relation et nécessitent des opérations préalables d’écrêtage, de normalisation distributionnelle (comme les transformations par rangs centiles) ou l’usage d’estimateurs robustes aux asymétries prononcées.
4.2 Régresseurs catégoriels, codage muet (dummy coding) et contrastes
L’analyse quantitative ne saurait se cantonner aux attributs mesurables continus ; elle doit impérativement intégrer des variables qualitatives fondamentales telles que l’appartenance à un groupe thérapeutique expérimental, le sexe biologique, le statut socio-professionnel ou une catégorie nosographique psychiatrique. Ces variables nominales ne possèdent pas d’ordre métrique intrinsèque permettant une insertion arithmétique directe au sein d’une équation linéaire. Il est formellement interdit d’attribuer des valeurs scalaires arbitraires (par exemple, assigner $1$ aux célibataires, $2$ aux mariés et $3$ aux divorcés) sous peine d’imposer au modèle une structure métrique factice et dénuée de sens opératoire.
Pour contourner cet obstacle, la statistique computationnelle utilise la technique de codage muet (dummy coding), également appelée codage binaire. Une variable catégorielle comportant $C$ modalités mutuellement exclusives est formellement transmutée en un ensemble de $(C – 1)$ régresseurs dichotomiques distincts prenant exclusivement les valeurs $0$ ou $1$. L’une des modalités est délibérément exclue de l’espace des régresseurs pour être érigée en « catégorie de référence ». Par exemple, dans une étude clinique évaluant l’efficacité comparée de trois protocoles (Thérapie Cognitive, Psychanalyse, et Groupe Contrôle Liste d’attente), la modalité Liste d’attente peut servir de pivot :
- Le régresseur $X_1$ prend la valeur $1$ si le sujet reçoit la Thérapie Cognitive, et $0$ dans tous les autres cas.
- Le régresseur $X_2$ prend la valeur $1$ si le sujet suit la Psychanalyse, et $0$ dans tous les autres cas.
Dans ce système, le coefficient $\beta_0$ capte la moyenne empirique du groupe de référence (Liste d’attente, où $X_1 = 0$ et $X_2 = 0$). Le coefficient $\beta_1$ associé au premier régresseur dichotomique ne quantifie plus une pente d’inclinaison continue, mais matérialise l’écart de moyenne exact séparant le groupe Thérapie Cognitive du groupe Liste d’attente. De façon complémentaire, le chercheur peut mobiliser un « codage par contraste » ou « codage d’effets » (effect coding), dans lequel la catégorie de référence se voit attribuer la valeur $-1$ pour l’ensemble des régresseurs binaires. Dans ce cadre précis, l’intercept $\beta_0$ s’identifie à la moyenne générale non pondérée de l’échantillon (grand mean), et chaque coefficient associé à un régresseur reflète la déviation spécifique de la catégorie évaluée par rapport à cette moyenne transversale globale.
4.3 Régresseurs ordinaux et échelles de type Likert
L’utilisation d’échelles de cotation graduée de type Likert (allant généralement de « Fortement en désaccord » à « Fortement d’accord » en 5 ou 7 points) place le méthodologue face à un dilemme récurrent de la recherche quantitative. Les données ordinales possèdent une hiérarchie intrinsèque évidente (un score de 5 indique une adhésion supérieure à un score de 4), mais elles sont strictement privées de la propriété d’équidistance des intervalles. Rien ne garantit objectivement que la distance psychologique séparant « Indécis » (3) de « D’accord » (4) soit équivalente à la distance séparant « D’accord » (4) de « Fortement d’accord » (5).
Deux postures méthodologiques s’opposent face à ce type de régresseur. La première, éminemment pragmatique et prévalente dans une large part de la littérature psychométrique, consiste à traiter les scores d’échelles de Likert comme des régresseurs quasi-continus. Les simulations mathématiques de Monte Carlo ont largement démontré que lorsque le régresseur ordinal comporte au minimum cinq, voire sept échelons de réponse, et que sa distribution ne présente pas une asymétrie démesurée (coefficients de Skewness et Kurtosis compris dans des bornes acceptables de $[-1, +1]$), le biais d’estimation infligé aux coefficients de régression linéaire par l’hypothèse de continuité demeure négligeable.
Cependant, lorsque les échelles ordinales ne comptent que trois ou quatre modalités, ou lorsque les seuils de bascule subjectifs entre catégories sont manifestement asymétriques, l’inclusion aveugle de ces variables en tant que régresseurs continus altère sévèrement la précision des prédictions et vicie le calcul des erreurs-types. Il convient alors de mobiliser des approches alternatives rigoureuses : décomposer l’échelle ordinale en un ensemble de régresseurs binaires indicateurs de seuil, ou se tourner vers des modèles de régression spécifiquement adaptés aux structures ordinales, tels que les modèles à cotes proportionnelles (proportional odds models) développés par Peter McCullagh, garantissant le respect de la nature discrète sous-jacente des régresseurs.
5. Modèles à régresseur unique : la régression linéaire simple
5.1 Principes fondamentaux du modèle bivarié
Le modèle de régression linéaire simple constitue la structure géométrique et analytique élémentaire de l’analyse multivariée. Il formalise la relation entre une variable dépendante continue $Y$ et un unique régresseur $X$, s’exprimant à travers l’équation fondamentale :
$$Y_i = \beta_0 + \beta_1 X_i + \varepsilon_i$$
Sur le plan visuel, ce modèle bivarié se matérialise par la confrontation directe des observations au sein d’un diagramme de dispersion cartésien bidimensionnel. Chaque observation individuelle est représentée par un point de coordonnées $(X_i, Y_i)$. La finalité de la modélisation consiste à tracer au milieu de ce nuage de points une droite vectorielle optimale, appelée « droite de régression », qui synthétise la tendance d’ajustement global de la distribution conjointe.
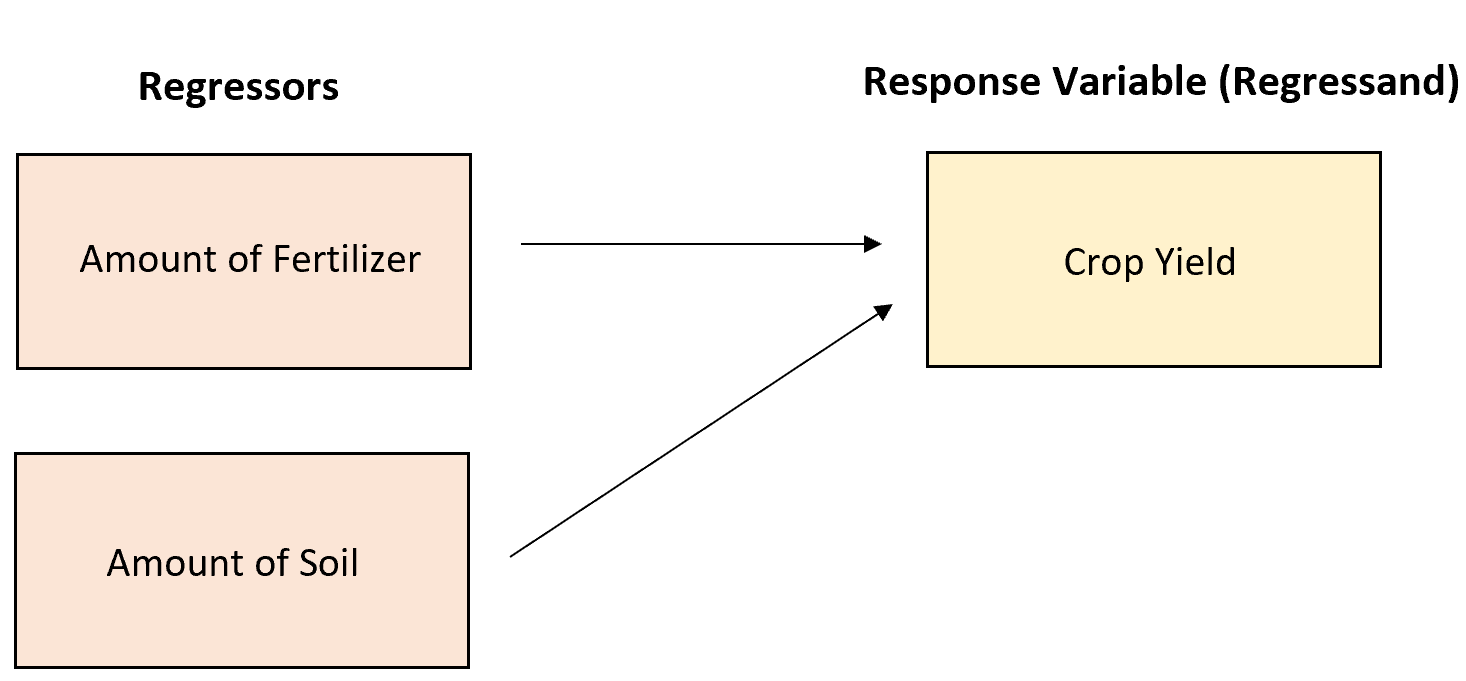
Dans ce modèle épuré à un seul régresseur, il existe une correspondance mathématique directe entre la pente du régresseur et le coefficient de corrélation linéaire de Pearson ($r_{XY}$). Plus précisément, la pente brute non standardisée $\hat{\beta}_1$ est mathématiquement dépendante de la covariance empirique normalisée par la dispersion du régresseur :
$$\hat{\beta}_1 = \frac{\text{Cov}(X, Y)}{\text{Var}(X)} = r_{XY} \frac{s_Y}{s_X}$$
où $s_Y$ et $s_X$ désignent respectivement les écarts-types empiriques du régressant et du régresseur. Cette relation dévoile une propriété essentielle : lorsque les variables sont préalablement standardisées (de sorte que $s_Y = s_X = 1$), le coefficient du régresseur unique $\hat{\beta}_1^*$ devient rigoureusement identique au coefficient de corrélation linéaire $r_{XY}$. La régression simple ne constitue donc pas une avancée informationnelle fondamentale par rapport à la simple corrélation en termes d’intensité d’association bivariée ; sa valeur ajoutée réside dans la fixation d’une pente directionnelle métrique utilisable pour générer des prédictions concrètes et calibrer le calcul des résidus individuels.
5.2 Estimation par les moindres carrés ordinaires (MCO)
La méthode canonique employée pour extraire la valeur estimée des coefficients $\hat{\beta}_0$ et $\hat{\beta}_1$ à partir des données échantillonnales est l’optimisation par les Moindres Carrés Ordinaires (MCO), dont la formalisation initiale est attribuée conjointement à Carl Friedrich Gauss et Adrien-Marie Legendre. Le principe directeur repose sur une minimisation géométrique stricte de l’énergie résiduelle du modèle. L’analyste cherche à minimiser la Somme des Carrés des Résidus (SCR ou $SS_{\text{res}}$), formulée par :
$$S(\beta_0, \beta_1) = \sum_{i=1}^n e_i^2 = \sum_{i=1}^n (Y_i – (\beta_0 + \beta_1 X_i))^2$$
En dérivant partiellement cette fonction quadratique par rapport à $\beta_0$ puis par rapport à $\beta_1$, et en égalisant ces dérivées partielles à zéro (conditions de premier ordre nécessaires à l’obtention d’un extremum global), on obtient le système classique des équations normales. La résolution analytique de ce système conduit aux estimateurs bien connus :
$$\hat{\beta}_1 = \frac{\sum_{i=1}^n (X_i – \bar{X})(Y_i – \bar{Y})}{\sum_{i=1}^n (X_i – \bar{X})^2} \quad \text{et} \quad \hat{\beta}_0 = \bar{Y} – \hat{\beta}_1 \bar{X}$$
Selon le célébrissime théorème de Gauss-Markov, sous les hypothèses de spécification linéaire correcte, d’exogénéité stricte, d’homoscédasticité et d’absence d’autocorrélation résiduelle, l’estimateur des MCO associé au régresseur $X$ possède le statut de BLUE (Best Linear Unbiased Estimator). Cela signifie qu’au sein de la classe des estimateurs linéaires et sans biais, l’estimateur par les MCO présente la variance d’échantillonnage minimale possible, garantissant une efficacité statistique optimale.
Cependant, cette élégance algébrique masque une vulnérabilité chronique aux observations extrêmes ou atypiques. L’élévation au carré des résidus dans la fonction de coût confère un poids disproportionné aux points situés aux marges extrêmes de l’espace échantillonnal. Un individu présentant une valeur de régresseur atypique associée à un résidu substantiel exerce ce que l’on qualifie d’« effet de levier » (leverage), capable de faire basculer l’orientation spatiale de la droite de régression à lui seul, dégradant la représentativité du modèle pour le reste de la population.
5.3 Limites inhérentes à l’utilisation d’un régresseur isolé
L’utilisation d’un modèle n’incorporant qu’un unique régresseur se heurte à des limitations méthodologiques majeures, tout particulièrement lors de l’investigation de conduites psychologiques, comportementales ou sociales. Le comportement humain se caractérise par une causalité hautement plurielle et interactive. Prétendre isoler la genèse d’un phénomène complexe — tel que la performance académique, le comportement d’épargne ou la rechute toxicomanique — en ne mobilisant qu’un unique facteur d’influence expose l’analyste à un aveuglement théorique structurel.
La défaillance analytique la plus dévastatrice du modèle bivarié réside dans son impuissance absolue face au biais de variable omise, communément identifié comme le problème de la variable de confusion (confounding variable). Si la trajectoire de l’unique régresseur $X$ est elle-même façonnée ou corrélée à une variable tierce latente $Z$ qui exerce par ailleurs un effet d’entraînement direct sur la variable de réponse $Y$, le coefficient estimé $\hat{\beta}_1$ attribuera frauduleusement à $X$ l’impact structurel découlant en réalité de $Z$.
Cette carence méthodologique est à l’origine d’un nombre considérable de corrélations fallacieuses (spurious correlations) documentées dans les annales scientifiques. Une régression simple exhibant un lien positif vigoureux entre le volume des ventes de crème glacée d’une ville (régresseur) et le nombre d’admissions hospitalières pour déshydratation aiguë (régressant) ne saurait conduire à légiférer sur la toxicité thermique des glaces : l’omission du régresseur température caniculaire génère une distorsion complète de l’inférence. Pour dépasser ce biais d’attribution bivarié, l’extension vers un formalisme multivarié capable d’intégrer conjointement plusieurs régresseurs est un impératif statistique non négociable.
6. Modèles à régresseurs multiples : complexité et ajustement prédictif
6.1 Extension multivariée et principe d’addition des prédicteurs
Le passage méthodologique de la régression simple à la régression multiple consacre l’émancipation de l’analyse empirique, lui permettant de s’arrimer fidèlement à la trame polyfactorielle du réel. En déployant un ensemble ordonné de $k$ régresseurs distincts ($X_1, X_2, dots, X_k$), le chercheur abandonne la droite de projection bivariée pour modéliser des surfaces d’ajustement déployées dans un espace vectoriel de dimension $(k + 1)$. Lorsque $k = 2$, l’ajustement géométrique prend la forme d’un plan tridimensionnel ; dès lors que $k ge 3$, il se structure sous la forme d’un hyperplan multidimensionnel mathématiquement appréhensible par le calcul tensoriel et matriciel.
Cette extension offre la capacité d’incorporer simultanément dans une matrice computationnelle unique des régresseurs de statuts théoriques variés : des indicateurs d’exposition proximale, des régulateurs environnementaux distaux, des traits de personnalité sous-jacents et des variables sociodémographiques de stratification. Chaque régresseur additionnel inséré dans le modèle contribue à densifier le faisceau d’informations utilisé pour sonder la morphologie distributionnelle du régressant. L’espace de prédiction n’est plus asservi à une vision linéaire unifactorielle, mais devient un système articulé où les prédicteurs concourent à la délimitation de la valeur attendue.
Toutefois, l’adjonction de régresseurs supplémentaires entraîne une conséquence purement mathématique qu’il convient de ne jamais confondre avec un progrès heuristique réel : l’augmentation mécanique et inévitable du coefficient de détermination global ($R^2$). Par construction algorithmique, l’adjonction d’une colonne vectorielle au sein de la matrice d’expérience $\mathbf{X}$ ne peut en aucun cas réduire la somme des carrés expliquée ($SS_{\text{reg}}$), même si le régresseur introduit ne consiste qu’en une série de nombres aléatoires dénuée de toute cohérence théorique. Dès lors que cette nouvelle colonne possède une covariance empirique strictement non nulle par pur hasard d’échantillonnage avec le régressant, le modèle l’exploitera pour optimiser artificiellement la métrique d’ajustement.
6.2 Contrôle statistique et isolement de l’effet propre
La puissance intellectuelle majeure du modèle à régresseurs multiples réside dans sa capacité opératoire à implémenter ce que la philosophie des sciences nomme le contrôle statistique ou la clause ceteris paribus (« toutes choses étant égales par ailleurs »). Dans le monde réel, en dehors de la cage étanche du laboratoire d’expérimentation physique, il est rigoureusement impossible d’immobiliser le cours des événements pour observer la réaction d’un système à la variation d’un facteur unique. Le modèle de régression multiple offre une solution élégante à cette aporie grâce au calcul des coefficients de régression partiels.
La mécanique intime de ce mécanisme de contrôle a été immortalisée par le célèbre théorème de Frisch-Waugh-Lovell. Ce théorème démontre mathématiquement que pour estimer le coefficient partiel $\beta_j$ associé au régresseur $X_j$ dans une régression multiple complexe, l’opération revient conceptuellement à suivre un protocole séquentiel en trois étapes :
- Régresser le régressant principal $Y$ sur l’ensemble de tous les autres régresseurs du système (à l’exclusion de $X_j$) et en extraire le vecteur des résidus $e_{Y|autres}$. Ces résidus incarnent la variabilité de $Y$ complètement purgée et nettoyée de toute l’influence attribuable aux autres prédicteurs.
- Régresser le régresseur focal $X_j$ sur ce même ensemble de prédicteurs concurrents, et en extraire le vecteur des résidus $e_{X_j|autres}$. Ce résidu spécifique représente la part d’information inédite et exclusive contenue dans le régresseur $X_j$, totalement isolée de ses corrélations partagées avec ses pairs.
- Réaliser une régression linéaire simple reliant le résidu épuré $e_{Y|autres}$ au résidu exclusif $e_{X_j|autres}$. Le coefficient obtenu par cette opération bivariée résiduelle est strictement identique au coefficient de régression partielle $\hat{\beta}_j$ calculé par l’inversion matricielle globale simultanée du modèle complet.
Cette démonstration algébrique illustre concrètement ce que signifie « contrôler pour les autres variables » : le régresseur n’est plus autorisé à transférer dans la relation des covariations partagées avec d’autres dimensions. Son coefficient isole précisément sa contribution marginale nette, offrant un rempart méthodologique contre les biais d’association qui gangrènent la recherche observationnelle.
6.3 Évaluation de la qualité de l’ajustement : R² et R² ajusté
L’évaluation de la performance globale d’un modèle multipredicteur requiert la décomposition rigoureuse de la variance de la variable dépendante. La variabilité totale observée, quantifiée par la Somme Totale des Carrés ($SS_{\text{tot}} = \sum (Y_i – \bar{Y})^2$), se scinde formellement en deux composantes orthogonales additives : la Somme des Carrés de la Régression ($SS_{\text{reg}} = \sum (\hat{Y}_i – \bar{Y})^2$), matérialisant la part de déviation capturée par les régresseurs, et la Somme des Carrés des Résidus ($SS_{\text{res}} = \sum e_i^2$), quantifiant l’énergie inexpliquée. Le ratio liant la composante expliquée à la variabilité totale définit le coefficient de détermination classique :
$$R^2 = \frac{SS_{\text{reg}}}{SS_{\text{tot}}} = 1 – \frac{SS_{\text{res}}}{SS_{\text{tot}}}$$
Face au problème précédemment soulevé de la majoration mécanique et opportuniste du $R^2$ lors de l’injection effrénée de régresseurs, la statistique inférentielle a forgé un indicateur pénalisé : le coefficient de détermination ajusté ($R^2_{\text{adj}}$ ou $\bar{R}^2$), formulé selon l’expression mathématique de Henri Theil :
$$R^2_{\text{adj}} = 1 – \left[ \frac{SS_{\text{res}} / (n – k – 1)}{SS_{\text{tot}} / (n – 1)} \right] = 1 – (1 – R^2) \frac{n – 1}{n – k – 1}$$
Dans cette formulation, les sommes des carrés sont pondérées par leurs degrés de liberté respectifs. L’introduction d’un nouveau régresseur réduit d’une unité le dénominateur des degrés de liberté résiduels ($n – k – 1$). Par conséquent, si le nouveau régresseur n’apporte pas une réduction de la variance résiduelle substantielle (supérieure à ce que la simple chute des degrés de liberté impose), le $R^2_{\text{adj}}$ subira une pénalité et diminuera arithmétiquement. Ce coefficient opère ainsi comme un mécanisme de parcimonie scientifique, sanctionnant l’inflation artificielle de régresseurs futiles.
L’appréciation inférentielle conjointe de la validité de l’ensemble de ces régresseurs est formalisée par le test $F$ global de Fisher-Snedecor. Ce test confronte l’hypothèse nulle radicale ($\mathcal{H}_0 : \beta_1 = \beta_2 = dots = \beta_k = 0$), postulant l’inanité explicative collective des régresseurs, face à l’hypothèse alternative d’au moins un coefficient non nul. La statistique de test se calibre selon le ratio :
$$F = \frac{SS_{\text{reg}} / k}{SS_{\text{res}} / (n – k – 1)}$$
Un test $F$ statistiquement significatif autorise le rejet de l’hypothèse nulle, confirmant que le groupe de régresseurs sélectionnés extrait collectivement une part de variabilité qui surpasse le simple bruit d’échantillonnage, sans pour autant certifier que chaque régresseur individuel pris isolément soit doté d’une pertinence théorique robuste.
7. Interactions et formes non linéaires entre régresseurs
7.1 Régresseurs polynomiaux pour trajectoires curvilignes
L’hypothèse selon laquelle les phénomènes biologiques, psychologiques ou économiques suivent invariablement une trajectoire strictement rectiligne constitue une simplification abusive de la réalité empirique. De nombreuses dynamiques naturelles présentent des saturations, des seuils critiques, des amplifications exponentielles ou des dégradations asymptotiques. Le modèle de régression linéaire possède la flexibilité mathématique d’incorporer ces non-linéarités fonctionnelles sans violer le principe de linéarité de son infrastructure. Il convient ici de rappeler une distinction théorique fondamentale : la « linéarité » au sens du modèle linéaire renvoie à la linéarité par rapport aux paramètres ($\beta$) et non à la linéarité par rapport aux variables observables.
Il est donc parfaitement licite de forger des régresseurs polynomiaux en injectant dans la matrice d’expérience des puissances d’un régresseur de base, donnant naissance à un modèle quadratique :
$$Y_i = \beta_0 + \beta_1 X_i + \beta_2 X_i^2 + \varepsilon_i$$
Ce type de spécification trouve une application emblématique en psychologie expérimentale et cognitive dans l’ajustement empirique de la célèbre loi de Yerkes et Dodson. Cette théorie stipule que l’efficacité de la performance cognitive ou motrice ($Y$) s’accroît initialement avec l’élévation du niveau de stress physiologique ou d’éveil attentionnel ($X$) jusqu’à un point d’optimum adaptatif, avant de s’effondrer dramatiquement sous des niveaux d’activation neurovégétative trop intenses, décrivant ainsi une trajectoire en « U inversé ». Le modèle capture cette topographie grâce au signe opposé de ses régresseurs : un terme linéaire $\beta_1$ positif vigoureux couplé à un terme quadratique $\beta_2$ strictement négatif. L’abscisse du point culminant d’efficacité optimale se dérive directement par l’annulation de la première dérivée : $X_{\text{optimal}} = -\beta_1 / (2\beta_2)$.
L’usage des régresseurs polynomiaux introduit toutefois une contrainte technique insidieuse : la multicolinéarité structurelle induite. Par construction arithmétique, si les valeurs de $X$ sont exclusivement positives, le régresseur quadratique $X^2$ sera mathématiquement très fortement corrélé à son régresseur parent $X$. Cette colinéarité artificielle gonfle les erreurs-types des estimations. Pour assainir la matrice d’expérience sans modifier la forme intrinsèque de la fonction d’ajustement, le recours préalable au recentrage sur la moyenne empirique ($\tilde{X} = X – \bar{X}$) s’avère indispensable avant de générer le régresseur polynomial quadratique $\tilde{X}^2$.
7.2 Termes d’interaction ou modération : produit de deux régresseurs
Les modèles additifs supposent implicitement que l’impact d’un régresseur $X_1$ sur le régressant $Y$ demeure strictement invariant quel que soit le niveau atteint par un second régresseur $X_2$. Cette hypothèse d’indépendance contextuelle est fréquemment contredite par l’observation clinique ou sociologique. L’influence d’un facteur dépend très couramment du terrain réceptif offert par d’autres conditions environnantes. Dans le formalisme statistique quantitatif, cette dépendance contextuelle est théorisée sous le concept d’effet modérateur et se matérialise analytiquement par la création d’un régresseur multiplicatif.
L’équation de régression incorporant un terme d’interaction bidirectionnel s’articule selon l’architecture canonique :
$$Y_i = \beta_0 + \beta_1 X_{i1} + \beta_2 X_{i2} + \beta_3 (X_{i1} \times X_{i2}) + \varepsilon_i$$
L’entité synthétique $(X_{i1} \times X_{i2})$ constitue un régresseur à part entière. La présence de ce terme d’interaction redéfinit en profondeur le statut sémantique des coefficients $\beta_1$ et $\beta_2$. Ces derniers ne désignent plus des « effets principaux » absolus, mais deviennent des « effets conditionnels simples » : $\beta_1$ représente la pente marginale de $Y$ en réponse aux variations de $X_1$ exclusivement lorsque $X_2 = 0$, et réciproquement. La dérivée partielle conditionnelle met en lumière ce dynamisme relationnel :
$$\frac{\partial \mathbb{E}[Y|\mathbf{X}]}{\partial X_1} = \beta_1 + \beta_3 X_2$$
Le coefficient d’interaction $\beta_3$ gouverne la modulation de la trajectoire : s’il est significativement différent de zéro, il démontre que l’impact du régresseur principal s’infléchit, s’amplifie ou s’inverse selon la magnitude manifestée par le modérateur $X_2$. Pour décomposer et interpréter ces régresseurs interactifs, la littérature contemporaine — largement influencée par les travaux de Leona Aiken et Stephen West — préconise l’analyse des pentes simples (simple slopes analysis), consistant à calculer et tester la significativité de la pente de $X_1$ à différentes strates conditionnelles de $X_2$ (généralement à la moyenne, à $+1$ écart-type et à $-1$ écart-type), ainsi que l’utilisation de la technique d’évaluation continue des frontières de significativité de Johnson-Neyman.
7.3 Transformations analytiques des régresseurs
Face à des données empiriques réfractaires aux hypothèses structurales du modèle linéaire — qu’il s’agisse d’asymétries distributionnelles sévères, d’hétéroscédasticité manifeste ou de relations multiplicatives sous-jacentes —, l’analyste n’est pas contraint d’abandonner l’estimation paramétrique. Il peut procéder à des transformations fonctionnelles préalables de ses régresseurs. La transformation logarithmique népérienne ($ln(X)$) représente à cet égard l’outil d’ingénierie mathématique le plus sollicité dans les disciplines quantitatives.
L’intégration d’un régresseur transformé sous forme logarithmique reconfigure la métrique des coefficients dans des proportions qu’il importe de maîtriser. Dans un modèle de type semi-logarithmique lin-log :
$$Y_i = \beta_0 + \beta_1 \ln(X_i) + \varepsilon_i$$
le coefficient $\beta_1$ ne cartographie plus un incrément absolu d’une unité de $X$, mais quantifie une déformation proportionnelle : une augmentation relative de 1 % de la magnitude du régresseur $X$ génère un incrément attendu sur la variable dépendante d’une amplitude de $(\beta_1 / 100)$ unités métriques de $Y$. Si le régressant subit lui aussi une telle transformation (modèle log-log ou à élasticité constante) :
$$\ln(Y_i) = \beta_0 + \beta_1 \ln(X_i) + \varepsilon_i$$
le coefficient du régresseur $\beta_1$ s’interprète directement comme un indice d’élasticité sans unité : une élévation de 1 % du régresseur engendre une réévaluation conditionnelle de $\beta_1$ % du régressant. Les transformations non linéaires incluent également la décomposition en racine carrée ($\sqrt{X}$), fréquemment prescrite pour stabiliser la variance de régresseurs procédant de décomptes discrets (distributions de Poisson), ou la transformation inverse ($1 / X$), appropriée pour modéliser des temps de complétion de tâches psychomotrices convertis en indices de vitesse de traitement cognitive.
8. Exemples concrets d’application empirique en psychologie
8.1 Prédiction de l’épuisement professionnel (Burnout) en entreprise
Afin d’illustrer concrètement l’articulation de ces principes conceptuels, examinons une investigation portant sur les déterminants organisationnels du syndrome d’épuisement professionnel (burnout) au sein d’une multinationale. Le régressant continu modélisé ($Y$) est le score global obtenu à l’échelle d’épuisement émotionnel de l’inventaire de Maslach (Maslach Burnout Inventory, MBI), mesuré sur une échelle continue théorique de 0 à 100 points standardisés.
Pour rendre compte de la dispersion de ce syndrome, l’équipe de recherche retient trois régresseurs substantiels étayés par le modèle théorique des exigences-ressources professionnelles (Job Demands-Resources model) :
- $X_1$ : La charge de travail perçue (évaluation subjective continue sur une échelle psychométrique de 10 à 50 points).
- $X_2$ : Le degré d’autonomie décisionnelle (mesuré sur une échelle continue de 5 à 25 points).
- $X_3$ : Le niveau de soutien social perçu de la part des superviseurs (régresseur continu allant de 0 à 40 points).
L’estimation paramétrique déploie l’équation matricielle intégrant un terme d’interaction modérateur entre les exigences ($X_1$) et les ressources ($X_3$) :
$$\hat{Y}_i = 25.4 + 1.15 X_{i1} – 0.82 X_{i2} – 0.45 X_{i3} – 0.03 (X_{i1} \times X_{i3})$$
L’analyse minutieuse des coefficients issus des régresseurs éclaire la mécanique du phénomène sous étude. L’intercept ($25.4$) chiffre le niveau de base théorique d’épuisement lorsque tous les prédicteurs sont nuls. Le régresseur de charge de travail ($X_1$) exhibe un coefficient brut positif hautement significatif ($B = +1.15, p < 0.001$), indiquant que pour chaque point supplémentaire de charge perçue, le score d’épuisement émotionnel croît de 1.15 point, ceteris paribus. Inversement, l’autonomie décisionnelle ($X_2$) agit comme un bouclier d’atténuation structurelle avec un coefficient négatif ($B = -0.82, p < 0.01$). Enfin, le régresseur interactif multiplicatif $(X_1 \times X_3)$ atteste de l’existence d’une modération adaptative protectrice ($B = -0.03, p < 0.05$) : le coefficient indique que la nocivité de la charge de travail sur la genèse de l’épuisement émotionnel est significativement comprimée chez les travailleurs bénéficiant d’un ancrage relationnel et d’un soutien managérial élevé.
8.2 Modélisation de la performance cognitive chez l’adulte âgé
Un deuxième terrain d’illustration empirique s’ancre dans la neuropsychologie du vieillissement. Des chercheurs cherchent à cartographier les facteurs déterminant le maintien de la vitesse de traitement de l’information ($Y$, mesurée par le score de performance temporelle au Digit Symbol Substitution Test, DSST) au sein d’une cohorte de 600 personnes âgées de 65 à 85 ans. Dans cette configuration, le système mobilise un équilibre entre régresseurs substantiels et covariables de contrôle statistique.
Le chercheur structure son modèle en intégrant comme premier régresseur d’intérêt théorique la durée moyenne du sommeil à ondes lentes ($X_1$, mesurée en heures nocturnes par polysomnographie), et comme second régresseur l’activité physique hebdomadaire ($X_2$, quantifiée en équivalents métaboliques MET-heures). Toutefois, la vitesse de traitement déclinant naturellement sous l’effet de la sénescence biologique, il est impératif d’introduire des régresseurs d’ajustement : l’âge chronologique ($X_3$, en années révolues) et le niveau de scolarité initial ($X_4$, en années d’études formelles) qui constitue un proxy de la réserve cognitive.
L’estimation des coefficients standardisés ($\beta^*$) révèle que le régresseur âge chronologique exerce un poids prédictif négatif massif ($\beta^* = -0.42, p < 0.001$). Néanmoins, après neutralisation rigoureuse de la variance captée par l’âge et le niveau d’éducation, le régresseur durée du sommeil profond préserve une contribution positive statistiquement irréfutable ($\beta^* = +0.24, p < 0.001$). Pour prouver la valeur ajoutée de ces régresseurs, l’équipe applique une stratégie de régression hiérarchique : l’introduction successive des régresseurs biomécaniques (sommeil et sport) au-delà des régresseurs démographiques (âge et scolarité) génère un saut significatif du coefficient de détermination ($\Delta R^2 = 0.08, p < 0.001$), démontrant le pouvoir explicatif incrémentiel de ces variables cibles.
8.3 Évaluation de l’efficacité d’une intervention en psychologie clinique
Le troisième scénario d’application aborde la modélisation de l’issue d’un essai clinique randomisé en psychothérapie comparant un protocole basé sur la Pleine Conscience (Mindfulness) à une thérapie de soutien non directive dans le traitement de la dépression majeure récurrente. Le régressant ($Y$) est le score final obtenu à l’inventaire de dépression de Beck (BDI-II) à l’issue de 12 semaines d’intervention thérapeutique.
Dans ce modèle d’analyse de covariance (ANCOVA) formulé par le prisme de la régression multiple, l’analyste combine des régresseurs catégoriels et des régresseurs continus :
- $X_1$ : Le régresseur binaire (dummy) assignant la valeur $1$ au groupe Thérapie Pleine Conscience et $0$ au groupe Thérapie de Soutien (groupe de référence).
- $X_2$ : Le score initial de sévérité dépressive pré-test mesuré avant l’initiation du protocole (régresseur continu de contrôle).
- $X_3$ : La qualité de l’alliance thérapeutique perçue par le patient (régresseur continu centré sur la moyenne, mesuré par le Working Alliance Inventory).
L’équation paramétrée s’énonce :
$$\hat{Y}_i = 8.30 – 4.12 X_{i1} + 0.65 X_{i2} – 0.28 X_{i3}$$
L’inclusion du score pré-test ($X_2$) en tant que régresseur est capitale : avec un coefficient de $B = +0.65$, il absorbe une part substantielle de la variance interindividuelle initiale de la symptomatologie dépressive résiduelle, dégonflant mécaniquement l’erreur quadratique du modèle. L’interprétation du régresseur catégoriel principal $X_1$ en ressort clarifiée : le coefficient partiel $B = -4.12$ ($p = 0.002$) certifie qu’à niveau d’alliance relationnelle identique et à sévérité inaugurale rigoureusement égale, la thérapie de pleine conscience produit une réduction additionnelle moyenne de plus de quatre points sur l’échelle BDI-II par rapport à la modalité thérapeutique concurrente, fournissant la preuve empirique de sa supériorité clinique conditionnelle.
9. Hypothèses fondamentales concernant les régresseurs et diagnostics
9.1 Exogénéité stricte et absence d’endogénéité
La validité statistique et inférentielle des coefficients attribués aux régresseurs repose sur le respect d’un ensemble de postulats probabilistes, au sommet desquels trône l’hypothèse primordiale d’exogénéité stricte. Dans le formalisme contemporain développé par des figures tutélaires de l’économétrie telles que Wooldridge ou Greene, cette hypothèse énonce que l’espérance mathématique du vecteur des perturbations stochastiques conditionnellement à la matrice d’expérience doit être rigoureusement nulle :
$$\mathbb{E}[\varepsilon_i | X_{i1}, X_{i2}, dots, X_{ik}] = 0 \quad \forall i$$
Cette condition formelle stipule une orthogonalité absolue : aucune trace d’information contenue dans les régresseurs ne doit présenter la moindre corrélation avec les facteurs non observés absorbés dans le terme d’erreur $varepsilon$. Dès lors que cette frontière est enfreinte ($\text{Cov}(X_j, \varepsilon) \neq 0$), le régresseur ciblé cesse d’être exogène pour basculer dans l’état pathologique d’endogénéité. Les répercussions mathématiques de l’endogénéité sur l’estimation par les Moindres Carrés Ordinaires sont désastreuses : l’estimateur des MCO perd immédiatement sa propriété fondamentale de convergence asymptotique et devient structurellement inconsistant et biaisé. Quelle que soit la taille de l’échantillon amassé, la valeur vers laquelle converge le coefficient estimé diverge de la cible théorique réelle.
Les sources génératrices de ce fléau méthodologique sont documentées sous trois mécanismes prévalents :
- L’omission de variables explicatives pertinentes : le fait de négliger un régresseur déterminant mécaniquement corrélé aux régresseurs déjà spécifiés dans la matrice d’expérience.
- La causalité inverse et la simultanéité : le scénario pernicieux où le régresseur $X$ module le régressant $Y$, tandis que des rétroactions font que les variations de $Y$ rétroagissent simultanément sur le comportement empirique de $X$.
- L’erreur de mesure non aléatoire intégrée au sein même de l’instrument d’évaluation du régresseur.
Pour contrer les distorsions découlant d’une violation avérée de l’exogénéité, le chercheur doit recourir à des architectures de contournement quasi-expérimentales. La stratégie phare consiste en l’implémentation de la méthode des variables instrumentales via le protocole des Moindres Carrés en Deux Étapes (2SLS). L’analyste identifie une variable instrumentale $Z$ qui vérifie une condition de pertinence (forte corrélation directe avec le régresseur endogène $X$) et une stricte condition d’exclusion (absence d’effet causal direct sur $Y$ et absence de corrélation avec l’erreur $varepsilon$). La projection du régresseur sur l’instrument permet d’extraire la variance exogène propre de $X$ et de restaurer la consistance des coefficients estimés.
9.2 Problématique de la multicolinéarité entre régresseurs
L’idéal théorique du modèle linéaire multivarié postule que chaque régresseur intégré dans la matrice d’expérience apporte une quantité substantielle d’information orthogonale originale. Néanmoins, dans les investigations non expérimentales, les régresseurs collectés présentent souvent des liens de dépendance mutuelle très serrés. Ce phénomène d’interdépendance linéaire exacerbée porte le nom de multicolinéarité.
Il est crucial de comprendre la nature précise de la défaillance induite par la multicolinéarité : elle ne constitue pas, en tant que telle, une violation des hypothèses canoniques de Gauss-Markov. Les estimateurs des MCO demeurent rigoureusement sans biais et convergents. La dégradation se manifeste au niveau de la matrice de covariance des estimateurs. Sur le plan de l’inversion matricielle, la matrice des covariances des coefficients s’écrit $\text{Var}(\hat{boldsymbol{\beta}}) = \sigma^2 (\mathbf{X}^T\mathbf{X})^{-1}$. Lorsque deux régresseurs ou davantage sont presque parfaitement redondants, les colonnes de la matrice d’expérience s’approchent d’une dépendance linéaire parfaite. Il en résulte que le déterminant de la matrice $(\mathbf{X}^T\mathbf{X})$ s’effondre vers zéro, rendant la matrice quasi-singulière. Cette quasi-singularité provoque une inflation exponentielle des erreurs-types asymptotiques associées aux coefficients régresseurs concernés.
Les symptômes manifestes de la multicolinéarité s’identifient par un paradoxe diagnostique classique : le modèle déploie un coefficient de détermination $R^2$ global très élevé et un test $F$ hautement significatif, mais les tests d’inférence bivariés individuels (tests de Student $t$) ne parviennent pas à déclarer de significativité statistique pour les régresseurs incriminés ($p > 0.05$). Les régresseurs se cannibalisent mutuellement : le modèle sait qu’une information prédictive majeure est présente dans le groupe de variables, mais il se révèle incapable d’attribuer arithmétiquement le mérite marginal à l’un des régresseurs aux dépens de l’autre.
Pour cartographier et quantifier la sévérité de cette pathologie, deux indicateurs métriques règnent sur la pratique contemporaine : la Tolérance ($Tol_j = 1 – R_j^2$) et le Facteur d’Inflation de la Variance (Variance Inflation Factor, $VIF_j$), où $R_j^2$ représente le coefficient de détermination issu de la régression auxiliaire du régresseur focal $X_j$ sur l’ensemble de tous les autres régresseurs concurrents :
$$VIF_j = \frac{1}{1 – R_j^2} = \frac{1}{Tol_j}$$
Le seuil critique d’alarme méthodologique est conventionnellement fixé à un $VIF$ dépassant la borne de 5 ou 10 (ce qui équivaut à une tolérance inférieure à 0.20 ou 0.10). Dès lors que ces plafonds sont transgressés, les solutions de remédiation doivent être déployées : élagage parcimonieux du régresseur le plus redondant, agrégation des prédicteurs colinéaires par des techniques de réduction dimensionnelle (analyse en composantes principales, modèles factoriels), ou bascule délibérée vers des procédures d’estimation pénalisée (régression Ridge).
9.3 Linéarité de la relation et absence d’erreur de mesure
L’architecture du modèle linéaire standard repose sur l’hypothèse de spécification fonctionnelle correcte : l’analyste postule que l’espérance conditionnelle du régressant est fidèlement approchée par une combinaison linéaire des régresseurs sélectionnés. La confrontation empirique à ce postulat s’opère au travers de l’examen minutieux des tracés résiduels, en projetant les résidus empiriques en fonction des valeurs ajustées ($\hat{Y}_i$) ou directement face aux valeurs de chaque régresseur isolé. L’apparition récurrente de motifs géométriques structurés (formes paraboliques, sinusoïdes, entonnoirs asymétriques) sonne l’alerte méthodologique d’une non-linéarité non modélisée, intimant l’incorporation d’ajustements polynomiaux, splines ou logarithmiques appropriés.
Parallèlement à la linéarité fonctionnelle, la modélisation statistique standard s’appuie sur une hypothèse implicite que la réalité de la collecte de données piétine quotidiennement : la parfaite fidélité des mesures des régresseurs, postulant une absence totale d’erreur d’enregistrement ou de bruit instrumentale dans $\mathbf{X}$. Or, tout particulièrement dans le périmètre des échelles psychologiques, des questionnaires autodéclarés et des biomarqueurs physiologiques, les régresseurs enregistrés sont intrinsèquement porteurs d’un bruit stochastique résiduel. Ce phénomène est théorisé sous l’intitulé des modèles à erreurs de mesure (errors-in-variables models).
Les conséquences analytiques de la présence d’une erreur de mesure dans le régresseur sont pernicieuses. Si l’on décompose la mesure empirique observée $X_i$ en sa valeur réelle sous-jacente inobservable $X_i^*$ contaminée par une erreur de mesure aléatoire classique $u_i$ telle que $X_i = X_i^* + u_i$, l’estimation par les MCO n’affiche plus un comportement neutre. Elle génère ce qui est désigné sous le terme de biais d’atténuation (attenuation bias) :
$$\text{p\lim } \hat{\beta}_1 = \beta_1 \left( \frac{\sigma_{X^*}^2}{\sigma_{X^*}^2 + \sigma_u^2} \right) = \beta_1 \times \text{Fiabilité}$$
La pente estimée converge vers une valeur systématiquement rabotée, comprimée et atténuée vers zéro par le coefficient de fiabilité de l’instrument de mesure. Ce biais d’atténuation induit une sous-évaluation structurelle de l’impact réel du régresseur dans la population, augmentant indûment le risque d’erreur de type II (non-rejet à tort d’un effet nul). Face à des régresseurs entachés d’une imperméabilité instrumentale marquée, le recours aux modèles d’équations structurelles (SEM) mobilisant des variables latentes débarrassées de l’erreur de mesure observable s’impose comme la solution méthodologique d’excellence.
10. Méthodes de sélection et d’optimisation des régresseurs
10.1 Sélection basée sur la théorie versus sélection automatisée
L’une des controverses méthodologiques les plus vives au sein de la communauté scientifique oppose la primauté de la sélection déductive guidée par la théorie a priori aux procédures d’exploration algorithmique automatisée de l’espace des régresseurs. La tradition épistémologique dominante en recherche comportementale soutient fermement que le choix d’intégrer ou d’exclure un régresseur de la matrice d’expérience doit découler impérativement d’un modèle conceptuel nomologique forgé en amont de la récolte des données empiriques. L’analyste formule des hypothèses d’effets substantiels, et la régression est déployée pour tester spécifiquement ces conjonctures formulées a priori.
À l’opposé de cette orthodoxie théorique, la tentation pragmatique du traitement computationnel a popularisé les techniques de sélection pas à pas (stepwise regression), déclinées sous trois algorithmes principaux :
- La sélection ascendante (forward selection) : débutant avec un modèle saturé exclusivement par l’intercept, l’algorithme teste itérativement chaque régresseur candidat et incorpore à chaque étape celui qui optimise la chute de la variance résiduelle au seuil de significativité préalablement prescrit.
- L’élimination descendante (backward elimination) : s’initialisant avec l’ensemble gigantesque de tous les régresseurs imaginables intégrés simultanément, l’algorithme éjecte séquentiellement un par un les prédicteurs les moins significatifs (valeurs $p$ les plus dégradées) jusqu’à ce que tous les éléments résiduels soient certifiés statistiquement valides.
- La procédure pas à pas bidirectionnelle (stepwise standard) : alternant l’inclusion de nouveaux régresseurs prometteurs et la réévaluation de l’expulsion de prédicteurs devenus redondants suite aux adjonctions successives.
Malgré leur séduction apparente, les méthodes de régression pas à pas font l’objet d’une condamnation sévère de la part des méthodologues statisticiens contemporains. Ces procédures mécaniques sont frappées de tares méthodologiques rédhibitoires : elles exploitent effrontément les fluctuations d’échantillonnage aléatoires les plus triviales pour déclarer des régresseurs arbitraires « significatifs », générant un surajustement (overfitting) massif. De surcroît, ces méthodes biaisen dramatiquement les valeurs $p$ résultantes en raison d’une multiplicité de tests implicites non corrigés (ce qui relève du p-hacking algorithmique) et affichent une instabilité d’échantillonnage chronique : une altération infinitésimale de quelques observations suffit fréquemment à faire diverger de manière radicale la composition finale de la sous-sélection de régresseurs retenus par la machine.
10.2 Critères d’information pour la comparaison de sous-modèles
Pour orchestrer un arbitrage rigoureux entre l’exhaustivité informative d’un modèle et la vertu de parcimonie scientifique, sans sombrer dans les travers des algorithmes de sélection pas à pas, la statistique mathématique a forgé une famille de métriques décisionnelles formalisées sous le concept de critères d’information. Fondés sur des bases théoriques issues de la théorie de l’information et de la thermodynamique de Boltzmann, ces critères n’ont pas pour objet de tester une hypothèse nulle au sens de Neyman-Pearson, mais de quantifier la perte relative d’information infligée par l’usage d’un modèle approximatif par rapport à la réalité génératrice des données (la divergence de Kullback-Leibler).
Le Critère d’Information d’Akaike (AIC), articulé par le statisticien Hirotugu Akaike en 1974, formalise ce compromis entre la vraisemblance empirique maximisée du modèle et le nombre de paramètres mobilisés :
$$\text{AIC} = 2k – 2\ln(\hat{L})$$
où $\hat{L}$ désigne la valeur maximale de la fonction de vraisemblance du modèle estimé, et $k$ symbolise le cardinal total des paramètres libres estimés (incluant les régresseurs, l’intercept et la variance de l’erreur résiduelle). La composante $2k$ agit comme une pénalité linéaire directe : plus l’analyste incorpore de régresseurs futiles, plus la statistique de l’AIC enfle. Le meilleur modèle parmi un panel de configurations concurrentes préétablies est celui qui minimise la valeur scalaire de l’AIC.
En parallèle, Gideon Schwarz a formalisé en 1978 le Critère d’Information Bayésien (BIC ou Schwarz Criterion), dérivé d’une approximation asymptotique de l’évidence marginale bayésienne :
$$\text{BIC} = k\ln(n) – 2\ln(\hat{L})$$
La distinction opératoire entre l’AIC et le BIC réside dans la rigidité de la pénalité infligée au nombre de régresseurs. Alors que l’AIC applique une pénalité invariante ($2k$), le BIC module sa sanction par le logarithme de la taille de l’échantillon ($kln(n)$). Dès lors que l’effectif d’échantillonnage $n ge 8$, le facteur $ln(n)$ surpasse 2. Le BIC se montre donc nettement plus sévère à l’égard de l’inflation de régresseurs marginaux, privilégiant des sous-ensembles de prédicteurs beaucoup plus concentrés et parcimonieux que ceux sélectionnés sous l’égide de l’AIC.
10.3 Régression pénalisée : Ridge, Lasso et Elastic Net
Lorsque la structure empirique est saturée par un nombre gigantesque de régresseurs corrélés, ou lorsque la dimension de la matrice d’expérience approche voire surpasse l’effectif total d’observations ($p > n$), l’estimation par les Moindres Carrés Ordinaires s’effondre dans la singularité ou le surapprentissage absolu. Les sciences des données ont apporté une révolution conceptuelle pour résoudre cette crise par l’invention des techniques de régression pénalisée ou méthodes de rétrécissement paramétrique (shrinkage).
La régression Ridge, introduite par Hoerl et Kennard, altère la fonction de coût des MCO en lui assignant une pénalité sur la norme $L_2$ des coefficients de régression associés aux régresseurs :
$$\hat{boldsymbol{\beta}}_{\text{Ridge}} = arg\min_{boldsymbol{\beta}} \left{ \sum_{i=1}^n \left( Y_i – \beta_0 – \sum_{j=1}^p \beta_j X_{ij} \right)^2 + \lambda \sum_{j=1}^p \beta_j^2 \right}$$
Le paramètre d’ajustement $lambda ge 0$, sélectionné par des procédures de validation croisée, module l’intensité de la contrainte. La pénalité $L_2$ comprime l’amplitude globale des coefficients associés aux régresseurs sans jamais les annuler totalement. Cette compression rétablit la stricte inversibilité de la matrice de covariance perturbée par la multicolinéarité, introduisant un biais mathématique mineur et contrôlé dans l’estimation en échange d’une réduction drastique de la variance d’échantillonnage des coefficients (arbitrage biais-variance).
La régression Lasso (Least Absolute Shrinkage and Selection Operator), formalisée par Robert Tibshirani en 1996, substitue à la contrainte quadratique une pénalité formulée sur la norme $L_1$ des paramètres des régresseurs :
$$\hat{boldsymbol{\beta}}_{\text{Lasso}} = arg\min_{boldsymbol{\beta}} \left{ \sum_{i=1}^n \left( Y_i – \beta_0 – \sum_{j=1}^p \beta_j X_{ij} \right)^2 + \lambda \sum_{j=1}^p |\beta_j| \right}$$
La géométrie spécifique de la contrainte de norme $L_1$ (qui présente des pointes angulaires sur les axes du polytope des paramètres) produit une conséquence algorithmique majeure : la sélection parcimonieuse automatique (sparsity). Lorsque le paramètre d’ajustement $lambda$ monte en puissance, les coefficients des régresseurs les moins informatifs ou les plus redondants sont inexorablement poussés vers zéro pour s’y écraser exactement. Le Lasso élimine purement et simplement les prédicteurs superflus, assurant à la fois le rétrécissement régularisé et la sélection autonome d’un sous-ensemble optimisé de régresseurs explicatifs.
Enfin, pour dépasser certaines limites du Lasso pur (qui tend à sélectionner de manière arbitraire un seul régresseur au sein d’un bloc de prédicteurs fortement colinéaires en ignorant les autres), Zou et Hastie ont synthétisé ces deux approches sous l’architecture de l’Elastic Net. Cette méthode incorpore conjointement une combinaison convexe des pénalités $L_1$ et $L_2$, autorisant une sélection parcimonieuse tout en préservant la dynamique de sélection groupée des régresseurs fortement associés.
11. Rôles conceptuels avancés : médiation, modération et variables confondantes
11.1 Le régresseur en tant que variable médiatrice
L’approfondissement de la structure mécanistique reliant des variables conduit fréquemment à transcender le schéma d’un impact causal direct entre un régresseur primaire $X$ et une variable de sortie $Y$. L’ambition des sciences fondamentales consiste à percer les chaînons intermédiaires qui véhiculent l’effet. Le régresseur peut alors assumer formellement le statut conceptuel de variable médiatrice ($M$).
Dans le schéma paradigmatique immortalisé par Reuben Baron et David Kenny en 1986, le phénomène est décomposé en une séquence ordonnée d’équations de régression :
- Régression du médiateur $M$ sur le régresseur initial $X$ ($M = i_1 + a X + \varepsilon_1$), où le coefficient $a$ chiffre la transmissibilité de l’influence vers le médiateur.
- Régression du régressant final $Y$ simultanément sur le régresseur initial $X$ et le médiateur $M$ ($Y = i_2 + c’ X + b M + \varepsilon_2$).
Dans ce système bi-étagé, $M$ opère une double métamorphose analytique : il agit en tant que régressant face à $X$ dans la première équation, pour ensuite se muer en régresseur partiel face à $Y$ dans la seconde équation, opérant aux côtés du régresseur d’origine. L’effet indirect véhiculé par le médiateur — qui matérialise le cœur du mécanisme d’explication interne — est quantitativement estimé par le produit des coefficients régresseurs :
$$\text{Effet Indirect} = a \times b$$
La méthodologie contemporaine s’est émancipée des règles de décision séquentielles de Baron et Kenny ainsi que du test de Sobel classique, qui souffrait d’une hypothèse de normalité asymptotique intenable pour la distribution du produit $(ab)$. Les chercheurs recourent désormais universellement aux méthodes de rééchantillonnage non paramétrique (bootstrapping), comme systématisées dans les macros logicielles PROCESS d’Andrew Hayes, générant des intervalles de confiance robustes pour tester la plausibilité statistique du régresseur médiateur.
Il est impératif d’ancrer une démarcation catégorique et sans équivoque entre le statut de médiateur et celui de modérateur. Comme formalisé précédemment, un régresseur modérateur ne se situe pas à l’intérieur d’une chaîne causale séquentielle : il ne constitue pas une conséquence provoquée par le régresseur initial ($X to M$). Le modérateur est une condition périphérique transversale qui altère l’intensité ou la direction de la liaison reliant $X$ à $Y$, tandis que le médiateur absorbe et transmet l’impact fonctionnel émis par le prédicteur amont.
11.2 Le régresseur comme variable de contrôle ou de confusion
L’attribution abusive d’une force causale substantielle à un régresseur d’intérêt théorique peut résulter de la présence masquée d’une « variable confondante » (confounder). Une variable confondante $Z$ se définit théoriquement comme une entité étiologique parente qui agit comme une cause commune conjointe du régresseur focal $X$ et du régressant de sortie $Y$. En l’absence de neutralisation explicite de cette cause amont, une partie ou l’intégralité de la covariation apparente entre $X$ et $Y$ est le produit trompeur de ce carrefour informationnel partagé.
L’intégration de la variable confondante en tant que régresseur de contrôle au sein d’une spécification multivariée permet d’annihiler ce biais de confusion. La méthodologie inférentielle a franchi une avancée décisive sous l’impulsion des travaux de Judea Pearl sur les Diagrammes Causaux Acycliques (Directed Acyclic Graphs, DAGs). Les DAGs formalisent graphiquement les flux de transfert causal et fournissent un ensemble de règles mathématiques explicites, regroupées sous le « critère de la porte dérobée » (backdoor criterion), dictant de manière incontestable quels régresseurs doivent obligatoirement être intégrés au modèle de régression pour bloquer les circuits de corrélation fallacieuse.
Cette algébrisation de la causalité met également en garde les analystes contre une dérive méthodologique funeste : l’illusion du sur-contrôle statistique aveugle. Insérer indistinctement toutes les variables disponibles dans la matrice des régresseurs d’une équation ne constitue nullement une garantie d’impartialité ; cela peut au contraire contaminer gravement l’estimation par l’induction de biais artificiels catastrophiques. Deux écueils majeurs sont mis en évidence par les DAGs :
- Le contrôle d’un médiateur intermédiaire : introduire dans l’équation un régresseur qui se positionne en aval direct de la trajectoire causale reliant le prédicteur principal à l’issue ($X to M to Y$) a pour effet de bloquer le chemin d’influence légitime, annihilant artificiellement l’effet causal total que l’analyste prétendait initialement mesurer.
- Le biais du collisionneur (collider bias ou paradoxe de Berkson) : un collisionneur est une variable $C$ conditionnée conjointement par deux causes indépendantes dans le système étudié ($X to C \leftarrow Y$). L’adjonction malencontreuse de ce collisionneur en tant que régresseur dans le modèle ouvre frauduleusement une connexion dépendante rétroactive entre $X$ et $Y$, créant de toutes pièces une association fallacieuse absente de la population d’origine.
11.3 Distinction épistémologique : prédiction vs causalité
La diffusion massive des logiciels de calcul statistique a favorisé l’ancrage d’une confusion épistémique dommageable : la projection inconsciente d’une interprétation strictement causale sur de simples coefficients de régression issus d’un modèle empirique ajusté. Qu’un régresseur $X$ démontre un coefficient $\hat{\beta}$ vigoureux et assorti d’une valeur $p$ infinitésimale au sein d’un échantillon représentatif de grande dimension n’offre, en soi, aucune garantie formelle attestant que des manipulations délibérées appliquées à $X$ engendreront les modifications calculées sur $Y$ dans l’arène concrète du monde réel.
Dans le domaine prédictif, un régresseur peut remplir une mission de calibrage avec un brio algorithmique incontestable en agissant simplement comme un substitut informationnel (un proxy). Par exemple, le niveau de dépense annuel alloué aux produits d’entretien domestique ou le type d’abonnement téléphonique détenu par un individu peuvent constituer des régresseurs puissants pour anticiper sa solvabilité de remboursement d’un emprunt bancaire. Ces prédicteurs captent un profil d’organisation comportementale et de discipline de gestion quotidienne, sans que quiconque n’imagine que le fait de forcer un consommateur à acquérir davantage de détergent suffira à transformer magiquement sa situation financière ou à conjurer son insolvabilité.
Pour autoriser l’investigateur à interpréter le coefficient d’un régresseur en termes d’impact causal réel au sens nomologique, des conditions méthodologiques d’une sévérité implacable doivent être rigoureusement satisfaites, telles que condensées dans les critères historiques d’Austin Bradford Hill et enrichies par le formalisme contrefactuel de Donald Rubin (Potential Outcomes Framework) :
- La précédence temporelle inattaquable du régresseur sur la manifestation du régressant.
- L’isolation totale du système de régression contre toute source plausible de confusion non observée (fermeture de l’ensemble des chemins de porte dérobée).
- L’invariance et la robustesse de l’estimation face aux interventions structurelles directes (absence de rétroactions endogènes de type simultanéité).
Le chercheur quantitatif porte une responsabilité éthique et intellectuelle majeure dans la diffusion de ses travaux : il lui incombe de désigner ses entités de calcul sous le terme modeste de régresseurs ou de covariables statistiques, en refusant catégoriquement de qualifier les coefficients obtenus de « conséquences », « leviers » ou « impacts causaux » dès lors que le dispositif empirique investigué n’a pas été rigoureusement blindé contre les pathologies de l’endogénéité.
12. Bonnes pratiques pour intégrer et interpréter les régresseurs
12.1 Standardisation et comparabilité des coefficients
La question de la comparabilité directe de l’impact exercé par des régresseurs mesurés sur des échelles hétérogènes constitue une préoccupation technique récurrente pour le praticien. Au sein d’un modèle examinant les déterminants de l’anxiété préopératoire, la confrontation brute d’un coefficient associé à l’âge chronologique ($B_{\text{âge}} = 0.12$ point par an) et d’un coefficient rattaché à une concentration d’adrénaline sanguine ($B_{\text{adr}} = 85.30$ points par microgramme par millilitre) interdit toute conclusion hâtive quant à la primauté relative de l’un de ces facteurs.
Le recours aux coefficients régresseurs standardisés ($\beta^*$) offre une passerelle métrique immédiate en convertissant toutes les variables du modèle en scores réduits (moyenne nulle et variance unitaire) :
$$\beta_j^* = B_j \left( \frac{s_{X_j}}{s_Y} \right)$$
Dans cette nouvelle configuration, la magnitude relative de chaque coefficient $\beta_j^*$ indique le déplacement attendu sur le régressant, chiffré en portions d’écart-type de $Y$, induit par une translation d’exactement un écart-type du régresseur concerné. Cette standardisation autorise une hiérarchisation visuelle ordonnée de la contribution relative des régresseurs au sein de l’échantillon modélisé.
Néanmoins, la conversion standardisée recèle des pièges d’interprétation insidieux qu’il convient de dénoncer. Les écarts-types d’échantillonnage ($s_{X_j}$ et $s_Y$) sont tributaires de la composition démographique du groupe sélectionné. Si deux études distinctes répliquent un protocole identique dans deux populations présentant des variabilités dissemblables — par exemple, une cohorte universitaire très homogène en âge opposée à un échantillon communautaire très dispersé —, les coefficients standardisés divergeront structurellement, même si le mécanisme biométrique fondamental sous-jacent est strictement invariant ($B_{\text{brut}}$ identique). Les méthodologues prescrivent par conséquent de rapporter systématiquement dans les publications scientifiques les deux métriques de front : les coefficients non standardisés assortis de leurs unités réelles afin d’éclairer la portée concrète de l’effet, et les coefficients standardisés pour étayer l’évaluation comparative théorique globale.
12.2 Visualisation graphique des effets partiels et résiduels
L’esprit humain appréhende mal la structure multidimensionnelle des hyperplans au travers de simples listes de matrices numériques imprimées dans des tables de régression. L’intégration de routines de visualisation graphique constitue une condition indispensable pour sonder l’intégrité du modèle et communiquer les résultats avec transparence. Pour déchiffrer le comportement isolé d’un régresseur précis dans un système multipredicteur, l’outil graphique par excellence réside dans le graphique de régression partielle (partial regression plot ou added-variable plot).
Ce graphique applique visuellement le mécanisme du théorème de Frisch-Waugh-Lovell : il reporte en ordonnée le résidu de la variable réponse $Y$ purgée de tous les prédicteurs concurrents, et en abscisse le résidu du régresseur focal $X_j$ débarrassé de sa corrélation avec ces mêmes variables concurrentes. La pente de la droite linéaire traversant ce nuage de résidus correspond exactement à l’estimateur de régression partielle $\hat{\beta}_j$. Ce dispositif visuel permet d’évaluer instantanément si la relation isolée conserve une linéarité satisfaisante, et d’identifier au premier coup d’œil les observations aberrantes ou points de levier marginaux qui faussent artificiellement l’estimation du régresseur.
De même, la modélisation rigoureuse des régresseurs impose la cartographie systématique des intervalles de confiance à 95 % ceignant les trajectoires prédites, visualisant ainsi l’éventail de précision de l’ajustement qui s’élargit naturellement à mesure que l’on s’écarte du barycentre moyen des données. Concernant les termes d’interaction et de modération, le recours aux graphiques d’effets marginaux conditionnels — représentant les courbes d’évolution du régressant face au régresseur focal superposées pour différentes tranches du régresseur modérateur — est un prérequis incontournable pour rendre intelligible la dynamique interactive auprès de la communauté scientifique.
12.3 Normes de reporting scientifique conformes aux directives APA
L’exercice de formalisation analytique ne saurait s’achever sans l’application rigoureuse des normes de communication académique prescrites par les consortiums scientifiques, dont les directives de la 7e édition du manuel de l’American Psychological Association constituent la référence prééminente dans les sciences sociales et biomédicales. Le compte-rendu d’un modèle de régression multivarié requiert une présentation tabulaire exhaustive et standardisée, évitant toute dissimulation d’indices de fragilité inférentielle.
Une table de régression conforme aux standards APA doit obligatoirement détailler pour chaque régresseur inclus :
- Le coefficient de régression brut non standardisé ($B$ ou $b$).
- L’erreur-type asymptotique associée au coefficient brut ($SE_B$ ou $SE$).
- L’intervalle de confiance à 95 % entourant le coefficient brut ($95% \text{ CI } [LL, UL]$).
- Le coefficient de régression standardisé ($\beta$).
- La valeur empirique de la statistique de test déduite ($t$).
- La valeur $p$ exacte calculée (exprimée par exemple sous la forme $p = .014$ plutôt que par une simple catégorisation par astérisques).
En pied de tableau, l’analyste se doit de rapporter les métriques globales régissant la structure de l’équation complète : l’effectif d’échantillonnage total ($N$ ou $n$), le coefficient de détermination global ($R^2$), le coefficient de détermination ajusté ($R^2_{\text{adj}}$), ainsi que le test $F$ de significativité globale stipulant rigoureusement les degrés de liberté du modèle et des résidus (par exemple, $F(4, 295) = 14.82, p < .001$). Dans le corps du texte du manuscrit scientifique, ces éléments computationnels doivent s’accompagner de la déclaration explicite des vérifications de diagnostic préalablement conduites : l’inspection des indices de multicolinéarité ($VIF$ et tolérance), le test de normalité et d’homoscédasticité des résidus de projection, ainsi que la justification conceptuelle de l’ordre hiérarchique d’introduction des régresseurs sélectionnés.
Références
- Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. SAGE Publications.
- Akaike, H. (1974). A new look at the statistical model identification. IEEE Transactions on Automatic Control, 19(6), 716–723. https://doi.org/10.1109/TAC.1974.1100705
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Baron, R. M., & Kenny, D. A. (1986). The moderator-mediator variable distinction in social psychological research: Conceptual, strategic, and statistical considerations. Journal of Personality and Social Psychology, 51(6), 1173–1182. https://doi.org/10.1037/0022-3514.51.6.1173
- Galton, F. (1886). Regression towards mediocrity in hereditary stature. The Journal of the Anthropological Institute of Great Britain and Ireland, 15, 246–263. https://doi.org/10.2307/2841583
- Greene, W. H. (2018). Econometric analysis (8th ed.). Pearson.
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Hayes, A. F. (2022). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.). The Guilford Press.
- Hoerl, A. E., & Kennard, R. W. (1970). Ridge regression: Biased estimation for nonorthogonal problems. Technometrics, 12(1), 55–67. https://doi.org/10.1080/00401706.1970.10488634
- Pearl, J. (2009). Causality: Models, reasoning, and inference (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9780511803161
- Schwarz, G. (1978). Estimating the dimension of a model. The Annals of Statistics, 6(2), 461–464. https://doi.org/10.1214/aos/1176344136
- Tibshirani, R. (1996). Regression shrinkage and selection via the Lasso. Journal of the Royal Statistical Society: Series B (Methodological), 58(1), 267–288. https://doi.org/10.1111/j.2517-6161.1996.tb02080.x
- Wooldridge, J. M. (2020). Introductory econometrics: A modern approach (7th ed.). Cengage Learning.
- Zou, H., & Hastie, T. (2005). Regularization and variable selection via the Elastic Net. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 67(2), 301–320. https://doi.org/10.1111/j.1467-9868.2005.00503.x