
Dans l’édifice de la théorie des probabilités et de la statistique moderne, la distribution conditionnelle constitue sans doute la structure conceptuelle la plus féconde et la plus indispensable à la compréhension du monde empirique. Loin d’être une simple déclinaison calculatoire réservée aux théoriciens, elle matérialise l’acte fondamental de l’apprentissage : comment notre connaissance d’un phénomène incertain se transforme-t-elle, se précise-t-elle et se restructure-t-elle à la lumière d’une information nouvelle ? Qu’il s’agisse de mesurer l’impact d’une psychothérapie selon le profil génétique d’un patient, de quantifier la probabilité de réussite à un test cognitif sachant le niveau de fatigue du sujet, ou d’estimer des trajectoires de développement en sciences comportementales, l’analyse ne repose jamais sur des variables isolées, mais sur le comportement d’une variable au prisme d’une autre.
D’un point de vue épistémologique, l’omniprésence du conditionnement illustre le passage d’une vision déterministe et laplacienne de la nature à une compréhension probabiliste où toute affirmation est intrinsèquement contextualisée. L’interrogation statistique fondamentale n’est plus simplement « quelle est la dispersion de ce comportement au sein de la population générale ? », mais plutôt « quelle forme prend cette variabilité lorsque nous restreignons notre regard à une sous-population partageant un ensemble rigoureusement défini de caractéristiques ? ». C’est précisément à cette question que répond la distribution conditionnelle, en fournissant un modèle mathématique complet pour décrire l’aléa résiduel après l’acquisition d’une information partielle.
Le présent traité propose une exploration exhaustive de la distribution conditionnelle en statistique, alliant rigueur axiomatique, profondeur mathématique et applications substantielles aux sciences comportementales et psychométriques. Des fondements de l’axiomatique de Kolmogorov aux modèles d’apprentissage profond à densité de mélange, en passant par le paradoxe de Borel-Kolmogorov, la théorie de la réponse à l’item et les subtilités de l’inférence causale contrefactuelle, cette analyse offre aux chercheurs et praticiens une synthèse de référence indispensable pour maîtriser la modélisation statistique avancée.
1. Fondements théoriques et définition formelle de la distribution conditionnelle
Pour appréhender la distribution conditionnelle, il est impératif de revenir aux origines formelles du calcul des probabilités. Loin des intuitions simplistes, la conditionnalité impose une reformulation complète de l’espace sur lequel les incertitudes sont quantifiées, exigeant une armature mathématique irréprochable.
1.1 Définition probabiliste et formalisme mathématique fondamental
Soit un espace probabilisé fondamental défini par le triplet $(\Omega, \mathcal{F}, P)$, où $\Omega$ représente l’univers des événements élémentaires, $\mathcal{F}$ une tribu (ou $\sigma$-algèbre) sur $\Omega$, et $P$ une mesure de probabilité assignant une valeur comprise entre 0 et 1 aux ensembles de $\mathcal{F}$. Considérons deux variables aléatoires, notées $X$ et $Y$, définies sur cet univers et prenant respectivement leurs valeurs dans des espaces mesurables $(E_X, \mathcal{E}_X)$ et $(E_Y, \mathcal{E}_Y)$. La formalisation de la distribution de $Y$ sachant l’événement $X = x$ consiste à déterminer comment la mesure de probabilité régissant $Y$ se trouve altérée par la réalisation effective de la condition $X = x$.
Historiquement, l’interprétation de cette relation a connu une métamorphose profonde. Dans la tradition fréquentiste originelle, conditionner revenait à calculer une fréquence relative au sein d’une sous-population infinie observée sous des conditions expérimentales rigoureusement identiques. À l’inverse, l’approche épistémique contemporaine conçoit la distribution conditionnelle comme une mise à jour systématique de l’état d’information d’un observateur rationnel. L’acquisition de la donnée $X = x$ élimine une infinité d’états du monde possibles, forçant une réallocation du poids de probabilité sur les événements restants compatibles avec cette observation.
La notation standard $P(Y = y mid X = x)$ désigne la probabilité que la variable dépendante $Y$ prenne la valeur spécifique $y$, sous la restriction structurelle de domaine imposée par $X = x$. Cette construction s’enracine directement dans l’axiomatique des probabilités d’Andrei Kolmogorov établie en 1933. Kolmogorov définit la probabilité conditionnelle d’un événement $B$ sachant un événement $A$ de probabilité non nulle par le ratio $P(B mid A) = \frac{P(A \cap B)}{P(A)}$. Lorsque nous transposons cette formule aux variables aléatoires, l’événement conditionnant devient ${\omega in \Omega : X(\omega) = x}$ et l’événement conditionné ${\omega in \Omega : Y(\omega) = y}$, posant les bases de tout le formalisme analytique ultérieur.
1.2 Distinction conceptuelle entre distributions marginales, conjointes et conditionnelles
Une compréhension limpide de la conditionnalité requiert une différenciation rigoureuse entre trois notions cardinales de l’analyse multivariée : la distribution conjointe, les distributions marginales et la distribution conditionnelle. La distribution conjointe, modélisée par la fonction de masse $p_{X,Y}(x, y)$ ou la fonction de densité $f_{X,Y}(x, y)$, caractérise l’incertitude simultanée du couple de variables aléatoires $(X, Y)$ sur l’espace produit $E_X \times E_Y$. Elle encapsule l’intégralité de l’information statistique disponible, incluant la dispersion propre de chaque variable ainsi que toutes les formes possibles de dépendance, qu’elles soient linéaires ou non linéaires.
À l’opposé, la distribution marginale s’obtient par une opération de réduction dimensionnelle nommée marginalisation. Cette procédure consiste à sommer (dans le cas discret) ou à intégrer (dans le cas continu) la distribution conjointe sur l’ensemble du spectre de variation de l’autre variable :
$$p_X(x) = \sum_{y in E_Y} p_{X,Y}(x, y) \quad \text{ou} \quad f_X(x) = \int_{-\infty}^{+\infty} f_{X,Y}(x, y) , dy$$
La marginale ignore délibérément l’information véhiculée par l’autre dimension pour restituer le profil stochastique global d’une unique variable isolée dans la population totale.
La distribution conditionnelle intervient comme le produit d’une mise à jour cognitive consécutive à la levée d’une incertitude. Géométriquement, cette distinction est magistrale : alors que la distribution conjointe se déploie comme un volume tridimensionnel (une colline ou une surface de densité au-dessus du plan $(x, y)$), la distribution conditionnelle correspond à une coupe transversale infinitely mince le long de la ligne droite $X = x$. Cependant, cette coupe brute ne possède pas une intégrale ou une somme unitaire ; pour redevenir une distribution de probabilité légitime, elle doit subir une renormalisation par division par l’aire ou la masse de la coupe, représentée par la marginale $f_X(x)$ ou $p_X(x)$.
1.3 La conditionnalité vue comme restriction de l’univers des possibles
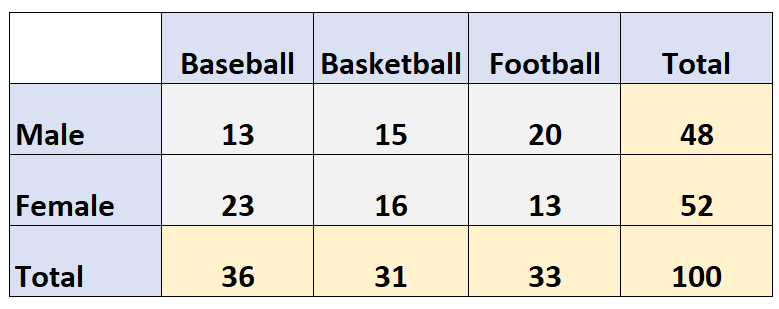
D’un point de vue ensembliste, la conditionnalité opère un véritable effet de loupe mathématique. En posant que $X = x$, nous décrétons que l’espace des événements élémentaires $\Omega$ se contracte instantanément en un sous-ensemble $\Omega_x = {\omega in \Omega : X(\omega) = x}$. Tous les événements situés en dehors de cette partition deviennent impossibles et se voient assigner une probabilité conditionnelle nulle. La mesure de probabilité originelle $P$ est alors redéfinie localement sur la sous-tribu induite par cette restriction.
Cette contraction d’univers préserve rigoureusement la structure probabiliste fondamentale. Les axiomes de Kolmogorov de positivité, d’additivité dénombrable et de normalisation demeurent intégralement satisfaits au sein de ce sous-espace d’observation. Cette invariance structurelle garantit que tous les théorèmes classiques de l’analyse stochastique restent opérationnels à l’intérieur de chaque strate conditionnelle.
En psychologie différentielle et dans la recherche clinique, cette propriété est déterminante pour l’étude des profils atypiques ou des populations hautement spécialisées. Lorsque l’on étudie, par exemple, les fonctions exécutives chez des sujets présentant un trouble du spectre de l’autisme à haut niveau de fonctionnement intellectuel, l’analyse marginale globale fournit des estimations biaisées et inopérantes pour cette sous-population. La restriction de l’univers à ce sous-espace clinique spécifique modifie l’architecture des corrélations entre mémoire de travail et flexibilité mentale, révélant des organisations cognitives qui demeurent totalement invisibles au sein de l’échantillon tout-venant.
2. Calcul et dérivation pour les variables aléatoires discrètes
Lorsque les variables aléatoires opèrent sur des ensembles dénombrables ou finis, le calcul conditionnel s’exprime sous une forme algébrique directe, offrant une transparence calculatoire particulièrement adaptée aux sciences humaines et sociales.
2.1 Formulation algébrique discrète et théorème de Bayes
Dans l’univers discret, la fonction de masse de probabilité conditionnelle de $Y$ sachant $X = x$, conventionnellement désignée par $p_{Y mid X}(y mid x)$ ou $P(Y = y mid X = x)$, s’obtient au moyen de l’équation maîtresse reliant la probabilité conjointe et la probabilité marginale de la condition :
$$P(Y = y mid X = x) = \frac{P(X = x \cap Y = y)}{P(X = x)} = \frac{p_{X,Y}(x, y)}{p_X(x)}$$
Cette égalité n’est rigoureusement définie que si la probabilité de l’événement conditionnant est strictement positive, c’est-à-dire $P(X = x) > 0$. Dans l’éventualité où $P(X = x) = 0$, la probabilité conditionnelle n’est pas définie au sens strict du calcul discret, signalant que l’on tente de conditionner sur un état impossible dans la modélisation choisie.
L’inversion de ce conditionnement fait intervenir le théorème de Bayes, fondement inaliénable de l’induction statistique. En exploitant la commutativité de l’intersection ($X = x \cap Y = y \equiv Y = y \cap X = x$), nous pouvons reformuler la probabilité conjointe comme le produit $P(Y = y) P(X = x mid Y = y)$, ce qui permet d’écrire :
$$P(Y = y mid X = x) = \frac{P(Y = y) P(X = x mid Y = y)}{\sum_{y’ in E_Y} P(Y = y’) P(X = x mid Y = y’)}$$
Cette formule prend une importance capitale en psychopathologie cognitive. Supposons que des chercheurs discrétisent des échelles continues d’anxiété et de dépression en catégories diagnostiques ordonnées (faible, modérée, sévère). L’application de la règle de Bayes permet de déduire la probabilité conditionnelle d’un trouble affectif sous-jacent sachant l’occurrence d’un ensemble discret de plaintes somatiques. Néanmoins, cette discrétisation arbitraire de variables intrinsèquement continues engendre une perte irrémédiable de variance intra-classe et peut altérer artificiellement les distributions conditionnelles calculées.
2.2 Méthodologie d’analyse à travers les tables de contingence
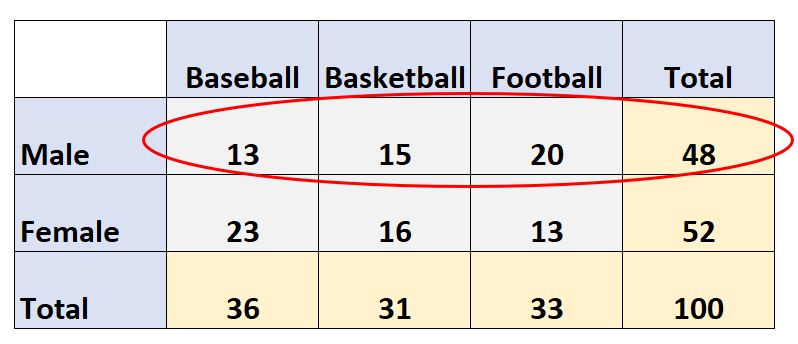
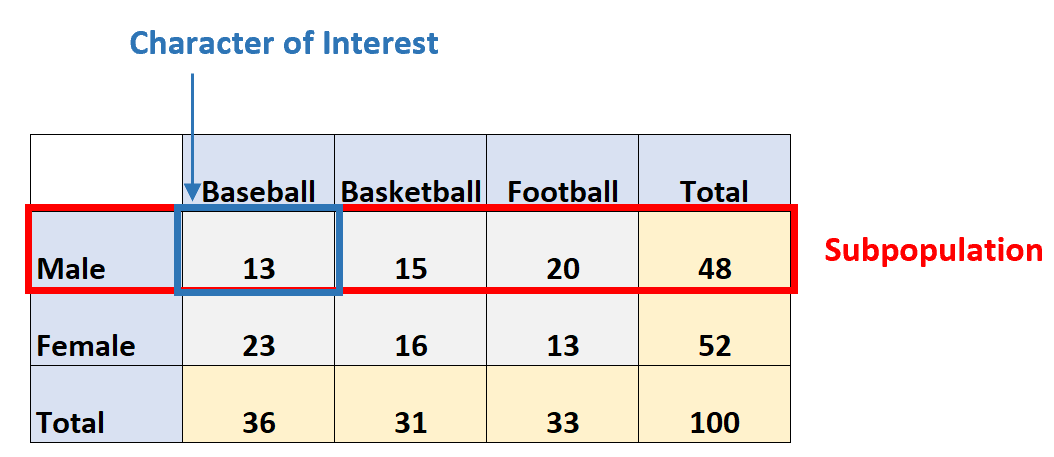
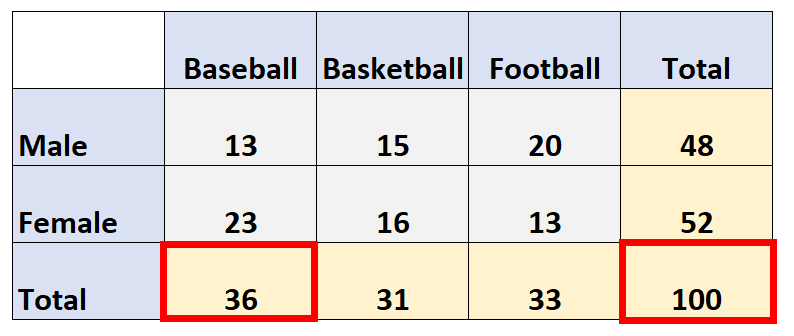
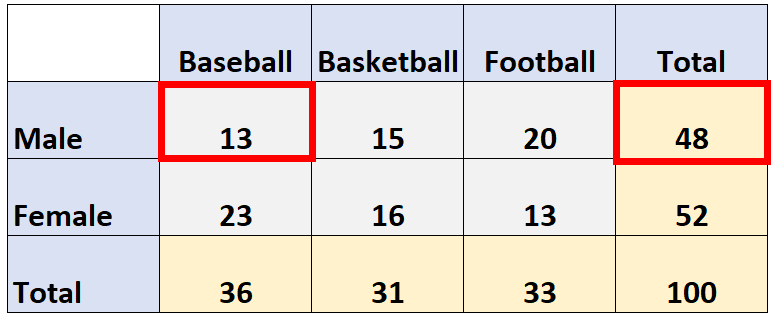
L’incarnation la plus tangible de la distribution conditionnelle discrète réside dans l’exploitation des tables de contingence bivariées croisant deux variables catégorielles. Considérons une table associant une variable d’exposition ou de classification $X$ possédant $I$ modalités et une variable de réponse comportementale $Y$ dotée de $J$ modalités. La table brute contient les effectifs observés $n_{ij}$, où $n = \sum_{i=1}^I \sum_{j=1}^J n_{ij}$ représente l’effectif total de l’échantillon.
L’analyse structurelle de cette matrice s’articule autour de deux lectures fondamentales :
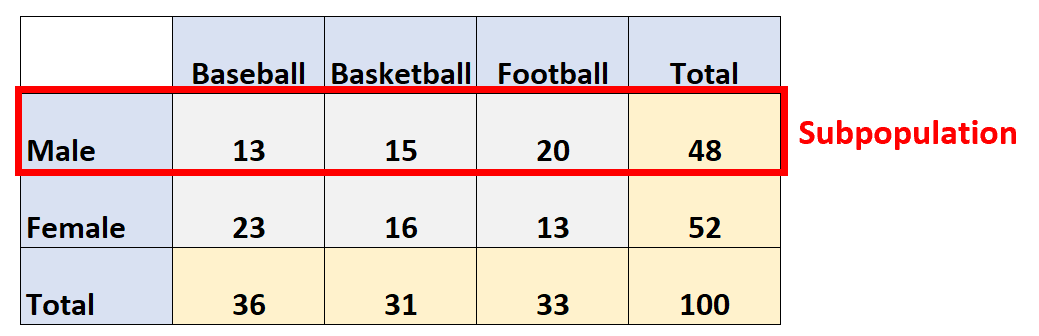
- Les profils-lignes : ils représentent la distribution conditionnelle empirique de la variable de colonne $Y$ sachant que la variable de ligne $X$ est fixée à la modalité $i$. Chaque cellule du profil-ligne est calculée par le ratio $\hat{p}_{Y mid X}(j mid i) = \frac{n_{ij}}{n_{ibullet}}$, où $n_{ibullet} = \sum_{j=1}^J n_{ij}$ représente l’effectif marginal de la ligne.
- Les profils-colonnes : ils inversent la conditionnalité et modélisent la distribution empirique de $X$ sachant $Y = j$, obtenus via $\hat{p}_{X mid Y}(i mid j) = \frac{n_{ij}}{n_{bullet j}}$, avec $n_{bullet j} = \sum_{i=1}^I n_{ij}$.
Considérons une étude empirique en psychologie sociale examinant le choix d’une stratégie de résolution de conflit (Négociation, Retrait, Confrontation) selon le statut d’affiliation du participant. Sur un échantillon représentatif de 400 individus stratifié en deux groupes d’âge (Jeunes Adultes, Adultes Âgés), l’observation des effectifs conjoints ne permet pas d’évaluer directement l’orientation comportementale sans calculer les distributions conditionnelles. Si 60 jeunes adultes sur 200 choisissent la négociation, la probabilité conditionnelle empirique est de $60 / 200 = 0{,}30$. Si 120 adultes âgés sur 200 choisissent la même stratégie, la probabilité conditionnelle s’élève à $120 / 200 = 0{,}60$. L’analyse des fréquences relatives conditionnelles met en lumière des divergences comportementales substantielles que les effectifs bruts ou les marges globales masquaient totalement.
2.3 Propriété de normalisation et axiome d’exhaustivité
Toute distribution conditionnelle valide constitue une mesure de probabilité à part entière sur l’espace d’arrivée de la variable conditionnée. En conséquence, elle se doit de respecter rigoureusement l’axiome d’exhaustivité, ce qui se traduit par la propriété de normalisation unitaire :
$$\sum_{y in E_Y} P(Y = y mid X = x) = \sum_{y in E_Y} \frac{P(X = x \cap Y = y)}{P(X = x)} = \frac{1}{P(X = x)} \sum_{y in E_Y} P(X = x \cap Y = y) = \frac{P(X = x)}{P(X = x)} = 1$$
Cette démonstration élémentaire met en exergue une distinction logique absolue trop fréquemment méconnue dans les analyses appliquées : la sommation s’exécute toujours sur la variable conditionnée $Y$, et non sur la variable conditionnante $X$. La somme $\sum_{x in E_X} P(Y = y mid X = x)$ n’a aucun sens probabiliste systématique et ne converge que par pure coïncidence vers 1 dans des configurations symétriques rarissimes.
Dans les pipelines de traitement de données et l’implémentation d’algorithmes statistiques, la vérification de la cohérence stochastique constitue une étape critique de contrôle qualité. Les matrices de transition dans les chaînes de Markov ou les tables de profils conditionnels en analyse factorielle des correspondances doivent impérativement présenter une somme égale à l’unité sur chacune de leurs lignes (ou colonnes selon l’orientation adoptée), sous peine de propager des biais multiplicatifs destructeurs au sein des modélisations subséquentes.
3. La distribution conditionnelle pour les variables aléatoires continues
Le passage au domaine continu transforme l’arithmétique des sommes discrètes en une mécanique infinitésimale complexe. Conditionner une variable sur une valeur exacte soulève des interrogations théoriques vertigineuses, car la probabilité ponctuelle d’un événement continu est rigoureusement nulle.
3.1 Fonction de densité de probabilité conditionnelle
Soient deux variables aléatoires continues $X$ et $Y$ admettant une fonction de densité de probabilité conjointe $f_{X,Y}(x, y)$ continue et intégrable sur $\mathbb{R}^2$. Pour toute valeur $x$ telle que la densité marginale $f_X(x) = \int_{-\infty}^{+\infty} f_{X,Y}(x, u) , du > 0$, la fonction de densité de probabilité conditionnelle de $Y$ sachant $X = x$ est formellement définie par le quotient :
$$f_{Y mid X}(y mid x) = \frac{f_{X,Y}(x, y)}{f_X(x)}$$
L’évaluation analytique de cette densité en un point précis $y$ n’exprime pas une probabilité brute — concept vide de sens pour un point isolé dans le continu —, mais reflète une densité d’intensité stochastique locale. Elle stipule que la probabilité infinitésimale que $Y$ s’immisce dans l’intervalle ultra-court $[y, y + dy]$, sachant que $X$ se situe dans $[x, x + dx]$, converge vers $f_{Y mid X}(y mid x) , dy$ lorsque $dx$ tend vers zéro.
Sous l’hypothèse de distributions régulières et continues, $f_{Y mid X}(y mid x)$ conserve intrinsèquement les propriétés cardinales d’une densité unidimensionnelle : la non-négativité stricte sur tout son support ($f_{Y mid X}(y mid x) ge 0$) et une intégrale de Riemann convergeant exactement vers l’unité. Sur le plan visuel, imaginez un paysage topographique tridimensionnel décrivant $f_{X,Y}$. Trancher cette surface par un plan perpendiculaire à l’axe des abscisses à l’ordonnée $X = x$ engendre une courbe plane. La densité conditionnelle est précisément cette courbe aplatie, dont la hauteur a été ajustée par un facteur d’échelle constant $1 / f_X(x)$ pour que l’aire sous la courbe soit égale à 1.
3.2 Résolution du paradoxe de Borel-Kolmogorov et singularités
Le traitement des variables continues heurte une aporie fondamentale connue sous le nom de paradoxe de Borel-Kolmogorov. En théorie classique de la mesure, la probabilité d’un singleton pour une variable continue est strictement nulle : $P(X = x) = 0$. Dès lors, tenter d’appliquer la définition élémentaire de Kolmogorov conduit à une indétermination mathématique du type zéro sur zéro :
$$P(Y le y mid X = x) = \frac{P(Y le y \cap X = x)}{P(X = x)} = \frac{0}{0}$$
Pour contourner cette singularité, Kolmogorov a formalisé le conditionnement par rapport à une sous-$\sigma$-algèbre plutôt que par rapport à un événement individuel de mesure nulle. L’approche opérationnelle standard consiste à procéder par un passage à la limite infinitésimale au moyen d’une bande différentielle :
$$f_{Y mid X}(y mid x) = \lim_{\epsilon to 0} \frac{\partial}{\partial y} P(Y le y mid x – \epsilon le X le x + \epsilon)$$
Le paradoxe surgit de manière troublante lorsque l’on réalise que ce passage à la limite dépend intrinsèquement de la métrique et du système de coordonnées employés pour définir le voisinage $epsilon$. Selon que l’on approche un sous-espace géométrique (comme le cercle équatorial sur une sphère) en coordonnées cartésiennes ou en coordonnées sphériques, la distribution conditionnelle résultante peut diverger de façon radicale.
En psychophysiologie quantitative, cette subtilité méthodologique est loin d’être anecdotique. Lors du traitement de signaux continus multidimensionnels — tels que les couplages entre électroencéphalographie (EEG) et variations du rythme cardiaque (VRC) —, le choix de la transformation de variables (espace linéaire versus log-transformation des puissances spectrales) reconfigure la topologie des voisinages différentiels. Si l’analyste n’y prend garde, le conditionnement sur des valeurs limites de puissance spectrale peut produire des artefacts mathématiques induits uniquement par la paramétrisation choisie.
3.3 Intégration conditionnelle et fonction de répartition
À partir de la densité conditionnelle $f_{Y mid X}$, il devient possible d’échafauder la fonction de répartition conditionnelle cumulée, notée $F_{Y mid X}(y mid x)$ ou $P(Y le y mid X = x)$. Elle s’obtient par l’intégration continue de la densité depuis l’infini négatif jusqu’au seuil d’intérêt $y$ :
$$F_{Y mid X}(y mid x) = \int_{-\infty}^{y} f_{Y mid X}(u mid x) , du$$
Par construction, cette fonction est monotone non décroissante, continue à droite, et vérifie les limites universelles de toute fonction de répartition :
$$\lim_{y to -\infty} F_{Y mid X}(y mid x) = 0 \quad \text{et} \quad \lim_{y to +\infty} F_{Y mid X}(y mid x) = 1$$
Cette formalisation sous-tend une application diagnostique fondamentale : le calcul des quantiles conditionnels. En inversant la fonction de répartition conditionnelle par rapport à un niveau de probabilité $tau in ]0, 1[$, nous obtenons la fonction quantile :
$$Q_Y(\tau mid x) = F_{Y mid X}^{-1}(\tau mid x) = \inf { y in \mathbb{R} : F_{Y mid X}(y mid x) ge \tau }$$
Dans l’établissement des normes neuropsychologiques contemporaines (comme les étalonnages des échelles de Wechsler), cette approche évite le découpage arbitraire des participants en tranches d’âge rigides. La fonction quantile conditionnelle permet d’établir une trajectoire normative continue où le percentile de performance d’un individu est dynamiquement pondéré par son âge exact, son niveau de scolarité continu et d’autres biomarqueurs déterminants.
4. Moments conditionnels : espérance et variance conditionnelles
La caractérisation intégrale d’une distribution conditionnelle par sa fonction de densité ou de masse est parfois redondante ou difficilement exploitable en recherche empirique. La réduction de cette information à ses moments fondamentaux — au premier rang desquels figurent la moyenne et la variance — offre un levier prédictif et explicatif incomparable.
4.1 L’espérance conditionnelle comme fonction et variable aléatoire
L’espérance conditionnelle de $Y$ sachant que la variable conditionnante s’est matérialisée par la valeur numérique $x$, désignée par $\mathbb{E}[Y mid X = x]$, est la moyenne de la distribution conditionnelle sous-jacente. Elle s’évalue analytiquement par :
$$\mathbb{E}[Y mid X = x] = \int_{-\infty}^{+\infty} y , f_{Y mid X}(y mid x) , dy \quad \text{(cas conti\nu)} \quad \text{ou} \quad \sum_{y in E_Y} y , P(Y = y mid X = x) \quad \text{(cas discret)}$$
Cette quantité représente un scalaire déterminé, une valeur numérique spécifique propre au point $x$. Cependant, la puissance de l’analyse stochastique moderne réside dans l’étape d’abstraction supérieure consistant à envisager $x$ non plus comme une réalisation figée, mais comme l’argument variable d’une fonction borélienne $g(x) = \mathbb{E}[Y mid X = x]$. Dès lors, l’expression $\mathbb{E}[Y mid X] = g(X)$ devient une nouvelle variable aléatoire à part entière. Sa propre incertitude découle directement de l’aléa qui pèse sur $X$.
Dans le cadre théorique des espaces fonctionnels de Hilbert $L^2(\Omega, \mathcal{F}, P)$ — c’est-à-dire l’espace des variables aléatoires admettant un moment d’ordre deux fini —, l’espérance conditionnelle $\mathbb{E}[Y mid X]$ possède un statut mathématique exceptionnel : elle est la projection orthogonale de $Y$ sur le sous-espace fermé des fonctions mesurables par rapport à la tribu engendrée par $X$, notée $\sigma(X)$. Cette propriété géométrique garantit que $\mathbb{E}[Y mid X]$ constitue le prédicteur optimal absolu de $Y$ à partir de $X$ au sens du critère des moindres carrés, minimisant l’erreur quadratique moyenne :
$$\mathbb{E}[(Y – g(X))^2] ge \mathbb{E}[(Y – \mathbb{E}[Y mid X])^2] \quad \forall g$$
Illustrons ce statut par une application clinique : considérons la prédiction de l’indice de détresse psychologique ($Y$) chez des étudiants en période d’examens à partir de leur durée moyenne de sommeil ($X$). Fixer $X = 5\text{ heures}$ donne un niveau de détresse attendu chiffré, par exemple $\mathbb{E}[Y mid X = 5] = 7{,}2$. Mais envisager $\mathbb{E}[Y mid X]$ comme une variable aléatoire permet d’analyser comment l’hétérogénéité des rythmes de sommeil dans l’ensemble de la population étudiante régit la distribution globale de la détresse moyenne attendue.
4.2 La loi des espérances itérées et ses implications
Une des propriétés les plus monumentales des probabilités appliquées est sans conteste la loi des espérances itérées, également immortalisée sous le nom de théorème de l’espérance totale :
$$\mathbb{E}[\mathbb{E}[Y mid X]] = \mathbb{E}[Y]$$
La démonstration s’établit avec une remarquable élégance dans le domaine continu à l’aide du théorème de Fubini. En intégrant l’espérance conditionnelle par rapport à la mesure marginale de $X$, nous avons :
$$\mathbb{E}[\mathbb{E}[Y mid X]] = \int_{-\infty}^{+\infty} \mathbb{E}[Y mid X = x] , f_X(x) , dx = \int_{-\infty}^{+\infty} \left( \int_{-\infty}^{+\infty} y , \frac{f_{X,Y}(x, y)}{f_X(x)} , dy \right) f_X(x) , dx$$
En simplifiant par la densité marginale $f_X(x)$ supposée non nulle, l’expression se contracte :
$$\int_{-\infty}^{+\infty} \int_{-\infty}^{+\infty} y , f_{X,Y}(x, y) , dy , dx = \int_{-\infty}^{+\infty} y \left( \int_{-\infty}^{+\infty} f_{X,Y}(x, y) , dx \right) dy = \int_{-\infty}^{+\infty} y , f_Y(y) , dy = \mathbb{E}[Y]$$
Ce résultat fournit une méthode de décomposition d’une puissance redoutable. Lorsqu’un problème d’estimation global est trop intriqué pour être modélisé directement, il suffit de segmenter la population en sous-groupes conditionnels homogènes, de calculer les moyennes au sein de chaque strate, puis de recombiner ces espérances conditionnelles par une moyenne pondérée selon les poids démographiques de chaque strate.
En épidémiologie psychiatrique, cette approche permet d’estimer avec une précision rigoureuse le taux marginal de prévalence d’un trouble anxio-dépressif à l’échelle nationale. Il est souvent impossible de mener une enquête aléatoire simple parfaitement représentative. Les chercheurs calculent les espérances conditionnelles de prévalence par strates socio-économiques et régionales hautement ciblées, puis appliquent la loi des espérances itérées en utilisant les distributions marginales issues des recensements nationaux pour reconstituer l’espérance globale non biaisée.
4.3 Variance conditionnelle et loi de la variance totale
Tandis que l’espérance conditionnelle capture le centre de gravité de la distribution mise à jour, la variance conditionnelle quantifie l’amplitude de l’incertitude ou de l’ignorance résiduelle subsistant après l’observation de la condition. Elle est formellement définie comme le second moment centré de la distribution conditionnelle :
$$\text{Var}(Y mid X = x) = \mathbb{E}\left[ (Y – \mathbb{E}[Y mid X = x])^2 mid X = x \right] = \mathbb{E}[Y^2 mid X = x] – (\mathbb{E}[Y mid X = x])^2$$
Tout comme pour l’espérance, l’expression $\text{Var}(Y mid X)$ acquiert le statut de variable aléatoire gouvernée par la variabilité de $X$. L’articulation magistrale reliant ces moments à la variabilité globale non conditionnée de $Y$ est consignée dans la loi de la variance totale (parfois désignée sous le nom d’équation d’Eve) :
$$\text{Var}(Y) = \mathbb{E}[\text{Var}(Y mid X)] + \text{Var}(\mathbb{E}[Y mid X])$$
Cette équation sépare la variance marginale de $Y$ en deux composantes mutuellement exclusives et exhaustives :
- La variance résiduelle moyenne (intra-groupe), $\mathbb{E}[\text{Var}(Y mid X)]$ : elle mesure la part de l’aléa qui échappe intrinsèquement à toute tentative d’explication par la variable conditionnante $X$. C’est l’incertitude moyenne qui subsiste au sein des strates.
- La variance des espérances (inter-groupe), $\text{Var}(\mathbb{E}[Y mid X])$ : elle mesure la variabilité des prédictions moyennes d’un groupe conditionnel à un autre. C’est la part de la variabilité totale directement imputable et expliquée par l’hétérogénéité de la condition $X$.
Ce théorème représente le fondement axiomatique direct de l’analyse de variance (ANOVA) employée massivement en psychologie expérimentale. Dans un protocole étudiant l’efficacité d’un protocole d’entraînement cognitif, la décomposition de la dispersion des scores mnésiques montre précisément comment la dispersion inter-classes ($\text{Var}(\mathbb{E}[Y mid X])$) s’oppose au bruit expérimental résiduel non contrôlé ($\mathbb{E}[\text{Var}(Y mid X)]$).
5. Modélisation bivariée et multivariée : le cas gaussien
Dans la boîte à outils des modèles statistiques continus, la loi normale multidimensionnelle occupe une position prééminente en raison de ses propriétés d’invariance et de sa régularité analytique unique.
5.1 La distribution normale bivariée et ses coupes conditionnelles
Soit un vecteur aléatoire bidimensionnel $(X, Y)$ suivant une loi conjointe normale bivariée $\mathcal{N}_2(boldsymbol{\mu}, boldsymbol{\Sigma})$, caractérisé par son vecteur de moyennes $boldsymbol{\mu} = (\mu_X, \mu_Y)^T$ et sa matrice de variance-covariance symétrique semi-définie positive :
$$boldsymbol{\Sigma} = \begin{\pmatrix} \sigma_X^2 &a\mp; \rho \sigma_X \sigma_Y \rho \sigma_X \sigma_Y &a\mp; \sigma_Y^2 \end{\pmatrix}$$
où $rho in ]-1, 1[$ symbolise le coefficient de corrélation linéaire de Pearson. La fonction de densité conjointe s’écrit formellement sous la forme :
$$f_{X,Y}(x, y) = \frac{1}{2\pi \sigma_X \sigma_Y \sqrt{1-\rho^2}} \exp\left( -\frac{1}{2(1-\rho^2)} \left[ \frac{(x-\mu_X)^2}{\sigma_X^2} – 2\rho\frac{(x-\mu_X)(y-\mu_Y)}{\sigma_X \sigma_Y} + \frac{(y-\mu_Y)^2}{\sigma_Y^2} \right] \right)$$
L’un des théorèmes les plus remarquables de l’analyse multivariée postule que toute distribution conditionnelle issue d’un vecteur conjointement gaussien est elle-même rigoureusement gaussienne unidimensionnelle :
$$Y mid (X = x) \sim \mathcal{N}\left( \mu_{Y mid X}(x), \sigma_{Y mid X}^2 \right)$$
Par un développement algébrique direct consistant à factoriser les termes quadratiques dans l’exponentielle du quotient $\frac{f_{X,Y}(x, y)}{f_X(x)}$, nous obtenons explicitement les paramètres fondamentaux de cette loi conditionnelle :
$$\mu_{Y mid X}(x) = \mathbb{E}[Y mid X = x] = \mu_Y + \rho \frac{\sigma_Y}{\sigma_X} (x – \mu_X)$$
$$\sigma_{Y mid X}^2 = \text{Var}(Y mid X = x) = \sigma_Y^2 (1 – \rho^2)$$
Cette formulation analytique appelle deux constats théoriques capitaux. En premier lieu, l’espérance conditionnelle se révèle être une fonction strictement affine de $x$. Elle s’aligne fidèlement sur la droite de régression linéaire de moindres carrés avec une pente égale à $\beta = \rho \frac{\sigma_Y}{\sigma_X}$. En second lieu, la variance conditionnelle se distingue par son indépendance absolue vis-à-vis de la valeur conditionnante $x$ : elle demeure constante quel que soit le point où la coupe transversale est opérée.
5.2 Homoscédasticité et régularité structurelle
Cette invariance de la variance conditionnelle porte le nom statistique d’homoscédasticité. Dans le cadre de la normalité conjointe, l’incertitude quant à la position de $Y$ est systématiquement amoindrie par le facteur multiplicatif $(1 – \rho^2)$, soulignant qu’une corrélation élevée ($\rho to \pm 1$) effondre l’aléa résiduel de la distribution conditionnelle, jusqu’à rendre la prédiction quasi-déterministe.
Cependant, dans la pratique empirique de la psychologie différentielle ou de la biométrie, cette homoscédasticité structurelle constitue souvent une idéalisation théorique violée par la réalité clinique. Dès lors que la relation entre deux variables n’est pas conjointement gaussienne, la variance conditionnelle devient dépendante de la valeur conditionnante $x$, phénomène appelé hétéroscédasticité. Les outils de diagnostic graphique des résidus conditionnels — tels que les diagrammes de dispersion confrontant les valeurs ajustées aux résidus standardisés — permettent d’identifier ces écarts à la régularité gaussienne et de mettre en garde contre une confiance indue dans des intervalles de prédiction constants.
5.3 Extension aux distributions conditionnelles multivariées
La théorie gaussienne conditionnelle déploie toute son envergure lorsqu’elle est généralisée à des espaces multivariés arbitraires de dimension $p > 2$. Considérons un vecteur aléatoire $\mathbf{Z} \sim \mathcal{N}_p(boldsymbol{\mu}, boldsymbol{\Sigma})$ partitionné en deux sous-vecteurs aléatoires $\mathbf{Y}$ (de dimension $p_1$) et $\mathbf{X}$ (de dimension $p_2$, avec $p_1 + p_2 = p$) :
$$\mathbf{Z} = \begin{\pmatrix} \mathbf{Y} \mathbf{X} \end{\pmatrix}, \quad boldsymbol{\mu} = \begin{\pmatrix} boldsymbol{\mu}_Y boldsymbol{\mu}_X \end{\pmatrix}, \quad boldsymbol{\Sigma} = \begin{\pmatrix} boldsymbol{\Sigma}_{YY} &a\mp; boldsymbol{\Sigma}_{YX} boldsymbol{\Sigma}_{XY} &a\mp; boldsymbol{\Sigma}_{XX} \end{\pmatrix}$$
En employant les propriétés du complément de Schur pour inverser la matrice de covariance par blocs, nous démontrons formellement que la distribution conditionnelle conjointe de $\mathbf{Y}$ sachant la réalisation du sous-vecteur $\mathbf{X} = \mathbf{x}$ est une loi normale multivariée $\mathcal{N}_{p_1}(boldsymbol{\mu}_{\mathbf{Y} mid \mathbf{X}}(\mathbf{x}), boldsymbol{\Sigma}_{\mathbf{Y} mid \mathbf{X}})$ dont les moments matriciels s’expriment par :
$$boldsymbol{\mu}_{\mathbf{Y} mid \mathbf{X}}(\mathbf{x}) = boldsymbol{\mu}_Y + boldsymbol{\Sigma}_{YX} boldsymbol{\Sigma}_{XX}^{-1} (\mathbf{x} – boldsymbol{\mu}_X)$$
$$boldsymbol{\Sigma}_{\mathbf{Y} mid \mathbf{X}} = boldsymbol{\Sigma}_{YY} – boldsymbol{\Sigma}_{YX} boldsymbol{\Sigma}_{XX}^{-1} boldsymbol{\Sigma}_{XY}$$
Ce résultat constitue le socle mathématique de la modélisation simultanée de multiples dimensions comportementales. En neurosciences computationnelles et en neuropsychologie clinique, ce formalisme permet de modéliser l’état cognitif multidimensionnel d’un patient (par exemple, une batterie de sous-tests de mémoire épisodique, de mémoire de travail et d’attention sélective formant $\mathbf{Y}$) conditionnellement à un profil de covariables cliniques et génétiques ($\mathbf{X}$). La matrice de covariance conditionnelle $boldsymbol{\Sigma}_{\mathbf{Y} mid \mathbf{X}}$ dévoile les corrélations résiduelles pures unissant les fonctions cognitives, purgées de l’influence commune des covariables de contrôle.
6. Applications directes en psychométrie et théorie de la mesure
La psychométrie moderne ne se contente plus de manipuler les scores bruts observés ; elle postule l’existence d’attributs latents inobservables que l’on tente d’inférer à travers les réponses manifestes des sujets. Dans cette perspective, la distribution conditionnelle devient la pierre angulaire de toute la théorie de la mesure.
6.1 La théorie de la réponse à l’item (TRI) et les courbes caractéristiques
Dans le paradigme de la théorie de la réponse à l’item (TRI), l’attention se détourne du score total au profit de la probabilité conditionnelle qu’un individu fournisse une réponse spécifique à un item donné, sachant son niveau sur un trait latent continu conventionnellement désigné par la variable $\theta in \mathbb{R}$. Pour une réponse dichotomique $U_i in {0, 1}$ à l’item $i$, la distribution conditionnelle de la réponse est une loi de Bernoulli dont le paramètre de succès dépend fonctionnellement de $\theta$ :
$$P(U_i = 1 mid \theta) = p_i(\theta) = \mathbb{E}[U_i mid \theta]$$
La modélisation de cette espérance conditionnelle binaire s’effectue couramment via des fonctions sigmoïdes dérivées de la régression logistique :
- Le modèle de Rasch (à 1 paramètre) : $P(U_i = 1 mid \theta) = \frac{\exp(\theta – b_i)}{1 + \exp(\theta – b_i)}$, où $b_i$ caractérise la difficulté intrinsèque de l’item.
- Le modèle logistique à 2 paramètres (2PL) : intègre un coefficient de discrimination $a_i$ modulant la sensibilité de l’item aux fluctuations de $\theta$ : $P(U_i = 1 mid \theta) = \frac{\exp(a_i(\theta – b_i))}{1 + \exp(a_i(\theta – b_i))}$.
- Le modèle logistique à 3 paramètres (3PL) : adjoint un paramètre de pseudo-hasard $c_i$ modélisant la probabilité de réussite conditionnelle pour les sujets de compétence infiniment faible : $P(U_i = 1 mid \theta) = c_i + (1 – c_i) \frac{\exp(a_i(\theta – b_i))}{1 + \exp(a_i(\theta – b_i))}$.
Ces formulations révèlent une rupture avec la théorie classique des tests : la précision de la mesure n’est plus considérée comme une constante globale (le coefficient alpha de Cronbach), mais varie conditionnellement le long du continuum latent. L’information de Fisher conditionnelle apportée par un item, notée $I_i(\theta)$, mesure localement l’inverse de la variance conditionnelle de l’estimateur de $\theta$, autorisant la conception de tests adaptatifs informatisés où les items administrés maximisent dynamiquement l’information conditionnelle pour chaque niveau de compétence estimé.
6.2 L’axiome d’indépendance locale comme indépendance conditionnelle
L’édifice entier de la mesure psychométrique repose sur un postulat axiomatique fondamental : l’indépendance locale. Cet axiome énonce que les réponses fournies par un individu aux différents items d’une échelle doivent être mutuellement indépendantes dès lors que l’on conditionne sur le trait latent commun $\theta$ sous-jacent. Formellement, pour un vecteur de réponses $\mathbf{U} = (U_1, U_2, dots, U_K)^T$, la fonction de probabilité conjointe conditionnelle factorise sans reste :
$$P(U_1 = u_1, U_2 = u_2, dots, U_K = u_K mid \theta) = \prod_{k=1}^K P(U_k = u_k mid \theta)$$
L’indépendance conditionnelle ne signifie nullement que les réponses manifestes aux items ne sont pas corrélées dans la population globale — elles le sont nécessairement, car elles partagent la causalité latente commune $\theta$. Elle stipule que cette corrélation doit s’évaporer intégralement au sein de chaque tranche conditionnelle $\theta$. Si une corrélation résiduelle persiste entre deux items après avoir conditionné sur $\theta$, nous sommes en présence d’une violation d’indépendance locale, signalant l’existence d’une dimension latente parasite (comme une proximité lexicale entre deux questions ou un biais de formulation).
Les psychométriciens évaluent cette propriété en examinant la matrice des corrélations résiduelles conditionnelles (les résidus de Yen ou de Chen-Thissen). Des résidus conditionnels s’écartant significativement de zéro constituent une preuve statistique réfutant l’hypothèse d’unidimensionnalité de l’instrument de mesure.
6.3 Détection du fonctionnement différentiel de l’item (DIF)
L’éthique et la validité scientifique de l’évaluation psychologique et neuropsychologique exigent l’équité de la mesure : un test ne doit pas pénaliser un sous-groupe démographique (défini par le genre, l’origine ethnique ou le statut socio-économique) à niveau d’aptitude réel équivalent. C’est le domaine du fonctionnement différentiel de l’item (DIF).
La détection du DIF repose rigoureusement sur la comparaison des distributions de réponse conditionnelles entre deux groupes — conventionnellement désignés comme le groupe de référence ($R$) et le groupe focal ($F$). Un item est dit exempt de fonctionnement différentiel si, et seulement si, pour tout niveau du trait latent $\theta$, la probabilité conditionnelle de succès est rigoureusement identique entre les deux groupes :
$$P(U_i = 1 mid \theta, G = R) = P(U_i = 1 mid \theta, G = F) \quad \forall \theta$$
Si cette égalité est violée, l’item manifeste un DIF uniforme (si l’écart de probabilité conditionnelle est constant sur tout le spectre de $\theta$) ou non uniforme (si les courbes de probabilités conditionnelles se croisent, favorisant un groupe à bas niveau de compétence et l’autre à haut niveau). La méthode non paramétrique classique de Mantel-Haenszel formalise ce contrôle en conditionnant sur des strates définies par le score total observé au test, pris comme approximation discrète de $\theta$, pour calculer un rapport de cotes conditionnel commun et tester son écart à l’unité.
7. Lien fondamental avec l’analyse de régression en sciences comportementales
La quasi-totalité des modélisations statistiques supervisées appliquées à la psychologie, aux neurosciences et aux sciences sociales s’articule autour de l’analyse de régression. Pourtant, la portée profonde de ces modèles demeure fréquemment obscurcie par des approches mécaniques qui oublient que régresser, c’est avant tout estimer une distribution conditionnelle.
7.1 La fonction de régression vue comme moyenne conditionnelle
Dans sa formulation la plus épurée, le modèle de régression linéaire simple ou multiple ne se propose rien d’autre que de modéliser paramétriquement l’espérance conditionnelle d’une variable de réponse $Y$ sachant un ensemble de prédicteurs vectoriels $\mathbf{X} = \mathbf{x}$ :
$$m(\mathbf{x}) = \mathbb{E}[Y mid \mathbf{X} = \mathbf{x}] = \mathbf{x}^T boldsymbol{\beta} = \beta_0 + \beta_1 x_1 + dots + \beta_p x_p$$
Il existe un gouffre conceptuel fondamental entre le calcul d’une corrélation bivariée symétrique et l’estimation d’une fonction de régression conditionnelle orientée. La corrélation traite les deux variables sur un pied d’égalité et quantifie leur co-variation linéaire globale au sein de l’espace conjoint. La régression postule une asymétrie fonctionnelle : elle immobilise le vecteur conditionnant $\mathbf{X}$ à une valeur déterminée pour examiner comment se déplace le barycentre conditionnel de $Y$.
Dans ce cadre, la formulation conventionnelle du modèle linéaire avec un terme de perturbation résiduel $Y = \mathbf{X}^T boldsymbol{\beta} + \varepsilon$ n’est cohérente que sous l’hypothèse critique d’exogénéité stricte des résidus, formulée mathématiquement en termes de moments conditionnels :
$$\mathbb{E}[\varepsilon mid \mathbf{X}] = 0$$
Cette condition implique ipso facto que la corrélation entre les prédicteurs et le terme d’erreur est strictement nulle, mais elle est infiniment plus exigeante : elle stipule que pour chaque point du domaine de variation de $\mathbf{X}$, la moyenne de la distribution conditionnelle des erreurs est rigoureusement alignée sur zéro, attestant que la forme fonctionnelle paramétrique choisie capture la totalité du signal systématique liant les variables.
7.2 Hétéroscédasticité et instabilité de la variance conditionnelle
L’hypothèse classique des moindres carrés ordinaires (MCO) requiert également l’homoscédasticité des perturbations, c’est-à-dire que la variance conditionnelle des erreurs résiduelles soit indépendante de la valeur prise par les covariables : $\text{Var}(\varepsilon mid \mathbf{X} = \mathbf{x}) = \sigma^2$. Or, dans les données issues des sciences comportementales, cette stabilité de la dispersion conditionnelle est régulièrement mise en défaut par la nature même des processus psychologiques.
Considérons l’étude des performances cognitives en fonction de l’âge tout au long de la vie adulte. Chez les adultes jeunes, la distribution conditionnelle des temps de réponse à une tâche cognitive complexe est généralement homogène et fortement concentrée autour de la moyenne. Chez les personnes âgées, en revanche, la dispersion conditionnelle explose : certains individus conservent une vitesse de traitement optimale grâce à une réserve cognitive préservée, tandis que d’autres s’effondrent sous l’effet du vieillissement cérébral pathologique. Cette variabilité accrue aux extrêmes est une manifestation patente d’hétéroscédasticité psychologique.
Lorsque la variance conditionnelle $\text{Var}(Y mid \mathbf{X} = \mathbf{x}) = \sigma^2(\mathbf{x})$ fluctue, les estimateurs des moindres carrés ordinaires demeurent sans biais pour les coefficients de la moyenne conditionnelle, mais ils cessent d’être à variance minimale (perte d’optimalité au sens du théorème de Gauss-Markov). Pire encore, les erreurs-types standards asymptotiques sont biaisées, conduisant à des tests d’hypothèses ($t$ de Student, $F$ de Fisher) et des $p$-valeurs erronés. Pour restaurer l’intégrité de l’inférence statistique sans imposer une structure rigide à la variance conditionnelle, le recours aux moindres carrés pondérés (WLS) ou aux estimateurs de matrice de covariance sandwich asymptotiquement robustes à l’hétéroscédasticité — dits estimateurs de White-Huber — devient impératif.
7.3 Régression quantile pour capturer la distribution conditionnelle complète
La focalisation exclusive sur la moyenne conditionnelle $\mathbb{E}[Y mid \mathbf{X} = \mathbf{x}]$ induit une vision réductrice du phénomène sous étude. La modélisation par la régression classique postule implicitement que l’effet des prédicteurs se traduit par une simple translation en bloc de la distribution de réponse, sans en altérer la forme, l’asymétrie ou l’étalement des queues. La régression quantile, conceptualisée par Roger Koenker et Gilbert Bassett en 1978, transcende cette limite en permettant de modéliser n’importe quel centile conditionnel de la variable dépendante :
$$Q_Y(\tau mid \mathbf{X} = \mathbf{x}) = \mathbf{x}^T boldsymbol{\beta}(\tau)$$
où $tau in ]0, 1[$ désigne le niveau du quantile ciblé (par exemple, $\tau = 0{,}10$ pour le premier décile, $\tau = 0{,}50$ pour la médiane conditionnelle, $\tau = 0{,}90$ pour le neuvième décile). L’estimation des coefficients vectoriels $boldsymbol{\beta}(\tau)$ s’obtient par la minimisation non quadratique d’une fonction de perte asymétrique par morceaux (la fonction check function ou perte de type « pinball ») :
$$\hat{boldsymbol{\beta}}(\tau) = arg\min_{boldsymbol{\beta}} \sum_{i=1}^n \rho_\tau(y_i – \mathbf{x}_i^T boldsymbol{\beta}), \quad \text{a\vec } \rho_\tau(u) = u (\tau – \mathbb{I}(u < 0))$$
Dans l’évaluation des interventions psychothérapeutiques, cette approche offre une acuité clinique exceptionnelle. Imaginons une étude clinique randomisée évaluant l’efficacité d’une thérapie comportementale et cognitive sur la dépression. Une régression linéaire classique sur la moyenne peut révéler un effet global modeste. En revanche, l’analyse par régression quantile peut démontrer que l’intervention n’a que peu d’influence sur les patients présentant des scores modérés ($\tau = 0{,}50$), mais exerce une réduction spectaculaire de la détresse psychologique chez les patients situés dans le décile supérieur de sévérité symptomatique ($\tau = 0{,}90$). Estimer la famille complète des quantiles conditionnels équivaut à cartographier la métamorphose intégrale de la distribution conditionnelle sous l’effet du traitement.
8. Inférence causale, conditionnement et biais d’interprétation
L’une des confusions les plus dommageables en statistique appliquée consiste à assimiler passivement le conditionnement probabiliste à une manipulation expérimentale active. L’avènement des théories modernes de l’inférence causale a permis de délimiter rigoureusement ce que conditionner signifie — et surtout ce que cela ne signifie pas.
8.1 La distinction fondamentale entre conditionnement statistique et intervention causale
Dans le cadre théorique formalisé par Judea Pearl à travers son calcul interventionnel (calcul do), la distribution conditionnelle passive $P(Y = y mid X = x)$ se distingue ontologiquement de la distribution causale interventionnelle $P(Y = y mid \text{do}(X = x))$.
Le conditionnement statistique standard $P(Y mid X = x)$ consiste à filtrer rétrospectivement les observations existantes : nous sélectionnons dans la cohorte les individus qui se trouvent, par leur propre dynamique ou par hasard, avoir $X = x$. En opérant ce filtrage passif, nous laissons circuler non seulement l’effet causal direct de $X$ sur $Y$, mais également toutes les corrélations induites par des causes communes non observées (variables de confusion). L’intervention causale $\text{do}(X = x)$ représente en revanche une altération physique active de la réalité : nous forçons expérimentalement l’ensemble de la population à prendre la valeur $X = x$, rompant chirurgicalement tous les arcs de dépendance entrants vers $X$ dans le graphe causal orienté.
Considérons la psychologie du développement. Si l’on calcule la distribution conditionnelle de la réussite scolaire ($Y$) sachant le nombre de livres présents au domicile parental ($X$), on observera une probabilité conditionnelle élevée de succès pour les grands volumes de livres. Mais interpréter cette observation comme la preuve qu’une intervention consistant à déposer des livres au domicile d’une famille défavorisée ($\text{do}(X = 500)$) induira magiquement la même distribution de réussite scolaire constitue une grave erreur causale. Le conditionnement passif capte l’influence massive du capital culturel et du statut socio-économique des parents, qui sont des facteurs de confusion communs régissant simultanément la présence de livres et la réussite académique de l’enfant.
8.2 Le paradoxe de Simpson comme artefact de mauvaise spécification conditionnelle
Le paradoxe de Simpson représente l’illustration la plus spectaculaire des distorsions induites par une négligence des distributions conditionnelles sous-jacentes. Il décrit une situation mathématique dans laquelle une tendance ou une association statistique positive (ou négative) observée au sein de plusieurs sous-groupes conditionnels distincts s’inverse totalement lorsque les données sont agrégées pour analyser la distribution marginale globale.
Considérons un essai clinique multicentrique évaluant l’efficacité d’un nouveau traitement psychiatrique ($X in {\text{Traitement}, \text{Contrôle}}$) sur la rémission d’un trouble anxieux sévère ($Y in {\text{Succès}, \text{Échec}}$), en stratifiant par la sévérité initiale du trouble ($Z in {\text{Légère}, \text{Sévère}}$). Les distributions conditionnelles par strate de sévérité peuvent révéler les succès suivants :
- Chez les patients légers ($Z = \text{Légère}$) : le traitement présente un taux conditionnel de succès de 80 % contre 70 % pour le contrôle : $P(Y=1 mid X=1, Z=0) > P(Y=1 mid X=0, Z=0)$.
- Chez les patients sévères ($Z = \text{Sévère}$) : le traitement présente un taux conditionnel de succès de 30 % contre 20 % pour le contrôle : $P(Y=1 mid X=1, Z=1) > P(Y=1 mid X=0, Z=1)$.
Le traitement est donc indiscutablement supérieur dans chaque strate conditionnelle. Pourtant, si les psychiatres affectent préférentiellement les patients les plus sévères au groupe traitement et les patients légers au groupe témoin, la distribution marginale non conditionnée de rémission $P(Y=1 mid X)$ peut s’inverser totalement en raison du déséquilibre des marges, faisant apparaître le traitement comme nocif dans l’échantillon global. L’inversion statistique n’est pas un paradoxe logique, mais un artefact arithmétique inhérent au mélange de sous-populations dont les distributions conditionnelles de base différent structurellement.
8.3 Le biais du collisionneur (collider bias) issu d’un conditionnement erroné
Si ne pas conditionner sur une variable de confusion constitue une erreur méthodologique classique, la démarche inverse — conditionner aveuglément sur n’importe quelle variable disponible — peut s’avérer tout aussi destructrice. Ce phénomène pernicieux porte le nom de biais du collisionneur (ou collider bias), étroitement apparenté au paradoxe de Berkson.
Dans un graphe acyclique dirigé (DAG), une variable $C$ est un collisionneur sur la trajectoire entre deux variables $A$ et $B$ si elle reçoit des flèches causales directes provenant simultanément de ces deux variables ($A to C \leftarrow B$). Si $A$ et $B$ sont totalement indépendantes dans la population générale, leur corrélation marginale est nulle ($P(A, B) = P(A)P(B)$). Cependant, si le chercheur décide de conditionner sur le collisionneur $C$ — que ce soit par restriction de l’échantillon, stratification ou inclusion de $C$ comme covariable dans un modèle de régression —, une corrélation conditionnelle fallacieuse surgit instantanément entre $A$ et $B$ :
$$P(A \cap B mid C = c) ne P(A mid C = c) P(B mid C = c)$$
Considérons une étude clinique menée exclusivement auprès de patients hospitalisés en unité de soins psychiatriques complexes ($C = 1$). Supposons que l’hospitalisation puisse être déclenchée soit par une prédisposition génétique majeure ($A$), soit par un choc post-traumatique sévère ($B$), ces deux causes étant indépendantes dans la population générale. Au sein de la population hospitalière (c’est-à-dire conditionnellement à $C = 1$), si un soignant examine un patient sans facteur génétique ($A = 0$), la probabilité qu’il ait subi un choc traumatique ($B = 1$) devient extrêmement élevée pour expliquer sa présence dans l’unité. Conditionner sur le collisionneur crée artificiellement une fausse corrélation négative entre la génétique et le trauma, conduisant à des inférences physiopathologiques totalement erronées.
9. Paradigme bayésien : distribution conditionnelle a posteriori en sciences cognitives
Tandis que l’école fréquentiste envisage les paramètres de modèle comme des constantes déterministes inconnues, le cadre bayésien adopte une démarche où toute incertitude est traitée comme une distribution de probabilité. L’apprentissage bayésien est, par essence, une construction continue de distributions conditionnelles.
9.1 Le théorème de Bayes comme actualisation de la distribution conditionnelle
Dans l’inférence bayésienne, l’objectif fondamental consiste à déterminer la distribution conditionnelle des paramètres du modèle, notés vectoriellement $boldsymbol{\theta} in boldsymbol{\Theta}$, sachant le vecteur des données empiriques recueillies $\mathbf{D} = (y_1, dots, y_n)$. Cette distribution conditionnelle finale est désignée sous le terme de distribution a posteriori :
$$p(boldsymbol{\theta} mid \mathbf{D}) = \frac{p(boldsymbol{\theta}) , p(\mathbf{D} mid boldsymbol{\theta})}{p(\mathbf{D})} = \frac{p(boldsymbol{\theta}) , \mathcal{L}(boldsymbol{\theta}; \mathbf{D})}{\int_{boldsymbol{\Theta}} p(boldsymbol{\theta}’) , \mathcal{L}(boldsymbol{\theta}’; \mathbf{D}) , dboldsymbol{\theta}’}$$
Cette formule magistrale matérialise l’actualisation cognitive formelle :
- La distribution a priori $p(boldsymbol{\theta})$ quantifie l’état d’incertitude ou les connaissances épistémiques théoriques accumulées avant la récolte des données du protocole expérimental.
- La fonction de vraisemblance $\mathcal{L}(boldsymbol{\theta}; \mathbf{D}) = p(\mathbf{D} mid boldsymbol{\theta})$ représente la densité conditionnelle inverse : la probabilité générative d’observer les données $\mathbf{D}$ si la configuration des paramètres était effectivement $boldsymbol{\theta}$.
- L’évidence du modèle $p(\mathbf{D})$ agit comme la constante de normalisation intégrale assurant que la distribution conditionnelle a posteriori s’intègre rigoureusement à l’unité sur tout le support $boldsymbol{\Theta}$.
Sous les théorèmes asymptotiques bayésiens de Bernstein-von Mises, à mesure que le volume d’échantillonnage s’accroît vers l’infini, la distribution conditionnelle a posteriori se resserre exponentiellement autour de la valeur génératrice réelle, effaçant progressivement l’influence du prior pour converger vers la distribution conditionnelle dictée par la seule vraisemblance des données.
9.2 Le cerveau bayésien et le codage prédictif
Au cours des deux dernières décennies, les neurosciences théoriques ont fait de la distribution conditionnelle le principe computationnel unificateur du fonctionnement cérébral à travers la théorie du cerveau bayésien et du codage prédictif développé notamment par Karl Friston. Selon ce paradigme, le système nerveux central ne traite pas les flux sensoriels de manière purement ascendante (bottom-up), mais opère comme un moteur d’inférence statistique active régulé par des distributions conditionnelles continues.
Le cortex cérébral maintient en permanence une distribution a priori sur les causes sous-jacentes du monde environnemental ($boldsymbol{\theta}$). Dès que des flux sensoriels afférents ($\mathbf{D}$) atteignent les récepteurs primaires, le cerveau effectue une mise à jour stochastique pour calculer la distribution conditionnelle de l’état du monde extérieur sachant les entrées sensorielles $p(boldsymbol{\theta} mid \mathbf{D})$. La précision perceptive correspond exactement à l’inverse de la variance conditionnelle de cette distribution postérieure ($\Pi = \frac{1}{\sigma_{boldsymbol{\theta} mid \mathbf{D}}^2}$).
Cette approche computationnelle éclaire de manière inédite l’étiologie des hallucinations et des délires dans les troubles schizophréniques. Une surpondération anormale de la précision accordée aux attentes internes (le prior) vis-à-vis des données sensorielles produit une distribution conditionnelle a posteriori imperméable aux signaux correctifs environnementaux, contraignant le sujet à percevoir un monde généré exclusivement par ses inférences conditionnelles internes déconnectées de la réalité sensorielle.
9.3 Algorithmes d’échantillonnage conditionnel (MCMC et Gibbs)
Dans les modèles psychométriques ou hiérarchiques bayésiens complexes comportant des dizaines ou des centaines de paramètres latents, la distribution conditionnelle jointe a posteriori $p(boldsymbol{\theta} mid \mathbf{D})$ ne possède pas de forme analytique fermée, car l’intégrale du dénominateur (l’évidence) s’avère intirable sur des dimensions élevées. La résolution repose alors sur les méthodes stochastiques de Monte-Carlo par chaînes de Markov (MCMC), dont la variante la plus dépendante de la conditionnalité est l’échantillonneur de Gibbs.
L’échantillonneur de Gibbs dérive d’une élégance algorithmique absolue : plutôt que d’échantillonner simultanément tout le vecteur multidimensionnel complexe $boldsymbol{\theta} = (\theta_1, \theta_2, dots, \theta_K)$, l’algorithme génère itérativement chaque composante individuelle à partir de sa loi conditionnelle complète unidimensionnelle (full conditional distribution), où tous les autres paramètres et les données sont tenus pour constants :
$$\theta_j^{(t+1)} \sim p(\theta_j mid \theta_1^{(t+1)}, dots, \theta_{j-1}^{(t+1)}, \theta_{j+1}^{(t)}, dots, \theta_K^{(t)}, \mathbf{D})$$
Sous des conditions mathématiques de régularité et d’ergodicité, cette marche aléatoire conditionnelle itérée converge asymptotiquement vers une chaîne de Markov dont la mesure stationnaire correspond exactement à la distribution conjointe a posteriori désirée. Grâce à la décomposition par lois conditionnelles complètes, les chercheurs peuvent ajuster des modèles psychométriques hautement dimensionnels incorporant des variables latentes croisées et des effets de modération complexes.
10. Étude de cas détaillée : analyse empirique en psychologie expérimentale
Afin d’ancrer ces développements théoriques dans la réalité tangible du laboratoire de recherche, déployons une étude empirique contrôlée portant sur la dynamique des processus adaptatifs face au stress aigu.
10.1 Décomposition complète d’une table d’association comportementale
Soit un protocole expérimental mené auprès de 600 adultes soumis au test de stress social de Trier (TSST). Les chercheurs s’intéressent à l’influence de la nature de la consigne de préparation cognitive ($X in {\text{Contrôle neutre } (x_1), \text{Réévaluation cognitive } (x_2), \text{Suppression expressive } (x_3)}$) sur la stratégie adaptative spontanée retenue lors du débriefing ($Y in {\text{Approche analytique } (y_1), \text{Évitement émotionnel } (y_2), \text{Somatisation } (y_3)}$). L’échantillon a été réparti équitablement à raison de 200 participants par condition expérimentale.
Les effectifs conjoints observés $n_{ij}$ se distribuent ainsi dans la matrice de contingence :
- Condition Neutre ($x_1$) : $y_1 = 50$, $y_2 = 90$, $y_3 = 60$ (Total ligne $n_{1bullet} = 200$)
- Réévaluation ($x_2$) : $y_1 = 120$, $y_2 = 50$, $y_3 = 30$ (Total ligne $n_{2bullet} = 200$)
- Suppression ($x_3$) : $y_1 = 30$, $y_2 = 80$, $y_3 = 90$ (Total ligne $n_{3bullet} = 200$)
Les totaux marginaux de colonne sont donc : Approche ($y_1$) : $n_{bullet 1} = 200$ ; Évitement ($y_2$) : $n_{bullet 2} = 220$ ; Somatisation ($y_3$) : $n_{bullet 3} = 180$. Effectif total $n = 600$.
Calculons de manière explicite les distributions conditionnelles des réponses empiriques $\hat{P}(Y = y_j mid X = x_i)$ au sein de chaque groupe :
- Sous condition neutre ($x_1$) :
$$\hat{P}(Y = y_1 mid x_1) = \frac{50}{200} = 0{,}250 \quad | \quad \hat{P}(Y = y_2 mid x_1) = \frac{90}{200} = 0{,}450 \quad | \quad \hat{P}(Y = y_3 mid x_1) = \frac{60}{200} = 0{,}300$$
Somme de la distribution : $0{,}250 + 0{,}450 + 0{,}300 = 1{,}000$. - Sous condition réévaluation ($x_2$) :
$$\hat{P}(Y = y_1 mid x_2) = \frac{120}{200} = 0{,}600 \quad | \quad \hat{P}(Y = y_2 mid x_2) = \frac{50}{200} = 0{,}250 \quad | \quad \hat{P}(Y = y_3 mid x_2) = \frac{30}{200} = 0{,}150$$
Somme de la distribution : $0{,}600 + 0{,}250 + 0{,}150 = 1{,}000$. - Sous condition suppression ($x_3$) :
$$\hat{P}(Y = y_1 mid x_3) = \frac{30}{200} = 0{,}150 \quad | \quad \hat{P}(Y = y_2 mid x_3) = \frac{80}{200} = 0{,}400 \quad | \quad \hat{P}(Y = y_3 mid x_3) = \frac{90}{200} = 0{,}450$$
Somme de la distribution : $0{,}150 + 0{,}400 + 0{,}450 = 1{,}000$.
La normalisation unitaire est vérifiée pour l’ensemble des strates. Les distributions conditionnelles démontrent avec acuité la divergence induite par l’induction expérimentale : l’induction de réévaluation cognitive multiplie par quatre la probabilité conditionnelle d’adopter une stratégie d’approche par rapport à la suppression ($0{,}60$ versus $0{,}15$). Sous l’hypothèse d’indépendance statistique globale, la distribution conditionnelle théorique devrait être rigoureusement égale à la distribution marginale de réponse ($\hat{P}(Y = y_1) = \frac{200}{600} = 0{,}333$, $\hat{P}(Y = y_2) = \frac{220}{600} = 0{,}367$, $\hat{P}(Y = y_3) = \frac{180}{600} = 0{,}300$). Le test du chi-carré d’indépendance corrobore un écart hautement significatif ($\chi^2(4) = 100{,}87, p < 0{,}001$), attestant l'effet déterminant du conditionnement expérimental.
10.2 Distribution conditionnelle du temps de réaction selon la charge cognitive
Analysons à présent une variable continue positive asymétrique : le temps de réaction (TR, en millisecondes) mesuré lors d’une tâche d’attention soutenue sous deux niveaux de charge cognitive : faible ($X = 0$) versus élevée ($X = 1$). Dans la littérature chronométrique, ces distributions continues sont fidèlement capturées par la distribution Ex-Gaussienne — qui résulte de la convolution conjointe d’une loi normale (décrivant les composantes motrices et sensorielles périphériques) et d’une loi exponentielle (reflétant les fluctuations des processus attentionnels centraux) :
$$f_{Y mid X}(y mid x) = \frac{1}{\tau_x} \exp\left( \frac{\mu_x – y}{\tau_x} + \frac{\sigma_x^2}{2\tau_x^2} \right) \Phi\left( \frac{y – \mu_x – \frac{\sigma_x^2}{\tau_x}}{\sigma_x} \right)$$
où $Phi$ désigne la fonction de répartition de la loi normale centrée réduite. L’estimation paramétrique empirique sur un échantillon clinique révèle les paramètres conditionnels suivants :
- Sous faible charge ($X = 0$) : $\mu_0 = 350\text{ ms}$, $\sigma_0 = 40\text{ ms}$, $\tau_0 = 50\text{ ms}$.
L’espérance conditionnelle est $\mathbb{E}[Y mid X = 0] = \mu_0 + \tau_0 = 400\text{ ms}$ et la variance conditionnelle est $\text{Var}(Y mid X = 0) = \sigma_0^2 + \tau_0^2 = 1600 + 2500 = 4100\text{ ms}^2$ (écart-type $\approx 64\text{ ms}$). - Sous forte charge ($X = 1$) : $\mu_1 = 420\text{ ms}$, $\sigma_1 = 45\text{ ms}$, $\tau_1 = 150\text{ ms}$.
L’espérance conditionnelle est $\mathbb{E}[Y mid X = 1] = \mu_1 + \tau_1 = 570\text{ ms}$ et la variance conditionnelle s’élève à $\text{Var}(Y mid X = 1) = \sigma_1^2 + \tau_1^2 = 2025 + 22500 = 24525\text{ ms}^2$ (écart-type $\approx 156{,}6\text{ ms}$).
L’examen des moments conditionnels démontre que la charge cognitive n’induit pas simplement un décalage moyen de translation spatiale ($\Delta \mu = 70\text{ ms}$), mais altère drastiquement la structure distributionnelle : le paramètre exponentiel $tau$ triple sous contrainte, générant un allongement prononcé de la queue de distribution droite conditionnelle. Les tests de comparaison non paramétriques de Kolmogorov-Smirnov confirment l’incompatibilité des formes de distribution ($D = 0{,}48, p < 0{,}0001$), invalidant tout modèle statistique postulant une variance conditionnelle constante.
10.3 Stratification clinique et contrôle de covariables
L’ultime volet de notre analyse empirique porte sur l’évaluation d’un traitement neuroprotecteur expérimental destiné à freiner le déclin mnésique chez des personnes âgées présentant un déficit cognitif léger (MCI). Dans l’essai non randomisé initial (cohorte observationnelle de $N = 800$), l’effet marginal brut montre paradoxalement un déclin plus prononcé chez les individus recevant le médicament ($X = 1$) que chez les témoins ($X = 0$).
Pour neutraliser ce biais majeur, les chercheurs procèdent à une stratification conditionnelle rigoureuse en fonction de l’âge chronologique des participants ($Z in {[60-69], [70-79], [80+]}$) et calculent les probabilités conditionnelles de rémission post-thérapeutique ($Y = 1$) :
- Strate [60-69 ans] : $\hat{P}(Y = 1 mid X = 1, Z = 1) = 0{,}72$ vs $\hat{P}(Y = 1 mid X = 0, Z = 1) = 0{,}55$
- Strate [70-79 ans] : $\hat{P}(Y = 1 mid X = 1, Z = 2) = 0{,}58$ vs $\hat{P}(Y = 1 mid X = 0, Z = 2) = 0{,}41$
- Strate [80 ans et plus] : $\hat{P}(Y = 1 mid X = 1, Z = 3) = 0{,}43$ vs $\hat{P}(Y = 1 mid X = 0, Z = 3) = 0{,}28$
Dans chaque tranche d’âge conditionnelle, la probabilité de rémission est systématiquement et significativement supérieure d’environ 15 à 17 points de pourcentage chez les patients sous traitement. Le résultat marginal fallacieux s’expliquait intégralement par le fait que les prescripteurs réservaient le traitement aux patients les plus âgés et les plus détériorés cognitivement. La standardisation directe par intégration conditionnelle sur la distribution marginale de référence de l’âge restitue l’effet causal bénéfique moyen non biaisé du principe actif.
11. Méthodes d’estimation non paramétriques et approches algorithmiques
Lorsque la forme sous-jacente des distributions conditionnelles déroge aux hypothèses paramétriques rigides (telles que la normalité bivariée ou la linéarité stricte), la statistique computationnelle contemporaine offre des alternatives non paramétriques et semi-paramétriques flexibles.
11.1 Estimation de densité conditionnelle par noyau (KCDE)
L’estimation de densité par noyau (Kernel Density Estimation) développée initialement par Emanuel Parzen et Murray Rosenblatt s’étend de manière naturelle à l’estimation de densités conditionnelles (KCDE). L’estimateur non paramétrique classique de $f_{Y mid X}(y mid x)$ s’articule comme le rapport de deux estimateurs de densité à noyau bivarié et univarié :
$$\hat{f}_{Y mid X}(y mid x) = \frac{\hat{f}_{X,Y}(x, y)}{\hat{f}_X(x)} = \frac{\sum_{i=1}^n K_{h_X}(x – X_i) , K_{h_Y}(y – Y_i)}{\sum_{i=1}^n K_{h_X}(x – X_i)}$$
où $K_{h_X}(u) = \frac{1}{h_X} K\left(\frac{u}{h_X}\right)$ représente une fonction noyau symétrique unitaire (souvent gaussienne) et $h_X, h_Y > 0$ sont les largeurs de bande (bandwidths) lissant l’estimation.
Le choix des paramètres de lissage $h_X$ et $h_Y$ revêt une importance critique : un sous-lissage engendre une instabilité avec une variance empirique excessive créant des bosses artefactuelles, tandis qu’un sur-lissage induit un biais sévère étouffant les structures réelles de la distribution conditionnelle (telles que des bimodalités locales). L’optimisation repose généralement sur des procédures automatisées de validation croisée par minimisation de l’erreur quadratique intégrée conditionnelle (ICISE). Cette approche non paramétrique est particulièrement puissante en psychométrie pour détecter des profils de réponse multimodaux sans formuler d’a priori sur la famille génératrice sous-jacente.
11.2 Réseaux à densité de mélange (Mixture Density Networks)
Dans les contextes d’apprentissage automatique supervisé complexe et d’analyse comportementale à haute dimensionnalité (comme les trajectoires temporelles issues de l’oculométrie ou de la biomécanique gestuelle), les estimateurs à noyau souffrent du fléau de la dimensionnalité. Pour pallier cette faiblesse, Christopher Bishop a conçu les réseaux à densité de mélange (Mixture Density Networks, MDN).
Un réseau MDN couple la capacité d’approximation universelle des réseaux de neurones profonds à un modèle de mélange de lois de probabilités paramétriques. Au lieu d’entraîner le réseau à prédire une valeur scalaire déterministe $\hat{y}$ en sortie, le réseau génère les paramètres d’une combinaison linéaire de plusieurs composantes gaussiennes conditionnelles dépendantes des prédicteurs d’entrée $\mathbf{x}$ :
$$f_{Y mid \mathbf{X}}(y mid \mathbf{x}) = \sum_{k=1}^K \pi_k(\mathbf{x}) , \mathcal{N}\left( y mid \mu_k(\mathbf{x}), \sigma_k^2(\mathbf{x}) \right)$$
où $\pi_k(\mathbf{x})$ symbolisent les coefficients de mélange contraints par une activation softmax ($\sum_{k=1}^K \pi_k(\mathbf{x}) = 1$), $\mu_k(\mathbf{x})$ les centres conditionnels, et $\sigma_k^2(\mathbf{x})$ les variances locales. Ce formalisme permet de modéliser avec souplesse des distributions conditionnelles arbitrairement complexes, asymétriques, et surtout multimodales — configuration fréquente dans les décisions comportementales humaines impliquant des arbitrages perceptifs bistables.
11.3 Métriques de validation et qualité de l’ajustement
L’évaluation rigoureuse de la qualité d’ajustement d’un modèle estimant une distribution conditionnelle ne peut se cantonner aux métriques usuelles de résidus déterministes comme le coefficient de détermination $R^2$ ou l’erreur quadratique moyenne (RMSE). Il est impératif d’évaluer la concordance probabiliste intégrale entre la densité modélisée $\hat{f}_{Y mid X}$ et la véritable mesure empirique sous-jacente $f_{Y mid X}$.
Le critère d’évaluation premier repose sur la log-vraisemblance conditionnelle moyenne calculée sur un jeu de données de test indépendant :
$$\mathcal{L}_{\text{cond}} = \frac{1}{n_{\text{test}}} \sum_{i=1}^{n_{\text{test}}} \ln \hat{f}_{Y mid X}(y_i mid \mathbf{x}_i)$$
D’un point de vue théorique de l’information, maximiser cette log-vraisemblance équivaut rigoureusement à minimiser l’espérance de la divergence de Kullback-Leibler conditionnelle entre la densité génératrice réelle $p$ et la densité prédite $q$ :
$$\mathbb{E}_{\mathbf{X}}\left[ D_{\text{KL}}(p_{Y mid \mathbf{X}} parallel q_{Y mid \mathbf{X}}) \right] = \int_{\mathcal{X}} \left( \int_{\mathcal{Y}} p(y mid \mathbf{x}) \ln \frac{p(y mid \mathbf{x})}{q(y mid \mathbf{x})} , dy \right) p(\mathbf{x}) , d\mathbf{x}$$
Dans les protocoles expérimentaux impliquant des structures de mesures répétées longitudinales au sein de multiples centres hospitaliers, ces métriques de perte informationnelle doivent impérativement être couplées à des procédures de validation croisée par blocs (k-fold block cross-validation) afin d’éviter le surapprentissage lié aux autocorrélations internes.
12. Erreurs méthodologiques fréquentes, pièges interprétatifs et recommandations APA
En dépit de son omniprésence dans les cursus universitaires de méthodologie, la manipulation des probabilités conditionnelles demeure le terreau des biais interprétatifs les plus dévastateurs de la recherche appliquée.
12.1 L’illusion du procureur et l’inversion conditionnelle erronée
L’erreur logique la plus commune — et potentiellement désastreuse sur le plan médico-légal et diagnostique — est la confusion fallacieuse des termes du conditionnement, souvent désignée sous l’appellation d’illusion du procureur ou de sophisme de la transposition conditionnelle. Cette dérive consiste à tenir pour équivalentes la probabilité conditionnelle directe $P(A mid B)$ et sa probabilité conditionnelle inverse $P(B mid A)$.
Considérons l’évaluation d’un marqueur cognitif précoce pour le dépistage d’une pathologie neurodégénérative rare affichant une prévalence de 1 % dans la population cible ($P(\text{Maladie}) = 0{,}01$). Supposons que le test psychométrique possède une sensibilité clinique remarquable de 95 % ($P(\text{Positif} mid \text{Maladie}) = 0{,}95$) et une spécificité solide de 90 % ($P(\text{Négatif} mid \text{Sain}) = 0{,}90$). Face à un résultat positif, une intuition profane assimilera la probabilité que le patient soit malade à la sensibilité du test, déclarant un risque de 95 %.
L’application rigoureuse du théorème de Bayes déconstruit instantanément cette conclusion fallacieuse en calculant la véritable probabilité conditionnelle inverse, dite valeur prédictive positive (VPP) :
$$P(\text{Maladie} mid \text{Positif}) = \frac{0{,}95 \times 0{,}01}{(0{,}95 \times 0{,}01) + (0{,}10 \times 0{,}99)} = \frac{0{,}0095}{0{,}0095 + 0{,}0990} \approx 0{,}0876 \quad (8{,}76,%)$$
En réalité, un patient testé positif n’a qu’environ 8,8 % de risque d’être effectivement atteint par la pathologie, en raison du poids écrasant de la distribution marginale a priori de la population saine qui dilue les vrais positifs dans un volume supérieur de faux positifs. L’utilisation systématique d’arbres de fréquences naturelles ou de matrices de confusion brutes constitue une recommandation didactique absolue pour prémunir les praticiens contre cette confusion diagnostique.
12.2 Le sur-conditionnement et l’écueil de la multicolinéarité
Dans la course au contrôle expérimental, de nombreux chercheurs succombent au mirage du sur-conditionnement en injectant une quantité pléthorique de covariables explicatives dans leurs modèles multivariés. Cette pratique soulève deux risques statistiques majeurs :
- L’émiettement de l’échantillon : conditionner simultanément sur de multiples variables catégorielles segmente les données en sous-strates à effectifs microscopiques, voire nuls. La variance des estimateurs conditionnels explose alors de façon incontrôlée, détruisant toute puissance statistique.
- La multicolinéarité sévère : si des covariables conditionnantes partagent de fortes dépendances mutuelles, la matrice de variance-covariance empirique $\mathbf{X}^T \mathbf{X}$ devient quasi-singulière. Son inversion numérique induit une instabilité extrême des coefficients de régression conditionnels, dont les signes et amplitudes peuvent osciller au gré d’infimes variations d’échantillonnage.
Le principe d’économie conceptuelle impose d’adopter des règles de sélection guidées par les graphes causaux formels (critère de la porte dérobée de Pearl) plutôt que d’empiler systématiquement toutes les données disponibles dans une modélisation conditionnelle.
12.3 Directives de communication scientifique et standards méthodologiques APA
Pour assurer la reproductibilité et la transparence absolue des inférences statistiques, les directives éditoriales de l’American Psychological Association (APA 7th edition) prescrivent un ensemble de standards stricts pour la communication des distributions conditionnelles :
- Transparence descriptive intégrale : tout rapport mobilisant des distributions conditionnelles discrètes (comme les profils-lignes d’une table de contingence) doit impérativement fournir la table des effectifs conjoints bruts non modifiés $n_{ij}$, permettant au lecteur de reconstruire les distributions marginales et conditionnelles alternatives.
- Désignation formelle des conditions : il est rigoureusement prohibé de désigner une moyenne conditionnelle sans expliciter la conditionnalité sous-jacente. L’écriture conventionnelle impose de stipuler clairement l’estimateur de localisation accompagné de son intervalle de confiance ou de dispersion conditionnelle (ex. : $M = 45{,}2\text{ ms}$, $IC_{95,%} [41{,}1, 49{,}3]$ pour le groupe $X = x_1$).
- Notification explicite de l’orientation causale : les auteurs doivent s’abstenir de glisser vers un lexique causal (« impacte », « modifie », « affecte ») lors de la description de simples associations conditionnelles issues de données observationnelles sans assignation aléatoire, sous peine de biaiser l’interprétation théorique des résultats.
- Représentation graphique standardisée : les graphiques illustrant des distributions conditionnelles continues doivent privilégier les visualisations complètes — telles que les diagrammes en violon ou les tracés de densités superposées avec nuages de points réels (strip-plots) — au détriment des diagrammes en barres qui masquent l’asymétrie et l’hétérogénéité des variances conditionnelles.
Références
- Bishop, C. M. (1994). Mixture density networks (Technical Report NCRG/94/004). Aston University. https://www.microsoft.com/en-us/research/publication/mixture-density-networks/
- Borel, É. (1909). Éléments de la théorie des probabilités. Hermann.
- Chen, W. H., & Thissen, D. (1997). Local dependence indexes for item pairs using item response theory. Journal of Educational and Behavioral Statistics, 22(3), 265–289. https://doi.org/10.3102/10769986022003265
- Friston, K. (2010). The free-energy principle: A unified brain theory?. Nature Reviews Neuroscience, 11(2), 127–138. https://doi.org/10.1038/nrn2787
- Gelman, A., Carlin, J. B., Stern, H. S., Dunson, D. B., Vehtari, A., & Rubin, D. B. (2013). Bayesian Data Analysis (3rd ed.). CRC Press. https://doi.org/10.1201/b16018
- Holland, P. W., & Wainer, H. (Eds.). (1993). Differential Item Functioning. Lawrence Erlbaum Associates.
- Koenker, R., & Bassett, G. (1978). Regression quantiles. Econometrica, 46(1), 33–50. https://doi.org/10.2307/1913643
- Kolmogorov, A. N. (1933). Grundbegriffe der Wahrscheinlichkeitsrechnung. Springer. https://doi.org/10.1007/978-3-642-49888-6
- Lord, F. M. (1980). Applications of Item Response Theory to Practical Testing Problems. Lawrence Erlbaum Associates.
- Parzen, E. (1962). On estimation of a probability density function and mode. The Annals of Mathematical Statistics, 33(3), 1065–1076. https://doi.org/10.1214/aoms/1177704472
- Pearl, J. (2009). Causality: Models, Reasoning, and Inference (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9780511803161
- Rosenblatt, M. (1956). Remarks on some nonparametric estimates of a density function. The Annals of Mathematical Statistics, 27(3), 832–837. https://doi.org/10.1214/aoms/1177728190
- White, H. (1980). A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity. Econometrica, 48(4), 817–838. https://doi.org/10.2307/1912934