
L’un des écueils épistémologiques les plus redoutables et récurrents de la démarche scientifique moderne réside dans l’interprétation abusive des associations statistiques. Dans les sciences humaines, sociales et biomédicales, où la complexité systémique du vivant défie toute simplification naïve, l’observation d’une covariation substantielle entre deux phénomènes est fréquemment et hâtivement assimilée à l’existence d’un lien de causalité univoque. Pourtant, l’édifice de la méthode scientifique rappelle avec insistance qu’une concomitance temporelle ou quantitative ne constitue en rien la preuve d’un déterminisme direct. Cette faille d’inférence trouve son incarnation la plus spectaculaire dans ce que la statistique méthodologique nomme le problème de la troisième variable.
Le problème de la troisième variable survient lorsqu’une corrélation mesurée entre deux grandeurs observables dissimule en réalité l’intervention silencieuse d’une entité sous-jacente non intégrée au modèle initial. Cette entité, souvent qualifiée de facteur de confusion, de variable omise ou de tiers facteur, orchestre en amont les fluctuations des deux variables étudiées, engendrant une association mathématique trompeuse. Loin d’être une simple curiosité théorique cantonnée aux manuels d’économétrie élémentaire, cette anomalie d’inférence menace au quotidien la validité interne des recherches empiriques les plus rigoureuses, égare les politiques de santé publique et fausse les conclusions d’innombrables études cliniques et sociologiques.
Pour le praticien, le chercheur comme pour l’analyste de données, maîtriser la dynamique propre à ce tiers facteur constitue un impératif méthodologique de premier ordre. Comprendre la manière dont une structure latente peut générer, amplifier, atténuer voire inverser une relation observée représente l’unique rempart contre la prolifération des corrélations illusoires. Cette exploration exhaustive a pour vocation de disséquer le problème de la troisième variable sous toutes ses facettes : depuis ses fondements conceptuels et son formalisme mathématique jusqu’aux techniques de détection, stratégies préventives d’assignation expérimentale et modélisations a posteriori les plus sophistiquées issues de l’inférence causale moderne.
1. Introduction épistémologique au problème de la troisième variable
1.1 Définition canonique en statistique et méthodologie psychologique
Dans le paradigme des sciences comportementales et quantitatives, le problème de la troisième variable désigne la situation méthodologique critique au sein de laquelle une corrélation empirique observée entre une variable présumée prédictive ($X$) et une variable critère ($Y$) découle entièrement ou partiellement de l’action d’une troisième variable non contrôlée ($Z$). Cette variable tierce, souvent non observée, négligée ou délibérément omise dans le dispositif de recueil de données, exerce une influence simultanée sur $X$ et sur $Y$, produisant un lien statistique artificiel. En présence d’un tel mécanisme, l’observateur non averti commet l’erreur d’attribuer à la relation entre $X$ et $Y$ une dynamique causale directe, alors même que les deux indicateurs ne sont que les symptômes collatéraux et synchrones d’une racine commune.
Cette distorsion invalide gravement la validité interne d’une investigation empirique, c’est-à-dire la certitude avec laquelle il est possible de déclarer que les variations de la variable dépendante découlent exclusivement des manipulations ou des états de la variable indépendante. Dans le lexique méthodologique, plusieurs terminologies coexistent pour conceptualiser ce phénomène : on parlera indistinctement de facteur de confusion (ou confounder en anglais), de variable latente perturbatrice, ou de tiers facteur omis. Tous ces termes renvoient à une rupture du postulat d’isolation causale, sans lequel l’inférence scientifique se trouve irrémédiablement compromise.
L’enjeu dépasse le simple cadre académique. Lorsqu’un chercheur conclut faussement qu’un comportement spécifique provoque une pathologie psychologique, ou qu’un programme pédagogique singulier améliore directement les scores académiques des élèves, l’oubli d’une variable sociologique, génétique ou économique sous-jacente peut engager des réformes institutionnelles inefficaces ou des prises en charge cliniques erronées. La rigueur méthodologique impose ainsi de considérer chaque corrélation observée comme une hypothèse de travail ouverte plutôt que comme une certitude étiologique.
1.2 Distinction fondamentale entre corrélation et causalité
L’adage latin cum hoc ergo propter hoc (« avec ceci, donc à cause de ceci ») formalise l’un des sophismes logiques les plus enracinés dans l’esprit humain. L’appareil cognitif de notre espèce s’est structuré au cours de l’évolution pour identifier des motifs répétitifs et établir des liens d’anticipation dans l’environnement immédiat. Cette heuristique de causalité perceptive conduit spontanément à inférer qu’une séquence temporelle ou une conjonction d’événements traduit nécessairement un lien d’engendrement physique ou psychologique. Or, sur le plan épistémologique, la corrélation relève de l’espace de la mesure et de la description mathématique d’une symétrie d’association, tandis que la causalité appartient à l’ordre de l’ontologie et de la génération asymétrique des phénomènes.
Dès le XIXe siècle, le philosophe et économiste britannique John Stuart Mill a systématisé dans son ouvrage A System of Logic les règles rigoureuses nécessaires à l’établissement formel d’un lien de causalité. Selon les canons de Mill, trois conditions sine qua non doivent être satisfaites :
- La covariation temporelle systématique : la cause présumée et l’effet supposé doivent varier conjointement de manière statistiquement démontrable.
- La préséance temporelle : la cause présumée doit impérativement précéder l’effet dans le temps.
- L’absence d’explications alternatives plausibles : toutes les autres variables susceptibles de produire l’effet observé doivent être impérativement éliminées ou contrôlées.
C’est précisément sur cette troisième condition fondamentale que trébuchent inévitablement les recherches non expérimentales. Dans les études observationnelles, longitudinales ou transversales pures, le chercheur observe les sujets dans leur milieu naturel sans manipulation active. La covariation empirique ($r \neq 0$) est certes constatée, mais elle ne garantit en rien la détermination ontologique. La covariation est une condition nécessaire mais radicalement insuffisante pour prouver la causalité. Confondre les deux registres revient à ignorer la possibilité architecturale qu’un faisceau infini de forces tierces dicte simultanément les variations des grandeurs enregistrées.
1.3 Genèse historique du concept dans les sciences sociales et comportementales
L’histoire de la quantification statistique est intimement liée à la découverte progressive et souvent douloureuse des pièges posés par les variables cachées. Lorsque sir Francis Galton introduit à la fin du XIXe siècle la notion de corrélation et de régression vers la moyenne à travers l’étude de la transmission des caractères héréditaires, il pose les jalons du calcul des dépendances. Cependant, c’est son élève et biographe, le mathématicien Karl Pearson, qui formule l’indice canonique du coefficient de corrélation produit-moment ($r$). Pearson adopte une posture positiviste radicale, rejetant initialement la notion même de « causalité » métaphysique au profit de la pure description des contingences mathématiques.
Toutefois, les sociologues, démographes et épidémiologistes du début du XXe siècle se heurtent rapidement aux impasses d’un tel réductionnisme. Dès les années 1930, avec les travaux de George Udny Yule sur les séries chronologiques et l’analyse des associations illusoires entre variables temporelles dénuées de lien substantiel (comme l’évolution conjointe du nombre d’églises et de la criminalité urbaine), la nécessité de formaliser mathématiquement les biais de confusion devient incontournable. Les méthodologistes comprennent que deux variables sans aucune affinité fonctionnelle peuvent afficher une corrélation presque parfaite si elles partagent une trajectoire tendancielle dictée par l’industrialisation ou la croissance démographique.
Au milieu du XXe siècle, la confrontation dramatique entre l’industrie du tabac et les épidémiologistes concernant le rôle cancérigène de la cigarette marque un tournant historique décisif. Les partisans du tabac, appuyés notamment par le célèbre statisticien Ronald Aylmer Fisher, soutiennent que la corrélation indiscutable entre tabagisme et carcinome pulmonaire pourrait être imputable à une troisième variable génétique sous-jacente prédisposant conjointement à l’addiction nicotinique et aux mutations cellulaires. Pour sortir de cette impasse éthique et scientifique, sir Austin Bradford Hill énonce en 1965 ses célèbres neuf critères de causalité (force de l’association, constance, spécificité, temporalité, gradient biologique, plausibilité, cohérence, preuve expérimentale et analogie).
À la même époque, la psychologie expérimentale américaine, sous la houlette de pionniers tels que Donald Campbell et Julian Stanley, formalise les concepts de validité interne et de validité externe. L’effort collectif de formalisation aboutit à un consensus épistémologique : aucune discipline étudiant la conduite humaine ne peut prétendre au statut de science empirique sans une doctrine explicite d’identification et de neutralisation du problème de la troisième variable.
2. Le mécanisme statistique sous-jacent : corrélation fallacieuse et confusion
2.1 Nature mathématique de la corrélation illusoire (spurious correlation)
L’expression « corrélation illusoire » ou « corrélation fallacieuse » (calquée sur l’anglais spurious correlation) renvoie à une situation où l’indice de corrélation linéaire de Pearson $r_{XY}$ calculé sur un échantillon est substantiellement différent de zéro, alors que la covariance théorique réelle entre les deux variables conditionnellement à la population est rigoureusement nulle ($\text{Cov}(X, Y mid Z) = 0$). D’un point de vue algébrique, si l’on suppose un modèle génératif linéaire où deux variables centrées $X$ et $Y$ sont toutes deux déterminées de manière linéaire et indépendante par une même variable latente $Z$, le système d’équations s’écrit :
$$X = \alpha Z + \epsilon_X$$
$$Y = \beta Z + \epsilon_Y$$
où $\epsilon_X$ et $\epsilon_Y$ représentent des termes d’erreur aléatoires non corrélés entre eux et orthogonaux à $Z$ ($\text{Cov}(\epsilon_X, \epsilon_Y) = 0$, $\text{Cov}(Z, \epsilon_X) = 0$, $\text{Cov}(Z, \epsilon_Y) = 0$). Dans ce système, la covariance non conditionnelle entre $X$ et $Y$ est égale au produit des coefficients structuraux multiplié par la variance de la variable confondante :
$$\text{Cov}(X, Y) = \mathbb{E}[XY] = \mathbb{E}[(\alpha Z + \epsilon_X)(\beta Z + \epsilon_Y)] = \alpha \beta , \text{Var}(Z)$$
Dès lors que $\alpha \neq 0$ et $\beta \neq 0$, et sous réserve que $Z$ présente une variabilité réelle ($\text{Var}(Z) > 0$), la covariance non conditionnelle entre $X$ et $Y$ est strictement non nulle. Le calcul naïf du coefficient de Pearson reflétera une interdépendance prononcée, entièrement imputable à la dispersion commune induite par $Z$. Ce mécanisme provoque une décomposition spectaculaire de la variance partagée : la variabilité conjointe observée entre $X$ et $Y$ n’est que de la variance projetée par $Z$.
Sur le plan inférentiel, l’omission du tiers facteur perturbe gravement le terme d’erreur résiduelle dans les analyses de régression bivariées ordinaires. Le terme résiduel incorpore la part de variance omise de $Z$, violant directement l’hypothèse canonique de Gauss-Markov stipulant l’indépendance stricte entre les prédicteurs et les erreurs. Cette violation provoque une inflation catastrophique du risque d’erreur de type I ($\alpha$), conduisant le statisticien à rejeter à tort l’hypothèse nulle ($H_0$) d’absence d’effet direct entre $X$ et $Y$.
2.2 La variable confondante : définition et propriétés formelles
Dans l’arsenal conceptuel de l’épidémiologie moderne et de la psychométrie, une variable confondante formelle ne peut être désignée comme telle au hasard. Elle doit répondre rigoureusement à un triptyque de critères théoriques et empiriques formalisés par les méthodologistes de l’inférence causale :
- Le critère d’association bilatérale : La variable $Z$ doit être statistiquement corrélée de manière significative avec la variable présumée indépendante ou d’exposition ($X$), tout en étant indépendamment associée à la variable d’issue ou critère ($Y$).
- Le critère de non-intermédiarité : La variable $Z$ ne doit pas se situer sur la trajectoire causale directe reliant $X$ à $Y$. En termes rigoureux, $Z$ ne doit pas être une conséquence de $X$ qui provoquerait ensuite $Y$, ce qui caractériserait un médiateur et non un facteur de confusion.
- Le critère de distribution asymétrique : La variable $Z$ doit être inégalement répartie à travers les différents niveaux ou sous-groupes définis par la variable indépendante $X$.
L’asymétrie d’information induite par l’absence de mesure de $Z$ crée ce que l’on nomme le biais de confusion. Un aspect particulièrement sournois de cette anomalie réside dans la confusion résiduelle. Même lorsqu’un chercheur tente de neutraliser $Z$ par stratification ou catégorisation sommaire (par exemple, en segmentant l’âge en tranches très larges telles que « moins de 40 ans » et « plus de 40 ans » au lieu d’utiliser une mesure continue fine), une portion substantielle de la variance de la variable confondante continue d’opérer clandestinement au sein des strates créées, maintenant une part non négligeable de corrélation fallacieuse résiduelle.
2.3 Modélisation causale et graphes acycliques dirigés (DAG)
Le traitement contemporain de la confusion causale a été profondément révolutionné par les travaux du lauréat du prix Turing Judea Pearl et sa formalisation rigoureuse via les graphes acycliques dirigés (Directed Acyclic Graphs ou DAG). Un DAG est une structure mathématique composée de nœuds (représentant les variables aléatoires) et d’arêtes orientées ou flèches unilatérales (représentant les relations causales directes d’un parent vers un enfant), ne comportant aucune boucle fermée permettant de revenir à son point de départ.
Dans la grammaire des DAG de Pearl, le problème de la troisième variable correspond à la configuration géométrique canonique de la « bifurcation » ou embranchement commun (fork). Cette structure se schématise formellement par la chaîne relationnelle $X \leftarrow Z \rightarrow Y$. Le nœud $Z$ agit comme un ancêtre commun direct (ou parent) de $X$ et de $Y$. Selon les axiomes de la causalité probabiliste, le chemin structurel reliant $X$ à $Y$ à travers $Z$ est qualifié de « chemin de porte dérobée » (backdoor path). Tant que ce chemin demeure grand ouvert par l’absence de contrôle sur le nœud $Z$, une information probabiliste non causale circule librement entre $X$ et $Y$, créant une dépendance marginale trompeuse.
Pour éliminer formellement cette dépendance non causale, Pearl a énoncé le théorème fondamental de la d-séparation (séparation directionnelle). Le critère de la porte dérobée stipule qu’un ensemble de covariables $S$ bloque un chemin non causal entre le traitement $X$ et l’issue $Y$ si aucun élément de $S$ n’est un descendant de $X$ et si $S$ conditionne (ou bloque) chaque chemin reliant $X$ et $Y$ qui comporte une flèche pointant vers $X$. Conditionner sur le nœud $Z$ (par ajustement statistique, stratification ou contrôle expérimental) bloque la bifurcation, isole $X$ et $Y$, et force leur indépendance conditionnelle ($X perp !!! perp Y mid Z$). L’utilisation rigoureuse des DAG permet ainsi d’identifier immédiatement quels tiers facteurs doivent obligatoirement être ajustés et, tout aussi crucial, quelles variables ne doivent jamais être conditionnées sous peine d’induire de nouveaux biais de sélection catastrophiques (comme les collisionneurs).
3. Exemples classiques et archétypaux du phénomène
3.1 L’exemple paradigmatique : ventes de glaces et attaques de requins
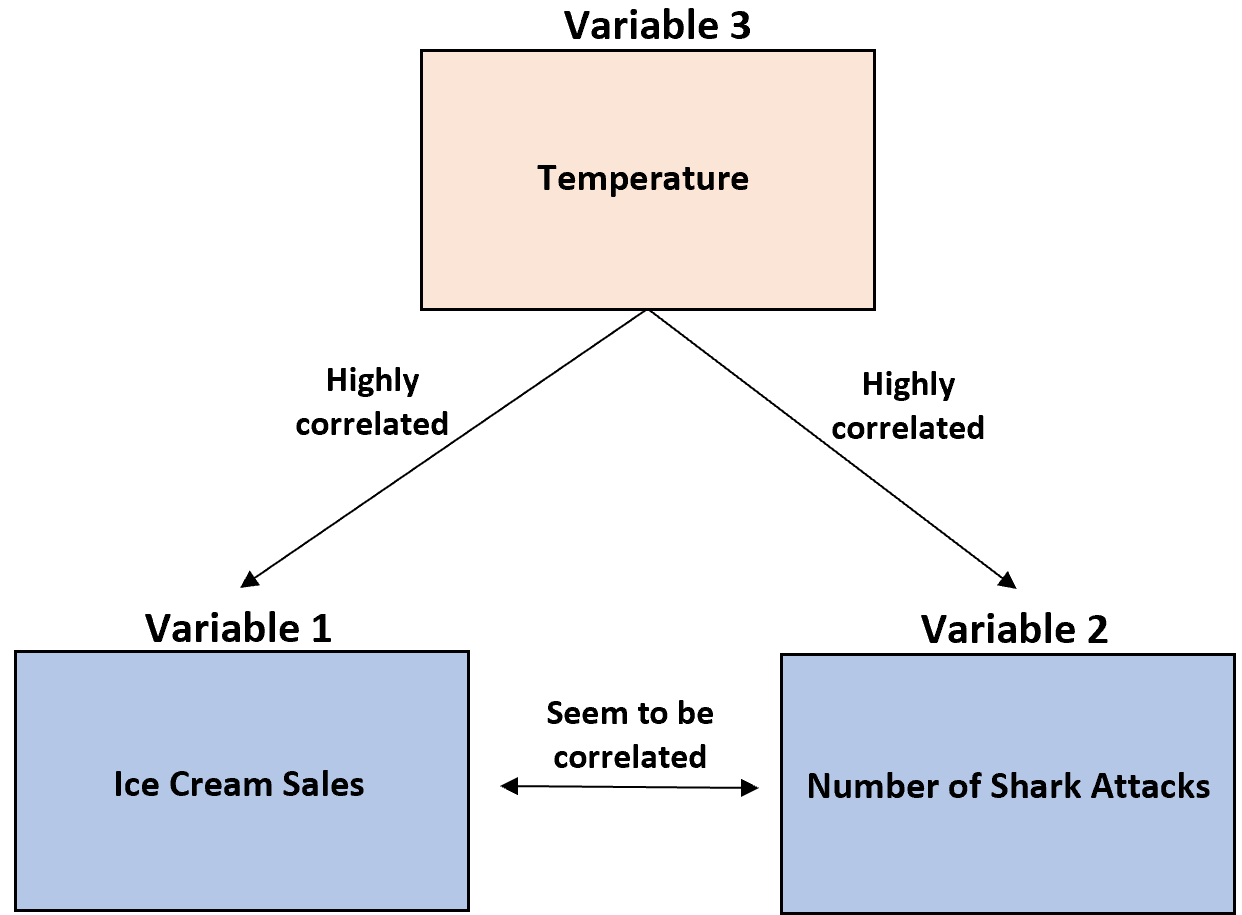
L’illustration la plus célèbre et pédagogique du problème de la troisième variable est sans conteste celle associant la consommation de crème glacée et le taux d’attaques perpétrées par des squales le long des côtes littorales. Si l’on compile les séries temporelles hebdomadaires sur une décennie dans des régions balnéaires de Floride ou d’Australie, on observe de façon systématique une corrélation positive statistiquement éclatante ($r \approx 0,85, p < 0,001$) : plus le chiffre d'affaires des glaciers ambulants explose, plus le registre des interventions médicales d'urgence consécutives à des morsures de requins s'alourdit.
Une lecture superficielle et littérale de cette covariation pourrait conduire un esprit délirant à conclure que les requins développent une prédilection carnassière ciblée pour les nageurs imprégnés d’arômes sucrés de vanille ou de fraise, ou inversement, que le choc psychologique post-traumatique lié à l’aperçu d’un aileron pousse les baigneurs traumatisés à consommer compulsivement des desserts glacés pour apaiser leur angoisse. La réalité causale sous-jacente est infiniment plus prosaïque et désamorce instantanément cette illusion : la variable confondante motrice est la température extérieure ambiante ou la saisonnalité climatique.
L’élévation thermique estivale déclenche deux comportements anthropologiques indépendants mais parallèles. D’un côté, la chaleur incitative pousse les individus à se rafraîchir en achetant des crèmes glacées ; de l’autre côté, cette même chaleur provoque un afflux massif de vacanciers dans les eaux océaniques, multipliant l’exposition spatio-temporelle de la population humaine aux habitats naturels des requins. Dès lors que l’on stratifie les données en analysant exclusivement les semaines affichant une température moyenne rigoureusement identique (par exemple $32^circ\text{C}$), la corrélation s’effondre intégralement vers zéro. La corrélation n’était qu’un artefact généré par l’oscillation thermique saisonnière.
3.2 L’exemple urbain : bornes d’incendie et population canine
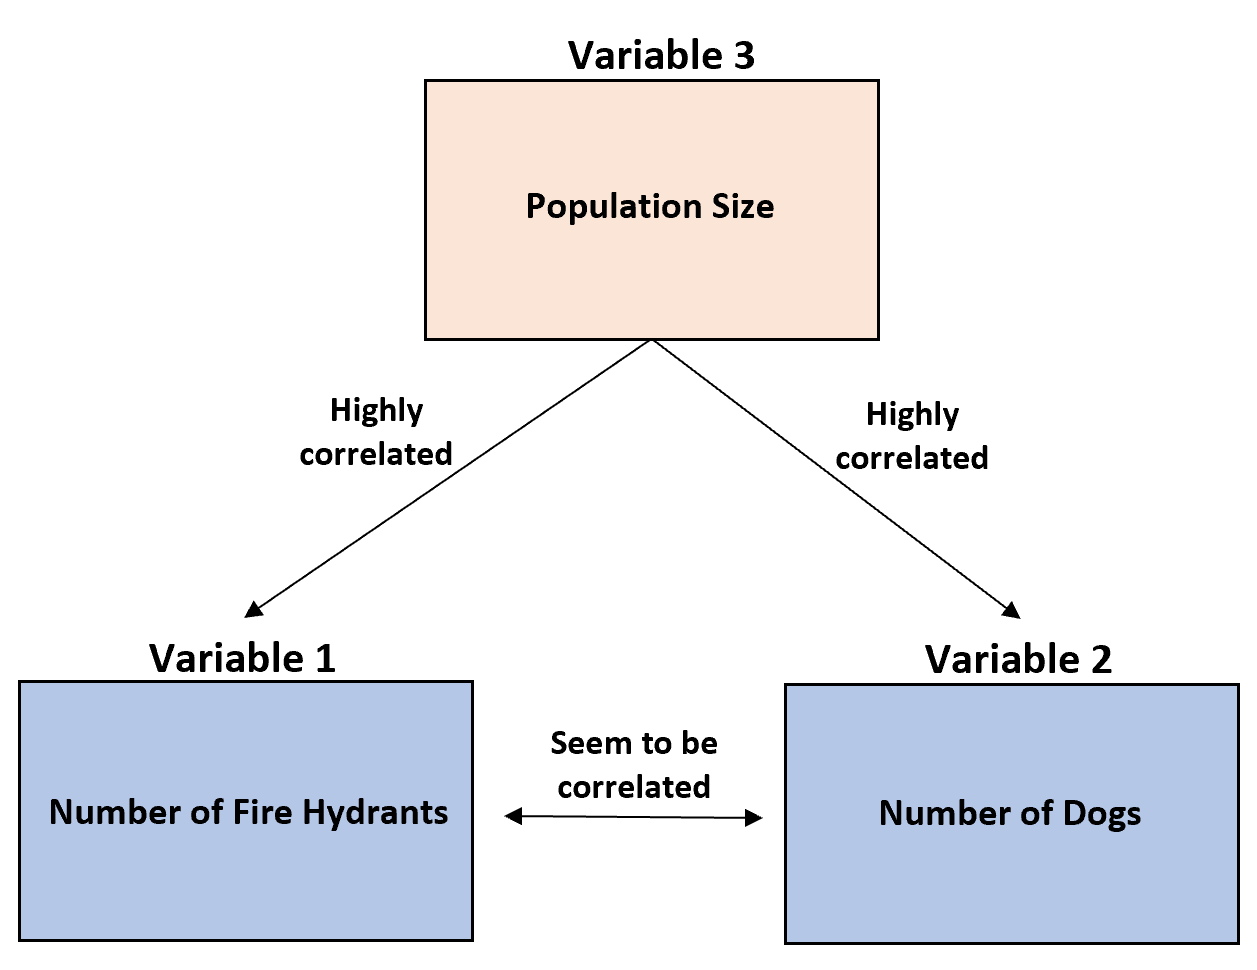
Dans le domaine de l’urbanisme et de la sociologie spatiale, une corrélation positive très nette peut être documentée entre le maillage territorial des bouches et bornes d’incendie installées par les services municipaux et le recensement volumétrique de la population de chiens domestiques vivant dans les différents quartiers d’une région administrative. Les esprits facétieux pourraient y voir une causalité fonctionnelle immédiate, suggérant que les services techniques installent préférentiellement ces bornes métalliques pour satisfaire l’impératif physiologique territorial des canidés, ou que les propriétaires adoptent délibérément des animaux pour rentabiliser la proximité de ces infrastructures de voirie.
Ce paradoxe urbain s’explique évidemment par une troisième variable structurelle massive : la densité de la population humaine et la taille globale de l’agglomération. Les départements de sécurité publique déploient un nombre d’équipements hydrauliques de lutte contre les incendies qui est rigoureusement proportionnel au nombre de résidences, d’immeubles collectifs et d’habitants au kilomètre carré afin de prévenir les sinistres majeurs. Simultanément, le volume absolu de chiens de compagnie est une fonction directe du volume d’êtres humains peuplant ce même espace géographique.
Cet exemple met en relief le piège omniprésent de l’agrégation spatiale non standardisée. En comparant des métropoles de dix millions d’âmes à des hameaux ruraux de deux cents habitants, n’importe quel indicateur cumulatif d’infrastructure (écoles, lampadaires, feux de signalisation) apparaîtra colossalement corrélé avec n’importe quel inventaire de caractéristiques biologiques ou domestiques locales. L’absence de normalisation par le dénominateur fondamental — ici le ratio par habitant — laisse libre cours à la confusion causale induite par l’effet de taille de l’échantillon géographique.
3.3 L’exemple socioculturel : taille des chaussures et capacités en lecture chez l’enfant
Dans les manuels d’évaluation psychométrique et de psychologie du développement cognitif, l’association observée au sein d’une population d’âge scolaire entre la pointure des souliers portés par un enfant et son score à des épreuves standardisées de fluence en lecture constitue un modèle d’école pour tester l’esprit critique des étudiants. Les mesures psychométriques démontrent avec une régularité spectaculaire que les enfants affichant des pieds plus volumineux déchiffrent les textes avec une rapidité supérieure, commettent infiniment moins d’erreurs phonologiques et possèdent un lexique orthographique considérablement plus étendu que leurs pairs aux pieds menus.
L’aberration consisterait évidemment à formuler une théorie neurophysiologique reliant la surface plantaire au développement synaptique du gyrus angulaire ou de l’aire de Wernicke dans le cortex cérébral. Le tiers facteur souverain qui explique la quasi-totalité de la variance commune est tout simplement l’âge chronologique et la maturation biologique globale de l’enfant. Si l’on analyse une cohorte composite regroupant des individus âgés de 5 ans à 13 ans, les préadolescents ont des pieds biologiquement plus développés en raison de la croissance somatique, et ils disposent simultanément de six à sept années de scolarisation intensive et d’instruction formelle de plus que les jeunes enfants de classe de maternelle.
Dès lors que l’analyste isole un groupe homogène d’enfants ayant tous précisément 8 ans et 2 mois, la corrélation s’évanouit instantanément dans le bruit de mesure statistique. Cet exemple canonique rappelle une règle méthodologique fondamentale : lorsqu’une étude implique des échantillons en cours de développement ontogénétique ou de vieillissement biologique, l’âge chronologique doit impérativement être modélisé comme un tiers facteur prioritaire sous peine de produire des conclusions grotesques sur le déterminisme des acquisitions cognitives.
4. Manifestations du problème en psychologie clinique et psychopathologie
4.1 Dépression et insomnie : le rôle médiateur ou confondant du stress chronique
L’exploration étiologique des troubles de l’humeur offre un terrain d’investigation où le problème de la troisième variable prend une tournure éminemment complexe. L’observation clinique séculaire, confirmée par les inventaires psychométriques contemporains (comme le BDI-II ou l’échelle de Hamilton), établit une liaison étroite entre les perturbations sévères de l’architecture du sommeil (insomnie d’endormissement, réveils nocturnes fragmentés) et l’intensité des épisodes dépressifs majeurs. Pendant des décennies, cette concomitance a alimenté des théories unilatérales postulant soit que le dérèglement dépressif altère passivement les centres hypniques diencéphaliques, soit que le déficit de sommeil détruit directement la résilience émotionnelle, précipitant l’effondrement thymique.
Cependant, la prise en compte des biomarqueurs neuroendocriniens a mis en lumière l’action d’une troisième variable systémique majeure : l’hyperactivation chronique de l’axe hypothalamo-hypophyso-surrénalien (HPA) en réponse à un stress environnemental permanent. Une exposition continue à des facteurs de stress psychosociaux non résolus entraîne une libération massive et non modulée de facteur de libération de la corticotropine (CRF) et de cortisol. Cette tempête biochimique produit indépendamment deux tableaux cliniques parallèles :
- Un état d’hyperéveil central (hyperarousal) cortical et autonome qui inhibe les mécanismes de bascule vers le sommeil lent profond, générant une insomnie tenace.
- Une neuro-inflammation diffuse doublée d’une régulation négative du facteur neurotrophique dérivé du cerveau (BDNF) dans l’hippocampe, induisant l’anhédonie, l’épuisement cognitif et l’humeur dépressive.
Si le clinicien omet d’analyser et de traiter cette variable sous-jacente de charge allostatique et d’hyperréactivité biologique au stress, focaliser l’intervention purement sur la gestion symptomatique de l’insomnie à l’aide d’hypnotiques sédatifs risque de ne produire aucun impact sur la trajectoire de récidive de l’épisode dépressif, l’étiologie sous-jacente demeurant intacte.
4.2 Consommation de substances et troubles anxieux : le facteur génétique et contextuel
L’épidémiologie psychiatrique a documenté de longue date une forte comorbidité entre l’usage précoce ou abusif de substances psychoactives (notamment le tétrahydrocannabinol ou cannabis) et l’émergence d’entités psychopathologiques anxieuses, incluant le trouble panique et l’anxiété généralisée. Deux discours antagonistes se sont affrontés dans le débat public : l’un imputant directement à la toxicité du principe actif l’altération fonctionnelle des circuits amygdaliens (causalité unidirectionnelle $X \rightarrow Y$), l’autre invoquant la théorie de l’automédication selon laquelle le sujet anxieux consomme des psychotropes pour tamiser sa détresse émotionnelle ($Y \rightarrow X$).
Pourtant, les études de génétique comportementale sur jumeaux monozygotes et dizygotes ont démontré la prégnance d’une troisième variable déterminante : la vulnérabilité neurogénétique partagée, souvent adossée à un profil de tempérament marqué par l’inhibition comportementale ou une instabilité dopaminergique constitutionnelle. Des polymorphismes sur les transporteurs de la sérotonine (5-HTTLPR) ou les enzymes de dégradation des catécholamines (COMT) créent une réactivité accrue aux stimuli aversifs tout en accentuant la susceptibilité aux mécanismes de renforcement pharmacologique des drogues.
À cette prédisposition biologique s’ajoute une autre variable confondante de premier plan : l’histoire précoce de traumatismes interpersonnels et de carences affectives graves dans l’enfance. Un environnement familial dysfonctionnel génère à la fois une dérégulation affective chronique rendant l’individu hautement perméable aux crises d’angoisse et une insertion précoce dans des réseaux de pairs déviants facilitant l’accès et l’expérimentation de substances illicites. Omettre ces tiers facteurs conduit à une lecture simpliste et biaisée de la trajectoire développementale des addictions.
4.3 Traumatisme infantile et troubles de l’attachement : le statut socio-économique
La théorie de l’attachement, initiée par John Bowlby et formalisée par Mary Ainsworth, stipule que la qualité des interactions précoces parent-nourrisson détermine les modèles internes opérants de l’individu à l’âge adulte. De nombreuses recherches corrélationnelles rapportent un lien statistique étroit entre les pratiques de maternage jugées froides, imprévisibles ou intrusives et l’apparition subséquente de troubles de l’attachement insécure ou désorganisé chez le jeune enfant, débouchant sur des psychopathologies relationnelles durables.
Toutefois, les spécialistes de la recherche sur la famille soulignent la présence massive d’un facteur de confusion socio-écologique souvent sous-estimé : le stress lié à l’extrême précarité socio-économique. Les parents vivant sous le seuil d’extrême pauvreté subissent quotidiennement un cumul de contraintes matérielles dévastatrices : logements insalubres, insécurité alimentaire chronique, instabilité professionnelle, isolement géographique et épuisement physique. Ce contexte d’angoisse existentielle permanente obère dramatiquement la disponibilité psychique de l’adulte, altérant sa réactivité sensible aux signaux du nourrisson non par déficit structurel de compétence parentale, mais par saturation adaptative de ses ressources exécutives et attentionnelles.
Simultanément, ce même contexte de privation économique impose à l’enfant un environnement bruyant, instable, dépourvu de stimulations sécurisantes et marqué par des ruptures fréquentes dans les modalités de garde. Si les chercheurs négligent de neutraliser rigoureusement le statut socio-économique par appariement ou régression multivariée, ils risquent d’imputer abusivement la totalité de la désorganisation relationnelle à un prétendu profil pathologique individuel de la mère ou du père, ouvrant la voie à des jugements normatifs et à des politiques d’assistance sociale inadaptées.
5. Le problème de la troisième variable en psychologie sociale et cognitive
5.1 Réseaux sociaux et détresse psychologique : l’isolement préalable comme tiers facteur
Au cours de la dernière décennie, un débat scientifique et médiatique d’une virulence sans précédent s’est cristallisé autour des effets pervers présumés des plateformes de réseaux sociaux sur la santé mentale des adolescents. Une profusion d’enquêtes observationnelles transversales a proclamé l’existence d’une corrélation statistiquement significative entre le nombre quotidien d’heures passées devant les écrans d’applications numériques et l’élévation des scores d’anxiété, de dépression et d’idéations suicidaires au sein des cohortes de jeunes scolarisés.
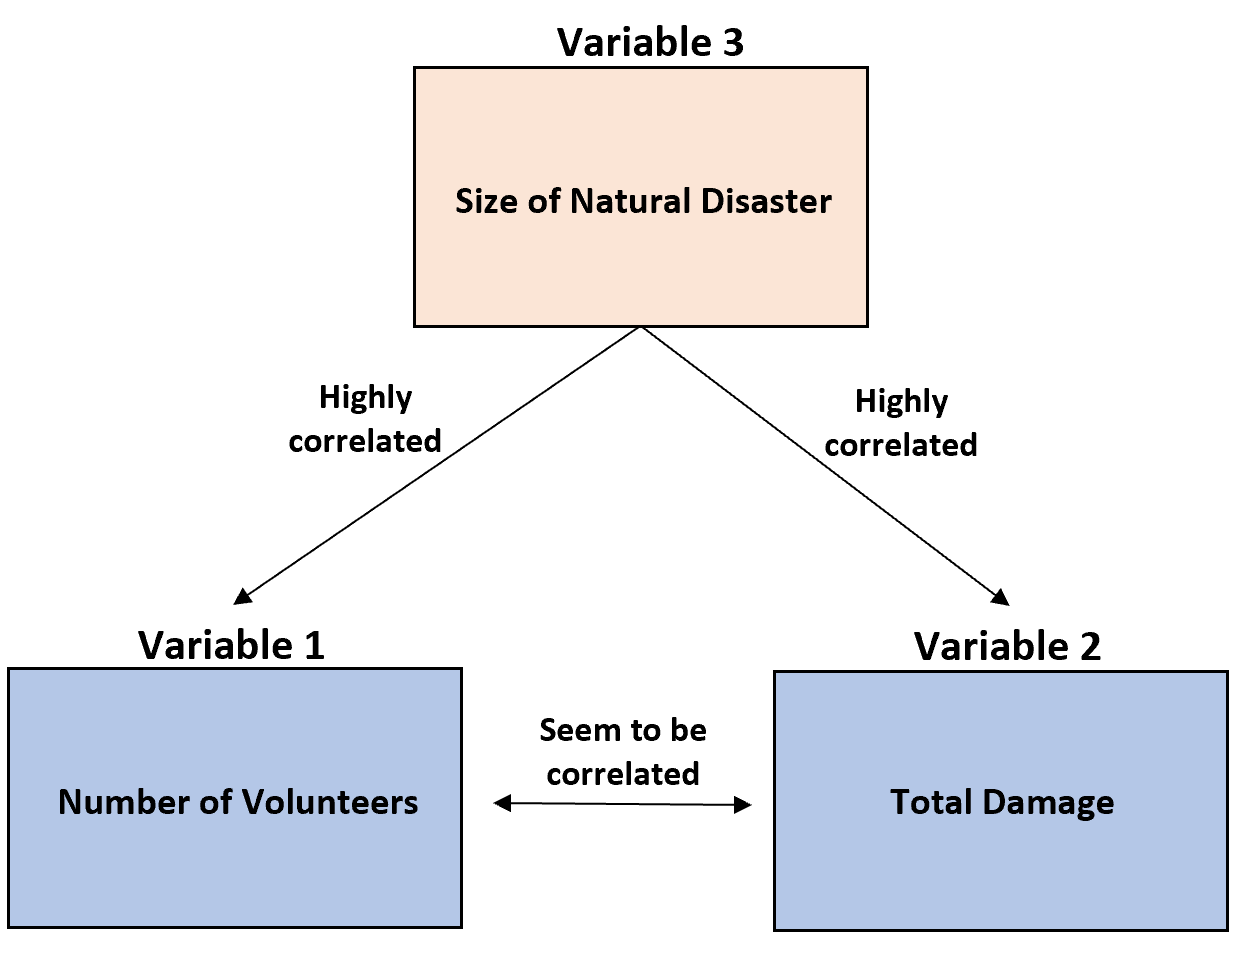
De nombreux commentateurs ont rapidement franchi le rubicon causologique en affirmant que les interfaces algorithmiques et la comparaison sociale ascendante détruisent mécaniquement l’équilibre affectif de la jeunesse. Néanmoins, les épidémiologistes critiques ont rapidement pointé du doigt l’intervention d’une troisième variable maîtresse : l’isolement social préexistant et le déficit structurel de soutien relationnel dans le monde réel. Un jeune souffrant préalablement de marginalisation scolaire, d’exclusion familiale ou d’un tempérament neuro-atypique non diagnostiqué se retrouve fréquemment confiné dans la sphère domestique. Cet isolement le pousse naturellement à rechercher des substituts compensatoires ou des dérivatifs relationnels au sein des espaces virtuels en y passant un temps colossal.
Ce même isolement social primaire est par ailleurs l’un des déterminants les plus puissants et solidement validés de la détresse psychique et de la décompensation thymique chez l’être humain. En présence d’un protocole d’observation purement transversal où l’exposition aux écrans et le niveau de détresse sont relevés simultanément, l’incapacité à contrôler le degré de connectivité sociale réelle antérieure fausse complètement l’équation, transformant une simple stratégie d’adaptation de jeunes esseulés en une prétendue arme létale technologique universelle.
5.2 Performances cognitives et écoute de musique classique : la déconstruction de l’effet Mozart
En 1993, la publication dans la prestigieuse revue Nature d’une courte étude menée par Rauscher, Shaw et Ky a déclenché un phénomène planétaire resté célèbre sous le nom d’« effet Mozart ». Les auteurs affirmaient que des étudiants ayant écouté dix minutes durant la sonate pour deux pianos en ré majeur (K. 448) de Wolfgang Amadeus Mozart obtenaient par la suite des performances significativement supérieures à une épreuve de raisonnement spatial abstrait issue de l’échelle d’intelligence de Stanford-Binet, en comparaison d’étudiants soumis à une consigne de relaxation passive ou au silence absolu.
L’emballement médiatique et commercial fut immédiat : des millions de disques compacts furent vendus à destination des femmes enceintes et des crèches dans l’espoir de façonner une génération de génies intellectuels. Cependant, l’incapacité répétée des laboratoires indépendants de psychologie cognitive à reproduire l’effet a suscité une remise en question méthodologique approfondie. Des recherches ultérieures rigoureuses, notamment celles menées par Kenneth Steele et Glenn Schellenberg, ont définitivement identifié la troisième variable explicative : l’activation de l’éveil cortical (arousal) et l’induction d’un affect positif passager.
L’écoute d’une composition rythmée, joyeuse et stimulante comme une sonate mozartienne réhausse transitoirement le tonus neurovégétatif, le niveau de vigilance et la bonne humeur des auditeurs, comparativement à dix minutes d’ennui profond passées dans un silence total ou à l’écoute d’un texte d’instruction monotone. Or, les lois classiques de la neuropsychologie (notamment la loi de Yerkes-Dodson) stipulent qu’un niveau optimal d’activation physiologique et de motivation émotionnelle maximise les performances de la mémoire de travail et du traitement perceptif. Lorsque les chercheurs ont remplacé Mozart par la lecture enthousiaste d’un roman de Stephen King ou par un morceau de rock entraînant, le prétendu « effet Mozart » s’est matérialisé à l’identique. La supériorité cognitive n’avait aucun lien avec la structure contrapuntique de la musique viennoise ; elle découlait uniquement de l’état d’éveil induit par une stimulation divertissante.
5.3 Motivation intrinsèque et rendement académique : l’influence du capital culturel
Dans la littérature relative aux sciences de l’éducation et à la psychologie positive appliquée, la documentation d’une covariation substantielle entre la motivation autodéterminée d’un apprenant (sa curiosité intellectuelle, son amour intrinsèque de la connaissance) et son rendement scolaire final est souvent brandie pour justifier des pédagogies centrées exclusivement sur l’épanouissement personnel. Les modèles simplistes présupposent que susciter le goût intime du savoir chez l’enfant constitue le levier causal direct de sa réussite aux épreuves sommatives.
Cette vision édulcorée oblitère fréquemment le rôle colossal d’une troisième variable sociologique majeure modélisée par Pierre Bourdieu : le volume de capital culturel hérité et l’encadrement éducatif familial. Les enfants issus de foyers hautement scolarisés baignent dès leur plus jeune âge dans un écosystème littératien : présence d’une bibliothèque volumineuse, expositions régulières à un registre linguistique soutenu, incitations aux musées, maîtrise des implicites scolaires et recours à du soutien scolaire privé en cas de fléchissement.
Ce capital culturel engendre simultanément chez l’élève une affinité presque naturelle et spontanée pour les savoirs institutionnalisés (ce que l’on qualifie d’intérêt intrinsèque) et lui confère les compétences techniques objectives requises pour exceller aux examens scolaires. Si une enquête universitaire se borne à corréler motivation et notes sans neutraliser le niveau de diplôme des ascendants et les conditions matérielles d’apprentissage, elle attribue à une supposée vertu psychologique individuelle une trajectoire qui découle en réalité d’une puissante mécanique de reproduction sociale de classe.
6. Variables confondantes versus variables médiatrices et modératrices
6.1 Définition différentielle de la variable confondante
La sémantique méthodologique souffre fréquemment d’un laxisme coupable qui pousse de nombreux auteurs à confondre variable confondante, variable médiatrice et variable modératrice sous l’appellation générique et trompeuse de « variables intermédiaires ». Il est impératif d’établir une démarcation épistémologique stricte de ces concepts, car leurs implications sur la validité des modèles d’inférence sont diamétralement opposées.
Sur le plan topologique et causal, la variable confondante ($Z$) se situe structurellement en amont temporel et fonctionnel des variables d’intérêt $X$ et $Y$. Elle n’est aucunement le fruit de l’action de $X$, mais au contraire un facteur initiateur indépendant qui influence conjointement l’exposition et l’effet ($X \leftarrow Z \rightarrow Y$). Sa présence a pour conséquence délétère de créer une corrélation fallacieuse ou de masquer/inverser un lien causal authentique. Par conséquent, la règle d’or vis-à-vis d’une variable confondante est l’impératif catégorique de neutralisation : elle doit obligatoirement être contrôlée, isolée, ajustée ou éliminée par le dispositif de recherche ou l’outil statistique afin de purifier la relation focale entre $X$ et $Y$.
6.2 La variable médiatrice : chaîne causale intermédiaire
À l’opposé absolu de la variable confondante, la variable médiatrice ($M$) ne se situe pas en amont, mais au cœur même de la chaîne causale reliant la variable indépendante à la variable dépendante. Le flux structural d’engendrement adopte ici une topologie séquentielle stricte : $X \rightarrow M \rightarrow Y$. Le facteur prédictif $X$ produit une variation de l’état du médiateur $M$, lequel entraîne à son tour une modification de l’issue finale $Y$. Le médiateur ne parasite pas la relation causale : il en constitue le mécanisme opérationnel, le rouage interne ou l’explication fonctionnelle intime.
L’approche classique formulée par Reuben Baron et David Kenny en 1986 décompose cette architecture en effets directs (l’impact résiduel de $X$ sur $Y$ qui ne transite pas par $M$) et en effets indirects (le produit des coefficients structuraux de $X$ vers $M$ et de $M$ vers $Y$). Considérons un exemple paradigmatique en psychologie de la santé : l’exposition à un environnement de travail hautement stressant ($X$) augmente la probabilité de développer un infarctus du myocarde ($Y$). Si l’on s’intéresse à la consommation tabagique compulsive comme médiateur ($M$), on observe que le stress pousse l’employé à fumer intensivement ($X \rightarrow M$), et que les composés toxiques de la fumée de tabac entraînent l’athérosclérose coronarienne ($M \rightarrow Y$).
L’erreur méthodologique monumentale — hélas trop fréquente — consisterait pour un chercheur à traiter la variable médiatrice $M$ comme s’il s’agissait d’un facteur de confusion $Z$ en ajustant statistiquement le tabagisme dans le modèle de régression du stress sur l’infarctus. En « contrôlant » pour $M$, le chercheur neutralise et volatilise l’effet indirect qui transporte précisément l’action de la cause initiale. Conditionner sur un médiateur revient à commettre un « sujustement » (overadjustment), qui étouffe le mécanisme causal authentique et conduit le chercheur à proclamer à tort l’absence de lien causal entre $X$ et $Y$.
6.3 La variable modératrice : interaction statistique et modification d’effet
La variable modératrice ($W$) obéit à une logique conceptuelle radicalement disjointe de la confusion et de la médiation. Un modérateur ne s’intéresse ni à l’engendrement ni à la pollution causale : il s’agit d’une variable qualitative (comme le sexe, le groupe ethnique, le statut marital) ou quantitative continue (comme l’âge, l’estime de soi) qui modifie la force, l’amplitude ou la polarité de la relation d’influence entre la variable indépendante $X$ et la variable dépendante $Y$.
Dans la modélisation mathématique linéaire, la modération se traduit par l’intégration d’un terme de produit croisé ou d’interaction statistique dans l’équation de régression :
$$Y = \beta_0 + \beta_1 X + \beta_2 W + \beta_3 (X \times W) + \epsilon$$
L’existence d’une modération statistiquement significative est formellement actée dès lors que le coefficient $\beta_3$ s’avère non nul avec un seuil critique $p < 0,05$. Si $\beta_3 \neq 0$, cela démontre que l'impact marginal de $X$ sur $Y$ dépend explicitement de la valeur spécifique prise par le modérateur $W$. Contrairement à la variable confondante, le modérateur n'a aucune obligation statistique d'être corrélé avec la variable indépendante $X$.
Pour illustrer cette distinction, imaginons une étude clinique évaluant l’efficacité d’une thérapie cognitivo-comportementale ($X$) sur la réduction de l’évitement agoraphobique ($Y$). L’alliance thérapeutique perçue par le patient peut agir comme un modérateur ($W$) : chez les patients rapportant une alliance thérapeutique solide, la psychothérapie produit une régression massive de l’évitement ($\beta_1$ très élevé), tandis que chez les patients éprouvant une méfiance envers le clinicien, la thérapie demeure inopérante ($\beta_1 \approx 0$). Le modérateur répond à la question : « Pour qui, ou dans quelles conditions contextuelles spécifiques, l’effet causal opère-t-il ? », là où le problème de la troisième variable interroge : « L’effet n’est-il qu’un leurre induit par une racine extérieure partagée ? ».
7. Conséquences méthodologiques et risques d’erreurs d’inférence
7.1 Le paradoxe de Simpson : inversion statistique par sous-groupes
La manifestation la plus spectaculaire, contre-intuitive et dramatique du problème de la troisième variable porte le nom de paradoxe de Simpson (parfois désigné sous le vocable d’effet Yule-Simpson). Ce paradoxe désigne la configuration mathématique formelle où une tendance, une corrélation ou une différence statistique observée de manière hautement significative au niveau agrégé de l’ensemble d’une population se retrouve totalement inversée lorsque l’on décompose et examine les données au sein de chaque sous-groupe stratifié selon une troisième variable occultée.
Le cas historique le plus célèbre de ce phénomène a éclaté à l’université de Californie à Berkeley en 1973 lors de l’examen des taux d’admission en cycle universitaire supérieur. Les données agrégées indiquaient une disparité frappante : 44 % des candidats masculins étaient admis contre seulement 35 % des candidates féminines, une différence d’une telle amplitude qu’elle laissait immédiatement suspecter une discrimination systémique à l’encontre des femmes. Cependant, en désagrégeant les dossiers département par département (la troisième variable étant ici la filière académique sollicitée), les statisticiens PJ Bickel et ses collègues ont découvert avec stupeur que dans la quasi-totalité des départements pris isolément, le taux d’admission des femmes était soit égal, soit statistiquement supérieur à celui des hommes !
L’explication de cette inversion résidait dans l’existence d’une troisième variable cachée : la sélectivité concurrentielle des départements et la distribution différentielle des candidatures selon le genre. Les femmes avaient massivement candidaté dans des départements d’humanités et de sciences sociales recevant des milliers de postulants pour un nombre infime de places (taux d’acceptation structurellement très bas de l’ordre de 10 %), tandis que les hommes s’orientaient majoritairement vers des filières d’ingénierie et de sciences dures disposant de financements massifs et offrant des ratios d’admission de l’ordre de 60 à 70 %. L’agrégation aveugle avait mélangé des strates hétérogènes, créant une corrélation globale fallacieuse inversant la réalité locale. Ignorer le tiers facteur catégoriel dans ce contexte aboutissait à une conclusion éthiquement et juridiquement explosive mais empiriquement fausse.
7.2 Biais d’attribution causale et dérives théoriques
La conséquence intellectuelle directe de l’inattention portée aux tiers facteurs est la prolifération de théories fantaisistes qui saturent la littérature académique et le débat social. Lorsqu’une communauté de chercheurs s’enthousiasme pour une association contingente, des pans entiers de la recherche peuvent se fourvoyer pendant des décennies dans la construction de modèles conceptuels sophistiqués mais construits sur du sable épistémologique.
Ces biais d’attribution causale induisent des dérives de stigmatisation sociologique désastreuses. Par exemple, au cours de l’histoire de la psychiatrie infantile, l’observation d’une corrélation entre les styles de communication rigides ou la réserve émotionnelle de certaines mères et la présence d’un trouble du spectre de l’autisme chez leur enfant a mené à la funeste théorie psychanalytique des « mères réfrigérateurs » développée par Bruno Bettelheim. Cette théorie incriminait la froideur maternelle présumée comme la cause étiologique de l’autisme, infligeant une culpabilisation destructrice à des milliers de familles. Il a fallu des décennies d’avancées en génétique moléculaire et en imagerie neuro-développementale pour dissiper cette construction théorique calomnieuse et prouver que la génétique et la neurobiologie précoce constituaient les véritables tiers facteurs architecturaux du trouble, la réaction maternelle de détresse ou de retrait n’étant qu’une adaptation secondaire face à l’impossibilité de synchronisation sensorielle avec un bébé biologiquement désorganisé.
Outre les ravages humains, de telles dérives se soldent par un gaspillage titanesque de crédits alloués à la recherche fondamentale. Des laboratoires entiers investissent leur temps, leurs équipements et la force vive de leurs doctorants pour répliquer ou raffiner les nuances de liaisons circonstancielles totalement dénuées de pertinence causale matérielle, retardant d’autant la découverte des leviers d’action réels.
7.3 Erreurs d’évaluation des politiques publiques et programmes d’intervention
Si les égarements théoriques pénalisent la sphère universitaire, les défaillances inférentielles liées au problème de la troisième variable s’avèrent encore plus délétères lorsqu’elles s’infiltrent dans les politiques publiques de santé, d’éducation et de justice pénale. La mise en œuvre de programmes interventionnels d’envergure nationale requiert l’injection de sommes considérables prélevées sur les fonds publics. Lorsqu’une telle décision se fonde sur l’identification erronée d’un prétendu facteur de causalité, l’échec opérationnel est non seulement garanti, mais il peut s’accompagner d’effets iatrogènes majeurs.
Un cas d’école emblématique fut le programme américain D.A.R.E. (Drug Abuse Resistance Education), initié dans les années 1980 et déployé dans des dizaines de milliers d’écoles à travers le monde. Les concepteurs du programme s’étaient basés sur des données corrélationnelles transversales démontrant que les élèves possédant des connaissances déclaratives sur les drogues et affichant une haute « estime de soi » consommaient statistiquement moins de stupéfiants. En déduisant naïvement que la valorisation de l’estime de soi et l’information policière sur les drogues agissaient comme un frein causal direct contre l’addiction, le gouvernement a injecté des centaines de millions de dollars dans ce dispositif.
Les évaluations expérimentales ultérieures menées avec des groupes témoins rigoureux ont établi que le programme n’avait aucune efficacité préventive sur la consommation réelle de drogue, et qu’il produisait même dans certains cas une élévation de l’expérimentation par effet de curiosité morbide. Le tiers facteur déterminant — englobant l’impulsivité neurocognitive sous-jacente, la dynamique dysfonctionnelle des pairs et l’adversité environnementale du quartier — avait été royalement ignoré. Cibler un épiphénomène décoratif au lieu du moteur causal réel condamne invariablement l’action publique à l’inefficacité dispendieuse.
8. Techniques de détection du problème de la troisième variable
8.1 Matrices de corrélation exploratoires et tests de colinéarité
Avant d’engager toute modélisation causale avancée, la première ligne de défense méthodologique consiste en une inspection analytique systématique des interdépendances multivariées à travers les matrices de corrélation exploratoires. Une matrice de corrélation bivariée permet de visualiser d’un coup d’œil l’intégralité des coefficients d’association linéaire entre chaque paire d’indicateurs collectés au sein de la base de données. L’émergence d’un réseau dense de corrélations de forte amplitude ($r > 0,60$) entre de multiples variables prédictives doit immédiatement alerter le méthodologiste sur l’existence potentielle d’un facteur latent partagé.
Cependant, l’inspection visuelle d’une matrice ne suffit pas à diagnostiquer formellement l’ampleur de l’interférence d’une troisième variable dans un modèle d’estimation. Il est indispensable de procéder à des tests formels de colinéarité et de multicolinéarité au sein des modèles de régression multivariée. Les deux indices canoniques utilisés sont la Tolérance ($T$) et son inverse algébrique, le Facteur d’Inflation de la Variance (Variance Inflation Factor ou VIF) :
$$\text{VIF}_j = \frac{1}{1 – R_j^2} = \frac{1}{\text{Tolérance}_j}$$
où $R_j^2$ représente le coefficient de détermination obtenu en régressant le prédicteur $X_j$ sur l’ensemble des autres variables indépendantes incluses dans l’équation. Lorsque la tolérance d’une variable chute en dessous de 0,20 (correspondant à un VIF supérieur à 5, voire à 10 selon les seuils les plus conservateurs), la multicolinéarité est critique. Cela indique qu’une troisième variable (ou une combinaison linéaire de celles-ci) capture la quasi-totalité de la variance de $X_j$. Les conséquences statistiques sont immédiates : inflation disproportionnée des erreurs types associées aux coefficients de régression, perte dramatique de puissance statistique et risque d’obtenir des coefficients qui changent de signe de manière erratique sous l’effet de perturbations mineures dans les données.
8.2 Analyse des corrélations partielles et semi-partielles
L’instrument analytique fondamental pour isoler empiriquement l’impact d’une troisième variable est le calcul de la corrélation partielle. La corrélation partielle de premier ordre mesure le degré d’association linéaire résiduelle subsistant entre deux variables $X$ et $Y$ après avoir mathématiquement extrait et soustrait de chacune d’elles la portion de variance partagée attribuable à une troisième variable candidate $Z$. La formule algébrique canonique de la corrélation partielle s’écrit :
$$r_{XY.Z} = \frac{r_{XY} – r_{XZ} \cdot r_{YZ}}{\sqrt{(1 – r_{XZ}^2)(1 – r_{YZ}^2)}}$$
L’interprétation de la valeur obtenue fournit un diagnostic sans équivoque sur le rôle de $Z$ :
- Si le coefficient de corrélation bivarié brut initial $r_{XY}$ est substantiel (par exemple $r = 0,65$) mais que la corrélation partielle $r_{XY.Z}$ s’effondre brutalement pour approcher zéro de manière non significative ($r_{XY.Z} \approx 0$), le chercheur dispose de la preuve mathématique que la corrélation initiale était intégralement fallacieuse et générée par le tiers facteur $Z$.
- Si la corrélation partielle $r_{XY.Z}$ demeure rigoureusement identique au coefficient brut ($r_{XY.Z} \approx r_{XY}$), la variable candidate $Z$ ne joue aucun rôle perturbateur de confusion dans cette relation.
- Si la corrélation partielle diminue de manière notable tout en restant statistiquement différente de zéro, $Z$ opère comme un facteur de confusion partielle, expliquant une fraction de la variance commune mais laissant subsister un lien direct potentiel.
Il convient de distinguer conceptuellement la corrélation partielle de la corrélation semi-partielle (ou corrélation part). Alors que la corrélation partielle retire la variance de $Z$ à la fois de $X$ et de $Y$, la corrélation semi-partielle soustrait l’influence de $Z$ uniquement de la variable prédictive $X$. Cette dernière technique s’avère particulièrement précieuse dans le cadre d’une régression hiérarchique pour quantifier précisément l’incrément de variance expliqué unique ($R^2_{\text{change}}$) qu’un facteur $X$ ajoute à l’explication de l’issue $Y$, au-delà de ce qui est déjà capturé par la troisième variable $Z$.
8.3 Inspection visuelle des données et stratification graphique
Bien avant la lecture aveugle des sorties d’algorithmes statistiques, l’analyse graphique exploratoire demeure une méthode irremplaçable pour démasquer l’opération d’une troisième variable. Tracer un simple nuage de points (scatterplot) représentant $Y$ en fonction de $X$ sur l’échantillon complet peut masquer des réalités diamétralement trompeuses en raison du lissage global. L’utilisation systématique de tracés de dispersion stratifiés ou de visualisations sous forme de facettes graphiques (comme les coplots ou les panneaux conditionnels) permet d’inspecter visuellement les dynamiques locales.
Cette approche consiste à découper la variable candidate $Z$ en classes d’amplitudes ou catégories discrètes, puis à générer un sous-graphique pour chaque modalité de $Z$ tout en y superposant la droite d’ajustement par moindres carrés locaux. Si la pente de régression globale agrégée s’affiche avec une inclinaison positive prononcée, mais que l’examen attentif de chaque fenêtre stratifiée révèle des pentes strictement horizontales (absence d’effet) ou franchement négatives, l’analyste pose un diagnostic visuel immédiat d’interférence confondante ou de paradoxe de Simpson.
Les représentations graphiques contemporaines enrichies par des codes de couleurs chromatiques différentiels assignés aux gradients de la troisième variable offrent également une compréhension spatiale intuitive. Elles permettent de détecter instantanément si les données forment des sous-grappes disjointes (clusters) éparpillées dans l’espace multidimensionnel, avertissant immédiatement l’expérimentateur que le modèle global dissimule une structure hétérogène dominée par le tiers facteur.
9. Stratégies de contrôle lors de la conception de la recherche (a priori)
9.1 L’assignation aléatoire (randomisation) dans les plans expérimentaux
Dans l’arsenal de la méthode scientifique, l’assignation aléatoire des participants aux différentes conditions expérimentales — pierre angulaire de l’essai contrôlé randomisé (ECR) formalisé par Sir Ronald Fisher — constitue l’étalon-or absolu et l’arme méthodologique la plus élégante pour annihiler définitivement le problème de la troisième variable. Contrairement à une croyance répandue chez les profanes, le but premier de la randomisation n’est pas d’éliminer la variabilité humaine intrinsèque, mais de redistribuer cette variabilité de manière parfaitement symétrique entre les groupes de traitement et de contrôle.
Sur le plan probabiliste, dès lors que la taille de l’échantillon ($N$) est suffisamment robuste, le processus de tirage au sort garantit que toutes les variables tierces imaginables — qu’elles soient démographiques, génétiques, psychologiques, cognitives, ou même des facteurs inconnus et non mesurés dont l’existence n’est pas soupçonnée par le chercheur — se distribuent avec des espérances mathématiques rigoureusement identiques dans chaque bras expérimental. Par voie de conséquence, dans un DAG causal au sens de Pearl, la randomisation opère une intervention physique formelle (l’opérateur $do(X)$) qui déracine chirurgicalement toutes les flèches causales pointant vers la variable indépendante ($X \leftarrow Z$). Le chemin de porte dérobée est rompu dans le monde réel avant même le recueil du premier score.
Toutefois, la psychologie clinique, la psychopathologie et la sociologie se heurtent quotidiennement aux frontières déontologiques et pratiques infranchissables de la randomisation. Il est formellement impossible, pour d’évidentes raisons éthiques, d’assigner aléatoirement des sujets à des conditions d’abus infantile précoce, de divorce parental dévastateur, de traumatisme crânien, d’inhalation quotidienne de substances cancérigènes ou d’exclusion économique extrême. Dans l’impossibilité d’expérimenter physiquement ces expositions aversives, la recherche comportementale doit nécessairement s’appuyer sur des plans d’observation quasi-expérimentaux où d’autres remparts contre la troisième variable doivent impérativement être érigés.
9.2 L’appariement (matching) des participants selon les caractéristiques clés
Lorsqu’un plan d’expérimentation avec randomisation pure est irréalisable, la méthode de l’appariement représente une alternative de conception robuste dans les protocoles observationnels ou quasi-expérimentaux. Cette technique consiste à constituer artificiellement des groupes de comparaison en associant, pour chaque individu exposé ou présentant une condition clinique spécifique ($X=1$), un individu témoin non exposé ($X=0$) qui partage rigoureusement un ensemble de caractéristiques prédéfinies sur les variables confondantes potentielles identifiées a priori ($Z_1, Z_2, Z_3$).
On distingue traditionnellement :
- L’appariement exact (case-control matching) : Le chercheur impose que chaque sujet clinique soit apparié à un sujet contrôle ayant strictement le même âge à un an près, le même genre biologique, le même niveau d’études et le même revenu fiscal médian. L’équilibrage déterministe qui en résulte annule l’asymétrie de distribution de ces covariables entre les groupes.
- L’appariement par score de propension (Propensity Score Matching – PSM) : Développé par Paul Rosenbaum et Donald Rubin en 1983, le score de propension pallie l’impossibilité pratique de trouver des paires exactes lorsque le nombre de variables confondantes candidates explose (la « malédiction de la dimensionnalité »). Le score de propension résume l’ensemble des caractéristiques observées d’un participant en une probabilité scalaire unique comprise entre 0 et 1 : la probabilité qu’avait cet individu de se retrouver dans le groupe d’exposition au vu de ses caractéristiques de base, modélisée généralement par une régression logistique binaire :
$$e(Z) = P(X = 1 mid Z)$$
L’appariement consiste ensuite à associer des sujets traités et non traités affichant des scores de propension mathématiquement quasi-identiques.
Bien que d’une formidable élégance opérationnelle, l’appariement comporte deux vulnérabilités intrinsèques sévères : il tend à réduire drastiquement la taille de l’échantillon final exploitable par l’élimination des sujets hors de la zone de « support commun », et surtout, il ne neutralise que les variables de confusion explicitement mesurées et incluses dans l’algorithme, laissant l’étude totalement exposée aux facteurs de confusion latents non enregistrés.
9.3 La restriction des critères d’inclusion et la stratification expérimentale
Une troisième stratégie d’intervention a priori, souvent qualifiée de technique d’isolation mécanique, repose sur la restriction stricte des critères d’inclusion des participants au sein de la cohorte d’étude. Le principe sous-jacent est de transformer artificiellement une variable confondante majeure en une constante invariable au sein de l’échantillon analysé.
Si, par exemple, un chercheur soupçonne fortement que le genre biologique et l’indice de masse corporelle (IMC) agissent comme des facteurs de confusion redoutables dans l’analyse de l’efficacité d’un protocole d’entraînement attentionnel sur la régulation de l’anxiété, il peut décider de manière délibérée de restreindre son recrutement exclusivement à des sujets féminins, non fumeurs, âgés de 20 à 25 ans, et présentant un IMC normal strictement calibré entre 20 et 22 $\text{kg/m}^2$. En neutralisant toute variation sur $Z$ ($\text{Var}(Z) = 0$), le tiers facteur perd mathématiquement toute capacité à covarier avec la variable dépendante ou indépendante, annihilant mécaniquement le problème de confusion pour ces dimensions.
L’avantage méthodologique d’une telle tactique est la pureté interne absolue des comparaisons effectuées. En revanche, le coût scientifique est considérable : cette manœuvre entraîne une érosion dramatique de la validité externe et de la généralisabilité des résultats. Un effet démontré au sein d’un échantillon ultra-homogène de jeunes femmes minces ne peut aucunement être extrapolé à une population masculine âgée ou présentant des comorbidités métaboliques, enfermant les conclusions dans un isolat écologique artificiel.
10. Méthodes statistiques de contrôle a posteriori
10.1 Régression multiple : ajustement statistique des covariables
Lorsque la phase de collecte des données est achevée sans possibilité de randomisation ou de restriction drastique, la modélisation statistique a posteriori constitue l’échafaudage indispensable pour désintriquer les effets réels des corrélations trompeuses. Au cœur de cette démarche trône l’analyse de régression linéaire multiple. Le principe fondamental de la régression multivariée est d’estimer la relation linéaire propre unissant la variable indépendante ($X$) à l’issue ($Y$) sous la condition restrictive formelle du ceteris paribus (« toutes choses étant égales par ailleurs »).
Considérons l’équation générale incorporant un ensemble de covariables de confusion suspectées ($Z_1, Z_2, dots, Z_k$) :
$$Y = \beta_0 + \beta_1 X + \beta_2 Z_1 + \beta_3 Z_2 + dots + \beta_{k+1} Z_k + \epsilon$$
Dans ce formalisme matriciel, le coefficient de régression partiel $\beta_1$ quantifie le changement moyen attendu sur la variable critère $Y$ consécutif à une élévation d’une unité de la variable indépendante $X$, en maintenant rigoureusement constantes les valeurs de l’intégralité des variables $Z_k$ introduites dans le système. L’algorithme des moindres carrés ordinaires (MCO) projette mathématiquement $X$ et $Y$ sur le sous-espace orthogonal aux vecteurs des covariables de confusion, purgeant ainsi mécaniquement la pente $\beta_1$ de la contamination causale liée à ces facteurs identifiés.
Cependant, la validité de cet ajustement repose sur des postulats statistiques stricts : la stricte linéarité de la relation, l’absence de colinéarité excessive, l’homoscédasticité et la normalité des résidus, et par-dessus tout, l’hypothèse héroïque qu’aucun facteur de confusion critique n’a été exclu de l’équation. Si un tiers facteur influent est omis du modèle, l’estimation du paramètre $\beta_1$ demeure structurellement biaisée (biais des variables omises), réintroduisant le problème de la troisième variable par la porte des résidus corrélés.
10.2 Analyse de covariance (ANCOVA) et équations structurelles (SEM)
Dans le paradigme des comparaisons de groupes (plans quasi-expérimentaux à groupes non équivalents), l’Analyse de Covariance (ANCOVA) combine harmonieusement les mécanismes de l’analyse de variance classique (ANOVA) et de la régression linéaire. L’ANCOVA permet de comparer les moyennes d’une variable continue $Y$ entre différents niveaux d’un facteur catégoriel $X$, tout en ajustant statistiquement ces moyennes de groupe en fonction des fluctuations d’une ou plusieurs covariables continues métriques $Z$. L’ANCOVA calcule des « moyennes marginales ajustées » (estimated marginal means) : elle simule ce que seraient les scores moyens des différents groupes si tous les participants avaient affiché un score rigoureusement identique sur la covariable $Z$.
Pour dépasser les limites des modèles linéaires simples qui supposent des mesures parfaites sans bruit d’échantillonnage, la Modélisation par Équations Structurelles (Structural Equation Modeling ou SEM) constitue l’outil le plus puissant de la psychométrie moderne. La méthode SEM permet de traiter directement le problème de la troisième variable en modélisant des variables latentes non directement observables (comme l’intelligence générale, le névrosisme, ou le bien-être subjectif), estimées à partir d’un faisceau d’indicateurs empiriques manifestes multiples.
L’apport révolutionnaire de la SEM réside dans sa capacité à isoler et à purger explicitement l’erreur de mesure aléatoire et systématique affectant les variables confondantes. Dans une régression multiple classique, si une variable confondante $Z$ est mesurée avec une fiabilité médiocre (par exemple un coefficient alpha de Cronbach modeste à 0,65), l’ajustement statistique est incomplet : l’erreur de mesure agit comme un tampon qui empêche la neutralisation totale du tiers facteur, laissant persister une confusion résiduelle masquée. La SEM décompose la variance des indicateurs en variance vraie et variance d’erreur, permettant un contrôle structurel immaculé des chemins de confusion au niveau latent.
10.3 Méthodes quasi-expérimentales avancées : variables instrumentales et designs longitudinaux
Lorsque des variables confondantes non observables ou impossibles à mesurer persistent clandestinement, l’économétrie et la biostatistique ont conçu des artifices analytiques d’une formidable ingéniosité pour contourner l’obstacle. La méthode de la variable instrumentale (VI) en est l’illustration la plus éclatante. Supposons une relation entre une exposition $X$ et une issue $Y$ polluée par un tiers facteur non mesuré $U$. Une variable instrumentale $Z$ est une variable exogène valide si elle remplit trois conditions absolues :
- Elle doit influencer directement et puissamment la variable d’exposition $X$ (pertinence de l’instrument).
- Elle ne doit être reliée au tiers facteur non mesuré $U$ par aucun chemin direct ou indirect (indépendance de l’instrument).
- Elle ne doit affecter l’issue $Y$ exclusivement qu’à travers son impact sur $X$, et par aucune autre voie causale alternative (restriction d’exclusion).
Par l’intermédiaire de la méthode des doubles moindres carrés (Two-Stage Least Squares – 2SLS), le chercheur utilise dans un premier temps l’instrument $Z$ pour prédire la portion de variance exogène de $X$, puis utilise dans un second temps ces valeurs prédites épurées pour modéliser $Y$. La part de variance de $X$ corrélée avec la troisième variable invisible $U$ est ainsi mécaniquement rejetée.
Parallèlement, les designs longitudinaux à panels répétés offrent des solutions longitudinales élégantes. Les modèles à effets fixes sur données de panel permettent d’éliminer définitivement l’ensemble des facteurs de confusion invariants dans le temps (tels que le profil génétique constitutionnel, l’origine socioculturelle de naissance ou les traits stables de personnalité), car chaque individu sert de son propre contrôle temporel face à ses fluctuations longitudinales. Enfin, les modèles de panel croisé décalé (Cross-Lagged Panel Models – CLPM et leurs déclinaisons contemporaines random-intercept RI-CLPM) permettent de démêler la préséance temporelle en estimant simultanément les liens autorégressifs longitudinaux ($X_{t} \rightarrow X_{t+1}$ et $Y_{t} \rightarrow Y_{t+1}$) et les influences croisées mutuelles ($X_{t} \rightarrow Y_{t+1}$ versus $Y_{t} \rightarrow X_{t+1}$), isolant les effets prospectifs stables des artefacts synchrones de confusion momentanée.
11. Défis contemporains à l’ère des mégadonnées et de l’apprentissage automatique
11.1 L’illusion de la causalité dans le Big Data : prolifération des corrélations fortuites
L’avènement contemporain du Big Data, de la prolifération des capteurs connectés et de l’agrégation massive d’enregistrements comportementaux numériques a engendré une illusion d’omniscience statistique. Certains technologues ont hâtivement prophétisé « la fin de la théorie », prétendant que des volumes massifs de données rendraient le concept d’explication causale archaïque et inutile, au motif que des corrélations prédictives à grande échelle suffiraient à piloter les décisions du monde moderne.
Cette idéologie positiviste naïve ignore une loi fondamentale de la théorie probabiliste énoncée par la théorie de Ramsey : plus la taille d’un ensemble de données et le nombre de variables collectées augmentent, plus la probabilité de découvrir des corrélations fortuites ultra-significatives sans aucun fondement réel converge vers 1 (la certitude absolue). Lorsque des algorithmes automatisés scannent des matrices croisant des centaines de milliers de métriques sans ancrage théorique a priori, le test statistique classique perd toute valeur protectrice. En vertu de la puissance statistique exponentielle liée à des échantillons de plusieurs millions d’observations ($N to \infty$), la moindre micro-variation contingente ($r = 0,005$) devient « statistiquement ultra-significative » avec des valeurs de $p < 10^{-15}$.
Le problème de la troisième variable ne s’évapore pas dans le Big Data : il y prospère de manière incontrôlée. Des pans entiers de flux massifs de données partagent des tendances sociétales, macroéconomiques, temporelles ou démographiques globales qui agissent comme des tiers facteurs géants et invisibles, générant des myriades d’associations prédictives qui s’effondrent lamentablement dès lors qu’un système opérationnel tente d’intervenir physiquement sur les leviers désignés.
11.2 Apprentissage automatique et boîtes noires : reproduction non critique de biais confondants
L’application non critique de l’apprentissage automatique (Machine Learning) et du Deep Learning dans des domaines sociétaux hypersensibles — tels que l’octroi automatisé de crédits bancaires, les diagnostics médicaux informatisés, la sélection algorithmique de candidats à l’embauche ou les logiciels d’évaluation de la récidive pénale (comme l’algorithme COMPAS aux États-Unis) — a mis en évidence le danger éthique et opérationnel des variables de substitution (proxy variables).
Un modèle prédictif supervisé opaque (type forêt aléatoire ou réseau de neurones multicouches profonds) a pour unique fonction mathématique d’optimiser une fonction de coût afin de maximiser la précision prédictive sur l’échantillon d’apprentissage. Il ne possède aucun discernement étiologique ou ontologique. Si le concepteur de l’algorithme retire délibérément la variable d’appartenance ethnique ou de genre pour des raisons de conformité éthique, le modèle explorera et découvrira automatiquement des variables de substitution qui agissent comme les proxies directs de cette troisième variable omise. L’algorithme exploitera des informations telles que le code postal, les préférences de vocabulaire, les écoles fréquentées ou les historiques de navigation en ligne pour reconstruire clandestinement le facteur discriminant sous-jacent.
Cette faille a donné naissance au champ de recherche indispensable de l’IA causale (Causal AI), portée par des pionniers qui réaffirment que les systèmes d’apprentissage artificiel ne pourront jamais atteindre une fiabilité robuste sans intégrer explicitement des contraintes de raisonnement contrefactuel et des structures graphiques causales immunisées contre la confusion statistique.
11.3 Pratiques de recherche contestables (QRP) et crise de la reproductibilité
La psychologie scientifique et les neurosciences traversent depuis le début des années 2010 une crise profonde dite « crise de la reproductibilité » (Replication Crisis). L’incapacité manifeste à reproduire les résultats expérimentaux de travaux fondateurs a contraint la communauté académique à analyser avec lucidité les pratiques de recherche contestables (Questionable Research Practices – QRP) qui gangrènent le processus de production du savoir.
Le problème de la troisième variable se trouve au cœur de ces dérives méthodologiques à travers deux pratiques majeures : le p-hacking et la sélection opportuniste a posteriori des covariables. Face à une association empirique entre un traitement thérapeutique et une amélioration psychologique qui s’avère non significative ($p = 0,08$) dans un modèle univarié direct, un chercheur sous pression du dogme institutionnel du « publier ou périr » est violemment tenté de tester de multiples combinaisons de covariables d’ajustement. En intégrant ou en retirant arbitrairement l’âge, l’anxiété de base, le milieu socioprofessionnel ou des traits de personnalité sous prétexte de « contrôler les facteurs de confusion », le chercheur exploite les degrés de liberté de l’expérimentateur jusqu’à ce que la valeur magique du seuil de significativité descende sous la barre convenue ($p < 0,05$).
Cette instrumentalisation a posteriori des covariables transforme le contrôle méthodologique en une technique perverse de fabrication artificielle de faux positifs. Pour éradiquer ce fléau, le mouvement de la Science Ouverte impose désormais des protocoles rigoureux :
- Le préenregistrement des études (Pre-registration / Registered Reports) : Les chercheurs déposent publiquement sur des registres pérennes (comme l’Open Science Framework) leurs hypothèses, leur plan d’échantillonnage, la liste exhaustive et fermée des covariables qui seront intégrées aux modèles ainsi que la justification causale théorique de leur inclusion, avant même le début de la récolte des données.
- L’obligation d’accès ouvert aux données brutes (Open Data) : Permettre aux équipes tierces et aux auditeurs méthodologistes de réanalyser les bases sans sélection opportuniste pour vérifier la robustesse des allégations formulées.
12. Guide pratique pour le chercheur et l’étudiant en psychologie
12.1 Grille d’évaluation critique de la causalité face à une publication
Tout étudiant de master, doctorant ou clinicien confronté à un article scientifique affirmant l’existence d’une relation novatrice entre une variable d’exposition et une condition psychologique doit déployer une grille de lecture critique systématique pour diagnostiquer la vulnérabilité de la recherche au problème de la troisième variable. Voici le protocole de vérification en quatre étapes indispensables :
- Nature exacte du design de recherche : S’agit-il d’un véritable essai contrôlé avec randomisation effective et respectée (avec intention de traiter) ? S’il s’agit d’une étude observationnelle, corrélationnelle ou transversale, le postulat de causalité directe doit être suspendu d’emblée, quelle que soit la renommée des auteurs ou la sophistication des régressions présentées.
- Temporalité et préséance chronologique : La mesure de la variable indépendante $X$ a-t-elle été matériellement sécurisée à un instant temporel $t_1$ résolument antérieur à l’enregistrement de l’issue $Y$ à un instant $t_2$ ? Si le protocole a collecté l’ensemble des données dans une session d’évaluation unique (données transversales), l’orientation de la flèche causale et la neutralisation de tiers facteurs synchrones sont impossibles à certifier.
- Inventaire et justification théorique des covariables : Les auteurs ont-ils rédigé une sous-section explicite justifiant la sélection de leurs covariables ? L’introduction de ces tiers facteurs repose-t-elle sur un modèle théorique articulé en amont (idéalement appuyé sur un DAG formel), ou ressemble-t-elle à un inventaire hétéroclite guidé par la simple disponibilité des métriques dans la base ? Des déterminants fondamentaux (statut socio-économique, intelligence générale, traits majeurs de personnalité, antécédents psychiatriques familiaux) ont-ils été mystérieusement omis ?
- Analyses de sensibilité et robustesse des conclusions : Les chercheurs présentent-ils des tests de robustesse face aux facteurs de confusion non mesurés ? L’utilisation de métriques modernes d’évaluation de la sensibilité, comme la E-value formalisée par Tyler VanderWeele — qui quantifie la force minimale d’association qu’un tiers facteur non mesuré devrait obligatoirement posséder avec l’exposition et l’issue pour réduire l’effet observé à néant —, doit être scrutée pour juger de la résistance du résultat face au doute méthodologique.
12.2 Bonnes pratiques rédactionnelles pour la section méthodologique et discussion
La rigueur scientifique ne s’arrête pas à l’exécution d’un script de programmation statistique ; elle s’incarne de façon critique dans la probité linguistique employée lors de la rédaction du manuscrit destiné à la communauté des pairs. L’usage abusif et fallacieux de tournures verbales causales actives au sein d’articles reposant exclusivement sur des données d’association représente un manquement déontologique récurrent dans les sciences du comportement.
Il convient de respecter scrupuleusement les règles d’hygiène stylistique et épistémologique suivantes :
- Proscrire formellement les verbes de transitivité causale directe dans les études observationnelles : des termes tels que « $X$ provoque », « $X$ détermine », « $X$ altère », « $X$ améliore » ou « l’impact dévastateur de $X$ sur $Y$ » doivent être impérativement bannis au profit de termes descriptifs rigoureux tels que « $X$ est associé à », « les variations de $X$ covarient significativement avec celles de $Y$ », ou « $X$ constitue un prédicteur statistique de $Y$ dans le cadre de ce modèle ».
- Consacrer un paragraphe exhaustif aux variables confondantes non mesurées au début de la section consacrée aux limites de l’étude (Limitations). L’auteur doit faire preuve d’humilité épistémique en dressant lui-même la liste des tiers facteurs potentiels que son dispositif n’a pas été en mesure d’enregistrer ou de contrôler, en explicitant comment ces facteurs pourraient biaiser les coefficients vers le haut ou vers le bas.
- Fournir la matrice complète des corrélations bivariées brutes et documenter explicitement les variations des coefficients d’intérêt à chaque étape de l’introduction successive des covariables dans les modèles multivariés (par exemple via des tableaux de régression hiérarchique détaillés), permettant aux réviseurs et lecteurs d’assister en toute transparence à l’évolution du signal statistique sous contrôle du tiers facteur.
12.3 Développement de la vigilance épistémique face aux médias grand public
L’espace médiatique contemporain est saturé en continu d’annonces spectaculaires simplificatrices façonnées pour générer des flux d’attention et des clics numériques : « Consommer du chocolat quotidiennement augmente vos chances de décrocher le prix Nobel », « L’usage des smartphones est la cause unique de la dépression chez les adolescents », « Vivre près d’un espace vert allonge l’espérance de vie de dix ans ». Dans l’écrasante majorité des cas, ces gros titres sensationnalistes transforment illégitimement une simple association bivariée observationnelle en un décret de causalité performative, oblitérant complètement le problème de la troisième variable.
Face à cette pollution informationnelle systémique, le chercheur, le psychologue praticien et l’étudiant en sciences humaines ont la responsabilité morale et civique d’exercer une fonction de sentinelle épistémique au bénéfice du grand public. Cet engagement requiert d’interroger publiquement et sans relâche les maillons faibles de la communication scientifique :
Quelle est la troisième variable absente que le rédacteur ou l’institution a choisi de dissimuler ou d’ignorer pour rendre le titre spectaculaire ? Dans l’exemple du chocolat et du prix Nobel, le tiers facteur est évidemment le PIB par habitant et le niveau de richesse économique de la nation, qui favorise simultanément le pouvoir d’achat pour des biens de consommation d’agrément et le financement massif d’infrastructures de recherche scientifique de pointe. Dans l’exemple des espaces verts, le tiers facteur souverain est le niveau de fortune immobilière et socio-économique des résidents qui leur permet d’acquérir des logements au sein des quartiers paysagers périurbains tout en bénéficiant par ailleurs d’une alimentation biologique de premier choix et des meilleurs soins médicaux préventifs.
Sensibiliser le corps social à l’omniprésence du tiers facteur ne constitue pas une simple dispute de spécialistes en statistiques mathématiques. C’est un combat démocratique crucial pour l’édification de l’esprit critique rationnel, protégeant les citoyens contre les marchands d’illusions, les paniques morales infondées et les théories complotistes qui prospèrent toutes, sans exception, sur la négation méthodique de la complexité multivariée du réel.
Références
- Baron, R. M., & Kenny, D. A. (1986). The moderator-mediator variable distinction in social psychological research: Conceptual, strategic, and statistical considerations. Journal of Personality and Social Psychology, 51(6), 1173–1182. https://doi.org/10.1037/0022-3514.51.6.1173
- Bickel, P. J., Hammel, E. A., & O’Connell, J. W. (1975). Sex bias in graduate admissions: Data from Berkeley. Science, 187(4175), 398–404. https://doi.org/10.1126/science.187.4175.398
- Campbell, D. T., & Stanley, J. C. (1963). Experimental and quasi-experimental designs for research. Rand McNally.
- Hill, A. B. (1965). The environment and disease: Association or causation? Proceedings of the Royal Society of Medicine, 58(5), 295–300. https://doi.org/10.1177/003591576505800503
- Mill, J. S. (1843). A system of logic, ratiocinative and inductive. John W. Parker.
- Pearl, J. (2009). Causality: Models, reasoning, and inference (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9780511803161
- Pearl, J., & Mackenzie, D. (2018). The book of why: The new science of cause and effect. Basic Books.
- Pearson, K. (1896). Mathematical contributions to the theory of evolution. III. Regression, heredity, and panmixia. Philosophical Transactions of the Royal Society of London, Series A, 187, 253–318. https://doi.org/10.1098/rsta.1896.0007
- Rauscher, F. H., Shaw, G. L., & Ky, K. N. (1993). Music and spatial task performance. Nature, 365(6447), 611. https://doi.org/10.1038/365611a0
- Rosenbaum, P. R., & Rubin, D. B. (1983). The central role of the propensity score in observational studies for causal effects. Biometrika, 70(1), 41–55. https://doi.org/10.1093/biomet/70.1.41
- Schellenberg, E. G. (2005). Music and cognitive abilities. Current Directions in Psychological Science, 14(6), 317–320. https://doi.org/10.1111/j.0963-7214.2005.00389.x
- Simpson, E. H. (1951). The interpretation of interaction in contingency tables. Journal of the Royal Statistical Society: Series B (Methodological), 13(2), 238–241. https://doi.org/10.1111/j.2517-6161.1951.tb00088.x
- VanderWeele, T. J., & Ding, P. (2017). Sensitivity analysis in observational research: Introducing the E-value. Annals of Internal Medicine, 167(4), 268–274. https://doi.org/10.7326/M16-2607
- Yule, G. U. (1926). Why do we sometimes get nonsense-correlations between time-series? A study in sampling and the nature of time-series. Journal of the Royal Statistical Society, 89(1), 1–63. https://doi.org/10.2307/2341482