
Dans l’arsenal méthodologique des sciences contemporaines, et tout particulièrement au sein des sciences du comportement, de la psychologie quantitative et de l’épidémiologie, peu de notions sont aussi omniprésentes et pourtant aussi insidieusement confondues que celles de probabilité et de proportion. Bien que le profane emploie fréquemment ces termes de manière interchangeable dans le discours quotidien pour évoquer des pourcentages ou quantifier l’aléa, ils renvoient sur le plan épistémologique et opératoire à deux univers fondamentalement distincts : le monde abstrait des modèles théoriques a priori d’une part, et l’univers matériel des observations empiriques a posteriori d’autre part. L’assimilation erronée de ces concepts engendre des contresens méthodologiques majeurs, altérant aussi bien l’interprétation des diagnostics cliniques que l’analyse des propriétés métrologiques des instruments d’évaluation ou la formulation des conclusions inférentielles.
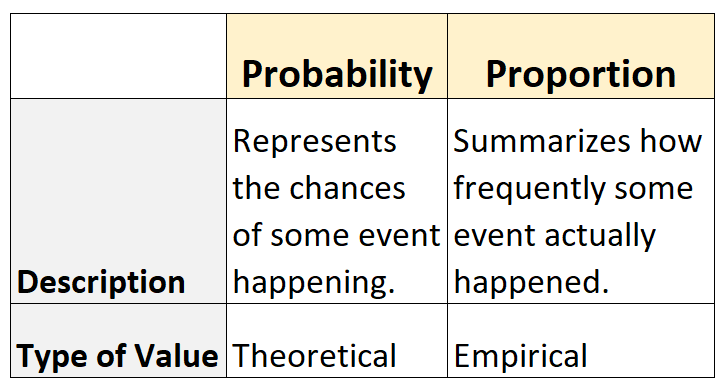
La distinction cardinale entre la probabilité et la proportion ne réside pas dans leur échelle numérique — toutes deux étant communément bornées entre zéro et un, ou exprimées sous forme de pourcentages —, mais dans leur statut ontologique, leur temporalité et leur ancrage expérimental. La probabilité constitue une mesure théorique idéale, assignée par modélisation ou déduction axiomatique aux potentialités d’un espace d’événements avant toute concrétisation factuelle. La proportion, en revanche, s’établit comme un ratio de dénombrement strictement descriptif, issu du dépouillement d’un ensemble fini d’observations empiriques recueillies sur le terrain. Alors que la première anticipe l’incertitude du futur au moyen d’un cadre normatif invariant, la seconde dresse l’inventaire historique et figé de réalisations passées, soumises aux contingences de l’échantillonnage et aux fluctuations aléatoires du réel.
Le présent traité propose une déconstruction minutieuse et exhaustive de cette dualité conceptuelle. En explorant successivement les fondements axiomatiques hérités de Kolmogorov, la mécanique opératoire des fréquences d’échantillonnage, les asymétries temporelles et causales, ainsi que les passerelles asymptotiques formalisées par la loi des grands nombres, cet article entend équiper le chercheur, l’étudiant et le praticien d’une grille d’analyse rigoureuse. Face aux heuristiques cognitives spontanées qui incitent l’esprit humain à confondre l’espérance mathématique avec le constat ponctuel, il devient impératif de réaffirmer la frontière nette séparant la modélisation probabiliste du dénombrement proportionnel, condition sine qua non de toute démarche scientifique intègre et reproductible.
1. Introduction épistémologique et conceptuelle : Définir la probabilité et la proportion
Pour appréhender avec clarté l’édifice des statistiques inférentielles, il est primordial d’interroger la nature ontologique des métriques quantitatives fondamentales. La probabilité et la proportion, bien qu’elles partagent des similitudes de surface dans leur écriture décimale ou fractionnaire, répondent à des démarches d’investigation de la réalité profondément divergentes, s’opposant terme à terme sur les plans théorique, pratique et sémantique.
1.1 La dimension purement théorique de la probabilité
La probabilité se définit formellement comme une mesure mathématique abstraite assignée à l’occurrence potentielle d’un événement au sein d’un univers des possibles rigoureusement délimité. En tant qu’entité théorique, elle s’établit a priori, c’est-à-dire indépendamment de toute expérimentation physique directe ou de tout recueil concret de données de terrain. Lorsqu’un mathématicien ou un physicien postule la probabilité d’un phénomène, il élabore un modèle idéal reposant sur des hypothèses structurelles régissant le système étudié : symétrie d’un objet géométrique, homogénéité thermodynamique ou postulats de dynamique stochastique. La probabilité n’a nullement besoin d’attendre qu’une expérience soit menée pour exister ; elle préexiste à l’événement en tant que propriété fondamentale du modèle déductif conçu par l’esprit.
Son domaine de définition est rigoureusement et universellement compris dans l’intervalle fermé [0, 1], correspondant dans la notation usuelle à une plage de 0 % à 100 %. Une valeur de 0 caractérise un événement impossible au regard de la structure axiomatique posée, tandis qu’une valeur de 1 désigne un événement certain. Dans les architectures mathématiques et les sciences computationnelles contemporaines, la probabilité remplit la fonction d’un modèle idéal normatif et prédictif. Elle sert de référence invariante, fournissant un étalon théorique par rapport auquel les manifestations de l’univers matériel peuvent être jugées, projetées et quantifiées, fournissant ainsi la base de toute la mécanique de la décision rationnelle en situation d’incertitude.
1.2 La nature empirique et descriptive de la proportion
À l’opposé de l’idéalité probabiliste, la proportion est une mesure intrinsèquement empirique, descriptive et historique. Elle se définit formellement comme un ratio arithmétique calculé a posteriori, issu de la confrontation directe avec le réel : il s’agit du quotient entre le nombre de fois où une caractéristique spécifique a été effectivement observée et le volume total d’unités statistiques soumises à l’observation. La proportion est nécessairement ancrée dans des faits concrets, observables et déjà advenus. Contrairement à la probabilité, elle ne possède aucune existence en dehors du protocole de recueil qui l’a fait naître ; elle représente la cristallisation numérique d’une série de mesures tangibles réalisées au sein d’un échantillon délimité dans le temps et dans l’espace.
De par cet ancrage dans la matérialité de l’investigation expérimentale, la proportion manifeste une sensibilité immédiate et inévitable à la variabilité de terrain, aux fluctuations de l’échantillonnage, aux erreurs instrumentales et aux conditions environnementales particulières du protocole de recherche. Si l’on réitère le recueil d’observations sur un échantillon distinct issu d’une même population parente, la proportion observée variera inéluctablement, témoignant de sa plasticité empirique. Sa fonction première au sein d’une série statistique collectée est purement descriptive : elle synthétise l’état d’un jeu de données factuel sans présupposer formellement, à ce stade élémentaire, des lois sous-jacentes qui ont gouverné la genèse des observations.
1.3 La genèse des confusions sémantiques en sciences du comportement
En psychologie, en sociologie quantitative et dans l’analyse comportementale, la confusion entre probabilité et proportion constitue un écueil épistémologique omniprésent. Dans le langage courant comme dans les cercles de recherche appliquée, l’utilisation interchangeable de ces termes est monnaie courante, fréquemment catalysée par l’usage indistinct du symbole du pourcentage (%). Les chercheurs et les praticiens ont tendance à dire qu’une personne « a 30 % de probabilité de réussir un test » alors qu’ils constatent simplement qu’une « proportion de 30 % de l’échantillon testé a validé l’épreuve ». Cette indistinction linguistique masque une transposition conceptuelle abusive, attribuant indûment à une unité individuelle prospective une propriété agrégée descriptive passée.
Cette ambiguïté engendre des biais d’attribution statistique et cognitive sévères, particulièrement lors de l’interprétation des données psychométriques, cliniques ou neuropsychologiques. Assimiler une fréquence observée dans un groupe restreint à la probabilité intrinsèque d’apparition d’un trait psychologique revient à ignorer la fluctuation d’échantillonnage et la structure probabiliste sous-jacente du trait latent. L’exigence d’une rigueur terminologique intraitable ne relève donc pas d’un pédantisme académique stérile, mais d’une impérieuse nécessité méthodologique : garantir que le chercheur ne confonde pas la trace documentaire laissée par une expérience finie avec la loi mathématique qui en structure les potentialités infinies.
2. Fondements mathématiques : Modélisation axiomatique versus comptage statistique
L’édification de la pensée mathématique moderne a permis de dissiper les flottements conceptuels du siècle des Lumières en formalisant de manière étanche les cadres d’analyse. Pour comprendre en profondeur la divergence qui sépare la probabilité de la proportion, il convient de juxtaposer l’architecture formelle de l’espace probabilisé élaborée par Andreï Kolmogorov et la simple arithmétique combinatoire du comptage discret d’échantillon.
2.1 L’axiomatisation kolmogorovienne de la probabilité
En 1933, le mathématicien soviétique Andreï Nikolaïevitch Kolmogorov affranchit la théorie des probabilités de ses attaches intuitives et de ses circularités logiques en formulant un cadre axiomatique universel fondé sur la théorie de la mesure. Au cœur de cette construction se trouve l’espace probabilisé fondamental, désigné par le triplet mathématique constitué d’un univers Ω, d’une tribu ou σ-algèbre notée Σ (l’ensemble des événements admissibles respectant les règles de stabilité par union, intersection et passage au complémentaire), et d’une mesure de probabilité P. Cette dernière est une application univoque associant à tout événement A de la tribu un nombre réel.
L’ensemble de l’édifice mathématique probabiliste repose dès lors sur trois axiomes cardinaux non négociables :
- Axiome de positivité : Pour tout événement A appartenant à la tribu Σ, la mesure associée est strictement non négative, soit P(A) ≥ 0.
- Axiome de certitude de l’univers : La mesure de probabilité assignée à l’univers Ω dans sa globalité est rigoureusement unitaire, soit P(Ω) = 1.
- Axiome de σ-additivité (ou additivité dénombrable) : Pour toute suite dénombrable d’événements deux à deux disjoints (mutuellement exclusifs), la probabilité de leur union disjointe est exactement égale à la somme infinie de leurs probabilités individuelles.
Cette armature axiomatique autorise la déduction d’innombrables théorèmes et propriétés invariables sans qu’aucune donnée empirique concrète ne soit injectée dans les équations. La probabilité kolmogorovienne existe de façon autosuffisante et axiomatiquement parfaite dans l’univers de la logique déductive pure.
2.2 Le calcul opératoire de la proportion d’échantillon
En totale rupture avec cette abstraction de la théorie de la mesure, la proportion d’échantillon, universellement symbolisée dans les traités de statistique par la notation p̂ (p-chapeau) ou par la fréquence relative f, découle d’un algorithme de calcul strictement arithmétique et empirique. Soit une expérience statistique portant sur un sous-ensemble fini comprenant n observations réelles indépendantes. Si l’on s’intéresse à l’apparition d’un critère binaire d’intérêt (par exemple, la résolution correcte d’un item cognitif, ou la présence d’un symptôme anxieux), on procède au comptage du nombre d’unités statistiques manifestant ce critère, quantité désignée par l’entier discret k, avec la contrainte structurelle que 0 ≤ k ≤ n.
La proportion d’échantillon s’obtient alors par la formulation opératoire directe :
p̂ = k / n
Ce calcul élémentaire révèle immédiatement les dépendances intrinsèques et les limites de la proportion. D’une part, la métrique obtenue est directement conditionnée par la taille de l’échantillon n sélectionné : un effectif modeste impose des sauts de quantification discrets drastiques (si n = 4, les seules proportions observables sont 0,00 ; 0,25 ; 0,50 ; 0,75 et 1,00). D’autre part, la proportion ne s’applique qu’au sous-ensemble strict des données collectées ; elle ne possède aucune capacité intrinsèque à transcender le jeu d’enregistrements duquel elle provient sans l’adjonction ultérieure d’outils probabilistes spécifiques.
2.3 Espace échantillon théorique versus réalisations effectives
L’abîme conceptuel qui sépare les probabilités des proportions s’incarne magistralement dans la distinction fonctionnelle entre l’espace probabilisable théorique et le recueil brut des données effectives. L’espace des possibles, formellement modélisé par l’ensemble Ω, contient l’exhaustivité abstraite de toutes les trajectoires imaginables d’un protocole expérimental. Par exemple, si l’on étudie une batterie de dix items psychométriques binaires, Ω comprend exactement 210 = 1024 combinaisons théoriques de profils de réponse, chacune étant pondérée par une probabilité calculable via un modèle probabiliste approprié.
En revanche, la passation de cette épreuve auprès d’une cohorte concrète de participants ne génère qu’un ensemble discret de réalisations effectives. L’observateur n’a jamais accès à la plénitude de Ω ; il ne recueille qu’un faisceau restreint de points de données contingents. Sur le plan de la formalisation mathématique, on assiste à la projection d’une variable aléatoire théorique (qui est une fonction mesurable reliant l’espace Ω à l’espace des réels) vers ses réalisations ponctuelles incarnées par des vecteurs de nombres. L’estimation statistique sans biais consistera précisément à tenter de reconstruire les paramètres méconnus de la loi probabiliste sous-jacente en s’appuyant exclusivement sur les propriétés distributionnelles des proportions locales calculées à partir de ces réalisations effectives.
3. Temporalité et causalité : L’anticipation future versus le bilan rétrospectif
Au-delà de leurs divergences formelles, la probabilité et la proportion se distinguent par une asymétrie temporelle irréductible. La relation que ces deux concepts entretiennent avec la flèche du temps façonne l’ensemble de leurs usages dans l’analyse causale et la prise de décision stratégique.
3.1 La probabilité comme vecteur de projection prospective
Par essence, la probabilité regarde vers l’avant. Elle est ontologiquement prospectrice et intrinsèquement orientée vers la gestion et la quantification de l’incertitude inhérente aux événements futurs. Formuler un énoncé probabiliste — qu’il s’agisse de la trajectoire d’une particule, du comportement d’un consommateur lors d’un test d’utilisabilité ou de l’adhésion d’un patient à une psychothérapie — revient à projeter sur un avenir non encore advenu une structure de vraisemblance déductive. La probabilité quantifie le potentiel, l’attente et la potentialité d’existence ; elle n’exige en rien la concrétisation empirique immédiate du phénomène pour posséder une valeur de vérité formelle dans son modèle.
C’est précisément cette orientation prospective qui confère à la probabilité son rôle central d’outil décisionnel préalable à l’engagement dans l’action. Dans les architectures cognitives humaines comme dans les algorithmes de la théorie des jeux et du choix rationnel, le calcul d’espérance probabiliste constitue le moteur de l’arbitrage face au risque psychologique ou financier. Néanmoins, cette vertu prospective s’accompagne d’une impuissance ontologique absolue : la probabilité est structurellement inapte à décrire ce qui a déjà définitivement eu lieu. Dès lors qu’une expérience est close et que l’événement s’est matérialisé, la probabilité théorique s’efface devant le fait accompli ; le phénomène cesse d’être probabiliste pour devenir un événement historique absolu.
3.2 La proportion comme cartographie descriptive du passé
Si la probabilité sonde les potentialités du futur, la proportion dresse l’inventaire rigide du passé. Le calcul d’une proportion s’inscrit toujours dans un temps révolu : il intervient obligatoirement une fois les essais achevés, les mesures enregistrées et les protocoles scellés. La proportion est une fonction de synthèse historique qui ordonne a posteriori un ensemble d’occurrences déjà matérialisées dans l’espace physique. Par voie de conséquence, elle se caractérise par une stabilité immuable une fois le relevé d’échantillon terminé : les données recueillies le 15 mars auprès de 200 participants ne subiront plus aucune mutation ontologique ; la proportion observée ce jour-là demeure figée pour l’éternité au sein du registre d’expérimentation.
Dans les bases de données observationnelles, les registres épidémiologiques et les cohortes longitudinales en psychologie de la santé, la proportion exerce la fonction fondamentale d’un constat empirique. Elle renseigne fidèlement le chercheur sur ce qui s’est produit dans un intervalle spatio-temporel précis, sous certaines conditions d’observation données. Toutefois, par elle-même, la proportion est incapable de sauter le gouffre de la temporalité : elle ne peut pas, par sa seule vertu descriptive, affirmer ce qui adviendra lors d’une session future ou au sein d’un échantillon différent. Pour franchir ce seuil temporel et redevenir projective, elle doit nécessairement subir une opération d’inférence, c’est-à-dire se métamorphoser en une estimation probabiliste encadrée par une marge d’incertitude.
3.3 L’illusion causale liée à l’asymétrie temporelle
L’asymétrie temporelle séparant la probabilité prospective de la proportion rétrospective constitue l’un des terreaux les plus fertiles pour le déploiement des distorsions cognitives et des raisonnements fallacieux. Les êtres humains, y compris les scientifiques rompus à la démarche expérimentale, succombent régulièrement à l’illusion causale consistant à confondre le pronostic prédictif et l’inventaire historique. Cette confusion se manifeste avec une acuité particulière dans l’interprétation rétrospective non fondée : lorsqu’un chercheur observe une proportion élevée d’individus présentant un comportement atypique au sein d’un groupe clinique, il infère spontanément et à tort que la probabilité a priori que ce comportement survienne dans le futur chez un individu comparable est tout aussi écrasante.
Pour prévenir cette dérive épistémologique, la méthodologie de la recherche expérimentale impose un cadre rigoureux séparant l’élaboration hypothético-déductive (fondée sur des modèles probabilistes prospectifs avant le début des relevés) de l’analyse empirique descriptive (fondée sur les proportions constatées après clôture de la collecte). Le respect scrupuleux de l’orientation temporelle des hypothèses conditionne la validité interne des protocoles : substituer rétroactivement une proportion constatée à une probabilité théorique postulée sans réplication indépendante revient à commettre un sophisme de post-rationalisation qui anéantit toute portée explicative causale.
4. Les modèles classiques d’illustration : Analyse comparative des jeux de hasard
Depuis les correspondances fondatrices entre Pierre de Fermat et Blaise Pascal en 1654, les jeux de hasard offrent un laboratoire conceptuel idéal pour matérialiser sans ambiguïté les divergences opérationnelles existant entre une probabilité fixée par les symétries de la matière et les proportions mouvantes générées par les caprices de l’échantillonnage.
4.1 Le lancer de pièce équilibrée : théorie versus réalisations empiriques
Considérons l’exemple paradigmatique du lancer d’une pièce de monnaie parfaitement équilibrée. Sur le plan de la probabilité théorique, les propriétés physiques intrinsèques de la pièce — son centre de gravité parfaitement centré et ses deux faces rigoureusement symétriques — permettent de poser a priori que l’espace des événements Ω = {Pile, Face} est gouverné par une mesure de probabilité invariante : P(Face) = 0,5 (soit 50 %). Cette valeur mathématique est absolue, immuable et indépendante de tout geste humain ; elle demeure rigoureusement égale à 0,5, que la pièce soit lancée zéro fois, dix fois ou un milliard de fois.
Engageons à présent une phase d’expérimentation concrète consistant à jeter cette pièce au cours d’une série finie de 20 lancers consécutifs. Supposons que le dépouillement minutieux de cette session révèle l’obtention de 12 apparitions de la face « Face ». Le calcul de la proportion observée fournit immédiatement :
p̂ = 12 / 20 = 0,60 = 60 %
Cet écart manifeste entre la probabilité théorique (0,50) et la proportion empirique (0,60) ne traduit nullement une défaillance de la mécanique de la pièce ou une invalidation des lois mathématiques. Il illustre de façon limpide la dissociation nette entre l’espérance mathématique d’un modèle abstrait et le constat ponctuel dressé sur un micro-échantillon. La proportion est ici une réalité historique locale de la série de 20 lancers ; la probabilité reste le paramètre générateur universel.
4.2 Le lancer de dé à six faces : uniformité discrète et dispersion observée
L’extension du raisonnement au lancer d’un dé cubique régulier à six faces numérotées de 1 à 6 enrichit la compréhension de la dispersion empirique face à une loi uniforme discrète. Dans le modèle théorique, chaque face bénéficie d’une chance symétrique d’apparaître, ce qui se traduit par une probabilité uniforme identique pour tout événement élémentaire i :
P(X = i) = 1 / 6 ≈ 0,1667 (soit 16,67 %)
Imaginons un protocole expérimental comportemental au sein duquel un sujet réalise une séquence de 60 lancers successifs. Si la réalité empirique calquait servilement la structure probabiliste idéale, l’observateur devrait constater exactement 10 apparitions pour chaque face, soit une proportion effective de 10/60 = 16,67 % pour chacune d’entre elles. Or, dans la quasi-totalité des réalisations réelles, les proportions effectives présenteront une variabilité notable : la face 3 pourra être observée 14 fois (23,33 %), tandis que la face 5 ne surviendra que 7 fois (11,67 %).
Cette variabilité des proportions effectives s’explique mathématiquement par l’erreur type de la distribution multinomiale sous-jacente. L’écart type de la fréquence relative observée pour un événement de probabilité p sur n essais s’exprime rigoureusement par la formule :
σp̂ = √[p(1 – p) / n]
Dans notre cas de 60 lancers d’un dé, cet écart type théorique vaut environ √[(1/6 × 5/6) / 60] ≈ 0,048, soit 4,8 points de pourcentage. La dispersion des proportions autour de la probabilité théorique de 16,67 % est donc non seulement inévitable, mais elle obéit elle-même à une loi probabiliste précise régissant les fluctuations d’échantillonnage.
4.3 Le tirage sans remise dans une urne : complexification des proportions
Pour observer l’interaction dynamique entre la probabilité et la proportion au cours d’un processus stochastique séquentiel, le modèle de l’urne de Pólya sans remise offre une illustration saisissante. Supposons une urne contenant au départ 10 boules : 4 boules noires et 6 boules blanches. Au moment initial t = 0, la proportion de boules noires dans la population de l’urne est de 4/10 = 0,40, ce qui coïncide rigoureusement avec la probabilité théorique d’extraire une boule noire lors du premier tirage : P(N1) = 0,40.
Procédons à un premier tirage qui amène effectivement une boule noire. Cette boule est retirée définitivement du système. À l’instant t = 1, la composition matérielle de l’urne est altérée : elle ne contient plus que 3 boules noires sur un total de 9 boules. Par conséquent, la proportion d’éléments cibles restants s’est modifiée, s’établissant à 3/9 ≈ 0,333. Cette altération empirique physique entraîne une mise à jour immédiate de la probabilité conditionnelle du tirage suivant :
P(N2 | N1) = 3 / 9 = 0,333
Cet exemple met en lumière la dépendance temporelle : à chaque étape d’un échantillonnage sans remise, la proportion cumulée d’éléments déjà extraits de l’urne dicte la composition de la population restante, laquelle redéfinit dynamiquement la probabilité théorique qui régira l’essai à venir. Cette articulation séquentielle trouve de puissantes applications en psychologie cognitive dans la modélisation des choix séquentiels adaptatifs, où les décisions passées modifient irréversiblement l’environnement décisionnel futur du sujet.
5. La Loi des Grands Nombres : La passerelle formelle entre proportion et probabilité
L’abîme conceptuel qui sépare la proportion empirique de la probabilité théorique ne condamne heureusement pas ces deux notions à une étanchéité définitive. Les mathématiques ont érigé un pont conceptuel colossal permettant d’unir formellement le monde des fréquences observées à celui des mesures abstraites : la loi des grands nombres et ses théorèmes limites associés.
5.1 Énoncé et distinctions entre loi faible et loi forte
La formalisation rigoureuse de la convergence de l’empirique vers le théorique s’est déployée sur deux siècles, depuis les intuitions de Jacques Bernoulli dans son Ars Conjectandi (1713) jusqu’aux démonstrations modernes d’Émile Borel et Andreï Kolmogorov. Il est essentiel de distinguer les deux versions fondamentales de ce résultat : la loi faible et la loi forte des grands nombres.
La loi faible des grands nombres, formalisée par Khintchine, stipule que pour toute suite de variables aléatoires indépendantes et identiquement distribuées admettant une espérance finie μ (ou une probabilité théorique p dans le cas d’événements binaires de Bernoulli), la moyenne arithmétique de l’échantillon — c’est-à-dire la proportion observée p̂n — converge en probabilité vers l’espérance mathématique lorsque la taille n de l’échantillon croît indéfiniment. Formellement, pour tout seuil de tolérance réel ε > 0, si minuscule soit-il :
limn→∞ P(|p̂n – p| ≥ ε) = 0
La loi forte des grands nombres, d’une portée ontologique plus profonde, démontre une convergence presque sûre (notée p.s.). Selon ce théorème, la trajectoire individuelle de la proportion observée tend vers la probabilité théorique avec une probabilité égale à 1 :
P(limn→∞ p̂n = p) = 1
Cela signifie rigoureusement que si l’on poursuivait indéfiniment une séquence d’essais réels, la probabilité que la série des proportions observées ne finisse pas par s’aligner exactement sur la probabilité idéale est un événement mathématiquement négligeable (de mesure nulle). La loi des grands nombres prouve ainsi que la proportion n’est pas le reflet direct de la probabilité, mais son asymptote empirique infinie.
5.2 La vitesse de convergence et le théorème central limite
Bien que la loi forte garantisse un alignement théorique lorsque l’échantillon tend vers l’infini, la pratique scientifique opère toujours sur des cohortes finies. Il est dès lors fondamental d’interroger la vitesse de convergence de la proportion observée vers la probabilité sous-jacente. Cette cinétique est dictée de façon universelle par le théorème central limite (TCL), formalisé par Pierre-Simon de Laplace et Carl Friedrich Gauss.
Le théorème central limite établit que, pour des tirages indépendants, la distribution d’échantillonnage de la proportion standardisée converge en loi vers une loi normale centrée réduite :
(p̂n – p) / √[p(1 – p) / n] →d N(0, 1) quand n → ∞
La conséquence pratique majeure de ce résultat réside dans le dénominateur de l’expression : l’erreur standard de la proportion est inversement proportionnelle à la racine carrée de la taille d’échantillon, soit en 1 / √n. Ce facteur de racine carrée implique un ralentissement drastique des gains de précision à mesure que l’échantillon grandit. Pour diviser par deux l’écart type de fluctuation de la proportion observée autour de la probabilité théorique, il ne suffit pas de doubler l’effectif : il faut impérativement quadrupler la taille de l’échantillon (multiplier n par 4). Si l’on souhaite réduire l’imprécision d’un facteur 10, l’effort expérimental doit être multiplié par 100. Cette cinétique sous-linéaire explique pourquoi les proportions issues d’échantillons d’amplitude intermédiaire conservent toujours une zone résiduelle d’incertitude notable.
5.3 L’illusion de la taille d’échantillon en milieu de recherche restreint
Dans de nombreux laboratoires de psychologie expérimentale, de neurosciences cognitives ou d’ergonomie, les contraintes financières, logistiques ou le recours à des populations cliniques rares conduisent fréquemment à la réalisation d’études sur des micro-échantillons (par exemple, n = 15 ou n = 25 sujets). En ces circonstances, les chercheurs succombent régulièrement à ce que les psychologues Daniel Kahneman et Amos Tversky ont qualifié de croyance en la loi des petits nombres.
Cette illusion cognitive consiste à supposer fallacieusement que les petits échantillons doivent nécessairement refléter fidèlement les caractéristiques probabilistes de la population parente globale. Or, lorsque la taille n est restreinte, la variabilité stochastique explose. Une proportion observée de p̂ = 0,70 au sein d’une cohorte de 20 individus est parfaitement compatible, au sens des lois probabilistes de la distribution binomiale, avec une probabilité sous-jacente réelle aussi basse que 0,47 ou aussi élevée que 0,87 à un niveau de confiance de 95 %. Ignorer cette dispersion induite par la faiblesse de l’effectif engendre des publications encombrées de faux positifs et de conclusions hâtives, soulignant la nécessité impérieuse de calculer a priori la puissance statistique requise pour dimensionner adéquatement toute recherche empirique.
6. Distorsions cognitives et heuristiques : Pourquoi l’esprit humain confond ces concepts
L’incapacité quasi universelle de l’intuition humaine à manier correctement les probabilités et les proportions ne résulte pas d’un déficit d’instruction, mais d’une architecture cognitive façonnée par l’évolution, qui privilégie des heuristiques rapides et frugales au détriment du calcul formel des lois du hasard.
6.1 L’heuristique de représentativité et le sophisme du joueur
L’heuristique de représentativité, documentée par Kahneman et Tversky (1972), amène les individus à évaluer la probabilité d’un événement non pas en calculant ses chances d’occurrence théoriques, mais en mesurant son degré de ressemblance superficielle avec la représentation mentale qu’ils se font du phénomène générateur. Cette heuristique donne directement naissance au célèbre sophisme du joueur (gambler’s fallacy).
Supposons qu’à la table d’une roulette équilibrée de casino, la couleur rouge apparaisse consécutivement lors de six lancers successifs. La proportion empirique observée sur cette courte séquence est de 100 % en faveur du rouge. Le joueur intuitif, victime d’une attente d’autocorrection immédiate des séries stochastiques, est irrésistiblement tenté de croire que « le noir a désormais une probabilité supérieure à 50 % de sortir au prochain tour pour rétablir l’équilibre ». Cette croyance est une erreur logique absolue :
- Les tirages de la roulette sont rigoureusement indépendants sur le plan physique et probabiliste (mémoire nulle).
- La probabilité théorique de l’essai suivant demeure obstinément invariante à 18 / 37 ≈ 48,65 % pour le noir.
- Le mécanisme de compensation n’existe pas : la loi des grands nombres n’efface pas les anomalies passées, elle se contente de les diluer mathématiquement dans le flux d’un nombre infini d’essais futurs.
Cette distorsion cognitive constitue l’un des moteurs neurobiologiques et psychologiques majeurs du jeu pathologique et de l’addiction aux jeux de hasard.
6.2 L’oubli de la fréquence de base (Base Rate Neglect)
Une autre distorsion cognitive fondamentale réside dans l’oubli de la fréquence de base (ou négligence du taux de base), documentée de manière éclatante dans les paradigmes d’évaluation diagnostique. Ce biais survient lorsqu’un décideur confronté à une information spécifique personnalisée omet de prendre en considération la proportion initiale du phénomène existant au sein de la population générale (la probabilité a priori).
Imaginons un test de dépistage clinique pour une pathologie psychiatrique rare affectant une proportion de 1 individu sur 1 000 dans la population globale (soit une prévalence de base de 0,001). Supposons que ce test possède une excellente précision technique avec une sensibilité de 99 % (taux de détection chez les malades) et une spécificité de 95 % (taux de détection des non-malades). Si un patient lambda est testé positif lors d’une campagne de dépistage aléatoire, la majorité des cliniciens et des profanes estime intuitivement que sa probabilité d’être effectivement atteint est voisine de 95 % à 99 %.
Le calcul rigoureux au moyen du théorème de Bayes démontre que la probabilité réelle a posteriori d’être malade sachant que le test est positif ne s’élève qu’à environ 1,94 % ! L’esprit humain confond la proportion de signaux positifs chez les malades avec la probabilité d’être malade en présence d’un signal positif, oubliant que la proportion écrasante d’individus sains dans la population (999 sur 1 000) génère un volume de faux positifs qui submerge largement le petit nombre de vrais positifs identifiés.
6.3 L’effet de formulation et l’encadrement des données numériques
L’architecture cognitive humaine est également hautement vulnérable à l’effet d’encadrement (framing effect), selon que les données numériques relatives au risque sont exprimées sous une forme probabiliste abstraite ou sous un format fréquentiste basé sur des proportions explicites d’individus. Gerd Gigerenzer et son équipe ont démontré de manière reproductible que la présentation fréquentiste améliore considérablement le raisonnement bayésien chez les professionnels de santé et les profanes.
Cependant, le format fréquentiste modifie aussi drastiquement la résonance émotionnelle et la perception du danger. Annoncer à un patient qu’un traitement pharmacologique présente « une probabilité d’effets indésirables sévères de 0,001 (0,1 %) » génère un sentiment de sécurité relatif, le cerveau interprétant ce nombre décimal abstrait comme une quantité infime négligeable. En revanche, formuler la même réalité épidémiologique sous la forme d’une proportion concrète telle que « 1 personne sur 1 000 recevant ce traitement développe une réaction sévère » active une heuristique d’imagerie mentale : le sujet visualise immédiatement cette unité humaine incarnée, ce qui majore l’anxiété et le refus vaccinal ou thérapeutique. La maîtrise de ces nuances de communication statistique représente un impératif éthique crucial dans l’information des patients et la recherche médicale.
7. Applications directes en psychométrie et évaluation comportementale
Dans les disciplines psychologiques quantitatives, la distinction rigoureuse entre probabilité et proportion cesse d’être une pure réflexion d’épistémologie théorique pour devenir la condition technique d’une mesure valide. La psychométrie moderne, en abandonnant la théorie classique des tests au profit des modèles de traits latents, a formalisé de façon spectaculaire cette démarcation.
7.1 Analyse de la difficulté des items : indice de difficulté p
Dans le cadre de la Théorie Classique des Tests (TCT), l’indicateur universellement utilisé pour qualifier la difficulté d’une épreuve binaire est paradoxalement désigné par la lettre p, ce qui entretient une regrettable ambiguïté avec la notation d’une probabilité théorique. Cet indice de difficulté d’item n’est pourtant rien d’autre qu’une proportion empirique pure :
p = nréussite / Ntotal
Plus cet indice est élevé (par exemple, p = 0,85), plus l’item est empiriquement facile au sein de la cohorte évaluée ; inversement, une valeur faible (p = 0,15) désigne un item auquel peu de sujets ont correctement répondu. La limite structurelle majeure de cet indicateur de proportion réside dans sa dépendance absolue à l’échantillon testé : si l’épreuve est administrée à une cohorte d’étudiants surdoués, la proportion de réussite sera très forte ; si elle est soumise à un groupe de sujets en difficulté d’apprentissage, la proportion s’effondrera. L’indice p de la TCT décrit la performance d’un groupe circonscrit dans le passé ; il ne mesure pas la propriété intrinsèque d’accessibilité de l’item ni la compétence intrinsèque d’un sujet individuel futur.
7.2 Modélisation par la Théorie de Réponse aux Items (TRI)
Pour dépasser l’impasse méthodologique de la dépendance de l’échantillon propre aux proportions descriptives, la métrologie moderne a développé la Théorie de Réponse aux Items (TRI). Dans les modèles de TRI, tels que le modèle logistique univarié de Georg Rasch (modèle à un paramètre) ou les modèles à deux et trois paramètres de Birnbaum, la proportion brute est transcendée au profit d’une fonction mathématique probabiliste continue : la Courbe Caractéristique de l’Item (CCI).
Le modèle de Rasch postule que la probabilité théorique qu’un sujet d’habileté latente notée θ (thêta) réussisse un item de difficulté intrinsèque β (bêta) s’exprime par la fonction logistique :
P(Xij = 1 | θi, βj) = exp(θi – βj) / [1 + exp(θi – βj)]
Ici, la probabilité théorique d’accomplissement devient une fonction invariante de la distance existant sur un continuum latent abstrait entre la compétence de la personne et la difficulté de l’item. Cette approche confère aux estimations la propriété d’invariance : la mesure de la compétence du sujet est statistiquement affranchie du groupe particulier d’items auquel il a été confronté, et l’étalonnage de l’item ne dépend plus de la cohorte d’individus ayant servi à l’expérimentation. On assiste ici au triomphe du modèle probabiliste inférentiel sur la compilation descriptive des proportions brutes.
7.3 Sensibilité, spécificité et valeurs prédictives en diagnostic clinique
L’évaluation diagnostique en psychopathologie, en neuropsychologie et en psychiatrie clinique mobilise quotidiennement un jeu de métriques dont la confusion sémantique conduit à des erreurs d’interprétation lourdes de conséquences pronostiques. Il importe de classifier avec une rigueur absolue ces différents ratios :
- La sensibilité : La proportion d’individus présentant la pathologie qui obtiennent effectivement un score positif au test lors de la validation clinique empirique.
- La spécificité : La proportion d’individus indemnes de la pathologie qui obtiennent un résultat négatif au test.
- La Valeur Prédictive Positive (VPP) : La probabilité a posteriori qu’un patient ayant reçu un score positif soit effectivement atteint du trouble en question.
La sensibilité et la spécificité sont des proportions rétrospectives descriptives, établies sur des cohortes d’étalonnage dont le statut clinique était préalablement connu de manière certaine par d’autres moyens. En revanche, lorsqu’un praticien se trouve en consultation face à un nouveau patient isolé, ces proportions d’étalonnage ne peuvent pas être directement plaquées sur l’individu. Le clinicien doit faire appel à la formule bayésienne pour intégrer la prévalence épidémiologique locale (la proportion de la maladie dans son bassin de population) afin de déterminer la probabilité diagnostique individualisée (la VPP). Ignorer cette étape en assimilant la proportion de sensibilité du manuel du test à la probabilité clinique du patient examiné constitue une faute méthodologique majeure.
8. Inférence statistique : Estimer une probabilité inconnue à partir d’une proportion
L’incontournable défi méthodologique auquel se heurtent en permanence les sciences empiriques réside dans le saut qualitatif suivant : comment utiliser la modeste proportion p̂ constatée au sein d’un échantillon limité pour inférer avec rigueur la valeur de la probabilité théorique inconnue p qui gouverne l’ensemble de la population globale ? Cette problématique constitue le cœur même de la théorie de l’inférence statistique.
8.1 La proportion d’échantillon comme estimateur ponctuel
Dans le cadre de l’inférence paramétrique classique, la proportion observée au sein d’un échantillon aléatoire représentatif de taille n est retenue comme estimateur ponctuel canonique du paramètre de probabilité populationnelle p. Cet estimateur statistique possède des vertus mathématiques hautement désirables démontrées par la théorie de Fisher et le lemme de Cramér-Rao :
- Propriété de non-biais : L’espérance mathématique de la proportion d’échantillon est rigoureusement égale au paramètre théorique visé : E(p̂) = p. En moyenne, l’estimateur ne commet aucune sous-estimation ni surestimation systématique.
- Convergence asymptotique : Au fur et à mesure que la taille d’échantillon n augmente, la variance de l’estimateur tend vers zéro : limn→∞ Var(p̂) = limn→∞ [p(1 – p) / n] = 0. L’estimateur se resserre inéluctablement sur la cible théorique.
- Efficacité : Sous l’hypothèse d’échantillonnage bernoullien, la proportion d’échantillon atteint la borne minimale d’information de Fisher, constituant l’estimateur sans biais de variance minimale (MVUE).
Cependant, l’estimation ponctuelle demeure un acte risqué et intrinsèquement incomplet. Sur un échantillon singulier de taille finie, la proportion observée p̂ n’est pratiquement jamais exactement égale à p. Présenter une proportion d’échantillon unique sans adjoindre la métrique de son instabilité d’échantillonnage constitue une démarche scientifiquement lacunaire.
8.2 Construction et interprétation des intervalles de confiance
Pour encadrer l’imprécision structurelle de l’estimation ponctuelle, la statistique moderne recourt aux intervalles de confiance. L’intervalle de confiance traditionnel de Wald, fondé sur l’approximation normale de Laplace-Gauss, prend la forme familière :
IC1-α = p̂ ± z1-α/2 × √[p̂(1 – p̂) / n]
Toutefois, pour les petites tailles d’échantillon ou lorsque la proportion est proche de 0 ou de 1, l’intervalle de Wald présente des défauts majeurs de couverture empirique. On lui préfère l’intervalle de Wilson avec correction de continuité, ou les méthodes exactes fondées sur la loi binomiale développées par Clopper et Pearson.
L’erreur d’interprétation la plus universelle chez les chercheurs novices concerne la signification probabiliste du niveau de confiance (typiquement fixé à 95 %). Il est formellement erroné d’affirmer que « la probabilité que le paramètre vrai p se trouve dans l’intervalle calculé [0,42 ; 0,58] est de 95 % ». En épistémologie fréquentiste, le paramètre théorique inconnu p est une valeur constante fixe du monde réel, non une variable aléatoire ; il n’a aucune probabilité mobile. C’est l’intervalle lui-même qui est stochastique : si l’on répétait l’expérience 100 fois en calculant 100 intervalles de confiance distincts à partir de 100 échantillons indépendants, exactement 95 de ces intervalles couvriraient la valeur fixe de p, tandis que 5 la manqueraient.
8.3 Tests d’hypothèses univariés et bivariés sur les proportions
Lorsque la recherche vise à statuer sur la conformité d’une proportion empirique face à une norme théorique, ou à comparer deux conditions expérimentales distinctes, le chercheur bascule dans le champ du test d’hypothèse statistique. Dans le test z pour une proportion unique, on confronte l’hypothèse nulle H0: p = p0 à une hypothèse alternative en évaluant l’écart standardisé :
z = (p̂ – p0) / √[p0(1 – p0) / n]
Pour l’analyse de tableaux de contingence croisant plusieurs variables catégorielles, le test du Chi-carré d’adéquation ou d’indépendance de Karl Pearson confronte les effectifs proportionnels observés Oi aux effectifs théoriques attendus Ei sous l’hypothèse nulle :
χ2 = ∑ [(Oi – Ei)2 / Ei]
L’aboutissement de ces procédures est la délivrance de la célèbre p-valeur (p-value). Il convient de souligner l’abîme sémantique entre cette p-valeur et une quelconque proportion empirique d’effet : la p-valeur est la probabilité conditionnelle, calculée sous la stricte hypothèse que H0 est vraie, d’obtenir une statistique de test (ou une proportion observée) au moins aussi extrême que celle relevée au cours de l’expérimentation. Elle ne quantifie nullement la probabilité que l’hypothèse soit vraie ou fausse, ni la proportion de sujets qui réagiront positivement au traitement lors d’applications ultérieures.
9. Divergences épistémologiques : Fréquentisme, bayésianisme et vision subjective
La relation entre la probabilité et la proportion ne relève pas d’une technicité arithmétique neutre ; elle s’enracine dans une querelle philosophique séculaire touchant à la nature même de la connaissance scientifique : la confrontation entre le paradigme fréquentiste objectif et l’approche bayésienne subjective ou épistémique.
9.1 Le paradigme fréquentiste : la probabilité comme limite de la proportion
Pour l’école fréquentiste — incarnée par des figures tutélaires telles que Richard von Mises, Ronald A. Fisher ou Jerzy Neyman —, la probabilité d’un événement n’a de sens ontologique et de légitimité scientifique que si elle est définie de manière strictement opérationnelle comme la limite mathématique de sa fréquence relative (proportion) observée au cours d’une suite infinie d’essais identiques et indépendants :
P(A) = limn→∞ (kn / n)
Cette posture épistémologique stricte entraîne des conséquences radicales :
- Le concept de probabilité est rigoureusement inapplicable à des événements uniques, singuliers ou non reproductibles (par exemple, estimer la probabilité d’une guerre nucléaire avant 2030 ou la probabilité qu’un individu précis réussisse son examen de doctorat n’a aucun sens probabiliste fréquentiste).
- Le paramètre sous-jacent p de la population est postulée comme une réalité physique invariable et objective, inaccessible en pratique mais déterministe.
- Toute attribution de croyance préalable ou de jugement d’expert non fondé sur des comptages effectifs d’échantillons est proscrite du formalisme scientifique.
Ce paradigme a dominé sans partage l’édification de la recherche expérimentale et des protocoles de psychologie comportementale tout au long du vingtième siècle.
9.2 L’approche bayésienne : la probabilité comme degré de certitude rationnelle
En rupture radicale avec cette exigence de répétition infinie, l’école bayésienne — dont les fondements remontent aux travaux du révérend Thomas Bayes et de Pierre-Simon de Laplace, puis formalisée au XXe siècle par Harold Jeffreys, Bruno de Finetti et Leonard Jimmie Savage — redéfinit la probabilité comme la mesure formelle d’un degré de certitude ou de croyance rationnelle en la vérité d’une proposition ou d’un état du monde, conditionnellement à l’information disponible.
Dans ce cadre conceptuel, la probabilité n’est plus une propriété matérielle de l’objet physique, mais un état épistémique de l’observateur rationnel. Le modèle bayésien s’articule autour de la fameuse formule d’actualisation :
P(θ | D) = [P(D | θ) × P(θ)] / P(D)
Ici, la proportion de données empiriques observées dans l’échantillon D s’incarne dans la fonction de vraisemblance P(D | θ). Cette proportion observée vient actualiser la distribution a priori P(θ) (qui formalisait les connaissances probabilistes théoriques antérieures ou l’incertitude initiale du chercheur) afin de générer une distribution a posteriori P(θ | D). L’approche bayésienne résout élégamment l’asymétrie temporelle en créant une dialectique continue : la probabilité a priori informe l’attente, la proportion empirique fournit l’épreuve des faits, et leur synthèse probabiliste a posteriori devient la nouvelle probabilité de référence pour les futures déductions.
9.3 Conséquences méthodologiques pour l’analyse des comportements
Le choix entre posture fréquentiste et bayésienne détermine en profondeur la manière dont les chercheurs en sciences du comportement collectent, traitent et interprètent leurs résultats empiriques. Les débats récents entourant la crise de la reproductibilité en psychologie expérimentale ont ravivé les controverses sur l’emploi exclusif des tests de significativité de l’hypothèse nulle (NHST) et de la fameuse p-valeur de seuil (α = 0,05).
De plus en plus de laboratoires migrent vers les méthodologies d’analyse bayésienne, mobilisant le Facteur de Bayes (BF) plutôt que les tests sur les proportions conventionnelles. Le Facteur de Bayes permet de quantifier directement le soutien relatif apporté par les proportions observées à une hypothèse théorique H1 comparativement à l’hypothèse nulle H0, autorisant formellement à quantifier l’évidence en faveur de l’absence d’effet (ce que la statistique fréquentiste interdit). Cette évolution épistémologique exige des scientifiques une transparence terminologique absolue : énoncer clairement si les « probabilités » publiées découlent d’un modèle de croyance a posteriori bayésien ou de l’asymptote d’un processus de proportions fréquentistes.
10. Variabilité d’échantillonnage, biais de sélection et erreurs d’estimation
Même lorsque les fondements axiomatiques et philosophiques sont maîtrisés, le passage de la proportion observée à la probabilité réelle se heurte à des pièges méthodologiques redoutables. Deux écueils majeurs menacent en permanence l’intégrité de l’estimation : l’aléa irréductible de la fluctuation d’échantillonnage et les distorsions systématiques causées par les biais de sélection.
10.1 La fluctuation d’échantillonnage et l’erreur type de la proportion
La fluctuation d’échantillonnage désigne le phénomène universel selon lequel deux échantillons aléatoires indépendants extraits d’une même population parente ne génèrent jamais des jeux de données strictement identiques. La proportion d’un trait observée au sein de chaque échantillon est elle-même une variable aléatoire dotée de sa propre distribution de probabilité d’échantillonnage.
L’amplitude de cette dispersion est formellement quantifiée par l’erreur type de la proportion (Standard Error), calculée par l’équation :
SEp̂ = √[p(1 – p) / n]
Une analyse mathématique fine de cette fonction révèle deux enseignements cruciaux pour le chercheur :
- L’erreur type atteint son maximum absolu lorsque p = 0,50. C’est lorsque l’événement a autant de chances d’advenir que d’échouer que l’imprécision des proportions observées est maximale pour un effectif n donné.
- À mesure que la probabilité théorique p se rapproche des bornes extrêmes (0 ou 1), l’erreur type diminue mécaniquement, ce qui exige des corrections statistiques spécifiques pour éviter que les intervalles d’estimation ne débordent de l’intervalle d’admissibilité [0, 1].
L’erreur type gouverne directement la marge d’erreur des sondages d’opinion et des enquêtes épidémiologiques : prétendre mesurer l’adhésion d’une population à un protocole comportemental avec une marge d’incertitude inférieure à 1 % exige d’interroger un effectif réel approchant les 10 000 répondants, ce qui disqualifie les inférences hâtives menées sur des panels restreints.
10.2 Les biais d’échantillonnage déformant la proportion observée
Si l’erreur type mesure l’imprécision due au hasard, les biais d’échantillonnage introduisent une distorsion systématique qui invalide l’estimation de la probabilité théorique, quelle que soit la taille de l’échantillon recueilli. Un échantillon biaisé de 100 000 personnes fournira une estimation infiniment plus trompeuse de la probabilité réelle qu’un échantillon aléatoire pur de 500 individus.
Les sciences psychologiques sont confrontées de manière chronique à ce problème à travers le phénomène documenté par Joseph Henrich et ses collègues : le biais des populations WEIRD (Western, Educated, Industrialized, Rich, and Democratic). Une immense majorité des recherches expérimentales en psychologie s’appuie sur des cohortes d’étudiants universitaires de premier cycle en sciences humaines, sélectionnés par auto-inscription contre crédits d’enseignement. Les proportions de réponses relevées chez ces sujets à des tâches d’évaluation sociale, cognitive ou morale reflètent des conditionnements socioculturels hautement spécifiques.
Calculer la proportion de participants validant un item comportemental au sein d’un échantillon d’étudiants nord-américains et l’ériger en probabilité universelle de fonctionnement du cerveau humain constitue une faute scientifique caractérisée. Pour combler cet écart systématique entre la proportion d’échantillon et la probabilité populationnelle globale, les biostatisticiens recourent à des méthodologies complexes d’ajustement : redressement statistique par post-stratification, pondération par l’inverse de la probabilité de sélection (IPW), ou modélisation multi-niveaux.
10.3 Erreurs de Type I et de Type II dans la prise de décision statistique
La confrontation de la proportion empirique aux modèles probabilistes théoriques expose inévitablement le chercheur à l’arbitrage fondamental formalisé par Jerzy Neyman et Egon Pearson : le compromis entre l’erreur de type I (α) et l’erreur de type II (β).
- L’erreur de Type I (faux positif) : Consiste à rejeter l’hypothèse nulle H0 alors qu’elle est en réalité vraie. La probabilité d’un tel écueil est directement fixée par le chercheur avant l’expérience au moyen du seuil de significativité α (habituellement fixé à 0,05 ou 5 %).
- L’erreur de Type II (faux négatif) : Consiste à ne pas rejeter l’hypothèse nulle alors qu’elle est factuellement fausse dans la réalité du monde physique. La probabilité de cette erreur est désignée par le coefficient β.
La puissance statistique d’un protocole, définie par la probabilité théorique 1 – β de détecter un effet empirique lorsqu’il existe véritablement, est intrinsèquement liée à la taille de l’échantillon, à la taille de l’effet attendu et à la variabilité des proportions. Si une étude en neurosciences comportementales teste une proportion de réussite à une tâche cognitive avec un effectif insuffisant, sa puissance statistique peut s’effondrer à 30 %. Dans ce cas, même si la proportion observée présente un écart apparent avec le témoin, le test statistique probabiliste échouera à rejeter H0, condamnant une découverte scientifique authentique à l’oubli des résultats non concluants.
11. Études de cas appliquées en psychologie et neurosciences
Pour ancrer ces concepts dans la réalité de la pratique scientifique, analysons trois études de cas représentatives où l’articulation méticuleuse de la probabilité et de la proportion se révèle indispensable à la rigueur de l’interprétation empirique.
11.1 Étude 1 : Essais randomisés contrôlés et proportion d’effets placebo
Dans l’évaluation de l’efficacité d’une nouvelle molécule psychopharmacologique destinée au traitement du trouble dépressif majeur, la méthodologie de référence impose l’essai clinique randomisé contrôlé en double aveugle (RCT). Supposons que l’étude porte sur une cohorte de 400 patients répartis par tirage aléatoire en deux groupes de 200 individus : le groupe actif recevant le psychotrope et le groupe contrôle recevant un placebo visuellement identique.
Au terme de 8 semaines de protocole, les proportions empiriques d’amélioration clinique significative (définie par une réduction de plus de 50 % sur l’échelle de dépression de Hamilton) sont colligées :
- Groupe Placebo : Une proportion de 35 % de répondeurs est constatée (70 patients sur 200).
- Groupe Traitement Actif : Une proportion de 52 % de répondeurs est constatée (104 patients sur 200).
L’erreur conceptuelle consisterait à attribuer l’intégralité des 52 % de succès observés dans le groupe actif aux vertus pharmacologiques de la molécule chimique. La proportion brute observée de 52 % est en réalité un amalgame composite intégrant la probabilité théorique de rémission spontanée de la pathologie sur 8 semaines, l’effet psycho-comportemental induit par la prise en charge (l’effet placebo mesuré à 35 %), et la proportion d’action thérapeutique pharmacologique pure.
L’inférence biostatistique vise à dissocier ces composantes en calculant la réduction absolue du risque (ARR = 0,52 – 0,35 = 0,17) et le nombre de sujets à traiter (NNT = 1 / 0,17 ≈ 6). C’est uniquement par cette modélisation probabiliste différentielle que l’on peut isoler la probabilité théorique qu’un patient donné doive sa guérison spécifiquement aux principes actifs de la molécule administrée.
11.2 Étude 2 : Taux de récidive comportementale en psychologie médico-légale
Le champ de la psychologie médico-légale et de la criminologie actuarielle confronte les experts à des dilemmes éthiques et statistiques d’une extrême gravité, où la confusion entre la proportion d’un groupe et la probabilité individuelle peut altérer le cours d’une vie humaine lors des audiences d’application des peines.
Dans le cadre de l’évaluation du risque de récidive violente, des outils d’évaluation actuarielle standardisés tels que le VRAG (Violence Risk Appraisal Guide) compilent les dossiers historiques de milliers de contrevenants passés. Supposons qu’un condamné obtienne un profil le classant dans une catégorie pour laquelle les données épidémiologiques historiques établissent que la proportion de récidive violente observée sur 7 ans est de 40 % (soit 400 récidivistes sur une cohorte historique de 1 000 individus présentant un profil similaire).
Le psychologue expert commet un glissement ontologique inacceptable s’il affirme devant le tribunal que « ce détenu a 40 % de probabilité de commettre un crime à sa sortie ». Une proportion de groupe est une propriété distributionnelle descriptive d’un agrégat statistique historique ; elle ne peut pas être univoquement projetée comme une probabilité intrinsèque caractérisant l’ontologie d’un individu singulier. L’individu réel est face à une dynamique binaire absolue : il récidivera (100 %) ou il ne récidivera pas (0 %). Projeter la proportion de groupe sur la trajectoire singulière d’une personne occulte ses ressources individuelles, ses changements d’environnement et sa liberté d’action, soulevant des défis juridiques cruciaux dans l’usage des algorithmes prédictifs.
11.3 Étude 3 : Perception du risque d’accident aérien et phobies spécifiques
Les protocoles de thérapie cognitivo-comportementale (TCC) dédiés au traitement de l’aérophobie (la phobie des voyages en avion) offrent un cas d’application magistral illustrant l’abîme séparant la probabilité objective calculée et la proportion subjectivement perçue par le système psychique du patient.
Sur le plan de l’épidémiologie statistique mondiale et de la théorie probabiliste du risque, la probabilité théorique de décès par passager lors d’un vol commercial sur un appareil de ligne moderne est estimée par l’OACI et l’IATA à environ 1 sur 11 millions de vols (soit une probabilité infinitésimale de l’ordre de 0,00000009). Pourtant, lorsqu’un sujet souffrant de phobie de l’avion est placé dans un simulateur de cabine avant le décollage, son niveau d’anxiété subjective reflète une anticipation catastrophiste : interrogé sur son évaluation du risque de crash, il estime fréquemment que la proportion de vols connaissant un accident grave est de « 1 sur 100 » ou « 1 sur 1 000 ».
Cette distorsion cognitive majeure est catalysée par l’heuristique de disponibilité documentée par Tversky et Kahneman : les accidents aériens bénéficient d’une couverture médiatique sensationnaliste exhaustive et saturée d’images hautement anxiogènes. La facilité avec laquelle ces scènes de désastre sont rappelées en mémoire de travail conduit le système limbique du sujet à surestimer massivement la proportion historique d’accidents réels. La restructuration cognitive en TCC repose précisément sur un travail méticuleux de psycho-éducation statistique : contraindre l’esprit du patient à réconcilier sa proportion émotionnellement imaginée avec la froide réalité des probabilités de survie aérienne, désactivant ainsi le signal d’alarme amygdalien pathologique.
12. Synthèse méthodologique et recommandations pour la recherche académique
Afin de prémunir la production scientifique et la communication clinique contre les erreurs méthodologiques récurrentes, il est indispensable d’édicter des règles rédactionnelles et opérationnelles précises, régissant l’emploi systématique des concepts de probabilité et de proportion au sein des publications universitaires.
12.1 Arbre décisionnel pour l’emploi correct des termes
Pour déterminer sans ambiguïté la terminologie exacte à mobiliser lors de la rédaction d’un manuscrit scientifique, le chercheur peut se référer aux critères discriminants synthétisés ci-dessous :
- La métrique provient-elle d’un comptage direct de données finies déjà collectées ?
- Oui : Utilisez impérativement le terme proportion, fréquence relative ou pourcentage d’échantillon. Exemple : « La proportion de sujets ayant validé l’item est de 0,65 ». Proscrivez formellement le mot probabilité dans la section descriptive des résultats.
- La métrique découle-t-elle d’une modélisation mathématique déductive, de l’application d’une fonction de densité, ou de l’estimation d’un paramètre latent a priori ?
- Oui : Utilisez le terme probabilité. Exemple : « La probabilité attendue de réussite sous le modèle logistique de Rasch est modélisée par la fonction P(θ) ».
- S’agit-il d’un ratio confrontant le nombre d’occurrences d’un événement au nombre de non-occurrences de ce même événement ?
- Oui : Utilisez le terme cote (en anglais, odds, égal à p / (1 – p)) ou rapport de cotes (odds ratio). Ne le qualifiez jamais de proportion ni de probabilité.
- S’agit-il du nombre d’événements nouveaux survenant par unité de temps au sein d’une population dynamique ?
- Oui : Utilisez le terme taux d’incidence (en anglais, rate). Un taux n’est pas une proportion car son dénominateur intègre une dimension temporelle (personnes-années).
12.2 Standards de publication et normes rédactionnelles APA
L’American Psychological Association (APA, 7e édition) prescrit des règles strictes de présentation des résultats quantitatifs afin de bannir les ambiguïtés statistiques. Les auteurs sont tenus de respecter scrupuleusement les consignes suivantes :
- Rapport des proportions empiriques : Toute proportion doit être obligatoirement accompagnée de l’effectif brut numérateur et du dénominateur d’échantillon réel. La formulation canonique s’écrit sous la forme : « 45 % (n = 90/200) ». Il est proscrit de ne fournir qu’un pourcentage isolé, qui masquerait l’instabilité induite par la petitesse d’un échantillon éventuel.
- Rapport des probabilités inférentielles : Les probabilités associées aux tests de significativité statistique (p-valeurs) doivent être formulées avec la lettre minuscule italique p. Si la p-valeur calculée est inférieure au millième, elle ne doit jamais s’écrire sous la forme fallacieuse p = 0,000 (la probabilité d’une statistique sous une loi continue n’étant jamais strictement nulle), mais être notée p < 0,001.
- Explicitation des intervalles d’estimation : Conformément aux recommandations de l’APA pour la science ouverte et robuste, l’estimation ponctuelle d’une proportion doit impérativement être escortée de son intervalle de confiance à 95 % (par exemple : p̂ = 0,60, IC 95 % [0,53 ; 0,67]), ce qui matérialise pour le lecteur l’écart potentiel existant entre la proportion constatée et la probabilité réelle sous-jacente.
12.3 Tableau comparatif exhaustif : axes de différenciation fondamentaux
Pour récapituler l’ensemble des divergences conceptuelles et opératoires développées tout au long de ce traité, le tableau comparatif ci-dessous synthétise les propriétés distinctives fondamentales séparant la probabilité de la proportion sur tous leurs axes d’analyse majeurs :
| Axe de différenciation | Probabilité | Proportion |
|---|---|---|
| Statut ontologique | Mesure mathématique idéale, abstraite, immatérielle et a priori. | Ratio arithmétique factuel, empirique, mesurable et a posteriori. |
| Cadre formel | Théorie de la mesure, axiomes de Kolmogorov sur espace (Ω, Σ, P). | Dénombrement combinatoire discret : p̂ = k / n sur données réelles. |
| Orientation temporelle | Prospective : tournée vers l’incertitude des événements futurs. | Rétrospective : ancrée dans l’inventaire historique d’événements passés. |
| Rôle fonctionnel | Modèle prédictif, normatif et théorique pour la décision face au risque. | Description condensée d’une série statistique collectée sur le terrain. |
| Sensibilité d’échantillonnage | Invariante et insensible aux aléas d’un relevé d’échantillon singulier. | Hautement sensible à la fluctuation d’échantillonnage et aux biais de sélection. |
| Régime asymptotique | Cible immuable (espérance mathématique ou paramètre de population p). | Estimateur convergent tendant vers la probabilité lorsque n → ∞ (LLN). |
| Expression sémiotique | Notation mathématique P(A) ; bornée formellement dans l’intervalle [0, 1]. | Notation statistique p̂, f ou pourcentage (%) ; contrainte par la taille n. |
| Écueils cognitifs majeurs | Sophisme du joueur, illusion d’autocorrection des séries aléatoires. | Oubli du taux de base, généralisation hâtive de petits échantillons. |
| Application psychométrique | Courbe Caractéristique d’Item dans la TRI ; fonction du trait latent θ. | Indice classique de difficulté de l’épreuve (p de la TCT) dépendant du groupe. |
En dernière analyse, la probabilité et la proportion ne doivent être perçues ni comme des synonymes interchangeables, ni comme des rivales conceptuelles étanches. Elles constituent les deux faces indissociables d’une même médaille épistémologique : la proportion empirique matérialise l’empreinte tangible laissée par le réel dans nos instruments de mesure, tandis que la probabilité théorique offre la grammaire intelligible permettant d’ordonner ces empreintes pour en déduire les lois universelles de l’esprit et de la nature.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Bayes, T. (1763). An essay towards solving a problem in the doctrine of chances. Philosophical Transactions of the Royal Society of London, 53, 370–418. https://doi.org/10.1098/rstl.1763.0053
- Bernoulli, J. (1713). Ars conjectandi, opus posthumum. Impensis Thurnisiorum, Fratrum.
- Clopper, C. J., & Pearson, E. S. (1934). The use of confidence or fiducial limits illustrated in the case of the binomial. Biometrika, 26(4), 404–413. https://doi.org/10.2307/2331986
- Gigerenzer, G., & Hoffrage, U. (1995). How to improve Bayesian reasoning without instruction: Frequency formats. Psychological Review, 102(4), 684–704. https://doi.org/10.1037/0033-295X.102.4.684
- Henrich, J., Heine, S. J., & Norenzayan, A. (2010). The weirdest people in the world? Behavioral and Brain Sciences, 33(2–3), 61–83. https://doi.org/10.1017/S0140525X0999152X
- Kahneman, D., & Tversky, A. (1972). Subjective probability: A judgment of representativeness. Cognitive Psychology, 3(3), 430–454. https://doi.org/10.1016/0010-0285(72)90016-3
- Kolmogorov, A. N. (1933). Grundbegriffe der Wahrscheinlichkeitsrechnung. Julius Springer.
- Neyman, J., & Pearson, E. S. (1933). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society of London. Series A, 231, 289–337. https://doi.org/10.1098/rsta.1933.0009
- Rasch, G. (1960). Probabilistic models for some intelligence and attainment tests. Danmarks Paedagogiske Institut.
- Tversky, A., & Kahneman, D. (1974). Judgment under uncertainty: Heuristics and biases. Science, 185(4157), 1124–1131. https://doi.org/10.1126/science.185.4157.1124
- Von Mises, R. (1957). Probability, statistics and truth (2nd English ed.). George Allen & Unwin Ltd.
- Wilson, E. B. (1927). Probable inference, the law of succession, and statistical inference. Journal of the American Statistical Association, 22(158), 209–212. https://doi.org/10.1080/01621459.1927.10502953