
Dans le domaine de l’économétrie appliquée et de la science de la gestion des opérations, la modélisation prédictive représente un pivot décisionnel incontournable. Face à l’accroissement exponentiel des volumes de données et à la prolifération d’algorithmes d’apprentissage automatique d’une complexité sans précédent, les praticiens sont fréquemment tentés de privilégier des architectures statistiques opaques. Néanmoins, l’efficacité prédictive ne dépend pas mécaniquement de la sophistication mathématique d’un modèle. Il existe une méthode fondamentale, désignée sous l’appellation de prévision naïve (ou méthode de la marche aléatoire sans dérive), qui constitue la pierre angulaire absolue de l’évaluation quantitative dans l’analyse des séries temporelles.
La prévision naïve repose sur un principe d’une désarmante simplicité : assigner à la prochaine période la valeur exactement observée lors de la période la plus récente. Bien que cette approche puisse intuitivement sembler rudimentaire, voire dépourvue de toute valeur ajoutée analytique, elle incarne les enseignements les plus profonds de l’épistémologie statistique moderne et des théories de l’efficience des marchés. En servant d’étalon de mesure universel (benchmark), la prévision naïve impose une exigence méthodologique stricte : aucun modèle complexe ne peut être légitimé s’il s’avère incapable de surpasser les performances de cette heuristique fondamentale.
Le présent article propose une exploration intégrale et hautement formalisée de la prévision naïve, orchestrée au sein du tableur Microsoft Excel. Au travers d’un cheminement logique articulé autour d’un cas pratique de ventes réelles s’étalant sur douze mois, nous déconstruirons les fondements théoriques, les biais psychologiques associés, l’instrumentation pas à pas dans la feuille de calcul, ainsi que le déploiement rigoureux des métriques d’évaluation de la précision telles que l’écart absolu moyen (MAD) et le pourcentage d’erreur moyen absolu (MAPE). Cette étude s’adresse aux analystes financiers, aux gestionnaires de la chaîne logistique et aux chercheurs désireux de maîtriser l’équilibre subtil entre parcimonie méthodologique et robustesse opérationnelle.
1. Fondements théoriques et épistémologiques de la prévision naïve
1.1 Définition mathématique et principe de la marche aléatoire
La formalisation mathématique de la prévision naïve s’exprime avec une concision remarquable au sein de l’espace des séries chronologiques discrètes. Soit une série temporelle observée ${Y_t}_{t in \mathbb{Z}}$, où $Y_t$ représente la grandeur scalaire réalisée à la période discrète $t$. L’opérateur de prévision pour un horizon d’une période en avant, noté $\hat{Y}_{t+1|t}$, conditionné par l’ensemble d’information disponible à l’instant $t$ (noté $\mathcal{F}_t$), se définit formellement par l’équation constitutive :
$$\hat{Y}_{t+1|t} = Y_t$$
Cette expression stipule que l’espérance conditionnelle de l’état futur du système correspond strictement à son état présent. Sur le plan stochastique, cette formulation établit un lien structurel indéfectible avec le modèle de la marche aléatoire pure (Random Walk). Dans un tel processus, la dynamique génératrice des données est régie par la relation $Y_t = Y_{t-1} + \varepsilon_t$, où $\varepsilon_t$ désigne un terme d’innovation stochastique, classiquement modélisé comme un bruit blanc gaussien vérifiant les hypothèses fondamentales d’indépendance et d’identique distribution : $\mathbb{E}[\varepsilon_t] = 0$, $\mathbb{V}(\varepsilon_t) = \sigma^2$, et $operatorname{Cov}(\varepsilon_t, \varepsilon_s) = 0$ pour tout $t \neq s$.
Il découle de cette structure que les résidus du modèle naïf, définis par l’écart $e_{t+1} = Y_{t+1} – \hat{Y}_{t+1|t} = Y_{t+1} – Y_t = \varepsilon_{t+1}$, héritent directement des propriétés du terme d’erreur sous-jacent. Si la série temporelle obéit rigoureusement à une marche aléatoire, la distribution des écarts prédictifs présente une autocorrélation strictement nulle et une stationnarité parfaite en différence première. Dès lors, la prévision naïve s’impose non pas comme une approximation par défaut, mais comme l’estimateur sans biais optimal au sens de la minimisation de l’espérance de la perte quadratique sous la condition d’un processus martingalien.
En économétrie appliquée, cette élégance structurelle confère à la méthode naïve un statut épistémologique capital : celui de référence minimale obligatoire, ou benchmark universel. Selon les préceptes édictés par Rob J. Hyndman et George Athanasopoulos, la valeur prédictive ajoutée d’un algorithme quelconque, qu’il s’agisse d’un lissage lourd ou d’un réseau neuronal récurrent, se mesure exclusivement à l’aune de sa capacité à réduire la variance de l’erreur au-delà du seuil fixé par cette projection élémentaire.
1.2 Évolution historique et place dans l’économétrie appliquée
L’émergence formelle de la méthode naïve en tant que référence méthodologique remonte aux premières investigations empiriques sur les fluctuations économiques au cours de la première moitié du XXe siècle. Dès les travaux pionniers du National Bureau of Economic Research (NBER) conduits par Wesley Clair Mitchell et Arthur F. Burns, la nécessité de comparer les prévisions macroéconomiques à des trajectoires passives s’est imposée pour juguler l’optimisme non fondé des prévisionnistes. La prévision naïve a ainsi été baptisée dans les cercles économétriques anglo-saxons sous l’intitulé révélateur de « Naïve Forecast 1 » (NF1), marquant l’absence délibérée d’ajustement structurel.
Avec l’avènement des méthodes de lissage exponentiel introduites par Charles C. Holt et Peter R. Winters à la fin des années 1950, puis la théorisation systématique des processus autorégressifs intégrés et moyennes mobiles (ARIMA) par George Box et Gwilym Jenkins en 1970, la prévision naïve a souvent été dépréciée par les analystes académiques, qui la percevaient comme un vestige pré-scientifique. Ces nouvelles approches promettaient d’extraire des signaux déterministes au sein de séries bruitées grâce à des raffinements paramétriques complexes.
Cependant, les compétitions empiriques de prévision à grande échelle, notamment les célèbres compétitions M organisées par Spyros Makridakis dès 1982, ont provoqué un séisme conceptuel retentissant. Les résultats compilés sur des milliers de séries chronologiques ont démontré de façon répétée que les modèles statistiques hautement paramétrés échouaient fréquemment à surclasser la prévision naïve, particulièrement à court terme. Cette survie pragmatique s’explique par l’absence totale de surapprentissage (overfitting) inhérente au modèle naïf, faisant de cette heuristique un refuge analytique remarquable dans les environnements volatils caractérisés par une rareté ou une imprécision des observations historiques.
1.3 Conditions de validité et hypothèses sous-jacentes
L’adéquation opérationnelle de la prévision naïve repose sur un ensemble strict d’hypothèses relatives à la dynamique sous-jacente de la série temporelle. La première condition sine qua non est la stationnarité locale de la moyenne ou l’absence d’une tendance linéaire marquée et persistante. En présence d’un trend ascendant déterministe ($Y_t = \alpha + \beta t + \varepsilon_t$), l’assignation $\hat{Y}_{t+1|t} = Y_t$ induit un biais systématique négatif persistant, l’erreur moyenne convergeant vers $-\beta$. De même, en présence d’une saisonnalité périodique stricte sans ajustement préalable, l’application aveugle de la règle naïve classique produit un déphasage critique, créant des résidus cycliques artificiels.
La seconde hypothèse postule la stabilité structurelle du processus générateur de données au voisinage immédiat du pas de temps $t$. La prévision naïve présume que la dernière réalisation encapsule la totalité des effets cumulés des forces économiques ou opérationnelles qui continueront de prévaloir à l’instant $t+1$. Cette prémisse s’avère particulièrement robuste dans les systèmes où l’information se diffuse instantanément et où les coûts d’ajustement immédiats empêchent des variations brutales et divergentes.
Enfin, les limites théoriques de l’approche se manifestent avec acuité lors de la survenue de ruptures de séries, de points d’inflexion macroéconomiques ou de chocs exogènes imprévisibles (les « cygnes noirs » théorisés par Nassim Nicholas Taleb). Dans ces configurations critiques, la prévision naïve subit un retard systématique d’une période : elle réagit avec force à l’anomalie au moment exact où celle-ci a déjà cessé de produire ses effets, amplifiant ainsi l’instabilité de la décision logistique ou budgétaire subséquente par un effet d’écho préjudiciable.
2. Perspective psychologique et cognitive de l’heuristique naïve
2.1 La prévision naïve comme heuristique de jugement naturel
Au-delà de son formalisme mathématique, la prévision naïve constitue une manifestation emblématique des mécanismes cognitifs humains régissant la prise de décision en univers incertain. Dans le cadre de la théorie des heuristiques rapides et frugales formalisée par Gerd Gigerenzer et ses collaborateurs de l’Institut Max Planck, la projection de l’état présent sur l’état futur immédiat répond à une logique écologique rationnelle. Loin de représenter une déficience intellectuelle ou une paresse calculatoire, l’usage de cette règle d’inférence minimale permet aux praticiens de naviguer au sein d’environnements informationnels saturés en minimisant la charge cognitive.
Face à des tableaux de bord pléthoriques compilant des dizaines d’indicateurs contradictoires, le cerveau humain déploie instinctivement la règle de la dernière observation disponible comme filtre de sélection économique. Cette démarche court-circuite ce que les psychologues cognitivistes nomment la « paralysie par l’analyse ». En élaguant les signaux faibles périphériques pour ne conserver que la réalisation tangible la plus récente, le gestionnaire élimine le risque d’intégrer des corrélations illusoires issues d’un excès de modélisation.
Cette efficacité pragmatique s’oppose frontalement à l’illusion de contrôle, un biais documenté par Ellen Langer, selon lequel un individu s’attribue une capacité de maîtrise sur des événements largement aléatoires dès lors qu’il manipule des paramètres complexes. La prévision naïve agit comme un désillusionniste méthodologique : elle rappelle que l’accumulation d’hypothèses sophistiquées ne confère pas mécaniquement une vision plus claire de l’avenir, consacrant la puissance de la frugalité informative face aux bruits erratiques du marché.
2.2 Biais cognitifs associés : ancrage et représentativité
Si la méthode naïve brille par sa frugalité, elle n’en demeure pas moins vulnérable à des distorsions cognitives systématiques lorsqu’elle est employée sans discernement critique. Le mécanisme central à l’œuvre est le phénomène d’ancrage psychologique, mis en évidence par Daniel Kahneman et Amos Tversky dans leurs travaux séminaux de 1974. Dans l’implémentation de la prévision naïve, la valeur $Y_t$ opère comme une ancre mentale rigide. Même si des indicateurs avancés suggèrent une modification imminente de la dynamique des ventes, l’esprit du décideur demeure disproportionnellement fixé sur ce chiffre récent, ajustant insuffisamment son anticipation.
Ce phénomène s’articule étroitement avec le biais de représentativité, en vertu duquel le décideur traite l’état le plus récent du système comme le prototype même de son fonctionnement futur. Cette heuristique erronée pousse à interpréter une fluctuation transitoire — par exemple, un pic de commandes éphémère provoqué par une commande institutionnelle isolée — comme la nouvelle norme fondamentale. En projetant indûment cet état ponctuel sur la période suivante, la méthode naïve transforme un accident de variance en prévision nominale, exposant l’organisation à des désillusions opérationnelles sévères.
Paradoxalement, il existe également une résistance psychologique inverse chez les gestionnaires et ingénieurs d’affaires : l’aversion pour l’extrême simplicité. Confrontés à une formule n’impliquant aucune transformation algébrique sophistiquée, nombre de professionnels éprouvent un malaise méthodologique, redoutant que leur expertise professionnelle ne soit remise en cause par l’adoption d’un outil prédictif accessible à un novice. Cette dissonance cognitive engendre une réticence institutionnelle dommageable à l’égard de la démarche naïve.
2.3 Incertitude radicale et rationalité limitée
L’analyse décisionnelle moderne, héritière des thèses d’Herbert Simon sur la rationalité limitée, enseigne que l’optimisation absolue est une fiction épistémique face à une complexité computationnelle ingérable. Dans les situations d’incertitude radicale — où l’espace même des états possibles du futur demeure inconnu —, les décideurs ne peuvent prétendre calculer des distributions de probabilités objectives. L’heuristique naïve s’inscrit précisément dans cette philosophie du « satisficing » (satisfaction sous contrainte), visant un niveau d’erreur acceptable plutôt qu’une perfection inaccessible.
Dans ce contexte, le recours délibéré au minimalisme constitue un rempart robuste contre le surapprentissage statistique. Les modèles complexes ont tendance à traiter le bruit stochastique passé comme une information structurelle récurrente, incorporant les idiosyncrasies de l’échantillon historique dans leur paramétrage interne. La méthode naïve, en refusant d’ajuster des coefficients aux fluctuations antérieures, neutralise le risque d’estimer des paramètres chimériques, garantissant ainsi une stabilité remarquable de son espérance d’erreur hors échantillon.
L’adoption sereine de la prévision naïve requiert donc une acceptation psychologique mature du risque d’erreur inhérent à toute action humaine. Plutôt que de rechercher l’immunité illusoire conférée par des algorithmes sophistiqués à boîte noire, le gestionnaire éclairé reconnaît la part d’irréductible contingence du monde réel. Il concentre ses ressources organisationnelles non pas sur l’artifice de prévisions théoriquement optimales mais sur l’élasticité opérationnelle et la réactivité de sa chaîne logistique face aux écarts inévitables.
3. Configuration préalable de l’environnement de travail dans Excel
3.1 Normalisation et structuration de la feuille de calcul
L’implémentation rigoureuse d’un modèle quantitatif dans Microsoft Excel nécessite une discipline architecturale stricte afin d’éliminer toute ambiguïté référentielle et de prévenir les corruptions de données. Avant d’introduire la moindre équation, il convient d’établir une typographie financière normalisée et un découpage spatial logique. Le classeur doit être structuré autour d’une table unique dont les en-têtes sont explicitement libellés, proscrivant toute fusion de cellules au sein de la matrice opérationnelle pour préserver l’adressage relationnel.
Une bonne pratique consiste à appliquer une séparation spatiale et visuelle stricte entre trois strates d’information :
- Les données d’entrée brutes (Inputs) : les identifiants temporels et les observations réelles du phénomène étudié, qui doivent bénéficier d’un formatage spécifique (souvent caractérisé par un fond neutre et une police sobre) signalant leur immuabilité opérationnelle.
- Les calculs intermédiaires et projections (Processing) : les colonnes dédiées à l’assignation de la formule naïve et aux écarts résiduels, clairement distinguées par des bordures précises et des libellés de colonnes rigoureux.
- Les métriques de performance synthétiques (Outputs) : les indicateurs d’évaluation globale (MAD, MAPE, RMSE), regroupés dans un bloc dédié, en marge de la série ou sous celle-ci, dotés de formats d’affichage normalisés (séparateurs de milliers, décimales uniformes).
Il est vivement recommandé d’attribuer un nommage explicite aux plages critiques via le gestionnaire de noms d’Excel (par exemple, désigner la plage des ventes observées sous l’étiquette Ventes_Reelles). Cette pratique élimine les erreurs courantes de glissement de références et facilite l’auditabilité algorithmique par des tiers au sein de la gouvernance de données de l’entreprise.
3.2 Paramétrage des options de calcul et gestion des références
La pérennité des résultats calculés sous Excel est conditionnée par l’intégrité du moteur de calcul du logiciel. Il est impératif d’accéder au menu Fichier > Options > Formules afin de s’assurer que l’option de calcul est positionnée sur Automatique. Un mode de calcul fortuitement basculé sur « Manuel » bloquerait la propagation dynamique des prévisions lors de la mise à jour des réalisations mensuelles, générant des faux négatifs lors des revues d’exploitation.
Une attention méticuleuse doit être accordée à la syntaxe des références de cellules. La prévision naïve repose structurellement sur le mécanisme des références relatives (par exemple, =B2). L’insertion intempestive du symbole de verrouillage absolu $ (tel que =$B$2) constitue une faute récurrente qui gèlerait l’ensemble des projections sur la première observation disponible, invalidant l’ensemble de la démarche chronologique dynamique. Les références absolues doivent être réservées exclusivement aux paramètres fixes situés hors tableau, tels que les coefficients d’ajustement ou les seuils de tolérance critiques.
Enfin, la gestion des cellules vides et des zéros arithmétiques requiert une vigilance absolue. Dans la syntaxe interne d’Excel, une cellule entièrement vierge référencée dans une formule arithmétique simple est implicitement convertie en zéro numérique (0). Ce comportement peut induire des biais dévastateurs dans le calcul des métriques de précision relative (division par zéro ou amplification artificielle de l’erreur en pourcentage). L’analyste doit impérativement paramétrer des règles d’audit pour interdire l’existence de cellules fantômes au sein de la série historique.
4. Étape 1 : Saisie, validation et exploration des données de ventes
4.1 Structure tabulaire du jeu de données sur 12 mois
Afin d’ancrer notre démonstration méthodologique dans une réalité opérationnelle tangible, nous construisons un scénario étalon portant sur la distribution mensuelle d’un équipement industriel de haute précision sur une temporalité continue de douze mois. La grille de travail s’articule de manière orthodoxe dans la feuille de calcul, occupant les colonnes A et B.
La colonne A héberge la séquence chronologique discrète, codifiée sous forme d’identifiants séquentiels stricts : de « Mois 1 » en cellule A2 jusqu’à « Mois 12 » en cellule A13. Cette linéarité chronologique est fondamentale : elle garantit l’équidistance temporelle des observations ($\Delta t = 1 \text{ mois}$), condition indispensable à l’application rigoureuse des modèles autorégressifs et naïfs. La colonne B consigne les grandeurs scalaires observées représentant les volumes de ventes réelles constatées à l’issue de chaque cycle de clôture d’inventaire.
Le jeu de données numériques retenu pour notre étude se configure de manière exhaustive comme suit :
- Mois 1 (Cellule A2) : 35 unités (Cellule B2)
- Mois 2 (Cellule A3) : 38 unités (Cellule B3)
- Mois 3 (Cellule A4) : 34 unités (Cellule B4)
- Mois 4 (Cellule A5) : 40 unités (Cellule B5)
- Mois 5 (Cellule A6) : 37 unités (Cellule B6)
- Mois 6 (Cellule A7) : 39 unités (Cellule B7)
- Mois 7 (Cellule A8) : 36 unités (Cellule B8)
- Mois 8 (Cellule A9) : 41 unités (Cellule B9)
- Mois 9 (Cellule A10) : 38 unités (Cellule B10)
- Mois 10 (Cellule A11) : 42 unités (Cellule B11)
- Mois 11 (Cellule A12) : 39 unités (Cellule B12)
- Mois 12 (Cellule A13) : 44 unités (Cellule B13)
Ce jeu de données présente un équilibre statistique remarquable : une légère tendance haussière couplée à des oscillations stochastiques d’amplitude modérée, offrant un terrain d’investigation idéal pour jauger le comportement d’une approche prédictive élémentaire sans dérive.
4.2 Audit d’intégrité et validation quantitative des données
Toute modélisation prédictive sérieuse s’ouvre par une phase incontournable de salubrité computationnelle. Il est formellement prohibé d’appliquer des algorithmes sur un jeu de données brut sans avoir préalablement validé son intégrité typologique. Au sein de la colonne F de vérification technique, l’analyste déploie systématiquement la fonction =ESTNUM(B2), étendue verticalement jusqu’à B13. Cette précaution élémentaire confirme qu’aucune valeur numérique n’est insidieusement encodée sous forme textuelle (notamment suite à des exports défectueux de bases SQL contenant des espaces insécables ou des délimiteurs régionaux incompatibles).
Parallèlement, la détection des lacunes séquentielles s’effectue via la formule =NB.VIDE(B2:B13), dont le retour doit être strictement égal à zéro. La présence d’un mois manquant fausserait irrémédiablement l’horizon temporel de la méthode naïve, transformant une prévision à $t+1$ en une prévision indéterminée à $t+k$.
L’exploration quantitative préliminaire s’achève par le calcul des statistiques descriptives élémentaires, disposées dans un tableau auxiliaire :
- Moyenne arithmétique : calculée via
=MOYENNE(B2:B13), elle s’établit à 38,58 unités. - Médiane : obtenue avec
=MEDIANE(B2:B13), affichant une valeur de 38,50 unités, ce qui atteste d’une distribution remarquablement symétrique des ventes autour du centre de gravité. - Écart-type échantillonnal : extrait par la syntaxe
=ECARTYPE.STANDARD(B2:B13), s’élevant à 2,97 unités, traduisant un coefficient de variation ($CV = \sigma / \mu$) de seulement 7,7 %, synonyme d’un processus générateur particulièrement stable et discipliné.
5. Étape 2 : Implémentation pas à pas de la prévision naïve dans Excel
5.1 Formulation mathématique appliquée aux cellules
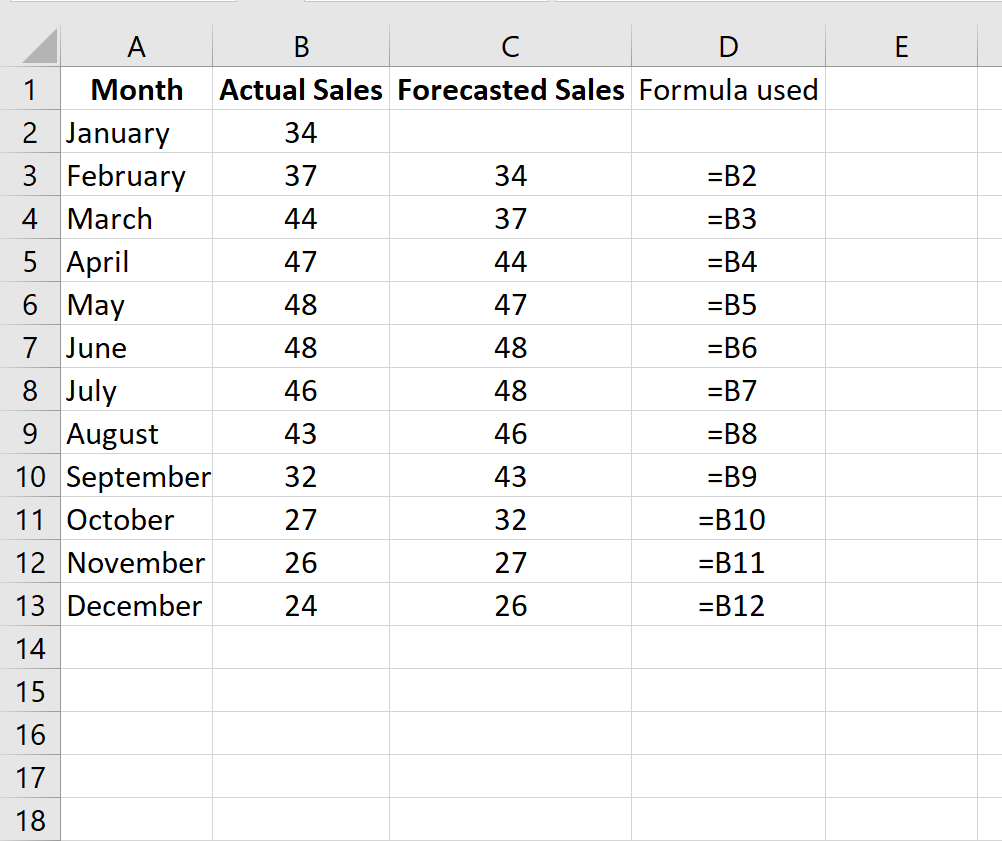
L’opérationnalisation de la prévision naïve s’effectue au sein de la colonne C de la feuille de calcul, que nous intitulerons formellement Prévision naïve (t). Dès l’entame de cette phase, l’analyste se heurte à une contrainte épistémologique et logique fondamentale : l’impossibilité matérielle de concevoir une prévision pour la période initiale (le Mois 1, situé en ligne 2).
En vertu de l’équation $\hat{Y}_{t|t-1} = Y_{t-1}$, la projection de la valeur du Mois 1 exigerait la possession de la réalisation survenue au Mois 0. Puisque l’échantillon démarre formellement au Mois 1, l’ensemble d’information $\mathcal{F}_0$ est strictement vide. En conséquence, la cellule C2 doit impérativement rester vide, ou recevoir la mention conventionnelle #N/A (via la fonction =NON.DISP()), afin de proscrire toute extrapolation fictive qui corromprait les moyennes d’évaluation ultérieures.
Le véritable processus prédictif s’enclenche donc à la période $t=2$, matérialisée par la cellule C3. Pour générer la prévision naïve du Mois 2 sur la base des ventes réelles du Mois 1, l’utilisateur saisit avec une simplicité déconcertante la formule suivante :
=B2
Cette syntaxe purement relative ordonne au tableur de copier l’observation scalaire du pas de temps immédiatement antérieur. Une fois cette instruction validée, l’analyste procède à l’incrémentation verticale de la formule : il suffit de saisir la poignée de recopie située dans le coin inférieur droit de la cellule C3 et de la faire glisser vers le bas jusqu’à la cellule C13 (correspondant au Mois 12). La dynamique des références relatives met à jour instantanément la projection pour chaque période : C4 fait référence à B3, C5 à B4, et ainsi de suite jusqu’à C13 qui hérite fidèlement du contenu de B12.
5.2 Projection hors échantillon pour la période future
L’intérêt ultime d’un modèle prédictif réside dans sa capacité à éclairer l’horizon futur non encore réalisé, c’est-à-dire l’émission de projections « hors échantillon » (out-of-sample forecast). Dans notre modélisation sur douze mois, l’analyste doit formuler la décision opérationnelle pour le treizième mois à venir, étape où aucune valeur réelle n’existe pour arbitrer l’exactitude du jugement.
Pour concrétiser cette projection prospective, il convient d’insérer un nouvel identifiant temporel dans la cellule A14, sous le libellé Mois 13. La cellule B14, dédiée aux ventes réelles, demeure naturellement vacante dans l’attente du dénouement réel de l’exercice commercial futur. L’assignation de la prévision naïve pour cette période s’opère alors en cellule C14 en mobilisant l’observation réalisée la plus récente :
=B13
Le résultat généré en C14 affiche la valeur 44. Cette projection hors échantillon cristallise l’essence même de l’heuristique naïve : l’entreprise anticipe qu’au treizième mois d’activité, le niveau de la demande reproduira fidèlement la magnitude observée lors du douzième mois. Cette valeur servira de point d’ancrage absolu pour la programmation des approvisionnements, le calibrage des cadences de production et l’allocation des budgets de trésorerie.
Toutefois, une réflexion analytique s’impose quant à la sensibilité de cette projection. Puisque la valeur 44 correspond au point le plus élevé de la distribution historique (qui s’étendait de 34 à 44 unités), la prévision pour le Mois 13 est intrinsèquement dépendante d’une observation terminale exceptionnellement dynamique. Si le Mois 12 résultait d’une perturbation transitoire sans lendemain, la prévision hors échantillon projetterait une surcapacité manifeste dans l’organisation industrielle.
5.3 Diagnostics des erreurs courantes lors de l’implémentation
Bien que l’architecture technique d’une prévision naïve apparaisse triviale, la pratique en entreprise révèle la survenue régulière de défaillances opératoires susceptibles d’annihiler la crédibilité des résultats. La première erreur classique relève du décalage chronologique involontaire. Par inattention, un utilisateur peut être amené à saisir en cellule C3 la formule =B3. Dans cette situation, la prévision n’anticipe plus l’avenir mais reflète instantanément le présent, simulant une précision parfaite et fictive qui échappe aux tests superficiels mais détruit toute fonction décisionnelle réelle.
La seconde anomalie découle de l’activation erronée de références absolues. L’insertion involontaire de la touche F4 lors de l’édition transforme la syntaxe en =$B$2. Lorsque l’analyste étend la formule vers le bas, l’ensemble des cellules C3 à C13 demeure bloqué sur la valeur statique 35. Ce phénomène d’ancrage artificiel induit une distorsion majeure dans l’évaluation de la performance du modèle, amplifiant inconsidérément les erreurs au fur et à mesure que la série temporelle s’écarte de son niveau d’origine.
Enfin, il convient de diagnostiquer le risque lié aux formats numériques hétérogènes. Si une cellule source contient un espace insécable ou un séparateur décimal non reconnu par les paramètres régionaux d’Excel (le point au lieu de la virgule dans l’environnement francophone), la référence naïve renverra une chaîne de caractères. Toute tentative subséquente de calcul d’écart arithmétique générera alors l’erreur bloquante #VALEUR!, paralysant la chaîne analytique globale.
6. Étape 3 : Mesure de la précision par l’écart absolu moyen (MAD)
6.1 Formalisation mathématique de l’écart absolu
L’évaluation de la performance d’un système prédictif exige une confrontation rigoureuse entre les réalisations historiques et les valeurs estimées par le modèle rétrospectif. Pour chaque période temporelle $t$, l’erreur de prévision unitaire, ou résidu brut noté $e_t$, est formellement définie par la soustraction de la projection à la réalisation effective :
$$e_t = Y_t – \hat{Y}_{t|t-1}$$
Une sommation arithmétique simple de ces résidus bruts conduirait à un écueil analytique majeur : les erreurs positives (situations de sous-estimation où la demande dépasse la prévision) viendraient compenser et neutraliser les erreurs négatives (situations de sur-estimation où le stock demeure invendu). Une telle moyenne brute pourrait afficher une valeur proche de zéro, masquant fallacieusement des défaillances prédictives colossales au niveau unitaire.
Pour contourner ce biais d’annulation mutuelle, l’économétrie opérationnelle applique l’opérateur de la valeur absolue. L’écart absolu moyen, universellement désigné sous l’acronyme MAD (Mean Absolute Deviation) ou MAE (Mean Absolute Error), agrège la magnitude brute des écarts sans considération de leur signe algébrique :
$$\text{MAD} = \frac{1}{n} \sum_{t=2}^{T} |Y_t – \hat{Y}_{t|t-1}|$$
où $n = T – 1$ représente le nombre effectif de périodes d’évaluation (onze dans notre jeu de données). La vertu prééminente de la MAD réside dans son interprétabilité opérationnelle immédiate : elle s’exprime rigoureusement dans la même unité de mesure physique que la grandeur étudiée (ici, un nombre entier ou décimal de pièces industrielles vendues).
6.2 Déploiement pas à pas des calculs de la MAD dans Excel
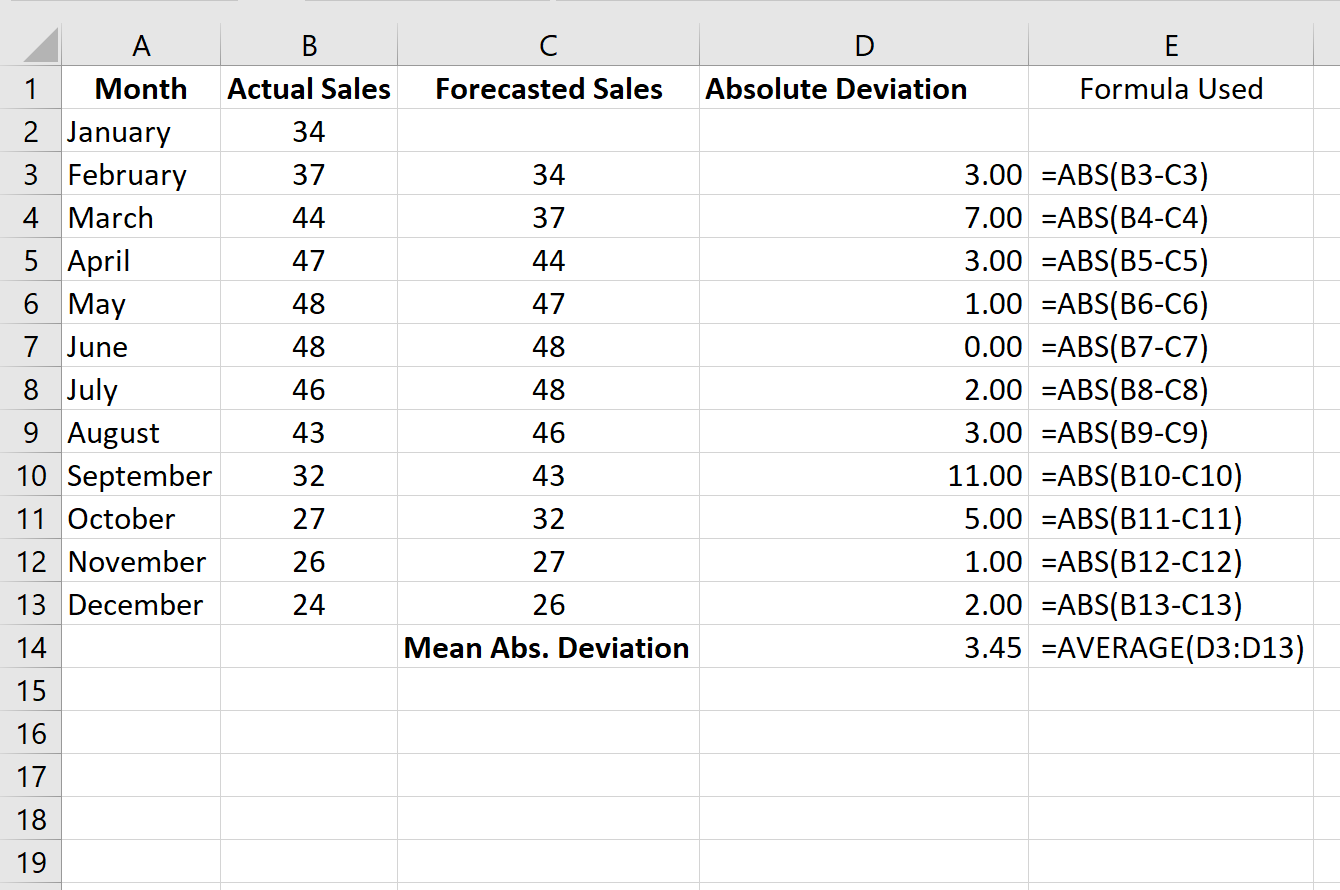
L’instrumentation de la MAD au sein de notre feuille de calcul s’opère via la création d’une quatrième colonne, positionnée en D, arborant l’en-tête explicite |Erreur| ou Écart absolu. La première cellule d’évaluation correspond au Mois 2, logée en D3. La syntaxe algorithmique mobilisée convoque la fonction mathématique intégrée d’Excel dédiée à la valeur absolue :
=ABS(B3-C3)
Cette formule soustrait la prévision (C3) de la réalité (B3), puis convertit le résultat en grandeur positive scalaire. L’analyste déploie cette logique vers le bas par étirement vertical de D3 jusqu’à D13. L’inspection des cellules révèle la chronique exhaustive des écarts absolus constatés période par période :
- D3 (Mois 2) : $|38 – 35| = \mathbf{3}$
- D4 (Mois 3) : $|34 – 38| = \mathbf{4}$
- D5 (Mois 4) : $|40 – 34| = \mathbf{6}$
- D6 (Mois 5) : $|37 – 40| = \mathbf{3}$
- D7 (Mois 6) : $|39 – 37| = \mathbf{2}$
- D8 (Mois 7) : $|36 – 39| = \mathbf{3}$
- D9 (Mois 8) : $|41 – 36| = \mathbf{5}$
- D10 (Mois 9) : $|38 – 41| = \mathbf{3}$
- D11 (Mois 10) : $|42 – 38| = \mathbf{4}$
- D12 (Mois 11) : $|39 – 42| = \mathbf{3}$
- D13 (Mois 12) : $|44 – 39| = \mathbf{5}$
La sommation des onze écarts individuels donne un cumul arithmétique de 38 unités ($3 + 4 + 6 + 3 + 2 + 3 + 5 + 3 + 4 + 3 + 5 = 38$). Pour extraire la valeur finale de l’écart absolu moyen, l’utilisateur positionne en cellule D15 l’agrégation finale suivante :
=MOYENNE(D3:D13)
L’exécution de cette formule renvoie avec une netteté absolue le résultat canonique : 3,45 unités (arrondi à deux décimales de 38 / 11 = 3,4545…). Ce résultat statistique formalise avec précision l’erreur unitaire moyenne consentie par l’application de la méthode naïve sur la période sous revue.
6.3 Interprétation analytique et portée de la métrique
L’obtention d’une MAD calibrée à 3,45 unités offre une lecture managériale sans équivoque : sur les onze derniers cycles mensuels d’exploitation, la prévision naïve s’est écartée, en moyenne et en valeur absolue, d’environ 3,5 pièces du carnet de commandes réel. Rapportée au volume moyen de ventes qui s’établit à 38,58 unités, cette déviation représente un ordre de grandeur maîtrisé, attestant de l’adéquation opérationnelle de la méthode dans le contexte d’une volatilité contenue.
Sur le plan de la robustesse statistique, la MAD se distingue par sa tolérance relative aux valeurs extrêmes par rapport aux métriques quadratiques. En ne surpondérant pas artificiellement les écarts ponctuels importants via une mise au carré, la MAD fournit une vision équilibrée de l’erreur typique rencontrée au quotidien par les équipes de planification opérationnelle.
Dans la gestion contemporaine de la chaîne logistique, la MAD sert de paramètre fondamental pour le dimensionnement quantitatif des stocks de sécurité. En supposant que les résidus d’erreur prédictive suivent une loi normale de moyenne nulle, la relation mathématique liant l’écart-type des erreurs ($\sigma_e$) à la déviation absolue moyenne est régie par l’approximation universelle $\sigma_e \approx 1,25 \times \text{MAD}$. Ainsi, l’analyste peut directement extrapoler l’écart-type opérationnel ($3,45 \times 1,25 \approx 4,31 \text{ unités}$) pour calibrer avec précision le coefficient de service $Z$ et éviter les ruptures de stocks sans recourir à des formules statistiques lourdes.
7. Étape 4 : Évaluation de la précision relative par le MAPE
7.1 Fondement mathématique du pourcentage d’erreur moyen absolu
Bien que l’écart absolu moyen fournisse une indication tangible dans l’unité de mesure du produit, il souffre d’une limitation théorique substantielle : son incapacité intrinsèque à permettre des comparaisons d’échelle. Une MAD de 3,45 unités présente une gravité négligeable s’il s’agit de la commercialisation de semi-conducteurs produits par centaines de milliers, mais s’avère catastrophique s’il est question de turbines d’avions de ligne vendues à quelques exemplaires par an.
Pour surmonter cette barrière de normalisation, l’économétrie applique le pourcentage d’erreur moyen absolu, universally désigné par l’acronyme MAPE (Mean Absolute Percentage Error). Cette métrique relativise chaque écart résiduel individuel en le rapportant directement à la valeur effective observée lors de la période correspondante. L’équation formelle s’écrit :
$$\text{MAPE} = \frac{1}{n} \sum_{t=2}^{T} left| \frac{Y_t – \hat{Y}_{t|t-1}}{Y_t} right| \times 100$$
Le MAPE convertit l’erreur brute en une proportion adimensionnelle universelle, permettant aux directeurs supply chain d’évaluer, sur une même échelle normalisée de 0 à 100 %, l’exactitude prédictive de catégories de produits hétérogènes réparties sur différents marchés géographiques.
Toutefois, le formalisme du MAPE recèle une singularité mathématique critique qui exige une vigilance extrême : le risque de divergence computationnelle par division par zéro. Si, au sein de la série chronologique, une période quelconque enregistre une vente réelle nulle ($Y_t = 0$), le quotient devient indéfini, provoquant une interruption immédiate du calcul sous Excel. De surcroît, lorsque les réalisations effectives sont extrêmement faibles (proches de zéro), le dénominateur amplifie de manière disproportionnée le pourcentage d’erreur, introduisant une distorsion statistique sévère.
7.2 Mise en œuvre concrète du MAPE dans la feuille de calcul
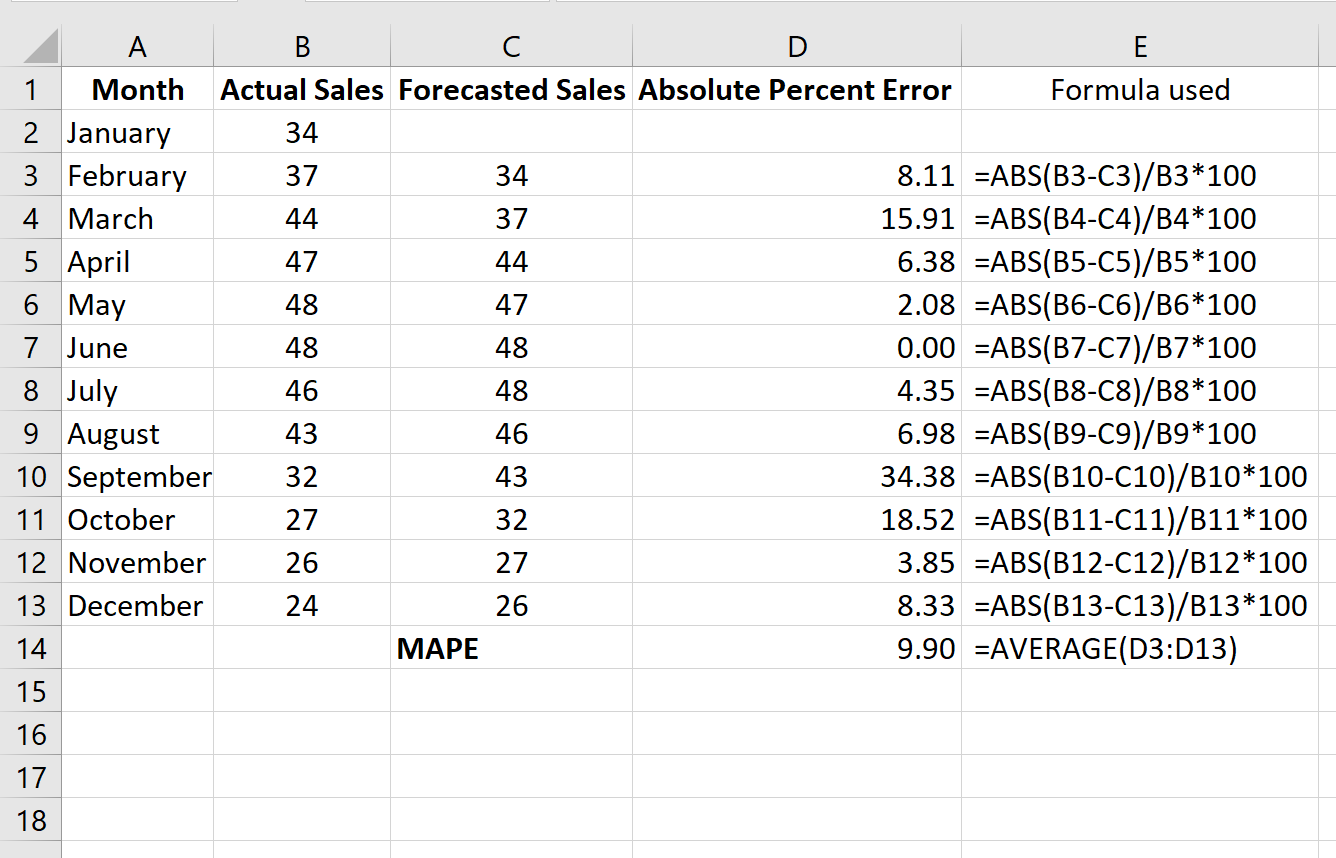
Pour matérialiser le MAPE dans notre modèle, nous ouvrons la colonne E sous l’intitulé normalisé Erreur relative (%). La syntaxe élémentaire s’implémente en cellule E3, correspondant à la première confrontation temporelle du Mois 2. L’analyste dispose de deux syntaxes rigoureusement équivalentes :
=ABS(B3-C3)/B3 ou, en tirant profit du travail déjà exécuté en colonne D : =D3/B3
Il est impératif d’appliquer immédiatement à la plage E3:E13 le formatage Pourcentage d’Excel, assorti d’une précision fixée à une décimale via le ruban Accueil > Nombre. Cette disposition évite la multiplication explicite par 100 au sein de la formule, laissant au tableur la prise en charge cosmétique de la mise à l’échelle. La propagation verticale de la formule génère la chronique relative suivante :
- E3 (Mois 2) : $3 / 38 = \mathbf{7,9%}$
- E4 (Mois 3) : $4 / 34 = \mathbf{11,8%}$
- E5 (Mois 4) : $6 / 40 = \mathbf{15,0%}$
- E6 (Mois 5) : $3 / 37 = \mathbf{8,1%}$
- E7 (Mois 6) : $2 / 39 = \mathbf{5,1%}$
- E8 (Mois 7) : $3 / 36 = \mathbf{8,3%}$
- E9 (Mois 8) : $5 / 41 = \mathbf{12,2%}$
- E10 (Mois 9) : $3 / 38 = \mathbf{7,9%}$
- E11 (Mois 10) : $4 / 42 = \mathbf{9,5%}$
- E12 (Mois 11) : $3 / 39 = \mathbf{7,7%}$
- E13 (Mois 12) : $5 / 44 = \mathbf{11,4%}$
L’étape conclusive consiste à consolider la métrique finale. En cellule E15, alignée horizontalement avec la synthèse de la MAD, l’analyste insère la formule synthétique d’agrégation :
=MOYENNE(E3:E13)
Le tableur renvoie immédiatement un résultat consolidé de 9,9 %. Ce chiffre constitue le certificat d’efficacité globale du modèle naïf sur notre cas d’école industriel.
7.3 Grille de lecture et seuils d’acceptabilité opérationnels
L’évaluation qualitative d’un score de MAPE s’adosse traditionnellement à la taxonomie académique établie par C. D. Lewis dans ses traités fondateurs sur la gestion industrielle de la demande. Cette grille de référence segmente les performances prédictives selon des seuils empiriques normalisés :
- MAPE < 10 % : Modélisation de haute précision (Highly accurate forecasting).
- 10 % $le$ MAPE < 20 % : Prévision bonne et exploitable (Good forecasting).
- 20 % $le$ MAPE < 50 % : Prévision raisonnable mais vulnérable (Reasonable forecasting).
- MAPE $ge$ 50 % : Prévision inexacte et dangereuse pour la gestion des opérations (Inaccurate forecasting).
À l’aune de ce référentiel standard, le score de 9,9 % obtenu par notre implémentation naïve franchit de justesse le seuil d’excellence le plus exigeant, s’inscrivant formellement dans la catégorie des prévisions de haute précision. Ce constat statistique apporte la preuve éclatante qu’une heuristique pure, totalement dénuée de sophistication paramétrique, peut délivrer des résultats remarquables lorsque la série temporelle sous-jacente présente une régularité suffisante.
Néanmoins, l’analyste rigoureux se doit de conserver une perspective critique face aux biais inhérents au MAPE. Cette métrique souffre d’une asymétrie structurelle de pénalisation. Puisque le dénominateur est constitué par la valeur réelle $Y_t$, les erreurs commises lorsque les ventes sont faibles pèsent proportionnellement beaucoup plus lourd que celles constatées lors des périodes d’abondance commerciale. De surcroît, le MAPE pénalise davantage les prévisions trop élevées que les prévisions trop basses : l’erreur par sous-estimation est bornée à 100 % (lorsque $\hat{Y}=0$), alors que l’erreur par surestimation n’a pas de limite supérieure théorique, ce qui peut inciter inconsciemment les planificateurs à concevoir des prévisions structurellement déficitaires.
8. Analyses statistiques complémentaires et métriques avancées
8.1 Erreur quadratique moyenne (MSE) et racine carrée (RMSE)
Si la MAD et le MAPE offrent une appréciation linéaire et intuitive des écarts, la théorie de la décision statistique requiert fréquemment la prise en compte de métriques de pénalisation quadratique. L’erreur quadratique moyenne, ou MSE (Mean Squared Error), et son extension naturelle, la racine carrée de l’erreur quadratique moyenne, ou RMSE (Root Mean Squared Error), constituent les piliers de la modélisation gaussienne standard.
La formulation de la MSE repose sur l’élévation des résidus au carré, amplifiant délibérément le poids des écarts volumineux. Pour l’implémenter sous Excel, l’analyste insère une nouvelle colonne de calculs intermédiaires, par exemple la colonne F, intitulée Erreur au carré. En cellule F3, la syntaxe s’énonce indifféremment via l’opérateur exponentiel ou la fonction puissance :
=(B3-C3)^2 ou =PUISSANCE(B3-C3; 2)
La sommation des carrés sur notre période historique donne les valeurs respectives : $9, 16, 36, 9, 4, 9, 25, 9, 16, 9, 25$, dont la somme arithmétique globale culmine à 167. La moyenne de cette série d’erreurs quadratiques, calculée en F15 via =MOYENNE(F3:F13), aboutit à une MSE de 15,18.
Afin de ramener cet indicateur dans la dimension d’origine de la série chronologique (les unités de vente), l’extraction de la RMSE s’accomplit par l’encapsulation de la moyenne quadratique au sein de la fonction racine carrée :
=RACINE(MOYENNE(F3:F13)) ou directement =RACINE(F15)
Le résultat obtenu pour la RMSE s’établit à 3,90 unités. La divergence structurelle entre la MAD ($3,45$) et la RMSE ($3,90$) fournit une indication statistique fondamentale : par construction géométrique, la RMSE est systématiquement supérieure ou égale à la MAD ($\text{RMSE} ge \text{MAD}$). Plus l’écart entre ces deux métriques s’élargit, plus la distribution des erreurs est hétérogène et ponctuée de chocs prédictifs exceptionnels. Dans notre scénario, l’écart modéré (0,45 unité) confirme l’absence de perturbations extrêmes et témoigne de la régularité des écarts constatés le long de la séquence.
8.2 Évaluation du biais de prévision (Tracking Signal et MPE)
Un modèle prédictif peut afficher une excellente précision moyenne tout en étant porteur d’un vice rédhibitoire : le biais systématique. Une prévision non biaisée doit osciller aléatoirement de part et d’autre de la réalité, distribuant ses résidus de façon symétrique autour d’une espérance nulle ($\mathbb{E}[e_t] = 0$).
Pour mesurer ce phénomène, l’analyste déploie le calcul de l’erreur moyenne brute, ou MFE (Mean Forecast Error), également qualifiée de biais de prévision. Contrairement à la MAD, cette métrique préserve impérativement les signes arithmétiques. Dans une colonne dédiée aux erreurs brutes simples ($B3-C3$), l’instruction =MOYENNE(...) renvoie pour notre jeu de données :
$$\text{MFE} = \frac{(+3) + (-4) + (+6) + (-3) + (+2) + (-3) + (+5) + (-3) + (+4) + (-3) + (+5)}{11} = \frac{+9}{11} \approx \mathbf{+0,82 \text{ unité}}$$
Ce résultat positif (+0,82) signale que notre modèle naïf tend légèrement à la sous-estimation : les réalisations dépassent en moyenne les projections d’environ 0,8 pièce par mois. Ce résultat découle mécaniquement de la légère tendance haussière traversant la série, que la prévision naïve réplique avec un temps de retard permanent.
Pour surveiller l’apparition d’une dérive structurelle dangereuse en exploitation industrielle, la supply chain fait appel au Tracking Signal (signal de poursuite). Cet indicateur dynamique se définit comme le ratio de la somme cumulée des erreurs de prévision (CFE, pour Cumulative Forecast Error) rapportée à la MAD courante :
$$\text{Tracking Signal}_t = \frac{\sum_{i=2}^{t} e_i}{\text{MAD}_t}$$
Sous Excel, ce ratio se surveille à chaque période. Tant que le Tracking Signal demeure confiné à l’intérieur d’un intervalle de contrôle standard compris entre -4 et +4, le modèle est déclaré sous contrôle statistique. Dans notre exemple, le Tracking Signal final se monte à $9 / 3,45 = \mathbf{2,61}$. Bien qu’il demeure à l’intérieur des limites admissibles, sa trajectoire constamment positive alerte le planificateur sur le fait que la prévision naïve pure accumule un retard structurel face à l’accroissement continu de la demande.
9. Variantes méthodologiques du modèle naïf dans Excel
9.1 Le modèle naïf avec dérive (Drift Method)
Afin de corriger l’inertie constatée lors de l’application de la méthode naïve standard sur des séries orientées, les théoriciens de la prévision ont élaboré une déclinaison dynamique : la méthode naïve avec dérive (Drift Method ou Random Walk with Drift). Cette approche stipule que la prévision future ne doit pas seulement reproduire la dernière observation, mais doit y agréger la variation moyenne historique observée le long de l’échantillon temporel.
Sur le plan formel, la projection à l’horizon $h$ conditionnée aux observations jusqu’à $T$ s’exprime par :
$$\hat{Y}_{T+h|T} = Y_T + h \left( \frac{Y_T – Y_1}{T – 1} \right)$$
Le terme entre parenthèses formalise le coefficient de dérive directionnelle $\hat{c}$, qui correspond à la pente de la droite reliant directement la toute première observation historique ($Y_1 = 35$) à la toute dernière ($Y_{T} = 44$). Dans notre échantillon de 12 mois, l’accroissement moyen absolu par mois s’établit arithmétiquement à :
$$\hat{c} = \frac{44 – 35}{12 – 1} = \frac{9}{11} \approx \mathbf{0,818 \text{ unité par période}}$$
L’implémentation de la projection hors échantillon pour le Mois 13 sous Excel en bénéficiant de la dérive s’effectue via une formule combinatoire directe en cellule C14 :
=B13 + ( (B13 - B2) / (LIGNES(B2:B13) - 1) )
Alternativement, l’utilisateur peut convoquer la fonction linéaire native d’Excel pour calibrer la pente tendancielle globale : =B13 + PENTE(B2:B13; LIGNE(B2:B13)-LIGNE(B2)+1). L’évaluation de l’équation avec dérive renvoie pour le Mois 13 une projection de 44,82 unités, contre 44,00 pour le modèle naïf pur. En intégrant de façon explicite le vecteur directionnel passé, la méthode avec dérive compense le biais négatif constaté à la section précédente, offrant une trajectoire plus réaliste en présence de tendances monotones.
9.2 Le modèle naïf saisonnier (Seasonal Naive)
Dans un grand nombre d’industries manufacturières ou d’activités tertiaires (agroalimentaire, distribution d’énergie, tourisme), la dynamique temporelle est gouvernée par des oscillations périodiques rigides de nature calendaire. Dans cette conjoncture, projeter la valeur du mois immédiatement antérieur est une hérésie : les ventes de manteaux d’hiver en décembre ne reflètent en rien celles de novembre, mais s’alignent sur les comportements d’achat observés en décembre de l’année précédente.
Pour répondre à cette régularité structurelle, le modèle naïf saisonnier (Seasonal Naive Method) postule que la prévision pour la période actuelle correspond strictement à l’observation réalisée lors de la même saison au cours du cycle périodique précédent. Soit $m$ la durée de la saisonnalité ($m=12$ pour un cycle annuel mensuel, $m=4$ pour des trimestres, $m=7$ pour des jours de la semaine). La formulation théorique s’écrit :
$$\hat{Y}_{t|t-m} = Y_{t-m}$$
Pour implémenter ce modèle dans un tableur Excel structuré sur plusieurs années d’historique mensuel, la formulation change radicalement d’adressage relatif. Si les données démarrent en janvier de l’année 1 en ligne 2, la première prévision saisonnière ne peut être calculée qu’en janvier de l’année 2 (ligne 14). La formule saisie en cellule C14 s’énonce alors :
=B2
L’analyste pointe non pas vers la cellule adjacente supérieure ($t-1$), mais vers la cellule décalée de douze rangs dans le passé ($t-12$). Cette approche élimine l’obligation d’estimer des coefficients saisonniers complexes, des indices multiplicatifs ou des sinusoïdes de Fourier. Si une organisation dispose d’une série chronologique saisonnière stable sans tendance lourde, l’approche naïve saisonnière s’érige en référence méthodologique imbattable, surclassant fréquemment des réseaux récurrents mal entraînés sur des historiques restreints.
10. Restitution visuelle et sémiologie graphique des résultats
10.1 Conception d’un graphique linéaire comparatif sous Excel
La communication managériale de données quantitatives exige une sémiologie graphique rigoureuse respectant les principes d’optimisation du ratio encre-données théorisés par Edward Tufte. L’objectif premier est de restituer visuellement la dynamique de synchronisation et l’effet miroir décalé propres au modèle naïf.
La procédure de construction sous Microsoft Excel s’organise selon le protocole séquentiel suivant :
- Sélectionnez la matrice complète des données comprenant les trois colonnes maîtresses : les libellés de mois (A1:A13), les réalisations effectives (B1:B13) et les prévisions naïves (C1:C13).
- Accédez au ruban Insertion > Graphiques > Graphique en courbes 2D avec marqueurs.
- Procédez à la différenciation stylistique immédiate des séries pour guider la perception cognitive de l’auditoire :
- Série réelle (Ventes observées) : sélectionnez la ligne correspondante, appliquez un trait plein d’un bleu marine profond ou d’un gris anthracite d’une épaisseur de 2,25 points, assorti de marqueurs circulaires discrets. Cette courbe doit incarner l’autorité du fait historique incontestable.
- Série prédictive (Prévision naïve) : sélectionnez la courbe des estimations et appliquez un trait discontinu (tirets moyens) d’une teinte contrastée, par exemple un orange sécurité ou un vermillon, avec une épaisseur légèrement inférieure de 1,5 point.
Cette distinction visuelle met instantanément en relief la signature graphique indélébile de la prévision naïve : la courbe prédictive apparaît comme une réplique exacte de la trajectoire réelle, mais systématiquement décalée d’un pas d’espace vers la droite. Cette lecture visuelle intuitive permet à n’importe quel dirigeant de saisir d’un simple coup d’œil la mécanique d’écho inhérente au modèle.
10.2 Représentation dynamique des écarts résiduels
L’auscultation critique d’un modèle prédictif ne s’arrête pas à la comparaison des séries brutes ; elle nécessite l’analyse visuelle de la distribution des résidus d’erreur dans le temps. Pour réaliser cet audit graphique sous Excel, l’analyste conçoit un graphique combiné d’écarts.
À partir des valeurs de la colonne D (Écarts absolus, D3:D13), insérez un Histogramme groupé 2D. Chaque barre verticale illustre l’amplitude de l’erreur commise lors d’un cycle donné. Afin d’enrichir le niveau d’information du visuel, ajoutez une ligne horizontale de seuil critique matérialisant la MAD (3,45 unités). Cette ligne de repère s’intègre en introduisant une colonne auxiliaire remplie de façon homogène par la valeur 3,45, que l’on trace sous la forme d’une ligne continue rouge fine.
En complément, déployez les mécanismes de mise en forme conditionnelle d’Excel pour dynamiser la lecture du tableau de bord :
- Sélectionnez la plage des écarts absolus D3:D13.
- Naviguez vers Accueil > Mise en forme conditionnelle > Nouvelle règle.
- Définissez la formule d’évaluation :
=D3>$D$15(marquant tout écart unitaire dépassant la MAD globale). - Attribuez un remplissage rouge pastel avec une police bordeaux foncée aux cellules en dépassement.
Cette disposition signale instantanément les mois atypiques (tels que le Mois 4 avec une erreur de 6 unités, ou les Mois 8 et 12 avec 5 unités d’écart), guidant sans délai l’attention des équipes d’audit sur les anomalies méritant une analyse causale approfondie.
11. Facteurs psychologiques dans l’adoption et l’arbitrage managérial
11.1 L’aversion pour la simplicité et le syndrome du sophistiqué
L’implémentation opérationnelle de la prévision naïve se heurte régulièrement à des obstacles d’ordre sociologique et organisationnel au sein des entreprises contemporaines. Le principal frein réside dans ce que les consultants en transformation désignent sous le terme d’aversion pour la simplicité ou « syndrome du sophistiqué ». Dans une culture d’entreprise dominée par la valorisation des technologies d’intelligence artificielle, des réseaux neuronaux profonds et de l’analyse Big Data, proposer une règle décisionnelle formulée par l’égalité =B2 est souvent perçu par le management comme un archaïsme dénué d’ambition intellectuelle.
Ce biais de prestige incite les directions des systèmes d’information et les départements d’analytique financière à financer des projets de modélisation algorithmique extrêmement coûteux, dans l’espoir chimérique de capturer des signaux prédictifs invisibles. Il s’installe une conviction erronée selon laquelle le niveau d’exactitude d’une prévision est mécaniquement corrélé à la complexité de son infrastructure sous-jacente. Les praticiens chevronnés rappellent que cette quête de sophistication conduit fréquemment à des modèles fragiles et hyper-paramétrés, incapables de maintenir leur performance hors échantillon.
Face à ces dérives technologiques, la prévision naïve se pose en parangon de la transparence méthodologique. Sa structure élémentaire garantit une totale explicabilité auprès des parties prenantes non techniciennes. Un directeur financier ou un responsable d’atelier comprend instantanément d’où provient le chiffre inscrit au plan industriel et commercial. Cette transparence élimine l’effet « boîte noire », favorisant une confiance managériale éclairée et facilitant l’auditabilité réglementaire des processus décisionnels.
11.2 Optimisation de la prise de décision sous stress temporel
L’utilité managériale d’un outil prédictif ne s’évalue pas uniquement au prisme de son殚nergie mathématique, mais intègre au premier chef son coût de déploiement temporel et computationnel. En situation de crise de gouvernance, de perturbation logistique mondiale ou de récession macroéconomique brutale, le facteur temps devient la ressource organisationnelle la plus critique. Les modèles économétriques avancés exigent des temps d’ingénierie prohibitifs : nettoyage de bases de données, sélection de covariables, ré-estimation d’hyperparamètres et tests de convergence stationnaire.
À l’inverse, la méthode naïve s’exécute de façon instantanée, sans nécessiter la moindre ressource d’optimisation computationnelle ni l’intervention d’ingénieurs spécialisés en science des données. Dans un contexte de cellule de crise, le tableur Excel s’actualise au fur et à mesure des clôtures comptables journalières ou hebdomadaires sans risque d’instabilité logicielle. Cette instantanéité opérationnelle libère une bande passante cognitive considérable au profit de l’action corrective tactique plutôt que de la spéculation sur les décimales des modèles.
De surcroît, la prévision naïve neutralise les controverses intestines et les tensions interservices relatives aux hypothèses d’extrapolation. En fournissant une projection neutre, mécanique et impersonnelle, elle dépolitise l’élaboration des prévisions. Elle s’érige en garde-fou institutionnel contre les projections ultra-optimistes généralement formulées par les équipes commerciales lors des revues budgétaires, servant d’arbitre froid et factuel face aux désirs d’expansion non étayés par l’historique d’exploitation.
11.3 Intégration du jugement d’expert par ajustement résiduel
Le déploiement de la prévision naïve en environnement d’affaires ne condamne nullement les équipes de direction à une passivité algorithmique aveugle. La méthodologie moderne recommande d’exploiter la prévision naïve comme une base de référence quantitative non biaisée, laquelle est ensuite enrichie par le jugement qualitatif raisonné des experts de terrain. Cette symbiose entre heuristique frugale et apport d’expertise humaine compose ce que la littérature nomme la prévision hybride ou ajustée.
Toutefois, cette intervention manuelle doit faire l’objet d’un encadrement méthodologique strict pour endiguer le biais d’interventionnisme. Les études conduites par Paul Goodwin et Robert Fildes révèlent que les gestionnaires ont une tendance compulsive à ajuster manuellement les prévisions automatiques, même lorsque les variations du marché sont d’origine purement stochastique. Dans plus de 60 % des cas observés, ces micro-ajustements empiriques non documentés dégradent significativement la précision finale par rapport à la trajectoire naïve initiale.
Pour immuniser l’organisation contre cette dégradation cognitive, le protocole d’ingénierie sous Excel doit imposer la tenue d’un registre d’audit formalisé des corrections managériales :
- Conservez intacte la colonne originelle de la prévision naïve brute (colonne C).
- Déployez une colonne complémentaire intitulée
Ajustement managérial motivé, exprimée en écart arithmétique ou en coefficient multiplicateur. - Exigez la consignation obligatoire, dans une cellule textuelle contiguë ou un système de métadonnées, de la justification causale documentée rendant l’intervention légitime (par exemple, la signature d’un contrat cadre d’envergure, l’arrêt planifié d’une ligne de fabrication concurrente, ou une rupture avérée de composant chez un fournisseur clé).
12. Bonnes pratiques, automatisation et protocoles d’extension
12.1 Automatisation et dynamisation du modèle dans Excel
Pour transcender le stade du cas d’école statique et hisser le classeur Excel au niveau d’un outil de production industrielle pérenne, il est impératif de dynamiser l’architecture référentielle. La technique la plus éprouvée consiste à convertir la plage de cellules brutes en un Tableau de données structuré Excel (raccourci clavier Ctrl + L ou Ctrl + T).
Cette conversion offre des bénéfices opérationnels déterminants :
- Auto-expansion structurelle : lorsque l’analyste consigne un nouveau mois d’activité sous la dernière ligne, le tableau s’élargit automatiquement sans nécessiter la copie manuelle des formules d’erreur ou d’écart absolu.
- Références structurées : les formules s’affranchissent des coordonnées matricielles figées ($B3) au profit d’une sémantique lisible et robuste du type
=[@Ventes] - DECALER([@Ventes]; -1; 0), éliminant les corruptions de syntaxes lors des tris ou insertions de colonnes.
Les versions récentes de Microsoft Excel supportant les moteurs de matrices dynamiques permettent également de mobiliser des fonctions modernes pour extraire la projection naïve hors échantillon de façon totalement autonome. Pour récupérer instantanément la dernière valeur observée d’une série sans connaître la dimension exacte du tableau, la syntaxe moderne fait appel aux fonctions matricielles :
=PRENDRE(FILTRE(Tableau1[Ventes]; Tableau1[Ventes]<>""); -1)
Cette formulation filtre les enregistrements vides éventuels et extrait la dernière valeur scalaire valide de la colonne des ventes réelles. Cette logique peut ensuite être incorporée dans un modèle de classeur réutilisable doté de l’extension .xltx, garantissant à l’ensemble des départements opérationnels de l’entreprise l’accès immédiat à un gabarit de modélisation prédictive nativement audité et sécurisé.
12.2 Protocole de sélection : quand abandonner le modèle naïf ?
Le respect scrupuleux de la méthode naïve ne relève pas d’un dogme immuable : elle n’a pas vocation à être conservée si l’environnement d’affaires fournit un signal d’une régularité suffisante pour rentabiliser un investissement méthodologique plus lourd. L’analyste doit instaurer un protocole d’arbitrage objectif dictant le moment exact où le modèle naïf doit être délaissé au profit d’architectures paramétriques plus sophistiquées.
Le diagnostic de rupture s’appuie en premier lieu sur le test d’autocorrélation des résidus. Si les erreurs de prévision de la méthode naïve ($e_t$) présentent une dépendance sérielle significative (mesurable via la statistique de Durbin-Watson accessible sous Excel via des modules d’analyse, ou par le calcul du coefficient de corrélation linéaire entre $e_t$ et $e_{t-1}$ via la fonction =COEFFICIENT.CORRELATION(...)), cela atteste mathématiquement qu’une composante d’information structurée — une inertie cyclique ou une tendance — est laissée en déshérence dans les résidus, attendant d’être modélisée.
L’arbitrage formel s’exécute ensuite par le calcul du coefficient U de Theil (Theil’s U statistic). Cet indicateur statistique compare directement l’erreur quadratique moyenne du modèle élaboré (par exemple, un lissage de Holt-Winters ou une régression exponentielle) à l’erreur quadratique moyenne de la prévision naïve pure :
$$U = \frac{\sqrt{\sum_{t=2}^{T} (Y_t – \hat{Y}_{t}^{\text{Modèle}})^2}}{\sqrt{\sum_{t=2}^{T} (Y_t – \hat{Y}_{t}^{\text{Naïf}})^2}} = \frac{\text{RMSE}_{\text{Modèle}}}{\text{RMSE}_{\text{Naïf}}}$$
L’interprétation managériale du coefficient U de Theil s’articule selon une règle décisionnelle binaire indiscutable :
- Si $U ge 1$ : Le modèle sophistiqué fait pire ou jeu égal avec la prévision naïve. Il doit être rejeté sans délai : sa complexité mathématique constitue une surcharge inutile qui détruit de la valeur analytique et amplifie le risque opérationnel.
- Si $U < 1$ : Le modèle sophistiqué parvient à réduire la variance de l’erreur au-delà du seuil minimal. L’organisation peut alors légitimement envisager son adoption industrielle, sous réserve que le gain de précision compense le coût de maintenance algorithmique.
12.3 Synthèse procédurale et liste de contrôle pour l’analyste
Pour couronner cette monographie exhaustive de la modélisation naïve sous Microsoft Excel, nous condensons l’ensemble des protocoles opérationnels développés au cours de notre étude au sein d’une liste de contrôle méthodologique standardisée. Avant de diffuser un rapport décisionnel auprès d’un comité de direction, l’analyste d’affaires doit obligatoirement valider chacun des jalons opérationnels suivants :
- Audit de continuité temporelle : S’assurer que l’indexation chronologique (colonne A) ne présente aucune rupture d’équidistance temporelle ($\Delta t$ uniforme) et qu’aucune période d’activité vacante n’a été éludée au sein du jeu d’observations.
- Sanctuarisation de la première période : Vérifier impérativement que la cellule C2 demeure vide ou configurée sur
#N/A, pour éviter l’insertion frauduleuse d’une valeur rétroactive altérant l’indépendance de l’échantillon. - Vérification des liaisons relatives : Examiner la formule logée en C3 (stricte conformité avec la syntaxe
=B2) et confirmer l’absence absolue de symboles de verrouillage$afin de garantir le glissement dynamique de la marche aléatoire. - Validation de la projection hors échantillon : Vérifier que la cellule C14 dédiée au Mois 13 hérite rigoureusement de la dernière observation disponible (Mois 12, cellule B13, affichant la valeur de 44 unités).
- Conformité des métriques de précision : Recouper rigoureusement les métriques globales de synthèse :
- L’écart absolu moyen (MAD) calculé en cellule D15 doit correspondre formellement à 3,45 unités.
- Le pourcentage d’erreur moyen absolu (MAPE) calculé en cellule E15 doit afficher très exactement le score d’excellence de 9,9 %.
- Le biais de prévision moyen (MFE) doit être positivement identifié à environ +0,82 unité, informant les équipes d’une tendance marginale au sous-dimensionnement.
- Documentation des réserves analytiques : Joindre systématiquement à la restitution managériale une note méthodologique explicitant la sensibilité de la prévision future à la volatilité du dernier point d’ancrage, rappelant les conditions d’abandon du modèle au profit de méthodes tendancielles si le coefficient U de Theil venait à l’exiger.
Références
Box, G. E. P., Jenkins, G. M., Reinsel, G. C., & Ljung, G. M. (2015). Time series analysis: Forecasting and control (5th ed.). John Wiley & Sons. https://www.wiley.com/en-us/Time+Series+Analysis
Fildes, R., & Goodwin, P. (2007). Against your better judgment? How organizations can improve their use of management judgment in forecasting. Interfaces, 37(6), 570-576. https://doi.org/10.1287/inte.1070.0309
Gigerenzer, G., & Gaissmaier, W. (2011). Heuristic decision making. Annual Review of Psychology, 62, 451-482. https://doi.org/10.1146/annurev-psych-120709-145346
Hyndman, R. J., & Athanasopoulos, G. (2021). Forecasting: Principles and practice (3rd ed.). OTexts. https://otexts.com/fpp3/
Kahneman, D., & Tversky, A. (1974). Judgment under uncertainty: Heuristics and biases. Science, 185(4157), 1124-1131. https://doi.org/10.1126/science.185.4157.1124
Lewis, C. D. (1982). Industrial and business forecasting methods: A practical guide to exponential smoothing and curve fitting. Butterworth-Heinemann.
Makridakis, S., Wheelwright, S. C., & Hyndman, R. J. (1998). Forecasting: Methods and applications (3rd ed.). John Wiley & Sons. https://www.wiley.com/en-us/Forecasting
Simon, H. A. (1955). A behavioral model of rational choice. The Quarterly Journal of Economics, 69(1), 99-118. https://doi.org/10.2307/1884852
Theil, H. (1966). Applied economic forecasting. North-Holland Publishing Company.