
Dans le champ de l’analyse quantitative, de la psychométrie et des sciences du comportement, l’évaluation numérique des phénomènes humains repose fréquemment sur des indicateurs de synthèse capables de résumer la masse des observations recueillies. Parmi ces outils, les mesures de tendance centrale, au premier rang desquelles trône la moyenne arithmétique, constituent traditionnellement la porte d’entrée de toute démarche descriptive. Pourtant, résumer un ensemble complexe de conduites, d’aptitudes cognitives ou de variables physiologiques à une seule valeur médiane ou centrale revient à ignorer la trame même de la réalité empirique : la diversité interindividuelle. La moyenne informe sur le point d’équilibre d’une série de mesures, mais elle demeure totalement muette quant à la dispersion des observations autour de ce pivot. Deux cohortes cliniques présentant une moyenne d’anxiété rigoureusement identique peuvent recouvrir des réalités psychologiques diamétralement opposées, l’une étant composée d’individus modérément anxieux de façon homogène, tandis que l’autre juxtapose des sujets parfaitement sereins et des patients en état de détresse aiguë.
C’est précisément pour lever cette ambiguïté fondamentale que la statistique descriptive et inférentielle mobilise l’écart-type, désigné sous le terme anglais de standard deviation. Loin de constituer un simple artifice calculatoire ou une exigence purement formelle réservée aux manuels d’économétrie, l’écart-type incarne l’outil par excellence de quantification de l’hétérogénéité d’un groupe. En mesurant la distance typique séparant chaque observation individuelle du centre de gravité de la distribution, il confère une profondeur indispensable aux données chiffrées, transformant un chiffre isolé en une géographie précise des variations humaines. Sans lui, le chercheur navigue à l’aveugle, incapable d’évaluer la représentativité de ses moyennes, la précision de ses instruments ou la robustesse de ses conclusions méthodologiques.
L’objectif du présent traité est d’explorer de manière exhaustive pourquoi l’écart-type constitue la pierre angulaire de la rigueur méthodologique en sciences humaines et médicales. À travers l’examen minutieux de ses fondements conceptuels, le décorticage analytique de son architecture mathématique et l’illustration concrète de son rôle dans des domaines aussi cruciaux que l’évaluation du quotient intellectuel, la psychopathologie cognitive ou l’analyse des traits de personnalité, nous mettrons en lumière la manière dont cette métrique structure notre compréhension du normal, du singulier et du pathologique.
1. Introduction fondamentale : Qu’est-ce que l’écart-type et pourquoi compte-t-il ?
1.1 Définition conceptuelle de la dispersion des données
Pour appréhender la notion d’écart-type, il convient d’abord de clarifier le concept de variabilité, qui se situe au cœur même de toute démarche scientifique s’intéressant au vivant. Dans n’importe quel échantillon issu d’une population humaine, qu’il s’agisse d’étudiants soumis à un examen de mémoire de travail, de patients évaluant leur niveau de douleur chronique ou de candidats passant un test de recrutement, les réponses observées ne sont jamais strictement identiques. Cette fluctuation spontanée reflète la variabilité biologique, environnementale et psychologique inhérente aux systèmes complexes. La statistique descriptive dispose de deux familles d’indices pour appréhender cette matière brute : les paramètres de position, qui localisent le centre d’attraction des données (tels que la moyenne arithmétique, la médiane ou le mode), et les paramètres de dispersion, qui décrivent l’étalement, l’éparpillement ou la concentration de ces mêmes données autour du centre.
L’écart-type se définit formellement comme la mesure standardisée de la distance moyenne — ou plus rigoureusement, de la moyenne quadratique des écarts — qui sépare chaque score individuel de la moyenne arithmétique du groupe. Alors que l’étendue se contente de calculer la différence brute entre la valeur maximale et la valeur minimale d’une série sans se soucier des observations intermédiaires, l’écart-type prend en compte l’intégralité des données disponibles. Chaque participant, par son positionnement singulier, contribue activement à l’élaboration de cette métrique. Une distribution caractérisée par un faible écart-type indique une grande concentration des observations : les sujets se comportent de manière relativement uniforme, oscillant très près de la valeur moyenne. À l’inverse, un écart-type élevé témoigne d’une dispersion substantielle, révélant une population fragmentée, hétérogène, où les écarts individuels par rapport au centre sont prononcés.
La quantification objective de cette hétérogénéité n’est pas un luxe théorique ; elle constitue une exigence épistémologique majeure. En quantifiant la dispersion, l’écart-type permet d’objectiver le degré de cohésion d’un groupe expérimental. Par exemple, affirmer qu’un groupe de sujets âgés met en moyenne 400 millisecondes pour réagir à un stimulus visuel est une information incomplète si l’on ignore si la majorité d’entre eux réagit entre 390 et 410 millisecondes (écart-type faible) ou si les réponses s’échelonnent entre 200 et 600 millisecondes (écart-type massif). Dans le second cas, la moyenne de 400 millisecondes ne constitue qu’un artefact mathématique qui ne reflète la réalité d’aucun sujet réel. L’écart-type rétablit la réalité du terrain contre les simplifications abusives des résumés univariés.
1.2 L’intérêt clinique et méthodologique en sciences humaines
Dans le contexte des sciences humaines et de la psychologie clinique, l’illusion d’uniformité engendrée par le recours exclusif à la moyenne arithmétique représente un écueil diagnostique et thérapeutique redoutable. Lorsqu’un praticien examine l’efficacité d’un protocole de remédiation cognitive pour des enfants présentant des troubles de l’attention, une amélioration moyenne de 15 % du score d’attention sélective peut masquer des trajectoires de développement divergentes. Une analyse approfondie de la dispersion via l’écart-type peut mettre en évidence qu’une partie de la cohorte a progressé de manière spectaculaire tandis qu’une autre a stagné ou s’est détériorée. Sans la mesure de l’écart-type pré- et post-intervention, cette réalité clinique demeure totalement invisible, conduisant potentiellement à l’adoption généralisée d’une intervention inadaptée à certains sous-profils cliniques.
Sur le plan de la méthodologie de recherche, l’identification précise des variations interindividuelles au sein d’une cohorte conditionne directement la validité interne et externe des résultats. En psychométrie contemporaine, la qualité d’une échelle de mesure — qu’il s’agisse d’un questionnaire mesurant l’épuisement professionnel ou d’une batterie neuropsychologique évaluant les fonctions exécutives — dépend intrinsèquement de sa capacité à capturer la variance réelle du construit étudié. Si un test psychologique engendre un écart-type excessivement restreint au sein de la population générale, cela dénote généralement un effet de plancher ou un effet de plafond, signifiant que l’outil échoue à discriminer les nuances subtiles qui séparent les individus. L’écart-type sert ainsi de baromètre pour attester de la sensibilité et de la puissance discriminante des instruments de mesure.
Enfin, la représentativité des données et l’inférence statistique reposent sur l’estimation rigoureuse de la dispersion. Lorsqu’un échantillon présente une dispersion disproportionnée, la marge d’erreur entourant toute tentative de généralisation des résultats à la population globale s’accroît de façon exponentielle. L’écart-type permet ainsi d’évaluer dans quelle mesure l’échantillon étudié constitue un miroir fidèle ou déformant de la réalité populationnelle. Il offre au chercheur la boussole méthodologique nécessaire pour déterminer si les variations observées entre différentes conditions expérimentales découlent d’un phénomène véritablement robuste ou d’un simple bruit de fond statistique lié à l’instabilité naturelle des réponses individuelles.
2. La formule mathématique de l’écart-type décryptée pas à pas
2.1 Anatomie de l’équation de l’échantillon
Pour comprendre la puissance heuristique de l’écart-type, il est impératif de se pencher sur son architecture mathématique. Loin d’être une formule arbitraire, son équation découle d’une logique rigoureuse visant à mesurer l’éloignement sans subir les annulations algébriques parasites. Pour un échantillon de taille n, la formule standard s’énonce comme suit :
$$s = \sqrt{\frac{\sum_{i=1}^{n} (x_i – \bar{x})^2}{n – 1}}$$
L’analyse pas à pas des composantes de cette équation révèle la mécanique sous-jacente du calcul de dispersion :
- Les écarts individuels $(x_i – \bar{x})$ : Cette première étape consiste à calculer la distance linéaire qui sépare chaque score individuel $x_i$ de la moyenne de l’échantillon $\bar{x}$. Si une observation est supérieure à la moyenne, l’écart est positif ; si elle lui est inférieure, l’écart est négatif. Si l’on tentait d’additionner simplement ces écarts bruts pour obtenir une déviation totale, la somme obtenue serait rigoureusement égale à zéro, car les déviations positives et négatives s’annulent mutuellement en vertu des propriétés algébriques fondamentales de la moyenne arithmétique.
- L’élévation au carré $(x_i – \bar{x})^2$ : Pour contourner cette neutralisation mathématique, chaque écart individuel est élevé au carré. Cette opération transforme obligatoirement toutes les valeurs en quantités strictement positives. Parallèlement, l’élévation au carré possède une propriété géométrique capitale : elle accorde un poids disproportionné aux déviations massives. Un écart de 4 unités se transforme en 16, tandis qu’un écart de 2 unités devient 4. Cette pénalisation accentuée des scores très éloignés du centre reflète la volonté méthodologique de considérer les grandes divergences comme des anomalies structurelles plus informatives que les menues variations périphériques.
- La somme des carrés des écarts $\sum (x_i – \bar{x})^2$ : Souvent abrégée sous le sigle SCE (ou SS pour Sum of Squares), cette somme consolide l’ensemble de la variabilité brute présente dans le jeu de données. Elle représente l’énergie dispersive totale de l’échantillon avant toute tentative de normalisation par le nombre d’observations.
- Le diviseur $(n – 1)$ et les degrés de liberté : Contrairement à ce que l’intuition arithmétique suggérerait — à savoir diviser simplement par l’effectif total n pour obtenir une moyenne des carrés —, l’équation applique ici ce que l’on nomme la correction de Bessel. En soustrayant 1 à la taille de l’échantillon, on intègre la contrainte des degrés de liberté. Étant donné que la moyenne de l’échantillon $\bar{x}$ a déjà été calculée à partir des données, les $(n – 1)$ premiers scores sont libres de varier, mais le dernier score est mathématiquement déterminé pour que la moyenne globale soit respectée. Diviser par $(n – 1)$ compense la tendance naturelle d’un échantillon restreint à sous-estimer la variabilité réelle de la population parente.
- L’extraction de la racine carrée $\sqrt{dots}$ : L’étape ultime du processus consiste à extraire la racine carrée du quotient obtenu. Le ratio situé sous le radical constitue la variance ($s^2$), une métrique exprimée dans le carré de l’unité de mesure initiale (par exemple, des millisecondes au carré ou des points d’anxiété au carré). L’application de la racine carrée annule cette mise au carré initiale et ramène la statistique à l’unité de mesure d’origine du phénomène observé. Ainsi, un écart-type de 15 points de quotient intellectuel s’interprète directement dans l’échelle d’administration du test.
2.2 Différence cruciale entre écart-type d’échantillon et de population
La distinction entre la statistique descriptive d’un échantillon particulier et le paramètre théorique d’une population globale gouverne toute la théorie de l’échantillonnage probabiliste. Dans la littérature académique et les logiciels de traitement de données, cette frontière s’incarne par une différenciation rigoureuse des notations conventionnelles : l’écart-type d’une population entière est désigné par la lettre grecque minuscule $\sigma$ (sigma), tandis que l’écart-type calculé sur un échantillon extrait de cette population est noté par la lettre latine $s$ (ou parfois $SD$ pour Standard Deviation). Cette nuance typographique dissimule une divergence mathématique et conceptuelle de premier ordre qui influence directement la validité des inférences statistiques conduites en laboratoire.
Lorsque l’on possède l’intégralité des données exhaustives d’une population finie — cas de figure exceptionnel dans la recherche empirique, mais envisageable lors du recensement exhaustif d’une institution fermée —, le calcul de l’écart-type de population $\sigma$ utilise au dénominateur l’effectif total $N$ sans modification :
$$\sigma = \sqrt{\frac{\sum_{i=1}^{N} (X_i – \mu)^2}{N}}$$
Dans cette formule, $\mu$ représente la véritable moyenne populationnelle. En revanche, lorsque les chercheurs travaillent sur un échantillon probabiliste pour estimer les paramètres inconnus de la population, l’utilisation naïve de $n$ au dénominateur engendre un estimateur biaisé. En effet, les scores d’un échantillon ont statistiquement tendance à être plus proches de leur propre moyenne d’échantillon $\bar{x}$ qu’ils ne le sont de la véritable moyenne populationnelle inconnue $\mu$. Ce phénomène mécanique entraîne une sous-estimation systématique de la dispersion réelle du phénomène dans la nature.
L’adoption du dénominateur $(n – 1)$ corrige rigoureusement ce biais mathématique, faisant de la variance de l’échantillon un estimateur sans biais de la variance populationnelle. Lorsque la taille de l’échantillon est massive (par exemple, plusieurs milliers de participants), la différence numérique entre $n$ et $(n – 1)$ devient virtuellement négligeable. En revanche, dans le cadre d’études expérimentales portant sur des échantillons cliniques restreints (par exemple, des cohortes de 15 à 30 patients atteints de pathologies neurodégénératives rares), omettre la correction de Bessel induit une distorsion substantielle. Cette sous-estimation de la variabilité produit des intervalles de confiance artificiellement resserrés et gonfle indûment le taux d’erreur de première espèce ($\alpha$), poussant le chercheur à déclarer significatifs des effets qui ne sont en réalité que le produit du hasard d’échantillonnage.
3. Au-delà de la moyenne : Pourquoi la tendance centrale ne suffit pas
3.1 Le piège de la moyenne identique
L’un des enseignements cardinaux de la statistique descriptive réside dans le postulat suivant : une mesure de tendance centrale considérée isolément fournit une représentation tronquée, voire trompeuse, de la réalité d’un ensemble de données. Pour illustrer de façon tangible ce « piège de la moyenne », considérons un scénario pédagogique impliquant deux classes distinctes d’étudiants ayant composé sur le même examen standardisé de neuropsychologie clinique, noté sur 100 points.
Dans la première cohorte (Groupe Alpha), composée de cinq étudiants, les scores obtenus s’établissent comme suit : 48, 49, 50, 51 et 52. La moyenne arithmétique de ce groupe s’élève rigoureusement à 50 points sur 100. Dans la seconde cohorte (Groupe Bêta), également constituée de cinq individus, les notes observées sont radicalement différentes : 10, 20, 50, 80 et 90. Le calcul de la moyenne arithmétique pour ce second collectif donne également :
$$\bar{x} = \frac{10 + 20 + 50 + 80 + 90}{5} = \frac{250}{5} = 50$$
Si un administrateur universitaire ou un chercheur se fiait exclusivement à la moyenne arithmétique pour évaluer le niveau académique de ces deux classes, il conclurait à une équivalence parfaite de leurs performances d’apprentissage. Pourtant, l’analyse clinique de ces distributions révèle deux dynamiques pédagogiques aux antipodes l’une de l’autre. Le Groupe Alpha se caractérise par une homogénéité remarquable : chaque étudiant maîtrise environ la moitié du programme, et l’écart-type de cette cohorte est extrêmement restreint ($s \approx 1,58$). L’enseignant fait face à un groupe uni, pour lequel un ajustement global du cours sera bénéfique à tous les membres de manière similaire.
À l’inverse, le Groupe Bêta présente une hétérogénéité polarisée avec un écart-type considérable ($s \approx 35,36$). Dans cette classe, la moyenne de 50 points ne correspond à la réalité d’aucun profil clinique ou pédagogique concret, à l’exception d’un seul individu isolé. Le groupe se subdivise en réalité en deux sous-populations extrêmes : d’une part, des étudiants en situation de décrochage critique (notes de 10 et 20) nécessitant un soutien d’urgence, et d’autre part, des étudiants faisant preuve d’une excellente maîtrise des compétences requises (notes de 80 et 90) pour lesquels le contenu standard s’avère manifestement sous-stimulant. Fonder une décision pédagogique ou institutionnelle sur la seule moyenne reviendrait ici à ignorer une fracture académique majeure, prouvant de manière éclatante l’insuffisance ontologique de la tendance centrale non assortie de sa mesure de dispersion.
3.2 La complémentarité incontournable des deux métriques
L’évaluation scientifique des données empiriques exige une synergie indissociable entre paramètres de position et paramètres de dispersion. En statistique appliquée, ces deux dimensions fonctionnent à la manière des coordonnées cartésiennes d’un espace géographique : la moyenne (ou la médiane) fixe la latitude du phénomène sur l’axe des valeurs mesurées, tandis que l’écart-type définit son étendue longitudinale et sa géométrie interne. Pris isolément, chacun de ces indices produit une description borgne de la structure sous-jacente des observations.
Cette complémentarité fonctionnelle s’avère particulièrement cruciale dans l’établissement des profils psychologiques individuels. Lorsqu’un neuropsychologue analyse la batterie de tests d’un patient victime d’un traumatisme crânien, un score brut n’a aucune signification clinique intrinsèque. Si le patient obtient un score de 42 à un test de fluence verbale sémantique, cette valeur brute ne révèle rien tant qu’elle n’est pas confrontée à la distribution normative de référence. Si la population générale d’âge et de niveau socioculturel comparables présente une moyenne de 40 avec un écart-type de 2, le score de 42 situe le patient à une déviation standard complète au-dessus de la moyenne, témoignant d’une préservation optimale de la fonction lexicale. Si, au contraire, la norme générale affiche une moyenne de 40 mais avec un écart-type de 15, ce même score de 42 se noie dans la variabilité interindividuelle banale, ne reflétant aucune supériorité particulière.
Dans le domaine de la décision clinique et de la recherche expérimentale, la prise en compte simultanée du couple moyenne/écart-type protège le chercheur contre les biais d’interprétation les plus pernicieux. Lors de la comparaison de deux groupes au moyen d’un test d’hypothèse paramétrique, l’amplitude de la différence entre les deux moyennes (le signal expérimental) doit systématiquement être mise en rapport avec la dispersion interne de chaque groupe (le bruit statistique de fond). Deux moyennes très distantes peuvent perdre toute signification statistique si la variabilité interne des cohortes est titanesque ; à l’inverse, une modeste différence de moyennes peut s’avérer hautement significative si les écarts-types respectifs sont infinitésimaux. C’est de cette dialectique permanente entre le signal et le bruit que découle l’édifice de la statistique moderne.
4. L’importance de l’écart-type dans la recherche en psychologie
4.1 Mesure de la fidélité et de l’erreur de mesure
Dans la recherche contemporaine en psychologie et en sciences de l’éducation, la précision des instruments d’évaluation constitue un défi méthodologique permanent. Tout instrument psychométrique, qu’il mesure l’intelligence émotionnelle, l’estime de soi ou le raisonnement abstrait, est inévitablement entaché d’un certain degré d’imprécision inhérent à la mesure du comportement humain. La théorie classique des tests (TCT) formalise cette réalité au travers du célèbre postulat de Charles Spearman : le score observé d’un sujet ($X$) est la résultante de l’addition de son score vrai théorique ($V$) et d’une composante d’erreur aléatoire de mesure ($E$), soit l’équation $X = V + E$. C’est ici que l’écart-type intervient comme un outil d’arbitrage méthodologique incontournable.
La dispersion de ces erreurs aléatoires autour du score vrai définit l’erreur type de mesure (ETM), dont la formule dépend directement de l’écart-type global de l’échantillon de standardisation ($s_X$) et du coefficient de fidélité du test ($r_{xx’}$) :
$$\text{ETM} = s_X \sqrt{1 – r_{xx’}}$$
Cette équation illustre magnifiquement la filiation directe unissant l’écart-type à la métrologie clinique. Sans un calcul précis de l’écart-type de l’échelle, il est rigoureusement impossible de déterminer l’intervalle de confiance à l’intérieur duquel oscille le score véritable d’un sujet avec un degré de certitude donné (généralement 95 %). Par exemple, si un clinicien sait que l’écart-type d’une échelle de dépression est de 8 points et que son coefficient de consistance interne est modeste, l’ETM qui en découle permettra de comprendre qu’un score observé de 24 points peut en réalité recouvrir un score vrai compris entre 18 et 30 points. Cette prise de conscience probabiliste, entièrement tributaire de l’écart-type, évite aux thérapeutes de surinterpréter de légères fluctuations de scores entre deux consultations successives, ces variations n’étant bien souvent que l’expression de l’oscillation naturelle de l’erreur de mesure.
Sur le versant des protocoles expérimentaux, la fidélité de la réplication des données entre différents laboratoires dépend directement du contrôle exercé sur l’écart-type des mesures. Lorsqu’une expérience psychophysiologique enregistrant des potentiels évoqués visuels ou des variations de la conductance cutanée rapporte un écart-type disproportionné au sein de ses groupes de contrôle, la probabilité que d’autres équipes scientifiques parviennent à reproduire la significativité statistique de l’effet tend vers zéro. La maîtrise de la dispersion, documentée méticuleusement par l’écart-type, constitue le garant fondamental de la transition de la psychologie depuis un statut spéculatif vers celui d’une science cumulative et réplicable.
4.2 Calcul de la taille d’effet et puissance statistique
L’évolution épistémologique récente de la recherche empirique a conduit la communauté internationale des chercheurs à se détacher de la soumission aveugle à la seule valeur $p$ ($p$-value) pour embrasser la quantification concrète de la magnitude des phénomènes découverts. Cette révolution méthodologique repose sur le calcul de la taille d’effet (effect size), dont l’indicateur le plus universellement employé dans les protocoles comparatifs est le $d$ de Cohen. Or, la définition même du $d$ de Cohen repose entièrement sur une standardisation de la différence des moyennes par l’écart-type combiné des groupes étudiés :
$$d = \frac{\bar{x}_1 – \bar{x}_2}{s_{\text{combiné}}}$$
Dans cette formalisation mathématique, l’écart-type joue le rôle de dénominateur universel. Une différence brute de 5 points entre un groupe expérimental recevant une thérapie innovante et un groupe témoin placé sur liste d’attente ne possède aucune signification universelle en soi. Si l’écart-type combiné ($s_{\text{combiné}}$) est de 20 points, le ratio aboutit à un $d$ de Cohen égal à $5 / 20 = 0,25$, ce qui correspond selon les critères conventionnels établis par Jacob Cohen (1988) à un effet de faible ampleur clinique. En revanche, si la même différence brute de 5 points s’observe au sein d’une population extrêmement homogène dont l’écart-type n’excède pas 2,5 points, le ratio s’élève à $5 / 2,5 = 2,0$, traduisant un effet expérimental titanesque, capable de modifier radicalement les pratiques de soin.
De surcroît, l’écart-type influe de façon déterminante sur la puissance statistique ($\beta$) des modèles inférentiels classiques, tels que les tests $t$ de Student ou les analyses de variance (ANOVA). Dans ces modélisations, la statistique de test calculée est proportionnelle au rapport entre la variance expliquée par le traitement et la variance résiduelle non contrôlée. Lorsque l’écart-type au sein des échantillons s’accroît, le dénominateur des tests paramétriques gonfle, diluant le signal recherché et précipitant l’effondrement de la puissance statistique de l’étude. Pour compenser un écart-type d’échantillon trop vaste et maintenir une probabilité acceptable de détecter un effet réel s’il existe, les chercheurs sont contraints de recruter des cohortes d’une taille logistiquement prohibitive. La gestion, la compréhension et la minimisation rigoureuse du bruit de dispersion via le prisme de l’écart-type conditionnent donc la viabilité financière, logistique et théorique de tout programme de recherche en sciences humaines.
5. La distribution normale et la règle empirique (68-95-99,7)
5.1 Les fondements de la loi normale en psychométrie
La prépondérance de l’écart-type dans la boîte à outils du psychologue et du statisticien est indissociable d’un objet mathématique fondamental : la distribution normale, immortalisée par Carl Friedrich Gauss sous la forme de sa célèbre courbe en cloche. Dans les sciences du comportement, un très vaste éventail de dimensions psychologiques, cognitives et morphologiques — qu’il s’agisse de la capacité d’empathie, de la vitesse de traitement de l’information, de la mémoire de travail ou de la taille corporelle — tend à se distribuer selon cette loi de probabilité continue dès lors que la mesure agrège un grand nombre de facteurs génétiques et environnementaux indépendants, en vertu du théorème central limite.
La courbe de Gauss se distingue par une élégance géométrique et des propriétés formelles remarquables :
- Une symétrie bilatérale parfaite : La courbe est parfaitement symétrique autour de son axe vertical central. À cet endroit précis se confondent rigoureusement les trois paramètres de tendance centrale : la moyenne, la médiane et le mode. Le sommet de la cloche représente ainsi à la fois la performance la plus fréquente, le point de bascule séparant les 50 % supérieurs des 50 % inférieurs, et l’espérance mathématique de la variable.
- Le rôle géométrique de l’écart-type comme point d’inflexion : Alors que la moyenne gouverne l’ancrage horizontal du sommet de la cloche, l’écart-type conditionne sa silhouette et son étalement. D’un point de vue analytique, l’écart-type possède une traduction géométrique d’une précision mathématique absolue : il marque l’abscisse exacte des points d’inflexion de la courbe. C’est à la distance précise d’un écart-type de la moyenne ($\mu \pm 1\sigma$) que la concavité de la courbe bascule, passant d’une courbure tournée vers le bas (forme de dôme) à une courbure orientée vers le haut (forme d’ailes étalées).
- L’indépendance de l’échelle : Quelle que soit la dimension physique ou psychologique mesurée, dès lors qu’une variable suit une distribution gaussienne, sa structure probabiliste interne peut être entièrement décrite par seulement deux paramètres : sa moyenne ($\mu$) et son écart-type ($\sigma$). L’écart-type devient ainsi l’unité de mesure métrique naturelle de la distribution.
Cette modélisation confère à l’écart-type une universalité conceptuelle inégalée : il cesse d’être une simple mesure empirique pour devenir une fonction de calibrage mathématique de l’ensemble de l’espace d’observation psychologique.
5.2 Application concrète de la règle des trois sigmas
L’intégration conjointe de la loi normale et de l’écart-type permet d’énoncer un théorème descriptif d’une utilité pratique monumentale en méthodologie expérimentale et en psychométrie : la règle empirique, communément désignée sous l’appellation de « règle des 68-95-99,7 » ou règle des trois sigmas. Cette propriété mathématique définit avec une rigueur déterministe le pourcentage de la population regroupé à l’intérieur de zones spécifiques délimitées par des multiples de l’écart-type autour du centre de gravité :
Dans un premier temps, l’intervalle délimité par $[\mu – 1\sigma , ; , \mu + 1\sigma]$ englobe précisément 68,26 % de l’ensemble des observations. Dans la pratique psychométrique courante, cette bande centrale constitue la zone d’expressivité modérée ou banale d’une conduite humaine. Un clinicien évaluant une cohorte normale sait que plus de deux tiers des individus manifesteront des performances oscillant à l’intérieur de cette fenêtre d’un écart-type de part et d’autre de la moyenne. C’est le sanctuaire de la norme statistique de premier niveau.
Dans un second temps, lorsque l’on élargit les bornes pour englober deux écarts-types de part et d’autre de la moyenne, soit l’intervalle $[\mu – 2\sigma , ; , \mu + 2\sigma]$, la surface sous la courbe accueille désormais 95,44 % de la distribution totale. Les individus dont les scores franchissent ces frontières se situent dans les fractions résiduelles de part et d’autre de la cloche (environ 2,28 % dans la queue inférieure et 2,28 % dans la queue supérieure). Dans la quasi-totalité des disciplines médicales et psychologiques, cet intervalle de deux écarts-types délimite la frontière conventionnelle de la normalité fonctionnelle. Tout franchissement de ce seuil signale une déviation suffisamment atypique pour justifier une attention clinique ou une qualification diagnostique spécifique.
Enfin, l’intervalle étendu à trois écarts-types, défini par $[\mu – 3\sigma , ; , \mu + 3\sigma]$, capture 99,73 % de la population théorique. Les données émergeant au-delà de cette frontière titanesque ne concernent qu’une infime fraction résiduelle d’environ 0,27 % de la totalité des cas (soit environ un individu sur 370). En laboratoire, les observations identifiées au-delà du seuil de $\pm 3\sigma$ sont immédiatement catégorisées comme des valeurs hautement singulières, voire des données aberrantes (outliers), imposant des vérifications méthodologiques scrupuleuses pour éliminer toute erreur de codage, de saisie ou de dysfonctionnement technique des appareils de mesure.
6. Écart-type vs Autres mesures de dispersion
6.1 Comparaison avec la variance et l’étendue
Pour apprécier pleinement l’hégémonie de l’écart-type dans la littérature scientifique contemporaine, il est instructif de le confronter aux autres mesures de variabilité traditionnellement disponibles en statistique descriptive, à savoir la variance d’une part et l’étendue d’autre part. Chacune de ces métriques possède une utilité technique propre, mais l’écart-type résout avec brio les limitations structurelles qui pénalisent ses concurrentes immédiates.
La variance ($s^2$), qui constitue mathématiquement le cœur algébrique de l’écart-type avant l’extraction finale de la racine carrée, offre des propriétés de décomposition analytique indispensables. Elle permet notamment d’effectuer des calculs d’additivité statistique sophistiqués au sein des modèles linéaires généraux (tels que la décomposition de la variance inter-groupes et intra-groupes dans les analyses factorielles). Cependant, la variance souffre d’un défaut rédhibitoire pour l’esprit humain et la communication scientifique : son inadéquation métrique absolue avec le phénomène étudié. Si un psychologue du travail évalue le temps de réaction de contrôleurs aériens mesuré en secondes, la variance de son échantillon s’exprimera en « secondes au carré » ($\text{s}^2$). Si un neuropsychologue mesure le volume hippocampique en millimètres cubes, la variance s’exprimera en millimètres à la puissance six ($\text{mm}^6$). Cette distorsion d’échelle rend toute interprétation intuitive ou clinique littéralement impossible. L’écart-type, en restaurant l’unité de mesure primitive grâce à l’opération de racine carrée, réconcilie la rigueur algébrique avec l’intelligibilité phénoménologique la plus totale.
À l’opposé de la complexité de la variance se trouve l’étendue (ou range), qui représente la mesure de dispersion la plus primaire qui soit, calculée par la simple soustraction $X_{\max} – X_{\min}$. Si sa facilité d’obtention est imbattable, sa vulnérabilité statistique est dramatique. L’étendue ne mobilise que deux points d’ancrage arbitraires et ignore délibérément la totalité des observations situées entre ces deux extrémités. Il suffit qu’un seul participant distrait coche par erreur la valeur maximale d’une échelle de Likert, ou qu’un patient présente un score aberré en raison d’un malaise passager durant la passation, pour que l’étendue soit multipliée par dix, dépeignant une fausse image d’éparpillement généralisé. L’écart-type, en moyennant quadratiquement l’ensemble exhaustif des écarts individuels, dilue l’impact des variations accidentelles isolées tout en demeurant fermement ancré dans la structure globale de l’échantillon.
6.2 Écart-type versus écart interquartile (EIQ)
Face aux limites de l’écart-type lorsqu’il s’agit de traiter des distributions manifestement asymétriques ou parasitées par des valeurs résolument aberrantes, les méthodologistes se tournent fréquemment vers l’écart interquartile (EIQ, ou IQR pour Interquartile Range). L’EIQ se définit formellement comme la distance séparant le troisième quartile ($Q_3$, le 75e percentile) du premier quartile ($Q_1$, le 25e percentile), soit l’équation élémentaire :
$$\text{EIQ} = Q_3 – Q_1$$
Cette métrique quantifie l’étendue occupée par les 50 % centraux de la population observée. Contrairement à l’écart-type, qui prend en compte chaque millimètre de déviation d’une valeur extrême (en l’élevant de surcroît au carré), l’écart interquartile est une statistique dite robuste. Il fait preuve d’une imperméabilité totale face aux distorsions marginales : qu’un sujet atypique obtienne un score modérément élevé ou un score astronomique situé à mille lieues de la norme, les positions relatives des quartiles $Q_1$ et $Q_3$ demeurent rigoureusement immobiles.
Le tableau comparatif suivant illustre les arbitrages épistémologiques et méthodologiques qui dictent le choix entre ces deux instruments d’évaluation de la dispersion :
- Forme de la distribution : L’écart-type constitue le paramètre optimal et mathématiquement exhaustif lorsque la distribution des données est approximativement symétrique et suit une allure normale (mésokurtique). L’écart interquartile s’impose impérativement dès lors que les données présentent une asymétrie marquée (positive ou négative) ou une distribution bimodale.
- Sensibilité aux données aberrantes : L’écart-type présente une très forte sensibilité aux outliers ; une seule valeur erronée peut le faire doubler ou tripler. L’écart interquartile présente une sensibilité nulle ou négligeable face aux scores aberrants situés en deçà du 25e percentile ou au-delà du 75e percentile.
- Propriétés mathématiques et inférence : L’écart-type s’intègre avec une fluidité remarquable dans la théorie des probabilités, les équations différentielles, les régressions et les tests paramétriques classiques ($z$, $t$, $F$). L’écart interquartile ne se prête que difficilement aux dérivations algébriques complexes et se cantonne généralement à la statistique non paramétrique et aux représentations graphiques en boîtes à moustaches (boxplots).
- Paramètre central associé : L’écart-type forme un couple méthodologique indissociable avec la moyenne arithmétique. L’écart interquartile s’associe structurellement avec la médiane.
Le chercheur rigoureux ne doit donc pas envisager ces deux grandeurs comme des rivales idéologiques, mais plutôt comme des outils d’analyse complémentaires. Si l’écart-type demeure l’étalon d’or incontesté des architectures de modélisation mathématique standard, l’écart interquartile constitue le filet de sécurité méthodologique par excellence pour diagnostiquer et cartographier les réalités cliniques hautement hétérodoxes.
7. Exemple concret 1 : L’évaluation de l’intelligence et des scores de QI
7.1 Standardisation des échelles de Wechsler
L’un des exemples les plus éclatants et universellement reconnus de l’application pratique de l’écart-type en sciences humaines réside dans la psychométrie cognitive contemporaine, et plus particulièrement dans le calibrage des échelles d’intelligence pour enfants et adultes développées par David Wechsler (notamment le WISC-V et la WAIS-IV). Historiquement, les premiers tests de développement intellectuel élaborés par Alfred Binet calculaient un âge mental qu’ils divisaient par l’âge chronologique réel de l’enfant pour obtenir un « quotient » au sens arithmétique strict du terme. Cette approche souffrait toutefois de limites théoriques majeures, notamment l’impossibilité d’évaluer de façon sensée les adultes, dont le développement cognitif ne croît plus linéairement avec le temps chronologique.
Wechsler a révolutionné l’évaluation psychologique en introduisant le concept de « QI standardisé » ou « QI par déviation », un dispositif d’étalonnage mathématique dont la viabilité dépend en totalité de la standardisation par l’écart-type. Lors des vastes opérations d’échantillonnage normatif menées à l’échelle nationale, les scores bruts recueillis à travers les différents sous-tests (mémoire des chiffres, cubes, matrices, similitudes) sont projetés sur une distribution théorique normale dont la moyenne arithmétique globale est conventionnellement fixée à 100 et l’écart-type à 15 :
$$\mu = 100, \quad \sigma = 15$$
Grâce à ce calibrage d’une élégance absolue, le score de QI d’un individu ne reflète plus une capacité intrinsèque absolue, mais sa position ordinale relative au sein de son groupe de référence d’âge équivalent. L’écart-type de 15 points devient la règle graduée fondamentale permettant de naviguer dans le spectre cognitif :
- Le cœur de la normalité (QI 85 à 115) : Cet intervalle encadre la performance comprise entre $[\mu – 1\sigma]$ et $[\mu + 1\sigma]$. En vertu de la règle empirique de Gauss, cette bande héberge précisément 68,26 % de la population globale. Un individu obtenant un score de 105 ou de 95 ne présente aucune divergence cognitive significative : il évolue en plein centre statistique de l’intelligence moyenne standard.
- Les variations modérées (+1 et -1 écart-type) : Un score de 115 place un sujet exactement à $+1\sigma$ au-dessus de la moyenne. L’intégration de la loi normale permet de déduire immédiatement que ce candidat surpasse environ 84,1 % de la population générale (les 50 % situés sous la moyenne plus les 34,1 % situés entre la moyenne et le premier écart-type). Inversement, un score de 85 ($-1\sigma$) indique que l’individu ne dépasse que 15,9 % de ses pairs.
Sans la fixation standardisée de cet écart-type à 15 points, les scores de QI perdraient instantanément toute universalité. C’est l’écart-type qui confère aux échelles d’intelligence leur comparabilité à travers les décennies, les cultures et les instruments de mesure.
7.2 Critères diagnostiques de la déficience et du haut potentiel
L’impact concret de l’écart-type dans la société dépasse largement la théorie statistique ; il possède des conséquences juridiques, éducatives, médicales et socio-économiques majeures, particulièrement lors de la pose de diagnostics cliniques différentiels à chaque extrémité de la distribution du fonctionnement intellectuel. Le cadre nosographique contemporain, adopté conjointement par le Manuel diagnostique et statistique des troubles mentaux (DSM-5) de l’Association Américaine de Psychiatrie et par la Classification Internationale des Maladies (CIM-11) de l’Organisation Mondiale de la Santé, s’appuie structurellement sur l’écart-type pour tracer les frontières de l’atypie cognitive.
Dans le registre des performances cognitives particulièrement élevées, le seuil identifiant le haut potentiel intellectuel (HPI) a été conventionnellement fixé par la communauté scientifique internationale à une distance d’exactement deux écarts-types au-dessus de la moyenne populationnelle :
$$\text{Seuil HPI} = \mu + 2\sigma = 100 + (2 \times 15) = 130$$
Un score supérieur ou égal à 130 isole les 2,28 % supérieurs de la distribution générale (soit moins d’une personne sur quarante). Ce repérage psychométrique normé conditionne souvent l’accès à des filières scolaires aménagées, à des programmes d’enrichissement pédagogique ou à des bilans de fonctionnement affectif adaptés.
À l’opposé du spectre cognitif, le critère psychométrique de la déficience intellectuelle (ou trouble du développement intellectuel) est symétriquement ancré à une distance de deux écarts-types en deçà de la moyenne :
$$\text{Seuil Déficience} = \mu – 2\sigma = 100 – (2 \times 15) = 70$$
Un quotient intellectuel inférieur ou égal à 70 place le sujet dans la tranche des 2,28 % les plus fragiles de la cohorte. Ce seuil statistique précis ne constitue pas une simple curiosité académique : il s’érige en prérequis médico-légal impératif pour l’octroi de ressources institutionnelles fondamentales, telles que la reconnaissance d’un statut de handicap, l’attribution de financements d’aide sociale, l’intervention d’auxiliaires de vie scolaire ou l’admission au sein d’instituts médico-éducatifs spécialisés.
Une erreur d’estimation de seulement 2 ou 3 points sur l’écart-type lors de l’étalonnage national d’une échelle de Wechsler aurait pour conséquence tragique d’inclure ou d’exclure indûment des dizaines de milliers de personnes de l’accès à ces aides vitales. Cet enjeu souligne avec force la responsabilité sociétale qui pèse sur la calibration métrologique de cette statistique de dispersion.
8. Exemple concret 2 : L’évaluation des interventions thérapeutiques et du stress
8.1 Mesure de la réponse clinique à une thérapie cognitivo-comportementale
L’évaluation de l’efficacité des protocoles thérapeutiques en santé mentale constitue un terrain privilégié pour observer l’utilité clinique de l’écart-type. Imaginons une étude clinique randomisée contrôlée examinant l’impact d’un programme standardisé de psychothérapie cognitivo-comportementale (TCC) de 12 semaines sur des patients souffrant de trouble d’anxiété généralisée (TAG). La sévérité de l’anxiété est quantifiée au moyen de l’échelle validée GAD-7 (Generalized Anxiety Disorder-7), cotée de 0 à 21 points.
Avant le lancement de l’intervention, la cohorte expérimentale de 100 patients affiche un score moyen d’anxiété de 16,5 points, avec un écart-type restreint de $s = 2,1$. Cette configuration témoigne d’un échantillon uniformément en souffrance, solidement ancré dans la catégorie de l’anxiété sévère. À l’issue des douze semaines de prise en charge psychothérapeutique, l’évaluation post-traitement révèle que le score moyen a chuté à 8,2 points, signalant une atténuation globale spectaculaire de la symptomatologie anxieuse moyenne. Toutefois, si le clinicien se limite à ce constat, il passe à côté de l’information thérapeutique la plus révélatrice.
C’est l’examen attentif de l’écart-type post-intervention qui transforme le diagnostic méthodologique :
Si l’écart-type post-thérapeutique s’est contracté à $s = 1,2$, le clinicien assiste à une homogénéisation du bien-être. La thérapie a fonctionné de façon uniforme et cohérente sur l’ensemble de la cohorte : chaque participant a répondu de manière positive et prévisible au protocole, validant son application généralisée sans réserve.
En revanche, si les données post-thérapeutiques indiquent un score moyen de 8,2 points mais accompagné d’un écart-type qui a explosé à $s = 6,8$, la conclusion clinique s’inverse radicalement. Cette divergence massive des scores signale que la moyenne est désormais un trompe-l’œil masquant une fracture thérapeutique. Une analyse désagrégée montrera invariablement que l’échantillon s’est scindé en deux sous-groupes : d’un côté, d’excellents répondeurs dont les scores sont tombés près de zéro (rémission complète), et de l’autre, des patients non-répondeurs — voire des patients victimes d’une aggravation paradoxale — dont les scores stagnent à 18 ou 19 points. L’écart-type devient ici un indicateur direct de l’hétérogénéité de la réponse au traitement, forçant l’équipe soignante à investiguer les modérateurs cliniques (traumatismes de l’enfance, comorbidités dépressives, observance thérapeutique) responsables de cette divergence de trajectoires cliniques.
8.2 Variabilité des biomarqueurs du stress en laboratoire
Dans le domaine de la psychoneuroendocrinologie et de la médecine comportementale, l’écart-type joue un rôle diagnostique tout aussi crucial dans l’interprétation des biomarqueurs physiologiques du stress, au premier rang desquels figure la cinétique du cortisol salivaire. Lorsqu’un protocole expérimental en laboratoire confronte des volontaires sains à un stresseur psychosocial standardisé — à l’instar du prestigieux Trier Social Stress Test (TSST), qui combine une prise de parole en public improvisée et une épreuve d’arithmétique mentale sous le regard impassible d’un jury d’experts —, l’organisme réagit par une cascade neuroendocrine orchestrée par l’axe hypothalamo-hypophyso-surrénalien (HHS).
Dans les conditions physiologiques basales, le taux de cortisol salivaire mesuré chez des adultes sains au repos présente une moyenne de l’ordre de 8 nmol/L avec un écart-type modéré d’environ 2,5 nmol/L. Vingt minutes après l’exposition au stresseur aigu du TSST, la moyenne générale du groupe grimpe substantiellement, atteignant par exemple 22 nmol/L. Cependant, ce qui intéresse au plus haut point les neurobiologistes, c’est l’envolée conjointe de l’écart-type, qui peut passer de 2,5 à plus de 11 nmol/L sous l’effet du stress. Cette démultiplication de la dispersion n’est pas un biais d’échantillonnage ; elle reflète fidèlement la réalité de la régulation biologique face à la menace.
L’analyse clinique de cette variabilité documentée par l’écart-type permet d’isoler des phénotypes neuroendocriniens distincts :
- Les profils hyper-réactifs ($> +2\sigma$) : Ces individus manifestent une décharge cortisolaire disproportionnée par rapport à la moyenne du groupe. Cette réactivité explosive met en lumière une sensibilité exacerbée du système nerveux central, souvent associée à des vulnérabilités psychiques préexistantes, des troubles paniques ou des antécédents de stress chronique altérant la boucle de rétroaction négative des récepteurs aux glucocorticoïdes.
- Les profils hypo-réactifs ($< -2\sigma$) : À l’autre extrémité de la dispersion, certains participants ne présentent quasiment aucune élévation de leur concentration de cortisol salivaire après le stress, conservant des niveaux proches de la ligne de base. Loin d’incarner une zénitude idyllique, cet effondrement de la réactivité physiologique au-delà des bornes standard de l’écart-type est fréquemment le marqueur somatique d’un épuisement neuroendocrine sévère, observable dans le syndrome d’épuisement professionnel (burnout) au stade avancé ou l’état de stress post-traumatique (ESPT).
Sans la quantification millimétrée de la variabilité normale fournie par l’écart-type, il serait impossible d’établir les frontières au-delà desquelles une réponse physiologique cesse d’être adaptative pour devenir pathologique.
9. Exemple concret 3 : La mesure des traits de personnalité (Modèle des Big Five)
9.1 Distribution normative des dimensions de la personnalité
La psychologie différentielle moderne s’est largement unifiée autour du modèle structural des Big Five (ou modèle OCEAN), formalisé par Paul Costa et Robert McCrae, qui postule que la personnalité humaine peut se cartographier le long de cinq grands axes fondamentaux : l’Ouverture à l’expérience, la Conscienciosité, l’Extraversion, l’Agréabilité et le Névrosisme. Contrairement aux typologies antiques ou aux classifications rigides d’inspiration jungienne (telles que le MBTI), le modèle des Big Five n’enferme pas les individus dans des catégories binaires étanches. La personnalité n’est pas faite de cases, mais de continus dimensionnels distribués de façon continue au sein de la population générale selon une allure gaussienne.
Dans ce paradigme psychométrique, l’écart-type constitue la clé de voûte de l’étalonnage des inventaires de personnalité, tels que le NEO-PI-R ou le BFI-2 :
Pour chaque dimension évaluée, les scores bruts sont standardisés afin d’établir des normes représentatives. Prenons l’exemple de l’échelle d’Extraversion, dont le score total théorique oscille entre 0 et 50 points. Si l’échantillon normatif national présente une moyenne $\mu = 30$ avec un écart-type $s = 6$, ces repères statistiques dictent la qualification sémantique et clinique de l’attitude sociale d’un sujet :
- Le registre médian (scores de 24 à 36) : Délimité par l’intervalle $[\mu – 1\sigma , ; , \mu + 1\sigma]$, il englobe environ 68 % des sujets testés. Un score de 28 ne qualifie pas un individu d’introverti, mais d’ambiverti normal : la personne apprécie la sociabilité tout en chérissant les moments de solitude, sans excès comportemental dans un sens ou dans l’autre.
- Le registre modérément typé (scores de 37 à 42, ou de 18 à 23) : Situé entre un et deux écarts-types de part et d’autre de la moyenne, il isole des sujets dont la tendance est clairement affirmée. À $+1,5\sigma$ (score de 39), on décrit une personnalité résolument sociable, proactive et énergique dans les collectifs.
- Le registre extrême ($> 42$ ou $< 18$) : Au-delà de deux écarts-types de la moyenne ($> +2\sigma$ ou $< -2\sigma$), les scores concernent moins de 5 % des individus. À ce niveau de dispersion, l'attitude comportementale sort des nuances habituelles pour imprimer une marque prépondérante et constante sur le fonctionnement quotidien du sujet.
L’écart-type agit ainsi comme un translateur métrique, transformant des points de questionnaires en une qualification graduée, nuancée et scientifiquement éprouvée de la personnalité humaine.
9.2 Distinction entre variation adaptative et trouble de la personnalité
La psychologie de la personnalité ne s’arrête pas à la simple description académique des comportements ordinaires ; elle plonge profondément dans l’analyse clinique des perturbations adaptatives majeures qui fondent la psychopathologie. Dans la section III du DSM-5, le modèle alternatif des troubles de la personnalité repose explicitement sur une approche dimensionnelle où l’écart-type joue le rôle d’opérateur diagnostique de discrimination. La frontière séparant une particularité de caractère tolérable d’un véritable trouble de la personnalité pathologique et invalidant ne repose pas sur une rupture ontologique qualitative, mais sur un éloignement statistique et fonctionnel quantitatif calculé à partir de l’écart-type de la population générale.
Prenons la dimension du Névrosisme (ou Instabilité émotionnelle), qui traduit la propension à éprouver des émotions négatives telles que la peur, la colère, la tristesse, l’anxiété et l’impuissance face aux aléas de l’existence. Une personne se situant à $+1\sigma$ au-dessus de la moyenne de névrosisme présentera une vigilance anxieuse accrue et une réactivité affective sensible, mais conservera généralement une flexibilité psychologique suffisante pour s’adapter à la vie professionnelle et affective. Elle sera perçue comme un individu inquiet ou perfectionniste, sans que son fonctionnement sociétal ne s’effondre. En revanche, lorsque le score franchit le cap des deux ou trois écarts-types au-dessus de la norme ($> +2\sigma$ ou $> +3\sigma$), la variation comportementale quitte le champ de l’adaptativité fonctionnelle. Les schémas de pensée deviennent rigides, envahissants, cataclysmiques, précipitant le sujet dans des troubles anxio-dépressifs récurrents ou configurant la matrice d’un trouble de la personnalité limite (borderline).
Ce recours systématique à l’écart-type pour repérer la dangerosité fonctionnelle trouve une application tout aussi stratégique en psychologie organisationnelle et dans la sélection de profils à haut risque. Pour le recrutement de pilotes de ligne, d’opérateurs de centrales nucléaires ou de membres d’unités d’intervention d’élite, l’analyse psychométrique élimine impérativement les candidats dont le névrosisme excède la moyenne de plus d’un demi-écart-type, tout en rejetant également ceux dont la conscienciosité se situe en deçà de $-1\sigma$. L’écart-type protège ainsi les organisations contre les erreurs de sélection catastrophiques en objectivant la compatibilité précise entre le profil psychologique d’un individu et les exigences impitoyables de son environnement opérationnel.
10. Les scores standardisés (Z-scores) et leur dépendance à l’écart-type
10.1 Formulation mathématique et logique du score Z
Dans le prolongement direct de la théorie de l’écart-type se trouve l’un des outils de normalisation les plus fondamentaux de toute la méthodologie statistique : le score standardisé, universellement désigné sous le terme de score $Z$ (ou $Z$-score). La raison d’être du score $Z$ répond à une impasse pratique récurrente : comment comparer entre elles des variables hétérogènes mesurées sur des échelles numériques incommensurables ? Comment évaluer si un patient est plus détérioré dans sa vitesse de frappe motrice (mesurée en millisecondes) que dans son rappel libre de mots (mesuré en nombre d’items mémorisés) ou dans sa force de préhension manuelle (mesurée en kilogrammes) ?
Pour résoudre cette incompatibilité ontologique des unités de mesure, le score $Z$ opère une transformation linéaire des données brutes en prenant l’écart-type de la distribution comme unité de mesure relative universelle. La formule de standardisation d’un score individuel $X$ s’exprime ainsi :
$$Z = \frac{X – \mu}{\sigma}$$
Cette équation accomplit deux opérations complémentaires successives :
- Le recentrage $(X – \mu)$ : En soustrayant la moyenne de la population au score brut du sujet, on élimine la constante d’ancrage de l’échelle d’origine. Cette opération recentre l’ensemble de la distribution sur un zéro théorique. Si le score brut est supérieur à la moyenne, le numérateur est positif ; s’il est inférieur, il devient négatif.
- La réduction par l’écart-type $(\div \sigma)$ : En divisant cette déviation brute par l’écart-type de la population, on neutralise l’unité de mesure initiale (les kilogrammes, les secondes ou les points s’annulent au numérateur et au dénominateur). Le score obtenu devient un nombre pur, adimensionnel, qui exprime sans équivoque possible la distance physique séparant le participant du centre, mesurée exclusivement en unités d’écart-type.
Par construction mathématique, toute distribution de variables projetée dans l’espace des scores $Z$ adopte instantanément une moyenne universelle strictement égale à 0 et un écart-type rigoureusement égal à 1 :
$$\mu_Z = 0, \quad \sigma_Z = 1$$
Grâce à cette prouesse calculatoire, l’écart-type transcende sa fonction descriptive locale pour s’ériger en monnaie d’échange universelle de la mesure quantitative. Un score de $Z = +1,5$ signifie sans la moindre ambiguïté que l’observation se situe à un écart-type et demi au-dessus de sa moyenne d’origine, que la variable initiale ait concerné la densité minérale osseuse, le temps de latence oculaire ou l’empathie cognitive.
10.2 Applications pratiques en neuropsychologie et diagnostic
Dans la pratique neuropsychologique quotidienne, la transformation des scores bruts en scores $Z$ conditionne la précision et l’éthique même du diagnostic clinique. Lorsqu’un patient consulte pour une suspicion de trouble neurocognitif majeur (démence de type Alzheimer au stade précoce), le praticien lui administre une batterie exhaustive d’épreuves cognitives hétérogènes : le test de rappel libre/rappel indicé à 16 items (RL/RI-16), le test des tracés (Trail Making Test, parties A et B), l’épreuve des figures de Rey et le test de Stroop. Chacune de ces épreuves produit des métriques radicalement différentes : nombres de mots rappelés, durées en secondes, scores de fidélité graphique ou nombre d’erreurs d’interférence.
La conversion de chaque résultat brut en score $Z$ normé en fonction de l’âge précis et du niveau d’études du patient permet de tracer instantanément un profil neuropsychologique standardisé d’une clarté diagnostique absolue :
Si le patient obtient à la tâche de rappel différé du RL/RI-16 un score correspondant à $Z = -2,8$, le praticien sait immédiatement que la performance mnésique s’effondre à près de trois écarts-types en deçà de la norme attendue. Ce score est pathologique, se situant au-delà du seuil critique habituel de $-2\sigma$. En revanche, si aux épreuves du Trail Making Test mesurant la flexibilité mentale, le même patient réalise des temps équivalant à $Z = +0,3$, ses capacités exécutives s’avèrent parfaitement préservées, logées au cœur de la dispersion ordinaire. L’écart-type permet ainsi d’établir un diagnostic différentiel net entre une atteinte mnésique focale hautement alarmante et la conservation d’autres pans cognitifs, empêchant des diagnostics parcellaires ou erronés.
Cette rigueur métrologique gouverne également les diagnostics neuropsychiatriques d’autres disciplines, comme la rhumatologie ou la pédiatrie. En densitométrie osseuse pour le dépistage de l’ostéoporose, le diagnostic officiel repose exclusivement sur le T-score, qui n’est rien d’autre qu’un score $Z$ comparant la densité minérale du patient à l’écart-type d’une population de référence jeune et saine ; un score de $-2,5$ écarts-types signe formellement la maladie ostéoporotique. Partout où le diagnostic humain se veut scientifique, l’écart-type s’impose comme l’étalon de mesure du réel.
11. Pièges courants, limites et mauvaises interprétations de l’écart-type
11.1 Sensibilité accrue aux valeurs extrêmes
En dépit de sa remarquable puissance théorique et mathématique, l’écart-type n’est pas exempt de limites structurelles que tout chercheur et clinicien doit impérativement maîtriser sous peine de commettre de lourdes bévues interprétatives. La plus fondamentale de ces vulnérabilités réside dans sa sensibilité exacerbée aux valeurs aberrantes ou extrêmes (les fameux outliers), une fragilité méthodologique induite par la nature même de son algorithme de calcul.
Comme nous l’avons disséqué dans l’analyse de sa formule, le calcul de l’écart-type implique d’élever au carré chaque écart $(x_i – \bar{x})^2$. Si cette opération résout avec brio le problème de l’annulation arithmétique des écarts, elle accorde mécaniquement un levier d’influence démesuré aux observations situées aux marges lointaines de la distribution. Considérons une cohorte de dix sujets mesurant le temps de réaction visuel à un signal lumineux, dont les scores en millisecondes sont les suivants : 200, 205, 210, 215, 220, 225, 230, 235, 240 et 245. La moyenne de cet échantillon s’élève à 222,5 ms, et son écart-type est remarquablement compact, s’établissant à environ $s \approx 15,1$ ms. Supposons maintenant que, lors de la saisie numérique des résultats, un expérimentateur distrait ajoute malencontreusement un zéro au dernier score, transformant 245 en 2450 ms (ou qu’un participant s’endorme brièvement sur le dispositif d’enregistrement). La nouvelle moyenne saute à 443 ms, mais l’écart-type s’embrase littéralement pour atteindre $s \approx 705,3$ ms !
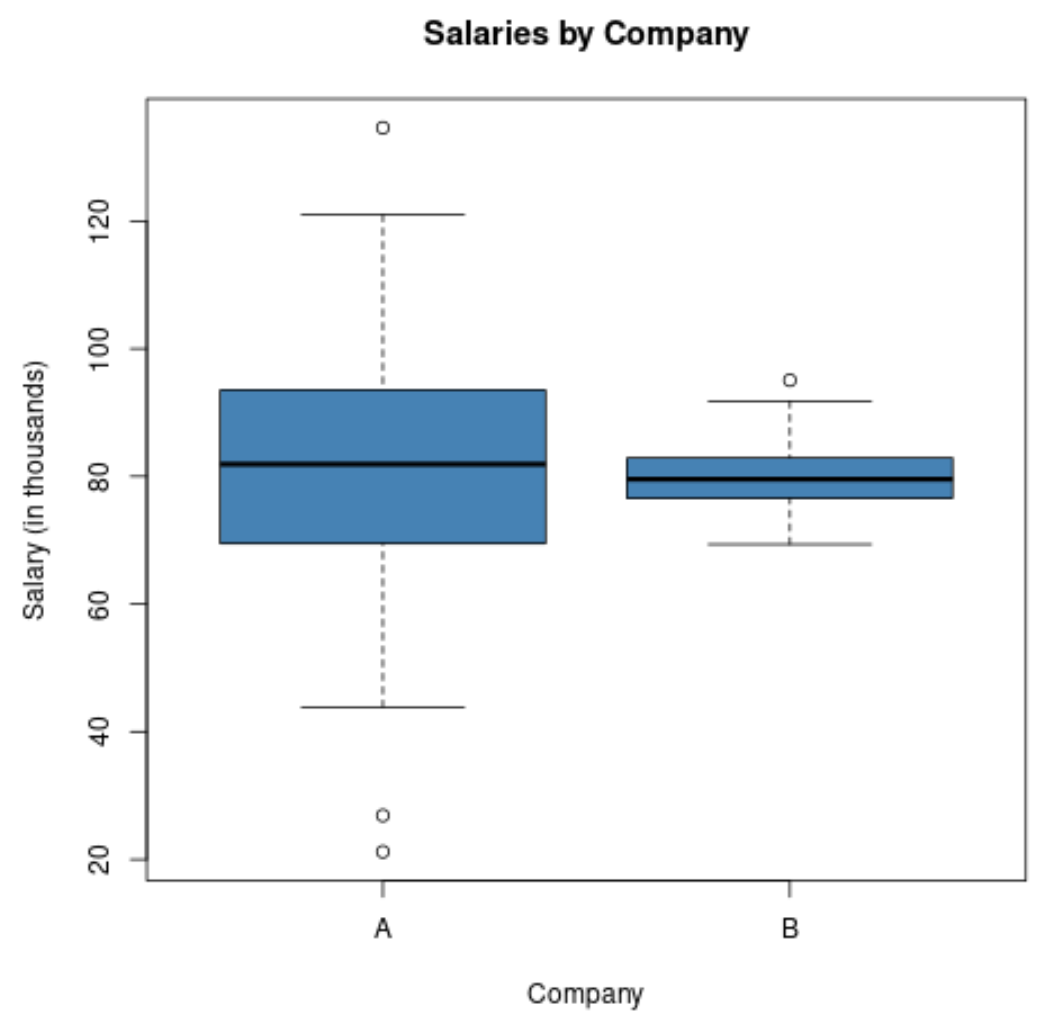
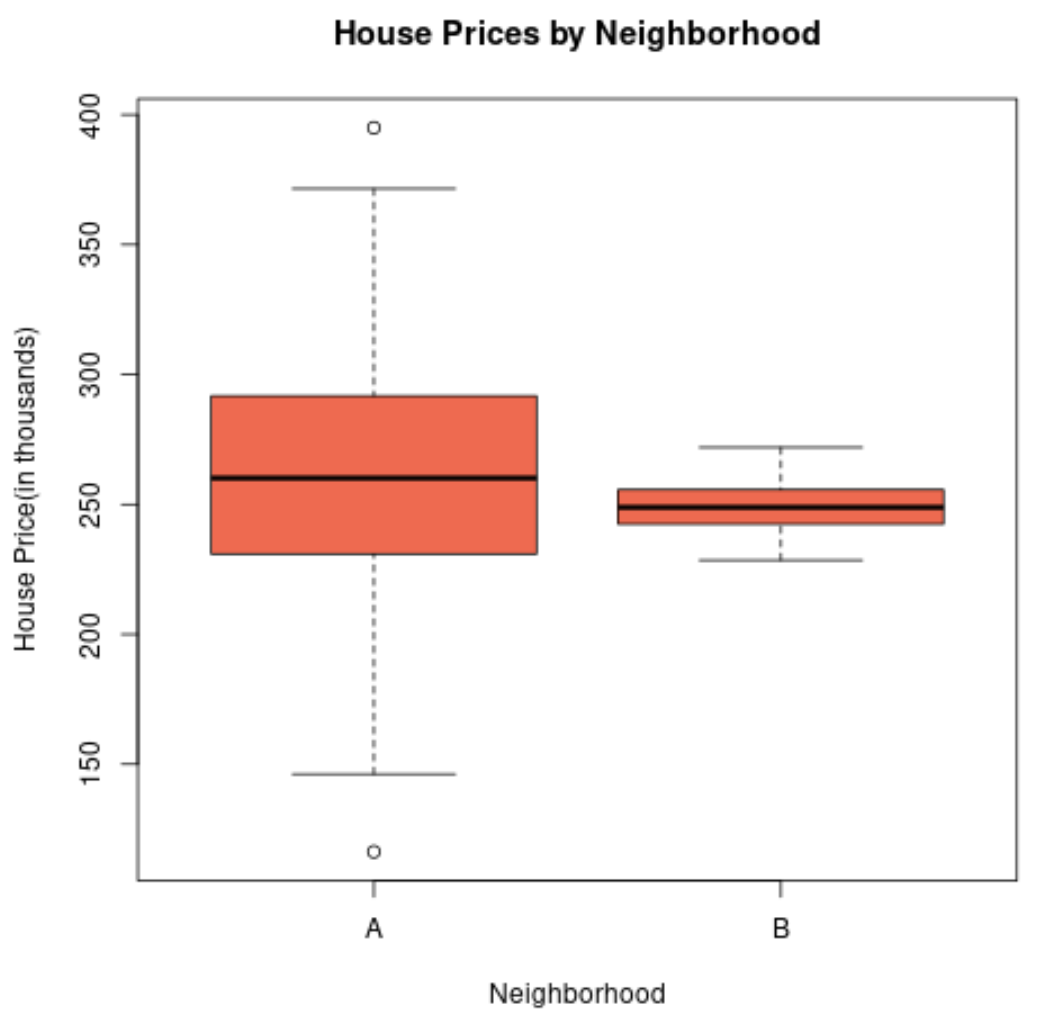
Une unique observation erronée ou exceptionnellement atypique au sein d’un échantillon de taille modérée suffit à défigurer entièrement l’écart-type, multipliant artificiellement sa valeur par cinquante et conférant à l’ensemble du jeu de données une fausse réputation d’éparpillement titanesque. Cet écueil impose aux chercheurs des protocoles stricts de nettoyage préalable des données (data cleaning), combinant la détection visuelle par boîtes à moustaches, le calcul de distances statistiques robustes (comme la distance de Mahalanobis) et, lorsque la distribution s’avère asymétrique ou contaminée de façon irréductible, la substitution de l’écart-type par l’écart interquartile (EIQ) assorti de la médiane.
11.2 Confusion récurrente entre écart-type et erreur type de la moyenne
Parmi l’ensemble des confusions terminologiques et conceptuelles qui pullulent dans les publications scientifiques et les thèses de doctorat, l’assimilation erronée de l’écart-type (SD) à l’erreur type de la moyenne (SEM pour Standard Error of the Mean) figure sans conteste parmi les plus délétères et persistantes. Bien que ces deux métriques partagent des racines calculatoires communes, elles s’adressent à des objets ontologiques radicalement différents :
- L’écart-type ($s$ ou $SD$) est une mesure descriptive de l’échantillon : Il quantifie la variabilité réelle, empirique, biologique ou psychologique existant entre les individus composant l’échantillon étudié. Il décrit la façon dont les scores individuels se dispersent autour de la moyenne observée. Si vous augmentez la taille de votre échantillon en recrutant 1 000 participants au lieu de 100, l’écart-type ne va pas diminuer substantiellement : il va au contraire se stabiliser autour de la véritable variabilité intrinsèque de la population cible.
- L’erreur type de la moyenne ($SEM$) est une mesure inférentielle de la précision de l’estimateur : Elle quantifie l’incertitude entourant l’estimation de la moyenne de la population globale à partir de la moyenne calculée sur notre échantillon unique. Elle correspond mathématiquement à l’écart-type de la distribution d’échantillonnage de la moyenne, et se calcule en divisant l’écart-type de l’échantillon par la racine carrée de la taille de ce dernier :
$$\text{SEM} = \frac{s}{\sqrt{n}}$$
Contrairement à l’écart-type descriptif, l’erreur type dépend mécaniquement et dramatiquement de la taille de l’échantillon $n$. Plus l’effectif recruté augmente, plus le dénominateur $\sqrt{n}$ grandit, compressant l’erreur type vers zéro.
Cette divergence fonctionnelle est fréquemment instrumentalisée, parfois de façon inconsciente, par des auteurs cherchant à embellir visuellement leurs résultats expérimentaux. Dans les graphiques scientifiques illustrant les moyennes de différents groupes, tracer des barres d’erreur basées sur le $SEM$ plutôt que sur le $SD$ produit des moustaches considérablement plus courtes et resserrées, donnant une illusion trompeuse d’homogénéité et de perfection métrologique. Les normes éditoriales les plus strictes de la psychologie contemporaine, portées par l’American Psychological Association (APA), imposent désormais de nommer explicitement la nature des barres d’erreur rapportées et d’utiliser préférentiellement l’écart-type véritable pour restituer fidèlement la réalité de la variabilité interindividuelle observée.
12. Synthèse et perspectives : Pourquoi l’écart-type reste un pilier de la rigueur scientifique
12.1 Intégration systématique dans les modèles statistiques avancés
Au terme de ce panorama analytique, il apparaît avec une éclatante clarté que l’écart-type dépasse très largement le simple rôle d’auxiliaire descriptif de la moyenne arithmétique : il constitue l’ossature fondamentale sur laquelle repose l’ensemble de la modélisation statistique avancée contemporaine. Que l’on considère les régressions linéaires multiples, les modèles mixtes hiérarchiques, les analyses factorielles confirmatoires ou la modélisation par équations structurelles (SEM), l’écart-type est omniprésent comme opérateur d’étalonnage et de contrôle de la variabilité résiduelle.
Dans l’analyse de régression, par exemple, la confrontation de variables prédictives issues d’échelles disparates (comme l’âge en années, le revenu en euros et le score d’anxiété sur une échelle de Likert) interdit toute interprétation comparative directe des coefficients non standardisés ($B$). C’est la standardisation de ces coefficients par le rapport des écarts-types respectifs de la variable prédictive et de la variable dépendante qui engendre les célèbres coefficients bêta standardisés ($\beta$). Ces coefficients $\beta$ permettent enfin au chercheur d’affirmer avec rigueur quelle variable exerce le poids relatif le plus puissant sur le comportement étudié, mesurant l’effet prédictif en fractions d’écart-type.
De surcroît, dans les plans expérimentaux factoriels complexes, la compréhension de la variance d’erreur — qui n’est autre que le carré de l’écart-type intra-groupe non expliqué par les manipulations expérimentales — guide toutes les démarches d’optimisation de la puissance statistique. L’introduction de covariables dans les analyses de covariance (ANCOVA) a précisément pour finalité mathématique d’absorber une portion de la dispersion brute des données afin de réduire artificiellement l’écart-type d’erreur résiduel. En diminuant ce dénominateur, le signal expérimental émerge avec une netteté décuplée, autorisant la mise en lumière de découvertes scientifiques qui seraient autrement restées ensevelies sous le bruit de fond de la variance non contrôlée.
12.2 Recommandations pour les étudiants et chercheurs praticiens
Face à la centralité méthodologique avérée de l’écart-type, il est indispensable de promouvoir une culture de la rigueur et de la transparence statistique au sein de la communauté des étudiants, des cliniciens et des chercheurs en sciences humaines. Les recommandations suivantes constituent des prérequis déontologiques incontournables pour garantir la qualité de la production scientifique :
- L’association obligatoire de l’écart-type à toute mention de moyenne : Présenter une moyenne isolée dans le texte d’un rapport de recherche ou d’un bilan clinique doit être considéré comme une faute méthodologique majeure. La notation standardisée préconisée par l’APA exige d’associer systématiquement les deux métriques (par exemple sous la forme : $M = 45,2 , ; , SD = 8,4$). Cette habitude linguistique protège immédiatement le lecteur contre le piège de la moyenne aveugle.
- La clarté absolue des représentations iconographiques : Lors de l’élaboration de figures, d’histogrammes ou de diagrammes en barres, les auteurs doivent spécifier explicitement dans la légende si les barres d’erreur représentent des écarts-types ($SD$), des erreurs types de la moyenne ($SEM$) ou des intervalles de confiance à 95 %. L’utilisation de représentations graphiques plus riches, telles que les diagrammes en violon (violin plots) combinant la distribution de densité, la boîte à moustaches et l’écart-type, doit être encouragée pour restituer la topographie intégrale du phénomène.
- La vérification systématique de l’homoscédasticité : Dans les comparaisons de groupes, l’égalité des écarts-types entre les différentes conditions expérimentales (le postulat d’homogénéité des variances ou homoscédasticité, vérifié par le test de Levene) constitue une condition sine qua non de la validité de la plupart des tests paramétriques. Si les écarts-types divergent de façon flagrante, le chercheur doit obligatoirement abandonner le test $t$ classique pour adopter des alternatives robustes, telles que le test de Welch.
- Le respect de la complexité du vivant : Enfin, l’écart-type rappelle en permanence au chercheur comme au praticien une vérité philosophique profonde : la variabilité n’est pas un ennemi ou un déchet analytique à éradiquer, mais l’expression la plus pure de la singularité des trajectoires humaines. Apprendre à mesurer, décrypter et respecter l’écart-type, c’est conférer à la science psychologique la précision métrique nécessaire pour appréhender toute la richesse du spectre de l’esprit humain.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical Power Analysis for the Behavioral Sciences (2nd ed.). Lawrence Erlbaum Associates. https://www.sciencedirect.com/book/9780121790608/statistical-power-analysis-for-the-behavioral-sciences
- Costa, P. T., & McCrae, R. R. (1992). Revised NEO Personality Inventory (NEO-PI-R) and NEO Five-Factor Inventory (NEO-FFI) professional manual. Psychological Assessment Resources.
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7-29. https://doi.org/10.1177/0956797613504966
- Field, A. (2018). Discovering Statistics Using IBM SPSS Statistics (5th ed.). SAGE Publications.
- Hays, W. L. (1994). Statistics (5th ed.). Harcourt Brace College Publishers.
- Howell, D. C. (2012). Statistical Methods for Psychology (8th ed.). Cengage Learning.
- Kruschke, J. K. (2015). Doing Bayesian Data Analysis: A Tutorial with R, JAGS, and Stan (2nd ed.). Academic Press. https://doi.org/10.1016/B978-0-12-405888-0.09999-2
- Nunnally, J. C., & Bernstein, I. H. (1994). Psychometric Theory (3rd ed.). McGraw-Hill.
- Tabachnick, B. G., & Fidell, L. S. (2019). Using Multivariate Statistics (7th ed.). Pearson.
- Wechsler, D. (2008). Wechsler Adult Intelligence Scale–Fourth Edition (WAIS-IV). NCS Pearson.
- World Health Organization. (2019). International Statistical Classification of Diseases and Related Health Problems (11th ed.). World Health Organization. https://icd.who.int