
Dans le vaste champ de la recherche scientifique contemporaine, qu’il s’agisse de la psychologie cognitive, de la biomédecine, des neurosciences ou des sciences sociales computationnelles, la démonstration irréfutable de relations de causalité demeure la pierre angulaire de l’édifice empirique. Face à la variabilité intrinsèque et ubiquitaire des organismes vivants, l’expérimentateur se heurte continuellement au défi d’isoler l’impact authentique d’une variable indépendante au milieu d’un océan de bruits parasites et de facteurs confondants. Les différences interindividuelles, telles que les prédispositions génétiques, le quotient intellectuel, le statut socio-économique ou l’histoire développementale, introduisent une hétérogénéité substantielle qui menace d’obscurcir l’effet de traitement ou de susciter des inférences trompeuses si elles ne sont pas méthodologiquement jugulées.
Pour répondre à cette contrainte épistémologique majeure, l’ingénierie des protocoles expérimentaux a donné naissance à des architectures méthodologiques raffinées, parmi lesquelles le devis à paires appariées (ou matched pairs design) occupe une place d’élection remarquable. Positionné à la croisée des chemins entre les protocoles inter-sujets (visant l’indépendance des observations) et les protocoles intra-sujets (fondés sur la répétition des mesures au sein d’une même unité biologique), ce devis propose une synthèse opérationnelle brillante : simuler la comparabilité parfaite du sujet utilisé comme son propre témoin tout en évitant les écueils rédhibitoires des contaminations temporelles, des effets d’apprentissage ou des séquelles irréversibles de traitement.
Le présent article propose une analyse exhaustive, rigoureuse et multidimensionnelle du devis expérimental à paires appariées. À travers l’examen minutieux de ses assises épistémologiques, de sa modélisation mathématique et statistique, de son déploiement logistique au moyen d’algorithmes d’optimisation dyadique, et par l’étude détaillée d’exemples canoniques puisés dans la littérature clinique et comportementale, ce guide doctoral a vocation à constituer le manuel de référence pour les chercheurs, statisticiens et méthodologistes désireux de maximiser la puissance de leurs tests empiriques tout en blindant la validité interne de leurs inférences causales.
1. Introduction et fondements conceptuels du plan à paires appariées
1.1 Origine et place dans la typologie des devis expérimentaux
L’histoire de l’expérimentation contrôlée en sciences du comportement et en biologie humaine s’est forgée autour de la quête permanente de neutralisation de l’erreur expérimentale. Dès les premières formalisations statistiques initiées par Sir Ronald A. Fisher au début du XXe siècle au sein de la station agronomique de Rothamsted, la nécessité de contrôler la variabilité non maîtrisée a conduit à l’invention de structures par blocs randomisés. Transposé aux sciences humaines et biomédicales, où les « parcelles de terre » deviennent des êtres humains dotés d’une variabilité psychologique et biologique incommensurable, le devis à paires appariées s’est imposé comme la miniaturisation ultime du plan en blocs : un bloc composé d’exactement deux unités expérimentales rendues artificiellement jumelles sur des dimensions critiques.
Dans la typologie canonique des plans de recherche, le plan à paires appariées occupe un positionnement intermédiaire hautement stratégique entre le devis inter-sujets classique (ou plan à groupes complètement randomisés) et le devis intra-sujets (ou plan à mesures répétées). Dans un devis inter-sujets traditionnel, chaque participant est assigné de façon purement aléatoire à l’une des conditions expérimentales. Si la loi des grands nombres garantit théoriquement une égalisation asymptotique des caractéristiques individuelles entre les groupes lorsque les effectifs tendent vers l’infini, elle s’avère cruellement défaillante en présence d’échantillons restreints, laissant subsister des déséquilibres initiaux dramatiques. À l’opposé, le plan intra-sujets résout cette hétérogénéité en soumettant chaque participant à l’ensemble des modalités du facteur étudié, faisant de chaque individu son propre contrôle absolu. Toutefois, ce dernier modèle est fréquemment inapplicable dès lors que l’intervention engendre un apprentissage indélébile, une modification cognitive structurelle ou une guérison clinique définitive.
C’est précisément pour combler cette aporie méthodologique que le devis à paires appariées s’articule. Son objectif fondamental réside dans l’élimination quasi-totale de la variance d’erreur imputable aux différences individuelles non pertinentes, sans pour autant exposer le sujet à de multiples traitements successifs. Face à des contraintes de recrutement drastiques, fréquentes dans l’étude des pathologies rares, des sous-populations neuropsychologiques ou des protocoles chirurgicaux de pointe, ce devis représente la solution par excellence pour extraire un signal causal net au sein d’un échantillon intrinsèquement limité en effectif, en transformant le bruit interindividuel en une variance contrôlée et extraite de l’estimation de l’erreur résiduelle.
1.2 Principe épistémologique de l’équivalence des groupes
Sur le plan de la philosophie des sciences et de l’épistémologie de l’inférence causale, formalisée notamment dans le cadre des résultats potentiels de Rubin (Rubin Causal Model), la validité d’une conclusion causale repose sur l’hypothèse d’échangeabilité contrefactuelle. Cette hypothèse postule que le groupe exposé au traitement expérimental aurait manifesté la même trajectoire moyenne que le groupe témoin s’il avait été privé de cette intervention, et vice-versa. Dans un cadre randomisé classique, cette comparabilité découle de l’équiprobabilité de l’assignation. Dans le devis à paires appariées, cette équivalence n’est pas abandonnée aux seuls caprices du hasard stochastique : elle est délibérément construite, en amont, par une homogénéisation structurelle des unités comparées.
Le postulat sous-jacent repose sur la neutralisation a priori des facteurs de confusion majeurs. En constituant des dyades de sujets partageant des valeurs identiques ou quasi-identiques sur des variables dont on sait qu’elles influencent lourdement la variable dépendante, l’expérimentateur force le modèle expérimental à une comparabilité maximale. Cette démarche induit une homogénéité artificielle entre les groupes formés par la partition des paires. Dès lors, toute divergence observée post-intervention entre les membres des dyades ne peut logiquement découler des variables d’appariement, puisque celles-ci ont été maintenues constantes au sein de chaque micro-système comparatif que constitue la paire.
Il importe néanmoins d’opérer une distinction théorique fondamentale entre l’équivalence statistique et l’équivalence nominale. L’équivalence nominale, souvent observée dans les quasi-expériences défectueuses, se contente de constater que deux groupes possèdent des moyennes similaires sur une variable (par exemple, un âge moyen de 40 ans dans les deux bras de l’étude), ce qui n’exclut aucunement des disparités de dispersion ou des distributions asymétriques divergentes au sein des cohortes. À l’inverse, l’équivalence statistique produite par le plan à paires appariées est infiniment plus contraignante et puissante : elle garantit une identité distributionnelle locale, individu par individu. Chaque participant du groupe expérimental possède son alter ego direct dans le groupe contrôle, ce qui verrouille la comparabilité au niveau granulaire le plus élevé accessible à l’observation empirique.
1.3 Champ d’application préférentiel en psychologie et sciences sociales
En raison de ses exigences de conception rigoureuses, le devis à paires appariées ne saurait être appliqué de façon universelle et indiscriminée à l’ensemble des problématiques scientifiques ; il trouve son terrain de prédilection dans des contextes expérimentaux bien délimités où ses bénéfices surpassent largement ses coûts logistiques. En psychologie cognitive et comportementale, il constitue l’étalon de référence pour les expérimentations impliquant deux conditions de traitement hautement distinctes dont l’administration séquentielle au même individu détruirait l’intégrité cognitive du phénomène. C’est typiquement le cas des protocoles évaluant des méthodes d’apprentissage contrastées : un étudiant ayant assimilé un corpus pédagogique selon une heuristique spécifique ne peut plus redevenir « naïf » pour servir de contrôle à une méthode concurrente sur le même matériel.
Dans la recherche clinique, psychothérapeutique et psychiatrique, le plan à paires appariées s’impose comme une réponse indispensable face aux contraintes éthiques et pratiques insurmontables associées aux populations vulnérables. Lorsqu’il s’agit de tester l’impact d’une psychothérapie innovante face au traitement usuel chez des patients présentant un état de stress post-traumatique complexe ou une dépression pharmaco-résistante, l’accès aux participants est restreint et l’hétérogénéité symptomatique est vertigineuse. Utiliser un plan inter-sujets simple risquerait d’attribuer par malchance les cas les plus dégradés au groupe témoin, faussant l’évaluation clinique. L’appariement systématique sur la chronicité du trouble, l’intensité de la détresse basale et les comorbidités associées assure une équité expérimentale absolue tout en respectant l’impératif éthique d’optimisation de l’information extraite de chaque individu exposé aux contraintes du protocole.
Enfin, le domaine de la neuropsychologie lésionnelle et de l’évaluation des interventions éducatives ciblées mobilise massivement ce dispositif méthodologique. La singularité anatomique et fonctionnelle des atteintes cérébrales d’origine vasculaire ou traumatique interdit toute randomisation naïve non stratifiée. En associant deux patients présentant des volumes lésionnels identiques, des localisations hémisphériques homologues et des niveaux cognitifs prémorbides équivalents, le neuropsychologue parvient à isoler l’efficience spécifique d’un programme de remédiation cognitive sur tablette face à une prise en charge orthophonique classique. Dans les sciences de l’éducation, ce devis permet de confronter deux curriculums pédagogiques en appariant des enfants sur leurs quotients intellectuels, leurs milieux socioculturels et leurs compétences lexicales initiales, garantissant ainsi que l’avantage académique observé émane du modèle d’enseignement et non de privilèges cognitifs ou environnementaux préalables.
2. Définition rigoureuse et mécanique opérationnelle
2.1 Définition canonique du devis à paires appariées
Sur le plan morphologique et structural, le devis à paires appariées se définit comme un protocole expérimental à deux modalités de traitement dans lequel l’ensemble de l’échantillon d’observation est subdivisé en sous-ensembles d’exactement deux unités expérimentales (appelées dyades ou paires), appariées sur la base d’une proximité géométrique, statistique ou catégorielle définie a priori sur une ou plusieurs variables concomitantes. La règle de démarcation absolue de ce devis réside dans sa limitation stricte à deux conditions de traitement : la modalité expérimentale (ou traitement actif, noté $T_1$) et la modalité témoin (ou traitement de contrôle/comparateur, noté $T_0$).
La mécanique fondamentale repose sur une scission binaire intra-paire : au sein de chaque dyade préalablement constituée, l’un des membres est affecté à la condition $T_1$ tandis que son homologue est assigné à la condition $T_0$. Cette attribution n’est jamais laissée au choix des sujets ni au jugement de l’expérimentateur, mais procède d’une distribution probabiliste stricte, garantissant l’orthogonalité de l’intervention par rapport à toutes les variables non appariées. Il résulte de cette architecture une caractéristique statistique primordiale qui structure l’ensemble de la démarche inférentielle : la dépendance structurelle des données collectées. Les scores observés au sein d’une même paire ne sont pas indépendants, mais corrélés positivement sous l’effet des variables partagées ayant servi à la calibration de la dyade.
Cette covariation délibérément induite modifie profondément l’espace d’échantillonnage de l’expérience. Plutôt que de modéliser $2N$ observations indépendantes réparties dans deux vecteurs orthogonaux, le statisticien traite $N$ unités d’analyse bivariées, où l’objet d’étude empirique n’est plus la valeur brute manifestée par un individu isolé, mais la différence algébrique intra-paire $\Delta_i = Y_{i1} – Y_{i0}$, mesurant l’écart de réponse entre le sujet traité et son jumeau méthodologique au sein de la $i$-ième paire.
2.2 Architecture séquentielle de la mise en œuvre
L’opérationnalisation d’un devis à paires appariées ne tolère aucune improvisation et requiert l’exécution rigoureuse d’une chaîne logistique séquentielle articulée en quatre phases immuables :
- Phase 1 : Recrutement et phénotypage initial (Screening pré-test). L’expérimentateur recrute un bassin de participants éligibles et procède à l’administration d’une batterie d’évaluations standardisées visant à quantifier avec une précision psychométrique ou biométrique maximale les variables sélectionnées pour l’appariement. Aucun traitement n’est administré à ce stade ; l’unique finalité est d’obtenir le vecteur de caractéristiques individuelles $X_k = (x_{k1}, x_{k2}, …, x_{kp})$ pour chaque sujet $k$.
- Phase 2 : Ordonnancement et constitution algorithmique des dyades. Les participants sont ordonnés dans l’espace multidimensionnel défini par les covariables d’intérêt. Selon la nature des variables, un algorithme d’appariement (appariement exact, calcul de la plus petite distance euclidienne ou minimisation de la distance de Mahalanobis) associe les participants deux à deux de manière à minimiser la divergence globale intra-paire $\sum_{i=1}^N d(k, l)$. Tout sujet ne trouvant pas d’homologue dans la plage de tolérance fixée est impitoyablement exclu de la phase subséquente.
- Phase 3 : Randomisation intra-paire de l’affectation. Une fois la dyade ${S_{iA}, S_{iB}}$ irrévocablement scellée, l’expérimentateur procède à un tirage au sort probabiliste ($p = 0{,}5$) pour décider lequel des deux individus intègre le groupe expérimental ($T_1$), son jumeau étant ipso facto assigné au groupe témoin ($T_0$). Cette étape garantit la préservation intégrale du caractère expérimental véritable de la recherche.
- Phase 4 : Administration standardisée et collecte simultanée des données. Les deux membres de chaque dyade sont soumis à leurs protocoles respectifs selon un calendrier strictement contrôlé, minimisant les variations environnementales ou saisonnières. À l’échéance temporelle fixée par le devis, la variable dépendante $Y$ est mesurée avec des instruments identiques pour tous les sujets, permettant l’extraction immédiate des deltas différentiels au sein de chaque paire.
2.3 Différenciation avec les plans factoriels et quasi-expérimentaux
Pour appréhender avec exactitude l’identité méthodologique du plan à paires appariées, il est impératif de dissiper certaines confusions terminologiques et conceptuelles récurrentes dans la littérature empirique, notamment la distinction avec l’appariement par score de propension (propensity score matching) et les plans factoriels classiques.
L’appariement par score de propension, popularisé par Rosenbaum et Rubin, relève du paradigme quasi-expérimental ou observationnel. Dans ce cadre, les données sont collectées a posteriori au sein d’une cohorte où les individus ont déjà choisi ou subi leur statut d’exposition (par exemple, des fumeurs versus des non-fumeurs). L’appariement statistique intervient ex post pour tenter de corriger mathématiquement les biais de sélection massifs inhérents à l’absence de randomisation. En revanche, dans un devis expérimental à paires appariées canonique, le contrôle est instauré ex ante, par conception délibérée du protocole : les participants sont d’abord appariés dans un état de neutralité thérapeutique totale, puis la randomisation intra-paire distribue le traitement de manière prospective. L’appariement expérimental protège ainsi contre les facteurs de confusion inconnus grâce à la randomisation conjointe, prérogative inaccessible aux analyses par score de propension.
Par ailleurs, le plan à paires appariées se distingue radicalement des plans factoriels croisés complexes (tels que les plans $2 \times 2$ ou $3 \times 2$). Un plan factoriel vise à explorer simultanément l’effet principal de plusieurs variables indépendantes ainsi que leurs interactions multiplicatives potentielles au sein d’une matrice de cellules orthogonales. Le plan à paires appariées, lui, refuse d’ériger les variables parasites en facteurs expérimentaux formels ; il ne cherche pas à analyser la variance propre à la variable d’appariement, mais à la court-circuiter en la neutralisant. Il ne comporte qu’un unique facteur expérimental d’intérêt opérationnalisé à strictement deux niveaux, concentrant toute la puissance statistique du dispositif sur le test de l’effet univarié de l’intervention sans dispersion de l’information dans des termes d’interaction marginaux.
3. Les variables d’appariement : Critères de sélection et contrôle méthodologique
3.1 Critères d’identification des variables pertinentes
Le succès d’un plan à paires appariées repose sur la pertinence méthodologique des variables choisies pour constituer les dyades. Apparier des participants sur des critères arbitraires ou dénués de lien fonctionnel avec le phénomène investigué non seulement n’apporte aucun bénéfice, mais dégrade la puissance du dispositif statistique. Le premier critère absolu d’éligibilité réside dans l’existence d’une corrélation empirique et théorique substantielle entre la variable d’appariement potentielle ($Z$) et la variable dépendante ($Y$). En règle générale, l’appariement n’est statistiquement rentable que si le coefficient de corrélation linéaire vérifie $|r_{ZY}| ge 0{,}50$. Lorsque cette corrélation est élevée, la variance partagée entre $Z$ et $Y$ est substantielle, et sa soustraction du terme d’erreur résiduelle induit une réduction drastique de la variance d’échantillonnage.
Le deuxième critère réside dans le potentiel de nuisance de la variable : il doit s’agir d’une source majeure de variance parasite qui, en l’absence de contrôle, risquerait d’introduire un bruit expérimental massif ou de corrompre l’interprétation des résultats. Le troisième critère relève de la métrologie : l’instrument utilisé pour quantifier la variable d’appariement doit présenter des qualités psychométriques irréprochables, caractérisées par une fidélité test-retest irréprochable et une erreur standard de mesure minime. Si l’instrument de mesure préliminaire est affligé d’une faible consistance interne, l’appariement reposera sur des valeurs bruitées, créant une illusion d’équivalence qui trahira la réalité biologique ou psychologique des sujets.
Enfin, la caractéristique mesurée doit faire preuve d’une stabilité temporelle absolue tout au long du déroulement de l’investigation. Une variable oscillant de manière erratique sous l’effet de fluctuations circadiennes, d’états émotionnels transitoires ou de facteurs contextuels incontrôlés ne peut en aucun cas servir d’ancrage méthodologique pour un appariement rigoureux, sous peine de voir les dyades se désynchroniser structurellement avant même l’administration du traitement expérimental.
3.2 Typologie des variables couramment mobilisées
Dans la pratique scientifique, l’éventail des variables mobilisées pour l’appariement se structure autour de quatre grandes classes taxonomiques :
- Variables sociodémographiques fondamentales : L’âge chronologique, le sexe biologique, l’orientation identitaire et le niveau d’éducation formelle constituent les covariables les plus universellement neutralisées. L’âge exerce une influence pervasive sur la vitesse de traitement de l’information, la plasticité neuronale et les paramètres métaboliques, rendant son appariement quasi systématique dans les études sur le vieillissement ou les fonctions cognitives.
- Variables psychométriques et cognitives : Le quotient intellectuel global (évalué via les échelles de Wechsler), la capacité de la mémoire de travail (empan complexe), le niveau de dépression basale (inventaire de Beck) ou les traits de personnalité structurels (modèle du Big Five). Ces métriques permettent de créer des paires d’individus partageant des architectures psychiques équivalentes face aux sollicitations expérimentales.
- Variables physiologiques, biomédicales et biologiques : L’indice de masse corporelle (IMC), la pression artérielle systolique au repos, le profil glycémique à jeun, la charge virale ou la concentration de biomarqueurs neuroendocriniens (tels que le cortisol salivaire). Ces indicateurs sont privilégiés dans les essais cliniques nutritionnels, pharmacologiques ou de gestion du stress aigu.
- La performance au pré-test (la mesure baseline directe) : Il s’agit sans conteste de la variable d’appariement la plus puissante sur le plan méthodologique. Elle consiste à administrer, préalablement à toute intervention, une version parallèle ou strictement identique de la tâche expérimentale finale. La corrélation entre le pré-test et le post-test oscillant fréquemment entre $r = 0{,}70$ et $r = 0{,}90$, l’appariement sur cette métrique permet d’absorber la quasi-totalité de la variance interindividuelle baseline liée à l’aptitude intrinsèque des participants dans la tâche spécifique.
3.3 Risques associés à un sur-appariement ou un sous-appariement
L’acte de sélectionner les covariables d’appariement relève d’un arbitrage méthodologique d’une précision chirurgicale, cerné par deux écueils symétriques : le sous-appariement et le sur-appariement (overmatching).
Le sous-appariement survient lorsque le chercheur omet d’apparier les sujets sur un facteur de confusion de premier ordre, se focalisant sur des variables secondaires. Dans cette configuration, la variance d’erreur demeure excessivement élevée, et un risque résiduel de biais de sélection intra-paire persiste si la randomisation restreinte échoue à équilibrer cette variable omise, compromettant la validité interne du dispositif.
À l’autre extrémité du spectre se dresse le péril du sur-appariement, qui se manifeste sous deux formes distinctes : statistique et opérationnelle. Sur le plan statistique, apparier les participants sur des variables superflues, n’entretenant qu’une corrélation négligeable ($r < 0{,}20$) avec la variable dépendante, constitue une erreur méthodologique pénalisante. Chaque paire formée consomme un degré de liberté lors du test d'hypothèse ultérieur (l'analyse passant de $2N – 2$ à $N – 1$ degrés de liberté). Si la variable d'appariement ne parvient pas à réduire la somme des carrés de l'erreur dans une proportion supérieure à la perte mécanique du dénominateur des degrés de liberté, la puissance statistique globale du test diminue au lieu d'augmenter.
Sur le plan opérationnel, la prolifération excessive des critères d’appariement (tenter d’associer deux sujets ayant exactement le même âge au mois près, le même QI, le même revenu, le même microbiote et le même taux d’insuline) conduit à une impasse logistique absolue connue sous le nom de fléau de la dimensionnalité. L’expérimentateur se retrouve dans l’incapacité matérielle de former des paires au sein de la cohorte recrutée, ce qui l’oblige à rejeter une proportion massive de participants non appariables. Cette attrition artificielle restreint la cohorte finale à un sous-ensemble homogène de profils hyper-spécifiques, ruinant la validité externe et l’écologie des conclusions scientifiques qui ne peuvent plus être extrapolées à la diversité de la population générale.
4. Processus d’assignation aléatoire intra-paire et randomisation
4.1 Nécessité de la randomisation au sein de la dyade
Une incompréhension récurrente chez les chercheurs novices consiste à présumer que l’appariement méticuleux de deux participants dispense l’expérimentateur de recourir au tirage au sort. Cette illusion méthodologique est fatale : l’appariement sans randomisation ne constitue en aucun cas une expérience scientifique véritable, mais retombe au statut de simple étude observationnelle correlative, exposée aux dérives systématiques des biais de sélection.
L’appariement neutralise uniquement les variables spécifiques que l’expérimentateur a explicitement mesurées et intégrées dans sa matrice de constitution des paires. Or, la complexité d’un organisme biologique ou d’un psychisme humain implique l’existence d’une infinité d’autres caractéristiques idiosyncrasiques latentes, non mesurées et parfois conceptuellement insoupçonnées (facteurs épigénétiques, micro-traumatismes infantiles, variations de la motivation du jour, traits de suggestibilité subliminaux). Seule l’assignation strictement aléatoire du traitement au sein de chaque micro-système que représente la dyade possède la puissance probabiliste d’assurer que ces facteurs non contrôlés se répartiront de manière équitable et non biaisée entre la condition expérimentale et la condition témoin.
D’un point de vue inférentiel, la randomisation intra-paire constitue le fondement mathématique irréductible qui légitime l’utilisation ultérieure de la statistique fréquentiste et de la théorie des probabilités. La validité des distributions d’échantillonnage des tests paramétriques (comme le test $t$ de Student) et non paramétriques (comme le test des rangs signés) repose formellement sur l’hypothèse que, sous l’hypothèse nulle ($H_0$), chaque membre de la dyade avait une chance équiprobable ($p = 0{,}5$) de recevoir l’une ou l’autre des assignations thérapeutiques. L’aléa probabiliste est le moteur théorique qui transforme une agrégation artificielle de paires en un protocole de causalité pure.
4.2 Techniques pratiques d’affectation aléatoire
Pour préserver l’imperméabilité du processus d’assignation, la mise en œuvre de la randomisation intra-paire exige des protocoles instrumentaux standardisés écartant tout arbitrage subjectif de l’investigateur. La méthode la plus robuste repose sur l’utilisation d’algorithmes informatiques de génération de nombres pseudo-aléatoires cryptographiquement sécurisés (PRNG), intégrés dans des systèmes de gestion des données cliniques informatisés (EDC).
Dans la pratique de laboratoire, une fois la dyade $i$ constituée et identifiée par ses codes alphanumériques anonymisés ${ID_{i1}, ID_{i2}}$, la séquence de randomisation est générée de façon centralisée par une unité de biostatistique tierce et totalement indépendante de l’équipe de collecte clinique. Pour chaque paire, un générateur binaire attribue le traitement expérimental au sujet 1 ($ID_{i1} to T_1$ et $ID_{i2} to T_0$) si la valeur aléatoire uniforme générée sur l’intervalle $[0, 1[$ est strictement inférieure à $0{,}50$, et l’inverse dans le cas contraire ($ID_{i1} to T_0$ et $ID_{i2} to T_1$).
Dans les protocoles où les dyades se constituent de manière dynamique au fil des inclusions progressives de participants (flux continu de patients dans un service hospitalier), on recourt à la minimisation par blocs permutés intra-paires sous enveloppes scellées opaques et numérotées séquentiellement, ou par notification algorithmique instantanée débloquée uniquement après la saisie définitive des paramètres d’appariement dans le registre centralisé. Cette imperméabilité prévient toute tentative de manipulation consciente ou inconsciente de l’expérimentateur, garantissant une traçabilité d’audit conforme aux exigences internationales des bonnes pratiques cliniques.
4.3 Procédures de contrôle en double insu
L’équivalence structurelle conférée par l’appariement et la pureté probabiliste de la randomisation intra-paire demeurent vulnérables aux artefacts psychologiques si les acteurs de l’expérimentation conservent la connaissance des modalités administrées. L’intégration de protocoles en aveugle constitue donc le prolongement défensif indispensable du plan à paires appariées.
Le contrôle en simple aveugle garantit que les deux membres de chaque dyade ignorent complètement s’ils sont affectés au régime expérimental ou au comparateur neutre. Cette précaution neutralise de facto l’effet placebo différentiel, les distorsions d’auto-évaluation et le biais de désirabilité sociale qui verrait le sujet traité modifier inconsciemment ses conduites quotidiennes pour complaire aux attentes perçues de l’investigateur. Les participants doivent être informés de la teneur générale de l’étude sans que les éléments distinctifs du traitement actif versus témoin ne leur soient divulgués.
Le double insu porte cette rigueur au sommet méthodologique : ni le participant, ni l’évaluateur clinique chargé de mesurer les critères de jugement post-test n’ont accès au décodage de l’assignation intra-paire. Cette précaution est cruciale dans les devis appariés. Étant donné que les deux sujets d’une même dyade possèdent des phénotypes initiaux très similaires, un évaluateur non aveugle conscient du traitement administré pourrait être tenté d’interpréter des nuances comportementales subtiles comme la preuve de l’efficacité thérapeutique, générant un biais de confirmation majeur. Lorsque les interventions sont de nature comportementale ou chirurgicale et interdisent techniquement l’insu de l’intervenant direct (qui sait quelle psychothérapie il dispense), il est impératif d’instaurer un insu rigoureux pour des évaluateurs indépendants (blinded outcome assessors), chargés de coter à l’aveugle les enregistrements audio-vidéo ou les bilans psychométriques standardisés des participants.
5. Exemple canonique détaillé : Étude clinique sur la perte de poids et l’alimentation
5.1 Contexte de l’expérimentation et formulation des hypothèses
Afin d’ancrer les concepts méthodologiques dans une démonstration empirique transparente, considérons un essai clinique interventionnel portant sur la régulation pondérale et le métabolisme des macronutriments. Un consortium de recherche en nutrition médicale formule l’hypothèse de travail selon laquelle un régime nutritionnel innovant à haute teneur protéique et à faible charge glycémique enrichi en fibres spécifiques ($T_1$) induira une réduction de la masse corporelle significativement plus prononcée qu’un protocole diététique isocalorique standard équilibré en macronutriments ($T_0$).
L’évaluation des interventions pondérales est notoirement affligée par une variabilité biologique interindividuelle massive. Le métabolisme de base, l’activité endocrinienne, la thermogenèse adaptative et la lipolyse sont fortement modulés par deux facteurs de confusion déterminants : l’âge chronologique (le métabolisme basal déclinant inexorablement avec l’avancée en âge) et le sexe biologique (la masse musculaire squelettique et la répartition du tissu adipeux présentant un dimorphisme sexuel structurel marqué). Abandonner l’équilibrage de ces facteurs à une randomisation inter-sujets simple sur une cohorte de taille modérée exposerait l’investigation à un déséquilibre de composition : la moindre surreprésentation d’hommes jeunes dans le groupe $T_1$ suffirait à créer une illusion de supériorité métabolique sans lien réel avec le programme nutritionnel.
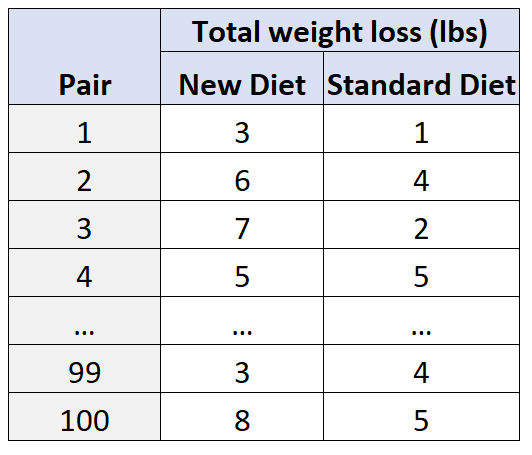
Les chercheurs décident d’adopter un devis expérimental à paires appariées strict. L’hypothèse nulle ($H_0$) opérationnelle stipule que la différence moyenne des pertes de poids intra-paires sera égale à zéro ($\mu_D = 0$). L’hypothèse alternative bilatérale ($H_1$) avance que la différence moyenne intra-paire divergera significativement de zéro ($\mu_D \neq 0$). L’étude recrute un échantillon initial de 100 adultes volontaires présentant un surpoids modéré, avec pour objectif opérationnel la constitution rigoureuse de 50 dyades expérimentales hautement calibrées.
5.2 Constitution concrète des dyades et assignation
La procédure d’appariement est déployée en amont de toute distribution diététique sur la base d’un algorithme d’appariement exact pour la variable catégorielle (sexe biologique) et d’un intervalle de tolérance ultra-strict pour la variable continue (âge chronologique $\pm 1$ an). Ainsi, une femme de 30 ans ne peut être appariée qu’avec une autre femme dont l’âge est rigoureusement compris entre 29 et 31 ans. De manière analogue, un homme de 48 ans est couplé exclusivement à un alter ego masculin âgé de 47 à 49 ans. Pour parfaire l’homogénéité, l’indice de masse corporelle (IMC) de départ est inclus comme variable d’appariement tertiaire, avec une tolérance maximale fixée à $\pm 1{,}5 \text{kg/m}^2$.
L’ensemble de la cohorte est ainsi scindé en 50 dyades mutuellement exclusives. Dès la validation formelle d’une paire, l’unité de biostatistique exécute la randomisation intra-paire par tirage au sort binaire informatisé. Dans chaque paire, le participant $A$ ou le participant $B$ est orienté vers le nouveau régime hyperprotéiné ($T_1$), son jumeau d’étude étant affecté au régime standard de contrôle ($T_0$). L’intervention est déployée avec une standardisation draconienne : la durée d’adhésion au programme est fixée à exactement 30 jours consécutifs. Durant cette fenêtre temporelle, l’apport énergétique global est strictement calibré pour être isocalorique entre les deux membres de chaque dyade, et des repas pré-conditionnés étiquetés en aveugle sont livrés directement aux domiciles des participants afin de garantir une fidélité d’intervention maximale.
5.3 Mesure, recueil et comparaison des deltas individuels
La collecte des données répond à des critères d’évaluation physique méticuleux. La masse corporelle est quantifiée au matin du premier jour (J0 – baseline pré-test) et au matin suivant le trentième jour de l’intervention (J30 – post-test final). Pour évacuer les variations liées à l’état d’hydratation et au transit, les pesées s’effectuent à jeun, vessie vide, à l’aide d’une balance à impédancemétrie médicale de classe III calibrée avec une précision de 50 grammes, sous la supervision d’un infirmier de recherche aveugle aux groupes d’affectation.
Pour chaque participant individuel $k$, la perte de poids nette est calculée par la soustraction différentielle : $\Delta Poids_k = Poids_{\text{initial}} – Poids_{\text{final}}$. Un score positif reflète une déperdition pondérale effective. L’analyse statistique ne s’intéresse pas à la simple juxtaposition des moyennes globales non appariées, mais calcule pour chacune des $N = 50$ paires la variable différentielle appariée $D_i$ :
$$D_i = \Delta Poids_{i(T_1)} – \Delta Poids_{i(T_0)}$$
Cette métrique capture l’avantage (ou le désavantage) pondéral net conféré par le traitement expérimental au sein de la $i$-ième unité biologique appariée. Si, au sein de la paire numéro 12 (composée de deux femmes de 34 ans au profil initial identique), la patiente sous régime hyperprotéiné ($T_1$) a perdu 4,8 kg tandis que sa partenaire sous régime standard ($T_0$) a perdu 2,3 kg, le delta différentiel s’établit à $D_{12} = 4{,}8 – 2{,}3 = +2{,}5 \text{kg}$. Les données consolidées des 50 paires permettent ensuite de dériver la moyenne de ces deltas ($\overline{D}$) et leur variance d’échantillonnage spécifique ($s_D^2$), étapes préalables à la sanction par le test statistique inférentiel.
6. Exemples d’application en psychologie cognitive et expérimentale
6.1 Évaluation de techniques d’apprentissage mnésique
Dans le domaine de la psychologie cognitive appliquée à l’éducation, la question de l’optimisation de la rétention à long terme des concepts complexes a suscité une abondante littérature expérimentale. Considérons une recherche visant à mesurer l’efficacité causale de la répétition espacée (spaced retrieval practice) par rapport à la révision massée intensive (massed cramming) sur la maîtrise d’une nomenclature de neuroanatomie par des étudiants universitaires.
Il est de notoriété scientifique que la capacité intrinsèque de la mémoire de travail et l’empan mnésique de base exercent un pouvoir prédictif écrasant sur l’aptitude à retenir de nouvelles informations abstraites. Soumettre un même étudiant successivement aux deux méthodes sur un corpus similaire induirait une contamination cognitive flagrante : les stratégies métacognitives acquises durant la première modalité seraient inévitablement réinvesties dans la seconde (effet de transfert asymétrique). Le plan à paires appariées offre ici l’architecture méthodologique idéale.
Les étudiants volontaires sont pré-testés à l’aide de l’épreuve standardisée de l’empan de travail envers (Backward Digit Span) et d’un test d’empan d’opérations (Ospan). Des dyades d’étudiants présentant des capacités de rétention basales strictement identiques sont forgées. Au sein de chaque paire, l’un apprend le corpus selon un calendrier d’intervalles exponentiels sur 15 jours, tandis que son homologue l’étudie selon un calendrier massé équivalent en temps cumulé total. À l’issue d’un délai d’oubli de 7 jours post-apprentissage sans aucune révision, un examen terminal standardisé est administré. L’appariement préalable permet d’extraire la variance liée au « génie mnésique » naturel des étudiants, isolant mathématiquement la supériorité structurelle de l’espacement temporel dans la consolidation mnésique synaptique.
6.2 Étude des temps de réaction sous stress sensoriel
La psychologie ergonomique et la recherche sur les facteurs humains exploitent fréquemment le devis à paires appariées pour sonder les limites du système nerveux central face à des environnements perturbateurs extrêmes. Prenons le cas d’une simulation de conduite automobile d’urgence destinée à tester l’effet d’une pollution sonore aiguë (sirènes d’alarme et bruits d’explosion simulés) sur le temps de réaction de freinage face à l’irruption soudaine d’un piéton virtuel sur la chaussée.
Le temps de réaction sensori-moteur brut varie d’un individu à un autre en fonction de variables neurobiologiques difficilement modulables : la conduction nerveuse périphérique, l’acuité visuelle dynamique, l’expérience préalable des jeux vidéo d’action et les antécédents d’heures réelles de conduite automobile au compteur. L’utilisation d’un plan intra-sujets (tester le conducteur d’abord dans le silence, puis sous vacarme sonore) se heurte à un effet d’habituation et d’anticipation motrice inévitable : le conducteur surpris la première fois anticipera le déclenchement de l’événement lors du second passage, réduisant artificiellement son temps de freinage.
Pour contourner ce biais sans perdre la précision de l’équivalence interindividuelle, les chercheurs mesurent au préalable l’acuité visuo-motrice des conducteurs sur une tâche neutre d’écho spatial et apparient les conducteurs sur cette métrique conjointe avec leurs années d’expérience de permis. Chaque paire ainsi synchronisée voit l’un de ses membres placé dans le cockpit sous environnement sonore calme et l’autre sous tempête acoustique stochastique. L’évaluation milliseconde du déclenchement du freinage d’urgence permet de quantifier l’altération causée par le stress sensoriel avec une fidélité absolue, exempte de tout biais d’apprentissage préalable.
6.3 Études de jumeaux en génétique comportementale
L’incarnation la plus pure, élégante et biologiquement parfaite du plan expérimental à paires appariées réside sans conteste dans les protocoles de co-jumeaux (discordant twin design) déployés en génétique comportementale et en épigénétique clinique. Les paires de jumeaux monozygotes (identiques) partagent une identité génétique de 100 % au niveau de la séquence d’ADN nucléaire, ainsi qu’un environnement intra-utérin et, le plus souvent, un cadre d’élevage familial et socio-culturel partagé durant leur enfance.
Ce statut biologique unique résout l’épineux problème de la validité de l’appariement : le jumeau monozygote constitue le contrôle contrefactuel absolu d’un organisme vivant. Dans les protocoles expérimentaux d’exposition différentielle, l’un des co-jumeaux est assigné de façon contrôlée (ou exposé naturellement par le cours de l’existence) à une condition environnementale spécifique — par exemple, un programme d’entraînement à l’instrument de musique intensif précoce, une supplémentation en acides gras polyinsaturés, ou une intervention de gestion de pleine conscience — tandis que le co-jumeau en est préservé.
L’évaluation consécutive de la plasticité cérébrale (par imagerie par résonance magnétique fonctionnelle – IRMf) ou de la régulation de l’humeur permet d’attribuer toute divergence phénotypique subséquente avec une certitude quasi mathématique à la variable environnementale manipulée. L’appariement génétique complet neutralise la totalité du génome humain dans l’équation d’erreur, offrant une puissance d’inférence causale qui égale, voire surpasse dans certains contextes, celle des essais randomisés purs sur de larges cohortes hétérogènes.
7. Exemples en psychologie clinique et psychothérapie comparative
7.1 Comparaison de deux approches thérapeutiques du trouble panique
L’évaluation de l’efficacité comparative de deux modalités de psychothérapie active — par exemple, la thérapie cognitivo-comportementale (TCC) centrée sur l’exposition intéroceptive versus la thérapie psychodynamique brève focalisée sur les conflits relationnels — pose des défis méthodologiques considérables. Si l’on applique une randomisation inter-sujets simple à un échantillon hospitalier restreint de 40 patients souffrant de trouble panique avec agoraphobie, le hasard stochastique peut accidentellement concentrer les patients présentant les attaques les plus sévères, les plus invalidantes et les plus anciennes au sein de l’un des bras thérapeutiques.
Le devis à paires appariées prévient souverainement cette asymétrie psychopathologique. Avant la première séance d’intervention, chaque patient passe un bilan diagnostique complet comprenant la passation de l’échelle de sévérité du trouble panique (Panic Disorder Severity Scale – PDSS) et l’enregistrement de l’ancienneté chronologique du trouble (en mois d’évolution). Des paires de patients présentant un score PDSS équivalent ($\pm 2$ points) et une durée de maladie similaire sont formées. La randomisation intra-paire attribue ensuite chaque patient de la dyade soit au protocole de TCC en 12 séances, soit au protocole psychodynamique de durée identique.
Le critère d’évaluation principal réside dans la fréquence hebdomadaire des attaques de panique enregistrée via un carnet de bord standardisé au terme des trois mois de thérapie. En traitant l’écart d’efficacité au sein de chaque paire de sévérité homologue, les chercheurs éliminent le biais d’inégalité psychopathologique initiale. Si une modalité thérapeutique surpasse l’autre, cette suprématie ne pourra en aucun cas être attribuée au fait qu’elle aurait bénéficié d’une cohorte de patients présentant une symptomatologie plus légère ou plus malléable au départ.
7.2 Efficacité d’un programme de remédiation cognitive post-AVC
Les accidents vasculaires cérébraux (AVC) ischémiques de l’artère cérébrale moyenne laissent fréquemment des séquelles invalidantes sur les fonctions exécutives, l’attention sélective et la mémoire de travail. Les cliniciens cherchent à déterminer si l’intégration d’un entraînement cognitif informatisé immersif sur tablette tactile apporte une plus-value mesurable par rapport à la rééducation neuropsychologique conventionnelle sur support papier-crayon.
L’hétérogénéité des lésions neurologiques constitue ici un obstacle méthodologique titanesque. Deux patients ayant subi un AVC diffèrent souvent radicalement par le volume de parenchyme cérébral nécrosé (exprimé en centimètres cubes à l’IRM de diffusion), par l’hémisphère lésé (gauche ou droit) et par le délai écoulé depuis l’événement aigu (stade subaigu précoce vs stade chronique séquellaire). Une telle dispersion rend les comparaisons inter-sujets traditionnelles bruitées et peu concluantes à faible effectif.
La mise en place d’un devis à paires appariées impose d’associer deux à deux des patients victimes d’un AVC sur la base de critères anatomiques et temporels stricts : même latéralisation hémisphérique, volume lésionnel comparable (classé par strates volumétriques) et délai post-AVC homologue ($\pm 15$ jours). L’un des patients bénéficie du protocole digitalisé innovant, l’autre de la prise en charge classique, à raison de trois sessions hebdomadaires de 45 minutes pendant six semaines consécutives. L’évaluation terminale de la vitesse de traitement et du contrôle inhibiteur (mesurés par le test de Stroop et le Trail Making Test) permet d’extraire la variance liée à la sévérité initiale de la brèche anatomique, attestant de l’impact direct et exclusif du vecteur technologique de réhabilitation.
7.3 Protocoles de sevrage tabagique et soutien motivationnel
Dans le domaine de l’addictologie comportementale, la comparaison de dispositifs d’aide à l’arrêt du tabac illustre avec éclat la pertinence du plan apparié. Supposons une recherche évaluant l’efficacité d’une application mobile d’accompagnement motivationnel basée sur des algorithmes d’intelligence artificielle et de renforcement positif géolocalisé, comparativement à un suivi téléphonique standardisé hebdomadaire assuré par un tabacologue.
L’addiction à la nicotine ne se résume pas à une habitude comportementale homogène ; elle est sous-tendue par une dépendance physique pharmacologique profonde et variable. La probabilité de rechute d’un fumeur est directement corrélée à son niveau de dépendance nicotinique de base et à l’historique d’imprégnation tabagique. En ignorant cette réalité, un devis d’échantillonnage aléatoire simple risquerait de fausser les conclusions si l’un des bras intégrait accidentellement une majorité de petits fumeurs sociaux.
Les chercheurs instaurent un appariement systématique fondé sur deux variables quantitatives déterminantes : le score au test de dépendance de Fagerström (allant de 0 à 10) et la quantification de l’exposition globale en paquets-années (nombre de paquets consommés par jour multiplié par le nombre d’années d’intoxication). Les dyades sont constituées sur cette base de sévérité addictive. Après randomisation intra-paire et déploiement de l’accompagnement durant six mois, l’abstinence tabagique continue est mesurée et validée biologiquement par le dosage spectrophotométrique du monoxyde de carbone (CO) dans l’air expiré ($\text{CO} < 6 \text{p\pm}$). En isolant le profil de dépendance physique initial via l'appariement, les résultats démontrent sans ambiguïté la performance relative du suivi digital face à la consultation humaine.
8. Analyse comparative : Plan à paires appariées vs plans inter-sujets et intra-sujets
8.1 Comparaison avec le plan inter-sujets classique (indépendant)
L’arbitrage méthodologique entre un devis à paires appariées et un plan inter-sujets complètement randomisé (souvent désigné sous le terme de plan à groupes indépendants) repose sur une balance complexe entre rigueur métrologique, gestion du risque d’échantillonnage et contraintes opérationnelles de terrain.
Le plan inter-sujets standard délègue la mission d’équilibrer les covariables à la seule puissance de la randomisation simple. Si cette approche offre une commodité logistique indiscutable (recrutement direct, absence d’évaluation pré-test approfondie obligatoire, aucune déperdition de sujets non appariés), elle présente une vulnérabilité critique en présence d’échantillons de taille modeste ou intermédiaire ($N < 30$ par groupe). Dans ce scénario, les fluctuations d'échantillonnage introduisent fréquemment des asymétries pré-expérimentales notables sur des variables clés, affaiblissant la validité interne de la recherche. De surcroît, la variance d'erreur dans le plan inter-sujets englobe l'intégralité des différences individuelles :
$$\sigma^2_{\text{erreur(inter)}} = \sigma^2_{\text{biologique/psy}} + \sigma^2_{\text{aléatoire}}$$
Dans le devis à paires appariées, la variance associée aux caractéristiques appariées est mathématiquement extraite du terme résiduel. En conséquence, la variance d’erreur devient considérablement plus resserrée, ce qui se traduit par des intervalles de confiance plus étroits et une précision accrue de l’estimation de la taille de l’effet thérapeutique. La complexité logistique substantielle inhérente à l’appariement préalable est ainsi amplement rentabilisée par un gain massif d’assurance méthodologique et de sensibilité statistique.
8.2 Comparaison avec le plan intra-sujets (mesures répétées)
Le plan intra-sujets (ou devis à mesures répétées) représente le summum théorique de l’élimination des différences individuelles, dans la mesure où chaque participant sert de propre témoin. Il partage avec le plan à paires appariées la propriété mathématique de corrélation des observations appariées. Cependant, sa vulnérabilité empirique est souvent rédhibitoire en psychologie et en médecine interventionnelle.
Le talon d’Achille du plan intra-sujets réside dans sa dépendance vis-à-vis de l’axe temporel. Dès lors qu’un participant traverse la première condition, son statut cognitif, affectif ou physiologique est irréversiblement altéré. Les effets d’ordre, la fatigue attentionnelle, l’habituation nerveuse, la maturation temporelle et surtout les effets d’apprentissage (ou de transfert) rendent impossible la réinitialisation de l’organisme à son état de virginité préalable. L’application d’une technique de contrebalancement (carré latin) peut parfois contrôler l’effet d’ordre global, mais s’effondre en présence d’un transfert asymétrique (lorsque l’effet du traitement A sur B diffère de celui de B sur A).
C’est ici que le plan à paires appariées déploie son avantage conceptuel : il offre tous les bénéfices analytiques du plan intra-sujets (corrélation des données, réduction de la variance résiduelle) tout en préservant l’étanchéité absolue propre aux protocoles inter-sujets. Étant donné que le traitement $T_1$ et le témoin $T_0$ sont administrés à deux corps et deux cerveaux distincts, les artefacts temporels de contamination, de rémanence pharmacologique ou de remémoration cognitive sont structurellement neutralisés. Le sujet témoin demeure un participant naïf, indemne de toute exposition préalable.
8.3 Arbre de décision méthodologique pour le choix du devis
Le choix raisonné de l’architecture expérimentale ne doit pas relever de l’habitude ou de la facilité, mais de l’application scrupuleuse d’un algorithme de décision méthodologique fondé sur les caractéristiques du phénomène étudié :
- Axe 1 : Identifiabilité et magnitude d’un facteur de confusion. Existe-t-il une variable d’influence majeure capable d’expliquer une part prépondérante ($r > 0{,}50$) de la variance de la réponse finale ? Si la réponse est négative, le devis inter-sujets simple est suffisant. Si la réponse est affirmative, la neutralisation de cette variable s’impose impérativement.
- Axe 2 : Faisabilité de l’évaluation préliminaire (Screening). L’expérimentateur possède-t-il les ressources temporelles, financières et métrologiques nécessaires pour mesurer avec une fidélité éprouvée cette variable auprès de l’ensemble de la cohorte candidate avant le démarrage de l’intervention ? Si le pré-test est impossible ou destructeur de validité, l’appariement doit être abandonné au profit d’un devis inter-sujets avec randomisation stratifiée ou ajustement par analyse de covariance (ANCOVA) a posteriori.
- Axe 3 : Réversibilité de l’effet expérimental. L’intervention expérimentale engendre-t-elle une modification permanente, un apprentissage consolidé, une guérison clinique ou des altérations tissulaires irréversibles ? Si l’intervention est parfaitement réversible et que son effet de rémanence est nul (par exemple, tester des verres de lunettes correcteurs temporaires), le devis intra-sujets à mesures répétées demeure le premier choix pour des raisons d’économie d’échantillon. Si l’effet est persistant, irréversible ou curatif, le plan à paires appariées s’impose comme l’unique alternative robuste.
- Axe 4 : Bilan coût/puissance de la perte de degrés de liberté. L’échantillon prévisionnel est-il suffisant pour absorber la réduction de moitié des degrés de liberté sans effondrer la significativité statistique ? Si la corrélation intra-paire escomptée excède largement le seuil compensatoire de la réduction dimensionnelle, l’arbre de décision conclut formellement à la supériorité absolue du plan à paires appariées.
9. Traitement statistique des données issues de paires appariées
9.1 Violation de l’indépendance et nécessité d’analyses adaptées
La règle d’or de l’analyse biostatistique appliquée aux plans à paires appariées réside dans la reconnaissance explicite de la structure de dépendance interne des données. Dans un modèle inter-sujets standard, les observations des deux groupes sont postulées mutuellement indépendantes et identiquement distribuées ($i.i.d.$). La variance de la différence entre deux moyennes d’échantillons indépendants $\bar{Y}_1$ et $\bar{Y}_0$ est donnée par la somme classique de leurs variances d’échantillonnage respectives :
$$\text{Var}(\bar{Y}_1 – \bar{Y}_0) = \frac{\sigma^2_1}{n_1} + \frac{\sigma^2_0}{n_0}$$
En revanche, lorsque les unités d’observation sont appariées sur une variable corrélée avec la réponse, la covariance entre les deux séries d’observations est strictement positive ($\text{Cov}(Y_{i1}, Y_{i0}) > 0$). La formule mathématique rigoureuse de la variance d’échantillonnage de la différence moyenne devient :
$$\text{Var}(\bar{D}) = \text{Var}(\bar{Y}_1 – \bar{Y}_0) = \frac{\sigma^2_1}{N} + \frac{\sigma^2_0}{N} – \frac{2,\text{Cov}(Y_1, Y_0)}{N} = \frac{\sigma^2_1 + \sigma^2_0 – 2\rho\sigma_1\sigma_0}{N}$$
où $rho$ représente le coefficient de corrélation linéaire de Pearson intra-paire. Si un statisticien applique par mégarde un test de comparaison pour échantillons indépendants à des données appariées, il ignore le terme soustractif $- \frac{2,\text{Cov}(Y_1, Y_0)}{N}$. Par conséquent, il surestime l’erreur standard de la différence, gonfle démesurément le dénominateur de sa statistique de test et commet une erreur méthodologique gravissime : une sous-estimation massive de la puissance du test, conduisant à une inflation inacceptable du risque d’erreur de type II ($\beta$). Le chercheur conclura à tort à l’absence d’effet significatif du traitement alors même que l’effet était avéré.
9.2 Tests paramétriques : Le test t de Student pour échantillons appariés
Dès lors que les scores quantitatifs vérifient les postulats de la métrologie paramétrique, le test de choix canonique pour analyser un plan à paires appariées est le test $t$ de Student pour mesures dépendantes (ou appariées). La procédure analytique débute par la réduction univariée de la matrice de données bivariée. Pour chacune des $N$ paires d’observation, on calcule la différence algébrique :
$$D_i = Y_{i(T_1)} – Y_{i(T_0)}$$
La statistique inférentielle teste formellement l’hypothèse nulle d’absence d’effet intra-paire au sein de la population générale, formulée sous la forme $H_0: \mu_D = 0$, contre l’hypothèse alternative bilatérale $H_1: \mu_D \neq 0$ (ou unilatérale le cas échéant). L’unique postulat distributionnel requis par ce test paramétrique ne porte pas sur la normalité des distributions brutes de $Y_1$ ou de $Y_0$ prises isolément, mais sur la normalité de la distribution des différences $D_i \sim \mathcal{N}(\mu_D, \sigma_D^2)$. Ce postulat doit être systématiquement examiné au moyen de tests d’adéquation (tels que le test de Shapiro-Wilk) ou de représentations graphiques (diagrammes quantile-quantile, Q-Q plots).
La statistique empirique $t_{\text{obs}}$ est calculée par le rapport entre la moyenne des différences observées ($\bar{D}$) et l’erreur standard de la moyenne des différences ($SE_{\bar{D}}$) :
$$t_{\text{obs}} = \frac{\bar{D} – 0}{SE_{\bar{D}}} = \frac{\frac{1}{N}\sum_{i=1}^N D_i}{\frac{s_D}{\sqrt{N}}}$$
où $s_D$ représente l’écart-type d’échantillonnage de la variable de différence :
$$s_D = \sqrt{\frac{\sum_{i=1}^N (D_i – \bar{D})^2}{N – 1}}$$
Cette statistique $t_{\text{obs}}$ suit exactement une loi de Student à $df = N – 1$ degrés de liberté (où $N$ correspond au nombre total de paires constituées). L’expérimentateur dérive la valeur critique (ou la $p$-value exacte associée). Pour parachever l’interprétation, la construction de l’intervalle de confiance à $(1 – \alpha)%$ de la différence moyenne intra-paire s’impose :
$$IC_{1-\alpha}(\mu_D) = \left[ \bar{D} – t_{\text{critique}(df)} \cdot \frac{s_D}{\sqrt{N}} ; ; ; \bar{D} + t_{\text{critique}(df)} \cdot \frac{s_D}{\sqrt{N}} \right]$$
Si la borne inférieure et la borne supérieure de cet intervalle excluent formellement la valeur zéro, l’effet causal de l’intervention est déclaré statistiquement significatif au seuil nominal choisi.
9.3 Alternatives non paramétriques pour paires appariées
Lorsque la variable dépendante est mesurée sur une échelle ordinale, ou que la distribution des scores de différence intra-paire $D_i$ s’avère sévèrement asymétrique, multimodale ou polluée par des valeurs aberrantes insurmontables, les postulats du modèle paramétrique sont violés. Le chercheur doit alors mobiliser la boîte à outils des statistiques non paramétriques pour données appariées.
La première alternative de référence est le test des rangs signés de Wilcoxon (Wilcoxon signed-rank test). Ce test prend en considération non seulement le sens (signe arithmétique) de la différence intra-paire, mais également l’amplitude relative de cet écart. La procédure consiste à éliminer les paires nulles ($D_i = 0$), à classer les valeurs absolues des différences non nulles $|D_i|$ par ordre croissant en leur assignant un rang moyen en cas d’ex æquo, puis à calculer la somme des rangs associés aux différences positives ($W^+$) et celle associée aux différences négatives ($W^-$). Sous l’hypothèse nulle de symétrie de la distribution des différences autour de zéro, ces deux sommes tendent à être équivalentes. L’évaluation de la statistique $W = \min(W^+, W^-)$ permet de rejeter $H_0$ en cas de dissymétrie marquée.
Pour les contextes où l’amplitude n’a pas de sens métrologique fiable ou lorsque les distributions sont extrêmement discordantes, on peut avoir recours au test des signes (Sign test), purement binomial, bien que sa puissance statistique soit substantiellement inférieure à celle du test de Wilcoxon.
Enfin, dans l’éventualité critique où la variable de jugement est purement qualitative dichotomique (par exemple, succès thérapeutique vs échec ; guérison vs récidive au sein de chaque membre de la paire), l’analyse inférentielle doit impérativement mobiliser le test de McNemar. Reposant sur la construction d’une table de contingence $2 \times 2$ appariée, ce test ignore délibérément les paires concordantes (où les deux sujets guérissent ou échouent tous les deux) et concentre toute sa force sur l’analyse des paires discordantes ($b$ : succès pour $T_1$ et échec pour $T_0$ ; $c$ : échec pour $T_1$ et succès pour $T_0$). La statistique évalue si le ratio des discordances s’écarte significativement de l’équiprobabilité :
$$\chi^2_{\text{McNemar}} = \frac{(|b – c| – 1)^2}{b + c} \sim \chi^2(1)$$
Quelle que soit la technique retenue, la communication des conclusions scientifiques doit systématiquement adjoindre à la $p$-value une mesure d’amplitude standardisée. Dans le cadre paramétrique, le calcul du $d$ de Cohen pour échantillons appariés s’effectue sous la forme :
$$d_z = \frac{\bar{D}}{s_D}$$
Il convient de noter que cette métrique standardisée capture l’amplitude du changement rapportée à la variabilité des deltas intra-paires, reflétant la puissance brute de discrimination propre à la conception appariée.
10. Avantages méthodologiques et puissance statistique
10.1 Augmentation substantielle de la puissance statistique
L’argument princeps qui motive le déploiement d’un plan à paires appariées réside dans son extraordinaire capacité à maximiser la puissance statistique ($\text{Puissance} = 1 – \beta$), c’est-à-dire la probabilité de détecter un effet expérimental réel lorsque celui-ci existe au sein de la population. Ce phénomène s’explique par la mécanique interne de calcul des tests de significativité.
Dans toute analyse inférentielle, le ratio empirique confronté aux lois de distribution statistique se formalise schématiquement sous la structure universelle :
$$\text{Statistique de test} = \frac{\text{Effet observé}}{\text{Erreur standard de l’effet}}$$
L’effet observé (au numérateur) est déterminé par l’écart moyen généré par l’intervention. L’expérimentateur n’a que peu de prise sur cette quantité biologique intrinsèque. En revanche, le dénominateur — l’erreur standard — représente l’incertitude stochastique résiduelle. En contraignant les paires à partager une part massive de leur variance via l’appariement préalable, la corrélation positive $rho$ induite vient directement soustraire de l’équation mathématique la portion commune de fluctuation. Le terme d’erreur résiduel $s_D$ se rétracte drastiquement. Dès lors, pour une même magnitude d’effet au numérateur, la valeur calculée de la statistique de test ($t$ ou $W$) se trouve propulsée vers le haut, franchissant avec aisance les seuils de significativité conventionnels.
Cette dynamique permet d’atteindre des niveaux de puissance statistique comparables à ceux d’un plan inter-sujets avec un effectif d’échantillon global considérablement plus réduit. Dans des contextes de recherche hautement concurrentiels ou soumis à des contraintes financières strictes, où le recrutement et l’évaluation de chaque patient impliquent des coûts prohibitifs, le devis à paires appariées s’impose comme une optimisation économique et métrologique de premier ordre.
10.2 Neutralisation des biais de confusion identifiés
Au-delà de la seule puissance probabiliste, le plan à paires appariées élève le niveau de validité interne de la recherche à un degré de certitude rarement égalé. Dans une expérimentation standard à groupes indépendants, le chercheur s’en remet à la « foi aveugle » dans les lois asymptotiques du hasard pour espérer que les covariables non contrôlées se distribueront de façon parfaitement équilibrée entre les conditions. Or, dans la réalité clinique d’un échantillon fini de 20 ou 30 sujets par groupe, les anomalies d’échantillonnage aléatoire sont monnaie courante : déséquilibre de l’âge médian, asymétrie de sévérité initiale, proportion disparate d’hommes et de femmes.
Le plan à paires appariées apporte un verrou méthodologique structurel et déterministe contre ces dérives d’échantillonnage. En verrouillant l’équivalence profil par profil sur les variables de confusion critiques répertoriées, le chercheur neutralise de manière transparente et vérifiable ces menaces potentielles. Il n’y a plus lieu de débattre pour savoir si l’avantage constaté dans le groupe expérimental pourrait être le sous-produit accidentel d’un échantillon légèrement plus jeune ou doté d’une meilleure réserve cognitive : la conception expérimentale elle-même rend cette explication alternative irrecevable.
Cette immunité structurelle fluidifie l’interprétation causale des résultats. La communauté scientifique et les comités de lecture académiques bénéficient d’une démonstration limpide : la variance observée est directement imputable au principe actif du traitement manipulé, renforçant la reproductibilité et la solidité des conclusions publiées.
10.3 Absence des artefacts temporels propres aux mesures répétées
L’autre atout comparatif majeur de cette architecture réside dans son imperméabilité totale vis-à-vis des artefacts temporels qui dégradent de manière chronique la validité interne des devis intra-sujets (mesures répétées sur le même individu). Lorsqu’un sujet subit plusieurs conditions successives, son système nerveux central et son organisme réagissent de façon dynamique à la répétition même de l’exposition.
Parmi ces distorsions classiques figurent en première ligne les effets d’apprentissage et de familiarisation : confronté à une épreuve cognitive ou motrice pour la seconde fois, le participant déploie des stratégies mnésiques plus fluides et anticipe la tâche, indépendamment de tout effet de traitement. S’y ajoutent les effets d’épuisement cognitif et de fatigue physique, qui dégradent artificiellement la performance lors des blocs expérimentaux terminaux, ainsi que les phénomènes d’habituation sensorielle et de démobilisation motivationnelle.
Dans un plan à paires appariées, ces menaces sont évacuées de l’équation expérimentale. Chaque participant ne vit qu’une seule et unique condition expérimentale. Sa naïveté psychologique vis-à-vis du protocole est rigoureusement préservée du début à la fin de l’investigation. Il n’existe aucun risque d’effet de rémanence pharmacologique résiduel ou de croisement cognitif non désiré. Cette dissociation corporelle et mentale permet d’administrer des traitements dont l’impact modifie durablement ou irréversiblement la physiologie du sujet — comme une résection chirurgicale ciblée, un reconditionnement psychothérapeutique d’extinction de phobie ou une pharmacothérapie à longue demi-vie — sans encourir la moindre contamination croisée.
11. Limites, biais potentiels et défis pratiques
11.1 Le problème majeur de l’attrition asymétrique (perdus de vue)
En dépit de sa remarquable puissance théorique, le plan à paires appariées présente une vulnérabilité logistique qui constitue son talon d’Achille opérationnel le plus redouté : l’extrême fragilité du couple d’observation face à l’attrition expérimentale. Dans un protocole inter-sujets standard, si un participant abandonne l’étude en cours de route, déménage, manifeste des effets secondaires ou devient injoignable (perdu de vue), l’analyse statistique subit une réduction d’une seule unité expérimentale ($N_{\text{total}} – 1$).
Dans un devis à paires appariées, la mécanique de l’analyse repose entièrement sur le calcul des scores de différence intra-paire $D_i = Y_{i1} – Y_{i0}$. En conséquence, si un seul membre d’une dyade abandonne le protocole, la paire entière devient métrologiquement orpheline et doit être purement et simplement retirée de l’analyse par cas complets. La défection d’un seul participant entraîne la destruction statistique des données récoltées auprès de son jumeau d’étude, pourtant assidu et conforme au protocole. Cette réaction en chaîne induit une fonte accélérée de la taille de l’échantillon final effectivement analysable.
De surcroît, cette attrition soulève une menace de biais de sélection si l’abandon n’est pas le fruit du pur hasard stochastique, mais découle de la nature même du traitement expérimental (par exemple, si le nouveau régime engendre des nausées sévères poussant les sujets à jeter l’éponge). Éliminer l’ensemble de ces dyades problématiques conduit à une surreprésentation des participants les plus résilients, corrompant la représentativité de la cohorte finale. Pour contrer ce désastre méthodologique, les chercheurs doivent déployer des modèles linéaires mixtes (LMM) ou des approches d’imputation multiple par équations enchaînées (MICE) adaptées à la structure hiérarchique des paires, afin d’exploiter les données partielles dans une perspective rigoureuse d’intention de traiter (ITT).
11.2 Complexité logistique et coût de recrutement
Le second défi structurel imposé par le plan à paires appariées relève de l’ingénierie financière, temporelle et logistique du recrutement expérimental. Constituer des dyades répondant à des critères d’équivalence stricts exige un bassin d’inclusion initial considérablement plus volumineux que celui requis par un protocole inter-sujets simple.
Pour parvenir à former 50 paires d’individus présentant une gémellité statistique satisfaisante, l’expérimentateur est souvent contraint de procéder au criblage (screening) méticuleux de 200 à 300 candidats potentiels. Cette phase d’investigation préliminaire impose un fardeau financier et opérationnel substantiel : passation d’examens d’imagerie, dosages sanguins, bilans psychométriques standardisés chronophages. Tous ces actes d’évaluation consomment des ressources humaines et matérielles avant même que le moindre traitement ne soit administré.
Par ailleurs, la constitution des paires génère des délais d’attente prolongés pour les participants précoces. Un sujet recruté au jour 1 peut être contraint de patienter plusieurs semaines en suspens avant que l’équipe de recherche ne parvienne à identifier et recruter un alter ego présentant les mêmes caractéristiques biométriques. Si cette attente se prolonge, les paramètres de base du premier participant peuvent évoluer, détruisant l’étalonnage initial. Enfin, le chercheur se heurte inéluctablement à la problématique des « exclus de l’appariement » : les participants présentant des profils physiologiques atypiques ou des scores extrêmes (outliers) ne trouveront jamais leur homologue dans la cohorte disponible et seront rejetés du protocole, matérialisant un gaspillage éthique et scientifique des données pré-test.
11.3 Diminution des degrés de liberté et contrainte des deux conditions
Sur le plan de la géométrie statistique, le devis à paires appariées impose une contrainte mathématique qui peut se révéler pénalisante si l’hypothèse de forte corrélation intra-paire est démentie par la réalité empirique. Dans une analyse inter-sujets classique regroupant $2N$ sujets, le nombre de degrés de liberté disponible pour estimer l’erreur résiduelle de la distribution de Student est de :
$$df_{\text{inter}} = 2N – 2$$
Dans un plan à paires appariées regroupant ce même effectif total de $2N$ sujets distribués en $N$ dyades, l’unité d’analyse statistique devient la paire. Les degrés de liberté s’effondrent mécaniquement de moitié :
$$df_{\text{apparié}} = N – 1$$
Cette baisse abrupte élève la valeur seuil du $t$ critique nécessaire pour rejeter l’hypothèse nulle au seuil $\alpha$ choisi. Ce sacrifice mathématique n’est rentable que si la corrélation $rho$ induite par l’appariement est suffisamment élevée pour comprimer l’erreur standard de manière à compenser largement cette perte de degrés de liberté. Si l’expérimentateur a maladroitement apparié ses sujets sur des variables non prédictives de la réponse ($r \approx 0$), l’erreur standard ne subit aucune contraction notable, tandis que le seuil critique du test statistique augmente. L’opération se solde alors par un déficit net de puissance statistique par rapport à un plan inter-sujets classique : le chercheur a complexifié son protocole pour obtenir un test inférentiel moins performant.
Enfin, le cadre conceptuel du plan à paires appariées est structurellement borné à la manipulation d’exactement deux modalités de traitement ($T_1$ versus $T_0$). Il est rigoureusement incompatible avec les problématiques scientifiques nécessitant l’exploration de relations dose-réponse (trois modalités ou plus) ou la mise en lumière d’interactions multifactorielles complexes, à moins d’étendre la conception vers des plans en blocs aléatoires complets généralisés (triades, tétrades), dont la complexité logistique de recrutement devient exponentiellement prohibitive dans la pratique clinique.
12. Bonnes pratiques méthodologiques et recommandations pour la recherche psychologique
12.1 Procédure standardisée de planification de la recherche
L’excellence méthodologique dans la conduite d’un devis à paires appariées exige une rigueur de planification qui ne laisse aucune place à l’empirisme intuitif. La première exigence fondamentale réside dans la formalisation a priori d’une justification théorique et empirique solide pour chaque variable d’appariement sélectionnée. Le chercheur doit pouvoir s’appuyer sur des méta-analyses antérieures ou des études pilotes rigoureuses démontrant l’existence d’une corrélation robuste ($r ge 0{,}50$) entre les covariables postulées et le critère de jugement principal.
La deuxième étape cardinale consiste en l’exécution d’un calcul formel de puissance statistique a priori spécifique aux modèles de données appariées, au moyen de progiciels statistiques validés tels que G*Power. L’erreur commune consistant à appliquer les formules d’échantillonnage inter-sujets doit être bannie. Les paramètres de saisie doivent impérativement intégrer la taille de l’effet attendue (par exemple le $d_z$ apparié), le niveau d’erreur de première espèce bilatéral ($\alpha = 0{,}05$), la puissance ciblée ($1 – \beta ge 0{,}80$ ou $0{,}90$), et surtout l’estimation prudente de la corrélation intra-paire $rho$. Une marge de sécurité de 15 à 20 % de recrutement additionnel doit être programmée pour absorber l’attrition prévisible sans compromettre la puissance finale.
Enfin, la lutte contre les pratiques de recherche douteuses (questionable research practices) impose le pré-enregistrement exhaustif du protocole expérimental sur des plateformes institutionnelles certifiées telles que l’Open Science Framework (OSF) ou ClinicalTrials.gov. Ce document contractuel rédigé en amont doit détailler explicitement l’algorithme d’appariement qui sera mobilisé, les plages de tolérance autorisées, l’ordre de priorité des covariables en cas de conflit d’association, ainsi que la politique de traitement des données manquantes et des cas atypiques non appariables, verrouillant ainsi la recherche contre le piratage méthodologique a posteriori (p-hacking).
12.2 Gestion des écarts d’appariement et tolérance d’imprécision
Dans la recherche humaine, l’appariement parfait (exact matching) sur des variables continues est un idéal mathématique inatteignable. Deux individus ne partageront jamais une glycémie au milligramme près ou un temps de réaction à la microseconde équivalent. L’expérimentateur doit donc définir en amont des intervalles de tolérance (calipers) réalistes, fondés sur la clinique ou la métrologie des instruments de mesure.
Pour ce faire, le recours aux algorithmes d’optimisation combinatoire globale surpasse très largement les méthodes archaïques de matching glouton (greedy matching, où les paires sont formées au fil de l’eau en éliminant les options subséquentes). Les méthodologistes recommandent d’appliquer l’algorithme d’appariement optimal sans remise, résolu par l’algorithme hongrois ou la programmation linéaire, qui calcule l’ensemble des appariements possibles et retient la configuration globale minimisant la somme absolue des distances de toutes les paires constituées :
$$\min \sum_{i=1}^N d(k_i, l_i)$$
Sur des espaces multidimensionnels complexes comportant plusieurs covariables continues corrélées entre elles, la standardisation métrique par le calcul de la distance de Mahalanobis est préconisée. Contrairement à la simple distance euclidienne, la métrique de Mahalanobis intègre la matrice de variance-covariance des covariables ($S$), évitant ainsi de surpondérer des variables redondantes :
$$D_M(k, l) = \sqrt{(X_k – X_l)^T S^{-1} (X_k – X_l)}$$
En parallèle, l’expérimentateur doit conduire des analyses de sensibilité méthodologique systématiques. Ces vérifications consistent à relancer les tests inférentiels après avoir exclu les paires se situant aux limites extrêmes des calipers de tolérance acceptés, afin de vérifier que la significativité de l’effet expérimental ne dépend pas d’un sous-ensemble de paires imparfaitement appariées.
12.3 Rédaction et communication des résultats selon les normes scientifiques
La restitution académique d’une étude articulée autour d’un devis à paires appariées doit se conformer de manière scrupuleuse aux standards internationaux d’intégrité rédactionnelle édictés par les déclarations CONSORT (Consolidated Standards of Reporting Trials) et les directives méthodologiques de l’American Psychological Association (APA 7th Edition).
La publication scientifique doit comporter un diagramme de flux CONSORT transparent et complet, spécifiquement adapté à l’anatomie du devis apparié :
- Le nombre total de sujets screenés lors de la phase préliminaire de filtrage.
- Le nombre exact de participants exclus faute d’avoir pu identifier un partenaire d’appariement éligible (avec mention détaillée des critères d’échec d’association).
- Le nombre définitif de dyades consolidées entrant dans la phase de randomisation intra-paire.
- Le suivi rigoureux des perdus de vue au sein de chaque bras de traitement, en explicitant le sort réservé au partenaire apparié orphelin.
- Le nombre final de paires intégrées dans l’analyse inférentielle principale par cas complets, confronté aux analyses menées en intention de traiter.
Sur le plan de la communication statistique, il est impératif de ne jamais se limiter à la présentation isolée des moyennes et écarts-types des deux groupes d’exposition. L’article doit consigner de manière transparente :
- La corrélation empirique constatée au sein des paires entre les mesures post-test des deux bras ($rho$ ou coefficient de corrélation intra-classe, ICC).
- La distribution de la variable différentielle intra-paire, incluant la moyenne des deltas ($\bar{D}$), son écart-type spécifique ($s_D$) et son erreur standard ($SE_{\bar{D}}$).
- La valeur exacte de la statistique de test ($t$ avec ses degrés de liberté $N – 1$, ou $W$ pour Wilcoxon), la $p$-value exacte (sans arrondir paresseusement à $p < 0{,}05$), et l'intervalle de confiance à 95 % de la différence moyenne appariée.
- La taille d’effet standardisée spécifique ($d_z$ de Cohen ou $r$ de rang-bisérial).
Enfin, la section de discussion doit réserver un paragraphe approfondi à l’examen lucide de la validité externe du protocole. L’équipe de recherche doit évaluer avec honnêteté intellectuelle dans quelle mesure le filtrage draconien imposé pour l’appariement des profils a pu modifier la composition de l’échantillon analysé en l’écartant des réalités hétérogènes de la clinique quotidienne, offrant ainsi une contextualisation mesurée et scientifique de la portée réelle des découvertes obtenues.
Références
- Cohen, J. (1988). Statistical Power Analysis for the Behavioral Sciences (2nd ed.). Lawrence Erlbaum Associates. https://www.routledge.com/Statistical-Power-Analysis-for-the-Behavioral-Sciences-2nd-Edition/Cohen/p/book/9780805802832
- Fisher, R. A. (1935). The Design of Experiments. Oliver and Boyd. https://www.nature.com/articles/137252a0
- Moher, D., Hopewell, S., Schulz, K. F., Montori, V., Gøtzsche, P. C., Devereaux, P. J., Elbourne, D., Egger, M., & Altman, D. G. (2010). CONSORT 2010 explanation and elaboration: Updated guidelines for reporting parallel group randomised trials. BMJ, 340, c869. https://doi.org/10.1136/bmj.c869
- Rosenbaum, P. R. (2002). Observational Studies (2nd ed.). Springer. https://doi.org/10.1007/978-1-4757-3692-2
- Rosenbaum, P. R., & Rubin, D. B. (1983). The central role of the propensity score in observational studies for causal effects. Biometrika, 70(1), 41–55. https://doi.org/10.1093/biomet/70.1.41
- Rubin, D. B. (1974). Estimating causal effects of treatments in randomized and nonrandomized studies. Journal of Educational Psychology, 66(5), 688–701. https://doi.org/10.1037/h0037350
- Shadish, W. R., Cook, T. D., & Campbell, D. T. (2002). Experimental and Quasi-Experimental Designs for Generalized Causal Inference. Houghton Mifflin.
- Wilcoxon, F. (1945). Individual comparisons by ranking methods. Biometrics Bulletin, 1(6), 80–83. https://doi.org/10.2307/3001968