
L’évaluation quantitative des phénomènes psychologiques, cognitifs et comportementaux soulève depuis les origines de la psychométrie une difficulté fondamentale : celle de la nature des échelles de mesure et de la forme réelle des distributions observées au sein des populations humaines. Alors que les sciences physiques s’appuient fréquemment sur des unités de mesure fondamentales et des distributions qui approchent des lois théoriques idéales, les sciences de l’esprit et du comportement se heurtent continuellement à l’asymétrie, à l’hétérogénéité des variances et à des variables latentes dont la métrique sous-jacente relève davantage de l’ordre que de la stricte égalité des intervalles. Dans ce contexte épistémologique complexe, les statistiques non paramétriques et, plus particulièrement, les mesures de position ordinale constituent un socle méthodologique indispensable pour quiconque cherche à situer rigoureusement une observation individuelle par rapport à un ensemble normatif.
Au cœur de cette métrologie ordinale réside un triptyque terminologique souvent source de confusions, d’approximations sémantiques et d’erreurs d’interprétation clinique : le quantile, le quartile et le percentile. Si ces trois vocables partagent une racine conceptuelle commune et reposent sur un mécanisme mathématique unifié — à savoir la partition ordonnée d’un continuum empirique de données —, ils ne désignent nullement les mêmes objets ni le même degré de résolution analytique. Le quantile représente la famille mathématique générique, la classe conceptuelle abstraite qui englobe toute division proportionnelle d’une distribution de probabilité ou d’un échantillon empirique ordonné. Les quartiles incarnent une déclinaison spécifique de cette famille, restreinte à un découpage en quatre segments équiprobables délimités par trois points de coupure fondamentaux. Les percentiles (ou centiles), quant à eux, poussent la granularité jusqu’à fractionner la distribution en cent segments distincts, offrant ainsi une échelle de positionnement de un à cent particulièrement plébiscitée dans l’étalonnage des épreuves neuropsychologiques et des inventaires de personnalité standardisés.
Comprendre la distinction exacte, la dynamique fonctionnelle et les passerelles de conversion entre quantiles, quartiles et percentiles ne relève pas d’une simple coquetterie académique. Il s’agit d’un impératif diagnostique, méthodologique et déontologique pour les neuropsychologues, les cliniciens, les psychométriciens et les chercheurs en sciences sociales. Une méprise sur la signification d’un rang percentile ou sur les propriétés de dispersion d’un écart interquartile peut altérer le diagnostic d’un trouble neurodéveloppemental, fausser l’appréciation du déclin cognitif dans une démence débutante ou invalider les conclusions d’un essai randomisé contrôlé. Le présent traité se propose de décortiquer ces concepts avec une exhaustivité mathématique et clinique sans compromis, en explorant leurs fondements théoriques, leurs algorithmes de calcul, leurs représentations graphiques et leurs applications directes dans la pratique psychologique contemporaine.
1. Introduction aux mesures de position non paramétriques en psychologie et statistiques
1.1 La nécessité des statistiques de position face aux asymétries de distribution
La statistique inférentielle et descriptive classique a longtemps été dominée par le paradigme de la loi normale, formalisée par Carl Friedrich Gauss. Sous ce modèle séduisant, la moyenne arithmétique et l’écart type constituent des résumés statistiques optimaux, dits suffisants, car ils capturent l’intégralité de l’information relative à la localisation et à la dispersion d’une distribution symétrique unimodale. Néanmoins, l’application aveugle de ce cadre théorique aux données issues de la psychologie clinique et des neurosciences se heurte à une réalité empirique récalcitrante : les scores psychométriques présentent presque systématiquement de sévères asymétries (positives ou négatives) ainsi que des queues de distribution épaisses, caractérisées par un kurtosis élevé. Qu’il s’agisse de mesurer le temps de latence d’une réponse motrice, le nombre d’erreurs commises à une épreuve de flexibilité cognitive ou la sévérité d’une symptomatologie dépressive à l’Inventaire de Dépression de Beck, les données réelles défient la symétrie gaussienne.
Dans ces conditions d’asymétrie structurelle, la moyenne arithmétique subit une attraction disproportionnée exercée par les observations extrêmes, perdant instantanément sa représentativité en tant que valeur centrale typique. De manière corrélative, l’écart type gonfle artificiellement, projetant des intervalles de confiance théoriques qui peuvent inclure des valeurs biologiquement ou psychologiquement impossibles, telles que des scores négatifs sur une échelle de performance absolue. Face à cette défaillance des estimateurs paramétriques, la métrologie ordinale et les statistiques de position s’imposent comme une alternative rigoureuse. En s’affranchissant de toute hypothèse quant à la forme analytique de la distribution sous-jacente, les statistiques de rang permettent de modéliser des populations cliniques hautement hétérogènes sans introduire de biais de distribution.
La préservation rigoureuse de la hiérarchie des observations sans postuler la normalité des données garantit que le rang attribué à un individu reflète fidèlement sa place relative au sein de son groupe de référence sociodémographique ou nosographique. Cette approche non paramétrique n’opère aucune distorsion de l’espace métrique : elle prend acte du fait que dans de nombreuses épreuves psychologiques, nous ne disposons que d’une échelle ordinale au sens de la célèbre taxonomie de Stanley Smith Stevens. La distance séparant un score brut de 10 d’un score de 12 n’est pas nécessairement équivalente à celle séparant un score de 40 d’un score de 42 sur le plan du construit latent sous-jacent. En se focalisant sur les rangs d’ordonnancement plutôt que sur les grandeurs numériques brutes, les statistiques de position offrent un cadre d’inférence robuste, insensible aux transformations monotones croissantes et pleinement adapté à la vulnérabilité intrinsèque des mesures comportementales.
1.2 Évolution historique de la métrologie ordinale dans les sciences du comportement
L’émergence des statistiques de positionnement ordonné est intrinsèquement liée à la naissance de la psychologie différentielle et de l’anthropométrie au XIXe siècle. Les travaux précurseurs de Sir Francis Galton ont marqué un tournant épistémologique décisif. En tentant de quantifier la transmission héréditaire des facultés physiques et intellectuelles, Galton prit rapidement conscience des limites inhérentes au calcul des moyennes lorsqu’il s’agissait de comparer des caractères humains fortement asymétriques. C’est à lui que l’on doit l’invention conceptuelle de l’« ogive », cette courbe cumulative en forme de S qui trace la proportion cumulée des individus atteignant ou dépassant un niveau donné de performance. Galton introduisit explicitement la notion de centile (percentile) pour cartographier les capacités humaines, jetant ainsi les bases du découpage distributionnel moderne.
Au début du XXe siècle, avec l’avènement des premiers tests d’intelligence standardisés développés par Alfred Binet et Théodore Simon, puis adaptés aux États-Unis par Lewis Terman dans le cadre de la célèbre échelle de Stanford-Binet, la question de l’étalonnage psychométrique devint une préoccupation scientifique majeure. La notion initiale d’« âge mental », bien que séduisante de prime abord pour le grand public, montra rapidement ses faiblesses conceptuelles : un retard de deux ans n’a évidemment pas la même signification développementale à l’âge de 4 ans qu’à l’âge de 14 ans. Le quotient intellectuel de développement (QI ratio), formulé par William Stern en divisant l’âge mental par l’âge chronologique, ne résolvait que partiellement le problème en raison de la non-linéarité de la maturation cognitive.
Il fallut attendre la seconde moitié du XXe siècle et les contributions majeures de psychométriciens tels que David Wechsler pour voir s’opérer une transition méthodologique fondamentale : l’abandon définitif des pourcentages bruts et des âges mentaux au profit d’indicateurs de position standardisés universels. Wechsler introduisit le QI de déviation fondé sur l’étalonnage normatif, tout en intégrant systématiquement des tables de correspondances en rangs percentiles. Dès lors, situer un individu ne consistait plus à quantifier un pourcentage arbitraire de réussite à des items disparates, mais à déterminer avec exactitude la proportion de la population de référence qu’il surpasse ou qui le surpasse. Cette transition des pourcentages absolus vers les positions relatives standardisées a définitivement scellé l’hégémonie des quantiles et des centiles dans l’ensemble des batteries d’évaluation neuropsychologique contemporaines.
1.3 Distinction fondamentale entre mesures de tendance centrale et mesures de dispersion
Pour appréhender la mécanique des quantiles dans toute sa plénitude, il convient de rappeler la bipartition fondamentale qui structure l’analyse exploratoire des données : la dialectique entre mesures de tendance centrale et mesures de dispersion. L’objectif d’une mesure de tendance centrale est d’identifier un point d’ancrage synthétique, une valeur unique capable de résumer le centre de gravité ou l’emplacement typique d’une distribution. À l’opposé, les mesures de dispersion visent à quantifier l’amplitude de l’étalement, l’hétérogénéité ou la variabilité des observations autour de ce point central. Dans le paradigme paramétrique, ce couple est incarné par le tandem moyenne-écart type ; dans le paradigme non paramétrique ou distributionnel, il est matérialisé par le couple médiane-écart interquartile.
Les coupures distributionnelles issues de la partition en quantiles jouent un double rôle morphologique remarquable au sein d’un ensemble de données. D’une part, certains quantiles spécifiques fonctionnent stricto sensu comme des mesures de tendance centrale : c’est précisément le cas de la médiane, qui correspond indifféremment au deuxième quartile, au cinquantième percentile ou au cinquième décile. Cette médiane partitionne le jeu de données en deux moitiés rigoureusement équiprobables, offrant une localisation centrale qui demeure totalement invulnérable aux perturbations causées par des scores aberrants situés aux confins de la distribution.
D’autre part, la distance spatiale séparant différents quantiles stratégiques constitue une mesure directe et robuste de la dispersion statistique. L’écart interquartile (la distance séparant le 75e percentile du 25e percentile) capture l’étendue occupée par les 50 % centraux de la population observée. Contrairement à l’écart type, dont la formule mathématique élève les écarts au carré — conférant ainsi un poids disproportionné aux déviations périphériques —, l’écart interquartile offre une lecture directe, ordinale et non amplifiée de la variabilité. Ainsi, le recours aux quantiles ne se limite pas à classifier des sujets ; il permet de construire une géométrie distributionnelle complète, articulant de façon harmonieuse la localisation du centre de masse et la dynamique d’étalement des scores individuels.
2. Le concept unificateur de quantile : définitions mathématiques et taxonomiques
2.1 Définition formelle de la fonction quantile
D’un point de vue formel et probabiliste, la notion de quantile s’enracine dans la théorie des probabilités à travers le concept de fonction quantile, couramment appelée fonction de répartition inverse ou réciproque généralisée de la fonction de répartition cumulative. Soit une variable aléatoire réelle $X$ définie sur un espace probabilisé, et soit $F_X(x) = P(X \leq x)$ sa fonction de répartition, laquelle est monotone non décroissante et continue à droite par définition. Pour tout paramètre de probabilité $p$ strictement compris dans l’intervalle ouvert $]0, 1[$, la fonction quantile $Q(p)$, souvent notée $F^{-1}(p)$, est définie mathématiquement par l’infimum :
Q(p) = inf { x in mathbb{R} : F_X(x) geq p }
Cette formulation par l’infimum (la plus petite valeur de $x$ pour laquelle la probabilité cumulée atteint ou dépasse le seuil $p$) est indispensable d’un point de vue analytique. En effet, si la variable aléatoire $X$ est absolument continue et possède une fonction de densité strictement positive sur son support, la fonction $F_X$ est bijective, strictement croissante et continue, ce qui rend l’inversion simple et directe : $Q(p) = F_X^{-1}(p)$. Toutefois, dans le champ des données psychométriques réelles, les scores observés sont intrinsèquement discrets (nombres entiers de points obtenus à une épreuve, scores entiers sur une échelle de Likert). La fonction de répartition empirique présente alors des sauts de discontinuité en escalier et des paliers horizontaux lorsque des valeurs sont absentes.
La définition variationnelle par l’infimum résout élégamment ces discontinuités en garantissant l’existence et l’unicité de la valeur seuil pour n’importe quel ordre de probabilité $p in ]0, 1[$. En termes pratiques, le quantile d’ordre $p$ représente la valeur seuil en dessous de laquelle se trouve au minimum une proportion $p$ de la population théorique, et au-dessus de laquelle se situe au maximum une proportion $1 – p$. Ce formalisme rigoureux constitue le socle mathématique invariant sur lequel reposent toutes les déclinaisons ultérieures, qu’il s’agisse des quartiles ($p in {0.25, 0.50, 0.75}$), des déciles ($p in {0.10, 0.20, dots, 0.90}$) ou des percentiles ($p in {0.01, 0.02, dots, 0.99}$).
2.2 La famille des quantiles : principe de découpage d’un continuum ordonné
La taxonomie des mesures de position gagne en clarté dès lors que l’on envisage le mot « quantile » comme le terme hyperonyme de cette discipline. Un quantile n’est rien d’autre que l’opérateur générique désignant tout point de coupure résultant de la division systématique d’une distribution continue ou d’un échantillon ordonné en $k$ segments de fréquences théoriques parfaitement égales. Cette règle fondamentale d’équipartition implique une distinction géométrique élémentaire mais cruciale : la distinction entre les points de coupure (les frontières numériques) et les intervalles ou tranches délimités par ces frontières.
Pour partitionner un continuum en $k$ sous-ensembles équiprobables, le mathématicien n’a pas besoin de $k$ frontières, mais très exactement de $k – 1$ points de démarcation intérieurs. Si l’on adjoint conventionnellement les bornes extrêmes de la distribution (le minimum absolu correspondant à $p = 0$ et le maximum absolu correspondant à $p = 1$), on obtient une structure de $k + 1$ balises encadrant $k$ classes de fréquences. Ainsi :
- Une partition en $k = 2$ classes (bisection) nécessite 1 point de coupure : la médiane.
- Une partition en $k = 4$ classes nécessite 3 points de coupure : les quartiles.
- Une partition en $k = 10$ classes nécessite 9 points de coupure : les déciles.
- Une partition en $k = 100$ classes nécessite 99 points de coupure : les percentiles (ou centiles).
La terminologie scientifique commet fréquemment un glissement de langage en désignant par le nom du quantile l’intervalle lui-même plutôt que le point seuil qui le sépare. Dans le langage courant des cliniciens, il n’est pas rare d’entendre qu’un patient « se situe dans le premier quartile » pour signifier que son score se loge dans l’intervalle délimité entre la valeur minimale et le premier point de coupure $Q_1$. Bien que cette métonymie soit tolérée dans la communication informelle, la rigueur métrologique exige de distinguer le point de coupure ponctuel (le quantile stricto sensu, qui est une valeur numérique scalaire sur l’axe des abscisses) de l’intervalle inter-quantiles qui englobe une proportion définie d’observations.
2.3 Propriétés d’invariance et robustesse aux valeurs aberrantes
Ce qui confère aux quantiles leur statut de référence dans l’évaluation psychométrique moderne réside dans un ensemble remarquable de propriétés mathématiques, au premier rang desquelles figurent la robustesse statistique et l’invariance par homéomorphisme ou transformation monotone. En théorie de l’estimation robuste, un indicateur est caractérisé par son point de rupture (breakdown point), qui mesure la proportion minimale d’observations arbitrairement aberrantes qu’un échantillon peut contenir avant que l’estimateur ne devienne lui-même infiniment faux ou indéterminé. Alors que la moyenne arithmétique possède un point de rupture nul de $1/n$ (une seule observation aberrante suffit à déplacer la moyenne au-delà de toute limite fixée), la médiane possède un point de rupture optimal de 50 %, le plus élevé possible pour un paramètre de localisation.
Cette résilience face aux valeurs aberrantes est vitale dans les cohortes psychopathologiques. Par exemple, lors de l’enregistrement informatisé de temps de réaction chez des patients atteints de schizophrénie ou de traumatisme crânien, des décrochages attentionnels soudains ou des artéfacts moteurs génèrent fréquemment des temps de réponse massifs (plusieurs dizaines de secondes) qui ne reflètent en rien la vitesse de traitement sous-jacente. L’utilisation des quantiles protège l’analyse statistique contre ces contaminations : le déplacement, la modification ou l’extrusion d’une valeur dans les queues de distribution n’a strictement aucun impact sur la valeur des quantiles médians tant que l’ordre des rangs demeure préservé.
De surcroît, les quantiles bénéficient de la propriété fondamentale d’invariance sous transformations strictement monotones croissantes. Si une variable aléatoire $X$ subit une transformation $g(X)$ où $g$ est une fonction continue strictement croissante (comme une transformation logarithmique, exponentielle ou une conversion de score polynomiale), le quantile d’ordre $p$ de la variable transformée est rigoureusement égal à la transformation du quantile d’origine :
Q_{g(X)}(p) = g(Q_X(p))
Cette propriété est formellement violée par les moments d’ordre supérieur (la moyenne de $log(X)$ n’est jamais égale au logarithme de la moyenne de $X$, en vertu de l’inégalité de Jensen). Cette invariance garantit aux chercheurs que les classements psychométriques établis à partir des quantiles restent parfaitement stables, que l’on analyse les données sous leur forme brute ou après une transformation mathématique visant à stabiliser les variances.
3. Les quartiles : division de la distribution en quatre segments clés
3.1 Les quatre jalons fondamentaux : du minimum au maximum
Les quartiles constituent la division canonique la plus populaire dans l’analyse exploratoire des données, introduite formellement par Donald MacAlister en 1879 à la suite des suggestions de Francis Galton. Comme leur étymologie latine (quartus, le quart) l’indique sans ambiguïté, les quartiles fractionnent la distribution triée des observations en quatre quarts d’effectifs théoriquement identiques, correspondant chacun à 25 % de la masse de probabilité cumulée. Pour baliser cette partition, la nomenclature statistique identifie trois points intérieurs essentiels, complétés par les deux bornes extrêmes du domaine d’observation.
Le jalon initial, parfois désigné sous le terme technique de « quartile zéro » ($Q_0$), correspond à l’infimum absolu du jeu de données, c’est-à-dire le score minimal observé ($x_{(1)}$). Le premier quartile ($Q_1$), associé à un ordre de probabilité $p = 0.25$, représente la valeur seuil sous laquelle se situent exactement 25 % des observations les plus basses et au-dessus de laquelle résident les 75 % des scores supérieurs. Le deuxième quartile ($Q_2$), paramétré à $p = 0.50$, correspond point pour point à la médiane distributionnelle : il divise l’ensemble en deux moitiés égales de 50 %. Le troisième quartile ($Q_3$), situé à $p = 0.75$, constitue la démarcation au-dessus de laquelle ne subsistent que les 25 % des performances les plus élevées du groupe de comparaison. Enfin, le quatrième et dernier quartile ($Q_4$) clôt la distribution en s’alignant sur le supremum absolu, le score maximal observé ($x_{(n)}$).
Dans l’évaluation clinique standardisée, cette partition en quatre zones permet d’établir une cartographie préliminaire du profil d’un patient. Les quatre intervalles qui en résultent — souvent qualifiés à tort de « quartiles » par abus de langage — définissent des catégories fonctionnelles d’une redoutable efficacité : le premier quart regroupe les performances déficitaires ou très faibles ($[Q_0, Q_1]$), le deuxième quart rassemble les scores moyens inférieurs ($]Q_1, Q_2]$), le troisième quart héberge les scores moyens supérieurs ($]Q_2, Q_3]$), et le quatrième quart consacre les performances élevées à exceptionnelles ($]Q_3, Q_4]$). Cette catégorisation macroscopique offre une première grille de lecture diagnostique avant tout approfondissement granulaire.
3.2 L’écart interquartile comme métrique de dispersion robuste
Si les points $Q_1$, $Q_2$ et $Q_3$ bornent l’espace distributionnel, la distance arithmétique qui sépare le troisième quartile du premier quartile constitue l’un des indicateurs de variabilité les plus puissants de la statistique moderne : l’écart interquartile (souvent abrégé IQR pour Interquartile Range). Sa définition algébrique est d’une grande simplicité :
text{IQR} = Q_3 – Q_1
Sur le plan géométrique et probabiliste, l’écart interquartile mesure l’amplitude spatiale occupée par les 50 % centraux de l’échantillon ou de la distribution théorique. En éliminant délibérément les 25 % des scores les plus faibles et les 25 % des scores les plus élevés, l’IQR s’affranchit totalement du comportement des queues de distribution. Alors que l’étendue totale ($x_{\max} – x_{\min}$) est par nature l’estimateur de dispersion le plus instable qui soit — puisqu’il dépend exclusivement des deux valeurs les plus extrêmes et potentiellement erratiques —, l’écart interquartile affiche une remarquable constance face à l’adjonction de données bruitées ou atypiques.
En neuropsychologie expérimentale, l’IQR trouve une application privilégiée dans la modélisation de la variabilité intra-individuelle des temps de réaction. Lors de l’administration de tâches d’attention soutenue comme le test de performance continue (CPT), l’hétérogénéité des temps de réponse d’un sujet au fil des blocs d’essais reflète la stabilité de son contrôle exécutif. Un sujet neurotypique présente généralement un IQR étroit, témoignant d’une cadence temporelle régulière. À l’inverse, un patient présentant un trouble du déficit de l’attention avec ou sans hyperactivité (TDAH) manifestera fréquemment un IQR très élargi. Ce gonflement de l’écart interquartile traduit la survenue épisodique de défaillances attentionnelles sans que le clinicien n’ait à craindre que quelques lapsus de plusieurs secondes ne détruisent la validité de l’indice de dispersion global, ce qui surviendrait inévitablement avec l’écart type traditionnel.
3.3 Utilisation des quartiles pour la détection empirique des valeurs extrêmes
L’une des contributions méthodologiques les plus influentes de John Tukey à l’analyse exploratoire des données réside dans l’utilisation formalisée des quartiles et de l’écart interquartile pour l’identification objective et non paramétrique des données aberrantes (outliers). Dans son ouvrage séminal paru en 1977, Tukey introduisit la célèbre règle des clôtures (inner and outer fences), qui s’est imposée comme le standard algorithmique universel pour filtrer les séries quantitatives sans présupposer une distribution sous-jacente particulière.
Selon l’algorithme de Tukey, on définit les clôtures intérieures par rapport aux charnières quartiliques :
- Clôture intérieure inférieure : $\text{CI}_{\text{\inf}} = Q_1 – 1{,}5 \times \text{IQR}$
- Clôture intérieure supérieure : $\text{CI}_{\text{\sup}} = Q_3 + 1{,}5 \times \text{IQR}$
Toute observation qui franchit ces clôtures intérieures (c’est-à-dire une valeur inférieure à $\text{CI}_{\text{\inf}}$ ou supérieure à $\text{CI}_{\text{\sup}}$) est formellement qualifiée de valeur aberrante modérée. Pour discriminer les anomalies encore plus sévères, Tukey définit des clôtures extérieures en triplant le coefficient multiplicateur de l’écart interquartile :
- Clôture extérieure inférieure : $\text{CE}_{\text{\inf}} = Q_1 – 3{,}0 \times \text{IQR}$
- Clôture extérieure supérieure : $\text{CE}_{\text{\sup}} = Q_3 + 3{,}0 \times \text{IQR}$
Toute donnée se projetant au-delà de ces clôtures extérieures est cataloguée comme valeur aberrante extrême. Dans l’administration des inventaires d’auto-évaluation de la personnalité (tels que le MMPI-3 ou le NEO-PI-3), cette modélisation quartilique joue un rôle diagnostique de tout premier plan. L’identification d’un temps de réponse global ou d’un indice d’incohérence franchissant les clôtures de Tukey permet d’objectiver mathématiquement des patrons de réponses non valides — qu’il s’agisse de réponses aléatoires générées par désintérêt, de biais de désirabilité sociale massive ou de tentatives délibérées de simulation pathologique — sans introduire d’arbitraire subjectif dans l’exclusion des protocoles.
4. Les percentiles : granularité fine et étalonnage psychométrique
4.1 Définition et spectre des centiles : de zéro à cent
Si les quartiles segmentent la distribution en quatre macro-zones, les percentiles — également appelés centiles dans la littérature francophone — poussent la finesse de résolution jusqu’à son paroxysme usuel en opérant une division de la population en cent segments d’effectifs théoriquement équiprobables. L’échelle des centiles s’étend de 1 à 99 pour les points de coupure stricts, encadrés par le percentile 0 (le minimum de l’échantillon de référence) et le percentile 100 (le maximum absolu observable). Le percentile d’ordre $k$ (noté $P_k$, où $k in {1, 2, dots, 99}$) est le score brut en deçà duquel s’accumule exactement $k$ % des observations de l’échantillon d’étalonnage.
Cette granularité fine confère aux percentiles une capacité discriminative inégalée le long de l’ensemble du continuum des aptitudes psychologiques et cognitives. Contrairement aux approches par classes larges (comme les stanines divisées en 9 classes ou les stens divisés en 10 classes), le rang percentile permet de différencier avec précision deux individus dont les scores bruts ne divergent que de quelques unités, à la condition expresse que l’échantillon d’étalonnage soit de taille suffisamment robuste ($N \geq 1000$) pour que chaque centile repose sur une densité empirique substantielle.
Il est fondamental de souligner la nature strictement non probabiliste et descriptive du positionnement par percentile dans son usage quotidien. Lorsqu’un clinicien rapporte qu’un sujet obtient un rang percentile de 37 à une épreuve de rétention mnésique, cette valeur n’indique pas la probabilité que le sujet réussisse un item futur, mais résume un fait empirique et relationnel immuable : dans le groupe de référence ayant servi à normaliser le test, 37 % des individus ont obtenu une performance inférieure ou égale à la sienne, tandis que 63 % ont réalisé une performance strictement supérieure. Le percentile est par essence une métrique de comparaison sociale et populationnelle standardisée.
4.2 L’usage des percentiles dans les tests neuropsychologiques standardisés
Dans l’arsenal méthodologique de l’évaluation neuropsychologique contemporaine, le rang percentile s’est imposé comme la monnaie d’échange universelle. Des batteries d’efficience globale comme la WAIS-IV aux instruments spécialisés évaluant les fonctions exécutives (tels que la Tour de Londres, le Test de Stroop ou le Trail Making Test), tous les manuels de référence fournissent des tables de conversion permettant de transposer instantanément un score brut en rang percentile normatif.
Cette omniprésence s’explique par la nécessité clinique d’ajuster l’interprétation des performances aux déterminants sociodémographiques qui modulent la réserve cognitive. Un score brut de 35 mots produits au test de fluence verbale n’a pas la même valeur sémiologique chez un jeune adulte de 22 ans titulaire d’un diplôme d’études supérieures que chez une personne âgée de 84 ans sans qualification formelle. L’étalonnage en percentiles permet de stratifier les tables normatives en sous-groupes homogènes selon l’âge, le sexe et le niveau d’études (souvent catégorisé de 1 à 4). En consultant la cellule d’étalonnage idoine, le praticien extrait directement le rang percentile ajusté qui neutralise les biais socioculturels et démographiques.
Dans les batteries d’évaluation les plus récentes, cette normalisation transculturelle et démographique atteint un haut degré de sophistication mathématique grâce au lissage continu des percentiles (continuous norming). Au lieu de découper artificiellement l’échantillon en tranches d’âge rigides (par exemple 60-64 ans, puis 65-69 ans) — ce qui induit des sauts de seuil artificiels pour un patient fêtant son anniversaire à quelques jours d’intervalle —, les logiciels d’évaluation calculent le percentile exact par régression polynomiale sur la fonction quantile continue. Cette approche offre une précision d’étalonnage optimale qui sécurise le suivi longitudinal des trajectoires cognitives au cours du vieillissement normal ou pathologique.
4.3 Distinction cruciale entre pourcentage brut et rang percentile
L’une des erreurs les plus fréquentes commises par les étudiants, les cliniciens débutants et le grand public réside dans la confusion pernicieuse entre le pourcentage de réussite brut et le rang percentile. Bien que ces deux métriques partagent une échelle numérique apparente bornée entre 0 et 100, leurs natures mathématiques et leurs significations cliniques sont diamétralement opposées.
Le pourcentage brut (ou taux de précision) est une mesure absolue et linéaire qui rapporte le nombre de réponses correctes fournies par un individu au nombre total d’items composant l’épreuve. Si un patient réussit 40 items sur un test qui en comporte 50, son pourcentage brut de réussite s’établit exactement à :
frac{40}{50} times 100 = 80,%
Cette valeur ne nous renseigne absolument pas sur la difficulté intrinsèque du test ni sur la performance relative des autres individus. Si l’épreuve était d’une simplicité enfantine, il est fort probable que la quasi-totalité de la population obtienne 48 ou 49 bonnes réponses. Dans ce scénario, notre patient ayant réussi 80 % des items réalise en réalité une contre-performance alarmante.
Le rang percentile, à l’opposé, est une mesure purement ordinale et relative. Si le score brut de 40 place ce sujet au 5e percentile ($P_5$), cela signifie que malgré son taux de précision apparent de 80 %, 95 % de ses pairs font mieux que lui. Inversement, sur une épreuve d’une difficulté extrême (comme un test d’analogie abstraite de haute volée), un taux de réussite brut de seulement 30 % des items peut parfaitement propulser le sujet au 99e percentile ($P_{99}$) si l’immense majorité de la cohorte échoue à dépasser 15 % de bonnes réponses. Confondre le pourcentage brut de réussite avec le rang percentile conduit à des erreurs diagnostiques majeures, consistant tantôt à rassurer faussement un patient en échec massif relatif, tantôt à dramatiser les résultats d’un sujet brillant confronté à un instrument intentionnellement surchargé en difficulté.
5. Les relations mathématiques et correspondances directes entre quantiles, quartiles et percentiles
5.1 La table d’équivalence universelle des points de coupure
Puisque les quartiles et les percentiles constituent des instanciations particulières de la classe générale des quantiles, il existe entre eux un ensemble de correspondances mathématiques absolues, régies par l’équivalence des ordres de probabilité cumulée $p$. Ces passerelles théoriques permettent de basculer sans perte d’information d’une nomenclature à une autre, garantissant l’harmonie des descriptions statistiques.
L’architecture de ces équivalences universelles peut être résumée par les égalités suivantes :
- Le minimum absolu : $Q_0 \equiv P_0 \equiv \text{Quantile}(p = 0.0)$
- Le premier quartile : $Q_1 \equiv P_{25} \equiv \text{Quantile}(p = 0.25)$
- Le deuxième quartile (médiane) : $Q_2 \equiv P_{50} \equiv \text{Quantile}(p = 0.50)$
- Le troisième quartile : $Q_3 \equiv P_{75} \equiv \text{Quantile}(p = 0.75)$
- Le maximum absolu : $Q_4 \equiv P_{100} \equiv \text{Quantile}(p = 1.0)$
Cette table d’équivalence met en lumière la nature fractale et hiérarchique du découpage quantilique. Le premier quartile $Q_1$ n’est rien d’autre que la valeur qui sature exactement le premier quart de l’axe des ordonnées cumulées, ce qui correspond point par point au 25e centile. De même, le troisième quartile $Q_3$ est la réplique exacte du 75e centile. Par conséquent, affirmer qu’un patient présente un score inférieur au premier quartile équivaut strictement à déclarer que sa performance le situe sous le 25e percentile. La distinction ne réside pas dans la valeur mathématique du point critique, mais dans le système de notation retenu pour communiquer l’information.
5.2 La médiane comme pivot central des quantiles
Au confluent de l’ensemble de ces familles statistiques trône un jalon universel dont le statut métrologique est unique : la médiane. La médiane représente le cas singulier où la bisection distributionnelle coïncide rigoureusement avec le point milieu de toutes les décompositions symétriques. Nous pouvons poser l’identité théorique fondamentale :
text{Médiane} equiv Q_2 equiv P_{50} equiv D_5 equiv text{Quantile}(p = 0.50)
Cette quadruple identité confère à la médiane un rôle de pivot structurant dans l’ensemble des sciences quantitatives. Elle matérialise l’exact barycentre ordinal de la population : 50 % des observations lui sont inférieures ou égales, et 50 % des observations lui sont supérieures ou égales. Sur une courbe de densité théorique, la droite verticale érigée au niveau de la médiane sépare la surface sous la courbe en deux aires rigoureusement identiques de 0,5 chacune, et ce, quelle que soit la complexité, la multimodalité ou l’asymétrie de la fonction mathématique modélisant le phénomène.
Ce statut de pivot central confère à la médiane une stabilité remarquable lors de l’exploration des données psychopathologiques. Si l’on modifie unilatéralement la distribution des scores en aggravant arbitrairement la sévérité des cas les plus lourds (étirement indéfini de la queue droite de la distribution), la médiane $Q_2 = P_{50}$ demeure parfaitement immuable, alors que la moyenne arithmétique subit une dérive pathologique vers la droite. C’est cette invariance fonctionnelle qui conduit la majorité des protocoles de recherche internationaux à préférer le 50e percentile à la moyenne comme référentiel normatif zéro dans l’analyse non paramétrique des populations cliniques hétérogènes.
5.3 Conversions et harmonisation des données issues d’instruments composites
Dans la recherche translationnelle ou lors de méta-analyses intégrant des cohortes évaluées à l’aide d’instruments psychométriques différents, les chercheurs sont confrontés au défi de l’harmonisation des données. Il arrive fréquemment qu’une étude ancienne n’ait publié que les scores bornés par quartiles (par exemple, des résumés en termes de $Q_1$, Médiane, $Q_3$), tandis qu’une étude prospective plus moderne dispose de données granulaires étalonnées en centiles précis ($P_1$ à $P_{99}$).
Le passage d’un étalonnage à l’autre impose une méthodologie rigoureuse pour éviter l’introduction d’artéfacts de mesure. Si l’agrégation descendante d’une échelle de percentiles vers des quartiles est triviale (il suffit de fusionner les tranches $P_1-P_{25}$, $P_{26}-P_{50}$, $P_{51}-P_{75}$ et $P_{76}-P_{100}$), l’opération inverse — la désagrégation ascendante d’une structure en quartiles vers des percentiles — exige des modèles d’interpolation mathématique. L’interpolation linéaire par morceaux constitue l’approche la plus intuitive, mais elle postule une densité uniforme intra-quartile qui s’avère fausse dans les queues de distribution. Pour surmonter cet écueil, les statisticiens emploient des splines d’interpolation monotone ou recourent à des méthodes d’imputation fondées sur la loi bêta généralisée.
Ce travail d’harmonisation métrologique est indispensable lorsqu’un neuropsychologue synthétise le profil d’un patient ayant complété une batterie hétérogène de sous-tests. Si les épreuves attentionnelles sont calibrées en déciles, les épreuves de mémoire en centiles et les questionnaires comportementaux en quartiles, le clinicien doit maîtriser la table d’équivalence sous-jacente pour projeter tous les résultats sur une même matrice d’analyse sans distordre la hiérarchie clinique des dysfonctions observées.
6. Les autres types de quantiles notables : tertiles, quintiles, déciles et octiles
6.1 Tertiles et quintiles dans les études socio-émotionnelles et épidémiologiques
Si le découpage en 4 segments (quartiles) et en 100 segments (percentiles) domine la clinique, d’autres subdivisions quantiliques occupent une place stratégique dans les protocoles de recherche épidémiologique, sociologique et psychologique. Les tertiles correspondent à une partition en $k = 3$ segments de fréquences égales (délimités par deux points de coupure : $T_1$ à $p \approx 0.333$ et $T_2$ à $p \approx 0.667$). Cette tripartition est plébiscitée dans les recherches portant sur les variables socio-émotionnelles pour catégoriser des populations en trois groupes fonctionnels nets : « niveau faible », « niveau intermédiaire » et « niveau élevé ». Bien que ce découpage sacrifie une partie de la finesse métrique, il présente l’immense avantage d’éviter la prolifération de classes d’effectifs réduits et d’offrir une lisibilité clinique immédiate.
Les quintiles, qui fractionnent la cohorte en $k = 5$ segments de 20 % chacun (délimités par quatre points de coupure : $Qn_1$ à $p = 0.20$, $Qn_2$ à $p = 0.40$, $Qn_3$ à $p = 0.60$ et $Qn_4$ à $p = 0.80$), constituent l’étalon d’or des études portant sur les inégalités sociales de santé et la psychiatrie communautaire. Dans les rapports de l’Organisation Mondiale de la Santé (OMS), les gradients de vulnérabilité mentale face au niveau de revenu, à l’accès aux soins ou à l’exposition au stress environnemental sont presque systématiquement présentés par quintiles socio-économiques. Le premier quintile regroupe les 20 % les plus défavorisés de la population, tandis que le cinquième quintile rassemble les 20 % les plus nantis. Les correspondances avec les centiles sont directes : $Qn_1 = P_{20}$, $Qn_2 = P_{40}$, $Qn_3 = P_{60}$ et $Qn_4 = P_{80}$.
6.2 Déciles : seuillage clinique et segmentation populationnelle
Les déciles découpent la distribution ordonnée en dix tranches égales de 10 % d’effectifs chacune, nécessitant l’établissement de neuf points de coupure intérieurs désignés par $D_1, D_2, dots, D_9$. Les équivalences avec les dizaines de percentiles sont parfaites :
- $D_1 \equiv P_{10}$
- $D_2 \equiv P_{20}$
- $D_5 \equiv P_{50} \equiv \text{Médiane} \equiv Q_2$
- $D_8 \equiv P_{80}$
- $D_9 \equiv P_{90}$
Dans l’évaluation médico-légale et la pratique psychiatrique, les déciles fournissent un seuillage clinique particulièrement opérant pour la catégorisation populationnelle. Le premier décile ($D_1$ ou $P_{10}$) et le neuvième décile ($D_9$ ou $P_{90}$) sont couramment utilisés dans les systèmes de santé publique comme des repères conventionnels pour désigner les populations dites « à risque » ou « hors normes ».
Par exemple, lors du dépistage de troubles du comportement externalisés en milieu scolaire ou de la dépendance alcoolique via des questionnaires standardisés comme l’AUDIT, un score franchissant le neuvième décile sert de signal d’alarme déclenchant une évaluation diagnostique approfondie de second niveau. L’écart interdécile ($D_9 – D_1$), qui embrasse 80 % de la masse centrale des scores en occultant les 10 % les plus bas et les 10 % les plus élevés, constitue une autre mesure de dispersion robuste très appréciée des macro-statisticiens pour comparer la variabilité des systèmes de notation entre différents pays ou différentes cultures sans être pollué par les valeurs marginales.
6.3 Octiles et n-quantiles : modélisations granulaires avancées
Moins connus du grand public, les octiles segmentent la distribution en huit segments équiprobables de 12,5 % chacun grâce à sept points de coupure intérieurs ($O_1$ à $p = 0.125$, $O_2$ à $p = 0.25 \equiv Q_1$, $O_4$ à $p = 0.50 \equiv \text{Médiane}$, etc.). Les octiles trouvent une application contemporaine dans les modèles de psychométrie de réseau et l’analyse factorielle confirmatoire granulaire, où les chercheurs cherchent à discrétiser des variables continues sans perdre la sensibilité fine requise pour détecter des interactions non linéaires complexes entre nœuds psychopathologiques.
D’un point de vue fondamental, la théorie statistique formalise le concept de $n$-quantiles (ou quantiles d’ordre $n$). Rien n’interdit théoriquement de construire une partition d’une distribution en 500, 1000 ou 10 000 segments égaux si la puissance de l’échantillon le permet. Toutefois, dans toute démarche empirique, il existe un arbitrage incontournable entre la résolution statistique souhaitée et la puissance d’échantillonnage disponible. Si l’on désire calculer des centiles ($n = 100$) fiables et non biaisés, un échantillon minimal de plusieurs centaines d’individus est requis ; pour des octiles ($n = 8$), un effectif plus restreint suffit à stabiliser les points de coupure. Choisir l’ordre de la partition quantilique revient donc toujours à équilibrer la précision diagnostique espérée et la densité d’échantillonnage réellement observée au sein de la matrice de données.
7. Méthodologie de calcul pratique : formules manuelles et algorithmes d’interpolation
7.1 L’ordonnancement des données et l’identification des rangs pivots
Le calcul concret des quantiles sur un échantillon empirique d’effectif fini $N$ commence obligatoirement par une phase d’ordonnancement séquentiel. Soit un échantillon de mesures quantitatives ${x_1, x_2, dots, x_N}$. La première étape consiste à trier ces observations dans l’ordre croissant pour former la suite des statistiques d’ordre, traditionnellement notées entre parenthèses :
x_{(1)} leq x_{(2)} leq x_{(3)} leq dots leq x_{(N)}
Une fois cette série ordonnée établie, la recherche du quantile d’ordre $p$ (avec $0 < p < 1$) implique la détermination de son rang pivot ou indice théorique $h$. Plusieurs conventions d’indexation coexistent dans la littérature scientifique pour calculer cette position théorique, la plus intuitive reposant sur la multiplication directe de l’ordre $p$ par la taille de l’échantillon $N$ :
h = N times p
Deux situations se présentent alors :
- Si le produit $h$ n’est pas un nombre entier, on arrondit systématiquement $h$ à l’entier immédiatement supérieur, noté $lceil h rceil$. La valeur du quantile recherché est alors la statistique d’ordre correspondante : $Q(p) = x_{(\lceil h \rceil)}$.
- Si le produit $h$ est un nombre entier parfait, le quantile d’ordre $p$ est défini comme la moyenne arithmétique des deux observations occupant les positions $h$ et $h + 1$ :
Q(p) = frac{x_{(h)} + x_{(h+1)}}{2}
Bien que cette méthode classique fonctionne convenablement pour de grands échantillons, elle présente des aspérités lorsque la taille de la cohorte est modeste, conduisant à des ruptures de pente sur la fonction de distribution empirique.
7.2 Les méthodes d’interpolation linéaire standardisées
Pour résoudre les incohérences de calcul entre logiciels statistiques, Rob J. Hyndman et Yanan Fan ont publié en 1996 un article fondamental dans la revue The American Statistician, répertoriant et unifiant les neuf algorithmes distincts utilisés pour estimer les quantiles sur des échantillons continus. Cette taxonomie fait aujourd’hui autorité et structure le fonctionnement interne des logiciels R, Python, SPSS, SAS et Minitab.
Dans cette formalisation unifiée, la position théorique réelle d’un quantile est formulée sous la forme générique :
h = (N – m) times p + m
où $m$ est une constante dépendant du modèle choisi (les 9 types variant selon la valeur attribuée à $m$ et le mode d’arrondi). Une fois le rang fractionnaire décomposé en sa partie entière $j = lfloor h rfloor$ et sa partie fractionnaire $\gamma = h – j$ (avec $0 \leq \gamma < 1$), le quantile estimé $\hat{Q}(p)$ s'obtient par interpolation linéaire entre deux statistiques d'ordre consécutives :
hat{Q}(p) = (1 – gamma) x_{(j)} + gamma x_{(j+1)}
Cette approche d’interpolation linéaire continue évite les sauts discrets artificiels. Toutefois, les divergences entre logiciels peuvent surprendre le praticien non averti : par exemple, le logiciel R utilise par défaut le Type 7 ($m = 1$, ce qui donne $h = (N – 1)p + 1$), tandis que le logiciel SPSS emploie traditionnellement le Type 6 ($h = (N + 1)p$, également retenu par Minitab). Sur un échantillon restreint de 25 patients, ces variations algorithmiques peuvent entraîner un décalage de plusieurs unités sur les percentiles marginaux ($P_5$ ou $P_{95}$), soulignant la nécessité méthodologique de consigner explicitement le type d’algorithme employé lors de la publication de travaux de recherche psychométrique.
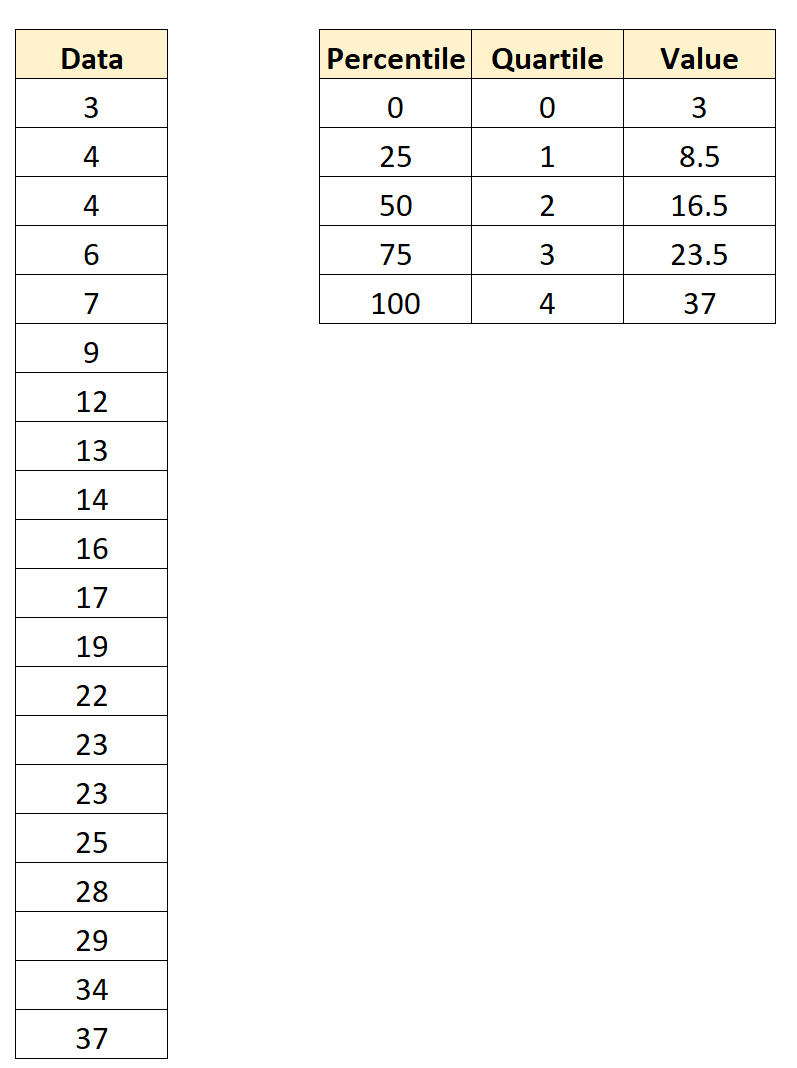
7.3 Exemple pas-à-pas sur un échantillon clinique de scores de dépression
Pour illustrer de manière limpide la mécanique du calcul manuel, considérons une cohorte clinique réelle de $N = 20$ patients consultant dans un centre expert des troubles de l’humeur, ayant tous complété l’Inventaire de Dépression de Beck-II (BDI-II, où le score varie de 0 à 63). Les scores bruts enregistrés sont les suivants :
24, 12, 38, 15, 7, 42, 19, 29, 31, 14, 8, 22, 18, 35, 27, 11, 45, 16, 23, 20
Étape 1 : Tri croissant des observations
Nous ordonnons rigoureusement la série d’observations du minimum ($x_{(1)}$) au maximum ($x_{(20)}$) :
x_{(1)}=7, x_{(2)}=8, x_{(3)}=11, x_{(4)}=12, x_{(5)}=14, x_{(6)}=15, x_{(7)}=16, x_{(8)}=18, x_{(9)}=19, x_{(10)}=20,
x_{(11)}=22, x_{(12)}=23, x_{(13)}=24, x_{(14)}=27, x_{(15)}=29, x_{(16)}=31, x_{(17)}=35, x_{(18)}=38, x_{(19)}=42, x_{(20)}=45
Étape 2 : Détermination des bornes extrêmes
- Quartile zéro ($Q_0 \equiv P_0$) : Score minimal = 7
- Quatrième quartile ($Q_4 \equiv P_{100}$) : Score maximal = 45
Étape 3 : Calcul de la médiane ($Q_2 \equiv P_{50}$)
Pour $p = 0.50$, l’indice est $h = 20 \times 0.50 = 10$. Le résultat étant un nombre entier exact, nous faisons la moyenne de la 10e et de la 11e observation :
Q_2 = frac{x_{(10)} + x_{(11)}}{2} = frac{20 + 22}{2} = 21{,}0
La médiane de dépression dans ce groupe est donc de 21 points.
Étape 4 : Calcul du premier quartile ($Q_1 \equiv P_{25}$)
Pour $p = 0.25$, l’indice est $h = 20 \times 0.25 = 5$. Le résultat étant un entier, nous appliquons la moyenne des 5e et 6e observations :
Q_1 = frac{x_{(5)} + x_{(6)}}{2} = frac{14 + 15}{2} = 14{,}5
Étape 5 : Calcul du troisième quartile ($Q_3 \equiv P_{75}$)
Pour $p = 0.75$, l’indice est $h = 20 \times 0.75 = 15$. Nous faisons la moyenne des 15e et 16e observations :
Q_3 = frac{x_{(15)} + x_{(16)}}{2} = frac{29 + 31}{2} = 30{,}0
Étape 6 : Synthèse de la dispersion interquartile et interprétation
L’écart interquartile s’établit à $\text{IQR} = Q_3 – Q_1 = 30{,}0 – 14{,}5 = 15{,}5$ points. Sur le plan sémiologique, cela nous indique que les 50 % centraux de notre cohorte clinique présentent un niveau de sévérité dépressive concentré entre 14,5 et 30 points sur l’échelle de Beck, balayant le spectre allant de la dépression légère à la dépression sévère modérée. Les clôtures de Tukey se calculeraient ainsi :
- $\text{CI}_{\text{\inf}} = 14{,}5 – 1{,}5 \times 15{,}5 = 14{,}5 – 23{,}25 = -8{,}75$ (aucun score négatif n’existant, aucune valeur n’est aberrante basse).
- $\text{CI}_{\text{\sup}} = 30{,}0 + 1{,}5 \times 15{,}5 = 30{,}0 + 23{,}25 = 53{,}25$ (le score maximal étant de 45, aucune valeur aberrante haute n’est identifiée dans cette série).
8. Applications cliniques et psychométriques : évaluation des tests psychologiques
8.1 Étalonnage des échelles d’intelligence et profils cognitifs
Dans l’évaluation psychométrique de l’intelligence de l’adulte et de l’enfant au moyen des échelles de David Wechsler (WISC-V pour l’enfant, WAIS-IV pour l’adulte), l’utilisation des percentiles constitue la pierre angulaire de l’interprétation diagnostique. Bien que les indices globaux soient standardisés sous la forme de quotients intellectuels standards (moyenne = 100, écart type = 15), chaque score standard est adossé à son rang percentile précis. Ainsi, un QI de 100 correspond mathématiquement au 50e percentile, tandis qu’un QI de 130 se positionne au 98e percentile et qu’un QI de 70 s’établit au 2e percentile.
L’apport déterminant de l’analyse quantilique réside dans l’analyse des dissociations intra-individuelles. Les indices composites de la WAIS-IV (Compréhension Verbale, Raisonnement Perceptif, Mémoire de Travail, Vitesse de Traitement) ne progressent pas toujours de manière homogène. L’examen des écarts interquartiles intra-sujets permet d’objectiver l’hétérogénéité d’un profil : une dispersion excessive entre le percentile le plus bas et le percentile le plus haut d’un même individu invalide la représentativité du QI Total en tant que mesure synthétique de l’intelligence générale (facteur $g$ de Spearman).
Néanmoins, les cliniciens doivent faire preuve d’une prudence méthodologique extrême lorsqu’ils manipulent les percentiles dans les zones extrêmes de la distribution. Dans les marges supérieures (associées au Haut Potentiel Intellectuel, percentiles 98 à 99,9) ou inférieures (associées à la Déficience Intellectuelle, percentiles inférieurs à 2), la fidélité de mesure des tests psychométriques décline. Les erreurs types de mesure ($SEM$) s’élargissent en raison du nombre réduit d’items capables de discriminer des aptitudes aussi exceptionnelles. L’illusion d’une précision absolue procurée par un chiffre comme « 99,6e percentile » doit impérativement être tempérée par l’adjonction d’un intervalle de confiance robuste.
8.2 Diagnostics différentiels et seuils pathologiques basés sur les centiles
Dans le domaine des troubles neurodéveloppementaux et de la neuropsychologie clinique du vieillissement, la fixation de seuils pathologiques conventionnels repose historiquement sur des coupures quantiliques rigoureuses. En neuropsychologie francophone et anglo-saxonne, deux seuils majeurs gouvernent la nosographie différentielle :
- Le seuil de fragilité ou de zone limite : traditionnellement fixé au 16e percentile (qui correspond approximativement à une déviation de $-1$ écart type sous la moyenne dans une loi normale). Un score se situant entre le 5e et le 16e percentile alerte le praticien sur une vulnérabilité cognitive ou un déclin débutant méritant une surveillance longitudinale.
- Le seuil de déficit pathologique avéré : conventionnellement fixé au 5e percentile (environ $-1{,}65$ écart type) ou, plus sévèrement encore, au 2e percentile (environ $-2$ écarts types sous la moyenne).
Dans le diagnostic différentiel d’un Trouble Spécifique des Apprentissages (dyslexie, dyscalculie) selon les critères du DSM-5 ou de la CIM-11, une performance mesurée en deçà du 5e percentile à des épreuves standardisées de lecture ou de calcul constitue un argument métrologique majeur pour attester que le déficit n’est pas une simple variation statistique ordinaire, mais une altération cliniquement significative du fonctionnement académique.
Toutefois, la sensibilité diagnostique de ces coupures centiliques dépend intimement de la validité écologique de l’échantillon d’étalonnage. Un clinicien qui évalue un patient âgé issu d’un milieu socioculturel très favorisé face à une norme globale non stratifiée sur le niveau d’études risque de sous-diagnostiquer une pathologie neurodégénérative débutante (comme une maladie d’Alzheimer au stade prodromal). Dans ce cas, les mécanismes de compensation cognitive peuvent maintenir le score brut du patient au 20e percentile général, masquant un effondrement massif par rapport à son niveau prémorbide qui aurait dû le situer au-delà du 90e percentile.
8.3 Communication éthique des résultats aux patients et aidants
L’un des avantages les plus méconnus mais essentiels des percentiles concerne la restitution orale et écrite des bilans neuropsychologiques aux patients, aux familles et aux équipes éducatives. La communication de scores bruts ou d’indicateurs abstraits tels que les scores z (écarts types négatifs) génère fréquemment une anxiété iatrogène considérable chez les sujets évalués. Entendre annoncer par un spécialiste que l’on se situe à « moins deux écarts types de la norme » induit une charge anxiogène violente, évoquant une anomalie biologique grave ou une sentence irrévocable.
À l’inverse, la métaphore spatiale et sociale du rang percentile s’avère infiniment plus pédagogique, accessible et déontologiquement vertueuse. Expliquer à des parents que sur un groupe représentatif de 100 enfants du même âge scolaire, leur fils se classe au 35e rang pour la vitesse d’écriture et au 82e rang pour la compréhension lexicale permet une appréhension intuitive immédiate de la réalité sans stigmatisation mathématique. Cette formulation désamorce l’angoisse liée aux chiffres négatifs et replace le sujet dans un continuum humain bienveillant.
Cette responsabilité déontologique exige cependant du praticien une vigilance constante pour lutter contre la réification des chiffres. Un individu n’« est » pas un 5e percentile : il a réalisé, à un instant $t$, dans un contexte émotionnel, clinique et motivationnel précis, une performance qui le positionne temporairement à ce niveau ordinal. Le respect du code de déontologie des psychologues impose de toujours contextualiser le chiffre, de rappeler l’existence de marges d’erreur de mesure et d’enrichir systématiquement les données quantiliques par l’observation clinique qualitative de la démarche de résolution de l’individu.
9. Visualisation graphique : boîtes à moustaches, courbes cumulatives et ogives
9.1 Anatomie d’un diagramme en boîte de Tukey
La transcription visuelle des statistiques de position a trouvé son expression la plus accomplie dans le diagramme en boîte (boxplot), imaginé par John Tukey en 1977. Ce dispositif graphique synthétise en une figure unifiée l’intégralité du « résumé à cinq nombres » d’une série distributionnelle : le minimum, le premier quartile, la médiane, le troisième quartile et le maximum.
L’anatomie d’une boîte à moustaches moderne se décompose en plusieurs composantes structurelles hautement codifiées :
- Le corps central rectangulaire (la boîte) : La base inférieure de la boîte matérialise l’emplacement exact du premier quartile $Q_1$, tandis que son sommet supérieur représente le troisième quartile $Q_3$. La hauteur géométrique du rectangle correspond donc rigoureusement à l’écart interquartile ($\text{IQR} = Q_3 – Q_1$). Ainsi, la boîte matérialise visuellement la zone où se condensent les 50 % centraux des données de l’échantillon.
- La ligne de fracture médiane : À l’intérieur de la boîte, une ligne horizontale marquée (souvent épaissie ou colorée) désigne l’emplacement exact du deuxième quartile $Q_2$ (la médiane). Sa position relative dans la boîte renseigne instantanément sur l’asymétrie de la moitié centrale de la distribution : si la médiane est collée au bord inférieur $Q_1$, la moitié centrale présente une forte asymétrie positive.
- Les moustaches (whiskers) : Deux segments verticaux s’étendent de part et d’autre de la boîte. Contrairement à une croyance répandue, les moustaches ne rejoignent pas nécessairement le minimum et le maximum absolus. Dans la convention standard de Tukey, la moustache inférieure descend jusqu’à la plus petite valeur observée qui soit supérieure ou égale à la clôture intérieure basse ($Q_1 – 1{,}5 \times \text{IQR}$). De même, la moustache supérieure monte jusqu’à la plus grande valeur observée inférieure ou égale à la clôture intérieure haute ($Q_3 + 1{,}5 \times \text{IQR}$).
- Les points isolés (outliers) : Toute donnée située au-delà de l’extrémité des moustaches est représentée individuellement sous la forme de points ou d’astérisques, signalant au regard du chercheur l’existence d’anomalies de mesure ou de sujets hautement atypiques.
9.2 Fonctions de répartition empirique et ogives de Galton
Tandis que la boîte à moustaches offre une lecture statique par quartiles, la fonction de répartition empirique (ECDF pour Empirical Cumulative Distribution Function) et son pendant continu historique, l’ogive de Galton, permettent de visualiser graphiquement l’intégralité du continuum des quantiles et percentiles. Pour un échantillon trié de taille $N$, l’ECDF est une fonction en escalier qui associe à chaque valeur observée sur l’axe des abscisses la proportion cumulée d’observations qui lui sont inférieures ou égales :
hat{F}_N(x) = frac{1}{N} sum_{i=1}^N mathbf{1}_{{x_i leq x}}
L’ogive se présente généralement sous une allure sigmoïde (en forme de S). Son tracé permet une interpolation visuelle directe : pour connaître le rang percentile d’un patient à partir de son score brut, il suffit de repérer le score sur l’axe horizontal, de monter verticalement jusqu’à l’intersection avec la courbe sigmoïde, puis de lire la probabilité cumulée sur l’axe vertical (multipliée par 100 pour obtenir le centile). Inversement, pour trouver un quantile donné (par exemple le 75e percentile), on trace une ligne horizontale à partir de 0,75 sur l’axe des ordonnées jusqu’à la courbe, dont la projection sur l’axe des abscisses livre le score seuil recherché.
En recherche neuropsychologique, la superposition d’ogives constitue une méthode visuelle d’une élégance rare pour comparer des groupes pathologiques à des groupes témoins. Si l’on trace sur un même graphique l’ogive cumulative des temps de réaction de sujets sains et celle de patients atteints de la maladie de Parkinson, le décalage horizontal des deux courbes vers la droite objective l’ampleur du ralentissement moteur et cognitif, tandis que la diminution de la pente de la sigmoïde des patients traduit une augmentation massive de la variabilité intra-groupe.
9.3 Identification graphique de l’asymétrie et de l’aplatissement via les quantiles
L’observation morphologique conjointe des diagrammes en boîte et des courbes cumulatives permet d’évaluer de manière qualitative et quantitative l’asymétrie (skewness) et l’aplatissement (kurtosis) d’un jeu de données sans jamais recourir aux calculs paramétriques traditionnels de Pearson ou de Fisher.
L’asymétrie se déduit immédiatement de la comparaison spatiale des distances séparant les quartiles. Dans une distribution parfaitement symétrique, la distance séparant la médiane du premier quartile est rigoureusement identique à la distance séparant le troisième quartile de la médiane :
Q_2 – Q_1 = Q_3 – Q_2
Si la boîte montre une distorsion où $(Q_3 – Q_2) gg (Q_2 – Q_1)$, accompagnée d’une moustache supérieure bien plus longue que la moustache inférieure, la distribution présente une asymétrie positive (étalement vers les scores élevés). Ce phénomène est couramment observé dans les inventaires de douleur ou de symptomatologie psychiatrique au sein de la population générale, où la vaste majorité des individus présente un score nul ou minime, alors qu’une minorité étire la queue supérieure vers des scores de détresse intenses.
De façon analogue, l’épaisseur des queues de distribution peut être quantifiée via l’indice de kurtosis de Moors, qui exploite la partition en octiles. Cet indice compare la dispersion des octiles extrêmes à la dispersion des octiles centraux :
text{Kurtosis}_{text{Moors}} = frac{(O_7 – O_5) + (O_3 – O_1)}{O_6 – O_2}
Cette approche purement quantilique offre un diagnostic visuel et chiffré immédiat de la structure des données, permettant aux chercheurs d’identifier des anomalies méthodologiques, telles que des réponses en miroir ou des falsifications d’inventaires, sans être tributaires de tests d’hypothèse de normalité formels souvent trop sensibles aux grands effectifs.
10. Comparaison avec d’autres métriques : scores z, scores T et rangs percentiles
10.1 Transformation non linéaire versus standardisation paramétrique
L’évaluation psychométrique contemporaine jongle en permanence entre deux grandes familles de métriques standardisées : les métriques paramétriques issues de transformations linéaires (comme les scores z et les scores T) et les métriques de rang issues de transformations non linéaires (les percentiles). Comprendre la rupture épistémologique qui sépare ces deux modes de standardisation est impératif pour tout utilisateur d’instruments de mesure psychologique.
La transformation d’un score brut $X$ en un score centré-réduit standardisé (score $z$) s’effectue via l’équation linéaire canonique :
z = frac{X – mu}{sigma}
où $\mu$ représente la moyenne arithmétique de la population de référence et $\sigma$ son écart type. La propriété essentielle de cette transformation est qu’elle est strictement linéaire. Elle ne modifie en rien la géométrie de la distribution d’origine : les distances métriques relatives entre les individus sont rigoureusement préservées. Si la distance séparant les sujets A et B était le double de celle séparant B et C sur l’échelle brute, ce rapport de deux demeure inaltéré sur l’échelle des scores $z$. Il en va de même pour les scores T (obtenus par la transformation linéaire $T = 50 + 10z$), fréquemment employés dans les inventaires de personnalité comme le MMPI.
À l’inverse fondamental, la conversion d’un score brut en rang percentile constitue une transformation non linéaire monotone. Cette opération abandonne délibérément la préservation des distances métriques spatiales pour ne retenir que l’information relative à l’ordre d’accumulation des effectifs. Ce processus opère une distorsion structurelle majeure sur la métrique : il étire considérablement les écarts situés dans les zones de forte densité (au centre de la courbe) et compresse drastiquement les distances métriques dans les zones de faible densité (les queues de distribution). Il est par conséquent impossible de calculer une moyenne arithmétique de rangs percentiles sans commettre une faute mathématique grossière.
10.2 Rapprochement théorique sous l’hypothèse de la loi normale
Bien que les scores standardisés paramétriques et les rangs percentiles relèvent de paradigmes distincts, il existe un pont théorique unificateur remarquable lorsque la distribution empirique des scores bruts se conforme fidèlement à la loi normale univariée $\mathcal{N}(\mu, \sigma^2)$. Dans cette hypothèse gaussienne stricte, nous pouvons modéliser une table de conversion universelle liant sans ambiguïté les scores $z$, les scores T, les quartiles et les percentiles.
Dans ce cadre normatif idéal :
- Le point d’ancrage central $z = 0{,}0$ ($T = 50$) coïncide rigoureusement avec la médiane, le 2e quartile $Q_2$ et le 50e percentile ($P_{50}$).
- Le premier quartile $Q_1$ ($P_{25}$) se situe très précisément à $z = \Phi^{-1}(0{,}25) \approx -0{,}6745$ (soit $T \approx 43{,}3$).
- Le troisième quartile $Q_3$ ($P_{75}$) se positionne symétriquement à $z = \Phi^{-1}(0{,}75) \approx +0{,}6745$ (soit $T \approx 56{,}7$).
- Le seuil classique de déviation clinique à $-1{,}0$ écart type ($z = -1{,}0$ ; $T = 40$) correspond exactement au 15,87e percentile (couramment arrondi à $P_{16}$).
- Le seuil de significativité critique à $-1{,}645$ écart type (unilatéral à 5 %) correspond au 5e percentile ($P_5$).
- Les jalons bilatéraux classiques d’inférence statistique fixés à $z = -1{,}96$ et $z = +1{,}96$ (excluant 5 % de la surface totale) s’alignent respectivement sur le 2,5e percentile ($P_{2{,}5}$) et le 97,5e percentile ($P_{97{,}5}$).
- Enfin, la barrière de sévérité clinique extrême à $-2{,}0$ écarts types ($z = -2{,}0$ ; $T = 30$) correspond au 2,28e percentile (couramment arrondi à $P_2$).
Cette convergence mathématique sous l’égide de la fonction de répartition gaussienne permet aux psychométriciens de traduire instantanément un diagnostic formulé en scores $z$ dans le langage universel des percentiles pour la rédaction de leurs conclusions cliniques.
10.3 Critères de sélection de la métrique selon l’objectif psychométrique
Face à la diversité de ces métriques, le statisticien ou le psychologue clinicien doit arbitrer de façon raisonnée sur le choix du système d’évaluation en fonction de la finalité spécifique de sa démarche. Le tableau suivant présente une synthèse comparative des critères de sélection métrologique :
| Indicateur | Type de transformation | Hypothèse distributionnelle | Usage préférentiel | Limites principales |
|---|---|---|---|---|
| Rangs Percentiles | Ordinale, non linéaire | Aucune (non paramétrique) | Communication clinique, diagnostic individuel, bilans grand public | Distorsion des intervalles réels ; moyenne arithmétique interdite |
| Quartiles (et IQR) | Partition en 4 classes | Aucune (non paramétrique) | Analyse exploratoire, détection robuste d’outliers, macro-profilage | Granularité trop grossière pour le diagnostic fin des cas limites |
| Scores z | Continue, strictement linéaire | Forte dépendance à la normalité | Modélisations statistiques, régressions, méta-analyses, équations structurelles | Inintelligible pour les non-spécialistes ; chiffres négatifs anxiogènes |
| Scores T | Linéaire ($T = 50 + 10z$) | Forte dépendance à la normalité | Inventaires de personnalité (MMPI), profils cliniques standardisés multi-échelles | Faussement linéaire si les scores bruts sont lourdement asymétriques |
En synthèse, la règle méthodologique fondamentale est la suivante : pour la modélisation mathématique inférentielle, les calculs de covariances et l’analyse multivariée, les scores continus linéaires ($z$ ou $T$) sont irremplaçables. En revanche, pour la description typologique non paramétrique, le diagnostic pragmatique au lit du malade et la communication déontologique avec le patient et son entourage, le rang percentile et les repères quartiliques offrent une robustesse et une intelligibilité cliniques insurpassables.
11. Erreurs fréquentes, biais d’interprétation et limites métrologiques
11.1 L’illusion d’équidistance le long de l’échelle des percentiles
L’écueil le plus redoutable qui guette l’utilisateur régulier des percentiles est ce que la psychométrie cognitive qualifie d’illusion d’équidistance. Puisque les rangs percentiles progressent selon une suite arithmétique d’entiers réguliers (1, 2, 3, …, 99), l’esprit humain est naturellement enclin à postuler que la quantité de compétence ou de construit psychologique séparant deux centiles consécutifs est rigoureusement identique tout au long de l’échelle. Or, il n’en est rien : l’échelle des percentiles est fondamentalement anélastique et déformée.
Sous une distribution de données approximativement gaussienne, la masse des observations est fortement concentrée autour du centre. Par conséquent, au milieu de la courbe, une variation minuscule de score brut génère un saut spectaculaire en termes de rangs percentiles. Par exemple, au test de vocabulaire de la WAIS-IV, progresser de seulement 2 points bruts peut faire bondir un sujet du 45e au 55e percentile, soit un gain apparent impressionnant de 10 centiles. À l’opposé, dans les extrémités de la distribution où les effectifs se raréfient, il faut fournir un saut de score brut massif pour gagner ne serait-ce qu’un seul centile : franchir l’espace séparant le 98e du 99e percentile peut exiger la réussite de 5 ou 6 items hautement ardus supplémentaires.
Cette non-linéarité engendre des erreurs graves lors de l’évaluation de l’efficacité d’un programme de remédiation cognitive. Si un neuropsychologue réévalue un patient présentant un traumatisme crânien sévère après six mois d’entraînement mnésique, et constate que son patient n’est passé que du 1er au 3e percentile, il pourrait conclure à tort à l’échec de la thérapie. En réalité, franchir l’intervalle $P_1-P_3$ dans une zone d’effondrement cérébral requiert une récupération fonctionnelle et un gain de points bruts bien plus considérables que de faire passer un sujet sain du 49e au 55e percentile. L’appréciation de l’évolution longitudinale exige donc de toujours revenir aux scores bruts ou aux scores standards continus pour neutraliser l’illusion d’équidistance des centiles.
11.2 Effets de plafond, de plancher et perte d’information statistique
Une autre limite intrinsèque des métriques ordonné-quantiliques concerne leur vulnérabilité face aux effets de plafond (ceiling effects) et effets de plancher (floor effects), fréquemment rencontrés dans les inventaires cliniques et les tests neuropsychologiques de dépistage rapide (tels que le Mini-Mental State Examination ou le MoCA).
Lorsqu’une épreuve présente un niveau de difficulté inadapté à une fraction de la cohorte, les scores s’agglutinent massivement sur la borne supérieure ou inférieure de l’instrument. Si 40 % des sujets d’un échantillon normatif réalisent le score parfait de 30/30 à un test cognitif, le calcul des quantiles subit une anomalie structurelle : la valeur 30 absorbera l’intégralité de la plage allant du 60e au 100e percentile. Dès lors, il devient rigoureusement impossible de distinguer un individu doué d’un individu de génie, tous deux étant satellisés au même percentile maximal.
Plus dramatique encore pour la clinique, lors d’un effet de plancher massif à une tâche de fluence verbale difficile chez des patients aphasiques, tous les sujets obtenant un score nul de zéro se voient attribuer le même centile plancher ($P_1$). Cette situation anéantit la sensibilité diagnostique de l’outil : le clinicien est dans l’incapacité de différencier le patient totalement mutique de celui qui conserve des ébauches d’accès lexical sans parvenir à produire un mot complet dans le temps imparti. Pour pallier cette perte dramatique d’information statistique, la psychométrie moderne se tourne vers les modèles formalisés par la théorie des réponses aux items (TRI). En estimant un paramètre de trait latent continu ($\theta$) via des fonctions logistiques à un, deux ou trois paramètres (modèles de Rasch ou de Birnbaum), la TRI s’affranchit des bornes artificielles des centiles et préserve la sensibilité différentielle aux confins du continuum.
11.3 Mauvaises interprétations des seuils critiques dans les bilans diagnostiques
La dernière dérive majeure concerne le biais de dichotomisation rigide autour d’un seuil critique quantilique arbitraire. Dans de nombreux protocoles médico-sociaux ou démarches d’attribution d’allocations de compensation du handicap, la réglementation impose un seuil d’accès binaire : un individu est éligible si son score se situe « strictement en dessous du 5e percentile ».
Cette approche rigide témoigne d’une méconnaissance profonde de la métrologie scientifique, car elle fait fi de l’erreur type de mesure ($SEM$). Tout instrument psychométrique possède une fidélité (fiabilité) imparfaite (le coefficient alpha de Cronbach ou oméga de McDonald n’étant jamais égal à 1,00). Il en résulte que le score observé d’un individu n’est qu’une estimation ponctuelle fluctuant autour de son score vrai théorique. Un sujet dont le score observé se loge au 6e percentile n’est statistiquement pas différent, au seuil de confiance de 95 %, d’un sujet obtenant un score situé au 4e percentile.
Trancher une trajectoire humaine, un aménagement scolaire ou une mise sous tutelle sur la base exclusive d’un franchissement mécanique de seuil (4e versus 5e centile) relève d’une faute épistémologique et déontologique grave. L’évaluation psychologique et neuropsychologique ne saurait se réduire à un automatisme statistique. Les indicateurs quantiliques ne sont que des instruments de repérage formel ; ils n’ont de valeur diagnostique réelle que s’ils sont intégrés, interprétés et pondérés à la lumière d’une anamnèse minutieuse, de l’observation clinique qualitative des stratégies compensatoires du patient et de l’évaluation de son retentissement fonctionnel dans sa vie quotidienne.
12. Guide pratique d’implémentation informatique : R, Python et SPSS pour les chercheurs
12.1 Traitement sous R : exploitation avancée de la fonction quantile()
L’environnement de programmation statistique R (R Core Team) constitue le logiciel de référence absolue pour le traitement des quantiles, grâce à la flexibilité exceptionnelle de sa fonction générique de base. Pour illustrer son exécution, considérons un vecteur de données cliniques correspondant aux scores d’anxiété de Hamilton (HAMA) d’une cohorte expérimentale :
# Vecteur de scores cliniques d'anxiété
scores_hama <- c(14, 19, 8, 26, 31, 12, 17, 22, 25, 10, 15, 28, 33, 18, 20)

# 1. Calcul simultané des quartiles fondamentaux (Q0, Q1, Q2, Q3, Q4)
quartiles_res <- quantile(scores_hama, probs = seq(0, 1, 0.25))
print(quartiles_res)

# 2. Calcul ciblé des seuils cliniques déciliques et centiliques (P5, P10, Médiane, P90, P95)
seuils_patho <- quantile(scores_hama, probs = c(0.05, 0.10, 0.50, 0.90, 0.95), type = 7)
print(seuils_patho)
Le paramètre critique de la fonction quantile() sous R réside dans l’argument technique type, qui permet de basculer explicitement entre les neuf algorithmes documentés par Hyndman et Fan (1996). Par défaut, R implémente le type = 7. Si un chercheur désire reproduire rigoureusement les sorties obtenues par ses collègues travaillant sous SPSS ou Minitab, il lui suffit de configurer l’argument sur le type idoine :
# Reproduction stricte de l'algorithme d'interpolation de SPSS (Type 6)
quantiles_spss_mode <- quantile(scores_hama, probs = c(0.25, 0.75), type = 6)
Pour la visualisation de haute qualité publiable, l’écosystème ggplot2 permet de tracer instantanément les diagrammes en boîte avec affichage superposé des données individuelles sous forme de nuage de points jitterisé :
library(ggplot2)

df <- data.frame(Groupe = "Clinique", Score = scores_hama)

ggplot(df, aes(x = Groupe, y = Score)) +
  geom_boxplot(fill = "lightblue", outlier.shape = NA, width = 0.5) +
  geom_jitter(width = 0.1, color = "darkblue", size = 2) +
  stat_summary(fun = median, geom = "point", shape = 18, size = 4, color = "red") +
  theme_minimal() +
  labs(title = "Dispersion Quartilique des Scores HAMA", y = "Score Brut")
12.2 Implémentation sous Python avec NumPy, SciPy et Pandas
Dans l’écosystème scientifique Python, l’analyse des quantiles s’articule autour des bibliothèques fondamentales que sont NumPy, SciPy et Pandas. Chacune de ces briques logicielles offre des méthodes hautement optimisées et vectorisées pour opérer des découpages quantiliques sur des cohortes psychologiques massives.
Avec NumPy, le calcul s’effectue via la méthode universelle np.percentile() ou son équivalent probabiliste np.quantile() :
import numpy as np
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt

# Matrice de scores observés
data = np.array([14, 19, 8, 26, 31, 12, 17, 22, 25, 10, 15, 28, 33, 18, 20])

# Calcul des trois quartiles via NumPy (avec interpolation linéaire par défaut)
q1, q2, q3 = np.percentile(data, [25, 50, 75])
iqr = q3 - q1
print(f"Q1: {q1}, Médiane: {q2}, Q3: {q3}, IQR: {iqr}")
Depuis la version 1.22 de NumPy, le paramètre method permet de choisir parmi les neuf algorithmes standard d’interpolation de Hyndman et Fan, en utilisant des mots-clés explicites tels que method='weibull' (correspondant au Type 6 de SPSS) ou method='linear' (Type 7 par défaut de R).
Pour l’analyse de cohortes structurées sous forme de dataframes, Pandas propose des fonctionnalités intégrées remarquables. La méthode df.quantile() extrait automatiquement les positions ordinales, tandis que la fonction pd.qcut() permet de discrétiser une variable continue en classes quantiliques étiquetées :
df = pd.DataFrame({'Patient_ID': range(1, 16), 'Score': data})

# Discrétisation vectorisée en quatre quartiles étiquetés
df['Quartile_Classe'] = pd.qcut(df['Score'], q=4, labels=['Faible', 'Moyen_Inf', 'Moyen_Sup', 'Eleve'])
print(df.head())

# Visualisation élégante avec Seaborn
sns.boxplot(y='Score', data=df, palette='Blues')
plt.title('Profil Quartilique de la Cohorte')
plt.show()
12.3 Extraction sous SPSS et interprétation des tables de fréquences cumulées
Bien que le recours à la ligne de code se généralise, IBM SPSS Statistics demeure un outil extrêmement répandu au sein des services hospitalo-universitaires de psychiatrie et de psychologie clinique. L’extraction des percentiles et quartiles sous SPSS s’effectue traditionnellement via l’interface graphique par la procédure des Fréquences.
Le cheminement algorithmique dans les menus est le suivant :
- Naviguer vers le menu :
Analyser>Statistiques descriptives>Fréquences... - Insérer la variable psychométrique quantitative d’intérêt dans la boîte de dialogue des variables sélectionnées.
- Cliquer sur l’onglet
Statistiques...à droite de la fenêtre. - Dans le cadran supérieur intitulé Valeurs de centiles, cocher la case
Quartilespour obtenir immédiatement $Q_1$, $Q_2$ et $Q_3$. - Pour obtenir des seuils personnalisés, cocher la case
Points de coupure pour :et saisir le nombre de segments égaux désiré (par exemple 10 pour générer tous les déciles). - Pour spécifier un jalon pathologique précis (par exemple le 5e centile), cocher l’option
Centile(s), saisir la valeur numérique5, puis cliquer surAjouter. - Valider les options et exécuter la procédure en cliquant sur
OK.
Dans la fenêtre des résultats, SPSS génère deux tables majeures qu’il importe d’interpréter avec rigueur :
- Le tableau synthétique Statistiques récapitule les points de coupure scalaires exacts correspondant aux percentiles demandés (calculés selon l’algorithme d’interpolation linéaire Type 6 de Hyndman et Fan, fondé sur la formule de Weibull).
- Le tableau des Fréquences cumulées affiche pour chaque score brut observé son effectif absolu, son pourcentage valide au sein de l’échantillon, et sa colonne la plus précieuse : le pourcentage cumulé. Ce pourcentage cumulé indique pour chaque ligne le rang percentile empirique brut correspondant au palier supérieur de ce score.
Ces sorties tabulaires permettent au chercheur ou au psychologue clinicien d’exporter directement les données pour concevoir les grilles d’étalonnage normatif définitives qui figureront dans les annexes techniques des manuels de tests cliniques.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Galton, F. (1889). Natural inheritance. Macmillan and Co. https://galton.org/books/natural-inheritance/
- Hyndman, R. J., & Fan, Y. (1996). Sample quantiles in statistical packages. The American Statistician, 50(4), 361–365. https://doi.org/10.1080/00031305.1996.10473541
- MacAlister, D. (1879). The law of the geometric mean. Proceedings of the Royal Society of London, 29(196–199), 367–376. https://doi.org/10.1098/rspl.1879.0061
- Moors, J. J. A. (1988). A quantile alternative for kurtosis. The Statistician, 37(1), 25–32. https://doi.org/10.2307/2348376
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley Publishing Company.
- Wechsler, D. (2008). Wechsler Adult Intelligence Scale–Fourth Edition (WAIS-IV). NCS Pearson. https://www.pearsonclinical.fr/wais-iv
- World Health Organization. (2019). International statistical classification of diseases and related health problems (11th ed.). World Health Organization. https://icd.who.int/