
Dans le domaine de l’épidémiologie clinique, de la psychiatrie biologique et de la recherche translationnelle en santé mentale, la modélisation rigoureuse des associations entre expositions étiologiques et états pathologiques constitue le socle de l’inférence causale. Bien que le calcul de proportions et d’occurrences paraisse élémentaire au premier abord, la quantification précise de la force d’un lien statistique convoque des instruments métrologiques distincts dont les propriétés algébriques et les implications cliniques diffèrent substantiellement. Parmi ces instruments, le rapport de cotes (odds ratio ou OR) et le risque relatif (RR) occupent une place prépondérante, tout en suscitant une confusion conceptuelle persistante et délétère au sein de la littérature biomédicale.
Cette ambiguïté récurrente découle en grande partie de la perméabilité sémantique de la langue commune, où les termes « cote », « risque », « probabilité » et « chance » sont fréquemment employés de manière interchangeable. Or, sur le plan mathématique et épistémologique, assimiler une cote à un risque relève d’une erreur d’équivocité majeure capable de distordre gravement l’appréciation de l’efficacité d’un traitement ou de la toxicité d’un déterminant environnemental. Alors que le risque relatif quantifie l’évolution proportionnelle d’une probabilité absolue dans le cadre d’un échantillonnage prospectif, le rapport de cotes évalue le produit croisé des probabilités conditionnelles de survenue et de non-survenue, conférant à cette seconde métrique une invariance analytique indispensable aux devis d’observation rétrospectifs, mais au prix d’une perte d’intuitivité cognitive.
L’objectif du présent traité exhaustif est de déconstruire méticuleusement la dialectique unissant et opposant l’odds ratio et le risque relatif. À travers l’examen de leurs fondations probabilistes, de leurs contraintes de validité selon les plans d’expérience, de leur comportement face aux pathologies rares versus prévalentes, et de leurs répercussions dans la recherche psychiatrique et neuroscientifique contemporaine, nous proposerons un cadre d’analyse mathématique et pratique complet. Cet exposé entend doter les chercheurs quantitativistes et les praticiens hospitalo-universitaires des repères méthodologiques indispensables pour sélectionner judicieusement leurs indices d’effet, éviter les pièges interprétatifs et garantir l’intégrité de la médecine fondée sur les preuves.
1. Fondements conceptuels des mesures d’association en recherche quantitative
1.1 La nécessité de quantifier le lien entre exposition et issue clinique
L’investigation scientifique en psychologie clinique, en psychiatrie et en épidémiologie sociale s’attache à identifier des liens réguliers entre des déterminants spécifiques — qu’ils soient de nature génétique, neurobiologique, traumatique ou environnementale — et l’apparition ou la rémission de troubles du comportement et de pathologies affectives. Face à la variabilité interindividuelle inhérente aux systèmes biologiques complexes, la simple observation descriptive s’avère incapable d’isoler l’impact authentique d’un facteur d’exposition. Il devient impératif de formaliser le passage d’une phénoménologie purement narrative à une modélisation probabiliste de la causalité, capable de discriminer la part attribuable à l’exposition de celle relevant des fluctuations stochastiques d’échantillonnage.
La quantification de ces associations repose sur la construction d’indices statistiques d’effet normalisés, essentiels pour répondre aux impératifs de la médecine fondée sur les preuves (Evidence-Based Medicine). Ces indices synthétisent l’amplitude du différentiel clinique observé entre deux groupes de comparaison, permettant d’éclairer la décision diagnostique, le pronostic thérapeutique et la priorisation des politiques d’hygiène publique. La normalisation des critères d’évaluation de l’effet dans la littérature scientifique internationale garantit l’homogénéité des protocoles, la reproductibilité des observations empiriques et l’interchangeabilité des données au sein des protocoles de recherche multicentriques.
En psychiatrie quantitative, cette formalisation métrique s’avère d’autant plus critique que les entités nosologiques reposent fréquemment sur des spectres syndromiques continus plutôt que sur des seuils physiopathologiques binaires stricts. L’établissement d’une mesure d’association standardisée autorise la transformation d’observations cliniques disparates en paramètres numériques rigoureux, servant de vecteurs aux inférences statistiques avancées et permettant de modéliser avec précision le fardeau attribuable aux facteurs de stress environnementaux ou aux prédispositions neurodéveloppementales.
1.2 La table de contingence 2×2 comme matrice d’analyse fondamentale
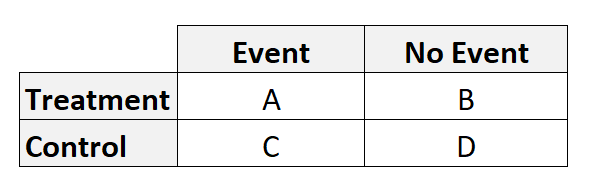
L’analyse bivariée des relations entre une exposition dichotomique et une issue clinique binaire s’organise autour d’une matrice fondamentale dénommée table de contingence 2×2. Cette structure matricielle formalise la distribution croisée exhaustive des sujets observés au sein d’une cohorte ou d’un échantillon expérimental, répartissant les individus selon leur statut vis-à-vis du facteur d’exposition ($E^+$ pour exposé, $E^-$ pour non exposé) et leur statut clinique final ($M^+$ pour atteint ou malade, $M^-$ pour indemne ou sain). Cette schématisation bidimensionnelle constitue le creuset d’où sont extraites l’ensemble des propriétés algébriques sous-tendant les ratios épidémiologiques contemporains.
Au sein de cette matrice, les quatre cellules fondamentales représentent des effectifs d’intersection stricts : la cellule $A$ dénombre les sujets simultanément exposés et atteints (vrais exposés-atteints) ; la cellule $B$ isole les individus exposés mais demeurés indemnes (exposés-indemnes) ; la cellule $C$ quantifie les participants non exposés développant néanmoins l’affection clinique (non exposés-atteints) ; enfin, la cellule $D$ regroupe les sujets vierges de toute exposition et préservés de la pathologie (non exposés-indemnes). Les marges horizontales correspondent aux totaux d’exposition, soit $(A + B)$ pour les exposés et $(C + D)$ pour les non-exposés, tandis que les marges verticales expriment les totaux pathologiques, soit $(A + C)$ pour la totalité des malades et $(B + D)$ pour la totalité des témoins sains.
La distinction méthodologique majeure réside dans la nature probabiliste de ces marges, conditionnée par le plan expérimental retenu par le chercheur. Dans une étude de cohorte prospective, les marges d’exposition $(A + B)$ et $(C + D)$ sont fixées par le protocole d’inclusion ou observées dans une population déterminée, tandis que les effectifs verticaux $(A + C)$ et $(B + D)$ demeurent des variables aléatoires tributaires de la survenue des événements au fil du suivi. Inversement, dans une étude cas-témoins, ce sont les totaux de l’issue $(A + C)$ et $(B + D)$ qui sont déterminés a priori par le recrutement de l’investigateur, conférant aux marges d’exposition un caractère strictement aléatoire. Cette divergence fondamentale dans la fixation des marges gouverne directement la légitimité mathématique des mesures d’association qui peuvent en être extraites.
1.3 Distinction épistémologique fondamentale : probabilité versus cote (odds)
Au cœur de la divergence entre le risque relatif et l’odds ratio se trouve la distinction conceptuelle et algébrique entre une probabilité et une cote. Une probabilité standard, assimilable au risque au sein d’une population définie, exprime la fréquence relative d’un événement au sein d’un ensemble de possibles. Formellement, si $n$ représente le nombre total de sujets à risque et $k$ le sous-ensemble de ceux développant le trouble, la probabilité $p$ s’énonce selon le rapport des cas favorables sur le total des cas possibles :
$$p = \frac{k}{n}$$
Par essence, la probabilité est une mesure bornée par l’intervalle fermé $[0, 1]$, où 0 formalise l’impossibilité théorique et 1 la certitude absolue de survenue de l’événement.
À l’opposé, la cote — désignée sous l’anglicisme odds emprunté au lexique des paris probabilistes — se définit comme le rapport direct entre la probabilité de survenue d’un événement et la probabilité de sa non-survenue. Si la probabilité d’un état est notée $p$, sa cote correspondante $\omega$ s’établit selon l’expression :
$$\omega = \frac{p}{1 – p}$$
Cette transformation non linéaire redéfinit l’espace d’évaluation : alors que le numérateur quantifie la survenue, le dénominateur chiffre l’évitement du phénomène. Dès lors que $p$ s’approche de 0, la cote converge vers 0 ; en revanche, au fur et à mesure que $p$ progresse vers 1, le dénominateur $(1 – p)$ tend vers zéro, propulsant la valeur de la cote vers l’infini positif. L’espace mathématique de la cote n’est donc plus un intervalle borné mais le semi-axe infini $[0, +\infty[$.
Cette disparité dans la topologie des grandeurs induit de profondes conséquences sur l’intuition humaine et la cognition probabiliste du chercheur. L’esprit humain appréhende naturellement les probabilités comme des parts de gâteau ou des pourcentages intuitifs d’une population globale. En revanche, la conceptualisation des cotes requiert une gymnastique intellectuelle comparative : une cote de 4 ne signifie nullement que 4 personnes sur 5 ou 4 personnes sur 4 tombent malades, mais que la survenue de la pathologie est quatre fois plus fréquente que sa non-survenue au sein du groupe, ce qui équivaut à une probabilité réelle de $p = 4 / (1 + 4) = 0,80$ (soit 80 %). L’assimilation non critique de la cote au risque brut constitue le ferment principal des extrapolations erronées relevées dans la littérature psychiatrique.
2. Définition et mécanismes mathématiques du risque relatif (RR)
2.1 Formule canonique et calcul du risque relatif dans une cohorte
Le risque relatif ($RR$), fréquemment désigné sous le vocable de ratio de risque ou rapport de risques d’incidence, quantifie la variation proportionnelle de l’incidence d’un événement clinique entre deux populations différant par leur statut d’exposition. Au sein de la matrice d’une table de contingence 2×2 issue d’un devis prospectif longitudinal, le calcul du risque relatif s’obtient en établissant le quotient direct entre l’incidence cumulée observée dans la strate des sujets exposés et l’incidence cumulée relevée chez les sujets non exposés :
$$RR = \frac{I_{E^+}}{I_{E^-}} = \frac{\frac{A}{A + B}}{\frac{C}{C + D}}$$
Dans cette formulation canonique, le numérateur $A / (A + B)$ modélise la probabilité empirique conditionnelle qu’un individu exposé développe l’affection considérée au cours d’un intervalle temporel donné, notée $P(M^+ mid E^+)$. Le dénominateur $C / (C + D)$ exprime quant à lui la probabilité conditionnelle équivalente au sein de la cohorte témoin non exposée, soit $P(M^+ mid E^-)$. Le risque relatif mesure ainsi le facteur d’échelle par lequel le risque absolu de base se trouve multiplié ou contracté sous l’effet de l’exposition.
Ce calcul implique une sensibilité absolue à la représentativité de la population source à risque. Toute modification artificielle des totaux marginaux $(A + B)$ ou $(C + D)$ altère irrémédiablement la valeur de l’incidence calculée et, par voie de conséquence directe, falsifie l’estimation du risque relatif. Le recours à cette métrique exige par conséquent un échantillonnage où les dénominateurs des fractions d’incidence reflètent fidèlement la dynamique temporelle de la population observée, garantissant que chaque sujet inclus ait possédé une chance mesurable et documentée de manifester l’issue d’intérêt.
2.2 Interprétation numérique rigoureuse des valeurs de risque relatif
L’échelle d’interprétation numérique du risque relatif s’articule autour de la valeur unitaire pivot de 1,0, qui incarne l’hypothèse nulle ($H_0$) d’absence totale d’effet ou d’indépendance stochastique stricte entre la variable d’exposition et la trajectoire clinique. Lorsqu’une étude épidémiologique rapporte un $RR = 1,0$, cela démontre que le taux de survenue de la pathologie demeure rigoureusement superposable entre le groupe exposé et le groupe non exposé ($I_{E^+} = I_{E^-}$), indiquant l’inopérance du facteur incriminé sur la cinétique du trouble.
Lorsque la valeur calculée excède l’unité ($RR > 1,0$), le facteur d’exposition est formellement qualifié de facteur de risque. La quantité $(RR – 1) \times 100$ traduit l’accroissement relatif en pourcentage du risque attribuable à l’exposition. À titre d’illustration, un $RR = 1,45$ documenté entre la précarité socio-économique et l’émergence d’épisodes dépressifs majeurs indique que les individus exposés présentent une incidence de dépression supérieure de 45 % à celle mesurée chez leurs homologues non précaires, ou encore que le risque absolu d’être atteint est multiplié par un facteur de 1,45.
À l’inverse, une valeur strictement inférieure à l’unité ($0 le RR < 1,0$) caractérise un facteur d'exposition protecteur ou une intervention thérapeutique bénéfique. Dans ce cas de figure, l'effet clinique se quantifie préférentiellement via la réduction relative du risque ($RRR$), définie par la formule :
$$RRR = 1 – RR = \frac{I_{E^-} – I_{E^+}}{I_{E^-}}$$
Ainsi, dans l’évaluation d’un essai clinique randomisé comparant un psychotrope innovant à un placebo, l’obtention d’un $RR = 0,60$ pour la récidive suicidaire signifie que l’incidence des événements indésirables chez les patients traités équivaut à 60 % de celle du bras témoin, ce qui se traduit par une réduction relative du risque de rechute de $1 – 0,60 = 0,40$, soit un bénéfice thérapeutique relatif net de 40 %.
2.3 Conditions méthodologiques indispensables pour le calcul du RR
L’estimation rigoureuse d’un risque relatif dépend de contraintes épidémiologiques incontournables. La condition sine qua non réside dans la connaissance exhaustive ou la représentativité stochastique parfaite de la population source globale exposée au risque d’émergence du trouble. En d’autres termes, l’expérimentateur doit être en capacité de recenser avec précision l’ensemble des dénominateurs $(A + B)$ et $(C + D)$ au sein d’une cohorte indemne de l’événement d’intérêt au temps zéro ($T_0$) du protocole d’observation.
Cette exigence interdit formellement l’extraction directe du risque relatif à partir de protocoles observationnels rétrospectifs fondés sur un échantillonnage sélectif de l’issue, tels que les études cas-témoins traditionnelles. Dans un tel devis, le clinicien sélectionne arbitrairement un nombre défini de cas atteints ($A + C$) et un nombre arbitraire de témoins sains ($B + D$). Dès lors, les rapports $A / (A + B)$ et $C / (C + D)$ ne reflètent plus en aucune manière l’incidence réelle de la maladie au sein d’une quelconque population naturelle, mais constituent des artéfacts purement mathématiques dérivés du ratio cas/témoins fixé par le protocole de recherche.
Par ailleurs, les études longitudinales autorisant le calcul du risque relatif demeurent particulièrement vulnérables aux biais d’attrition. Les perdus de vue lors de suivis prospectifs prolongés, fréquents lors de cohortes évaluant les conduites addictives ou les troubles de la personnalité, introduisent des distorsions asymétriques si les abandons d’études sont corrélés simultanément au niveau d’exposition et à la sévérité psychopathologique sous-jacente. Une telle déperdition altère la justesse des dénominateurs de personnes-années ou d’incidence cumulée, biaisant l’estimation définitive du $RR$.
3. Définition et fondements algébriques du rapport de cotes (Odds Ratio – OR)
3.1 Concept mathématique de la cote et transformation logistique
Le rapport de cotes, ou odds ratio ($OR$), trouve son ancrage dans la théorie probabiliste et la modélisation statistique avancée. Comme défini précédemment, la cote d’un événement clinique probabilisé par $p$ correspond à $\omega = p / (1 – p)$. Sur le plan fonctionnel, cette opération réalise une première mise à l’échelle en transformant un paramètre borné entre 0 et 1 en une quantité variant librement de 0 à $+\infty$. Pour conférer à cette grandeur une structure algébrique parfaitement manipulable au sein des modèles linéaires généralisés, la statistique recourt à la transformation logistique, ou fonction logit, définie comme le logarithme népérien de la cote :
$$\text{logit}(p) = \ln(\omega) = \ln\left(\frac{p}{1 – p}\right)$$
Cette fonction de lien canonique projette le domaine restreint $[0, 1]$ sur l’ensemble de la droite des nombres réels $]-\infty, +\infty[$. Cette propriété d’ouverture du domaine mathématique résout les problèmes de prédictions aberrantes (valeurs prédites inférieures à 0 ou supérieures à 1) inhérents aux régressions linéaires appliquées à des issues binaires. Sur cette échelle logarithmique des cotes (les log-odds), l’effet multiplicatif des variables explicatives se linéarise en contributions additives élémentaires.
De surcroît, l’échelle logarithmique confère une symétrie mathématique parfaite autour de l’hypothèse nulle. Alors que sur l’échelle naturelle des cotes, l’espace d’atténuation d’un effet s’étend de façon compressée entre 0 et 1 tandis que l’espace d’amplification s’étend de 1 à l’infini, l’application du logarithme transforme un rapport de cotes protecteur (par exemple $OR = 0,20$, dont le $\ln(0,20) \approx -1,609$) en l’exact symétrique d’un effet néfaste d’ampleur inverse ($OR = 5,0$, dont le $\ln(5,0) \approx +1,609$).
3.2 Dérivation de la formule du rapport de cotes croisés
Le rapport de cotes s’obtient en calculant le quotient de deux cotes indépendantes : la cote de survenue de la pathologie chez les sujets exposés ($\text{Cote}_{E^+}$) rapportée à la cote d’apparition de cette même pathologie chez les sujets non exposés ($\text{Cote}_{E^-}$). En injectant les probabilités conditionnelles calculées à partir des cellules de notre matrice de contingence 2×2, nous obtenons :
$$\text{Cote}_{E^+} = \frac{P(M^+ mid E^+)}{P(M^- mid E^+)} = \frac{\frac{A}{A + B}}{\frac{B}{A + B}} = \frac{A}{B}$$
$$\text{Cote}_{E^-} = \frac{P(M^+ mid E^-)}{P(M^- mid E^-)} = \frac{\frac{C}{C + D}}{\frac{D}{C + D}} = \frac{C}{D}$$
L’établissement du rapport de ces deux cotes d’événement produit une simplification algébrique remarquable :
$$OR = \frac{\text{Cote}_{E^+}}{\text{Cote}_{E^-}} = \frac{\frac{A}{B}}{\frac{C}{D}} = \frac{A \cdot D}{B \cdot C}$$
Cette expression canonique finale est universellement dénommée « produit croisé » ou « rapport des produits croisés ». L’élégance de cette simplification réside dans l’élimination totale des totaux marginaux de lignes $(A + B)$ et $(C + D)$ de l’équation finale. Le calcul de l’odds ratio repose exclusivement sur l’interaction croisée directe des quatre sous-groupes fondamentaux de la table de contingence.
Cette propriété confère à l’OR une stabilité structurelle en présence de déséquilibres importants dans le protocole d’échantillonnage. Peu importe que l’investigateur recrute deux fois, cinq fois ou dix fois plus de témoins sains que de malades dans une investigation observationnelle : la fraction conserve son universalité et converge asymptotiquement vers la même estimation paramétrique, neutralisant les distorsions imposées par la sélection expérimentale.
3.3 Interprétation symétrique et propriétés d’invariance de l’OR
Une propriété mathématique remarquable de l’odds ratio réside dans son invariance rétrospective absolue. Si l’on inverse la perspective d’observation en s’intéressant à la cote d’exposition chez les malades comparativement à la cote d’exposition chez les sujets sains, l’algèbre démontre une équivalence parfaite :
$$OR_{\text{maladie}} = \frac{\frac{A}{B}}{\frac{C}{D}} = \frac{A \cdot D}{B \cdot C} = \frac{\frac{A}{C}}{\frac{B}{D}} = OR_{\text{exposition}}$$
Cette équivalence algébrique garantit que le calcul du rapport de cotes croisés mené au sein d’une enquête rétrospective cas-témoins produit une grandeur rigoureusement identique à celle qu’aurait générée un suivi prospectif de cohorte sur la même population source sous-jacente. Cette propriété d’invariance fait de l’OR le pivot méthodologique irremplaçable de l’épidémiologie rétrospective, comme l’a formalisé Jerome Cornfield dans sa publication séminale de 1951.
Par ailleurs, à l’instar du risque relatif, l’interprétation directionnelle de l’odds ratio s’articule autour de la valeur neutre de 1,0 :
- Un $OR = 1,0$ dénote l’absence totale d’association statistique.
- Un $OR > 1,0$ indique une prépondérance de l’événement dans le groupe exposé (ou une surexposition chez les cas).
- Un $OR < 1,0$ traduit une diminution de la cote d'apparition du trouble sous l'effet de l'exposition.
De surcroît, l’inversion des catégories d’analyse (désigner l’absence d’exposition ou la guérison comme événement de référence) produit l’inverse arithmétique de la métrique originale ($OR’ = 1 / OR$), attestant de la cohérence interne du modèle sans perte d’information statistique.
4. Comparaison structurelle : Probabilités absolues versus rapports de cotes
4.1 Divergence comportementale face aux événements fréquents
La divergence entre risque relatif et rapport de cotes devient flagrante dès que l’on analyse le comportement asymptotique de ces deux grandeurs face à des événements fréquents. Lorsque le risque d’apparition d’un événement clinique au sein d’une population devient élevé (arbitrairement au-delà d’une incidence cumulée de 10 % à 20 %), la probabilité $p$ et la cote $p / (1 – p)$ cessent d’évoluer de concert. Alors que la probabilité progresse de manière linéaire jusqu’à son plafond théorique de 1, la cote subit une accélération non linéaire marquée, son dénominateur $(1 – p)$ tendant vers zéro.
Cette divergence mathématique se transmet au rapport de ces grandeurs. Pour une même distribution de données empiriques, dès lors que l’issue clinique cesse d’être rare, l’odds ratio s’éloigne systématiquement de la valeur neutre 1,0 avec une intensité bien supérieure à celle constatée pour le risque relatif. On assiste à un phénomène d’inflation mathématique intrinsèque de l’OR. Plus la prévalence ou l’incidence de départ de l’affection est substantielle, plus la déconnexion d’amplitude entre l’OR et le RR s’accentue, au point où un traitement conférant une modeste augmentation du taux de guérison peut générer un OR spectaculairement élevé.
Ce comportement divergent s’illustre analytiquement en reformulant l’odds ratio en fonction directe du risque relatif et de l’incidence basale chez les non-exposés ($I_{E^-}$) :
$$OR = RR \cdot \frac{1 – I_{E^-}}{1 – (RR \cdot I_{E^-})}$$
Cette formulation démontre sans ambiguïté que l’odds ratio n’est égal au risque relatif que si l’incidence basale $I_{E^-}$ tend vers zéro, ou si le $RR$ vaut 1. Dès lors que $I_{E^-} > 0$ et $RR > 1$, la fraction multiplicatrice excède strictement 1, contraignant mathématiquement l’OR à être strictement supérieur au RR. Inversement, pour un facteur protecteur ($RR < 1$), cette distorsion pousse l'OR vers des valeurs inférieures au RR, le rapprochant davantage de zéro.
4.2 L’asymétrie de l’échelle des cotes face à la borne unitaire des probabilités
La structure géométrique du risque relatif impose une contrainte méconnue : le plafonnement mathématique supérieur par l’inverse du risque de base. Considérons une pathologie psychiatrique dont l’incidence cumulée chez les individus non exposés s’établit déjà à 40 % ($I_{E^-} = 0,40$). L’incidence maximale théorique chez les sujets exposés ne pouvant excéder 100 % ($I_{E^+} le 1,00$), la valeur plafond absolue que peut atteindre le risque relatif est mécaniquement bornée :
$$RR_{\max} = \frac{1,00}{0,40} = 2,50$$
Dans ce contexte épidémiologique, il est mathématiquement impossible d’observer un risque relatif de 3,0 ou de 4,0, indépendamment de la virulence du facteur étiologique étudié. Cette borne supérieure découle directement de la contrainte physique de l’espace des probabilités absolues $[0, 1]$.
En revanche, le rapport de cotes est libéré de ce plafond supérieur unitaire. Les cotes étant définies sur $[0, +\infty[$, une incidence de 40 % correspond à une cote basale de $0,40 / 0,60 = 0,667$, tandis qu’une incidence de 95 % sous forte exposition génère une cote de $0,95 / 0,05 = 19,0$. L’odds ratio résultant explose alors à la valeur de :
$$OR = \frac{19,0}{0,667} = 28,48$$
Ce chiffre illustre la disparité d’échelle : un facteur de risque qui multiplie la probabilité brute par 2,375 ($RR = 0,95 / 0,40 = 2,375$, proche de son maximum théorique de 2,50) produit simultanément un odds ratio de près de 28,5. L’absence de plafond pour l’OR engendre des échelles de réponse hautement sigmoïdes qui compliquent la conceptualisation intuitive des grandeurs réelles par les cliniciens.
4.3 Pourquoi l’OR amplifie systématiquement la perception de l’effet
L’inflation numérique inhérente à l’odds ratio induit des distorsions majeures de perception chez les praticiens, les décideurs institutionnels et le grand public. L’esprit humain interprète quasi universellement les ratios comme des multiplicateurs de risque absolu. Lorsqu’une publication scientifique met en lumière qu’un traumatisme infantile est associé à un odds ratio de 4,0 pour l’émergence d’un trouble anxieux à l’âge adulte, la quasi-totalité des lecteurs non statisticiens conclut à tort que les enfants traumatisés présentent quatre fois plus de risques de devenir anxieux.
Or, si la prévalence de l’anxiété au sein de la population témoin s’élève par exemple à 30 %, une application rigoureuse de la formule d’équivalence démontre qu’un $OR = 4,0$ correspond en réalité à un risque relatif de seulement 2,1. Le risque réel n’est donc pas quadruplé mais approximativement doublé. L’emploi non explicité de l’odds ratio agit comme une lentille grossissante artificielle, amplifiant dramatiquement l’impact clinique perçu de l’exposition.
Ce biais cognitif génère des conséquences néfastes dans la communication médicale. En psychologie clinique et en psychiatrie, il conduit régulièrement à une dramatisation injustifiée des facteurs de vulnérabilité ou, à l’inverse, à une surestimation illusoire de l’efficacité d’interventions psychothérapeutiques ou médicamenteuses évaluées par régression logistique. Cette distorsion de jugement est d’autant plus insidieuse qu’elle repose sur un calcul formellement valide, mais dont l’étiquette sémantique est transposée de la cote vers la probabilité sans précaution épistémologique.
5. L’hypothèse de maladie rare : le pont asymptotique entre OR et RR
5.1 Démonstration mathématique de l’approximation de l’OR vers le RR
Si le risque relatif et le rapport de cotes s’écartent sensiblement lors de l’étude de phénomènes fréquents, il existe un domaine mathématique spécifique où ces deux métriques convergent vers une quasi-identité : celui régi par ce que l’épidémiologie classique qualifie d’hypothèse de maladie rare (rare disease assumption). La démonstration algébrique de ce pont asymptotique s’appuie directement sur la dynamique des dénominateurs de la table de contingence 2×2.
Considérons la formule explicite du risque relatif mise en parallèle avec celle de l’odds ratio :
$$RR = \frac{\frac{A}{A + B}}{\frac{C}{C + D}} \quad \text{versus} \quad OR = \frac{\frac{A}{B}}{\frac{C}{D}}$$
Supposons à présent que l’affection clinique sous examen soit exceptionnellement rare dans l’ensemble de la population suivie, que ce soit chez les sujets exposés ou non exposés. Sur le plan quantitatif, cette faible occurrence implique que le nombre de sujets atteints ($A$ et $C$) devient marginal par rapport au volume des individus demeurant indemnes ($B$ et $D$). En termes de limites mathématiques, lorsque la proportion de malades tend vers 0 :
$$A ll B implies (A + B) \approx B$$
$$C ll D implies (C + D) \approx D$$
En substituant ces approximations asymptotiques au sein de la formule canonique du risque relatif, nous obtenons l’équivalence directe :
$$RR = \frac{\frac{A}{A + B}}{\frac{C}{C + D}} \approx \frac{\frac{A}{B}}{\frac{C}{D}} = \frac{A \cdot D}{B \cdot C} = OR$$
Cette élégante convergence démontre que lorsque le taux d’attaque d’une maladie est extrêmement bas, la probabilité d’un individu $p$ et sa cote correspondante $p / (1 – p)$ deviennent mathématiquement interchangeables, le terme $(1 – p)$ tendant vers 1. Dans ces conditions strictes, l’odds ratio extrait d’une étude d’observation peut être interprété comme une approximation empirique fidèle du risque relatif.
5.2 Le seuil d’incidence critique dans les études biomédicales
Une question méthodologique récurrente concerne la fixation du seuil empirique d’incidence ou de prévalence en deçà duquel cette équivalence asymptotique demeure scientifiquement acceptable. Dans la communauté épidémiologique internationale, la règle empirique conventionnelle fixe ce seuil critique maximal à 10 % (soit un taux d’événement $p le 0,10$), bien que certains biostatisticiens rigoureux préconisent une limite plus conservatrice fixée à 5 %.
L’analyse de l’erreur relative induite par l’utilisation de l’OR comme substitut du RR illustre la progression de cette distorsion. Considérons un risque relatif théorique constant de 2,0 et observons l’évolution de l’odds ratio calculé au fur et à mesure que l’incidence de base chez les témoins ($I_{E^-}$) augmente :
- Pour une incidence basale de 1 % ($I_{E^-} = 0,01$) : l’OR s’établit à 2,02, soit une distorsion négligeable de +1,0 %.
- Pour une incidence basale de 5 % ($I_{E^-} = 0,05$) : l’OR atteint 2,11, soit une marge d’erreur relative de +5,5 %.
- Pour une incidence basale de 10 % ($I_{E^-} = 0,10$) : l’OR s’élève à 2,25, traduisant une surévaluation de +12,5 %.
- Pour une incidence basale de 30 % ($I_{E^-} = 0,30$) : l’OR bondit à 3,50, engendrant une distorsion majeure de +75,0 %.
Ces données démontrent que le respect du seuil de 10 % garantit une approximation clinique satisfaisante où l’erreur relative n’excède pas 10 à 15 %. Au-delà de ce seuil, l’hypothèse de rareté s’effondre irrémédiablement, rendant caduque toute assimilation de l’odds ratio à un risque relatif.
5.3 Risques de surestimation en psychopathologie à haute prévalence
Si l’hypothèse de maladie rare est validée pour l’investigation de pathologies psychiatriques sévères mais peu fréquentes dans la population générale — telles que la schizophrénie (prévalence vie entière avoisinant 0,7 à 1 %) ou la maladie de Huntington —, elle s’avère totalement inappropriée pour un pan substantiel de la recherche en santé mentale contemporaine. Les troubles psychiatriques les plus répandus se caractérisent par des prévalences épidémiologiques massives qui violent frontalement les conditions de validité de l’approximation de Cornfield.
À titre d’exemple, les données de l’Organisation Mondiale de la Santé indiquent que la dépression majeure unipolaire présente une prévalence vie entière oscillant entre 15 % et 25 % au sein des nations industrialisées, tandis que le groupe global des troubles anxieux affecte jusqu’à 30 % de la population générale. De façon plus marquée encore, des états de détresse psychologique tels que le syndrome d’épuisement professionnel (burn-out) ou les troubles de l’adaptation en milieu universitaire peuvent afficher des prévalences d’échantillon dépassant 40 % à 50 %.
L’application non critique d’analyses par régression logistique binaire dans ces contextes de haute prévalence conduit à des distorsions interprétatives majeures. Dans ces cohortes, présenter des odds ratios issus de modélisations multivariées comme s’ils s’agissait de risques relatifs aboutit à une surévaluation systématique et substantielle de la nocivité des stresseurs environnementaux ou de l’impact réel des interventions psychothérapeutiques. Il existe dès lors un impératif méthodologique de proscrire formellement l’assimilation sémantique de la cote au risque dès lors que l’échantillon étudié concerne ces entités cliniques à forte endémie.
6. Choix du devis de recherche et faisabilité empirique
6.1 Études de cohorte et essais randomisés : le terrain d’élection du RR
La typologie du devis de recherche dictant la structure de l’échantillonnage détermine directement l’éligibilité du chercheur au calcul direct du risque relatif. Les protocoles expérimentaux d’essais cliniques randomisés contrôlés ainsi que les études de cohorte observationnelles prospectives représentent le terrain d’élection méthodologique pour le déploiement du risque relatif. Dans ces architectures longitudinales, les sujets sont initialement recrutés et catégorisés sur la base exclusive de leur exposition (ou assignés aléatoirement à une modalité thérapeutique), à un stade où l’issue clinique n’est pas encore manifestée.
Cette approche séquentielle permet de surveiller prospectivement l’émergence des nouveaux cas au sein des cohortes d’exposés et de non-exposés, autorisant l’évaluation directe de l’incidence cumulée ($A / [A+B]$ et $C / [C+D]$) ou de la densité d’incidence en personnes-temps de suivi. Le calcul du risque relatif en découle avec une parfaite validité interne. Le clinicien dispose alors d’une mesure intuitive, aisément communicable aux comités d’éthique et aux patients.
En outre, l’accès direct aux incidences brutes dans ce type de plan d’expérience autorise l’extraction simultanée de grandeurs absolues indispensables à la décision médicale éclairée : la réduction absolue du risque ($RAR = I_{E^-} – I_{E^+}$) et son corollaire immédiat, le nombre de sujets à traiter pour prévenir un événement indésirable ($NNT = 1 / RAR$). Cette complétude métrique situe les études prospectives au sommet de la hiérarchie de la preuve épidémiologique.
6.2 Études cas-témoins en santé mentale : le monopole mathématique de l’OR
À l’inverse, l’investigation étiologique des pathologies rares ou caractérisées par une période de latence neurodéveloppementale prolongée — telles que les psychoses chroniques précoces ou les comportements autolytiques létaux — impose fréquemment le recours au devis d’étude cas-témoins rétrospectif. Dans cette modalité expérimentale, le chercheur sélectionne proactivement un ensemble d’individus présentant le tableau psychopathologique établi (les cas) et leur adjoint un groupe d’individus en étant indemnes (les témoins), avant d’explorer rétrospectivement leurs trajectoires de vie à la recherche d’expositions passées.
Dans un tel plan d’échantillonnage, les totaux de colonnes de la matrice 2×2 sont arbitrairement fixés par l’investigateur en fonction des ressources disponibles (par exemple, recrutement de 100 patients schizophrènes et de 200 témoins appariés). La proportion globale de malades au sein de cet échantillon (100 sur 300, soit 33,3 %) n’a aucun lien avec la prévalence réelle de la schizophrénie dans la population générale (proche de 1 %). Par conséquent, les fractions $A / (A + B)$ et $C / (C + D)$ ne constituent pas des incidences réelles et leur division produit un résultat dénué de tout sens probabiliste : le risque relatif est mathématiquement incalculable.
C’est ici que s’exerce le monopole mathématique de l’odds ratio. En exploitant la propriété d’invariance par inversion rétrospective démontrée par Cornfield, l’investigateur peut calculer le rapport des produits croisés $(A \cdot D) / (B \cdot C)$. L’OR d’exposition entre cas et témoins constitue un estimateur non biaisé de l’OR de maladie qui aurait été observé au sein de l’ensemble de la population source. Dès lors que l’affection étudiée vérifie l’hypothèse de rareté, ce rapport de cotes rétrospectif devient la seule et unique passerelle empirique permettant d’approcher le risque relatif sans recourir au suivi coûteux et parfois irréalisable de dizaines de milliers de personnes sur plusieurs décennies.
6.3 Études transversales : prévalence ratio versus rapport de cotes de prévalence
Le devis d’étude transversale (cross-sectional study) occupe une posture intermédiaire délicate. Mesurant simultanément le statut d’exposition et l’état psychologique d’un échantillon à un instant donné $T$, ce protocole ne quantifie pas des taux d’incidence (flux d’apparition de nouveaux cas dans le temps), mais des taux de prévalence (proportion d’individus présentant l’affection au moment de l’évaluation). Face à une table de contingence transversale, le statisticien est confronté à une alternative métrique : estimer un rapport de cotes de prévalence (prevalence odds ratio ou POR) ou estimer directement un ratio de prévalences (prevalence ratio ou PR).
Le ratio de prévalences s’exprime de façon similaire au risque relatif en remplaçant l’incidence par la proportion de cas prévalents :
$$PR = \frac{\frac{A}{A + B}}{\frac{C}{C + D}}$$
L’utilisation du $PR$ présente le bénéfice immédiat de conserver la limpidité interprétative du risque relatif : un $PR = 1,5$ s’interprète rigoureusement comme une prévalence accrue de 50 % chez les sujets exposés. Néanmoins, l’estimation multivariée du PR soulève des contraintes algorithmiques lors du recours aux modèles de régression classiques.
Face à cette complexité technique, nombre d’auteurs ont historiquement opté pour le recours au rapport de cotes de prévalence via la régression logistique standard. Cependant, lorsque la prévalence du trouble excède les 10 % habituels, le POR présente la même dynamique d’inflation que l’OR d’incidence, surestimant considérablement l’ampleur de l’association. Les consensus biostatistiques actuels recommandent d’abandonner l’usage non critique du POR au profit de modélisations adaptées permettant l’extraction directe de ratios de prévalences ajustés, telles que la régression log-binomiale ou la régression de Poisson modifiée.
7. Études de cas appliquées et simulations numériques comparatives
7.1 Cas 1 : Évaluation d’une psychothérapie pour trouble panique à faible incidence
Afin d’illustrer la concordance empirique entre risque relatif et rapport de cotes sous l’hypothèse de maladie rare, examinons une étude d’intervention évaluant l’efficacité d’un protocole novateur de thérapie cognitivo-comportementale (TCC) digitalisée, visant la prévention de crises de panique nocturnes sévères au sein d’une large cohorte de 10 000 patients ambulatoires suivis durant douze mois. Dans cette population, l’événement indésirable clinique cible est rare : son incidence annuelle globale ne dépasse pas 1,5 %.
Les participants sont répartis équitablement en deux bras de suivi de 5 000 individus chacun : le groupe interventionnel bénéficiant de la TCC digitalisée ($E^+$) et le groupe témoin inscrit sur liste d’attente avec suivi habituel ($E^-$). Au terme de l’année d’observation, les données épidémiologiques se structurent selon la table de contingence suivante :
- Groupe TCC ($E^+$) : 25 patients développent des crises de panique nocturnes ($A = 25$), tandis que 4 975 demeurent asymptomatiques ($B = 4,975$). Total du bras : $A + B = 5,000$.
- Groupe Témoin ($E^-$) : 100 patients manifestent des crises nocturnes ($C = 100$), tandis que 4 900 restent indemnes ($D = 4,900$). Total du bras : $C + D = 5,000$.
Procédons au calcul rigoureux des incidences cumulées et des grandeurs d’association :
$$I_{E^+} = \frac{25}{5,000} = 0,005 \quad (0,5,%)$$
$$I_{E^-} = \frac{100}{5,000} = 0,020 \quad (2,0,%)$$
Le risque relatif d’apparition de crises nocturnes sous psychothérapie s’élève donc à :
$$RR = \frac{0,005}{0,020} = 0,250$$
Ce résultat traduit une réduction relative du risque de récidive de $1 – 0,25 = 0,75$, soit un bénéfice préventif net de 75 % conféré par la TCC digitalisée.
Calculons parallèlement l’odds ratio sur la même table d’effectifs :
$$OR = \frac{A \cdot D}{B \cdot C} = \frac{25 \cdot 4,900}{4,975 \cdot 100} = \frac{122,500}{497,500} \approx 0,246$$
La comparaison numérique révèle une quasi-identité entre les deux indices ($RR = 0,250$ versus $OR = 0,246$). L’écart relatif entre les deux estimations est inférieur à 1,6 %. Cette simulation numérique confirme empiriquement que lorsque le taux de base de l’événement n’excède pas quelques pourcents, le rapport de cotes reflète fidèlement le risque relatif, autorisant une interprétation clinique directe.
7.2 Cas 2 : Programme de réduction du stress académique à haute incidence
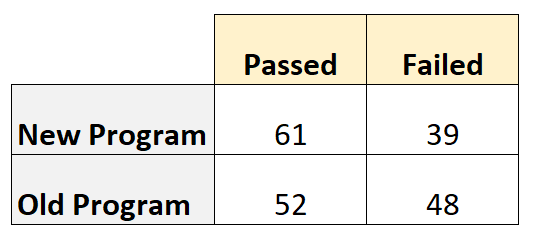
Examinons à présent un second scénario expérimental où l’issue clinique d’intérêt est hautement prévalente. Une équipe de pédopsychiatrie universitaire met en place un programme psychoéducatif fondé sur la méditation de pleine conscience (Mindfulness-Based Stress Reduction – MBSR) auprès d’un effectif de 1 000 étudiants en médecine de première année confrontés à un stress académique majeur. Dans cette cohorte à risque, l’issue clinique évaluée est la survenue d’une rémission complète de l’anxiété au terme de la période d’examens semestrielle.
L’échantillon est distribué en deux groupes équilibrés de 500 étudiants : le premier suit l’intervention MBSR ($E^+$), tandis que le second forme le groupe témoin sans intervention ($E^-$). Dans ce contexte d’évaluation de fin de semestre, les taux de rémission spontanée ou thérapeutique sont élevés. Les observations cliniques finales se distribuent comme suit :
- Groupe Intervention MBSR ($E^+$) : 350 étudiants atteignent le seuil de rémission complète ($A = 350$), tandis que 150 conservent des symptômes résiduels ($B = 150$). Total : $A + B = 500$.
- Groupe Témoin ($E^-$) : 250 étudiants connaissent une rémission ($C = 250$), tandis que 250 demeurent symptomatiques ($D = 250$). Total : $C + D = 500$.
L’extraction des taux de succès au sein des deux sous-populations fournit les incidences suivantes :
$$I_{E^+} = \frac{350}{500} = 0,70 \quad (70,%)$$
$$I_{E^-} = \frac{250}{500} = 0,50 \quad (50,%)$$
Le calcul du risque relatif de rémission sous MBSR donne :
$$RR = \frac{0,70}{0,50} = 1,40$$
Ce chiffre indique que le programme de pleine conscience majore proportionnellement la probabilité de rémission clinique d’un facteur 1,40, soit un gain relatif net de 40 % par rapport au cours évolutif spontané de la détresse académique.
Évaluons désormais l’odds ratio extrait de cette même matrice :
$$OR = \frac{A \cdot D}{B \cdot C} = \frac{350 \cdot 250}{150 \cdot 250} = \frac{87,500}{37,500} \approx 2,333$$
La divergence entre les deux grandeurs est ici manifeste : le risque relatif s’établit à 1,40 tandis que l’odds ratio s’envole à 2,33. L’OR amplifie numériquement la mesure de l’effet d’une proportion considérable, la cote d’amélioration étant multipliée par plus de 2,3 alors que le risque absolu de guérison ne progresse que de 40 %.
7.3 Déconstruction critique de l’interprétation sémantique des deux scénarios
L’analyse comparative de ces deux cas met en lumière le danger des glissements sémantiques dans la restitution des données. Dans le cas 1 (trouble panique), l’auteur d’une publication scientifique peut rapporter sans dommage interprétatif majeur que les patients sous TCC digitalisée présentent une réduction de 75 % du risque de crises nocturnes, que ce résultat découle formellement de la formulation du $RR$ ($0,250$) ou de celle de l’OR ($0,246$). L’erreur d’approximation reste marginale et ne dénature pas la perception de l’efficacité préventive du protocole.
En revanche, dans le cas 2 (détresse psychologique des étudiants), affirmer que les participants à l’atelier de pleine conscience ont « 2,3 fois plus de chances de guérir » ou que l’intervention « multiplie par plus de deux le taux de rémission » constitue une assertion erronée. Un clinicien ou un responsable universitaire recevant cette information surinterprétera l’efficacité du programme, anticipant une élévation des taux de rémission hors de proportion avec la réalité empirique du terrain (qui passe de 50 % à 70 %, soit une augmentation absolue de 20 points de pourcentage, et non un doublement du taux de succès qui exigerait théoriquement d’atteindre 116 %, une impossibilité mathématique).
Dans le cadre de revues à comité de lecture et d’exposés grand public, le standard éthique impose une restitution rigoureuse : il incombe au chercheur de rapporter prioritairement le risque relatif ($RR = 1,40$ ; IC 95 % [1,24 ; 1,58]), de l’adosser à la réduction absolue du risque ($RAR = +20,%$) et de calculer le nombre de sujets à traiter ($NNT = 1 / 0,20 = 5$ étudiants à intégrer dans le programme pour induire une rémission supplémentaire). Si seul l’odds ratio peut être estimé en raison d’ajustements multivariés par modélisation logistique, ce paramètre doit être explicitement libellé comme un « rapport de cotes ajusté » sans jamais être travesti en risque relatif dans le résumé ou les conclusions de l’article.
8. Inférence statistique, intervalles de confiance et tests d’hypothèse
8.1 Erreur type et transformation logarithmique nécessaire
L’estimation ponctuelle d’un risque relatif ou d’un rapport de cotes ne prend tout son sens clinique que si elle s’accompagne d’une caractérisation de son incertitude d’échantillonnage, matérialisée par un intervalle de confiance. Or, la distribution théorique de l’échantillonnage de ratios tels que le RR ou l’OR sur leur échelle arithmétique originale pose un défi statistique complexe : elle est asymétrique et fortement étalée vers la droite. Les valeurs inférieures à 1 (les effets protecteurs) se trouvent comprimées entre 0 et 1, tandis que les valeurs supérieures à 1 (les facteurs délétères) se dispersent sans borne supérieure vers l’infini.
Cette asymétrie interdit l’application directe des formules standard d’intervalles de confiance symétriques fondées sur l’approximation normale de Gauss ($\text{Estimateur} \pm 1,96 \times SE$). Pour contourner cet obstacle, l’inférence statistique procède obligatoirement par l’intermédiaire d’une transformation logarithmique népérienne. En prenant le logarithme naturel du ratio — $ln(RR)$ ou $ln(OR)$ —, la distribution d’échantillonnage recouvre une morphologie quasi-gaussienne symétrique, centrée autour de zéro sous l’hypothèse nulle.
La dérivation de l’erreur type asymptotique du logarithme de l’odds ratio repose sur la méthode delta, formalisée par la formule classique d’erreur type de Woolf :
$$SE(\ln(OR)) = \sqrt{\frac{1}{A} + \frac{1}{B} + \frac{1}{C} + \frac{1}{D}}$$
Pour le logarithme du risque relatif, la formulation de l’erreur type asymptotique, établie originellement par Katz et Greenwood, intègre les dénominateurs des totaux de strates :
$$SE(\ln(RR)) = \sqrt{\frac{1}{A} – \frac{1}{A + B} + \frac{1}{C} – \frac{1}{C + D}} = \sqrt{\frac{B}{A(A + B)} + \frac{D}{C(C + D)}}$$
Ces formulations révèlent que l’erreur type dépend directement de la taille des effectifs cellulaires. Des cellules clairsemées induisent une variance importante du log-ratio, ce qui se traduit par une instabilité de l’estimation ponctuelle finale.
8.2 Construction des intervalles de confiance à 95 %
Une fois l’erreur type sur l’échelle logarithmique calculée, la construction de l’intervalle de confiance bilatéral au niveau de confiance standard de 95 % s’effectue en dérivant les bornes inférieure et supérieure sur l’échelle normale en appliquant la valeur critique de la distribution de Gauss ($Z_{alpha/2} = 1,96$ pour un risque d’erreur consenti de $\alpha = 5,%$) :
$$\ln(\text{Borne Inférieure}) = \ln(\text{Ratio}) – 1,96 \cdot SE(\ln(\text{Ratio}))$$
$$\ln(\text{Borne Supérieure}) = \ln(\text{Ratio}) + 1,96 \cdot SE(\ln(\text{Ratio}))$$
L’étape finale consiste à opérer une exponentiation inverse pour transposer ces bornes logarithmiques vers l’échelle arithmétique naturelle originale :
$$IC_{95%}(\text{Ratio}) = \left[ \exp\left(\ln(\text{Ratio}) – 1,96 \cdot SE\right) ; ; ; \exp\left(\ln(\text{Ratio}) + 1,96 \cdot SE\right) \right]$$
Sur l’échelle originale, l’intervalle de confiance ainsi recalculé présente une allure asymétrique autour de la valeur ponctuelle de l’estimateur (la distance séparant la borne inférieure de la valeur centrale est inférieure à celle séparant la valeur centrale de la borne supérieure). Cette morphologie reflète fidèlement la structure non linéaire de l’espace métrique sous-jacent.
Sur le plan interprétatif, la propriété décisionnelle cardinale de cet intervalle de confiance à 95 % réside dans le non-englobement de la valeur critique d’indépendance 1,0. Si la valeur 1,0 est contenue entre la borne inférieure et la borne supérieure (par exemple, $IC_{95%} = [0,88 ; 1,42]$), l’investigateur ne peut rejeter l’hypothèse nulle au seuil alpha de 5 %, signifiant que les données observationnelles ne démontrent pas d’association statistiquement significative entre l’exposition et la trajectoire clinique. À l’inverse, l’exclusion de l’unité valide la significativité statistique de l’effet mesuré.
8.3 Lien avec les tests statistiques usuels du Chi-carré et de Fisher
La significativité statistique d’un risque relatif ou d’un odds ratio calculé au sein d’une table de contingence 2×2 est intimement liée aux tests d’hypothèse classiques d’association bivariée, au premier rang desquels figure le test d’indépendance du Chi-carré de Pearson ($\chi^2$). Ce test évalue formellement l’écart quadratique entre les effectifs expérimentaux observés dans chacune des quatre cellules et les effectifs théoriques que l’on observerait sous l’hypothèse d’une indépendance stochastique stricte :
$$\chi^2 = \sum \frac{(O – E)^2}{E} = \frac{N(A \cdot D – B \cdot C)^2}{(A + B)(C + D)(A + C)(B + D)}$$
Il existe une concordance mathématique directe entre la statistique du Chi-carré et l’odds ratio : le terme $(A \cdot D – B \cdot C)$ présent au numérateur du Chi-carré est rigoureusement nul si et seulement si l’odds ratio est égal à 1,0 ($A \cdot D = B \cdot C$). Par conséquent, au seuil de significativité conventionnel $\alpha = 0,05$, un test du $\chi^2$ rejetant l’hypothèse nulle ($p < 0,05$) produira un intervalle de confiance à 95 % du rapport de cotes et du risque relatif n'englobant pas la valeur unitaire.
Toutefois, lorsque les effectifs d’échantillonnage s’avèrent limités — une contrainte fréquente lors de l’étude de sous-groupes psychiatriques hyperspécialisés (ex. : comorbidités suicidaires chez les patients porteurs d’un trouble bipolaire de type I avec cycles ultra-rapides) —, la règle empirique de Cochran exigeant des effectifs théoriques supérieurs ou égaux à 5 dans chaque cellule de la matrice n’est plus satisfaite. Le test du Chi-carré devient invalide en raison de l’écroulement de son approximation continue. Il devient alors obligatoire de substituer à ces calculs le test exact de Fisher, qui dérive la probabilité hypergéométrique combinatoire exacte des distributions observées en conditionnant les quatre marges marginales fixes.
Il importe enfin de souligner les limites inhérentes à la valeur $p$ seule. L’obtention d’un $p < 0,001$ n'informe aucunement sur l'amplitude clinique du phénomène exploré : elle atteste simplement de la faible probabilité d'observer un tel déséquilibre d'effectifs sous l'hypothèse nulle du seul hasard d'échantillonnage. Seule la conjonction du risque relatif ou de l'odds ratio, flanqué de son intervalle de confiance rigoureux, permet d'apprécier la pertinence translationnelle et l'envergure réelle de l'effet thérapeutique ou étiologique au lit du malade.
9. Applications concrètes en psychologie clinique, psychiatrie et neurosciences
9.1 Étiologie psychiatrique et facteurs de vulnérabilité génétique
L’exploration des soubassements génomiques des troubles psychiatriques complexes fournit une illustration parlante de l’usage prépondérant du rapport de cotes. Les études d’association pangénomique (Genome-Wide Association Studies – GWAS) analysent des centaines de milliers de polymorphismes nucléotidiques simples (Single Nucleotide Polymorphisms – SNP) répartis sur l’ensemble du génome humain au sein de volumineuses cohortes cas-témoins centralisant des dizaines de milliers de patients atteints de trouble bipolaire, de dépression récurrente ou de troubles du spectre autistique.
Dans ce paradigme de génétique statistique, le phénotype clinique étant déterminé rétrospectivement lors du recrutement, le rapport de cotes constitue la mesure standard d’association allolique. L’OR quantifie la variation de la cote d’apparition du phénotype psychiatrique en présence d’un allèle variant déterminé comparativement à l’allèle de référence. Dans la mesure où les variants génétiques communs confèrent individuellement des vulnérabilités modestes mais réelles (avec des odds ratios oscillant couramment entre 1,05 et 1,20 pour chaque allèle à risque additionnel) et que la prévalence des troubles psychotiques sévères vérifie globalement l’hypothèse de rareté relative, l’OR génétique fournit une estimation non biaisée de la progression proportionnelle du risque sous-jacent.
Ces odds ratios alloliques individuels sont ensuite intégrés sous forme de pondérations logarithmiques ($\beta = \ln(OR)$) au sein d’algorithmes mathématiques permettant le calcul de scores de risque polygénique (Polygenic Risk Scores – PRS). Ces scores évaluent la charge génétique globale d’un individu en sommant le produit de ses allèles de vulnérabilité par leurs cotes d’association respectives. Cette modélisation moléculaire met en exergue l’importance de l’odds ratio comme brique fondamentale pour quantifier l’architecture biologique de la vulnérabilité mentale face aux déterminants environnementaux tels que les traumatismes infantiles ou les stress psychosociaux chroniques.
9.2 Évaluation d’interventions psychothérapeutiques et psychopharmacologiques
Le champ des essais thérapeutiques contrôlés randomisés (ECR) en neuropsychopharmacologie et en psychologie clinique interventionnelle illustre les arbitrages métrologiques quotidiens entre RR et OR. Dans l’analyse primaire d’efficacité d’une molécule psychotrope — qu’il s’agisse de la supériorité d’un antipsychotique de seconde génération face à un placebo ou de l’adjonction d’une remédiation cognitive —, le protocole prospectif place l’évaluation de la réponse clinique (traditionnellement formalisée par une réduction de 50 % des scores sur l’échelle MADRS pour la dépression ou l’échelle PANSS pour la schizophrénie) sous le primat méthodologique du risque relatif.
Dans ce contexte prospectif où les taux de réponse oscillent classiquement entre 30 % et 60 %, le risque relatif préserve l’intégrité de l’interprétation clinique en fournissant une mesure proportionnelle non gonflée de l’effet. Il informe directement le prescripteur : un $RR = 1,35$ pour la réponse thérapeutique indique que le nouveau protocole accroît d’un tiers la fraction de patients atteignant le seuil de rémission comparativement au traitement de référence, autorisant le clinicien à calculer directement la réduction absolue du risque et le bénéfice net de la molécule.
Néanmoins, la prise en charge des affections psychiatriques nécessite la surveillance vigilante d’événements indésirables iatrogènes graves mais rares, tels que le syndrome malin des neuroleptiques, la survenue d’un allongement pathologique de l’intervalle QTc cardiaque ou l’émergence d’agranulocytose sous clozapine. Lors de la quantification de ces signaux de sécurité à très faible incidence (fréquemment inférieure à 0,1 % des patients traités), l’odds ratio et le risque relatif convergent vers des valeurs identiques. L’OR ajusté dérivé des registres de pharmacovigilance offre alors une estimation robuste pour pondérer la balance bénéfice-risque globale de la thérapeutique.
9.3 Recherche prédictive et biomarqueurs en imagerie cérébrale
L’essor des neurosciences computationnelles et de la psychiatrie de précision a favorisé le développement de modèles prédictifs fondés sur l’imagerie par résonance magnétique fonctionnelle (IRMf) et l’imagerie structurelle morphométrique. L’objectif translationnel consiste à isoler des biomarqueurs neuroanatomiques — tels qu’un amincissement cortical préfrontal, une altération de l’intégrité des faisceaux de substance blanche visualisée en tenseur de diffusion (DTI) ou une hypo-connectivité du réseau du mode par défaut — capables de prédire la transition vers un état psychotique franc chez des adolescents repérés comme présentant un état clinique à haut risque (Clinical High Risk – CHR).
Dans ces protocoles prédictifs, les chercheurs utilisent fréquemment des architectures de régression logistique pénalisée (telles que les régressions Ridge ou Lasso) où les descripteurs cérébraux agissent comme prédicteurs multivariés continus. Les coefficients d’ajustement extraits de ces modèles sont restitués sous forme d’odds ratios associés à chaque déviation standard de variation volumétrique ou fonctionnelle cérébrale. L’odds ratio permet de mesurer l’accroissement relatif de la cote d’entrée dans la psychose induit par une détérioration mesurée des réseaux de connectivité fronto-striataux.
Cependant, l’utilisation de ces paramètres prédictifs exige une attention rigoureuse à la prévalence de transition au sein de l’échantillon d’entraînement de l’algorithme. Si l’échantillon de recherche est enrichi artificiellement pour atteindre un taux de transition psychotique de 35 % (alors que le taux de transition réel en population non sélectionnée est très inférieur), l’odds ratio issu du modèle ne reflète pas le risque relatif de conversion clinique. Confondre l’OR d’un biomarqueur d’imagerie avec son impact multiplicatif direct sur la probabilité de survenue expose les cliniciens à de faux diagnostics de transition imminente, illustrant l’importance d’une manipulation rigoureuse de ces métriques lors du déploiement de modèles de machine learning en psychiatrie.
10. Rôle prépondérant de l’Odds Ratio dans la modélisation multivariée et les méta-analyses
10.1 Pourquoi la régression logistique modélise nativement le log-odds
La primauté de l’odds ratio dans la littérature scientifique contemporaine découle de considérations computationnelles liées aux modèles linéaires généralisés (GLM). Lorsqu’un investigateur cherche à évaluer la relation unissant une issue clinique dichotomique (malade / sain) à de multiples covariables d’ajustement simultanées (incluant des facteurs de confusion tels que l’âge, le sexe, la sévérité initiale des symptômes ou les comorbidités addictives), l’application de la régression linéaire simple par moindres carrés ordinaires se heurte à des verrous formels majeurs : elle viole les hypothèses d’homoscédasticité et peut générer des probabilités prédites absurdes, inférieures à 0 ou excédant 1.
La formulation de la régression logistique binaire contourne ces obstacles théoriques en modélisant non pas la probabilité brute de survenue de l’événement $p$, mais sa transformation logit, c’est-à-dire le logarithme de sa cote :
$$\text{logit}(p) = \ln\left(\frac{p}{1 – p}\right) = \beta_0 + \beta_1 X_1 + \beta_2 X_2 + dots + \beta_k X_k$$
Sous cette paramétrisation, l’effet de chaque covariable $X_i$ s’exprime par son coefficient de régression partiel $\beta_i$. En appliquant l’exponentiation inverse à ce coefficient de régression ($\exp(\beta_i)$), on obtient directement le rapport de cotes ajusté ($OR_{\text{ajusté}}$) associé à une augmentation d’une unité de la variable prédictive $X_i$, toutes les autres covariables du modèle étant maintenues constantes :
$$OR_{\text{ajusté}} = \exp(\beta_i)$$
Le calcul mathématique interne de la régression logistique produit ainsi nativement des odds ratios et demeure structurellement incapable de délivrer directement des risques relatifs ajustés. La régression logistique s’étant imposée comme le standard dominant du contrôle des facteurs de confusion en recherche biomédicale, l’odds ratio s’est retrouvé mécaniquement propulsé au statut d’indice d’effet hégémonique dans la littérature empirique.
10.2 Modèles alternatifs pour estimer directement le risque relatif ajusté
Conscients des distorsions interprétatives générées par l’usage automatique de l’odds ratio face à des pathologies à haute prévalence, les méthodologistes et biostatisticiens contemporains ont développé des alternatives rigoureuses destinées à extraire directement des risques relatifs multivariés ajustés. La première option repose sur la régression log-binomiale, qui adopte une fonction de lien logarithmique directe ($\ln(p) = \beta_0 + \sum \beta_i X_i$). Les coefficients exponentiés du modèle correspondent alors à des risques relatifs stricts ($\exp(\beta_i) = RR$). Néanmoins, ce modèle présente une fragilité numérique notoire : il souffre fréquemment d’échecs de convergence algorithmique dès lors que les valeurs de probabilités prédites s’approchent des limites physiques supérieures de l’espace unitaire.
Pour pallier ces instabilités numériques, le standard méthodologique privilégie désormais le déploiement de la régression de Poisson modifiée avec estimation de variance robuste par sandwich de Huber-White, initialement démontrée par Zou en 2004. Bien que la distribution de Poisson soit initialement conçue pour modéliser des variables de comptage et produise une surdispersion de la variance lorsqu’elle est appliquée à des issues binaires, l’adjonction de l’estimateur de variance robuste corrige les erreurs types, fournissant des intervalles de confiance précis et des risques relatifs ajustés exempts de toute distorsion d’inflation.
Parallèlement, lorsque la dimension temporelle de l’occurrence des événements est explicitement documentée, la régression des risques proportionnels de Cox (Cox proportional hazards model) s’impose comme le cadre d’analyse privilégié. Ce modèle de survie dérive le rapport de risques instantanés (Hazard Ratio – HR). Le Hazard Ratio quantifie le rapport des taux de transition vers l’événement par unité de temps entre exposés et non-exposés, fournissant un analogue temporel dynamique du risque relatif particulièrement adapté à l’analyse longitudinale des récidives dépressives ou des réadmissions psychiatriques.
10.3 Méta-analyses et techniques de conversion mathématique
L’hégémonie de l’odds ratio s’étend également au champ de la synthèse quantitative de la littérature au sein des méta-analyses Cochrane et des synthèses systématiques internationales. L’OR possède des propriétés mathématiques qui en font l’indice d’agrégation privilégié : ses propriétés d’invariance rétrospective autorisent le regroupement statistique d’études de cohortes prospectives et d’études cas-témoins d’observation au sein d’un même modèle à effets aléatoires (random-effects model), tandis que sa distribution d’échantillonnage log-transformée se prête bien aux opérations d’homogénéisation statistique de la variance de DerSimonian et Laird.
Néanmoins, lorsqu’un méta-analyste fait face à des données primaires hétérogènes intégrant des prévalences variables, la synthèse brute d’odds ratios peut masquer d’importantes disparités cliniques sous-jacentes. Face à cette difficulté, plusieurs biostatisticiens ont développé des formulations mathématiques permettant de convertir rétrospectivement un odds ratio ajusté en risque relatif estimé. La méthode la plus renommée est l’équation de Zhang et Yu (1998) :
$$RR_{\text{estimé}} = \frac{OR}{(1 – P_0) + (P_0 \cdot OR)}$$
Dans cette équation de correction, $P_0$ incarne l’incidence observée au sein du groupe témoin non exposé. Si cette équation permet de corriger visuellement l’inflation numérique de l’OR pour rétablir une métrique plus conforme à l’intuition du risque proportionnel, son usage fait l’objet de réserves méthodologiques substantielles.
Plusieurs auteurs ont démontré que l’application de la formule de Zhang et Yu sur des odds ratios ajustés issus de régressions multivariées complexes produit une distorsion asymétrique des erreurs types et fausse la largeur des intervalles de confiance recalculés. De surcroît, elle méconnaît le fait que l’incidence du groupe de référence $P_0$ varie fréquemment d’une sous-population à une autre. Par conséquent, les recommandations contemporaines en synthèse systématique encouragent la collecte prioritaire des matrices de données brutes pour ré-estimer des modèles de Poisson modifiés globaux plutôt que de recourir à des formules d’approximation rétrospective imparfaites.
11. Biais cognitifs, erreurs récurrentes d’interprétation et éthique de communication
11.1 La confusion sémantique classique entre cote et risque
L’une des distorsions les plus répandues dans le discours scientifique concerne l’assimilation sémantique abusive de l’odds ratio au risque relatif. Il est courant de relever dans les sections de discussion de revues psychiatriques de premier rang des assertions de type : « L’odds ratio ajusté étant de 2,8, les individus porteurs de cette altération génétique présentent un risque presque triplé de développer la pathologie. » Une telle formulation est inexacte dès lors que l’affection étudiée n’est pas rare.
Ce glissement dérive de biais heuristiques ancrés dans la cognition probabiliste. Pour un chercheur non formé aux subtilités de l’algèbre épidémiologique, le vocable « odds » est traduit spontanément par « chances » ou « risques ». Cette confusion est entretenue par l’absence d’équivalent lexical intuitif en français pour le terme « odds », ce qui conduit à l’usage imprécis de « probabilité » pour désigner un rapport de cotes. Plusieurs enquêtes docimologiques évaluant les compétences de lecture critique chez les praticiens hospitaliers ont mis en évidence que plus de 75 % des médecins interrogés interprètent textuellement les valeurs numériques des odds ratios comme des multiplicateurs stricts de risque relatif.
L’histoire de la santé publique documente de nombreux exemples où cette confusion a alimenté des mouvements d’alarmisme sanitaire injustifiés. La publication de rapports de cotes élevés reliant des expositions courantes (telles que la consommation modérée de caféine durant la gestation ou l’usage régulier des écrans chez les jeunes) à des perturbations psychologiques mineures à haute fréquence a régulièrement été relayée par la presse grand public sous forme de multiplicateurs de risque brut terrifiants, altérant la confiance sociétale envers l’intégrité de la communication médicale.
11.2 Conséquences cliniques et éthiques de l’exagération de l’effet
Les conséquences cliniques de cette inflation métrique dépassent le cadre théorique : elles affectent directement le processus de décision médicale partagée et la validité du consentement éclairé des patients en psychiatrie. Lorsqu’un praticien présente à un individu souffrant d’anxiété généralisée un programme psychothérapeutique novateur en affirmant, sur la base d’un odds ratio non corrigé, que le protocole « double ses chances de rémission complète », il implante chez le sujet une attente pronostique faussée si le bénéfice réel correspond à un modeste accroissement du risque relatif de 1,25 (soit un gain relatif de 25 % sur un taux de base déjà élevé).
De façon symétrique, cette surestimation de l’effet peut biaiser les choix de prescription pharmacologique. L’adoption accélérée de nouvelles molécules psychotropes au profil d’effets secondaires plus lourd ou d’un coût financier supérieur est fréquemment soutenue par des publications valorisant des odds ratios ajustés spectaculaires, masquant des gains réels en termes de réduction absolue du risque ou de risques relatifs cliniques souvent marginaux par rapport aux traitements conventionnels tombés dans le domaine public.
Sur le plan de l’éthique de la recherche biomédicale, persister à présenter sciemment des odds ratios en laissant planer l’ambiguïté d’une équivalence avec le risque relatif s’apparente à un délit d’exactitude scientifique. Les auteurs de recherches translationnelles portent la responsabilité déontologique d’exposer leurs résultats d’association sans exploiter les propriétés d’inflation mathématique pour rehausser artificiellement l’attractivité académique de leurs travaux auprès des comités éditoriaux.
11.3 Lignes directrices éditoriales et standards de publication
Face à ces dérives récurrentes, les comités internationaux d’éthique et de standardisation de la publication scientifique ont édicté des directives méthodologiques strictes visant à contraindre les pratiques des investigateurs en épidémiologie et en sciences du comportement :
- Les directives STROBE (Strengthening the Reporting of Observational Studies in Epidemiology) imposent que la désignation précise de la mesure d’association employée (RR, OR, HR, PR) apparaisse dès le résumé de l’article, proscrivant l’usage générique du terme « risque » pour commenter des cotes.
- Les recommandations CONSORT (Consolidated Standards of Reporting Trials) régissant la publication des essais cliniques randomisés stipulent l’obligation de documenter systématiquement à la fois les tailles d’effet relatives ($RR$) et les tailles d’effet absolues ($RAR$, pourcentages d’événements dans chaque groupe, et $NNT$).
Les politiques éditoriales des plus grandes revues internationales de psychiatrie et de psychologie clinique intègrent des critères rigoureux de vérification statistique. Il est désormais formellement exigé des auteurs fournissant des odds ratios issus de modélisations logistiques qu’ils mentionnent explicitement le risque absolu de base de l’événement dans le groupe témoin ($P_0$) afin de permettre aux lecteurs de calibrer l’ampleur réelle de l’effet. Plusieurs revues majeures n’hésitent plus à refuser des manuscrits ou à contraindre leurs auteurs à ré-estimer leurs associations via des régressions de Poisson modifiées lorsque l’issue d’intérêt dépasse le seuil critique d’incidence de 10 %.
12. Guide décisionnel pratique pour le chercheur et le clinicien
12.1 Arbre de décision pour le choix de la métrique appropriée
Afin de guider méthodiquement le chercheur dans le choix de l’indicateur d’association le plus pertinent pour ses travaux quantitatifs, nous proposons un algorithme décisionnel séquentiel articulé autour de trois critères fondamentaux : le devis expérimental, le taux de survenue du phénomène, et la nécessité d’ajustements multivariés.
Le premier embranchement concerne le devis de recherche :
- Si le devis est rétrospectif de type cas-témoins, la taille de la population source à risque est inconnue : l’Odds Ratio constitue l’unique mesure mathématiquement valide. Si la maladie vérifie l’hypothèse de rareté ($p < 10,%$), l'OR approche le risque relatif de la population source. Si elle n'est pas rare, l'OR doit être interprété comme un rapport de cotes, sans assimilation au risque proportionnel.
- Si le devis est transversal, la métrique naturelle est le Prevalence Ratio (PR). En présence d’ajustements multivariés requis, privilégier une régression log-binomiale ou une régression de Poisson modifiée pour extraire des PR ajustés. L’usage du rapport de cotes de prévalence (POR) doit être réservé aux issues rares ou explicitement assumé comme une cote.
- Si le devis est longitudinal prospectif (essai randomisé contrôlé ou étude de cohorte), le calcul de l’incidence est maîtrisé : le Risque Relatif (RR) représente la métrique d’élection universelle, à laquelle il convient d’adjoindre la réduction absolue du risque et le NNT.
Le second filtre décisionnel intervient lors de la modélisation multivariée en présence d’une issue fréquente ($p > 10,%$) : l’analyste doit éviter le réflexe pavlovien de la régression logistique binaire et implémenter une régression de Poisson robuste ou une régression de survie de Cox si des données temporelles d’incidence sont disponibles. L’application de cet arbre décisionnel garantit l’alignement entre les propriétés mathématiques des données et le message scientifique délivré.
12.2 Boîte à outils pour une communication transparente avec les patients
Au-delà de la rigueur académique interne aux laboratoires, le clinicien en santé mentale doit être capable de transposer ces grandeurs probabilistes abstraites en un langage accessible et opérant pour le patient au sein de la consultation. Pour y parvenir, plusieurs approches issues des sciences cognitives de la décision s’avèrent utiles.
La première stratégie repose sur la conversion des ratios relatifs en fréquences naturelles. Les pourcentages, probabilités et rapports de cotes activent fréquemment des heuristiques erronées dans l’esprit du public, tandis que les fréquences naturelles ancrent le propos dans le concret. Par exemple, au lieu d’énoncer : « Cette intervention réduit le risque d’un RR de 0,60 », le médecin traduira : « Sur 100 personnes présentant votre profil clinique qui ne suivent pas ce traitement, 20 font une rechute au cours de l’année. Avec ce nouveau programme thérapeutique, ce chiffre tombe à 12 personnes sur 100. Ainsi, le traitement évite la rechute à 8 personnes sur 100. »
La seconde boîte à outils mobilise les représentations iconographiques, telles que les diagrammes d’icônes matriciels (tableaux de 100 pictogrammes de silhouettes humaines visualisant les proportions d’individus sains, malades et protégés) ou les arbres de fréquences hiérarchiques. Ces supports visuels éliminent les ambiguïtés induites par les rapports de cotes et permettent au patient d’évaluer directement l’équilibre entre l’effort consenti pour le suivi thérapeutique (prise quotidienne d’un traitement, contraintes des séances psychologiques) et l’amplitude réelle du bénéfice escompté.
12.3 Synthèse récapitulative des forces, faiblesses et pièges méthodologiques
Pour conclure cette analyse approfondie, le tableau analytique ci-dessous synthétise l’ensemble des caractéristiques métrologiques, algébriques et cliniques confrontant le Risque Relatif et l’Odds Ratio :
| Critère de comparaison | Risque Relatif (RR) | Odds Ratio (OR) |
|---|---|---|
| Définition sous-jacente | Rapport direct de deux probabilités absolues d’incidence cumulée : $[A/(A+B)] / [C/(C+D)]$ | Rapport direct de deux cotes indépendantes (produit croisé des cellules) : $(A \cdot D) / (B \cdot C)$ |
| Devis de prédilection | Essais cliniques randomisés, études de cohorte longitudinales prospectives | Études observationnelles cas-témoins, modélisations multivariées logistiques, GWAS |
| Faisabilité en cas-témoins | Mathématiquement incalculable en raison de l’arbitraire des dénominateurs populationnels | Parfaitement valide et stable grâce à la propriété fondamentale d’invariance rétrospective |
| Comportement si issue fréquente ($>10%$) | Reste borné par l’inverse du risque basal, conserve sa signification probabiliste proportionnelle | Subit une inflation mathématique exponentielle, s’éloignant drastiquement de la valeur 1,0 |
| Hypothèse de maladie rare ($<10%$) | Constitue la référence absolue du calcul | Converge asymptotiquement vers une quasi-identité numérique avec le Risque Relatif |
| Intuitivité cognitive clinique | Élevée : correspond directement à la notion intuitive de multiplication ou réduction du risque | Faible : mesure la variation relative d’une cote d’événement, conceptuellement difficile à appréhender |
| Modélisation multivariée | Requiert des modèles spécifiques (Poisson modifiée avec variance robuste, régression log-binomiale) | Modélisé nativement comme la fonction de lien canonique au sein des régressions logistiques ($\exp(\beta)$) |
| Sensibilité à la prévalence basale | Non influencé par la prévalence basale quant à sa structure relative, mais contraint par le plafond unitaire | Totalement indépendant des marges de l’échantillonnage expérimental, mais amplificateur d’effet |
L’intégrité de la science translationnelle en médecine et en santé mentale dépend de la rigueur appliquée au traitement quantitatif des données d’association. L’odds ratio et le risque relatif ne constituent pas deux appellations concurrentes d’un même phénomène statistique, mais deux instruments géométriquement et conceptuellement distincts, chacun répondant à des contraintes méthodologiques précises. L’analyste se doit de choisir son instrument à la lumière du devis expérimental adopté et de la prévalence basale du trouble exploré, tandis que le clinicien a le devoir moral de traduire ces indices sans déformation sémantique, garantissant une communication scientifique rigoureuse au service des patients et de la santé publique.
Références
- Altman, D. G., Deeks, J. J., & Sackett, D. L. (1998). Odds ratios should be avoided when events are common. BMJ, 317(7168), 1318. https://doi.org/10.1136/bmj.317.7168.1318
- Bland, J. M., & Altman, D. G. (2000). Statistics notes: The odds ratio. BMJ, 320(7247), 1468. https://doi.org/10.1136/bmj.320.7247.1468
- Cornfield, J. (1951). A method of estimating comparative rates from clinical data; applications to cancer of the lung, breast, and cervix. Journal of the National Cancer Institute, 11(6), 1269–1275. https://doi.org/10.1093/jnci/11.6.1269
- Cummings, P. (2009). The relative merits of risk ratios and odds ratios. Archives of Pediatrics & Adolescent Medicine, 163(5), 438–445. https://doi.org/10.1001/archpediatrics.2009.31
- Davies, H. T., Crombie, I. K., & Tavakoli, M. (1998). When can odds ratios mislead? BMJ, 316(7136), 989–991. https://doi.org/10.1136/bmj.316.7136.989
- Gigerenzer, G., Gaissmaier, W., Kurz-Milcke, E., Schwartz, L. M., & Woloshin, S. (2007). Helping doctors and patients make sense of health statistics. Psychological Science in the Public Interest, 8(2), 53–96. https://doi.org/10.1111/j.1539-6053.2008.00033.x
- Greenland, S. (1987). Interpretation and choice of effect measures in epidemiologic analyses. American Journal of Epidemiology, 125(5), 761–768. https://doi.org/10.1093/oxfordjournals.aje.a114593
- Knol, M. J., Vandenbroucke, J. P., Scott, P., & Egger, M. (2012). What do clinical findings tell us about the risk ratio? European Journal of Epidemiology, 27(6), 405–411. https://doi.org/10.1007/s10654-012-9694-3
- Norton, E. C., Dowd, B. E., & Maciejewski, M. L. (2018). Odds ratios—current best practice and use. JAMA, 320(1), 84–85. https://doi.org/10.1001/jama.2018.6971
- Rothman, K. J., Greenland, S., & Lash, T. L. (2008). Modern Epidemiology (3rd ed.). Lippincott Williams & Wilkins.
- Sackett, D. L., Deeks, J. J., & Altman, D. G. (1996). Down with odds ratios! Evidence-Based Medicine, 1(6), 164–166. https://doi.org/10.1136/ebm.1.6.164
- Schulz, K. F., Altman, D. G., & Moher, D. (2010). CONSORT 2010 statement: Updated guidelines for reporting parallel group randomised trials. BMJ, 340, c332. https://doi.org/10.1136/bmj.c332
- Vandenbroucke, J. P., von Elm, E., Altman, D. G., Gøtzsche, P. C., Mulrow, C. D., Pocock, S. J., Poole, C., Schlesselman, J. J., & Egger, M. (2007). Strengthening the Reporting of Observational Studies in Epidemiology (STROBE): Explanation and elaboration. PLOS Medicine, 4(10), e297. https://doi.org/10.1371/journal.pmed.0040297
- von Elm, E., Altman, D. G., Egger, M., Pocock, S. J., Gøtzsche, P. C., & Vandenbroucke, J. P. (2007). The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies. The Lancet, 370(9596), 1453–1457. https://doi.org/10.1016/S0140-6736(07)61602-X
- Woolf, B. (1955). On estimating the relation between blood group and disease. Annals of Human Genetics, 19(4), 251–253. https://doi.org/10.1111/j.1469-1809.1955.tb01348.x
- Zhang, J., & Yu, K. F. (1998). What’s the relative risk? A method of correcting the odds ratio in cohort studies of common outcomes. JAMA, 280(19), 1690–1691. https://doi.org/10.1001/jama.280.19.1690
- Zocchetti, C., Consonni, D., & Bertazzi, P. A. (1997). Relationship between prevalence rate ratios and odds ratios in cross-sectional studies. International Journal of Epidemiology, 26(1), 220–223. https://doi.org/10.1093/ije/26.1.220
- Zou, G. (2004). A modified poisson regression approach to prospective studies with binary data. American Journal of Epidemiology, 159(7), 702–706. https://doi.org/10.1093/aje/kwh090