
Dans le champ de la modélisation statistique appliquée aux sciences humaines, sociales et comportementales, l’analyse de régression linéaire multiple s’impose comme une pierre angulaire méthodologique. Elle permet d’examiner les relations complexes unissant un ensemble de variables explicatives à un critère d’intérêt, en quantifiant l’influence propre de chaque prédicteur tout en contrôlant l’effet des autres. Cependant, la validité mathématique et l’interprétabilité théorique de ces modèles reposent sur un ensemble d’hypothèses fondamentales formalisées au sein du modèle linéaire classique. Parmi ces conditions figure l’hypothèse d’absence d’interdépendance linéaire exacte entre les prédicteurs, principe essentiel sans lequel l’ensemble de l’édifice des moindres carrés s’effondre.
Lorsque cette condition est violée de manière absolue, les statisticiens et psychométriciens font face au phénomène de multicolinéarité parfaite. Loin d’être un simple artefact technique ou un problème mineur d’échantillonnage, cette configuration pathologique correspond à l’existence d’une relation déterministe et rigide liant deux ou plusieurs variables indépendantes. Dans une telle situation, la matrice des prédicteurs perd son plein rang, ce qui interdit structurellement toute inversion de la matrice de dispersion sous-jacente. L’estimation des paramètres selon la méthode des moindres carrés ordinaires devient alors mathématiquement impossible, plongeant le chercheur dans une impasse algorithmique et conceptuelle majeure.
Le présent article propose une exploration exhaustive, rigoureuse et didactique de la multicolinéarité parfaite, en prêtant une attention particulière aux défis singuliers rencontrés en psychologie quantitative, en psychométrie et en sciences du comportement. À travers la dissection de ses fondements algébriques, de ses causes structurelles les plus fréquentes dans la construction des instruments de mesure, et de ses manifestations empiriques concrètes, nous analyserons les raisons pour lesquelles la multicolinéarité parfaite paralyse l’inférence statistique. Enfin, nous détaillerons les outils diagnostiques incontournables et les solutions méthodologiques éprouvées pour préserver l’intégrité analytique et la robustesse épistémologique des recherches empiriques.
1. 1. Introduction conceptuelle : Définition formelle de la multicolinéarité parfaite
1.1 Compréhension fondamentale du phénomène
La multicolinéarité parfaite se définit formellement comme une situation dans laquelle au moins une variable prédictive d’un modèle de régression linéaire multiple peut être exprimée exactement comme une combinaison linéaire d’une ou plusieurs autres variables indépendantes. Contrairement aux fluctuations empiriques ordinaires caractérisées par des coefficients de corrélation de Pearson élevés mais imparfaits (comme r = 0,80 ou r = 0,90), la multicolinéarité parfaite élimine toute composante stochastique ou terme d’erreur résiduelle dans la relation unissant les prédicteurs. Il s’agit d’une dépendance algébrique absolue, absolue au sens où la valeur prise par une variable détermine instantanément et sans incertitude aucune la valeur des autres régresseurs impliqués dans l’équation.
Cette distinction conceptuelle entre association empirique et dépendance algébrique est fondamentale. Une forte corrélation traduit un chevauchement partiel de variance partagée au sein d’un échantillon donné, tandis que la colinéarité parfaite reflète une tautologie mathématique ou une identité structurelle. Dans ce dernier cas, la variable redondante n’apporte aucune fraction de variance unique ou d’information nouvelle susceptible d’expliquer la variabilité de la variable dépendante. Elle constitue un clone mathématique, déguisé sous une échelle de mesure alternative ou dissimulé par une sommation d’items, ce qui neutralise le principe même d’orthogonalité informationnelle au cœur de la modélisation multivariée.
1.2 Origine du terme et pertinence en modélisation linéaire
L’origine historique du terme remonte aux travaux séminaux de l’économiste et statisticien norvégien Ragnar Frisch, corécipiendaire du premier prix Nobel d’économie en 1969. Dans son ouvrage fondamental publié en 1934, Statistical Confluence Analysis by Means of Complete Regression Systems, Frisch a introduit le terme « collinéarité » (qui a ensuite évolué vers multicolinéarité) pour décrire une situation où les variables explicatives sont soumises à une ou plusieurs relations linéaires exactes au sein d’un système dynamique. Initialement formulé dans le cadre des équations macroéconomiques simultanées, le concept s’est rapidement diffusé à l’ensemble de la statistique inférentielle et de la psychométrie naissante.
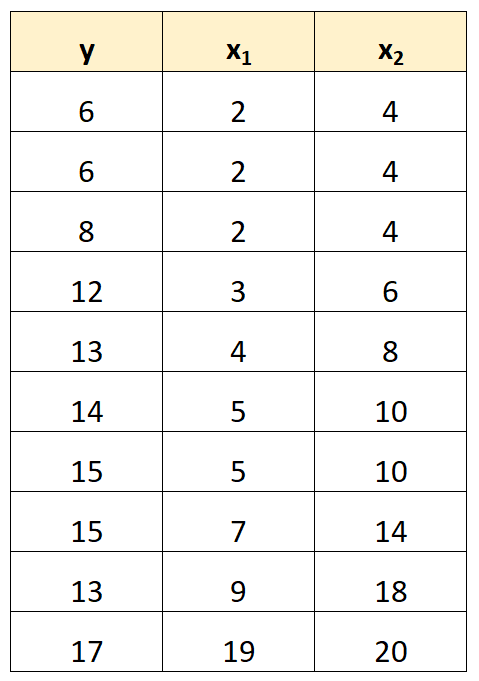
Dans la théorie du modèle linéaire généralisé, l’orthogonalité théorique des prédicteurs représente l’idéal méthodologique absolu. Lorsque les régresseurs sont parfaitement orthogonaux, c’est-à-dire non corrélés entre eux, l’attribution des effets partiels est directe et la variance expliquée globale correspond à la somme arithmétique exacte des variances expliquées par chaque variable prise individuellement. Bien que cette indépendance totale soit rarement observée dans les données observationnelles, l’absence de colinéarité parfaite demeure une condition sine qua non, une hypothèse structurelle non négociable sans laquelle les équations normales de la régression ne possèdent pas de solution unique.
1.3 Pertinence épistémologique pour la psychologie quantitative
Pour la psychologie quantitative et les sciences cognitives, la multicolinéarité parfaite pose des défis épistémologiques singuliers. Les psychologues travaillent par essence avec des construits latents non observables directement, tels que l’intelligence fluide, l’anxiété de trait, l’extraversion ou l’auto-efficacité, qu’ils tentent de capturer à travers des échelles composites et des batteries d’épreuves comportementales. Or, ces construits partagent souvent des frontières théoriques ténues et des réseaux nomologiques denses, ce qui favorise l’émergence de fortes intrications empiriques.
Le risque majeur pour le chercheur réside dans la confusion pernicieuse entre redondance conceptuelle et redondance mathématique. Une redondance conceptuelle peut être féconde pour affiner un modèle théorique en psychologie clinique ou sociale, mais si cette redondance est encodée sous la forme d’une sommation arithmétique ou d’une reformulation déterministe intégrée au même modèle de régression, elle mute en une colinéarité mathématique absolue. Cela souligne la nécessité impérieuse de faire preuve d’une rigueur formelle lors de la dérivation des hypothèses opérationnelles et de la structuration des bases de données psychométriques, sous peine de transformer une investigation théorique prometteuse en une simple anomalie matricielle.
2. 2. Fondements mathématiques et algébriques de la multicolinéarité parfaite
2.1 Formulation algébrique de la combinaison linéaire
Sur le plan de l’algèbre vectorielle, la multicolinéarité parfaite au sein d’un ensemble de $k$ variables prédictives $X_1, X_2, dots, X_k$ s’exprime rigoureusement par l’existence d’une combinaison linéaire scalaire nulle non triviale. En d’autres termes, il existe un vecteur de constantes réelles non toutes nulles $(c_1, c_2, dots, c_k) \neq (0, 0, dots, 0)$ tel que pour chaque observation $i$ de l’échantillon, la relation suivante soit scrupuleusement satisfaite :
$$c_1 X_{1i} + c_2 X_{2i} + dots + c_k X_{ki} = 0$$
Si l’on inclut l’ordonnée à l’origine (ou constante du modèle), notée conventionnellement par un vecteur unitaire $X_0 = (1, 1, dots, 1)^T$, l’équation de dépendance linéaire exacte prend la forme plus générale :
$$c_0 + c_1 X_{1i} + c_2 X_{2i} + dots + c_k X_{ki} = 0$$
Dès lors qu’au moins un coefficient $c_j$ est strictement non nul, la variable correspondante $X_j$ peut être réécrite comme une fonction déterministe parfaite des autres variables explicatives. Par exemple, si $c_1 \neq 0$ :
$$X_{1i} = -\frac{c_0}{c_1} – \sum_{j=2}^k \frac{c_j}{c_1} X_{ji}$$
Cette formulation rend limpide l’impossibilité d’isoler la variance spécifique attribuable à chaque variable. Tout mouvement, toute variation de $X_1$ est par essence parfaitement compensé ou reproduit par la combinaison linéaire des autres variables régulatrices. Il n’existe aucun résidu, aucun degré de liberté résiduel permettant au modèle d’estimer l’effet marginal de $X_1$ de façon isolée.
2.2 Représentation matricielle et espace des colonnes
Pour appréhender l’impact de ce phénomène sur la modélisation, il convient de se tourner vers la formulation matricielle du modèle linéaire général. Considérons la matrice de plan ou matrice d’expérience, notée $\mathbf{X}$, de dimensions $n \times (k + 1)$, où $n$ représente le nombre d’observations et $(k + 1)$ le nombre de paramètres à estimer (incluant la constante unitaire) :
$$\mathbf{X} = \begin{\bmatrix} 1 &a\mp; X_{11} &a\mp; X_{12} &a\mp; dots &a\mp; X_{1k} 1 &a\mp; X_{21} &a\mp; X_{22} &a\mp; dots &a\mp; X_{2k} \vdots &a\mp; \vdots &a\mp; \vdots &a\mp; \ddots &a\mp; \vdots 1 &a\mp; X_{n1} &a\mp; X_{n2} &a\mp; dots &a\mp; X_{nk} \end{\bmatrix}$$
Chaque colonne de la matrice $\mathbf{X}$ correspond à un vecteur dans l’espace euclidien $\mathbb{R}^n$. Le rang d’une matrice, noté $\text{rang}(\mathbf{X})$, correspond au nombre maximal de vecteurs-colonnes linéairement indépendants qu’elle contient. Pour que le modèle de régression classique fonctionne, la matrice $\mathbf{X}$ doit impérativement être de plein rang colonne, ce qui signifie que :
$$\text{rang}(\mathbf{X}) = k + 1 \quad (\text{en supposant } n > k + 1)$$
En présence de multicolinéarité parfaite, les colonnes de $\mathbf{X}$ ne forment plus une famille libre dans $\mathbb{R}^n$. Il existe au moins une colonne qui peut s’exprimer sous forme de somme pondérée des autres. Par conséquent, la matrice souffre d’un rang déficient (rank-deficient matrix), tel que :
$$\text{rang}(\mathbf{X}) < k + 1$$
Sur le plan géométrique, l’espace vectoriel engendré par les colonnes de $\mathbf{X}$, appelé l’espace des colonnes $\text{Col}(\mathbf{X})$, s’effondre dans un sous-espace de dimension strictement inférieure à $(k + 1)$. Au lieu de se déployer dans un hyperplan de dimension complète permettant de projeter orthogonalement le vecteur de la variable dépendante $\mathbf{y}$, l’espace des prédicteurs se retrouve compressé, rendant la projection géométrique indéterminée quant au choix des coordonnées axiales.
2.3 La non-inversibilité de la matrice de dispersion (X’X)
L’estimation des coefficients du vecteur de régression $boldsymbol{\beta}$ par la méthode des moindres carrés ordinaires repose sur la résolution du système des équations normales formulé par Carl Friedrich Gauss et Adrien-Marie Legendre :
$$\mathbf{X}^T \mathbf{X} \hat{boldsymbol{\beta}} = \mathbf{X}^T \mathbf{y}$$
Pour obtenir un vecteur unique d’estimateurs $\hat{boldsymbol{\beta}}$, il est impératif d’isoler $\hat{boldsymbol{\beta}}$ en multipliant chaque membre de l’équation par l’inverse de la matrice carrée symétrique $(\mathbf{X}^T \mathbf{X})$, de dimensions $(k + 1) \times (k + 1)$ :
$$\hat{boldsymbol{\beta}} = (\mathbf{X}^T \mathbf{X})^{-1} \mathbf{X}^T \mathbf{y}$$
Or, d’après les théorèmes fondamentaux de l’algèbre matricielle, le rang du produit matriciel $\mathbf{X}^T \mathbf{X}$ est rigoureusement identique au rang de la matrice originale $\mathbf{X}$ :
$$\text{rang}(\mathbf{X}^T \mathbf{X}) = \text{rang}(\mathbf{X})$$
Dès lors que $\mathbf{X}$ présente un rang déficient en raison d’une multicolinéarité absolue, $\mathbf{X}^T \mathbf{X}$ est une matrice carrée d’ordre $(k + 1)$ dont le rang est strictement inférieur à son ordre. Une telle matrice est dite singulière. Une propriété universelle des matrices singulières est que leur déterminant est rigoureusement nul :
$$det(\mathbf{X}^T \mathbf{X}) = 0$$
Puisque le calcul de l’inverse d’une matrice fait intervenir la division par son déterminant (selon la formule $\mathbf{A}^{-1} = \frac{1}{det(\mathbf{A})} \text{adj}(\mathbf{A})$, où $\text{adj}(\mathbf{A})$ désigne la matrice complémentaire ou adjointe), l’expression $(\mathbf{X}^T \mathbf{X})^{-1}$ nécessite une division par zéro, ce qui est une impossibilité mathématique absolue. L’inverse n’existe tout simplement pas. Les moindres carrés ordinaires se trouvent ainsi dans l’incapacité totale de fournir une solution algébrique unique, bloquant de facto l’exécution des procédures d’optimisation numérique usuelles.
3. 3. Causes structurelles de la multicolinéarité parfaite en recherche psychologique
3.1 Inclusion simultanée des sous-échelles et du score global
L’une des causes structurelles les plus courantes de multicolinéarité parfaite dans les publications et mémoires de recherche en psychologie réside dans l’introduction naïve, au sein d’un même modèle de régression, à la fois d’un score composite global et de l’ensemble de ses sous-dimensions constitutives. De nombreux tests psychologiques standardisés reposent sur une structure hiérarchique où un score global est obtenu par simple addition arithmétique ou pondération fixe des scores obtenus aux différentes sous-échelles.
Considérons par exemple un instrument d’évaluation de l’épuisement professionnel (burnout) articulé autour de trois dimensions : l’épuisement émotionnel ($E$), la dépersonnalisation ou cynisme ($D$), et la perte d’accomplissement personnel ($A$). Le chercheur calcule le score total de burnout ($T$) selon la formule :
$$T_i = E_i + D_i + A_i$$
Si ce chercheur souhaite prédire la performance au travail ou le nombre de jours d’arrêt maladie et introduit simultanément dans son équation de régression $E$, $D$, $A$ et $T$, il crée une dépendance linéaire rigide :
$$T_i – E_i – D_i – A_i = 0$$
Les coefficients de cette combinaison linéaire sont respectivement $c_T = 1$, $c_E = -1$, $c_D = -1$ et $c_A = -1$. Aucun d’entre eux n’est nul. Le modèle hérite d’une contrainte d’égalité parfaite qui élimine un degré de liberté et rend la matrice des prédicteurs irrémédiablement singulière. L’ordinateur ne peut alors distinguer l’effet global de la somme des effets spécifiques.
3.2 Transformations et conversions redondantes
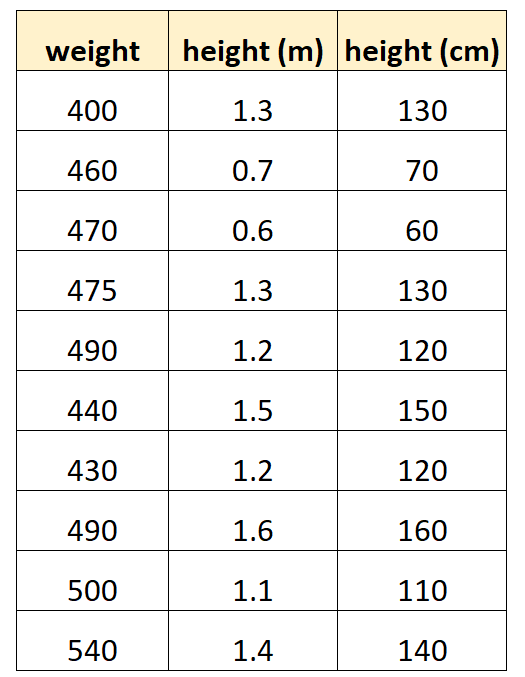
Une autre source fréquente d’erreur réside dans l’utilisation non intentionnelle de variables transformées de manière linéaire et redondante au sein de la même batterie de prédicteurs. Ce phénomène survient notamment lorsque différentes unités de mesure d’un même phénomène physiologique ou comportemental sont conservées par mégarde dans le jeu de données final.
Par exemple, un chercheur en psychopharmacologie ou en chronométrie mentale mesurant le temps de latence cognitive dans une tâche d’inhibition (comme le test de Stroop) peut enregistrer les latences moyennes en millisecondes ($TR_{ms}$), puis créer une nouvelle variable exprimée en secondes ($TR_{s}$) à des fins d’affichage graphique ou de standardisation, définie par :
$$TR_{s} = 0{,}001 \times TR_{ms}$$
S’il inclut par mégarde ces deux variables dans un modèle linéaire explicatif, la relation $1 \cdot TR_{s} – 0{,}001 \cdot TR_{ms} = 0$ s’applique rigoureusement pour chaque participant. De même, l’introduction conjointe d’un score brut et d’un score centré (par la soustraction de la moyenne de l’échantillon, $\bar{X}$), sans autre transformation non linéaire, engendre une relation déterministe parfaite avec le vecteur unitaire de la constante :
$$X_{\text{centré}} = X – \bar{X} implies X_{\text{centré}} – X + \bar{X} \cdot 1 = 0$$
De telles duplications, souvent masquées par des libellés méthodologiques différents lors du nettoyage de bases de données volumineuses, génèrent des singularités matricielles immédiates.
3.3 Données de composition et contraintes de somme constante
Les données dites de composition représentent un cas d’école particulièrement récurrent en psychologie différentielle, en ergonomie et en psychologie du travail. Il s’agit de variables qui décrivent des proportions, des pourcentages ou des allocations de temps dont la somme globale pour chaque individu est nécessairement contrainte à une constante fixe (généralement 1 ou 100 %).
Dans un protocole évaluant la gestion du temps chez des cadres d’entreprise, on peut mesurer les pourcentages de la journée de travail consacrés respectivement aux tâches administratives ($P_1$), aux réunions d’équipe ($P_2$), au travail technique individuel ($P_3$) et aux pauses ($P_4$). Par définition expérimentale, pour chaque sujet :
$$P_1 + P_2 + P_3 + P_4 = 100%$$
Ce problème se manifeste également dans les questionnaires de personnalité à choix forcé ou dits « ipsatifs », où le répondant doit répartir un nombre fixe de points entre différentes propositions décrivant ses préférences comportementales. Si le chercheur insère l’ensemble des composantes ($P_1$ à $P_4$) dans une régression incluant une ordonnée à l’origine (laquelle est représentée par une colonne de 1), la somme arithmétique des quatre colonnes de pourcentages est égale à $100 \times \text{Constante}$. L’indépendance linéaire des colonnes est brisée de manière déterministe.
4. 4. Exemples empiriques concrets en psychométrie et sciences du comportement
4.1 Exemple 1 : Évaluation de l’anxiété et composantes cognitives/somatiques
Pour illustrer ce phénomène avec des données empiriques plausibles, considérons une étude menée en psychologie de l’éducation visant à prédire la réussite à un examen standardisé ($Y$, notée de 0 à 100) auprès d’un échantillon de 200 étudiants universitaires. L’investigateur utilise un questionnaire validé mesurant l’anxiété d’évaluation, qui distingue traditionnellement deux facettes majeures : l’anxiété cognitive ($X_1$, inquiétudes récurrentes, pensées intrusives) et l’anxiété somatique ($X_2$, manifestations physiologiques d’activation autonome, tachycardie, tremblements). Les items sont mesurés sur une échelle de Likert, produisant des scores de 10 à 50 pour chaque sous-dimension.
Soucieux d’évaluer l’impact global autant que les contributions spécifiques, le chercheur crée une variable $X_3$, dénommée « Anxiété Globale », définie très exactement par $X_3 = X_1 + X_2$. Le modèle théorique de régression multiple est spécifié comme suit :
$$Y_i = \beta_0 + \beta_1 X_{1i} + \beta_2 X_{2i} + \beta_3 X_{3i} + \varepsilon_i$$
Examinons ce qui se produit lors de l’estimation. Si le logiciel statistique tente d’estimer les coefficients par minimisation des résidus, il cherche à déterminer l’effet d’une augmentation d’une unité d’anxiété cognitive ($X_1$) tout en maintenant constants l’anxiété somatique ($X_2$) et l’anxiété globale ($X_3$). Or, c’est une impossibilité logique et physique absolue : si l’on augmente $X_1$ d’un point et que l’on maintient $X_2$ rigoureusement fixe, $X_3$ augmente obligatoirement d’un point ! La condition du ceteris paribus est violée par la définition même des variables. Le modèle mathématique ne peut imputer le changement à $\beta_1$ plutôt qu’à $\beta_3$. Les deux paramètres deviennent indéterminés.
4.2 Exemple 2 : Temps de réaction et tâches d’attention soutenue
Un deuxième cas concret émane de la neuropsychologie cognitive. Lors d’un test d’attention soutenue de type Conners (Continuous Performance Test – CPT), un neuropsychologue évalue la vitesse de traitement chez des patients présentant un trouble du déficit de l’attention avec hyperactivité (TDAH). La variable d’intérêt clinique ($Y$) est le nombre d’erreurs d’omission commises au cours de la tâche.
Pour analyser les données, deux assistants de recherche préparent la matrice des données de façon indépendante. Le premier extrait le temps de réaction moyen sous la désignation $TR_{\text{milli}}$, mesuré en millisecondes (par exemple 450 ms, 520 ms). Le second code la même mesure sous la dénomination $TR_{\text{\sec}}$, mesurée en secondes (0,45 s, 0,52 s). Lors de la fusion des bases de données dans un logiciel d’analyse, les deux colonnes sont conservées et intégrées par inadvertance dans le modèle de régression prédisant les omissions :
$$\text{Omissions}_i = \beta_0 + \beta_1 TR_{\text{milli}, i} + \beta_2 TR_{\text{\sec}, i} + \varepsilon_i$$
Le nuage de points tridimensionnel confrontant les deux prédicteurs montre un alignement parfait de l’ensemble des observations sur une droite pure passant par l’origine, obéissant à la fonction $TR_{\text{\sec}} = 0{,}001 \times TR_{\text{milli}}$. La variance conjointe résiduelle orthogonale à cette droite est rigoureusement égale à zéro. La matrice $(\mathbf{X}^T \mathbf{X})$ possède alors une valeur propre nulle, illustrant la colinéarité parfaite dans sa forme la plus nue.
4.3 Exemple 3 : Échelles d’évaluation comportementale bipolaires
Dans le domaine de la psychologie de la santé et des recherches sur le bien-être subjectif, certains protocoles exploitent des échelles bipolaires ou des scores de balance affective. Imaginons un protocole évaluant l’adhésion thérapeutique de patients chroniques à travers une mesure d’équilibre émotionnel mesurée sur une échelle de 0 à 100.
L’expérimentateur utilise une interface numérique où le participant déplace un curseur entre deux pôles : « Détresse psychologique » et « Sérénité psychologique ». Le système enregistre le pourcentage attribué à la Détresse ($X_D$, de 0 à 100) et, par construction de l’algorithme d’enregistrement, calcule le score de Sérénité par complémentarité exacte :
$$X_S = 100 – X_D$$
Voulant tester l’hypothèse selon laquelle la détresse réduit l’observance tandis que la sérénité la favorise, le chercheur injecte simultanément $X_D$ et $X_S$ dans l’analyse de régression :
$$\text{Adhésion}_i = \beta_0 + \beta_D X_{Di} + \beta_S X_{Si} + \varepsilon_i$$
La relation linéaire exacte implique ici la constante : $X_D + X_S – 100 \times 1 = 0$. Le modèle ne possède aucun moyen mathématique d’attribuer un coefficient distinct à la détresse par rapport à la sérénité, car tout effet attribué à $X_D$ peut être parfaitement reproduit, au signe près, par un réajustement conjoint de $X_S$ et de la constante $\beta_0$. L’analyse échoue à discriminer les effets psychologiques opposés de ces deux pôles inséparables.
5. 5. Le piège des variables muettes (Dummy Variable Trap) dans les modèles psychologiques
5.1 Mécanisme de codage des variables catégorielles
L’une des manifestations les plus universelles de multicolinéarité parfaite en statistique appliquée ne découle pas d’une maladresse psychométrique, mais de l’incompréhension des règles de codage des prédicteurs qualitatifs ou catégoriels. C’est ce que l’économétrie et la psychométrie désignent sous l’appellation canonique de piège des variables muettes (en anglais, Dummy Variable Trap).
Considérons une étude clinique contrôlée randomisée comparant l’efficacité de différentes modalités de prise en charge de la dépression majeure. La variable indépendante « Traitement » est polytomique et comporte trois modalités mutuellement exclusives :
- Groupe 1 : Témoin / Liste d’attente ($T_1$)
- Groupe 2 : Thérapie Comportementale et Cognitive ($T_2$)
- Groupe 3 : Thérapie d’Inspiration Analytique ($T_3$)
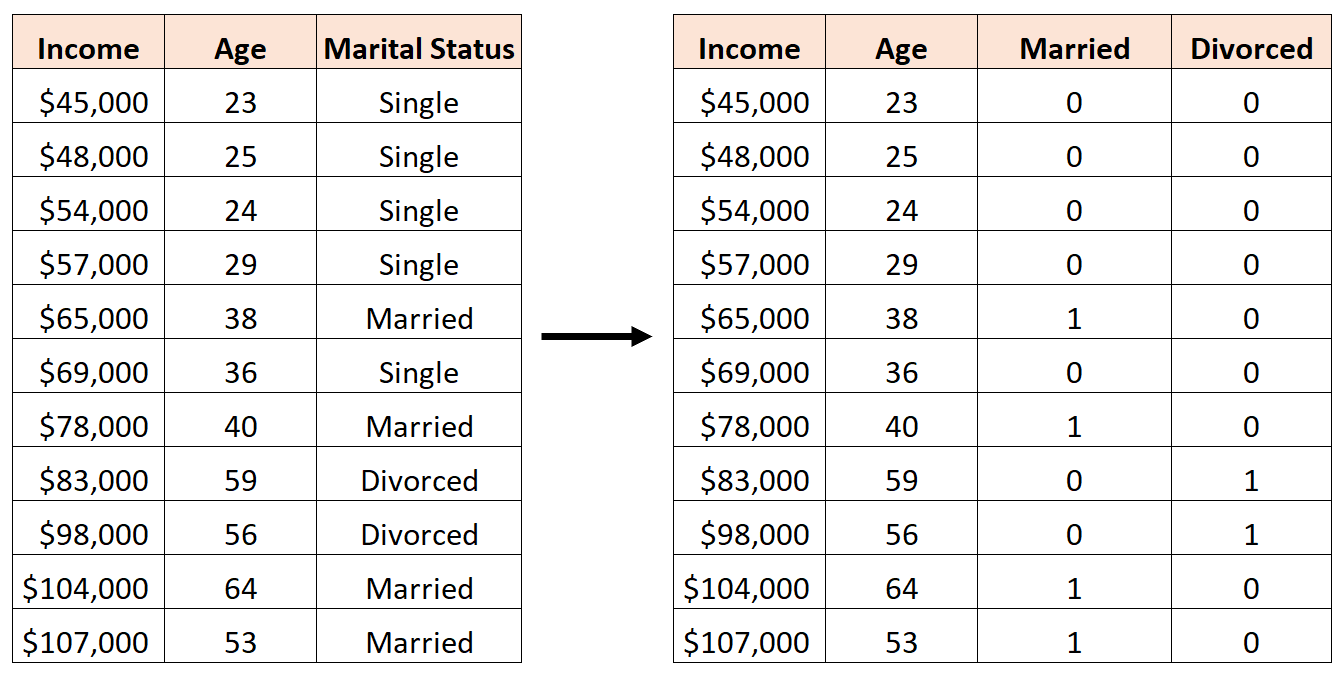
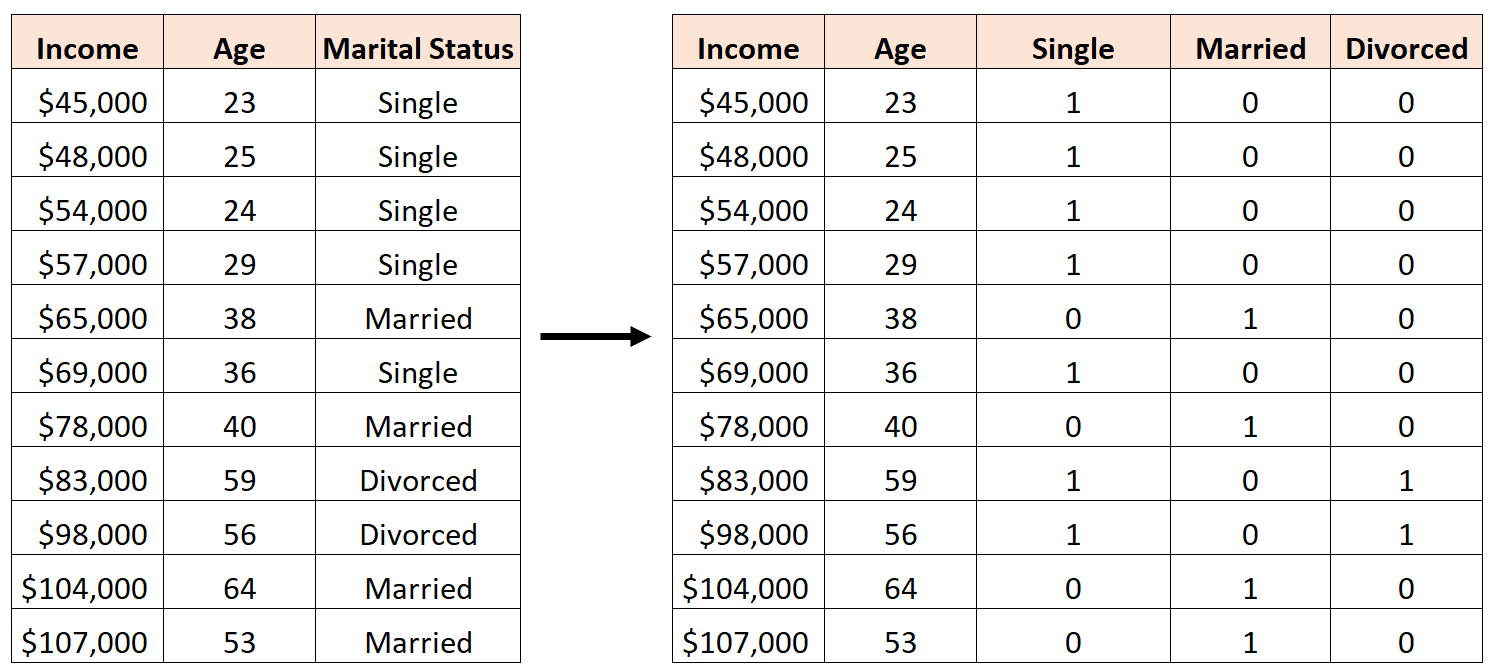
Pour intégrer cette variable nominale dans un modèle de régression linéaire, chaque modalité est généralement convertie en une variable binaire ou indicatrice (dummy variable), prenant la valeur 1 si le sujet appartient au groupe désigné, et 0 sinon. Ainsi, pour chaque individu $i$, on génère trois vecteurs d’indicatrices : $D_{1i}, D_{2i}, D_{3i}$.
Puisque chaque participant n’appartient qu’à un et un seul groupe, la somme de ces trois indicatrices pour n’importe quel individu de l’échantillon vaut nécessairement 1 :
$$D_{1i} + D_{2i} + D_{3i} = 1$$
5.2 Conflit mathématique avec la constante du modèle
L’équation de régression classique intègre par défaut une ordonnée à l’origine $\beta_0$, associée à une colonne de 1 dans la matrice de plan $\mathbf{X}$ (le vecteur unitaire $\mathbf{1}_n$). Si l’on tente d’introduire l’ensemble des $k$ variables muettes (ici $k = 3$) tout en conservant la constante, l’équation s’écrit :
$$Y_i = \beta_0 (1) + \beta_1 D_{1i} + \beta_2 D_{2i} + \beta_3 D_{3i} + \varepsilon_i$$
La somme des prédicteurs catégoriels est vectoriellement indiscernable de la constante :
$$\sum_{j=1}^3 D_{ji} = 1 implies \mathbf{d}_1 + \mathbf{d}_2 + \mathbf{d}_3 = \mathbf{1}_n$$
Ce résultat établit une multicolinéarité parfaite directe entre les colonnes des variables indicatrices et la colonne de l’intercept. La matrice $\mathbf{X}$ souffre instantanément d’un rang déficient d’au moins une dimension. Le logiciel est mathématiquement incapable d’estimer conjointement l’ordonnée à l’origine et les coefficients de l’ensemble des trois groupes, car le modèle tente d’estimer quatre paramètres de position à partir de seulement trois moyennes de groupe observables.
Pour débloquer la matrice, deux solutions mathématiques équivalentes existent :
- L’omission d’une catégorie de référence : On supprime l’une des variables muettes (par exemple le groupe témoin $D_1$). Le modèle estime alors la constante $\beta_0$, qui représente désormais la moyenne du groupe de référence omis, tandis que $\beta_2$ et $\beta_3$ estiment les écarts respectifs des groupes 2 et 3 par rapport à cette référence. C’est la convention par défaut de logiciels comme R, SPSS ou SAS.
- La régression sans constante : On impose $\beta_0 = 0$. Le modèle estime alors directement la moyenne empirique de chaque groupe ($\beta_1 = \bar{Y}_1, \beta_2 = \bar{Y}_2, \beta_3 = \bar{Y}_3$). Cependant, cette option modifie le calcul usuel du coefficient de détermination $R^2$ et complique les comparaisons de modèles hiérarchiques.
5.3 Illustrations dans les devis quasi-expérimentaux
Le piège des variables muettes ne se limite pas aux designs univariés simples. Il resurgit avec une intensité accrue dans les devis quasi-expérimentaux factoriels comportant des mesures répétées ou des facteurs croisés. Considérons une recherche examinant l’évolution de la résilience psychologique avant et après une intervention de gestion du stress, en comparant deux populations (cadres vs ouvriers).
Si le chercheur crée une variable pour chaque condition croisée :
- $D_{11}$ : Cadre – Pré-test
- $D_{12}$ : Cadre – Post-test
- $D_{21}$ : Ouvrier – Pré-test
- $D_{22}$ : Ouvrier – Post-test
et qu’il intègre simultanément ces quatre indicatrices, plus une indicatrice du statut professionnel principal ($Cadre = D_{11} + D_{12}$), le modèle replonge dans une colinéarité déterministe. Dans de nombreuses situations complexes impliquant des contrastes d’interaction non standard, les analystes introduisent des sous-catégories superposées sans percevoir que la matrice d’expérience a dépassé la dimension de son sous-espace de base, provoquant des éjections silencieuses ou arbitraires de prédicteurs par le compilateur statistique.
6. 6. L’impact mathématique sur la méthode des moindres carrés ordinaires (MCO)
6.1 Indétermination fondamentale des coefficients de régression
Pour saisir l’impact dévastateur de la multicolinéarité parfaite, il est éclairant de descendre au niveau de la fonction de perte minimisée par la méthode des moindres carrés ordinaires. L’objectif des MCO est de trouver le vecteur de paramètres $\hat{boldsymbol{\beta}}$ qui minimise la somme des carrés des résidus (notée $SCR$) :
$$SCR(boldsymbol{\beta}) = (\mathbf{y} – \mathbf{X}boldsymbol{\beta})^T (\mathbf{y} – \mathbf{X}boldsymbol{\beta})$$
Dans des conditions de régularité mathématique (où $\mathbf{X}$ est de plein rang), cette fonction quadratique décrit un paraboloïde elliptique possédant un point de minimum global unique. Le gradient s’annule en un seul et unique point de l’espace des paramètres $\mathbb{R}^{k+1}$, garantissant l’unicité de la solution $\hat{boldsymbol{\beta}}$.
En revanche, lorsque la multicolinéarité parfaite frappe la matrice $\mathbf{X}$, la surface de la somme des résidus au carré cesse d’être un bol régulier pour devenir une surface concave ou un « fond de vallée » parfaitement plat dans une ou plusieurs directions de l’hyperplan. Il n’existe plus de point de minimum isolé, mais une infinité continue de vecteurs $\hat{boldsymbol{\beta}}$ produisant rigoureusement la même somme des carrés des résidus minimale, et générant exactement le même vecteur de valeurs ajustées $\hat{\mathbf{y}}$.
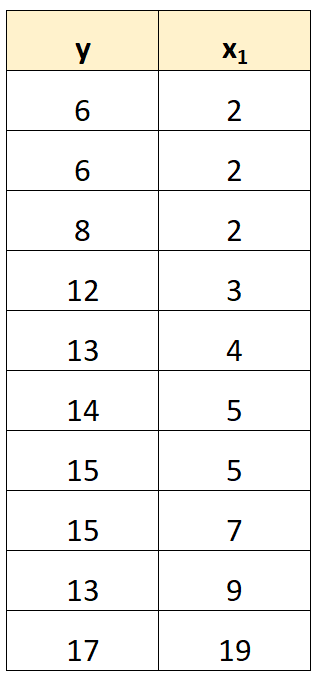
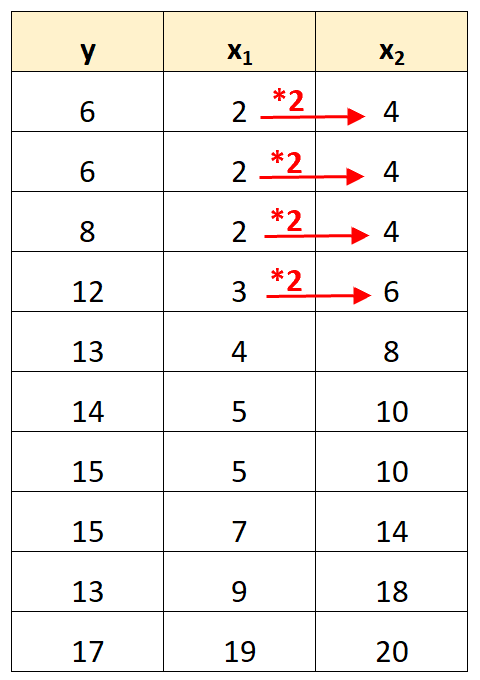
Pour illustrer ce phénomène algébrique de façon élémentaire, reprenons le cas où $X_2 = 2 X_1$. L’équation prédite est $\hat{Y} = \beta_1 X_1 + \beta_2 X_2$. Elle peut s’écrire :
$$\hat{Y} = \beta_1 X_1 + \beta_2 (2 X_1) = (\beta_1 + 2\beta_2) X_1$$
Si la valeur optimale globale permettant de prédire au mieux $\hat{Y}$ est que le coefficient total devant $X_1$ soit égal à 10, alors toute combinaison de paramètres vérifiant $\beta_1 + 2\beta_2 = 10$ produit des résidus absolument identiques. Les solutions $(\beta_1 = 10, \beta_2 = 0)$, $(\beta_1 = 0, \beta_2 = 5)$, $(\beta_1 = -100, \beta_2 = 55)$ ou $(\beta_1 = 1000, \beta_2 = -495)$ constituent toutes des minimiseurs parfaits de la fonction d’erreur. Toute attribution d’une valeur numérique spécifique par un algorithme qui n’échouerait pas devient arbitraire et dénuée de sens physique ou psychologique.
6.2 Échec de l’hypothèse ‘Ceteris Paribus’
L’une des avancées majeures apportées par la régression multiple par rapport aux corrélations bivariées simples réside dans la capacité à évaluer l’effet partiel d’un prédicteur selon la condition logique latine ceteris paribus (« toutes choses étant égales par ailleurs »). Sur le plan mathématique, le coefficient de régression $\beta_j$ représente la dérivée partielle de l’espérance mathématique de la variable critère $Y$ par rapport à la variable régresseur $X_j$ :
$$\beta_j = \frac{\partial \mathbb{E}(Y mid X_1, dots, X_k)}{\partial X_j}$$
Or, la définition même d’une dérivée partielle implique que toutes les autres variables prédictives ($X_m$ pour $m \neq j$) soient traitées comme des constantes pendant que $X_j$ subit une variation infinitésimale. Lorsque la multicolinéarité parfaite prévaut, cette opération différentielle est logiquement impossible. Il n’existe aucun chemin dans le domaine des prédicteurs permettant de faire varier $X_j$ sans modifier simultanément la ou les variables qui lui sont algébriquement asservies.
Par voie de conséquence, l’interprétation des paramètres comme « effets purs », « poids contrôlés » ou « contributions uniques » s’écroule. Les coefficients ne possèdent plus aucune signification causale ou isolable au sein du système théorique. Tenter d’interpréter le coefficient d’une variable parfaitement colinéaire revient à chercher à mesurer la vitesse propre d’un passager sans tenir compte de la trajectoire du train qui le transporte solidairement.
6.3 Comportement des erreurs types et de la variance de l’échantillonnage
L’estimation des coefficients de régression n’a de valeur scientifique que si elle est adossée à une mesure de son incertitude d’échantillonnage. La matrice de variance-covariance des coefficients estimés $\hat{boldsymbol{\beta}}$ s’exprime dans le cadre des moindres carrés par l’équation :
$$\text{Var}(\hat{boldsymbol{\beta}}) = \sigma^2 (\mathbf{X}^T \mathbf{X})^{-1}$$
où $\sigma^2$ représente la variance des erreurs résiduelles du modèle. Pour chaque coefficient individuel $\hat{\beta}_j$, sa variance d’échantillonnage peut être formulée de façon explicite au moyen du facteur d’inflation de la variance ($VIF_j$) et du coefficient de détermination multiple $R_j^2$ issu de la régression de la variable $X_j$ sur tous les autres prédicteurs :
$$\text{Var}(\hat{\beta}_j) = \frac{\sigma^2}{(n – 1) S_{X_j}^2} \times \frac{1}{1 – R_j^2}$$
où $S_{X_j}^2$ est la variance empirique de la variable $X_j$. En présence de multicolinéarité parfaite, la variable $X_j$ est prédite de manière absolue par les autres régresseurs, ce qui signifie que :
$$R_j^2 = 1{,}00$$
En substituant cette valeur dans la formule analytique de la variance, le dénominateur s’annule :
$$\text{Var}(\hat{\beta}_j) = \frac{\sigma^2}{(n – 1) S_{X_j}^2 (1 – 1)} = \frac{\sigma^2}{0} long\rightarrow \infty$$
La variance d’échantillonnage et, par extension, l’erreur type (la racine carrée de la variance) explosent vers l’infini mathématique. Une erreur type infinie signifie une absence absolue de précision dans l’estimation : l’intervalle de confiance associé au paramètre s’étend de moins l’infini à plus l’infini ($]-\infty, +\infty[$). Le célèbre théorème de Gauss-Markov, qui stipule que les estimateurs MCO sont les meilleurs estimateurs linéaires sans biais (propriété BLUE : Best Linear Unbiased Estimator), cesse totalement de s’appliquer puisque la variance minimale accessible n’est plus finie.
7. 7. Conséquences statistiques et interprétatives pour le chercheur
7.1 Paralysie des tests d’hypothèse inférentiels
L’explosion des erreurs types vers l’infini a pour corollaire la neutralisation complète des tests d’hypothèse inférentiels classiques appliqués aux paramètres individuels. Le test de conformité à zéro d’un paramètre repose sur la statistique $t$ de Student empirique :
$$t_{\text{stat}} = \frac{\hat{\beta}_j – 0}{\text{SE}(\hat{\beta}_j)}$$
où $\text{SE}(\hat{\beta}_j)$ désigne l’erreur type du coefficient. Puisque $\text{SE}(\hat{\beta}_j) to \infty$, la statistique $t$ prend formellement une valeur de division par l’infini ou produit des formes indéterminées de type $\frac{\text{indéterminé}}{\infty}$ ou $\frac{0}{0}$. Les logiciels statistiques sont alors incapables de dériver une $p$-value valide, remplaçant ces valeurs par des codes d’erreur du type « NaN » (Not a Number), des points d’interrogation ou des espaces vides dans les tableaux de sortie.
De surcroît, le test de significativité globale du modèle (le test $F$ de Fisher-Snedecor), qui évalue si l’ensemble des prédicteurs explique une part significative de variance par rapport à un modèle restreint à la seule constante, est également affecté. Bien que l’espace vectoriel engendré par les prédicteurs possède une variance globale projetable, la détermination des degrés de liberté du modèle est perturbée. Au lieu de reposer sur $k$ degrés de liberté, le numérateur doit être ajusté au rang effectif de la matrice. Tout test $F$ calculé sans correction de rang produit une dévaluation statistique erronée.
7.2 Comportement des logiciels statistiques majeurs
Face à une matrice de plan singulière induite par une multicolinéarité parfaite, les différents environnements logiciels de traitement de données adoptent des stratégies de gestion d’erreur variées, qu’il est indispensable de savoir reconnaître.
L’environnement R : Lors de l’utilisation de la fonction générique lm(), R s’appuie sur une décomposition QR de la matrice d’expérience par pivotement. Lorsqu’il détecte une singularité numérique (un pivot inférieur au seuil de tolérance machine, généralement $10^{-7}$), R supprime automatiquement la variable redondante problématique. Il renvoie pour cette variable la valeur NA pour le coefficient, l’erreur type et la significativité, en signalant dans le résumé du modèle : « Coefficients: (1 not defined because of singularities) ». La fonction alias() permet d’inspecter explicitement les relations linéaires de dépendance qui ont causé l’exclusion.
SPSS (IBM SPSS Statistics) : Dans sa procédure de régression linéaire, SPSS évalue la tolérance avant d’inverser la matrice. Si la tolérance d’une variable tombe à 0,000, le logiciel éjecte unilatéralement le prédicteur du modèle final. Il relègue la variable dans un tableau annexe intitulé « Variables exclues » (Excluded Variables), assortie d’une note de bas de page indiquant une tolérance nulle, souvent sans alerter bruyamment l’analyste distrait par un message d’erreur bloquant.
Python (Statsmodels et Scikit-Learn) : Sous la bibliothèque Statsmodels (avec OLS), une matrice singulière lève généralement un avertissement sévère ou une erreur d’inversion matricielle (LinAlgError: Singular matrix). Si la méthode de résolution exploite la pseudo-inverse de Moore-Penrose, le code s’exécute mais renvoie des erreurs types gigantesques (ex. $10^{15}$) dénuées de pertinence. À l’inverse, Scikit-Learn (module LinearRegression), conçu pour la prédiction brute et non l’inférence, calcule une solution par décomposition en valeurs singulières (SVD) sans émettre d’erreur, renvoyant un vecteur de coefficients parmi l’infinité de solutions possibles, ce qui constitue un piège redoutable pour un chercheur croyant interpréter des paramètres optimaux uniques.
7.3 Risques de mauvaises interprétations substantielles
Les comportements logiciels automatiques masquent des pièges conceptuels majeurs. Le risque le plus sérieux pour le psychologue non averti consiste à imputer une signification substantive à l’exclusion d’une variable par l’algorithme. Si SPSS ou R éjecte la sous-échelle « Anxiété Somatique », le chercheur non familier de ces mécanismes pourrait être tenté d’écrire : « L’anxiété somatique n’exerce aucune influence prédictive sur la réussite académique », alors que cette variable a simplement été victime de la redondance parfaite avec le score global inclus par erreur.
Ce phénomène altère considérablement la reproductibilité de la recherche scientifique. D’un logiciel à l’autre, ou selon l’ordre strict de saisie des colonnes dans le jeu de données, la variable exclue ne sera pas la même : le programme éliminera invariablement la dernière colonne qui enfreint l’indépendance linéaire. Deux chercheurs travaillant sur le même échantillon avec les mêmes variables, mais ayant interverti l’ordre des colonnes, arriveront à des conclusions diamétralement opposées sur la variable « dépourvue d’effet », alimentant ainsi les biais de publication et des controverses théoriques parfaitement stériles.
8. 8. Multicolinéarité parfaite versus multicolinéarité imparfaite : distinctions clés
8.1 Nature de la relation : déterministe contre stochastique
Il est impératif d’opérer une ligne de démarcation nette entre la multicolinéarité parfaite et la multicolinéarité imparfaite (ou quasi-colinéarité), car leurs implications théoriques et pratiques divergent fondamentalement. Cette distinction repose sur la nature mathématique de la relation unissant les régresseurs :
La colinéarité imparfaite est de nature stochastique. Elle se produit lorsque des variables sont fortement corrélées sur le plan empirique au sein d’un échantillon, mais sans identité algébrique stricte :
$$X_{1i} = \alpha_0 + \alpha_1 X_{2i} + \nu_i$$
où $\nu_i$ est un terme de résidu aléatoire non nul. Dans cette configuration, le coefficient de corrélation de Pearson peut atteindre des valeurs impressionnantes comme $r = 0{,}85$, $r = 0{,}95$ ou même $r = 0{,}99$, mais tant que $\text{Var}(\nu) > 0$, l’association n’est pas déterministe. Chaque variable conserve une frange infinitésimale de variance unique non partagée.
À l’opposé, la colinéarité parfaite est déterministe ($\nu_i = 0$ pour tout $i$). Le coefficient de corrélation multiple $R_j$ atteint rigoureusement 1,000. Il ne s’agit plus d’un échantillon partageant beaucoup de covariance, mais d’une tautologie logique ou d’une équivalence mathématique structurelle.
8.2 Différences de solubilité algorithmique
Sur le plan computationnel, la distinction change la nature même du problème :
En présence de colinéarité imparfaite, la matrice $(\mathbf{X}^T \mathbf{X})$ est mal conditionnée (ill-conditioned), mais elle demeure strictement régulière. Son déterminant est très petit ($det \approx 0$), mais strictement supérieur à zéro. L’inverse $(\mathbf{X}^T \mathbf{X})^{-1}$ existe mathématiquement et peut être calculé par les algorithmes standard. Les moindres carrés ordinaires conservent une solution unique. Cependant, le modèle souffre d’imprécision : les erreurs types des estimateurs sont fortement gonflées, les intervalles de confiance s’élargissent, et la stabilité numérique devient extrêmement sensible aux micro-variations de l’échantillon. C’est un problème de précision statistique, souvent qualifié par Arthur Goldberger de « micronumérisité » (manque d’information matricielle propre, comparable au problème d’un échantillon de trop petite taille).
En présence de colinéarité parfaite, le problème n’est pas une question d’imprécision statistique, mais d’impossibilité logique absolue. L’inverse n’existe pas. L’algorithme des MCO s’interrompt net en raison d’une singularité stricte. Il ne s’agit pas d’un manque de données empiriques, mais d’une mauvaise formulation du modèle par l’expérimentateur.
8.3 Matrice comparative des caractéristiques fondamentales
Pour clarifier ces divergences de manière synthétique, examinons les critères structurels qui opposent ces deux régimes statistiques :
| Critère d’évaluation | Multicolinéarité Imparfaite | Multicolinéarité Parfaite |
|---|---|---|
| Nature du lien | Stochastique (empirique avec résidu $\nu \neq 0$) | Déterministe (algébrique stricte $\nu = 0$) |
| Corrélation ($R^2_j$) | Élevée mais strictement inférieure à 1 ($R^2_j < 1{,}0$) | Rigoureusement égale à 1 ($R^2_j = 1{,}000$) |
| Rang de $\mathbf{X}$ | Plein rang : $\text{rang}(\mathbf{X}) = k + 1$ | Déficient : $\text{rang}(\mathbf{X}) < k + 1$ |
| Déterminant $det(\mathbf{X}^T\mathbf{X})$ | Strictement positif mais très proche de 0 | Rigoureusement égal à zéro ($det = 0$) |
| Inversibilité de $(\mathbf{X}^T\mathbf{X})$ | Inversible (instable numériquement) | Non inversible (matrice singulière) |
| Unicité des coefficients MCO | Solution unique garantie | Infinité de solutions possibles (indéterminées) |
| Erreurs types des coefficients | Gonflées (grandes variances d’échantillonnage) | Infinies théoriquement ($\text{SE} to \infty$) |
| Sensibilité à la taille d’échantillon | Atténuée par l’augmentation de $N$ | Invariable : persiste quel que soit $N$ (même infini) |
L’observation du dernier critère est capitale : alors que l’augmentation de la taille de l’échantillon ($N$) constitue l’un des remèdes les plus efficaces pour compenser une multicolinéarité imparfaite (en fournissant davantage de points pour dissocier les effets conjoints), elle est totalement inopérante face à une colinéarité parfaite. Une relation algébrique exacte reliant deux variables persiste que l’on observe 30 participants ou 30 millions d’individus.
9. 9. Méthodes de diagnostic et d’identification de la multicolinéarité parfaite
9.1 Examen de la matrice de corrélation bivariée et du déterminant
L’identification de la multicolinéarité parfaite commence par des analyses exploratoires simples. Lorsque la colinéarité implique seulement deux variables, l’examen de la matrice de corrélation de Pearson bivariée constitue l’outil de détection le plus immédiat. La présence d’un coefficient strictement égal à l’unité en valeur absolue :
$$|r_{X_j, X_m}| = 1{,}000$$
signale sans ambiguïté une dépendance fonctionnelle parfaite entre les variables $X_j$ et $X_m$.
Toutefois, la corrélation bivariée est aveugle aux colinéarités multivariées complexes, c’est-à-dire aux situations où une variable dépend de la combinaison linéaire de trois prédicteurs ou plus (comme dans l’exemple du score total égal à la somme de trois sous-échelles). Dans ce cas, chaque coefficient de corrélation bivarié pris isolément peut être modéré (par exemple $r \approx 0{,}50$ ou $0{,}60$), masquant totalement la colinéarité structurelle sous-jacente.
Pour dépasser cette limite, il convient d’examiner le déterminant de la matrice de corrélation des variables indépendantes, notée $\mathbf{R}$. Le déterminant d’une matrice de corrélation est compris entre 0 et 1 :
- Si tous les prédicteurs sont parfaitement orthogonaux, $\mathbf{R}$ est la matrice identité et $det(\mathbf{R}) = 1$.
- Si au moins une relation linéaire parfaite lie les prédicteurs, $det(\mathbf{R}) = 0$.
Un déterminant tombant sous la limite de précision numérique de la machine ($< 10^{-15}$) est le témoin formel d'une singularité matricielle imminente.
9.2 Facteur d’inflation de la variance (VIF) et tolérance
Parmi les indicateurs diagnostiques les plus fréquemment exploités dans les études quantitatives figurent la tolérance et son inverse, le facteur d’inflation de la variance (Variance Inflation Factor – VIF). Pour un prédicteur $X_j$ donné, ces indices reposent sur l’ajustement d’une régression auxiliaire où $X_j$ est régressé sur l’ensemble des $(k – 1)$ autres variables explicatives du modèle :
$$\text{Tolérance}_j = 1 – R_j^2$$
$$\text{VIF}_j = \frac{1}{\text{Tolérance}_j} = \frac{1}{1 – R_j^2}$$
La tolérance mesure la proportion de la variance de $X_j$ qui n’est pas expliquée par les autres régresseurs. En présence de multicolinéarité parfaite, les autres prédicteurs expliquent 100 % de la variance de $X_j$ ($R_j^2 = 1$). Les indicateurs prennent dès lors les valeurs théoriques limites suivantes :
$$\text{Tolérance}_j = 1 – 1 = 0{,}000$$
$$\text{VIF}_j = \frac{1}{0} long\rightarrow \infty$$
Dans les guides pratiques de recherche, un VIF supérieur à 5 ou 10 est couramment considéré comme le marqueur d’une multicolinéarité imparfaite sévère nécessitant des précautions méthodologiques. En revanche, un VIF infini ou une tolérance affichée à zéro signale une multicolinéarité parfaite stricte. Les progiciels réagissent soit en refusant de calculer le VIF pour les variables concernées, soit en renvoyant une alerte indiquant que la tolérance est inférieure au seuil critique de calculabilité.
9.3 Décomposition des valeurs propres et analyse de conditionnement
La méthode de diagnostic la plus puissante, la plus rigoureuse et la plus élégante repose sur l’analyse spectrale de la matrice d’expérience standardisée et centrée, conceptualisée par David Belsley, Edwin Kuh et Roy Welsch dans leur ouvrage de référence Regression Diagnostics (1980). Cette approche utilise les valeurs propres (eigenvalues) de la matrice $\mathbf{X}^T \mathbf{X}$.
Soient $\lambda_1 ge \lambda_2 ge dots ge \lambda_{k+1} ge 0$ les valeurs propres ordonnées de la matrice. L’indice de conditionnement maximal, ou nombre de condition (Condition Number, noté $kappa$), est défini par la racine carrée du rapport entre la plus grande et la plus petite valeur propre :
$$\kappa = \sqrt{\frac{\lambda_{\max}}{\lambda_{\min}}} = \sqrt{\frac{\lambda_1}{\lambda_{k+1}}}$$
En présence d’une multicolinéarité parfaite :
- Au moins une valeur propre de la matrice est strictement nulle : $\lambda_{\min} = \lambda_{k+1} = 0$.
- Le nombre de condition tend immédiatement vers l’infini : $\kappa to \infty$.
Belsley et ses collaborateurs ont établi que des indices de condition supérieurs à 30 indiquent une colinéarité empirique préoccupante. Un indice infini constitue la preuve irréfutable de la déficience de rang. De plus, la table de décomposition des proportions de variance associée permet d’identifier précisément quelles variables sont associées à la valeur propre nulle, révélant ainsi les composantes exactes de la combinaison linéaire fautive sans qu’il soit nécessaire de procéder par tâtonnements.
10. 10. Stratégies de résolution et correction méthodologique
10.1 Élimination raisonnée des prédicteurs redondants
Contrairement aux dilemmes posés par la multicolinéarité imparfaite — qui requièrent souvent des compromis délicats entre biais et variance —, la résolution de la multicolinéarité parfaite est conceptuellement limpide : il est obligatoire de modifier la spécification du modèle pour rétablir le plein rang matriciel. L’approche la plus directe consiste en l’élimination raisonnée de la ou des variables redondantes.
Cette élimination ne doit pas être abandonnée aux automatismes des logiciels statistiques (qui procèdent selon des règles purement positionnelles dans la base de données), mais guidée par le cadre théorique du chercheur :
- Choix entre composantes et globalité : Si la question de recherche porte sur l’impact multidimensionnel d’un phénomène (par exemple, déterminer si c’est l’anxiété cognitive ou l’anxiété somatique qui prédit l’échec), il convient de conserver les sous-échelles et de supprimer le score total. Inversement, si le modèle théorique postule que seul le niveau général d’activation importe, on conservera le score total en supprimant les sous-échelles.
- Restauration immédiate du plein rang : La suppression d’une seule variable au sein d’une relation colinéaire exacte suffit mathématiquement à briser la dépendance. Dès que la colonne tautologique est ôtée, la matrice $\mathbf{X}^T \mathbf{X}$ redevient strictement régulière ($det > 0$), et le système des moindres carrés recouvre une solution unique et parfaitement stable.
10.2 Reformulation du modèle et paramétrisation alternative
Lorsque le chercheur souhaite légitimement évaluer à la fois l’effet des composantes et celui d’un déséquilibre relatif, une simple reformulation algébrique permet de contourner la singularité tout en testant l’hypothèse sous-jacente sous une forme orthogonale.
Considérons l’exemple de deux processus cognitifs complémentaires dont la somme est constante ($X_1 + X_2 = C$). Au lieu d’intégrer $X_1$ et $X_2$, on peut paramétrer le modèle à l’aide d’un score de différence ou de contraste :
$$\Delta X = X_1 – X_2$$
Le modèle devient alors : $Y_i = \beta_0 + \beta_{\Delta} (X_{1i} – X_{2i}) + \varepsilon_i$. Cette reformulation élimine la colinéarité parfaite tout en capturant précisément l’effet de dominance d’un processus sur l’autre.
De même, dans les designs catégoriels, l’adoption d’un système de codage des effets (sum-to-zero contrasts) ou le recours à une modélisation hiérarchique séquentielle (Tester d’abord le bloc des composantes au Pas 1, puis évaluer si un score d’interaction non linéaire apporte un incrément au Pas 2) permet de préserver la validité de l’inférence sans violer les hypothèses matricielles fondamentales.
10.3 Approches avancées : Régularisation et modélisation en variables latentes
Dans des contextes d’analyse exploratoire complexe, de génomique comportementale ou de neuro-imagerie computationnelle (où le nombre de prédicteurs $p$ dépasse largement le nombre de sujets $n$, induisant mécaniquement une multicolinéarité parfaite structurelle), des méthodologies mathématiques avancées permettent de surmonter la non-inversibilité.
La régression Ridge (pénalisation L2) : Introduite par Hoerl et Kennard (1970), la régression Ridge modifie directement la matrice singulière avant inversion en y ajoutant une constante positive $lambda$ sur sa diagonale principale :
$$\hat{boldsymbol{\beta}}_{\text{Ridge}} = (\mathbf{X}^T \mathbf{X} + \lambda \mathbf{I}_{k+1})^{-1} \mathbf{X}^T \mathbf{y} \quad (\lambda > 0)$$
L’ajout de $\lambda \mathbf{I}$ garantit mathématiquement que toutes les valeurs propres deviennent strictement positives, ce qui rend la matrice immédiatement inversible même en présence d’une colinéarité parfaite. Bien que les estimateurs ainsi produits soient légèrement biaisés, leur variance est drastiquement réduite, stabilisant ainsi la prédiction.
L’Analyse en Composantes Principales (ACP) et la régression sur composantes principales (PCR) : Cette stratégie consiste à projeter l’ensemble des prédicteurs redondants sur un ensemble restreint de vecteurs orthogonaux non corrélés (les composantes principales), éliminant par définition toute colinéarité avant d’ajuster le modèle linéaire.
La Modélisation par Équations Structurelles (SEM) : En psychométrie, l’approche reine consiste à abandonner les modèles de régression sur variables observées manifestes au profit de modèles en variables latentes. Au lieu d’additionner des items pour créer des scores composites générateurs de colinéarité, les items sont modélisés comme des indicateurs imparfaits reflétant des facteurs latents continus, permettant de dissocier formellement la variance commune, la variance spécifique et l’erreur de mesure aléatoire.
11. 11. Implications pour la validité des tests psychométriques et des échelles
11.1 Menace sur la validité discriminante
L’existence ou la proximité immédiate d’une multicolinéarité parfaite entre des échelles psychométriques pose une menace épistémologique frontale contre la validité discriminante des instruments de mesure. La validité discriminante, telle que définie dans le cadre classique de la matrice multi-traits multi-méthodes de Campbell et Fiske (1959), exige qu’un instrument mesurant un construit théorique spécifique ne soit pas redondant avec des mesures évaluant d’autres construits censés être distincts.
Lorsqu’un chercheur conçoit un nouvel instrument évaluant par exemple la « fatigue cognitive au travail » et constate que cette nouvelle échelle corrèle à $r = 0{,}98$ avec une échelle existante d’« épuisement professionnel général », la quasi-colinéarité observée signale que les deux instruments mesurent en réalité la même entité psychologique. Selon le critère classique de Fornell et Larcker (1981), la variance partagée entre deux construits ne doit jamais excéder la variance moyenne extraite (AVE) de chacun d’eux. La colinéarité parfaite représente la violation ultime de ce principe : elle matérialise une tautologie où l’on a simplement rebaptisé un ancien construit sous un néologisme scientifique, sans apporter la moindre contribution empirique nouvelle.
Ce problème alimente également une inflation artificielle des indices de cohérence interne. Un coefficient alpha de Cronbach ou un oméga de McDonald anormalement élevé (ex. $\alpha > 0{,}96$) au sein d’une échelle courte n’est souvent pas le signe d’une fiabilité remarquable, mais le symptôme de la présence d’items quasi-identiques formulés sous de légères variations paraphrastiques, induisant une colinéarité latente pathologique.
11.2 Défis dans les modèles factoriels confirmatoires (CFA)
Dans le domaine de l’analyse factorielle confirmatoire (CFA) et des modèles structurels, la présence de multicolinéarité parfaite entre les indicateurs manifestes ou entre les variables latentes engendre des blocages mathématiques sévères lors de l’estimation par le maximum de vraisemblance.
L’estimation des paramètres en CFA repose sur la minimisation d’une fonction d’écart (la fonction de perte $F_{\text{ML}}$) comparant la matrice de covariance empirique de l’échantillon ($\mathbf{S}$) à la matrice de covariance théorique implicite générée par le modèle ($boldsymbol{\Sigma}(boldsymbol{\theta})$) :
$$F_{\text{ML}} = ln|boldsymbol{\Sigma}(boldsymbol{\theta})| + \text{tr}(\mathbf{S}boldsymbol{\Sigma}(boldsymbol{\theta})^{-1}) – ln|\mathbf{S}| – p$$
Si des variables observées présentent une colinéarité parfaite, la matrice $\mathbf{S}$ est singulière ($det(\mathbf{S}) = 0$). Le terme $ln|\mathbf{S}|$ tend vers $-\infty$, rendant la fonction de perte impossible à évaluer. De même, si deux facteurs latents présentent une corrélation structurelle fixée ou estimée à 1,00, la matrice implicite $boldsymbol{\Sigma}(boldsymbol{\theta})$ cesse d’être définie positive (Non-Positive Definite Matrix).
Ces anomalies se traduisent dans les logiciels de SEM (tels que Mplus, lavaan en R, ou AMOS) par l’apparition de « cas de Heywood » (Heywood cases), caractérisés par des estimations aberrantes de variances résiduelles négatives, des corrélations standardisées supérieures à 1, ou par un refus d’inversion de la matrice d’information de Fisher, empêchant le calcul des erreurs types des saturations factorielles.
11.3 Réfutation du faux postulat d’incrément prédictif
L’évaluation de la validité incrémentielle est une étape décisive pour justifier l’utilité clinique ou organisationnelle d’un nouvel outil diagnostique. Un nouveau test de personnalité ou d’évaluation neuropsychologique doit démontrer qu’il améliore la prédiction d’un critère clinique ou comportemental par rapport aux tests déjà établis et validés.
Or, la multicolinéarité parfaite détruit par définition toute possibilité de démontrer une validité incrémentielle. Si un nouveau test d’aptitude cognitive ($X_{\text{nouveau}}$) est une transformation quasi-linéaire d’un sous-test de l’échelle d’intelligence de Wechsler ($X_{\text{WAIS}}$), son introduction dans un modèle hiérarchique au Pas 2 ne produira aucun changement significatif du coefficient de détermination :
$$\Delta R^2 = R^2_{\text{modèle 2}} – R^2_{\text{modèle 1}} = 0$$
Le chercheur ou le praticien qui ignore l’existence de cette colinéarité structurelle pourrait conclure à tort que le nouveau test est inefficace pour prédire le critère, alors qu’en vérité, sa capacité prédictive intrinsèque est réelle mais totalement masquée par l’isomorphisme mathématique avec l’outil de référence déjà présent dans le modèle. Dans les contextes de sélection du personnel ou de diagnostic neuropsychologique, cela peut conduire à des décisions erronées ou à des redondances budgétaires coûteuses en administrant deux tests redondants là où un seul serait suffisant.
12. 12. Bonnes pratiques de modélisation et recommandations pour la recherche empirique
12.1 Protocoles de nettoyage et de contrôle pré-analytique
Pour prévenir l’apparition de singularités matricielles avant même d’ajuster le moindre modèle de régression, il est essentiel d’intégrer des protocoles stricts de contrôle pré-analytique au sein des flux de travail des chercheurs en psychologie. Ces étapes doivent être documentées dans les plans de gestion des données :
1. Vérification systématique de l’algèbre de construction : Le statisticien doit vérifier minutieusement la syntaxe ayant servi à calculer les variables composites. Une règle fondamentale est de ne jamais inclure dans une même matrice de prédicteurs une variable dont la définition résulte d’une commande d’addition arithmétique ou de calcul direct impliquant les autres colonnes sélectionnées.
2. Inspection automatisée de la matrice de corrélation : Avant toute modélisation, le calcul du déterminant de la matrice des prédicteurs doit être programmé. Si le déterminant est inférieur à $10^{-8}$, un script d’alerte doit interrompre l’exécution et dresser la liste des variables présentant des corrélations bivariées supérieures à 0,95 ou des combinaisons linéaires suspectes.
3. Évaluation du rang numérique : Sous R ou Python, l’utilisation systématique de la fonction évaluant le rang matriciel (par exemple qr(X)$rank sous R, ou np.linalg.matrix_rank(X) avec NumPy) confronté au nombre théorique de colonnes permet d’identifier instantanément toute déficience de rang avant de lancer des procédures d’optimisation complexes.
12.2 Transparence et reproductibilité méthodologique
Conformément aux exigences de la science ouverte et aux directives des organismes internationaux tels que l’American Psychological Association (normes JARS : Journal Article Reporting Standards), la gestion des variables et des exclusions matricielles doit faire l’objet d’une transparence irréprochable dans les manuscrits scientifiques :
Si un logiciel statistique exclut silencieusement une variable muette ou un prédicteur colinéaire, le chercheur a la responsabilité impérieuse de ne pas occulter cette omission dans la section des résultats. Trop d’articles omettent de mentionner qu’une variable a été disqualifiée par le compilateur, laissant le lecteur supposer que la variable n’était pas significative au sens biologique ou psychologique.
Le partage public des scripts d’analyse reproductibles (sur des dépôts certifiés comme l’Open Science Framework – OSF ou GitHub) constitue le rempart le plus efficace contre ces biais. La documentation explicite du schéma de codage des variables catégorielles (choix de la modalité de référence pour les contrastes de dummy coding) et des transformations linéaires appliquées garantit que les pairs peuvent répliquer scrupuleusement les résultats sans achopper sur des matrices singulières masquées.
12.3 Check-list pratique à l’usage des chercheurs en psychologie
Pour accompagner les psychologues et analystes quantitatifs dans leur pratique quotidienne, le protocole décisionnel suivant résume la marche à suivre face au risque de multicolinéarité parfaite :
- Phase de conception du modèle : Ai-je inclus à la fois un score total et ses sous-facettes constitutives ? Si oui, faites un choix théorique préalable et n’en conservez qu’un seul type.
- Phase de codage des variables catégorielles : Pour une variable qualitative à $k$ modalités, ai-je bien généré $(k – 1)$ variables indicatrices en réservant explicitement une modalité de référence ? Si le modèle inclut une constante $\beta_0$, l’inclusion de $k$ indicatrices mènera systématiquement au blocage matriciel.
- Phase de diagnostic préliminaire : Le déterminant de la matrice des prédicteurs est-il strictement supérieur à zéro ? Les facteurs d’inflation de la variance (VIF) sont-ils tous finis ? Une valeur propre est-elle égale à zéro ?
- Phase d’interprétation des sorties logicielles : Le résumé de mon modèle contient-il des mentions « NA », « Excluded », « Singularity » ou des erreurs types gigantesques ? Si c’est le cas, ne tentez pas d’interpréter les $p$-values : identifiez immédiatement la variable redondante éjectée par le système.
- Phase de validation clinique/théorique : La séparation mathématique des prédicteurs correspond-elle à une distinction fonctionnelle réelle ? Assurez-vous que l’indépendance statistique recoupe une plausibilité psychologique substantielle.
En observant ces principes fondamentaux avec rigueur, le chercheur s’assure que ses modèles statistiques reposent sur des bases mathématiques solides, garantissant ainsi que les inférences tirées de ses données contribuent fidèlement et durablement à l’avancement des connaissances en psychologie et en sciences du comportement.
Références
- Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. John Wiley & Sons. https://doi.org/10.1002/0471725153
- Campbell, D. T., & Fiske, D. W. (1959). Convergent and discriminant validation by the multitrait-multimethod matrix. Psychological Bulletin, 56(2), 81–105. https://doi.org/10.1037/h0046016
- Farrar, D. E., & Glauber, R. R. (1967). Multicollinearity in regression analysis: The problem revisited. The Review of Economics and Statistics, 49(1), 92–107. https://doi.org/10.2307/1937887
- Fornell, C., & Larcker, D. F. (1981). Evaluating structural equation models with unobservable variables and measurement error. Journal of Marketing Research, 18(1), 39–50. https://doi.org/10.1177/002224378101800104
- Frisch, R. (1934). Statistical confluence analysis by means of complete regression systems. Universitetets Økonomiske Institutt, Publication No. 5.
- Goldberger, A. S. (1991). A course in econometrics. Harvard University Press.
- Greene, W. H. (2018). Econometric analysis (8th ed.). Pearson.
- Hoerl, A. E., & Kennard, R. W. (1970). Ridge regression: Biased estimation for nonorthogonal problems. Technometrics, 12(1), 55–67. https://doi.org/10.1080/00401706.1970.10488634
- Kline, R. B. (2016). Principles and practice of structural equation modeling (4th ed.). Guilford Press.
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Wooldridge, J. M. (2020). Introductory econometrics: A modern approach (7th ed.). Cengage Learning.