
Dans le champ de la modélisation statistique contemporaine et de l’apprentissage automatique appliqué aux sciences du comportement, l’évaluation de la performance prédictive constitue la pierre angulaire de toute démarche de validation empirique. Qu’il s’agisse de calibrer un algorithme de régression destiné à anticiper des scores d’anxiété clinique, d’estimer des temps de réaction cognitive à partir de signaux neurophysiologiques ou de modéliser des trajectoires longitudinales d’apprentissage, le chercheur se heurte inévitablement à la question du choix des métriques d’erreur. Parmi le vaste répertoire des fonctions d’évaluation, deux mesures dominent la littérature avec une omniprésence presque incontestée : l’erreur quadratique moyenne (Mean Squared Error, MSE) et sa déclinaison directe, la racine de l’erreur quadratique moyenne (Root Mean Squared Error, RMSE). Bien qu’intrinsèquement liées sur le plan algébrique, ces deux métriques soulèvent des implications théoriques, dimensionnelles, computationnelles et cliniques profondément divergentes.
La confusion entre le rôle purement algorithmique d’une fonction de perte et la fonction communicative d’un indicateur de performance conduit fréquemment à des erreurs d’interprétation dans les publications scientifiques. Le choix d’une métrique ne relève pas d’une simple préférence cosmétique ou de convenances logicielles arbitraires ; il engage une posture épistémologique sur la manière dont les déviations empiriques doivent être pénalisées, comprises et transmises à la communauté académique. Alors que le MSE s’impose comme une entité naturelle au sein des espaces hilbertiens et des cadres d’optimisation différentiable, il souffre d’une tare majeure en matière d’intelligibilité pratique : l’élévation au carré des unités de mesure d’origine, rendant les résidus abstraits pour le praticien. Inversement, le RMSE réintroduit l’échelle native de la variable réponse grâce à l’application d’une racine carrée, mais introduit des subtilités d’estimation statistique non négligeables, notamment un biais d’échantillonnage induit par la non-linéarité de sa transformation.
Ce guide exhaustif a pour vocation d’analyser de manière approfondie les dynamiques mathématiques, géométriques et pratiques qui distinguent et unissent le MSE et le RMSE. En explorant leurs racines dans la théorie de l’estimation de Gauss et Legendre, leurs comportements asymptotiques, leur sensibilité exacerbée face aux distributions asymétriques ou contaminées par des valeurs aberrantes, ainsi que leurs applications concrètes en psychométrie computationnelle, cet article propose une grille de lecture méthodologique et un arbre décisionnel rigoureux. L’objectif ultime est de fournir aux chercheurs, statisticiens et analystes de données les compétences nécessaires pour sélectionner, calculer et interpréter ces métriques avec un niveau de rigueur optimal.
1. Introduction aux métriques d’évaluation en modélisation statistique
1.1 Le rôle central de l’évaluation dans les modèles de régression
L’adéquation d’un modèle statistique aux données empiriques représente la mesure dans laquelle une structure théorique formalisée parvient à capturer la variabilité sous-jacente d’un phénomène sans incorporer le bruit stochastique propre à l’échantillonnage. Dans le cadre de l’analyse de régression, qu’elle soit linéaire, polynomiale ou non paramétrique, cette adéquation se matérialise par l’écart résiduel séparant les observations manifestes des prédictions générées par l’estimateur. La quantification précise de cette erreur résiduelle n’est pas un simple accessoire descriptif ; elle constitue le critère fondamental à partir duquel la validité de construit, la puissance explicative et l’utilité clinique d’un modèle sont formellement jugées.
Dans la recherche comportementale, cognitive et psychométrique, la transition vers la modélisation prédictive a imposé une révision des exigences métrologiques. Pendant des décennies, l’accent a été mis quasi exclusivement sur l’ajustement théorique intra-échantillon, mesuré par des indices d’adéquation globale tels que le coefficient de détermination ou les tests du rapport de vraisemblance. Or, l’évaluation moderne exige d’estimer la performance empirique de généralisation, c’est-à-dire la capacité d’un système mathématique à prédire les manifestations comportementales futures chez de nouvelles cohortes de participants. Cette rigueur impose une mesure de la déviation qui soit à la fois mathématiquement stable, représentative des risques d’erreur et cliniquement signifiante.
La quantification de l’erreur résiduelle sert ainsi de pont entre l’abstraction formelle d’un algorithme et la réalité concrète des phénomènes psychologiques. Si un modèle cherchant à prédire des épisodes dépressifs majeurs échoue en sous-estimant systématiquement les niveaux de détresse sévères, la métrique d’évaluation doit refléter cette défaillance avec une sensibilité adaptée aux coûts réels des faux négatifs. Par conséquent, la métrique sélectionnée n’est pas un spectateur passif de l’analyse, mais le moteur même qui guide le raffinement, la sélection et l’acceptation finale des modèles scientifiques.
1.2 Présentation synoptique du MSE et du RMSE
L’origine historique des estimateurs d’erreur quadratique remonte aux travaux fondateurs de Carl Friedrich Gauss et Adrien-Marie Legendre au début du XIXe siècle, dans le cadre de la détermination des orbites célestes et du développement de la méthode des moindres carrés ordinaires. En proposant de minimiser la somme des carrés des déviations plutôt que les déviations absolues, Gauss a posé le socle analytique sur lequel reposent aujourd’hui le MSE (Mean Squared Error) et le RMSE (Root Mean Squared Error). Ces métriques partagent un objectif convergent : fournir une évaluation agrégée de l’amplitude de l’erreur commise par un prédicteur continu sur un ensemble défini d’observations.
Le MSE se définit conceptuellement comme la moyenne arithmétique des carrés des différences entre les valeurs prédites par le modèle et les valeurs réelles observées. Le RMSE n’en est que l’extension immédiate, obtenue par l’extraction de la racine carrée du résultat produit par le MSE. En dépit de cette parenté algébrique absolue, une problématique récurrente traverse les sciences appliquées : la confusion quant aux contextes dans lesquels l’une de ces formulations doit prévaloir sur l’autre. Alors que certains praticiens traitent la racine carrée comme une simple opération esthétique, elle modifie fondamentalement la géométrie interprétative et les propriétés dimensionnelles de la statistique résultante.
Le choix entre ces deux métriques s’articule autour de critères statistiques précis. Le MSE préserve l’additivité analytique et s’intègre harmonieusement dans les cadres théoriques d’estimation de la variance résiduelle et de décomposition des sources d’incertitude. Le RMSE, pour sa part, rétablit l’échelle originale du phénomène psychologique ou physiologique étudié, favorisant une comparaison intuitive avec les seuils de significativité clinique et la variabilité interindividuelle de base.
1.3 Enjeux méthodologiques de la quantification de l’erreur
L’application inconsidérée d’une métrique inadaptée peut avoir des conséquences dommageables sur l’interprétation des résultats empiriques. En psychologie computationnelle et en neurosciences quantitatives, rapporter exclusivement un MSE peut conduire à une déconnexion cognitive sévère : un chercheur lisant une erreur de prédiction exprimée en millisecondes au carré ou en points d’inventaire clinique au carré éprouve des difficultés structurelles à mesurer si l’incertitude du modèle invalide son application thérapeutique ou diagnostique. De surcroît, la comparaison inter-études devient laborieuse lorsque les échelles subissent des transformations non linéaires sans justification explicite.
Il convient de tracer une ligne de démarcation nette entre deux impératifs scientifiques distincts : l’optimisation algorithmique interne et la communication scientifique externe des résultats. Alors que le moteur computationnel d’un algorithme requiert des fonctions de coût hautement traitables sur le plan différentiel pour converger efficacement vers un minimum global ou local, le destinataire de la recherche a besoin d’indicateurs dont la magnitude est directement transposable dans le système d’unités de sa discipline. Ignorer cette dualité induit fréquemment des biais d’interprétation, où la performance d’un modèle est soit artificiellement magnifiée, soit injustement dépréciée par l’illusion d’échelle créée par la fonction de perte.
Enfin, la crise de la reproductibilité qui traverse les sciences biomédicales et humaines renforce l’exigence d’une rigueur absolue dans la déclaration des métriques d’erreur. Omettre de spécifier si une valeur d’erreur résiduelle correspond à un MSE ou un RMSE, ou passer de l’une à l’autre sans ajuster les critères statistiques de comparaison, compromet l’agrégation méta-analytique et fausse l’évaluation comparative des modèles concurrents développés par des équipes indépendantes.
2. Fondements mathématiques et théoriques de l’erreur quadratique moyenne (MSE)
2.1 Dérivation formelle et formule analytique
L’expression mathématique de l’erreur quadratique moyenne repose sur une formulation discrète standardisée, établie sur un échantillon de taille n d’observations appariées. Pour chaque individu ou essai statistique noté i, où yi désigne la valeur empirique observée et ŷi la valeur prédite par le modèle statistique ou l’architecture d’apprentissage, le résidu d’estimation est défini par la différence algébrique élémentaire ei = (ŷi – yi). Le MSE est formellement exprimé par la relation analytique :
MSE = (1 / n) * Σi=1n (ŷi – yi)²
Dans cette équation, le terme résiduel (ŷi – yi) isole l’erreur ponctuelle. L’opération d’élévation à la puissance deux applique une transformation quadratique à chaque composante d’erreur individuelle avant toute agrégation. La sommation finie calcule l’accumulation totale de cette énergie d’erreur sur l’ensemble des données d’évaluation, tandis que le dénominateur n assure la normalisation arithmétique de l’échantillon. Cette division par l’effectif transforme la somme des carrés résiduels (Residual Sum of Squares, RSS) en une espérance empirique, rendant la mesure invariante par rapport à l’augmentation purement quantitative de la taille de l’échantillon sous l’hypothèse de distributions d’erreurs indépendantes et identiquement distribuées (i.i.d.).
L’utilisation du dénominateur n reflète la définition probabiliste du moment centré d’ordre deux de l’erreur. Dans le contexte de l’inférence statistique classique sur les modèles linéaires, il arrive que ce dénominateur soit corrigé par les degrés de liberté résiduels (n – p – 1), où p correspond au nombre de paramètres libres estimés, afin de fournir un estimateur non biaisé de la variance du terme d’erreur de population σ². Néanmoins, au sein de l’apprentissage automatique et du paradigme prédictif contemporain, la formulation par n demeure le standard algorithmique universel.
2.2 Propriétés géométriques et algébriques de l’élévation au carré
L’élévation au carré des résidus produit deux conséquences mathématiques fondamentales. Sur le plan algébrique, elle supprime la polarité des déviations. Étant donné que les résidus peuvent être positifs (surestimation de la cible empirique) ou négatifs (sous-estimation), une simple sommation arithmétique linéaire entraînerait une compensation artificielle, aboutissant à une erreur totale nulle pour un estimateur sans biais qui commettrait pourtant des erreurs massives en sens opposés. L’opérateur de puissance deux garantit une métrique strictement positive ou nulle, le zéro étant atteint si et seulement si l’adéquation est parfaite pour chaque point de données (ŷi = yi pour tout i).
Sur le plan géométrique, le MSE s’inscrit au sein d’un espace euclidien réel de dimension n (noté ℝn). Le vecteur des observations empiriques y et le vecteur des projections modélisées ŷ définissent un vecteur d’erreur résiduelle e = ŷ – y. La somme des carrés des erreurs correspond au carré de la longueur euclidienne de ce vecteur résiduel, ce qui équivaut au produit scalaire interne de l’erreur avec elle-même : ||e||₂² = ⟨e, e⟩. Le MSE correspond donc à cette norme euclidienne au carré, projetée et normalisée par la dimension de l’espace d’échantillonnage.
La conséquence la plus marquante de cette opération réside dans la pondération quadratique asymétrique des amplitudes d’erreur. Contrairement à une échelle linéaire, l’élévation au carré punit les grands écarts avec une sévérité géométriquement croissante. Un résidu d’une magnitude de 4 unités ne produit pas une pénalité quatre fois supérieure à celle d’un résidu de 1 unité, mais une pénalité seize fois plus importante. Cette disproportion influe lourdement sur la morphologie de la surface d’erreur, conférant au MSE une sensibilité prononcée à la structure des queues de distribution de l’échantillon.
2.3 Le MSE comme fonction de perte en apprentissage automatique
Dans le domaine de l’optimisation mathématique et du génie algorithmique, le MSE occupe un statut prééminent en raison de ses propriétés d’analyse fonctionnelle. En tant que fonction de perte continue, le MSE est strictement convexe sur les espaces de paramètres des modèles linéaires et de nombreuses configurations non linéaires. Cette convexité garantit que la surface de coût ne présente pas de minima locaux trompeurs dans les configurations linéaires fondamentales, assurant l’existence d’une solution optimale globale unique accessible par des méthodes variationnelles.
De plus, le MSE se distingue par sa différentiabilité d’ordre supérieur sur l’ensemble du domaine réel. Le gradient du MSE par rapport aux paramètres prédictifs du modèle présente une forme linéaire d’une grande simplicité analytique, exempte de discontinuités ou de singularités aux frontières. Cette régularité permet aux algorithmes de descente de gradient, qu’ils soient stochastiques, par mini-lots ou adaptatifs (tels qu’Adam ou RMSprop), d’ajuster les poids synaptiques ou les coefficients de régression de manière fluide et stable à chaque itération computationnelle.
Cette commodité analytique reflète une correspondance statistique profonde : la minimisation du MSE est strictement équivalente à l’estimation par le maximum de vraisemblance (Maximum Likelihood Estimation, MLE) des paramètres sous l’hypothèse canonique selon laquelle les résidus suivent une distribution normale indépendante d’espérance nulle et de variance constante homogène (homoscédasticité). Lorsque la distribution des bruits physiques ou comportementaux est gaussienne, la solution qui minimise le MSE maximise la probabilité d’observer les données recueillies, conférant à cette métrique une légitimité probabiliste solide au plan asymptotique.
3. Fondements mathématiques et théoriques de la racine de l’erreur quadratique moyenne (RMSE)
3.1 Formulation mathématique et transformation par racine carrée
La racine de l’erreur quadratique moyenne constitue la transformation concave naturelle du MSE, conçue pour réconcilier l’élégance de la norme quadratique avec les exigences pratiques de métrologie dimensionnelle. Sa formulation analytique standard s’obtient en extrayant la racine carrée positive de la moyenne des carrés des écarts résiduels, s’exprimant rigoureusement selon l’équation :
RMSE = √[ (1 / n) * Σi=1n (ŷi – yi)² ] = √(MSE)
L’introduction de l’opérateur racine carrée applique une fonction monotone strictement croissante sur le domaine des réels positifs [0, +∞). Cette monotonie fondamentale assure une concordance d’ordre entre le MSE et le RMSE : pour tout ensemble de modèles statistiques concurrents M₁ et M₂ évalués sur un même corpus de test clos, la condition MSE(M₁) < MSE(M₂) implique nécessairement la relation RMSE(M₁) < RMSE(M₂). Par conséquent, l’utilisation de l’une ou l’autre de ces mesures n’altère en rien l’ordonnancement hiérarchique relatif des modèles lors d’une procédure de sélection.
Cependant, la concavité de la racine carrée modifie l’échelle de dispersion des valeurs calculées. En contractant les magnitudes élevées tout en dilatant proportionnellement les petits intervalles, cette transformation modifie l’écart d’amplitude apparent entre deux modèles d’efficacité inégale. Deux modèles présentant des MSE respectifs de 100 et 144 affichent une différence d’erreur brute de 44 unités au carré, qui se réduit après passage à la racine à un écart de seulement 2 unités réelles (10 contre 12). Cette compression d’échelle joue un rôle psychologique et analytique déterminant dans la lecture de la robustesse des modèles.
3.2 Alignement dimensionnel avec la variable dépendante
L’avantage cardinal du RMSE réside dans sa conformité avec les règles de l’analyse dimensionnelle en métrologie physique et quantitative. Lors de l’évaluation d’un modèle de régression prédisant une variable clinique continue Y mesurée dans une unité spécifique U (par exemple, des microvolts en électroencéphalographie, des battements par minute en variabilité cardiaque, ou des scores scalaires sur l’échelle de dépression de Beck), le MSE produit une quantité exprimée dans une unité artificielle au carré : U². Or, la notion de « points de dépression au carré » ou de « millisecondes au carré » est dépourvue de sens opérationnel pour le clinicien et le chercheur.
En appliquant la racine carrée, le RMSE élimine cette distorsion dimensionnelle et rétablit l’unité d’origine U :
dim(RMSE) = √(dim(MSE)) = √(U²) = U
Ce rétablissement confère au RMSE une lisibilité immédiate. Il devient possible de superposer directement l’amplitude du RMSE à la distribution des observations empiriques, à la moyenne de l’échantillon ou à ses limites de dispersion naturelle. Le RMSE partage la dimension métrique de l’écart-type résiduel empirique. Il constitue ainsi un repère interprétatif standardisé, facilitant la communication des performances du modèle auprès des pairs, des comités d’éthique et des professionnels de santé non initiés aux subtilités de l’algèbre bilinéaire.
3.3 Propriétés en tant que norme mathématique
Au-delà de son adéquation dimensionnelle, le RMSE bénéficie d’une assise solide au sein de l’analyse fonctionnelle moderne par son affiliation directe à la norme euclidienne L2 de l’espace vectoriel des résidus. Plus précisément, le RMSE est égal à la norme euclidienne standard du vecteur résiduel e = ŷ – y pondérée par le facteur d’échelle scalaire 1 / √n :
RMSE = (1 / √n) * ||ŷ – y||₂
En conséquence de cette équivalence structurelle, le RMSE hérite de l’ensemble des axiomes fondamentaux qui régissent les espaces métriques et normés. Il satisfait l’axiome de séparation (||e|| = 0 si et seulement si e = 0), l’axiome d’homogénéité absolue sous multiplication scalaire (||αe|| = |α| * ||e|| pour tout réel α), ainsi que l’inégalité triangulaire cardinale : pour deux vecteurs d’estimation d’erreur e₁ et e₂, la relation ||e₁ + e₂|| ≤ ||e₁|| + ||e₂|| est systématiquement vérifiée.
Sur le plan géométrique, cela implique que le RMSE mesure la distance géométrique euclidienne la plus directe entre le point défini par les observations de terrain et le point prédit par la variété d’ajustement du modèle dans l’espace multidimensionnel. Cette formulation préserve la stabilité de l’évaluation lors de transformations géométriques affines et garantit que les projections orthogonales caractéristiques des régressions par moindres carrés conservent leur cohérence architecturale interne.
4. Comparaison dimensionnelle et interprétabilité pratique
4.1 Le problème des unités au carré du MSE
L’obstacle majeur qui entrave l’utilisation du MSE comme outil d’interprétation réside dans l’opacité conceptuelle de son unité de mesure. En sciences comportementales et biomédicales, les variables dépendent d’échelles de mesure standardisées dont chaque graduation possède une signification sémiotique ou clinique précise. Lorsque le chercheur évalue un système algorithmique de criblage prédisant l’intensité des symptômes de l’échelle d’évaluation de la dépression de Hamilton (HAM-D, graduée de 0 à 52), annoncer que le système présente un MSE de 36 « points de Hamilton au carré » engendre une rupture cognitive immédiate.
Cette déconnexion cognitive entre l’ampleur brute du chiffre généré par le MSE et la réalité clinique observée empêche d’évaluer instinctivement si l’erreur résiduelle compromet l’usage du modèle. L’esprit humain ne conceptualise pas spontanément des grandeurs physiques ou psychologiques sous leur forme quadratique. Un MSE de 144 points au carré sur une échelle cognitive de 100 points donne l’illusion trompeuse d’un effondrement prédictif majeur, alors qu’il ne correspond en réalité qu’à un écart type résiduel moyen de 12 points réels, ce qui peut s’avérer acceptable selon le niveau de bruit psychométrique inhérent au protocole.
De plus, cette distorsion quadratique rend problématique la comparaison simultanée de plusieurs variables réponses soumises à des métriques distinctes. Dans les protocoles évaluant simultanément le cortisol salivaire (mesuré en nmol/L) et le temps de réaction (mesuré en millisecondes), les valeurs de MSE respectives ne partagent plus aucun ordre d’amplitude comparable, confinant le reporting statistique à un catalogue de chiffres disparates inaccessibles aux décideurs et aux cliniciens.
4.2 La lisibilité directe du RMSE sur l’échelle originale
En restaurant l’échelle originale des données de terrain, le RMSE se substitue aux unités quadratiques du MSE pour offrir une lisibilité intuitive. Dans le cadre d’une modélisation linéaire homoscédastique, le RMSE se comporte comme une approximation directe de l’écart-type des résidus non expliqués (Standard Deviation of Residuals). Cela confère à sa valeur numérique une signification opérationnelle immédiate : le RMSE représente la marge d’incertitude typique ou la déviation caractéristique du modèle autour des données empiriques.
Cette lisibilité directe présente un intérêt notable lors de l’application de modèles écologiques à des métriques physiologiques ou cognitives du quotidien. Si un algorithme prédictif du stress professionnel continu génère un RMSE de 4,2 points sur une échelle d’évaluation du stress perçu (PSS-10) s’étalant de 0 à 40, l’analyste peut immédiatement appréhender que les projections du système dévient en moyenne de moins d’un demi-intervalle de classe clinique par rapport à l’auto-évaluation du sujet. Cette lisibilité permet d’adosser l’évaluation statistique aux critères de pertinence clinique minimale (Minimal Clinically Important Difference, MCID).
De façon analogue, dans le champ de la chronométrie mentale où l’on modélise les temps de réponse motrice lors de tâches d’attention soutenue, un RMSE exprimé directement en millisecondes (ms) permet une confrontation immédiate avec la littérature neurophysiologique connue : un RMSE de 15 ms s’inscrit en deçà du seuil de conduction axonale standard, garantissant que l’erreur prédictive du modèle ne masque pas les variations subtiles induites par l’intervention cognitive étudiée.
4.3 Étude de cas comparatif : scores psychométriques continus
Pour illustrer concrètement la disparité d’intelligibilité entre ces deux métriques, considérons une recherche longitudinale portant sur la prédiction de l’anxiété-état évaluée par l’inventaire STAI-Y (State-Trait Anxiety Inventory), dont le score continu varie rigoureusement entre 20 et 80 points. Un échantillon clinique hétérogène de 250 patients suivis en psychiatrie est soumis à une régression multivariée intégrant des marqueurs autonomes et des données écologiques instantanées. L’optimisation algorithmique parvient à un modèle présentant une somme d’erreurs quadratiques résiduelles normalisée conduisant aux valeurs suivantes :
- Erreur quadratique moyenne (MSE) = 49,00
- Racine de l’erreur quadratique moyenne (RMSE) = 7,00 points STAI
Lors de la présentation de ces données devant un comité pluridisciplinaire composé de cliniciens, de psychiatres et de gestionnaires de santé, l’annonce d’un MSE de 49 induit fréquemment une réaction de rejet méthodologique. Le chiffre 49 évoque instinctivement la quasi-totalité de l’intervalle dynamique de l’échelle (qui s’étend sur une amplitude de 60 points entre le score minimal de 20 et le maximal de 80), laissant supposer à tort que le modèle est incapable de distinguer un état d’anxiété légère d’une crise de panique sévère. La formulation en MSE donne ainsi une impression erronée de faillite algorithmique.
À l’inverse, l’exposition du RMSE dissipe instantanément cette méprise. Un écart type résiduel moyen de 7 points STAI montre que les prédictions du modèle restent circonscrites à une marge de tolérance raisonnable, sachant que l’erreur standard de mesure (SEM) intrinsèque à cet instrument de mesure psychométrique tourne classiquement autour de 3 à 5 points. Le clinicien comprend immédiatement que l’erreur résiduelle du modèle algorithmique est presque comparable au bruit de mesure inhérent au questionnaire lui-même. C’est pourquoi la présentation tabulaire des synthèses statistiques pour la diffusion biomédicale requiert impérativement l’intégration du RMSE, le MSE demeurant confiné aux annexes méthodologiques relatives à la convergence des optimiseurs.
5. Sensibilité aux valeurs aberrantes et pénalisation des erreurs
5.1 La dynamique d’amplification quadratique des grands écarts
La caractéristique fondamentale qui structure conjointement le MSE et le RMSE réside dans la cinétique quadratique de pénalisation des déviations résiduelles. En élevant la différence (ŷi – yi) au carré, l’algorithme assigne un poids mathématique disproportionné aux résidus dont la magnitude s’éloigne de la masse centrale des erreurs. Cette mécanique engendre une amplification phénoménologique des grands écarts qui oriente l’estimation au détriment des déviations de faible ampleur.
Pour conceptualiser cette asymétrie de pénalisation, il suffit d’analyser l’impact différentiel sur le calcul global de l’erreur qu’exercent dix erreurs mineures réparties face à une unique erreur aberrante isolée :
- Dix observations présentant chacune une déviation résiduelle marginale de 1 unité génèrent une contribution individuelle au numérateur quadratique de 1² = 1. L’accumulation de ces dix déviations aboutit à une somme de résidus au carré égale à 10.
- Une unique observation contaminée par un artéfact instrumental ou une erreur de saisie, présentant un écart de 10 unités (les neuf autres observations disposant d’un ajustement parfait d’erreur 0), génère à elle seule une contribution quadratique de 10² = 100. La somme des carrés s’élève ici à 100.
Bien que dans les deux configurations la somme arithmétique absolue des résidus bruts soit strictement identique (10 * 1 = 10 d’un côté, 1 * 10 = 10 de l’autre), la mécanique quadratique attribue à la déviation isolée un impact dix fois supérieur sur l’estimation de l’erreur moyenne. Cette dynamique démontre la sensibilité aiguë du MSE et du RMSE aux observations extrêmes situées dans les queues épaisses des distributions de données réelles.
5.2 Analyse comparative de la robustesse entre MSE et RMSE
Une confusion théorique fréquente consiste à postuler que l’application de la racine carrée conférerait au RMSE une résistance supérieure face aux valeurs aberrantes par rapport au MSE. Cette interprétation procède d’une mauvaise lecture de la hiérarchie des opérations arithmétiques. La racine carrée est une transformation globale appliquée a posteriori à l’agrégat moyen des carrés préalablement sommés ; elle n’annule aucunement la distorsion quadratique subie au niveau élémentaire par chaque terme résiduel au sein du calcul.
Le RMSE n’est pas une métrique robuste au sens formel de la statistique non paramétrique ou résistante (au sens de Huber ou de Tukey). La valeur du RMSE demeure tributaire des points d’influence extrêmes et son point de rupture asymptotique (breakdown point) est rigoureusement égal à 0 %, à l’instar du MSE. Cela signifie qu’une seule observation tendant vers l’infini (|ei| → ∞) suffit à provoquer la divergence vers l’infini de l’ensemble de la métrique, indépendamment de la taille finie de l’échantillon n.
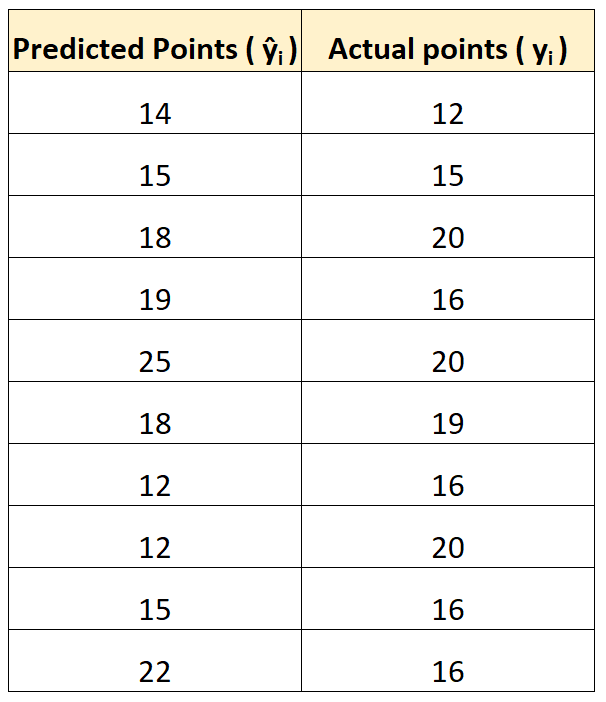
La distinction opérée par le RMSE relève exclusivement d’une compression de l’échelle d’affichage globale, qui peut masquer à l’œil non averti l’hégémonie exercée par les observations aberrantes. Dans un échantillon comportemental comprenant des participants inattentifs produisant des temps de réaction déviants de trois écarts-types, le RMSE sera gonflé vers le haut par ces observations atypiques tout autant que le MSE sur le plan structurel. L’analyste ne doit donc pas considérer le RMSE comme une alternative robuste au MSE : toutes deux partagent une vulnérabilité identique aux queues de distribution lourdes.
5.3 Scénarios où la pénalisation sévère est méthodologiquement souhaitable
Si la vulnérabilité aux valeurs aberrantes est fréquemment déplorée dans les environnements de données bruitées, cette sensibilité quadratique devient un atout méthodologique majeur dans les domaines où les erreurs prédictives d’amplitude élevée engendrent des répercussions cliniques, industrielles ou sociétales critiques. Dans ces situations, la fonction de coût doit décourager le modèle de commettre des déviations massives, même si cela requiert une légère dégradation de la précision moyenne sur les cas standards.
L’évaluation des algorithmes de psychiatrie computationnelle dédiés à l’anticipation du risque suicidaire imminent ou des passages à l’acte hétéro-agressifs constitue une illustration clinique pertinente. Une prédiction commettant une série d’erreurs marginales d’un demi-point sur une échelle d’idéation suicidaire n’entraîne pas de conséquences pronostiques défavorables ; en revanche, une sous-estimation majeure de 15 points chez un patient en crise aiguë représente un événement potentiellement fatal. L’amplification quadratique propre au MSE et au RMSE force l’architecture prédictive à orienter ses paramètres pour éliminer en priorité ces défaillances critiques, jouant un rôle de garde-fou statistique.
De manière similaire, lors de l’audit et de l’équité algorithmique appliqués aux sous-populations minoritaires, une métrique quadratique met immédiatement en lumière l’incapacité d’un système à s’ajuster à un sous-groupe spécifique. Si le modèle fonctionne correctement sur 95 % de la cohorte dominante mais s’effondre sur 5 % d’individus atypiques, le MSE et le RMSE augmentent nettement sous l’effet de ces erreurs groupées. Cela signale une anomalie structurelle d’ajustement que des métriques plus tolérantes, comme la déviation absolue médiane, pourraient dissimuler sous un masque de performance médiane apparemment optimale.
6. Propriétés computationnelles et rôle dans l’optimisation
6.1 Différentiabilité et calcul vectoriel
Dans l’ingénierie mathématique des algorithmes de régression, la dérivabilité continue d’une métrique d’erreur conditionne directement la faisabilité de son optimisation numérique. Sur ce point précis, le MSE présente des propriétés analytiques qui lui confèrent une supériorité structurelle sur le RMSE au sein des solveurs itératifs et des architectures matricielles fermées.
Le calcul du gradient vectoriel du MSE par rapport au vecteur de paramètres w d’un modèle linéaire s’effectue avec une remarquable économie de calcul. En désignant par X la matrice de conception des prédicteurs et y le vecteur cible, la dérivée première de la fonction de perte MSE prend la forme suivante :
∇w MSE(w) = (2 / n) * XT (Xw – y)
Cette expression est linéaire par rapport aux données observées et exempte de non-linéarités complexes, ce qui permet la résolution directe du problème d’optimisation via le système classique des équations normales de la méthode des moindres carrés ordinaires :
w* = (XT X)-1 XT y
À l’inverse, la dérivation analytique du RMSE introduit une complexité de calcul supplémentaire en raison de l’application de la règle de dérivation des fonctions composées :
∇w RMSE(w) = ∇w √(MSE(w)) = (1 / (2 * √(MSE(w)))) * ∇w MSE(w) = (XT (Xw – y)) / (n * RMSE(w))
Cette dérivation fait apparaître le terme RMSE(w) au dénominateur du gradient vectoriel. Cette particularité engendre deux inconvénients majeurs : un surcoût computationnel induit par l’évaluation répétée de la racine carrée sur des millions de paramètres, et surtout un risque d’instabilité numérique lorsque le modèle s’approche d’un ajustement parfait (RMSE → 0), induisant des gradients qui explosent vers l’infini (division par zéro).
6.2 Fonction de coût vs métrique de reporting
Cette dissociation analytique entre dérivabilité matricielle et interprétation des échelles structure une dichotomie opérationnelle fondamentale en apprentissage statistique : la distinction stricte entre fonction de coût interne (optimisée par le système) et métrique d’évaluation externe (analysée par le chercheur). Le MSE s’impose comme l’étalon préférentiel des fonctions de perte internes, tandis que le RMSE s’illustre comme le vecteur privilégié de la restitution cognitive externe.
Dans la mesure où l’opérateur racine carrée est monotone et strictement croissant, l’emplacement du minimum global au sein de l’espace des paramètres est mathématiquement identique pour les deux fonctions. Les paramètres optimaux w* qui minimisent le MSE sont rigoureusement identiques à ceux qui minimisent le RMSE :
arg minw MSE(w) ≡ arg minw RMSE(w)
Cependant, la dynamique de convergence d’un algorithme de descente de gradient itératif appliqué directement sur le RMSE diffère substantiellement de celle observée sur le MSE. Le facteur d’échelle 1 / RMSE(w) présent dans le gradient altère l’amplitude effective du pas d’apprentissage (learning rate). À mesure que l’erreur décroît, le pas effectif augmente, ce qui perturbe le comportement des algorithmes adaptatifs s’ils ne sont pas spécifiquement recalibrés. Le MSE offre ainsi une surface de perte aux courbures plus douces et mieux contrôlées lors de l’apprentissage.
6.3 Considérations de calcul à grande échelle
Dans le traitement de données massives (Big Data), de flux neuro-imagerie fonctionnelle continus ou de séries temporelles issues d’objets connectés en santé, le coût computationnel agrégé des opérations élémentaires redevient un paramètre dimensionnant. L’opération d’extraction de la racine carrée, bien qu’implémentée de façon optimisée au niveau des processeurs modernes via des instructions vectorielles (telles que SSE ou AVX), requiert plusieurs cycles d’horloge de plus qu’une addition ou une multiplication flottante basique.
Calculer systématiquement le RMSE à chaque étape d’un pipeline d’apprentissage profond comprenant des centaines d’époques, des dizaines de couches cachées et des millions de micro-lots (mini-batches) induit une pénalité computationnelle mesurable sans bénéfice d’optimisation. Les bibliothèques de référence comme PyTorch ou TensorFlow définissent nativement la fonction de perte pour les régressions continues sous la forme du MSE (via la classe torch.nn.MSELoss), cantonnant l’extraction de la racine carrée aux phases ponctuelles de test, de validation et de restitution visuelle des courbes d’apprentissage.
De plus, l’absence de racine carrée facilite la parallélisation du MSE sur les architectures graphiques (GPU). La somme des carrés résiduels se prête à des opérations de réduction parallèle arborescente hautement scalables, sans nécessiter de point de synchronisation globale pour appliquer une fonction racine à l’ensemble du tenseur distribué, renforçant la suprématie du MSE en tant qu’outil d’optimisation machine.
7. Applications en psychologie quantitative et sciences comportementales
7.1 Modélisation des processus cognitifs et chronométriques
La recherche expérimentale en psychologie cognitive et en neuropsychologie s’appuie massivement sur l’analyse chronométrique des temps de réaction (TR). Qu’il s’agisse d’évaluer le coût attentionnel d’une tâche de Stroop ou le temps de prise de décision perceptuelle, les distributions de TR empiriques ne sont presque jamais gaussiennes ; elles présentent de façon caractéristique une asymétrie positive marquée (skewness) assortie d’une longue queue d’observations ralenties, souvent modélisée par des lois ex-gaussiennes ou de Wald.
Dans ce contexte précis, l’application du MSE et du RMSE soulève des enjeux d’interprétation notables. Un essai au cours duquel un participant subit une absence attentionnelle transitoire, générant un temps de réaction de 1 800 ms alors que sa médiane se situe à 400 ms, génère un résidu d’une magnitude considérable de 1 400 ms. Élevé au carré dans le calcul du MSE, cet écart contribue pour 1 960 000 ms² au total de l’erreur. Cette valeur démesurée déforme la métrique et peut masquer le fait que l’algorithme modélise avec une précision millimétrique 98 % des processus décisionnels standards.
Le reporting en RMSE permet de restituer la dispersion d’estimation dans l’unité naturelle du chronomètre de laboratoire : les millisecondes (ms). Dans l’ajustement des architectures computationnelles sophistiquées, telles que les modèles de diffusion de Ratcliff (Drift-Diffusion Models), le RMSE sert à quantifier la fidélité de reconstitution des quantiles de latence de décision. Présenter un RMSE de 28 ms permet immédiatement d’établir que la distorsion de prédiction cognitive reste inférieure au seuil de discrimination temporelle visuelle humaine, validant l’utilité du modèle computationnel pour la recherche neurofonctionnelle.
7.2 Psychométrie et théorie de réponse aux items
Dans l’évaluation psychométrique moderne, formalisée par la théorie des réponses aux items (TRI) et les modèles d’équations structurelles (SEM), l’objectif réside dans l’estimation de variables inobservables nommées traits latents (usuellement notés θ), représentant par exemple l’intelligence fluide, le névrosisme ou l’habileté spatiale. L’erreur standard d’estimation (Standard Error of Estimation, SEE) qui caractérise le positionnement d’un sujet sur le continuum latent est intrinsèquement liée à des logiques d’erreur quadratique.
L’usage du RMSE s’avère particulièrement répandu pour quantifier la concordance entre le niveau de trait théorique simulé lors de validations par méthode de Monte-Carlo et le trait effectivement estimé à travers des batteries de tests adaptatifs informatisés (CAT) :
RMSE(θ) = √[ (1 / N) * Σj=1N (θ̂j – θj)² ]
Ce calcul fournit une estimation directe de la fidélité de l’instrument sur l’échelle métrique du trait latent (le plus souvent calibrée selon une échelle de distribution normale standard centrée en zéro avec un écart-type de un : N(0, 1)). Un RMSE(θ) de 0,22 indique que l’erreur de localisation psychométrique moyenne correspond à environ un quart d’écart-type de la population générale, ce qui s’avère suffisant pour des applications de sélection scolaire ou de catégorisation diagnostique.
Il est toutefois impératif de dissiper une confusion terminologique persistante chez les psychométriciens : la distinction absolue entre le RMSE résiduel discuté ici et le RMSEA (Root Mean Square Error of Approximation) développé par Steiger et Lind. Bien que le RMSEA emprunte une nomenclature quadratique similaire, il évalue le calage global des structures de covariance matricielle dans l’analyse factorielle confirmatoire en pénalisant la complexité des degrés de liberté, et non la déviation de prédiction individuelle point par point.
7.3 Études longitudinales et données de suivi écologique (ESM/EMA)
L’essor des méthodologies d’évaluation écologique instantanée (Ecological Momentary Assessment, EMA ou Experience Sampling Methodology, ESM) a transformé la recherche comportementale en permettant le recueil intensif de séries temporelles en temps réel dans le cadre de vie naturel des participants via leurs ordiphones. Les chercheurs modélisent ainsi les fluctuations ultradiennes de l’affect négatif, de la douleur chronique ou des pulsions addictives.
Ces données de panel dynamiques présentent des structures résiduelles corrélées dans le temps (autocorrélation d’ordre 1 ou supérieur) et une forte hétérogénéité intra-individuelle. Lorsque l’on déploie des modèles mixtes autorégressifs personnalisés (N-of-1), la survenue d’une crise émotionnelle aiguë imprévisible constitue une anomalie transitoire par rapport à l’homéostasie affective habituelle. Utiliser le MSE pour piloter ces modèles longitudinaux conduit fréquemment les estimateurs à sur-ajuster le système pour compenser ces chocs sporadiques, dégradant la modélisation des tendances globales d’humeur.
L’analyse du RMSE calculé au niveau individuel fournit un indicateur clinique de l’instabilité résiduelle de chaque patient. En conservant l’échelle des items d’évaluation instantanée (par exemple une échelle visuelle analogique cotée de 0 à 100), le clinicien exploitant un tableau de bord digital identifie immédiatement qu’un patient affichant un RMSE de 18 points présente une volatilité émotionnelle difficilement anticipable par l’algorithme, nécessitant une réévaluation thérapeutique, alors qu’un RMSE de 4 points reflète une homéostasie affective hautement prévisible.
8. Décomposition du biais-variance et théorie statistique
8.1 La décomposition canonique du MSE
L’un des fondements conceptuels majeurs qui justifient la prédominance du MSE dans la théorie statistique de l’apprentissage est son étroite articulation avec le dilemme biais-variance. Pour un estimateur statistique f̂(x) visant à modéliser une variable aléatoire Y = f(x) + ε (où le terme d’erreur stochastique irréductible présente une espérance nulle E[ε] = 0 et une variance intrinsèque Var(ε) = σε²), l’espérance mathématique de l’erreur quadratique sur une nouvelle observation s’exprime selon une décomposition canonique rigoureuse :
E[ (Y – f̂(x))² ] = [ Biais(f̂(x)) ]² + Var(f̂(x)) + σε²
Dans cette formalisation mathématique :
- Le Biais au carré correspond à la différence systématique entre la prédiction moyenne théorique de l’algorithme et la réalité objective sous-jacente : Biais(f̂(x)) = E[f̂(x)] – f(x). Un biais élevé traduit un sous-apprentissage (underfitting), caractérisé par l’incapacité du modèle à capturer la géométrie du signal.
- La Variance capture la variabilité de la prédiction du modèle autour de sa propre espérance lorsqu’il est entraîné sur différents échantillons aléatoires issus de la même population : Var(f̂(x)) = E[ (f̂(x) – E[f̂(x)])² ]. Une variance excessive traduit un sur-apprentissage (overfitting), où le système mémorise le bruit d’échantillonnage spécifique.
- L’Erreur irréductible (σε²) matérialise la limite absolue d’incertitude physique ou comportementale, inhérente aux facteurs non mesurés du système.
L’élégance de cette décomposition réside dans son additivité orthogonale parfaite. Elle constitue le socle théorique sur lequel reposent l’ensemble des techniques modernes de régularisation statistique (telles que la régression Ridge pénalisant la norme L2 ou la régression Lasso pénalisant la norme L1). Le chercheur accepte d’introduire un léger biais délibéré dans l’ajustement du modèle afin de comprimer massivement la variance paramétrique, aboutissant à une réduction nette du MSE global.
Il est fondamental de noter qu’aucune décomposition additive directe de ce type n’existe pour le RMSE. En raison de la concavité de la racine carrée, on a :
√( [Biais]² + Var + σε² ) ≠ Biais + √(Var) + σε
Le RMSE fusionne les trois composantes au sein d’une transformation non linéaire qui obscurcit la contribution respective de chaque source d’erreur. Dès lors que l’objectif scientifique consiste à isoler théoriquement la sous-spécification d’un modèle de sa sensibilité stochastique à l’échantillonnage, le MSE demeure l’unique instrument analytique adapté.
8.2 Propriétés d’invariance et de convergence statistique
Dans le cadre de la théorie de l’estimation classique de Gauss-Markov, le MSE s’impose comme le critère de référence pour l’identification des meilleurs estimateurs linéaires sans biais (BLUE : Best Linear Unbiased Estimator). La propriété de non-biais d’un estimateur θ̂ implique formellement que son biais théorique s’annule (E[θ̂] – θ = 0). Dès lors, le MSE de cet estimateur coïncide rigoureusement avec sa variance d’échantillonnage : MSE(θ̂) = Var(θ̂).
Toutefois, une complication mathématique survient dès lors que l’on transpose ces postulats à la racine carrée du MSE. En vertu de l’inégalité de Jensen régissant l’espérance mathématique des fonctions concaves, pour toute variable aléatoire non constante Z et pour toute fonction concave g, on vérifie la relation E[g(Z)] < g(E[Z]). En appliquant cette loi fondamentale à la transformation par racine carrée (qui est une fonction strictement concave sur les réels positifs), on obtient le théorème d’inflexion suivant :
E[ RMSE ] = E[ √(MSE) ] < √( E[MSE] )
Ce résultat théorique emporte une conséquence majeure pour la recherche expérimentale menée sur des échantillons restreints : le RMSE calculé sur un échantillon empirique fini est un estimateur systématiquement biaisé par défaut de l’écart-type vrai des résidus de la population. Il tend structurellement à sous-estimer la dispersion résiduelle théorique globale. Bien que ce biais asymptotique s’estompe progressivement à mesure que la taille d’échantillon n s’accroît vers l’infini, il convient de faire preuve d’une grande prudence lorsque des modèles prédictifs comportementaux sont évalués sur de petites cohortes cliniques (par exemple, n < 30).
8.3 Puissance statistique des tests de comparaison de modèles
Lorsque deux modèles statistiques concurrents ou hiérarchiquement imbriqués doivent être départagés, la théorie de l’inférence par le modèle linéaire généralisé s’articule autour de la somme des résidus quadratiques, c’est-à-dire directement autour des grandeurs du MSE. Les procédures formelles de comparaison de modèles, telles que le test F de Fisher-Snedecor pour les termes résiduels incrémentaux, comparent le ratio des sommes de carrés d’erreurs normalisées par leurs degrés de liberté respectifs :
F = [ (RSS₁ – RSS₂) / (df₁ – df₂) ] / [ RSS₂ / df₂ ]
Cette formulation repose sur le fait que, sous l’hypothèse nulle de distribution gaussienne homoscédastique des résidus, la somme des carrés résiduels normalisée par la variance de population suit rigoureusement une distribution du Chi-deux (χ²). La somme de variables aléatoires normales standardisées élevées au carré engendre la loi du Chi-deux, dont le ratio normalisé donne naissance à la loi F de Fisher. Le MSE s’insère sans couture dans cette architecture distributionnelle fondamentale.
Tenter de fonder des tests d’hypothèses comparatifs directs sur les différences arithmétiques de RMSE s’avère hasardeux, car la racine carrée d’une variable distribuée selon une loi du Chi-deux suit une distribution de Nakagami ou une loi du Chi non standardisée, ce qui complexifie la détermination analytique exacte des valeurs de p (p-values) et réduit la puissance statistique des tests de détection d’effets incrémentaux subtils.
9. Comparaison contextuelle avec les métriques alternatives
9.1 MSE et RMSE face à l’erreur absolue moyenne (MAE)
L’analyse comparative des métriques d’erreur ne saurait être complète sans confronter le couple MSE/RMSE à l’erreur absolue moyenne (Mean Absolute Error, MAE). Alors que le MSE et le RMSE relèvent de la norme euclidienne L2, le MAE dérive directement de la métrique de Manhattan ou norme de premier ordre L1. Sa formulation consiste en la moyenne arithmétique simple des valeurs absolues des déviations résiduelles :
MAE = (1 / n) * Σi=1n |ŷi – yi|
Contrairement à l’élévation au carré, l’opérateur de valeur absolue applique une pondération strictement linéaire à chaque erreur, indépendamment de son amplitude. Une erreur de magnitude 10 est pénalisée exactement dix fois plus qu’une erreur de magnitude 1, et non pas cent fois plus comme dans le cadre du MSE. Il en découle que le MAE est une métrique beaucoup plus robuste et résistante aux valeurs aberrantes que le RMSE, reflétant la médiane conditionnelle de la distribution des erreurs là où le MSE cible son espérance mathématique.
En vertu de l’inégalité de Cauchy-Schwarz, le RMSE et le MAE satisfont systématiquement une relation d’ordre déterministe invariable sur n’importe quel jeu de données empiriques :
MAE ≤ RMSE ≤ √n * MAE
L’égalité parfaite (RMSE = MAE) ne se produit que dans la situation hautement théorique où l’ensemble des résidus du modèle ont rigoureusement la même amplitude absolue (|e₁| = |e₂| = … = |en|). Dès lors qu’il existe une variance dans la distribution de l’amplitude des erreurs, le RMSE dépasse mécaniquement le MAE. L’amplitude de l’écart arithmétique (RMSE – MAE) constitue ainsi un indicateur diagnostique précieux : plus cet écart est prononcé, plus la dispersion des résidus est hétérogène et plus l’impact des grandes erreurs est dominant dans l’échantillon.
9.2 Relation mathématique avec le coefficient de détermination (R²)
Le coefficient de détermination, universellement désigné par le symbole R², représente la métrique d’évaluation la plus répandue en modélisation linéaire classique. Son articulation avec le MSE est directe et structurelle. Si l’on désigne par Var(Y) la variance empirique totale de la variable cible observée (qui correspond mathématiquement au MSE d’un modèle trivial naïf prédisant constamment la moyenne arithmétique globale de l’échantillon, notée Ȳ), le R² s’exprime selon la formule canonique :
R² = 1 – [ SSres / SStot ] = 1 – [ MSE / Var(Y) ]
Le R² n’est rien d’autre qu’une normalisation sans dimension (adimensionnelle) du MSE, projetée sur une échelle théoriquement bornée entre -∞ et 1 (et entre 0 et 1 dans le cadre des moindres carrés ordinaires appliqués sur les données d’entraînement avec ordonnée à l’origine). Alors que le MSE exprime l’erreur absolue en unités au carré et le RMSE en unités originales réelles, le R² contextualise cette erreur en la rapportant à la variance totale du phénomène étudié. Il répond à la question : « Quelle proportion de la variance de la variable cible a été résorbée par les prédicteurs du modèle ? »
Toutefois, une dépendance exclusive au R² sans consultation simultanée du RMSE expose le chercheur à des erreurs d’interprétation notables. Dans des échantillons cliniques présentant une variance totale Var(Y) très élevée par suite d’une forte hétérogénéité des participants, un modèle peut afficher un R² en apparence très flatteur (par exemple 0,85) tout en conservant un RMSE important qui le rend inapte à toute décision diagnostique individuelle fine. Inversement, sur un échantillon hautement homogène où Var(Y) est faible, un modèle très précis présentant un RMSE minime peut afficher un R² décevant (par exemple 0,30). La consultation croisée du RMSE et du R² permet de dissocier la qualité absolue de prédiction de la variabilité contextuelle de l’échantillon d’évaluation.
9.3 Panorama des métriques d’erreur relative (MAPE, WAPE)
Dans certains secteurs de la modélisation comportementale appliquée, les analystes recourent à des métriques d’erreur relative exprimées en pourcentages, à l’instar de l’erreur moyenne absolue en pourcentage (Mean Absolute Percentage Error, MAPE) :
MAPE = (100% / n) * Σi=1n | (ŷi – yi) / yi |
Bien que séduisante par son apparente universalité, la transposition du MAPE aux échelles psychométriques et comportementales soulève de profondes impasses méthodologiques. D’une part, le dénominateur yi engendre une instabilité numérique fatale : si une seule observation empirique prend une valeur nulle (yi = 0), le calcul produit une indétermination mathématique avec division par zéro. Même pour des valeurs très proches de zéro, le MAPE explose de manière disproportionnée, pénalisant arbitrairement les erreurs commises sur les bas niveaux d’une échelle.
D’autre part, la majorité des instruments psychométriques (échelles de Likert, inventaires de dépression, tests de personnalité) reposent sur des échelles d’intervalles et non de rapports. Elles ne possèdent pas de zéro absolu naturel. Le chiffre zéro y est une convention métrologique arbitraire. Calculer un pourcentage d’erreur sur un score dont l’origine est dénuée de sens physique est une aberration méthodologique. C’est pourquoi le MSE et le RMSE s’avèrent infiniment plus rigoureux pour les données de sciences humaines, préservant la validité de l’évaluation indépendamment des translations d’origine de l’échelle de mesure.
10. Arbre décisionnel : critères pour choisir entre MSE et RMSE
10.1 Critère 1 : Le public cible et l’objectif de communication
Le premier paramètre guidant l’arbitrage entre l’emploi du MSE ou du RMSE concerne le destinataire des analyses produites et le canal de communication académique ou opérationnel sélectionné. Dès lors que l’objectif principal consiste à rédiger un article scientifique dans une revue à comité de lecture, un rapport d’évaluation clinique destiné à des praticiens hospitaliers ou un exposé décisionnel pour des gestionnaires institutionnels, le RMSE s’impose comme le standard méthodologique absolu.
La conformité du RMSE avec les règles d’intelligibilité des sciences empiriques permet au lecteur de situer instantanément l’incertitude prédictive par rapport aux bornes de dispersion de la variable dépendante. Selon les directives éditoriales fixées par le manuel de publication de l’American Psychological Association (APA) dans sa 7e édition, la restitution des statistiques d’effet et d’erreur doit être formulée dans les unités métriques originales des instruments d’évaluation pour garantir la validité écologique des résultats. Un rapport déclarant un RMSE de 3,4 points sur une échelle d’évaluation du burn-out permet à la communauté clinique d’interpréter le résultat au regard des normes diagnostiques établies.
L’usage du MSE auprès de publics non mathématiciens engendre immanquablement des erreurs de lecture. Les utilisateurs non rompus à la manipulation mentale des unités quadratiques tendent soit à ignorer la dimension de puissance deux (surévaluant alors considérablement la gravité de l’erreur moyenne), soit à rejeter la crédibilité de l’analyse en la jugeant opaque. Par souci de translucidité et d’utilisabilité de la recherche, le RMSE constitue le vecteur de dissémination scientifique préconisé pour l’ensemble des restitutions textuelles et tabulaires descriptives.
10.2 Critère 2 : L’intégration dans des chaînes de calcul mathématique
Lorsque la finalité du travail s’écarte de la communication descriptive pour s’insérer dans des architectures de calcul analytique formel, de dérivation différentielle itérative ou de programmation probabiliste complexe, le MSE reprend sans conteste sa suprématie opérationnelle. L’absence d’opérateur racine carrée simplifie la manipulation des équations algébriques et supprime les singularités numériques inhérentes au gradient du RMSE.
Le MSE se révèle indispensable dans les opérations de décomposition statistique des plans d’échantillonnage stratifiés ou de calcul de variances résiduelles combinées. Dans les plans factoriels ou les analyses de méta-régression combinant des sous-populations distinctes, l’erreur globale s’obtient par la combinaison linéaire simple et additive des sommes de carrés résiduels de chaque strate, normalisée par l’effectif global agrégé :
MSEtotal = (n₁ * MSE₁ + n₂ * MSE₂) / (n₁ + n₂)
Une telle opération d’agrégation linéaire arithmétique est mathématiquement impossible à appliquer directement sur les valeurs de RMSE sans devoir préalablement réélever chaque valeur au carré pour revenir au MSE, puis appliquer la moyenne pondérée, avant d’extraire de nouveau une racine carrée finale :
RMSEtotal = √[ (n₁ * RMSE₁² + n₂ * RMSE₂²) / (n₁ + n₂) ]
De surcroît, lors de l’intégration dans des procédures d’optimisation bayésienne, de filtrage de Kalman continu ou de régularisation sous contraintes quadratiques, conserver le MSE évite des opérations d’inversion matricielle alourdies par la dérivation de radicaux, garantissant une meilleure stabilité numérique et une convergence accélérée des calculateurs scientifiques.
10.3 Critère 3 : La nature de la pénalisation et l’évaluation des risques
Le troisième critère repose sur une appréciation de la topologie de l’erreur tolérable au sein du dispositif de recherche. Bien que le MSE et le RMSE imposent structurellement la même pénalisation quadratique interne face aux grands écarts, leur lecture conjointe avec des métriques complémentaires constitue une stratégie diagnostique de choix pour scruter la structure du bruit résiduel.
Dans les environnements méthodologiques rigoureux, la recommandation contemporaine n’est plus d’opérer un choix binaire exclusif entre les métriques, mais d’adopter une stratégie de reporting multi-dimensionnelle et transparente combinant le RMSE et le MAE. La consultation du ratio adimensionnel suivant fournit une clé de lecture immédiate de la structure d’erreur :
Ratio = RMSE / MAE
Ce ratio varie nécessairement entre la valeur minimale de 1 (indiquant une variance d’erreur nulle, où chaque résidu présente strictement la même taille absolue) et la limite théorique de √n (indiquant la présence d’une seule déviation aberrante massive isolée dans un océan d’erreurs nulles). Pour une distribution d’erreurs parfaitement gaussienne non contaminée, ce ratio tend asymptotiquement vers une valeur théorique connue d’environ √(π / 2) ≈ 1,253. Tout écart important au-delà de 1,30 signale au méthodologiste la présence d’observations aberrantes ou de sous-groupes mal ajustés qui tirent le RMSE vers le haut de manière disproportionnée.
11. Implémentation pratique et interprétation logicielle
11.1 Calcul et extraction sous l’environnement R
Dans l’environnement de programmation statistique R, le calcul et l’extraction du MSE et du RMSE s’effectuent classiquement à partir des objets de classe lm ou glm via des opérations vectorisées natives, ou à travers l’écosystème spécialisé de bibliothèques telles que performance, caret ou Metrics. À partir d’un modèle de régression linéaire ajusté sur des données empiriques, l’extraction vectorielle directe s’opère de façon transparente :
Le calcul du MSE à partir des résidus extraits du modèle requiert de sommer les carrés de ces écarts et de les diviser par l’effectif total length(residus). Le passage au RMSE s’obtient alors en appliquant simplement la fonction sqrt() au résultat obtenu. Bien que cette approche manuelle soit courante, l’utilisation de packages dédiés facilite l’intégration dans des pipelines de modélisation plus complexes :
- La bibliothèque
performanceoffre la fonctionperformance_rmse(modele)qui gère nativement les degrés de liberté résiduels et fournit des diagnostics d’hétéroscédasticité complémentaires. - Le package
caretpropose des fonctions intégrées lors des phases d’évaluation croisée (cross-validation), permettant de spécifiermetric = "RMSE"dans la fonction d’entraînement pour orienter automatiquement le choix du modèle optimal.
Un piège méthodologique fréquent dans l’écosystème R réside dans la gestion des données manquantes (missing values, NA). Si les vecteurs de prédictions et d’observations réelles ne sont pas préalablement nettoyés via na.omit() ou un masque booléen strict, les calculs vectoriels renvoient systématiquement une valeur non numérique (NA), conduisant parfois des utilisateurs à imputer des valeurs moyennes globales de façon hâtive, ce qui biaise vers le bas l’estimation de l’erreur résiduelle.
11.2 Calcul et déploiement avec l’écosystème Python (Scikit-Learn)
Au sein de l’écosystème Python dédié à la science des données, la bibliothèque de référence scikit-learn propose des modules d’évaluation normalisés dans son sous-paquet sklearn.metrics. Historiquement, l’extraction du RMSE nécessitait de calculer le MSE via la fonction mean_squared_error en lui associant le paramètre booléen squared=False :
Dans les versions contemporaines de la bibliothèque, une fonction dédiée root_mean_squared_error(y_true, y_pred) a été formellement introduite afin de clarifier la syntaxe du code et d’éviter les confusions de lecture logicielle. Cette avancée normalise la terminologie algorithmique au sein des scripts d’apprentissage supervisé.
Toutefois, une convention structurelle de scikit-learn doit être maîtrisée lors de l’intégration dans des pipelines d’optimisation d’hyperparamètres via GridSearchCV ou lors de l’évaluation croisée avec cross_val_score : la convention du score négatif. Dans l’architecture logicielle de la bibliothèque, les optimiseurs maximisent systématiquement une fonction d’utilité plutôt que de minimiser une fonction de coût. Par conséquent, les métriques d’erreur quadratique sont inversées sous la forme neg_mean_squared_error ou neg_root_mean_squared_error, renvoyant des valeurs strictement négatives :
Le chercheur doit réappliquer un opérateur de négation arithmétique (multiplier par -1) aux valeurs renvoyées par la validation croisée avant d’extraire la racine carrée ou d’interpréter les résultats, sous peine de manipuler des grandeurs absurdes dans ses tableaux de synthèse.
11.3 Interprétation dans SPSS et les logiciels d’équations structurelles
Dans les progiciels statistiques à interface graphique largement déployés dans les laboratoires de sciences humaines, tels que IBM SPSS Statistics, le vocabulaire d’affichage ne mentionne pas explicitement les termes d’origine anglophone « MSE » ou « RMSE » dans les sorties de régression linéaire standard. Cette divergence lexicale engendre fréquemment un désarroi chez les étudiants et chercheurs non statisticiens.
Dans le tableau intitulé « Récapitulatif des modèles » (Model Summary) généré par la procédure de régression linéaire sous SPSS, le chercheur doit identifier la colonne intitulée « Erreur standard de l’estimation » (Std. Error of the Estimate). Cette grandeur correspond rigoureusement à l’estimation non biaisée du RMSE de la population, calculée en utilisant comme dénominateur les degrés de liberté résiduels :
Erreur Standard de l’Estimation = √[ SSres / (n – p – 1) ]
Parallèlement, dans le tableau d’analyse de variance (ANOVA) sous-jacent, la ligne des « Résidus » fournit la somme des carrés (Sum of Squares) ainsi que la « Moyenne des carrés » (Mean Square) résiduelle. Cette valeur de « Mean Square » résiduel correspond exactement à la variante non biaisée du MSE (parfois notée MSe ou s²). Il suffit d’extraire la racine carrée de ce carré moyen résiduel de l’ANOVA pour retrouver au millième près la valeur de l’erreur standard de l’estimation.
Dans les environnements dédiés à la modélisation structurelle (SEM) tels qu’AMOS, Mplus ou le package R lavaan, une vigilance absolue s’impose à nouveau pour ne pas confondre le RMSE résiduel issu d’une régression avec le SRMR (Standardized Root Mean Square Residual) ou le RMSEA. Alors que le RMSE évalue la dispersion brute des erreurs résiduelles de prédiction individuelle, le SRMR mesure l’écart moyen quadratique entre la matrice de corrélation empirique observée et la matrice de corrélation implicite postulée par le modèle théorique. La transposition de l’un à l’autre constitue une confusion méthodologique rédhibitoire lors de la rédaction d’un manuscrit soumis à publication.
12. Synthèse méthodologique et recommandations finales
12.1 Tableau comparatif récapitulatif des dimensions clés
Pour résumer les caractéristiques structurelles, algébriques et opérationnelles qui distinguent et unissent le MSE et le RMSE, le tableau synoptique suivant fournit une vue intégrée des critères directeurs :
| Dimension | Erreur quadratique moyenne (MSE) | Racine de l’erreur quadratique moyenne (RMSE) |
|---|---|---|
| Formulation analytique | MSE = (1 / n) * Σ (ŷi – yi)² | RMSE = √[ (1 / n) * Σ (ŷi – yi)² ] |
| Unités de mesure | Unités empiriques au carré (U²) | Unités empiriques originales natives (U) |
| Propriété métrique | Carré de la norme L2 normalisée (pseudo-distance) | Norme euclidienne L2 normalisée (vraie distance métrique) |
| Sensibilité aux valeurs aberrantes | Quadratique sévère (point de rupture asymptotique = 0 %) | Quadratique sévère (point de rupture asymptotique = 0 %) |
| Différentiabilité analytique | Gradient linéaire continu, très simple et numériquement stable | Gradient non linéaire avec radical au dénominateur, instable à 0 |
| Décomposition formelle | Décomposition additive directe : Biais² + Variance + Bruit | Absence de décomposition additive canonique simple |
| Estimateur d’échantillon | Estimateur sans biais de la variance (ajusté pour df) | Estimateur systématiquement biaisé par défaut (Jensen) |
| Usage préférentiel | Fonction de perte interne, optimisation mathématique, dérivation | Reporting académique, évaluation clinique, comparabilité externe |
12.2 Bonnes pratiques pour la modélisation en sciences quantitatives
Au terme de cette analyse, l’évaluation de la performance d’un modèle statistique ne saurait être réduite à un acte réflexe consistant à exécuter une fonction logicielle sans analyse critique de ses implications dimensionnelles. Une démarche de recherche quantitative rigoureuse impose de respecter un ensemble de bonnes pratiques méthodologiques établies :
- Ne jamais isoler une seule métrique d’évaluation : Aucune valeur isolée, qu’il s’agisse du MSE, du RMSE ou du coefficient de détermination, ne suffit à caractériser la validité d’une modélisation. Les rapports d’évaluation doivent systématiquement intégrer conjointement le RMSE (pour l’ampleur sur l’échelle native), le MAE (pour son profil linéaire moins sensible aux queues de distribution) et le R² (pour la réduction relative de variance).
- Contextualiser l’amplitude du RMSE : Un RMSE dénué de contexte est ininterprétable. Sa valeur doit impérativement être rapportée à la moyenne arithmétique de la variable dépendante, à son écart-type global de référence et à l’étendue interquartile du phénomène observé. Mentionner le ratio RMSE / σY permet d’évaluer immédiatement la réduction de variabilité apportée par le modèle.
- Systématiser l’analyse exploratoire des résidus : Ni le MSE ni le RMSE ne renseignent sur l’orientation d’une éventuelle asymétrie de l’erreur (sur-estimation vs sous-estimation systématique). Le diagnostic des modèles impose l’inspection visuelle détaillée des résidus studentisés via des graphiques quantile-quantile (Q-Q plots) et des représentations des résidus en fonction des valeurs ajustées pour diagnostiquer l’hétéroscédasticité ou la non-linéarité.
- Documenter avec transparence les choix méthodologiques : Dans la section « Méthode » ou « Analyse de données » des manuscrits scientifiques, le chercheur doit spécifier explicitement la formule de calcul employée (notamment le choix du dénominateur : division par n ou par n – p – 1), ainsi que la gestion rigoureuse des valeurs extrêmes ou manquantes au cours des procédures d’évaluation croisée.
12.3 Perspectives futures dans l’évaluation des modèles complexes
L’essor continu de la modélisation contemporaine vers des architectures non linéaires complexes, telles que les réseaux de neurones profonds récurrents ou convolutifs, les processus gaussiens et les modèles additifs généralisés pour la localisation, l’échelle et la forme (GAMLSS), redéfinit la manière dont l’erreur résiduelle est théorisée. Dans les environnements multi-niveaux et longitudinaux caractérisés par des mesures répétées chez des patients imbriqués au sein de structures hospitalières variées, la décomposition quadratique simple de l’erreur est contrainte de s’adapter aux composantes de variance aléatoires (random intercepts et random slopes).
De surcroît, la prise en compte de l’incertitude épistémique (liée au manque de données d’apprentissage) et de l’incertitude aléatoire (le bruit physique irréductible) pousse l’évaluation prédictive vers des métriques distributionnelles globales, à l’instar des scores de probabilité classés continus (Continuous Ranked Probability Score, CRPS) ou de la divergence de Kullback-Leibler. Ces approches évaluent la capacité du système à prédire la distribution de probabilité complète du comportement futur plutôt qu’un point singulier déterministe.
Néanmoins, quelle que soit la complexité formelle des architectures statistiques développées demain, le binôme MSE/RMSE demeurera l’axe fondamental de l’analyse résiduelle. La dualité fonctionnelle qui les unit conserve toute sa pertinence épistémologique : le MSE s’impose comme l’outil privilégié de l’optimisation mathématique et du raisonnement théorique sous-jacent, tandis que le RMSE s’affirme comme le véhicule incontournable de l’intelligibilité humaine, de l’évaluation clinique et de la décision empirique partagée.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Bishop, C. M. (2006). Pattern recognition and machine learning. Springer. https://www.microsoft.com/en-us/research/publication/pattern-recognition-and-machine-learning/
Chai, T., & Draxler, R. R. (2014). Root mean squared error (RMSE) or mean absolute error (MAE)? – Arguments against avoiding RMSE in the literature. Geoscientific Model Development, 7(3), 1247–1250. https://doi.org/10.5194/gmd-7-1247-2014
Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
Huber, P. J. (1981). Robust statistics. John Wiley & Sons. https://doi.org/10.1002/0471725250
Kingma, D. P., & Ba, J. (2014). Adam: A method for stochastic optimization. arXiv preprint arXiv:1412.6980. https://doi.org/10.48550/arXiv.1412.6980
Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O., Blondel, M., Prettenhofer, P., Weiss, R., Dubourg, V., Vanderplas, J., Passos, A., Cournapeau, D., Brucher, M., Perrot, M., & Duchesnay, É. (2011). Scikit-learn: Machine learning in Python. Journal of Machine Learning Research, 12, 2825–2830. https://jmlr.csail.mit.edu/papers/v12/pedregosa11a.html
Ratcliff, R., & McKoon, G. (2008). The diffusion decision model: Theory and data for two-choice decision tasks. Neural Computation, 20(4), 873–922. https://doi.org/10.1162/neco.2008.12-06-420
Spielberger, C. D., Gorsuch, R. L., Lushene, R., Vagg, P. R., & Jacobs, G. A. (1983). Manual for the State-Trait Anxiety Inventory. Consulting Psychologists Press.
Steiger, J. H. (1990). Structural model evaluation and modification: An interval estimation approach. Multivariate Behavioral Research, 25(2), 173–180. https://doi.org/10.1207/s15327906mbr2502_4
Willmott, C. J., & Matsuura, K. (2005). Advantages of the mean absolute error (MAE) over the root mean squared error (RMSE) in assessing average model performance. Climate Research, 30(1), 79–82. https://doi.org/10.3354/cr030079