
L’analyse rigoureuse des séries temporelles constitue l’un des piliers fondamentaux de la statistique appliquée, de l’économétrie contemporaine et de la science des données opérationnelle. Face à l’omniprésence d’aléas stochastiques et de micro-fluctuations haute fréquence qui obscurcissent la lecture des dynamiques sous-jacentes, le chercheur ou l’analyste se trouve confronté à l’impérieuse nécessité d’extraire un signal structurel pur à partir d’un environnement informationnel bruité. Parmi l’arsenal méthodologique développé au fil des décennies, la moyenne mobile exponentielle (MME), ou Exponential Moving Average (EMA) selon la terminologie anglo-saxonne, s’impose comme une technique de filtrage linéaire à réponse impulsionnelle infinie dont l’élégance mathématique n’a d’égal que son efficacité pragmatique.
Contrairement aux approches arithmétiques rudimentaires qui attribuent un poids équivalent à des observations temporelles distantes, la moyenne mobile exponentielle instaure un schéma de pondération géométrique décroissant. Ce mécanisme confère une primauté analytique aux réalisations les plus récentes de la variable étudiée, tout en conservant une mémoire asymptotique, bien qu’atténuée, de l’intégralité du sentier historique. Dans le cadre contemporain du travail collaboratif et du prototypage rapide de modèles prédictifs, l’environnement en nuage de Google Sheets s’est hissé au rang d’outil privilégié pour le déploiement de ces architectures de calcul récursif, alliant accessibilité universelle, puissance de calcul matriciel et interopérabilité via des interfaces de scripts avancées.
Ce guide exhaustif a pour vocation d’articuler une passerelle méthodologique complète entre les fondements épistémologiques et mathématiques du lissage exponentiel et son implémentation algorithmique méticuleuse au sein du tableur de Google. De la dérivation formelle du facteur d’amortissement à l’automatisation via des fonctions d’accumulation modernes comme SCAN et LAMBDA, jusqu’à l’évaluation quantitative des métriques d’erreur de prévision et la programmation en Google Apps Script, cette monographie propose un itinéraire technique sans concession, pensé pour transformer une feuille de calcul ordinaire en un moteur d’analyse prédictive de premier ordre.
1. Introduction théorique à la moyenne mobile exponentielle (MME)
1.1 Définition statistique et fondements mathématiques du lissage
Le concept de lissage statistique au sein des séries temporelles puise ses racines historiques dans les travaux pionniers de pionniers de la recherche opérationnelle et de la cybernétique du milieu du XXe siècle, notamment sous l’impulsion fondamentale de Charles C. Holt et Robert Goodell Brown. L’objectif premier de cette discipline consiste à opérer une décomposition fonctionnelle d’un signal temporel discret en une composante déterministe pérenne — la tendance séculaire —, d’éventuelles oscillations cycliques ou saisonnières, et un terme résiduel stochastique, fréquemment modélisé sous la forme d’un bruit blanc gaussien. Le lissage se définit formellement comme une transformation mathématique visant à minimiser la variance du terme d’erreur aléatoire afin de rendre lisible l’évolution cinématique du processus générateur de données.
D’un point de vue structural, le lissage exponentiel repose sur les propriétés de la loi de probabilité géométrique discrète. Alors qu’un filtre linéaire traditionnel calcule une combinaison linéaire bornée dans le temps, la moyenne mobile exponentielle déploie un opérateur à mémoire infinie dont la structure de pondération s’estompe de manière strictement non linéaire à mesure que l’on s’enfonce dans le passé temporel de l’échantillon. Cette décroissance géométrique garantit que l’intégrale — ou la somme discrète — des poids affectés à chaque observation historique converge rigoureusement vers l’unité, respectant ainsi l’axiome fondamental d’un estimateur non biaisé en situation stationnaire.
Sur le plan épistémologique, l’adoption de la MME traduit une posture méthodologique claire : l’information passée ne s’éteint jamais brutalement à l’instant où elle franchit un seuil arbitraire, mais s’évapore progressivement sous l’effet de l’entropie informationnelle. Ce modèle conceptuel formalise l’idée selon laquelle le passé lointain conserve une pertinence résiduelle infinitésimale pour expliquer le présent, tandis que le passé immédiat concentre la densité la plus forte de causalités actives. La MME agit par conséquent comme un filtre passe-bas sophistiqué, laissant transiter les variations fréquentielles lentes porteuses de tendance tout en amortissant les artefacts haute fréquence consécutifs aux chocs exogènes transitoires.
1.2 Distinction fondamentale entre moyenne mobile simple (MMS) et moyenne mobile exponentielle (MME)
La distinction opératoire entre la moyenne mobile simple (MMS) et la moyenne mobile exponentielle s’articule autour de la distribution des masses de Dirac appliquées à la fenêtre d’échantillonnage. La MMS procède par sommation arithmétique uniforme sur un horizon temporel fini de longueur n, assignant à chaque observation un coefficient invariable égal à 1/n, avant d’annihiler purement et simplement toute influence de la donnée dès lors que son indice temporel excède n. Cette approche engendre un double inconvénient mathématique : d’une part, elle génère un retard de phase substantiel — ou latence temporelle — dans l’identification des changements de concavité de la série ; d’autre part, elle induit un effet pervers d’« écho » ou de sursaut artificiel lorsque des valeurs extrêmes sortent abruptement de la fenêtre glissante de calcul.
À l’inverse, la MME ne purge jamais de manière discrète les réalisations antérieures du système. En substituant une fonction de transfert exponentielle continue à la fenêtre rectangulaire de la MMS, la MME élimine intégralement le phénomène d’écho lié à l’exclusion d’anciennes données aberrantes. Dès l’émergence d’un décrochage structurel ou d’une rupture de pente au sein de la série chronologique brute, la MME réagit avec une vivacité nettement supérieure. Sa fonction de réponse impulsionnelle décroît de manière monotone, ce qui confère à la courbe lissée une adéquation cinétique supérieure vis-à-vis des trajectoires réelles du phénomène étudié.
L’analyse comparative de la mémoire du signal révèle une divergence conceptuelle profonde : la MMS possède une mémoire dite « à boîte noire finie » sans hiérarchisation interne, incapable de discriminer l’antériorité relative des données comprises dans son intervalle, tandis que la MME structure la mémoire du système sous la forme d’un continuum d’influence amortie. Ce différentiel de latence temporelle implique que pour un degré de lissage globalement équivalent, le déphasage géométrique de la MME par rapport au signal originel demeure toujours inférieur à celui induit par une moyenne mobile arithmétique, faisant de la MME un instrument prédictif et descriptif beaucoup plus agile.
1.3 Dimension psychologique et perception cognitive des séries chronologiques
Au-delà de ses attributs formels en matière de calcul matriciel et stochastique, la modélisation par lissage exponentiel trouve un écho singulier au sein des sciences cognitives et de la psychologie de la décision. Les travaux fondateurs de Kahneman et Tversky sur les heuristiques de jugement ont mis en lumière le « biais de récence », mécanisme par lequel l’esprit humain accorde spontanément une importance démesurée aux événements les plus récents au détriment des distributions historiques globales. L’architecture de la MME, loin d’être une simple commodité calculatoire, formalise rigoureusement cette prédisposition mnésique naturelle en lui conférant un cadre mathématique normé et contrôlable.
Dans un contexte d’exposition continue à des flux quantitatifs complexes — qu’il s’agisse de métriques de performance commerciale, d’indicateurs de trafic réseau ou de flux de valorisation d’actifs —, l’œil et le cerveau humain se trouvent rapidement submergés par la surcharge cognitive générée par la volatilité microscopique des tracés graphiques. La superposition d’une MME sur une série brute joue le rôle d’un réducteur d’entropie perceptuelle. En adoucissant les aspérités chaotiques sans gommer la sensibilité aux réorientations fondamentales, elle permet au décideur d’opérer une ségrégation immédiate entre le signal signifiant et le bruit contextuel.
Cette convergence entre modèle statistique et traitement cognitif de l’information s’avère décisive pour la prise de décision sous incertitude. La MME stabilise l’espace visuel d’évaluation, limitant les réactions impulsives de surajustement face à des variations éphémères tout en prévenant l’inertie léthargique qui caractérise l’usage des filtres arithmétiques trop rigides. Elle constitue de ce fait un instrument d’intermédiation cognitive d’une redoutable efficacité opérationnelle.
2. Composantes mathématiques et dérivation de la formule de la MME
2.1 Anatomie de l’équation récursive standard
La formulation analytique de la moyenne mobile exponentielle s’exprime traditionnellement sous la forme d’une relation de récurrence du premier ordre à coefficients constants. Si l’on désigne par Yt la valeur observée du processus empirique à l’instant temporel discret t, et par MMEt l’estimation de la moyenne lissée correspondante, l’équation fondamentale se déploie selon l’expression suivante :
MMEt = alpha * Yt + (1 – alpha) * MMEt-1
Une manipulation algébrique élémentaire permet de reformuler cette équation sous une structure d’ajustement correcteur particulièrement éclairante pour l’esprit méthodologique :
MMEt = MMEt-1 + alpha * (Yt – MMEt-1)
Sous cette variante équivalente, le terme (Yt – MMEt-1) s’interprète rigoureusement comme le résidu d’estimation ou l’erreur de prévision à l’étape t commise par la projection issue de la période antérieure. Dès lors, le nouveau niveau de la série lissée MMEt apparaît comme la résultante de l’état précédent MMEt-1 révisé d’une fraction alpha de cette erreur de prévision instantanée. Cette écriture met en exergue la dynamique intrinsèquement cybernétique de la MME : il s’agit d’un système à rétroaction négative proportionnelle où chaque nouvelle observation vient corriger l’état interne de l’estimateur.
Cette formulation récursive induit une contrainte technique majeure : l’évaluation de l’estimateur à l’instant présent exige impérativement la connaissance formelle de sa valeur à l’instant immédiatement antérieur. En cascade, MMEt-1 encapsule lui-même l’empreinte de Yt-1 et de MMEt-2, de sorte qu’un développement par substitutions récursives successives permet d’exprimer la MME comme une somme pondérée infinie :
MMEt = alpha * SUM_{k=0}^{infinity} [(1 – alpha)^k * Y_{t-k}]
Cette forme développée démontre de manière irréfutable que la somme des coefficients associés à chaque observation passée forme une série géométrique de raison (1 – alpha) dont la limite tend parfaitement vers 1, scellant ainsi la cohérence mathématique globale du modèle de lissage.
2.2 Calcul et signification théorique du facteur de lissage (alpha)
Le paramètre alpha, conventionnellement désigné sous l’appellation de « constante de lissage » ou « facteur d’amortissement », constitue le rouage central déterminant l’élasticité temporelle de la MME. Ce paramètre scalaire sans dimension est strictement circonscrit à l’intervalle semi-ouvert ]0, 1]. Sur le plan théorique, l’attribution d’une valeur unitaire à alpha transforme l’équation en une simple identité tautologique où MMEt = Yt, ce qui équivaut à un filtrage totalement absent où la série lissée calque servilement la série brute sans la moindre atténuation de variance.
Inversement, lorsque alpha tend asymptotiquement vers zéro, l’influence du flux incident de données s’évanouit, figeant la prévision dans un état d’immutabilité absolue insensible aux évolutions empiriques. L’arbitrage de calibration d’alpha conditionne donc directement le taux de décroissance exponentielle du filtre. Plus alpha est élevé, plus l’empreinte des données historiques s’estompe rapidement, induisant une réactivité accrue aux inflexions de court terme, mais au prix d’une vulnérabilité accrue aux résidus stochastiques et aux fausses alertes structurelles.
Pour faire correspondre une constante de lissage alpha donnée aux propriétés d’une moyenne mobile simple d’horizon temporel fini équivalent à n périodes, les statisticiens ont établi une relation de passerelle universelle basée sur l’égalisation des retards moyens d’échantillonnage (ou centres de gravité temporels) :
alpha = 2 / (n + 1)
Cette égalité canonique permet d’ancrer un paramétrage abstrait d’alpha dans une échelle temporelle concrète compréhensible pour les praticiens, reliant de manière bijective une période de lissage discrète à son multiplicateur d’amortissement optimal.
2.3 Rôle déterminant du paramètre de période (n)
Le paramètre de période n ne doit pas être appréhendé comme une fenêtre d’exclusion mécanique, à la manière du dénominateur d’une moyenne mobile arithmétique, mais plutôt comme une métrique d’inertie temporelle équivalente. Il intervient comme la variable de contrôle exogène par laquelle l’analyste pilote le compromis fondamental entre la vitesse de convergence cinématique du filtre et la stabilité structurelle du lissage résultant.
L’impact de la sélection de n sur la variance de l’estimateur s’analyse à l’aune de la théorie des processus aléatoires. Pour une série stationnaire affectée d’un bruit blanc de variance sigma^2, la variance asymptotique de la MME s’exprime par le produit [alpha / (2 – alpha)] * sigma^2. En substituant alpha par son expression en fonction de n, il apparaît avec netteté que plus l’amplitude de n s’élargit, plus le ratio de réduction de variance devient prononcé, garantissant un filtrage impitoyable des perturbations de haute fréquence.
Néanmoins, cette réduction drastique de l’écart-type résiduel s’obtient au détriment direct de l’instantanéité de la détection. Une valeur de n surdimensionnée contraint l’estimateur à une inertie disproportionnée, générant des retards de phase préjudiciables lors de ruptures de tendance macroscopiques. Le calibrage optimal de n résulte ainsi d’une négociation délibérée entre l’appétence pour la réactivité du signal et la tolérance au risque de bruit aléatoire.
3. Préparation et structuration rigoureuse de la feuille de calcul
3.1 Normalisation des colonnes et intégrité structurelle des données
Le déploiement sans faille d’une modélisation séquentielle au sein d’un tableur tel que Google Sheets requiert une discipline d’architecture matricielle irréprochable. L’adage fondamental de l’ingénierie logicielle « garbage in, garbage out » trouve une résonance particulière dans les calculs récursifs, où toute imperfection initiale se propage de façon démultipliée sur l’ensemble de la série descendante. La première règle méthodologique consiste à instaurer une stricte ségrégation entre la dimension chronologique de repérage et la métrique quantitative observée.
L’organisation typique prescrit la constitution d’un tableau à deux dimensions étiqueté avec rigueur en ligne d’en-tête (ligne 1). La colonne A doit être réservée à la séquence temporelle, qu’il s’agisse de dates calendaires formellement typées au format ISO 8601 (AAAA-MM-JJ) ou d’un index temporel entier discret invariant (1, 2, 3, …). La colonne B accueille la série des observations brutes Yt, tandis que la colonne C est allouée à la trajectoire calculée de la MME. Il est impératif d’assigner explicitement le typage des cellules via le menu « Format » de Google Sheets pour éviter que des valeurs numériques ne soient insidieusement interprétées comme des chaînes de texte alpha-numériques, ce qui paralyserait les opérateurs arithmétiques sous-jacents.
Un prérequis absolu réside dans le tri systématique et strict du jeu de données selon un ordre chronologique ascendant. Les dépendances récursives imposant que le calcul à la ligne i interroge l’état évalué à la ligne i-1, tout désordre chronologique ou inversion d’indices corromprait instantanément la validité conceptuelle de la moyenne mobile exponentielle, aboutissant à une aberration prédictive où le passé serait rétro-ajusté par le futur.
3.2 Saisie empirique du jeu d’échantillons
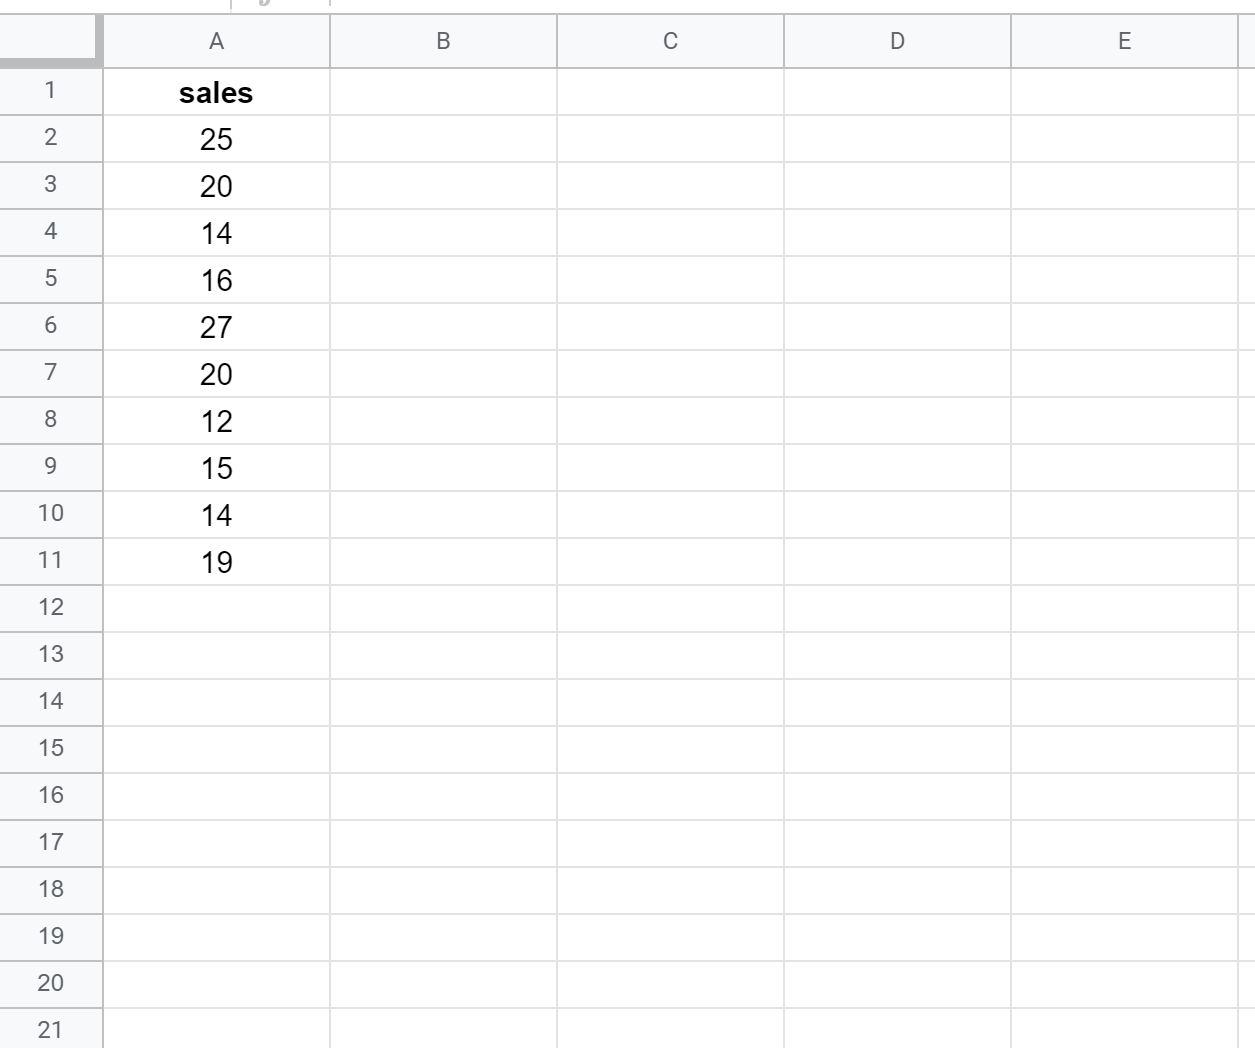
Pour asseoir la démonstration sur des bases empiriques solides et vérifiables pas à pas, considérons la mise en place d’un tableau de suivi représentatif d’une série chronologique continue s’étalant sur vingt périodes consécutives. La configuration matricielle s’établit selon la répartition suivante :
- Cellule A1 : Étiquette « Période (t) » ou « Date d’enregistrement »
- Cellule B1 : Étiquette « Valeur Observée (Y_t) »
- Cellule C1 : Étiquette « MME calculée »
- Cellule E1 : Paramètre d’horizon temporel n (par exemple, la valeur numérique 10)
- Cellule F1 : Formule du facteur de lissage alpha, calculée dynamiquement via la syntaxe
=2/(E1+1)
La transcription des observations dans la plage B2:B21 doit faire l’objet d’une vérification d’homogénéité temporelle. Il est fondamental de s’assurer qu’aucun saut d’intervalle n’existe dans la grille chronologique de la colonne A. La mécanique théorique de la MME présuppose en effet un échantillonnage à pas discret constant delta t. Si un intervalle temporel entre deux relevés successifs s’avérait deux fois supérieur à la norme de l’échantillon, la constante de lissage alpha théorique devrait subir un réajustement exponentiel proportionnel pour compenser cette distorsion temporelle, complexifiant inutilement le traitement matriciel élémentaire.
3.3 Prétraitement et gestion des valeurs aberrantes ou manquantes
Les environnements de données réels sont chroniquement exposés à des anomalies d’acquisition, sous la forme de lacunes d’enregistrement (cellules vides) ou de valeurs aberrantes résultant d’erreurs de mesure instrumentales. Dans le cadre d’un calcul récursif, la présence d’une cellule vide au sein de la colonne B engendre une rupture de calcul désastreuse : Google Sheets interprétant par défaut une cellule vide comme un zéro numérique dans un contexte arithmétique, le terme résiduel (Yt – MMEt-1) enregistrera une contraction artificielle brutale, polluant de manière rémanente l’ensemble des projections ultérieures.
Pour remédier aux lacunes de transmission, deux stratégies d’imputation formelle s’offrent à l’analyste :
- L’imputation linéaire locale : Elle consiste à substituer à la case vide la moyenne arithmétique immédiate des cellules adjacente supérieure et inférieure selon la formule
=(B_{t-1} + B_{t+1})/2, préservant la continuité cinématique du processus. - Le report de la dernière observation valide (LOCF – Last Observation Carried Forward) : Cette approche consiste à recopier purement et simplement la valeur B_{t-1} dans la case manquante, postulant l’immobilité temporaire du phénomène.
Quant au filtrage des valeurs aberrantes majeures non imputables à la cinématique du système, il convient d’instaurer des mécanismes de validation des données stricts au sein de Google Sheets (via le menu « Données » > « Validation des données »), encadrant les saisies entre des bornes d’écarts-types cohérentes pour prévenir toute contamination du germe de lissage.
4. Étape 1 : Initialisation de la série de calcul dans Google Sheets
4.1 Sélection de la valeur germe pour amorcer la récurrence
L’épineuse question de la condition aux limites initiale — souvent désignée sous le terme de « problème d’amorçage » ou de détermination de la valeur germe MME0 — constitue une problématique statistique fondamentale inhérente à l’ensemble des systèmes récursifs discrets. L’équation de la MME prescrivant pour l’instant t=1 l’évaluation formelle du terme alpha * Y1 + (1 – alpha) * MME0, l’absence intrinsèque d’historique antérieur à l’observation inaugurale impose une hypothèse de départ structurante.
Deux méthodologies académiques dominent le champ de l’analyse séquentielle :
- L’amorçage direct par la première observation empirique : Cette convention pose de manière déterministe que MME1 = Y1. L’avantage fondamental réside dans sa simplicité algorithmique et son absence d’exigence en termes d’historique préalable, permettant de lancer la série de calcul dès la toute première ligne disponible de la base de données.
- L’amorçage par la moyenne arithmétique de calage : Cette approche plus conservatrice consiste à calculer la moyenne arithmétique simple des n premières observations pour fixer la valeur de la MME à l’instant n, ne démarrant la récurrence exponentielle proprement dite qu’à partir de la période n+1.
Bien que la méthode par moyenne arithmétique initiale offre une modération accrue face à l’éventuelle volatilité de la première mesure, l’amorçage direct par Y1 s’avère extrêmement robuste lorsque l’échantillon comporte un volume suffisant d’observations. Du fait de la décroissance géométrique des pondérations passées régie par le coefficient (1 – alpha)^t, le biais d’initialisation induit par le choix arbitraire de la valeur germe s’amortit de façon exponentielle pour devenir infinitésimal après un nombre d’itérations équivalent à environ trois à quatre fois la valeur de la période n.
4.2 Configuration de la cellule d’ancrage (Cellule C2)
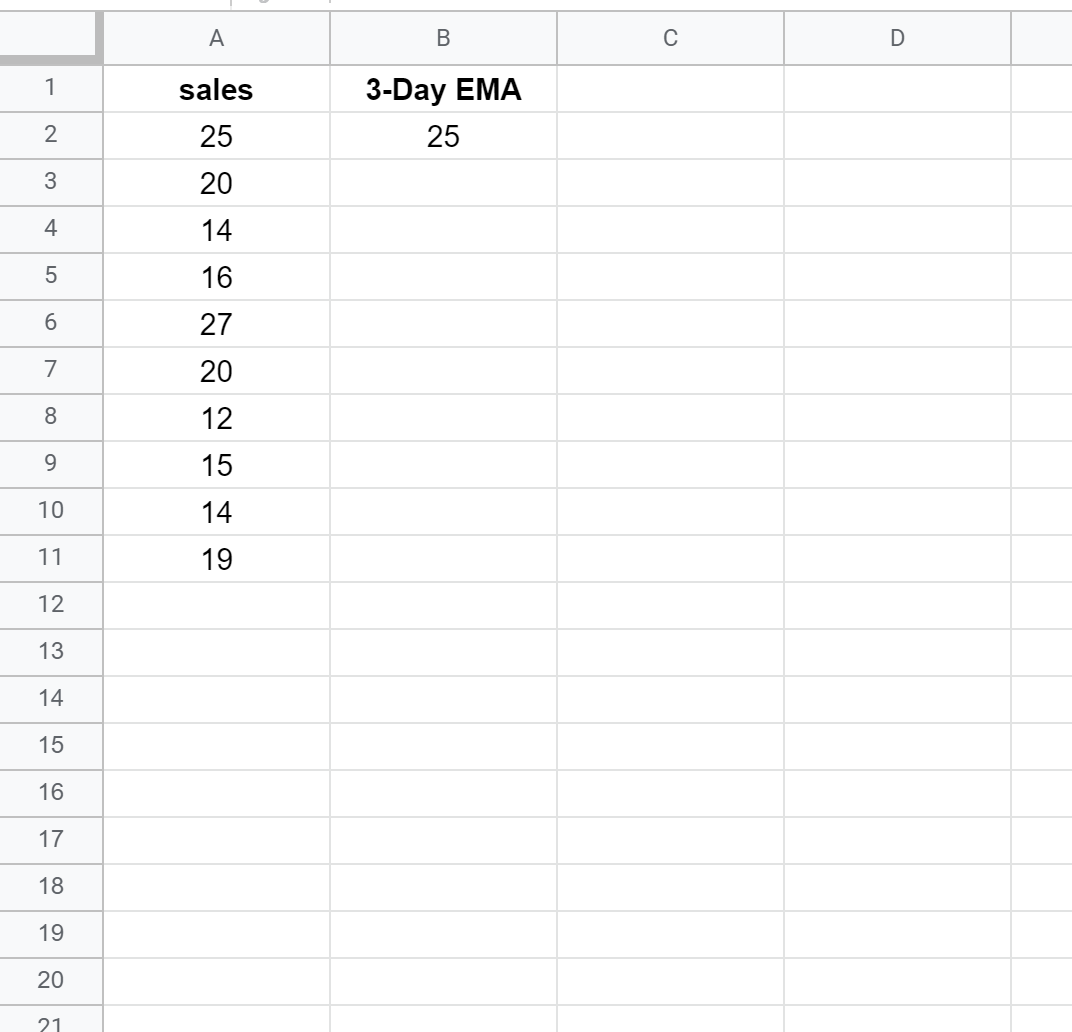
Dans l’architecture de notre feuille de calcul Google Sheets, le tableau de données débute rigoureusement à la ligne 2, la ligne 1 étant consacrée aux en-têtes descriptifs. La cellule B2 matérialise donc la toute première réalisation quantitative de l’échantillon Y1, et la cellule adjacente C2 incarne la cellule d’ancrage inaugural de notre estimateur lissé.
Pour matérialiser l’option d’amorçage direct par la valeur initiale, positionnez le curseur sur la cellule C2 et saisissez l’instruction d’affectation directe suivante :
=B2
Cette affectation élémentaire remplit une triple fonction opératoire :
- Elle initialise formellement la séquence récursive sans recourir à des données antérieures inexistantes.
- Elle préserve la transparence structurelle du classeur en documentant explicitement l’hypothèse de départ retenue par l’analyste.
- Elle prévient de manière définitive l’apparition d’erreurs d’exécution fatales, telles que la référence circulaire, qui se manifesterait inévitablement si la formule de récurrence tentait d’appeler l’en-tête textuel situé en C1.
Il est préconisé, dans une démarche d’auditabilité professionnelle, d’adjoindre un commentaire ou une mise en forme chromatique discrète à cette cellule C2 afin de signaler aux utilisateurs ultérieurs du classeur qu’il s’agit d’une cellule d’amorçage structurelle devant échapper aux opérations de recopie descendante aveugle.
5. Étape 2 : Implémentation formelle de la syntaxe de lissage
5.1 Construction de la formule pour la première période lissée
Une fois l’ancrage de départ scellé en C2, la cellule C3 accueille la première traduction algorithmique de l’équation récursive complète de la moyenne mobile exponentielle. À ce stade, le moteur de calcul dispose simultanément de l’observation brute courante Y2 (localisée en B3) et de l’état préalable du lissage MME1 (hébergé en C2).
En adoptant la formulation basée sur la correction du résidu de prévision, la syntaxe à insérer dans la cellule C3 s’établit formellement comme suit :
=(B3 - C2) * (2 / (10 + 1)) + C2
Dans cette formulation numérique directe, l’expression (2 / (10 + 1)) quantifie explicitement le multiplicateur alpha pour une période conventionnelle de dix unités, soit une valeur décimale approchée de 0,1818. L’agencement des parenthèses revêt une importance critique : le moteur d’évaluation syntaxique de Google Sheets respectant scrupuleusement la priorité opératoire standard (multiplication prioritaire sur l’addition), l’expression soustrait d’abord C2 de B3 pour isoler l’écart instantané, applique le facteur d’amortissement à ce différentiel, puis intègre le résultat au niveau précédent matérialisé par C2.
Il convient d’effectuer une contre-vérification manuelle immédiate au moyen d’un calcul arithmétique externe. Si, à titre d’illustration, la valeur d’ancrage en B2 (et donc en C2) était égale à 100, et que l’observation en B3 s’établissait à 110, le résidu d’estimation correspondrait à 110 - 100 = 10. En pondérant cette divergence par alpha = 0,1818, l’incrément correcteur s’élèverait à 1,818, ce qui porterait l’évaluation résultante en C3 à précisément 101,818. Tout écart avec ce résultat témoignerait d’une altération de la séquence de parenthèses au sein du tableur.
5.2 Gestion des références cellulaires relatives et absolues
Bien que l’intégration directe de constantes numériques au sein d’une formule fonctionne pour des calculs ponctuels, elle enfreint les règles élémentaires d’architecture logicielle sous tableur. Figer la valeur numérique de la période (en écrivant 10 en dur dans l’expression) interdit toute reconfiguration dynamique et prive l’analyste de la possibilité d’ajuster son modèle pour en éprouver la sensibilité.
La démarche méthodologique optimale impose l’externalisation des métadonnées de paramétrage au sein de cellules de contrôle isolées. Supposons que le paramètre de période n soit consigné dans la cellule E1, et que le calcul de la constante de lissage alpha soit réalisé dans la cellule F1 par la formule =2 / (E1 + 1). Dès lors, la syntaxe inscrite en C3 se restructure de la manière suivante :
=(B3 - C2) * $F$1 + C2
ou alternativement, en substituant directement la référence à la période sans passer par une cellule intermédiaire de coefficient :
=(B3 - C2) * (2 / ($E$1 + 1)) + C2
L’utilisation rigoureuse des ancrages absolus au moyen du symbole dollar ($E$1 ou $F$1) constitue le pivot mécanique de cette configuration. Alors que les coordonnées B3 et C2 sont délibérément laissées en références relatives afin qu’elles glissent dynamiquement d’une ligne vers le bas au fur et à mesure de l’incrémentation séquentielle, les coordonnées du paramètre d’amortissement sont verrouillées de manière absolue, assurant que chaque strate temporelle demeure invariablement assujettie à la même constante de contrôle.
6. Étape 3 : Automatisation et propagation de la formule sur l’échantillon
6.1 Méthode de recopie incrémentale standard
Avec une formule paramétrique irréprochable insérée dans la cellule C3, l’extension du calcul à l’ensemble du jeu de données s’opère par propagation verticale descendante. Google Sheets offre plusieurs modalités ergonomiques pour exécuter cette projection sans risque de corruption des pointeurs d’adressage relatifs.
La technique la plus expéditive consiste à sélectionner la cellule C3, puis à diriger le pointeur de la souris vers le coin inférieur droit de la cellule jusqu’à ce que le curseur conventionnel se métamorphose en une croix sombre, désignée sous le nom de « poignée de recopie ». Un double-clic consécutif appliqué sur cette poignée déclenche une auto-extension algorithmique : le tableur analyse la profondeur de la matrice adjacente gauche (colonne B) et duplique instantanément la formule de C3 jusqu’au niveau exact de la dernière cellule non vide de cette colonne.
Alternativement, pour les utilisateurs privilégiant les manipulations au clavier ou opérant sur des segments de données spécifiques :
- Positionnez-vous sur la cellule C3.
- Actionnez la combinaison de touches
Ctrl + Maj + Flèche Bas(ouCmd + Maj + Flèche Bassur macOS) en bordure de la colonne cible, ou étendez manuellement votre sélection jusqu’à la cellule C21. - Exécutez la commande de remplissage séquentiel vers le bas via le raccourci
Ctrl + D(ouCmd + D).
Au terme de cette opération mécanique, un audit visuel d’intégrité s’impose. En inspectant successivement les cellules C4, C5 et C6, assurez-vous que les arguments relatifs progressent fidèlement : la cellule C4 doit impérativement afficher =(B4 - C3) * $F$1 + C3, attestant de la chaîne de transmission ininterrompue de la mémoire séquentielle.
6.2 Approche alternative avancée par fonctions matricielles et SCAN
Les praticiens chevronnés de Google Sheets se heurtent fréquemment aux limitations de la fonction standard ARRAYFORMULA dès lors qu’il s’agit d’implémenter des équations aux différences récursives. Par sa nature purement vectorielle parallèle, ARRAYFORMULA traite chaque ligne de façon isolée et se révèle structurellement incapable d’interroger le résultat d’évaluation de la ligne immédiatement précédente au sein de sa propre plage d’extension.
Néanmoins, l’introduction récente dans le moteur de calcul de Google Sheets des fonctions d’ordre supérieur issues du lambda-calcul — plus particulièrement la fonction SCAN combinée à LAMBDA — a révolutionné le traitement des séries cumulatives récursives. La fonction SCAN est conçue pour itérer sur un tableau en conservant et mettant à jour un accumulateur interne d’état à chaque incrément temporel, reproduisant fidèlement le comportement d’une boucle itérative récursive sans exiger la moindre recopie manuelle de cellule.
Pour générer l’intégralité de la colonne MME d’un seul jet matriciel depuis une cellule unique sans jamais étirer de formule, l’analyste peut déployer en cellule C2 l’architecture matricielle moderne suivante :
=LET(donnees; B2:B21; alpha; 2 / (E1 + 1); SCAN(INDEX(donnees; 1); donnees; LAMBDA(prev; curr; prev + alpha * (curr - prev))))
L’anatomie de cette construction se décompose selon une élégance mathématique absolue :
- La fonction LET instancie des variables locales nommées (
donneesetalpha) afin de clarifier la syntaxe et d’optimiser les performances de compilation. - L’instruction INDEX(donnees; 1) isole l’observation inaugurale pour pré-charger la valeur d’ancrage initiale au sein de l’accumulateur.
- La fonction SCAN balaie ensuite la plage séquentielle, transmettant à chaque cycle à l’opérateur LAMBDA l’état accumulé antérieur
prevet l’observation incidentecurr. - La fonction
LAMBDArenvoie la valeur corrigée par le facteur d’amortissement, déployant automatiquement un vecteur dynamique fluide sur toute la profondeur de la série sans risque d’altération consécutive à l’insertion ou à la suppression d’une ligne intermédiaire.
7. Étude de cas paramétrique : Comparaison multi-horizons (MME 3, 5 et 10)
7.1 Modélisation d’une MME réactive à ultra-court terme (n=3)
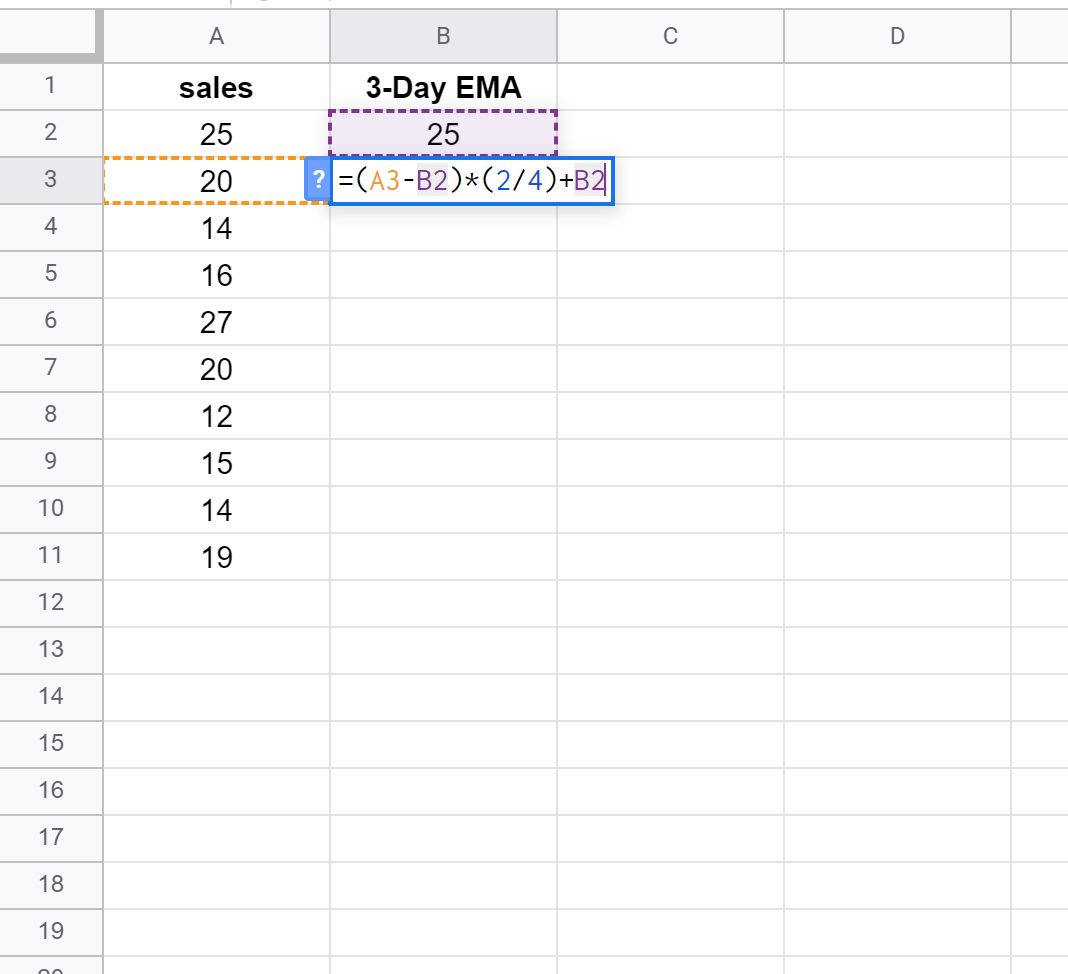
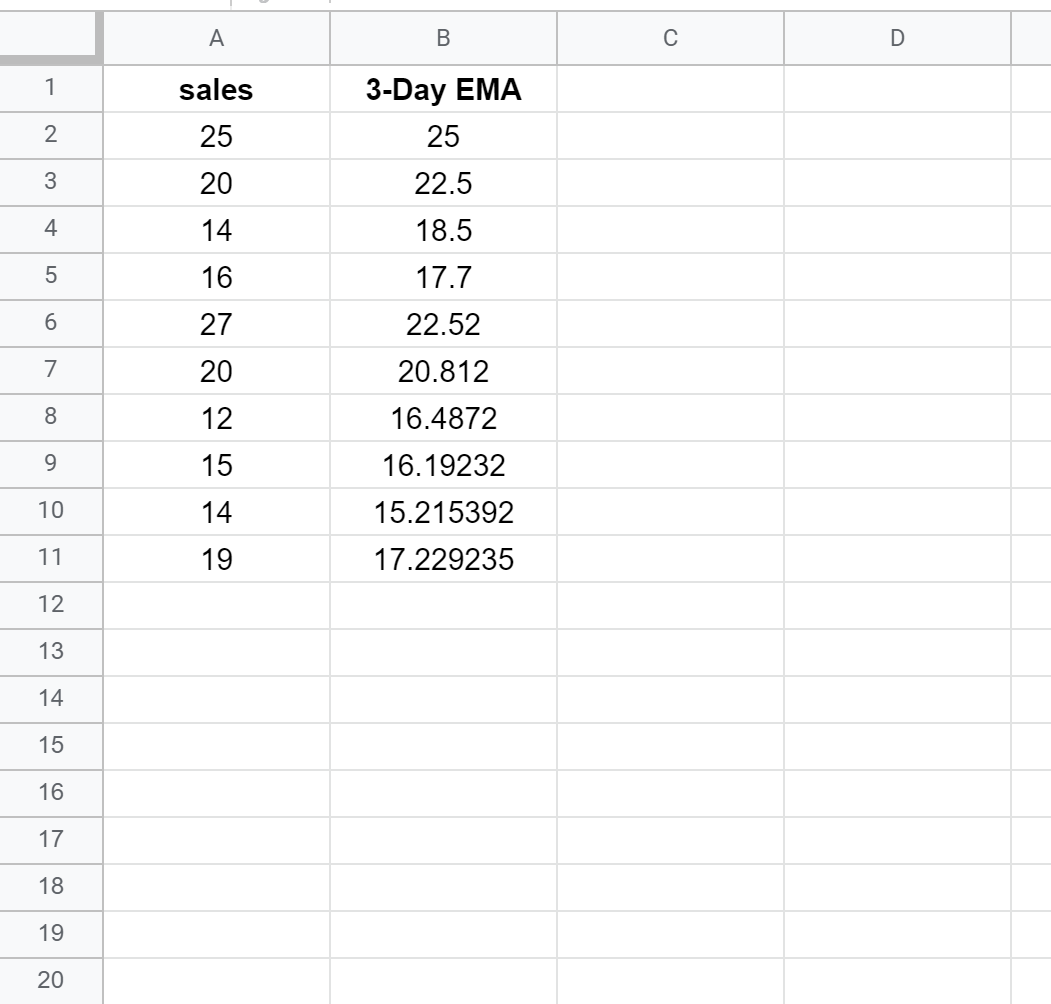
Pour appréhender concrètement l’influence de la temporalité sur le comportement dynamique du filtre, il est instructif de soumettre un échantillon identique à une grille d’horizons contrastés. Considérons dans un premier temps l’ajustement d’une moyenne mobile exponentielle configurée pour une réactivité à ultra-court terme sur une période n = 3.
L’application de la relation fondamentale détermine un facteur d’amortissement particulièrement agressif :
alpha_{3} = 2 / (3 + 1) = 2 / 4 = 0,5
Un coefficient alpha de 0,5 signifie que chaque nouvelle observation brute contribue pour moitié intégrale à la détermination de la valeur lissée contemporaine, le passé tout entier n’assurant que les 50 % restants de l’information structurelle. Sur le plan cinématique, cette MME se distingue par une quasi-absence de déphasage temporel : elle colle avec une fidélité aiguë aux accélérations, décélérations et inversions de pente du processus sous-jacent.
Néanmoins, cette sensibilité exacerbée s’accompagne d’un coût statistique non négligeable. En laissant passer la moitié de la variance du bruit stochastique haute fréquence, la MME 3 se révèle extrêmement vulnérable aux fausses cassures et aux soubresauts idiosyncratiques du marché ou du flux mesuré. Elle s’apparente davantage à un filtre de contournement qu’à un véritable révélateur de tendance structurelle lourde.
7.2 Paramétrage d’horizons médians et longs (n=5 et n=10)
Élargissons à présent la focale temporelle en introduisant deux fenêtres complémentaires calibrées respectivement sur des horizons médians (n = 5) et longs (n = 10) :
- Pour n = 5 : alpha_{5} = 2 / (5 + 1) = 2 / 6 = 0,3333 (le tiers de la valeur contemporaine est injecté dans le filtre).
- Pour n = 10 : alpha_{10} = 2 / (10 + 1) = 2 / 11 = 0,1818 (l’observation récente ne pèse plus que 18,2 % du niveau résultant).
L’inflexion progressive des multiplicateurs induit une métamorphose visible du comportement de l’estimateur. Pour n = 5, le signal commence à absorber harmonieusement les chocs de faible intensité tout en épousant les mouvements tactiques hebdomadaires ou mensuels. Pour n = 10, la dynamique entre dans une phase d’amortissement profond : la courbe adopte un profil adouci, insensible aux remous ponctuels, isolant la trajectoire de fond avec une remarquable autorité.
Toutefois, cette stabilisation accrue s’accompagne d’une sanction mécanique inévitable : le retard temporel ou temps de latence de phase. Lors d’une inversion brusque et durable de la trajectoire empirique, la MME 10 mettra un nombre significatif de cycles avant que son inertie interne ne soit vaincue par l’accumulation continue des nouveaux résidus, matérialisant visuellement un retard d’ajustement structurel face aux configurations de rupture de régime.
7.3 Architecture comparative multi-colonnes
Pour formaliser cette analyse comparée de manière ergonomique au sein de Google Sheets, l’analyste avisera de structurer une matrice d’évaluation comparative ordonnée selon un déploiement multi-colonnes adjacent. Cette disposition permet une lecture multidimensionnelle immédiate de la cinématique des flux :
- Colonne A : Index temporel chronologique (Période t).
- Colonne B : Observation quantitative empirique (Y_t).
- Colonne C : MME Réactive (n = 3, formule faisant référence à alpha = 0,5).
- Colonne D : MME Intermédiaire (n = 5, formule faisant référence à alpha = 0,3333).
- Colonne E : MME Structurelle (n = 10, formule faisant référence à alpha = 0,1818).
Cette juxtaposition révèle toute sa puissance diagnostique lors de l’étude géométrique des croisements de moyennes mobiles. L’intersection ascendante de la MME 3 au-dessus de la MME 10 formalise une accélération positive nette du momentum de court terme s’émancipant de l’inertie de long terme, signalant conventionnellement une impulsion tendancielle majeure. Inversement, l’écartement géométrique relatif — ou divergence — entre ces différentes trajectoires fournit un indicateur précieux sur l’état de tension ou de surchauffe dynamique caractérisant le phénomène sous observation.
8. Visualisation graphique et analyse sémiotique des courbes
8.1 Génération du graphique combiné dans Google Sheets
La transcription graphique de l’analyse séquentielle constitue l’aboutissement indispensable de toute modélisation quantitative. L’interprétation sémiotique d’une courbe continue supplante largement la simple lecture de matrices tabulaires denses, à condition que le moteur graphique de Google Sheets soit paramétré avec une rigueur méthodologique sans faille.
Pour insérer un graphique composite de haute qualité diagnostique :
- Mettez en surbrillance l’intégralité de la plage de données comparative, en incluant la ligne d’en-tête (par exemple,
A1:E21). - Naviguez dans l’arborescence du ruban supérieur et activez la séquence Insertion > Graphique.
- Dans le panneau latéral de configuration qui s’affiche à droite de l’écran, sélectionnez l’onglet « Configuration » et choisissez le type « Graphique en courbes » ou « Graphique combiné ».
- Veillez impérativement à cocher les options structurelles : « Utiliser la ligne 1 comme en-tête » et « Utiliser la colonne A comme étiquettes d’axe X ».
Dans l’onglet « Personnaliser », accédez à la section « Séries » pour attribuer à chaque tracé une signature visuelle discriminante. Il est méthodologiquement recommandé d’affecter à la série des observations brutes réelles (Y_t) une ligne fine d’un gris neutre ou un tracé discontinu agrémenté de points discrets circulaires, afin de matérialiser sa nature de nuage empirique bruité. En contraste, les tracés de la MME doivent être habillés de couleurs chromatiques franches à forte visibilité (par exemple, un bleu roi pour la MME 3 et un bordeaux profond pour la MME 10), avec une épaisseur de trait portée à deux ou trois pixels afin de magnifier la clarté sémiologique du signal extrait.
8.2 Ergonomie visuelle et optimisation de la charge cognitive
L’efficacité d’un tableau de bord décisionnel repose sur sa capacité à respecter les lois universelles de la psychologie de la forme (théorie de la Gestalt), notamment les principes de continuité, de proximité et de saillance visuelle. Une surcharge d’éléments graphiques accessoires nuit gravement à la décantation intuitive de la composante tendancielle.
Pour purger le graphique de tout parasitisme informationnel (le fameux chartjunk dénoncé par Edward Tufte) :
- Allégez substantiellement le quadrillage d’arrière-plan en désactivant le quadrillage secondaire et en atténuant la tonalité des lignes maîtresses d’échelle.
- Ajustez précisément la graduation des axes vertical (ordonnées) et horizontal (abscisses) via les options d’échelle afin de circonscrire la représentation à la fenêtre effective de variabilité des données, proscrivant les zones de vide spatial qui écrasent artificiellement les dynamiques de fluctuation.
- Intégrez des annotations textuelles ponctuelles (via l’insertion d’annotations dans les séries de données de Google Sheets) directement sur les coordonnées d’inversion structurelle majeure ou de basculement de régime, guidant instantanément la cognition de l’auditeur vers les faits stylisés porteurs de sens opérationnel.
8.3 Interprétation analytique des comportements de courbe
L’examen géométrique attentif des trajectoires tracées permet de segmenter l’état du système en trois régimes comportementaux universels :
1. La phase d’orientation directionnelle (Tendance affirmée) : Lors d’une expansion ou d’une contraction linéaire soutenue, les différentes moyennes mobiles exponentielles s’ordonnent selon un étagement géométrique parfait en éventail sans chevauchement parasite. Dans une dynamique haussière structurelle, la série brute survole la MME réactive (n=3), qui surplombe elle-même la MME intermédiaire (n=5), cette dernière dominant rigoureusement la MME lente (n=10). L’espacement spatial régulier entre ces courbes mesure l’intensité de l’accélération tendancielle.
2. Le régime stationnaire oscillatoire (Phase de congestion ou de range) : Lorsque le phénomène étudié fluctue de manière anarchique autour d’une espérance mathématique horizontale sans direction affirmée, les courbes de MME convergent spatialement les unes vers les autres jusqu’à s’entrelacer intimement. Cette compression d’écartement témoigne d’une quasi-annulation du momentum de moyen terme et alerte l’analyste sur l’inefficacité temporaire des modèles suiveurs de tendance.
3. Le phénomène de retour à la moyenne (Mean Reversion) : Toute divergence géométrique extrême mesurée par la distance euclidienne verticale entre l’observation instantanée Y_t et sa MME 10 traduit un étirement cinématique hors-norme. Les lois stochastiques sous-jacentes tendant à ramener périodiquement les réalisations vers leur centre d’inertie dynamique, ces distorsions spatiales majeures préfigurent fréquemment des corrections abruptes ou des consolidations horizontales imminentes.
9. Évaluation quantitative de la précision et métriques d’erreur
9.1 Calcul de l’erreur absolue moyenne (MAD / MAE)
L’appréciation de la pertinence d’un modèle de lissage ne saurait reposer sur une simple impression visuelle subjective. L’exigence scientifique impose d’objectiver la qualité d’ajustement du filtre au moyen d’indicateurs de performance statistiques normalisés mesurant la dispersion des résidus de prévision. Le premier de ces indicateurs est l’écart absolu moyen (MAD pour Mean Absolute Deviation, ou MAE pour Mean Absolute Error).
Sur le plan mathématique, la MAD se définit comme la moyenne arithmétique de la valeur absolue des écarts d’estimation constatés sur les N observations exploitables :
MAD = (1 / N) * SUM_{t=1}^{N} |Y_t – MME_t|
Pour opérationnaliser cette métrique dans Google Sheets sans alourdir la feuille de calcul par une colonne intermédiaire de résidus absolus, insérez dans une cellule de synthèse dédiée la formule matricielle suivante :
=MOYENNE(INDEX(ABS(B2:B21 - C2:C21); 0))
ou plus sobrement, par validation matricielle standard :
=SOMMEPROD(ABS(B2:B21 - C2:C21)) / LIGNES(B2:B21)
La vertu prépondérante de la MAD réside dans sa robustesse face aux données atypiques isolées. En ne procédant à aucune élévation au carré des écarts, elle préserve une proportionnalité stricte et linéaire de l’évaluation : une erreur d’ampleur dix pèse rigoureusement dix fois plus qu’une déviation d’ampleur unité. Elle fournit ainsi une indication limpide de l’erreur moyenne attendue, exprimée fidèlement dans la même unité de mesure physique que la variable originelle.
9.2 Modélisation de l’erreur quadratique moyenne (MSE / RMSE)
Bien que la MAD offre une lecture immédiate et intuitive, la théorie statistique classique privilégie fréquemment les métriques quadratiques pour la calibration optimale des modèles gaussiens. L’erreur quadratique moyenne (MSE pour Mean Squared Error) et sa racine carrée (RMSE pour Root Mean Squared Error) amplifient de façon non linéaire l’impact des divergences résiduelles majeures :
MSE = (1 / N) * SUM_{t=1}^{N} (Y_t – MME_t)^2
RMSE = SQRT(MSE)
L’implémentation directe de la RMSE au sein de Google Sheets mobilise l’association des fonctions RACINE et SOMMEPROD pour éviter la création de colonnes parasites :
=RACINE(SOMMEPROD((B2:B21 - C2:C21)^2) / LIGNES(B2:B21))
La RMSE opère comme une fonction de pénalisation géométrique sévère à l’encontre des défaillances prédictives de grande amplitude. Une unique divergence extrême au sein de la série chronologique viendra dégrader lourdement le score global de RMSE. Cette métrique se révèle indispensable pour évaluer des contextes opérationnels critiques — gestion de chaîne d’approvisionnement tendue ou marges de solvabilité financière — où la survenue d’une déviation macroscopique engendre des coûts de rupture infiniment plus dévastateurs qu’une suite continue de micro-imprécisions réparties.
9.3 Mesure du pourcentage d’erreur absolue moyen (MAPE)
Lorsque l’analyste se trouve confronté à la nécessité de comparer les performances relatives de filtres MME appliqués à des séries de données d’échelles physiques disparates (par exemple, comparer la précision du lissage des volumes d’un composant électronique vendu par millions d’unités avec celui d’un équipement lourd manufacturé à l’unité), les métriques absolues comme la MAD ou la RMSE s’avèrent inopérantes.
Le pourcentage d’erreur absolue moyen (MAPE pour Mean Absolute Percentage Error) contourne cet écueil en procédant à une normalisation relative systématique des résidus d’estimation rapportés à l’amplitude réelle de chaque réalisation empirique :
MAPE = (1 / N) * SUM_{t=1}^{N} [|Y_t – MME_t| / Y_t] * 100
La syntaxe matricielle compacte correspondante sous Google Sheets se structure selon le code suivant :
=SOMMEPROD(ABS((B2:B21 - C2:C21) / B2:B21)) / LIGNES(B2:B21)
Pour afficher le résultat de manière lisible, assignez simplement le format d’affichage « Pourcentage » à la cellule hôte. Le praticien doit toutefois garder à l’esprit une limitation structurelle rédhibitoire de la métrique MAPE : dès lors qu’une série chronologique intègre des valeurs empiriques nulles (Y_t = 0) ou asymptotiquement proches de zéro, le dénominateur de l’équation provoque une instabilité par division par zéro ou une explosion mathématique artificielle de l’erreur relative, imposant alors le basculement vers des formulations alternatives symétriques telles que le sMAPE (symmetric MAPE).
10. Techniques avancées et automatisation via Google Apps Script
10.1 Conception d’une fonction personnalisée MME en JavaScript
Bien que les formulations natives sous feuille de calcul et les fonctions modernes matricielles SCAN couvrent une large palette de cas d’usage, le traitement analytique de jeux de données massifs ou la nécessité d’encapsuler la logique métier dans des modules réutilisables justifie le recours à l’environnement de développement Google Apps Script. L’écriture d’une fonction personnalisée (Custom Function) permet d’étendre le vocabulaire syntaxique natif de Google Sheets en créant une formule dédiée accessible directement depuis la barre d’édition.
Pour déployer cette solution d’ingénierie logicielle, ouvrez le tableur hôte et empruntez le chemin Extensions > Apps Script. Effacez l’ensemble des instructions génériques présentes dans l’éditeur de code et transférez rigoureusement le script optimisé suivant :
/**
 * Calcule la moyenne mobile exponentielle (MME) d'une série temporelle discrète.
 *
 * @param {range} rangeObservations Plage matricielle verticale contenant les valeurs observées.
 * @param {number} periode Horizon temporel équivalent n (par défaut 10).
 * @return Vecteur vertical contenant la trajectoire de la série lissée.
 * @customfunction
 */
function MOYENNE_MOBILE_EXPONENTIELLE(rangeObservations, periode) {
  // Contrôle d'intégrité et affectation des paramètres par défaut
  var n = (periode && !isNaN(periode) && periode > 0) ? Number(periode) : 10;
  var alpha = 2.0 / (n + 1.0);

  // Aplatissement matriciel pour convertir la sélection en tableau unidimensionnel
  var observations = [];
  if (Array.isArray(rangeObservations)) {
    for (var i = 0; i < rangeObservations.length; i++) {
      var val = rangeObservations[i][0];
      if (val !== "" && !isNaN(val) && val !== null) {
        observations.push(Number(val));
      }
    }
  } else if (!isNaN(rangeObservations)) {
    observations.push(Number(rangeObservations));
  }

  var longueur = observations.length;
  if (longueur === 0) {
    return [];
  }

  // Déclaration du conteneur vectoriel de sortie
  var resultatMME = [];

  // Initialisation de la première valeur (condition germe MME_1 = Y_1)
  var valeurCourante = observations[0];
  resultatMME.push([valeurCourante]);

  // Boucle de récurrence itérative vectorielle du premier ordre
  for (var t = 1; t < longueur; t++) {
    valeurCourante = (observations[t] - valeurCourante) * alpha + valeurCourante;
    resultatMME.push([valeurCourante]);
  }

  return resultatMME;
}
La mention de l’annotation déclarative JSDoc @customfunction revêt un rôle clé : elle informe le compilateur interne de Google Sheets de référencer immédiatement cette fonction au sein du dictionnaire de complétion automatique du tableur. Désormais, l’utilisateur peut inscrire simplement en cellule C2 l’instruction épurée :
=MOYENNE_MOBILE_EXPONENTIELLE(B2:B21; 10)
et observer le déversement automatique de la colonne lissée intégrale sans avoir eu à paramétrer une seule référence cellulaire relative ou absolue.
10.2 Optimisation des performances sur volumétries massives
Dès lors que les séries chronologiques atteignent des dimensions industrielles — dépassant plusieurs dizaines de milliers d’enregistrements temporels consécutifs —, la mise en œuvre de scripts personnalisés exige un respect intransigeant des principes d’optimisation computationnelle liés à l’architecture en nuage de Google Apps Script.
L’écueil de programmation le plus destructeur consiste à exécuter des appels périodiques de l’API de feuille de calcul (méthodes getValue() ou setValue()) à l’intérieur du corps de la boucle itérative. Chaque interaction avec l’environnement Google Sheets engendre une pénalité de latence réseau et des surcoûts de sérialisation JSON colossaux, menant rapidement à l’interruption prématurée du script pour dépassement du temps d’exécution maximal alloué (typiquement six minutes sous licence standard).
Le script présenté à la section 10.1 applique strictement le paradigme de l’ingénierie vectorielle in-memory : l’intégralité de la plage cellulaire source est capturée en un appel système unique, convertie en un tableau JavaScript natif en mémoire vive, traitée via une boucle itérative séquentielle ultra-rapide n’opérant que sur des registres locaux de type primitif flottant, puis restituée au moteur de la feuille de calcul sous forme d’une matrice bi-dimensionnelle globale via un unique retour de fonction. Cette approche réduit de plus de 99 % les temps de traitement CPU et assure une réactivité parfaite même lors des recalculs consécutifs à la mise à jour dynamique des données sources.
11. Champs d’application transversaux : Économie, opérations et sciences humaines
11.1 Analyse opérationnelle et prévision des flux logistiques
Dans le domaine du management des opérations et du pilotage des chaînes d’approvisionnement (Supply Chain Management), la moyenne mobile exponentielle forme la pierre angulaire des systèmes adaptatifs de réapprovisionnement sous point de commande. La demande des clients étant par nature assujettie à une volatilité stochastique permanente, les gestionnaires de stocks ne peuvent dimensionner leurs approvisionnements sur des valeurs ponctuelles brutes au risque de provoquer le redoutable « effet coup de fouet » (Bullwhip effect), caractérisé par une amplification exponentielle de la variabilité en amont de la chaîne de valeur.
L’utilisation de la MME permet d’établir un lissage robuste de la demande moyenne par période de réapprovisionnement. Plus décisif encore : le calcul en continu de l’écart absolu moyen (MAD) issu des résidus de la MME sert de paramètre direct pour le calibrage probabiliste du stock de sécurité. En postulant une distribution d’erreurs approximativement normale, l’écart-type résiduel estimé est obtenu en multipliant la MAD par un facteur de proportionnalité standard d’environ 1,25, garantissant ainsi un dimensionnement précis des matelas de protection face aux ruptures de stock sans immobilisation excessive de capital circulant.
Cette méthodologie d’amortissement procure aux décideurs opérationnels une résilience accrue face aux crises de disponibilité, absorbant les micro-pics éphémères de surconsommation sans déclencher d’ordres de fabrication paniques tout en suivant fidèlement les réorientations durables des tendances de consommation réelles.
11.2 Modélisation en psychométrie et dynamique comportementale
L’application du filtrage exponentiel s’étend avec une remarquable fécondité au domaine des sciences humaines et de la psychologie quantitative expérimentale. Dans le cadre de l’évaluation continue des états affectifs, des niveaux d’engagement au travail ou de la vigilance cognitive au sein de protocoles de mesure écologique momentanée (Ecological Momentary Assessment), les observations recueillies par questionnaires auto-rapportés sont notoires pour leur taux élevé de bruit subjectif transitoire lié à l’humeur instantanée ou à la fatigue passagère du participant.
En soumettant ces métriques comportementales denses à un lissage exponentiel, les chercheurs parviennent à filtrer les artéfacts circonstanciels pour révéler les profils dispositionnels profonds des individus. Par ailleurs, la MME constitue un modèle mathématique direct de la courbe d’apprentissage humain régie par la loi de pratique de Thurstone : elle formalise la manière dont les performances d’un individu progressent par révision adaptative pondérée sous l’effet de la rétroaction immédiate de ses succès et erreurs passés.
Cette approche trouve également des débouchés majeurs en sociométrie computationnelle et dans l’analyse de sentiment sur les réseaux sociaux. L’agrégation séquentielle des tonalités émotionnelles d’un groupe d’individus via une MME permet d’identifier l’émergence d’ondes sociologiques profondes ou de changements d’opinion publique pérennes, tout en ignorant les flambées de polarisations fugaces sans ancrage structurel.
11.3 Surveillance des indicateurs financiers et de rentabilité
L’univers des marchés financiers et de l’ingénierie financière quantitative constitue le terrain d’élection historique le plus documenté de la moyenne mobile exponentielle. Dans l’analyse des séries temporelles boursières, les cours de clôture quotidiens ou intrajournaliers sont soumis à une composante aléatoire brownienne qui obscurcit la lecture de la tendance fondamentale dictée par les forces macroéconomiques de l’offre et de la demande.
Les professionnels de l’analyse technique mobilisent massivement les MME d’horizons standardisés — notamment les fameuses MME à 20, 50 et 200 périodes. La vitesse de réaction supérieure de la MME permet d’identifier précocement le fléchissement d’une dynamique de prix bien avant que les moyennes arithmétiques équivalentes ne pivotent, optimisant les fenêtres temporelles d’allocation d’actifs ou de couverture de portefeuille (hedging). De célèbres indicateurs composites, au premier rang desquels figure le MACD (Moving Average Convergence Divergence) conceptualisé par Gerald Appel, reposent intégralement sur le différentiel d’écartement calculé entre deux MME d’échéances dissemblables.
Toutefois, l’usage des moyennes exponentielles en matière financière s’accompagne d’un impératif éthique et méthodologique d’humilité. Face à l’hypothèse d’efficience des marchés formalisée par Eugene Fama, l’analyste doit se garder de considérer la MME comme un oracle déterministe prédictif infaillible. Elle demeure un indicateur descriptif retardé (lagging indicator) mesurant l’état des forces cinématiques passées, dont l’automatisation intégrale sans contrôle humain des régimes de volatilité extrême expose le capital à des risques de pertes consécutives (drawdown) considérables lors des faux signaux d’inversion.
12. Synthèse méthodologique, diagnostics d’erreurs et recommandations
12.1 Typologie des erreurs fréquentes dans Google Sheets
L’implémentation opérationnelle de la récurrence au sein d’un tableur expose fréquemment l’utilisateur non averti à un faisceau d’erreurs méthodologiques et techniques spécifiques qu’il convient de savoir diagnostiquer avec célérité :
- Le décalage temporel d’indice (confusion t et t-1) : L’erreur la plus pernicieuse consiste à introduire dans la formule d’actualisation de la cellule C3 la référence courante B3 mais en retranchant par mégarde la cellule C3 elle-même au lieu de C2. Cette bévue déclenche immédiatement un message d’alerte rouge d’erreur de référence circulaire bloquante, le moteur de calcul entrant dans une boucle de calcul infinie non convergente.
- L’altération de la dynamique séquentielle lors d’insertions de lignes : L’insertion incontrôlée d’une nouvelle ligne de données en plein milieu d’une plage préexistante brise fréquemment les continuités de formules relatives si l’opération n’est pas suivie d’une ré-application scrupuleuse de la poignée de recopie, fragmentant la mémoire de la série chronologique.
- La pollution par format texte insidieux : Si des valeurs quantitatives ont été importées via des fichiers plats CSV mal délimités où la virgule décimale est substituée par un point ou vice-versa, Google Sheets traite ces entrées comme des étiquettes textuelles pures. La formule récursive renvoie alors une erreur d’argument
#VALEUR!, faute de pouvoir appliquer l’opérateur arithmétique de soustraction sur une chaîne alphanumérique.
Pour auditer promptement l’architecture d’un classeur, utilisez le raccourci d’affichage global des formules Ctrl + ~ (ou via le menu « Affichage » > « Afficher » > « Formules »). Ce mode révèle instantanément l’ensemble du code sous-jacent, permettant d’inspecter visuellement l’alignement continu des indices relatifs et le verrouillage permanent des ancrages absolus.
12.2 Limites intrinsèques du modèle exponentiel univarié
En dépit de son élégance mathématique et de son incontestable efficacité pratique, la moyenne mobile exponentielle simple (MME d’ordre 1) demeure un modèle univarié fondamentalement bridé par des hypothèses structurelles simplificatrices dont l’analyste doit impérativement avoir conscience sous peine de déconvenues prédictives majeures :
1. L’inaptitude structurelle face aux tendances continues fortes : Lorsque la série sous-jacente s’engage dans une croissance ou une décroissance séculaire régulière non stationnaire, la MME simple présente un biais asymptotique structurel : elle se traîne perpétuellement en contrebas (en cas de hausse) ou au-dessus (en cas de baisse) de la série observée, incapable de résorber ce décalage géométrique permanent. Pour neutraliser cette faiblesse, il est impératif d’évoluer vers le modèle de lissage exponentiel double de Holt, qui adjoint un second accumulateur récursif spécifiquement dédié à l’estimation de la pente de la tendance locale.
2. L’aveuglement face aux composantes saisonnières cycliques : La MME simple traite chaque choc comme un événement transitoire amortissable, sans posséder la structure mémorielle idoine pour anticiper qu’un écart mesuré à l’instant t répond à une périodicité saisonnière stricte (par exemple, un pic de consommation estival récurrent). En présence de rythmes calendaires affirmés, seul le modèle complet de Holt-Winters (lissage exponentiel triple) combinant coefficients de niveau, de pente et facteurs saisonniers multiplicatifs ou additifs permet une modélisation intègre du processus.
3. L’amplification délétère du déphasage lors d’accélérations paraboliques : Si le phénomène modélisé quitte une dynamique linéaire pour adopter une trajectoire d’expansion exponentielle (régime épidémiologique non freiné ou emballement spéculatif), le retard temporel de la MME s’accroît de façon disproportionnée, fournissant une estimation trompeuse et radicalement sous-évaluée de l’amplitude contemporaine réelle du système.
12.3 Bonnes pratiques académiques pour la réplicabilité des analyses
Pour conférer à vos classeurs de calcul Google Sheets la rigueur et la pérennité attendues dans un contexte d’ingénierie statistique, de recherche académique ou d’audit d’entreprise, il convient d’adopter un protocole méthodologique standardisé assurant la parfaite réplicabilité des résultats :
- L’immuabilité de la source brute : La colonne initiale contenant la série brute primaire (colonne B) doit être sanctuarisée et verrouillée en lecture seule (via « Données » > « Protéger les feuilles et les plages »). Aucune altération, ajustement subjectif ou écrasement manuel ne doit être toléré sur ces données d’ancrage afin de garantir la traçabilité intégrale de la chaîne de calcul.
- La documentation explicite des métadonnées : Ne laissez jamais des paramètres statistiques flotter implicitement au sein des formules. Chaque paramètre d’arbitrage — l’horizon n, la constante de lissage alpha, la convention retenue pour l’initialisation du germe MME_0 — doit figurer dans un tableau d’hypothèses clairement identifié et commenté en tête de feuille de calcul.
- La standardisation de la batterie d’évaluation d’ajustement : Toute publication d’une série chronologique lissée par MME devrait être systématiquement accompagnée de son encart d’évaluation statistique reportant simultanément la MAD, la RMSE et le MAPE. Cette transparence offre aux destinataires de l’analyse une mesure objective immédiate de la fidélité de la modélisation et du niveau de confiance pouvant être accordé aux extrapolations prédictives qui en découlent.
En observant scrupuleusement l’ensemble de ces préceptes algorithmiques, mathématiques et ergonomiques, vous transformez l’environnement accessible de Google Sheets en une station d’analyse prédictive de haute précision, combinant la souplesse du travail collaboratif dématérialisé avec la rigueur méthodologique sans concession requise par les standards les plus exigeants de la science des données moderne.
Références
- Box, G. E. P., Jenkins, G. M., Reinsel, G. C., & Ljung, G. M. (2015). Time series analysis: Forecasting and control (5th ed.). John Wiley & Sons. https://www.wiley.com/en-us/Time+Series+Analysis%3A+Forecasting+and+Control%2C+5th+Edition-p-9781118675021
- Brown, R. G. (1959). Statistical forecasting for inventory control. McGraw-Hill.
- Brown, R. G. (1963). Smoothing, forecasting and prediction of discrete time series. Prentice-Hall.
- Google. (2024). Aide Google Sheets : Fonction SCAN et fonctions LAMBDA. Centre d’aide Google Docs. https://support.google.com/docs/answer/12087541
- Holt, C. C. (2004). Forecasting seasonals and trends by exponentially weighted moving averages. International Journal of Forecasting, 20(1), 5–10. https://doi.org/10.1016/j.ijforecast.2003.09.015
- Hyndman, R. J., & Athanasopoulos, G. (2021). Forecasting: Principles and practice (3rd ed.). OTexts. https://otexts.com/fpp3/
- Kahneman, D., & Tversky, A. (1973). Availability: A heuristic for judging frequency and probability. Cognitive Psychology, 5(2), 207–232. https://doi.org/10.1016/0010-0285(73)90033-9
- Murphy, J. J. (1999). Technical analysis of the financial markets: A comprehensive guide to trading methods and applications. New York Institute of Finance.
- Silver, E. A., Pyke, D. F., & Thomas, D. J. (2016). Inventory and production management in supply chains (4th ed.). CRC Press. https://doi.org/10.1201/9781315374406
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.