
Dans le domaine de l’ingénierie des données et de l’analyse décisionnelle sous tableur, le traitement des séries temporelles constitue une composante fondamentale pour la modélisation financière, le suivi logistique et l’étude statistique des comportements organisationnels. Parmi les opérations récurrentes, le calcul d’une somme cumulée progressive — souvent qualifiée de total cumulé ou de total progressif — représente une nécessité méthodologique pour quiconque cherche à observer la cinétique d’un flux financier ou matériel au fil des jours. Néanmoins, l’introduction d’une granularité chronologique discrète, exigeant soit une accumulation continue, soit une réinitialisation systématique des totaux lors du franchissement d’une frontière journalière ou périodique, complexifie significativement l’architecture du calcul dans un environnement comme Microsoft Excel.
Trop souvent abordée sous un angle purement pragmatique et réducteur, la sommation par date requiert en réalité une compréhension rigoureuse des structures de données matricielles, de la mécanique interne de recalcul du logiciel et de la gestion de la mémoire vive par le processeur. Qu’il s’agisse de mesurer la distribution intra-journalière des flux de trésorerie, d’évaluer la consommation énergétique d’un parc de capteurs ou de quantifier des réponses comportementales dans un protocole d’expérimentation clinique, le choix de la méthode computationnelle conditionne directement l’exactitude des résultats, la robustesse du modèle face aux insertions de lignes et la fluidité d’exécution sur des volumes d’enregistrements massifs.
Le présent traité propose une analyse exhaustive et pluridimensionnelle des méthodologies permettant d’opérer une somme cumulée par date au sein d’Excel. En explorant successivement les fondements mathématiques sous-jacents, la préparation méticuleuse des données sources, les techniques traditionnelles fondées sur l’adressage semi-absolu et les fonctions logiques conditionnelles, les fonctions d’agrégation conditionnelle, les structures tabulaires dynamiques, les fonctions matricielles de dernière génération, ainsi que les solutions en amont offertes par le moteur d’extraction et de transformation, cette étude vise à équiper l’analyste d’un cadre conceptuel et pratique de premier ordre, adapté aux contraintes industrielles contemporaines.
1. Cadre théorique et modélisation de la somme cumulée par date dans Excel
1.1 Définition conceptuelle de la sommation progressive et cumulée
D’un point de vue strictement mathématique, une sommation progressive correspond à l’application séquentielle de l’opérateur d’addition sur une suite d’éléments discrets ordonnés dans le temps. Si l’on considère une série temporelle discrète notée X = (x₁, x₂, …, xₙ), où chaque indice correspond à un événement horodaté, le cumul partiel à l’instant k, traditionnellement noté Sₖ, est défini par la somme des termes xᵢ pour i variant de 1 à k. Cette formalisation implique une propriété d’invariance d’échelle locale : l’état du système à l’étape k est fonction exclusive de l’état précédent Sₖ₋₁ et de l’incrément courant xₖ, conférant au processus une nature récursive intrinsèque de type markovien dans sa dérivation arithmétique élémentaire.
Il convient de distinguer de manière structurelle la somme arithmétique globale, qui vise à agréger l’ensemble d’une population statistique en une valeur scalaire unique indépendamment de toute considération d’ordre chronologique, de la somme incrémentale discrète. Cette dernière génère un vecteur de dimension équivalente au vecteur source, préservant la topologie séquentielle des flux de données. Dans un espace où les valeurs sont strictement positives, la série cumulée résultante possède des propriétés fondamentales de monotonie croissante, ce qui permet d’analyser la pente instantanée comme un indicateur d’accélération ou de décélération du phénomène sous-jacent, qu’il s’agisse de liquidités, de ventes ou d’unités de production.
Dans l’écosystème d’un tableur tel qu’Excel, la modélisation de cette opération ne se limite pas à une simple transcription symbolique. Elle interagit avec le paradigme computationnel de la cellule, où chaque nœud de calcul doit théoriquement maintenir la traçabilité de ses dépendances fonctionnelles. Comprendre la somme progressive exige donc de concevoir le classeur non pas comme une grille statique, mais comme un graphe orienté acyclique dans lequel la propagation de l’information temporelle suit une trajectoire directionnelle stricte, garantissant l’intégrité de la série cumulée face aux mutations potentielles des données initiales.
1.2 Pertinence de la segmentation chronologique discrète
L’agrégation cumulative continue sur l’intégralité d’un historique temporel présente des limites analytiques évidentes dès lors que l’analyste cherche à isoler des cycles opérationnels périodiques. La segmentation chronologique discrète — consistant à borner l’accumulation à l’intérieur d’une journée calendaire ou d’une période temporelle arbitraire et à opérer une réinitialisation à zéro dès le franchissement de la frontière — répond à une nécessité impérieuse en sciences économiques, industrielles et comportementales. Cette approche permet de neutraliser les effets de niveau inter-journaliers pour se concentrer exclusivement sur la dynamique intra-journalière.
Dans l’analyse des séries temporelles haute fréquence, comme celles issues des marchés financiers ou des systèmes de métrologie industrielle, la granularité intra-journalière révèle des profils d’activité en cloche ou en « U » que l’accumulation globale masque inévitablement. Par exemple, mesurer le cumul progressif des volumes de transactions boursières entre 09:00 et 17:30 pour chaque journée indépendante permet d’établir des profils de référence moyens et de détecter des anomalies volumétriques locales. Réinitialiser le compteur à minuit ou au début de chaque vacation commerciale garantit que la métrique demeure stationnaire au sens stochastique sur le plan inter-journalier, facilitant les comparaisons longitudinales standardisées.
En sciences comportementales, l’exposition séquentielle de sujets expérimentaux à des stimuli nécessite fréquemment de cumuler des temps de réaction, des scores ou des occurrences d’actions à l’intérieur de sessions journalières étanches. Si le modèle ne prévoit pas la partition par date, l’accumulation transcende les ruptures de charge cognitives induites par le sommeil ou l’interruption de l’expérimentation, faussant irrémédiablement l’interprétation des courbes d’apprentissage. La segmentation discrète s’affirme ainsi comme une barrière étanche protégeant l’homogénéité contextuelle des mesures cumulées au sein d’une même fenêtre temporelle.
1.3 Typologie des architectures de calcul disponibles sous Excel
Face à la problématique de la sommation cumulée indexée sur le temps, l’environnement logiciel Excel ne propose pas une solution unitaire, mais un ensemble hétérogène de paradigmes computationnels, chacun présentant des compromis spécifiques en matière de performance, d’auditabilité et de maintenabilité. La première famille architecturale repose sur des mécanismes récursifs locaux, dans lesquels une cellule donnée exploite la fonction conditionnelle SI pour interroger l’état de la cellule immédiatement précédente. Cette méthode dite « d’adjacence » présente une complexité temporelle optimale, mais introduit une dépendance linéaire rigide qui la rend vulnérable aux altérations structurelles de la feuille de calcul.
La seconde famille regroupe les approches ensemblistes exploitant les plages semi-absolues — combinées avec des fonctions de sommation conditionnelle telles que SOMME.SI ou SOMME.SI.ENS. Dans cette configuration, chaque ligne réévalue l’intégralité de l’historique antérieur borné par l’ancre d’origine. Si cette typologie confère une résilience conceptuelle accrue face aux suppressions de lignes intermédiaires, elle déplace la charge computationnelle vers un ordre de complexité quadratique, susceptible d’asphyxier le moteur de calcul sur des cohortes d’enregistrements volumineuses. Ces subtilités sont documentées dans les référentiels d’ingénierie de calcul proposés par le réseau de support officiel de Microsoft Support.
Enfin, les versions contemporaines du tableur — notamment issues de Microsoft 365 et d’Office 2021 — ont vu émerger une troisième voie d’excellence : celle des formules matricielles dynamiques natives propulsées par le moteur de calcul repensé. L’introduction de fonctions de réduction vectorielle de haut niveau, à l’instar de SCAN, permet désormais de traiter l’accumulation comme une abstraction fonctionnelle pure (paradigme fonctionnel via LAMBDA), sans nécessiter d’étirement physique de formules à travers la grille. Parallèlement, l’outil d’ingestion et de transformation de données Power Query offre une architecture de prétraitement hors grille, garantissant une séparation nette entre la couche de stockage brut et la couche de visualisation.
2. Préparation et structuration rigoureuse du jeu de données source
2.1 Normalisation des formats temporels et horodatages
Avant d’initier la moindre équation de cumul, la fiabilisation des composantes temporelles constitue une condition préalable non négociable. Le moteur d’Excel modélise le temps selon un système de numérotation séquentielle hérité de son architecture originelle, où le chiffre entier 1 correspond conventionnellement au 1er janvier 1900, et où chaque unité incrémentale entière représente une journée calendaire complète de 24 heures. En corollaire, les fractions décimales sont rigoureusement réservées à la quantification du temps sous-journalier : une valeur de 0,5 correspond précisément à 12 heures d’écart, c’est-à-dire midi pile. Une confusion fréquente réside dans la coexistence accidentelle de dates tronquées (sans heure) et d’horodatages exhaustifs comportant des fractions décimales imperceptibles à l’affichage standard.
Lorsqu’une variable temporelle contient une composante horaire résiduelle alors que l’objectif analytique consiste à effectuer un cumul partitionné par date journalière, tout test logique d’égalité entre deux cellules consécutives échouera si l’égalité temporelle stricte n’est pas vérifiée à la seconde près. Pour neutraliser cet écueil, l’analyste doit impérativement procéder à la troncature systématique de la composante fractionnaire à l’aide de la fonction ENT, qui extrait la partie entière du numéro de série temporel, garantissant ainsi que deux horodatages distincts survenus le même jour (par exemple 08:30 et 16:45) partagent une identité numérique absolue. La conversion des chaînes textuelles importées depuis des bases SQL ou des fichiers CSV doit parallèlement être opérée via les fonctions DATEVAL ou l’assistant de conversion texte-en-colonnes d’Excel.
Il importe également de surveiller l’ambiguïté des formats régionaux lors des échanges transnationaux de jeux de données. La discordance entre le système calendaire grégorien européen (jour/mois/année) et la convention anglo-saxonne (mois/jour/année) constitue l’un des vecteurs majeurs de corruption silencieuse des séries chronologiques dans Excel. Si une date textuelle est interprétée de manière erronée lors de la phase d’ingestion, elle peut se voir assigner un numéro de série séquentiel totalement déconnecté de sa réalité chronologique, brisant ainsi la continuité ordonnée indispensable au mécanisme de sommation incrémentale.
2.2 Nettoyage et validation des variables numériques
L’intégrité de la sommation cumulative dépend symétriquement de la qualité sémiotique et typologique du champ quantitatif destiné à être agrégé. L’apparition d’une seule valeur non numérique — qu’il s’agisse d’un espace insécable invisible (code ASCII 160) issu d’un export ERP, d’une chaîne vide générée par une condition "" antérieure, ou d’une valeur textuelle explicite telle que « N/A » — peut entraîner la défaillance globale de la chaîne de calcul ou générer l’erreur #VALEUR! selon l’opérateur arithmétique mobilisé. Il convient d’appliquer des filtres de typage stricts et de substituer ces anomalies par des zéros numériques formels via des constructions combinant SIERREUR ou la fonction CNUM.
La mise en place de règles de validation des données directement intégrées aux colonnes de saisie prévient les altérations en amont. En contraignant les valeurs numériques à appartenir à un domaine de définition cohérent (par exemple l’ensemble des réels positifs pour des volumes physiques ou des temps de latence), l’analyste prémunit son modèle contre les saisies accidentelles de montants négatifs susceptibles d’inverser artificiellement la monotonie du cumul partiel. L’intégrité computationnelle exige également de surveiller les valeurs nulles, qui, bien qu’arithmétiquement inoffensives lors d’une addition, peuvent fausser les représentations graphiques ou les calculs ultérieurs de moyennes pondérées basés sur les occurrences non nulles.
Un autre défi structurel réside dans la précision des nombres à virgule flottante régie par la norme internationale IEEE 754. Excel opère ses calculs internes sur une précision limitée à 15 chiffres significatifs. Dans le cas de cumuls successifs impliquant des montants financiers fractionnaires ou des mesures physiques micrométriques, l’accumulation résiduelle d’erreurs d’arrondi binaire infinitésimales peut conduire à des discordances logiques inattendues lors de tests d’égalité conditionnelle ultérieurs. L’incorporation stratégique de la fonction ARRONDI(valeur; 2) ou ARRONDI(valeur; 4) au niveau de la variable d’entrée garantit une stabilité computationnelle absolue lors des processus itératifs de sommation.
2.3 Impératif du tri chronologique séquentiel
Une somme cumulée n’a de sens épistémologique et fonctionnel que si et seulement si les observations sont agencées selon une séquence ordonnée rigoureuse. Contrairement aux opérateurs d’agrégation globale qui bénéficient des propriétés de commutativité de l’addition mathématique — où l’ordre des termes n’altère en rien la somme finale —, le calcul progressif génère un vecteur d’états dont chaque composante dépend directement de la chronologie des états antérieurs. Tout désordre au sein du vecteur source corrompt instantanément la signification de la trajectoire cumulative.
Dans un contexte où de multiples transactions ou événements surviennent à l’intérieur d’une même date journalière, l’analyste doit instaurer un protocole de tri multicritère formel. Le premier niveau d’ordonnancement doit être assigné à la date calendaire principale par ordre croissant (de la plus ancienne à la plus récente). Le second niveau de tri doit s’articuler sur l’horodatage fin (l’heure précise) ou, à défaut, sur un identifiant transactionnel séquentiel univoque (tel qu’un numéro d’incrément, un numéro de facture ou un index chronologique d’enregistrement). Cette démarche garantit une reproductibilité déterministe intégrale du modèle : deux recalculs indépendants produiront rigoureusement la même trajectoire progressive.
Avant d’injecter la moindre syntaxe de calcul dans la feuille de calcul, une vérification algorithmique ou visuelle de la continuité chronologique doit être opérée. L’insertion d’une colonne de contrôle temporaire vérifiant le prédicat booléen Date_Courante >= Date_Precedente permet d’identifier immédiatement les anomalies de tri ou les inversions de lignes. Ce verrouillage préalable constitue la clé de voûte sur laquelle repose la viabilité de l’ensemble des méthodes algorithmiques détaillées ci-après.
3. Calcul de la somme cumulée globale standard : La référence matricielle
3.1 Mécanique opérationnelle de l’adressage semi-absolu
L’approche canonique enseignée pour générer un total cumulé continu dans un tableur repose sur l’exploitation subtile des mécanismes d’adressage de cellules, plus spécifiquement sur le concept de référence semi-absolue (ou semi-relative). Au sein de l’environnement Excel, le symbole dollar ($) agit comme un opérateur de verrouillage directionnel qui neutralise l’incrémentation automatique des coordonnées de lignes ou de colonnes lors de la translation de la formule à travers l’espace de la grille. En combinant judicieusement une coordonnée figée et une coordonnée mobile au sein d’un même opérateur de plage représenté par le caractère deux-points (:), on crée ce que l’on nomme techniquement une plage expansive.
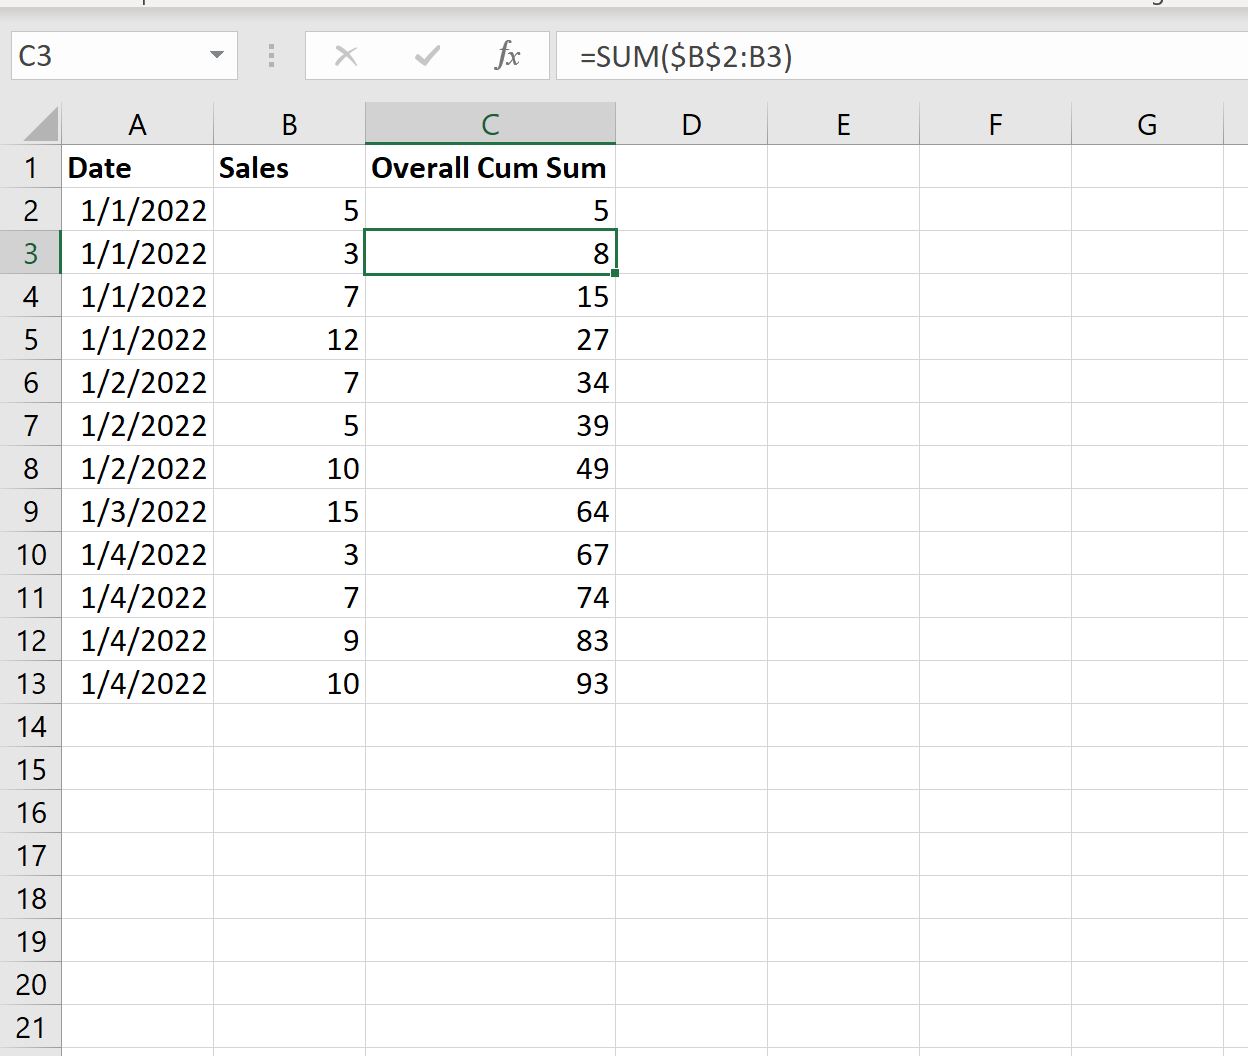
Considérons une série temporelle continue de valeurs numériques situées dans la plage B2:B100. La formule fondamentale régissant la somme cumulée globale s’énonce comme suit, saisie initialement en cellule C2 :
=SOMME($B$2:B2)
Dans cette formulation, le premier segment $B$2 constitue l’ancre fixe originelle du système de sommation. La double présence du caractère dollar sur l’identifiant de colonne et sur l’index de ligne garantit que le point de départ de l’intervalle demeurera irrévocablement rivé à la première observation, quelle que soit la cellule réceptrice finale. À l’inverse, le second segment B2 est entièrement relatif. Il ne possède aucun verrou dollar, ce qui autorise le compilateur d’Excel à réajuster dynamiquement l’indice inférieur de sommation en fonction du vecteur de translation appliqué lors du déploiement de la formule vers le bas.
3.2 Déploiement et extension incrémentale de la formule
Lorsque la formule =SOMME($B$2:B2) est copiée ou étirée verticalement le long de la colonne C, l’adresse relative s’adapte de manière strictement synchrone avec l’avancement des lignes. À la ligne 3, la syntaxe interne se transmute automatiquement en =SOMME($B$2:B3), agrégeant ainsi la partition des deux premières entrées. À la ligne 4, elle devient =SOMME($B$2:B4), et ainsi de suite jusqu’au terme de la série statistique. Ce comportement confère à la plage une propriété d’expansion géométrique unidirectionnelle, capturant à chaque palier l’intégralité de l’historique depuis l’origine jusqu’à la ligne active.
L’utilisation de la poignée de recopie (le carré noir miniature situé à l’angle inférieur droit du curseur de sélection) permet d’automatiser cette duplication à l’échelle de milliers de cellules par simple double-clic. Néanmoins, l’analyste rigoureux doit surveiller le mode de recalcul configuré dans le classeur. Dans le cas exceptionnel où le moteur est positionné en mode de recalcul manuel (accessible via l’onglet Formules > Options de calcul), la valeur affichée dans les cellules réceptrices semblera dupliquer invariablement le montant de la première ligne, suscitant une illusion de dysfonctionnement logique alors qu’il ne s’agit que d’une suspension temporaire de l’évaluation du graphe de calcul.
Il importe également d’auditer avec précision les risques de glissement référentiel lors de déplacements accidentels de blocs de cellules via la commande Couper-Coller. Si la cellule source supérieure correspondant à l’ancre $B$2 est déplacée physiquement vers un nouvel emplacement, Excel mettra à jour l’ensemble des formules dépendantes pour pointer vers cette nouvelle coordonnée, brisant involontairement la structure initiale de la plage expansive. La validation périodique de l’intégrité de la formule sur l’ultime ligne de la série constitue une bonne pratique pour certifier que le total cumulé affiché sur la ligne n coïncide rigoureusement avec la sommation globale de la table entière.
3.3 Limites de la sommation globale face aux sous-groupes temporels
En dépit de sa simplicité et de son élégance mathématique, la méthode de la plage expansive SOMME($B$2:B2) présente une lacune méthodologique majeure dès lors qu’il s’agit de traiter des données comportant des temporalités distinctes. Cette formulation est totalement agnostique vis-à-vis du contenu sémantique des colonnes adjacentes. Elle est incapable d’interpréter le passage d’une date calendaire à une autre, accumulant aveuglément les flux à l’infini jusqu’à épuisement de la plage. Dans un contexte où des événements surviennent par grappes journalières et nécessitent une réinitialisation quotidienne, la fonction SOMME simple s’avère conceptuellement inadaptée.
L’effet secondaire de cette cécité chronologique est le masquage systématique des dynamiques intra-périodiques. Si un responsable logistique cherche à identifier l’heure précise de la journée où la capacité maximale d’un entrepôt est saturée par des flux cumulés, un cumul perpétuel inter-journalier ne fournira qu’un chiffre exponentiel dépourvu de pertinence opérationnelle journalière. La courbe résultante s’élève de manière ininterrompue, occultant le phénomène de remise à zéro nocturne ou périodique propre au cycle de production.
Par conséquent, pour parvenir à scinder cette accumulation continue en segments temporels autonomes — c’est-à-dire faire en sorte que le compteur s’incrémente lors de chaque nouvelle transaction de la journée du 12 octobre, puis se réinitialise à la valeur brute de la première transaction du 13 octobre —, l’architecture computationnelle doit impérativement intégrer des opérateurs de branchement logique conditionnel. C’est ici qu’intervient la transition vers des approches analytiques plus élaborées.
4. La méthode conditionnelle fondamentale : Utilisation de la fonction SI
4.1 Formulation de l’hypothèse de transition de date
Pour construire un algorithme capable de distinguer la poursuite d’une accumulation au sein d’une même journée d’une rupture chronologique nécessitant une réinitialisation, il est impératif de formaliser un test d’équivalence logique binaire. Ce test repose sur la comparaison bilatérale entre l’horodatage de la ligne courante et l’horodatage de la ligne immédiatement antérieure. Si les deux valeurs sont identiques au sens de leur numéro de série temporel entier, le système se situe dans un état de continuité temporelle. Si les deux valeurs divergent — ce qui, sous l’hypothèse d’un tri croissant, signifie que la date courante est strictement supérieure à la date précédente —, le système traverse une frontière de transition temporelle.
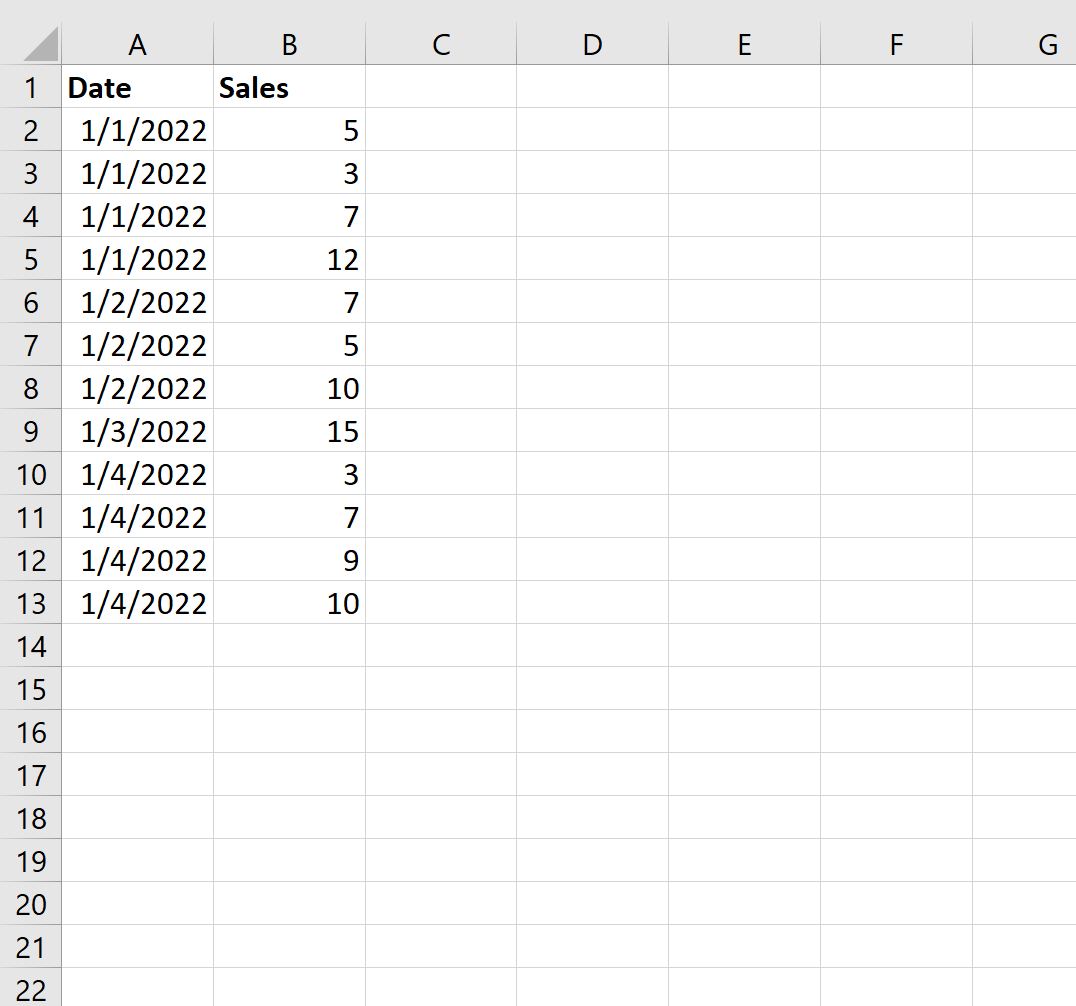
Supposons que la colonne A contienne les dates journalières ordonnées, que la colonne B héberge les valeurs scalaires à cumuler, et que la colonne C soit dédiée à l’enregistrement du total cumulé journalier réinitialisé. Pour la deuxième observation du jeu de données (ligne 3), la condition logique s’exprime par le prédicat booléen élémentaire suivant :
A3 = A2
Ce test renvoie invariablement la valeur logique VRAI si les deux enregistrements appartiennent à la même date calendaire, et la valeur FAUX dès lors que l’on bascule sur une journée nouvelle. Il est primordial d’observer que la première ligne de données (la cellule C2) échappe par définition à cette comparaison rétrospective, ne possédant aucun prédécesseur temporel valide. Elle constitue le point d’initialisation du système et doit obligatoirement recevoir une formule simplifiée ou une instanciation directe correspondant à la valeur initiale :
=B2
4.2 Construction algorithmique de l’instruction alternative
Une fois l’hypothèse de transition formalisée, le traitement des deux branches de l’alternative est confié à la fonction conditionnelle SI. L’architecture interne de cette fonction requiert trois arguments : le test logique, la valeur à retourner si le test est évalué à VRAI, et la valeur de repli si le test est évalué à FAUX. En transposant cette logique à notre problématique séquentielle, la formule complète à renseigner en cellule C3 se structure rigoureusement comme suit :
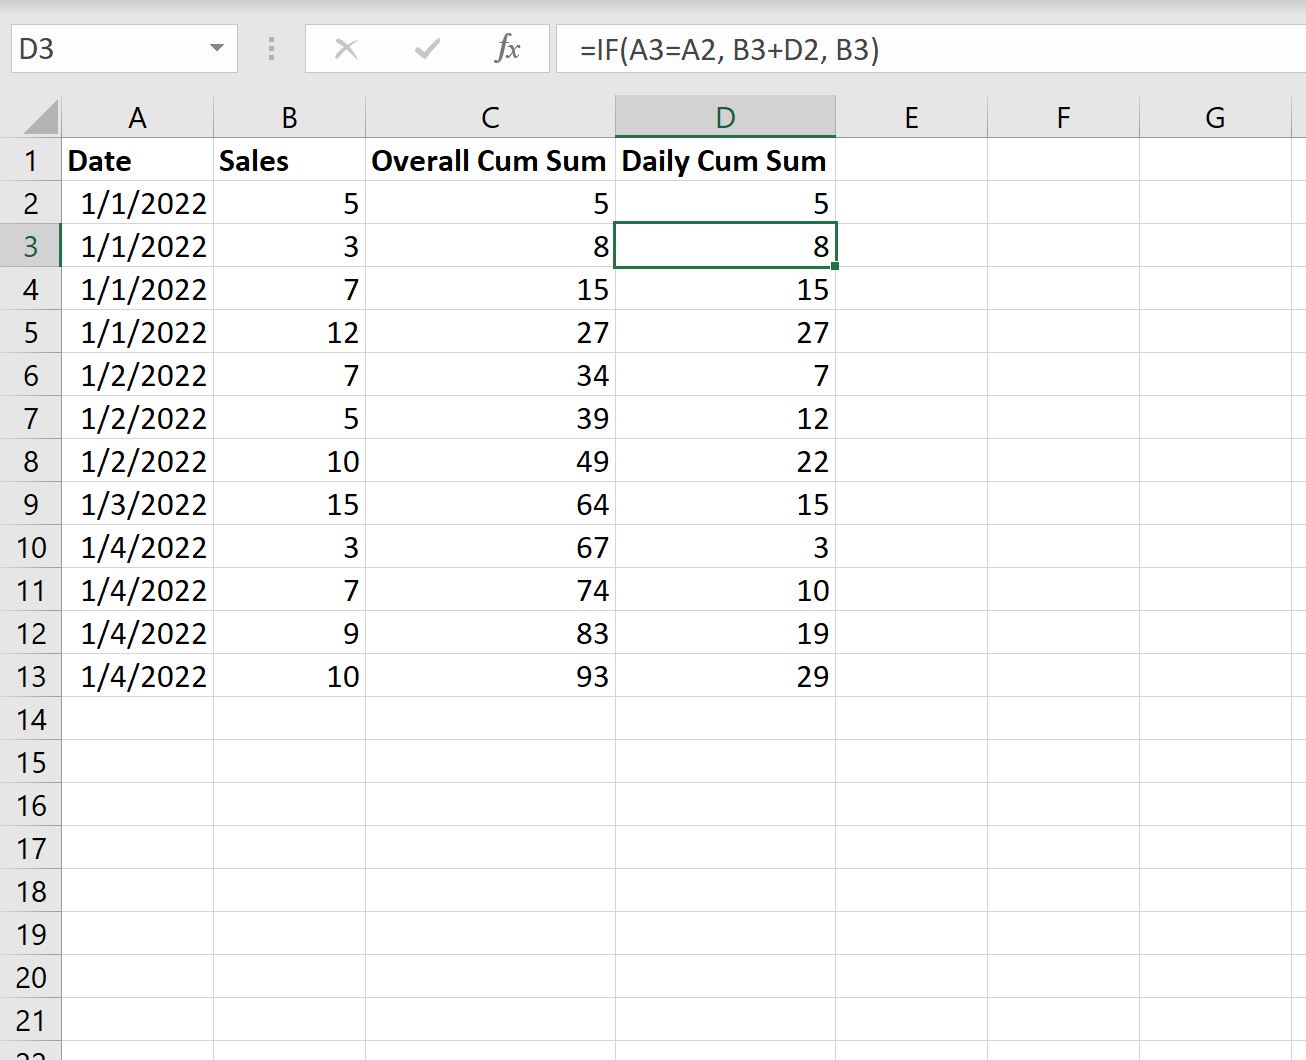
=SI(A3=A2; C2+B3; B3)
L’analyse détaillée du flux de calcul révèle l’ingéniosité de ce mécanisme récursif à mémoire courte. Dans l’éventualité où le prédicat A3=A2 est vérifié (continuité journalière), la fonction ordonne au moteur de calcul de prélever le montant cumulé déjà calculé sur la ligne précédente (C2) et de lui additionner la valeur unitaire courante (B3). On assiste ici à une exploitation du principe de la récurrence arithmétique : le cumul présent capitalise sur l’intégralité du travail de sommation préalablement consolidé dans la cellule d’au-dessus, éliminant ainsi le besoin de reparcourir l’ensemble de la plage amont.
En revanche, dans l’hypothèse où le prédicat s’avère FAUX (rupture de date), la formule bascule immédiatement sur sa branche alternative. Elle ignore totalement le contenu cumulatif de la cellule précédente C2 et retourne purement et simplement la valeur brute de la ligne active B3. La réinitialisation est ainsi consommée de manière instantanée, isolant le nouveau sous-groupe chronologique de la trajectoire cumulative de la journée antérieure.
4.3 Validation empirique et comportement de rupture journalière
L’application itérative de cette formule par étirement vertical le long de la série temporelle produit un profil d’accumulation parfaitement en dents de scie, typique des séries à réinitialisation périodique. Chaque nouvelle journée s’ouvre par la valeur faciale de son premier enregistrement, croît de manière monotone au gré des transactions intra-journalières successives, puis subit un décrochage structurel lors du saut temporel suivant. Pour valider l’exactitude du graphe de dépendance, l’analyste peut mobiliser les fonctionnalités d’audit de formules intégrées à Excel, notamment l’outil Repérer les antécédents, qui dessinera une flèche bleue pointant vers la cellule temporelle précédente A2, la date courante A3, la valeur courante B3 et le cumul antérieur C2.
Toutefois, la robustesse de cette méthode présente une vulnérabilité intrinsèque majeure : elle est extrêmement sensible aux interventions mécaniques sur la feuille de calcul. Si un utilisateur insère une nouvelle ligne vierge au milieu d’une journée existante sans y répercuter scrupuleusement la formule, ou s’il supprime accidentellement une ligne intermédiaire, la chaîne de dépendance récursive est immédiatement rompue. La suppression de la ligne référencée par C2 provoquera en chaîne l’apparition fatale de l’erreur de référence #REF! sur l’ensemble des cellules dépendantes situées en aval au sein de la même journée.
De plus, cette technique suppose de maintenir une asymétrie de conception permanente entre la toute première ligne de données — qui héberge la formule statique =B2 — et le reste du tableau qui héberge l’expression conditionnelle =SI(A3=A2; C2+B3; B3). Cette hétérogénéité structurelle complique les opérations de maintenance industrielle et interdit l’application d’un gabarit de formule unique et uniforme sur l’ensemble de la colonne analytique, un problème que les méthodes ensemblistes permettent de contourner.
5. Implémentation alternative via la fonction SOMME.SI et les plages expansives
5.1 Configuration des plages de critères semi-ancrées
Pour s’affranchir de la dépendance récursive fragile envers la cellule immédiatement supérieure et harmoniser l’écriture algorithmique dès la première ligne du jeu de données, il est possible de mobiliser la fonction d’agrégation conditionnelle SOMME.SI en la couplant avec le paradigme des plages expansives semi-ancrées. Cette approche dite « ensembliste » déplace la responsabilité de l’accumulation : au lieu de s’en remettre à la mémoire de l’étape précédente, la cellule réinterroge l’intégralité du sous-ensemble des données générées depuis l’origine jusqu’à sa propre position spatiale.
La mise en œuvre requiert la définition méticuleuse de deux plages synchrones expansives et d’un critère d’évaluation scalaire. La plage de critères, chargée de tester l’appartenance temporelle, doit englober l’historique des dates depuis la cellule d’ancrage jusqu’à la date de la ligne active. Elle s’exprime donc sous la syntaxe semi-absolue $A$2:A2. La plage de sommation, qui contient les grandeurs quantitatives à cumuler, suit rigoureusement la même cinétique géométrique en s’articulant sous la forme $B$2:B2.
Le critère de filtrage, quant à lui, est constitué par la valeur scalaire de la date de la ligne courante, représentée par la référence relative A2. Ainsi configuré, le moteur d’Excel reçoit l’instruction d’explorer l’intervalle temporel restreint débutant à la première ligne du tableau et se terminant à la ligne en cours d’évaluation, d’identifier exclusivement les cellules dont le contenu est rigoureusement identique à la date courante, et de sommer les valeurs associées au sein de la plage quantitative correspondante.
5.2 Synthèse mathématique de la formule SOMME.SI
L’assemblage syntaxique complet de cette méthode s’inscrit avec une uniformité parfaite dès la première cellule de résultat (cellule C2) :
=SOMME.SI($A$2:A2; A2; $B$2:B2)
Analysons le comportement pas à pas de cette instruction lors de sa descente le long des enregistrements. À la première ligne, la formule évalue =SOMME.SI($A$2:A2; A2; $B$2:B2). L’intervalle de recherche ne contient qu’une seule cellule (A2), qui correspond obligatoirement au critère A2 ; la fonction renvoie donc instantanément la valeur B2. À la deuxième ligne, si la date A3 est identique à A2, la formule =SOMME.SI($A$2:A3; A3; $B$2:B3) inspecte l’intervalle A2:A3, identifie deux correspondances exactes, et cumule B2 + B3.
Si, en revanche, la ligne 4 inaugure une nouvelle date calendaire (par exemple A4 est différent de A3), la formule déploiera l’expression suivante :
=SOMME.SI($A$2:A4; A4; $B$2:B4)
Le moteur balaie la plage A2:A4. Les cellules A2 et A3 ne validant pas le critère d’égalité avec A4, elles sont purement et simplement écartées de l’addition. Seule la cellule quantitative B4 est prise en compte, produisant ainsi une réinitialisation automatique du cumul sans nécessiter l’intervention du moindre opérateur logique SI. L’indépendance de chaque cellule vis-à-vis du résultat calculé par sa voisine immédiate est totale.
5.3 Évaluation comparative des approches récursive et ensembliste
Sur le plan de l’ingénierie et de la maintenance de modèles de données, la méthode SOMME.SI sur plages expansives surpasse incontestablement l’approche conditionnelle séquentielle SI(A3=A2; ...) en termes d’intégrité structurelle. D’une part, elle permet de propager une formule rigoureusement identique de la ligne 2 jusqu’à la ligne n, simplifiant le déploiement par script ou par double-clic d’en-tête. D’autre part, la suppression d’une ou plusieurs lignes au cœur de la base de données ne provoque aucune rupture référentielle de type #REF! : Excel réajuste automatiquement les bornes inférieures des plages expansives des cellules subséquentes sans corrompre le modèle.
Un autre atout fondamental réside dans sa tolérance relative aux désordres de tri chronologique. Tandis que l’algorithme SI(A3=A2) s’effondre lamentablement dès lors que les données ne sont pas triées — réinitialisant le compteur à chaque permutation accidentelle de dates —, la fonction SOMME.SI est capable d’agréger toutes les occurrences d’une date donnée apparaissant en amont dans la table, même si elles sont séparées par des enregistrements parasites d’une autre journée. Néanmoins, bien que le résultat mathématique soit exact, le cumul perd dans ce cas précis sa signification de progression temporelle ordonnée.
Cette supériorité architecturale s’accompagne toutefois d’un coût informatique prohibitif. La réévaluation permanente de plages croissantes implique que pour une table de n lignes, le nombre d’opérations d’inspection de cellules suit une suite arithmétique proportionnelle à n(n+1)/2. Cette complexité quadratique, invisible sur quelques centaines d’enregistrements, devient un facteur de ralentissement critique et de gel de l’application dès lors que le classeur franchit les dizaines de milliers de lignes, un phénomène dont l’analyse computationnelle sera détaillée dans la dernière partie de cette étude.
6. Utilisation avancée de la fonction SOMME.SI.ENS pour critères multiples
6.1 Extension de l’agrégation à plusieurs dimensions analytiques
Dans la pratique professionnelle des entreprises et des laboratoires de recherche, la sommation cumulative chronologique ne s’opère que très rarement sur une dimension temporelle isolée. Les bases de données agrègent quasi systématiquement des variables de segmentation catégorielles supplémentaires, telles qu’un identifiant de compte bancaire, une référence produit, un secteur géographique ou l’identifiant d’un sujet expérimental. La problématique évolue alors : il ne s’agit plus seulement de calculer un total cumulé par date, mais un total cumulé par date et par entité analytique.
Pour répondre à cette exigence multidimensionnelle, la fonction SOMME.SI.ENS s’impose comme l’outil privilégié de l’analyste sous Excel. Contrairement à son homologue univariée SOMME.SI, SOMME.SI.ENS a été conçue dès l’origine pour traiter un nombre arbitraire de paires de plages et de critères d’évaluation. Cette extension logique permet d’imposer une conjonction stricte de prédicats (opérateur logique ET) : une valeur quantitative ne sera intégrée au cumul courant que si elle valide simultanément le critère de concordance temporelle et le critère d’appartenance catégorielle.
Il convient de noter une divergence syntaxique fondamentale qui déroute fréquemment les utilisateurs lors du passage de SOMME.SI à SOMME.SI.ENS : l’ordre des arguments est inversé. Dans SOMME.SI.ENS, la plage de sommation numérique figure impérativement en toute première position dans la signature de la fonction, suivie séquentiellement des couples [Plage_Critère; Critère]. Ce remaniement syntaxique vise à standardiser l’adjonction indéfinie de dimensions analytiques sans perturber la localisation de la cible arithmétique.
6.2 Écriture de la formule multi-conditions
Considérons une structure de table où la colonne A héberge les dates calendaires, la colonne B contient l’identifiant catégoriel (par exemple le code du sujet ou du département), et la colonne C consigne le montant quantitatif du flux transactionnel. La colonne D est allouée au calcul de la somme cumulée conditionnelle progressive. Dès la cellule D2, la syntaxe exhaustive s’articule comme suit :
=SOMME.SI.ENS($C$2:C2; $A$2:A2; A2; $B$2:B2; B2)
La mécanique interne d’évaluation repose sur la synchronisation spatiale absolue des trois plages expansives :
$C$2:C2définit le vecteur des valeurs numériques candidates à l’agrégation.$A$2:A2constitue le premier vecteur d’inspection dimensionnelle, évalué face au critère scalaireA2(la date de l’enregistrement actif).$B$2:B2représente le second vecteur d’inspection dimensionnelle, testé en miroir vis-à-vis du critère scalaireB2(la catégorie de l’enregistrement actif).
Une règle architecturale intangible régit le fonctionnement de SOMME.SI.ENS : toutes les plages d’inspection et de calcul doivent impérativement présenter des dimensions géométriques isomorphes (même nombre de lignes et même nombre de colonnes). Toute disparité dimensionnelle — par exemple en écrivant par mégarde $A$2:A3 au lieu de $A$2:A2 dans l’un des arguments — provoquera irrémédiablement le renvoi de l’erreur d’incompatibilité de forme #VALEUR!.
6.3 Cas d’usage : Cumuls par sujet d’expérimentation et par date
Pour illustrer la puissance opérationnelle de cette construction, analysons un protocole d’expérimentation clinique en neurosciences comportementales. Durant plusieurs jours consécutifs, plusieurs cohortes de participants (identifiés par un code univoque tel que SUJET_01, SUJET_02) sont soumises à des séries d’épreuves cognitives répétées au cours de chaque journée. Chaque épreuve génère un score d’effort ou une charge attentionnelle chiffrée. L’objectif consiste à observer la dynamique d’épuisement cognitif en cumulant les scores au fil des épreuves, en garantissant l’étanchéité absolue des cumuls entre sujets d’une part, et entre journées d’autre part.
Grâce à la formule SOMME.SI.ENS($C$2:C2; $A$2:A2; A2; $B$2:B2; B2), le tableau de données peut accueillir les enregistrements des différents sujets entremêlés au fil de la journée sans altérer la rigueur des résultats. Lorsque l’algorithme évalue une ligne relative au SUJET_01 pour la journée du 15 novembre, il exclut instantanément de la sommation les scores obtenus par le SUJET_02 le même jour, ainsi que l’ensemble des scores enregistrés par le SUJET_01 lors des journées antérieures.
Le tableau analytique suivant illustre la mécanique opératoire sur un échantillon représentatif de données expérimentales :
| Ligne | Date (Col A) | Sujet (Col B) | Score (Col C) | Cumul Journalier Sujet (Col D) | Commentaire d’évaluation de la formule |
|---|---|---|---|---|---|
| 2 | 2024-05-01 | SUJET_A | 15 | 15 | Initialisation SUJET_A pour le 01/05. |
| 3 | 2024-05-01 | SUJET_B | 20 | 20 | Initialisation SUJET_B pour le 01/05 (exclut le score de A). |
| 4 | 2024-05-01 | SUJET_A | 10 | 25 | Cumul incrémental de SUJET_A (15 + 10). |
| 5 | 2024-05-01 | SUJET_B | 30 | 50 | Cumul incrémental de SUJET_B (20 + 30). |
| 6 | 2024-05-02 | SUJET_A | 12 | 12 | Rupture de date : réinitialisation complète de SUJET_A. |
Cette granularité analytique garantit une conformité statistique absolue des données de sortie, autorisant un contrôle qualité continu sans nécessiter de retraitements manuels fastidieux par filtres successifs.
7. Intégration au sein des tableaux structurés Excel (ListObjects)
7.1 Particularités et syntaxe des références structurées
L’introduction des tableaux structurés — historiquement désignés sous l’appellation d’objets ListObjects dans le modèle d’objet Excel et formalisés depuis Excel 2007 — a profondément bouleversé l’écriture des formules dans le tableur. Les références traditionnelles aux coordonnées alphanumériques de type A2:C100 cèdent la place à des références structurées nominatives basées sur le nom explicite du tableau et l’intitulé de ses colonnes. Cette abstraction renforce considérablement la lisibilité sémantique des modèles financiers et scientifiques.
Toutefois, la transposition du concept de plage expansive semi-absolue au sein d’un tableau structuré pose un défi syntaxique singulier. Par défaut, la notation structurée standard ne propose pas d’équivalent natif direct et intuitif au symbole dollar pour ancrer une cellule de départ. Si l’on nomme notre table Table_Ventes, une référence de la forme Table_Ventes[@Montant] désigne la valeur de la colonne « Montant » située sur la ligne active, l’arobase (@) faisant office d’opérateur d’intersection implicite.
Pour simuler une plage expansive semi-ancrée depuis la première ligne de données jusqu’à la ligne active au sein d’un ListObject, il convient d’exploiter une syntaxe double articulée autour des crochets d’en-tête et de la notation de délimitation. La formulation standardisée pour ancrer la tête de colonne prend la forme suivante :
Table_Ventes[[#En-têtes];[Montant]] ou plus communément l’ancrage direct sur la première cellule de données via une référence mixte : INDEX([Montant]; 1):[@Montant].
7.2 Formulation conditionnelle adaptée aux tables dynamiques
Face à la complexité de l’expansion structurée, la mise en œuvre de la méthode récursive conditionnelle SI s’affirme comme une alternative particulièrement élégante, sous réserve de maîtriser l’adressage de la ligne antérieure. Au sein d’un tableau structuré, faire référence à la cellule de la ligne précédente exige une prudence méthodologique extrême pour éviter de corrompre l’intégrité du tableau lors de tris ultérieurs ou de provoquer des références circulaires involontaires.
La solution la plus robuste consiste à combiner l’adressage relatif conventionnel au sein de la syntaxe de la table ou à utiliser la fonction INDEX. Supposons que notre tableau structuré se nomme DataLog et contienne les colonnes Date_Mesure, Flux et Cumul_Jour. Si l’on écrit la formule directement dans la colonne Cumul_Jour en exploitant la référence relative standard pour le terme précédent, la formule de la ligne 3 (deuxième ligne de données du tableau) s’énonce :
=SI([@Date_Mesure]=DECALER([@Date_Mesure]; -1; 0); DECALER([@Cumul_Jour]; -1; 0) + [@Flux]; [@Flux])
L’emploi de la fonction DECALER([@Date_Mesure]; -1; 0) permet de cibler rigoureusement la cellule située exactement une ligne au-dessus de la ligne en cours d’évaluation, indépendamment du nom spécifique de cette coordonnée. Cependant, la fonction DECALER étant par nature volatile — ce qui contraint Excel à recalculer la totalité de la colonne dès la moindre modification apportée au classeur entier —, les architectes de bases de données privilégient souvent l’écriture d’une référence mixte sur l’en-tête ou l’usage de la fonction INDEX non volatile :
=SI([@Date_Mesure]=INDEX([Date_Mesure]; LIGNE()-LIGNE(DataLog[#En-têtes])-1); INDEX([Cumul_Jour]; LIGNE()-LIGNE(DataLog[#En-têtes])-1) + [@Flux]; [@Flux])
Une précaution impérative s’impose : la toute première ligne de la table générera une erreur si la fonction DECALER ou INDEX tente d’interroger la ligne d’en-tête textuelle. Il est donc indispensable d’envelopper cette expression dans une vérification de la position ordinale de la ligne, par exemple via SI(LIGNE()=LIGNE(DataLog[#En-têtes])+1; [@Flux]; ...).
7.3 Avantages de la maintenance automatisée des formules
En dépit des exigences syntaxiques initiales, l’intégration de la sommation cumulative par date au sein des tableaux structurés procure des bénéfices considérables pour l’automatisation des flux de travail administratifs et industriels. La propriété la plus remarquable des ListObjects réside dans le mécanisme des colonnes calculées auto-expansives. Dès lors qu’une formule valide est confirmée sur une ligne quelconque de la colonne, Excel la propage instantanément et de façon homogène sur l’ensemble des enregistrements présents et futurs de cette même colonne.
Lors de l’adjonction de nouvelles données — que ce soit par saisie manuelle en bas de liste ou par collage d’un bloc d’enregistrements externes —, la table structurée redimensionne automatiquement son périmètre. Les formules de cumul sont instantanément appliquées aux nouvelles lignes sans nécessiter aucune opération manuelle de recopie vers le bas de la part des utilisateurs finaux. Cette caractéristique élimine radicalement les erreurs d’omission de formule qui pullulent traditionnellement dans les classeurs non structurés.
Par ailleurs, la stabilité référentielle offerte par les tableaux protège le classeur contre les ruptures de formules lors du renommage des en-têtes de colonnes. Si la colonne Date_Mesure est renommée en Date_Evenement, Excel mettra à jour en temps réel l’ensemble des expressions mathématiques internes sans générer d’erreurs #NOM?. La documentation et la transmissibilité des feuilles de calcul s’en trouvent substantiellement assainies au sein des équipes d’analystes.
8. Approche moderne par formules matricielles dynamiques (Excel 365 et 2021)
8.1 Exploitation de la fonction SCAN pour un cumul vectoriel pur
L’avènement du moteur de calcul matriciel dynamique au sein de Microsoft 365 a constitué une véritable révolution de paradigme, reléguant les techniques traditionnelles d’étirement de cellules au rang d’artefacts historiques. Au cœur de cette modernisation figure la fonction d’ordre supérieur SCAN, membre éminent de la famille des fonctions d’assistance LAMBDA. Inspirée des concepts d’accumulation fonctionnelle (tels que le fold ou le reduce incrémental dans les langages de programmation contemporains), SCAN permet de balayer un vecteur séquentiel et d’accumuler un état intermédiaire sans jamais écrire une seule cellule intermédiaire sur la grille.
La signature canonique de la fonction SCAN s’articule autour de trois composants majeurs : un accumulateur initial, le tableau de données à parcourir, et une fonction personnalisée LAMBDA qui prescrit la transformation arithmétique à appliquer à chaque palier. Dans un cas de sommation cumulative globale sans contrainte de date, l’instruction =SCAN(0; B2:B100; LAMBDA(a; b; a+b)) suffit à générer l’intégralité du vecteur cumulé en une seule opération unifiée.
Pour introduire la réinitialisation conditionnelle par date dans ce paradigme fonctionnel pur, la fonction LAMBDA doit pouvoir évaluer simultanément la valeur quantitative et la rupture chronologique. Dès lors que l’analyste exploite la puissance des itérateurs vectoriels, il élimine purement et simplement le concept de boucle manuelle et confie au moteur multithread d’Excel l’optimisation bas niveau de la trajectoire cumulative.
8.2 Déploiement d’une formule matricielle unifiée
Pour déployer une somme cumulée par date réinitialisée à chaque nouvelle occurrence journalière via une formule unique logée dans une seule et unique cellule, on peut mobiliser une technique combinant la génération d’un index séquentiel via SEQUENCE et la fonction SCAN. Considérons que les dates ordonnées soient logées dans la plage A2:A100 et les montants dans la plage B2:B100. En cellule C2, l’analyste peut inscrire l’architecture matricielle avancée suivante :
=LET(

  Dates; A2:A100;

  Flux; B2:B100;

  Indices; SEQUENCE(LIGNES(Dates));

  SCAN(0; Indices; LAMBDA(cumul; idx;

    SI(idx=1; INDEX(Flux; 1);

      SI(INDEX(Dates; idx) = INDEX(Dates; idx-1);

        cumul + INDEX(Flux; idx);

        INDEX(Flux; idx)

      )

    )

  ))

)
Cette formulation déploie une efficacité algorithmique remarquable. La fonction LET assigne des variables sémantiques locales pour éviter la réévaluation répétée des bornes géométriques. La fonction SCAN parcourt ensuite la série ordinale d’indices 1, 2, ..., n. Pour chaque index idx, la fonction LAMBDA examine si l’indice courant est le premier (initialisation), puis vérifie si la date associée à l’index courant coïncide avec celle de l’index idx-1.
L’intégralité du vecteur résultat est déversée (« spill ») sur la feuille de calcul de manière dynamique depuis la cellule C2 jusqu’à la cellule C100 sans qu’aucune formule ne soit présente dans les cellules sous-jacentes. Si une valeur vient obstruer la zone de déversement (par exemple un texte préexistant en C50), Excel intercepte immédiatement le conflit et affiche l’erreur protectrice #PROPAGATION! (ou #SPILL!), empêchant tout écrasement silencieux de données préexistantes.
8.3 Combinaison avec les fonctions LET, UNIQUE et FILTRE
L’adoption des fonctions matricielles contemporaines ne se borne pas à reproduire les architectures colonnaires traditionnelles : elle permet de concevoir des modules de synthèse cumulatifs totalement autonomes et déconnectés de la grille de saisie brute. En associant LET, UNIQUE, FILTRE et SCAN, l’analyste peut concevoir un tableau de bord capable d’extraire dynamiquement la liste des dates uniques d’une base brute, d’extraire les flux associés et de générer une table cumulative en une seule ligne de commande déclarative.
Cette modularisation interne assure une lisibilité inégalée du code de calcul. Les variables définies à l’intérieur du bloc LET sont stockées temporairement dans la mémoire cache du moteur d’évaluation, ce qui élimine les temps de latence induits par l’interrogation récurrente des cellules physiques de la feuille. En termes de clarté algorithmique, l’analyste transforme Excel en un environnement de programmation fonctionnelle appliqué à la comptabilité et à l’économétrie.
De surcroît, cette démarche matricielle unifiée garantit une étanchéité absolue contre les manipulations frauduleuses ou maladroites des opérateurs tiers. Les utilisateurs ne peuvent pas altérer ou effacer par inadvertance une portion intermédiaire de la colonne de cumul : la formule n’existant physiquement qu’au sein de la première cellule de tête, toute tentative de modification d’une cellule intermédiaire de la plage propagée est bloquée par l’interface logicielle.
9. Traitement et modélisation en amont via Power Query
9.1 Structuration du flux de données dans l’éditeur Power Query
Lorsque les volumes de données temporelles excèdent les capacités d’évaluation fluide de la grille de calcul — par exemple lors de l’importation de journaux d’événements industriels (logs) comportant plusieurs centaines de milliers d’entrées —, l’exécution du calcul cumulatif in situ via des formules natives devient sous-optimale. L’environnement Power Query, moteur de transformation et de chargement (ETL) intégré nativement à Excel, constitue le réceptacle architectural idéal pour exécuter cette modélisation en amont de la restitution.
La première phase opératoire consiste à importer la source brute dans l’éditeur Power Query et à procéder à un typage drastique des attributs. Le champ temporel doit être converti explicitement au type Date (ou Date/Heure selon le besoin), et le champ quantitatif au type Nombre décimal ou Nombre entier. Cette standardisation élimine à la source les ambiguïtés textuelles et les anomalies de formats régionaux qui polluent couramment les formules de feuilles de calcul.
Immédiatement après l’étape de typage, un tri chronologique croissant rigoureux doit être appliqué sur la colonne de date principale, doublé le cas échéant d’un tri secondaire sur l’horodatage fin ou l’identifiant séquentiel d’événement. Dans l’écosystème du langage M sous-jacent à Power Query, il est capital de figer cet ordonnancement en mémoire vive à l’aide de la fonction Table.Buffer. Cette étape de mise en tampon garantit que le moteur de streaming n’altérera pas l’ordre physique des lignes lors des phases ultérieures de partitionnement et d’agrégation matricielle.
9.2 Partitionnement par date et ajout de colonnes personnalisées
L’implémentation d’une somme cumulée réinitialisée par date au sein de Power Query repose sur une technique de partitionnement logique en groupes locaux. L’analyste applique l’instruction Regrouper par sur la colonne temporelle, en sélectionnant l’opération Toutes les lignes. Cette transformation scinde la table principale en un dictionnaire de sous-tables étanches, où chaque journée calendaire héberge sa propre sous-table autonome contenant exclusivement les transactions lui appartenant.
À partir de cet état partitionné, il est possible d’itérer sur chaque sous-table pour y incorporer un cumul progressif à l’aide des fonctions fonctionnelles du langage M. Deux alternatives s’offrent alors :
- L’ajout d’une colonne d’index local (de 1 à k) au sein de chaque sous-table, suivi de l’extraction séquentielle des sous-listes via
List.FirstNcouplée à la fonction d’agrégation arithmétiqueList.Sum. - L’utilisation de la fonction de parcours récursif de liste
List.Generate, qui génère directement la série cumulée avec des performances computationnelles optimales.
Le fragment de code de script M ci-après détaille la transformation type appliquée à la table partitionnée :
= Table.AddColumn(PrecedentEtape, "CumulTable", each Table.AddColumn([DonneesGroupees], "CumulJour", (ligne) => List.Sum(List.FirstN([DonneesGroupees][Montant], Table.PositionOf([DonneesGroupees], ligne) + 1))))
Une fois la transformation cumulative validée au sein de chaque compartiment journalier, l’analyste procède au redéploiement (développement) de l’ensemble des sous-colonnes initiales. Le jeu de données retrouve sa structure tabulaire tabulaire continue initiale, enrichi d’une colonne de somme cumulée par date rigoureusement calculée et exempte de la moindre formule active sur la grille de sortie.
9.3 Rapatriement et actualisation automatique dans la feuille de calcul
L’ultime étape du flux Power Query consiste à charger le modèle finalisé dans la feuille de calcul Excel sous la forme d’une table structurée statique optimisée (ou directement dans le modèle de données Power Pivot pour analyse relationnelle). Ce mode d’opération procure un avantage décisif sur le plan des ressources matérielles : les valeurs cumulées étant désormais matérialisées sous forme de données brutes calculées en mémoire amont, elles ne sollicitent absolument aucun cycle CPU lors de la navigation, du filtrage ou de la manipulation interactive du classeur.
La persistance des résultats offre une stabilité absolue. Il n’existe aucun risque d’altération accidentelle des formules par les opérateurs finaux, ni de ralentissement lors de l’ouverture du classeur. Dès lors que de nouveaux enregistrements transactionnels sont injectés dans la source initiale (qu’il s’agisse d’un fichier CSV externe, d’une base de données SQL ou d’une feuille de saisie), la régénération de l’intégralité de la chaîne de calcul s’exécute d’un simple clic sur le bouton Actualiser tout (ou via le raccourci Ctrl + Alt + F5).
Cette séparation claire entre la couche d’ingestion/transformation de données et la couche de visualisation constitue le standard de référence dans le cadre des bonnes pratiques d’architecture décisionnelle contemporaine, libérant le tableur de ses contraintes d’évaluation scalaire sur les gros volumes.
10. Agrégation chronologique cumulée via les Tableaux Croisés Dynamiques
10.1 Paramétrage des champs de valeurs en affichage cumulatif
Pour les scénarios où l’analyste souhaite agréger et visualiser une somme cumulée par date sans injecter la moindre formule sur la grille et sans recourir à l’éditeur Power Query, le moteur des Tableaux Croisés Dynamiques (TCD) offre une solution native méconnue : les calculs de champs secondaires en mode cumulatif. Cette fonctionnalité délègue au moteur d’analyse OLAP interne d’Excel la gestion intégrale de l’accumulation séquentielle des flux.
La mise en œuvre s’effectue en glissant la dimension temporelle (le champ de date) dans la zone des Lignes du tableau croisé, et la variable quantitative à sommer dans la zone des Valeurs. Par défaut, Excel génère une sommation classique non cumulée. Pour métamorphoser cet affichage en série progressive :
- Accéder aux Paramètres des champs de valeurs via un clic droit sur l’en-tête de la colonne de résultat.
- Sélectionner l’onglet Afficher les valeurs.
- Dérouler le menu contextuel et choisir l’option Résultat cumulé par.
- Désigner rigoureusement le champ temporel de base (la colonne des dates) comme élément d’incrémentation séquentiel dans la liste déroulante des champs de base.
Cette configuration ordonne au composant de pivot d’agréger incrémentalement les montants au fur et à mesure de l’avancement chronologique le long des lignes du tableau. Il est généralement préconisé de désactiver le grand total général de fin de table ou de l’auditer avec discernement, sa valeur finale étant mécaniquement équivalente à l’ultime palier cumulé de la dernière ligne temporelle.
10.2 Gestion des niveaux hiérarchiques de dates
L’un des comportements automatisés du moteur de TCD sous les versions modernes d’Excel réside dans le regroupement chronologique spontané. Lors du dépôt d’un champ de date dans la zone des lignes, Excel segmente fréquemment la variable en une hiérarchie arborescente intégrant les Années, les Trimestres et les Mois. Cette abstraction peut profondément modifier l’interprétation du résultat cumulé par date.
Si la hiérarchie temporelle est déployée, l’analyste peut paramétrer l’affichage cumulatif de façon à ce que l’incrémentation s’opère soit au niveau de la date journalière individuelle au sein de chaque mois, soit au niveau global de l’année. Lorsque le regroupement s’articule par mois, le basculement vers un nouveau dossier mensuel réinitialise automatiquement le cumul si l’élément de base sélectionné est le jour, créant une somme progressive intra-mensuelle d’une grande valeur analytique pour le contrôle de gestion budgétaire.
Si l’objectif réside en revanche dans l’observation stricte de la série chronologique brute non segmentée, l’analyste doit dissoudre ces agrégations arborescentes. Un clic droit sur n’importe quel nœud temporel de la table, suivi de la commande Dissocier, restaure instantanément l’affichage linéaire des dates originelles dans leur plus fine granularité, permettant à l’option de cumul de balayer le calendrier de manière ininterrompue.
10.3 Limites fonctionnelles du Tableau Croisé Dynamique pour les cumuls réinitialisés
En dépit de sa vélocité de configuration, le Tableau Croisé Dynamique présente une limitation fonctionnelle rédhibitoire pour l’analyste confronté à des événements intra-journaliers multiples qui requièrent un cumul progressif ligne par ligne. Le TCD opère par essence une condensation synthétique des observations : il agrège obligatoirement l’ensemble des transactions survenues au cours d’une même journée calendaire en un sous-total unique par date.
Par conséquent, il est rigoureusement impossible d’utiliser un TCD pour visualiser le cumul progressif transaction par transaction à l’intérieur d’une journée donnée, sauf à intégrer l’horodatage fin à la seconde ou l’identifiant transactionnel unique dans la zone des lignes, ce qui détruit la lisibilité synthétique du rapport. De surcroît, le TCD ne permet pas nativement de programmer une condition de réinitialisation journalière arbitraire sur des flux transactionnels désordonnés sans l’imbrication préalable d’une hiérarchie temporelle formelle.
L’arbitrage décisionnel entre l’emploi du Tableau Croisé Dynamique et le déploiement de formules in situ (telles que SI, SOMME.SI ou SCAN) se résume donc à une question de granularité : pour une analyse macroéconomique synthétique cumulée au jour le jour, le TCD constitue une solution d’une remarquable efficacité ; pour une analyse micro-opérationnelle décortiquant les fluctuations internes d’une vacation journalière, l’écriture de formules matricielles ou relationnelles demeure la seule issue technique viable.
11. Analyse des anomalies, pièges courants et méthodes de débogage
11.1 Discordances typologiques et dates sérialisées sous forme de texte
La source la plus pernicieuse de dysfonctionnement lors du calcul d’une somme cumulée par date provient de l’altération typologique des champs temporels. Dans une proportion non négligeable de fichiers issus d’extractions logicielles hétéroclites, les dates affichées ne sont pas des numéros de série séquentiels internes d’Excel, mais de simples chaînes de caractères typographiques (format texte) déguisées par un alignement visuel trompeur. Cette divergence sémantique brise irrémédiablement toute tentative d’évaluation logique.
Considérons la formule conditionnelle =SI(A3=A2; C2+B3; B3). Si la cellule A2 héberge un numéro de série séquentiel authentique (par exemple la valeur numérique 45425 mise en forme en 12/05/2024) tandis que la cellule A3 contient la chaîne textuelle "12/05/2024", le test logique d’égalité A3=A2 retournera inéluctablement la valeur FAUX, nonobstant leur ressemblance visuelle parfaite à l’écran. Le moteur réinitialisera alors indûment le cumul, créant une rupture chronologique artificielle.
Pour déceler et éradiquer ces anomalies, l’analyste dispose de protocoles de test normalisés :
- L’application de la fonction
ESTNUM(cellule)doit impérativement retournerVRAIsur l’ensemble de la colonne des dates. - En cas de renvoi de la valeur
FAUX, l’injection de la fonctionDATEVAL(cellule)ou la multiplication unitaire par le scalaire 1 (ex.cellule*1) force la coercition du texte en valeur séquentielle. - L’utilisation de l’outil natif Convertir (situé dans l’onglet Données) permet de transformer une colonne entière de dates textuelles en numéros de série en spécifiant le format de source d’origine (JMA ou MAJ) lors de la troisième étape de l’assistant.
11.2 Désordres séquentiels consécutifs à des opérations de tri ultérieures
L’extrême sensibilité des formules de cumul progressif aux manipulations manuelles constitue un facteur de fragilité opérationnelle souvent sous-estimé par les concepteurs de classeurs. L’intégrité de la formule récursive =SI(A3=A2; C2+B3; B3) repose sur une hypothèse implicite fondamentale : l’ordonnancement séquentiel rigoureusement continu des enregistrements. Si un utilisateur ultérieur applique un filtre de tri ponctuel sur une autre dimension — par exemple en triant la table par ordre alphabétique de client ou par montant décroissant de transaction —, la relation d’adjacence entre les lignes est anéantie.
Dans cette hypothèse, les transactions appartenant à une même date calendaire se retrouvent dispersées de manière discontinue à travers l’espace de la feuille de calcul. L’algorithme SI(A3=A2) ne rencontrant plus ses pairs temporels sur les lignes adjacentes directes, la colonne de cumul se met à réinitialiser le sous-total de façon anarchique à chaque changement de ligne. Pire encore : l’absence d’erreur formelle (aucun message d’erreur explicite tel que #VALEUR! n’est généré) masque la défaillance logique aux yeux des auditeurs non avertis.
Pour prémunir les modèles contre ce péril, deux mesures conservatoires s’imposent :
- L’insertion d’une colonne d’indexation immuable attribuant un numéro d’ordre chronologique d’origine (de 1 à n), couplée à une règle de mise en forme conditionnelle signalant en rouge tout désordre séquentiel via une formule de contrôle
=A2>A3. - Le basculement délibéré vers l’approche ensembliste
SOMME.SIou vers les formules matricielles dynamiques fermées, qui intègrent une résilience intrinsèque supérieure face aux opérations de filtrage ou de tri partiel.
11.3 Éradication des références circulaires et des décalages d’offset
Les erreurs de manipulation d’adresses de plages lors de l’écriture ou de l’étirement des formules génèrent régulièrement deux pathologies computationnelles classiques : la référence circulaire involontaire et le décalage d’offset asymétrique. La référence circulaire survient dès lors qu’une cellule de cumul s’inclut elle-même, directement ou indirectement, au sein de sa propre plage de sommation. Ce phénomène survient fréquemment lors de l’usage inattentif de SOMME.SI, par exemple en saisissant en cellule C3 :
=SOMME.SI($A$2:A3; A3; $C$2:C3) (au lieu de pointer vers la colonne des montants bruts B).
Dans ce scénario, la cellule C3 tente de sommer une plage qui englobe sa propre valeur non encore stabilisée. Excel déclenche instantanément une alerte modale d’avertissement de boucle itérative et bloque l’évaluation du graphe de calcul, attribuant à la cellule la valeur résiduelle 0 ou figeant les calculs du classeur.
Le décalage d’offset asymétrique, quant à lui, résulte d’une incohérence dans l’alignement vertical des arguments d’une fonction d’agrégation conditionnelle. Si l’analyste écrit en cellule C3 :
=SOMME.SI($A$2:A3; A3; $B$1:B2)
Les bornes géométriques de la plage de test (lignes 2 à 3) ne coïncident pas avec les bornes de la plage de calcul (lignes 1 à 2). Bien qu’Excel tente parfois d’opérer une compensation interne silencieuse, cette distorsion spatiale conduit à des agrégations totalement erronées où le montant cumulé associé à la date de la ligne courante correspond en réalité aux grandeurs de la ligne antérieure. Le déploiement méthodique de l’outil Évaluer la formule (accessible via l’onglet Formules) permet d’inspecter l’évaluation étape par étape de chaque opérande pour localiser et rectifier instantanément ces décalages spatiaux.
12. Optimisation des performances et complexité algorithmique sur grands volumes
12.1 Complexité computationnelle comparée des méthodes
D’un point de vue de l’informatique théorique et de la théorie de la complexité des algorithmes appliquée aux tableurs, l’ensemble des méthodes présentées dans ce mémoire ne présente pas la même efficience lors du passage à l’échelle. L’analyse de la complexité temporelle formelle — modélisée à l’aide de la notation grand O — met en lumière des écarts de comportement d’une magnitude considérable dès que la volumétrie dépasse le seuil des dizaines de milliers d’enregistrements.
La méthode récursive séquentielle fondée sur l’expression conditionnelle SI(A3=A2; C2+B3; B3) opère selon une complexité linéaire parfaite notée O(n). En effet, pour chaque nouvelle ligne ajoutée au tableau, le moteur d’évaluation n’exécute qu’un nombre strictement constant et unitaire d’opérations élémentaires : un test d’égalité logique scalaire et une addition arithmétique simple à deux termes. Le coût informatique total croît de manière strictement proportionnelle au nombre de lignes n, ce qui en fait l’algorithme in situ le plus performant pour l’environnement logiciel.
À l’opposé diamétral, la méthode ensembliste articulée sur les plages expansives semi-absolues de type SOMME.SI($A$2:A2; A2; $B$2:B2) relève d’une complexité algorithmique quadratique formalisée par O(n²). À la ligne k, le moteur doit inspecter séquentiellement k cellules temporelles et sommer potentiellement k cellules numériques. Le volume cumulé d’accès mémoire pour évaluer une table de taille n équivaut à la somme des entiers de 1 à n, soit exactement :
Nombre total d’opérations = n(n + 1) / 2
Pour un classeur de 1 000 lignes, l’impact reste marginal (environ 500 000 opérations élémentaires). En revanche, sur un volume professionnel de 200 000 lignes, l’évaluation de la formule SOMME.SI requiert l’exécution vertigineuse de plus de 20 milliards d’itérations d’inspection de cellules. Cette surcharge computationnelle gargantuesque conduit inéluctablement à la saturation intégrale des cœurs du processeur, à des gels d’interface prolongés et, dans les cas extrêmes, au crash brutal du processus EXCEL.EXE par épuisement des ressources d’exécution.
12.2 Gestion des ressources mémoire et du moteur multi-cœur
Au-delà de la volumétrie brute d’opérations arithmétiques, l’impact sur les performances interagit profondément avec l’architecture matérielle du terminal informatique et le modèle de threading du moteur de recalcul d’Excel. Depuis sa version 2007, Excel embarque un moteur de calcul parallèle multithread sophistiqué, conçu pour scinder les chaînes d’évaluation indépendantes et les assigner simultanément aux différents cœurs logiques du processeur. Toutefois, la structure intrinsèque des algorithmes de sommation cumulative influe drastiquement sur l’efficacité de cette parallélisation.
La méthode récursive =SI(A3=A2; C2+B3; B3) impose une dépendance directionnelle sérielle absolue : la cellule C100 ne peut en aucun cas être évaluée avant que C99 ne soit définitivement stabilisée, qui elle-même exige la résolution préalable de C98, et ainsi de suite jusqu’à l’ancre d’origine. Cette chaîne de dépendance séquentielle irréductible empêche le moteur de calcul de paralléliser l’évaluation le long d’une même colonne. Le travail est confiné à un seul cœur de traitement, neutralisant les avantages théoriques d’une station de travail multi-cœurs. Néanmoins, en raison de la localité spatiale des données et de l’accès immédiat aux adresses mémoires contiguës au sein de la mémoire cache L1/L2 du processeur, la vitesse d’exécution d’une chaîne SI demeure remarquablement fulgurante par rapport à une formule quadratique.
À l’inverse, l’approche SOMME.SI expansive ne présente aucune dépendance de résultat vis-à-vis des cellules voisines : la cellule C100 peut techniquement être calculée indépendamment de l’état de C99, ce qui autorise Excel à distribuer les blocs de lignes sur l’ensemble des cœurs logiques disponibles. Toutefois, cet avantage théorique de parallélisation est balayé par l’explosion exponentielle de la complexité O(n²) et les goulets d’étranglement d’accès concurrent à la mémoire vive (RAM bandwidth). Dans les environnements à haute densité de calcul, il est donc fortement recommandé de désactiver le recalcul automatique (mode manuel) lors des phases de saisie ou d’injection massive de données, puis de ne forcer le recalcul global qu’une fois la structure stabilisée via la touche F9.
12.3 Guide décisionnel pour la sélection de la méthode appropriée
Pour guider l’ingénieur de données ou le contrôleur de gestion dans le choix de l’architecture la plus efficiente, il est possible de formaliser une matrice de décision synthétisant les compromis techniques identifiés tout au long de cette étude. Ce cadre décisionnel prend en considération le volume d’enregistrements, la version logicielle cible, les exigences d’auditabilité interne et le niveau de criticité face aux manipulations structurelles des tiers.
| Scénario Opérationnel | Volumétrie Estimée | Version Requise | Méthode Recommandée | Justification Architecturale et Arbitrage |
|---|---|---|---|---|
| Modèle simple à faible volume avec saisie continue | Moins de 2 000 lignes | Toutes versions (Excel 2000-2024) | SOMME.SI Expansive | Uniformité syntaxique dès la première ligne. Résilience absolue face aux suppressions ou insertions physiques de lignes. |
| Grands volumes opérationnels avec recalcul in situ | De 2 000 à 100 000 lignes | Toutes versions (Excel 2000-2024) | Récursive SI(A3=A2) | Complexité optimale linéaire O(n). Maintien d’une fluidité interactive parfaite du classeur sans gel de l’interface. |
| Architecture moderne centralisée sans formules d’étirement | De 1 à 50 000 lignes | Microsoft 365 / Excel 2021 | SCAN / LAMBDA Matriciel | Formule unique logée en tête de colonne, protection contre l’effacement accidentel, déversement dynamique, maintenabilité optimale. |
| Traitement de Big Data / Logs transactionnels massifs | Au-delà de 100 000 lignes | Excel 2016 à 365 (avec Power Query) | Power Query (M Engine) | Externalisation totale du coût computationnel hors de la grille. Données statiques persistées, actualisation planifiée ou sur demande. |
| Reporting exécutif multidimensionnel de synthèse | Toutes tailles (après agrégation) | Toutes versions | Tableau Croisé Dynamique | Configuration « sans code » via l’option Résultat cumulé par. Idéal pour l’analyse macro inter-journalière ou mensuelle. |
En synthèse, l’analyste avisé évitera impérativement d’ériger une méthode unique en dogme universel. L’excellence en matière de modélisation sous tableur réside dans la faculté d’évaluer avec lucidité la balance entre la robustesse structurelle (garantie par les méthodes ensemblistes et les tables dynamiques) et l’économie drastique des ressources computationnelles (offerte par la logique récursive et les modules de prétraitement Power Query). La documentation rigoureuse de la méthode adoptée au sein du classeur — via l’insertion de commentaires de cellule détaillant la mécanique de rupture temporelle choisie — parachèvera l’œuvre de modélisation, garantissant l’auditabilité et la pérennité du système analytique face aux successions d’équipes opérationnelles.
Références
- Chandoo. (2020). Running totals and cumulative sums in Excel – Formulas and tips. Chandoo.org: Data Science & Excel. https://chandoo.org/wp/running-total-excel/
- Harvey, G. (2021). Excel 2021 all-in-one for dummies. John Wiley & Sons.
- Microsoft Support. (s. d.). Fonction SOMME.SI. Support Microsoft. Consulté le 15 mai 2024, à l’adresse https://support.microsoft.com/fr-fr/office/fonction-somme-si-169b8c99-c05c-4483-a712-1697a653039b
- Microsoft Support. (s. d.). Fonction SCAN. Support Microsoft. Consulté le 15 mai 2024, à l’adresse https://support.microsoft.com/fr-fr/office/fonction-scan-d58dfd11-7967-4e6d-9266-56a4224c3a64
- Peltier, J. (2018). Cumulative charting techniques for financial time series in Excel. Peltier Tech Blog. https://peltiertech.com
- Walkenbach, J. (2015). Microsoft Excel 2016 bible. John Wiley & Sons.
- Winston, W. L. (2021). Microsoft Excel data analysis and business modeling (Office 2021 and Microsoft 365) (7ᵉ éd.). Microsoft Press.