
L’analyse statistique des données contemporaines en sciences du comportement, en neurosciences, en métabolomique et en économétrie appliquée se heurte fréquemment à une aporie fondamentale : la prolifération dimensionnelle combinée à une interdépendance structurelle aiguë entre les variables explicatives. Alors que les protocoles de recherche permettent désormais l’acquisition simultanée de centaines, voire de milliers d’indicateurs psychométriques, physiologiques ou environnementaux, les postulats mathématiques sous-jacents aux techniques de régression linéaire classique s’effondrent. La singularité ou le quasi-conditionnement des matrices de covariance engendre une instabilité numérique notoire, rendant illusoire toute tentative d’inférence causale ou de prédiction robuste via les moindres carrés ordinaires. Face à ce verrou méthodologique, les chercheurs sont souvent contraints de naviguer entre la perte d’information inhérente aux sélections drastiques de variables et l’arbitraire des simplifications paramétriques.
C’est précisément au cœur de cette tension épistémologique et computationnelle que s’enracine la régression par les moindres carrés partiels, universellement désignée sous l’acronyme PLS (Partial Least Squares). Conçue initialement pour contourner les limitations des modèles économétriques structurels et perfectionnée dans le champ de la chimiométrie, la régression PLS transcende le faux dilemme entre modélisation prédictive et réduction dimensionnelle. En construisant des dimensions latentes qui maximisent délibérément la covariance entre l’espace des prédicteurs et l’espace des réponses, elle fournit une réponse élégante et mathématiquement rigoureuse aux pathologies induites par la multicolinéarité et les configurations où le nombre de variables excède substantiellement la taille de l’échantillon observable.
Le présent article propose une immersion exhaustive, théorique et appliquée, dans la modélisation par moindres carrés partiels au sein de l’environnement de calcul statistique R. Conçu selon une progression méthodique rigoureuse, ce guide décortique les fondements d’algèbre matricielle qui sous-tendent les algorithmes d’extraction factorielle, formalise la procédure itérative de déflation des covariances, et guide le chercheur à travers chacune des étapes pratiques de l’implémentation : de la configuration de l’écosystème numérique à l’exploration des données, de l’optimisation par validation croisée à l’interprétation avancée des métriques d’importance (VIP) et des diagnostics résiduels multivariés. En articulant théorie de l’estimation et rigueur de script, ce traité offre aux praticiens les clés nécessaires pour déployer la régression PLS avec un niveau d’exigence conforme aux plus hauts standards de la publication scientifique internationale.
1. Introduction aux moindres carrés partiels et au défi de la multicolinéarité
1.1 Le problème fondamental de la multicolinéarité en recherche empirique
Dans le paradigme classique du modèle linéaire général, la précision des estimateurs repose sur l’hypothèse d’indépendance linéaire des colonnes constituant la matrice des prédicteurs. Sur le plan formel, si l’on considère le modèle linéaire standard exprimé sous forme matricielle où le vecteur de réponse dépend d’une matrice de régresseurs de rang plein, l’estimation des coefficients par les moindres carrés ordinaires requiert l’inversion de la matrice carrée des produits croisés. Dès lors que deux ou plusieurs variables explicatives partagent des relations linéaires fortes, le déterminant de cette matrice tend vers zéro, traduisant un état de quasi-singularité mathématique. Cette pathologie, dénommée multicolinéarité, n’invalide pas la nature non biaisée des estimateurs, mais dégrade catastrophiquement leur précision statistique en provoquant une explosion de leur variance d’échantillonnage.
L’inflation de la variance des estimateurs a pour corollaire immédiat une instabilité numérique majeure : de subtiles variations dans l’échantillon d’apprentissage, ou de simples arrondis computationnels, peuvent induire des basculements spectaculaires de l’amplitude, voire du signe algébrique des coefficients de régression. Ce phénomène masque la significativité statistique de variables pourtant cruciales en gonflant artificiellement les erreurs standards et en réduisant drastiquement la puissance des tests de Student. En outre, lorsque les dimensions explicatives sont redondantes, le modèle linéaire compense mathématiquement les fortes corrélations positives en attribuant à des prédicteurs adjacents des poids opposés disproportionnés, créant ainsi une illusion de rétroaction négative dénuée de tout fondement théorique.
Au-delà de l’instabilité inférentielle, la multicolinéarité sévère conduit inévitablement au surapprentissage statistique. Bien que le coefficient de détermination apparent puisse atteindre des valeurs flatteuses au sein de l’échantillon d’ajustement, la surface de régression estimée présente une rigidité excessive et une courbure artificielle le long des axes de colinéarité. Cette configuration prive le modèle de toute capacité de généralisation : confronté à de nouvelles observations provenant de la même population parente mais présentant de légères fluctuations structurelles, le modèle commet des erreurs prédictives considérables. L’incapacité de distinguer le signal structurel du bruit stochastique partagé transforme ainsi le modèle en un simple dispositif d’interpolation locale, inapte à satisfaire les exigences fondamentales de reproductibilité scientifique.
1.2 Présentation méthodologique de la régression PLS
La régression par les moindres carrés partiels trouve ses origines historiques et algorithmiques dans les travaux pionniers de l’économètre et statisticien suédois Herman Wold durant les années 1960 et 1970. Confronté aux apories de la modélisation économétrique formalisée par des systèmes d’équations interdépendantes complexes et aux défaillances de l’estimation du maximum de vraisemblance en présence d’échantillons restreints, Wold conçut une approche non paramétrique guidée par les données, initialement dénommée NIPALS (Nonlinear Iterative Partial Least Squares). Cette démarche privilégiait l’optimalité prédictive et la convergence itérative par blocs sur les hypothèses distributionnelles rigides, posant ainsi les jalons d’un nouveau paradigme de modélisation orientée vers la prédiction des composantes latentes.
La philosophie fondamentale de la régression PLS repose sur une synthèse harmonieuse entre deux objectifs computationnels autrefois disjoints : la réduction de dimensionnalité non supervisée et la régression linéaire multivariée supervisée. Plutôt que de contraindre le modèle à opérer un arbitrage destructeur entre la conservation intégrale des prédicteurs bruités et leur élimination sélective, la PLS opère une projection des données d’origine vers un sous-espace vectoriel de faible dimension constitué d’un nombre restreint de composantes orthogonales, appelées scores ou variables latentes. Contrairement aux approches par projection purement descriptives, ces composantes ne sont pas construites de manière isolée au sein de la matrice explicative ; elles sont explicitement dérivées pour capturer la structure de variance des prédicteurs qui s’avère la plus prédictive de la variable dépendante.
Cette architecture computationnelle confère à la régression PLS une pertinence méthodologique singulière dans l’analyse de modèles comportementaux, psychométriques et sociologiques complexes. Dans ces disciplines, les construits théoriques sous-jacents — tels que l’anxiété, la charge cognitive, l’intelligence émotionnelle ou le statut socio-économique — échappent à toute mesure directe et doivent être approchés au moyen de multiples indicateurs empiriques ou d’items de questionnaires fortement intercorrélés. La PLS permet d’agréger ces faisceaux d’indicateurs redondants en dimensions synthétiques hautement stables, captant l’essence du phénomène latent tout en neutralisant le bruit de mesure individuel de chaque item. Le chercheur dispose ainsi d’un cadre analytique capable d’estimer simultanément les relations internes entre construits et les impacts marginaux de chaque indicateur observable.
1.3 Comparaison critique entre OLS, ACP/PCR et PLS
L’évaluation des mérites respectifs des méthodes d’estimation en contexte de haute dimensionnalité et de colinéarité exige une comparaison formelle entre la régression linéaire ordinaire (OLS), la régression sur composantes principales (PCR) et la régression PLS. Les moindres carrés ordinaires souffrent d’une limite structurelle rédhibitoire dès que les prédicteurs sont redondants ou lorsque leur nombre excède l’effectif des individus statistiques observés. Dans ces configurations, l’hyperplan de régression n’est plus identifiable de manière univoque, imposant le recours à des régularisations pénalisées de type Ridge ou Lasso, ou à des méthodes factorielles de substitution qui projettent préalablement l’information sur des sous-espaces orthogonaux stables.
La régression sur composantes principales (PCR) résout la singularité matricielle en substituant aux prédicteurs originaux les composantes orthogonales issues d’une analyse en composantes principales (ACP). Toutefois, la faiblesse conceptuelle majeure de la PCR réside dans son caractère strictement non supervisé : l’extraction des composantes principales est gouvernée exclusivement par la maximisation de la variance au sein de l’espace des prédicteurs, sans considération aucune pour la variable dépendante à prédire. Il en résulte un risque méthodologique substantiel, formalisé par de nombreux théoriciens : les dimensions qui capturent la plus grande variance intrinsèque des variables explicatives peuvent s’avérer totalement orthogonales ou non pertinentes vis-à-vis de la réponse, tandis que l’information véritablement prédictive peut être reléguée dans les dernières composantes principales, souvent abandonnées lors du filtrage dimensionnel.
À l’inverse, la régression PLS surmonte cette aporie en intégrant la variable dépendante dès la phase génératrice des composantes latentes. Le critère d’optimisation de la PLS consiste à maximiser conjointement le carré de la covariance entre les scores des prédicteurs et la variable de réponse. Cette formulation bicritère garantit que les axes factoriels extraits capturent non seulement une fraction substantielle de l’information structurelle contenue dans l’ensemble des prédicteurs, mais retiennent prioritairement les directions de l’espace vectoriel qui possèdent la plus grande force explicative vis-à-vis du phénomène étudié. L’estimateur PLS combine ainsi l’efficacité dimensionnelle de la réduction factorielle et la pertinence fonctionnelle de la modélisation supervisée, surpassant empiriquement la PCR en termes de parcimonie et l’OLS en termes de robustesse stochastique.
2. Fondements mathématiques et fonctionnement interne de l’algorithme PLS
2.1 Extraction itérative des composantes latentes
L’architecture mathématique de la régression PLS repose sur la décomposition bilinéaire simultanée de deux matrices de données centrées : la matrice des variables explicatives, de dimensions n observations par p variables, et la matrice (ou vecteur) des variables dépendantes, de dimensions n observations par m réponses. L’objectif consiste à factoriser ces matrices sous la forme d’un produit matriciel associant des scores latents d’observations et des charges factorielles de variables, complété par des matrices de résidus statistiques. Le modèle d’extraction s’exprime ainsi à travers la décomposition vectorielle conjointe de chaque bloc de données selon des dimensions latentes successives et mutuellement indépendantes.
Le calcul des scores pour chaque composante repose sur la recherche d’un vecteur de poids factoriels unitaire qui maximise l’espérance du produit scalaire des projections. Sur le plan de l’optimisation mathématique sous contrainte, le problème revient à maximiser la covariance empirique entre les scores des prédicteurs et les scores des réponses, sous la contrainte d’orthogonalité ou de norme euclidienne unitaire imposée aux vecteurs de pondération. Par application du formalisme des multiplicateurs de Lagrange, cette optimisation se résout par le calcul du vecteur propre dominant associé à la plus grande valeur propre de la matrice de covariance croisée entre les deux espaces de mesure, isolant ainsi la trajectoire directionnelle qui lie le plus intimement les variations de l’espace d’entrée à celles de la cible.
Dans l’écosystème algorithmique de la PLS, deux procédures dominent la littérature statistique : l’algorithme historique NIPALS perfectionné par Svante Wold, et l’algorithme SIMPLS introduit par Sijmen de Jong en 1993. L’algorithme NIPALS opère par approximations successives par régressions univariées alternées jusqu’à convergence de la norme des scores, garantissant une décomposition exacte des matrices de départ au prix d’une boucle itérative par composante. À l’opposé, l’algorithme SIMPLS contourne le calcul itératif lourd en opérant directement sur la matrice de variance-covariance empirique globale à travers une décomposition en valeurs singulières (SVD) séquentielle. Dans le cas univarié où la variable réponse est unique (PLS1), les deux formulations convergent rigoureusement vers des solutions identiques, mais SIMPLS offre un gain de vitesse de calcul spectaculaire particulièrement précieux lors des procédures d’échantillonnage intensif.
2.2 Standardisation et déflation des matrices de covariance
L’étape préliminaire absolue à toute factorisation PLS réside dans la standardisation métrique des variables d’étude. Puisque le critère d’extraction repose sur la maximisation de la covariance croisée, les grandeurs dotées de variances absolues très élevées ou mesurées sur des échelles numériques étendues domineraient artificiellement la détermination des poids factoriels, reléguant les variables à faible dispersion au rang de composantes résiduelles négligeables, nonobstant leur pertinence théorique réelle. Le centrage des variables autour de leur moyenne empirique respective est impératif pour annuler le terme d’interception dans les projections latentes, tandis que la réduction par division par l’écart-type garantit que chaque prédicteur contribue avec un poids stochastique unitaire au calcul de l’inertie factorielle globale.
Une fois la première composante latente extraite, l’algorithme doit procéder à l’élimination de la part de variance désormais expliquée afin d’isoler l’information résiduelle requise pour la construction des composantes subséquentes. Cette étape critique porte le nom de déflation matricielle. Dans la formulation NIPALS, la matrice des prédicteurs est mise à jour en lui soustrayant le produit extérieur du vecteur de scores latents par le vecteur des charges factorielles de variables correspondant, obtenu par projection orthogonale des variables d’origine sur ce score. De manière analogue, la matrice de covariance de la réponse est purgée de l’effet direct de la composante extraite. Ce mécanisme garantit que l’information extraite à l’étape k est formellement soustraite des structures matricielles résiduelles soumises à l’étape k+1.
Le processus de déflation assure l’orthogonalité mutuelle stricte des vecteurs de scores latents au sein de l’espace des prédicteurs, ce qui confère à ces nouvelles variables construites une absence totale de colinéarité. Contrairement à l’ACP où les charges factorielles sont également mutuellement orthogonales, les charges factorielles de la PLS ne le sont généralement pas, car elles s’ajustent pour refléter au mieux la covariance directionnelle avec la variable dépendante. La déflation préserve scrupuleusement la variance résiduelle non encore expliquée dans un sous-espace vectoriel complémentaire, permettant d’itérer la décomposition jusqu’à ce que la totalité de la variance informative soit épuisée ou que l’adjonction de dimensions supplémentaires ne produise plus que la capture de perturbations stochastiques purement aléatoires.
2.3 Modélisation de la relation interne et prédiction
La puissance prédictive de la régression PLS émerge de l’articulation entre le modèle externe — qui décrit la décomposition des matrices observables en scores et charges factorielles — et le modèle interne (ou « inner model »), qui modélise la dépendance linéaire directe entre les composantes latentes construites. Puisque les scores factoriels des prédicteurs constituent un ensemble de variables orthogonales dépourvues de toute multicolinéarité, l’estimation des coefficients de régression reliant la réponse aux scores latents se réduit à une séquence de régressions linéaires simples triviales ou à une régression multiple parfaitement conditionnée. L’équation interne établit ainsi une correspondance déterministe optimale entre la projection de l’individu dans l’espace factoriel et sa réponse attendue.
L’utilité pratique d’un modèle statistique exigeant de pouvoir prédire la valeur de la réponse à partir de nouvelles observations mesurées dans leur système d’unités d’origine, le modèle interne sur scores latents doit subir une rétro-transformation mathématique vers l’espace initial des variables p. En combinant analytiquement la matrice des poids factoriels de pondération, la matrice des charges factorielles des prédicteurs et les coefficients de la relation interne, on dérive un vecteur unique de coefficients de régression partiels de dimension p. Ces coefficients rétro-projetés s’appliquent directement aux prédicteurs bruts centrés et réduits, conférant à la PLS une structure syntaxique finale strictement équivalente à celle d’une régression linéaire classique, tout en bénéficiant de la régularisation sous-jacente.
L’estimateur PLS ainsi constitué se comporte mathématiquement comme un estimateur à rétrécissement (shrinkage operator), présentant une parenté fonctionnelle profonde avec la régression Ridge et le Lasso, tout en conservant une dynamique d’ajustement distincte. Dans les contextes délicats caractérisés par des échantillons de taille modeste confrontés à un nombre massif d’indicateurs empiriques, l’estimateur PLS sacrifie une fraction infinitésimale de son absence de biais théorique pour opérer une réduction drastique de sa variance globale d’échantillonnage. Ce compromis biais-variance magistralement orchestré permet de juguler le risque d’explosion des erreurs de généralisation et confère au modèle une robustesse prédictive hors pair, validée tant par l’analyse asymptotique que par les simulations numériques intensives de Monte-Carlo.
3. Étape 1 : Configuration de l’environnement de calcul dans R
3.1 Installation et chargement du package pls
Pour implémenter les moindres carrés partiels dans l’environnement R, le recours au package de référence pls s’impose comme la démarche la plus rigoureuse et la plus largement documentée au sein de la communauté scientifique internationale. Développé initialement par Bjørn-Helge Mevik et Ron Wehrens, ce paquetage fournit une infrastructure logicielle complète, optimisée pour l’analyse de régression multivariée linéaire basée sur les algorithmes SIMPLS et NIPALS. Pour installer la version stable la plus récente distribuée sur le réseau officiel CRAN, le chercheur exécute la commande standardisée install.packages("pls") dans sa console R active, garantissant ainsi l’intégration de toutes les dépendances binaires requises.
Une fois l’installation menée à son terme, le chargement de la bibliothèque s’opère par l’invocation canonique library(pls). Ce chargement initialise l’accès à un ensemble de méthodes génériques et d’objets de classe spécialisée conçus pour s’interfacer de manière transparente avec les conventions idiomatiques de modélisation du langage R, calquées sur la syntaxe universelle des fonctions lm() et glm(). L’architecture interne du package met en œuvre des routines computationnelles écrites en langage compilé, garantissant une exécution rapide des calculs matriciels complexes et une gestion optimisée de la mémoire vive lors du traitement de jeux de données massifs.
Au cœur de l’écosystème pls figure la fonction générique mvr() (Multivariate Regression), laquelle sert de moteur sous-jacent polyvalent. Néanmoins, pour des raisons de clarté conceptuelle et de conformité applicative, les utilisateurs recourent quasi exclusivement aux interfaces spécialisées plsr() pour la régression par moindres carrés partiels et pcr() pour la régression sur composantes principales. La fonction plsr() encapsule les spécifications paramétriques adaptées aux variantes univariées et multivariées de la PLS, proposant des arguments hautement configurables pour le choix de l’algorithme, la gestion du centrage et de la réduction, ainsi que l’automatisation des architectures de validation croisée interne.
3.2 Packages complémentaires pour l’analyse avancée
Bien que le package pls suffise au déploiement de l’algorithme fondamental, une démarche empirique professionnelle exige l’adjonction de bibliothèques tierces pour structurer le flux de travail de manière fluide et reproductible. L’intégration de la suite de paquetages tidyverse, et plus particulièrement des modules dplyr, tibble et readr, s’avère indispensable pour orchestrer les phases préalables de nettoyage, de filtrage d’observations, de recodage d’items et de restructuration tabulaire. La manipulation préalable des structures matricielles au format « tidy » garantit une traçabilité intégrale des transformations appliquées à la cohorte d’étude avant la conversion formelle des données en formats analytiques matriciels.
L’exploration visuelle approfondie des résultats factoriels et diagnostiques bénéficie immensément de la puissance expressive du package ggplot2. Bien que le package pls incorpore des fonctions graphiques natives basées sur le système graphique de base de R, leurs capacités de personnalisation demeurent contraintes. Le couplage avec ggplot2 — appuyé si nécessaire par ggrepel pour la gestion typographique des chevauchements d’étiquettes de variables — permet de concevoir des représentations visuelles conformes aux exigences éditoriales des revues académiques à fort facteur d’impact, facilitant ainsi la mise en exergue des regroupements d’individus et des trajectoires de projection des covariances.
Enfin, la modélisation rigoureuse de la multicolinéarité impose la quantification instrumentale préalable du degré de redondance linéaire au moyen du package car (Companion to Applied Regression). La fonction vif() contenue dans ce dernier offre un calcul direct des facteurs d’inflation de la variance sur un modèle préliminaire estimé par les moindres carrés ordinaires. Par ailleurs, pour l’étape subséquente de sélection des variables explicatives fondatrice de l’interprétation théorique, l’installation conjointe du package plsVarSel permet d’accéder à une collection étendue d’heuristiques de filtrage des prédicteurs, enrichissant substantiellement l’éventail des diagnostics standard disponibles.
3.3 Reproductibilité et gestion des générateurs aléatoires
La recherche computationnelle moderne érige la reproductibilité intégrale des analyses au rang d’impératif méthodologique catégorique. Dans le contexte de la régression PLS, la détermination de l’architecture dimensionnelle optimale repose structurellement sur des mécanismes d’échantillonnage stochastique, qu’il s’agisse de la répartition aléatoire des observations entre les plis de validation croisée k-fold ou du tirage probabiliste des sous-échantillons lors des procédures de Jackknife et de rééchantillonnage par Bootstrap. Par conséquent, deux exécutions consécutives d’un même script sur les mêmes données matricielles peuvent générer des estimations subtilement discordantes du nombre optimal de composantes latentes si l’état initial du générateur de nombres pseudo-aléatoires n’est pas rigoureusement verrouillé.
Pour neutraliser toute source de variabilité stochastique indésirable, l’inclusion formelle de la commande set.seed() au sommet du script d’analyse constitue une précaution technique incontournable. L’attribution d’une graine entière spécifique (par exemple, set.seed(12345)) réinitialise l’algorithme sous-jacent générateur de pseudo-hasard de R (par défaut le Mersenne-Twister) sur un point de départ invariable. Cette opération garantit qu’à chaque exécution séquentielle, les permutations internes, la stratification des partitions de validation croisée et les rééchantillonnages d’inférence se dérouleront selon une trajectoire numérique rigoureusement superposable, assurant la stabilité absolue des résultats publiés.
Enfin, la gestion environnementale rigoureuse implique la configuration préalable des options d’affichage de la console R afin de contrôler la précision d’arrondi des matrices numériques sans corrompre les objets stockés en mémoire vive (via la commande options(digits = 4, scipen = 999)). La session d’analyse doit impérativement se clore par l’appel à la fonction sessionInfo(), dont la sortie doit être archivée avec les résultats finaux. Cet appel consigne explicitement les numéros de version de R, du système d’exploitation hôte, ainsi que l’ensemble des bibliothèques logicielles chargées et de leurs dépendances compilées, prémunissant ainsi le laboratoire de recherche contre toute altération rétroactive causée par les évolutions futures de l’écosystème open-source.
4. Étape 2 : Chargement et exploration préalable du jeu de données
4.1 Importation et structure des variables d’étude
Pour illustrer de manière tangible le déploiement de la régression PLS dans un cadre scientifique rigoureux, nous considérons un cas d’étude emblématique emprunté à la psychologie différentielle et aux neurosciences comportementales. L’investigation porte sur la prédiction d’un indice composite d’épuisement émotionnel professionnel (dimension centrale du syndrome d’épuisement professionnel ou « burnout ») à partir d’un ensemble de trente indicateurs psychométriques quantitatifs continus. Ces prédicteurs documentent des dimensions fortement interconnectées : charges de travail perçues, conflits de rôle, pression temporelle, perfectionnisme désadaptatif, anxiété situationnelle, ruminations cognitives, ainsi que des marqueurs physiologiques d’activation du système nerveux sympathique tels que le rythme cardiaque de repos et la variabilité tensionnelle.
L’importation de la table de données brutes s’effectue via les commandes usuelles de lecture matricielle adaptées aux données tabulaires délimitées, assurant une conversion irréprochable des chaînes de caractères en vecteurs numériques standard. Dès l’intégration en mémoire vive, l’inspection de l’architecture structurelle de l’objet s’opère par l’appel aux primitives dim(), str() et glimpse(). Ces commandes permettent de vérifier l’absence d’aberrations typologiques au niveau des colonnes, de confirmer que l’ensemble des régresseurs appartient au domaine numérique réel continu, et de quantifier l’effectif global des observations disponibles, paramètre critique conditionnant la représentativité de la cohorte analysée.
La présence de valeurs manquantes ou de données aberrantes représente une menace sévère pour les algorithmes factoriels basés sur l’algèbre matricielle, l’algorithme standard du package pls ne tolérant aucune case vide dans les matrices soumises à la décomposition. Un audit exhaustif des profils de complétude est exécuté à l’aide de fonctions de sommation booléenne. Lorsqu’une absence de réponse marginale est constatée sur un sous-ensemble infime d’items distribués aléatoirement, une imputation statistique robuste par les k-plus-proches voisins (k-NN) ou par forêts aléatoires univariées est mise en œuvre pour préserver l’intégrité de la puissance statistique, en écartant résolument les exclusions sauvages par liste qui biaiserait la distribution de la cohorte d’échantillonnage.
4.2 Analyse exploratoire de la colinéarité
L’argumentation scientifique en faveur du recours aux moindres carrés partiels débute impérativement par une démonstration empirique sans équivoque de l’inadéquation des méthodes d’estimation usuelles face aux interdépendances des prédicteurs. Cette démonstration s’amorce par l’estimation de la matrice de corrélation de Pearson calculée sur l’ensemble des trente prédicteurs centrés. L’analyse révèle immédiatement l’existence de grappes d’items présentant des coefficients d’association linéaire bivariée excédant fréquemment des valeurs de 0.80 ou 0.85, traduisant le fait que plusieurs échelles psychométriques documentent des facettes sémantiques et comportementales virtuellement indiscernables sur le plan observationnel.
La transcription graphique de cette trame associative complexe gagne à être formalisée sous la forme d’un corrélogramme ordonné par regroupement hiérarchique. Cette représentation met visuellement en exergue des blocs de variables fortement corrélées le long de la diagonale principale, confirmant que l’espace vectoriel des prédicteurs est saturé par une forte redondance informationnelle. Les trajectoires de variance partagée s’entremêlent, signalant à l’analyste que toute modélisation linéaire univariée traditionnelle se heurtera à une incertitude géométrique majeure lors de la tentative d’attribution isolée des contributions marginales propres à chaque prédicteur individuel.
Le constat exploratoire est confirmé quantitativement par l’ajustement d’un modèle linéaire standard par la commande lm() suivi du calcul systématique des facteurs d’inflation de la variance au moyen de car::vif(). Dans l’exemple analysé, une proportion substantielle des indicateurs psychométriques affiche des valeurs de VIF dépassant largement le seuil conventionnel d’alerte fixé à 5, plusieurs items critiques franchissant même le cap pathologique de 10 ou 15. Ces indices témoignent d’une contraction drastique de la tolérance mathématique, confirmant qu’une régression OLS conventionnelle souffrirait d’une instabilité inacceptable des coefficients de régression et produirait des inférences purement fallacieuses, justifiant de jure le déploiement de la régression PLS.
4.3 Partitionnement des données en ensembles d’entraînement et de test
La validation scientifique de la supériorité opérationnelle d’un modèle prédictif moderne requiert l’évaluation de ses performances sur un échantillon d’observations strictement indépendant, préservé de toute interaction avec le processus d’ajustement des paramètres factoriels et des coefficients de régression. À cette fin, le jeu de données d’origine est scindé en deux sous-ensembles méthodologiquement étanches : une partition d’entraînement (ou d’apprentissage) regroupant 80 % des observations totales, et une partition de test (ou de validation externe) isolant les 20 % restants. Ce partitionnement fournit le cadre requis pour une confrontation empirique impartiale entre prédictions théoriques et valeurs réalisées.
Pour éviter toute dérive d’échantillonnage consécutive à une séparation purement stochastique susceptible de biaiser la distribution de la réponse cible au sein des sous-groupes, l’attribution des individus s’effectue par stratification probabiliste sur les quantiles de la variable dépendante d’épuisement émotionnel. La fonction createDataPartition() issue du package caret orchestre cette partition équilibrée en garantissant que la moyenne, la variance et l’asymétrie de la cible demeurent rigoureusement identiques entre l’ensemble d’entraînement et l’ensemble de test, éliminant ainsi toute distorsion distributionnelle exogène entre les deux phases d’analyse.
Dès l’exécution de la coupure matricielle, la partition de test est formellement consignée dans un environnement de stockage distinct et isolée du flux de traitement courant. Aucun centrage, aucune réduction globale préalable n’est appliquée à l’ensemble du fichier brut avant cette séparation : une telle démarche constituerait une violation méthodologique grave connue sous le terme de « fuite de données » (data leakage), consistant à contaminer la matrice d’entraînement par des paramètres statistiques (moyennes, écarts-types) dérivés de la matrice de test. Les paramètres de mise à l’échelle seront donc exclusivement extraits de l’échantillon d’apprentissage puis appliqués de manière asymétrique sur l’échantillon de test lors des phases d’évaluation finale.
5. Étape 3 : Ajustement du modèle de régression PLS initial
5.1 Syntaxe fondamentale de la fonction plsr()
L’estimation du modèle de régression par les moindres carrés partiels s’effectue par l’appel à la fonction plsr() fournie par le package pls. L’architecture de la commande s’articule autour du formalisme symbolique standard de R, où la variable dépendante d’intérêt est positionnée à gauche du signe tilde et reliée à l’ensemble des prédicteurs psychométriques explicatifs positionnés à droite. Dans le contexte de notre partition d’apprentissage, la formule s’exprime sous la forme condensée Epuisement ~ ., indiquant à l’interpréteur de langage de mobiliser la totalité des colonnes restantes de la table de données d’entraînement en tant que régresseurs explicatifs potentiels du construit cible.
Un paramètre capital à intégrer scrupuleusement au sein de l’instruction d’appel est le modificateur booléen scale = TRUE. Par défaut, la fonction plsr() applique un centrage systématique sur la moyenne pour l’ensemble des variables, mais omet l’opération de réduction par l’écart-type si celle-ci n’est pas explicitement requise. L’activation délibérée de l’argument force la fonction à transformer les covariances brutes en corrélations normées, prévenant ainsi toute distorsion géométrique artificielle induite par l’amplitude disparate des échelles de mesure des items psychologiques ou des paramètres physiologiques collectés au sein de la cohorte d’individus.
Le contrôle computationnel de la factorisation est complété par la désignation de l’algorithme numérique via l’argument method. L’utilisateur dispose de la faculté de basculer entre l’approche géométrique orthogonale historique dérivée de NIPALS (method = "oscorespls") et la formulation contemporaine hautement parallélisable de de Jong (method = "simpls"). Dans la quasi-totalité des architectures analytiques univariées standards, l’implémentation SIMPLS est privilégiée en raison de sa stabilité numérique absolue et de sa rapidité d’exécution exceptionnelle, laquelle réduit drastiquement les délais de calcul lors des phases subséquentes d’échantillonnage répété et de validation croisée intensive.
5.2 Intégration de la validation croisée interne
L’ajustement non régulé d’une régression factorielle comporte le risque inhérent d’ajuster un nombre excessif de dimensions latentes, ce qui réintroduirait la pathologie du surapprentissage au lieu de l’endiguer. Pour prévenir cette dérive, l’estimation initiale doit intégrer un protocole d’évaluation de la performance prédictive généralisable via le paramètre validation. La valeur standard validation = "CV" déclenche l’exécution automatique d’une validation croisée par blocs (k-fold cross-validation) imbriquée directement au sein du cycle d’estimation de la fonction plsr(), fournissant ainsi une évaluation objective de l’erreur d’ajustement pour chaque composante successive ajoutée.
La structuration des plis de validation croisée requiert une attention méthodologique soutenue. L’argument complémentaire segments = 10 partitionne aléatoirement l’échantillon d’apprentissage en dix segments disjoints de dimensions équivalentes. À chaque itération de la boucle de validation, neuf segments sont alloués à la reconstitution intégrale des composantes latentes et à l’estimation des coefficients de régression, tandis que le dixième segment, temporairement exclu, sert de banc d’évaluation pour quantifier l’erreur de prédiction commise sur des données non impliquées dans la calibration dimensionnelle du modèle.
Il importe de distinguer formellement la validation croisée standard à 10 blocs de la stratégie du « Leave-One-Out » (LOO), activable par validation = "LOO". Bien que conceptuellement séduisante car déterministe et exempte de variabilité stochastique, la procédure LOO — qui exclut séquentiellement une observation unique — tend à sous-estimer systématiquement la variance réelle de prédiction sur les jeux de données caractérisés par une forte colinéarité, tout en imposant un coût de calcul prohibitif lorsque l’échantillon d’entraînement s’accroît. La validation k-fold à 10 plis offre un compromis optimal unanimement validé par la théorie asymptotique, garantissant une estimation robuste et non biaisée de l’erreur de généralisation.
5.3 Inspection globale du premier sommaire de modèle
L’évaluation préliminaire du modèle calibré s’initie par l’exécution de la méthode polymorphe summary(modele_pls) dans la console d’analyse. La restitution textuelle produite par le package pls s’organise en sections tabulaires claires, rapportant de manière séquentielle le pourcentage d’inertie ou de variance expliquée au sein de la matrice des prédicteurs explicatifs X ainsi qu’au sein de la variable de réponse Y, mesuré composante par composante ainsi qu’en valeur cumulative totale. Cette lecture offre une vision immédiate de l’efficacité de la compression factorielle opérée sur les données.
L’examen minutieux des pourcentages de variance révèle la spécificité opératoire de la PLS par rapport aux analyses purement descriptives. Très fréquemment, la première composante latente n’explique qu’une fraction modérée de la variance globale de X (par exemple 20 à 30 %), mais réussit simultanément à capter une part substantielle de la variance de la variable cible Y (souvent 45 à 55 %). Cette divergence structurelle valide empiriquement la nature supervisée de l’algorithme : l’extraction écarte délibérément les sources majeures de variance interne de X qui s’avèrent non corrélées à l’épuisement émotionnel, focalisant la totalité de l’énergie géométrique sur la capture de l’information utile à la modélisation de la cible.
Enfin, le sommaire textuel détaille les métriques d’erreur de prédiction brutes et ajustées pour chaque dimension latente additionnelle considérée, débutant obligatoirement par la composante zéro représentant le modèle nul contenant uniquement la constante moyenne. La consultation de ces colonnes permet au chercheur de s’assurer de la bonne convergence de l’algorithme d’estimation et de repérer visuellement le point d’inflexion où l’incorporation de composantes factorielles supplémentaires cesse d’améliorer la prédiction de la réponse pour ne plus refléter que des fluctuations résiduelles statistiquement négligeables.
6. Étape 4 : Détermination du nombre optimal de composantes latentes
6.1 Critères d’erreur de prédiction : RMSEP et MSEP
Le choix du nombre de composantes factorielles M à conserver constitue la décision architecturale cardinale en modélisation PLS. Conserver un nombre insuffisant de composantes prive le modèle d’une information explicative légitime (sous-ajustement), tandis que l’inclusion de composantes superflues réintroduit le bruit idiosyncratique des données d’apprentissage et détériore les capacités prédictives externes (surajustement). Pour trancher ce dilemme avec une objectivité mathématique irréprochable, l’analyste exploite la métrique de l’erreur quadratique moyenne de prédiction (MSEP, Mean Squared Error of Prediction) et son expression standardisée sous forme de racine carrée, le RMSEP (Root Mean Squared Error of Prediction).
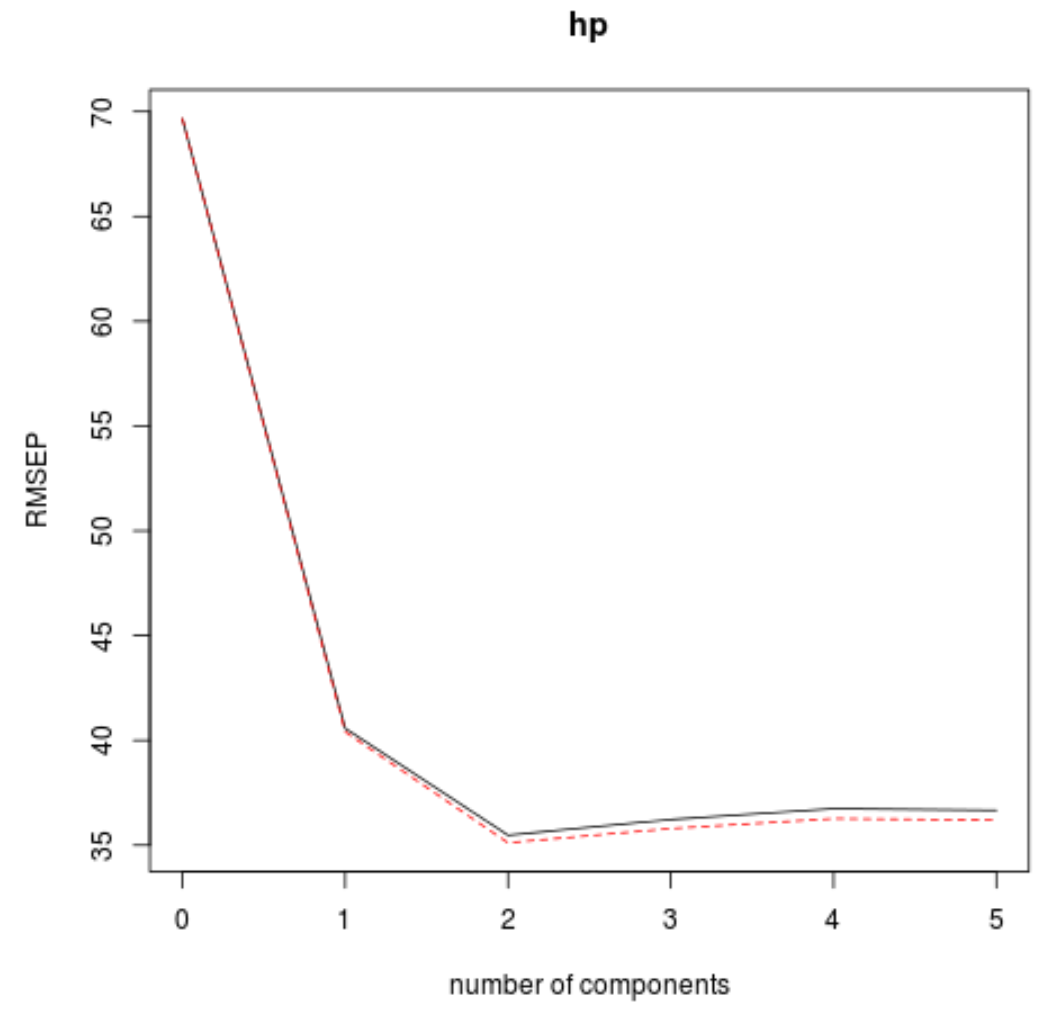
L’extraction de ces indicateurs s’effectue via la commande RMSEP(modele_pls). La matrice de sortie générée par la fonction discrimine rigoureusement deux grandeurs méthodologiquement dissemblables : l’erreur apparente d’apprentissage (dénommée « train »), calculée en réappliquant directement le modèle estimé sur les observations mêmes ayant servi à son paramétrage, et l’erreur de validation croisée (notée « CV » ou « adjCV »). Alors que l’erreur d’apprentissage décroît de façon monotone et artificielle à mesure que l’on incrémente le nombre de composantes latentes jusqu’à atteindre un minimum trivial à p dimensions, l’erreur de validation croisée reflète fidèlement la performance de généralisation extrapolative.
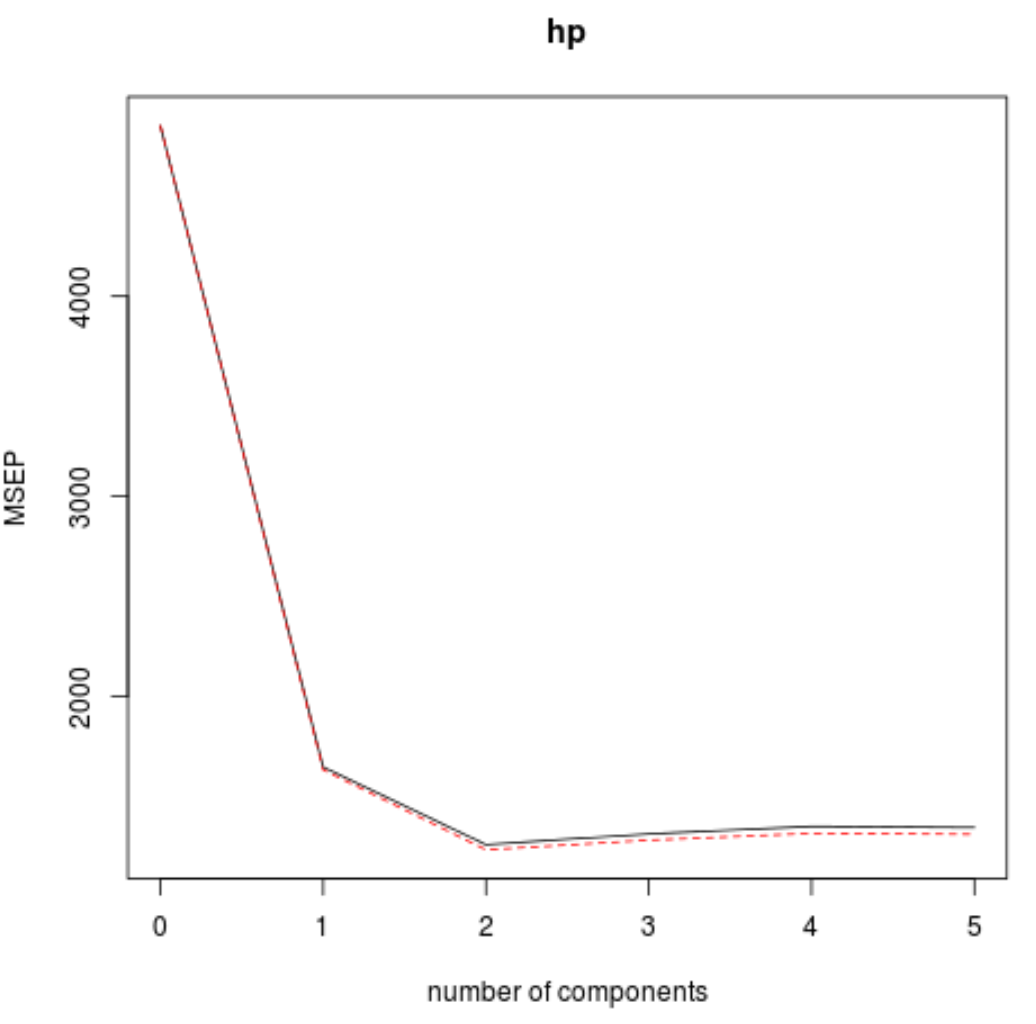
Le tracé de la courbe du RMSEP de validation croisée adopte généralement un profil en U asymétrique caractéristique des compromis biais-variance en apprentissage statistique. Dans un premier temps, l’adjonction de composantes latentes produit un effondrement spectaculaire de l’erreur prédictive, traduisant la capture des structures covariantes fondamentales unissant les prédicteurs à la cible. Passé un certain seuil dimensionnel, la courbe se stabilise sur un plateau horizontal avant de s’infléchir vers le haut. Le minimum absolu de cette courbe de validation croisée identifie le modèle qui minimise mathématiquement l’espérance du risque quadratique d’erreur sur des données indépendantes.
6.2 Visualisation du profil de validation croisée
La transcription graphique de l’évolution des erreurs de prédiction constitue l’outil diagnostique de référence pour valider visuellement la dimensionnalité du modèle. La fonction native validationplot(modele_pls, val.type = "RMSEP") génère instantanément le profil fonctionnel reliant l’erreur de prédiction au nombre de composantes latentes actives. Pour une exploitation académique plus avancée, l’extraction manuelle des composantes de l’objet modele_pls$validation$PRESS permet d’élaborer une visualisation enrichie sous ggplot2, associant aux points moyens des barres d’erreur standard matérialisant l’incertitude stochastique propre à la partition en plis de validation croisée.
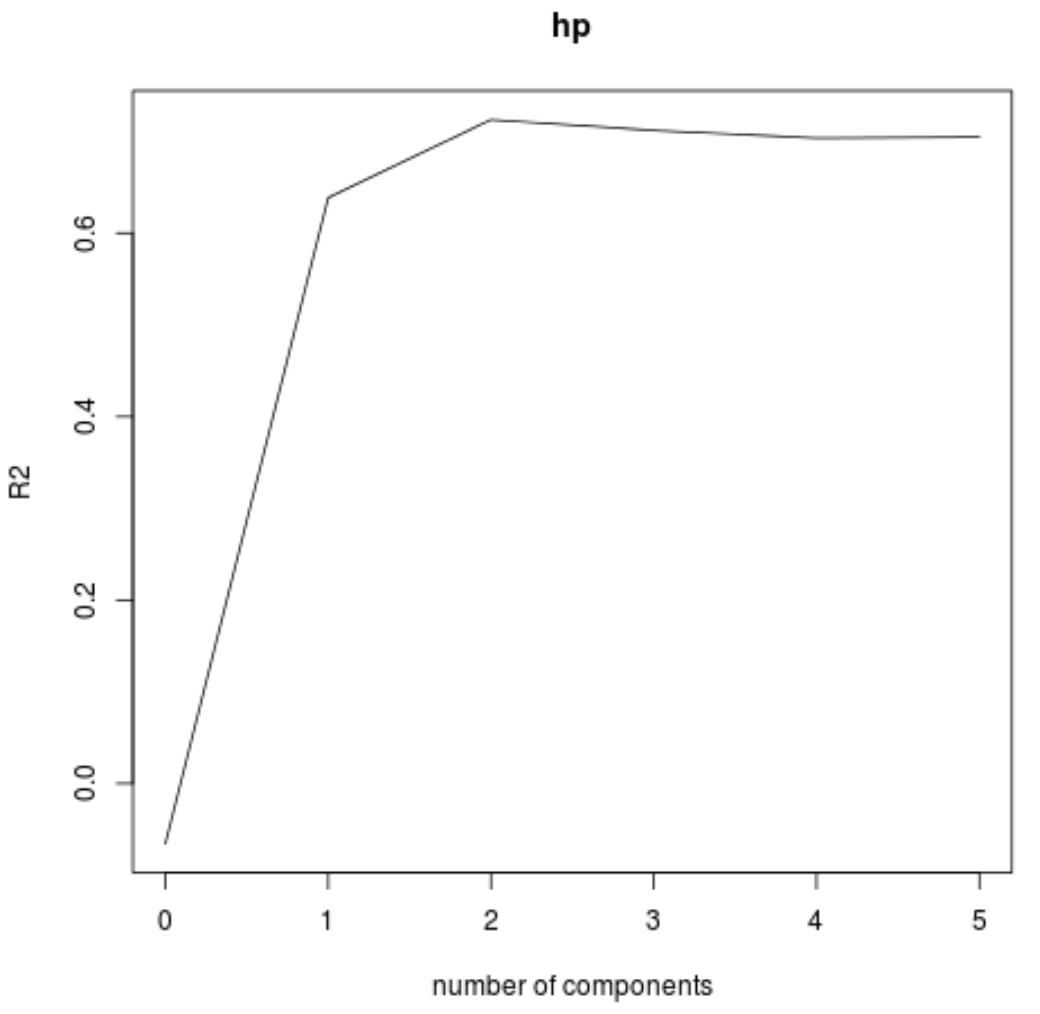
L’analyse sémiotique de cette courbe repose sur l’identification du « coude » méthodologique (elbow rule), point d’inflexion où la pente de décroissance de l’erreur subit une rupture brutale pour devenir quasi nulle. Si le minimum absolu du RMSEP est par exemple atteint à sept composantes latentes, mais que le passage de trois à quatre composantes n’abaisse l’erreur que d’une fraction marginale insignifiante (inférieure à 1 %), l’analyste doit s’interroger sur la pertinence théorique de mobiliser un modèle à haute complexité paramétrique au détriment de la simplicité explicative.
Dans ce contexte, l’application de la règle heuristique parcimonieuse du « un écart-type » (One-Standard-Error rule, ou règle du 1 SE), popularisée par Hastie, Tibshirani et Friedman, s’impose comme une garantie contre le surajustement. Cette règle stipule que si un modèle simplifié à k composantes affiche une erreur prédictive située à l’intérieur de l’intervalle de confiance stochastique à plus ou moins un écart-type de l’erreur du modèle minimal absolu à k+m composantes, le principe d’économie scientifique de Guillaume d’Ockham commande de retenir impérativement le modèle le plus parcimonieux. Cette décision protège les estimations contre l’inclusion de dimensions latentes marginales captant des artéfacts résiduels.
6.3 Automatisation programmatique du choix des composantes
Afin d’émanciper la décision finale de toute appréciation subjective de la courbe d’erreur, le package pls met à la disposition des chercheurs une routine algorithmique dédiée : la fonction selectNcomp(). Cette procédure teste formellement si l’adjonction de chaque composante supplémentaire apporte un gain d’exactitude prédictive statistiquement significatif par rapport à l’architecture précédente. L’analyste configure la fonction en spécifiant le critère d’optimisation souhaité, transformant un arbitrage empirique intuitif en une décision d’ingénierie statistique formalisée.
L’argument central de selectNcomp() réside dans le choix de la méthode d’inférence sous-jacente via l’argument method. L’option method = "onesigma" implémente mathématiquement la règle heuristique du 1 SE décrite précédemment, identifiant la dimensionnalité la plus compacte dont l’erreur quadratique n’excède pas d’un écart-type le minimum global estimé par validation croisée. Alternativement, le chercheur peut solliciter l’option method = "randomization", laquelle exécute des tests de permutation non paramétriques comparant les résidus de prédiction croisée sous l’hypothèse nulle d’équivalence prédictive entre deux modèles consécutifs, fixant un seuil de significativité alpha conventionnel (par exemple p < 0.10 ou p < 0.05).
L’assignation programmatique du résultat de cette routine à un scalaire dédié — formalisée par l’instruction ncomp_opt <- selectNcomp(modele_pls, method = "onesigma") — constitue la charnière de liaison vers les phases ultérieures de l’analyse. Dans le cas d’étude psychométrique analysé, admettons que cette sélection algorithmique converge univoquement vers la rétention de quatre composantes latentes fondamentales. Toutes les extractions matricielles subséquentes — projections de scores, calculs de poids factoriels, évaluations des VIP et régressions rétro-projetées — seront rigoureusement verrouillées sur cette valeur optimale M = 4, garantissant une cohérence systémique intégrale de la modélisation.
7. Étape 5 : Analyse des scores et des poids factoriels
7.1 Interprétation des projections d’individus (Scores)
Une fois la dimensionnalité optimale arrêtée, l’exploration substantielle du modèle débute par l’extraction et l’analyse sémiotique des scores factoriels des observations, formalisés par le terme mathématique T. Les scores représentent les coordonnées orthogonales des individus statistiques projetés sur les axes latents nouvellement construits. L’extraction de cette matrice s’opère par l’appel à la fonction scores(modele_pls) restreinte aux dimensions retenues, produisant un tableau de dimensions n individus par M composantes. Ces valeurs reflètent la position relative de chaque participant au sein de l’espace factoriel purgé des colinéarités brutes.
La cartographie de ces scores au sein d’un plan factoriel bivarié, associant typiquement la première composante latente en abscisse et la seconde en ordonnée, s’exécute classiquement par plot(modele_pls, plottype = "scores", comps = 1:2) ou via une construction personnalisée sous ggplot2. L’inspection attentive de ce nuage de points permet de déceler d’éventuelles hétérogénéités structurales au sein de l’échantillon, telles que des agrégations distinctes en sous-groupes d’individus (par exemple des profils de cadres versus employés non-cadres) ou l’émergence de trajectoires d’épuisement non linéaires.
Sur le plan psychométrique, le positionnement d’un individu le long de l’axe de la première composante latente traduit son niveau d’exposition au macro-facteur de risque sous-jacent qui maximise la covariance avec l’épuisement émotionnel. Les observations situées aux extrémités polaires de cet axe factoriel incarnent les archétypes phénoménologiques de la cohorte : d’un côté, les profils résilients caractérisés par des scores latents fortement négatifs ; de l’autre, les sujets en situation de détresse sévère affichant des scores positifs extrêmes. L’orthogonalité stricte garantit que la seconde composante latente capture une source de différenciation comportementale entièrement décorrélée de la première, enrichissant la caractérisation multidimensionnelle de chaque participant.
7.2 Exploration des contributions des prédicteurs (Loadings et Weights)
L’interprétation théorique de la signification des composantes latentes impose de disséquer le rôle assigné à chaque variable explicative au sein de la machinerie algorithmique. À cet égard, une distinction méthodologique fondamentale doit être opérée entre les charges factorielles (notées loadings, P) et les poids factoriels (notés weights, W ou W*). Les charges factorielles classiques, extraites par loadings(modele_pls), correspondent aux coefficients de régression des prédicteurs d’origine sur les scores latents orthogonaux ; elles documentent la quantité de variance d’un item donné qui est absorbée par la composante considérée.
En revanche, les poids factoriels W, et plus spécifiquement les poids transformés W* (accessibles via modele_pls$loading.weights), quantifient la contribution directionnelle directe et conjointe de chaque prédicteur à la genèse même de la composante latente pour maximiser sa covariance avec la variable cible. Contrairement aux loadings qui peuvent être brouillés par les intercorrélations résiduelles des prédicteurs lors de la déflation, les poids W* reflètent la force causale ou explicative immédiate injectée par chaque item dans le processus d’ajustement dirigé. La visualisation des poids s’obtient au moyen de l’instruction loadingplot(modele_pls, comps = 1:2, scatter = TRUE).
L’analyse substantive de la magnitude et du signe algébrique des poids factoriels permet de donner un sens conceptuel univoque aux axes latents. Dans notre investigation sur le burnout, si la première dimension exhibe des poids factoriels massifs et positifs sur les items de surcharge quantitative, de pression temporelle et de ruminations nocturnes, combinés à des poids négligeables sur les variables physiologiques brutes, cette composante sera rigoureusement qualifiée d’axe de « saturation cognitive et temporelle ». La comparaison des magnitudes relatives des poids permet de hiérarchiser immédiatement les leviers psychologiques qui structurent de manière prépondérante la projection globale du phénomène étudié.
7.3 Cartes de corrélation et cercles de corrélation
Pour parachever l’analyse géométrique, la représentation simultanée des variables explicatives X et de la réponse dépendante Y au sein d’un espace factoriel commun fournit une synthèse visuelle d’une puissance expressive exceptionnelle. Connue sous la désignation de cercle de corrélation ou de biplot factoriel supervisé, cette carte projette les coefficients de corrélation empirique liant chaque indicateur mesuré aux composantes latentes sous la forme de vecteurs directionnels partant de l’origine du repère orthogonal. Cette visualisation s’élabore en combinant les scores et les charges ou via la fonction dédiée biplot(modele_pls, which = "x").
La géométrie vectorielle régit strictement l’interprétation des relations au sein du cercle des corrélations. La proximité angulaire entre deux vecteurs prédictifs matérialise l’intensité et le sens de leur association linéaire dans le sous-espace factoriel : un angle aigu traduisant une forte corrélation positive, un angle droit (orthogonalité) une indépendance statistique absolue, et un angle plat (180 degrés) une colinéarité négative parfaite. La projection de la variable dépendante Y (l’épuisement émotionnel) au sein de ce même biplot permet d’identifier visuellement d’un seul regard les régresseurs qui s’alignent le plus fidèlement sur la trajectoire directionnelle de la cible.
Parallèlement, la norme euclidienne de chaque vecteur — représentée par sa longueur géométrique s’étendant du centre vers le cercle unité circonscrit — mesure la qualité de représentation de la variable sur le plan factoriel considéré. Les prédicteurs dont le vecteur affleure la périphérie du cercle unité sont intégralement expliqués et mobilisés par les dimensions latentes retenues, conférant une confiance absolue à leur positionnement angulaire. À l’opposé, les indicateurs psychométriques dont la terminaison reste confinée à proximité du barycentre central possèdent une faible communauté avec les dimensions sélectionnées, signalant leur rôle périphérique ou redondant dans la dynamique globale du système modélisé.
8. Étape 6 : Évaluation de l’importance des variables dans la projection (VIP)
8.1 Fondement théorique du score VIP (Variable Importance in Projection)
Bien que l’analyse des poids et des charges factorielles fournisse un éclairage dimension par dimension, le chercheur requiert une métrique synthétique globale capable de quantifier la contribution marginale totale de chaque prédicteur à travers l’ensemble des composantes latentes validées. Cette nécessité méthodologique a conduit Svante Wold et ses collaborateurs à formaliser l’indice d’importance de la variable dans la projection, universellement désigné par l’acronyme VIP (Variable Importance in Projection). Le score VIP constitue le standard de référence pour opérer la sélection de variables dans les modèles linéaires régularisés par projection.
Sur le plan mathématique, le score VIP du j-ième prédicteur s’obtient en calculant la somme pondérée des carrés de ses poids factoriels normalisés sur l’ensemble des M composantes latentes actives, où le coefficient de pondération associé à chaque composante correspond exactement à la fraction de variance de la variable réponse Y expliquée par cette dimension spécifique. Cette sommation matricielle est ensuite normalisée par la quantité totale de variance de Y captée par l’ensemble des M composantes, puis multipliée par le nombre total p de prédicteurs initiaux avant extraction finale de la racine carrée. Par construction mathématique, la moyenne des carrés des scores VIP de l’ensemble des variables du modèle est rigoureusement égale à l’unité.
Cette propriété de centrage structurel autour de 1.0 fonde les règles d’interprétation et les seuils critiques conventionnels adoptés dans la littérature scientifique. Un prédicteur affichant un score VIP substantiellement supérieur à 1.0 est formellement catégorisé comme hautement influent et structurellement déterminant dans la prédiction de la réponse. Inversement, les variables présentant un score VIP inférieur à 0.8 ou 0.7 sont considérées comme non informatives, voire parasitaires : leur contribution à l’explication de la cible est marginale par rapport à l’inertie dimensionnelle globale qu’elles mobilisent. L’intervalle intermédiaire compris entre 0.8 et 1.0 délimite une zone d’impact modéré, où la décision de rétention dépend du cadre théorique sous-jacent.
8.2 Implémentation d’une fonction de calcul VIP dans R
Fait surprenant dans l’architecture du package standard pls, la commande directe de calcul du VIP n’a pas été implémentée sous la forme d’une fonction autonome native dans les premières versions stables. Pour pallier cette lacune sans recourir à des dépendances superflues, il est d’usage au sein des laboratoires de recherche de formaliser une routine de calcul matriciel direct dérivée de la définition mathématique de Wold, exploitant directement les éléments internes de l’objet mvr retourné par plsr().
L’implémentation algorithmique de cette fonction personnalisée consiste à extraire la matrice des poids factoriels normalisés W*, accessible via la méthode loading.weights(modele_pls), et à calculer pour chaque dimension k la proportion de variance de Y expliquée au moyen des sommes de carrés de régression dérivées des résidus d’apprentissage. En vectorisant le produit entre le carré de ces poids et le vecteur de variance expliquée de la cible, puis en appliquant les facteurs de normalisation dimensionnelle p et la racine carrée, on génère un vecteur ordonné assignant à chaque variable son indice VIP scalaire pour le sous-espace dimensionnel restreint aux M composantes optimales.
Pour les praticiens privilégiant les solutions logicielles standardisées, le package spécialisé plsVarSel ou le package mixOmics intègrent des fonctions immédiatement opérationnelles sous la désignation canonique VIP(modele_pls). L’exécution de cette directive génère un tableau matriciel présentant l’évolution de la valeur VIP variable par variable à travers les composantes séquentielles ainsi que son score cumulé définitif. La structuration de ce résultat au sein d’un tableau standard (tibble) facilite l’interfaçage avec les outils de visualisation moderne et autorise le filtrage automatisé des descripteurs.
8.3 Représentation graphique et hiérarchisation des prédicteurs
La communication scientifique des scores VIP exige une représentation graphique rigoureuse, hiérarchisant sans ambiguïté les prédicteurs selon leur degré d’impact prédictif. Le standard académique consiste à générer un diagramme en barres horizontales ordonnées à l’aide de ggplot2, où les trente items psychométriques et physiologiques sont rangés de manière décroissante, du score VIP le plus élevé au plus faible le long de l’axe vertical, tandis que l’axe horizontal consigne la valeur numérique du score.
L’adjonction graphique d’une ligne verticale pointillée rouge positionnée rigoureusement à l’abscisse critique VIP = 1.0 matérialise instantanément le seuil d’admissibilité statistique. Dans le scénario de notre étude sur le burnout, ce graphique met en relief une partition nette : des indicateurs tels que « Ruminations nocturnes » (VIP = 1.68), « Conflits de rôle » (VIP = 1.45) et « Pression d’urgence » (VIP = 1.32) se détachent nettement au sommet de la hiérarchie empirique, révélant leur primauté étiologique absolue. À l’inverse, plusieurs marqueurs physiologiques isolés affichent des scores VIP avoisinant 0.45, attestant de leur parfaite inutilité prédictive une fois contrôlée l’influence des variables cognitives.
Cette visualisation fonde la mise en œuvre d’une stratégie raisonnée d’élagage ou de réduction de modèle (model refinement). En écartant méthodiquement les variables dont le score VIP s’effondre en deçà du seuil de 0.8, le chercheur peut recalibrer un modèle PLS parcimonieux sur un sous-ensemble restreint de régresseurs hautement informatifs. Cette purge dimensionnelle réduit la charge de passation des protocoles d’évaluation empirique ultérieurs, élimine le bruit résiduel lié aux items non pertinents, et consolide fréquemment l’exactitude de prédiction externe en optimisant le rapport signal sur bruit global de la matrice explicative.
9. Étape 7 : Ajustement final et interprétation des coefficients de régression
9.1 Extraction des coefficients ramenés à l’espace original
L’aboutissement de la modélisation PLS réside dans la formulation de l’équation prédictive liant directement l’espérance mathématique de la réponse cible à la matrice originelle des prédicteurs empiriques. Pour obtenir les coefficients de régression partiels rétro-projetés, le chercheur sollicite la fonction générique coef(modele_pls, ncomp = ncomp_opt, intercept = TRUE). Cette instruction commande au moteur matriciel d’exécuter la recombinaison linéaire des poids W* et des charges internes pour projeter la relation estimée sur les composantes latentes directement vers le repère euclidien d’origine des p régresseurs.
Une vigilance épistémologique absolue s’impose quant à l’échelle de mesure des coefficients extraits. Si les calculs factoriels ont été conduits sur des variables préalablement centrées et réduites (via l’argument fondamental scale = TRUE), les coefficients bruts délivrés par défaut par la méthode coef() s’appliquent aux variables standardisées (coefficients bêta standardisés). Ces coefficients possèdent une valeur inestimable pour comparer la force d’impact relative des prédicteurs indépendamment de leurs unités physiques respectives, un incrément d’un écart-type sur le prédicteur se traduisant par une variation de bêta écarts-types sur la cible d’épuisement émotionnel.
Pour des finalités d’application concrète sur le terrain clinique ou organisationnel, le modèle doit être traduit dans la métrique naturelle des instruments de mesure. La rétro-transformation déstandardise chaque coefficient de régression en le divisant par l’écart-type de son prédicteur d’origine et en le multipliant par l’écart-type de la variable réponse, tandis que l’interception globale est recalculée pour compenser le décentrage des moyennes empiriques. L’équation prédictive finale s’exprime alors dans les unités réelles des échelles de Likert et des constantes physiologiques, devenant immédiatement exploitable pour générer des évaluations diagnostiques individuelles chez de nouveaux sujets sans nécessiter de prétraitement complexe.
9.2 Inférence statistique et intervalles de confiance par Jackknife / Bootstrap
Une limitation historique inhérente à la nature algorithmique de la régression PLS réside dans l’absence de théorie distributionnelle asymptotique fermée permettant de dériver analytiquement les erreurs types et les p-valeurs des coefficients de régression, comme le permettent les hypothèses de normalité gaussienne sous OLS. Puisque les prédicteurs latents sont construits de manière supervisée et conditionnée par la variable cible, la distribution d’échantillonnage des coefficients rétro-projetés s’écarte de la loi classique de Student. L’inférence statistique formelle doit donc impérativement s’appuyer sur des méthodologies intensives de rééchantillonnage non paramétrique.
Le package pls implémente de manière native la procédure du Jackknife (ou validation croisée d’extrapolation d’erreur de Quenouille-Tukey), directement articulée avec la fonction de test jack.test(). Lorsque le modèle initial a été configuré avec l’argument de validation validation = "CV" ou validation = "LOO", la fonction recalcule la matrice des coefficients de régression sur chaque sous-échantillon d’omission séquentielle. À partir de la dispersion empirique de ces estimations partielles, la routine calcule les erreurs types asymptotiques jackknife et génère des p-valeurs associées à des statistiques t approchées pour chaque régresseur explicatif.
Pour une rigueur scientifique encore supérieure, le déploiement d’un rééchantillonnage par Bootstrap non paramétrique à 2 000 tirages avec remise — orchestré via le package de référence boot — constitue le standard méthodologique d’excellence. Par l’extraction des quantiles à 2.5 % et 97.5 % de la distribution empirique générée pour chaque coefficient de régression bêta, le chercheur dérive des intervalles de confiance ajustés par la méthode BCa (bias-corrected and accelerated). Si l’intervalle de confiance à 95 % d’un prédicteur englobe la valeur zéro, l’hypothèse nulle d’absence d’impact marginal ne peut être rejetée, fournissant ainsi un critère formel d’inférence statistique immunisé contre les biais de non-normalité.
9.3 Tableau récapitulatif standardisé pour publication académique
La restitution éditoriale des résultats d’une régression par moindres carrés partiels dans une revue scientifique à comité de lecture (conforme par exemple aux normes de l’American Psychological Association, APA 7th edition) ne saurait se limiter à la mention isolée des coefficients de régression finaux. La présentation tabulaire de synthèse doit articuler une vue tridimensionnelle intégrant l’analyse dimensionnelle, la force marginale et la validité inférentielle de chaque variable observée au sein du modèle optimal calibré.
Le tableau récapitulatif standardisé s’organise en colonnes successives rigoureusement documentées :
(1) le nom explicite de la variable prédictrice ou de l’item psychométrique ;
(2) le coefficient de régression standardisé rétro-projeté (Bêta) ;
(3) l’erreur type dérivée par Jackknife ou Bootstrap (SE) ;
(4) l’intervalle de confiance non paramétrique à 95 % [IC 95 %] ;
(5) la valeur de la statistique de test t et sa significativité stochastique associée ;
(6) le score synthétique d’importance dans la projection (VIP).
En note infrapaginale, le tableau consigne scrupuleusement le nombre de composantes latentes M retenues, la taille de l’échantillon d’apprentissage, ainsi que les pourcentages cumulés de variance expliquée dans l’espace X et dans l’espace Y.
Cette mise en regard simultanée des coefficients bêta et des scores VIP prévient toute erreur d’interprétation substantielle. En effet, en présence d’une multicolinéarité résiduelle au sein d’un bloc de variables corrélées ayant toutes un score VIP élevé (VIP > 1.3), le modèle PLS peut répartir le poids prédictif en attribuant un coefficient bêta élevé à l’un des indicateurs et un coefficient d’amplitude modeste à son voisin immédiat. La lecture croisée informe le lecteur scientifique que le second item, bien que doté d’un coefficient direct modéré par effet de partage de variance, demeure une variable structurellement fondamentale dans l’architecture factorielle globale du modèle prédictif.
10. Étape 8 : Évaluation des performances et validation externe sur le jeu de test
10.1 Génération des prédictions sur données indépendantes
L’épreuve de vérité méthodologique de toute modélisation prédictive réside dans sa confrontation formelle à des données externes n’ayant exercé aucune influence sur l’estimation des composantes factorielles ni sur la calibration des coefficients. À cette étape, la partition de test isolée au départ (regroupant les 20 % des observations mises de côté) est réintroduite dans le flux d’analyse. L’analyste applique la méthode générique predict() en renseignant scrupuleusement l’argument newdata = donnees_test et en spécifiant formellement la dimensionnalité arrêtée via ncomp = ncomp_opt.
L’exécution de cette directive met en jeu une machinerie computationnelle rigoureuse. La fonction predict.mvr() standardise automatiquement les nouvelles observations de l’échantillon de test en mobilisant impérativement les centres (moyennes empiriques) et les facteurs d’échelle (écarts-types) extraits de l’échantillon d’entraînement, préservés au sein de la structure de l’objet modele_pls. Cette standardisation asymétrique garantit une fidélité absolue au protocole scientifique : aucune information distributionnelle propre à la partition de test n’est injectée dans la procédure de mise à l’échelle, respectant le confinement d’indépendance statistique le plus strict.
La sortie générée se présente sous la forme d’un vecteur de valeurs prédictives modélisées pour la variable d’épuisement émotionnel, mesurées dans l’unité continue d’origine de l’échelle cible. Ces estimations ponctuelles reflètent l’extrapolation exacte de la surface factorielle calibrée sur les nouveaux profils de répondants. Le vecteur des prédictions est immédiatement adossé au vecteur des valeurs empiriques réelles observées sur la partition de test au sein d’un tableau comparatif dédié, autorisant le déploiement des calculs d’exactitude numérique.
10.2 Calcul des métriques d’exactitude prédictive
La quantification objective des facultés d’extrapolation du modèle PLS s’opère au moyen d’un triptyque d’indicateurs de performance universellement reconnus en modélisation statistique. Le premier et le plus déterminant est la racine carrée de l’erreur quadratique moyenne de prédiction externe (RMSEP externe). Calculée par la racine carrée de la moyenne des écarts au carré entre les réponses réelles du groupe test et les valeurs projetées par le modèle, cette métrique pénalise lourdement les déviations prédictives de forte amplitude et fournit une estimation directe de l’incertitude type d’extrapolation exprimée dans l’unité de la cible.
Le second indicateur analytique réside dans l’erreur absolue moyenne (MAE, Mean Absolute Error). Moins sensible aux valeurs résiduelles atypiques isolées que le RMSEP en raison de l’absence d’élévation quadratique, la MAE chiffre l’écart moyen arithmétique absolu séparant la prédiction du modèle de l’état réel du sujet. L’observation d’une convergence étroite entre les grandeurs du RMSEP et de la MAE sur l’échantillon de test atteste de la grande régularité de la distribution des erreurs prédictives et confirme l’absence de biais résiduels massifs concentrés sur des observations individuelles spécifiques.
Enfin, le troisième pilier de cette évaluation consiste en l’estimation du coefficient de détermination prédictif externe, couramment désigné sous le vocable de Q² de test ou de R² prédictif externe. Contrairement au coefficient de détermination classique R² calculé sur l’échantillon d’apprentissage qui ne mesure qu’une simple proximité descriptive locale, le Q² évalue le pourcentage de la variance totale des nouvelles observations indépendantes qui est effectivement capté et restitué par le modèle factoriel calibré. Une valeur de Q² franchissant le seuil critique de 0.50 ou 0.60 atteste d’une capacité prédictive externe hautement substantielle, confirmant la validité nomologique du modèle empirique.
10.3 Comparaison empirique avec la régression linéaire multiple
Pour apporter la preuve empirique définitive de l’utilité des moindres carrés partiels face aux pathologies de multicolinéarité, l’analyste soumet simultanément la partition d’apprentissage à une estimation par les moindres carrés ordinaires conventionnels via la fonction canonique lm(Epuisement ~ ., data = donnees_train). Les coefficients issus de ce modèle OLS non régularisé sont ensuite immédiatement appliqués aux prédicteurs de l’échantillon de test via predict.lm(), générant un jeu concurrent de prédictions soumis aux mêmes métriques de vérification externe.
La confrontation des résultats chiffrés tourne systématiquement à l’avantage déterminant de la régression PLS lorsque les régresseurs présentent de fortes interdépendances. Si l’ajustement OLS affiche un coefficient R² d’apprentissage faussement flatteur (souvent artificiellement gonflé à 0.85 ou 0.90 par absorption servile du bruit stochastique), son RMSEP calculé sur les données de test subit une dégradation spectaculaire, matérialisée par un bond exponentiel de l’erreur quadratique et un effondrement corrélatif de son Q² externe, qui plonge fréquemment vers des valeurs négatives traduisant une performance pire que celle d’une simple prédiction par la moyenne globale.
À l’opposé, le modèle PLS régularisé à quatre composantes latentes maintient sur la partition de test des métriques stables et robustes, exhibant un RMSEP externe substantiellement compressé et un Q² de test préservé à un niveau élevé. Cette démonstration comparative fournit la validation tangible de la théorie statistique : en purgeant l’espace explicatif de ses redondances linaires destructrices et en contraignant l’estimation le long des axes de covariance maximale, la PLS a jugulé le surapprentissage et doté le chercheur d’un instrument d’inférence réellement généralisable à la population parente.
11. Diagnostics résiduels et détection des observations atypiques
11.1 Analyse de la distribution et de l’homoscédasticité des résidus
La validation scientifique d’une modélisation statistique avancée impose un audit diagnostique scrupuleux du comportement de ses résidus prédictifs. Dans le cadre de la PLS, le vecteur des résidus se définit comme la différence arithmétique entre la valeur observée de la variable réponse et la valeur projetée par le modèle factoriel tronqué à M composantes. Bien que la PLS soit une méthode de modélisation non paramétrique exempte d’hypothèse distributionnelle stricte a priori sur les données brutes, l’optimalité fonctionnelle de ses estimations repose sur la structure de ces erreurs résiduelles.
Le premier diagnostic graphique s’articule autour de la visualisation du diagramme de dispersion des résidus standardisés en fonction des valeurs ajustées prédites. Ce tracé permet d’examiner l’hypothèse fondamentale d’homoscédasticité (constance de la variance de l’erreur le long du continuum de prédiction). L’observation d’un motif résiduel en entonnoir, où l’amplitude des résidus s’élargit à mesure que le score d’épuisement émotionnel prédit croît, révélerait un phénomène d’hétéroscédasticité exigeant une transformation logarithmique ou Box-Cox préalable de la cible. Parallèlement, l’absence de courbures systématiques ou de profils sinusoïdaux valide formellement la linéarité fonctionnelle du modèle interne reliant les composantes latentes.
Le second volet diagnostique examine la conformité distributionnelle de ces résidus à travers la génération d’un tracé Quantile-Quantile normal (Normal Q-Q Plot). L’alignement rigoureux des points empiriques le long de la bissectrice théorique idéale atteste de la quasi-normalité des déviations résiduelles. Une déviation marquée observée aux queues de distribution (queues lourdes ou asymétrie marquée) signale au chercheur que certains individus statistiques subissent des écarts d’ajustement disproportionnés, orientant l’investigation vers la détection formelle des observations aberrantes ou influentes au sein de l’espace factoriel multivarié.
11.2 Détection des points leviers et des valeurs aberrantes
L’évaluation des cas atypiques en régression PLS transcende l’analyse unidimensionnelle des résidus pour embrasser la géométrie multivariée de l’espace factoriel. Le protocole diagnostique d’excellence combine l’évaluation conjointe de deux métriques géométriques complémentaires : la distance aux scores au sein du sous-espace factoriel retenu, mesurée par la statistique du T² de Hotelling, et la distance orthogonale aux résidus factoriels de la matrice des prédicteurs, universellement quantifiée par la métrique des résidus Q (ou DModX, Distance to the Model in X-space).
La statistique du T² de Hotelling calcule la distance de Mahalanobis d’une observation par rapport au barycentre des scores latents dans le sous-espace des M composantes conservées. Un T² qui franchit le seuil critique d’admissibilité statistique dérivé de la loi de Fisher-Snedecor désigne une observation qui se comporte comme un point levier majeur (leverage point) : l’individu s’écarte radicalement du profil moyen de l’échantillon tout en se situant fidèlement à l’intérieur de l’hyperplan factoriel modélisé, exerçant ainsi une traction géométrique disproportionnée sur l’orientation directionnelle des poids factoriels.
À l’inverse, la statistique des résidus Q évalue la distance euclidienne séparant une observation de sa projection orthogonale théorique sur le sous-espace factoriel des composantes latentes. Une valeur résiduelle Q excessive trahit une observation atypique orthogonale (outlier structurel) : le sujet présente une configuration d’items ou de marqueurs anormale qui échappe totalement aux corrélations captées par le modèle PLS. La restitution combinée de ces deux métriques sur un diagramme cartésien bivarié T² versus Q permet de catégoriser instantanément les observations saines, les points leviers réguliers, et les cas aberrants critiques cumulant une déviation extrême sur les deux axes diagnostiques.
11.3 Impact des cas atypiques sur la stabilité factorielle
L’identification de profils individuels affichant des valeurs extrêmes de résidus Q ou de T² de Hotelling pose la question critique de leur incidence sur la robustesse globale du modèle estimé. La démarche scientifique impose de conduire une analyse de sensibilité systématique. Cette procédure consiste à réajuster l’intégralité du flux analytique PLS — depuis le centrage-réduction jusqu’au choix dimensionnel par validation croisée — après avoir temporairement neutralisé les observations catégorisées comme atypiques sévères.
L’analyste examine attentivement le degré de résilience des paramètres structuraux clés face à cette soustraction d’individus. Si le nombre optimal de composantes latentes sélectionné par validation croisée demeure invariant et que les vecteurs de poids factoriels W* ainsi que les scores VIP conservent une colinéarité supérieure à 0.98 avec ceux du modèle complet, la modélisation fait la démonstration de sa robustesse intrinsèque. Les cas atypiques constituent alors de simples fluctuations stochastiques extrêmes n’altérant pas la validité nomologique du système factoriel dérivé.
Sur le plan méthodologique et éthique, l’exclusion définitive d’observations ne saurait être décidée sur le seul fondement d’une déviation statistique abstraite. Le chercheur doit conduire une enquête qualitative et contextuelle approfondie sur les dossiers des participants concernés afin d’élucider l’origine de l’anomalie : erreur manifeste de saisie numérique, dysfonctionnement avéré d’un capteur physiologique lors de la collecte, ou comportement de réponse aberrant (réponses stéréotypées invariantes à un questionnaire). En l’absence de motif substantiel documenté, la bonne pratique scientifique commande de conserver les observations au sein de l’échantillon principal tout en rapportant en annexe technique l’analyse de sensibilité confirmant la stabilité des conclusions scientifiques.
12. Synthèse critique, extensions avancées et recommandations pratiques
12.1 Distinction essentielle entre PLS-R (Régression) et PLS-SEM (Modélisation causale)
La popularité croissante des méthodologies labellisées sous le vocable « PLS » engendre une confusion récurrente dans la littérature empirique entre deux architectures computationnelles foncièrement distinctes : la régression par moindres carrés partiels (PLS-R) et la modélisation d’équations structurelles par les moindres carrés partiels (PLS-SEM, ou PLS Path Modeling). Bien que toutes deux procèdent des intuitions fondamentales de Herman Wold sur l’inférence souple orientée vers les composantes (soft modeling), leurs finalités opérationnelles et leurs algorithmes sous-jacents divergent profondément.
La PLS-R, implémentée dans le package de référence pls et développée tout au long de cet article, est une méthode d’analyse prédictive multivariée supervisée. Elle traite un ensemble structuré de régresseurs observables X pour prédire de manière optimale une ou plusieurs réponses cibles Y à travers la décomposition de leur matrice de covariance croisée. L’algorithme ne formule aucune hypothèse a priori sur des sous-réseaux conceptuels causaux complexes liant les variables prédictrices entre elles, opérant une régularisation dimensionnelle descendante guidée par la minimisation du risque quadratique de prédiction.
À l’opposé, la PLS-SEM (implémentée dans des bibliothèques R dédiées telles que seminr ou cSEM) est une technique confirmatoire d’analyse de chemin visant à estimer un réseau complexe de relations causales hypothétiques unissant de multiples construits latents réflexifs ou formatifs. La PLS-SEM résout séquentiellement un système d’équations de mesure et de structure via un schéma de pondération itératif entre blocs conceptuels. Le choix entre ces deux approches s’articule autour de la question de recherche : si l’objectif prépondérant réside dans la prédiction robuste d’un phénomène quantitatif face à la multicolinéarité sévère, la PLS-R s’impose souverainement ; si le but est de tester formellement une théorie causale systémique articulée en réseau de médiations latentes, la PLS-SEM constitue l’architecture analytique appropriée.
12.2 Variantes avancées : Sparse PLS et régression logistique PLS
L’architecture fondamentale de la PLS linéaire continue a donné naissance à une lignée d’extensions méthodologiques avancées conçues pour surmonter des verrous spécifiques de l’analyse contemporaine des données. Parmi ces développements figure en premier lieu la Sparse PLS (ou sPLS), développée notamment par Chun et Keleş et implémentée dans le package spécialisé spls ainsi que dans la suite mixOmics. La PLS standard présente l’inconvénient théorique d’attribuer des poids factoriels non nuls à l’intégralité des prédicteurs, contraignant le modèle à maintenir toutes les variables dans sa formulation finale, y compris après calcul du VIP.
La Sparse PLS pallie cette limitation en introduisant une pénalité de parcimonie de type L1 (analogue à celle du Lasso) directement au sein du critère d’optimisation de l’algorithme d’extraction des poids factoriels NIPALS ou SIMPLS. Cette régularisation mathématique force les coefficients de pondération des prédicteurs les moins explicatifs à converger exactement vers zéro lors de la décomposition factorielle. La sPLS réalise ainsi une sélection de variables intrinsèque simultanément à la réduction de dimensionnalité, produisant des composantes latentes épurées qui ne dépendent que d’un sous-ensemble restreint de biomarqueurs ou d’indicateurs psychométriques majeurs, ce qui décuple l’interprétabilité biomédicale ou comportementale des modèles dérivés en très haute dimension.
Parallèlement, lorsque la variable cible à modéliser n’est plus une grandeur numérique continue mais une variable qualitative discrète (binaire ou multinomiale — par exemple la présence versus l’absence d’une pathologie neuropsychiatrique), l’hypothèse de linéarité de la relation interne s’avère inadéquate. Les chercheurs recourent alors à la régression logistique PLS (PLS-DA pour Discriminant Analysis, ou classification logistique par composantes PLS), accessible via le package plsRglm. Cette variante couple l’extraction factorielle supervisée par moindres carrés partiels à une fonction de lien logit appartenant à la famille des modèles linéaires généralisés, autorisant l’inférence probabiliste et la classification supervisée robuste en présence de prédicteurs hautement corrélés.
12.3 Guide récapitulatif des bonnes pratiques de modélisation
Pour garantir la rigueur scientifique intégrale et la pérennité méthodologique des conclusions dérivées d’une modélisation par moindres carrés partiels, le chercheur veillera à respecter scrupuleusement les jalons de la check-list séquentielle suivante :
- Vérification formelle de la justification méthodologique : Démontrer préalablement l’échec structurel des approches linéaires conventionnelles par le calcul documenté des indices VIF et l’inspection de la matrice de corrélation avant de recourir à la PLS.
- Évitement catégorique de la contamination des données (Data Leakage) : Procéder impérativement au partitionnement étanche des ensembles d’apprentissage (80 %) et de test (20 %) avant toute opération de centrage, de réduction ou d’imputation de valeurs manquantes.
- Optimisation objective de la dimensionnalité : Arrêter le nombre définitif de composantes latentes au moyen d’une validation croisée k-fold (typiquement 10 plis) guidée par la règle du minimum absolu ou la règle parcimonieuse du un écart-type (1 SE), sans céder à la tentation d’une sélection visuelle opportuniste.
- Exploration géométrique bilatérale : Analyser conjointement les projections des individus (scores T) pour déceler d’éventuelles sous-populations et la cartographie des prédicteurs (poids W* et loadings P) afin d’assurer l’assise théorique des axes construits.
- Hiérarchisation par les métriques validées : Exploiter prioritairement le score d’importance de la variable dans la projection (VIP) et les intervalles de confiance non paramétriques (Jackknife ou Bootstrap à 2 000 tirages) pour filtrer et hiérarchiser les régresseurs.
- Validation extrapolative externe rigoureuse : Évaluer les performances du modèle calibré sur la partition de test indépendante à l’aide des métriques de RMSEP externe, de MAE et du coefficient prédictif Q², en confrontant ces résultats à un contrefactuel OLS classique.
- Audit diagnostique multivarié des résidus : Vérifier l’homoscédasticité résiduelle et documenter l’absence d’observations atypiques ou de points leviers destructeurs via l’analyse couplée des distances du T² de Hotelling et des résidus Q.
- Transparence et reproductibilité algorithmique : Verrouiller systématiquement le générateur de nombres pseudo-aléatoires au moyen de
set.seed()et publier l’intégralité du script R commenté ainsi que la sortie formelle desessionInfo()en annexes ouvertes de la publication.
L’observation rigoureuse de ces exigences méthodologiques immunise le protocole d’analyse contre les écueils usuels du surapprentissage masqué et de l’inflation d’exactitude. En déployant la régression par moindres carrés partiels dans l’environnement R conformément à ces préceptes d’excellence, le chercheur s’assure de transformer un corpus complexe de données empiriques hautement colinéaires en un modèle explicatif et prédictif d’une élégance mathématique et d’une robustesse statistique irréprochables.
Références
- Chun, H., & Keleş, S. (2010). Sparse partial least squares regression for simultaneous dimension reduction and variable selection. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 72(1), 3-25. https://doi.org/10.1111/j.1467-9868.2009.00723.x
- de Jong, S. (1993). SIMPLS: An alternative approach to partial least squares regression. Chemometrics and Intelligent Laboratory Systems, 18(3), 251-263. https://doi.org/10.1016/0169-7439(93)85002-X
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Mehmood, T., Liland, K. H., Snipen, L., & Sæbø, S. (2012). A review of variable selection methods in Partial Least Squares Regression. Chemometrics and Intelligent Laboratory Systems, 118, 62-69. https://doi.org/10.1016/j.chemolab.2012.07.010
- Mevik, B.-H., & Wehrens, R. (2007). The pls Package: Principle Component and Partial Least Squares Regression in R. Journal of Statistical Software, 18(2), 1-23. https://doi.org/10.18637/jss.v018.i02
- Wold, H. (1966). Estimation of principal components and related models by iterative least squares. In P. R. Krishnaiah (Ed.), Multivariate Analysis (pp. 391-420). Academic Press.
- Wold, S., Sjöström, M., & Eriksson, L. (2001). PLS-regression: a basic tool of chemometrics. Chemometrics and Intelligent Laboratory Systems, 58(2), 109-130. https://doi.org/10.1016/S0169-7439(01)00155-1