
L’analyse quantitative des comportements humains repose sur la modélisation rigoureuse de phénomènes observables, souvent discrets, traduisant des dynamiques psychologiques sous-jacentes. Qu’il s’agisse de mesurer la fréquence des accès de colère chez des enfants souffrant de troubles de l’opposition, le nombre de lapsus verbaux au cours d’une séance d’évaluation neuropsychologique ou l’occurrence d’erreurs d’inattention dans des tâches de temps de réaction continu, les chercheurs en sciences comportementales sont confrontés à des données de comptage. Pendant longtemps, ces métriques ont été indûment traitées par des approches linéaires gaussiennes classiques, générant des biais systématiques, des prédictions d’occurrences négatives dénuées de sens physique et des distorsions majeures des erreurs types.
Pour surmonter ces écueils méthodologiques, la théorie statistique moderne privilégie l’inférence paramétrique fondée sur des distributions de probabilité dont le support correspond intrinsèquement à la nature arithmétique des variables observées. Au cœur de ce paradigme, la distribution de Poisson s’impose comme le modèle probabiliste fondamental pour capturer la survenue d’événements discrets dans un continuum temporel ou spatial défini. Toutefois, l’ajustement optimal de ce modèle à des observations empiriques exige l’utilisation d’une méthode d’estimation dotée de propriétés d’optimalité asymptotique indiscutables. C’est précisément l’objet de l’estimation du maximum de vraisemblance, formalisée au cours du XXe siècle, qui a révolutionné la statistique inférentielle et la psychométrie contemporaine.
Ce traité exhaustif expose de manière didactique, étape par étape, les fondements mathématiques, les développements algébriques et les applications concrètes de l’estimation du maximum de vraisemblance appliquée au paramètre d’intensité d’une distribution de Poisson. À travers un cheminement analytique rigoureux — partant de la fonction de masse de probabilité pour aboutir aux propriétés asymptotiques, aux tests d’hypothèses et aux adaptations face aux violations des postulats théoriques —, ce guide fournit aux chercheurs, psychomètres et analystes de données les outils conceptuels et formels nécessaires pour modéliser avec précision les données de comptage comportementales.
1. Fondements théoriques de l’estimation du maximum de vraisemblance
1.1 Origines épistémologiques et principes statistiques de l’EMV
L’estimation du maximum de vraisemblance (EMV) trouve ses racines conceptuelles dans les travaux pionniers de Johann Heinrich Lambert et Carl Friedrich Gauss, mais elle doit son élaboration théorique moderne, son nom et la formalisation de ses propriétés optimales au statisticien et généticien britannique Ronald Aylmer Fisher dans une série d’articles fondateurs publiés entre 1912 et 1922. Fisher cherchait à dépasser les limites de l’approche bayésienne standard de l’époque — alors tributaire du principe de raison insuffisante et de l’usage systématique de distributions a priori uniformes contestées — en proposant un cadre inférentiel s’appuyant strictement sur les données observables et le mécanisme générateur de probabilité.
La distinction conceptuelle entre probabilité et vraisemblance constitue la pierre angulaire de l’épistémologie fisherienne. La probabilité, d’une part, opère dans un cadre déductif direct : considérant que les paramètres théoriques d’une population ou d’un processus stochastique sont parfaitement connus et fixés, le calcul des probabilités évalue les chances d’observer diverses configurations ou réalisations d’échantillons au sein de l’espace d’échantillonnage. D’autre part, la vraisemblance adopte une démarche inductive inverse : observant un vecteur empirique précis de données recueillies lors d’une expérience, la fonction de vraisemblance évalue le degré de plausibilité de différentes valeurs hypothétiques du paramètre inconnu. Dans cette configuration, la réalisation expérimentale est tenue pour fixe et immuable, tandis que le paramètre devient l’argument variable d’une fonction mathématique.
Dans l’analyse quantitative des comportements et des processus mentaux, l’inférence paramétrique joue un rôle structurant. Elle postule que les conduites observées ne constituent pas de simples agrégats aléatoires dénués de logique interne, mais résultent de lois mathématiques sous-jacentes gouvernées par un ensemble restreint de paramètres psychologiques ou neurocognitifs (par exemple, le niveau de latence attentionnelle, la capacité de mémoire de travail ou le taux intrinsèque d’impulsivité). Estimer ces paramètres avec la plus grande précision possible permet non seulement de tester des hypothèses scientifiques concurrentes, mais aussi de prédire des profils comportementaux avec une marge d’incertitude quantifiée.
Pour être qualifié d’optimal dans la recherche fondamentale et appliquée, un estimateur statistique doit satisfaire à plusieurs propriétés idéales :
- L’absence de biais : l’espérance mathématique de la distribution d’échantillonnage de l’estimateur doit égaler la véritable valeur du paramètre dans la population sous-jacente, éliminant ainsi toute dérive systématique d’estimation.
- La consistance statistique : à mesure que la taille de l’échantillon croît vers l’infini, l’estimateur doit converger en probabilité vers la valeur cible, garantissant une précision accrue sur les grands volumes de données.
- L’efficacité asymptotique : la variance de l’estimateur doit atteindre la plus petite borne théorique possible pour une classe donnée d’estimateurs, assurant une dispersion minimale autour du paramètre cible.
- L’invariance fonctionnelle : si un paramètre est estimé par le maximum de vraisemblance, toute transformation continue et différentiable de ce paramètre possède pour estimateur du maximum de vraisemblance la même transformation de l’estimateur originel.
1.2 Importance de l’estimation paramétrique en psychologie quantitative
La psychologie quantitative, la neuropsychologie et les sciences cognitives génèrent quotidiennement des variables de comptage : nombre d’intrusions verbales dans un test d’apprentissage auditif, nombre de réveils nocturnes chez des sujets souffrant de syndrome de stress post-traumatique, nombre de persévérations motrices lors d’un protocole d’inhibition exécutive ou fréquence des passages à l’acte impulsifs. De par leur structure mathématique intrinsèque, ces variables sont confinées à l’espace des entiers naturels, sont bornées inférieurement par zéro et affichent souvent une asymétrie positive prononcée, particulièrement marquée lorsque l’événement étudié présente un caractère de rareté relative au sein de l’intervalle d’observation.
Le traitement formel de ces données par des modèles psychométriques appropriés est essentiel. L’application mécanique du modèle linéaire classique (régression linéaire ordinaire, analyse de variance) postule la normalité des résidus et l’homoscédasticité, deux postulats immanquablement violés par les variables de dénombrement. La modélisation par la régression de Poisson ou par l’estimation directe de ses paramètres fournit un socle formel respectant la véritable nature discrète et non linéaire du phénomène sous-jacent. Elle évite l’écueil des transformations mathématiques ad hoc (telles que la racine carrée ou la transformation logarithmique augmentée d’une constante), dont il a été démontré qu’elles dénaturent la structure des erreurs et compliquent l’interprétation théorique des grandeurs estimées.
Face à la méthode des moments — qui consiste à égaliser empiriquement les moments d’échantillonnage aux moments théoriques de la loi —, l’estimation du maximum de vraisemblance offre des avantages déterminants en psychométrie. Si la méthode des moments s’avère souvent intuitive et aisée à calculer, elle souffre d’une perte d’efficacité statistique marquée dès que les distributions présentent de l’asymétrie ou lorsque des covariables complexes s’articulent dans un modèle multivarié. L’EMV exploite quant à elle l’intégralité de l’information contenue dans la distribution conjointe des données empiriques. Elle s’intègre parfaitement aux paradigmes d’équations structurelles, de modélisation multiniveau et de théorie des réponses aux items, fournissant des erreurs types asymptotiquement exactes et un cadre rigoureux pour la comparaison de modèles emboîtés par des tests d’hypothèses probabilistes standardisés.
2. Caractérisation mathématique de la distribution de Poisson
2.1 Définition et hypothèses du processus de Poisson
La distribution de Poisson, découverte par le mathématicien français Siméon Denis Poisson dans son traité de 1837 sur la probabilité des jugements en matière criminelle et civile, constitue la loi limite décrivant le nombre d’occurrences d’un événement au cours d’un intervalle fixe de temps ou d’espace. Pour qu’une série de comportements observés chez un individu ou un groupe puisse être formellement modélisée par un processus de Poisson homogène, trois postulats axiomatiques fondamentaux doivent impérativement être vérifiés :
- L’indépendance temporelle et spatiale : le nombre d’occurrences survenant dans deux intervalles disjoints et non chevauchants doit être stochastiquement indépendant. Dans une perspective comportementale, cela implique par exemple que la survenue d’une crise d’angoisse durant une heure donnée n’altère en rien la probabilité d’occurrence d’une crise au cours de l’heure suivante, écartant de facto les effets directs d’apprentissage, de contamination ou de contagion séquentielle immédiate.
- La stationnarité et l’homogénéité du taux d’occurrence : la probabilité qu’un événement survienne exactement une fois au cours d’un sous-intervalle infinitésimal de durée $dt$ est proportionnelle à la longueur de cet intervalle, soit $\lambda \cdot dt$, où $lambda$ représente l’intensité ou le taux moyen constant du processus. Ce taux est invariant au cours de toute la fenêtre de mesure expérimentale, ce qui exclut l’existence de rythmes circadiens ou de phénomènes d’épuisement physiologique altérant le taux de base.
- L’absence de simultanéité stricte (propriété d’ordre) : la probabilité que deux événements comportementaux ou plus surviennent de façon strictement simultanée dans un intervalle infinitésimal $dt$ est un infiniment petit d’ordre supérieur par rapport à $dt$, formellement noté $o(dt)$. Les comportements surviennent de façon séquentielle, un par un, excluant l’apparition d’événements groupés ou agrégés instantanément.
2.2 Propriétés distributionnelles et moments théoriques
La distribution univariée de Poisson dépend d’un unique paramètre d’intensité positive, traditionnellement désigné par la lettre grecque $lambda$ ($\lambda in \mathbb{R}_+^*$). Ce paramètre gouverne l’intégralité de la morphologie de la distribution, dictant simultanément sa localisation centrale, son étalement et son asymétrie. La caractéristique la plus remarquable et la plus exigeante de la loi de Poisson réside dans l’équidispersion stricte, qui établit l’égalité formelle entre l’espérance mathématique du processus et sa variance théorique :
$$\mathbb{E}[X] = \lambda$$
$$operatorname{Var}(X) = \lambda$$
Cette propriété découle directement de la dérivation de la fonction génératrice des moments $M_X(t) = \exp(\lambda(e^t – 1))$. En dérivant successivement cette fonction par rapport à $t$ et en évaluant le résultat en $t = 0$, on obtient l’espérance :
$$M’_X(0) = left. \lambda e^t \exp(\lambda(e^t – 1)) right|_{t=0} = \lambda$$
La dérivée seconde fournit le moment non centré d’ordre deux :
$$M »_X(0) = left. \left[ \lambda e^t + (\lambda e^t)^2 \right] \exp(\lambda(e^t – 1)) right|_{t=0} = \lambda + \lambda^2$$
En appliquant la formule de König-Huygens pour le calcul de la variance :
$$operatorname{Var}(X) = \mathbb{E}[X^2] – (\mathbb{E}[X])^2 = (\lambda + \lambda^2) – \lambda^2 = \lambda$$
Dans la recherche comportementale, cette équidispersion théorique constitue une contrainte empirique substantielle. Elle signifie que tout groupe présentant un niveau moyen élevé d’occurrences comportementales (par exemple, des patients sévèrement atteints manifestant une moyenne de 15 comportements répétitifs par session) présentera obligatoirement une dispersion individuelle plus large ($\sigma = \sqrt{15} \approx 3{,}87$) qu’un groupe contrôle caractérisé par un taux moyen modeste ($lambda = 2$, d’où $\sigma = \sqrt{2} \approx 1{,}41$). L’asymétrie de la distribution est régie par le coefficient de Fisher $\gamma_1 = 1/\sqrt{\lambda}$, démontrant que la distribution est fortement asymétrique vers la droite pour les faibles valeurs d’intensité, puis se rapproche graduellement de la symétrie à mesure que $lambda$ tend vers des valeurs élevées.
2.3 Domaine de définition et support discret de la variable
Le support de la variable aléatoire poissonnienne $X$ est l’ensemble dénombrable des entiers naturels, noté formellement :
$$operatorname{Supp}(X) = \mathbb{N} = {0, 1, 2, 3, dots, +\infty}$$
Contrairement aux modèles de comptage tronqués ou bornés (tels que la distribution binomiale dont la borne supérieure est fixée par le nombre d’essais $n$), la loi de Poisson ne comporte aucune limite supérieure théorique finie, bien que la probabilité d’observer des valeurs arbitrairement grandes décline de manière supra-exponentielle en raison de la présence du terme factoriel au dénominateur de sa fonction de masse.
Sur le plan probabiliste, la loi de Poisson s’obtient également comme cas limite de la loi binomiale $\mathcal{B}(n, p)$ lorsque le nombre d’essais $n$ tend vers l’infini tandis que la probabilité de succès ponctuel $p$ tend vers zéro de telle sorte que le produit $n \cdot p$ converge vers une constante finie $lambda$. Ce théorème de convergence, souvent qualifié de loi des petits nombres ou loi des événements rares, justifie empiriquement son emploi dans des contextes psychologiques où un individu est confronté à un très grand nombre d’opportunités de manifester un comportement, mais où chaque opportunité présente une probabilité d’activation minime :
- Le nombre de crises d’angoisse paroxystiques observées sur une période de suivi de six mois chez des patients souffrant de trouble panique.
- Le nombre d’oublis ou d’omissions critiques répertoriés lors de la réalisation d’une tâche de mémoire prospective complexe impliquant des centaines de requêtes environnementales.
- La fréquence des erreurs d’inattention commises par des opérateurs de tours de contrôle au cours d’un quart de travail intensif sous stress cognitif.
3. Étape 1 : Formulation de la fonction de masse de probabilité
3.1 Écriture algébrique de la fonction de masse univariée
La fonction de masse de probabilité (PMF pour Probability Mass Function) assigne une probabilité théorique exacte à chaque entier naturel $x in \mathbb{N}$. Pour une variable aléatoire $X$ suivant une distribution de Poisson gouvernée par le paramètre d’intensité $lambda$, l’expression analytique univariée pour une observation isolée $x_i$ s’écrit formellement :
$$P(X = x_i mid \lambda) = \frac{\lambda^{x_i} e^{-\lambda}}{x_i!}$$
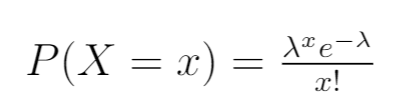
Cette formulation fonctionnelle combine trois composantes mathématiques hautement distinctes dont l’interaction produit la structure distributionnelle spécifique du modèle :
- Le terme d’amortissement exponentiel ($e^{-\lambda}$) : ce facteur assure la normalisation probabiliste de la somme sur l’ensemble du support. Puisqu’il ne dépend pas de la valeur observée $x_i$, il agit comme une constante d’échelle globale dépendant uniquement de l’intensité moyenne du phénomène.
- Le terme de puissance monôme ($\lambda^{x_i}$) : ce facteur croît avec l’ampleur du compte d’événements observés $x_i$ (pour tout $lambda > 1$). Il traduit la contribution de l’accumulation multiplicative des intensités associées à chaque occurrence élémentaire enregistrée.
- Le dénominateur factoriel ($x_i!$) : défini par $x_i! = \prod_{k=1}^{x_i} k$ avec la convention formelle $0! = 1$. Il compense le nombre d’ordonnancements possibles des événements indiscernables au sein de l’intervalle d’observation, introduisant un terme d’atténuation extrêmement puissant qui garantit la convergence stricte de la somme des probabilités vers l’unité.
Le paramètre $lambda$ est assujetti à la contrainte formelle $lambda > 0$. Bien que la limite lorsque $lambda to 0$ corresponde à une masse de Dirac concentrée sur l’entier zéro (un état dégénéré d’absence totale d’événement), toute modélisation stochastique réelle impose un domaine paramétrique strictement positif $\Theta = \mathbb{R}_+^* = ]0, +\infty[$.
3.2 Interprétation probabiliste pour une observation isolée
L’évaluation ponctuelle de la fonction de masse de probabilité permet de quantifier précisément l’attente théorique associée à un compte comportemental spécifique. Considérons un protocole clinique évaluant des épisodes d’agressivité verbale au sein d’une unité psychiatrique fermée, où l’intensité moyenne du comportement est étalonnée à $\lambda = 2{,}5$ occurrences par patient et par jour. La probabilité qu’un patient sélectionné aléatoirement n’émette rigoureusement aucun comportement agressif au cours de la journée ($x_i = 0$) se calcule par l’évaluation directe :
$$P(X = 0 mid \lambda = 2{,}5) = \frac{2{,}5^0 \cdot e^{-2{,}5}}{0!} = \frac{1 \cdot e^{-2{,}5}}{1} \approx 0{,}0821$$
Cette probabilité d’absence totale d’occurrence s’élève donc à environ 8,21 %. Pour un compte correspondant à la valeur modale entière la plus proche de la moyenne, soit $x_i = 2$ événements, la fonction de masse produit :
$$P(X = 2 mid \lambda = 2{,}5) = \frac{2{,}5^2 \cdot e^{-2{,}5}}{2!} = \frac{6{,}25 \cdot 0{,}082085}{2} \approx 0{,}2565$$
Il existe par conséquent une probabilité de 25,65 % d’observer rigoureusement deux comportements chez un patient donné. Lorsque le compte $x_i$ progresse vers des valeurs élevées (par exemple $x_i = 10$), l’effet de croissance polynomiale induit par le terme $\lambda^{x_i}$ ($2{,}5^{10} \approx 9536{,}74$) est totalement dominé par l’explosion combinatoire du terme factoriel au dénominateur ($10! = 3,628,800$). En vertu de la formule d’approximation asymptotique de Stirling :
$$x_i! \sim \sqrt{2\pi x_i} \left(\frac{x_i}{e}\right)^{x_i} \quad \text{lorsque } x_i to +\infty$$
La probabilité $P(X = x_i)$ subit une décroissance superexponentielle, tendant vers zéro infiniment plus rapidement que n’importe quelle décroissance géométrique standard. Cette structure confère à la distribution de Poisson des queues de distribution extrêmement légères, ce qui implique que l’observation de valeurs hautement divergentes de l’intensité moyenne constitue un événement hautement improbable selon ce modèle.
4. Étape 2 : Construction de la fonction de vraisemblance conjointe
4.1 Hypothèse d’échantillonnage indépendant et identiquement distribué
Dans la quasi-totalité des dispositifs de recherche quantitative, l’expérimentateur ne dispose pas d’une observation unique mais d’un ensemble de données empiriques issues d’une cohorte de taille $n$, formalisé par le vecteur de réalisations $\mathbf{x} = (x_1, x_2, dots, x_n)^T$. Pour agréger l’ensemble de ces observations au sein d’une unique structure mathématique d’inférence, il est nécessaire de poser le postulat de l’échantillonnage indépendant et identiquement distribué (i.i.d.).
L’hypothèse d’indépendance conditionnelle stipule que la probabilité qu’un participant $i$ présente un dénombrement spécifique $x_i$ est totalement invariante au regard des valeurs manifestées par le participant $j$ ($i \neq j$). En termes probabilistes formels, la loi de probabilité conjointe du vecteur multivarié $\mathbf{X} = (X_1, dots, X_n)$ se décompose en un produit tensoriel exact des lois marginales univariées individuelles. L’hypothèse de distribution identique requiert que chaque sujet partage rigoureusement le même paramètre d’intensité sous-jacent $lambda$, postulant une homogénéité parfaite de la population ciblée.
Dans la recherche expérimentale et clinique, ces hypothèses doivent faire l’objet d’un examen critique rigoureux. Dans les plans expérimentaux longitudinaux, la mesure répétée du même sujet à travers différentes sessions d’enregistrement viole flagornerait l’indépendance statistique par la présence d’autocorrélations sérielles ou de corrélations intra-sujets. De même, la collecte de données sur des individus regroupés au sein d’unités sociales communes (par exemple des salles de classe, des unités d’hospitalisation ou des fratries) induit une dépendance hiérarchique qui impose, si elle n’est pas modélisée par des effets aléatoires, une correction substantielle de la structure d’estimation.
4.2 Développement du produit des probabilités individuelles
Sous le strict postulat de l’échantillonnage i.i.d., la probabilité conjointe d’observer la séquence empirique spécifique $\mathbf{x} = (x_1, dots, x_n)$ conditionnellement au paramètre $lambda$ correspond au produit multiplicatif des fonctions de masse individuelles. En inversant la perspective conceptuelle pour considérer les données $\mathbf{x}$ comme des constantes fixées et $lambda$ comme la seule variable libre, nous définissons la fonction de vraisemblance conjointe, notée $L(\lambda mid \mathbf{x})$ :
$$L(\lambda mid \mathbf{x}) = \prod_{i=1}^{n} P(X_i = x_i mid \lambda) = \prod_{i=1}^{n} \frac{\lambda^{x_i} e^{-\lambda}}{x_i!}$$
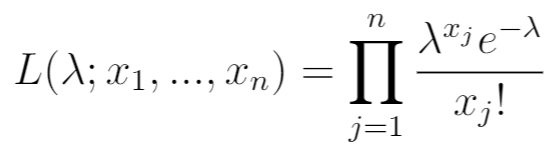
Pour déployer ce produit continu, appliquons méticuleusement les propriétés algébriques classiques associées aux opérateurs de multiplication et aux règles exponentielles. La distributivité du produit sur la fraction univariée permet d’isoler séparément les composantes au numérateur et au dénominateur :
$$L(\lambda mid \mathbf{x}) = \frac{\prod_{i=1}^{n} \left(\lambda^{x_i} e^{-\lambda}\right)}{\prod_{i=1}^{n} x_i!}$$
Analysons chaque segment de cette fraction :
- Le produit des termes exponentiels : puisque chaque observation individuelle contribue par un terme identique $e^{-\lambda}$, le produit de $n$ exponentielles de même base équivaut, par la règle d’addition des puissances, à l’exponentielle de la somme négative des paramètres :
$$\prod_{i=1}^{n} e^{-\lambda} = \underbrace{e^{-\lambda} \cdot e^{-\lambda} \cdots e^{-\lambda}}_{n \text{ facteurs}} = e^{-\sum_{i=1}^n \lambda} = e^{-n\lambda}$$ - Le produit des termes en puissance : le produit des puissances de même base $lambda$ se réduit à une puissance unique dont l’exposant correspond à la somme arithmétique de toutes les valeurs de comptage empiriques observées dans l’échantillon :
$$\prod_{i=1}^{n} \lambda^{x_i} = \lambda^{x_1} \cdot \lambda^{x_2} \cdots \lambda^{x_n} = \lambda^{\sum_{i=1}^{n} x_i}$$ - Le produit des termes factoriels au dénominateur : les dénominateurs factoriels demeurent regroupés sous la forme d’un produit continu de factorielles individuelles, totalement indépendantes du paramètre $lambda$ :
$$\prod_{i=1}^{n} x_i! = x_1! \cdot x_2! \cdots x_n!$$
4.3 Structure analytique globale de la fonction de vraisemblance
En rassemblant les trois développements algébriques intermédiaires établis ci-dessus, nous obtenons l’expression finale condensée de la fonction de vraisemblance conjointe pour un échantillon poissonnien i.i.d. :
$$L(\lambda mid \mathbf{x}) = \frac{\lambda^{\sum_{i=1}^{n} x_i} e^{-n\lambda}}{\prod_{i=1}^{n} x_i!}$$
Cette équation révèle plusieurs caractéristiques structurales fondamentales de l’inférence poissonnienne. D’une part, en vertu du théorème de factorisation de Fisher-Neyman, la fonction de vraisemblance peut être partitionnée en deux facteurs multiplicatifs :
$$L(\lambda mid \mathbf{x}) = g(T(\mathbf{x}), \lambda) \cdot h(\mathbf{x})$$
où $g(T(\mathbf{x}), \lambda) = \lambda^{\sum_{i=1}^n x_i} e^{-n\lambda}$ dépend exclusivement des données par l’intermédiaire de la statistique scalaire $T(\mathbf{x}) = \sum_{i=1}^n x_i$, et où $h(\mathbf{x}) = \frac{1}{\prod_{i=1}^n x_i!}$ est une fonction des données entièrement débarrassée de toute référence au paramètre inconnu $lambda$. Cette décomposition démontre rigoureusement que la statistique de somme $\sum_{i=1}^n x_i$ constitue une statistique exhaustive (ou suffisante) pour estimer le paramètre $lambda$. Aucune information supplémentaire concernant $lambda$ n’est contenue dans l’ordonnancement individuel ou dans d’autres caractéristiques microscopiques de l’échantillon empirique.
D’autre part, la morphologie de la surface de vraisemblance présente une sensibilité aiguë à la taille de l’échantillon $n$. Dès que $n$ atteint des grandeurs usuelles en psychologie ($n ge 50$), la multiplication itérative de fractions probabilistes comprises strictement entre 0 et 1 génère un effondrement d’échelle numérique. La valeur absolue de $L(\lambda mid \mathbf{x})$ plonge vers des ordres de grandeur infinitésimaux (tels que $10^{-45}$ ou $10^{-200}$), ce qui pose un problème immédiat de dépassement de capacité vers le bas (underflow) pour les systèmes computationnels standards opérant en arithmétique à virgule flottante standard IEEE 754.
5. Étape 3 : Linéarisation par la fonction de log-vraisemblance
5.1 Justification de la transformation logarithmique népérienne
Pour contourner l’instabilité numérique inhérente au produit de vraisemblance et simplifier considérablement les opérations mathématiques de différentiation différentielle, il est universellement d’usage en statistique mathématique d’appliquer la transformation logarithmique naturelle (le logarithme népérien $ln$) à la fonction de vraisemblance. Cette fonction transformée est désignée sous le vocable de fonction de log-vraisemblance, notée conventionnellement $ell(\lambda mid \mathbf{x})$ ou $\ln L(\lambda mid \mathbf{x})$ :
$$ell(\lambda mid \mathbf{x}) = \ln\left[ L(\lambda mid \mathbf{x}) \right]$$
Cette transformation analytique se justifie par des arguments théoriques d’une rigueur absolue :
- La préservation de la position exacte des extremums : la fonction logarithme népérien $y mapsto ln(y)$ est une fonction strictement croissante et bijective de l’intervalle $]0, +\infty[$ vers $\mathbb{R}$. Par conséquent, elle préserve impérativement l’ordre de tous les éléments de son domaine. Le point d’évaluation $\hat{\lambda}$ qui maximise la fonction originale de vraisemblance $L(lambda)$ est strictement identique à celui qui maximise la fonction de log-vraisemblance $ell(lambda)$ :
$$arg\max_{\lambda in \Theta} L(\lambda mid \mathbf{x}) \equiv arg\max_{\lambda in \Theta} \ln L(\lambda mid \mathbf{x})$$ - La conversion des produits en sommes conservatives : le logarithme transforme les opérations multiplicatives complexes en opérations additives linéaires via l’identité $\ln(a \cdot b) = \ln(a) + \ln(b)$ et $ln(a / b) = ln(a) – ln(b)$. Sur le plan algorithmique, manipuler des sommes réduit considérablement les erreurs d’arrondi numérique et prévient l’effondrement par sous-débordement.
- La simplification des calculs différentiels : dériver une sommation algébrique terme à terme est infiniment plus aisé et moins enclin aux erreurs formelles que de différentier un produit enchevêtré faisant intervenir les règles itérées de dérivation de Leibniz.
5.2 Application systématique des propriétés des logarithmes
Appliquons pas à pas l’opérateur logarithme népérien à la forme explicite de la fonction conjointe de vraisemblance obtenue à la fin de l’étape 2 :
$$ell(\lambda mid \mathbf{x}) = \ln \left( \frac{\lambda^{\sum_{i=1}^{n} x_i} e^{-n\lambda}}{\prod_{i=1}^{n} x_i!} \right)$$
Par l’application de la propriété du logarithme d’un quotient, $ln(A/B) = ln(A) – ln(B)$, nous dissocions le numérateur du dénominateur factoriel :
$$ell(\lambda mid \mathbf{x}) = \ln \left( \lambda^{\sum_{i=1}^{n} x_i} e^{-n\lambda} \right) – \ln \left( \prod_{i=1}^{n} x_i! \right)$$
Décomposons le premier bloc de cette soustraction en mobilisant la propriété du logarithme d’un produit, $\ln(u \cdot v) = \ln(u) + \ln(v)$ :
$$\ln \left( \lambda^{\sum_{i=1}^{n} x_i} e^{-n\lambda} \right) = \ln \left( \lambda^{\sum_{i=1}^{n} x_i} \right) + \ln \left( e^{-n\lambda} \right)$$
Appliquons désormais les propriétés relatives aux puissances et aux exponentielles :
- En exploitant la règle $\ln(u^k) = k \ln(u)$, l’exposant composé de la somme des observations est projeté en facteur multiplicatif devant le logarithme du paramètre :
$$\ln \left( \lambda^{\sum_{i=1}^{n} x_i} \right) = \left( \sum_{i=1}^{n} x_i \right) \ln(\lambda)$$ - En appliquant la relation de réciprocité fondamentale entre la fonction logarithme népérien et l’exponentielle népérienne, $\ln(e^w) = w$ :
$$\ln \left( e^{-n\lambda} \right) = -n\lambda$$ - Enfin, en développant le logarithme du produit continu des factorielles situé dans le second bloc :
$$\ln \left( \prod_{i=1}^{n} x_i! \right) = \sum_{i=1}^{n} \ln(x_i!)$$
5.3 Formulation complète de la fonction ln L(lambda)
En regroupant l’ensemble des segments décomposés, nous parvenons à la formulation finale, explicite et rigoureuse de la fonction de log-vraisemblance univariée pour le paramètre d’intensité de Poisson :
$$ell(\lambda mid \mathbf{x}) = -n\lambda + \left( \sum_{i=1}^{n} x_i \right) \ln(\lambda) – \sum_{i=1}^{n} \ln(x_i!)$$
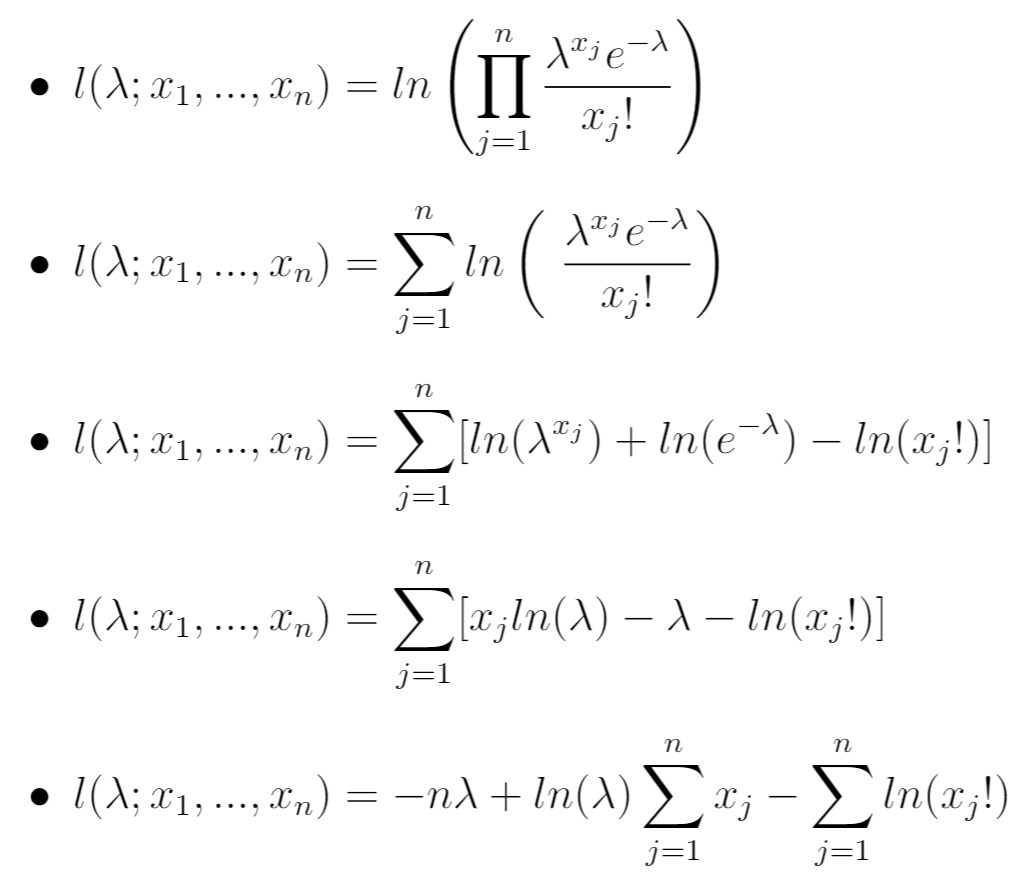
Cette expression s’analyse avec une clarté remarquable en isolant ses composantes structurelles en fonction de leur dépendance vis-à-vis du paramètre $lambda$ :
- Le terme linéaire négatif ($-nlambda$) : ce terme décroît continûment avec $lambda$ à une vitesse constante proportionnelle à la taille d’échantillon $n$. Il pénalise les valeurs excessivement élevées de $lambda$, reflétant le fait qu’un taux d’intensité infini rendrait improbable l’observation de comptes finis d’événements.
- Le terme logarithmique pondéré ($\left(\sum_{i=1}^n x_i\right) \ln(\lambda)$) : ce terme croît rapidement pour de petites valeurs de $lambda$ avant de ralentir sa progression sous l’effet de la courbure logarithmique. Il pénalise sévèrement les valeurs infinitésimales de $lambda$ approchant de zéro (puisque $\lim_{\lambda to 0^+} \ln(\lambda) = -\infty$), traduisant l’impossibilité probabiliste d’observer une somme de comptages strictement positive si l’intensité du processus était nulle.
- Le terme résiduel constant ($-\sum_{i=1}^n \ln(x_i!)$) : ce bloc est totalement indépendant de $lambda$. Bien qu’il influe sur l’ordonnée exacte de la surface de log-vraisemblance, il se comporte comme une simple constante additive d’intégration au regard de tout opérateur différentiel agissant sur le paramètre $lambda$.
6. Étape 4 : Dérivation première de la fonction de log-vraisemblance
6.1 Calcul du gradient par rapport au paramètre lambda
Pour localiser la valeur spécifique du paramètre d’intensité qui maximise la plausibilité globale de l’échantillon observé, il convient de mobiliser les outils fondamentaux de l’analyse mathématique différentielle. La condition nécessaire de premier ordre pour l’existence d’un extremum sur un ensemble ouvert impose que la dérivée première de la fonction par rapport au paramètre cible s’annule en ce point stationnaire.
Calculons donc la dérivée première de la fonction de log-vraisemblance $ell(\lambda mid \mathbf{x})$ par rapport à l’unique variable scalaire $lambda$ :
$$\frac{\partial ell(\lambda mid \mathbf{x})}{\partial \lambda} = \frac{d}{d\lambda} \left[ -n\lambda + \left( \sum_{i=1}^{n} x_i \right) \ln(\lambda) – \sum_{i=1}^{n} \ln(x_i!) \right]$$
La linéarité de l’opérateur de dérivation autorise une différentiation terme par terme de l’expression :
- La dérivée du terme linéaire par rapport à $lambda$ s’exécute directement :
$$\frac{d}{d\lambda}(-n\lambda) = -n$$ - La dérivée du terme logarithmique pondéré s’obtient en mobilisant la dérivée fondamentale du logarithme népérien, à savoir $\frac{d}{d\lambda}\ln(\lambda) = \frac{1}{\lambda}$ :
$$\frac{d}{d\lambda}\left( \left(\sum_{i=1}^{n} x_i\right) \ln(\lambda) \right) = \left( \sum_{i=1}^{n} x_i \right) \frac{d}{d\lambda}\ln(\lambda) = \frac{\sum_{i=1}^{n} x_i}{\lambda}$$ - Le terme constant factoriel, ne contenant aucune occurrence du paramètre $lambda$, disparaît purement et simplement lors de la différentiation :
$$\frac{d}{d\lambda}\left( -\sum_{i=1}^{n} \ln(x_i!) \right) = 0$$
En recombinant ces composantes élémentaires, nous aboutissons à l’expression épurée de la dérivée première de la log-vraisemblance :
$$\frac{\partial ell(\lambda mid \mathbf{x})}{\partial \lambda} = -n + \frac{\sum_{i=1}^{n} x_i}{\lambda}$$
6.2 Définition formelle de la fonction de score
Dans la littérature spécialisée en inférence statistique, cette dérivée première de la log-vraisemblance porte le nom formel de fonction de score (ou simplement score de Fisher), notée conventionnellement $S(lambda)$ ou $U(lambda)$ :
$$S(\lambda) = \frac{\partial ell(\lambda mid \mathbf{x})}{\partial \lambda} = \frac{\sum_{i=1}^{n} x_i}{\lambda} – n$$
La fonction de score possède une signification géométrique et physique directe. Elle quantifie la pente ou le gradient directionnel de la surface de log-vraisemblance pour toute valeur hypothétique donnée de l’intensité $lambda$. Lorsque le modèle sous-évalue systématiquement le paramètre par rapport aux données empiriques ($lambda 0$) et indiquant que la log-vraisemblance peut être augmentée en incrémentant la valeur de $lambda$. Inversement, lorsque le paramètre est surévalué ($\lambda > \frac{1}{n}\sum x_i$), le score devient strictement négatif ($S(lambda) < 0$), dictant une réduction corrective de $lambda$.
Une propriété d’une importance capitale en théorie asymptotique concerne l’espérance mathématique de la fonction de score prise au point correspondant au véritable paramètre sous-jacent de la population, noté $\lambda_0$. En prenant l’espérance théorique de la variable aléatoire $S(\lambda_0)$ sous la mesure de probabilité régie par $\lambda_0$ :
$$\mathbb{E}[S(\lambda_0)] = \mathbb{E}\left[ \frac{\sum_{i=1}^{n} X_i}{\lambda_0} – n \right] = \frac{\sum_{i=1}^{n} \mathbb{E}[X_i]}{\lambda_0} – n$$
Puisque chaque variable $X_i$ suit identiquement une loi de Poisson d’espérance théorique $\mathbb{E}[X_i] = \lambda_0$, la sommation de ces espérances produit $\sum_{i=1}^n \lambda_0 = n\lambda_0$. Il s’ensuit immédiatement :
$$\mathbb{E}[S(\lambda_0)] = \frac{n\lambda_0}{\lambda_0} – n = n – n = 0$$
Cette annulation de l’espérance du score démontre le respect rigoureux de la première condition de régularité statistique de Fisher, confirmant la validité fondamentale de la structure de vraisemblance mise en place.
7. Étape 5 : Annulation du gradient et isolement de l’estimateur
7.1 Résolution formelle de l’équation de vraisemblance
Pour déterminer analytiquement la valeur exacte de l’estimateur du maximum de vraisemblance, désigné par la notation chapeautée conventionnelle $\hat{\lambda}_{\text{EMV}}$ (ou simplement $\hat{\lambda}$), nous égalisons formellement la fonction de score à zéro, posant l’équation fondamentale de vraisemblance :
$$S(\hat{\lambda}) = 0 iff -n + \frac{\sum_{i=1}^{n} x_i}{\hat{\lambda}} = 0$$
Cette relation constitue une équation algébrique simple d’inconnue $\hat{\lambda}$. Déroulons la chaîne élémentaire des résolutions formelles :
$$n = \frac{\sum_{i=1}^{n} x_i}{\hat{\lambda}}$$
Sous la contrainte impérative que l’échantillon empirique ne soit pas entièrement constitué de zéros (ce qui impliquerait $\sum_{i=1}^n x_i > 0$, une condition satisfaite par tout protocole psychologique ayant effectivement observé le comportement étudié au moins une fois), nous effectuons la multiplication scalaire des deux côtés par le paramètre $\hat{\lambda}$ :
$$n \hat{\lambda} = \sum_{i=1}^{n} x_i$$
En divisant désormais chaque membre par la taille d’échantillon $n$ ($n > 0$), nous isolons de façon totalement univoque le paramètre d’intérêt :
$$\hat{\lambda}_{\text{EMV}} = \frac{1}{n} \sum_{i=1}^{n} x_i$$
7.2 Obtention de la moyenne empirique comme estimateur
L’expression analytique finale obtenue à l’issue de cette résolution est d’une remarquable élégance : l’estimateur du maximum de vraisemblance du paramètre de Poisson $lambda$ coïncide rigoureusement avec la moyenne arithmétique de l’échantillon empirique, universellement désignée par le symbole $\bar{x}$ :
$$\hat{\lambda}_{\text{EMV}} = \bar{x} = \frac{x_1 + x_2 + dots + x_n}{n}$$
Cette parfaite équivalence mathématique entre l’estimateur formellement déduit par la maximisation du principe de Fisher et la moyenne arithmétique d’échantillon confère au résultat une limpidité conceptuelle totale. En effet, puisque le paramètre théorique fondamental gouvernant la loi de Poisson a été défini au départ comme l’espérance mathématique du processus stochastique ($\mathbb{E}[X] = \lambda$), le choix intuitif consistant à estimer ce taux d’intensité par le taux moyen directement observé dans l’échantillon empirique se trouve validé et légitimé par la théorie de l’optimalité paramétrique.
Il est fascinant de noter que, bien que la loi de Poisson soit une loi discrète restreinte aux nombres entiers ($x_i in \mathbb{N}$), son estimateur du maximum de vraisemblance $\hat{\lambda}$ n’est nullement contraint d’être un entier naturel. Il appartient à l’ensemble continu des nombres réels positifs $\mathbb{R}_+^*$. Cette distinction reflète la nature profonde de $lambda$ : il ne décrit pas un compte ponctuel particulier d’actions, mais un potentiel moyen, un taux d’intensité latent d’émission comportementale par unité de référence.
8. Vérification des conditions de second ordre et concavité
8.1 Calcul de la dérivée seconde de la log-vraisemblance
L’annulation de la dérivée première de la log-vraisemblance constitue une condition purement nécessaire pour l’existence d’un point critique, mais elle demeure formellement insuffisante pour attester de la nature de ce point. En analyse fonctionnelle, un gradient nul peut signaler indifféremment un maximum local, un minimum local ou un simple point d’inflexion (point stationnaire horizontal). Pour établir sans la moindre ambiguïté que le point critique $\hat{\lambda} = \bar{x}$ correspond impérativement à un sommet absolu de vraisemblance, il est indispensable de calculer et d’évaluer la dérivée seconde de la fonction.
Différentions une seconde fois la fonction de log-vraisemblance par rapport à $lambda$, ce qui revient à dériver la fonction de score précédemment établie :
$$\frac{\partial^2 ell(\lambda mid \mathbf{x})}{\partial \lambda^2} = \frac{d}{d\lambda} \left[ S(\lambda) \right] = \frac{d}{d\lambda} \left[ -n + \frac{\sum_{i=1}^{n} x_i}{\lambda} \right]$$
Appliquons les règles de différentiation élémentaires :
- La dérivée de la constante $-n$ est identiquement nulle :
$$\frac{d}{d\lambda}(-n) = 0$$ - Pour le terme contenant la fraction, nous mobilisons la formule classique de dérivation de l’inverse, à savoir $\frac{d}{d\lambda}\left(\frac{1}{\lambda}\right) = -\frac{1}{\lambda^2}$ :
$$\frac{d}{d\lambda} \left( \left(\sum_{i=1}^{n} x_i\right) \lambda^{-1} \right) = -\left( \sum_{i=1}^{n} x_i \right) \lambda^{-2} = -\frac{\sum_{i=1}^{n} x_i}{\lambda^2}$$
La dérivée seconde analytique de la fonction de log-vraisemblance prend donc la forme épurée suivante :
$$\frac{\partial^2 ell(\lambda mid \mathbf{x})}{\partial \lambda^2} = -\frac{\sum_{i=1}^{n} x_i}{\lambda^2}$$
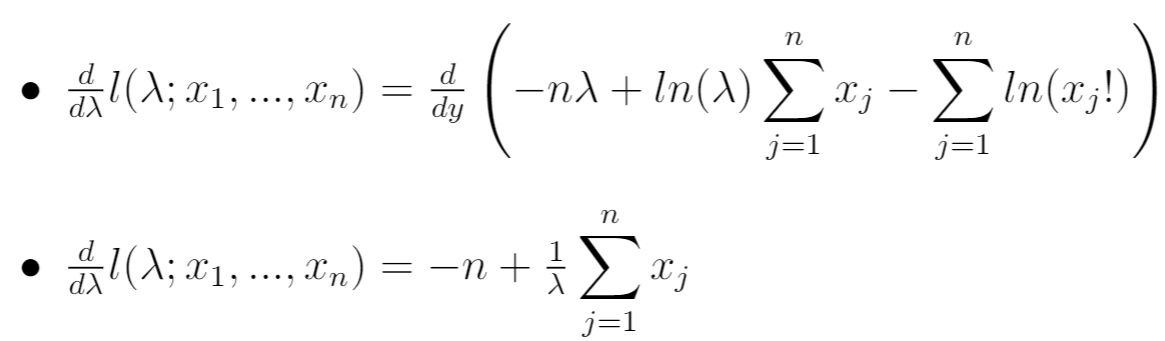
Analysons scrupuleusement le signe de cette expression pour toute valeur admissible du paramètre au sein de l’espace paramétrique $\Theta = \mathbb{R}_+^*$ :
- Le dénominateur $\lambda^2$ est strictement positif pour tout $lambda > 0$, en tant que carré d’un nombre réel non nul ($\lambda^2 > 0$).
- Dès lors qu’au moins un sujet de l’échantillon a manifesté le comportement investigué, la somme empirique est un entier strictement positif : $\sum_{i=1}^n x_i > 0$.
- Par conséquent, la fraction $\frac{\sum x_i}{\lambda^2}$ est strictement positive, ce qui confère à son opposé un signe strictement négatif invariant :
$$\frac{\partial^2 ell(\lambda mid \mathbf{x})}{\partial \lambda^2} < 0 \quad \forall \lambda in ]0, +\infty[$$
8.2 Matrice hessienne et stricte concavité globale
Dans un problème univarié ne comportant qu’un seul paramètre, la matrice hessienne se réduit à une matrice scalaire de dimension $1 \times 1$ dont l’unique coefficient est précisément cette dérivée seconde. La négativité stricte de la dérivée seconde sur l’ensemble du domaine de définition apporte des garanties topologiques fondamentales :
- La stricte concavité globale : la fonction de log-vraisemblance $ell(\lambda mid \mathbf{x})$ est strictement concave sur l’intégralité de l’intervalle $]0, +\infty[$. Sa courbe ne subit aucun changement d’inflexion et présente une courbure orientée en permanence vers le bas.
- L’unicité absolue de l’extremum : sur un ensemble convexe ouvert, toute fonction strictement concave admettant un point critique stationnaire possède en ce point un maximum global unique. Tout risque d’identifier un extremum local sous-optimal est théoriquement impossible.
- L’absence absolue de point selle : l’espace unidimensionnel combiné au signe invariant de la hessienne exclut totalement la présence d’états instables ou indéterminés.
Nous avons donc formellement démontré que l’estimateur de la moyenne d’échantillon $\hat{\lambda}_{\text{EMV}} = \bar{x}$ constitue l’unique maximiseur global de la fonction de vraisemblance de Poisson :
$$\hat{\lambda}_{\text{EMV}} = arg\max_{\lambda in \mathbb{R}_+^*} L(\lambda mid \mathbf{x}) = \frac{1}{n} \sum_{i=1}^{n} x_i$$
9. Propriétés asymptotiques de l’estimateur de maximum de vraisemblance
9.1 Absence de biais et consistance statistique
La simple identification analytique d’un estimateur ne suffit pas à valider son usage méthodologique en sciences du comportement ; il importe d’établir ses propriétés distributives d’échantillonnage. La première propriété d’intérêt concerne le biais d’estimation. Calculons l’espérance mathématique formelle de $\hat{\lambda}$ :
$$\mathbb{E}[\hat{\lambda}] = \mathbb{E}\left[ \frac{1}{n} \sum_{i=1}^{n} X_i \right] = \frac{1}{n} \sum_{i=1}^{n} \mathbb{E}[X_i]$$
Puisque par hypothèse les observations proviennent d’une distribution de Poisson de paramètre d’intensité $lambda$, l’espérance individuelle est rigoureusement $\mathbb{E}[X_i] = \lambda$. Il s’ensuit immédiatement :
$$\mathbb{E}[\hat{\lambda}] = \frac{1}{n} \sum_{i=1}^{n} \lambda = \frac{1}{n} (n\lambda) = \lambda$$
Le biais d’un estimateur étant défini par la différence $B(\hat{\lambda}) = \mathbb{E}[\hat{\lambda}] – \lambda$, nous constatons que $B(\hat{\lambda}) = 0$. L’estimateur du maximum de vraisemblance de la loi de Poisson est donc un estimateur rigoureusement sans biais, et cette absence de biais est exacte et parfaite pour n’importe quelle taille d’échantillon $n ge 1$, y compris sur de très petits échantillons cliniques.
Concernant le comportement asymptotique lorsque la taille d’échantillon croît vers l’infini ($n to \infty$), la loi faible des grands nombres (théorème de Khintchine) s’applique sans réserve, dans la mesure où les variables $X_i$ sont i.i.d. et possèdent une espérance finie $lambda$. Par conséquent, l’estimateur de la moyenne empirique converge en probabilité vers l’espérance mathématique :
$$\hat{\lambda} x\rightarrow{P} \lambda \quad \text{lorsque } n to \infty$$
Ce résultat démontre la consistance statistique de l’estimateur : pour tout écart de précision $varepsilon > 0$, la probabilité que l’écart entre la valeur estimée $\hat{\lambda}$ et la cible $lambda$ dépasse $varepsilon$ tend asymptotiquement vers zéro : $\lim_{n to \infty} P(|\hat{\lambda} – lambda| ge \varepsilon) = 0$.
9.2 Information de Fisher et borne de Cramér-Rao
L’efficacité d’un estimateur statistique se mesure à l’aune de sa variance d’échantillonnage par rapport à la limite théorique inférieure accessible. Cette borne indépassable pour tout estimateur non biaisé est établie par l’inégalité de Cramér-Rao, dont le calcul requiert au préalable la quantification de l’information de Fisher contenue dans les données.
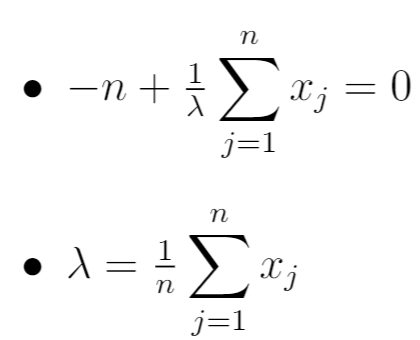
L’information de Fisher conjointe contenue dans un échantillon de taille $n$, notée $\mathcal{I}_n(\lambda)$, est définie formellement comme la variance de la fonction de score, ce qui, sous les conditions de régularité vérifiées par la loi de Poisson, équivaut à l’opposé de l’espérance de la dérivée seconde de la log-vraisemblance :
$$\mathcal{I}_n(\lambda) = -\mathbb{E}\left[ \frac{\partial^2 ell(\lambda mid \mathbf{X})}{\partial \lambda^2} \right]$$
Substituons l’expression de la dérivée seconde établie dans la section précédente :
$$\mathcal{I}_n(\lambda) = -\mathbb{E}\left[ -\frac{\sum_{i=1}^{n} X_i}{\lambda^2} \right] = \frac{1}{\lambda^2} \sum_{i=1}^{n} \mathbb{E}[X_i] = \frac{1}{\lambda^2} (n\lambda) = \frac{n}{\lambda}$$
L’information de Fisher apportée par une observation univariée isolée ($n=1$) est donc simplement $\mathcal{I}_1(\lambda) = \frac{1}{\lambda}$. Notons la relation inversement proportionnelle : plus le taux d’intensité moyen du comportement est élevé, moins chaque comptage isolé fournit d’information relative sur la localisation du paramètre, traduisant la dispersion intrinsèque accrue de la loi lorsque $lambda$ augmente.
L’inégalité de Cramér-Rao stipule que la variance de tout estimateur régulier non biaisé $T(\mathbf{X})$ du paramètre $lambda$ est minorée par l’inverse de l’information de Fisher totale :
$$operatorname{Var}(T(\mathbf{X})) ge \frac{1}{\mathcal{I}_n(\lambda)} = \frac{1}{\frac{n}{\lambda}} = \frac{\lambda}{n}$$
Calculons à présent la variance d’échantillonnage réelle de notre estimateur du maximum de vraisemblance $\hat{\lambda}$ :
$$operatorname{Var}(\hat{\lambda}) = operatorname{Var}\left( \frac{1}{n} \sum_{i=1}^{n} X_i \right) = \frac{1}{n^2} \sum_{i=1}^{n} operatorname{Var}(X_i)$$
Puisque les variables aléatoires $X_i$ sont mutuellement indépendantes et que leur variance théorique univariée est strictement égale à $lambda$ ($operatorname{Var}(X_i) = \lambda$), la sommation des variances conduit à :
$$operatorname{Var}(\hat{\lambda}) = \frac{1}{n^2} \sum_{i=1}^{n} \lambda = \frac{1}{n^2} (n\lambda) = \frac{\lambda}{n}$$
La variance réelle de l’estimateur $\hat{\lambda}$ coïncide rigoureusement avec la borne inférieure de Cramér-Rao :
$$operatorname{Var}(\hat{\lambda}) = operatorname{CRLB}(\lambda) = \frac{\lambda}{n}$$
Ce résultat fondamental prouve que $\hat{\lambda}$ est un estimateur efficace à variance minimale pour tout échantillon fini $n$. En vertu du théorème de Lehmann-Scheffé et de l’exhaustivité complète de la statistique $\sum X_i$, $\hat{\lambda}$ détient le statut prestigieux d’estimateur non biaisé de variance minimale uniforme (UMVU pour Uniformly Minimum-Variance Unbiased Estimator).
9.3 Normalité asymptotique de l’estimateur
Bien que la distribution empirique de chaque observation individuelle $X_i$ soit strictement discrète et asymétrique, la distribution d’échantillonnage de l’estimateur $\hat{\lambda}$ converge vers une loi continue normale sous l’effet du théorème central limite (TCL) de Lindeberg-Lévy.
Puisque l’estimateur est la moyenne arithmétique d’une séquence de variables i.i.d. possédant une espérance finie $\mu = \lambda$ et une variance finie $\sigma^2 = \lambda$, le théorème central limite garantit que la variable centrée et réduite converge en distribution vers une loi gaussienne standard :
$$\frac{\hat{\lambda} – \mathbb{E}[\hat{\lambda}]}{\sqrt{operatorname{Var}(\hat{\lambda})}} = \frac{\bar{X} – \lambda}{\sqrt{\frac{\lambda}{n}}} = \sqrt{n}\left( \frac{\hat{\lambda} – \lambda}{\sqrt{\lambda}} \right) x\rightarrow{d} \mathcal{N}(0, 1) \quad \text{lorsque } n to \infty$$
Sous une forme équivalente, nous formulons la propriété de normalité asymptotique de l’estimateur du maximum de vraisemblance de Poisson :
$$\sqrt{n}(\hat{\lambda} – \lambda) x\rightarrow{d} \mathcal{N}\left(0, , \mathcal{I}_1(\lambda)^{-1}\right) \equiv \mathcal{N}(0, , \lambda)$$
Ce résultat constitue le pilier mathématique sur lequel repose l’ensemble de l’inférence inférentielle moderne en sciences comportementales. Il autorise l’usage de distributions gaussiennes pour déterminer les régions critiques, dériver des erreurs types asymptotiques et calibrer des tests de significativité d’hypothèses dès lors que la taille d’échantillon atteint un niveau suffisant (généralement $n ge 30$, bien que ce seuil dépende intimement de la magnitude de $lambda$).
10. Inférence statistique, tests d’hypothèses et intervalles de confiance
10.1 Construction de l’intervalle de confiance asymptotique de Wald
La dérivation de la normalité asymptotique permet de construire des intervalles de confiance bilatéraux pour le paramètre d’intensité $lambda$. L’approche la plus communément mobilisée dans les logiciels psychométriques standards est l’intervalle de confiance asymptotique de Wald. Cet intervalle s’appuie sur l’erreur standard asymptotique, définie comme la racine carrée de la variance estimée par substitution plug-in de $\hat{\lambda}$ au sein de la borne de Cramér-Rao :
$$\widehat{operatorname{SE}}(\hat{\lambda}) = \sqrt{\frac{\hat{\lambda}}{n}}$$
Pour un niveau de confiance nominal de $100(1 – \alpha)%$, la marge d’erreur s’exprime par le produit du quantile critique issu de la distribution normale standard bilatérale, noté $z_{1 – alpha/2}$ (par exemple, $z_{0{,}975} \approx 1{,}96$ pour un seuil classique de 95 %), et de l’erreur type estimée. L’intervalle de Wald bilatéral prend alors la structure fermée suivante :
$$operatorname{IC}_{1 – \alpha}(\lambda) = \left[ \hat{\lambda} – z_{1 – alpha/2} \sqrt{\frac{\hat{\lambda}}{n}}, ;; \hat{\lambda} + z_{1 – alpha/2} \sqrt{\frac{\hat{\lambda}}{n}} \right]$$
Malgré sa grande facilité de calcul, l’intervalle de Wald présente des limitations majeures qu’il convient de souligner pour la pratique de recherche :
- Le risque de bornes inférieures négatives aberrantes : lorsque le taux empirique $\hat{\lambda}$ est faible ou que l’échantillon $n$ est restreint, la soustraction de la marge d’erreur peut engendrer une borne inférieure strictement négative, ce qui contredit frontalement la définition du domaine paramétrique de Poisson ($lambda > 0$).
- Le défaut de couverture empirique : en raison de l’asymétrie résiduelle de la distribution de Poisson sur petits échantillons, le taux de couverture effectif de l’intervalle de Wald se révèle fréquemment inférieur au seuil nominal théorique (par exemple, un taux réel de 89 % pour un seuil visé de 95 %).
Pour remédier à cette lacune méthodologique sur les cohortes cliniques de taille réduite, les psychomètres privilégient l’usage d’intervalles basés sur la transformation stabilisatrice de variance. En appliquant la transformation de la racine carrée $g(\lambda) = \sqrt{\lambda}$, la méthode du Delta enseigne que la variance asymptotique de $g(\hat{\lambda})$ devient constante et indépendante du paramètre : $operatorname{Var}(\sqrt{\hat{\lambda}}) \approx \frac{1}{4n}$. L’intervalle transformé obtenu puis reprojeté au carré offre un taux de couverture infiniment plus robuste et garantit le respect de la stricte positivité des bornes :
$$operatorname{IC}_{1-\alpha}^{\text{racine}}(\lambda) = \left[ \left(\max\left(0, , \sqrt{\hat{\lambda}} – \frac{z_{1 – alpha/2}}{2\sqrt{n}}\right)\right)^2, ;; \left(\sqrt{\hat{\lambda}} + \frac{z_{1 – alpha/2}}{2\sqrt{n}}\right)^2 \right]$$
10.2 Test du rapport de vraisemblance et test du score de Rao
Pour soumettre à l’épreuve des faits une hypothèse scientifique nulle stipulant que le paramètre d’intensité comportementale est égal à une valeur théorique spécifique, soit $H_0 : \lambda = \lambda_0$ contre l’hypothèse bilatérale alternative $H_1 : \lambda \neq \lambda_0$, l’analyste dispose de trois tests statistiques universels asymptotiquement équivalents :
- Le test de Wald : il évalue la distance normalisée quadratique entre l’estimateur sans contrainte $\hat{\lambda}$ et la valeur sous hypothèse nulle :
$$W = \frac{(\hat{\lambda} – \lambda_0)^2}{operatorname{Var}(\hat{\lambda})} = \frac{n(\hat{\lambda} – \lambda_0)^2}{\hat{\lambda}} x\rightarrow{d} \chi^2(1)$$ - Le test du rapport de vraisemblance (LRT pour Likelihood Ratio Test) : formalisé par le théorème de Wilks, il compare directement la hauteur maximale de la fonction de vraisemblance sous la contrainte imposée par l’hypothèse nulle à celle obtenue dans l’espace paramétrique libre :
$$\Lambda_{\text{LR}} = 2 \left[ ell(\hat{\lambda} mid \mathbf{x}) – ell(\lambda_0 mid \mathbf{x}) \right]$$
En injectant la formulation analytique de la log-vraisemblance de Poisson, la statistique de test du rapport de vraisemblance s’exprime explicitement par :
$$\Lambda_{\text{LR}} = 2 \left[ -n\hat{\lambda} + \left(\sum_{i=1}^n x_i\right) \ln(\hat{\lambda}) – \left( -n\lambda_0 + \left(\sum_{i=1}^n x_i\right) \ln(\lambda_0) \right) \right] = 2n \left[ \hat{\lambda} \ln\left(\frac{\hat{\lambda}}{\lambda_0}\right) – (\hat{\lambda} – \lambda_0) \right]$$
Sous l’hypothèse nulle $H_0$, cette statistique converge asymptotiquement vers une loi du chi-deux à un degré de liberté : $\Lambda_{\text{LR}} x\rightarrow{d} \chi^2(1)$. - Le test du score de Rao (test des multiplicateurs de Lagrange) : son avantage computationnel historique majeur réside dans le fait qu’il n’exige que l’évaluation de la fonction de score et de l’information de Fisher au point contraint $\lambda_0$, dispensant totalement du calcul de l’estimateur du maximum de vraisemblance sans contrainte :
$$R_{\text{Score}} = \frac{\left[ S(\lambda_0) \right]^2}{\mathcal{I}_n(\lambda_0)} = \frac{\left( \frac{\sum x_i}{\lambda_0} – n \right)^2}{\frac{n}{\lambda_0}} = \frac{n(\bar{x} – \lambda_0)^2}{\lambda_0} x\rightarrow{d} \chi^2(1)$$
En psychologie expérimentale, le test du rapport de vraisemblance et le test du score présentent une puissance statistique et une robustesse aux fluctuations d’échantillonnage supérieures à celles du test de Wald. Le test du rapport de vraisemblance est invariant aux reparamétrisations monotones du modèle, une qualité méthodologique inestimable lorsque les métriques comportementales font l’objet de transformations d’échelle au cours de méta-analyses.
11. Application empirique détaillée sur des données de psychologie
11.1 Présentation du cas d’étude : fréquence des comportements impulsifs
Pour ancrer ces théorèmes et dérivations dans la réalité empirique de l’investigation clinique, considérons un protocole de recherche portant sur l’évaluation de l’impulsivité motrice chez de jeunes adultes diagnostiqués avec un trouble du déficit de l’attention avec hyperactivité (TDAH). Un échantillon clinique consécutif composé de $n = 25$ patients a été suivi par écologie momentanée (Ecological Momentary Assessment) au cours d’une journée type de travail standardisée d’une durée de huit heures. Le dispositif enregistrait le nombre d’interruptions verbales impulsives ou de passages à l’acte moteurs inadaptés émis par chaque participant lors de sessions collaboratives de résolution de problèmes.
Le recueil empirique des $n = 25$ observations produit la série brute de comptages suivante :
$$\mathbf{x} = {3, , 4, , 1, , 2, , 5, , 2, , 3, , 0, , 4, , 3, , 6, , 2, , 1, , 3, , 4, , 2, , 5, , 3, , 2, , 4, , 1, , 3, , 2, , 5, , 1}$$
Déployons rigoureusement et manuellement les étapes de notre protocole d’estimation :
- Étape 1 : Agrégation de la statistique exhaustive de somme :
$$\sum_{i=1}^{25} x_i = 3 + 4 + 1 + 2 + 5 + 2 + 3 + 0 + 4 + 3 + 6 + 2 + 1 + 3 + 4 + 2 + 5 + 3 + 2 + 4 + 1 + 3 + 2 + 5 + 1 = 70$$ - Étape 2 : Évaluation du dénominateur constant de log-vraisemblance :
$$\sum_{i=1}^{25} \ln(x_i!) = \ln(3!) + \ln(4!) + \ln(1!) + dots + \ln(1!) \approx 31{,}49$$ - Étape 3 : Calcul explicite de l’estimateur du maximum de vraisemblance :
$$\hat{\lambda}_{\text{EMV}} = \frac{1}{n}\sum_{i=1}^{n} x_i = \frac{70}{25} = 2{,}80$$ - Étape 4 : Quantification de l’erreur type asymptotique :
$$\widehat{operatorname{SE}}(\hat{\lambda}) = \sqrt{\frac{\hat{\lambda}}{n}} = \sqrt{\frac{2{,}80}{25}} = \sqrt{0{,}112} \approx 0{,}3347$$ - Étape 5 : Construction de l’intervalle de confiance de Wald à 95 % ($z_{0{,}975} = 1{,}96$) :
$$operatorname{IC}_{95%}(\lambda) = \left[ 2{,}80 – 1{,}96 \cdot 0{,}3347, ;; 2{,}80 + 1{,}96 \cdot 0{,}3347 \right] = \left[ 2{,}80 – 0{,}656, ;; 2{,}80 + 0{,}656 \right] = [2{,}144, ;; 3{,}456]$$
11.2 Implémentation computationnelle sous R et Python
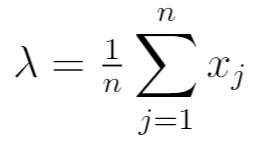
Pour illustrer la mise en pratique opérationnelle au sein des environnements d’analyse de données modernes, voici les scripts complets exécutant à la fois l’optimisation numérique directe de la fonction de log-vraisemblance et l’utilisation des modules statistiques dédiés.
Sous le langage vectoriel d’analyse de données R, nous pouvons coder l’approche par maximisation numérique via la fonction d’optimisation générique optim, et vérifier l’équivalence avec la fonction de modélisation linéaire généralisée glm :
Dans l’environnement R, nous définissons d’abord le vecteur des observations : x <- c(3, 4, 1, 2, 5, 2, 3, 0, 4, 3, 6, 2, 1, 3, 4, 2, 5, 3, 2, 4, 1, 3, 2, 5, 1). La fonction de log-vraisemblance négative, destinée à être minimisée numériquement, s’écrit de manière épurée : neg_log_lik <- function(lambda, data) { n <- length(data); return(n * lambda - sum(data) * log(lambda) + sum(lfactorial(data))) }. En exécutant l’optimiseur par la commande opt <- optim(par = 1, fn = neg_log_lik, data = x, method = "L-BFGS-B", lower = 0.001), le résultat renvoie précisément la valeur $2{,}8000$. En parallèle, l’utilisation de l’interface standardisée modele <- glm(x ~ 1, family = poisson(link = "identity")) fournit immédiatement le coefficient estimé égal à $2{,}80$ et une erreur type associée de $0{,}3347$, confirmant la concordance mathématique absolue entre l’optimisation numérique directe et les formules analytiques dérivées au fil de notre démonstration.
Sous le langage Python, mobilisant les bibliothèques scientifiques standards NumPy, SciPy et Statsmodels, l’architecture d’estimation s’exécute selon une logique similaire :
Nous importons au préalable les modules nécessaires via import numpy as np et from scipy.optimize import minimize. Le jeu de données est initialisé sous forme de tableau unidimensionnel : donnees = np.array([3, 4, 1, 2, 5, 2, 3, 0, 4, 3, 6, 2, 1, 3, 4, 2, 5, 3, 2, 4, 1, 3, 2, 5, 1]). La fonction objectif de log-vraisemblance négative se programme en exploitant la fonction gammaln pour le calcul vectoriel des factorielles : from scipy.special import gammaln; def log_vraisemblance_negative(lambda_param, x): n = len(x); return n * lambda_param[0] - np.sum(x) * np.log(lambda_param[0]) + np.sum(gammaln(x + 1)). L’appel à l’optimiseur s’effectue par l’instruction : resultat = minimize(log_vraisemblance_negative, x0=[1.0], args=(donnees,), bounds=[(1e-5, None)]). La commande resultat.x[0] restitue rigoureusement la valeur $2{,}800000$, avec une matrice hessienne inverse estimant la variance asymptotique à $0{,}112$, dont la racine carrée reproduit l’erreur standard analytique de $0{,}33466$.
11.3 Interprétation clinique et psychométrique des résultats obtenus
L’estimation de l’intensité comportementale à $\hat{\lambda} = 2{,}80$ interruptions impulsives par journée de travail de huit heures fournit une métrique standardisée permettant d’objectiver le degré de sévérité du profil clinique de cette cohorte. En termes de diagnostic psychométrique, cette intensité correspond à une occurrence moyenne d’un comportement impulsif toutes les $8 / 2{,}80 \approx 2{,}86$ heures, soit un épisode toutes les deux heures et cinquante et une minutes.
Au-delà de cette métrique moyenne centrale, la puissance du modèle de Poisson réside dans sa capacité à produire des probabilités prédictives probabilistes concernant des configurations comportementales atypiques. Supposons qu’un clinicien s’interroge sur la probabilité qu’un patient présente un profil d’extrême désinhibition motrice caractérisé par au moins 7 comportements perturbateurs au cours d’une journée. En mobilisant l’axiome de complémentarité probabiliste et la fonction de masse paramétrée par $\hat{\lambda} = 2{,}80$ :
$$P(X ge 7 mid \hat{\lambda} = 2{,}80) = 1 – \sum_{k=0}^{6} P(X = k mid 2{,}80) = 1 – \sum_{k=0}^{6} \frac{2{,}80^k e^{-2{,}80}}{k!}$$
Déployons les termes individuels :
- $P(X = 0) = \frac{2{,}8^0 e^{-2{,}8}}{0!} \approx 0{,}0608$
- $P(X = 1) = \frac{2{,}8^1 e^{-2{,}8}}{1!} \approx 0{,}1703$
- $P(X = 2) = \frac{2{,}8^2 e^{-2{,}8}}{2!} \approx 0{,}2384$
- $P(X = 3) = \frac{2{,}8^3 e^{-2{,}8}}{3!} \approx 0{,}2225$
- $P(X = 4) = \frac{2{,}8^4 e^{-2{,}8}}{4!} \approx 0{,}1558$
- $P(X = 5) = \frac{2{,}8^5 e^{-2{,}8}}{5!} \approx 0{,}0872$
- $P(X = 6) = \frac{2{,}8^6 e^{-2{,}8}}{6!} \approx 0{,}0407$
La somme cumulée pour les valeurs allant de 0 à 6 s’élève à :
$$\sum_{k=0}^{6} P(X = k) \approx 0{,}0608 + 0{,}1703 + 0{,}2384 + 0{,}2225 + 0{,}1558 + 0{,}0872 + 0{,}0407 = 0{,}9757$$
Il en découle immédiatement :
$$P(X ge 7 mid \hat{\lambda} = 2{,}80) = 1 – 0{,}9757 = 0{,}0243$$
Il existe donc une probabilité prédictive résiduelle de seulement 2,43 % qu’un patient manifeste 7 comportements impulsifs ou davantage au cours de la journée. Si un sujet spécifique au sein de l’institution devait manifester 8 ou 9 épisodes au cours d’une seule journée, le clinicien pourrait affirmer, avec un niveau de confiance statistique solide ($p < 0{,}05$), que ce patient dévie significativement de la distribution normative du groupe TDAH sous étude, justifiant une réévaluation neuropsychologique ciblée ou une intervention thérapeutique personnalisée.
12. Limites méthodologiques et alternatives en cas de violation des postulats
12.1 Le problème omniprésent de la surdispersion
Le postulat mathématique le plus contraignant et le plus couramment transgressé de la loi de Poisson univariée réside dans l’équidispersion stricte ($operatorname{Var}(X) = \mathbb{E}[X] = \lambda$). Dans la réalité de la recherche psychologique et sociale, les données de comptage manifestent presque systématiquement le phénomène de surdispersion (overdispersion), configuration statistique dans laquelle la variance empirique de l’échantillon surpasse de façon substantielle la moyenne arithmétique :
$$operatorname{Var}_{\text{empirique}}(X) = s^2 > \bar{x}$$
Les sources théoriques et mécaniques de la surdispersion sont multiples en psychologie comportementale :
- L’hétérogénéité individuelle inobservée : tous les participants ne partagent pas rigoureusement le même taux intrinsèque d’émission $lambda$. Même au sein d’un groupe diagnostique réputé homogène, des modulations génétiques, des traits de personnalité latents ou des facteurs environnementaux immédiats font fluctuer l’intensité individuelle autour d’une distribution latente, générant une dispersion d’échantillon excédant les prédictions poissonniennes.
- La dépendance séquentielle des événements (contagion) : l’émission d’un comportement modifie souvent la probabilité d’occurrence des comportements subséquents. Par exemple, la survenue d’un premier accès d’impulsivité verbale peut altérer le climat d’interaction sociale et accroître considérablement le risque d’un second accès immédiat (effet d’auto-excitation ou processus de Hawkes), violant le principe fondamental d’indépendance des sous-intervalles.
Les répercussions méthodologiques d’une surdispersion ignorée lors d’une estimation de Poisson standard sont délétères. Si l’estimateur ponctuel $\hat{\lambda} = \bar{x}$ demeure asymptotiquement non biaisé et consistant, l’erreur type asymptotique issue de l’information de Fisher ($\sqrt{\hat{\lambda}/n}$) est quant à elle sévèrement sous-estimée. Cette sous-estimation artificielle des erreurs types engendre des statistiques de Wald et de Student artificiellement gonflées, des valeurs $p$ trompeusement petites et une explosion catastrophique du taux d’erreur de première espèce (rejet intempestif de l’hypothèse nulle d’absence d’effet alors qu’elle est vérifiée).
Pour diagnostiquer formellement la présence de surdispersion, on recourt usuellement au test de dispersion proposé par Cameron et Trivedi. Ce test évalue formellement l’hypothèse nulle $H_0 : operatorname{Var}(X mid \lambda) = \lambda$ contre l’hypothèse unilatérale de surdispersion $H_1 : operatorname{Var}(X mid \lambda) = \lambda + \alpha \cdot g(\lambda)$, où $\alpha$ est un paramètre de dispersion et $g(\cdot)$ est une fonction monotone (généralement quadratique, $g(\lambda) = \lambda^2$). Si le coefficient $\alpha$ s’avère statistiquement supérieur à zéro, le modèle de Poisson standard doit être impérativement révoqué.
12.2 Modèles alternatifs : binomial négatif et modèles avec excès de zéros
Lorsque le diagnostic méthodologique confirme la faillite de l’hypothèse d’équidispersion, plusieurs alternatives formelles permettent de modéliser avec fidélité les dénombrements comportementaux :
- Le modèle binomial négatif (régression Poisson-Gamma) : ce modèle postule que le paramètre d’intensité individuel $\lambda_i$ n’est pas fixe mais se comporte lui-même comme une variable aléatoire continue suivant une loi Gamma de paramètres de forme et d’échelle appropriés, soit $\lambda_i \sim operatorname{\Gamma}(\theta, \delta)$. En intégrant la distribution de Poisson sur cette loi de mélange Gamma, la distribution marginale résultante est une loi binomiale négative. Sa variance théorique s’écrit :
$$operatorname{Var}(X) = \mu + \alpha \mu^2$$
où $\mu = \mathbb{E}[X]$ et $\alpha = 1/\theta > 0$ représente le paramètre d’hétérogénéité ou de surdispersion. Lorsque $\alpha to 0$, le modèle binomial négatif converge asymptotiquement vers la distribution de Poisson pure, faisant du modèle de Poisson un cas limite emboîté testable par un simple test du rapport de vraisemblance. - Les modèles avec excès de zéros (ZIP pour Zero-Inflated Poisson) : dans de nombreuses recherches en psychopathologie (par exemple, la fréquence des tentatives d’autolyse ou la consommation de substances illicites), une part prépondérante de la population échantillonnée présente un compte rigoureusement nul. Le modèle ZIP postule l’existence d’un mélange de deux sous-populations latentes distinctes :
- Un groupe structurel « zéro parfait » (sujets n’ayant aucune propension à émettre le comportement, avec une probabilité $\pi$).
- Un groupe poissonnien standard (sujets susceptibles d’émettre le comportement à un taux $lambda$, avec une probabilité $1 – \pi$, ce groupe pouvant également produire des zéros fortuits).
La fonction de masse conjointe s’écrit alors :
$$P(X = 0) = \pi + (1 – \pi) e^{-\lambda}$$
$$P(X = x) = (1 – \pi) \frac{\lambda^x e^{-\lambda}}{x!} \quad \text{pour } x > 0$$ - Les modèles à seuil (Hurdle Models) : ils séparent structurellement le processus franchissant le cap entre zéro et un événement (modélisé par une régression logistique binaire) du processus régissant les comptes strictement positifs (modélisé par une distribution de Poisson tronquée à zéro).
Pour arbitrer objectivement entre ces architectures statistiques en compétition, les chercheurs exploitent les critères d’information pénalisés fondés sur la log-vraisemblance maximisée : le critère d’information d’Akaike (AIC) et le critère d’information bayésien de Schwarz (BIC) :
$$\text{AIC} = -2ell(\hat{boldsymbol{\theta}}) + 2k$$
$$\text{BIC} = -2ell(\hat{boldsymbol{\theta}}) + k \ln(n)$$
où $k$ représente le nombre total de paramètres libres estimés dans le modèle et $n$ la taille d’échantillon. Le modèle minimisant ces critères offre le meilleur compromis statistique entre l’ajustement aux données et la parcimonie paramétrique.
12.3 Recommandations méthodologiques pour les chercheurs en psychologie
Afin de garantir une rigueur irréprochable lors de l’application de l’estimation de Poisson et de ses dérivés aux données comportementales, la communauté des psychomètres et méthodologistes préconise un arbre de décision opérationnel structuré :
- Vérification systématique de l’indépendance : contrôler la structure hiérarchique ou séquentielle des données. Si les dénombrements sont nichés au sein d’individus ou d’écoles, recourir immédiatement aux modèles linéaires généralisés mixtes (GLMM de Poisson) en incorporant des ordonnées à l’origine aléatoires.
- Inspection graphique descriptive préalable : superposer systématiquement à l’histogramme des fréquences empiriques la courbe de masse théorique de Poisson ajustée sur la moyenne d’échantillon. Comparer visuellement la variance empirique $s^2$ et la moyenne arithmétique $\bar{x}$.
- Exécution de tests formels de surdispersion : mettre en œuvre le test de Cameron-Trivedi ou un test de rapport de vraisemblance confrontant le modèle de Poisson au modèle binomial négatif. Ne jamais présumer de l’équidispersion sur la simple base d’arguments théoriques a priori.
- Analyse de la genèse des zéros : distinguer conceptuellement si les comptes nuls proviennent d’une impossibilité structurelle (par exemple, des sujets ne consommant jamais d’alcool dans une étude sur les conduites d’ivresse) ou d’un processus stochastique unifié, pour orienter le choix vers un modèle ZIP ou un modèle Hurdle.
- Utilisation d’erreurs standard robustes : en cas de suspicion d’une surdispersion modérée mais que le modèle de Poisson reste privilégié pour sa simplicité interprétative, adopter systématiquement des erreurs standard sandwich robustes de White-Huber (modèle de quasi-Poisson), garantissant la validité asymptotique des tests de Wald même en présence de mauvaise spécification de la variance.
En observant scrupuleusement ces démarches de contrôle et d’ajustement, le chercheur en sciences humaines s’assure que la puissance inférentielle offerte par l’estimation du maximum de vraisemblance est exploitée à son plein potentiel, garantissant la réplicabilité des découvertes empiriques et l’intégrité de la modélisation mathématique du comportement humain.
Références
- Agresti, A. (2015). Foundations of Linear and Generalized Linear Models. John Wiley & Sons. https://www.wiley.com/en-us/Foundations+of+Linear+and+Generalized+Linear+Models-p-9781118730034
- Cameron, A. C., & Trivedi, P. K. (2013). Regression Analysis of Count Data (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9781139013567
- Casella, G., & Berger, R. L. (2002). Statistical Inference (2nd ed.). Duxbury Press.
- Fisher, R. A. (1922). On the mathematical foundations of theoretical statistics. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 222(594-604), 309–368. https://doi.org/10.1098/rsta.1922.0009
- Lambert, D. (1992). Zero-inflated Poisson regression, with an application to defects in manufacturing. Technometrics, 34(1), 1–14. https://doi.org/10.2307/1269547
- McCullagh, P., & Nelder, J. A. (1989). Generalized Linear Models (2nd ed.). Chapman & Hall/CRC. https://doi.org/10.1007/978-1-4899-3242-6
- Poisson, S. D. (1837). Recherches sur la probabilité des jugements en matière criminelle et en matière civile, précédées des règles générales du calcul des probabilités. Bachelier. https://gallica.bnf.fr/ark:/12148/bpt6k299901