
L’analyse des données quantitatives et qualitatives constitue le socle fondamental sur lequel reposent la recherche scientifique contemporaine, l’évaluation clinique et la modélisation décisionnelle. Qu’il s’agisse de mesurer l’efficacité d’un protocole pharmacologique innovant, de quantifier des variations neurocognitives chez des sujets soumis à un stress aigu ou d’étalonner les instruments psychométriques utilisés dans les diagnostics hospitaliers, le statisticien ou le chercheur est invariablement confronté à une masse imposante de valeurs numériques brutes. Face à cette profusion empirique, l’esprit humain ne peut appréhender la structure sous-jacente des phénomènes sans un travail systématique de réduction et de modélisation mathématique. C’est précisément dans cette optique de clarification structurée qu’interviennent les statistiques descriptives, dont le premier jalon analytique réside dans la détermination des indices de position.
Au cœur de ces outils descriptifs figurent les mesures de tendance centrale. Ces paramètres synthétiques visent à condenser une distribution statistique entière en une valeur numérique unique, perçue comme la plus typique, la plus représentative ou la plus centrale de la série observée. Bien loin de constituer de simples artifices de calcul automatisé, le recours à la moyenne arithmétique, à la médiane ou au mode procède d’un cadre épistémologique précis et répond à des contraintes méthodologiques rigoureuses. En condensant l’hétérogénéité des observations empiriques, ces indicateurs offrent un point d’ancrage fondamental permettant de résumer la réalité expérimentale, d’en extraire le signal pertinent au milieu du bruit aléatoire et d’établir des comparaisons signifiantes entre différentes cohortes ou populations d’étude.
Toutefois, la sélection et l’interprétation de ces mesures ne sauraient s’effectuer de manière automatique ou arbitraire. L’architecture métrique des variables étudiées, la configuration géométrique de leur distribution, la présence éventuelle d’asymétries sévères ou la survenue de données aberrantes constituent autant de paramètres critiques qui orientent impérativement le choix du statisticien. Un usage inconsidéré de ces métriques peut engendrer de profonds biais d’interprétation, conduire à des diagnostics cliniques erronés ou masquer des réalités scientifiques majeures. Ce guide complet explore en profondeur les fondements théoriques, les formules algébriques, les protocoles algorithmiques de calcul et les champs d’application pratiques des mesures de tendance centrale, afin d’offrir aux étudiants, cliniciens et chercheurs une compréhension rigoureuse et exhaustive de ces instruments indispensables de la recherche scientifique.
1. Introduction aux mesures de tendance centrale : Fondements théoriques
1.1 Définition conceptuelle de la tendance centrale
Sur le plan conceptuel, une mesure de tendance centrale désigne une valeur numérique unique qui tente d’identifier la position centrale ou typique au sein d’un ensemble de données. Lorsque nous observons une variable empirique au sein d’un échantillon — qu’il s’agisse de la pression artérielle systolique, du score à une épreuve de raisonnement fluide ou du temps requis pour accomplir une tâche sensorimotrice —, les valeurs individuelles se répartissent le long d’un continuum avec une certaine variabilité. La tendance centrale opère une réduction dimensionnelle drastique en captant le centre de gravité ou le pivot autour duquel oscillent l’ensemble de ces mesures individuelles. Elle permet ainsi d’extraire une information condensée et opérationnelle à partir d’un ensemble de mesures autrement inintelligible par simple lecture brute.
Cette approche remplit un rôle crucial de réduction des données en méthodologie empirique. Sans la capacité de résumer des centaines, voire des milliers d’observations individuelles en un indice numérique intelligible, la communication scientifique et la modélisation statistique s’avéreraient impossibles. D’un point de vue épistémologique, il convient d’opérer une distinction cardinale entre la position centrale et la dispersion des données. Si la tendance centrale localise l’ancrage général de la distribution sur l’axe des réels, les mesures de dispersion (comme l’écart-type, la variance ou l’écart interquartile) quantifient quant à elles l’étalement et l’hétérogénéité des observations autour de ce pôle d’attraction. Ces deux dimensions sont strictement complémentaires : connaître la valeur centrale d’un groupe sans connaître la dispersion de ses observations ne fournit qu’une vision parcellaire, voire trompeuse, du phénomène mesuré.
D’un point de vue historique, la genèse mathématique de la tendance centrale prend racine dans les travaux pionniers de l’astronomie et de la géodésie au XVIIIe siècle. Des mathématiciens illustres tels que Carl Friedrich Gauss et Pierre-Simon de Laplace cherchaient alors à combiner des mesures astronomiques multiples et entachées d’erreurs instrumentales afin d’estimer la position réelle des corps célestes. La généralisation ultérieure de ces concepts aux sciences humaines et sociales, menée notamment par Adolphe Quetelet au XIXe siècle à travers son concept de « l’homme moyen », a consacré l’utilisation des indicateurs de centralité comme instruments d’objectivation des régularités biologiques, psychologiques et sociologiques au sein des populations humaines.
1.2 Importance méthodologique en sciences humaines et psychologie
Dans le domaine des sciences du comportement, de la psychiatrie et de la psychologie cognitive, les mesures de tendance centrale ne se cantonnent pas à une fonction descriptive élémentaire ; elles constituent la pierre angulaire de l’ensemble des protocoles de standardisation psychométrique. Lorsqu’un instrument psychométrique — tel qu’une échelle d’intelligence comme la WAIS ou un inventaire de personnalité — est développé, les scores bruts collectés auprès des individus ne possèdent aucune signification intrinsèque absolue. Obtenir un score de 42 à un questionnaire mesurant le perfectionnisme pathologique ne renseigne en rien sur la sévérité du trait sans une mise en perspective normative.
L’étalonnage repose précisément sur le calcul des mesures de tendance centrale obtenues au sein d’échantillons de standardisation stratifiés. En identifiant la performance centrale d’un groupe d’âge ou d’une catégorie démographique donnée, le psychomètre peut convertir les scores bruts en notes standardisées (notes Z, scores T, quotients intellectuels standardisés). Ces transformations permettent d’établir les normes comportementales et cognitives définissant le fonctionnement moyen de la population générale, contrebalancé par les écarts observés dans les cohortes cliniques souffrant de troubles neurodéveloppementaux ou de pathologies psychiatriques.
De surcroît, les mesures de tendance centrale interviennent directement dans l’identification des seuils décisionnels lors des démarches d’évaluation diagnostique. La détermination de critères d’exclusion ou d’inclusion clinique repose fréquemment sur le positionnement du score d’un patient par rapport à la tendance centrale du groupe de référence. Par exemple, la définition diagnostique du déficit intellectuel ou des troubles spécifiques des apprentissages nécessite classiquement de démontrer une performance se situant à une distance statistique déterminée en deçà de la moyenne de la population de référence, conférant ainsi à ces indicateurs une portée clinique et sociale d’une exceptionnelle gravité.
1.3 Typologie générale des échelles de mesure selon Stevens
La sélection rigoureuse d’une mesure de tendance centrale exige une compréhension approfondie de la nature mathématique des données traitées. En 1946, le psychologue et métrologue Stanley Smith Stevens a proposé une typologie devenue universelle, classant les échelles de mesure en quatre niveaux hiérarchisés : nominal, ordinal, d’intervalle et de rapport. Cette classification délimite formellement la légitimité des opérations arithmétiques autorisées sur les données recueillies.
Les échelles nominales représentent le niveau de mesure le plus élémentaire. Elles réalisent une classification purement qualitative au sein de catégories mutuellement exclusives et collectivement exhaustives, sans qu’aucune notion de hiérarchie ou d’ordre n’intervienne (par exemple, le sexe biologique, le statut matrimonial ou le sous-type nosologique d’un trouble de l’humeur). Sur de telles données, les opérations arithmétiques de sommation ou de soustraction sont formellement dénuées de sens. À ce niveau, seule l’évaluation des fréquences d’apparition est possible, ce qui restreint l’usage de la tendance centrale au mode exclusif.
Les échelles ordinales introduisent quant à elles une relation d’ordre direct entre les modalités observées. Les observations peuvent être classées selon une hiérarchie croissante ou décroissante (par exemple, les stades de sévérité d’une pathologie, les rangs au sein d’une promotion universitaire, ou les échelons d’une échelle de Likert mesurant l’intensité d’une phobie). Toutefois, l’intervalle séparant deux rangs consécutifs demeure indéterminé et non constant : l’écart psychologique séparant les modalités « pas du tout d’accord » et « plutôt en désaccord » n’est pas mathématiquement équivalent à celui séparant « plutôt d’accord » et « entièrement d’accord ». Cette absence d’équidistance interdit le calcul strict de la moyenne arithmétique et consacre la médiane comme mesure de position centrale par excellence.
Enfin, les échelles d’intervalle et de rapport constituent les niveaux de métrique continue les plus avancés. Les échelles d’intervalle possèdent des unités de mesure égales et constantes sur l’ensemble de la dimension mesurée, bien que leur zéro soit arbitraire et conventionnel (l’exemple canonique étant la température en degrés Celsius, ou le score standardisé de quotient intellectuel). Les échelles de rapport y adjoignent un zéro absolu non arbitraire signifiant l’absence totale de la grandeur mesurée (comme le temps de réaction physique en millisecondes, le poids corporel ou la concentration sérique de cortisol). Ces niveaux de mesure autorisent l’ensemble des manipulations algébriques classiques, autorisant ainsi pleinement l’usage de la moyenne arithmétique, tout en rendant également envisageable le recours à la médiane et au mode.
2. L’utilité fondamentale des mesures de position en analyse de données
2.1 Simplification de la complexité des grands ensembles de données
L’essor des méthodologies empiriques modernes, de la collecte de données numériques massives (big data) et des études épidémiologiques impliquant des cohortes de plusieurs dizaines de milliers d’individus place les chercheurs face à un défi cognitif redoutable. Examiner un tableau brut recensant les profils physiologiques ou psychologiques d’une cohorte d’envergure est tout bonnement impraticable pour le cerveau humain. Les mesures de position centrale opèrent une compression d’information salutaire : elles réduisent la variance multidimensionnelle d’un échantillon massif en une quantité scalaire unique, immédiatement appréhendable et communicable.
Cette simplification offre aux praticiens et aux scientifiques une base pragmatique pour la prise de décision rapide. En santé publique, décider du déploiement d’un programme de prévention vaccinale ou allouer des subventions thérapeutiques repose sur la connaissance de la valeur centrale d’un indicateur de prévalence ou de charge morbide au sein des bassins de vie. Cette condensation mathématique présente l’immense vertu d’atténuer le bruit stochastique propre aux fluctuations d’échantillonnage mineures, permettant de dégager la dynamique principale ou la tendance sous-jacente du phénomène biologique ou social observé sans l’altérer.
2.2 Comparaison intergroupes et intragroupes en recherche empirique
Dans les dispositifs expérimentaux rigoureux, la question de recherche s’articule quasi systématiquement autour de la comparaison d’entités distinctes. L’expérimentateur oppose fréquemment un groupe expérimental — soumis à un principe actif, à une remédiation cognitive ou à un stimulus environnemental particulier — à un groupe contrôle recevant un placebo ou bénéficiant d’une prise en charge standardisée. Sans un indicateur central représentatif de chaque cohorte, la mise en contraste directe de ces conditions deviendrait inextricable.
Les mesures de tendance centrale fournissent précisément cette métrique unifiée permettant d’évaluer la divergence entre deux distributions. L’estimation de l’ampleur de l’effet thérapeutique dépend substantiellement de la différence observée entre les valeurs centrales des deux groupes. De façon analogue, dans le cadre de protocoles d’évaluation longitudinale à mesures répétées, l’analyse de l’évolution intragroupe (comparaison des scores préalablement et consécutivement à une intervention ciblée) se fonde sur le glissement temporel de la tendance centrale de l’échantillon, attestant ainsi empiriquement du progrès, de la stagnation ou de la dégradation de l’état fonctionnel des participants au fil des semaines d’observation.
2.3 Fondement des statistiques inférentielles paramétriques et non paramétriques
Au-delà de leur mission descriptive immédiate, les mesures de position constituent le socle mathématique fondamental de l’ensemble de l’arsenal des statistiques inférentielles. L’estimation des paramètres réels de la population parente — formalisés sous les symboles grecs canoniques — s’opère par le truchement d’estimateurs statistiques dérivés de l’échantillon, au premier rang desquels figure la moyenne d’échantillonnage.
Dans le cadre de l’inférence paramétrique, le concept de moyenne est intimement intriqué avec le calcul de la somme des carrés des écarts, qui définit à son tour la variance et l’écart-type. Les tests d’hypothèses classiques les plus répandus, tels que le test t de Student ou les modèles d’analyse de variance (ANOVA), sont structurellement des procédures de test d’égalités de moyennes. Ils interrogent la probabilité que les divergences observées entre les tendances centrales de différents groupes résultent uniquement de fluctuations d’échantillonnage aléatoires.
Inversement, lorsque les données enfreignent les postulats distributionnels sous-jacents aux tests paramétriques — notamment en raison d’une asymétrie marquée ou d’un niveau d’échelle strictement ordinal —, l’univers des statistiques non paramétriques prend le relais. Des épreuves telles que le test U de Mann-Whitney ou le test des rangs signés de Wilcoxon s’articulent alors non plus autour de l’estimation de la moyenne arithmétique, mais autour de l’ordonnancement des scores et de la comparaison des médianes ou des distributions de rangs, garantissant une validité inférentielle irréprochable même en conditions d’échantillonnage non idéales.
3. La moyenne arithmétique : Définition, propriétés mathématiques et calcul
3.1 Formulation algébrique de la moyenne pour un échantillon et une population
La moyenne arithmétique constitue sans conteste la mesure de tendance centrale la plus universellement employée, tant dans le milieu académique que dans les applications de la vie civile. Sur le plan algébrique, elle représente la somme de l’ensemble des valeurs observées au sein d’une série statistique, divisée par le nombre total d’observations composant cette série. Il convient toutefois de distinguer formellement la moyenne calculée sur un échantillon empirique de la moyenne théorique d’une population globale.
Pour un échantillon composé de n observations individuelles désignées par x1, x2, …, xn, la moyenne empirique, universellement notée x̄ (x-barre), se formalise à l’aide de la notation sommatoire grecque Σ (sigma majuscule) selon l’équation :
x̄ = (1 / n) Σi=1n xi = (x1 + x2 + … + xn) / n
Lorsque le statisticien s’intéresse à la population exhaustive de taille N, la moyenne populationnelle est désignée par la lettre grecque μ (mu). Son expression mathématique est formellement équivalente :
μ = (1 / N) Σi=1N Xi
Dans les contextes où les données ne sont pas répertoriées sous forme d’une liste brute d’individus, mais regroupées par fréquences au sein d’un tableau de distribution comportant k modalités distinctes, la moyenne arithmétique pondérée s’obtient en associant à chaque valeur xj son effectif d’apparition nj, selon la formule :
x̄ = (Σj=1k nj xj) / (Σj=1k nj)
Une propriété géométrique et mécanique fondamentale de la moyenne réside dans son statut de véritable centre de gravité de la distribution. En effet, la somme algébrique des écarts de chaque observation individuelle par rapport à la moyenne arithmétique est rigoureusement égale à zéro :
Σi=1n (xi – x̄) = 0
Cette égalité démontre que les déviations positives (les valeurs supérieures à la moyenne) compensent exactement et parfaitement l’ensemble des déviations négatives (les valeurs inférieures à la moyenne), traduisant un point d’équilibre parfait sur la droite numérique.
3.2 Propriétés d’optimalité et limites inhérentes
L’importance primordiale accordée à la moyenne arithmétique dans les sciences quantitatives découle de propriétés mathématiques remarquables d’optimalité. La première d’entre elles est le critère des moindres carrés : la moyenne arithmétique est l’unique valeur c qui minimise la somme des carrés des écarts entre les observations empiriques et cette constante. Autrement dit, la fonction définie par f(c) = Σi=1n (xi – c)2 atteint son minimum absolu strict lorsque c = x̄. Cette propriété fonde la quasi-totalité des modèles d’ajustement statistique, de la régression linéaire aux méthodes d’estimation en apprentissage automatique.
De plus, la moyenne arithmétique jouit d’une propriété de linéarité remarquable issue de la théorie des opérateurs statistiques : si chaque observation d’une série xi subit une transformation linéaire affine de type yi = a × xi + b (où a et b sont des constantes réelles), la nouvelle moyenne arithmétique correspondante devient strictement ȳ = a × x̄ + b. Cette caractéristique simplifie considérablement les conversions d’échelles de mesure (par exemple, la transformation de scores bruts en pourcentages ou le passage de degrés Celsius à Fahrenheit).
Néanmoins, la moyenne arithmétique traîne avec elle un écueil méthodologique majeur : son extrême vulnérabilité face aux valeurs aberrantes (outliers) et aux asymétries de distribution. Parce que chaque observation entre arithmétiquement dans la sommation avec un poids unitaire dans le calcul, une seule valeur excessivement disproportionnée vers le haut ou vers le bas suffit à déplacer substantiellement la moyenne dans sa direction. Dès lors, sur des distributions asymétriques ou polluées par des erreurs de saisie monumentales, la moyenne perd instantanément sa représentativité et peut projeter une image totalement biaisée du centre de la cohorte.
3.3 Calcul pas à pas de la moyenne arithmétique simple
Pour exécuter manuellement et rigoureusement le calcul d’une moyenne arithmétique simple sur une série de données quantitatives non groupées, le praticien doit suivre un algorithme séquentiel composé de trois étapes canoniques.
Étape 1 : Collecte exhaustive et vérification de l’intégrité de la série de données. Il convient d’abord de répertorier l’intégralité des observations quantitatives recueillies en s’assurant de l’absence de valeurs aberrantes impossibles résultant d’erreurs d’encodage (par exemple, un âge négatif ou un temps de réaction invraisemblable de zéro milliseconde). Notons n la taille totale effective de cet échantillon après validation.
Étape 2 : Sommation intégrale des valeurs observées. L’expérimentateur additionne l’ensemble des n valeurs numériques de la distribution de manière séquentielle pour obtenir le terme Σ xi. Il convient d’accorder une vigilance accrue au traitement des signes négatifs éventuels si la variable sous-jacente en comporte.
Étape 3 : Division arithmétique par la taille d’échantillon n. La valeur globale issue de la sommation est divisée par la taille de l’échantillon n validé. Le quotient ainsi obtenu constitue la moyenne arithmétique de la série.
Interprétation du résultat dans l’unité de mesure d’origine. Le résultat quantitatif final s’exprime obligatoirement et strictement dans la même unité de mesure que la variable initiale (en millisecondes, en points de score, en kilogrammes, etc.). Il convient généralement de conserver un ou deux chiffres après la virgule supplémentaires par rapport à la précision initiale des données brutes afin de préserver l’information lors des analyses subséquentes, tout en veillant à ne pas surévaluer la précision réelle du protocole d’observation.
4. Exemples concrets de calcul de la moyenne en recherche psychologique
4.1 Exemple 1 : Mesure des temps de réaction cognitive (en millisecondes)
Afin d’illustrer la mécanique de la moyenne arithmétique et d’en dévoiler simultanément la sensibilité aux scores déviants, considérons une expérience de neurosciences cognitives utilisant le paradigme classique de l’effet Stroop. Un chercheur mesure la latence de réponse vocale (exprimée en millisecondes) chez dix participants soumis à une condition de forte interférence cognitive (nommer la couleur de l’encre rouge lorsque le mot écrit est « BLEU »). Les dix temps de réaction chronométrés sont les suivants :
Série A (temps de réaction en ms) : 480, 510, 495, 530, 505, 520, 490, 515, 525, 510.
Appliquons scrupuleusement la procédure arithmétique explicitée précédemment :
- Étape 1 : Taille de l’échantillon validé : n = 10 observations continues.
- Étape 2 : Sommation intégrale : Σ xi = 480 + 510 + 495 + 530 + 505 + 520 + 490 + 515 + 525 + 510 = 5080 ms.
- Étape 3 : Division par la taille : x̄ = 5080 / 10 = 508,0 ms.
L’indice moyen obtenu de 508 millisecondes reflète fidèlement la tendance centrale de ce groupe, l’ensemble des scores individuels oscillant de manière homogène et resserrée entre 480 et 530 ms autour de cette valeur. Imaginons désormais qu’un incident technique ou un décrochage attentionnel majeur survienne chez le dernier participant, entraînant un temps de réaction anormalement prolongé de 1250 ms, la nouvelle série devenant : 480, 510, 495, 530, 505, 520, 490, 515, 525, 1250.
La nouvelle somme s’élève désormais à 5820 ms, ce qui porte la nouvelle moyenne arithmétique à 5820 / 10 = 582,0 ms. Cette valeur de 582 ms ne représente plus correctement le groupe : neuf participants sur dix ont réagi en un temps considérablement plus bref que cette pseudo-tendance centrale. Cet exemple démontre sans ambiguïté comment une unique valeur retardée peut distordre artificiellement la moyenne et induire une interprétation cognitive erronée de la performance typique du collectif.
4.2 Exemple 2 : Scores d’un inventaire d’anxiété standardisé (STAI)
Examinons une seconde application issue de la psychométrie clinique. Une équipe de psychologues de la santé administre l’inventaire d’anxiété-état de Spielberger (STAI-Y1) à une cohorte de huit étudiants universitaires se présentant aux urgences d’un campus la veille d’un examen déterminant. Les scores à cet instrument s’échelonnent sur un continuum de 20 (absence absolue d’anxiété ressentie) à 80 (niveau d’anxiété paroxystique maximal). Les données individuelles collectées sont les suivantes :
Série B (scores au STAI) : 54, 62, 58, 65, 49, 71, 60, 57.
Pour déterminer le niveau moyen d’anxiété vécue par cette cohorte, nous exécutons la sommation des scores individuels :
Σ xi = 54 + 62 + 58 + 65 + 49 + 71 + 60 + 57 = 476 points.
Puis nous appliquons la division par le nombre de sujets (n = 8) :
x̄ = 476 / 8 = 59,5 points.
La moyenne arithmétique s’établit ainsi à 59,5 points. En confrontant ce résultat aux normes publiées dans la littérature psychologique, où la moyenne de la population générale adulte se situe classiquement aux alentours de 38 à 40 points, les cliniciens peuvent formellement conclure que le groupe d’étudiants présente une élévation substantielle de son état d’anxiété moyen (+1,5 à +2 écarts-types au-dessus de la norme normative), justifiant la mise à disposition immédiate d’ateliers de gestion du stress aigu.
4.3 Exemple 3 : Évaluation de la mémoire de travail (empan mnésique)
Dans le domaine de l’évaluation neuropsychologique, l’empan mnésique direct (empan de chiffres) permet d’évaluer la capacité de stockage immédiat de la boucle phonologique de la mémoire de travail. Un neuropsychologue soumet sept patients victimes d’un traumatisme crânien léger à cette épreuve. Le score correspond au nombre maximal de chiffres rappelés dans l’ordre séquentiel exact :
Série C (empan de chiffres) : 5, 6, 4, 5, 7, 4, 5.
Calcul de la moyenne arithmétique :
Σ xi = 5 + 6 + 4 + 5 + 7 + 4 + 5 = 36 items.
x̄ = 36 / 7 = 5,1428… ≈ 5,14 items.
Cet exemple met en exergue une particularité inhérente à la manipulation des variables quantitatives discrètes. Bien qu’un individu ne puisse théoriquement rappeler qu’un nombre entier de chiffres (il est matériellement impossible de mémoriser 5,14 chiffres), la moyenne arithmétique obtenue comporte une partie fractionnaire décimale. Il ne faut en aucun cas arrondir abusivement cette moyenne à 5 au motif que la variable est discrète : la décimale 5,14 constitue une grandeur mathématique continue indispensable pour apprécier la précision du modèle et comparer ce groupe traumatisé au seuil canonique établi par George Miller (la capacité cognitive standard se situant classiquement à 7 ± 2 éléments).
5. La médiane : Définition, méthode d’ordonnancement et robustesse
5.1 Définition conceptuelle et positionnelle de la médiane
La médiane, couramment notée Mdn dans la littérature scientifique, représente une mesure de tendance centrale strictement positionnelle. Contrairement à la moyenne arithmétique, qui sollicite les grandeurs numériques précises de chaque score pour en dégager une résultante algébrique globale, la médiane s’intéresse exclusivement à la topologie de la distribution ordonnée. Conceptuellement, la médiane est définie comme la valeur qui sépare une série statistique préalablement classée par ordre de grandeur en deux sous-ensembles d’effectifs strictement égaux.
Elle correspond par essence au 50e percentile (P50) ainsi qu’au deuxième quartile (Q2) de la distribution cumulée. En pratique, cela signifie exactement que 50 % des observations de l’échantillon présentent une valeur inférieure ou égale à la médiane, tandis que 50 % des observations présentent une valeur supérieure ou égale à celle-ci. Cette logique de bipartition confère à la médiane une indépendance absolue à l’égard des valeurs numériques réelles situées aux extrémités : que la valeur la plus élevée de la série soit modérément grande ou vertigineusement disproportionnée, la position d’équilibre ordinal délimitant le 50e centile demeurera rigoureusement inchangée.
Sur le plan mathématique formel, la médiane possède une propriété d’optimalité remarquable, symétrique de celle de la moyenne : elle constitue l’unique valeur m qui minimise la somme des valeurs absolues des écarts individuels. Ainsi, la fonction d’écart g(m) = Σi=1n |xi – m| atteint son extremum minimal lorsque m est la médiane empirique de la distribution. Cette métrique de distance en norme L1 est précisément celle qui fonde l’ensemble des méthodes statistiques dites robustes.
5.2 Algorithme de calcul selon la parité de l’échantillon
Le calcul de la médiane exige préalablement une condition absolue sans laquelle aucun traitement n’est possible : l’ordonnancement préalable de la série statistique par ordre croissant (ou décroissant). La méthode de détermination dépend ensuite directement de la parité de la taille n de l’échantillon.
Cas d’un effectif impair (n est impair) : Lorsque le nombre total d’observations est impair, la médiane correspond précisément à la valeur centrale physique occupant le rang ordinal calculé par la formule :
Rang de la Médiane = (n + 1) / 2
Dans cette configuration, la médiane correspond nécessairement à une valeur empirique réelle observée au sein de l’échantillon, et elle scinde les n – 1 valeurs restantes en deux contingents parfaitement symétriques de (n – 1) / 2 éléments.
Cas d’un effectif pair (n est pair) : Lorsque la taille de l’échantillon est paire, il n’existe pas d’élément physique unique occupant le milieu géométrique strict de la liste ordonnée. La césure médiane s’intercale exactement entre les deux observations occupant les rangs ordinaux n / 2 et (n / 2) + 1. Par convention universelle admise en mathématiques et en statistique, la médiane est définie comme la demi-somme (la moyenne arithmétique) de ces deux valeurs centrales :
Mdn = [ x(n/2) + x( (n/2) + 1 ) ] / 2
Dans l’hypothèse de données continues préalablement groupées en classes d’intervalles [Linf, Lsup[, l’estimation de la médiane nécessite la construction de la courbe des fréquences cumulées et l’application d’une formule d’interpolation linéaire au sein de la classe médiane identifiée, selon l’expression classique :
Mdn = Linf + [ ( (n / 2) – Fcum_inf ) / fmed ] × w
où Linf désigne la borne inférieure de la classe médiane, Fcum_inf la fréquence cumulée jusqu’à cette borne, fmed l’effectif propre de la classe médiane, et w l’amplitude de l’intervalle.
5.3 Le concept de robustesse statistique de la médiane
La notoriété méthodologique de la médiane découle principalement de sa remarquable robustesse statistique. En théorie de l’estimation statistique robuste, la sensibilité d’un paramètre face aux perturbations ou aux contaminations de l’échantillon est formellement quantifiée par son point de rupture (ou breakdown point). Ce point représente la proportion minimale d’observations arbitrairement aberrantes qu’un échantillon doit contenir pour que l’estimateur puisse être entraîné vers l’infini positif ou négatif.
Tandis que la moyenne arithmétique présente un point de rupture désastreux de 1 / n (il suffit d’une seule valeur aberrante sur un million d’enregistrements pour faire exploser la moyenne), la médiane jouit d’un point de rupture asymptotique exceptionnel de 0,50 (soit 50 %). Cela signifie qu’il faudrait falsifier ou déplacer vers l’infini plus de la moitié des observations d’un groupe pour parvenir à corrompre sans limite la valeur de la médiane. Cette imperméabilité phénoménale fait de la médiane le filtre de protection par excellence contre les erreurs de manipulation, les pannes d’appareillage d’enregistrement de données physiologiques ou les réponses fantaisistes dans les formulaires d’enquête informatisés.
6. Exemples d’application de la médiane face à des distributions asymétriques
6.1 Exemple 1 : Durée des épisodes dépressifs majeurs (en semaines)
L’asymétrie positive (ou étalement prononcé de la distribution vers la droite) est un phénomène omniprésent en psychopathologie clinique, particulièrement dans l’évaluation de la chronicité des troubles affectifs. Considérons un échantillon de 11 patients admis consécutivement au sein d’un centre hospitalier universitaire spécialisé dans le traitement des troubles de l’humeur. Les durées enregistrées de leur épisode dépressif majeur actuel, quantifiées en semaines complètes, sont les suivantes :
Série brute : 8, 14, 6, 52, 10, 12, 16, 9, 104, 11, 7.
Pour déterminer la tendance centrale la plus honnête et représentative de cet échantillon clinique, procédons méthodiquement au calcul comparatif de la médiane et de la moyenne :
Étape 1 : Ordonnancement strict de la série par ordre croissant :
6, 7, 8, 9, 10, 11, 12, 14, 16, 52, 104.
Étape 2 : Détermination de la position médiane pour un effectif impair (n = 11) :
Rang = (11 + 1) / 2 = 12 / 2 = 6e position.
Étape 3 : Identification de la valeur centrale :
En dénombrant la série ordonnée jusqu’au 6e élément, nous identifions la valeur : Mdn = 11 semaines. Cinq patients présentent un épisode dépressif d’une durée inférieure ou égale à 11 semaines, et cinq patients présentent un épisode d’une durée égale ou supérieure à cette valeur.
Calculons parallèlement la moyenne arithmétique de cette même série empirique :
Σ xi = 6 + 7 + 8 + 9 + 10 + 11 + 12 + 14 + 16 + 52 + 104 = 249 semaines.
x̄ = 249 / 11 ≈ 22,64 semaines.
La divergence entre les deux indicateurs est spectaculaire : la moyenne arithmétique (22,64 semaines) est plus de deux fois supérieure à la médiane (11 semaines). Cette surévaluation est entièrement imputable aux deux patients présentant une évolution chronique sévère (52 et 104 semaines). Si un psychiatre affirmait que la durée typique d’un épisode au sein de son service est de 23 semaines, il déformerait profondément la réalité clinique de près de 80 % des patients de l’échantillon (qui guérissent en moins de 16 semaines). La médiane constitue ici indiscutablement l’unique paramètre cliniquement pertinent.
6.2 Exemple 2 : Temps d’endormissement dans les troubles de l’insomnie
Un laboratoire d’étude du sommeil évalue la latence d’endormissement (temps écoulé entre l’extinction de la lumière et l’apparition du premier fuseau de sommeil de stade 2 en polysomnographie) chez un échantillon pair de 8 patients souffrant d’insomnie d’endormissement psychophysiologique. Les durées enregistrées en minutes sont :
Série brute : 45, 120, 30, 95, 25, 40, 60, 35.
Calculons la médiane selon l’algorithme des effectifs pairs :
- Tri croissant des données brutes : 25, 30, 35, 40, 45, 60, 95, 120.
- Détermination des rangs centraux (n = 8) : Rang 1 = n / 2 = 8 / 2 = 4e position ; Rang 2 = (n / 2) + 1 = 5e position.
- Localisation des deux valeurs centrales : Le 4e score est 40 minutes ; le 5e score est 45 minutes.
- Calcul de la demi-somme : Mdn = (40 + 45) / 2 = 85 / 2 = 42,5 minutes.
L’estimation médiane de 42,5 minutes reflète remarquablement le centre ordinal du groupe. Comparativement, la moyenne arithmétique de cette série vaut (25 + 30 + 35 + 40 + 45 + 60 + 95 + 120) / 8 = 450 / 8 = 56,25 minutes. Là encore, le calcul de la moyenne est tiré vers le haut par les deux patients dont l’insomnie a dépassé une heure et demie, confirmant que la médiane délivre une appréciation plus juste de la latence médiane d’endormissement au sein de ce groupe de consultation.
6.3 Exemple 3 : Revenus des participants et niveau socio-économique en épidémiologie
Dans la recherche épidémiologique et les enquêtes sociodémographiques sur la santé mentale, le revenu mensuel net des ménages est une variable déterminante du risque d’exposition aux stresseurs chroniques. C’est également l’exemple canonique par excellence des distributions asymétriques positives à queue lourde. Considérons un échantillon miniature représentatif de sept ménages participant à une étude sur les déterminants sociaux du bien-être :
Revenus mensuels nets (en euros) : 1 400 €, 1 650 €, 1 800 €, 2 100 €, 2 400 €, 3 200 €, 28 000 €.
La série étant déjà classée par ordre croissant, le rang médian pour n = 7 correspond à (7 + 1) / 2 = 4e position. Le revenu médian s’établit donc directement à 2 100 €. Exactement trois ménages perçoivent moins de 2 100 €, et trois ménages perçoivent davantage.
Calculons à présent la moyenne arithmétique de cette communauté :
Σ xi = 1 400 + 1 650 + 1 800 + 2 100 + 2 400 + 3 200 + 28 000 = 40 550 €.
x̄ = 40 550 / 7 ≈ 5 792,86 €.
Déclarer que le revenu moyen de cette cohorte d’étude avoisine les 5 800 euros mensuels relève de l’absurdité descriptive la plus complète : six foyers sur sept (soit près de 86 % de l’échantillon) gagnent une somme drastiquement inférieure à cette prétendue moyenne. Ce phénomène illustre à la perfection la raison fondamentale pour laquelle l’ensemble des instituts nationaux de statistique (tels que l’INSEE en France ou l’OCDE à l’échelle internationale) emploient exclusivement le revenu médian pour mesurer le niveau de vie réel des populations et établir les seuils de pauvreté.
7. Le mode : Définition, distributions plurimodales et spécificités catégorielles
7.1 Définition théorique et identification du mode
Le mode, fréquemment symbolisé par Mo dans les répertoires statistiques, constitue la mesure de tendance centrale la plus spontanée et la plus intuitive du point de vue perceptif. Sur le plan théorique, le mode d’une série statistique est défini comme la valeur, l’état ou la modalité qui apparaît avec l’effectif absolu le plus élevé, c’est-à-dire la fréquence relative maximale. Il représente tout simplement l’événement empiriquement le plus fréquent ou le plus probable au sein de l’échantillon analysé.
Le mode jouit d’une spécificité méthodologique unique qui lui confère une valeur irremplaçable : il s’agit de la seule et unique mesure de tendance centrale universellement applicable aux variables mesurées sur une échelle purement nominale. Alors que la moyenne exige une métrique continue et des opérations de division, et que la médiane impose obligatoirement un étalement ordinal permettant le classement séquentiel, le mode exige uniquement la capacité de distinguer et de dénombrer des catégories d’équivalence distinctes.
Cette mesure de position s’affranchit de tout postulat métrique. Elle est totalement insensible à l’ordre des catégories comme aux écarts numériques séparant les observations. Elle répond directement à la question éminemment pratique et empirique que se posent couramment les cliniciens, épidémiologistes et gestionnaires : « Quel est le profil, le diagnostic ou la modalité de réponse qui se présente le plus couramment dans le groupe sous étude ? ».
7.2 Typologie des configurations modales
L’observation du paysage modal d’une distribution offre des indications structurelles d’une richesse diagnostique souvent supérieure à celle fournie par la simple moyenne arithmétique. Selon la configuration des pics de fréquence émergeant des représentations tabulaires ou des histogrammes, on distingue quatre topologies fondamentales :
Distributions unimodales : La distribution ne présente qu’un seul pic de fréquence prédominant nettement individualisé. Il s’agit du cas de figure classique attendu pour des variables biologiques homogènes au sein d’une population saine (par exemple, le score d’intelligence globale dans un groupe standardisé ou le taux d’hémoglobine chez des adultes sains).
Distributions bimodales : La distribution révèle l’existence conjointe de deux pics de fréquence distincts et statistiquement notables, séparés par un creux intermédiaire (une vallée). En épidémiologie et en sciences comportementales, la mise en évidence d’une bimodalité constitue un signal d’alarme méthodologique de première magnitude : elle trahit presque invariablement la présence de deux sous-populations hétérogènes confondues au sein du même groupe expérimental (par exemple, le regroupement accidentel de sujets sains et de patients porteurs d’une affection génétique ignorée, ou le dimorphisme sexuel prononcé sur un trait biométrique).
Distributions multimodales (ou plurimodales) : La distribution comporte trois pics d’occurrence majeurs ou davantage. Cette configuration complexe dénote un haut degré de fragmentation de l’échantillon, suggérant l’influence combinée de multiples facteurs de causalité discrets ou une stratification démographique profonde du groupe sous-jacent.
Distributions uniformes (amodales) : Toutes les modalités observables de la variable présentent des effectifs strictement ou approximativement identiques. Dans cette configuration géométrique plane (comme le résultat du lancer d’un dé non biaisé à six faces), il n’existe rigoureusement aucun mode identifiable, signifiant l’absence absolue de point de ralliement préférentiel des observations.
7.3 Procédure d’identification selon le type de variable
La procédure pratique servant à déterminer le mode varie selon la structure discrète ou continue de la variable explorée.
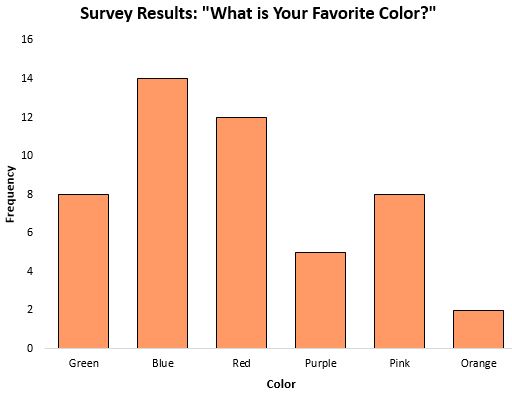
Pour les variables qualitatives et discrètes : La démarche est d’une simplicité désarmante. Elle consiste à construire un tableau d’effectifs répertoriant chaque modalité observée et à dénombrer ses occurrences. La modalité qui concentre l’effectif le plus lourd constitue immédiatement le mode empirique. En présence de deux modalités distinctes partageant exactement le même effectif record maximal, la série est formellement déclarée bimodale.
Pour les variables quantitatives continues regroupées en classes : Lorsque les données sont continues et ont été agglomérées en intervalles de classe (par exemple, des tranches d’âge de 10 ans), le repérage s’opère dans un premier temps au niveau de la classe modale, définie comme la classe d’intervalle présentant la plus forte densité de fréquence par unité d’amplitude. Afin d’estimer un mode ponctuel au sein de cette classe continue sans recourir à un histogramme, les statisticiens utilisent couramment la formule d’interpolation modale :
Mo = Linf + [ Δ1 / ( Δ1 + Δ2 ) ] × w
où Linf désigne la borne inférieure de la classe modale, w l’amplitude de l’intervalle, Δ1 l’excès de fréquence de la classe modale par rapport à la classe immédiatement inférieure (Δ1 = fmod – finf), et Δ2 l’excès de fréquence de la classe modale par rapport à la classe immédiatement supérieure (Δ2 = fmod – fsup).
Il est impératif de souligner la vulnérabilité méthodologique du mode sur données continues : sa valeur est profondément tributaire de la largeur arbitraire retenue pour découper les classes lors de l’encodage. Deux chercheurs découpant le même échantillon avec des largeurs d’intervalles divergentes peuvent aisément aboutir à des classes modales discordantes.
8. Exemples concrets d’utilisation du mode en contextes cliniques et sociaux
8.1 Exemple 1 : Diagnostic psychiatrique prévalent dans un centre médico-psychologique
Illustrons la primauté incontestée du mode sur les variables nominales qualitatives en milieu hospitalier. La direction d’un centre médico-psychologique (CMP) dépouille les dossiers cliniques de 150 patients admis pour la première fois en consultation d’urgence psychiatrique au cours d’un trimestre donné. L’équipe médicale cherche à déterminer le tableau nosologique central afin de recruter des cliniciens spécialisés et de restructurer son offre de soins ambulatoires. Les diagnostics principaux posés selon les critères du Manuel diagnostique et statistique des troubles mentaux (DSM-5) se répartissent comme suit :
- Trouble Dépressif Majeur : 48 admissions
- Trouble Anxiété Généralisée : 32 admissions
- Trouble Panique avec Agoraphobie : 41 admissions
- Troubles liés à l’usage de substances : 19 admissions
- Trouble Obsessionnel Compulsif : 10 admissions
Dans ce contexte épidémiologique élémentaire, calculer une moyenne ou ordonner une médiane est conceptuellement insensé, le diagnostic psychiatrique étant une variable strictement nominale sans gradation arithmétique continue sous-jacente. L’observation directe du décompte des effectifs révèle que la catégorie « Trouble Dépressif Majeur » concentre le pic d’occurrence maximal avec un effectif de 48 patients (soit 32 % de la patientèle accueillie). Le mode nominal de cette distribution diagnostique est donc formellement le Trouble Dépressif Majeur.
Cette donnée de tendance centrale catégorielle fournit une justification managériale et clinique immédiate : elle commande d’orienter prioritairement les ressources budgétaires vers la mise en place de thérapies cognitivo-comportementales de groupe dédiées à la dépression et d’assurer une formation continue ciblée du personnel soignant sur la gestion de la crise suicidaire.
8.2 Exemple 2 : Modalité de réponse dominante sur une échelle d’accord de Likert
Dans le cadre d’un audit sur la qualité de vie au travail mené auprès de 85 soignants d’un pôle d’onco-hématologie pédiatrique, les participants réagissent à l’affirmation standardisée suivante : « Je me sens soutenu par ma hiérarchie lors de situations de détresse éthique ». Les réponses sont recueillies sur une échelle de Likert classique ordonnée à cinq points d’ancrage. Le relevé des fréquences absolues produit les résultats suivants :
- Modalité 1 : « Pas du tout d’accord » → 38 soignants
- Modalité 2 : « Plutôt en désaccord » → 22 soignants
- Modalité 3 : « Neutre / Sans avis » → 12 soignants
- Modalité 4 : « Plutôt d’accord » → 8 soignants
- Modalité 5 : « Tout à fait d’accord » → 5 soignants
L’examen des effectifs permet d’identifier sans équivoque le mode ordinal de cette consultation : la modalité 1 (« Pas du tout d’accord ») s’impose avec une fréquence dominante de 38 répondants (soit 44,7 % de l’effectif soignant). Bien que l’on puisse calculer une médiane (qui se situerait ici sur le rang ordinal 43, correspondant à la modalité 2 « Plutôt en désaccord »), le mode projette une lumière crue sur le sentiment de rupture managériale ressenti par l’équipe. Il met en exergue l’avis tranché le plus populaire, interdisant à la gouvernance hospitalière de se réfugier derrière une lecture adoucie qui masquerait la violence de la détresse institutionnelle observée sur le terrain.
8.3 Exemple 3 : Distribution bimodale des scores d’anxiété pré-examen
Considérons à présent une étude conduite par des enseignants-chercheurs en psychologie de l’éducation évaluant le niveau d’anxiété anticipatoire de 60 étudiants en médecine une heure avant le début d’une épreuve éliminatoire classante. Le questionnaire utilisé fournit un score d’anxiété gradué de 0 (sérénité totale) à 100 (panique absolue). Le tracé de la distribution de ces 60 scores révèle une configuration saisissante à deux sommets :
- Un premier sommet de fréquence apparaît autour du score de 25 points (regroupant 22 étudiants présentant une excellente maîtrise émotionnelle et une préparation intensive).
- Un creux marqué s’observe entre 40 et 60 points (ne rassemblant que 6 étudiants au total).
- Un second sommet massif de fréquence culmine autour du score de 85 points (regroupant 24 étudiants en état de tétanie psychique aiguë).
- Les 8 étudiants restants se répartissent de manière marginale aux extrémités absolues (vers 10 et 95 points).
Si un statisticien peu scrupuleux calculait machinalement la moyenne arithmétique globale de cet échantillon, il obtiendrait une valeur approximative de 55 points. La médiane se positionnerait similairement autour de 54 points. Conclure sur cette base que « le niveau d’anxiété central de cette promotion d’étudiants est moyen (55/100) » relèverait d’un contresens méthodologique gravissime. En réalité, aucun étudiant ou presque ne ressent une anxiété de 55 points !
La distribution est indiscutablement bimodale (modes à 25 et 85 points). Cette bimodalité révèle l’existence de deux sous-groupes structurellement distincts qui nécessitent des interventions pédagogiques et médicales diamétralement opposées : les premiers ne sollicitent aucun accompagnement particulier, tandis que les seconds requièrent la mise en place urgente d’un soutien psychologique de crise et d’une prise en charge des attaques de panique pré-examen.
9. Analyse comparative : Critères décisionnels pour choisir la mesure appropriée
9.1 Choix fondé sur le niveau de mesure de la variable
La décision relative au choix de la mesure de tendance centrale ne relève en aucun cas d’une préférence subjective du chercheur ; elle obéit à une stricte hiérarchie d’éligibilité mathématique dictée par le niveau d’échelle de la variable considérée, conformément à la théorie axiomatique de Stevens. Tout manquement à ces règles élémentaires vicie irrémédiablement la rigueur scientifique des conclusions publiées.
Au niveau de l’échelle nominale, la situation est univoque : seul le mode est théoriquement et mathématiquement licite. Calculer la moyenne ou la médiane de variables catégorielles (par exemple, prétendre calculer la moyenne arithmétique du groupe sanguin des patients en codant A=1, B=2, AB=3, O=4) constitue une hérésie statistique élémentaire. Les codes numériques affectés aux catégories ne possèdent aucune vertu quantitative ou ordinale ; ce ne sont que des étiquettes sémantiques arbitraires.
Au niveau de l’échelle ordinale, la médiane s’impose comme la mesure de position centrale d’élection. Les scores pouvant être séquentiellement hiérarchisés, la médiane capte fidèlement le centre de gravité ordinal de la cohorte. Le mode peut être conservé à titre de complément descriptif précieux afin de souligner la catégorie plébiscitée. En revanche, le calcul de la moyenne arithmétique est théoriquement prohibé, en raison de l’inégalité indémontrable des intervalles séparant les degrés successifs de l’échelle, bien qu’une tolérance empirique pragmatique s’observe fréquemment dans les sciences sociales sur les échelles de Likert comptant un nombre suffisant de points (généralement 7 points ou plus).
Enfin, pour les échelles d’intervalle et de rapport, l’ensemble de l’arsenal des trois mesures de tendance centrale devient mathématiquement légitime. La moyenne arithmétique y règne en souveraine incontestée, car elle est la seule à intégrer scrupuleusement la valeur métrique précise de chaque observation, maximisant ainsi l’exploitation de l’information quantitative recueillie. Toutefois, son règne n’est pas inconditionnel : en présence d’asymétries distributionnelles majeures ou d’observations aberrantes, la médiane doit être préférée ou impérativement présentée conjointement.
9.2 Critères comparatifs : Sensibilité, efficacité et robustesse
Pour arbitrer scientifiquement entre ces trois indicateurs sur une variable métrique continue, l’analyste doit mettre en balance trois propriétés statistiques cardinales : l’efficacité d’estimation, la sensibilité informationnelle et la robustesse face aux violations du protocole.
L’efficacité statistique constitue le triomphe incontesté de la moyenne arithmétique lorsque la population d’origine suit une distribution normale gaussienne. D’après le théorème fondamental de Gauss-Markov et la théorie des estimateurs du maximum de vraisemblance, la moyenne d’échantillon x̄ est l’estimateur sans biais de variance minimale (MVUE). Concrètement, si l’on extrait mille échantillons aléatoires de même taille d’une même population normale, la dispersion des moyennes observées sera considérablement plus faible que la dispersion des médianes ou des modes correspondants. La moyenne garantit une précision d’estimation paramétrique supérieure à tout autre indice.
La sensibilité informationnelle traduit la capacité d’un indicateur à réagir à la moindre fluctuation de l’échantillon. La moyenne arithmétique présente une sensibilité absolue : modifier la valeur d’une seule observation d’un demi-point modifie instantanément la moyenne. Cette caractéristique en fait un instrument de calcul d’une haute précision métrique, mais devient son plus lourd handicap dès lors que l’échantillon comporte des bruits de mesure ou des scores déviants.
La robustesse, quant à elle, consacre la supériorité sans partage de la médiane. Face à des distributions hautement asymétriques, face à des queues de distribution épaisses ou face à des artefacts de codage, la médiane conserve une stabilité exemplaire grâce à son point de rupture de 50 %. Le mode offre une intelligibilité descriptive immédiate et ne requiert aucune hypothèse métrique, mais il pâtit d’une extrême instabilité d’échantillonnage sur les petits échantillons continus, ce qui limite considérablement son usage en statistique inférentielle formelle.
9.3 Grille matricielle de décision pour les chercheurs
Afin de guider méthodiquement le praticien dans sa démarche d’analyse de données, l’arbre de décision suivant synthétise les arbitrages requis en fonction du niveau d’échelle, de la morphologie de la distribution et de la présence de valeurs atypiques :
- Cas 1 : Variable strictement qualitative nominale
- Mesure obligatoire exclusive : Le Mode.
- Contre-indications absolues : Moyenne arithmétique et Médiane formellement interdites.
- Cas 2 : Variable ordinale (rangs, stades cliniques, échelles de Likert à faible granularité)
- Mesure principale recommandée : La Médiane.
- Mesure secondaire complémentaire : Le Mode.
- Contre-indication : Moyenne arithmétique déconseillée ou à manier avec une extrême prudence méthodologique.
- Cas 3 : Variable quantitative continue/discrète — Distribution symétrique et absence d’outliers majeurs
- Mesure principale recommandée : La Moyenne arithmétique (maximisation de l’efficacité inférentielle).
- Mesures secondaires optionnelles : Médiane et Mode (qui coïncident théoriquement avec la moyenne au centre).
- Cas 4 : Variable quantitative continue/discrète — Distribution fortement asymétrique (skewed) ou présence d’outliers avérés
- Mesure principale d’excellence : La Médiane (immunité contre l’étalement des queues de distribution).
- Mesures complémentaires obligatoires : Rapporter systématiquement la Moyenne conjointement à la Médiane afin de quantifier l’asymétrie pour la communauté scientifique.
- Cas 5 : Distribution empirique bimodale ou plurimodale évidente
- Mesure principale obligatoire : Le Mode (mention explicite des modes multiples).
- Mise en garde capitale : Proscrire formellement l’usage exclusif de la moyenne ou de la médiane, sous peine d’effacer les sous-groupes structurels constituant l’échantillon.
10. L’influence de la forme des distributions et des valeurs aberrantes
10.1 Distribution symétrique normale (loi de Gauss)
L’architecture géométrique d’une distribution de probabilité conditionne intimement les relations algébriques unissant la moyenne, la médiane et le mode. Le modèle théorique le plus illustre de la statistique paramétrique est sans nul doute la distribution normale, ou courbe en cloche de Gauss-Laplace. Cette loi continue régit une profusion de phénomènes naturels, biologiques et comportementaux résultant de la sommation d’une infinité de micro-causes aléatoires indépendantes (en vertu du théorème central limite).
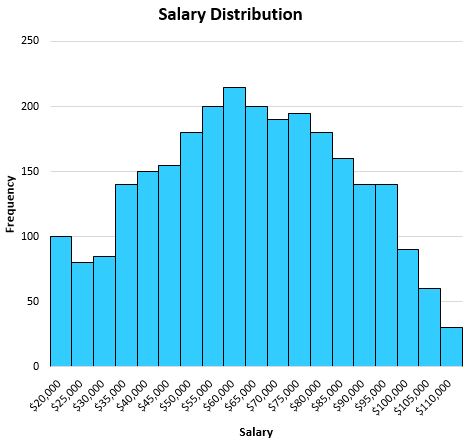
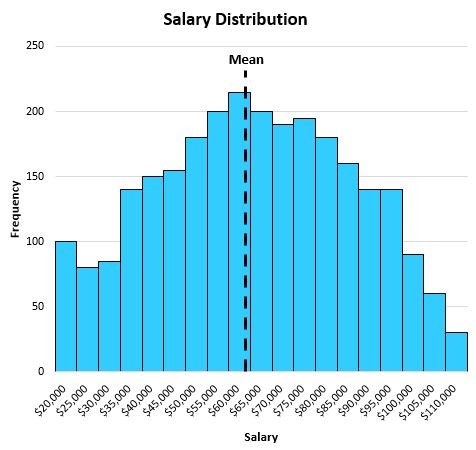
Sur le plan topologique, la distribution normale se caractérise par une symétrie axiale parfaite de sa fonction de densité par rapport à son centre de gravité. Les deux versants de la courbe se déploient en miroir absolu de part et d’autre de cette verticale centrale. La conséquence mathématique directe de cette symétrie parfaite est la coïncidence rigoureuse et intégrale des trois mesures de tendance centrale :
Moyenne = Médiane = Mode
Dans un tel contexte distributionnel idéal, le dilemme du choix de la mesure de position s’éteint spontanément. Les trois indicateurs désignent sans ambiguïté le même point géométrique sur la droite des réels. Les statisticiens optent alors quasi universellement pour la moyenne arithmétique, en raison de son efficacité supérieure pour paramétrer les fonctions de vraisemblance et nourrir les modèles inférentiels paramétriques.
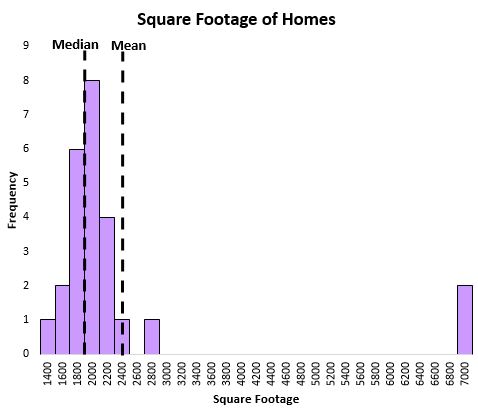
10.2 Distributions asymétriques positives et négatives (Skewness)
Dès lors qu’une série de données dévie de la symétrie gaussienne pour adopter un profil asymétrique (phénomène quantifié par le coefficient d’asymétrie ou skewness de Fisher-Pearson), l’harmonie centrale se brise. Les trois mesures de position se désolidarisent et s’écartent les unes des autres le long d’un axe directionnel dicté par la queue de distribution.
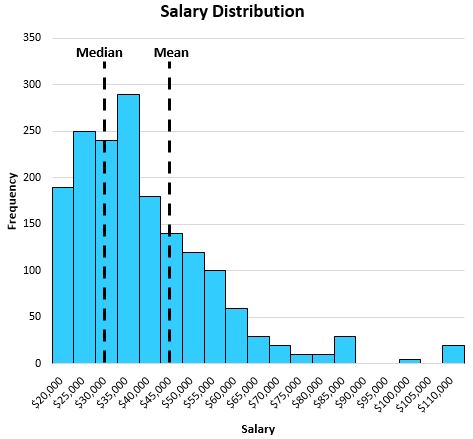
Dans le cas d’une asymétrie positive (ou étalement vers la droite, skewness > 0), les observations se concentrent massivement vers les valeurs faibles de l’échelle, tandis qu’une queue de distribution allongée s’étire vers les valeurs positives élevées. Ce profil caractérise typiquement les temps de réaction, le nombre de rechutes toxicomanologiques, la consommation d’alcool ou les salaires. Les trois mesures s’ordonnent alors selon une hiérarchie classique quasi invariable :
Mode < Médiane < Moyenne
Le mode demeure solidement ancré au niveau du pic de densité initial (la valeur la plus populaire). La médiane se déplace modérément vers la droite pour absorber le contingent d’observations, mais s’arrête dès que 50 % de l’effectif est atteint. En revanche, la moyenne arithmétique subit une attraction gravitationnelle sévère exercée par les scores démesurés de la queue droite, étant tirée à une distance considérable du mode. La distance séparant la moyenne de la médiane fournit d’ailleurs un premier indice heuristique visuel de l’intensité de l’asymétrie (approximée par la relation empirique de Karl Pearson : Moyenne – Mode ≈ 3 × [Moyenne – Médiane]).
Inversement, dans le cas d’une asymétrie négative (ou étalement vers la gauche, skewness < 0), les données s’agglutinent vers les valeurs élevées de l’échelle (phénomène d’effet plafond, comme les scores d’un examen excessivement facile ou l’âge au décès dans un pays à haut indice de développement humain), tandis qu’une queue résiduelle s’étire vers les valeurs faibles. La hiérarchie géométrique s’inverse rigoureusement :
Moyenne < Médiane < Mode
Ici, la moyenne arithmétique est lourdement abaissée par les quelques observations extrêmement faibles situées dans la queue gauche, tandis que le mode trône au sommet supérieur de la distribution et que la médiane occupe prudemment la position de compromis ordinal.
10.3 Gestion des valeurs aberrantes (Outliers) et distorsion de l’analyse
L’une des menaces les plus pernicieuses pesant sur la validité interne d’une étude quantitative réside dans la présence de données atypiques ou aberrantes (outliers). Une valeur aberrante est une observation qui s’écarte de façon tellement spectaculaire du reste du nuage de points qu’elle éveille le soupçon légitime d’avoir été générée par un mécanisme sous-jacent fondamentalement différent de celui qui gouverne le reste de la cohorte.
Il convient de distinguer méthodologiquement deux origines aux valeurs aberrantes :
- Les aberrations artificielles : issues d’une coquille de frappe humaine (enregistrer par inadvertance un âge de 250 ans au lieu de 25 ans), d’une défaillance logicielle ou d’un capteur biométrique déconnecté. Ces valeurs relèvent du déchet méthodologique pur et doivent impérativement être expurgées de la base de données.
- Les aberrations authentiques : issues de la variabilité biologique, comportementale ou socio-économique intrinsèque et extrême du sujet (par exemple, le score d’un génie universel à un test de raisonnement perceptif, ou le revenu d’un chef d’entreprise multimilliardaire dans une enquête locale). Ces observations sont empiriquement véridiques et leur suppression cavalière relève de la falsification scientifique.
Considérons l’impact chiffré dévastateur d’un score extrême authentique sur un échantillon de taille n = 5 mesurant le nombre de verres d’alcool consommés en une semaine par des adolescents scolarisés : 0, 1, 0, 2, 1. La moyenne arithmétique vaut x̄ = 4 / 5 = 0,8 verre par semaine, et la médiane vaut 1 verre. Intégrons désormais un sixième adolescent souffrant d’une addiction sévère consommant 45 verres par semaine. La nouvelle série devient : 0, 0, 1, 1, 2, 45.
Le recalcul immédiat de la médiane pour n = 6 produit une demi-somme des 3e et 4e rangs : Mdn = (1 + 1) / 2 = 1 verre. La médiane fait preuve d’une imperméabilité absolue et continue d’exprimer fidèlement la consommation de la quasi-totalité des collégiens. À l’opposé, la nouvelle moyenne arithmétique explose littéralement : x̄ = (0 + 0 + 1 + 1 + 2 + 45) / 6 = 49 / 6 = 8,17 verres par semaine !
Par l’effet d’une seule observation extrême, la moyenne arithmétique a été multipliée par dix, dépeignant le groupe des adolescents comme de lourds buveurs réguliers. Cet exemple met en lumière la distorsion dramatique que peut infliger une confiance aveugle accordée à la moyenne arithmétique sans vérification préalable de la forme de la distribution.
11. Mesures de tendance centrale alternatives et perfectionnées
11.1 La moyenne tronquée (Trimmed Mean) et la moyenne winsorisée
Face au dilemme récurrent opposant l’efficacité paramétrique sans égale de la moyenne arithmétique et l’immunité protectrice de la médiane, les théoriciens de la statistique robuste ont élaboré des compromis algorithmiques particulièrement ingénieux. Parmi ces estimateurs de position de compromis, la moyenne tronquée (ou moyenne rognée, trimmed mean) occupe une place de choix.
Le principe de la moyenne tronquée à k % repose sur l’élimination systématique et symétrique d’une proportion k de données aux deux extrémités de la distribution préalablement ordonnée, suivie du calcul de la moyenne arithmétique classique sur les observations restantes. Par exemple, une moyenne tronquée à 10 % (l’un des calibrages les plus fréquents en recherche robuste) consiste à supprimer les 10 % des scores les plus faibles et les 10 % des scores les plus élevés de la série ordonnée, puis à calculer la moyenne des 80 % de données conservées au cœur de la distribution. Ce faisant, l’estimateur s’émousse face aux valeurs aberrantes les plus sauvages tout en conservant une efficacité statistique nettement supérieure à celle de la médiane brute sur les distributions quasi symétriques.
Une variante voisine est la moyenne winsorisée (nommée en hommage au biostatisticien Charles Winsor). Contrairement à la moyenne tronquée qui supprime purement et simplement les fractions extrêmes, la méthode de winsorisation à k % remplace les valeurs situées au-delà des percentiles limites par la valeur exacte de ces percentiles eux-mêmes. Ainsi, dans une distribution winsorisée à 10 %, tous les scores inférieurs au 10e percentile sont recodés à la valeur exacte de ce 10e centile, et tous les scores supérieurs au 90e percentile sont recodés à la valeur du 90e centile. La moyenne arithmétique est ensuite calculée sur cette série modifiée dont la taille d’échantillon globale n demeure intégralement préservée, prévenant l’amputation de puissance statistique.
11.2 La moyenne pondérée (Weighted Mean)
Dans la formulation arithmétique standard, chaque observation contribue au résultat final avec un poids strictement identique, formalisé par le coefficient unitaire 1 / n. Or, dans de multiples situations de recherche empirique, toutes les observations ne jouissent pas d’une fiabilité métrique ou d’une représentativité équivalente. C’est ici qu’intervient la moyenne pondérée (weighted mean).
Soit une série de n observations x1, x2, …, xn, à chacune desquelles est alloué un poids d’importance wi (avec wi > 0). La moyenne arithmétique pondérée, notée x̄w, se formalise algébriquement par l’équation :
x̄w = ( Σi=1n wi xi ) / ( Σi=1n wi )
Le champ d’application le plus prestigieux et le plus déterminant de la moyenne pondérée en médecine et en psychologie contemporaine réside dans la méta-analyse. Lorsqu’une équipe de recherche synthétise l’efficacité d’un traitement à travers les résultats de quarante essais cliniques mondiaux indépendants, les études incluses n’offrent pas toutes la même précision statistique : un essai contrôlé randomisé conduit sur 5 000 patients fournit une estimation bien plus solide qu’un protocole exploratoire mené sur 15 sujets.
Dans le cadre des modèles méta-analytiques à effets fixes ou aléatoires, le poids wi accordé à la taille d’effet de chaque étude i est classiquement défini comme l’inverse de sa variance d’échantillonnage (wi = 1 / vi = 1 / SEi2). Cette pondération confère automatiquement un poids déterminant aux études de grande échelle dotées d’une erreur-type minuscule, reléguant les petites études instables à une influence proportionnellement marginale dans la taille d’effet globale combinée.
11.3 Les moyennes géométrique et harmonique
Au-delà de la moyenne arithmétique, la famille mathématique des moyennes pythagoriciennes comprend deux autres métriques hautement spécialisées, indispensables lorsque la variable étudiée n’entretient pas des relations d’additivité linéaires simples : la moyenne géométrique et la moyenne harmonique.
La moyenne géométrique, notée G, est définie pour une série de n valeurs réelles strictement positives comme la racine n-ième du produit cumulé de l’ensemble des observations :
G = ( Πi=1n xi )1/n = [ x1 × x2 × … × xn ]1/n
Sur le plan calculatoire, la moyenne géométrique s’obtient couramment en calculant la moyenne arithmétique des logarithmes des données, puis en prenant l’exponentielle du résultat obtenu : G = exp[ (1 / n) Σ ln(xi) ]. La moyenne géométrique constitue la seule mesure centrale mathématiquement valide pour agréger des taux de croissance proportionnels, des ratios d’amplification biologique, des facteurs d’échelle sériels (comme les dilutions de titrage d’anticorps en sérologie ou les échelles logarithmiques en psychoacoustique de décibels).
La moyenne harmonique, notée H, se définit quant à elle comme l’inverse de la moyenne arithmétique des inverses des observations individuelles strictement positives :
H = n / [ Σi=1n (1 / xi) ]
La moyenne harmonique s’impose rigoureusement dès lors que la variable analysée s’exprime sous la forme d’un ratio ou d’un rendement physique rapporté à une unité de temps fixe (par exemple, des vitesses de déplacement en kilomètres par heure, des taux de débit de traitement de paquets informatiques ou des rendements d’exécution cognitive par minute de passation). Calculer une moyenne arithmétique sur des vitesses pour un trajet de distance identique constitue un piège classique qui surestime substantiellement la vitesse moyenne réelle.
Ces trois moyennes pythagoriciennes sont unies par une relation d’inégalité générale immuable, valide pour tout ensemble d’observations strictement positives comportant des valeurs dissemblables :
Moyenne Harmonique (H) ≤ Moyenne Géométrique (G) ≤ Moyenne Arithmétique (x̄)
L’égalité stricte (H = G = x̄) ne survient que dans la circonstance singulière où l’ensemble des observations de la série sont rigoureusement identiques entre elles.
12. Directives de rédaction et de communication scientifique selon les normes APA
12.1 Normes de notation et de rapport textuel (APA 7e édition)
La diffusion des résultats scientifiques au sein des revues internationales à comité de lecture est soumise aux conventions typographiques et méthodologiques d’une précision chirurgicale édictées par l’American Psychological Association (normes APA, actuellement dans leur 7e édition). La présentation d’une mesure de tendance centrale ne tolère aucune approximation rédactionnelle.
Sur le plan de la symbologie et de la mise en forme typographique, les symboles statistiques textuels s’impriment obligatoirement en caractères italiques lorsqu’ils sont représentés par des lettres latines, tandis que les lettres grecques demeurent en romain droit standard. Ainsi, la moyenne empirique d’échantillon se note strictement M (en majuscule italique), et la médiane se note Mdn (en italique). À titre d’exemple, on écrira dans le corps du texte : « Le score moyen de dépression des participants est de 24,35 (M = 24,35)… » ou « Le temps d’endormissement médian s’élève à 42,50 minutes (Mdn = 42,50)… ».
Une directive méthodologique fondamentale des normes APA impose une règle d’or déontologique : une mesure de tendance centrale ne doit JAMAIS être rapportée de manière isolée sans être formellement couplée à sa mesure de dispersion associée. Rapporter une moyenne sans son indice de variabilité constitue un vice de communication majeur. Les associations obligatoires se déclinent comme suit :
- Toute Moyenne (M) doit être indissociablement accompagnée de son Écart-Type (SD pour Standard Deviation, ou ET en français). Exemple APA : (M = 104,20, SD = 12,45). Il est hautement recommandé d’y adjoindre l’intervalle de confiance à 95 % (IC 95 %).
- Toute Médiane (Mdn) doit obligatoirement être couplée à l’Écart Interquartile (IQR pour Interquartile Range, ou EIQ en français) ou aux limites des premier et troisième quartiles [Q1, Q3]. Exemple APA : (Mdn = 11,00 semaines, IQR = 7,00) ou (Mdn = 11,00 [Q1 = 8,00, Q3 = 15,00]).
12.2 Présentation tabulaire et graphique des mesures de tendance centrale
Au-delà de l’insertion textuelle, la restitution des mesures de position au sein des publications savantes s’appuie massivement sur des artefacts visuels normés : les tableaux de synthèse et les représentations graphiques.
Pour la présentation tabulaire, les normes APA prescrivent une mise en page d’une sobriété exemplaire : interdiction absolue de filets verticaux, usage exclusif de trois lignes horizontales principales (sous le titre de tableau, sous l’en-tête de colonnes et sous la rangée finale de données). Les colonnes regroupant les moyennes et écarts-types doivent être clairement libellées M et SD, alignées de façon constante sur les séparateurs décimaux pour faciliter la comparaison visuelle instantanée entre cohortes.
Sur le versant de la visualisation graphique, un glissement paradigmatique majeur a été opéré ces dernières décennies pour bannir les représentations opaques ou frauduleuses :
- Les diagrammes en boîte à moustaches (boxplots de Tukey) : Il s’agit du format graphique d’excellence pour valoriser la médiane. La barre intérieure de la boîte figure la médiane exacte, les bords de la boîte matérialisent l’écart interquartile (Q1 et Q3), tandis que les moustaches et les points isolés révèlent la dispersion globale et identifient visuellement chaque observation aberrante sans fard.
- Les diagrammes à barres d’erreur pour les moyennes : Si l’on choisit d’illustrer des moyennes arithmétiques par des histogrammes ou des points reliés, il est impératif d’intégrer des barres d’erreur verticales symétriques. L’auteur doit expliciter sans équivoque dans la légende du graphique si ces barres représentent l’écart-type (±1 SD), l’erreur-type de la moyenne (±1 SEM) ou l’intervalle de confiance à 95 % (IC 95 %), ce dernier étant le format universellement privilégié en inférence visuelle.
- L’interdiction des barres dites « dynamites » (dynamite plots) : Les revues académiques de premier rang proscrivent désormais catégoriquement les diagrammes en bâtons pleins représentant une moyenne surmontée d’une seule demi-barre d’écart-type. Ces graphiques gaspillent une surface d’encre massive sans transmettre la moindre information sur la morphologie réelle de la distribution sous-jacente, masquant pernicieusement d’éventuelles bimodalités ou asymétries criantes.
12.3 Synthèse critique et bonnes pratiques pour l’interprétation des données
L’acte final du chercheur consiste à interpréter avec discernement et humilité épistémologique les valeurs obtenues, en évitant les écueils interprétatifs classiques qui pullulent dans la vulgarisation profane et les mémoires débutants.
Le premier piège intellectuel est l’erreur écologique ou sophisme de surgénéralisation : attribuer mécaniquement à un individu singulier les propriétés mathématiques de la tendance centrale de son groupe d’appartenance. Affirmer qu’un patient donné issu d’une cohorte caractérisée par une latence médiane de rémission de 6 semaines guérira nécessairement en 6 semaines constitue une faute clinique majeure. Une mesure de tendance centrale est une propriété agrégée d’un collectif d’observations, et non un déterminisme prédictif individuel intangible.
Le second impératif concerne la contextualisation socioculturelle et méthodologique des normes. Une valeur centrale observée n’a de validité écologique que dans les limites du contexte expérimental et de la population cible au sein de laquelle elle a été extraite. Transposer la moyenne d’un test psychométrique standardisé sur des étudiants d’Amérique du Nord à une cohorte de personnes âgées en Afrique subsaharienne est dénué de pertinence scientifique.
Avant de soumettre tout manuscrit ou rapport d’évaluation pour diffusion scientifique, le chercheur avisé s’astreindra à vérifier scrupuleusement la présente check-list d’intégrité descriptive :
- La métrique de la variable (nominale, ordinale, continue) autorise-t-elle sans équivoque la mesure de tendance centrale sélectionnée ?
- La morphologie distributionnelle a-t-elle été explorée visuellement (histogramme, densité) et statistiquement (tests de normalité de Shapiro-Wilk, skewness) pour dépister une asymétrie ou une bimodalité éventuelle ?
- Les valeurs aberrantes potentielles ont-elles été systématiquement documentées, vérifiées et traitées selon un protocole rigoureux ?
- La mesure de tendance centrale (M ou Mdn) est-elle systématiquement et indissociablement couplée à sa mesure de variabilité correspondante (SD ou IQR) dans le texte et les tableaux ?
- En présence d’une asymétrie manifeste, la médiane a-t-elle été privilégiée ou rapportée parallèlement à la moyenne pour garantir une totale transparence épistémologique ?
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Gauss, C. F. (1809). Theoria motus corporum coelestium in sectionibus conicis solem ambientium. F. Perthes et I. H. Besser.
- Howell, D. C. (2016). Fundamental statistics for the behavioral sciences (9th ed.). Cengage Learning.
- Miller, G. A. (1956). The magical number seven, plus or minus two: Some limits on our capacity for processing information. Psychological Review, 63(2), 81–97. https://doi.org/10.1037/h0043158
- Pearson, K. (1895). Contributions to the mathematical theory of evolution. II. Skew variation in homogeneous material. Philosophical Transactions of the Royal Society of London. A, 186, 343–414. https://doi.org/10.1098/rsta.1895.0010
- Spielberger, C. D., Gorsuch, R. L., Lushene, R., Vagg, P. R., & Jacobs, G. A. (1983). Manual for the State-Trait Anxiety Inventory. Consulting Psychologists Press.
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press. https://doi.org/10.1016/C2015-0-02220-4