
Dans le paysage contemporain de la science des données, de la biométrie et de la recherche en psychologie quantitative, l’analyse des données constitue le socle méthodologique à partir duquel s’élaborent les théories et se valident les modèles empiriques. Face à l’accroissement exponentiel des volumes de données et à la sophistication des algorithmes d’apprentissage automatique, la tentation est souvent grande de recourir immédiatement à des modélisations multivariées complexes, occultant ainsi les caractéristiques intrinsèques des données recueillies. Pourtant, toute démarche scientifique rigoureuse impose de débuter par un examen scrupuleux, élémentaire et méthodique de chaque grandeur observée prise isolément. C’est précisément l’objet de l’analyse univariée, véritable pivot de la statistique descriptive et exploratoire.
L’analyse univariée se consacre à l’étude approfondie d’une seule et unique variable à la fois. Loin de constituer un simple exercice préliminaire ou une étape mécanique de formalisme académique, elle représente le premier acte d’intelligibilité du réel mesuré. En faisant abstraction temporaire des interactions, des corrélations croisées et des causalités complexes qui unissent les différents phénomènes observés, le chercheur s’attache à comprendre l’anatomie propre d’un vecteur de données : sa tendance dominante, sa dispersion, son degré d’asymétrie, ainsi que la présence éventuelle de valeurs singulières ou aberrantes. Sans cette radiographie inaugurale, les inférences ultérieures reposent sur des bases fragiles, susceptibles d’induire des biais statistiques sévères ou des erreurs d’interprétation clinique préjudiciables.
Le présent article propose une exploration exhaustive des fondements, des instruments mathématiques, des représentations graphiques et des applications pratiques de l’analyse univariée. De la typologie des échelles de mesure théorisée par Stanley Smith Stevens jusqu’aux tests d’adéquation inférentiels, en passant par une étude de cas détaillée consacrée à l’évaluation psychométrique de l’anxiété, ce guide se veut une référence méthodologique complète pour les chercheurs, les statisticiens et les étudiants désireux de maîtriser l’art d’analyser rigoureusement une variable dans toute sa singularité.
1. Fondements conceptuels et définition de l’analyse univariée
1.1 Étymologie et principe fondamental
L’étymologie du terme « univarié » éclaire directement sa portée épistémologique et opératoire. Composé du préfixe d’origine latine uni- (dérivé de unus, signifiant « un seul ») et du substantif « variable » (du latin variabilis, qui renvoie à ce qui est susceptible de changer, de se modifier ou de prendre différentes valeurs), le concept désigne rigoureusement l’analyse statistique conduite sur une entité empirique isolée. Dans ce cadre, le chercheur neutralise délibérément toute mise en relation avec d’autres dimensions mesurées. L’objet d’étude n’est pas d’examiner comment une grandeur fluctue en réponse aux variations d’une autre, mais de documenter de manière exhaustive l’éventail des valeurs observées au sein d’une population ou d’un échantillon donné.
L’objectif primaire de l’analyse univariée réside dans l’exploration, la synthèse et la caractérisation de la distribution d’une variable unique. Elle vise à répondre à des interrogations fondamentales : quelles sont les valeurs observables ? Avec quelle fréquence chacune d’entre elles se manifeste-t-elle ? Existe-t-il une valeur typique ou un centre de gravité autour duquel s’agrègent les données ? Les observations sont-elles homogènes ou s’éparpillent-elles largement sur l’étendue des possibles ? Cette démarche descriptive exclut par définition toute visée explicative directe ou toute inférence de causalité. En effet, postuler un lien de cause à effet requiert au minimum d’évaluer la covariation de deux phénomènes distincts, ce qui outrepasse les prérogatives du paradigme univarié.
D’un point de vue épistémologique, il convient d’opérer une distinction nette entre la description pure et la modélisation explicative. La première, incarnée par l’analyse univariée, s’efforce de restituer le réel empirique avec la plus grande fidélité possible, en condensant l’information brute sans en dénaturer la structure sous-jacente. La seconde ambitionne d’articuler des hypothèses prédictives et d’élucider des mécanismes générateurs. Confondre ces deux étapes revient à fragiliser l’édifice scientifique : une variable dont la distribution univariée est mal comprise ou mal résumée faussera inévitablement les tentatives subséquentes de modélisation causale ou relationnelle.
1.2 La distinction méthodologique : univarié, bivarié et multivarié
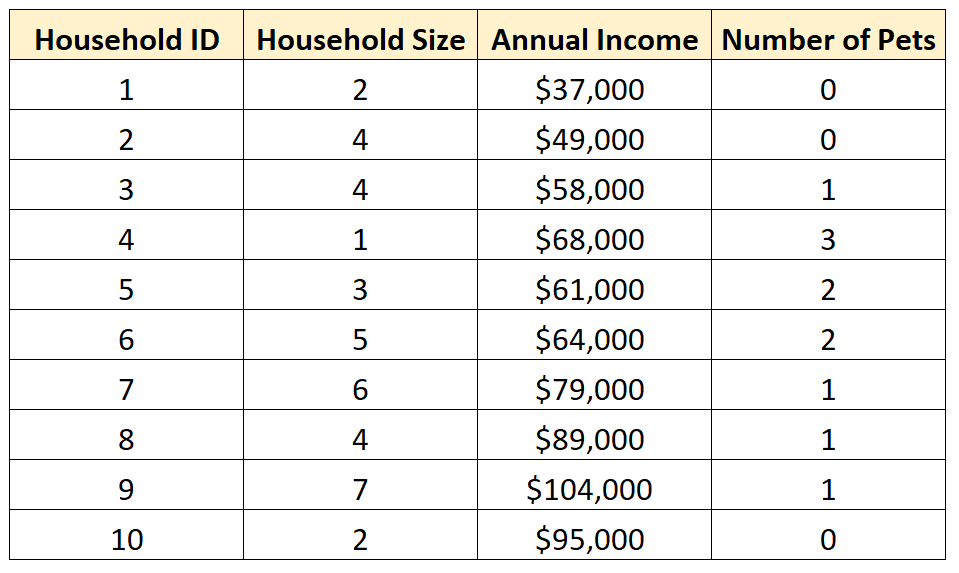
Pour appréhender pleinement le statut de l’analyse univariée, il est indispensable de la situer dans la taxonomie générale des approches statistiques, laquelle s’organise selon le nombre de variables considérées simultanément. Lorsque le chercheur franchit le seuil de l’unité pour examiner conjointement deux variables, il s’engage dans l’analyse bivariée. Cette dernière a pour objet l’investigation empirique de la relation, de l’association ou de la dépendance réciproque unissant deux grandeurs. C’est le domaine privilégié du calcul des coefficients de corrélation de Pearson ou de Spearman, des tableaux de contingence croisés par le test du Khi-carré d’indépendance, ou encore de la régression linéaire simple, dans laquelle une variable prédictive tente d’expliquer les variations d’une variable réponse.
L’analyse multivariée, quant à elle, opère un saut de complexité méthodologique en traitant concomitamment trois variables ou davantage. Ce champ d’analyse englobe des techniques sophistiquées telles que la régression multiple, l’analyse de variance factorielle (ANOVA multivariée ou MANOVA), l’analyse en composantes principales (ACP), ou encore la modélisation par équations structurelles. L’objectif consiste ici à isoler les contributions respectives de multiples facteurs indépendants, à contrôler les variables de confusion (ou variables parasites) et à démêler les effets d’interaction systémiques qui caractérisent les phénomènes écologiques, sociaux et psychologiques complexes.
Il existe une stricte hiérarchie de traitement des données dans la pratique de la recherche scientifique. L’analyse univariée constitue le premier niveau incontournable de cette séquence analytique. L’accès aux niveaux bivarié puis multivarié ne peut se concevoir de façon valide sans une exploration univariée préalable minutieuse. Vouloir estimer un coefficient de corrélation linéaire bivarié sans avoir vérifié au préalable l’univariance de chaque distribution (notamment la présence de points d’inflexion, de bimodalité ou de valeurs aberrantes) expose le chercheur à des artefacts méthodologiques majeurs susceptibles de vicier l’ensemble de ses conclusions scientifiques.
1.3 Rôle épistémologique dans la recherche scientifique et psychologique
Dans l’arsenal méthodologique des sciences empiriques, et singulièrement au sein de la psychologie et des sciences comportementales, l’analyse univariée remplit une fonction épistémologique de salubrité des données. Dès lors qu’une campagne de recueil de données s’achève — qu’il s’agisse de questionnaires psychométriques auto-rapportés, de mesures chronométriques de temps de réaction ou d’enregistrements physiologiques —, la base de données brute recèle inévitablement des imperfections. L’examen univarié constitue le crible à travers lequel chaque vecteur d’observations est passé au peigne fin afin de valider son intégrité avant tout traitement complexe.
Ce nettoyage préliminaire permet d’identifier avec célérité les anomalies de saisie, les incohérences métriques (par exemple, un participant âgé de 250 ans ou un score d’inventaire clinique excédant la borne maximale théorique) et les biais d’échantillonnage initiaux. Dans les protocoles en psychométrie, l’analyse univariée documente immédiatement le phénomène de restriction de variance ou l’existence d’effets de plancher (une concentration anormale de réponses sur la modalité la plus faible de l’instrument) et d’effets de plafond (une accumulation des observations sur la valeur maximale). De telles configurations univariées limitent drastiquement la sensibilité des mesures et compromettent d’emblée la pertinence d’analyses différentielles ultérieures.
Enfin, l’analyse univariée représente l’étape d’audit incontournable pour contrôler les postulats mathématiques prérequis (souvent désignés sous le terme d’assumptions statistiques) indispensables à la légitimité des tests paramétriques. La majorité des modèles inférentiels classiques, tels que le test t de Student ou les modèles linéaires généraux, reposent sur l’hypothèse explicite d’une distribution normale des résidus ou des scores sous-jacents. L’investigation univariée de la forme des distributions conditionne ainsi le choix entre des modélisations paramétriques robustes ou l’adoption de stratégies non paramétriques alternatives, garantissant ainsi l’intégrité déontologique et scientifique des résultats publiés.
2. Typologie des variables applicables à l’analyse univariée
2.1 Variables qualitatives nominales et ordinales
La nature mathématique de la variable soumise à une analyse univariée dicte impérativement le champ des opérations statistiques admissibles. Les variables qualitatives (ou catégorielles) se définissent par le fait que leurs valeurs correspondent à des catégories mutuellement exclusives, des modalités qualitatives qui ne résultent pas intrinsèquement d’une opération de mesure métrique. Au sein de cette catégorie générale, la sous-classe des variables nominales rassemble des attributs pour lesquels il n’existe aucune relation d’ordre, de préséance logique ou de hiérarchie naturelle entre les modalités. Le genre biologique, le statut diagnostique (par exemple : trouble anxieux généralisé, dépression caractérisée, état de stress post-traumatique, groupe contrôle) ou l’orientation professionnelle relèvent typiquement de cette modalité nominale.
À l’opposé, les variables ordinales introduisent une propriété relationnelle supplémentaire : leurs différentes modalités peuvent être rigoureusement hiérarchisées ou classées selon un ordre croissant ou décroissant. Les exemples canoniques abondent dans le domaine de la psychologie et des sciences sociales, en particulier avec les échelles de type Likert (allant de « pas du tout d’accord » à « tout à fait d’accord ») ou les stades de gravité clinique d’une pathologie (léger, modéré, sévère). Dans une variable ordinale, on sait avec certitude que la modalité B représente un degré plus élevé de l’attribut mesuré que la modalité A.
Cependant, l’analyse univariée des données ordinales se heurte à des limites mathématiques formelles : l’espace séparant deux catégories contiguës n’est pas quantifiable et rien ne garantit son invariance le long de l’échelle. On ne peut postuler que l’écart psychologique entre « pas du tout d’accord » et « modérément d’accord » soit strictement équivalent à l’écart entre « d’accord » et « totalement d’accord ». Cette absence d’intervalle constant interdit formellement l’utilisation directe de métriques arithmétiques standards comme l’addition et la soustraction pures sur les codes numériques arbitraires assignés aux modalités.
2.2 Variables quantitatives discrètes et continues
Les variables quantitatives se caractérisent par le fait que leurs modalités sont des nombres réels représentant des quantités effectives, sur lesquelles l’ensemble des opérations arithmétiques conventionnelles revêt un sens direct et univoque. Ces variables se subdivisent rigoureusement en deux catégories fonctionnelles : les variables discrètes et les variables continues. Une variable quantitative est qualifiée de discrète lorsque son ensemble de valeurs admissibles est constitué d’entiers dénombrables, sans valeurs intermédiaires possibles. Elle résulte généralement d’une opération de comptage ou de dénombrement d’événements finis.
Dans la pratique de la recherche psychiatrique ou cognitive, le nombre d’épisodes dépressifs majeurs documentés au cours de l’existence d’un individu, le nombre de tentatives de sevrage réussies ou la quantité d’erreurs commises lors d’une épreuve informatisée de flexibilité mentale constituent des variables quantitatives discrètes. On ne saurait observer 2,43 épisodes cliniques ou dénombrer 1,5 erreur : l’espace mathématique de ces variables est un sous-ensemble des entiers naturels, ce qui nécessite des modélisations univariées spécifiques, souvent adossées à des distributions théoriques de Poisson ou binomiales.
Inversement, une variable quantitative continue peut théoriquement prendre une infinité de valeurs réelles au sein d’un intervalle défini. La finesse des données recueillies n’est limitée que par la précision instrumentale de l’appareil de mesure. Les grandeurs biométriques telles que le temps de réaction mesuré en millisecondes, la concentration sanguine de cortisol salivaire en nanomoles par litre, ou l’activité électrodermale relèvent de ce continuum infini. Ce caractère continu conditionne profondément le traitement statistique univarié : la probabilité exacte d’observer ponctuellement une valeur spécifique infiniment précise devient mathématiquement nulle, imposant ainsi le recours à des densités de probabilités et à des regroupements d’intervalles pour caractériser la distribution descriptive.
2.3 Les échelles de mesure de Stevens et leur impact analytique
L’harmonisation épistémologique du traitement des variables a trouvé son cadre de référence formel dans la taxonomie quadripartite formulée en 1946 par le psychologue et psychophysicien américain Stanley Smith Stevens. Dans son article séminal publié dans la revue Science, Stevens a classé l’ensemble des grandeurs observables en quatre échelles de mesure fondamentales : nominale, ordinale, d’intervalle et de rapport (ou de ratio). Cette hiérarchie cumulative détermine rigoureusement les transformations mathématiques et les opérations statistiques invariantes permises pour chaque catégorie de données.
Une échelle d’intervalle possède toutes les propriétés d’une échelle ordinale, auxquelles s’ajoute l’égalité avérée de la distance numérique entre deux graduations successives de l’échelle : l’intervalle unitaire y est métriquement constant. Cependant, l’échelle d’intervalle se distingue par l’arbitraire complet de son point zéro, qui ne signale nullement l’absence absolue de la dimension mesurée. La température mesurée en degrés Celsius ou les scores standardisés d’efficience intellectuelle (QI conventionnel) illustrent cette modalité : un quotient intellectuel de 0 ne traduit pas un néant cognitif absolu, et l’on ne saurait affirmer qu’un score de 140 correspond au « double » des capacités intellectuelles associées à un score de 70.
Enfin, l’échelle de rapport présente la propriété suprême d’intégrer un zéro absolu, non arbitraire, qui correspond à l’extinction totale du phénomène mesuré (la masse corporelle en kilogrammes, la durée en secondes ou la distance en mètres). L’impact de cette taxonomie sur l’analyse univariée est absolu. L’une des erreurs méthodologiques les plus ubiquitaires dans la littérature académique consiste à attribuer de force des indicateurs propres aux échelles d’intervalle ou de rapport (tels que la moyenne arithmétique ou l’écart-type) à des variables strictement ordinales. Cette dérive épistémologique peut générer des conclusions fallacieuses en manipulant des distances numériques dénuées de réalité empirique tangible.
3. Les mesures de tendance centrale en analyse univariée
3.1 La moyenne arithmétique : calcul, interprétation et sensibilité
Dans l’arsenal univarié consacré aux variables quantitatives, la moyenne arithmétique constitue incontestablement l’indicateur le plus familier et le plus universellement sollicité pour synthétiser un jeu de données. D’un point de vue mathématique, la moyenne de l’échantillon, universellement notée x̄, représente le centre de gravité physique ou le barycentre de la distribution des observations empiriques. Elle se formalise rigoureusement par le quotient de la somme arithmétique de toutes les valeurs individuelles recueillies (x₁) par la taille globale de l’échantillon analysé (n) :
x̄ = (1 / n) * Σ xᵢ (pour i variant de 1 à n)
L’intérêt de la moyenne arithmétique réside dans sa capacité à intégrer de manière pondérée et exhaustive l’ensemble de l’information numérique disponible : chaque observation singulière participe activement à la détermination finale du paramètre. Elle possède des propriétés mathématiques élégantes indispensables à la théorie statistique fréquentiste, se prêtant commodément aux calculs d’algèbre linéaire et facilitant l’estimation de paramètres populationnels inconnus.
Toutefois, cette caractéristique constituante constitue simultanément son talon d’Achille méthodologique majeur. La moyenne arithmétique fait preuve d’une sensibilité extrême aux valeurs aberrantes (ou outliers) ainsi qu’aux asymétries de distribution. La présence d’une seule valeur outrancièrement élevée dans un échantillon de taille modérée a pour effet mécanique de tracter brutalement le barycentre vers le haut du continuum de mesure, donnant une image erronée de la réalité sous-jacente. Pour cette raison, l’usage de la moyenne arithmétique doit être strictement réservé aux variables mesurées sur des échelles d’intervalle ou de rapport dont la distribution présente une allure symétrique et unimodale non dégradée.
3.2 La médiane : robustesse et point d’équilibre ordinal
Confronté à des distributions asymétriques ou parasitées par des observations singulières, le statisticien privilégie la médiane comme mesure de tendance centrale. Par définition, la médiane (couramment abrégée Med ou Md) correspond au cinquantième percentile de la série statistique. Il s’agit de la valeur seuil qui sépare l’ensemble ordonné des observations en deux effectifs strictement équivalents : 50 % des individus de l’échantillon présentent une valeur inférieure ou égale à la médiane, et 50 % des individus exhibent une valeur supérieure ou égale à cette démarcation.
Le calcul de la médiane implique impérativement d’ordonner au préalable l’ensemble des données numériques de manière croissante. Si la taille de l’échantillon n est un nombre impair, la médiane correspond précisément à la valeur centrale située au rang ordinal (n + 1) / 2. Si le nombre d’observations n s’avère pair, il n’existe pas d’élément central unique au sein du vecteur ; la médiane est alors traditionnellement conventionnée comme la moyenne arithmétique des deux valeurs occupant respectivement les rangs centraux n / 2 et (n / 2) + 1.
L’attribut méthodologique cardinal de la médiane réside dans son insensibilité quasi-absolue aux valeurs extrêmes, un phénomène désigné dans la littérature sous le concept de robustesse statistique. Qu’une observation maximale soit égale à 100 ou qu’elle atteigne accidentellement 100 000, la valeur de la médiane demeure inchangée car seul son rang d’apparition dans la distribution ordonnée détermine son calcul. Cette résilience fait de la médiane le paramètre de choix dans les contextes de recherche psychologique et comportementale caractérisés par des distributions empiriques fortement tronquées, telles que les durées de séjour psychiatrique ou les mesures de revenus économiques au sein de cohortes sociales.
3.3 Le mode et les distributions multimodales
Le mode (désigné usuellement par la notation Mo) constitue la mesure de tendance centrale la plus élémentaire sur le plan calculatoire mais l’une des plus riches d’un point de vue sémiologique et typologique. Le mode d’une variable correspond à la modalité, à la valeur discrète ou à la classe d’intervalles qui présente la fréquence d’apparition absolue la plus élevée dans le jeu de données analysé. C’est, par excellence, la mesure correspondant au « cas typique » ou au comportement le plus fréquemment représenté dans le groupe sous examen.
Contrairement à la moyenne arithmétique et à la médiane, le mode présente la caractéristique épistémologique unique d’être universellement calculable sur tous les niveaux d’échelles de Stevens. Il s’agit de la seule et unique mesure de tendance centrale théoriquement recevable et mathématiquement signifiante pour les variables qualitatives de nature purement nominale. Déterminer la catégorie socioprofessionnelle ou le type psychopathologique modal au sein d’un groupe d’étude constitue ainsi la seule synthèse univariée de centrage envisageable.
En outre, l’inspection univariée de la modalité permet d’identifier l’existence de distributions bimodales ou multimodales, caractérisées par la présence de deux ou plusieurs pics de fréquence proéminents au sein du profil des observations. La mise en évidence d’une bimodalité dans un indice psychologique représente un signal d’alerte analytique fondamental : elle suggère presque systématiquement que l’échantillon agrège artificiellement deux sous-populations distinctes régies par des mécanismes générateurs hétérogènes (par exemple, un mélange d’individus sains et de patients cliniques non identifiés). Traiter une distribution bimodale par une moyenne arithmétique unique constitue une hérésie méthodologique, celle-ci s’établissant précisément dans le creux entre les deux sommets, dans une zone où ne réside virtuellement aucun sujet.
4. Les mesures de dispersion et de variabilité
4.1 L’étendue et l’intervalle interquartile (IQR)
Caractériser une distribution empirique par sa seule tendance centrale s’avère profondément incomplet, voire trompeur. Deux échantillons de sujets peuvent afficher une moyenne rigoureusement identique de 50 à un test psychologique tout en présentant des dynamiques structurelles radicalement dissemblables : le premier échantillon peut rassembler des scores ultra-concentrés entre 48 et 52, tandis que le second agrège des scores disparates oscillant entre 0 et 100. Les mesures de dispersion ont pour fonction d’évaluer quantitativement le degré d’étalement, d’éparpillement ou de variabilité des observations individuelles autour du centre de gravité.
La mesure de dispersion la plus basique est l’étendue (ou range en anglais), qui s’obtient par la soustraction de la valeur minimale observée de la valeur maximale relevée dans le jeu de données :
Étendue = Max(x) – Min(x)
Bien que d’une lecture intuitive immédiate, l’étendue présente une vulnérabilité méthodologique critique : elle repose exclusivement sur les deux scores les plus marginaux de l’échantillon, ce qui la rend intégralement dépendante des valeurs aberrantes ou des erreurs accidentelles de saisie.
Pour contourner cet écueil, les statisticiens emploient l’intervalle interquartile (usuellement abrégé IQR pour Interquartile Range). Les quartiles scindent la distribution ordonnée des données en quatre portions numériquement égales, représentant chacune 25 % de l’effectif. L’intervalle interquartile mesure l’écart arithmétique séparant le troisième quartile (Q3, marquant le 75e percentile) du premier quartile (Q1, marquant le 25e percentile) :
IQR = Q3 – Q1
L’IQR synthétise l’amplitude de dispersion au sein de laquelle se concentrent les 50 % d’individus situés au cœur de la distribution, en éliminant méthodiquement l’influence déstabilisatrice des 25 % d’observations les plus basses et des 25 % d’observations les plus hautes. L’association de la médiane et de l’intervalle interquartile forme le binôme d’indicateurs le plus performant pour résumer une variable quantitative de façon robuste lorsque les postulats de normalité ne sont pas honorés.
4.2 La variance et l’écart-type : formalisme et interprétation
Lorsque la distribution d’une variable quantitative d’intervalle ou de rapport est symétrique et qu’aucun score aberrant ne vient compromettre sa structure, la variance et l’écart-type constituent les métriques paramétriques de référence absolue de la dispersion. La variance est issue de la théorie des moindres carrés : elle quantifie la moyenne arithmétique des carrés des écarts de chaque observation individuelle par rapport à la moyenne globale du groupe. L’élévation au carré de ces déviations résout le problème mathématique de l’annulation mutuelle des écarts positifs et négatifs autour du barycentre.
Toutefois, lorsqu’il s’agit d’analyser un échantillon dans l’optique d’estimer sans distorsion la variance inconnue de la population parente, la formule conventionnelle sous-estime systématiquement la vraie dispersion en raison de la perte d’un degré de liberté mobilisé par le calcul de la moyenne. Les statisticiens introduisent alors la célèbre correction de Bessel, en divisant la somme des carrés des écarts non pas par n, mais par (n – 1). La variance échantillonnale sans biais (s²) s’énonce mathématiquement :
s² = (1 / (n – 1)) * Σ (xᵢ – x̄)²
La variance souffre d’un défaut interprétatif majeur : en raison de l’élévation mathématique des écarts à la puissance deux, son résultat s’exprime dans le carré de l’unité de mesure d’origine (par exemple, des « millisecondes au carré » ou des « points au carré »), ce qui prive le chercheur d’une compréhension clinique intuitive. C’est pourquoi on calcule l’écart-type (universellement symbolisé par la lettre s pour l’échantillon ou σ pour la population théorique), qui n’est autre que la racine carrée arithmétique positive de la variance :
s = √[ (1 / (n – 1)) * Σ (xᵢ – x̄)² ]
En ramenant la mesure de dispersion dans l’unité métrique originelle de l’instrument psychométrique ou biologique, l’écart-type offre une lisibilité directe de la variabilité moyenne des scores individuels autour de leur pôle central.
4.3 Le coefficient de variation
Si l’écart-type excelle dans la quantification de la dispersion absolue au sein d’une série de mesures homogènes, il échoue méthodologiquement dès lors qu’il s’agit de comparer la variabilité relative de deux variables exprimées dans des unités hétérogènes, ou de deux échantillons caractérisés par des ordres de grandeur moyens radicalement dissemblables. Pour pallier cette contrainte, le biostatisticien et mathématicien Karl Pearson a formalisé le concept de coefficient de variation (généralement désigné par le sigle CV).
Le coefficient de variation est un indicateur de dispersion relative sans dimension, obtenu en divisant l’écart-type de la distribution par sa moyenne arithmétique. Il est d’usage constant de multiplier le résultat fractionnaire par 100 afin d’exprimer ce ratio sous forme d’un pourcentage de variabilité :
CV = (s / x̄) * 100
Dans la recherche translationnelle et psychométrique, le coefficient de variation s’avère particulièrement utile pour évaluer la stabilité ou la précision comparée de deux instruments d’évaluation clinique. Par exemple, si l’on désire évaluer si la dispersion des temps de réponse motrice (exprimés en centaines de millisecondes) est proportionnellement plus vaste que celle des taux de sécrétion hormonale (exprimés en microgrammes par millilitre), seul le CV neutralise l’effet d’échelle de mesure et permet une comparaison rigoureuse.
Sur le plan interprétatif, un coefficient de variation inférieur à 10 % ou 15 % témoigne d’une remarquable homogénéité intra-groupe, les scores individuels étant intimement agglutinés autour du barycentre. À l’inverse, un CV supérieur à 30 % ou 40 % alerte le clinicien sur une hétérogénéité prononcée des observations, signalant une dispersion substantielle qui exige une investigation minutieuse des sous-profils au sein de la cohorte étudiée. Il convient toutefois de rappeler que le coefficient de variation n’est mathématiquement valide et stable que sur des échelles de rapport dotées d’un zéro absolu et pour des moyennes strictement positives.
5. Caractérisation de la forme d’une distribution univariée
5.1 L’asymétrie (Skewness) : déviation par rapport à la symétrie
L’examen univarié exhaustif d’une variable quantitative ne saurait se borner à synthétiser sa tendance centrale et son niveau de dispersion. La structure géométrique et la morphologie de la distribution fournissent des indications de premier ordre sur la nature du phénomène mesuré. Le premier paramètre de forme statistique est le coefficient d’asymétrie, universellement désigné sous le vocable anglo-saxon de skewness. Ce paramètre correspond au troisième moment centré de la distribution normalisé par l’écart-type à la puissance trois. L’estimateur sans biais le plus répandu en logiciel d’analyse est la formule ajustée de Fisher-Pearson :
G₁ = [ n / ((n – 1)(n – 2)) ] * Σ [ (xᵢ – x̄) / s ]³
Dans une distribution parfaitement symétrique, conforme au modèle gaussien idéalisé, le coefficient de skewness est strictement nul (G₁ = 0). Les observations se répartissent en proportions rigoureusement miroirs de part et d’autre de l’axe central. Lorsque le coefficient présente une valeur positive substantielle (G₁ > 0), la distribution est dite asymétrique positive, ou étalée à droite. Ce cas de figure, omniprésent dans les sciences psychologiques évaluant des pathologies ou des conduites addictives, signifie que la majeure partie des participants accumulent des scores faibles, tandis qu’une longue traîne de valeurs exceptionnellement élevées s’étire vers la droite de l’abscisse.
À l’inverse, un coefficient négatif (G₁ < 0) traduit une asymétrie négative, ou étalement vers la gauche. La présence d’une asymétrie univariée a un impact immédiat sur la hiérarchie spatiale des indicateurs de tendance centrale. En cas d’asymétrie positive prononcée, la moyenne arithmétique est violemment aspirée vers les valeurs hautes par la longue queue de distribution, se positionnant systématiquement au-dessus de la médiane, laquelle surpasse à son tour le mode mathématique (Mode < Médiane < Moyenne). Inversement, dans une distribution asymétrique négative, l’ordre arithmétique s’inverse rigoureusement (Moyenne < Médiane < Mode).
5.2 L’aplatissement (Kurtosis) : concentration des queues de distribution
Le second paramètre morphologique fondamental d’une distribution univariée est l’aplatissement, désigné sous le terme technique de kurtosis. Relié au quatrième moment centré des observations statistiques, le kurtosis quantifie la propension de la distribution à concentrer sa masse de probabilité dans ses queues extrêmes (les franges périphériques) par opposition à ses flancs intermédiaires. Dans la littérature contemporaine et au sein des packages statistiques spécialisés, on manipule quasi-exclusivement l’excès de kurtosis (ou excess kurtosis), formulé de telle sorte que la loi normale standardisée serve de niveau zéro de référence :
G₂ = { [ n(n + 1) ] / [ (n – 1)(n – 2)(n – 3) ] } * Σ [ (xᵢ – x̄) / s ]⁴ – { [ 3(n – 1)² ] / [ (n – 2)(n – 3) ] }
Lorsque le coefficient d’excès de kurtosis est proche de zéro (G₂ ≈ 0), la distribution est qualifiée de mésocurtique, indiquant un comportement d’épaississement de queues parfaitement équivalent à celui de la courbe de Gauss conventionnelle. Si le coefficient adopte une valeur positive tangible (G₂ > 0), la morphologie devient leptocurtique. Une distribution leptocurtique se caractérise visuellement par un sommet pointu et élancé, mais surtout par des queues de distribution épaisses et lourdes (phénomène de fat tails), ce qui indique une probabilité empirique anormalement élevée de voir émerger des observations extrêmes par rapport à ce que prédirait le modèle normal standard.
À l’opposé, une valeur négative marquée (G₂ < 0) signale une structure platycurtique. La distribution se révèle alors écrasée, aplatie, présentant des queues très effilées ou tronquées. Dans les analyses statistiques ultérieures, l’omission du diagnostic du kurtosis peut s’avérer dommageable : des distributions leptocurtiques sous-estimées majorent considérablement le risque d’erreurs de type I (faux positifs) lors de la conduite de tests d’inférence classiques, en faussant l’estimation des erreurs types de mesure.
5.3 Tests formels de normalité univariée
L’appréciation de l’asymétrie et de l’aplatissement débouche naturellement sur l’évaluation globale de la conformité de la distribution univariée au postulat de normalité statistique. Pour étayer cette démarche, les méthodologistes s’appuient sur des tests d’adéquation formels. Le test de Shapiro-Wilk (W) représente aujourd’hui le test d’hypothèse le plus puissant et le plus recommandé pour statuer sur la normalité d’une distribution univariée pour des échantillons de taille faible à modérée (généralement n < 50). Il repose sur l’évaluation mathématique de la corrélation existant entre les quantiles ordonnés des données empiriques et les scores attendus d’une loi normale théorique parfaite.
Un autre test historique largement implanté est le test de Kolmogorov-Smirnov. Ce dernier quantifie la divergence spatiale maximale (notée D) entre la fonction de répartition cumulative observée de l’échantillon et la fonction de répartition cumulative théorique de la loi de référence. Toutefois, le test standard de Kolmogorov-Smirnov postule que les paramètres de moyenne et d’écart-type sont connus a priori au niveau populationnel. Lorsque ces paramètres sont estimés à partir des données de l’échantillon — ce qui constitue le cas presque universel en recherche —, il est impératif d’appliquer la correction de Lilliefors sous peine d’une sous-estimation drastique du risque statistique d’erreur.
Cependant, les statisticiens chevronnés mettent en garde contre une dépendance aveugle à l’égard de ces tests formels univariés. Dans les grands échantillons (n > 200 ou 300), le théorème central limite s’applique, mais les tests de normalité voient leur puissance statistique croître de manière disproportionnée : la moindre déviation cosmétique et sans conséquence pratique par rapport à la courbe de Gauss génère alors une valeur p hautement significative (p < 0,05), conduisant au rejet injustifié de la normalité. Inversement, sur les petits échantillons (n < 20), ils manquent cruellement de puissance pour déceler des déviations majeures. Il est dès lors formellement requis d’adjoindre systématiquement à ces tests une inspection graphique qualitative experte, via l’analyse du diagramme quantile-quantile (Q-Q plot).
6. Les distributions de fréquences et tabulations statistiques
6.1 Fréquences absolues, relatives et pourcentages cumulés
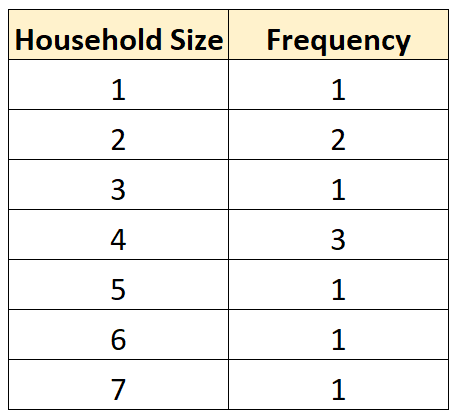
Avant d’extraire des coefficients numériques complexes, la manière la plus intuitive et structurelle de concevoir une variable univariée réside dans l’ordonnancement de ses distributions de fréquences à travers des tabulations statistiques standardisées. Une table de fréquences a pour ambition de dénombrer l’occurrence de chaque modalité qualitative ou valeur quantitative discrète identifiée au sein de l’échantillon. L’effectif brut correspond à la fréquence absolue (notée nᵢ), indiquant le nombre total d’unités statistiques ayant exhibé la catégorie considérée.
Toutefois, la manipulation exclusive des fréquences absolues restreint considérablement les possibilités de comparaison méthodologique entre cohortes d’effectifs inégaux. L’analyste procède dès lors à la normalisation de ces quantités par le calcul des fréquences relatives (ou proportions, notées fᵢ), obtenues en rapportant chaque effectif catégoriel nᵢ à l’effectif global total N :
fᵢ = nᵢ / N
La multiplication de ces proportions par 100 produit les pourcentages simples, instruments privilégiés de la communication scientifique descriptive.
Lorsque la variable analysée possède un niveau de mesure minimalement ordonné (variables ordinales, discrètes ou continues regroupées en classes), la tabulation s’enrichit obligatoirement de la colonne des pourcentages cumulés. Calculés en additionnant séquentiellement les pourcentages des modalités précédentes à celui de la modalité courante, ils permettent d’évaluer immédiatement la proportion de sujets qui se situent sous ou à un niveau donné de l’échelle d’observation. Dans la pratique du diagnostic psychométrique, cette métrique univariée permet de déterminer instantanément les rangs percentiles et d’étalonner les performances individuelles au regard du profil de l’échantillon normatif d’étalonnage.
6.2 Regroupement en classes pour variables quantitatives continues
L’application d’une table de fréquences à une variable quantitative continue ou pseudo-continue (comme un score composite de test psychologique) se heurte à un obstacle d’éparpillement : la quasi-totalité des valeurs individuelles n’apparaissant qu’une ou deux fois, l’énumération brute engendre un tableau infini et totalement inintelligible. La technique de réduction statistique consiste alors à procéder à une discrétisation par regroupement en classes d’intervalles contigus mutuellement exclusifs.
Cette opération heuristique obéit à des règles empiriques formalisées pour éviter aussi bien la sur-simplification (qui oblitère les particularismes de la distribution) que le sur-détail (qui noie l’analyste sous le bruit statistique). Deux formulations dominent la pratique contemporaine. La première, la formule de Herbert Sturges, s’adresse aux distributions présumées approximativement symétriques et calcule le nombre optimal de classes (k) en fonction de la taille globale de l’échantillon N :
k = 1 + 3,322 * log₁₀(N)
Pour les distributions empiriques asymétriques ou suspectées d’abriter des queues épaisses, la règle de David Freedman et Persi Diaconis est nettement préférable. Elle fonde la détermination de la largeur optimale d’intervalle (h) non pas sur la variance, mais sur la robustesse de l’écart interquartile (IQR) :
h = 2 * IQR * N^(-1/3)
Une fois la largeur d’intervalle h ou le nombre de classes k déterminé, l’analyste fixe les frontières inférieures et supérieures de chaque catégorie. Ce partitionnement ordonné préserve l’essence informative des données univariées continues tout en conférant à la distribution une armature analytique claire, préalable indispensable à son illustration graphique par histogramme.
6.3 Tables univariées et traitement des données manquantes
Une distribution univariée en milieu expérimental ou clinique réel est rarement exhaustive : elle est continuellement confrontée à la problématique des données non renseignées, universellement qualifiées de valeurs manquantes (ou missing data). Qu’un participant ait refusé de répondre à un item hautement invasif, qu’une panne technique ait interrompu la captation d’un signal biologique ou qu’un patient ait abandonné prématurément le suivi (phénomène d’attrition), l’analyse univariée doit documenter avec une absolue transparence la proportion et la nature de ces absences.
La structuration déontologique d’une table univariée exige dès lors de ventiler explicitement les pourcentages dits « totaux » (calculés sur l’ensemble complet de l’échantillon recruté, incluant les défaillances de mesure) et les pourcentages dits « valides » (recalculés exclusivement sur le sous-ensemble effectif des sujets ayant produit une réponse exploitable). Omettre de formaliser cette distinction peut biaiser la lecture : un score pathologique représentant 40 % des données valides mais seulement 20 % de l’échantillon total en raison d’un taux massif de 50 % de non-réponses induit un profil épidémiologique radicalement différent.
De surcroît, l’inspection univariée de la fréquence d’absence variable par variable constitue la base diagnostique pour déterminer le mécanisme sous-jacent de non-réponse selon la célèbre typologie conceptualisée par Donald Rubin : données manquantes complètement aléatoires (MCAR), aléatoires (MAR) ou non aléatoires (MNAR). Si un item univarié présente un taux d’omission anomalement élevé comparativement aux autres questions de la batterie, cela signale généralement une ambiguïté dans sa formulation linguistique ou un rejet conscient de la thématique abordée par les répondants, invitant à une révision psychométrique de l’item.
7. Visualisation graphique des données univariées
7.1 Histogrammes et courbes de densité
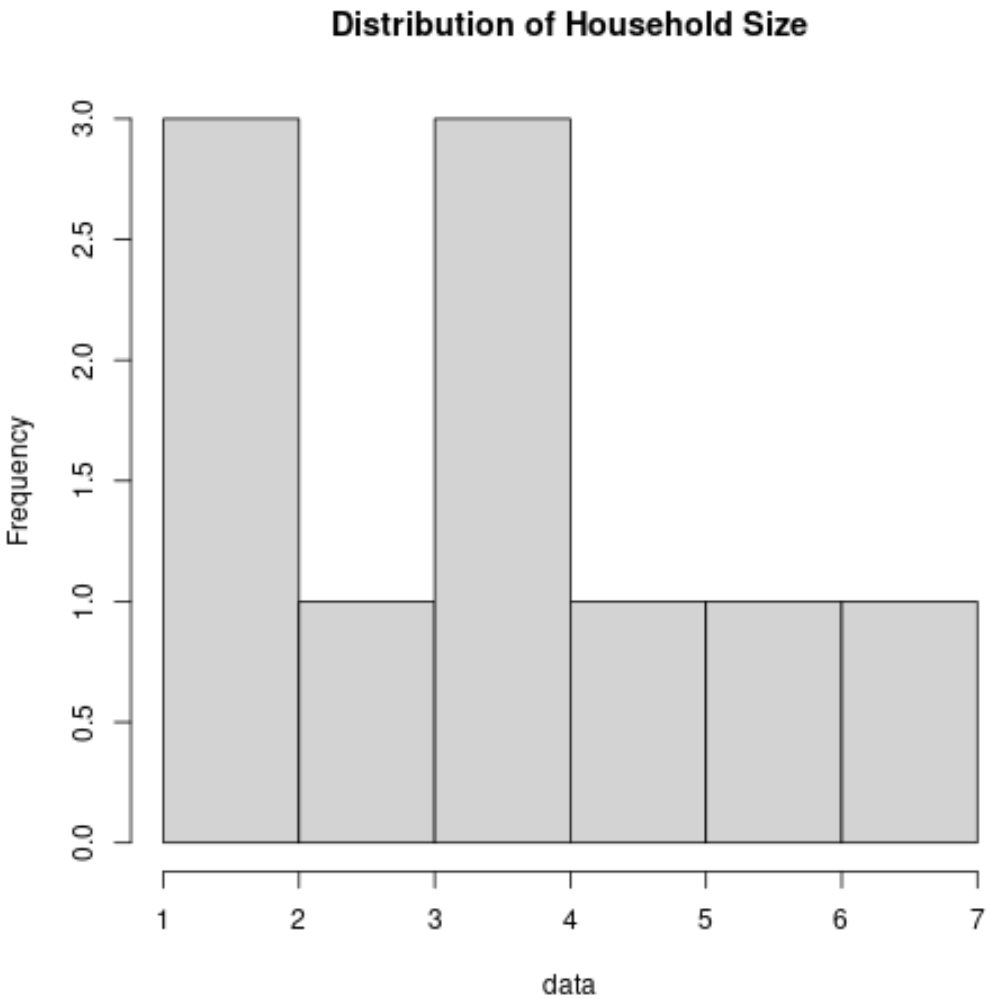
L’esprit humain appréhendant avec une aisance bien supérieure les structures géométriques spatiales par rapport aux tableaux de chiffres abstraits, la représentation graphique univariée constitue le prolongement obligé des calculs tabulaires. Pour les variables quantitatives continues, l’histogramme représente le standard méthodologique séculaire. Structuré dans un repère cartésien, il figure les classes de valeurs sur l’axe des abscisses, tandis que l’axe des ordonnées accueille les fréquences absolues, relatives ou, de façon plus rigoureuse sur le plan formel, la densité de probabilité.
Dans un histogramme de densité scientifiquement irréprochable, ce n’est pas la hauteur intrinsèque de chaque colonne qui traduit l’importance de l’effectif, mais l’aire géométrique totale de chaque rectangle vertical (largeur de classe multipliée par la hauteur). Il est crucial de souligner que l’apparence visuelle d’un histogramme dépend de la largeur retenue pour les intervalles de classes : des barres trop larges gomment l’information structurelle fine (bimodalités masquées), tandis que des barres excessivement étroites génèrent un tracé chaotique dicté par le bruit d’échantillonnage.
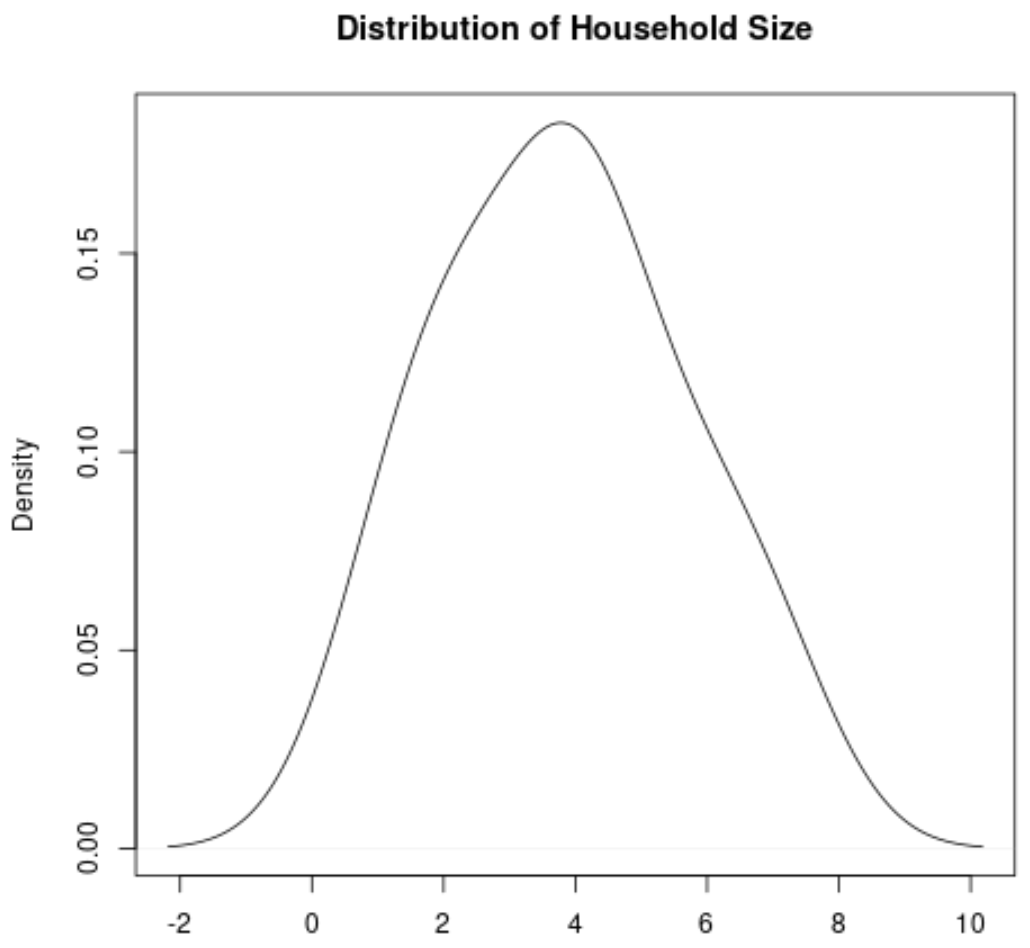
Pour contourner cet écueil de discrétisation arbitraire, la visualisation moderne superpose fréquemment à l’histogramme une courbe d’estimation de densité par noyau (communément désignée par l’acronyme anglophone KDE pour Kernel Density Estimation). La méthode de KDE permet de lisser la distribution univariée sans l’emprisonner dans un découpage discontinu rigide. En associant à chaque point empirique une fonction noyau gaussienne continue dotée d’une fenêtre de lissage optimisée (le paramètre bandwidth), l’algorithme génère une courbe fluide de probabilité. Cette dernière permet au chercheur de repérer instantanément et sans ambiguïté les anomalies morphologiques, les plateaux d’asymétrie ou les dédoublements de pics au sein du vecteur d’observations.
7.2 Diagrammes en boîte à moustaches (Boxplots)
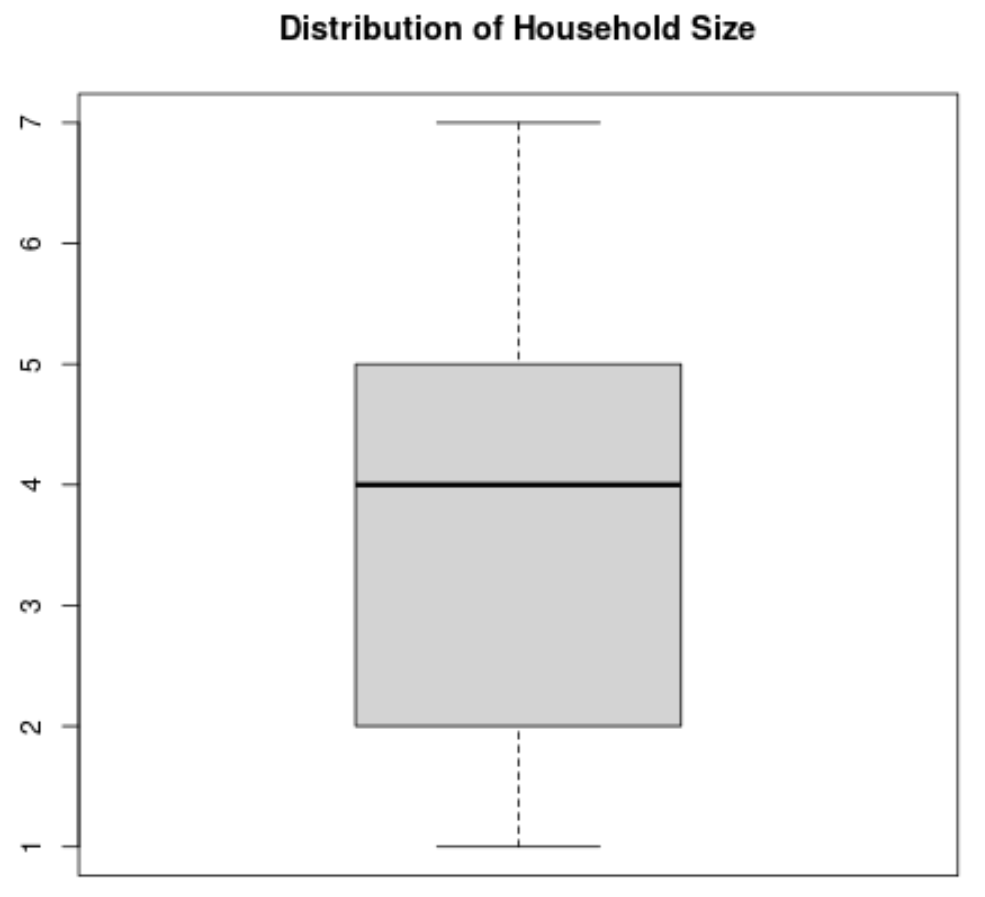
Conçu et popularisé par le statisticien américain John W. Tukey au sein de son ouvrage fondateur sur l’analyse exploratoire des données en 1977, le diagramme en boîte à moustaches (ou boxplot) constitue un modèle graphique d’efficacité descriptive. Le boxplot résume graphiquement l’intégralité d’une distribution univariée à l’aide d’un schéma reposant sur cinq nombres cardinaux : le minimum non atypique, le premier quartile (Q1), la médiane (Q2), le troisième quartile (Q3) et le maximum non atypique.
Le corps central du graphique est matérialisé par un rectangle (la boîte) dont les délimitations inférieure et supérieure correspondent précisément aux quartiles Q1 et Q3. De facto, la hauteur de cette boîte figure graphiquement l’intervalle interquartile (IQR) et matérialise l’espace où sont confinés les 50 % médians de l’échantillon. Une barre horizontale interne vient scinder la boîte pour indiquer l’emplacement de la médiane. Les moustaches supérieure et inférieure s’étirent ensuite depuis les limites de la boîte jusqu’aux valeurs extrêmes observées n’excédant pas des seuils critiques conventionnels (la frontière de Tukey étant usuellement fixée à 1,5 fois l’IQR au-delà des bords de la boîte).
L’apport majeur du diagramme en boîte à moustaches réside dans sa neutralité paramétrique totale : il ne dépend ni de la moyenne arithmétique ni de la variance, ce qui le rend fonctionnel face aux distributions hautement non symétriques. De surcroît, le boxplot fournit une norme visuelle universelle pour la discrimination des valeurs aberrantes : les points empiriques franchissant le périmètre des 1,5 IQR sont automatiquement figurés par des points individuels isolés (valeurs atypiques modérées), tandis que ceux outrepassant la barre des 3 IQR sont codifiés comme des valeurs aberrantes sévères, appelant un examen diagnostique immédiat.
7.3 Diagrammes en barres et graphiques circulaires pour données qualitatives
Lorsque la variable univariée sous examen est de nature qualitative catégorielle (nominale ou ordinale) ou quantitative discrète à faible amplitude, l’histogramme n’est pas applicable, sous peine de suggérer visuellement une continuité métrique artificielle inexistante. Le statisticien a recours dans cette situation au diagramme en barres (ou bar chart). Dans ce format, chaque modalité qualitative fait l’objet d’une colonne distincte, une séparation spatiale physique (un espace vide) venant délibérément disjoindre les différents rectangles pour signifier à l’œil la rupture catégorielle entre les attributs.
Une variante avancée et particulièrement éclairante du diagramme en barres est le diagramme de Pareto. Dans ce tracé univarié, les barres catégorielles sont ordonnancées selon un ordre strictement décroissant de fréquences d’apparition, tandis qu’une courbe cumulée vient se superposer pour indiquer la progression des pourcentages accumulés d’occurrence. Cet agencement graphique permet de vérifier la célèbre loi empirique des 80/20 (le principe de Pareto), identifiant les quelques modalités cruciales qui concentrent à elles seules l’immense majorité des observations empiriques au sein de la cohorte.
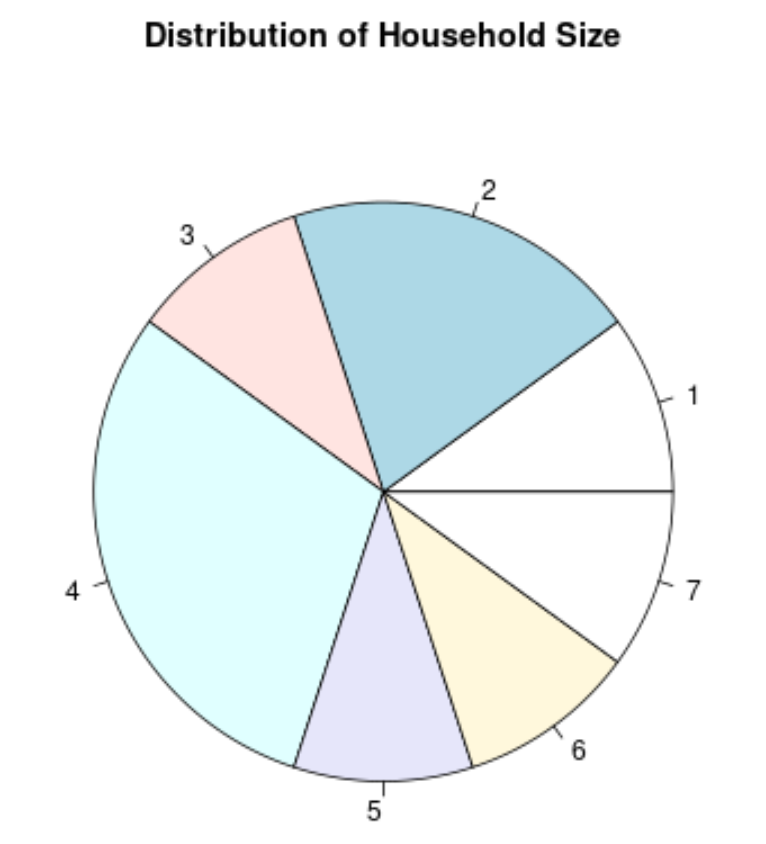
En revanche, la communauté statistique internationale émet des réserves méthodologiques sévères quant à l’usage des diagrammes circulaires (souvent appelés camemberts ou pie charts). Bien que très répandus dans les rapports institutionnels profanes en raison de leur esthétique circulaire, les diagrammes en secteurs s’avèrent scientifiquement médiocres : le système visuel humain rencontre d’importantes difficultés psychophysiques pour discriminer des variations subtiles d’angles géométriques ou de surfaces angulaires, alors qu’il évalue avec une acuité maximale les différences d’alignement de longueurs linéaires sur un axe gradué. Les diagrammes circulaires doivent être proscrits dès lors qu’une variable qualitative possède plus de trois modalités ou que les proportions catégorielles s’avèrent numériquement proches.
8. Exemple empirique détaillé : Analyse univariée d’un score d’anxiété
8.1 Contexte de recherche et description de la cohorte
Pour matérialiser la mise en œuvre concrète d’une analyse univariée dans un protocole de recherche empirique, considérons une étude clinique fictive mais méthodologiquement réaliste, menée au sein d’une unité universitaire de recherche en psychopathologie cognitive. Le protocole s’intéresse à l’évaluation du profil anxieux initial d’un échantillon de convenance rassemblant N = 120 adultes volontaires (âgés de 18 à 55 ans) admis dans un programme pilote d’intervention thérapeutique basée sur la réduction du stress par la pleine conscience (MBSR).
L’instrument métrique retenu pour cette investigation est l’Inventaire d’Anxiété de Beck (Beck Anxiety Inventory – BAI), un auto-questionnaire validé au niveau international, comprenant 21 items évaluant les symptômes subjectifs, somatiques et cognitifs de l’anxiété au cours de la semaine écoulée. Chaque item est évalué sur une échelle ordinale de gravité graduée de 0 (« Pas du tout ») à 3 (« Sévèrement, j’ai eu beaucoup de mal à le supporter »). Le score global univarié agrégé résulte de la sommation simple des 21 items individuels, produisant une variable quantitative discrète dont l’étendue théorique oscille entre un minimum absolu de 0 et un plafond théorique maximal de 63 points.
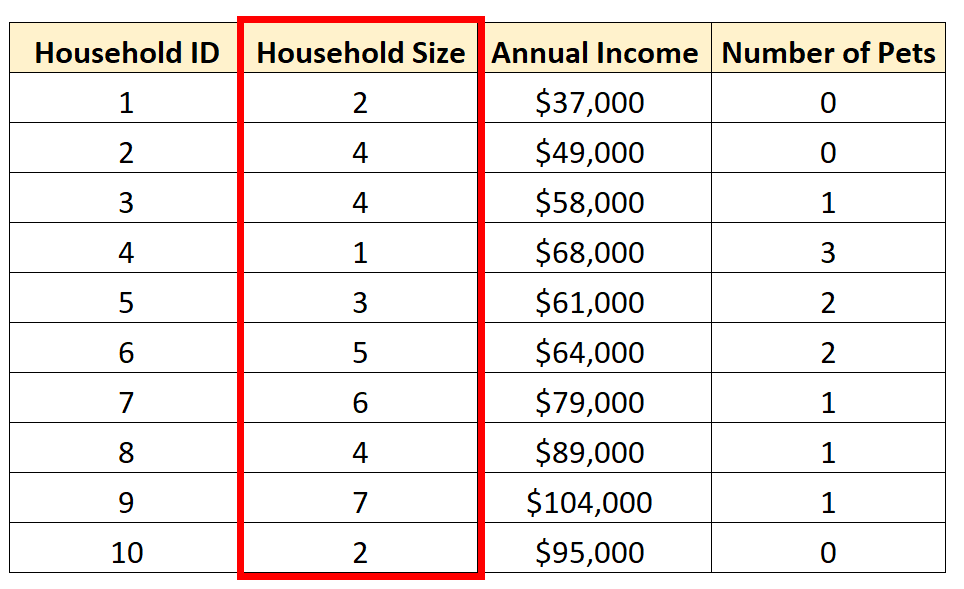
L’objectif exclusif de cette analyse univariée préliminaire est d’examiner scrupuleusement les caractéristiques de ce score composite BAI au sein de la cohorte avant l’instauration de toute intervention thérapeutique. Il s’agit de décrire précisément la sévérité moyenne des manifestations anxieuses, de documenter le degré de variabilité interindividuelle, de contrôler la symétrie de la distribution clinique et de s’assurer de l’absence de valeurs aberrantes susceptibles de fausser les futures évaluations d’efficacité post-thérapeutique.
8.2 Calcul exhaustif des paramètres statistiques univariés
Le traitement statistique automatisé des scores globaux du BAI recueillis auprès des 120 participants a généré une distribution empirique complète, s’étendant d’un score minimum relevé de 3 à un score maximum observé de 47. L’application séquentielle des algorithmes descriptifs produit la série de paramètres univariés récapitulée et analysée ci-après :
- Taille de l’échantillon valide (n) : 120 observations (aucune donnée manquante n’a été recensée dans cette passation supervisée).
- Indicateurs de tendance centrale : La moyenne arithmétique globale s’élève à x̄ = 22,40 points. La médiane s’établit précisément à Med = 21,00 points. Le mode statistique univarié ressort à Mo = 19,00 points (cette valeur exacte ayant été cochée par 14 participants distincts).
- Indicateurs de dispersion et de variabilité : L’étendue brute totale de la série est de 44 points (47 – 3). La variance échantillonnale sans biais est calculée à s² = 96,04, ce qui fournit un écart-type de s = 9,80 points. Le premier quartile s’établit à Q1 = 15,00 et le troisième quartile s’élève à Q3 = 28,00, générant un intervalle interquartile de IQR = 13,00 points. Le coefficient de variation est estimé à CV = (9,80 / 22,40) * 100 = 43,75 %.
- Morphologie et moments de forme : Le coefficient d’asymétrie ajusté de Fisher-Pearson affiche une valeur modérément positive de G₁ = +0,48. L’excès de kurtosis ressort quant à lui à G₂ = -0,22, témoignant d’une allure très légèrement platycurtique mais proche du standard mésocurtique.
La hiérarchie spatiale observée entre les mesures de tendance centrale (Mode = 19,00 < Médiane = 21,00 < Moyenne = 22,40) corrobore rigoureusement la présence d’une asymétrie univariée positive modérée, la moyenne ayant été mécaniquement déportée vers le haut par les scores de quelques patients particulièrement symptomatiques.
8.3 Interprétation clinique et sémiologique des résultats
Sur le plan sémiologique et clinique, ces résultats univariés renseignent précisément sur la constitution de la cohorte recrutée. Si l’on confronte le barycentre de notre distribution (x̄ = 22,40 ; Med = 21,00) aux grilles de classification normatives validées pour l’Inventaire d’Anxiété de Beck — où les scores compris entre 0 et 7 indiquent un niveau d’anxiété minimal, de 8 à 15 une anxiété légère, de 16 à 25 une anxiété modérée, et de 26 à 63 une détresse anxieuse sévère —, notre échantillon s’inscrit typiquement dans la catégorie d’une anxiété modérée.
L’amplitude interquartile (IQR = 13,00) révèle que 50 % des patients de l’étude se situent dans une zone comprise entre 15 et 28 points. Cette concentration démontre que la cohorte est constituée de patients présentant des niveaux anxieux cliniquement perceptibles, évitant un « effet de plancher » qui aurait découlé de l’inclusion massive de participants asymptomatiques. Cependant, le coefficient de variation élevé (CV = 43,75 %) rappelle au médecin et au chercheur l’existence d’une hétérogénéité individuelle substantielle : la symptomatologie anxieuse n’est pas uniforme au sein du groupe, fluctuant d’états légers à des profils frôlant les 47 points.
Enfin, sur le versant de la méthodologie quantitative, le coefficient d’asymétrie (+0,48) et l’excès d’aplatissement (-0,22) s’inscrivent parfaitement à l’intérieur de la fourchette de tolérance conventionnelle [ -1,00 ; +1,00 ]. Le test formel de normalité de Shapiro-Wilk appliqué sur cette série génère une statistique W = 0,978 assortie d’une p-value associée de p = 0,084. La valeur p excédant le seuil alpha conventionnel de 0,05, on ne peut rejeter l’hypothèse nulle de normalité. Les chercheurs peuvent légitimement conclure que la distribution du score BAI dans cette cohorte est suffisamment proche d’une loi gaussienne pour autoriser, ultérieurement, la mise en œuvre de modèles statistiques paramétriques sensibles (comme des tests t de Student appariés ou des modèles d’analyse de variance à mesures répétées).
9. Identification et traitement des valeurs aberrantes univariées
9.1 Méthodes numériques de détection des scores extrêmes
L’intégrité de toute analyse univariée repose sur sa capacité à détecter les valeurs qui s’écartent drastiquement de la structure globale du jeu de données, communément appelées valeurs aberrantes ou outliers. La première méthode numérique formalisée repose sur le calcul des scores centrés réduits, ou Z-scores. Pour chaque observation individuelle, le Z-score exprime la déviation de la valeur xᵢ par rapport à la moyenne du groupe x̄ en unités d’écart-type s :
Zᵢ = (xᵢ – x̄) / s
Dans le cadre d’une distribution approximativement gaussienne, la règle empirique stipule que plus de 99,7 % des données doivent être confinées dans l’intervalle [-3 ; +3]. En conséquence, toute observation présentant un Z-score absolu supérieur à 3,00 (ou parfois 3,29 dans les protocoles conservateurs) est formellement étiquetée comme une valeur extrême univariée nécessitant une inspection manuelle.
Toutefois, la technique du Z-score souffre d’un biais circulaire évident : le calcul de la moyenne arithmétique et de l’écart-type étant lui-même altéré par la présence de la valeur aberrante, celle-ci déforme l’étalon utilisé pour la démasquer. Pour neutraliser cet écueil, les méthodologistes privilégient la règle de l’intervalle interquartile de Tukey, fondée sur des estimateurs robustes. Selon ce critère universel, une valeur est catégorisée comme atypique modérée si elle s’inscrit au-delà des limites suivantes :
Seuil supérieur = Q3 + 1,5 * IQR
Seuil inférieur = Q1 – 1,5 * IQR
Si la valeur dépasse la barre des 3 * IQR au-delà des quartiles extérieurs, elle est requalifiée en valeur aberrante sévère. Cette approche non paramétrique présente l’avantage majeur d’identifier les singularités univariées sans dépendre des postulats restrictifs de normalité.
9.2 Étiologie des valeurs atypiques en psychologie expérimentale
L’identification numérique d’un score extrême univarié ne constitue que le point de départ d’une enquête sémiologique. Le statisticien et le chercheur doivent impérativement déterminer l’étiologie du score atypique, laquelle relève généralement de trois registres causaux distincts. Le premier registre, le plus trivial mais le plus fréquent en pratique, est celui de l’erreur purement technique ou humaine : coquille de saisie manuelle (par exemple, encodage d’un score d’anxiété de 222 au lieu de 22), défaillance logicielle lors de l’enregistrement de l’horodatage expérimental ou bug lors de l’extraction automatisée d’une table SQL.
Le second registre est lié à un problème de validité écologique ou d’adhésion au protocole expérimental de la part du participant. En psychologie cognitive ou sociale, des temps de réaction univariés anormalement compressés (par exemple, des temps de latence de 50 millisecondes sur une tâche d’inhibition) trahissent généralement une stratégie de réponses aléatoires anticipatoires : le sujet a appuyé machinalement sur les touches sans traiter cognitivement les stimuli présentés. De même, des patterns de réponses figés sur des questionnaires d’auto-évaluation révèlent souvent un désengagement motivationnel complet.
Le troisième registre, le plus délicat sur le plan épistémologique, est celui de la variabilité biologique ou clinique authentique. Un participant peut afficher un score de cortisol salivaire ou un niveau de détresse affective extraordinairement élevé sans qu’il n’y ait eu la moindre erreur matérielle ou le moindre désengagement : il s’agit d’un cas clinique exceptionnel, d’une véritable singularité phénotypique. Éliminer d’emblée de tels profils revient à écarter artificiellement les cas les plus informatifs du spectre de recherche, introduisant un biais de représentativité susceptible de fausser les connaissances médicales.
9.3 Options de prise en charge méthodologique
Une fois l’étiologie investiguée, l’analyste dispose d’un éventail d’options méthodologiques régulées pour traiter la variable univariée impactée. Si l’anomalie résulte d’une erreur matérielle avérée et documentée, la rectification immédiate (si la source originelle est disponible) ou l’imputation en donnée manquante s’impose comme une nécessité absolue. En revanche, si la valeur singulière reflète une variabilité authentique de l’échantillon, la suppression arbitraire constitue une faute méthodologique.
La première stratégie alternative consiste à maintenir le score tout en abandonnant la métrique paramétrique standard au profit de statistiques robustes. L’analyse descriptive se focalisera alors rigoureusement sur le binôme médiane – intervalle interquartile, totalement immunisé contre l’influence distorsive du point extrême.
La seconde option réside dans l’élagage statistique contrôlé ou la winsorisation (d’après le statisticien Charles P. Winsor). La winsorisation consiste à ne pas supprimer l’observation atypique, mais à réassigner sa valeur numérique au seuil percentile acceptable le plus proche (par exemple, au 95e percentile de la distribution). Cette manipulation permet de conserver l’ensemble des degrés de liberté de l’échantillon tout en neutralisant l’impact déstabilisateur de la queue de distribution sur le calcul de la moyenne arithmétique.
Enfin, la troisième option classique implique l’application d’une transformation mathématique non linéaire à l’ensemble du vecteur de données. L’application d’une transformation logarithmique, d’une racine carrée ou d’une fonction réciproque permet de comprimer l’échelle métrique des valeurs élevées, d’atténuer drastiquement l’asymétrie univariée positive et de restaurer la normalité morphologique indispensable à la validité des modèles d’inférence ultérieurs.
10. Inférence statistique dans le cadre univarié
10.1 Estimation ponctuelle et intervalles de confiance
Si la vocation primaire de l’analyse univariée est incontestablement descriptive, elle s’étend tout aussi naturellement au domaine de l’inférence statistique. Le chercheur ne se contente pas d’étudier l’échantillon pour lui-même : il aspire à extrapoler les caractéristiques quantitatives observées pour estimer les paramètres inconnus de la population générale parente. C’est l’objet de l’estimation ponctuelle et par intervalle de confiance.
Selon le théorème central limite, quelle que soit la forme morphologique de la distribution d’une variable dans la population d’origine (même fortement asymétrique), la distribution d’échantillonnage de sa moyenne arithmétique converge asymptotiquement vers une loi normale dès lors que la taille de l’échantillon devient suffisamment volumineuse (conventionnellement n ≥ 30). L’incertitude liée à l’échantillonnage est quantifiée par l’erreur standard de la moyenne (couramment notée SEM pour Standard Error of the Mean), qui s’obtient en divisant l’écart-type de l’échantillon par la racine carrée de la taille d’échantillon :
SEM = s / √n
L’estimation ponctuelle de la moyenne (x̄) ne fournissant aucune indication sur la marge d’erreur inhérente aux fluctuations d’échantillonnage, la construction d’un intervalle de confiance à 95 % s’avère indispensable. Cet intervalle définit une zone probabiliste calculée à partir de la distribution univariée de l’échantillon, au sein de laquelle le véritable paramètre moyen de la population a 95 % de chances théoriques de se trouver. Pour une loi de Student à (n – 1) degrés de liberté, la formule s’énonce :
IC₉₅% = [ x̄ – t_{crit} * SEM ; x̄ + t_{crit} * SEM ]
Cette métrique univariée enrichit l’analyse d’une dimension probabiliste, offrant une interprétation plus solide que la simple moyenne ponctuelle.
10.2 Le test t de Student pour échantillon unique
L’inférence statistique univariée permet de tester formellement des hypothèses scientifiques quantitatives à l’aide du test t de Student pour échantillon unique (ou one-sample t-test). Ce test vise à comparer statistiquement la moyenne observée x̄ d’une variable quantitative continue au sein d’un échantillon donné à une valeur théorique de référence, universellement notée μ₀.
Cette valeur de référence μ₀ peut être issue d’un étalonnage normatif standardisé, d’une prédiction théorique issue d’un modèle cognitif préalable ou encore d’une constante de référence (par exemple, comparer si la performance moyenne à une tâche de détection est statistiquement différente du niveau de chance fixé à 50 %). Le ratio empirique t se formalise par la déviation de la moyenne observée par rapport à la constante théorique, normalisée par l’erreur standard d’échantillonnage :
t = (x̄ – μ₀) / (s / √n)
La valeur t obtenue est ensuite confrontée aux valeurs critiques de la table de Student au seuil de signification bilatéral alpha retenu (habituellement α = 0,05) pour les (n – 1) degrés de liberté disponibles. La validité de ce test univarié dépend de deux postulats fondamentaux : l’indépendance stricte des observations et la normalité de la distribution de la variable au sein de la population. En cas d’écart significatif à la normalité sur de petits échantillons, les méthodologistes privilégient l’alternative non paramétrique univariée, incarnée par le test des rangs signés de Wilcoxon pour échantillon unique.
De plus, l’analyse inférentielle moderne exige de compléter impérativement la valeur p par le calcul d’une taille d’effet standardisée, immunisée contre la taille d’échantillon : le d de Cohen univarié, exprimant la distance entre la moyenne empirique et la norme en fractions d’écart-type :
d = (x̄ – μ₀) / s
10.3 Le test d’adéquation du Khi-carré pour variable catégorielle unique
Lorsque la variable univariée soumise à l’inférence est de nature qualitative catégorielle (nominale ou ordinale), le test t de Student devient mathématiquement inapplicable. Le paradigme inférentiel adéquat est alors le test d’adéquation du Khi-carré (ou Goodness-of-Fit Chi-Square Test), théorisé par Karl Pearson. Ce test vise à déterminer si la répartition empirique des fréquences observées dans les k modalités de la variable catégorielle est statistiquement conforme à une grille de distribution théorique ou attendue sous l’hypothèse nulle (H₀).
L’application la plus fréquente en méthodologie de recherche consiste à vérifier l’adéquation d’un échantillon aux proportions socio-démographiques connues de la population générale (par exemple, tester si la répartition du niveau d’études ou du statut socio-économique dans une cohorte est représentative du recensement national), ou à évaluer l’équiprobabilité des choix dans une tâche de préférence comportementale forcée à plusieurs options. La statistique de test s’obtient en sommant pour chaque catégorie k l’écart quadratique entre les effectifs empiriquement observés (Oᵢ) et les effectifs théoriquement attendus (Eᵢ), normalisé par l’effectif attendu :
χ² = Σ [ (Oᵢ – Eᵢ)² / Eᵢ ]
Cette statistique empirique suit asymptotiquement une loi du Khi-carré à (k – 1) degrés de liberté. Pour que le test conserve une puissance et une précision statistique valide, l’analyse univariée doit impérativement honorer les conditions de validité édictées par William Cochran : l’effectif total de l’échantillon doit être suffisant, et aucun effectif théorique attendu (Eᵢ) ne doit être strictement inférieur à 1, au moins 80 % des cellules devant exhiber un effectif théorique supérieur ou égal à 5. Si ces postulats univariés sont enfreints, le statisticien devra agréger logiquement certaines classes contiguës ou recourir au test multinomial exact.
11. Mise en œuvre logicielle de l’analyse univariée
11.1 Programmation statistique sous R
L’écosystème open source R s’est imposé comme l’une des plateformes de référence pour l’analyse computationnelle des données statistiques. L’environnement R de base (base R) fournit nativement les fonctions pour réaliser une exploration univariée exhaustive. L’instruction élémentaire summary(donnees$variable) génère instantanément les cinq nombres cardinaux de Tukey accompagnés de la moyenne arithmétique. Les fonctions vectorielles mean(), sd(), median() et IQR() permettent des extractions ciblées en spécifiant l’argument déontologique na.rm = TRUE pour gérer les valeurs manquantes.
Pour l’exploration de packages dédiés à la psychométrie et à la recherche académique, le package psych propose la fonction avancée describe(), qui automatise l’édition d’une table descriptive complète incluant systématiquement la taille d’échantillon valide, la moyenne arithmétique, l’écart-type, la médiane, la moyenne tronquée (trimmed mean), l’écart absolu médian (MAD), les valeurs extrêmes minimales et maximales, l’étendue brute, le coefficient d’asymétrie (skewness), l’excès de kurtosis, ainsi que l’erreur standard de la moyenne (SEM).
Sur le plan de l’expression graphique, la bibliothèque ggplot2 offre les fonctionnalités nécessaires pour construire des visualisations de niveau publication. Les géométries univariées geom_histogram(), geom_density() et geom_boxplot() s’articulent pour composer des figures informatives. Les chercheurs peuvent ainsi superposer un histogramme à l’échelle de densité, une estimation de noyau KDE et un tapis d’observations individuelles (rug plot) via geom_rug(), visualisant la totalité de l’information empirique sous-jacente sans occulter les cas singuliers.
11.2 Analyse univariée en Python (SciPy, Pandas, Seaborn)
Dans l’univers du machine learning, de la science des données et de la bio-informatique, le langage Python constitue l’autre standard majeur d’implémentation algorithmique. Le framework matriciel Pandas constitue le point d’ancrage de toute manipulation univariée via ses structures en colonnes Series. L’invocation de la méthode vectorielle df['variable'].describe() fournit une synthèse instantanée adaptée à la nature de la variable : pour les grandeurs numériques, elle renvoie le décompte (count), la moyenne, l’écart-type, le minimum, les quartiles Q1, Q2, Q3 et le maximum ; pour les variables de type chaîne ou catégorielles, elle documente le cardinal des modalités uniques (unique), la modalité modale (top) et la fréquence associée (freq).
Pour le calcul des moments morphologiques d’ordre supérieur indispensables au diagnostic de la forme de distribution, l’analyste fait appel aux modules mathématiques spécialisés de la bibliothèque scipy.stats. Les fonctions dédiées scipy.stats.skew() et scipy.stats.kurtosis() (en paramétrant fisher=True pour obtenir l’excès de kurtosis ajusté) exécutent les calculs avec précision. De même, les tests formels univariés de Shapiro-Wilk s’exécutent en une seule ligne syntaxique à travers l’instruction scipy.stats.shapiro(df['variable'].dropna()), extrayant la statistique W et la p-value associée.
Enfin, la modélisation graphique des distributions univariées s’appuie sur la bibliothèque statistique seaborn. La fonction histplot() permet de tracer simultanément l’histogramme empirique et l’estimation de densité par noyau (en renseignant le paramètre booléen kde=True). La fonction boxplot() restitue fidèlement la règle de détection des atypicités de Tukey, tandis que violinplot() combine un diagramme en boîte à moustaches et une estimation de densité en miroir, révélant les structures d’hétérogénéité ou de bimodalité univariée.
11.3 Exploration sous interfaces graphiques (SPSS et JASP)
Pour les chercheurs et étudiants préférant les interfaces graphiques sans programmation scriptée, des solutions logicielles professionnelles permettent de conduire des analyses univariées rigoureuses. Au sein du logiciel propriétaire IBM SPSS Statistics, la démarche s’effectue traditionnellement via le menu déroulant Analyse > Statistiques descriptives, scindé entre la procédure Fréquences (optimale pour les données qualitatives ou discrètes avec édition automatique des tables et diagrammes en barres) et la procédure Explorer.
La commande Explorer de SPSS constitue sans doute l’environnement univarié intégré le plus exhaustif pour les variables quantitatives. Elle active par défaut le calcul des statistiques de tendance centrale, de dispersion robuste (médiane, IQR, moyenne tronquée à 5 %) ainsi que les coefficients de skewness et kurtosis escortés de leurs erreurs types respectives. Dans les sous-menus de configuration graphique, le chercheur peut cocher l’option Graphiques de normalité avec tests, déclenchant l’édition automatique des tests de Kolmogorov-Smirnov (avec correction de Lilliefors) et de Shapiro-Wilk, accompagnés des tracés Q-Q plots et des diagrammes de déviation détrendés.
Sur le versant des logiciels contemporains, le programme open-source JASP (développé sous l’égide de l’Université d’Amsterdam) propose une approche moderne combinant statistiques fréquentistes classiques et paradigmes bayésiens. Son interface dynamique actualise instantanément les sorties numériques à chaque ajustement de paramètres. JASP se distingue par sa capacité à générer des tableaux de statistiques univariées nativement formatés selon les normes typographiques et académiques strictes édictées par l’American Psychological Association (normes APA, 7e édition), simplifiant le transfert des synthèses univariées vers les manuscrits scientifiques finaux.
12. Limites inhérentes à l’analyse univariée et perspectives d’extension
12.1 L’illusion de l’isolation et omission du contexte relationnel
Malgré sa valeur méthodologique fondamentale, l’analyse univariée souffre de limites épistémologiques intrinsèques. La première et la plus évidente réside dans « l’illusion de l’isolation ». En observant une variable coupée de son environnement empirique, le chercheur fait abstraction du réseau relationnel complexe au sein duquel elle s’inscrit naturellement. L’analyse univariée est, par définition, aveugle aux associations, aux covariations, aux médiations et aux dépendances conditionnelles.
Il est par conséquent scientifiquement périlleux d’inférer des jugements prospectifs ou pronostiques à partir de la seule contemplation univariée. Savoir qu’un groupe de participants présente un score moyen de dépression élevé ne permet aucunement de déduire si cette détresse est corrélée à un âge avancé, conditionnée par le genre, modulée par un traumatisme infantile précoce ou totalement indépendante de ces facteurs. Vouloir tirer des conclusions relationnelles à ce stade relève de la spéculation non contrôlée.
De plus, l’isolation univariée est incapable de repérer les valeurs aberrantes dites multivariées. Un individu peut parfaitement afficher un poids corporel de 50 kg (ce qui constitue une valeur univariée fréquente et normale) et une taille de 1,95 m (valeur univariée également documentée). Toutefois, la conjonction simultanée de ces deux paramètres chez un même individu génère une singularité biométrique extrême (un indice de masse corporelle extraordinairement faible) qui échappe complètement aux filtres de détection univariés indépendants, soulignant la nécessité d’étendre ultérieurement l’examen au calcul de distances multivariées (comme la distance de Mahalanobis).
12.2 Le paradoxe de Simpson et ses prémices descriptives
L’une des manifestations méthodologiques les plus frappantes des risques inhérents à une lecture univariée agrégée exclusive est illustrée par le célèbre paradoxe formalisé par le mathématicien britannique Edward Simpson en 1951. Le paradoxe de Simpson désigne une configuration probabiliste déconcertante dans laquelle une tendance ou une disparité observée au niveau d’une distribution globale agrégée s’inverse complètement ou disparaît dès lors que l’échantillon est stratifié en sous-groupes homogènes selon une variable de confusion sous-jacente.
Dans un cadre univarié pur, l’analyste contemple la variable agrégée globale sans percevoir la composition structurelle des sous-cohortes. Supposons une étude médicale mesurant le taux de succès global d’un traitement biologique : l’examen descriptif univarié global peut documenter un taux de guérison agrégé de 70 % chez les patients traités contre 80 % dans le groupe témoin, conduisant hâtivement à conclure à l’inefficacité du protocole. Or, si le traitement a été administré majoritairement à des patients atteints de formes sévères et le placebo à des formes légères, une stratification bivariée subséquente peut révéler que le traitement est supérieur au placebo au sein du groupe sévère, et également supérieur au sein du groupe léger.
Cet exemple méthodologique souligne que l’analyse univariée constitue un indicateur global préliminaire qui ne saurait s’affranchir de la décomposition structurelle. Le rôle d’alerte de l’analyse univariée consiste précisément à détecter les hétérogénéités internes, les étalements asymétriques et les bimodalités morphologiques qui agissent comme des indicateurs précoces, signalant au statisticien la présence probable de variables latentes de confusion et l’invitant à approfondir ses analyses.
12.3 Rôle intégrateur dans le pipeline d’analyse de données
En synthèse ultime, l’analyse univariée ne doit être perçue ni comme une finalité autosuffisante, ni comme une corvée exploratoire marginale. Elle constitue le socle indispensable sur lequel s’érige la totalité du pipeline d’analyse quantitative en sciences contemporaines. Elle conditionne la fiabilité et la validité de l’ensemble des modélisations statistiques ultérieures.
Le cheminement méthodologique conventionnel d’une recherche empirique rigoureuse progresse selon une séquence ordonnée :
- Niveau univarié : Nettoyage des données brutes, détection des anomalies métriques, calcul des indicateurs de tendance centrale et de dispersion, caractérisation géométrique de la forme des distributions, vérification stricte des postulats paramétriques de normalité et gestion documentée des valeurs aberrantes.
- Niveau bivarié : Mise en relation probabiliste de deux variables conjointes, évaluation des coefficients d’association, tests d’hypothèses comparatifs (tests t, Khi-carré d’indépendance) et corrélations linéaires ou non paramétriques.
- Niveau multivarié : Intégration de la complexité systémique via les régressions multiples, les analyses multivariées de covariance (MANCOVA), les réductions factorielles exploratoires et confirmatoires, ou les réseaux d’équations structurelles complexes.
En respectant scrupuleusement cette progression hiérarchique, le chercheur s’assure que chaque étape s’appuie sur un matériau empirique vérifié et fiabilisé. L’analyse univariée demeure ainsi la boussole méthodologique assurant la transition harmonieuse entre la collecte brute et la découverte scientifique validée.
Références
- Beck, A. T., Epstein, N., Brown, G., & Steer, R. A. (1988). An inventory for measuring clinical anxiety: Psychometric properties. Journal of Consulting and Clinical Psychology, 56(6), 893–897. https://doi.org/10.1037/0022-006X.56.6.893
- Cochran, W. G. (1954). Some methods for strengthening the common χ² tests. Biometrics, 10(4), 417–451. https://doi.org/10.2307/3001616
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: L₂ theory. Zeitschrift für Wahrscheinlichkeitstheorie und Verwandte Gebiete, 57(4), 453–476. https://doi.org/10.1007/BF01025868
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
- Lilliefors, H. W. (1967). On the Kolmogorov-Smirnov test for normality with mean and variance unknown. Journal of the American Statistical Association, 62(318), 399–402. https://doi.org/10.1080/01621459.1967.10482916
- Pearson, K. (1895). Notes on regression and inheritance in the case of two parents. Proceedings of the Royal Society of London, 58, 240–242.
- Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581–592. https://doi.org/10.1093/biomet/63.3.581
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
- Simpson, E. H. (1951). The interpretation of interaction in contingency tables. Journal of the Royal Statistical Society: Series B (Methodological), 13(2), 238–241. https://doi.org/10.1111/j.2517-6161.1951.tb00088.x
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
- Sturges, H. A. (1926). The choice of a class interval. Journal of the American Statistical Association, 21(153), 65–66. https://doi.org/10.1080/01621459.1926.10502161
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4